把想法做成能用的东西

工具、产品、作品集与资料库。做过的都在下面;没做过的,可以聊聊。

  • 工具

    免费工具,解决零碎活

    查违规词、清格式、理结构 —— 免注册,粘贴即用。

    笔记合规体检 · 已上线
  • 内容工厂
    把想法,做成能用的东西

    上线一个,放一个:工具、长文、项目,都在下面。

  • 内容

    技术长文,讲深不讲浅

    128 篇长文 · 219.9 万字 · 13 个专题。

    图文并茂,逐章拆解每个专题
  • 作品集

    上线过的东西,都是真的

    从想法到上线,过程与复盘都在。

    项目 + 实验
技术博客
专题 01 · 5 篇已发布

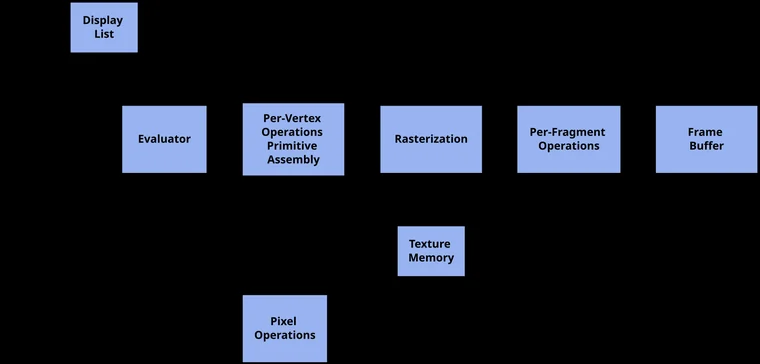
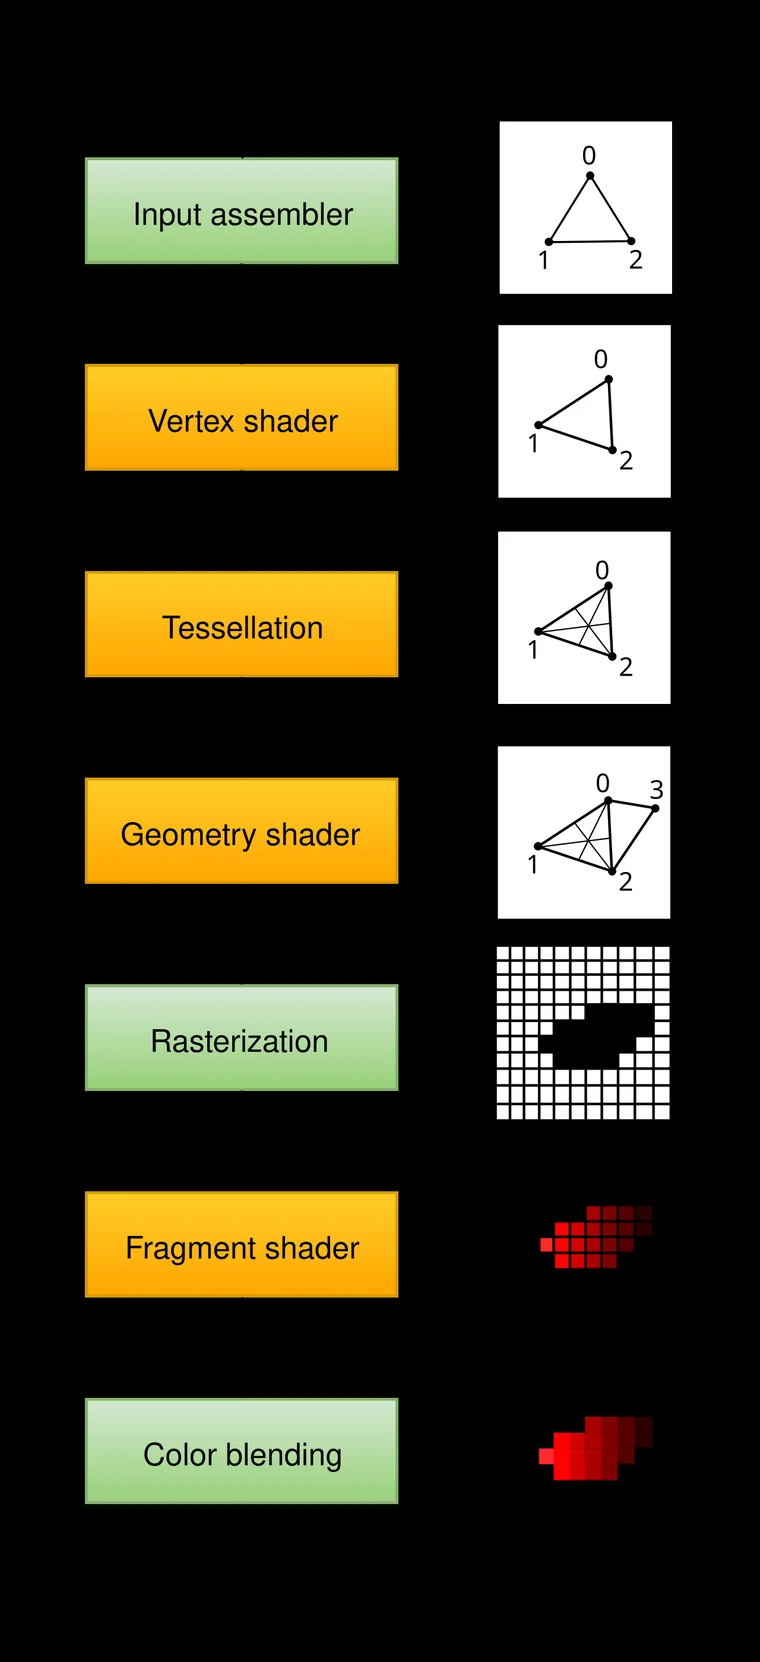
实时渲染管线探析

从 G-Buffer 讲到 GPU-Driven,一条管线走完。按「这一章要解决什么 → 怎么解 → 代价是什么」的顺序写,每篇末尾留三件收尾:要点、问题、下一步。

5篇
92,667字
813张配图
专题 02 · 7 篇已完结

移动端图形与功耗

从物理约束出发,一路算到测量本身:移动端为什么必须在约束里做取舍,这些取舍在一线工程里长什么样,以及怎么证明一次优化真的生效。七篇已完结。

7篇
172,211字
1,074张配图
专题 03 · 12 篇已发布

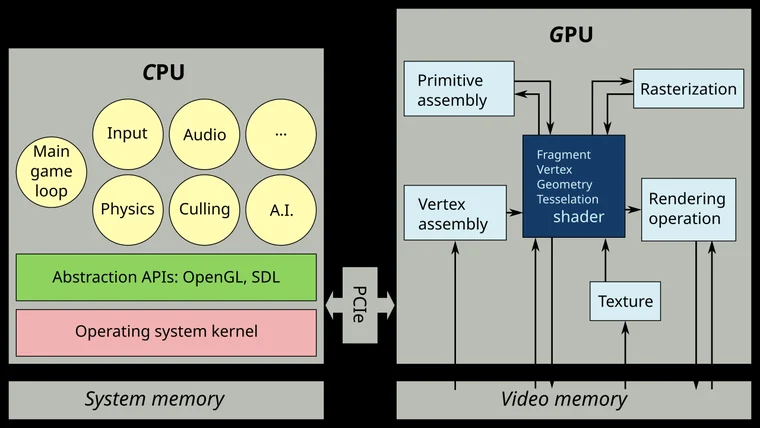
GPU 架构剖析

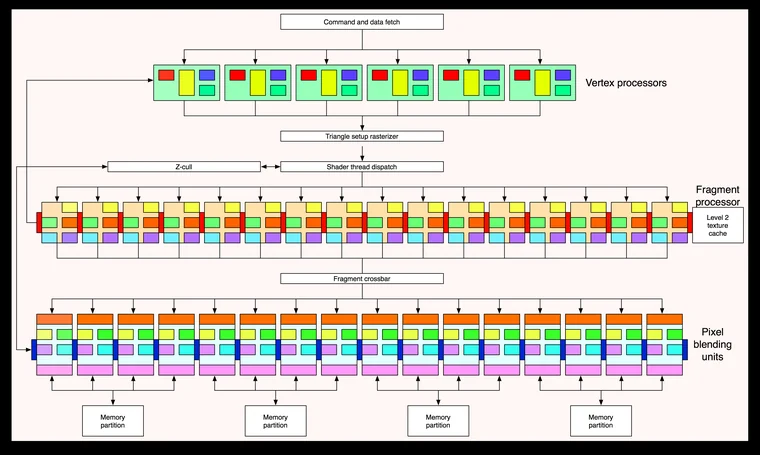
把「一次 Draw 走了多少路」拆成硅片上的实账:命令怎么提交、前端怎么消化、显存与着色器如何接力 —— 十二篇,从命令前端一路走到像素背后。

12篇
193,047字
870张配图
专题 04 · 13 篇已完结

实时光线追踪与混合渲染

给定硬件能力与引擎约束,混合渲染管线该怎么组织、代价落在哪里、哪些常见做法其实不划算。从「什么时候该从光栅切到光线」这条分界线出发,一路算到加速结构、降噪、采样与跨平台差异。

13篇
222,373字
378张配图
专题 05 · 5 篇已发布

神经渲染与神经着色器

把渲染管线里的某一环,它的先验从「人手写的启发式」换成「训练出来的网络」——代价到底转移到了哪里。先从四类替换的落点与三道判据立起分界线,再经过最成熟的落地(降噪、纹理、外观),进到着色器内部的推理,最后落到资产、时间轴与总账。

5篇
80,801字
125张配图
专题 06 · 13 篇已发布

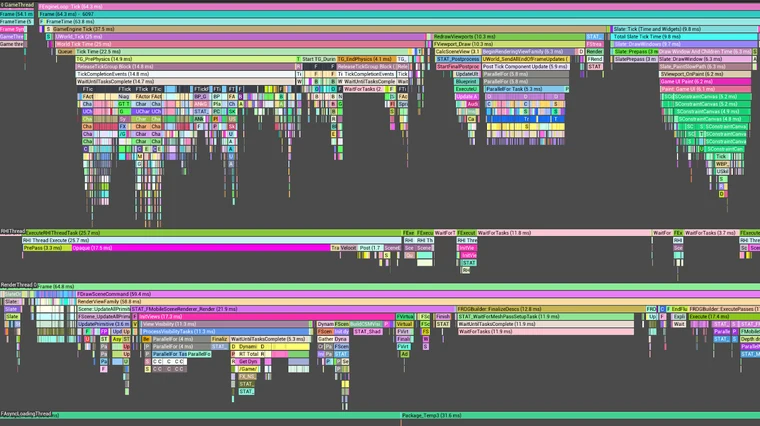
图形性能剖析工具链

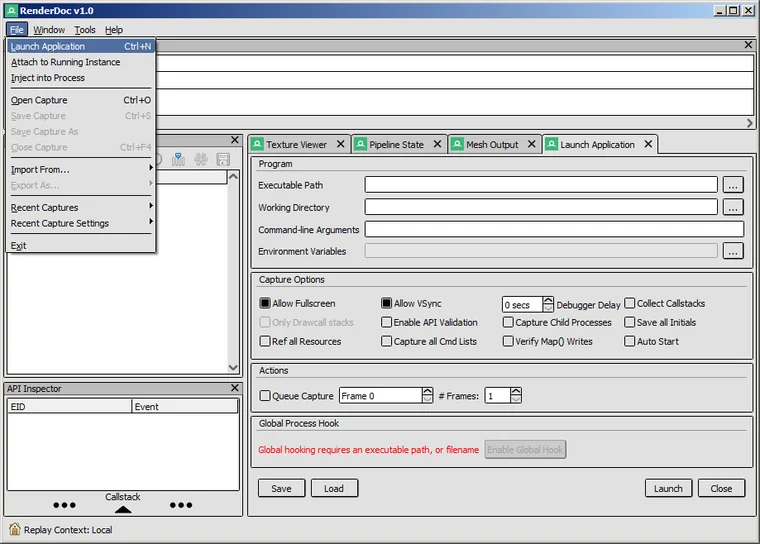
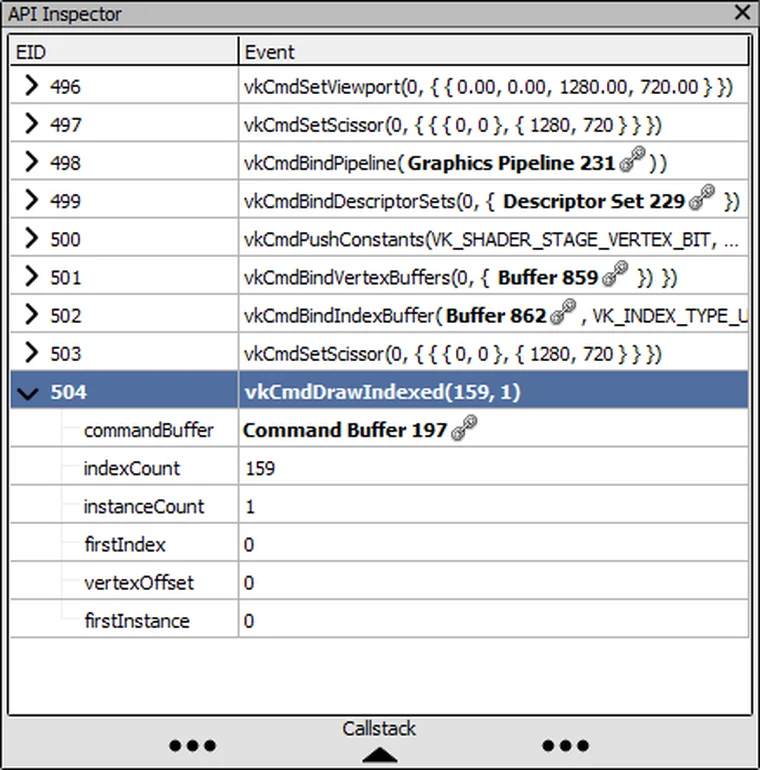
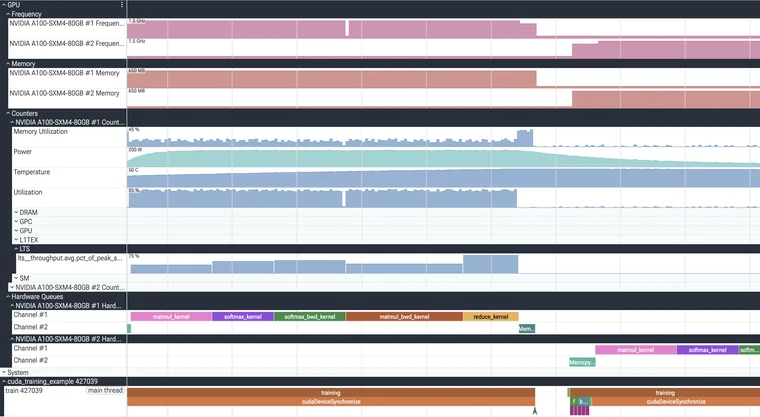
会渲染,不等于会验证。以 RenderDoc 量 API 层的一帧、Perfetto 量系统层的整条路径,交叉出一张「画错 / 画慢 / 卡 / 迟延」各归其位的决策地图;再以「自跑 → 真图 → 归因 → 结论」这条可复现证据链,把图形性能验证做成方法论底座。全系列 13 篇都在这张图上走。

13篇
199,025字
306张配图
专题 07 · 11 篇已完结

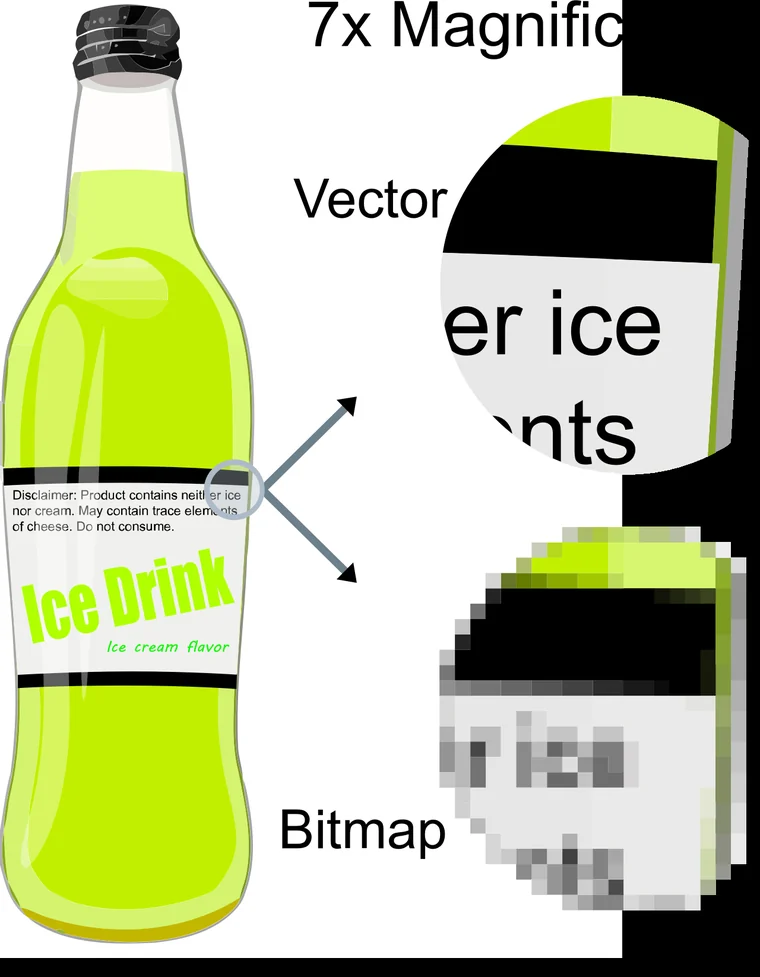
2D 矢量引擎深挖

从「矢量怎么变成像素」出发,把几套引擎摆在一起比:Skia 的两代后端、Vello 的 GPU compute,以及字形光栅化这条最容易被略过的支线。另一条线是自跑三篇(第七、八、十)——换后端、换输入,把同一件事量到底;其中第十篇再把 Vello 的 GPU、CPU 与混合三路摆在一起对账。十一篇已完结。

11篇
181,267字
299张配图
专题 08 · 13 篇已完结

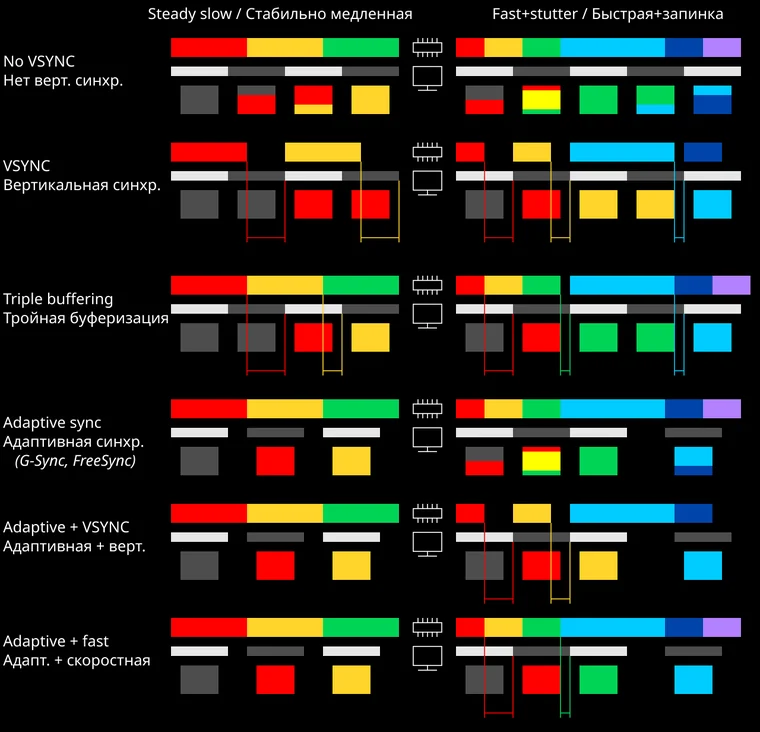
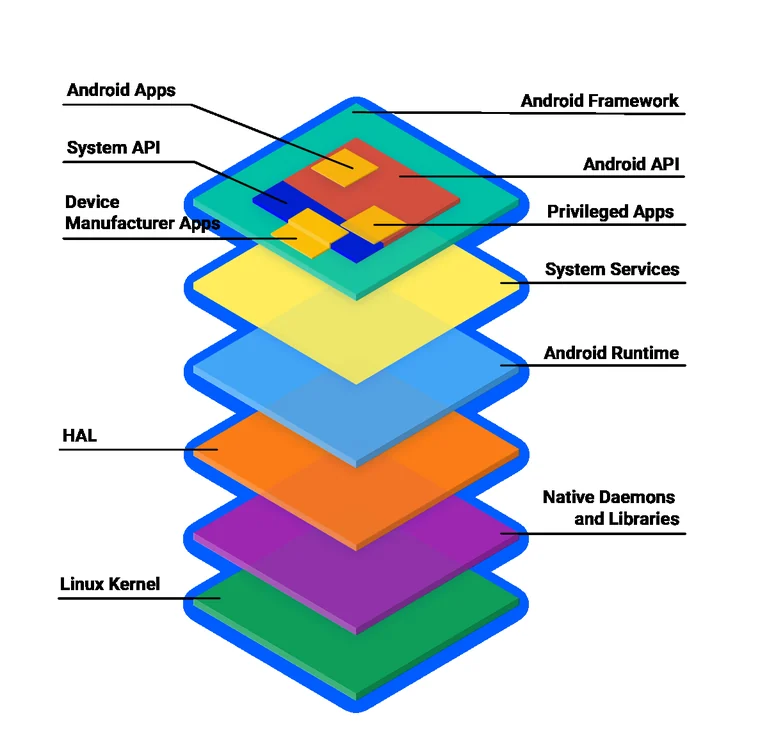
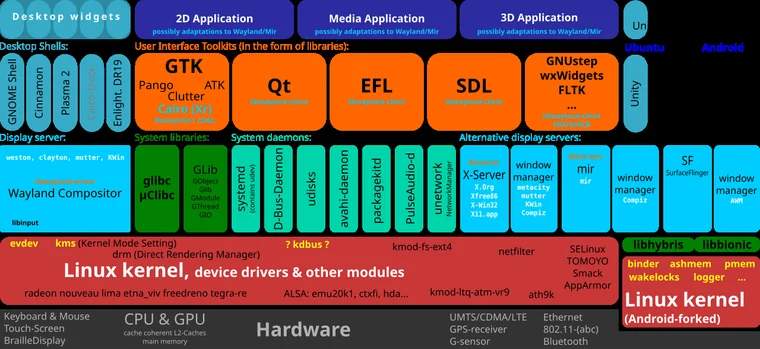
Android 图形显示系统

前面七个专题讲的是「画面怎么被算出来」,这一个专题换到平台侧:一帧从 App 到屏幕要穿过 Choreographer、RenderThread、BufferQueue、SurfaceFlinger、HWC 与 vsync 这条链,每一环都拿本机的 dumpsys 与 trace 对账。十三篇已完结。

13篇
203,982字
368张配图
专题 09 · 13 篇已发布

Jolt Physics 3D

本站第一次把镜头转向渲染之外的题域:物理引擎。Jolt 把「多核扩展性」与「确定性」押在最前——本机实测 8 线程 6.44×、1 至 16 线程下终态哈希全同;两处流传很广的说法也在这里被钉死:v5.6 的 GPU Compute 只服务发束头发、不是 GPU 刚体,官方清单里查无 Solver 与 TGS 命名。十三篇规划中,首篇为全景与边界。

13篇
243,931字
545张配图
专题 10 · 11 篇已发布

Godot 4 引擎架构

本站第一次写「应用框架层的引擎」。前九个专题都在讲画面与物理怎么被算出来,这一个换到引擎内部:把一次 2D 绘制拆成四层落点,逐层给出源码坐标。首篇把这条链走通,并用本机三后端启动读数把「三种渲染方法 × 四种驱动」的矩阵现场演示出来。第二篇把镜头压到场景层,回答一条绘制命令是谁在什么时候下发的。第三篇进服务层,讲 RenderingServer 的接口为什么长成一组 RID 型命令。第四篇讲画布剔除与排序,回答一条绘制命令有没有被画出来、在谁前面。第五篇进画布渲染抽象层,讲那条链交出去之后长什么样、又是怎么变成一次提交的。第六篇进批处理,讲这批是怎么切出来的、容量从哪来、代价又付在哪。第七篇进渲染设备抽象层,讲一批命令怎么变成一张有序的依赖图、屏障又凭什么能变少。第八篇换了个问题:同一批命令落到四张不同的桌子上会怎样,分叉在哪三处、默认值又藏在哪几层。第九篇换到时间轴上问:这套账在什么时刻、被哪个线程算出来,顺带把两个帧率口径分清。第十篇继续往上游走一步:盘上的东西是怎么进到引擎里的,导入那一次又换出去了什么。第十一篇是收官:这条线官方先后给过三种口径,而每一段账都在本机重算了一遍。

11篇
182,086字
446张配图
专题 11 · 10 篇已发布

ReShade 注入式后处理

本站第一次写「从进程外面挤进来」的那类工具。前十个专题都在讲画面、物理与平台怎么被算出来,这一个换到渲染之外的位置上:注入式后处理不是后处理的一种实现,而是后处理的一种位置——引擎自己的后处理链跑完之后、交换链呈现之前那一段原本没人的缺口。位置一变,能拿到什么、要付什么代价全都跟着变:它手里只有成品帧与条件满足时的深度,没有几何缓冲,所以只能做屏幕空间近似;换来的是不挑引擎、零侵入。本机在自有开源场景上把这句话量了一遍。第二篇往里走一步,回答一次调用是怎么被接过去的:凭什么轮到你被加载,同一批导出函数又有哪三种接法——这两件事都在本机量过,四组实验全部单变量带反向对照。第三篇换到语言这一层:这门着色语言到底是不是 HLSL 的一个子集、它为什么会自带编译器,都在本机编过一遍。第四篇回到运行时的账上:一个 effect 从源码到画面中间过了几道、执行顺序从哪来、那些写在文件里的渲染状态最后落到 API 的哪几个调用上。第五篇换到「差异去哪了」这个问题上:同一行 add-on 代码凭什么在六种图形 API 上都跑——官方的答案不是抹平差异,而是先选一个坐标系(modeled after the Direct3D 12 and Vulkan APIs),其余四个后端是被翻译进来的那一侧;本篇把「抽象住了」「翻译了」「没抽」三件事分开说。第六篇把镜头从「差异去哪了」转到「接口面长什么样」:一个 add-on 凭什么不导出函数、也不用链接任何库,靠的是一张 100 个格子的事件表、18 个跨 DLL 边界的 C 导出,和一个三档取值的构建开关——签名版在编译期就摘掉了其中 30 个事件。第七篇换到「条件」这一层:为什么深度类效果时灵时不灵——关掉它的那一手根本不在深度模块里,而 MSAA 的能力位、界面不在深度里、子矩形判据这三道条件各自独立。第八篇横切一刀,落到「生态与许可」:那些效果能不能转,取决于这份清单有没有托管任何东西——45 个包全部是指针,同一份清单里并存七种许可状态。第九篇第一次真的把它装上去:在自有的极简 D3D11 demo 上布线、注入、逐档抓图,把「开与不开差多少」拆成四档可核的格子——同一台机器上,深度探针与色调映射一眼可见,而景深几乎看不出。第十篇把画面换成了账:把「多花多少」定义成毫秒每帧,三笔钱分开记——注入层常驻约 0.15 毫秒每帧,而八个单效果里五个同口径档全部低于「效果全关」档,叠加的边际也不等于三个单效果之和;顺带自写了一个小 .fx,把从源码到屏幕那条链走通一遍。十一篇规划中,前十篇分别立边界、拆入口、讲清语言本身、摊开运行时、统一坐标系、摊开接口面、拆开深度条件、横切生态与许可、把画面真的跑出来、把账算出来。

10篇
159,280字
248张配图
专题 12 · 12 篇已发布(完结)

C/C++ 现代语言与底层

同一段 C/C++,编译器和链接器到底对它做了什么、代价落在哪。这一卷不写语法,也不写面试题速查——它把已有几卷里天天出现的 sizeof、对齐、虚表、异常、内存序、编译时间接过来,专讲这些东西是怎么被决定的。取材只有两种:机制引原文(标准条款、Itanium ABI、官方文档快照),代价靠自跑(两套工具链的布局转储与读数;探针源码、编译命令、原始输出随篇入库)。十二篇分四波:布局与内存 → 编译器与链接器 → 运行时代价 → 跨平台专项。

12篇
211,741字
470张配图
专题 13 · 3 篇已发布

Vulkan 官方最佳实践

「官方最佳实践」这五个字,在 Vulkan 这边找不到对应的那一份文档——它散在四套体系里(Guide 的 74 页、Tutorial 的 18 章加 10 门进阶课、Samples 的 25 个 Performance 样本、以及验证层里一个开关),而其中最关键的那个开关默认是关的。这一系列不写 API 教程,只回答两件事:官方那条建议原本是什么形态、连同它的硬件前提;以及搬到这台机器上,它到底值多少。取材以自写最小用例的自跑读数为主,官方 Samples / Guide / Validation 只作 Do/Don't 的文本来源与对照,十篇按「2026 新范式 → 同步 → 管线缓存 → render pass → 命令缓冲 → 描述符 → layout transition → swapchain → 验证层闭环」推进。
3篇
56,474字
115张配图
1 / 13 用 ← → 切换专题
命令提交
01

一次 Draw 走了多少路:从 API 到命令前端

谁在提交、提交成什么、前端怎么消化 —— 五层软件栈、一块环形缓冲与一颗命令处理器。
14,473 字125 图11 章
显存与地址空间
02

显存与地址空间:带宽极高,延迟也极高

带宽几百 GB/s 起步,延迟却比一级缓存慢上百倍 —— 存储层次、页表与 TLB、页错误与有效带宽逐层拆开。
26,956 字171 图16 章
着色器核
03

着色器核:SIMD、波前与占用率

占用率不是越高越好:两套口径、三类约束资源,以及从「装得多」到「发得出」的那道沟。

17,825 字126 图14 章
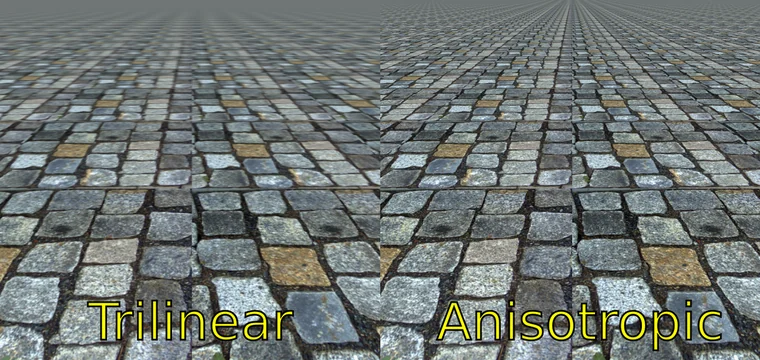
纹理采样器
04

纹理采样器:一条几百级的流水线

采样请求怎么进 TMU、坐标怎么换算、滤波与 LOD 怎么落地,缓存与压缩怎么把取数那头省下来 —— 一条几百级深流水线的硅片实账。

9,445 字50 图10 章
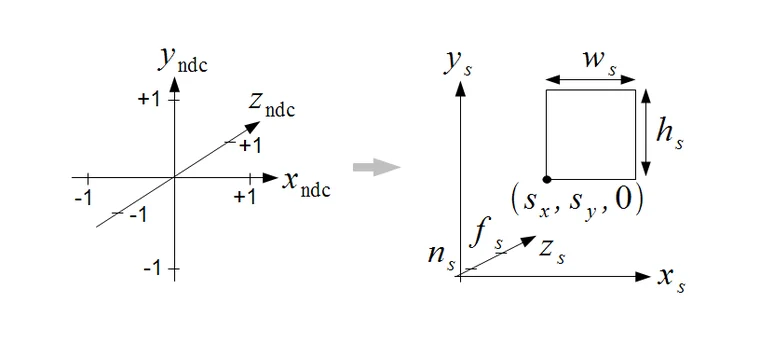
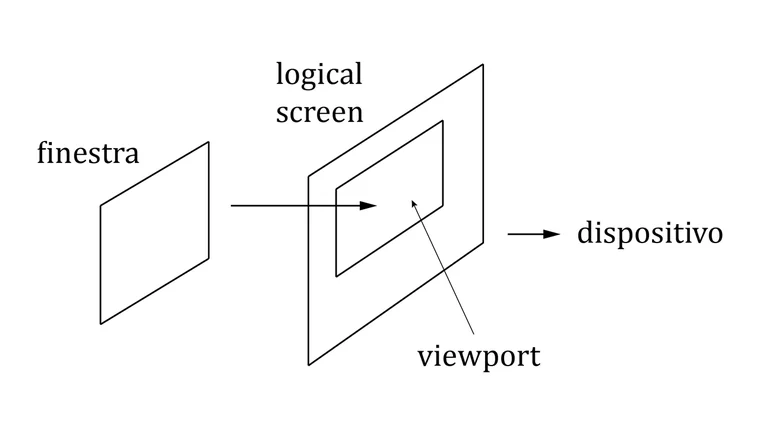
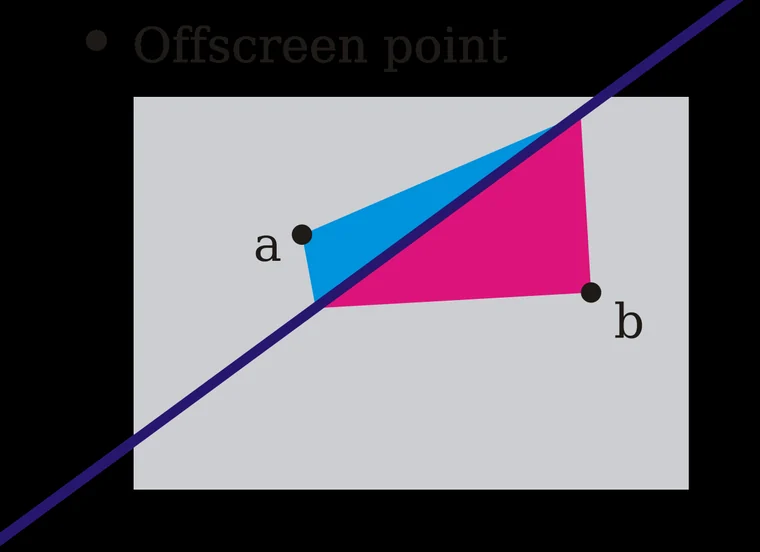
图元装配、裁剪与视口变换
05

图元装配、裁剪与视口变换:屏幕坐标是怎么定下来的

顶点着色器算完 clip 坐标,屏幕像素位置不是它定的 —— 装配捆图元、透视除法与视口定坐标、guard band 兜底、背面与退化剔除,中间压着整整一段固定功能。

20,095 字123 图9 章
光栅化与三角形建立:边函数、填充规则与小三角形
06

光栅化与三角形建立:边函数、填充规则与小三角形

顶点进了光栅化,屏幕上的像素到底由谁、按什么规则被三角形填上色?setup 阶段的一笔账、边函数怎么在硅片上算、顶左规则怎么保共享边只画一次、重心坐标与透视校正插值,再到小三角形为什么那么贵。

21,469 字111 图10 章
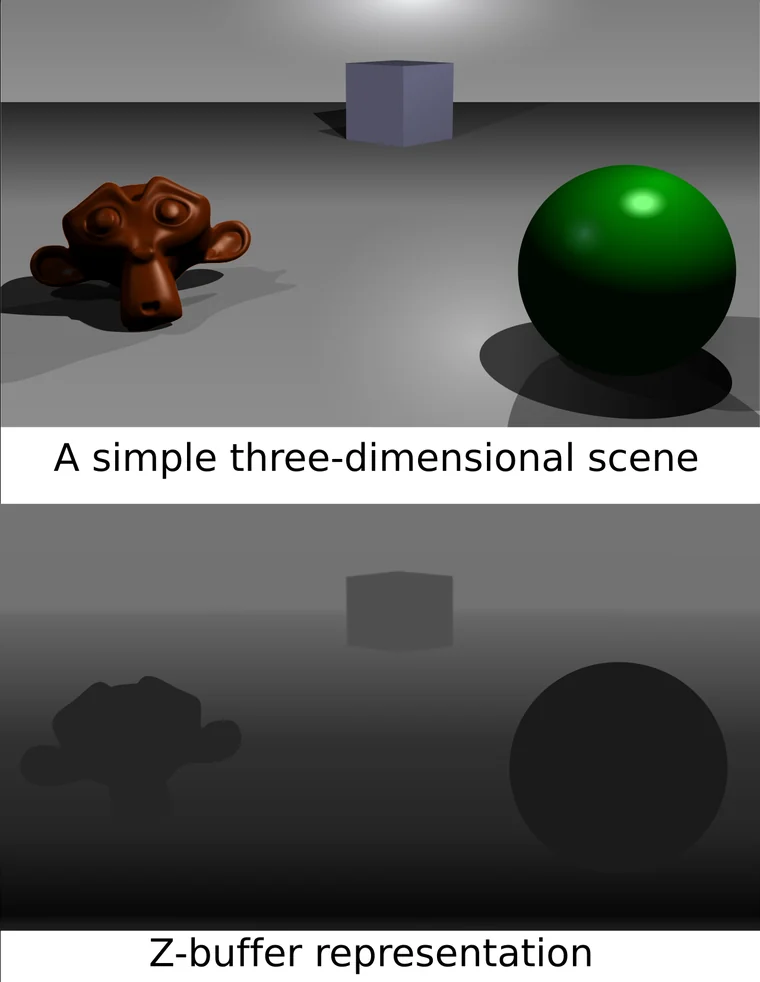
Z 缓冲与隐藏面消除:early-Z 到底什么时候生效
07

Z 缓冲与隐藏面消除:early-Z 到底什么时候生效

深度缓冲这张"第三张图像",怎么被生产又被消耗——early-Z 何时敢提前、何时必须退到 late-Z,stencil 这 8 位通道能干哪些活,移动端 TBDR 又怎么用 HSR 把整条 hidden-surface 换成另一个算法。

13,129 字16 图11 章
像素后端:fork/join、ROP 与那笔带宽账
08

像素后端:fork/join、ROP 与那笔带宽账

光栅厂把三角形倒成像素流之后,颜色、深度、模板、覆盖要怎样真正落进显存?像素怎么在最后一站 fork 派发、着色后 join 回 render target,ROP/Output Merger 做哪六件事——再到 overdraw、压缩、MSAA resolve、TBDR 的 HSR,这笔带宽账在同一处结算。

7,244 字19 图14 章
几何前端:几何着色器、流输出与细分
09

几何前端:几何着色器、流输出与细分

图元装配把顶点连成三角形之后、光栅化把它倒成像素之前,GPU 还有一段能改变图元命运的几何前端:几何着色器按图元改/生成图元、流输出把顶点旁路写回内存、细分把低位图元按 patch 铺细——二次装配、不可预知的输出规模、成倍增长的顶点流,这笔量价账在同一处结算。

12,007 字16 图13 章
计算着色器:波前、共享内存与三种屏障
10

计算着色器:波前、共享内存与三种屏障

图形管线告别几何着色器之后,"改几何"这件事换了一整套更通用的模型来做——计算着色器(compute shader,CS)。它把线程当成只有 32 条 lane 一起前进的执行单元原子(波前),自带一块能协作的共享内存(shared memory / LDS),用屏障在不同层级间建立执行序与内存可见性。波前怎么被调度进执行槽、bank 冲突要赔几拍、三种屏障各自贵在哪里、occupancy 占得高不等于快——这笔并行账在同一处结算。

9,724 字24 图14 章
同步与资源生命周期:为什么「看起来没画出来」
11

同步与资源生命周期:为什么「看起来没画出来」

命令明明提交了、API 也没报错,屏幕上却「看起来没画出来」——问题不在某次绘制,而在 CPU 与 GPU 之间那层异步鸿沟,以及资源换用途时没被正确声明的身份切换。本篇把「规范怎么写」和「硬件实际怎么做」分开:fence、semaphore、barrier、event 只是正确性规则的遥控器,硬件真正做的是 cache flush、pipeline drain、fence register 写标记与跨队列一致性切换。提交、可见、资源身份三笔账摊开,最后落到「范围与对象」两个词的判据上。

19,235 字33 图11 章
2011 之后:哪些机制变了,哪些没有
12

2011 之后:哪些机制变了,哪些没有

十一期拆完硬件环节,这一期回答收官问题:2011 到 2026,那张硬件地图上哪些位置被改写了、哪些一动没动。写法是判定式而不是编年史——每条机制都落到三问:替代了哪个环节、代价转移到哪一侧、哪条原本由硬件兜底的保证被降级了。变的是几何前端、绑定模型、工作发起,外加求交硬件化、着色速率可按需降级、渲染目标与片上内存显式化、chiplet 与 HBM;没变的是 SIMT 波前、固定光栅与 ROP、纹理采样器,以及留在应用侧的同步职责。所有数字按规范事实 / 厂商宣传 / 第三方实测三档标注。

16,583 字37 图12 章
分界线:什么时候该从光栅切到光线
01

分界线:什么时候该从光栅切到光线

把「光栅还是光线」从新旧之争换成三道可核对的问题:屏幕空间近似在什么硬条件下会失效、走光追的成本与什么成正比、这次切换把代价转移到了哪一侧。从 SSAO/SSR/SDFGI 的官方失效清单,到三条成本模型与一页六类效果速查表,再到两条接口路线与降噪器那笔常驻预算。

18,842 字30 图10 章
加速结构工程账(上):构建、更新与压缩
02

加速结构工程账(上):构建、更新与压缩

加速结构是一笔预付:构建一次,买下之后每一次遍历的便宜。本篇把三科账摆开——构建(尺寸与标志、建树器怎么挑)、更新(什么能改、改完遍历会变成什么样)、压缩(能省多少、省下来的钱要不要还回去),附一张可直接套用的内存预算表。

16,655 字26 图10 章
加速结构工程账(下):动态场景与内存开销
03

加速结构工程账(下):动态场景与内存开销

场景一动,预付账就变成活账。本篇算动态场景那一本:TLAS 的分区更新与决策树、BLAS 的 refit/rebuild/混合三选、CLAS 与 OMM 各自换到了什么,以及一笔从 10 万到 100 万 instance 的压测账——规模上去以后,哪些开销不是等比例长的。

16,088 字34 图9 章
命中着色器与 SBT:别被自己的表绊倒
04

命中着色器与 SBT:别被自己的表绊倒

光线停下来之后呢?一个场景里金属、玻璃、木头、皮肤、植被各有一套算法,SBT 就是那张「谁执行哪段」的电话簿。本篇讲清四区域结构、hit group 的三着色器组合、any-hit 为什么最贵、intersection 留给谁,以及 SBT 能踩的五个坑。

16,016 字26 图9 章
混合管线编排:光栅化与光追的接力赛
05

混合管线编排:光栅化与光追的接力赛

光栅化与光追是一条接力赛的两棒。本篇拆开这条赛道:G-buffer 六个通道与它的带宽账、两种工作模式的选型依据、一帧的 Pass 顺序与两个队列的重叠空间、16.67 ms 预算怎么分,以及阴影/反射/GI/AO 四类效果的混合档位矩阵。

15,884 字29 图9 章
降噪(上):时域复用的原理与失效模式
06

降噪(上):时域复用的原理与失效模式

1 spp 的输出几乎全是噪声,把它变成可看的画面靠的是时域复用。本篇讲透原理与失效模式:EMA 与 α 的取值带、运动矢量与重投影、disocclusion 检测、鬼影的六种触发场景,配上四种工业降噪器的横向对比与实战调优清单。

16,576 字31 图9 章
降噪(下):从 SVGF 到神经降噪的取舍
07

降噪(下):从 SVGF 到神经降噪的取舍

时域之后剩下的残差是空间上的块状噪声与高频斑点。本篇接着讲空间滤波与学习型重建:联合双边滤波的四因子权重与三组边缘停权为什么缺一不可、à-trous 怎样用 125 次采样换到 32 像素半径(附 JCGT 2026 的访存账 1.3–2.5×)、方差如何同时驱动 α 与滤波强度,以及三根 σ 调错时的九种可见症状。工业侧对比 NRD 的 ReBLUR/ReLAX 两条路线与内存三级账,最后按 2026 年 DLSS 4.5 已覆盖全部 RTX 的事实算一笔五维工程账。

16,923 字28 图11 章
ReSTIR 与光照采样:小样本怎么骗过大方差
08

ReSTIR 与光照采样:小样本怎么骗过大方差

降噪只能修、不能造:一个像素一帧只发一两条阴影光线,挑错地方谁都救不回来。这一篇转到采样侧——不是把光线发得更多,而是让每条光线更值钱。RIS 用便宜分布抽候选再按分数筛,WRS 的蓄水池常数内存且可合并,二者撑起时空复用;随后是复用的代价:随机数共享、支持集不匹配、条件概率三条偏的来源,以及 2025–2026 仍在被修的三条边界(运动下的投递、去遮挡、邻居选择)。

17,623 字27 图11 章
光线预算表:反射、阴影、全局光怎么分钱
09

光线预算表:反射、阴影、全局光怎么分钱

前面八篇各算了一笔账,但它们有一个共同的分母从未被摆到台面上:光线。一帧里能发出的光线总数是有限的,反射多要一条,阴影就少一条。本篇把这条预算线摊开——先给光线定价(遍历、命中着色、降噪是三项独立支出),再逐格拆账:反射凭什么 8 到 22 条、阴影凭什么只要 1 到 2 条、全局光为什么连花钱单位都跟别人不一样。之后是三种分配策略各自的代价、预算不够时误差的三种暴露形式,以及一张从帧时间倒推的可自己填的预算表。

17,953 字29 图11 章
RT 资源的生命周期:加速结构的可见性与同步
10

RT 资源的生命周期:加速结构的可见性与同步

前面九篇各算了一笔账,但它们有一个共同的隐含前提:加速结构已经在那里了,着色器只管用。本篇翻过来看这个前提——AS 在每一帧里都经历构建、对 GPU 可见、被着色器读取、最终退役的完整生命周期。先建四态心智模型,再讲 Build 到 Trace 之间那道屏障的 Vulkan/D3D12 具体写法,之后是双缓冲与延迟一帧、AS 压缩与 RTXMU、SBT 绑定、跨队列同步、scratch buffer 回收与 AS 池化三池结构,最后对照三种生产方案。

16,662 字25 图12 章
RT 资源的流式加载:大世界的 AS 管理
11

RT 资源的流式加载:大世界的 AS 管理

ep10 讲了 AS 在单帧内的生命周期,本篇把时间轴拉长——当世界大到 AS 装不进显存时,BLAS 怎么序列化到磁盘、怎么按 tile 流式加载、怎么用 LOD 控制远近精度、加载卸载时怎么不让画面闪。从 Vulkan/D3D12 的序列化 API 讲起,经过 tile 生命周期状态机、BLAS LOD 与 CLAS、时域过渡方案、UE5 的 World Partition+Nanite+Lumen 三件套、显存预算的 bytes/triangle 实测、P0-P4 优先级队列、GPU-driven multi-indirect build,最后落在跨厂商兼容性与 streaming AS 标准化的演进方向上。

16,663 字26 图13 章
透明、半透明与体积:光追里最难盈利的部分
12

透明、半透明与体积:光追里最难盈利的部分

透明、体积和 SSS 是光追管线里的"利润黑洞"——每像素光线数从 1 条暴涨到 N 条、128 步或 16-64 次采样,而视觉收益却非线性递减。本篇从 alpha 合成操作符和 OIT 方案谱系出发,拆解光追透明的三条路径(any-hit shader alpha test、closest-hit 递归追踪、Opacity Micromap 硬件加速),用 Indiana Jones 的 7.90ms→3.58ms 实测数据证明 OMM 的工程价值;再讲体积渲染的 ray marching 与 froxel grid 代价差异、SSS 的 BSSRDF 扩散剖面与屏幕空间近似方案;最后用 UE5/Frostbite/Unity HDRP 三家引擎的跳过/降级/统一策略对比,论证把光花在利润最高的地方才是混合渲染的工程智慧。

17,240 字27 图9 章
混合渲染决策地图:十二篇系列总结与未来展望
13

混合渲染决策地图:十二篇系列总结与未来展望

十二篇各算了一笔账,但它们必须同时成立、且互相抢资源。收官篇把 ep01–ep12 的结论合成一张可查的决策地图:按几何与加速结构、着色与采样、降噪与合成三段给出三棵决策树,用四张总账表把每个数字的口径与成立边界摊开(含 [A]/[O]/[P]/[T]/[C] 五级口径标注),再以四个真实项目形态(主机 60fps / 高端 PC 路径追踪常开 / 大世界开放世界 / 移动与低端回退)走查验证;随后回答下一代硬件会改写哪几条(Mega Geometry 与分区 TLAS、SER 与 2-state OMM、ML 光照缓存)、标准化两条线各自落地到哪一步,以及哪四条判据不随硬件改变。

17,670 字26 图11 章
神经渲染的分界线:哪一环该换成网络
01

神经渲染的分界线:哪一环该换成网络

把「神经渲染」拆成四类可分别判断的替换——着色计算、表示、采样分布、时间轴,再给三道可核对的判据:粒度看能不能让每次调用独立算,数据看输入分布是否由自己控制,开销看代价落在算力、带宽还是显存哪一本账。从手写先验的能力上限切入,用自算的对照实验与自由许可真图逐条落地,最后收成一张可直接查的速查矩阵。

16,352 字24 图10 章
神经降噪(上):当先验从人手写变成学出来
02

神经降噪(上):当先验从人手写变成学出来

手写降噪的先验是「人定的形状 + 可调的参数」。本篇算清把这一环的先验换成学出来的之后账本怎么变:先沿 2017–2019 四个节点看清先验如何从人手交到网络手里,再把最常被混为一谈的「鬼影」拆成三类、给出看图就能用的判别问题,最后用 NRD 官方实测与学习式方案的公开数字算一笔同口径的账,并给出两条「换了不划算」的反例。

17,349 字24 图10 章
神经降噪(下):数据从哪来,以及它在哪里失效
03

神经降噪(下):数据从哪来,以及它在哪里失效

上篇算的是「先验换成学出来的之后多了什么」,这一篇算的是那笔账背后真正稀缺的东西——数据。能拿到训练数据只有三条通道,差别不只是成本:公开数据集要看许可(最常用的几套恰恰不可商用),自产要自己有渲染器,自建要自己标。NVIDIA 官方自述里有一句比收益更值得记的话——为提升泛化去扩大训练集,先撞上的是新的失效模式。由此建立一套归因框架:把失效压成输入锅、数据锅、容量锅三类,给出按修法成本排序的判别顺序,并明确标注为本文归纳而非厂商标准;再把「怎么知道它失效了」讲透——PSNR 在压缩这条直线上表现得完全正确,所以它最有欺骗性。最后给三条反例与一条边界。

17,064 字23 图10 章
神经纹理压缩:把纹理解码交给网络
04

神经纹理压缩:把纹理解码交给网络

把纹理解码交给网络,这一环表面上是纯显存问题,「省 8 倍」听起来不需要权衡,但把三种模式摊开,权衡藏在「省的是什么存储器」上。本篇先把同一技术的五个数字摆上桌(磁盘 8×、显存与系统内存 7×、on-Load 一分不省、官方 2K 表 on-Sample 约 5×、中媒 96%),立下口径纪律——没有一个数字是错的,错的是把它们当同一个数用;再讲清纹理为什么不能照图片那套压——随机访问把大部分现成压缩方案挡在门外;随后拆开 NTC 的做法(特征金字塔 + 量化隐向量 + 每材质小 MLP),算清 on-Load/on-Sample/on-Feedback 三笔账,把最硬的一环「过滤」讲透(为何要换成随机纹理过滤 STF),并说明出货路径不是取代 BC、而是把 BC 当载体。最后给反证与边界(mip 2/3 略差 PSNR)、门槛与许可,以及一组「什么时候不值得换」的决策表。

15,126 字27 图11 章
神经外观:从解析 BRDF 到学习式材质
05

神经外观:从解析 BRDF 到学习式材质

把材质这一环的反射函数也交给网络,是从解析 BRDF 到学习式材质的一次拼接。本篇先铺现状(材质 = 纹理 + 解析 BRDF)与解析模型的表达能力上限,再讲神经材质的框架与工程细节——从 latent 解码、自解码一路到逐采样解码,随即摊开显存/算力/训练/画质四元账,处理过滤困境与 STF,落到材质重建这条生产路径,最后给一张反例决策表。凡是倍数一律标注口径,不做没有出处的转述。

14,721 字27 图11 章
如何验证的全景图:从 API 层到系统层的剖析坐标系
01

如何验证的全景图:从 API 层到系统层的剖析坐标系

把图形性能验证立成一套坐标系:RenderDoc 量 API 层的一帧(帧级),Perfetto 量系统层的整条路径(系统级),两轴交叉出「画错 / 画慢 / 卡 / 迟延」四类症状各归其位的决策地图;再落地「自跑 → 真图 → 归因 → 结论」这条可复现的证据链,并把开源、可重放、可进 CI 作为不可妥协的选择红线。全系列 13 篇都将在这张图上走。

14,011 字14 图9 章
一帧是怎么被抓下来的:RenderDoc 抓帧机制解剖
02

一帧是怎么被抓下来的:RenderDoc 抓帧机制解剖

把 RenderDoc 前端从「你按下抓帧」到「一帧完整落到盘中」的机制链剖开:三种注入路径怎么进进程、Vulkan 的 implicit layer 与 D3D/GL 的 GetProcAddress hook 两套拦截机制的差异、帧边界怎么用 vkQueuePresentKHR 卡出一帧的起止、抓帧窗口内命令外发与资源快照分别在干什么,最后落到 .rdc 文件里到底是什么、怎么回到前端展示。让你用工具前先看穿工具。

12,712 字24 图9 章
一帧被抓下来之后
03

一帧被抓下来之后:.rdc 如何被回放引擎重放与分析

会抓帧只是前半程:.rdc 怎么被回放引擎重新打开,并一点一点重建出那一帧。

14,000 字22 图9 章
事件浏览器
04

事件浏览器:一帧 draw-call 列表到底怎么读

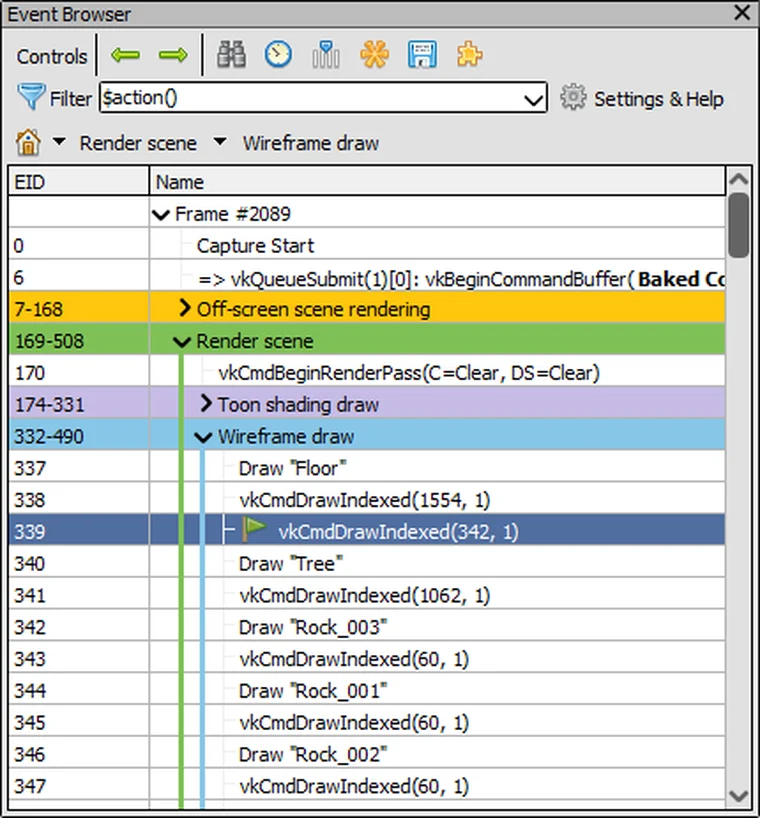
把事件浏览器里那长串 draw-call 列表,读成一帧的结构化索引。

12,692 字20 图11 章
资源与描述符
05

资源与描述符:一帧里那几百个 buffer 和纹理,怎么和 draw 对得上

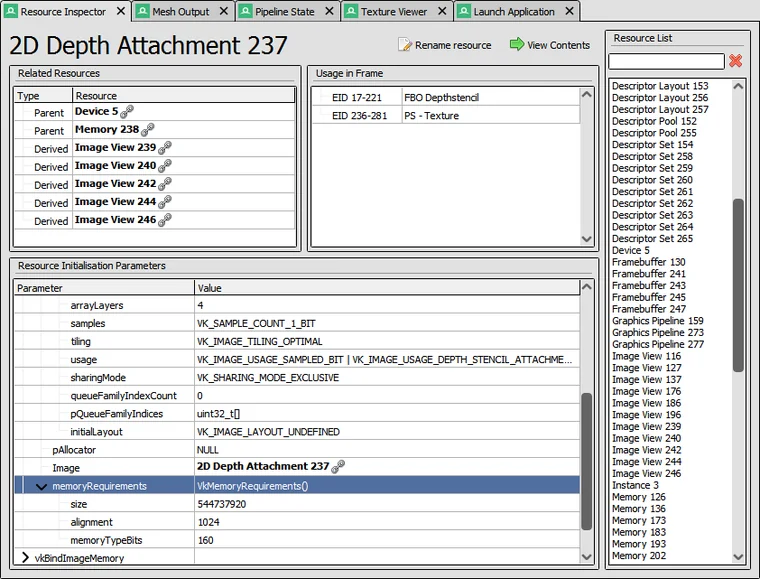
资源清单里那几百个 buffer 与纹理,怎么和命令流里的 draw 一一对上。

13,446 字24 图10 章
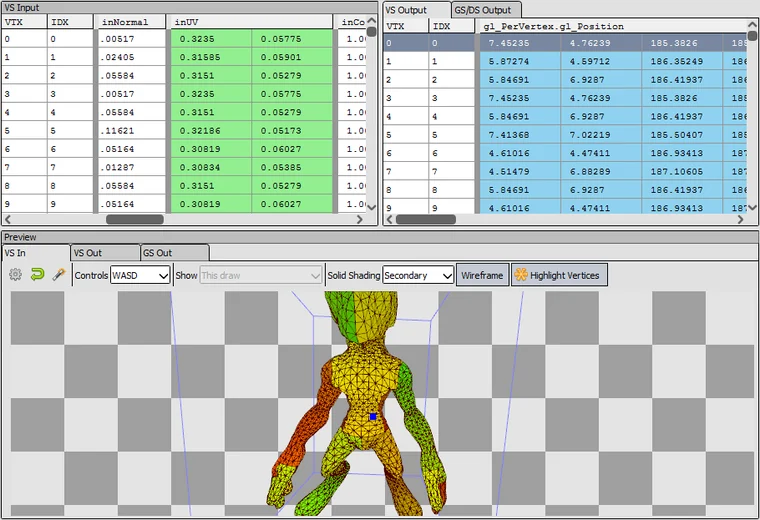
Mesh Viewer 与反汇编
06

Mesh Viewer 与反汇编:读懂 GPU 在顶点与像素级到底算了什么

Mesh Viewer 与 shader 反汇编:GPU 在顶点与像素级到底算了什么。

14,105 字21 图10 章
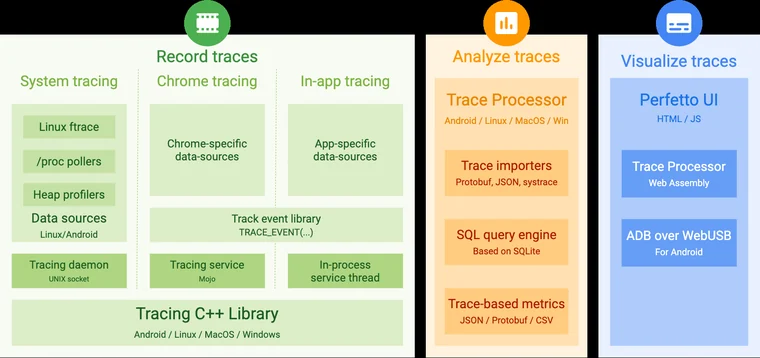
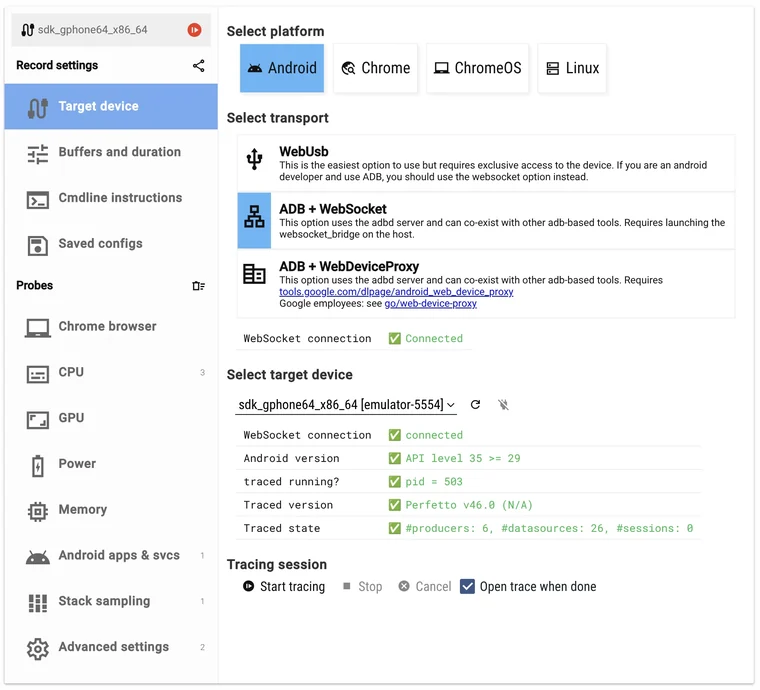
trace 即 protobuf
07

trace 即 protobuf:.pftrace 内部长这样

换个文件看:.pftrace 内部长什么样,一路拆到字节与 SQL 表。

14,335 字25 图9 章
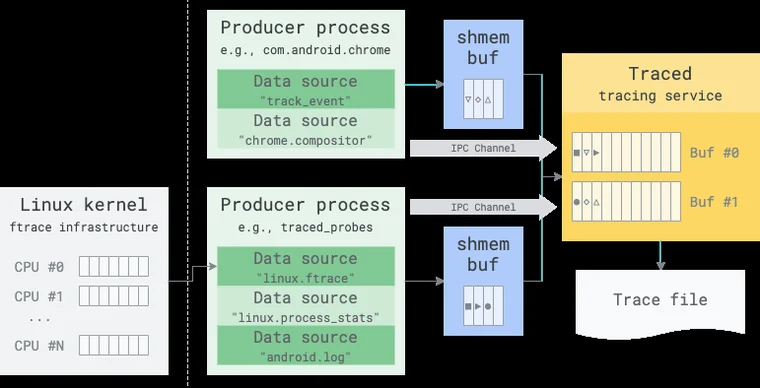
data-source 全景
08

data-source 全景:谁来画这些火焰图

翻个面:这些数据是谁写进去的 —— Perfetto 的 data-source 全景。

17,180 字24 图9 章
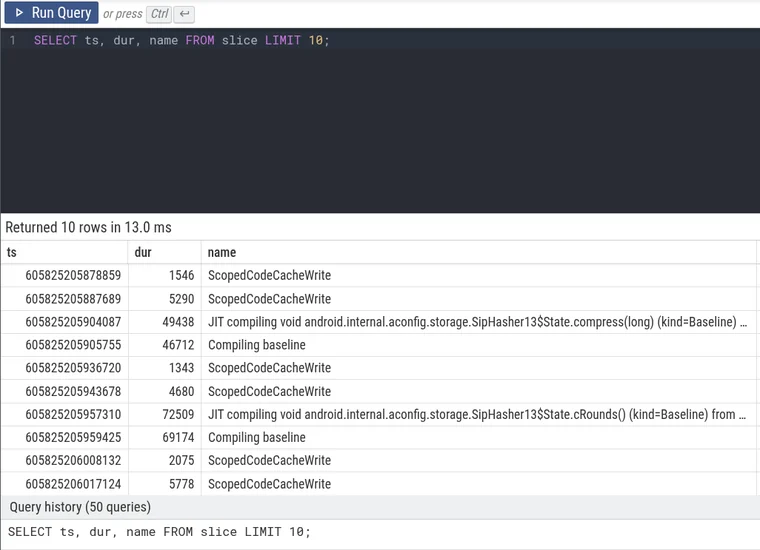
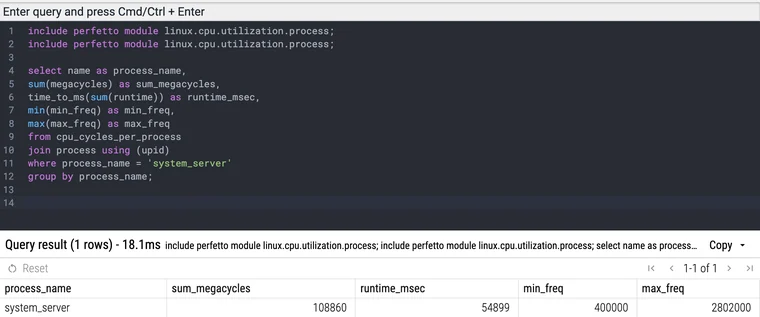
'SQL 调优
09

'SQL 调优:把"能查"变成"查得快、算得对"'

数据已经在库里了,该怎么把它们问对、问快。

18,490 字27 图9 章
FrameTimeline
10

FrameTimeline:一帧到底有没有掉

只回答一个问题:这一帧到底掉没掉。

16,651 字25 图9 章
实战一
11

实战一:一条链路揪 GPU 瓶颈

实战一:一个症状进来 —— 帧率上不去,问题出在哪,沿链路一处处排除。

17,324 字26 图9 章
实战二
12

实战二:掉帧,到底是 jank 还是 shader

实战二:某一帧确确实实超期了,这个「掉」该记在 jank 还是 shader 头上。

17,188 字26 图9 章
实战三
13

实战三:"如何验证"闭环手册

实战三:把散在前十二篇的判据、边界、工具能力与缺口,收成一套可复用的验证阶梯。

16,891 字26 图9 章
2D 矢量引擎全景
01

2D 矢量引擎全景:五款引擎各在哪个生态

同样是「把矢量变成像素」,五套做法完全不同的引擎为什么能同时活着。

15,760 字26 图11 章
Skia 架构
02

Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend

钻入 Skia:一次 draw 从 SkCanvas 到像素,怎么在 CPU 与 GPU 两条后端分岔。

16,198 字26 图11 章
矢量引擎核心
03

矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage

曲线在变成像素之前,先要变成什么:贝塞尔细分、tessellation 与解析抗锯齿。

19,981 字32 图13 章
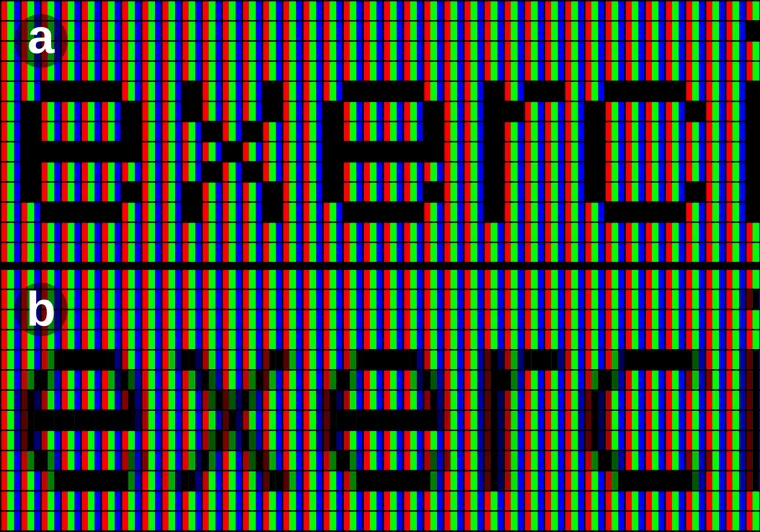
字形光栅化
04

字形光栅化:字形数据组织、blob 与 CJK

换一种输入:字形的数据怎么组织,blob 与 CJK 又有什么不一样。

17,486 字28 图13 章
Skia GPU backend
05

Skia GPU backend:覆盖 approach 与 instanced tessellation

把前四篇的前提拿掉——那些工作都由 CPU 干;这一篇讲 GPU 后端的两条覆盖路线。

15,974 字27 图13 章
Graphite
06

Graphite:Skia 新一代 compute 后端

为什么把 Ganesh 这一代整体换掉,以及换成了什么:Skia 的新一代 compute 后端。

17,193 字28 图13 章
自跑一
07

自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化

自跑一:同一段场景分别交给 CPU 光栅与 GPU 后端,量输出差、耗时差与 overdraw。

15,649 字26 图13 章
自跑二
08

自跑二:SKP 回放与字体渲染差异

自跑二:换的不是后端而是输入——一份录好的 SKP 与一批当场排的字。

16,816 字27 图14 章
Vello
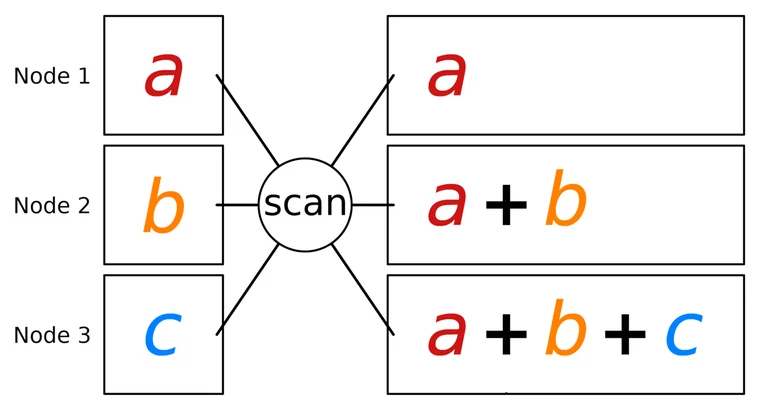
09

Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan

换引擎:Vello 用 GPU compute 的 Sparse Strips 与 prefix-scan 怎么做矢量。

15,993 字26 图15 章
自跑三
10

自跑三:Vello GPU、CPU、Hybrid 三路对比

自跑三:Vello 的 GPU、CPU 与混合三路对比,把「本机跑不了 Vello 本体」那句补上。

15,346 字26 图11 章
收官
11

收官:与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引

收官:与 Godot 2D、Cairo、Rive 对照,并交叉索引 Android 显示栈与 VFX。

14,871 字27 图11 章
总览
01

总览:从 App 到屏幕的图形管线

总览:从 App 到屏幕,一帧在 Android 上到底走了哪几段路。

17,769 字29 图10 章
Choreographer
02

Choreographer:谁在召唤 Vsync

屏幕静止不动时,CPU 为什么不归零:谁在召唤 Vsync。

17,454 字28 图10 章
RenderThread 与帧提
03

RenderThread 与帧提交:从显示列表到一块缓冲

滑动卡顿到底卡在哪一步:从显示列表到一块缓冲的帧提交。

16,012 字29 图10 章
BufferQueue
04

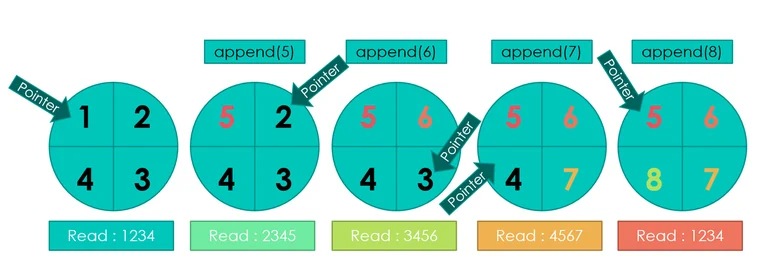
BufferQueue:图形缓冲区的邮局

「三缓冲」到底指什么:图形缓冲区的那条队列与它的派发规则。

15,882 字28 图10 章
Vulkan on Androi
05

Vulkan on Android:低开销渲染入口

在 Android 上,一个应用到底走哪条入口接上 GPU。

14,247 字30 图11 章
SurfaceFlinger
06

SurfaceFlinger:在 Vsync 之后做什么

缓冲交出去之后:系统侧在 Vsync 之后到底做了什么。

14,037 字28 图11 章
ASurfaceControl
07

ASurfaceControl:Android 10 的透明事务

把「Vsync 之后」的第一段打开:Android 10 的 ASurfaceControl 透明事务。

14,239 字28 图11 章
HWC
08

HWC:GPU 合成之外的硬件叠加

屏幕上这一帧由谁去摞:HWC 的硬件叠加,以及这个决定是谁下的。

15,985 字28 图12 章
HWC2
09

HWC2:Vsync 回调和虚拟显示路径

把 vsync 当成既定条件之前:HWC2 的回调与虚拟显示路径。

15,626 字28 图12 章
Vsync 偏移
10

Vsync 偏移:应用、SF、屏幕的三步舞

那几条 vsync 回调的相位到底错开了多少:应用、SF 与屏幕的三步舞。

17,248 字28 图12 章
三缓冲、多刷新率与 ARR
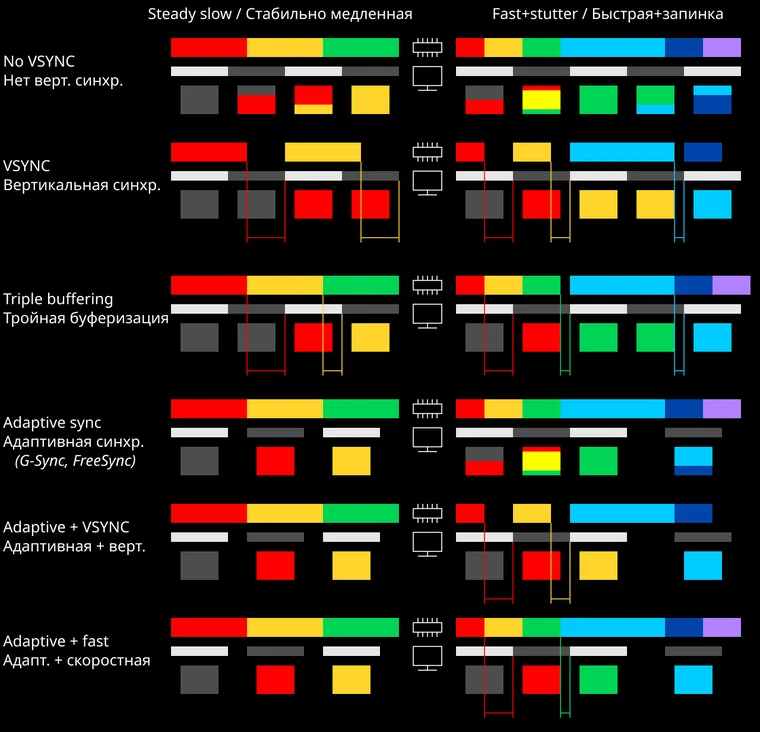
11

三缓冲、多刷新率与 ARR:队列有多深,屏幕有几个档

队列有多深、屏幕有几个档:三缓冲、多刷新率与 ARR。

16,067 字28 图12 章
虚拟显示与屏幕录制
12

虚拟显示与屏幕录制:一块不存在的屏,凭什么也算一块屏

「屏」这个字一直默认成立——虚拟显示凭什么也算一块屏,屏幕录制怎么接进去。

14,608 字28 图12 章
剖帧实战
13

剖帧实战:Perfetto FrameTimeline 抓 jank

取一次「过程」而不是快照:Perfetto FrameTimeline 怎么把 jank 的账剖开。

14,808 字28 图12 章
全景与边界
01

全景与边界:它在物理引擎谱系里的第几格

Jolt 是一个把多核扩展性与确定性押在最前的 3D 刚体库——本机实测 8 线程 6.44×。

14,698 字32 图10 章
一次 step 的流水
02

一次 step 的流水:Update 里到底排了哪些活

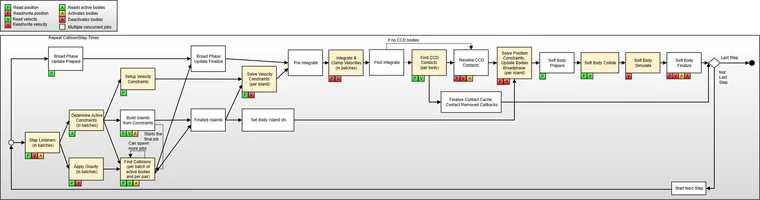
一次 Update 排了 22 个作业句柄、四条主干链;本机 16 线程下最重的不是求解,碰撞检测占 19.3%。

15,500 字48 图9 章
Body 与 MotionProperties
03

Body 与 MotionProperties:三态、两副面孔的接口、批量增删

会动的刚体才带 MotionProperties,静态体每体省下 60% 内存;官方那句「必须批量添加」,本机量出逐个比批量慢 185×。

18,060 字50 图9 章
宽相四叉树
04

宽相:QuadTree 的无锁双树

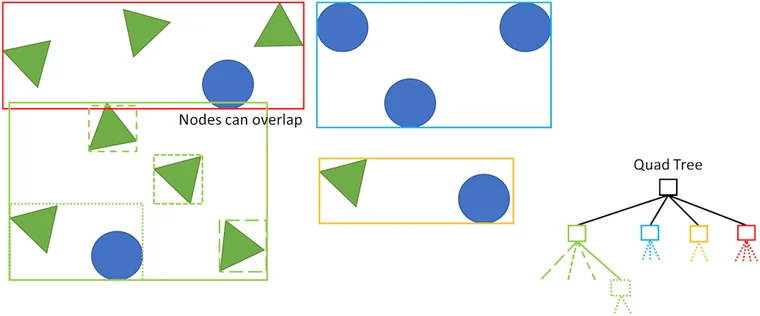
宽相是一棵无锁四叉 AABB 树,同一时刻还并存两棵;10 万体逐个插入会把树撑成 667 层的链。

15,556 字46 图10 章
三层过滤
05

三层过滤:谁能撞谁

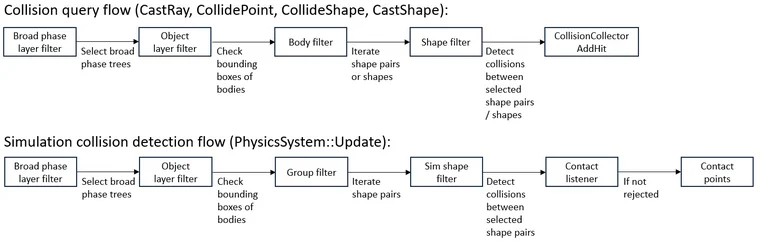
「碰不碰」不是开关,而是六级漏斗,越往下越贵;只改一行层映射返回,稳态每步快 1.62 倍。

15,900 字42 图11 章
窄相
06

窄相:GJK、EPA 与流形裁剪

窄相分两半:GJK 判相交、EPA 只在核心真重叠时才跑;接触点容量是 64 不是 4。

17,964 字44 图11 章
形状谱系
07

形状谱系:34 个形状类型与 32 位路径

12 个形状类型、34 个子类型,顺序都是追加演进的化石层;「打中了哪一块」压进 32 位。

18,883 字50 图10 章
约束家族
08

约束家族:13 类约束与可复用的求解原语

13 个内置约束类型加 4 个用户槽,求解抽成 14 个可复用原语;纯刚度写法 901 步仍未收敛。

18,197 字31 图10 章
接触求解
09

接触求解:sequential impulse、暖启动与 Baumgarte

求解器在文档里叫顺序冲量加暖启动,落到代码是两个 job;关掉暖启动,十层塔穿透从 27.90 mm 跳到 4571.98 mm。

20,134 字35 图10 章
岛、并行与睡眠
10

岛、并行与睡眠:IslandBuilder、LargeIslandSplitter 与三判据

一步里谁跟谁可以同时解、什么可以根本不参与;睡眠把每步成本压到约六分之一,但线程 1 加到 8 几乎无收益。

19,026 字34 图11 章
CCD 与确定性
11

CCD 与确定性:LinearCast 的「偷时间」与状态回归

又小又快的东西为什么没穿过去,同一份输入凭什么跑出同一份世界;打开确定性开关,三次复跑同一个末态哈希。

18,792 字35 图12 章
角色与载具成品件
12

角色与载具成品件:CharacterVirtual 的三件套与 VehicleConstraint 的四个部件

引擎已经把哪些东西做成了可以直接接入的成品件;快照往返后角色漂移 999.999084 mm、动态刚体 0.000000 mm。

27,046 字54 图12 章
柔体、毛发与 GPU
13

柔体、毛发与 GPU Compute 的真相:三条线各自的边界

收官篇问三个问题:顶点网格怎样被约束成软物体、头发怎样在显卡上被模拟、「Jolt 有 GPU 物理」该怎么读。

24,169 字44 图10 章
全景与边界
01

全景与边界:Godot 4 的四层架构,以及一次 2D 绘制要经过谁

一次 2D 绘制要过四层;本机只改一个 --rendering-driver 开关,OpenGL 一路自动落到 Compatibility。

17,580 字39 图10 章
对象模型
02

对象模型:Node、SceneTree、CanvasItem 为什么分成三层,以及一次绘制命令交给谁

同帧连调 23 次只画 4 次;门面那个 create 在实现层查不到。

17,544 字39 图10 章
服务层接口
03

服务层接口:RenderingServer 为什么是一组 RID 型命令

句柄是「代际接槽位」;已释放的句柄用起来报错、释放起来却无声。

17,702 字39 图10 章
画布剔除与排序
04

画布剔除与排序:RendererCanvasCull 决定画什么、按什么顺序

顺序分三层箱位、剔除有五道闸门;两百个方块套上画布组,draw call 从一变成二。

14,610 字40 图10 章
画布渲染抽象
05

画布渲染抽象:RendererCanvasRender 与一次绘制的中间表示

一条链交出去之后长什么样?四层嵌套、六条换批判据,本机测出 draw call 取决于切换次数。

19,372 字45 图12 章
批处理与攒批规则
06

批处理:从 CanvasItem 到一次 draw call 的攒批规则,与四个后端的演进

容量从哪来、按什么切、装不下会怎样?两档探针测出分界真的跟着设置走。

15,229 字44 图15 章
渲染依赖图与 4.3 的同步返工
07

RenderingDevice 抽象:从命令列表到渲染依赖图,以及 4.3 那次同步返工

4.3 把同步责任挪进一张有向无环图:依赖记进邻接表,屏障先问驱动,重排默认开。

14,813 字39 图13 章
四后端分叉与两张能力表
08

后端分叉:Vulkan / Direct3D 12 / Metal / OpenGL,怎么选、分叉在哪

同一份顺序落到四张桌子上:分叉长在编译期、工程设置与运行期三处;本机那三档里还有一档起不来。

15,049 字40 图14 章
三个节拍与跨线程边界
09

主循环与多线程:这套账在什么时刻、被哪个线程算出来

换到时间轴上问同一套账:三个节拍怎么错位、累加器怎么攒出物理步数、跨线程的边界又分几档。

15,879 字40 图14 章
一张纹理从盘上到显存
10

资源侧:一张纹理从盘上到显存

同一张图从盘上到显存要换三个身份:源、点 import 配置、ctex 产物;压缩那五档在三根轴上各站一边。

18,075 字42 图14 章
Godot 引擎启动画面
11

收官:这套架构的取舍,以及 Godot 为什么让 2D 也吃 GPU

收官篇把整条链翻过来看一遍:2D 批处理这条线官方先后给过三种口径,断批的代价是两千倍而不是两倍。

16,233 字39 图13 章
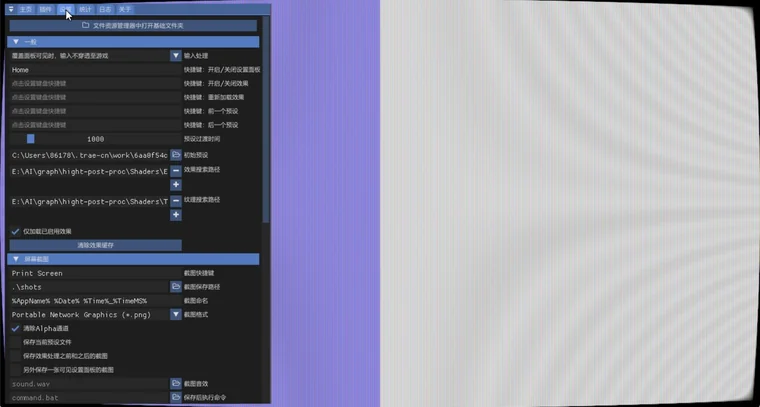
靶子上真实跑出来的一帧(CRT_Lottes 那一档开着)
01

总论:什么是注入式后处理——它与管线内后处理的边界

它站的是位置而不是算法:注入前后只改一个开关,本机对照组实测逐字节相同,六组效果从 15.9 到 63.2。

14,438 字24 图13 章
ReShade 自己的日志页
02

代理 DLL 与导出表挂钩:一次调用是怎么被接过去的

同一个探针文件,命名对了就被加载、命名错了连加载都没发生;日志逐模块宣布挂了 31 处,末行却报卸载 40 处。

14,742 字25 图10 章
ReShade 的设置页:效果与纹理搜索路径
03

ReShade FX:语言血统、独立编译器与纹理语义

官方只说自己是「以 DX9 风格 HLSL 为底子的方言」;本篇把那「少量扩展」拆成四类,并自己写一个 .fx 编一遍看产物。

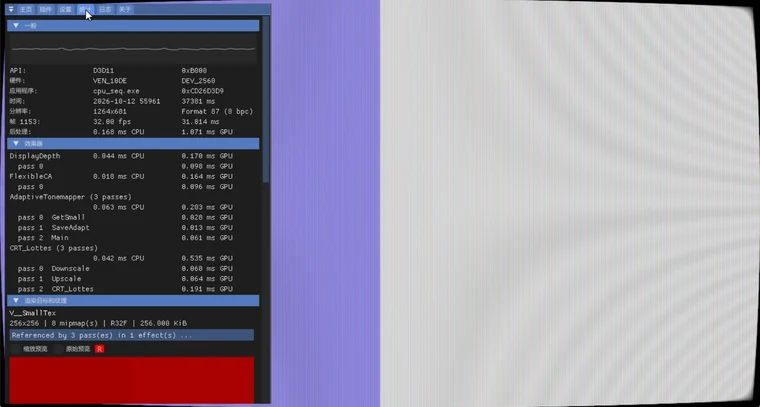
18,528 字28 图15 章
ReShade 的统计页:逐 effect 与逐 pass 的 CPU 毫秒
04

effect runtime:technique / pass 图、render state 与运行时数据源

顺序不靠依赖图,靠一份表:效果文件里的声明顺序加预设那一行排序表。十六个运行时数据源里,第十六个由 add-on 从外面塞进来。

16,226 字27 图13 章
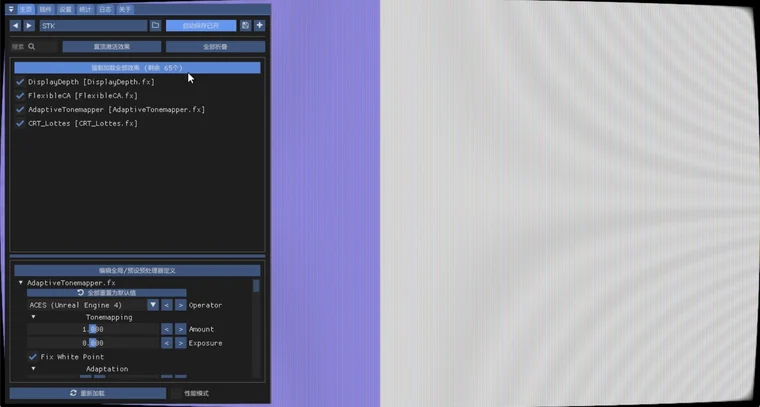
叠加层主页上的效果列表
05

跨 API 抽象:D3D9/10/11/12、OpenGL、Vulkan 的差异与统一

差异没被抹平,只是被收走了:收进六个不透明句柄的注释里、收进四个后端各自的四份状态块里、也收进九处 present 入口与六份格式转换器里。D3D12 与 Vulkan 干脆没有状态块那个文件。

15,787 字24 图13 章
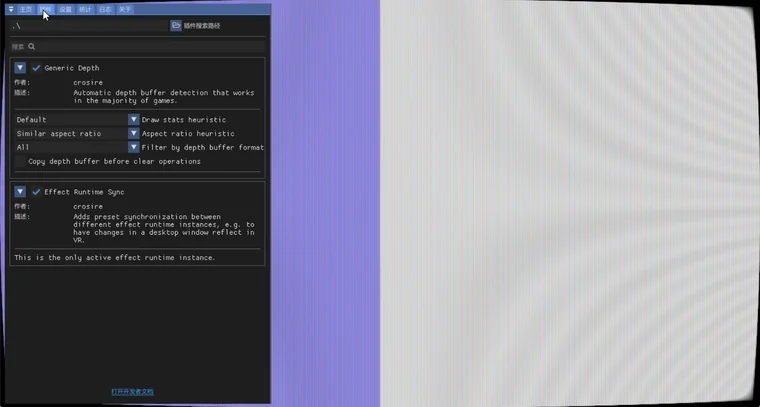
ReShade 的插件页
06

Add-on API:事件模型、跨 API 资源交换与两种构建的分野

add-on 不导出函数、也不链接库,靠的是一张 100 个格子的事件表、18 个跨 DLL 边界的 C 导出,和一个三档取值的构建开关:签名版在编译期就摘掉了其中 30 个事件。

16,254 字24 图13 章
深度缓冲可视化那一档的画面
07

深度缓冲的工程学:自动关闭、MSAA、UI 缺失与子矩形错位

深度类效果为什么时灵时不灵?关掉它的那一手不在深度模块里:网络一有流量,61 帧一个窗口、≥10 帧就把 add-ons 整体停掉,而且只有签名版这么做。再叠上 MSAA 的能力位、界面不在深度里、子矩形判据这三道独立条件。

16,046 字24 图13 章
ReShade 的关于页:许可证清单
08

效果生态与许可地图:同一份清单里的 MIT 与"禁止再分发"

那些 effect 到底能不能用、能不能转?答案不在许可条款的比较表里,而在「这份清单有没有托管任何东西」这个形态问题上:45 个包全部是指针,官方一个字节都不托管。于是同一份清单里并存七种许可状态,最大的一格是既无文件也无声明的 10 个仓库。

15,332 字24 图14 章
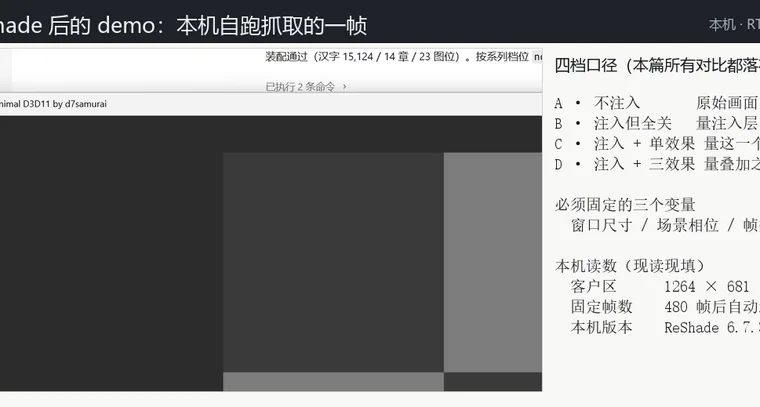
注入 ReShade 后 demo 的画面与四档口径并置
09

自跑一:注入本地 D3D11 demo——逐效果前后对比

第一次真的把它装上去:在一个自有的极简 D3D11 demo 上布线、注入、逐档抓图。四档口径把「开与不开差多少」拆成可核的格子,而结果并不均匀——同一台机器上,深度探针与色调映射一眼可见,色差与 CRT 看得出但轻,景深几乎看不出:靶子太简单、深度跨度太小,这是靶子的限制,不是效果的毛病。

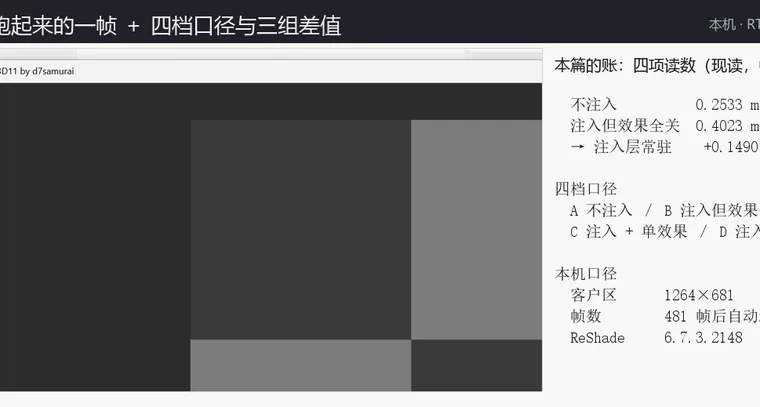
14,993 字24 图14 章
四档口径的逐次读数与三组差值并置
10

自跑二:效果栈与帧耗账,外加自写一个小 .fx

第一次把账算出来:把「多花多少」定义成毫秒每帧,三笔钱分开记。三笔的性质并不相同——注入层常驻约 0.15 毫秒每帧(两场独立复跑一致),而八个单效果里五个同口径档全部低于「效果全关」档,三效果叠加的边际也不等于三个单效果之和;分辨率这条乘数同样不线性。最后一节自写一个小 .fx,走通整条链。

16,969 字24 图13 章
同一段字节:联合体成员全部从偏移 0 开始
01

对象布局、对齐与 padding:sizeof 的真相

同一个结构体,字段一样、只换个声明顺序,一个是 12 字节、一个是 8 字节——差出来的全是编译器塞的填充。本机两套工具链的布局转储与读数是主力证据;全篇唯一一处真分叉是那行 C++20 属性:g++ 省下 4 个字节,MSVC 一个字节没省,而两家都合规。

16,771 字39 图12 章
三家分配器的峰值工作集与提交内存对照
02

分配器解剖:malloc → jemalloc/mimalloc → pmr arena

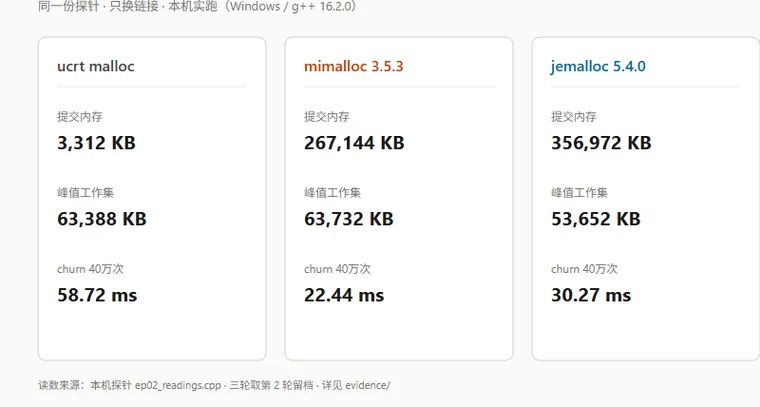
同一句 new 往下要过语言层、实现层、系统层,每一层都能换。本机的三条通道给出两个反直觉结论:池资源不一定更快(synchronized_pool_resource 在一次性长序列上比 new_delete 慢约 60 倍,它的收益在「重复同尺寸 + 批量归还」),而峰值工作集差不多的三家分配器,提交内存能差出 100 倍(3.3 MB / 267 MB / 357 MB)。

15,002 字37 图11 章
构造计数探针与三家 SSO 缓冲策略对照
03

值语义的账:move/拷贝/SSO/emplace_back

std::move 到底搬了什么东西?它只是个 static_cast,真正偷资源的是移动构造;而短字符串的 move 其实就是一次拷贝。本篇用构造计数探针、反汇编片段与地址同一性实测把拷贝三板斧、copy elision、三家 SSO 策略和 emplace_back 的真实收益逐个量掉 —— emplace_back 不是万能的,传对象时它和 push_back 一样快。

16,447 字37 图11 章
编译器前端与后端的分阶段时间读数
04

编译期账本:模板实例化与 -ftime-trace

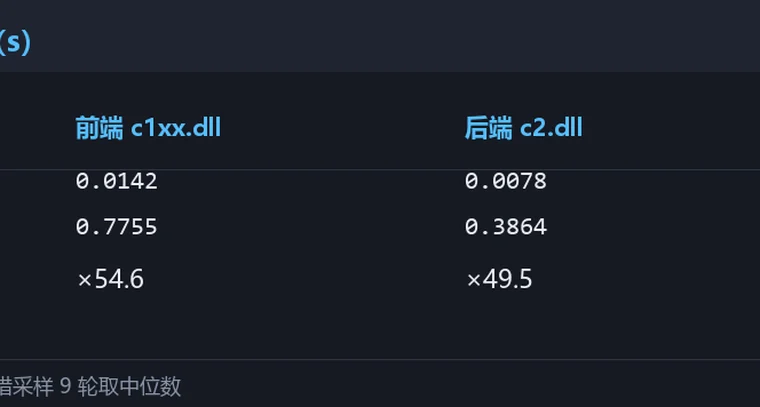
编译慢到底慢在哪一步?把前端与后端的时间分开量之后:同一份 main,仅因包含并使用容器模板,前端 c1xx.dll 就从 0.0142 s 涨到 0.7755 s,55 倍。最意外的一处是 extern template —— 它在 GCC 16.2 上按标准生效(全量构建 −26.2%),在 MSVC 19.44 上实测未生效,原本准备的「省十倍教程」被自己的实测推翻。

16,131 字36 图11 章
MSVC 向量化报告的 16 条判定与原因码
05

优化器的边界:UB、严格别名与向量化报告

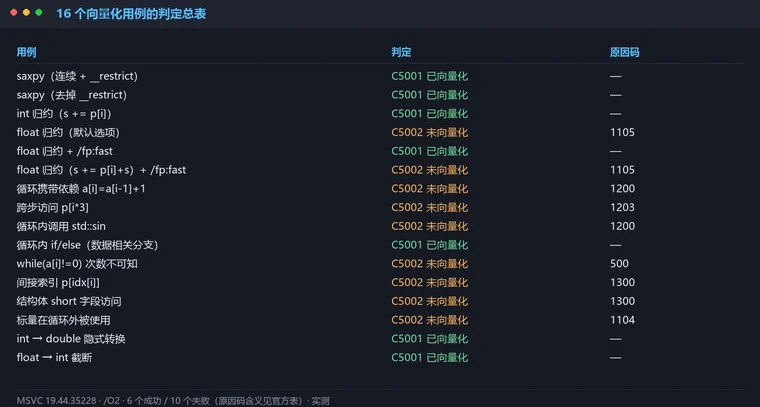
同一个循环为什么有时向量化、有时不?MSVC 的 /Qvec-report:2 把 16 个循环的判定逐条拍出来(成功 6、失败 10,每条都带官方原因码):一个再普通不过的 float 求和默认不会被向量化,原因码是浮点归约需要重结合。最硬的一处是类型双关 —— 同一份代码在 GCC -O2 下返回 132、165、193(每次都不一样),加 -fno-strict-aliasing 立刻修回 -1,而 MSVC 两侧都正确。

15,283 字36 图11 章
两套工具链的名字修饰与符号名对照
06

名字与符号:ABI、修饰、可见性、PLT 与 IAT

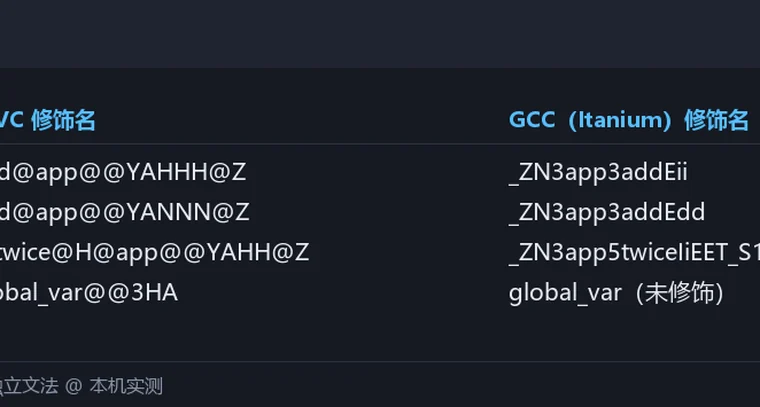
为什么 undefined reference 里那串字符完全看不懂?因为链接器只认符号名,不认你的类型与重载:源码里同一个 app::add(int, int),MSVC 编出 ?add@app@@YAHHH@Z,GCC 编出 _ZN3app3addEii,两列之间不存在任何可以机械转换的关系。决定性实验是 mingw 的 main 链接 MSVC 的 .obj —— 走 C 符号成功、走 C++ 符号失败,同一份 provider 只因名字有没有被修饰而结果相反。

15,924 字36 图11 章
MSVC 侧 LTO 档的计时与体积读数面板
07

链在一起:LTO 与 PGO 的收益从哪来

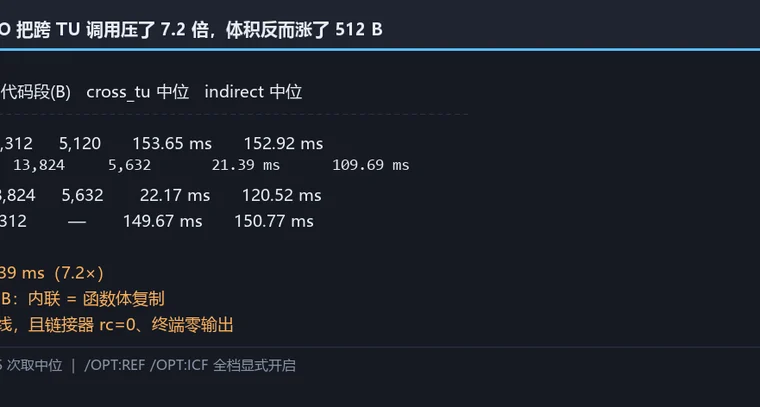
两个被并列成「高级优化开关」的选项,动的东西完全不一样:LTO 拆翻译单元边界,PGO 拆类型与分支边界。跨 TU 的 step 在 MSVC 上从 153.65 ms 降到 21.39 ms,exe 反而涨了 512 字节;决定性对照是把 step 手工搬进同一个 TU、完全不开 LTO,得 19.73 ms,与 LTO 档同量级,说明书里的收益全部来自跨 TU 内联。

16,623 字36 图11 章
11 档分发阶梯在四组配置下的读数并排
08

分发的代价:虚函数、模板、variant 与类型擦除

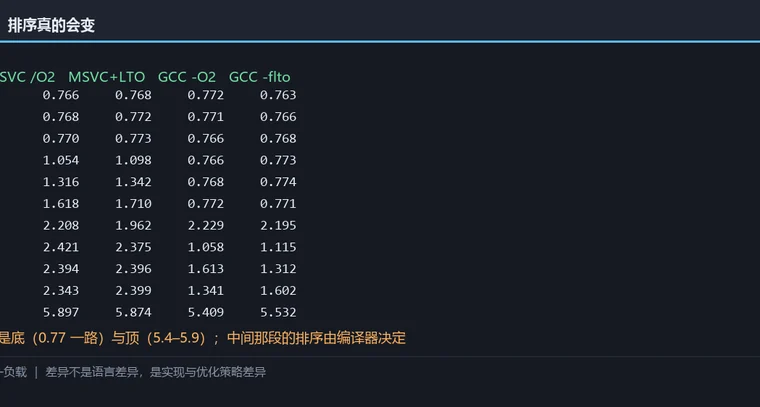
同一段「把类型藏起来」的代码,代价到底落在哪?11 档分发阶梯量下来,排序会随工具链变 —— 同一份单态虚调用,GCC -O2 把它划掉(0.772 ns/op,与直调同量级),MSVC /O2 没划掉(1.618,2.11 倍)。流行建议也在这一篇被实测推翻:variant-poll4 在 MSVC 上 2.421 比 virtual-poll4 的 2.208 更慢,在 GCC 上反过来是 1.058 对 2.229。

15,590 字36 图11 章
全篇读数汇总:时间侧、空间侧、表结构、noexcept 与 RTTI
09

异常与 RTTI:零成本到底成不成立

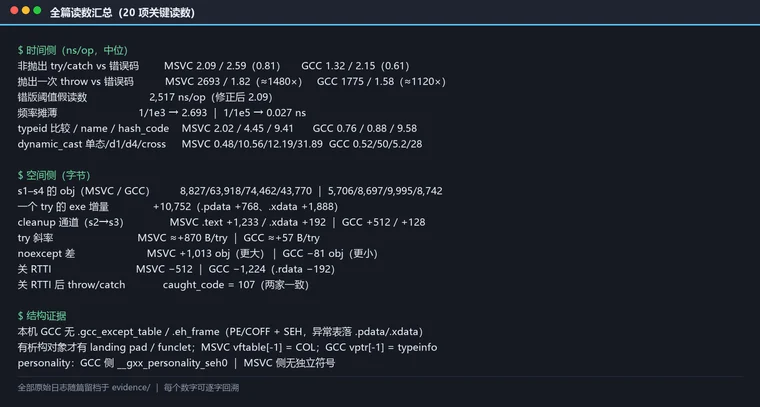
「零成本」这句宣传语 claim 的到底是什么?本篇把它拆成两笔账:不抛异常时 try/catch 与错误码同速(2.09 对 2.59 ns/op),但一旦真抛,一次就是 2,693 ns,是错误码的千倍量级;而空间侧不免费,只加一个 try 块,MSVC 的 exe 就涨 10,752 字节。全篇还有两处与流传说法不符:本机 GCC 的 PE/COFF 段表里没有 .gcc_except_table 与 .eh_frame;关掉 RTTI 之后异常捕获照常工作,只省 512 到 1,224 字节。

17,476 字38 图11 章
全篇读数汇总:反汇编、单线程、lock 成本、重排命中率、竞争与布局六组读数
10

内存序与原子:seq_cst 在 x86 上免费吗

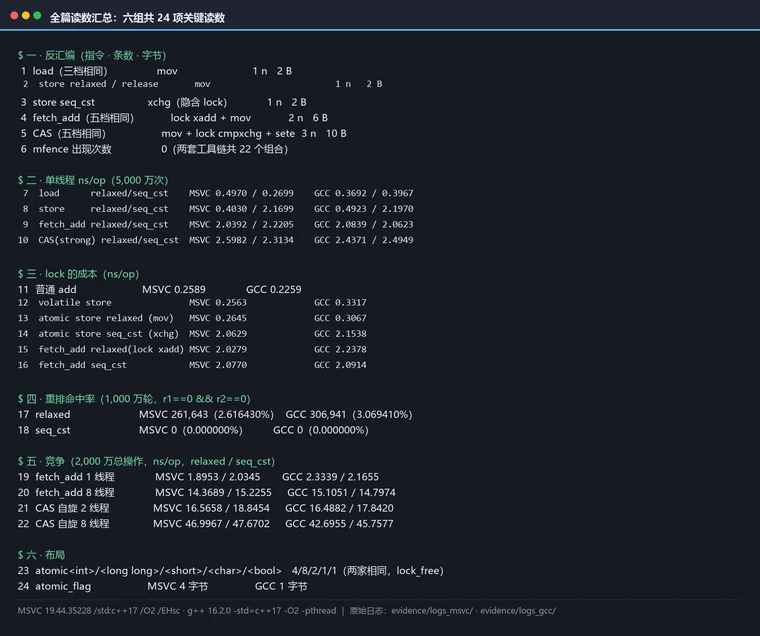
「seq_cst 在 x86 上免费吗」这个问题,多数文章给的是一个单词的答案。本篇把它拆成 load / store / RMW 三类,用 MSVC 19.44 与 GCC 16.2 各量一遍:load 免费(三档同一条 mov)、fetch_add 与 CAS 也免费,只有 seq_cst 的 store 不免费——mov 换成隐含 lock 的 xchg,单线程 0.40 ns 变 2.17 ns。更反直觉的是 22 个组合里一条 mfence 都没有,seq_cst fence 落到栈上一个哑元位置。本篇还把「可能发生」变成了频率:1,000 万轮实测,relaxed 的重排命中 2.62% 与 3.07%,seq_cst 一次不中。

18,075 字40 图11 章
全篇读数汇总:硬件转储、布局转储、三档共享标尺、填充档位扫描、线程扫描与拓扑对照六组读数
11

缓存与布局:AoS/SoA、伪共享与 cache line 的账

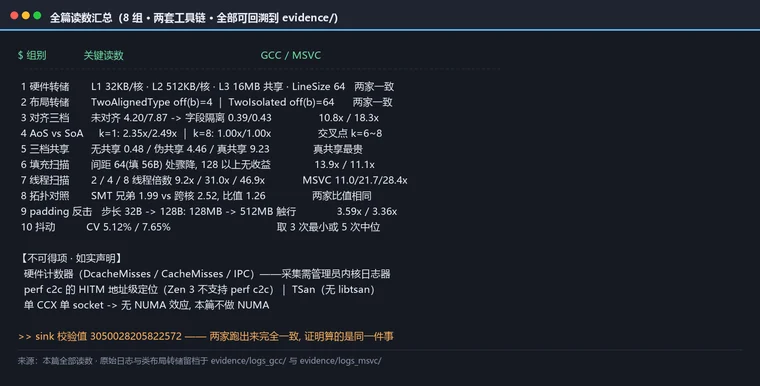
「SoA 比 AoS 快」与「填 64 字节」这两句流传最广的口号,本篇都用本机读数拆开。alignas(64) 加在类型上,与完全不加对齐一样慢(4.20 对 4.61 ns/op,GCC),只有加到每个字段上才掉到 0.3902 ns/op,差 10.8 倍;间距从 32 跨到 64 的那一步骤降 11 到 14 倍,再往上没有任何进一步收益。AoS/SoA 的答案是「看 k」:只读 1 个字段 SoA 快 2.35×,读满 8 个字段两家完全打平。而 padding 不是免费的——把步长从 32 抬到 128,单线程遍历慢 3.59×,触及字节从 128 MB 涨到 512 MB。

21,711 字45 图11 章
全篇读数汇总:硬件与工具链、报告条目、浮点归约、分支、手写、对齐、规模与标准 SIMD 八组读数
12

SIMD:自动向量化与手写 intrinsic 的分界

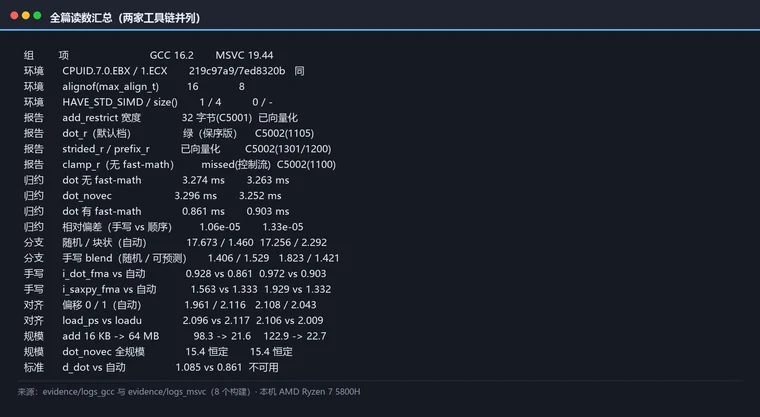
「加 -O3 就会自动向量化」这句话,本篇用 8 个构建逐个拆。第一个反直觉来自报告与读数不一致:GCC 报 loop vectorized using 32 byte vectors,而关掉向量化的同循环是 3.296 对 3.274 ms——收益是 0,反汇编给出解释(乘法已向量化,累加仍是 12 条串行 addss)。第二个是语义开关:加上 -ffast-math / /fp:fast,点积从 3.274 掉到 0.861 ms、3.263 掉到 0.903 ms。第三个是数据:同一份二进制上随机符号 17.256 ms 对块状符号 2.292 ms,手写无分支版的优势从 9.47 倍缩到 1.61 倍。第四个与流行说法相反——开了 fast-math 之后编译器赢了手写 intrinsic。

26,708 字54 图11 章
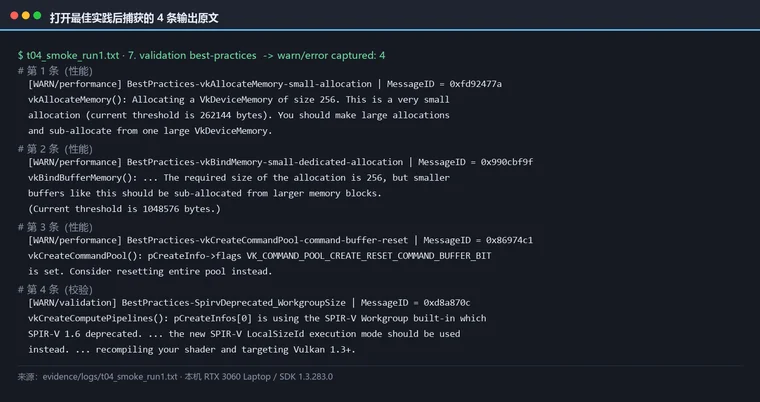
打开最佳实践检查后的四条输出:两条分配阈值、一条命令池重置、一条 SPIR-V 弃用提示
01

官方最佳实践到底在哪:四套体系的边界与本机能力实勘

「官方最佳实践」这五个字,在 Vulkan 这边找不到对应的那一份文档——它散在四套体系里(Guide 74 页、Tutorial 18 章加 10 门进阶课、Samples 25 个 Performance 样本、以及验证层一个开关),而那个开关官方默认值写的是 false。本机同一份没有在代码里请求该特性的构建,默认配置路径捕获 0 条告警,环境变量与 vk_layer_settings.txt 各捕获 4 条。另有量尺与边界:timestampPeriod = 1.0、223 项扩展,100 次派发五次复跑 20,992 到 27,424 ns、极差 30.6%;RenderDoc 注入成功但纯计算用例没有帧边界,抓不出 .rdc。

18,605 字39 图13 章
2026 新范式:Vulkan 1.4 基线、Dynamic Rendering 与 Shader Objects
02

2026 新范式:Vulkan 1.4 基线、Dynamic Rendering 与 Shader Objects

官方在 SIGGRAPH 2026 给出的那套「2026 写法」,搬到本机只剩两件能跑:三件套里 shader objects 与 dynamic rendering 有扩展、可实测,descriptor heap 是 0 命中——不是查漏,是设备能力表里就没有。能跑的两件用「一个二进制、五条路径、只改 API 形态」量了一遍:单帧录制 45.3 → 56.2 → 74.6 µs(换 dynamic rendering 贵 24%、换 shader objects 贵 65%),整帧却只有个位数变化,成本全落在 CPU 侧录制上。另有两处「读数被自己作废」都做成了可复跑路径:FIFO 把差异压平(复现 5,764.1 µs)、漏设 18 项动态状态让一万多条验证层报错被读成性能(复现 1,956.4 µs)。

20,063 字40 图17 章
同步最佳实践:barrier 精细化、sync2 与时间线信号量
03

同步最佳实践:barrier 精细化、sync2 与时间线信号量

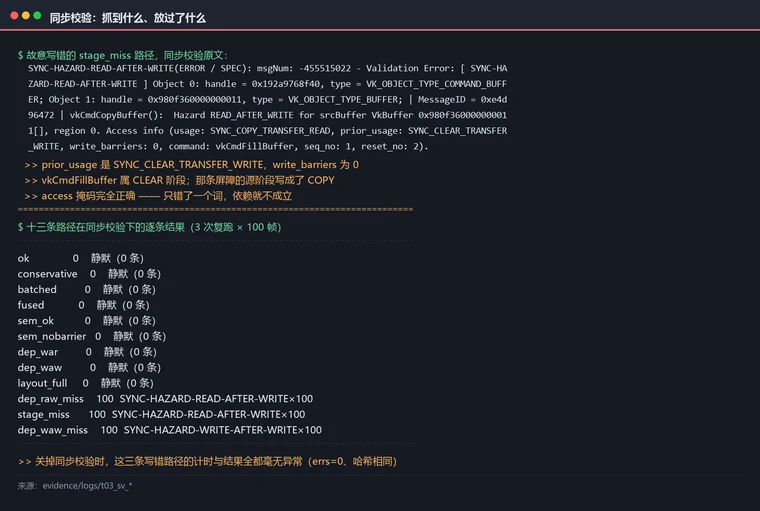
这一篇量的是「屏障怎么写」。官方四个体系里,Guide 给九条可执行的判据、Tutorial 讲清 sync2 的动机、Samples 给方向、Validation 给工具——四者共同缺的那一样是数字。做法是「一个二进制、十三条路径、唯一变量是屏障写法」,每帧内容完全相同,每条路径 ×5 次复跑报区间。结果分两层:65 次运行读回缓冲的 FNV-1a 全为同一个值,删屏障、合并屏障、把掩码写成 ALL_COMMANDS,结果字节完全一样;但唯一区间不相交的一对只有被判据明令禁止的全掩码写法(录制 +2.8%),而「合并调用」「合并掩码」「删掉官方点名可删的那条屏障」三项差异全部落在复跑噪声里——官方那句 creating a bottleneck,本机量不到。真正抓到东西的是验证层:三条故意写错的路径在同步校验关闭时计时正常、结果正确、一条错都不报;打开后各报满 100/100 帧,其中一条是 vkCmdFillBuffer 属 CLEAR 阶段、源阶段写成 COPY 的粒度陷阱。

17,806 字36 图17 章
演示空间

能动手的
图形原理演示

把原理做成能驱动的程序:拖动参数、看画面怎么变、再拿中间量表格自己算一遍。每一段都配一个真在跑的活例,不是动效。

25课已上线
89段已写
已交付 · 3 课 9 段 ● 可跑

管线各阶段的数据处理

一个几何顶点从进来那一刻起被逐阶段变换与消费的全过程。三课各自只加一个变量,控件保持一致,画面与数值同步变。

01 顶点怎么变成裁剪空间坐标 · 4 段
02 三角形怎么变成像素 · 2 段
03 像素上贴什么 · 3 段
纯 WebGPU · 拖动参数即刻生效→
已交付 · 7 课 25 段 ● 可跑

PBR 高级效果

着色不是「给表面涂颜色」,而是解一个积分。沿模型谱系走:光从哪里来、朗伯为什么与视角无关、经验模型那一代怎么近似。

七课全上线→
已交付 · 5 课 15 段 ● 可跑

全局光照 GI

一个着色点接收到的光,有一部分来自别的物体反射的光;而别的物体,又接收到它反射的光。要算清这一点只能在场景里采样 —— 一旦靠采样,就受 1/√N 支配。

01 最便宜的一次近似 · 3 段
02 把半球装进几个数 · 3 段
03 反弹一次 · 3 段
04 反弹多次 · 3 段
05 工程上的取舍 · 3 段
五课全上线→
已交付 · 5 课 20 段 ● 可跑

物理模拟

物理每一帧只做三件事:积分、找接触、解约束。前三课各讲透一件,第四课把约束放松成软体,第五课到了关节与骨骼 —— 也就是 ragdoll 为什么会抖成面条。

01 积分器与稳定性 · 5 段
02 接触与隧穿 · 3 段
03 约束求解 · 4 段
04 软体与 PBD · 4 段
05 关节与骨骼 · 4 段
纯 Canvas 2D · 拖动参数即刻生效→
已交付 · 5 课 20 段 ● 可跑

动画与骨骼

动画 = 先算骨架姿态,再把网格顶点按权重挂到骨头上。第一课讲"读姿态"(蒙皮),第 2–4 课把"写姿态"的三条路走完:解出来的(IK)、演出来的(弹簧骨)、补出来的(关键帧);第 5 课把这些动作叠起来 —— 权重混合、相位、遮罩、加层。

01 骨骼蒙皮 · 4 段
02 反向动力学 IK · 4 段
03 弹簧骨 · 4 段
04 关键帧与插值 · 4 段
05 动画混合 · 4 段
纯 Canvas 2D · 可直接拖动目标→
作品集

做过的项目
与技术实验

工具、产品、概念验证与 AI 工作台,做成之后会陆续放到这里。上线之前,这个位置不放占位内容。

+

筹备中

第一个作品上线后,这里会换成它的实拍与说明。现在留白,是为了不放没有的东西。

有想法?说说看

能不能做、大概要多久、要花多少 —— 说清楚了我直接告诉你。做不了的也会直说。