本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
上一篇我们把 Ganesh 这一代的 GPU 侧答案走完了:一次 draw 怎么被记成 op、op 怎么被合进 render pass、曲线怎么变成一个实例、覆盖率从哪来。那一篇里有一句话被有意留了下来没有展开——这套答案自己也知道自己不长久。2023 年官方在讨论组里就把结论写死了:
"The long-term goal for Skia is to deprecate Ganesh and move forward with Graphite only." —— [2]
这一篇就接着那句结论往下走。名字大家应该都听过:Graphite(石墨),Skia 新一代 GPU 后端。但我想先把一个问题摆正——「新一代」这三个字容易被读成「更快的同一套东西」,这就读偏了。Graphite 换掉的不是某个算法的常数,而是录制与回放的边界:谁来记、在哪个线程记、记下来之后按什么顺序摊到 GPU 上。这三件事一动,整个后端的形状就跟着变了。
本篇的落点是机制,不是评测。所以我们会花大量篇幅读源码里的结构体和常量,而不是看帧率曲线——原因写在 §0.4,那里有一条关于本篇证据能力的坦白,请务必先读。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更好/更快」的说法,绑定官方原文常量或可复核的算术;
- 凡引必注:源码常量给文件路径与快照日期,官方文档给链接,本机重算给口径;
- 本篇不涉及(边界见 0.3):Ganesh 的覆盖 approach、实例化细分与 Wang 公式(上一篇已讲透,本篇只引用不复述)、Vello 的 sparse strips 与 4×4 tile 流水线、Pathfinder 的 GPU tiling-dicing、CPU 光栅与字形(第三、四篇)、WebGPU/Dawn 规范本身的绑定模型与着色语言细节;
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机自算/源码摘录由官方源码常量与公式重算得出(图注写明口径);自绘图为本系列绘制,走 styles/qianmo/palette.json 色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(Ganesh 这一代的答案):【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 本篇引用最密的两个源码文件:Recorder.h | DrawList.h
- 本篇对常量与位域做算术重算的依据:DrawOrder.h | GraphiteTypes.h
- 官方宣布 Graphite 上线的原文:Introducing Skia Graphite
本篇只回答三件事
先来看看这一篇要回答的三个问题。它们不是并列的知识点,而是一条从「谁在记」到「按什么顺序摊到 GPU 上」的动线,顺序不能颠倒:先明白录制被拆成哪几块,才谈得上「多线程到底多在哪」;先看清绘制命令怎么被排成一列,才谈得上「为什么要用一个 30 位的字段去装流水线」。
0.1 全篇知识地图:三件事,一条动线
第一件:录制与回放被拆开了。 Ganesh 时代,画布、绘制状态、GPU 资源都在一条线上走;Graphite 把它们切成三段——记录器(Recorder)产出录制(Recording),录制被主线程插入(insert)到上下文(Context),最后统一提交(submit)。第一件要看清的就是这三段的职责边界,以及那段「每份录制只能裁一次」(snap())的硬约束。
第二件:多线程的边界画在哪里。 官方那句「multithreaded by default」很容易被读成「什么都并行」。实际不是——录制可以在多个线程上做,但录制之间要不要同步、能不能乱序插入,是有开关的。第二件要看清的是:Chromium 里实际开了几个 Recorder、insertRecording 会返回哪六种结果、以及那个「预编译上下文」为什么可以搬到别的线程上去。
第三件:画家顺序交给深度值之后,绘制怎么被排。 这是本篇篇幅最重的一段。Graphite 给每条绘制命令分配一个 z 值当作画家顺序的索引,然后在准备命令缓冲时按 z 递增排序,排序后相邻且流水线等价的命令会被合并。第三件要看清的是这个 z 值的编码方式(它为什么要「翻转」)、裁剪怎么被变成一次只写深度的绘制、以及那条排序带来的流水线组合空间到底有多大。
这三件事说完了。
OK,把这三件事压成一句话。
0.2 一句话说清 Graphite 换了什么
Ganesh 的问题是「一套 GL 底座上能塞多少特例」,Graphite 的问题是「最少要几条流水线才够用」。
这句话不是修辞。看过上一篇的朋友应该有印象:Ganesh 的着色器是按绘制类型特化出来的,路径填充、路径描边、任意几何各有一套;每加一种效果就多一批管线,管线一多,启动期编译不完,只能等到运行时第一次用到再编译,于是动画和滚动里就冒出偶发的掉帧。Graphite 的选择是把这条曲线掰回来——官方原话是「consolidate the number of rendering pipelines as much as possible」[1],把流水线种类压到尽量少,用更少的管线覆盖更多的绘制。
顺便说清另一件事:Graphite 并不承诺「同样内容一定更快」。它换来的东西是可预期的多线程与更少的管线种类,代价是更依赖现代图形 API(Metal / Vulkan / D3D12)的能力,尤其是深度测试这个 Ganesh 时代基本没用上的东西。这个判断在后面第十节会有一条硬条件约束,那里我们只拿到一个官方自测数字。
0.3 边界:本篇不涉及什么
把话说在前面,避免把精力花在别处:
- Ganesh 的覆盖 approach、固定次数实例化细分、Wang 公式、边数上限:上一篇已经逐条讲过,本篇只在需要对照两代差异时引用,不复述;
- Vello / piet-gpu:sparse strips、flatten/binning/coarse/fine 四阶段、prefix-scan 与 GPU 排序、4×4 tile——属 ep09/ep10;
- Pathfinder 与 NV_path_rendering:作为「另一条范式」只在坐标系里出现,不展开;
- WebGPU 与 Dawn 规范本身:绑定模型、着色语言、管线描述对象的字段语义——本篇只用到抽象层边界上的那几条约束,不展开规范;
- 具体 GPU 微架构与驱动行为:哪家驱动怎么优化、tile-based 与 immediate-mode 的差别——不在本篇范围。
关键参数的取值范围(本篇反复用到的四个数,先立在这里):记录器默认内存预算 256 MB;排序键总宽 64 位;单个绘制列表的渲染步上限 4096 步;画家顺序的深度档位 0xffff。
0.4 证据口径:本篇的事实主源是源码
这一节要放在最前面,因为它决定了大家怎么读后面的每一句话。
第一类:官方源码的常量与注释原文。 本篇的结构体成员、位域定义、上限常量、枚举取值,全部取自 google/skia 的 main 分支,抓取日 2026-09-28。这里有一条容易踩的坑必须说明:这个快照与第三、四、五篇用的 2023-11 的 flutter_engine 镜像不是同一个时点,同一个类在两处的成员可能已经不一样。所以本篇凡是给源码常量,都会带上文件名;混着读会读出互相矛盾的结构。
第二类:本机对常量与公式的算术重算。 这是本篇 src_* 类图片的全部来源,也是必须先坦白的地方:本机没有 Graphite 运行环境。手边的 skia-python 绑定走的是 CPU 光栅,并不暴露 Graphite 的 Context;本机也没有 RenderDoc、AGI 这类抓帧工具。所以本篇标注「本机重算」的图,一律不是跑出来的读数,而是两类可复核动作:
- 把官方源码里的常量与位域按算术重算一遍(例如 30 位的字段能装多少种组合、16 位的深度字段有多少档);
- 把抓到的官方源码摘录并置,让两段互相限定的注释挨着放。
图注会逐张写明用的是哪一种,不冒充实测,也不冒充抓帧。凡是只能用真实 GPU 回答的量(实例数、draw call 数、命令缓冲大小、帧耗时),本篇一律引官方口径或直接写「拿不到」。
另有一条检索结论先立在这里:Commons 上没有对位「GPU 引擎内部机制」的示意图。这一轮枚举的 21 个类目里有 12 个是空的(WebGPU、Render pass、Compute shader、Skia 等全部不存在),intitle:graphite 的 1,324 条命中全是石墨矿物,intitle:skia 的命中是斯凯岛古地图和一款叫 Skia 的字体。所以本篇的机制示意图全部自绘或本机重算,外部示意图只用在「通用原理」那几个位置。
0.5 本章收在哪里
下面我们进入第一阶段。 本篇的线索是「重排」:录制被重排到多个线程上,绘制被重排成按 z 递增的一列,流水线被重排到尽量少的几种。
官方依据:Ganesh 的终局与两代后端的划分见 skia-discuss 讨论帖;Graphite 的设计取向与 Dawn 抽象层见 Skia Graphite 官方博客;本篇源码口径为
google/skiamain 分支(2026-09-28 抓取)。
一、Ganesh 的债到底欠在哪
下面我们进入第一阶段:为什么必须换。这一章不列功能清单,只回答一个问题——换掉一个渲染后端,通常不是因为某个功能做不出来,而是因为底座决定了上限。
1.1 底座决定了上限
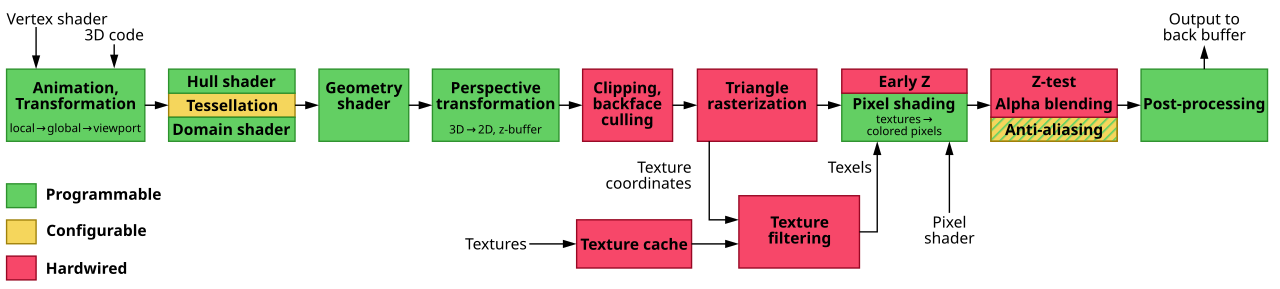
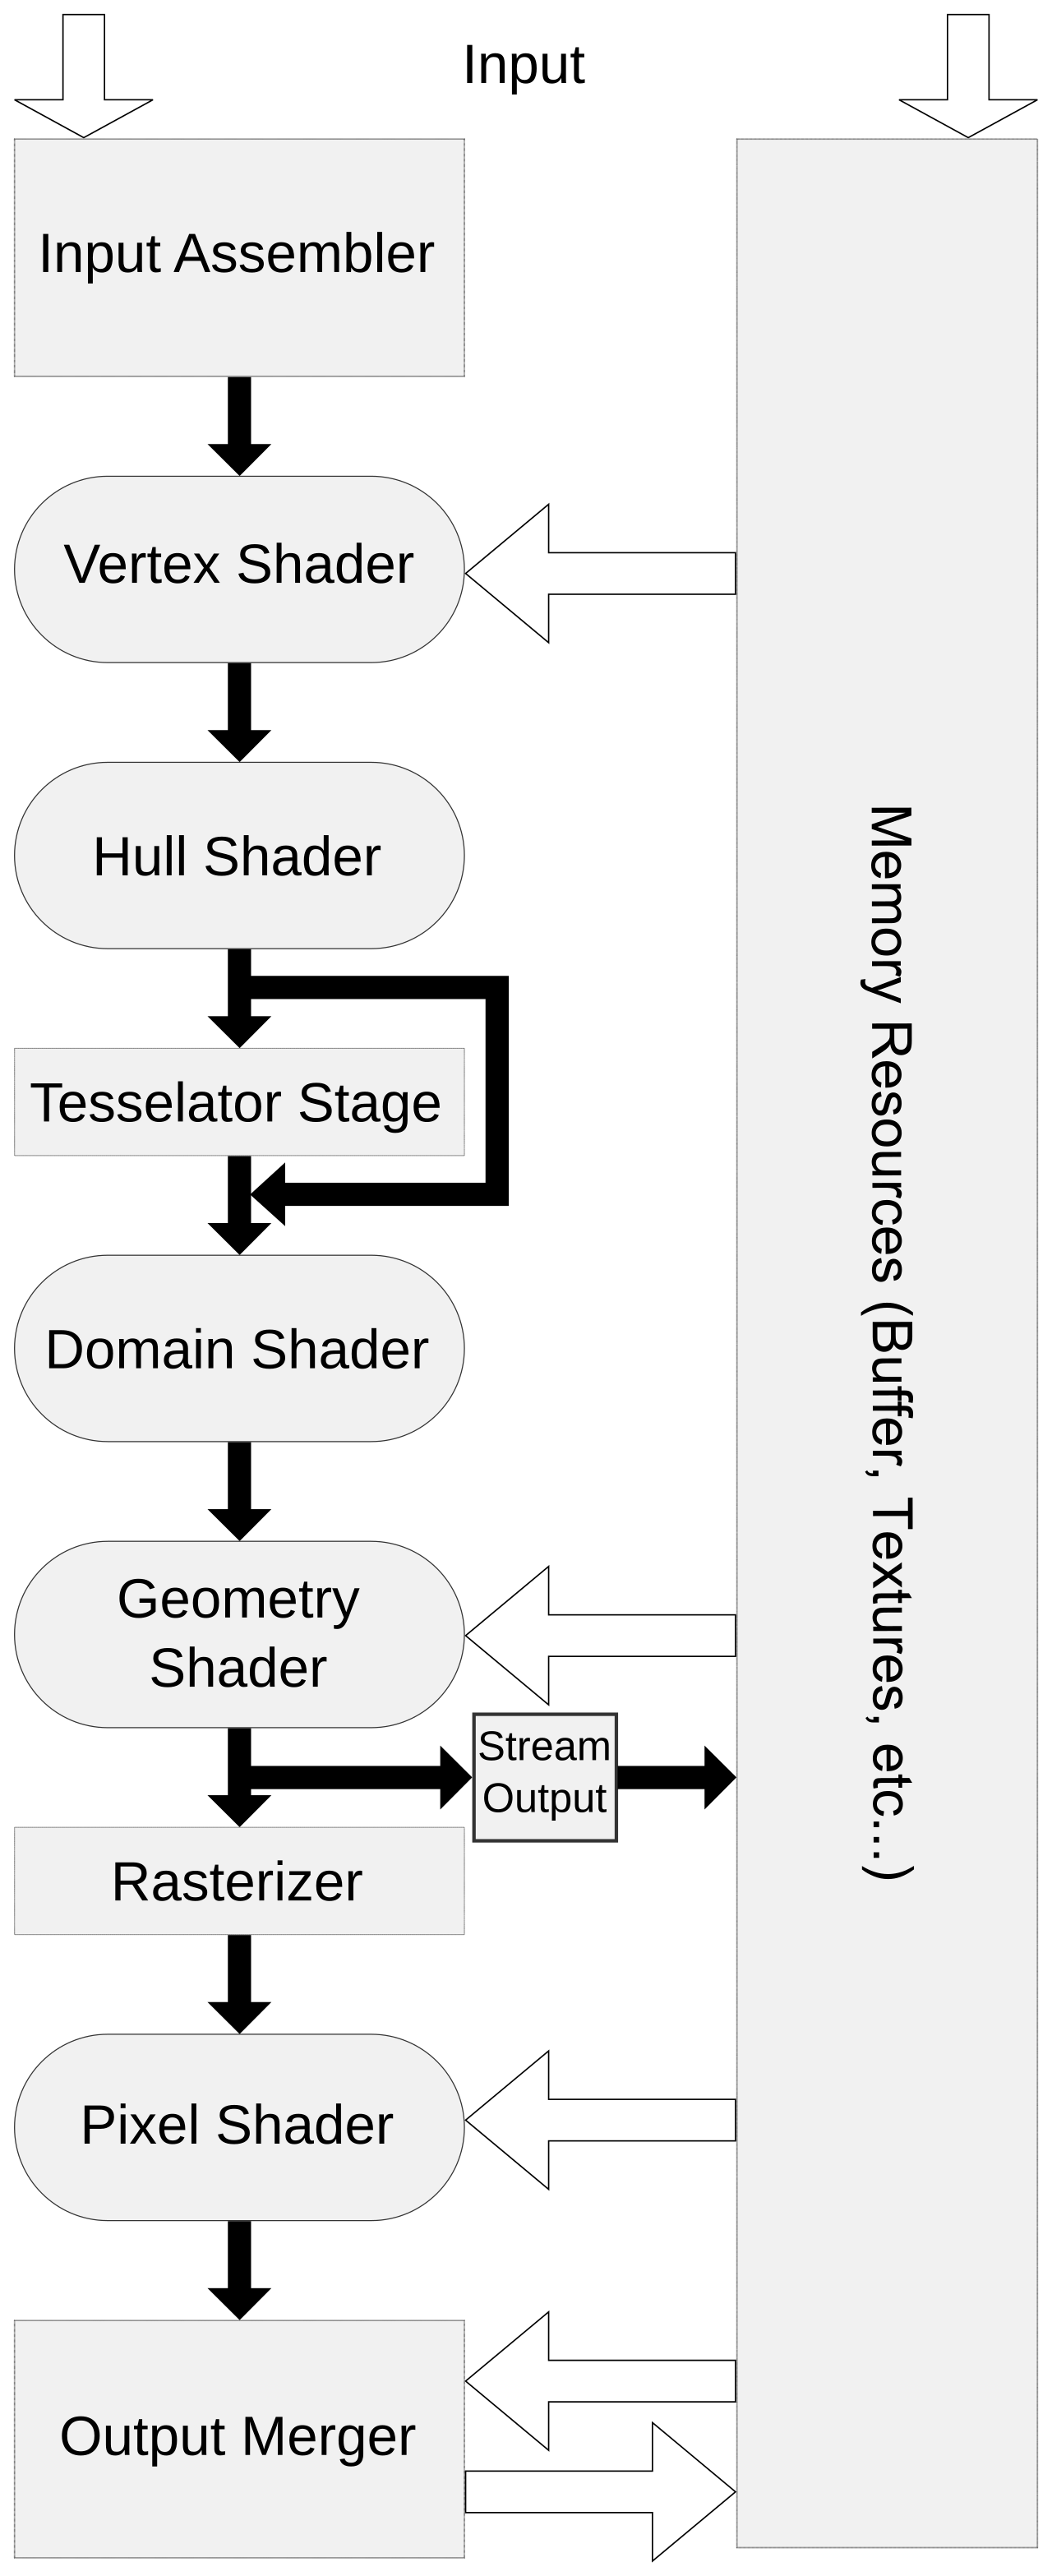
上面这张图把渲染管线的阶段摆开了。看这张图的时候容易忽略一件事:它不是「硬件长这样」,而是「API 允许你这样用」。管线的每一段在真实硬件里可能根本不对应独立单元,图里画成这样,是因为图形 API 的抽象层次就是这么切的。
而 Ganesh 的底座是以 OpenGL 为中心的。这个选择在它诞生的年代完全合理:那会儿 OpenGL ES 2.0 遍地都是,跨平台靠它最省事。但它的代价藏在后面这些年里慢慢显出来:
- OpenGL 的状态机模型没有可编程的管线描述对象,管线是隐式推导出来的。想预编译?得先知道运行时才会确定的那一堆状态组合;
- OpenGL 的深度测试虽然存在,但在 2D 绘制里用得很少(后面 §7.1 会讲为什么),于是 Ganesh 没有把深度当作顺序工具,而是自己维护一个裁剪栈(clip stack);
- 更要紧的是,GL 的驱动实现差异巨大,同一个调用在不同厂商那里表现可以完全不同,于是上层只能按「最保守」「最特化」两条路走——特化出更多着色器,用来绕开驱动的不可预测性。
这三条拧在一起,就得到了一句官方后来的总结:「surprising performance cliffs」。不是慢,是说不准——大部分时候挺好,某些内容或某些驱动上突然掉下去,而且不好预判。
先看看「单线程」是不是设计选择。
1.2 单线程不是选择,是 GL 底座的后果
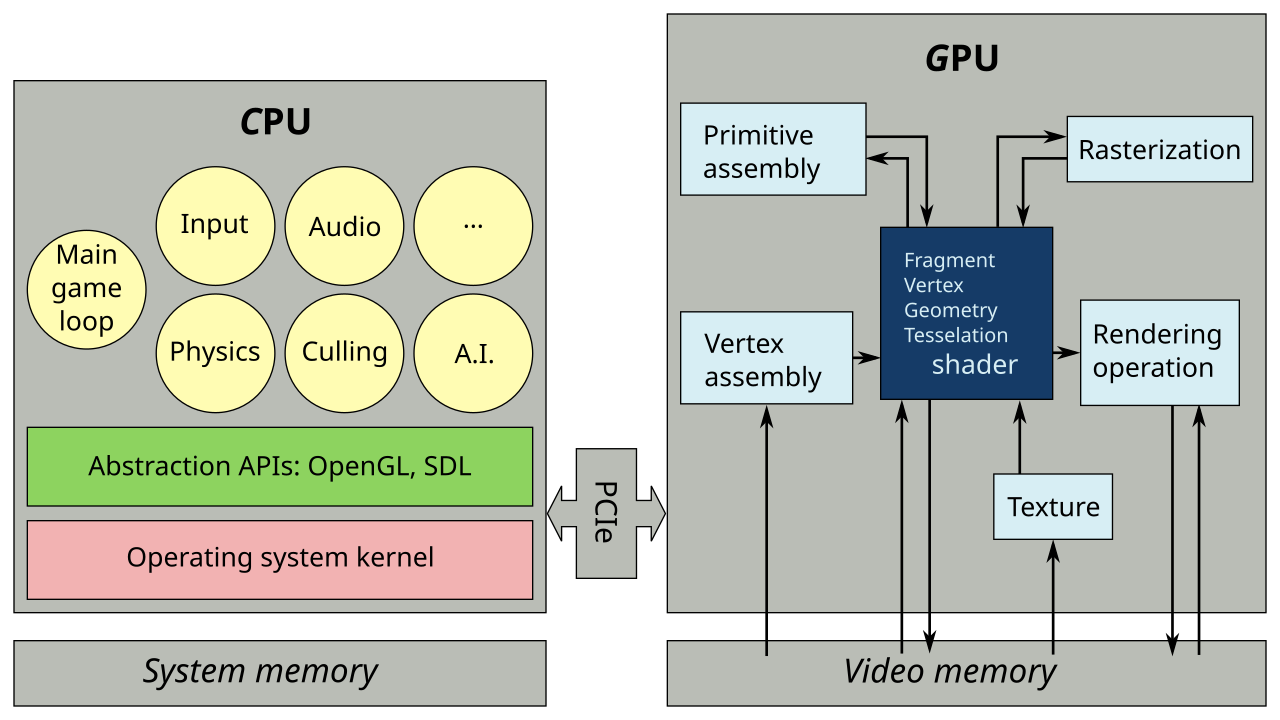
很多文章把 Ganesh 的单线程说成「早期设计没考虑多线程」,这个说法其实不准。它更像是 GL 底座的必然后果:OpenGL 上下文(context)绑定在创建它的那个线程上,一个上下文在多个线程上并发使用是未定义行为。所以只要底座是 GL,绘制命令的记录这一侧就很难真正并行——你可以把别的活挪走,但「记命令」这件事只能留在主线程。
官方对这段历史的表述很直接:
"Due to the single threaded nature of Ganesh and OpenGL, only a limited set of work could be moved to other threads, making it easy to overload the main thread..." —— [1]
这句话里有个词很关键——overload the main thread。它说的不是 GPU 忙不过来,而是主线程被记录工作压住了。这就解释了为什么那几年浏览器主线程的优化重点一直是「减少绘制命令的产生量」:因为产生命令的线程就一个。
Graphite 的破局点也在这里。它把底座从 GL 换成了 Dawn(Google 对 WebGPU 的实现,也是 Chrome 里的 WebGPU 后端),而现代 API(Metal / Vulkan / D3D12)允许命令缓冲在多个线程上并行录制。底座换了,「记录可以并行」这件事才第一次变得可行。
说白了,症状可以归成三笔债。
1.3 三笔债的清单与归类
把上面散落的问题收成一份清单,并按「债的性质」分成三类——这个归类很重要,因为它正好对上 Graphite 的三条设计主线:
| # | 债 | 性质 | 表现 | Graphite 的对策 |
|---|---|---|---|---|
| 1 | 以 GL 为中心的底座 | 底座层 | 驱动差异大,状态靠隐式推导,难以预编译 | 换 Dawn,用显式的管线描述对象 |
| 2 | 绘制命令只能单线程记录 | 并发层 | 主线程容易被记录工作压住 | 拆出 Recorder / Recording,录制可跨线程 |
| 3 | 着色器与流水线按绘制类型特化 | 结构层 | 管线数量爆炸,启动期编译不完 | 把流水线种类压到尽量少 |
这三笔债不是并列的,它们的依赖顺序不能颠倒:第 1 条是另外两条的前提——底座不换,命令描述就没法显式化,也就谈不上「预编译」和「并行录制」;第 3 条是前两条的结果——只有底座显式了,才敢反过来砍流水线种类。
还有一笔「隐形债」值得单独点一下:裁剪栈。Ganesh 靠维护一个裁剪栈来表达「后面画的都被前面某个形状挡住」。这个栈天生是有顺序的、有状态的,很难并行;而它存在的唯一理由,是深度测试没被用来干这件事。Graphite 直接用深度值把裁剪变成一次「只写深度的绘制」,裁剪栈就整个不见了——这也是为什么 §7 要专门讲深度。
1.4 本章收在哪里
这一章我们没写一行代码,只做了两件事:把 Ganesh 的债按性质归了类,并说明它们之间的依赖顺序。下一章我们看 Graphite 用什么结构把这笔债还掉——答案是把「记录」这件事单独抽出来,做成一个可以被多个线程各自持有的对象。
官方依据:Ganesh 的单线程瓶口与 Graphite 的设计取向见 Skia Graphite 官方博客;两代后端的官方划分与弃用目标见 skia-discuss 讨论帖;管线阶段总览图出处见参考资料第 33 条。
二、新核心的三段式
下面我们进入第二阶段。这一章要看的是一组对象:Recorder(记录器)、Recording(录制)、Context(上下文)。它们三个的职责边界,是整篇后面所有讨论的地基。
2.1 Recorder / Recording / Context 各持有什么
官方在 2023 年就把这套结构说清楚了:
"GrContext will only work with Ganesh -- there is an entirely new setup for Graphite that uses
skgpu::graphite::Contextandskgpu::graphite::Recorder." —— [2]
到了 main 分支的代码里,这三个对象的边界可以这样读:
Recorder是「记录现场」。它持有资源缓存、绘制列表、被记下来的绘制状态。我们要画东西,先向它要一个画布;Recording是「一叠记好的命令」,由Recorder::snap()产出。它自己不持有上层资源,只持有那段记录;Context是「GPU 的连接」。它对外只有三个关键入口:makeRecorder()造记录器、insertRecording(const InsertRecordingInfo&)把录制插进上下文、submit(SubmitInfo)真正提交。
这个切分最值得琢磨的是「Recording 不能自己造」。在源码里,Recording 的构造函数是私有的,只对 Recorder 开了 friend class Recorder;,而且它内部还存着一个 uint32_t fRecorderID,用来在插入时校验顺序。换句话说,一份录制天然知道自己是被谁、按什么顺序产出的——类型系统在帮运行时记这笔账。按这个定义,三段式分别是:谁持有状态、谁持有命令、谁持有 GPU 连接。
先看看一次 snap 要经过哪几步。
2.2 一次 snap 的生命周期
snap() 的注释里藏着三条约束,值得逐字读:
"This can only be called once per Recording; subsequent calls will return null until a Recording is snapped. Additionally, the returned SkCanvas is only valid until the next Recording snap, at which point it is deleted."
翻译成操作顺序就是:
- 我们调用
snap(),拿回一个Recording和一个SkCanvas; - 往这个画布上画——这期间所有命令进入这份录制;
- 再调
snap(),上一份录制被「裁断」,同时上一块画布被销毁,新的画布先生成; - 把裁断好的录制交给
Context::insertRecording。
关键在于第 3 步的「销毁」。画布不是一直有效的对象,它的生命周期只到下一次 snap 为止。这个设计把「一份录制对应一段连续的命令流」变成了类型上的事实,而不是靠约定——想偷偷往旧画布上再画一笔,编译器就不让。
顺带说一句 Recorder 的内存预算:源码里写的是 static constexpr size_t kDefaultRecorderBudget = 256 * (1 << 20);,也就是默认 256 MB。这个预算管的是记录期能占多少内存,不是显存——它约束的是「一份录制能堆多大」,防止某个线程记到失控。
好了,把边界收紧成三条约束。
2.3 录制期的三条硬约束
把 §2.1 和 §2.2 的信息并起来,录制期实际上有三条硬约束,它们的来源各不相同:
- 单次裁断:一份录制只能被 snap 一次,这是类型层的约束(私有构造 + 单一产出者);
- 线程守卫:源码里有一个
mutable SingleOwner fSingleOwner;,注释写着「In debug builds we guard against improper thread handling」——这是调试期的约束,它不阻止你在多线程上并发录制,而是阻止你在错误的线程上碰同一个记录器; - 内存预算:
kDefaultRecorderBudget = 256 MB,这是资源层的约束。
这三条合起来才说清了「多线程录制」的准确含义:每个线程有自己的 Recorder,各自记各自的;跨线程共享的是 Context,而共享点被推迟到了插入那一刻。官方对此的表述是「with minimal need to synchronize between them」[1]——注意是 minimal,不是 none。
2.4 本章收在哪里
这一章我们把三段式的边界和三条约束立住了。下一章我们看这套结构在真实产品里怎么被用——Chromium 开了几个 Recorder、它们各管什么、以及「插入」这个动作会以哪几种方式失败。
官方依据:
Context与Recorder的分工见 skia-discuss 讨论帖;snap()的单次语义、SingleOwner线程守卫与kDefaultRecorderBudget见 Recorder.h;Recording的私有构造与fRecorderID见 Recording.h;Context的三个入口见 Context.h。
三、录制与回放拆开之后,多线程边界在哪
下面我们进入第三阶段:这套三段式放到真实产品里长什么样。这一章的材料主要来自两条线——官方博客里对 Chromium 集成的描述,以及源码里 insertRecording 的返回值定义。前者告诉我们「实际开了几个 Recorder」,后者告诉我们「插入这件事有多容易失败」。
3.1 Chromium 里的两个 Recorder
官方对当前集成的描述非常具体:
"Currently, Graphite is integrated into Chromium using two Recorders: one handles web content tiles and Canvas2D on the main thread, while the other is for compositing." —— [1]
这句话值得逐段拆。两个 Recorder 不是「两个线程」,而是两条职责线:
- 内容线:网页内容瓦片(tile)与 Canvas2D 的绘制,跑在 Chromium 的主线程上。也就是说,主线程仍然要记命令——Graphite 并没有把主线程上的记录工作消灭掉;
- 合成线:合成器(compositor)的那一路绘制,跑在合成线程上。
那 Graphite 到底省了什么?省的是「曾经必须在主线程上做的事」——光栅化相关的产出、以及渲染准备的相当一部分工作量,现在可以在记录阶段就分发出去。官方对此的说法是「more expensive work is moved to other threads when producing Recordings, keeping the GPU main thread free」[1]。关键词是 producing Recordings 那一刻:钱花在「把命令记下来」这件事上,而不是花在「把命令发给 GPU」上。
这里有一个容易被误读的点,得说明白:「多线程」在 Graphite 里主要指的是「录制可以被分到多个线程」,而不是「一次绘制被拆到多个线程上并行完成」。后者的难度完全是另一个量级(要处理排序、同步与合并),Graphite 的排序合并恰恰是在单条线程上按 z 排完之后才做的。
OK,先看插入会怎么失败。
3.2 insertRecording 的六种结果
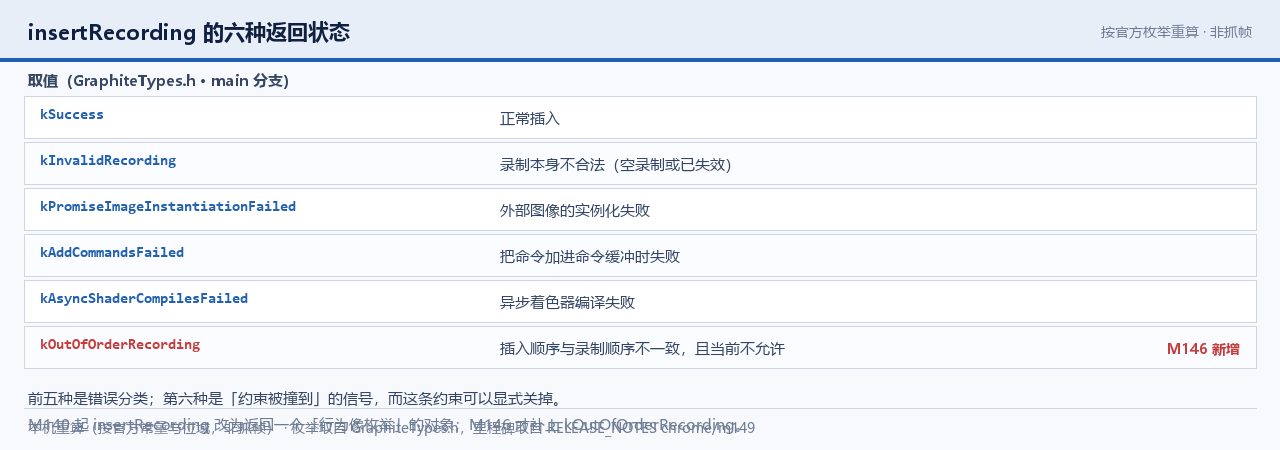
Context::insertRecording 不是「要么成功要么抛异常」,它返回一个状态对象。main 分支的 GraphiteTypes.h 里,InsertStatus 取了六种值:
| 取值 | 含义 |
|---|---|
kSuccess |
正常插入 |
kInvalidRecording |
录制本身不合法(例如空录制或已失效) |
kPromiseImageInstantiationFailed |
外部图像的实例化失败 |
kAddCommandsFailed |
把命令加进命令缓冲时失败 |
kAsyncShaderCompilesFailed |
异步着色器编译失败 |
kOutOfOrderRecording |
插入顺序与录制顺序不一致,且当前不允许 |
这六种值里,前五种是错误分类,第六种不一样——它是约束被撞到的信号。而这条约束是可以关掉的,这就是下面一节的内容。
顺带记一段历史:InsertStatus 不是一开始就有。RELEASE_NOTES 里,M140 的条目写着 Context::insertRecording 改成返回一个「行为像枚举」的对象,并建议迁移到与 InsertStatus::kSuccess 比较;M146 才补上 kOutOfOrderRecording。这两个里程碑说明一件事:「插入可能以多种方式失败」这件事,是被后来踩出来的,不是设计之初就列全的。
3.3 顺序与乱序:一个可以关掉的开关
源码里有一个成员很能说明问题:
std::optional<bool> fRequireOrderedRecordings;
注释写的是:「If Recordings are known to be played back in the order they are recorded, then Graphite may be able to make certain assumptions that improve performance.」
把它和 Recording 里那个 fRecorderID、以及 kOutOfOrderRecording 三处并起来读,逻辑就清楚了:
- 默认假设是「按录制顺序插入」。这是多数场景下最自然的情况,也是性能最好的情况;
- 一旦某份录制的插入顺序和它的录制顺序不一致,
insertRecording就可能返回kOutOfOrderRecording; - 「允许乱序」是一个可选开关。打开意味着放弃那部分性能假设,换取调度上的自由度。
这是一个很典型的取舍写法:把「顺序」从隐含前提提升为一个显式契约,让调用方自己决定要不要为自由度付性能。Ganesh 时代做不到这一点,因为 GL 的上下文本身就是那唯一的顺序。
先看看编译被搬到了哪里。
3.4 预编译通道:把编译搬出主线程
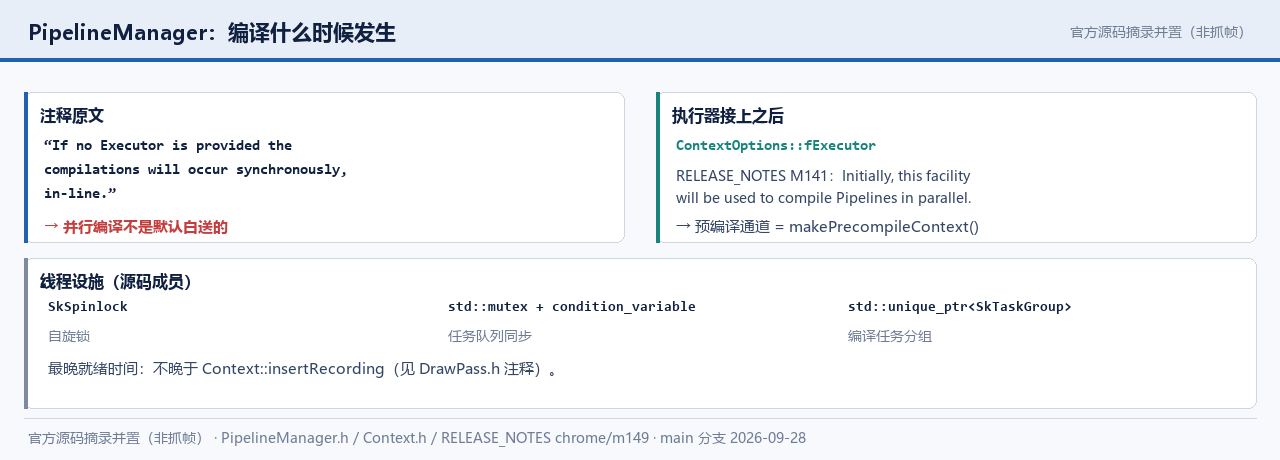
Context 的入口里有一个容易被忽略的:makePrecompileContext()。它的注释说的是这个上下文可以搬到别的线程上用于预编译。为什么这件事重要?回到 §1.3 的第三笔债——管线数量爆炸导致启动期编译不完。预编译通道就是应对它的:把能提前编译的管线,在别的线程上提前编掉。
官方对这笔投入的收益只有机制性说法,没有数字:避免动画或滚动过程中「第一次用到某条管线」造成的 jank。这一点我们照实写——官方没有给量化数字,第三方也没有独立复测,所以这里不放任何百分比。
配套的机制在 PipelineManager.h:它内部用到了 SkSpinlock、std::mutex 加 condition_variable、以及一个 std::unique_ptr<SkTaskGroup> 来组织编译任务。关于执行器,注释里有一句很重要的话:「If no Executor is provided the compilations will occur synchronously, in-line.」——没给执行器就同步编译。也就是说,并行编译不是默认白送的,得显式接上执行器(fExecutor)才成立。这条对应 RELEASE_NOTES 的 M141:ContextOptions 新增 fExecutor,并注明「Initially, this facility will be used to compile Pipelines in parallel.」
最后补一句命名上的坑,免得大家按旧文章去搜:main 分支上已经不存在 PipelineCache 了,它被 PipelineManager 取代。旧文章里的 PipelineCache 是过期信息。
3.5 本章收在哪里
这一章我们把多线程的边界画清楚了:两个 Recorder 各管一条职责线,插入顺序是可以谈判的契约,编译可以被搬到别的线程。下一章我们往下走一层,看 Graphite 底下的那个抽象层为什么值得复用。
官方依据:两个 Recorder 的集成方式、预编译的收益说法见 Skia Graphite 官方博客;
InsertStatus六值、fExecutor、kOutOfOrderRecording的引入见 GraphiteTypes.h 与 Skia RELEASE_NOTES chrome/m149;fRequireOrderedRecordings见 Recorder.h;同步编译与线程设施见 PipelineManager.h。
四、Dawn 为什么值得复用
下面我们进入第四阶段:抽象层。Graphite 不是直接对着 Metal / Vulkan / D3D12 写代码,中间隔了一层 Dawn。这一章要回答两个问题:为什么复用 Dawn,以及复用它的代价是什么。
4.1 Dawn 在分层里的位置
官方的选择写得很明确:
"For Graphite in Chrome, we chose to use Chrome's WebGPU implementation, Dawn, as the abstraction layer for platform native graphics APIs like Metal, Vulkan and D3D." —— [1]
于是分层变成这样:Skia 的 Graphite 核心 → Dawn → 原生 API(Metal / Vulkan / D3D12)。上面那张图画的是原生 API 这一层的管线阶段;Dawn 做的事,是把这三家 API 的差异收敛成一套 WebGPU 风格的接口。
这里要提醒一句命名:Dawn 就是 Google 对 WebGPU 的实现,不是「另一个图形 API」。官方在讨论组里说得更直白:「Dawn is Google's internal library for WebGPU.」[2] 所以 Graphite 复用 Dawn,本质上等于让 Skia 的 GPU 后端跟 Chrome 的 WebGPU 后端共用一套设备抽象——两边要维护的代码路径因此短了一截。
先看看为什么不自己写一层。
4.2 复用抽象层的三个理由
为什么不自己写一层?把线索并起来,至少有三个理由:
- 同一份抽象已经在为 Chrome 的 WebGPU 服务。Dawn 要同时支撑 WebGPU 规范与 Chrome 自身的底层需求,成熟度和覆盖的平台数量不是一个新写的薄封装能比的;
- WebGPU 的语义已经足够现代。命令缓冲、渲染通道、可编程的管线描述对象这些概念都是现成的,Graphite 需要的「显式 + 可预编译」正好落在这套语义里;
- 两家共用意味着同一处 bug 只修一次。渲染后端的成本大头其实在平台适配与驱动绕坑,共用的收益是长期的。
代价也很清楚——抽象层会抹掉各家的特性。下面一节就是代价的具体清单。
4.3 DawnCaps 的三条约束
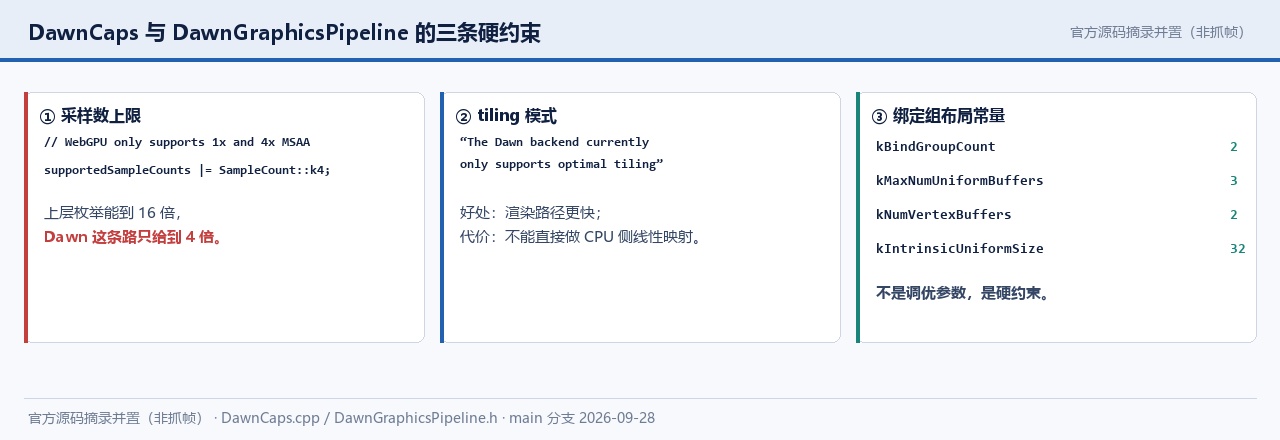
抽象的代价在 DawnCaps 与 DawnGraphicsPipeline 里可以直接读到:
- 采样数上限。
DawnCaps.cpp里有一行注释和它下面的代码:// WebGPU only supports 1x and 4x MSAA,紧接着把SampleCount::k4加进支持的集合。也就是说,走 Dawn 这条路,抗锯齿只有「1 倍」和「4 倍」两档可用,中间与更高档都是抽象的代价; - tiling 模式。注释写着「The Dawn backend currently only supports optimal tiling」,即只支持 optimal tiling(按 GPU 最优布局排布),不支持 linear tiling(按可线性寻址的布局排布)。好处是渲染路径更快,代价是不能直接对这块内存做 CPU 侧的内存映射或线性拷贝;
- 绑定组布局被写进常量。
DawnGraphicsPipeline.h里,绑定组数量是kBindGroupCount = 2,uniform 缓冲上限kMaxNumUniformBuffers = 3,顶点缓冲数量kNumVertexBuffers = 2,还有kIntrinsicUniformSize = 32。这些不是性能调优参数,是硬约束——写代码时资源就得按这个形状组织。
三条约束里,第一条的后果最直观:Skia 的采样档位枚举能到 16 倍(SampleCount 含 1/2/4/8/16),但 Dawn 这条路实际只能给到 4 倍。这两个数字并列放着看,就能明白「上层能力」与「后端可达能力」之间的距离是怎么产生的。
4.4 本章收在哪里
这一章我们把 Dawn 的位置与代价说清楚了。下一章我们往上一层,看绘制命令是怎么被组织成一列、再被翻译成命令缓冲的——这中间有四层结构,它们是理解排序与合并的前提。
官方依据:Dawn 作为抽象层的定位见 Skia Graphite 官方博客 与 skia-discuss 讨论帖;采样数上限与 tiling 约束见 DawnCaps.cpp;绑定组布局常量见 DawnGraphicsPipeline.h;
SampleCount的五个合法取值见 GraphiteTypes.h。
五、绘制怎么被组织成命令缓冲
下面我们进入第五阶段。前面几章讲的是「谁在记」和「记在哪」,从这一章开始讲「记下来的东西怎么变成 GPU 能执行的一列」。中间隔着四层结构,每一层都在做一次筛选或合并。
5.1 从 DrawList 到命令缓冲的四层
这四层各有各的职责,逐层读下来能看到「形态每过一层就变一次」:
DrawList(绘制列表):命令按任意顺序累积进来。此刻它还是「一堆待整理的命令」;DrawPass(绘制通道):把绘制列表定型。源码注释里说得很好:「Unlike DrawList, DrawPasses are immutable and represent as closely as possible what will be stored in the command buffer…」——不可变,而且尽量贴近命令缓冲的形态;RenderPassTask(渲染通道任务):把若干个兼容的 DrawPass 分组,让它们在一次渲染通道里执行完;CommandBuffer(命令缓冲):真正交给 GPU 的那一列指令。
这条链上有个细节值得单独拎出来:DrawPass 到命令缓冲之间还隔着一层「可能没编完的流水线」。DrawPass.h 的注释写着:由于流水线可能被线程化编译,它们不能保证在 Context::insertRecording 之前就绪。也就是说,DrawPass 定型的时候,它引用的流水线对象可能还是个「承诺」——真正兑现要等到插入那一刻。这一句是理解「为什么编译要提前」的关键:预编译做得越早,这里要等的就越少。流水线的就绪定义,因此被推迟到了插入那一刻。
先看看这个「不可变」为的是什么。
5.2 为什么 DrawPass 必须不可变
「不可变」这个约束不是洁癖,它是有功能前提的。RenderPassTask.h 里有一段更进一步的说明:如果后端的子通道(subpass)机制可用、并且绘制列表与目标表面彼此兼容,那么一个 RenderPassTask 可以跨不同表面执行多个绘制列表,把它们作为嵌套在同一个渲染通道里的子通道。
能这么做的前提正是——每个 DrawPass 是定型的、不会中途变化的。要是一个 DrawPass 还能被改,跨表面的子通道嵌套就没法安全地排布。所以「不可变」换来的是排布的自由度。
另一条相关的机制在 CommandBuffer.h:命令缓冲会持有它所引用资源的引用计数,并且注释说明了这个引用的释放时机——等命令缓冲执行完毕才释放。这样一来,资源可以在命令缓冲还在 GPU 上跑的时候就被还回资源缓存等待复用。这条机制专门解决「不能让 CPU 干等 GPU 跑完」的问题,是资源侧流水线化的基础。
好了,往下走一层,看结果写哪儿。
5.3 多渲染目标与 attachment 语义
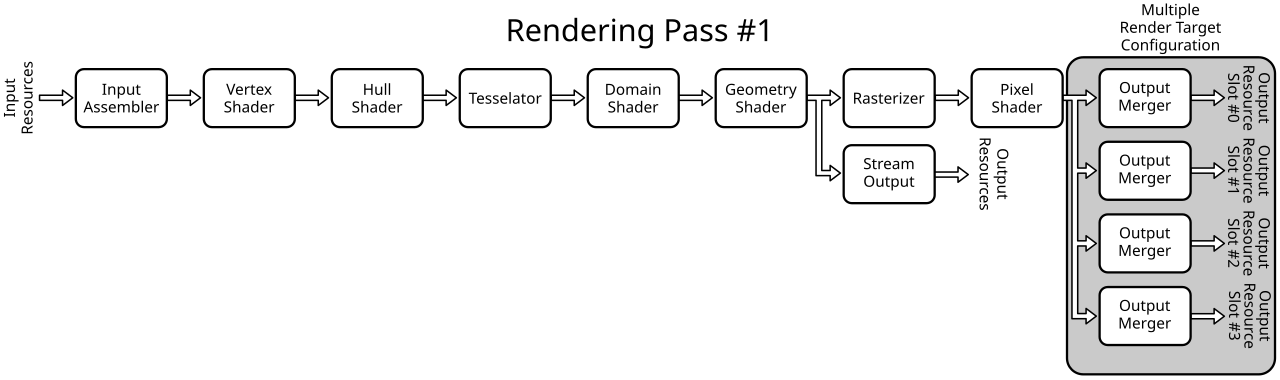
上面这张图讲的是渲染通道里「结果写哪儿」。一次渲染通道会绑定若干张附件(attachment),其中颜色附件可以不止一张,这就是多渲染目标(Multiple Render Targets, MRT)。
这件事在 Graphite 里的意义,要跟这一章的主线连起来读:RenderPassTask 之所以要「把兼容的 DrawPass 分到一组」,判据之一就是附件集合是否一致。附件不一致,就不能共用一个渲染通道——因为渲染通道的附件布局在开始时就得定下来。这也解释了为什么 §4.3 那几条绑定约束会一路影响到这里:上层的分组自由度,最终受限于后端的附件与绑定能力。
顺带说一句采样数的处理:ResourceTypes.h 里有一句很实在的注释——「There are only a few possible valid sample counts (1, 2, 4, 8, 16). So we can key on those 5 options instead of the actual sample value.」于是采样数被编码成 3 位(kNumSampleKeyBits = 3)。把「采样数值」换成「档位索引」,是为了让缓存键更短、比较更快——这类小设计在 Graphite 里到处都是。
5.4 本章收在哪里
这一章我们把四层结构和它们的约束立住了:累积 → 定型 → 分组 → 执行,其中定型不可逆、分组看附件兼容。下一章我们看这条链上最关键的一步:那张任意序累积起来的绘制列表,是怎么被排成一列的。
官方依据:
DrawPass的不可变语义与流水线就绪时机见 DrawPass.h;RenderPassTask的分组与子通道嵌套见 RenderPassTask.h;命令缓冲的资源引用释放见 CommandBuffer.h;采样数编码见 ResourceTypes.h。
六、排序与合并:pipeline 组合空间有多大
下面我们进入第六阶段,也是本篇机制部分最重的一章。这一章要回答的是:那张「任意序累积」的绘制列表,最后是按什么标准排成一列的,排完之后又合并了什么。
6.1 SortKey 的位域账
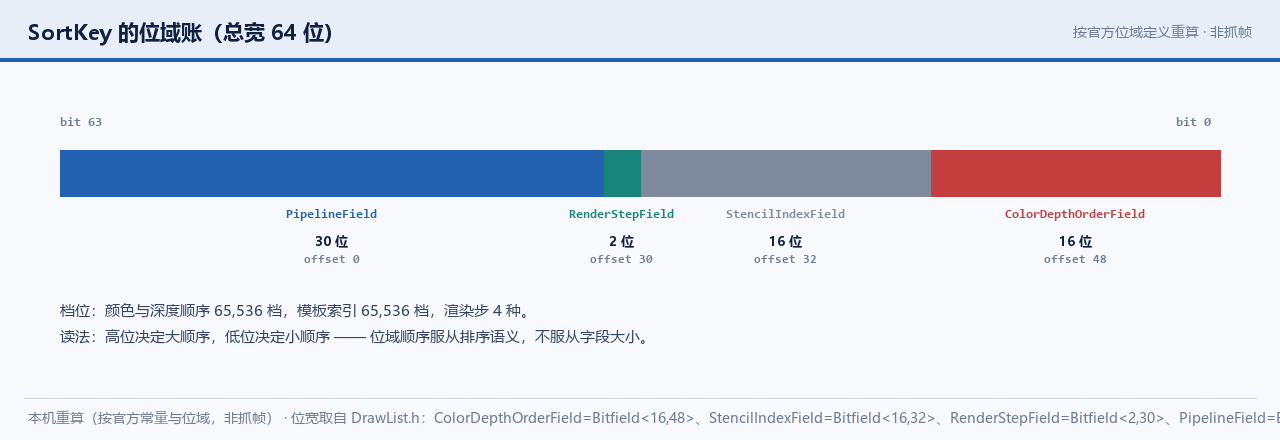
排序靠的是一个 排序键(SortKey)。它被切成四段位域,四段拼起来正好 64 位:
| 字段 | 位宽 | 偏移 | 承载什么 |
|---|---|---|---|
ColorDepthOrderField |
16 | 48 | 颜色与深度顺序(画家顺序的主序) |
StencilIndexField |
16 | 32 | 模板索引 |
RenderStepField |
2 | 30 | 渲染步类型 |
PipelineField |
30 | 0 | 流水线标识 |
四个字段在源码里都写成 Bitfield<位宽, 偏移> 的形式,逐字是 ColorDepthOrderField = Bitfield<16,48>、StencilIndexField = Bitfield<16,32>、RenderStepField = Bitfield<2,30>、PipelineField = Bitfield<30,0>。
这是一张「谁先谁后」的账本,读法是:高位决定大顺序,低位决定小顺序。位宽的分配本身就是设计意图的体现——
- 颜色与深度顺序占了最高的 16 位,也就是 65,536 档。它是画家顺序的主序,所以要最宽、要排在最前面,保证「先画的在后面」这条语义不会被别的因素打乱;
- 模板索引占了次高的 16 位,同样 65,536 档。它紧跟主序,说明模板状态的变化被当成「同一画家顺序内的一次分组」;
- 渲染步只占 2 位,也就是 4 种。这个数字很小,符合直觉:渲染步的种类本来就不多;
- 流水线占了最低的 30 位。它虽然信息量最大(下面 §6.3 会算),却排在最末尾——因为同一条画家顺序、同一个渲染步之内,换流水线是最「便宜」的差异,不该影响绘画顺序。
注意这四段的顺序和位宽是反直觉的:信息量最大的字段(30 位)放在了最低位,信息量最小的字段(2 位)反而在中段。这不是随意排的——位域顺序要服从排序语义的优先级,而不是服从字段的大小。
先看看排序这一步做了什么。
6.2 任意序累积 → 按 z 排序 → 合并
排序这一步的官方注释,一句话把前后都说清了:
"Commands are accumulated in an arbitrary order and then sorted by increasing sort z when the list is prepared into an actual command buffer."
而合并的规则紧跟着:
"Adjacent commands (post sort) that would use equivalent GPU pipelines are merged to produce fewer (but larger) operations on the GPU."
把这两句和另外两条注释并起来,整条动线就是四步:
- 累积:命令按任意顺序进入绘制列表,此时顺序没有意义;
- 排序:按 sort z 递增排列。排完之后,同一条画家顺序的命令挨在了一起;
- 合并:排完之后相邻且流水线等价的命令合并成一次更大的操作。注意合并的判据是「排序之后的相邻」,所以排序质量直接决定合并机会;
- 分流:没有着色描述的命令,
DrawList.h里说得很清楚——「if not, it will be a depth-only draw」,只写深度、不着色。
第 4 步那条「只写深度」的绘制,正是 §7.3 要讲的裁剪的载体,先在这里埋下。另外还有一条容易忽略的细节:深度比较用的是 GREATER 而不是 GEQUAL,注释里给了理由——对可能自相交的几何(例如描边),用 GREATER 可以避免重叠处被命中两次。这是个很小的选择,但它把「描边的重叠区」从「潜在的双重着色」变成了「只写一次」。
好了,现在来算这笔账。
6.3 pipeline 组合空间有多大
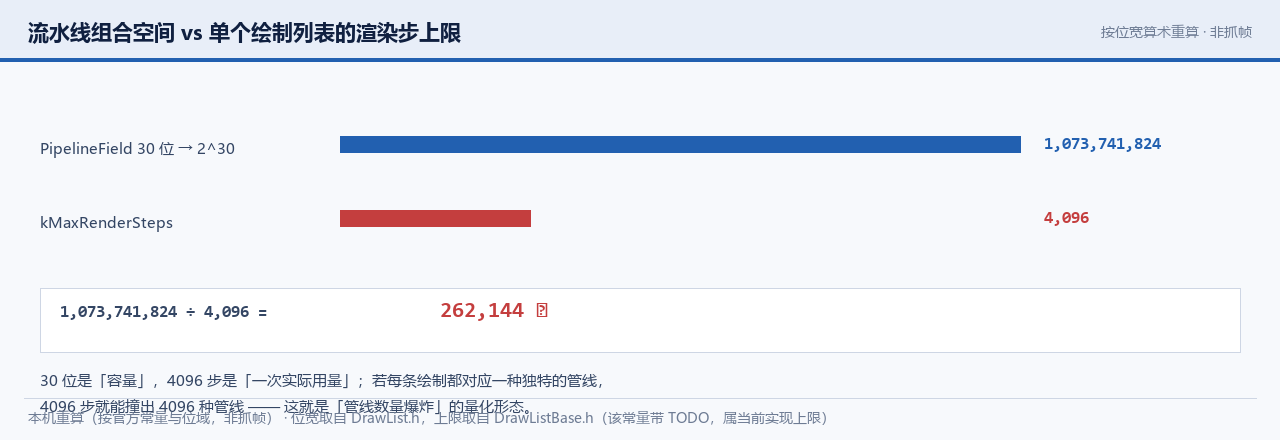
现在来算这笔账——这是本篇唯一一处需要动笔的地方,但全程只用源码里的常量做算术。口径先声明:以下全部是本机按位宽重算,不是抓帧读数。
PipelineField占 30 位,理论组合上限是 2³⁰ = 1,073,741,824;RenderStepField占 2 位,所以渲染步有 4 种;DrawListBase.h里还有一个上限:static constexpr int kMaxRenderSteps = 4096;,即单个绘制列表最多 4096 个渲染步;- 把「流水线组合空间」与「单列表渲染步上限」相除:1,073,741,824 ÷ 4096 = 262,144。
这几行算术说明了两件事。第一,流水线字段的空间远远大于一次绘制列表能用掉的步数——30 位是「容量」,4096 步是「一次实际用量」,两者差了 262,144 倍。第二,这个巨大的空间正是「管线数量爆炸」的量化形态:如果每条绘制都对应一种独特的管线,那么 4096 步就能撞出 4096 种管线,启动期想全编完几乎不可能。
于是官方那句「consolidate the number of rendering pipelines as much as possible」[1] 就有了具体的敌人:不是「管线太多」这种模糊抱怨,而是一个 30 位的字段被当成「每种情况都开一个新值」来用。把管线种类压少,等于主动浪费这个字段的容量,换来的是「少数几条管线覆盖绝大多数绘制」——那样启动期预编译才谈得上可能。
顺带补一句范围上的说明:kMaxRenderSteps = 4096 这条在源码里带着一个 TODO 注释,大意是等 DrawListLayer 落地之后可以移除。所以这个数是一个「当前实现的上限」,不是不变量——引用它的时候要带上这个前提。
6.4 启动期预编译
把 §6.3 的账和 §3.4 的预编译通道接起来,这一节的内容就顺下来了。
「管线数量」和「编译时机」是同一个问题的两面:
- 管线种类多 → 启动期编不完 → 只能等到运行期第一次用到再编 → 编译落在动画或滚动过程中 → 表现为偶发 jank;
- 管线种类少 → 启动期有机会编完 → 运行期不再遇到「第一次」→ 动画与滚动里不会因为编译掉帧。
Graphite 同时从两头下注:结构侧把管线种类压少(§6.3),机制侧提供预编译通道把编译搬离主线程(§3.4)。这也解释了 RELEASE_NOTES 里为什么 M143 会出现「persistent pipeline storage」(持久化管线存储)这条——如果编译结果能存下来、下次直接加载,那启动期的窗口就更宽裕。不过这条要照实说:该特性目前只与 Graphite 的原生 Vulkan 后端相关,不是所有平台都有。
6.5 本章收在哪里
这一章我们把排序键的账、排序合并的动线、以及组合空间的量级都算清了。下一章我们看那个 z 值本身——它怎么被编码,为什么装进深度缓冲的时候要先「翻转」,以及裁剪怎么变成一次绘制。
官方依据:任意序累积、按 z 排序、相邻合并、depth-only 绘制与 GREATER 比较见 DrawList.h;
kMaxRenderSteps见 DrawListBase.h;管线收敛的表述见 Skia Graphite 官方博客;持久化管线存储见 Skia RELEASE_NOTES chrome/m149。
七、z 值怎么承载画家顺序,裁剪怎么变成一次绘制
下面我们进入第七阶段。前面两章反复提到一个量:z 值。这一章把它自己讲清楚——它怎么被编码、装进深度缓冲时为什么要翻转、以及它顺手把裁剪这件原本很麻烦的事变成了什么。
7.1 z 值编码与 depthAsFloat
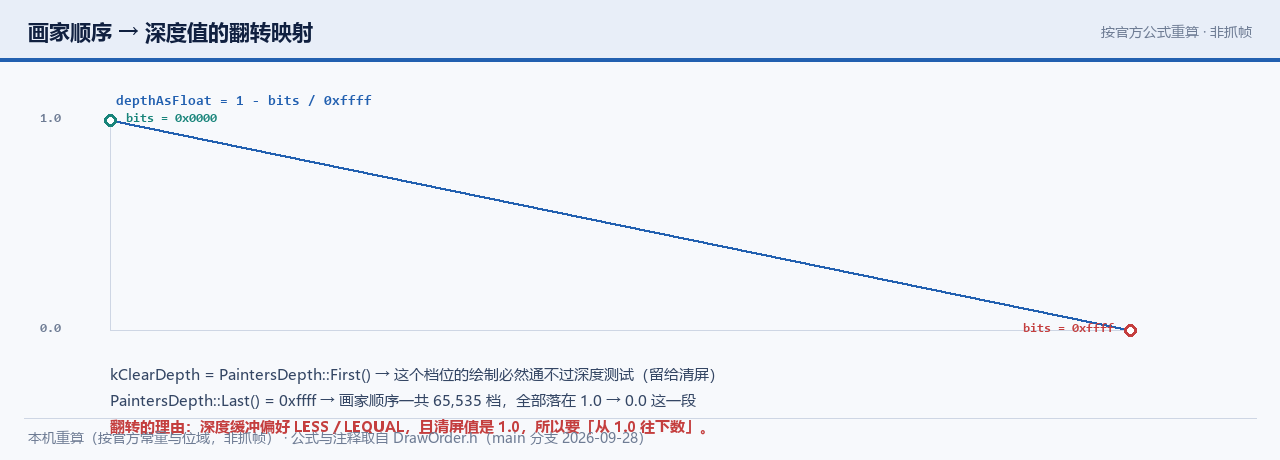
官方对这套设计的表述是:
"Graphite extends Skia's GPU rendering to take advantage of the depth test by assigning each "draw" a z value defining its painter's ordering index." —— [1]
也就是说,每条绘制命令拿到一个单调递增的 z 值,它就代表「这是第几笔画上去的」。但图形硬件对深度的偏好跟我们正好相反,所以不能直接塞进去。DrawOrder.h 里那段转换只有一行:
float depthAsFloat() const {
    return 1.f - fDepth.bits() / (float) PaintersDepth::Last().bits();
}
配套的注释把理由说全了:
"While the PaintersDepth is a monotonically increasing value, the depth buffer prefers to use LESS and LEQUAL comparisons starting with a clear value of 1.f, so we normalize and flip the floating point value to count down from 1.0."
逐段读这行代码,三件事就清楚了:
- 画家顺序是「越大越晚画」(单调递增),而深度缓冲的判断偏好是值越小越靠前;
- 于是要做一次归一化 + 翻转:把递增的整数除以最大值,变成 0 到 1 的比例,再用 1 去减,得到从 1.0 往下数的浮点深度;
- 上界取的是
PaintersDepth::Last(),源码里它的值是 0xffff。所以画家顺序一共 65,535 档,全部映射到 1.0 到 0 这一段里。
还有一个细节很有意思:kClearDepth 取的是 PaintersDepth::First(),注释说明了它的用途——用这个深度值的绘制必然通不过深度测试,也就是把它留给清屏操作用。「清屏」和「第一笔绘制」因此共享了同一个档位,不需要额外的判断。
最后补一句格式转换的边角:在 framebuffer fetch(F2B,帧缓冲回读)这类路径上,还得把反向深度编码进模板索引(reverseDepthAsStencil())。深度值在这套设计里不只是深度值,它同时是顺序、是裁剪、还是某些路径上的格式适配对象——这一点在下一节会更明显。
先看看代价落在哪一侧。
7.2 深度精度的代价
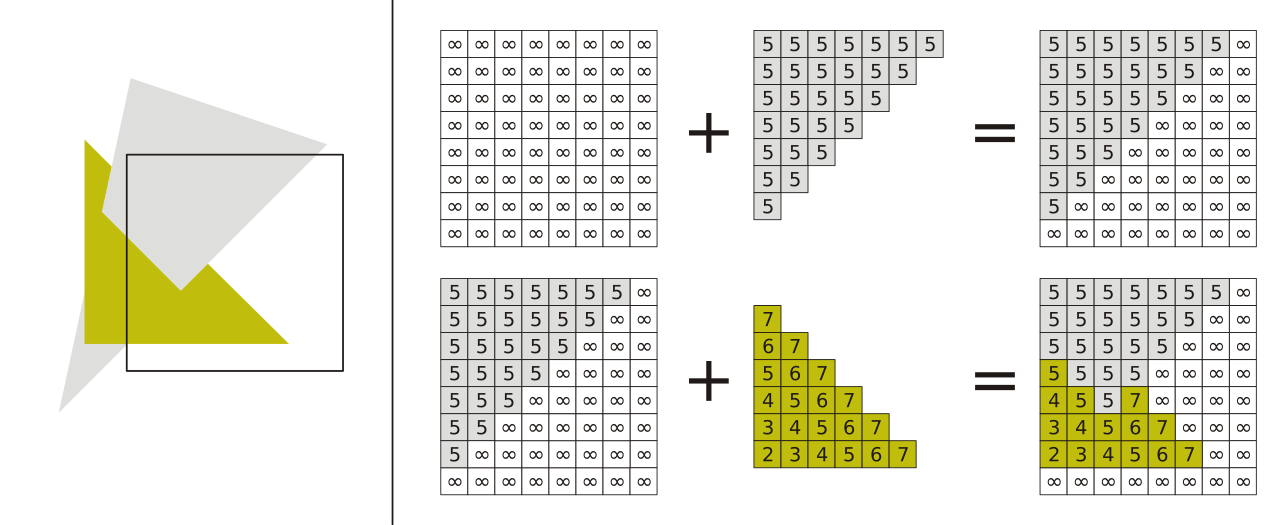
先把一件要坦白的事说在前面:本机没有 Graphite 运行环境,所以这一节没有实测数字。上面那张图讲的是深度缓冲(Z-buffer)的一般原理,不是 Graphite 上的实测截图——它在这里的作用是说明「把顺序塞进深度值」这个选择的代价形状:深度值必须写进一块有精度上限的缓冲,然后逐像素比较,而精度一旦不够,本该有先后的两笔就会被判成同一档,画面于是出现斑驳或闪烁。
具体到数字:画家顺序的档位是 0xffff,也就是 65,535 档,这本身够用;危险的是两类情形——量化误差(两笔靠得极近,在硬件那里被判成同一个值)与档位用尽(内容本身要求的先后超出了 65,535 档)。后者就不再是精度问题,而是一个容量上限。
Graphite 对这个问题的处理方式,跟它对别的精度问题一样——尽量不去依赖细微的深度差:画家顺序是整数档位、逐笔递增,相邻两笔之间天然差着一整档;而深度比较用的是 GREATER(§6.2),配合「清屏值 1.0 + 向下计数」的映射,第一笔绘制与清屏之间有一条明确的边界。换句话说,它是把「细微」这件事从设计里去掉,而不是把精度做高。
这一段里我们能给的,是机制与常量;能给到「Graphite 在某种内容上会不会闪」这种问题答案的,是实测与抓帧,那是本篇能力之外的(§0.4 已声明)。不做估算,也不做推测。
7.3 裁剪的三档优先级
回到 §7.1 埋的那条线:深度测试既然能表达顺序,也就能表达「被挡住」。官方对这一点的表述是:
"Depth testing is also used to implement clipping in Graphite by treating clip shapes as depth only draws as opposed to maintaining a clip stack like in Ganesh." —— [1]
把源码里的线索并起来,裁剪实际上是三档优先级,从快到慢依次退让:
- 裁剪 atlas(clip atlas)。
AtlasProvider.h里写着:如果拿到了这个句柄,裁剪栈应当先用它处理裁剪元素。它把裁剪形状提前栅格化进 atlas 复用,是最省的一档; - 只写深度的裁剪绘制。「把裁剪形状当成一次 depth-only draw」,这是 §6.2 里那条「没有着色描述就只写深度」的直接用途。它不需要把裁剪形状画成颜色,只需要在深度上留下痕迹;
- 退让到直接绘制。前面两档都不可用时,就退回不做裁剪的普通绘制路径。
这里有一句注释把优先级说得非常清楚——「before falling back to depth-only rasterization」,也就是atlas 优先、深度次之。另外,RELEASE_NOTES 的 M139 里出现过一个新值 kAnalyticClip(加进了 DrawTypeFlags 枚举),说明裁剪的实现方式还在继续细分。本篇不展开这一档的具体算法,只记下它的存在与时间点。
这三档设计真正解决的问题,是 §1.3 里那笔「隐形债」——裁剪栈不见了。Ganesh 需要维护一个有顺序、有状态的栈,很难并行;Graphite 把它换成了「几次按裁剪形状写深度的绘制」,而绘制是可以被排进同一个绘制列表、一起排序合并的。这就是为什么深度测试在这个后端里是核心,而不是可选优化。
7.4 本章收在哪里
这一章我们把 z 值的编码、深度的代价、裁剪的三档都过了一遍。下一章看另一个被官方明确标为「还没做完」的方向:路径光栅化。 这一章要特别小心一句话的准确性——它涉及「已有什么」与「还没有什么」的精确区分。
官方依据:z 值与深度裁剪的设计表述见 Skia Graphite 官方博客;
depthAsFloat的翻转注释、PaintersDepth::Last()与kClearDepth见 DrawOrder.h;裁剪 atlas 的优先级见 AtlasProvider.h;kAnalyticClip见 Skia RELEASE_NOTES chrome/m149;深度缓冲的一般原理图出处见参考资料第 37 条。
八、路径光栅化:已有两条路,第三条还没来
下面我们进入第八阶段。这一章是全篇最需要小心措辞的一章——因为在中文技术圈里,关于「Graphite 的路径光栅化到底做没做」这件事,流传的说法和官方源码对不上。我们会把三条路并列摆开,然后逐句核对。
8.1 路径光栅化的三条路
先把清单摆开,再归类。路径光栅化(path rasterization)在 Graphite 里目前有三条路:
| # | 路线 | 状态 | 载体 |
|---|---|---|---|
| 1 | CPU 光栅 + atlas 缓存 | 已落地 | RasterPathAtlas |
| 2 | compute 着色器生成覆盖率掩码 + atlas 缓存 | 已落地(受限) | ComputePathAtlas |
| 3 | 不受 atlas 限制的通用 compute 路径光栅化 | 尚未落地 | 官方博客里的将来式 |
这三条路的分界线不在「用不用 compute」,而在「覆盖率掩码往哪儿放」:前两条都要经过 atlas(一张复用的纹理),第三条才是不受这个约束的通用方案。第 3 条的官方表述用的是将来式——「GPU compute based path rasterization would allow us to improve…」,紧接着还说了「We would like to implement these ideas in Skia, possibly using a hybrid approach」[1]。would / would like to,都是「还没做」的语气。
顺带回收一条上一篇的线索,好让两篇接上:上一篇里开启抗锯齿会让每条 chunk 的绘制次数变成 2 倍(一次主线 drawIndexedInstanced 加一次裙边 drawInstanced)。那是 Ganesh 的实例化细分路线;这一篇讲的 atlas 路线是另一条家族,两者的取舍点不同:前者用几何膨胀换批处理,后者用一张缓存纹理换复用。
先看看这两段注释怎么写的。
8.2 两条 atlas 路线的源码原话
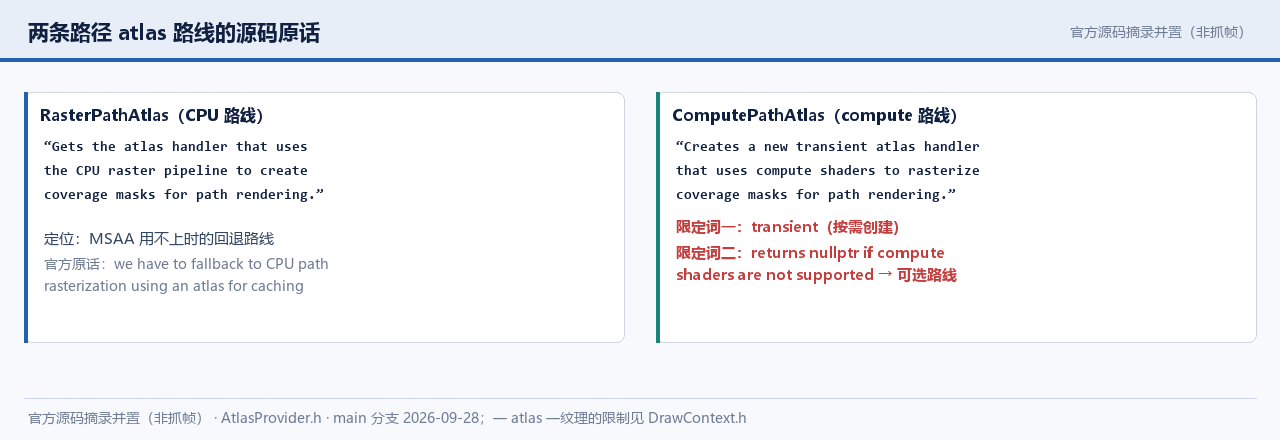
AtlasProvider.h 里这两条路的注释挨着放,正好构成一份对照证据:
CPU 路线:「Gets the atlas handler that uses the CPU raster pipeline to create coverage masks for path rendering.」
compute 路线:「Creates a new transient atlas handler that uses compute shaders to rasterize coverage masks for path rendering. This method returns nullptr if compute shaders are not supported by the owning Recorder's context.」
两段话各自带一个限定条件,都得读出来:
- CPU 路线是「用 CPU 的光栅管线算覆盖率掩码」,也就是回退路线。官方博客里说得很直白:MSAA 常常用不上(老集成显卡上性能差、非 tiling GPU 上显存开销高),于是只能回退到用 atlas 缓存的 CPU 路径光栅化[1];
- compute 路线有两个限定:一是「transient」(临时)——它是按需创建的;二是「compute 着色器不支持就返回 nullptr」。返回空指针这件事本身就是设计信号:这是一条可选路线,不是必备路线。
那这条 compute 路线为什么只是「受限」的?答案在 DrawContext.h:
"Currently every PathAtlas contains a single texture… This is currently not an issue since there is only one DrawPass per flush…"
每个路径 atlas 只持有一张纹理,而这条限制目前不成问题,是因为一次 flush 只有一个 DrawPass。也就是说——它今天够用,是因为当前的执行结构恰好给了它空间。这是一句典型的「临时性说明」,它的存在本身就暗示了后面会变。
8.3 一句话把这件事说准
把上面两节合起来,本篇要给出的判断只有一句:
「compute 路径光栅化已落地」和「compute 路径光栅化还没做」,两句话都能找到出处,关键在于说的是哪一层。
拆开说就是:
- 源码层面:确实已经有一条「用 compute 着色器生成覆盖率掩码并放进 atlas」的路线(
ComputePathAtlas),它是受限的——一个 atlas 一张纹理、不支持就返回空; - 官方博客层面:说的「还没做」指的是不受 atlas 限制的通用 compute 路径光栅化,用的还是将来式。
两者不矛盾。 但如果把前者写成「已落地」的通用方案,或者把后者写成「已实现」,都是错的。这也是为什么我们在 §0.4 要把证据口径写在最前面——这类错误不是抄错了一个数,而是把两层的边界混成了一层。判据可以这样定义:看这条路线写的是「受限」还是「通用」。
再补一句避坑提示:本轮检索里有一篇第三方可视化文章称 Graphite 的路径渲染已经「leans on compute shaders」。这与官方口径冲突,本篇不引。判断依据就是上面那两段源码注释的限定词——「transient」与「返回 nullptr」。
8.4 本章收在哪里
这一章我们把三条路、两条注释和一句判断立住了。下一章我们把散落在各处的资源与缓存机制收一收——它们不显眼,但决定了前面那些「可以提前做」的事情能不能真的提前做。
官方依据:CPU 回退、compute 路线的将来式表述见 Skia Graphite 官方博客;两条 atlas 路线的原话见 AtlasProvider.h;一 atlas 一纹理的限制见 DrawContext.h;上一章的重复绘制口径见本系列第五篇。
九、资源、缓存与 pipeline 编译怎么配合
下面我们进入第九阶段。这一章相对轻一些,但它把前面几章反复出现的几个「提前」串起来了:提前编译、提前上传、提前还回。
9.1 资源从哪来:ResourceProvider 与 ResourceCache
Graphite 里资源和缓存被切成了几个各管一段的对象,先按职责归类:
ResourceProvider(资源提供者):负责按需创建或取得 GPU 资源——纹理、缓冲这些;ResourceCache(资源缓存):负责复用。命令缓冲执行完之后,资源被还回来,等待下一轮复用(§5.2 里那条「命令缓冲持有引用、执行完毕才释放」就是为它服务的);Recorder的资源域:注意资源缓存是挂在 Recorder 上的,不是全局的。这一点与前两章的三段式严丝合缝——每个 Recorder 各自持有自己那套资源视图。
这里有一条与 Ganesh 的关键差异,藏在 ProxyCache.h 的注释里:「unlike Ganesh, the internal proxy cache is not used for uploaded client-provided bitmaps…」。也就是说,客户端上传的位图不再走内部代理缓存这条捷径。为什么值得记这一笔?因为它意味着上传路径被拆成了独立的一条——就是下一节那个对象。
先看看客户端数据走哪条路。
9.2 客户端数据的路径:ProxyCache 与 UploadBufferManager
上面这张图把四个对象的边界画在一起。其中 UploadBufferManager.h 的职责写得最有操作性——它提供两个转交方法:transferToRecording(Recording*) 与 transferToCommandBuffer(CommandBuffer*),注释说明的动作是「Finalizes all buffers and transfers ownership of them to a Recording」。
「转交所有权」这四个字是关键:上传缓冲不是长期驻留的对象,它把数据准备好之后,把所有权交给录制或命令缓冲,自己退场。这样设计的好处是生命周期跟得上下游——交给录制,数据就随录制一起被插入和提交;交给命令缓冲,就随命令缓冲一起执行完再释放。上传这件事因此不需要一个全局的同步点,这正是多线程录制能成立的前提之一。
把它和 §9.1 的差异并起来看,客户端数据的路径就清晰了:上传走 UploadBufferManager 这条路,代理缓存只管引擎内部的工具型代理,两者不再混在一条缓存里。
9.3 编译什么时候发生:PipelineManager 与 Executor
最后一节回到编译。PipelineManager 这个名字前面出现过两次(§3.4 的线程设施、§3.4 结尾的命名提醒),这一节补上它的时机语义:
- 没接执行器 → 「compilations will occur synchronously, in-line」,同步、就地编译;
- 接了执行器(
fExecutor) → 编译可以被并行安排,对应 RELEASE_NOTES 的 M141; - 什么时候必须就绪 → 不晚于
Context::insertRecording(§5.1 引用过DrawPass.h的注释)。
三句话连起来,就得到 Graphite 在编译这件事上的完整策略:「可以早、可以并行、但最晚不能晚于插入」。换成一句契约的定义:编译可以迟到,但不许缺席。而 §6.3 算出来的那笔组合空间的账说明了「为什么必须早」——只要管线种类还多,早编译就永远编不完。所以这两件事必须一起做:压少种类(结构)+ 提前编译(机制),缺一条都不成立。
9.4 本章收在哪里
这一章我们把资源、缓存、上传与编译的配合关系收在了一起。下一章我们回到现实:看时间线、平台矩阵、官方承认的缺口,以及本篇唯一能用的那个性能数字及其条件。
官方依据:代理缓存与上传缓冲的职责见 ProxyCache.h 与 UploadBufferManager.h;资源提供与缓存见 ResourceProvider.h;同步编译与执行器见 PipelineManager.h;
fExecutor的引入见 Skia RELEASE_NOTES chrome/m149;流水线就绪时机见 DrawPass.h。
十、代价与现状
下面我们进入第十阶段。前面九章讲的都是「怎么设计的」,这一章讲「现在到哪一步了」——时间线、平台矩阵、官方自己承认的缺口,以及那个被转述了无数遍的性能数字到底带什么条件。
10.1 版本时间线
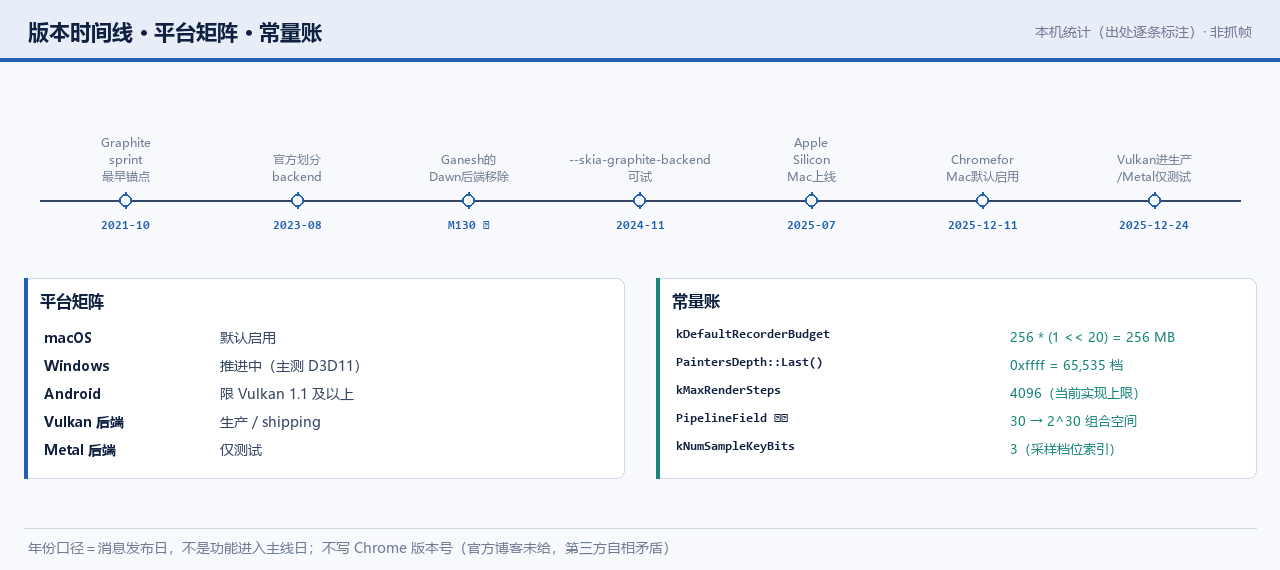
上面这张图把几个有明确出处的节点摆在一起,年份口径统一为「消息发布日」,不是「功能进入主线日」:
| 时间 | 节点 | 出处 |
|---|---|---|
| 2021-10-19 | bug 追踪里出现「Graphite sprint」,早期开发锚点 | [3] |
| 2023-08-04 | 官方划分 backend:Ganesh 稳定、Graphite 开发中;明确长期目标为弃用 Ganesh | [2] |
| Chrome 130 期 | Ganesh 的 Dawn 后端被移除,Dawn 归入 Graphite | [25] |
| 2024-11-20 | Chrome 可用 --skia-graphite-backend 开关试用 |
[2] |
| 2025-07-08 | 官方博客宣布在 Apple Silicon Mac 的 Chrome 上线 | [1] |
| 2025-12-11 | Chrome for Mac 默认启用;Windows 与 Android 推进中 | [2] |
| 2025-12-24 | Vulkan 后端进生产/shipping;Metal 后端降为「维持可跑、供测试」 | [2] |
有两处要按实说:第一,Chrome 的具体版本号不给——官方博客正文没写,第三方说法自相矛盾(同一篇里一处写 138、一处写 125+),所以统一用日期口径;第二,2021 那条只是「sprint」这个词的最早锚点,不是首个提交的日期,它的作用是标出「这件事从哪一年开始被当项目推」。
先看看各平台到了哪一步。
10.2 平台矩阵与官方承认的缺口
把官方在讨论组里的状态更新并起来,当前的平台情况是:
| 平台 | 状态 | 备注 |
|---|---|---|
| macOS | 默认启用 | 官方明确「enabled by default on Chrome for Mac」 |
| Windows | 推进中 | 主测 Dawn 的 D3D11 后端,D3D12「should be functional」 |
| Android | 限定设备 | 仅支持 Vulkan 1.1 及以上的设备 |
| Vulkan 后端 | 生产/shipping | 「will definitely be maintained and be used in production/shipping code」 |
| Metal 后端 | 仅测试 | 「maintained and kept working for testing purposes」 |
官方自己列出的缺口也很具体,而且是一条功能缺口而不是性能缺口:有几个较少用的 SkCanvas API 还没有被移植到 Graphite,官方点名的两个是 drawMesh 与 drawImageLattice,并说目标是当年内完成[2]。这类「少数 API 还没跟上」的缺口,是后端换代过程中最典型的一类成本——它不出现在性能图表里,只出现在「某些页面在某个后端上画不出来」这种偶发报告里。
10.3 唯一的性能数字与它的条件
这一节要格外克制。本篇能引的性能数字只有一个:MotionMark 1.3 上约 +15%,条件也都得写上——测试机是 MacBook Pro M3,浏览器是 Chrome,来源是官方自测[1]。
三件事必须同时说清:
- 它是官方自测,不是独立第三方复测。本轮检索里所有出现「15%」的地方,追下去都是转述同一条官方口径,没有找到第三方独立复测的 Ganesh 对比数字;
- 它绑定具体机型与内容。MotionMark 是图形基准测试,不是任意网页的通用结论;换成别的内容、别的 GPU,「+15%」不能直接搬;
- 官方其余表述是定性的。同一篇里对 INP、LCP、掉帧、GPU 进程内存的改善只有「均有改善」这类说法,没有给数字——所以这里也不放数字。
因此本篇不做任何「Graphite 更快」的推广性结论。 能给的是机制层的判断(更少的流水线种类、可并行的录制、把顺序交给深度值),以及一个带条件的官方数字。机制优雅不等于实测更快——这句话上一篇用一次真实的性能回退记录说过,本篇继续成立。结论的边界在这里定义清楚:机制层可以下断言,性能层只报一个带条件的官方数字。
10.4 本章收在哪里
这一章我们把时间线、平台矩阵、缺口和唯一那个数字的条件都摆清楚了。最后一章做收束:给三句选型判断,把不属于本篇的题域显式让出去,然后预告下一篇。
官方依据:Graphite 上线与 MotionMark 数字、内容判断见 Skia Graphite 官方博客;平台状态、默认启用、
drawMesh/drawImageLattice缺口、后端维护策略见 skia-discuss 讨论帖;早期开发锚点见 Skia bug 追踪帖;Ganesh 侧 Dawn 移除见 Skia RELEASE_NOTES chrome/m130。
十一、边界回指与预告
好了,最后一章来做收束。
11.1 三句判断
把开头那条动线说到底,意思就是:多个 Recorder 各自录制,主线程把录制插入上下文,绘制命令按 z 值排成一列,排完合并成少数几次操作,顺序与裁剪一律交给深度值。 本篇讲的三段式、四层结构、四个位域字段、三档裁剪,全都挂在这句话上。
判断可以压成三句:
- 要把主线程上的记录与准备工作量挪走 → 值得考虑 Graphite 这类「录制 / 回放分离」的结构;
- 内容里有大量可合并的同管线绘制 → 排序收益最大,因为合并的判据是「排序后相邻且管线等价」;
- 要提前把管线编译完 → 必须同时压少管线种类(结构侧)和接上执行器(机制侧),只做一头不成立。
这三句判断背后其实是三个可核对的量:
- 录制是否已在多个线程上分散(决定了主线程的负担);
- 单次绘制列表的渲染步数与排序后相邻同管线命令的比例(决定了合并机会);
- 管线种类数(决定了启动期预编译是否可能)。
好了,该把不属于本篇的题域让出去了。
11.2 让出去的题域
按本系列的习惯,把不在本篇的题域显式让出去:
- Ganesh 的覆盖 approach、实例化细分、Wang 公式、边数上限 → 上一篇已讲透;
- Vello / piet-gpu(sparse strips、四阶段流水线、prefix-scan、4×4 tile)→ ep09/ep10;
- Pathfinder 的 tiling-dicing 与 NV_path_rendering 的完整接口 → 只作坐标系,不展开;
- WebGPU 与 Dawn 规范本身(绑定模型、着色语言、管线描述字段)→ 只在抽象层边界处点一句;
- CPU 光栅与字形 → 第三、四篇。
11.3 下篇预告
本篇到此为止。下一篇(ep07)开始「自跑」系列:前面六篇大多在读数与读源码,从下一篇起我们把工具搬出来——同一条路径,在 Skia 的 CPU 与 GPU 两条路线上各跑一遍,再用可视化把 overdraw(重复着色)摊开来看。
换句话说,本篇讲的是 Graphite 这套结构「应该」怎么跑,下一篇开始把能跑的部分真跑起来,并坦白标注哪些部分本机跑不了。这条界线会一直带到 ep08 与 ep10。
官方依据:
Context与Recorder的分工、录制与提交的边界见 Skia Graphite 官方博客 与 skia-discuss 讨论帖;本篇源码口径为google/skiamain 分支(2026-09-28 抓取);下一篇的路线见本系列第六篇末与第七篇预告。
参考资料
- Skia Graphite 官方博客 — Introducing Skia Graphite
- skia-discuss — 后端状态与 Graphite 演进
- Skia bug 追踪 — Graphite sprint 早期锚点
- Recorder.h(snap 语义、线程守卫、默认预算)
- Recording.h(私有构造与记录器标识)
- Context.h(三个入口与预编译上下文)
- GraphiteTypes.h(InsertStatus 六值与 SampleCount)
- Device.h(渲染器与 atlas 句柄的选路)
- DrawList.h(任意序累积、排序、合并与 SortKey 位域)
- DrawListBase.h(渲染步上限 4096)
- DrawPass.h(不可变语义与流水线就绪时机)
- DrawPass.cpp(绘制通道的构建)
- DrawOrder.h(depthAsFloat 与画家顺序档位)
- DrawContext.h(路径 atlas 一图一纹理的限制)
- CommandBuffer.h(资源引用的释放时机)
- RenderPassTask.h(分组与子通道嵌套)
- AtlasProvider.h(CPU 路线 / compute 路线 / 裁剪 atlas)
- ResourceProvider.h(资源提供者)
- ResourceTypes.h(采样档位编码与目标读取策略)
- ProxyCache.h(记录器本地的代理缓存)
- UploadBufferManager.h(上传缓冲的所有权转交)
- PipelineManager.h(同步编译、执行器与线程设施)
- DawnCaps.cpp(采样数上限与 tiling 约束)
- DawnGraphicsPipeline.h(绑定组与缓冲数量的硬约束)
- Skia RELEASE_NOTES chrome/m149(M139–M149 里程碑)
- Skia RELEASE_NOTES chrome/m130(Ganesh 的 Dawn 后端移除)
- Skia RELEASE_NOTES main 分支
- Dawn — Google 的 WebGPU 实现(官方仓库)
- Phoronix — Chromium 转向 Skia Graphite
- Raph Levien — Fast 2D rendering on GPU
- Pathfinder — GPU 矢量渲染的 tiling-dicing 实现
- Vello — 基于 compute 的 2D 渲染引擎
- Commons — 3D-Pipeline.svg(系统级渲染管线总览)
- Commons — Graphicspipeline fig3.png(窗口到设备的图形管线)
- Commons — Division of labor cpu and gpu.svg(CPU 与 GPU 的分工)
- Commons — MultiRenderTarget.svg(多渲染目标)
- Commons — Z-buffer.svg(深度缓冲的一般原理)
- Commons — D3D11 Pipeline.svg(D3D11 管线矩阵)


本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机自算/源码摘录由官方源码常量与公式重算得出(图注写明口径);自绘图为本系列绘制,走
styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:下一篇进入「自跑」系列——同一条路径,在 Skia 的 CPU 与 GPU 两条路线上各跑一遍,再用可视化把重复着色摊开来看。哪些量本机能测、哪些测不了,会在开篇就写清楚。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.