系列文章前言
系列定位
这个系列只回答一个问题:当渲染管线里的某一环,它的先验从"人手写的启发式"换成"训练出来的网络",代价到底转移到了哪里?
面向的读者已经能读懂渲染管线、也大致知道神经网络是什么,但没亲手把学习式环节接进过真实管线。所以这里不推导反向传播、不复述算法综述,而是算那笔账:算力、带宽、显存、训练成本,以及最容易被忽略的"泛化边界"。
开篇 ep01《神经渲染的分界线》立了判据;ep02/ep03 把最成熟的落地(降噪)讲透,数据从哪来、又在哪里失效;ep04《神经纹理压缩》把纹理(数据)的解码交给网络;本文把这个接力棒递给材质这一环的反射函数。
全系列内容总览
本文是当前已发布篇目里的第五篇(至此为止共发布五篇,后续规划暂缓,以系列现状为准)。全系列目录如下:
| 序号 | 篇目 | 主题 |
|---|---|---|
| 一 | 神经渲染的分界线 | 哪一环该换成网络 |
| 二 | 神经降噪(上) | 当先验从人手写变成学出来 |
| 三 | 神经降噪(下) | 数据从哪来,以及它在哪里失效 |
| 四 | 神经纹理压缩 | 把纹理解码交给网络 |
| 五 | 神经外观 | 从解析 BRDF 到学习式材质(本篇) |
本篇在系列里的位置
前三篇围绕降噪,替换的是一条时域链路;ep04 替换的是"纹理在显存里长什么样"(数据侧)。而本篇替换的性质又不一样——它替换的是"一个表面怎么把光折回去"(反射函数侧):把本文前面章节铺好的解析 BRDF 家族,换成由网络权重刻出的神经材质。读完本篇,你手里应该同时握有三笔账:ep04 的"纹理存储账"、本篇的"外观表达力 + 显存/算力/训练/画质四元账"、以及一张"什么时候不值得换网络"的选型决策表。
背景铺垫
渲染管线的最后一里路,是"这一面墙该反射出什么颜色"。过去三十年,这条路走得非常稳妥:我们用一组贴图加一个手动写死的 BRDF 公式,就让它发光。可这条稳路的账本有一条隐形的上限——表达能力是封闭的。你想让墙面呈现"脏旧的金属折痕",要么叠贴图叠到显存叫苦,要么换一套更复杂的解析模型,而每一套解析模型最终都要靠人来写。
神经渲染这条线处理的问题本质上与之一类:渲染管线里的某一环,其"先验"从人手写的启发式,换成训练出来的网络。ep04《神经纹理压缩》把纹理(数据)的解码交给网络,本文把接力棒递给外观(BRDF,即反射函数)——材质这一环本身换成网络,先验换掉之后,表达力是不是真的更高,代价又换到了哪里。
在正式动笔前,先声明边界,免得大家带着错误预期读下去。本文不重写 ④ 系列已经讲透的降噪机制(SVGF 的空间滤波、à-trous、时域重投影),不重写硬件机制(波前、张量单元内部)——那是《GPU 架构剖析》的地盘,这里只引用结论;也不做深度学习教学与反向传播推导(读者默认具备基本 ML 常识);更不做离线重建的学术综述(NeRF / 3DGS 只作为运行时资产时的实时化路径与许可边界提及)。我们的重心固定在这一件事上:"把网络塞进材质这一环"之后,账本怎么变。凡是涉及倍数的说法,都会标注口径,不做没有出处的转述。
先说本文要用到的一张"地图",把要覆盖的内容摊平:我们先看现状(材质 = 纹理 + 解析 BRDF),再看解析模型的表达能力上限,然后把先验换成网络(神经材质的框架与工程细节),接着摊开工程账(显存 / 算力 / 训练 / 画质四元),处理过滤困境与 STF,落到材质重建这条生产路径,最后给一张反例决策表收尾。
一、现状:材质 = 纹理 + 解析 BRDF
1.1 一句话点题
在现代 GPU 渲染里,"材质"(Material)这个概念拆开看其实是两件东西的叠加:一组描述表面属性的贴图,加一个把光怎么来回算出来的反射模型。前者回答"这个表面长什么样"(颜色、凹凸、粗糙、是金属还是介质),后者回答"光打到它身上,往哪个方向飞出去多少"。这一节把这两件东西各是什么、它们的边界在哪里讲清楚,这是本文全部讨论的起点。
1.2 反射模型:BRDF 的定义
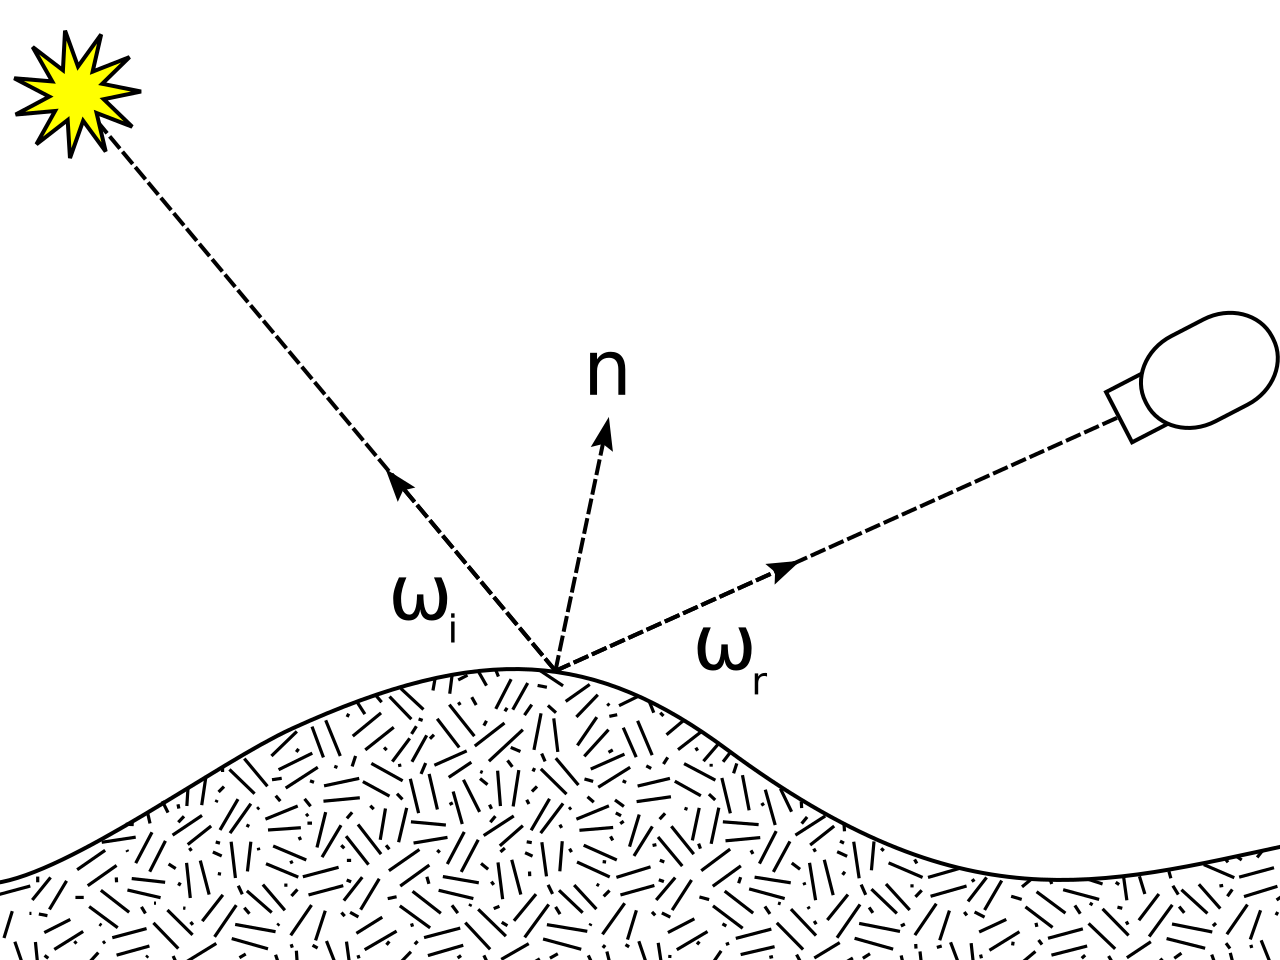
双向反射分布函数(Bidirectional Reflectance Distribution Function,BRDF)$f_r$ 刻画的是:一束从入射方向 $\omega_i$ 射来的光,经表面一点 $p$ 反射后,有多少能量沿出射方向 $\omega_o$ 走。它是整个外观建模的最小单位。
公式:
$$ f_r(\omega_i, \omega_o) = \frac{\mathrm d L_o(\omega_o)}{\mathrm d E_i(\omega_i)} $$
其中: - $\omega_i$ 是入射光方向。 - $\omega_o$ 是出射光方向。 - $L_o(\omega_o)$ 是出射光亮度(radiance)。 - $E_i(\omega_i)$ 是半球微元上的入射辐照度(irradiance),分母把"打进来的总能量"归一化,BRDF 因此是一个不含方向的比值。
要理解 BRDF 为什么是材质的"最小单位",得把它放回渲染方程(Rendering Equation)里看。渲染方程把出射亮度写成光照积分:
$$ L_o(p,\omega_o) = L_e(p,\omega_o) + \int_{\Omega} f_r(p,\omega_i,\omega_o)\, L_i(p,\omega_i)\, (\omega_i\cdot n)\, \mathrm d\omega_i $$
其中: - $L_e$ 是该点自发光项。 - 积分跑遍以法线 $n$ 为轴的上半球 $\Omega$。 - $L_i$ 是入射辐射度,$(\omega_i\cdot n)$ 是投影余弦。
可以看到,BRDF $f_r$ 是渲染方程里唯一一个"完全由材质决定"的因子——光照 $L_i$ 来自场景,几何来自模型,而 $f_r$ 决定表面怎么把光折算成反射。所以"换材质"在数学上几乎等价于"换 $f_r$",这就是为什么本文全部讨论都围绕这个函数展开。
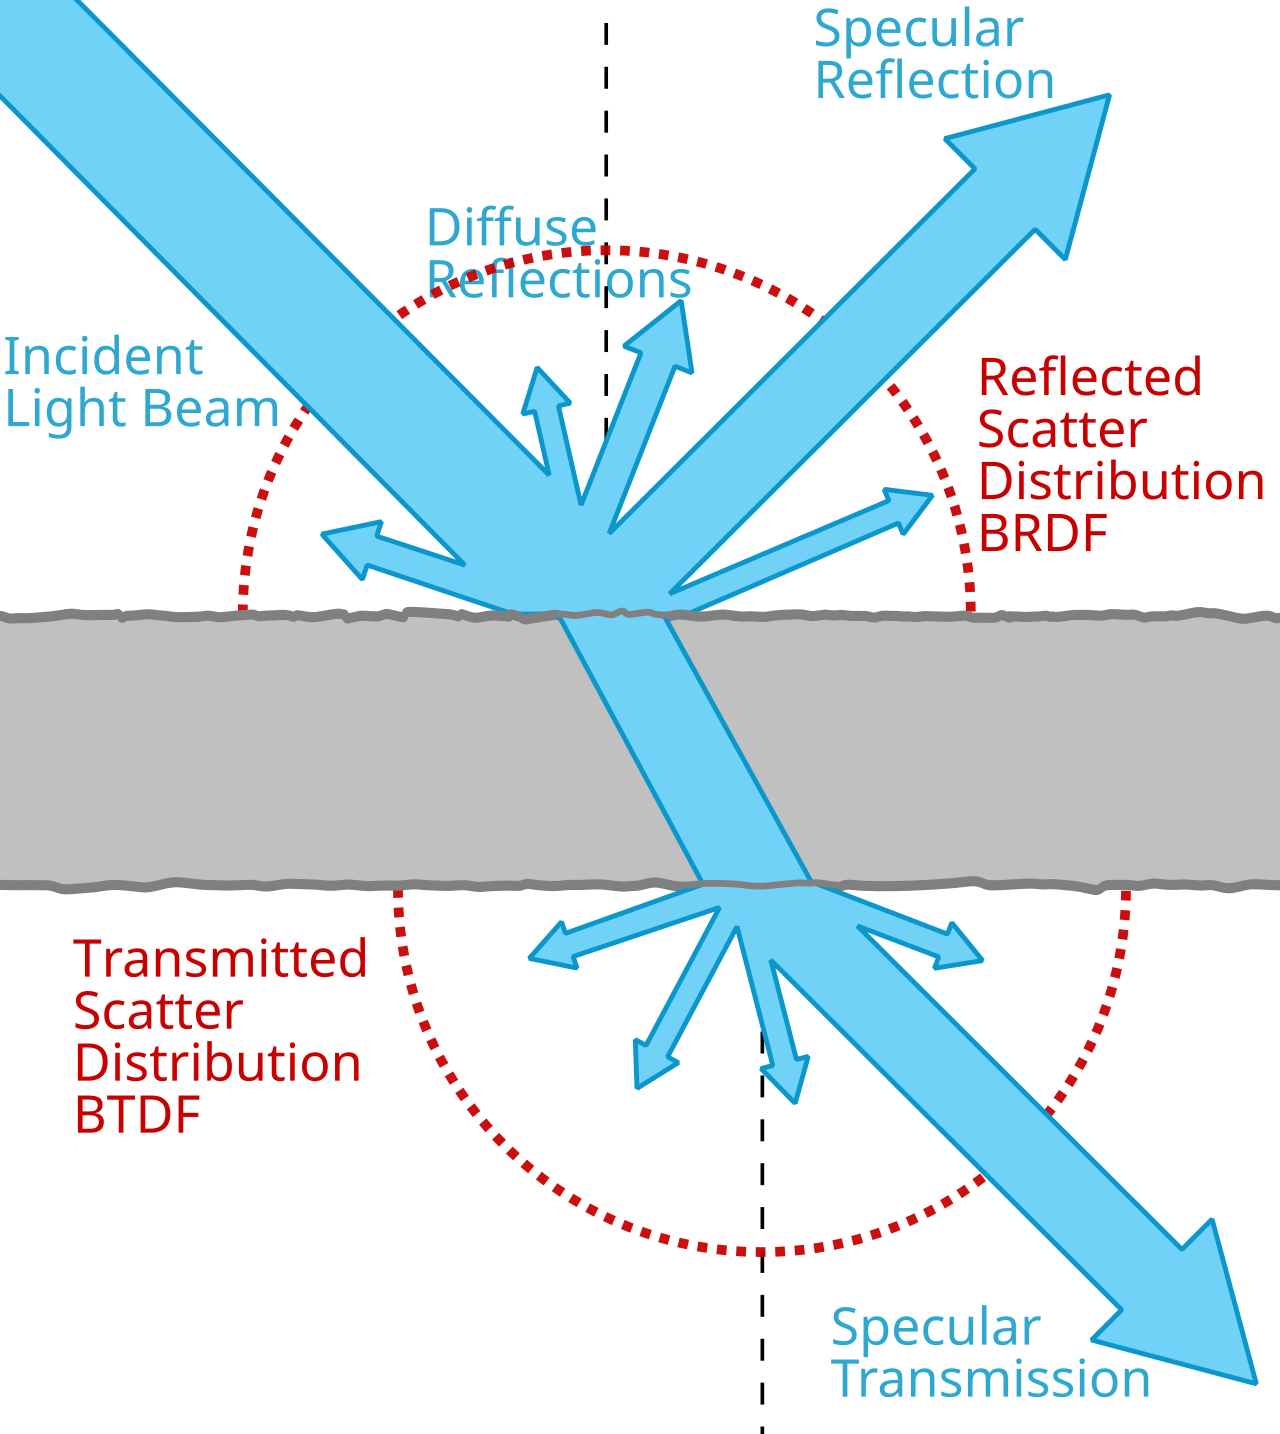
这个公式本身没有任何"材质"信息——它是空的。材质信息全部藏在函数的形式里:函数是漫反射占主导还是高光占主导、高光是一点还是拉成一条、随观察角怎么变化,这些"形状"决定了这个表面看起来是布、塑料还是拉丝金属。而我们用手写的解析 BRDF,本质上是在给这个"形状"预先画好一个封闭的族:你只能在里头挑,不能跳出这个族。
1.3 三种散射形状:漫反射、镜面、高光镜面
BRDF 的形状可以粗分成三类,大家对照图会更好理解。
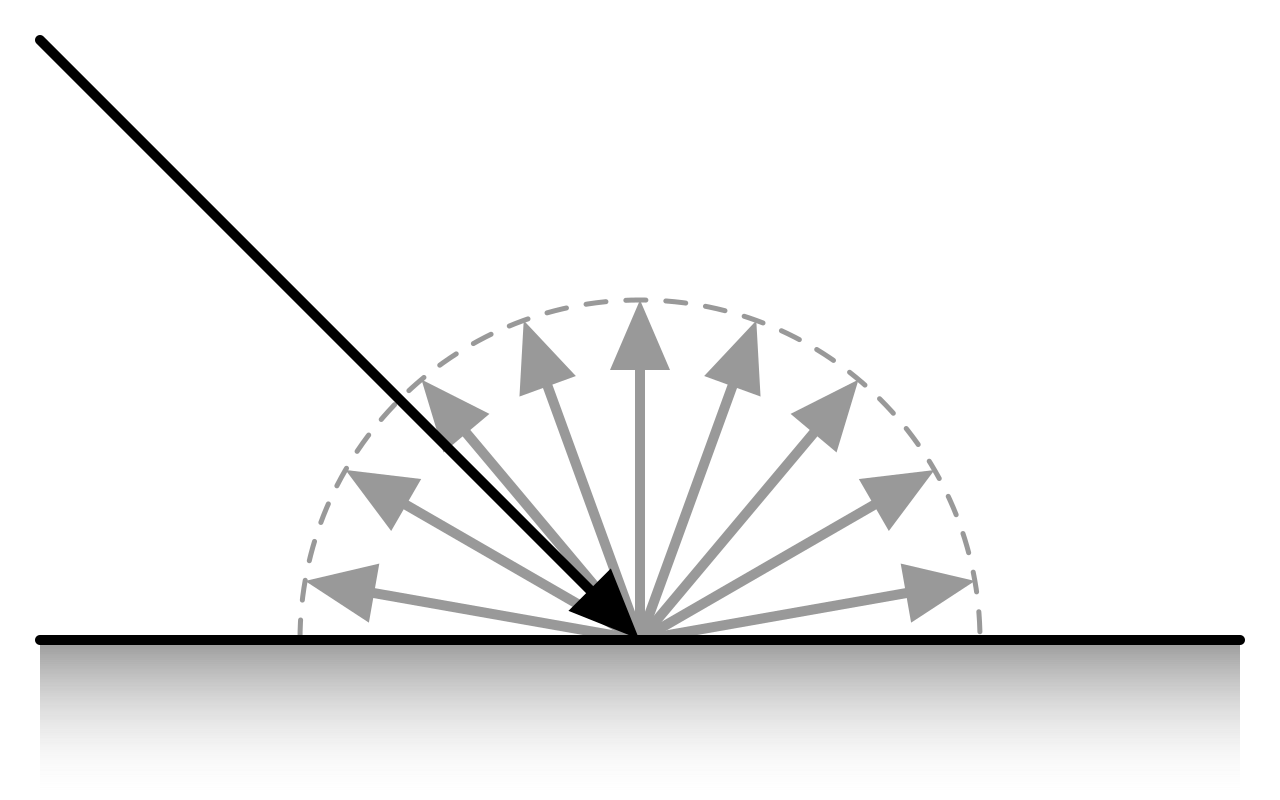
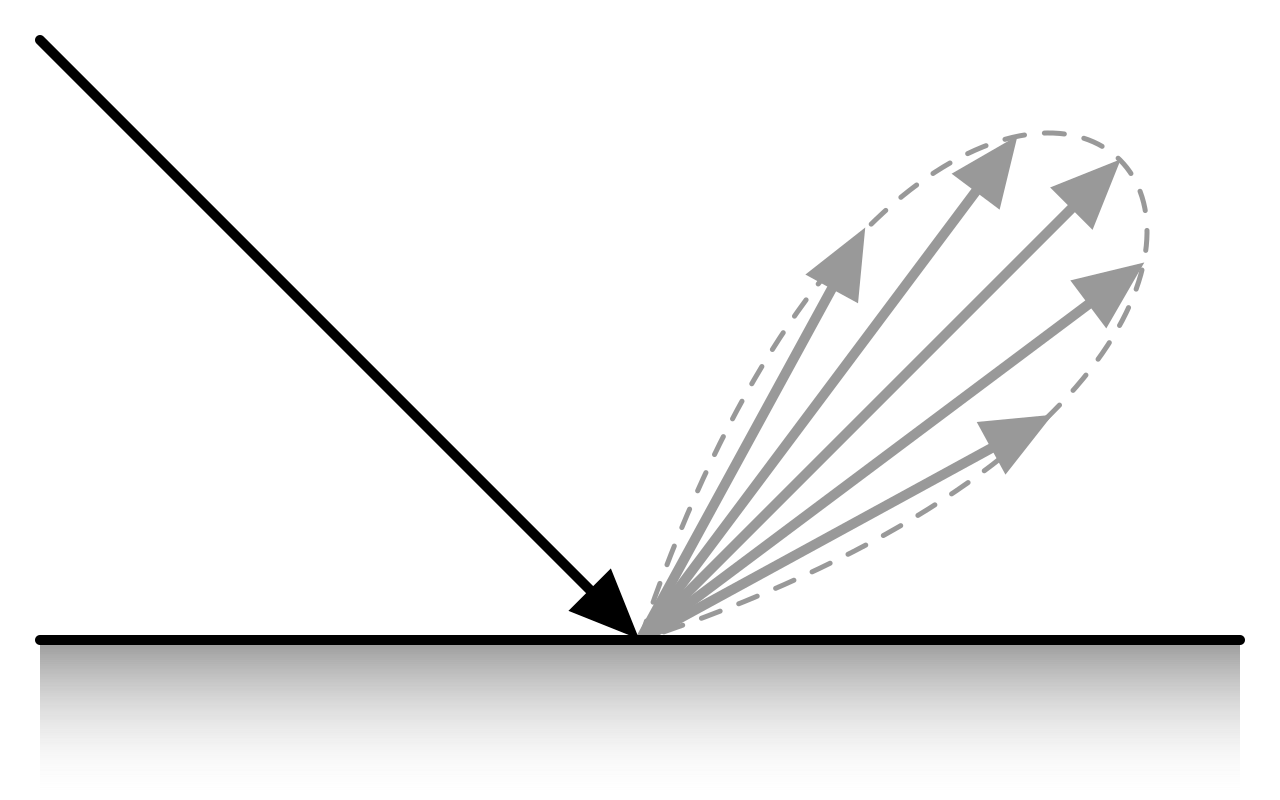
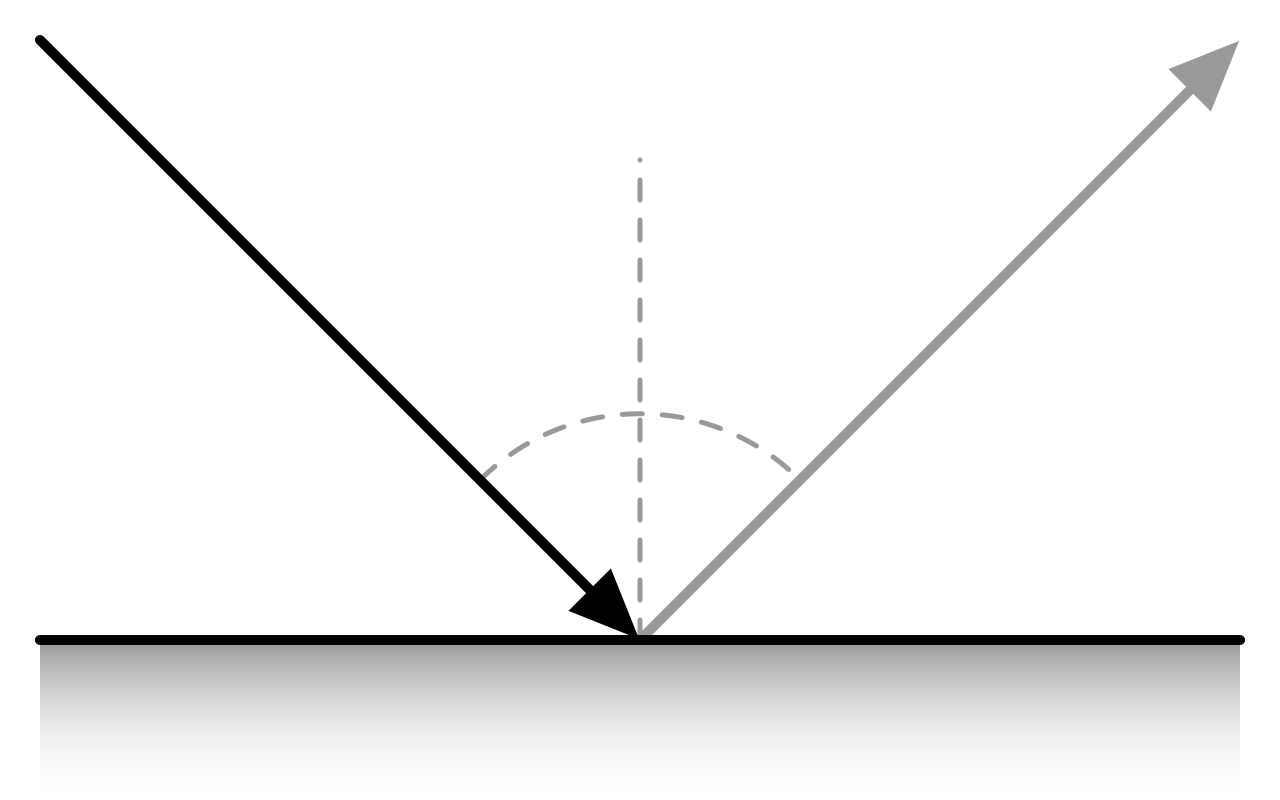
- 漫反射(Lambert):能量被均匀地再射到整个上半球,看哪个方向亮度都一样,是"布、墙、石膏"那类表面的主力。
- 高光镜面 / 光泽反射(Glossy):能量集中在一个 lobe 里,lobe 越窄表面越"亮",是塑料、油漆、打磨过的金属的主场。
- 理想镜面 / 镜面反射(Mirror):能量全部沿反射方向走,只有一处,是光滑镜面金属。
真实材质几乎都是这三类的加权组合。但这三类有个容易漏掉的维度:各向同性(isotropic)还是各向异性(anisotropic)。前述三类都是绕法线对称的各向同性形状;而拉丝金属、发丝、织物绒毛这类表面,反射形状会随方位角拉扁成一条,就必须用各向异性 BRDF 描述——这是实时 GGX 在基础版之外最容易踩的坑,后文解析材质那节还会回到它。
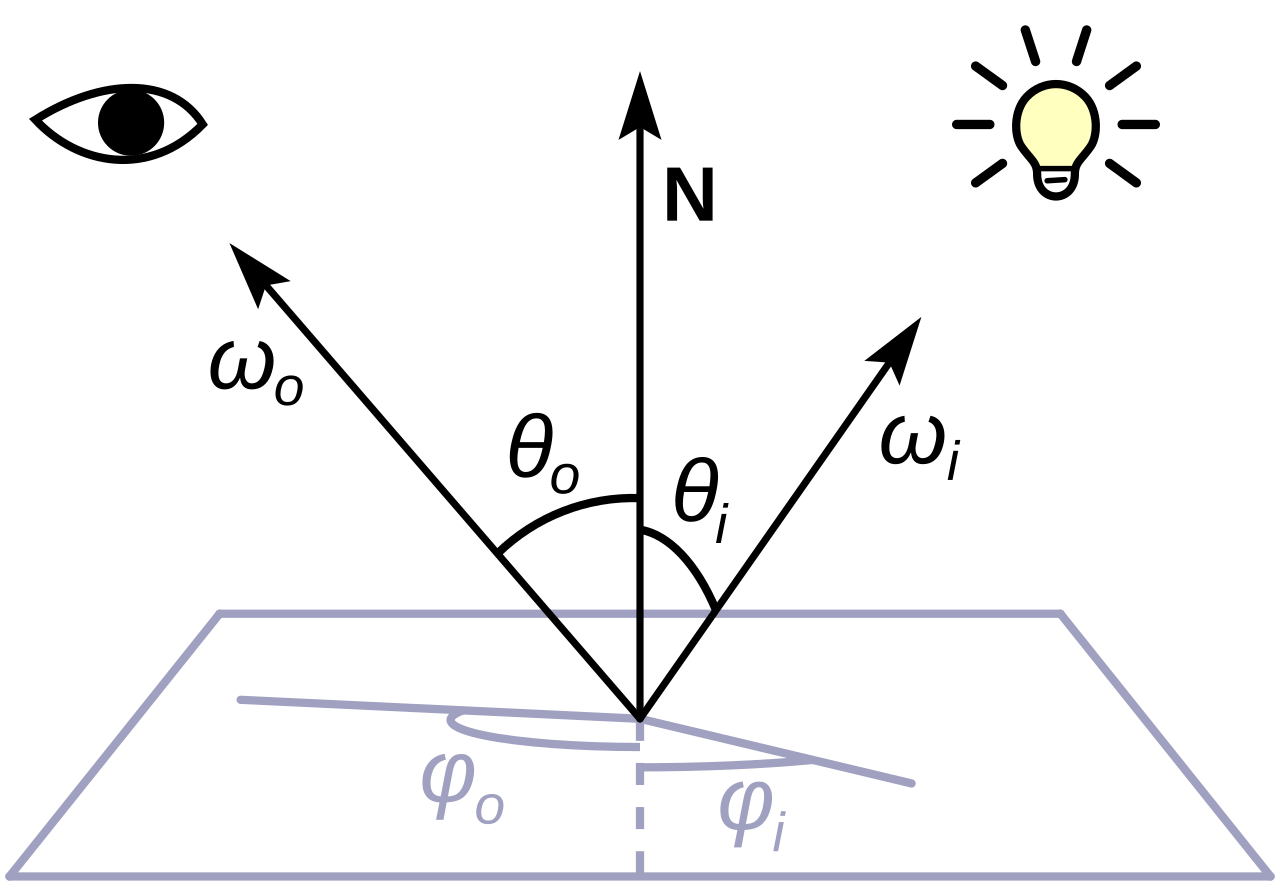
解析材质的全部工作,就是设计这些 lobe 的形状,并规定它们之间怎么加权——这件"规定权重"的事做到了极致,就演化出下面要讲的 Cook-Torrance 与 PBR 标准模型。
1.4 PBR 标准模型:Cook-Torrance
基于物理的渲染(Physically Based Rendering,PBR)的核心,是把 BRDF 拆成漫反射与高光两部分的加权和,并保证能量守恒。实时渲染里用得最多的标准模型是 Cook-Torrance 形式(其推导脉络可见经典资料 Physically Based Rendering Cook-Torrance):
$$ f_r = k_d f_{lambert} + k_s f_{cooktorrance} $$
其中: - $k_d$ 是漫反射权重,$k_s$ 是高光权重,约束 $k_d + k_s \le 1$ 保证能量不乱增长(energy conservation)。 - $f_{lambert} = \cfrac{\mathrm{baseColor}}{\pi}$ 是漫反射项。 - $f_{cooktorrance}$ 是高光项,具体展开为三项之积除以归一化分母: $$ f_{cooktorrance} = \frac{D(h)\, G(l,v)\, F(v,h)}{4\,(\omega_o\cdot n)(\omega_i\cdot n)} $$
其中: - $D$ 是法线分布函数(Normal Distribution Function,NDF),决定微表面法线如何散布,即高光 lobe 的"锐利度"。 - $G$ 是几何项(Geometry / Visibility),处理微表面之间的自遮蔽与遮挡。 - $F$ 是菲涅尔项(Fresnel),决定随观察角的反射率变化。 - $h$ 是半程向量,分母 $4\,(\omega_o\cdot n)(\omega_i\cdot n)$ 是几何归一化常量。
GGX 是当前最主流的 NDF,用 $\alpha = roughness^2$(roughness 粗糙度)控制 lobe 宽度。它的分布函数写成:
$$ D(h) = \frac{\alpha^2}{\pi\Big((n\cdot h)^2\,(\alpha^2 - 1) + 1\Big)^2} $$
其中: - $n\cdot h$ 是法线与半程向量的点积,衡量微面法线与半程向量的对齐程度。 - $\alpha = roughness^2$,越小 lobe 越窄越高光;roughness 从 0 到 1 对应从镜面到哑光的变化,这是调材质时最常碰的旋钮。 - GGX 相比早期 Blinn-Phong 的一个关键差别是它的长尾:在高光外缘衰减不那么陡,更贴近真实材质那种"亮但还有一点散"的过渡。
几何项 $G$ 在工程上常用 Smith 近似,与 NDF 共用同一个粗糙度参数,处理微表面自遮蔽;菲涅尔项 $F$ 用 Schlick 近似,$F(v,h)=F_0 + (1-F_0)(1-v\cdot h)^5$,其中 $F_0$ 是垂直入射时的反射率,金属由 base color 的色通道决定、电介质固定在一个低灰度。这三个近似的组合,就是"实时 GGX 三件套"的日常形态,Filament、glTF 的标准模型路线都是这套的近亲(参见 Filament PBR 标准模型 与 glTF 微面元模型教程;GGX/Smith 的数学背景可参考 PBR notes)。
参数侧,大家在项目里主要打交道的其实就是四个:baseColor(基础色)、roughness(粗糙度)、metallic(金属度)、normal(法线)。这几个量决定了下一小节那组"材质纹理",也决定了我们的讨论要往哪个方向延伸。
这里有必要把"解析模型的族谱"铺开一层,方便大家后续对照"网络模型"时理解自己手上握着的是哪一支。按演进顺序,实时反射模型大概可以归成三代:
| 阶段 | 代表模型 | 提出者与年份 | 关键特征 |
|---|---|---|---|
| 早期经验型 | Phong、Blinn-Phong | Phong 1975、Blinn 1977 | 依赖观察角/半程向量,能量不守恒 |
| 物理型(微表面) | Cook-Torrance、TORRANCE-SPARROW | Torrance & Sparrow 1967、Cook & Torrance 1982 | 引入 NDF / 几何项 / Fresnel,能量守恒 |
| 现代标准化 | GGX(Trowbridge-Reitz)、Disney Principled | Walter et al. 2007、Burley 2012 | 长尾高光更真实、多参数"原则性"模型、被 industries 广泛采用 |
口径说明:这里年份取论文首次公开的年份,不追更早的技术报告版本。这一族谱说明一件事:解析模型是在"用更大的公式族逼近真实光"的路上演进,每一步都要人来写公式——这是它最根本的约束,也正是本文后面要论证的换网络的动机来源之一。
再看一眼"实时三件套"在实际光照积分里怎么被消费,因为这是后面和神经材质对照的基准。一个典型的延迟着色像素,其高光项 $f_{cooktorrance}$ 被塞进渲染方程做一次(或带重要性采样的多次)求值:光栅管线里通常每个直接光源求值一次,路径追踪里则要对每条入射路径求值一次,再乘上 $(\omega_i\cdot n)$ 余弦与光源贡献。这意味着无论网络还是解析,材质函数在管线里被调用的次数都由"采样次数"决定——解析模型好在每一次调用只是几十条指令,快、可预测;但它表达的形状平庸。后面第五节会看到,神经材质正好把这两个性质反过来:形状丰富,但每一次调用都变成一次网络前向。
这里还要补一个容易被忽略的现实:实时解析材质在工程上从来不是"裸的 Cook-Torrance"。生产管线会给 roughness 做滤波(对应各向异性时还会用不具旋转对称的 GGX 变体,即各向异性 GGX,见 glTF 的 anisotropy 扩展)、给法线贴图做 mip 化的导数滤波,还会引入清漆(clearcoat)、次表面近似、两个 highlobe 合成等"工程补丁"。这些补丁本身又是一串要被维护的代码与参数。等位对到神经材质时你会发现:神经方案把"一堆补丁"并成"一组权重 + latent",这是后文要细算储蓄点的地方,但补丁带来的可预测性与调试性,也正是它之后要支付的第一笔隐性成本。
1.5 材质 = 一组纹理 + 参数
把上面的 BRDF 塞进一张贴图,就得到实时渲染里"材质"的日常形态:一组 PBR 纹理 + 几个标量参数渲染出一个表面。
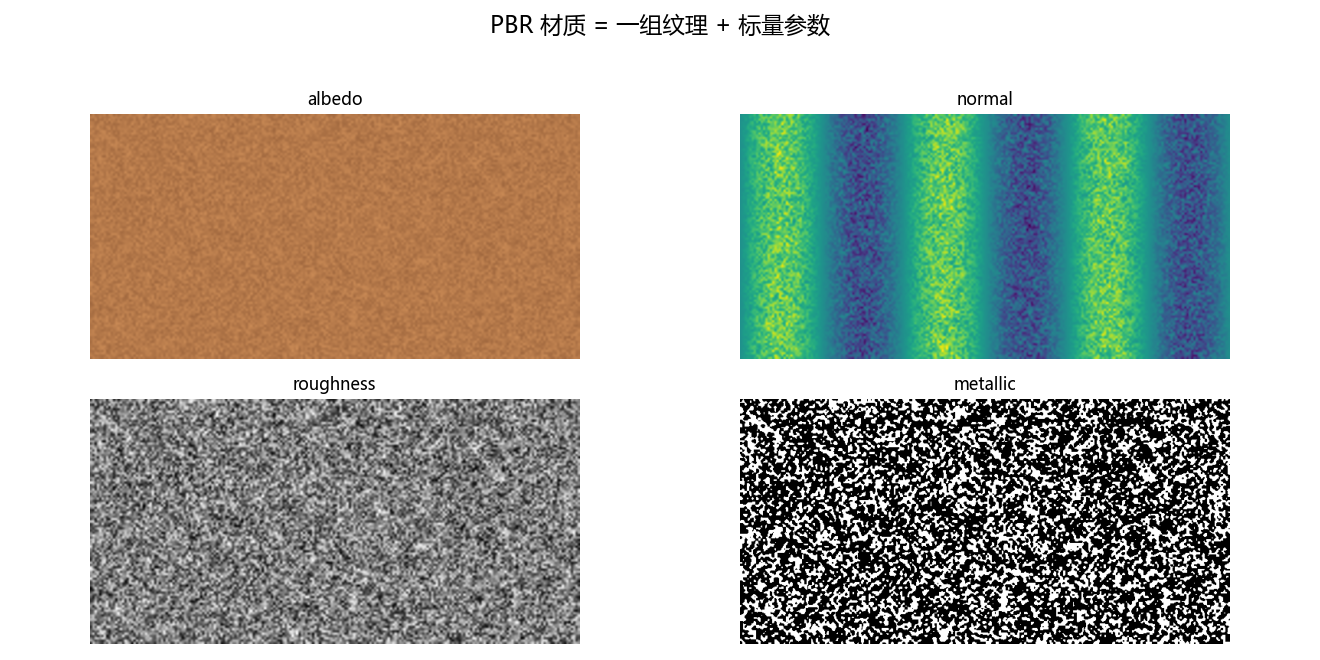
这一组的成员几乎已成惯例:baseColor(或 albedo)贴图给颜色,法线贴图(normal map)给微表面朝向的扰动,roughness 贴图给粗糙度的空间变化,metallic 贴图区分金属与电介质,外加可选的 AO(环境光遮蔽)与 emissive(自发光)。空间的细节靠贴图分辨率去扛,方向性的细节靠 BRDF lobe 的锐利度去表达——这就是解析材质框架的两个把手。
单就这组纹理,大家就能感受到解析框架的"显存成本"从哪来:一张 4K 的 baseColor 加 4K normal 加 2K roughness 加 2K metallic,仅四张无压缩的 R8G8B8A8 叠加就是上百 MB 的命中——这还没算 mipmap 的 1.33× 放大。这一笔,正是 ep05 最直观的收益起始点,也是 ep04《神经纹理压缩》着力解决的数据侧的账。
但"显存账"只是这组纹理的一半,另一半是带宽:纹理在像素着色里每采样一次,就要从缓存/显存搬一次数据。一张 baseColor 一次双线性采样是 4 个纹素、每纹素 4 通道,缩放/斜视视角再吃各向异性多档。于是反射材质越重、采样越密集,带宽压力越大——这就是为什么"省显存"和"省带宽"经常被混为一谈,但它们是两笔不同的账:显存是"住得下",带宽是"跑得动"。神经流派(ep04 与本文)真正想同时解决的正是这两笔,只是各自侧重不同——ep04 侧重把纹理压缩进 latent,本文这组纹理的着力点在"反射函数的形状"这一侧。先把带宽这层皮戳破,后面工程账才不至于只看显存一个数。
1.6 这一节的小结
把前五小节收拢成一句话:当前材质 = 一组纹理(存"长什么样")+ 一个解析 BRDF(存"怎么反光"),两者加起来的表达能力是封闭的——纹理受分辨率和显存限制,BRDF 受"人写出来的公式族"限制。下一节我们来量化"封闭"到底封在哪儿。
二、解析材质的表达能力上限
2.1 为什么谈"上限"
谈"上限"不是劝大家放弃 PBR。恰恰相反,PBR 是实时渲染之所以能稳定的地基,本文从头到尾不否定它。但我们要回答一个研发取舍问题:"我用网络替代解析 BRDF,到底买到的是什么?"答案必须从解析模型的短处说起,否则"换网络"就没有动机。这就像换引擎之前,得先说明旧引擎的转速表为什么打不上去。
2.2 实时单 lobe vs 离线多层:形状单一的代价
实时模型的默认配置几乎都是一个漫反射 lobe + 一个(或两个)GGX 高光 lobe,最多加个 sheen(织物光泽)。这套配置对绝大多数金属、塑料、皮肤初阶假设够用,但它把"反射形状"锁死在了少数几个 lobe 上。
离线渲染里的材质要复杂得多。Disney 提出的 Principled BSDF(原则性材质模型)用十几个参数把漫反射、高光、透射、清漆、次表面散射叠进一个"原则性"框架里(Disney Physically Based Shading);学术与影视侧甚至出现多 lobe 微表面模型(可参考 2025 年 PBS 课程的 Weidlich 多层材质讲义),让一个表面同时有多种光泽贡献,逼近真实材质那种"既像油亮又有细粉"的复合感。这些在全离线、一帧渲十几分钟的设定里可行,但在实时管线里,每多一个 lobe 就多在着色里加一次 BRDF 求值——表达力与算力在解析框架里是强绑定的。用一个大致量级说话:实时单 GGX 的高光求值掩模在生产里通常要控制在每个像素数十个指令以内,而离线多层模型的着色成本往往是它的一个数量级以上,全靠不实时来兜。
要强调那句"表达力与算力强绑定"不是抽象口号,它在实时侧的体验很具体:当你想让墙角既保留"亮面反射"又带一层"磨砂泛光",实时 GGX 通常只能两选一,或者用两层贴图近似;要更真,就得加一个第二 lobe(sheen / clearcoat),着色里多一次 GGX 求值、多一次 roughness 采样,fill rate 一起涨。这就是解析框架的"边际成本"——你每加一档真实感,都要为它写一行公式、多一次求值。它不像网络那样"形状学一次就有大范围迁移",而是每一处复杂度都要显式实现。搞清楚这个机制,才能理解后文"网络把一批补丁折算成权重"到底省在哪。
2.3 解析模型是"人手写的先验"
这一步是关键词。所有上述 lobe 形状、权重、能量守恒约束,都是人预先写好、并声称"大致像真实光"的启发式。它的表达范围是先验的闭空间:你不可能让一个单 GGX lobe 自动学会粗糙度随空间变化的镜面,因为那个"分布函数长什么样"是刻死的。真要表达,只能靠堆贴图把"空间变化"搬进显存,或者手工调出一套更大的解析模型——两条路都在人的设计里打转。
2.4 于是问题变成
解析模型做不到的,恰恰是"一个表面在空间上、方向上都有复杂且彼此纠缠的变化"。要做到,得让"反射形状本身"不是一个写死的公式,而是可以从数据里学出来的东西。这就是把先验换成网络的全部理由。下一节我们把网络请上台。
三、把先验换成网络:神经材质的框架
3.1 框架一句话
神经材质(Neural Appearance / Neural BRDF)的核心,是把"解析 BRDF 公式"这一个环节,换成"一个由权重刻出的小网络":表面每一点的反射行为不再由 $D G F$ 三项公式刻画,而是由网络在该位置解出的输出刻画。这里的"解出",依赖一个和 ep04 NTC 一脉相承的骨架——latent 向量加 MLP 解码器。
先给大家一张方法清单,把"神经材质"这个名字底下的不同流派摊开,免得一说到这个词就只想到某一家:
| 流派 | 代表工作 | 年份口径 | 解决的问题 | 表达介质 |
|---|---|---|---|---|
| 神经纹理压缩式 | NVIDIA Neural Texture Compression | 2023 起 | 把压缩与解码交给网络 | latent tensor + 小 MLP 解码 |
| 神经 BRDF / 外观模型 | NVIDIA Real-Time Neural Appearance Models | 2025(TOG) | 实时逐采样解码反射 | latent(z) + BRDF decoder + 重要性采样器 |
| 物理正确的神经 BRDF | PBNBRDF | 2024 | 强制 Helmholtz 互易 + 能量守恒 | 约束式网络 |
| 神经材质重建 | NeuMatEx、PBR-NeRF | 2024–2026 | 从多视角图反推材质 | 逆渲染 + latent 正则 |
| 生成式材质获取 | Generative Neural Materials | 2025(SIGGRAPH) | 从生成式视频模型提取可复用材质资产 | 生成式 latent |
口径说明:这五支并不是同一层级的概念,前两行是"如何用",后两行是"怎么得到"(生产),最后一行是更前沿的获取范式。把它们并排是为了给读者一张"神经材质是个大家族"的全景,避免把某个厂商的实现当成行业通例。
其中几份打下述结论时能直接引用的关键出处,先在这里集中给出,后文不再重复贴:实时神经外观模型的代表作 (NVIDIA Real-Time Neural Appearance Models, TOG 2025)、把能量守恒与互易性显式种进网络的 (PBNBRDF)、逆渲染与神经材质碰撞的 (PBR-NeRF) 与偏重建的 (NeuMatEx)、以及从生成式侧获取可复用材质的 (Generative Neural Materials, SIGGRAPH 2025)。一个备注:这些工作都在快速迭代,本文只引用其方法论层面的事实(是否做了物理约束、是否来自生成式),不把它们当行业定论。
3.2 骨架:latent + MLP decoder
延续 ep04 《神经纹理压缩》的既有结构:空间信息不直接存成高分辨率像素贴图,而是压缩进一张低分辨率 latent 张量(latent tensor),真正把 latent 翻译回可用属性的,是一个几层的小 MLP 解码器。
对材质而言这条链是:
位置 x → 查 latent 张量 → 得到该点 latent 向量 z(x) → MLP 解码器(z(x)) → 反射参数/输出 fr
关键差异在于:解析框架里"形状"由公式 NDF/几何/Fresnel 决定;网络框架里"形状"由 z(x) 与解码器权重共同决定,而 z(x) 落在 latent 空间里,是可以被训练调校的。这就是"先验被换掉"的结构含义。
这条数据流的高层形态与神经纹理压缩几乎完全同构:一个低维潜在表示 + 一个连续函数(MLP)在运行期重建。区别只在被重建的"东西"不同——NTC 重建的是纹素的颜色/数据,神经材质重建的是反射行为。这个"换汤不换药"的同构关系,读者如果先读过 ep04 会非常眼熟,也是本文到处借用 ep04 结论的原因。
3.3 表达式:神经 BRDF 输入输出
把这个思想写成表达式。解析 BRDF $f_r(\omega_i,\omega_o)$ 直接吃两个方向;神经 BRDF 则引入位置:
$$ \hat f_r\big(x,\omega_i,\omega_o\big) = \mathrm{MLP}_\theta\big( z(x),\, \phi(\omega_i),\, \phi(\omega_o) \big) $$
其中: - $x$ 是表面位置,$z(x)=\phi(x)$ 是位置向 latent 空间的嵌入。 - $MLP_\theta$ 是参数为 $\theta$ 的小解码网络。 - 输出 $\hat f_r$ 替代了解析的 $f_r$,参与球面光照积分。
有意思的地方在输入输出空间:解析 BRDF 是一个纯函数吃两个角;神经 BRDF 多吃了位置 $x$(决定空间变化),并且几乎一定同时多输出一个重要性采样方向与对应的概率密度,否则后续的光线积分没法稳定做。也就是说,网络不仅卖给你反射值,还顺带把"该往哪个方向采样"这件事也学会了——这把两个环节压缩进一次网络前向。
注意这个"多输出一个采样方向"不是免费送的:它在训练时需要额外的监督信号(真实光的反射方向分布或蒙特卡洛采样目标),也给推理加了一路输出。工程上要不要这个方向输出,取决于你的管线用不用它来驱动光线分叉——路径追踪用,纯光栅着色未必用。
这套上下文的训练配方也值得说几句。监督信号通常有两类来源:一类是衰减(闭式)真值,即用解析/数值方法求出的参考反射分布去监督网络;另一类是自监督/渲染一致性,即把网络输出接进渲染器,对比渲染结果与参考图,用梯度回传反推网络。前者稳定但可能继承解析模型的先验偏差,后者更接近"端到端"但训练更不稳。现实中多用两者混合——先期用解析真值把网络训到一个合理起点,再用渲染一致性微调高频细节。这条训练管线是"训练侧工程"那个单独的母题,本文不展开,只点到这里。
3.4 翻译回实时渲染
落到实时路径追踪里,执行单元变成:每次在表面点做材质查询,先用 $x$ 查 latent 张量取得 $z(x)$,再跑一次 MLP 前向(每采样一次就跑一次),拿到该点的反射参数与重要性采样方向。每一次采样都意味着一次网络推理——这个概念请先记下,它是本文第五节算力账、第六节过滤困境讨论的源头。
再看一眼 3.2 那条链的执行频率,就能算出为什么"算力"会成为神经材质绕不过的坎:假设一个路径追踪器在表面命中点上平均做 4 次采样,那么每次命中点流畅要 4 次 MLP 前向;一帧 1080p 上百万命中点,累计就是数百万次小网络前向。单次前向量级很小不代表总账小——总成本由次数主导,而不是由单次成本主导。
把量级摆开看更直白。给一个便于自己复算的工作量算式:令 $N$ 为一帧内表面命中点总数、$S$ 为每命中点平均采样数、$C_{mlp}$ 为单次网络前向的(等价)指令数,则神经材质的帧级解码成本约 $N \times S \times C_{mlp}$。取 N 约 1080p 的一百万、S 取 4、网络以约百条指令算,即约 $10^6 \times 4 \times 10^2 = 4 \times 10^8$ 量级的指令当量——这已经接近一个没门槛的中型像素着色器负载。换解析模型,同样的位置每一采样少则几条指令,成本能低一到两个数量级。这个算式本身就是后续第五、六节所有"什么时候划算"讨论的公分母。
四、工程细节:latent、解码器与物理约束
4.1 表达力账:网络到底买到什么
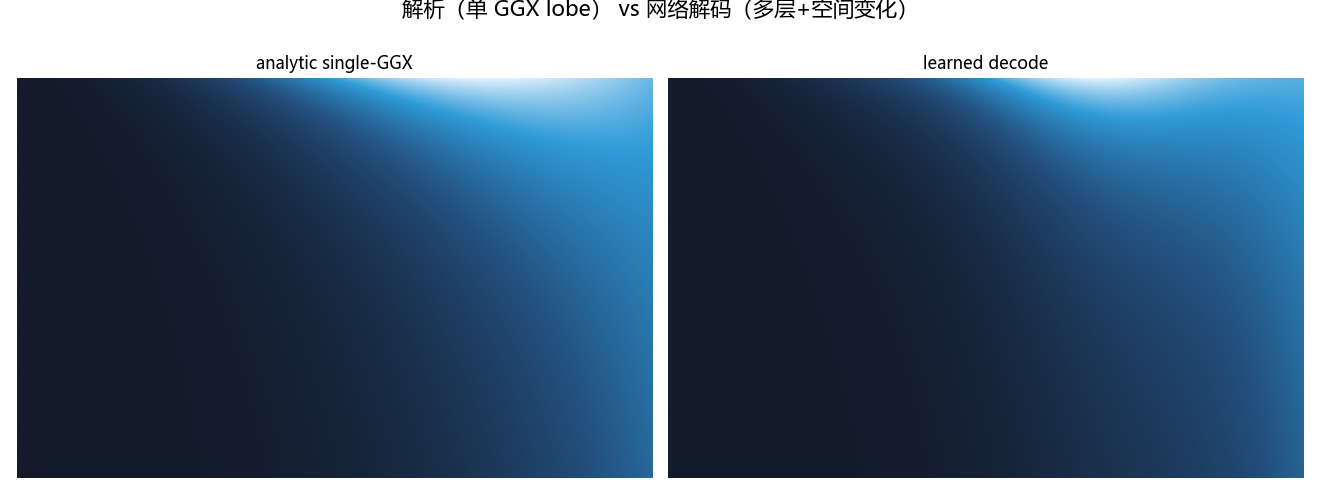
先回答本文的总问题之一:"换网络有没有真的买到表达力?"答案是有,而且是结构性的:网络权重刻画的是连续函数,latent 空间让"反射形状"随空间、方向连续变化,能做到解析框架需要无穷 lobe 才能逼近的多层面、空间变化反射。Neural Appearance Models 体系里,一个材质资产的反射行为可以包含多层高光、随空间变化的粗糙度/金属度连续场,这些在单/双 GGX lobe 的解析框架下要么做不了,要么得靠堆贴图。
但请大家听清限定语:是"表达力"更高,不代表"处处更划算"。泛化是有边界的——网络是对训练分布拟合,训练分布之外的材质(没见过的新光泽、异常比例)会退化。这一条我们放到第七、八节展开。
4.2 latent 空间是什么样
latent 空间不是贴图那样"每个像素存个颜色",它存的是"这个点反射行为的压缩描述"。相邻材质的 latent 在空间上相近、语义相近,于是它拥有贴图没有的一个性质:可被插值与平滑过渡。但也因此有一个隐患——它不是可解释的,你不能像看 roughness 贴图那样直接"读出"某个通道的含义。
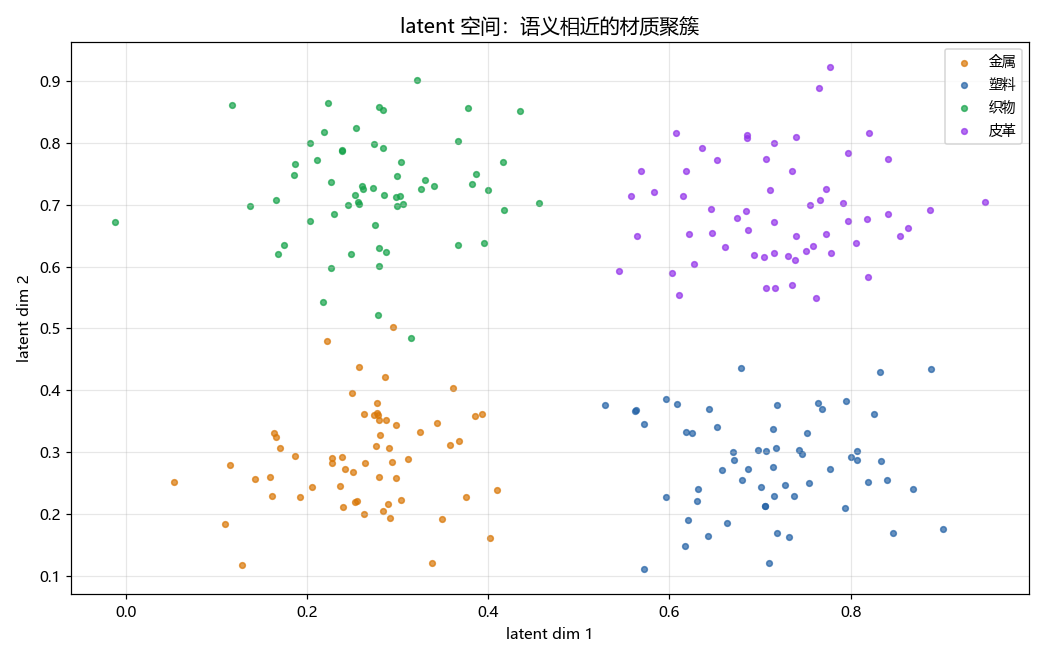
对工程来说,这说明调 bug 的方式变了:过去怀疑 roughness 贴图发白,直接开 GIMP 看那个通道;现在一个反光不正常,你要反查的是 latent 空间里那个点落在哪儿、解码器贡献了什么。这是学习式材质在可调试性上要付出的隐性成本,中文社区里谈得少,但它是真实项目里最常见的落差。
4.3 物理约束:互易与能量守恒
网络也不是想怎么乱来就怎么乱来。把解析 BRDF 的"物理约束"请回来,最要紧的两条是能量守恒(输出反射能流不超入射)与 Helmholtz 互易性($f_r(\omega_i,\omega_o)=f_r(\omega_o,\omega_i)$)。物理正确的神经 BRDF(如 PBNBRDF 方向的工作)通过在网络输出与损失里显式加入守恒项,让学出来的反射不至于违反物理,否则光照积分算不对,更别说做逆渲染反推。
这条其实回答了很多人对神经渲染的直觉顾虑——"网络会不会学着学着就放飞自我"。约束是可以在架构里种进去的;代价是这些约束会限制网络可到达的反射族。物理正确与表达自由,是一对要反复权衡的跷跷板。
4.4 解码器的规模与成本
解码器通常是一个 2–4 层的小 MLP,权重规模很小(RTX NTC 体系的每材质网络权重约十几 KB 量级,latent ≤16 通道),真正的数据大头在 latent 张量。这个规模意味着:单次前向的绝对算力不高,但次数极多(每个采样一次),于是总成本由"调用频率"主导,而不是由"单次成本"主导——这与 3.4 的推算互相印证。也正因为解码器小,才可能指望 GPU 在着色器层面用张量单元去加速——这是"着色器内推理"那条线的起点,先在这里埋个引子。
规模小还带来两个工程上的利好:一是内存装载快、热切换便宜,材质资产可以按需加载,不用在显存里常驻一大堆 PBR 贴图的 mip 链;二是网络权重通常可以用量化(比如把权重压到 8-bit/4-bit)进一步缩体积,量化误差对小网络的影响相对可控。当然,"小"也意味着表达更依赖 latent 张量的分辨率:latent 张量横向定的是"空间的颗粒度",网络权重定的是"单点反射的复杂度",两者各管一摊,调参时要分开看,别混为一谈。
把"解码器 vs 解析三件套"的工程征并排放在一张表里,是最直观的对照基准:
| 维度 | 解析 Cook-Torrance(实时三件套) | 神经材质(latent + MLP 解码) |
|---|---|---|
| 每采样成本 | 数十条指令的可预测固定值 | 一次小型网络前向,随采样线性放大 |
| 空间变化表达 | 靠 texture 分辨率 + normal/roughness 场 | 靠 latent 张量分辨率 + 解码器权重 |
| 形状丰富度 | 受公式族限制(lobe 数量有限) | 由权重描述,可覆盖多层/空间变化反射 |
| 显存形态 | 高分辨率纹理 + mip 链 | 低分辨率 latent + 共享权重 |
| 调试方式 | 直接看通道(roughness 发白→查通道) | 反查 latent 位置 + 解码器贡献(隐性成本) |
这张表的每一行,几乎都能在后文五至八节找到它的"代价落点"。尤其最后一行可调试性:它常常不在论文里、也不在基准里,但在真实项目里最容易劝退团队——这是中文社区谈得最少、却是决定"上不上神经材质"的现实阻力之一。
把"latent 调试难"落到具体动作上会更清楚。一个普遍的现场是:美术反馈"这面墙在某个角度看反光了,但换角度又完全没有"。解析管线里,美术打开 rough 通道、把偏高光区域压下去即可;神经管线里,你得先确认是 latent 里那个像素对应的语义、还是 解码器在该方向的输出 出了问题——两者分别对应"空间采样这里"与"方向解码这里",但故障现场常常同时牵动两者。更糟的是 latent 通道没有"roughness 的那根旋钮",你要么接受网络行为,要么重新训。这不是不能解决,而是它把调试从"看一个通道"变成"看一整条 latent+解码链路"。把它写进账本的意义在于:项目里 90% 的"看着不对"不是理论问题,是这种工程摩擦。这也是 5.4 那张账本里"可调试性"那一栏真正要扣的分数。
4.5 与 ep04 的复用关系
到这里大家应该看清,神经外观与 ep04 的神经纹理压缩共享同一个 latent+decoder 骨架,差异只在"被解码的一端":NTC 解码的是颜色/压缩纹理样本,神经材质解码的是 BRDF/反射输出。中文语境里常听到的"神经材质(Neural Materials)",很大程度上就是把这套骨架从 texture 再往前推一格到 appearance。
一个直接的工程推论:任何为 NTC 写的显存/带宽优化经验,几乎可以平移到这里;而 NTC 遇到的过滤与稳定性问题,神经材质也一个不少都会遇到——这就引到第六节。
五、工程账:显存、算力、训练与画质
这一节用统一的一本账,把我们最关心的四个维度逐一摊开。任何"神经材质更省/更快"的说法,都必须落到这几个数上,不接受纯形容词。
5.1 显存账:压缩省下来的
神经材质最直白的收益是显存。latent 张量加小网络,相对同画质的高分辨率 PBR 纹理集,内存可以压到很低的水平。工程实现里 NTC 体系给出的口径是数量级的差距——官方演示里的 Tuscan Villa 资产从 6.5GB 级别压到约 970MB 级别(Vulkanised 2025 的 Panteleev 演进,NTC 研究页面),这与 ep04 的纹理压缩同源。对显存紧张的移动端和 6–8GB 独显笔记本,这是实实在在的救命钱。
再给一组社区实测的工程账参考(StraySpark 的 UE5.7 NTC 完整指南 口径):同一场景,BC7 纹理约 10.8GB、单帧解码约 4.1ms;NTC-Small 压到约 3.6GB 显存,但单帧解码升到约 4.9ms。省了约 7GB 显存,却多了约 0.8ms 每一帧的解码开销——这笔账的"买"和"卖"清清楚楚。显存红利与传统格式的差异,社区在 6–8GB 显卡上反反复复讨论过(例如 这里的长楼),结论基本一致:省显存是真,但解码成本得单独买单。
注意因果要拎清:省显存是"压缩"带来的,不是因为"网络"本身省。若只谈求值快慢,网络前向并不天然比像素贴图访问便宜——这是下一小节的对称提醒。
工业落地层面,神经纹理/材质链路已经有可核对的 3A 案例,而不是停留在论文。Ubisoft 的研发团队 La Forge 在《刺客信条:幻景》(Assassin's Creed Mirage)里上线了 NTC,把神经纹理解码接进材质纹理链路,作为大场景显存优化的实证(官方口径约 30% 量级的纹理压缩应用)。这类案例的价值不在那 30% 的数字本身,而在它证明了"网络解码放进商业素材流水线"这件事是能过美术与稳定性评审的——这比任何演示都更能说服项目立项。另一条硬件侧的证据是 NVIDIA 在 OptiX 里引入 cooperative vectors:为了让神经材质/纹理解码能跑得更快,光线追踪框架层把你想要的"逐采样解码小网络"用硬件加速这条路铺出来了——这也反过来说明"算力账"是业界公认的瓶颈,大家都在为它造硬件。("着色器内推理"这条线本文不再展开。)
5.2 算力账:sample-time MLP 的代价
网络求值发生在"每个采样点"上。于是算力画像非常清晰:纹理 fetch 是固定的带宽命中成本,网络前向是一个小 MLP 的固定开销,但在做逐采样解码时,这个固定开销会随采样次数线性放大。
更直观的对照:纹理单元取一个纹素是几 KB 带宽的固定命中,一次小 MLP 前向可能是几十到一两百条指令。单次看前者更便宜;但当采样次数上到百万级,神经材质那"每采样一次前向"的代价就追平甚至反超——它把固定成本换成了与采样数成正比的变动成本。
这也是为什么神经材质通常和"本来就是高采样、满噪声的路径追踪"绑定:路径追踪不缺那点样本抖动,而光线较少的纯光栅场景,逐采样解码的账单反而更难看。
要理解神经材质在真实路径追踪里落在哪,不妨把一帧的 GPU 预算粗摊一遍:路径追踪帧的开销大头通常是 BVH 遍历、相交测试与光照采样,材质解码只是其中一个环节。神经材质做的事情,是把"材质解码"这个原本只占小头的环节,从"每次几十条指令"抬到"每次一次网络前向"。于是真正决定它是否划算的,是材质解码在整帧预算里的占比:占比小的场景(几何重、光照采样密集)加进来几乎无感;占比大的场景(大面积高反射材质、半透明叠加、多次反弹)就会显著吃掉帧预算。这也是为什么 5.1 里那句"省显存是真,解码成本单独买单"要和本节合起来看——显存与算力是两个经常此消彼长的坐标,选型时不能只盯一个数。
5.3 训练运营成本
论训练成本,神经材质需要为它表示的一批材质准备训练数据并跑一波(或持续)训练。训练侧的数据来源与耗时窗口是研发要单独兜的一笔账:它不再是"美术改贴图即所得",而是"先训练、再跑推理、再看效果"的迭代。
训练采集的常规配方是在材质表面按 UV 采样位置、配合随机入射/出射方向,构造一大批 (位置, 方向) → 真反射 的样本,再拿衰减或解析真值去监督网络。这听起来和烘焙很像,但两个本质不同:① 样本空间是连续的方向×位置,不是离散的光照贴图;② 训练是批量离线做足迭代,运行期只剩一次前向。广义地讲,学习式方案把一部分离线人力(画贴图)换成了算力 + 数据(训练)……但画贴图的复杂材质劳动,很多时候用训练也逃不掉,只是转移了手艺。
这里要特别强调一个"面子 vs 里子"的错位:论文里展示的神经材质往往是特定一批资产训练出来的,训练时长、GPU 数量、数据清洗都是"研发已付"的沉没成本,不会写进实时运行时的画质报告里。但一旦换到项目语境,这笔成本就变得现实:一套材质要服务整批场景,就得保证训练分布覆盖这些场景的材质变化范围,否则就是 5.4 要说的"分布外退化"。所以"训练运营成本"四个字,实质是"为覆盖目标材质分布而准备的算力、数据与人力"——它不随运行时画质报告浮现,但一定随项目周期出现。这也是为什么第八节的决策表会把它列进"算这笔账时要真算进去"的项。
5.4 画质与稳定性
最后是画质与稳定性。画质侧,表达力上去了、显存下来了,但稳定性是新引入的风险:解码器在训练分布外的材质上会有退化,且逐采样解码的噪声(见第六节过滤困境)在时域上需要额外的稳定性处理。一买一卖,买表达力,卖一定的确定性与可调试性。这张四元账(显存/算力/训练/画质)建议大家在做选型时原文照抄,逐项打分。
这里想把"画质"拆成两个容易被混在一起的口径,供验收用:一是单帧静态质量(一张离线渲染对比,神经方案在多层/空间变化反射上确实更接近参考);二是动态稳定性(时序上的闪烁、抖噪、肉眼可见的 overdraw)。很多团队看到单帧图"哇更清楚了"就立项,上线后发现动态稳定性是另一回事——STF 的抖噪在路径追踪里被纳入全局噪声看着尚可,但一旦接了时域降噪(好比 ⑤ 系列讲过的 TAA / 时域重投影那套纪律),抖噪的时域特征是否能被降噪器吸收,直接决定观感。所以验收神经材质画质,单帧图+一段动态镜头两个都要给,缺一个都是只见一面。这正是系列总账本那一条"别用一句'更省''更清楚'糊弄过去"在本节的具体化。
六、过滤困境与 STF
6.1 困境:解码没有 mipmap
这是把网络塞进材质之后真正"硌手"的一个工程点。硬件纹理单元有两个免费的礼物:mipmap(多分辨率预过滤,解决缩放锯齿)与各向异性过滤(解决斜视模糊)。这两个都是硬件在访问像素贴图时的内核级红利。但网络解码器解码的是 latent 的连续场,没有硬件 mipmap,也没有硬件各向异性过滤——你问硬件要"该点过滤后的反射值",硬件没有这个操作,因为它从来没为"神经网络前向"准备过纹理过滤硬件。
习惯上我们把 mipmap 与各向异性过滤当成"免费"是对的,因为这套机制几十年来一直是硬件纹理管线的标配;其原理与硬件实现思路,可参看经典读物(GPU Gems 2 · Advanced High-Performance Mipmap Generation/AF 与 Mipmapping at Reasonably Low Cost)。先把它当成"免费"记下,是后面理解"神经材质把这层免费去了"的关键铺垫。
6.2 解法思路:抖动位置代替确定性过滤
既然没有免费的硬件过滤,工程界给出的主流答案不是去造硬件,而是用随机的抖动替代确定性的过滤——经典的一族叫随机纹理过滤(Stochastic Texture Filtering,STF)。
STF 的核心直觉:与其精确算"这个 footprint 里的平均",不如在 footprint 里随机取若干样本位置,让每一次解码是"某个具体位置的精确值",多次样本的统计期望逼近真实过滤。对路径追踪这种本来就满帧噪声的管线,噪声是"可接受的媒介",于是把求均值换成采样,代价是方差(噪声)略升,换来的却是"过滤的复杂度与硬件型号解耦"。
这条思路在实时侧早已有成熟出处——Akenine-Möller 们提出的 Stochastic Texture Filtering 系列方案(Akenine-Möller et al., Stochastic All The Way Down / Real-Time Stochastic Texture Filtering)就是把确定性过滤换成随机采样的一族代表;它把"过滤"从"精确求和"改成"随机期望",正好呼应路径追踪"把确定性替换成统计一致性"的一贯哲学。
6.3 各向异性等级的成本曲线
物理直觉上,各向异性过滤希望沿视线方向拉长 footprint,采样更密集。但在神经材质里,每多一个各向异性等级,往往意味着一次(或多次)额外的网络前向,于是成本随各向异性等级线性上升。这就是社区里那句经验总结的出处:高各向异性的地面大角度观看场景,保留传统 BC7 往往比上神经材质更划算。
量化的判定锚点也值得记住:设各向异性等级为 $K$,神经材质的帧级解码成本粗略正比于 $(1 + K)$(基础采样 + 每级额外解码);相对地,硬件纹理单元在解析侧做同样 $K$ 级各向异性过滤,几乎不增加着色器指令——成本被硬件吃掉了。于是"该不该为这个镜头开高各向异性"变成一道简单乘法:当场景里高 $K$ 的反射点足够多、角度足够斜,$(1+K)$ 的累计解码量就会盖过解析方案的任何优势。这正好是 8.2 反例清单里"高各向异性 + 大角度观看"那条的出处,不是拍脑袋,是这道乘法算出来的。
6.4 由困境引出"着色器内推理"这条线
STF 与逐采样解码把压力全部堆到了"在着色器里高效地跑小网络推理"这条路上。怎么办?硬件侧的方向是 cooperative vector / matrix——GPU 的 Tensor 单元按 wave 粒度协作地替着色器承担矩阵乘。这条"着色器内推理"线不在本系列已发布篇目里展开,本节只需要记住链条:没有硬件过滤 → STF 抖动替代 → 逐采样解码 → 成本转嫁给"在 shader 里跑小网络"。
七、材质重建:从图反向估计
7.1 从消费到生产
前面的章节讲的是"怎么用"一个神经材质;这一节谈"这个材质从哪来"。神经材质不只是"画/烘焙"出来的,最诱人的一条生产路径是从照片/多视角图反推材质——逆渲染(inverse rendering)。
7.2 朴素逆渲染为何失败
从图反推材质的直觉是:已知光照与几何,反解出能让渲染结果匹配输入的反射参数。但在神经材质的世界里,这个天真方案会撞上一个结构性的墙:latent 空间是非线性的、不可直接优化的。你在参数空间里梯度下降,遇到的损失面坑坑洼洼,直接优化往往收敛不到"合理材质",而落进一个让渲染对得上、但材质语义完全错的局部极小。
7.3 现实的做法
而实际可落地的重建管线,往往在 latent 内外都加结构:要么在 latent 空间加先验/正则,要么联合训练一个能从观测反推 latent 的编码器,要么把重建限定在"材质分布内的某个邻域"。业界这一侧还在快速演进。一条有代表性的支线把"重建"和"逆渲染"掰开:偏重建的工作(如 NeuMatEx 一类)会显式声明 latent 空间的高度非线性,表明朴素反推不可行;偏逆渲染的工作(如 PBR-NeRF 一类)则关注用 PBR 先验做能量守恒时,神经表示会不会不守恒、进而把重建结果搞脏——这类问题在 4.3 的物理约束里已经埋了伏笔。更前沿的一条,是从生成式视频模型提取可复用神经材质资产,材质从"重建"升格为"生成式获取"——但这也带来许可与可控性的新问题,离生产流水线还远。
一个更冷静的判断:神经材质的重建/获取,在今天更像一条有回报但仍在快速变动的赛道,而不是像纹理烘焙那样稳定的工艺。它能不能大规模替代美术手工,很大程度上取决于"把材质分布学得够不够全",这又绕回训练的泛化边界——我们下一章(反例决策表)会正面处理这条边界。
把当前几条重建路线放到一张表里比较好记——每条路都是"加什么结构来锁住 latent"的不同选择:
| 路线 | 加的结构 | 适用前提 | 主要代价 |
|---|---|---|---|
| latent 空间加先验/正则 | 让 latent 落在材质分布内 | 有稳定的材质分布先验 | 先验质量决定上限 |
| 联合训练反推编码器 | 一个 观测→ latent 的编码器 | 数据量足够撑端到端 | 训练更重、更不稳 |
| 限制在材质邻域内重建 | 只允许偏离初始 latent 小步 | 有可用的初始 latent(如邻接资产) | 搜索范围受限 |
这张表的价值在于它回答了"为什么神经材质重建没有变成烘焙那样'一步到位'的工艺":三条路都在跟 latent 空间的非线性角力,而最常见的成功项目都选了第三条——从一个尽量接近的初始 latent 出发、只做小幅精修。这也是为什么我说它"在快速变动":谁能把这条路的口子再放大一点,谁就离工业化近一步。
7.4 一句话小结
材质重建把"买表达力"的账本又加了一行——神经材质的获取(从图反推)没有纹理烘焙那么成熟、那么可预期。对大多数实时项目,这行字正在变成是否采用学习式材质的关键分母。
八、边界与反例决策表
8.1 不是处处都值得换
现在我们把"神经材质是一个更聪明的工具"这句话说完整:它是个好工具,但只在你最该用它的地方显灵。为了帮大家做决策,我们用一张决策表,把"什么时候不值得换成网络"这个反例场景一次性列出——这是全篇最重要的选型产出。
8.2 反例场景清单
逐一展开表格里的四个反例:
- 固定材质与纯镜面:一个静态的、本来就该用一张贴图解决的材质,没有空间变化、没有复杂高光,上神经网络纯属增加无谓的推理开销与训练负担——贴图就是最优解。
- 瓶颈不在材质/显存的场景:如果压帧的是 draw call、几何、光照计算,那换神经材质解决不了你的问题,反而新增解码开销。
- 高各向异性 + 大角度观看:地面、道路这类从地平线扫过的大角度表面,逐采样解码 + 高各向异性等级的成本线性上升,第六节已给结论——保留传统纹理更划算。
- 超低显存硬件 / 无 Tensor 加速:在 6GB 以下的卡或没有张量单元的硬件上,解码算力与显存红利都打折扣,甚至得不偿失。
8.3 什么时候确实划算
对应地,神经材质最划算的场景是:高分辨率复杂反射材质 + 显存卡脖子 + 有路径追踪这类"本来就满噪声、能吞下 STF 方差"的管线 + 材质批量复用。这四个条件同时满足时,买到的表达力与省下的显存才真正过得了账。
把决策收敛成一个可执行的顺序,供团队立项时原文照抄:第一步,先问显存是不是当前瓶颈(卡 6–8GB、场景大、反射材质密集);第二步,再问是不是一定要"空间变化 + 多层"的表达力(否则解析贴图即可);第三步,问管线是否有高采样/高噪声的路径追踪去消化逐采样的解码与 STF 方差;第四步,问这套材质是否会被批量复用(否则训练的沉没成本摊不平)。四步的顺序别打乱——它其实是把本文五、六、七、三节各自的结论排成了一条决策链路:显存账(五)→ 表达力账(三、四)→ 过滤账(六)→ 训练运营账(五)。四问里任何一问是"否",都值得先回到那一节把账算细,而不是直接上神经网络。
8.4 一个可放回去的算例:同镜头下两家的成本曲线
讲完四问,如果还嫌"划算不划算"过于抽象,这里给一个可以直接套进自己项目的量级模板。设一个典型镜头:铺满屏幕的反射材质、每个像素平均做 4 次路径采样、路径里平均命中 2 次表面。按 3.4 那个算式,神经材质一帧的材质解码开销约是:
$$ N_{pixel} \times S_{per\_hit} \times H_{hit} \times C_{mlp} \approx 10^6 \times 4 \times 2 \times 10^2 = 8 \times 10^8 $$
(帧内像素 $\approx 10^6$,每命中点采样 $S=4$,每路径命中点 $H=2$,单次小型网络前向以约百条指令 100 计。)同样的镜头换成解析 Cook-Torrance,同一处乘的是每采样"几十条指令",量级掉到 $10^7$–$10^8$ 之间,而且是固定、可预测的花销。差距拉开的不是单次,而是数量级。
这里有两个细节会让这条曲线更真实:
- 噪声消化额度有限。我们前面反复强调"路径追踪能吞下 STF 的方差",但这不等于无限吞。降噪器(好比 ⑤ 系列那套时域重投影纪律)能吸收的抖动幅度是有上界的;一旦逐采样解码把方差抬过这套上界,画质就会在时域上破功。所以"路径追踪 + 神经材质"的搭配,对它的降噪后端有额外要求——这不是只看一帧图能发现的坑。
- 算力不是唯一的稀缺品,功耗才是。移动端与 VR 场景里,$8\times10^8$ 这个量级的解码指令落进功耗预算,往往比显存更早成为瓶颈。显存红利省下来,但如果同一颗 SoC 的 ALU 预算被逐采样解码吃掉,照样过不了温控与续航那关。折算下来,一帧多出的那几百万次网络前向,在持续改版与发热降频面前,省下的几百 MB 显存反而不那么受待见——这是移动团队立项时最先被挑战的一栏。
这段算例的价值,是帮团队在立项彩排阶段就把"换网络到底贵在哪"用自家数据列成一张纸,而不是等上线后拿帧时间硬碰。cooperative vector 之所以被造出来,正是要把这里 $8\times10^8$ 的指令当量重新压回可负担区间。把上面的 $N/S/H/C$ 换成你自己项目的量值,就能提前一年回答"这笔账买不买得起"——因为算力到底值多少钱,从来不是一句"更省"能糊弄过去的事。
九、这一章留下的问题
一路走下来,我们把神经材质这一环的账本摊开在桌上:表达力更高、显存更低,代价是逐采样的解码算力、训练运营与获取成本、以及过滤困境与稳定性。
真正卡住它落地的那一手,是把"逐采样解码"跑得足够便宜——这需要 GPU 在 shader 层面高效地执行小网络前向。硬件给出的回答是 cooperative vector:把矩阵乘下放到 Tensor 单元、按 wave 粒度协作完成。这条"着色器内推理"线属于后续暂缓篇目,本文不复述其实现细节。
用哪一笔账验收这一章,答案大家应该已经清楚了:显存、算力、训练、画质四元,逐项打分,谁也别用一句话的"省"来糊弄过去。
相关链接 - 上一篇:ep04《神经纹理压缩:把纹理解码交给网络》 - 全系列目录:神经渲染与神经着色器(本系列现收录至第五篇,后续暂缓) - 相关系列:实时渲染管线探析 / 移动端图形与功耗 / GPU 架构剖析 / 实时光线追踪与混合渲染
With Best Wishes.