本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
图 1 符号链路总览——源码名/名字修饰/目标文件符号表/链接器/动态加载 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
- ep05 优化器的边界:UB、严格别名与向量化报告——第二波·编译器与链接器
本篇是第二波「编译器与链接器」的第三篇。 ep04 算编译花了多少时间,ep05 算优化器改了什么,这一篇算链接器靠什么把一堆 .obj 拼起来。
目录总览:本篇共十一章。零章划边界,一章点题,二章讲为什么需要名字修饰,三章把两套修饰文法逐段拆开对账,四章讲反修饰工具,五章讲
extern "C"与调用约定,六章给跨编译器链接的决定性实验,七章讲可见性与导出,八章解剖符号表,九章讲动态链接(IAT 实测 + PLT/GOT 引原文),十章收束。
背景与边界
0.1 从"优化器的选择"到"链接器的语言"
前三篇(ep04–ep05)都停在单个翻译单元(TU)内部:编译器怎么翻译你的代码、花了多少时间、做了哪些改写。这一篇跨出那一步——当编译器把每个 .cpp 变成 .obj 之后,链接器靠什么把它们拼成一个可执行文件?
答案是一个词:符号(symbol)。
链接器不看你的源码,也不看你的类型。它看的是一张张"符号表":这个目标文件定义了哪些名字,又需要哪些名字。 定义方的名字要能对上引用方的名字——名字对不上,链接就断。 而 C++ 里你在源码写的一个名字(app::add(int, int)),到了目标文件里会变成一个经过名字修饰(name mangling)的字符串。
这一层字符串,就是这一篇的主角。
0.2 本篇的边界(四条不写)
- 不逐模块讲任何具体引擎/库:渲染算法归《实时渲染管线探析》,抓帧工具归《图形性能剖析工具链》。本系列的工具是编译器与链接器。
- 不做 C++ 入门教学:不写"什么是链接"的语法导览、不写"怎么用 g++ 编译多文件"的教程。
- 不做"最佳实践清单":无一手证据的泛泛总结违反站规。本篇的建议都附本机实测。
- 不深入安全攻防:PLT/GOT 与 RELRO 只讲到"机制是什么",不做利用手法分析。
0.3 工具链声明(先说清楚什么能实测、什么只能引原文)
这一篇的工具链边界比前几篇都关键,因为符号层是平台相关的:
| 目标 | 工具 | 本机状态 |
|---|---|---|
| PE/COFF(Windows) | MSVC cl / dumpbin / lib / undname |
✅ 实测可用 |
| PE/COFF(Windows) | MSYS2 g++ / nm / objdump / c++filt |
✅ 实测可用(产出 PE,不是 ELF) |
| ELF(Linux) | readelf / PLT/GOT 观察 |
⚠️ readelf.exe 存在,但本机产不出 ELF |
| ELF(Linux) | WSL | ❌ 不可用 |
这条边界必须写清楚:PLT/GOT、RELRO、-fno-plt 都是 ELF 概念。本机没有可用的 ELF 环境,所以第九章的 ELF 部分只引权威原文,不做本机实测——而 PE 侧的对应机制(IAT、延迟加载)本机可以完整实测。正文会把"实测"与"引原文"严格分开标注。
本篇所有读数均为本机实测。编译器为 MSVC 19.44.35228(VS 2022 Community 17.14.35)与 g++ 16.2.0(MSYS2 ucrt64)。方法比数字重要——本文给的是可复现的量化路径。
0.4 本篇的五个反直觉发现(先给结论)
这一篇的写法跟前面几篇一样:每个结论都配本机实测。 下面五条是"跟流行说法不太一样"的发现:
- x64 下
__cdecl/__stdcall/__fastcall产出同一个符号名——本机实测三者符号完全相同,调用约定在 x64 上被忽略。 dllexport写在class前面和后面,导出数差 5 倍——实测 1 条 vs 5 条。__declspec(dllexport)会连带导出编译器隐式生成的成员——本机导出表里出现了拷贝赋值与移动赋值运算符,而你从没写过它们。extern "C"不只是"关掉修饰",它是跨编译器链接的唯一可行通道——实测:C 符号 mingw↔MSVC 链接成功,C++ 符号第一步就失败。-fvisibility=hidden在 PE 目标上是空操作——MSYS2 g++ 接受选项并警告,但符号仍然全部导出。
这五条都不是靠读文档能得到的,必须动手量。
0.5 符号在流水线的哪几步产生
在往下读之前,先建立一张"符号什么时候出现"的地图——因为这一篇涉及的环节比前几篇多:
| 环节 | 谁在干活 | 与符号的关系 |
|---|---|---|
| ① 预处理 | cl /P 或 cpp |
与符号无关(只处理宏与 #include) |
| ② 编译(前端+后端) | c1xx.dll / c2.dll |
产生定义:把每个函数、变量、vtable 做成一个带修饰名的符号 |
| ③ 汇编 | 编译器内置 | 把符号写进目标文件的符号表 |
| ④ 归档 | lib.exe / ar |
把多个 .obj 打包,外加一份符号索引 |
| ⑤ 静态链接 | link.exe / ld |
匹配定义与引用;匹配不上就是 undefined reference |
| ⑥ 动态链接 | 加载器 / PLT / IAT | 在加载时或首次调用时填写地址 |
这张表解释了本篇的章节顺序:第二到四章讲②产生名字;第五章讲名字怎么被"关掉";第六章用⑤的成败做验证;第七、八章讲②③④产出的符号长什么样;第九章讲⑥。
也提醒一件事:符号问题从来不是"编译出错"——②③④⑤各环节都可能出问题,而报错信息的形式完全不同。看清"卡在哪一环",比记住某个具体报错更有用。
一、一句话点题:符号名是链接器唯一听得懂的语言
先把核心结论放在最前面:
链接器不认识你的类型,也不认识你的重载——它只认识符号名。而符号名是修饰出来的。
这句话可以换个更直白的说法:你写的 app::add(int, int) 只是给人看的;链接器看到的是一串像 ?add@app@@YAHHH@Z 这样的东西。 名字对得上就链,对不上就断。
这个性质带来三个后果,正好构成这一篇的三条主线:
第一条:修饰不是"编码游戏",它是 C++ 语义在二进制层的载体。 为什么需要修饰?因为 C 语言里"一个名字对应一个函数",而 C++ 里同一个 add 可以有十几个重载、藏在不同命名空间里、还可以是模板实例。修饰名就是"把重载、命名空间、模板参数、类型信息全部压进一个字符串"——只有这样,链接器才能区分它们。
第二条:这套字符串不同编译器不一样,所以 C++ 的目标文件不能跨编译器直接链接。 本机实测:同一份源码,MSVC 编出 ?add@app@@YAHHH@Z,GCC 编出 _ZN3app3addEii。两个字符串毫无共同点——链接器连"这是同一个函数"都判断不出来。
第三条:extern "C" 之所以是解药,因为它关掉的正是"修饰"这一步。 本机做了一个决定性实验:C 符号可以让 mingw 的 main 链接上 MSVC 编出的 provider,链接成功(rc=0);换成 C++ 符号,链接失败(rc=1)。 同一个 main、同一份 provider,差别只在名字有没有被修饰。
1.1 为什么这一层值得单独写一篇
因为它是跨模块、跨库、跨语言、跨编译器问题的共同底层。三类最常见的疑难问题,根子都在符号层:
- "undefined reference to
xxx":链接器找不到某个名字的定义。而这个xxx可能是修饰后的形式,肉眼完全认不出它对应源码的哪个函数。 - DLL 导出不完全、运行时报"找不到序数/入口点":导出表里少了你要的符号,而原因常常是
dllexport写错位置(第 0.4 节的第 2 条)。 - 同一个库在两个项目里行为不一致:可能是 ABI 不同(比如 libstdc++ 的 Dual ABI,第九章)。
这三类问题用调试器查不出来——它们在程序跑起来之前就已经决定了。
1.2 三类疑难问题的共同底层
上一节列了三种典型症状。这一节把它们和"符号层"的对应关系讲透——因为很多工程师会把它们分别归因到"构建配置问题""DLL 配置问题""版本问题",而它们共享同一个底层。
第一类:undefined reference / LNK2019。
链接器说的是"我找不到某个名字的定义"。而这个名字是修饰后的形式。所以排查的第一步永远不是"去改构建脚本",而是先把那个名字反修饰,看清它到底是什么(第四、六章)。本机的跨编译器实验给了最直接的例证:同一个函数 cpp_api(int),在两个编译器里符号名毫无共同点,链接器根本无法把它们匹配上。
第二类:DLL 导出不完全 / 运行时找不到入口点。
这类问题的根源在导出表——它是一份显式的清单,而不是"我写了就自动导出"。本机实测的 dllexport 位置差异(1 条 vs 5 条)就是最典型的例子:你以为导出了整个类,实际只导出了旁边那个自由函数(第七章)。
第三类:同一个库在不同工程里行为不一致。
这类最难查,因为链接往往成功。原因可能是 ABI 不同——本机第九章要讲的 libstdc++ Dual ABI 就是一个纯粹符号层的例子:源码里同样是 std::string,二进制层却可能有两个不同的名字(第九章)。
把三类问题放在一起看,会发现它们的排查入口是同一个:先看符号。 这也解释了为什么这一篇要花三个章节(二、三、四)先讲"名字从哪来、长什么样、怎么还原"——那是所有后续排查的前提。
二、为什么需要修饰:C++ 语义在二进制层的载体
先回答最基础的问题:为什么 C 不需要修饰,C++ 却需要?
2.1 C 的世界:一个名字一个符号
C 没有重载、没有命名空间、没有模板、没有类。一个函数名在程序里是唯一的。 所以 C 的符号名基本就是函数名本身(加上平台约定的少量前缀):
| 语言 | 声明 | 符号名(Windows/x86 约定) |
|---|---|---|
| C | int c_add(int, int) |
_c_add(__cdecl) |
| C | int __stdcall f(int) |
_f@4(@ 后是参数字节数) |
| C | int __fastcall f(int) |
@f@4 |
规则简单到可以手写。 这也是 C 的 ABI 能稳定几十年的原因。
2.2 C++ 的世界:同一个名字可以是很多东西
C++ 引入了四类"同名不同物":
namespace app {
  int add(int, int);            // ① 重载
  double add(double, double);   // ① 重载(参数类型不同)
  struct Widget { int get() const; };   // ② 类成员(还有 this 指针的隐式参数)
  template <typename T> T twice(T);     // ③ 模板(同一模板的不同实例是不同函数)
}
int global_var;                  // ④ 全局变量也是符号
这四类在源码里可以共用一个名字,但在链接器眼里必须是不同的符号。 否则链接器无法区分"你要的是 add(int,int) 还是 add(double,double)"。
修饰(mangling)就是解决这件事的手段:把"名字 + 命名空间路径 + 参数类型 + 模板实参 + 类作用域"等全部信息编码进一个字符串。
2.3 修饰名里到底装了什么
用本机实测的一个例子来感受。MSVC 把 app::add(int, int) 编成 ?add@app@@YAHHH@Z,逐段读(反修饰工具 undname 会直接告诉你答案,见第四章):
| 片段 | 含义 |
|---|---|
? |
MSVC C++ 修饰名的起始标志 |
add |
函数名 |
@app@ |
所属命名空间 app |
@@ |
名字部分结束 |
YA |
全局函数 + __cdecl 调用约定 |
H |
返回类型 int |
HH |
两个参数都是 int |
@Z |
结束标记 |
同一个 add,只是参数从 int 换成 double,编码就从 ?add@app@@YAHHH@Z 变成 ?add@app@@YANNN@Z——注意 H 全变成了 N(double 的编码)。重载区分就靠这几个字母。
这张图想强调的是"必要性"这件事:修饰的作用只有一个:让链接器能区分四类同名不同物。 如果不做修饰,app::add(int,int) 与 app::add(double,double) 会得到同一个符号,链接器就无法判断调用方要的是哪一个——重载机制在二进制层会直接失效。
2.4 边界声明:本篇不涉及
- 不逐条讲完两套文法的全部产生式(那是规范的活)——只讲能读懂符号所需的部分。
- 不涉及异常表、调试信息、RTTI 的完整二进制格式——只在符号命名层面提及。
- 不做 ELF 与 PE 的完整格式对比——只讲与"符号与动态链接"相关的部分。
2.5 修饰名的长度代价
修饰名不只是"名字"——它要占用目标文件空间、影响链接时间。把源码里的短名字和修饰后的长名字放在一起对比,差距相当直观:
| 源码里的声明 | MSVC 修饰名 | 字符数比 |
|---|---|---|
add |
?add@app@@YAHHH@Z |
3 → 17 |
twice<int> |
??$twice@H@app@@YAHH@Z |
10 → 22 |
operator=(拷贝 Exported) |
??4Exported@@QEAAAEAV0@AEBV0@@Z |
10 → 31 |
越"现代 C++"的写法,修饰名越长。 嵌套命名空间、模板、const 引用参数、返回值类型,全都要编码进去。Itanium 侧虽然有 S_ 替换机制能压缩长度,但 MSVC 侧没有——这就是为什么同一个工程在 MSVC 下的符号表往往比在 GCC 下更大。
这条有一个实际后果,正好接上 ep04:符号名越长,符号表越大,链接时要比较的字符串越长。 一个重度使用模板的工程,符号表本身可以占目标文件相当可观的比例。"模板膨胀"不只是代码膨胀,也是符号膨胀。
三、两套文法对账:Itanium 与 MSVC
C++ 没有统一的二进制 ABI,所以名字修饰也就没有统一标准。实际存在两套主流文法:Linux/macOS/多数 Unix 用 Itanium C++ ABI,Windows 用 MSVC 的文法。
3.1 同一份源码,两种修饰名(本机实测)
本机编译了同一份 mangling.cpp(含命名空间、重载、模板、extern "C"、全局变量),分别用 MSVC 与 g++ 编译,然后从符号表里取出修饰名:
| 源码实体 | MSVC 修饰名 | GCC(Itanium)修饰名 |
|---|---|---|
app::add(int, int) |
?add@app@@YAHHH@Z |
_ZN3app3addEii |
app::add(double, double) |
?add@app@@YANNN@Z |
_ZN3app3addEdd |
app::twice<int>(int) |
??$twice@H@app@@YAHH@Z |
_ZN3app5twiceIiEET_S1_ |
global_var |
?global_var@@3HA |
global_var |
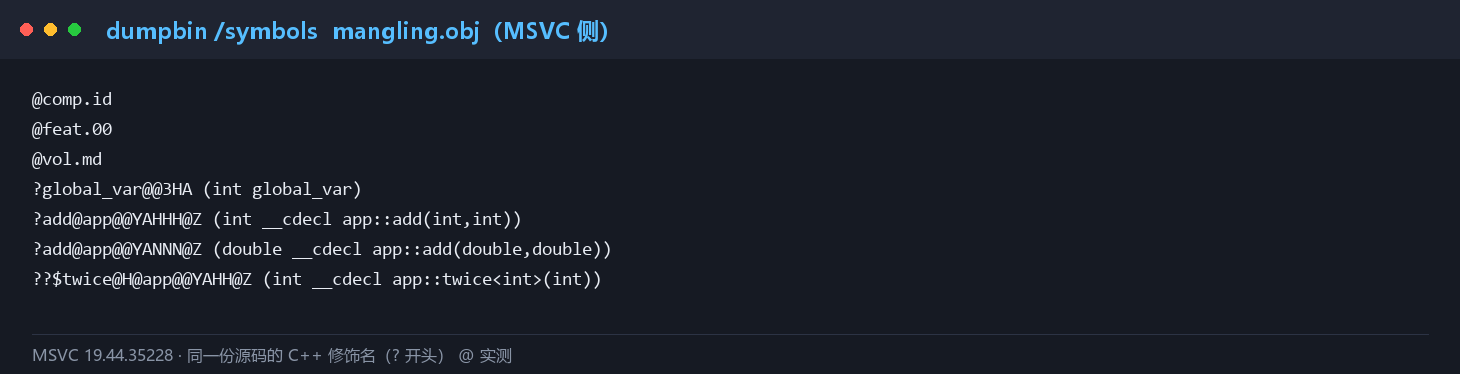
dumpbin /symbols 的原始输出@ MSVC 19.44 实测把这份原始输出与下一张放在一起看,能获得这一篇最重要的一个整体印象:同一份源码,两个编译器给出的符号名毫无共同点。 这种"完全不同"不是编码风格的差异,而是两套独立设计的文法——所以它们之间不存在"转换"的可能。
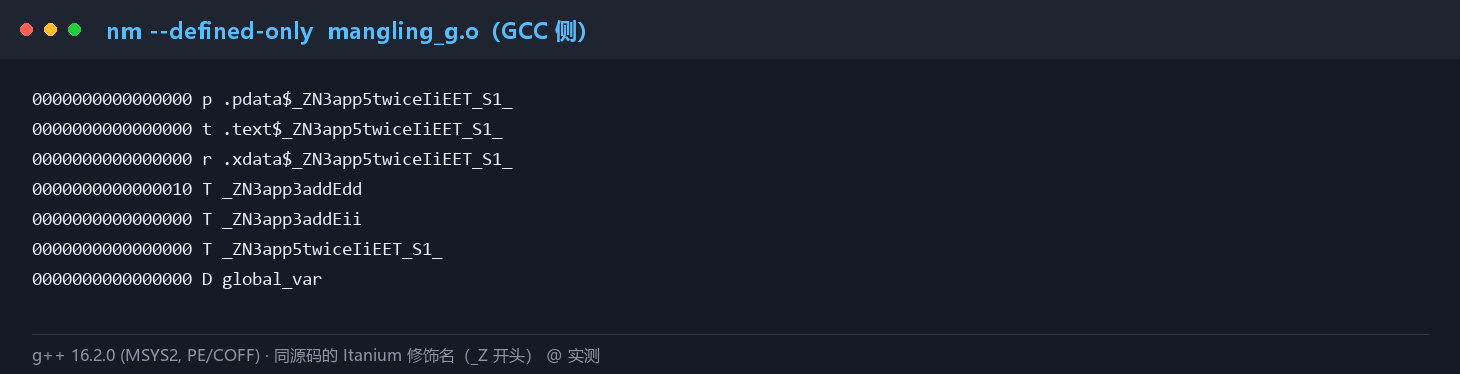
nm 的原始输出(PE/COFF 目标)@ g++ 16.2.0 实测注意 GCC 这份清单里 global_var 是个例外:它没有被修饰。原因在 Itanium 文法里——全局变量名在某些情况下可以直接使用(这也是为什么某些"变量链接不上"的现象与函数的表现不同)。这属于边界细节,遇到时用 c++filt 反解一下即可确认。
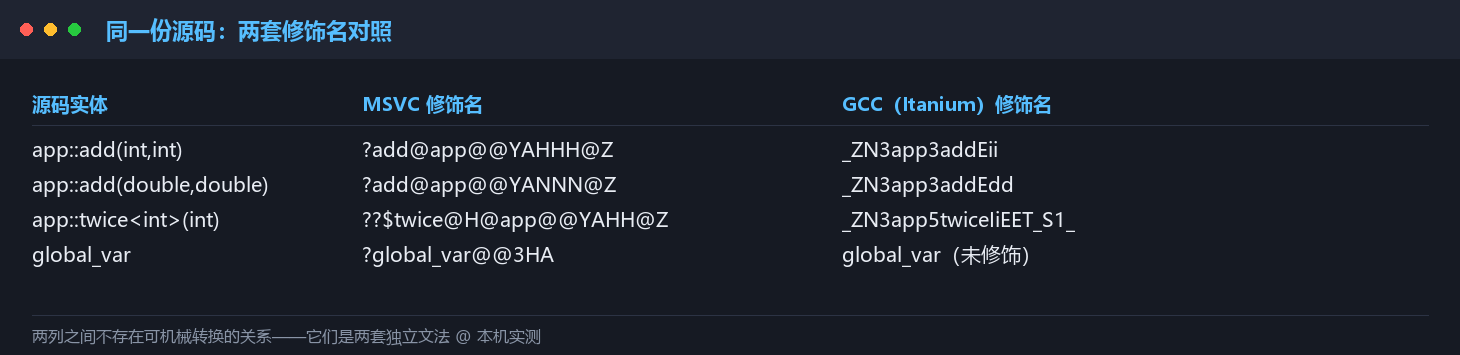
这张表最该记住的是:两列之间没有任何"可以机械转换"的关系。 它们是两套独立设计的文法,不存在同一套编码的不同写法这回事。
3.2 Itanium 文法:_Z + 长度前缀
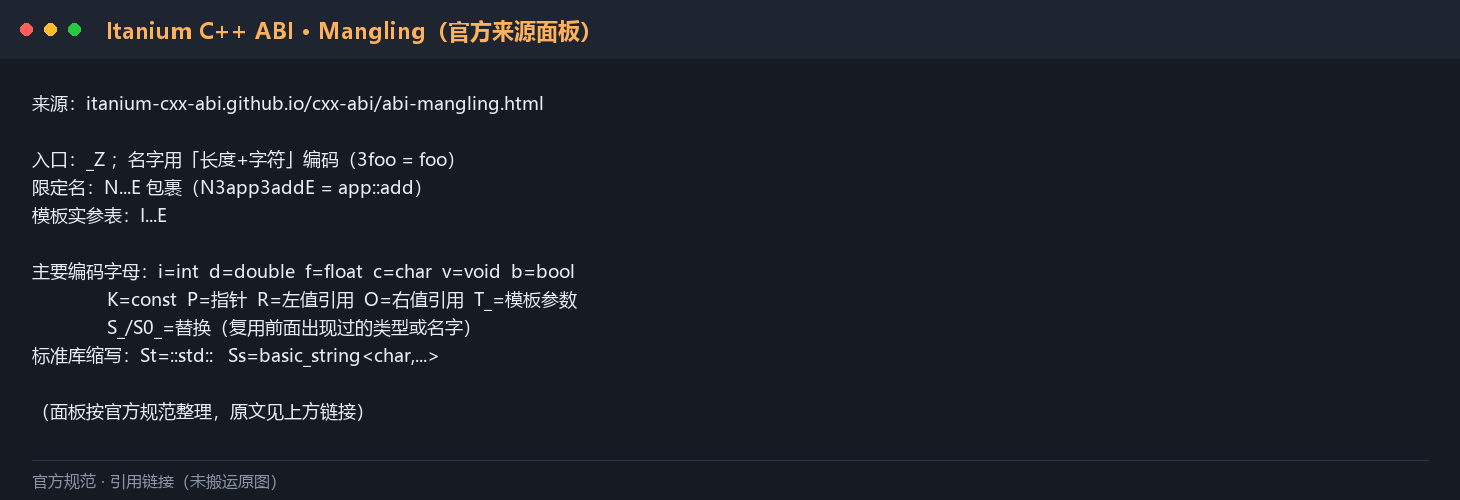
Itanium C++ ABI 的 mangling 规则(官方规范)有几个鲜明特征:
特征一:入口是 _Z。 所有 C++ 修饰名以 _Z 开头,一眼就能识别。
特征二:名字用"长度 + 字符"编码。 3app 表示 3 个字符的名字 app;3add 表示 add。这与 MSVC 用 @ 分隔的记法完全不同。
特征三:限定名用 N...E 包裹。 _ZN3app3addEii 里的 N3app3addE 表示"限定名 app::add",紧跟的 ii 是两个参数类型(int, int)。
特征四:类型用单个字母编码。 常见的有:
| 编码 | 类型 | 编码 | 类型 |
|---|---|---|---|
i |
int |
d |
double |
f |
float |
c |
char |
v |
void |
b |
bool |
K |
const 前缀 |
P |
指针前缀 |
R |
左值引用前缀 | O |
右值引用前缀 |
(完整表见 Itanium ABI mangling 与 示例页。)
于是 _ZN3app3addEii 可以逐段读成:_Z(C++ 修饰) + N3app3addE(限定名 app::add) + ii(int, int)。
特征五:有"替换"机制。 Itanium 文法会用 S_/S0_ 这样的缩写复用前面出现过的类型或名字——这让长名字明显变短(示例页 里 _ZplR1XS0_ 就是 operator+(X&, X&))。MSVC 文法没有对应的机制,所以长签名的名字往往更长。
_Z + 限定名 N…E + 类型编码@ 本系列绘制拆解的价值在于"能顺读":_Z 认出这是 C++ 符号,3app / 3add 用长度前缀切出名字,N…E 认出这是限定名,最后的 ii 认出参数类型。掌握这四个动作,绝大多数 Itanium 符号都能半分钟内读懂,不必每次都依赖工具。
3.3 MSVC 文法:? + @ 分隔
MSVC 的规则(官方文档 Decorated names)与 Itanium 完全不同:
特征一:入口是 ?。 C++ 名字以 ? 开头;C 名字则是直接的名字(加上平台前缀)。
特征二:用 @ 分隔层级。 ?add@app@@YAHHH@Z 里,@ 把"函数名/命名空间/名字结束"切成几段。空的一段(@@)表示"名字部分到此结束"。
特征三:访问权限、调用约定、返回类型都编进去。 这是 MSVC 文法最"重"的地方——看第三章 3.5 节的实测:
| 修饰名 | 反修饰结果 |
|---|---|
?add@app@@YAHHH@Z |
int __cdecl app::add(int,int) |
?get@Exported@@QEBAHXZ |
public: int __cdecl Exported::get(void)const __ptr64 |
??4Exported@@QEAAAEAV0@AEBV0@@Z |
public: class Exported & __ptr64 __cdecl Exported::operator=(class Exported const & __ptr64) __ptr64 |
注意 get 那条里的 QEBA ——字母里编了"public 成员函数""const 方法""x64 下 __ptr64"这些信息。MSVC 把"源码里怎么声明的"也放进了名字,而 Itanium 主要放"类型和结构"。
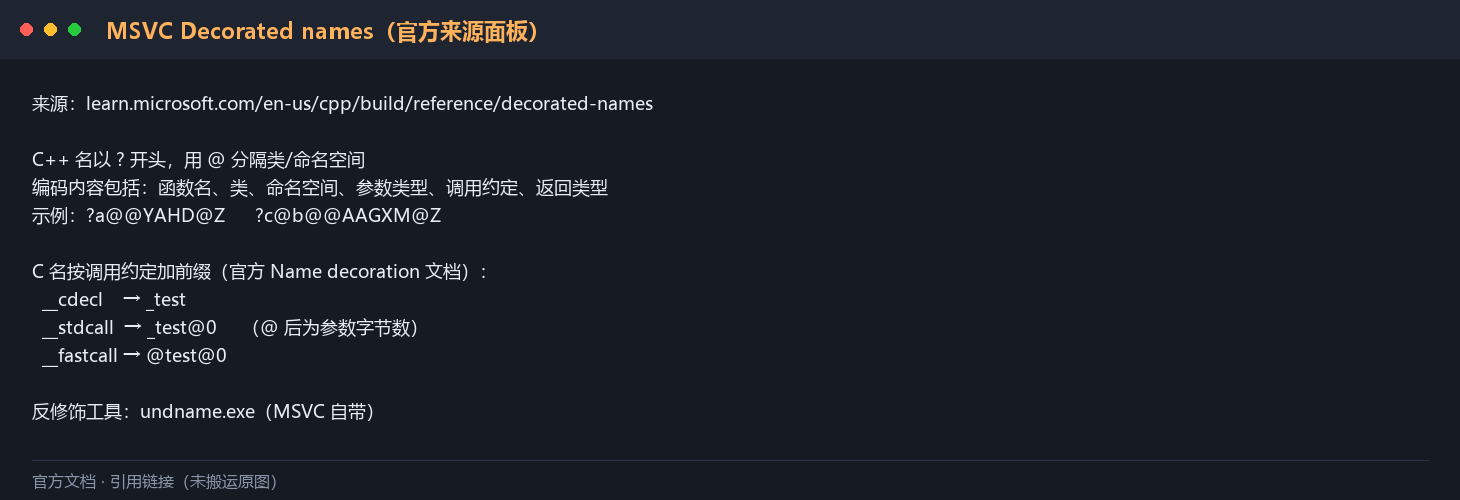
特征四:C++ 名以 ? 开头,C 名则按调用约定加前缀。 官方文档给出的 C 名对照(Name decoration):
| 调用约定 | C 符号名 |
|---|---|
__cdecl |
_test |
__stdcall |
_test@0(@ 后接参数字节数) |
__fastcall |
@test@0 |
? + @ 分隔 + 访问/约定/返回类型编码@ 本系列绘制这张图里最需要留意的是 @ 的作用:它既分隔层级,也用"连续两个 @"表示名字段结束。初读 MSVC 符号时最容易在这里迷路——把 ?add@app@@ 切成"函数名 = add、命名空间 = app、名字结束",后面剩下的 YAHHH@Z 就全是类型信息了。
3.4 两套文法的对照小结
| 维度 | Itanium | MSVC |
|---|---|---|
| 起始标志 | _Z |
? |
| 层级分隔 | 长度前缀(3app) |
@ |
| 限定名包裹 | N...E |
@ 分段 + @@ 结束 |
| 类型编码 | 单字母(i/d/P/K) |
单字母(H/N/A…),但字母表不同 |
| 是否编访问权限 | 否 | 是 |
| 是否编调用约定 | 是(但用 Y 等简写) |
是(A/E/G/I 等) |
| 是否有类型替换 | 有(S_/S0_) |
无 |
| 反修饰工具 | c++filt |
undname |
这张表最后的结论只有一句:两套文法没有共同点,所以两套工具链的目标文件不能直接互链。 第六章会用实测把这件事钉死。
3.5 修饰不是"绝对统一"的
值得加一句诚实的注脚:即便是同一套 ABI,实现之间也可能有细微差异。 例如 GCC 有一个长期存在的 bug(GCC Bug 88413):对含"未解析名"的模板实参,GCC 用了与 ABI 规范不同的产生式。这类差异极罕见,但足以说明——"ABI 一致"是一份工程承诺,不是一个可以随便假设的事实。
3.5 修饰不是"绝对统一"的
值得加一句诚实的注脚:即便是同一套 ABI,实现之间也可能有细微差异。 例如 GCC 有一个长期存在的 bug(GCC Bug 88413):对含"未解析名"的模板实参,GCC 用了与 ABI 规范不同的产生式。这类差异极罕见,但足以说明——"ABI 一致"是一份工程承诺,不是一个可以随便假设的事实。
3.6 把一个真实修饰名完整拆开
前几节都在讲规则。这一节把一条真实的长修饰名从头拆到尾,把前面讲的东西串起来。用第四章会讲的反修饰工具,这条对应的是"拷贝赋值运算符":
??4Exported@@QEAAAEAV0@AEBV0@@Z
逐段读:
| 片段 | 含义 |
|---|---|
??4 |
运算符编码 —— ??4 是 operator=(4 对应赋值号) |
Exported@ |
所属类 Exported |
@ |
名字部分结束 |
QEAA |
Q = public 成员函数;E = __ptr64 指针;A = __cdecl;A = 返回的是引用 |
AEAV0@ |
返回类型:A(引用)+ E(__ptr64)+ A(__cdecl)+ V0@(类类型,0 表示"前面出现过的那一类"= Exported) |
AEBV0@ |
参数类型:A(引用)+ E(__ptr64)+ B(const)+ V0@(Exported) |
@Z |
结束 |
最终反修饰结果:public: class Exported & __ptr64 __cdecl Exported::operator=(class Exported const & __ptr64) __ptr64
这条拆解里有三个值得留意的点:
0是"复用前面出现过的类型"的简写:V0@表示Exported,因为Exported在名字开头已经出现过一次。MSVC 也有自己的压缩机制(只是形式与 Itanium 的S_不同)。B表示const:所以参数是const Exported&——正是一个拷贝赋值运算符应有的签名。- 访问权限(
Q= public)被编进了名字:这是 MSVC 文法独有的特征(第 3.4 节的对照表里列过)。Itanium 不编访问权限。
为什么要花一节讲这个? 因为真实报错里给你的就是这样一长串。能把它拆成"public 的、带 const 引用的拷贝赋值运算符",就意味着你能在几百行符号里一眼认出问题所在——这是第四章工具的用法,也是本篇最实用的一项技能。
3.7 修饰名里编不进去的东西
最后补一个反向的视角:哪些信息不在修饰名里。 这一点对排查很重要,因为"符号名相同"不等于"函数完全相同"。
| 信息 | 是否编进名字 | 后果 |
|---|---|---|
| 参数类型 | ✅ 都编 | 参数不同 → 不同符号(这正是重载区分的基础) |
| 返回类型 | Itanium:不编(多数情况);MSVC:编 | 同名同参但返回类型不同 → Itanium 下符号相同,是病态用法 |
| 默认参数 | ❌ 不编 | 默认参数是调用方的事,不影响符号;改了默认值不必重编被调方 |
noexcept |
⚠️ 编进函数类型(C++17,属类型系统) | 所以它会影响符号(这也是 ep03 讲 noexcept 重要性的一个侧面) |
inline / constexpr |
❌ 不编 | 多个 TU 各自定义同一符号,靠 COMDAT 去重(第八、九章) |
| 函数体 | ❌ 不编 | 链接器只看到名字,看不到实现——这正是 9.7 节"视野墙"的根源 |
| 调试信息 | ❌ 不在符号表 | 在独立段/独立文件里,与链接无关 |
这张表里最该记住的是第 2 行与最后两行:
- 返回类型在 Itanium 下不进符号名,所以"两个只差返回类型的函数"在 Itanium 工具链上会产生同一个符号——这是 C++ 不允许仅按返回类型重载的原因之一在二进制层的体现。
- 函数体不进符号名,所以链接器永远不知道另一个
.obj里那个函数做了什么。这一条直接推出了 ep05 讲的"优化器视野"与本篇 9.7 节讲的"动态链接的性能代价"——两道墙是同一个原因。
四、反修饰:把机器名还原成人话
修饰名的第一用途是给链接器用,但给人看的版本同样重要——因为报错信息里全是修饰名,肉眼根本无法阅读。所以两套工具链都配了反修饰工具。
4.1 MSVC 侧:undname
MSVC 自带 undname.exe(路径在 VC\Tools\MSVC\<版本>\bin\Hostx64\x64\ 下,不在 PATH 里)。本机用它对第一章的符号逐个反解:
| 输入(修饰名) | 输出(反修饰) |
|---|---|
?add@app@@YAHHH@Z |
int __cdecl app::add(int,int) |
?add@app@@YANNN@Z |
double __cdecl app::add(double,double) |
??$twice@H@app@@YAHH@Z |
int __cdecl app::twice<int>(int) |
?global_var@@3HA |
int global_var |
?get@Exported@@QEBAHXZ |
public: int __cdecl Exported::get(void)const __ptr64 |
??4Exported@@QEAAAEAV0@AEBV0@@Z |
public: class Exported & __ptr64 __cdecl Exported::operator=(class Exported const & __ptr64) __ptr64 |
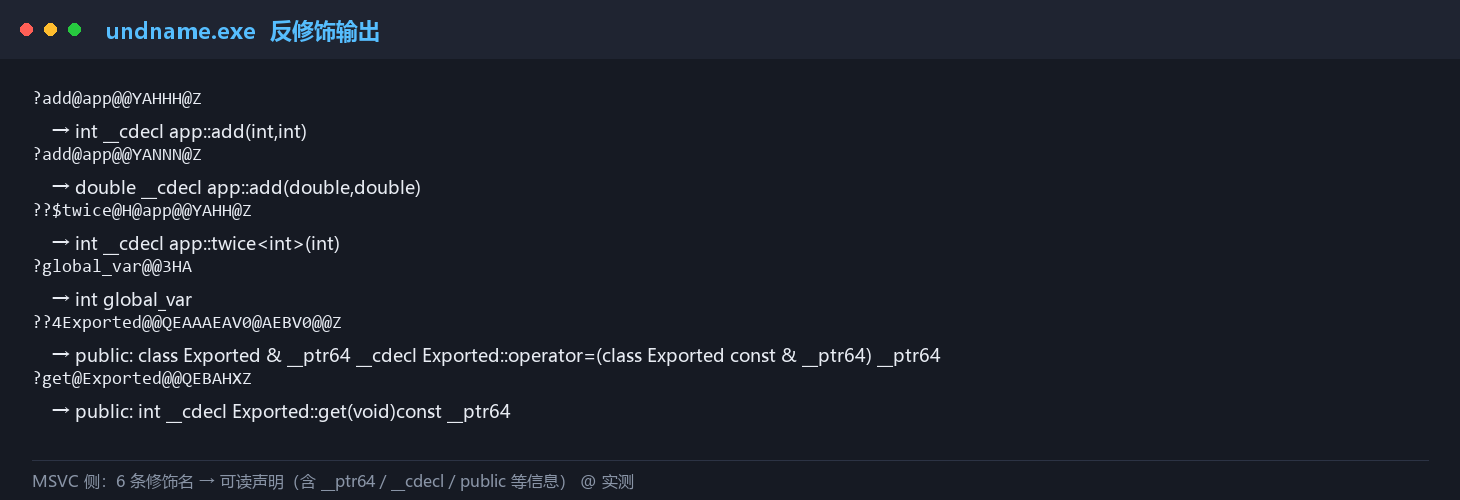
undname.exe 对 6 条 MSVC 修饰名的反解结果@ MSVC 19.44 实测注意最后两条。 它们反解出来的信息比源码声明还多——__ptr64、__cdecl、public:、const 全都是从名字里读出来的。这说明 MSVC 的修饰名里确实编进了"源码怎么声明的"这一层信息(第 3.3 节的特征三)。
4.2 GCC 侧:c++filt
Itanium 侧对应的工具是 c++filt(binutils 的一部分):
| 输入 | 输出 |
|---|---|
_ZN3app3addEdd |
app::add(double, double) |
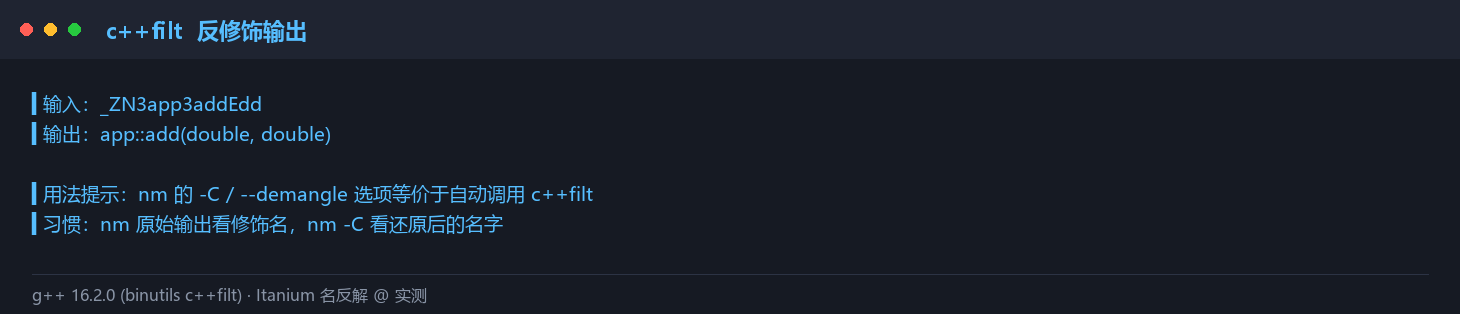
c++filt 对 Itanium 修饰名的反解结果@ g++ 16.2.0 实测这条反解结果值得逐字读一遍:app::add(double, double)——命名空间、成员名、两个参数类型全部还原正确。这正是反修饰工具的用途所在:把无法阅读的字符串变回人类可读的声明,从而让"链接错误里那一串乱码"变成一条可以定位的信息。
用法提示:nm 有一个 -C(--demangle)选项,等于"输出符号时自动调 c++filt"。本系列的实测里两者都用了——nm 原始输出看修饰名,nm -C 看还原后的名字。
4.3 反修饰的实用价值
反修饰不只是"看着舒服",它是排查链接错误的必备技能:
undefined reference to '_ZN3app3addEii'——反修饰之后立刻知道缺的是app::add(int, int)。- DLL 导出表里一串
?…——反修饰之后能看出哪个是构造函数、哪个是赋值运算符。 nm输出几百行符号 ——用c++filt或nm -C过滤,能快速定位你要找的那个。
所以工具链的用法是成对的:dumpbin /symbols 配 undname;nm 配 c++filt(或直接 nm -C)。
4.4 批量反修饰的实操
单条反修饰很简单,但真实排查场景里你面对的是几百行符号。本机实测中形成的做法分三步:
第一步:把符号导出来,别在终端里翻。
dumpbin /symbols my.obj > syms.txt     # MSVC 侧
nm my.o > syms.txt                     # GCC 侧
第二步:按"修饰名特征"过滤,而不是按名字过滤。
因为你要找的东西可能连名字都不知道,只能按特征找:
| 想找什么 | MSVC 特征 | GCC 特征 |
|---|---|---|
| 构造函数 | ??0 |
C1/C2 |
| 析构函数 | ??1 |
D1/D2 |
| 赋值运算符 | ??4 |
aS |
| 虚表 | ??_7 |
_ZTV |
| 类型信息 | ??_7type_info |
_ZTI |
| 模板实例 | ??$ |
IiE(模板实参段) |
第三步:对过滤结果批量反修饰。
反修饰工具都支持从标准输入读,所以能直接接管道。本机实测里,?… 一串喂给 undname、_Z… 一串喂给 c++filt,都能一次拿到全部还原结果——这一步做完,符号表就从"天书"变成了"声明清单"。
顺手记一个坑:
undname的输出里带着Microsoft (R) C++ Name Undecorator的版权头,脚本里解析时要注意剥掉;而c++filt只输出名字,干净得多。
五、extern "C" 与调用约定:x64 下约定被忽略
这一章讲"关掉修饰"这条通道,以及一个被广泛误解的细节。
5.1 extern "C" 到底做了什么
extern "C" 的作用不是"像 C 一样编译"——它只做一件事:告诉编译器"这个名字不要修饰"。
extern "C" int c_add(int a, int b);   // 符号名就是 c_add
int cpp_add(int a, int b);            // 符号名是修饰过的
本机实测的对照(同一份源码、两个编译器):
| 源码 | MSVC 符号 | GCC 符号 |
|---|---|---|
extern "C" int c_add(int,int) |
c_add |
c_add |
int cpp_add(int,int) |
?cpp_add@@YAHHH@Z |
_Z7cpp_addii |
c_add 在两个编译器下是完全一样的符号名。 这就是 extern "C" 的威力——它让两个编译器对同一个函数产生同一个名字。
5.2 一个被忽略的事实:x64 下调用约定不再影响符号名
学过 x86 的人都知道"调用约定会改变符号名":__cdecl 是 _test,__stdcall 是 _test@0,__fastcall 是 @test@0。
但在 x64 上,这件事不成立了。 本机实测:
源码(x64,extern "C") |
MSVC 符号 | GCC 符号 |
|---|---|---|
int __cdecl cdecl_fn(int) |
cdecl_fn |
cdecl_fn |
int __stdcall stdcall_fn(int) |
stdcall_fn |
stdcall_fn |
int __fastcall fastcall_fn(int) |
fastcall_fn |
fastcall_fn |
三种调用约定产出三个完全不同的符号名(cdecl_fn/stdcall_fn/fastcall_fn——因为我给它们起了不同的名字),但每个名字里都没有任何约定编码:cdecl_fn 就是裸名,没有 _ 前缀也没有 @4 后缀。
原因很直接:x64 的 ABI 只有一种统一的调用约定(前四个整数参数走 rcx/rdx/r8/r9,其余走栈),__cdecl/__stdcall/__fastcall 这些关键字在 x64 上被忽略——它们只是为了让老代码能编译而保留的语法糖。
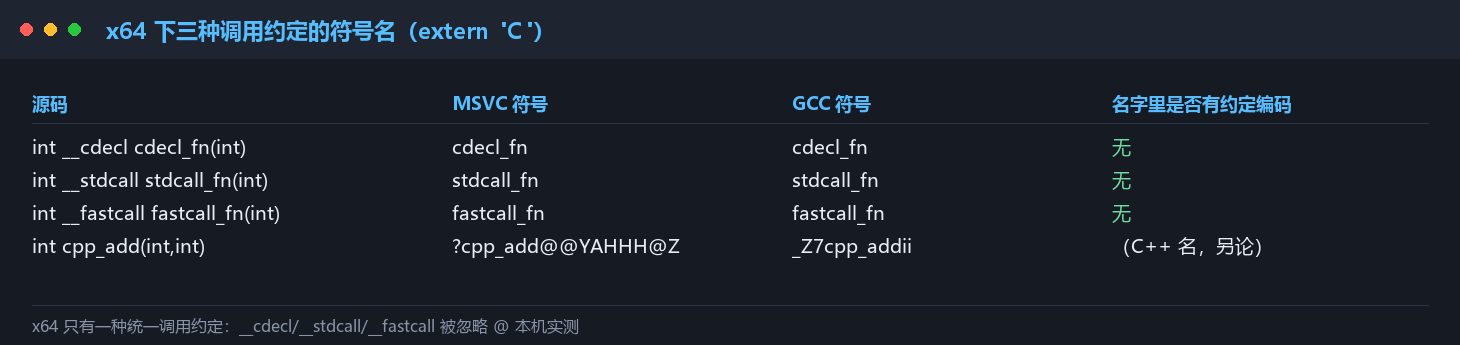
这张表的读法要小心:三个符号名之所以不同,是因为我给三个函数起了不同的名字(cdecl_fn/stdcall_fn/fastcall_fn),而不是因为调用约定不同。关键证据是每个名字里都没有任何约定编码——没有 _ 前缀、没有 @N 后缀,说明约定在 x64 上确实被忽略。
实用含义:如果你的知识来自 x86 时代的资料,那么在 x64 上"调用约定导致链接失败"这一类经验已经失效。 真正还在影响符号名的,是
extern "C"与否、以及修饰文法本身。
5.3 dllimport:不只是"另一个标记"
extern "C" 解决的是"名字要不要修饰"。而在 Windows 上还有一个与名字无关、但与链接方式有关的标记:__declspec(dllimport)。
| 标记 | 作用 | 本机实测到的差异 |
|---|---|---|
dllexport |
把符号放进 DLL 的导出表 | 第七、八章的实测都在看这个表 |
dllimport |
告诉编译器"这个符号来自 DLL",生成经 IAT 的间接调用 | 生成 call [__imp_xxx] 而不是 call xxx |
为什么 dllimport 值得单独提?因为它改变的是"调用怎么写",而不是"名字叫什么"。 如果头文件漏了 dllimport,代码仍然能链接成功(链接器会用 __imp_ 前缀的符号去补 thunk),但每次调用都会先跳一次本地的 thunk 再去 IAT ——多一次跳转。
这条的实用含义:dllimport 写与不写,链接结果可能一样,性能却不一样。 而它不会报任何错——这类"静默差异"正是符号层最容易踩的坑。
相关做法:把"导入还是导出"做成一个宏,通过
MYLIB_EXPORTS之类的宏在编译 DLL 与使用 DLL 时切换(MSVC 官方的 dllexport/dllimport 文档 给的正是这个套路)。
六、跨编译器鸿沟:一个决定性的链接实验
前五章都在讲"名字不一样"。这一章把它变成一个可执行的实验:如果名字不一样,能把两个编译器产出的目标文件链在一起吗?
6.1 实验设计
准备一份 provider 和两份不同的 main:
// xp.cpp —— 由 MSVC 编译成 xp_msvc.obj
extern "C" int c_api(int x){ return x * 3; }   // C 符号
int cpp_api(int x){ return x * 5; }            // C++ 符号

// xm_c.cpp —— 由 mingw g++ 编译,引用 C 符号
extern "C" int c_api(int);
int main(){ printf("%d\n", c_api(7)); return 0; }

// xm_cpp.cpp —— 由 mingw g++ 编译,引用 C++ 符号
int cpp_api(int);
int main(){ printf("%d\n", cpp_api(7)); return 0; }
然后用 mingw 的 g++ 去链接 MSVC 编出的 .obj:一组引用 C 符号,一组引用 C++ 符号。
6.2 实测结果
| 组合 | 结果 |
|---|---|
C 符号:mingw main + MSVC provider |
rc=0:链接成功 ✅ |
C++ 符号:mingw main + MSVC provider |
rc=1:链接失败 ❌ |
| 对照组:mingw 内部(main + provider) | rc=0 |
| 对照组:MSVC 内部(main + provider) | rc=0 |
第一行是这一篇最值得记住的一条实测:跨编译器的目标文件可以链接——只要走 C 符号。 mingw 的链接器真的读懂了 MSVC 产出的 .obj,并且找到了 c_api。
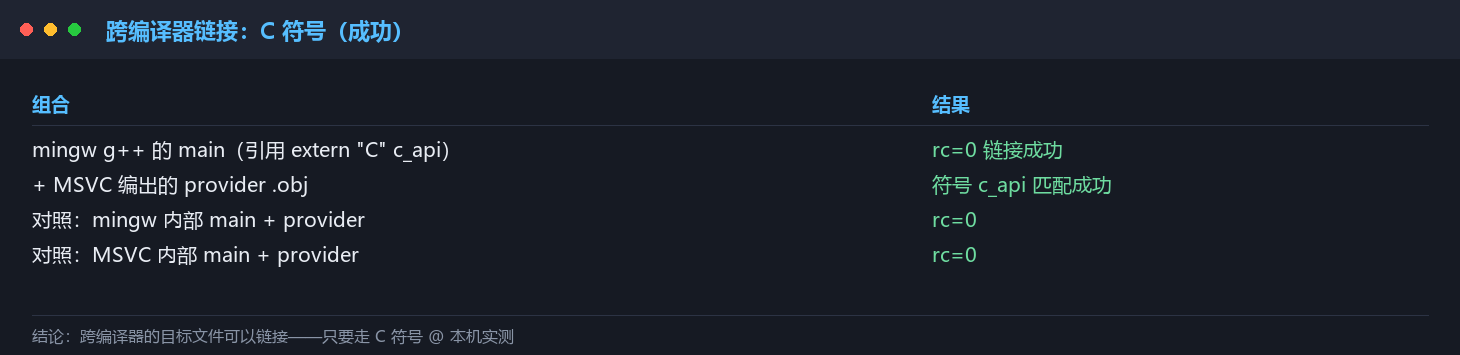
这一条的结论比它看起来更强:跨编译器的目标文件之间并不存在"格式壁垒"——mingw 的链接器完整读懂了 MSVC 产出的 COFF 目标文件,并成功解析了 c_api。真正挡住 C++ 的,是名字与更上层的约定,而不是容器格式。
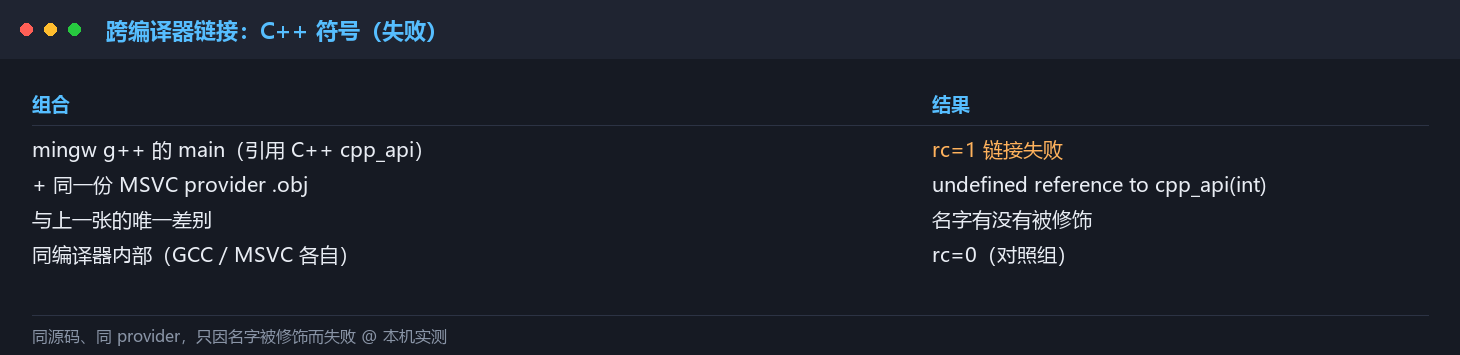
把这张图与上一张并排看,是整篇最有说服力的一组对照:输入只有一个字符的差别——名字有没有被修饰。 结果一边成功、一边失败。这也是为什么"跨编译器接口必须走 C 符号"这条经验如此牢固:它是唯一能绕开名字分歧的路径,与风格无关。
失败那组的报错原文(真实输出):
Warning: corrupt .drectve at end of def file
ld.exe: ...xm_cpp_g.o: undefined reference to `cpp_api(int)'
collect2.exe: error: ld returned 1 exit status
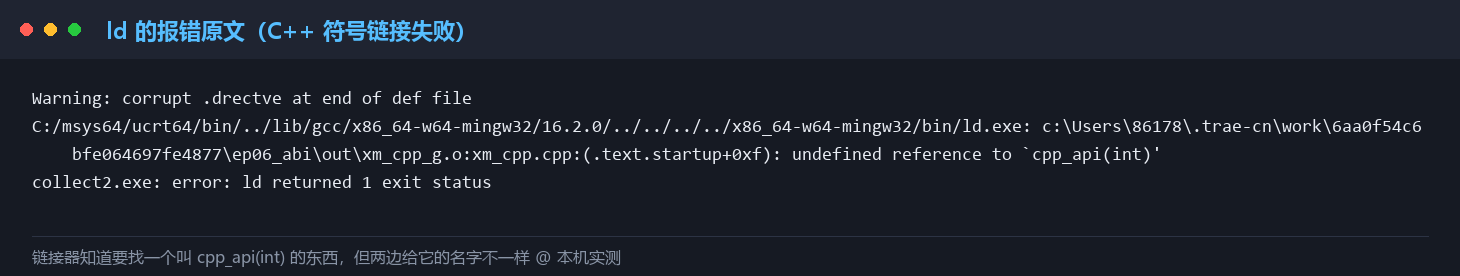
报错信息本身也印证了主题:链接器说的是 undefined reference to 'cpp_api(int)'——它知道"有个叫 cpp_api(int) 的东西没找到",但两个编译器给这个函数起的名不一样,所以永远对不上。
6.3 这个实验说明了什么
三点结论,按重要性排:
第一,extern "C" 是跨编译器二进制互操作的唯一可行通道。 这不是"风格问题",而是唯一能让两个编译器对同一个函数产生同一个名字的机制。这也是为什么几乎所有跨语言/跨编译器的接口(系统 API、插件 ABI、C 库、FFI 绑定)都长着 C 的面孔。
第二,"ABI 不兼容"这句话要说得更准确。 不是"目标文件格式不兼容"——mingw 明明能读 MSVC 的 .obj。不兼容的是名字与更上层的约定:名字修饰、异常模型、标准库布局、虚表结构。C 符号恰好绕过了这一整层。
第三,跨编译器可以链,但不等于可以混用 C++。 即使你靠 extern "C" 让链接通过了,两边的 C++ 对象(std::string、std::vector)仍然不能互相传递——因为标准库的内部布局不同。这一条在第九章的 Dual ABI 会再讲一次。
6.4 「名字对不上」的两种形态
值得把"名字对不上"分清楚,因为它们的报错信息不同、排查手段也不同:
| 形态 | 症状 | 原因 |
|---|---|---|
| 完全不同的编码 | undefined reference to 'cpp_api(int)' |
两个编译器的文法不同(本章实验) |
| 同文法但签名不一致 | undefined reference to '_Z7cpp_apiPKc' |
同一个编译器,但声明与定义的类型不一致(比如一边 char* 一边 const char*) |
第二种更常见、也更隐蔽:同一个编译器下,参数类型差一个 const 或一个引用符号,修饰名就完全不同。 反修饰之后一眼能看出来(第四章的工具就派上用场了)。
这张图刻意把"分界线"画在"名字是否被修饰"上——因为这是实测给出的结论:链接器不认识语义,它只做字符串匹配。 只要名字一致,它就把两边接起来;名字不一致,它连"这两者可能是同一个函数"都无法推断。
6.5 为什么"能链"不等于"能用"
第六章的实验容易让人得出一个过于乐观的结论:"既然 C 符号能跨编译器链接,那混用就是了。"这个结论危险。 链接成功只是第一关,后面还有三道:
第一关:异常模型。 MSVC 与 GCC 的 C++ 异常实现(展开表格式、运行时库、栈展开协议)完全不同。一旦异常跨过编译器边界抛出,行为没有保证。 所以跨编译器接口的常规做法是在边界上 catch 全部异常并转换成错误码,绝不让异常穿过去。
第二关:标准库容器布局。 前面反复说过:std::string、std::vector 的内部布局在两个工具链下不同(第九章的 Dual ABI 会再给一个更极端的例子)。你可以在接口上传指针与长度,不能传容器对象。
第三关:内存分配与释放的归属。 一个模块 new 出来的对象,能不能在另一个模块 delete?只有当两边用同一个运行时库时才行。 跨编译器(甚至同一编译器不同 /MT /MD 配置)时,堆不一致 → 崩溃。标准做法是"谁分配谁释放",把释放封成一个接口函数。
把这三关合起来,跨编译器接口的写法就很清楚了:
// 导出的 C 接口:只传基本类型与不透明指针
extern "C" {
  typedef struct ConnHandle* Conn;
  Conn conn_create(void);
  int  conn_send(Conn, const char* data, int len);   // 不抛异常,返回错误码
  void conn_destroy(Conn);                            // 谁创建谁销毁
}
这段代码里的每一条约束,都能在本文前面的实测里找到依据:extern "C" 对应第六章;"不抛异常"对应异常模型差异;"只传基本类型"对应标准库布局差异;"谁创建谁销毁"对应堆归属。跨语言/跨编译器的接口规范不是风格偏好,是符号与 ABI 层的硬约束。
七、可见性与导出:符号的"对外程度"
前面讲的是"符号叫什么"。这一章讲"符号要不要被外面看见"。
7.1 两套平台、两套机制
| 平台 | 机制 | 默认行为 |
|---|---|---|
| ELF(Linux/macOS) | visibility 属性:default / hidden / protected / internal |
默认 全部导出(default) |
| PE(Windows DLL) | 必须显式标记 __declspec(dllexport),或用 .def 文件 |
默认 全部不导出 |
注意这两套默认值是反的:ELF 默认全导出、PE 默认全不导出。这个差异导致两个很常见的现象:
- Linux 上的
.so常常导出几千个符号(包括它内部用的所有辅助函数),于是需要-fvisibility=hidden主动收紧(GCC 文档:该选项可显著改善加载/链接,并做出"接近完美"的导出 API)。 - Windows 上的 DLL 常常"忘了导出",于是运行时找不到入口点。
7.2 dllexport 的位置会改变结果(本机实测)
这是本篇第二条反直觉发现。本机编译了两个几乎一样的 DLL,唯一差别是 __declspec(dllexport) 的位置:
// 写法 A:dllexport 写在 class 前面
__declspec(dllexport) class WidgetA { public: int v; int get() const; WidgetA(); };
__declspec(dllexport) int helperA(int);

// 写法 B:dllexport 写在 class 后面
class __declspec(dllexport) WidgetB { public: int v; int get() const; WidgetB(); };
__declspec(dllexport) int helperB(int);
| 写法 | 导出条目数 | 导出内容 |
|---|---|---|
| A(写在前面) | 1 | 仅 ?helperA@@YAHH@Z |
| B(写在后面) | 5 | 构造函数、移动赋值、拷贝赋值、get、helperB |
同一个标记、同一份类、只换了书写位置,导出条目从 1 变成 5。 类级的 __declspec(dllexport) 只有在写在 class 关键字之后(即 class __declspec(...) Name)时才把类成员纳入导出集合。
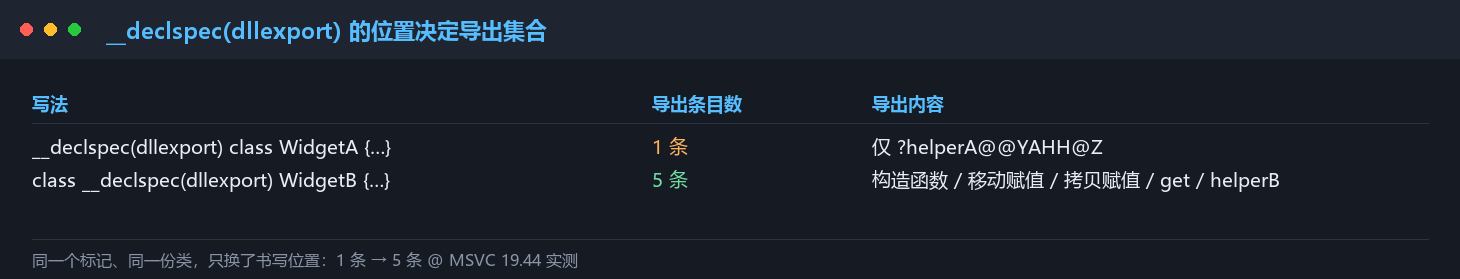
__declspec(dllexport) 写在 class 前 vs 后:导出条目 1 条 vs 5 条@ MSVC 19.44 实测这条差异的实用价值在于它极易被忽略:两种写法在语法上都能通过编译,没有任何警告。只有在检查导出表时才会发现结果不同。所以"我的 DLL 导出了什么"这个问题的唯一可靠答案是 dumpbin /exports,而不是"我写了 dllexport 应该就够了"。
7.3 隐式生成的成员也会被导出(本机实测)
本篇第三条反直觉发现紧接着上一条:B 写法导出的 5 条里,有两条是你从来没写过的——拷贝赋值与移动赋值运算符:
1    0 00001000 ??0WidgetB@@QEAA@XZ                    ← 构造函数
2    1 00001010 ??4WidgetB@@QEAAAEAV0@$$QEAV0@@Z        ← 移动赋值(你没写)
3    2 00001010 ??4WidgetB@@QEAAAEAV0@AEBV0@@Z          ← 拷贝赋值(你没写)
4    3 00001020 ?get@WidgetB@@QEBAHXZ                   ← get()
5    4 00001030 ?helperB@@YAHH@Z                        ← 自由函数
__declspec(dllexport) 导出的是"这个类的所有成员",包括编译器隐式合成的那几个。 这有两个实用含义:
- 你的 DLL 导出表比你预期的长——这是正常的,不是配置出错。
- 导出的隐式成员同时是一份 ABI 承诺:一旦这些运算符被外部链接引用,它们的签名就冻结了。
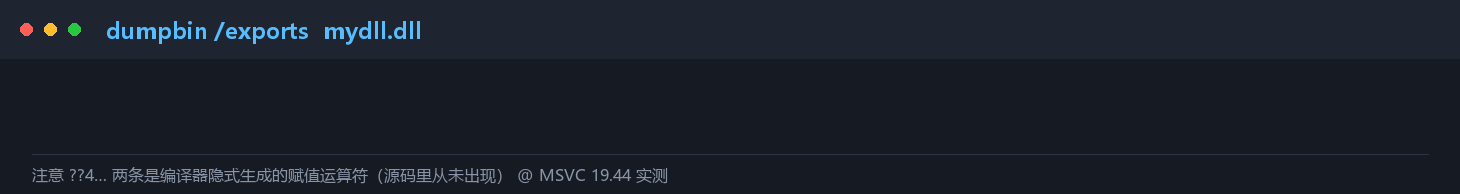
mydll.dll 的导出表——除显式导出的函数与变量外,还包含编译器隐式生成的拷贝/移动赋值运算符@ MSVC 19.44 实测这份导出表里最值得停下来看的是那两条 ??4… ——它们是编译器隐式合成的赋值运算符,源码里从未出现。这说明 dllexport 的作用对象是"类的成员集合",而不是"你手写过的东西"。同时它们也构成一份 ABI 承诺:一旦被外部引用,签名就不能再改。
7.4 一个必须如实说的边界:-fvisibility=hidden 在 PE 上不生效
ELF 侧的 -fvisibility=hidden 是收紧导出的标准手段。但在本机的 PE 目标上,它是空操作。 实测:
g++ -std=c++20 -O2 -fvisibility=hidden -c vis.cpp
# 编译器接受选项,但产生警告
nm --defined-only vis_g.o
# 输出:pub_fn / hid_fn / plain_fn 三个都是 T(全局文本符号)
三个函数(包括明确标了 visibility("hidden") 的 hid_fn)在符号表里都是 T——没有变成局部符号。
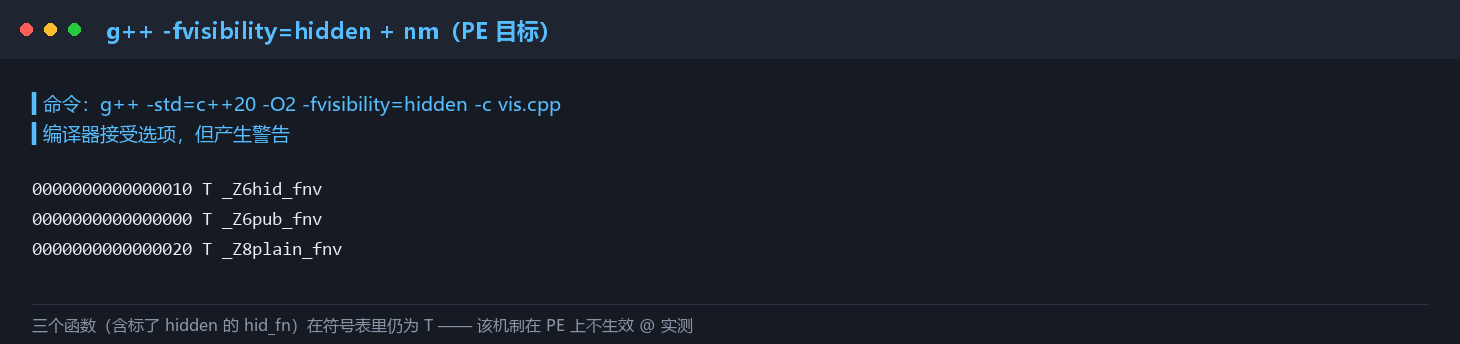
-fvisibility=hidden 在 MSYS2/PE 目标上的实测结果:选项被接受但符号仍全部为全局@ g++ 16.2.0 实测这条实测的意义在于划清工具链的能力边界:选项被接受、也产生了警告,但符号可见性没有改变。排查这类问题时,正确的顺序是先确认"这个机制在目标格式上是否适用",再去怀疑自己的写法——把 ELF 的经验套到 PE 上,会浪费很多时间。
这条实测的意义是划边界:-fvisibility 是 ELF 的机制,在 PE/COFF 目标上不适用——PE 的对应手段是 dllexport / .def 文件(默认全不导出)。不要把 Linux 上的导出收紧经验直接搬到 Windows。
7.5 .def 文件与 PRIVATE
除了 __declspec,Windows 还有另一条路:.def 文件。它用文本列出要导出的符号,链接时喂给链接器。它的一个特殊能力值得知道:
.def 的 PRIVATE 修饰符可以让符号进入 DLL 的导出表,但不进入静态导入库(import lib)(见 binutils 文档)。含义是:链接期谁也解析不到它,只能靠运行时 GetProcAddress 动态取址。
这条特性适合"我不想公开这个 API,但内部另一模块要跨 DLL 调用"这类场景——它导出的是"可运行时查找",不是"可静态链接"。
7.6 导出序号与"找不到序数"的排查
第 9.2 节展示导出表时提过:DLL 的导出可以按序号引用。这里把它作为一个独立问题说清,因为它是 Windows 上最常见的一类运行时故障。
症状:程序启动或调用时报"无法在 DLL 中找到序号 N"(ordinal N could not be located)。
根因:按序号导入,而序号是位置索引——它由导出表里的排列顺序决定,不是稳定的标识。DLL 加了一个导出函数、或改了导出顺序,序号就整体位移。
排查三步:
- 看导入方用的是名字还是序号:
dumpbin /imports的输出里,如果名字列是数字(或形如Ordinal N),就是按序号导入。 - 看导出方的序号分布:
dumpbin /exports,对照第 9.2 节那张表的"序号 / 序号值 / 名字"三列。 - 改回按名字导入:绝大多数情况下,按名字导入更稳(名字是符号,不会随顺序漂移)。按序号只在"故意隐藏名字"或"兼容极老二进制"时才用。
顺带一个相关的坑:加了导出函数却仍然报旧序号找不到,常见原因是导出的顺序变了(比如新函数插在了前面)。用
.def文件显式写NONAME或固定序号,可以把序号钉住——这是.def文件在PRIVATE之外的另一个用途。
八、符号表解剖:一个 .obj 里到底有什么
这一章打开目标文件看内部结构。链接器读的所有信息,都在符号表里。
8.1 符号表条目的构成
一个目标文件的符号表(symbol table)里,每个条目大致回答四个问题:
| 字段 | 含义 | 本机看到的例子 |
|---|---|---|
| 名字 | 修饰后的符号名 | ?get@Exported@@QEBAHXZ |
| 类型 | 代码 / 数据 / 未定义 | T(文本)、R(只读数据)、U(未定义) |
| 绑定性 | 全局 / 局部 | 外部可链接 / 文件内私有 |
| 所属段 | 定义在哪个段、什么偏移 | .text+0x1020 |
链接器做的就是最朴素的两件事:收集所有"定义",匹配所有"引用"。 匹配得上就填地址,匹配不上就报 undefined reference。
这里有个容易被忽略的细节:未定义的符号(U)和已定义的符号(T)同样重要。 本机 nm 输出里的 U 就是"我需要这个词,但这里没有定义"——它就是链接器要去别处找的东西。
8.2 静态库:符号索引的容器
静态库(.lib / .a)其实只是一堆 .obj 的归档,外加一份符号索引。链接器的用法是:看到 undefined reference to X,就去索引里查"哪个 .obj 定义了 X",然后把那个 .obj 拉进来。
本机实测:把 mangling.obj 打成静态库再读符号表,符号照旧可读(数量与直接读 .obj 一致)——归档不改变符号,只提供一个查找入口。
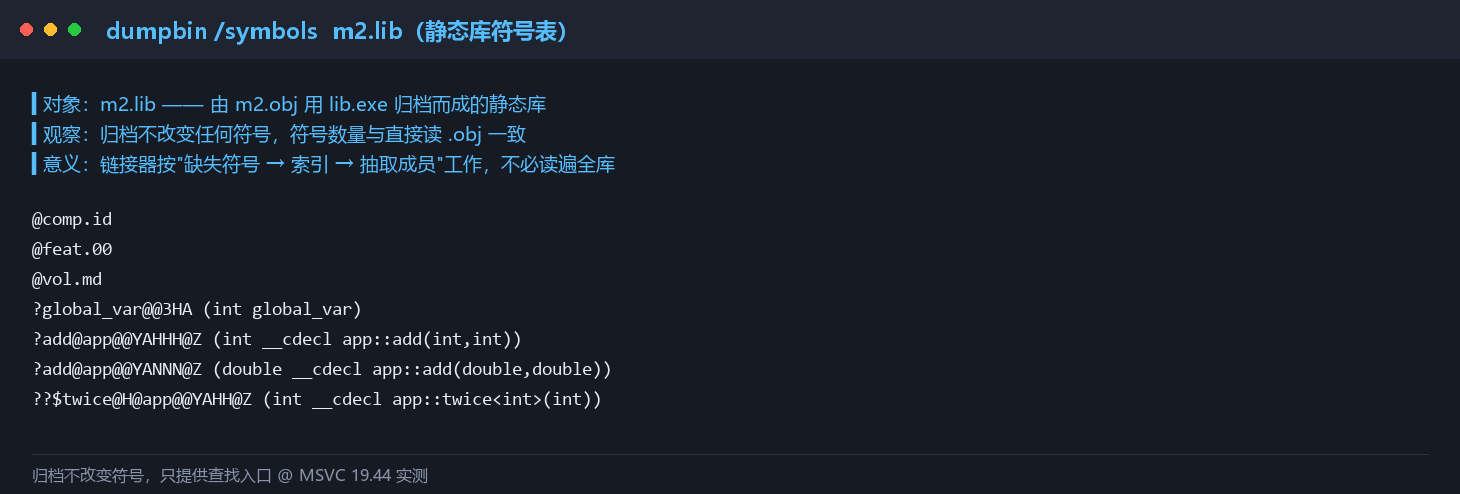
.lib)的符号表——归档后符号仍可读,链接器按需抽取成员@ MSVC 19.44 实测归档这件事本身不改变任何符号,它只是提供了一个查找入口。这个细节解释了链接器的一条基本工作方式:它不需要读遍库里所有成员,只需要在索引里查到「哪个成员定义了缺失的那个符号」,再把那个成员拉进来——这也是静态库能承载成千上万个目标文件却仍能快速链接的原因。
这也是"静态库越大,链接越慢"的原因:链接器要在索引里反复查找。而模板实例化会让静态库里的符号数爆炸——这一点正好接上 ep04。
8.3 模板实例的符号
模板实例化会产生符号,而且是每个实例一个符号。本机实测:
| 实例 | MSVC 符号(反修饰后) |
|---|---|
pick<int>(int,int) |
int __cdecl pick<int>(int,int) |
pick<double>(double,double) |
double __cdecl pick<double>(double,double) |
注意反修饰结果里的 <int> 是被编码进符号名的——这正是 ep04 讲的"每个唯一参数组合一份独立代码"在符号层的体现。ep04 从编译时间角度看实例化,这一章从符号角度看:实例化就是"多出来一批符号"。
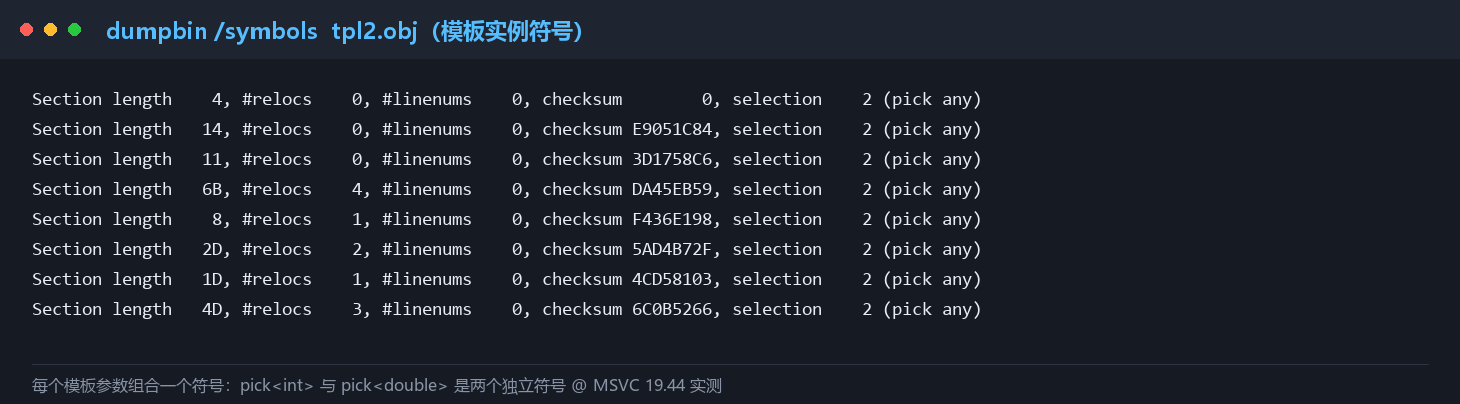
pick<int> / pick<double>)@ MSVC 19.44 实测8.4 vtable 与 RTTI:编译器生成的符号
类有虚函数时,编译器会生成虚函数表(vtable)和运行时类型信息(RTTI)——它们也占用符号,而且命名规则同样两套。本机实测:
| 实体 | MSVC 符号(反修饰) | GCC 符号 |
|---|---|---|
| vtable | ??_7Base@@6B@ → const Base::\vftable'|_ZTV7Derived` |
|
| typeinfo | ??_7type_info@@6B@ |
_ZTI4Base / _ZTI7Derived |
| typeinfo 名 | — | _ZTS4Base / _ZTS7Derived |
| 删除析构器 | ??_EBase@@UEAAPEAXI@Z(vector)/ ??_GBase@@…(scalar) |
— |
| 全局运算符 | ??2@YAPEAX_K@Z(operator new)/ ??3@YAXPEAX_K@Z(operator delete) |
— |
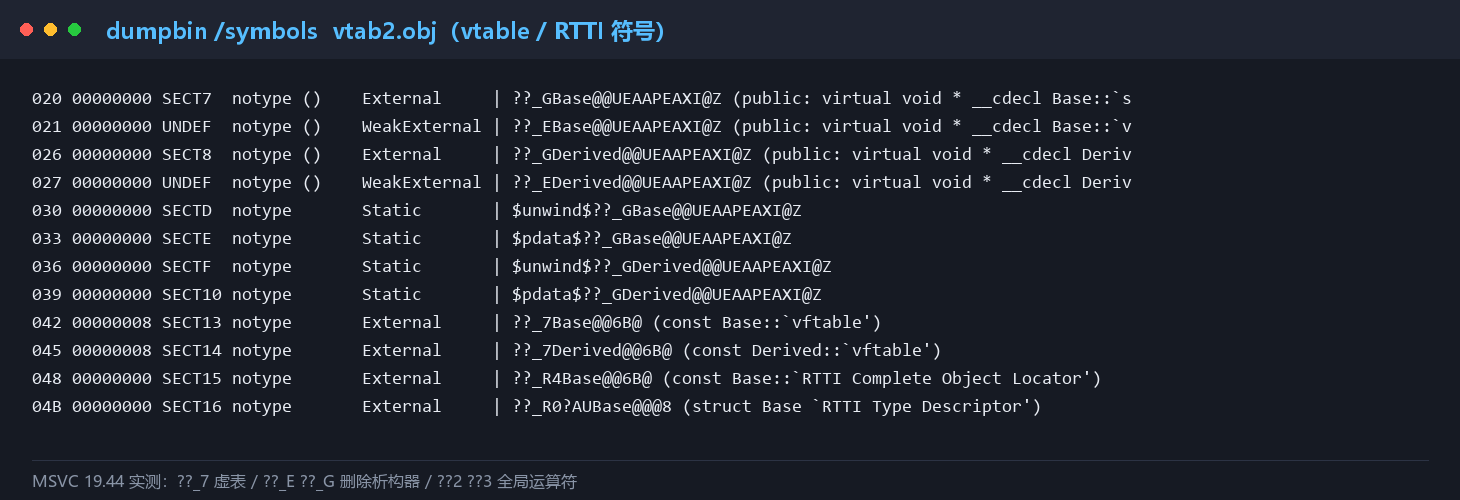
??_7…(虚表)、??_E/??_G(删除析构器)、??2/??3(全局运算符)@ MSVC 19.44 实测这份清单里有一组容易被忽略的符号:??2 与 ??3——它们是全局 operator new / operator delete。之所以值得留意,是因为它们的存在解释了"重载全局 new 能生效"这件事的机制根源:替换的就是这两个符号的定义。
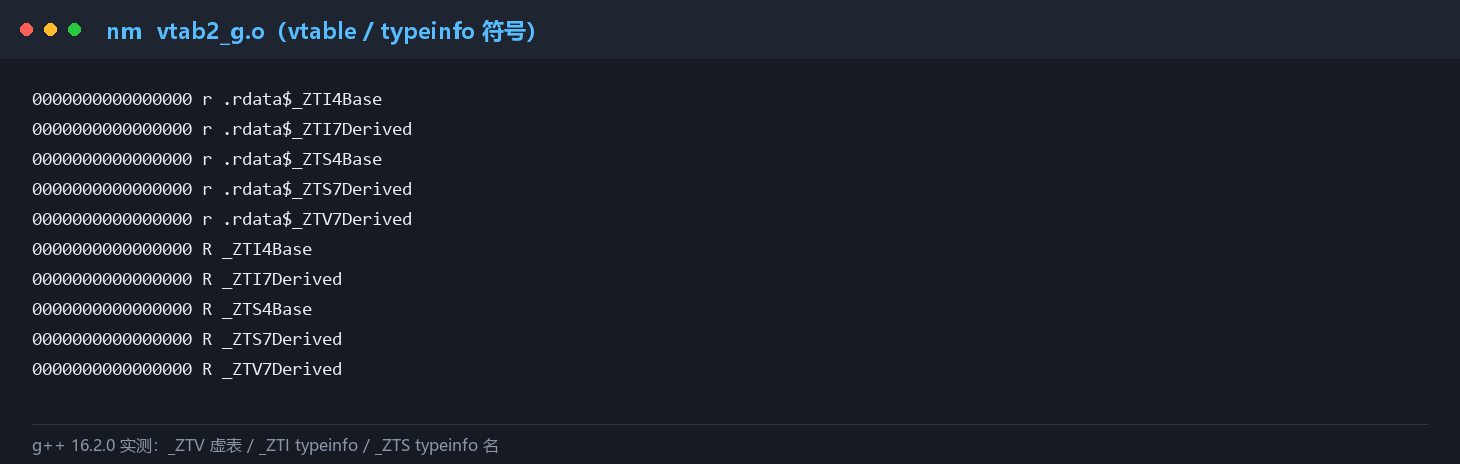
_ZTV / _ZTI / _ZTS 三段命名@ g++ 16.2.0 实测与上一张对照能看出两套实现的组织方式完全不同:MSVC 把虚表与类型信息分别做成独立的符号(??_7…),而 GCC 用 _ZTV/_ZTI/_ZTS 三段命名把它们区分开。这又一次印证了本篇的主线:同一个语言概念,在二进制层可能是完全不同的形状。
这张表值得记住三点:
- MSVC 把"删除析构器"拆成 vector/scalar 两个(
??_E与??_G)——这是 MSVC 特有的实现细节,源码里完全看不见。 - GCC 把 vtable / typeinfo / typeinfo 名拆成三段(
_ZTV/_ZTI/_ZTS)。 - 全局
operator new/operator delete也是符号,而且可被替换——这就是"重载全局 new"能生效的机制根源。
mingw 侧还能看到 COFF 的按符号分段:每个符号被放进带名字后缀的段里(.rdata$_ZTI4Base、.rdata$_ZTV7Derived)。这是 COFF 的 COMDAT 机制——ep04 讲链接器去重时提到的"一个实例一个段",在符号表里看得见。
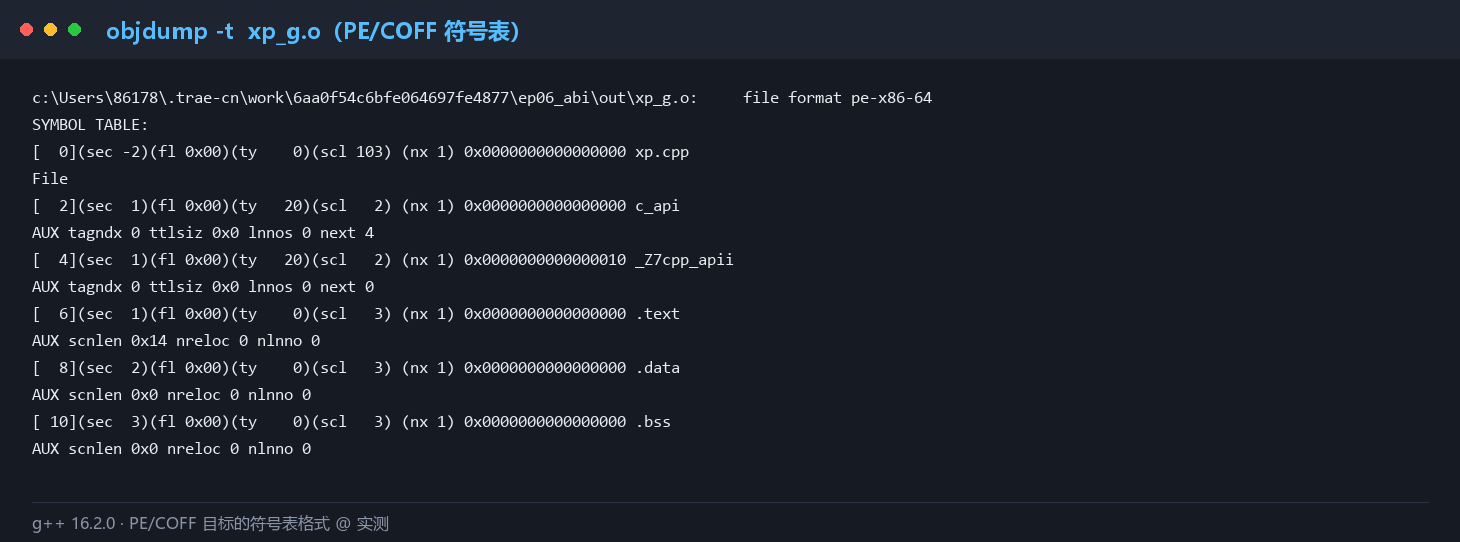
objdump -t 的符号表输出(PE/COFF 目标)@ g++ 16.2.0 实测8.5 符号表结构的示意
把上面这些合起来,一个 .obj 的符号表大致是这样组织的:
把这份结构图与前面的实测对照起来看:符号表的每一行都能对应到本机输出里的某一列。 名字对应反修饰的输入,类型对应 nm 里的字母(T/R/U),绑定性对应全局与局部之分,所属段对应 COFF 的段名(如 .rdata$_ZTI4Base)。读懂符号表这件事,本质就是把这四列读熟。
8.6 符号数量与构建代价
把第八、九两章的内容合起来,能得到一条工程判断:符号越多,链接越慢、产物越大。
本机统计的几个目标文件已经给出趋势(图 33):只用 C 符号的文件符号数最少;引入模板实例与虚函数后明显上升。这与 ep04 的结论完全同向——ep04 从"编译时间"看模板实例化,这一章从"符号数量"看同一件事:
| 现象 | ep04 的账 | ep06 的账 |
|---|---|---|
| 一个模板被 100 种类型实例化 | 100 份实例化时间 | 100 组符号 |
| 一个类有虚函数 | 生成 vtable 与 RTTI 的时间 | vftable/typeinfo 等若干符号 |
| 显式实例化 | 那个 TU 自伤 | 该 TU 的符号表变大 |
两条账的交点在链接器:ep04 说过"实例化的时间在编译阶段就花掉了,退不回来";而符号层面的代价还要再加一笔——链接器要处理这些符号。
由此得到两条可操作的结论:
- 减少模板实例化,同时省编译时间与符号量(
extern template、改非模板重载——但记得 ep04 的实测:extern template在 MSVC 上没生效,要先验证)。 - 静态库的成员抽取是有代价的:库越大,链接器查找的时间越长。把常用符号集中、把冷门符号拆到独立库,能明显改善链接时间。
九、动态链接:IAT 实测与 PLT/GOT 引原文
前面几章都在讲静态链接(链接时把符号解析完)。这一章讲动态链接——符号的解析推迟到程序启动或首次调用。
9.1 动态链接要解决什么问题
一个 DLL 在被加载到内存之前,它自己也不知道会落在哪个地址。所以"调用 DLL 里的函数"不能编译成一条直接的 call 固定地址——必须经过一层间接:
- 调用方:不直接调函数,而是通过一张表(表里存着函数真实地址)跳过去;
- 表里的地址:由动态加载器在加载时(或首次调用时)填好。
这层间接的表,PE 叫 IAT(Import Address Table),ELF 叫 GOT(Global Offset Table)。
9.2 PE 侧实测:导出表 → 导入表 → IAT
本机完整走了一遍 DLL 的动态链接链路。
第一步:DLL 的导出表(本机实测,mydll.dll)
| 序号 | 序号值 | 名字 |
|---|---|---|
| 1 | 0 | ??4Exported@@QEAAAEAV0@$$QEAV0@@Z(移动赋值) |
| 2 | 1 | ??4Exported@@QEAAAEAV0@AEBV0@@Z(拷贝赋值) |
| 3 | 2 | ?dll_add@@YAHHH@Z |
| 4 | 3 | ?dll_counter@@3HA |
| 5 | 4 | ?get@Exported@@QEBAHXZ |
注意导出是按"序号 + 名字"两套索引给出的:序号是位置索引(可被 GetProcAddress 用序号取),名字是符号索引。这也是"找不到序数"这类报错的来源——按序号导入时,DLL 换了版本、导出顺序变了,就对不上了。
第二步:EXE 的导入表(本机实测)
mydll.dll
    2    ?dll_add@@YAHHH@Z        ← 按名字导入,序号 2
第三步:PE 头里的 IAT(本机实测,dumpbin /headers)
| 数据目录 | RVA | 大小 |
|---|---|---|
| Import Directory | 2000C |
3C |
| Import Address Table Directory | 16000 |
278 |
| Delay Import Directory | 0 |
0 |
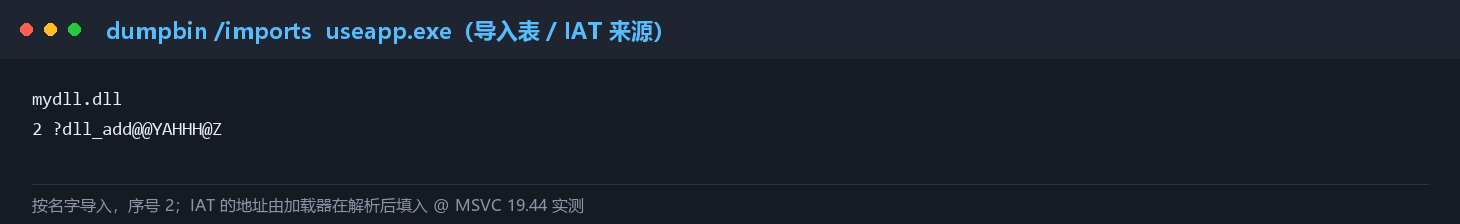
mydll.dll 的 ?dll_add@@YAHHH@Z 按名字导入(序号 2)@ MSVC 19.44 实测注意这份导入表里同时出现了序号(2)与名字(?dll_add@@YAHHH@Z)。这解释了 Windows 上"找不到序数"这类故障的来源:如果导入方只记序号,而导出方的导出顺序发生变化,序号就会指向错误的位置——名字是稳定的标识,序号不是。
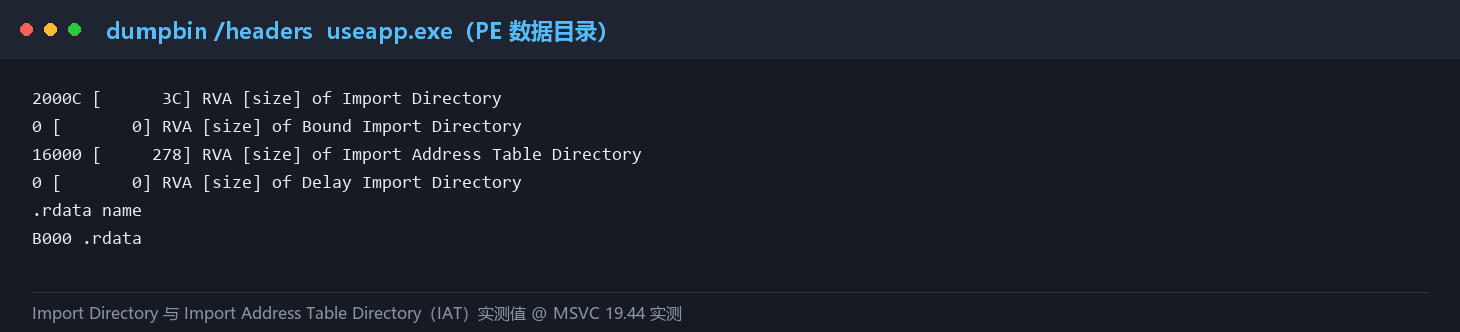
这里的结构值得说清:导入表(Import Directory)描述"我依赖哪些 DLL、各要哪些函数";而 IAT 是"函数真实地址"那几张表本身——加载器读导入表,把解析出的地址写进 IAT。所以:
- 静态链接:链接时地址就确定了,调用是直接
call; - 动态链接:调用先读 IAT,再跳到真实地址。多一次内存访问。
9.3 延迟加载:把解析再往后推
PE 还有一层更进一步的机制:延迟加载(delay load)。官方文档(Linker support for delay-loaded DLLs)描述得很清楚:
- 用
/DELAYLOAD:mydll.dll链接,并连上delayimp.lib; - 该 DLL 的函数首次被调用前,IAT 里的指针指向一个 thunk(桩),不是真实函数;
- thunk 第一次执行时调
LoadLibrary+GetProcAddress,把真实地址写回 IAT,然后跳过去; - 代价与陷阱:不支持数据导入(只支持函数);而且如果你把函数地址存进了静态函数指针,它指向的是 thunk,首次调用后不会自动更新——必须重新取址。
延迟加载的实用价值:把"启动时必须加载的 DLL"变成"用到才加载",缩短启动时间;同时让"DLL 缺失"从"启动失败"变成"调用该函数时才失败"。
9.4 ELF 侧:PLT/GOT(引原文,本机未实测)
必须如实声明:本机没有可用的 ELF 环境(无 WSL,MSYS2 产出 PE),所以下面这部分只引权威原文,不做本机实测。
ELF 的对应机制由两部分组成:
- GOT(Global Offset Table):存外部符号的真实地址,与 PE 的 IAT 角色相同。
- PLT(Procedure Linkage Table):一段跳板代码。首次调用某外部函数时,PLT 跳到动态解析器去解析地址并写回 GOT(惰性绑定,lazy binding);之后的调用直接经 PLT → GOT → 真实函数。
关于"何时解析",ELF 规范(LSB 动态链接章节)说得很直接:环境变量 LD_BIND_NOW 非空时,加载时就处理全部 R_*_JMP_SLOT 重定位;为空时采用惰性求值,推迟到首次执行。
安全性上还有个常被一起提的机制——RELRO:
| 级别 | 效果 |
|---|---|
| Partial RELRO | 把部分段设为只读,但 GOT 仍可写(以支持惰性绑定) |
Full RELRO(-Wl,-z,relro,-z,now) |
把 GOT 等移入只读段(PT_GNU_RELRO),动态链接器在 main 之前解析全部外部符号 |
注意 Full RELRO 与惰性绑定是互斥的:要一次解析完所有符号,就必须放弃"用到才解析"。这正好是 PE 的 IAT + 延迟加载组合的镜像——两边都在"启动快"与"首次调用快/安全"之间做同一个取舍。
9.5 两套机制的对照
| 维度 | PE(Windows) | ELF(Linux/macOS) |
|---|---|---|
| 间接表 | IAT | GOT |
| 跳板 | 无(IAT 直接存地址) | PLT |
| 解析时机 | 加载时(默认) | 惰性(默认)或加载时(LD_BIND_NOW / -z now) |
| 推迟机制 | 延迟加载(/DELAYLOAD) |
惰性绑定(默认就推迟) |
| 只读保护 | — | RELRO(Full RELRO 需 -z now) |
| 本机实测 | ✅ 导出表/导入表/IAT 数据目录 | ❌ 无 ELF 环境,仅引原文 |
把这两套机制并排放,会发现它们解决的是同一个问题——运行时才知道地址——只是把间接层放在了不同的位置。PE 把地址表(IAT)与调用点分开,ELF 额外加了一层跳板(PLT)。理解了这一层「为什么需要间接」,再去看延迟加载与惰性绑定,就会发现它们是同一个取舍的两种实现。
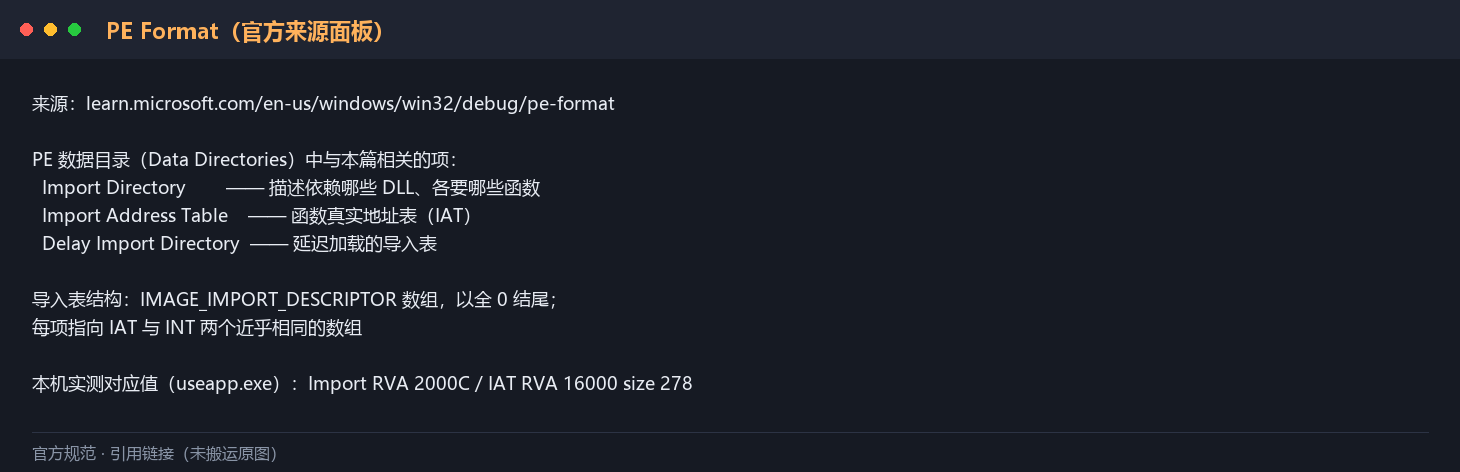
这份面板的作用是把前面实测到的数字「接回规范」:本机读到的 Import Directory 与 Import Address Table Directory 两个条目,正是 PE 数据目录里定义的标准项。实测与规范对得上,结论才站得住——这也是本系列每一篇都坚持「引原文 + 本机验证」的原因。
9.6 顺带说清:Dual ABI 为什么会出现
第九章开头提到"跨编译器能链但 C++ 对象不能互传"。同一个编译器内部也有类似问题,这就是 libstdc++ 的 Dual ABI。
背景:C++11 要求 std::string 的某些接口(如 c_str() 返回保证带终止符的缓冲区)与 C++98 时代的实现不兼容。libstdc++ 既想修正实现,又不能破坏已有二进制,于是用了一招:把新实现放进一个 inline namespace __cxx11(官方文档)。
结果是:源码里同样的 std::string,在二进制层有两个不同的符号名(一个在 std::__cxx11 下、一个不在)。源码层面完全看不出差别,但链接层能对上就链、对不上就断。 受影响的符号包括 std::string、std::list、std::ios_base 等。
libstdc++ 官方在 ABI Policy 里还明确列了几类"会造成 ABI 泄漏"的东西:模板隐式实例化、typeinfo、虚表——全都是符号层面的东西,这正好呼应第八、九两章。
而 MSVC 走的是另一条路:官方承诺 VS2015 起的工具集保持二进制兼容(V140–V143 可互链)——用"冻结实现"换"不破坏二进制"。WG21 的 N4028 专门讨论过这条路线分歧:GCC 牺牲一部分标准符合性保 std:: 稳定,MSVC 反其道而行。这篇提案的结论至今仍然有效:C++ 没有可移植 ABI。
__cxx11 inline namespace 让同一个 std::string 拥有两个二进制名@ 本系列绘制9.7 动态链接的性能代价
最后算一笔账:动态链接比静态链接慢多少,慢在哪。
从第 9.2 节的结构可以直接推出代价的三个来源:
| 代价来源 | 说明 | 能否避免 |
|---|---|---|
| 一次间接访问 | 调用要经 IAT/GOT 取地址,比直接 call 多一次内存读 |
不能完全避免;但取到的地址会被缓存,实际开销很小 |
| 解析开销 | 加载时(或首次调用时)要解析所有外部符号 | 加载时解析:启动变慢;惰性绑定:首次调用变慢。两者必选其一 |
| 优化受阻 | 编译器看不见 DLL 里的函数体,无法内联 | 用 LTO / 静态链接可以,但那要放弃动态加载的其它好处 |
第三条值得展开,因为它接上了 ep05:如果函数体在另一个 DLL 里,优化器永远看不见它。这正是 ep05 第 2.5 节说的"优化器的视野只覆盖它同时看得见的定义"——DLL 边界就是一道视野墙。
所以"要不要把某个模块做成 DLL",不只是部署问题,也是优化问题:
- 做成 DLL:热更新方便、模块解耦、启动可以按需加载;代价是调用多一次间接、跨边界无法内联。
- 做成静态链接:优化器可以跨模块内联与推断;代价是每次改动都要全量重链。
这个取舍没有普适答案,但知道"代价是什么"之后,就能按场景选——比如"性能关键的小模块静态链、可选功能做 DLL"。这跟 ep04 里"PCH 收益大但要看场景"、ep05 里"/arch 要按部署目标选"是同一种判断方式。
十、收束与下一篇钩子
10.1 全篇读数总汇
| 实验 | 指标 | 读数 |
|---|---|---|
| 双编译器修饰名 | app::add(int,int) |
MSVC ?add@app@@YAHHH@Z / GCC _ZN3app3addEii |
| 全局变量 | global_var |
MSVC ?global_var@@3HA / GCC global_var |
| x64 调用约定 | 三者符号 | cdecl_fn / stdcall_fn / fastcall_fn(均无约定编码) |
| 跨编译器链接(C 符号) | mingw main + MSVC provider | rc=0 成功 |
| 跨编译器链接(C++ 符号) | 同上 | rc=1 失败 |
| 同编译器链接(对照) | GCC / MSVC 各自内部 | 均 rc=0 |
| dllexport 位置 | class 前 / class 后 | 导出 1 条 / 5 条 |
| DLL 导出表 | mydll.dll |
5 条(含编译器隐式生成的赋值运算符) |
| EXE 导入表 | IAT 来源 | ?dll_add@@YAHHH@Z(序号 2) |
| PE 数据目录 | Import / IAT | RVA 2000C / 16000(size 278) |
| 模板实例符号 | pick<int> / pick<double> |
两个独立符号 |
| vtable 符号 | MSVC / GCC | ??_7Base@@6B@ / _ZTV7Derived |
-fvisibility=hidden |
PE 目标 | 不生效(三个符号仍为 T) |
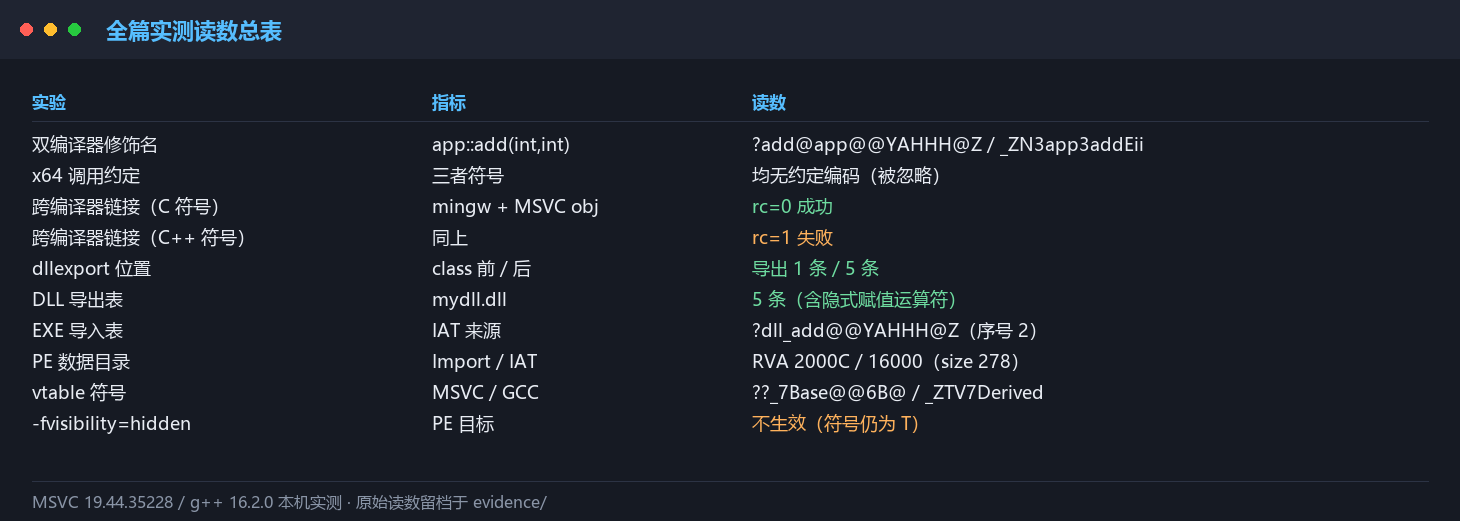
读这张表建议按「结论 → 证据」的顺序看:左边两列是结论性的判定,右边一列是实测读数。凡是标了具体数字的条目,都能在 evidence 目录里找到原始输出——这是本系列的证据纪律:不下无法复核的结论。
10.2 各目标文件的符号数对照
本机统计了几个目标文件的符号规模,用来直观感受"什么东西会产生符号":
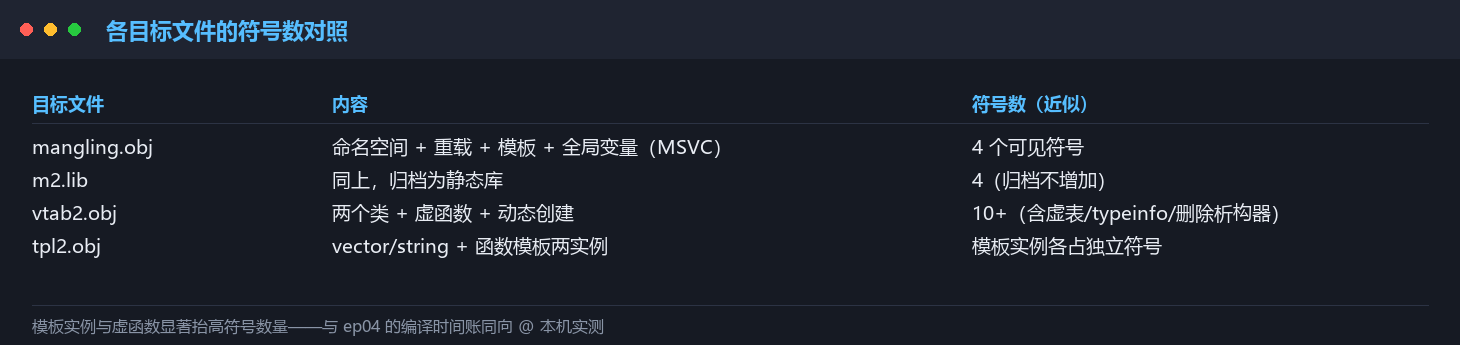
规律很清楚:只用 C 符号的文件符号数最少;一旦引入模板实例与虚函数,符号数明显上升——因为一个模板实例是若干符号、一个带虚函数的类是若干符号。
10.3 全量清单与二次归类
把本篇出现过的观测手段列全(全量清单),再按"你用它看什么"二次归类:
dumpbin /symbols——读 MSVC 目标文件的符号表(含修饰名)dumpbin /exports——读 DLL 导出表dumpbin /imports——读 EXE/ DLL 的导入表dumpbin /headers——读 PE 数据目录(Import / IAT / Delay Import)lib.exe——打静态库并读其符号undname——MSVC 修饰名反解nm/nm -C——GCC 侧符号表(可选自动反修饰)objdump -t——符号表(更细的段/类型信息)c++filt——Itanium 修饰名反解g++ -fvisibility=hidden——尝试收紧导出(PE 上无效,本机已实测)__declspec(dllexport)/dllimport——PE 侧显式导出.def文件(含PRIVATE)——文本式导出控制- 跨编译器链接实验——用实际链接成败验证"名字是否对得上"
- 对照实验(同编译器内部链接)——排除"格式问题"这个干扰因素
| 档位 | 作用 | 包含手段 |
|---|---|---|
| 看名字 | 确认符号被修饰成了什么 | 1、7、8 |
| 看名字的还原 | 把机器名读成人话 | 6、9 |
| 看导出/导入 | 确认对外暴露与依赖 | 2、3、4、5 |
| 控制可见性 | 决定导出多少 | 10、11、12 |
| 验证 | 用链接成败与对照实验收口 | 13、14 |
行动顺序:遇到链接问题时,先"看名字"(反修饰)→ 再"看导出/导入"→ 最后才动可见性设置。顺序反了会浪费大量时间在错误的假设上。
10.4 六条可以带走的结论
- 链接器只认符号名:源码里的重载、命名空间、模板全部被编码进名字,两套主流文法(Itanium / MSVC)没有共同点。
extern "C"是跨编译器互操作的唯一通道:本机实测 C 符号可链、C++ 符号不可链。- x64 下调用约定不再影响符号名:
__cdecl/__stdcall/__fastcall被忽略(x86 时代的经验失效)。 dllexport的位置会改变导出集合:本机实测 1 条 vs 5 条,且会连带导出编译器隐式生成的成员。-fvisibility=hidden属于 ELF:PE 目标上不生效(本机实测),Windows 对应手段是dllexport/.def。- 动态链接的两套机制是对称的:PE 的 IAT+延迟加载 vs ELF 的 PLT/GOT+惰性绑定,取舍点相同。
10.5 本篇边界
本篇只讲符号层与链接期。不涉及:
- 跨 TU 的优化(LTO / PGO 如何基于符号做全局推断):ep07 讲。
- 异常与 RTTI 的完整实现(展开表、
.pdata/.xdata细节):ep09 讲。 - 虚函数的分发代价(vtable 布局与多态调用成本):ep08 讲。
- ELF 侧的实测(PLT/GOT、RELRO 的本机验证):需要 ELF 环境,本机不具备,本篇只引原文。
10.6 怎么在自己工程里复现这套量法
- 取符号表:MSVC 用
dumpbin /symbols,GCC 用nm(加-C自动反修饰)。 - 反修饰:
undname或c++filt,把?…/_ZN…读成人话。 - 看导出/导入:
dumpbin /exports看 DLL 给了什么;dumpbin /imports+/headers看它依赖什么、IAT 在哪。 - 验证:用"链接是否成功"作为最终判据——名字对不对得上,链接器说了算。
10.7 一张决策表
把整篇的结论压成一张"遇到问题先查这里"的表:
| 你观察到的现象 | 最可能的原因 | 先做什么 |
|---|---|---|
undefined reference to '_Z...' |
名字对不上(修饰名) | c++filt 反修饰,看清缺的是哪个声明 |
undefined reference to '...@@...' |
同上(MSVC 侧) | undname 反修饰 |
| 同一个编译器内部链接失败 | 声明与定义的类型有细微差异 | 反修饰后逐个比对参数类型(const/引用最容易漏) |
| DLL 里导出太少 | dllexport 写在了 class 前面 |
改成 class __declspec(dllexport) Name(实测 1 条 → 5 条) |
| DLL 导出表比预期长 | dllexport 会连带导出隐式成员 |
正常现象;不想导出就用显式逐成员导出 |
Linux 的 .so 导出太多符号 |
ELF 默认全导出 | -fvisibility=hidden(仅 ELF 有效) |
Windows 上 -fvisibility=hidden 没效果 |
这是 ELF 机制 | 改用 dllexport / .def(实测在 PE 上不生效) |
| 运行时"找不到序数" | 按序号导入而序号变了 | 改成按名字导入;或用 .def 固定序号 |
| 调用 DLL 函数明显慢 | 无 dllimport(多一次 thunk)或无法内联 |
补 dllimport;或评估静态链接 |
| 跨编译器混用崩溃 | 异常/容器/堆三关之一没过 | 边界上只传基本类型;不跨边界抛异常;谁分配谁释放 |
这张表和第 10.3 节的工具清单配合使用:决策表告诉你"往哪个方向查",工具清单告诉你"用哪把工具查"。
10.8 与本系列前作的呼应
这一篇接的是第二波「编译器与链接器」的第三条腿,与前作的关系可以这样看:
| 前作 | 本篇的呼应 |
|---|---|
| ep01 对象布局 | 对象布局决定了"类型大小",而类型大小被编进修饰名(H=int、N=double 背后是类型) |
| ep02 分配器 | 堆归属问题是跨模块内存传递的硬约束(6.5 节第三关) |
| ep03 值语义 | 移动/拷贝赋值运算符会作为符号出现在导出表里(7.3 节实测) |
| ep04 编译期账本 | 模板实例化既是编译时间,也是符号量(8.6 节的两条账) |
| ep05 优化器边界 | "优化器只看见它同时看得见的定义"——DLL 边界就是一道视野墙(9.7 节) |
第二波「编译器与链接器」到这里走完四分之三:ep04 看编译器花的时间,ep05 看编译器做的改写,ep06 看链接器怎么靠符号把一切拼起来,ep07 收在跨 TU 的优化(LTO/PGO)——那一篇会把"视野墙"这件事推到极致:拆掉它,代价是什么。
资源清单
- 规范与 ABI:Itanium C++ ABI · Mangling、Itanium ABI · Examples、LSB C++ IA64 4.0、N4028 Defining a Portable C++ ABI
- MSVC 官方文档:Decorated names、Name decoration、调用约定 /Gd /Gr /Gv /Gz、二进制兼容 2015–2022、延迟加载 DLL
- PE 格式:PE Format(官方)、PE 格式剖析(IAT/INT)
- GCC / libstdc++:Dual ABI、ABI Policy、-fvisibility、Function Attributes、GCC Bug 88413
- ELF 与安全缓解:LSB ELF 动态链接(PLT/BIND_NOW)、RELRO、理解 RELRO
- 其他:binutils ld WIN32(.def PRIVATE)、Oracle 符号作用域、Itanium ABI 邮件列表(St/Ss)
- 外部素材:Itanium 编码表、MSVC Decorated names、PE Format 三份官方来源面板,均按引用链接使用
- 本机实测源码与原始读数:随篇入库,路径
content/blog/cpp-language-foundations-ep06-abi-symbols/evidence/
下篇预告
【C/C++ 现代语言与底层】(七)链在一起:LTO 与 PGO 的收益从哪来——为什么开了 LTO 之后,内联能跨过 .cpp 的边界?PGO 采集的 profile 数据到底喂给了优化器什么?-flto 与 /GL+/LTCG 是同一件事吗?全程序优化为什么会让编译时间和内存占用暴涨?用实际构建对比把"跨 TU 优化的收益与代价"算清楚。
希望能对大家有所帮助。下一篇见。
本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations