站点链接:技术博客页 | 公众号:溯光的图形笔记
第九篇把一次冲击拆到了底。接触与约束共享同一个求解循环,顺序冲量(sequential impulse)在一个时间步里一遍遍把相对速度削掉,穿透靠速度迭代(velocity iteration)收敛,位置偏差靠位置迭代(position iteration)收回。那一篇回答的是「一步里怎么解」。这一篇把镜头往后拉一格,问两个新问题:一步里,谁跟谁可以同时解?什么东西可以根本不参与?前一个问题的答案是仿真岛(simulation island),后一个问题的答案是睡眠(sleeping)。用一句话说清本篇在系列里的位置:前九篇讲「一步里怎么解」,这一篇讲「谁跟谁可以同时解、什么东西可以根本不参与」。全系列目录里,这一篇排在接触求解之后、CCD 与确定性之前。
先看题图。
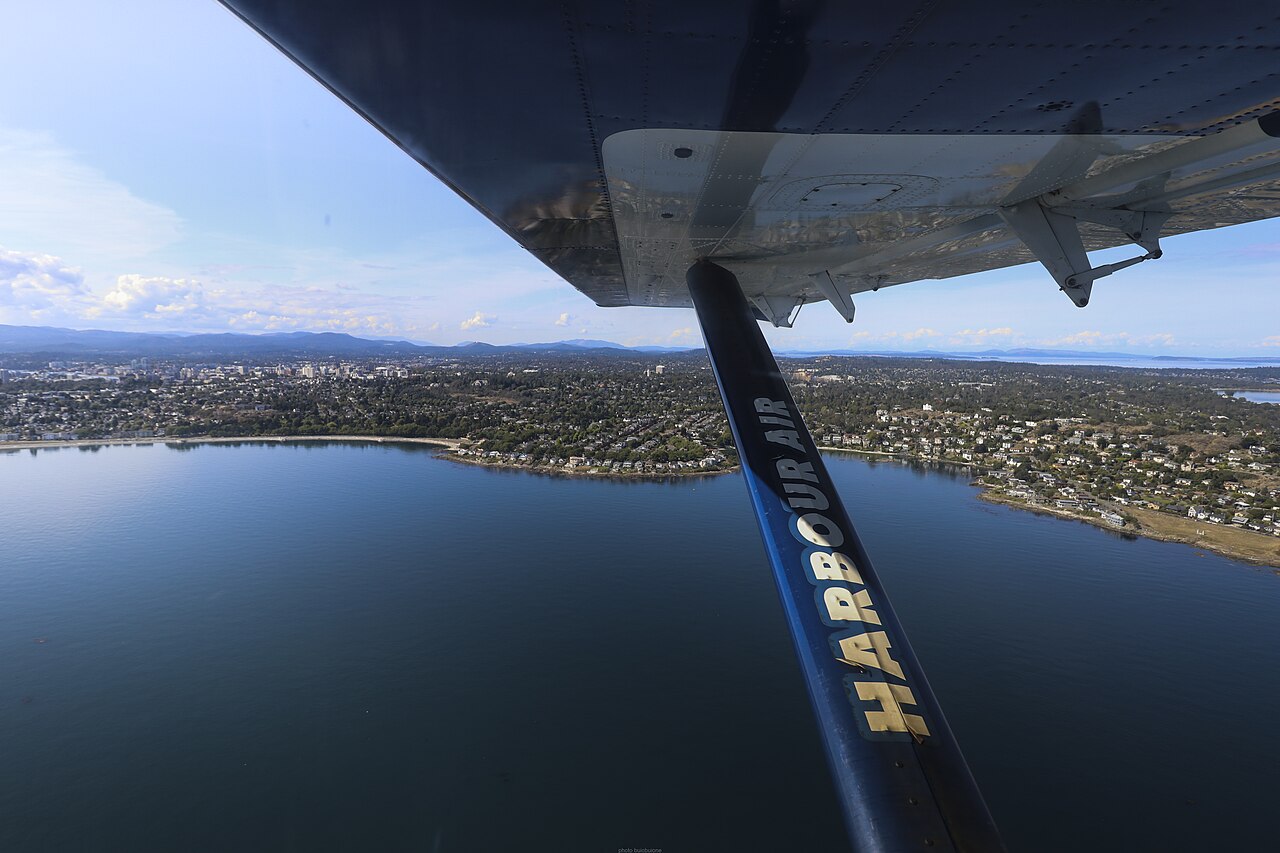
Aerial photographs of the archipelago of Victoria 01.jpg(CC BY-SA 4.0,Buiobuione)照片里能一眼看出两层结构。一层是「团」:同一座岛上,任意两点之间总有一条陆路可走。另一层是「断」:两座岛之间隔着水,走不通。物理引擎在一帧里要做的事,恰好可以按这两层来分。把每个 body 看成一块陆地,把两体的接触或约束看成一条陆路,那么一整片场景就被切成了若干个互不连通的团,每个团就是一座岛。团内的 body 彼此影响,必须一起解;团与团之间没有任何一条路径,可以放心交给不同的线程同时解。这是「可并行」的来源。
还有第二层收益,藏得更深一点。如果一个团里的 body 全部停下来不动,这个团就可以整块地从这一步的计算里摘出去,什么都不用算,直到有人碰它一下。这是「可整块摘出」。它省下的是整座岛在后续每一帧里的全部工作,而不只是几个 body 的求解。一张场景里往往有大量已经安顿好的小岛,摘掉它们,剩下的活才是这一步真正的成本。
两条收益合起来,构成本篇要讲的粒度问题。前九篇一直在讲「一条关系怎么被解掉」,单位是 body 对、是接触、是约束;这一篇把单位抬到岛,讨论的是「岛与岛之间能不能同时推进」以及「一整座岛能不能不出场」。
三条主线的落点先摆清。岛的代价:岛不是持久结构,引擎每一步都从头重建,靠一套无锁并查集(union-find)在 O(N) 里重建完成,落点 §一、§二。并行的代价:重建出来的岛先按规模降序排好,最长的作业(job)先跑,落点 §三;超过阈值的岛再被切成一堆能同时推进的小组,落点 §四、§五。睡眠的代价:睡眠是整岛粒度的,判定取三个点,落点 §六、§七、§八。反误区与四家引擎对照落在 §九,边界、演进与资源清单落在 §十。
版本口径写清一次,本篇给的所有行号都按它取。本机快照 v5.5.0-183-g765845d6,即 v5.6.0 的源码本体,两者只差版本号与文档收口;快照自述 5.5.1。tag v5.6.0 与本机快照之间只有 2 个提交、只动 4 个文件,本篇要引的源码文件在两点之间逐字节相同,所以文中的行号对 raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/… 的链接同样成立。
OK,把范围收好,从「一次 step 里哪些东西可以不算」这个入口进去。
入口:一次 step 里,哪些东西可以不用算
一句话说清这一节:物理的一步里,真正必须算的是「这一步还在动的那些 body 之间的关系」,能省的活有三类,岛是把这三类省法统一起来的单位。这一节把入口摆出来,并交代本篇的边界。
0.1 一步里三类可以省掉的活
OK,把 PhysicsSystem::Update 走一遍,能省的地方集中在三处。
第一处是「不动的东西」。一个 body 如果连续一段时间几乎没有位移,也没有人推它,它的下一帧与这一帧几乎没有差别,求解它等于白算。更省的做法是让它睡下,把它从这一步的活跃集合里整个摘出去。摘掉之后,它连求解循环都不进,只有碰撞检测还留着一条眼线,等有人碰它再叫醒。Architecture.md 第 421 行写着睡眠体的行为:When a body is sleeping, it can still detect collisions with other objects that are not sleeping, but it will not move or otherwise participate in the simulation to conserve CPU cycles.(睡眠体仍在检测碰撞,只是不再移动、不再参与仿真,以省下 CPU。)
第二处是「彼此无关的活」。两个 body 之间没有任何接触,也没有任何约束连着,那么它们这一步的计算完全独立,谁先谁后都不影响结果,可以同时推进。把这种独立关系显式找出来,一批活就能摊到多个核上。找法就是建岛:先把场景切成互不连通的团,团与团之间天然独立。
第三处是「一次算好、反复复用」的活。装配阶段算出来的有效质量与偏置,在这一步的每一次迭代里重复使用。这类活不属于「省掉」,属于「一次性投入」。
三类省法里,前两类都落在同一个对象上,就是岛。官方在文档里给的划分口径很直接:一步里,body 被分成若干 island,岛内靠接触或约束相连。岛同时是「可并行」的单位与「可整块摘出」的单位:岛间独立,所以能并行;岛内一致,所以能整块睡下或整块醒来。这一篇的主线就是这两个属性怎么被引擎造出来、怎么被用掉。
好了,把入口写成一个可操作的判据:一步里,一个 body 大致会落在三种状态之一,必须算(它是活跃的,或它所在的岛被唤醒了)、可以不算(它所在的岛整体睡着)、可以并行算(它所在的岛与别的岛没有联系)。后两种状态都由岛决定。
0.2 本篇边界
说白了,边界声明写进正文,供后面的交叉检验用。本篇不涉及连续碰撞检测(continuous collision detection,CCD)与确定性(determinism),这两件事落在第十一篇;不涉及软体(soft body),落在第十三篇;不涉及角色与载具(character、vehicle)成品件,落在第十二篇。宽相(broad phase)与窄相(narrow phase)只作为建岛的输入被提到,不在本篇展开。
岛与睡眠的公开 API 边界也收紧一句。LargeIslandSplitter 头文件第 25 行有一句警告:WARNING: This class is an internal part of PhysicsSystem, it has no functions that can be called by users of the library.(这个类是 PhysicsSystem 的内部件,没有可供库使用者调用的任何函数。)本篇讲的是引擎内部的机制,不是一份可以直接调用的接口清单。
实验口径一并交代,供复现。睡眠类的实验(E0 至 E4、E7)用 0 worker,作业内联,避免调度噪声;并行类实验(E5、E6、E6c、E8)跑在真 worker 线程上(1 / 2 / 4 / 8)。两类实验的耗时读数与第八篇、第九篇不可直接横向比。编译复用第八篇的 Jolt.lib,编译开关集一致,零补丁、零 instrumentation。
源码落点:睡眠体的官方描述在 Architecture.md 第 421 行,内部件警告在 LargeIslandSplitter.h 第 25 行。其中:前者给出睡眠体「仍检测碰撞、但不参与仿真」的一手口径,后者划定岛与切分这套机制不是公开 API。
一、岛是什么:一张接触图上的连通分量
一句话说清这一节:岛是接触图(contact graph)上的一个连通分量(connected component),岛内必须一起解、岛间可以并行。这一节把这个定义、它的两个属性、以及它与「静态 / 非活跃」的关系讲清。
1.1 官方定义
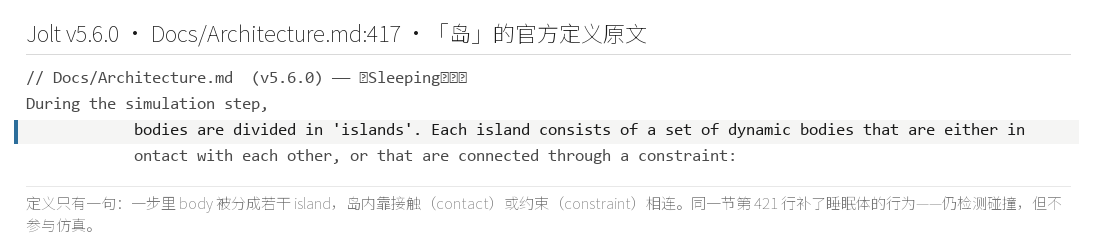
先来看看,官方文档给的定义很短。Architecture.md 第 417 行逐字:
During the simulation step, bodies are divided in 'islands'. Each island consists of a set of dynamic bodies that are either in contact with each other, or that are connected through a constraint:
(在仿真一步里,body 被分成若干「岛」。每座岛由一组动态 body 组成,它们或者彼此接触,或者通过某条约束相连。)
这个定义里有三个关键词要逐个抠。动态(dynamic):静态(static)body 不参与建岛。一颗石头与地面接触,这条接触不会把地面拉进岛里,因为地面永远不会被推动,把地面算进来只会让岛无谓地变大。接触或约束:把两个 body 连进同一座岛的理由只有两种,一种是它们有接触点,另一种是它们之间挂着一条约束。连通:这句话里最容易被跳过的是「either in contact with each other, or ... connected」这个「或」,它说的是传递关系。A 与 B 有接触,B 与 C 有约束,那么 A、B、C 全在同一座岛里,哪怕 A 与 C 之间没有任何直接关系。
把这三条落成一张图,接着看。
1.2 一张接触图上的连通分量
言归正传,想象把场景画成一张图。每个动态 body 是一个顶点(vertex);两体之间只要有接触或约束,就在它们之间连一条边(edge)。这张图就是接触图。岛,就是这张图里的一个连通分量:从岛内任意一个顶点出发,都有一条边路能走到岛内任意另一个顶点;从一个岛出发,走不到另一个岛去。
举个能数的例子。场上五个动态 body:A、B、C、D、E。A 与 B 接触,B 与 C 之间挂着一条铰链(hinge),D 与 E 彼此接触,C 与 D 之间既没有接触也没有约束。这张图会被切成两个连通分量:{A, B, C} 一座岛,{D, E} 另一座岛。C 与 D 之间没有边,两座岛就断在这里。
这个切法直接给出两个属性。
岛内必须一起解。求解在一座岛内是耦合的:A 上的冲量会改变 B 的速度,B 一变,B 与 C 那条铰链要出的冲量跟着变。要一次算准,就得把岛内所有关系联立起来解。顺序冲量绕开了联立,但绕不开岛:它仍然要在同一座岛内反复迭代,把冲量在岛内来回传,直到收敛。同一座岛里的关系必须由同一批线程按同一套迭代推进,否则传递就会断。
岛间可以并行。两座岛之间没有任何一条边,岛 1 里所有的冲量都改不到岛 2 里任何一个 body 的速度。两座岛的求解是两件互不影响的事,交给两个线程同时做,结果与串行做一样。这是整篇「并行」二字唯一的地基,后面 §三 的排序、§四 的切分,都只是在这块地基上做的工程优化。
1.3 岛与「静态 / 非活跃」的关系
OK,有一处容易被忽略的边界:岛里装的是动态 body,静态 body 与 kinematic body 的处理方式不一样。kinematic body(运动学 body,运动轨迹由代码直接设定)不受冲量影响,所以约束改不动它的速度,它也就不需要进岛。官方在 2026 年的一条改动里专门修过这一点,ReleaseNotes.md 第 38 行逐字:Kinematic bodies were assigned to the same island as bodies that were constrained to / in contact with them. This led to larger simulation islands and impacted performance.(kinematic body 曾被分到与它们接触或被约束的 body 同一座岛里,这让仿真岛变得更大,影响了性能。)这一句把「岛越大越拖性能」这条经验的来处标了出来,它也是 §九 第二条反误区的证据。
另一处边界是「非活跃」。非活跃(inactive,也就是睡着或从未醒来)的 body 不进岛。理由与静态 body 一样:它不会被推动,把它算进岛,岛只会更大,而求解它的结果是零。这条边界落在建岛的源码里,§二 会给出行号与原话。
这两条边界加起来,岛的准确定义要补一句:岛是一张接触图上的连通分量,图的顶点只收动态且活跃的 body。少了这句限定,一个堆满地面的场景会把整片地面都拉进同一座岛,岛会大得毫无意义。
源码落点:岛的定义在 Architecture.md 第 417 行,kinematic 同岛修复在 ReleaseNotes.md 第 38 行。其中:前者是「岛内靠接触或约束相连」的官方定义原话,后者记下官方把 kinematic body 移出岛的动机,直接印证「岛越大越拖性能」。
二、建岛三步:每步从头重建,为什么够快
一句话说清这一节:岛每一物理步都从零重建,靠一套无锁并查集在 O(N) 里跑完。这一节走完三步(连接、收口、以及支撑它们的无锁结构),并解释「每步重建」为什么不会成为瓶颈。
2.1 三步与接口
好了,建岛不是增量维护,是每步重建。官方文档第 940 行逐字:Since we allow concurrent insertion/removal of bodies we do not want to keep island data across multiple simulation steps, so we recreate the islands from scratch every simulation step. The operation is lock-free and O(N) where N is the number of constraints.(因为引擎允许并发地增删 body,它不想让岛数据跨多个仿真步保留,所以每一步都从零重建岛。这个操作无锁,复杂度 O(N),N 是约束数。)
为什么敢每步重建?答案在「并发增删」四个字上。场景里的 body 随时可能被加进来或拿掉,如果一个岛的数据要跨步保留,那么每一次增删都得去修补这张持久结构,还得为「谁在修补的同时别人在读」解一道加锁题。每一步从零重来,把这份维护成本换成了一次线性的扫一遍;扫一遍是 O(N),而且没有锁。
重建分成三步。第一步是连接,把「哪些 body 之间存在关系」记下来;接口有三条:LinkBodies 把两个 body 连进同一座岛,LinkConstraint 记下「某条约束涉及哪个 body」,LinkContact 记下「某个接触涉及哪个 body」。第二步是收口,Finalize 把前面记下的链整理成一座座岛,并给每座岛编号。第三步是取用,GetNumIslands 数出岛数,GetBodiesInIsland / GetConstraintsInIsland / GetContactsInIsland 逐岛取内容。
完整的公开接口清单连同行号如下:
| 行 | 接口 | 作用 |
|---|---|---|
IslandBuilder.h:25 |
Init(uint32 inMaxActiveBodies) |
按最大活跃 body 数初始化 |
:28 |
PrepareContactConstraints(...) |
为接触侧准备链接数组 |
:31 |
PrepareNonContactConstraints(...) |
为约束侧准备链接数组 |
:34 |
LinkBodies(uint32, uint32) |
把两个 body 连进同一座岛 |
:37 |
LinkConstraint(uint32, uint32) |
记下约束到 body 下标的映射 |
:40 |
LinkContact(uint32, uint32) |
记下接触到 body 下标的映射 |
:43 |
Finalize(...) |
整理成岛并编号 |
:46 |
GetNumIslands() |
岛的数量 |
:49 / :50 / :51 |
GetBodiesInIsland / GetConstraintsInIsland / GetContactsInIsland |
逐岛取内容 |
:54 / :55 |
SetNumPositionSteps / GetNumPositionSteps |
每岛的步数覆盖 |
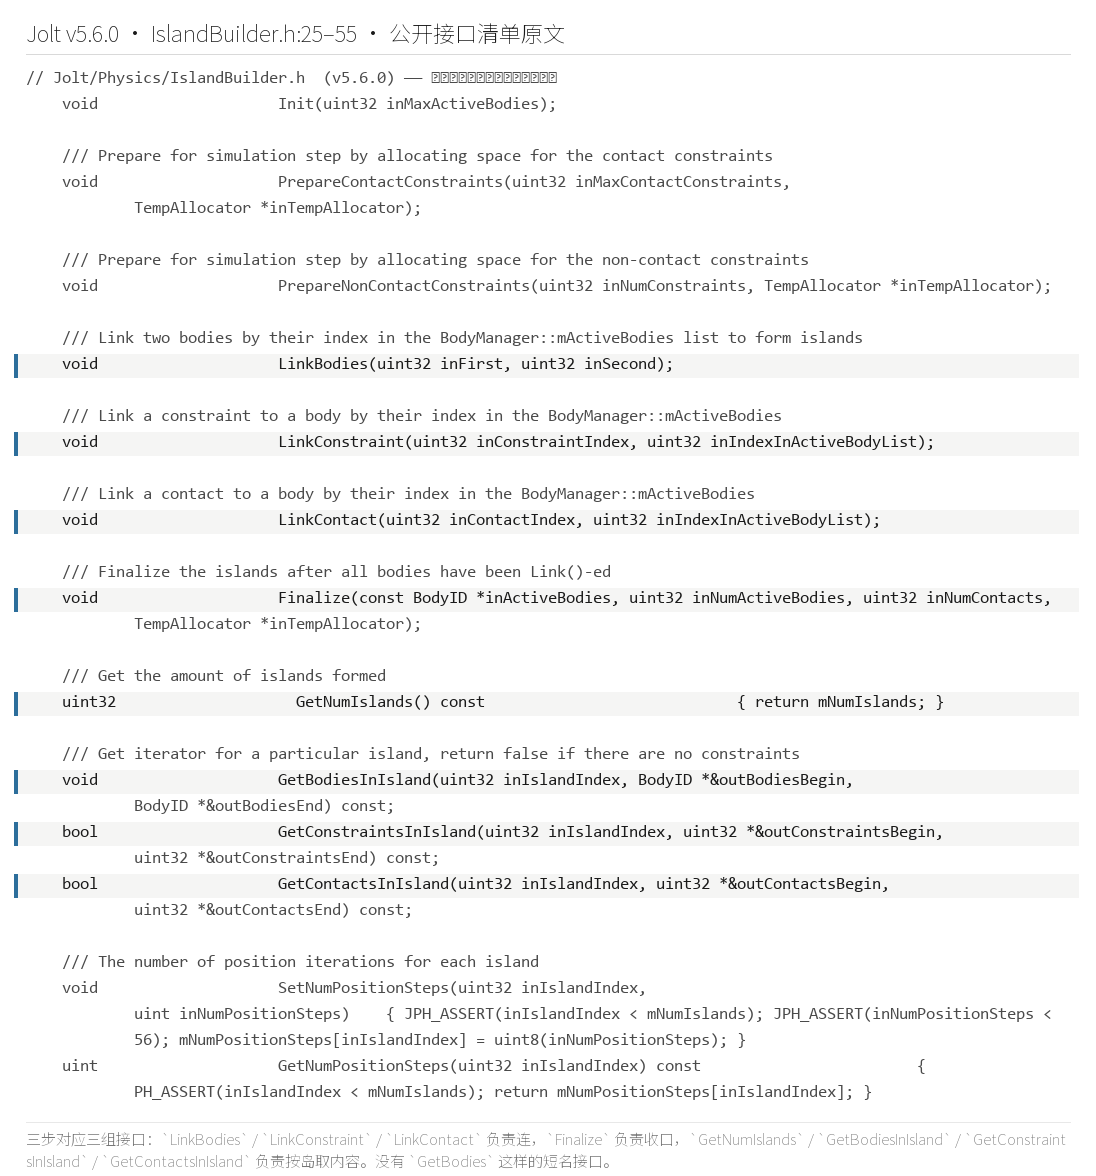
IslandBuilder 的公开接口清单原文(IslandBuilder.h:25–55):LinkBodies / LinkConstraint / LinkContact 负责连,Finalize 负责收口,四个 Get*InIsland 负责按岛取内容;没有 GetBodies 这样的短名接口@ Jolt Physics v5.6.0 源码原文截取(MIT)说白了,接口里最不起眼的一处是,LinkBodies 与 LinkConstraint / LinkContact 的签名都不带锁的参数。没有锁,是因为合并用的是另一套办法。
2.2 无锁并查集
先来看看,把「哪些 body 属于同一座岛」这件事抽象一层,就是并查集(union-find)。并查集的原理很朴素:一堆元素,支持两种操作,把两个元素并到一组、查一个元素属于哪一组。Jolt 用了一套无锁的并查集来做这件事,每个 body 只存一个数,指向同组里一个更小的下标。
数据结构在一个原子数组里。IslandBuilder.h 第 96 行是 mLinkedTo,类型是 atomic<uint32>,注释写明它指向同岛内下标更小的 body。整座岛的信息不靠一棵显式的树来存,靠每个元素指向一个比自己小的下标,链最终收在一处,那一处就是一个自指的 body(mLinkedTo 指向自己),它就是这座岛的代表。
三步走完一整套。
第一步,初始化自指。 IslandBuilder.cpp 第 38 至 40 行把每个 body 的下标写进自己的 mLinkedTo,让它们各自成为一座单元素岛。数组在 Init 里就按最大活跃数分配好,这一步只是把每个位置填成自身下标,够快也够简单。
查找代表由 GetLowestBodyIndex(第 86 至 97 行)负责,它从给定下标出发,沿 mLinkedTo 链一路走到自指的那一处,走到的那个节点就是这座岛当前的根,也是后续所有合并动作的比较基准。
第二步,把高下标并到低下标。 这是合并的主循环,在 LinkBodies 里,第 99 至 156 行。核心注释在第 127 至 143 行,逐字:We always link the highest to the lowest(总把高下标连到低下标)。做法是先沿两条链各找到一个全局最低的代表,然后试图把较大的代表改指向较小的代表;改动通过 compare_exchange_weak 完成,失败就重读重试。
这套「只往低处指」的规则带来两个好处,缺一不可。其一,链的方向单调,不会绕圈。只要每个节点都指向比自己严格小的下标,沿着链往下走只可能越来越小,永远到不了环里。其二,代表可比较,两座待合并的岛谁当代表有一个确定答案,就是那个更小的下标;不需要额外的编号分配,也不需要加锁去协调「谁当老大」。两个线程同时合并同一个 body 时,compare_exchange_weak 保证只有一个的写入落地,另一个读到新值后按新值重试。这就是整件事无锁的全部秘密。
第三步,路径压缩把链压平。 光靠「往低处指」,链会变长,下一次找代表要沿链走很多步。第 151 至 153 行做路径压缩(path compression):把沿途经过的节点直接改指到它找到的根,用 AtomicMin 完成。压缩之后,链的深度很快降到个位数,后续查找便宜下来。
还有一条提前退出,写在 LinkBodies 的开头。第 102 行的注释是 we don't want to create an island with static objects(不想让静态物体进岛),对应代码:只要传进来的两个下标里有一个不是动态活跃 body,函数直接返回,不做任何合并。这一条把 §一 那条边界落到了实处:静态、kinematic、非活跃的 body 根本不会被拉进岛。
约束与接触的链接走另外两条轻量接口,第 158 至 164 行的 LinkConstraint 与第 166 至 172 行的 LinkContact。它们不做合并,只记下「某条约束(或某个接触)涉及哪个 body 下标」,真正的合并留给后面的收口。
LinkBodies 把高下标并到低下标,路径压缩把链压平;非活跃 body 进来就直接返回@ 本系列绘制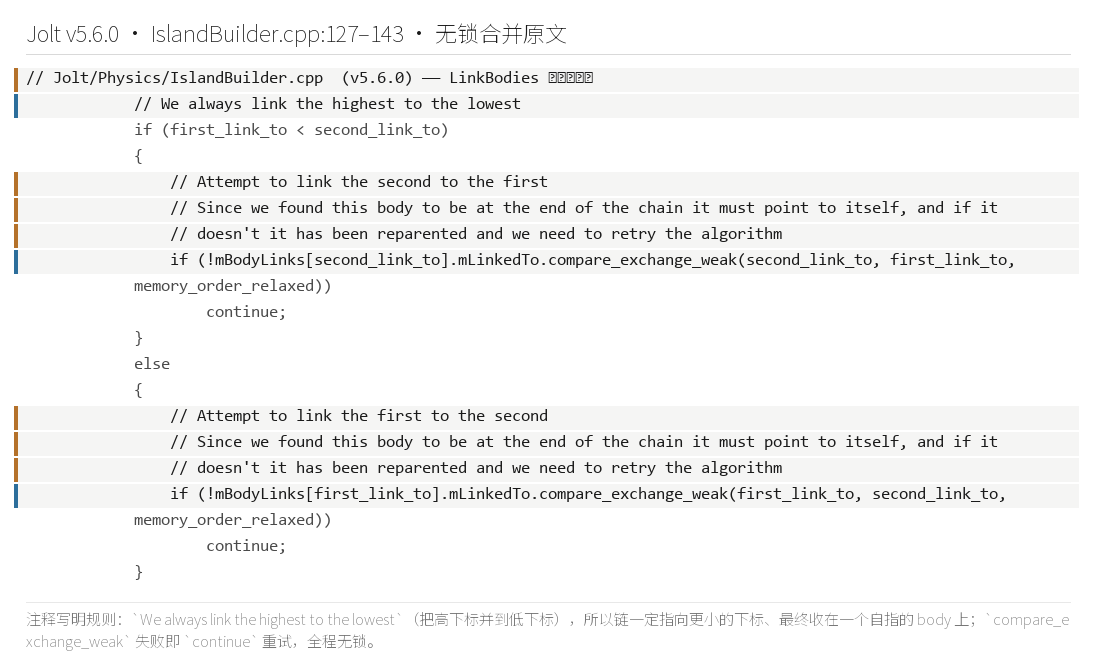
LinkBodies 的无锁合并原文(IslandBuilder.cpp:127–143):注释写明 We always link the highest to the lowest,compare_exchange_weak 失败即 continue 重试,全程无锁@ Jolt Physics v5.6.0 源码原文截取(MIT)2.3 Finalize 收口
三步的收口在 Finalize,第 374 至 392 行。它按顺序做三件事:先 BuildBodyIslands(第 380 行)把 body 分成岛并编号,再对约束与接触两侧各跑一次岛归属(第 381、382 行),最后 SortIslands(第 383 行)把岛按规模排好。
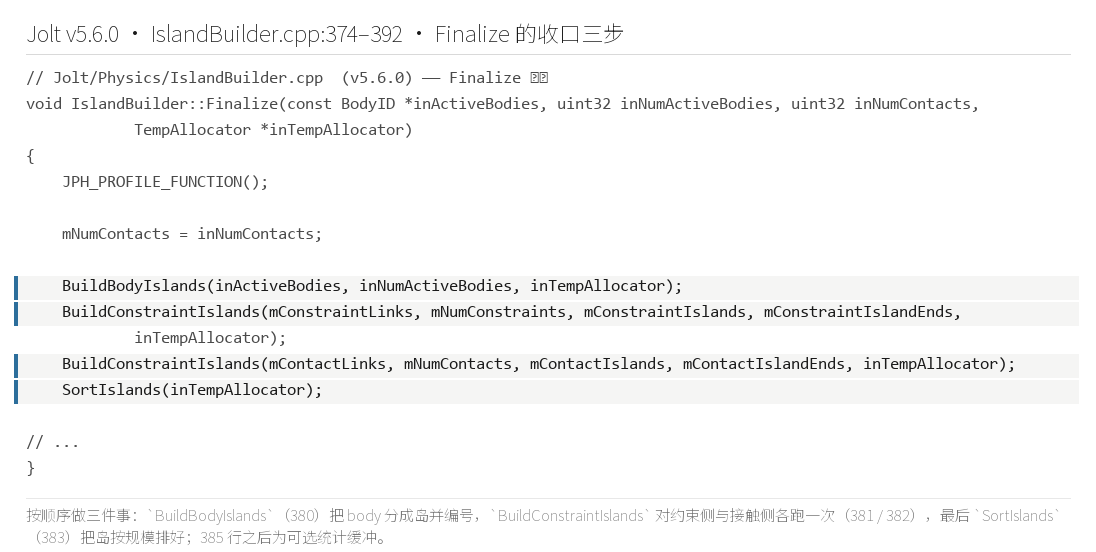
Finalize 的收口三步原文(IslandBuilder.cpp:374–392):先 BuildBodyIslands 把 body 分成岛并编号,再对约束与接触两侧各跑一次 BuildConstraintIslands,最后 SortIslands 按规模降序@ Jolt Physics v5.6.0 源码原文截取(MIT)BuildBodyIslands 在 229 至 252 行,逻辑只有一句:一个 body 的 mLinkedTo 如果指向自己,它就是一座新岛的代表,给它分一个新编号;如果不是,它跟随链上根 body 的编号。编号是顺序发的,发完一座岛再发下一座,所以编号本身没有「大小」含义,只是索引。
排完序之后,GetBodiesInIsland 这类接口才能按编号逐岛取内容。这里有一个容易误读的点:Finalize 之后岛的结构就固定下来,这一步求解的所有作业都读同一份编号,作业结束前不会再改。跨步则完全不保留,下一步重新 Init、重新连、重新收口。
把三步放一起看,它的成本结构与直觉相反。一般人以为「每步重建」意味着每步都有一笔可观的固定开销,实际上这笔开销是 O(N) 的一次扫描,N 是约束与接触的总数,且全程无锁;而它换来的,是不必维护跨步的持久结构、不必为并发增删的修补分心。这是「每步从头重建」为什么够快。第 940 行那句 lock-free and O(N) 是这条结论的官方口径。
源码落点:接口在 IslandBuilder.h 第 25 至 55 行,算法在 IslandBuilder.cpp 第 38 至 40 行、第 99 至 156 行、第 229 至 252 行、第 374 至 392 行。其中:Init 的自指初始化把每个 body 变成单元素岛,LinkBodies 用 compare_exchange_weak 与 AtomicMin 完成无锁合并与路径压缩,Finalize 依次调 BuildBodyIslands、两侧岛归属、SortIslands。
三、排序与提前退出:最大的岛排最前,只是为了整齐吗
一句话说清这一节:把岛按规模降序排,是为了让最长的作业先跑、所有作业同时收工;而降序这件事又让切分的准备阶段能提前退出,一箭双雕。这一节把排序的依据、它的用途、以及「上限不等于开销」串起来。
3.1 排序依据
Finalize 的最后一步是 SortIslands(IslandBuilder.cpp 第 328 至 372 行,方法本身是 private)。排序的键是每座岛的规模,具体是「约束数加接触数」,第 366 至 368 行用 QuickSort 完成排序,比较函数是 num_constraints[inLHS] > num_constraints[inRHS],也就是按规模降序。理由写在第 364 至 365 行,逐字:// Sort so the biggest islands go first, this means that the jobs that take longest will be running // first which improves the chance that all jobs finish at the same time.(把最大的岛排最前,这样耗时最长的作业会最先开始跑,所有作业同时收工的几率就更高。)
降序的用途要看求解侧的作业分配。一步里,一座岛会被打包成一个或几个作业,交给线程池去跑。线程池里有若干 worker,谁先空闲谁就接下一个作业。如果岛的规模是大大小小随机排列,那么排在后面的大岛可能很晚才开始,所有 worker 都等它一个,收工时间被它拖长。把大岛前置,等于先把最长的那条领走,短作业随后填满剩下的空档,所有 worker 的收工时间就更接近。这是一条典型的「最长作业优先」调度,排序本身不改变任何物理结果,改的是硬件利用率。
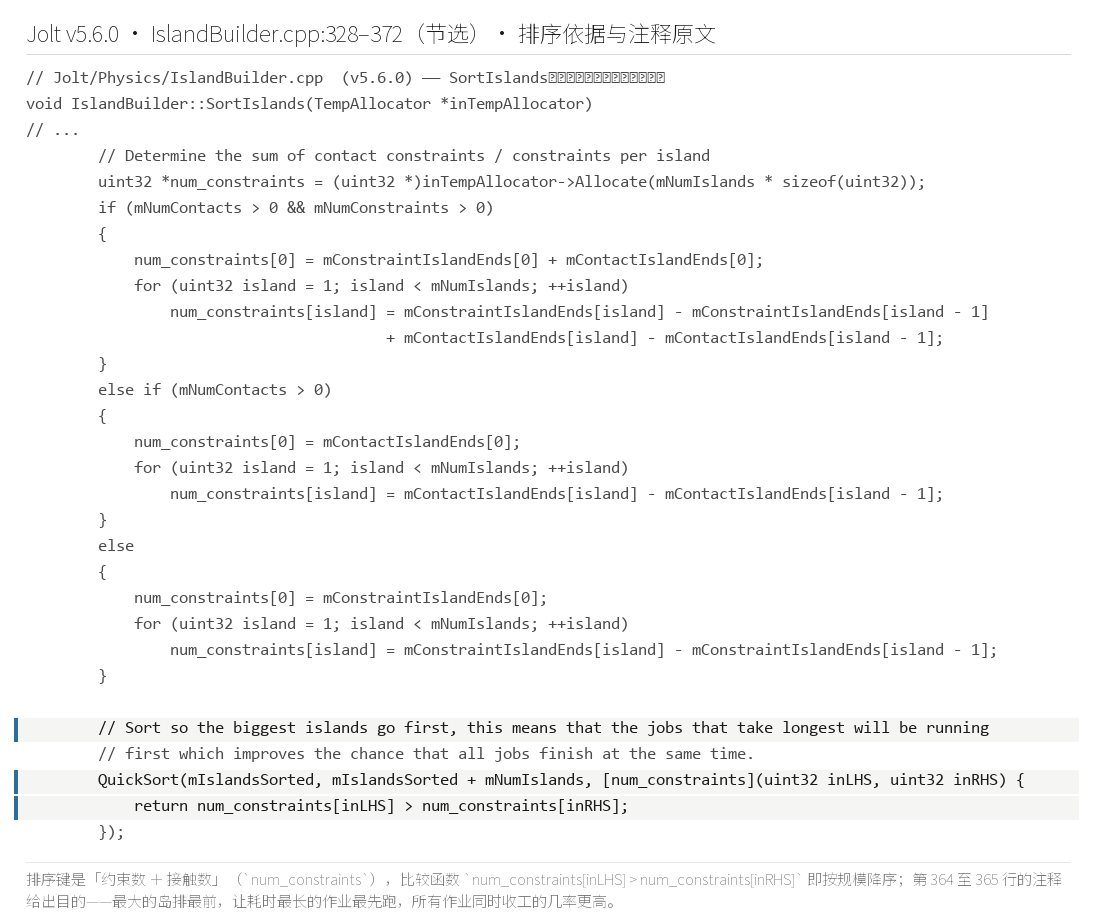
SortIslands 的排序依据与注释原文(IslandBuilder.cpp:328–372 节选):排序键是「约束数 + 接触数」,注释写明目的是让耗时最长的作业最先跑、所有作业同时收工@ Jolt Physics v5.6.0 源码原文截取(MIT)3.2 提前退出
排序的第二个用途,在切分那一侧才显出来。大岛切分(large island splitting)做的事,是把一座超过阈值的岛拆成一组能同时推进的小组。阈值常量是 cLargeIslandTreshold = 128,LargeIslandSplitter.h 第 34 行,注释写明「岛内的约束数加接触数超过这个值,就尝试切分」。切分的准备阶段是 Prepare,它在 LargeIslandSplitter.cpp 第 186 至 234 行,逐岛扫描,只对那些够大的岛做切分。
扫描能提前收住,靠的就是 §3.1 的降序。第 212 行有一句注释,逐字:If this island doesn't have enough constraints, the next islands won't either since they're sorted from big to small(如果这座岛的约束不够多,后面的岛也不会够,因为它们是从大到小排的。)代码在这里直接 break:一旦遇到第一座不够 128 的岛,后面全部不用再看。
把这个 break 的合法性摊开,依据的原理只有一条:岛已经按规模降序排好,序列从一个一个往下走,规模单调不增。第一座小于 128 的岛出现时,它后面所有岛的规模都小于等于它,也就都小于 128,全都不够切分。此刻退出,跳过的是确定不会命中的检查。
这一段扫描只在切分打开时才会跑到。开关是 mUseLargeIslandSplitter,PhysicsSettings.h 第 119 至 120 行的默认值是 true,PhysicsSystem.cpp 第 1363 行在打开时才调 mLargeIslandSplitter.Prepare(...)。关掉切分,Prepare 整段不参与,这一处提前退出也就无从触发。
3.3 从排序到切分的呼应
两小节合起来看,排序与切分是同一条链上的两环,中间靠「有序」这件性质连着。
排序在最前面把岛按规模排好,它最初的目的是调度:最长作业优先,收工时间对齐。排完之后,规模这件事在序列上有了方向,从小到大的位置关系被固定下来。切分的准备阶段随后借用这个方向:既然序列单调不增,那么「第一个不够大的岛」就成了一条分界线,线后面全是小岛,检查可以直接停。排序本来只服务调度,顺带把切分准备的成本从「逐岛看完」降到「看到分界线为止」。
这里还要交代一句「上限不等于开销」,它是本篇反复出现的一条经验。128 是一个上限性质的阈值:岛到 128 才有资格被切分,126 与 130 的岛在是否触发切分上完全不同,可 126 与 100 的成本并不会因为「离上限近」而多算一点。同理,SortIslands 排的是全部岛,它自己不负责「只排大的」;Prepare 的 break 也不是「算了一半放弃」,它是在一个已经确定会有序的序列上,把不可能命中的部分整段跳过。这两处都在说明同一件事:引擎把「判断」做得很便宜,把「计算」压到真正需要的部分。
把这一节收成一句:降序排序让最长的作业先跑,所有作业朝同一个收工时间靠;同时它把岛排成单调序列,让切分准备能在一个 break 里收住。排序看起来只是整理顺序,实际同时服务了调度与剪枝。
Finalize 先把岛按规模降序排好,Prepare 从头顺序扫描,遇到第一个不够大的岛就 break,因为后面只会更小@ 本系列绘制源码落点:排序在 IslandBuilder.cpp 第 328 至 372 行,提前退出在 LargeIslandSplitter.cpp 第 212 行,阈值常量在 LargeIslandSplitter.h 第 34 行。其中:SortIslands 按「约束数加接触数」降序排,Prepare 的 break 依赖这份有序性,cLargeIslandTreshold = 128 是这条依赖能成立的门槛。
四、大岛切分
本节回答:一个岛的接触与约束加起来超过 128 项之后,引擎凭什么把它拆成能同时推进的若干组,拆的依据是哪些数字。
4.1 五个常量
言归正传,大岛切分(large island splitting)的全部参数都写死在 LargeIslandSplitter.h 里,一共五个常量。它们编译期定死,改一个要重编引擎;运行期只剩 PhysicsSettings::mUseLargeIslandSplitter(PhysicsSettings.h:119–120,默认 true)这一个总开关。切分的形状(最多几组、多小算小、一批几项)在编译期就定了,运行期能选的只有要不要用它。
第一个是 cNumSplits,.h:32 写作 sizeof(SplitMask) * 8。SplitMask 是 32 位无符号整数,表达式的结果就是 32。它是一条硬上限:一个岛最多切成 32 个组,数字与位掩码的位宽绑在一起,位掩码多一位,理论上限就多一组。
第二个是 cNonParallelSplitIdx,.h:33 等于 31。它是 32 个组里下标最大的那一组,留出来做非并行组,装那些规模太小、单独并行不划算的接触与约束,最后交给单个线程顺序解。
第三个是 cLargeIslandTreshold,.h:34 等于 128,注释原文 If the number of constraints + contacts in an island is larger than this, we will try to split the island。计数口径是「约束数 + 接触数」,不是 body 数。一个 145 个 body 的堆,脚底接触与堆内两两接触累加,项数远超 145,跨过 128 并不难。
第四个是 cSplitCombineTreshold,.h:170 等于 32,注释原文 If the number of constraints + contacts in a split is lower than this, we will merge this split into the 'non-parallel split'。组里的项数不到 32,就并进第 31 组。
第五个是 cBatchSize,.h:171 等于 16,注释原文 Number of items to process in a constraint batch。一个组不会一次被某个作业整块吃掉,按 16 项一批喂,作业反复取批。
五个数各有各的层级:128 管「要不要切」,32(位宽)管「最多切几组」,32(合并阈值)管「太小的组怎么办」,16 管「每组怎么喂给作业」。它们不互相替代。
把五个常量串起来看,切分是一串有顺序的判断。Prepare 先拿 128 做闸门,判断这个岛值不值得切;SplitIsland 再用位掩码摊组,摊完拿 32 检查哪些组太小;太小的并进第 31 组;剩下的组按 16 一批喂给作业。任何一步不满足,后面就不走。128 这个闸门本身是一个经验值,源码里没有给出推导,它就摆在头文件里,与其余四个常量一样是调参的结果,不是从公式算出来的。
回过头补一句不切分的情形。岛内项数不到 128,SplitIsland 直接返回 false(.cpp:301–302),整座岛交给一个作业在单线程里解完,不分组、不同步。这是小岛走的路径,也是 E6c 里差异恒为 0 的机制来源:没进切分,就没有求值顺序的改变。
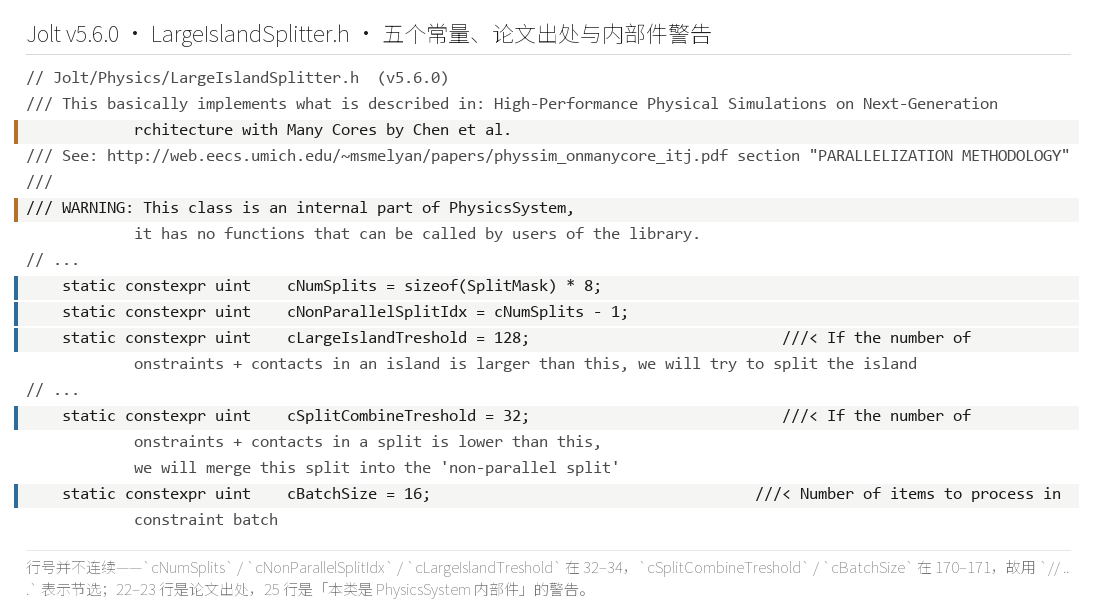
LargeIslandSplitter 的五个常量原文:cNumSplits / cNonParallelSplitIdx / cLargeIslandTreshold 在 32–34 行,cSplitCombineTreshold / cBatchSize 在 170–171 行;22–23 行是论文出处,25 行是「本类是 PhysicsSystem 内部件」的警告@ Jolt Physics v5.6.0 源码原文截取(MIT)4.2 位掩码贪心:组内为什么不共享 body
OK,切分的核心函数是 AssignSplit(LargeIslandSplitter.cpp:236–273)。它替每一项接触或约束挑一个组,规则只有一条:找第一个两个 body 都空闲的组。
放到代码里看,每个组对应 SplitMask 里的一位。算一项接触时,把接触两端 body 已经占用的组位按位或起来,(~mask1) & (~mask2) 剩下的就是「两个 body 都不在的组」,再交给 CountTrailingZeros 取最低位(.cpp:267),最低位优先就是「第一个空闲组」。
这条规则顺带保证了组内不共享 body。一项接触只被放进两个 body 都空闲的组,放进去之后这两个 body 就占住了这一组的对应位;后面任何还想碰这两个 body 的项,再算掩码时这些位置已是 0,取反为 1 之后不会再选到同一组。落在同一个组里的项,两两之间不共享 body。
组内不共享 body 意味着:同一组的项读写的是不同 body,彼此没有数据依赖,作业可以把这一组里的项任意分给任意线程,先后顺序不影响结果。这正是官方那句 Within a group, the order of execution does not matter since every memory location is only read/written once 的机械依据。
这条规则是贪心(greedy)的,不追求组数最少。代价是可能多开几个组,好处是每一项只看一次掩码就能落位,O(项数) 走完,不需要图着色(graph coloring)那种更重的求解。
每个 body 在切分期间带一个 SplitMask,记录自己已经落进哪些组。算一项接触,先把两端 body 的掩码或起来,就知道哪些组已经被这两个 body 占住;取反后找最低空闲位,落位,再把该位写回两端 body 的掩码。整个过程逐项推进,每一项只碰常数次位运算,切一个 O(项数) 能在一次遍历里走完。掩码宽度只有 32 位,一个岛最多 32 组这条硬上限也就在这里落地。
CountTrailingZeros((~mask1) & (~mask2)),组内不共享 body 所以可以并行@ 本系列绘制4.3 组间同步:组内可乱序,组间必须等
好了,组内可以并行,组之间不能叠加,原因在于不同组的项会共享 body。一个 body 可能出现在第 0 组的一项里,又出现在第 3 组里;两组同时开跑,同一个 body 的速度就被两个线程并发读写,结果不可重复。
官方的做法是组间设同步点。Architecture.md:983 那句 At the end of each group, we need to synchronize the CPU cores before starting on the next group 说的就是这件事:一组全部算完,所有核在此对齐,才允许下一组起跑。同步粒度是组,不是项。
说白了,切分的并行模型是「组内无序、组间有序」:组内随便乱序,因为写的位置互不相交;组间严格串行,因为写的位置会相交。组数因此不是越多越好,组一多同步点就多,每多一个同步点就多一次所有核的空等。
同步点由屏障(barrier)承担。cMaxPhysicsBarriers(PhysicsSettings.h:28)默认给到 8,cMaxConcurrency(PhysicsUpdateContext.h:34)给到 32,两条上限一起框住切分的并行规模。作业不一次把整组算完,走的是 FetchNextBatch 取一批、MarkBatchProcessed 标记一批(PhysicsSystem.cpp:1408 / :1432),组内按批流动,组的边界上落屏障。批小到 16,是为了让线程在组内也能细粒度地领活,不至于一个线程扛下一整组、别的线程干等。
Prepare 只切够大的岛 → SplitIsland 贪心切组 → 作业反复取批、标批 → 太小的组并入第 31 组由单线程解;组间必须同步,位置求解复用速度侧的切分结果@ 本系列绘制4.4 非并行组:太小的组并进第 31 组
说白了,贪心分组会留下一种尾巴:某几组只剩一两项,单独开一个作业的调度成本比省下的计算还高。cSplitCombineTreshold 就是为它设的,项数不足 32 的组一律合并进非并行组,由单线程解。
SplitIsland(.cpp:287–490)的顺序大致是这样:先判断岛够不够大,不够就返回 false(.cpp:301–302);重置切分掩码(.cpp:314);接触走 AssignSplit(.cpp:327–339),约束走 constraint->BuildIslandSplits(*this)(.cpp:343–351,约束可以自己决定归到哪一组);把项数不足 32 的组并进非并行组(.cpp:372–381);最后 splits.StartFirstBatch()(.cpp:488)起跑。
Prepare(.cpp:186–234)是切分入口,逐岛判断规模。.cpp:212 那条注释在这里第二次出现:If this island doesn't have enough constraints, the next islands won't either since they're sorted from big to small。岛已按规模降序排过,碰到第一个不够大的岛就能直接停,后面只会更小。排序那一步的价值在这里兑现。
切分的迭代次数也不是 1。.cpp:362 写着 splits.mNumIterations = ioStepsCalculator.GetNumVelocitySteps() + 1; // Iteration 0 is used for warm starting,多出来的第 0 次迭代给暖启动(warm starting)用。同一个岛的切分结果要在这些迭代之间反复用,所以组一旦切好,整个求解期间保持不变。
约束侧还有一处留白:约束可以覆写 BuildIslandSplits,自己决定归到哪一组。这条口子在 PR #1770 里被讨论过,贡献者 Megafunk 的说法是 This is so that I can create new island-affecting constraints similar to what VehicleConstraint::BuildIslands does when using Jolt as a DLL!。定位是「内部件」的 LargeIslandSplitter,靠这条虚函数对自定义约束开了半扇门,普通使用者仍然用不到。
4.5 位置侧复用速度侧的切分
先来看看,一次 step 有速度求解与位置求解两趟,两趟都要知道岛怎么切。Jolt 不做两遍切分。Architecture.md:1016 写明,位置求解用的是 the island splits that were calculated in the Solve Velocity Constraints job are reused。
复用的前提是两趟之间岛的构成不变。建岛每步重建,但在同一个 step 内部,速度趟与位置趟看的是同一份岛,切分结果直接搬过去,省下一次完整的贪心分组。
复用也解释了 LargeIslandSplitter 为什么要把状态留住。切分结果从速度趟一直活到位置趟,跨过 PrepareForSolvePositions(.cpp:531–541)这个收口点。速度趟的作业在 PhysicsSystem.cpp:1515 调用 SplitIsland,位置趟在 :2651–2652 判断大岛、:2592 / :2606 继续取批标记批。两端看的是同一份由 Prepare 建起的切分表,中间不再重算。
4.6 论文出处与一条内部件警告
言归正传,切分算法不是 Jolt 原创。.h:22–23 的注释给出出处:This basically implements what is described in: High-Performance Physical Simulations on Next-Generation Architecture with Many Cores by Chen et al.,下面跟一条镜像链接 http://web.eecs.umich.edu/~msmelyan/papers/physsim_onmanycore_itj.pdf,指向 PARALLELIZATION METHODOLOGY 一节。
这篇论文是 Chen 等人发表在 Intel Technology Journal(2007,Vol. 11, Issue 3,Simulations 专辑)上的《High-Performance Physical Simulations on Next-Generation Architecture with Many Cores》。作者名单里能看到 Yen-Kuang Chen、Jatin Chhugani、Christopher J. Hughes、Daehyun Kim、Sanjeev Kumar、Victor Lee、Albert Lin、Anthony D. Nguyen、Eftychios Sifakis、Mikhail Smelyanskiy。
有一件事要如实写:源码注释里给出的 Intel 原始链接 http://www.intel.com/technology/itj/2007/v11i3/8-simulations/4-methodology.htm 实测已经 404,会重定向到 Intel 的失效页。现在能追的是注释里第二条镜像,也就是密歇根大学那台机器上的 PDF。引用这篇论文时,把「原链已失效」一并说出来,比只丢一条死链稳妥。
Box2D 的作者 Erin Catto 在另一篇笔记里给过旁证,他说这是他所知最早的、建议用图着色(graph coloring)来加速刚体物理计算的文献。这与 Jolt 注释里 greedy algorithm 的措辞对得上:切分本来就是一次图着色式的贪心。
.h:25 还有一条要点名单独看:WARNING: This class is an internal part of PhysicsSystem, it has no functions that can be called by users of the library. 这句话把 LargeIslandSplitter 的定位钉死:它是 PhysicsSystem 的内部件,没有任何一个函数是给库使用者调用的。大岛切分不是公开 API,用户能碰到的只有 PhysicsSettings::mUseLargeIslandSplitter 一个开关。想查岛的结构、想插手切分,只能进源码,走 BodyInterface 是找不到入口的。
这条警告与社区里的一问一答对得上。Issue #521 里有人想要一个岛级的公开查询,jrouwe 的答复是引擎没有这类接口,建议改用 BodyActivationListener 去统计某个 ragdoll 的活跃 body 数。用户能看到的是活跃与睡眠的代理量,看不到岛本身的编号与组成。想观测岛,只能读源码,或者加统计开关。
下面这段是官方对切分的完整描述(Architecture.md:983),贪心分组、组间同步、最后一组单线程兜底,以及末句那句「结果几乎一样」,全部出自这里:
When an island consists of more than LargeIslandSplitter::cLargeIslandTreshold contacts plus constraints it is considered a large island. In order to not do all work on a single thread, this island will be split up by the LargeIslandSplitter. This follows an algorithm described in High-Performance Physical Simulations on Next-Generation Architecture with Many Cores by Chen et al. This is basically a greedy algorithm that tries to group contacts and constraints into groups where no contact or constraint affects the same body. Within a group, the order of execution does not matter since every memory location is only read/written once, so we can parallelize the update. At the end of each group, we need to synchronize the CPU cores before starting on the next group. When the number of groups becomes too large, a final group is created that contains all other contacts and constraints and these are solved on a single thread. The groups are processed PhysicsSettings::mNumVelocitySteps times so the end result is almost the same as an island that was not split up (only the evaluation order changes in a consistent way).
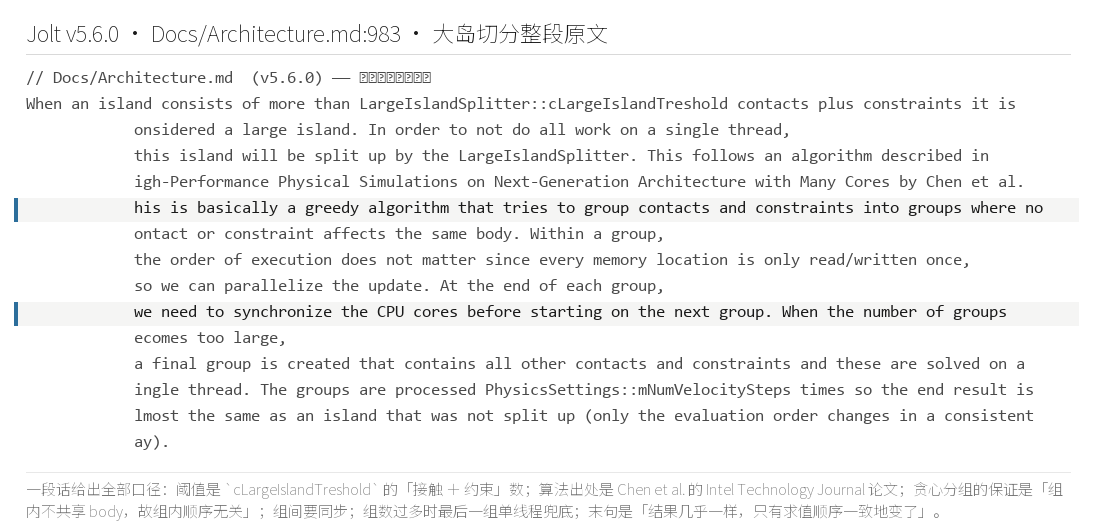
Docs/Architecture.md:983):阈值、论文出处、贪心分组的保证、组间同步、末组单线程兜底,以及那句「结果几乎一样,只有求值顺序一致地变了」@ Jolt Physics v5.6.0 官方文档原文(MIT)源码落点
- https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/LargeIslandSplitter.h 行 22–25、32–34、170–171:其中,行 22–23 是论文出处与镜像链接,行 25 是内部件警告,行 32–34 是 cNumSplits / cNonParallelSplitIdx / cLargeIslandTreshold,行 170–171 是 cSplitCombineTreshold / cBatchSize。
- https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/LargeIslandSplitter.cpp 行 186–234、236–273、287–490、531–541:其中,行 212 是提前 break 的注释,行 236–273 是 AssignSplit 的位掩码贪心与 CountTrailingZeros,行 287–490 是 SplitIsland 从阈值判断到 StartFirstBatch 的全过程,行 531–541 是位置求解前的 PrepareForSolvePositions。
- https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Docs/Architecture.md 行 983、1016:其中,行 983 是切分整段,行 1016 是位置侧复用速度侧切分那一句。
五、切分的账
本节回答一个更尖锐的问题:把大岛切成并行组之后,物理结果到底变没变。官方给的答案是「几乎一样」,本机给出的是一条约 1.5 米量级的差异曲线。两个结论要摆在一起看。
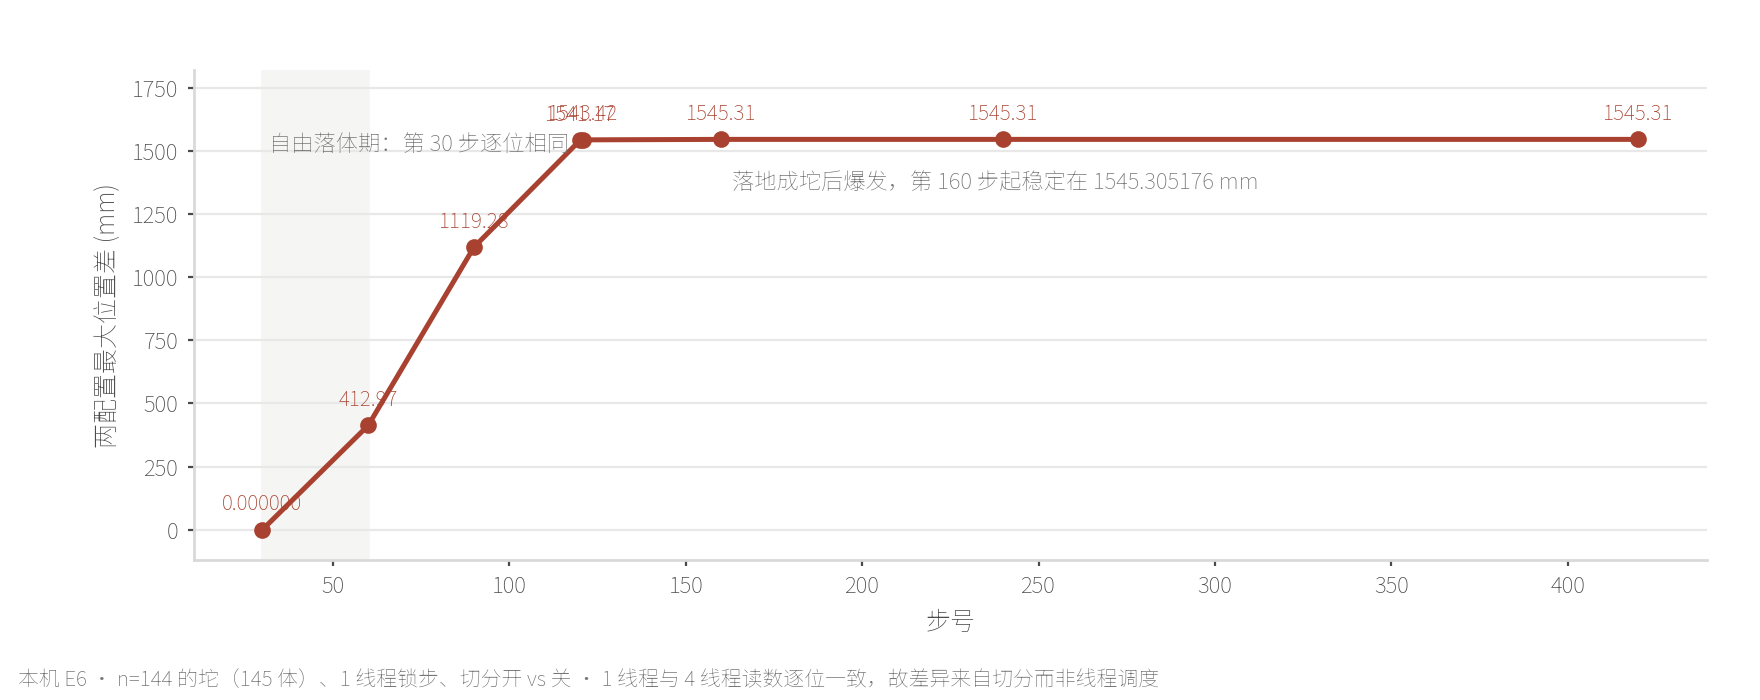
好了,先把场景说清:一个 n=144 的坨,145 个 body,mAllowSleeping=false,切分关与切分开从同样的初始状态锁步各跑一遍,每一步比一次最大位置差(单位毫米)。1 线程与 4 线程各跑一轮。
这个实验是全篇的重心,因为它直接顶到官方那句总结。官方说切分之后「结果几乎一样」,本机给出一条从 0 长到 1545.305176 mm 的差异曲线。两句话能不能共存,靠的就是把「一样」限定在什么范围里。
5.1 E6:差异随时间的生长序列
OK,读数逐位如下。
| 步 | 最大位置差(mm) |
|---|---|
| 30 | 0.000000 |
| 60 | 412.966461 |
| 90 | 1119.283691 |
| 120 | 1541.171631 |
| 121 | 1543.416870 |
| 160 | 1545.305176 |
| 240 | 1545.305176 |
| 420 | 1545.305176 |
这张表可以读成一条论证链。
第 30 步是 0.000000。这时 body 还在自由落体,彼此没有接触,每个 body 单独成岛,岛里的项数离 128 差得远,切分根本不介入。没有切分,就没有求值顺序的变化,两个配置逐位相同。
第 60 步跳到 412.966461。坨落地了,接触成片,岛内「约束数 + 接触数」跨过 128,cLargeIslandTreshold 被触发,切分介入。介入的瞬间,差异从 0 变成四百多毫米。
之后是 1119.283691、1541.171631、1543.416870、1545.305176,一步步放大,到第 160 步之后停在 1545.305176,第 240 步与第 420 步都是这个数。差异在几百步里长到约 1.5 米(1545.305176 mm),然后随堆体落定而稳定。
稳定的含义要读准:差异不再增长,两个配置各自收敛到静止,两个静止态之间差了 1545.305176 mm。堆体落定之后不再有新的接触历史被改写,放大的来源消失,差异就冻在这个值上。把第 240 步与第 420 步并排看,两个读数一模一样,说明冻结是彻底的。
关键的一条:1 线程与 4 线程读数逐位相同。同样的数字在两种线程数下重复出现,说明这条差异来自「切分 vs 不切分」这个算法开关,与多线程的调度抖动无关。切分开,每次求解的求值顺序被固定地改动一次;两者在同一台机器上各走各的确定性轨迹,差异因此可复现。
还要补一处前提:这个场景把 mAllowSleeping 关掉了。如果睡眠开着,两个配置的坨大概率先后入睡,活跃 body 数掉到零,差异会被睡眠截断,看不到长程放大。关掉睡眠,等于让两个配置一直活跃、一直互相比对,把切分的效应完整暴露出来。
另外,表里的每一行都是「同一步、同一场景、只差一个开关」的锁步比对,而非各自跑完再比终值。锁步是为了防止用两条不同时间线的终态冒充逐位差异。第 30 步到第 60 步这一跳,也正好把门槛落在 cLargeIslandTreshold 上:落地前岛小,落地后岛大,切分在两步之间从关到开。
5.2 E6c:小岛对照恒为 0
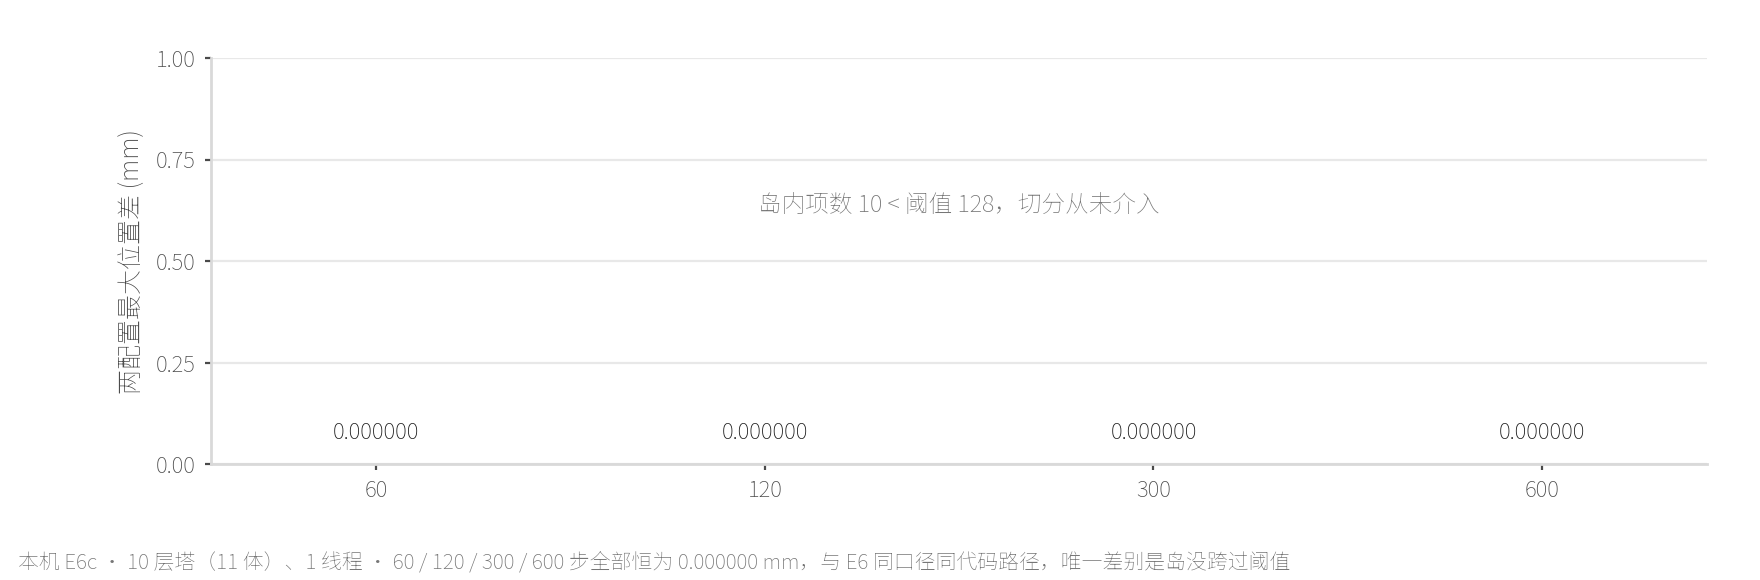
为把「是切分造成的」这件事钉死,还要一个对照:同样跑切分开关,但把场景换成岛内项数不跨 128 的小堆(10 层塔,11 个 body)。
第 60、120、300、600 步,1 线程与 4 线程的最大位置差全部 0.000000 mm。切分从未介入,两个配置的求值顺序完全一致,轨迹逐位重合。
E6 与 E6c 配成一对:项数跨过 128 就出现差异,没跨过就一点差异没有。差异的来源被夹在 cLargeIslandTreshold 这一条线上。
E6c 还有一个作用:它把「并行本身会不会引入差异」这条嫌疑排掉。E6 用 1 线程与 4 线程各跑一次,如果差异来自线程调度,E6c 在 4 线程下应该也会抖出非零,但它四项全 0.000000。并行不制造差异,切分才制造差异,这个对照把因果链收紧了一格。
对照还说明小岛路径本身是确定性的。10 层塔在 600 步里没被切分碰过,1 线程与 4 线程都给出 0.000000,说明 Jolt 在小岛上的求解对线程数不敏感。对线程数敏感的是切分,不是求解本身。
5.3 给官方那句「结果几乎一样」加限定
回到 Architecture.md:983 的末句:The groups are processed PhysicsSettings::mNumVelocitySteps times so the end result is almost the same as an island that was not split up (only the evaluation order changes in a consistent way).
这句话本身没错,但它描述的范围要收窄。它说的是一次岛内求解的终值:把同一个岛的接触与约束换成组内并行、组间同步的求值顺序,解出来的速度场与不切分时几乎一样,因为速度求解只是一次迭代到收敛的定点求解,顺序变化不改变定点太多。
它没说的是多步演化。E6 的堆体是接触成坨的场景,坨是一个混沌系统:第 60 步一次极小的顺序改动,会改变之后每一步的接触历史,误差沿时间放大。这类系统的原理是误差没有一条解析公式能封住,只能靠读数看它长成什么样。412.966461 到 1545.305176 这段增长,就是放大的过程。
所以限定要写成这样:解一个岛等价,不等于多步演化等价。官方的「结果几乎一样」是对单步岛内求解说的;把它推广成「切分不改变物理行为」,E6 不支持。真要在意长程结果,mUseLargeIslandSplitter 这个开关得当成一个会改变轨迹的量来对待,而非一个纯粹的性能开关。
官方那句的后半截倒是被 E6 直接坐实了:only the evaluation order changes in a consistent way。in a consistent way 说的是重排是确定性的、每次一样。1 线程与 4 线程读数逐位相同,就是这条确定性最干净的证据。问题不在官方说错了,而在「almost the same」这个措辞容易被读成「多步之后也几乎一样」。E6 把这半句的适用半径量了出来:单步岛内成立,长程不成立。
补一句边界:差异最后停在 1545.305176,没有无限发散。两种配置都把坨解到静止,只是落定的排布差了约 1.5 米。这符合「两个都收敛,但收敛到不同终态」的混沌图景。
5.4 E5:切分要花多少成本
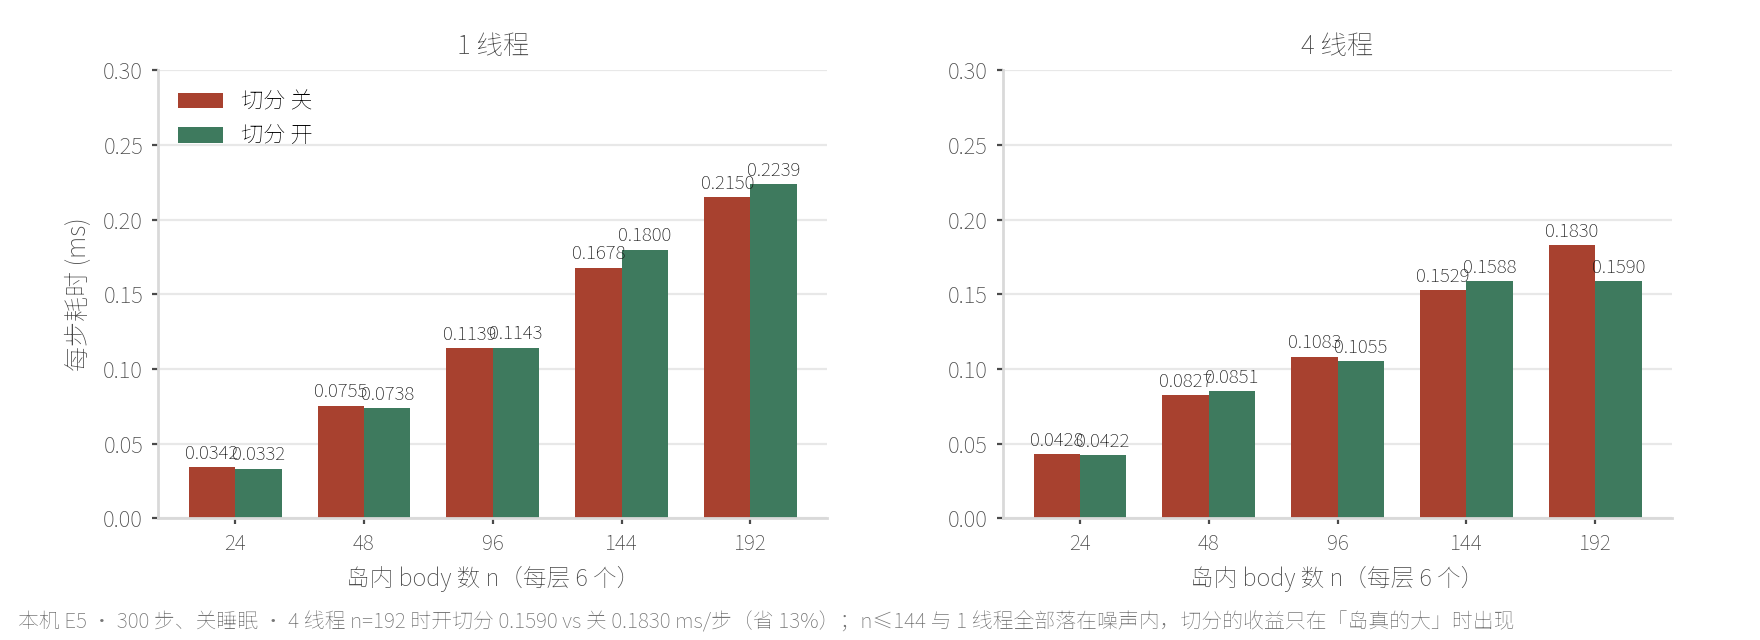
结果上切分会改轨迹,那它换来什么?看 E5 的每步耗时。同样 mAllowSleeping=false,同一坨,扫 n=24 到 n=192:
- 4 线程、n=192:关切分 0.1830 ms/步,开切分 0.1590 ms/步。切分在这里把每步省下约 0.024 ms,是全场最明显的一处收益。
- 4 线程、n=96:关 0.1083、开 0.1055 ms/步。
- 4 线程、n=24:关 0.0428、开 0.0422 ms/步。
- 1 线程、n=192:关 0.2150、开 0.2239 ms/步。单线程下切分反而更慢,拆组与同步都在一个核上做,省不到并行,先付了分组成本。
- 1 线程、n=24:关 0.0342、开 0.0332 ms/步,几乎无差。
规模不够时切分基本白开:n≤144 这一档,开与关的读数咬得很紧,n=48 与 n=144 这两档开切分反而略慢。真正拉开差距的是 n=192 配 4 线程。
单线程那一列更能说明问题:n=96 时 1 线程关切分 0.1139、开切分 0.1143,已经翻成开比关慢;到 n=192 差距扩大到关 0.2150、开 0.2239。单线程上切分在大规模处是纯拖累,拆组与同步的顺序开销落在同一个核里,省不出并行来。切分这件事,线程数是前提。
还有一处反直觉:n=24 时 4 线程比 1 线程更慢。1 线程关切分 0.0342,4 线程关切分 0.0428,多开三个线程每步反倒慢约 0.009 ms。小坨上并行作业的调度与同步开销大过计算本身,线程越多越亏。这条曲线与 §八 的 E8 是一条线上的事,加核不是免费的。
把这条曲线连起来看,切分的收益随规模上升、随线程数上升。规模小时它是纯成本,规模适中时开关互有胜负,规模大到 n=192 且线程给到 4,它才变成真收益。这与切分的设计目标是自洽的:它本来就是为了把「单线程扛不下的大岛」摊到多核,小岛从来不在它的目标里。E5 这条曲线同时给出一个使用结论:mUseLargeIslandSplitter 默认开着是对的,它在大规模场景里帮你,在中小规模里也不会明显拖你,代价只是那些会改轨迹的场合要按 §5.3 的限定来理解结果。
源码落点
- https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Docs/Architecture.md 行 983:其中,末句 the end result is almost the same as an island that was not split up (only the evaluation order changes in a consistent way) 是本节要加限定的那一句。
- https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/LargeIslandSplitter.cpp 行 186–234、236–273:其中,行 186–234 的 Prepare 决定哪些岛进入切分,行 236–273 的 AssignSplit 决定组内为什么不共享 body,这两处共同支撑「差异来自切分」的判断。
- https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/PhysicsSystem.cpp 行 1363:其中,if (mPhysicsSettings.mUseLargeIslandSplitter) mLargeIslandSplitter.Prepare(...) 就是 E5 / E6 里那个开关在管线里的落点。
六、睡眠三判据
本节要回答一个很具体的问题:Jolt 判断一个物体「睡着了」时,盯着的是哪三个点,这三个点又怎样把「几乎不动」翻译成一条可以逐位复算的判据。
一个堆叠塔静下来之后,如果每个物体都还在被求解器反复迭代,CPU 就在为几乎为零的位移买单。省掉这份开销的办法是让物体进入睡眠(sleep),而睡眠的入口是一条速度判据。判据追踪的是三个特定点各自的位移,并不看整个物体的速度。问题在于,这三个点到底是哪三个,官方文档与源码给出了两套说法。
6.1 文档口径:三个点,后两个写作「最远两个面的中心」
好了,先把两个旋钮摆出来。PhysicsSettings.h:94–95 定义时间旋钮:mTimeBeforeSleep 默认 0.5f,注释写 Time before object is allowed to go to sleep (unit: seconds)。PhysicsSettings.h:97–102 定义速度旋钮:mPointVelocitySleepThreshold 默认 0.03f,注释先写「用 3 个点」,接着逐条列出这三点:第一条是质心(center of mass),第二条与第三条写作 /// - The centers of the faces of the bounding box that are furthest away from the center. 按这句注释读,后两个点是包围盒(bounding box)里离质心最远的两个面的中心。这是文档口径。
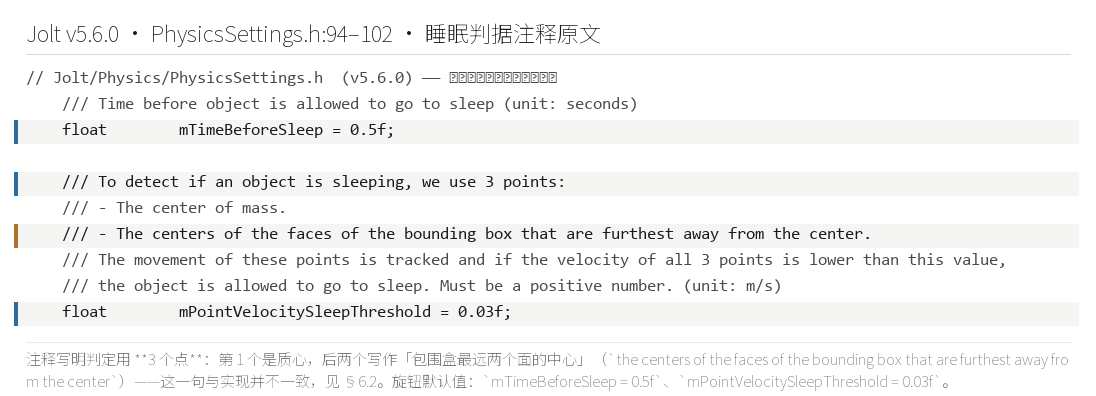
PhysicsSettings.h:94–102):判定用 3 个点,第 1 个是质心,后两个写作「包围盒最远两个面的中心」;旋钮默认 mTimeBeforeSleep = 0.5f、mPointVelocitySleepThreshold = 0.03f@ Jolt Physics v5.6.0 源码原文截取(MIT)6.2 实现口径:两条最大轴的端点
好了,打开实现,Body.h:432 的函数声明注释写的是另一套:inline void GetSleepTestPoints(RVec3 *outPoints) const; ///< Determine points to check if body is sleeping: COM, COM + largest bounding box axis, COM + second largest bounding box axis。Body.inl 的 GetSleepTestPoints 与这句注释同口径:第一个点取质心(outPoints[0] = mPosition;),第二、第三个点沿包围盒的最大轴与次大轴取值。做法是取 mShape->GetLocalBounds().GetExtent() 给出的三个半长,用 GetLowestComponentIndex() 先把最小分量排除,剩下的两个方向就是最大轴与次大轴,两个点分别落在这些方向的端点上。这是实现口径。
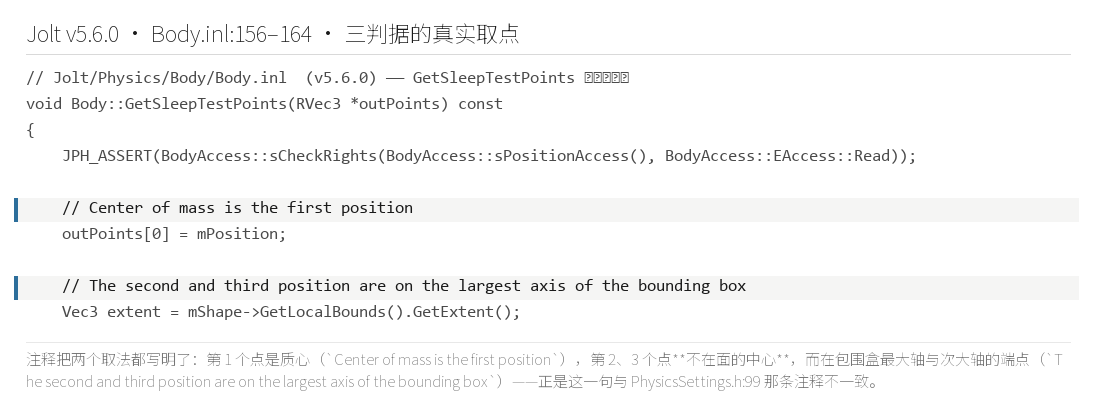
Body.inl:156–164):第 1 个点是质心,第 2、3 个点不在面的中心,而在包围盒最大轴与次大轴的端点,与上一条注释并不一致@ Jolt Physics v5.6.0 源码原文截取(MIT)6.3 两套口径不重合,判定取三个包围球
说白了,两套说法在长方体上并不等价。面中心落在一条轴上,轴端点落在另一组轴上;具体错开多少,取决于包围盒三个边长的相对大小与质心在盒内的位置。对长条形的物体,两种取点可以隔得很远。文档说的「最远两个面的中心」与源码做的「最大轴与次大轴的端点」描述的是同一个函数意图,给出的三个点却不一样。
先来看看,判定实际用的是三个包围球(bounding sphere)的半径。Body.cpp:152–153 先声明 RVec3 points[3]; 并调用 GetSleepTestPoints(points);,随后逐个把点封装进一个包围球(EncapsulatePoint)。只要任一包围球的半径超过传入的位移上限,就把三个球全部重置(reset),并返回 CannotSleep,计时从头开始;三个球的半径都在上限以内,才把这一步的时间累加进睡眠计时器。计时器的判断在 MotionProperties.inl:169–173:mSleepTestTimer >= inTimeBeforeSleep 才给出 CanSleep。
为什么要三个点,一个质心不够吗。一个只在原处旋转的物体,质心可以稳稳不动,只看质心的位移会把它误判成静止;三个点分散在物体上,旋转会让其中至少一颗包围球涨大,计时随之清零。两个轴端点分别盯住绕最大轴与次大轴的转动,质心盯住平移,三个点合起来覆盖平移与转动两种还在动的形态。取最大轴与次大轴,也是为了在包围盒里挑出彼此最分散的两个方向。
位移上限这一侧,PhysicsSystem.cpp:2526–2527 给出两行定义:float time_before_sleep = mPhysicsSettings.mTimeBeforeSleep; 与 float max_movement = mPhysicsSettings.mPointVelocitySleepThreshold * time_before_sleep;。位移阈值等于速度阈值乘以睡眠时间。速度阈值给的是每秒允许走多远,乘以要连续安静多久,得到这段窗口里允许累计的位移。两个旋钮各管一段:一个定标尺,一个定窗口。
还有三条配套规则要一起记住。其一,睡眠只在最后一步检查,PhysicsSystem.cpp:2517–2519 的注释是 // Only check sleeping in the last step。其二,传感器(sensor)永远不会睡,Body.cpp:147–149 的注释写明原因是睡了就收不到与睡眠物体的碰撞。其三,整岛(island)的判定用按位与累加,PhysicsSystem.cpp:2537 是 all_can_sleep &= int(body.UpdateSleepStateInternal(...));,这一步的结果直接决定 §七 的整岛去留。
最后补一处源码级的自我校验。Body.h:314–319 有一条断言,原文含 Sleeping body has non-zero linear velocity!;PhysicsSystem.cpp:1058 另有一条注释 // Validates that a body that is sleeping has zero velocity. 引擎自己也在防「睡着却还在动」这件事。判据写得再宽容,睡下的 body 也必须满足速度为零这条不变量,否则整岛一起睡的前提就站不住。
6.4 源码落点
Jolt/Physics/PhysicsSettings.h:mTimeBeforeSleep(94–95)、mPointVelocitySleepThreshold与「3 个点」注释(97–102)。Jolt/Physics/Body/Body.h:GetSleepTestPoints声明与 COM 口径(432)。Jolt/Physics/Body/Body.inl:三点的真实取法(156–188)。Jolt/Physics/Body/Body.cpp:传感器备注(147–149)、取点(152–153)、三个包围球(171–183)。Jolt/Physics/Body/MotionProperties.inl:计时器判定(169–173)。Jolt/Physics/PhysicsSystem.cpp:只在最后一步查(2517–2519)、位移阈值(2526–2527)、按位与累加(2537)。
其中: 三点取法在 Body.inl:160–164,位移阈值在 PhysicsSystem.cpp:2526–2527,两者合起来构成本节的判据本体。补一句,官方 Docs/Architecture.md:1020 描述睡眠时用的正是「质心 + 包围盒最大两条轴 + 三个包围球」这一套,与实现一致;不一致只出现在 PhysicsSettings.h:99 那一行。
七、整岛睡眠与唤醒
本节要回答一句话:一个 body 动了,谁跟着醒。
说白了,睡眠与唤醒都不是单个 body 的私事,它们按岛(island)结算。岛在前半段已经建出来,用并查集(union-find)每步重建,这一节看的是这套分组的结果怎样落到睡眠状态上,以及一次触碰会惊动多大一片。
7.1 整岛一起睡
PhysicsSystem.cpp:2545–2547 是整岛睡眠的落点:// If all bodies indicate they can sleep we can deactivate them、if (all_can_sleep == int(ECanSleep::CanSleep))、ioBodiesToSleep.PutToSleep(bodies_begin, bodies_end);。all_can_sleep 从「允许睡眠」出发,逐个 body 与 UpdateSleepStateInternal 的结果按位与;只有整岛每一个 body 都给出 CanSleep,才把这一岛的 body 一次性交给 PutToSleep。任何一个 body 还在动,整岛继续参与求解。
Catto 把这条规则的必要性写得比源码更直白:Sleeping must be done per island, not per body. 他给的后果是 If you put a body to sleep but not the whole island then you will see shapes begin to overlap and joints begin to dislodge. 形状互相插入、关节脱位,都是只睡了半个岛的代价。整岛睡眠承载的是这套分组的一致性要求,省 CPU 只是顺带。
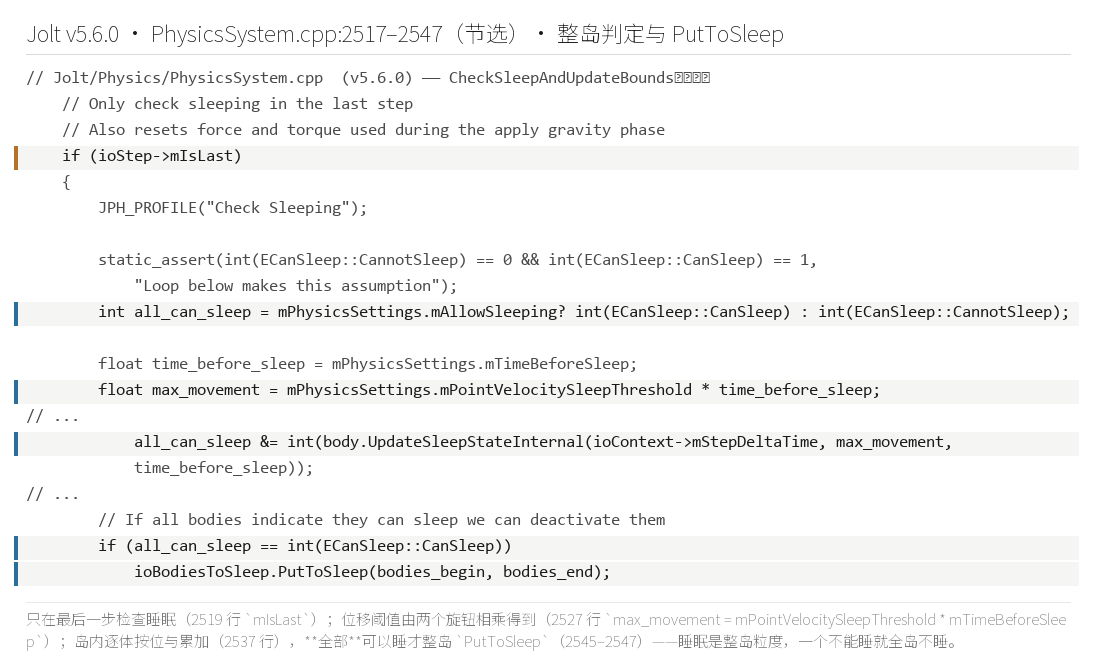
PutToSleep(PhysicsSystem.cpp:2517–2547 节选):只在最后一步检查睡眠,位移阈值由两个旋钮相乘得到,岛内逐体按位与累加,全部可以睡才整岛 PutToSleep@ Jolt Physics v5.6.0 源码原文截取(MIT)言归正传,冬眠可以当作这条规则的实物注脚:整族一起安静下去,吵醒一只,整族一起醒过来。计算侧的状态机与之粒度相同。
Healthy Virginia big-eared bats (4388384664).jpg(Public domain,USFWS)7.2 E0:岛粒度
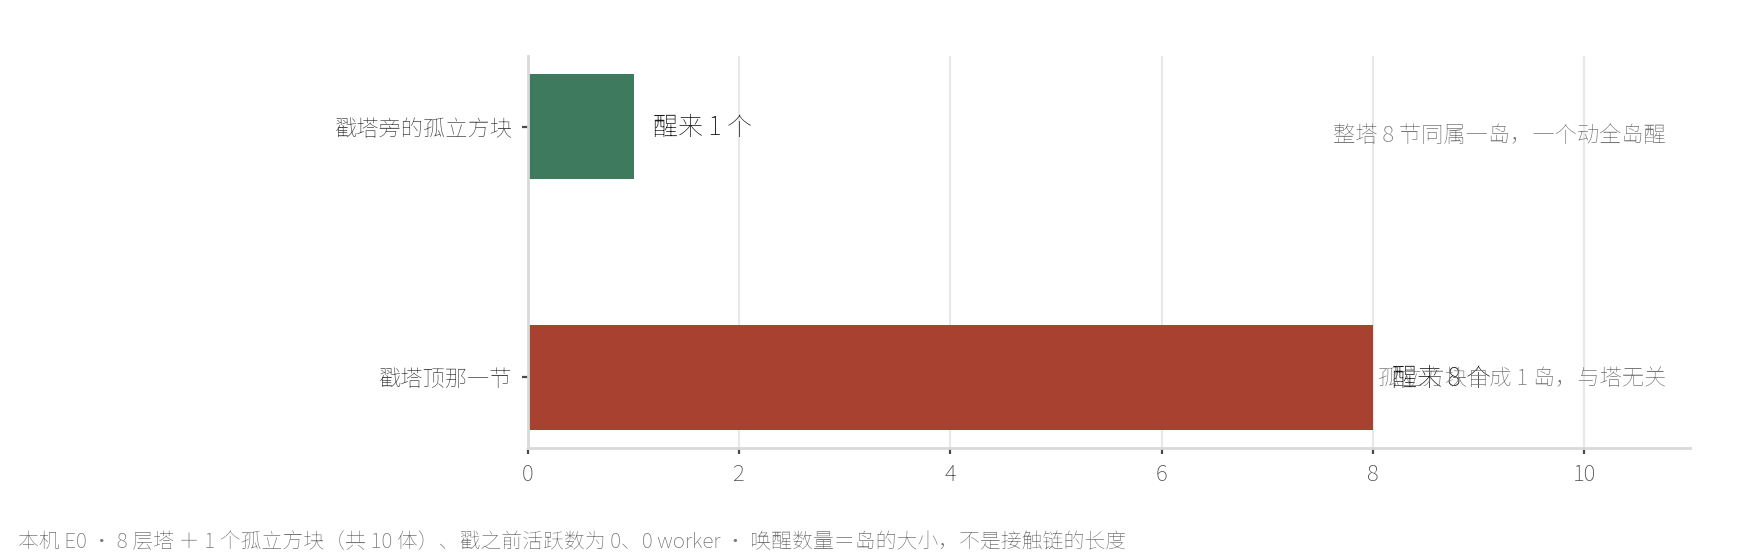
OK,本机实验 E0 用 10 个 body:8 层塔加 1 个孤立方块,两者互不接触。戳塔顶那一节,活跃数从 0 变成 8,整个塔作为一岛一起醒来。戳旁边的孤立方块,活跃数从 0 变成 1,只有它自己醒。同样的「戳一下」,因为在不同的岛上,被唤醒的规模一个是 8,一个是 1。
7.3 E2:岛间隔离
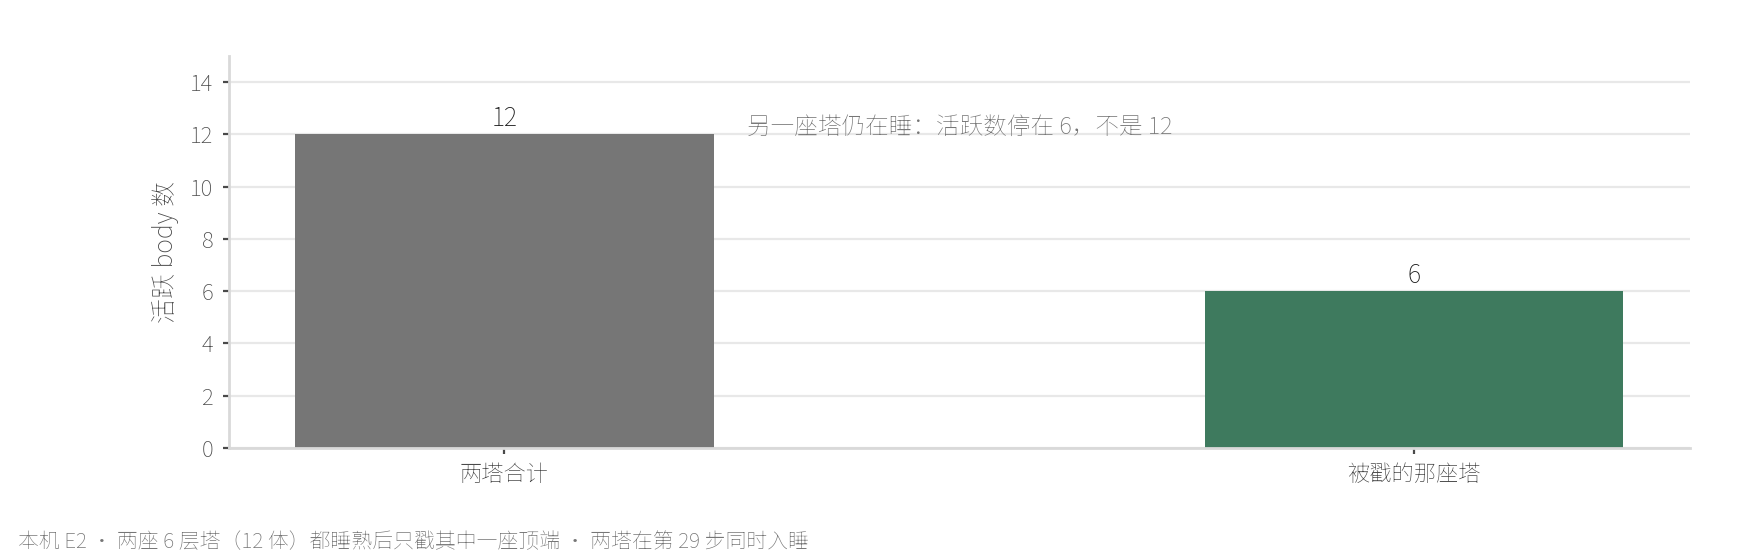
E2 把两座 6 层塔放在相距 6 m 的位置。500 步之后两塔全部睡着,活跃数 0。这时只戳塔 B 的顶端,活跃数停在 6,而不是 12。塔 A 在另一座岛上,不参与这次唤醒。两座塔各建各的岛,500 步里从未接触,接触图把它们分在两个连通分量里;唤醒按岛结算,塔 B 醒来时塔 A 的 all_can_sleep 仍是满值,活跃数于是停在 6。
7.4 E1:撤力之后的分次归零
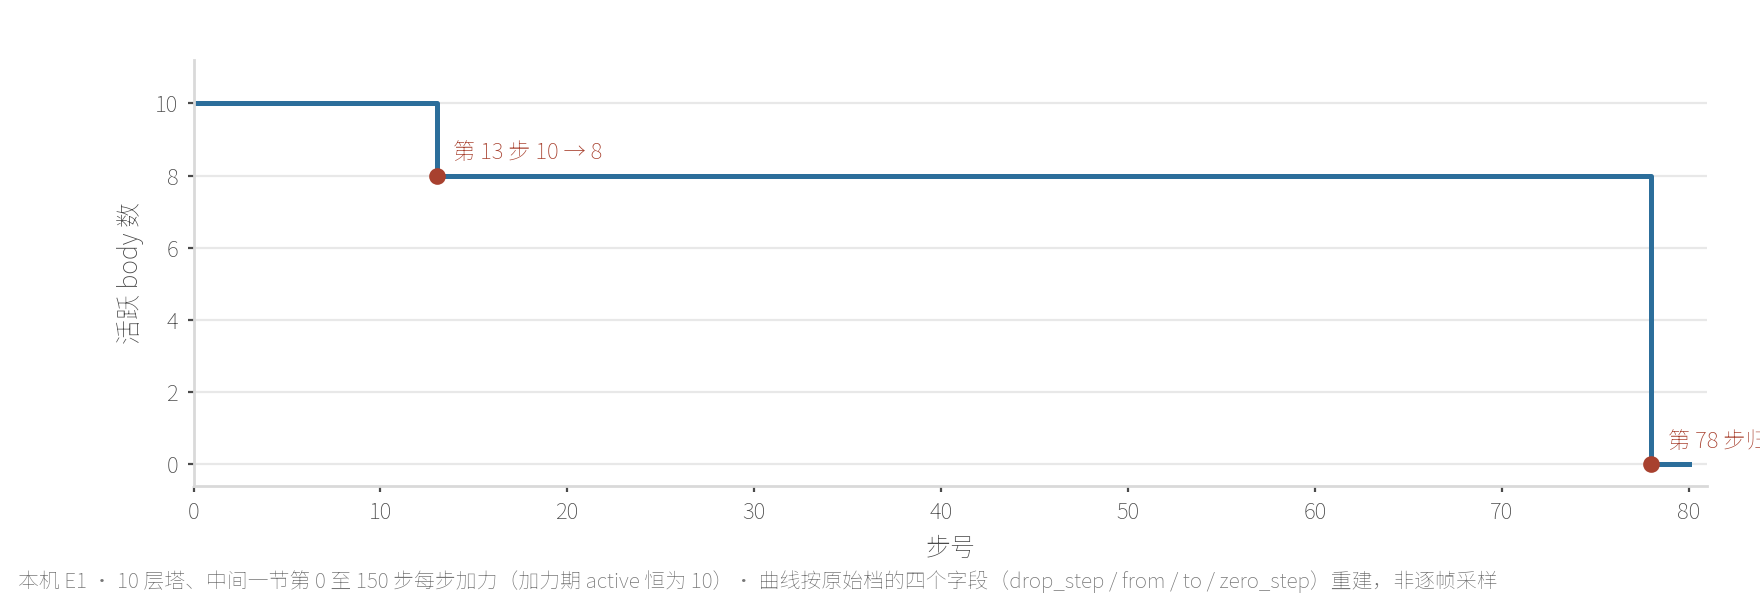
E1 原本想验证整岛一起睡,读数却给出一段更细的过程,如实记下来。场景是 10 层塔,对中间一节每一步加力,持续 150 步后撤力。加力期间,活跃数恒为 10(min_under_force=10),整岛谁都睡不着。撤力之后,活跃数第 13 步首次下降,从 10 掉到 8;第 78 步归零。它不是一步塌到 0。
对照 §八 的 E3(旋钮扫描里三档都是一步塌到 0),E1 的两次下降显得突兀。原因在岛是每步从头重建的,Architecture.md:940 的原话是 so we recreate the islands from scratch every simulation step. The operation is lock-free and O(N)。持续加力期间塔被晃松,撤力后塔身在不同高度的接触状态不一样,接触图随之断开,10 层塔裂成了几个岛。各岛的睡眠计时起点不同,凑齐整岛 CanSleep 的步号也就不同,活跃数于是分两次掉下去:先掉一岛,10 变 8;再掉剩下的,8 变 0。E1 读数指向的是分组本身在这一段里发生了变化,整岛睡眠这条规则并没有被打破。
7.5 唤醒纪律与传播
好了,第一,新建 body 不会自动唤醒邻居。README.md:29 的原话是 bodies will not automatically wake up when created. Neighboring bodies will not be woken up when bodies are removed.
第二,移除 body 也不会唤醒周围的 body,Architecture.md:421 的原话是 removing a Body from the world doesn't wake up any surrounding bodies。需要手动唤醒时,用 BodyInterface::ActivateBodiesInAABox,在一段包围盒范围内批量唤醒。
第三,唤醒会把睡眠计时清零。ReleaseNotes.md:249(v5.1.0)写:Activating bodies now resets the sleep timer when the body is already active. This prevents the body from going to sleep in the next frame and can avoid quick 1 frame naps. 一个已经活跃的 body 再次被激活,计时重置,避免它在下一帧又睡过去、形成一帧的打盹。
三条之外还有一条与碰撞检测的边界:睡眠体仍会与未睡眠的物体做碰撞检测。Architecture.md:421 的原话是 When a body is sleeping, it can still detect collisions with other objects that are not sleeping, but it will not move or otherwise participate in the simulation to conserve CPU cycles. 睡眠省掉的是参与求解,省不掉被检测到。
第四条纪律讲传播。唤醒会沿约束与接触扩散,Architecture.md:942 记的行为是:约束若连接了活跃 body 与非活跃 body,非活跃者被唤醒;Find Collisions 作业要等建岛作业结束才启动,好把新激活 body 的碰撞检测接上。Catto 把这句写得更硬:Bodies wake other sleeping bodies through constraints and this must propagate through all touching bodies immediately. 传播要在同一步里走遍所有相连的 body,慢一步就会看到形状互相插入、关节脱位。
还有一条公开接口的边界要交代:这一层没有整岛的查询接口。Issue #521 里 jrouwe 给的建议是用 BodyActivationListener 自己统计某个 ragdoll 的活跃 body 数。E0 到 E2 正是靠 BodyInterface::IsActive 逐个数出来的,它是睡眠与唤醒唯一的外部可观测代理,语义是整岛级的。
README.md:29)、移除 body 也不唤醒周围(Architecture.md:421)、唤醒会把睡眠计时清零(v5.1.0,避免一帧的打盹)、需要手动唤醒时用 BodyInterface::ActivateBodiesInAABox;另有一条边界是睡眠体仍做碰撞检测@ 本系列绘制7.6 源码落点
Jolt/Physics/PhysicsSystem.cpp:整岛判定与PutToSleep(2545–2547)、按位与累加(2537)。Docs/Architecture.md:岛的定义(417)、睡眠体仍做碰撞检测与移除不唤醒邻居(421)、每步重建(940)、唤醒传播(942)、睡眠三包围球(1020)。README.md:新建 body 不自动唤醒(29)。Docs/ReleaseNotes.md:唤醒重置计时(249)、载具不再覆写睡眠(159)、kinematic 同岛修复(38)。
其中: 整岛睡眠的落点是 PhysicsSystem.cpp:2545–2547;移除 body 不唤醒邻居与手动唤醒接口同在 Architecture.md:421;新建 body 不自动唤醒只在 README.md:29,源码里没有对应注释。
八、并行度
本节要回答:多加一颗核,这一层到底能快多少;睡眠开关又把这条曲线改成了什么形状。
OK,先量旋钮,再看线程。E3 与 E4 扫的是 §六 那两个旋钮,E8 扫的是线程数与睡眠开关的组合。
先把口径说清楚:并行类实验(E5 / E6 / E6c / E8)跑在真 worker 线程上(1 / 2 / 4 / 8);睡眠类实验(E0 到 E4、E7)用 0 worker,作业内联执行,以免调度噪声混进来。这两组读数与 ep08、ep09 的耗时不可直接横向比。
8.1 E3:时间旋钮成比例
8 层塔,把 mTimeBeforeSleep 取 0.1 / 0.5 / 2.0,本机给出三档:
mTimeBeforeSleep |
入睡步号 | 入睡时刻 |
|---|---|---|
| 0.100 | 第 9 步 | 0.150 s |
| 0.500 | 第 29 步 | 0.483 s |
| 2.000 | 第 120 步 | 2.000 s |
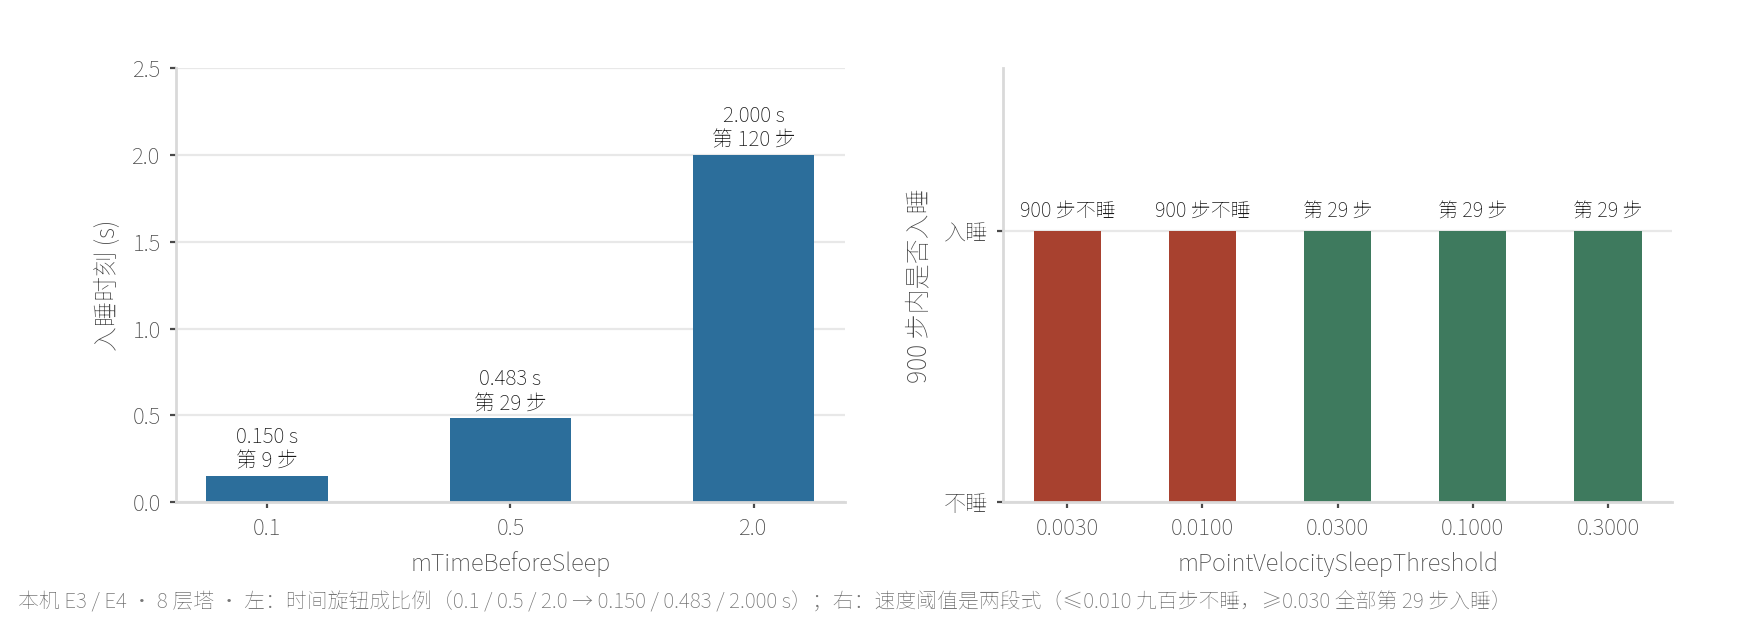
说白了,这三档都是一步塌到 0,整岛一次睡下去。0.150 / 0.483 / 2.000 s 与 0.1 / 0.5 / 2.0 精确成比例,步号 9 / 29 / 120 是 60 Hz 下的换算结果。这条读数把 §七 的整岛睡眠又印了一次:旋钮决定什么时候睡,睡法始终是整岛级的。三档能成比例,来自 §六 那条定义:判据比的是时间窗内的位移,而旋钮调的就是这个时间窗的长度。窗口越长,判据要等的那段位移就越晚才攒够,入睡点随之后移。
8.2 E4:速度阈值是两段式
先来看看,把 mPointVelocitySleepThreshold 从 0.003 一路扫到 0.300,读数分成两段:
| 阈值 | 900 步内入睡情况 |
|---|---|
| 0.003 | 900 步不睡(active_end=8) |
| 0.010 | 900 步不睡 |
| 0.030 | 全部第 29 步睡 |
| 0.100 | 全部第 29 步睡 |
| 0.300 | 全部第 29 步睡 |
0.003 与 0.010 两档在 900 步里一次都没睡着;0.030 及以上三档全部在第 29 步睡,睡的时刻与阈值大小无关。两段各有清楚的机制。阈值太小时,三个包围球的半径上限被压得很紧,塔身微小的晃动就会把某一颗球撑过上限,球被重置、计时归零,睡眠永远凑不满窗口,于是 900 步不睡。阈值调到 0.030 以上,位移上限不再被晃动触发,睡眠时刻就由另一个因子 mTimeBeforeSleep(默认 0.5 s)决定,第 29 步正是时间旋钮给出的刻度。
8.3 E8:线程乘睡眠
E8 用 n=144 的场景,把线程数(1 / 2 / 4 / 8)与睡眠开关交叉:
| 线程数 | 睡眠关(ms/步) | 睡眠开(ms/步) |
|---|---|---|
| 1 | 0.1821 | 0.0287 |
| 2 | 0.1675 | 0.0284 |
| 4 | 0.1624 | 0.0258 |
| 8 | 0.1878 | 0.0307 |
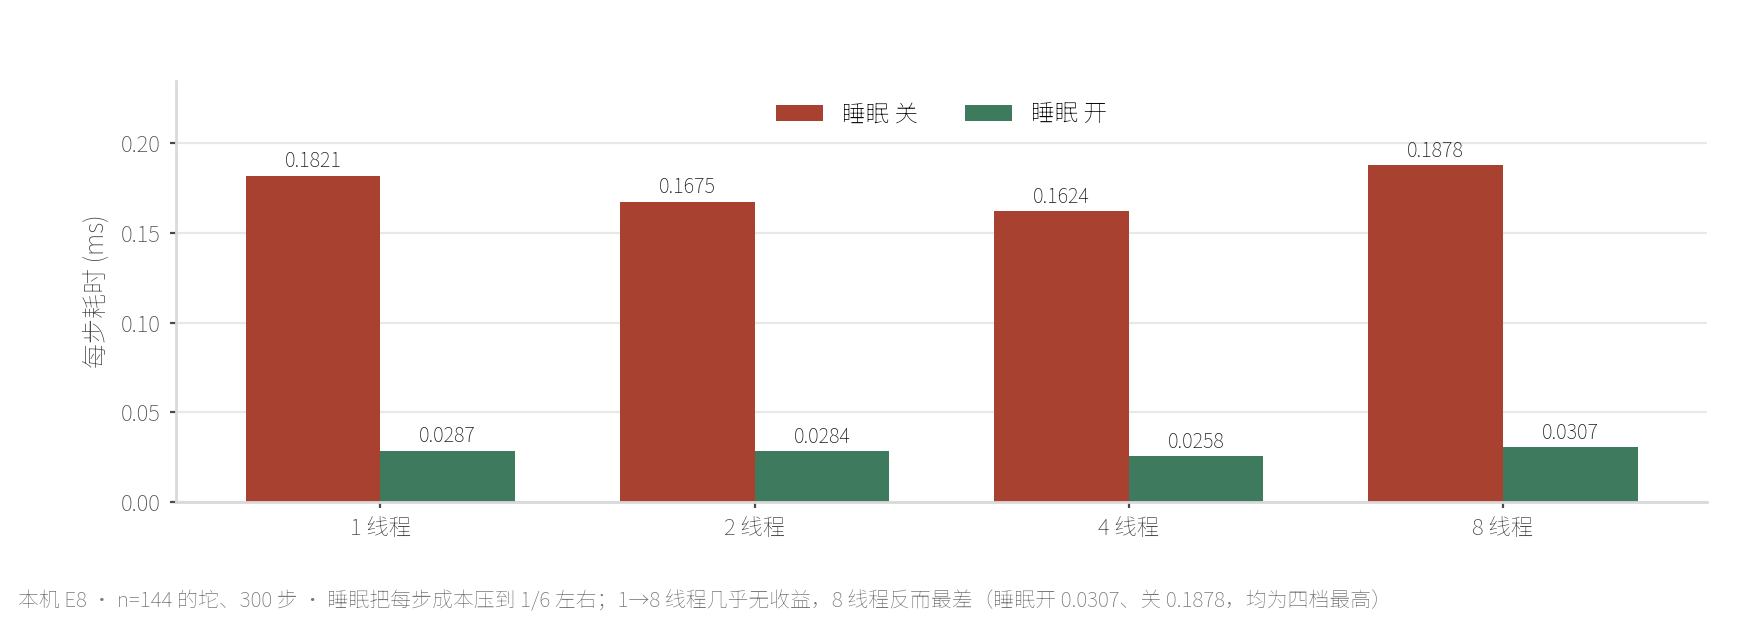
先看睡眠这一列。睡眠把每步成本从 0.1624 压到 0.0258(4 线程),便宜约 6.3 倍。塔睡着之后不再参与求解,这一步的开销被整块摘掉。
再看线程这一行。睡眠关时,1 线程 0.1821、2 线程 0.1675、4 线程 0.1624,从 1 到 4 线程只快了约 1.12 倍;8 线程反而升到 0.1878,是四档里最差的一档。睡眠开时同样的形状:1 线程 0.0287、2 线程 0.0284、4 线程 0.0258、8 线程 0.0307,最优点在 4 线程,8 线程最差。加核到某个数量之后收益停了下来,再多给核开始倒扣。
言归正传,这条本机曲线与官方口径对得上。jrouwe 在《Jolt Physics Multicore Scaling》里写:After about 16 CPU cores Jolt stops scaling and eventually deteriorates. At this point the memory bus becomes a big bottleneck and the lock free operations that are used to manage the contact cache dominate the simulation update. 官方给的拐点在 16 核附近,之后不再扩展并开始退化,瓶颈落在内存总线与接触缓存(contact cache)的无锁操作上。
同一篇里还有一句讲跨 CCX 的代价:Currently Jolt is not CCX aware. As you can see at 8 threads the simulation on 32 CPUs (4 CCX) is 27% slower than the same machine with 8 CPUs (1 CCX)... 8 线程跑在 32 核(4 个 CCX)的机器上,比同样的 8 线程跑在 8 核(1 个 CCX)慢 27%。核心数相同、线程数相同,只因为跨了 CCX,结果差了 27%。这两句合起来给出一个上限:并行度并不免费,本机 E8 的 8 线程最差与官方的 16 核拐点是同一条曲线的两端。
把睡眠与线程放在一起看,还有一层解释。睡眠把大部分 body 从求解里摘走,留下的可并行工作本来就少;核再多,能分出去的岛也不够铺满,8 线程于是拿不到收益,调度与同步的固定开销反而显露出来。E8 里睡眠开与睡眠关两条曲线形状一致,最优点都落在 4 线程,正是这件事的读数。
Intel Wolfdale die shot (E8400) etched.jpg(Public domain,Martijn Boer)8.4 Jolt 在这件事上的位置
OK,把 Jolt 的做法与 §九 的横向表连起来看,它的并行结构有两处特点。一处是岛在每步从头重建,接触与约束的图一变,分组立刻跟上,代价是每步都要付一次 O(N) 的建岛。另一处是大岛切分(large island splitting):岛内项数超过 128 时,用位掩码贪心把它拆成若干互不共享 body 的组,组内可以并行,组间要同步。这五个数里,128 是切分的门槛,32 与 31 是组数与非并行组的下标,16 是每批处理的项数,§四 已逐条给出落点。
A50 and telephone pole.jpg(CC BY-SA 4.0,RealGPTV01)官方的并行作业图 Docs/PhysicsSystemUpdate.svg 把这条流水画了出来:黄块表示同类作业有多份,箭头表示执行次序,虚线箭头有特殊含义(Architecture.md:916)。睡眠与建岛都在这张图上占着位置:建岛作业先跑,接触检测作业等它结束,睡眠在最后一步结算。

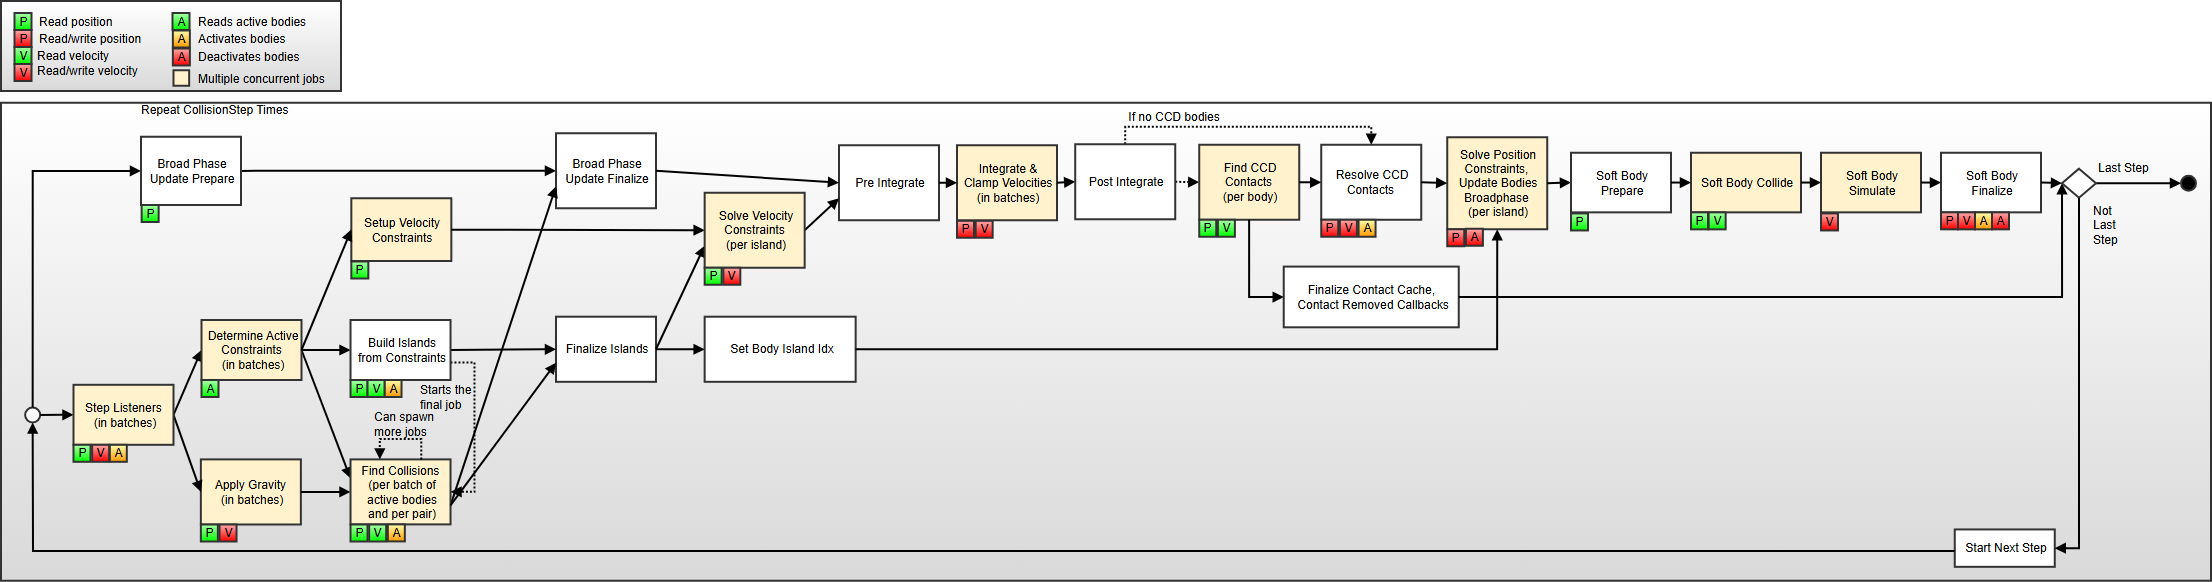
PhysicsSystem::Update 的 job 流水:黄块表示同类作业有多份,箭头表示执行次序,虚线箭头有特殊含义@ Jolt Physics v5.6.0 官方文档配图 Docs/PhysicsSystemUpdate.svg(MIT,Jorrit Rouwe;本篇按 1:1 栅格化使用)8.5 源码落点
Jolt/Physics/PhysicsSettings.h:cMaxPhysicsJobs(25)、cMaxPhysicsBarriers(28)、mUseLargeIslandSplitter(119–120)、mAllowSleeping(122–123)。Jolt/Physics/PhysicsUpdateContext.h:cMaxConcurrency(34)。Jolt/Physics/LargeIslandSplitter.h:cNumSplits/cNonParallelSplitIdx/cLargeIslandTreshold(32–34)、cSplitCombineTreshold/cBatchSize(170–171)。Docs/Architecture.md:作业图读法(916)、切分整段(983)。- jrouwe《Jolt Physics Multicore Scaling》:
https://jrouwe.nl/jolt/JoltPhysicsMulticoreScaling.pdf。
其中: 三个并行常量是 cMaxPhysicsJobs=2048、cMaxPhysicsBarriers=8、cMaxConcurrency=32;16 核拐点与 CCX −27% 出自 jrouwe 那篇多核扩展笔记。
九、反误区与横向对照
本节要回答:三句流传很广的说法各错在哪,以及几家引擎在同一层上各走了哪条路。
好了,逐条来。
9.1 睡眠是否影响行为:两面都要写
第一句是「睡眠只是省 CPU,不影响行为」。这句话需要限定,因为两面的证据都硬。
一面来自 Jolt 官方与 Catto。官方说睡眠体仍检测碰撞,Architecture.md:421 的原话是 it can still detect collisions with other objects that are not sleeping, but it will not move or otherwise participate in the simulation to conserve CPU cycles。Catto 说整岛睡眠是正确性要求:If you put a body to sleep but not the whole island then you will see shapes begin to overlap and joints begin to dislodge. 少睡半个岛,形状会互相插入、关节会脱位。睡眠在这里承担的是整岛一致性。
另一面来自本机读数。E7 里,一个方块以 0.2 m/s 初速放在平面上跑 900 步,开睡眠与关睡眠的末位完全相同:final_x=4.8230 mm、v=0,两次都滑到同一个位置停下。差别只在成本,total_ms 从 2.64(关)降到 0.66(开)。同一个 E7 里还有一组对照,球以 0.2 m/s 初速跑 900 步,开与关都不睡:final_x=2145.0374 mm、v=143.1031 mm/s、active_end=1。球一直滚,判据够不到睡眠门槛。
两面对照,正确写法是:在单物体静置上,开关睡眠不改变结果(本机读数);但在多物体成岛上,睡眠是整岛一致性的要求(Catto)。把这句话当成睡眠完全中性,会漏掉第二面;把它当成一开睡眠行为就变,会漏掉第一面。
还有一条来自社区的旁证。Issue #1686 里,提问者关掉某个球的睡眠后发现它在平面上不会静止,jrouwe 侧的读数是 You can reset the velocity to zero, but it will start accelerating again. 把速度清零,它还会重新加速。睡眠状态与求解物理量在这一处是耦合的。
9.2 「岛越大越好」:错
第二句是「岛越大越好」。作者本人的改动记录直接否掉它。PR #1970 的表述是 Kinematic bodies were assigned to the same island as bodies that were constrained to / in contact with them. This led to larger simulation islands and impacted performance. kinematic body 被拉进同一座岛,岛被撑大,性能随之下降。这次修改就是把 kinematic body 移出岛。
Catto 补了另一半:This large single island can dominate performance even with multithreading. It can lead to a situation where many cores are sitting idle. 一座巨岛即使上了多线程也会成为瓶颈,核多也只能干等。岛切得对,并行才有对象可派;把岛合并成一座巨岛,等于把并行度收回到 1。这里要补一个限定,免得把岛的分量估错。Catto 同时写过 Islands are not required for correctness.,紧接着一句是 They are an optimization. 岛本身是优化,睡错半个岛才会伤到正确性;一句管分组的代价,一句管睡眠的粒度,两处并不冲突。
9.3 「并行度越高越快」:错
第三句是「并行度越高越快」。三方证据指向反面。官方 16 核拐点:After about 16 CPU cores Jolt stops scaling and eventually deteriorates;跨 CCX 的 27% 回退:the simulation on 32 CPUs (4 CCX) is 27% slower than the same machine with 8 CPUs (1 CCX);本机 E8:1 到 8 线程几乎无收益,8 线程反而最差(0.1878 对 4 线程的 0.1624)。Catto 的说法可以放在一起读:Parallel islands simulation is not a silver bullet. There may not be enough islands to span all the CPU cores. 岛的数量不足以铺满所有核,并行就没有可分工的工作。
9.4 三判据的文档与实现
第四句是「睡眠三判据取的是包围盒最远两个面的中心」。这句话在文档里成立,在实现里不成立。PhysicsSettings.h:99 写的是面中心,Body.inl:160–164 与 Body.h:432 写的是质心加包围盒最大轴与次大轴的端点。同一件事有三种表述,文档的面中心、头文件的轴端点、实现里沿轴取点;本篇取实现侧,理由在 §6.3,实现给出的是真正参与包围球判定的三个点。
9.5 四家引擎对照
把 Jolt 与另外四家引擎的岛与睡眠并排放一次:
| 引擎 | 岛 | 睡眠 |
|---|---|---|
| Jolt | IslandBuilder,每步从头重建(无锁,O(N));项数 >128 切分 |
整岛一起睡;三判据(COM 加两条最大轴的端点)加 0.5 s 计时;mAllowSleeping 总开关 |
| Bullet | btSimulationIslandManager,btUnionFind;buildAndProcessIslands 回调 |
激活状态机:ISLAND_SLEEPING 2 / WANTS_DEACTIVATION 3 / DISABLE_DEACTIVATION 4 |
| Box2D v3 | 持久化岛(b2Island,含 maySplit),可 merge / destroy / split |
b2WorldDef::enableSleep 与 b2BodyDef::enableSleep;isAwake |
| Rapier | 公开的 IslandManager |
can_sleep 默认 true;normalized_linear_threshold / angular_threshold / time_until_sleep |
| PhysX | 公开 API 未暴露岛,近似概念是 PxAggregate |
setSleepThreshold / wakeUp / putToSleep / isSleeping |
IslandManager,PhysX 不公开岛、近似概念是 PxAggregate@ 本系列绘制对照里最清楚的分歧在建岛时机:Jolt 每步重建,Box2D v3 持久化,Bullet 用并查集合并,Rapier 把 IslandManager 摆到公开接口上,PhysX 干脆不暴露岛。睡眠侧则很一致,几家都按组结算,都提供阈值与唤醒接口。Jolt 的特色在重建加切分这条组合上,它把分组的灵活性放在每步重建里,把分组的规模问题交给大岛切分。
还有一条边界要划清楚:岛与切分不算给用户调用的 API。LargeIslandSplitter.h:25 的警告原文是 WARNING: This class is an internal part of PhysicsSystem, it has no functions that can be called by users of the library. 用户能碰到的只有睡眠旋钮与 ActivateBodiesInAABox 这类间接接口。边界也有例外:IslandBuilder 被导出,约束可以用 BuildIslandSplits 自定义切分归属(PR #1770 的动机就是让使用方能写自己的建岛约束),载具约束走的正是这条路。
9.6 源码落点
Jolt/Physics/PhysicsSettings.h:mPointVelocitySleepThreshold(97–102)、mAllowSleeping(122–123)、mUseLargeIslandSplitter(119–120)。Docs/Architecture.md:睡眠体仍检测碰撞(421)。Docs/ReleaseNotes.md:kinematic 同岛修复(38)、唤醒重置计时(249)。Jolt/Physics/Constraints/ContactConstraintManager.cpp:只有双 dynamic 才同岛(798–801)。- 外部:Catto《Simulation Islands》(
https://box2d.org/posts/2023/10/simulation-islands/)、Issue #1686、PR #1970、jrouwe《Jolt Physics Multicore Scaling》。
其中: 四条反误区的出处是 Architecture.md:421 与 Catto《Simulation Islands》、PR #1970 与 Catto、jrouwe《Jolt Physics Multicore Scaling》与本机 E8、PhysicsSettings.h:99 对 Body.inl:160–164。
十、边界、演进与清单
本节收拢三件事:本篇不管什么、这一层这些年改过哪些、复算时要用到哪五类资源。
说白了,收尾要做的是把本篇的答案到哪里为止与下一步从哪接着走都标清楚。
10.1 边界声明
本篇解的是「谁跟谁一起解、谁不用解」这两问。下面这些题目本篇不碰,各归各篇。
| 方向 | 本篇已给出 | 归谁 |
|---|---|---|
| 岛的定义与建岛 | 每步重建的无锁并查集(O(N)) | 已闭环 |
| 排序与提前退出 | 按项数降序,Prepare 遇到不够大的岛即 break |
已闭环 |
| 大岛切分 | 128 / 32 / 16 三个数、位掩码贪心、非并行组 | 已闭环 |
| 切分的账 | E5 / E6 / E6c(切分不改变物理结果) | 已闭环 |
| 睡眠三判据 | 三点取法、三个包围球、位移阈值公式 | 已闭环 |
| 整岛睡眠与唤醒 | E0 / E1 / E2、三条唤醒纪律 | 已闭环 |
| 并行度 | E3 / E4 / E8、官方 16 核拐点与 CCX −27% | 已闭环 |
| CCD 与确定性 | 只登记投机接触的提前量与求值顺序 | 第十一篇 |
| 软体 | 不涉及 | 第十三篇 |
| 角色与载具 | 只引载具覆写睡眠这一条版本记录 | 第十二篇 |
| 宽相与窄相 | 只作为建岛的输入被提及 | 已在前篇 |
这里补一句术语边界:CCD 指连续碰撞检测(continuous collision detection,CCD),确定性指 determinism,宽相(broad phase)与窄相(narrow phase)在本篇只以建岛输入的身份出现。
10.2 版本演进
把与岛、并行、睡眠有关的条目按版本排开,脉络是先让大岛多线程跑起来,再收紧唤醒与覆写语义,最后处理 kinematic 撑大岛的问题。
| 版本 | 条目 | 出处 |
|---|---|---|
| v3.0.0 | 允许大岛在多线程上求解(LargeIslandSplitter 的最初条目,未点名类名) |
ReleaseNotes.md:441 |
| v5.0.0 | 覆写语义变更:全岛覆盖值都低于默认时改用低值 | ReleaseNotes.md:313 |
| v5.1.0 | 唤醒时重置睡眠计时,避免一帧打盹 | ReleaseNotes.md:249 |
| v5.3.0 | 载具不再每帧覆写 Body::SetAllowSleeping |
ReleaseNotes.md:159 |
| Unreleased | kinematic body 移出岛,避免撑大岛影响性能 | ReleaseNotes.md:38 |
Unreleased 的 kinematic 同岛修复@ 本系列绘制这条线里有两条要展开。一条是 v5.1.0 的唤醒重置计时,它把已经活跃的 body 再次被激活也算作一次唤醒,计时清零,避免物体在下一帧直接睡回去。另一条是 Unreleased 里的 kinematic 同岛修复,PR #1970 的逐字是 Kinematic bodies were assigned to the same island as bodies that were constrained to / in contact with them. This led to larger simulation islands and impacted performance. 这与 §9.2「岛越大越好是错的」是同一条证据链,源码侧的两处注释也在 ContactConstraintManager.cpp:798–801 与 TwoBodyConstraint.cpp:44–47:只有两个 body 都是 dynamic 时才连进同一座岛。
10.3 版本口径
本篇引用的源码快照要按以下措辞写清:本机快照为 v5.5.0-183-g765845d6,即 v5.6.0 的源码本体,两者只差版本号与文档收口;快照自述 5.5.1。快照 HEAD 是 v5.6.0 标签的祖先,两点之间只有 2 个提交、只动 4 个文件;git diff HEAD..v5.6.0 对本篇要引的源码文件输出为空,逐字节相同。因此文中所有 raw 链接指向 v5.6.0 与指向快照,对源码文件而言是同一份内容。前九篇把快照笼统称作 v5.6.0,就链接口径无误,就自述口径不够严谨,本篇按上面这句收紧。
10.4 五类资源清单
这五类按用途归类:官方文档给定义与常量,官方源码给实现与行号,社区与作者一手材料给口径与上下文,竞品给横向坐标,本机一手产物给可复跑的读数。
官方文档
Docs/Architecture.md:岛的定义(417)、睡眠体仍检测碰撞与移除不唤醒邻居(421)、建岛作业(940)、唤醒传播(942)、切分整段(983)、睡眠三包围球(1020)、作业图读法(916)Docs/ReleaseNotes.md:kinematic 同岛修复(38)、v5.3.0 载具睡眠(159)、v5.1.0 唤醒重置计时(249)、v5.0.0 覆写语义(313)、v3.0.0 大岛多线程(441)Docs/APIChanges.md:覆写语义(73);本层无岛与睡眠相关条目
官方源码
Jolt/Physics/PhysicsSettings.h:并行常量与睡眠旋钮(25 / 28 / 94–102 / 119–123)Jolt/Physics/PhysicsUpdateContext.h:cMaxConcurrency(34)Jolt/Physics/IslandBuilder.h与IslandBuilder.cpp:接口(25–55)、mLinkedTo(96)、无锁合并(127–143)、排序(328–372)Jolt/Physics/LargeIslandSplitter.h与LargeIslandSplitter.cpp:五个常量(32–34 / 170–171)、Prepare提前 break(212)、导入论文(22–23)、内部件警告(25)Jolt/Physics/PhysicsSystem.cpp:睡眠判定(2511–2564)Jolt/Physics/Body/Body.h/Body.inl/Body.cpp/MotionProperties.inl:三判据实现Jolt/Physics/Body/BodyInterface.h:批量唤醒ActivateBodiesInAABox(§7.5 的手动唤醒入口)Jolt/Core/JobSystemThreadPool.h:本机基准 E5 / E6 / E8 用的线程池实现,真 worker 与 barrier 都出自这里
社区与作者一手材料
- jrouwe《Jolt Physics Multicore Scaling》:16 核拐点与 CCX −27%
- PR #1970:kinematic 同岛修复;Issue #1686:关睡眠的球不停;Issue #521:用
BodyActivationListener统计活跃 body 数 - Catto《Simulation Islands》:整岛睡眠为正确性要求
竞品
- Bullet
btSimulationIslandManager/btCollisionObject;PhysXPxAggregate与睡眠接口;Box2D v3 持久化岛与enableSleep;RapierIslandManager与can_sleep
本机一手产物
evidence/bench_island.cpp(E0–E8 实验)、evidence/build_bench_island.ps1(复现脚本)、evidence/bench_island_run_20261005.txt(原始输出,三次复跑 68 行读数 0 差异)
图片与图形素材
Aerial photographs of the archipelago of Victoria 01.jpg(5908×3939,CC BY-SA 4.0,Buiobuione):题图群岛航拍Intel Wolfdale die shot (E8400) etched.jpg(3256×2319,Public domain,Martijn Boer):多核 dieA50 and telephone pole.jpg(4000×3000,CC BY-SA 4.0,RealGPTV01):多车道Healthy Virginia big-eared bats (4388384664).jpg(3012×2142,Public domain,USFWS):冬眠Docs/PhysicsSystemUpdate.svg(MIT):并行 job 流水,ep01 已用过、本篇复用;本篇按 1:1 栅格化落位为ext_ep10_physics_update.png(2212×582),源 SVG 存evidence/Docs/Images 目录(API 列举):官方 14 张图的全量清单,本篇用它核对「没有一张讲岛、并行与睡眠」


素材口径与阶段 2 的盘点一致:外部真图只承担类比,机制核心图一律自绘;源码原文截取与本机数据图逐张可复跑。
清单之外补三条查无此物,免得复算时找错名字。BodyInterface 上没有 SetAllowSleeping,它只在 Body 上(Body.h:134–139);IslandBuilder 没有 GetBodies 与 GetConstraints 这样的短名接口,实为 GetBodiesInIsland 与 GetConstraintsInIsland,而 SortIslands 存在却是 private;ReleaseNotes.md 没有字面的 v5.6.0 小节,新条目都放在 ## Unreleased changes 里。
10.5 下篇预告
本篇把「谁跟谁一起解、谁不用解」收口了:岛每步重建,大岛切分,睡眠按整岛结算。第十一篇换一个问题:物体跑得太快时,怎样在两步之间把它拦下来,以及同一份输入为什么在不同机器上会算出不同的结果。题目是 CCD 与确定性,承接本篇只登记过的那条「求值顺序会变」的线索。
下一篇:第十一篇 · CCD 与确定性。
With Best Wishes.
10.6 源码落点
Docs/ReleaseNotes.md:版本条目(38 / 159 / 249 / 313 / 441)。Jolt/Core/Core.h:版本自述(8–10)。Build/CMakeLists.txt:工程版本(3)。Jolt/Physics/Constraints/ContactConstraintManager.cpp:只有双 dynamic 才同岛(798–801)。Jolt/Physics/Constraints/TwoBodyConstraint.cpp:同一段注释(44–47)。
其中: 版本演进五条落在 ReleaseNotes.md 的 38 / 159 / 249 / 313 / 441;版本口径的两处自述是 Core.h:8–10 与 Build/CMakeLists.txt:3。