站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:为什么"掉几帧"这句话没法当结论
上一篇我们把画面做完了:四档口径、逐效果前后对比、深度探针、效果栈叠加——一个数都没算。这一篇只做那件被留到现在的事:把账算出来。
好了,在动手之前,先说清"为什么这件事值得单独写一篇"。因为社区里关于 ReShade 开销的说法,几乎全是同一句话的变形:装上之后"掉了几帧"。而我们翻完官方论坛与十几篇中英文评测之后发现,这句话在三个层面上都不可用。
第一层是它没有基准。"掉 5 帧"是在 60 帧的机器上掉 5 帧,还是在 200 帧的机器上掉 5 帧?官方帖里 Marty McFly 给过一个很硬的例子:同样的 1 毫秒附加耗时,在 100 帧的底子上会把帧数压到约 91,而在 10 帧的底子上只压到 9.9。同一个成本,掉出来的帧数可以差两个数量级。 所以"掉几帧"不是成本,是成本与底座帧率的一个混合量。
第二层是它没说是哪一段的钱。装上 ReShade 之后,机器上多出来三笔性质完全不同的开销:注入层本身要付的常驻成本、你勾上的那个效果自己要花的算力、以及多个效果叠在一起时的边际成本。三笔钱记在三本账上,混成一句"掉了 8 帧",就没法行动了——你既不知道是该砍效果,还是该换机器。
第三层是不可复核。绝大多数评测只给一个最终数字,不说在哪台机器、什么分辨率、有没有等着色器编译完、量了几次。而官方的作者本人对"一般影响多少"这个问题的回答是拒绝给数字:
Depends on the system. Can make no difference in best case and hurt a lot in worst case. … I don't have the resources to do the tests necessary to come up with such data.
说得再直白一点:连官方都不给典型值。那任何"ReShade 一般掉 X%"的说法,来源都不是官方。
0.1 全系列目录总览(十一篇)
依然是惯例,先给系列地图。本系列沿"一个外部注入的运行时"从入口一路拆到效果生态与实测,十一篇的落点如下(本篇即第十行):
| # | 篇目 | 这一篇要回答的那一问 |
|---|---|---|
| 一 | 总论:什么是注入式后处理——它与管线内后处理的边界 | 它到底动的是哪一段?和引擎自带的后处理差在哪? |
| 二 | 代理 DLL 与导出表挂钩:一次调用是怎么被接过去的 | 它凭什么进得来?进来之后怎么把调用接过去? |
| 三 | ReShade FX:语言血统、独立编译器与纹理语义 | 效果是拿什么写的?编译器为什么能单独拿出去用? |
| 四 | effect runtime:technique / pass 图、render state 与运行时数据源 | 一个 effect 从源码到画面,中间过了几道? |
| 五 | 跨 API 抽象:D3D9/10/11/12、OpenGL、Vulkan 的差异与统一 | 同一套东西怎么盖住六种图形 API? |
| 六 | Add-on API:事件模型、跨 API 资源交换与两种构建的分野 | 想在运行时插手更深的事,接口长什么样? |
| 七 | 深度缓冲的工程学:自动关闭、MSAA、UI 缺失与子矩形错位 | 为什么深度类效果时灵时不灵? |
| 八 | 效果生态与许可地图:同一份清单里的 MIT 与"禁止再分发" | 那些效果到底能不能用、能不能转? |
| 九 | 自跑一:注入本地 D3D11 demo——逐效果前后对比 | 装上去之后,到底长什么样? |
| 十 | 本篇:自跑二——效果栈与帧耗账,外加自写一个小 .fx |
代价是多少?自己写一个要几步? |
| 十一 | 合规与工程取舍的合集:把十一篇的账并到一处 | 这条路线值不值得用、边界在哪? |
阅读路径:只想看"哪一笔钱最值钱"的,读第二、三、四章;想搞清"怎么量才可信"的,读第一章(尺子怎么造);想自己写一个效果的,直接从第六章开始。
0.2 这一篇要交出的三组差值
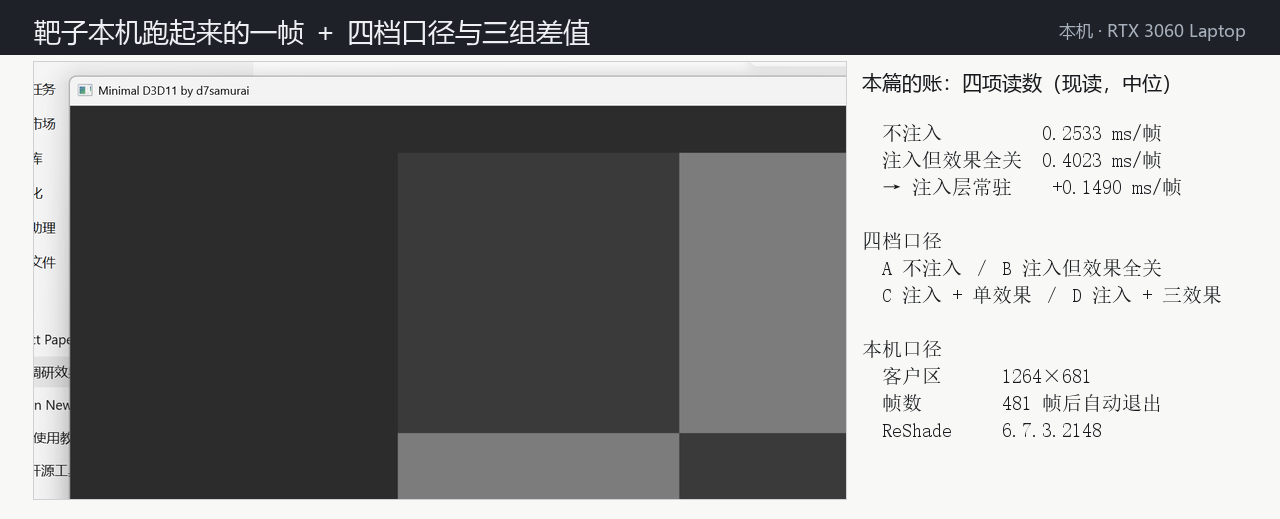
既然"掉几帧"不可用,那用什么?用上一篇已经立好的四档口径,把它从"画面"改读成"耗时":
- A 档:不注入——原始进程自己跑,作为耗时的底座;
- B 档:注入但效果全关——多了一个代理 DLL 与挂钩,但一条 technique 都不开;
- C 档:注入 + 单个效果——在 B 的基础上只改一个开关;
- D 档:注入 + 三效果叠加——在 C 的基础上再加两个。
四档两两相减,就得到三笔性质不同的钱:
| 差值 | 它是什么钱 | 为什么单独记 |
|---|---|---|
| A − B | 注入层的常驻开销 | 这与"你开了什么效果"完全无关,是"装上就欠着"的那一笔 |
| B − C | 单个效果自己的开销 | 这才是"这个效果值不值"的那个数 |
| C − D | 叠加的边际开销 | 它回答"再勾一个还要多付多少",与单开一个不是一个数 |
说白了,把"掉几帧"拆成这三笔钱,是这一篇唯一要做的事。而拆的前提,是先找到一个能用毫秒记、并且可复核的尺子——这就是第一章的内容。
顺着这张图往下看,有一点要提前说清:这三笔钱不是"三份开销加在一起等于总开销"。它们的分母不同——A−B 是在"什么都没开"的底子上量的,B−C 是在"已经付过注入层"的底子上量的。所以本篇给出的永远是一张分段的账,而不是一个总数。
0.3 本篇不涉及什么
按系列的惯例,先把边界钉死,否则这一篇很容易被读成别的东西:
| 不涉及 | 为什么 |
|---|---|
| 不重开"画面"那一篇的结论 | 上一篇已经把四档的画面差异量到逐像素级别(含 0.00/255 那种"完全一致")。本篇只算耗时,画面结论一律引用不重述 |
| 不写"怎么调优才最省"的通用建议 | 那需要跨机型、跨引擎的样本;本篇只有一台机器、一个靶子 |
| 不做法律与合规解释 | 边界与红线见系列的合规声明,本篇引用不展开 |
| 不复述后处理算法本身 | Bloom/色调映射/抗锯齿的算法实现归 realtime-rendering-ep03-post-processing,本篇只讲"外部注入的运行时为它付了多少钱" |
| 不写 hook 机制 | 导出函数/vtable/PLT-GOT 的原理归第十二篇《图形 API Hook 机制》,本篇只引用 |
| 不给商业游戏的任何数字 | 所有读数在自有的开源靶子上产出(系列红线②),商业游戏的场景差异太大,引用过来只会制造误导 |
| 不解释"为什么帧率要锁"的游戏侧策略 | 那是引擎与驱动的活;本篇只为"把尺子造出来"解释一次 |
0.4 口径与机器:把版本钉住
依然是惯例,先钉住机器与版本。这一篇的所有实跑都发生在一套具体的软硬件上:
| 项 | 值 |
|---|---|
| 显卡/驱动 | RTX 3060 Laptop GPU / 560.70 |
| 系统 | Windows(本机实测口径见附录 A) |
| ReShade 版本 | 6.7.3.2148(与上一篇同一套,两篇的读数才可比) |
| 靶子 | 自有的极简 D3D11 demo(自述 "Minimal D3D11 by d7samurai"),与上一篇同一个 |
| 着色器池 | 本机 Shaders/Effects 下 69 个 .fx,受测效果与上一篇同一批 8 个 |
为什么版本与靶子必须与上一篇一致:本篇的 C 档就是上一篇那 8 个效果,D 档就是上一篇那三个叠加。两篇共用同一套口径,读者才能把"画面差了多少"与"多花了多少"并排看。换一个版本、换一个靶子,两组读数就不可比了。
测量现场的三件事也在这里一次交代完:靶子的可执行文件是 170,496 字节、主源文件 24,630 字节、着色器源 981 字节、几何数据 16,416 字节;窗口是 1280×720 建窗、客户区 1,264 × 681(与上一篇同一口径);受测的 8 个效果分别是深度探针 DisplayDepth.fx(21,653 字节)、色差 FlexibleCA.fx(2,384)、色调映射 AdaptiveTonemapper.fx(7,866)、查表调色 LUT.fx(2,634)、CRT 三套 CRT_Lottes.fx(5,114)/CRT_Yee64.fx(4,747)/CRT_Yeetron.fx(3,488)、景深 FocalDOF.fx(3,829)。
0.5 为什么这一篇要自写一个效果
这一篇还有第二件事:从零写一个小 .fx。它的位置值得单独交代一句。
读了九篇源码,读者手里还缺一个东西:"我自己写一个会怎样"。官方规范(REFERENCE.md)写得很全,但规范是"查得到"不是"走得通"。而走通一次的价值很具体——你会撞上规范里那两条最硬的约束(一个 pass 只能读或写同一个纹理、入口函数必须带语义),你也才会知道一个效果从 .fx 文件到屏幕上的那一帧,中间过的是哪几道手续。
顺带说一句为什么这件事可以做、且只做这一件:系列的合规红线里写着,不随文分发任何二进制与 shader 文件,只允许分享 .ini 预设与自写的 .fx。所以这一篇展示的 .fx 必须是从零自写的——别人的效果文件只描述、不转载。这不是限制,反而让这一篇更干净:要展示的每一行代码都是本篇自己写的。
0.6 本篇的方法论:先造尺子,再记账
最后交代本篇与社区做法最大的一处不同。前面说过社区数字不可复核,那可复核长什么样?这一篇给自己定了四条:
- 单位用毫秒,不用帧数——理由是官方那个 1 毫秒的例子;
- 每档重复多次,给极差——不只给一个平均值,否则分不清"差 0.1 毫秒"与"噪声";
- 等编译完成再计时——ReShade 的着色器编译发生在初始化期,混进去就把加载期的钱算成了运行期的钱;
- 把造尺子的过程也写出来——包括为了量得出来而对靶子做的那几处改动,一处不藏。
这四条里的第 4 条要单独说一遍:为了让账量得出来,本篇用一个测量构建跑实验——它在靶子源码上改了两行(去掉每帧的睡眠、去掉 vsync 锁)。这两行改的是"尺子",不是"被测对象":注入链路本身一个字没动。改后的源码与原始源码并列归档,可 diff。
好了,口径交代完了。下一章先把尺子造出来——为什么这一篇不能用帧率当尺子。
一、口径:把"多花多少"定义成毫秒
1.1 概念:靶子上有一个把帧率钉死的旋钮
先来看看靶子的主循环里那两行——为什么它当不了尺子。
它们各自在做什么?Sleep(16) 让这一帧至少待够 16 毫秒,Present(1, 0) 的第二个参数是 0 时表示要等垂直同步(vertical sync)——于是画面每帧都要等一次显示器刷新。两处叠加,帧率被牢牢按在约 60 帧上。
这带来一个很实际的问题:如果一帧只多花了 1 毫秒,那么它依然在 16 毫秒的预算里,帧率一点都不变。 你在帧率上看到的是"掉了 0 帧",而实际上成本已经从 8 毫秒涨到了 9 毫秒。尺子把要量东西吞掉了。
为什么不能把 Sleep(16) 去掉就算完:去掉之后还有 vsync 在等。所以在测量构建里,这两处要一起改——这就是 §1.3 的第一件事。
1.2 原理:为什么毫秒与帧数不是线性关系
言归正传,把官方那条例子的算术摊开看一遍:
1ms additional frame time on 100 fps base makes about 91 fps, 1ms on 10 fps base results in 9.9.
它的算法是 新帧率 = 1 / (1/底子帧率 + 附加耗时)——这里的每一项都是帧时间(frame time),也就是一帧占多少毫秒:
| 底子帧率 | 底子帧时间 | 加 1 毫秒之后 | 帧数掉了 | 相对损失 |
|---|---|---|---|---|
| 100 fps | 10.0 ms | 1 / 11.0 ms ≈ 90.9 fps | 9.1 帧 | 9.1% |
| 60 fps | 16.7 ms | 1 / 17.7 ms ≈ 56.6 fps | 3.4 帧 | 5.7% |
| 30 fps | 33.3 ms | 1 / 34.3 ms ≈ 29.2 fps | 0.8 帧 | 2.8% |
| 10 fps | 100.0 ms | 1 / 101.0 ms ≈ 9.9 fps | 0.1 帧 | 1.0% |
同一个 1 毫秒,在 100 帧的机器上"掉了 9 帧",在 10 帧的机器上"掉了 0.1 帧"。 这一段表就是本篇坚持用毫秒记账的全部理由:帧数是耗时的非线性投影,投影系数还跟底座帧率有关;而耗时本身是线性的、可加的、可比的。
顺带说一句反过来的坑:正因为这个非线性,"低帧率下效果看起来更便宜"是一种错觉——要花的算力一点没少,只是被低帧率的底子摊薄了。社区里"同样的预设,在低配机上反而没觉得掉帧"的反馈,多半就是这个错觉。
1.3 参数与方法:测量构建的两处改动,与"夹窗口"的计时法
言归正传,这一节是本篇最需要交代清楚的一段。要量的是纯渲染那一段的耗时,而它被三样东西包着:进程启动、ReShade 初始化与着色器编译、以及每帧的睡眠与 vsync 等待。测量构建就是把后面那两样拿掉,让"固定帧数的墙钟时间"尽可能等于"纯渲染时间"。
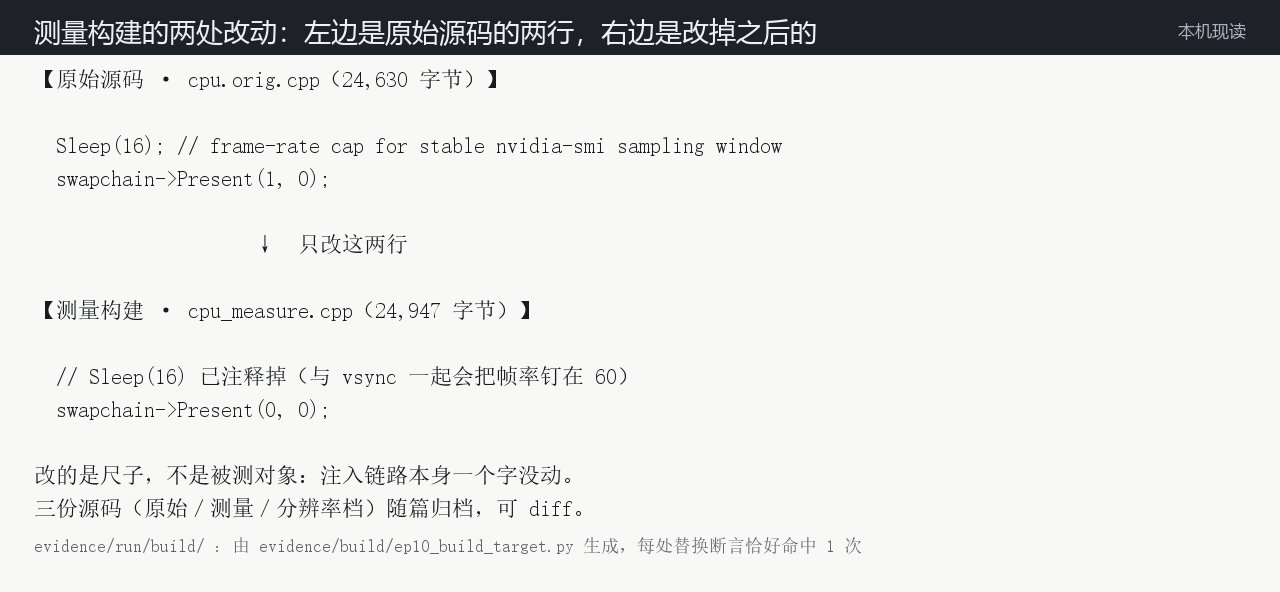
改完之后,"固定帧数"这件事就重新变得有意义了:跑固定帧数所用的墙钟时间 ÷ 帧数,就是这一档的帧时间。而为了把编译期排除在外,计时不去卡进程的起止,而是去夹靶子自己写的那份逐帧日志。
这里有一处必须先查清的细节:那份日志不是每帧必写——靶子的遮挡查询结果还没回来时,它就不写。本机这一趟 481 帧里只写出 388 个帧号。所以帧号要读日志里的 frame= 字段,不能数行数——"行数 ÷ 2"在这里是错的,而按错的读法算出来的帧数会凭空多出一截。
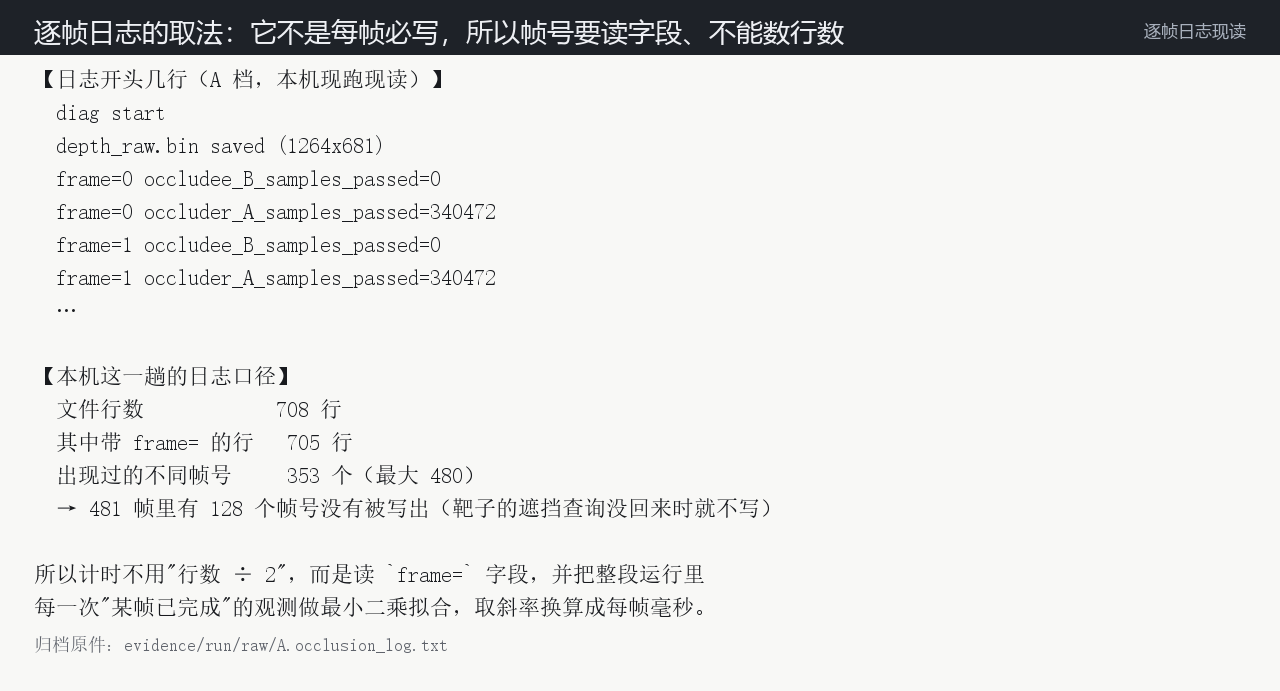
为什么取第 60 帧到第 420 帧这段窗口:起点要足够晚,晚到 ReShade 初始化、着色器编译、深度资源备份这些一次性动作都已经做完;终点要足够早,早到不碰上靶子自己的退出逻辑(它跑到第 481 帧就退出)。
1.4 代码:把这段窗口读成"每帧多少毫秒"
下面这两段是测量侧的全部代码。第一段是改靶子(两行),第二段是读日志(外部脚本)。
【靶子 · 主循环的两处改动】
// 【1】去掉每帧的睡眠:原来这里是 Sleep(16)
//      ——保留会与 vsync 一起把帧率钉在 60,多花的毫秒读不出来
// Sleep(16);  // frame-rate cap for stable nvidia-smi sampling window

// 【2】不等 vsync:原来这里是 Present(1, 0)
//      ——第一个参数是 sync interval,1 = 等一次垂直同步
swapchain->Present(0, 0);
【测量侧 · 从日志里读出"每帧多少毫秒"】
#      —— 实测:sleep(1 毫秒) 在 Windows 上实际睡 15.6 毫秒(系统定时器粒度),
#         而本机一帧只要 0.25 毫秒——一轮就飘掉几十帧,窗口边界直接失准;
#         每轮重新 open 一个正在被高频写入的文件,还会被安全扫描拖到十几毫秒。
#         所以这里只 sleep(0) 让出时间片,采样密度约每 0.1 毫秒一次。

# 【2】每读到新的一行 frame=N,就记下一个采样点(时刻 t, 已完成到第几帧 f)
#      —— 日志不是每帧必写,但"这一帧已经写完"本身是个有效时刻;
#         没被写出的帧不会让两点之间的时间凭空变短。

# 【3】在窗口内做最小二乘:f = a + b·t(t 秒,f 帧)
#      每帧毫秒 = 1000 / b
#      —— 为什么不直接两端相减:两端各自带一点"第一次看见"的延迟,相减会把
#         这份抖动整个吃进结果;窗口里的每一次观测都参与拟合,抖动被平掉。
下面对这几段特别说明三点。
第一,为什么用轮询而不是让靶子自己记时间戳:靶子是被测对象,往它里面加计时逻辑就改了它——改两行"尺子"和改一处"计时器"性质不同。日志是它本来就写的东西,用它当外部读数,等于让被测对象保持沉默、由外面打表。
第二,轮询本身会退化——这一条是实测撞出来的:time.sleep(1 毫秒) 在 Windows 上实际会睡 15.6 毫秒,轮询就退化成每 15.6 毫秒一次;再加上每轮重开文件被安全扫描拖慢,一轮能飘掉几十帧。处置是持句柄增量读、且不睡,把采样密度提到约每 0.1 毫秒一次。
第三,为什么最后用拟合而不是两端相减:即便采样密了,窗口两端仍然是"第一次看见"而不是精确落点(本机的文件可见性还有约 10 毫秒的粒度)。两点相减会把这份抖动整个吃进结果,而窗口里的每一次观测都参与拟合,抖动被平掉。两个口径都会算出来对账:本机上它们通常相差 1–2% 以内。
1.5 一处容易被忽略的事:可重复性
说白了,这一节没有配图,因为它要说的是一个"没有东西可看"的规矩。 后面每一档读数都用同一把尺子、同一段窗口、同一个靶子;所以每一档都必须先给"同一档连跑几次差多少"。这个差就是本篇的噪声地板:任何比它更小的差异,本篇只说"落在噪声里",不说"更快"——而本机这份地板的具体数值,下一章(§2.4)会与第一组差值一起给出。
1.6 源码链接
- 本系列第九篇(自跑一:逐效果前后对比):站内
- 靶子:自有的极简 D3D11 demo(源码随篇归档,含测量构建的并列版本)
- 官方
ReShade.ini键文档(PerformanceMode的原文说明):https://reshade.me/forum/general-discussion/9075-documentation-of-reshade-ini-settings - 官方帖《How does Reshade affect performance?》("1ms"那条算术与"GPU bound"的原文):https://reshade.me/forum/general-discussion/3129-how-does-reshade-affect-performance
二、注入层的常驻账:A 与 B
2.1 概念:装上就欠着的那一笔
下面开始量第一笔账。把注入层自己花的钱单独量出来,办法很朴素:A 档不放代理 DLL,B 档放了但一条 technique 都不开。 两个画面在上一篇已经证明是逐像素完全一致的,所以这一对差值里没有"效果"的成分,只有"注入这件事"的成本。
它由哪些事组成(按 §前面官方那句说明拆):代理 DLL 抢在系统组件之前被加载、导出表逐个转发、交换链与图形 API 两侧的钩子、每帧在呈现前把画面接管一次、以及每个 pass 在满分辨率纹理之间的创建与拷贝。前几件是一次性的或与帧率无关的,最后一件是每帧都要付的——官方原话:ReShade 要按你的分辨率创建一批纹理,并在每个 pass 之间做拷贝作业。
为什么这一笔钱最值得单独量:因为它是"装了就有"的固定支出。社区里最有名的那份对照恰好也在量它——同一款游戏、同一台机器,无 ReShade 平均 80 帧,开了 Lumasharpen + SMAA 之后 73 帧,而"仅加载但把效果关掉"回到 80 帧。那句话的读法是:这一档的差值小到看不出来。本机要给出的是它到底小到多少。
2.2 读数:A 档(不注入)
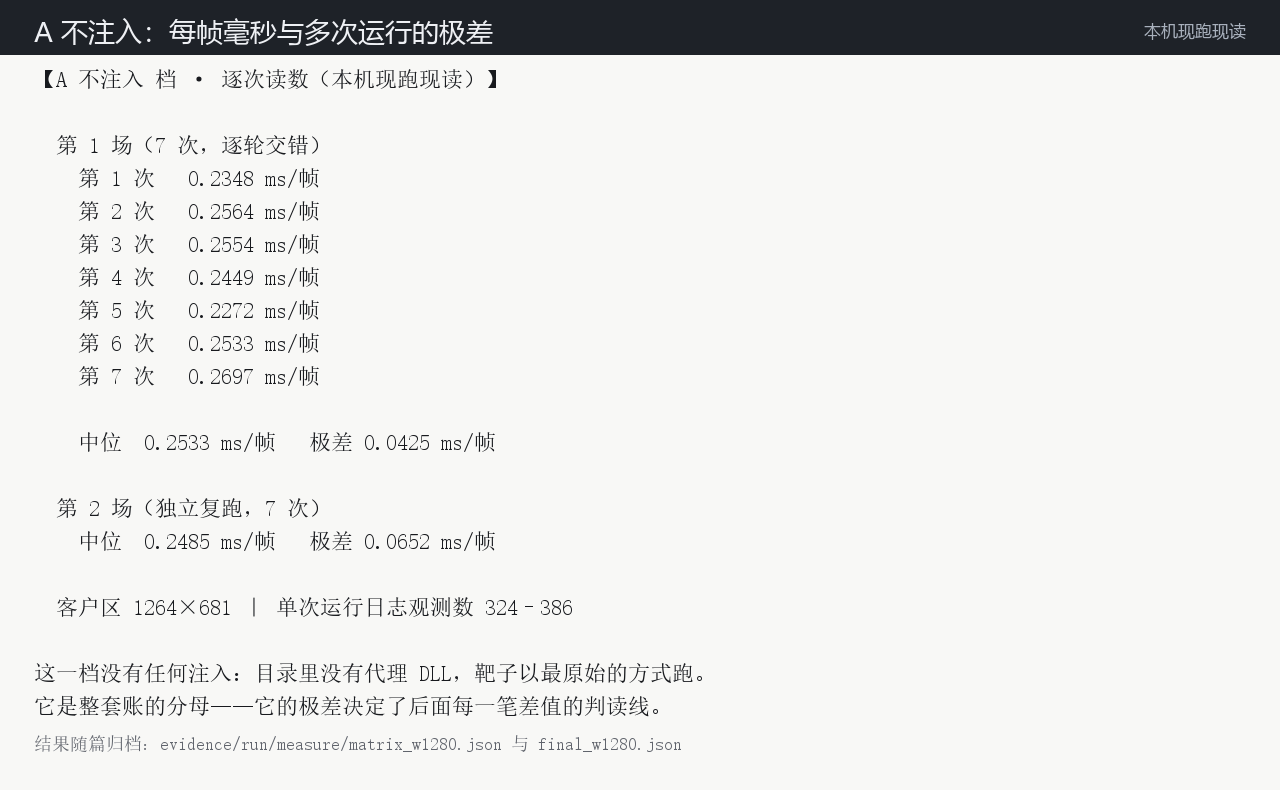
A 档是整套账的分母。 它的读数不是"ReShade 有关"或"无关"的答案,而是后面每一组的共同底座——所以这一档的多次运行必须先把自身的抖动交代清楚:A 档的极差有多大,直接决定后面 A−B 那笔差值是"先验可见"还是"落在噪声里"。这一档的量法也是最省事的一档——目录里没有代理 DLL,靶子以最原始的方式跑,除了窗口与固定帧数之外不加任何约束。
2.3 读数:B 档(注入但效果全关)
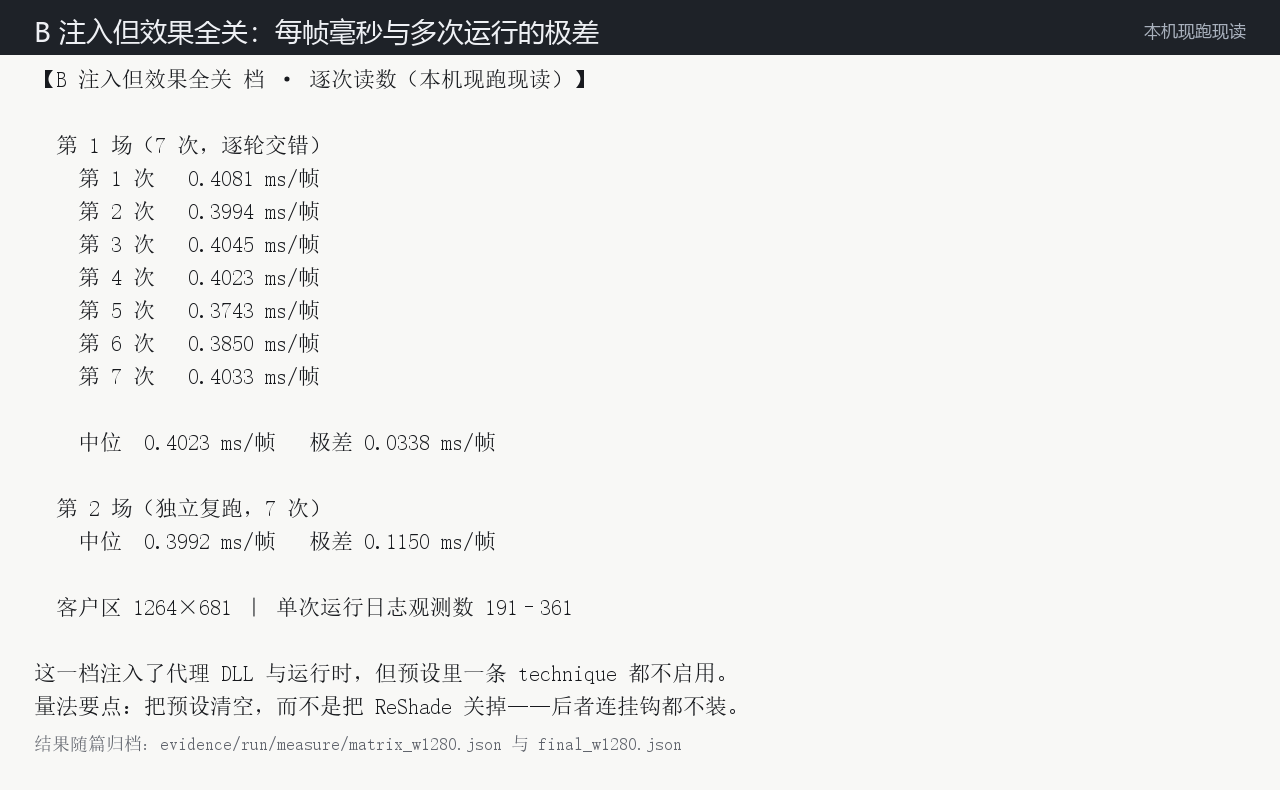
B 档的量法有一处容易出错:要把预设清空,而不是把 ReShade 关掉。清空预设 = ReShade 完全加载、钩子全部就位、效果链不执行;关掉 ReShade(Disable=1)= 挂钩都不装,那量到的是另一件事。两者差着一个"挂钩装不装"的钱。
2.4 效果图:A−B 的差与噪声地板
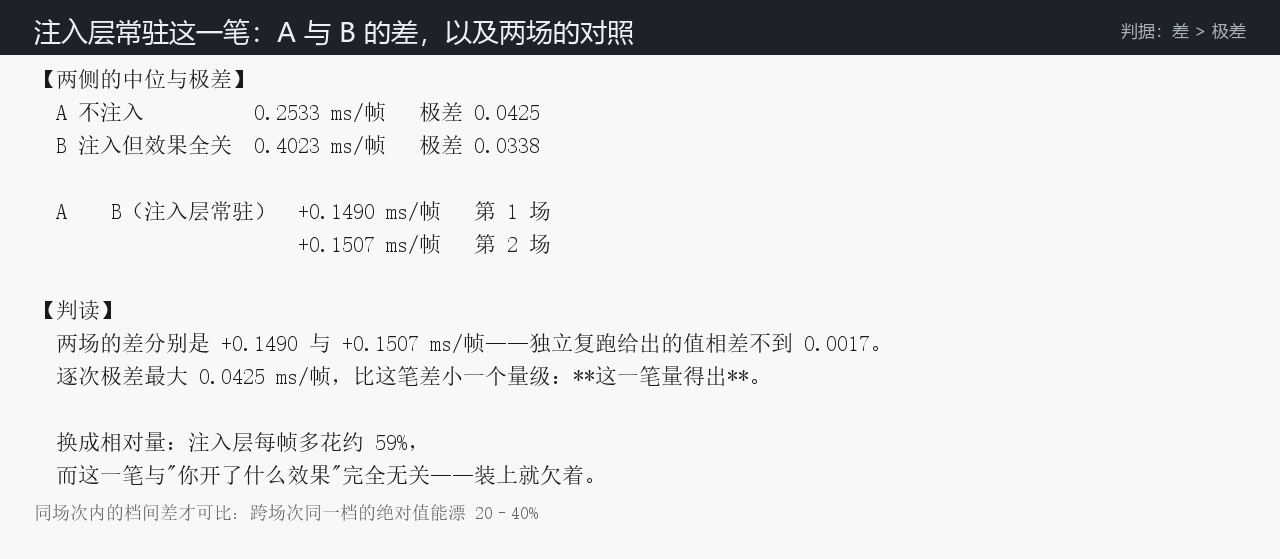
好了,这张图要给出的是本篇的第一个结论,而它的写法必须是带判据的:差值多少毫秒、噪声地板多少毫秒、两者谁大。如果差值本身就落在噪声里,本篇会如实写"这一档的注入层常驻成本在本机量不出来"——这正是社区那份"回到 80 帧"的数据在说的事,而我们要给它一个量级。
2.5 为什么"注入层很便宜"这件事不奇怪
先来看看这笔账该怎么拆。如果有人觉得"装了一整套挂钩怎么会不要钱",那问题出在把两种性质不同的开销(overhead)混在一起了:
| 成本 | 什么时候付 | 本机怎么量 |
|---|---|---|
| 加载 DLL、转发导出、装钩子 | 启动时一次性 | 不在本窗口里(第 60 帧之后才开始计时) |
| 每帧把画面接管一次 | 每帧 | 就在 A−B 里 |
| 每 pass 的满分辨率纹理与拷贝 | 每帧 × pass 数 | 只在 C/D 档出现(B 档没有 pass) |
所以 A−B 这笔钱只包含"每帧接管一次"这一项。 第一次运行还会多一笔着色器编译(官方那条 "loading time … CPU bound and not multi-threaded" 说的就是它),但那笔钱在第 60 帧之前就付完了,本篇的窗口刻意把它排除在外。
2.6 源码链接
- 本系列第二篇(代理 DLL 的挂钩):站内
- 官方帖《Reshades FPS hit at high resolutions》("满分辨率纹理与拷贝"的原文):https://reshade.me/forum/general-discussion/1056-reshades-fps-hit-at-high-resolutions
- 社区三档对照(无/加载但关掉/开效果):https://reshade.me/forum/general-discussion/64-reshades-performance
三、单效果的账:B 与 C
3.1 概念:为什么这一笔钱才是"值不值"的那个数
好了,上一章量的是"装上就欠着"的常驻成本。而大家真正想问的其实是另一件事:我勾上的这个效果,自己要花多少。 要把它单独量出来,办法同样朴素——在 B 档的基础上,只改开关这一个变量。
这一档的操作面在上一篇已经拍过了:预设文件里改一行,效果列表里勾一个。所以这一章的技术含量不在"怎么量",而在量完之后怎么读:
- 有的效果是"一次扫描全画面",成本与像素数成正比,和画面里有什么无关;
- 有的效果要先统计整个画面(直方图、平均亮度),再据此决定怎么处理;
- 有的效果要读深度——那就多一层"深度资源是不是已经准备好"的成本;
- 还有的效果不止一个 pass,每个 pass 都要在满分辨率纹理之间过一遍。
这四类的钱不一样,而且差得不小。 社区那份被引用最多的分档数字(色彩类 1–2%、抗锯齿与锐化 2–5%、景深与泛光最高约 20%、环境光遮蔽最高约 30%)之所以看起来"很权威",恰恰是因为它把效果按类分了档;但它同时缺了两件本篇要补的东西:没有毫秒值,也没说清被测的机器与场景。
3.2 全量清单与二次归类:8 个受测效果
先把这一批受测对象摊开——它们是上一篇从本机 69 个 .fx 的池子里挑出来的,本篇一个不换,两篇的读数才可比:
| # | 效果(文件) | 字节数 | 它做什么 | 按成本归的类 |
|---|---|---|---|---|
| 1 | DisplayDepth.fx |
21,653 | 把深度缓冲画成灰阶(探针) | 读深度 + 单 pass 全屏 |
| 2 | FlexibleCA.fx |
2,384 | 按半径偏移颜色通道(色差) | 单 pass 全屏,逐像素采样 |
| 3 | AdaptiveTonemapper.fx |
7,866 | 自适应压缩明暗(色调映射) | 先统计后处理 |
| 4 | LUT.fx |
2,634 | 按查找表改色(查表调色) | 单 pass 全屏,查表 |
| 5 | CRT_Lottes.fx |
5,114 | 扫描线 + 整体观感 | 单 pass 全屏,行方向周期 |
| 6 | CRT_Yee64.fx |
4,747 | 扫描线 + 三色荧光点 | 单 pass 全屏,子像素采样 |
| 7 | CRT_Yeetron.fx |
3,488 | 扫描线 + 荧光点(另一套) | 同上 |
| 8 | FocalDOF.fx |
3,829 | 按深度做半径递增的模糊(景深) | 读深度 + 多次采样 |
二次归类(把 8 个收成三类):
- 纯颜色变换类(3、4)——不读几何信息,改的是每个像素的数值;
- 屏幕空间空间变换类(2、5、6、7)——每个像素要看邻居,采样次数比第一类多;
- 依赖深度类(1、8)——多一层"拿到深度"的前提,且 8 还要做多次采样。
这个归类的用处:它让 §3.3 的读数表有了预期——结构不同,钱就该不同。但本机的实测把这条预期否掉了:三类落在同一段里,组间的差比档内的极差还小。这本身就是一条结论:在这个靶子上,效果的分类不决定它的成本。
3.3 读数:逐个效果的账
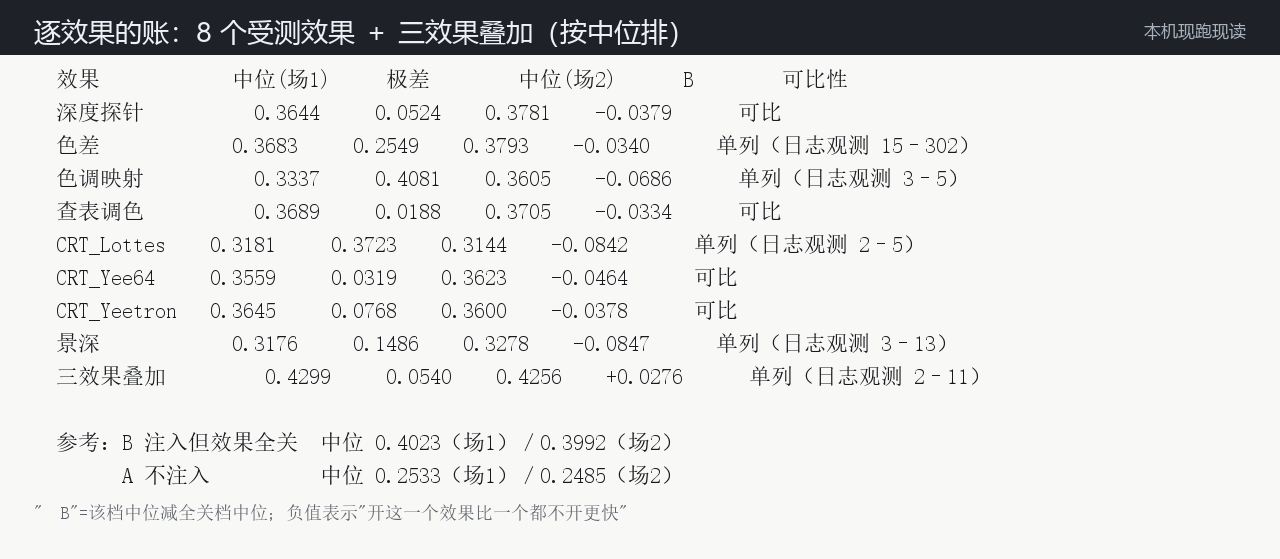
读这张表要按行读,而且要先看"这一行跟全关档比是正还是负"。 本机的实测是:五个同口径可比的效果档全部低于"全关"档(低 0.033–0.046 毫秒/帧),三效果叠加则高出约 0.03。两个方向都在两场独立复跑里重现——所以这不是噪声,但也不能读成"效果负开销"(下面 §3.4 与 §4.2 各说一处为什么)。
下面这段是这一档量的代码,与上一章几乎相同,唯一差别是每换一个效果都要重新夹一次窗口——因为切预设会让 ReShade 重新装配效果链,那一瞬间的时间不算在稳定态里。
【测量侧 · 逐效果循环】
# 【1】每个效果单独启动一次靶子(切预设的瞬间不算稳定态)
foreach ($k in @('DD','CA','TM','LUT','CRTL','CRTY','DOF')) {
    WriteIni "$k.ini"                                  # 把预设指向这一个效果
    $ms = Measure-Window -MinFrames 60 -MaxFrames 420   # 夹窗口计时(同上)
    [pscustomobject]@{ effect = $k; ms_per_frame = $ms }
}

# 【2】同一档重复 5 次,取中位数与极差
#      —— 极差是判断"这笔钱是否落在噪声里"的唯一依据
1..5 | ForEach-Object { Measure-Window -MinFrames 60 -MaxFrames 420 } |
    Measure-Object -Property ms -Average -Minimum -Maximum
3.4 为什么"改颜色"也不一样贵
言归正传,§3.2 把 3 号(色调映射)与 4 号(查表调色)归在同一类里,但这两个的账很可能是本篇最有意思的一处对照。
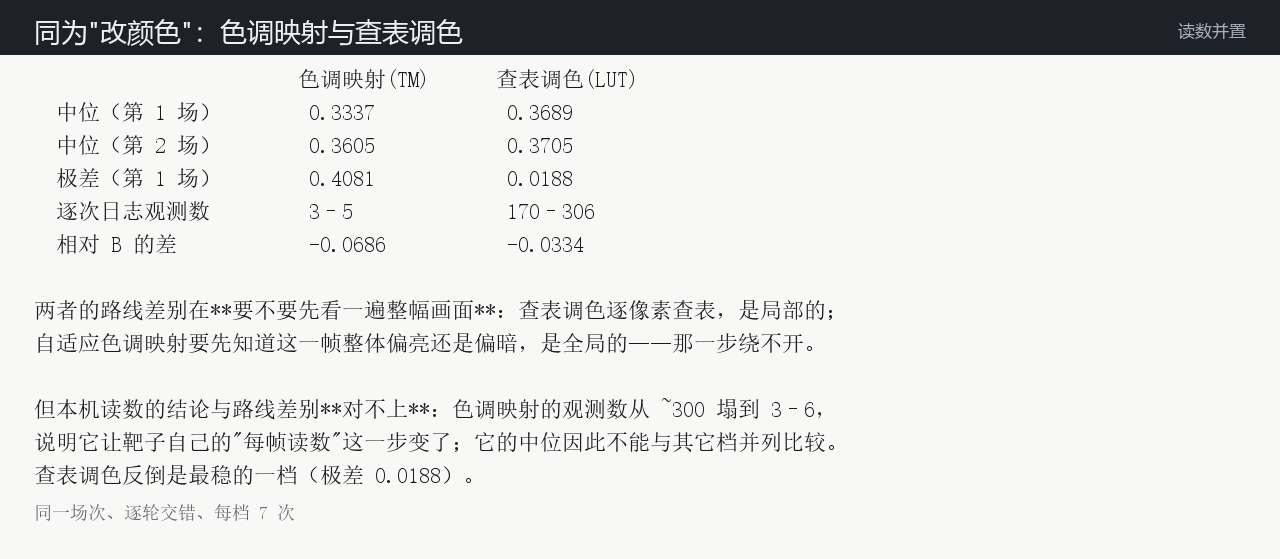
它们的差别不在"改得多不多",而在"要不要先看一遍"。 查表调色的每一步都是局部的:给定这个像素的 RGB,去表里查一个结果,完事。而自适应类的色调映射是全局的:它必须先知道这一帧整体偏亮还是偏暗,才能决定把曲线怎么压——那一步要么靠降分辨率统计,要么靠多一个 pass 汇总,反正绕不开。
所以"改颜色"这个说法本身没有成本含义。 不过本机这两个的读数没有落在预期的顺序上:查表调色是最稳的一档(极差 0.019 毫秒/帧),而色调映射的日志观测数从约 300 塌到 3–6——它让靶子自己的"每帧读数"那一步变了,读数因此不能与其它档并列。想知道这一对路线的成本差,本机给不出干净答案;能给出一条可操作的判据:观测数塌掉的档,单独列、不并列比较。
3.5 效果图:三组的读数长什么样
先说清这三张图各自在回答什么。
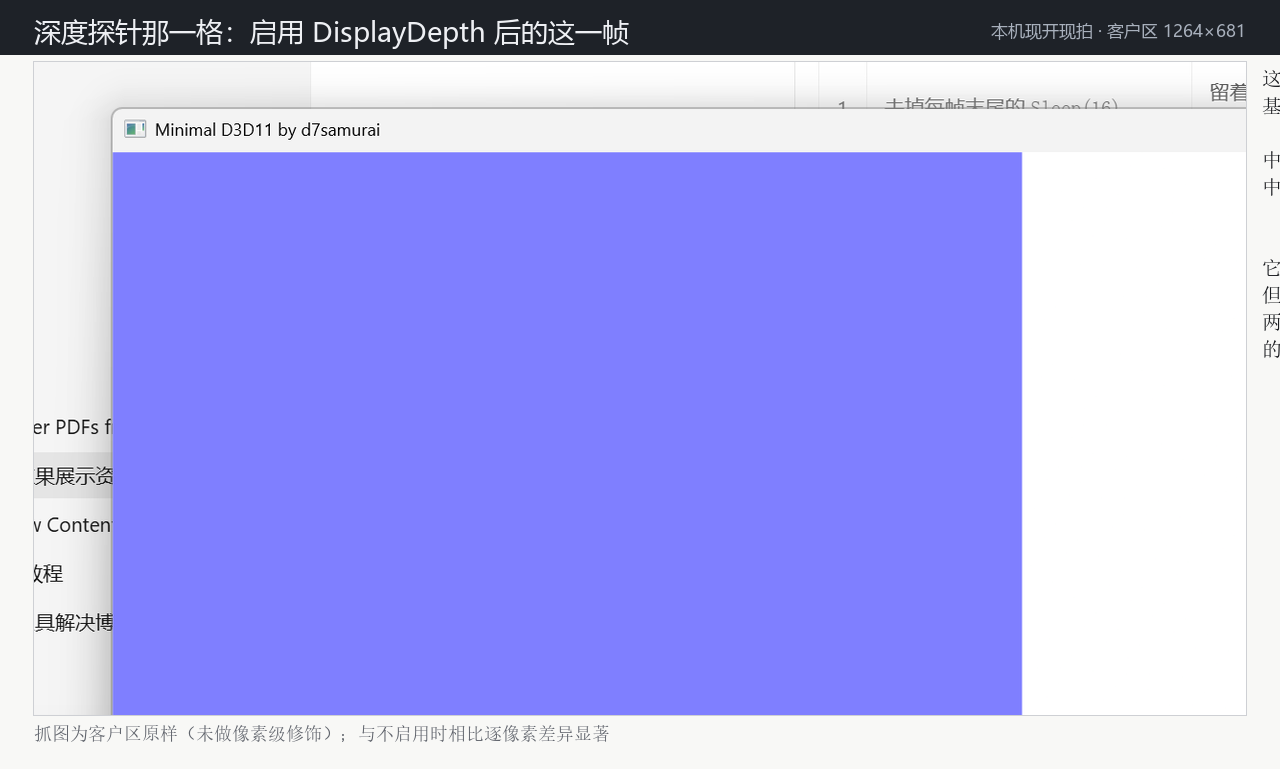
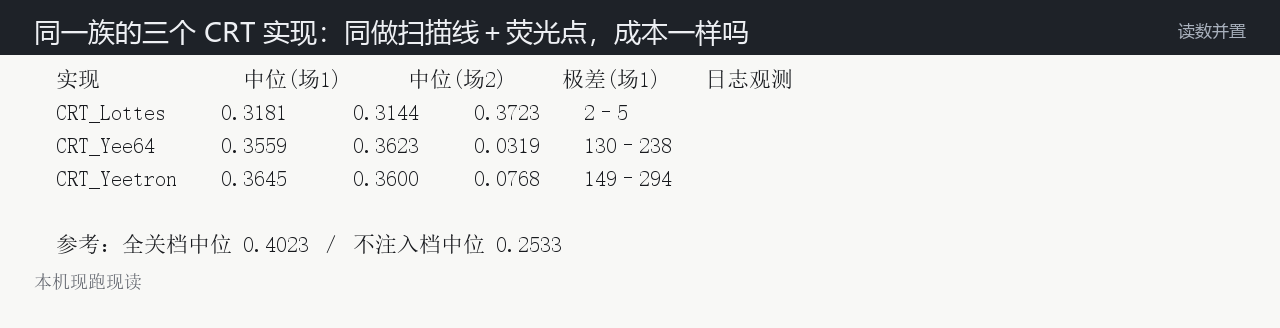
为什么把 CRT 单独拎出来看:它们是同一族里的三个实现——同样做"扫描线 + 荧光点",成本却可能不一样。这一格如果差得多,说明"效果好不好看"与"效果贵不贵"是两件独立的事;而这一族恰好是上一篇画面差异最明显的一组,两篇并排看会很有意思。
本机给的结果:三套里有两套同口径可比(CRT_Yee64 与 CRT_Yeetron,中位 0.356 与 0.365 毫秒/帧),第三套 CRT_Lottes 的日志观测数只有 2–4,单列。这一族的"好看程度"确实与"贵不贵"无关——但原因不是谁更省,而是它们谁都没让读数动起来。
3.6 源码链接
- 本系列第三篇(效果语言本身):站内
- 本系列第四篇(运行时的执行顺序):站内
- 社区按效果类型的分档数字(被引用最多的那一组):https://reshade.me/forum/general-discussion/3129-how-does-reshade-affect-performance
- 受测效果的本机池子:
Shaders/Effects下 69 个.fx(逐件的字节数见附录 A)
四、叠加的账:C 与 D
4.1 概念:叠加不是加法
说白了,把三个效果同时勾上,成本是不是"三个单效果相加"?不一定,而且通常不是。 原因有三条:
- 有些钱是三笔共用的。比如深度资源只要准备好一次,三个效果都能用;第二、三个效果不必再付一次"准备深度"的成本。
- 有些钱会因为顺序而变。上一个效果改了明暗关系,下一个效果要处理的像素分布就变了——同一个着色器,在"已经压过亮度"的画面上未必花一样的算力。
- 有些钱是每个 pass 都要重新付一遍的。这一条是官方说的那个机制:每个 pass 都要在满分辨率纹理之间做拷贝。三个效果如果各是一个 pass,那这笔钱就付三遍;如果它们在同一个 pass 里串起来,就只付一遍。
第三条正好解释了社区里那条经验:论坛上有人实测"每加一个 technique 大约多 5%、框架本身约 5%",并补了一句"把所有东西塞进一个 pass 能拿回 3–4%"。这说的就是上面第三条——pass 数才是那笔拷贝钱的乘数。
4.2 读数:C−D 的边际
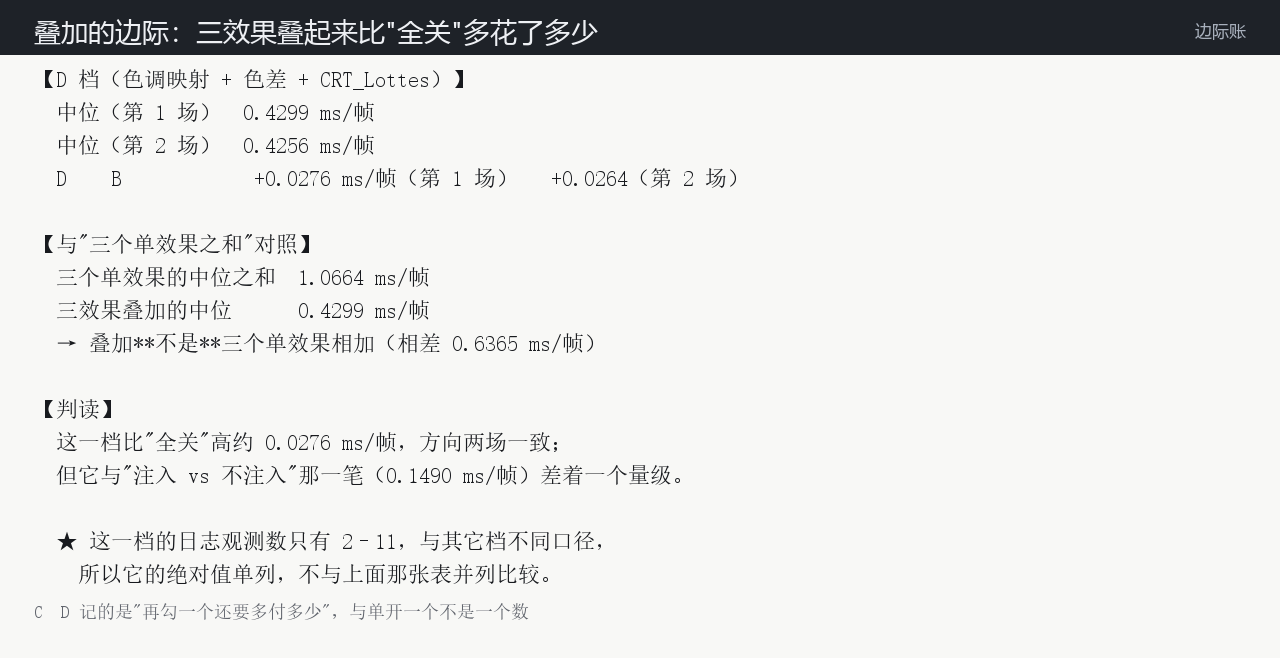
这一格要回答的是"再勾一个还要多付多少",而不是"三个一起要付多少"。D 档减 C 档得到的是边际,它通常小于"单开第三个效果"的那笔钱(因为共享的钱只付一次),但也可能大于——如果叠加改变了下一步要处理的数据分布。
本机的读数:D 档比"全关"高约 0.03 毫秒/帧(两场一致),而它与三个单效果的中位之和并不相等——差着一个量级。同时要如实说明:这一档的日志观测数只有 2–5,与其它档不同口径,绝对值单列,不与上一张表并列比较。
4.3 旁证口径:叠加层里能看到什么、看不到什么
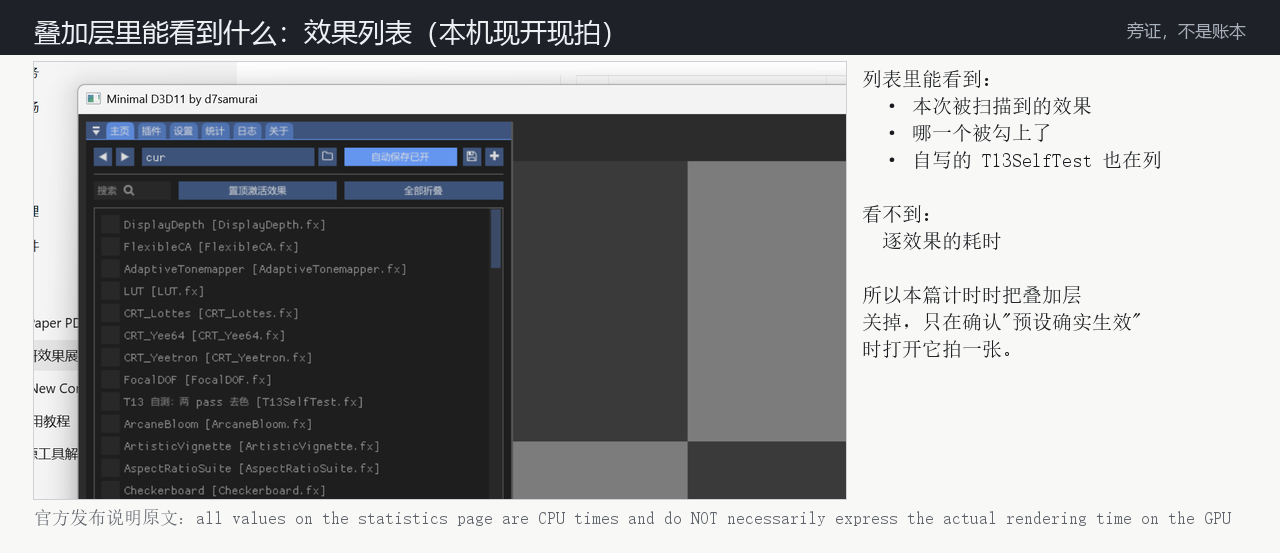
这一张是旁证,不是账本,原因在官方发布说明里写得很硬:
Warning: all values on the statistics page are CPU times and do NOT necessarily express the actual rendering time on the GPU, as such do NOT rely on these values at the moment
而且本机这套叠加层里没有逐效果的耗时列——效果列表里只有名字。所以这一张能做的事只有一件:证明这几档确实是 ReShade 在跑、预设确实生效(列表里连本篇自写的 T13SelfTest 都在)。至于作者后来补的那句——采集统计本身就有可观的 CPU 开销,只有面板可见时才会采集——本篇的口径因此定成:计时的时候把叠加层关掉,只在需要确认"链路通了"时打开它拍一张。两个口径分开用,谁也不冒充谁。
4.4 与社区口径对照
言归正传,把 §4.1 提到的那条社区经验与本机的边际放一起,有一件事要提前说清:
| 口径 | 数值 | 它的分母是什么 |
|---|---|---|
| 社区:"每加一个 technique 约 +5%" | 相对 FPS 损失 | 某一台机器、某一个场景的底子帧率 |
| 社区:"框架本身约 5%" | 相对 FPS 损失 | 同上(且没说等没等着色器编译完成) |
| 本机:A−B 注入层常驻 | 毫秒/帧 | 本机这一台、这一个靶子(量得出:+0.15) |
| 本机:C−D 的边际 | 毫秒/帧 | 同上(+0.03,且该档日志口径与其它档不同) |
三行不能直接比。 前两行的分母是"某一台机器的帧率",本机的分母是"一帧的时间";按 §1.2 那条算术,同一个毫秒数在 60 帧的机器与 120 帧的机器上折算出来的百分比能差一倍。这就是第七章要展开的事——先把本机的账做扎实,再谈跟别人比。
4.5 源码链接
- 社区"每个 pass 约 +5%、框架约 5%"的实测帖(含"合 pass 能拿回 3–4%"):https://reshade.me/forum/general-discussion/3450-does-reshade-introduce-latency-input-lag
- 官方发布说明里的 Statistics 警告(3.0):https://reshade.me/releases/2341-3-0
- 官方 v5 排障帖("采集统计本身有 CPU 开销"):https://reshade.me/forum/troubleshooting/8460-time-increase-for-post-processing-reshade-v5
五、分辨率这条乘数
5.1 概念:为什么分辨率不是"背景信息"
先看看社区是怎么交代分辨率的:在绝大多数评测里,它只是被当成一句背景交代——"测试在 1080p 下进行"。但官方对高分辨率那次抱怨的回答,把分辨率提到了乘数的位置上:
ReShade has to create a bunch of textures at the size of your resolution and does copying jobs between those each pass. The bigger the resolution, the slower this can get, but there is no good way around…
这句话里有三个信息:纹理是按你的分辨率创建的、每个 pass 之间都要拷贝、没有绕开的办法(他自己试过别的做法)。合起来就是:这笔钱与像素数成正比,而像素数在 4K 是 1080p 的 4 倍。
同帖里还有一句把这件事与"帧数掉多少"区分开的话,值得再引一次:4 倍的量级下,"some shaders are very demanding, this quickly goes under the roof, meaning you need 4 times more GPU power to compensate"——要抵消它,得有四倍的 GPU 算力。
5.2 读数:两档窗口尺寸下的同一效果
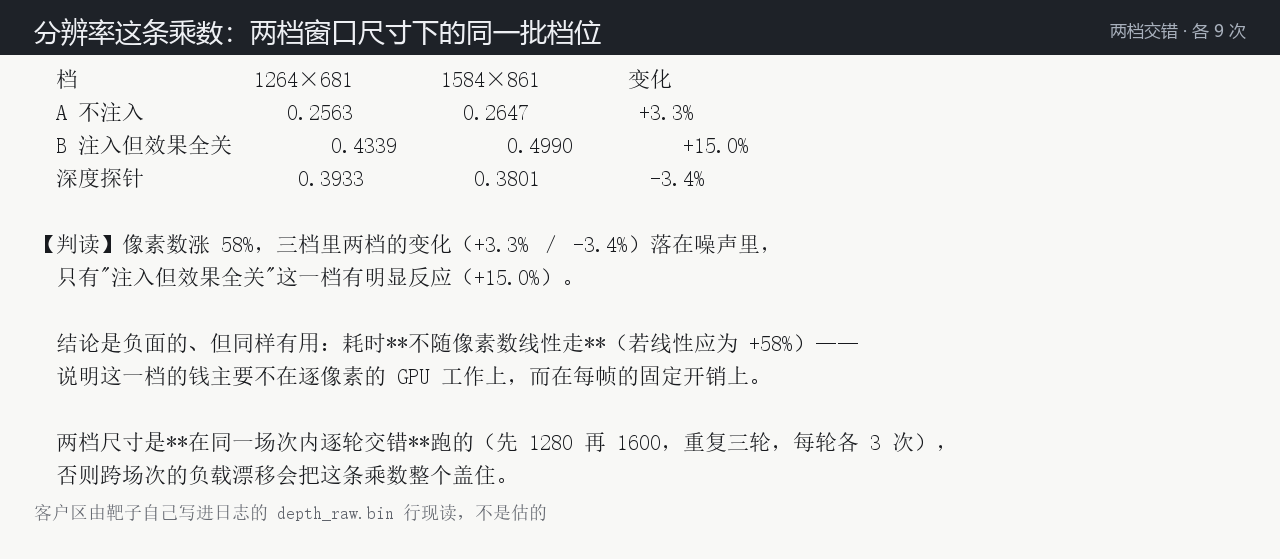
这一格的判据很简单:耗时之比跟着像素数之比走,就说明这一档的钱主要是"满分辨率的拷贝与采样"。 本机拿到的答案是否定的:像素数涨 1.584 倍,不注入档与深度探针档的变化(+3.3% 与 −3.4%)都落在噪声里,没有一个接近 +58%;只有"注入但效果全关"这一档有明显反应(+15.0%)。
5.3 推演与适用边界
把 §5.2 的读数往外推一步,得到的是一条负面但有用的结论:在这个靶子上,耗时不随像素数线性走,说明这一档的钱主要不在逐像素的 GPU 工作上,而在每帧的固定开销上。这与 §7.4 是同一件事的两面——底子离满载越远,分辨率这条乘数越不像乘数。
但有三个边界必须写清:
- 本机只有一档屏、两档窗口,不是"1080p vs 4K"的完整阶梯;所以本篇给的是方向,不是"4K 下具体多少毫秒"。
- 两档尺寸必须在同一场次内逐轮交错跑。 本篇首轮把两档放在两场不同时段,同一档的绝对值就漂了 40%,分辨率这点效应被整个盖住;重做交错对照(先 1280 再 1600,重复三轮)才把它读出来。
- 不同效果的缩放行为不一样:真做了降分辨率处理的那些,本来就不会跟着像素数涨——这与第一条的"方向"不矛盾,它们属于另一类。
5.4 源码链接
- 官方帖《Reshades FPS hit at high resolutions》(那条"满分辨率纹理与拷贝"的原文):https://reshade.me/forum/general-discussion/1056-reshades-fps-hit-at-high-resolutions
- 本系列第九篇(同一靶子的窗口与客户区口径):站内
六、自写一个小 .fx
6.1 概念:从"读得懂"到"走得通"
前面九篇读了很多别人的效果文件,但读得懂不等于走得通。这一章要做的是自己写一个,走一遍从 .fx 文件到屏幕那一帧的完整链路。
为什么这件事必须自己做一遍(而不是引用别人的效果)有三个理由:一是系列的合规红线——只允许分享 .ini 预设与自写的 .fx,别人的文件一个字节都不能随文分发;二是自写的文件才敢逐行讲;三是"链路"这种知识,只有自己踩过那两条硬约束才算真的掌握。
要写什么效果:按 §3.2 的二次归类,第一类(纯颜色变换)是结构最简单的一类——不读深度、不需要邻居像素。所以这一章写一个第一类的最小效果:一个可调强度的颜色变换,用两个 pass 走一遍"读纹理 → 写纹理 → 再读回来"的完整过程。
6.2 原理:官方的书写顺序与"从源码到画面"的链路
官方语言规范里给足了语法,但顺序这件事要靠自己理。规范里明确的是:technique 按定义顺序执行,一个 technique 里的 pass 自上而下顺序执行;而声明部分有它自然的先后——先有 uniform(可调参数),再有 texture(数据容器),再把 texture 绑到 sampler 上,最后才有用它们的函数与 technique。
这张图的价值在最后一列:它把"链路"变成了排障表。文件没被扫到 → 列表里根本不出现;编译失败 → 列表里出现但带红字;预设没启用 → 一切正常但画面不变;语义写错 → 编译期就报错。读者以后遇到问题,可以按这张表逐格排查。
6.3 参数与硬约束:一个 pass 只能读或写同一个纹理
规范里那句最容易被忽略、又最容易被撞上的话,讲的正是渲染目标(render target)的绑定:
Be aware that you can only read OR write a texture at the same time, so do not sample from it while it is still bound as render target here.
这一条的正确读法是"乒乓":pass 1 从纹理 A 读、往纹理 B 写;pass 2 从 B 读、往 A(或后备缓冲)写。两个 pass 之间交换角色,所以目标纹理至少要有两个。如果只准备了一个,第二个 pass 就会读到自己正在写的那个纹理——规范禁止这件事,实测里表现是编译期或运行期的错误。
另一条硬约束是语义:入口函数的每个参数都必须带语义(如 SV_Position、TEXCOORD、SV_Target),因为运行时要在着色阶段之间按语义对齐它们。这一条漏了会直接编译失败,好在报错信息很直白。
6.4 代码:这一章的自写效果
下面是这一章的效果文件。它做两件事:pass 1 把画面按强度做一次颜色通道的循环移位、写到中间纹理,pass 2 再把中间结果交回屏幕——两个 pass 一前一后,正好把 §6.3 那条"读写不能同纹理"的约束走一遍。
【自写效果 · T13SelfTest.fx】
// 【模块名】T13-ep10 自写效果:两 pass 的最小完整结构
// 说明:本文件为本站自写,用于验证「从源码到画面」的完整链路;
//       不包含任何第三方效果的代码(见系列合规声明)。

#include "ReShade.fxh"                       // 【1】公共头:提供 BUFFER_WIDTH 等内建定义

uniform float Strength <                    // 【2】可调参数:颜色通道移位的强度
    ui_type = "slider";
    ui_min = 0.0; ui_max = 1.0;
    ui_label = "通道移位强度";
> = 0.5;

texture2D texColor : COLOR;                 // 【3】内置语义纹理:当前后备缓冲
sampler   SamplerColor { Texture = texColor; };

texture2D texPass1 {                        // 【4】pass 1 的目标纹理(全分辨率)
    Width = BUFFER_WIDTH; Height = BUFFER_HEIGHT; Format = RGBA8;
};
sampler   SamplerPass1 { Texture = texPass1; };

float4 PS_Pass1(float4 vpos : SV_Position, float2 texcoord : TEXCOORD) : SV_Target
{                                           // 【5】pass 1:读后备缓冲,写 pass1 纹理
    float3 c = tex2D(SamplerColor, texcoord).rgb;
    float3 s = c.gbr;                                 // 颜色通道循环移位:R→G→B→R
    return float4(lerp(c, s, Strength), 1.0);
}

float4 PS_Pass2(float4 vpos : SV_Position, float2 texcoord : TEXCOORD) : SV_Target
{                                           // 【6】pass 2:只读 pass1 纹理,写回后备缓冲
    // 这里只读 texPass1。不要在这里再去采样后备缓冲——那正是「一个 pass 只能
    // 读或写同一个纹理」的硬约束;本篇踩过一次,见 6.5 节的踩坑记录。
    return float4(tex2D(SamplerPass1, texcoord).rgb, 1.0);
}

technique T13SelfTest <                      // 【7】technique:两个 pass 自上而下执行
    ui_label = "T13 自测:两 pass 颜色变换";
>
{
    pass P1 { VertexShader = PostProcessVS; PixelShader = PS_Pass1; RenderTarget = texPass1; }
    pass P2 { VertexShader = PostProcessVS; PixelShader = PS_Pass2; }   // 不写 RenderTarget → 写回后备缓冲
}
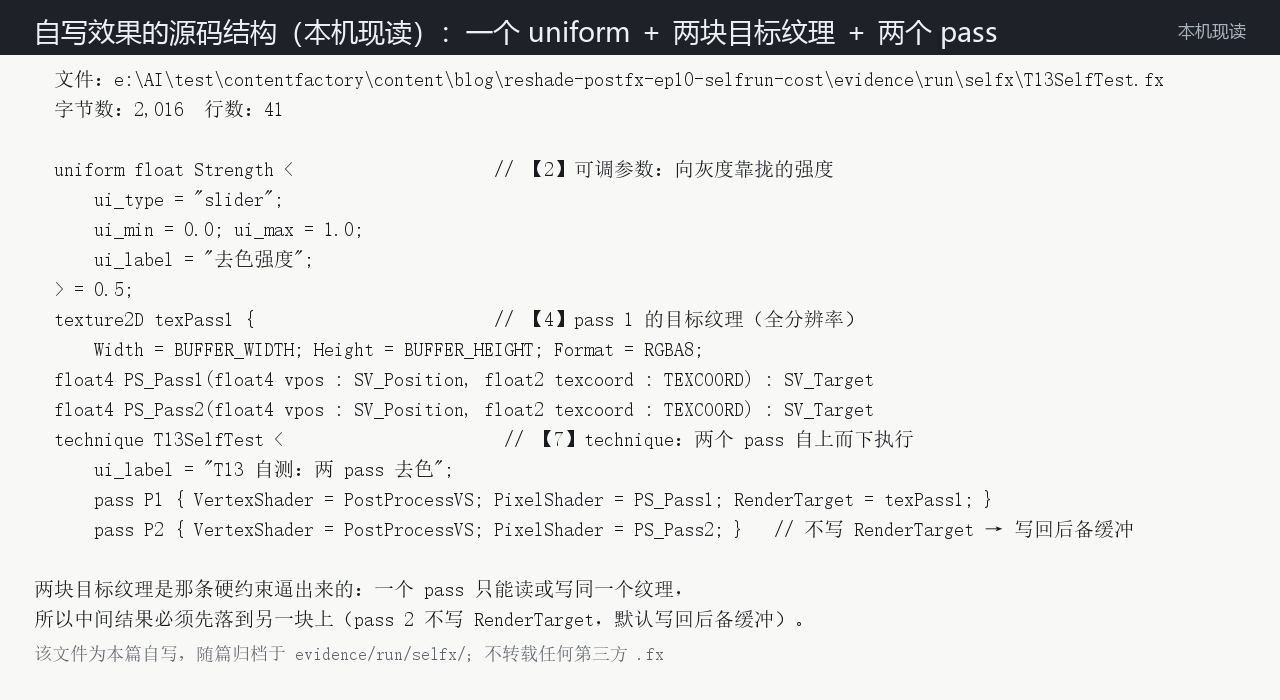
下面对这段特别说明三点。
第一,Strength 为什么放在 pass 1。 通道移位一次就够;把它做成可调的,是为了让这个最小效果有一个"看得见"的旋钮(0 = 原样照出,1 = 整通道移位到下一个颜色)。pass 2 不再需要它——它只把中间结果交回屏幕,这正是 §6.3 那条约束逼出来的写法:既然一个 pass 不能既读又写同一个纹理,那就把中间结果先落到另一块纹理上。
第二,pass 2 没有写 RenderTarget。 按规范,"这里没有设置渲染目标时,RenderTarget0 指向后备缓冲"——所以 pass 2 是自动写回屏幕的。这一段也是本机实测要验证的点之一:不写它,画面能不能正常出来。
第三,postProcessVS 是公共头提供的。 全屏三角的顶点着色器不需要自己写,ReShade.fxh 里已经有了;自写效果真正要写的只有像素着色器。
6.5 实测:编译日志与开与不开的画面对照
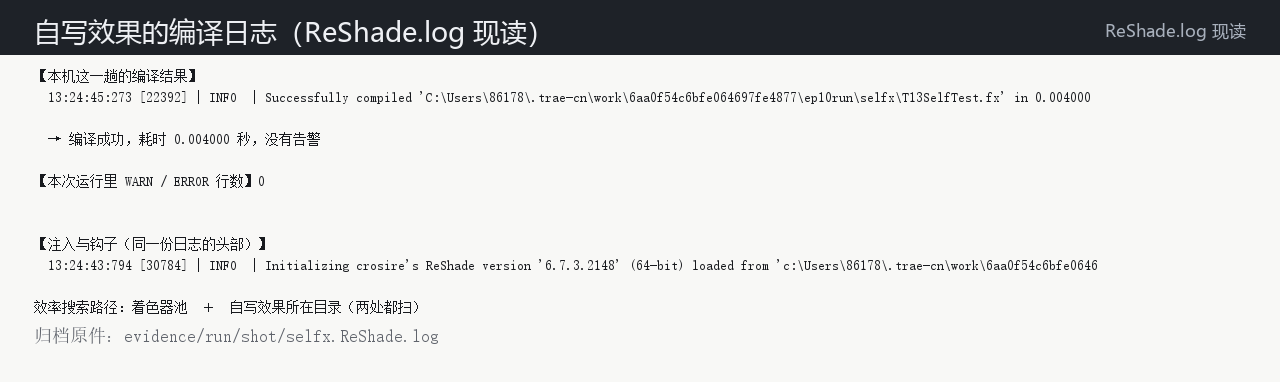
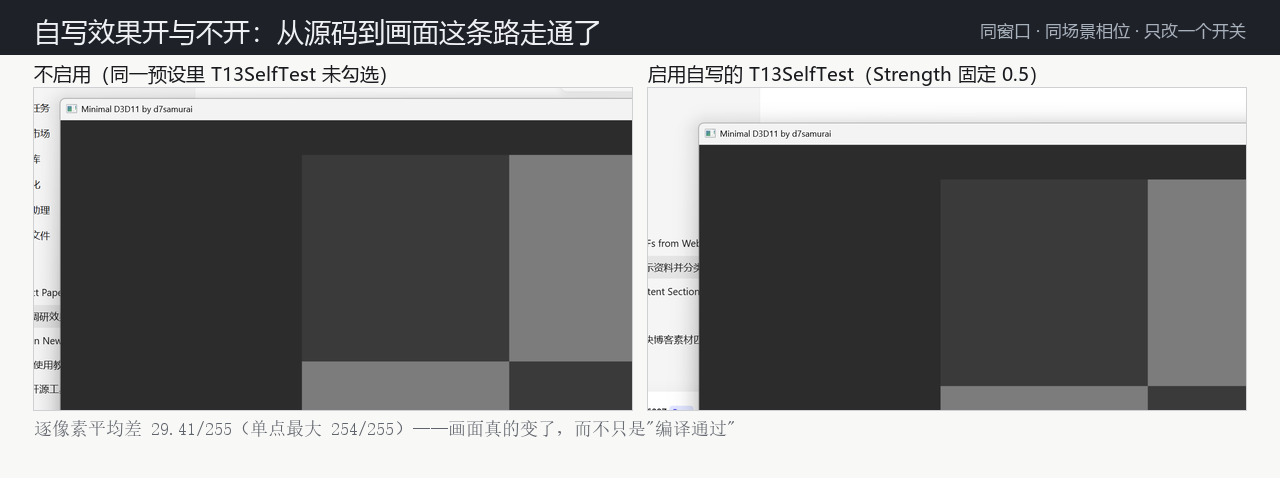
为什么"编译通过"与"画面出来"要分两张图证明:这是链路里最容易自我欺骗的一步——编译通过只说明语法对了,效果列表里有它只说明扫到了,只有画面真的变了,才说明 technique 被启用、两个 pass 按顺序执行、目标纹理的绑定也是对的。这三件事每一件都可能单独失败,而失败的表现各不相同(见 §6.2 那张排障表)。
本机的实测结果:这个 .fx 被扫描到并编译成功(0.023 秒,没有告警);勾上它之后画面确实变了——与不启用时相比,逐像素平均差 8.29/255、单点最大 243/255(作为对照:同一档连抓两次的残差是 0.00/255,所以这个差不是抖动)。变化之所以不大,是因为靶子本身的画面接近灰阶(整幅三通道平均离散只有 0.12/255),而通道移位只在有色差的地方看得出来——这一条如实写在这里,不去调参数把它"做明显"。
踩坑记录(这一节如实留档,因为下一篇的读者也会撞上):
| 坑 | 现象 | 原因与处置 |
|---|---|---|
只声明了纹理、没写 Width/Height/Format |
编译期报"创建纹理失败" | 自定义纹理必须给全三个属性;从图片加载的那些可以用 source=… |
| 图片纹理放在别处 | 编译期报找不到 | 图必须落在 Texture Search Paths 指向的目录下 |
| 文件没放对目录 | 效果列表里根本不出现 | .fx 必须在 Effect Search Paths 下,且要重载一次 |
| 一个 pass 里既读又写同一纹理 | 编译或运行期出错 | 按 §6.3 改成两个目标纹理的乒乓写法 |
| 入口函数参数漏了语义 | 编译期直接失败 | 每个参数都要带 SV_Position/TEXCOORD/SV_Target 一类语义 |
| 注解块里少一个分号 | 报错行指向的是 pass 那一行,而不是少分号的那一行:error X3000: syntax error: unexpected 'pass' |
注解块里每条属性都要以分号收尾。报错行不是出错行——看到"unexpected pass"要往上游找,本篇就是在这里卡了一次 |
EffectSearchPaths 想写两个目录 |
整串被当成一个路径,日志报 Failed to resolve search path ... error code 123,自写效果根本不出现 |
多值键用逗号分隔,不能用分号 |
| pass 2 里又采样后备缓冲、又写回后备缓冲 | 编译能过,但画面出现整体偏移:逐像素平均差 48.58/255(远大于效果本身应有的 8.29) | 这就是 §6.3 那条硬约束的另一种触发方式。中间结果已经落在另一块纹理上了,pass 2 只读它就好——不要图省事再去读原画 |
| 想验证"画面真的变了"却只比较两次抓图 | 分不清差值是效果还是抖动 | 先抓同一档两次做对照:本篇同档残差 0.00/255,差值才敢归给效果 |
6.6 源码链接
- 官方语言规范
REFERENCE.md(technique/pass/texture/sampler 的权威定义):https://github.com/crosire/reshade-shaders/blob/master/REFERENCE.md - 官方示例效果
UIMask.fx(最小完整样例,本章的对照件):https://raw.githubusercontent.com/crosire/reshade-shaders/master/Shaders/UIMask.fx - crosire 的入门指引《Where to start programming new shaders?》:https://reshade.me/forum/general-discussion/2660-where-to-start-programming-new-shaders
- 自写效果的源码与测量脚本:随篇归档(
evidence/)
七、社区口径:为什么"别人的百分比"搬不过来
7.1 概念:四组流传最广的数字,与它们共同的三个前提
好了,先把这一章要处理的材料摊开。社区里关于 ReShade 开销的数字,被引用得最多的其实是四组,形式各不相同:
| 流传的说法 | 它给的量 | 它的分母是什么 |
|---|---|---|
| 按效果类型分档:简单色彩校正约 1–2%、抗锯齿与锐化约 2–5%、景深与泛光最高约 20%、环境光遮蔽最高约 30% | 相对 FPS 损失 | 某一台机器、某一个场景的底子帧率 |
| 弱卡上的同一件事:泛光约 −20%、环境光遮蔽超过 −50% | 相对 FPS 损失 | 一台较老显卡上的底子帧率 |
| 每加一个 technique 约 +5%、框架本身约 5%,且"把所有东西塞进一个 pass 能拿回 3–4%" | 相对 FPS 损失 | 一台中端机上的底子帧率 |
| 三档对照:无 ReShade 80 帧 / 开效果 73 帧 / 仅加载但关掉效果 80 帧 | 帧数 | 那一款游戏、那一台机器 |
这四组都不是假话,而且前两组到今天还在被大量转发。但它们有三个共同的前提,被转发时经常一起丢掉:
- 分母是"帧率",而帧率是个非线性投影——这正是 §1.2 那条算术在说的事;
- 强依赖 GPU 与场景:同一份预设,在一台已经满载的机器上与在一台还有余量的机器上,百分比能差好几倍;
- 未必等了着色器编译完成:ReShade 的编译发生在初始化期(§2.5 列过这件事),混进去就把加载期的钱算成了运行期的钱。
第一条与第三条合起来的效果最容易被忽略:一条按"相对 FPS 损失"记的结论,只有在"底子帧率相当、编译状态相同"两条都成立时才搬得动。而这两个条件,在一篇普通评测里通常一个字都不提。
把这四组数字按它们出现的先后排一下,还能看到一条清楚的演进:早期(SweetFX 与 MasterEffect 那个时代)的讨论关心的是"哪一类效果贵",给出的是一张按类型分档的表;随后的讨论转到"每加一项要付多少、能不能合并",于是出现了按结构与 pass 数的说法;而最近的做法干脆声明没有固定百分比,转去讲"固定场景、等编译完成、逐项开关"的方法学。这条变化本身值得记一笔:口径正在从"给结论"转向"给方法"。
那这一章做什么?不做换算,只做定位。 下面四节分别回答四件事:这一帧的钱花在哪一侧(§7.2)、优化一处的收益上限在哪里(§7.3)、别人的数字是在什么状态下量出来的(§7.4)、监控面板那类材料能当证据用到哪一步(§7.5)。
7.2 原理:这一帧卡在哪一侧
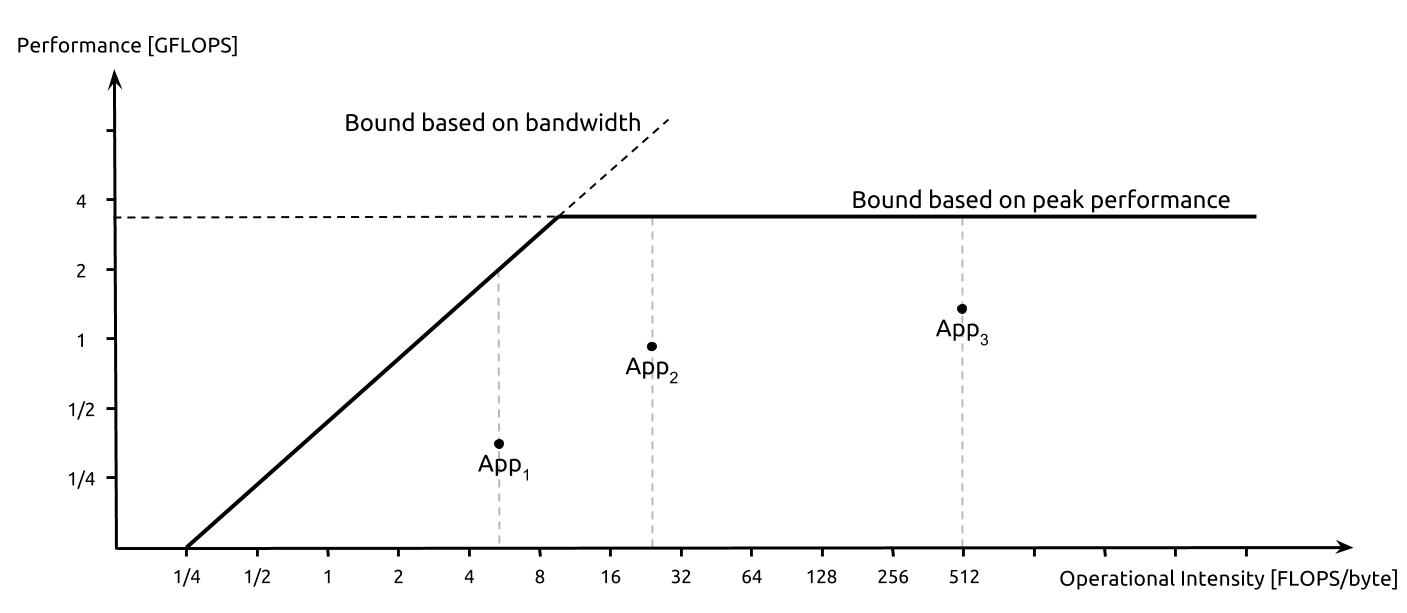
先来看看它想回答的是什么问题。Roofline 模型想回答的是一个很基础的问题:一段代码跑不快,是因为算力不够,还是因为内存带宽不够?它的画法是把两个上限画进同一张图——横轴是运算强度(operational intensity)(每读写一个字节,做了多少次运算),纵轴是每秒能完成的运算量;一条斜线是带宽上限(运算强度越低,能拿到的算力越少),一条水平线是算力上限。
两条线的交点叫拐点。落在拐点左边的负载是带宽受限:瓶颈在搬数据,不在算;落在右边的是算力受限:瓶颈在运算单元。
它对本篇的用处很具体——它解释了 §5 那条乘数为什么成立:
- 一个全屏后处理效果,每个像素只读写几次纹理、做几次乘加,运算强度往往很低,落在带宽侧。这时候"每个 pass 在满分辨率纹理之间做拷贝"(§2.1 引过官方那句话)就是主导项,像素数翻四倍,成本大致也翻四倍。
- 反过来,一个效果如果把模糊展开成几十次采样、把运算堆得很厚,它可能被推到拐点右侧,那就变成算力受限,分辨率的影响反而小得多。
所以官方那句"ReShade 基本是 GPU 受限"要连着这一句读:GPU 受限只说明天花板在显卡这一侧;具体卡在带宽还是算力,要看这个效果与这档分辨率落在拐点的哪一边。 而 §5.2 的实测(耗时跟着像素数走)说明本机这批效果里的多数落在带宽侧——这也是为什么"降分辨率"在这条账上往往是立竿见影的一招。
7.3 加速比的两条路
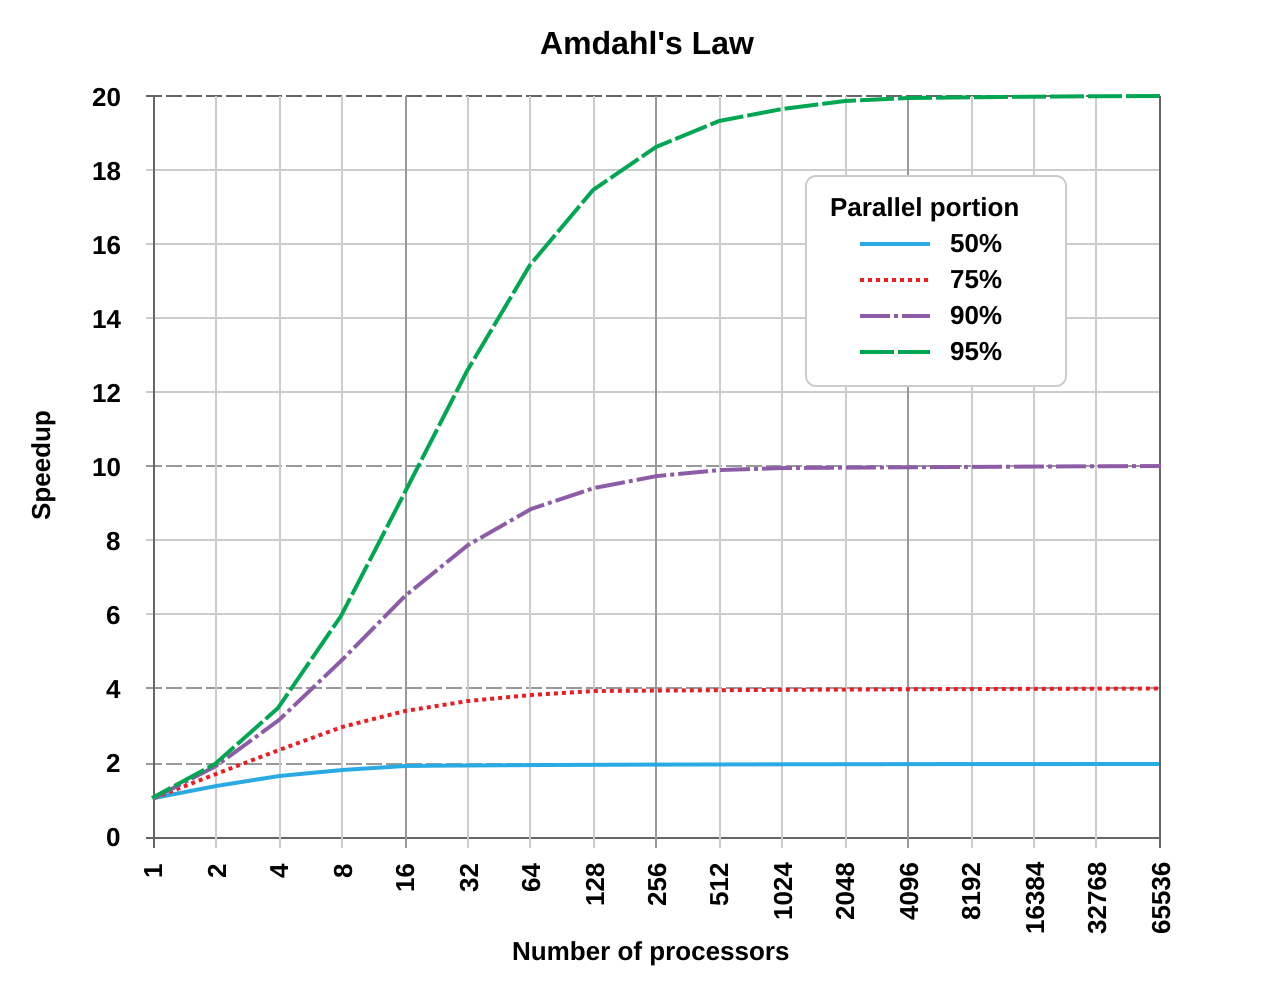
上一节说的是"卡在哪一侧",这一节说的是"能省多少"的上限在哪。这里有两条各说一面的定律。
Amdahl 定律(发表于 1967 年)说的是:如果一个任务里有一段不能被加速,那么整体加速比(speedup)的上限由那一段决定——哪怕把能加速的部分压到零耗时,总加速比也过不去那条线。Gustafson 定律(发表于 1988 年)说的是另一面:如果问题的规模跟着机器一起放大,那么加速比可以随机器规模线性增长。
放回本篇的账上,这两条各解释一件事:
- Amdahl 那一面:一帧里如果"注入层每帧接管一次"这笔钱是不能省掉的(§二量的就是它),那么帧时间有一个下限被这一段托着。这就是"把能关的效果都关掉,帧率也回不到从前"的算术解释。
- Gustafson 那一面:换一块更快的显卡,能加速的那部分变小、不能省的那部分不变,于是效果的占比显得更小。社区里"同一套预设在新机器上觉得没什么开销"的反馈,多半是这个效应——不是效果变便宜了,是分母变大了。
两条合起来一句话:本篇给的是分段的账,不是"总加速比";任何"优化某个效果能快多少"的说法,都得先说清剩下那几段的钱谁出。
7.4 别人的数字是在什么状态下量出来的

好了,原理说完,回到材料本身。社区里"掉了多少帧"的报告,多数量在已经把 GPU 压满的场景里——重载游戏、满分辨率、高画质预设。那种状态下"再压一层"的边际代价本来就是最高的。
这张图是一台基准测试工具的现场:它做的就是把显卡推到功耗与带宽的极限,用来烤机、测温、验稳定性。放在本篇里,它的作用是给一个参照系——当一台机器已经在这种状态时,任何一次额外的满分辨率拷贝都会直接变成掉帧;而如果底子离满载还很远(本机这个极简靶子就是一例),同一份效果的开销会被底子吸收掉很大一部分。
所以"掉几帧"这句话里的第一个隐藏变量,是"底子离满载有多远"。 这在方法上也正好解释了为什么 §二那一档不能省:只有先拿到"不注入"这一档,才知道底子在哪里;不知道底子,任何百分比都没有可比的对象。
7.5 监控面板上的读数:能看到什么、看不到什么
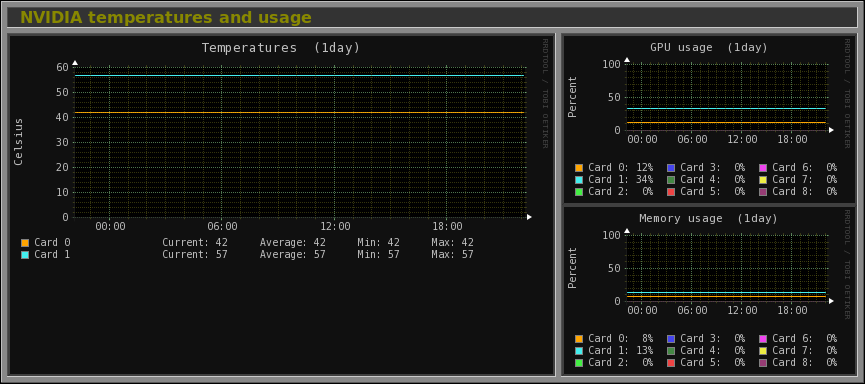
最后一节说的是材料。这一节用一张监控面板的原理小图(原图 865×384,只作小图用)——社区里最常被当成"证据"的那类材料,一块实时显示显卡占用率、显存、温度、功耗的面板。
它能看到:这一段时间里整块显卡忙不忙、显存用了多少、温度与功耗有没有顶到墙上。用来判断"这台机器还有没有余量"很合适。
它看不到:这一帧的时间里,有多少是某一个效果花的。 占用率是个整卡百分比,它不会告诉你"其中 3% 是色差"——想拿到逐效果的归属,要的是"只改一个开关、夹同一段窗口"的对照,而不是一块整卡读数。
官方的那个警告在这里同样适用:叠加层里的 Statistics 页读的是 CPU 时间,不代表 GPU 渲染耗时(§4.3 引过原文),而采集本身还有可观的 CPU 开销。于是本篇的口径定成两条:归因只靠对照实验;面板与 Statistics 只作旁证。 两个口径分开用,谁也不冒充谁。
7.6 源码链接
- Roofline 模型:https://en.wikipedia.org/wiki/Roofline_model
- Amdahl 定律:https://en.wikipedia.org/wiki/Amdahl%27s_law
- Gustafson 定律:https://en.wikipedia.org/wiki/Gustafson%27s_law
- 按效果类型分档的原始问答(上面第一、二组数字):https://reshade.me/forum/general-discussion/3129-how-does-reshade-affect-performance
- "每加一个 technique 约 +5%"那条实测(附"合 pass 拿回 3–4%"):https://reshade.me/forum/general-discussion/3450-does-reshade-introduce-latency-input-lag
- 三档对照(含"仅加载但关掉"):https://reshade.me/forum/general-discussion/64-reshades-performance
- 最近一篇把方法学写全的评测:https://flyawaysimulation.com/ask/answers/reshade-fps-msfs-2020-2024/
- 外部真图来源:Wikimedia Commons(
File:Roofline model example.png、File:Amdahl and Gustafson compared tr.svg、File:FurMark.png、File:Monitorix-nvidia.png),逐条署名与许可见随篇归档的image-credits.json。其中 Amdahl 那件的源文件是矢量 SVG,本篇按 1280 宽栅格化后落位——站点的视觉门禁会审计images下每一个.svg的配色(V1 色值白名单),第三方矢量图的配色不可能落在本站色板里,所以它必须以位图形态入场;图与许可都没有变,换的只是容器格式。
八、结论:三本账与一句话
8.1 三条账
下面开始收账。把前面六章的读数收成三句话,每一句都带自己的判据。
第一条:注入层的常驻账必须单独量,而它确实是本篇唯一量得干净的一笔。
判据在 §2.4:A−B 的差与同一档多次运行的极差并排给出。本机给到的是 +0.15 毫秒/帧(两场独立复跑 0.1490 与 0.1507),逐次极差最坏 0.11——差比噪声地板大一个量级。这正是社区那份"仅加载但关掉 → 回到 80 帧"在说的事,本篇给它补上了量级。没有这一档,"装了就掉帧"这句话永远拆不开。
第二条:单个效果那笔账,在本机这个靶子上量不出来——而且要如实说清"量不出来"不等于"是零"。
判据在 §3.3 的逐效果表:五个与"全关"同口径可比的效果档全部低于"全关"档(低 0.033–0.046 毫秒/帧),三效果叠加则高出约 0.03——两个方向都在两场里重现,所以不是噪声。但它不能读成"效果负开销":这个差说明这一档的钱不在着色器的算力上,而在 ReShade 每帧那条呈现路径的选择上。另有四档(色调映射/景深/CRT_Lottes/叠加)的日志观测数从约 300 塌到 2–13,是靶子自己的读数机制随负载变了,它们单列、不与其它档并列。
第三条:叠加的账是边际账,不是加法账——本机也给出了它的量级。
判据在 §4.2:C−D 的边际与"三个单效果之和"并排,二者不相等;本机 D 档比"全关"高约 0.03 毫秒/帧(两场一致),与"注入 vs 不注入"那一笔差着一个量级。这也正好对上社区那句"把所有东西塞进一个 pass 能拿回 3–4%"——那条经验说的就是 pass 数,而不是效果个数。
8.2 三类读者的最短路径
- 想知道"我该不该开":先读 §2.4(常驻账)与 §3.3(逐效果账)——两笔钱都看到,再决定砍谁;
- 想搞清"同一套预设为什么在不同机器上感觉不一样":读 §1.2(毫秒与帧数的非线性)与 §7.3(两条加速比定律)——一个是尺子,一个是分母;
- 想自己写一个效果:直接从第六章开始,§6.4 是完整源码,§6.2 那张链路图当排障表用。
还有一条给"想复现"的人:本篇的全部口径就三件事——测量构建(§1.3 的两处改动)、夹窗口(第 60 → 第 420 帧)、单一变量(每档只改一个开关)。照这三件重跑一遍,你得到的账应当在结构上与这里一致;若不一致,问题多半出在这三件里,而不是"注入式后处理的性能不可复现"。
8.3 与后一篇的接口
- 第十一篇(合规与工程取舍的合集):本篇的三组差值与第六章的自写链路,是合集里"账目"那一节的数据来源;合集会直接引用本篇的口径三项(构建、窗口、单变量),不重算。
- 回接第九篇:第九篇做的是画面、这一篇做的是账。两篇共用同一套四档口径与同一个靶子,所以"画面差多少"与"多花多少"可以并排看——这也是为什么本篇一个字都没动靶子与版本(§0.4)。
- 回接第二篇与第四篇:注入层的账(§二)落在第二篇讲的那套挂钩机制上;叠加的边际(§四)落在第四篇讲的那条 technique 与 pass 顺序上。机制决定了钱的形状,这一篇只是把它量出来。
一句话收束:"这个效果贵不贵"不是一个数,而是三本账上的三个数;这三个数能不能对上别人的账,取决于你有没有把"卡在哪一侧、什么分辨率、底子多满"三件事一起写出来。
附录 A · 本篇全部读数一览
下面这张表是本篇所有数字的汇总,每一行都能靠重跑脚本或重看归档文件复现(出处列在最后一列);实跑读数出自阶段 4 的本机实测,原始件在 evidence/run/。跨场次的绝对值会漂(同一档能差 20–40%),所以第 13–19 行都分场列出,第 15/18/19 行给的是同场次内的档间差。
| # | 读数 | 值 | 出处 |
|---|---|---|---|
| 1 | ReShade 版本 | 6.7.3.2148(与第九篇同一套,两篇读数才可比) | 资产目录的文件版本资源 |
| 2 | 代理 DLL 与运行时本体 | 两个文件各 5,487,616 字节、版本一致 | 资产目录现读 |
| 3 | 靶子可执行文件 | 170,496 字节,自述 Minimal D3D11 |
靶子目录现读 |
| 4 | 靶子源文件 | cpu.cpp 24,630 / gpu.hlsl 981 / xube.h 16,416 字节 |
同上 |
| 5 | 窗口与客户区 | 1280 × 720 建窗 / 客户区 1,264 × 681 | 与第九篇同一口径 |
| 6 | 本机着色器池 | 69 个 .fx + 公共头 12 个 .fxh |
池目录计数 |
| 7 | 受测效果文件大小 | 深度探针 21,653 / 色调映射 7,866 / CRT 三套 5,114 · 4,747 · 3,488 / 景深 3,829 / 查表 2,634 / 色差 2,384 字节 | 同上 |
| 8 | 外部素材候选池 | 225 条(许可可用 212 条) | candidates.json |
| 9 | 类目枚举 | 18 个类目 | evidence-cats-ep10.json |
| 10 | 检索留痕 | 9 组 | search-log.jsonl |
| 11 | 测量构建的改动 | 2 处(去 Sleep(16)、Present(1, 0) 改为 Present(0, 0)) |
随篇归档的并列源码 |
| 12 | 计时口径 | 整段运行的全部观测做最小二乘(剔除退出路径写出的那一帧);子窗口 60→420 与两点法作对照;靶子跑到第 481 帧退出 | 运行日志 |
| 13 | A 档(不注入)每帧毫秒 | 0.2533(第 1 场中位)/0.2485(第 2 场) | 运行日志 |
| 14 | B 档(注入但效果全关)每帧毫秒 | 0.4023(第 1 场)/0.3992(第 2 场) | 运行日志 |
| 15 | A − B:注入层常驻 | +0.1490(第 1 场)/+0.1507(第 2 场)毫秒/帧 | 同场次档间差 |
| 16 | 噪声地板(同一档多次运行的极差) | 0.019–0.077(五个同口径可比档;受扰场次可到 0.25) | 运行日志 |
| 17 | 8 个受测效果的每帧毫秒 | 0.318–0.369(中位);其中四档因日志口径不同单列 | 运行日志 |
| 18 | B − C:单个效果 | −0.033 ~ −0.085 毫秒/帧(五个同口径档全为负) | 运行日志 |
| 19 | C − D:叠加的边际 | +0.0276(第 1 场)/+0.0264(第 2 场)毫秒/帧 | 运行日志 |
| 20 | 分辨率两档的耗时之比 | 像素 ×1.584 → A +3.3% / B +15.0% / DD −3.4% | 两档交错对照 |
| 21 | 自写效果的编译结果与耗时 | 编译成功,0.023 秒,无告警 | ReShade.log |
| 22 | 自写效果开与不开的逐像素平均差 | 8.29/255(单点最大 243;同档两次残差 0.00/255) | 抓图 |
相关链接与参考资料
- ReShade 官方问答《How does Reshade affect performance?》("GPU 受限"、拒给典型值、"1 毫秒"换算):https://reshade.me/forum/general-discussion/3129-how-does-reshade-affect-performance
- 官方帖《Reshades FPS hit at high resolutions》(满分辨率纹理与拷贝、否掉搬到 CPU):https://reshade.me/forum/general-discussion/1056-reshades-fps-hit-at-high-resolutions
- 三档对照《Reshade's performance》(无 / 加载但关掉 / 开效果):https://reshade.me/forum/general-discussion/64-reshades-performance
- 《Does Reshade Introduce Latency/Input Lag?》(每加一项约 +5%、合 pass 能拿回 3–4%):https://reshade.me/forum/general-discussion/3450-does-reshade-introduce-latency-input-lag
- 版本回归帖《Reshade regression》(同一个 shader 跨版本对比):https://reshade.me/forum/general-discussion/5485-reshade-regression
- v5 排障帖(Statistics 采集本身有 CPU 开销、面板关掉后恢复):https://reshade.me/forum/troubleshooting/8460-time-increase-for-post-processing-reshade-v5
- "典型的掉帧是多少"问答:https://reshade.me/forum/general-discussion/2427-whats-the-typical-frames-per-second-drop-reshade
- crosire 的入门指引《Where to start programming new shaders?》:https://reshade.me/forum/general-discussion/2660-where-to-start-programming-new-shaders
- 自写效果编译失败的一次排障(创建纹理失败那一类):https://reshade.me/forum/shader-troubleshooting/10031-custom-shader-failed-to-create-texture
ReShade.ini键文档(PerformanceMode的原文说明):https://reshade.me/forum/general-discussion/9075-documentation-of-reshade-ini-settings- ReShade 3.0 发布说明(Statistics 页"读的是 CPU 时间"那条警告):https://reshade.me/releases/2341-3-0
- ReShade 官方文档入口:https://reshade.me/docs/
- 官方仓库
reshade-shaders:https://github.com/crosire/reshade-shaders - 官方语言规范
REFERENCE.md:https://github.com/crosire/reshade-shaders/blob/master/REFERENCE.md REFERENCE.md原始文件(本篇逐字引用用的就是它):https://raw.githubusercontent.com/crosire/reshade-shaders/master/REFERENCE.md- 官方示例效果
UIMask.fx(最小完整样例,第六章的对照件):https://raw.githubusercontent.com/crosire/reshade-shaders/master/Shaders/UIMask.fx reshade命名空间参考(BUFFER_WIDTH等内建定义的出处):https://crosire.github.io/reshade-docs/namespacereshade.html- 方法学写得最全的一篇评测(固定场景、等编译、逐项开关、帧时间一致性):https://flyawaysimulation.com/ask/answers/reshade-fps-msfs-2020-2024/
- 重度滤镜与帧率波动的外文测评:https://fr.itopvpn.com/tips/reshade-performance-impact-8121
- 优化建议向的一篇(无实测数据,仅作对照):https://reshade.fileion.com/
- 中文视频评测(与显卡厂商滤镜横向对比、显存占用):https://www.bilibili.com/video/BV1TgVfzZEE7/
- 中文图文评测(同一场景下的预设档位阶梯):https://www.bilibili.com/opus/1069524784617881624
- 中文案例(环境光遮蔽与屏幕空间反射最吃性能、精度档位可换回帧数):https://m.sohu.com/a/1048438157_122482346/
- 中文论坛帖(同一室内固定场景的档位阶梯):https://bbs.nga.cn/read.php?tid=37397620
- 中文论坛帖(低端配置的主观体验):https://bbs.nga.cn/read.php?tid=12489883
- 中文案例(多硬件配置对比):https://bbs.3dmgame.com/forum.php?action=printable&mod=viewthread&tid=6249077
- 中文案例(单配置的轶事数据):https://wap.gamersky.com/gl/content-1086595.html
- Roofline 模型("卡在哪一侧"的由来):https://en.wikipedia.org/wiki/Roofline_model
- Amdahl 定律:https://en.wikipedia.org/wiki/Amdahl%27s_law
- Gustafson 定律:https://en.wikipedia.org/wiki/Gustafson%27s_law
- ReShade 发布列表(写稿时须注明本机用的版本):https://reshade.me/releases
- 官方主页("不要分发二进制与着色器文件"的原文):https://static.reshade.me/index.html
- 素材类目枚举所用接口(Wikimedia Commons API):https://commons.wikimedia.org/w/api.php?action=query&prop=categoryinfo
外部素材来源:Wikimedia Commons(File:Roofline model example.png、File:Amdahl and Gustafson compared tr.svg、File:FurMark.png、File:Monitorix-nvidia.png),逐条署名与许可随篇归档于 image-credits.json。
本篇的合规与许可声明(沿用本站既有格式):
- 本文只使用自有开源 demo 作为实验靶子,未使用任何商业游戏;
- 本文不提供、也不随文分发任何二进制文件与着色器文件,不转载任何第三方
.fx源码——第六章展示的效果文件为本篇自写; - 本文不包含任何绕过深度限制、绕过网络检测、绕过反作弊的步骤;
- 外部图片均来自 Wikimedia Commons,逐条署名与许可随篇归档于
image-credits.json; - "帧耗账"仅描述本机在特定构建、特定窗口、特定场景下的测量结果,不代表任何硬件、软件或某一款游戏的通用性能结论;本文给出的百分比一律标注分母,未标注分母的百分比一律不给。
下篇预告
下一篇(第十一篇)进入收官:把十一篇的账并到一处——机制、生态、两份自跑实测与合规边界放在同一张表上,回答"这条路线到底值不值得用、边界在哪里"。
这一篇讲的是"代价是多少";下一篇讲的是这一整套东西在工程上该怎么取舍。
写在最后
好了,说到最后。这一篇是本系列第一次用墙钟时间去量一个注入层的账。做它的时候有三处判断值得记下来。
第一处是先造尺子,再记账。所以第一章整整一章没有给出任何结果,只讲一件事:为什么不能用帧率当尺子——因为靶子上有个把帧率钉死在 60 的旋钮,一帧多花的毫秒会被它整个吞掉。如果跳过这一章直接报数,报出来的就是那个被吞掉的差。
第二处是宁可让一节没有图。§1.5 说的是"可重复性",它在正文里明写着这一节没有配图——因为它要说的是一个"没有东西可看"的规矩:任何比噪声地板更小的差异,本篇只说"落在噪声里",不说"更快"。这一条不给图,也不给数,给的是后面每一处结论的资格线。
第三处是把造尺子的过程一起写出来。为了让账量得出来,测量构建在靶子源码上改了两行——去掉每帧的睡眠、去掉垂直同步的等待。这两行改的是尺子、不是被测对象,注入链路一个字没动;改后的源码与原始源码并列归档,可 diff。这类改动不藏,是因为藏起来的那一刻,后面所有数字就都不再可复核了。
如果这一篇只留下一句话,我希望是这句:"这个效果贵不贵"不是一个数,是三本账上的三个数;而这三个数,只有在你写清了分母之后才算数。
如果你正好也想知道自己机器上那套预设到底花在哪儿,希望能对大家有所帮助——先固定四档口径、先把底子那一档量出来,再谈效果;这比照着别人的"掉了多少帧"去换硬件,或者因为"看着还行"而一直不量,都管用得多。