本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
题图 两条边界:LTO 拆翻译单元、PGO 拆类型与分支 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
- ep05 优化器的边界:UB、严格别名与向量化报告——第二波·编译器与链接器
- ep06 名字与符号:ABI、修饰、可见性、PLT 与 IAT——第二波·编译器与链接器
背景与边界
LTO(Link-Time Optimization,链接时优化)与 PGO(Profile-Guided Optimization,配置文件引导优化)总是成对出现。它们常被并列成"两个高级优化开关",一起写进构建脚本,一起被当成"性能调优的第二步"。但它们动的东西完全不一样,代价也不一样,失败的方式更不一样。
这一篇不讲"怎么开这两个开关"。本篇要算的是一笔账:这两个开关各自把什么边界拆掉了,收益从哪个循环里长出来,代价落在体积、构建时间还是数据的保鲜期上。
0.1 一句话结论先放这里
- LTO 拆的是翻译单元(translation unit)边界。它让编译器在链接期看见全部 TU,于是"跨文件的小函数"终于能被内联。收益出现在函数调用上。
- PGO 拆的是类型与分支边界。它让编译器知道"这个虚调用在训练里永远走同一个实现""这个分支几乎不会走",于是能把间接调用消掉、把冷代码挪出热路径。收益出现在间接调用与分支上。
两句话各管一段,谁也替代不了谁。这不是修辞——本篇会给出一个把两者分开量到各自循环上的实验。
0.2 实测环境(本篇所有数字都出自这里)
| 项 | 值 |
|---|---|
| MSVC | cl / link / dumpbin 19.44.35228(Visual Studio 2022 Community,工具集 14.44.35207) |
| GCC | MSYS2 ucrt64 g++ 16.2.0(Rev3, Built by MSYS2 project),配 objdump / ar / gcc-ar |
| 计时 | 被测进程内 std::chrono::steady_clock,每档跑 5–7 次取中位数 |
| 平台 | Windows x64,PE/COFF |
0.3 本篇不涉及什么(边界声明)
- 不做编译器入门教学:不解释什么是 IR、什么是基本块、什么是支配树。需要这些前置的朋友,先看本系列 ep04(编译期账本)与 ep05(优化器的边界)。
- 不做 Clang/LLVM 的本机实测:本机无 Clang、无 WSL。ThinLTO、BOLT、AutoFDO、CSIR 这类只属于 LLVM 生态的东西,本篇一律只引官方原文,绝不冒充实测。这是硬边界,不是为了省事。
- 不做 ELF 侧的实测:MSYS2 产出的是 PE/COFF 而不是 ELF,所以链接器插件、
--plugin、ELF 段布局这些只在 Linux 上成立的东西,同样只引原文。 - 不给"最佳实践清单":本篇只给判据和读数,不给"你应该开 LTO"这种没有上下文就没有意义的建议。
0.4 实验用例:刻意做成两个靶子
好了,为了让两种收益量在各自的循环上,用例被刻意设计成四文件、两个独立靶子:
- 靶子一(LTO 的靶子):
step(int)定义在a.cpp,被b.cpp里的run()在 4096 次循环中逐元素调用。它很小(x*3+1过一遍饱和到 0..255),小到"如果看得见就一定会被内联"——所以它是否被内联,只取决于编译器能不能跨过 TU 边界。 - 靶子二(PGO 的靶子):
drive()里一次虚调用op->apply(s + p[i])。抽象基类Op有三个实现(AddOp/MulOp/XorOp),但训练和实测都只喂AddOp——这正是 PGO 的虚拟调用推测(virtual call speculation)想要的场景。
两个循环各跑 20000 轮 × 4096 次迭代 ≈ 8,192 万次,各报一个毫秒读数。两个读数互不干扰:谁的收益长在哪个循环上,一眼可辨。
一、一句话点题:两条边界
1.1 一条边界的名字叫"翻译单元"
先来看看C++ 的编译模型是按翻译单元切开的:每个 .cpp 加它引到的头文件,编成一个目标文件(object file,.obj / .o)。编译器在编 b.cpp 的时候,看不见 a.cpp 的内容。它只看见一个声明:
int step(int x); /* 声明可见,定义不可见 */
于是它只能生成一条真正的调用指令——把参数放好、call 过去、拿返回值。至于被调函数体是不是只有两条指令,编译器无从判断。
LTO 做的事非常直白:把"看不见"变成"看得见"。编译期不再直接生成最终机器码,而是先把中间表示(IR / GIMPLE)留在目标文件里;链接期把所有目标文件的 IR 合到一起,再做一遍全程序优化,此时 step 的函数体和 run 的循环在同一张图里,内联就顺理成章了。
1.2 另一条边界的名字叫"类型"
说白了,虚调用卡在另一处。op->apply(x) 这行代码里,静态类型是 Op&,编译器不知道它指向哪个子类,于是生成"取虚表指针 → 取槽位 → 间接调用"三步。这条间接调用还有第二个受害者:CPU 的分支预测器——间接跳转的目标只有在运行时才知道。
PGO 做的事也很直白:跑一遍程序,把"实际发生了什么"记下来。训练数据显示这个虚调用 100% 落在 AddOp::apply 上,编译器就可以生成一条带守卫的快路径:先比较虚表槽位是不是 AddOp::apply,是就直接算(甚至可以内联),不是才跳到冷路径去走通用间接调用。
1.3 行业刻度:这笔账在真实产品上有多大
言归正传,在动手之前,先给出一个外部参照——这两个开关在成熟产品上的收益量级。这些数字全部来自官方文档或官方工程博客,与本篇的玩具用例无关,只用来校准预期:
| 案例 | 官方给的数字 |
|---|---|
| Chrome on Windows(PGO) | 新标签页加载快 14.8%、首次绘制快 5.9%、启动快 16.8% |
| Chrome 整体 | 启动最高快 25%、页面加载最高快 7% |
| Chrome on Android(PGO + orderfile + 更激进内联) | 这些构建优化"贡献了 Speedometer 分数提升的一半以上" |
| Firefox | "PGO 默认关闭,可提升运行时最高约 20%,但构建耗时很长" |
| MSVC 采样 PGO(SPGO) | 典型加速 5–15%(取决于 profile 质量) |
| CSSPGO(伪插桩 + 采样) | 在 AutoFDO 基础上再提升 1–5% |
三句读法:
- 个位数到十几个百分点是常态。凡是宣传"开 LTO/PGO 提速数倍"的说法,其基准多半是"关掉全部优化"或者恰好命中了某个可被完全内联的极热函数——本篇 §3 的 7.2 倍就是后一种情况,它成立,但不可外推。
- 数字越大的案例,构建代价也越大。Firefox 那句"提升最高约 20% 但构建耗时很长"是同一个句子里说完了收益和代价的——这才是这两个开关的常态描述方式。
- PGO 的收益通常比 LTO 大(Chrome 那组数字主要来自 PGO)。原因是 PGO 拿到的信息是"运行时事实",而 LTO 拿到的只是"更大的可见范围"。
1.4 分开讲的理由
因为它们在构建系统里的位置不同、失败方式不同、保鲜期也不同:
| 维度 | LTO | PGO |
|---|---|---|
| 输入 | 全部目标文件的 IR | 一次真实运行的采样/计数 |
| 发生在 | 链接期(编译期产出 IR) | 编译 + 链接(两遍链接) |
| 主要收益位 | 函数调用(内联) | 间接调用、分支、代码布局 |
| 主要代价 | 构建时间、体积 | 训练流程 + 数据的保鲜期 |
| 失效方式 | 静默失效(链接器一声不吭) | 静默失效 + 静默过期(两套编译器都不报) |
| 是否依赖运行场景 | 不依赖 | 强依赖,训练数据不代表真实负载就会反向优化 |
最后两行是这一篇的分量所在。LTO 与 PGO 最危险的共性不是"复杂",而是它们失败的时候页面一片安静:没有报错、没有警告,甚至还有"100% 命中"的漂亮统计报告。本篇会用实测把这些安静的位置逐个指出来。
二、两条边界分别卡住什么
2.1 LTO 卡住的那一类调用
先来看看被 TU 边界卡住的是小函数。这一点值得说清:大函数本来就不该被内联(内联的代价是代码复制),所以"看不见"对它们影响不大。真正吃亏的是这样一类函数:
/* a.cpp */
static int clamp8(int v) { return v < 0 ? 0 : (v > 255 ? 255 : v); }
int step(int x) { return clamp8(x * 3 + 1); }
step 展开后不过三四个算术指令。不内联意味着每次调用要付出:
- 参数搬运与栈帧建立;
- 一条
call与一条ret; - 最要命的:编译器看不见函数体,就无法做常量传播、无法把
clamp8提前化简、无法把结果直接接到下一次运算上——指令级并行的机会全丢了。
在一个逐元素调用的循环里,这三项会被乘上"循环次数"。本篇的用例是 8,192 万次,所以 7 倍的差距并不奇怪。
2.2 PGO 卡住的那一类调用
说白了,被类型卡住的是间接调用。这里有两个层级的代价,很多人只算第一层:
- 第一层(执行开销):取虚表指针、取槽位、间接跳转,比直接调用多几条指令;
- 第二层(预测开销):间接跳转的目标要在运行时才知道,分支预测器只能用历史去猜。猜错的代价是流水线冲刷——这一层常常比第一层大一个量级。
PGO 的价值正在第二层:它把"猜"变成"验"。带守卫的快路径让分支从"间接跳转"退化成"比较 + 条件跳转",两者对预测器的友好度完全不同。
2.3 两个靶子在汇编上长什么样
本篇后面会反复引用两段汇编,这里先把"看什么"立好,后面就不必每次解释:
- 跨 TU 小函数被内联 ⇔ 反汇编里再也找不到对被调函数的
call指令; - 间接调用被消掉 ⇔ 热路径里出现了"比较虚表槽位与某个已知实现地址"的
cmp/jne对,且命中分支上没有任何call。
这两条判据是纯机械的、可脚本化的。它们不依赖任何"编译器应该说"的文档承诺——这是本篇全部结论的证据形态:不是"编译器应该内联",而是"反汇编里那条 call 没了"。
2.4 一个必须提前说清的坑:注释的编码
下面进入在动手之前先记一个真实的坑,它拖掉了本篇第一轮实测。
本组源文件最初带中文注释,用 UTF-8 保存。MSVC 在简体中文 Windows(代码页 936)下会把 UTF-8 字节按 GBK 解码,于是报出 warning C4819: 该文件包含不能在当前代码页(936)中表示的字符。这个警告本身不致命,致命的是它的副作用:GBK 的双字节字符里,尾字节可能是 0x5C——也就是反斜杠。当它落在一行注释的末尾时,编译器会把这一行的换行符"吃掉",于是下一行的代码被并进注释,接着是一串莫名其妙的语法错误:
iface.h(6): error C2270: "apply": 非成员函数上不允许修饰符
iface.h(7): error C2588: "::~Op": 非法的全局 析构函数
第一条错误指向 virtual int apply(int x) const = 0; ——明明完全合法。看到"合法代码被判非法、且错误行号成片漂移",先怀疑编码,而不是先怀疑语法。 本篇的做法是把实测源文件的注释全部改成 ASCII;工程上的正规修法是给编译命令加 /utf-8,或把源文件存成带 BOM 的 UTF-8。
这条坑也解释了为什么它值得写进正文:它和本篇主题是同一类问题——工具链在你不看的地方做了一个决定(这里是"按系统代码页解码"),代价却出现在很远的地方。
2.5 LTO 还会顺手改掉一件不太被提起的事
除了函数调用,LTO 还会顺手改掉一件和可观测性有关的事:它会把一批内部符号变成不可见的。
原理不复杂:当 step 被内联进 run 之后,step 本身不再需要作为独立函数存在;同理,a.cpp 里那些只在本 TU 用到的静态函数、模板实例、常量表,在全程序视角下如果确认无人引用,就会被直接消掉,或者退化成局部符号。
这件事在体积上是好事,在两个场景里却是麻烦:
- 符号级性能工具(采样剖析器、符号化回溯)看到的函数会变少。你按函数名去看火焰图,发现某个函数"消失"了——它没消失,它是被内联进调用者了。
- 动态追踪/打桩(依赖 PLT/IAT 或符号名挂钩)会失去挂点。一个被内联掉的函数,你没法再"钩"它。
这类代价在本篇用例里是看得见的:MSVC 基线档里
?run@@与?drive@@都是独立符号,LTO 档里两个符号都不存在了(§8.2)。"函数不见了" 是 LTO 最容易被误读的现象——它不是优化失败,恰恰是优化成功。
三、LTO 的收益:跨 TU 内联(MSVC 实测)
3.1 原理:把 IR 留到链接期
说白了,MSVC 的 LTO 由两个开关分工:
/GL(Whole Program Optimization,全程序优化):编译期不生成最终机器码,而是在目标文件里留下中间语言(IL)。官方文档的原话是,/GL还额外"让 PGO 可用"MSVC /GL 文档。/LTCG(Link-Time Code Generation,链接时代码生成):链接期把各模块的 IL 读出、合并、做跨模块优化,再生成最终代码MSVC /LTCG 文档。
GCC 侧的名字更简单:-flto。官方手册对它的描述一句话就到点子上——链接时把所有函数体读出来,"as if they had been part of the same translation unit"(就像它们本来就在同一个翻译单元里)GCC 优化选项手册。这句"as if"就是 LTO 的全部定义。
3.2 参数逐项释义(本组实测用到的)
| 开关 | 作用 | 本篇实测取值 |
|---|---|---|
/O2 |
优化级别,作为所有对照组的公共基线 | 全部档位 |
/GL |
编译期产出 IL,不产出最终代码 | 基线档不写;LTO/PGO 档写 |
/LTCG |
链接期做跨模块代码生成 | 见 §5.3 的开关语义实测 |
/MD |
动态 CRT,保证各档的运行时一致 | 全部档位 |
/OPT:REF /OPT:ICF |
链接器默认开:未被引用的 COMDAT 消除 + 相同 COMDAT 折叠MSVC /OPT 文档 | 全部档位显式写出 |
最后一行的口径必须说清:/OPT:REF 与 /OPT:ICF 在命令行下本来就是默认开启的,所以下表里"基线 13,312 B"这个数字已经享受过它们的好处。两组之间只差 LTO 本身,不存在"基线没开去重"这种不公平。
3.3 代码:四文件用例的关键部分
/* a.cpp —— 靶子一:跨 TU 小函数 */
#include "iface.h"
static int clamp8(int v) { return v < 0 ? 0 : (v > 255 ? 255 : v); }   /* 【1】 */
int step(int x) { return clamp8(x * 3 + 1); }

/* b.cpp —— 调用方,在另一个 TU 里 */
#include "iface.h"
int run(const int *p, int n) {
    int s = 0;
    for (int i = 0; i < n; ++i) s += step(p[i] ^ (i & 7));             /* 【2】 */
    return s;
}
【1】clamp8 是 static:它已经是 TU 局部的,所以基线档里它就能被内联进 step——这一项不受 TU 边界影响,把它写进来是为了让"没被内联"的成本集中在 step 本身。
【2】这一行是本篇所有跨 TU 数字的来源:step 的定义在 a.cpp,调用点在 b.cpp。基线档里编译器只看得见一条声明,只能生成 call;LTO 档里两边同图,clamp8 与 step 会被一起展开进这个循环。
3.4 效果:两列读数
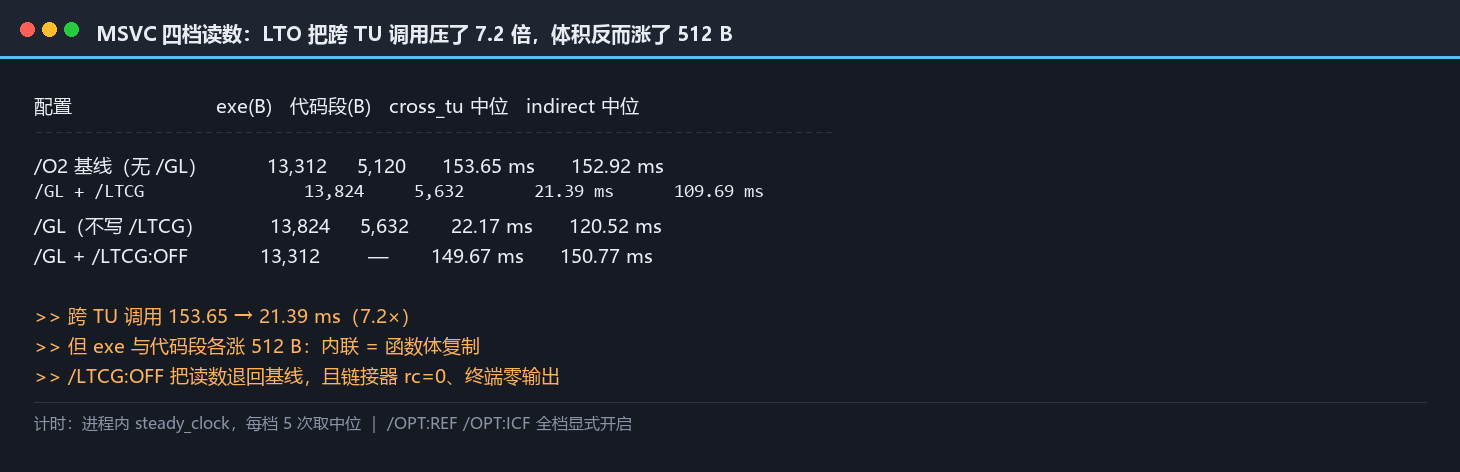
配置                             exe(B)   代码段(B)   cross_tu 中位   indirect 中位
/O2 基线(无 /GL)               13,312     5,120      153.65 ms      152.92 ms
/GL + /LTCG                     13,824     5,632       21.39 ms      109.69 ms
/GL(不写 /LTCG)                13,824     5,632       22.17 ms      120.52 ms
/GL + /LTCG:OFF                 13,312        —       149.67 ms      150.77 ms
好了,读这张表要抓住三件事:
- 收益是真的,而且很大:跨 TU 循环 153.65 → 21.39 ms,7.2 倍。
- 体积反而变大了:13,312 → 13,824 B,代码段 5,120 → 5,632 B,各涨 512 字节。这不是异常,是内联的必然结果——
step与clamp8的函数体被复制进了调用点。 - 基线档的间接调用也很慢(152.92 ms),因为它和 LTO 档差了同一条内联(下面 §8 会解释为什么 LTO 之后间接调用还剩 109.69 ms)。
3.5 静态证据:那条 call 去哪了
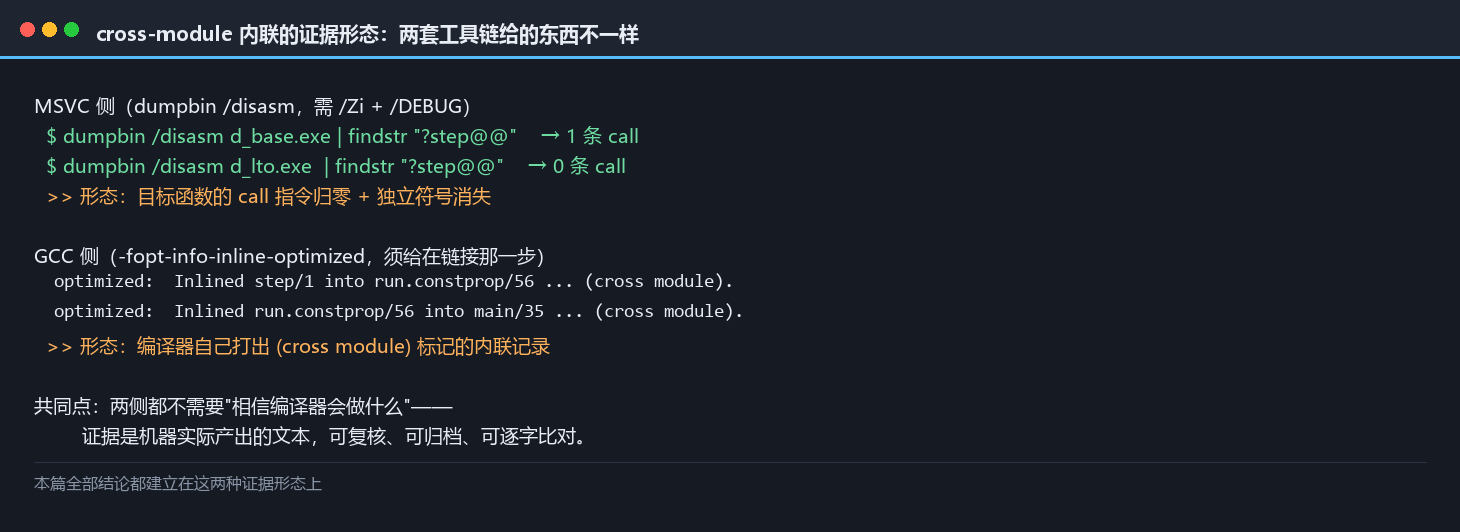
读数只是"更快了",它回答不了"为什么更快"。要回答后一个问题,必须看汇编——只有汇编能告诉你那条调用指令到底还在不在。这里有一个实操前提:默认编出来的 EXE 不带符号表,dumpbin /disasm 只会打印一串裸地址,看不出哪条 call 指向谁。必须加 /Zi 编译、并用 /DEBUG 链接,把 COFF 符号表留在映像里,反汇编才会把调用目标解析成 ?step@@YAHH@Z 这样的名字。
有了能解析名字的反汇编,判据就变得非常机械:在 dumpbin /disasm 的输出里搜 call ?step@@YAHH@Z 这个串,出现几次就是几条。不需要看计时、不需要跑程序、不需要任何统计工具。
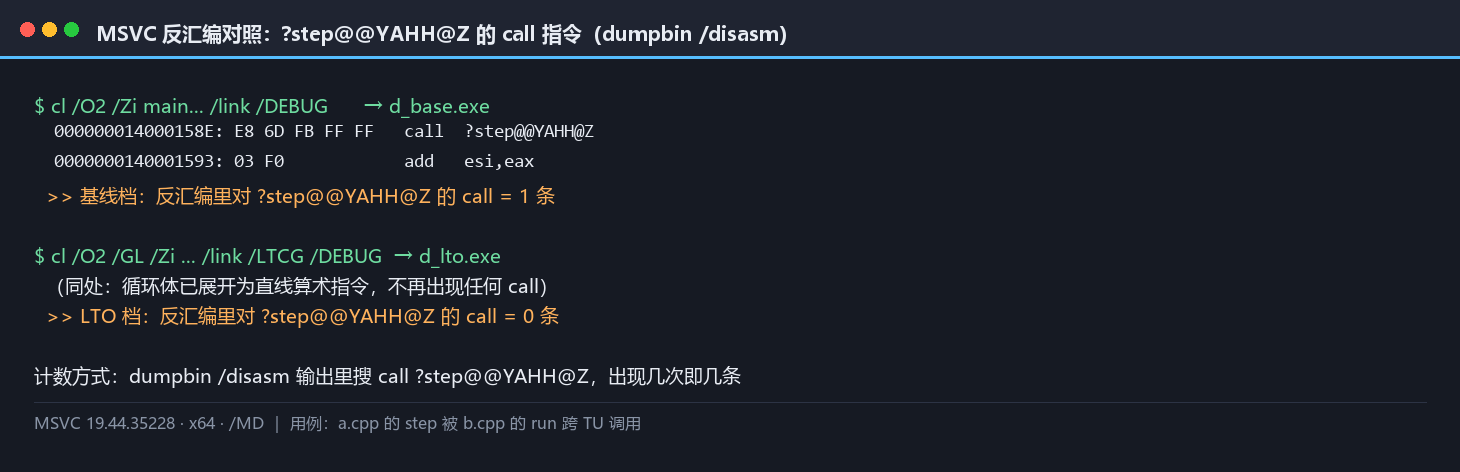
| 构建 | 反汇编里对 ?step@@YAHH@Z 的 call 指令 |
|---|---|
/O2 + /DEBUG |
1 条 |
/GL + /LTCG + /DEBUG |
0 条 |
这就是"收益从哪来"的第一层答案:那条调用指令消失了。计数是机械的——dumpbin /disasm 的输出里搜 call ?step@@YAHH@Z 这个串,出现几次就是几条。
3.6 用符号存活做交叉验证
读数会受机器状态影响,符号存活不会。所以每做完一组对比,本篇都做一次符号存活交叉验证——它把"更快了"这个感受,钉在"编译器具体做了什么"上:
| 构建 | ?step@@YAHH@Z |
?run@@ |
?drive@@ |
结论 |
|---|---|---|---|---|
/O2 基线 |
存在(1 条 call 指向它) | 存在 | 存在 | 无跨 TU 内联 |
/GL + /LTCG |
不存在 | 不存在(已内联) | 不存在(已内联) | 跨 TU 内联发生 |
/GL + /LTCG + PGO |
不存在 | 存在 | 存在 | 见 §8.6 的反直觉 |
第三行值得先埋一个伏笔:PGO 档里那两个符号又回来了,而它更快。
这个验证为什么单独成节:本节的三行表格全部可以由一条命令生成(dumpbin /symbols 或 dumpbin /disasm 后搜符号名),不需要重跑程序、不需要计时的稳定性。当计时读数出现互相矛盾时(本篇 §6.4 那组 1% 的差异就是这种情形),符号与汇编层面的证据是最后的裁判。
3.7 完整实现外链
本篇用例的五个源文件(iface.h / a.cpp / b.cpp / c.cpp / main.cpp)与全部原始日志随篇留档,位于本篇素材目录的 evidence/ 下;两套工具链的完整编译/链接/运行记录见 evidence/logs_msvc/ 与 evidence/logs_gcc/。同一份源码在 GCC 侧的结果见 §六。
四、收益来源的判定实验
4.1 一个问题:LTO 的收益会不会来自别处
到这里我们可以说"LTO 让跨 TU 调用快了 7.2 倍,且那条 call 没了"。但严格地说,这还只证明了相关,没有排除别的可能:
- 会不会是
/GL改变了编译期的某些默认(比如打开了某个别的优化)? - 会不会是链接器顺带做了别的调整?
要排除这些,需要一个"只有 TU 边界被拿掉、其他一切不变"的对照组。
4.2 做法:把函数搬进同一个 TU,不开任何 LTO
先来看看最干净的做法是手工消除那条边界:把 step 的定义从 a.cpp 搬进 b.cpp(就在 run 上面),然后完全不开 LTO,只用 /O2 编一遍。
这时编译器在编 b.cpp 时能看见 step 的全部函数体——它拥有了 LTO 提供的唯一那一项好处,而 /GL、/LTCG、链接期代码生成这些一个都没开。
这组对照的分量在这里:它把"TU 边界是否消失"这一个变量单独拿了出来,同时把 LTO 引入的其它一切(链接期代码生成、跨模块的寄存器分配、链接器的额外遍历)全部排除在外。如果同 TU 无 LTO 的读数与 LTO 档落在同一量级,那么 LTO 的收益就只能是"边界被拆掉"这一件事带来的;反之,如果同 TU 无 LTO 明显更慢,就说明 LTO 里还有别的收益来源——那样本篇的结论就得改写。
这组对照的成本极低:代价只是把函数挪个文件,不改任何编译选项。
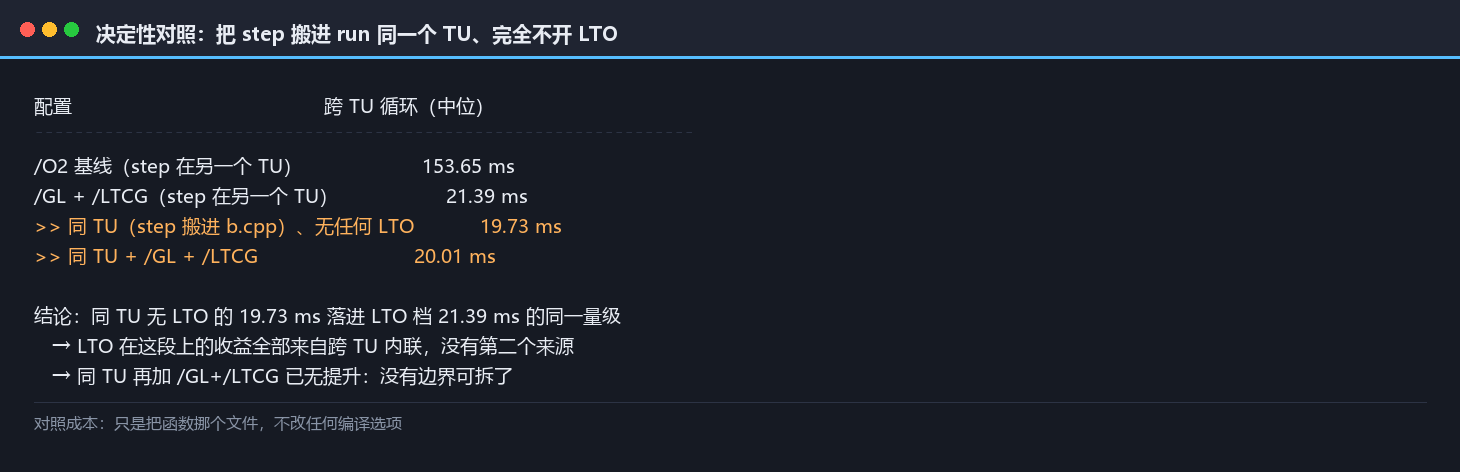
| 配置 | 跨 TU 循环(中位) |
|---|---|
/O2 基线(step 在另一个 TU) |
153.65 ms |
/GL + /LTCG(step 在另一个 TU) |
21.39 ms |
同 TU(step 搬进 b.cpp)、无任何 LTO |
19.73 ms |
同 TU + /GL + /LTCG |
20.01 ms |
4.3 结论
同 TU 无 LTO 的 19.73 ms,落进了 LTO 档 21.39 ms 的同一量级(差异 8%,在计时抖动范围内)。
这组对照把话说死了:
- LTO 在这段代码上的收益全部来自跨 TU 内联,没有第二个来源;
- 而且内联之后的收益基本到顶了——同 TU 组再加
/GL + /LTCG(20.01 ms)没有任何进一步提升,因为已经没有边界可拆。
方法论备注:这条"手工消除边界"的对照,是本篇最有用的一件工具。它把"某个开关带来了多少收益"这个模糊问题,转成"把边界手工拿掉,能达到多少"这个可测问题。凡是怀疑某条优化"是不是真在起作用",都可以照这个方法做一遍——代价只是把函数挪个文件。
4.4 顺便排除一个误解
有人会说:"那我直接把小函数写进头文件里 inline 不就行了,何必 LTO?"
这句在代码量小时是对的,在代码量大时反而是错的,而且错得很具体:
- 把函数放进头文件,意味着每个包含它的 TU 都要编译一遍。函数一多,编译期账本(这正是 ep04 的主题)会立刻恶化;
- 头文件里的函数体一旦改动,所有包含者全部重编,增量构建直接失效;
- 而 LTO 把这项成本挪到了链接期,且只在最终链接时付出一次。
inline 把代价前移到每个 TU,LTO 把代价后移到一次链接。 两者都在拆同一条边界,但付账的位置不同——这是选型时真正该比较的东西。
五、LTO 的代价与开关语义
5.1 代价清单:三笔账
拆边界不是免费的。值得逐笔算的三笔是:
| 代价 | 机制 | 本篇是否实测 |
|---|---|---|
| 体积 | 内联 = 函数体复制 | 实测(§5.2) |
| 构建时间 | 链接期要重跑一遍全程序优化 | 实测(§5.2,含规模解释) |
| 可调试性 | 优化跨过 TU 边界后,行号与栈帧的对应关系变复杂 | 未实测,只作说明(本机无源码级调试器接入场景) |
5.2 体积与构建时间:两套工具链给出相反的体积方向
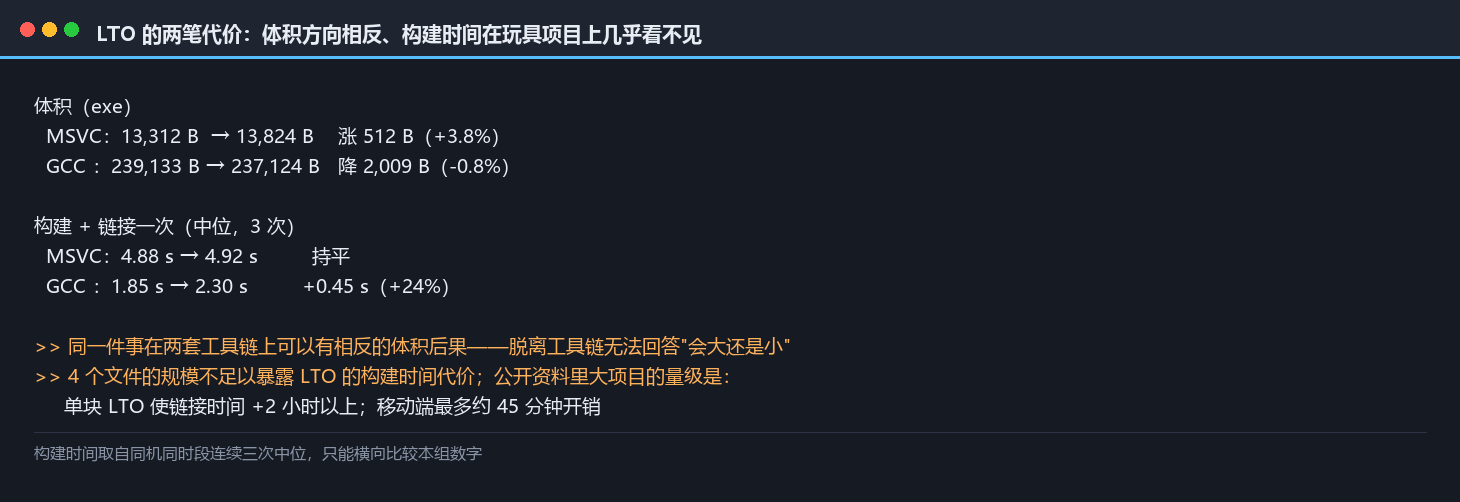
体积(exe)
  MSVC:13,312 B  → 13,824 B   (涨 512 B,+3.8%)
  GCC :239,133 B → 237,124 B  (降 2,009 B,−0.8%)

构建+链接一次(中位,3 次)
  MSVC:4.88 s → 4.92 s        (持平)
  GCC :1.85 s → 2.30 s        (+0.45 s,+24%)
言归正传,这三行值得逐个说:
- 体积方向相反:MSVC 涨、GCC 降。这不是谁对谁错——GCC 侧的体积下降主要来自 LTO 之后跨模块的死代码消除(
?run@@与?drive@@都被内联,独立的函数体随之被消除,/OPT:REF式的收益被放大),而 MSVC 侧的内联复制量压过了消除量。同一件事在两套工具链上可以有相反的体积后果——所以"开 LTO 会变小还是变大"这个问题,脱离具体工具链和具体代码是没法回答的。 - 构建时间在玩具项目上几乎看不见:MSVC 持平,GCC 涨 24%(绝对值 0.45 秒)。原因很直白:只有 4 个文件时,"全程序优化"无非是把 4 个文件重编一遍,而且 LTO 的优化质量恰恰让一部分代码变少、编得更快。
- 所以"LTO 构建时间暴涨"的报告都来自大项目。公开资料里的量级是:单块 LTO 让链接时间 +2 小时以上(LLVM 开发者会议 2022 的链路级报告)LLVM 开发者会议 2022(链接期代价)、移动端项目里单块 LTO 因"只能单线程处理合并后的模块"而给构建管线带来最多约 45 分钟开销移动端链接期优化论文。GCC 与 LLVM 都为此做了并行化:GCC 的 WHOPR 把调用图切成分区并行编译(§6.3),LLVM 的 ThinLTO 更进一步(§6.4)。
口径声明:本节的构建时间是在同一台机器、同一时段、连续三次取中位得到的,只能横向比较本节内的两组数字,不能与其他机器上的绝对值相比。更要紧的是:4 个文件的规模不足以暴露 LTO 的构建时间代价,所以本节把公开资料里的量级一并列出,避免读者拿玩具数字去推一个真实项目。
5.3 /LTCG 到底是不是开关:三个方向都有意外
好了,这是本篇第一个反直觉发现。官方文档说 /LTCG 由 /GL 隐含——"implied"。但"隐含"这个词掩盖了两件事,实测把三个方向都试了一遍:
| 写法 | 实测跨 TU 读数 | 链接器输出 |
|---|---|---|
/GL + 不写 /LTCG |
22.17 ms(LTO 生效) | 无警告、无提示 |
/GL + /LTCG(显式) |
21.39 ms(LTO 生效) | 正在生成代码 / 已完成代码的生成 |
/GL + /LTCG:OFF |
149.67 ms(退回基线) | rc=0,零输出 |
三个结论:
/LTCG不是"开"的必要条件。不写它,链接器自己发现目标文件里有 IL,LTO 照常发生(22.17 ms 与显式的 21.39 ms 同量级)。官方文档说未显式指定时链接器会"自动检测并重启链接"MSVC /LTCG 文档——那个重启是你看得见的构建时间,看不见的才是它已经替你做完了 LTO。/LTCG:OFF是有效的"关"。加上它,读数退回基线(149.67 ms),体积也退回 13,312 B。"我以为我关了 LTO"这件事是可以做到的——但你必须显式写:OFF。- 关闭是静默的。那一次链接 rc=0、终端零输出——没有警告、没有提示、没有任何一行告诉你"IL 被当作普通目标文件处理了"。而官方文档对
/LTCG:OFF的语义说得很清楚:"把用/GL编译的模块当作没用该选项编译"— 只是它不打算提醒你。
这就是本篇想说的第一类"安静的失效":一个决定被做掉了,页面上什么都没有。如果构建系统里有人为了排查某个问题临时加了 /LTCG:OFF,而后来忘了删,你会得到一个看起来完全正常、只是慢了 7 倍的二进制。
5.4 -flto 侧对应的口径
GCC 这边没有 /LTCG:OFF 这种"半开"状态。-flto 给在编译与链接两侧,LTO 就发生;不给就不发生。但 GCC 有一个方向相反的隐式开关值得记住:-ffat-lto-objects 会让目标文件同时保存 GIMPLE 与机器码GCC Internals · LTO Overview。官方文档指出它的副作用很危险:"工具链里任何一处失误都会导致 LTO 信息不被使用,而用户不会被告知优化已被禁用"。fat 模式提高兼容性的代价,正是又一种静默失效。
5.5 一个容易被忽略的口径:/O2 与 /GL 的叠加关系
上面所有对照都写着 /O2 /GL,这里说清两者的关系,否则容易被误读成"LTO 取代了 /O2":
/O2管的是单个 TU 内部的优化强度(内联预算、循环变换、向量化、寄存器分配);/GL管的是可见性边界(把 IR 留到链接期,让跨 TU 的优化有可能发生);- 链接期的 LTCG 不是从零开始优化,它是在各模块已有的优化结果之上,再做一轮跨模块的决策。
所以两者是叠加关系,不是替代关系。官方 /LTCG 页也明确把跨模块内联、过程间寄存器分配(仅 64 位)这些能力挂在"用 /GL 并按 /Og /O1 /O2 /Ox 编译"这个前提上——没有优化级别,/GL 本身不产生优化。
这也解释了一个常见困惑:"我加了 /GL /LTCG,为什么没变快?"——如果代码里本来就没有跨 TU 的小函数调用,LTO 就没有可拆的边界,收益自然接近 0。收益的前提是"被边界挡住的东西确实存在",这一点和 §8.5 里"PGO 对跨 TU 调用差 0.07%"是同一枚硬币的两面。
5.6 官方口径备查
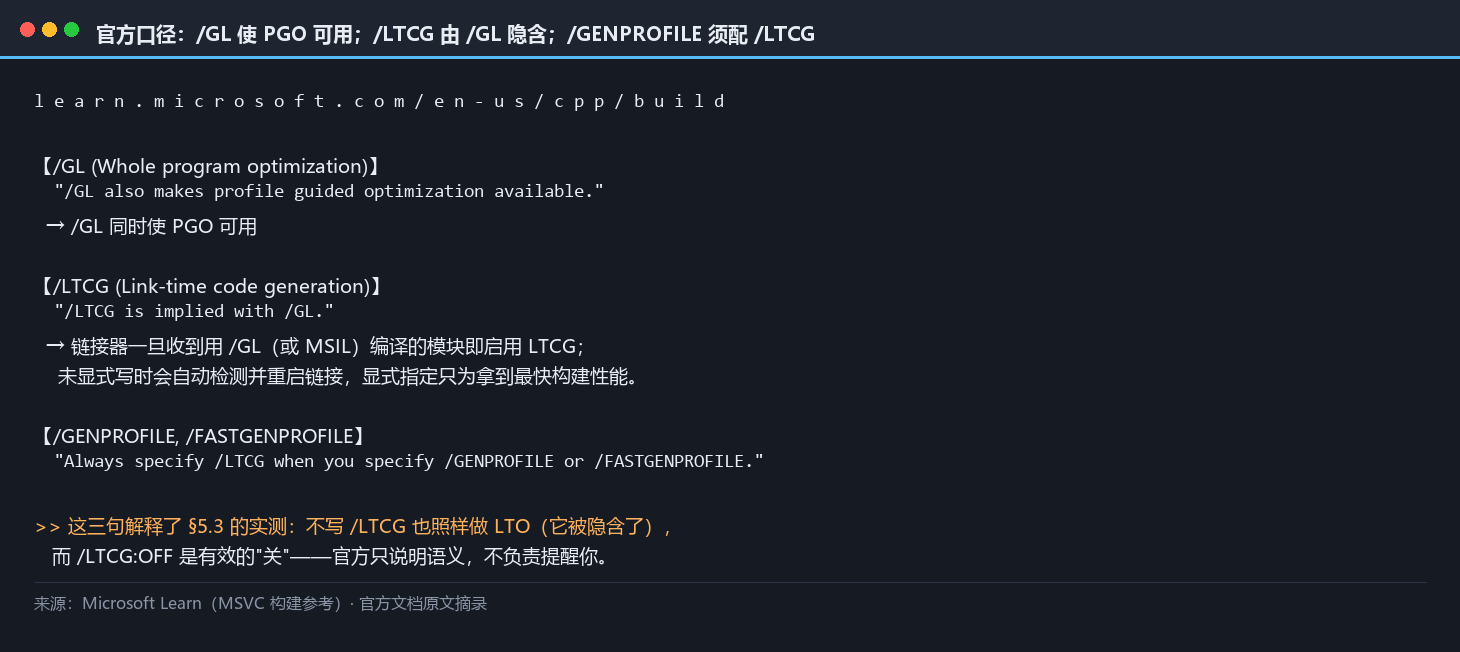
三条需要在文中写准的官方表述(原文摘录):
/GL页:"/GLalso makes profile guided optimization available."(/GL同时使 PGO 可用)MSVC /GL 文档/LTCG页:"/LTCGis implied with/GL.",且说明链接器一旦收到/GL(或 MSIL)模块即启用 LTCG;未显式写时会自动检测并重启链接,显式指定只为拿到最快的构建性能MSVC /LTCG 文档。/GENPROFILE页:"Always specify/LTCGwhen you specify/GENPROFILEor/FASTGENPROFILE."MSVC /GENPROFILE 文档
六、GCC 侧:-flto、WHOPR 与两处实测
6.1 同一份源码,GCC 给出的四档读数
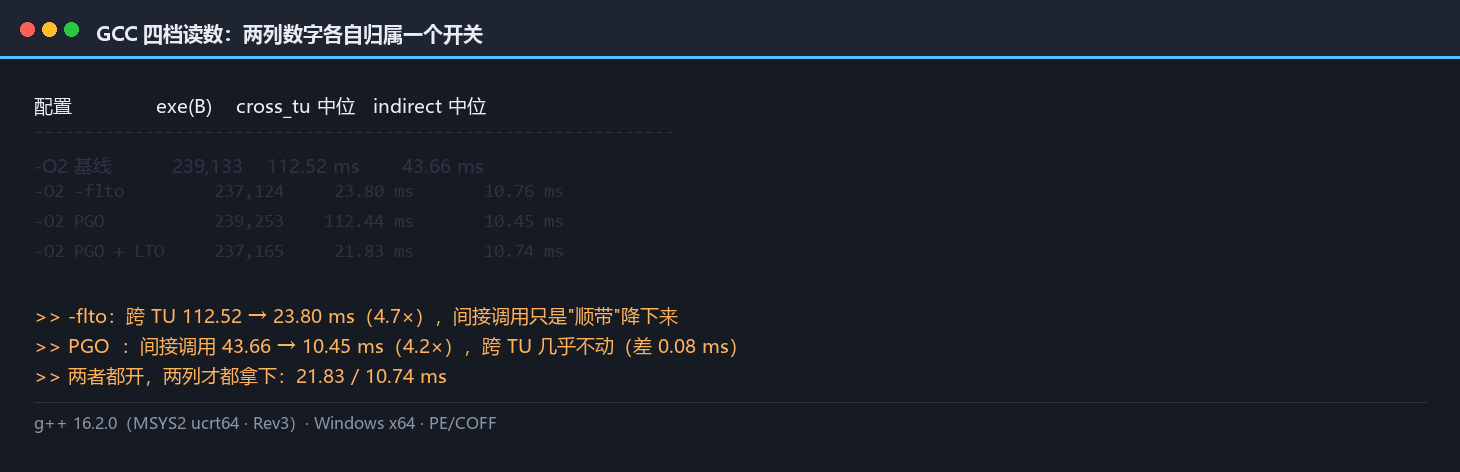
配置              exe(B)    cross_tu 中位   indirect 中位
-O2 基线          239,133    112.52 ms       43.66 ms
-O2 -flto         237,124     23.80 ms       10.76 ms
-O2 PGO           239,253    112.44 ms       10.45 ms
-O2 PGO + LTO     237,165     21.83 ms       10.74 ms
下面进入同一份四文件用例,GCC 这边一次把四档都编了出来。这张表比 MSVC 那张更有用,因为它把四个组合放在一行里对比——只看 MSVC 的数据,你很难判断"跨 TU 变快"和"间接调用变快"究竟是不是同一个开关带来的;而 GCC 这张表里,两列数字自己就把答案写出来了。
这张表是本篇的结构骨干,它把两件事分得干干净净:
-flto把跨 TU 调用从 112.52 压到 23.80 ms(4.7 倍),但间接调用只从 43.66 降到 10.76 ms——降是降了,但那是顺带的;- PGO 把间接调用从 43.66 压到 10.45 ms(4.2 倍),但跨 TU 调用几乎一动不动(112.52 → 112.44 ms,差 0.08 ms);
- 两者都开,两列才都拿下(21.83 / 10.74 ms)。
这里有一个容易被跳过的细节:-flto 那一档的间接调用也确实从 43.66 降到了 10.76 ms,看起来"LTO 也优化了间接调用"。但这不是 LTO 在直接优化间接调用,而是跨 TU 内联的连带结果——drive 被内联进 main 之后,对象的具体类型(main 里那个栈上的 AddOp)在调用点变得可见,编译器于是顺手做了去虚拟化。收益的来源仍然是"可见性",不是"LTO 这个开关本身"。 这也是为什么下面 §8.3 里要看汇编:只有看汇编,才能把"顺带"和"直接"分开。
6.2 内联决策的原文证据
GCC 有一个 MSVC 没有的好东西:-fopt-info 系列可以直接把优化决策打成文本。要看跨 TU 内联,用 -fopt-info-inline-optimized。
这里有一个实操要点:LTO 阶段的决策发生在链接期,所以这个选项必须给在链接那一步。只给在 -c 上,你只会看到 TU 内部的内联(比如 clamp8 进 step),看不到跨模块的那两条。
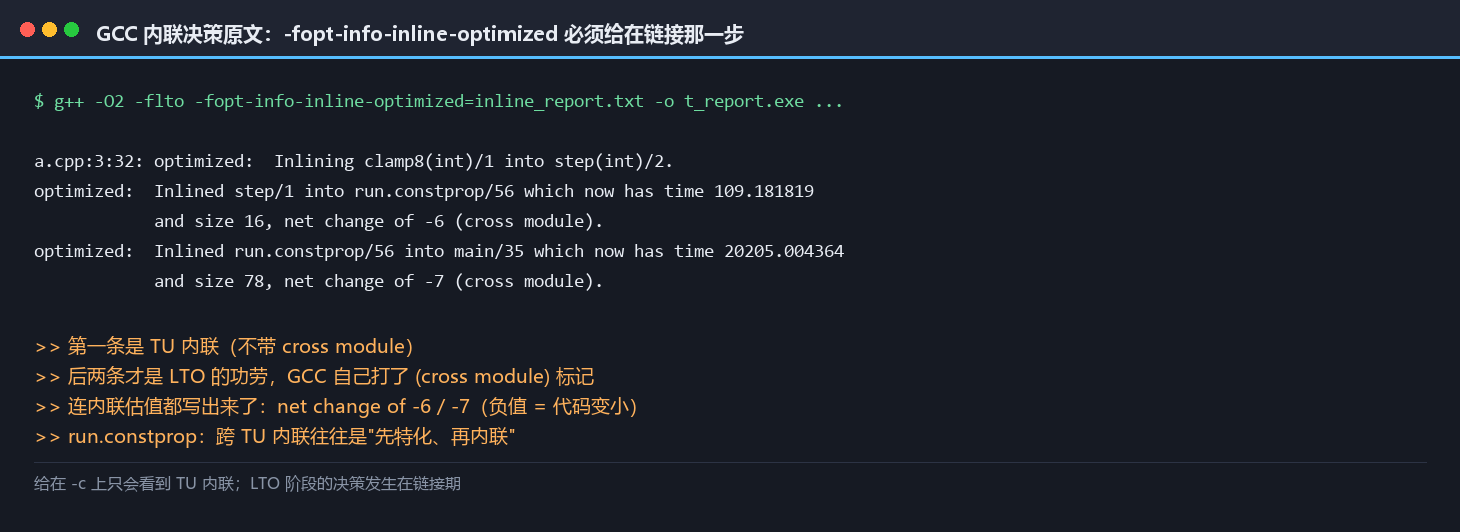
a.cpp:3:32: optimized:  Inlining clamp8(int)/1 into step(int)/2.
optimized:  Inlined step/1 into run.constprop/56 which now has time 109.181819
            and size 16, net change of -6 (cross module).
optimized:  Inlined run.constprop/56 into main/35 which now has time 20205.004364
            and size 78, net change of -7 (cross module).
三条记录,两个层次:
- 第一条是 TU 内联(
clamp8进step)——不带(cross module),基线档也会有; - 后两条才是 LTO 的功劳,GCC 自己打了
(cross module)标记。注意它连内联的估值都写出来了:把step内联进run后-6(净减 6 个单位),把run内联进main后-7。收益为正(为负值表示代码变小),所以编译器认为值得做。 - 顺带一提:
run.constprop/56这个名字里的constprop是"常量传播"(constant propagation)的缩写——说明run在被内联前已经被复制成了一份针对特定调用点的特化版本。跨 TU 内联往往不是简单搬运,而是"先特化、再内联"。
6.3 WHOPR:大项目为什么还能用 LTO
GCC 的 LTO 有一个和 MSVC 完全不同的设计:它不把全部 IR 合成一个巨型模块,而是分三段(GCC Internals 的 LTO Overview):
- LGEN(Local GENeration,本地生成):每个 TU 编译时产出 GIMPLE 字节码,放进目标文件的特殊节里;
- WPA(Whole Program Analysis,全程序分析):串行。生成全局调用图,做全局分析决策,并把调用图切成分区——切分目标是"最大化并行、最小化跨分区引用";
- LTRANS(Local TRANSformations,本地变换):并行。每个分区独立优化并生成最终汇编。
三段的分工出自 GCC Internals 的 LTO OverviewGCC Internals · LTO Overview 与 WHOPR 页(该页同时解释了链接器插件与 collect2 的分工:带 LTO 节的目标文件会先交给 lto1 处理,再进链接器)GCC Internals · WHOPR。
为什么这个设计重要:它把"全程序优化"里唯一无法并行的部分(全局分析)压到最薄,剩下的重活全部下推到可并行的 LTRANS。GCC 4.6 起 WHOPR 稳定下来并成为 LTO 的默认模式,支持 -flto=n 控制并行编译数GCC 4.6 发行说明;GCC 10 起 LTO 的并行阶段还能自动识别 make 的 jobserver,或回落到可用核心数(即 -flto=auto / -flto=jobserver 的来源)GCC 10 发行说明。
对照一下 LLVM 的两种模式(只引官方原文,本机无 Clang,不做实测):
| 模式 | 做法 | 官方给的性质 |
|---|---|---|
Full LTO(-flto=full) |
全部 bitcode 合并成单一 Module,做串行的 IPA/IPO | 时间与内存不可扩展 |
ThinLTO(-flto=thin) |
编译期产出模块摘要;链接期只合并摘要为 combined summary index,在其上做快速全程序分析;函数导入与优化下推到各后端并行Clang ThinLTO 文档 | 构建时间非常接近非 LTO 构建,且可增量、可缓存LLVM 项目博客(ThinLTO) |
6.4 三套工具链的 profile 数据结构对照
把三家的 profile 产物放在一起看,能看出设计取向的差别——这也解释了为什么"坑"的形状各家不同:
| MSVC | GCC | Clang/LLVM | |
|---|---|---|---|
| 单次运行计数 | app!N.pgc |
<out>-<src>.gcda |
*.profraw |
| 中间/数据库层 | app.pgd(显式) |
无(累加进 .gcda) |
.profdata(显式,须 merge) |
| 多次训练怎么合 | pgomgr /merge[:权重] |
再次运行即累加 | llvm-profdata merge |
| 命名绑定的是什么 | 输出映像名(app) |
输出名 + 源文件名 | 生成时的输出名 |
| 常见"静默失效" | /PGD 指错文件 → LNK1266(这个会报错) |
改了 -o → 只给警告、rc=0 |
忘记 merge → 直接没有可用数据 |
从这张表能读出一条设计规律:MSVC 与 LLVM 都有显式的中间层(.pgd / .profdata),而 GCC 把累加直接写进 .gcda。中间层带来两个后果——多一次"合并"的操作步骤(所以 Clang 那边"忘记 merge"是高频坑),换来了一个可以"加权"的地方(所以只有 MSVC 有 pgomgr /merge:6 这种写法)。
而 GCC 没有中间层、命名又绑了源文件名与输出名,于是"改个输出名"就能让整份数据静默失配(§7.4)——这是同一张表上唯一一个连警告都很轻的失效路径。
6.5 一处"流传很广但实测不成立"的规则
说白了,GCC 生态里有一条几乎人人都会背的规则:
用 LTO 编静态库时,必须用
gcc-ar/gcc-ranlib打包,用普通ar会让 LTO 静默失效。
这条的本意有官方依据:gcc-ar 的 man 页写得很明确——它是 ar 的包装,自动加上 --plugin,好让 ar/nm/ranlib 看得懂 LTO 目标文件的符号表gcc-ranlib man 页;GCC 邮件列表里也有相应的讨论,结论是 LTO 静态库要把 lto_plugin.so 交给 ar/nm/ranlibGCC 邮件列表(链接器插件)。
但实测没有复现:
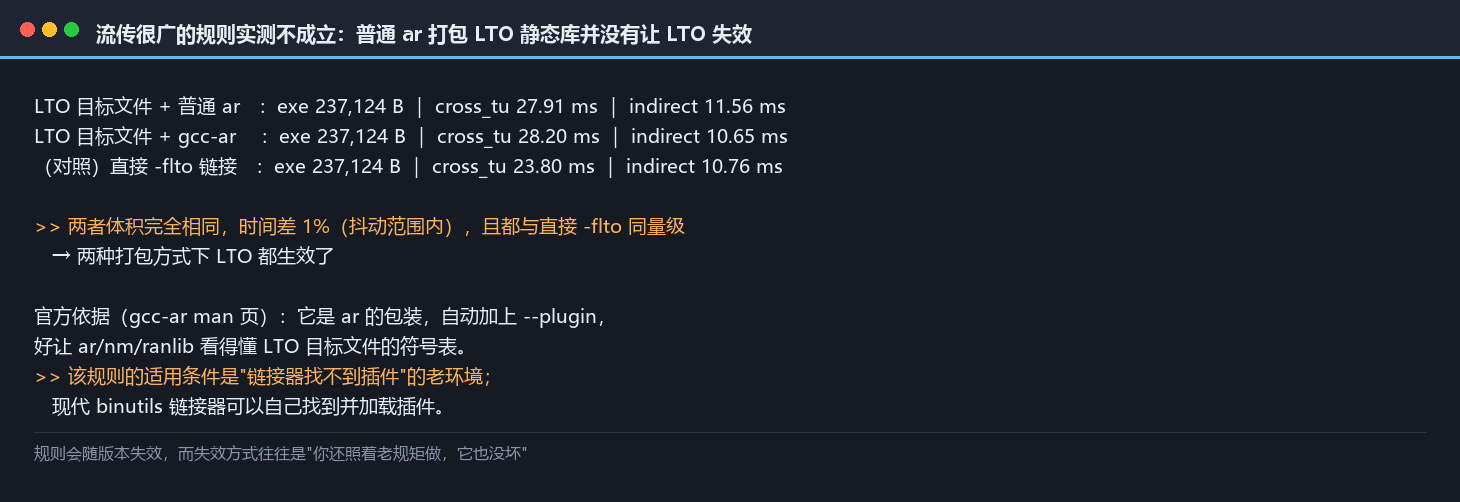
LTO 目标文件 + 普通 ar   :exe 237,124 B | cross_tu 27.91 ms | indirect 11.56 ms
LTO 目标文件 + gcc-ar    :exe 237,124 B | cross_tu 28.20 ms | indirect 10.65 ms
两者体积完全相同,时间差异 1%,在抖动范围内;且都与直接 -flto 链接的 23.80 ms 同量级——说明 LTO 在这两种打包方式下都生效了。
为什么会这样:--plugin 的作用是让归档工具"看得懂"插件,而现代 binutils 的链接器可以自己找到并加载 liblto_plugin。那条规则的适用条件是"链接器找不到插件"的老环境,它被当成普适规则流传下来,但至少在本机这套 binutils 上不成立。
这条要如实写成"实测不成立",而不是照抄网上的结论。 本篇把一个"大家都这么说"的规则单独拿出来测一遍,正是为了说明:构建工具的规则会随版本失效,而失效的方式往往是"你还照着老规矩做,它也没坏"——这比报错更难发现。
七、PGO 的工程链路与四个坑
7.1 三步:插桩 → 训练 → 使用
先来看看PGO 不是编译期的一个开关,而是一条三阶段的流水线,中间夹着"跑一次真实程序":
| 步 | MSVC | GCC | 产物 |
|---|---|---|---|
| ① 插桩构建 | /GL + /GENPROFILE 编译,/LTCG /GENPROFILE 链接MSVC /GENPROFILE 文档 |
-fprofile-generateGCC 插桩选项手册 |
MSVC:插桩 exe + .pgd;GCC:插桩 exe |
| ② 训练 | 运行插桩 exe | 运行插桩 exe | MSVC:app!N.pgc;GCC:*.gcda(每 TU 一个) |
| ③ 使用 | /GL + /USEPROFILE 编译,/LTCG /USEPROFILE 链接 |
-fprofile-use |
优化后的二进制 |
这张图里最该被注意的是中间那一步。前面所有篇章(ep01–ep06)讲的都是"同一份源码 → 不同开关 → 不同二进制"的单向流程;PGO 第一次在流程中间插入了一个必须在部署环境里跑起来的程序。这一步带来了本篇其余所有风险。
7.2 坑一:插桩二进制在裸环境里根本跑不起来
先来看看第一个坑在第一步就出现,而且它伪装成"程序没反应"。
用 /GENPROFILE 生成的插桩 exe,如果在一个没有 Visual Studio 工具目录的 PATH 的环境里直接运行,它会不打印任何输出、直接退出。退出码是 -1073741515,换成十六进制是 0xC0000135,也就是 Windows 的 STATUS_DLL_NOT_FOUND。
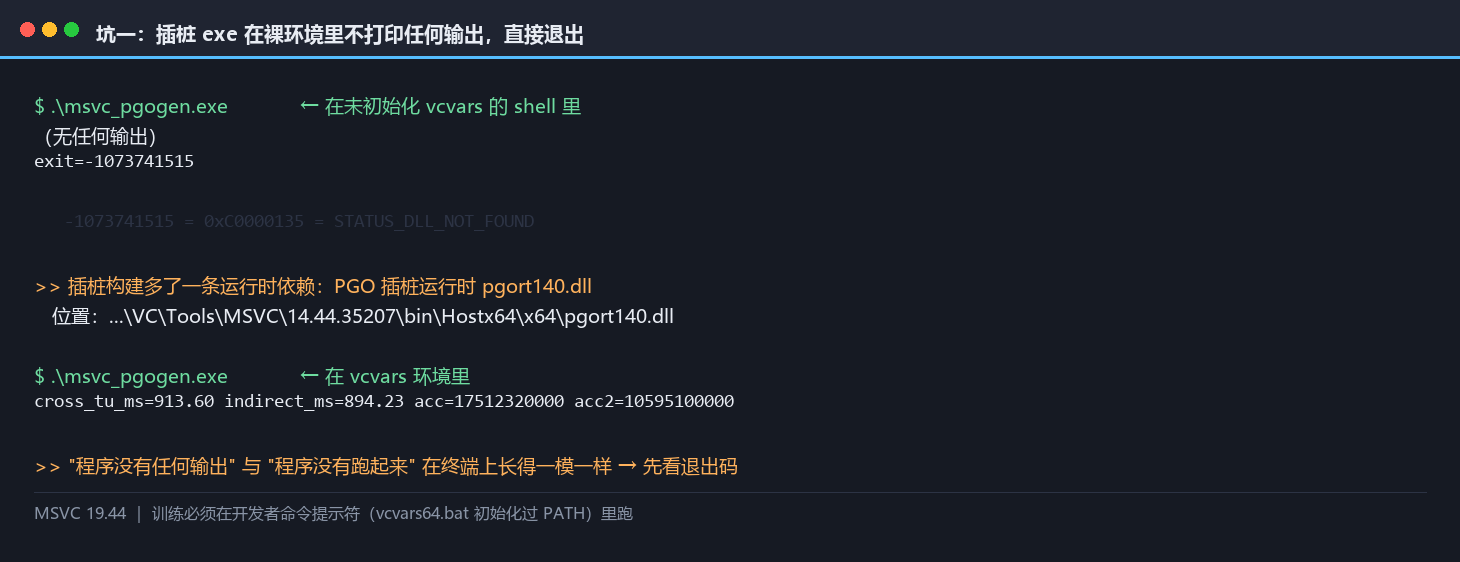
原因:插桩构建多了一条运行时依赖——PGO 插桩运行时 pgort140.dll(在 ...\VC\Tools\MSVC\<版本>\bin\Hostx64\x64\ 下)。这个依赖不是编译期就会提醒你的东西:编译成功、链接成功、产物存在,只有运行时才会炸,而且炸得毫无提示。
修法很简单:训练必须在开发者命令提示符(vcvars64.bat 初始化过 PATH)里跑。但要记住这个坑的形态——"程序没有任何输出" 和 "程序没有跑起来" 在终端上长得一模一样,所以排查时第一件事是看退出码。
7.3 坑二:/PGD 要指 .pgd,不是 .pgc
下面开始看这一步的产物。第二步训练完之后,目录里会出现两个文件,体积差了将近 200 倍:
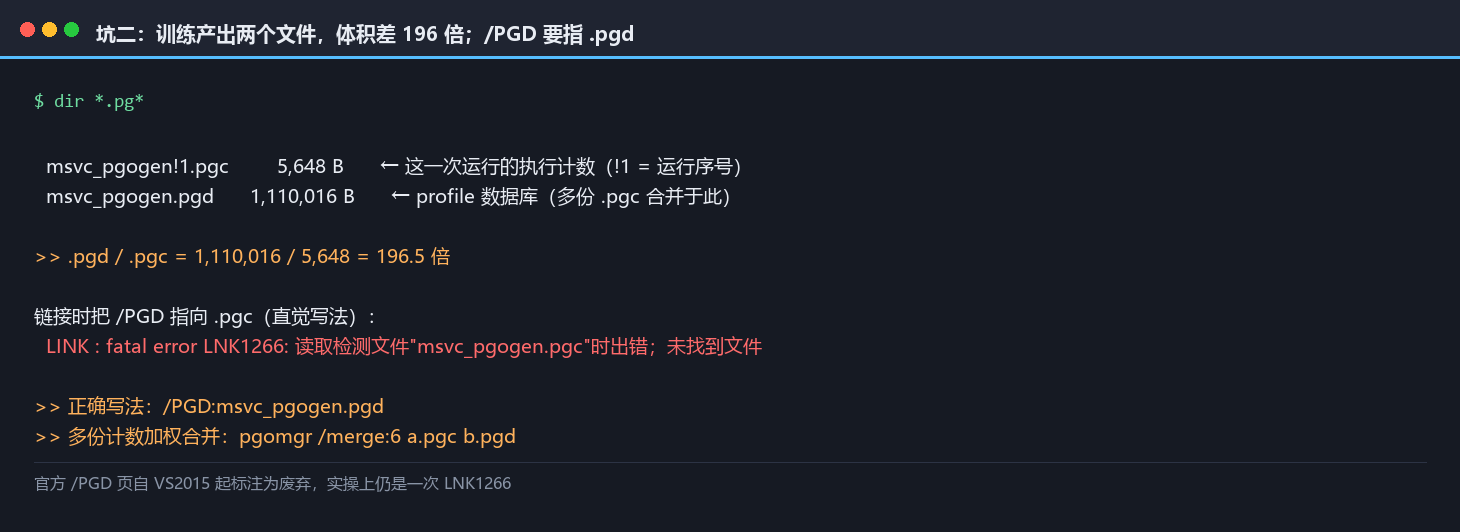
msvc_pgogen!1.pgc     5,648 B      ← 执行计数
msvc_pgogen.pgd   1,110,016 B      ← profile 数据库
.pgc是这一次运行的计数(名字里的!1是运行序号,可以有多份);.pgd是数据库,把多份.pgc合并在一起。
第三步链接时,如果按直觉写 /PGD:msvc_pgogen.pgc,会直接报错:
LINK : fatal error LNK1266: 读取检测文件"msvc_pgogen.pgc"时出错;未找到文件
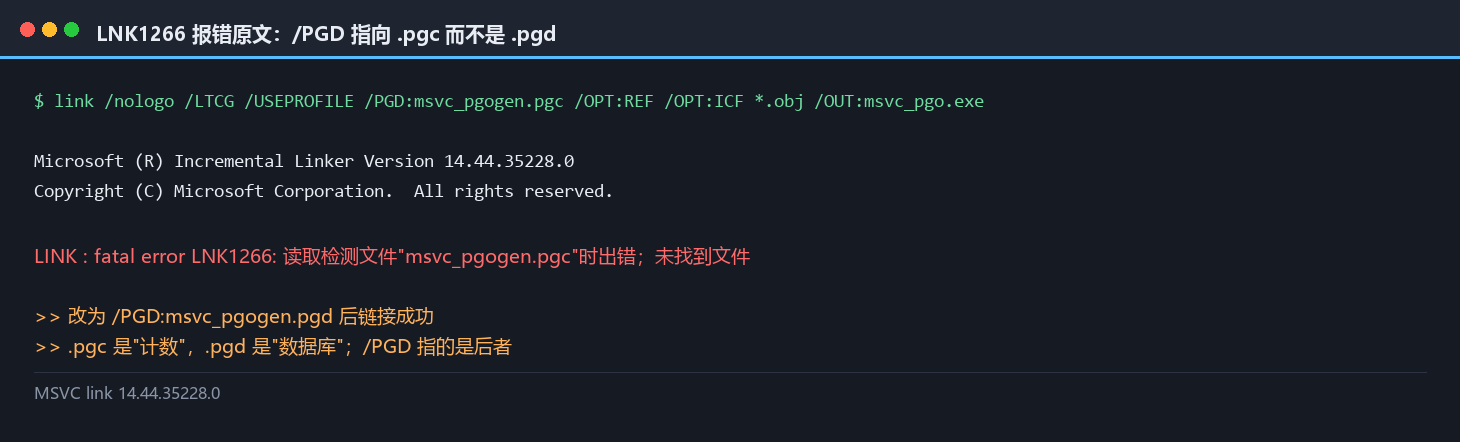
/PGD: 指的是那个数据库(.pgd),不是计数文件(.pgc)。 这条在官方文档里说得不算清楚(/PGD 页面已被标注为自 VS2015 起废弃、建议改用 /GENPROFILE),实操上就是一次 LNK1266。
多份计数怎么合并:如果一次训练覆盖不到所有场景(比如"启动路径"和"高负载路径"要分两次跑),MSVC 用 pgomgr /merge[:权重],官方示例是 pgomgr /merge:6 a.pgc b.pgd——可以给每份计数加权。GCC 侧对应的分工是:-fprofile-generate 跑多次(默认是累加到同一批 .gcda 上),Clang 侧则必须显式 llvm-profdata merge 把 .profraw 合成 .profdata。
顺带一句诚实的边界:GCC 的多次训练是累加语义,所以"权重"要靠多跑几次来调;Clang 的 merge 是显式语义。MSVC 是三者里唯一提供"加权合并"开关的——因为它有
.pgd这个显式的数据库层。
7.4 坑三:GCC 的 .gcda 名字跟着 -o 走
第三个坑最阴,因为它不会让任何一步失败。
说白了,GCC 的 .gcda 文件命名规则是 <输出名>-<源文件>.gcda。所以:
- 训练时用
-o g_pgogen.exe构建插桩版 → 生成g_pgogen-a.gcda、g_pgogen-b.gcda… - 使用 profile 时如果习惯性写成
-o g_pgo.exe→ GCC 去找g_pgo-*.gcda,找不到。
找不到会怎样?它给一条警告:
a.cpp:3:45: warning: '...\g_pgo-a.gcda' profile count data file not found [-Wmissing-profile]
...然后rc=0、链接照常成功。
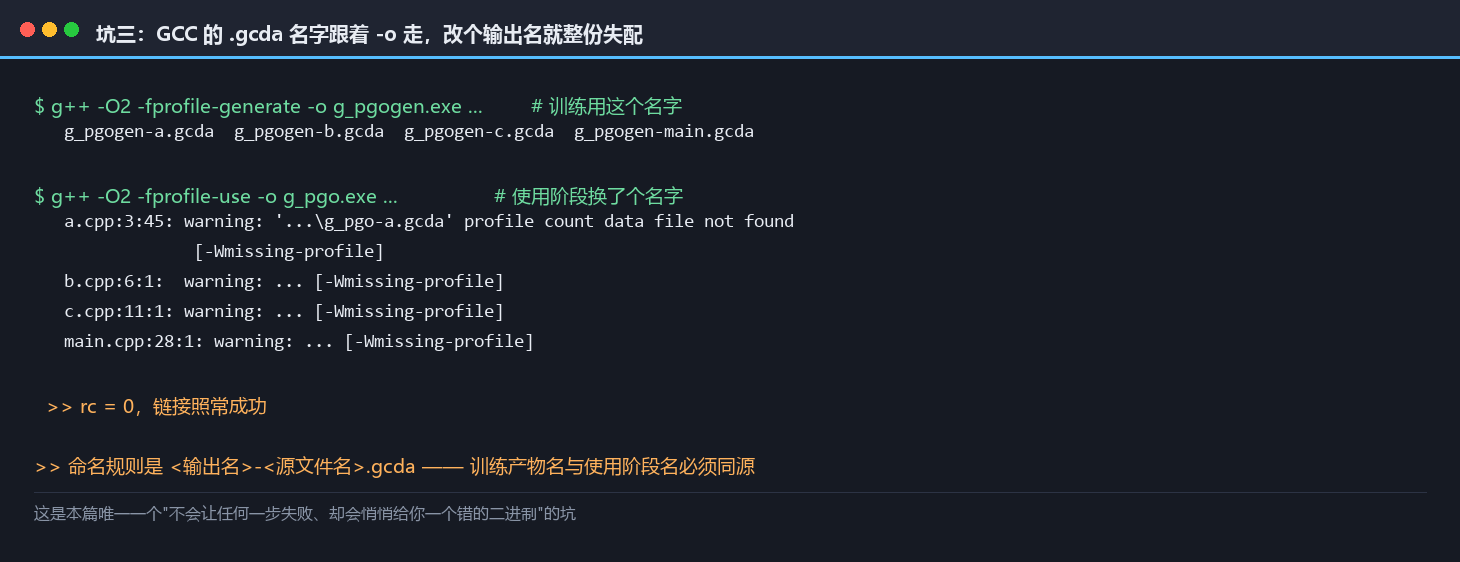
这就是本篇想说的第二类"安静的失效",而且比第一类更隐蔽:/LTCG:OFF 至少需要你写一个显式选项,而这个坑只需要你改了输出文件名——一个在构建脚本里再平常不过的动作。
这个坑真实地污染过本篇的第一轮数据。第一轮的 "PGO 组"就是这样一个"名义 PGO、实际无 profile"的构建,它的间接调用读数是 115.34 ms(详见 §9.3)——比基线还慢 2.5 倍。数据看起来"有变化、有差异、像是 PGO 起了作用",只是作用方向是反的。发现它靠的不是读数,而是回头核对 .gcda 的实际文件名。
可操作的经验:PGO 的构建脚本里,训练产物名与使用阶段名必须由同一个变量生成,不允许手写两遍。这不是洁癖——本节的 196 倍体积差、
0xC0000135、LNK1266三个坑都只是"麻烦",只有这一个会悄悄给你一个错的二进制。
7.5 坑四:训练数据必须代表真实负载
好了,第四个坑是语义层面的,没有工具能替你检查。
PGO 的全部结论都建立在"训练时跑的就是真实负载"这个假设上。如果训练跑的是 AddOp、生产里跑的是 XorOp,那么编译器为 AddOp 精心准备的守卫快路径每次都会失败,每次都跳到冷路径——比不做优化还差(多了一次比较和一次跳转)。
Linux 内核的 AutoFDO 文档措辞很直白:训练负载必须"具有代表性",否则会朝错误的目标优化。微软的采样 PGO 文档给了一条可操作的监控指标:"被 profile 优化的函数比例若显著下降(低于 90%),就该重新采集"——注意它监控的是"用了多少 profile",不是"profile 对不对"。
这一点会在 §九 展开:本篇实测到,两套编译器都不会告诉你 profile 已经过期。所以"训练数据保鲜"这件事,最终只能靠构建流程里的人来管。
八、PGO 的收益:把间接调用消掉
8.1 官方定义:虚拟调用推测
先来看看先看官方怎么定义这件事。MSVC 的 PGO 总览页写得很清楚:
Virtual Call Speculation:"If a virtual call, or other call through a function pointer, frequently targets a certain function, a profile-guided optimization can insert a conditionally executed direct call to the frequently targeted function, and the direct call can be inlined."
翻译过来就是三步:① 如果某个虚调用/函数指针调用频繁指向同一个函数 → ② 插入一条"条件执行的直接调用" → ③ 这条直接调用还可以被内联。
"条件执行 + 可内联"这七个字就是本节的判据,而且它是可以直接在反汇编里核对的:如果编译器真的做了这件事,那么热路径上应当出现一对"比较 + 条件跳转"的守卫,且命中分支上没有任何 call。§2.3 立的两条判据正好对上这一形态。
反过来说,凡是"命中分支上仍有一条 call"的形态,都不算虚拟调用推测真正落地——哪怕它前面已经加了一串比较。这一点很重要,因为这两种形态在源码层面完全看不出区别,计时读数也可能都"变快了";只有数命中路径上的 call,才能把两者分开。下一节的两段汇编就是这两种形态的实例。
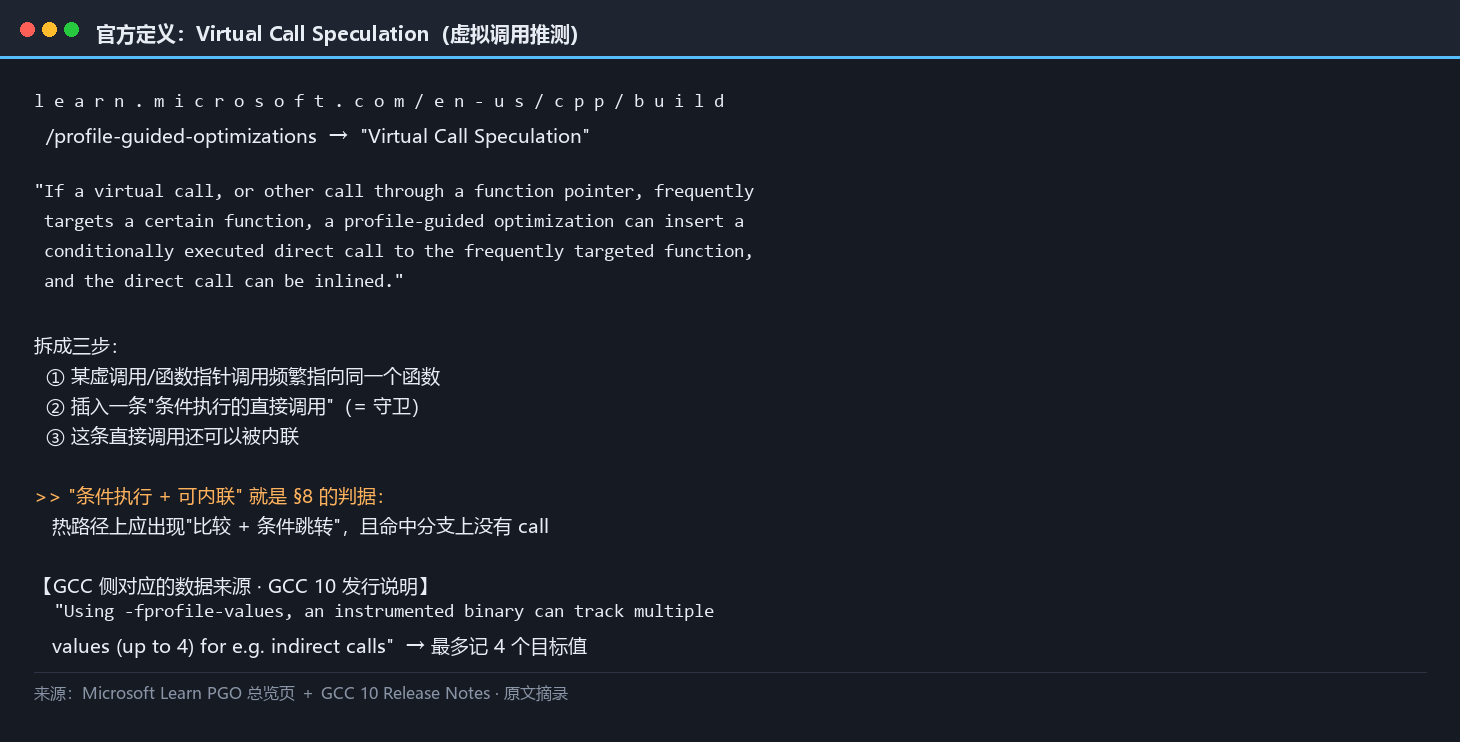
GCC 侧对应的数据来源是间接调用值剖析。GCC 10 发行说明原文:"Using -fprofile-values, an instrumented binary can track multiple values (up to 4) for e.g. indirect calls and provide more precise profile information."——最多记 4 个目标值。这句解释了 GCC 为什么能做到下面 §8.3 那个"只比一个目标"的形态。
8.2 MSVC:两段汇编的对照
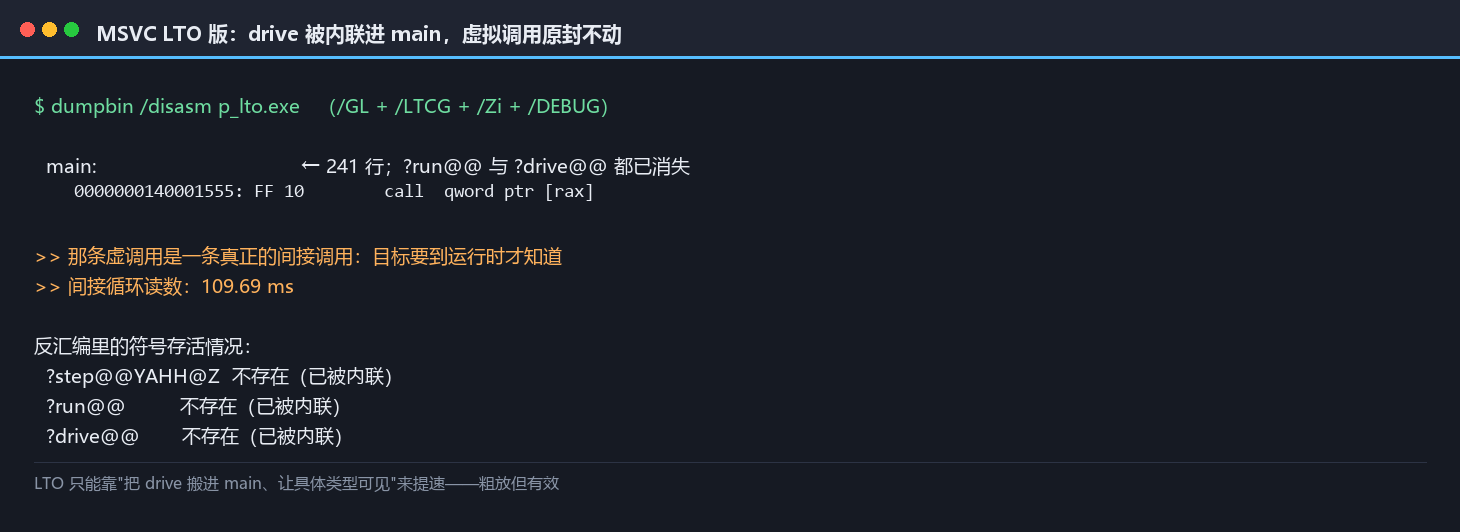
好了,LTO 版(有 /GL、无 profile):main 有 241 行,?run@@ 与 ?drive@@ 都已被内联进去(两个符号在反汇编里都不存在了)。而那个虚调用原封不动——它是一条真正的间接调用:
; MSVC /GL + /LTCG,main 里被内联进来的 drive 循环
mov  rax,qword ptr [rax]      ; 取 vptr
call qword ptr [rax]          ; ★ 间接调用:目标要到运行时才知道
于是中间接循环停在 109.69 ms。
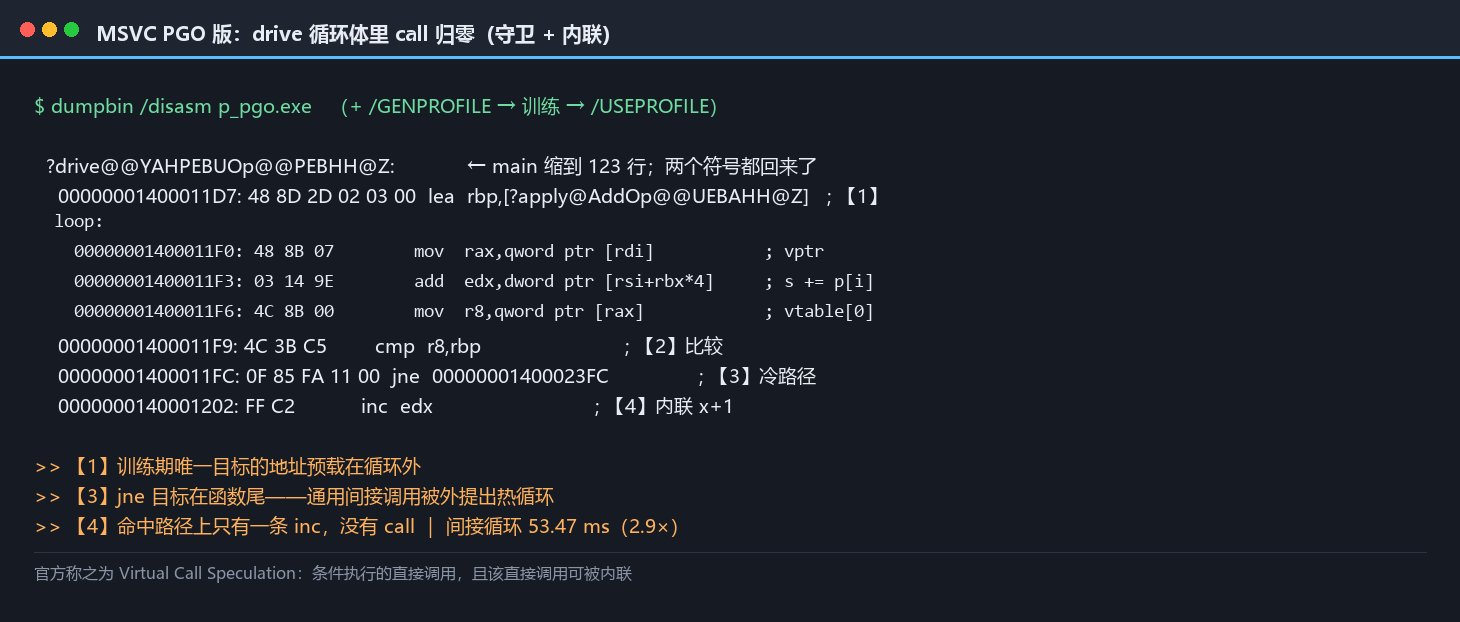
PGO 版(/GENPROFILE → 训练 → /USEPROFILE):main 缩到 123 行,?run@@ 与 ?drive@@ 重新成为独立函数。但 ?drive@@ 的循环体里,call 归零:
; MSVC LTO + PGO,?drive@@ 的循环体
lea  rbp,[?apply@AddOp@@UEBAHH@Z]     ; 【1】训练期唯一目标的地址
loop:
  mov  rax,qword ptr [rdi]            ; 取 vptr
  add  edx,dword ptr [rsi+rbx*4]      ; s += p[i]
  mov  r8,qword ptr [rax]             ; 取 vtable[0] = apply 的实际地址
  cmp  r8,rbp                         ; 【2】与训练期唯一目标比较
  jne  00000001400023FC               ; 【3】不等 → 冷路径(被外提到函数尾)
  inc  edx                            ; 【4】命中 → 直接算 AddOp::apply 的 x+1
同一处改成 53.47 ms(2.9 倍)。
逐条读:
- 【1】 编译器在循环外就把
AddOp::apply的地址装进了一个寄存器——这是"训练期唯一目标"这个信息的落点; - 【2】【3】 守卫:把 vtable 槽位与那个已知地址比较,不等就跳走。注意
jne的目标0x1400023FC远在函数尾——通用间接调用被移出了热循环,这就是"冷路径外提"; - 【4】 命中路径上只有一条
inc(x+1)。没有call——AddOp::apply被内联了。
8.3 GCC:基线本来就会去虚拟化,PGO 把命中路径的 call 也去掉
先来看看GCC 这边有一个额外发现,而且它推翻了"只有 PGO 才能去虚拟化"这个印象。
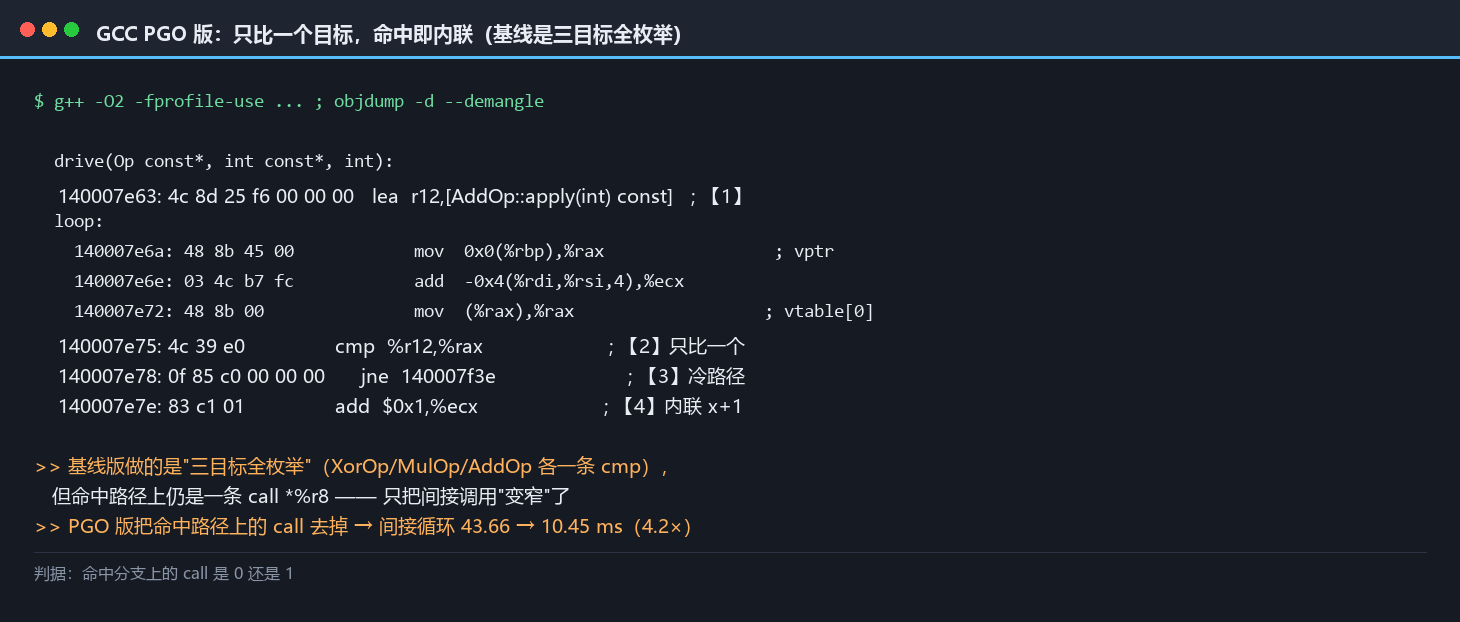
基线 -O2 版的 drive() 就已经在做推测性去虚拟化了——而且做得更"贪":它把三个已知子类的 apply 地址全部预载,循环里逐个比较:
; GCC -O2 基线,drive() 循环体
lea  -0x35(%rip),%rbp        # XorOp::apply(int) const    ┐
lea  -0x52(%rip),%r13        # MulOp::apply(int) const    ├ 【1】三个目标全枚举
lea  -0x69(%rip),%rdi        # AddOp::apply(int) const    ┘
loop:
  mov  (%rsi),%rdx           ; 取 vptr
  add  (%rbx),%eax
  mov  (%rdx),%r8            ; 取 vtable[0]
  cmp  %rbp,%r8              ; 【2】逐个比较
  je   <直接调用点>
  cmp  %r13,%r8
  je   <直接调用点>
  ...
  call *%r8                  ; 【3】命中路径上仍是一条间接 call
这一版的间接循环是 43.66 ms。
为什么基线也敢这么干:因为 Op 的子类在程序里是封闭的——c.cpp 里只有三个实现,编译器在全程序视角下知道"不可能有第四个"。这不是 profile 信息,是类型可见性信息。 所以这一层去虚拟化是 -O2 就能拿到的。
但它只做到"变窄",没做到"消掉":命中路径上【3】那条 call *%r8 还在——它只是从"随便哪个 apply"变成了"三个之一",仍然是间接调用。
PGO 版换成"只比一个目标 + 命中即内联":
; GCC -O2 + PGO,drive() 循环体
lea  r12,[AddOp::apply(int) const]   ; 【1】只预载训练期唯一目标
loop:
  mov  (%rbp),%rax           ; 取 vptr
  add  -0x4(%rdi,%rsi,4),%ecx
  mov  (%rax),%rax           ; 取 vtable[0]
  cmp  %r12,%rax             ; 【2】只比一个
  jne  140007f3e             ; 【3】不等 → 冷路径
  add  $0x1,%ecx             ; 【4】命中 → 内联 AddOp::apply 的 x+1,命中路径上再无 call
这一版落到 10.45 ms(4.2 倍)。
8.4 判据图:什么叫"变窄",什么叫"消掉"
上面两段汇编放在一起,能看出一个此前没有被点破的层次差别:GCC 的基线档与 PGO 档都做了去虚拟化,都有守卫比较,但它们的收益差了 4.2 倍。这说明"有没有去虚拟化"这个二分法太粗——真正决定性能的是命中路径上还剩什么。把这件事拆成两个层级来看,就得到了下面这张判据表。
| 形态 | 守卫 | 命中路径 | 谁是它的来源 |
|---|---|---|---|
| 无优化 | 无 | 间接 call |
— |
| 变窄(枚举已知类型) | 逐个 cmp 三个目标 |
仍是间接 call |
类型可见性(-O2 就有) |
| 消掉(单目标 + 内联) | 一个 cmp |
无 call,直接算 |
profile 数据(PGO) |
这张表就是本篇的核心结论之一:-O2 能把间接调用"变窄",只有 profile 能让它"消失"。两者的时间差距(43.66 → 10.45 ms)就摆在这里。
把这张表当成一条通用判据来用:任何时候你想确认"某条去虚拟化优化到底做没做到位",就去反汇编里找热路径,数一数命中分支上的 call 是 0 还是 1。是 0,说明目标函数已经被内联进来;是 1,说明它只是被收窄了范围、仍然要付出一次间接跳转的代价——包括分支预测那一层的代价。
8.5 两套工具链的 PGO 对照
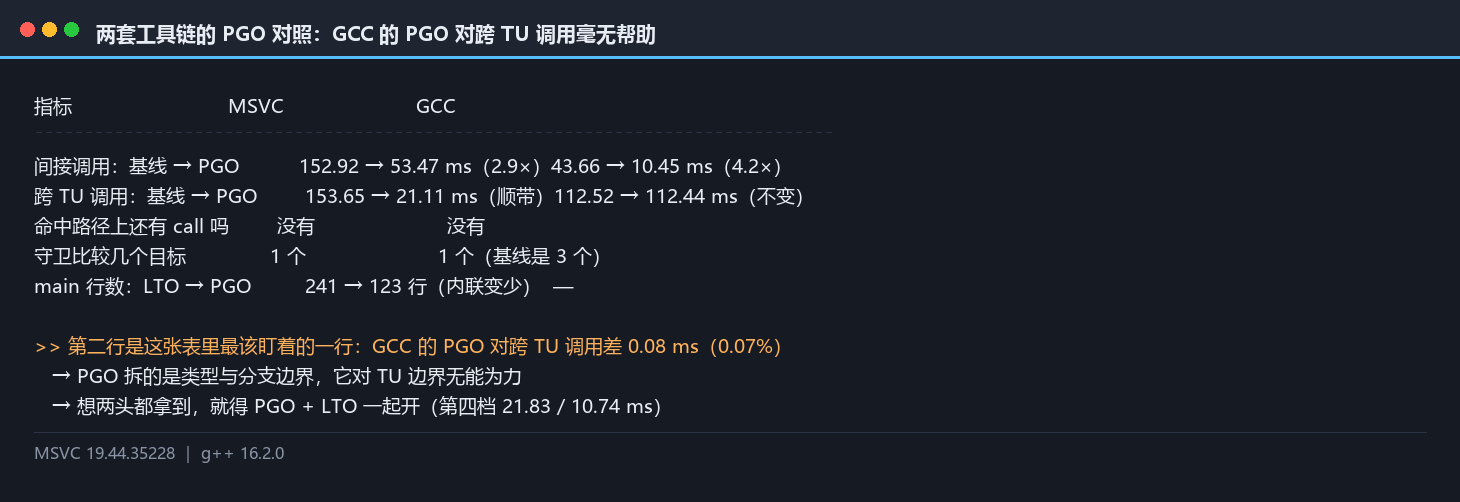
| 指标 | MSVC | GCC |
|---|---|---|
| 间接调用:基线 → PGO | 152.92 → 53.47 ms(2.9×) | 43.66 → 10.45 ms(4.2×) |
| 跨 TU 调用:基线 → PGO | 153.65 → 21.11 ms(顺带,因为 PGO 档同时开了 /GL) |
112.52 → 112.44 ms(几乎不变) |
命中路径上还有 call 吗 |
没有 | 没有 |
| 守卫比较几个目标 | 1 个 | 1 个(基线是 3 个) |
第二行是这张表里最该盯着的一行:GCC 的 PGO 对跨 TU 调用毫无帮助(差 0.08 ms,即 0.07%)。这一条把 §1.3 的论点从"讲道理"变成了实测:PGO 拆的是类型与分支边界,它对 TU 边界无能为力。 想同时拿到两边,就得 PGO + LTO 一起开(§6.1 的第四档:21.83 / 10.74 ms)。
8.6 一个反直觉:PGO 会"少内联"
再看一眼 MSVC 那组数字:main 从 241 行缩到 123 行,?run@@ 与 ?drive@@ 两个符号从"消失"变回"存在"。
开了 PGO 之后,LTO 反而没有把这两个函数内联进 main。而 PGO 版更快(间接调用 53.47 vs 109.69 ms)。
这件事初看很怪,但理由很干净:
- LTO 版为什么内联?因为没有别的办法——它只能靠"把
drive搬进main、让对象的具体类型在调用点可见"来提速。这是一条粗放但有效的路。 - PGO 版为什么可以不内联?因为它有更精准的武器:它直接把
drive内部的间接调用消掉了。这个收益比"把drive内联进main"更大,而且不必付出代码复制的代价——main因此反而更小。
结论:内联数量不是优化质量的度量。这两个构建给出了同一个提醒——看内联次数(或看 main 有多少行)来判断优化做得好不好,是会看错的。要看的是热路径上还有没有该消失的指令。
8.7 为什么"变窄"和"消掉"能差 4 倍
GCC 那两组数字(43.66 → 10.45 ms)差 4.2 倍,而两者都做了去虚拟化、都有守卫比较。差距从哪来?把两段循环体的指令数摆在一起就清楚了:
基线(变窄)循环一次迭代要做:
  取 vptr → 取槽位 → cmp(目标1)→ [不中] cmp(目标2)→ [不中] cmp(目标3)
  → call *%r8              ← 命中后是一次间接调用

PGO(消掉)循环一次迭代要做:
  取 vptr → 取槽位 → cmp(唯一目标)→ [中] add $0x1
                          ↑ 命中路径上没有 call
三个来源,按贡献排序:
- 命中路径少一条
call(最主要)。间接调用不只是几条指令的问题——它影响分支预测与返回地址栈。用守卫把它换成"比较 + 条件跳转"后,预测器面对的是一个规则到不能再规则的形状。 - 守卫从三个比较变成一个。基线要为每个已知子类各准备一条比较与跳转;PGO 只准备一条。这在每次迭代都要付的循环里,是实打实的指令数减少。
- 冷路径被外提。通用间接调用(以及为它准备的寄存器保存/恢复)被移出了热循环,只在守卫失败时才进入。
这里有一个可迁移的判据:当两种优化都能"去掉间接调用"的时候,看命中路径上还剩不剩 call——剩着,就是"变窄";不剩,才是"消掉"。这条判据不依赖任何文档,只需要一次反汇编。
8.8 小结:收益从哪来
把这一章收成一句话:
- LTO 把间接调用变窄(因为类型可见了),也把跨 TU 调用变快(因为函数体可见了);
- PGO 把间接调用消掉(因为知道谁是主目标),并把冷路径外提出热循环。
两者的收益位不同、证据形态相同(都是反汇编里少了一条 call),所以可以分别量、可以叠加——这就是 §6.1 那张四档表存在的意义。
九、PGO 的风险:过期 profile 没人告诉你
9.1 一个问题:profile 过期了,编译器知道吗
言归正传,PGO 的 profile 文件是一份和源码绑定的产物——它记的是"某个函数的某个分支被走了多少次"。一旦源码改动(哪怕只是改了热路径里一个运算符),旧 profile 描述的就不再是这份代码了。
常识会让人以为:编译器手里同时有源码和 profile,一旦对不上,它应该报错。
实测结果:两套编译器都不报。
9.2 MSVC:不但不报过期,还告诉你"100% 命中"
实验做法:/GENPROFILE 插桩 → 训练 → 修改 drive() 的热路径(把 s + p[i] 改成 s ^ p[i],热行为完全变了)→ 不重新训练,直接 /USEPROFILE 重链。
链接器的输出是:
正在生成代码
86 of 86 (100.00%) profiled functions will be compiled for speed
86 of 86 functions (100.0%) were optimized using profile data
2566369444 of 2566369444 instructions (100.0%) were optimized using profile data
已完成代码的生成
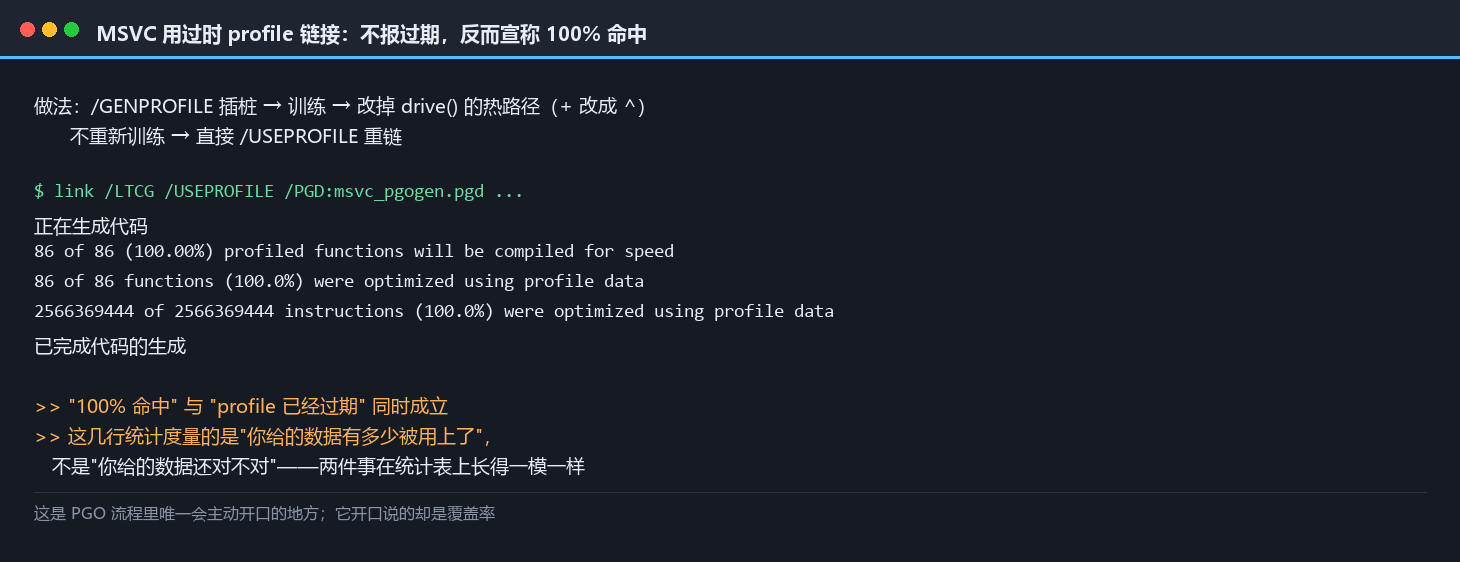
"100% 命中" 与 "profile 已经过期" 同时成立。 顺带一提,这几行统计本来就是 PGO 流程里唯一会主动开口的地方;它开口说的却是覆盖率。
这句要反复看:86 of 86 与 100.0% 度量的是"你给的数据有多少被用上了",而不是"你给的数据还对不对"。这两件事在统计表上长得一模一样。 一个团队如果只看这几行输出,会得到"PGO 工作正常、覆盖率 100%"的结论——而底层代码已经和 profile 脱节了。
9.3 GCC:没有数据时,它反而更慢
GCC 这边的问题形态不同,但同样会给你一个看起来像"PGO 生效了"的结果。
GCC 的 .gcda 缺失(§7.4 那个命名坑)时,-O2 -fprofile-use 的表现是:
rc = 0
warning: '...\m_nodata-a.gcda' profile count data file not found [-Wmissing-profile]   (4 条,每 TU 一条)

体积:239,133 B   ← 与纯 -O2 完全相同
indirect 中位:44.05 ms  →  111.53 ms   ← 慢 2.5 倍
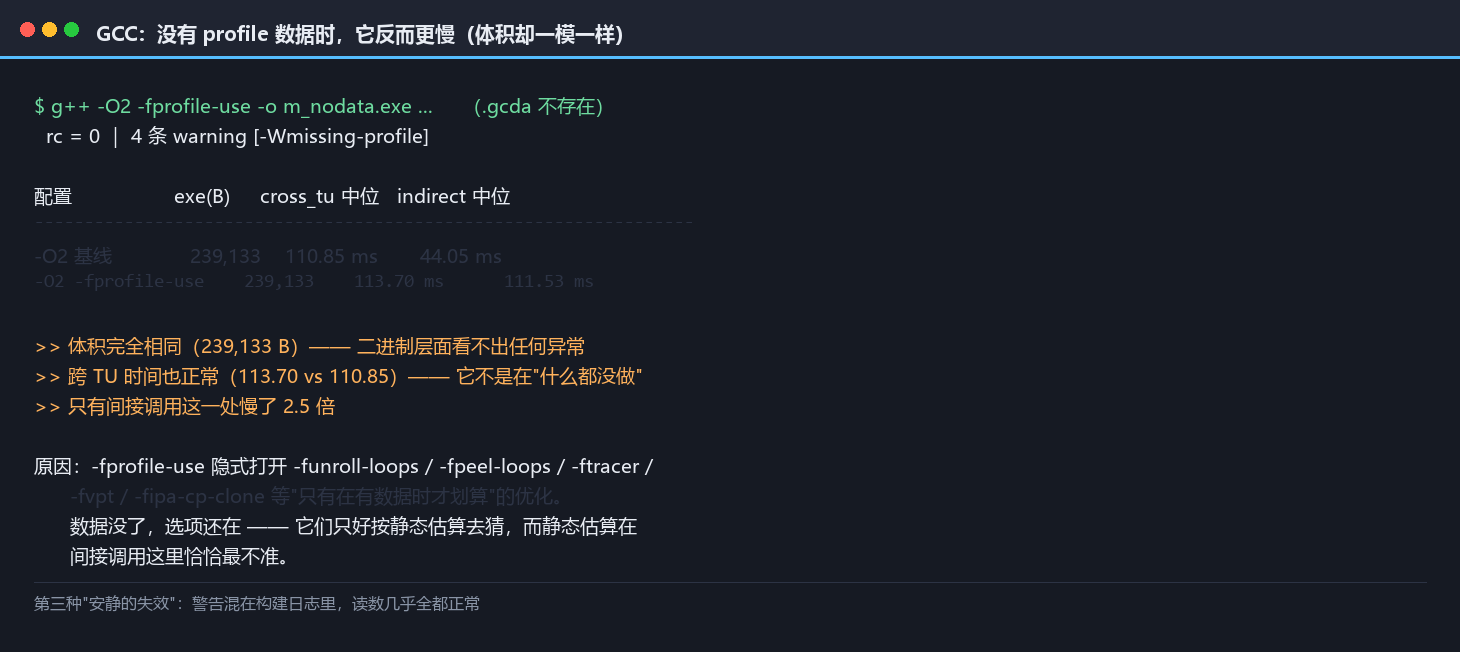
这一组数字很值得琢磨:
- 体积一模一样:说明二进制层面看不出任何异常;
- 跨 TU 时间也正常:说明它不是在"什么都没做";
- 只有间接调用这一处慢了 2.5 倍。
原因在 -fprofile-use 的语义里:GCC 手册对它的描述是"启用 profile 反馈驱动的优化,以及下列只有在有 profile 反馈时才划算的优化",后面跟着一长串——-fbranch-probabilities、-fvpt、-funroll-loops、-fpeel-loops、-ftracer、-ftree-loop-distribute-patternsGCC 优化选项手册、以及一组 -fipa-* 的过程间优化(含 -fipa-cp-clone)GCC 警告选项手册(14.x)。
关键点:这一串是被 -fprofile-use 这个选项打开的,不是被 profile 数据打开的。 数据没了,选项还在,于是那些"只有在有数据时才划算"的优化在没数据的情况下也照做——它们依据的是编译器的静态估算,而静态估算在间接调用这里恰恰最不准。
这就是第三种"安静的失效",也是最难受的一种:它慢,但慢得不明显(只有一处循环,2.5 倍);它报了警,但只是 4 条 -Wmissing-profile,混在成百上千行构建日志里;它的体积和大部分读数都完全正常,只有逐项对比读数才看得出来。
9.4 手册与实测的一处出入(如实记录)
这里必须交代一处不一致。
GCC 手册对 -Wcoverage-mismatch 的原文是:"By default, this warning is enabled and is treated as an error"——默认开启,且默认当成 error;语义是"profile 存在但与源码匹配不上"GCC 警告选项手册。按这条,§9.3 之外的"真·过期"场景应当报错。
但实测不是这样:同名 -o 重编、源码已改(改函数体、甚至改头文件加新声明),GCC 16.2 rc=0、完全静默,一条警告都没有。
可能的解释是:GCC 在发现某个函数的校验和对不上时,会静默丢弃该函数的 profile 数据(只保留能对上的部分),于是"部分过期"退化成了 §9.3 那类"部分缺失",而不是"整体不匹配"。但这个解释本篇没有验证到源码级,所以只能作为推测记录在此。
本篇的处理原则:正文与结论一律按实测写,并显式标注"与手册描述存在出入"。不去替编译器圆场,也不把手册当实测的替代品——一个"默认 error"的开关在实测里静默通过,这件事本身比它报不报错更重要,因为它正是构建流水线敢把 PGO 交给自动化去跑的心理依据。
9.5 风险链与三条对策
好了,把它连成一条链:
源码改动(哪怕只有一个运算符)
  → profile 描述的热路径不再存在
  → 编译器不报警,统计仍显示 100% 命中
  → 守卫快路径每次落空、冷路径被反复走
  → 性能反向(比不做 PGO 更差)
三条对策,按可操作性排序:
- profile 与源码同版本:把"训练"纳入 CI,每次源码变更后重跑训练,而不是把一份
.pgd/.gcda当长期资产提交进仓库缓存。profile 是有保鲜期的构建中间物,不是配置。 - 构建脚本单一变量:训练产物名与使用阶段名由同一个变量生成(§7.4 的坑三)。这一条是"防止静默失效"里性价比最高的一条,成本几乎为零。
- 监控"被优化函数比例":这是微软采样 PGO 文档给的指标——低于 90% 就重采MSVC 采样 PGO 文档。要提醒的是,它拦截的是"数据用不上",拦不住"数据用错了"。所以它只能当兜底告警,不能当保鲜机制。
9.6 官方口径备查
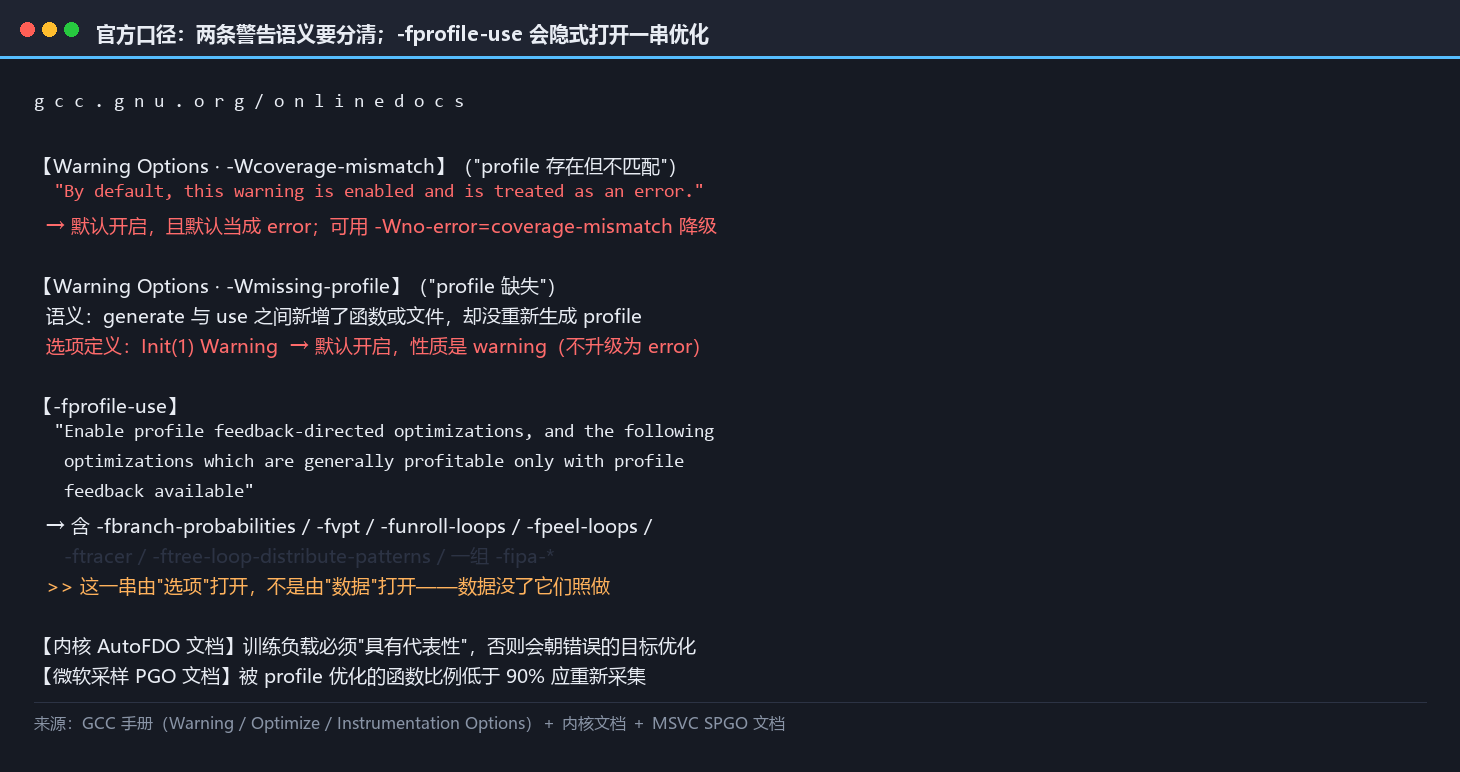
- MSVC 采样 PGO 文档:监控 LINK 的 profile 完整度统计,被 profile 优化的函数比例显著下降(低于 90%)时应重新采集,因为代码累积改动会使 profile 变陈旧MSVC 采样 PGO 文档。
- GCC 手册:
-Wcoverage-mismatch默认开启且默认 treated as an error("profile 存在但不匹配")GCC 警告选项手册;-Wmissing-profile默认开启,性质是 warning("profile 缺失",语义正是"generate 与 use 之间新增了函数或文件却没重新生成 profile")GCC 警告选项手册(14.x)。两者的语义要分清——本篇实测到的都是后者。 - Linux 内核 AutoFDO 文档:训练负载必须"具有代表性",否则会朝错误的目标优化;文档同时指出采样型 PGO 需要
perf的硬件支持(x86 LBR、arm64 SPE/ETM)内核 AutoFDO 文档。
十、收束与下一篇钩子
10.1 全篇读数汇总
把全篇实测读数收在一张表里,方便对照与复核。每一行的原始输出都随篇留档(见 §10.3 的目录说明),所以这张表里的任何一行都可以逐字核对——本篇不给"约"、"大约"这样的措辞,所有数字都是某一份日志里的原文。
表里有两行值得最后再看一遍:GCC 那一栏"PGO 对跨 TU 调用"只差 0.08 ms(说明两种手段互不替代),以及 MSVC 那一行"main 行数 241 → 123"(说明内联变少了、程序反而更快了)。这两行是全篇两个反直觉发现的落点。
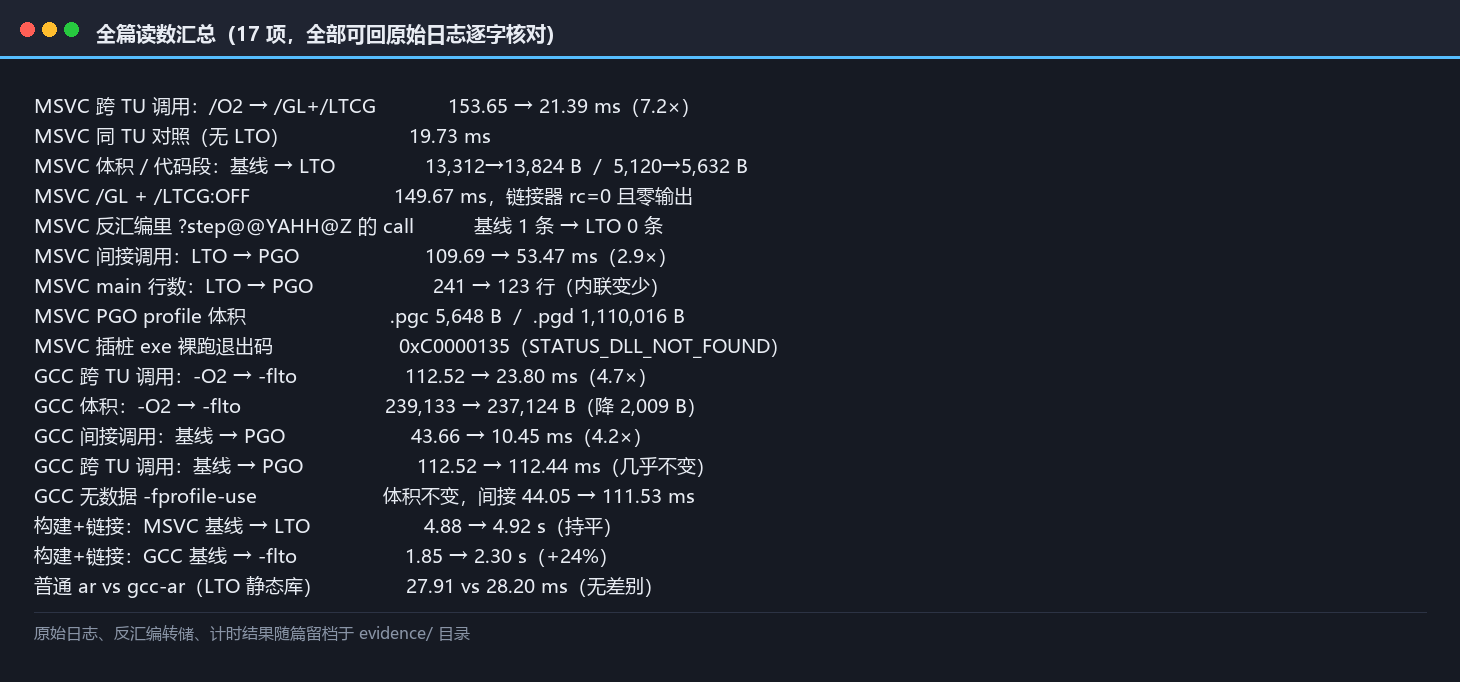
| 读数 | 值 |
|---|---|
MSVC 跨 TU 调用:/O2 → /GL+/LTCG |
153.65 → 21.39 ms(7.2×) |
| MSVC 同 TU 对照(无 LTO) | 19.73 ms(与 LTO 档同量级) |
| MSVC 体积 / 代码段:基线 → LTO | 13,312→13,824 B / 5,120→5,632 B(涨) |
MSVC /GL + /LTCG:OFF |
149.67 ms,链接器 rc=0 且零输出 |
MSVC 反汇编里 ?step@@YAHH@Z 的 call |
基线 1 条 → LTO 0 条 |
| MSVC 间接调用:LTO → PGO | 109.69 → 53.47 ms(2.9×) |
MSVC main 行数:LTO → PGO |
241 → 123 行(**内联变少) |
| MSVC PGO profile 体积 | .pgc 5,648 B / .pgd 1,110,016 B |
| MSVC 插桩 exe 裸跑退出码 | 0xC0000135(STATUS_DLL_NOT_FOUND) |
GCC 跨 TU 调用:-O2 → -flto |
112.52 → 23.80 ms(4.7×) |
GCC 体积:-O2 → -flto |
239,133 → 237,124 B(降 2,009 B) |
| GCC 间接调用:基线 → PGO | 43.66 → 10.45 ms(4.2×) |
| GCC 跨 TU 调用:基线 → PGO | 112.52 → 112.44 ms(几乎不变) |
GCC 无数据 -fprofile-use |
体积不变,间接 44.05 → 111.53 ms |
| 构建+链接:MSVC 基线 → LTO | 4.88 → 4.92 s(持平) |
构建+链接:GCC 基线 → -flto |
1.85 → 2.30 s(+24%) |
普通 ar vs gcc-ar(LTO 静态库) |
27.91 vs 28.20 ms(无差别) |
10.2 LTO / PGO 选型判据
| 维度 | LTO | PGO |
|---|---|---|
| 收益位 | 函数调用(跨 TU 内联) | 间接调用、分支、代码布局 |
| 依赖运行场景 | 不依赖 | 强依赖(训练必须代表真实负载) |
| 主要代价 | 构建时间(大项目才显著)、体积可能变大 | 训练流程、profile 保鲜期 |
| 失效方式 | 选项写错时静默(/LTCG:OFF) |
数据缺失/过期时静默(两种编译器都不报过期) |
| 取证手段 | 反汇编里目标函数的 call 归零 |
反汇编里热路径出现 cmp+jne 守卫且命中路径无 call |
| 合起来用 | colspan:两者收益位不同,可以叠加(GCC 第四档 21.83 / 10.74 ms) |
好了,三条可以直接用的判据:
- 先问"热在哪里":热在小函数调用 → LTO;热在虚调用/函数指针 → PGO。开错开关的收益是 0(§8.5 第二行:PGO 对跨 TU 调用差 0.07%)。
- 再问"能不能跑真实负载":跑不了(比如部署在客户现场、或训练成本高到无法进 CI),PGO 就不要上——一份过期的 profile 比没有 profile 更危险(§9.3 实测慢 2.5 倍)。
- 到最后才轮到"能不能接受构建变慢":这一条在大项目上才成为约束(单块 LTO 链接时间可 +2 小时)。小项目上它根本不是问题(本篇 4 文件:MSVC 持平、GCC +0.45 秒)。
10.3 复现流程
说白了,复现只需要三样东西:五个源文件(iface.h / a.cpp / b.cpp / c.cpp / main.cpp)、两套工具链(MSVC 19.44 与 g++ 16.2)、一组开关组合。全部原始日志、反汇编转储、计时结果随篇留档在本篇 evidence/ 目录下(logs_msvc/、logs_gcc/、bins_*/、*.json),可以直接逐行核对本文表格里的每一个数字。
10.4 自检清单
- [ ] 训练产物名与使用阶段名由同一个变量生成
- [ ] profile 与源码同版本,且训练已纳入 CI
- [ ] 构建脚本里没有遗留
/LTCG:OFF(它会静默把 LTO 关掉) - [ ] 链接/编译日志里核对实际文件名(
.gcda/.pgd),不是核对"命令看起来对" - [ ] 反汇编核对:目标函数的
call是否真的归零 - [ ] 体积与构建时间都记了基线(不记基线就没法发现"反向优化")
- [ ] 训练负载代表真实负载(至少覆盖主路径)
- [ ] 监控"被优化函数比例"(低于 90% 重采)
- [ ] 有条件时双工具链交叉验证(本篇就出现了体积方向相反的结果)
- [ ] 全部原始输出留档(否则上面九条都只是"相信")
10.5 资源清单
- MSVC 官方:PGO 总览与 virtual call speculationMSVC PGO 总览|
/GLMSVC /GL 文档|/LTCGMSVC /LTCG 文档|/GENPROFILE//FASTGENPROFILEMSVC /GENPROFILE 文档|/USEPROFILE(含AGGRESSIVE)MSVC /USEPROFILE 文档|/OPT:REF//OPT:ICFMSVC /OPT 文档|/PGD(已废弃)MSVC /PGD 文档|pgosweepMSVC pgosweep|多 profile 加权合并pgomgrMSVC profile 合并指南|采样 PGO(SPGO)MSVC 采样 PGO 文档|桌面应用的 PGO 实践(pgort140.dll的交付方式)MSVC 桌面 PGO 实践 - GCC 官方:Optimize Options(
-flto/-fprofile-use/-fprofile-values)GCC 优化选项手册|Instrumentation Options(-fprofile-generate,含它隐式打开的四个选项)GCC 插桩选项手册|GCC Internals 的 LTO Overview(WHOPR 三阶段)GCC Internals · LTO Overview|Warning Options(-Wcoverage-mismatch)GCC 警告选项手册|gcc-ar的--plugin包装语义gcc-ranlib man 页 - LLVM/Clang 官方:ThinLTO 文档Clang ThinLTO 文档|LLVM 项目博客的 ThinLTO 设计说明(含 full LTO 的串行瓶颈与构建时间对比)LLVM 项目博客(ThinLTO)|Clang 用户手册的 PGO 章节(instr 与 sampling 两类、
-fcs-profile-generate)Clang 用户手册 · PGO|多阶段 PGO 与llvm-profdata merge流程LLVM 构建文档(多阶段 PGO)、LLVM PGO 构建指南|BOLT 的定位与落地数据BOLT 实践(LLVM 讲师材料) - 业界收益刻度:Chrome on Windows 的 PGO 实测(启动 16.8%、新标签页 14.8%、首次绘制 5.9%)Chrome on Windows PGO 实测|Chrome 官方博客(启动最高 25%、页面加载最高 7%)Chrome 官方博客|Chrome Android 的构建优化贡献了 Speedometer 提升的一半以上Chrome Android 构建优化|Firefox 官方文档(PGO 最高约 20% 但构建耗时很长)Firefox 官方文档(PGO)|微软采样 PGO(典型 5–15%)MSVC 采样 PGO 文档|CSSPGO 在 AutoFDO 之上再 1–5%CSSPGO 提案(llvm-dev)
- 本篇证据:用例五源文件 + 两套工具链全部原始日志与反汇编转储,见本篇目录
evidence/
10.6 一条可以搬走的通用方法
把本篇的做法抽象出来,是三步,它可以搬到任何"某个开关到底有没有起作用"的问题上:
- 立判据:先说清"起作用的话,机器输出里应该少掉/多出什么"。本篇的两条判据是"目标函数的
call归零"与"热路径出现守卫且命中无call"。判据必须是机械可数的,不能是"感觉快多了"。 - 做对照:至少两组,只差一个变量。本篇的关键对照组是"同 TU 无 LTO"——它把"边界是否消失"这一个变量单独拿了出来(§4.2)。
- 交叉验证:用不同性质的证据互相印证——计时(易抖动)、汇编(确定)、符号存活(确定)、体积(确定)。当计时读数出现互相矛盾的差异时,以确定性的那几种为准(§3.6、§6.4 的 1% 差异就是这样处理的)。
这套方法的价值在于它不依赖对编译器的信任。本篇全部结论都建立在"机器实际产出了什么"上——不是"编译器应该会内联",而是"那条 call 没了"。
10.7 本篇与系列其他篇目的关系
三个交叉点,方便按需跳读:
- 与 ep04《编译期账本》:ep04 算的是"编译时间花在哪",本篇算的是"链接期还能再赚回多少"。两者合起来才是完整的"编译期—链接期"账本。若你的项目因为编译太慢而犹豫要不要开 LTO,ep04 的读数方法(模板实例化计数、Unity Build、PCH)可以先试,它们不改运行期行为、不引入 profile 保鲜问题。
- 与 ep05《优化器的边界》:ep05 立的是"优化器在单 TU 内的自由度边界"(UB、严格别名、
__restrict、向量化报告)。本篇是它的续集——单 TU 内能做的都做完了,剩下的收益只能靠拆边界(LTO)或靠运行时事实(PGO)去拿。 - 与 ep06《名字与符号》:ep06 讲的是"链接器只认符号名"。LTO 会把一批符号消掉或降为局部(§2.5),这正是 ep06 那套符号表知识的一个直接后果——两篇连着看,能把"符号表里少了几行"这件事解释到底。
10.8 下一篇:分发的代价
这一篇算的是"构建期"这笔账。下一篇要算的是运行期的那一笔:
ep08《分发的代价:虚函数、模板、variant 与类型擦除》 本篇已经证明"类型可见性"能换来性能(§8.3 那个三目标枚举)。下一篇反过来问:把类型藏起来——虚函数表、模板实例、
std::variant、类型擦除(std::function、any)——各自要付多少运行时代价?哪些可以白拿,哪些必须付现金? 下一篇会继续用反汇编作判据,把"多一次间接跳转"和"多一次堆分配"两种代价分开量。
本篇实测环境:MSVC 19.44.35228(VS 2022 Community,工具集 14.44.35207)|MSYS2 ucrt64 g++ 16.2.0(Rev3)|Windows x64 / PE-COFF。本机无 Clang、无 WSL,故 LLVM 侧(ThinLTO / BOLT / AutoFDO / CSIR)与 ELF 侧(链接器插件、PLT/GOT)只引官方原文,不做本机实测;计时为进程内
steady_clock中位数,非跨机器可比。本文由@溯光 出品 | 站点:https://yyy3d.online/blog/ | 本系列共 12 篇,本篇为第 7 篇
这一篇把「两种开关各自动了哪条边界」从头量到了汇编一级。如果它能帮你少一次「开了优化却没变快」的困惑,希望能对大家有所帮助。