本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
前六篇都在做同一件事:读源码。第二篇拆了 SkCanvas 的分层,第三篇走完 CPU 光栅那条动线,第四篇换了输入去讲字形,第五篇读 Ganesh 的实例化细分,第六篇读 Graphite 的录制模型。六篇下来,我们手里攒了一堆机制结论,也坦白过好几次同一件事——这些数字是读出来的,不是跑出来的。
这一篇换个做法:把工具搬出来。
同一段场景代码,交给 Skia 的两条路各跑一遍——一条在 CPU 上跑(光栅),一条在 GPU 上跑。然后把三件事量出来:两条路的输出差在哪些像素、耗时的量级差多少、以及同一条绘制命令到底碰了多少像素(overdraw)。最后再把本机测不了的东西逐条交出去。
这是「自跑」系列的第一篇。它会比前六篇更依赖本机的环境,所以开篇就要把边界划清(见 0.4)——哪些量是真跑出来的,哪些量本机根本拿不到,这一篇里我会写得比前六篇都死。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更快/更差」的说法,绑定本机读数并写明口径与条件;
- 凡引必注:官方定义给链接,本机读数给环境、命令与脚本口径;
- 本篇不涉及(边界见 0.3):Graphite 的运行(本机跑不了,见第六篇)、Vello 与 sparse strips(ep09/ep10)、 字体渲染差异与 SKP 回放(ep08)、GPU 抓帧与片元计数(本机无工具)、跨机型性能结论;
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑/真算的读数图由本篇的测量脚本产出(图注写明口径);
自绘图为本系列绘制,走 styles/qianmo/palette.json 色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(Graphite 的机制):【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 本篇本机跑用的绑定:skia-python 发行页 | 官方教程「Canvas Creation」
- 建 GL 上下文用的库:GLFW 官网
- overdraw 的两份官方口径:Chromium GPU Overdraw Debugging Tool | Android: Reduce overdraw
本篇只回答三件事
先来看看这一篇要回答的三个问题。它们不是并列的知识点,而是一条从「同一段代码」到「两组读数」的动线:先让两条后端都跑起来,才谈得上比较输出;先看清 overdraw 的官方口径是什么,才谈得上自己实现一套等价的计数。
0.1 全篇知识地图:三个问题,一条动线
第一件:本机能不能把 GPU 后端跑起来? 这是本篇的前提,也是最容易被跳过的一步。Skia 官方教程里有一句话把责任划得很清楚——Skia 不替你建 GL 上下文。所以我们要先自己建一个,再向 Skia 要一个 GPU 上下文;建之前,MakeGL() 给出的答案是「空」。这一章要看清的就是这两次调用之间的差别,以及 Python 绑定里缺了哪几样东西。
第二件:同一个场景,两条路的输出差在哪? 我们把同一段绘制代码分别喂给 CPU 光栅表面与 GPU 渲染目标,然后逐像素比对。读者应该记住的不是「差多少」,而是差在哪儿、为什么差:差异几乎全落在边缘,因为两条路算灰度的依据本来就不是同一个量。
第三件:overdraw 到底是什么、本机怎么量? 这是篇幅最重的一段。官方的 overdraw 画布在 Python 绑定里不存在,所以我们要按它的语义自己实现一套:把每条绘制命令单独画一遍、取出它触达的像素、逐像素累加。然后拿三个场景去量:半透明叠层、裁剪、画家顺序。最后把算出来的读数与官方口径对齐。
这三个问题说完了。
OK,把这套做法先定义清楚,再压成一句话。
0.2 一句话说清这篇换了什么做法
前六篇问「引擎是怎么设计的」,这一篇问「设计在真机上长什么样」。
这句话不是修辞。读源码能回答「实例基座是四个控制点」「记录器默认预算 256 MB」这类问题,但回答不了「两笔画在同一像素上会怎样」「一次提交到底花多久」。后一类问题只有跑起来才有答案——而跑起来的第一件事,往往是发现自己的环境不够。
所以这一篇的诚实标准跟前六篇不一样:前六篇的诚实是「这条常量出自哪个文件的哪一行」,这一篇的诚实是「这个数字是在什么环境、什么口径下测出来的,换一个环境还算不算数」。
还有一件事得提前说清:自跑篇最容易出的错,不是数算错了,而是把口径丢了。同一个「耗时」,在 CPU 侧是完成时间、在 GPU 侧默认是提交时间;同一个「overdraw」,在官方口径里是片元着色调用数、在本机可测口径里是绘制触达次数。数字一旦离开口径,就只剩「好不好看」这一个属性了——本篇会反复回到这句话。
先把不做的那部分定义清楚,直接让出去。
0.3 边界:本篇不涉及什么
把话说在前面,避免把精力花在别处:
- Graphite 的运行:本机绑定里没有
MakeDawn,所以第六篇讲的那套结构在本篇跑不起来——本篇只用它做一次对照(见 §2.2); - GPU 抓帧与片元计数:本机没有 RenderDoc、AGI 这类工具,Chromium 的 overdraw 计数器也需要
ARB_occlusion_query。每像素的片元着色调用数,本篇测不了,只在本节与第十章交代; - Vello / sparse strips / prefix-scan:属 ep09/ep10;
- SKP 回放与字体渲染差异:属 ep08;
- 跨机型、跨驱动的性能结论:本篇只报本机读数,不外推。
关键参数的取值范围(本篇反复用到的几个数,先立在这里):场景画布 512×512 与 1024×1024; 两条后端的绘制命令都是 6 条(底色 + 3 张半透明圆角矩形 + 1 条贝塞尔填充 + 1 条描边); overdraw 的触达计数档位沿用官方 六档配色。
0.4 证据口径与能力边界
这一节要放在最前面,因为它决定了大家怎么读后面的每一个数字。
第一类:本机真跑。 两条后端都在本机跑起来,读数取自同一份测量脚本,环境是:Windows 10.0.26200 | Python 3.10.11 |
skia-python 144.0.post2 | GLFW 3.4.0(Win32 WGL)| NVIDIA 驱动 560.70 | GeForce RTX 3060 Laptop GPU。这是一台机器的读数。
第二类:本机真算。 overdraw 的触达计数是自己实现的,不是官方工具——因为绑定里没有官方工具(§6.1)。
它的语义按 SkOverdrawCanvas.h 的头注释对齐,但它是「绘制触达计数」,不是 GPU 的片元着色调用数。这两件事相关,但不等同。
本机明确拿不到的三样东西(逐条给原因):
- GPU 片元着色调用数:需要抓帧工具或 GPU 计数器,本机都没有;
- draw call 数与提交次数:需要抓帧;本机能数的只有「自己发了多少条绘制命令」;
- Graphite 的任何运行读数:绑定里没有
MakeDawn,跑不起来。
一条额外的自我约束:本篇的耗时读数不做「谁快多少倍」的推广。原因写在 §4.3——GPU 那一侧的耗时要等真正的执行完成才有意义, 而「提交」与「执行完」不是一回事。
0.5 本章收在哪里
下面我们进入第一阶段。 本篇的线索是「同一段代码、两条路」:先把分叉点找到,再让两条路都跑起来。
官方依据:Skia 的 Raster 与 GPU 两条后端见 SkCanvas Creation; Python 绑定的官方教程与「Skia 不替你建上下文」的原话见 skia-python Tutorial: Canvas Creation; 本篇的环境与版本见参考资料第 25–27 条。
一、两条路在同一次调用里的分叉点
下面我们进入第一阶段:先看清两条路在哪儿分开。这一章不写测量,只做一件准备工作——把「CPU 光栅」与「GPU 后端」这两句话,落到两个具体的对象上。
1.1 CPU 侧:扫描转换在做什么
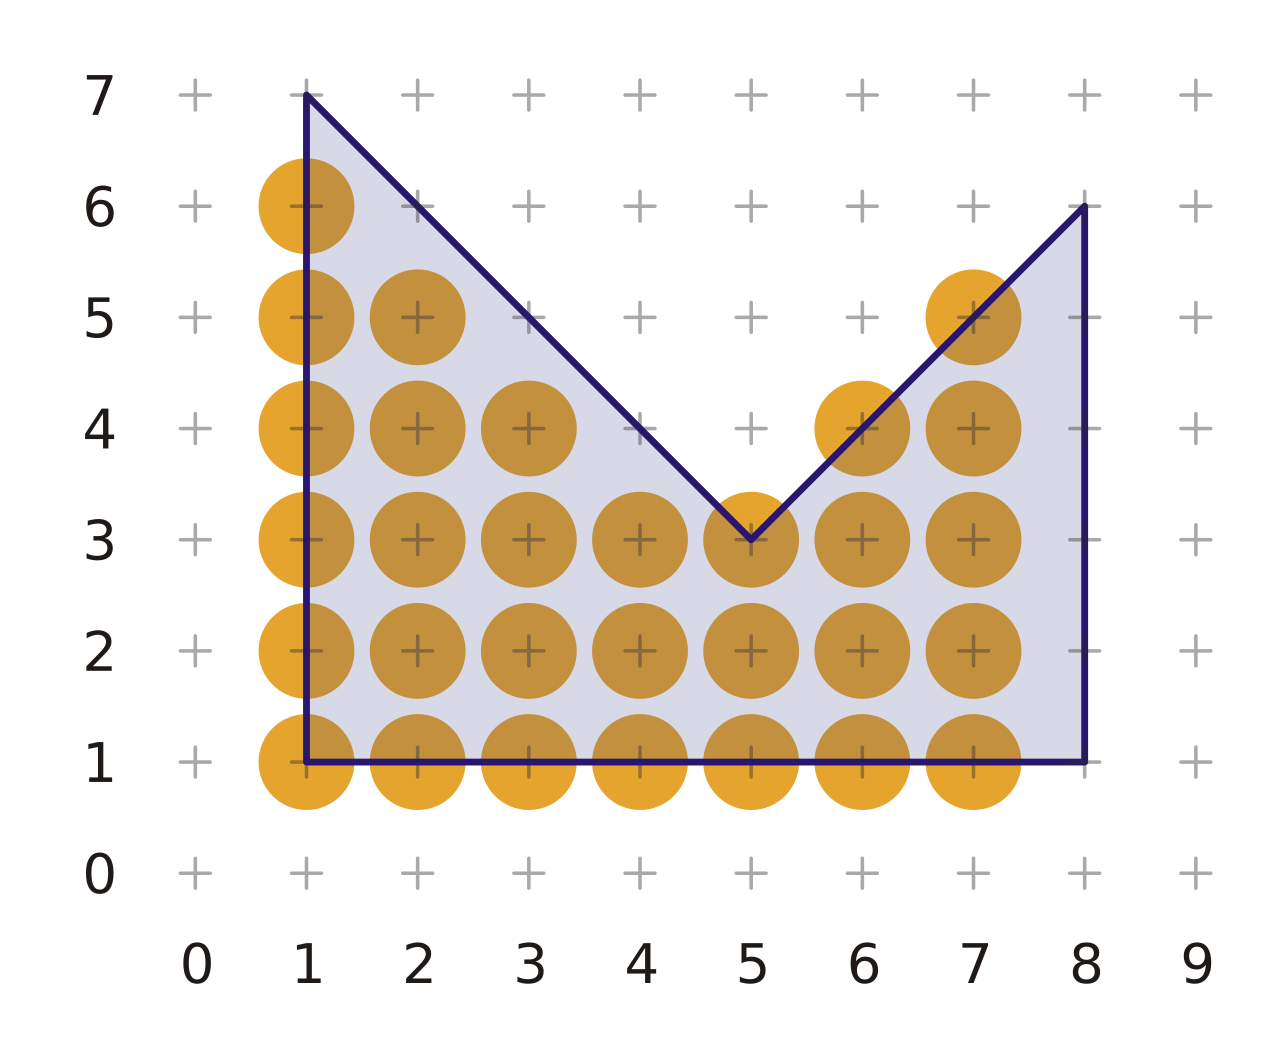
上面这张图是 CPU 光栅的核心动作:一条边穿过像素网格,哪些像素算「被覆盖」由规则定死。Skia 的 CPU 侧做的就是这件事——把路径的曲线先展成线段,再用扫描转换器一行一行地判定像素归属,最后给边缘像素算一个覆盖率(第三篇把这条动线走过一遍)。
这里要单独拎出一个词:「被触达」(touched)。它在 CPU 侧就是一个可以直接读出来的事实——这条绘制命令改动了哪些像素。后面 §6 的自建计数,数的正是它。
CPU 侧的另一个特点是它是同步的。一次 drawPath 返回的时候,像素已经写好了,没有「稍后由另一个设备完成」这一层。
这里还有一个容易被忽略的细节:「被覆盖」的判定本身就带规则。一个像素算不算被图元盖住,取决于规则是看像素中心、还是看覆盖面积;相邻两个图元共享一条边时,还要靠一条「左上规则」保证这条边只归属于其中一方。这些规则的存在意味着一件事——「哪些像素被触达」不是几何上的唯一答案,而是引擎与规范约定出来的答案。这也是为什么本篇的自建计数不去自己实现规则,而是让 Skia 画一遍再读结果(§6.2)。
1.2 GPU 侧:这条 GL 管线的位置
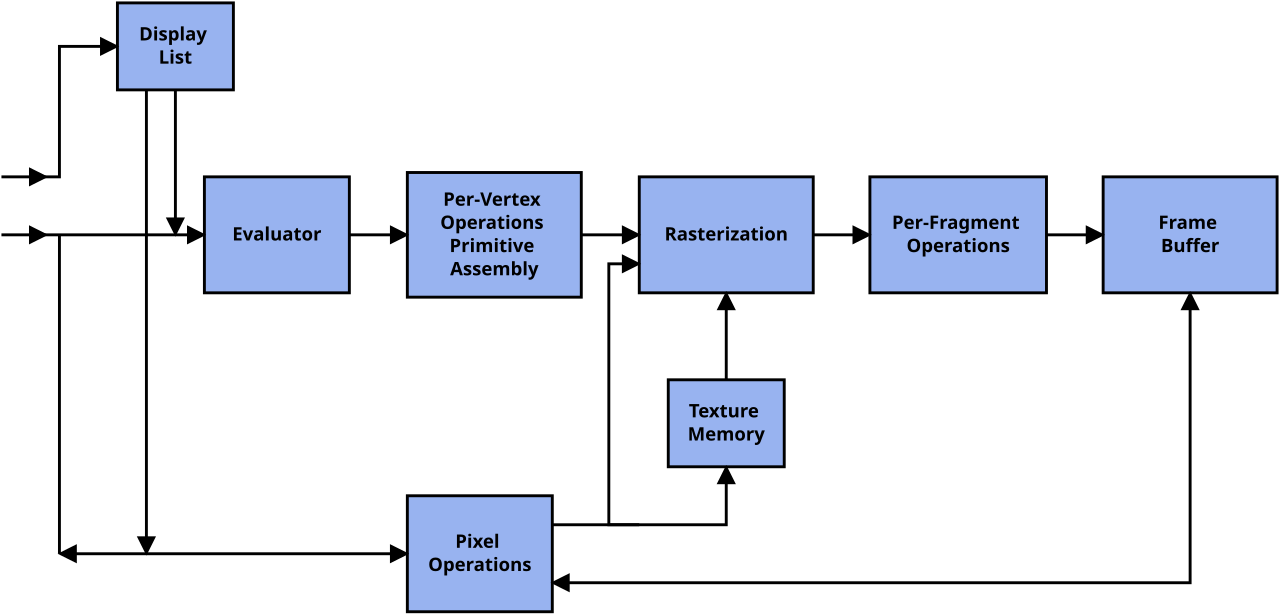
本篇的 GPU 侧走的是 GL(OpenGL)这条管线,也就是 Skia 里的 Ganesh 后端——不是第六篇讲的 Graphite,原因在 §2.2。
两条路的分工可以在这一层说清:CPU 侧把几何变成像素,用的是扫描转换器;GPU 侧把几何变成图元,交给硬件光栅器。同样是「算灰度」,CPU 侧的依据是一条边到像素中心的距离(解析式覆盖),GPU 侧的依据是采样点落没落在图元里(多重采样)。依据不同,答案就必然不完全一样——这就是第三章那个 68.42% 的由来。
再说细一层:GPU 侧的采样点是按一个固定档位铺在像素里的,比如 4 倍采样就是每像素四个位置。四个采样点能组合出的覆盖率档位只有 5 档(0/4 到 4/4),而 CPU 侧的解析式覆盖能给出连续的值。档位少不等于不准——它只是「把连续量做成了离散量」,代价是边缘过渡会更「台阶化」,好处是判定可以完全并行、不需要知道邻居像素的状态。这个取舍是两条路分歧的根。
先看看这两条路各自落到什么地方——这是本篇的第一个定义问题。
1.3 同一次调用的两个落点
把两条路并到一次调用上看:我们写下的仍然是同一句 canvas.drawPath(path, paint)。
在 CPU 侧,它落到一块内存里的像素缓冲上;在 GPU 侧,它落到一块由 GL 管理的渲染目标上。
两者在 API 层的差别只有一处:创建 Surface 的方式不同。CPU 侧用 MakeRaster(不需要任何外部上下文),GPU 侧用 MakeRenderTarget(必须先有一个 GrDirectContext)。这一处差别,就是下一章的内容。
1.4 本章收在哪里
这一章我们把两条路落到了两个对象上,并说清了它们算灰度的依据不同。下一章我们动手把 GPU 那条路跑起来——按官方教程的路径走一遍,把每一步的返回值都记下来。
官方依据:Raster 后端与 GPU 后端的创建方式见 SkCanvas Creation; 解析式覆盖与像素选择见本系列第三篇;GL 管线的阶段图出处见参考资料第 40 条。
二、本机能把 GPU 后端跑起来吗
下面我们进入第二阶段,也是本篇的前提。这一章不绕弯子:先给结论(跑通了),再把每一步的返回值摆出来,最后说清绑定里缺的那几样。
2.1 两段式:同一句 MakeGL,两个结果
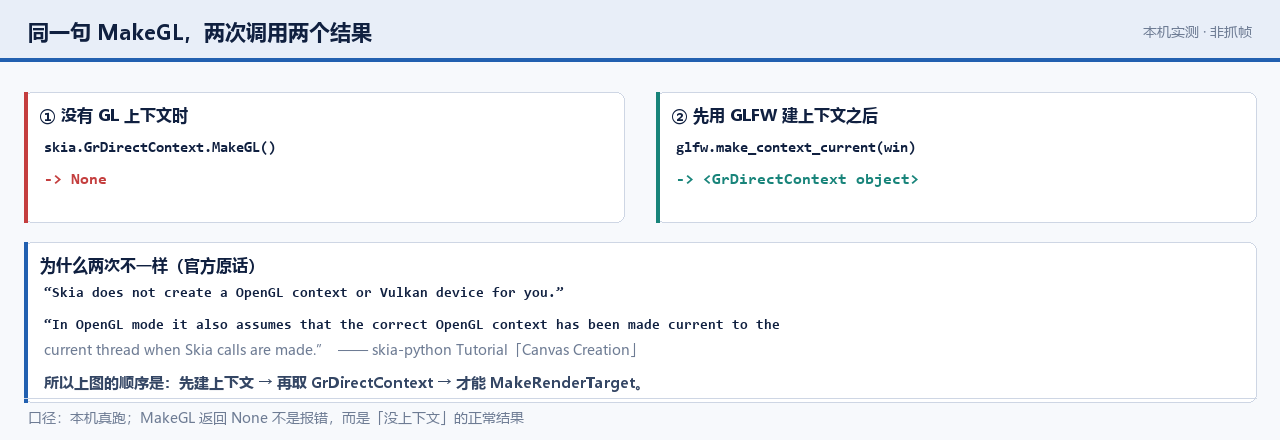
官方教程里有一句话,把责任划得很清楚:
"GPU Surfaces must have a
GrDirectContextobject which manages the GPU context, and related caches for textures and fonts. ... Skia does not create a OpenGL context or Vulkan device for you. In OpenGL mode it also assumes that the correct OpenGL context has been made current to the current thread when Skia calls are made." —— [26]
把这句话落到代码上,就是两次调用:
# 【第一段】还没建 GL 上下文
ctx = skia.GrDirectContext.MakeGL()      # -> None

# 【第二段】先用 GLFW 建一个隐藏窗口的 GL 上下文
glfw.init()
glfw.window_hint(glfw.VISIBLE, glfw.FALSE)
glfw.window_hint(glfw.CONTEXT_VERSION_MAJOR, 3)
glfw.window_hint(glfw.CONTEXT_VERSION_MINOR, 2)
glfw.window_hint(glfw.OPENGL_PROFILE, glfw.OPENGL_CORE_PROFILE)
win = glfw.create_window(64, 64, "ep07", None, None)
glfw.make_context_current(win)
ctx = skia.GrDirectContext.MakeGL()      # -> <GrDirectContext>
下面对这两段特别说明:第一次返回 None 不是报错,而是「当前线程上没有可用的 GL 上下文」这个事实的正常表达。
第二次拿到真对象之后,Surface.MakeRenderTarget(ctx, skia.Budgeted.kNo, info) 才能建出离屏的 GPU 表面。
顺序不能换——这就是「Skia 不替你建上下文」的实操含义。
顺带说明:这套失败在别的环境里很常见。绑定的 Issue #345 记录过 Linux headless EGL/GLES 下 MakeGL() 恒返回 None——
同一句调用,环境不同,结果就不同。
先看看绑定里到底缺了什么。
2.2 绑定里缺的四项
本机把 dir() 与 hasattr 过了一遍,四项能力是缺的:
| 缺什么 | 后果 | 本机的替代 |
|---|---|---|
SkOverdrawCanvas |
官方那套 overdraw 画布用不了 | 自建等价计数(§6) |
SkOverdrawColorFilter |
官方的六档配色滤镜用不了 | 自建调色板(语义对齐) |
SkNWayCanvas |
官方 Fiddle 那个「双路分流」示例的做法用不了 | 逐条命令单独取掩码 |
MakeMetal / MakeDawn |
Graphite 在本机跑不了 | 只用 GL 这一条 GPU 路 |
这四项里最要紧的是最后一项,因为它把第六篇的结论又印证了一遍:Graphite 的机制读得到,运行时跑不到。 第六篇靠源码常量把结构讲清楚了,而这一篇要跑的是它的上一代 Ganesh——两篇合起来,正好是一句「读得到与跑得到之间的那段距离」。顺带把这两代后端的演进摆一句:Ganesh 是 OpenGL 这一代,Graphite 是 Dawn 与现代图形 API 这一代,本篇跑的是前者。
另外还有一处细节:官方文档里那个「GPU or CPU backed execution」的 overdraw 可视化, 是 Skia Debugger 里的一个勾选项,官方自己注了一句「As of Dec 2019, this feature may not be working correctly」。 也就是说,连官方的 overdraw 视图都带着不确定,本篇自建一套并做正确性校验,反而是更可控的做法。
好了,把环境记成一张账。
2.3 环境与常量账
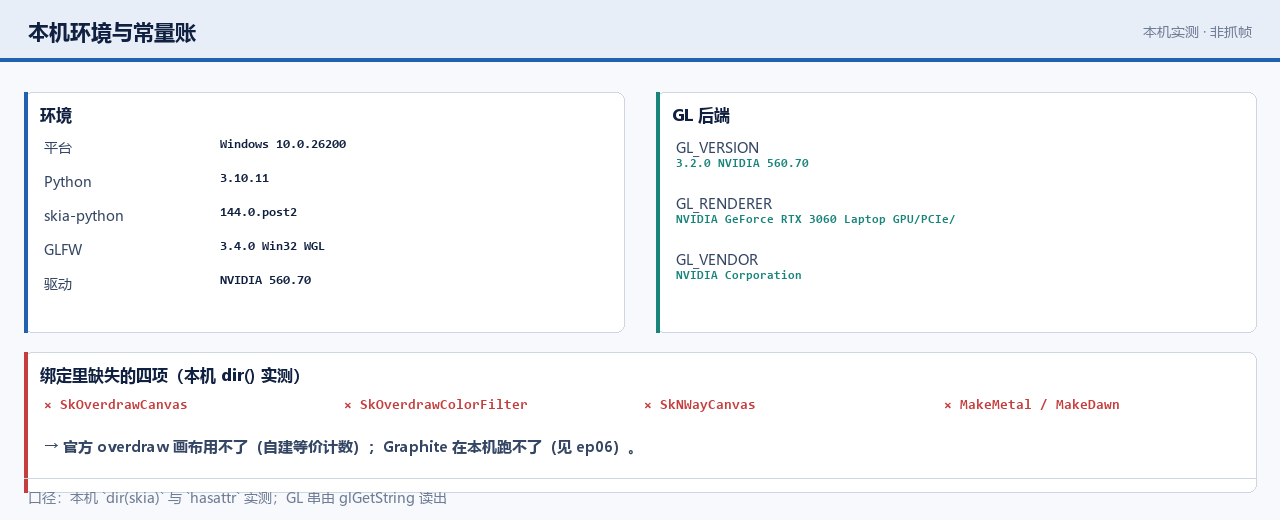
上面这张图把本篇的环境一次列清。其中 GL 那一栏由 glGetString 直接读出:
GL_VERSION  = 3.2.0 NVIDIA 560.70
GL_RENDERER = NVIDIA GeForce RTX 3060 Laptop GPU/PCIe/SSE2
GL_VENDOR   = NVIDIA Corporation
为什么要把这三行贴出来:本篇的每一个 GPU 读数都只在这套组合下成立。
还要说明一件事:这些读数不是「插上显卡就能跑」。 上游的记录里有三条值得摆出来:绑定的 CI 里大量 GL 相关的测试在 Windows 上是跳过的,并且 CI 里出现过 WGL: The driver does not appear to support OpenGL 这样的报错【19】;更早的一次提交说明里写着 GPU surface 相关 API「很可能在 Windows 上崩」【20】;而发行说明里提到 Windows 上的 OpenGL 支持是被补丁重新打开的——上游一度禁用了它【21】。三条合起来说明:本机跑通是结果,不是默认。这也顺便解释了为什么 §4 的耗时读数必须带环境。
换一张显卡、换一版驱动、甚至换成核显,读数都会变——这不是免责声明,而是「本机自跑」这类文章的固有属性。
2.4 本章收在哪里
这一章我们把 GPU 后端跑通了,也把「跑不了什么」列清了。下一章我们让两条路各画一遍同一个场景,然后逐像素比对。
官方依据:「Skia 不替你建上下文」见 skia-python Tutorial;
MakeGL的四种重载与MakeMetal/MakeDawn的缺席见 GrDirectContext 参考页; headless 环境下的MakeGL() -> None见 Issue #345; Windows 上 GL 测试被跳过与 WGL 报错见 Issue #218。
三、同一个场景跑到两条路上,像素差在哪
下面我们进入第三阶段。这一章的场景很固定:512×512 画布,六条绘制命令——一层底色、三张互相重叠的半透明圆角矩形、一条半透明贝塞尔填充路径、一条描边贝塞尔路径。两条路跑的是同一份场景代码,唯一的差别是 Surface 怎么建。
3.1 两条路的输出并置
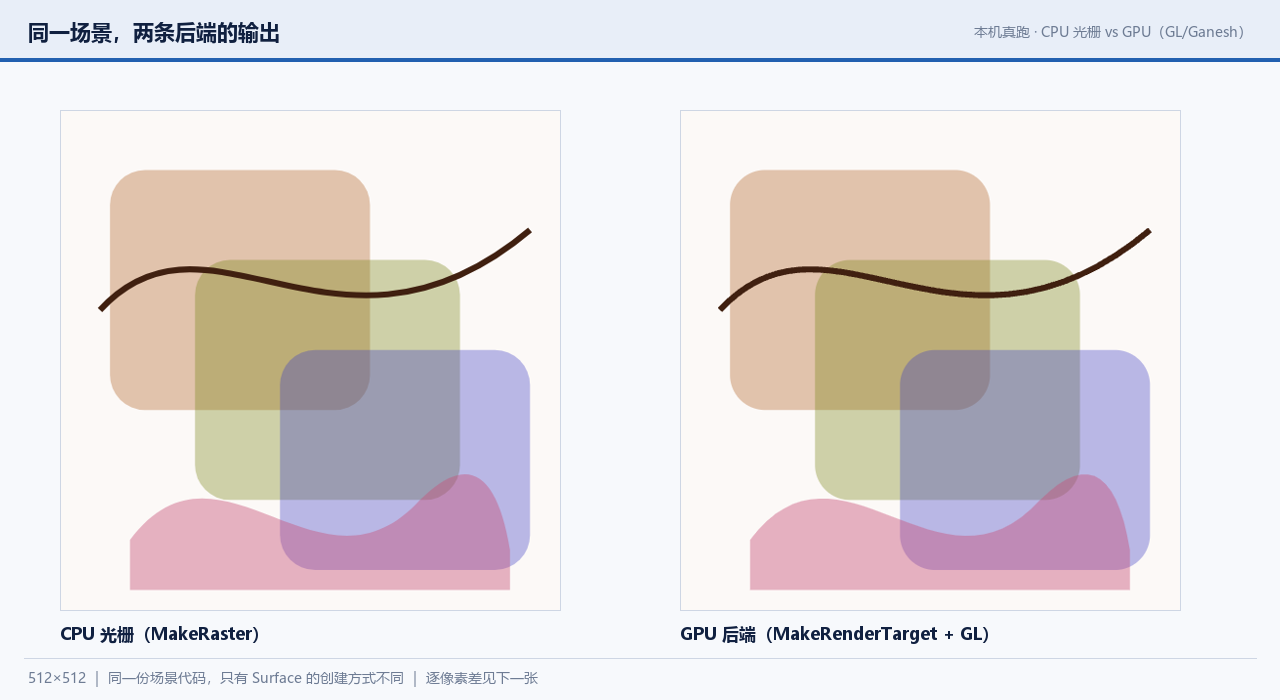
上面两张是同一份场景分别在两条路上的输出。肉眼几乎看不出差别——这正是这类比较最容易被误读的地方: 「看起来一样」不等于「逐像素一样」,而后者才是引擎工程师关心的。
把两张图并排放在这里,也为后面两节做准备:接下来我们会把「一样」这件事量化,再把「不一样」的那部分放大。
顺便交代场景是怎么挑的:这六条命令覆盖了 2D 绘制最常见的四类操作——大面积填充(底色)、带圆角的填充(三张矩形)、曲线填充(那条贝塞尔 blob)与描边(最后那条线)。它们各自触达的像素形状完全不同:矩形是整块,描边是窄带,曲线是异形。只有这样混着来,「触达次数」才不是一个由单一几何形状导致的偶然数字。
先看看「一样」这件事的能量化到什么程度。
3.2 逐像素差分
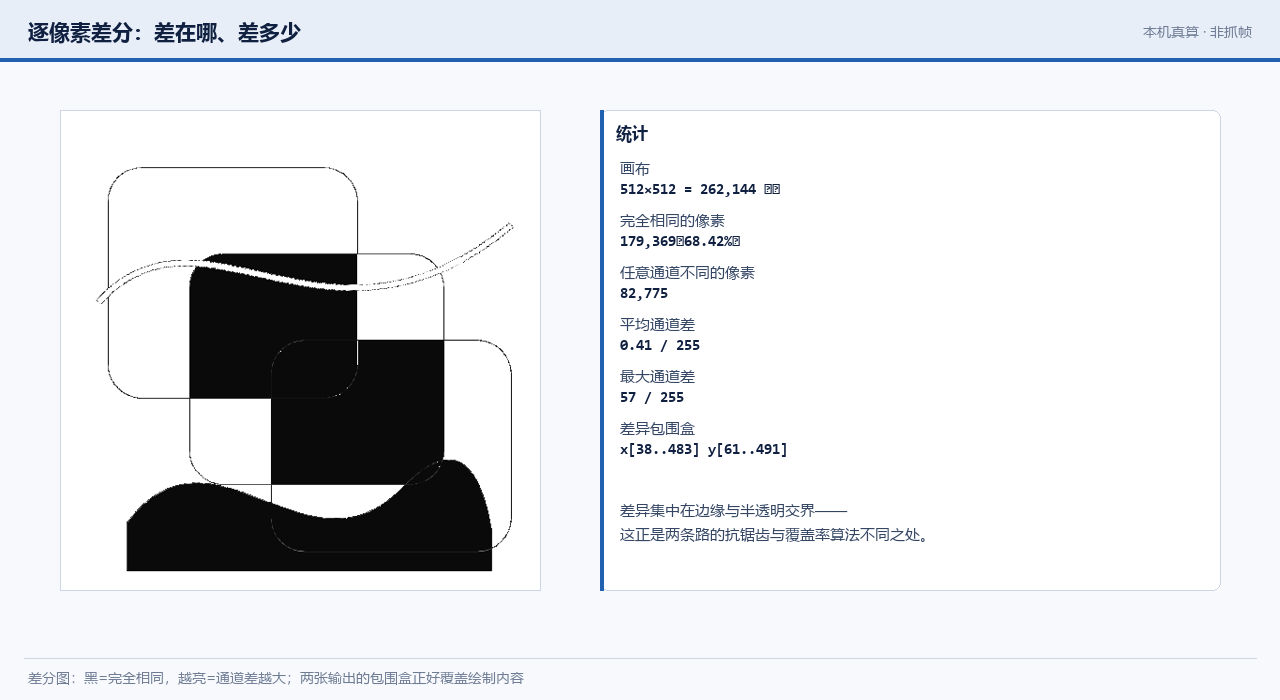
把两张输出逐像素相减,读数是这样:
| 指标 | 读数 |
|---|---|
| 画布 | 512×512 = 262,144 像素 |
| 完全相同的像素 | 179,369(68.42%) |
| 任意通道不同的像素 | 82,775 |
| 平均通道差 | 0.41 / 255 |
| 最大通道差 | 57 / 255 |
| 差异像素包围盒 | x[38..483] y[61..491] |
三个数字值得单独读一遍。
第一,「68.42% 相同」意味着 31.58% 的像素有差——在一张「看起来一样」的图上,这是个不小的比例。 第二,平均通道差只有 0.41——差异像素虽然多,但绝大多数只是差一两个灰阶,肉眼不可辨。 第三,最大通道差 57 出现在哪里?几乎都在边缘:两条路对边缘像素给的灰度不同,差到几十个灰阶是正常的。
反过来看,包围盒 x[38..483]、y[61..491] 正好覆盖了绘制内容的范围——说明差异不是某个角落的噪点,而是跟着内容走的。
3.3 抗锯齿:两条路算灰度的依据不同
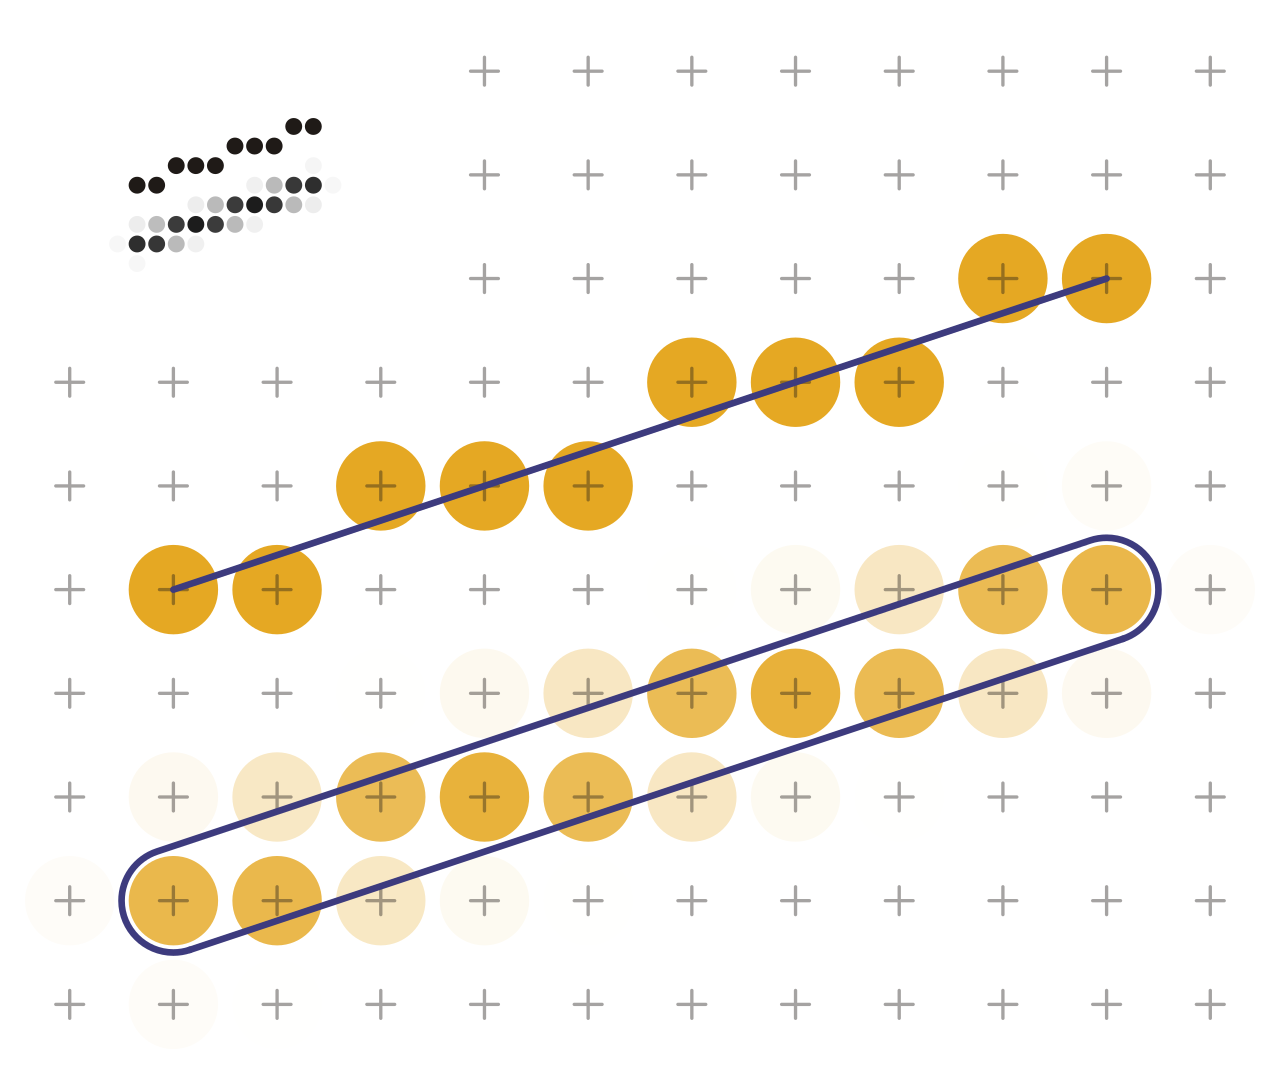
上面这张图是 CPU 侧算灰度的依据:一条边到像素中心的距离决定这个像素拿到多少覆盖率。 Skia 的 CPU 光栅走的是解析式抗锯齿(analytic AA),它算的是一个连续量。
GPU 侧不一样。它算的是采样点落在图元里没有——采样点越多,档位越细。 所以两条路的差别就在这儿:一方算距离,一方数采样。距离是连续的,采样是离散的。
这就解释了两个现象:为什么差异几乎全在边缘(内部像素两边都算满分,没有分歧), 以及为什么平均差那么小(边缘上双方都想给一个中间灰度,只是落在不同的档位上)。
把这一段和第三篇接起来看会更清楚:第三篇讲 CPU 侧的解析式抗锯齿时,花了不少篇幅讲「覆盖率怎么从距离算出来」;而 GPU 侧这条路根本没有那一步——它把「算覆盖率」换成了「数采样点」。同一个名词(抗锯齿),两侧实现的是两条完全不同的算法。所以本篇第三到第四节看到的差异,不是实现质量问题,而是算法层面的必然分歧。
顺带说一句,这也解释了为什么第六篇讲的 Graphite 要把深度测试用起来——GPU 侧的效率问题往往不在算得准不准, 而在算了不该算的。这句话在本篇第七章会有一个本机的数字。
先看看边缘的定义在两条路上差在哪。
3.4 把同一条边放大
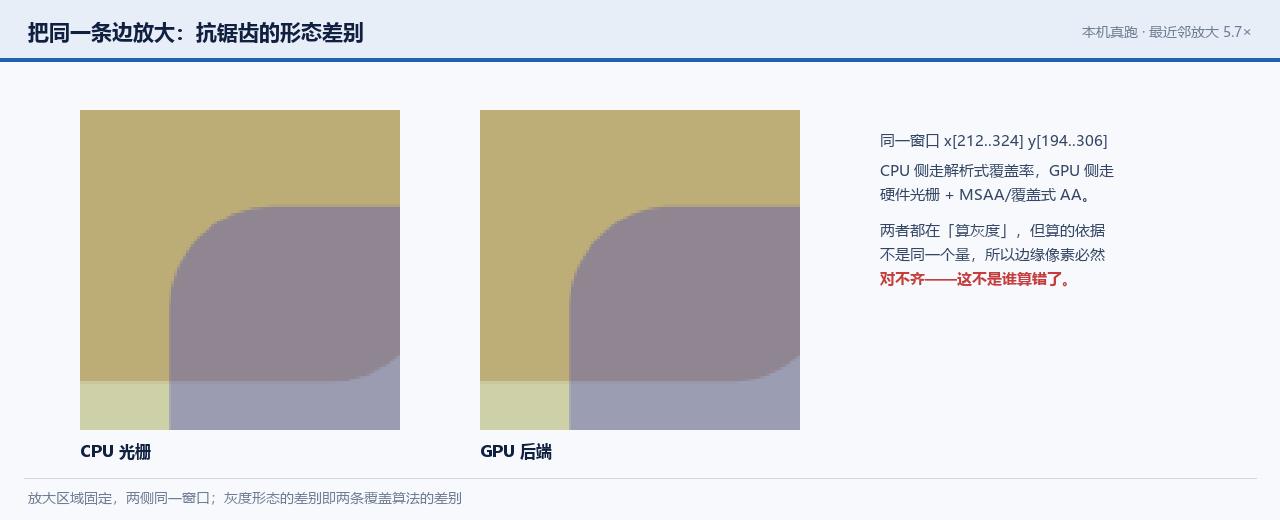
把同一个窗口放大来看,两条路的边缘形态差别就出来了:灰度过渡的宽度与步进不一样。 这不是谁算错了——它们算的根本不是同一个量。
写这一段的时候我想强调一件事:这类差异不该被包装成「谁更准」。 CPU 侧的解析式覆盖在某些情况下更接近几何真值,GPU 侧的采样在动画与并行上更划算。 本篇能给的只是「它们不一样」,以及「不一样在哪里」。
3.5 本章收在哪里
这一章我们把「看起来一样」量化成了 68.42%,并把差异归到了边缘与灰度档位上。 下一章看另一个更容易被误读的量:耗时。
官方依据:Raster 与 GPU 两条后端的创建与差异见 SkCanvas Creation; 解析式覆盖的像素选择图出处见参考资料第 39 条;本篇的差分与放大图为本机真跑(口径见 §0.4)。
四、耗时怎么量才是可信的
下面我们进入第四阶段。这一章要格外小心,因为耗时是最容易被写成错误结论的一个量。
4.1 口径三条
上面这张图把本机的耗时口径列清了,逐条说明:
- 预热 3 次,再连续跑 20 次,报最小值与中位。第一次调用往往包含缓存与驱动的初始化开销, 单次采样必然失真;最小值反映「稳定态下最快能到多少」,中位反映「典型值」。
- CPU 侧只计绘制:从进入绘制循环到返回,不含建 Surface。
- GPU 侧计绘制 +
flushAndSubmit()。这一条是本篇最要紧的口径,也是 §4.3 要展开的地方。
另有一列单独计量:像素读回(snapshot + toarray)。它不进绘制耗时,因为它不是「画」的成本, 而是「把结果搬回 CPU」的成本——但对 GPU 侧来说,这一列往往才是「真正等它画完」的那个时间。
为什么要同时报最小与中位:这两个数回答的是不同问题。最小值回答「稳定态下最快能到多少」,它反映的是这套代码在理想情况下的下界;中位回答「典型情况下是多少」,它是你实际体感会遇到的数。两者差得远,说明这套测量的抖动大——这时候单看一个数就是在赌。本机这几组读数里两者差得都很小(比如 CPU 侧 17.49 与 17.95),说明重复性还不错,这是采样次数足够的信号。
4.2 读数
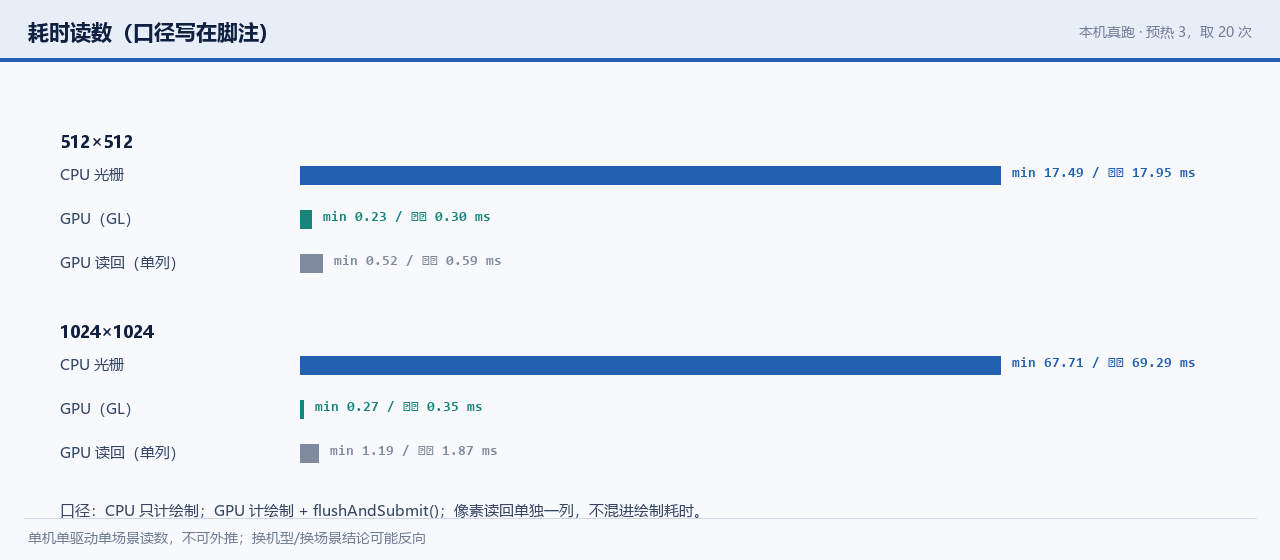
| 画布 | CPU 光栅(min/中位) | GPU(min/中位) | GPU 读回(min/中位) |
|---|---|---|---|
| 512×512 | 17.49 / 17.95 ms | 0.23 / 0.30 ms | 0.52 / 0.59 ms |
| 1024×1024 | 67.71 / 69.29 ms | 0.27 / 0.35 ms | 1.19 / 1.87 ms |
(单位毫秒;同一份六条命令的场景;本机单机单驱动。)
先看 CPU 那一列的比例:画布从 512² 到 1024²,像素数是 4 倍,耗时从 17.95 ms 到 69.29 ms, 正好约 3.9 倍——CPU 光栅的开销跟着像素数走,这是扫描转换的性质决定的。
再看 GPU 那一列:0.30 ms 到 0.35 ms,几乎没有变。这个数字如果单独拿出来,很容易被读成「GPU 不受分辨率影响」—— 那就读错了。它不变,是因为它根本没有在等绘制完成(§4.3)。
最后看读回那一列:0.59 ms 到 1.87 ms,跟着像素数增长(4 倍像素、约 3.2 倍耗时)。 读回是同步的:它必须等 GPU 上那条命令真的画完,才能把像素搬回来。所以这一列里, 包含了 GPU 的实际执行时间加上传输时间。
再补一句:读回那一列还包含了把像素从显存搬到内存的时间,所以它不是纯粹的「GPU 执行时间」。要单独拿到 GPU 执行时间,得用 GPU 计时器或 fence,那又是另一套工具(本机没有,§10.1)。本篇把这一列放出来的目的不是给一个「GPU 完成时间」,而是证明「提交」与「完成」之间确实隔着东西。
说白了,这里有个关于「时间」的定义陷阱。
4.3 为什么不能写成「GPU 快 N 倍」
把 §4.2 的三列摆在一起,就能看出一个陷阱。
CPU 侧的耗时是「完成时间」——函数返回时像素已经写好了。 GPU 侧的 0.30 ms 是「提交时间」——函数返回时命令只是被交给了驱动,GPU 可能还没开始画。
这两者不能相减。要拿到可比的「完成时间」,GPU 侧必须加一道同步:或者读回像素(本机这一列:0.59 ms), 或者插入 fence 等信号。只有把这一步算进去,两边的读数才在同一个语义下。
所以本篇的结论只能写成这样:
- CPU 光栅的开销随像素数近似线性增长(512²→1024²:3.9 倍);
- GPU 侧的提交开销几乎不随画布大小变化,但要真正拿到结果必须再加一次同步,那一步的开销随像素数增长;
- 两条路各自的成本结构不同,不能直接用两个数作差得出「谁快多少倍」。
4.4 本章收在哪里
这一章我们把耗时拆成了三列,并把最容易出错的那一步指了出来。下一章换一个量:overdraw——它比耗时更抽象,因为它是「重复做工」,本身不是时间。
官方依据:本机读数出自本篇测量脚本(口径见 §4.1 与本机环境 §2.3); GL 上下文与提交的语义见 GLFW 文档。
五、overdraw 到底是什么
下面我们进入第五阶段,后半篇的主线。这一章先不动手,只把官方的三条口径摆清楚——因为「overdraw」这个词在不同平台上指的并不完全是一回事。
5.1 三份官方口径
Android 的定义最简单【1】:一个像素在同一帧里被画了不止一次,就是 overdraw。 官方还补了一句成因:按画家算法从后往前画,天然会产生 overdraw。 半透明更贵,因为「透明物体要求先把已有像素画出来,才能做正确的混合」。
Chromium 的量化方式最直接【2】:开 viz.overdraw 这个轨迹类别,它会记录每一帧的 overdraw 量,
输出成一个随时间变化的计数器,单位是百分比——官方举的例子是「半屏无 overdraw、半屏 1 倍,计数器读 50」。
注意后面那句限制:这个指标只在 ARB_occlusion_query 可用时才有效。
一线厂商给的是比例口径【14】【15】:Arm 的案例里写的是「总片元实例数 ~10m ÷ 帧缓冲 2560×1600 = 2.44 fragment instances/pixel」; Apple 的说法同义——「overdraw is the number of fragment shader invocations per pixel」。 另外 Web Tracing Framework 给过一份更口语的描述:它报的是「平均每像素被绘制的次数」, 1 到 4 之间是典型值【4】——这个数字正好可以拿来做后面的对照。
把这三份口径做一个归类,再加上本机这一份,就成了这样一张表:
| 口径 | 量的东西 | 本机可测? |
|---|---|---|
| Android:定义 | 像素被画的次数 | 定义,不可测 |
Chromium:viz.overdraw 计数器 |
每帧 overdraw 的百分比 | 不可测(需 ARB_occlusion_query) |
| Arm / Apple:片元实例 ÷ 像素 | 片元着色调用数 | 不可测(需抓帧或 GPU 计数器) |
| 本篇:绘制触达计数 | 像素被多少条绘制命令触达 | 可测(自建,§6) |
请注意最后一行与前两行的差别——这正是下一章要展开的事。
先看看「被触达」该怎么定义。
5.2 哪些像素算「被触达」
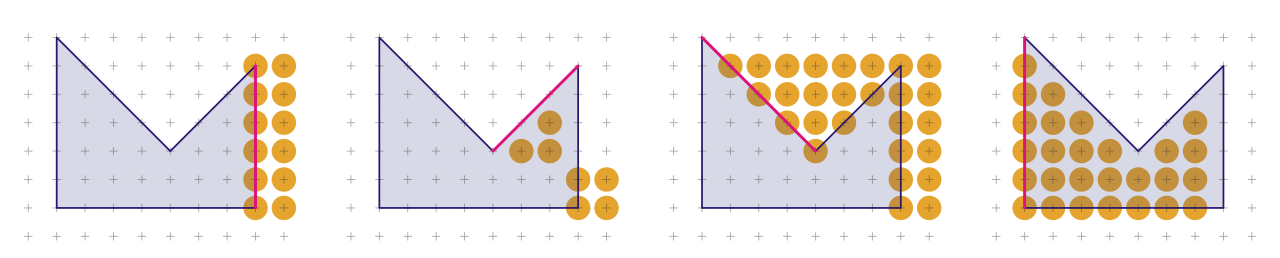
要把 overdraw 数出来,先得把「被触达」定义清楚。这件事在光栅化里有个专门的名字:填充规则(fill rule)—— 一条边两侧的像素,哪一侧算内侧。上面这张图给的是这条规则的一个具体形态。
为什么这一节的图很重要:如果「被触达」的判定不统一,那么所有的计数都是无意义的。 所以在自建计数之前,我们先把判定权交给 Skia 自己—— 让 Skia 把每条命令单独画一遍,读它的 alpha 通道,非零就是被触达(§6.2)。 这样判定规则与本机渲染完全一致,不用我们自己实现一套边界规则。
反过来说也成立:如果自己实现一套判定规则,就会先陷进「我的规则对、引擎的规则错」的争论里,而这场争论跟 overdraw 完全无关。把判定权交出去,计数这件事就只剩下「累加」这一个动作——它把最容易出错的一环变成了别人负责的一环,这是自建工具时最划算的一种做法。
5.3 本机测的是哪一个
把话说死:本篇测的是「绘制触达计数」,不是「片元着色调用数」。
两者的关系是:一个像素被 N 条绘制命令触达,在 GPU 上通常意味着至少 N 次片元着色尝试—— 但硬件可以在早期深度测试或裁剪阶段把这些尝试丢掉一部分,所以实际着色次数可能更少。 换句话说,触达计数是片元着色调用数的一个上界(在不考虑多重采样放大与 shader 内部循环的前提下)。
这个区分不是抠字眼。如果把触达计数当成片元着色数报出去,就会得出「GPU 白干了 N 倍的活」这种结论—— 而真实硬件恰恰会通过深度测试把这些活省掉一部分,第六篇讲 Graphite 用 z 值与深度裁剪, 优化的正是这一部分。
有人会问:既然触达计数是上界,那按硬件常见行为打个折去近似片元数不就行了吗?本篇不做这件事,理由很直接——折扣系数取决于内容、硬件与驱动,本机没有任何手段验证它。一旦引入一个没法验证的系数,整篇文章的读数就从「可复现」退化成「看起来合理」。宁可只给出一个口径明确的上界,也不给一个口径模糊的近似值。
5.4 本章收在哪里
这一章我们把「overdraw」拆成了三份官方口径与一份本机口径,并说清了本机口径的语义边界。 下一章动手:在没有官方工具的情况下,自己实现一套等价计数。
官方依据:Android 的定义与成因见 Reduce overdraw; Chromium 的计数器与
ARB_occlusion_query限制见 GPU Overdraw Debugging Tool; Arm 的片元每像素口径见参考资料第 15 条,Apple 的同义表述见参考资料第 14 条; 边填充规则的图出处见参考资料第 38 条。
六、官方工具用不了,自己实现一套
下面我们进入第六阶段,也是本篇动手量最多的一章。
6.1 官方那套做了什么
Skia 里其实早就有一个专做 overdraw 的画布。SkOverdrawCanvas.h 的头注释就是它的定义:
"Captures all drawing commands. Rather than draw the actual content, this device increments the alpha channel of each pixel every time it would have been touched by a draw call. This is useful for detecting overdraw." —— [7]
它的实现方式很巧:不画内容,而是每碰一次就给 alpha 加 1/255——用 kPlus 混合模式叠一个增量色彩矩阵【8】。
配套还有一个 SkOverdrawColorFilter,把累加出来的 alpha 映射成六档颜色(0 到 5 及以上)【9】。
可惜这三件套在 Python 绑定里一个都没有(§2.2)。官方 Fiddle 上那个有名的 overdraw 示例,
靠的是 SkOverdrawCanvas + SkNWayCanvas 双路分流——这两个类本机都用不了。
这三件套本机一件都用不了,等于说官方已经把工具写好了,但通往它的那条路它没铺到。这种情况在自跑类文章里很常见:文档里有的东西,绑定里不一定有;SDK 里能调的东西,脚本环境里不一定能调。本篇的处理方式是——不绕过去,也不拿别的东西冒充它,而是照着它的语义自己实现一遍。
6.2 自建等价计数:三步
思路只有三步,正好对应上面那张流程图:
- 逐条绘制取掩码:把每一条绘制命令单独画到一块透明底上,读 alpha 通道,非零的像素就是「这条命令触达的像素」;
- 逐像素累加:把所有命令的掩码相加,得到一张「每像素被多少条命令触达」的计数图;
- 六档配色输出:按官方的档位语义上色——触达 1 次蓝、2 次绿、3 次粉、4 次红、5 次及以上深红【3】。
这里有两条口径要写死。
第一条:底色不算触达。 最底那一层是背景,Android 的说法是「True color:无 overdraw」—— 背景本身不算 overdraw。所以计数时把背景那条命令排除在外,只数它上面的绘制。
第二条:掩码在 CPU 光栅侧取。 原因见 §6.4——两条后端对边缘像素的覆盖判定并不完全一致。
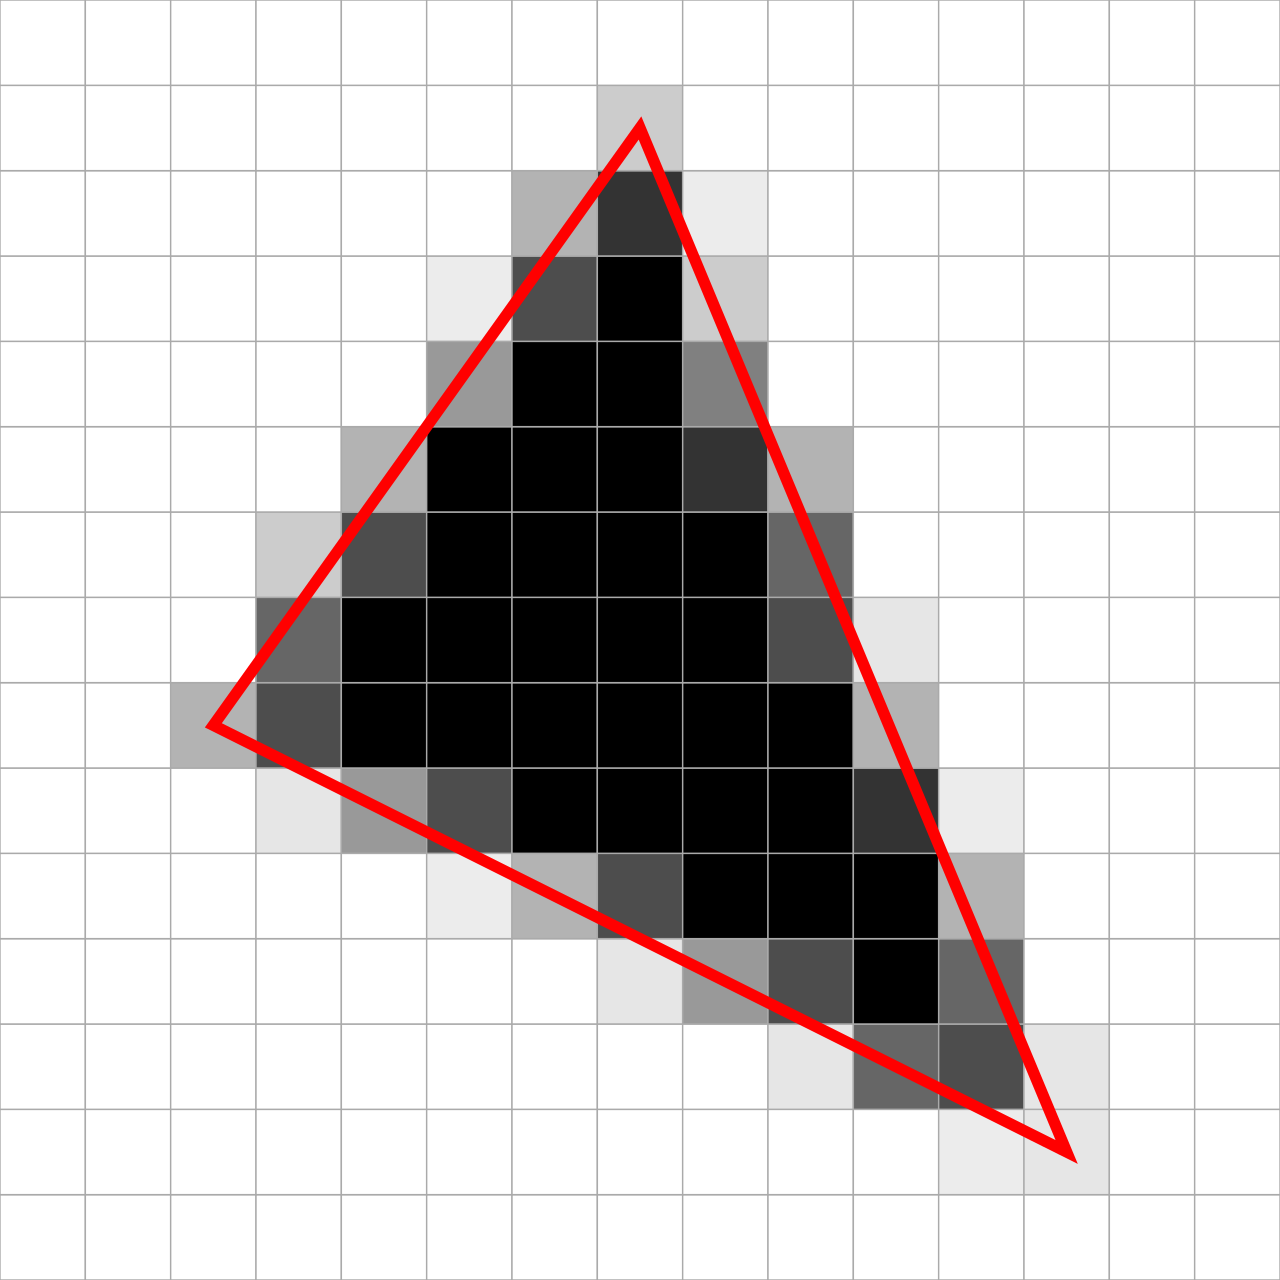
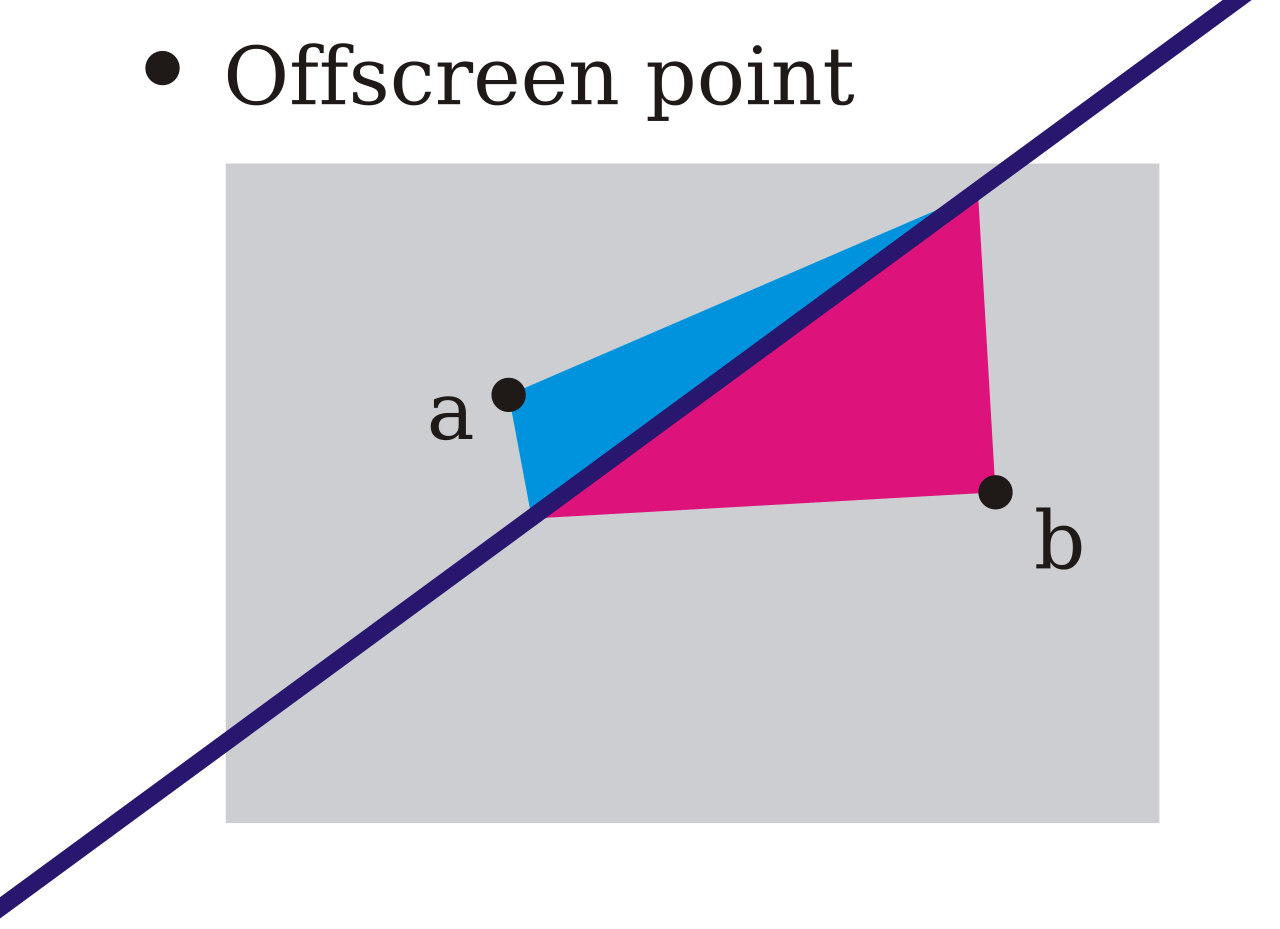
上面这张图是计数的最小单元:一个像素算不算被三角形覆盖,取决于判定规则。 把这条命令单独画一遍再读 alpha,等价于把判定权交给 Skia 自己——这比我们自己写一套边界规则要稳。
好了,自己写的东西要先对答案。
6.3 正确性校验
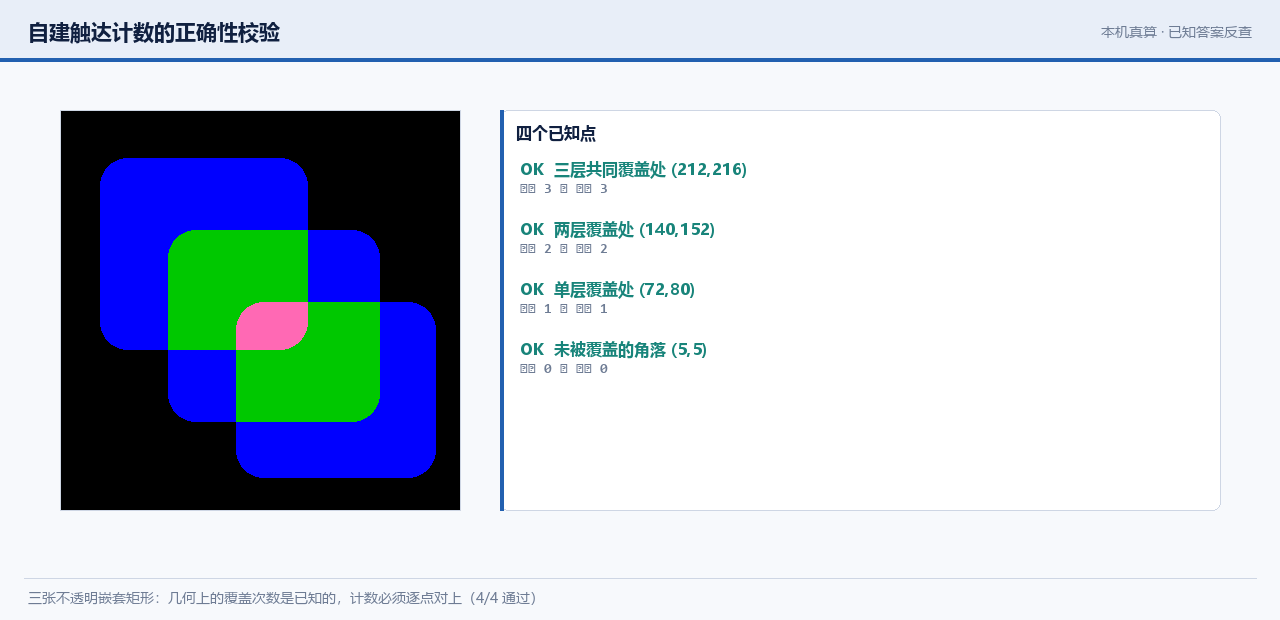
自己实现的东西必须能对上一个已知答案。本机用的校验场景很笨但很硬:三张位置固定的不透明圆角矩形, 它们在几何上的覆盖次数是可以手算的——某个点落在几张矩形里,就应该被触达几次。
| 探针点 | 几何预期 | 计数实测 |
|---|---|---|
| 三张矩形共同覆盖处 | 3 | 3 |
| 两张覆盖处 | 2 | 2 |
| 单张覆盖处 | 1 | 1 |
| 未被覆盖的角落 | 0 | 0 |
4 个探针全部对上。这说明「逐条取掩码再累加」这套流程,在覆盖判定的口径上是自洽的。
另外还有一条反向校验:把同一个场景的掩码分别在两条后端上取一遍,算出的计数图有 38 个像素不一致(0.037%)。 这个数很小,但它说明了一件事——边缘像素的覆盖判定,本来就跟着后端走。所以本篇把计数统一声明在 CPU 光栅侧, 并且不声称这套计数在 GPU 上逐像素等价。
38 个像素差在哪,值得猜一次(但只作为讨论,不作为结论):最可能是边缘像素的归属判定——两条路对「这个像素算不算被盖住」的边界处理不同(§1.1 讲的那条左上规则就是干这个的)。毕竟这只是 0.037% 的像素,且都在边界上。但本篇只把它当作「口径必须声明」的理由,不把它当作任何一侧的缺陷——因为 GPU 侧那条掩码本来就不是本篇用来计数的通道。
6.4 一条必须声明的边界
把第六章的结论压成一句话:
本篇的 overdraw 数字,是「在 CPU 光栅上、按绘制命令逐条累加出来的触达计数」,
语义对齐 SkOverdrawCanvas,但它不是 GPU 的片元着色调用数,也不是 Chromium 的 viz.overdraw 百分比。
这句话要写死,因为后面第七章的三个场景都会给出具体数字。不给口径的数字,比没有数字更糟。
那这套计数适合回答什么?适合回答「重复做工落在哪块区域、随配置怎么变」这类结构性问题——比如叠层数增加会怎样、裁剪能不能砍掉一半触达、顺序错了会浪费多少。它不适合回答「这块内容在某个 GPU 上跑了多少次着色器」,也不适合拿去和别人的性能计数器做绝对比较。把工具用在它能回答的问题上,是自建工具的第一条纪律。
6.5 本章收在哪里
这一章我们把官方的工具、自建的实现、以及一条 4/4 的正确性校验都过了一遍。 下一章开始用它量三个真实场景。
官方依据:
SkOverdrawCanvas的定义见 SkOverdrawCanvas.h, 增量矩阵的实现见 SkOverdrawCanvas.cpp; 六档映射见 SkOverdrawColorFilter.h; 官方 Debugger 的 overdraw 视图与其「2019-12 起可能不准」的自注见 Skia Debugger。
七、场景一:半透明叠层,overdraw 从哪来
下面我们进入第七阶段,开始上量。第一个场景是 2D 界面里最常见的那种:一块底色 + 三张互相重叠的半透明圆角矩形 + 一条半透明贝塞尔填充 + 一条描边。 一共 6 条绘制命令(底色不计入触达)。
7.1 触达次数长什么样
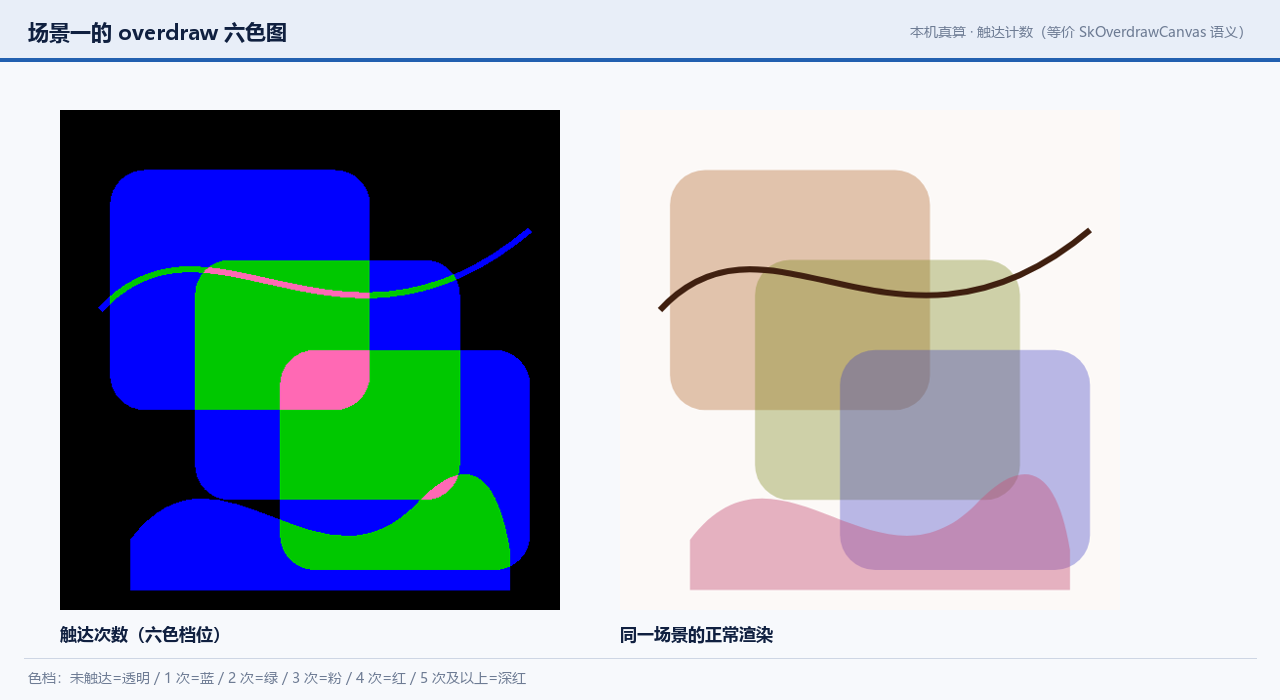
左边是触达计数图,右边是同一场景的正常渲染。两者对照着看,能读出三件事:
- 最深的颜色出现在三张圆角矩形的三重叠加区——那里被触达了 3 次;
- 大片蓝色覆盖在每张矩形自己的独占区——只被触达 1 次;
- 贝塞尔填充与描边带来的触达是窄带状的——它们各自只占一部分像素。
这张图最直接的价值是:overdraw 不是均匀分布的,它集中在你叠了多少层的那块区域。 这也是为什么「减少叠层」永远比「优化单笔绘制」更有效。
但这张图不会告诉你「该省掉哪一层」——那是内容语义的问题,不是计数能回答的。比如一个带阴影的卡片,阴影那一层虽然叠了三次,却是视觉设计的一部分;而一个被完全遮住的中间层,才是真正可以删的。计数工具给的是「哪里热」,删哪一层要靠人对内容的判断,两者不能互相替代。
先看看这些触达是怎么分布的。
7.2 分布与平均值
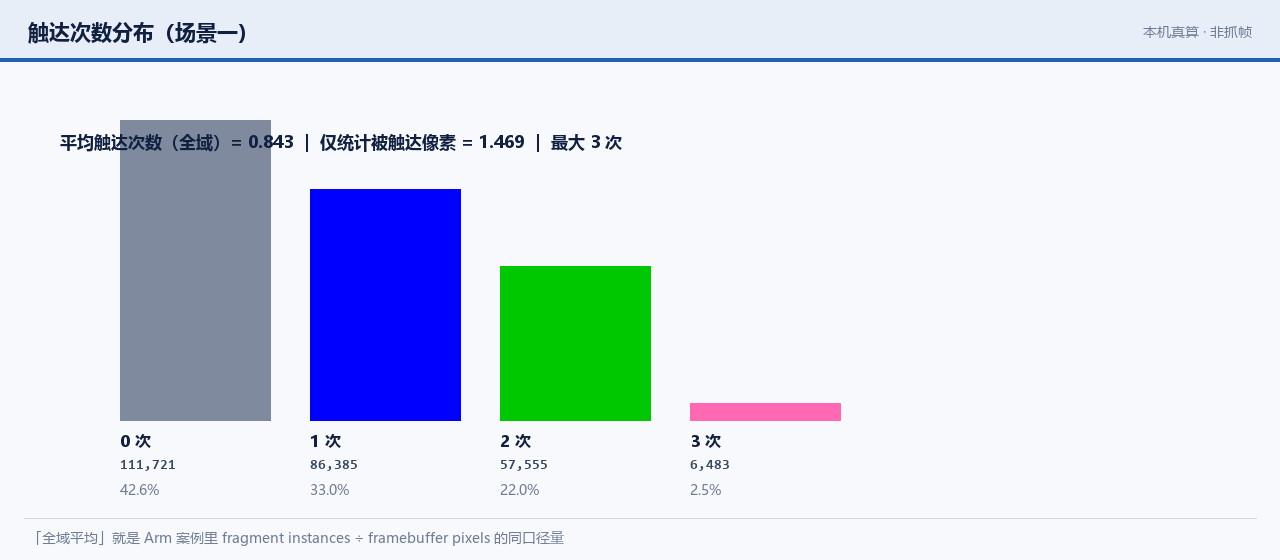
把计数图做成分布,读数是这样:
| 触达次数 | 像素数 | 占比 |
|---|---|---|
| 0 次(未触达) | 111,721 | 42.6% |
| 1 次 | 86,385 | 33.0% |
| 2 次 | 57,555 | 22.0% |
| 3 次 | 6,483 | 2.5% |
| ≥1 次(被触达)合计 | 150,423 | 57.4% |
| 全域平均 | — | 0.843 |
| 仅统计被触达像素的平均 | — | 1.469 |
| 最大触达次数 | — | 3 |
三个读数各有各的用。
「全域平均 0.843」是 §5.1 里 Arm 那个口径的同款算法——总触达次数 ÷ 总像素数。 它小于 1,是因为画布上有 42.6% 的像素根本没被碰过(这道场景的内容没铺满画布)。 这个数字如果拿去和别人的数字比,必须先把「画布上内容占多少」对齐,否则毫无意义。
「仅统计被触达像素的平均 1.469」更贴近直觉:凡是画到的像素,平均被画了约 1.5 次。 把它和 Web Tracing Framework 那句「1 到 4 之间是典型值」【4】对一下——我们这个场景落在典型区间的低端, 因为叠层只有三层、且都在半透明状态下互相错开。
「最大 3 次」则对应三张矩形的三重叠加区。3 这个数字不是巧合:它等于叠层数。
可以顺手和 §5.1 里 Arm 那个例子对照一下,但要小心:那个 2.44 是片元实例 ÷ 帧缓冲像素,分母是整个帧缓冲(2560×1600),而本机这个 0.843 的分母也是整个画布。两个数字在算法上是同一件事,但内容密度完全不同——Arm 那个案例是 3D 场景,画面铺满;本机这道场景内容只占画布的 57.4%。所以不能直接比较大小,只能比较「同一个场景在不同配置下的变化趋势」——这正是下一节做的事。
7.3 叠得多一层,代价涨多少
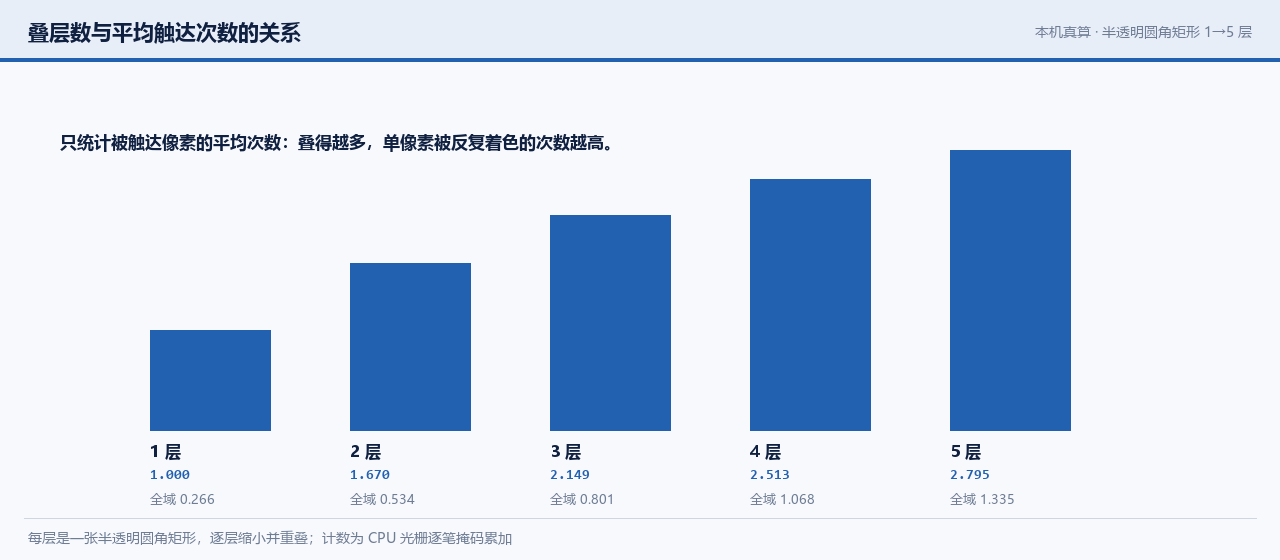
把圆角矩形从 1 层加到 5 层(每层略微错开,面积也随之增长),读数是这样:
| 层数 | 被触达像素 | 全域平均触达 | 最大触达 |
|---|---|---|---|
| 1 | 69,858 | 0.266 | 1 |
| 2 | 83,776 | 0.534 | 2 |
| 3 | 97,710 | 0.801 | 3 |
| 4 | 111,435 | 1.068 | 4 |
| 5 | 125,158 | 1.335 | 5 |
两件事一起涨:被触达的面积在涨(每加一层都多覆盖一条边),单位像素上的触达次数也在涨。 后者是真正的 overdraw 增量——每加一层,重叠区的每个像素就多被画一次。
这条曲线也解释了为什么移动端的 2D 界面要「压层数」:层数不是线性成本,它叠在重叠区上是乘积式的。
7.4 本章收在哪里
这一章我们量出了叠层场景的 overdraw 分布、平均值和层数关系。下一章换一个一直被认为「能省」的手段:裁剪。看看它到底省了什么。
官方依据:overdraw 的定义与「画家算法是成因」见 Reduce overdraw; 平均每像素被绘制次数的口径见 Web Tracing Framework; 本篇的场景图与读数为本机真算(口径见 §6.4)。
八、场景二:裁剪省掉的到底是什么
下面我们进入第八阶段。「用裁剪减少 overdraw」是一条被反复推荐的经验,这一章我们来验一下它省的是哪一样东西。
场景用的是第一到第四节那四条绘制(去掉描边),一次不加裁剪,一次加一个圆角矩形裁剪。 两次发的绘制命令数完全相同:都是 4 条。
8.1 裁剪前后
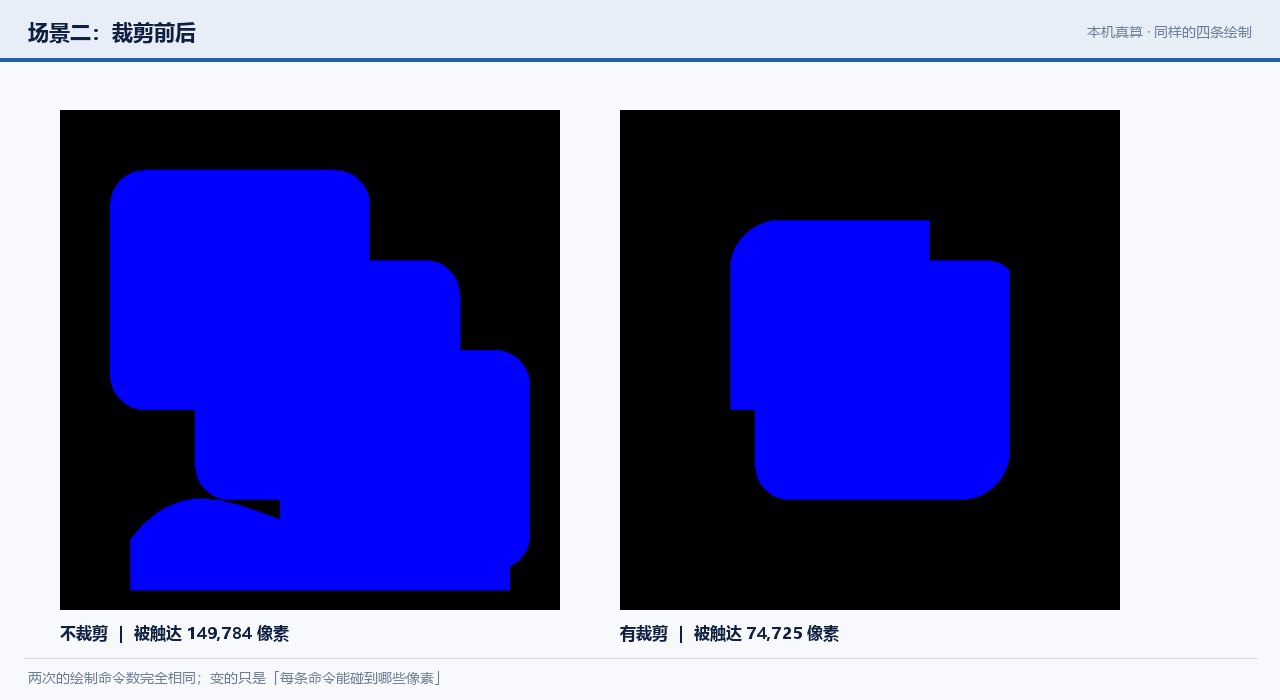
上面两张图放在一起看就清楚了:裁剪把触达范围「切」到了裁剪区内,区外的触达整个消失。 但请注意一个细节——裁剪区内的触达次数一点没变。原来在区内的三重叠还是三重叠。
说白了,省的是另一样东西——先把「省」这个字定义清楚。
8.2 省的是触达像素,不是绘制命令
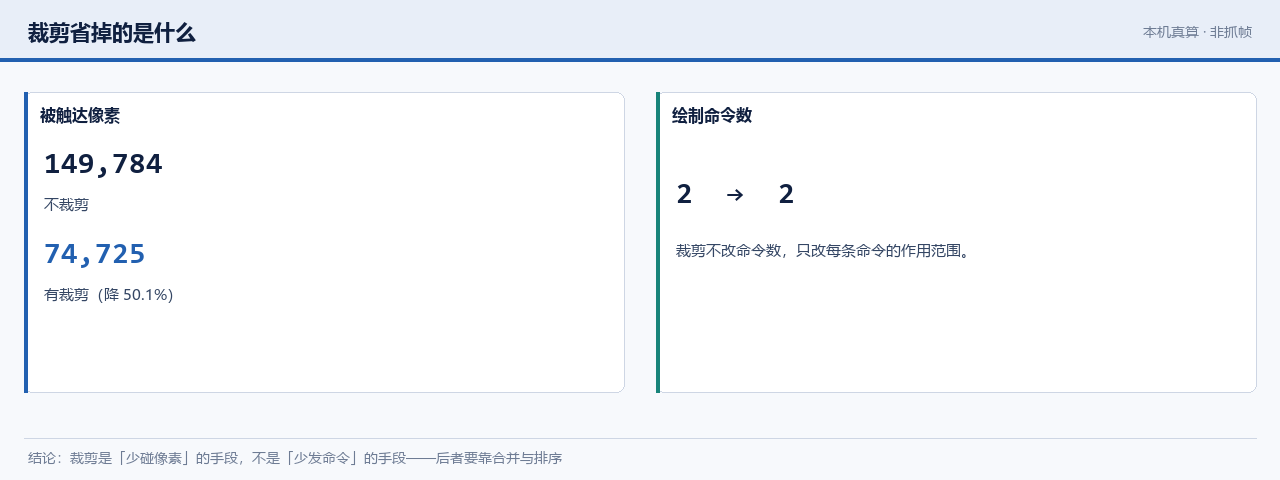
| 指标 | 不裁剪 | 有裁剪 | 变化 |
|---|---|---|---|
| 被触达像素 | 149,784 | 74,725 | −50.1% |
| 全域平均触达 | 0.571 | 0.285 | 减半 |
| 绘制命令数 | 4 | 4 | 不变 |
这张表把「裁剪省什么」说死了:
- 省的是「每条绘制命令能碰到哪些像素」——被触达像素直接少了一半;
- 不省「发多少条命令」——命令数一条没减。
这个区分有实际意义:裁剪优化的是填充成本(fill cost),不是提交成本(submit cost)。 如果你的瓶颈在「命令太多、状态切换太频繁」,裁剪帮不上忙——那要靠排序与合并(第五、六篇讲过的那套)。 反过来说,如果瓶颈在「一条大面积半透明图层反复重绘」,裁剪就是最直接的手段。
但裁剪也不是免费的,这一点常被忽略。设置裁剪本身要更新裁剪状态;在 CPU 侧,扫描转换器需要按裁剪边界收窄每行的跨度;在 GPU 侧,如果走的是模板或深度那条路,还要额外付出几次只写深度或模板的绘制——这正是第六篇讲的「裁剪的三档优先级」要处理的事。所以实务上的判断是:裁剪面积越大、被裁掉的绘制越重,收益越明显;如果裁剪边界和绘制范围本来就差不多,那省下的没多少,反而多了一次状态变更。
8.3 本章收在哪里
这一章量清了裁剪的收益边界。下一章看第三个场景,也是 2D 渲染里最容易被写错的一处:画家顺序。
官方依据:裁剪与填充成本的关系见 Reduce overdraw 中「用更少的透明窗口 / 避免不必要的固定定位与 3D 变换」那一段的思路;本机读数为真算(口径见 §6.4)。
九、场景三:画家顺序为什么不能换
下面我们进入第九阶段。这个场景最像「小实验」:一张不透明大块 + 两张半透明图形,只改一件事——不透明大块画在第几笔。
9.1 两种顺序的代价
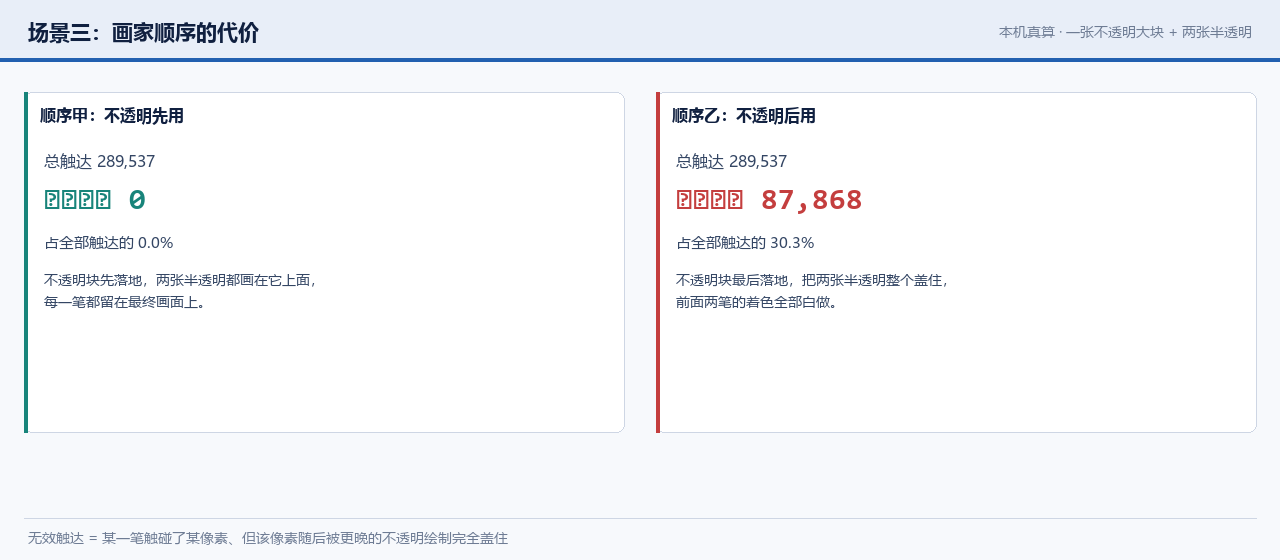
结果非常干净:
| 顺序 | 总触达 | 无效触达 | 占比 |
|---|---|---|---|
| 甲:不透明 → 半透明 ×2 | 289,537 | 0 | 0.0% |
| 乙:半透明 ×2 → 不透明 | 289,537 | 87,868 | 30.3% |
两种顺序的总触达完全一样(289,537)——因为画的东西没变。 但无效触达差了 87,868 次:顺序乙里,那两张半透明图形先画、随后被不透明大块整个盖住,每一笔着色都白做了。
这里的「无效触达」口径要写清:某一笔触碰了某像素,但该像素随后被更晚的不透明绘制完全盖住。 它不是估算,是逐像素数出来的——先取每笔的掩码,再从最后一笔往前扫,把已被不透明覆盖的触达标记为无效。
这个口径有两条限制,得一并说明。第一,它只认「完全不透明」的覆盖:如果后画的那一笔是半透明的,先画的触达并没有白费(它仍然参与了混合),所以不计入无效。第二,它不处理部分遮挡:一个像素要么被完全盖住、要么没被盖住,没有「盖住一半」这一档。两条限制都让这个数字偏保守——真实场景里的浪费只会比它更多,不会更少。
先看看官方对这件事的定义是怎么说的。
9.2 这正好对上两段官方说法
第一段是 NVIDIA 对深度复杂度的描述【5】:场景的深度复杂度是「每个片元被写入的次数」, 而最坏的情况就是从后往前画(画家算法)——因为那会让大量片元被重复写入。本机这 30.3% 就是它的一个具体形状。
第二段是 Skia 自己的说法【6】:官方在讲 Graphite 时承认, 「Ganesh 因为严格遵循画家顺序而承受 overdraw」,而 GPU 渲染管线里的深度测试 「可以通过把不透明物体按前到后画、半透明按后到前画,来减少甚至消除 overdraw」。
把这两段话和本机读数接起来,就是本篇最想说的那句:overdraw 的根源不在单笔绘制,而在顺序。 第六篇讲 Graphite 用 z 值与深度裁剪——它买的正是这 30.3% 这样的浪费。
那为什么 CPU 光栅侧不能这么干?因为深度测试在 CPU 侧默认没有对应的机制:扫描转换是一行一行往前推的,它不知道「这个像素后面还会被更高优先级的东西盖住」,也没有一块深度缓冲去替它记账。要拿到这个能力,要么应用层自己排序(先画不透明的、再画半透明的),要么换到 GPU 侧让硬件去挡。第六篇讲的 z 值(每条绘制一个画家顺序索引)与「把裁剪形状当成只写深度的绘制」,归根到底都是把顺序这件事交给一块缓冲去记账——本篇这 30.3% 就是那笔账的金额。
9.3 本章收在哪里
这一章我们把「顺序」这个抽象的说法量成了 0% 与 30.3% 的对照。最后一章把镜头拉回来:这套方法测不了什么。
官方依据:深度复杂度与「从后往前画是最坏情况」见参考资料第 5 条; 「Ganesh 因画家顺序而 overdraw」「深度测试可减少或消除 overdraw」见 Skia Graphite 官方博客。
十、这套方法测不了什么
下面我们进入第十阶段。自跑类文章最容易犯的错,是把能测的东西写满、把不能测的东西略过。这一章专门把边界列出来。
10.1 三场景与能测/测不了
| 量 | 本机能不能测 | 原因 |
|---|---|---|
| 绘制触达计数(每像素被多少条命令触达) | 能 | 自建计数(§6),语义对齐 SkOverdrawCanvas |
| 两条后端的逐像素差 | 能 | 逐像素比对(§3.2) |
| 提交侧与读回侧耗时 | 能 | 本机计时(§4.2) |
| GPU 片元着色调用数 | 不能 | 需抓帧工具或 GPU 计数器;本机没有 |
Chromium 的 viz.overdraw 百分比 |
不能 | 该计数器需 ARB_occlusion_query |
| draw call 数 / 提交次数 | 不能 | 需抓帧;本机能数的只是「自己发了多少条命令」 |
| Graphite 的任何运行时读数 | 不能 | 绑定里没有 MakeDawn(§2.2) |
| 跨机型、跨驱动的结论 | 不能 | 本篇是单机单驱动读数(§2.3) |
这张表比前面所有读数都重要。 因为它划出了「本机自跑」这类文章的诚实边界: 能测的量给出数字,不能测的量给出原因——而不是用能测的量去近似不能测的量。
还有一点要说清:本轮没有换第二台机器复测。这不是偷懒,而是本系列的定位——它做的是「把机制跑给人看」,不是「出一份跨机型基准报告」。真要出跨机型结论,需要固定内容、固定版本、多驱动多 GPU 采样,并且报分位数与方差——那是另一类工作。本机能给的是「这条路怎么走通、走通后看到什么」,以及一条明确写着的限制:这些数是单机单驱动的。
好了,把分母也定义清楚。
10.2 命令与路径规模:计数的分母
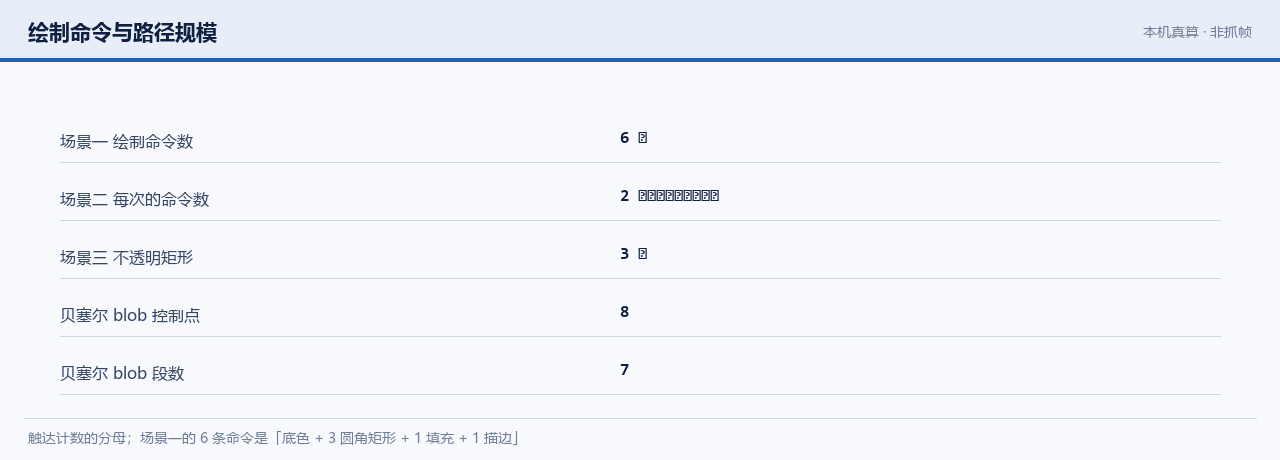
| 项 | 读数 |
|---|---|
| 场景一绘制命令数 | 6 条(底色 + 3 圆角矩形 + 1 填充 + 1 描边) |
| 场景二每次的绘制命令数 | 4 条(裁剪前后相同) |
| 场景三的不透明块 | 1 张 |
| 贝塞尔 blob 控制点 | 8 个 |
| 贝塞尔 blob 段数 | 7 段 |
为什么要单独列这张表:触达计数的分母就是「发了多少条命令」。 场景一平均触达 0.843,是用 5 条计入触达的命令(不含底色)在一张 512×512 画布上摊出来的结果。 离开命令数和画布尺寸,overdraw 的绝对值没有意义。
顺带一个细节:那条贝塞尔填充路径只有 8 个控制点、7 段,而它贡献了 31,729 个被触达像素。 路径的规模用控制点数衡量,和它覆盖的像素数完全不成比例——这也是矢量图形的特点: 几何描述可以很短,但光栅化的代价由覆盖面积决定。
这条性质对 overdraw 有个直接推论:减少路径的控制点数,基本不会减少 overdraw;而缩小绘制面积、压低叠层数才会。很多优化建议把这两件事混在一起讲(「把路径简化一下能省很多」),但从本篇这几个场景的构成看,真正在动的量是触达面积 × 叠层数,路径的控制点数只影响求交与展线的计算量——那是另一笔账。
10.3 本章收在哪里
这一章我们把「测不了什么」逐条交代了。最后一章做收束:给三句判断,把不属于本篇的题域让出去,然后预告下一篇。
官方依据:本机能测与不能测的判定依据见 §2.2(绑定缺失项)、§5.1(官方口径与硬件前提)与 §6.4(自建计数的语义边界)。;GPU 侧与 CPU 侧的后端划分见 SkCanvas Creation;
MakeDawn的缺席见 GrDirectContext 参考页。
十一、边界回指与预告
好了,最后一章来做收束。
11.1 三句判断
把本篇的读数压成三句可用的判断:
- 要看「重复做工」落在哪块区域 → 用触达计数图;它是本机唯一能得到的 overdraw 形状;
- 要减少填充成本 → 先压叠层数、再上裁剪:本机读数里,裁剪让被触达像素少了 50.1%, 而层数从 1 加到 5 让单位像素触达从 0.266 涨到 1.335;
- 要减少提交成本 → 裁剪没用(命令数一条不减),得靠排序与合并(第五、六篇那套)。
而三条判断背后各有一个可核对的量:触达计数图、被触达像素与全域平均触达、绘制命令数。换成一句更实用的写法,其中:触达计数图对应「重复做工落在哪」,被触达像素与全域平均触达对应「填充成本」,绘制命令数对应「提交成本」。
最后交代一句本篇没做的事:没有做多机复测、没有做长时稳定性、也没有去追 GPU 侧的片元计数。这三件都属于「把结论推到更广范围」的工作,而本篇的目标只是把一条路走通并把读数摆出来。把边界写在结论旁边,是自跑类文章唯一能守住的东西——因为读数会过时,边界不会。
再补一句本篇做得最刻意的事:把「提交时间」和「完成时间」分开报(§4.3)。 如果只报那 0.30 ms,读者会以为 GPU 比 CPU 快几十倍——而那个数根本没有包含它在画的时间。 自跑类文章的价值,一半在读数,一半在说清读数是什么。
好了,把不属于本篇的题域定义清楚、让出去。
11.2 让出去的题域
按本系列的习惯,把不在本篇的题域显式让出去:
- Graphite 的运行时行为与 compute 光栅化 → 第六篇已给机制读数,运行时本篇跑不了;
- Vello / piet-gpu(sparse strips、四阶段、prefix-scan)→ ep09/ep10;
- SKP 回放与字体渲染差异 → ep08;
- GPU 抓帧、片元计数、draw call 统计 → 需要 RenderDoc / AGI 一类工具,本系列暂不做;
- 跨机型与移动端功耗 → 超出本系列范围。
11.3 下篇预告
本篇到此为止。下一篇(ep08)继续「自跑」,换两个输入: 一个是 SKP 回放——把一段录好的绘制回放出来,看同一份内容在不同后端上怎么落地; 另一个是字体渲染差异——换大小字号与 CJK 字形,看渲染结果会怎么变。
本篇给的是一条路径的对照读数,下一篇给的是一批内容的对照读数。 两者合起来,「Skia 的两条路长什么样」这件事就算有了本机证据。
官方依据:本篇本机环境与全部读数的口径见 §0.4、§2.3、§4.1 与 §6.4; GPU 侧与 CPU 侧的后端划分见 SkCanvas Creation; 下一篇的路线见 .scratch/research/2D矢量引擎专题-20260923.md 第四节「可自跑实验集」。
参考资料
- Android — Reduce overdraw(overdraw 定义与成因)
- Chromium — GPU Overdraw Debugging Tool(viz.overdraw 计数器与颜色档位)
- Google Developer Training 4.1B — Debug GPU Overdraw(五档颜色逐字)
- Google Web Tracing Framework — Analyzing Traces(平均每像素被绘制次数)
- NVIDIA Jetson 开发者指南 — OpenGL ES Programming Tips(depth complexity)
- Skia Graphite 官方博客(overdraw 与深度测试)
- SkOverdrawCanvas.h(官方 overdraw 画布的定义)
- SkOverdrawCanvas.cpp(1/255 增量矩阵的实现)
- SkOverdrawColorFilter.h(六档颜色映射)
- SkKnownRuntimeEffects.cpp(内置 Overdraw runtime effect)
- Skia Debugger 官方文档(Display Overdraw Viz)
- SkCanvas Creation(Raster 与 GPU 两条后端)
- Skia Fiddle — overdraw 示例(SkOverdrawCanvas + SkNWayCanvas)
- Apple WWDC 2020/10602 — Harness Apple GPUs with Metal(片元着色调用数口径)
- Arm Community — Mali GPU Tools: A Case Study, Part 2(2.44 fragment instances/pixel)
- skia-python 参考页 — GrDirectContext(MakeGL 的重载清单)
- skia-python 参考页 — Surface(MakeRaster / MakeRenderTarget)
- skia-python Issue #345 — headless 环境下 MakeGL 返回 None
- skia-python Issue #218 — Windows 上 GL 测试被跳过与 WGL 报错
- skia-python PR #5 — OpenGL surface API(Likely crashes on Windows)
- skia-python 发行说明 m138 — OpenGL 补丁与平台要求
- GLFW 官网(本篇用来建 GL 上下文)
- skia-discuss — Overdraw Canvas save layer restore(CPU 与 GPU 的累加差异)
- skia-python-examples(官方整理的 GL 上下文示例)
- skia-python 发行页(本篇本机跑用的绑定)
- skia-python Tutorial — Canvas Creation(Skia 不替你建上下文)
- Frank Luna《Introduction to 3D Game Programming with DirectX 11》— depth complexity 的教科书表述(二手引用)
- CSDN — GPU 过度绘制实现原理(Skia 侧计数机理的中文梳理)
- Habr — Flutter Impeller vs Skia Raster 实测(跨引擎对比)
- pistack — C++ 2D Graphics Libraries 对比
- 掘金 — Flutter 性能优化实践(离屏与裁剪开销)
- sujeet.pro — Critical Rendering Path: Rasterization(软件光栅与 GPU 光栅两条路径)
- Commons — Category:Rasterization(本篇 EXT 的主要来源类目)
- Commons — Rasterizing triangle edge.svg(题图:一条边穿过哪些像素)
- Commons — Polygon scan-conversion.svg(扫描转换)
- Commons — Rasterisation-triangle example.svg(三角形覆盖判定)
- Commons — Gupta-Sproull pixel selection.svg(解析式覆盖的像素选择,备选)
- Commons — Edge fill.svg(边填充规则)
- Commons — Line scan-conversion.svg(直线扫描转换的像素选择)
- Commons — Pipeline OpenGL.svg(GL 管线的阶段)


本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑/真算的读数图由本篇测量脚本产出(图注写明口径); 自绘图为本系列绘制,走
styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:下一篇继续「自跑」——换两个输入:SKP 回放与字体渲染差异。看同一份绘制内容与同一批字形,在两条后端上会怎么落地。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.