核心问题:图元装配(primitive assembly)把顶点连成三角形之后、光栅化把三角形倒成像素之前,GPU 上还有一段能改变图元命运的"几何前端"——按图元改/生成图元(几何着色器,geometry shader)、把顶点旁路写回内存(流输出,stream-out)、把低位图元细分到更细(细分曲面,tessellation)。本篇把这三件事当作同一条几何前端来读:它们都在光栅化之前运行,都以图元/补片(patch)为单位而非以像素为单位,而且都付着一笔"改变图元形态"的量价账——二次装配、不可预知的输出规模、成倍增长的顶点流。全篇收在"GS 的能力常被计算着色器与 mesh shader 取代"这句对几何前端的告别上。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
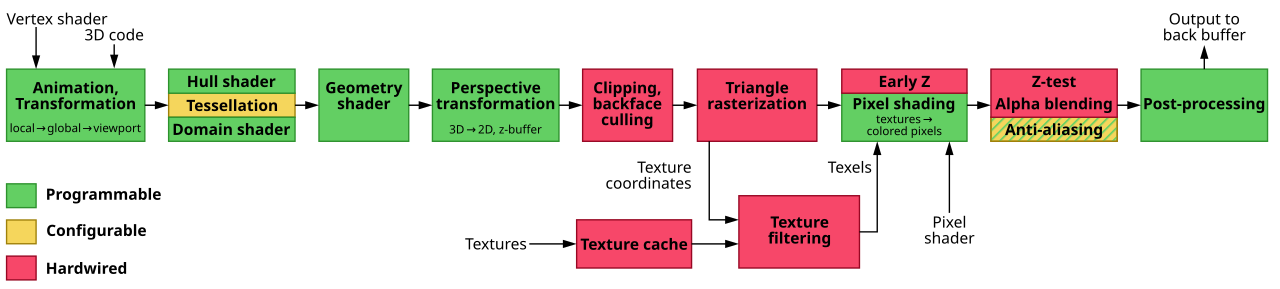
一句话点题:光栅化之前还有一段"几何前端"(set-context)
好了,上一系列我们把三角形一路送进了屏幕:顶点着色器把顶点搬到裁剪空间,图元装配把它们连成三角形,光栅化 setup 算好边函数,光栅化器把覆盖的像素逐一产生出来。故事讲到这儿,似乎三角形一旦连好,就该直接倒成像素了。但管线在装配与光栅化之间,还夹着一小段很多人听过名字、没认真读过的地带——按图元工作的可编程段与固定功能段,它们能在光栅化之前改写图元本身。
你可能会问:都已经把三角形准备好了,为什么还要在它身上动刀?说白了,问题恰恰藏在"图元"这两个字里。顶点着色器只能 1 进 1 出(fgiesen · Part 3:顶点处理),它没有能力把一个三角形变成五个、把顶点的中间结果写回内存、或把一个粗糙的大三角形按补片细分出几千个精细的小三角形。这些事需要一个以图元为单位的前端——而这正是本篇的主角:几何着色器(geometry shader,GS)、流输出(stream-out,SO)与细分(tessellation)。
本篇不涉及什么、为什么: - 不写"怎么写 GS/HS/DS 着色器"——HLSL/GLSL 语法、细分因子的调参技巧属于算法层(《实时渲染管线探析》)。 - 不重复网格着色器(mesh shader)的完整实现——那是 ep12"2011 之后"的预告,本篇只做对照与交棒。 - 不展开 Catmull-Clark 这类离线细分曲面(subdivision surface)——硬件 tessellation 是按 patch 实时铺点,两者机制不同。
出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》· Part 10/11/12(GS / Stream-Out / Tessellation 的硬件机制)(CC0 公有领域)。
这一章要回答的,是几何前端这条线:图元从哪来、GS 按图元执行到底要付什么代价、SO 怎么把顶点旁路写回内存、细分那五个阶段各自干什么、域坐标与缝合为什么是工程难点——更重要的是,为什么到 2011 年之后,GS 的这些能力被逐渐边缘化。读完全篇你会发现,"为什么被边缘化"的答案其实就藏在每一节的账里,其中:二次装配、不可预知的输出规模、成倍增长的顶点流——这些代价在 2011 年靠专用单元与固定功能硬扛,到 2011 年之后被更通用的计算模型摊平。这条"专用 → 通用"的迁移线,正是本系列从本篇到 ep12 的主旋律。
OK,下面我们先把这条几何前端放进系列的全景图里。我们已经走完的命令前端(ep01)把 Draw 送进 GPU、显存与地址空间(ep02)讲清了数据怎么进出、着色器核(ep03)解释了可编程阶段如何并行、图元装配(ep05)把顶点连成图元、光栅化(ep06)把图元倒成像素、像素后端(ep08)负责把像素写回显存——而本篇夹在装配之后、光栅化之前:这一小段"几何前端"不是装配的一部分,也不是光栅化的前置,它是能改写图元本身的独立地带。系列的知识地图在技术博客页汇总,本篇负责其中"几何前端"这一站。
而在谈"图元从哪来"之前,先来看看实物:下面的 Intel 810 芯片组是 1999 年的一块整合北桥,图形核心(含图元装配与光栅化)就嵌在这颗芯片里——"几何前端"在独立 GPU 诞生前,就是北桥里的几百万个晶体管。这块芯片与显卡实拍(§九)一头一尾,恰好框出几何硬件从北桥时代到独立 GPU 的二十年跨度。
一、图元从哪来:先再谈一次 primitive assembly(set-context)
好了,要把"几何前端"讲清楚,得先回到它的输入——图元装配(primitive assembly,PA)。上一系列 ep05 我们讲过装配的机制,这里只回放关键的几条:顶点着色器输出的是顶点流(一个顶点一个顶点),而 GS 的输入是完整图元——三角形三点、线段两端、或一个点。装配器(assembly unit)负责把索引缓冲引出的顶点按拓扑连成图元,再交给后续阶段。
这里值得再钉一层:顶点流从哪来。顶点数据躺在顶点缓冲(vertex buffer)里,但 GPU 不会按顺序把缓冲从头读到尾——绘制指令带上索引缓冲(index buffer),装配器按索引取值(fgiesen · Part 5:Primitive Assembly)。索引缓冲的意义是复用:一个顶点被 6 个三角形共享时,索引缓冲让它在内存里只存一份,装配阶段按索引引用三次(这正是索引绘制的带宽账,ep02 展开过)。拓扑则决定了装配器"几个顶点连一个图元":D3D11 定义了 8 种图元拓扑(D3D11 · Primitive Topologies),其中:除了点表、线段表/线段带、三角形表/三角形带,还有带邻接(adjacency)的变体——三角形带邻接一次喂 6 个顶点,多出的 3 个就是"共享这条边的邻居顶点",专供 GS 读取邻接信息(§十 会讲到这是 GS 的一项关键能力)。
装配之前还有最后一站值得钉一下:顶点变换后缓存(post-transform cache)。索引缓冲让装配器"按索引取顶点",但同一个顶点被 6 个三角形共享,意味着它可能被取 6 次——如果每次都重新跑一遍顶点着色器,就是 6 份重复计算。硬件于是在 VS 输出与装配之间加了一层按索引暂存的缓存:顶点经 VS 变换后按索引暂存,同索引再次被引用时直接命中缓存、跳过重复变换。缓存容量有限(2011 年前后桌面硬件是几十到上百个顶点),命中率决定装配的实际计算成本——这也是三角形带/扇这类顺序访问拓扑在旧硬件上更快的原因:共享顶点还活在缓存里时就被再次引用,命中率天然更高。这条缓存是"索引绘制为什么省"的第二层账:第一层省带宽(顶点只存一份,ep02),第二层省变换(共享顶点只算一次)。
先来看看装配器的输入打包成什么样:D3D11 把"顶点缓冲 + 索引缓冲 + 拓扑 + 实例化参数"捆成一个装配任务,交给 input assembler(IA)阶段执行。IA 同时还负责一层装配级实例化(instancing):不换顶点缓冲,靠"每实例数据"(instance step rate)让同一批顶点按实例重复装配——这跟 §二 的 GS 实例化是两种粒度:IA 实例化在装配层复制图元,GS 实例化在着色器层复制输出,前者不花着色器指令、后者不花装配带宽,工程上各有用武之地。
硬件得到的不是"随手扔过来的顶点",而是一份份装配好的图元数据。这带来一个直接后果:GS 必须先有 PA 才能工作。因为 GS 的输入拓扑是"三角形列表"或"三角形带",如果装配没有发生,GS 根本拿不到"一个完整三角形"。
术语一致性声明:下文"装配(PA)/ 二次装配(二次 PA)/ 几何着色器(GS)/ 流输出(SO)/ 细分"以 D3D11 世代的可编程图形管线为骨架,硬件实现以 2011 年前后 NVIDIA/AMD 的实例为参照——不代表所有 GPU 的细节完全一致,这点会在各节声明限定。
出处:Vulkan 规范 · Vertex Post-Processing/D3D11 图形管线/D3D11 · Input Assembler 阶段/fgiesen · Part 3(顶点变换后缓存)。
把输入钉牢,我们就可以下钻到第一个主角了——以图元为单位执行的几何着色器。
二、几何着色器:以 primitive 为单位执行(explain-structure)
好了,几何着色器(geometry shader,GS):以完整图元为输入、输出零到多个新图元的可编程阶段。它插在 PA 与光栅化之间,是管线里唯一一个"一个图元进、任意多个图元出"的可编程阶段。
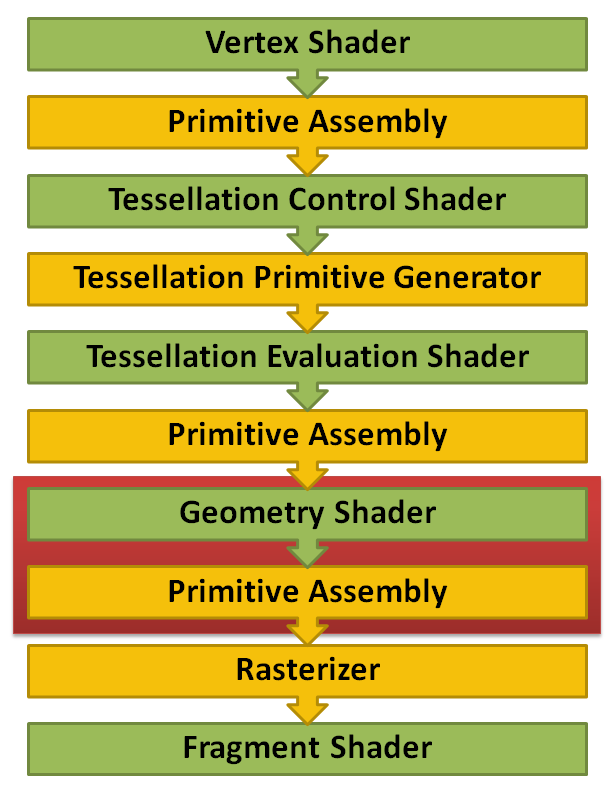
GS 的输入是完整图元(三角形三点,可选带邻接的六点),输出是新的顶点流——拓扑可变、顶点数可变。这与顶点着色器的根本差异在于:输出规模在运行时才知道。VS 的预算固定(1 顶点进 1 顶点出,硬件的执行槽可以预先排满),而 GS 一进可以出 0 个、1 个、几十个顶点——硬件无法预先知道这次调用要占多少执行槽、写多少数据。
GS 调用还有一层"实例化"(geometry shader instancing):一次输入图元可以按声明中的实例数重复执行多次,其中:每次实例拿到的 SV_GSInstanceID(D3D11 语义)从 0 起递增。这让 GS 能用一份代码对同一个图元做多份输出——比如把一个粒子点同时展开成面向六个方向的公告板(billboard),就是靠实例数 6 一次跑完,而不是把图元复制六遍交给六次调用(实例化的通用机制见 GPU Gems 2 · Ch.3 Inside Geometry Instancing)。输出规模则受声明上限约束:GS 在编译期声明 MaxVertexCount(每个实例最多输出多少顶点,D3D11 硬件上限通常 1024),这个上限直接决定硬件要预留多大的暂存——上限声明得越大,暂存越宽,这也是"输出规模不可预知"的第一层代价。
发射语义也值得说清:GS 不是"返回一个顶点数组",而是用 EmitVertex() 把当前顶点逐个发射、用 EndPrimitive() 结束当前图元(HLSL 语法)。发射出去的顶点立刻进入输出暂存,攒够一个图元(按输出拓扑的点数)就往下游送。输出拓扑被限定为点、线带、三角形带三种——因为只有 strip 是下游装配能流式消费的拓扑(§三 第二笔账)。发射多少次、何时结束一个图元,完全由着色器在运行时决定——这正是"GS 的输出规模不可预知"在 API 语义层面的来源。
先来看看硬件怎么应对这种"无法固定预算"——答案是不预先固定:GS 的执行以图元为单位派发,输出通过一块可增长的暂存区攒起来,攒够一个图元再往下游送。这带来两个直接后果:其一,GS 的执行开销不与输入顶点数成正比,而与输出顶点数成正比;其二,下游的装配必须重新做一次——这就是下一节的主角,二次 PA。
限定声明:GS 的硬件实现在不同厂商差异很大(有整段专用硬件、也有完全靠通用着色器核模拟的),但"输出规模不可预知"这条性质是 API 语义决定的,任何实现都躲不掉。
出处:Vulkan 规范 · Geometry Shading/WDDM 驱动模型 · Geometry Shader 阶段/fgiesen · Part 10。
GS 能按图元生成,那代价呢?下一节把这笔账算清楚。
三、GS 真正的代价:二次 PA 与 pass-through(prove-claim)
好了,先来看看 GS 的代价——它不在"着色器指令本身",而在破坏了下游两个假设:拓扑连续与预算固定。
第一笔账:二次装配(second PA)。 顶点着色器的输出是连续顶点流,装配器可以流式地"攒 3 个连成三角形";而 GS 的输出是可变数量的零散图元——其中:"零散"是关键。它可能把一个三角形变成 5 个三角形,也可能输出 0 个(直接丢弃)。下游光栅化器需要的是连续图元流,于是硬件必须把 GS 攒出来的零散顶点再装配一次。这一趟二次 PA 意味着:顶点数据要再走一遍装配单元、拓扑信息要重新计算——纯开销,不产生任何新几何。
第二笔账:只能输出 strip。 GS 的输出拓扑被限定为"点/线带/三角形带"(point/line strip/triangle strip),因为 strip 是下游装配唯一能流式消费的拓扑——GS 想输出独立的三角形列表,也得自己用 strip 语义拼。可 strip 拓扑有个老问题:切分(cut)时会产生退化图元,下游光栅化要浪费吞吐剔除它们。
第三笔账:pass-through 也慢。 说白了,fgiesen 在 2011 年的实测里指出:即便 GS 什么都不做、原样转发输入顶点(pass-through),整个几何阶段的吞吐也会比不启用 GS 慢 3–7 倍——因为顶点必须经过"装配 → GS 执行 → 二次装配 → 光栅化"这条更长的路径,而且 GS 输出暂存区的读写都占用片上带宽。这里要补一层背景:3–7 倍的差距不是"着色器指令贵",而是执行槽的浪费——GS 以图元为单位派发,一个三角形(哪怕只输出 3 个顶点)也要占一个完整的执行槽;硬件为可变输出准备的暂存区,无论这次实际发射几个顶点都要读写一遍;再加上二次装配的纯开销,几何阶段的吞吐被这条"多出来的路径"系统性拖慢。
量化口径:3–7 倍为 fgiesen 2011 年对当时硬件的实测观察,不代表现代 GPU 的绝对值;但"启用 GS 必经二次装配、pass-through 不比不启用快"这个方向性的账,到今天依然成立。
出处:fgiesen · Part 10(GS 开销)/fgiesen · Part 5(装配与 strip 语义)(CC0)。
既然 GS 这么贵,那"把顶点写回内存"这种事,能不能不走光栅化?能——这就是流输出。
四、流输出:把顶点旁路写回内存(show-flow)
流输出(stream-out,SO):从 GS(或 VS,或 DS)的输出口,把变换后的顶点原样写进显存里的 vertex buffer,旁路掉光栅化与像素阶段。它是"几何前端"里唯一一个不往屏幕走、往内存走的出口。
先来看看它在管线里的位置:D3D11 的管线里,SO 挂在可编程阶段输出口之后——启用 GS 时它是 GS 的输出口,不启用 GS 时可以直接从 VS(或细分后的 DS)输出口接出。这一点很关键:SO 不需要 GS 在场,它只是"输出口上的一根分叉"。而 SO 写什么、按什么布局写,由流输出声明(SoDecl)在编译期定死——声明里列出要写回的元素(位置、法线、自定义属性)与它们在顶点缓冲里的偏移,运行时把每个输出顶点按声明打包写回。布局有两种:交错式(interleaved)把所有元素打进一个缓冲、按顶点交错排列;分离式(separate)每个元素一个缓冲(D3D11 最多 4 个分离流)。选择取决于下游怎么读——粒子系统通常交错单缓冲,而需要单独取位置做碰撞的场景用分离流更省带宽。
好了,SO 的典型用例是把 GPU 算过的顶点数据拿回来继续用:物理粒子的位置更新后写回,下一帧再读出来渲染;布料模拟的顶点位移写回,用来做碰撞;网格变形、GPU 蒙皮——凡是"顶点要变、变完还要再进管线一次"的场合,SO 都是最直接的回写口。但它的工程账不便宜,有四个限制要记牢:
- 写口带宽:SO 写回的是完整顶点(可能几十字节一个),写回量 = 顶点数 × 顶点大小。粒子系统几百万粒子一帧,就是几百 MB 的写带宽——这笔账通常比渲染本身还贵。
- 缓冲 counter 上限:SO 写入的缓冲带一个隐藏的 counter(记录已写顶点数),D3D11 硬件这一代上限是 2^24 或 2^32 个顶点(64M/4096M)。写满后 SO 会静默停止写入,下一帧不加处理就会读到残缺数据。
- 同步/回读延迟:CPU 要读回 GPU 写的顶点,必须走"等待 GPU 完成 → 映射 → 拷贝回 CPU 可见内存",一帧的延迟是常态;每帧回读在移动/低功耗设备上基本不可行。
- 与光栅化的互斥:一条 GS 输出要么全走光栅化、要么全走 SO——想"既渲染又回写"得开两条 pass 或复制一份顶点流。
SO 与 counter 的搭配,还有一层工程细节值得展开:D3D11 提供了 DrawAuto——让 GPU 按 SO 写回的顶点数自动决定本次绘制取多少顶点,CPU 完全不用知道上一帧 SO 实际写了多少(否则 CPU 得读回 counter,又落进同步延迟的坑)。于是"SO 写回 → 下一帧 DrawAuto 读回再渲染"构成一条免 CPU 介入的 GPU 内循环:物理/粒子/布料这类"GPU 算、GPU 用"的数据,可以整条留在 GPU 上流转。与之对应的另一条路径是把 SO 缓冲绑成 UAV(unordered access view)给计算着色器当输入——这是 SO 与 CS 的第一次交汇,也是 §十 的核心论点"CS 直写 buffer 取代 SO"的接口基础:既然 SO 写回的数据最终要能被任意阶段读,那"写回"这件事本身由 CS 来做,就把 SO 这条专用路径整段省掉了。
需要说明:SO 的 counter 上限与同步延迟都是硬件与驱动实现层的限制,API 层只保证"SO 能写回",不保证"写回后立刻可用"——这正是 ep11"同步与资源生命周期"要展开的主题。
出处:fgiesen · Part 11(Stream-Out)/D3D11 · Stream-Output Stage/D3D11 · SO 计数器上手/UWP · Stream-Output Stage。
SO 是把顶点往内存送,而第三个主角的方向相反——它把一个粗图元往"细"里做。这就是细分。
五、细分:D3D11 世代的新固定功能段(explain-structure)
细分(tessellation):把输入的低模补片(patch)按细分因子实时铺成更密的网格。它在 D3D11 世代被引入管线,由两个可编程阶段 + 一个固定功能段组成,插在 PA 与 GS 之间(无 GS 时插在 PA 与光栅化之间):
- Hull shader(HS,外壳着色器):可编程。输入 patch 的控制点(D3D11 里一个 patch 最多 32 个控制点),输出两样东西:①变换后的控制点(交给 DS);②细分因子(tessellation factors)——沿 patch 每条边和内部要细分多少段(交给 Tessellator)。
- Tessellator(细分器):固定功能,不可编程。按细分因子在 patch 的域(domain)上铺点,生成一批带域坐标(u, v, w)的新顶点。它不碰任何几何数据,只负责"铺多少点、按什么规则连"。
- Domain shader(DS,域着色器):可编程。对 Tessellator 铺出的每个域坐标执行一次,把域坐标映射到对象/世界空间(控制点插值 + 可选的位移映射)。
先来看看 HS——它是"一个可编程阶段、两个入口"的典型:patch constant function 每个 patch 只执行一次(算因子、算 patch 级常量),main 函数每个控制点执行一次(变换控制点)。两个入口的输入输出在编译期分开声明,这决定了硬件如何派发——因子计算只有一次、控制点变换并行 N 次,两者天然是不同粒度的工作。说白了,Tessellator 的"不可编程"要往深里读一层:它不是"没有着色器",而是整个铺点算法被焊死在硬件里——域的类型、铺点规则、因子取整规则都是固定的,API 只传"域 + 因子"两个参数。固定换来的是吞吐:一个 Tessellator 单元每周期能铺出几十个新顶点(fgiesen 在 Part 12 里把它比作"一个极窄但极快的专用单元"),没有任何可编程单元能追上这个吞吐。
//-----------------------------【细分三阶段伪代码】-------------------------------
// 描述:HS/Tessellator/DS 各自负责什么(对应 D3D11 管线语义)
//-------------------------------------------------------------------------------
//【1】HS:读控制点(≤32) → 输出变换后控制点 + 内/外细分因子
//【2】Tessellator(固定功能):按因子铺域坐标(u,v,w),生成新顶点"壳"
//【3】DS:每个域坐标执行一次 → 插值控制点 + 位移映射 → 输出世界空间顶点
// 可选第 4 步:GS 按图元处理细分后的三角形(再入二次 PA 的代价)
关键在第 2 步的"不可编程":Tessellator 是固定功能单元,不执行着色器指令——它是被硬件"焊死"的铺点算法,这也是它吞吐极高的原因(一个 Tessellator 每周期能铺几十个新顶点)。这也是为什么我们说细分是"D3D11 世代的新固定功能段"。
限定声明:本节以 D3D11/Vulkan 的细分语义为骨架。OpenGL 4.x 的同名阶段(TES/TCS)行为等价,只是名称不同;移动端 GPU 上 Tessellator 的实现与桌面差异较大,详见《移动端图形与功耗》。
出处:Vulkan 规范 · Tessellation/D3D11 · Tessellation 阶段总览/fgiesen · Part 12。
五阶段的骨架有了,那 Tessellator 到底怎么"铺点"?下一节看域的铺法与细分因子。
六、域的铺点与细分因子(show-flow + prove-claim)
好了,Tessellator 在域(domain)上铺点。D3D11 支持三种域,对应三种"怎么把一个 patch 切成网格"的规则:
- triangle 域:patch 是三角形,域坐标是重心坐标 (u, v, w),u+v+w=1。
- quad 域:patch 是四边形,域坐标是 (u, v),各取 [0,1]。
- isolines 域:patch 是线带,域坐标 (u, v) 铺出等值线(适合做地形等高线这类"线"几何)。
铺多密由细分因子(tessellation factor)决定。其中:每边一个边因子(edge factor)、patch 内部一个内部因子(inside factor)。HS 算出因子后,Tessellator 严格按因子铺点——因子是浮点数,实际铺出的段数是 ceil(factor)(内部因子还有向偶数取整的规则,保证内部网格能对缝)。
"向偶数取整"值得展开:D3D11 的 Tessellator 支持四档取整模式(D3D11 · Tessellator 初始化)——integer(直接取整)、pow2(取到 2 的幂)、fractional_odd(取到 ≥1 的奇数)、fractional_even(取到 ≥2 的偶数)。后两档"分数取整"的妙处在于因子渐变时不跳变:相邻 patch 的因子从 4 平滑过渡到 5 时,顶点数不会突然蹦一跳,网格的 LOD 过渡是连续的(这对 §八 的缝合问题直接相关——因子取整模式决定了"共享边两侧的段数是否天然对齐")。内部因子还必须 ≥2(偶数档)或 ≥1(奇数档),避免内部退化成没有网格的空 patch。这些规则不是 API 的边角料,而是"铺点结果可预测"的契约——下游的 DS 与光栅化都依赖"这个 patch 到底会铺出多少顶点"这件事是确定的。
四档取整各自的主场值得点一下,工程上它们不是随便选的:integer 用于程序化生成的固定网格(铺点结果必须逐帧完全一致,比如 UI 网格、体素表面);pow2 用于要与 mipmap 层级对齐的场景(§七 会讲因子与 mip 的联动,因子取 2 的幂可以让几何密度与纹理密度同步进退);fractional_odd/even 用于地形、角色这类"近看细、远看粗"的连续 LOD——它们牺牲一点"铺点结果完全整数化"的确定性,换回 LOD 过渡不闪跳。而 isolines 域的铺法与三角/quad 不同:它沿 u 方向铺线段、沿 v 方向铺行数(边因子决定行数、内部因子决定每行段数),输出是线而非面——地形等高线、天气雷达剖面这类"要线不要面"的场景专用。三种域 + 四档取整,是"铺点规则"这个设计空间的全部切面,Tessellator 固定功能把它们焊死,DS 才拿到"输入 (u,v,w) 必落在已知网格上"的确定性。
先来看看顶点数怎么估:quad 域、内部因子 f 时,内部铺 (⌈f⌉+1)² 个顶点(含边界),三角形化后约 (⌈f⌉+1)²×2 个三角形。把数字放大看:
量化口径:quad 域 f=32 时,(33)²×2 ≈ 2178 个三角形——一个 patch 从"4 个顶点"变成"两千多个三角形",顶点量翻了两个数量级以上。这也是为什么"细分因子失控"是性能灾难的常见来源:铺点不花着色器指令,但下游光栅化与像素阶段要吃下全部新增三角形。
出处:fgiesen · Part 12(Tessellation 因子与顶点数)(CC0)。
Tessellator 铺出的只是一堆"域坐标",真正把它们变成世界里的顶点,是 DS 的活。
七、域坐标、DS 映射与带宽账(show-flow + compare-options)
好了,域坐标(domain coordinates):Tessellator 输出的、定义在 [0,1](或重心)空间里的归一化坐标。它不是世界空间里的位置——只是"这个新顶点在 patch 上的相对位置"。
DS 的映射:对每个域坐标,DS 做两件事——①把 patch 的控制点按插值权重合成位置(三角形用重心插值,quad 用双线性插值);②可选地叠加位移映射(displacement mapping):采样一张高度图,沿法线把顶点"顶"出去。这一步把域坐标变成对象空间顶点,交给光栅化。
位移映射的细节值得展开:高度图是普通纹理,DS 按域坐标采样得到高度值,再沿插值出的法线把顶点位移出去。问题随之而来——位移后的表面法线不再是插值法线,光照会错。标准做法是在 DS 里对高度图做有限差分(取相邻 texel 的高度差近似偏导),重建位移后的切线与法线,再传给像素阶段。这条链让"细分 + 位移"几乎等于"在 GPU 上实时做置换建模":低模控制点只定义大致形状,细节全部来自高度图。也正因为细节在纹理里,LOD 的粒度就多了一维——细分因子控制几何密度,mipmap 层级控制高度图分辨率,两者要联动才不会出现"几何密了、高度图糊了"的错位(这正是 §六 因子取整与 mip 选择的联动场景)。
位移映射的工程限制也要说透。其一,三角形密度与高度图分辨率要联动:细分把几何密度提上去之后,若高度图 mip 没有跟着提,顶点被"顶"出去的细节会糊成一片——§六 说的"因子取整与 mip 联动"就是为这件事准备的两道旋钮。其二,自相交问题:位移幅度超过 patch 局部特征尺寸时,相邻顶点可能互相穿透、网格自交,业界通常把位移幅度钳制在特征尺寸的某个比例以内。其三,碰撞与剔除的复杂度:位移后的表面与原始低模不再一致,物理碰撞、背面剔除都要以"位移后表面"为准,这部分成本常被低估。这些限制不是细分特有的,而是"运行时生成几何"共有的——DS 现场算顶点的自由度,同时把"正确性"也交到了着色器手里。
先来看看 DS 映射的带宽账——细分最漂亮的一张表。对比两条路:
- 传统 LR(linear rendering)顶点流:精度靠预生成——要精细就得在内存里存几百万个预细分顶点,加载、变换、写回全程吃显存带宽。
- patch 域按需生成:内存里只存低模控制点(几百个顶点 + 一张高度图),精细顶点是 DS 现场算出来的——同样精细度,内存带宽省一个量级(不预存、不回写,只有控制点进出)。
量化口径:"省一个量级"指同精细度下,patch 方案搬运的数据是预生成方案的 1/10 上下(控制点密度 vs 细分后顶点密度之比),具体比值取决于细分因子与 patch 大小。这是细分在带宽受限的移动/嵌入式场景(如 terrain、角色细分)被广泛采用的核心原因。
出处:fgiesen · Part 12(DS 与带宽)(CC0)。
DS 按域坐标现场算顶点,省了带宽,却埋下一个坑——相邻 patch 各算各的,共享边怎么办?这就是缝合问题。
八、缝合与工作集(show-flow + explain-structure)
先来看看细分最经典的工程坑:裂缝(crack)。相邻两个 patch 如果细分因子不一致,共享边上两侧的顶点密度就不同——一侧把边切成 8 段,另一侧切成 4 段,两边的顶点位置对不上,网格就裂开了一条缝(光照、深度测试都会穿帮)。
消除裂缝的标准手段,是让共享边的因子一致:
- 沿边取统一因子:每个 patch 的每条边,在 HS 里用与邻居相同的规则计算(通常由边两端的顶点属性 + LOD 函数决定)——只要规则一致,相邻 patch 在同一根边上就会算出同一个因子,顶点就对齐了。
- 顶点落边规则:DS 里对"落在共享边上的顶点",必须用同一条边的插值规则(而非自己 patch 的面规则)来算位置——这保证即使因子一致,两个 patch 算出的同一边上顶点坐标也逐位一致。
好了,工作集(working set)是第二个隐性成本:细分按 patch 逐块处理,但一个 patch 的因子会影响相邻 patch(LOD 选择要考虑邻居密度)。硬件为了一次性处理一块"相互影响的 patch 区域",要暂存一批 patch 的数据——这个暂存区就是细分的工作集。patch 越大、因子越细,工作集越大;width(一次能并行处理的 patch 宽度)决定了细分的吞吐上限。
这里再往工程里走一层:LOD 选择怎么算因子。标准做法是屏幕空间误差驱动——HS 在 patch constant function 里取每条边两端顶点的世界位置,投影到屏幕算出边长(像素数),再除以一个目标误差阈值(比如 1–4 像素),就得到这条边的细分段数。边越近、越大,因子越高;边退到屏幕外,因子可以降到 1(不再细分)。这套"投影尺寸 ÷ 误差预算"的公式,与 mipmap 的 LOD 选择是同一个思路——只是它作用在几何上。而 width 的硬件含义则是:Tessellator 一次吃进 width 个 patch 并行铺点(fgiesen 在 Part 12 里提到当时桌面硬件一次并行处理 32 个 patch 量级),工作集就是这 width 个 patch 的暂存。因子越细,单个 patch 铺出的顶点越多,暂存压力越大——所以"因子失控"不只是下游光栅化的问题,它首先撞爆的是细分自己的工作集。
"屏幕空间误差驱动"不是本篇发明的说法,它是细分曲面进入实时管线时的经典方案:GPU Gems 2 第 7 章《Adaptive Tessellation of Subdivision Surfaces》就把"按屏幕空间误差自适应决定细分密度"作为细分的主要动力之一,并给出过一套基于曲率的误差估计方法(以视距与表面曲率共同驱动因子)。这条谱系要说明的是:因子不是美术随手填的,它是一套可量化预算的输出——屏幕空间误差是"视觉质量"的度量,因子是"几何成本"的度量,两者之间的换算正是 HS 的 patch constant function 要干的活。工程上还会叠加一层帧间稳定:因子不允许逐帧剧烈跳动(否则 LOD 过渡在运动时闪烁),常见做法是把因子变化钳制在每帧 ±1 档以内——这与 §六 的取整模式配合,构成"细分 LOD 平滑性"的两道保险。
width 再往深一层读,它其实是"硬件把细分当作什么"的说明书:Tessellator 不是"给任意多个 patch 慢慢铺",而是一批吃下 width 个 patch、各自独立铺点——它把细分当成"固定批量的小任务",而不是"流水线式的流"。这带来一个工程后果:patch 的铺点负载不均衡(一个 patch 因子 64、邻居因子 2)时,硬件按 width 个中最慢的 对齐完成时间,负载落差直接变成吞吐浪费。所以网格划分时"让相邻 patch 的因子尽量接近"不仅是缝合问题的要求,也是让 Tessellator 满载的要求——负载均衡从 §八 的第一行起就是设计约束。
需要说明:裂缝消除的"沿边统一因子"是通用做法但不是 API 强制——API 只保证"相邻 patch 各算各的",不保证"结果不裂"。工程上裂缝处理属于"使用者要自己负责的正确性",这也是细分比想象中难用的主要原因。
出处:fgiesen · Part 12(缝合与工作集)(CC0)。
机制讲完了,把几何前端的所有账拢到一张表上——顺便看看它工作在哪片硬件上。
九、量化代价账:几何前端各单元吞吐(prove-claim)
好了,把几何前端的账拢在一起,看每个单元在"一个 patch 从 4 个顶点被细分到两千个三角形"的过程中各吃多少吞吐:
| 单元 | 输入 | 输出 | 吞吐压力 | 性质 |
|---|---|---|---|---|
| PA(装配) | 顶点流 | 图元 | 顶点数线性 | 固定功能 |
| GS(按图元执行) | 图元 | 可变顶点 | 输出顶点数(不可预知) | 可编程 |
| 二次 PA | GS 输出 | 图元 | 输出顶点数 | 纯开销 |
| Tessellator | 因子 + 域 | 域坐标顶点 | 因子平方级 | 固定功能 |
| DS | 域坐标 | 对象空间顶点 | 因子平方级 | 可编程 |
| 光栅化 | 三角形 | 像素 | 三角形数线性 | 固定功能 |
把"因子平方级"这条读成数字,才能感受到这条账的分量。设一个 quad 域 patch、内部因子 f=16,则 (⌈16⌉+1)²=289 个内部顶点、约 578 个三角形。其中:若场景里是一块 16×16 的 patch 网格(256 个 patch,一块地形 chunk 的常见尺寸),一次细分就铺出 256×578≈14.8 万个三角形——而输入只有 256×4=1024 个控制点。换句话说:细分把"几何带宽"换成了"几何吞吐"——你不再从内存搬几百万个预细分顶点,但光栅化与像素阶段要为这 14.8 万个小三角形全数付账。这正应了 §七 的结论:省下的是带宽,涨上去的是吞吐,账是同一笔。
GS 那条账的读法相反——它不是把顶点"变多",而是把"未知"塞进管线。GS 的执行槽按运行时实际输出分配(§二),下游必须准备二次 PA 与可增长暂存(§三),于是哪怕 GS 原样转发输入(pass-through),几何阶段吞吐也会掉到不启用时的 1/3–1/7(fgiesen 在 Part 10 的实测)。这条账的启示是:GS 的代价不随"效果"走,而随"启用"走——启用它,管线就为"输出规模不可预知"这件事本身付钱,与你实际发射了多少顶点无关。
SO 的账则写在带宽上。一个粒子系统 200 万粒子、每粒子 32 字节(位置+速度),SO 写回一帧就是 64 MB;若还要把结果读回 CPU 做碰撞(§四 第三笔账),映射拷贝再加 64 MB——一帧 128 MB 的带宽,从"GPU 写"到"CPU 读"来回两趟。作为对照,2011 年前后桌面 GPU 的系统内存带宽在 20–40 GB/s 量级,几何输出带宽是受限资源的常态;今天(2020 年代中期)GDDR6X 的带宽高了一个量级,但"写回→读回"这条链的延迟与带宽成本结构没有变——SO 依然适合"低频、批量、不需要 CPU 即时介入"的回写,不适合"每帧都读回来"的紧耦合循环。
先来看看当年的硬件坐标系:2011 年前后,桌面旗舰的填充率规格放在今天看小得惊人——GeForce GTX 580(GF110,Fermi 架构)的像素填充率 37.05 GP/s、纹理填充率 49.41 GT/s,带宽 192.4 GB/s;而今天(2020 年代中期)的旗舰已高出不止一个数量级。这个数量级的跨越,正是本篇叙事主线的注脚:2011 年"几何"是稀缺资源,GS 每多输出一个三角形都要精打细算;今天几何吞吐大幅宽松,"按图元编程"的价值被计算着色器与 mesh shader 重新定价。细分在当年是"用固定功能换吞吐"的奢侈品,今天依然靠固定功能保持单位面积最高吞吐,只是它服务的场景从"省带宽"扩展到了"程序化生成"。
这张表的读法是:几何前端把"几何复杂度"提前到了光栅化之前——GS 放大图元数、细分放大顶点数,下游光栅化与像素阶段要消化全部新增量。于是"几何前端省下的带宽"(patch 按需生成)和"几何前端制造的压力"(新增三角形全要光栅化)是同一枚硬币的两面。
而这一切账,最终都结算在那片真实的硬件上:
出处:fgiesen · Part 10/11/12 全篇量化数据(CC0)。
账算完了。最后一个问题:GS 的这些能力,到 2011 年之后为什么被逐渐取代?
十、GS 之后:CS 与 mesh shader(compare-options)
好了,GS 的定位其实很尴尬:它能做的三件事——按图元生成/复制、可变输出、读取邻接信息——每一件都有更强的替代品:
| 需求 | GS 的做法 | 替代方案 | 替代的优势 |
|---|---|---|---|
| 按图元生成新几何 | 图元进、图元出 | 计算着色器(CS) | 输出规模不受拓扑限制,任意读图元 |
| 把顶点数据回写再用 | SO 回写 | CS 直接写 buffer | 无需走 GS 执行槽,完全可编程 |
| 读邻接图元做效果 | GS 邻接输入 | CS 读顶点索引 | 拓扑之外任意访问,无 strip 限制 |
| 整块生成网格 | GS 逐图元生成 | mesh shader | GPU 上整块生成 mesh,可预知输出规模 |
为什么 CS 是更好的 GS? 说白了,根本原因回到 §二 的那条性质:GS 的输出规模不可预知,硬件只能靠二次 PA + 可增长暂存区兜底;而 CS 在拓扑之外任意读写 buffer——它可以在启动前就把输出规模算清楚(dispatch 的大小已知),把"不可预知"变成"可预知"。mesh shader(ep12 详述)更进一步:它在 GPU 上整块生成 mesh,用可预知的输出规模 + 无二次 PA 的方式,取代 GS 的逐图元生成。
CS 具体怎么"做 GS 的事"?两条路径值得点出。其一是间接绘制(indirect draw):CS 在 buffer 里写好"要画多少个实例、多少个顶点"的绘制参数,DrawIndirect 直接按它绘制——GS 当年靠 SO 写回 + counter + DrawAuto(§四)凑出来的"GPU 决定画什么",CS 用一次 dispatch 就能写全。其二是Append/Consume 缓冲:CS 用 AppendStructuredBuffer 把不定量输出攒进一个可增长的 buffer,再交给绘制或下一个 CS 消费——这正是 GS 输出暂存区的软件版,区别是 CS 完全可编程、没有 strip 拓扑限定、没有二次 PA。fgiesen 在 Part 13 里把 CS 称为"新的几何引擎"的预言,指的就是这两条路径合流:几何生成从"管线的可编程段"迁移到"通用的并行计算模型"。
mesh shader 的 Turing 落地:2018 年 NVIDIA Turing 架构引入 mesh shader 与 task shader(amplification shader),把"可编程几何生成"从逐图元推进到逐 mesh。它定义的核心数据结构是 meshlet——把大网格切成不超过 64 顶点、126 个图元的"小 mesh"(上限由硬件规定),每个 meshlet 由一次 mesh shader 调用整块生成;task shader 则负责在 meshlet 粒度上做簇级剔除(cluster culling)——整个 meshlet 不可见就直接丢弃,不必生成。对比 GS 的逐图元执行,mesh shader 的粒度大一个数量级、输出规模可预知、无二次 PA,还顺带解决了 GS 的邻接信息痛点(meshlet 内索引随意访问)。Vulkan 侧由 VK_EXT_mesh_shader 扩展提供(task/mesh 两阶段),D3D12 在 12.0 起原生支持——到 2020 年代中期,mesh shader 已成为新几何生成的主流路径,而 GS 在 D3D12/Vulkan 里保留但被明确标注为"兼容与遗留用途"。
GS 为什么没死透? 三个现实原因。其一,API 兼容:D3D11/OpenGL 时代的管线必须继续工作,GS 是那条管线里"按图元编程"的唯一选项,存量代码(粒子、草地、点精灵、阴影体积)还在跑。其二,小图元场景仍划算:GS 的二次 PA 开销对小输出规模影响小,一个 GS 输出 3–10 个顶点时,启用它的绝对成本可接受(3–7 倍是"全几何阶段吞吐"的口径,不是每次调用的成本)。其三,引擎兼容层:许多引擎的 geometry 通道仍把 GS 当"最后兜底"——当 mesh shader 不可用(旧设备、某些移动端)时,同一份效果逻辑退回 GS 实现。所以准确的图景是:GS 不是被删除,而是从"主路径"降级为"兜底路径"——新代码走 CS/mesh shader,旧代码继续走 GS。
限定声明:mesh shader 的完整实现、与光栅化的衔接、在桌面/移动端的支持现状,属于 ep12"2011 之后"的内容——本篇只给方向性对照,不展开。
出处:NVIDIA · Introduction to Turing Mesh Shaders(文字引用)/NVIDIA · Mesh Shaders for Professional Graphics/Khronos · Vulkan-Samples(mesh/tess 示例)/fgiesen · Part 10 结语(CC0)。
GS 退场、细分成了固定功能标准件、SO 被 CS 直写取代——几何前端这条线到这里收束。
十一、这一章留下的问题(bridge-to-next)
好了,几何前端走完了:GS 因二次 PA 与不可变预算被边缘化,细分成了固定功能标准件(Tessellator 不可编程、吞吐极高),SO 与回读延迟仍受限,最终被 CS 直写 buffer 取代。下一个主角是计算着色器(compute shader)——它不是"管线的某一段",而是一整套并行计算模型:波前(wavefront)、共享内存、三种屏障(barrier)。ep10 我们看它在 GPU 上怎么被调度、怎么用共享内存做协作、以及它凭什么成为 GS 之后"几何生成"的新主场。
但在把指挥棒交给 CS 之前,有一笔账必须在这里钉牢:谁保证"GPU 写"的数据,在"CPU/GPU 再读"时是就绪的? 这是本篇所有"写回"路径(SO 写回、CS 直写 buffer、间接绘制参数)共同的隐藏前提,也是工程里最常见的翻车点。
问题从 GPU 的异步本性开始。 其中:一次 Draw/Dispatch 提交后,命令只是进了队列——GPU 什么时候执行、执行到哪一步,CPU 完全不知道。于是"SO 写回完成"、"CS 把间接绘制参数写进 buffer"这些事件,对 CPU 而言是无通知的。如果 CPU 立刻映射这块 buffer 去读,读到的可能是半帧前的旧数据,甚至是正在被 GPU 写入的中间态。这就是 §四 第三笔账"同步/回读延迟"的底层机制:不是"读回慢",而是你根本不知道什么时候能安全地读。
D3D11 时代的答案:query 与多线程录制。 先来看看 query:D3D11 用 query(查询)对象做"GPU 事件"的观测:SO 写回计数可以用 SOStatistics query 取回,帧是否画完可以用 Event query 探知。query 的返回是异步的——CPU 先"布置"一个查询,等 GPU 走到那个位置时标记完成,CPU 之后轮询或等待结果。这条机制的局限很明显:它是观测不是同步——CPU 依然要猜"多久之后去取",而每帧取回 SO 计数本身就落回 §四 的回读延迟。同期 D3D11 还提供了 deferred context,把命令录制挪到 CPU 多线程并行——它解决的是"CPU 端录制瓶颈",不解决"GPU 执行到哪了",两条问题线不能混为一谈。
D3D12/Vulkan 的答案:fence 与 resource barrier。 现代 API 把"同步"显式化了。D3D12 用 fence(ID3D12Fence)做 GPU-CPU 同步点,其原理是:CPU Signal 一个值、GPU 执行到某处后把它推进,CPU Wait 到该值再访问资源——"写回 → fence → 映射读回"变成了标准姿势;命令列表之间、队列之间(图形/计算/拷贝)也用 fence 串行,跨队列依赖(比如拷贝队列把 SO 结果搬到 CPU 可见内存)是 fence 的典型场景。Vulkan 侧把同步分得更细:GPU-GPU 用 semaphore、GPU-CPU 用 fence,另有 event 与 pipeline barrier 管管线内部依赖——规范里"同步与内存可见性"是一整个章节,因为"两个命令谁先执行"与"前一个的写对后一个可见"是两件必须分别声明的事。resource barrier(D3D12)/ image layout transition + memory barrier(Vulkan)负责后者:一块 buffer 从"CS 当 UAV 写"切到"光栅化当顶点缓冲读",必须显式转换状态,否则硬件缓存/内存序不保证可见。这里最反直觉的一点是:CS 取代 SO 时,把"SO 的隐式同步"变成了"显式同步"——SO 写回 + DrawAuto 是一条免 CPU 介入的 GPU 内循环(§四),而 CS 直写 buffer 后,下游要么在同一 dispatch 里消费(靠 barrier 保证),要么跨命令消费(靠 fence/barrier 双重保证)。能力变强了,责任也变重了。
好了,把账收束。SO 与 CS 的写回路径,本质都是"生产者-消费者"问题——生产者是 GPU 的某个阶段,消费者是另一个阶段或 CPU。D3D11 时代靠 query 观测 + 隐式行为兜底(慢、不可靠、容易踩坑);D3D12/Vulkan 时代靠 fence/semaphore/barrier 显式声明(快、可控、但要求开发者懂同步)。ep11 展开的正是这张同步地图:fence/semaphore/资源状态机的完整语义、多队列并行、以及"GPU 写-CPU 读"在生产管线里的真实成本。在那之前,ep10 先把 CS 自己的内部同步讲透——波前内的 barrier 与共享内存,是比"跨命令同步"更靠前的一层。
待续:同步与资源生命周期(ep11)——SO 写回、CS 直写这些"GPU 写、CPU/GPU 再读"的路径,靠 fence/semaphore/barrier 保证不乱序;2011 之后(ep12)——mesh shader 完整实现、硬件细分器的演进。
出处:D3D12 · Fence-Based Resource Management/D3D12 · Executing and Synchronizing Command Lists/D3D11 · 多线程与 deferred context/Vulkan 规范 · 同步与内存可见性/fgiesen · Part 13(CS 与同步)(CC0)。
相关链接 - 上一篇:【GPU 架构剖析】(八)像素后端:fork/join、ROP 与那笔带宽账 - 下一篇(预告):【GPU 架构剖析】(十)计算着色器:波前、共享内存与三种屏障 - 核心参考:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 10 / Part 11 / Part 12 - 相关系列:技术博客页
With Best Wishes.
参考资料与可回溯出处
- Fabian Giesen《A trip through the Graphics Pipeline 2011》· 索引页(CC0)· Part 10(GS)/ Part 11(Stream-Out)/ Part 12(Tessellation)
- Vulkan 规范 · Tessellation
- Vulkan 规范 · Geometry Shading
- Vulkan 规范 · Vertex Post-Processing
- D3D11 Graphics Pipeline
- D3D11 · Stream-Output Stage
- NVIDIA · Introduction to Turing Mesh Shaders
- Wikimedia Commons:3D-Pipeline.svg(CC0)、Geometry-shader-pipeline-simple.png(CC BY-SA 4.0)、ZOTAC Gaming's GeForce RTX 50 Series Graphics Carda.jpg(CC BY-SA 4.0)、Intel 810 Chipset Digon3.JPG(CC BY-SA 3.0)


下篇预告:《GPU 架构剖析》系列进度:已完成【一】命令前端、【二】显存与地址空间、【三】着色器核、【六】光栅化、【七】Z 缓冲、【八】像素后端与 ROP,本篇【九】几何前端收束——接下来是【十】计算着色器:波前、共享内存与三种屏障。几何前端这条线的账已结清:GS 的二次装配与不可预知输出、SO 的回读延迟、细分的固定功能吞吐——下一站,这些"按图元/按补片工作"的能力将整体迁移到"通用并行计算"的模型里,由计算着色器接管;而所有写回路径的时序,则交给 ep11 的同步与资源生命周期。
(本篇完)