核心问题:上一期我们告别了几何着色器(GS)——因为"按图元改几何"这件事,最终被迁移到了一整套更通用的模型里。这套模型就是计算着色器(compute shader,CS)。它不把"线程"当作 OS 线程,而是当作一个只有 32 个 lane 一起前进的执行单元的原子;它自带一块能协作的共享内存(shared memory / LDS);它用屏障(barrier)在不同层级之间建立可见性。本篇把 CS 当作"GPU 上的并行计算模型"来读:波前怎么被调度进执行槽、共享内存是什么物理结构、为什么有 bank conflict、三种屏障各自贵在哪里。全篇收在"计算着色器为什么成了 GS 之后新的几何引擎"这句交棒给 ep12 的预告上。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
一句话点题:CS 不是管线的一段,是并行计算模型(set-context)
好了,上一期我们把几何前端送走了,留了一个疑问:GS 能做的三件事(按图元生成、可变输出、读邻接),为什么被计算着色器与 mesh shader 取代? 这个问题的答案,不在"某个新着色器阶段",而在一整套更底层的执行模型里——计算着色器(compute shader)。它不挂在渲染管线的某一段上,它本身就是一套"在 GPU 上运行任意并行代码"的方法论。
你可能想问:不就是个着色器吗,和顶点/像素着色器有什么本质差别?差别恰恰藏在"线程"这两个字里。CS 的"线程"不是操作系统里的线程——它没有独立的 PC(程序计数器)、没有自己的栈,它只是"32 个 lane 一起执行的执行单元的成员"(fgiesen · Part 13)。这个"32 个为一组、整组一起前进"的执行单元,是本篇的第一个主角:波前(wavefront,NVIDIA 叫 warp / subgroup)。
本篇不涉及什么、为什么: - 不写"怎么写一个调优过的 CS 内核"——矩阵乘优化、本地调和等具体算法属于算法层(《实时渲染管线探析》)。 - 不重复 mesh shader 的完整实现——那是 ep12"2011 之后"的内容,本篇只做方向性交棒。 - 不展开跨命令的 fence/semaphore 同步全图——那是 ep11 同步与资源生命周期的地盘,本篇只讲 CS 工作项内部那一层屏障。
出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》· Part 13(CS 与新的执行模型)(CC0)。
读法提示:这一篇我们把写渲染管线的"阶段"思维暂时放一放,换成"并行计算"的思维——它有三个核心构件,正好是标题的三个词:波前(执行原子)→ 共享内存(协作空间)→ 屏障(协调规则)。我们把这三样东西的硬件账一层层摊开,最后用它回答开头那个"为什么是 CS 取代 GS"的问题。
全系列知识地图:先把《GPU 架构剖析》整个系列的目录总览摊在这,好让你知道这一篇踩在哪条路上。整个系列分成四段在走:上游(ep01–ep04)讲命令怎么排队、显存怎么寻址、着色器核怎么调度、纹理怎么采样——"一条指令人去哪、数据藏在哪";装配(ep05–ep08)讲图元装配裁剪、光栅化、Z 与 early-Z、像素后端 ROP——"一个三角形怎么变成一屏像素";从几何到计算(ep09–ep10,本篇所在)讲几何着色器与计算着色器——"为什么'按图元改几何'这件事被迁到了一套通用并行计算里去";收束与未来(ep11–ep12)讲同步与资源生命周期、还有 2011 年之后哪些机制变了。本篇站在第三段的中后部:ep09 刚把 GS 送走,CS 是接棒它的那个"新几何引擎"。要回看前文,上一篇是【九】几何前端;相关系列的完整索引都在文末技术博客页。
一、把"线程"这个词掰开:lane、波前与执行槽(explain-structure)
先来看看一台 GPU 到底怎么"同时跑很多线程"。它当然不是真的给每个线程准备一个独立 CPU 核对吧。GPU 走的是 SIMT(单指令多线程)——一组线程共用一套取指/译码/发射单元,在同一个时钟里执行同一条指令,只是各自操作各自的数据(lane)。
关键在"一组"是多少。NVIDIA 从 Fermi 至今,warp = 32 条 lane;AMD 的 wavefront = 64 条 lane(GCN 系),Vulkan/HLSL 的抽象层则叫 subgroup,其大小由 VK_SUBGROUP_SIZE 查询得到(现代桌面硬件多为 32)。"一条指令 32/64 个 lane 一起执行"——这就是为什么 CS 里 if (laneId < 16) ... 的分支会造成整组都走,多余 lane 空转:the hardware doesn't skip lanes, it masks them.
这套"32-64 条 lane 一起前进"的单元,在硬件里落成一个执行槽(execution slot / processor)。一次 Dispatch 里,成千上万个波前会争抢 SM(流式多处理器)/ CU(计算单元)里有限的执行槽——硬件做的是 TDM 式调度:一批波前在执行槽上跑几拍,让出来给下一批,再轮回来。而"一个处理器能同时驻留多少个波前",就是 occupancy(占用率)。
为什么"整组一起动"反而是特性:以为"32 个 lane 一起流水"就是快?恰恰相反——它让取指/译码成本被 32 份数据摊薄。一条指令只取一次、译一次,却同时推进 32 份计算量,这是 SIMT 在面积受限时代能给出高吞吐的根本原因。
把代价也一句话说透:SIMT 的"整组前进一步"不是每人一条独立指令流,而是一条指令推进 32 条 lane。所以一旦代码里出现分支——比如 CS 里最常见的 if (laneId < 16)——真分支和假分支都要在时间上先后执行,只是另一组 lane 被掩码停住不去碰数据。这就是 warp divergence(波前分歧):指令本身始终是串行逐条发的,数据才是并行。它跟 CPU 的"分支预测命中"完全是两码事——CS 里你不能靠预测躲开分歧,只能靠让同一个 warp 的 lane 尽量落在同一条分支路径上来编排你的内核。这句判据,往后写 CS 时比"这个算子快不快"更经常决定性能。
出处:NVIDIA · CUDA GPGPU 白皮书(SIMT 执行模型)/AMD · ROCm HIP 性能优化(wavefront)/Vulkan · Subgroup 说明。
这一段的账先钉下:执行的最小原子不是"线程",是"波前"。下(二)我们看看波前怎么被"编织"出来。
二、线程层级:grid → block → warp → thread(show-flow)
在进入共享内存之前,得先看清 CS 的"组织架构"。一次 CS 执行从大到小是四层:
- grid:一次 dispatch 调度的整个栅格。
- block / workgroup(工作组):grid 分成若干块,共享内存就在这一个块内部——块是"能协作"的最大单位。
- warp / wavefront:块内再分波前,是"一起执行"的最小单位。
- thread / 元素:波前的 lane。
四层里最关键的一层是 block——它承载了两件大事:共享内存(块内所有线程共享一块显存区域的别名)与同步(块内线程可以用 barrier 互相等待)。块是"协作"的地基:跨块没有共享内存、没有轻量同步——两个 block 要交换数据,只能走全局内存 + 原子操作 + 显式栅栏(那是 ep11 的事了)。
边界划清楚了:共享内存与轻量同步都以 block 为界。那这块"共享内存"到底是什么物理结构?下一节把它的硅片排布摊开。
三、共享内存:SM 里的那块片上存储(explain-structure)
好了,共享内存(shared memory,AMD 叫 LDS / Local Data Share),它是一块在 SM/CU 内部的、低延迟的片上存储,所有 block 内线程都能以别名访问。为什么 GPU 要单独准备这么一块?因为它和全局显存的物理位置不同、延迟差一个量级——它挨着 ALU,走的是片上高速总线,不需要穿过 cache hierarchy(虽然 L1 cache 现在和它同频,但语义上是显式管理的"可编程缓存")。
关键要和"cache"分清:cache 是硬件自动管的,共享内存是你显式管的。你把数据写进共享内存,它不自动淘汰、不自动换出——数据待在那里直到块结束。这既是它的优点(可预测、无未命中),也是它的责任(你要自己管生命周期与谁先写谁后读,这就引出了屏障)。
工程上共享内存最常见的用途,是块内协作与数据复用:
- 矩阵分块:把全局内存里的数据块先搬到共享内存,块内多次复用,把"频繁访问全局内存"降为"一次搬运 + 多次片上访问"。
- 邻域交换:后处理滤镜里,每个线程需要邻域像素——邻域在共享内存里交换,比每个线程各自去全局内存取邻居快得多。
到底能放多少:共享内存是"按块声明"的、容量以 KiB 计。经典例子:NVIDIA Ampere 一代 SM 的共享内存 + L1 合计 128–256 KB,一个 block 最多能声明经典值 48 KB(通过
cudaFuncAttributeMaxDynamicSharedMemorySize可放大更多)/ 96 KB 需特殊申请(CUDA Programming Guide · 共享内存)。这一小片即决定一个块能存下多大的工作集——所以"用什么粒度分 block"本身就是排布决策。
出处:CUDA Programming Guide · 共享内存/AMD · AMDGPUUsage(LDS 是 local address space)。
共享内存看着是块"共享的池子",但它内部不是大家随便挤——它被硬件切成了一个个 bank。下一篇细讲这个能带来吞吐灾难的细节。
四、共享内存的物理排布:bank 与访存宽度(explain-structure)
先来看看为什么共享内存"快"也带坑。它虽然快,但每个时钟只能为有限的通路服务。硬件把一块共享内存横向切成若干 bank(存储体),每个 bank 一访问单元宽(典型 4 字节 × 32–64 bank,即每周期约 128–256 字节带宽)。当 32 个 lane 在这个周期里各自访问共享内存时,同时被访问的地址落在不同 bank,就能并行服务;一旦 2 条以上 lane 撞到同一个 bank 的不同地址,就发生 bank conflict——硬件只能串行化,一次只服务一个冲突组。
bank 冲突的代价是吞吐的整数倍损失:一条本应 1 拍的共享内存访问,若 32 条 lane 全部集中到同一 bank 的 32 个不同地址,就要串行化 32 拍——一个"应该很快"的内存访问,被打成一份慢操作。这是共享内存编程里"看不出来却吃吞吐"的头号陷阱。
规避的经典手段是 layout 偏移(padding/swizzle):不要用 index = tid 直读,而用 index = tid + (tid >> 5) 之类加一个 padding,把本来落在同一 bank 的邻居错开到不同 bank。工程上这叫避免 bank-conflict 的 data layout,编译器不会帮你做——因为它是"数据怎么排"的语义决策。
为什么"按序直读"也会冲突:你以为
smem[tid]顺序读很完美?未必。当数据元素本身大于一个 bank 单元时,tid与地址的映射会周期性回绕,后 32 个线程又可能落回前面的 bank。所以冲突不是"随机的乱序访问"才有,整齐的 stride 访问也会——这正是难调试的原因。
举个能把"整齐撞整齐"算清楚的例子。假设一块共享内存典型 16 KB、切 32 个 bank、每 bank 单元宽 4 字节。你要把一张 32×32 的 float 矩阵按行并行写,直接 idx = ty*32 + tx 行不行?——同一行的 32 个线程各占一个 bank,乍看完美。可问题是行的宽度(32)恰好是 bank 数(32)的整数倍,于是后一行又回绕撞回同一批 bank,每行都冲突一次。解法是在内存布局的行末塞一个 dummy 元素,把宽度错开成 33:idx = ty*33 + tx,32 个线程这才错散到不同 bank。这就是 padding/swizzle 的来路——它治的不是"乱序",恰恰是"整齐的带宽刚好撞上整齐的银行"这种最隐蔽的形。
把"冲突到底长什么样"再收敛成三种可诊断的模式,方便你对着代码认:一是 row-major 回绕——上面那个 32 的整数倍就是典型,行宽恰为 bank 数因子时,后行撞回前一行的 bank 位置;二是 stride 探针——按固定步长遍历时,步长与 bank 数不互质,会周期性踩中同一批 bank,常见于 for (i = tid; i < N; i += 64) 这类分段循环;三是 column 直访——按列读一个 row-major 矩阵时,跨行的列下标恰好同余于某个 bank,表现得像"随机",实际是隐性的周期。三种模式表面不同,底下的方程是同一个:访存地址对 bank 取模之后是否撞了车。所以调试 bank 冲突的第一件事,不是猜"我是不是乱序了",而是算"我这一步的 stride 和 bank 数互不互质"——互质就安全,不互质就踩雷。把这三种模式记熟,在 Nsight Compute 的共享内存页里看 stall_shared 分支时,就能直接对应上"哪一行代码、哪一种 stride 在制造串行"。
出处:NVIDIA · Using Shared Memory in CUDA C/C++/Vulkan 教程 · 性能优化/共享内存 bank。
bank 把"共享内存的吞吐"讲清了。可如果多个线程要等彼此写完再读呢?那就要屏障出场了。
五、三种屏障:执行序 vs 内存可见序(explain-structure)
好了,屏障(barrier)——它解决的核心问题只有一句:谁保证我先写的,你后读时是就绪的? 这承接了 ep09 第十一章埋下的那个问题,只是在这里缩到一个 workgroup 内部。
一句话先分清两件事:执行同步(synchronization)管"先后顺序",内存可见性(visibility)管"写了能不能读到"。两者的差别是:即使两条访存指令被 CPU 乱序/缓存重排,你也要保证"读的人看到写的人的结果"。GPU 的屏障把这两件事绑在一起——它既约束执行顺序,也刷新内存可见。
CS 内部的屏障,按"作用范围"可分为三类(这正好是标题里的"三种屏障"):
- 工作项内(intra-thread):只约束本线程自己发出的访存次序,不要求任何别的线程停下来会合。这一档在 OpenCL 里有对应原语——
mem_fence()/read_mem_fence()/write_mem_fence()(排序,但不同步,因此可以在分支里安全使用);CUDA 没有这一档(__threadfence()已经是设备域),HLSL 也没有——memoryBarrier()/GroupMemoryBarrier()/DeviceMemoryBarrier()虽然作用域不同,但都会阻塞工作组内的线程,不属于本级。它是最便宜的一档,因为它不真的让别的线程停下来。 - 工作组内(intra-block / workgroup):让 block 内所有线程在这一点会合(
barrier(CLK_LOCAL_MEM_FENCE)/groupMemoryBarrierWithGroupSync()/ CUDA__syncthreads())。代价是最贵的——块内所有波前都要到达这一点,最慢的波前决定等待时长,且会暂停执行槽上的所有波前。 - 跨命令(global / device scope):让全局/设备范围可见,通常与
memoryBarrier()搭配、或由 dispatch 之间的 fence/semaphore 承担(这是 ep11 的主场)。
量化口径"工作组内同步最贵":
__syncthreads()会把块里所有 warp 都停在同一处等齐——最慢的 warp 决定花费。有人测过,一次__syncthreads()本身只是几十个周期,真正贵的是它打断了 SM 的乱序/流水、强制所有波前会合,这在吞吐上是一笔隐性税(fgiesen · Part 13 结语)。所以"能少同步就少同步"不是风格偏好,是吞吐约束。
陷阱:barrier 没让所有线程都穿过会死锁。如果 block 里一部分线程执行了
__syncthreads()、另一部分因为if分支没执行就跳过了,那么到达 barrier 的线程会永远等一个"永远不会来"的会合——同步必须所有线程都到达。这是 barrier 用错最常见、也最容易在调试器里表现成"整个 kernel 卡死"的点。
再把"为什么屏障要一人管两件事"往下说一层。在 CPU 世界里你会习惯把"执行顺序"和"缓存可见"分开想:乱序执行用栅栏理顺,缓存一致性有 MESI 之类在后台兜底。但共享内存没有这种自动兜底——数据写进 LDS,完全是靠 barrier 把"写在先、读在后"变成一条对块内所有线程都成立的 happens-before(先行发生)关系:__syncthreads() 同时做两件事,一是让所有线程到达同一个执行点,二是让到达之前的写对到达之后的读可见。砍掉任何一半,要么你读到过期数据,要么别的线程还在半路你就先跑了。这也是为什么 Vulkan/OpenCL 里有的 barrier 被拆成"只刷可见性"和"只做同步"两份——两者是分开收费的两张账单,按需各买各的。
"按需各买"最典型的印证,就是三大 API 把"同步"与"可见性"拆成不同原语,而不是像 __syncthreads() 那样一个函数兜到底:
- CUDA:
__syncthreads()(同步 + 共享内存可见,最省事)之外,还有分布式共享内存 / 异步屏障cuda::barrier、mbarrier::arrive_tx这类更细粒度的到达-等待原语——它们允许"部分线程先到、部分后到",不再强制全员对齐(参考资料 5)。 - Vulkan/SPIR-V 用 semantics(内存语义) 显式声明:"我只做 acquire/release 的可见性,不需要
ControlBarrier那种执行同步"——同步与内存语义是两个独立参数,各卖各的。 - OpenCL 3.0 把 barrier 划成
work_group_barrier(flags):CLK_LOCAL_MEM_FENCE只管本地内存可见,CLK_GLOBAL_MEM_FENCE要单独加,CLK_SYNC才是成员同步——你不传内存语义,就只等不刷。(参考资料 23)
三条通路对照下来,共同的底层规则是:屏障是一张可以只买一半的票——执行同步(等齐)与内存可见(刷可见)是两个维度,GPU 允许你分开消费。代价很清晰:拆开用,语义更精确、少花钱;但拆错或用漏,就是你亲手制造了"读到了还没写好"的竞态。工程判据一句话:线程间要交换数据,两个维度都得买;只各干各的、不碰共享内存,才只买执行同步那一半。
出处:CUDA · 同步原语/Vulkan · 记忆模型/OpenCL · 工作组内屏障/OpenCL · mem_fence(每工作项排序,不同步)/Microsoft · HLSL 内建函数(memoryBarrier / GroupMemoryBarrier / DeviceMemoryBarrier 各自的作用域)。
三种屏障把"协调"的层级讲清了。可这么多波前按什么节奏挤进一个 SM/CU?下(六)看 occupancy。
六、occupancy:执行槽数量与"占得高不等于快"(prove-claim)
先来看看一个 SM/CU 到底能同时驻留多少个波前——这个"能驻留多少"就叫 occupancy(占用率)。它理论上 = 驻留波前数 ÷ 硬件可容纳波前端点。影响它的资源约束有四个,常常相互打架:
- 执行槽上限:每 SM 能驻留的最大 warp 数(Ampere 上限 64 warp,Ada 上限 48 warp)。
- 寄存器堆:一个 warp 占的寄存器 × 驻留 warp 数 ≤ 片上寄存器总量。
- 共享内存:每个 block 声明的 LDS × 驻留 block 数 ≤ 片上 LDS 总量。
- block 上限:每 SM 能放的最多 block 数。
为什么占用率越高不一定越划算? 两点。其一,波前数是拿来"藏延迟"的——当一个 warp 在等显存返回时,SM 立刻切去执行另一个 warp;占用率高=可切换的替补多=延迟被藏得好。但这只在"等你等在等延迟"时有意义。其二,高占用通常拿资源换的——要高占用就得压低每波前的寄存器/LDS,而寄存器/LDS 压太低,单波前的实际工作量(blocks、向量宽度)会掉,甚至触发寄存器溢出(spill 到本地内存,那是灾难)。
经典困惑:
__launch_bounds__与 occupancy 的关系。__launch_bounds__(或 HLSL 的numthreads)声明的不是"我要这个占用率",而是"我对每个波前给这个资源上限"——通过它限制每波前寄存器数,换来更多可驻留 warp。所以正确读法是:它不是免费提高性能,而是用资源换来占用率,换来的占用率又有边界效应。任何"提高占用率=变快"的说法,都要拿"每波前资源是否被压到太低"来对冲。
把"资源换占用"算成具体数字。假设一颗 SM 的通用寄存器文件是 128 KB,每 warp 恰好用满 255 个寄存器,那么寄存器侧最多能放 128 KB / (255×4B) ≈ 128 个 warp——可这个数还没摸到执行槽就说不上话,因为光执行槽上限通常只有 64 warp。反过来,你把每 warp 压到 128 个寄存器,寄存器侧容量涨到 64 KB / (128×4B) ≈ 128,仍然高于执行槽上限。结论很反直觉:在寄存器吃得多的卡上,"多压寄存器"根本提不动占用,卡你的是执行槽或 LDS;真正"压寄存器能换占用"只在寄存器刚好先触顶的那一小片布局里才成立。到底是哪个在卡,Nsight Compute 的 occupancy 页会直接标出"因哪一项受限"——第一步永远是读它,而不是猜。
把"四约束到底谁先触顶"落到真实 SKU 上。 不同卡的资源块比例差异极大,occupancy 的瓶颈往往不是算出来的某一个,而是随内核资源用量漂移的那一个。拿两块典型桌面卡对照:一块执行槽上限 64 warp、每 CU 共享内存 64 KB、寄存器文件 256 KB;另一块执行槽上限涨到 96 warp、共享内存仍是 64 KB、寄存器文件却只给 192 KB。对同一个"每 warp 256 寄存器、每 block 32 KB LDS"的内核——前一块寄存器侧先触顶(256KB/(256×4B)=256 warp,远超执行槽,但 register 通道压死),后一块执行槽侧反倒先到顶(96 warp)。同一个内核,在两代/两档卡上卡在不同资源——这正是 occupancy 易踩的坑:它不是一张卡上的固定常量,而是"你每个 block 声明的 LDS 和每 warp 抢的寄存器"这两个旋钮,拧到哪一档决定哪根柱子先戳到天花板。 Nsight/rocprof 的 occupancy 面板不会给你一个"理想占用",它给的正是这个"这一次 dispatch 被哪一项钳住"的答案——读它,再决定要不要动 numthreads / __launch_bounds__,而不是拍脑袋说"我要更高占用"。
出处:NVIDIA · Nsight Compute 概念(CTA/warp/occupancy)/AMD · occupancy math。
讲到这里,CS 内部的三大构件——波前、共享内存、三种屏障——都摊开了。下(七)用一张账把它和渲染管线的关系算清楚。
七、CS 与图形管线:一笔"几何引擎"的账(compare-options)
先把上一期的线接上:ep09 说 GS 的代价"不随效果走,随启用走"——因为它输出规模不可预知,硬件要备二次装配与可增长暂存。那 CS 为什么能"免费"替代它?因为 CS 在拓扑之外任意读写 buffer、输出规模在 dispatch 前就是可预知的:
| 能力 | GS | CS | CS 的优势 |
|---|---|---|---|
| 生成几何 | 图元进、图元出 | 任意线程写 buffer | 无 strip 拓扑限制 |
| 回写顶点数据 | SO 写回 + counter | CS 直接写 buffer | 无需 GS 执行槽、完全可编程 |
| 读邻接图元 | GS 邻接输入 | CS 按索引任意读 | 拓扑之外任意访问 |
| 输出规模 | 运行时才知道 | dispatch 前已知 | 无需二次装配兜底 |
为什么"输出规模可预知"这么关键? 因为在 SIMT 模型里,资源是按 dispatch 一次性划分的:dispatch 多大、每个 block 多大,都在启动前写死。CS 不需要"边跑边偷偷扩容",所以没有二次装配、没有可增长暂存——那个 ep09 里让 GS 掉到 1/3–1/7 吞吐的隐形税,在 CS 里根本不存在。
于是"CS 成为新的几何引擎"这句话就落到地基上了:它能做 GS 能做的事,却把 ep09 里那个最贵的"不可预知"变成了可预知。把"可预知到底怎么省税"再说透一点:GS 的问题在于硬件不知道一次 draw 到底会产出多少个新图元——变量输出后面藏着一个"边装配边扩容"的暂存区,满了就得 roll 到显存或二次装配;而 CS 的 dispatch 在启动前就把 numthreads、dispatch 的三维大小、输出 buffer 的容量全部写死,写入是写进一块"已经分配好、大小已知"的缓冲区,越不越界由你自己的代码负责。没有变量输出 = 没有可增长暂存 = 那笔随启用而生的兜底税直接不存在。这正是 ep09 断言"GS 的代价不随效果走、随启用走"的对立面:在 CS 这边,同样的账被一次性抹平了。而 mesh shader(ep12)则更进一步——它在 GPU 上整块生成 mesh,用 meshlet(≤64 顶点 / 126 图元一块)+可预知输出规模 + 无二次装配的方式工作(Turing Mesh Shaders)。CS 是这条路的中间形态,mesh shader 是终点形态。
出处:NVIDIA · Introduction to Turing Mesh Shaders/D3D12 · Work Graphs/fgiesen · Part 13(CC0)。
账拢到这,三构件+一张账都齐了。可这些都是"模型",它们最终跑在哪片硬件上?下(八)给一个可触摸的锚。
八、硬件锚:这些单元长在硅片上(prove-claim)
先来看看这片硅片——CS 的每个概念都有对应的物理块。一个 SM/CU 上实际有:执行槽(一堆 SIMD 处理器)、寄存器堆、共享内存/LDS、L1 cache、调度器。你把一个 dispatch 丢上去,调度器把波前一个个分槽执行,共享内存就是它们协作的那小块片上存储。
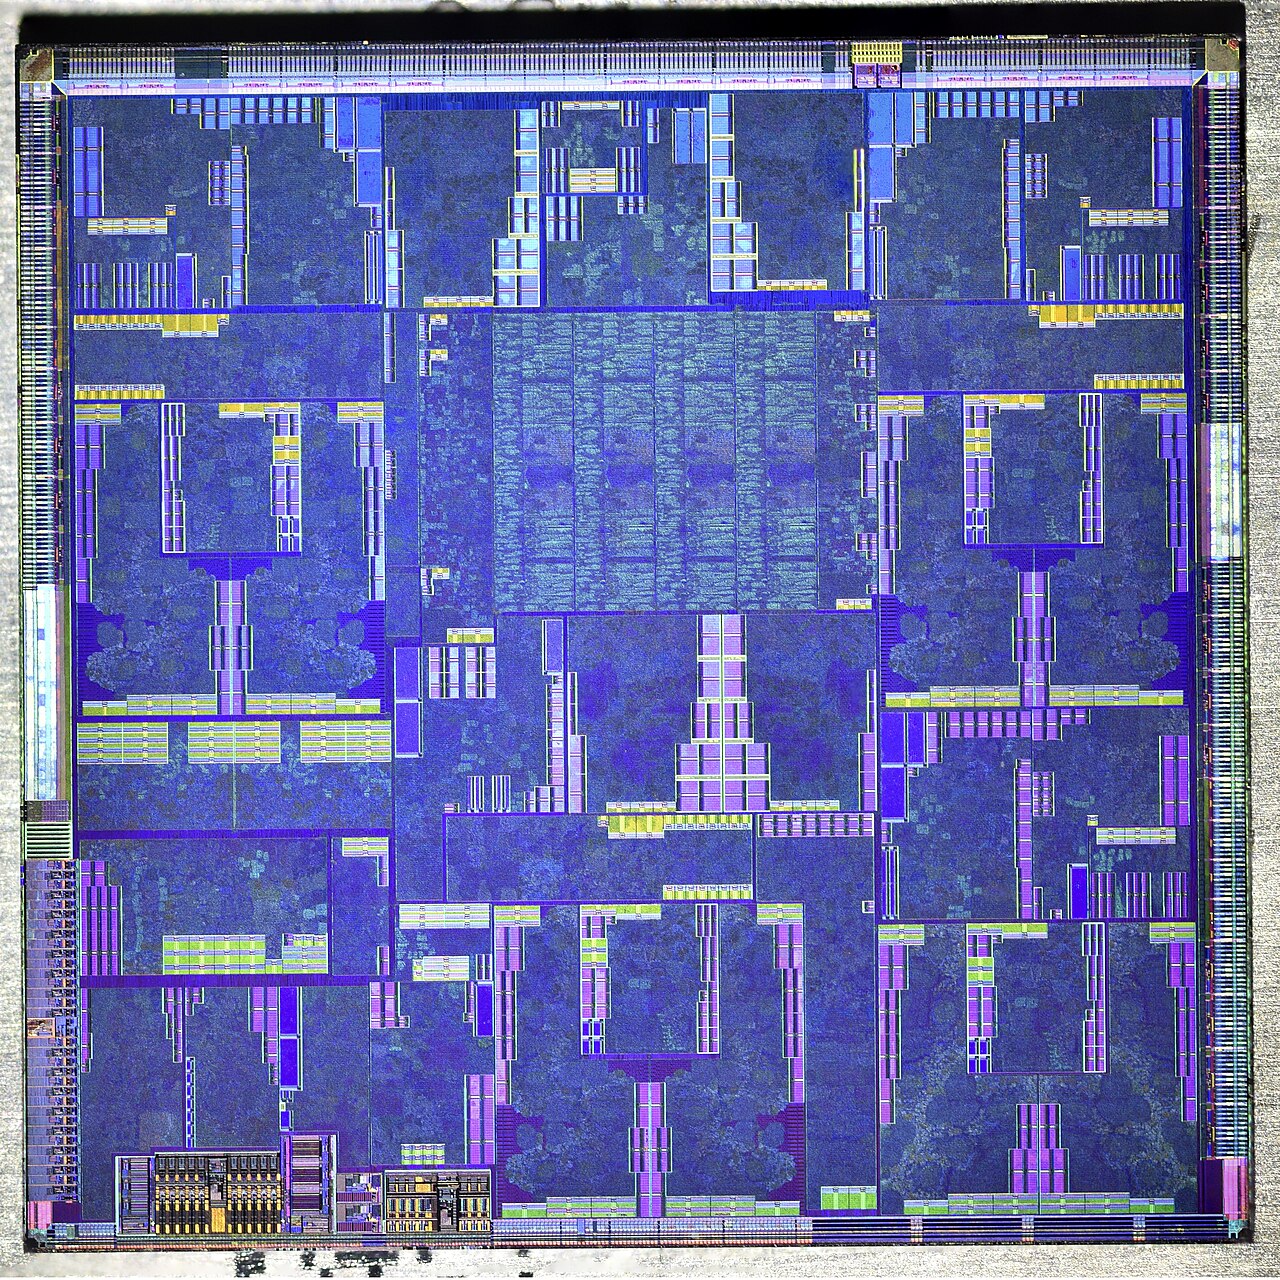
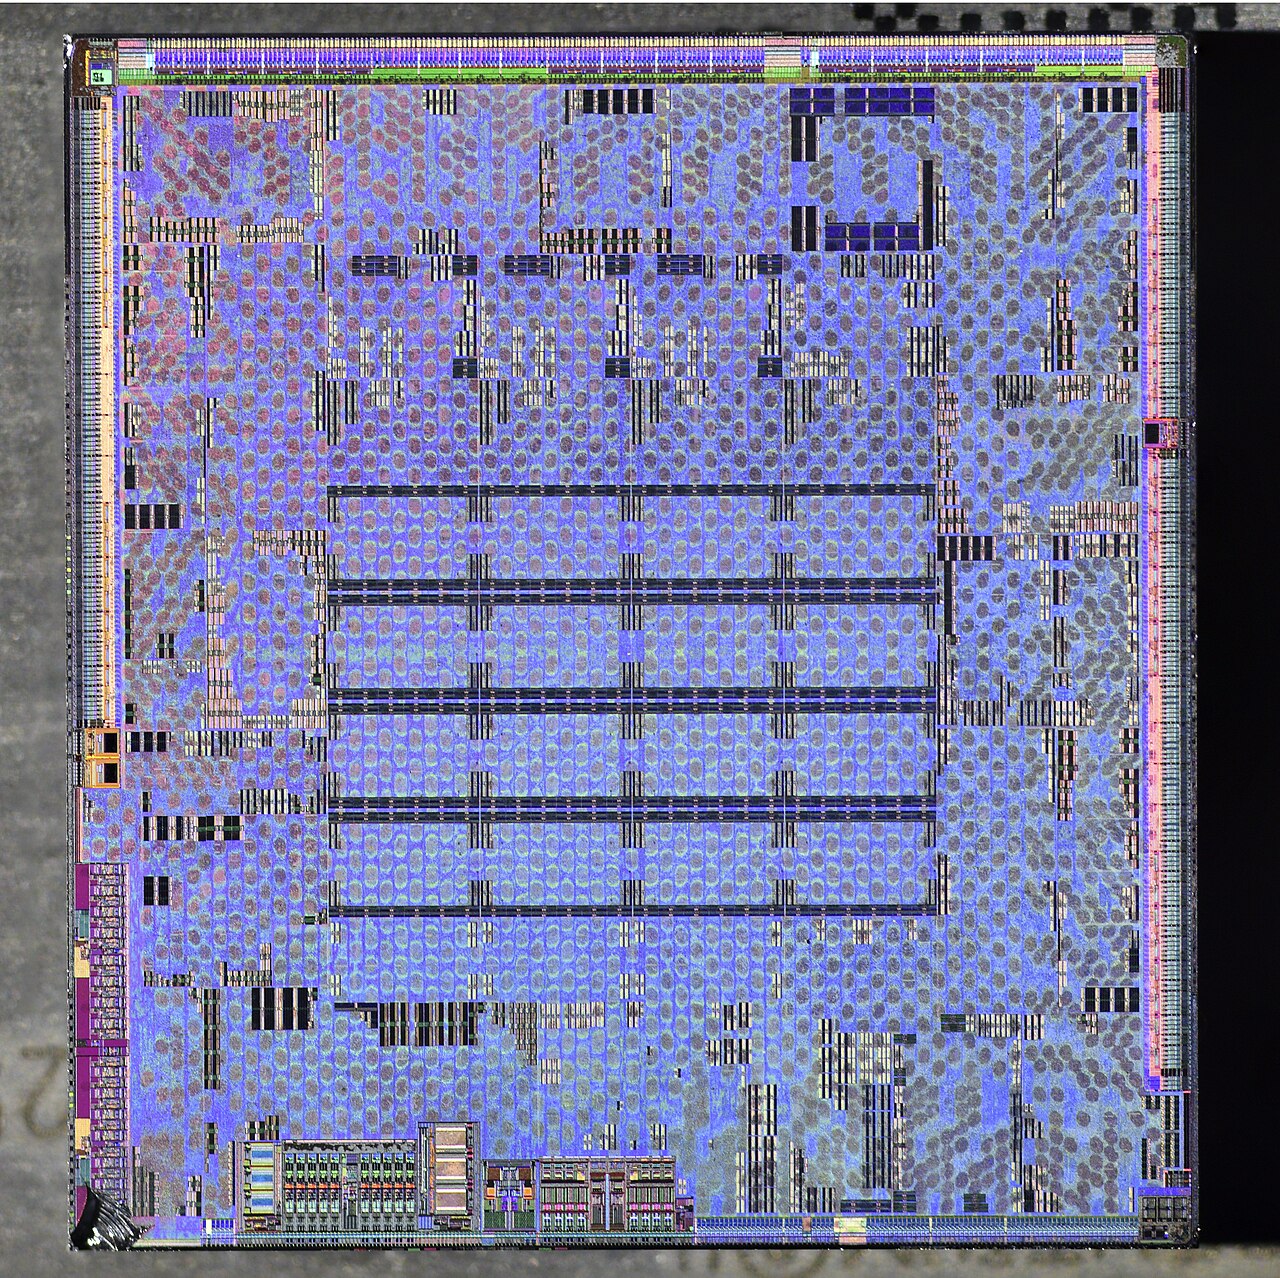
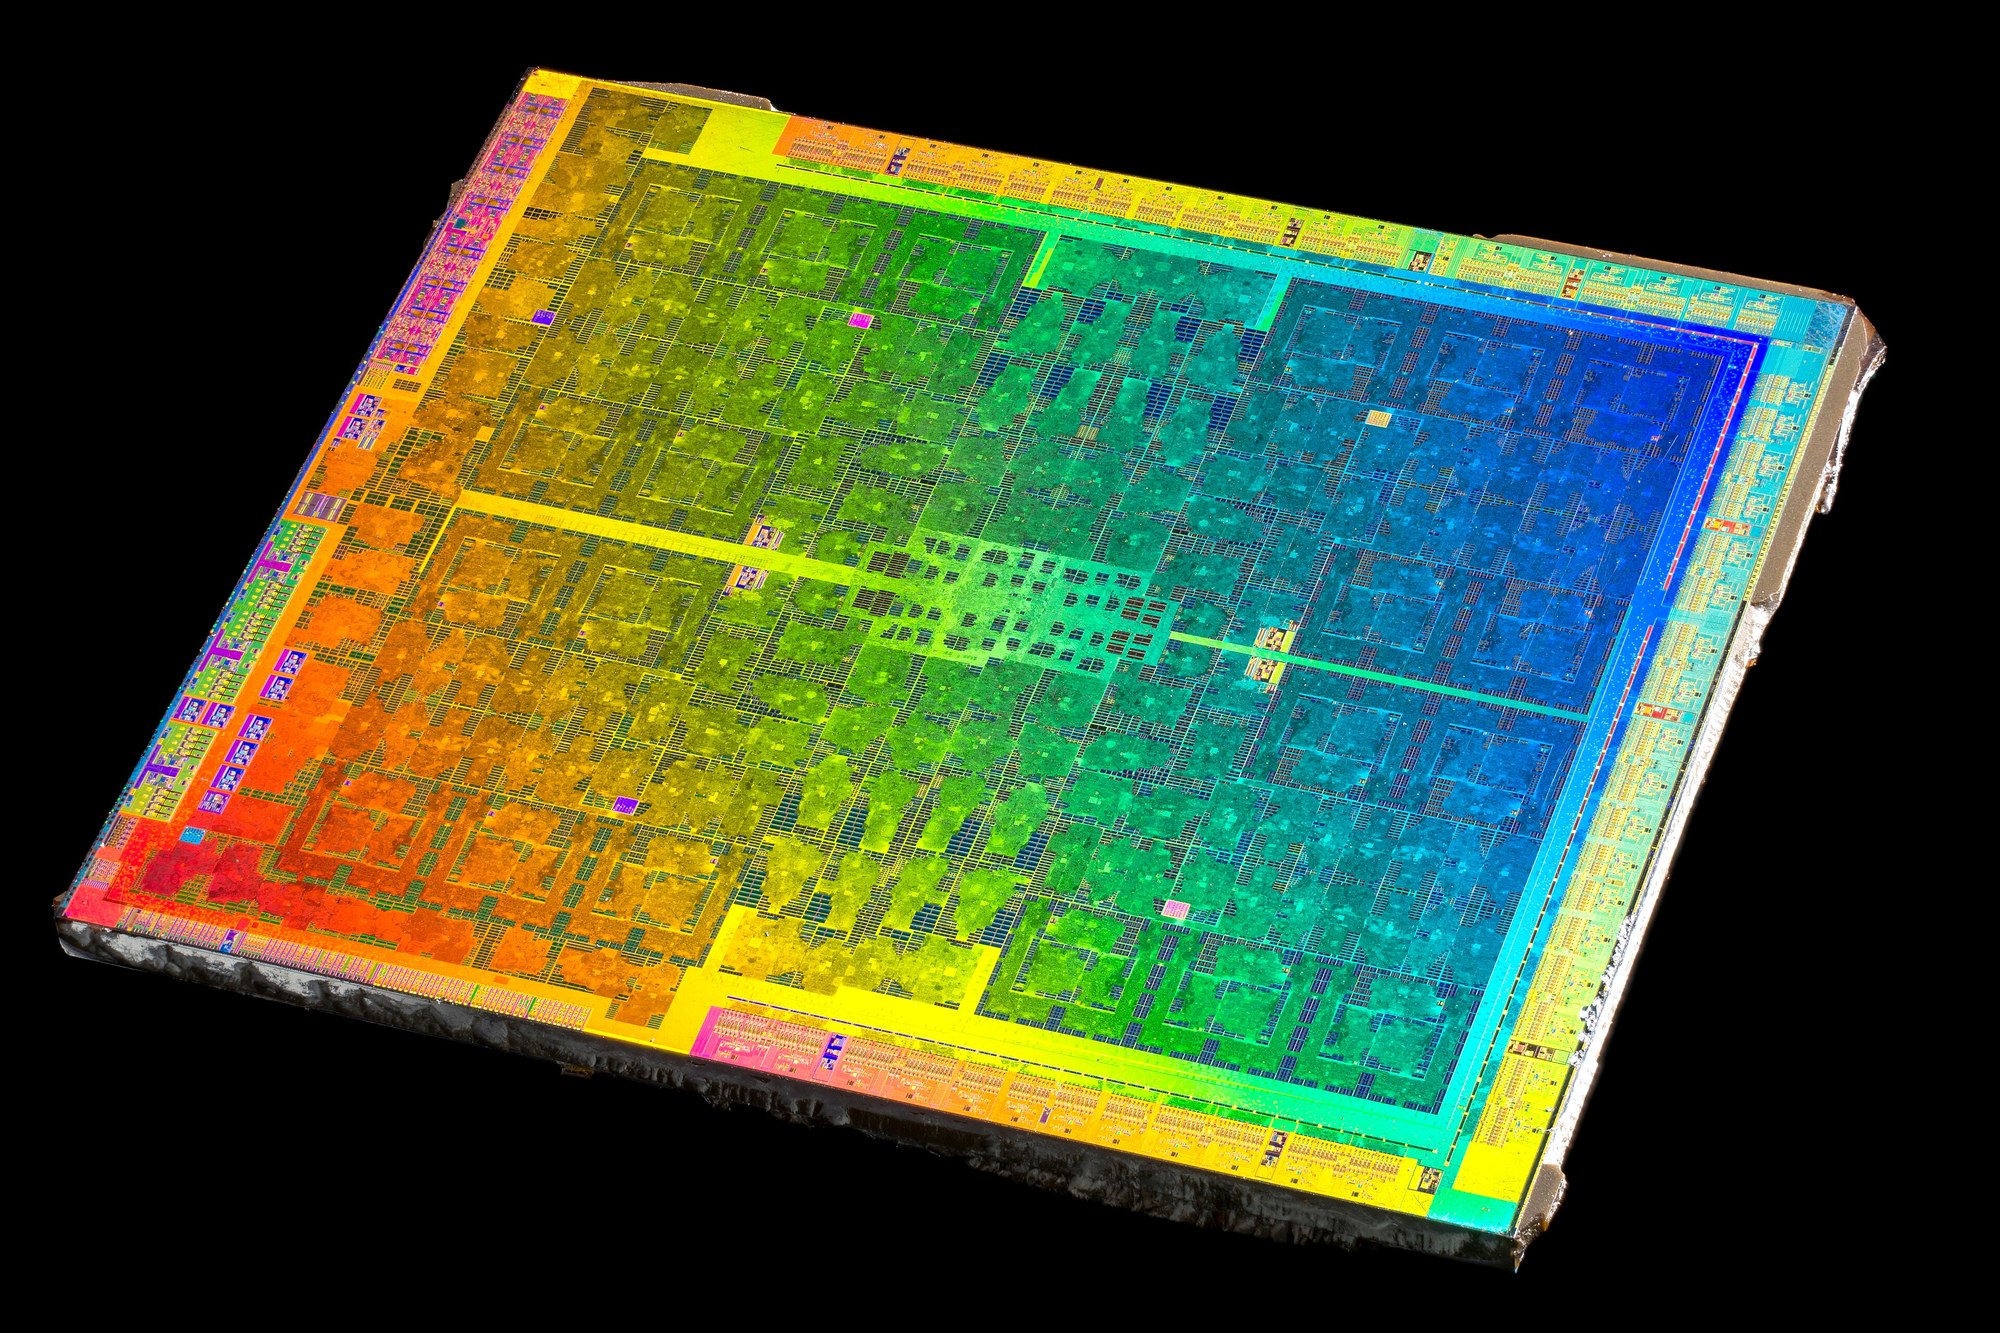
历史锚也值得一个注脚:ATI R580+/RV670 这类老 die,正好是"传统 GPU 上根本没有独立 LDS/CU 概念,计算靠着色器单元硬扛"时代的写照——那时候"计算"是借用图形管线,而今天 SM/CU 里有专门为通用计算准备的执行槽与共享内存。把 R580 与 RV670 两张 die 并排看,你能读出"SIMD 执行阵列一直是 GPU 的核心",区别只在于:新世代把"计算"从图形管线的附庸,扶正成了与渲染平级的"通用执行池"——共享内存(LDS)正是这个"扶正"在硬件上的落点:它让一个 block 的线程,能在一块与 ALU 紧邻的片上空间里真正协作,而不是每笔中间数据都绕回显存。这张 die 图既是"本篇名词的物理坐落",也是"从几何专用到通用计算"这条演进的脚注。
出处:Wikimedia Commons · GPU die shot(Public domain / CC)/AMD · GPU 硬件规格。
九、量化账:CS 的内部同步到底花多少(prove-claim)
好了,把"波前调度、共享内存、三种屏障"的机制都铺完,最后算笔账——为什么它们值得工程上精打细算:
| 机制 | 单位成本量级 | 为什么约束吞吐 |
|---|---|---|
| 波前调度切换 | 数十周期/切 | 切换本身就是开销;波前少→延迟无处藏 |
| 共享内存读(无冲突) | 1 拍(几十周期往返) | 片上近 ALU,比全局显存快一个量级 |
| 共享内存读(N 路冲突) | N 拍串行 | 冲突把快操作打成慢操作 |
__syncthreads(块内同步) |
数十周期 + 强同步 | 最慢波前决定重聚,打断流水 |
| 跨命令 barrier/fence | 全局内存刷新级 | 拖到 ep11 详述 |
把上表落成一张横向对照条,差距一眼可见——共享内存无冲突只要 1 拍,N 路冲突就打成了 N 拍,而块内同步看似只几十周期,真正贵的却是那记把整块所有波前都停下来的强同步;图里把三档成本并排放,读起来最直观:
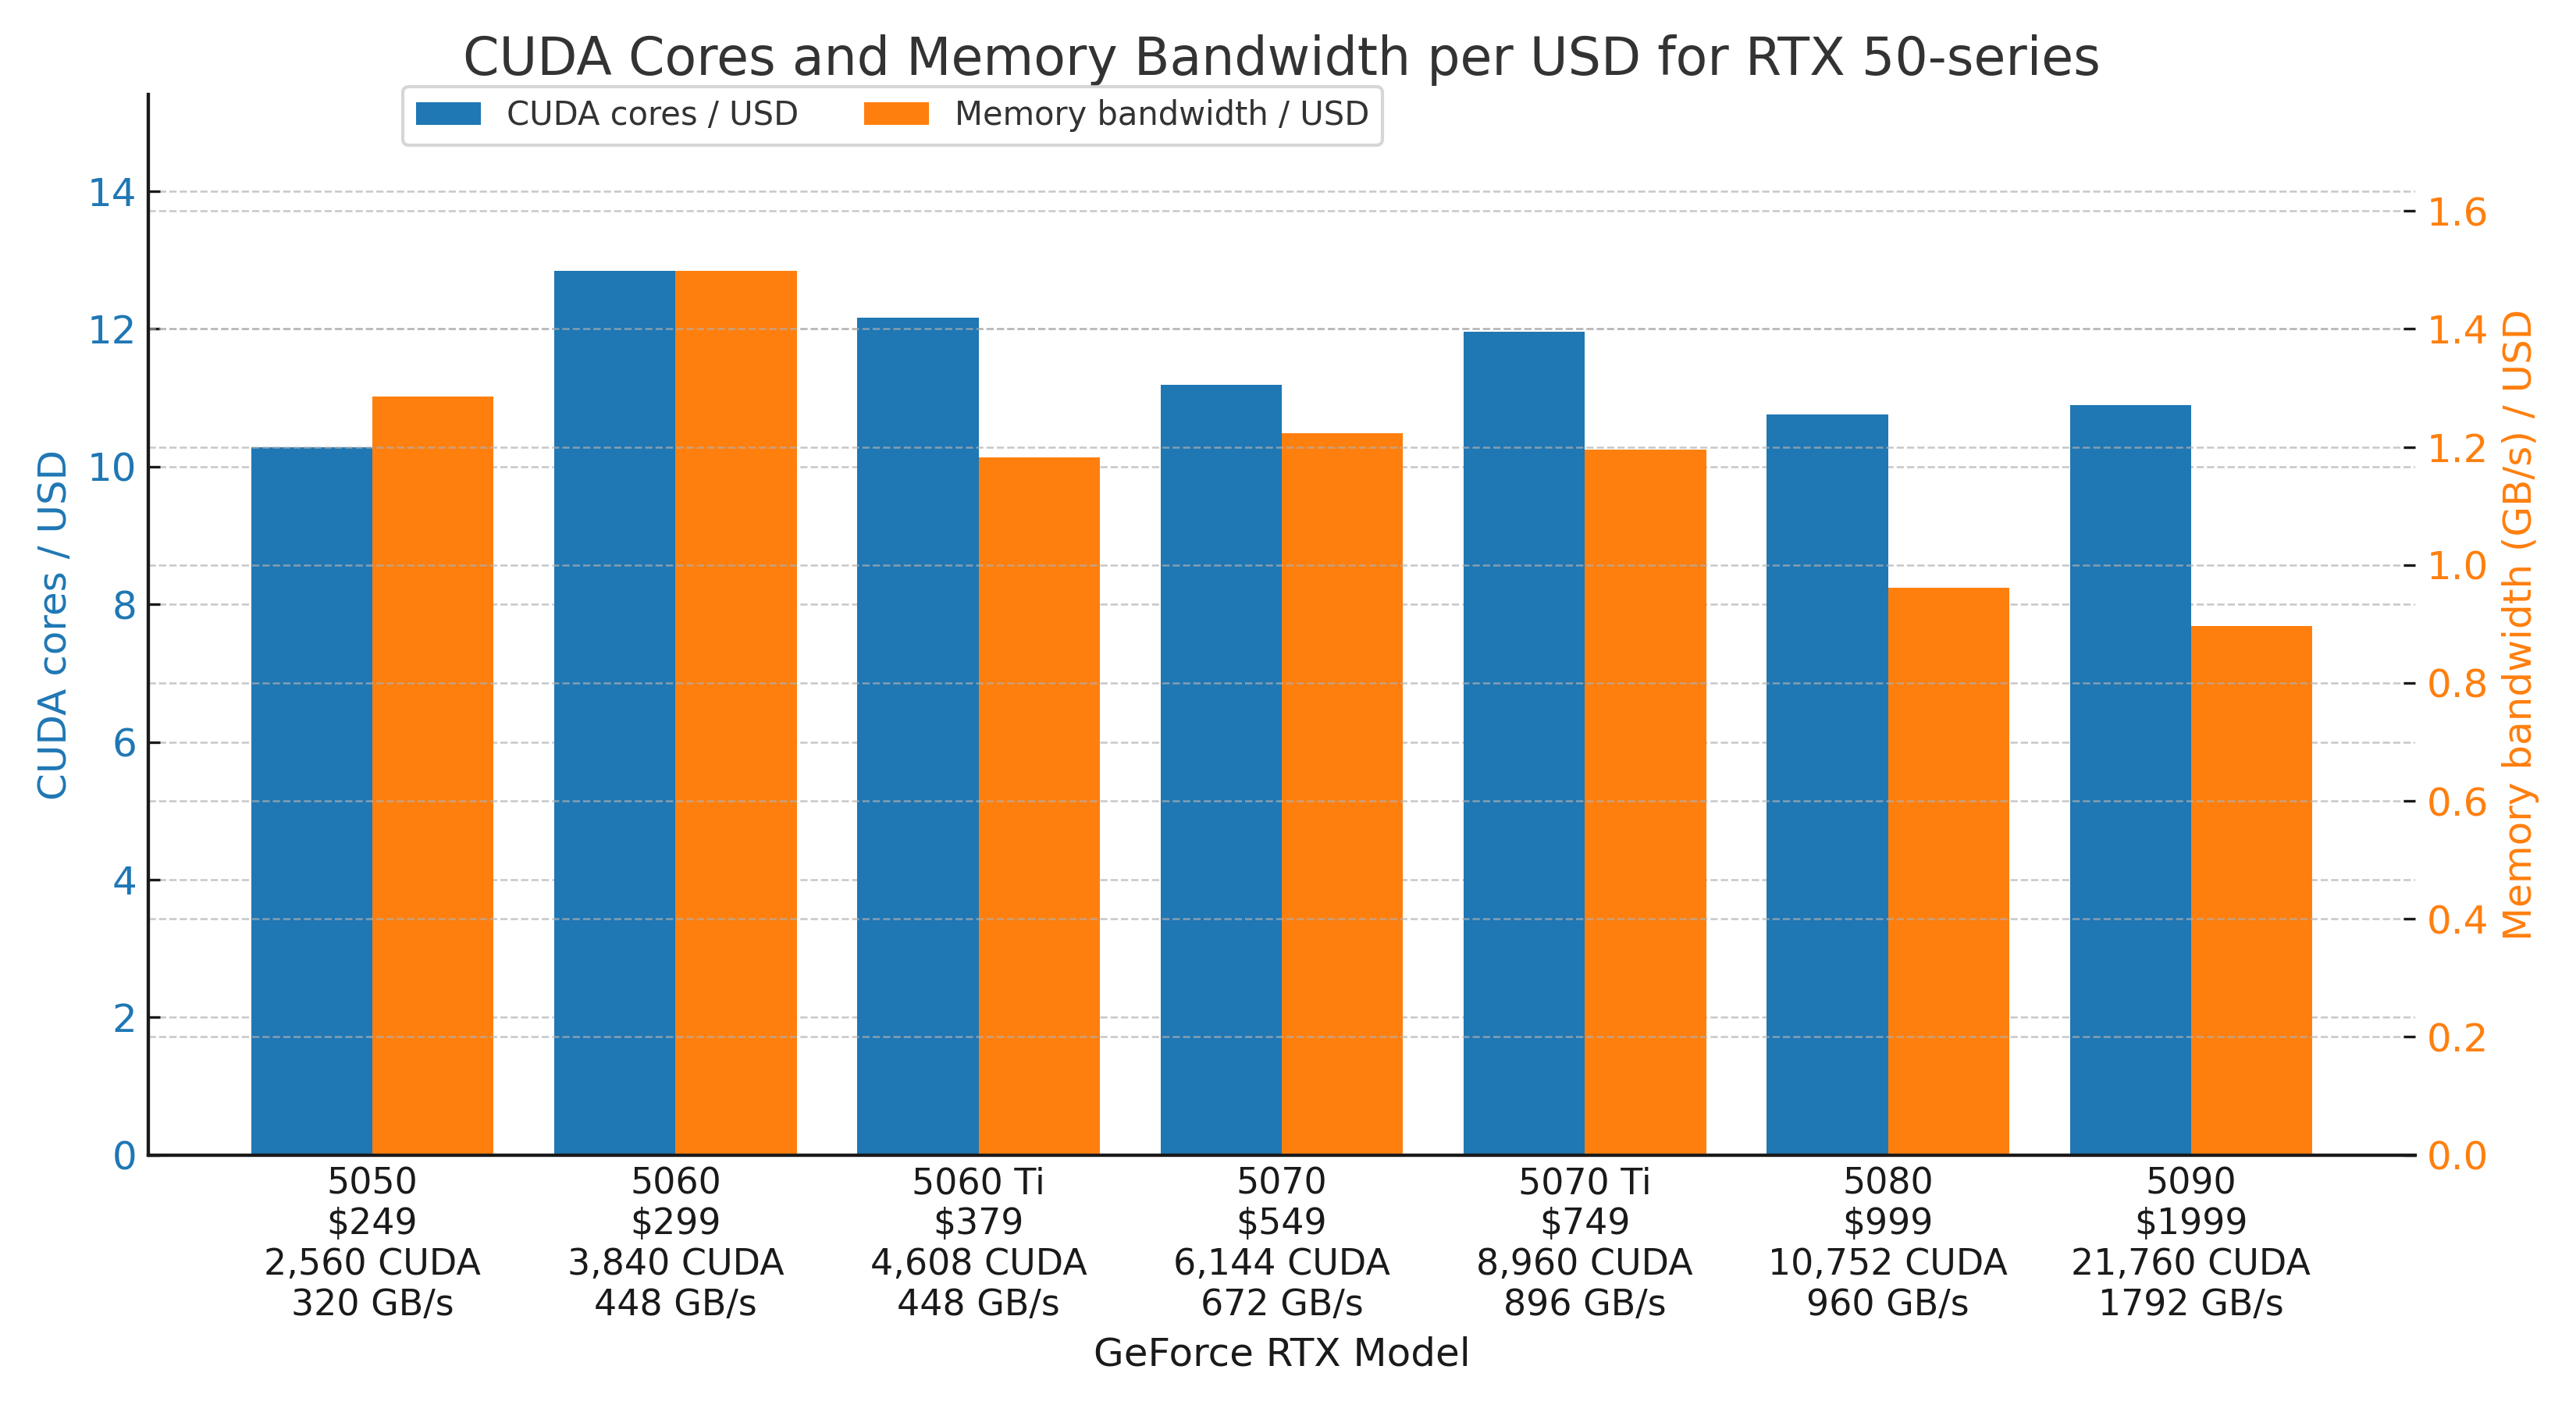
为什么"省带宽"往往比"省计算"更值钱:CS 里真正贵不是 FLOPs,而是喂不到 ALU 的数据。共享内存存在的全部意义,就是让同一份数据被多次复用而不反复从显存拉。有一张很能说明问题的对照图:RTX 50 系里,中端卡(如 5060)每花 1 美元能买到的显存带宽反而远高于旗舰——因为旗舰把晶体管花在堆核心上,带宽侧并不等比放。这对 CS 调优是一句很硬的提醒:当你纠结"要不要多搬一次数据进共享内存"时,答案几乎总是"多搬"——因为从显存读一次,代价是共享内存路径的几十倍,而多数内核恰恰卡在带宽这道瓶颈上,不是卡在算力上。
「占得高不等于快」的量化:一个经典经验值——可驻留波前端点 32 时,基本能掩盖二级缓存/显存延迟;低于某阈值(通常认为 8–16 个可切 warp 以下)延迟就开始露头(NVIDIA 性能指南)。所以工程上你常听人说"要保证 occupancy ≥ 32 warps/SM",背后的物理就是"让替补波前足够多,把内存延迟盖住"。
把这一章的三档成本并成一句记着走:无冲突的 LDS 往返大约只要 1 拍,N 路冲突就摊成 N 拍,块内一次 __syncthreads 看似几十周期、却要让全体波前停下来重聚。所以 CS 调优的先后顺序几乎总是固定的——先看有没有 bank 冲突,再看同步调了几次,最后才轮到占用率。这三件事的优先级顺序,恰好对应这一章标题三个词"波前→共享内存→屏障"里,从最便宜到最贵的那条成本阶梯。
出处:fgiesen · Part 13(CC0)/NVIDIA · 共享内存。
十、CS 之后:新的几何引擎与 work graphs(compare-options)
先来看看这条路走到今天的模样。CS 解决了 GS 的"不可预知",也顺带把几何生成从"管线的可编程段"推进到"通用的并行计算模型"。再往前一步,是两条更激进的路线:
- mesh shader(ep12):task shader 在 meshlet 粒度做簇级剔除,mesh shader 整块生成 mesh——把"按图元编程"升级成"按 mesh 编程",输出规模可预知、无二次装配。
- work graphs(工作图):D3D12 把 dispatch 也变成"图"——一个 dispatch 的输出可以是另一个 dispatch 的输入,理论上连"调度次数"都可以由 GPU 决定(NVIDIA · Work Graphs)。
work graphs 到底"革了谁的命"? 它革的不是"一个波前怎么跑",而是"谁来召唤下一个波前"。传统 CS 里,每次 dispatch 的规模、每个 block 跑多少,都是你在启动前写死的——这是本篇贯穿始终的"可预知"原则的代价:预知换来了无二次装配,却也把"自适应"关在了门外。work graphs 把这个控制权交给 GPU:一个工作节点跑完,可以在设备端决定要不要、以及派多少个后继节点,把"调度次数"本身变成动态的。这跟 mesh shader 的 meshlet 是同一句精神——把"编译器/驱动替你排"push 成"GPU 在运行时自己排":mesh shader 动态决定 cluster 剔不剔除,work graphs 动态决定 dispatch 派不派发,两者都是"空转检测"的进一步下沉。所以本篇说的"dispatch 前规模全写死",在 work graphs 语境下会被局部打破——但那是在"何时启动、怎么分频"这一层被打破,波前内部的 SIMT 执行模型、共享内存、三种屏障,一条都不变。理解本篇的这套地基,读 work graphs 时才不会把它错当成"另一种 SIMT"。
提醒:mesh shader 与 work graphs 的完整实现属于 ep12"2011 之后",本篇只给方向性对照,不作为核心内容展开。
出处:NVIDIA · Turing Mesh Shaders/NVIDIA · Work Graphs。
到这里,CS 的"内部世界"我们读完了。最后处理一下 ep09 埋给 CS 的、但需要更大同步模型的那些话。
十一、这一章留下的问题:从 workgroup 走到整个队列(bridge-to-next)
好了,我们这一期把 CS 的内部协调读透了:波前是执行原子、共享内存让块内协作、三种屏障在块内建可见性。但这个坐标系到 block 就停住了——一旦数据要跨越多个 dispatch、要传给 CPU,甚至只是从"CS 当 UAV 写"切到"光栅化当顶点缓冲读",就需要比"工作组内屏障"更外层的同步。
这正是 ep09 结尾埋的那笔账:"谁保证 GPU 写的数据,在 CPU/GPU 再读时是就绪的?" 在 CS 内部,我们用 __syncthreads/工作组屏障回答;一旦跨过 dispatch 边界,答案就升级成:
- fence(D3D12)/ semaphore + fence(Vulkan)——跨命令、跨队列的同步点;
- resource barrier / image layout transition + memory barrier——"这块 buffer 从写状态切到读状态"的可见性转换;
- 两队列并行(图形/计算/拷贝)——如何用 fence 串行化跨队列依赖。
待续:同步与内存可见性(ep11)——fence/semaphore/barrier 的完整语义、多队列并行、以及"GPU 写-CPU 读"在生产管线里的真实成本;2011 之后(ep12)——mesh shader 完整实现、硬件细分器的演进。
出处:D3D12 · Fence-Based Resource Management(预告)/Vulkan · 同步规范(预告)。
十二、术语速查:这一章的一页纸(summarize)
把本篇所有名词钉成一页,方便回看:
| 术语 | 一句话 | 范围/典型值 |
|---|---|---|
| 波前(wavefront/warp/subgroup) | 32–64 lane 一起执行的执行原子 | NV warp=32,AMD wavefront=64,Vulkan subgroup 可查 |
| 执行槽(execution slot) | 波前被分发去执行的目标单元 | 每 SM 数十个 |
| occupancy | 能同时驻留的波前比例 | 受执行槽/寄存器/共享内存/block 四约束 |
| 共享内存(shared memory/LDS) | 块内低延迟片上可编程存储 | 每 SM KiB 级(48–128+) |
| bank | 共享内存的存储体,决定并行访存 | 32–64,冲突→串行 |
| 三种屏障 | 线程内/工作组内/跨命令三种作用域 | 工作组内同步最贵 |
这篇的"硅片到像素"主线到这里收束:CS 把 GPU 从"逐图元处理"带到"通用并行计算"——波前是执行原子,共享内存把块变成协作体,三种屏障把协作边界划清。下一站我们去看比 CS 更外层的同步全图。
相关链接 - 上一篇:【GPU 架构剖析】(九)几何前端:几何着色器、流输出与细分 - 下一篇(预告):【GPU 架构剖析】(十一)同步与资源生命周期 - 核心参考:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 13 - 相关系列:技术博客页
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在硅片到像素之间,继续挖下去。
参考资料与可回溯出处
- fabian Giesen《A trip through the Graphics Pipeline 2011》Part 13(CC0)
- fgiesen · 系列索引(CC0)
- NVIDIA CUDA Programming Guide · SIMT 内核(线程层级/共享内存/同步)
- NVIDIA CUDA Programming Guide · 高级内核编程(线程作用域/同步原语)
- NVIDIA CUDA Programming Guide · 异步屏障(mbarrier)
- NVIDIA CUDA GPGPU 白皮书
- NVIDIA · 在 CUDA C/C++ 中使用共享内存
- NVIDIA · Nsight Compute(CTA/warp/occupancy)
- AMD · ROCm HIP 性能优化(wavefront/occupancy/bank conflict)
- AMD · AMDGPUUsage(LDS 为 local address space)
- AMD · GPU 硬件规格表(wavefront size/LDS/CU)
- AMD · occupancy math 博客
- Vulkan 规范 · 同步与内存可见性
- Vulkan 规范 · 记忆模型
- Vulkan · Compute Shader 指南
- Vulkan 教程 · Compute Shader 章节
- Vulkan 教程 · 性能优化(bank/swizzled layout)
- D3D12 · 使用资源屏障同步资源状态
- D3D12 · 用户模式堆同步(fence)
- D3D12 · Enhanced Barriers 规格
- NVIDIA · Introduction to Turing Mesh Shaders
- NVIDIA · Advancing GPU-Driven Rendering with Work Graphs
- OpenCL 规范 · 工作组内 barrier
- Wikimedia Commons:GPU die shot(Martijn Boer, Public domain)/GPU flip chip(Naked Hardware, CC BY 3.0)/RTX 50 带宽对比(WikiEwout, CC BY-SA 4.0)
下篇预告:《GPU 架构剖析》系列进度:已完成【三】着色器核、【九】几何前端,本篇【十】计算着色器收束——接下来是【十一】同步与资源生命周期(fence/semaphore/barrier)。波前、共享内存、三种屏障这套 CS 的内部账已经结清;下一站把这些"写回/再读"路径的时序,交给 ep11 的同步与资源生命周期。
(本篇完)