CSDN 版文章链接:待发布 知乎专栏版文章链接:待发布
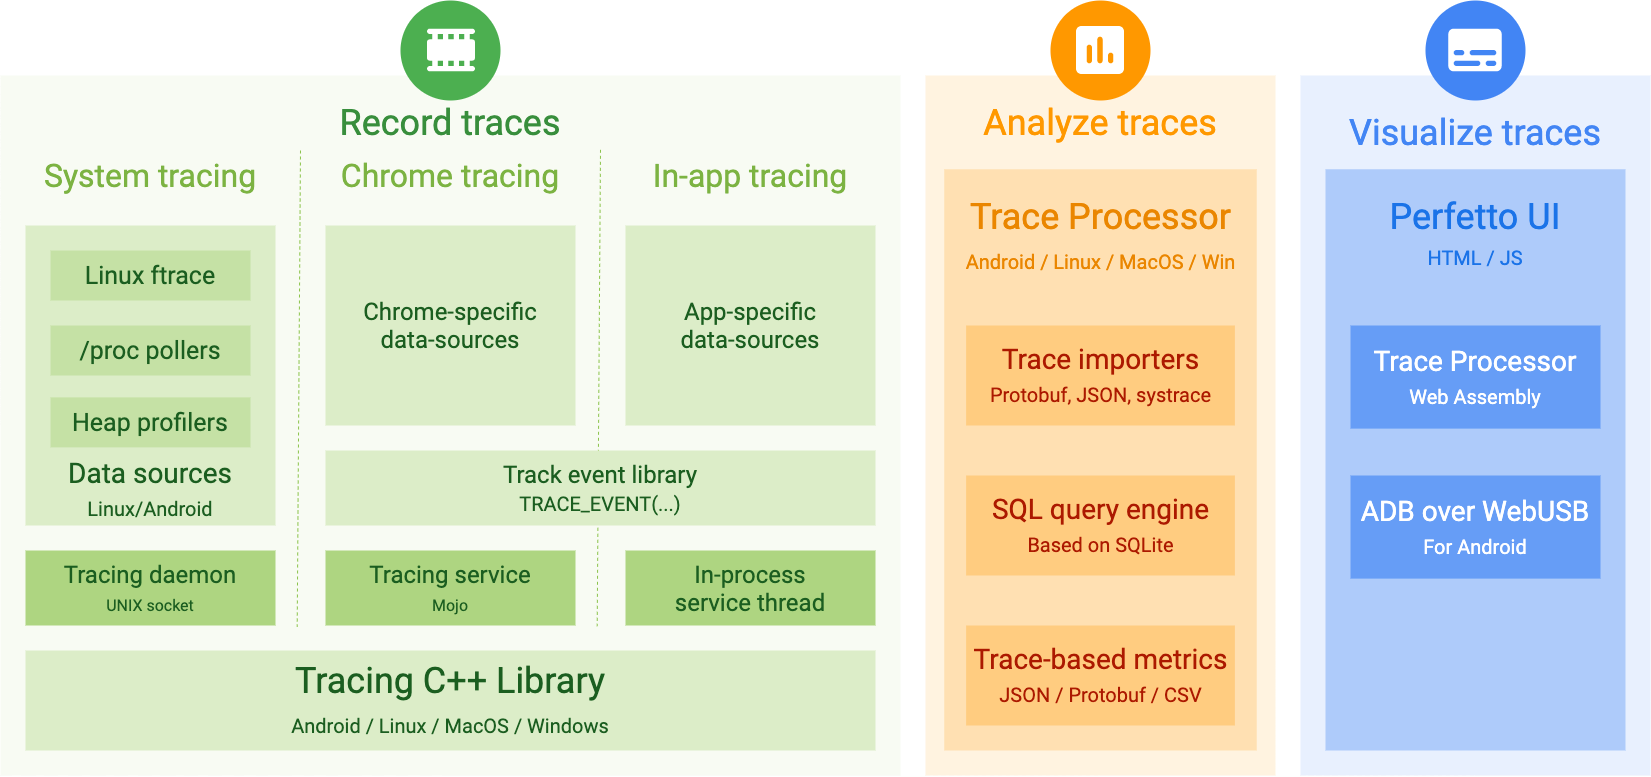
点题与全篇总览:trace 不是凭空有的
你在 Perfetto UI 里拖动时间轴,看到一条条横向轨道、一根根蓝色切片、一片片火焰图,很容易把它们当成"工具自带的功能"。可工具本身并不知道你的 App 在第几分钟分配了 4 MB 内存,也不知道 SurfaceFlinger 这一次合成为什么晚了一个 vsync——这些数据必须由一个具体的生产方,在具体的时刻,写进 trace 里。本篇回答的就是这件事:谁在写、谁被配置、写出来的东西最后落到哪张表。
上一站(ep07)做的是逆向拆解:拿到一份 .pftrace,把它拆成 TracePacket、varint 与 interned 字符串,最后落到 SQL 表。那一站回答"文件里有什么"。这一站翻个面:这些内容是谁写进去的。两站合起来才是一条完整链路——ep07 从字节追到表,ep08 从表追回源。这也是本系列为什么要单独用一篇讲 data source:没有这一层,前面所有的 SQL 都是"别人给的结论"。
0.1 为什么"抓到了 trace,却没有你要的数据"
先从一个几乎人人都踩过的坑说起。有同学按教程抓了一份 10 秒的 trace,打开 UI 准备看 GPU 占用,结果 GPU 分组一片空白;想看的 native 内存火焰图也没有;倒是 CPU 调度轨道很热闹。于是他怀疑是工具坏了、版本不对、或者设备不支持。
真实原因往往很朴素:他抓的 trace 里,根本没有对应的 data source 被启用过。Perfetto 与 rsyslog、logcat 这类"常开日志"不同,官方 配置概念页 第一句就把这件事讲明白了——所有 data source 默认闲置,只有被明确指示时才采集。GPU counter 要单独配、堆采样要单独配、perf 采样也要单独配;没配就是没有,UI 不会替你凭空造数据。
好了,先把"缺数据"这件事的归因链条摆正:UI 上缺一块,先问三件事——这个源注册了吗?这次会话的 TraceConfig 里声明它了吗?它采了但丢包了吗?前两问分别落在本篇第一章与第二章,第三问则回到第一章那块共享内存。这就是为什么"data source 全景"值得单独写一篇。
0.2 全篇知识地图:从"谁在采"到"落到哪张表"
先来看看这条路怎么走。后面八章不是并列的八个知识点,而是一条从"生产方"走到"存储方"的链路。先给地图,再爬坡:
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 一、四方模型 | 一套 trace 里有几个角色?谁在写、谁在读? | Service / Producer / Consumer / Data source 四角色 + 两条通道 |
| 二、一次会话的生命 | TraceConfig 怎么把一个源叫起来? |
data_sources{} / name / target_buffer / buffers{} / [lazy] 与兼容路由 |
| 三、Kernel 侧 | 内核的数据到底谁在采? | linux.ftrace 这一个宿主 + 它撑起的六个配置面 |
| 四、应用侧 | App 怎么自己产生数据? | TrackEvent SDK、DataSourceDescriptor、categories 的运行期过滤顺序 |
| 五、专业采集器 | 内存与调用栈的火焰图从哪来? | heapprofd / java_hprof / perf 的开销模型与产物形态 |
| 六、GPU 与功耗 | GPU 数据是不是另有一套体系? | gpu.* 四个源 + "GPU 频率与内存其实是 ftrace 事件" |
| 七、全景对照表 | 每个源最后落到哪张表? | 源名 ↔ 谁在采 ↔ 产出 packet ↔ SQL 表 四轴对齐 |
| 八、边界与结语 | 本篇讲到哪、下篇讲什么? | 边界再确认表 + ep09 预告 + 资源清单 |
注意地图里的第七章:它才是本篇的落点。官方文档对每个 data source 都有一页独立说明(官方 docs 首页 的 Data Sources 区按平台分栏,分页数量在二十个以上),但它是按源翻的字典,不会告诉你"这二十几个源的产物最后在 SQL 侧汇成哪几张表"。本篇要补的正是这一层横向拉通。
读上面这张表有个建议:先横着读一遍它回答的问题——左边是"数据从哪来",右边是"数据到哪去",中间那条腰线就是本篇七章的顺序。你会发现前六章都在解释"左边的方形怎么工作",第七章一次性把右半边对完。这种"先分述、再横拉"的结构,是为了让你在读到第七章时手里已经攒够了对照的细节,而不是被一张二十多行的表砸懵。
0.3 演进脉络:源不是一天长出来的
把 data source 体系放进时间线,你会发现今天这些源名不是设计出来的,而是一层层补上去的:
| 阶段 | 时间 | 关键变化 | 留下的痕迹 |
|---|---|---|---|
| 内核 ftrace 进主线 | 2008 年前后 | Linux 提供可插拔的内核 tracer,sched_switch 等事件成型 |
今天 linux.ftrace 的根基 |
| systrace / atrace 时代 | Android 4.1(2012)起;ATrace API 自 Android 4.3(API 18,2013) | 系统与 App 靠 libcutils 打点,host 端用 HTML 装载 |
atrace 至今仍是 Android 官方推荐入口 |
| Perfetto 诞生 | 2018 年前后 | 从 systrace 分家,改用 protobuf + 服务化架构 | Producer/Service/Consumer 四方模型定型 |
| 配置能力持续补齐 | v54 / v58(近年版本) | target_buffer_name 按名引用 buffer(v54)、compression 载荷压缩(v58) |
配置更好读、trace 文件更小 |
| 专业采集器落地 | Android 10(Q,2019) | heapprofd、battery counters / ODPM 上线 | 火焰图与功耗曲线进同一条时间轴 |
| Java 堆快照 | Android 11(R,2020) | android.java_hprof 提供 ART 保留图 |
保留图与调用栈被明确区分 |
| 帧与 GPU 侧补齐 | Android 12(S,2021) | FrameTimeline、ART 分配采样 | 期望/实际两条时间线进入 trace |
| 内核函数级洞察 | Android 14(U,2023)起 | function graph 可在 debuggable 构建上驱动 | slice 表里多出 Funcgraph 轨道 |
读这张表要抓住两个点。第一,"谁在采"这件事一直在搬家:早年内核事件靠 in-kernel lowmemorykiller 这类驱动直接发 ftrace 事件,Android 9 之后 LMK 搬到了用户态 lmkd,于是它改发 atrace counter,落到 instant 表里的 key 也换成了 mem.lmk。第二,门槛是硬件与系统版本共同决定的:battery counters 与 ODPM 都要求 Android 10(Q)以上且设备得真有那颗电源管理 IC,function graph 在 Android 上还要 debuggable 构建。
把这条时间线再往前推一层,你能读出本篇的一个隐含立场:"哪个源存在"这件事本身是历史产物,不是设计美学。LMK 从内核搬到用户态,于是它从 ftrace 事件变成了 atrace counter;GPU 内存统计一开始就没有独立接口,于是它至今挂在 ftrace 的 gpu_mem/gpu_mem_total 事件上。读源名的时候顺便想想"它为什么长这样",很多配置上的别扭之处就自洽了。
0.4 一张术语双语对照表(先备着)
先来看看这套术语的双语对照。后面会密集出现英文术语与官方术语原名,先放一张对照表,遇到不确定回来查:
| 中文 | English | 一句话 |
|---|---|---|
| 追踪服务 | tracing service(traced) | 唯一中枢:持有 buffer、分发配置、登记生产者 |
| 生产者 | producer | 一个进程一个,托管若干 data source |
| 消费者 | consumer | 发起会话、读走 trace 的一方 |
| 数据源 | data source | 真正干活的最小单位,只挂在一个 producer 上 |
| 数据源描述符 | DataSourceDescriptor | 注册时声明"我叫什么、能产什么" |
| 追踪配置 | TraceConfig | 一次会话的总配置,可写成 pbtx 文本 |
| 共享内存 | shared memory(shmem) | producer→service 的数据面通道 |
| 采样 | sampling | 每 n 字节 / n 个事件取一个样本 |
| 轨迹 | track | UI 上的一条横向轨道 |
| 数据包 | TracePacket | trace 的基本写入单元,与 ep07 同一对象 |
一句话记住本篇的方法:每个源都要能回答四个问题——谁注册它、谁配置它、它产出什么 packet、它落到哪张表。
0.5 边界声明:本篇不涉及什么
为了不让这篇变成"Perfetto 大百科",先把边界钉死,且在后文第八章会再确认一次:
- 不涉及抓取命令的具体用法。
perfetto命令行、--txt/-o参数、tracebox、权限怎么开,这些属于操作层,官方 命令行参考 写得比本文细,本文只在需要说明"配置长什么样"时贴配置本身的片段。 - 不涉及 SQL 的调优写法。本篇第七章会给出"源→packet→表"的对照,但只到"落到哪张表"为止;怎么把 SQL 写快、怎么用
INCLUDE PERFETTO MODULE组合标准库,留给 ep09。 - 不涉及 jank 判定公式。FrameTimeline 只作为"平台服务型源"的一个例子出现,
AppDeadlineMissed与SurfaceFlingerGpuDeadlineMissed的判据与计算,留给 ep10。 - 不涉及非 Android 平台的部署形态。Chrome、Windows ETW、多机 profiler 这些分支只顺带点名,不展开。
本篇要拿下的量化锚点也有四个,先给出来,后文逐一对上:atrace 单事件开销 1–10 µs(微秒)、heapprofd 默认采样间隔 4096 字节(即 4 KB)、producer 共享内存默认 256 KB、perf 采样频率常用 frequency: 1000。记住这四个数,你对"代价"就有了量感。
一、四方模型:一套 trace 里到底有几个人
下面我们开始拆第一层。要讲清"谁在画火焰图",先得把角色分清。Perfetto 不像 perf record 那样一个进程从采集到落盘全干完,它被拆成了四个角色,官方 service-model 把这一层定义得极干净。理解这四方,等于拿到了整篇的坐标系。
1.1 Service:唯一的中枢,也是 buffer 的所有者
下面我们开始从中枢看起。Service(在 Linux/Android 上就是 traced 这个常驻守护进程)是唯一的有状态中枢。官方给它的职责清单有五条:维护活跃 producer 及其 data source 的注册表、持有 trace buffer、处理多个会话的复用(multiplexing)、把 consumer 的配置路由给对应 producer、以及把数据从 producer 的共享内存搬到中心 trace buffer。
请特别留意最后一条:Service 是数据的搬运工,不是数据的生产者。traced 参考页 与 traced_probes 参考页 分别对应"中枢本体"与"内核侧采集代理"两个二进制,日常抓系统 trace 时打交道的多数是后者。理解这一点,后面第三章"内核事件其实由一个用户态进程在采"就不会觉得矛盾。
1.2 Producer 与 data source:一人托管多个源
Producer 被官方定义为"不受信任的实体",它只能贡献数据,不能读走别人的数据。它的配置极简:一个 producer 恰好拥有一块共享内存缓冲,和一条通往 service 的 IPC 通道。
而 data source 是挂在 producer 下面的"能力":一个 data source 就是"我能提供某类追踪数据"的声明,它几乎总会自带两个 proto——至多一个 DataSourceConfig 子消息(我吃什么样的配置),以及一个或多个 TracePacket 子消息(我吐出什么样的数据)。官方文档里有一句话几乎是本篇的题眼,值得原样记住:
典型的 Perfetto 运行时模型是:一个进程等于一个 Producer;一个 Producer 通常托管多个 data source。
这句话解释了两个常见困惑。其一,为什么你在配置里只写 name: "track_event",却能让一堆 App 同时开始埋点——因为每个 App 进程各是一个 producer,而它们都注册了同名的 track_event 源;配置概念页 明确说,这种情况下默认会让所有声明了该源的进程都启动它,需要限定范围时用 producer_name_filter(精确匹配)或 producer_name_regex_filter(正则匹配)。其二,为什么有的源是"单例"——比如系统级的调度采集,全系统只有一个,由 traced_probes 持有。
这张映射图是后面所有"为什么配了没用"类问题的通用解释器。 名字相同的源可以有一堆注册者(每个进程一个),于是"启用某个源"到底是"全局启用"还是"只启用某一个",就变成了配置层必须回答的问题;而名字唯一的源(如内核调度)根本没有这个烦恼。第四章的 TrackEvent 与前文的 track_event 正好分别是这两种情形的代表,读到那里时可以回来看这张图。
| 角色 | 一个进程几个 | 谁配置它 | 能不能读别人的数据 |
|---|---|---|---|
Service(traced) |
通常 1 个,常驻 | 由 consumer 驱动,自身配置有限 | 能(它是搬运工与仲裁者) |
| Producer | 一般 1 个(少数进程可多个) | 由 Service 转发配置 | 不能 |
| Consumer | 按需,可多个 | 自己 | 能(破坏性读取) |
| Data source | 一个 producer 下 N 个 | 只能被同名的 DataSourceConfig 配置 |
不适用(它只写) |
1.3 Consumer:发起者,也是"执法者"
Consumer 是受信任的一方:命令行客户端 perfetto、或者任何按 API 接上来的程序。它的权力清单基本等价于"会话的生命周期"——发配置、开 trace、关 trace、把 buffer 读回来。life-of-a-tracing-session 设计文档把这一串动作按时间顺序写成了完整时序,建议配合第二章一起读。
把这份权力清单铺开,就是控制面上跑过的一串消息(顺序即时间):
【一次会话在控制面上跑过的消息(顺序即时间,示意)】

consumer → service : EnableTracing(TraceConfig)         // 带配置、buffer 个数与大小
service  → producer: RegisterDataSource(Descriptor)     // 更早:进程启动时就已登记
service  → producer: SetupDataSource(DataSourceConfig)  // 原样转发属于它的那一段配置
service  → producer: StartDataSource(全局 buffer id)     // 注意:buffer id 此时被覆写
producer → service : 数据面写 shmem chunk(不经 socket)  // 真正的数据走这里
consumer → service : Flush() / DisableTracing()          // 收尾:先 flush 再停
service  → producer: StopDataSource(...)                // 等生产者确认
consumer ← service : ReadTrace()                        // 破坏性读走 buffer
下面对其中两行特别说明。 一是 RegisterDataSource 那一行发生得远比会话早——它在进程启动时就完成了,会话开始后 service 做的只是"从注册表里找出同名者";二是 StartDataSource 里那个 buffer id,正是第二章要讲的 target_buffer 被覆写的时刻。把这两行的时序记住,你对"注册"与"配置"这两件事就不会再混为一谈:注册是一次性的能力声明,配置是每次会话的临时决定。
这里有个安全模型上的细节值得单独拎出来:在系统模式下,producer 无权读回 trace。官方 Tracing SDK 文档 解释得很直白——系统 trace 里可能混着其他进程的信息,允许 producer 读回等于开了一条侧信道。所以"谁采"与"谁读"必须分开,这正是四方模型必须存在的根本理由,而不是纯粹的分层美学。
1.4 两条通道:控制面走 socket,数据面走共享内存
四方之间的连线只有两条,但性质完全不同,混起来就会写出错误的性能模型。
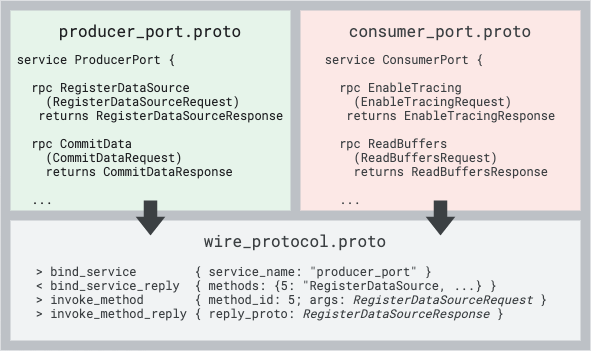
控制面(IPC / UNIX socket):负责握手类交互——(取消)注册、启动/停止 data source、启停 trace。官方 api-and-abi 里的 socket 协议就是这条通道的实现。它的特点是低频、不可省,但不是吞吐瓶颈。
数据面(shared memory):producer 通过一个叫 ProtoZero 的序列化库,把 protobuf 编码的二进制块直接写进自己的共享内存缓冲。官方给的规格是:这块缓冲大小固定且"通常很小",可配置,默认 256 KB;它被该 producer 的所有 data source 共享,与 trace buffer 的数量和大小无关;它在内部被切成大小可变的 chunk(碎片),一个 chunk 只归一个 TraceWriter 所有,chunk 内是 TracePacket 的线性序列——一个 packet 可以跨多个 chunk,而消费者永远看到完整的 packet,碎片对它不可见。
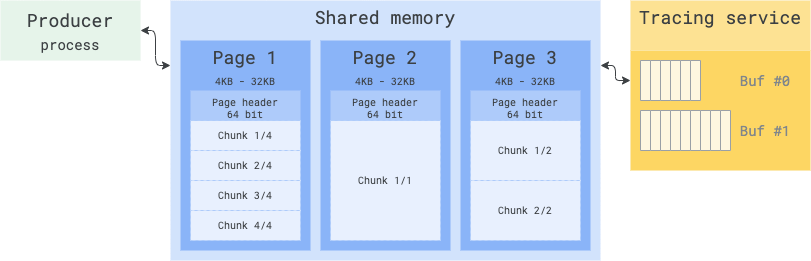
上面两张图最好对着看:socket 图上跑的是"协议",共享内存图上跑的是"字节"。这条分界线的工程含义是——注册与启停再怎么加,也不会拖慢采集;真正决定你会不会丢数据的,是 256 KB 那块共享内存和它承载的 chunk 序列。
说白了,如果你只记一句话,就记这句:控制面决定"谁在采",数据面决定"采得到多少"。 这也是后文第五章 heapprofd 出现"缓冲溢出导致会话提前结束"时,官方建议先调 --shmem-size 的原因——那是数据面的容量问题,不是采集逻辑写错了。
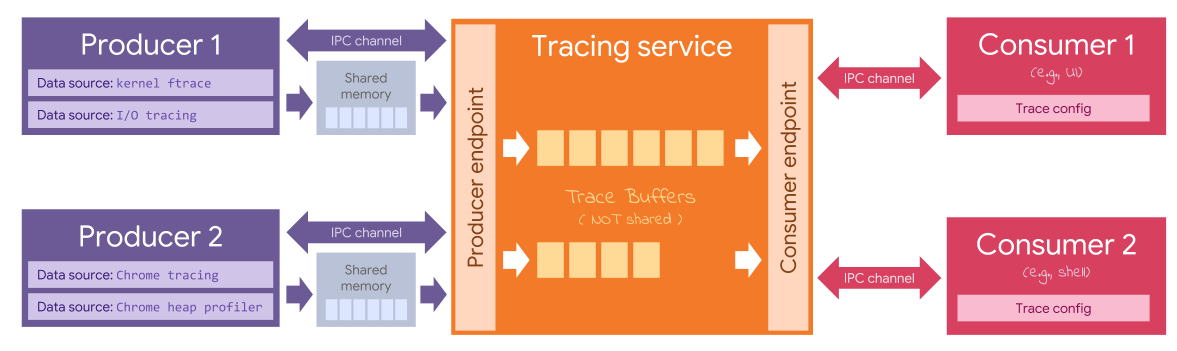
上面这张四方图就是本篇的地基,后面所有章节都在它上面加细节:第二章讲虚线怎么走(配置分发),第三章到第六章讲下面那些方形各自怎么干活,第七章把它们的产物对回 SQL 表。看的时候建议先找 traced 那个中心节点,再顺着箭头问一句"这条线上传的是什么"——控制面传的是配置,数据面传的是 packet,整篇就顺了。
1.5 谁在写 packet:连 Service 自己也算一个写者
最后一个容易被忽略的角色:Service 自己也会往 trace 里写字段。官方在 trace-packet-proto 的 TracePacket 页头就写明:Service 对 packet 内容基本不关心,唯独少数几个字段由它自己写入,典型就是 trusted_uid、trusted_pid、trusted_packet_sequence_id 这一族,以及 previous_packet_dropped 这种丢包标记。
更进一步,TraceConfig 里有一个 builtin_data_sources 段(见 trace-config-proto),可以开关 disable_clock_snapshotting、disable_system_info、disable_service_events 这些项——也就是说,时钟快照、系统信息、服务事件这些"元数据",是 service 作为内建数据源产出的。你在 trace 开头看到的进程树、时钟基准、设备信息,并不是某个 App 的功劳。
把这条讲完,四方模型就闭环了:业务数据来自 producer,元数据与可信字段来自 service,配置来自 consumer,而 data source 是这一切的最小执行单元。下一章我们看这份配置本身长什么样。
二、一次会话的生命:TraceConfig 怎么把源叫起来
言归正传,这一章我们跟着一份配置走完全程。上一章的四方模型是"静态布局",这一章把时间轴拉起来:从 consumer 递出配置的那一刻起,到一个 data source 真正开始往共享内存里写字,中间发生了什么。官方把这条路径写在 配置概念页 与 life-of-a-tracing-session 里,拼起来就是本节的内容。
2.1 配置的三段结构:全局、源列表、源与 buffer 的映射
TraceConfig 是一个 protobuf 消息(trace-config-proto 是它的完整字段表),官方把它定义的内容拆成三段:
- 全局行为:trace 最长跑多久(
duration_ms)、内存 buffer 有几个多大(buffers)、输出文件上限(max_file_size_bytes)。 - 要启用哪些源,以及每个源怎么配:比如内核侧要开哪些
ftrace_events、堆采样器要盯哪个进程、采样率多少。 - 数据源与 buffer 的对应关系:哪个源写进哪块 buffer。
service 收到配置后,会先把外层读掉(duration_ms、buffers 这些自己消化),再逐个读 data_sources 列表:如果某个 name 有对应的注册者,service 就把这一段 DataSourceConfig 的原始字节原样转给那个 producer,让它去启动这个源。注意"原样"两个字——配置概念页 特意强调 service 不解码、不重编码,这带来一个很关键的兼容性质,2.4 节还会回来讲。
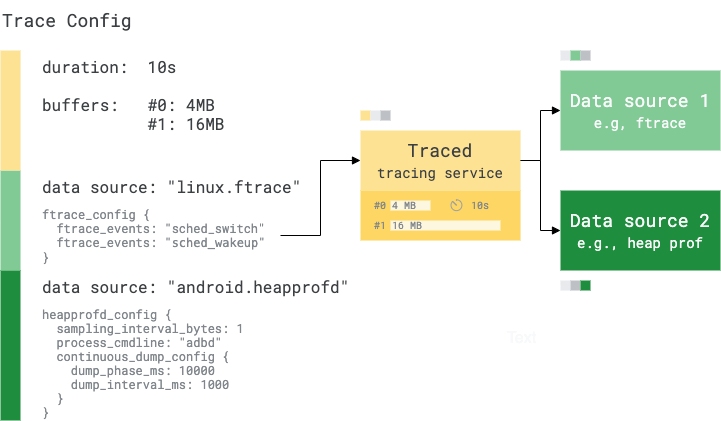
这张图里值得盯的是"分叉点":配置从 service 出发后不是广播,而是按名字定向投递。名字对不上,这段配置就被静默丢弃——这正是 0.1 节那个"抓了 trace 没数据"的第一种成因:源名写错(比如把 linux.ftrace 写成 ftrace,把 android.heapprofd 写成 heapprofd),service 找不到注册者,什么都不会发生。
2.2 data_sources{} 逐字段解剖
一个条目到底由什么组成?把官方 data_source_config.proto 的字段摊平,骨架只有四个:
| 字段 | 作用 | 坑点 |
|---|---|---|
name |
源的唯一名,如 linux.ftrace,必须与注册时一致 |
写错不会被报错,只会静默不生效 |
target_buffer |
写进第几块 buffer(配置内是 0 基下标) | 同一字段有双重语义,见 2.3 |
target_buffer_name |
按 buffer 名指定(v54+) | 与 target_buffer 同时出现时必须指向同一块,否则配置被拒 |
| 各源专属子消息 | ftrace_config / heapprofd_config / gpu_counter_config… |
由该源自己解析,service 只搬运 |
除了这四个,TraceConfig.DataSource 这一层还挂着 producer_name_filter / producer_name_regex_filter / machine_name_filter 三组过滤器,用来在"多个进程注册了同名源"时做选择。前两个在 1.2 节提过,第三个是多机场景(traced_relay)才用得上,本篇不展开。
下面对一段真实形态的配置特别说明。先对照上面那张解剖图把四个字段记清楚,再往下看它们被真正填成什么样子。它不是伪代码,字段名与嵌套层级都取自官方示例(配置概念页、cpu-scheduling、gpu、native-heap-profiler 各页的 TraceConfig 段落),只是把它们拼成了一次会话:
//-----------------------------------【一次多源会话的 pbtx 配置】-----------------------------------
// 描述:外层全局参数 + 四类源声明 + 源与 buffer 的映射
//------------------------------------------------------------------------------------------
duration_ms: 10000                                  //【1】会话时长:10 秒

buffers {
  size_kb: 65536                                    //【2】中心 trace buffer:64 MB
  fill_policy: RING_BUFFER                          //    环形:写满回卷覆盖最旧数据
}

data_sources {
  config {
    name: "linux.ftrace"                            //【3】内核宿主源
    target_buffer: 0                                //    写进 buffer 0
    ftrace_config {
      ftrace_events: "sched/sched_switch"           //    调度面
      ftrace_events: "sched/sched_waking"
      compact_sched: { enabled: true }              //    压缩调度记录
      atrace_categories: "am"                       //    atrace 面(走 trace_marker)
      atrace_apps: "com.google.android.apps.docs"
      ftrace_events: "power/gpu_frequency"          //    GPU 频率其实是 ftrace 事件
      ftrace_events: "gpu_mem/gpu_mem_total"        //    GPU 内存同样走 ftrace
    }
  }
}

data_sources {
  config {
    name: "linux.process_stats"                     //【4】补齐进程名与 线程↔进程 关系
    process_stats_config {
      scan_all_processes_on_start: true
      proc_stats_poll_ms: 1000                      //    轮询周期:1000 ms
    }
  }
}

data_sources {
  config {
    name: "gpu.counters"                            //【5】GPU 计数器(独立源)
    target_buffer: 1
    gpu_counter_config {
      counter_period_ns: 1000000                    //    采样周期:1000000 ns = 1 ms
      counter_ids: 1
    }
  }
}

data_sources {
  config {
    name: "android.heapprofd"                       //【6】堆采样(Android 10+)
    target_buffer: 1
    heapprofd_config {                              //    默认采样间隔 4096 字节
      process_cmdline: "com.example.myapp"
      continuous_dump_config { dump_interval_ms: 5000 }
    }
  }
}

data_sources {
  config {
    name: "track_event"                             //【7】应用埋点(谁注册谁响应)
    producer_name_filter: "com.example.myapp"       //    只在这一进程上启用
    track_event_config {
      enabled_categories: "rendering"
      disabled_categories: "*"
    }
  }
}
下面对这段配置特别说明三点。
- 【3】与【5】的差别是"内核侧还是生产者侧":
sched/sched_switch这类调度事件必须走linux.ftrace,而 GPU counter 是设备厂商 producer 提供的独立源(gpu.counters),两者产出的 packet 类型完全不同。但同在【3】里你会看到power/gpu_frequency与gpu_mem/gpu_mem_total——这两项 GPU 数据反而是 ftrace 事件,第六章会专门破除这个误解。 - 【4】看着"没什么用",其实是刚需:ftrace 只给你 tid 与 pid,进程名与"线程属于哪个进程"这两件事要靠
linux.process_stats补齐。官方在 cpu-scheduling 页 的示例里也把这一条单独列了出来。 - 【6】与【7】都限定了范围,但手段不同【6】是堆采样器自己的
process_cmdline目标进程,【7】是配置层过滤producer_name_filter。前者是"这个源只服务这个进程",后者是"同名源有很多注册者,只要这一个"——一个是源的语义,一个是配置的语义。
2.3 buffer 与 target_buffer:为什么源要分家
一份 trace 至少要有一块 buffer,最简单的情况是所有源都写同一块。但官方在 配置概念页 给了一个非常具体的反面案例,值得复述:假设你把内核调度器和内存计数器放进同一块 4 MB 的 buffer——调度器在典型 Android 手机上大约每秒一万个事件、约 1 MB/s 的写入速率(官方另给了一个整体口径:一份典型 trace 的数据速率约 1–4 MB/s),而内存计数器每 5 秒才吐一份 /proc/meminfo(约 100 KB)。结果就是:在那 5 秒的间隙里,调度数据已经把整块 buffer 卷了一圈,把内存快照挤了出去。于是"源明明配对了、也确实在采",但你打开 trace 却一份内存快照都找不到。
解法就是 target_buffer:把高频源和低频源分到不同 buffer。官方示例给得很清楚——linux.ftrace 进 target_buffer: 0,linux.sys_stats 与 android.heapprofd 一起进 target_buffer: 1。
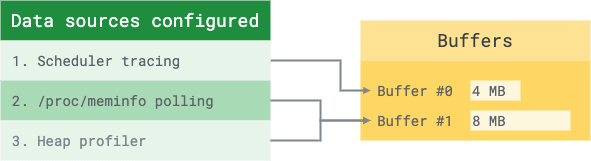
说白了,target_buffer 是"写入速率隔离"工具,不是"分类归档"工具。 判断要不要分家的标准只有一条:这两个源的写入速率差几个数量级。另外 target_buffer 有个必须知道的双重语义——在配置里它是 buffer 数组的 0 基下标;等 service 真正下发 SetupDataSource/StartDataSource 给 producer 时,它会把这个字段覆写成全局 buffer id(因为可能同时有别的会话占着 buffer)。v54 起可以用 target_buffer_name 按名字引用(配合 BufferConfig.name),可读性更好;两个都写时指向必须一致,否则配置直接被拒。
2.4 [lazy=true] 与旧名路由:兼容是怎么做到的
两个机制看起来很技术,其实都在回答同一个问题:怎么让新老组件和平共处。
第一个是 [lazy=true]。 在 data_source_config.proto 里,各源专属子消息被标成了懒加载,例如 optional FtraceConfig ftrace_config = 100 [lazy = true];、optional AndroidPowerConfig android_power_config = 106 [lazy = true];。官方 配置概念页 解释了这个标记在 ProtoZero 代码生成器里的含义:它生成的是"原始字节访问器"而不是类型化的嵌套消息访问器(ftrace_config_raw() 而不是 ftrace_config())。动机有两条——不把几十个数据源的 proto 头文件全 #include 进 service,避免二进制膨胀;同时让 service 对源的具体内容保持无知。
第二个是"配置原样透传"带来的向前兼容。 既然 service 不解码 DataSourceConfig,那么一份比 service 更新的配置——里面带了 service 编译时还不存在的字段——照样能被原样转给 data source。官方把这条写成了设计目标:新数据源可以在 service 完全不了解它的情况下被引入。
[lazy=true] 与配置原样透传:service 不解码源专属子消息,只按 name 投递——新源可在 service 不知情下引入@ 本系列绘制把这两条合起来看,你会发现 data source 体系其实是一个开放的插件协议:只要注册名对得上、配置能自解析,谁都能往这套 trace 里加一种新数据。第五章的 heapprofd、第六章的 GPU counter 源、乃至社区自造的采集器,走的都是同一条门。
2.5 一次会话的"源侧视角"
下面我们开始换个视角,站到 producer 这一边。站在 producer 的角度,这一章讲的事情可以压成一小段伪代码。它不涉及任何真实 API,只是把 2.1 的分发逻辑反过来写一遍:
【源侧视角:一次会话里 data source 都经历了什么】

注册期(进程启动时,只做一次)
  RegisterDataSource(DataSourceDescriptor)     → service 登记"我叫 linux.ftrace"
                                              → 顺手带上我能产出什么 packet 的描述

会话期(每次 StartTracing,逐源发生)
  OnSetup(DataSourceConfig 原始字节)           → 解析我自己的那一段(ftrace_config / …)
  OnStart(DataSourceDescriptor + 全局 buffer id) → 拿到 buffer id,准备 CreateTraceWriter
  持续 Trace():写 packet 到共享内存 chunk      → chunk 满则 flush 给 service

收尾期
  OnStop()                                     → 停止采集、提交尾部数据
这段"注册—配置—启动—写—停"的五步,落到图上是这样一个先后关系——注册只发生一次,其余四步每次会话重来一遍:
RegisterDataSource),OnSetup / OnStart / Trace() / OnStop 每次 StartTracing 重来一遍@ 本系列绘制下一章我们先把视角切到内核侧,看那些看起来最"底层"的数据,实际上是被一个用户态进程采出来的。而这五步里的第 1 步与第 3~5 步,正是第四章那段 C++ 注册代码要落到的地方。
三、Kernel 侧:linux.ftrace 一个宿主,撑起六个面
下面我们进入内核这一侧。这一章要讲一个反直觉结论:你在 Perfetto 里看到的调度、CPU 频率、系统计数器、系统调用、内核函数调用树,在内核侧都不是独立的 data source,它们全部由 linux.ftrace 这一个源(配一个叫 traced_probes 的用户态进程)采出来。
3.1 一个源,六个配置面
官方 cpu-scheduling 页开头就把机制交代了:Perfetto 通过 Linux 内核的 ftrace 基础设施 拿调度事件。ftrace 本身是内核的一个可插拔 tracer 框架,Perfetto 做的事情是打开若干个 ftrace 事件(event)、读事件缓冲、把结果打包成 packet。所以内核侧的结构是"一棵家族树":
| 面 | 配置入口(都在 ftrace_config 里) |
典型事件 / 字段 |
|---|---|---|
| 调度面 | ftrace_events + compact_sched |
sched/sched_switch、sched/sched_waking、sched/sched_process_exit |
| 用户态打点面 | atrace_categories / atrace_apps |
走 trace_marker,见 3.3 |
| 频率面 | ftrace_events |
power/gpu_frequency、CPU 频率相关事件 |
| 内存事件面 | ftrace_events |
kmem/rss_stat、mm_event/mm_event_record |
| 系统调用面 | ftrace_events |
raw_syscalls/sys_enter、raw_syscalls/sys_exit |
| 函数调用树面 | enable_function_graph + function_filters |
内核函数级进入/退出 |
这六个面的配置语义都是 FtraceConfig 的字段(ftrace_config.proto)。要验证"内核侧只有一个宿主"这件事,最直接的办法是翻官方文档的六个相关页面——cpu-scheduling、atrace、cpu-freq、memory-counters、syscalls、funcgraph——它们给的 TraceConfig 片段,name 全都写着 linux.ftrace。
下面对"为什么必须是一个宿主"特别说明。 报错的形态最能说明问题:官方 funcgraph 页 明确写了一句话——function graph 不能和另一个使用不同内核 tracer 的并发 linux.ftrace 源一起跑,因为内核 tracer 不能在 trace 中途切换。根因是 ftrace 在全局只有一份 current_tracer 状态:它是"进程级独占资源",不是"每源一份"。所以 Perfetto 干脆把内核侧收敛成一个宿主,用配置面来区分用途。这也解释了一个常见疑惑:为什么你没法用两个 data_sources 段同时开两个 linux.ftrace。
3.2 调度面:sched_switch 怎么变成 thread_state 轨道
下面我们开始看调度面,它是这条链路上最"日常"的一块。调度面是 ftrace 家族里使用最广的一支,也是"火焰图"这个词最常见的来源之一。官方要点是:Perfetto 从内核拿到的核心事件是 sched/sched_switch——它告诉你某一刻哪个线程在哪个 CPU 上开始跑、前一个线程为什么让出。为了把"为什么让出"讲清楚,官方还引入了 end_state 的编码表,比如 R 表示 Runnable、S 表示 Sleeping、D 表示 Uninterruptible Sleep、X 表示 Exit(Dead)、I 表示 Idle。落到 SQL 侧就是 sched_slice 表 的 end_state 列。
而"线程状态轨道"(thread_state)是把这些切换事件按线程重新归位得到的:对每个线程,把它的 ts → ts+dur 段与 end_state 串起来,就得到那条经典的"S→R→Running→S"状态带。官方在 UI 上给的效果是:展开进程后,每个线程都有一条状态轨道。
注意这里有两个"两个事件"的区别,官方特意点出过:sched_switch 只在"线程处于 Runnable 且真的上了 CPU 运行队列"时发出,而 sched_waking 在"任何导致线程状态改变的事件"发生时都会发。所以做唤醒延迟分析时必须额外开 sched/sched_waking(或 sched/sched_wakeup_new)——否则你只能看到"它跑了",看不到"它什么时候变得可以跑"。
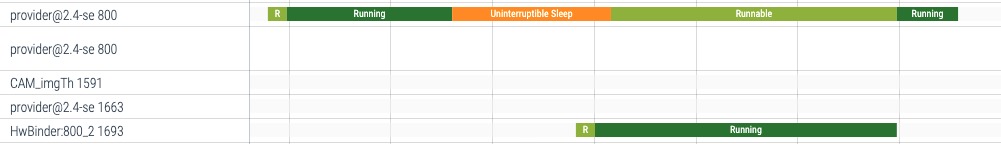
另外有个不能省的配套:compact_sched。开启 compact_sched: { enabled: true } 后,调度记录会用内部压缩编码而不是逐个 ftrace 事件展开,官方示例里它与 sched_switch 并列出现。它的意义是用更少的字节记住同一件事——调度事件是 trace 里数量级最大的一类,压缩与否直接决定你的 64 MB buffer 能装几秒。
下面对官方给的标准调度配置特别说明。 它不是伪代码,是官方 cpu-scheduling 页原文的配置段,也是绝大多数 Android trace 的调度部分起点:
//-----------------------------------【内核调度面的标准配置】-----------------------------------
// 描述:调度事件 + 精准线程生命周期 + 补齐进程名(官方示例)
// 来源:perfetto.dev/docs/data-sources/cpu-scheduling
//------------------------------------------------------------------------------------------
data_sources: {
  config {
    name: "linux.ftrace"                          //【1】内核侧唯一宿主
    ftrace_config {
      compact_sched: { enabled: true }            //【2】压缩编码,省 buffer
      ftrace_events: "sched/sched_switch"         //【3】核心:谁上谁下
      # optional: precise thread lifetime tracking
      ftrace_events: "sched/sched_process_exit"   //【4】线程生命周期四件套
      ftrace_events: "sched/sched_process_free"
      ftrace_events: "task/task_newtask"
      ftrace_events: "task/task_rename"
    }
  }
}

data_sources: {
  config {
    name: "linux.process_stats"                   //【5】补全进程名与 线程↔进程 关系
  }
}
【1】到【5】里最容易被漏掉的是【5】。 只开【1】你会得到一张"满屏 tid、看不到进程名"的调度图;而线程名与进程归属必须靠 procfs 侧的 linux.process_stats 补上。官方把这条单独列出来、并注明"用于线程与进程的关联和完整进程名",正说明调度面天然是"两个源配合"而不是"一个源搞定"。【4】的四件套则决定你能不能看清短命线程——不采 process_exit / process_free,一个刚起就死的线程可能整条消失。
3.3 atrace:看起来像"另一个源",其实是往 trace_marker 写字符串
atrace 是最好的"不要被名字骗了"的例子。你在配置里写的是 atrace_categories: "am"、atrace_apps: "com.google.android.apps.docs",看起来像另起了一个源——但它仍然是 linux.ftrace 的配置面。
机制是这样的:Android 从 4.3(API 18)起提供 ATrace API(Java 侧的 android.os.Trace、NDK 侧的 ATrace_beginSection()、内部进程用的 libcutils/trace.h),所有这些调用最终都路由到同一个内部实现,把标记写进内核的 /sys/kernel/tracing/trace_marker。Perfetto 要做的只是打开内核的 trace_marker 开关、并把这一段文本解析成 slice 与 counter。所以 atrace 数据在内核侧是"trace_marker 上的字符串流",在 UI 侧是 slice,在 SQL 侧落进标准的 slice 与 counter 表。
开销是 atrace 最该记住的数字:官方 atrace 页 给的是 1–10 µs(微秒)每事件,并解释了钱花在哪——一次字符串化、一次 JNI 调用(如果来自托管环境)、以及用户态到内核态的往返写入 trace_marker,官方明说最后这项最贵。这个量级意味着:单点埋点无感,成千上万次高频字符串埋点会显著改变被测程序的时序。
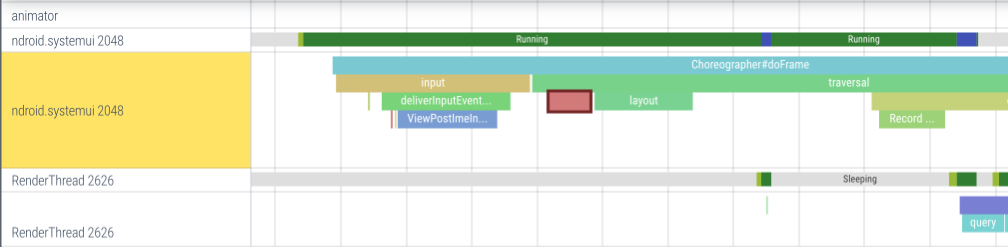
顺带说清一个容易混的点:atrace 有"系统事件"与"App 事件"两类。系统事件由 Android 内部用 libcutils 发出,按 category(也叫 tag,如 am、pm)分组,可以跨进程批量开;App 事件语义相同,但没有 tag 过滤能力,只能按 App 粒度开关(它们共用一个 ATRACE_TAG_APP)。这就是为什么配置里既有 atrace_categories 又有 atrace_apps。
3.4 频率、进程与系统计数器:三个"看着像独立源"的 ftrace 面
接下来这三个面,是"源名与宿主名不一致"的高发区,逐个说清。
CPU 频率:官方 cpu-freq 给的是双路径——既可以从 sysfs 读,也可以走 ftrace 事件。落到 SQL 侧,它是一条 counter 轨道。你在 UI 上看到频率曲线,本质上是"某个 CPU 的频率当前值"被周期性地记成一个 counter 采样点。
进程与系统计数器:这两个是真正的独立源,而且名字都在 linux.* 下,很容易和 ftrace 面混起来。linux.process_stats 负责按你给的周期轮询 /proc/<pid>/status 与 /proc/<pid>/oom_score_adj,官方示例配置里写的是 proc_stats_poll_ms: 1000,并特别警告这个值必须大于 100 ms,否则 CPU 开销过大;linux.sys_stats 负责轮询 /proc/stat、/proc/vmstat、/proc/meminfo,官方示例里 meminfo_period_ms / vmstat_period_ms / stat_period_ms 三个都取 1000(毫秒)。两者都不碰 ftrace,只读 procfs——这就是为什么它们能作为独立源存在。
还有一个"事件 vs 轮询"的对照,官方在 memory-counters 里讲得极清楚:kmem/rss_stat 是事件驱动的推模式——内核在 RSS 变化时主动发 ftrace 事件,能抓到 /proc 轮询抓不到的瞬时尖峰;而 mm_event/mm_event_record 属于高频事件,逐条采不可行,所以内核只周期性吐直方图(count / avg_lat / max_lat)。对分析者的启示是:想抓"尖峰"用事件,想看"趋势"用轮询。 这两条在 SQL 侧最终都被规范化成 counter 表里的 mem.* 系列 key,所以查询时不必关心它是推的还是拉的。
这张图可以当作"同名不同路"的索引:同样是频率或计数器,走 sysfs、走 ftrace、走 procfs,三种路径的采样粒度与代价都不一样。sysfs/ftrace 路径能贴合事件发生的时刻,procfs 路径只能给你一个周期性的均值。所以当你看到一条曲线很"平"的时候,先别下结论,回头看它是从哪条路径来的——这是原理层面最容易搞错、也最容易被忽略的一步。
3.5 syscalls 与 function graph:同门的两把"重剑"
这两个面同属 linux.ftrace,但代价都很大,所以要单独提醒。
syscalls:官方 syscalls 页 给的配置就是两个事件——raw_syscalls/sys_enter 与 raw_syscalls/sys_exit。入口记系统调用号与原始参数,出口记返回值;导入时 TraceProcessor 用内置的 syscall 映射表(支持 x86、x86_64、ArmEabi、aarch32、aarch64)把编号翻成名字。它的数据在 SQL 侧与普通用户态 slice 没有区别——就是线程切片栈里多了名字带 sys_ 前缀的切片。注意限制:只在 Linux 与 Android 的 userdebug 构建上可用。
function graph:官方 funcgraph 页 说得很直接——它记录每一次内核函数进入与退出,让你看到内核在这段时间里真正的调用树与每个函数的耗时。它是"重剑":官方警告不加过滤地全量跟踪会在毫秒级把 buffer 填满,所以必须与 function_filters(只跟匹配的函数)或 function_graph_roots(跟匹配函数及其所有被调者)配合,再用 function_graph_max_depth 限层数。另有两个硬门槛:内核要带 CONFIG_FUNCTION_GRAPH_TRACER;Android 上只在 debuggable(userdebug/eng)构建可用,且 traced_probes 需要 root 权限。还有一点必须记住:必须设 symbolize_ksyms: true,否则你看到的是 0xffffffff8108abcd 这样的裸地址,而且内核符号必须在录制时解析,事后用工具补不回来。
这两把剑共同指向同一个结论:内核侧的能力上限很高,但它的成本模型是"事件数量 × 单事件开销",而 buffer 是有限的。所以第三章真正的实践结论不是"开哪些面",而是"只开你要解释的那个面,并且给它加过滤器"。
四、应用侧:TrackEvent SDK 与"自己造一个源"
好了,视角切到应用进程里。前三章讲的源,都是 Perfetto 或 Android 平台已经写好的:内核调度、atrace、procfs 计数器。这一章讲另一条路——App 自己产生数据。它有两种写法:用 TrackEvent SDK 打点(省事),或者实现一个自定义 data source(强大但要动 TraceProcessor)。官方 Tracing SDK 文档 把这两条路的取舍讲得很清楚。
4.1 两条路:TrackEvent 与自定义 data source
先给结论:绝大多数场景用 TrackEvent,少数场景才需要自定义源。
| 走法 | 你要写什么 | 数据形态 | 代价 |
|---|---|---|---|
| TrackEvent 埋点 | TRACE_EVENT 宏 + 一组 categories |
slice / counter / flow,挂在 track 上 | 几乎为零,线程安全、flush、字符串去重都由 SDK 包办 |
| 自定义 data source | 继承 perfetto::DataSource 的类 + 自有 proto |
你自己定义的 packet 字段 | 还要改 TraceProcessor 才能导入(官方明说) |
SDK 提供两个后端模式,两者产出的文件格式完全一样:kInProcessBackend(service 与源都在应用进程内,只管自己,不需要特权)与 kSystemBackend(通过 UNIX socket 接系统 traced,能把应用事件与内核事件叠在同一条时间轴上)。官方建议:想看到"应用事件 + ftrace 调度"融合的时间线,就得用系统后端;而系统后端要求外部有 traced 在跑——Android 9(Pie)起 traced 随平台提供。
上面这张时序图给出的顺序是:先注册(进程启动期,只发生一次),再按每次会话反复走 OnSetup → OnStart → Trace(),最后 OnStop 收尾。把它记成"一次注册、多次会话",本章后面所有代码就都能对上号了——代码里那些看起来零散的钩子,位置全由这条时序决定。
4.2 注册一个源:DataSourceDescriptor + Register()
下面我们开始看一段真实的注册代码。它取自官方 Tracing SDK 文档的"CUSTOM DATA SOURCES"示例,是替换掉类名与源名后可直接编译的形态:
//-----------------------------------【自定义 data source:注册与写包】-----------------------------------
// 描述:继承 perfetto::DataSource,注册一个自有源,并在 Trace() 里写 packet
// 来源:perfetto.dev/docs/instrumentation/tracing-sdk(官方示例改写)
//------------------------------------------------------------------------------------------
#include <perfetto.h>

class CustomDataSource : public perfetto::DataSource<CustomDataSource> {
 public:
  //【1】OnSetup:拿到属于本源的这一段 DataSourceConfig,用来应用自己的配置
  void OnSetup(const SetupArgs&) override {}

  //【2】OnStart:会话真正开始时的钩子,适合在这里初始化 GPU 驱动、打开计数器
  void OnStart(const StartArgs&) override {}

  //【3】OnStop:撤销 OnStart 里做过的事
  void OnStop(const StopArgs&) override {}

  int my_custom_state = 0;   //【4】每个活跃会话各有一个实例,可以带自己的状态
};

PERFETTO_DECLARE_DATA_SOURCE_STATIC_MEMBERS(CustomDataSource);

int main(int argc, char** argv) {
  perfetto::TracingInitArgs args;
  args.backends |= perfetto::kSystemBackend;      //【5】接系统 traced,融合全栈
  perfetto::Tracing::Initialize(args);

  //【6】注册:Descriptor 声明名字,必须与 TraceConfig 里的 name 逐字一致
  perfetto::DataSourceDescriptor dsd;
  dsd.set_name("com.example.custom_data_source");
  CustomDataSource::Register(dsd);
}

//【7】写数据:lambda 只在"该源被启用"时才被调用
void EmitOneEvent() {
  CustomDataSource::Trace([](CustomDataSource::TraceContext ctx) {
    auto packet = ctx.NewTracePacket();
    packet->set_timestamp(perfetto::TrackEvent::GetTraceTimeNs());
    packet->set_for_testing()->set_str("Hello world!");
  });
}
下面对这段代码特别说明三点。
- 【6】是整段代码里最容易出错的一行。
dsd.set_name(...)里那个字符串,就是第二章TraceConfig.data_sources.config.name要匹配的东西。名字对不上,注册成功了、配置也写对了,但这个源会被静默忽略——这就是 2.1 节"按名字定向投递"在代码侧的样子。官方 trace-config-proto 对DataSourceConfig.name的措辞是"必须与注册时传给 service 的名字一致"。 - 【1】/【2】/【3】三个回调正好对应第二章 2.5 节那段"源侧视角"伪代码:
OnSetup收配置、OnStart备资源、OnStop收摊。把这三步想清楚,你就理解了"一个源"的生命周期,而不是把它当成一个函数。 - 【7】的 lambda 语义值得背下来:它只在追踪对该源开启时才会被调用。所以把它放在热路径上是安全的——没开追踪时它不执行,也不会去拼字符串。这与第六章要讲的 atrace 形成对比:SDK 路线的单次开销显著低于
trace_marker路线(后者是 1–10 µs 量级),这也是官方建议 Android 上"现有 atrace 够用就继续用,需要更细或更低开销时再上 SDK"的原因。
除了 C++,社区还维护了一条等价路径:官方 Rust SDK 页 记录了 Rust 侧的接入方式。它对 Rust 项目很有用,但语义与 C++ 侧一一对应,本篇不再重复。
4.3 categories 是运行期过滤,不是编译期开关
很多人以为 PERFETTO_DEFINE_CATEGORIES 里列出的类别就等于"这些埋点都在编",于是担心生产版本变慢。这是一个典型误解:categories 只是在源码里注册一份名单(让每个埋点拿到一个整型句柄,避免运行时拼字符串),开不开由运行期的 TrackEventConfig 决定。
官方的过滤规则是一份八步顺序表,按"精确匹配在前、通配匹配在后"、"enabled 在前、disabled 在后"排列:
【track_event_config 的过滤顺序(官方 TrackEventConfig 语义)】

字段默认值:
  disabled_categories = []                // 默认不禁用任何类别
  enabled_categories  = []                // 默认不显式开启
  disabled_tags       = ["slow","debug"]  // 默认屏蔽 slow / debug 两类标签
  enabled_tags        = []

判定一个 category 是否启用,按以下顺序查:
  【1】enabled_categories  精确匹配
  【2】enabled_tags        精确匹配
  【3】disabled_categories 精确匹配
  【4】disabled_tags       精确匹配
  【5】enabled_categories  通配(glob)匹配
  【6】enabled_tags        通配匹配
  【7】disabled_categories 通配匹配
  【8】disabled_tags       通配匹配
  八步全不命中:C++ API 默认"启用",C API 默认"禁用"
说白了,四步"精确"排在前、四步"通配"排在后,而 enabled 永远压 disabled 一头。 这条顺序解释了两个常见配置写法:想"只开三个类别"就写 enabled_categories = ["foo","bar","baz"] 配 disabled_categories = ["*"];想"开全部非 slow 类别"就写 enabled_categories = ["*"] 配 disabled_tags = ["*"] 再加你要的 enabled_tags。字段定义在 track_event_config.proto。
还有两个"标签"值得记住:slow 与 debug 默认就是被禁的(disabled_tags 的默认值)。这是官方给埋点作者的约束工具——如果一个类别会产生大量数据或明显影响交互性能,就给它打上 slow 标签,这样即使别人开了全量通配,也不会误伤性能。写埋点的人用标签保护别人,写配置的人用过滤器约束自己,这套机制才成立。
4.4 Track 三级:事件挂在哪条轨道上
TrackEvent 里的 "Event" 要落在某条 "Track" 上才算数。官方把轨道分成三种:Track(基础时间线)、ProcessTrack(代表一个进程)、ThreadTrack(代表一个线程)。默认情况下 TRACE_EVENT 用调用线程的 ThreadTrack,并且默认归到当前进程的 ProcessTrack 之下——这就是为什么 UI 上的事件总是层层缩进在进程分组里。
轨道还有几条规则值得知道:每条 track 由一个 uuid 唯一标识,且 uuid 在整份 trace 里必须唯一;为避免碰撞,子轨道的 uuid 会与父轨道组合,其中每个 ProcessTrack 有一个随机的进程级 uuid。另外,"事件按线程各自成栈"是个硬约束——TRACE_EVENT_BEGIN 与 TRACE_EVENT_END 成对出现在不同函数里是危险的,因为同线程上的所有事件共享同一个栈,别的无关事件可能先把你的 slice 关掉。跨函数的场景,官方建议换一条 track(TRACE_EVENT("cat","name", perfetto::Track(1234)))。
4.5 自造源的代价:还得改 TraceProcessor
走自定义 data source 这条路,注册与写包只是前半程。官方在 Tracing SDK 文档 里给了一句必须原样记住的提醒:与 track event 不同,用自定义 data source 时你还得在 TraceProcessor 里做对应改动,才能让你的数据被导入。也就是说,你写进 trace 的字节,要看 TraceProcessor 认不认;不认,UI 上就只剩一条"未识别 packet"。想绕过改上游仓库,可以走 TrackEvent extensions——把自定义消息作为 TrackEvent 的扩展字段,这样 TraceProcessor 能靠反射解析,不必把你的 proto 塞进 Perfetto 主仓库。
社区里"自造一个源"的经典案例有两个,都值得当范本读:Collabora 在 2020 年用 gfx-pps 给非 Android 平台造了一个 GPU counter data source(Panfrost 驱动);一年后又写了 给虚拟化 GPU 加速栈埋点的实践,里面明确对比了两条"自己产生数据"的路径——自定义 ftrace 事件 vs 走 trace_marker。这两篇正好说明第四章的边界:源是一个开放接口,不是一个封闭集合。
五、专业采集器:heapprofd / java_hprof / perf
下面我们进入本篇最"重"的一章。前面几章的源基本是"记录发生了什么",这一章三个源要回答的是"这些数字与栈是怎么被采出来的"——它们都带采样逻辑,都直接改变被测进程的运行时开销,也都有明确的系统版本门槛。
5.1 三个采集器的产物形态先摆在一起
| 采集器 | 源名 | 产物形态 | 关键参数 | 门槛 |
|---|---|---|---|---|
| 原生堆采样 | android.heapprofd |
native 分配火焰图(可连续 dump 出多个 slice) | 采样间隔 4096 字节 | Android 10+ |
| Java 保留图 | android.java_hprof |
ART 保留图(菱形标记,点击出火焰图) | 整份堆快照 | Android 11+ |
| CPU 调用栈采样 | linux.perf |
采样点 + 调用栈,可聚合成火焰图 / pprof | 示例频率 1000 Hz | 需 perf_event_open 权限 |
三者的共同点是"采样式"——都不记录每一个事件,而是按某种间隔抽样;不同点在抽样的对象:heapprofd 抽的是分配字节流,perf 抽的是 CPU 时间(或硬件事件计数),java_hprof 干脆不抽样,直接抓一份快照。采样就必然带来统计误差,这也是为什么三个源都要在文档里反复强调"这是采样结果,不是精确值"。
5.2 heapprofd:按字节采样,默认每 4096 字节取一个
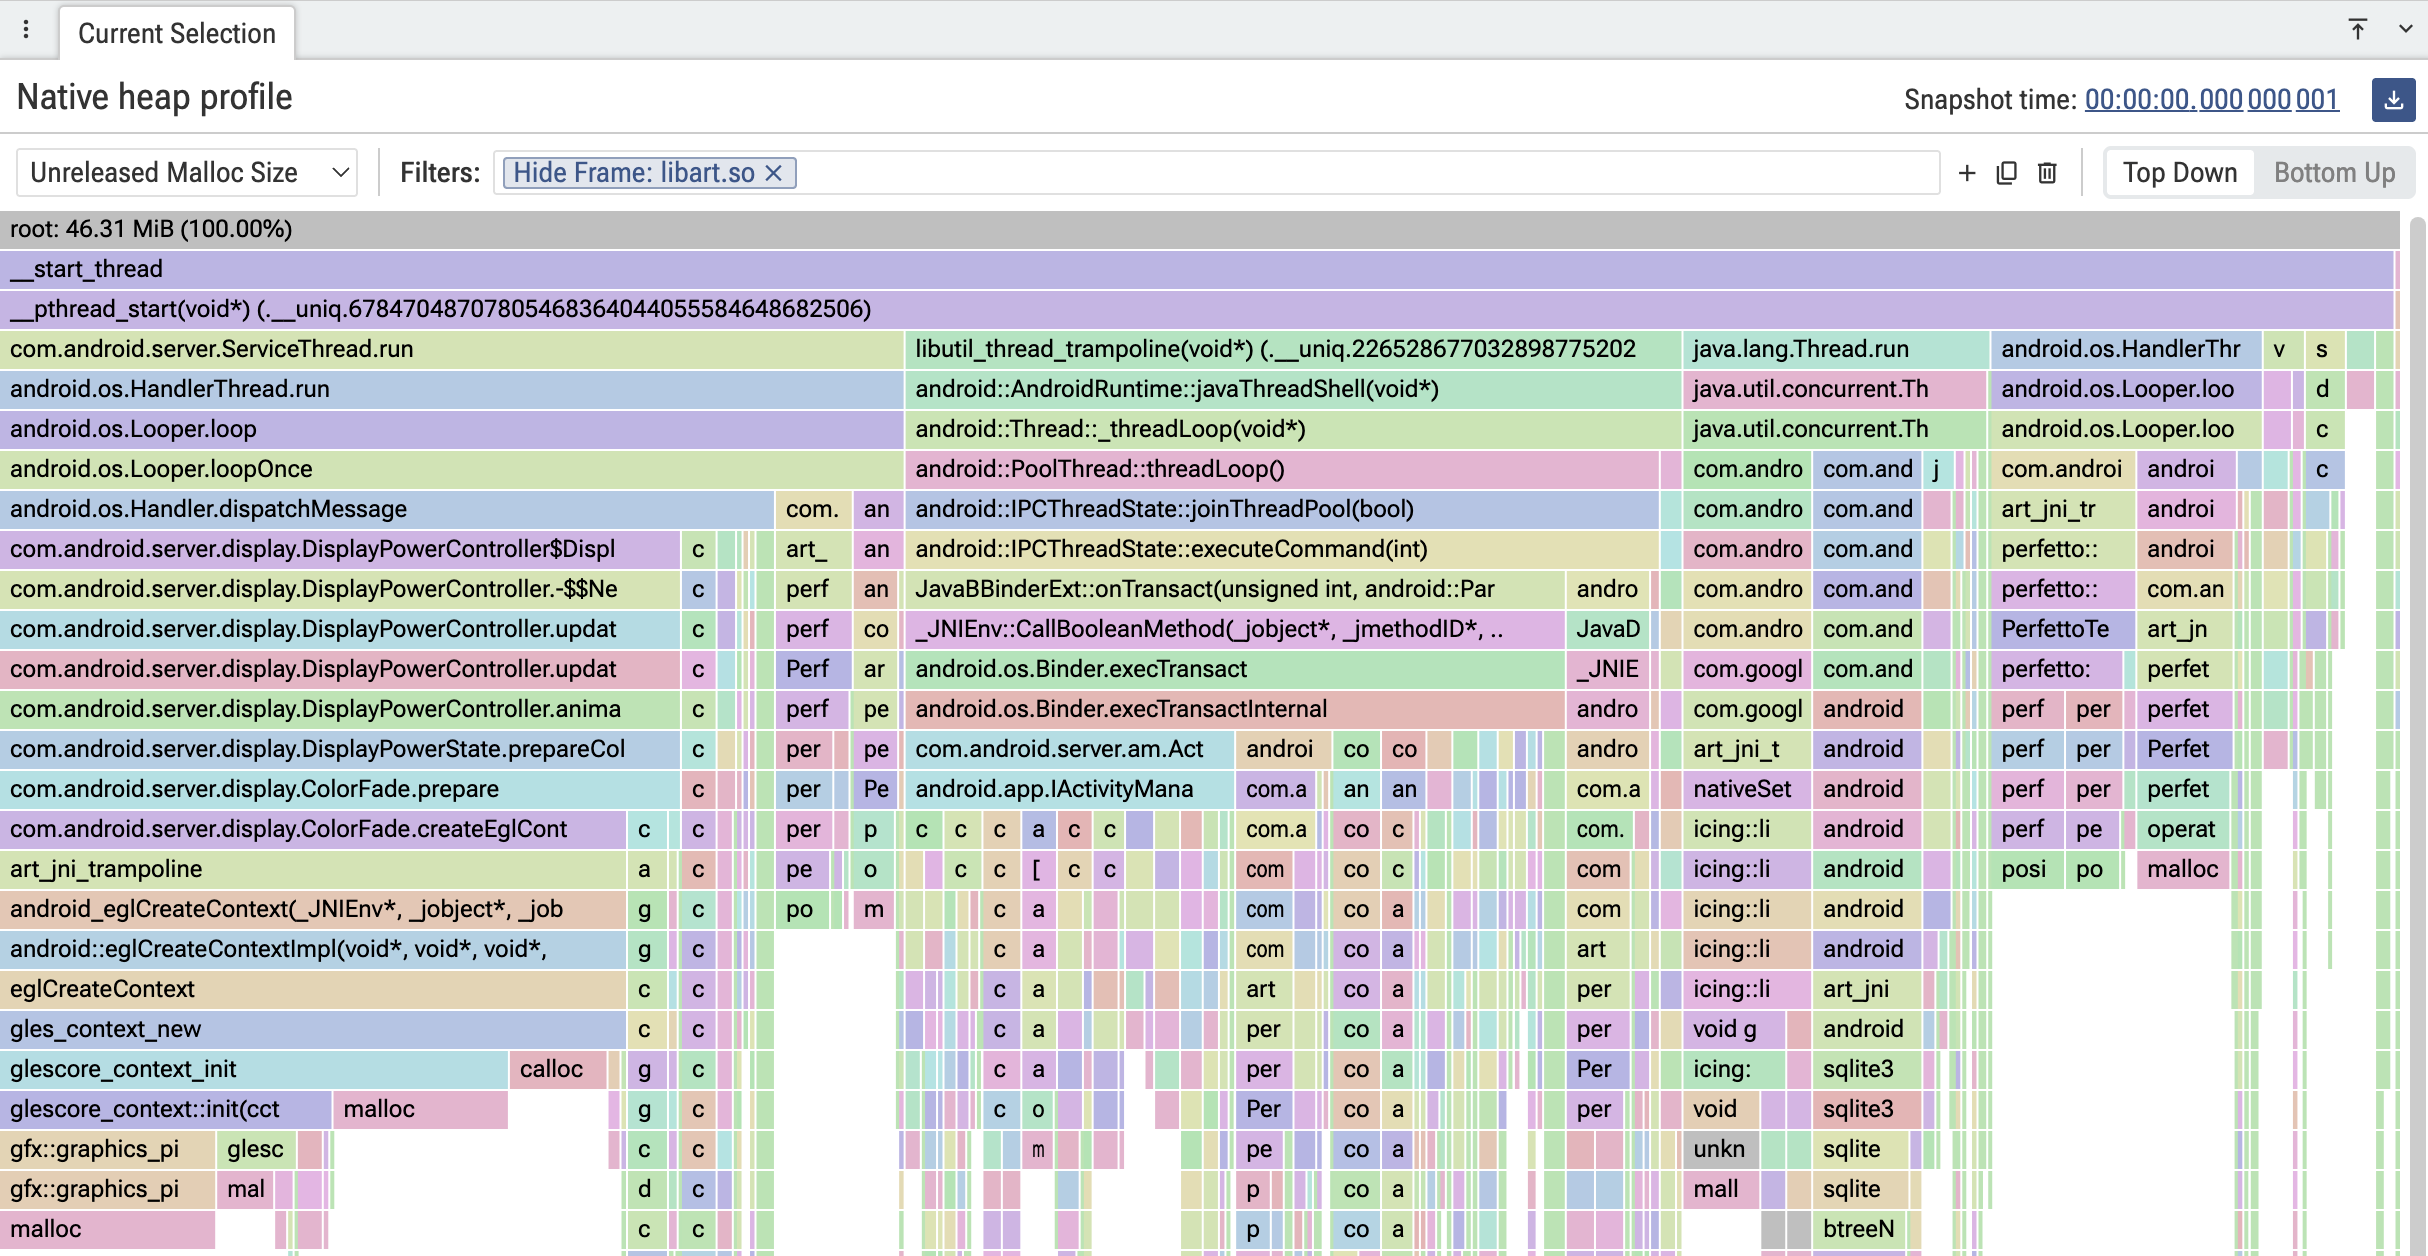
先来看看第一个采集器,也是最有"自证"味道的一个。heapprofd 的官方描述是"跟踪某个时间窗内 Android 进程的堆分配与释放",产物可以把内存占用归属到具体调用栈,且支持原生与 Java 代码混合。native-heap-profiler 页 给了三条必须记住的规则:
- 采样语义:给定采样间隔 n 字节,平均每分配 n 字节采到一个样本。官方给的比喻很好用——把分配想象成一条"逐字节"的流,每个字节有 1/n 的概率被选中,选中的那个调用栈就被记上完整的 n 字节。为了让大分配不被漏掉,大于采样间隔的分配会绕过采样逻辑,按真实大小记录。
- 默认间隔 = 4096 字节(即 4 KB),且可调(官方排障一节给的例子是
--interval=16000,代价是精度下降)。 - 门槛 = Android 10 或更高;且在 user(生产)构建上,只有带
profileable或debuggable标记的应用能被采,对不可采进程发出的请求会得到一份空 profile。
配置侧它长这样(官方给出的 TraceConfig 段落与 ContinuousDumpConfig):
//-----------------------------------【heapprofd 的配置与连续 dump】-----------------------------------
// 描述:指定目标进程,配置采样间隔与周期快照
// 来源:perfetto.dev/docs/data-sources/native-heap-profiler
//------------------------------------------------------------------------------------------
data_sources {
  config {
    name: "android.heapprofd"                              //【1】源名(Android 10+)
    heapprofd_config {
      process_cmdline: "com.example.myapp"                 //【2】目标进程;按名匹配会连新启进程一起采
      continuous_dump_config {
        dump_interval_ms: 5000                             //【3】每 5 秒存一份快照 → UI 上多个 slice
      }
    }
  }
}
下面对【2】【3】特别说明。【2】有两种目标写法,语义差别很大:按 PID 采是"此刻这个进程",按进程名(cmdline) 采则会连会话开始后新启动的同名进程一起采——对 Android 而言,这意味着能采到从 zygote 孵化出来的启动期分配(官方把这种情况在 ProcessHeapSamples 里标记为 from_startup)。【3】决定你在 UI 上看到一个 slice 还是多个 slice:不配就只有会话结束时的单一快照,配了就是周期性的连续 dump,可以拖选多个相邻 slice 看某一段时间窗的分配。另外提醒一个排障经验:分配速率超过 heapprofd 的处理能力会触发缓冲溢出、会话提前结束,官方建议先加 --shmem-size,再考虑加大采样间隔——这正好呼应第一章那块 256 KB 共享内存。
还有一条"名字相似、语义完全不同"的分支要点出来:heapprofd 可以通过 heaps: "com.android.art" 改成采 Java 分配(官方叫 ART allocation profiling,亦名 churn profiling),它给的是分配时刻的调用栈,不跟踪释放与 GC。这条路要求 Android 12 或更高。它和 5.3 节的"Java 堆快照"是两件不同的事,官方文档特意加了两条 NOTE 防止混淆。
5.3 java_hprof:给的是"保留图",不是调用栈
android.java_hprof 的定位很容易被误解。官方 java-heap-profiler 页 开头就给了两条 NOTE:抓取堆快照要求 Android 11 或更高;Perfetto 的 ART 堆快照与标准 JVM/HPROF 不同——它只包含引用关系图,不含对象内部数据。
它的产物形态是"保留图(retention graph)"而不是调用栈:记录的是"对象 X 通过名为 Z 的成员,保留住了 N 字节大小的对象 Y"。所以在 UI 上它表现为进程的 "ART heap dump" 轨道上的菱形标记,每个菱形是一次堆快照,点开才出火焰图。SQL 侧对应三张表:heap_graph_class、heap_graph_object、heap_graph_reference——分别对应类、对象、引用边。官方还提示:对象原生内存(native_size,仅 Android 13+ 可用)是从 libcore.util.NativeAllocationRegistry 提取的,不计入 self_size,所以看"谁占内存"时要分清这两笔账。
配置段落极简,核心只有目标进程与一个开关:
//-----------------------------------【java_hprof:抓一份 Java 堆保留图】-----------------------------------
// 描述:指定目标进程,并附带 smaps 以便看 native 映射
// 来源:perfetto.dev/docs/data-sources/java-heap-profiler
//------------------------------------------------------------------------------------------
data_sources {
  config {
    name: "android.java_hprof"                 //【1】Android 11+
    java_hprof_config {
      process_cmdline: "com.example.myapp"     //【2】目标进程
      dump_smaps: true                         //【3】附带 smaps,方便看 native 映射
    }
  }
}
一句话区分 5.2 与 5.3:heapprofd 回答"这块内存是在哪一行代码被分配的",java_hprof 回答"这块内存现在被谁抓着不放"——前者是时间维度的调用栈,后者是空间维度的引用图。做内存泄漏排查时两者往往要一起用。
5.4 perf:走 perf_event_open 的采样器
linux.perf 这条路的原理,官方 cpu-profiling 入门页 讲得最直白:它的两个模式都对应 perf record,用的是同一个系统调用 perf_event_open——一个是"按 CPU 记性能计数器",另一个是"在这些计数器的基础上采样调用栈"。配置由 PerfEventConfig 定义,三个关键概念是:
- timebase(组 leader):被计数的主事件,按 CPU 分别计数。常见选择是
SW_CPU_CLOCK(软件计时器)或硬件事件。 - 采样周期或频率:可以是固定
period(如每 1000 个事件采一次),也可以是frequency(如每秒 100 次)。 - followers:额外的计数项,会在 timebase 采样时一起快照。
调用栈采样的开关是 callstack_sampling,可以用 scope.target_cmdline 只对匹配进程展开栈(官方提醒这能避免"展开开销把 profiler 自己压垮")。一旦开了调用栈,就会多出一条实际约束:非原生栈的展开很贵,官方建议每 CPU 的采样频率保持在 200 Hz 以下——这和示例配置里的 frequency: 1000 并不矛盾:只计数(不展开栈)可以到 1000 Hz,要展开栈就得退到 100 Hz 量级。
//-----------------------------------【linux.perf:采样计时器 + 调用栈】-----------------------------------
// 描述:以 SW_CPU_CLOCK 为 leader 的周期采样,并只对目标进程展开调用栈
// 来源:perfetto.dev/docs/getting-started/cpu-profiling
//------------------------------------------------------------------------------------------
data_sources {
  config {
    name: "linux.perf"                                     //【1】perf 采样源
    perf_event_config {
      timebase {
        counter: SW_CPU_CLOCK                              //【2】用计时器做 leader
        frequency: 100                                     //【3】每秒 100 次
        timestamp_clock: PERF_CLOCK_MONOTONIC
      }
      callstack_sampling {
        scope { target_cmdline: "com.example.myapp" }      //【4】只对目标进程展开栈
        kernel_frames: true                                //【5】把内核栈也带上
      }
    }
  }
}
下面对【5】特别说明。 kernel_frames: true 决定你看到的火焰图会不会出现内核函数。它带来一个跨越本篇与 ep07 的提醒:内核符号必须在录制时解析——funcgraph 页 明确说内核符号不能事后用 trace_processor bundle 补回来。所以如果你想要"用户态 + 内核态"完整火焰图,就得在录制时把权限开好、把开关打开。
最后一个生态提醒:官方在 cpu-profiling 页的 "Alternatives" 里直说,Perfetto 的 profiling 实现是为持续(流式)采集优化的,不太适合短时高频的 profile;如果你只要聚合火焰图,Android 上的 simpleperf 与 Linux 上的 perf 更成熟。这句话值得抄在便签上——工具选型不是"谁更先进",而是"谁的成本模型更匹配你的问题"。
六、GPU 与功耗:四个专门源,和两个"其实不是源"
言归正传,这一章我们把图形人最关心的一块补上。GPU 数据在前六章里出现过两次(power/gpu_frequency、gpu_mem/gpu_mem_total),但那两条都被归到 ftrace 面里去了。这一章要正面回答:GPU 到底有几个源、谁在采、哪些是"看着像源其实不是"。
6.1 GPU 侧有四个专门的源
官方 gpu 页 给的清单其实是一张五行表,它把"GPU 相关数据源"和"承载 GPU 数据的 linux.ftrace"并列放在一起,这个排版本身就是提示:
| 源名 | 配置 proto | 用途 |
|---|---|---|
gpu.counters |
gpu_counter_config.proto | 周期性或插桩式的 GPU 计数器采样 |
gpu.renderstages |
gpu_renderstages_config.proto |
GPU 渲染阶段与计算活动的时间线 |
vulkan.memory_tracker |
vulkan_memory_config.proto |
Vulkan 内存分配与绑定追踪 |
gpu.log |
(无配置) | GPU 调试日志消息 |
linux.ftrace |
ftrace_config.proto | GPU 频率、内存总量、DRM 调度事件 |
前四个是"生产者侧"源——由 GPU 驱动或厂商 producer 实现,采集方式取决于设备。gpu.counters 的配置里你要指定计数器 ID(设备相关)与采样周期 counter_period_ns;官方示例里 counter_period_ns: 1000000 就是 1 毫秒采一次。gpu.renderstages 与 gpu.log 甚至不需要配置块,只要在 data_sources 里声明名字即可——"无配置的源"也是合法的源,这一点很反直觉但很好用。
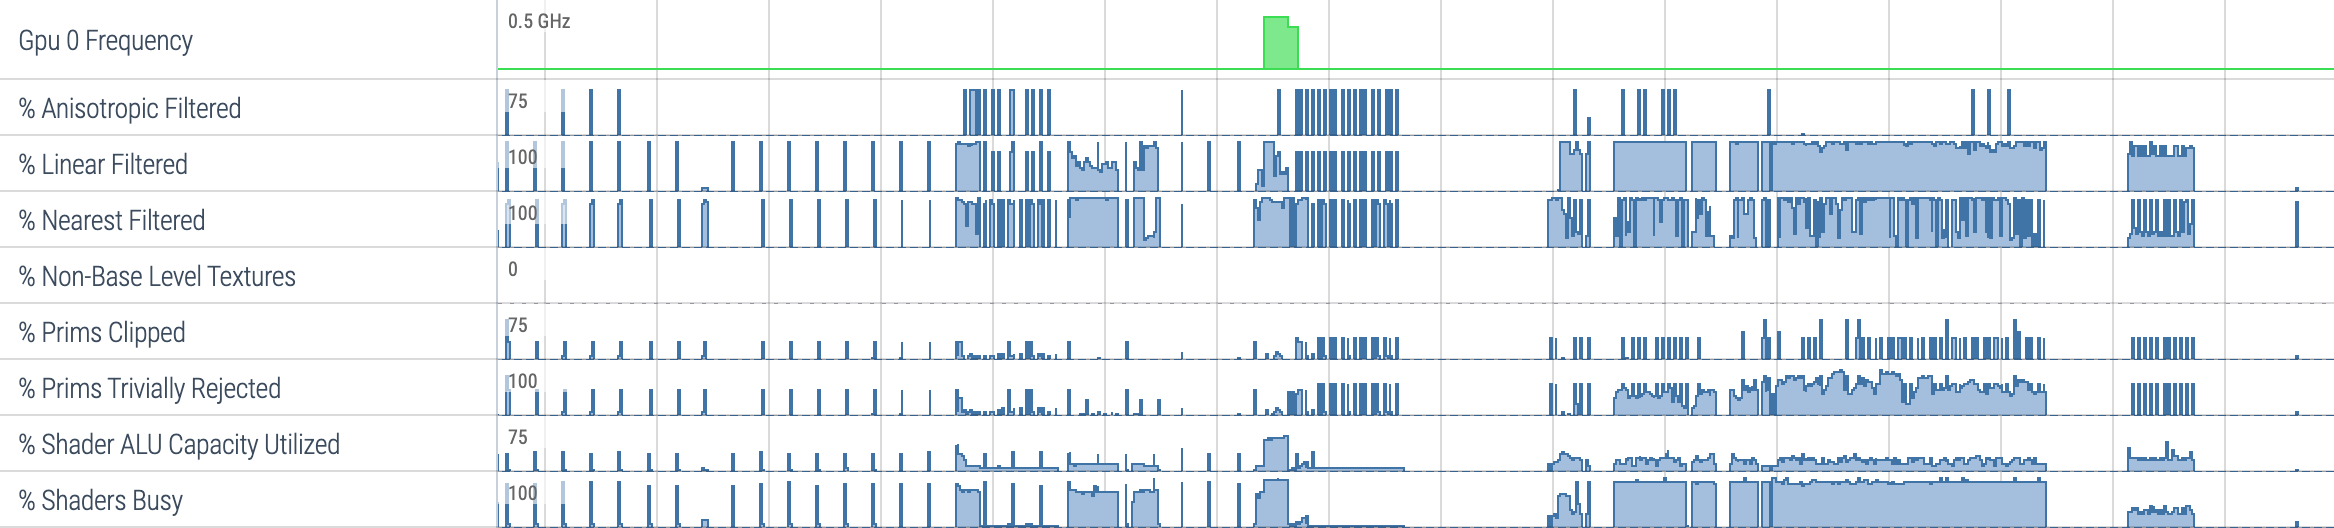
另外一个跨平台的加成:GPU 数据里带 gpu_id 字段,多机场景还会带 machine_id,UI 会按 GPU 与机器分组。GPU 的硬件元信息(名称、厂商、架构、UUID、PCI BDF)由 gpu_info 这个 packet 记录——也就是说,"这块卡是谁"也是被"采"进 trace 的,这与第一章"元数据由 service 产"是同一类设计。
6.2 破除误解:GPU 频率与内存其实是 ftrace 事件
这是本篇最想让人记住的一条。很多同学在配置里找"GPU 频率源"和"GPU 内存源",找不到,就以为要装厂商工具。其实它们一直都在 ftrace 里——官方 gpu 页给出的两个片段是这样的:GPU 频率用 power/gpu_frequency 事件,GPU 内存总量用 gpu_mem/gpu_mem_total 事件,而两次配置的 name 都写着 linux.ftrace。
这个事实带来三个立刻可用的推论:
- 想采 GPU 频率/内存,你开的是内核源(
linux.ftrace),不是 GPU 源。它受内核版本与 ftrace 可用性约束,不受厂商 producer 影响。 linux.process_stats也常常必须一起开,因为gpu_mem/gpu_mem_total是按进程维度上报的(哪个进程占了多少 GPU 内存),没有进程名与"线程↔进程"的映射,这条轨道就只能显示 pid。- "GPU 数据是一个独立体系"这个直觉是错的。真实情况是:GPU 数据分成两半,一半走厂商 producer(counter / renderstage / vulkan memory),一半走内核 ftrace(频率 / 内存总量 / DRM 调度)。想画一条完整的 GPU 时间线,两半都要配。
说白了,判断一个数据"是不是独立源",别看名字里有没有 gpu,看它的配置块挂在谁的名字下。 这是本篇一个通用的读文档技巧:源名 = 配置块所在的 data_sources.config.name,其他一切(文件放在哪一页、名字长什么样)都不算数。
6.3 一个配置层的硬坑:vendor 后缀必须精确匹配
GPU 源的另一个坑来自多厂商现实。官方明说:GPU producer 常常用带硬件后缀的名字注册源,例如 gpu.counters.adreno 或 gpu.renderstages.mali;而追踪服务对源名做的是精确匹配,所以你的配置必须写一模一样的后缀名。写 gpu.counters 而设备上注册的是 gpu.counters.adreno,结果就是——配置合法、没有任何报错、但一条数据都没有。
这里有个安慰性质的设计:TraceProcessor 是按 proto 字段类型解析 GPU 数据的,所以所有后缀变体在导入侧被同样对待。也就是说,"精确匹配"这个负担只落在配置层,一旦采到了,分析侧不会因为后缀不同而失效。
这个坑的成因在原理层其实只有一句话:源名是配置层与注册表之间唯一的匹配键。 没有类型系统、没有命名空间映射、也没有模糊匹配——第二章讲的"按名定向投递",在多厂商 GPU 这个场景下就退化成了"逐字对齐"。理解了这一层,你在遇到任何"配了没反应"的源时,第一反应都应该是去核对名字,而不是去怀疑权限或硬件。
//-----------------------------------【GPU 侧配置:厂商源 + 内核 ftrace 面】-----------------------------------
// 描述:一个常见的 GPU 采集组合——厂商 producer 与内核 ftrace 各出一半
// 来源:perfetto.dev/docs/data-sources/gpu
//------------------------------------------------------------------------------------------
data_sources {
  config {
    name: "gpu.counters"                       //【1】若设备注册的是带后缀的名字,必须逐字写后缀
    gpu_counter_config {
      counter_period_ns: 1000000               //【2】采样周期 1000000 ns = 1 ms
      counter_ids: 1
      counter_ids: 3
    }
  }
}

data_sources {
  config {
    name: "linux.ftrace"                       //【3】GPU 频率与显存总量走这里,不走上一条
    ftrace_config {
      ftrace_events: "power/gpu_frequency"
      ftrace_events: "gpu_mem/gpu_mem_total"
    }
  }
}

data_sources {
  config {
    name: "linux.process_stats"                //【4】给 gpu_mem_total 补进程名与进程归属
  }
}
下面对【1】【3】特别说明。【1】是"配置层显式匹配"的典型受害点,官方在 gpu 页的措辞是:想针对某个厂商的 producer,就在配置里用带后缀的名字。【3】与【1】的对照,就是 6.2 节那条结论的配置级证据——同一份"想看 GPU"的需求,被拆成了两个不同名字的 data_sources 段。
6.4 android.power:电池计数器与 ODPM
先来看看功耗这一侧。功耗侧的主力是 android.power,官方 battery-counters 页 给了它两条支线,配上 android_power_config.proto 看更清楚:
| 支线 | 采什么 | 硬件前提 | 单位 |
|---|---|---|---|
| 电池计数器 | 剩余容量、剩余电荷、瞬时电流 | 电源监测 IC(多数 Pixel 具备) | % / µAh / µA |
| ODPM 电源轨 | 各硬件子系统的能耗 | 专用 power rail 监测硬件(多数量产机暂无) | — |
两者都要 Android 10(Q)或更高。它有个很实用的采集细节:电池计数器测的是"流进/流出电池的电荷",所以插着 USB 采的时候你会看到正电流与电荷增长——在实验室里这会污染测量,官方给了几种绕法(可电气断开 USB 的专用 hub,或 root 后操作电源管理 IC 驱动)。配置上,轮询周期由 battery_poll_ms 决定,官方示例取 250(毫秒);ODPM 则用 collect_power_rails: true 打开,而且它和电池计数器可以在同一段里共存。
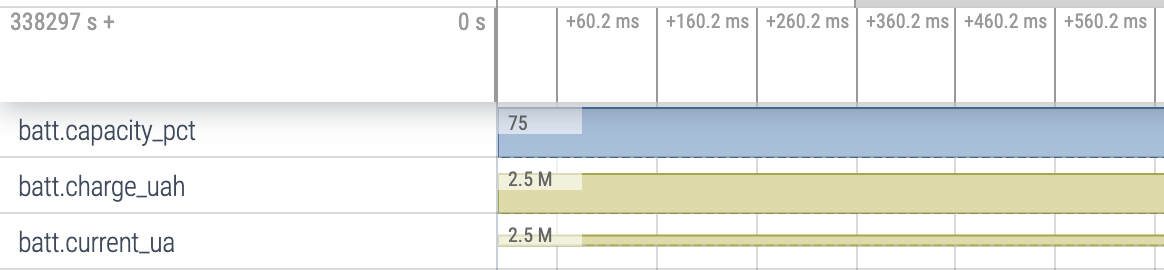
最后一个容易被忽略的配置细节:如果目标平台不是 Android,功耗走的是另一个源名 linux.sysfs_power。这条与 linux.* 家族的命名习惯一致——平台差异体现在源名上,而不是同一源里加开关。这句话可以当作本篇选源时的一条通用启发式。
七、全景对照表:源名 ↔ 谁在采 ↔ 产出 packet ↔ 落到哪张表
好了,到收口的地方了。前六章把每个家族讲了一遍,这一章做三件事:把官方源列全、二次归类、然后一次性对齐到 SQL 表。这也是全篇与 ep07 反向咬合的接口。
7.1 先把官方源全量列一遍
下面我们开始列清单。清单里的行按"宿主(谁在采)"分组,只列本篇正文涉及、且源名可从官方文档与 proto 直接核对的项(linux.ftrace 的面以事件名列出,因为它们不是独立源名):
| # | 源名 / 事件名 | 谁在采(宿主) | 配置入口 | 产出 packet |
|---|---|---|---|---|
| 1 | linux.ftrace |
traced_probes(内核侧代理) |
ftrace_config |
ftrace_events |
| 2 | ├ sched/*(sched_switch、sched_waking…) |
同上 | ftrace_events + compact_sched |
同上 |
| 3 | ├ atrace_categories / atrace_apps |
同上(写 trace_marker) |
atrace_* |
同上 |
| 4 | ├ power/gpu_frequency、gpu_mem/gpu_mem_total |
同上 | ftrace_events |
同上 |
| 5 | ├ kmem/rss_stat、mm_event/mm_event_record |
同上 | ftrace_events |
同上 |
| 6 | ├ raw_syscalls/sys_enter + sys_exit |
同上 | ftrace_events |
同上 |
| 7 | └ function graph(enable_function_graph) |
同上 | ftrace_config |
同上 |
| 8 | linux.process_stats |
traced_probes(读 procfs) |
process_stats_config |
process_stats |
| 9 | linux.sys_stats |
traced_probes(读 procfs) |
sys_stats_config |
sys_stats |
| 10 | linux.perf |
src/profiling/perf(独立 perf 采集器) |
perf_event_config |
perf_sample |
| 11 | track_event |
应用/浏览器进程(SDK Producer) | track_event_config |
track_event + track_descriptor |
| 12 | 自造源(com.example.*) |
应用自己 | 自有 DataSourceConfig |
自定义字段 |
| 13 | android.heapprofd |
traced_probes |
heapprofd_config |
profile_packet(+ streaming_*) |
| 14 | android.java_hprof |
traced_probes |
java_hprof_config |
profile_packet(保留图) |
| 15 | android.surfaceflinger.frametimeline |
SurfaceFlinger | 只声明源名,无专属配置块 | FrameTimelineEvent |
| 16 | android.power |
traced_probes |
android_power_config |
battery / power_rails |
| 17 | android.log |
traced_probes |
AndroidLogConfig |
android_log |
| 18 | gpu.counters(+ 厂商后缀) |
厂商 GPU producer | gpu_counter_config |
gpu_counter_event |
| 19 | gpu.renderstages |
厂商 GPU producer | 同名声明 | gpu_render_stage_event |
| 20 | vulkan.memory_tracker |
应用内 Vulkan 层 | vulkan_memory_config |
vulkan_memory_event |
| 21 | gpu.log |
厂商 GPU producer | 无 | gpu_log |
| 22 | linux.sysfs_power |
traced_probes(非 Android 平台) |
无 | (功耗 counter) |
| 23 | 内建源(builtin_data_sources) |
service 自己 | builtin_data_sources |
clock_snapshot / system_info / service_event |
这张表的意义在于"第 23 行":很多人会把 trace 里的所有数据都归给"某个 data source",但时钟快照、系统信息、服务事件是service 作为内建源产出的,配置里只能"关",不能"换"。把它算进来,"谁在写"才算完整——这正是第一章 1.5 节那句话的表格化。
7.2 二次归类:六个家族,一套判断法
把上面 23 行按"数据怎么产生"再归一次类,就得到本篇的家族谱:
| 家族 | 代表源 | 怎么产生数据 | 配置上的典型特征 |
|---|---|---|---|
| 内核宿主族 | linux.ftrace |
打开内核 tracer / 事件,读环形缓冲 | 一个源名 + 一堆 ftrace_events |
| 轮询族 | linux.process_stats、linux.sys_stats |
按周期读 procfs | 有 *_poll_ms / *_period_ms |
| 采样器族 | android.heapprofd、linux.perf |
按字节或事件间隔抽样 | 有采样间隔 / 频率字段 |
| 快照族 | android.java_hprof |
抓一份当前状态 | 有目标进程 + 可选 dump 开关 |
| 埋点族 | track_event、自造源 |
代码里主动写 | 有 categories / tags 或自有 proto |
| 平台服务族 | android.power、...frametimeline、android.log |
平台服务按 HAL / 模块上报 | 有 *_poll_ms 或干脆无配置 |
| 服务内建 | builtin_data_sources |
service 自己写 | 只能关,不能配 |
这套归类的实用价值在于"反推采集代价":看到"轮询族"先问周期(周期越短 CPU 越贵);看到"采样器族"先问间隔(间隔越小精度越高、开销越大);看到"内核宿主族"先问开了几个事件面(面越多 buffer 掉得越快)。官方 memory-counters 页 那句"想抓尖峰用事件、想看趋势用轮询",本质就是轮询族与内核宿主族的选择题。
7.3 全景对照表:一次对齐四条轴
下面我们开始把四条轴对齐。这张表是全篇的题眼——源名 ↔ 谁在采 ↔ 产出 packet ↔ 落到哪张 SQL 表。四条轴的顺序是有讲究的:从左往右是"生产链",从右往左是"排查链";前者回答了"trace 是怎么被造出来的",后者才是你实操时的方向。
看这张图有个诀窍:从最右列倒着读。先问"我想看的那张表是谁写的",再往左找宿主,最后回到中间确认配置入口——比从左往右扫一遍更容易记住,也更贴近你真实的排查动作。举个例:你想查"某个进程占了多少 GPU 显存",最右列会把你指到 counter 表,往左看到宿主是 traced_probes 而不是 GPU producer,于是你就知道该去开 linux.ftrace 而不是 gpu.counters。
把同一套轴落到明细行上,就是下面这张表:
| 源 | 谁在采 | 产出 packet 字段 | 主要落表 |
|---|---|---|---|
linux.ftrace(sched/*) |
traced_probes |
ftrace_events |
sched_slice、thread_state、slice |
linux.ftrace(atrace) |
traced_probes |
ftrace_events(trace_marker) |
slice、counter |
linux.ftrace(gpu 事件) |
traced_probes |
ftrace_events |
counter(GPU 频率/显存) |
linux.ftrace(rss/mm) |
traced_probes |
ftrace_events |
counter(mem.*) |
linux.ftrace(syscalls) |
traced_probes |
ftrace_events |
slice(sys_* 前缀) |
linux.ftrace(function graph) |
traced_probes |
ftrace_events |
slice(Funcgraph 轨道) |
linux.process_stats |
traced_probes |
process_stats |
process、thread、counter |
linux.sys_stats |
traced_probes |
sys_stats |
counter(MemAvailable 等) |
linux.perf |
src/profiling/perf(独立 perf 采集器) |
perf_sample |
perf_sample |
track_event |
App / 浏览器进程 | track_event、track_descriptor |
slice、counter、track、flow |
android.heapprofd |
traced_probes |
profile_packet |
heap_profile_allocation、stack_profile_* |
android.java_hprof |
traced_probes |
profile_packet |
heap_graph_object/class/reference |
android.surfaceflinger.frametimeline |
SurfaceFlinger | FrameTimelineEvent |
expected_frame_timeline_slice、actual_frame_timeline_slice |
android.power |
traced_probes |
battery、power_rails |
counter(batt.*) |
android.log |
traced_probes |
android_log |
android_logs |
gpu.counters |
厂商 producer | gpu_counter_event |
gpu_counter_group、counter |
gpu.renderstages |
厂商 producer | gpu_render_stage_event |
gpu_slice、gpu_track |
vulkan.memory_tracker |
应用内 Vulkan 层 | vulkan_memory_event |
vulkan_memory_allocations |
| 内建源 | service | clock_snapshot / system_info |
clock_snapshot、metadata |
关于这张表的"可核性",先交代一句:表中落表名以官方 sql-tables 页为准(thread_state、heap_profile_allocation、vulkan_memory_allocations、gpu_counter_group 均已逐名核对);perf_sample 一项沿用同名 packet,官方该页未单列,查询前请用 SELECT name FROM sqlite_master WHERE type='table' 在运行时核对。这一条不是免责,而是本篇一贯的态度——凡不能自证的,就给出自证的命令。
把这张表和第七章前面两张表合起来看,就是本篇的完整答案:7.1 告诉你"有哪些源",7.2 告诉你"它们按什么方式干活",7.3 告诉你"干完的活落在哪"。三张表叠起来,你手里就有了一份可以应付绝大多数"trace 里为什么有/没有这条数据"的对照手册。剩下一节,我们换个方向,从表反查源。
7.4 与 ep07 反向咬合:从表追回源
ep07 从字节追到表,本章从表追回源。这个"反向"具体怎么用?看一段查询——它不回答"是什么",而是回答"这条数据是谁写的":
-------------------------------------【从 SQL 侧反查数据源】-----------------------------------
-- 描述:用 counter 的名字前缀判断哪些源在这次会话里真的工作了
-- 依据:perfetto.dev/docs/data-sources/memory-counters 的查询示例
--------------------------------------------------------------------------------------------
-- 反查:这份 trace 里到底有哪些源在工作?
SELECT c.ts, t.name AS counter_name, c.value, p.name AS proc_name
FROM counter AS c
LEFT JOIN process_counter_track AS t ON c.track_id = t.id
LEFT JOIN process AS p USING (upid)
WHERE t.name LIKE 'mem.%'          --【1】前缀就是"源的指纹"
ORDER BY c.ts
LIMIT 20;
下面对【1】特别说明。 这类名字前缀是跨源推理的最小抓手:mem.* 告诉你有内存类源在工作(进程计数器或 rss_stat/mm_event),batt.* 说明 android.power 采到了,sys_ 开头的 slice 说明 syscalls 面开着,Funcgraph 轨道说明 function graph 开着,而 mem.lmk 这种落在 instant 表里的 key 则指向 LMK 事件。当你拿到一份别人给的 trace、又没有原始配置时,这条"从 key 反推源"的路,是唯一能自证的路径——这也正是 ep07 反复强调的"可自证"精神。
向上再走一层还有更硬的证据:TracePacket 里那些由 service 写入的可信字段(trusted_pid、trusted_packet_sequence_id)与 ep07 讲过的 trace_stats,可以用来判断"某个源是不是真的按预期启动过、有没有丢包"。至此,"谁在画这些火焰图"这个问题,从配置层问到了字节层——两篇对上,链路闭合。
八、边界再确认与结语:下篇、资源与落款
好了,最后我们把边界再钉一遍。开篇 0.5 节给过一次边界,走完全篇之后再确认一次,会让你更清楚"这篇到哪为止"。
8.1 边界再确认表
| 本篇讲了 | 本篇没讲(→ 对应篇目) |
|---|---|
| 四方模型与两条通道(socket / 共享内存) | 抓取命令、权限、部署形态 → 属操作层,见官方命令行与 tracebox 文档 |
TraceConfig 的声明与分发、buffer 映射、[lazy] 与兼容路由 |
trace_processor 的 SQL 调优与 PerfettoSQL 标准库组合 → ep09 |
| 内核侧 ftrace 家族、应用侧 SDK、三个专业采集器、GPU 与功耗 | FrameTimeline 的 jank 判定公式与归因 → ep10 |
| 源名 ↔ 谁在采 ↔ packet ↔ SQL 表 的四轴对照 | vsync / BufferQueue / SurfaceFlinger 的系统层流水线 → ep10 |
这张表里最值得留意的是第一行。 本篇刻意只讲"配置本身长什么样",不讲"用哪条命令把配置送进去"——因为命令与权限是环境强相关的(Android 要 adb、Linux 要 chown /sys/kernel/tracing 与 perf_event_paranoid),换台机器就变。而配置的字段语义是跨机器不变的,这才是值得占一篇篇幅的部分。
8.2 下篇预告:把对照表的另一头接上
本篇第七章把"源 → packet → SQL 表"对齐了,但只到"落到哪张表"为止。下一篇(ep09)的主题是 SQL 调优:同一份 trace,为什么有的查询 5 秒出结果、有的跑十分钟;INCLUDE PERFETTO MODULE 到底帮你省了什么;标准库里的视图与你自己手写的 JOIN 差在哪;以及那些"看起来对、算出来错"的口径陷阱怎么避。ep08 让你知道表是从哪来的,ep09 让你知道表该怎么用。
8.3 资源清单
- Perfetto 官方:service model(四方模型一手定义)—— https://perfetto.dev/docs/concepts/service-model
- Perfetto 官方:trace configuration(配置分发、buffer、lazy、兼容)—— https://perfetto.dev/docs/concepts/config
- Perfetto 官方:buffers 与数据流 —— https://perfetto.dev/docs/concepts/buffers
- Perfetto 官方:TraceConfig 参考(字段全表)—— https://perfetto.dev/docs/reference/trace-config-proto
- Perfetto 官方:TracePacket 参考(packet 字段全表)—— https://perfetto.dev/docs/reference/trace-packet-proto
- Perfetto 官方:Tracing SDK(自定义源注册示例)—— https://perfetto.dev/docs/instrumentation/tracing-sdk
- Perfetto 官方:track events(categories / tags / Track 三级)—— https://perfetto.dev/docs/instrumentation/track-events
- Perfetto 官方:CPU scheduling 数据源(
end_state解码表)—— https://perfetto.dev/docs/data-sources/cpu-scheduling - Perfetto 官方:ATrace 数据源(1–10 µs 开销)—— https://perfetto.dev/docs/data-sources/atrace
- Perfetto 官方:GPU 数据源(频率与显存走 ftrace)—— https://perfetto.dev/docs/data-sources/gpu
- Perfetto 官方:memory counters(事件 vs 轮询)—— https://perfetto.dev/docs/data-sources/memory-counters
- Perfetto 官方:native heap profiler(默认 4096 字节)—— https://perfetto.dev/docs/data-sources/native-heap-profiler
- Perfetto 官方:ART heap dumps(保留图)—— https://perfetto.dev/docs/data-sources/java-heap-profiler
- Perfetto 官方:power 数据源(battery counters 与 ODPM)—— https://perfetto.dev/docs/data-sources/battery-counters
- Perfetto 官方:socket 协议与 ABI —— https://perfetto.dev/docs/design-docs/api-and-abi
- Perfetto 官方:ProtoZero(生产者侧序列化)—— https://perfetto.dev/docs/design-docs/protozero
- Perfetto 官方:SQL 表索引(落表的权威定义)—— https://perfetto.dev/docs/analysis/sql-tables
- Perfetto 源码:真实配置样例集 —— https://github.com/google/perfetto/tree/main/test/configs
- Collabora:为非 Android 平台自造 GPU counter 源 —— https://www.collabora.com/news-and-blog/blog/2020/08/21/panfrost-performance-counters-with-perfetto/
- Microsoft DevBlogs:Perfetto 实战配置(改
linux.perf段)—— https://devblogs.microsoft.com/performance-diagnostics/perfetto-tooling-for-analyzing-android-linux-and-chromium-browser-performance-microsoft-performance-tools-linux-android/
参考资料来源:本篇所有机制、字段名与默认值均以 Perfetto 官方文档(含各 data source 分页与 proto 参考页)与 google/perfetto 仓库源码为一手依据;社区实践(Collabora、Microsoft DevBlogs、Mesa)仅作"源可自造"的旁证,正文已逐条标注。配图除自绘外均为官方文档配图(Google,Apache-2.0),出处见图注与文末脚注。
下篇预告:(九)SQL 调优:把"能查"变成"查得快、算得对"。
开篇快捷键:想快速上手,记住三件事——看源先看配置块的 name(源名就是身份,写错静默失效)、开 GPU 频率与显存要开 linux.ftrace(它们不是独立源)、采不到数据先查三问(注册了吗 / 配置声明了吗 / 丢包了吗)。
以上。 希望这一路"从配置到表"的梳理,能让你下次在 UI 上少一块轨道时,不再猜是设备问题,而是能一路问下去:这个源谁在采、我声明了吗、它写进哪块 buffer、最后落到哪张表。
本文由@溯光 出品,让"谁在画"成为可核对的链路。
With Best Wishes.
[^ext1]: 题图「Perfetto 分层栈」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/perfetto-stack.png,配套 https://perfetto.dev/docs/),作者:Google,Apache-2.0 许可。
[^ext2]: 图「producer↔service socket 协议」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/socket-protocol.png,配套 https://perfetto.dev/docs/design-docs/api-and-abi),作者:Google,Apache-2.0 许可。
[^ext3]: 图「共享内存 ABI 概览」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/shmem-abi-overview.png,配套 https://perfetto.dev/docs/design-docs/api-and-abi),作者:Google,Apache-2.0 许可。
[^ext4]: 图「Service / Producer / Consumer 四方模型」取自 Perfetto 官方文档(GitHub google/perfetto 的 markdown_img/producer-service-consumer.png,配套 https://perfetto.dev/docs/concepts/service-model),作者:Google,Apache-2.0 许可。
[^ext5]: 图「TraceConfig 分发」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/trace_config.png,配套 https://perfetto.dev/docs/concepts/config),作者:Google,Apache-2.0 许可。
[^ext6]: 图「target_buffer 映射」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/trace_config_buffer_mapping.png,配套 https://perfetto.dev/docs/concepts/config),作者:Google,Apache-2.0 许可。
[^ext7]: 图「线程状态轨道」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/thread-states.png,配套 https://perfetto.dev/docs/data-sources/cpu-scheduling),作者:Google,Apache-2.0 许可。
[^ext8]: 图「ATrace 产生的 slices 与 counters」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/atrace_slices.png,配套 https://perfetto.dev/docs/data-sources/atrace),作者:Google,Apache-2.0 许可。
[^ext9]: 图「native 分配火焰图」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/native-heap-prof.png,配套 https://perfetto.dev/docs/data-sources/native-heap-profiler),作者:Google,Apache-2.0 许可。
[^ext10]: 图「GPU counter 轨道总览」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/gpu-counters.png,配套 https://perfetto.dev/docs/data-sources/gpu),作者:Google,Apache-2.0 许可。
[^ext11]: 图「电池计数器 UI」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/battery-counters-ui.png,配套 https://perfetto.dev/docs/data-sources/battery-counters),作者:Google,Apache-2.0 许可。
[^ext2]: 图「producer↔service socket 协议」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/socket-protocol.png,配套 https://perfetto.dev/docs/design-docs/api-and-abi ),作者:Google,Apache-2.0 许可。
[^ext3]: 图「共享内存 ABI 概览」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/shmem-abi-overview.png,配套 https://perfetto.dev/docs/concepts/service-model ),作者:Google,Apache-2.0 许可。
[^ext4]: 图「TraceConfig 分发」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/trace_config.png,配套 https://perfetto.dev/docs/concepts/config ),作者:Google,Apache-2.0 许可。
[^ext5]: 图「target_buffer 映射」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/trace_config_buffer_mapping.png,配套 https://perfetto.dev/docs/concepts/config ),作者:Google,Apache-2.0 许可。
[^ext6]: 图「线程状态轨道」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/thread-states.png,配套 https://perfetto.dev/docs/data-sources/cpu-scheduling ),作者:Google,Apache-2.0 许可。
[^ext7]: 图「ATrace 产生的 slices 与 counters」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/atrace_slices.png,配套 https://perfetto.dev/docs/data-sources/atrace ),作者:Google,Apache-2.0 许可。
[^ext8]: 图「native 分配火焰图」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/native-heap-prof.png,配套 https://perfetto.dev/docs/data-sources/native-heap-profiler ),作者:Google,Apache-2.0 许可。
[^ext9]: 图「GPU counter 轨道总览」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/gpu-counters.png,配套 https://perfetto.dev/docs/data-sources/gpu ),作者:Google,Apache-2.0 许可。
[^ext10]: 图「电池计数器 UI」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/battery-counters-ui.png,配套 https://perfetto.dev/docs/data-sources/battery-counters ),作者:Google,Apache-2.0 许可。