站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:上一章留下一句话
上一篇我们跟着批处理那条线走到收口,末尾留下一句结论:一批一次发出去。那一篇把「批」当成一个已经存在的东西来用——它说了批怎么切、能装多少、代价在哪,没说的是:这批到底「发」到哪个对象上、谁替它排序、顺序乱了会怎样。
这一章要问的就是这三个问题。它们看着像是实现细节,合起来却是「一次 2D 绘制怎么落到 GPU 上」这句话里最容易被跳过的一段:从「引擎想画什么」到「驱动真的发什么」,中间还夹着一层专门管顺序的东西。
0.1 本系列的位置:这一篇走到第四层的下半截
好了,前面六篇把一次 2D 绘制的落点链走了一半:对象模型(第二篇)→ 服务层接口(第三篇)→ 画布剔除与排序(第四篇)→ 画布渲染抽象与中间表示(第五篇)→ 批处理(第六篇)。本篇接在第六篇后面,往同一条链的下游再走一层:第六篇讲「批是怎么攒出来的」,本篇讲「这些批怎么变成一张有序的提交图」。
整个系列按这条链路铺开,目录如下(本篇即第七行):
| # | 篇目 | 它回答的问题 | 状态 |
|---|---|---|---|
| 01 | 全景与边界 | 四层架构是什么、一次 2D 绘制要经过谁 | 已发布 |
| 02 | 对象模型 | 谁在什么时候把命令层下发 | 已发布 |
| 03 | 服务层接口 | 命令长什么样、怎么被排队 | 已发布 |
| 04 | 画布剔除与排序 | 画什么、按什么顺序 | 已发布 |
| 05 | 画布渲染抽象 | 绘制项里存了什么、怎么被提交 | 已发布 |
| 06 | 批处理 | 一批能装多少、按什么切、代价在哪 | 已发布 |
| 07 | RenderingDevice 抽象(本篇) |
命令列表怎么变成一张依赖图 | 本篇 |
| 08 | 后端分叉 | 四条驱动怎么选、分叉在哪 | 待写 |
| 09 | 主循环与多线程 | 逻辑与渲染怎么错位 | 待写 |
| 10 | 资源侧 | 一张纹理从盘上到显存 | 待写 |
| 11 | 收官 | 这条链整体买到了什么 | 待写 |
好了,其中:这张表的用处是给出本篇与相邻两篇的接缝——上一篇交出「一批批的实例数据」,下一篇接手「四条驱动怎么选」。本篇要讲的,就是夹在这两句话中间的那一段:一批命令从「写下来的顺序」变成「该执行的顺序」的那个过程。
本篇的主角是一个类,它的名字就写在源码里:RenderingDeviceGraph。为了行文方便,后文一律简称渲染图(render graph)。
0.2 沿用官方口径:三种渲染方法,四种驱动
口径先对齐,免得后面对不上。官方原句是「Godot 4 includes three renderers」——渲染方法是三种:Forward+、Mobile、Compatibility;驱动是四种:Vulkan、Direct3D 12、Metal、OpenGL(OpenGL 只能配 Compatibility)。可用组合一共 7 种。
本篇还会反复用到另一个区分,它比「三与四」更要紧:这三种渲染方法里,只有 Forward+ 与 Mobile 走 RenderingDevice(渲染设备,后文简称 RD);Compatibility 那一套根本不经过它。官方内部架构文档把这句话写得很直白,我们在第一章会逐字引出来。
0.3 三个可检验命题
这一篇要留下三个能当场检验的命题,后文逐条兑现:
OK,1. 一次提交的顺序不是「写下来的顺序」——引擎会自动构造一张有向无环图(directed acyclic graph,DAG),按依赖关系重排命令。 2. 重排不是免费的,它还有两个开关,默认值本身就说明了两件事:重排默认开、全屏障默认关。 3. 同一张图,在不同后端上要做的事不一样——图不是「把命令按顺序发出去」这么简单,它要先问驱动:你要不要屏障、你要不要布局转换。
0.4 三个词的边界:命令列表、屏障、依赖图
后面会反复用到三个词,它们常被混着说,先把边界划出来:
| 词 | 指的是什么 | 谁产的 | 本篇怎么看 |
|---|---|---|---|
| 命令列表(command list / draw list) | 一次绘制录制进去的那一串指令 | 渲染器(RendererCanvasRenderRD 等) |
只出现在源码里;draw_list_begin/end 是它的边界 |
| 屏障(barrier) | 命令缓冲里的一条同步指令:声明「谁必须在谁之前完成」 | 4.3 之前是 RD 手工插,4.3 之后是图算出来的 | 图上没有计数器;只能从源码分支读「什么时候会发」 |
| 依赖图(render graph) | 把命令当成节点、把资源读写当成边,排出一张有向无环图 | RenderingDeviceGraph |
源码里可逐行读;本机读数只能间接反映 |
其中:三者的关系是一句话——命令列表是「原料」,屏障是「规则」,依赖图是「把原料按规则排好序的那张纸」。所以「为什么同一段代码在不同后端上表现不同」这类问题,答案往往落在「规则不一样」,而「规则为什么不一样」又要落到「驱动能力位怎么报」。这条关系就是本篇反复要用的原理线。
这张表还有一层用处:它解释了本篇的证据结构为什么长这样。图和屏障都在引擎内部,没有现成的计数器可读;能直接读到的是后端启动行、draw call 数、帧时间——所以我们所有的结论,都是先读源码定机制、再用可读到的量去侧证。
0.5 边界声明:本篇不涉及什么
按系列约定,三条边界在本篇的落法如下:
OK,说白了,1. 不写矢量光栅算法(归《2D 矢量引擎深挖》)——本篇不写「一个像素怎么被算出来」,只写「一条命令为什么排在这一条后面」;
2. 不写渲染 API 教程(归《Vulkan/OpenGL 官方最佳实践》)——不写 Vulkan 的 vkCmdPipelineBarrier 用法,只写 Godot 怎么决定要不要发它;
3. 不写硬件微架构(归《GPU 架构剖析》)——只在「重排为什么可能更快」相接处点到为止,不下探波前与占用率。
还有两条本篇自定的边界,都是这一轮实测撞出来的,必须写在明面上:
- 不声称本机测得「关掉重排」或「改成全屏障」的差异。本机那份构建里没有
GODOT_RG_REORDER与GODOT_RG_FULL_BARRIERS这两个开关串(第七章给出字符串检索的判据),运行期开关在本机不可用;两个开关的默认值只从源码原文读。 - 不做 Vulkan 验证层实验。官方博客说他们「大量使用了这些验证工具」(extensive use was made of these validation tools),但本机没装验证层(
VK_LAYER_PATH为空、全盘未搜到VkLayer_khronos_validation*),所以本篇只转述官方做法,不声称本机跑过验证层。
0.6 本篇的读法:三层证据怎么配合
本篇的证据分三层,它们不是并列关系,而是互相钉住的关系:
| 层 | 它回答 | 它的局限 | 本篇用在哪 |
|---|---|---|---|
| 官方文档与文章 | 官方口径是什么、什么时候变的 | 只给结论,不给落点 | 一、二章(定位与版本转折) |
| 官方源码原文 | 在哪一行发生 | 静态阅读,不知道跑起来是不是这样 | 三到六、八到十章(机制全貌) |
| 本机探针读数 | 跑起来差多少 | 只有一台机器、一种方法 | 七章(RD 路与非 RD 路的对照) |
好了,其中:三层配合的方式是「文档定口径 → 源码定落点 → 读数定量级」。少了任何一层都会留下缺口:只有文档会停在「官方说有这么张图」;只有源码会停在「看起来它会重排」;只有读数会停在「现象对上了,但不知道谁干的」。这也是本系列一路以来固定下来的取证方式。
0.7 全量清单与归类:本篇要讲的十四个点
先把本篇会碰到的全部机制点列出来(宁全勿缺),再归一次类。清单来自三处:官方的四个页面、rendering_device_graph.h/.cpp、以及 rendering_device.h/.cpp。
全量清单(14 项)
RenderingDeviceGraph(独立一类,rendering_device.h里以draw_graph成员持有)using RDG = RenderingDeviceGraph;(源码级别名)enum ResourceUsage(24 个取值:复制/解析/五类缓冲读/采样/四个附件/加速结构)struct ResourceTracker(资源侧记账:读全量、读切片、写在哪条命令)- 邻接表与
_add_adjacent_command()(依赖是怎么被记下来的) - Kahn 拓扑排序(入度 → 入度 0 入栈 → 弹栈输出并减邻居入度)
PriorityTable[](按命令类型的第二把尺子,带static_assert)struct RecordedCommandSort { level; priority; index; }(排序键)end(bool p_reorder_commands, bool p_full_barriers, …)(收口,两个开关走这里)enum ApiTrait(15 项驱动能力)与initialize()里的 5 次api_trait_getRENDER_GRAPH_REORDER(默认 1)与RENDER_GRAPH_FULL_BARRIERS(默认 0) 言归正传,12.SECONDARY_COMMAND_BUFFERS_PER_FRAME(默认 0:后台录次级命令缓冲默认关)USE_BUFFER_BARRIERS与那段「缓冲屏障可能有害」的头注释- 本机三档探针:
--rendering-method换后端 × 两次重复 + 二进制字符串检索
二次归类(按「它在整条链的哪一段起作用」)
| 类 | 包含 | 它决定什么 |
|---|---|---|
| 定位与版本 | 1、2、10,以及官方的四个页面 | 这层是什么、什么时候变成这样的 |
| 依赖从哪来 | 3、4、5 | 图凭什么知道谁依赖谁 |
| 排序怎么排 | 6、7、8、9 | 一堆命令排出来的顺序 |
| 代价与边界 | 11、12、13、14 | 这套机制什么时候不划算 |
其中:这张归类表就是本篇的结构骨架——一章讲「定位与版本」,二章讲这次转折的账,三到五章讲「依赖从哪来」,四到六章讲「排序怎么排」,七到十章讲「代价与边界」。清单是「面」,归类是「骨」;有了这张骨头,后面每一章都知道自己补在哪。
源码可在 rendering_device_graph.cpp 的在线页面上对照阅读(与本篇引用的 raw 文件同一份内容)。
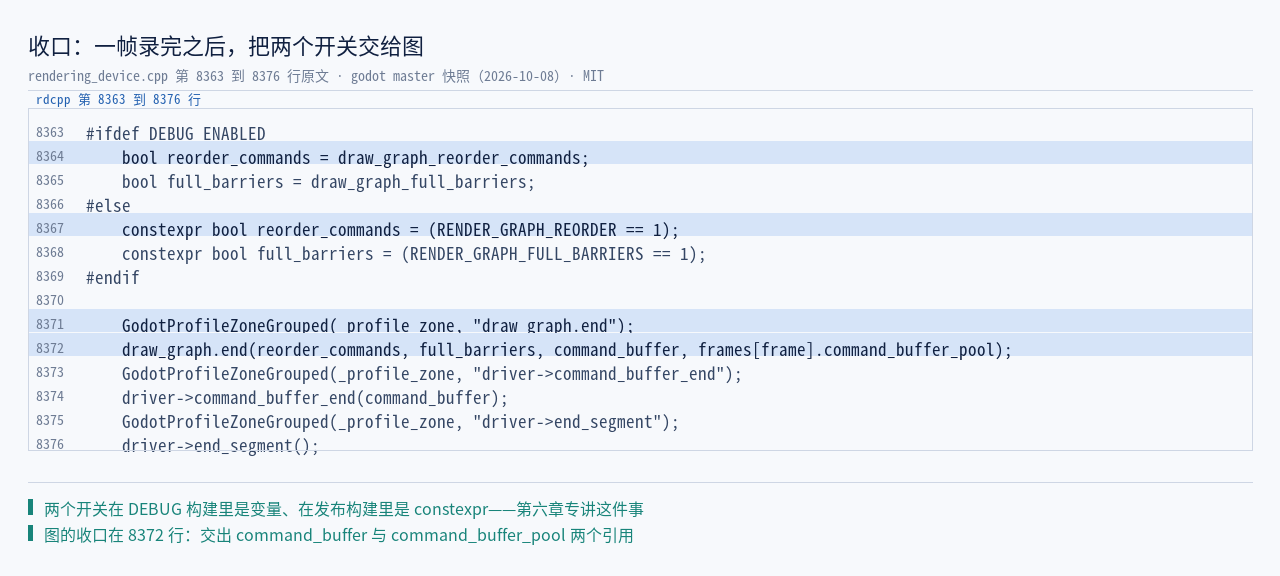
上图这一行是本篇的入口。其中:它出现在 RenderingDevice::submit() 的末尾,前面是几段传输任务的收尾、后面是驱动层的两个收口调用——也就是说:一帧里所有绘制命令都录完之后,交给图的那个人是 submit(),而图交出的是一个装好的命令缓冲。
// servers/rendering/rendering_device.cpp:8363–8376(master 快照 2026-10-08,节选)
#ifdef DEBUG_ENABLED
    bool reorder_commands = draw_graph_reorder_commands;
    bool full_barriers = draw_graph_full_barriers;
#else
    constexpr bool reorder_commands = (RENDER_GRAPH_REORDER == 1);
    constexpr bool full_barriers = (RENDER_GRAPH_FULL_BARRIERS == 1);
#endif

    GodotProfileZoneGrouped(_profile_zone, "draw_graph.end");
    draw_graph.end(reorder_commands, full_barriers, command_buffer, frames[frame].command_buffer_pool);
    GodotProfileZoneGrouped(_profile_zone, "driver->command_buffer_end");
    driver->command_buffer_end(command_buffer);
说白了,其中:这段代码只有两件事:取两个开关的值,然后调用图的收口函数。请注意那两个开关在两种构建下来源不同——这件事我们在第六章会专门讲,因为它是本篇唯一「编译期与运行期并存」的地方。
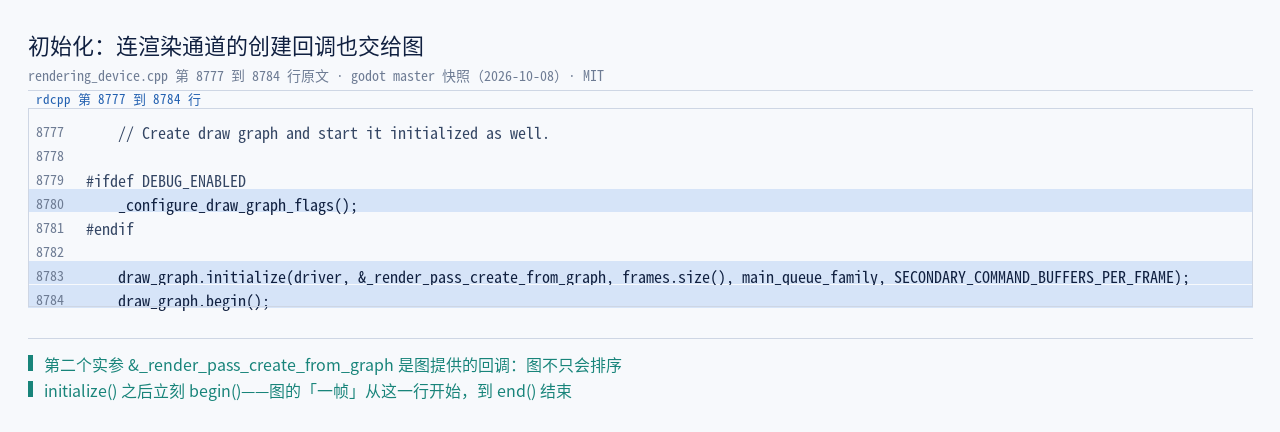
上面这四行是同一张图的另一端:初始化。其中:第二个参数 &_render_pass_create_from_graph 值得多看一眼——渲染通道(render pass)的创建回调也是图提供的。这层关系说明图不只是「排个序」,它还接手了「这组附件该怎么开一次通道」这件事。
// servers/rendering/rendering_device.cpp:8783–8784(master 快照 2026-10-08)
    draw_graph.initialize(driver, &_render_pass_create_from_graph, frames.size(), main_queue_family, SECONDARY_COMMAND_BUFFERS_PER_FRAME);
    draw_graph.begin();
本章出处:源码 rendering_device.cpp(:8363–8376、:8783–8784)|系列前六篇见第六篇 批处理;本文所有源码行号一律按 godot master 快照(2026-10-08),逐条回本机 clone 复核,不做算术平移。
这条链走到本篇,落成四层:场景与画布(前四篇)→ 批(第六篇)→ RD 与图(本篇)→ 驱动与 API(第八篇起)。其中:注意第三层里又分了两个环:RenderingDevice 管「资源与接口」,RenderingDeviceGraph 管「顺序与同步」。它们是同一层里的两个角色,而不是上下级——RD 持有图,图回填命令缓冲。
一、RenderingDevice 是什么、不是什么
这一章先解决一个前置问题:我们说「落到 RD 上」,这个 RD 到底站在哪一层?官方内部渲染架构文档里有一节专门讲它,原句如下:
To make the complexity of modern low-level graphics APIs more manageable, Godot uses its own abstraction called RenderingDevice.
This means that when writing code for modern rendering methods, you don't actually use the Vulkan or Direct3D 12 APIs directly. While this is still lower-level than an API like OpenGL, this makes working on the renderer easier, as RenderingDevice will abstract many API-specific quirks for you. The RenderingDevice presents a similar level of abstraction as Metal or WebGPU.
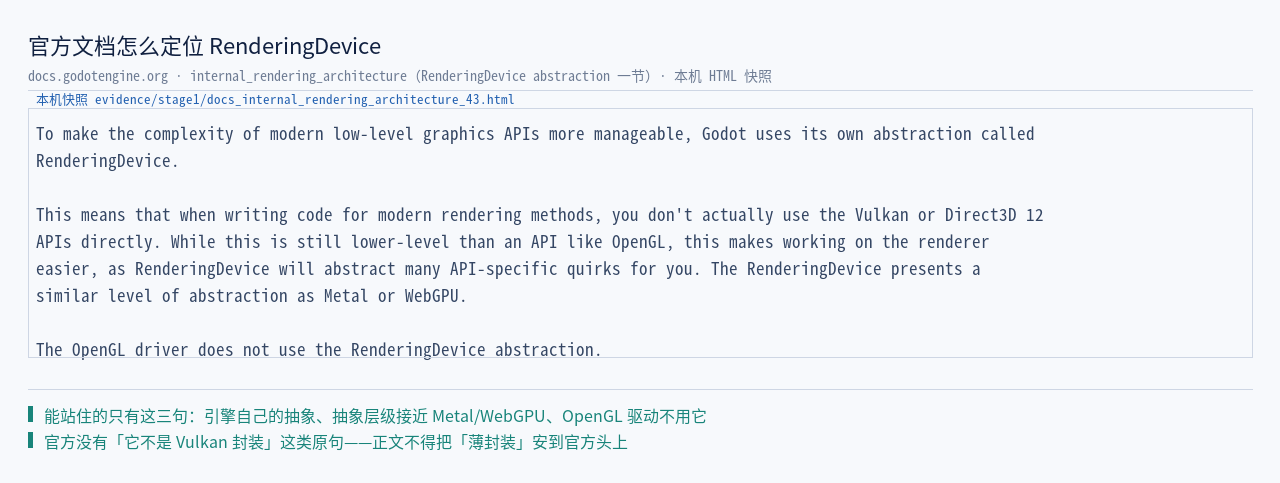
其中:这三句里有两个信息点值得单独拎出来。
第一,官方给的坐标是「接近 Metal 或 WebGPU」,不是「Vulkan 的薄封装」。这句话对我们后面所有讨论都有约束作用:图要处理的东西,是「WebGPU 这一档抽象」上的东西——资源用法、布局、访问位,而不是 Vulkan 的 VkImageMemoryBarrier 结构体字段。这一点在第五章会再次出现。
第二,同一节里还有一句否定句,它常被漏读:
The OpenGL driver does not use the RenderingDevice abstraction.
这句话的含义是:RD 不是「所有渲染路径的必经之地」。Compatibility 那一套走的是另一条路(OpenGL 直连)。所以「Godot 的渲染都经过 RD」是错的说法——本篇讨论的整条机制,只覆盖 Forward+ 与 Mobile 这两条路。
1.1 RD 的成员里为什么躺着一张图
口径定完,来看结构。rendering_device.h 里,RD 把图作为一个普通成员持有:
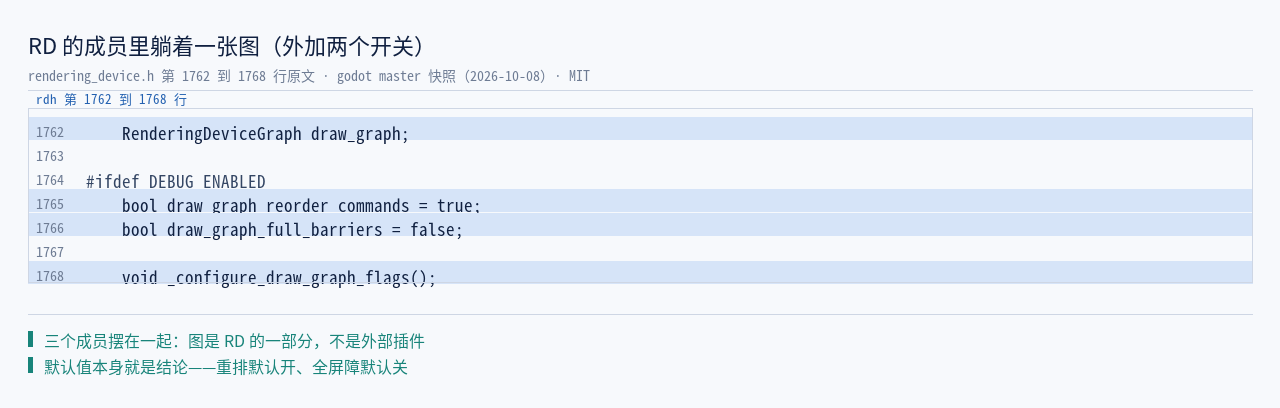
// servers/rendering/rendering_device.h:1762–1766(master 快照 2026-10-08)
    RenderingDeviceGraph draw_graph;
    ...
    bool draw_graph_reorder_commands = true;
    bool draw_graph_full_barriers = false;
好了,其中:三个成员摆在一起,已经把本篇的三个命题说了一半:图是 RD 的一部分(不是外部插件);重排默认开;全屏障默认关。后两条的默认值本身就是结论——「默认按依赖重排、默认只发必要的屏障」是这套设计的立场。
1.2 「不走 RD」到底差在哪
上图是本章最重要的一张对照,它要讲的原理只有一句:「走不走 RD」是一道硬分叉。其中:它把一个容易含混的说法拆成两半:「走不走 RD」与「快不快」是两件事。走 RD 的那两条路,命令要经过「录制 → 建图 → 排序 → 发屏障 → 提交」;不走的那条路,命令直接下到 OpenGL 的调用序列上。第七章会用本机读数把这两条路的差别量出来。
这里要先说清一件事,免得第七章的读数被过度解读:两条路的差别不等于「图的功劳」。图只是 RD 这条路上的一个环节;draw call 数、帧时间这些量,是整条渲染器实现的合并结果。我们在第七章会把这条归因边界再写一遍。
本章出处:官方文档 internal_rendering_architecture(RenderingDevice abstraction 一节)(本机 HTML 快照 evidence/stage1/docs_internal_rendering_architecture_43.html)|源码 rendering_device.h(:1762–1766)。
二、4.3 为什么要把同步责任从 RD 挪走
第二章是版本转折。这一章之所以放在最前面,是因为它决定了后面所有源码读法的口径:4.3 之前的同步策略与之后不是同一套东西。
先看官方发布说明里怎么写这一条:
RenderingDevice, the part of the engine that powers the Forward+ and Mobile rendering backends, was improved by the introduction of a directed acyclic render graph.As newer GPU APIs (Vulkan, D3D12, and Metal) give developers more direct access to graphic cards, the burden for making sure everything works correctly falls on the user. The acyclic graph permits the engine to reorder and optimize commands in order to minimize the overhead of the graphics API while ensuring that everything happens in the right order.
Without making any changes to your 3D scene, you should expect to see a frame rate improvement of 5% to 15% (and more if you heavily use
GPUParticles)!
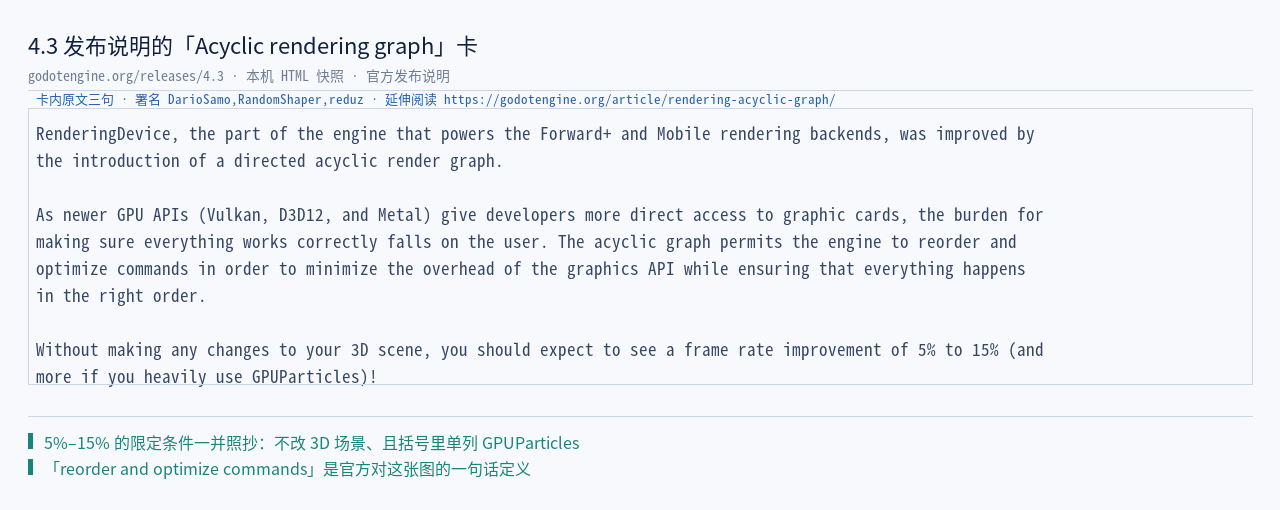
其中:注意第三句的限定条件:5%–15% 是对「没有改任何 3D 场景」的情况说的,括号里还单列了 GPUParticles。这类官方量化的限定条件必须一并转述,否则很容易被读成「所有项目都快 5%–15%」。
2.1 「维护噩梦」这四个字是官方自己写的
发布说明只给了结论。动机写在官方博客里,作者是这次改动的实现者 Darío Banini。原文有一段非常直白:
However, due to some internal design decisions, the introduction of a
CONTINUEaction was made that doesn't actually exist in Vulkan. This action essentially meant "the previous draw list is compatible and the texture should not be transitioned to a different state". For an engine like Godot, which must provide a lot of optional post-processing effects and drawing layers, this proved to be a maintenance nightmare, ending in a ton of branching in the code that was not very easy to follow and prone to mistakes.
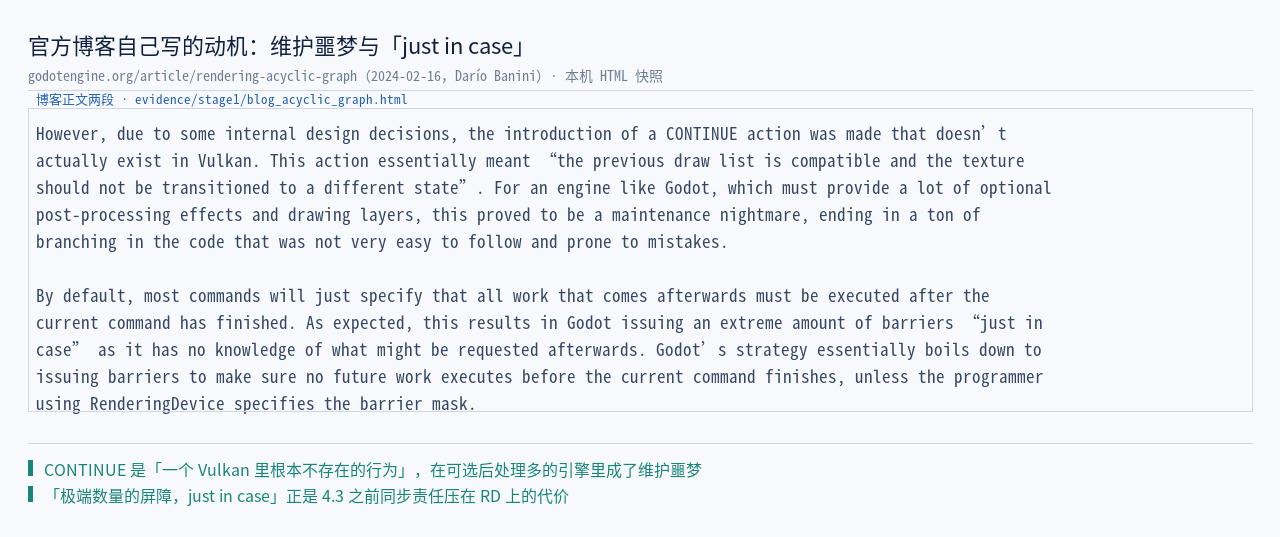
其中:这段话里最关键的不是「噩梦」这个形容,而是它为什么是噩梦——这条原理值得单独说:Godot 要提供大量可选的后处理与绘制层,而可选意味着组合爆炸:每加一个后处理,就要重新推一遍「上一张渲染目标的纹理现在是什么布局」。手工维护这类推导,错一次就是一个难查的花屏。
同一篇里还有另一段,解释「为什么要重排」而不是「只加依赖追踪就行」:
Solving the problems identified above does not actually require the introduction of an acyclic graph: inserting synchronization barriers and performing dependency tracking is entirely possible without applying this technique. This was actually debated internally for a while, but it was determined that if the engine was able to reorder commands, it'd allow for grouping them more effectively between the mandatory synchronization points and would result in better performance.
OK,这两段合起来回答了本章的标题——重排不是目的,是手段。目的是「让引擎自己知道谁依赖谁」;手段是「既然知道了,就顺手把命令按依赖重排一遍,让同类操作聚在一起」。
2.2 谁做的、什么时候合进去的
版本转折要落到「谁、何时」这两问上,本篇用两处一手材料钉住:
- PR #84976,标题
Acyclic Command Graph for Rendering Device,作者DarioSamo,创建 2023-11-16、合并 2024-01-09,里程碑 4.3(元数据取自 GitHub API,落盘evidence/stage1/pr84976.json):
PR #84976   Acyclic Command Graph for Rendering Device
author      DarioSamo
created     2023-11-16T14:41:21Z
merged      2024-01-09T10:30:23Z      (akien-mga)
milestone   4.3
merge       e9695d9fa22113f41348a0d2c7edb1138efc2b22
- 4.3 beta 1 的公告:
The acyclic command graph for Rendering Device is finally merged (GH-84976)! This is an optimization and a feature which automatically records and re-orders rendering commands in the RenderingDevice backend… This builds on top of the RenderingDeviceDriver refactoring (GH-83452) which was merged earlier in the release cycle.
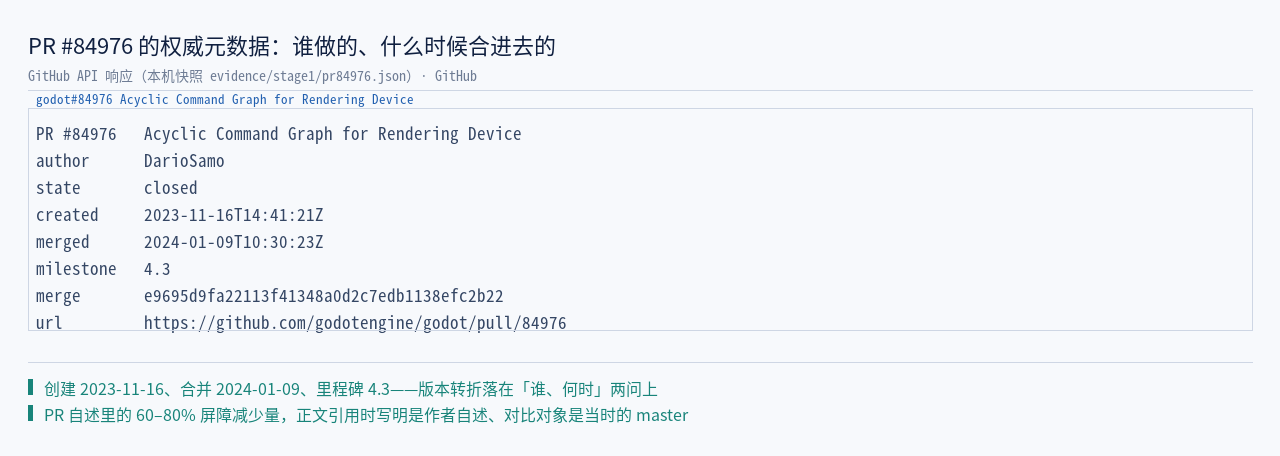
OK,其中:两处材料的关系是「页面 » 结论」:PR 页给出事实(谁、何时、里程碑),公告给出定位(它是「自动录制并重排」的优化,且建立在 #83452 的驱动接口重构之上)。注意后半句——这次改动不是孤立的,它先把驱动接口抽出来(RenderingDeviceDriver),才有地方安放「新的一层」。这条线索在第十章会接上。
2.3 官方自己给出的量化:屏障少了多少
发布说明只说「快 5%–15%」,但没给屏障数。屏障量的数字在 PR 自述里:
RenderingDevice's complexity has been drastically reduced as it no longer needs to solve pipeline barriers or layout transitions for pretty much all its functionality. This responsibility has been delegated to a new class called RenderingDeviceGraph.
Overall the total amount of
vkCmdPipelineBarriercalls has been reduced immensely. On average I've noticed a reduction of about 60-80% of the total amount of barrier calls in a frame when compared tomaster.
这里必须把口径写清楚:这个 60–80% 是作者在 PR 描述里的自述,对比对象是当时的 master,不是「任何项目都能少 60–80% 的屏障」,也不是我们本机测出来的。正文转述时保持这个限定。
2.4 之后呢:如实说「没有再找到同主题的官方改动」
一条时间线缺了后半段就不完整。本篇检索了 4.4 dev 快照、4.4 渲染优先事项、4.5 与 4.6 的发布说明与 dev 博客,未找到以「渲染图 / GPU 同步」为主题的继续改动原句;只找到 4.4 渲染优先事项里一句回顾:
Acyclic render graph optimization (GH-84976) (Done) — As expected we merged the new Acyclic Render graph in 4.3. It significantly improved stability of the engine and resolved many hard to fix errors as well as moderately improved performance.
上图这条线画到「之后未再见同主题改动」为止。其中:我们把话说到这里就打住——不写「4.4/4.5/4.6 沿用了它」这类没查到依据的推断,只写「没有查到同主题的继续改动」。这也是本系列一直在用的写法:查不到就说查不到。
2.5 手工同步时代,工程师要推的那几件事
官方博客里那句「极端数量的屏障,just in case」不是修辞。要理解它,得先知道手工插屏障时到底在推什么——这是本章唯一的背景知识,讲完就能看懂后面所有源码分支。
GPU 侧还有一类「顺序」问题,和 CPU 上的多线程很像,只是没有锁、只有屏障。同一个资源被多条命令用到时,可能撞上三类冲突:
| 冲突 | 什么意思 | 不管会怎样 |
|---|---|---|
| 写后读(RAW) | 先写、后读同一份数据 | 读到的可能是写之前的内容 |
| 读后写(WAR) | 先读、后写同一份数据 | 写可能盖掉还没读完的内容 |
| 写后写(WAW) | 两次写同一份数据 | 两次写的先后被调换,最终值不对 |
除此之外还有一类状态转换:同一张纹理,这一次当「渲染目标」用、下一次当「着色器采样」用,必须显式告诉驱动「它现在要换成哪种用途」——官方文档把这类操作与屏障并列叙述(原文用的是 barriers 与 layout transitions 两个词)。
其中:把这四件事放在一起,就能理解那句「just in case」:在没有全局视图的情况下,最安全的写法是「凡是可能相关的,我就加一道屏障」。这样做不会错,但会多——而多出来的每一道屏障,都可能把 GPU 本来能并行的工作切开。
说白了,其中:图要解决的就是这件事的两端:它把「谁读谁写」记全(第三章的用法表 + 追踪器),于是不必保守;它把「要不要发」交给驱动能力位(第五章),于是不必对每个后端都按最严的来。这就是「屏障能减少 60–80%」这句自述背后的机制。
本章出处:4.3 发布说明(本机 HTML 快照 evidence/stage1/release43.html)|官方博客《GPU synchronization in Godot 4.3 is getting a major upgrade》(2024-02-16,本机快照 blog_acyclic_graph.html)|4.3 beta 1 公告(本机快照 dev43beta1.html)|godot#84976(元数据 evidence/stage1/pr84976.json)|4.4 渲染优先事项(本机快照 rendering_priorities_202409.html)。
三、一张图里有什么
前两章把「为什么」讲完了。从这一章开始进源码:先看图的类骨架,再看它对外开哪几个口。
3.1 类的边界与那个源码级别名
图在 master 里是一个独立文件:servers/rendering/rendering_device_graph.h(968 行)与 .cpp(2885 行)。类的头尾各有一处值得记录:
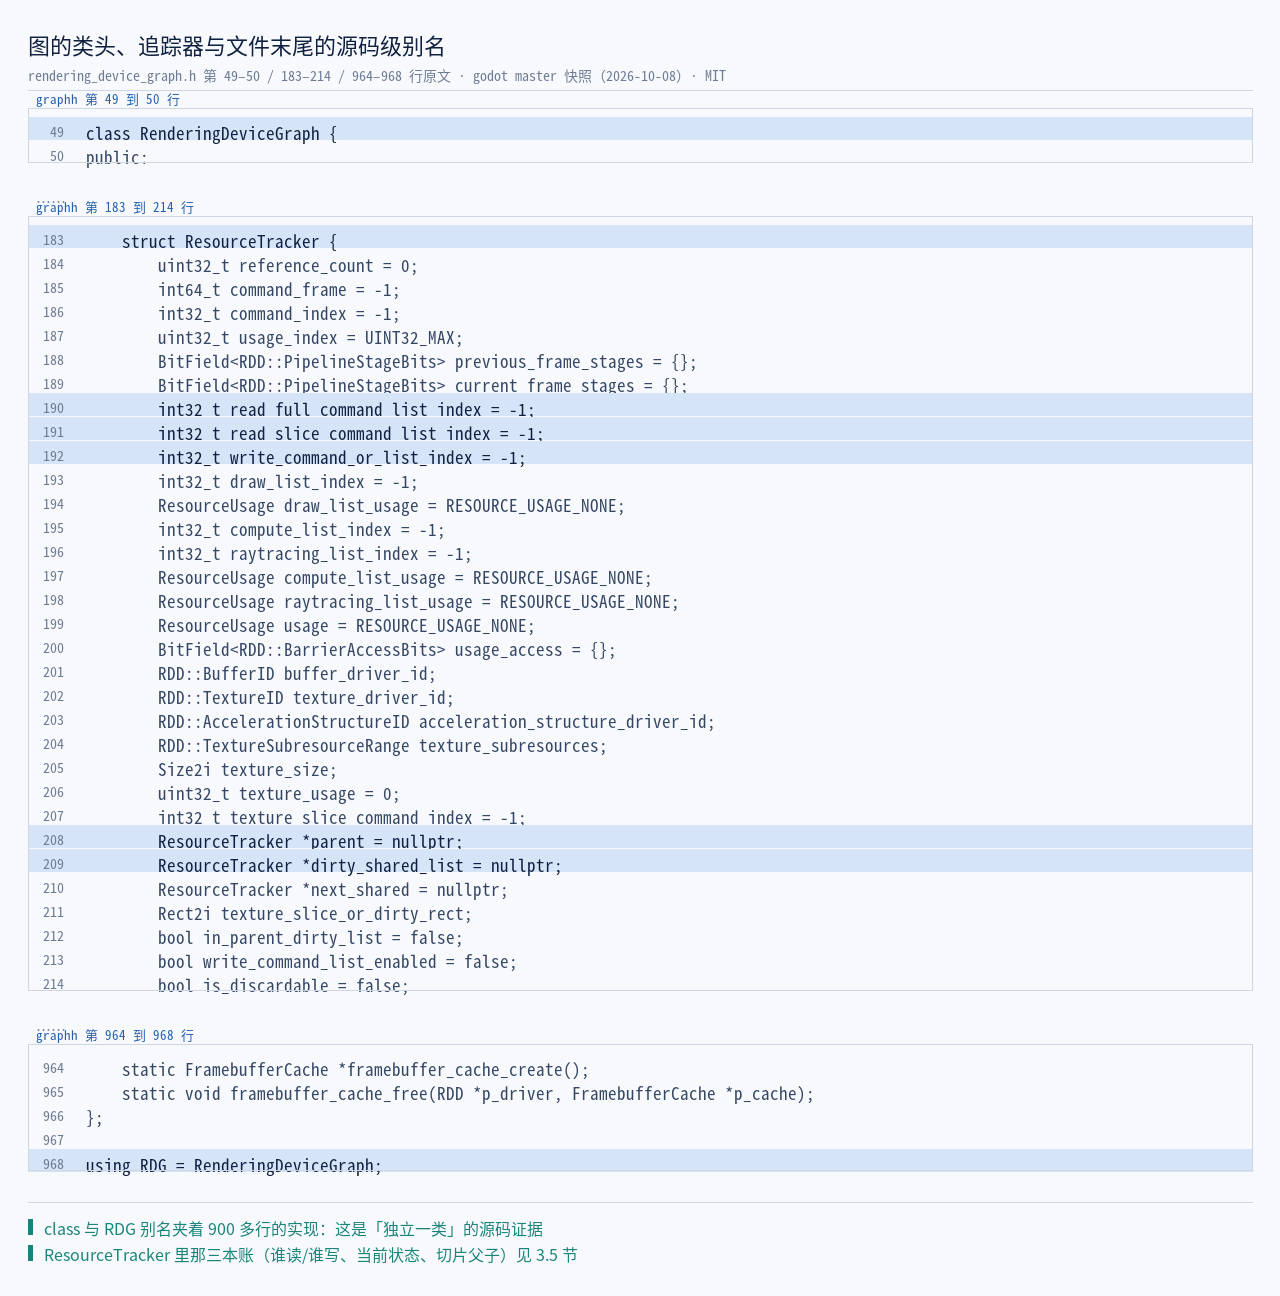
// servers/rendering/rendering_device_graph.h:49–50 / :183 / :966 / :968(master 快照 2026-10-08,节选)
class RenderingDeviceGraph {
public:
    struct ResourceTracker { ... };

    ...

};

using RDG = RenderingDeviceGraph;
其中:using RDG = RenderingDeviceGraph;(:968)这一行是「它已经长成体系」的标志:RD 的公开头文件里大量使用 RDG::ResourceTracker、RDG::ResourceUsage 这样的写法——图不是藏在实现里的临时结构,而是被 RD 当成正式邻居。这也决定了本篇的读法:要理解「一批命令怎么发出去」,得把 rendering_device.* 与 rendering_device_graph.* 两处对着读,缺一边都看不出全貌。
3.2 资源用法表:24 个取值
依赖关系从哪来?不靠猜命令文本,靠一张显式的用法表。图里定义了 24 个取值:
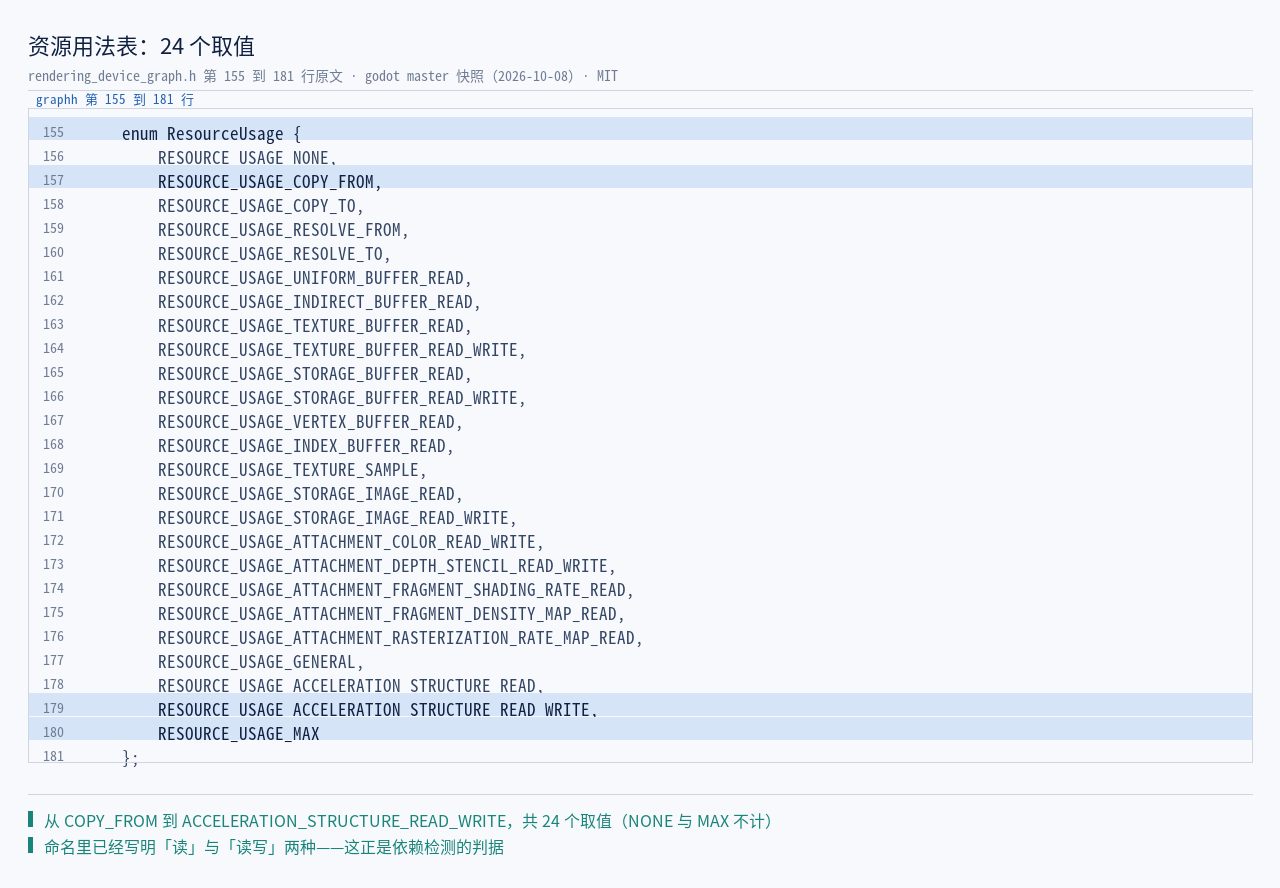
// servers/rendering/rendering_device_graph.h:155–181(master 快照 2026-10-08,节选)
    enum ResourceUsage {
        RESOURCE_USAGE_NONE,
        RESOURCE_USAGE_COPY_FROM,
        RESOURCE_USAGE_COPY_TO,
        RESOURCE_USAGE_RESOLVE_FROM,
        RESOURCE_USAGE_RESOLVE_TO,
        RESOURCE_USAGE_UNIFORM_BUFFER_READ,
        ...
        RESOURCE_USAGE_TEXTURE_SAMPLE,
        RESOURCE_USAGE_STORAGE_IMAGE_READ,
        RESOURCE_USAGE_STORAGE_IMAGE_READ_WRITE,
        RESOURCE_USAGE_ATTACHMENT_COLOR_READ_WRITE,
        RESOURCE_USAGE_ATTACHMENT_DEPTH_STENCIL_READ_WRITE,
        ...
        RESOURCE_USAGE_MAX
    };
好了,其中:这张表的设计意图可以从取值命名里读出来——它区分了「读」与「写」(*_READ / *_READ_WRITE),也区分了「整份资源」与「切片」(切片体现在配套的 ResourceTracker 里,用 read_slice_command_list_index 单独记)。这两条区分直接决定了图能排出多细的序:只有把「谁读、谁写、写哪一片」都记下来,才谈得上「把不冲突的命令挪到一起」。
3.3 三组进口:列表、资源登记、收口
看图对外开的接口(rendering_device_graph.h 的 public 段):方法很多,但按用途只有三组。
上图这三组的分工是这样的:第一组录命令,第二组报用法,第三组收口。其中:三组缺一不可——只录命令不报用法,图不知道依赖(退化成「按提交顺序发」);只报用法不录命令,图没有东西可排。
// servers/rendering/rendering_device_graph.h:895–965(master 快照 2026-10-08,节选与归类)
    void add_draw_list_begin(...);
    void add_draw_list_bind_pipeline(RDD::PipelineID p_pipeline, BitField<RDD::PipelineStageBits> p_pipeline_stage_bits);
    void add_draw_list_usage(ResourceTracker *p_tracker, ResourceUsage p_usage);
    void add_draw_list_end();

    void add_compute_list_begin(RDD::BreadcrumbMarker p_phase = ..., uint32_t p_breadcrumb_data = 0);
    void add_compute_list_usages(VectorView<ResourceTracker *> p_trackers, VectorView<ResourceUsage> p_usages);
    void add_compute_list_end();

    void add_synchronization();
    void end(bool p_reorder_commands, bool p_full_barriers, RDD::CommandBufferID &r_command_buffer, CommandBufferPool &r_command_buffer_pool);
其中:看 end() 的签名——两个开关是它的前两个参数。这解释了第六章为什么把「开关」单列一章:「排不排序」「发不发全屏障」不是图的内部策略,而是每帧由调用方传进来的实参。
3.4 收口函数的第一行
再看收口函数的第一行,它是一句很务实的早退:
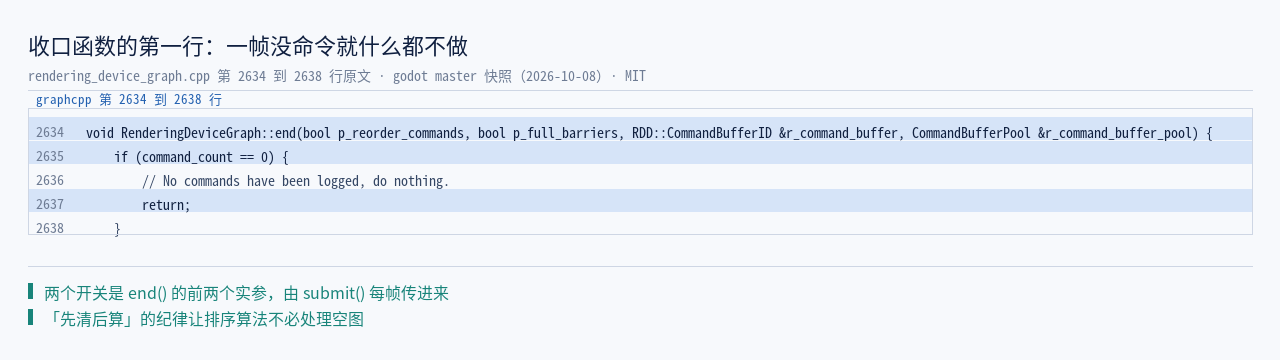
// servers/rendering/rendering_device_graph.cpp:2634–2638(master 快照 2026-10-08)
void RenderingDeviceGraph::end(bool p_reorder_commands, bool p_full_barriers, RDD::CommandBufferID &r_command_buffer, CommandBufferPool &r_command_buffer_pool) {
    if (command_count == 0) {
        // No commands have been logged, do nothing.
        return;
    }
好了,其中:「一帧里一条命令都没有,就什么都不做」这句看着像废话,但它划线很清楚:图在一条命令都没录的情况下不做事、也不留状态。下一章讲重排时,我们会看到这份「先清后算」的纪律是怎么让算法保持简单的。
3.5 追踪器里记了什么:一张资源的三本账
3.2 那张用法表说的是「有哪些用法」,追踪器(ResourceTracker)说的是「某个具体资源当前处于什么状态」。它是图里唯一跟着资源走的结构——所以字段列表值得逐项看一眼:
// servers/rendering/rendering_device_graph.h:183–233(master 快照 2026-10-08,节选)
    struct ResourceTracker {
        uint32_t reference_count = 0;
        int64_t command_frame = -1;
        int32_t command_index = -1;
        uint32_t usage_index = UINT32_MAX;
        BitField<RDD::PipelineStageBits> previous_frame_stages = {};
        BitField<RDD::PipelineStageBits> current_frame_stages = {};
        int32_t read_full_command_list_index = -1;
        int32_t read_slice_command_list_index = -1;
        int32_t write_command_or_list_index = -1;
        int32_t draw_list_index = -1;
        ResourceUsage draw_list_usage = RESOURCE_USAGE_NONE;
        ...
        ResourceUsage usage = RESOURCE_USAGE_NONE;
        BitField<RDD::BarrierAccessBits> usage_access = {};
        RDD::BufferID buffer_driver_id;
        RDD::TextureID texture_driver_id;
        ...
        ResourceTracker *parent = nullptr;
        ResourceTracker *dirty_shared_list = nullptr;
        ResourceTracker *next_shared = nullptr;
        Rect2i texture_slice_or_dirty_rect;
        bool in_parent_dirty_list = false;
        bool write_command_list_enabled = false;
        bool is_discardable = false;
    };
其中:这张字段表里有三本账,看懂了它们就看懂了依赖检测:
第一本账是「谁读过、谁写过」:read_full_command_list_index(谁读了整份资源)、read_slice_command_list_index(谁读了某一层/某一 mip)、write_command_or_list_index(谁写过)。图判断依赖,就是把当前命令与这三条记录比一遍。
第二本账是「现在处于什么状态」:usage(当前用法)与 usage_access(当前访问位)。下一章会看到,这两项加上即将使用的新用法,共同决定要不要插一条屏障。
第三本账是「切片与父资源的关系」:parent / dirty_shared_list / next_shared / in_parent_dirty_list。这是整张表里最难的一块——它处理的是「一张纹理的某一层被用作了 A 用法,而整张纹理被用作了 B 用法」这种交叠情况。is_discardable 则是另一条捷径:如果这一层的旧内容反正要被整层清掉,那所有读它的依赖都可以不作数。
3.6 一帧的边界:begin() 清十来个容器,end() 排一次序
图的「一帧」有明确的边界。begin() 的第一件事是把上一帧的东西全清掉:
// servers/rendering/rendering_device_graph.cpp:1801–1823(master 快照 2026-10-08,节选)
void RenderingDeviceGraph::begin() {
    command_data.clear();
    command_data_offsets.clear();
    command_normalization_barriers.clear();
    command_transition_barriers.clear();
    command_buffer_barriers.clear();
    command_acceleration_structure_barriers.clear();
    command_label_chars.clear();
    ...
    command_count = 0;
    command_label_count = 0;
    command_timestamp_index = -1;
    command_synchronization_index = -1;
    command_synchronization_pending = false;
    command_label_index = -1;
    frames[frame].secondary_command_buffers_used = 0;
    draw_instruction_list.index = 0;
    compute_instruction_list.index = 0;
    tracking_frame++;
先来看看,其中:这段清单透露出两件事。一是图的数据结构全是「一帧一清」的——命令数据、四类屏障数组、标签、指令列表,没有一项跨帧累积(command_data.clear() 起手就丢掉上一帧的全部命令)。二是唯一跨帧的那个变量叫 tracking_frame,它只做加法(结尾那行的 tracking_frame++);它的用途在下一章讲。
言归正传,begin() 清干净、end() 排好序、submit() 交出去——这就是图的一帧:没有常驻的中间态,没有跨帧的推导缓存。复杂度被压在单帧之内,这是它能被读懂的前提。
本章出处:源码 rendering_device_graph.h(:49、:155–181、:183–233、:895–965、:968)与 rendering_device_graph.cpp(:1801–1823、:2634–2638)。
四、依赖是从哪来的
第三章说完了「图有哪些口」。这一章回答本章标题这个问题:一堆命令录进来,图凭什么知道谁依赖谁?答案分两半:依赖是「记」下来的,顺序是「算」出来的。
4.1 依赖是记下来的:邻接表
图不分析命令的内容,它只在每次资源被用到时做一件事:把「这条命令」挂到「上一条用到同一资源的命令」的邻接表上。
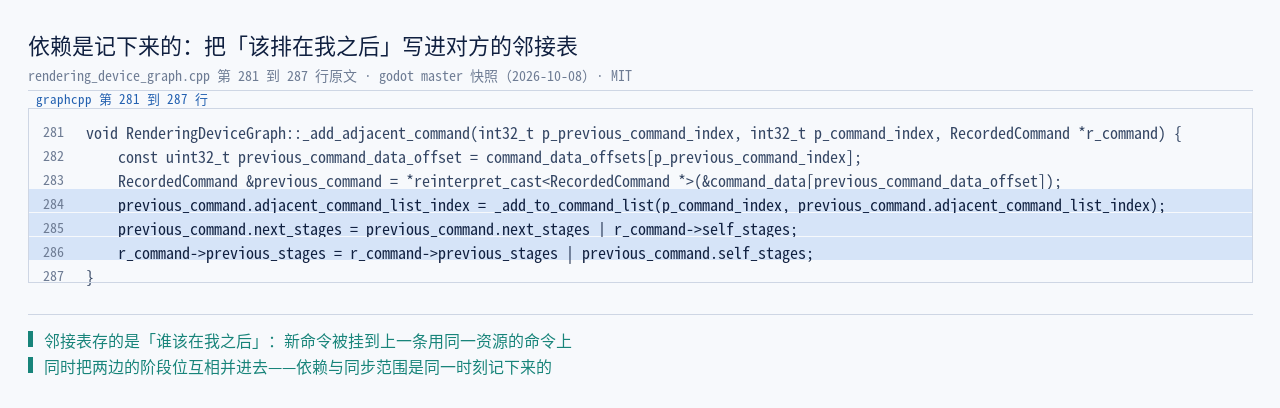
// servers/rendering/rendering_device_graph.cpp:281–287(master 快照 2026-10-08)
void RenderingDeviceGraph::_add_adjacent_command(int32_t p_previous_command_index, int32_t p_command_index, RecordedCommand *r_command) {
    const uint32_t previous_command_data_offset = command_data_offsets[p_previous_command_index];
    RecordedCommand &previous_command = *reinterpret_cast<RecordedCommand *>(&command_data[previous_command_data_offset]);
    previous_command.adjacent_command_list_index = _add_to_command_list(p_command_index, previous_command.adjacent_command_list_index);
    previous_command.next_stages = previous_command.next_stages | r_command->self_stages;
    r_command->previous_stages = r_command->previous_stages | previous_command.self_stages;
}
其中:这段只有四行,但把「依赖」这件事写得很完整:邻接表存的是「谁该在我之后」(把新命令挂到上一条的链表上);同时把两边的阶段位(stages)互相并进去(next_stages 与 previous_stages)——这两个位域后来会变成屏障的读写范围。换句话说:依赖关系与同步范围是同一时刻记下来的,不是两件事。
4.2 顺序是算出来的:一次拓扑排序
到了收口,图要做的第一件正事,是把这张邻接表变成一个线性的顺序。用的是教科书里那一套——Kahn 算法:先数入度,再把入度为 0 的节点一个个弹出来。
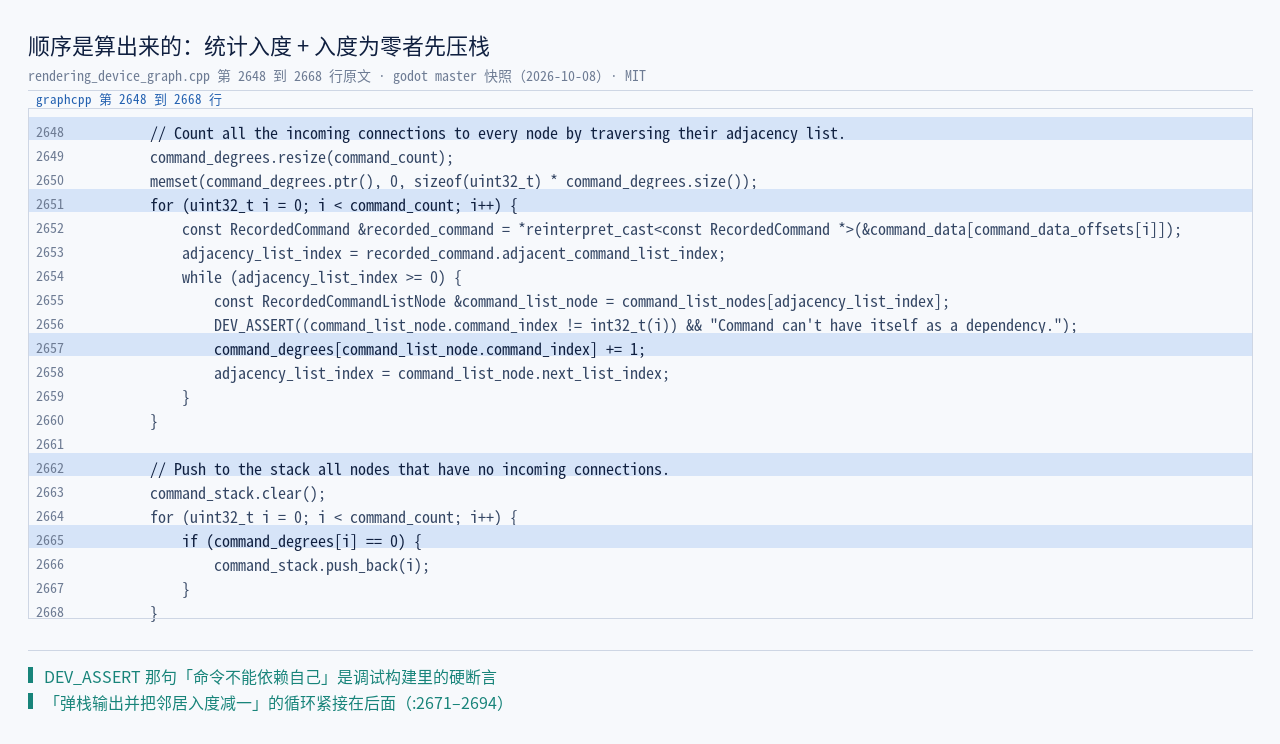
// servers/rendering/rendering_device_graph.cpp:2648–2678(master 快照 2026-10-08,节选)
    // Count all the incoming connections to every node by traversing their adjacency list.
    command_degrees.resize(command_count);
    memset(command_degrees.ptr(), 0, sizeof(uint32_t) * command_degrees.size());
    for (uint32_t i = 0; i < command_count; i++) {
        const RecordedCommand &recorded_command = ...;
        adjacency_list_index = recorded_command.adjacent_command_list_index;
        while (adjacency_list_index >= 0) {
            const RecordedCommandListNode &command_list_node = command_list_nodes[adjacency_list_index];
            DEV_ASSERT((command_list_node.command_index != int32_t(i)) && "Command can't have itself as a dependency.");
            command_degrees[command_list_node.command_index] += 1;
            adjacency_list_index = command_list_node.next_list_index;
        }
    }

    // Push to the stack all nodes that have no incoming connections.
    command_stack.clear();
    for (uint32_t i = 0; i < command_count; i++) {
        if (command_degrees[i] == 0) {
            command_stack.push_back(i);
        }
    }
其中:上图这三步就是后文所有「为什么它能重排」的根据。请注意那句 DEV_ASSERT——「命令不能依赖自己」在调试构建里是硬断言。这条断言的存在本身就说明:图的正确性依赖「这张图确实是有向无环的」;一旦有人记出一条环,拓扑排序会排不完,断言就会当场炸掉。
4.3 第二把尺子:按命令类型的优先级表
拓扑序只保证「不违反依赖」,它不唯一——同样合法的顺序有很多种,哪种更快?图在这里加了第二把尺子:一张按命令类型的优先级表。
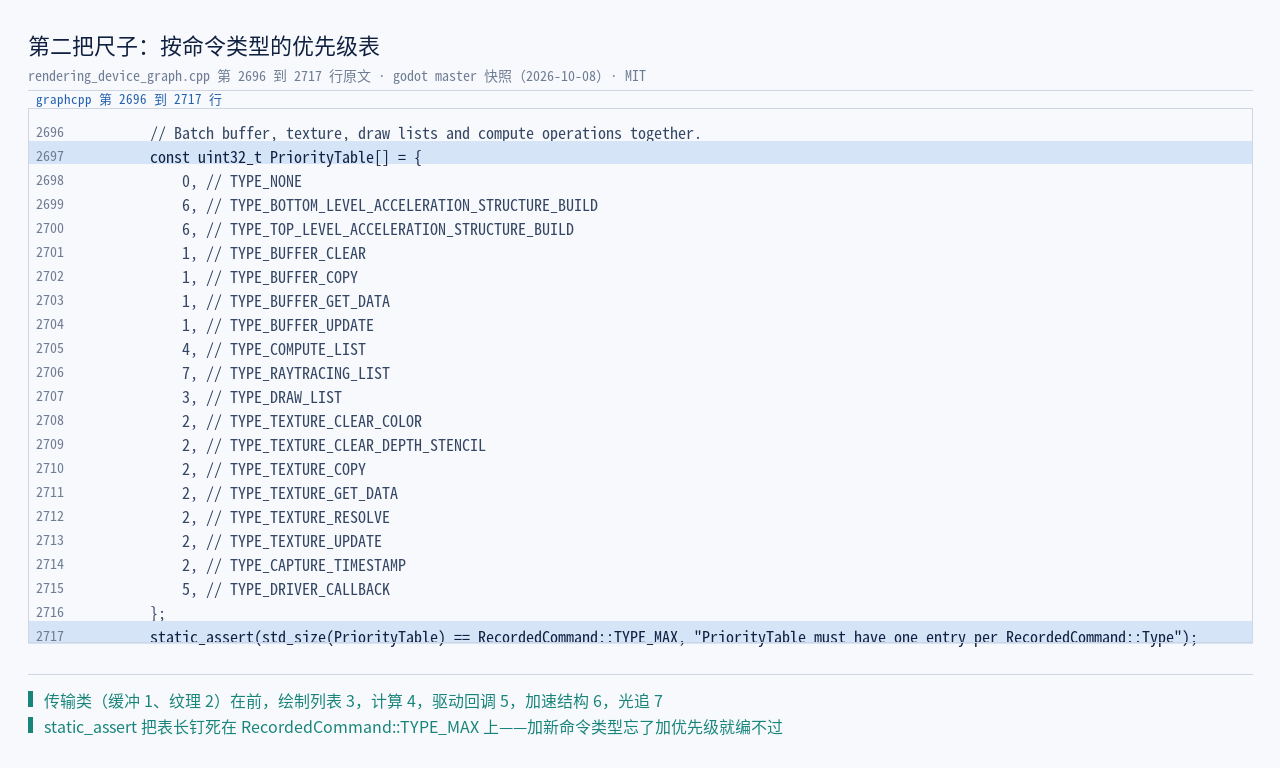
// servers/rendering/rendering_device_graph.cpp:2696–2717(master 快照 2026-10-08,节选)
    // Batch buffer, texture, draw lists and compute operations together.
    const uint32_t PriorityTable[] = {
        0, // TYPE_NONE
        6, // TYPE_BOTTOM_LEVEL_ACCELERATION_STRUCTURE_BUILD
        6, // TYPE_TOP_LEVEL_ACCELERATION_STRUCTURE_BUILD
        1, // TYPE_BUFFER_CLEAR
        1, // TYPE_BUFFER_COPY
        1, // TYPE_BUFFER_GET_DATA
        1, // TYPE_BUFFER_UPDATE
        4, // TYPE_COMPUTE_LIST
        7, // TYPE_RAYTRACING_LIST
        3, // TYPE_DRAW_LIST
        2, // TYPE_TEXTURE_CLEAR_COLOR
        ...
        2, // TYPE_CAPTURE_TIMESTAMP
        5, // TYPE_DRIVER_CALLBACK
    };
    static_assert(std_size(PriorityTable) == RecordedCommand::TYPE_MAX, "PriorityTable must have one entry per RecordedCommand::Type");
好了,其中:这张表有三处值得注意。
第一,它在注释里直说了目的:Batch buffer, texture, draw lists and compute operations together——把同类操作聚在一起。这正是第二章里官方说的「重排能让命令分组更有效」。
第二,值的大小关系是有含义的:传输类(缓冲 1、纹理 2)在前,绘制列表 3,计算 4,驱动回调 5,加速结构 6,光追 7。「先传输、再绘制」这条排序和很多引擎的手工优化顺序一致——只不过这里是表里写死的。
第三,那条 static_assert 是防呆:优先级表必须每个命令类型一项。以后谁加了新命令类型却忘了加优先级,编译就过不去。这类「用编译期断言钉住一张表」的手法和第六篇那条 static_assert(sizeof(InstanceData) == 128) 是同一个路子。
4.4 两把尺子怎么合起来用
排序键是一个小结构体:
// servers/rendering/rendering_device_graph.h:315–337(master 快照 2026-10-08,节选)
    struct RecordedCommandSort {
        uint32_t level = 0;
        uint32_t priority = 0;
        int32_t index = -1;

        bool operator<(const RecordedCommandSort &p_other) const { ... }
    };
其中:上图把两把尺子的关系摊开了。level 是「依赖层级」——拓扑排序时会顺手算:每条边会把对方的层级顶到「自己 + 1」(源码在 :2726–2736,写成 next_command_level = commands_sorted[sorted_command_index].level + 1)。priority 是「类型优先级」,来自上面那张表。
于是排序规则是:先按 level 从小到大,同 level 内再按 priority 从小到大。这样一来,依赖关系绝不会被破坏(level 保证),而同一层里同类操作会挨在一起(priority 保证)。
说白了,其中:这套设计的取舍很清楚——用一次拓扑排序保证正确,用一张常量表拿到性能。它不像某些引擎那样做复杂的图着色或内存复用推导;先把「对」做扎实,再在「对」的范围内挑一个「好」的顺序。
4.5 跨帧的那一小块:追踪器的寿命比一帧长
3.6 说过,图的数据结构全是「一帧一清」,只有 tracking_frame 在跨帧累加。那一章留了个尾巴:它干什么用?答案是给追踪器做惰性复位。
追踪器是跟着资源走的:一个缓冲或一张纹理被创建时拿到一个追踪器,之后每帧被反复使用。所以「图清空了」不等于「追踪器清空了」——上一帧留下的状态必须被判成「过期」,否则这一帧会读到旧的依赖记录。做法是一个很省的手法:
// servers/rendering/rendering_device_graph.h:216(master 快照 2026-10-08,节选)
    _FORCE_INLINE_ void reset_if_outdated(int64_t new_command_frame) {
其中:这个方法不接收「现在是不是新的一帧」,而是接收当前的帧号,然后自己比对——这就是惰性复位的全部:不主动遍历所有追踪器去清,而是在每次要用某个追踪器时顺手判一次。reset_if_outdated(tracking_frame) 在 rendering_device_graph.cpp 里被调用了九处(:427、:446、:486、:519、:583、:2028、:2135、:2347、:2414),每一处都是「马上要用它了」的位置。
这块代码还藏着一条设计边界,值得写出来:图不做跨帧依赖推导,但它会把上一帧的阶段位并进本帧的屏障范围——
// servers/rendering/rendering_device_graph.cpp:635–639(master 快照 2026-10-08)
        if (!search_tracker->previous_frame_stages.is_empty()) {
            // Add to the command the stages the tracker was used on in the previous frame.
            r_command->previous_stages = r_command->previous_stages | search_tracker->previous_frame_stages;
            search_tracker->previous_frame_stages.clear();
        }
OK,这段处理的正是「上一帧写了、这一帧读」这种跨帧情形:图不去分析上一帧的依赖,而是把上一帧用过的阶段位直接并进来,用一条更宽的屏障把它盖上。换句话说:帧内的顺序靠排序,帧之间的顺序靠屏障兜底,而两者用的是同一套记录(追踪器上那两个位域 previous_frame_stages / current_frame_stages,见 :188–189)。
本章出处:源码 rendering_device_graph.cpp(:281–287、:635–639、:2648–2678、:2696–2717、:2726–2736)与 rendering_device_graph.h(:188–189、:216、:315–337)|本篇与第六篇的对照:第六篇那条 static_assert(sizeof(InstanceData) == 128) 见第六篇。
五、屏障为什么能变少
第四章解决了「顺序」。但顺序排好之后还剩一个问题:每一步之间要不要插屏障?这一章的答案是:要不要,先问驱动。
5.1 图初始化时先读五个能力位
图的 initialize() 里有五行,读的不是配置、不是平台判断,而是驱动自己报的能力位:
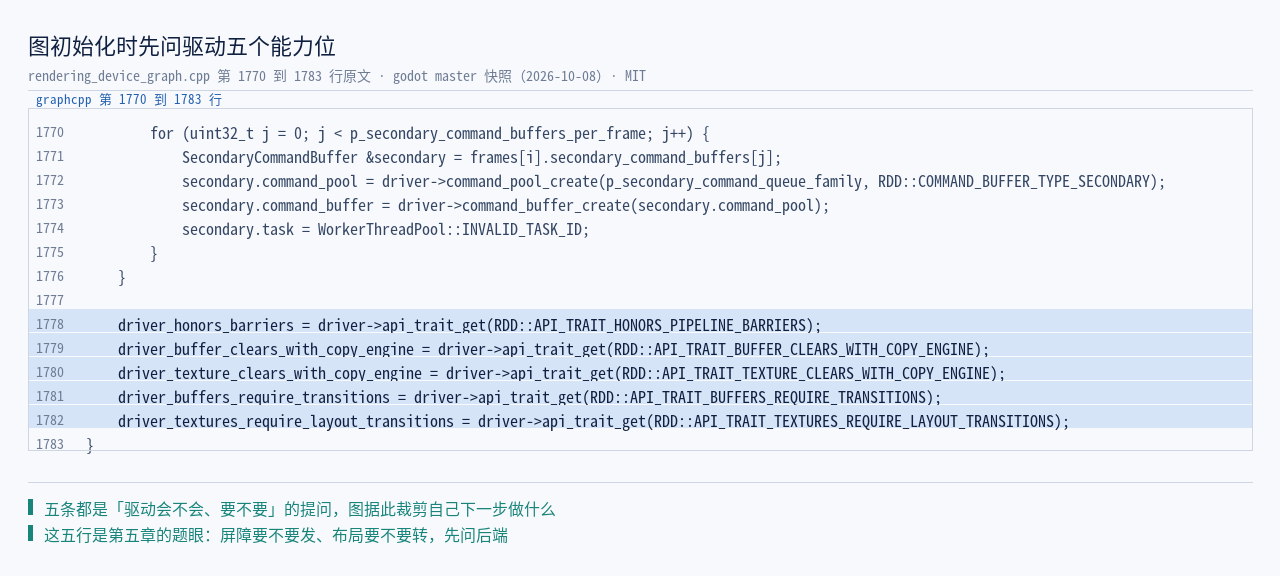
// servers/rendering/rendering_device_graph.cpp:1778–1782(master 快照 2026-10-08)
    driver_honors_barriers = driver->api_trait_get(RDD::API_TRAIT_HONORS_PIPELINE_BARRIERS);
    driver_buffer_clears_with_copy_engine = driver->api_trait_get(RDD::API_TRAIT_BUFFER_CLEARS_WITH_COPY_ENGINE);
    driver_texture_clears_with_copy_engine = driver->api_trait_get(RDD::API_TRAIT_TEXTURE_CLEARS_WITH_COPY_ENGINE);
    driver_buffers_require_transitions = driver->api_trait_get(RDD::API_TRAIT_BUFFERS_REQUIRE_TRANSITIONS);
    driver_textures_require_layout_transitions = driver->api_trait_get(RDD::API_TRAIT_TEXTURES_REQUIRE_LAYOUT_TRANSITIONS);
OK,其中:这五行是本章的题眼。请注意它们的共同点:每一条都是「驱动会不会?要不要?」的提问,而图据此决定自己下一步做什么。举两个最直接的:
driver_honors_barriers为真,说明这个后端认管线屏障,图才需要认真算屏障;为假(比如某些后端由驱动自己保证顺序),图干脆不发——源码里那些if (!driver_honors_barriers) { return; }的早退分支就是干这个的。driver_textures_require_layout_transitions决定「换用法要不要做布局转换」。如果后端不需要布局转换(例如抽象层次更浅的接口),图就省掉一整类推导。
5.2 能力位一共 15 项
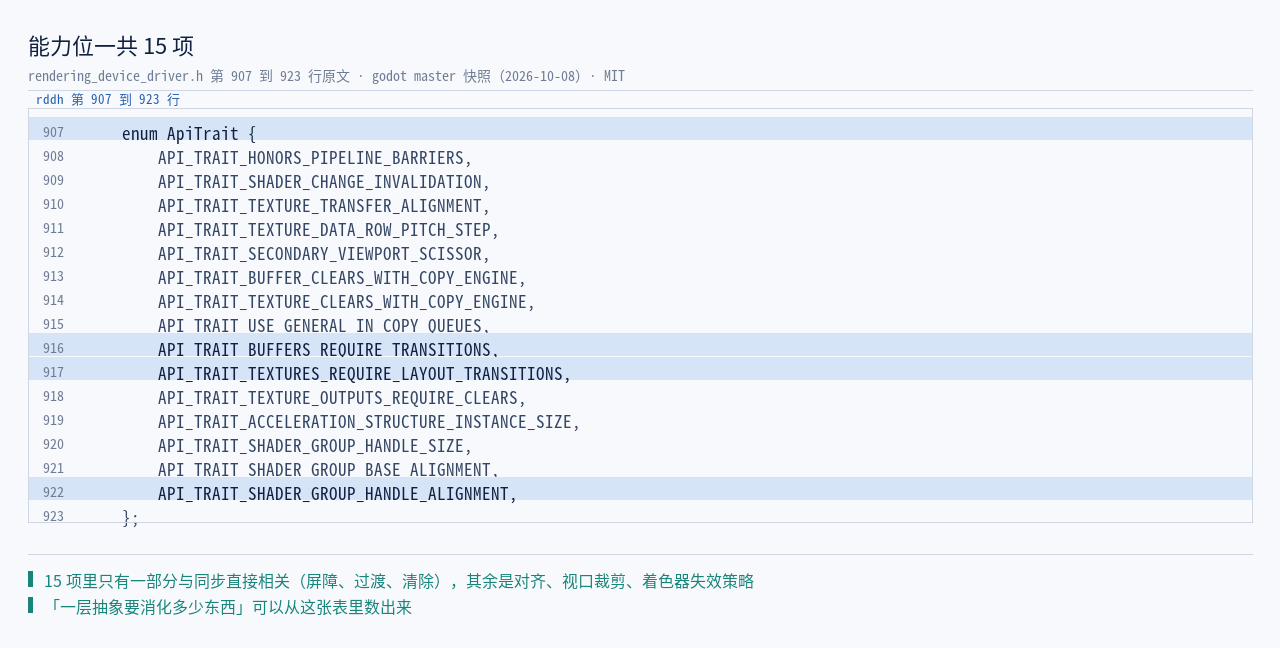
// servers/rendering/rendering_device_driver.h:907–923(master 快照 2026-10-08,节选)
    enum ApiTrait {
        API_TRAIT_HONORS_PIPELINE_BARRIERS,
        API_TRAIT_SHADER_CHANGE_INVALIDATION,
        API_TRAIT_TEXTURE_TRANSFER_ALIGNMENT,
        API_TRAIT_TEXTURE_DATA_ROW_PITCH_STEP,
        API_TRAIT_SECONDARY_VIEWPORT_SCISSOR,
        API_TRAIT_BUFFER_CLEARS_WITH_COPY_ENGINE,
        API_TRAIT_TEXTURE_CLEARS_WITH_COPY_ENGINE,
        API_TRAIT_USE_GENERAL_IN_COPY_QUEUES,
        API_TRAIT_BUFFERS_REQUIRE_TRANSITIONS,
        API_TRAIT_TEXTURES_REQUIRE_LAYOUT_TRANSITIONS,
        API_TRAIT_TEXTURE_OUTPUTS_REQUIRE_CLEARS,
        ...
    };
其中:15 项里只有一部分与同步直接相关(屏障、过渡、清除),其余是对齐、视口裁剪、着色器失效策略这类零碎差异。这正说明「一层抽象要消化多少东西」——RD 这层声称「接近 Metal 或 WebGPU 的抽象」,而它下面是三个差异不小的后端。
5.3 同一张图,不同后端上要做的事不一样
其中:上表是本章的收口。它的意思是:「图」不是一段与后端无关的纯算法,而是一段「按后端能力裁剪行为」的策略代码。同一份命令流,在需要布局转换的后端上要插纹理屏障,在不需要的后端上直接跳过;在认屏障的后端上要把屏障分组(源码里那个 _group_barriers_for_render_commands),在不认的后端上整段不发。
好了,其中:这解释了「官方为什么把同步责任挪进图」的另一半动机——手工插屏障时,「这个后端要不要」的判断散落在一堆 if 里;挪进图之后,这些判断被收进五个能力位、集中在一处初始化里。维护噩梦的根源之一,就是这种判断的分散。
「不同后端不一样」这句话在源码里有直接的注脚。能力位枚举下面紧跟着另一个枚举 ShaderChangeInvalidation,它的三个取值里有两个把出处写进了注释:// What Vulkan does. 与 // What D3D12 does.(rendering_device_driver.h:925–931)。同一个「换着色器要不要让已绑定的 uniform set 失效」的问题,两套 API 给的答案本来就不一样——这层抽象的职责,正是把这类差异并排收进一张表,让上面的图不必知道自己在哪套 API 上。
5.4 能力位是谁填的:基类给一套规范默认值,后端只覆盖特例
5.1 那五行读出来的值,到底是谁定的?答案分两层:基类给一套「规范默认值」,各后端只覆盖自己特殊的那些项。
先看基类。RenderingDeviceDriver::api_trait_get() 的开头就写着它给的是「合理的规范默认值」(Sensible canonical defaults):
// servers/rendering/rendering_device_driver.cpp:37–65(master 快照 2026-10-08,节选)
uint64_t RenderingDeviceDriver::api_trait_get(ApiTrait p_trait) {
    // Sensible canonical defaults.
    switch (p_trait) {
        case API_TRAIT_HONORS_PIPELINE_BARRIERS:
            return 1;
        ...
        case API_TRAIT_BUFFERS_REQUIRE_TRANSITIONS:
            return false;
        case API_TRAIT_TEXTURES_REQUIRE_LAYOUT_TRANSITIONS:
            return true;
        ...
    }
}
再看 Vulkan 这一侧。它在自己的 api_trait_get() 里只覆盖六项——纹理传输对齐、着色器失效策略、以及光追的三项句柄尺寸/对齐;其余全部 default: 落回基类:
// drivers/vulkan/rendering_device_driver_vulkan.cpp:7451–7468(master 快照 2026-10-08,节选)
uint64_t RenderingDeviceDriverVulkan::api_trait_get(ApiTrait p_trait) {
    switch (p_trait) {
        case API_TRAIT_TEXTURE_TRANSFER_ALIGNMENT:
            return (uint64_t)MAX((uint64_t)16, physical_device_properties.limits.optimalBufferCopyOffsetAlignment);
        case API_TRAIT_SHADER_CHANGE_INVALIDATION:
            return (uint64_t)SHADER_CHANGE_INVALIDATION_INCOMPATIBLE_SETS_PLUS_CASCADE;
        case API_TRAIT_ACCELERATION_STRUCTURE_INSTANCE_SIZE:
            return sizeof(VkAccelerationStructureInstanceKHR);
        ...
        default:
            return RenderingDeviceDriver::api_trait_get(p_trait);
    }
}
好了,其中:这两段合起来,把第五章的机制讲完了:在 Vulkan 这条路上,图读到的是「认管线屏障(真)、纹理需要布局转换(真)、缓冲需要过渡(假)」。后面这三条会直接决定它做多少活:
- 认屏障 ⇒ 图必须认真算屏障(不能指望驱动替它保证顺序);
- 纹理需要布局转换 ⇒ 每次换用法都要安排一次布局转换;
- 缓冲不需要过渡 ⇒ 缓冲那一侧少一整类推导(这也解释了第八章那句「缓冲屏障没看出改善」——对这类后端,它本来就不是必需的)。
说白了,其中:这是一种很务实的抽象写法:把「最通用的正确行为」写成基类默认值,把「各 API 的怪癖」留给后端覆盖。它同时解释了为什么 enum ApiTrait 只有 15 项——只有真的会影响上层决策的差异才值得开一栏;对齐与句柄尺寸这类「数值型」差异放进来,是因为上层确实要拿它们去算偏移。
本章出处:源码 rendering_device_graph.cpp(:1778–1782、:773、:1397)|rendering_device_driver.h(:907–923、:925–931)|rendering_device_driver.cpp(:37–65)|drivers/vulkan/rendering_device_driver_vulkan.cpp(:7451–7468)。
六、两个开关
前两章讲的是「图怎么算」。这一章讲它的两个总闸——因为它们最能说明这套设计的立场。
6.1 默认值就是结论
rendering_device.cpp 里,两个宏紧挨着,中间夹着两段注释:
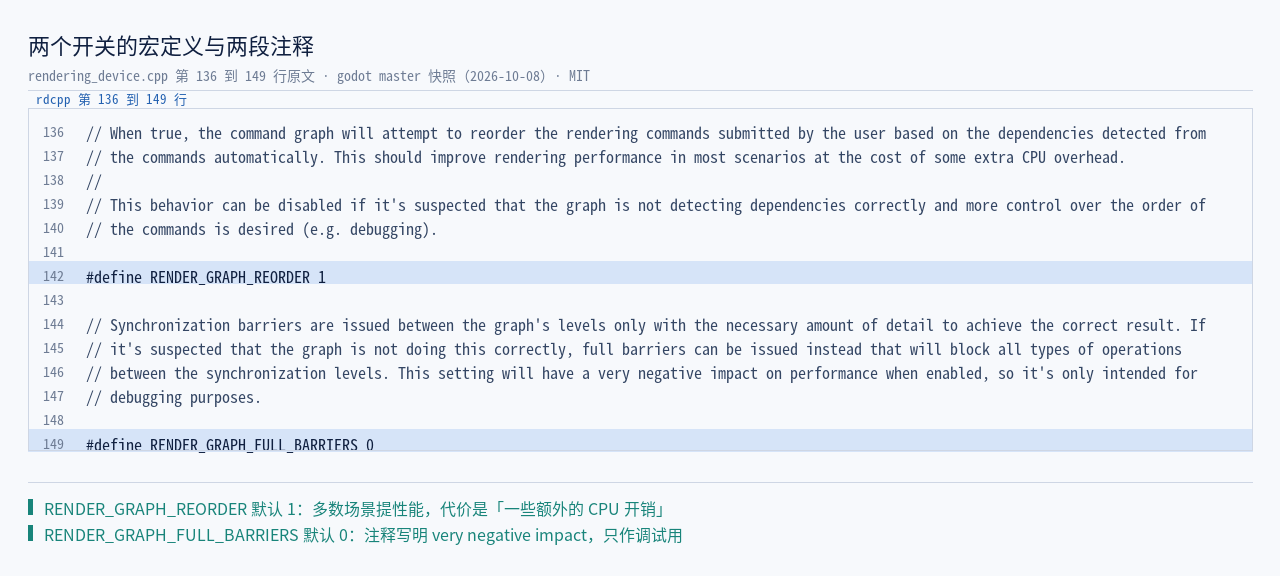
// servers/rendering/rendering_device.cpp:136–149(master 快照 2026-10-08)
// When true, the command graph will attempt to reorder the rendering commands submitted by the user based on the dependencies detected from
// the commands automatically. This should improve rendering performance in most scenarios at the cost of some extra CPU overhead.
//
// This behavior can be disabled if it's suspected that the graph is not detecting dependencies correctly and more control over the order of
// the commands is desired (e.g. debugging).

#define RENDER_GRAPH_REORDER 1

// Synchronization barriers are issued between the graph's levels only with the necessary amount of detail to achieve the correct result. If
// it's suspected that the graph is not doing this correctly, full barriers can be issued instead that will block all types of operations
// between the synchronization levels. This setting will have a very negative impact on performance when enabled, so it's only intended for
// debugging purposes.

#define RENDER_GRAPH_FULL_BARRIERS 0
其中:这两段注释把两个开关的性质说清了:
- 重排默认开(1),代价是「一些额外的 CPU 开销」,好处是「在多数场景下提升渲染性能」——注意它用的是 most scenarios,不是 all。
- 全屏障默认关(0),注释写得很重:
very negative impact on performance、only intended for debugging purposes——这是调试开关,不是性能开关。
6.2 运行期能不能改:看构建
回忆第零章那段代码:在两种构建下,两个开关的来源不同。DEBUG 构建走变量,发布构建走常量:
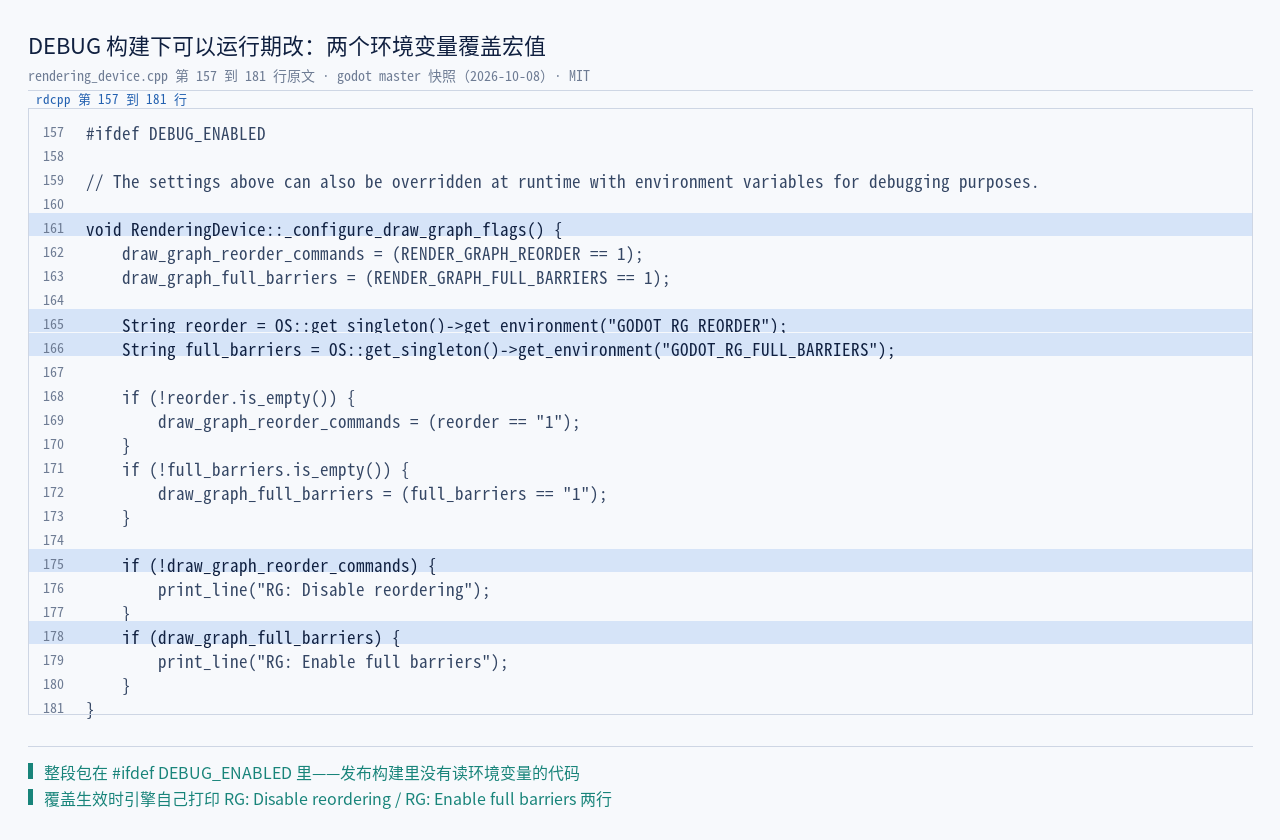
// servers/rendering/rendering_device.cpp:159–183(master 快照 2026-10-08,节选)
// The settings above can also be overridden at runtime with environment variables for debugging purposes.

void RenderingDevice::_configure_draw_graph_flags() {
    draw_graph_reorder_commands = (RENDER_GRAPH_REORDER == 1);
    draw_graph_full_barriers = (RENDER_GRAPH_FULL_BARRIERS == 1);

    String reorder = OS::get_singleton()->get_environment("GODOT_RG_REORDER");
    String full_barriers = OS::get_singleton()->get_environment("GODOT_RG_FULL_BARRIERS");

    if (!reorder.is_empty()) {
        draw_graph_reorder_commands = (reorder == "1");
    }
    if (!full_barriers.is_empty()) {
        draw_graph_full_barriers = (full_barriers == "1");
    }

    if (!draw_graph_reorder_commands) {
        print_line("RG: Disable reordering");
    }
    if (draw_graph_full_barriers) {
        print_line("RG: Enable full barriers");
    }
}
其中:这个函数有三层含义,一层比一层实用。
第一层:它只在 #ifdef DEBUG_ENABLED 里。发布构建里两个开关是 constexpr,编译器直接把值折进去——这也解释了第七章那个「本机测不了」的结论该怎么读:不是我们不会测,是这份构建里根本没有读环境变量的代码。
第二层:它读的是环境变量而不是项目设置。这条选择很务实——开关是用来「临时把某个构建切成另一档来排查问题」的,不适合做成一个会被用户改坏、还会跟着项目走的持久配置。
第三层:它会把当前档位打印出来。RG: Disable reordering 与 RG: Enable full barriers 这两行是给排查用的:日志里有没有它们,决定了「这一跑到底是哪一档」。我们在第七章会解释为什么本机一次都没打出来。
6.3 两个开关的三条路
上图与上表合起来,是本章的两个结论:
结论一:这两个开关的作用域是「整帧」,不是「某一张图的一小段」。它们从 submit() 一路传到 end(),作用于这一帧的所有命令。
结论二:默认配置就是「要性能、不要便利」。重排开着(拿性能、付 CPU 开销),全屏障关着(不要那份「什么都拦住」的保险)。这套默认值反过来告诉我们:官方对「依赖检测是否可靠」这件事是有信心的——毕竟如果 detect 常出错,全屏障早该默认开着。
本章出处:源码 rendering_device.cpp(:136–149、:159–183、:8363–8372)|与第六篇对照:第六篇那两个 GLOBALDEF 旋钮「改后需重启」,见第六篇 批处理。
七、本机对照:RD 路 vs 非 RD 路
前六章全是「读」。这一章换证据类型:把同一份场景分别跑在走 RD 与不走 RD 的两条路上,看读数差在哪。
7.1 实验怎么设计
按本系列的规矩,先把装置与口径写清楚:
| 项 | 值 |
|---|---|
| 引擎 | 本机自建 4.8.dev.custom_build.7177493c1(2026-07-03 构建),不是 stable |
| 显卡 / 驱动 | NVIDIA GeForce RTX 3060 Laptop GPU | NVIDIA 560.70 |
| 场景 | 2000 个 MeshInstance3D(共享同一 SphereMesh)+ SSAO + Glow |
| 窗口 | 1280×720,关闭垂直同步(否则帧率被刷新率钉死) |
| 自变量 | 只有命令行 --rendering-method:forward_plus(默认)/gl_compatibility |
| 重复 | forward_plus 跑两次,用来给出 run-to-run 抖动(噪声底) |
| 判据 | 前 60 帧预热不计;取后 240 帧的平均帧时间;同时读整帧 draw call / 图元 / 对象数 |
言归正传,其中:这份装置有两个刻意的选择。一是「只换一个变量」:工程、场景、窗口、垂直同步设置全都一样,唯一变化的是渲染方法——这样读数差才能归因到「两条路不一样」。二是「同一档跑两次」:单次读数容易被噪声骗,先量出抖动,后面的解读才有底。
7.2 走 RD 的那条路
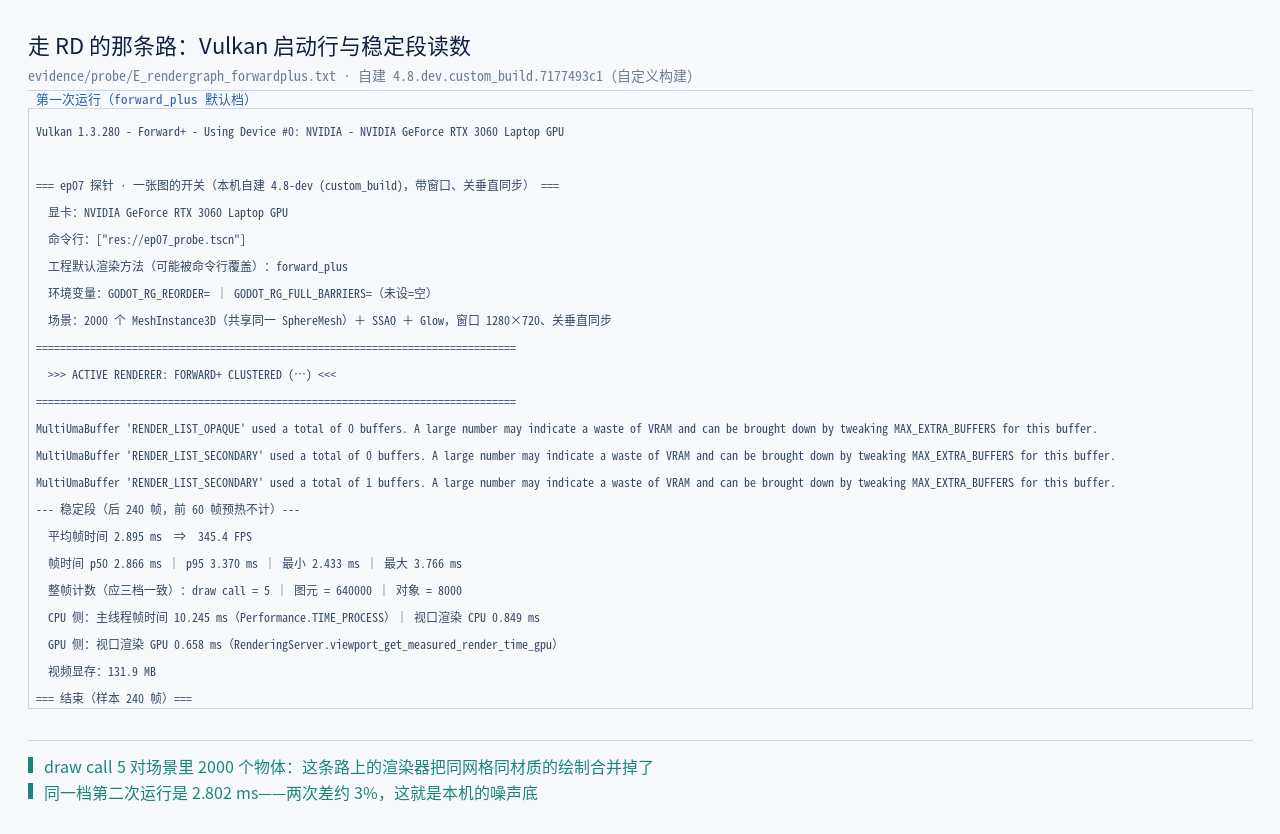
其中:这一档的启动行是 Vulkan 1.3.280 - Forward+ - Using Device #0: NVIDIA GeForce RTX 3060 Laptop GPU——它确实走在 RD 这条路上。读数:draw call 只有 5 个,图元 640,000,平均帧时间 2.895 ms(第二次 2.802 ms,两次差约 3%,这就是噪声底)。5 个 draw call 对应场景里 2000 个物体,说明这条路上的渲染器把大量同网格、同材质的绘制合并掉了——这是「RD 这条路自带一整套批处理与状态管理」的直接表现。
7.3 不走 RD 的那条路
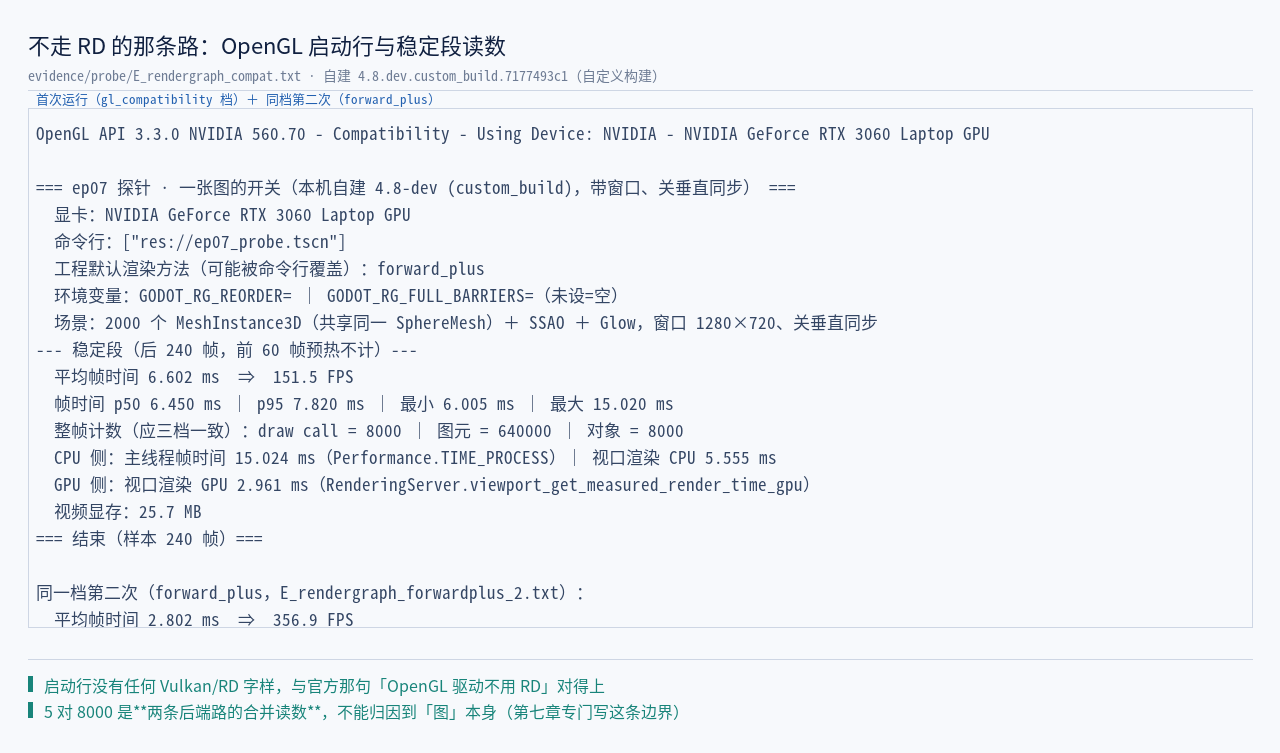
其中:这一档的启动行换成了 OpenGL API 3.3.0 NVIDIA 560.70 - Compatibility - Using Device: NVIDIA GeForce RTX 3060 Laptop GPU——没有任何 Vulkan/RD 字样,与第一章那句「The OpenGL driver does not use the RenderingDevice abstraction」对得上。读数:draw call 8000 个(整帧对象计数同为 8,000),平均帧时间 6.602 ms。同一份场景、同一个工程,只换了一个命令行参数,引擎内部走的就是两条完全不同的路。
上图把两档并排放在一起。其中:三个量的差别都很大:draw call 5 对 8000(差三个数量级不到、两个量级有余)、平均帧时间 2.85 ms 对 6.60 ms(约 2.3 倍)、显存 131.9 MB 对 25.7 MB(走 RD 那条路反而占得多)。
7.4 这条读数能说什么、不能说什么
先把不能说的说清楚——这是本节最重要的一段。这里有一条口径原理要先立好:读数只能证明「现象是什么」,源码才证明「机制为什么」。下面三条边界都是按这条原理划的。
第一,这 5 与 8000 不能归功于「图」。两条路差的不只是「有没有图」:渲染器本身的批处理策略、阴影渲染方式、资源分配策略全都不一样。这条读数证明的是「RD 这条路与不走 RD 那条路确实不是一套东西」,而不是「图省下了 7995 个 draw call」。
第二,这三档里没有「关掉重排」那一档。原因要拿证据说话:
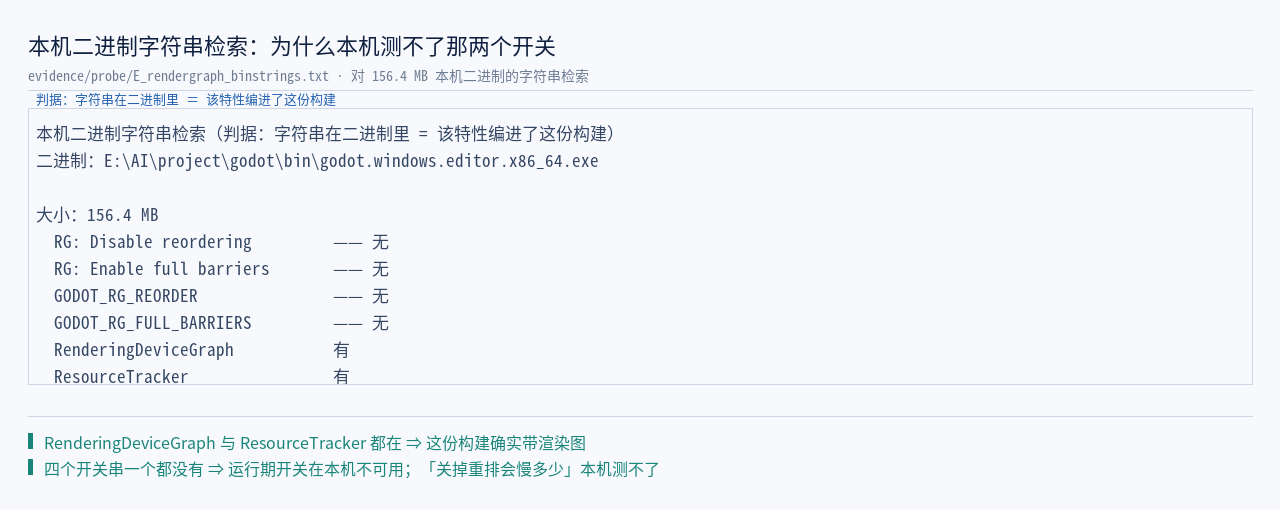
OK,其中:这张表是「本机能不能测开关」的判据:在本机那份 156.4 MB 的二进制里搜字符串——RenderingDeviceGraph 与 ResourceTracker 都在(说明这份构建确实带渲染图),而 GODOT_RG_REORDER、GODOT_RG_FULL_BARRIERS、RG: Disable reordering、RG: Enable full barriers 四个串一个都没有。结论明确:这份构建里没有第六章那个读环境变量的代码,运行期开关在本机不可用。
第三,本章也不做 Vulkan 验证层实验。官方博客说他们「大量使用了这些验证工具」(extensive use was made of these validation tools)来确认同步错误已清零,但我们这台机器没装验证层(VK_LAYER_PATH 为空、全盘未搜到 VkLayer_khronos_validation*)。所以那件事本篇只转述官方做法,不声称本机复现过。
OK,这一章的价值不在「量出了多大差别」,而在把可测与不可测的界线画清楚:RD 路与非 RD 路的差别可测(5 对 8000);「关掉重排会慢多少」本机不可测(构建里没有那个开关)。两条界线都写出来,读者才知道哪句是本机读数、哪句是源码原文。
本章出处:本机探针三档四次运行 evidence/probe/E_rendergraph_forwardplus.txt、E_rendergraph_forwardplus_2.txt、E_rendergraph_compat.txt(装置:evidence/probe/ep07_probe.gd / ep07_probe.tscn / run_probes_ep07.ps1)|二进制字符串检索 evidence/probe/E_rendergraph_binstrings.txt|对照源码 rendering_device.cpp(:159–183 的开关读取)。
八、代价与边界
第七章把读数摊开了。这一章把代价摊开:这套机制不是白拿的,而官方的源码注释里自己写下了三处。
8.1 第一处代价:后台录制默认关着
第四章提到过,图可以自动把命令录到次级命令缓冲(secondary command buffer)上、并放到后台线程去录。但这条能力默认是关的,源码注释把原因写得很实在:
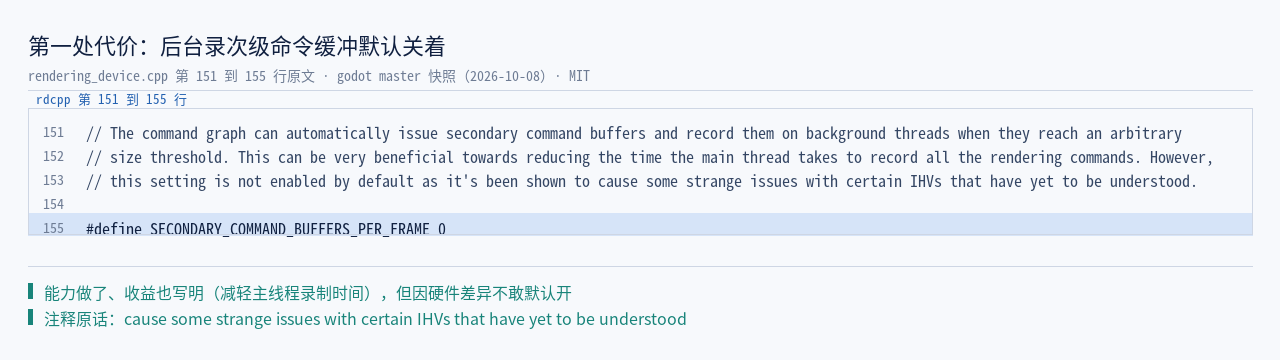
// servers/rendering/rendering_device.cpp:151–155(master 快照 2026-10-08)
// The command graph can automatically issue secondary command buffers and record them on background threads when they reach an arbitrary
// size threshold. This can be very beneficial towards reducing the time the main thread takes to record all the rendering commands. However,
// this setting is not enabled by default as it's been shown to cause some strange issues with certain IHVs that have yet to be understood.

#define SECONDARY_COMMAND_BUFFERS_PER_FRAME 0
其中:注释里那句 some strange issues with certain IHVs that have yet to be understood 很值得照抄——「某些厂商的硬件上会出现一些说不清的问题」。这是一句如实交代:能力做出来了、收益也写明(减轻主线程录制时间),但因为硬件差异暂时不敢默认开。这一类「做了但默认不开」的条目,比「没做」更能说明工程现实。
8.2 第二处代价:缓冲屏障可能有害
图会把资源的读写成屏障。但缓冲那一类,官方在源码里给了一个反向结论:
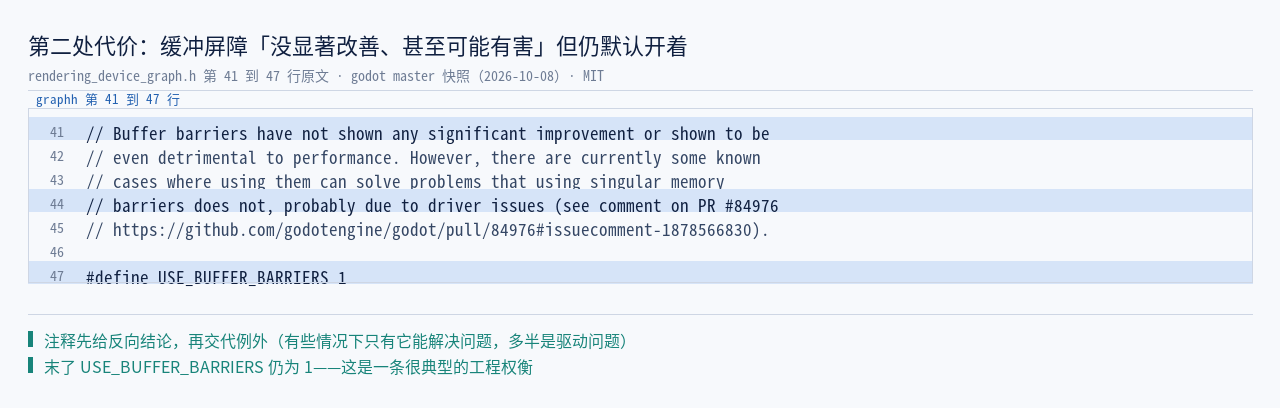
// servers/rendering/rendering_device_graph.h:41–47(master 快照 2026-10-08)
// Buffer barriers have not shown any significant improvement or shown to be
// even detrimental to performance. However, there are currently some known
// cases where using them can solve problems that using singular memory
// barriers does not, probably due to driver issues (see comment on PR #84976
// https://github.com/godotengine/godot/pull/84976#issuecomment-1878566830).

#define USE_BUFFER_BARRIERS 1
其中:这段注释的诚实程度值得单独说:它先讲「没显示出明显改善、甚至可能拖慢性能」,再讲「但确实有些情况下只有它能解决问题,多半是驱动的问题」,末了 USE_BUFFER_BARRIERS 1——还是开着。这就是一条典型的工程权衡:为一个已知的驱动问题留一条更细的同步手段,代价是可能多花一点性能。
8.3 第三处代价:驱动 workaround 会反过来限制图
图的目标是「自由地重排」,但硬件与驱动的约束会把它拉回来。源码里有一处很直白的例子:
// servers/rendering/rendering_device_graph.cpp:2757–2760(master 快照 2026-10-08)
    if (driver_workarounds.avoid_compute_after_draw) {
        // Reset the state of the workaround.
        workarounds_state.draw_list_found = false;
    }
好了,其中:avoid_compute_after_draw 这个名字已经把约束说清了:某些驱动上,计算不能排在绘制之后。图本来只按「资源依赖」排序,加上这条约束之后,排序的自由度被削掉一块——这正是「图知道的东西比算法多」的意思:它要同时照顾资源依赖、命令类型优先级、和一份驱动 workaround 清单。
上图把两侧的账摆在一起。其中:省下的一侧是主线程的同步推导(不用手工推布局,也不用「just in case」地发屏障);付出的一侧是建图与排序本身的 CPU 开销(第二章那句 at the cost of some extra CPU overhead)、多出来的显存(第七章量到的 131.9 MB 对 25.7 MB,当然那还包含渲染器差异)、以及被驱动约束削掉的排序自由度。
8.4 三处代价的共同形状
把 8.1 到 8.3 摆在一起看,会发现这三处代价形状是一样的:都是一条「理论上更好、但被现实条件限制」的路。
| 代价 | 理论上能得到什么 | 被什么限制住了 | 官方怎么取舍 |
|---|---|---|---|
| 后台录制次级命令缓冲 | 主线程录制时间大幅下降 | 某些 IHV 上「说不清的问题」 | 默认关(SECONDARY_COMMAND_BUFFERS_PER_FRAME 0) |
| 缓冲屏障 | 更细的同步粒度 | 没测出改善、甚至可能有害 | 仍开着(USE_BUFFER_BARRIERS 1),为绕驱动问题 |
| 自由重排 | 更好的并行与分组 | 某些驱动不许「计算排在绘制之后」 | 加一条 workaround 约束(avoid_compute_after_draw) |
其中:这张表里三行分别对应三种处理方式——「收益不确定就默认关」「收益不确定但能救火就留着」「自由度和硬件冲突就加约束」。它们都不是「技术做不到」,而是「在真实硬件上划不出一个统一安全的默认」。
好了,其中:这也是为什么第八章要单独存在:读源码最容易读到的是「它做了什么」,最容易漏的是「它故意没做什么」。上面这三条都属于后者,而它们恰恰决定了这套机制在你这台机器上会怎么表现。
本章出处:源码 rendering_device.cpp(:151–155)、rendering_device_graph.h(:41–47)与 rendering_device_graph.cpp(:2757–2760)|官方那句「at the cost of some extra CPU overhead」见本机快照 evidence/stage1/blog_acyclic_graph.html 与源码注释 :136–140。
九、一条容易想错的规则
前八章讲的是机制与代价。这一章讲一条使用上的坑——这条坑还不用我们推测,官方在头文件的注释里自己写了反例。
9.1 官方注释里的那个反例
RenderingDevice::buffer_update() 的文档注释(Doxygen 的 @remarks)里有一段逐字的反例:
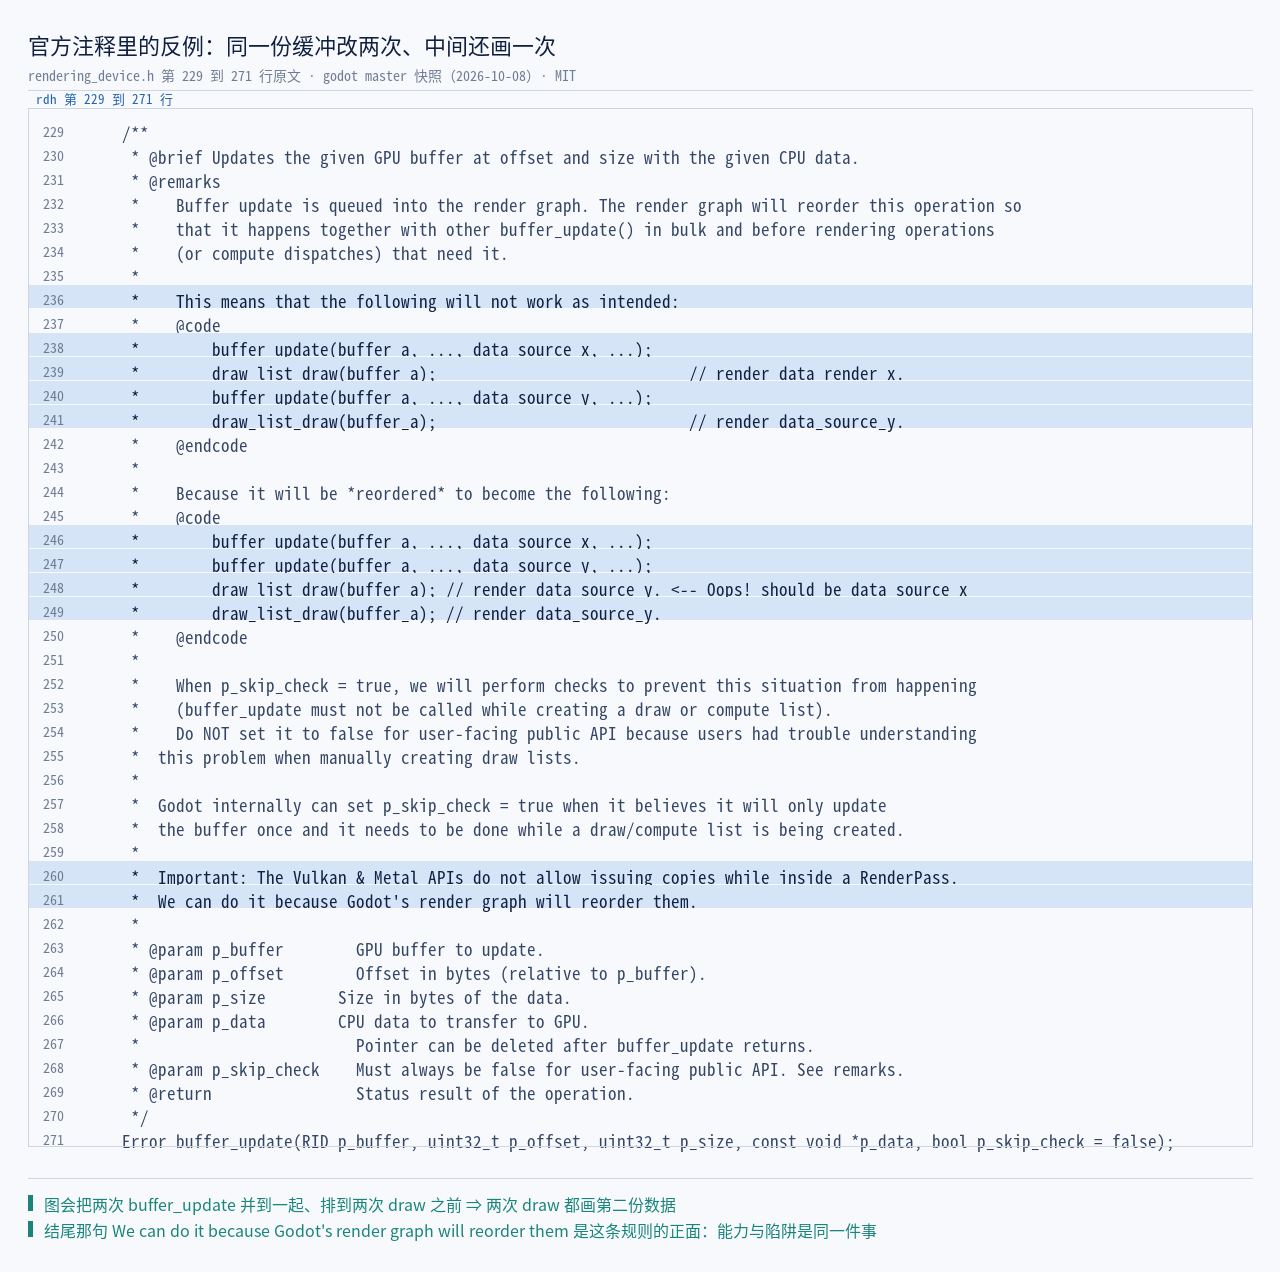
// servers/rendering/rendering_device.h:229–271(master 快照 2026-10-08,注释节选)
    /**
     * @brief Updates the given GPU buffer at offset and size with the given CPU data.
     * @remarks
     *  Buffer update is queued into the render graph. The render graph will reorder this operation so
     *  that it happens together with other buffer_update() in bulk and before rendering operations
     *  (or compute dispatches) that need it.
     *
     *  This means that the following will not work as intended:
     *  @code
     *      buffer_update(buffer_a, ..., data_source_x, ...);
     *      draw_list_draw(buffer_a);                           // render data_render_x.
     *      buffer_update(buffer_a, ..., data_source_y, ...);
     *      draw_list_draw(buffer_a);                           // render data_source_y.
     *  @endcode
     *
     *  Because it will be *reordered* to become the following:
     *  @code
     *      buffer_update(buffer_a, ..., data_source_x, ...);
     *      buffer_update(buffer_a, ..., data_source_y, ...);
     *      draw_list_draw(buffer_a); // render data_source_y. <-- Oops! should be data_source_x
     *      draw_list_draw(buffer_a); // render data_source_y.
     *  @endcode
     *
     *  Important: The Vulkan & Metal APIs do not allow issuing copies while inside a RenderPass.
     *  We can do it because Godot's render graph will reorder them.
     */
其中:上图把这段注释画成两条时序,差别一目了然:你以为的语义是「改一次、画一次、再改一次、再画一次」,而图排出来的语义是「改两次、画两次」。于是第二次 draw 与第一次 draw 都画的是第二份数据——注释里那句 Oops! 就是作者自己加的注脚。
9.2 这条规则的两个面
这一章的重点不是「图有 bug」,而是「图改变了语义」。它有两个面:
第一面:这是收益的来源。注释结尾那句写得很明白:The Vulkan & Metal APIs do not allow issuing copies while inside a RenderPass. We can do it because Godot's render graph will reorder them.——正因为图会把拷贝挪到渲染通道之外,引擎才敢在录制绘制列表的过程中顺手更新缓冲。这是一条能力:不重排的话,这种写法在 Vulkan 上根本不合法。
第二面:这是使用者的陷阱。「同一份资源在一帧里改两次、中间还要画一次」这种写法,在手工管理顺序的时代是合法的;进了图之后,它不再保证按你写的顺序发生。官方为此在 buffer_update() 上加了一个 p_skip_check 参数,注释里把话说得很重:Do NOT set it to false for user-facing public API because users had trouble understanding this problem when manually creating draw lists.
说白了,其中:这一节是本篇留给读者的一条实用结论:一旦把顺序交给图,就不要再依赖「提交顺序等于执行顺序」。要那种语义,就用图给的显式手段(add_synchronization()),或者把数据分到两份资源上去。
9.3 显式同步点:为什么它只是一个「待办标记」
上一段提到的 add_synchronization(),实现比想象中短——它不立刻插任何东西,只置一个标记:
// servers/rendering/rendering_device_graph.cpp:2611–2616(master 快照 2026-10-08)
void RenderingDeviceGraph::add_synchronization() {
    // Synchronization is only acknowledged if commands have been recorded on the graph already.
    if (command_count > 0) {
        command_synchronization_pending = true;
    }
}
先来看看,其中:三点值得注意。
第一,它只在「已经有命令」时才置标记(if (command_count > 0))——空图上的同步点没有意义,这是 3.4 那句早退的同一种务实。
第二,它是「待办」而不是「立即生效」:真正的落地发生在 _add_command_to_graph() 里——下一条命令进来时,才会把「从上一个同步点到现在」的所有命令都挂成这条命令的前驱。也就是说:同步点是给你划一条「之前的都得先做完」的边界线,而边界线本身不产生命令。
第三,它与排序的关系是「约束」而不是「替代」:加了同步点之后,图的自由度确实变小了(那一批命令被强制排在一条链上),但排序算法本身没有分叉——它照样跑拓扑排序,只是图里多了一批边。
言归正传,这一节回答了第九章那个反例的「正确写法」:要保住「改-画-改-画」的语义,就得在两次之间显式说「到此为止」,而不是指望提交顺序被尊重。
本章出处:源码 rendering_device.h(:229–271)|显式同步点见 rendering_device_graph.h(:958 的 add_synchronization())与 rendering_device_graph.cpp(:2611–2616)。
十、图与驱动的关系
第九章讲的坑,归根到底是「图在替驱动做决定」。这一章把图与驱动之间的那条线画清楚。
10.1 图不直接调 API,它调驱动接口
第二章结尾留了个尾巴:这次改动建立在 #83452 的驱动接口重构之上。这条线索在这里接上——图拿到的不是一个 Vulkan 设备,而是一个驱动接口对象(RenderingDeviceDriver)。
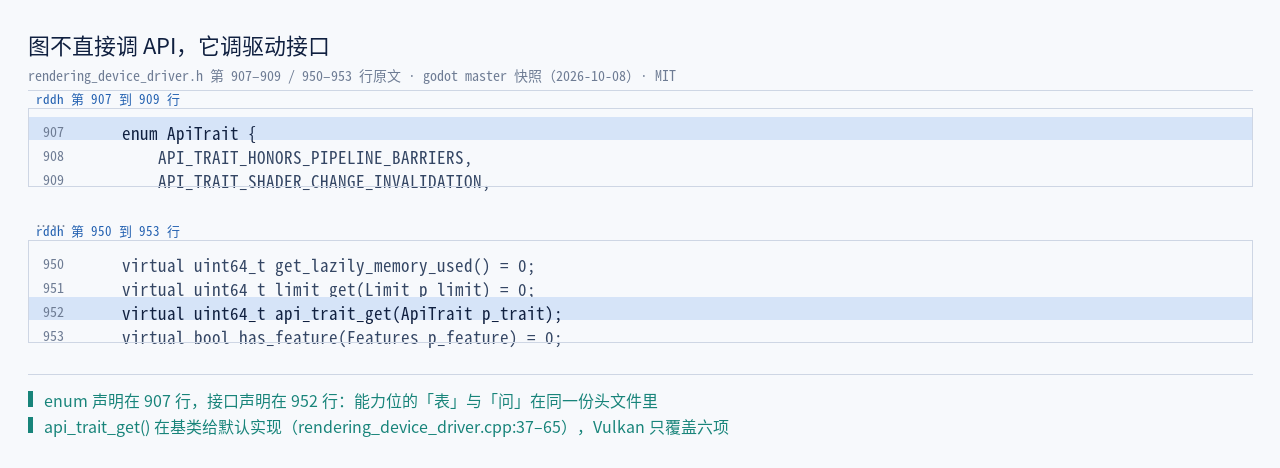
// servers/rendering/rendering_device_driver.h:907–923 / :952(master 快照 2026-10-08,节选)
    enum ApiTrait {
        API_TRAIT_HONORS_PIPELINE_BARRIERS,
        ...
    };

    virtual uint64_t api_trait_get(ApiTrait p_trait);
其中:api_trait_get() 在接口里是非纯虚的(伪代码里写作 = 0 是常见误记,真值是 virtual uint64_t api_trait_get(ApiTrait p_trait);,见 :952),图在 initialize() 里正是靠这条接口连问了五次(rendering_device_graph.cpp:1778–1782)。这个分层是整篇的结构基础:图只认驱动接口,不认具体 API。所以 Vulkan 后端报「我认屏障、我要布局转换」,OpenGL 后端(如果走 RD 的话)可以报另一套;图那颗「按能力裁剪行为」的大脑,靠的就是这条查询接口。
10.2 四层的完整样子
上图是本章的总结图。其中:请特别注意中间两层的并列关系:RenderingDevice 与 RenderingDeviceGraph 不是上下级,而是同一层里的「接口」与「调度」两个角色。RD 对外提供资源与命令接口,对内把顺序与同步交给图;它们在同一个类里以「一个成员」相连(第一章那个 RenderingDeviceGraph draw_graph;)。
说白了,其中:四层里只有第三层是 4.3 新增的——渲染器没改,驱动接口在 #83452 里先抽出来,然后在两者之间塞进了一张图。这也是本篇标题里「以及那次返工」想说的:这次改动的形状是「在中间插一层」,而不是「重写一套」。
本章出处:源码 rendering_device_driver.h(:907–923)|驱动接口重构 PR godot#83452|后端实现 drivers/vulkan/rendering_device_driver_vulkan.cpp|渲染器侧入口见第五篇 画布渲染抽象与第六篇 批处理。
十一、收官:这条链还剩哪一层
十二章走下来,从「官方文档怎么定位 RD」一路走到「图怎么算顺序、什么时候不划算」。这一章把这条链收拢。
11.1 三个命题的兑现情况
回到第零章留下的三个命题,逐条对照:
| 命题 | 兑现 | 证据 |
|---|---|---|
| 一次提交的顺序不是「写下来的顺序」 | 已兑现:依赖存在邻接表里,顺序由拓扑排序 + 优先级表算出 | 第四章(:2648–2717) |
| 重排不是免费的,且两个开关默认值就是结论 | 已兑现 | 第六章(RENDER_GRAPH_REORDER 1 / RENDER_GRAPH_FULL_BARRIERS 0) |
| 同一张图在不同后端上要做的事不一样 | 已兑现:5 个能力位决定图要不要发屏障、要不要做布局转换 | 第五章(:1778–1782、:925–931) |
其中:三条里前两条是源码级结论(逐行可核),第三条是跨后端结论(trait × API 的矩阵)。它们合起来回答了本篇开头那个问题:「一批命令发出去」这件事,中间夹着的到底是谁——是一张按依赖排好、按后端裁剪过行为的图。
11.2 六条可以带走的结论
- RD 的坐标是「接近 Metal 或 WebGPU 的抽象」,不是 Vulkan 的薄封装;官方没有「它不是封装」这类原句,能站住的只有官方文档里那三句定位。
- 不是所有后端都走 RD:
The OpenGL driver does not use the RenderingDevice abstraction.——本篇讨论的一切只覆盖 Forward+ 与 Mobile。这一条可以用本机读数侧证:同一份场景换后端,启动行从Vulkan 1.3.280 - Forward+变成OpenGL API 3.3.0 … Compatibility。 - 依赖是「记」下来的,顺序是「算」出来的:资源用法(24 个取值)进追踪器,依赖进邻接表,收口时跑一次 Kahn 拓扑排序。
- 排序有两把尺子:依赖层级(level)保证正确,命令类型优先级(priority)拿性能;那张表还用
static_assert钉住了长度。 - 屏障要不要发,先问驱动:5 个能力位集中在
initialize()里读一次,之后全篇按它们裁剪行为。 - 代价写在同一份源码里:后台录制默认关(说不清的 IHV 问题)、缓冲屏障「没改善甚至有害」但为绕驱动问题仍开着、驱动 workaround 会削掉排序自由度。
11.3 本机那三个量的边界
本篇给了一组本机读数(同场景只换后端:走 RD 那条路 5 个 draw call、2.85 ms(两次 2.895 与 2.802,抖动约 3%);不走 RD 那条路 8000 个、6.60 ms)。但必须再说一遍归因边界:
- 这组读数证明的是「两条路不是一套东西」,不能归因到图本身;
- 「关掉重排会慢多少」本机测不了(那份构建里没有开关串);
- 「同步错误是否清零」本机也没测(没装验证层)。
OK,三条边界都写出来,这一章才算站得住:能测的量测到位,测不了的说明白,剩下的交给源码。
11.4 下篇预告
下一篇顺着「后端」往下走:同一张图、同一份命令,在不同驱动上具体怎么落地——Vulkan 与 Direct3D 12 与 Metal 的分叉点在哪、--rendering-driver 一改引擎内部换掉了什么、以及 Compatibility 那条不走 RD 的路又长什么样。这一篇是把「顺序」讲完,下一篇讲「落到哪张桌子上」。
相关链接
源码落点:本篇全部源码事实均回本机 master 快照(2026-10-08)逐行复核,集中在
rendering_device.cpp、
rendering_device.h、
rendering_device_graph.cpp、
rendering_device_graph.h、
rendering_device_driver.h、
rendering_device_driver.cpp;
下面我们开始,其中:本篇特有的四处落点是 rendering_device.cpp:8372 的图收口、:8783 的图初始化、
rendering_device_graph.cpp:2697 的优先级表、以及 rendering_device_graph.cpp:1778 的五个能力位。行号一律按 master(2026-10-08 快照),不做算术平移。
资源清单
官方文档与文章(文档 CC BY 3.0 Unported,署名 “Juan Linietsky, Ariel Manzur and the Godot Engine community”,引用须标注改动): 4.3 发布说明、 官方博客《GPU synchronization in Godot 4.3 is getting a major upgrade》、 4.3 beta 1 公告、 4.4 渲染优先事项(回顾)、 内部渲染架构、 RenderingDevice 类参考、 RenderingServer 类参考、 ProjectSettings 类参考、 用服务器优化、 画布项着色器参考、 4.4 发布说明、 4.5 发布说明。
对应 PR:godot#84976(无环命令图)、 godot#83452(驱动接口重构)、 godot#61415(MSAA + SSAO 在 AMD Polaris 上的伪影,随图合并后消失)。
本机一手产物:evidence/probe/(三档四次运行日志 + 探针工程 + 一键复跑脚本 + 二进制字符串检索)、
evidence/stage1/(4.3 发布说明页、官方博客页、4.3 beta1 公告页、4.4 渲染优先事项页、官方文档页本机快照、PR #84976 元数据)。
前作:第六篇 批处理| 第五篇 画布渲染抽象| 第四篇 画布剔除与排序| 第三篇 服务层接口| 第二篇 对象模型| 第一篇 全景与边界。
下篇预告:下一篇讲同一张图在不同驱动上怎么落地——Vulkan / Direct3D 12 / Metal 的分叉点在哪、--rendering-driver 一改引擎内部换掉了什么、以及 Compatibility 那条不走 RD 的路长什么样。
With Best Wishes.