【移动端图形与功耗】第 5 篇 | 系列共 7 篇
站点链接:技术博客页
系列文章前言
1.1 一句话点题:系列定位
前三篇分别算清了三本账:分块渲染决定了机制上能不能不搬(第 2 篇),带宽账本决定了实际要搬多少字节(第 3 篇),功耗与热预算决定了每秒付得起多少焦耳(第 4 篇)。
这一篇要把这三本账合到一页上算一次。题目是延迟着色(Deferred Shading)在移动端能做什么、不能做什么——它不是一道选择题,而是一次三方会账:这类效果用带宽换画质,而带宽又要拿能耗去买,能耗又受制于第 4 篇那条几瓦的散热上限。
说白了,这一篇要回答的不是"延迟着色好不好",而是它在什么条件下成立、一旦条件不成立会赔掉什么。本篇只算延迟着色这一条路线的账:分块机制与 binning 的推导、带宽账本与四类压缩手段、功耗与热的预算推导都不涉及(见第 2、3、4 篇),这里只引用它们的结论。
1.2 原理与概念:本篇要回答的三个问题
这一篇要立的东西可以压成一句:延迟着色能不能省,取决于几何缓冲(G-Buffer)落不落地;留在片上就是 1 倍账,落到主存就是 10 倍账。
拆开是三个问题。第一,延迟着色到底省了什么、又花了什么——这要把 G-Buffer 的字节换算成一个无量纲单位,才能和别的方案横向比。第二,移动端的片上内存能装下多大的 G-Buffer——有一条硬线卡在那里。第三,一旦装不下会怎样,以及有没有别的路可以走。
三个问题有严格先后:不算清第一个,第二个的"装不下"就无从谈起;不搞清第二个,就会误以为"移动端不能做延迟着色";而不知道第三条,就会在错误的场景里硬上。
1.3 原理与概念:全系列内容总览
先看看整个系列怎么排。本系列共七篇,按"约束 → 机制 → 账本 → 代价 → 取舍 → 新特性 → 测量"推进:
| 篇 | 主题 | 回答的问题 |
|---|---|---|
| 一 | 两台不同的机器:移动 GPU 的物理约束 | 为什么移动端不能照搬桌面做法 |
| 二 | 分块渲染:binning、片上内存与它的代价 | 机制上怎么少搬 |
| 三 | 带宽:移动端最硬的那道墙 | 一帧搬多少、怎么搬得更少 |
| 四 | 功耗与热:帧率为什么会掉下去 | 为什么持续运行会降频、掉帧发生在哪一刻 |
| 五(本篇) | 延迟着色在移动端:能做什么、不能做什么 | 哪些高级效果值得做、代价是什么 |
| 六 | 现代特性落地:VRS、网格着色与移动光追 | 新特性在移动端的真实收益 |
| 七 | 测量与调优:怎么证明你真的优化了 | 怎么把结论做成可复现的证据 |
这张表里,第 3、4 篇和本篇是一组:前两篇分别把带宽账与能耗账算成了预算线,这一篇要拿这两条预算线去审一个具体的渲染算法。而第 2 篇讲的分块延迟渲染(Tile-Based Deferred Rendering, TBDR)是本篇的关键伏笔——这个名字里也有"延迟"两个字,但它和延迟着色不是一回事。零章就先把这个混用清理掉。整条系列线走到第 5 格「取舍」:前四篇把约束、机制、账本、代价立住了,该轮到审一审「哪些高级效果值得做」。
读取的顺序建议:若还没读过第 3、4 篇,先回看那两本账,否则本篇审算法时用到预算线会缺前提;跟着上面的系列线顺读即可。
1.4 原理与概念:与已有中文资料的差异
中文资料在这个题目上有个很整齐的断层。绝大多数文章停在"移动端不适合延迟着色"这一句结论上,给的理由是"太吃带宽"。这话没错,但它没有下一句。
没有下一句的后果是:大家不知道"吃多少带宽"到底是多少,也不知道有没有别的形态可以绕开。于是实际工程里出现两种典型误判——一种是看到"移动端不适合"就彻底放弃,明明能用片上延迟光照的场景也退回了前向渲染;另一种是照搬桌面的两趟延迟,把 G-Buffer 老老实实写进主存,然后在真机上发现帧率掉一半,却定位不到原因。
这一篇补的就是中间那一层:把 G-Buffer 的字节数换算成一个和分辨率无关的无量纲单位,然后算清楚"落主存"与"留片上"差多少倍,最后说明那条硬线卡在哪里。凡是有官方数字的地方一律给原文出处;凡是换算出来的值,一律标注"换算"并给算式。
1.5 原理与概念:阅读建议与边界声明
本篇按变体 B 呈现:这一系列以硬件约束与工程取舍为主线,代码密度天然偏低,硬凑长代码段只会稀释信息密度。因此关键做法以公式 + 参数逐项释义 + 可复现的配置清单给出,凡涉及具体实现仍给可复现的做法与官方文档链条。
本篇不涉及:分块机制与 binning 的细节推导(第 2 篇已讲,本篇只引用结论)、带宽账本与四类压缩手段(第 3 篇已讲,只引结论)、功耗与热预算的推导(第 4 篇已讲,只引结论)、移动端新特性如 VRS、网格着色与移动光追(第 6 篇)、完整测量协议(第 7 篇)。
本篇涉及的两个基准:目标分辨率按 1080p、目标帧率按 60fps(帧预算 16.7ms)。换基准会改变绝对数值,但不改变各项的相对量级。需要特别说明的是,本篇反复使用的 BU 是无量纲的归一化单位,它不随分辨率变化——这正是它比绝对带宽更适合做横向对比的原因。
1.6 原理与概念:本篇的因果链
把整篇的骨架先摆出来,后面每一章都在填其中一环:
延迟着色的收益来自把光照推迟到可见性确定之后 → 这需要一个中间缓冲存表面属性,也就是 G-Buffer → G-Buffer 一写一读就是两次主存往返,账面上约 10 BU → 而移动 GPU 有一块容量固定的片上内存 → 只要把 G-Buffer 与光照压进同一个 render pass,它就能全程留在片上,账变成 1 BU → 但片上预算只有 128 bit/像素,G-Buffer 一大就装不下 → 更麻烦的是,片上内存里的一个像素只能读它自己 → 于是任何需要读邻居的后处理都会逼你把两个 pass 拆开 → 一拆,10 BU 的账全部回来。
这条链的终点就是本篇的结论:延迟着色在移动端能否成立,等价于"G-Buffer 与光照能不能待在一起"这一个问题。
OK,言归正传,下面开始正文。
背景铺垫:一个被混用了二十年的词
2.1 一句话点题:三个"延迟"
在移动图形这个圈子里,"延迟"是被混用得最狠的一个词。它至少出现在三种完全不同的语境里:
- 分块延迟渲染(TBDR)——这是硬件架构,说的是 GPU 把画面切块、先判定可见性再着色;
- 延迟着色(Deferred Shading)——这是渲染算法,说的是把光照推迟到几何 pass 之后;
- 帧缓冲延迟写回——这是内存行为,说的是片上的颜色数据不立刻写回主存。
三者都叫"延迟",机制却互不相干。更要命的是,它们经常出现在同一段话里。下面先把这三义拆开。
2.2 原理与概念:TBDR 延迟的是「可见性判定」
先看第一种。第 2 篇已经讲过,移动 GPU 主流是分块架构:把屏幕切成小方块(PowerVR 的官方文档给出的典型值是 32×32 像素,具体尺寸在硬件设计期就定死了),先把整场景的几何提交完,逐块做隐面消除(Hidden Surface Removal, HSR),判定哪些像素最终可见,然后只对可见的那些跑像素着色器。
"延迟"在这里指的是:像素着色被推迟到可见性确定之后。它的收益非常直观。Imagination 官方给出的实测是,在一个典型帧里应用提交了平均每屏幕像素 4.7 个片段,而设备上实际着色的只有 1.2 个——少了 75%。这 75% 是硬件白送的,不需要你写一行代码。
注意这个机制解决的是遮挡造成的无效着色。它不关心光照怎么算,也不需要一个显式的属性缓冲——它用的是块内的一块硬件可见性结构。
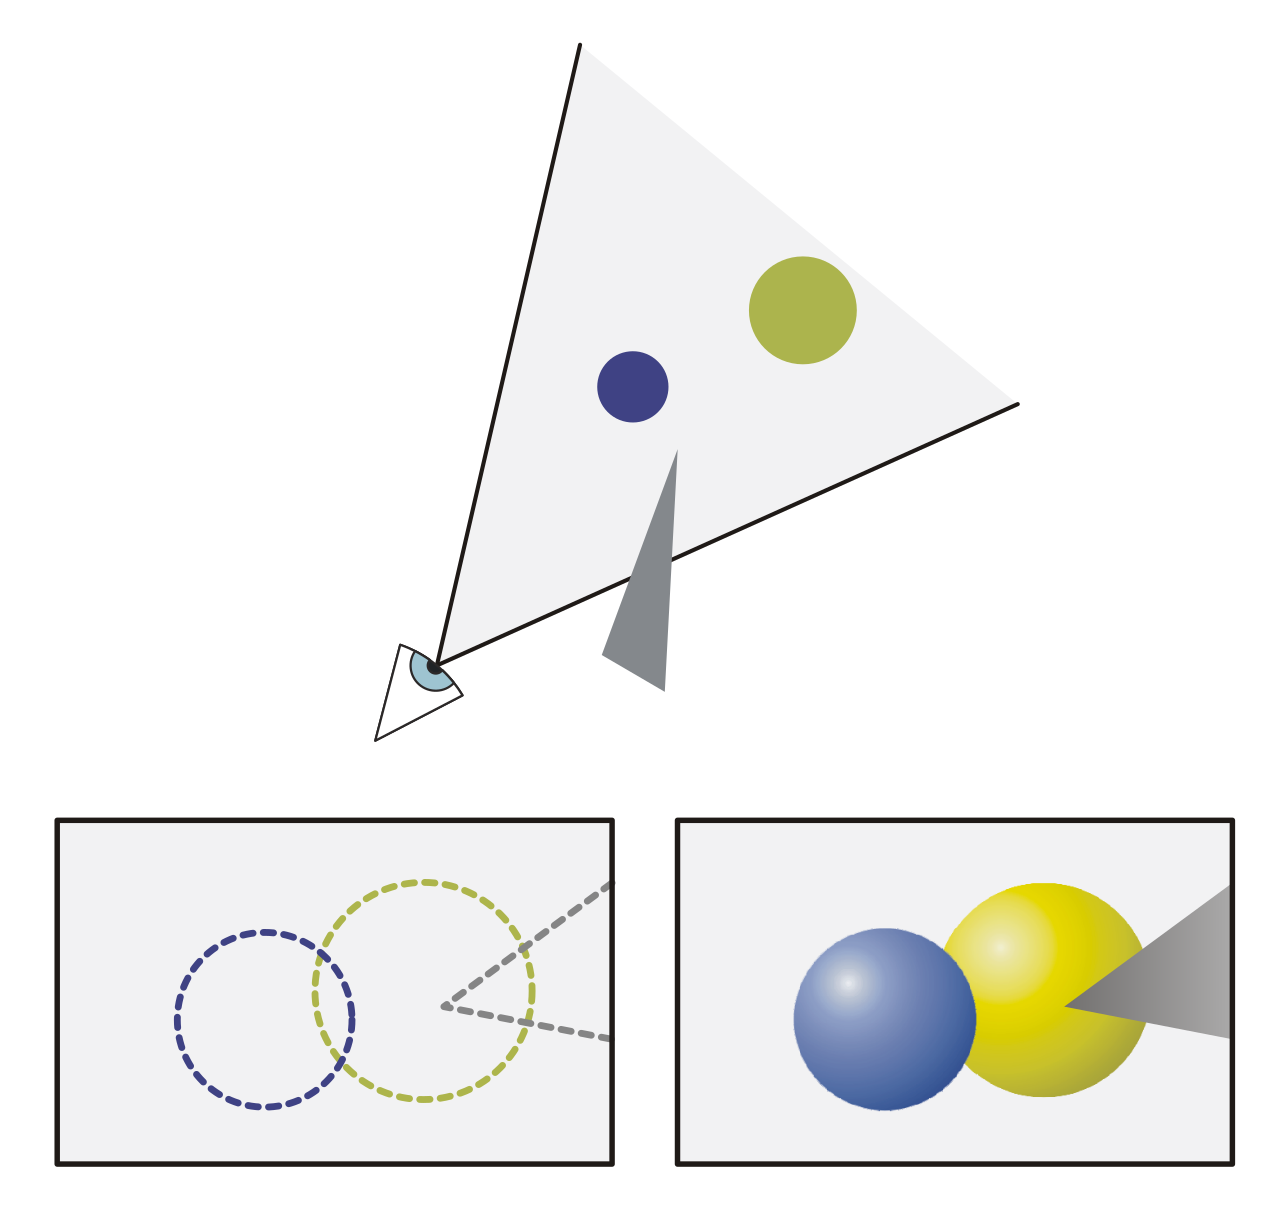
顺带放一张外部示意图,帮大家对齐"隐面判定"这个词的标准语义:
2.3 原理与概念:延迟着色延迟的是「光照」
第二种是完全不同的东西。延迟着色(Deferred Shading)把一帧拆成两趟:第一趟只做几何,把每个像素的表面属性——反射率、法线、粗糙度、深度——写进一组纹理,这组纹理就是几何缓冲(G-Buffer);第二趟遍铺屏幕,逐像素读回这些属性、算光照,直接输出最终颜色。
这里的"延迟"指的是:光照计算被推迟到几何信息全部就位之后。它解决的是另一个问题——重叠光源造成的重复着色。前向渲染里如果有 20 盏灯叠在一起,那 20 盏灯的着色都要在同一个像素上跑一遍;延迟着色下,每个可见像素的光照只算一次。
但代价也很明确:那一组 G-Buffer 纹理必须存在某个地方,而它通常很大。这是本篇的主线,第一章会把账算清。
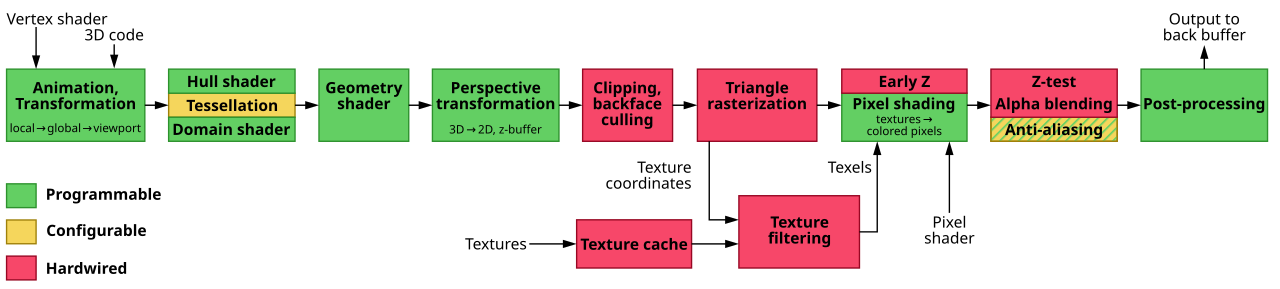
对照一下前向路径的基线,管线本身是这样的:
2.4 原理与概念:两者不是一回事
把两者并排放,差别就清楚了。
TBDR 管的是"哪些像素不用算",它是硬件在光栅化阶段替你做的剔除;延迟着色管的是"每个像素的光照算几次",它是你在应用层做的数据流重排。前者不需要你写代码,后者需要你重新设计整条管线。
还有一层更细的区别:TBDR 的中间物是块内的硬件可见性结构,它由硬件管理、你看不见也摸不着;延迟着色的中间物是显式的 G-Buffer 纹理,尺寸、格式、生命周期全由你决定——而"由你决定"意味着"由你负责",包括它到底落在哪儿。
| 维度 | TBDR(分块延迟渲染) | Deferred Shading(延迟着色) |
|---|---|---|
| 性质 | 硬件架构 | 渲染算法 |
| 延迟的对象 | 像素着色(等可见性) | 光照计算(等属性就位) |
| 解决的问题 | 遮挡造成的无效着色 | 重叠光源造成的重复着色 |
| 中间物 | 块内硬件可见性结构 | 显式 G-Buffer 纹理 |
| 中间物由谁管 | 硬件 | 应用(尺寸/格式/生命周期) |
| 需要写代码吗 | 不需要 | 需要,且要重排整条管线 |
这张表里最关键的一格是"中间物由谁管"。TBDR 的中间物你管不着,所以它不花你的带宽;延迟着色的中间物归你管,所以它花的每一字节都要记在你的账上。
2.5 原理与概念:把这个区分放到移动端
为什么这个区分在移动端特别要紧?因为移动 GPU 恰好同时具备这两个特性:它天生是 TBDR 架构,又有一块容量有限的片上内存。
这两件事加起来产生了一个反直觉的结论:移动端做延迟着色,真正的问题不是"能不能算",而是"G-Buffer 能不能不离开片上"。 如果它不离开片上,那 10 BU 的账能压到 1 BU,延迟着色在移动端反而比桌面更划算;如果它必须落到主存,那 10 BU 的账一分不少,而移动端的带宽预算比桌面紧得多。
所以"移动端不适合延迟着色"这句话是不完整的。完整的说法是:移动端不适合"G-Buffer 落主存"的延迟着色,但可能非常适合"G-Buffer 留片上"的延迟着色。 这个区别就是本篇全篇要论证的东西。
2.6 实现与配置:这个混淆是从哪来的
有必要解释一下这个混淆为什么能持续这么久。
第一个来源是厂商文档自己的用词。Arm 在 SIGGRAPH 2015 的一份官方材料里写:"'Hidden Surface Removal' or 'Deferred Rendering' can avoid rendering occluded pixels"——这里把 "Deferred Rendering" 直接当成了 HSR 的同义词,指的是硬件的延迟可见性判定,而不是后处理式的 G-Buffer 延迟着色。Qualcomm 的 FlexRender 文档里也有类似情况:它说的 "Deferred" 指的是帧缓冲的分块延迟写回,同样不是延迟着色。
第二个来源是名字本身。TBDR 的全称里就带着 "Deferred",而它确实"延迟"了某些东西——只是延迟的对象和延迟着色不一样。
第三个来源是收益的描述重叠。两者都能减少无效着色,讲效果的时候听起来很像。但一个减的是"被遮挡的像素",另一个减的是"重复的光照计算"。
所以读厂商文档时,看到一个 "deferred" 先别急着对号入座,先看它后面跟的动词是什么:跟 "rendering" 且讲遮挡的,大概率是 TBDR;跟 "shading" 且讲光照的,才是本篇要讲的延迟着色。
2.7 效果与量化:历史一眼
这个区间的两端其实都是 PowerVR。1996 年前后的 PowerVR PCX2 是第一批把分块与延迟可见性做进硅片的消费级图形芯片,它的设计初衷就是在极低的显存带宽下也能跑出可看的 3D 画面——带宽约束从第一天就是这个路线的主题。
二十多年后,这条路线的继承者们在同一块片上内存上做起了延迟着色。历史绕了一圈,回到了同一个约束上。
2.8 效果与量化:本章小结
| 项 | 结论 |
|---|---|
| 术语 | "延迟"至少三义:TBDR(硬件)、延迟着色(算法)、帧缓冲延迟写回(内存行为) |
| TBDR | 延迟的是像素着色,等的是可见性;中间物是硬件可见性结构,不花你的带宽 |
| 延迟着色 | 延迟的是光照,等的是属性就位;中间物是 G-Buffer 纹理,每一字节都记账 |
| 移动端 | 天生 TBDR + 片上内存容量有限。所以问题不是"能不能用",而是"G-Buffer 落不落地" |
| 量化锚点 | PowerVR HSR 把每像素着色的片段从 4.7 降到 1.2(−75%);PowerVR tile 典型 32×32 |
把零章压成一句话:TBDR 与延迟着色都叫“延迟”,但一个延迟的是像素着色、中间物由硬件管理,另一个延迟的是光照、中间物归应用管理。移动端恰好同时具备分块架构与容量有限的片上内存,这个组合把本篇的主线钉在了一处:那个中间物到底能不能不落地。只要它留在片上,账是 1 BU;落到主存,账就是 10 BU。
2.9 这一章留下的问题
区分清楚了,但账还没算。下一个问题是:那一组 G-Buffer 到底有多大?它离开片上、落到主存,究竟要多花多少带宽?
这两个问题需要一个新的计量单位——它要能摆脱分辨率的干扰,让不同实现之间可以直接比。Arm 那篇专门讲移动端延迟着色的官方文章给了一个:BU。
言归正传,我们正式开始算账。
一、账:G-Buffer 的字节怎么换算成 BU
3.1 一句话点题:为什么需要一个新的计量单位
零章留下了一个问题:那一组几何缓冲(G-Buffer)到底有多大。这问题看着直接,直接答却会被分辨率绑架——同一条管线,720p 一个数,1080p 另一个数。
先来看看换一种问法。我们不问"多少兆字节",改问"搬了几趟整屏":把屏幕上每个像素读一遍或写一遍,算一趟。这个问法把分辨率从题目里剔出去,剩下的只有比例。
Arm 在官方文章里给这个单位起了个简写:BU。本章就是把这本账算到能横向对比,出处见 Arm Community《Deferred shading on mobile》。
3.2 原理与概念:BU 是什么
Arm 给的定义是一句话:1 BU = width × height × sizeof(pixel) 的一次读或写。
拆开看是两个因子相乘:屏幕的像素总数(width × height),以及所讨论那份附件自己的单像素字节数(sizeof(pixel))。写一整屏是一趟,读一整屏也是一趟。写四份和屏幕等大的附件,就是 4 BU。
关键在于这两个因子是绑在一起进定义的。720p 换成 1080p,字节数涨了,但"整屏一遍"这个动作没变,BU 数也就不变。这正是它比绝对带宽更适合当横向尺子的原因——它量的是趟数,不是兆字节。
3.3 原理与概念:G-Buffer 里到底存哪些通道
延迟着色把光照推迟,代价是必须先把表面属性存下来。Arm 的四段账点名了四路:反射率、法线、材质参数、深度,每路对应一整屏,写完整组就是 4 BU。
这里最容易搞混的是:BU 数的是趟数,不是字节数。哪怕某一路只占 16 bit,它照样算 1 BU——位宽只决定每趟搬多少字节。这个区别在第二章会变成主角。Vulkan 指南把这批数据称作"延迟渲染器里的 G-Buffer 属性"(出处)。
| 通道 | 内容 | 记账 |
|---|---|---|
| albedo | 反射率/基础色 | 1 BU |
| normal | 法线方向 | 1 BU |
| pbr | 粗糙度/金属度/镜面 | 1 BU |
| depth | 深度(位置也可另算) | 1 BU |
| 合计 | 几何 pass 一次写出 | 4 BU |
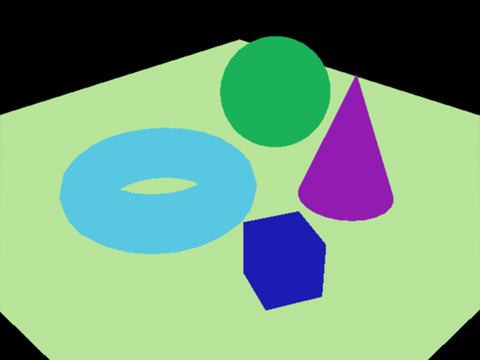
3.4 原理与概念:反射率与镜面反射通道
反射率(Albedo)回答的是"表面本来是什么颜色"。它刻意不带任何光照信息——正因为它干净,光照才能被推迟到后面统一乘一次。Unity 官方给的位宽是 Albedo 24 bit + Specular 24 bit,两路分开存(出处:Unity URP Deferred Rendering Path)。
为什么镜面要单独一路?因为漫反射只要基础色,高光还要靠粗糙度与金属度决定形状。两者揉进一路会互相抢位宽,分开存各拿各的精度更划算,代价是多出半张屏的写出。
下面这张是同一场景拆出来的反射率通道,也是这组四张图的起点(文件页)。

3.5 原理与概念:法线通道与它的编码
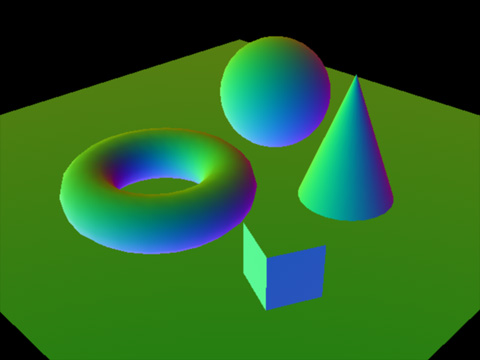
法线是 G-Buffer 里最容易吃亏的一路。它是个三维单位向量,老实按三个浮点数存要 96 bit,太贵;所以实际实现一律走有损编码。
Unity 给的做法是 ARGB2101010(R10G10B10A2),用 32 bit 装下三个 10 bit 分量。大家看下图会觉得它像一张彩色贴图——没错,它就是把这些分量映射成了 RGB。
还有更省的一路叫八面体编码(Octahedral Encoding)。Unity 把它做成开关(Accurate G-buffer normals),并提醒开启后在移动 GPU 上开销"可能相当可观";UE 则把它用在 lit decal 的法线上,代价是这一路法线不能混合,只能整体覆盖。其具体位宽与误差本篇不给——这次没取到一手来源。
3.6 原理与概念:深度通道
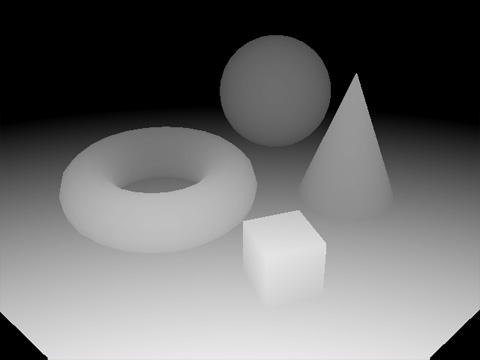
深度通道存的是相机到表面的距离。这里有一个反常识的实现细节:Unity 把深度当成颜色存,格式 R32_SFloat,也就是一路 32 bit 的浮点颜色附件,而不是走深度模板附件。
理由很具体:Metal 不允许在同一个 pass 里从深度模板附件取深度,光照 pass 既然要读深度,就只能让它变成一张普通纹理。这条限制直接决定了 G-Buffer 的附件数量,也就决定了片上预算够不够用——第二章的账会从这多出来的一路开始算。
3.7 公式或参数逐项释义:各通道的合成结果与 FBO 对应
好了,四路通道摆齐了,合起来看总数。Unity 官方给了两个总位宽:160 bit/像素(非 HDR)与 192 bit/像素(HDR)(出处:Unity Manual)。
按位宽反推(换算):160 ÷ 32 = 5,相当于 5 份 32 bit 的整屏附件;HDR 下发光/GI 那一路从 32 bit 升到 64 bit,总量就成了 192 bit。这个"份数"既是第一章的 BU 数,也是第二章位宽预算的底数。
| 通道 | 附件 | 官方给的格式 | 位宽 |
|---|---|---|---|
| 反射率 | RT0 | Albedo(sRGB) | 24 bit |
| 镜面 | RT1 | Specular | 24 bit |
| 法线 | RT2 | ARGB2101010 | 24 bit |
| 发光/GI/光照 | RT3 | B10G11R11 或 RGBA16F | 32 / 64 bit |
| 深度 | Depth as Color | R32_SFloat | 32 bit |
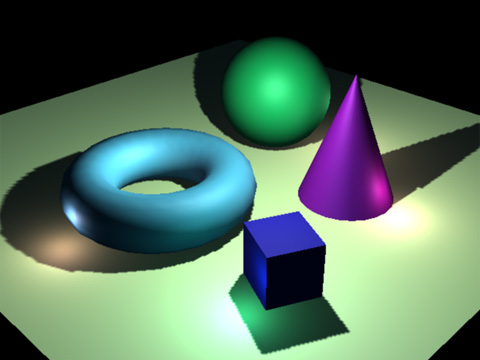
上表是按位宽反推的对应关系(换算),官方只逐路给了格式与总位宽。
这里有一处口径要交代清楚:Unity 官方只逐路给出了格式与总位宽,并没有点名哪一路对应哪个附件编号;上表的 RT0–RT3 是按位宽与用途反推出来的(换算),引用时请按推断对待。之所以仍要列出这张对应表,是因为下一章要按附件逐条核对片上预算——没有它,128 bit 这条线就落不到具体的附件上,只能停在口号层面。
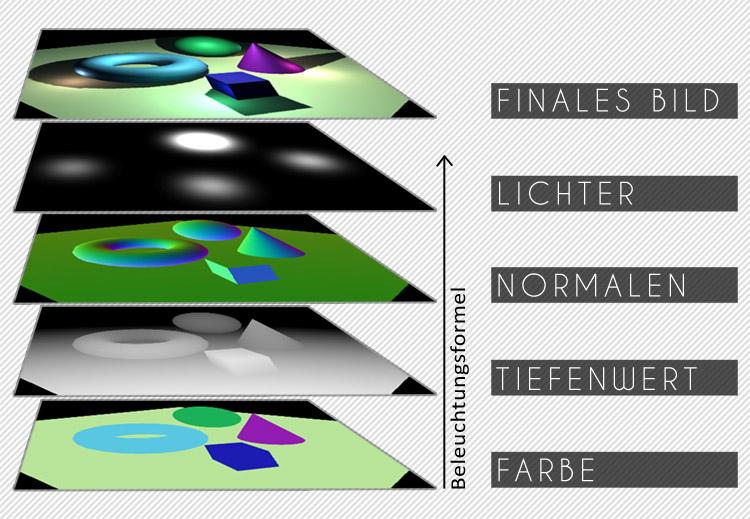
3.8 实现与配置:MRT 如何一次性写多个目标
这四路怎么一次写出去?靠多渲染目标(Multiple Render Targets, MRT):同一次几何 pass 里,片段着色器可以同时向多个颜色附件输出。趟数不变,写出的目标变成四个。
配置清单如下(变体 B):
- 几何 pass 声明 4 个颜色附件 + 1 个深度附件;
- 片元着色器用
layout(location = 0..3) out绑定四路属性; - 每路选最省格式:反射率 RGBA8、法线 ARGB2101010、深度 R32F;
- 关掉混合(blending):G-Buffer 写的是属性不是颜色;
- 附件不是越多越好。Qualcomm 官方最佳实践写着,用 MRT 要"待在设备性能限额之内"(出处)。
附件数上去后还得盯 load/store 语义,规范见 Vulkan Render Passes。
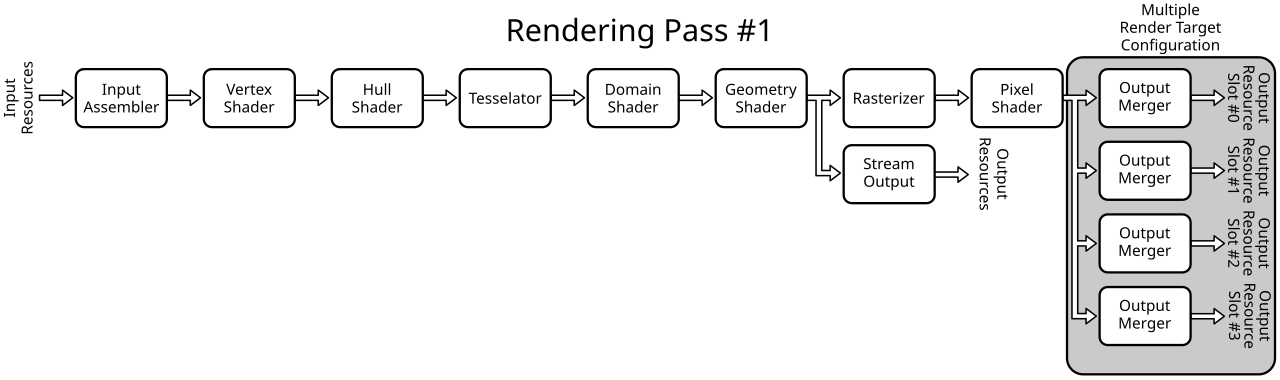
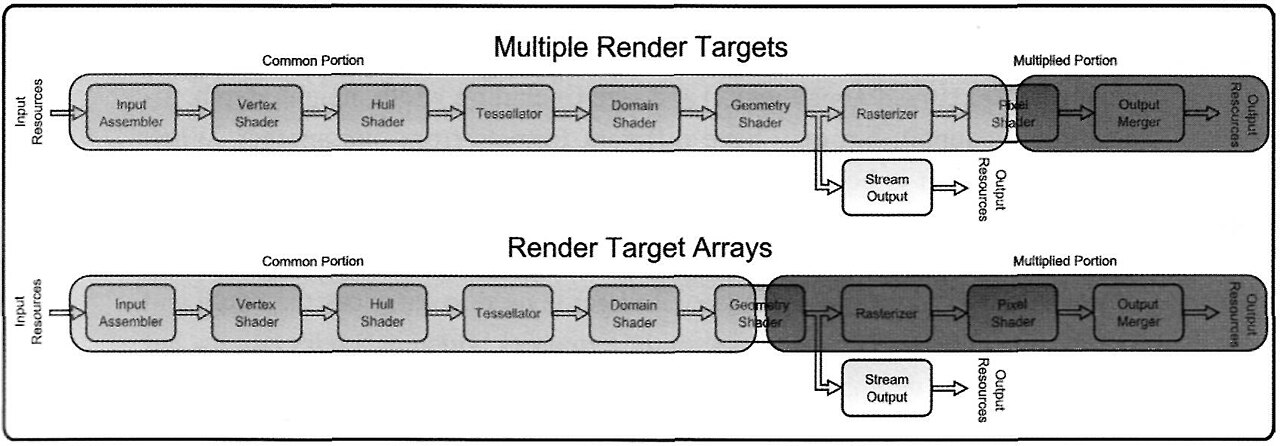
3.9 公式或参数逐项释义:经典延迟的四段账
下面我们开始记账。Arm 的算法四段相加:
| 环节 | 官方表述 | 代价 |
|---|---|---|
| 写 G-Buffer | Write G-buffer(albedo/normal/pbr/depth) | 4 BU |
| 读 G-Buffer | Read G-buffer in lighting pass | ≥ 4 |
| 混合光照缓冲 | Blend lighting buffer(1 读 1 写) | ≥ 2 |
| 合计 | Cost | ~10 BU |
两个"≥"值得盯一下:写出是确定的 4 BU,读回写着"≥ 4 BU",官方理由是缓存抖动或 overdraw 太多;混合同理。说白了,10 BU 是理想值,不是上限。
这两条"≥"也解释了:桌面跑得好的延迟着色搬到移动端后,账单常比算出来的高。经典延迟的三条老毛病(高带宽、无抗锯齿、缺真 alpha 混合)早被点过名(GPU Gems 3),Clustered Shading 论文也把透明与 MSAA 列为短板(HPG 2012)。
3.10 效果与量化:把 BU 换成绝对带宽与显存体积
BU 是无量纲的,工程上最终还得落到字节与 GB/s。下面按 20 B/像素与 24 B/像素两种口径各算一次,全部标注为换算。
体积(换算,1 MiB = 1,048,576 B;1080p = 1920×1080 = 2,073,600 px)
- 20 B/px:20 × 2,073,600 ÷ 1,048,576 ≈ 39.6 MiB
- 24 B/px:24 × 2,073,600 ÷ 1,048,576 ≈ 47.5 MiB
- 1440p(2560×1440 = 3,686,400 px):20 B/px ≈ 70.3 MiB;24 B/px ≈ 84.4 MiB
带宽(换算,1080p、60 fps)
- 20 B/px、10 BU:20 × 2,073,600 × 10 × 60 ≈ 24.9 GB/s
- 24 B/px、10 BU:24 × 2,073,600 × 10 × 60 ≈ 29.9 GB/s
两种口径只差每像素字节数,量级一致。
论文口径可以互相印证:4 MP 屏、每像素 4 个 24 B 样本、60 Hz 下,单次光照 pass 的 G-Buffer 写+读约 46 GB/s(出处:Burns & Hunt, JCGT 2013)。两条独立口径落在同一个量级上,说明这个 10 BU 不是纸面推演。
把 BU 换成绝对带宽只需要两个乘数:屏幕像素数与刷新率。BU 本身不带单位,要落到 GB/s 就必须先定基准分辨率;这也正是本篇反复强调 BU 与分辨率无关的原因——同一套算法在 720p 与 1440p 上的 BU 数完全相同,绝对带宽却差 4 倍。下面的换算链给的是“怎么换”,不是新结论;换了基准,数字会跟着变,倍数关系不变。
3.11 效果与量化:本章小结
| 项 | 结论 |
|---|---|
| BU 的定义 | 1 BU = width × height × sizeof(pixel) 的一次读或写;无量纲、不随分辨率变 |
| 通道构成 | 反射率、法线、材质参数、深度各 1 BU,写出合计 4 BU |
| 总账 | 写 4 + 读 ≥ 4 + 混合 ≥ 2 = ~10 BU(Arm 官方口径) |
| 落到体积 | 20 B/px → 1080p ≈ 39.6 MiB、1440p ≈ 70.3 MiB(换算) |
| 落到带宽 | 10 BU、1080p、60 fps、20 B/px ≈ 24.9 GB/s(换算),与论文口径 ~46 GB/s 同量级 |
表中体积与带宽两行都是换算值,其余为官方口径。
第一章只做了一件事:把“延迟着色很吃带宽”这句定性判断换成一个可比的数。四路通道 → 每像素 160 或 192 bit → 折算成 5 到 6 个整屏附件 → 写成 4 BU 写、≥4 BU 读、≥2 BU 混合,合计约 10 BU。这个数之所以重要,是因为它后面只会被拿来和另一个数比——留在片上的 1 BU。
账在纸面上算完了,但有个前提还没验:这 10 BU 之所以成立,是因为 G-Buffer 真的落到了片外。那它到底该不该落?下一章先看那块片上内存究竟有多大。
二、片上预算:128 bit/像素这条硬线
4.1 一句话点题:为什么这个预算比带宽预算更硬
带宽预算超了还有腾挪空间:降分辨率、降帧率、开压缩、少画点东西,都是可用手段。片上预算不一样,它是一条由面积换算出来的线——芯片流片那一刻就定了,应用层改不动。
所以这一章要回答三件事:这条线从哪来、怎么摊到具体附件上、撞上它会怎样——也就是总量约束、逐项分配、溢出后果。这三条算清了,才谈得上取舍。
4.2 原理与概念:片上内存不是缓存,是固定面积的暂存区
很多人一听"片上"就想到缓存,这是两回事。缓存由硬件自动管理,容量与替换策略程序看不见;片上内存(On-chip / Tile Memory)是按 tile 划分的暂存区,直接暴露给应用:你可以往里写属性,再在同一 pass 里读回。
Khronos 指南里有一句最关键的话:片上内存总量是固定的。固定就意味着零和:这一路多给,别处就得扣(出处:Vulkan 指南)。
依然是惯例,先看一个量级锚点:Qualcomm 官方博客的示例是"塞进 14 MB 的 tile memory",并说它通常小到"只能装下少数几个资源"(出处)。
4.3 原理与概念:tile 尺寸与片上容量的关系
片上内存不会一口气装下整屏,而是一格一格地装:光栅化把屏幕切成小方块(tile),一块处理完再换下一块。于是"一块 tile 占多少字节"可以直接算:
单 tile 字节数 = tile 宽 × tile 高 × 每像素位宽 ÷ 8
tile 越小,同样大小的片上内存就能容纳越高的每像素位宽——这就是"超预算就换小 tile"的由来。代价在另一头:tile 越多,binning 的负担、块间切换与几何重放都会涨。
tile 尺寸是厂商相关的,没有通用数字。能引的一手口径来自 Imagination:PowerVR 的典型值是 32×32 像素,设计期就定死(出处)。
把这条式子记住,第二章后面的判断都从它推出来:位宽预算是固定的,tile 尺寸是可调的,所以当附件总位宽超出预算时,唯一的下调手段就是缩小 tile。但缩小 tile 不是白拿的——块数变多,binning 阶段要处理的块头变多,块间切换与几何重放的次数也跟着涨。换句话说,超预算的代价不是“装不下”,而是“装得下但更慢”。
4.4 公式或参数逐项释义:128 bit/像素这条线从哪来
这条线有两个官方出处,说的是同一件事。
一个是 Arm 自己的延迟着色文章:用像素局部存储(Pixel Local Storage, PLS)把 G-Buffer 留在片上时,"我们得把自己限制在 128 bit"(出处:Arm Community)。
另一个是 Khronos 官方样例(由 Arm 编写):片上 tile buffer 的颜色存储"最多 128 bit/像素,不过像 Mali-G72 这样的较新 GPU 把上限提到了 256 bit/像素"(出处:Khronos《Subpasses》样例)。
所以 128 bit/像素不是规范条款,而是同期硬件的容量口径:它是"能留多少位宽在片上"的经验值,会随代际上移。把它当成"移动端的物理上限"并不准确。
两个出处给的是同一量级的数,但适用范围不同:Arm 那条讲的是 Pixel Local Storage 的通用上限;Khronos 那条讲的是 subpass 合并时 tile buffer 的颜色存储上限,并补了演进——较新的 Mali-G72 及之后把上限提到 256 bit/像素。写代码时不能只记住数字,还要记住它挂在哪个机制上,否则会把某一家、某一代的口径当成通用硬件规格。
4.5 公式或参数逐项释义:附件位宽预算表
下面我们就把位宽摊到附件上。规则只有一句:一个 render pass 里,所有需要留在片上的附件,每像素位宽加总不能超过那条线。
| 附件 | 典型格式 | 位宽 |
|---|---|---|
| 反射率 | RGBA8 | 32 bit |
| 法线 | ARGB2101010 | 32 bit |
| 材质参数 | RGBA8 | 32 bit |
| 深度 | R32_SFloat | 32 bit |
| 小计 | G-Buffer 四路 | 128 bit |
| 光照结果(混合目标) | RGBA8 | 32 bit |
| 合计 | 160 bit |
这就是问题的全貌:G-Buffer 刚好把 128 bit 吃满,光照结果没地方放。UE 在 Mali(Vulkan)上的官方限额正好印证了这条线——GBuffer 16 字节(即 128 bit)每像素、最多 4 个输入附件(Input Attachment),光照 pass 最多取 3 个颜色附件加 1 个深度附件(出处:UE《Mobile Deferred Shading》)。
4.6 原理与概念:超预算的后果——驱动改用更小 tile,效率反降
OK,言归正传,超了预算会怎样?Khronos 指南写得很直白:如果附件位宽超过该 tile 尺寸下的片上容量,驱动可能不得不改用更小的 tile,而更小的 tile 会降低效率(出处)。
注意方向:它不是报错,也不是自动降画质,而是悄悄换成更碎的切分方式。结果是你什么都没改,帧率却掉了。附件生命周期没写对同样挨罚:transient 没设好时 fragment jobs 会从 56/s 涨到 113/s(出处)。
这也解释了:为什么"顺手多塞一路 G-Buffer"这种看着无害的改动会带来不成比例的掉帧。
4.7 原理与概念:四家厂商的片上容量口径
四家主流移动 GPU 厂商都提供了"把中间数据留在片上"的机制:
| 厂商 | 机制 | 官方口径 |
|---|---|---|
| Apple | 无记忆存储(Memoryless)+ 可编程混合 + 光栅顺序组 | 延迟光照"可用单个 render pass 实现","不需要为几何缓冲纹理分配系统内存" |
| Imagination | 像素局部存储(Pixel Local Storage, PLS) | "延迟光照里的 G-Buffer"就是用途之一;中间缓冲"从不写回系统内存" |
| Arm | PLS / Framebuffer Fetch / Vulkan Multipass | 见第一章的 BU 账;PLS 上限 128 bit |
| Qualcomm | 子通道(Subpass)+ 片上内存堆(Tile Memory Heap) | 反射率、法线、深度先在 Deferred Pass 写出,再由后续 pass 访问 |
出处见 Apple TBDR 文档 与 Imagination PLS 文档。四种机制的共同点只有一件事:别让 G-Buffer 落片外。
四家的机制名字不同,做的事却是同一件:把中间缓冲留在片上、让它在 pass 内产生也 pass 内消费。差别落在三处——谁能显式声明(Vulkan 的 transient、Metal 的 memoryless)、谁只能靠驱动隐式判断(Adreno 的启发式切换)、以及容量与生命周期各由谁约束。记住这三处差别,比记住四个 API 名字有用得多。
4.8 效果与量化:一个算例,把 1080p 的 G-Buffer 塞进 128 bit
好了,来做一次具体的塞包:1080p 的 G-Buffer,预算 128 bit/像素。
先澄清口径:128 bit/像素管的是每像素位宽,14 MB 管的是整块片上内存的规模,两者不能直接相乘。
按 32×32 的 tile 换算:一块 tile 有 1024 个像素,1024 × 128 bit ÷ 8 = 16 KiB,这是单块 tile 需要的片上颜色存储(换算,tile 尺寸取 PowerVR 典型值)。
怎么把 1080p 塞进 128 bit?常见三条路:省掉深度改用深度重建位置、把法线换成更省的编码、或者索性不存 G-Buffer,把光照结果直接写成 pass 的最终颜色附件——也就是后面常提的"1 BU"。分配语义要用对,TRANSIENT_ATTACHMENT_BIT 的含义见 VkImageUsageFlagBits。
4.9 原理与概念:为什么 1080p 天生比 720p 更难
先澄清一点:128 bit/像素这条线与分辨率无关,720p 和 1080p 的每像素预算一模一样。
那为什么 1080p 更难?难在总账。720p 是 1280×720 = 921,600 像素,1080p 是 1920×1080 = 2,073,600 像素,相差 2.25 倍(换算)。每像素的趟数没变,需要处理的"像素 × 趟"总数却变成了 2.25 倍。
两头一夹就出问题了:单片容量没变、每像素预算没变,但 tile 总数涨了 2.25 倍,tile 切换与 binning 的相对开销随之上升。如果此时位宽又超预算,驱动再把 tile 改小,tile 数继续增加——负反馈叠加,掉帧会比线性预期来得更快。顺便对一次位宽账:G-Buffer 四路各 32 bit 就是 128 bit(出处:Unity Manual)。
4.10 效果与量化:本章小结
| 项 | 结论 |
|---|---|
| 片上内存 | 固定容量、按 tile 划分的暂存区;官方示例 14 MB |
| 单 tile 容量 | = tile 宽 × tile 高 × 每像素位宽 ÷ 8;32×32 @ 128 bit 即 16 KiB |
| 硬线 | 128 bit/像素(Arm 与 Khronos 一致),G72 起提到 256 bit |
| 典型冲突 | G-Buffer 四路各 32 bit 吃满 128 bit,光照结果无处安放 |
| 超预算后果 | 驱动改用更小 tile、效率反降;transient 没设好则 fragment jobs 翻倍 |
| 三条退路 | 降某一路位宽(损失精度)、深度重建位置(多一次 ALU)、光照写成最终颜色附件 |
第二章的结论可以压成两句:片上预算是面积约束,带宽预算是速率约束,前者比后者更难绕开,因为它不能靠“优化访问模式”缓解。而预算是按附件逐条累加的,所以真正的工程量不在“选一个格式”,而在把每一路的位宽都压到刚好够用——少一位会出量化瑕疵,多一位就把下一路挤出去。
到这里,"账"和"预算"都摆出来了:一边是落片外的 ~10 BU,一边是片上 128 bit/像素。接下来两章看"能做什么"——靠什么机制把两者压进同一个 pass。
三、能的①:把 G-Buffer 留在片上
5.1 一句话点题:唯一的正解是把两趟压成一趟
上一章把硬线摆上了台面:片上内存固定,附件位宽一超,驱动就退回更小的块。于是 G-Buffer 落不落地,成了非此即彼的分岔。
这一章只讲第一条路——把几何缓冲(G-Buffer)留在片上,形态只有一个:让几何与光照落在同一个渲染通道(Render Pass)里。Arm 的官方文章说得最直白:要让分块 GPU 的优势兑现,G-Buffer 与光照 pass 必须背靠背(back-to-back)发生(原文)。前提成立,读写在片上,账从 10 BU 掉到 1 BU。
好了,下面我们按 API 逐个看这条"背靠背"怎么落。
5.2 原理与概念:单 pass 延迟光照的管线结构
把两趟压成一趟,结构上并不神秘。一个渲染通道里挂两个子通道(Subpass):第一个跑几何,把反射率、法线、粗糙度、深度写进若干附件;第二个逐像素读回它们算光照,结果写进最终颜色附件。中间那几个附件只服务于第二个子通道。
Apple 在延迟光照样例里给的口径是:延迟光照渲染器可以用单个渲染通道实现(原文);它是分块延迟渲染(Tile-Based Deferred Rendering, TBDR)架构,渲染到片上内存能避开 GPU 与系统内存之间那些昂贵的往返(原文)。
说白了,第二趟光照并没有消失,它只是被搬进了同一个通道。
5.3 实现与配置:Vulkan 的 subpass 与 input attachment
Vulkan 这一侧的落点是子通道与输入附件(Input Attachment)。要点三条:G-Buffer 附件要按输入附件的用途声明,即 VK_IMAGE_USAGE_INPUT_ATTACHMENT_BIT(取值 0x80)(refpage);在 VkSubpassDescription 里用 pInputAttachments 指出"第几个附件、第几层";两个子通道之间用 vkCmdNextSubpass 推进(规范章)。
这里有一条最容易踩的语义:输入附件的读取被严格限制在当前像素,读不到邻居。它是后面第五章的主角,先记住——这条限制管的是邻域,不是容量。
配置骨架大致是这样:
// 子通道 0:几何,写 attachment 0..2
VkAttachmentReference gbuf[3] = {{0, VK_IMAGE_LAYOUT_COLOR_ATTACHMENT_OPTIMAL}, /* … */};
subpass[0].pColorAttachments = gbuf;  subpass[0].colorAttachmentCount = 3;

// 子通道 1:光照,读 G-Buffer,写 attachment 3
VkAttachmentReference in[3] = {{0, VK_IMAGE_LAYOUT_SHADER_READ_ONLY_OPTIMAL}, /* … */};
subpass[1].pInputAttachments = in;    subpass[1].inputAttachmentCount = 3;
subpass[1].pColorAttachments = &finalColor;

vkCmdNextSubpass(cmd, VK_SUBPASS_CONTENTS_INLINE);
5.4 实现与配置:transient attachment 与 lazily allocated 的分配语义
让 G-Buffer 附件只活在片上,要在创建阶段补两个声明:瞬时附件(Transient Attachment)与懒分配(Lazily Allocated)。用途位里加入 VK_IMAGE_USAGE_TRANSIENT_ATTACHMENT_BIT(取值 0x40),内存类型里选一个带 VK_MEMORY_PROPERTY_LAZILY_ALLOCATED_BIT 的。前者管用途,后者管分配。
合起来的效果,Khronos 的官方文字是:某些 GPU 可以完全不为这些附件分配物理系统内存(原文)。Qualcomm 官方博客给的量级示例是 14 MB 的片上内存,并说明这块内存"通常只装得下少量资源"(原文)。
这一条的分量在于:不分配,就没得落盘。
5.5 实现与配置:loadOp / storeOp 的正确组合与错误组合
先来看看这两组取值的语义。加载操作 VkAttachmentLoadOp 有三个取值:VK_ATTACHMENT_LOAD_OP_LOAD、VK_ATTACHMENT_LOAD_OP_CLEAR、VK_ATTACHMENT_LOAD_OP_DONT_CARE;其中 DONT_CARE 表示不需要上一帧内容,此时内容未定义(undefined)(refpage)。存储侧则用 VK_ATTACHMENT_STORE_OP_DONT_CARE 表达"这个结果没人要,别写回"。
Arm 的措辞很直接:glInvalidateFramebuffer() 或 STORE_OP_DONT_CARE 就是在表达这个意图(原文)。Qualcomm 的最佳实践也把 CLEAR / DONT_CARE 的正确使用单列为一条(原文)。
配置写完还得确认它真的生效——Khronos 给出的验证手段是扩展 VK_EXT_subpass_merge_feedback(原文)。
| 附件角色 | loadOp | storeOp | 说明 |
|---|---|---|---|
| G-Buffer 各通道 | DONT_CARE | DONT_CARE | 读回在片上完成,写回毫无意义 |
| 最终颜色附件 | CLEAR 或 LOAD | STORE | 屏幕要显示的东西,必须留下 |
| 深度附件 | CLEAR | DONT_CARE | 除非后续要做深度重建或后处理采样 |
三条组合规则可以压成一句话:只在必要时才让内容落到外部内存。G-Buffer 各通道在片上被读回之后就再无用处,所以 load 与 store 都设 DONT_CARE;最终颜色一定要留下,所以 store 必须是 STORE;深度只在做深度重建或后处理采样时才需要保留。下表把这三条落成具体的取值组合,配错任意一条,上一节的收益就会按比例还回去。
5.6 实现与配置:Apple Metal 的 memoryless 与 programmable blending
Metal 这一侧不需要显式的子通道概念,它把"只活在片上"直接做成一种存储模式:MTLStorageModeMemoryless。Apple 的官方表述是,系统内存不需要为几何缓冲纹理分配(原文);存储模式的整体取舍另有一篇专门文档(原文)。
另一个机制是可编程混合(Programmable Blending):片元着色器在同一次绘制里读回片上内存中当前像素已有的颜色,自己决定怎么合成,比"另开一趟"便宜得多。与之配套的是光栅顺序组(Raster Order Groups),用来约束同一像素上片元程序的执行次序。
5.7 实现与配置:Imagination 的像素局部存储(PLS)与它的"绝不写回系统内存"
PowerVR 路线上的对应机制叫像素局部存储(Pixel Local Storage, PLS),扩展名是 EXT_shader_pixel_local_storage。Imagination 官方对它的描述几乎就是照着延迟着色写的:这个扩展让应用把逐像素的中间数据存在片上,"例如延迟光照 pass 里的 G-Buffer";而这些中间缓冲"从不被分配、也从不写回系统内存"(原文)。
代价要写清楚:PLS 不是真正的渲染目标,没有硬件替你做 sRGB 编解码,得自己加几条 ALU 去近似(原文);容量同样卡在 128 bit/像素。Imagination 另有一篇讲 PLS 使用策略的文档(原文)。
5.8 实现与配置:Qualcomm Adreno 的 tile memory heap 与作用域约束
Qualcomm 的路线是在 Vulkan 上开一个扩展:VK_QCOM_tile_memory_heap。官方博客举的例子直接就是延迟着色——反射率、法线、深度三个资源先在延迟 pass 里写进片上,随后在后续 pass 中被访问(原文)。
它最关键的约束是作用域:片上内存堆的生命期被绑在一次渲染通道之内,数据一旦跨通道,还是得落回系统内存。所以正确写法不是"把 G-Buffer 塞进堆里",而是"确保所有消费者都在同一个通道里"。
5.9 实现与配置:四种片上机制对照表
四家厂商四种机制,语义一致,API 各异。并排放一张表,工程上最有用的部分就出来了:同一个意图在不同平台上该写哪个字段。
| 平台 / 厂商 | 机制 | 关键字段或扩展 | 上限口径 |
|---|---|---|---|
| Apple Metal | memoryless 存储模式 | MTLStorageModeMemoryless |
随 GPU 而定 |
| Vulkan 通用 | 子通道 + 输入附件 | VK_IMAGE_USAGE_INPUT_ATTACHMENT_BIT(0x80) |
128 bit/像素,Mali-G72 起 256 bit |
| Vulkan 通用 | transient + 懒分配 | VK_IMAGE_USAGE_TRANSIENT_ATTACHMENT_BIT(0x40)、VK_MEMORY_PROPERTY_LAZILY_ALLOCATED_BIT |
同上 |
| Imagination PowerVR | 像素局部存储 | EXT_shader_pixel_local_storage |
128 bit/像素 |
| Qualcomm Adreno | 片上内存堆 | VK_QCOM_tile_memory_heap |
示例 14 MB |
再补一份可复现的配置参照。UE 在 Mali(Vulkan)上的官方限额是:G-Buffer 每像素 16 字节 / 128 bit、最多 4 个输入附件、光照 pass 最多取 3 个颜色附件加 1 个深度附件;配置里的 MobileUsesExtendedGBuffer=true 可以解除(原文)。注意这是引擎的保守默认值,不是硬件上限。
5.10 效果与量化:收益——从 10 BU 降到 1 BU
OK,言归正传,回到账上。Arm 给的最优情况是:只剩 1 BU——写最终那张光照附件,换来约 10 倍的带宽削减(原文)。Khronos 讲的是同一件事的另一面:子通道合并后,驱动把多个逻辑子通道合成一次硬件通道,G-Buffer 属性这类中间数据全程待在片上,从不写入外部显存(原文)。
这中间的差值(换算:10 BU − 1 BU = 9 BU)就是本章全部的收益。它不来自任何聪明的着色技巧,只来自一个决定:让几何与光照挨着跑。
5.11 效果与量化:实测数字——Mali 的 55% 与未设 transient 的翻倍代价
Khronos 的 subpasses 样例(由 Arm 编写)给了一组 Mali-G76 的实测:合并子通道后,使用的 tile 数量约减少 55%(262.2k/s 对比 614.7k/s),带宽同样减少 55%(原文)。这是"合并真的生效"的硬证据,也是本节最值得记住的一对数字。
没设 transient 的代价同样有数字:每秒的 fragment jobs 大约翻倍,从 56 涨到 113(同上)。Qualcomm 的最佳实践另给了一条:子通道链带来的收益可以超过 10% 的帧时间(原文)。
5.12 效果与量化:本章小结
把这一章压成一张结算表。
| 项 | 结论 |
|---|---|
| 唯一正解 | 几何与光照同处一个渲染通道,中间数据不落外部显存 |
| Vulkan 侧 | 子通道 + 输入附件;transient(0x40)+ 懒分配 |
| 读写操作 | 读侧 DONT_CARE 内容未定义;写侧用 VK_ATTACHMENT_STORE_OP_DONT_CARE |
| Metal 侧 | MTLStorageModeMemoryless + 可编程混合 + 光栅顺序组 |
| PowerVR 侧 | PLS,"从不写回系统内存",但无硬件 sRGB |
| Adreno 侧 | VK_QCOM_tile_memory_heap,生命期绑在单次通道 |
| 收益 | 10 BU → 1 BU(换算:降 9 BU),约 10 倍削减 |
| 实测 | Mali-G76:tiles 与带宽各 −55%;未设 transient:56/s → 113/s |
| 硬线 | 合并上限 128 bit/像素,Mali-G72 起 256 bit |
第三章要给的是一份可落地的清单,而不是四个平台的产品说明。四种机制看似各写各的,实际要满足的条件是同一条:声明清楚哪些附件是瞬时的、并在同一个渲染通道里把生产者与消费者接在一起。做到这一条,平台差异就退化成字段名差异;做不到,换成哪家 GPU 都一样。
可这一切有个前提:G-Buffer 得装得下。装不下的时候,还有一条路。
四、能的②:把 G-Buffer 做小
6.1 一句话点题:装不下时的第二条路
上一章把 G-Buffer 留在了片上,但留住它的前提是它塞得进那 128 bit/像素的预算。而现实里桌面引擎的 G-Buffer 往往更胖:Unity 官方公布的位宽是 160 bit/像素(非 HDR)与 192 bit/像素(HDR)(原文)。
装不下时有两条路:要么放弃片上、接受 10 BU;要么把 G-Buffer 做小,让它重新塞回去。这一章讲第二条,手段一共四类——通道打包、法线编码、不存位置、换一种中间表示。下面我们开始逐条看。
6.2 实现与配置:通道打包(反射率 + 镜面反射合进一个 RGBA)
依然是惯例,先从最不动脑子的那条说起:把能挤的通道挤在一起。Unity 的 URP 延迟路径公布了它的 G-Buffer 布局——反射率(Albedo,sRGB)与镜面反射(Specular)各占 24 bit,法线占 24 bit,另有自发光、GI 与光照通道用 B10G11R11_UFloatPack32 或 R16G16B16A16_SFloat 承载(原文)。
打包的做法是把两者合进同一张 RGBA:RGB 存反射率,A 存镜面反射强度或粗糙度。省一张附件,就省下每像素 32 bit 的预算。这条思路与第 3 篇讲的通道合并是同一类手段。
6.3 实现与配置:法线编码的取舍——量化编码 vs 八面体编码
法线是 G-Buffer 里最占地方的一项。Unity 给了个开关:关闭 Accurate G-buffer normals 走量化编码,性能更好,官方注明"尤其在移动 GPU 上";开启则改用八面体编码(Octahedral Encoding),官方对移动端这部分开销用的词是"可能相当可观"(原文)。
取舍很直白:量化省带宽、省 ALU,但在掠射角与高光边缘容易露瑕疵;八面体编码精度更高,代价是编解码的 ALU。UE 那边还多一条限制:lit decal 的法线用八面体编码存储,因此无法混合,只能整体覆盖(原文)。
6.4 实现与配置:R10G10B10A2 的位分配与精度损失
量化编码最常用的承载格式之一是 R10G10B10A2。Unity 的 URP 就把法线渲染目标写成 ARGB2101010,也就是 R10G10B10A2(原文)。
位分配是 10 + 10 + 10 + 2 = 32 bit:三个法线分量各拿 10 bit,余下 2 bit 留给别的东西。精度损失可以估一下:把 [-1, 1] 区间的法线分量映到 10 bit,量化步长约 2 ÷ 1024 ≈ 0.00195(换算)。这个误差在漫反射上几乎看不出来,但会在高光边缘被放大。
顺带一句,A 那 2 bit 只能表示 4 个取值,够放一个材质标记,放不下粗糙度那样的连续量。
6.5 原理与概念:法线贴图在屏幕上长什么样
说白了,法线在 G-Buffer 里就是一张有颜色的图:X 映红、Y 映绿、Z 映蓝,所以"平面朝前"的区域呈淡紫色。下面这张外部示意图把同一只立方体的法线贴图与它的着色结果并排放着,帮大家对齐"法线通道长什么样"(图源页)。

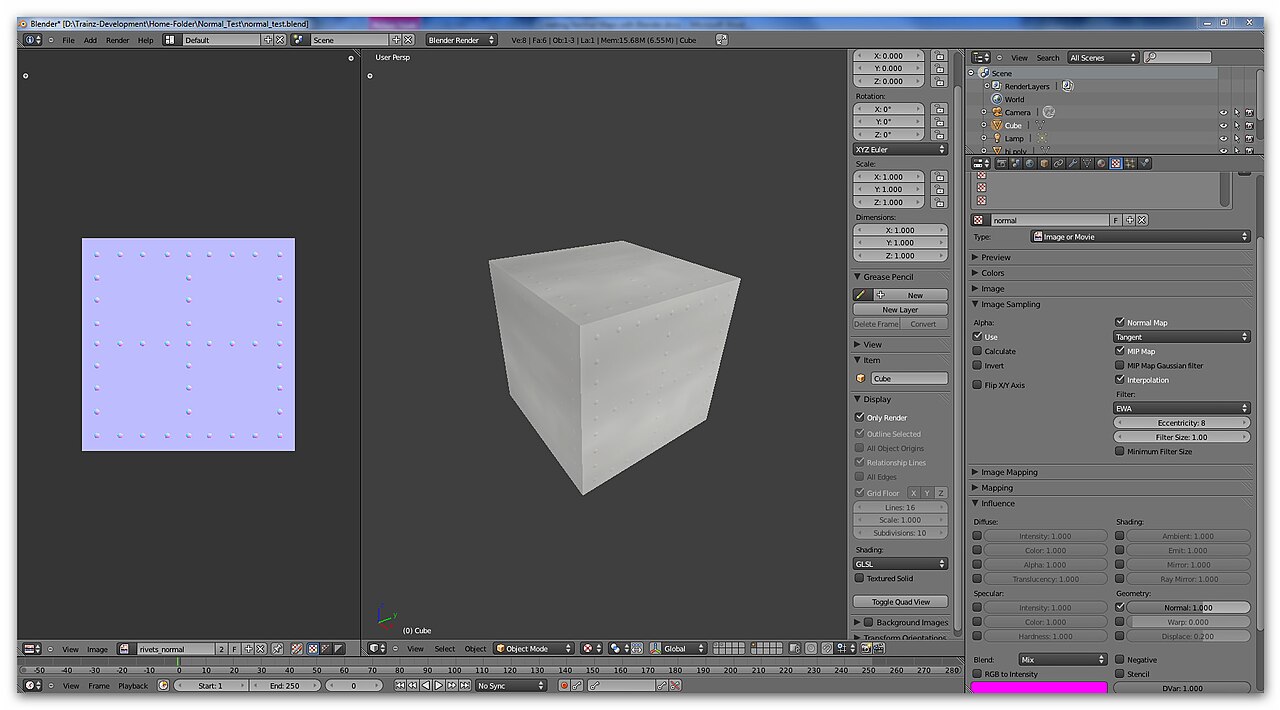
上一节那条"量化的瑕疵"要在哪里看?就看法线图里颜色渐变最陡的地方——那里正是 10 bit 分不开的区域。
6.6 实现与配置:不存位置——用 depth 重建
第三条是省掉整整一组通道:位置。世界坐标可以从深度重建——屏幕坐标加深度值,乘一次逆投影矩阵,就能把每个像素的位置还原出来。这样 G-Buffer 里只需存深度,不必存三个浮点分量。
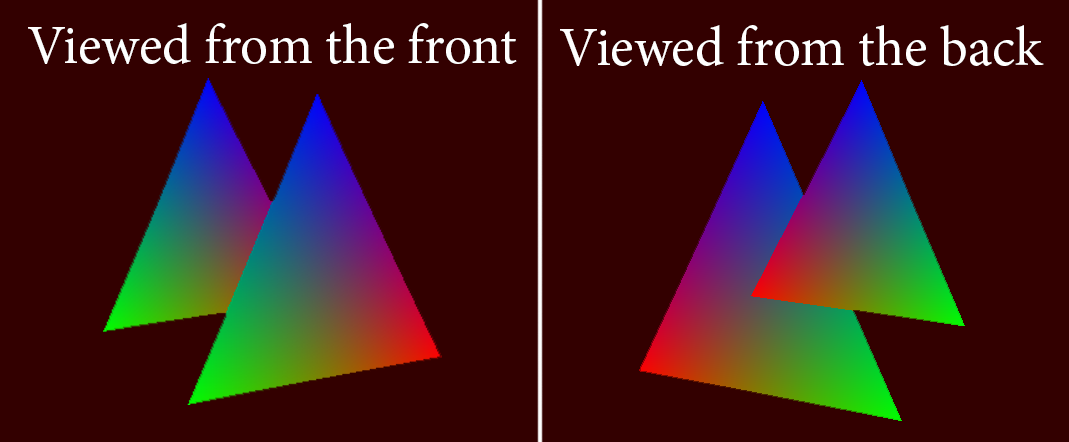
JCGT 那篇可见性缓冲论文给的口径是:一套 G-Buffer 每可见性样本通常占 16 至 32 字节(原文)。位置若不重建,这三个分量就是硬顶上去的。下面这张外部对照图展示的是没有深度缓冲时会发生什么——深度一旦失准,前后关系全乱。
6.7 原理与概念:深度缓冲的机制
重建位置的前提是深度本身可信,所以这里花一小节把机制对齐。深度缓冲(Depth Buffer)为每个像素留一个深度值,光栅化时新片元与已有值比较,通过测试才写入;于是一个像素最终留下的是最靠前的那一层(图源页)。

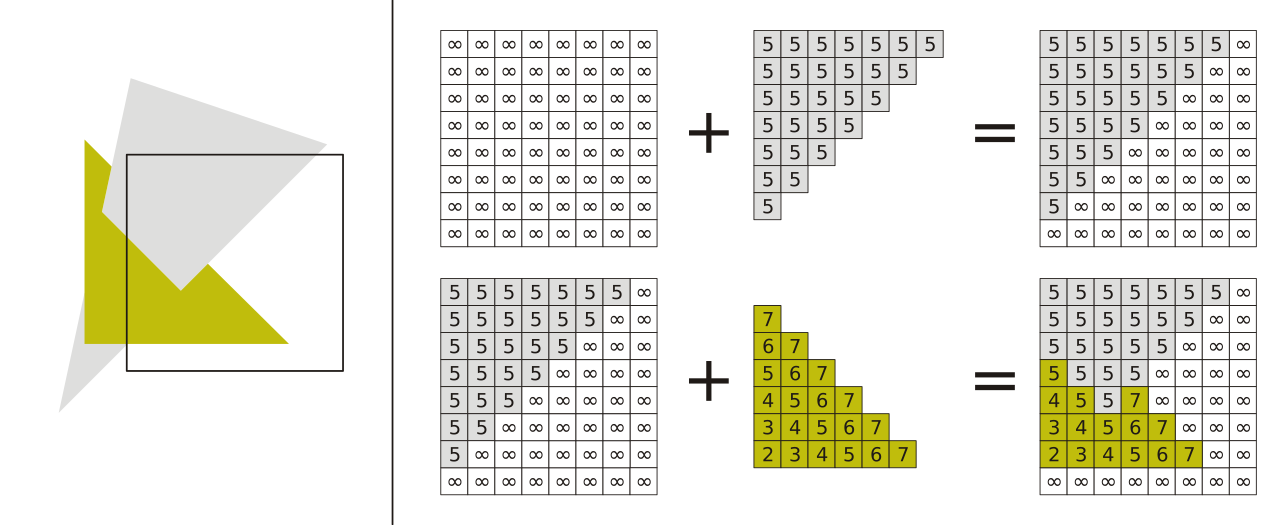
延迟着色把深度当成一张普通附件来写、来读;在移动端它还常常被当成"唯一必须精确的那一项",因为位置要靠它推出来。
6.8 原理与概念:光照预通道(Light Pre-Pass)——只存 Z 与法线
前三条都是"把列改窄",第四条是"把结构换掉"。光照预通道(Light Pre-Pass)把 G-Buffer 压到最小:几何通道只写深度与法线,光照通道只算"光长什么样"并把结果写进一张光照缓冲,最后由一次前向渲染(Forward Rendering)提交把材质颜色乘上去。
CMU 的延迟着色课程讲义梳理这一族做法时,把预通道与经典延迟并列讨论(讲义)。好处很直接:需要长期驻留的属性只剩 Z 与法线。
6.9 原理与概念:光照预通道的代价——多一趟几何提交
代价也在结构里:几何被提交了不止一次。经典延迟是"几何一次、光照一次",预通道变成三次提交——预通道几何、光照、前向各一次。多出来的那一趟要把几何重新光栅化一遍,第 4 篇讲过的 overdraw 成本原封不动地回来了。
所以这条路在移动端要谨慎:省下的是每像素的属性位宽,多付的是每帧的几何提交与像素遍历。Qualcomm 的最佳实践把多渲染目标(Multiple Render Targets, MRT)的使用上限单列为一条(原文),Unity 的移动光上限是每相机 1 盏主光加 32 盏附加光,GLES3 及更早 1 + 16(原文)——这些限额说的是同一件事:每像素能承担的东西有配额。
6.10 原理与概念:可见性缓冲(Visibility Buffer)
更激进的做法是干脆不存属性,只存"这是哪个三角形"。可见性缓冲(Visibility Buffer)只写三角形索引与实例 ID,属性等到着色时再拿索引去顶点缓冲里现取。
JCGT 那篇论文给的口径是:每样本可以少至 4 字节(原文)。在 1080p、8 倍 MSAA 的条件下,可见性缓冲的体积是 64 MB,而每样本 24 字节的 G-Buffer 是 398 MB(同篇)。差距来自一个事实:索引是紧凑的整数,属性不是。
6.11 效果与量化:瘦身后的预算核算表与本章小结
好了,把这一章的账并到一张表上,对照那条 128 bit/像素的线(换算:128 bit ÷ 8 = 16 字节/像素)。
| 方案 | 每像素 / 每样本 | 对 128 bit 预算 | 出处 |
|---|---|---|---|
| Unity 非 HDR G-Buffer | 160 bit | 超 32 bit(换算:160 − 128) | Unity Manual |
| Unity HDR G-Buffer | 192 bit | 超 64 bit(换算:192 − 128) | Unity Manual |
| UE 移动端 G-Buffer(Mali/Vulkan) | 16 字节 = 128 bit | 恰好踩线 | UE 官方文档 |
| G-Buffer 常规区间 | 16–32 字节(128–256 bit) | 下限踩线、上限翻倍 | Burns & Hunt, JCGT 2013 |
| 可见性缓冲 | 4 字节/样本 = 32 bit | 余 96 bit(换算:128 − 32) | 同上 |
论文里还有一个更直观的数字:4 MP 屏幕、每像素 4 个 24 字节样本、60 Hz,单次光照 pass 的 G-Buffer 写加读就要约 46 GB/s(同上)。而 24 字节/像素的 G-Buffer 在 1080p 下约 47.5 MiB(换算:1920 × 1080 × 24 B ≈ 47.5 MiB)。
瘦身的代价也不该忘。GPU Gems 3 里那篇 Tabula Rasa 早就把经典延迟的三大缺陷列清了:高内存带宽、无硬件抗锯齿、缺乏真正的 alpha 混合(原文)——本章做小的是第一条,另外两条留给后面两章。
本章结算如下。
| 项 | 结论 |
|---|---|
| 第一类:打包 | 反射率 + 镜面反射合进一个 RGBA |
| 第二类:编码 | 量化省 ALU,八面体精度高但移动端开销可观 |
| 第三类:不存位置 | 用深度重建,省掉三个分量 |
| 第四类:换结构 | 预通道只留 Z 与法线;可见性缓冲只留索引 |
| 尺子 | 128 bit/像素即 16 字节/像素 |
| 代价 | 预通道多一趟几何提交;打包与量化牺牲混合与精度 |
五、不能的①:一拆 pass 就前功尽弃
前面的章节都在讲"能做什么":把 G-Buffer 留在片上、把它的位宽压下来。从这一章起换到反面,先讲最容易被忽略、也最容易自己踩上的那一条。
7.1 一句话点题:最高频的自我拆台
"不能"里的第一种,也是工程上最高频的一种:不是硬件不给你,而是渲染管线自己把两趟拆开了。
Arm 那篇讲移动端延迟着色的官方文章,把代价写得毫不含糊:一旦 G-Buffer 与光照被拆进两个渲染通道(Render Pass),"we are back to 10 BU bandwidth cost, and any tile optimizations become meaningless"。
这句话有前后两半。前半是账回到 10 BU:写 4 + 读 ≥4 + 混合 ≥2。后半是前面所有 tile 优化全部作废——真正疼的是后半句。
说白了,这一章要讲的不是"某个效果做不了",而是"一个看起来无害的效果,能让前面几章的努力一起归零"。
(Arm《Deferred shading on mobile: An API overview》,https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/deferred-shading-on-mobile)
这一章要走的路径是:先说清"两趟必须背靠背"这条前提,再拿一个具体效果当反例看它怎么被破坏,最后落到规范层的判据上。原因也简单:G-Buffer 与光照一旦落进两个渲染通道,片上内存就失去意义,账本从 1 BU 弹回 10 BU。而这个回退发生在应用层,不需要硬件做任何"坏事",所以极难被归因。
7.2 原理与概念:back-to-back 这条前提
那句"回到 10 BU"不是意外,它对应一条明确前提,同一篇文章也给了出来:"to make tile-based GPUs shine, G-buffer, and lighting passes must happen back-to-back."
为什么必须背靠背?片上内存(On-chip Memory / Tile Memory)不是缓存(Cache),而是块内的一块暂存区。缓存丢了大不了慢一点;暂存区清空了,数据就是不存在,你只能重算或重搬。
所以"留在片上"这件事,没法等到优化阶段再补。它是一条结构约束:写 G-Buffer 的子通道(Subpass)与读它的光照子通道,必须在同一个渲染通道内。Khronos 官方指南把它写成:子通道合并(Subpass Merging)之后,中间数据 "stays entirely within the tile memory and is never written to external VRAM"。
(Khronos《Tile Based Rendering (TBR) Best Practices》,https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html)
7.3 原理与概念:SSAO 的反例——它为什么逼你把两趟拆开
证明这条前提的最好办法,是看一个会打破它的效果。Arm 选的反例是屏幕空间环境光遮蔽(Screen-Space Ambient Occlusion, SSAO)。
SSAO 要估计每个像素周围"被挡了多少",做法是围绕该像素采样一圈邻居的深度与法线。问题恰好出在"围绕"这两个字上:它需要邻域。而片上内存里的输入附件(Input Attachment)只能读当前像素自己,这条禁令下一节展开。于是 SSAO 只能在 G-Buffer 已经落进主存之后,另开一趟去读它。
顺序一变,前功尽弃。Arm 的原话是:加了 SSAO 之后,"now we are back to 10 BU bandwidth cost, and any tile optimizations become meaningless"。
(Khronos《Mobile rendering approaches》,https://docs.vulkan.org/tutorial/latest/Building_a_Simple_Engine/Mobile_Development/04_rendering_approaches.html)
7.4 效果与量化:拆开后回到 10 BU 的账
好了,把 10 BU 逐项摆开。下面这张表是 Arm 那篇文章的账本原样:
| 环节 | 官方口径 | 代价 |
|---|---|---|
| 写 G-Buffer | "Write G-buffer: 4 BU (albedo, normal, pbr, depth)" | 4 BU |
| 光照 pass 读 G-Buffer | ">= 4 BU (could be more if caches are thrashed or lots of overdraw)" | ≥4 BU |
| 光照 pass 混合光照缓冲 | ">= 2 BU (1 BU read + 1 BU write, could be more with overdraw)" | ≥2 BU |
| 合计 | "Cost: ~10 BU" | ~10 BU |
对照留在片上的最优情形:那 4 BU 的写与 ≥4 BU 的读 "all happens on-chip, and thus costs no external memory bandwidth",只剩最终附件的一次写,也就是 1 BU,官方给的结论是 ~10× 带宽削减。
这就是"能"的一面:同一份 G-Buffer,位置变了,账就差一个数量级。
注意表里两次出现的 overdraw:它让"读"与"混合"两段从有下限变成上不封顶。所以 10 BU 是最省的估计,实际只会更贵。
(Apple《Rendering a scene with deferred lighting》,https://developer.apple.com/documentation/metal/rendering-a-scene-with-deferred-lighting-in-objective-c)
把回退过程拆成动作看:第一步,某个后处理需要读邻居,于是光照不能和 G-Buffer 待在同一个通道;第二步,G-Buffer 必须落主存;第三步,写 4 BU 与读 ≥4 BU 同时回来;第四步,光照缓冲的混合再算 ≥2 BU。四步里没有一步是“错误写法”,每一步单独看都合理——这正是它能反复发生的原因。
7.5 原理与概念:邻居访问禁令——片上一个像素只能读它自己
禁令出自 Khronos 的 TBR 最佳实践,说的是输入附件这类片上读取:它 "is strictly restricted to the current pixel. You cannot use this extension to read neighboring pixels."
硬件为什么要这么定?因为片上是块内并行的:一个 tile 里成千上万个像素同时跑,彼此之间没有任何顺序保证。一旦允许读邻居,就必须引入同步与顺序,块内规则化的执行模型立刻失效。
这也正是光栅顺序组(Raster Order Groups)与像素局部存储(Pixel Local Storage, PLS)存在的理由:它们只在同一个像素上给顺序,不在像素之间开通道。
一句话:片上的读写都是"点对点"的,没有"面";而卷积、模糊、边缘检测都是"面"的操作。
(Vulkan Specification · Render Passes,https://docs.vulkan.org/spec/latest/chapters/renderpass.html)
7.6 原理与概念:为什么 bloom / FXAA / blur 必然要另开 pass
禁令的下半句,Khronos 也写了出来:"Common post-processing effects like bloom, FXAA, or blurs still require a separate sampling pass."
逐个看就明白了:泛光(bloom)要把高亮区域降采样成金字塔再逐级模糊,每一级都读上一级的邻域;模糊(blur)本质是卷积核,一个 3×3 核就要读八个邻居;快速近似抗锯齿(Fast Approximate Anti-Aliasing, FXAA)更直接,它靠比较像素与四周邻居的亮度来判定边缘方向。三者都需要"看别人"。
所以这不是"实现得不够好",而是屏幕空间后处理与片上执行模型在结构上互斥。你在 G-Buffer 上省下的每一次主存往返,都会被逼你另开 pass 的邻域操作要回去。
(Khronos《Appropriate use of render pass attachments》,https://docs.vulkan.org/samples/latest/samples/performance/render_passes/README.html)
7.7 原理与概念:破坏 subpass 合并的四种写法
合并失败不是感觉问题:Vulkan 规范有张合并状态清单,逐项说明为何没合上。先来看看最常见的四种:
- 插了显式依赖:子通道间写了依赖,驱动不敢合 → 状态码
..._NOT_MERGED_DEPENDENCIES_EXT。 - 附件别名:两个子通道的附件复用同一块存储 →
..._NOT_MERGED_ALIASING_EXT。 - 输入附件不合规:它不是上一子通道的颜色附件,或格式不兼容 →
..._NOT_MERGED_INCOMPATIBLE_INPUT_ATTACHMENT_EXT。 - 预算或数量超限:附件过多或片上存不下 →
..._NOT_MERGED_TOO_MANY_ATTACHMENTS_EXT/..._NOT_MERGED_INSUFFICIENT_STORAGE_EXT。
留一条给下一章:采样数不一致会得到 ..._NOT_MERGED_SAMPLES_MISMATCH_EXT——MSAA 与延迟着色冲突在规范层的落点。
(VkSubpassMergeStatusEXT,https://docs.vulkan.org/refpages/latest/refpages/source/VkSubpassMergeStatusEXT.html)
7.8 实现与配置:如何验证是否真合并(subpass merge feedback)
不要靠猜。Vulkan 给了直接问驱动的接口:VK_EXT_subpass_merge_feedback(设备扩展,编号 459,已批准,贡献者来自 Arm)。它会在创建 render pass 时回填每个子通道的合并状态 VkRenderPassSubpassFeedbackInfoEXT::subpassMergeStatus。
配置清单如下:
- 打开特性位
VkPhysicalDeviceSubpassMergeFeedbackFeaturesEXT::subpassMergeFeedback; - 在
VkRenderPassCreateInfo2上挂VkRenderPassCreationFeedbackCreateInfoEXT收结果; - 需要时用
VkRenderPassCreationControlEXT主动允许或禁止合并; - 附件声明
VK_IMAGE_USAGE_TRANSIENT_ATTACHMENT_BIT+VK_MEMORY_PROPERTY_LAZILY_ALLOCATED_BIT,让实现有机会完全不分配物理内存。
判读很简单:VK_SUBPASS_MERGE_STATUS_MERGED_EXT 是合上了,其余按后缀定位原因。有一个状态容易被误读——..._SINGLE_SUBPASS_EXT 表示这个 render pass 里只有一个子通道,没有可合的对象,它不是失败。
肉眼侧的旁证是 jobs 与带宽计数:未设 transient 附件时 fragment jobs 约翻倍(56/s → 113/s)。
(VK_EXT_subpass_merge_feedback,https://docs.vulkan.org/refpages/latest/refpages/source/VK_EXT_subpass_merge_feedback.html ;Khronos《Subpasses》样例(含 Mali-G76 实测),https://docs.vulkan.org/samples/latest/samples/performance/subpasses/README.html ;VkImageUsageFlagBits,https://docs.vulkan.org/refpages/latest/refpages/source/VkImageUsageFlagBits.html)
验证手段有两层。第一层是扩展本身:VK_EXT_subpass_merge_feedback 会在管线创建后回报一串状态码,明确告诉你合并没有,以及在哪个条件上失败。第二层是把状态码接到构建期或首帧的断言上——只在开发机上手动看一眼,等于把这条检查交给运气。工程上更稳的做法是让它失败即报错,而不是失败即降级。
7.9 效果与量化:本章小结
依然是惯例,把这章的账收一下:
| 项 | 结论 |
|---|---|
| 前提 | G-Buffer 与光照必须背靠背,即合并后的同一 render pass |
| 禁令 | 片上读取严格限于当前像素,不能读邻居 |
| 反例 | SSAO 需要邻域 → 被迫落盘 → 回到 ~10 BU(写 4 + 读 ≥4 + 混合 ≥2) |
| 代价 | "any tile optimizations become meaningless",1 BU 与 10× 削减一起作废 |
| 判据 | 合并状态可查(VkSubpassMergeStatusEXT);Mali-G76 合并后 tiles 与带宽各 −55%(262.2k/s vs 614.7k/s) |
| 连带 | bloom / FXAA / blur 必然另开 pass,这是结构成本,不是实现水平问题 |
一句话收尾:拆 pass 是最高频的一种自我拆台,因为它常常藏在"顺手加个 SSAO"里。
第五章的结论不是“别做后处理”,而是别让后处理成为 G-Buffer 与光照之间的那道墙。做法上有三种:把这类效果挪到 G-Buffer 之前(只依赖深度,不依赖表面属性)、把它们挪到光照之后(只读最终颜色)、或者接受拆分但把拆分点放到最省的那一处。三种都要在管线结构图上先想清楚,写到一半再改成本极高。
(VkAttachmentLoadOp 的 CLEAR / DONT_CARE 语义,https://docs.vulkan.org/refpages/latest/refpages/source/VkAttachmentLoadOp.html ;Arm《Mobile Best Practices》(Vulkanised 2025),https://www.vulkan.org/user/pages/09.events/vulkanised-2025/T18-Pete-Harris-Arm-MobileBestPractices.pdf ;Android GPU Inspector 渲染通道视图,https://developer.android.com/agi/frame-trace/renderpasses)
六、不能的②:MSAA 与延迟着色天然冲突
第五章讲的是"被拆开"的代价,这一章讲"从一开始就进不来"的那个特性。它被放弃得太彻底,以至于很多人不把它记成一项损失。
8.1 一句话点题:选了延迟就等于放弃了什么
选了延迟着色,第一件被放弃的是多重采样抗锯齿(Multisample Anti-Aliasing, MSAA)。这不是"性能不够",而是结构上不兼容:MSAA 靠的是每个像素内部保留多个样本(Sample)的几何覆盖,而延迟管线把每个像素压成"一份属性"。
两家的官方口径都很硬。Unreal Engine 5 的移动延迟着色文档,把不支持 MSAA 直接列进限制项;Unity URP 的支持矩阵里,MSAA 一栏 Forward 与 Forward+ 是支持,Deferred 是不支持。
结论只有一个:延迟管线想抗锯齿,就得走后处理抗锯齿(Post-Processing Anti-Aliasing)。而这一步一走,第五章那条邻居禁令立刻又跟了上来,代价只是换了个位置。
(UE《Mobile Deferred Shading》,https://dev.epicgames.com/documentation/en-us/unreal-engine/using-the-mobile-deferred-shading-mode-in-unreal-engine?application_version=5.4)
8.2 公式或参数逐项释义:MSAA 在 G-Buffer 下的体积膨胀
OK,言归正传,把膨胀算清楚。公式是:G-Buffer 字节数 = 宽度 × 高度 × 每像素位数 ÷ 8 × 采样数。逐项看:
| 参数 | 取值 | 出处 |
|---|---|---|
| 宽度 × 高度 | 1080p = 1920 × 1080 ≈ 2.07 M 像素 | 本篇基准 |
| 每像素位数 | 160 bit/px(非 HDR)/ 192 bit/px(HDR) | Unity Manual |
| 采样数 | MSAA 4× / 8× | 常规取值 |
| 每样本属性体积 | 16–32 B/样本 | Burns & Hunt, JCGT 2013 |
乘起来(换算):160 bit/px 在 4× 下是 640 bit/px,是片上 128 bit/px 预算的 5 倍;8× 下是 1280 bit/px,整整 10 倍。论文侧的对照更直观:1080p、8×MSAA,G-Buffer 体积 398 MB,而只存三角形索引与实例号的可见性缓冲(Visibility Buffer)只要 64 MB。
顺带看一眼分辨率这一项(换算):24 B/px 的 G-Buffer 在 1440p 上约 84.4 MiB——单采样已经不小,再乘采样数只会更远。
(Unity URP Deferred,https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@16.0/manual/rendering/deferred-rendering-path.html ;Burns & Hunt, JCGT 2013,https://www.jcgt.org/published/0002/02/04/paper.pdf)
这条膨胀公式里最值得记住的不是采样数,而是它是乘在这个数上的。G-Buffer 的体积本来就已经是整屏的好几倍,再乘 4 或 8,得到的量级会直接超过片上内存三到十倍。这不是"紧张",是差一个数量级。所以讨论 MSAA 与延迟着色时,结论才会如此干脆:不是不能凑合,是数不对。
8.3 原理与概念:为什么多数延迟实现被迫走 post AA
原因在 G-Buffer 的布局里。MSAA 的收益集中在几何边缘:边缘像素里既有前景也有背景,所以有多个覆盖样本。要用上它,光照与属性都得逐样本算、存。
而延迟管线的全部收益,恰来自"每像素一份属性、光照只算一次"。逐样本属性直接把体积乘 4 到乘 8(见 8.2 的算式),立刻越界。工程上只剩一个二选一:要么放弃 MSAA,要么放弃片上化。多数实现选前者。
post AA 也不是白拿的。Olsson 等人把 MSAA 缺失写进经典延迟的缺点清单;替代方案在屏幕空间做邻域判断,暗部与高对比纹理上容易误判边缘。
(Olsson et al., HPG 2012,https://dl.acm.org/doi/epdf/10.5555/2383795.2383809 ;GPU Gems 3 · Tabula Rasa,https://developer.nvidia.com/gpugems/gpugems3/part-iii-rendering/chapter-19-deferred-shading-tabula-rasa)
8.4 效果与量化:抗锯齿效果的外部对照(外部实图)
先建立直观基线。下面这张外部对照图展示的是几何边缘的锯齿与抗锯齿差异,这正是 MSAA 要解决的问题。
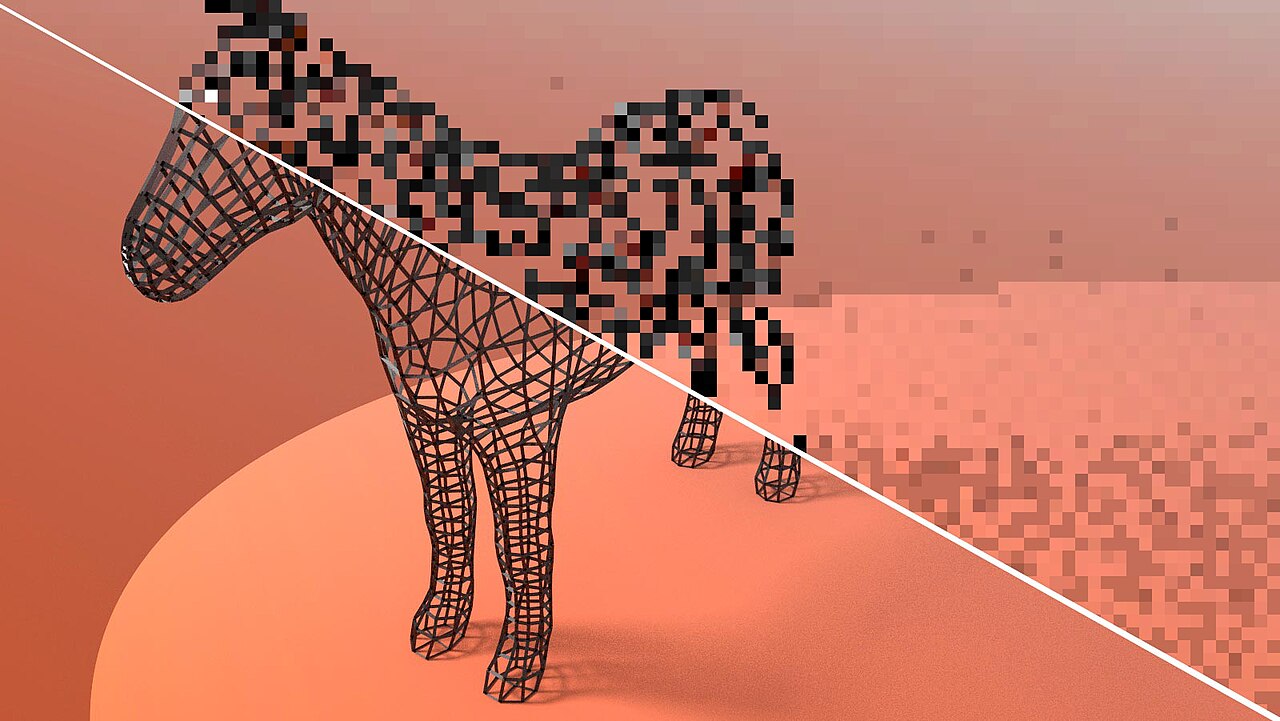
这里要说清边界:这张图给出的是"效果长什么样",不是移动端实测截图,本章的量化结论也不从它来。数字来自两条官方口径——MSAA 在延迟路径上被官方标为不支持(UE / URP);以及高采样率下的体积代价,1080p、8×MSAA 下 398 MB 对 64 MB。
换句话说:外部图证明"问题存在",官方文档负责回答"代价多大",两件事不能混用。
(Commons File:Anti-Aliasing in CGI.jpg,https://commons.wikimedia.org/wiki/File:Anti-Aliasing_in_CGI.jpg)
8.5 原理与概念:tiler 的 MSAA 红利为什么吃不到
这两句话必须分开,它们常被混成一句。
A:分块架构让 MSAA 变便宜。 这是硬件机制——逐样本数据与解析(Resolve)都在片上完成,不必把每个样本写回主存。Apple 官方把它表述为 "avoids potentially expensive round trips between the GPU and system memory";PowerVR 的架构文档也把它列进同一条红利。
B:延迟着色让 MSAA 变贵。 这是数据量——G-Buffer 要逐样本保留属性,体积随采样数上涨,而片上是固定的 128 bit/px(Mali-G72 起 256 bit/px)。
A 与 B 不矛盾,但 A 的红利会被 B 吃掉。原因很朴素:tiler 省的是"搬运"不是"容量"——片上省得下往返,却省不出额外的 bit。
(Apple《Tailor your apps for Apple GPUs and TBDR》,https://developer.apple.com/documentation/Metal/tailor-your-apps-for-apple-gpus-and-tile-based-deferred-rendering ;PowerVR 硬件架构总览,https://imagination-technologies-cloudfront-assets.s3.eu-west-1.amazonaws.com/website-files/documents/PowerVR+Hardware.Architecture+Overview+for+Developers.pdf)
8.6 原理与概念:G-Buffer 量化格式与 post AA 叠加出的瑕疵
要把 G-Buffer 塞进固定位宽,就得用量化格式:Unity 的法线渲染目标用 ARGB2101010 格式,G-Buffer 总位宽是 160 bit/px(非 HDR)与 192 bit/px(HDR);移动端更常见的是 B10G11R11_UFLOAT、RGBA8_SRGB 这类打包格式。法线还可以走八面体编码(Octahedral Encoding),但 Unity 提醒,打开 "Accurate G-buffer normals" 在移动 GPU 上的开销 "might be considerable"。
好了,来看两处误差怎么叠加。量化把法线与粗糙度压进 10 位,光照过渡会出现阶梯;而 post AA 按像素亮度工作,读不到逐样本的法线与深度,因此看不见成因,也修不掉它。结果是边缘被磨平了,梯度上的瑕疵还在。
(Unity《Deferred Shading Rendering Path》(5.6),https://docs.unity3d.com/560/Documentation/Manual/RenderTech-DeferredShading.html)
8.7 效果与量化:三家引擎与厂商的官方 AA 口径对照
| 来源 | 官方口径 | 对延迟着色的含义 |
|---|---|---|
| Unreal Engine 5 | 移动延迟着色的限制项里写明不支持 MSAA | 走延迟就得另配 AA |
| Unity URP | MSAA 支持矩阵:Forward 支持 / Forward+ 支持 / Deferred 不支持 | 同一份矩阵里的二选一 |
| Godot 4 | 不提供 deferred 路径,理由是 deferred "requires using hacks to be able to use MSAA" | 官方用脚投票选 clustered forward |
| Qualcomm | 最佳实践写 "Prefer MSAA to other anti-aliasing techniques" | 厂商推荐 MSAA,与延迟路径冲突 |
| Imagination | HSR 把每像素着色片段从 4.7 降到 1.2(−75%) | 硬件侧红利建立在逐像素属性之上 |
这张表的读法不是"谁对谁错",而是三家的官方口径指向同一个取舍:需要 MSAA 就别走延迟,走了延迟就把 AA 交给后处理。
(Unity URP Universal Renderer,https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@16.0/manual/urp-universal-renderer.html ;Godot 内部渲染架构,https://docs.godotengine.org/en/stable/engine_details/architecture/internal_rendering_architecture.html ;Qualcomm 移动最佳实践,https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html ;Imagination HSR Efficiency,https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/hidden-surface-removal-efficiency.html)
五方口径合起来看,指向同一个取舍:厂商侧普遍推荐 MSAA(因为它在 tile 架构上便宜),而三家引擎的延迟路径普遍不支持 MSAA(因为 G-Buffer 放不下多个样本)。两个陈述都成立,冲突不在技术层面,而在“你选了哪条路径”。因此这条结论应该写成条件句:要 MSAA,就先别走延迟;要走延迟,就把 AA 交给后处理。
8.8 效果与量化:本章小结
依然是惯例,把这一章的账收一下:
| 项 | 结论 |
|---|---|
| 冲突性质 | 结构不兼容:MSAA 要逐样本覆盖,延迟是每像素一份 |
| 体积账 | 160 bit/px × 4 采样 = 640 bit/px,为 128 bit/px 上限的 5 倍;8× 则 10 倍(换算) |
| 极端对照 | 1080p、8×MSAA:G-Buffer 398 MB vs 可见性缓冲 64 MB |
| 两句要分开 | tiler 让 MSAA便宜(省搬运),延迟让它变贵(要容量) |
| 被迫的路线 | 放弃 MSAA → post AA;它要邻域,第五章禁令依然生效 |
| 官方口径 | UE 不支持 MSAA;URP 矩阵 Deferred 为 ✗;Godot 4 不给 deferred;Qualcomm 仍推荐 |
一句话收尾:代价不是"抗锯齿差一点",而是抗锯齿换了机制,换来那套又踩在片上禁令上。
第六章的落脚点是三个可判定的问题:目标机型要不要 MSAA、画面透明物体占比高不高、材质种类多不多。三者只要有一个答“是”,延迟着的收益就会被后处理通道和材质分支吃掉大半。它不该被写成“移动端不能延迟着色”,而应写成“当且仅当三个答案都是否,延迟才划算”。
七、不能的③:透明、材质多样性与"一像素只能读自己"
前面两章分别讲了"一拆 pass 就前功尽弃"(第五章)与"MSAA 从一开始就进不来"(第六章)。这一章讲第三种不能:它不是参数没调好,而是延迟着色这套数据流形态自带的边界。
9.1 一句话点题:延迟着色不是通用解
前两条"不能"是"你做了什么"导致的;这一条不同,它长在延迟着色的形态里面。延迟管线把每个像素一份属性当成前提,而这个前提在三种情形下站不住:需要合成(透明)、需要多样(材质)、需要读别人的像素(邻域)。三者都不是实现问题,是结构问题。这一章只说清每条的机制与口径。
OK,言归正传,先看透明为什么回不去。
第七章的三条限制有个共同点:它们都不是性能问题,而是能力边界。透明物体回不到 G-Buffer 是数据模型问题;材质多样性是内存布局问题;片上一像素只能读自己是硬件语义问题。这三条没有“优化”的余地,只能靠管线结构绕开,所以它们决定了延迟着色在移动端的天花板,而不只是成本。
9.2 原理与概念:透明物体为什么回不到 G-Buffer
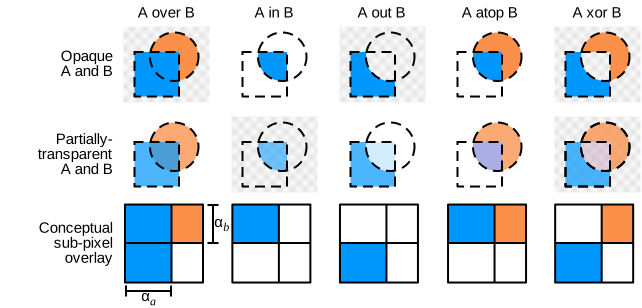
半透明像素没有唯一的一层。它的颜色是多层按透明度加权合成的结果,而 G-Buffer 每个像素只保留一份属性——写第二层时,第一层已经被覆盖。延迟管线只承认最靠前的不透明表面,而半透明的意义恰在于同时保留多层。
GPU Gems 3 那篇 Tabula Rasa 早把这条列进经典延迟的缺陷:"缺乏真正的 alpha blending"(原文)。UE 5 的移动延迟文档更干脆:半透明始终走前向渲染(原文)。
9.3 实现与配置:前向与延迟混合的可行结构
透明回不去,通行做法是让两条路分工:不透明走延迟,透明走前向,那一趟排在延迟光照之后(指引)。
配置要点两条:透明必须排在延迟光照之后,否则拿不到已算好的光照;深度上透明只测不写,延迟侧的深度附件随后按 DONT_CARE 放掉(refpage)。
附件要按输入附件声明(VK_IMAGE_USAGE_INPUT_ATTACHMENT_BIT,0x80)才允许同通道内读回,读写语义由规范定义(规范章|refpage)。
好了,下面我们开始看这条混合管线的落点。
混合结构的可行形态是“延迟管不透明、前向管透明”,但这条分界不是免费的:两条管线要共用深度缓冲,光照模型要能分别在前向与延迟下算出一致结果,透明物体的排序与混合还要额外维护。实践中真正省钱的做法通常反过来——先确认透明物体的覆盖面积,占比很小就不值得为它引入第二套管线。
9.4 原理与概念:材质多样性对 G-Buffer 的压力
G-Buffer 的每一列都是预付的:位宽在设计期就定死。Unity 的 URP 延迟布局给了数字——反射率、镜面反射、法线各 24 bit,另有自发光与 GI 通道,非 HDR 合计 160 bit/像素,HDR 则 192 bit/像素(原文)。而片上预算只有 128 bit/像素,Mali-G72 起 256 bit(原文|原文)。
先来看看后果(换算:160 − 128 = 32 bit;192 − 128 = 64 bit):想加一层自定义材质——布料各向异性、毛发散射、次表面——就得加通道,加通道就破预算。Olsson 等人把"自定义材质"与"模块化差"列成经典延迟的缺点(论文)。
9.5 原理与概念:可编程性被内存布局锁死
延迟着色的光照 pass 对整个屏幕跑同一支程序,能读到的只有 G-Buffer 里已声明好的附件。
前向里换光照模型只需换一支着色器;延迟里不行,因为光照 pass 看不到"这个像素是什么材质",除非材质类型也占一个通道。片上的读取还严格限于当前像素(原文)。
而片上省的是往返,不是位宽(原文)。说白了,"每像素一份属性"统一了光照,也统一了光照能看见的东西。
9.6 原理与概念:decal 法线只能整体覆盖的实例
贴花(Decal)的本质是"往已有表面贴一层新属性",在延迟管线里就是往 G-Buffer 的通道里写新值。
而这里撞上一个很硬的事实:法线通道用八面体编码(Octahedral Encoding)存储,无法混合,只能整体覆盖(原文)。后果是硬边:边缘没有过渡,多层贴花只留最后一层;前向里能逐像素混合,不成问题。PLS 让逐像素中间数据留在片上,从不写回系统内存(原文)。
9.7 效果与量化:本章小结
依然是惯例,把这章的账收一下。三条"不能"共用一个根:用"每像素一份属性"换光照只算一次,代价是把"多层、多种、多个"排除在外。
| 限制 | 机制 | 官方口径 |
|---|---|---|
| 透明 | 每像素只有一层 | UE:半透明走 forward |
| 材质多样性 | 通道数定死 | URP:160 / 192 bit/px |
| 可编程性 | 光照 pass 读固定布局 | Olsson:模块化差 |
| decal 法线 | 八面体编码不可混合 | UE:只能整体覆盖 |
| 邻域 | 读取限于当前像素 | Khronos:不可读邻居 |
一句话:这三条不是调参能绕的。
第七章把“延迟着色不是通用解”拆成了三件具体的事,而不是一句态度。工程上更有用的做法是给这三条各配一个可测量的判据:透明覆盖面积占比、每帧出现的材质分支数、以及后处理链里需要读邻居的效果个数。三个数字都能在真机上量出来,也都能在方案评审时拿出来对齐预期。
八、替代路线:Forward+、Clustered 与可见性缓冲
上一章把延迟着色的三条边界画完了。这一章换到解的另一面:既然延迟不是通用解,别的路线长什么样、各自适配什么场景。
10.1 一句话点题:没有最优解,只有匹配
先把结论放前面:渲染路径没有最优解,只有匹配。同一条路线在这里最优,换个场景就是负担。
如果给这些路线做一次二次归类,判据可以只取一条——中间物是什么、它放在哪。按这条线分下来是三个流派:无中间物派(纯前向,光源一多就重复着色)、中间物留片派(片上延迟、Forward+ 的光源列表、可见性缓冲都属于此派,差别只在中间物装的是什么)、中间物落主存派(经典两趟延迟)。本篇前六章论证的其实就是中间那一派为什么难做、以及它为什么是移动端唯一的出路。
三条候选是前向加(Forward+)、聚类着色(Clustered Shading)与可见性缓冲(Visibility Buffer),共同点是把中间物做小(论文)。
好了,换到解的这一面。
10.2 原理与概念:Forward+ 的机制(compute 光源剔除 + z-prepass)
前向加在前向渲染前插两步:先用深度预通道(Depth Pre-Pass)写好深度,再用计算着色器(Compute Shader)按屏幕分块(Tile)剔光源,得到每个 tile 命中的灯列表;着色时每像素只遍历本 tile 的灯(论文)。
Harada 的动机很直接:加了光源剔除就能按可见范围算光照,却不必付 G-Buffer 的字节。
先来看看它与光照预通道的血缘:两者都靠深度预通道把几何成本前置,而第四章已讲过预通道要多一趟提交(讲义)。
10.3 原理与概念:Clustered 的 3D 划分与光源分配
聚类着色把划分从屏幕二维扩到视锥三维:按屏幕的 x、y 与深度 z 各切几刀得到一组集群(Cluster),每个 cluster 配一张光源列表,依据是光源体与 cluster 视锥块相交。
Olsson 等人在 HPG 2012 提出它时,目标不是更快而是更通用——他们把经典延迟的缺点列了出来:透明、MSAA、内存、自定义材质与光照模型、模块化差(论文)。这种空间划分与移动 GPU 的 tile 同源(原文)。
10.4 原理与概念:clustered deferred 与 clustered forward 的分岔
两条路线共用一个阶段:光源剔除与 cluster 分配。
聚类延迟(Clustered Deferred)把剔除结果喂给延迟光照 pass,所以仍然需要 G-Buffer,也仍然要面对 128 bit/像素那条线;聚类前向(Clustered Forward)把剔除结果喂给前向着色,不要 G-Buffer,材质与透明都留在前向那一侧(原文)。
说白了,分岔点就一句话:光照与几何在哪一步相遇。在属性缓冲上相遇是延迟,在着色器里是前向。
10.5 效果与量化:三条路线的内存流量对比(论文口径)
依然是惯例,先声明评价标准:比的是每帧中间物的外部内存流量,即 G-Buffer 与光照缓冲的主存往返;单位是 Arm 的 BU(原文)。
| 路线 | 中间物 | 落地 | 每帧外部流量 |
|---|---|---|---|
| 经典前向 | 无 | — | 0 BU,可能重复算灯 |
| Forward+ | tile 光源列表 | 主存 | 远小于 10 BU |
| 聚类前向 | cluster 列表 | 主存 | 与 Forward+ 同量级 |
| 聚类延迟 | 列表 + G-Buffer | 主存 | ~10 BU(写 4 + 读 ≥4 + 混合 ≥2) |
| 片上延迟 | G-Buffer | 片上 | 1 BU |
论文侧的对照:Harada 称理论上比 compute 版延迟流量更少;Burns 与 Hunt 给的是 1080p、8×MSAA 下 398 MB 对 64 MB,以及 4 MP、4×24 B 样本、60 Hz 下单次光照 pass 约 46 GB/s(论文)。片上则不必付主存往返(原文)。
三条路线的对比容易陷入“各说各话”,所以先把评价标准钉死:只数每帧为中间物付出的外部内存往返,并且只计 G-Buffer 与光照缓冲这两项,单位为 Arm 的 BU。按这个口径,前向系的中间物是光源列表(很小)、延迟系落主存的中间物是整屏多通道(很大)、可见性缓冲的中间物每样本只有几字节。标准不同,结论就会反过来,所以这张表的价值一半在数字、一半在口径声明。
10.6 效果与量化:Forward+ 相对延迟的四个优势
四个优势逐条来。
| 优势 | 依据 |
|---|---|
| 没有 G-Buffer | 中间物只剩一张 tile 光源列表,省约 10 BU |
| MSAA 可用 | URP:Forward / Forward+ 支持,Deferred 不支持 |
| 材质可编程 | 每物体独立着色器 |
| 透明天然支持 | 半透明走同一条前向路径 |
代价也要说:像素被多次覆盖时光照仍会重复算;光源列表要额外算、额外读。引擎侧的约束能直接查到:URP 的渲染器文档给出 MSAA 矩阵与光源配额(原文),子通道链的收益另有官方口径(原文)。
10.7 效果与量化:为什么 Godot 4 干脆不给 deferred 路径
Godot 官方的理由值得原文引用:forward rendering "generally provides a better tradeoff for performance versus flexibility",尤其在配上 clustered 光照时;延迟虽然在有些情况下更快,但它 "less flexible and requires using hacks to be able to use MSAA"(原文)。这就是 Godot 4 选前向(聚类前向)而不提供延迟路径的理由,它的特性清单也把渲染路径写成 clustered forward(原文)。
顺带一句工程事实:Unity 的延迟路径明确不支持 OpenGL 与 OpenGL ES,构建时会自动回退到 Forward(原文)。两家引擎取舍相反,理由却是同一个:灵活性与 MSAA。取舍的落点最后还是这两项。
10.8 实现与配置:选型决策树
下面我们开始把判据写成可执行的分档。
| 顺序 | 判据 | 结论 |
|---|---|---|
| 1 | 目标含 OpenGL ES | 排除延迟,走 Forward |
| 2 | 需要硬件 MSAA | 排除延迟;post AA 有误判 |
| 3 | 单主光 + 少量辅助光 | 经典 Forward 足够(URP 移动上限 1 + 32,GLES3 及更早 1 + 16) |
| 4 | 几十盏灯重叠 | 片上延迟或聚类延迟 |
| 5 | 半透明特效为主 | 聚类前向 |
| 6 | 多套自定义材质 | 聚类前向 |
顺序不能颠倒:前两条是排除项,后四条是加分项。落地先用合并反馈问驱动,再用 GPU 计数器确认没落盘(样例);厂商侧对应 Android GPU Inspector(原文),附件存储模式另有明文(原文)。
10.9 效果与量化:本章小结
依然是惯例,把这一章收一下。
| 路线 | 中间物 | 适配场景 | 关键数字 |
|---|---|---|---|
| 经典 Forward | 无 | 少量光源、GLES 目标 | 每像素可能重复算灯 |
| Forward+ | tile 光源列表 | 中量光源、要 MSAA | 流量远小于 10 BU |
| 聚类前向 | cluster 列表 | 大量光源、透明多 | 同量级 |
| 聚类延迟 | 列表 + G-Buffer | 不透明为主 | 回到 ~10 BU |
| 片上延迟 | G-Buffer | 单一 PBR、几何简单 | 1 BU,约 10× 削减 |
一句话:选型挑的不是最强的,是被排除项最少的。第八章给的不是排名,而是一组匹配关系:画质目标越高、光照越复杂、透明越少,越偏向延迟;透明越多、材质越杂、目标设备越分散,越偏向前向或前向加。决策树里每一条判据都对应一个可测量的量,目的就是让“选哪条路”从经验判断变成可以在评审会上对齐的结论。
九、引擎怎么落地:三家引擎的官方口径与硬约束
11.1 一句话点题:引擎默认不给你 deferred,是有理由的
这一章站到引擎文档上看。三家的默认选择一致:都不选它——Godot 4 干脆不给这条路径;Unity 的 URP 列为可选,同时不支持 OpenGL ES;Unreal 给了开关,却附了一串限额(原文 / 原文 / 原文)。
先来看看三家各自把线画在哪儿。
引擎默认不给延迟路径,这不叫保守,而是它必须对最差的设备负责。延迟路径要求一堆硬件与 API 同时到位:可用的输入附件、能合并的子通道、可控的附件声明。少一项,回退到前向就能跑,硬上延迟就是崩溃或严重掉帧。引擎把这条判断做成了开关,用意是把“你的设备够不够”这个问题提前暴露出来。
11.2 实现与配置:Unreal 的 Mobile Shading 开关与 GBuffer 的去处
先看 Unreal。入口是一个项目设置:把 Mobile Shading 从默认的 Forward Shading 改成 Deferred Shading,引擎才会编译那条管线(原文)。
官方写明:GBuffer 驻留在 tile memory 内、从不写入系统内存;设备支持时还走 LAZILY_ALLOCATED,即不分配物理内存——与第三章的瞬时附件(Transient Attachment)加懒分配是同一套语义。代价是它不再是可随意采样的纹理。
11.3 实现与配置:Unreal 在 Mali(Vulkan) 上的三条限额
好了,看限额。官方把 Mali(Vulkan)上的限制列成三条:GBuffer 每像素 16 字节、即 128 bit;最多 4 个输入附件(Input Attachment);光照 pass 最多取 3 个颜色附件加 1 个深度附件(原文)。
要松动,配置里有 MobileUsesExtendedGBuffer=true 可解除;同类口径另见 Arm 的移动最佳实践(原文)。不过这是引擎的保守默认值,不等于硬件上限。
先把这三条限额写成一条位宽预算,余量就一目了然:
$$B_{\text{GBuffer}} = B_{\text{albedo}} + B_{\text{normal}} + B_{\text{depth}} + B_{\text{light}} \le 128\ \text{bit/px}$$
其中 $B_{\text{albedo}}$ 是反射率与材质标志位,$B_{\text{normal}}$ 是编码后的法线,$B_{\text{depth}}$ 是深度,$B_{\text{light}}$ 是光照输出缓冲。最后一项容易被忽略:光照缓冲通常也必须留在片上,否则它一写回主存,前两章攒下的收益又还回去了。
配置侧对应的是这一行(写在 Engine.ini 里):
MobileUsesExtendedGBuffer=true
改完重启编辑器生效。但请把它当成"解除引擎的保守默认",而不是"解除硬件限制"——真正的上限要看目标机型,见第九章后面的平台分叉。
11.4 实现与配置:Unreal 各平台的 tile memory 路径分叉
同一个引擎,到不同平台走的是不同机制:iOS 用 framebuffer_fetch;Android Vulkan 用子通道;Android GLES 上"没有对所有 GPU 通用的方法"——Mali 与 PowerVR 靠像素局部存储(Pixel Local Storage, PLS),Adreno 用 framebuffer_fetch(原文)。
这条分叉是每家有每家的写法:Apple 的 TBDR 文档与 Imagination 的 PLS 文档给的是同一套语义(Apple / Imagination / 索引页),Qualcomm 同样如此(原文)。
同一个引擎在三个平台上走三套机制,这件事本身就是移动端图形现状的缩影:iOS 的 framebuffer_fetch、Android Vulkan 的子通道、Android GLES 的两套厂商扩展,谁也不能覆盖谁。所以“一次写好、处处生效”在附件声明这一层不成立——这也是为什么引擎文档会把“对所有 GPU 没有通用方法”原话写出来,而不是给一个统一答案。
11.5 效果与量化:Unreal 给出的指令数对比(34 vs 147)
OK,言归正传。同一个简单材质,官方给的示例是:Mobile Forward 147 条指令加 2 个采样器;Mobile Deferred 只有 34 条指令、0 个采样器(原文)。
差一个量级,因为读属性的方式不同——前向走纹理采样,延迟走输入附件、不占采样单元。这条因果是本文推断,官方只给结果;Arm 的 BU 账讲的是同一件事(原文)。
11.6 实现与配置:Unity URP 三条路径的支持矩阵
换到 Unity。URP 分成三条路径:前向、前向加(Forward+)、延迟(Deferred)。硬约束有两条:延迟不支持 OpenGL 与 OpenGL ES,构建时自动回退前向(原文);多重采样抗锯齿(Multisample Anti-Aliasing, MSAA)矩阵是 Forward 与 Forward+ 支持、Deferred 不支持(原文)。Unity 6 另加一条 Tile-Only Mode 说明(原文)。
下面对一次矩阵,三条路径的差别就摊开了。
11.7 实现与配置:URP 的 G-Buffer 布局与 Depth as Color 的动机
说白了,Unity 的 G-Buffer 布局摊在文档上:反射率(Albedo,sRGB)24 bit、镜面反射(Specular)24 bit、法线 24 bit,自发光与 GI 那一路用 B10G11R11_UFloatPack32 或 R16G16B16A16_SFloat(原文)。
最该记的是深度:它被当成颜色存,格式 R32_SFloat,叫 Depth as Color。动机很具体——Metal 不许在同一 pass 里从深度模板附件取深度,光照 pass 要读它,就只能把它变成普通纹理。总位宽另有口径:非 HDR 160 bit/像素,HDR 192 bit/像素(原文)。
11.8 实现与配置:Unity 的移动光上限与法线编码开关
依然是惯例,看两个参数。光的上限:移动平台每相机 1 盏主光加 32 盏附加光,OpenGL ES 3.0 及更早则 1 + 16(原文)。
法线那一路有开关:关掉 Accurate G-buffer normals 走量化编码,官方说性能更好,"尤其在移动 GPU 上";开启改八面体编码(Octahedral Encoding),移动端开销官方用的词是"可能相当可观"(原文)。
另两条设置值得记:Depth Texture Mode 取 After Transparents 可改善带宽;Native RenderPass 启用可编程混合,但对 ES 无效果(原文 / Khronos)。
两个默认值合起来,透露出 Unity 对移动端的态度:光照上限按 1 主光加 32 附加光给,法线编码默认用更省的量化方案。它们都在表达同一件事——移动端优先保帧率,画质损失用开关交给开发者自己决定。真正要做的是把这两个默认值在目标机型上各测一次,而不是照搬文档里的数字。
11.9 效果与量化:Godot 的官方取舍原话(外部示意图对照)
Godot 4 的选择最干脆:没有延迟渲染路径。官方原话大意是——前向在性能与灵活性之间的平衡更好,尤其在配上聚类(Clustered)光照之后;延迟虽然有些情形更快,但"不够灵活,还要用 hack 才能上 MSAA";偏美术风格的游戏能从 MSAA 拿到很大好处,所以选了前向(原文)。特性清单也印证了这一点(原文)。
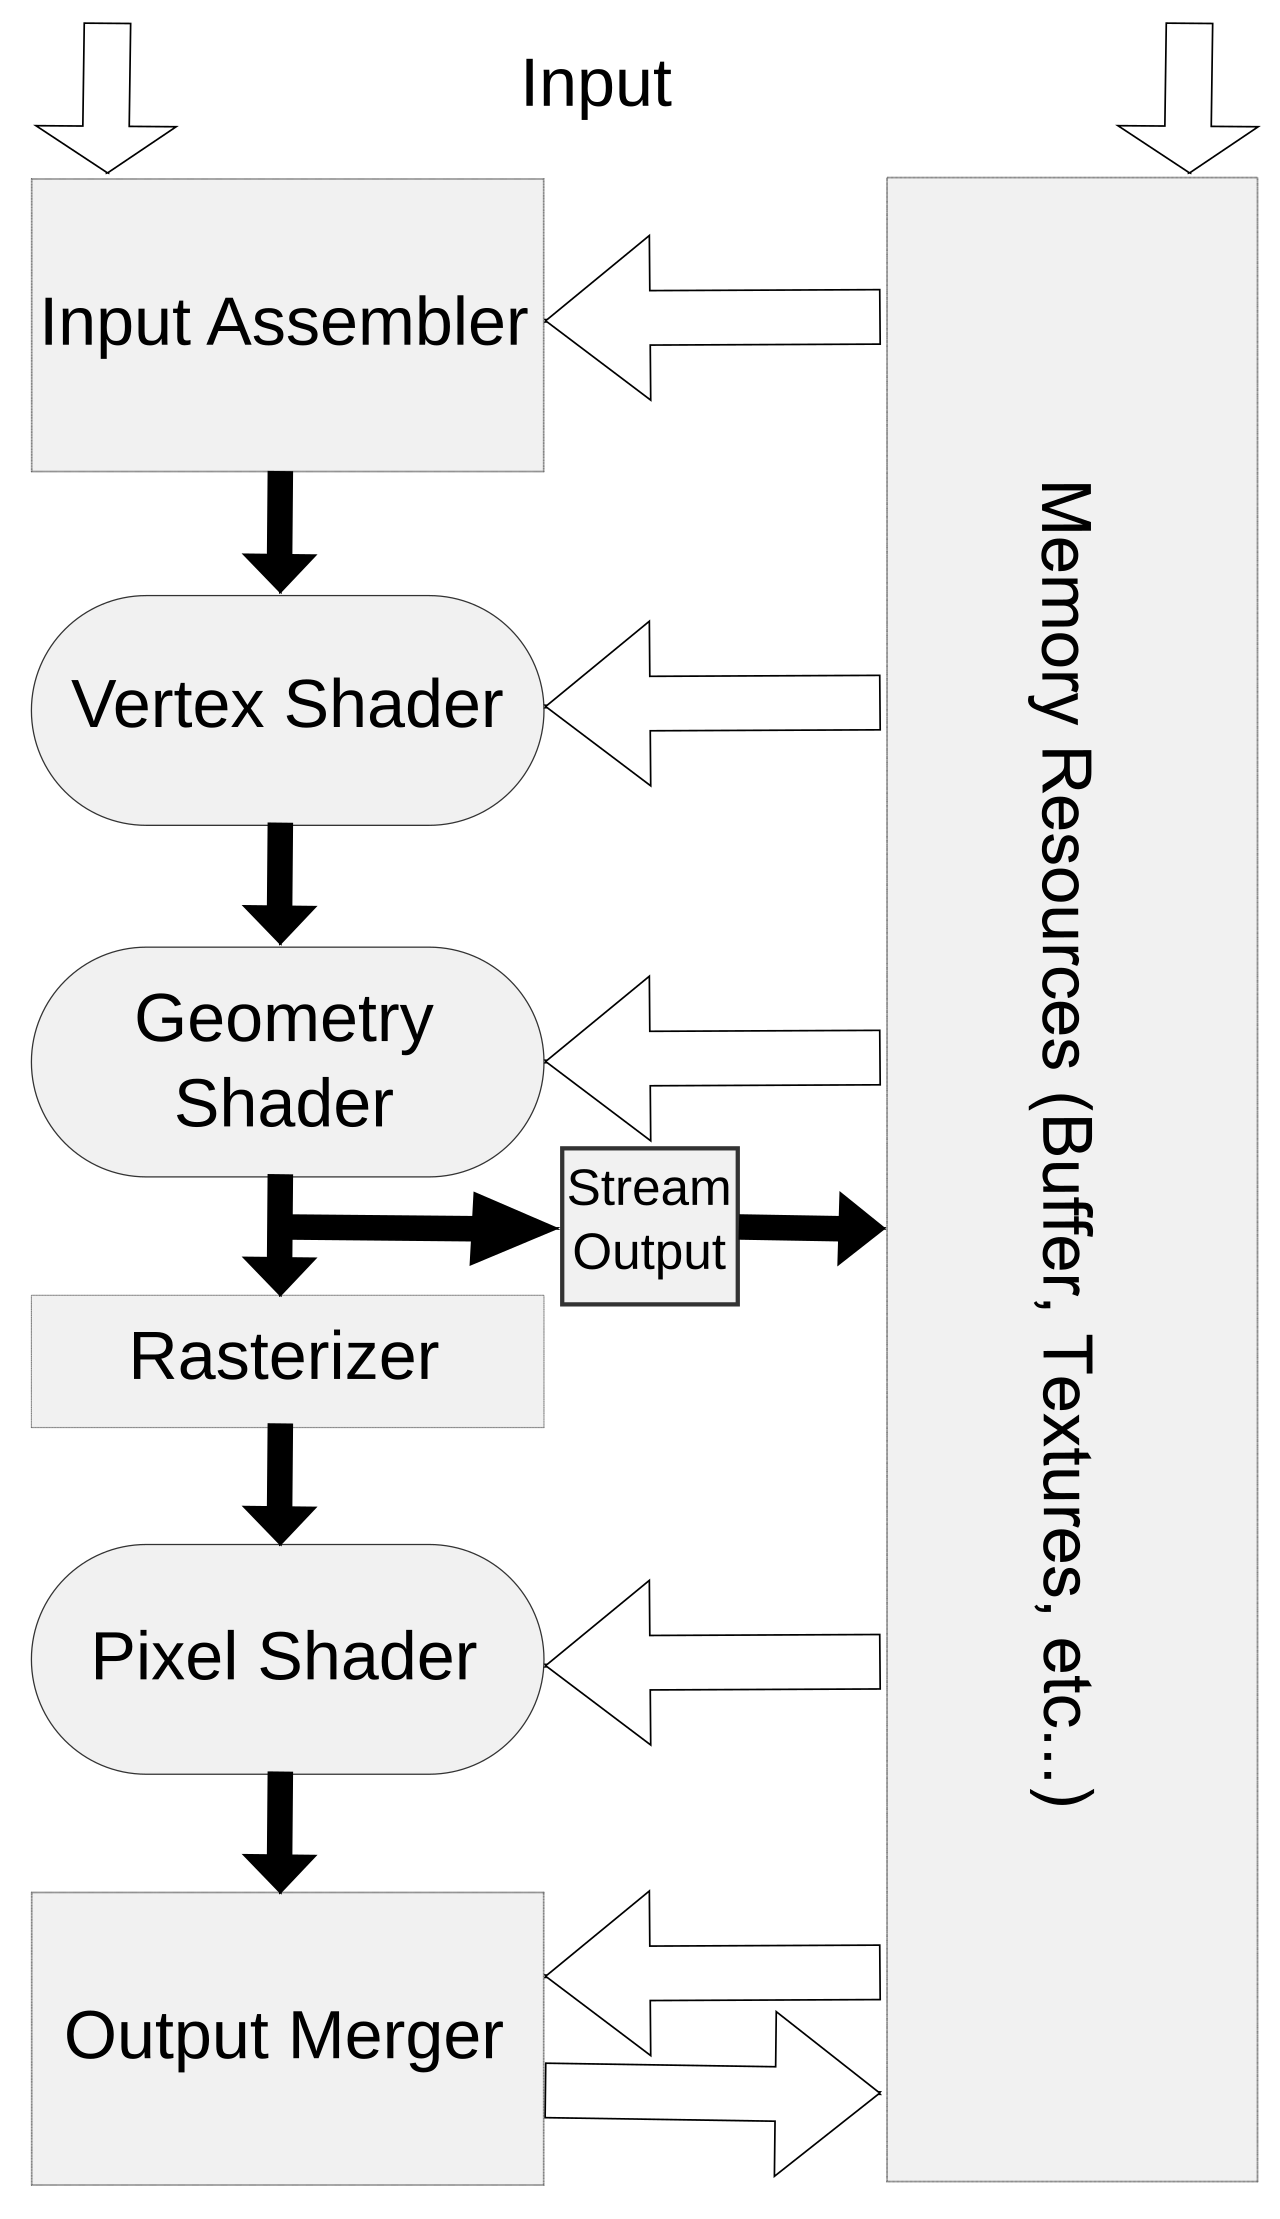
对照另一条管线的形状,下面是 Direct3D 10 的图形管线示意(图源页)。

11.10 效果与量化:三家引擎对照表与本章小结
下面我们开始收束,三家并到一张表上。
| 引擎 | 开启 | G-Buffer 去处 | 移动端硬约束 |
|---|---|---|---|
| Unreal 5 | Mobile Shading = Deferred Shading |
tile memory,不落系统内存 | 无 MSAA;预计算光照只剩 DefaultLit / Unlit;半透明走 forward;decal 法线只能整体覆盖 |
| Unity URP | Rendering Path 选 Deferred | 片上 | 不支持 OpenGL / ES;无 MSAA;每相机 1 + 32 盏光 |
| Godot 4 | 无 | — | clustered forward |
硬约束同源于官方文档(UE / URP / Godot)。通用三条:合并上限 128 bit/像素(Mali-G72 起 256 bit)、中间数据留在同一 pass、pass 语义见规范(原文 / 原文 / 原文)。
一句话收尾:引擎不给 deferred 不是保守,是它替你把限额算过一遍。
三家引擎的差别可以归成三种态度:Unreal 把延迟做成默认推荐并给了解除保守限制的开关;Unity 把延迟列成三条路径之一,但用 API 与设备限制明确圈出适用面;Godot 干脆不给这条路径,理由是灵活性与 MSAA。三者都不是技术能力问题,而是各自对“最差设备”的容忍度不同。
十、工程取舍:决策表与可复现配置清单
12.1 一句话点题:把取舍写成可执行的判据
官方口径摆齐了,但"有开关"不等于"该开"——这一章把前面的账压成一页能照着勾的判据。
说白了,机制、限额与实测最终都要落到三个动作上——看场景选路径、按字段写配置、上线前验收,一步都省不掉。
把取舍写成判据,关键在每条判据都要能测、能反驳。“光照复杂度高”不是判据,“每帧平均重叠光源数大于 8”才是;“透明物体多”不是判据,“透明像素材质覆盖面积占比超过 20%”才是。下面这张表就是把前面十一章的结论翻译成一串可测的条件,让方案选型可以在真机数据上被验证,而不是靠感觉。
12.2 实现与配置:决策表(场景 × 光照复杂度 × 透明比例 × 目标设备)
先来看看四个自变量:前两个定收益,后两个定付得起。
| 自变量 | 偏延迟 | 偏前向 |
|---|---|---|
| 场景 | 室内、静态为主 | 大世界、室外、植被多 |
| 光照 | 每像素多盏重叠 | 简单或大量预计算 |
| 透明占比 | 低于一成 | 半透明、粒子多 |
| 设备 | 支持 Vulkan / Metal | 仍有大量 GLES 机型 |
出处:Olsson 等人(原文)、URP 文档(原文)、厂商文档(总览)。
这张决策表有严格的使用顺序:先看目标设备支持不支持,再看画质档位要不要 MSAA,然后才看光照与透明。顺序不能颠倒——设备不支持时后面几项毫无意义;而 MSAA 这一项一旦答“要”,基本就已经排除了延迟路径,不必再算下去。表的作用是把这个淘汰过程写死,避免团队反复讨论一个已经出局的选项。
12.3 实现与配置:该上延迟的四种场景
OK,言归正传,四种该上的情形:光源多且重叠——每个可见像素的光照只算一次(原文);材质与光照模型统一,不必逐材质自定义 BRDF;屏幕空间效果可后处理化;G-Buffer 能压进 128 bit(位置用深度重建、法线走量化,见第四章)。
共同前提:两者待在同一 pass(原文)。中间表示极瘦时(可见性缓冲每样本 4 字节),片上更宽松(原文)。
12.4 实现与配置:该退回前向的四种场景
反过来,四种该退的。
半透明占比高:它们本就要在光照之后另开一趟,占比一高,省下的账又被吃掉。需要 MSAA:延迟路径在 UE 与 URP 上都标着不支持(见第九章)。GLES 机型多:配置会静默回退前向(原文)。光照本身简单:前向加聚类更划算,Harada 的 Forward+ 论文给的正是这条结论(原文)。
12.5 实现与配置:可复现配置清单——Vulkan 侧字段
下面我们开始给字段。Vulkan 侧分四组:
- 用途位:G-Buffer 附件声明
VK_IMAGE_USAGE_INPUT_ATTACHMENT_BIT;只活在片上的附件再加VK_IMAGE_USAGE_TRANSIENT_ATTACHMENT_BIT(0x40)(refpage)。 - 内存属性:选带
VK_MEMORY_PROPERTY_LAZILY_ALLOCATED_BIT的内存类型,实现才有机会完全不分配物理内存(原文)。 - load/store:G-Buffer 用
VK_ATTACHMENT_LOAD_OP_DONT_CARE配VK_ATTACHMENT_STORE_OP_DONT_CARE;最终颜色附件用VK_ATTACHMENT_LOAD_OP_CLEAR或 LOAD 配 STORE;深度附件 CLEAR 配 DONT_CARE(refpage)。 - 验证:打开
VK_EXT_subpass_merge_feedback,读回VkSubpassMergeStatusEXT(refpage)。
pass 结构第三章已给过。
12.6 实现与配置:可复现配置清单——Metal 侧字段
Metal 没有显式子通道,"只活在片上"是存储模式。
- 存储:G-Buffer 纹理选
MTLStorageModeMemoryless,系统内存不必为它分配(原文 / 取舍全景)。 - 动作:
MTLLoadAction取 Clear 或 DontCare,MTLStoreAction取 DontCare。 - 合成:同一 pass 内用可编程混合(Programmable Blending),延迟光照渲染器因此可用单个通道实现(原文)。
边界:可编程混合只在同一像素内成立,跨 pass 不适用。
Metal 侧的清单比 Vulkan 短,原因不是能力少,而是Apple 把很多约束收进了存储模式:一旦把附件声明成 memoryless,系统内存就不再为它分配,是否留在片上也不再由你决定。这让代码更简洁,也意味着少了一层“可以调”的余地——配置写错时,问题会以“附件读不到值”的形式出现,而不是以带宽升高的形式出现。
12.7 实现与配置:可复现配置清单——三家引擎的开关
引擎侧清单最短,因为开关都做在界面上,改动只落在编辑器与工程配置里,不用碰着色器代码。
- Unreal:
Mobile Shading = Deferred Shading;要解 GBuffer 限额就写MobileUsesExtendedGBuffer=true(原文)。 - Unity:Universal Renderer 的 Rendering Path 选 Deferred;
Depth Texture Mode取 After Transparents;勾 Native RenderPass(原文)。 - Godot 4:没有可选项,只有 clustered forward(原文)。
用法:编辑器里确认路径,真机上按 12.9 验收。
三家引擎的开关风格差异很大,但要做的事是同一件:让 G-Buffer 与光照待在同一次硬件 pass 里。Unreal 靠 shading path 加附件限额开关,Unity 靠渲染路径加 Native RenderPass,Godot 靠渲染器选择。所以迁移时的正确做法不是逐项翻译设置,而是先确认目标引擎的对应机制,再决定哪些设置根本不需要存在。
12.8 效果与量化:六种常见错误配置与各自后果
好了,最容易踩的六种。
| 错误配置 | 后果 | 机制 |
|---|---|---|
| 后处理另开 pass | 回到 ~10 BU | 数据离开片上 |
| loadOp 写 LOAD | 每帧多一次主存读 | 附件被要求保留 |
| 忘设 transient | jobs 翻倍(56/s → 113/s) | 内存被真实分配 |
| G-Buffer 超 128 bit | 非线性掉帧 | 驱动改用更小 tile |
| 走 GLES | 延迟配置静默失效 | 回退 Forward |
| 开 MSAA | 子通道合不上 | 采样数不匹配 |
出处依次见 Khronos 指南、官方样例、URP 文档、规范枚举(原文 / 原文 / 原文 / refpage)与 VkAttachmentLoadOp(refpage)。
这六种错误有一个共同的诊断特征:它们都不会报错,只会让带宽静默升高。pass 被拆开、loadOp 设成 LOAD、忘设 transient、附件超预算、走 GLES、开了 MSAA——每一件都能正常出画面,帧率却比预期低一截。所以验收不能只看“画面对不对”,必须同时看下一章给出的那组计数器。
12.9 效果与量化:上线前验收清单与本章小结
依然是惯例,一份可勾的清单。
- 合并状态:读回
VK_SUBPASS_MERGE_STATUS_MERGED_EXT(refpage)。 - 片上流量:AGI 渲染通道视图看 GMEM load / store 是否归零(原文)。
- 计数对照:fragment jobs 未翻倍(56/s → 113/s)(原文)。
- 路径生效:构建产物真跑在延迟路径(原文)。
- 账本复核:带宽与帧时间同看(原文)。
| 小结 | 该上延迟看光源重叠与 128 bit 预算;该退前向看半透明、MSAA 与 GLES |
|---|---|
取舍写不成判据,就等于没做取舍。
十一、测量与验证:怎么确认 G-Buffer 真的没落盘
13.1 一句话点题:一条可复现的验证协议
前一章把取舍写成了判据,但判据要能被验证才算数。这一章只回答一件事:怎么证明那块几何缓冲(G-Buffer)真的没落盘。
先来看看为什么不能靠"用工具看一眼":看一眼得出的结论不可复现。所以下面给的不是观察方法,而是一份协议——测什么(四个可观测信号)、怎么测(计数器读数加对照实验)、判据是什么(落在哪个区间算通过)。
13.2 原理与概念:四个可观测信号各有分工
外部带宽最直接:G-Buffer 一落盘,账上必然出现"写 4 + 读 ≥4"这两段(Arm 的账本)。GMEM load/store 看片上内存(On-chip Memory / Tile Memory)的进出:附件若全程待在片上,这两个计数器就不该有量。片段任务(Fragment Jobs) 反映 pass 有没有被拆,也含硬件剔除的红利——PowerVR 的实测是 4.7 → 1.2 片段/像素(HSR 实测);生命周期没写对时它约翻倍(56/s → 113/s)(Khronos Subpasses 样例)。帧时间(Frame Time) 是最终判据,但它受温控影响,必须与分辨率一起读。
依然是惯例,补一句:四条要交叉看,单条都能被别的因素解释掉——带宽受压缩影响,帧时间受降频影响。
13.3 实现与配置:AGI 的 GMEM load/store 计数器与定位方法
Android GPU Inspector(AGI)是官方剖析工具,它在一帧的渲染通道视图里给出与片上内存相关的计数器,GMEM load/store 就在其中(AGI 渲染通道视图;AGI 官方页)。用法是定性的:读数非零,就说明附件确实进出过片外。
下面我们开始定位,三步。一,截取一帧完整画面。二,在通道列表里找到承载 G-Buffer 的通道,记下子通道(Subpass)数与附件数。三,看它的 load/store 有没有量,再回附件声明处核对:是不是输入附件(Input Attachment)、有没有设成瞬时附件(Transient Attachment)(用途位取值)。
13.4 公式或参数逐项释义:用带宽计数器反推 BU 的算法
书面的 BU 是 width × height × sizeof(pixel) 的一次读或写,本身不可直接测量;计数器给的是字节数,两者只差一次换算:
BU_measured = BW_external ÷ (W × H × 4 B)
逐项:BW_external 是计数器给出的该 pass 一帧内的外部读写字节数;W × H 是屏幕像素总数;4 B 是参考像素宽度,取 32 bit(换算:32 bit ÷ 8 = 4 B)。分母就是 1 BU 的字节当量,1080p 下(换算:1920 × 1080 = 2,073,600 px):1 BU ≈ 2,073,600 × 4 B = 8,294,400 B ≈ 7.91 MiB。
判据随之确定:读数落在 1 BU 附近算合并生效,落在 ~10 BU 附近算失败。引擎侧有同一口径:UE 在 Mali 上的限额是每像素 16 字节即 128 bit(UE 官方文档)。
反推的关键是把“一次整屏读写”定义清楚:1 BU 就是 宽度 × 高度 × 4 字节。拿到外部内存流量之后,用它除以这个值,得到的商就是实际发生的趟数。判读很简单——商落在一附近,说明中间物确实没落盘;落在十附近,说明至少发生了两趟完整的整屏往返。这条算法不依赖任何厂商工具,只要有带宽计数器就能用。
13.5 原理与概念:合并失败的典型指纹
说白了,合并失败的指纹有五条,条条能对上账。一是 G-Buffer 附件出现非零的 store:附件一旦被写回片外,就不再是瞬时附件。二是渲染通道(Render Pass)个数从 1 变 2,写 G-Buffer 与读它的子通道被推进了两道。三是片段任务数跳档,生命周期没写对时约翻倍(56/s → 113/s)。四是带宽落回 ~10 BU。五是每帧 tile 数上升——合并生效的实测是下降 55%,反向读即未合并。
原因侧,规范逐条列了合并状态(VkSubpassMergeStatusEXT),依赖、别名、输入附件不合规、采样数不匹配最常见。
13.6 实现与配置:对照实验设计
对照实验的意义是让结论可归因,先固定五个:真机与系统版本、分辨率与刷新率、场景与镜头路径、引擎版本与画质档位、温控状态(预热到稳态再采)。
好了,五个钉死之后只改一个变量。首选是附件声明:在瞬时与普通附件之间切换,四条信号的前后差值就是收益(loadOp 语义、子通道依赖、Metal 存储模式、无记忆存储)。采样纪律:丢掉开头若干帧,取三次以上的中位数(移动端渲染路径的官方说明)。
13.7 效果与量化:两轮自变量,以及误差与置信度
先来看看分辨率这一轮。BU 无量纲,720p 换 1080p 只是把一份账整体放大:像素数从 921,600 涨到 2,073,600,正好 2.25 倍(换算)。
下一轮改采样率。采样数直接乘在体积上,片上预算却仍是 128 bit/像素:Unity 口径的 160 bit/px 在 4× 下已是 640 bit/px,为预算的 5 倍(换算)(Unity Manual),也与论文给出的每样本 16 至 32 字节区间对得上(Burns & Hunt)。这一轮的预期就是合并失败、读数弹回 ~10 BU,与第一轮互为反证。
误差与置信度:偏差超过 10% 视为不可判,热漂移、驱动版本、后台负载要排除。单次同向只算观察,三次同向才算结论。
两轮自变量的选取不是随意的:分辨率那一轮验证的是“按面积缩放”,采样率那一轮验证的是“按样本数缩放”。如果实测结果偏离这两条比例关系,通常意味着瓶颈已经不在 G-Buffer,而在别处——比如纹理采样或几何提交。把误差带一并记录下来,是为了在下结论时知道哪些差异是噪声,哪些是真实回退。
13.8 效果与量化:本章小结
下面把这一章压成一张判据表,四条信号各自的通过线如下。
| 信号 | 通过线 |
|---|---|
| 外部带宽 | BU ≈ 1;失败 ≈ 10 |
| GMEM load/store | 附件上为零 |
| 片段任务 | 无 56/s → 113/s 跳档 |
| 帧时间 | 热稳态下可比 |
这四条缺一不可:带宽可能被压缩改写,GMEM 计数可能被驱动改写,帧时间会被降频改写;只有四个读数同向,才排除得掉这几种解释。判据之外,还要把每轮的次数、温控状态与驱动版本一并写进实验记录,别人才能复现(Arm 的移动最佳实践)。
四条同时成立,才能说 G-Buffer 真的没落盘。
这一章的协议只有四步:固定五个变量、只改附件声明、用带宽计数器反推趟数、把三次以上的中位数记下来。它的价值不在于测得多精确,而在于结论可以被别人复现——换一台同型号设备、照着同一组设置跑,应该得到同一个量级的趟数。做不到这一点,前面所有关于 BU 的论证都只是纸面推演。
十二、结语:延迟着色在移动端的正确用法
14.1 一句话点题:结论速览
能做的两件事:把 G-Buffer 与光照压进同一个渲染通道,账从 ~10 BU 降到 1 BU,约 10 倍削减(Arm 的账本);把 G-Buffer 做小,让每像素位宽落进 128 bit/像素的预算里。
不能做的也有四件事:G-Buffer 落主存的经典两趟、多重采样抗锯齿(Multisample Anti-Aliasing, MSAA)、透明与材质多样性,以及任何需要读邻居的效果。说白了,能做的都建立在"同一个 pass"上,不能做的都出在"拆 pass"或"要邻域"这两点上。
14.2 原理与概念:全篇因果链回收
把这一篇的骨架再摆一次:属性必须先存下来(零、一)→ 一写一读是两次主存往返,账面 ~10 BU(一)→ 片上容量固定,预算 128 bit/像素(二)→ 压进同一 pass 就变 1 BU(三、官方口径)→ 装不下就把 G-Buffer 做小(四)→ 一拆 pass 前功尽弃(五、子通道语义)→ 采样与邻域需求让拆分几乎不可避免(六、七)。
好了,这条链上有两个硬:硬线是片上预算,硬前提是背靠背。而背靠背不是纸面推演——延迟光照可以用单个渲染通道实现(Apple 的官方样例)。
把全篇的因果链再走一遍:延迟着色把光照推迟到可见性之后 → 需要一个存表面属性的中间物 → 中间物一写一读就是两次主存往返,约 10 BU → 移动 GPU 的片上内存可以把这两趟并成一趟,压到 1 BU → 但片上预算只有 128 bit/像素 → 更麻烦的是片上单像素只能读自己 → 于是任何读邻居的后处理都会把两趟拆开 → 一拆,10 BU 与全部优化一起回来。七个环节,环环相扣。
14.3 原理与概念:这套账在桌面与主机的变体
桌面路径没有"片上内存"这条约束:G-Buffer 落显存是一等公民,10 BU 照付,只是它付得起。于是桌面引擎的 G-Buffer 越做越胖——Unity 官方口径是 160 bit/像素(非 HDR)与 192 bit/像素(HDR)(Unity Manual),搬进移动端第一步就撞上 128 bit/像素。
OK,言归正传,跨平台结论一句话:同一算法,移动端要问"能不能不搬",桌面端只问"搬得贵不贵"。主机同理:带宽与散热预算都宽得多,同一笔账好付得多——差异在预算,不在算法。移动侧那套"不搬"的机制(如 Apple 的无记忆存储,见 TBDR 文档)桌面用不上;引擎也照这个口径分家(UE、URP)。
同一套账搬到桌面与主机上,变的不是算法而是预算:桌面 GPU 上缓存层次更深、显存带宽高出一个量级以上,10 BU 不再是致命的,反而片上的灵活性受限(没有统一的 memoryless 语义);主机平台则介于两者之间。所以“延迟着色在移动端该不该用”这个问题不能照搬到别的平台,反过来也一样。
14.4 原理与概念:交棒第 6 篇
前四篇算清了带宽账与能耗账,这一篇把两本账合到一页上审了一个算法。先来看看第 6 篇的三个新特性——可变速率着色(Variable Rate Shading, VRS)、网格着色(Mesh Shading)与移动光追(Mobile Ray Tracing)——它们恰好也都在同一本账上。
VRS 改的是"每个像素付多少",网格着色改的是"几何怎么提交",光追改的是"每个像素算多少条射线"。三条老账,三个新特性(厂商侧的限额口径、引擎侧的取舍)。
14.5 效果与量化:给自己的自查清单
好了,这份清单可以直接对着自己的管线勾。
- [ ] G-Buffer 附件声明成输入附件,并设了瞬时附件与懒分配?
- [ ] 几何与光照子通道在同一个渲染通道内?
- [ ] G-Buffer 每像素位宽加总不超过 128 bit(Mali-G72 起 256 bit)?
- [ ] 管线里没有 SSAO、bloom、FXAA、blur 这类读邻居的 pass?
- [ ] 清楚这条路径上 MSAA 不可用,并已选定替代的 post AA?
- [ ] 用 AGI 的 GMEM load/store 计数器确认过附件没有落盘?(计数器入口)
有一条对不上,先去第十一章那套协议里测一遍(邻域操作的代价)。
14.6 原理与概念:数据口径说明
依然是惯例,把数字来源交代清楚,分三类。官方原文数字:~10 BU 与 1 BU 的账、128 bit/像素(Mali-G72 起 256 bit)、tiles 与带宽各 −55%、片段任务 56/s → 113/s、Unity 的 160 / 192 bit/px、Qualcomm 示例的 14 MB 片上量级(来源)。换算值:G-Buffer 体积、绝对带宽、分辨率的 2.25 倍、4× 下的 640 bit/px——正文一律标注"换算"并给出算式与参考口径(论文口径)。单位与基准:BU 是无量纲的归一化单位、不随分辨率变化;全篇基准是 1080p 与 60fps(帧预算 16.7ms),换基准只改绝对值,不改相对量级。
14.7 效果与量化:收尾
好了,回到最开始那句话:移动端的延迟着色不是"能不能用",而是 G-Buffer 落不落地。落地就是 ~10 BU,留片上就是 1 BU,中间差一个数量级(经典延迟的三条老账、聚类的替代路线)。这笔账的地基是分块架构本身(PowerVR 架构总览)。
正确用法只有一句:把 G-Buffer 与光照压进同一个渲染通道,并把 G-Buffer 压到预算之内。做不到,前向加与聚类着色往往更划算——这不是退让,是把账算明白了。
参考资料
本篇正文在每处论点就近给出了出处;以下是按类型汇总的完整来源清单,供查证与延伸阅读。
规范与厂商文档(Khronos / Arm / Qualcomm / Imagination / Apple)
- https://docs.vulkan.org/spec/latest/chapters/renderpass.html
- https://docs.vulkan.org/spec/latest/chapters/framebuffer.html
- https://docs.vulkan.org/spec/latest/chapters/fragops.html
- https://docs.vulkan.org/spec/latest/chapters/descriptorsets.html
- https://docs.vulkan.org/spec/latest/chapters/memory.html
- https://docs.vulkan.org/spec/latest/chapters/resources.html
- https://docs.vulkan.org/spec/latest/chapters/images.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkAttachmentLoadOp.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkAttachmentStoreOp.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkImageUsageFlagBits.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkMemoryPropertyFlagBits.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkSubpassDescription.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkSubpassDependency.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkRenderingAttachmentInfo.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_EXT_subpass_merge_feedback.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkSubpassMergeStatusEXT.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_KHR_dynamic_rendering.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_KHR_dynamic_rendering_local_read.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_EXT_shader_tile_image.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_QCOM_tile_memory_heap.html
- https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- https://docs.vulkan.org/samples/latest/samples/performance/subpasses/README.html
- https://docs.vulkan.org/samples/latest/samples/performance/render_passes/README.html
- https://docs.vulkan.org/samples/latest/samples/performance/descriptor_management/README.html
- https://docs.vulkan.org/tutorial/latest/Building_a_Simple_Engine/Mobile_Development/04_rendering_approaches.html
- https://vulkan.lunarg.com/doc/view/1.4.328.1/windows/antora/features/latest/features/proposals/VK_QCOM_tile_shading.html
- https://community.khronos.org/t/tile-based-rendering-best-practices/112538
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/deferred-shading-on-mobile
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/vulkan-subpasses-the-good-the-bad-and-the-ugly
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/the-mali-gpu-an-abstract-machine-part-1---frame-pipelining
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/the-mali-gpu-an-abstract-machine-part-2---tile-based-rendering
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/immortalis-g925-the-fragment-prepass
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/mali-bifrost-family-performance-counters
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/accelerating-mali-gpu-analysis-using-arm-mobile-studio
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_andy_2D00_slides.pdf
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph2015_2D00_mmg_2D00_marius_2D00_slides.pdf
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2_2D00_mmg2020_2D00_vulkan_2D00_emilio.pdf
- https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2066-00-00-00-00-55-30/GDC14_2D00_Martin_2D00_Bjorge_2D00_Revolution_2D00_FinalWithNotes.pdf
- https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2066-00-00-00-00-55-34/siggraph14_2D00_Bjorge_2D00_TLS_2D00_presentation.pdf
- https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Advance_Uses_of_Pixel_Local_Storage.pdf
- https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/GDC2017/Vulkan-Multipass-Final.pdf
- https://developer.arm.com/documentation/101897/latest
- https://vulkan.org/user/pages/09.events/vulkanised-2025/T18-Pete-Harris-Arm-MobileBestPractices.pdf
- https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_getting_started_on_mobile_and_best_practices_for_arm_gpus.pdf
- https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_battle_tested_optimisations_for_mobile_v2.pdf
- https://vulkan.org/user/pages/09.events/vulkanised-2025/T15-Ian-Elliott-Google-Vulkan-on-Android.pdf
- https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/overview.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/spec_sheets.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/vk_adreno_layer.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/sdp.html
- https://docs.qualcomm.com/doc/80-71528-1/topic/remove_unused_render_targets.html
- https://www.qualcomm.com/developer/blog/2026/05/high-performance-memory-extension-optimize-memory
- https://www.qualcomm.com/developer/blog/2025/08/optimize-performance-and-graphics-for-adreno-gpu-low-power-gaming
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/tile-based-deferred-rendering-index.html
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/hidden-surface-removal-efficiency.html
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/further-tbdr-details.html
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/vertex-processing.html
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/per-tile-rasterization.html
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/the-powervr-advantage.html
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/topics/rules/do-use-on-chip-memory-efficiently-for-deferred-rendering.html
- https://docs.imgtec.com/starter-guides/powervr-architecture/html/glossary.html
- https://docs.imgtec.com/performance-guides/graphics-recommendations/html/topics/pixel-local-storage-extension.html
- https://docs.imgtec.com/performance-guides/graphics-recommendations/html/topics/msaa-performance.html
- https://docs.imgtec.com/sdk-documentation/html/framework/renderpass-pls-strategies.html
- https://imagination-technologies-cloudfront-assets.s3.eu-west-1.amazonaws.com/website-files/documents/PowerVR+Hardware.Architecture+Overview+for+Developers.pdf
- https://imagination-technologies-cloudfront-assets.s3.eu-west-1.amazonaws.com/website-files/documents/Introduction_to_PowerVR_for_Developers.pdf
- https://developer.apple.com/documentation/metal/rendering-a-scene-with-deferred-lighting-in-objective-c
- https://developer.apple.com/documentation/Metal/tailor-your-apps-for-apple-gpus-and-tile-based-deferred-rendering
- https://developer.apple.com/documentation/Metal/implementing-order-independent-transparency-with-image-blocks
- https://developer.apple.com/documentation/metal/choosing-a-resource-storage-mode-for-apple-gpus
- https://developer.apple.com/documentation/metal/choosing-a-resource-storage-mode-for-intel-and-amd-gpus
- https://developer.apple.com/documentation/metal/setting-resource-storage-modes
- https://developer.apple.com/documentation/metal/reducing-the-memory-footprint-of-metal-apps
- https://developer.apple.com/documentation/metal/improving-edge-rendering-quality-with-multisample-antialiasing-msaa
- https://developer.apple.com/documentation/metal/mtlstoragemode
- https://developer.apple.com/documentation/metal/mtlgpufamily/apple4
- https://developer.apple.com/documentation/Apple-Silicon/porting-your-metal-code-to-apple-silicon
- https://developer.apple.com/documentation/Xcode/Metal-debugger
- https://developer.apple.com/documentation/Xcode/Analyzing-your-Metal-workload
- https://developer.apple.com/documentation/Xcode/Capturing-a-Metal-workload-in-Xcode
- https://developer.apple.com/library/archive/documentation/3DDrawing/Conceptual/MTLBestPracticesGuide/ResourceOptions.html
- https://developer.apple.com/metal/Metal-Feature-Set-Tables.pdf
- https://developer.apple.com/videos/play/wwdc2019/601/
- https://developer.apple.com/videos/play/wwdc2020/10602/
- https://developer.apple.com/videos/play/wwdc2020/10603/
- https://developer.apple.com/videos/play/wwdc2020/10605
- https://developer.apple.com/videos/play/wwdc2020/10631/
- https://developer.apple.com/videos/play/wwdc2020/10632/
- https://developer.apple.com/videos/play/wwdc2021/10153/
- https://developer.apple.com/videos/play/wwdc2023/10125
- https://developer.apple.com/videos/play/tech-talks/604/
- https://developer.apple.com/videos/play/tech-talks/111373
引擎官方文档与开源实现(Unity / Unreal / Godot / Filament)
- https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@16.0/manual/rendering/deferred-rendering-path.html
- https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@16.0/manual/urp-universal-renderer.html
- https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@16.0/manual/rendering/forward-plus-rendering-path.html
- https://docs.unity3d.com/6000.0/Documentation/Manual/urp/rendering-paths-comparison.html
- https://docs.unity3d.com/6000.0/Documentation/Manual/urp/rendering-paths-introduction-urp.html
- https://docs.unity3d.com/6000.0/Documentation/Manual/urp/rendering-paths-landing.html
- https://docs.unity3d.com/6000.5/Documentation/Manual/urp/urp-universal-renderer.html
- https://docs.unity3d.com/6000.5/Documentation/Manual/urp/rendering/g-buffer-layout.html
- https://docs.unity3d.com/6000.5/Documentation/Manual/urp/rendering/render-passes-deferred.html
- https://docs.unity3d.com/6000.5/Documentation/Manual/urp/rendering/accurate-g-buffer-normals.html
- https://docs.unity3d.com/560/Documentation/Manual/RenderTech-DeferredShading.html
- https://raw.githubusercontent.com/Unity-Technologies/Graphics/master/Packages/com.unity.render-pipelines.universal/Runtime/DeferredLights.cs
- https://raw.githubusercontent.com/Unity-Technologies/Graphics/master/Packages/com.unity.render-pipelines.universal/Runtime/Passes/GBufferPass.cs
- https://dev.epicgames.com/documentation/unreal-engine/using-the-mobile-deferred-shading-mode-in-unreal-engine
- https://dev.epicgames.com/documentation/en-us/unreal-engine/mobile-rendering-features-in-unreal-engine
- https://dev.epicgames.com/documentation/en-us/unreal-engine/mobile-feature-levels-and-rendering-modes-in-unreal-engine
- https://dev.epicgames.com/documentation/en-us/unreal-engine/using-the-desktop-renderer-on-mobile-in-unreal-engine
- https://dev.epicgames.com/documentation/en-us/unreal-engine/using-the-android-vulkan-mobile-renderer-in-unreal-engine
- https://docs.godotengine.org/en/stable/contributing/development/core_and_modules/internal_rendering_architecture.html
- https://docs.godotengine.org/en/stable/tutorials/rendering/renderers.html
- https://docs.godotengine.org/en/stable/tutorials/performance/general_optimization.html
- https://docs.godotengine.org/en/stable/about/list_of_features.html
- https://google.github.io/filament/Filament.html
- https://raw.githubusercontent.com/KhronosGroup/Vulkan-Samples/main/README.adoc
- https://raw.githubusercontent.com/KhronosGroup/Vulkan-Guide/main/README.adoc
论文、演讲与深度技术文章
- https://www.jcgt.org/published/0002/02/04/
- https://www.jcgt.org/published/0002/02/04/paper.pdf
- https://jcgt.org/published/0005/01/02/
- https://www.cse.chalmers.se/~uffe/tiled_shading_preprint.pdf
- https://newq.net/dl/pub/s2015_practical.pdf
- https://efficientshading.com/wp-content/uploads/clustered_with_shadows.pdf
- https://dl.acm.org/doi/epdf/10.5555/2383795.2383809
- https://takahiroharada.github.io/publications/forward_plus.pdf
- https://takahiroharada.github.io/forward+/
- https://takahiroharada.github.io/
- http://diaryofagraphicsprogrammer.blogspot.com/2008/03/light-pre-pass-renderer.html
- https://media.gdcvault.com/gdc2015/presentations/Thomas_Gareth_Advancements_in_Tile-Based.pdf
- https://developer.nvidia.com/gpugems/gpugems3/part-iii-rendering/chapter-19-deferred-shading-tabula-rasa
- http://graphics.cs.cmu.edu/courses/15869/fall2014content/lectures/09_deferred/09_deferred_slides.pdf
- https://trickybitsblog.github.io/2024/04/20/nanite.html
- https://cstopics.com/encyclopedia/graphics/real-time-rendering-techniques/rendering-pipelines/deferred-lighting
- https://imgtec.eetrend.com/sites/imgtec.eetrend.com/files/201803/blog/11300-32990-shixishuxuanranzhongchangyongdejichongrenderingpath.pdf
性能分析与测量工具
- https://developer.android.google.cn/agi/start
- https://developer.android.google.cn/agi/frame-trace/renderpasses
- https://developer.android.google.cn/agi/frame-trace/frame-profiler
- https://developer.android.google.cn/games/optimize
- https://developer.android.google.cn/games/optimize/vulkan-reduced-precision
- https://renderdoc.org/docs/index.html
- https://renderdoc.org/docs/window/performance_counter_viewer.html
- https://renderdoc.org/docs/window/event_browser.html
- https://docs.qualcomm.com/bundle/publicresource/80-80022-19/topics/graphics_developer_tools.md
- https://docs.qualcomm.com/bundle/publicresource/topics/80-71528-1/snapdragon_profiler.html
- https://developer.qualcomm.com/software/adreno-gpu-sdk/tools
- https://www.qualcomm.com/developer/snapdragon-game-toolkit/samples
- https://github.com/quic/adreno-gpu-vulkan-code-sample-framework/tree/main/samples/SubPass
- https://github.com/quic/adreno-gpu-vulkan-code-sample-framework/tree/main/samples/shaderResolveTonemap
- https://github.com/quic/adreno-gpu-opengl-es-code-sample-framework/tree/main/samples/avoid_gmem_loads
- https://github.com/quic/adreno-gpu-opengl-es-code-sample-framework/tree/main/samples/reduce_gmem_stores
图片版权
| 文件名 | 来源 | 作者 | 许可 |
|---|---|---|---|
ext_hidden_surface.svg |
Hidden Surface Determination | Vierge Marie | CC BY-SA 4.0 |
ext_3d_pipeline.svg |
3D-Pipeline | Wikimedia Commons | CC0 |
ext_powervr_pcx2.png |
NEC D62011GD (PowerVR PCX2) | Trio3D | CC BY-SA 4.0 |
ext_deferred_pass_col.jpg |
Deferred rendering pass col | astrofra | CC BY-SA 4.0 |
ext_deferred_pass_nor.jpg |
Deferred rendering pass nor | astrofra | CC BY-SA 4.0 |
ext_deferred_pass_dep.jpg |
Deferred rendering pass dep | astrofra | CC BY-SA 4.0 |
ext_deferred_pass_res.jpg |
Deferred rendering pass res | astrofra | CC BY-SA 4.0 |
ext_deferred_fbo.jpg |
Deferred Shading FBOs | McMalloc | CC BY-SA 3.0 |
ext_mrt_array.svg |
MultiRenderTarget | Faldrian | CC BY-SA 4.0 |
ext_mrt_targets.jpg |
Multiple Render Targets & Render Target Arrays | Rolf Zhukovsky | Public domain |
ext_normal_map_cube.jpg |
11-Normal map and GLSL view of cube | Wikimedia Commons | CC BY-SA 3.0 |
ext_no_depth_buffer.png |
No Depth Buffer | CallumPoole | CC BY-SA 3.0 |
ext_zbuffer.svg |
Z-buffer | Wikimedia Commons | Public domain |
ext_overdraw.jpg |
OverdrawTXT | StromBer | CC BY-SA 3.0 |
ext_aa_cgi.jpg |
Anti-Aliasing in CGI | Maximilian Schönherr | CC BY-SA 4.0 |
ext_vulkan_pipeline.svg |
Vulkan simplified pipeline | Alexander Overvoorde | CC BY-SA 4.0 |
ext_ssao.jpg |
Screen space ambient occlusion | Vlad3D | Public domain |
ext_alpha_compositing.svg |
Alpha compositing | Wereon | Public domain |


图片来自《移动端图形与功耗》系列整理 @ 本系列绘制
相关链接 - 上一篇:【移动端图形与功耗】(四) 功耗与热:帧率为什么会掉下去 - 下一篇(预告):【移动端图形与功耗】(六) 现代特性落地:VRS、网格着色与移动光追 - 参考资料:本篇引用的规范条款、厂商文档与量化材料见上文「参考资料」;图片素材的来源与许可见同节素材表 - 系列总览:移动端图形与功耗(全七篇)
With Best Wishes.