系列配套:GitHub 源码仓库(demo 代码与生成本文全部示意图的工具)|在线阅读入口(本站发布)
上一篇我们在装配阶段拿到了三角形的顶点,坐标已经从裁剪空间一路变到窗口——每个顶点变成了屏幕上的 (x, y) 和一个深度 z。账算到那里,像素还一个都没出现。这一篇要回答那个所有人心里都有的问题:屏幕上的那些像素,到底由谁、按什么规则、被哪些三角形填上色的。
这一篇在全系列的位置,是从「前端一半」跨到「后端一半」的转折点。§1–§5 讲完了从 CPU 提交、显存存取、着色器核、纹理采样、到图元装配;§6 第一次回答「屏幕上的像素由谁、按什么规则被三角形覆盖」。本篇聚焦硬件实现层:边函数怎么在硅片上算、顶左规则怎么由光栅器状态决定、小三角形的代价从哪来、三角形怎么被分块 dispatch 到多光栅引擎。(管线阶段的对齐见 Vulkan 规范·Pipelines。)
先放出本篇那句会被反复引用的结论:光栅化不是「把三角形一格一格涂满」,而是一次 setup 算好边函数、之后每个像素中心只剩三次加法的判定。 setup 阶段的开销是一次性的,但只要三角形足够小、足够多,一次性开销就会反过来成为吞吐瓶颈——小三角形会把宝贵的 CLK 烧在 setup 上,而不是像素上。
一句话点题:屏幕上的像素是谁填的
先把这一篇要回答的问题串起来,一共四件:
第一,setup 阶段花在哪儿。 像素循环开始之前,硬件要先为每个三角形备好一套边函数三参数。这一次准备到底算了什么、为什么之后每个像素就只剩三次加法。
第二,一个像素凭什么算「在三角形内」。 Pineda 在 1988 年给出的答案:像素中心代入三条边函数,符号一致即判定在三角形内。出处:Pineda, A Parallel Algorithm for Polygon Rasterization, SIGGRAPH 1988。
第三,共享边凭什么只画一次。 两个三角形共用一条边时,落在边上的像素到底归谁?顶左规则(top-left rule)给出答案——按边的方向决定边界像素归属,避免既画重又画漏。出处:Microsoft Rasterization Rules。(光栅这段在 D3D11 全管线的位置用 D3D11 Graphics Pipeline 概览 对照。)
第四,小三角形为什么那么贵。 这是本篇贯穿的主题:setup 是一次性的,但小三角形数量爆炸时,一次性就变成了瓶颈——建立吞吐(setup rate)决定了一个时钟能发起多少三角形。出处:Qualcomm Adreno Best Practices。
本篇按一条因果链串起四条主线:setup 开销 → 覆盖判定 → 共享边归属 → 小三角形代价,最终全部收敛到"小三角形为什么那么贵"这个贯穿主题。
动手之前把边界码清楚:本篇不讲光栅化的算法课程套路(那在《实时渲染管线探析》),不讲 TBR 的带宽成本账(那在《移动端图形与功耗》),也不需要你重新理解装配或裁剪(§5 已写)。本篇只讲线上一半——一条 Draw 的三角形进了光栅器,setup 怎么算、像素怎么判、共享边归谁、小三角形为什么贵。
在动手之前,值得先明白我们站在硬件的什么位置。光栅化这块,在显卡历史上经历过一次从「软件/驱动做」到「焊死的固定功能单元」的迁移:1996 年前后(3dfx Voodoo 之前),填充多边形靠 CPU 或显卡固件跑 scanline 软件光栅器,厂商比拼的是谁在固件里把这套循环写得聪明;而 Voodoo、之后的 GeForce 时代,光栅化被完整地搬进一块固定功能电路——于是「每时钟跑几个像素」成了硬指标,而「这个像素在不在三角形里」变成纯粹的电平判定。这一篇看的,就是那块被焊死电路里每一帧要执行几亿次的那几步加法。
这个时间点不是巧合。1988 年 Pineda 那篇经典的会议论文显著早于 Voodoo(1996),却几乎没人立刻把它做成硅片——因为当时的瓶颈根本不在这块,像素吞吐够用,软件 scanline 已经凑合。真正让光栅化器被焊进硅片的,是 3D 游戏的像素量在几年内涨到了软件填不过的数量:已经不再是「写循环写得聪明」,而是「压根来不及写」——只能交给无限行加法器去填。 于是 Voodoo 的固定功能光栅器出场,像素率从软件光栅化的「每帧几十万」跳升几个数量级,也把「每时钟扫多少像素」变成了一个可被算法优化硬啃的硬指标。(时代铺陈可对照 fgiesen Part 1 的软件栈与 Part 2 的图形内存架构历史。)
而「每时钟扫多少像素」这个指标,又在 2011 年以后被「每时钟处理多少三角形」抢了风头——这正是后面 §7.1 要讲的 setup rate。两代指标的变化,本身就是这篇主线最凝练的注脚:光栅化的瓶颈,从像素时代走到了三角形时代。
所以这一篇真正回答的问题是:当这块电路每秒要被调用几亿次,设计上要怎么取舍。 答案的主线我们已经在引言说了——把能算的一次性算好(setup)、把剩下每一像素的工作瘦身到只剩加法(edge function 增量)、用一条规则解决共享边归属(top-left)、再掰扯清楚小三角形为什么把前两步的努力全部浪费。四条线拧成一股因果链,就是本篇的逻辑骨架。
先把一句话记牢,后文会反复回到它:光栅化这一段的成本结构是「setup 恒定、像素线性」。 setup 每三角形固定价,像素每覆盖一次再走一步——两者哪条先抬头,取决于场景里三角形碎到什么程度。整篇就是在把这句话的每一环拆开。
一、setup 阶段:进入像素循环前的一次性准备
1.1 输入:三个窗口坐标顶点
承接 §5 的落点:装配完成、坐标已裁剪到窗口后,光栅器收到的每个三角形是三个窗口坐标顶点。出处参考:fgiesen《A trip…》Part 5(装配/裁剪/视口变换把顶点摊到窗口空间)。Vulkan 规范·Fixed-Function Vertex Post-Processing 的裁剪体与视口条款,也可对照这里的坐标系约定。顶点本身已经是 (x, y, z) 的整数网格坐标——但注意,这里的「整数」往往是子像素精度的定点数,不是普通像素整数。这个会在 §6 展开。
这里先给顶点定个「户口」。光栅器眼里一个三角形,就是三组窗口坐标,外加每顶点一路 perspective-correct 需要的透视权重 $1/w$(§5 会用它把 UV 插值从屏幕空间拉回裁剪空间)。至于眼睛颜色、法线、切线这些属性,此刻还不在光栅器的事权里——它们要到像素被覆盖、插值权重算出来之后,才由着色核接手。这个「谁先谁后」的分工在 §7.3 会彻底讲清:光栅器只关心『这个像素归谁』,不关心『这个像素长什么样』。
先给 setup 一个名分:它发生在像素循环之前的每三角形一次性阶段。 就像我们不需要对每个像素重新算一遍「这个三角形的边在哪」,setup 只算一次,把结果缓存成后面每一行都能增量复用的数。
出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》:setup 属于管线前端的「建立」阶段,与扫描/插值各阶段的划分可对照总览图。
setSETUP 具体算了哪些东西?这是一张可展开的清单,硬件厂商(AMD GPUOpen 的 compute rasterizer 学习样本)列过完整的 setup 顺序: - 顶点变换结果:窗口坐标 $x_i, y_i$(子像素定点数)与深度 $z_i$,以及各顶点的透视校正权重 $1/w_i$; - 边函数三参数:对三条边各算一组 $(a,b,c)$(见 1.2); - 包围盒/扫描范围:算出三角形的轴对齐包围盒,确定要扫哪几行哪几列(§3); - 深度平面与属性斜率:为 §5 的插值准备好平面方程系数。
这份清单读完要留住一个印象:里面几乎没有『判断』,全是『预计算』。 setup 不做任何「这个像素要不要」的决策,它只负责把后面像素循环要用的一堆常数一次性算好、摆到寄存器里。判断发生在循环里(§2 的 inside test),决策的表单在 setup 阶段全部摊平——这正是硬件管线「把 branching 挪到最外围」的惯用把戏:能提前算的,绝不放到被调用几亿次的循环里。
出处:AMD GPUOpen · Compute rasterizer learning sample。重要的是:这一串都只在每个三角形身上跑一次,它的成本按三角形个数计,不按像素个数计——这句在 §6 会变成整篇的爆点。
1.2 边函数的三参数:一个跨积的故事
每个三角形有三条边。对每条边,硬件要算好一组三参数 $(a, b, c)$,用它来判定任意一个像素点到这条边的「一边在内、一边在外」。这条边函数的标准形式(Pineda)是:
$$ E_{i}(x,\,y)\;=\;a\,x + b\,y + c $$
其中 $(a, b)$ 是这条边的法向量方向,$c$ 是让整条边等于 0 的常数偏移。关键性质:对边上的点 $E=0$,对三角形内侧的点 $E$ 符号一致,外侧符号相反。 这一个「符号一致」就是覆盖判定的全部依据。
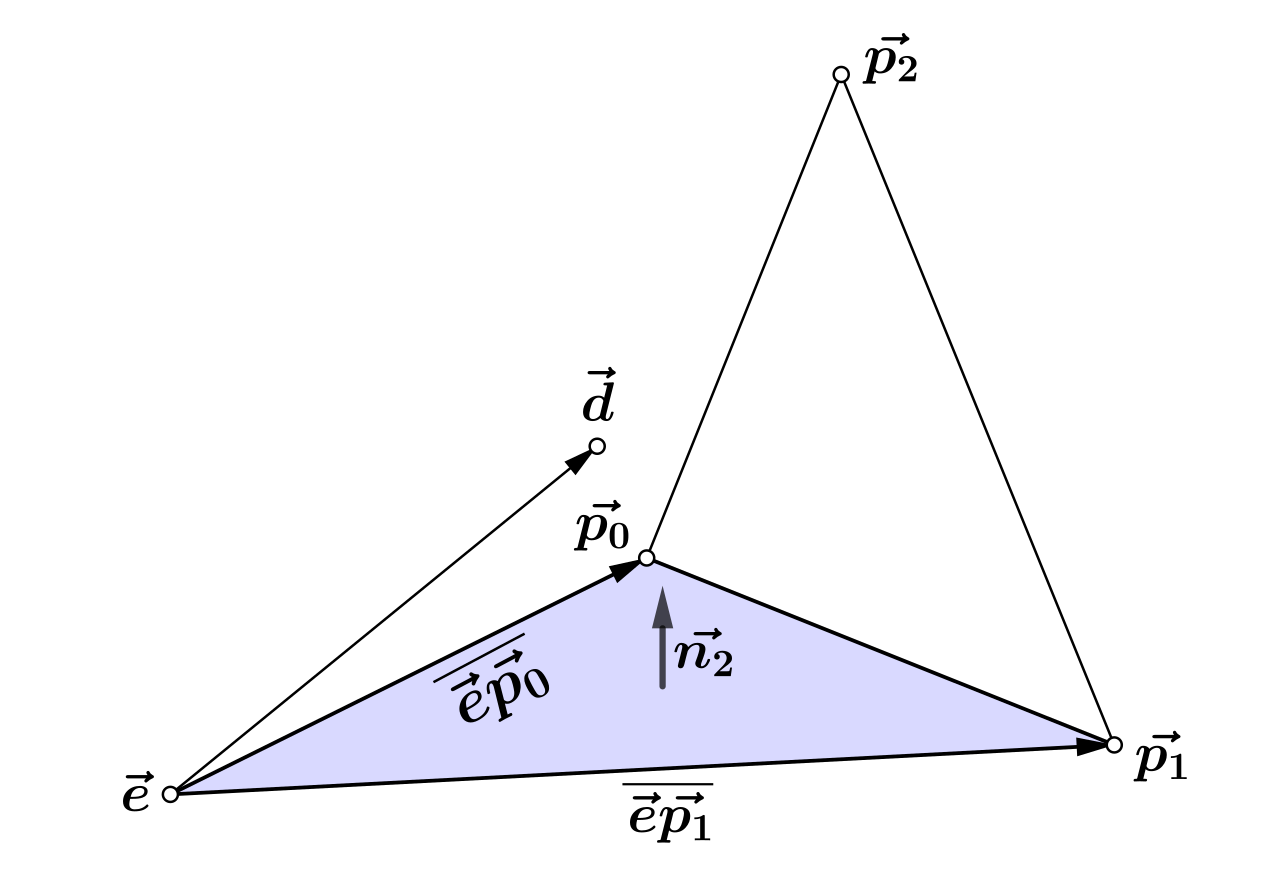
为什么用跨积?因为 $(a, b)$ 恰好就是边向量 $\vec{p_1}-\vec{p_0}$ 的旋转法向量,$c$ 则让 $E=0$ 恰好落在边所在的直线上。这样布置的结果是:整条边的内侧半空间被压缩成一个线性函数的正区或负区。 出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 6。
具体写出来:对边 $p_i\to p_j$,取 $$ a = p_{iy}-p_{jy},\qquad b = p_{jx}-p_{ix},\qquad c = p_{ix}p_{jy} - p_{jx}p_{iy} $$ 这三行合起来,$E_{ij}(p) = (p_j-p_i)\times(p-p_i)$ 恰好是向量跨积。它同时做到两件事:让 $E(p_i)=E(p_j)=0$(两个顶点都在直线上),且差一个常数 $1/2$ 就是带符号三角形面积 $[p_i,p_j,p]$。于是这一个量,既是「在不在直线上」的判据,又是「面积多大」的度量——这正是 §4.5 讲「面积判定」和 §5 讲「面积重心」能够复用的数学根据。 一个动作,三种说法(边函数/半空间/有符号面积),其实是一回事。规范级依据见 Vulkan 规范·Rasterization 的边函数/半空间片元覆盖定义。
出处:Pineda, A Parallel Algorithm for Polygon Rasterization, SIGGRAPH 1988:跨积/有符号面积的判别,是 Pineda 边函数定义的原始出处。完整著录可对照 Real-Time Rendering Bibliography。
把这段推导再收紧一步,你会看到它和「几何」的关系比想象的深。取边向量 $\vec{v}=(p_{jx}-p_{ix},\ p_{jy}-p_{iy})$,那么 $(a,b)=(v_y,\,-v_x)$ 正是让 $\vec{v}$ 旋转 90° 得到的法向量;而 $c$ 是让直线方程过 $p_i$:$c=-(a p_{ix}+b p_{iy})$。把这三行合起来,对着边 $\vec{p_0}\vec{p_1}$ 展开就是: $$ E_{01}(x,y) = (p_{0y}-p_{1y})\,x + (p_{1x}-p_{0x})\,y + (p_{0x}p_{1y}-p_{1x}p_{0y}) $$ 这个值本身,就是带符号三角形面积的两倍 $2[p_0,p_1,p]$ 的真身——不是比喻,是同一个数(对边 $p_0p_1$,跨积的模恰为 $|p_1-p_0|\times\text{点到边的距离}$,即底×高)。光栅器在 setup 里算的三组系数,本质上就是三条带符号面积直线;像素循环里的三次加法,本质上是三次「这个点在线的哪一侧」的带符号面积累加。
1.3 为什么之后每个像素只剩三次加法
这是整个 setup 里最值钱的一点。边函数是线性的,于是它满足增量化:
$$ E(x + \Delta x,\, y)\;=\;E(x,\,y) + a\,\Delta x $$
也就是说,从一格像素走到下一格,不用重算整个式子,只要在旧值上加一个由 $a$ 决定的常数。 所以硬件把 setup 算好的 $(a, b, c)$ 缓存下来,像素循环里每次水平步进只需一次加法、垂直步进又加一次。三条边就是三次加法,没有乘法,没有除法。这就是「像素循环只剩加法」的来处。
出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 6:增量式边函数扫描的逐像素演算,一个像素三次加法。
把符号问题也并入增量:如果从一行到下一行是 $y$ 步进 $\Delta y$,那增量就是 $b\,\Delta y$。于是三个累加器各自按「水平步进加 $a$、换行加 $b$」往前走。整数网格下 $\Delta x=\Delta y=1$,增量就退化成一次简单的加常数——连乘法都省了,纯累加。 这也是为什么硬件能一个时钟扫好几个像素:累加器之间还能打 SIMD 摊平行。
而 $a$、$b$ 本身又来自整条边的跨积,所以 setup 里其实藏了 6 次乘加来求三个 $(a,b,c)$,但这 6 次是每三角形一次,不是每像素一次。三角形一旦多起来,这 6 次的成本就会在吞吐账里现形——这就是 §6/§7 的准备。
把「增量」翻译成硬件真正跑的样子,是理解整篇的钥匙。假设我们要从像素 $(x_0,y_0)$ 开始、往右扫一格。硬件抽屉里有三组寄存器,分别存着当前 $E_0, E_1, E_2$ 的旧值。往右走一格:
E0 += a0;  E1 += a1;  E2 += a2;      # 往右扫,只加
E0 += b0;  E1 += b1;  E2 += b2;      # 换到下一行,再加
没有第二个乘加,没有查表,更没有任何「除以边长」的操作。三个累加器在像素循环里以恒定速度前进,彼此互不干涉——这正是它能被打成 SIMD 摊平、甚至一个时钟算 8 个像素的原因:8 个像素的 24 次加法,可以放进 24 条并行的加法器流水线,谁也不等谁。
这个「恒定步进」还有一层被低估的好处:它让光栅器的 timestep 完全可预测。因为每扫一格成本恒定,硬件可以精确算出「这个三角形扫完要几个时钟」,从而做精确的吞吐预算和风险规避(怕三角形太碎、跑不完,做切分)。可预测性在并行硬件里是金子——$2^+$ 条并行引擎靠的就是每个单元步调一致。
1.4 谁是 setup 的受益者
「一次算好、多次复用」成立,前提是:这个三角形的像素覆盖判定确实够多。 如果三角形只盖住 1~2 个像素,那 setup 的一次性投入分摊不下来,等于用 6 次乘加换两三次加法——这是纯粹的浪费。这正是贯穿全篇的病根:小三角形的 setup 成本分摊不死。
这句话可以化成一条有点像土法炼钢的直觉:三角形越大,setup 越「廉价」;三角形越小,setup 越「昂贵」。 一个能覆盖整块 16×16 tile 的大三角形,setup 的 6 次乘加被 256 个像素均摊,每个像素几乎等于免费;一个只盖 1 个像素的三角形,setup 的 6 次乘加全落在那 1 个像素头上——这个像素的「建档费」比它的「填色费」贵了一个数量级。
光是「三角形越碎越贵」还不够,后面 §6 会补上另一半:碎片化同时推高 setup 总量。场景里三角形数量翻倍,setup 调用次数也翻倍;而如果新增的三角形大多是 1~2 像素的碎件,像素总量几乎不变——于是 setup 总量暴涨、像素总量不变,两者的比值一路抬升。这就是为什么「顶点数爆炸」和「setup 瓶颈」常常同时出现:它们本是同一件事。
1.5 数值例:setup 的一次性 vs 像素的多次
给一个具体数字让「分摊」落地。假设 setup 的一次性开销折算下来约等于 8 个像素周期的基准(含 6 次跨积乘加 + 包围盒计算),而每个覆盖像素的增量成本约 1 个像素周期。
- 一个盖住 1024 像素的大三角形:setup 摊销约 8/1024 ≈ 0.8%,几乎可以忽略;
- 一个盖住 4 像素的三角形:setup 摊销 8/4 = 200%,等于每填 1 个像素还倒贴 2 个像素周期的建立开销;
- 一个盖住 1 像素的三角形:setup 成本是像素成本的 8 倍。
这组数字不是随手编的,它们指向一个可以在真机上看出的分界:当一个 Draw 里三角形平均只覆盖几个像素时,光栅器的时间几乎全在 setup 上打转,像素吞吐被闲置。这也是后文 6.3 说「屏幕空间三角形 ≥ 4 像素」的真正含义——4 像素是个「setup 摊销勉强能看」的最小值,再小就彻底亏本。
这条曲线就是全篇的眼睛。它解释 6.3 的 Adreno「≥4 像素」、6.4 的 G925 prepass、7.1 的 setup rate,全是同一张图的三个具体对策。 记住这条曲线,后文每处厂商数字都是它的一次落地。
把这条曲线再往下压一层,它会提醒我们一个常常被忽视的点:setup 的开销是「静默」的。 像素吞吐跟不上时,帧率下降一眼能看出来(fps 掉);setup 跟不上时,帧率同样下降,但 GPU 计数器里显示的是「像素引擎有不少空闲时钟」——不熟的人会误判成败在像素,其实瓶颈在建立。这也是为什么本篇讲了这么多 setup 的数学:它是藏在利润表最底层的隐性成本,得会读账的人才能发现。
二、像素覆盖判定:Pineda 边函数
2.1 对每个候选像素中心
setup 备好三组 $(a,b,c)$ 之后,进入像素循环。硬件要做的事只有一件:对每个候选像素中心,把三条边函数代进去,看符号是否一致。 全部同号(或含 0 按 §4 规则处理)→ 在三角形内;否则在外。
关键细节:判定用的是像素中心。像素是不是被三角形覆盖,取决于像素中心的采样点落在不在三角形内核——不是看像素方块和三角形有没有重叠。这个「中心采样」是环绕规则、MSAA 的基础,也是 §4 half-pixel 偏移的由来。
「像素中心采样」的另一个名字是 sample location 在(0.5, 0.5)归一化处的点采样。它把「一个像素被覆盖」从「一个方块被覆盖」重新定义为「一个点被覆盖」——这看起来是简化,实际上是让相邻三角形可以无缝拼合的前提:两个三角形共享边时,边界像素归属于谁,只看中心点在谁的核里。(微软的规则文档正是在这个采样点上定义的顶左规则。)
出处:Microsoft Rasterizer Stage Rules:覆盖判定基于像素中心 sample location,并在此定义 top-left 规则。
来一个极小的例子把「中心采样」和「边函数符号」焊到一起。设三角形三个窗口顶点 $p_0(0,0),\,p_1(4,0),\,p_2(0,3)$,逆时针。三组系数很快:
- 边 $p_0p_1$:$a=0,\,b=4,\,c=0$,$E_{01}=4y$;
- 边 $p_1p_2$:$a=3,\,b=4,\,c=-12$,$E_{12}=3x+4y-12$;
- 边 $p_2p_0$:$a=-3,\,b=0,\,c=0$,$E_{20}=-3x$。
现在问:像素 $(0.5,\,0.5)$ 在不在三角形里?代入得 $E_{01}=2>0,\ E_{12}=0.5+2-12<0$——一条边已经异号,所以不在,这格像素不覆盖。再问 $(1.5,\,1.5)$:$E_{01}=6>0,\ E_{12}=1.5+2-12<0$——仍在外。直到 $x$ 足够小、$y$ 足够小,三条才能同时非负。这个几十位的推演就是光栅器对每一格都会做的事——只不过它用的是加法累加(§1.3),比这个手动例子快几亿倍。
2.2 像素网格与步进向量
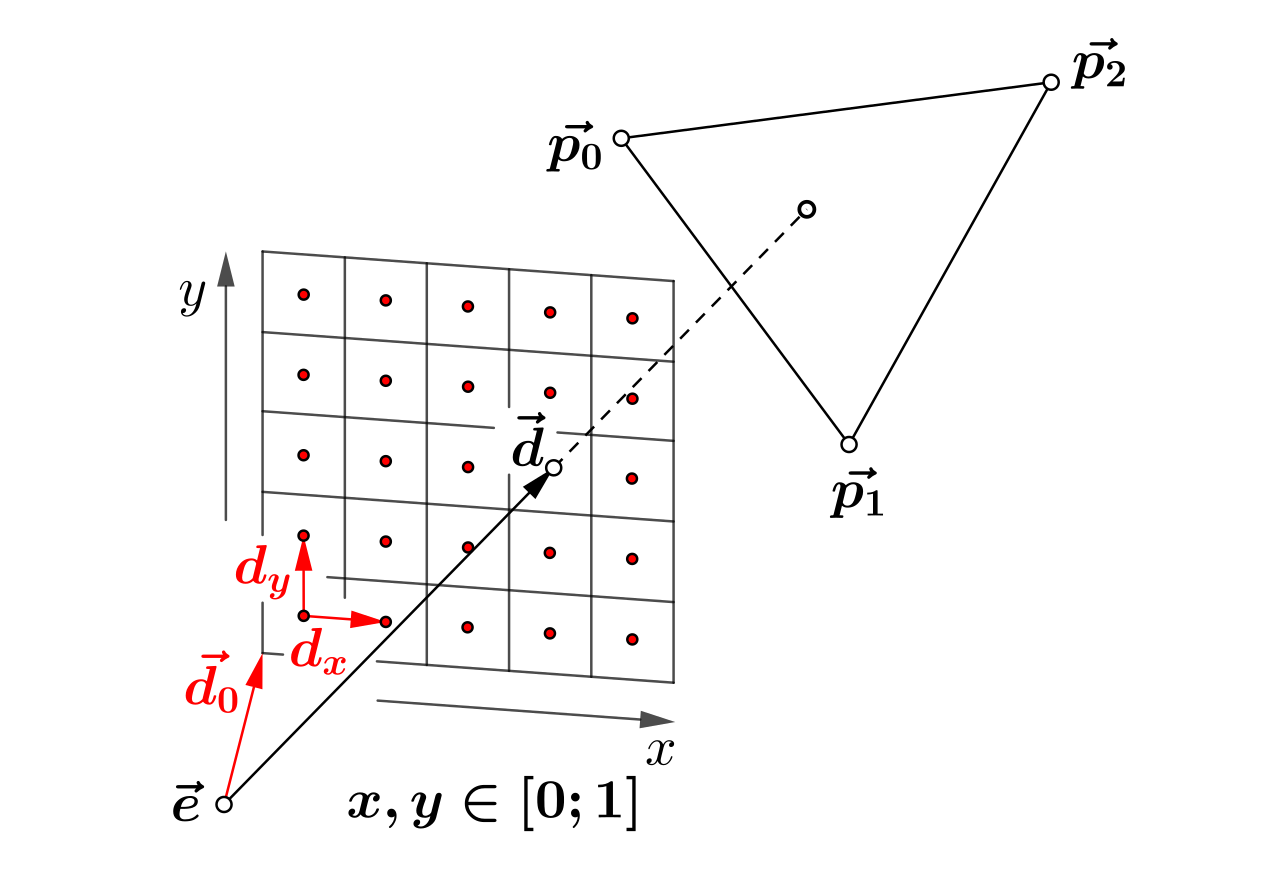
硬件不怎么「扫描」像素,它更像对一组规整的网格采样点算出「在/不在」。把采样点写成 $\vec{d} = \vec{d_0} + i\,\vec{d_x} + j\,\vec{d_y}$,其中 $\vec{d_0}$ 是起点的偏移、$\vec{d_x}$ 和 $\vec{d_y}$ 是水平和垂直的步进。于是整个覆盖判定变成对 $i, j$ 走一遍、每步做三条边函数的增量加法。
这张图把「网格步进 + 中心采样」一起说清:三角形 p₀p₁p₂ 落在 5×5 的像素格上,每个红点是当前要判定的像素中心,向量的分解 $d₀ + i·dₓ + j·dᵧ$ 就是硬件实际走的路径。这是比「一格一格涂」精确得多的模型。
值得注意,$d₀$ 是个很少被讲的细节:它不是 0,而是把整个网格对准设备像素的基准偏移。$dₓ$、$dᵧ$ 是网格的步长——正常情况是 (1, 0)、(0, 1),但如果这段光栅化是在做某种缩放/旋转后的粒度,步长可能不是单位向量。这一层抽象让「光栅化同一网格」可以复用同一条像素循环,不管屏幕分辨率怎么变。 出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 6(采样网格与像素步进的硬件视角)Vulkan 规范·Rasterization。
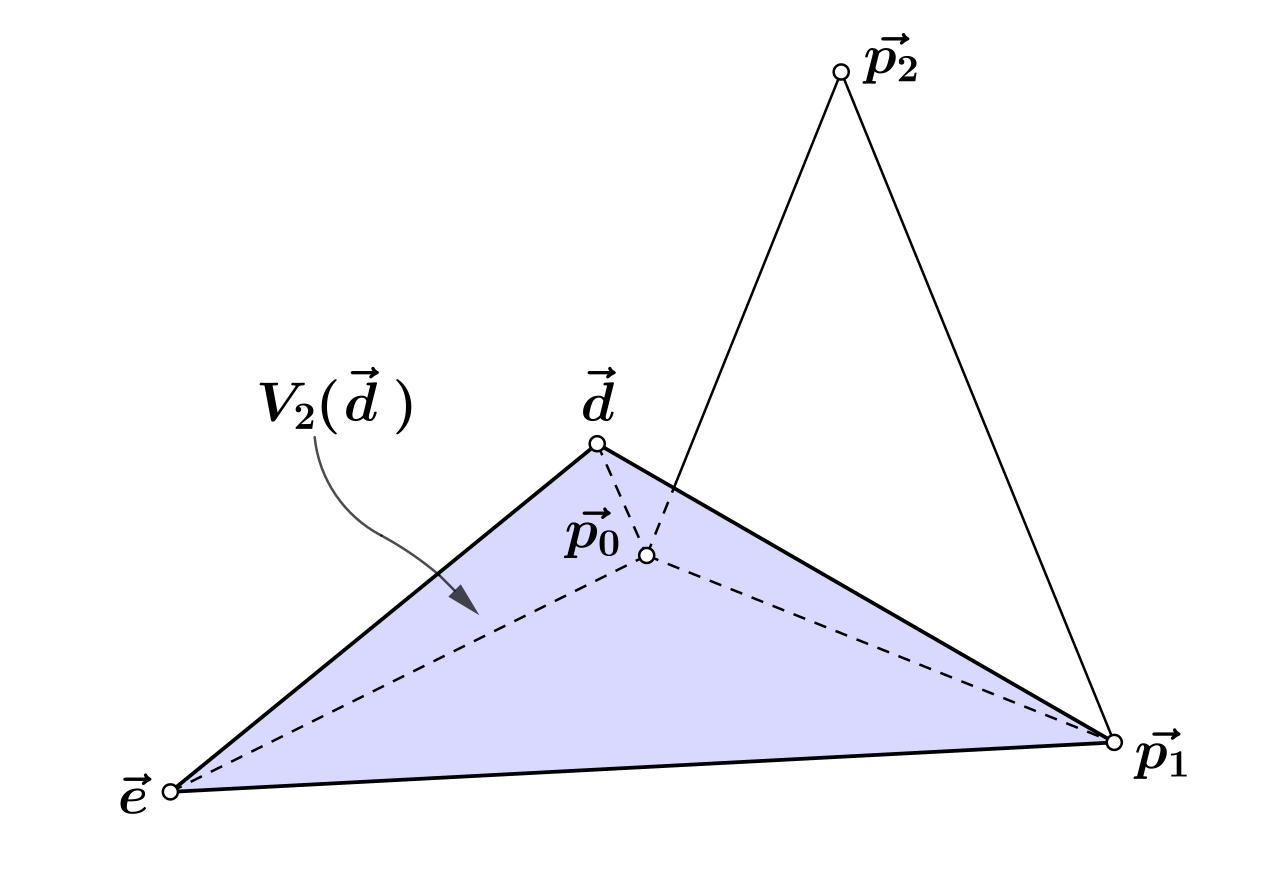
2.3 三条边函数合起来:三角形内核
三条边函数各定义了一个半空间,三角形的覆盖区域就是三个半空间的交集。因此「在三角形内」=「三式同时导向内侧」。这个交集在 §5 讲重心坐标时会复用——同一个边函数值,既是覆盖判定的依据,也是插值的权重。
把「交集」再形象化:三角形的每条边像一堵墙,「墙内」= 边函数为正的那一侧,三角形就是三堵墙围出来的那个角。像素中心只要在任一面墙的「墙外」,就出局;三面都在墙内,才算覆盖。这个「三墙交集」模型是 §5 重心坐标的直观基础。
2.4 绕序:符号约定在哪决定
这里有个绕不开的约定:三角形是逆时针还是顺时针顶点序?顶左规则与覆盖都依赖「内侧是正还是负」被固定下来。 通常约定:逆时针(正面)时,内侧为正;顺时针则内侧为负。用 §1.2 那组跨积系数 $E=(p_j-p_i)\times(p-p_i)$,能推出「顺时针三角形内侧为负」——即被背面剔除(back-face cull)。硬件于是可以「先看符号约定,再决定要不要在这一面做 setup」。
出处:NVIDIA Life of a Triangle:绕序决定正/背面朝向,影响 setup 前的预剔除流程。
这正是 7.3 讲的「固定功能单元」能省 work 的一处:如果在 setup 阶段就判出这个三角形的符号方向是背面,那连像素循环都可以不进,直接丢掉。 背面剔除不是像素阶段的活,它在 setup 的最前面就已经把一半三角形筛掉了。
把「背面剔除用边函数符号」说得再具体一点,它用的是 setup 里的现成货而不是新算的量。回到 §2.1 的三角形 $p_0(0,0),\,p_1(4,0),\,p_2(0,3)$:若顶点序是顺时针,套 §1.2 的 $E=(p_j-p_i)\times(p-p_i)$,会得到三条边上像素的 $E$ 统一为负——而约定里「内侧为正」。判朝向着眼的既不是任意内点(比如重心)的符号,也不是像素;正确做法是取一条边的边函数,在对面的那个顶点处求值——那正是带符号面积,其符号就给出这张面的正/背:为负即背面,直接丢弃;为正才继续。最省钱的是它真的只需取一条边:绕序固定时,某一条边函数在对边顶点的符号就足以判定这张面朝哪,其余的边函数连看都不用看。 这也是为什么模块会把「绕序」单独拎出来——它决定的不只是看清,而是 setup 阶段白扔还是白干。
2.5 保守光栅化:覆盖判定的一个变体
最后提一个覆盖判定的变体,因为它在光栅化硬件上真实存在:conservative rasterization(保守光栅化)。普通 inside test 只认中心点,导致个别只擦过角的小三角形被整颗丢走;保守光栅化改判「像素块与三角形有交集」,于是角上的像素也会被离散提(即便中心在外)。它是方向光阴影、体素化、以及一些后处理的底层依赖。
要不要提「保守」?它说明了光栅化这块的取舍并不止一种口味,而是硬件设计师在「精确 vs 完整」之间选择采样策略的窗口。本篇主线仍回中心采样,但这提醒我们:覆盖判定本身就是可产权设计的 overhead。
2.6 MSAA:从单个采样点到多个采样点
保守光栅化讲的是「判得全」,MSAA(multisample antialiasing)讲的是「判得细」。为了抗锯齿,MSAA 把一个像素劈成多个子采样点(典型 4x),像素中心采样变成「多个采样点分别 inside test,只要任一命中就着色一次」。光栅器因此不再对一个像素只问一次「在不在」,而是问多次——每次 still 是同样那套边函数增量,只是采样点从 (0.5,0.5) 挪到多个位置。 这再次印证 §6.2 那句「中心采样是地基」:MSAA 就是把这地基铺成多个点。
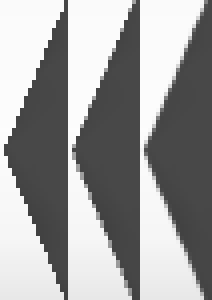
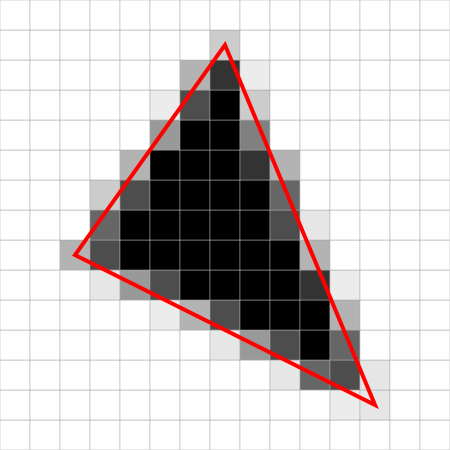
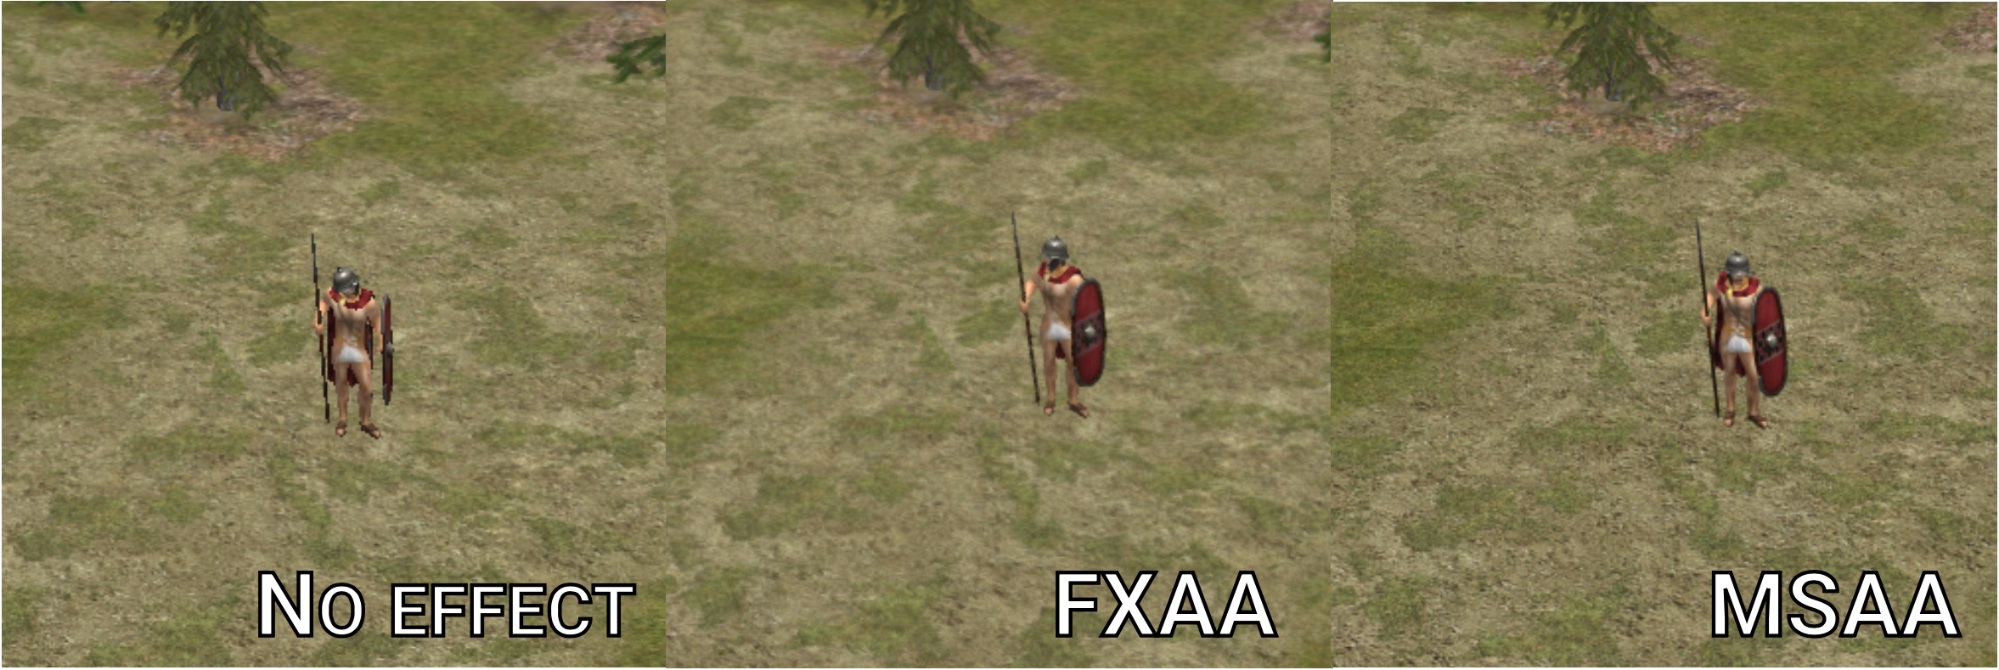
这里和 §6 的联系是深层共享的:子像素精度定点数(8.8)不仅描述边的位置,其位数上限决定了一个像素最多能放多少个稳定的子采样点。 边函数判定位置精确到 1/256,才让 4x 甚至 8x MSAA 的每个子采样点都能稳定复现;若子像素位数只有 3 位(分辨率 1/8),4x MSAA 的子采样点之间都互相打架,采样就毫无意义。所以 MSAA 不是「多采几个点」这么简单——它是子像素精度的第一个消费者,也是硬件宁可把位数做大的理由。
把 MSAA 落回 §7.3 的分工,会看到一个被低估的细节:MSAA 里「覆盖」和「颜色」是两笔账,发生在两端。 光栅器对每个像素产出的是一个 coverage mask——几位宽的位图,每一位标记「这个子采样点被覆盖没」(4x 就是 4 个 bit)。这个 mask 是固定功能单元(§7.3)直接吐出来的、纯几何的结果。然后颜色怎么算,分两种走法:
- 经典型(coverage-based MSAA):着色核只对一个像素跑一次着色(就一次,不管 4x 还是 8x),得到的颜色被
coverage mask决定「这格最终颜色里,三角形贡献多少」;后续的反锯齿混合(resolve)再把多个采样点的颜色/深度合成出一个最终像素。着色次数不随采样点数翻倍,这是 MSAA 比 SSAA(超采样,每个子采样点都单独着色)便宜的根本原因。 - 逐采样点走法(sample shading / per-sample shading):当应用开
sample shading = 1.0,每个子采样点被当成一个独立像素去着色——mask 的每一位都触发一次完整着色。它把「1 次着色/像素」重新细分成「N 次」,代价是填充率按 N 倍烧——这是纯粹的性能换质量,和 §7.3 里「固定功能只管几何、可编程才碰颜色」的分界线完全吻合。
出处:GPU Gems 2 · Pixel Quad 章节:MSAA 覆盖采样与逐采样着色(super-/multisampling)的不同粒度。
这个「mask 与着色分离」正是 MSAA 能落进硅片的关键:光栅器(固定功能)的多出一个 mask 寄存器、几个 bit 的几何,而着色核(可编程)的花费完全不变——硬件把「判得多细」的成本压在固定功能端,把「着多少色」的选择权留给软件调。 这也解释了为什么 MSAA 在某几代 GPU 上几乎是白送的抗锯齿:只要不打开 sample shading,抗锯齿的几何成本在固定功能端早已摊平。MSAA 的像素后端记账见 fgiesen Part 9(Pixel processing join phase)。
三、扫描转换:从 bounding box 到填充
3.1 硬件不扫任意行,只扫包围盒
直观的扫描转换是「把三角形夹在两条扫描线里逐行走」。但硬件更常用的模型是 bounding box + scan loop + inside test:先算三角形的轴对齐包围盒,再对盒内每一行、每一列的像素中心做 inside test;盒外的像素一进都不进。
出处:MIT 6.837 Raterizing Triangles:bounding box + 逐行 inside test 的经典课程实现。
包围盒的好处是硬件知道边界在哪,不需要任何条件判断来结束扫描——循环范围事先可算、可并行分块。这是「简单到能硬成电路」的关键:循环上界下界都是整数、循环体只是增量加法。
包围盒的取整细节先说破,因为它决定循环的整数坐标。三角形三个顶点的窗口坐标是子像素定点数(§6),包围盒就是三点的 $x$ 最小值与最大值、$y$ 最小值与最大值——但要用向上取整到覆盖它们的像素格:下界向上取整(floor 到像素边界之外第一格)、上界向下取整(ceil 到覆盖最后一格)。举例,顶点 $x$ 在 $[2.3,\ 5.7]$,那循环的 $x$ 范围就是 $2$ 到 $5$(四格),而不是 2 到 6。这个取整让循环体可以写成纯整数索引,也正是「循环上界下界都是整数」的由来。
更关键的是:包围盒是 setup 的产出,被算好一次、被整条像素循环直接使用——这也是刚才 1.1 那张 setup 清单里「包围盒/扫描范围」那一行的含义。硬件用包围盒而不是「扫描到三角形外才停」,等于把「什么时候停」这个本要分支判断的事,提前用几个求值解决掉了。
3.2 对比:scanline edge walking 旧思路
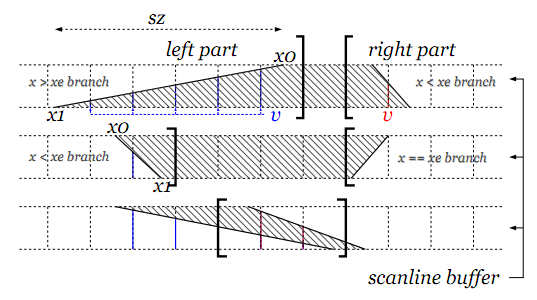
图形学教材里经典的另一种路数是 scanline edge walking:先从某条边出发,算出每条扫描线交在哪,再逐段填充。它更好懂,但充满除法、每次换行都要重新插值边交点——对硬件不友好。
出处:经典教材实现见 MIT 6.837 Rasterizing Triangles 的 scanline 与逐行交点求法。
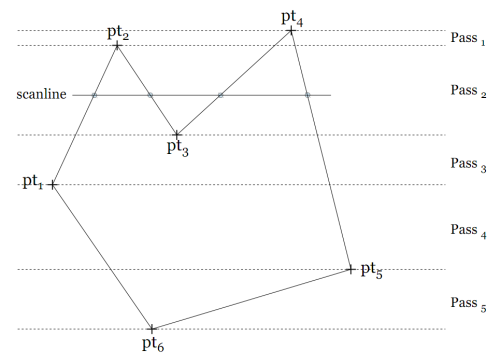
两者本质差别在数学形态:edge walking 每根扫描线都要解一条边交点(除法、条件分支在 warp 里还撕裂),而 bounding-box + inside test 是纯规整的增量子程序,能打满向量宽、也能做保守/逐块裁剪。这些差异正是「能在 GPU 里硬成固定功能单元」的判别式。出处:MIT CSAIL Rasterizing Triangles。
3.3 逐像素循环内部到底长什么样
把整个循环摊开,内部就是四段:
对包围盒内每一行 y:
  对每一列 x:
    d = d0 + i·dx + j·dy          # 网格坐标
    e0 = E0(d); e1 = E1(d); e2 = E2(d)   # 三次增量加法
    if 同侧(e0,e1,e2):  覆盖该像素 → 交给插值/Z/像素后端
没有分支、没有除法(除了外围的包围盒),三条边函数像三个累加器一样往前走。这是整个光栅化能「硬」起来的最小形态。 出处:Scratchapixel · Rasterization: a Practical Implementation 给出逐像素 inside test 的完整参考实现。
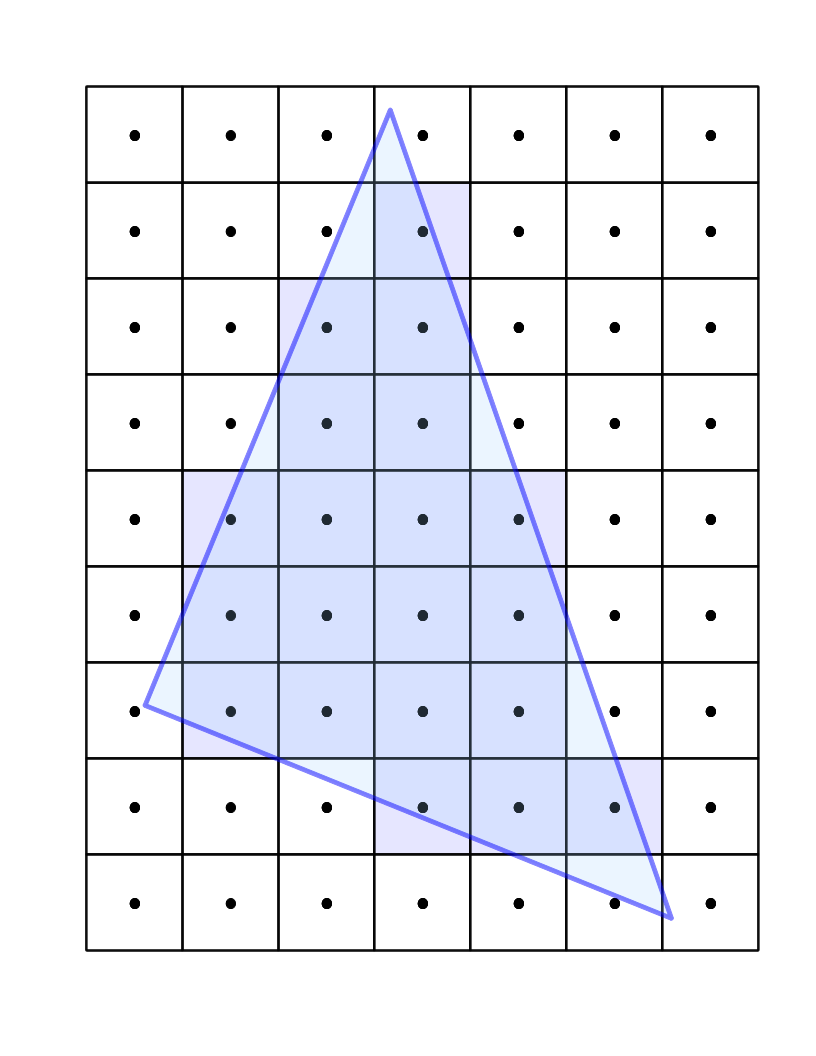
把这个循环套回 §2.1 的三角形,看得更清楚。顶点 $p_0(0,0),p_1(4,0),p_2(0,3)$ 的包围盒是 $x\in[0,4],y\in[0,3]$,一共 20 个像素中心。硬件不是「找哪些格子被盖住」,而是把 20 个格子全部跑一遍 inside test,跑完才知道其中有几个「在」。从像素 $(0.5,0.5)$ 出发,四行三列的扫描,每个 E 都按「加 $a$、换行加 $b$」更新——这正是前面方程的无损耗实拍。
这也解释了为什么 bounding box 会对瘦三角形浪费:一个 $0.1\times100$ 像素的细长三角形,包围盒可能宽 10、高 100,格子大多数在盒内却在三角形外,全被白扫一遍。不过对 GPU 来说,白扫的代价(纯加法)远低于改写循环的代价(分支)——这个权衡在 3.5 会收口。
3.4 与 §1 的闭环:为什么只有加法
回头看 §1.3:setup 已经缓存了 $(a,b,c)$,所以内循环里每条边都是「旧值 + 常数」。三条边、三个累加器、每格三次加法。Q:光栅化为什么能快到每时钟扫多个像素?A:因为像素循环里只剩加法,而加法是 GPU 最便宜的运算。
3.5 两种思路的取舍边界:什么时候 edge walking 反而更省
把话说圆:edge walking(扫描线求边交点)在纯填充、小三角形、无并行要求的场景其实是更省解——它只填三角形真正占的那几格,不像 bounding box 会多扫空档。那为什么 GPU 不用它?两个原因:
- 每行求边交点要除法:一行一交点、一行一除法或条件,除法在现代 GPU 上仍是相对贵且不均匀的指令,被 warp 摊平后更是撕裂;
- bounding box 的稀缺性可接受:对真实场景(三角形一般不会瘦到空档占大头),多扫的那点格子在「纯加法」面前不值一提——省掉的 branches 远比多扫的格子值钱。
这是一个典型的「硬件宁可用规模换掉分支」的设计哲学,也是贯穿 GPU 固定功能单元的一个总体倾向:凡是能改造成规整加法的问题,硬件都倾向往加法靠。
出处:MIT 6.837 Rasterizing Triangles:scanline edge walking 与 bounding-box+inside test 两种扫描方式的取舍对照。
这个「宁可多扫」到底多出多少,值得给个感觉。一个 $0.4\times100$ 像素的细长三角形,真身只占 40 格左右;但它的包围盒可能宽 8、高 100,共 800 格——纯加法要白扫约 95% 的格子。 单看这一个三角形,edge walking 能省十倍计算。可关键不在单个三角形,而在 GPU 是拿一整个 warp(32 像素宽)去处理网格的:800 格对 warp 可能也就是 25 次向量化的齐步走,而 edge walking 每行的一次除法(30 次除法)反而在向量里更烫。省下 95% 的格子,换来的是 30 次除法+大量分支——这笔买卖在像素尺度上算不过来。
还有一层更现实的原因值得点破:在移动端(§7.2 分块)和保守光栅化(§2.5)面前,edge walking 根本接不住。 分块要求「我能知道这一块从哪里到哪里的所有像素」——bounding box 的精确定性让它天然可分块;edge walking 逐行求交点,一旦切块就复杂度爆表。保守光栅化要求「我知道像素块和三角形的交集」——bounding box + inside test 能对每个像素块重新判,edge walking 则难。所以 edge walking 在教材里是「更好懂」,在 GPU 里是「更接不住后续需求」。
3.6 光栅器吐的不是单像素,而是 2×2 quad
上面把扫描转换讲成「一个像素一个像素地判」,但真实光栅器的输出粒度更大:它每次吐给着色核的是一组 2×2 的像素,叫 pixel quad。 这不是性能优化的自选动作,而是下游着色核的硬需求——着色核在算 mipmap 或纹理采样时,需要相邻像素间的梯度(derivative),也就是「这个像素上的 UV 变化率」;一个像素没有邻居就推不出梯度。所以只要这个像素会被着色,光栅器就得把它凑成 2×2 的一组,让着色核能算 4 个像素的差分。出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 8(像素处理 fork 阶段的 2×2 quad 与 helper pixel)、GPU Gems · Pixel Quad。
quad 化带来一个常被忽略、却直戳本篇主线的副作用:只有 1–2 个像素被三角形盖住的锐利边缘,着色核还得把这个 quad 另一侧「没被覆盖的邻居」也一起拉来算。 于是填充率账上多了一笔 quad overdraw——被覆盖的像素本应只算一次,但为了凑 quad,它被迫带着 0~3 个空邻居整组着色,每格的「有效着色成本」可能瞬间翻到 4 倍(一个 lone 像素 = 一组 4 像素的工作量,但只有 1 像素有用)。
这条副作用和小三角形主线是叠加关系,不冲突:碎三角形既烧 setup(§1.4、§6.3),又因为「盖不到的邻居像素被连带拉进 quad」而在填充端二次亏本。同一个 1 像素的小三角形,在两笔账里各亏一次——setup 付一遍建立费,quad 又付一遍空转费。 这正是 §6 反复强调「小三角形贵」的又一重硬件根源:不是 CPU/软件矫情,是光栅器与着色核的接口形态(quad)天然对细碎几何不友好。出处:quad overdraw 与小三角形是同一根筋,fgiesen Part 8 与 Stanford CS248 L18《Parallelizing and Optimizing Rasterization》 都把边缘 quad 的 overdraw 计价列成同一条罪状。
把这件事看成硬件代价还是软件机会,两档都有人选过:不想让 quad 拖累的引擎会对「整组 quad 都没被覆盖」的块提前短路(跳过进着色核),这是后面 §7.2 分块的另一个副产品;而 deferred 风格引擎(《移动端图形与功耗》里讲过)会用 prepass 先筛掉大部分不可见 quad,让真正进第二遍着色的都是「几乎整组被覆盖」的高效 quad。所以「以 quad 为工作面」不只是组织问题——它把填充率、深度测试的顺序、预处理架构全部串了起来,是本系列前端到后端之间被低估的那根轴。
四、顶左规则:共享边只画一次
4.1 问题:落在共享边上的像素归谁
两个三角形共用一条边时,边上的像素中心可能既落在 A 的内侧判定、又落在 B 的内侧判定。如果不加规则,会出现两类错误:边被画两次(像素着色被跑两遍、闪面/CV 穿帮),或边被漏画(相邻三角形之间出现 1px 的缝)。
你要理解这个问题为什么是结构性的:任何「像素中心落在恰好一条共享边上」的情形,A 和 B 的 inside test 里边的点都满足「$E=0$」——而 $E=0$ 既不大于 0 也不小于 0。如果不事先定规则,这个 0 到底算「在」还是「不在」,A、B 各猜各的,就会互相冲突。所以规则的本质是:给「边上的 0」一个确定的归属。
4.2 顶左规则的定义
规则本身一句话:当像素中心恰好落在某条边上时,只有该边是 top edge 或 left edge 才计入。 更精确的约定(D3D/Vulkan 一致):水平边中上面的边(top horizontal edge)计入、下面的边(bottom horizontal edge)不计入;非水平的边中朝左的边(left edge)计入、朝右的边(right edge)不计入。
出处:Microsoft Rasterizer Stage Rules:top-left / top-horizontal 计入约定的原文条款。
等价表述:对一条边,若它是上边(像素中心在上侧)或左边(像素中心在左侧、非水平),则边上的像素判定为「在」。其余情形判定为「不在」。
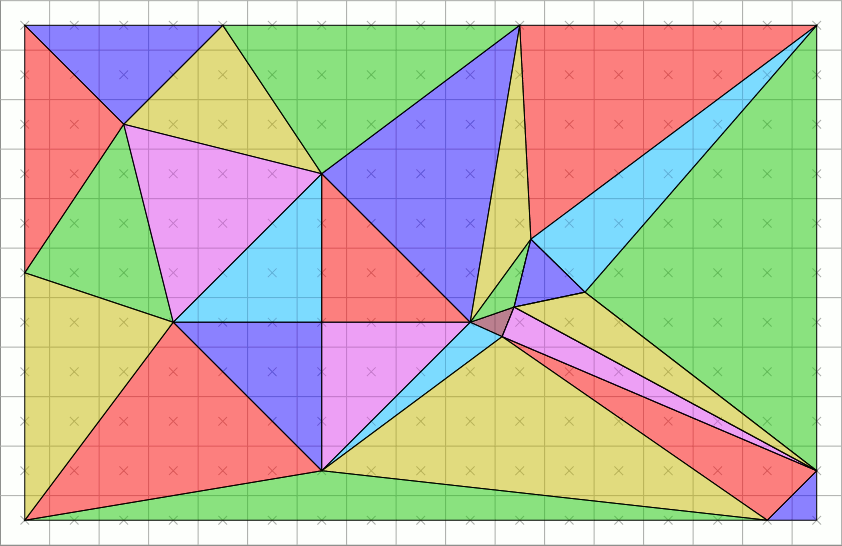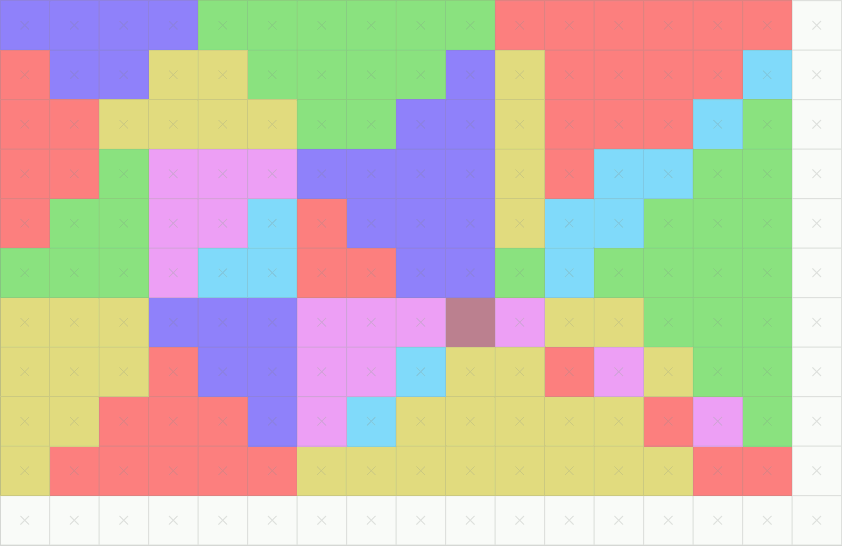
右上这张动图把顶左规则的效果一次演透:一堆相邻多边形共用边,按规则填完——没有缝隙也没有重叠,每条共享边只被一个多边形认领。这就是「水密填充(watertight rasterization)」:渲染一个闭合网格时不出现 T 型缝。
之所以要强调「无缝隙 + 无重叠」两个都要满足,是因为它们是矛盾的:要无缝隙,边界像素至少要被一个多边形认领;要无重叠,边界像素又不能被两个认领。 顶左规则保证的是「恰好一个」——这份「恰好」正是水密性的来源。
4.3 为什么是「顶」和「左」,不是别的
选 top/ left 不是随手定的。它的动机是保证方向一致性:无论图元从哪个方向被扫描,判定的「内侧」定义都统一,避免绕行的含糊。而且它跟面积法不冲突——你可以证明:顶左规则等价于「像素中心到边的有符号面积的符号按统一约定」。
出处:Microsoft Rasterizer Stage Rules:top-left 与有符号面积的等价性说明。
更精确地:把每条边的「计入条件」写成「该边为左向边,或为水平的拓扑边」: - 非水平边:若 $dx<0$(左向,即 y 增大时 x 减小)→ 该边的像素计入(left edge); - 水平边:只有上面那条(top edge,即法向量朝 +y 的那条)计入,下面的那条(bottom edge)不计入。 这两条合起来,正好保证「每个共享边像素恰好被一个多边形认领」。Vulkan 的 rasterization 文档与 D3D 的 rasterizer rules 对这个约定是措辞略有差异、实质一致的。D3D 侧的原生表述见 Microsoft Learn·Rasterizer Stage(该页把顶左规则与同族 clip/视口/像素着色启动条款并列);视口与半像素坐标系的设置细则在 Getting Started with the Rasterizer Stage。
4.4 与像素中心采样、half-pixel 偏移的关系
顶左规则里有个隐藏假设:判定用的是像素中心。 如果采样点在角上或网格线相交处,规则的边界会变得含糊。这里引出一个工程约定:有些 API/窗口约定把坐标揉到像素中心、有的则允许 half-pixel 偏移。边函数的 0 判据、顶左规则的边界分类,都建立在「中心采样」这个地基上。
实际影响:若坐标偏移半像素,边函数的 0 会落在像素块的四角而不是中心,顶左规则的「边」就会画在相邻像素共享的缝隙上,导致整行偏移一像素。所以顶左规则和 half-pixel 约定是绑定的,改一个必须改另一个。
这个「绑定」在真实 API 里是反差最大的坑之一。D3D 约定窗口坐标以像素整数为锚、像素中心落在 $(x+0.5,\ y+0.5)$——顶点坐标要自己把 0.5 加回来,才让顶左规则落在像素中心上;而 Vulkan/OpenGL 用半像素坐标系,顶点坐标天然以像素中心为原点,顶左规则的边就直接画在像素中心处。同一个三角形、同一条边、同样的 inside test,在两套坐标系下会得到错开半像素的覆盖结果——这个差异正是倒逼 D3D 应用在提交顶点前做 half-pixel 手脚的根因,也是跨 API 移植时最常踩的暗礁。固定功能侧的坐标系居中来由见 Windows 硬件驱动开发·Rendering Pipeline(primitive setup 与视口/透视除法的最细固定功能描述)。
4.5 顶左规则 vs 面积法(非零环绕)的关系
很多教材把顶左规则叫「top-left rule」,把另一种叫 non-zero winding / even-odd。前者是边界像素归属,用于「这个像素被哪个三角形认领」;后者是绕序/面积判定,用于「这个多边形是顺时针还是逆时针、正反」。两者在光栅化里一个管「覆盖解析」,一个管「面朝向」。本篇重点是前者。
这里的「关系」其实不是并列,而是先后:绕序(winding)在 setup 阶段(§2.4 背面剔除)先判完面朝向,被淘汰的顺时针背面直接丢;活下来的逆时针正面,才轮到顶左规则在像素阶段决定边界归属。先有绕序把关哪些三角形进循环,再有顶左决定边界像素分给谁——它们在管线前后端各管一摊,一个是入口的筛子,一个是出口的裁判。
出处:Pineda, SIGGRAPH 1988:同一组边函数既管绕序(面朝向)也管覆盖(内外),两个用途来自同一个跨积。
五、属性插值:重心坐标
5.1 覆盖之后要插值
像素被判定覆盖之后还不够——它得拿到自己的颜色/UV/深度。这三样来自三角形三个顶点,要按像素在三角形里的位置加权混合。这个权重就是重心坐标 $(u, v, w)$。
出处:Scratchapixel · Rasterization Stage:重心坐标用于对顶点属性做扫面后的插值。顶点属性从 VS 阶段的产出,可对照 fgiesen Part 3(3D pipeline overview, vertex processing)。

5.2 重心坐标就是归一化边函数
亮点来了:重心坐标和边函数是同一件事的两面。 对三角形内任意点,三柄权重 $u, v, w$ 恰好正比于三个边函数在该点的值(未归一化时),归一化后 $u+v+w=1$。
$$ (u,\,v,\,w) = \left(\frac{E_a}{E_a+E_b+E_c},\ \frac{E_b}{\Sigma},\ \frac{E_c}{\Sigma}\right) $$
所以 §2 里我们的 inside test 在算边函数,intest 顺手得到的边函数值,本来就是插值权重——不需要多算一遍。这就是为什么「覆盖判定」和「属性插值」在硬件里是同一段逻辑。
这条「同一段逻辑」含金量极高,值得说透。程序猿的印象里,光栅器是「先判在不在、再插值颜色」两步独立的活——但硬件没有两步,只有一步。因为像素循环里那三个累加器扫到某个像素时,$E_0,E_1,E_2$ 的值同时是两样东西:它们的符号告诉你「在不在」(§2),它们的比值告诉你「怎么插值」(本 §)。 硬件在一个时钟里既完成了覆盖判定,又把插值权重算好了,一个字都不浪费。这是边函数设计最漂亮的一点:一个量,两种用途,全程零冗余。
更妙的是,这个「比值」正好就是带符号面积之比。用 §1.5 的「面积说」:点 P 在三角形里的重心坐标 $u$,等于 $[P,p_1,p_2]/[p_0,p_1,p_2]$——P 与对边 $p_1p_2$ 围成的小三角形面积,占整个三角形面积的比例。P 越靠近 $p_0$,这块面积越大,$u$ 越接近 1。 这就是 5.3 那句「越靠近哪个顶点、那份权重越大」的几何本质:它说的不是抽象权重,是实打实的面积比。Scratchapixel · An Overview of the Rasterization Algorithm 对该 lesson 的边函数与重心算法有总览。
出处:Scratchapixel · Rasterization Stage:重心坐标作为面积比 / 边函数归一化的定义。
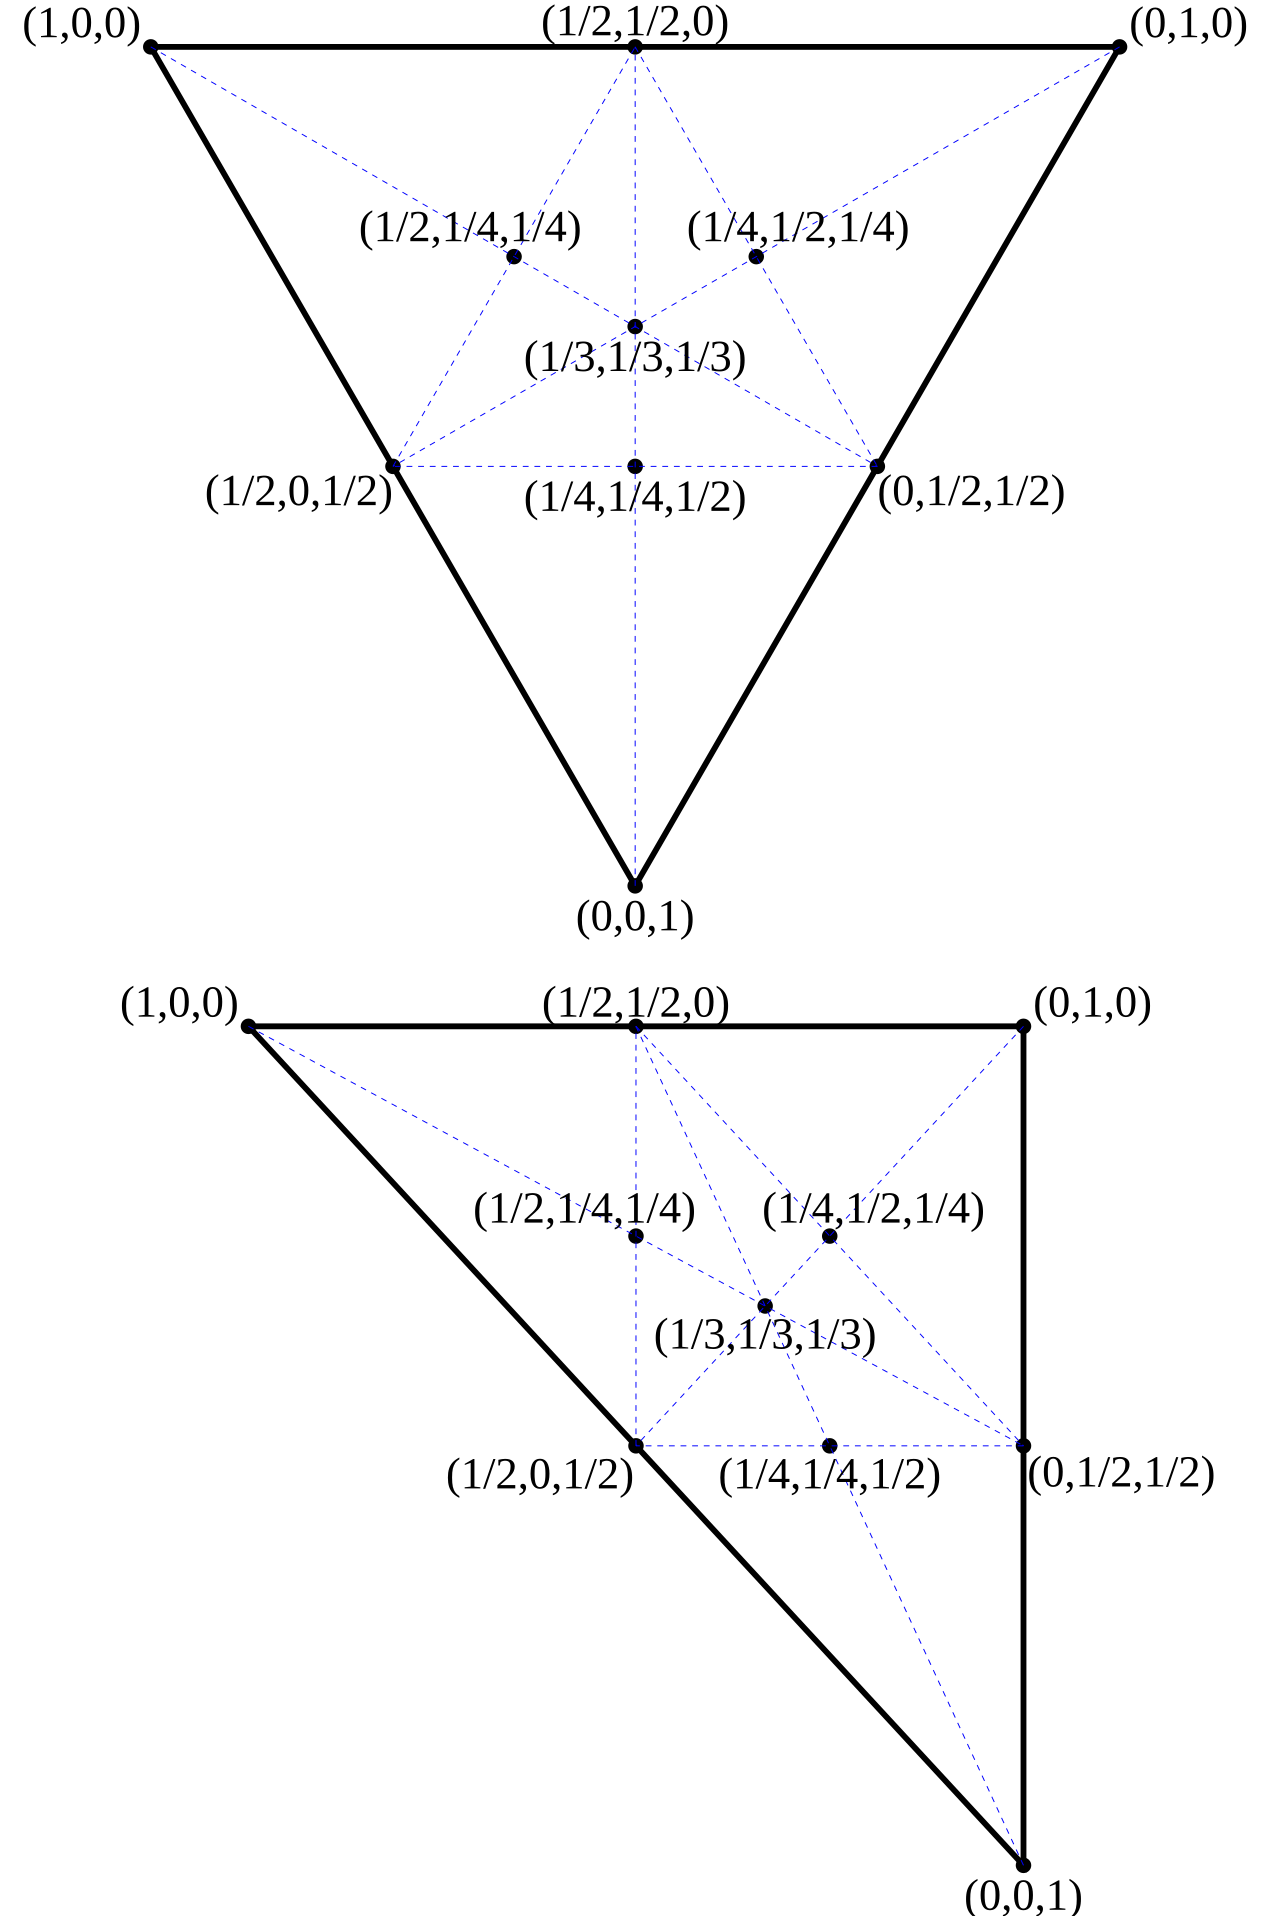
这张图把重心坐标的取值铺开:顶点是 $(1,0,0)$ 这类基准、边中点是 $(1/2,1/2,0)$、重心是 $(1/3,1/3,1/3)$。它直观证明:权重之和恒为 1,且在边、内部、顶点各自的取值形态不同。
5.3 数值算例:一个真正算出来的点
把几何落地成数字。三角形顶点 A(−2,3)、B(5,−1)、C(−6,−7),内部点 P(−1.5,−1.5)。按其面积法算出的重心坐标是 P(0.39, 0.267, 0.343)——三者之和恰为 1,且越靠近哪个顶点、那份权重越大。
这个数字不是查表来的,而是标准面积比,我们来手推一遍(用 §5.2 的面积说)。先算总面积(忽略 ×1/2 的常数,直接用 cross 的模):
$$ 2S = |(B-A)\times(C-A)| = \big|7\cdot(-10) - (-4)\cdot(-4)\big| = |-70-16| = 86 $$
三份权重分别是「P 与对边围成的子三角」占总面积的比例:
$$ \lambda_A = \frac{|(B-C)\times(P-C)|}{86} = \frac{|11\cdot5.5 - 6\cdot4.5|}{86} = \frac{33.5}{86} \approx 0.390 $$
$$ \lambda_B = \frac{|(A-C)\times(P-C)|}{86} = \frac{|4\cdot5.5 - 10\cdot4.5|}{86} = \frac{23}{86}\approx 0.267,\quad \lambda_C = 1-\lambda_A-\lambda_B \approx 0.343 $$
三份加起来正是 1。这份推导的价值不是算出三个数,而是亲眼看到「权重=面积比」,再到屏幕上「越靠近顶点权重越大」是面积实打实挤出来的。 而 §2 的边函数恰好就是同一套 cross——回到 §5.2 的那句话:在这里,覆盖判定的依据和插值的权重,是同一个量。
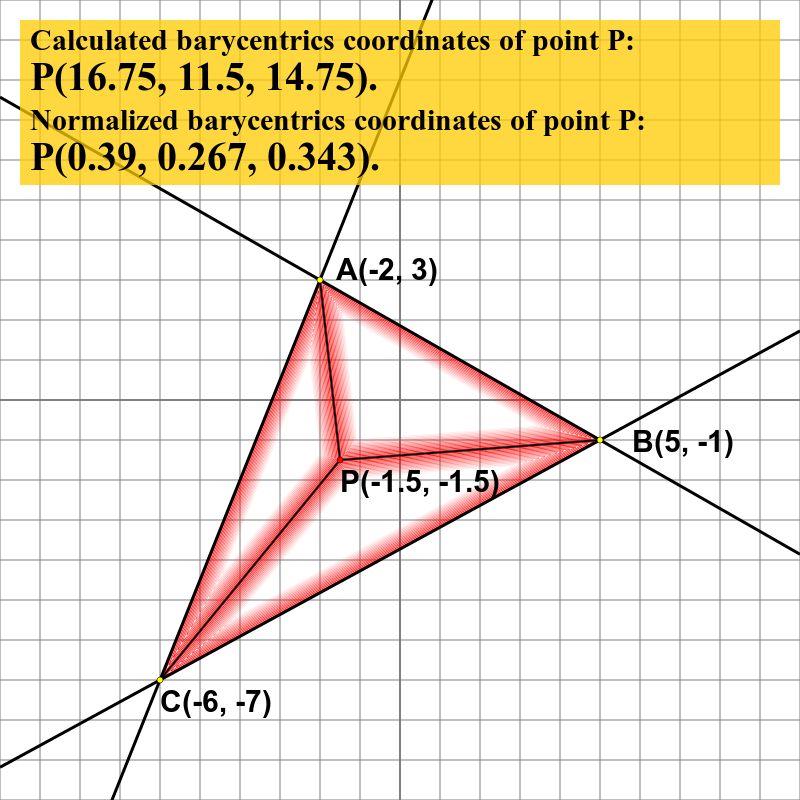
这个算例的价值在于验证三件事:① ∑=1;② 越靠近某顶点那份权重越大;③ 三者都正 → 点在三角形内。 这一切都跟前面边函数的符号判定严丝合缝。
5.4 有符号的值:点在外部时会怎样
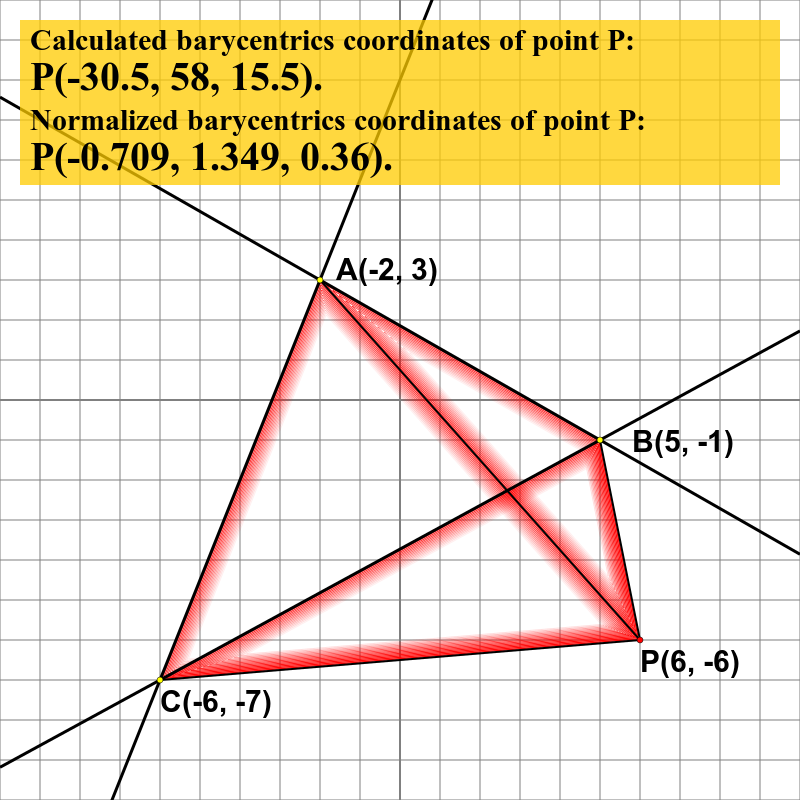
当插值点跑到三角形外,重心坐标会出现负分量。这是合理的——权重是「有符号面积」的比值,外部点的某个子三角形面积为负。这个性质不是 bug,而是保守光栅化、以及插值在边沿外扩时的依据。
出处:Scratchapixel · Rasterization Stage:有符号重心坐标及点在三角形外的负分量。
5.5 透视校正:为什么不能直接线性插值 UV
还有陷阱。屏幕空间的 x,y 与深度 z 之间有透视关系:屏幕坐标是「除以 w 之后」的坐标。若直接用屏幕空间的线性插值去插 UV,会出现纹理空间扭曲(perspective distortion)。解法:先对顶点属性除以 w(perspective-correct),在屏空间按重心坐标插值,再乘回 w。 这一除一乘,是纹理贴图正确落位的底线。
具体的正确插值式是:$u = \dfrac{u_0/w_0 \cdot \lambda_0 + u_1/w_1 \cdot \lambda_1 + u_2/w_2 \cdot \lambda_2}{\lambda_0/w_0 + \lambda_1/w_1 + \lambda_2/w_2}$。分母是对 w 的重心混合,分子是对「属性/w」的重心混合。深度 z 与 w 的关系是这套里最要命的一环——它直接牵到 §7 的 Z 与隐藏面消除。
把「为什么要除以 w」讲到底,它其实是一个坐标系的谎言。屏幕上的 $(x',y')$ 是裁剪空间 $(x,y,z,w)$ 除以 $w$ 得到的——屏幕空间是「除以 $w$ 之后」的平面,而顶点属性(UV、颜色)定义在原始的 3D 空间。 你的像素在屏幕上均匀移动一格,对应的 3D 点并不均匀移动——远处一格屏距等于近处好几格屏距。如果直接在屏幕空间线性插 UV,就等于把「编码在 3D 空间」的属性硬按「2D 投影平面」的比例摊开,纹理自然是扭曲的。投影/透视的数学出处见 Scratchapixel · The Projection Stage。
除以 $w$ 的本质,是先把属性「拉回 3D 空间」插值,再投影回屏幕。 顶点属性除以 $w$ 后,它就是「3D 空间里每单位长度的属性值」;对它做重心插值=在 3D 空间插值(因为除法把投影的压缩效应除掉)。这就是为什么「先除、再插、最后乘回」——一除一乘,把坐标系的谎言圆了回来。
深度 z 的插值是个常被误解的边界。因为顶点属性里 z 也是「3D 空间」的坐标,按理也要走除以 w 的路;但绝大多数光栅化硬件故意对 z 走一条不同的路——为了能用「每像素一个常数加法」的廉价增量(§1.3),它把 z 插值近似成「=某常数 + 另一常数×(重心坐标的倒数)」。这条近似的代价是 z 不是逐像素精确,但隐藏面消除(§7)对 z 的精度要求远低于逐像素对 UV 的需求,所以值得。这也是硬件常见的手笔:属性精度服从算法成本,不服从教科书洁癖。 z 插值算法与深度缓冲的关系见 Scratchapixel · The Visibility Problem, the Depth Buffer Algorithm and Depth Interpolation。
出处:Scratchapixel · Perspective Correct Interpolation:深度 z 与属性插值在近似的取舍、以及透视校正的代价。同一课程的光栅化 lesson 里还有一篇 Perspective Correct Interpolation and Vertex Attributes,把「除 w 再插」写成了逐像素代码。
出处:Scratchapixel · Perspective Correct Interpolation。
六、小三角形与亚像素精度
6.1 子像素精度:为什么像素坐标要带分位数
你可能觉得像素就是整数格。但顶点坐标到了窗口,往往落在整数格子之间。如果坐标按整像素舍入,边函数的判定位置会抖动、相邻帧会闪。所以硬件用子像素精度定点数表示顶点坐标——常见到几个小数位,决定了边的「真实」位置。
举一个具体的抖:一个顶点本在 $x=3.7$ 处,若按整数 4 记录下来,那条边的判定位置就向右挪了 0.3 像素。这个误差单独看不值一提,但同一个三角形在相邻帧里因为不同舍入方向而左右跳动半像素,就会表现为边缘闪烁、刮痕、以及粒子拖尾的分叉。子像素精度定点数要解决的,正是「让边的判定位置在帧间稳定复现」。
出处:Qualcomm Adreno Best Practices:小三角形历史上带来的亚像素精度与命中率问题。
6.2 亚像素位数与交点的代价
子像素位数越多,边交点的分辨率越细、填充越稳,但 setup 的乘法位数也越多。这是一组权衡:8 位子像素(256 分区)常见于满足直角网格,更多位数则更精确但更烧 setup 的 ALU 位宽。定点数保证每台设备填充结果可复现,这正是跨平台一致性的来源。出处:Scratchapixel Rasterization Stage。
一个业界常被引的实数锚:D3D 历史上用 8.8 定点——8 位整数 + 8 位小数——表示窗口坐标,子像素分辨率是 $1/256$ 像素。这个「8 位小数」不是随意拍脑袋,它意味着:一个三角形最细可以分辨到 1/256 像素的位置差,而打包进 16 位定点数的每个顶点坐标只占 2 字节。 位数越多,乘法器位宽就越宽、setup 越慢,还要在打包尺寸和吞吐之间做取舍;位数太少,填充就会在同一条边上来回跳。
你对「1/256」可能没概念,换算成违约金更直白:若边函数的判定位置精确到 1/256 像素,那意味着同一个三角形无论被哪台同规格设备光栅化,都能在 1/256 像素误差内复现同一批被覆盖的像素——跨平台水密、跨 vendor 一致,靠的就是这 8 位小数兜底。这也就是 §4「水密填充」能成立的硬件前提:判定位置本身够精确,top-left 规则才有意义。
6.3 小三角形为什么烧 setup
回到 §1.4 的本源:setup 是一次性的,但它按三角形数量收费,不按像素数量收费。 一个全屏大三角形,setup 摊销给几百万像素,微不足道;十个并排的小三角形盖同样面积,setup 就烧了十份。于是同样的屏幕覆盖面积,三角形数量越碎、setup 占比越高,光栅器越是「忙在建立、闲于填充」。
三角形为什么会碎?最常见的三个来源:远处的地面/粒子/植被(透视线条在远处被压缩成一两个像素高)、网格曲面细分的崂岛(LOD 切得过细时每条边都短)、以及次表面散射/体积光的条带。它们有个共同点:不是美术故意造小三角形,而是场景的几何复杂度在屏幕投影后天然退化——一个覆盖全屏的高模植物,投影到远处就剩十几条 1~2 像素的细线,setup 却在为每条细线付全价。
更狠的是,三角形碎化和上面的 setup 摊销成本是叠加而非抵消的:远处碎三角形(setup 高、像素少)与近处大三角形(setup 低、像素多)混在同一 Draw 里,光栅总成本是「大三角形像素吃到饱 + 小三角形 setup 纯亏」,两者都要买单。这也是为什么光栅化性能很难用单一「三角形数」或「像素数」预测——它是两者的加权混合,权重取决于几何在屏幕空间的分布。
这就是 Adreno 文档里那句「理想屏空间三角形至少 4 像素」的背后真相——它不是在给美术提审美要求,而是在划一条setup 摊销的下限。出处:Qualcomm Adreno Best Practices · screenspace triangle size。
6.4 G925 的 fragment prepass:硬件在替我们收拾小三角形
2024 的 Arm Mali Immortalis-G925 引入 Fragment Prepass:把光栅化拆成两遍——第一遍只算覆盖与深度(不吃像素着色),第二遍再真的着色。对小三角形特有的碎、浅深度属性,prepass 被设计成能一次性跳过小三角形的位置数据、避免把宝贵的时间耗在建立一堆只盖 1-2 像素的三角形上。
prepass 的巧妙在于它把「着色」和「建立」剥离开:第一遍只做 setup + 覆盖 + 深度(还没到像素着色),第二遍才对真正可见的像素着色。 对一层几乎全部被遮挡的网格(比如厚一层的皮),prepass 能算出哪些像素最终可见,第二遍直接跳过不可见部分——于是深度测试把「小三角形」在像素阶段筛掉,光栅器避免为一大批不可见的碎三角形付出双击的建立成本。 这是从 §1.5 那条 setup 摊销曲线的「对策端」出发做的硬件投资。prepass 把深度测试拆到着色前、且碎几何的建立开销可被跳过,这层机制与 early-Z 的讨论同源,见 therealmjp · To early-Z or not to early-Z,Z 阶段的三种实现见 fgiesen Part 7。
这个设计说明一件事:小三角形的成本不是「你以为小心点就没事」的边缘问题,而是厂商愿意专门整一块新硬件去伺候的、真实的性能主体。 它把「setup 吞吐」从理论直接拉进了 2020 年代的实际对策。
6.5 软件侧的反制:把 setup 摊平在管线里
如果硬件愿意为小三角形专门改版,软件自然更早地在管线的上层下手。对策分三档,全都指向同一个目标——减少 setup 的调用次数,而不是减少像素:
- 背面剔除与视锥裁剪更早做:在 CPU 侧(§1 命令提交)就把不可见三角形干掉了,进光栅器的三角形数自然下降——这是把 setup 的负担前移,而不是让光栅器替它卸。
- LOD 与实例化合并:把远处碎三角形降级成更粗的网格(LOD),或用实例化(instancing)让「同一三角形贴很多个位置」只 setup 一次——本质是用更少的大三角形替代大量小三角形,正撞在 setup 摊销曲线的心口上。
- 几何阶段消除退化三角形:一个投影后退化成长条或点的三角形(合法但不产生覆盖像素),最好在装配/几何阶段(§5)就掐掉,别让它活着进 setup——每一个被 setup 又发现"盖了0像素"的三角形,都是纯亏的 setup 时钟。
出处:Qualcomm Adreno Best Practices:屏空间三角形尺寸对建立/填充占比的建议,及退化三角形的代价提示。
对照 6.4 的 G925 prepass 会发现一个有趣的镜像:硬件用「更快地跳过小三角形」来应对,软件用「更少地生成小三角形」来应对——一个治标在建立环节,一个治根在几何环节。两者并不互斥,而是从两端夹击同一条成本曲线。这也是为什么「小三角形」值得被一整篇反复讲:它横跨软件层与硬件层,两头都在为它优化,说明它是真实存在的成本主线,而不是理论玩具。
七、硬件实现:建立吞吐、分块与多光栅引擎
7.1 建立吞吐 setup rate:一个时钟能起多少三角形
光栅器的硬件指标里最要紧的不是「每时钟扫几像素」,而是 triangle setup rate:每秒能建立多少三角形(prim/clk or /fs)。这个数由 setup 单元的数量、ALU 位宽和分频决定。它构成本篇的最终落点:当三角形数碎到 setup 成为瓶颈,光栅器的像素吞吐再高也无济于事。
把 setup rate 翻译成可感知的数字。假设一块光栅器 setup rate 是 每时钟 1 个三角形,在 1 GHz 频率下就是每秒 10 亿个三角形。这数字看着吓人,但对一个碎三角形场景(每秒 5 亿个三角形、平均盖 3 像素)来说,它满负荷跑 setup 也已经吃掉一半能力——而像素引擎(吞吐 32 像素/时钟)却在大部分时间闲着。setup 引擎和像素引擎的利用率,可以相差一个数量级,这就是「忙在建立、闲于填充」的硬件读数。
出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》:setup rate 由建立单元数、ALU 位宽与分频决定,是光栅器的关键硬指标。厂商把这项写入规格表,见 Qualcomm Adreno · Spec Sheets 的三角形 setup 速率。
要特别提醒的是:setup rate 是从「进入光栅器的三角形」算的,不是从「屏幕上的三角形」算的。 一个三角形被裁剪成三块,或重复经过分块,都会被 setup 单元各计一次。所以当你说「场景 5000 万个三角形」时,光栅器实际要 setup 的可能远多于 5 千万——这就是 7.2 分块会带来的额外放大。
计数的口径更琐碎:是送入光栅器的三角形数,还是剔除/裁剪之后真正求覆盖的三角形数。厂商性能计数器(如 Arm 的 PRIMITIVE_ 计数器)就区分这两种,排查「三角形碎不碎」要对着对的口径看——看错口径,会把「setup 瓶颈」误判成「像素瓶颈」,修到错误的地方去。* 出处:Arm Mali Bifrost Performance Counters。
7.2 分块与多光栅引擎:把差异摊到并行里
窗口坐标一进来,光栅器先在空间上把屏幕切成若干分块(tile / workgroup),再把不同分块 dispatch 给不同的光栅引擎并行扫。分块接近独立——每个分块只知道自己的屏幕范围、只对落在范围内的三角形做 setup——于是多个引擎可以同时开工。
分块有个一旦讲出来就回不去的细节:一个三角形几乎不会只待在一个 tile 里。 一个跨 2×2 tile 的三角形,会被四个 tile 各 setup 四次——每个 tile 只对自己那块范围内的部分做光栅化。这正是 7.1 说的「setup 按进入光栅器的三角形计」的放大来源。tile 数量和 setup 重复次数是成正比的,分得越细,并行越多,但每个跨 tile 三角形被 setup 的次数也越多——所以 tile 尺寸不是越小越好,得在并行度与 setup 重复之间取一个甜点位。
移动端这里跟《移动端图形与功耗》的 TBR 呼应:tile 既是并行的单位,也是片内缓存与逐 tile 渲染的载体。本篇不重复带宽账,只强调并行这一点——分块让 setup 的吞吐能靠加引擎堆起来,也让 setup 的重复次数随之上涨。 这是并行化的双刃:吞吐翻倍的同时,也可能因为 setup 重复而把增长吃掉一部分。
出处:Arm Mali · The Mali GPU: An Abstract Machine Part 1 - Frame Pipelining 与 Part 2 - Tile-based Rendering:分块渲染如何摊平 tile 化光栅引擎与片内存储,也可对照 Stanford CS348K L14《Scheduling the Graphics Pipeline on a GPU》(sort-middle tiled 的分箱模型)与 Vulkan Guide 的 Tile-Based Rendering Best Practices。
tile 尺寸本身是两股相反力量的平衡点,值得给一个能动手估算的模型,而不是一句空话。tile 越小,能塞进去的三角形引擎越多、并行度越高、片内显存占用越省(§7.2 的 TBR 逻辑);但跨 tile 的三角形占整体三角形的比例也越高,每个跨 tile 三角形要被 setup 的次数随之上升。tile 越大则相反:并行叠不满、片内驻留成本高,但几乎每个三角形都能在一个 tile 里一次 setup 完。甜点位落在「跨 tile 重复的 setup 增量」不再抵得上「并行度提升的收益」的临界处——常见的切片是 8×8 到 32×32 像素,各家在此之间贴着各自的编队和显存预算取。
跨 tile 概率的一阶模型可以推出来。设三角形平均屏幕边长为 $s$ 像素,tile 边长为 $T$ 像素,那么三角形「横跨至少一条 tile 边界」的概率大致正比于 $s/T$(边越长、tile 越小,越容易压到边界线)。一个平均 4 像素的小三角形在 $T=32$ 的 tile 里几乎不会跨线($s/T\approx0.12$),setup 几乎一价到底;但同一个场景若把 tile 压到 $T=8$,$s/T$ 涨到 0.5,相当比例的三角形开始跨线——setup 的算入次数从「一」往「多」爬,而它们盖的像素总量纹丝不动。 这就是 7.1 那句「setup rate 按进入光栅器、不按屏幕像素算」在此处被现形:tile 细分在并行上是利好,在 setup 账上却是放大器,两个方向必须一起结算。
把两笔账合并成一句话:快的引擎未必靠「更大的 tile」,而是靠「tile 尺寸适配了三角形尺寸」——场景三角形大(大地面、天空),大 tile 划算;场景三角形碎(远处网格、粒子),小 tile 的并行红利会被 setup 重复吃掉大半。 这也是为什么驱动会按几何特征动态挑 tile 策略,而不是死盯一个固定尺寸:setup 的账是「场景相关」的,tile 越懂场景,越能把双刃里好的那一面留给自己。
7.3 固定功能单元 vs 着色核的分工
最后是大分工。做 setup 的边函数、做覆盖判定的 inside test,都是固定功能单元(fixed-function)——没有指令流、没有通用寄存器,就是一块针对这个算法硬化的电路。着色核(shader core)只在光栅器吐出被覆盖的像素后,才接手那些半可编程的属性计算。
分工的界线很干净:凡是不变的、一万个三角形都用同一套算法的(边函数、inside test、顶左规则),硬成固定功能;凡是可编程的(属性插值策略之后的着色),托付着色核。 这也解释了为什么 setup 的乘法位数会跟芯片面积、光栅吞吐直接挂钩——它是被焊死的电路,不是被调度的代码。出处:Arm Mali · The Midgard Shader Core、Arm Mali · Part 4 - The Bifrost Shader Core、NVIDIA Life of a Triangle。
但这个分工本身也在移动。2011 年前后,光栅化这块「不可编程的固定功能」被打破了第一道缝:厂商开始把部分光栅化逻辑搬进可编程的着色器核(compute rasterizer、mesh-shader 时代的几何阶段下沉),理由是——当像素吞吐不再是瓶颈,而三角形数、setup rate 成为新瓶颈时,把光栅化交给可编程核,等于把原来焊死的能力释放给软件去重排。 这和 §7.1 的结论完全同构:硬件把空间让给软件,正是因为「哪个瓶颈先抬头」取决于场景,而场景只有软件才知道。固定功能的那一层(边函数、inside test、顶左)至今仍是内核,只是它的外围开始长出了可编程的壳。
出处:AMD GPUOpen · Compute rasterizer learning sample:光栅化下沉到可编程/计算核的现代实现样例;几何阶段可编程的历史起点见 fgiesen Part 10(Geometry Shaders),mesh shader 的改法动机见 NVIDIA · Advanced API Performance: Mesh Shaders。
八、收尾:四条线拧成一股
回到劈头那四件,现在每一件都有了落点。第一件,setup 阶段花在哪儿——它是每三角形的一次性预计算,写下三组边函数系数,换得像素循环里只剩三次加法(§1)。第二件,一个像素凭什么算「在三角形内」——它的中心代入三条边函数,符号一致即判定在(§2),而这个判定用 bounding box 框定、用增量加法跑满(§3)。第三件,共享边凭什么只画一次——top-left 规则按边的方向决定边界像素归属,恰好一个多边形认领,水密填充由此成立(§4)。第四件,小三角形为什么那么贵——setup 按三角形计、像素按覆盖计,三角形碎时 setup 占比一路抬升,直到设置 rate 成为瓶颈(§5 的插值、§6 的碎化、§7 的硬锚全部归到这里)。
全篇只有两个数值得记住:setup 恒定、像素线性,以及 Adreno 那句「屏空间三角形 ≥ 4 像素」。前者是你判断一段光栅化会不会撞 setup 瓶颈的语言,后者是厂商自己给的止损线。把它们串起来,就是一句话:光栅化不是把三角形一格格涂满,而是 setup 一次算好边函数,再用加法和一条规则,把像素精准地分给三角形——而小三角形,是这条精确链条里唯一能让它失速的因素。
下一篇我们顺着像素往下走:被覆盖的像素带着插值出来的 z 排进深度缓冲,Z 与隐藏面消除登场。光栅化的产物到这里告一段落——边函数、顶左规则、重心坐标的使命,将在 Z 缓冲里被检验、被消耗。Z 阶段的下一步看 Vulkan 规范·Fragment Operations 与 Microsoft Learn·Output Merger Stage。
(本篇完)
把全篇四问做个回落对照:setup 开销→§1,覆盖判定→§2/3,共享边归属→§4,小三角形代价→§5/6/7;就此收束本篇,并顺延预告下篇深度缓冲。
九、参考资料与可回溯出处
本篇的关键数字与机制全部来自厂商文档、规范与经典文献,正文中每一处引用都可回溯到出处。主要来源:
- Fabian Giesen《A trip through the Graphics Pipeline 2011》· 光栅化
- Pineda《A Parallel Algorithm for Polygon Rasterization》, SIGGRAPH 88
- MIT 6.837 · 三角形光栅化与边函数
- Microsoft Learn · 光栅化器阶段规则(顶左规则)
- NVIDIA · Life of a Triangle
- NVIDIA GPU Gems 2 · 像素四元组(pixel quad)
- Arm Mali · Midgard Shader Core(固定功能 vs 着色核)
- Qualcomm Adreno OpenGL ES 开发者指南 · 小三角形最佳实践
- Scratchapixel · 光栅化与透视校正插值
- GPUOpen · Work Graphs 学习样例
下篇预告:《GPU 架构剖析》系列进度:已完成【一】命令前端、【二】显存与地址空间、【三】着色器核、【四】纹理采样器、【五】图元装配、【六】光栅化与三角形建立,接下来是【七】Z缓冲与隐藏面消除。光栅化的边函数、顶左规则与重心坐标的使命,将在 Z 缓冲里被检验、被消耗。我们在硅片到像素之间,继续挖下去。
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在硅片到像素之间,继续挖下去。