本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
核心问题:前面两篇把 vsync 当成了一个既定的节拍——ep06 讲"一轮刷新里 SF 做了什么",起手就是"等 vsync";ep08 讲"这一帧归谁画",量的是归属结果。可这个节拍本身从哪来、谁在派、派给谁,一直没打开。
一个读数就能把它逼出来。本机
dumpsys SurfaceFlinger里有这么一段,打印的是 vsync 的派发器:VsyncDispatch: sf: workDuration: 15.67ms readyDuration: 0.00ms app: workDuration: 16.67ms readyDuration: 15.67ms appSf: workDuration: 16.67ms readyDuration: 15.67ms官方文档说 vsync 一共三路信号,设备上就印着三条——
sf:、app:、appSf:。三条的周期完全一样(都是 16.67 ms),差别只在"提前多久叫醒"和"要求多久准备好"这两项参数上。vsync 不是一根线,是一份排班表。
承接前两篇。ep06 讲的是"关口":一轮刷新里 SF 干了什么、合成归属怎么被标出来、present 怎么与刷新周期对齐。ep08 讲的是"归属":这一帧由显示控制器画还是由 GPU 画,判定权在 HWC 那一侧。可这两篇都把 vsync 当成了背景条件——ep06 §2.1 写的是"等到 vsync",ep08 §1.4 把 vsync 列在链路图里却没展开。这一篇就把它打开:这个节拍是谁造的、怎么派出去的、以及那块没有自己 vsync 的虚拟屏借的是谁。
这件事在前几篇里也挂过账。ep06 §9.3 的下一篇预告曾把"HWC2 与 vsync 回调"列在 ep09;ep08 §9.4 测出"同一时刻物理屏全 DEVICE、虚拟屏全 CLIENT",但没回答虚拟屏那一帧是谁在计时;ep02 讲 Choreographer 时也只说了"它接收显示子系统的脉冲",脉冲从哪来没往下追。所以这一篇是来还债的:把"谁造节拍 → 谁建模型 → 谁派发 → 谁接收"这一条链讲清。
三篇共用同一条链路,各篇量的东西仍然不同:
| 维度 | ep07《ASurfaceControl》 | ep08《HWC》 | ep09(本篇) |
|---|---|---|---|
| 关心的对象 | 改动:层的属性怎么被改 | 归属:这一帧由谁去摞 | 节拍:这一帧什么时候开始 |
| 量什么 | 层树结构与属性 | 每层合成类型与客户端合成代价 | vsync 的派发对象、派发速率与周期来源 |
| 主要命令 | --list + 层段 + gfxinfo framestats |
HWC layers 段 + --timestats |
dumpsys SurfaceFlinger 的 VsyncSchedule / VsyncDispatch 段 + 计数采样 |
| 典型结论 | 一次下拉 = 一笔 reparent:parentId 110 → 115 |
7 层仍全 DEVICE(2);退回客户端后 RenderEngine 0.000 → 9.093 ms |
滑动时 vsync 计数 57.57 Hz、静置 0.65 Hz;本机 No Last HW vsync |
本篇也不涉及:Vsync 偏移"三步怎么排"(ep10,本篇只讲偏移是"给最坏情况的余量")、三缓冲与多刷新率 ARR(ep11,需支持 ARR 的真机)、虚拟显示与录屏自身的实现(ep12,本篇只回答它的 vsync 从哪来)、Perfetto FrameTimeline 抓 jank 的完整方法论(ep13 与《图形性能剖析工具链》已写)、合成归属与 HWC 判定(ep08 已写,本篇只回指)、Choreographer 的应用侧调度细节(ep02 已写,本篇只取"一个 Looper 一个 Choreographer"这一句接口关系)、事务与层树(ep07 已写)。为什么不涉及:这一篇的价值集中在"节拍"这一个点,把谁造、谁派、谁收、虚拟屏借谁这四问讲透,掺进别的题域,这件事就讲不透了。完整边界见 §0.3。
系列文章写作风格说明(沿用前八篇,不再重复解释)
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、设备上读出来是什么,这三层分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、采样时刻);
- 模拟器与真机分开写:本机 composer 是官方文档点名的模拟器参考实现,而本篇新增一条更要紧的——它不提供硬件 vsync 时间戳(
No Last HW vsync)。所以"vsync 周期从哪来"在本机的答案是"软件模型自己算",不得写成 Android 的通用行为。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交:从显示模块到一块缓冲
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径(本篇)
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank
相关资源链接
- 官方一手来源:VSync | 硬件合成器 HAL 的 AIDL | SurfaceFlinger 和 Hardware Composer | SurfaceFlinger 的系统属性 | Hotplug handling
- 应用侧接口:DisplayEventReceiver | Choreographer
- 源码入口:
Scheduler/VSyncDispatch.h|Scheduler/VsyncSchedule.h|Scheduler/VsyncController.h|composer3/IComposerCallback.aidl - 与本文强绑定的前置:ep02《Choreographer》| ep06《SurfaceFlinger》| ep08《HWC》
这一篇回答什么,不回答什么
OK,先把坐标系挪正。前八篇给了地图、叫醒链、交接、账本、入口、关口、改动、归属;这一篇要给的是节拍——屏幕上这一帧什么时候开始动,这个"开始"是谁定的、怎么通知出去的。
0.0 内容总览:本篇知识地图
好了,先把十章各自回答的问题钉在一张表上。它同时也是本篇的目录总览。如果时间紧,第二章(为什么需要三路信号)、第七章(在设备上怎么读出来)、第八章(一次 vsync 速率的实测)是这篇最不可替代的三章:第二章给机制,第七章给读面,第八章给现场。
| 章 | 回答的问题 | 关键结论 |
|---|---|---|
| 零 | 这一篇补哪一段 | 一篇讲"节拍"的文章;与 ep06/ep08/ep10/ep11 的分工 |
| 一 | vsync 到底在同步什么 | 官方一句:它同步的是三段——应用渲染、SF 合成、HWC 送显 |
| 二 | 为什么需要三路信号 | 同一周期、不同相位;设备上真的印着 sf: / app: / appSf: 三条 |
| 三 | 谁在产生 vsync | HWC 提供硬件 vsync,但必须先被 SF 要求(setVsyncEnabled);同步建立后关掉、偏了就重开 |
| 四 | HWC 那五个回调各管什么 | onVsync(仅在启用时回调)/ onVsyncPeriodTimingChanged / onVsyncIdle(会让平台重置模型)/ onHotplug / onRefresh |
| 五 | 从 DispSync 到 VsyncSchedule | 四层结构:Schedule → Controller/Tracker → Dispatch → Scheduler;软件锁相环的老机制与新类划分 |
| 六 | 模型从哪来样本 | 硬件时间戳 / present fence 两条采样路径;本机两条都没走 |
| 七 | 在设备上怎么读出来 | VsyncSchedule 整段、三条回调条目、相位七组、连接表与 VSyncRequest |
| 八 | 一次 vsync 速率的实测 | 静置 0.65 Hz、滑动 57.57 Hz、录屏中 0.0 Hz、停录后 0.0 Hz |
| 九 | 虚拟显示的 vsync 从哪来 | 官方:虚拟屏没有自己的 VSYNC,借主屏触发合成;本机的反例说明两个读面量的不是同一件事 |
| 十 | 四处说法与四项动作 | 逐条核四种流传很广的说法,每条给一个可执行命令与判据 |
0.1 本篇那个"反直觉的现象"
好了,先把这个现象摆出来,因为它撑住了整篇的骨架。
没有人要 vsync 的时候,系统就真的不派发 vsync。 我们在同一台设备上量了四个窗口,只改"有没有人在动"这一件事:
| 场景 | 窗口 | vsync 计数增量 | 速率 | 上一次派发是多久前 |
|---|---|---|---|---|
| 静置 | 3.06 s | +2 | 0.65 Hz | 597.36 ms |
| 连续滑动 | 4.17 s | +240 | 57.57 Hz | 13.08 ms |
| 录屏中(不触摸) | 3.06 s | +0 | 0.0 Hz | 3288.85 ms |
| 停录后静置 | 3.05 s | +0 | 0.0 Hz | 8756.27 ms |
"上一次派发 vsync 是多久以前"这一列就是判据:滑动时它是 13 毫秒(一帧前),静置时它能涨到 8.7 秒。把它摊成一句话就是:vsync 不是一块永远在滴答的钟,它是一份按需排的班。 没人要,它就不派。
这句话听着平淡,但它推翻了很多人脑中的默认模型:把 vsync 想成"屏幕在滴答,系统跟着走",而实际是"系统按需向屏幕要节拍,要到了就按模型排班"。
把这件事摊成一条链,其实就是六个环节:有人要 → 派发器按模型算出该提前多久叫 → 到点派发 → 收到的一方渲染或合成 → 交出去上屏 → 没人要时整条链停摆。前三环在请求侧(谁在要),后三环在供给侧(谁在给、给得准不准)。
本篇要读的四个面,正好落在这六环上,所以先把取数命令列在这里,后面每一章各讲一段怎么读:
# 一、这条链在哪、对面是谁(§7.1)
adb shell dumpsys SurfaceFlinger | grep -A40 "VsyncSchedule for"

# 二、谁登记了、提前多久叫(§7.2)
adb shell dumpsys SurfaceFlinger | grep -A14 "VsyncDispatch:"

# 三、模型从哪来样本(§6.1)
adb shell dumpsys SurfaceFlinger | grep -A12 "VsyncController:"

# 四、当前有没有人在要(§8.3)
adb shell dumpsys SurfaceFlinger | grep "app: state="
四条命令都不需要 root,读到的也都是 SF 视角的状态——不是 HWC 内部的判定过程。这条边界对应着一个真实的限制:供给侧的核心字段(硬件时间戳)在本机是空的(§6.1 的 No Last HW vsync),所以本篇凡是与"硬件抖动"相关的结论都必须标"需真机"。
更多官方条款见VSync(AOSP)与硬件合成器 HAL 的 AIDL。
0.2 与相邻篇目的分工
言归正传。把"节拍"这件事拆开看,会发现它跨了四个篇目,本篇只拿其中最核心的一段:
| 篇目 | 它管的那一段 | 本篇与它的接口 |
|---|---|---|
| ep02《Choreographer》 | 应用侧怎么收脉冲、怎么排帧 | 本篇只取"一个 Looper 一个 Choreographer"与"一次请一个脉冲"这两句接口关系 |
| ep06《SurfaceFlinger》 | 一轮刷新里 SF 做什么 | 本篇回答它"等到 vsync"的那个 vsync 是谁给的 |
| ep08《HWC》 | 这一帧归谁画 | 本篇用它的"虚拟屏必然走客户端合成"当对照 |
| ep10《Vsync 偏移》 | 三步偏移怎么排 | 本篇只讲偏移是"给最坏情况的余量",不展开排布 |
| ep11《三缓冲与 ARR》 | 刷新率与缓冲数量的取舍 | 本篇只用到"本机只有一档刷新率"这一条 |
这里有一条必须说清的接口:这条链上有两个"侧",读数的归属完全不同。 一侧是请求侧(谁在要 vsync:应用线程、SF 自己),另一侧是供给侧(谁在给:HWC 的硬件时间戳、或者拿不到时由软件模型自己算)。§0.1 那张表里的 state= 与连接表属于请求侧,No Last HW vsync 属于供给侧——两边不能混着读,§2.9 与 §8.2 会各给一个反例。
0.3 边界声明:本篇不涉及什么,以及关键参数
先把边界画出来,省得后面对不上账。
本篇展开:vsync 同步哪三段、三路信号(HW_VSYNC / VSYNC / SF_VSYNC)与相位偏移、DispSync 作为软件锁相环到现代 VsyncSchedule 一族的演进、HWC 侧五个回调各自的触发条件(重点是 setVsyncEnabled 那条前置约束)、VsyncDispatch 的定时器与三条回调条目、VsyncController/VsyncReactor 的采样来源,以及虚拟显示那条"没有自己 vsync"的路径。
本篇不涉及(越界内容只给指针,不配图):
| 不涉及的内容 | 已在何处 | 本篇的交代 |
|---|---|---|
| Vsync 偏移三步怎么排 | ep10 | 只给"偏移是余量"这层结论与官方原文 |
| 三缓冲 / 多刷新率 / ARR | ep11(需真机) | 只用到"本机只有 60 Hz 一档" |
| 虚拟显示与录屏自身的实现 | ep12 | 只回答"它的 vsync 从哪来" |
| Perfetto FrameTimeline 抓 jank 的方法论 | ep13 / 《图形性能剖析工具链》 | 只引 jank 的定义一句 |
| 合成归属与 HWC 判定逻辑 | ep08 | 只回指 |
| 应用侧 Choreographer 的调度细节 | ep02 | 只取两句接口关系 |
| 厂商 HWC 的私有 vsync 策略 | 未公开 | 只写 AOSP 通用链路与官方参考实现 |
关键参数取值范围(后面所有读数都落在这个区间内,超出即视为异常):
| 参数 | 本机实测值 | 说明 |
|---|---|---|
| 刷新率 | 60.00 Hz |
activeMode 与 VsyncDispatch 的 workDuration 一致 |
| vsync 周期 | 16,666,666 ns |
与 --latency 首行同值 |
app phase / SF phase |
各 1,000,000 ns |
四组相位(常规 / early / GL early)完全相同 |
app duration / SF duration |
16,666,666 ns / 15,666,666 ns |
SF 比 app 少 1 ms |
| EventThread 连接数 | 22 |
层有 104 个,连接只有 22 条 |
| 滑动时 vsync 速率 | 57.57 Hz |
60 Hz 的 96% |
| 静置时 vsync 速率 | 0.65 Hz |
几乎不动 |
上面这张表里其实藏着一条分界线。本篇讲的所有东西都能归到"两个侧"上:一侧是请求侧——应用线程和 SF 自己向 vsync 派发器登记连接,state=Idle 与 state=VSync 是它在说话;另一侧是供给侧——HWC 拿硬件时间戳、或者拿上一帧真正上屏的时刻(present fence)来喂模型。两边各有各的开关:请求侧靠"有没有人登记",供给侧靠 setVsyncEnabled 与两条采样路径的取舍。本篇后面读到的每一个字段,都能一眼归到其中一侧——这也正是 §7 要把四个读面分开讲的原因:混着读,就会把"没人要"读成"机器停了"。
一、vsync 到底在同步什么
先看官方 VSync 页的第一句——它把范围定得比"屏幕刷新"宽得多:
"The VSync signal synchronizes the display pipeline. The display pipeline consists of app rendering, SurfaceFlinger composition, and the Hardware Composer (HWC) presenting images on the display."
来源:VSync(AOSP)
1.1 一句话:它给三段活排队
这句话是整篇的骨架:vsync 不是"屏幕刷新的信号"这么简单,它同时给三段活排队——应用渲染、SF 合成、HWC 送显。三段各有自己的时间预算,所以一段延迟会挤掉下一段。
这解释了一个常见的困惑:为什么"应用只是慢了一点点",最后会变成"整帧掉了一次"。因为这三段是串行的,而且共用同一个周期。应用多花的那几毫秒,不是从"自己的时间"里出的,是从"下一段的时间"里出的。
先把"周期"和"相位"这两个词钉死,后面全篇都在用:
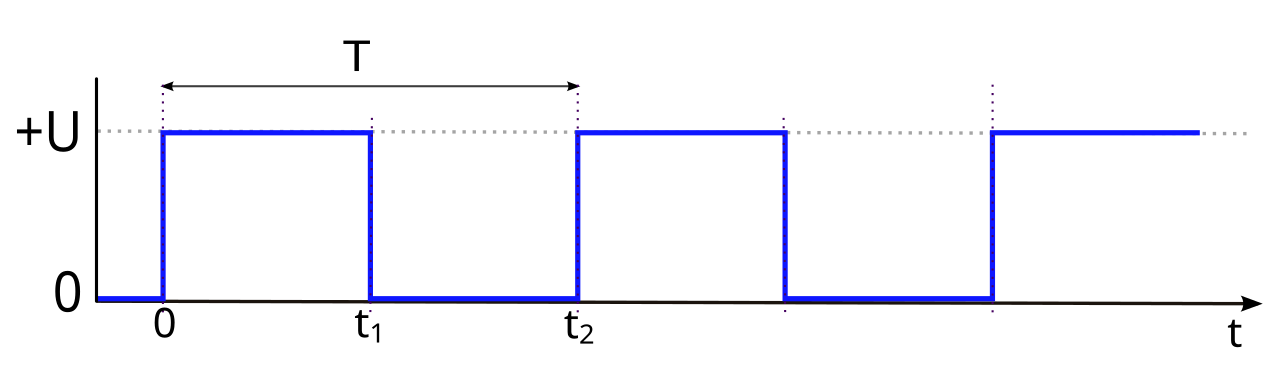
注意这张图的边界:它画的是通用时钟信号,不是 Android 的 vsync。本篇借它只是因为"周期 = 多长时间来一次,相位 = 这一次比参考点早或晚多久"这两个定义需要一个不含歧义的载体。
1.2 三段串行,所以相位才有意义
把 §1.1 那句官方定义摊成一张表,三段的角色与它们各自需要的时间就清楚了:
| 段 | 谁在做 | 做什么 | 本机对应读数 |
|---|---|---|---|
| 第一段 | 应用(RenderThread) | 读输入、跑动画、画出一块缓冲 | app duration: 16666666 ns |
| 第二段 | SurfaceFlinger | 收集可见层、判定归属、合成 | SF duration: 15666666 ns |
| 第三段 | HWC | 把合成结果送到屏幕上 | HWC min duration: 0 ns |
这张表的最后一行值得盯一下:SF duration 是 15,666,666 ns,而 app duration 是 16,666,666 ns——正好少 1,000,000 ns(1 ms)。这不是巧合,是故意把 SF 的预算压短 1 ms,让给应用侧。因为 SF 必须等应用的缓冲到手才能开始合成,它天然比应用晚,给它同样长的预算没有意义。
下面这张图把三段串行与它们各自的时间预算画出来:
1.3 三位一体的读数:本机观测环境
后面所有读数都来自同一套环境,先把它的身份交代清楚:
service list 第 31 项         android.hardware.graphics.composer3.IComposer/default
android.hardware.graphics.composer3.IComposer version:4    ← AIDL 那一代,版本 4
ro.boot.qemu.vsync        = 60        ← 模拟器给的 vsync 频率
ro.hardware               = ranchu    ← 模拟器虚拟板
ro.hardware.egl           = emulation ← 非硬件 EGL 实现
adb shell service list | grep -i composer
adb shell getprop | grep -i -E "vsync|surface_flinger"
adb shell dumpsys SurfaceFlinger | grep -A4 "h/w composer state"
四条读数合起来把身份钉死在模拟器上:服务名是 composer3(AIDL 代)、版本 4、ro.hardware 是 ranchu、ro.boot.qemu.vsync 是 60。看到 ranchu 与 qemu 这两个词,就该知道下面所有数字都属于模拟器参考实现。
下面这张图就是本机这一段原始输出的面板化呈现:
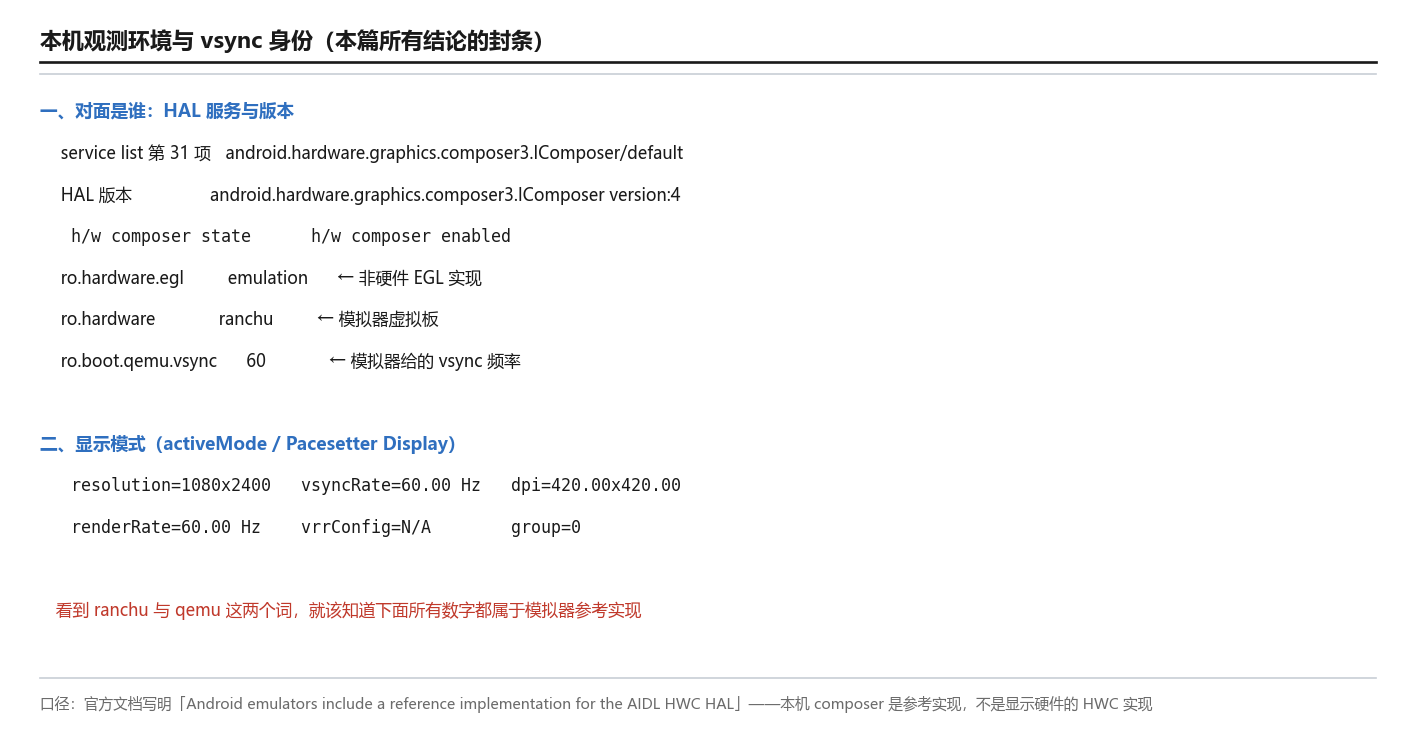
这张面板把上面几条读数并排放在一起,它的用处只有一个:封住本篇所有结论的适用半径。后面凡是从 dumpsys 里读出来的周期、相位、连接数,读者都可以拿这张面板核对它们出自哪台设备、哪个构建、哪一版 HAL。不在这个半径里的结论,一律要打问号——先钉身份、再谈读数,这是本系列每一篇都在做的事。
二、为什么需要三路信号
好了,概念清楚了,下面进入下一个问题:既然只有一块屏、一个刷新周期,为什么要有三路信号? 官方给的答案是一句话,但这句话里的每个词都有用——而且它在设备上能逐字对上(§2.2),这是本篇最干净的一处"文档 ↔ 设备"对齐。
2.1 官方那句"三路信号"
"The result of a VSync offset is three signals with the same period and offset phase: HW_VSYNC_0 — Display begins showing next frame. VSYNC — App reads input and generates next frame. SF_VSYNC — SurfaceFlinger begins compositing for next frame."
来源:VSync(AOSP)
"same period and offset phase" 这五个词是关键:三路信号的周期完全一样,差别只在相位——也就是"比硬件 vsync 早或晚多久开始"。为什么要早?因为 §1.2 那张表里的三段是串行的:如果三段都从同一个时刻开始,应用和 SF 就只有半个周期可用。
所以正确的分工是:让应用先动、SF 后动、屏幕最后动,每一段都拿到接近完整的周期。这才是"三路信号"存在的理由——不是为了给三个消费者三种节拍,而是为了让串行的三段尽量不互相挤。
"同一周期、不同相位"这件事在硬件上长什么样?下面这张图是四路时钟,周期相同、相位依次错开:
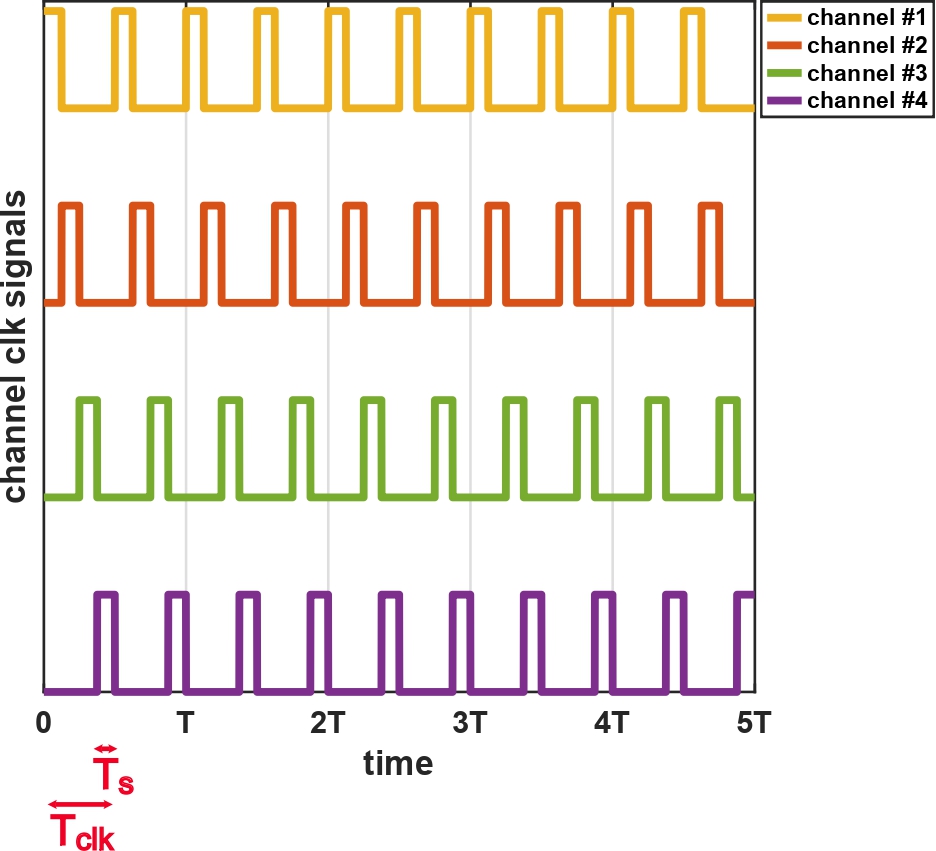
边界要再说一遍:这张图画的是四通道时间交织 ADC 的采样时钟,跟显示没有关系。本篇借它,是因为"同一个周期被切成几段、每段错开一点"这个结构,与 vsync 三路信号是同构的——而 Commons 上没有一张画 Android vsync 的图(阶段 2 检索了 10 轮类目、12 组关键词,候选池 323 条,一张也没有)。
2.2 三路信号在本机是怎么印出来的
理论说完了,看设备。本机的 VsyncDispatch 段里,回调列表就三条:
VsyncDispatch:
  Callbacks:
      sf:  [wake up in 7.19ms deadline in 22.85ms for vsync 22.84ms from now]
              workDuration: 15.67ms readyDuration: 0.00ms lastVsync: 6.16ms relative to now ...
      app:  [wake up in 7.13ms deadline in 23.79ms for vsync 39.45ms from now]
              workDuration: 16.67ms readyDuration: 15.67ms lastVsync: 22.77ms relative to now ...
      appSf:
              workDuration: 16.67ms readyDuration: 15.67ms lastVsync: -1260.59ms relative to now ...
官方说三路,设备上就是三条——这是本篇最漂亮的一处"文档 ↔ 设备"对齐。三条各有两项参数,而这两项参数的含义官方在源码注释里写明了:
schedule():"The callback will be dispatched at 'workDuration + readyDuration' nanoseconds before a vsync event."
它给出的定义是:workDuration 是"提前多久叫醒",readyDuration 是"要求你多久准备好"。三个条目对照着看:
| 条目 | workDuration(提前多久叫) |
readyDuration(要求多久 ready) |
谁在收 |
|---|---|---|---|
sf: |
15.67 ms | 0.00 ms | SurfaceFlinger 的合成线程 |
app: |
16.67 ms | 15.67 ms | 应用侧(Choreographer 那一路) |
appSf: |
16.67 ms | 15.67 ms | 第三路 |
两条的 workDuration 差 1 毫秒(sf: 15.67 ms、app: 16.67 ms)——正好对应 §1.2 里"SF 的预算比应用少 1 ms",两个读数从不同角度印出了同一件事,互为交叉验证。
但"提前多久唤起点"与 workDuration 不是同一个量:按官方那条注释,回调是在 workDuration + readyDuration 之前被派发的。代入本机两条就是——sf: 在 vsync 前 15.67 ms 被叫醒(15.67 + 0.00),app: 在 vsync 前 32.34 ms 被叫醒(16.67 + 15.67)。同一个 vsync 事件上,应用比 SF 早约 16.67 ms 被唤醒,正好一个刷新周期;而两条的 workDuration 只差 1 毫秒。这一条是算出来的、不是量出来的(两个参数都是登记值,官方注释也只给了这个算式),但它回答了一个用读数看不出来的问题:"应用先动、SF 后动"到底错开了多少。
还有一处容易看漏的:appSf: 这一条的 lastVsync 是 -1260.59 ms(负号表示"在 1260 毫秒之前"),而 sf: 与 app: 分别是 6.16 ms / 22.77 ms。三条并列 ≠ 三条都在跑——appSf: 这一路当前几乎没有被派发。
下面这张图把三条回调条目与它们的参数画成对照:
这张对照把"三条并列"与"三条都在跑"这两件事分开摆。要紧的是最后那一列:sf: 与 app: 的 lastVsync 都是毫秒级(说明刚刚被派过),而 appSf: 那条落在 1260 毫秒之前——同一个派发器、同一张表里印出来的三条,状态可以完全不同。这也是后面 §7.2 要把这份登记表再读一遍的原因:表里每一行都只是"登记",不等于"在用"。
2.3 相位偏移是余量,不是最优值
说白了,三路信号要错开,错开多少由一个叫相位偏移(phase offset)的量决定。官方给了取值理由,这段值得原样引:
"VSYNC_EVENT_PHASE_OFFSET_NS and SF_VSYNC_EVENT_PHASE_OFFSET_NS are set conservatively based on high-load use cases … These offsets allow for long app render time and long GPU composition time."
来源:VSync(AOSP)
"set conservatively based on high-load use cases" 这句话很重要:偏移不是"调出来的最优值",而是按最坏情况留出来的余量。因为如果偏移按平均值设,那负载一上来三段就会被挤爆。所以偏移的默认值是偏保守的——代价是常态下有闲置,收益是重载时不崩。
两个偏移量的系统属性名官方也给了映射:
"
VSYNC_EVENT_PHASE_OFFSET_NS→ro.surface_flinger.vsync_event_phase_offset_ns" "SF_VSYNC_EVENT_PHASE_OFFSET_NS→ro.surface_flinger.vsync_sf_event_phase_offset_ns"
本机这两个属性一个都没有(§7.3 会把这组读数完整摆出来)——所以走的是默认值。这直接解释了后面一个"看着奇怪"的现象:本机的 app / SF / early / GL early 四组相位数字完全相同,都是 1,000,000 ns。
下面这张图把"为什么要留余量"画成一张对照:
三、谁在产生 vsync
上一章讲的是"三路信号怎么排"。这一章往前追一步:这些信号的源头是谁?是屏幕自己在滴答,还是别人要它才滴答?
3.1 setVsyncEnabled:按需开启,同步了就关
官方这一段把"谁说了算"讲得很清楚,值得逐句读:
"SurfaceFlinger controls whether or not the HWC generates VSync events by calling to
setVsyncEnabled. SurfaceFlinger enablessetVsyncEnabledto generate VSync events so it can synchronize with the refresh cycle of the display. When SurfaceFlinger is synchronized to the display refresh cycle, SurfaceFlinger disablessetVsyncEnabledto stop the HWC from generating VSync events. If SurfaceFlinger detects a difference between the actual VSync and the VSync it previously established, SurfaceFlinger re-enables VSync event generation."
来源:VSync(AOSP)
这段话里有一条完整的状态循环:
- 开:SF 调
setVsyncEnabled,让 HWC 开始产生 vsync 事件; - 同步:SF 借这些事件把自己的模型对准屏幕;
- 关:一旦对准了,关掉——因为再开着也是白耗电;
- 偏了再开:如果发现"实际 vsync"与"模型预测的 vsync"出现偏差,重新打开。
"同步之后就关"这一条是最反直觉的:很多人以为硬件 vsync 是常开的定时器,实际是用完就关。这也解释了为什么 vsync 相关的代码里会有那么多"重同步(resync)"的逻辑——因为它是断续工作的,每次重启都要重新对准。
下面这张图把这个循环画出来:
3.2 HWC 不许自作主张:只在被要求时才回调
上面那条循环在 HWC 侧对应一条硬约束。IComposerCallback.aidl 里 onVsync 的注释写得很死:
"Notifies the client that a vsync event has occurred. This callback must only be triggered when vsync is enabled for this display (through
setVsyncEnabled)."
来源:IComposerCallback.aidl(AOSP)
"must only be triggered when vsync is enabled"——HWC 不许自作主张地推 vsync,必须先被 SF 要求。同一份文件里 onHotplug 的注释又补了一刀:
"Displays which have been connected are assumed to be in PowerMode.OFF, and the onVsync callback should not be called for a display until vsync has been enabled with setVsyncEnabled."
两条注释合起来,把"谁掌握开关"这件事说尽了:不只是"要了才给",连"刚连上的屏幕"也默认不推——得先被唤醒。
这条"默认关、要了才开"的原理值得单独记一笔:它把"要不要花这笔电"的决定权留在了请求侧,而不是让硬件自己猜。如果反过来——HWC 一上电就持续推 vsync——那么没有消费者的时候这些事件就成了纯粹的浪费,平台还得额外想办法把它关掉。"默认关"是一种把成本放在使用点上的设计,它与 §3.1 那条"同步完成就关"是同一个思路的两面。
下面这张图把"要"与"给"两侧的时序画出来,重点标出那条前置约束:
3.3 开与关各自的代价
OK,先说清为什么 SF 非要费这个劲来回开关——因为两侧各有代价,而且这两个代价不是同一类东西:开着的代价是电,关着的代价是准。
| 状态 | 好处 | 代价 |
|---|---|---|
| 硬件 vsync 开着 | 能拿到硬件时间戳,模型有真值可校准 | 硬件持续产生事件,耗电;且打断了电源管理 |
| 硬件 vsync 关着 | 省电,屏幕可以进低功耗状态 | 只能靠软件模型预测,漂移无人校正 |
这是一个典型的"精度换电"取舍——官方那句"set conservatively"讲的是偏移,而这条取舍讲的是采样:开着的目的是采样,关着的目的是省电。
"打断电源管理"这句不是修辞:硬件 vsync 一旦常开,显示控制器就得按固定周期持续产生事件,对应的电源状态就没法往"低功耗待机"里沉。所以"同步完成就关"不只是省下那几个事件的开销,它同时也是让屏幕能进低功耗档的前置条件——这两件事在设备上是同一根绳上的。反过来看也成立:如果一台设备的硬件 vsync 一直开着,那它多半在不停地重同步(因为只有"没对准"才需要一直开着采样),这本身就是一条诊断线索。
下面这张图把两侧代价并置:
四、HWC 那五个回调各管什么
上一章讲了"开关"这一条。但 HWC 侧的接口不止一个回调——一共五个,各有各的触发条件。这一章把它们逐个交代,因为漏掉任何一个都会在后面读 dump 时对不上号。
4.1 五个回调的触发条件
IComposerCallback.aidl(composer3)里的回调,逐个摘出官方注释里的触发条件:
| 回调 | 官方注释里的触发条件(原文要点) |
|---|---|
onVsync |
"must only be triggered when vsync is enabled for this display(through setVsyncEnabled)";带 CLOCK_MONOTONIC 时间戳与下一帧的预期周期 |
onVsyncPeriodTimingChanged |
"the previously reported timing for vsync period change has been updated";发生条件是 composer 错过切换截止时间,或客户端刷新帧提交过晚 |
onVsyncIdle |
"the display is idle, the refresh rate changed to a lower setting to preserve power and vsync cadence changed" |
onHotplug |
"Notifies the client that the given display has either been connected or disconnected.";每个活动显示至少要触发一次 |
onRefresh |
"Notifies the client to trigger a screen refresh. This forces all layer state for this display to be resent, and the display to be validated and presented, even if there have been no changes." |
来源:IComposerCallback.aidl(AOSP)、Hardware Composer HAL 的 AIDL(AOSP)
这张表里有两条容易被忽略的:
onVsyncPeriodTimingChanged的触发条件里写着"客户端提交过晚"——也就是说,这个回调本身就是一个"出问题"的信号。看到它,说明这一轮 vsync 周期切换没走顺。onRefresh是"强制重发"语义——哪怕这一帧什么都没变,也要把全部图层状态重发、重新校验、重新呈现。它是五个回调里唯一一个"我说了算"的,其余四个都是被动通知。
把五个回调做一次二次归类,两条轴各分一次。第一条轴按「谁发起」:四个"通知型"加一个"命令型"。通知型的四个各自对应一类外部变化(vsync 到了、周期切换了、屏幕闲了、屏幕插拔了),平台收到后更新自己这边的状态;而命令型的 onRefresh 反过来,是平台要求 HWC 做事(重发、重校验、重呈现)。第二条轴按「带不带时间信息」:只有 onVsync 一次带上两个时间量(这一刻 + 下一次周期),onVsyncPeriodTimingChanged 带的是"时序被改了"这件事而不带具体数值,其余三个完全不带时间量。两条轴合起来给出一条读日志的经验:只要某个回调同时是"通知型"又"带时间量",它就一定是喂模型的那一条(onVsync);其余四个都只改状态、不改模型。这条经验也决定了出现 onRefresh 时不该慌——它是 SF 主动发起的一轮强制刷新,不该被当成"硬件出了什么状况"。
下面这张图把五个回调的触发条件与"谁在主导"画成对照:
4.2 onVsyncIdle:它会让人把模型整个推翻
好了,五个回调里挑一个后果最重的单独讲——onVsyncIdle。它跟另外四个不一样:其余四个只是"通知一件事发生了",而这一个会让平台把辛苦对准的模型整个推翻。 官方在同一页给了因果:
"Using the
IComposerCallback.onVsyncIdlecallback indicates to the platform that the display is idle and the vsync cadence has changed. The platform responds to this callback by resetting its vsync model. It forces a vsync resync on the next frame, and learns the new vsync cadence."
来源:Hardware Composer HAL 的 AIDL(AOSP)
"resetting its vsync model" 这四个词解释了本机 dump 里的一堆字段:如果模型可以被整体推翻,那么它必然带着"我还在等样本""我正在确认周期"这类状态位——§6.1 会把这些字段逐个摆出来(mMoreSamplesNeeded、mPeriodConfirmationInProgress)。
这条因果还带回了一个应用侧的义务:官方接着说"When a new frame is queued for presentation, the client is expected to enable vsync callbacks to learn the new vsync cadence before sending a new frame." 也就是说,空闲之后要重新"学一遍"节奏——不能拿旧节奏直接开始送帧。
下面这张图把 onVsyncIdle 的前因后果画成一条链:
4.3 onVsync 给的两个参数
言归正传,回到最常用的那一个。onVsync 带两个参数,注释里都点明了单位与含义——这两个参数的配合方式,是整条接口设计里最值得抄的一处:
@param timestamp is the CLOCK_MONOTONIC time at which the vsync event occurred, in nanoseconds.
@param vsyncPeriodNanos is the display vsync period in nanoseconds
       i.e. the next onVsync is expected to be called vsyncPeriodNanos nanoseconds after this call.
两个参数各自承担一件事:
timestamp是"这一次在哪一刻"(CLOCK_MONOTONIC 纳秒)——它是样本,用来喂模型;vsyncPeriodNanos是"下一次大概隔多久"(周期纳秒)——它是预告,让接收方知道该怎么排下一次。
"样本 + 预告"这个组合是这条接口设计上最值得写的一处:如果只给时间戳,接收方得自己算周期;如果只给周期,接收方不知道从哪一刻起算。两个一起给,接收方才能把"这一刻"和"下一次"接成一条时间轴。
下面这张图把两个参数的作用画开:
五、从 DispSync 到 VsyncSchedule
机制讲完,这一章说清实现。官方的 vsync 页讲的是旧机制(DispSync),而 AOSP 现在的代码里已经是另一族类——两者要分开讲,否则读 dump 时会对不上。
5.1 DispSync:一个软件锁相环
先看看官方对旧机制的原话——这一段必须先读,因为不读它就读不懂新机制的 dump:
"DispSync maintains a model of the periodic hardware-based VSync events of a display and uses that model to execute callbacks at specific phase offsets from the hardware VSync events." "DispSync is a software phase-lock loop (PLL) that generates the VSYNC and SF_VSYNC signals used by Choreographer and SurfaceFlinger, even if not offset from hardware VSync."
来源:VSync(AOSP)
两个要点:① vsync 不是"把硬件信号原样转发",而是先建一个模型,再按模型派发;② 这个模型是软件锁相环。
锁相环本身是一个很老的电路概念,它的结构用一句话说就是"拿输出跟参考比,用差值去调输出"。下面这张图是 CDR 电路里的一阶锁相环框图,每个方框上都标着它的 Laplace 传递函数:
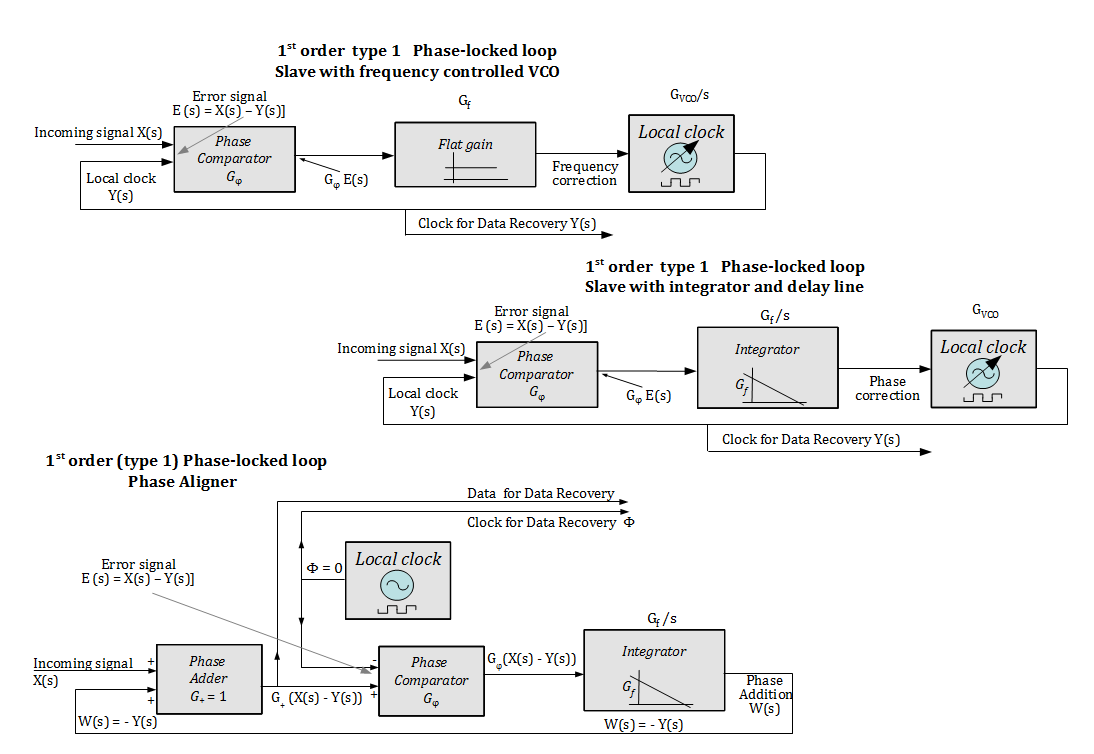
边界照例说清:这张图是通信电路(CDR)里的一阶锁相环,方框上那串 Laplace 表达式在本篇里用不到。借它只为一件事——说明"vsync 模型本质上是一个锁相环"不是一个比喻,而是字面意义上的同一类结构:都有一个参考、一个输出、一个比较器,以及把差值反馈回去的回路。
5.2 四层结构:从 Schedule 到 Scheduler
好了,旧机制讲完,看现在。AOSP 把这套东西拆成了一组类,四个头文件的注释正好构成一条链:
| 组件 | 官方注释(原文) |
|---|---|
VsyncSchedule |
"Schedule that synchronizes to hardware VSYNC of a physical display.";内部持有 VsyncTracker + VsyncController,另有 enableHardwareVsync() / disableHardwareVsync(bool disallow) / addResyncSample(...) |
VsyncController |
addPresentFence:"Adds a present fence to the model. The controller will use the fence time as a vsync signal.";addHwVsyncTimestamp 同理;setIgnorePresentFences(bool):"Tells the tracker to stop using present fences to get a vsync signal." |
VSyncDispatch |
"VSyncDispatch is a class that will dispatch callbacks relative to system vsync events.";schedule() 的语义是"dispatched at 'workDuration + readyDuration' nanoseconds before a vsync event" |
Scheduler |
"Resyncs the scheduler to hardware vsync. If allowToEnable is true, then hardware vsync will be turned on.";另有 dumpVsync(std::string&) |
来源(AOSP 源码,官方 gitiles 地址):VsyncSchedule.h、VsyncController.h、VSyncDispatch.h、Scheduler.h
这四层各回答一个问题,把它摊成一句话就是:
VsyncSchedule(对哪块屏):一块物理屏一个 schedule,里面装着"模型"和"派发器"两件东西;VsyncController/VsyncTracker(模型从哪来):喂样本给它的只有两条路——硬件时间戳,或 present fence;VSyncDispatch(按模型排定时器、叫醒谁):它不关心屏幕,只关心"谁登记了、提前多久叫";Scheduler(谁在管、相位怎么配):它是总装,负责重同步与相位配置。
关键的一点:这四层里只有 Controller 那一层与硬件有关,其余三层都是纯软件。这就解释了 §6.1 那个现象——只要 Controller 拿不到样本,整条链照样能跑,因为派发只需要一个周期值,而不需要一个真实的时间戳。
下面这张图把四层与"每层回答什么"画成结构图:
六、模型从哪来样本
第五章说了"模型从样本拟合"。这一章追一步:样本从哪来——以及如果一条都拿不到会怎样。
6.1 本机控制器段原样:No Last HW vsync
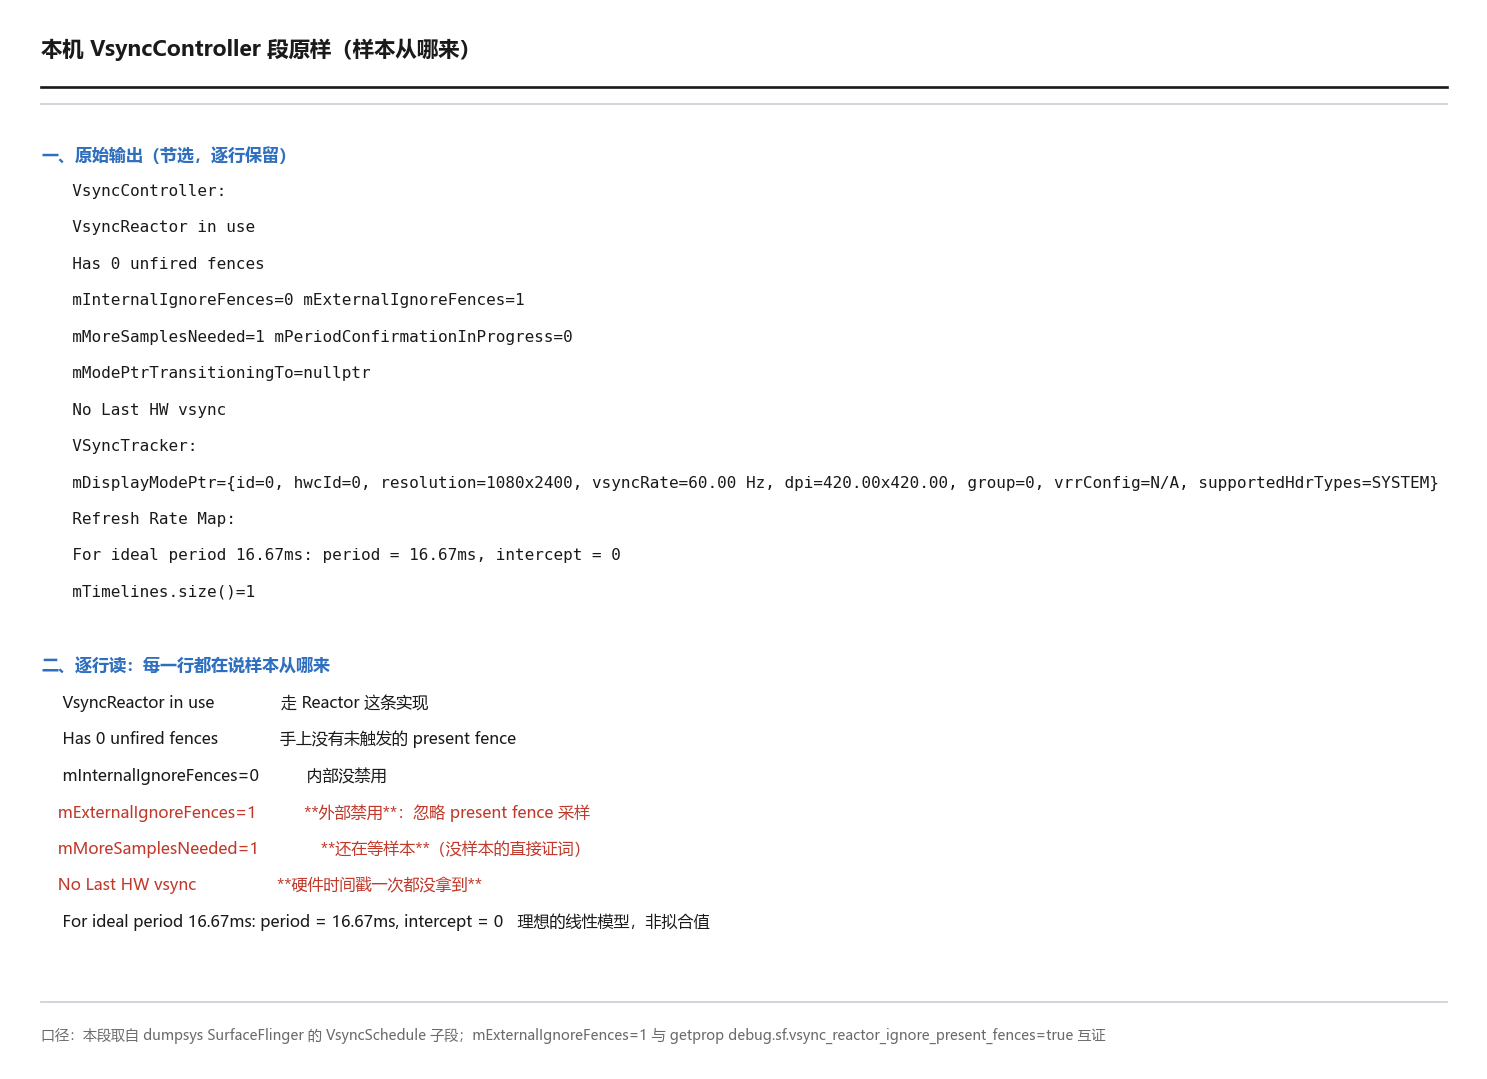
OK,说了两章"模型",现在看模型在本机到底长什么样。本机的 VsyncController 段原样如下:
VsyncController:
  VsyncReactor in use
  Has 0 unfired fences
  mInternalIgnoreFences=0 mExternalIgnoreFences=1
  mMoreSamplesNeeded=1 mPeriodConfirmationInProgress=0
  mModePtrTransitioningTo=nullptr
  No Last HW vsync
  VSyncTracker:
      mDisplayModePtr={id=0, hwcId=0, resolution=1080x2400, vsyncRate=60.00 Hz, ...}
      Refresh Rate Map:
              For ideal period 16.67ms: period = 16.67ms, intercept = 0
      mTimelines.size()=1
这一段的每一行都在说"样本从哪来",逐行读:
| 行 | 说的是什么 |
|---|---|
VsyncReactor in use |
走的是 Reactor 这条实现(负责拿硬件样本去校正模型) |
Has 0 unfired fences |
手上没有未触发的 present fence |
mInternalIgnoreFences=0 / mExternalIgnoreFences=1 |
内部不禁用、外部禁用——即"忽略 present fence 采样"被显式打开了 |
mMoreSamplesNeeded=1 |
还在等样本(这条是"没样本"的直接证词) |
mPeriodConfirmationInProgress=0 |
当前不在做周期确认 |
No Last HW vsync |
硬件 vsync 时间戳:一次都没拿到 |
Refresh Rate Map |
模型:period = 16.67ms, intercept = 0——理想的线性模型 |
把最后两行连着读,结论就出来了:这台设备的 vsync 周期不是从硬件跟出来的,是软件按显示模式里的 vsyncRate=60.00 Hz 自己算的。intercept = 0 这个"零截距"也说明模型没有任何实测偏移——它是干净的教科书值,不是拟合出来的值。
mExternalIgnoreFences=1 还与系统属性对得上:本机 getprop 里有 debug.sf.vsync_reactor_ignore_present_fences = true。也就是说,连"用 present fence 当样本"这条退路也被显式关掉了——两条采样路径都没走。
下面这张图把这一段的关键字段做成面板:
6.2 两条采样路径,本机两条都没走
好了,把上面那段读完,自然会问:样本究竟从哪来?官方对 VsyncController 的两条入口注释,正好定义了"样本"的两个来源:
addPresentFence      : "Adds a present fence to the model.
                        The controller will use the fence time as a vsync signal."
addHwVsyncTimestamp  : "Adds a hw sync timestamp to the model.
                        The controller will use the timestamp time as a vsync signal."
setIgnorePresentFences: "Tells the tracker to stop using present fences to get a vsync signal."
两条路径的性质完全不同:
| 路径 | 样本是什么 | 精度 | 本机状态 |
|---|---|---|---|
硬件时间戳(addHwVsyncTimestamp) |
HWC 报来的 onVsync 时间戳 |
直连显示控制器,最准 | ❌ No Last HW vsync |
present fence(addPresentFence) |
上一帧真正上屏的时刻 | 间接,但不依赖 HWC 说话 | ❌ mExternalIgnoreFences=1 |
第二条路径的存在本身就是一条重要的设计洞察:即使 HWC 不给时间戳,系统仍有一个"退而求其次"的采样源——上一帧什么时候真的上了屏。这在工程上叫"用结果反推节拍"。而本机把这条也关了。
两条都不走,模型就只能靠"显示模式里写的那个频率"——这正是本机 §6.1 里 period = 16.67ms, intercept = 0 的来源。所以本篇所有周期读数都是软件算的,不是量出来的。 这条边界必须写清,也是本篇与真机之间最大的一处差距。
下面这张图把两条采样路径与它们各自的本机状态画出来:
七、在设备上怎么读出来
前面六章讲的是机制,后面三章全部是实测。这一章先解决"读什么":把 vsync 这条链在设备上能读到的四个面逐个交代清。
四个面要按顺序读,顺序换了对不上:先看 VsyncSchedule 定"这条链服务哪块屏、状态稳不稳"(§7.1),再看 VsyncDispatch 定"谁登记了、提前多久叫"(§7.2),再看相位与预算定"三段各分到多少时间"(§7.3),最后看连接表定"到底有多少个消费者"(§7.4)。前两个面是"结构",后两个面是"分配"——先有结构,分配才有意义。这也解释了为什么 §6 那些"模型从哪来"的字段必须放在它们之前讲:不看样本来源,就看不懂 No Last HW vsync 那一行为什么重要。
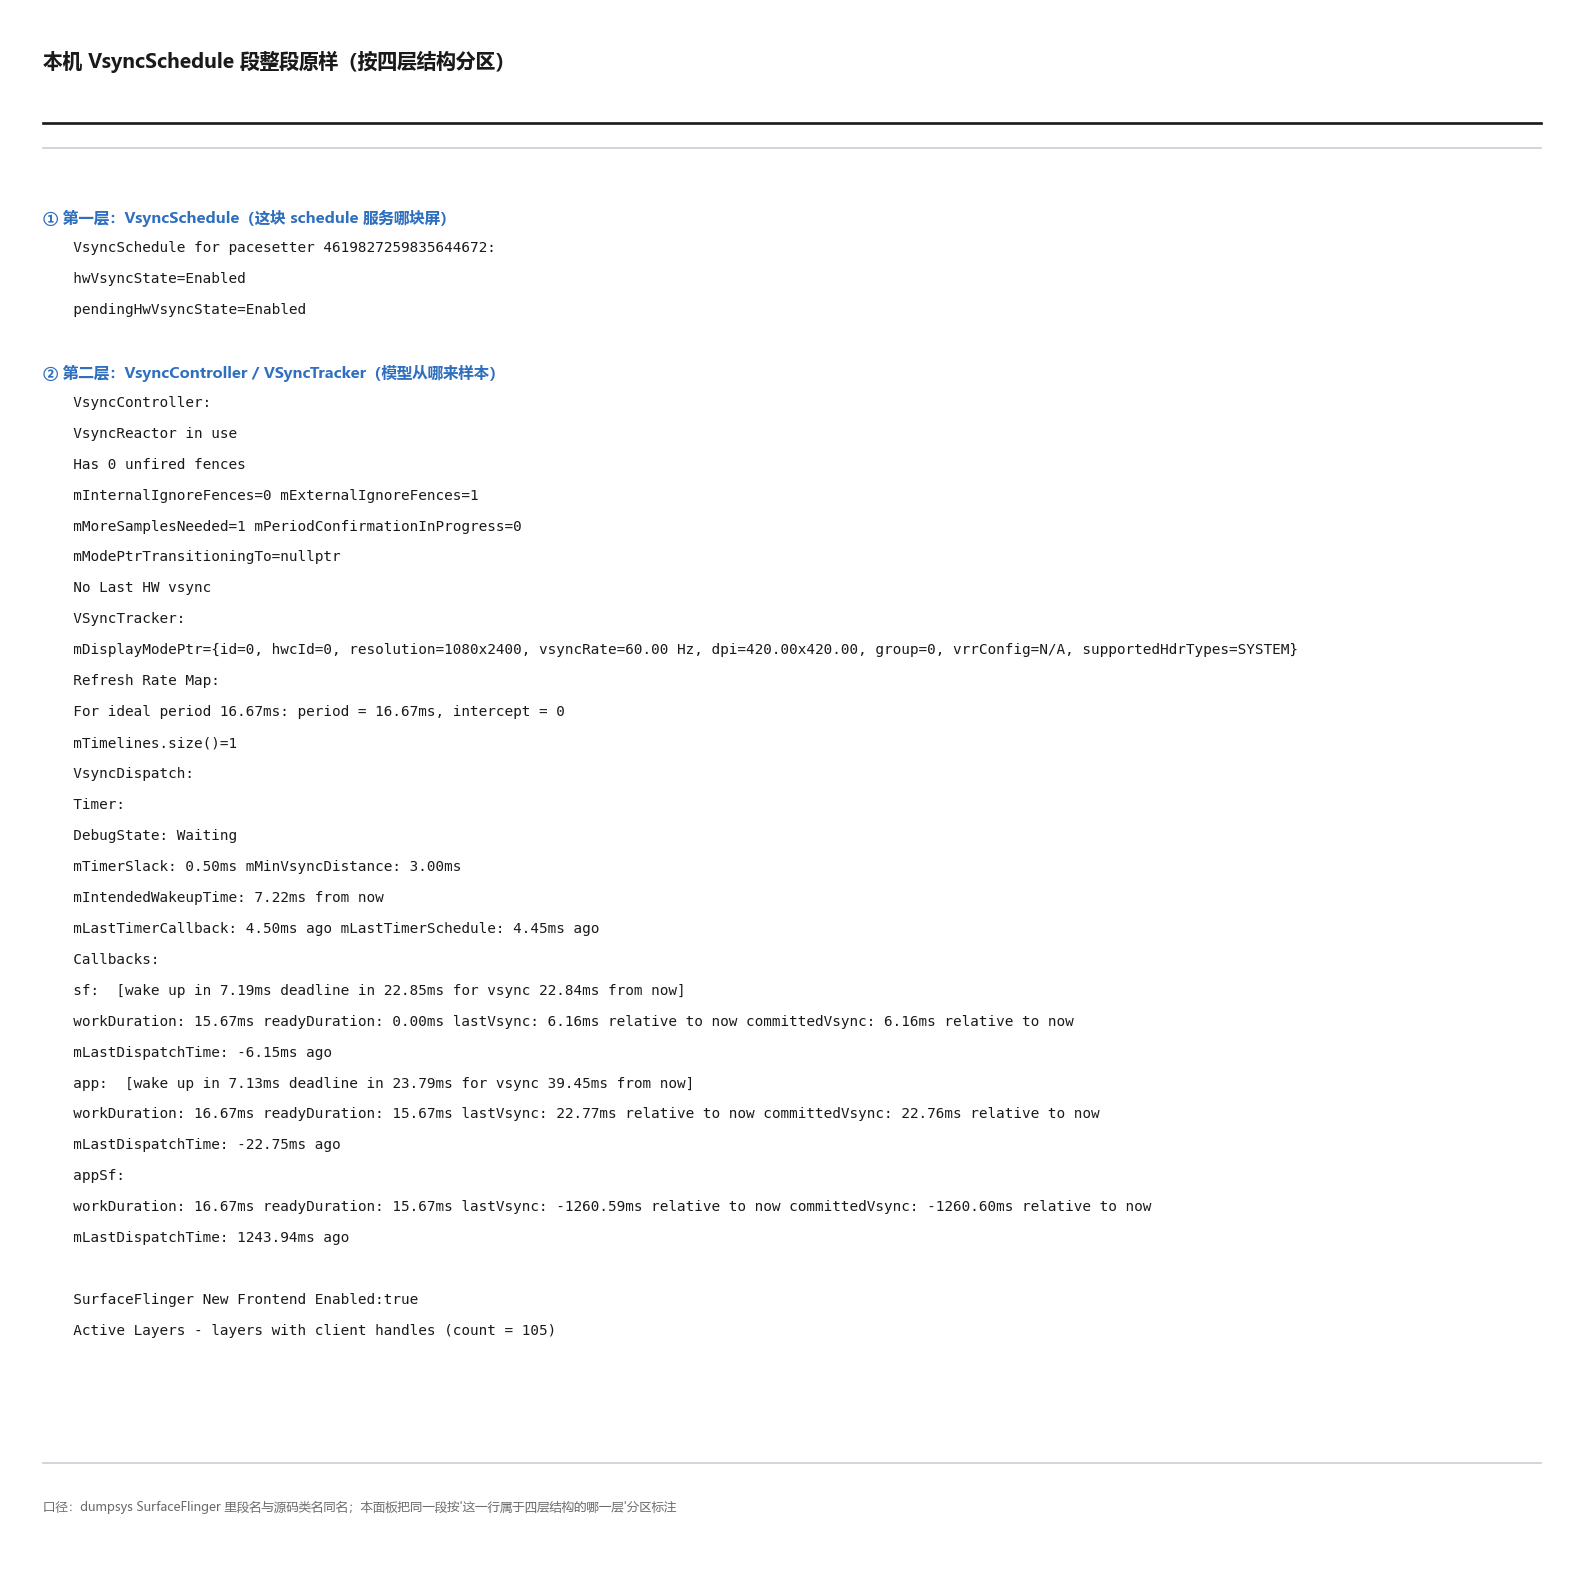
7.1 第一个面:VsyncSchedule 整段
先看看读 vsync 的入口——它是 dumpsys SurfaceFlinger 里的一段,段名与源码类名同名,这也让"文档里的类"与"设备上的段"能一一对上:
adb shell dumpsys SurfaceFlinger | grep -A40 "VsyncSchedule for"
本机原样如下(节选):
VsyncSchedule for pacesetter 4619827259835644672:
hwVsyncState=Enabled
pendingHwVsyncState=Enabled
三行就有三个信息量很大的字段:
| 字段 | 含义 | 本机读数 |
|---|---|---|
for pacesetter <id> |
这块 schedule 服务的是哪块屏(pacesetter 是"定拍者") | 物理屏 id |
hwVsyncState |
当前硬件 vsync 是开是关 | Enabled(开着) |
pendingHwVsyncState |
期望的状态(可能正在切换中) | Enabled(也是开着) |
前两个字段为什么会分开印? 因为它们可能不一致——一个表示"现在实际是什么",一个表示"我打算让它变成什么"。当两者不同时,说明正在切换过程里。本机两者一致,说明状态是稳的。
下面这张图是本机这一段的原样呈现,把整段按"属于哪一层"分了区:
7.2 第二个面:三条回调条目与它们的参数
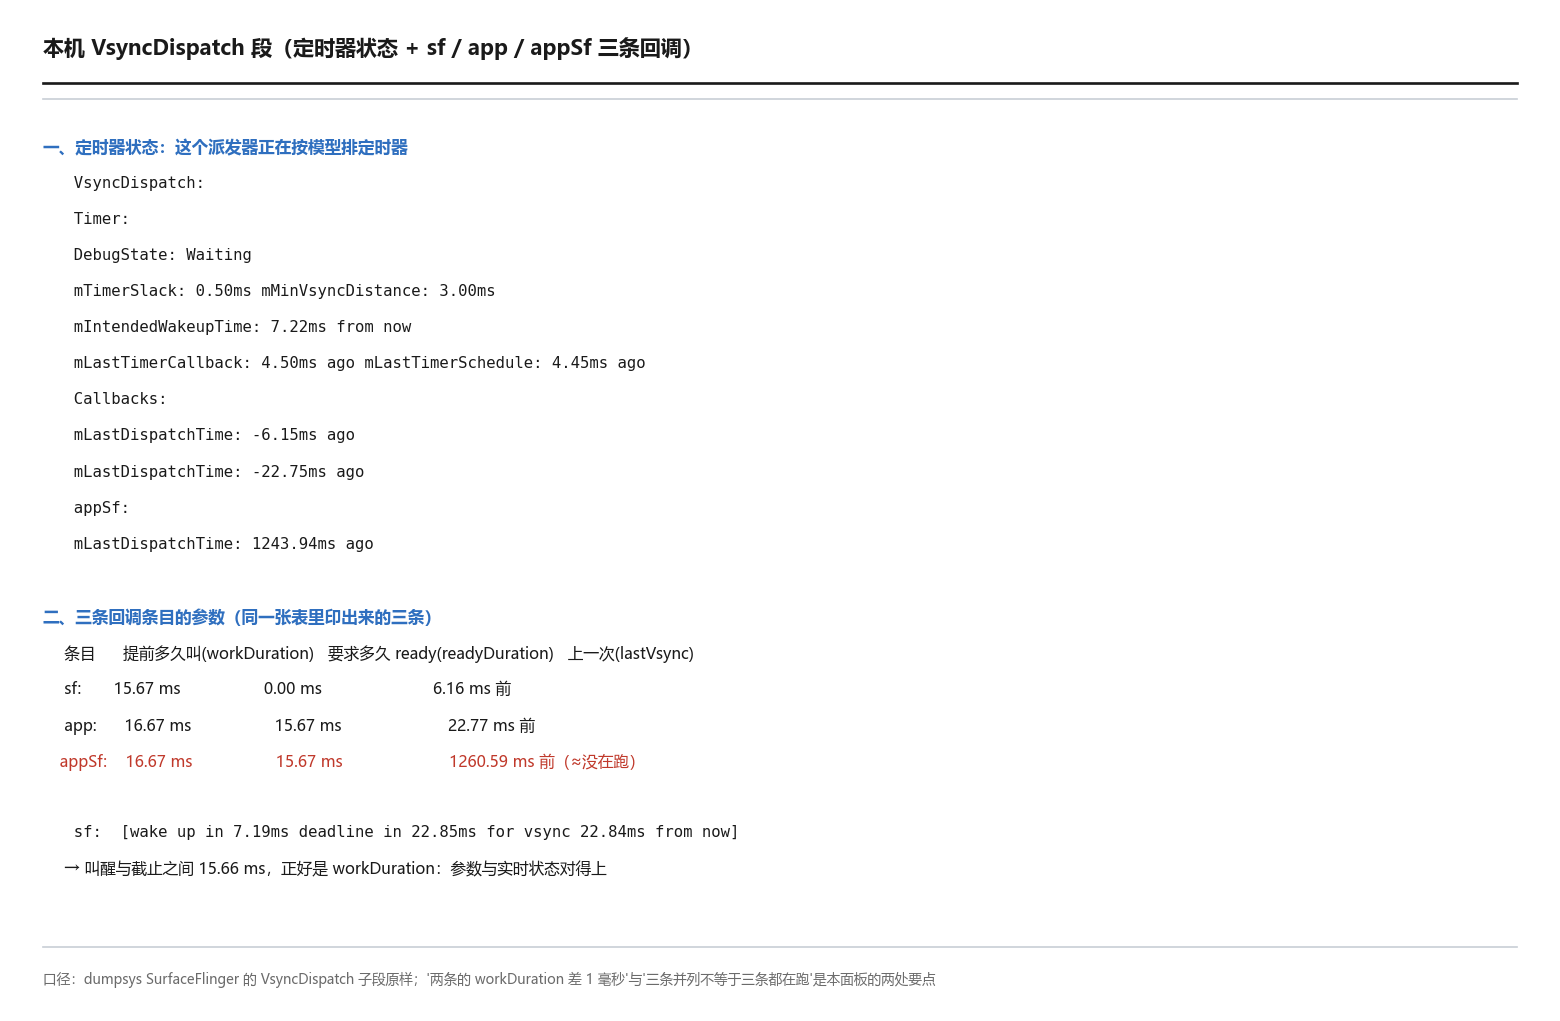
言归正传,同一段里的 VsyncDispatch 子段给出了登记表(§2.2 已引过,这里补上字段语义——那三条是"谁登记了",这一段还要看"派发器自己在下什么"):
adb shell dumpsys SurfaceFlinger | grep -A12 "VsyncDispatch:"
VsyncDispatch:
  Timer:
      DebugState: Waiting
  mTimerSlack: 0.50ms mMinVsyncDistance: 3.00ms
  mIntendedWakeupTime: 7.22ms from now
  mLastTimerCallback: 4.50ms ago mLastTimerSchedule: 4.45ms ago
  Callbacks:
      sf:  [wake up in 7.19ms deadline in 22.85ms for vsync 22.84ms from now]
              workDuration: 15.67ms readyDuration: 0.00ms lastVsync: 6.16ms relative to now ...
              mLastDispatchTime: -6.15ms ago
      app: ...
      appSf: ...
这一段的字段可以分成两组:
| 组 | 字段 | 读什么 |
|---|---|---|
| 定时器状态 | DebugState: Waiting、mTimerSlack: 0.50ms、mMinVsyncDistance: 3.00ms、mIntendedWakeupTime、mLastTimerCallback / mLastTimerSchedule |
这个派发器正在按模型排定时器:打算几点醒、上次几点醒的、松弛给多少 |
| 回调条目 | sf: / app: / appSf: 各自的 workDuration / readyDuration / lastVsync / mLastDispatchTime |
谁登记了、提前多久叫、上一次是什么时候 |
mTimerSlack: 0.50ms 这一项值得单独说:它表示"定时器可以晚 0.5 毫秒再醒"——这是给操作系统调度留的松弛。而 mMinVsyncDistance: 3.00ms 是"两次 vsync 至少隔 3 毫秒",防止派发抖动导致连续触发两次。
三条目里那串方括号也很有信息量,以 sf: 那条为例:
sf: [wake up in 7.19ms deadline in 22.85ms for vsync 22.84ms from now]
三个时刻一句话说清:wake up 是打算叫醒的时刻、deadline 是必须交付的截止、for vsync 是这次派发服务的是哪一次 vsync。"叫醒"与"截止"之间留了 15.66 毫秒,正好是 workDuration——参数与实时状态对得上。
这条"参数 ↔ 实时状态对得上"其实是本篇反复用到的一条校验原理:登记时给的 workDuration 是期望值,方括号里的 wake up 与 deadline 是当前这一轮的实现值;两者能对上,说明这一轮派发是照登记执行的——中间没被插队、也没被重新配置。反过来,如果哪天看到两者对不上,那就说明这一轮派发被改过,这比单看任何一边都更能说明问题。本篇三处交叉验证(§1.2 与 §2.2 的 1 毫秒、§2.2 与 §7.3 的 1 毫秒)用的都是这条原理。
下面这张图把三条目与定时器字段做成面板:
7.3 第三个面:相位与 duration 七组
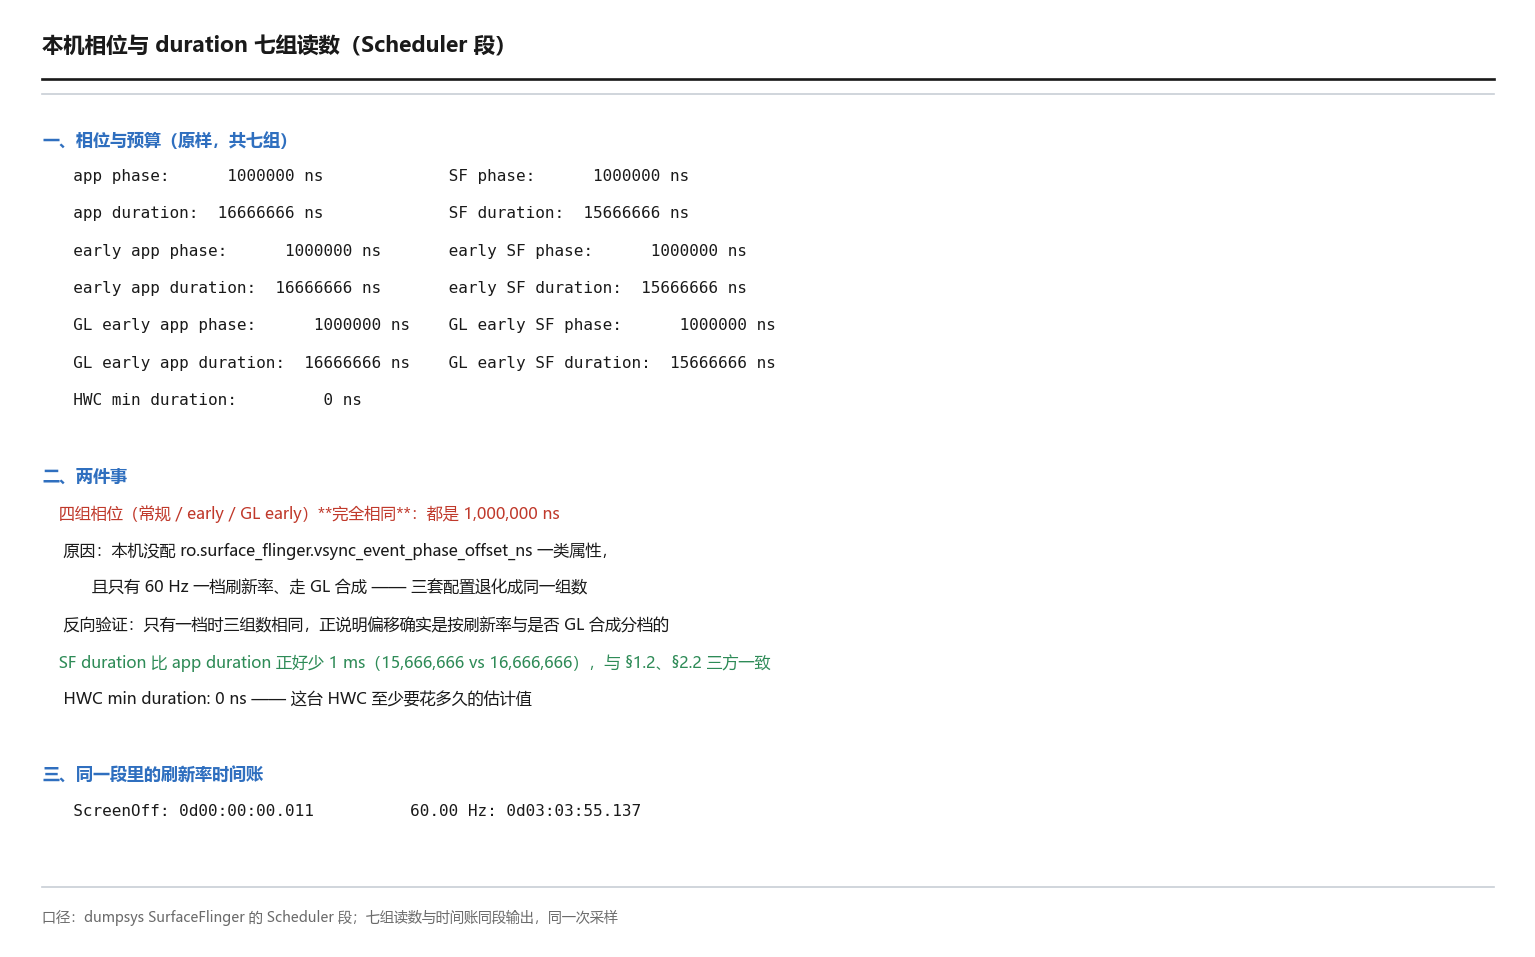
OK,第三个面看相位与预算。Scheduler 段里给出一组读数,本机原样:
adb shell dumpsys SurfaceFlinger | grep -A7 "app phase:"
           app phase:      1000000 ns            SF phase:      1000000 ns
           app duration:  16666666 ns            SF duration:  15666666 ns
     early app phase:      1000000 ns      early SF phase:      1000000 ns
     early app duration:  16666666 ns      early SF duration:  15666666 ns
  GL early app phase:      1000000 ns   GL early SF phase:      1000000 ns
  GL early app duration:  16666666 ns   GL early SF duration:  15666666 ns
       HWC min duration:         0 ns
七组读数,两件事:
- 四组相位(常规 / early / GL early 各自的 app 与 SF)数字完全相同——都是
1,000,000 ns。上一章说过原因:本机没有配ro.surface_flinger.vsync_event_phase_offset_ns这类属性,且只有 60 Hz 一档刷新率、走 GL 合成,所以三套配置退化成同一组数。这个"退化"本身是一条反向验证:§5.2 引的VsyncConfiguration注释说"不同的刷新率、是否 GL 合成要用不同偏移",只有一档时三组数相同,正说明偏移确实是按这些维度分档的。 SF duration比app duration正好少 1 ms(15,666,666 vs 16,666,666),与 §1.2、§2.2 那两处读数三方交叉一致。
最后一行 HWC min duration: 0 ns 是"这台 HWC 至少要花多久"的估计值,本机是 0。
下面这张图把七组读数做成面板:
7.4 第四个面:连接表与 VSyncRequest
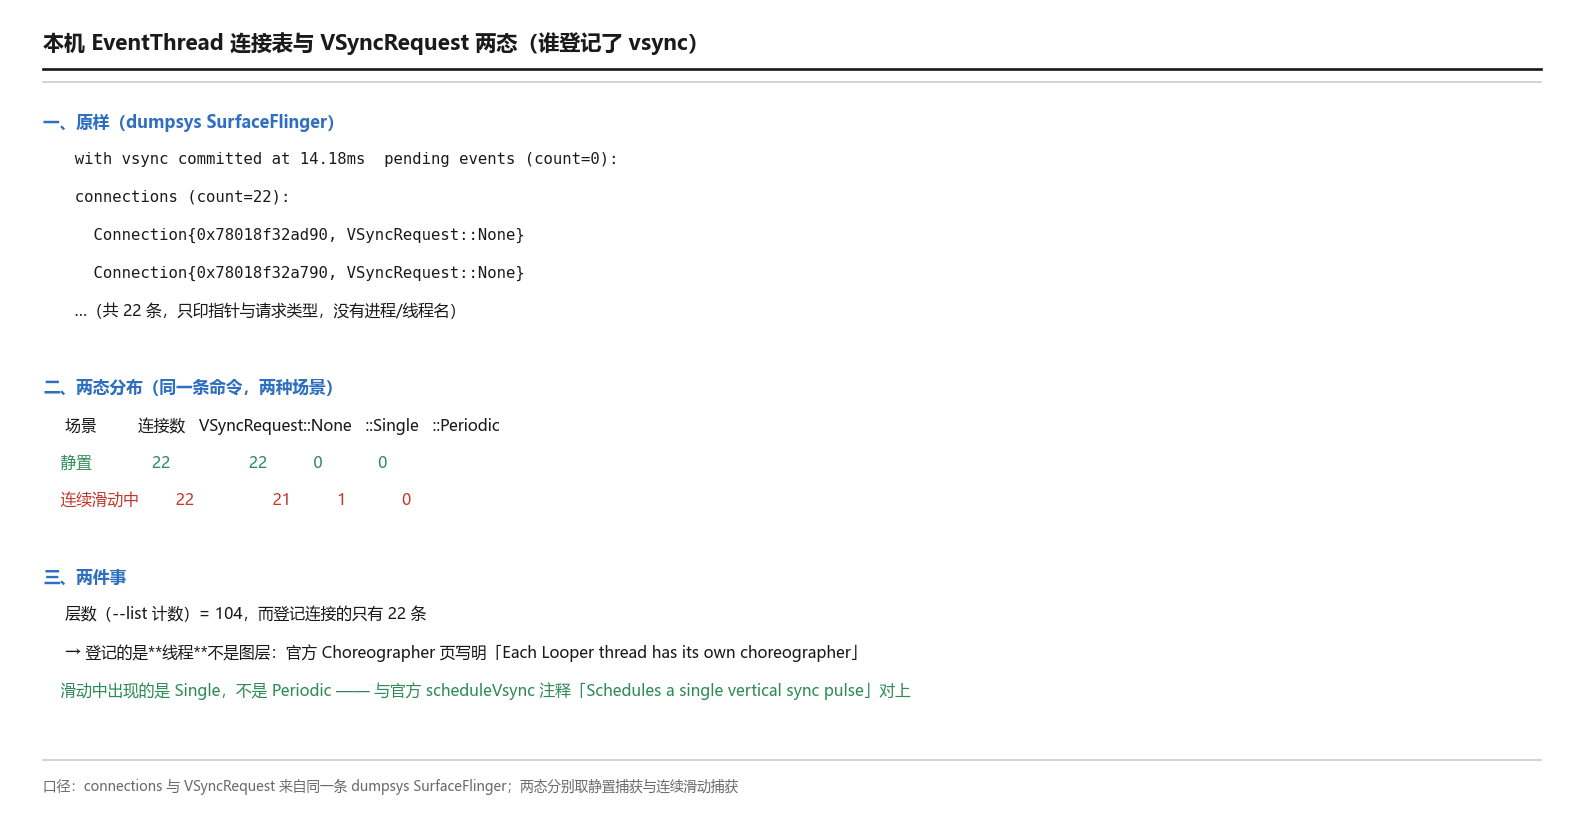
好了,最后一个面:dumpsys 里还有一份"谁登记了 vsync"的清单,它是四个面里唯一带"数量"的:
adb shell dumpsys SurfaceFlinger | grep -A30 "connections (count="
 with vsync committed at 14.18ms  pending events (count=0):
  connections (count=22):
    Connection{0x78018f32ad90, VSyncRequest::None}
    Connection{0x78018f32a790, VSyncRequest::None}
    …(共 22 条)
这条清单里有两个数会变:
| 状态 | 连接数 | VSyncRequest::None |
VSyncRequest::Single |
|---|---|---|---|
| 静置 | 22 | 22 | 0 |
| 连续滑动中 | 22 | 21 | 1 |
两件事值得写:
- 22 条连接 ≠ 104 个层。层有 104 个(
--list数出来的),而向 vsync 登记连接的只有 22 个——因为登记的是线程:官方在 Choreographer 页写明 "Each Looper thread has its own choreographer",所以一个 Looper 一条连接,跟图层数量无关。 - 滑动中出现的那个请求是
Single,不是Periodic。这与官方scheduleVsync()的注释("Schedules a single vertical sync pulse")完全对上。动画在跑的时候,应用并不是订阅了一条周期流,而是在每一帧里再请一次——这是一个"意料之外、情理之中"的细节。
下面这张图把连接表与两态分布做成面板:
八、一次 vsync 速率的实测
好了,读数面交代完,正式做实验。这一章的目的是回答一个问题:vsync 到底在什么时候被派发?
8.1 实验设计:只改"有没有人在动"
先看看做法——清掉一切干扰,然后在同一台设备上量四个窗口,只改"有没有人在动"这一件事。这是本篇唯一一处"主动改条件"的实验,也是全篇论据里最硬的一块:
# 取数:一行给出状态、计数与"上一次派发是多久前"
adb shell dumpsys SurfaceFlinger | grep "app: state="
adb shell dumpsys SurfaceFlinger | grep -E "mLastDispatchTime|last vsync time"
每组的窗口长度约 3 秒,读两次计数求差。判据只有两条:计数增量算出的速率,以及 lastDispatch 的推进。
实验原理:这里用的是单变量对照——四个窗口里,设备、命令、采样方式、窗口长度全都固定,唯一被改动的是"场景里有没有人在动"。之所以要这么做,是因为 vsync 派发同时受"有没有消费者"和"模型准不准"两件事影响;如果连命令或窗口长度也一起改,就分不清速率的变化到底来自哪一头。变量一次只改一个,读数才有归因力。
8.2 结果:ABCD 四组
| 组 | 场景 | 窗口 | 计数增量 | 速率 | lastDispatch 变化 |
|---|---|---|---|---|---|
| A | 静置(无触摸、无虚拟屏) | 3.06 s | +2 | 0.65 Hz | 167.03 → 597.36 ms ago |
| B | 连续滑动(22 次 swipe) | 4.17 s | +240 | 57.57 Hz | 644.44 → 13.08 ms ago |
| C | 录屏虚拟屏运行中(不触摸) | 3.06 s | +0 | 0.0 Hz | 223.41 → 3288.85 ms ago |
| D | 停录后回到静置 | 3.05 s | +0 | 0.0 Hz | 5700.72 → 8756.27 ms ago |
先说这个实验的误差口径,因为后面要拿这些数字下结论:窗口取 3 秒、读两次计数求差,所以速率的量化误差约在 ±0.33 Hz(一次计数除以 3 秒)。B 组那个 57.57 Hz 与 60 Hz 差 2.43 Hz,远大于量化误差,所以"滑动时确实按 60 Hz 在跑"这个结论是稳的;而 A 组 0.65 Hz(3 秒里只涨 2 次)与 C/D 组的 0.0 Hz 之间的差别小于误差、不能当区分用——它们要合并成一句"几乎不派发"。先量误差、再读数字,这一步不能省。
下面这张图把四组读数并排:
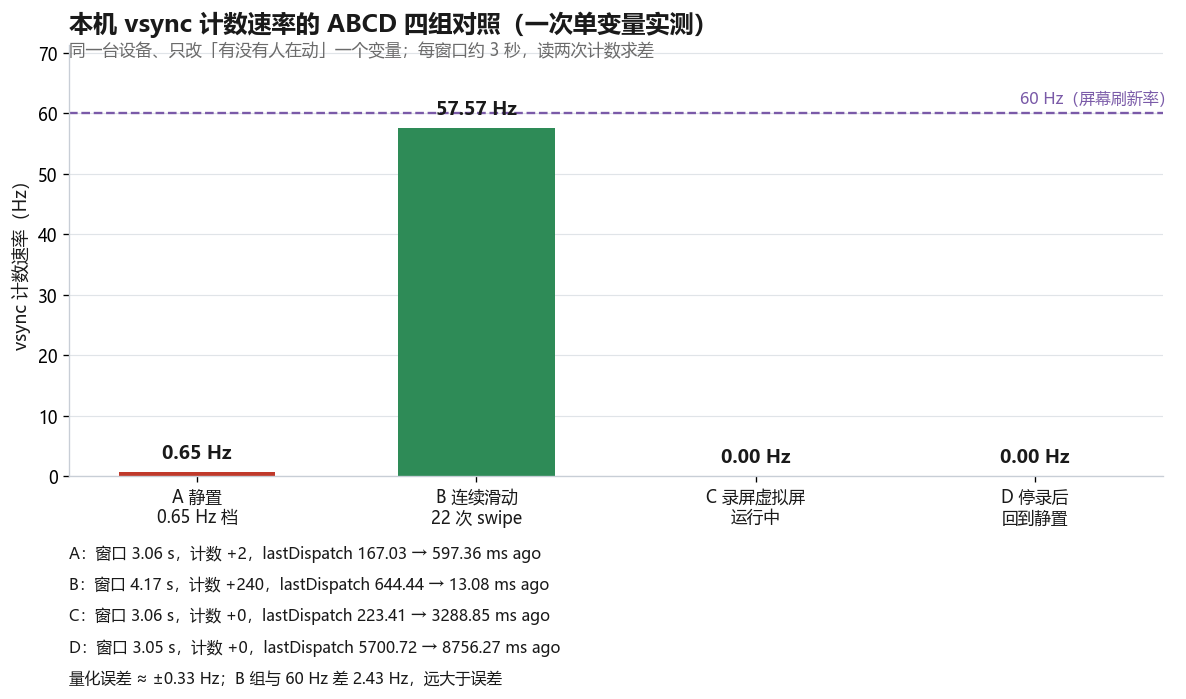
B 组是本篇的"现场":连续滑动时计数以 57.57 Hz 增长(60 Hz 的 96%,差值来自采样边界与滑动间隙),而 lastDispatch 落到 13.08 ms ago。"上一次派发 vsync 是 13 毫秒前",就是"这台设备正在按 60 Hz 跑 vsync"的直接读数。
A 组是它的反面:静置 3 秒只涨 2 次(0.65 Hz),lastDispatch 一路涨到 597 ms ago。没有人要 vsync 的时候,系统就不派发 vsync。
这条读数与 ep06 那组是同一件事的两端:ep06 §7 测出"静置窗口 totalFrames = 1、presentToPresent 直方图全零",量的是没合成;本篇量的是没派发。两者的因果顺序是——先没人要 → 才不派发 → 才不合成。三篇合起来,这条链才算完整。
8.3 状态字段:一个词就是开关量
OK,速率讲完了,但上面每一次 dumpsys 都还带出了另一个字段 state=,它的取值只有两种:
app: state=Idle   VSyncState={displayId=4619827259835644672, count=5361}   ← 静置
app: state=VSync  VSyncState={displayId=4619827259835644672, count=5813}   ← 滑动中
state=Idle / state=VSync 就是"当前有没有人在要 vsync"的开关量——A/B/C 三组分别是 Idle / VSync / Idle,与速率完全一致,两个读面互为验证。
注意前缀是 app:——这个 count 数的是派给应用侧的 vsync(VSYNC-app),不是"这块屏刷新了几次"。这个区别在下一章 C 组那个反例里会成为关键。
下面这张图把两态现场并置:
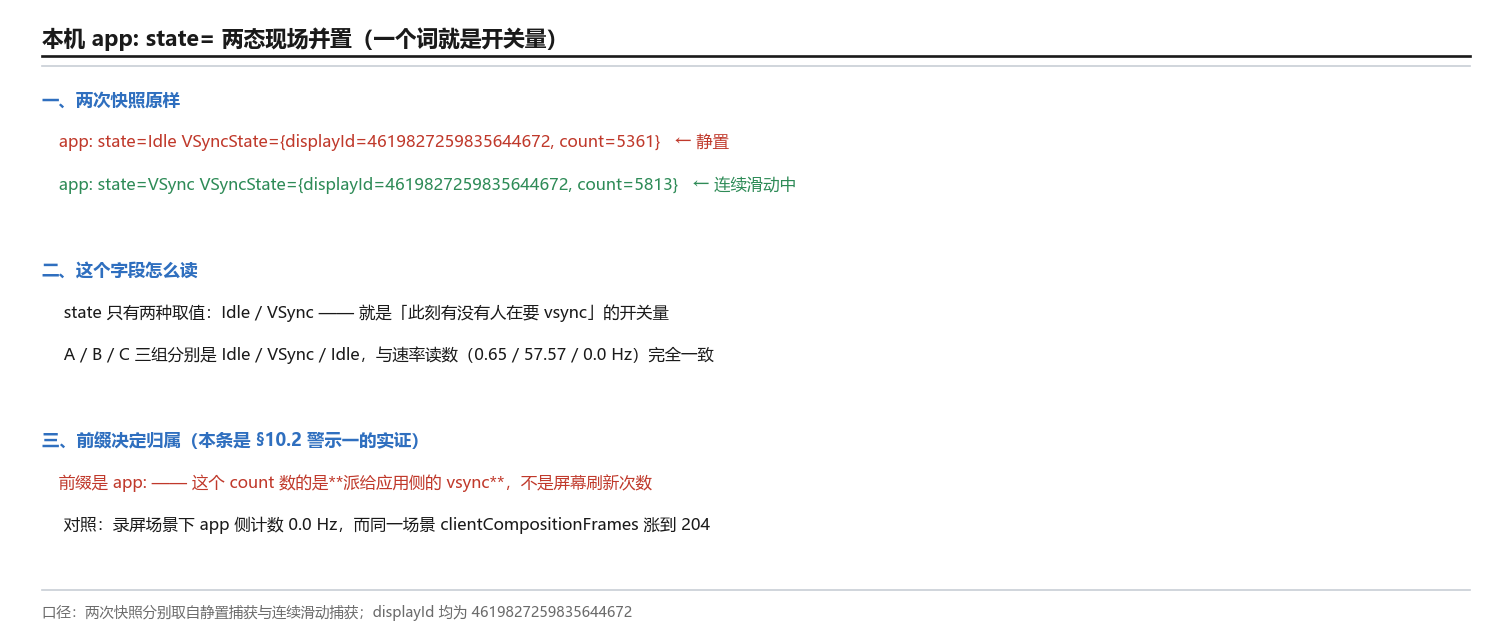
这张并置把"开关量"这件事说明白了:同一个 count,在两种状态下的增长速度差了近百倍(静置 0.65 Hz 对滑动 57.57 Hz),而区分它们的只是一个词。这也给了一条最省事的现场判断法:不想两次数、不想算速率的时候,直接看 state= 是 Idle 还是 VSync,就能知道此刻有没有人在要 vsync——代价是它只给"有或没有",不给"多快"。
8.4 刷新率的时间账
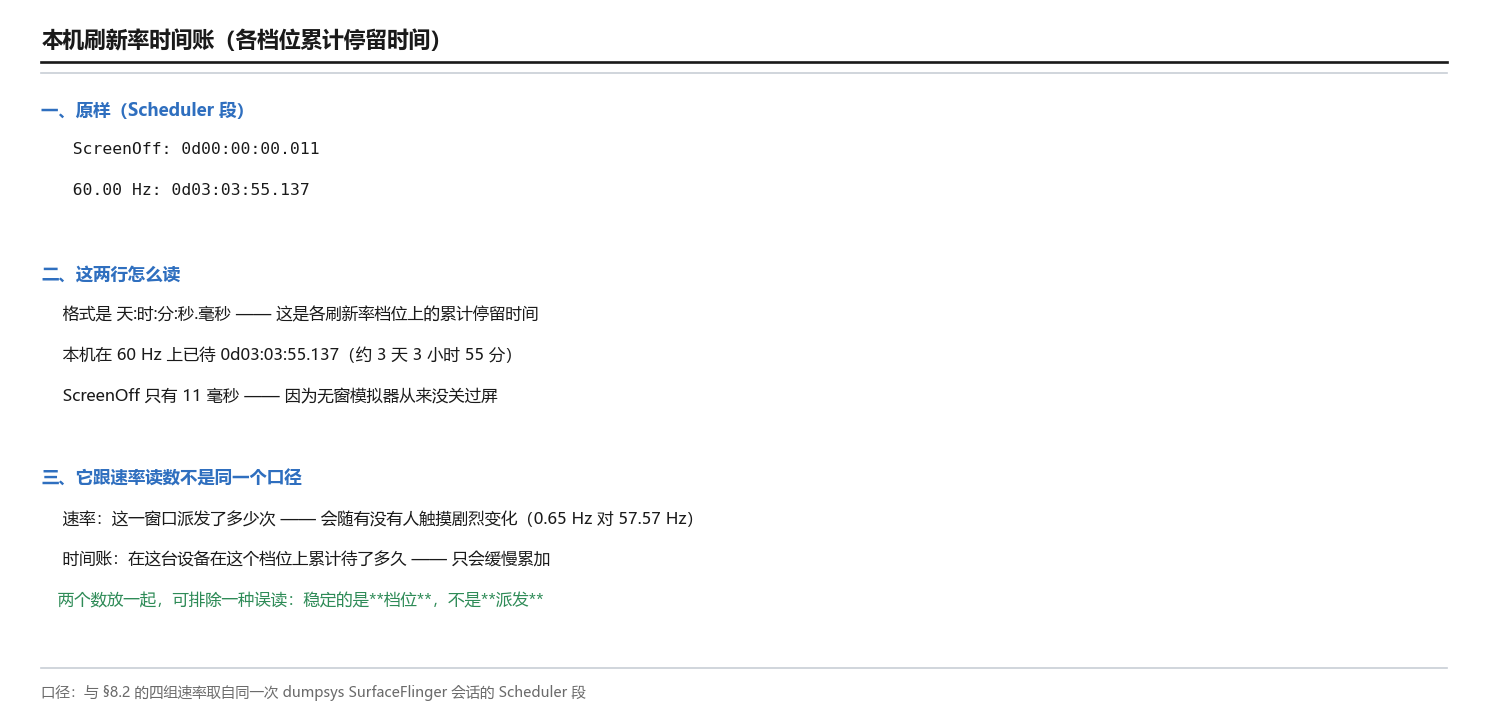
好了,最后补一张表——同一段 Scheduler 输出里还有一张很朴素的"时间账",它跟 vsync 速率不是一回事,但正好能当上面速率读数的旁证:
ScreenOff: 0d00:00:00.011
60.00 Hz: 0d03:03:55.137
这是各刷新率档位上的累计停留时间(天:时:分:秒.毫秒)。本机在 60 Hz 上已待了 3 天 3 小时 55 分,ScreenOff 只有 11 毫秒——因为无窗模拟器从来没关过屏。
这条时间账还有一个用法:它跟本节的速率读数不是同一个口径——速率量的是"这一窗口派发了多少次",时间账量的是"这台设备在这个档位上累计待了多久"。前者会随有没有人触摸而剧烈变化(0.65 Hz 对 57.57 Hz),后者只会缓慢累加。两个数放在一起看,就能排除一种误读:如果只看时间账,会以为"设备一直在 60 Hz 上稳定运行",但速率实测说明稳定的是档位,不是派发。
这张账的意义:它是"设备当前在哪个刷新率档位上、待了多久"最直接的读面。虽然本篇不做 ARR(那是 ep11),但它给了一个可复用的判据:想确认设备是不是一直待在同一个档位,看这两行就够了。
下面这张图把这张时间账做成面板:
九、虚拟显示的 vsync 从哪来
前面八章讲的是物理屏那条链。这一章回答 ep08 留下的那个坑:虚拟屏那一帧是谁在计时?
9.1 官方一句"没有 VSYNC"
先看看官方对虚拟显示说了什么。原文只有一句,但分量很重:
"虚拟显示设备没有 VSYNC,因此主显示设备的 VSYNC 用于为所有显示设备触发合成。"
英文原意即 Virtual displays do not have VSYNC, so the primary display's VSYNC is used to trigger composition for all displays.
来源:SurfaceFlinger 和 Hardware Composer(AOSP,含虚拟显示设备)
这句话解释了 ep08 §9.4 那个现象的另一半:ep08 只测出"同一时刻物理屏全 DEVICE、虚拟屏全 CLIENT"(因为虚拟屏背后没有显示硬件),但没回答"虚拟屏那一帧是谁在计时"。答案就是——它借主屏的。
而"借"这个说法要拆开看:虚拟屏没有自己的硬件 vsync,所以它的合成必须挂在主屏的节拍上;但这不等于"主屏的 vsync 计数器会替它涨"。§9.3 会给出一个本机反例来说明这一点。
这条"借"的原理其实落在一次挂接上:虚拟屏自己不产生节拍,所以它只能挂到一个已存在的 VsyncSchedule 上去——而系统里唯一有硬件节拍可挂的,就是主屏那一份。把这句话说到底,"虚拟屏用主屏的 vsync"不是一条特例规则,而是"没有硬件就只能挂到有硬件的那一份上"这个前提的必然结果。 这也顺带解释了 ep08 §9.4 那个"物理屏全 DEVICE、虚拟屏全 CLIENT"的读数:虚拟屏挂的是节拍,不是显示控制器。
下面这张图把虚拟屏的 vsync 归属画出来:
9.2 --latency:一条层的逐帧表
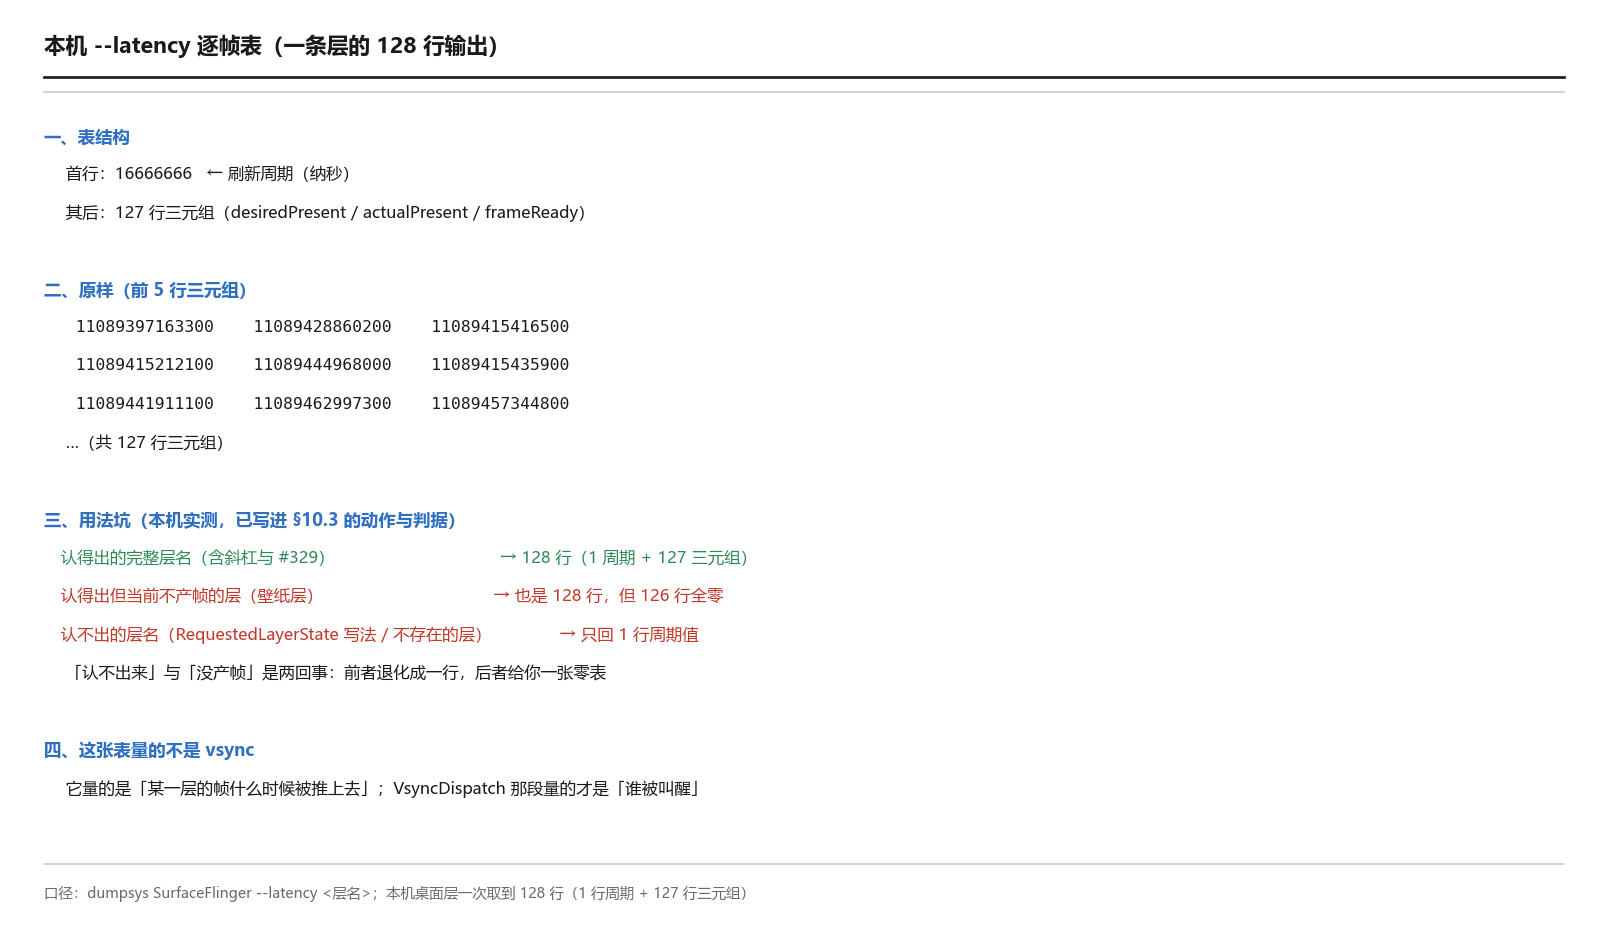
好了,虚拟屏的 vsync 归属清楚了,再看一个能落到"层"上的读面。--latency 对具体层会输出一张逐帧表(本机对桌面层得到 128 行:1 行周期 + 127 行三元组):
adb shell dumpsys SurfaceFlinger --latency "com.google.android.apps.nexuslauncher/com.google.android.apps.nexuslauncher.NexusLauncherActivity#329"
16666666
11089397163300  11089428860200  11089415416500
11089415212100  11089444968000  11089415435900
…(共 127 行三元组)
首行是刷新周期(16,666,666 ns,与 §2.2 的 app duration、§7.3 的 app duration 三处同值),后 127 行是三元组。
这张表的定位要说清:它量的是"某一层的帧什么时候被推上去",不是 vsync 本身。ep06 用过同一条命令(那一篇把它当作 present 时刻表来读)。两个读面不要混:VsyncDispatch 那段说的是"谁被叫醒",--latency 这一段说的是"某一层的帧什么时候成交"。
还有一个坑值得写进"动作与判据":--latency 认不认这个层名,返回的东西完全不同。本机实测三种输入——对桌面那个完整层名(含斜杠与 #329)得到 128 行(1 行周期 + 127 行三元组);对壁纸层名也能得到整张 128 行的表,但其中 126 行是全零(该层平时不产帧,只有最新一行有值);而对 RequestedLayerState{...} 这种写法、或者任何它认不出来的层名,只回一行周期值。"认不出来"与"没产帧"是两回事:前者退化成一行,后者给你一张零表——零表能读出"这一层活着但没在动",而一行什么都读不出来。
下面这张图把这张逐帧表的结构做成面板:
9.3 两个读面看着冲突:合成在跑,主屏计数不走
言归正传,上一章 C 组那个读数需要在这里展开——它是本篇里唯一一处"两个读面看着互相打脸"的地方,也是最容易读错的地方。
C 组场景是"录屏虚拟屏运行中、但没人触摸屏幕",测出来的是:主屏 app 侧 vsync 计数完全不走(0.0 Hz)。而 ep08 在同一场景下测出的是:clientCompositionFrames 从 0 涨到 204。
两个读数同时成立,而且不矛盾。 原因是它们量的根本不是同一件事:
| 读面 | 量的是什么 | 录屏时的表现 |
|---|---|---|
clientCompositionFrames |
合成工作量:这一窗口有多少帧走了客户端合成 | 204(合成照常在跑) |
app: state=… VSyncState 的 count |
派发工作量:这一窗口有多少次 vsync 派给了应用侧 | 0(没有应用在要) |
关键在那个 app: 前缀:它数的是"派给应用侧的 vsync",而录屏时主屏上没有应用在请求 vsync(屏幕内容不变、没有触摸),所以不派;但虚拟屏那条合成路径照样在按主屏节拍产出帧。
这条必须写成口径警示,因为读者看到"录屏时 vsync 计数为 0"很容易得出"vsync 停了"的错误结论——实际停的是"派给应用的 vsync",不是"整条链路"。
这张并置说明了一件容易看漏的事:"合成在跑"和"派发在跑"是两个独立的开关。录屏时虚拟屏那条路径照样按主屏节拍产出帧,clientCompositionFrames 一路涨;可主屏上没有应用在请求 vsync,app: 那条计数就一直平。结论就是:录屏不会让主屏的应用侧变忙,只会让合成侧变忙。 这也解释了为什么"录屏时更耗电"的直觉并不完全落在应用身上——多出来的活压在 SF 与编码器这一侧,不在应用线程那一侧。
9.4 读不到 / 做不到的清单
这一篇的结论里,有相当一部分是"读不到什么"。 单独列一张表:
| 想读什么 | 结果 | 原因 |
|---|---|---|
| HWC 的 vsync 回调本身 | ❌ | onVsync 是 HWC 推给 SF 的,不进 dumpsys;本机连硬件时间戳都没有(No Last HW vsync),所以"回调有没有按时到、抖动多少"读不出来 |
| composer HAL 自己的状态 | ❌ | adb shell dumpsys android.hardware.graphics.composer3.IComposer/default → FAILED_TRANSACTION |
setVsyncEnabled 的调用记录 |
❌ | 只能读到状态位(hwVsyncState=Enabled),读不到"什么时候开的、开过几次" |
| 22 条连接各属于谁 | ❌ | 连接表只印指针与 VSyncRequest,没有进程/线程名 |
| 真实硬件 vsync 的抖动/漂移 | ➖ | 需真机:本机无硬件样本,Refresh Rate Map 是理想的 period=16.67ms, intercept=0 |
| ARR / 多刷新率下的相位切换 | ➖ | 需真机支持 ARR(ep11 的正题);本机只有 60 Hz,四组相位完全相同 |
| 逐帧的 vsync 时序(Perfetto) | ➖ | 需真机 + root:android.surfaceflinger.frametimeline 数据源需采集;本机 user 构建无 root |
下面这张图把这张表做成面板:
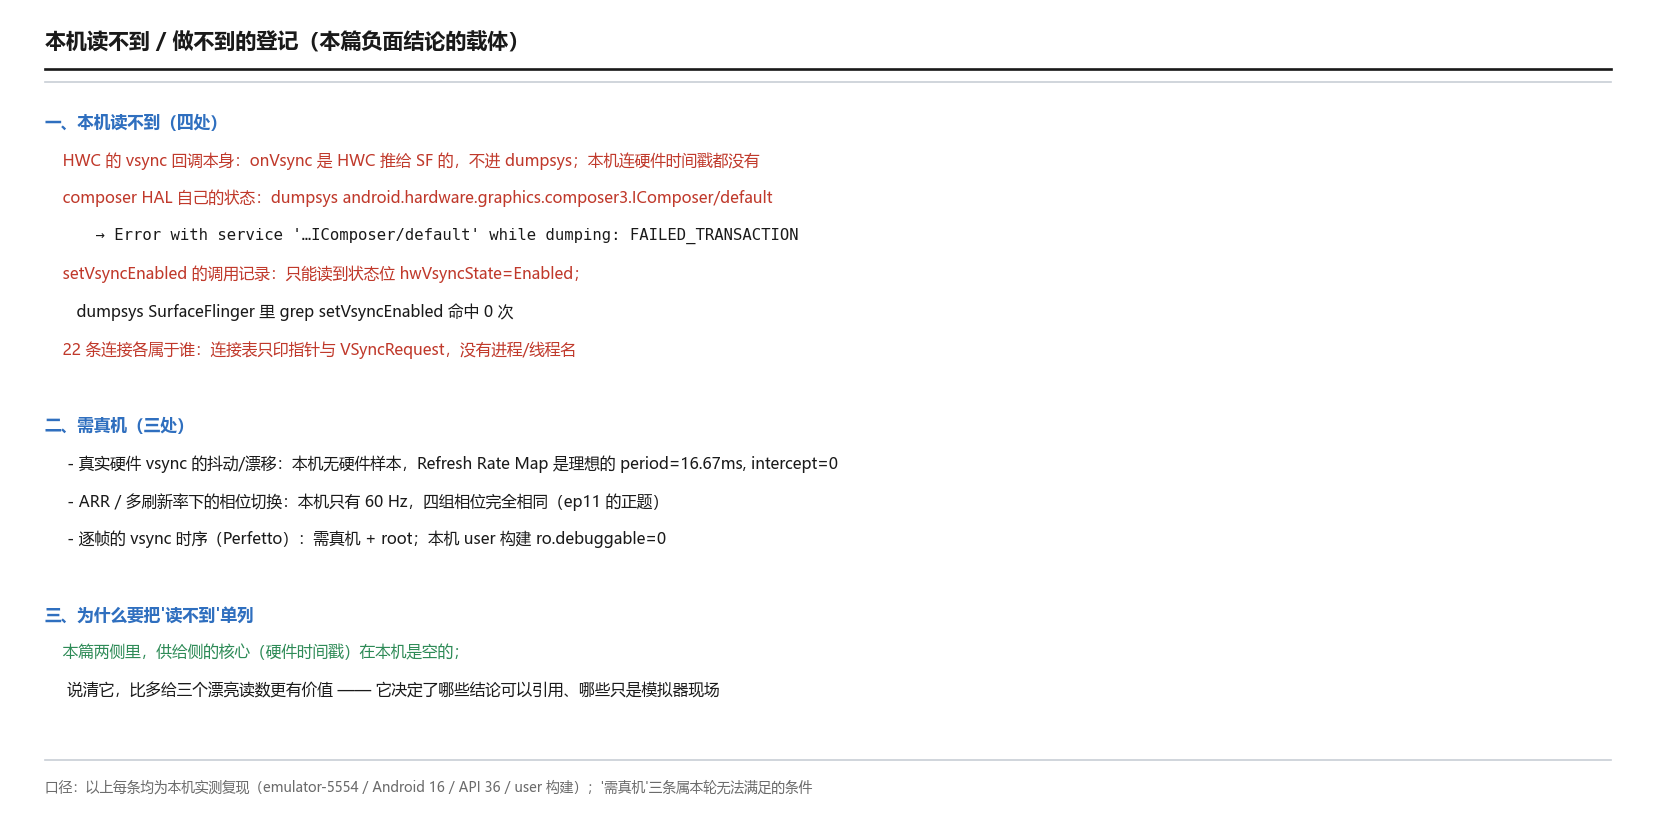
为什么要为"读不到"单开一节:因为这一篇的两侧——请求侧与供给侧——供给侧的核心(硬件时间戳)在本机是空的。把这条说明,比多给三个漂亮读数更有价值:它决定了本篇哪些结论可以引用、哪些只能被当作一台模拟器的现场记录。
十、四处说法与四项动作
10.1 四处流传很广的说法,逐条核
OK,机制与实测都讲完了,最后把四处流传很广的说法逐条对一遍。挑这四条的标准是:它们都能被本篇已有的读数直接判定,不需要引入新证据。
| 说法 | 核对结果 | 依据 |
|---|---|---|
| "vsync 就是屏幕发出的信号,系统原样转发" | 不成立 | 官方原文:DispSync 是"a software phase-lock loop",它"maintains a model … and uses that model to execute callbacks"——是建模型再派发,不是原样转发(§5.1) |
| "vsync 是一块一直在滴答的钟" | 不成立 | 本机实测:静置 3 秒只涨 2 次(0.65 Hz),lastDispatch 涨到 597 ms ago;停录静置时更是 8756 ms ago(§8.2) |
| "三路信号就是三个不同的节拍" | 不成立 | 官方:三路是"same period and offset phase"——周期完全一样,只差相位;设备上三条的 workDuration 只差 1 毫秒(§2.2、§7.3) |
| "虚拟显示有自己独立的 vsync" | 不成立 | 官方明文:"虚拟显示设备没有 VSYNC,因此主显示设备的 VSYNC 用于为所有显示设备触发合成"(§9.1) |
第二条值得多说一句:那条说法是最容易被"看起来像"骗过去的——因为设备上确实有个 count 在涨,滑动时还涨得挺快(57.57 Hz)。但静置时它几乎不动,这一条就把它证伪了:如果它是"屏幕在滴答",就不该受"有没有人触摸"影响。
10.2 两条口径警示:两类数字不能混着读
好了,把容易读错的数字单独登记一遍——本篇实测里出现了两对,各自记一次。
警示一:app: 前缀决定了这个计数是谁的。
app: state=Idle VSyncState={displayId=..., count=5361}
前缀是 app:——它数的是"派给应用侧的 vsync",不是"这块屏刷新了几次"。C 组那个反例(§9.3)就是这条警示的实证:录屏时它 0.0 Hz,而合成帧数涨到 204。
警示二:hwVsyncState=Enabled 与 No Last HW vsync 可以同时成立。
hwVsyncState=Enabled        ← "我要了"
pendingHwVsyncState=Enabled ← "我打算保持要着"
No Last HW vsync            ← "对面一次都没给"
mMoreSamplesNeeded=1        ← "所以我还得等"
四行是两个方向的事:前三行里前两行是请求侧(SF 的动作),后两行是供给侧(HWC 有没有回应)。"要过"不等于"拿到过"——这两个方向的字段不能互相代入。
下面这张图把这两条警示做成登记面板:
这张面板把两条警示放在一起,是因为它们踩的是同一个坑的两面:第一条防"把请求侧的数字当供给侧用",第二条防"把两条方向相反的字段硬凑成一个结论"。两条的共同解决办法是同一句——先看这个字段属于哪一侧,再读它的值。本篇 §0.3 那条"两个侧"的分界线,到这里才算真正兑现:它不只是开篇的一个说法,而是这两条警示背后的判据。
10.3 四项可执行动作与判据
好了,最后给四组命令,每组配一个判据。这四组覆盖了本篇从"确认链条在哪"到"量出派发速率"的完整路径,而且顺序不能换——第 ① 组确认链条存在,后面三组才有对象可查。
# ① 确认 vsync 链路在哪一段、对面是谁
adb shell dumpsys SurfaceFlinger | grep -A40 "VsyncSchedule for"
# 判据:出现 VsyncSchedule for pacesetter 即为该屏幕的调度链;
#       看 hwVsyncState 与 No Last HW vsync 是否同时成立(本机就是同时成立)

# ② 看三条回调条目与它们的参数
adb shell dumpsys SurfaceFlinger | grep -A14 "VsyncDispatch:"
# 判据:Callbacks 下应出现 sf / app / appSf 三条;
#       比它们的 workDuration —— 应用侧应比 sf 侧多 1 毫秒

# ③ 看当前有没有人在要 vsync(一次快照)
adb shell dumpsys SurfaceFlinger | grep "app: state="
# 判据:state=Idle 表示当前无人请求;state=VSync 表示正在派发

# ④ 量出派发速率(两次采样求差)
adb shell dumpsys SurfaceFlinger | grep "app: state="
sleep 3
adb shell dumpsys SurfaceFlinger | grep "app: state="
# 判据:count 增量 ÷ 窗口秒数 ≈ 60(滑动中)/≈ 0(静置);
#       同时看 mLastDispatchTime —— 十几毫秒说明刚派过、几秒说明早停了
第 ④ 组是四组里最有用的一个自检:它把"vsync 在不在跑"从"看文档猜"变成"两次数一减"。而且它有两条独立判据(速率与 lastDispatch),两条对不上时说明采样窗口跨了状态切换——这种错位本身就是值得记的诊断信号。
一条用法坑也写在这里:--latency 只认它认得出的层名——认得出就给你整张 127 行三元组(认得出但不产帧的层,给的是一张 126 行全零的表);认不出就只回一行周期值、整张表都拿不到(§9.2)。这是这几条命令里最容易白跑一次的地方。
10.4 三句结论
好了,把这一篇收成三句话:
第一句:vsync 不是一块永远在滴答的钟,而是一份按需排的班。 有人要才派发——滑动时 57.57 Hz、静置 0.65 Hz、停录静置时 lastDispatch 涨到 8756 ms。这一条与 ep06 的"静置不合成"是同一条链的两端,因果顺序是先没人要 → 才不派发 → 才不合成。
第二句:三路信号同周期、只差相位,而相位的取值是按最坏情况留的余量。 设备上印着的 sf: 与 app: 两条,workDuration 分别是 15.67 ms 与 16.67 ms——两条差 1 毫秒,而 SF 的预算也正好比应用少 1 毫秒;按官方那条 workDuration + readyDuration 规则算,同一个 vsync 上应用比 SF 早约 16.67 ms 被唤醒(正好一个周期)。官方对偏移的原话是 "set conservatively based on high-load use cases",它不是最优值,是余量。
第三句:这条链的供给侧在本机是空的,所以本篇的周期读数是软件算的。 hwVsyncState=Enabled 与 No Last HW vsync 同时成立,present fence 那条退路也被显式关掉,模型退化成"按显示模式的 vsyncRate 直接算"——period = 16.67ms, intercept = 0。硬件 vsync 的真实抖动要真机。
10.5 下一篇预告
OK,下一篇回到本篇反复提到、但一直没打开的那件事:既然三路信号的相位是"错开的",那到底该怎么错——也就是官方说"按最坏情况留余量"的那个偏移,在应用、SF、屏幕三方之间是怎么排的,以及调大调小各自会发生什么。也就是本篇 §2.3 只给了结论、没展开排布的那一块。
相关链接 - 上一篇:【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加 - 下一篇(预告):【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞 - 相关系列:实时渲染管线探析 | 移动端图形与功耗 | GPU 架构剖析 | 图形性能剖析工具链 | 2D 矢量引擎深挖
With Best Wishes.
参考资料
- VSync(三路信号 / DispSync 是软件 PLL / 两个相位属性 / setVsyncEnabled 按需开关)
- 硬件合成器 HAL 的 AIDL(onVsyncIdle → 重置 vsync 模型)
- SurfaceFlinger 和 Hardware Composer(含"虚拟显示设备没有 VSYNC")
- SurfaceFlinger and WindowManager
- SurfaceFlinger 的系统属性(两个相位属性名)
- Hotplug handling(onHotplug 的两条硬约束)
- Understand systrace(EventThread 唤醒 UI 线程 / FrameMissed)
- DisplayEventReceiver(VSYNC_SOURCE_APP / scheduleVsync 的 single pulse)
- Choreographer(每个 Looper 一个 Choreographer)
- Choreographer.VsyncCallback
- UI jank detection(VSYNC 轨道 / Choreographer#doFrame)
- Perfetto · FrameTimeline(jank 的定义与两张表)
- Perfetto · SQL tables(surfaceflinger_transactions 的 vsync_id)
- Perfetto · PerfettoSQL standard library(android_frames 的 vsync_interval_ms)
composer3/IComposerCallback.aidl(五个回调的注释原文)services/surfaceflinger/Scheduler/VSyncDispatch.hservices/surfaceflinger/Scheduler/VsyncSchedule.hservices/surfaceflinger/Scheduler/VsyncController.hservices/surfaceflinger/Scheduler/VsyncConfiguration.hservices/surfaceflinger/Scheduler/Scheduler.hcore/java/android/view/DisplayEventReceiver.java- composer3
Composition.aidl(回指 ep08 的合成类型枚举) device/generic/goldfish-opengl/system/hwc3/(模拟器 AIDL HWC 参考实现)- CSDN · surfaceflinger 与 HWC 的关系
- DeepWiki · SurfaceFlinger Configuration and Properties
- Wikimedia Commons · Clock Signal
- Wikimedia Commons · Clk signals 4 channels time interleaved adc
- Wikimedia Commons · 1st order type 1 loop


