站点链接:技术博客页 | 公众号:溯光的图形笔记
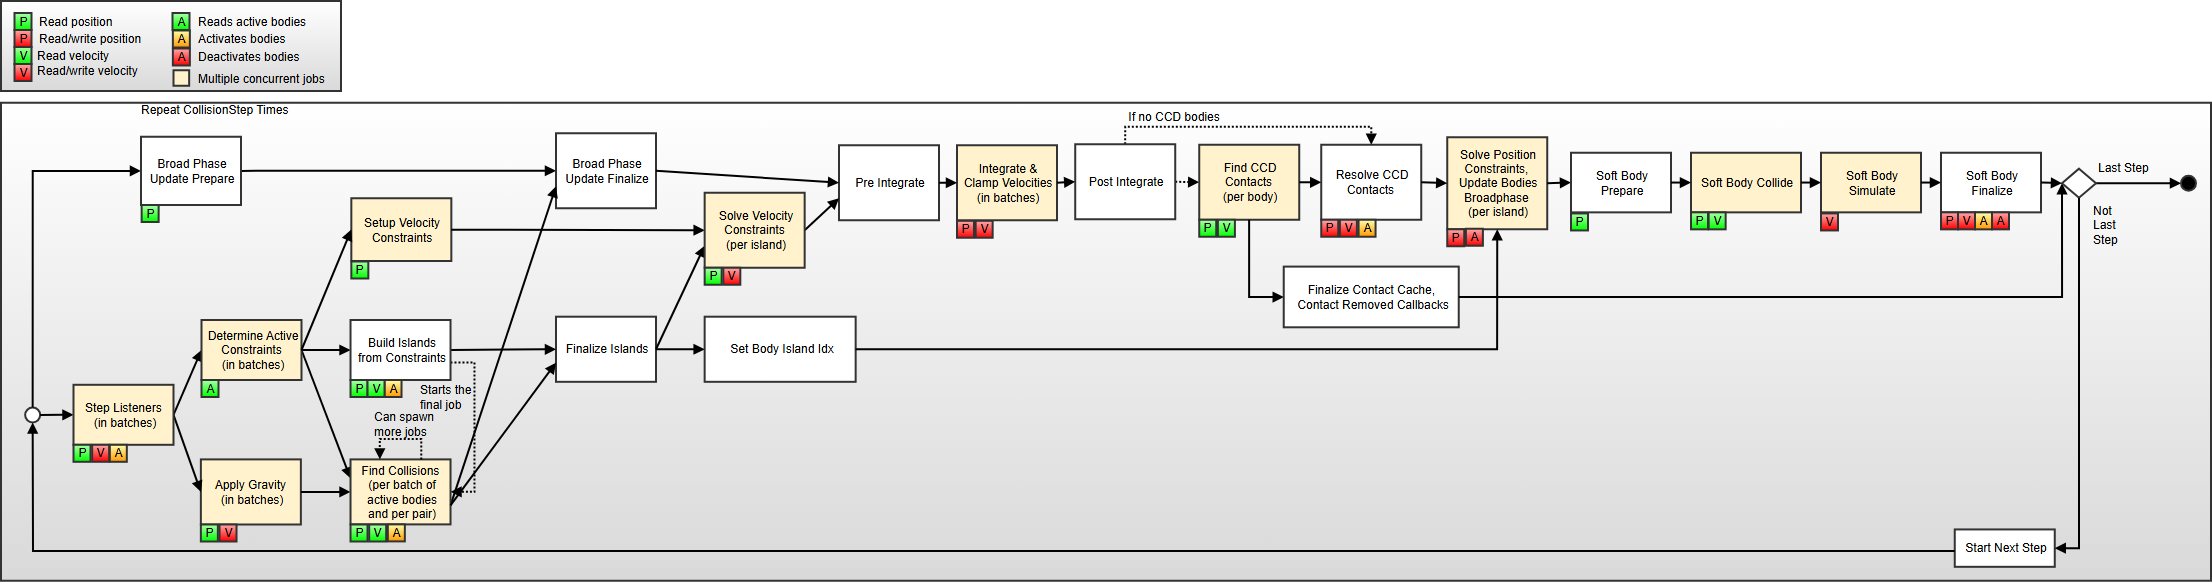
Docs/PhysicsSystemUpdate.svg(MIT)上一篇我们把 Jolt 放进了物理引擎的坐标系里,量出了它两条主线:多核扩展与确定性。但那只回答了"它凭什么",
没有回答"它怎么做到的"。这篇就来拆最核心的那一个动作——当你在游戏循环里调一次 PhysicsSystem::Update(),这一帧的物理到底被切成了多少段、这些段怎么排、哪些能同时跑。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、源码怎么实现、本机跑出来是什么,这三层在文中分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(版本、场景、线程数、命令、日期);
- 自跑优先:本专题的图以本机编译运行 Jolt 得到的真图与官方一手图为主,自绘为辅;
- 不写没有落点的说法:凡是官方文档与源码里找不到对应命名的说法,文中会明确指出查无落点;
-
篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,300 到 2,200 字。
-
本篇不涉及:宽相怎么建树、窄相怎么算接触、约束怎么迭代求解、CCD 怎么"偷时间", 这四件事各有专篇(第四、六、九、十一篇)。本篇只读流水与边界,不深入任何一段的算法。 理由很直接:本篇的价值是给出地图与因果;提前深入会让后面九篇无题可写,读者也拿不到整体形状。
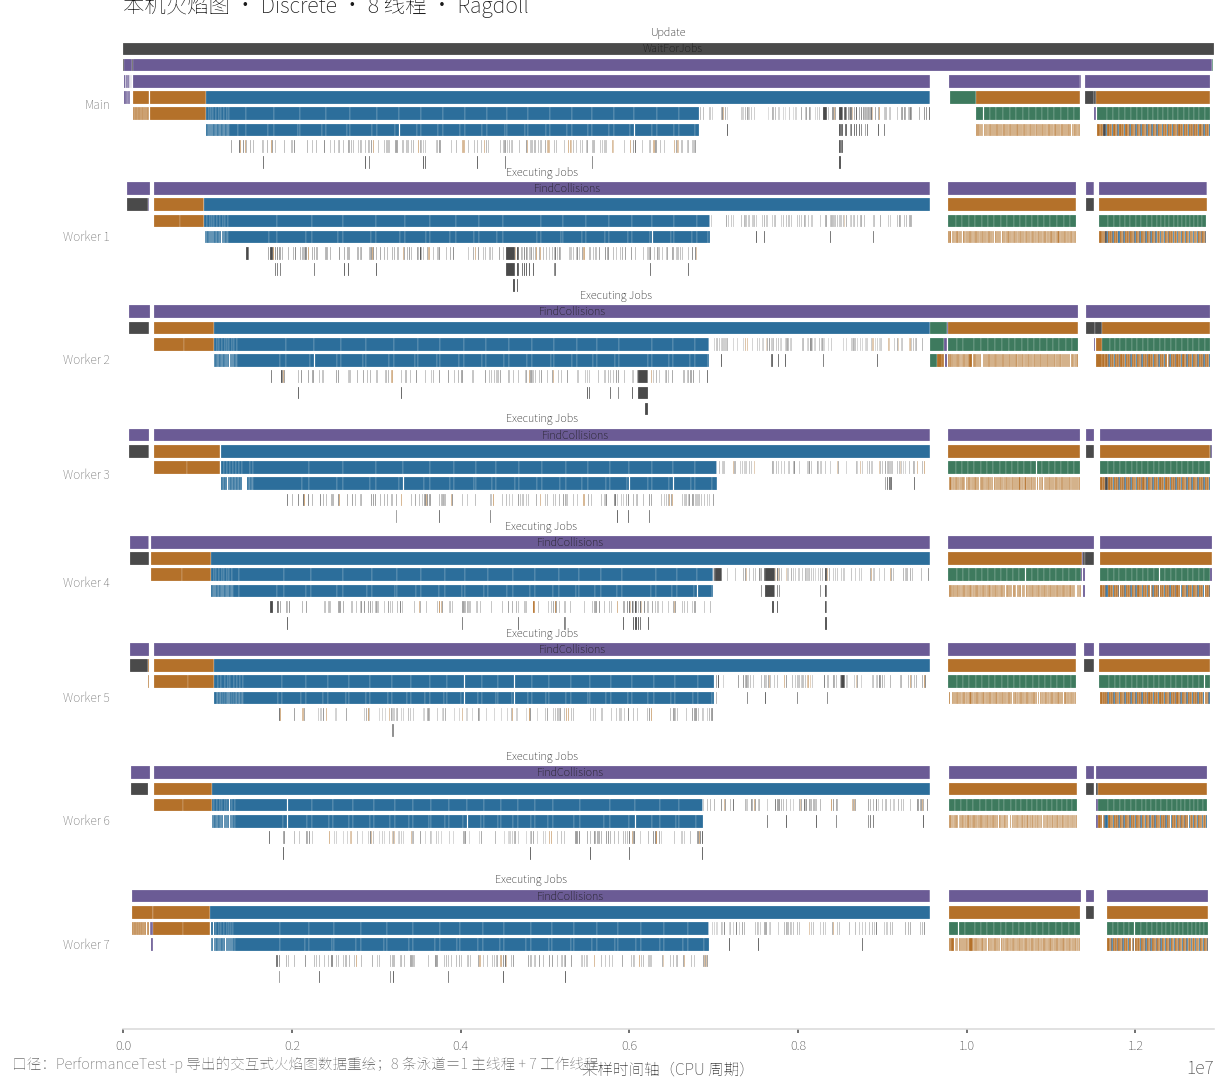
本篇的图分三类:本机自产真图(PerformanceTest -p 导出的火焰图,版权自有)、
外部真实素材(官方流程图与 .drawio 源件,MIT,图注标作者与许可)、
自绘示意图(走 styles/qianmo/palette.json 色板单源)。
需要提前说明的是:Jolt 的流水线图在公共素材库里不存在,本阶段用 6 组关键词在 Wikimedia Commons 检索,
命中 59 条候选,全是古籍扫描件与无关论文 PDF;真正的图只在项目自己的 Docs/ 目录里。
入口:Update 的签名与语义
0.1 一个函数,四个参数
OK,先说入口长什么样。这是官方头文件
PhysicsSystem.h
里的原文签名:
/// The world steps for a total of inDeltaTime seconds. This is divided in inCollisionSteps iterations.
EPhysicsUpdateError Update(float inDeltaTime, int inCollisionSteps, TempAllocator *inTempAllocator, JobSystem *inJobSystem);
四个参数里,真正决定本篇叙事的只有两个。inCollisionSteps(碰撞步数) 说明一帧内可以再分多次碰撞迭代,
你交给它 1/60 秒,它可以在内部切成两步各 1/120 秒来跑,这是防穿透的常规手段。
inJobSystem(作业系统) 是它干活的方式:官方注释原话是
This function internally spawns jobs using inJobSystem and waits for them to complete
,返回时所有作业已经跑完。
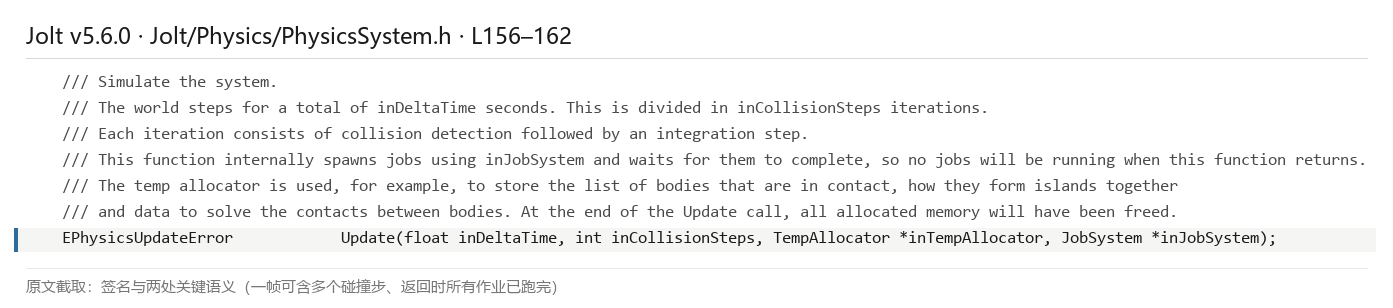
Update 的签名与两处关键语义——一帧可含多个碰撞步、返回时所有作业已跑完@ 本机构建 Jolt v5.6.0(原创)第二点尤其要留意:对调用方来说,物理耗时是一次阻塞调用。你在主线程敲下这行代码,然后等; 在它返回之前,这个函数内部已经把几十上百个作业派发出去、又全部等回来了。 这就是为什么物理优化对帧率的改善总是"要么全拿到、要么一点拿不到"——它是原子的一段,不是可以慢慢摊的流水。
0.2 三个常量,定住并行度的天花板
好了,然后看三个数字。它们不在一个文件里,但必须放在一起读(常量定义处见
PhysicsUpdateContext.h
与 PhysicsSettings.h):
cMaxConcurrency= 32:单个PhysicsUpdateContext支持的最大并发作业数(PhysicsUpdateContext.h);cMaxPhysicsJobs= 2048:一次更新里最多能有的作业数(PhysicsSettings.h);cMaxPhysicsBarriers= 8:屏障数量的上限(PhysicsSettings.h)。
第一个数字是"同时能有多少个活在飞",第二个是"一帧总共能有多少个活",第三个是"可以设几道栅栏"。
其中:
- cMaxConcurrency 是编译期常量,它是 StaticArray 的容量,不是运行时算出来的;
- cMaxPhysicsJobs 是句柄数组的容量,装的是所有碰撞步的所有作业实例;
- cMaxPhysicsBarriers 限制的是同时可存在的屏障数,与碰撞步数相关。
也就是说,超过 32 个并发作业,Jolt 不会"变慢",它结构上就不支持。
在这一点上,官方的措辞很克制:GetMaxConcurrency() 返回的是
min(cMaxConcurrency, mJobSystem->GetMaxConcurrency()),取编译期上限与作业系统实际能力的较小值。
本机的 JobSystemThreadPool 挂在 16 个逻辑核上,所以实际生效的上限是 16。
0.3 一帧的三条出口:不是每次 Update 都那么重
说白了,还有一处必须提前说清的地方:Update 有三条出口,只有一条会走完整流水。
出口一(轻量早退):世界是静止的。源码里的判断是这样的:
// If there are no active bodies (and no step listener to wake them up) or there's no time delta
uint32 num_active_rigid_bodies = mBodyManager.GetNumActiveBodies(EBodyType::RigidBody);
uint32 num_active_soft_bodies = mBodyManager.GetNumActiveBodies(EBodyType::SoftBody);
if ((num_active_rigid_bodies == 0 && num_active_soft_bodies == 0 && mStepListeners.empty()) || inDeltaTime <= 0.0f)
{
    mBodyManager.LockAllBodies();

    // Update broadphase
    mBroadPhase->LockModifications();
    BroadPhase::UpdateState update_state = mBroadPhase->UpdatePrepare();
    mBroadPhase->UpdateFinalize(update_state);
    mBroadPhase->UnlockModifications();

    // If time has passed, call contact removal callbacks from contacts that existed in the previous update
    if (inDeltaTime > 0.0f)
        mContactManager.FinalizeContactCacheAndCallContactPointRemovedCallbacks(0, 0);

    mBodyManager.UnlockAllBodies();
    return EPhysicsUpdateError::None;
}
注意这条早退路径做的事:宽相照更新、接触回调照调,但作业图一个都不建。
这是一个常被忽略的工程结论:物理系统的开销不是恒定的,
场景里所有刚体都睡着了(sleeping),Update 几乎不花钱。
这也解释了为什么 ep01 里"关掉睡眠"会让多核曲线变难看不,它把这条最省钱的出口堵死了。
出口二(时间零):inDeltaTime <= 0,同样早退,但不接触回调(因为没过时间)。
出口三(完整流水):下面七节讲的全是这条。走这条路径时,Update 会先做四件准备:
建立 PhysicsUpdateContext、创建屏障、给 body pair 数组一次性分配 mMaxInFlightBodyPairs 大小的内存、
然后 LockAllBodies() + LockModifications() 把整个世界锁起来。
最后这一步值得留意,整条流水期间,刚体的加删被禁止。
源码注释在 mUpdateBroadphaseFinalize 处写得很直接:Until then the positions will not be updated neither will bodies be added / removed.
这是刻意的设计,而非疏忽:把并发风险挡在 Update 之外,
换来流水内部"只有读写位置/速度的竞争,没有增删实体的竞争"。这也是 ep01 里
"从别的线程改刚体必须走加锁接口"那条规则的由来。
0.4 本篇的边界(本篇不涉及什么、为什么)
好了,边界说三条就够。
讲什么:一帧物理被切成哪几段、每段的职责边界在哪、这些段之间哪些必须串行哪些可以并行、 并行度的上限由什么决定、以及官方的流程图与本机跑出来的火焰图对不对得上。
只给指针、不展开什么:宽相的树怎么建(第四篇)、窄相怎么算接触流形(第六篇)、 约束怎么一轮轮迭代(第九篇)、CCD 怎么在位置积分后"补一次投射"(第十一篇)。 这几段在本篇里都是一个方块、一条边,不打开。
为什么不涉及:因为本篇要交付的是地图与因果。一张地图如果把每条街的门牌号都画出来, 它就不再是地图了。
0.5 本机环境与读数口径
言归正传,最后交代读数的来源,方便大家复核。本篇所有"本机"数字都出自同一台机器、同一次构建:
| 项 | 值 |
|---|---|
| 机型 | 16 逻辑核(8 物理核 + 超线程)x86-64 |
| 系统 | Windows,MSVC 19.44 / VS 2022 |
| Jolt 版本 | v5.6.0(Release,CMake 4.4.2 生成,VS2022 生成器) |
| 构建开关 | JPH_USE_VK / JPH_USE_DX12 / JPH_USE_MTL / JPH_PROFILE_ENABLED 均开 |
| 场景 | Ragdoll(16 堆 × 10 个布娃娃,3680 个刚体,马达开启,落在平地) |
| 命令 | PerformanceTest.exe -s=Ragdoll -i=50 -p |
| 产出 | 32 张火焰图 HTML(1–16 线程 × Discrete/LinearCast)+ 步频表 |
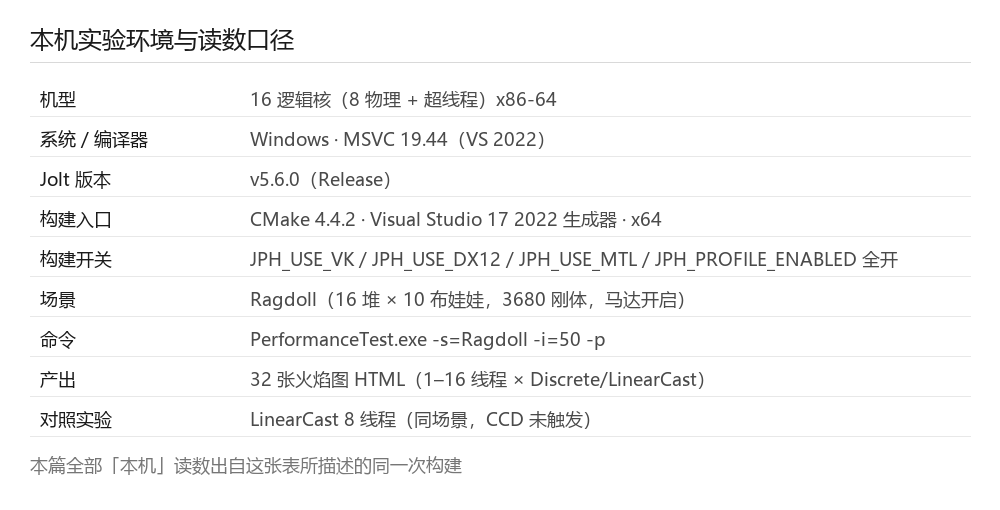
三点口径要说明。
第一,-i=50 是收敛前的采样。 PerformanceTest 的 -p 参数是"每 100 次迭代输出一次 profile 快照",
本次只跑了 50 步,所以拿到的是预热之后的单次快照,不是长稳态。
这解释了为什么同一线程数重跑会有几个百分点的浮动,火焰图适合看分段比例,
不适合看绝对值。
第二,百分比是"跨全部线程的采样占比",不是"墙钟时间占比"。 线程越多,同一个段可能被多个线程同时采样,占比会被放大。所以本系列只用它做段间比较, 不用它反推"某段花了多少毫秒"。
第三,-p 导出的火焰图是可交互 HTML。 每一根方框都能点开看调用栈,
本篇图注里引用的都是它的截图。想看原始文件的朋友,可以按上表自己跑一遍,
这是本系列"自跑优先"的具体含义:结论不是让你信,是让你能复现。
一、一张总图:22 个作业句柄的全景
1.1 先放官方的图
OK,言归正传。要理解这条流水,最省事的起点是官方自己画的那张图。
它在仓库的 Docs/ 目录下,是一张矢量图,文件名就叫 PhysicsSystemUpdate.svg,
就是本文开头那张题图,这里不再重复贴一遍,请大家往上翻一眼:那张图从左到右排开的方块,
就是本篇要逐个读开的作业。
这张图的信息密度很高,官方在 Architecture.md 里给了整段图注,其中有四句话是关键:
Note that each job indicates if it reads/writes positions/velocities and if it deactivates/activates bodies. We do not allow jobs to read/write the same data concurrently. The arrows indicate the order in which jobs are executed. Yellow blocks mean that there are multiple jobs of this type. Dotted arrows have special meaning and are explained below.
翻译过来三点:① 每个方块标了它读写位置/速度、是否激活/休眠刚体;② 箭头表示执行先后;③ 黄色方块表示"这类job有多个"。
第二条最容易被误读。"箭头表示执行顺序",但箭头画的是依赖边,不是时间轴。 一张有依赖边的图,只在"两个方块之间有路径"时才规定先后;没有路径的方块,谁先谁后是不定的。 这就是整篇的题眼。
1.2 声明顺序:源码里那句最危险的注释
下面我们开始看真正定义这些方块的代码。它们集中在
PhysicsUpdateContext.h
的一个 Step 结构体里,
前面挂着一句注释:
// Jobs in order of execution (some run in parallel)
JobHandle           mBroadPhasePrepare;                                     ///< Prepares the new tree in the background
JobHandleArray      mStepListeners;                                         ///< Listeners to notify of the beginning of a physics step
JobHandleArray      mDetermineActiveConstraints;                            ///< Determine which constraints will be active during this step
JobHandleArray      mApplyGravity;                                          ///< Update velocities of bodies with gravity
JobHandleArray      mFindCollisions;                                        ///< Find all collisions between active bodies an the world
JobHandle           mUpdateBroadphaseFinalize;                              ///< Swap the newly built tree with the current tree
// ... 中间省略 9 行 ...
JobHandle           mContactRemovedCallbacks;                               ///< Calls the contact removed callbacks
JobHandle           mSoftBodyPrepare;                                       ///< Prepares updating the soft bodies
JobHandleArray      mSoftBodyCollide;                                       ///< Finds all colliding shapes for soft bodies
JobHandleArray      mSoftBodySimulate;                                      ///< Simulates all particles
JobHandle           mSoftBodyFinalize;                                      ///< Finalizes the soft body update
JobHandle           mStartNextStep;                                         ///< Job that kicks the next step (empty for the last step)
注意那句注释:"Jobs in order of execution"。这句话是对的,也是危险的。
对,是因为这个顺序确实是作者按执行顺序排的;危险,是因为它只是排列顺序,不是执行机制。
把这 22 个句柄按行号从上往下念一遍,念出来的是一条"看起来的流水线",
但你很快就会在源码里发现:第 6 个句柄 mUpdateBroadphaseFinalize 实际要等到第 5 个 mFindCollisions 全部跑完才能动,
而第 2 个句柄 mStepListeners 才是整条流的真正起点。
一句题外话,也是本篇对上一篇的一处修正:研究笔记里我记的是"21 个句柄",
这次逐个核对源码,实际是 22 个,漏掉的那个是 mStartNextStep,它负责"踢出下一个碰撞步"。
这个句柄看着不起眼,却是理解"多个碰撞步怎么衔接"的钥匙(见 §2.2)。
1.3 全量清单:22 个句柄的前置与产物
OK,在往下走之前,先把全量清单摆出来。下表 22 行一次列全,每行给三样东西: 句柄名(源码原词)、它解锁的下游(谁在等它)、以及它的作业实例数。 第三列是理解并行度的关键,这一列不是"1"的行,才是可以展开的段。
| # | 句柄(源码原词) | 解锁的下游 | 实例数 |
|---|---|---|---|
| 1 | mBroadPhasePrepare |
mUpdateBroadphaseFinalize |
1 |
| 2 | mStepListeners |
mApplyGravity、mDetermineActiveConstraints |
按监听器批量算 |
| 3 | mDetermineActiveConstraints |
mBuildIslandsFromConstraints、mSetupVelocityConstraints、mFindCollisions |
按约束数批量算 |
| 4 | mApplyGravity |
mFindCollisions |
按活跃刚体批量算 |
| 5 | mFindCollisions |
mUpdateBroadphaseFinalize、mFinalizeIslands |
≥2,按活跃刚体批量算 |
| 6 | mUpdateBroadphaseFinalize |
mPreIntegrateVelocity |
1 |
| 7 | mSetupVelocityConstraints |
mSolveVelocityConstraints |
按约束数批量算 |
| 8 | mBuildIslandsFromConstraints |
mFindCollisions[0]、mFinalizeIslands |
1 |
| 9 | mFinalizeIslands |
mSolveVelocityConstraints、mBodySetIslandIndex |
1 |
| 10 | mBodySetIslandIndex |
mSolvePositionConstraints |
1 |
| 11 | mSolveVelocityConstraints |
mPreIntegrateVelocity |
max_concurrency |
| 12 | mPreIntegrateVelocity |
mIntegrateVelocity |
1 |
| 13 | mIntegrateVelocity |
mPostIntegrateVelocity |
按活跃刚体批量算 |
| 14 | mPostIntegrateVelocity |
mResolveCCDContacts |
1 |
| 15 | mResolveCCDContacts |
mSolvePositionConstraints |
1 |
| 16 | mSolvePositionConstraints |
mSoftBodyPrepare |
max_concurrency |
| 17 | mContactRemovedCallbacks |
mStartNextStep |
1 |
| 18 | mSoftBodyPrepare |
(柔体三段,运行期动态建) | max_concurrency(信号量语义) |
| 19–21 | mSoftBodyCollide / mSoftBodySimulate / mSoftBodyFinalize |
柔体收尾 | 运行期按柔体数定 |
| 22 | mStartNextStep |
下一步的全部作业 | 1(最后一步为空) |
这张表最容易被低估的是最右列。只有 4 个句柄的实例数不是 1:
mSolveVelocityConstraints、mSolvePositionConstraints(都是开满 max_concurrency)、
mFindCollisions(至少 2)、以及那几个"按批量算"的(mApplyGravity、mDetermineActiveConstraints、
mSetupVelocityConstraints、mIntegrateVelocity)。
其余十几个句柄永远只有一个作业实例,它们不管你有多少核,都只在一个线程上跑。
顺带把第二列也读一遍:被解锁次数最多的是 mFindCollisions(4 处解锁),
它同时是耗时最大的段,这解释了为什么 §3.3 里要专门把"第一个碰撞作业等建岛"这一手说清楚。
在这个位置上,任何一点等待都会被放大。
1.4 一帧跑完,等的是谁
再看一眼"返回时所有作业已跑完"是怎么实现的。答案在 Update 的末尾:
// Wait until all jobs finish
// Note we don't just wait for the last job. If we would and another job
// would be scheduled in between there is the possibility of a deadlock.
// The other job could try to e.g. add/remove a body which would try to
// lock a body mutex while this thread has already locked the mutex
inJobSystem->WaitForJobs(barrier);
官方注释解释得很清楚:不能只等最后一个作业。因为等的时候别的线程可能插进来要加/删刚体,
那会去抢 body mutex,而这个线程此刻正持着它,直接死锁。
所以做法是把这一步的所有作业句柄收集起来注册到屏障(Barrier)上,然后等屏障。
cMaxPhysicsJobs = 2048 这个常量,就是装这个句柄数组的容量。
1.5 横向对比:两种"把一帧切碎"的路线
到这里,Jolt 的切法已经清楚了:把一帧切成一张 CPU 作业图,靠依赖边决定并行。 这条路不是唯一的路。把另一条主流路线摆在一起看,本篇的边界会更清楚。
| 维度 | Jolt(本系列主角) | PhysX 5(对照参考) |
|---|---|---|
| 切分单位 | 作业(Job)+ 依赖边构成的图 | 阶段(phase)+ 任务队列 |
| 并行载体 | CPU 线程池(JobSystemThreadPool) |
CPU 任务 + GPU 刚体路径 |
| 刚体求解位置 | 全在 CPU,无 GPU 通路 | 提供 GPU 刚体(GPU articulation / rigid body) |
| 确定性 | 官方提供 -validate_hash 与跨平台确定性构建 |
官方口径不同,不做逐位回归承诺 |
| 柔体通路 | CPU + 可选 compute(仅发束头发) | GPU 侧另有实现 |
需要说明两点。第一,这个对照只用于说明"路线不同",不用来判优劣,
把同一个场景放在两台机器上比吞吐,受 GPU 型号、驱动、场景构成影响太大,
本系列不做这种没有控制变量的比较。第二,Jolt 这一格里的"无 GPU 通路"是它自己的官方口径,
不是外界的转述,上一篇已经用 Doxygen 文件清单检索确认过:Solver / TGS /
GPU 刚体相关的命名在 Jolt 里查无落点(详见 ep01 §7.1、§7.2)。
那为什么本篇要放这个对照?因为它解释了为什么 Jolt 的作业图值得逐格读。 如果你的引擎里刚体求解能甩给 GPU,CPU 这条流水只需要负责"发命令、收结果", 它就不会长成 22 个句柄、四条主干的样子。Jolt 的作业图,是"刚体求解留在 CPU"这个前提的直接结果。 前提变了,图就变了——这是本篇最想让大家带走的一条因果。
1.6 作业的名字与颜色:读火焰图的第一把钥匙
说白了,最后一个准备工作:认出这些作业。CreateJob 的第一个参数是作业名,
第二个参数是颜色,源码里每个作业都带一个 cColor* 常量:
step.mBroadPhasePrepare = inJobSystem->CreateJob("UpdateBroadPhasePrepare", cColorUpdateBroadPhasePrepare, ...);
step.mApplyGravity[i]   = inJobSystem->CreateJob("ApplyGravity", cColorApplyGravity, ...);
step.mFindCollisions[i] = inJobSystem->CreateJob("FindCollisions", cColorFindCollisions, ...);
// ... 其余 19 类同构 ...
这些名字和颜色不是装饰。名字是火焰图上的标签(本机导出的火焰图里, 每一根方的文字就是这里传进去的字符串),颜色是调试器里的分组依据。 本系列后面所有"某段占多少"的读数,靠的都是这里的字符串与火焰图对的号。
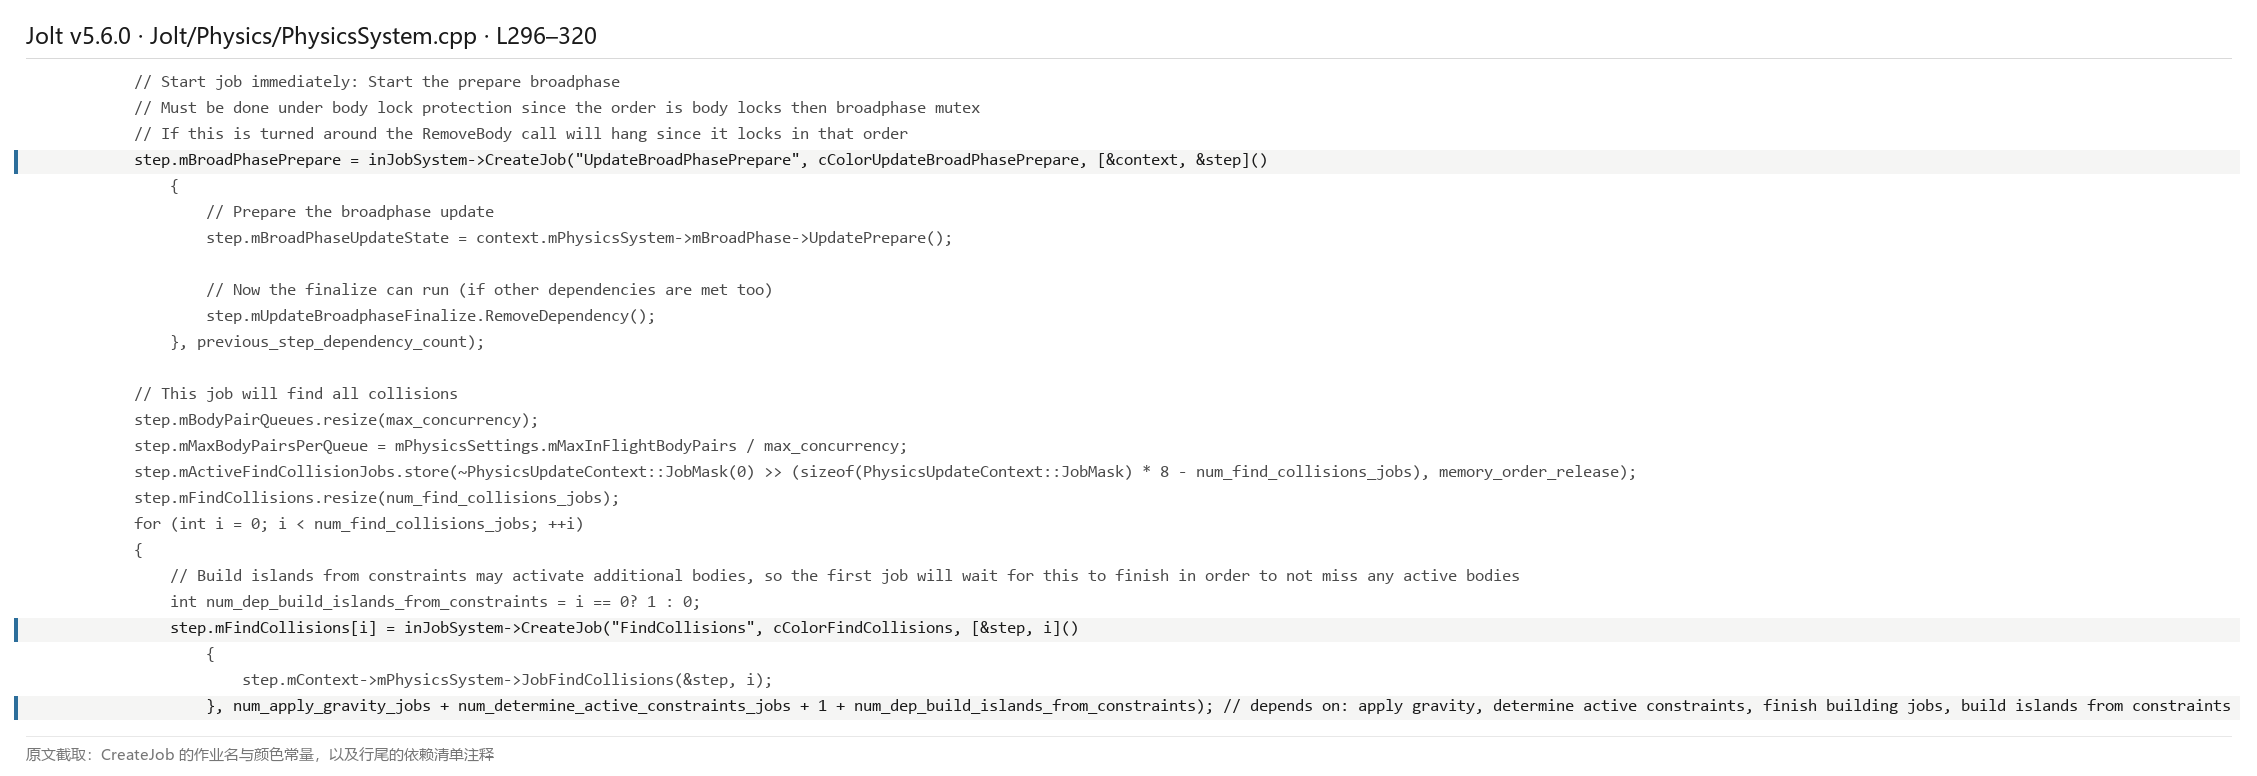
CreateJob 的作业名与颜色常量,以及行尾那份依赖清单注释@ 本机构建 Jolt v5.6.0(原创)这一点对大家自己排查问题也很实用。如果你们引擎里也有一套作业系统, 给每个作业起一个能对上的名字、配一个稳定的颜色,是让性能分析变得可用的最低成本投入, 否则你导出的火焰图就是一坨无法辨认的方框。
顺带说一个从命名能看出来的工程习惯:Jolt 的作业名全是"动词+名词"的短句
(UpdateBroadPhasePrepare、ApplyGravity、FindCollisions、SolvePositionConstraints),
句柄名则是"名词短语"(mFindCollisions)。两者一一对应。
这个小约定让你能从一行火焰图的标签,直接反查到源码里的那个句柄。
二、执行顺序 ≠ 声明顺序
2.1 顺序从哪来:依赖计数的加减法
说白了,既然顺序不是靠排列规定的,那靠什么?靠一套依赖计数机制。
用法很朴素。创建作业时给一个初始计数,表示"你要等几个前置";每有一个前置完成,
就调一次 RemoveDependency() 把计数减一;减到零,这个作业才允许被调度。
看一个真实例子,宽相(broadphase)收尾这个作业:
// Create job to do broadphase finalization
// This job must finish before integrating velocities. Until then the positions will not be updated neither will bodies be added / removed.
step.mUpdateBroadphaseFinalize = inJobSystem->CreateJob("UpdateBroadPhaseFinalize", cColorUpdateBroadPhaseFinalize, [&context, &step]()
    {
        // Finalize the broadphase update
        context.mPhysicsSystem->mBroadPhase->UpdateFinalize(step.mBroadPhaseUpdateState);
        step.mPreIntegrateVelocity.RemoveDependency();
    }, num_find_collisions_jobs + 2); // depends on: find collisions, broadphase prepare update, finish building jobs
行尾那句注释就把它的三个前置列全了:等所有 FindCollisions 作业、等 UpdateBroadPhasePrepare、等这一批作业全部创建完毕("finish building jobs")。
它做完之后,会去解开 mPreIntegrateVelocity(积分前处理)的一道依赖,
于是"宽相收尾 → 积分前处理"这条边就被建立起来了,而不是靠代码的先后行数。
左边是"读代码看到的顺序",右边是"作业系统实际认的顺序"。
两者在 6 个句柄上不一致:mStepListeners 实际最先跑、mUpdateBroadphaseFinalize 推迟到碰撞检测之后、
mBodySetIslandIndex 一直拖到岛收尾之后、mContactRemovedCallbacks 落在位置求解段之后、
柔体四段被动态创建、mStartNextStep 跨到下一步。
这里还有一个容易被忽略的机制细节:依赖计数里的那个"+1"。
看 §2.1 开头那段代码的行尾,num_find_collisions_jobs + 2,注释写的是
"find collisions, broadphase prepare update, finish building jobs"。
前两项好理解,第三项是什么?
它是"这一批作业建完了"这个事件本身。因为在建作业的循环里, 后面的作业可能还要去解开前面的作业,如果不等循环走完就去调度,行为不可预测。 做法是:每个作业先多欠一个依赖,等到所有作业都创建完毕,再由代码主动减掉这一个。 源码里对应的是循环末尾那几行:
// We prefer setup velocity constraints to finish first so we kick it first
JobHandle::sRemoveDependencies(step.mSetupVelocityConstraints);
JobHandle::sRemoveDependencies(step.mFindCollisions);

// Finalize islands is a dependency on find collisions so it can go last
step.mFinalizeIslands.RemoveDependency();
这段代码的位置在作业创建循环的末尾,四行减掉三个作业的"建完"依赖, 它之后才允许调度器真正开始跑这一批作业。
这个机制有个副产品:解锁的顺序是有讲究的。源码注释里那句
We prefer setup velocity constraints to finish first so we kick it first,
先解锁谁,谁就先被调度器看到。在依赖都已满足的前提下,
作者用解锁顺序表达了偏好:希望约束装配先跑起来,把碰撞检测放在后面,
免得碰撞检测一下子把所有线程吃光、让装配作业没线程可用。
这是在并发系统里用一个大小的顺序来表达优先级的做法,很轻,但有效。
2.2 依赖边与屏障:哪些必须串行
把 22 个作业的依赖边全画出来,得到的是一张有四条主干的图。四条主干是这样的:
第一条,准备链:mBroadPhasePrepare 与 mStepListeners 各自从上一帧接手 →
mStepListeners 解开 mApplyGravity 与 mDetermineActiveConstraints;
第二条,碰撞链:mApplyGravity + mDetermineActiveConstraints 解开 mFindCollisions,
其中只有第 0 个 FindCollisions 作业额外等 mBuildIslandsFromConstraints;
第三条,求解链:mFinalizeIslands + mSetupVelocityConstraints 解开 mSolveVelocityConstraints;
第四条,积分链:mUpdateBroadphaseFinalize + mSolveVelocityConstraints 解开 mPreIntegrateVelocity →
mIntegrateVelocity → mPostIntegrateVelocity → mResolveCCDContacts →
mSolvePositionConstraints → mSoftBodyPrepare。
这张图里有三处细节值得停一下。
第一处,为什么 mFindCollisions 要"至少两个"。 源码里写得很直白:
// Note that when we have more than 1 thread, we always spawn at least 2 find collisions jobs so that the first job can wait for build islands from constraints
// (which may activate additional bodies that need to be processed) while the second job can start processing collision work.
int num_find_collisions_jobs = max(max_concurrency == 1? 1 : 2, min(((int)num_active_rigid_bodies + cActiveBodiesBatchSize - 1) / cActiveBodiesBatchSize, max_concurrency));
翻译一下:建岛(build islands)可能把休眠的刚体激活,那些刚体也得做碰撞检测。 所以第 0 个碰撞作业选择"等一下,等建岛完再动",而第 1 个碰撞作业不等,它先开跑。 这是一个很典型的用作业划分换延迟的手法:宁可多起一个作业,也不让整条碰撞链干等。
第二处,mSolveVelocityConstraints 和 mSolvePositionConstraints 总是起 max_concurrency 个。
不按刚体数量算,而是有多少并发就起多少个:
step.mSolveVelocityConstraints.resize(max_concurrency);
for (int i = 0; i < max_concurrency; ++i)
    step.mSolveVelocityConstraints[i] = inJobSystem->CreateJob("SolveVelocityConstraints", ...);
原因是这两个作业内部做的是从共享队列里领岛(island), 每次领一个岛、解一个岛,领光了就退出。作业数开满,是为了让空闲线程都有活可领。
第三处,多碰撞步之间是"接龙"的。 mStartNextStep 的注释写着"踢出下一个碰撞步",
它做的是重置状态并解开下一步的作业:重置大岛切分器、重置岛构建器、回收到期接触、
然后按与第一步相同的顺序把下一步的作业全解开。也就是说,inCollisionSteps = 2 时,
两个碰撞步不会先跑完一个再跑另一个:后一步的准备能在前一步收尾时就开始。
2.3 作业系统:三种实现,同一张图
好了,最后补一句这张图跑在什么上。JobSystem.h 的定位写得很清楚:
A class that allows units of work (Jobs) to be scheduled across multiple threads. It allows dependencies between the jobs so that the jobs form a graph.
"作业构成一张图",这就是本篇反复说"依赖边"的出处。官方提供三种实现:
JobSystemThreadPool:默认,起一个线程池干活;JobSystemSingleThreaded:单线程,作业按依赖顺序在当前线程逐个执行(调试与确定性验证用);JobSystemWithBarriers:屏障机制的基类实现,上面两个都从它派生。
本机默认走的是第一种。这里有个容易被忽略的对应关系:换作业系统的实现,不会改动作业图。 图是一样的,只是"谁来执行这张图"变了。这正好解释了 ep01 的确定性实验为什么成立, 把线程数从 1 换到 16,图没变,只是执行者变了,所以结果哈希不变。
2.4 屏障:为什么"等全部作业"不等于"等最后一个"
上面反复出现"屏障(Barrier)",这里把它单独说清,因为它和依赖计数是两套不同的问题。
依赖计数管的是作业之间的先后;屏障管的是整批作业与调用线程之间的汇合。
JobSystem.h 对屏障的定位有一句关键的话:
屏障支持"在等待期间仍可继续添加作业"。这条能力是必需的,
因为柔体作业是运行期动态创建的(见 §5.1)。如果屏障一旦开始等待就不接受新作业,
这条动态子流水就没法注册进来。
源码里的用法分三步,也很直白:
JobSystem::Barrier *barrier = context.mBarrier;
{
    StaticArray<JobHandle, cMaxPhysicsJobs> handles;
    for (const PhysicsUpdateContext::Step &step : context.mSteps)
    {
        if (step.mBroadPhasePrepare.IsValid())
            handles.push_back(step.mBroadPhasePrepare);
        // ... 逐类 push 其余 21 类句柄 ...
    }
    barrier->AddJobs(handles.data(), handles.size());
}

inJobSystem->WaitForJobs(barrier);
两个细节:① 句柄数组的容量是 cMaxPhysicsJobs = 2048,不是 32,
因为要装的是"所有碰撞步的所有作业实例",而不只是同时并发的那 32 个;
② 收集与提交是分开的,先把这一步所有作业收进数组,再一次性 AddJobs。
至于为什么"不能只等最后一个",官方注释给了理由(死锁),§1.4 已引过原文,这里不重复。
2.5 作业实例数:四个批量公式
回头补一个 §1.3 表里"按批量算"到底怎么算的问题。源码里有四段几乎同构的式子,
每一段都遵循同一个形状:max(下限, min(向上取整(数量 / 批量), max_concurrency))。
| 段 | 公式(源码化简) | 下限 | 上限 |
|---|---|---|---|
mStepListeners |
max(1, min(监听器数 / 批尺寸 / 每作业批数, 并发)) |
0(无监听器时不建作业) | max_concurrency |
mApplyGravity |
max(1, min(活跃刚体数 / 重力批尺寸, **并发 − 2**)) |
1 | max_concurrency − 2 |
mDetermineActiveConstraints |
max(1, min(约束数 / 批尺寸, **并发 − 2**)) |
1 | max_concurrency − 2 |
mSetupVelocityConstraints |
max(1, min(约束数 / 批尺寸, 并发)) |
1 | max_concurrency |
mFindCollisions |
max(并发==1 ? 1 : 2, min(活跃刚体数 / 批尺寸, 并发)) |
1 或 2 | max_concurrency |
mIntegrateVelocity |
max(1, min(活跃刚体数 / 批尺寸, 并发)) |
1 | max_concurrency |
这张表里藏着两处刻意的保留:mApplyGravity 与 mDetermineActiveConstraints 的上限是
max_concurrency − 2,不是 max_concurrency。源码注释把理由写在旁边:
Leave 1 thread for update broadphase prepare and 1 for determine active constraints /
Leave 1 thread for update broadphase prepare and 1 for apply gravity。
这两段各自主动让出两个线程,好让宽相准备与另一段不被抢光线程。 这是一个很实在的工程判断:批作业不是越多越好, 把线程全占满,反而会让同时段的其他小作业排不上队。
三、逐段读流水(上):从宽相到碰撞检测
3.1 宽相准备:背景里悄悄重建的树
OK,第一段是 mBroadPhasePrepare,官方注释一句带过:Prepares the new tree in the background。
它在做什么?在后台重建一棵新的 AABB 树。 动机来自 Architecture.md 里的一段说明:
刚体移动时不做加锁,而是把从根到该刚体节点的整条路径上的 AABB 撑大(lock-free 扩张);
被撑大过的节点会打标记,于是下一次物理步期间,在后台重建一棵紧致的新树,
在这步结束前替换掉旧树。这就是 mBroadPhasePrepare 与 mUpdateBroadphaseFinalize 一前一后两段的存在意义。
这两段的时间差很关键。准备在最早的时刻就开始(它只等上一帧),但收尾要等到碰撞检测全跑完,
因为树一旦换掉,位置就不再更新,碰撞检测读到的东西就变了。
源码里那句注释写得很死:This job must finish before integrating velocities. Until then the positions will not be updated neither will bodies be added / removed.
换句话说,从 Update 开始到宽相收尾之间,刚体的位置是"冻结"的——这是整条流水的一根主轴。
再往前追一步,这个"后台重建"的动机是什么?Architecture.md 里有一段专门的说明,
讲的是宽相为什么要用 lock-free 的扩张方式(树本身在 QuadTree.h):
When a body moves, all nodes in the AABB tree from root to the node where the body resides will be expanded using a lock-free approach. This way multiple threads can move bodies at the same time without requiring a lock on the broad phase.
翻译过来:刚体移动时不去改树的形状,而是把从根到该节点的整条路径上的 AABB 撑大。 这样多个线程同时移动刚体时,谁都不用给宽相加锁。代价是树的包围盒越来越松, 所以需要一个"重建紧致树"的动作来还债。
这一段和 ep01 §5.4 讲的那句"一帧是怎么被拆成一张图的"是同一个话题的两个层次。 ep01 给的是结论(作业构成一张图),本篇给的是这张图里的第一段为什么长这样。 两篇连起来读,就能看清一个完整的因果链: "多线程移动刚体不加锁" → "树会变松" → "需要后台重建" → "于是有了 Prepare 与 Finalize 两段"。
顺带交代一个被 Update 开头就调用的东西:mBroadPhase->FrameSync()。
源码注释说它是"宽相的同步点,允许它在还没有任何互斥锁的时候做清理操作"
(This will allow it to do clean up operations without having any mutexes locked yet.)。
它出现在早退路径里也出现,说明它属于"帧边界"的活,不属于某一段流水。
3.2 步进监听与重力:整条流真正的起点
好了,第二段是 mStepListeners。它的注释是 Listeners to notify of the beginning of a physics step,
但它做的事远不止"通知",它解开了两个下游作业:
step.mStepListeners[i] = inJobSystem->CreateJob("StepListeners", cColorStepListeners, [&context, &step]()
    {
        // Call the step listeners
        context.mPhysicsSystem->JobStepListeners(&step);

        // Kick apply gravity and determine active constraint jobs
        JobHandle::sRemoveDependencies(step.mApplyGravity);
        JobHandle::sRemoveDependencies(step.mDetermineActiveConstraints);
    }, previous_step_dependency_count);
mStepListeners 是整条流的起点(第一步时依赖数为 0)。它之后再分叉出两条并行的活:
施加重力(mApplyGravity) 与 确定活跃约束(mDetermineActiveConstraints)。
这一段值得多说一句职责边界:步进监听器是给上层模块用的钩子,载具约束、角色控制器这类
"需要在物理步开始前看一眼世界"的东西挂在这里(接口定义见
PhysicsStepListener.h)。
但从物理系统的视角看,它只是两个解锁动作。
mApplyGravity 有一个容易看漏的约束,藏在 Step 结构体的字段注释里:
mNumActiveBodiesAtStepStart,"只有这些刚体会收到重力,它们是活跃列表里的前 N 个"。
为什么要卡住这个数量?因为碰撞检测过程本身会激活新的刚体,
如果重力作业边跑边看活跃列表,数量就在变,结果不可复现。
所以先把数量拍下来,本步就按这个数施加。这又是一处"确定性优先于灵活性"的取舍。
3.3 找出碰撞:整条流水里最重的一段
OK,第三段是 mFindCollisions,也是本机实测里最费时间的一段。先看它在本机火焰图里的分量。
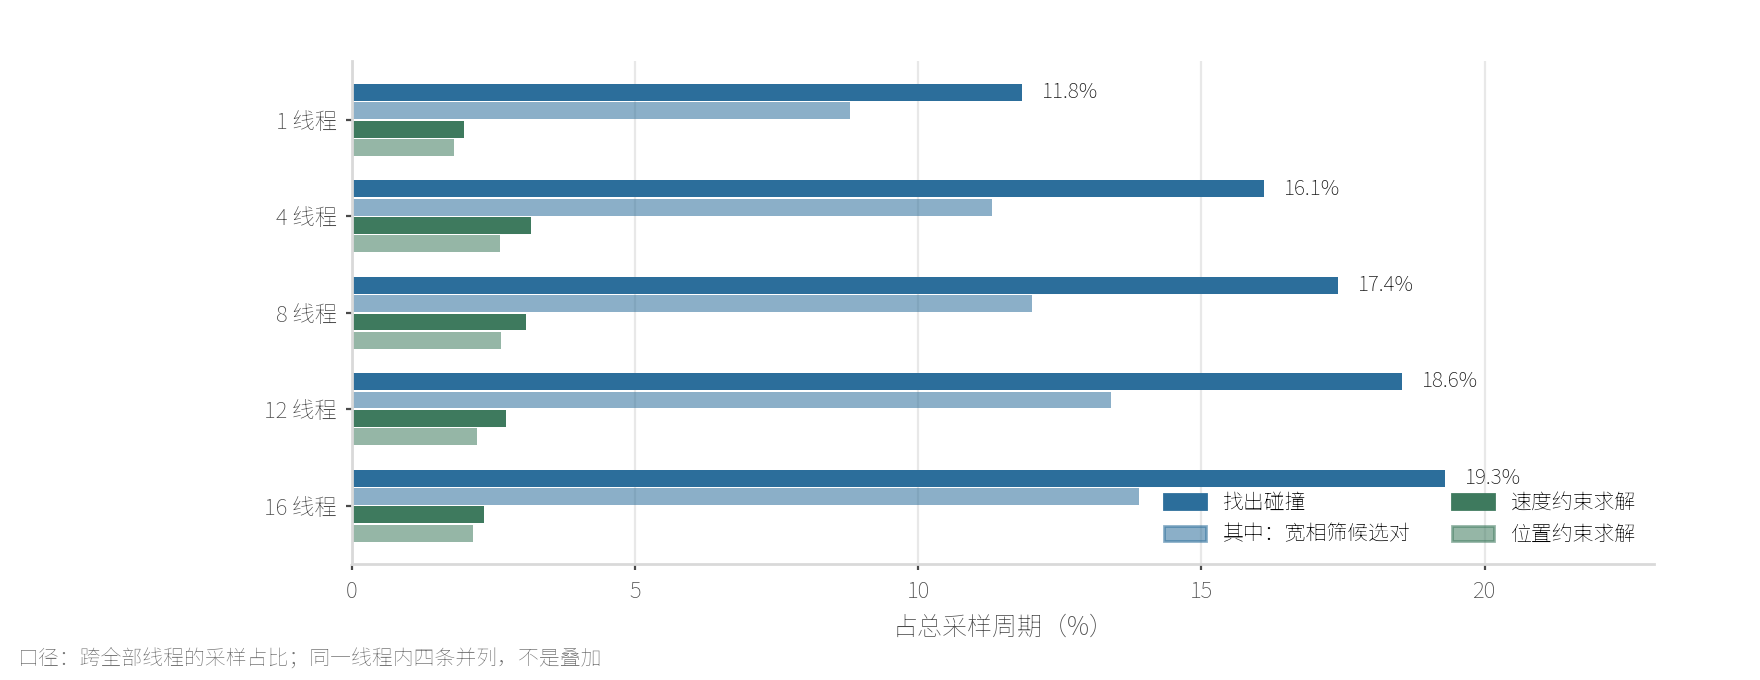
读数口径说清楚:这是 PerformanceTest.exe -s=Ragdoll -i=50 -p 在本机跑的 Ragdoll 场景,
数值取自导出的火焰图里 cycles_per_frame 的聚合占比。
FindCollisions 从单线程 11.8% 一路升到 16 线程 19.3%,是四条主干里唯一随线程数上升而占比变大的段。
作为对照,两个求解段(SolveVelocityConstraints 与 SolvePositionConstraints)都只占 2%–3%。
为什么会这样?因为碰撞检测是按刚体数量膨胀的那一段:3600 多个刚体、
每个活跃刚体都要去宽相里问"我可能跟谁碰",得到候选对之后再进窄相算接触。
本机同一个火焰图里,宽相内部的 BroadPhaseQuadTree::FindCollidingPairs 占 8.8%→13.9%,
窄相的几个 sCollide* 函数合计再占几个百分点。
源码里还有一处精巧的队列设计,就在 PhysicsUpdateContext.h 里:
struct BodyPairQueue
{
    atomic<uint32>      mWriteIdx { 0 };                                        ///< Next index to write in mBodyPair array
    uint8               mPadding1[JPH_CACHE_LINE_SIZE - sizeof(atomic<uint32>)];///< Moved to own cache line to avoid conflicts with consumer jobs

    atomic<uint32>      mReadIdx { 0 };                                         ///< Next index to read in mBodyPair array
    uint8               mPadding2[JPH_CACHE_LINE_SIZE - sizeof(atomic<uint32>)];///< Moved to own cache line to avoid conflicts with producer/consumer jobs
};
生产者(宽相)往队列里写候选对,消费者(窄相)从队列里读。
两个游标都是 atomic,而且各占一条缓存行,中间那段 uint8 padding[...] 不是占位符,
它的作用是避免伪共享(false sharing):如果读写游标挤在同一条缓存行上,
生产者一写、消费者的缓存就失效,两边会疯狂来回同步。
这类细节不会出现在流程图里,但它决定了"多线程为什么没有按线程数线性变快"。
3.4 宽相收尾:一次全流水的"记忆点"
好了,第四段是 mUpdateBroadphaseFinalize。它做的事就一行:context.mPhysicsSystem->mBroadPhase->UpdateFinalize(step.mBroadPhaseUpdateState);
,把 §3.1 里在后台建好的新树换成当前树。
它的位置很讲究:它同时是碰撞链的终点和积分链的起点。 在这之前,所有段读的都是旧树、旧位置;在这之后,位置开始被改写。 所以本机火焰图里这一段的占比接近于 0(太小,采样不到), 但它在语义上是整条流水最重的一个开关。
3.5 把这一步走一遍
先来看看四段串起来是什么样。四段读完,我们把一次 step 从时间上串一遍,看看"并行"到底发生在哪几个瞬间。 下面这张时序是按前四节的依赖边推出来的,括号里标的是同时段可以并行的段。
第 0 拍:mBroadPhasePrepare 与 mStepListeners 同时起(两者互不依赖)。
注意 mBroadPhasePrepare 从上一帧就接手了,所以严格说它比 mStepListeners 更早。
第 1 拍:mStepListeners 完成,解开 mApplyGravity 与 mDetermineActiveConstraints
(这两段并行,且都让出了 2 个线程给宽相准备)。
第 2 拍:mDetermineActiveConstraints 完成,解开 mBuildIslandsFromConstraints
与 mSetupVelocityConstraints(后者是并行开的)。
第 3 拍:mBuildIslandsFromConstraints 完成,解开 mFindCollisions[0] 与 mFinalizeIslands;
同时 mApplyGravity 早已完成,mFindCollisions[1..N] 已经在跑(碰撞检测与约束装配、建岛在这里重叠)。
第 4 拍:所有 mFindCollisions 完成,mUpdateBroadphaseFinalize 与 mFinalizeIslands
都拿到最后一个前置(两段并行:一个在换树,一个在收岛)。
第 5 拍:mFinalizeIslands + mSetupVelocityConstraints 齐 → mSolveVelocityConstraints 起,开满并发。
第 6 拍:mSolveVelocityConstraints + mUpdateBroadphaseFinalize 齐 → mPreIntegrateVelocity 起(单作业窄口)。
第 7 拍:mIntegrateVelocity(批量)→ mPostIntegrateVelocity(单作业窄口)→ mResolveCCDContacts
(单作业,且 CCD 未触发时几乎零耗时)。
第 8 拍:mResolveCCDContacts + mBodySetIslandIndex 齐 → mSolvePositionConstraints 起,开满并发。
第 9 拍:mSolvePositionConstraints 完成 → mSoftBodyPrepare 起(读 max_concurrency 个信号量,
无柔体时立刻释放);mContactRemovedCallbacks 也在此前后跑完。
第 10 拍:mSoftBodyFinalize + mContactRemovedCallbacks 齐 → mStartNextStep 踢出下一步。
这张时序图最值得看的是"同时段可并行"那几处: 第 3 拍的"碰撞检测 ∥ 建岛与约束装配"、第 4 拍的"换树 ∥ 收岛"。 如果这两处任一被取消,整条流水的时间会明显变长,因为它们是耗时最大的几段互相掩盖的地方。 反过来说,ep01 那条 8 线程 5.78× 的曲线,量出来的正是"这几处重叠能干多少活"。
四、逐段读流水(下):从约束求解到积分
4.1 装配速度约束:把接触变成方程
下面我们开始看约束这一段:第五段是 mSetupVelocityConstraints,注释 Calculate properties for all constraints in the constraint manager。
它依赖 mDetermineActiveConstraints,做完之后解开 mSolveVelocityConstraints。
职责边界要说清:这一段在建方程,还没到解方程。 接触点算出来了、约束对象就位了,但求解器还需要每个约束的雅可比与有效质量矩阵, 这些在这里算好。到下一段才是迭代求解。
本机读数:SetupVelocityConstraints 占 0.9%→1.2%。这是一个与刚体数弱相关、
与约束数强相关的段,所以它随线程数的变化很平。
4.2 构建模拟岛:为什么必须先分岛
好了,第六段是 mBuildIslandsFromConstraints。它的产物是模拟岛(simulation island),
一堆互相通过约束或接触连在一起的刚体。
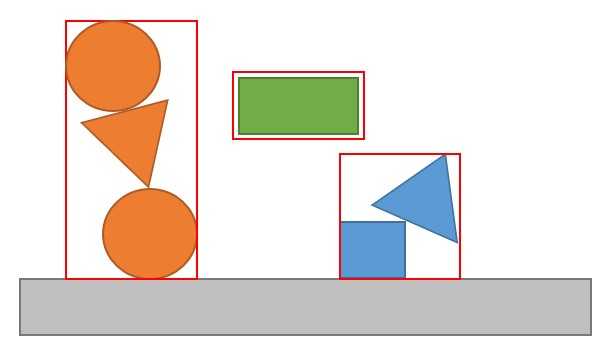
分岛的意义是并行度的来源:两个岛之间没有任何相互作用,所以可以放心地并行求解。
官方在 Docs/Images/ 下给过一张岛的可视化
SimulationIsland.jpg,
不过它讲的是岛的形态而非本篇的构建时序,本篇只作索引,不作配图。
反过来,一个大岛内部只能串行,这正是第六节要讲的并行度上限的根因之一。
顺带说一个本篇不展开、留给第十篇的钩子:岛太大时还有一个 LargeIslandSplitter(大岛切分器),
mStartNextStep 里就有一行 mLargeIslandSplitter.Reset(temp_allocator)。
本篇只记它的存在,不进去。
4.3 速度约束求解:2% 的时间,100% 的正确性
说白了,第七段是 mSolveVelocityConstraints。它等两个前置:mFinalizeIslands(岛收尾)与 mSetupVelocityConstraints,
做完之后解开 mPreIntegrateVelocity。
注意前面提过的那句:它总是起 max_concurrency 个作业(求解对象是
Constraint.h 定义的约束族)。
这种"作业数开满、内部靠队列领活"的模式,和 §3.3 的碰撞检测是两种不同的并行范式:
碰撞是"按刚体批量切",求解是"按岛动态领"。
本机读数有一个反直觉的地方:这一段只占 2%–3%,却是整条流水语义上最核心的一段。 为什么?因为它才是"物理引擎在解微分方程组"那件事本身;其余所有段都在为它准备数据或消化结果。 耗时占比小不等于不关键——这是读火焰图时最容易犯的错:火焰图告诉你时间花在哪,不告诉你价值在哪。
4.4 速度与位置积分:三段而不是一段
OK,第八段是积分,但它由三个作业串起来:
mPreIntegrateVelocity → mIntegrateVelocity → mPostIntegrateVelocity。
三者职责分得很干净:前一个准备、中间一个写、后面一个收尾。
之所以要拆成三段而不是写成一个大作业,是因为中间那一段(逐刚体写位置与朝向)
是唯一需要按刚体批量并行的部分,前后两段都要在它的两端做汇合,
拆开之后,并行的边界就清楚了。
mPreIntegrateVelocity 等 mUpdateBroadphaseFinalize 与 mSolveVelocityConstraints 两件事都齐,
它的注释解释了为什么宽相收尾必须在这里之前:位置一旦要开始改写,树就必须先换好。
换句话说,这个"准备"作业真正的职责,是给位置改写开闸,
闸门开之前,所有段读到的都是本步开始时的那份位置快照。
本机读数:IntegrateVelocity 占 0.16%→0.2%。这是四条主干里最轻的一段,
因为"把速度乘时间加到位置上"本身就是几次浮点运算,它的成本随刚体数线性,但单刚体成本极低。
与之相对,mPreIntegrateVelocity 与 mPostIntegrateVelocity 是单作业,
在本机读数里都低到采不到样(0.00%–0.01%);但它们承担的是"开闸"与"收闸"两个语义动作,
便宜不等于可以省略。
4.5 位置求解与 CCD:收尾的两个补丁
好了,第九段是 mSolvePositionConstraints,第十段是 mResolveCCDContacts(它其实在位置求解之前)。
两者都是"补丁"性质:速度求解出来的位置会有穿透(drift),位置求解去修它;快速物体可能两步之间穿过薄墙,CCD 去拦它。
源码里 CCD 那段的依赖注释有一处特别的措辞:
step.mResolveCCDContacts = inJobSystem->CreateJob("ResolveCCDContacts", cColorResolveCCDContacts, [&context, &step]()
    { ... }, 2); // depends on: integrate velocities, detect ccd contacts (added dynamically), finish building jobs.
"detect ccd contacts (added dynamically)",这是全篇唯一一个运行期动态增加的依赖。 前面所有依赖边在创建时就数好了,只有这一条是"等真检测到 CCD 接触了再解锁"。 这说明 CCD 是一条概率性触发的支路:没有快速物体时,它空转。
本机读数:ResolveCCDContacts 占 0.00%–0.01%(采样不到)。
和 §3.2 的取舍呼应上了,Ragdoll 场景里没有高速穿透,所以它基本不出力。
4.6 五段的耗时画像
把这一章的五段与它们的本机读数放在一起,能看出一条规律:
| 段 | 本机占比(1→16 线程) | 与什么强相关 | 实例数 |
|---|---|---|---|
mSetupVelocityConstraints |
0.90% → 1.18% | 约束数 | 批量 |
mBuildIslandsFromConstraints |
0.27% → 0.17% | 约束连通性 | 1 |
mSolveVelocityConstraints |
1.98% → 2.33% | 岛内约束数 × 迭代轮数 | max_concurrency |
mIntegrateVelocity |
0.16% → 0.17% | 活跃刚体数 | 批量 |
mSolvePositionConstraints |
1.81% → 2.14% | 穿透修正量 | max_concurrency |
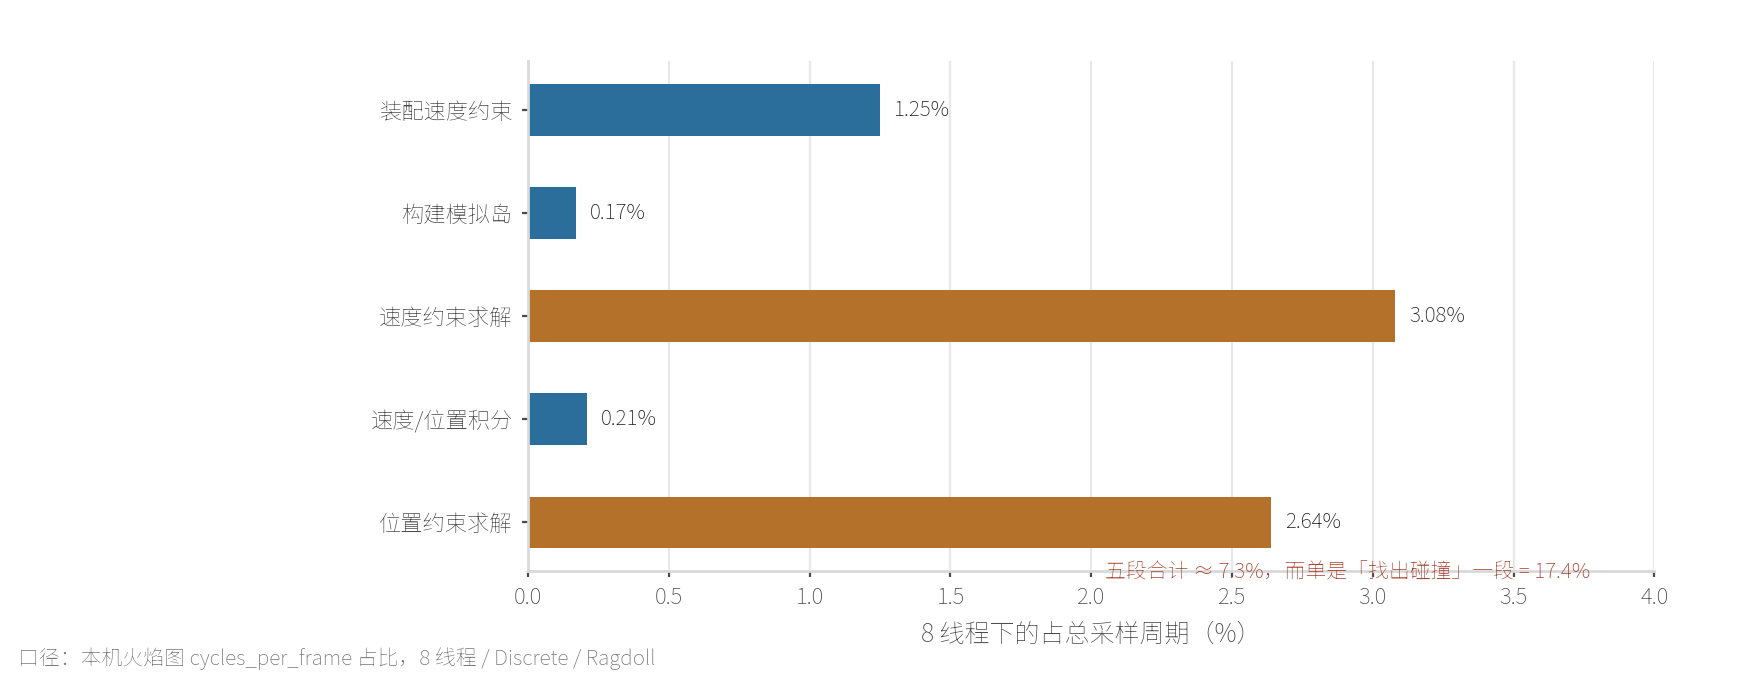
规律是:越靠近"解方程"的段越贵,越靠近"搬运数据"的段越便宜,但全都远低于碰撞检测。 这一章的五段加起来大约 7.3%,而 §3.3 的碰撞检测一段就 11.8%–19.3%。
这条对比有个实际用处:如果你的场景卡在物理上,先看碰撞检测,不要先看求解器迭代次数。 很多人一遇到"物理慢"就想去调求解迭代轮数,本机读数告诉你,那是一个只有 2% 的地方, 就算你把轮数砍一半,也只省下 1%。而碰撞检测那段: 减少活跃刚体数量、缩紧宽相的候选对,收益要大得多。
4.7 两种切法:按批量切 vs 按队列领
说白了,把 §3 与 §4 的段放在一起看,会发现 Jolt 用了两种不同的并行切法,而且用得很有讲究。
第一种:按批量切(静态划分),把活跃刚体列表(或约束列表)按固定批尺寸切成 N 段,
每段一个作业。用这种切法的有 mApplyGravity、mDetermineActiveConstraints、
mSetupVelocityConstraints、mIntegrateVelocity。
特点是作业数在创建时就定死,每个作业干的活量大致相同。
第二种:按队列领(动态划分),创建固定数量的作业(通常是 max_concurrency),
每个作业重复"从共享队列领一个单位、处理、再领",领光就退出。
用这种切法的有 mSolveVelocityConstraints、mSolvePositionConstraints
(领的是岛),以及 mFindCollisions(生产者-消费者队列)。
| 切法 | 使用者 | 作业数 | 负载均衡 | 适用条件 |
|---|---|---|---|---|
| 按批量切 | 重力、确定约束、装配约束、积分 | 由数量与批尺寸算出 | 靠批尺寸近似 | 每个单位耗时可预期 |
| 按队列领 | 速度求解、位置求解、找出碰撞 | 固定(并发数或 ≥2) | 天然均衡 | 每个单位耗时可差很多 |
为什么岛求解要用第二种? 因为岛的规模差异极大:一个岛可能只有两个箱子, 另一个(比如 160 个布娃娃堆在一起)可能包含上千个刚体,内部约束迭代次数也差很多。 如果按"每 N 个岛一个作业"来切,快慢会严重不均,某个作业领到全是大岛,其他线程早早空转。 而"领一个解一个"天然解决这个问题:领到大岛的那个线程自然地干得久, 但其他线程可以继续领走剩下的岛。这就是"工作窃取(work stealing)"思想的轻量变体。
反过来,重力为什么用第一种? 因为"给一个刚体加重力"的成本几乎是常数 (几次乘加),不存在负载不均问题。用第一种更简单,作业数一眼能算出来。
这条分界可以带走一句判断:当每个工作单位的耗时差异大时,用队列领;差异小时,用批量切。
Jolt 在两个位置上分别选了合适的那个,而不是一刀切。
这也是为什么 §2.5 那张公式表里,mFindCollisions 的下限被特别设为 2,
它同时具备"生产者"(走宽相找候选对)与"消费者"(进窄相算接触)两种角色,
所以要先保证有两个作业,才不会有角色空着。
五、柔体四段与跨步衔接
5.1 柔体四段:被动态创建的子流水
先来看看柔体(soft body)的四段:mSoftBodyPrepare、mSoftBodyCollide、mSoftBodySimulate、mSoftBodyFinalize
(柔体头文件见
SoftBodyCreationSettings.h)。
但如果你只在 Update 的作业构建循环里找它们,只会找到第一段:
// The soft body prepare job will create other jobs if needed
step.mSoftBodyPrepare = inJobSystem->CreateJob("SoftBodyPrepare", cColorSoftBodyPrepare, [&context, &step]()
    {
        context.mPhysicsSystem->JobSoftBodyPrepare(&context, &step);
    }, max_concurrency); // depends on: solve position constraints.
注释一句话点破:"如果需要,它会创建其他作业"。 这是一条条件性子流水,场景里没有柔体时,它什么都不创建; 有柔体时,它在位置约束求解之后长出一条并行的支路。 反过来说,刚体物理的流水是固定的,柔体的是一个可选的尾巴。
本机读数:本篇用的 Ragdoll 场景里没有柔体,所以四段占比都是 0。 这也是为什么本篇的第 13 篇要单独讲柔体,它的流水形状和刚体不一样。
5.2 接触移除回调与跨步衔接
剩下两个句柄,是整条流水里"看起来最不像物理"的两个。一个是 mContactRemovedCallbacks:
它的依赖注释写着"depends on the find ccd contacts",依赖 CCD 检测的结果。 因为只有 CCD 跑完,才知道哪些接触这一帧彻底消失了。
另一个是 mStartNextStep,它把当前步和下一步接起来:
step.mStartNextStep = inJobSystem->CreateJob("StartNextStep", cColorStartNextStep, [this, next_step]()
    {
        // Store the number of active bodies at the start of the step
        next_step->mNumActiveBodiesAtStepStart = mBodyManager.GetNumActiveBodies(EBodyType::RigidBody);

        // Clear the large island splitter
        mLargeIslandSplitter.Reset(temp_allocator);
        // Clear the island builder
        mIslandBuilder.ResetIslands(temp_allocator);
        // Setup island builder
        mIslandBuilder.PrepareContactConstraints(mContactManager.GetMaxConstraints(), temp_allocator);
        // Restart the contact manager
        mContactManager.RecycleConstraintBuffer();

        // Kick the jobs of the next step (in the same order as the first step)
        next_step->mBroadPhasePrepare.RemoveDependency();
        ...
    }, 3); // depends on: update soft bodies, contact removed callbacks, finish building the previous step
它的依赖注释里出现了"the previous step"这个词,这是整张图里唯一一处跨步依赖。
把 §2.2 的"接龙"结论落到数字上:inCollisionSteps = N 时,
Update 构建的是一条首尾相接的长流水,而非 N 条独立的流水。
5.3 为什么柔体要走"子流水"
OK,这里值得停下来问一句:为什么柔体不直接在主流水里排四段,而要动态建?
原因有三层,每一层都能从依赖关系读出来。
第一层,数量不定。 刚体的段数固定,因为"每个活跃刚体都要施加重力、都要找碰撞"。 但柔体的段数取决于场景里有几个柔体,0 个、1 个、100 个, 对应的作业数完全不同。用一个固定的段去装不定数量的工作,要么浪费、要么不够。
第二层,前置不在同一拍。 柔体的四段里,mSoftBodyPrepare 要等位置约束求解完成
(源码依赖注释:depends on: solve position constraints)。这是一个很靠后的位置,
在它之前,主流水已经跑完了碰撞检测、求解与积分。
如果它排进主流水,会让整条流水的作业创建阶段凭空多等一拍。
第三层,它是可选的。 Update 在收尾时会检查 step.mSoftBodyPrepare.IsValid()
(源码里多处有 if (step.mSoftBodyPrepare.IsValid())),
没有柔体时,这个句柄是无效的,屏障里也不会注册它的作业。
这就是"条件性子流水"的含义:它存在,但不一定被创建。
把这三层收成一个判断:主流水装的是"每个场景都固定要做的事",子流水装的是"这个场景要不要做的事"。 这条分界不是柔体独有的,任何"按场景内容变形的计算"都应该这样挂。 反过来说,如果你把柔体硬塞进固定的 22 个句柄里,得到的会是一条 "大部分时候在空转、偶尔很重"的流水,火焰图上会变成一堆看不见的小方框。
六、并行度上限:为什么 8 线程后效率下降
6.1 先把本机读数摆出来
好了,这一节来回答 ep01 留下的那个形状问题。ep01 实测过:单线程 31.65 步/秒,8 线程 6.44×, 13 线程峰值 7.59×,9–10 线程之后进噪声区。当时只能描述这个形状,不能解释它。 本篇有了作业图,可以解释了。
先看本机这次重跑的读数(同一台机器,Ragdoll 场景,Discrete):
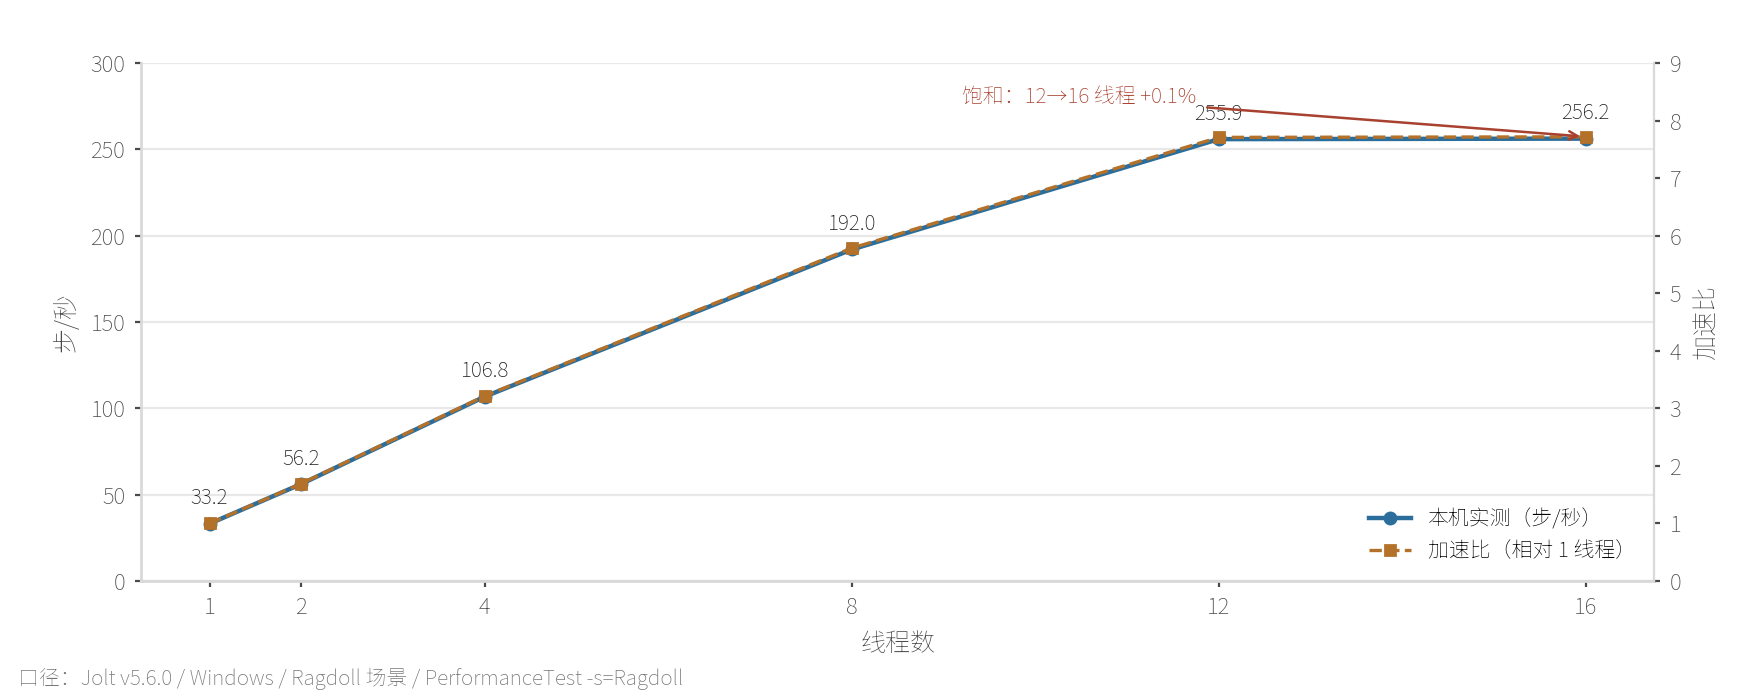
| 线程数 | 步/秒 | 相对 1 线程 |
|---|---|---|
| 1 | 33.2 | 1.00× |
| 4 | 106.8 | 3.22× |
| 8 | 192.0 | 5.78× |
| 12 | 255.9 | 7.71× |
| 16 | 256.2 | 7.72× |
这张表和 ep01 的形状一致:8 线程拿到 5.78×,12 线程以后基本贴平。
6.2 用作业图解释这个形状
说白了,三条原因都能在源码和火焰图里找到落点。
原因一,串行段的存在。 作业图不是完全可并行的。mStepListeners 必须先跑完,
mApplyGravity 与 mDetermineActiveConstraints 才能动;mFinalizeIslands 必须先跑完,
mSolveVelocityConstraints 才能动;mPreIntegrateVelocity 是一道单作业的窄口。
把这些串行段的耗时加起来,就是阿姆达尔定律里那个"无法加速的部分"。
原因二,调度本身有成本。 火焰图里这一段最直白:
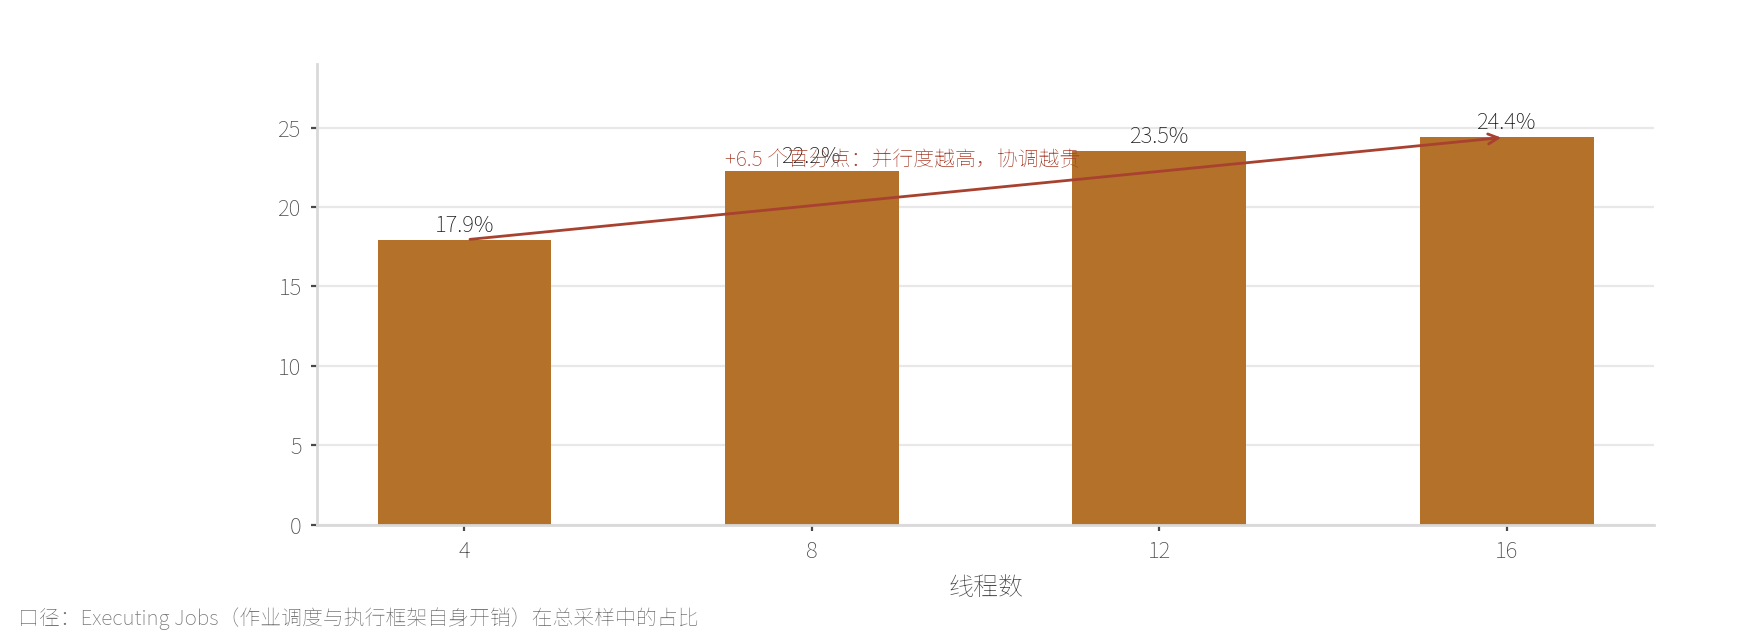
Executing Jobs(作业调度与执行框架自身的开销)从 4 线程的 17.9% 升到 16 线程的 24.4%,
近四分之一的采样周期花在"安排活"上,而不是"干活"上。
这一类开销包括屏障同步、依赖计数递减、队列争用。它不随线程数摊薄,反而随并行度上升。
原因三,缓存与内存带宽。 §3.3 那段 padding 就是为了这个。
但 padding 只能避免伪共享,不能避免真共享:碰撞检测要读同一批刚体的位置,
求解要读同一批接触点,这些数据在多核之间反复搬,最后卡在内存带宽上。
三条叠加的效果,就是本机那条在 8 线程后开始拐弯、12 线程后贴平的曲线。 多线程不会"开了线程就快":上限由这张作业图的依赖边决定。
6.3 官方的口径对本机读数
官方在 jrouwe.nl 的 scaling 文档里给过一条曲线,那个页面提到约 16 核之后停止扩展;
本机这台 16 逻辑核的机器实测饱和点也落在 12–16 线程之间。两者方向一致。
需要说明的是:官方那张曲线的机器与场景与本机不同,不能逐点对账,只能对"拐点量级"。
ep01 已把三条曲线(官方、本机、ep01 旧测)放在一起给过对照,本篇不重复。
6.4 把这条曲线拟合一次:串行占比约 5.5%,但残差在变大
第三条原因说完,可以把本机读数拿去做一次最小的定量检验。用阿姆达尔定律(Amdahl's law)反推:
$$ S(N) = \frac{1}{p + \frac{1-p}{N}} $$
其中: - $S(N)$ 是 $N$ 线程时的加速比; - $N$ 是线程数; - $p$ 是无法并行的串行占比。
拿本机 8 线程 5.78× 代入($N = 8$),解得 $p \approx 0.055$,也就是串行占比约 5.5%。 这个数在依赖图里能对得上:§8.1 会给出关键路径,上面那几个单作业窄口的耗时占比,量级正好在这个范围。
但检验的关键在残差。用 $p = 0.055$ 去外推 16 线程:
$$S(16) = \frac{1}{0.055 + 0.945 / 16} \approx 8.77\times$$
而本机 16 线程实测是 7.72×,预测偏高了约 1.05×。 更极端的是渐近值:$N \to \infty$ 时阿姆达尔给出 $1/p \approx 18.2\times$, 而本机 12 线程以后就贴平在 7.7× 附近,远没到 18 倍,也没到 8.77 倍。
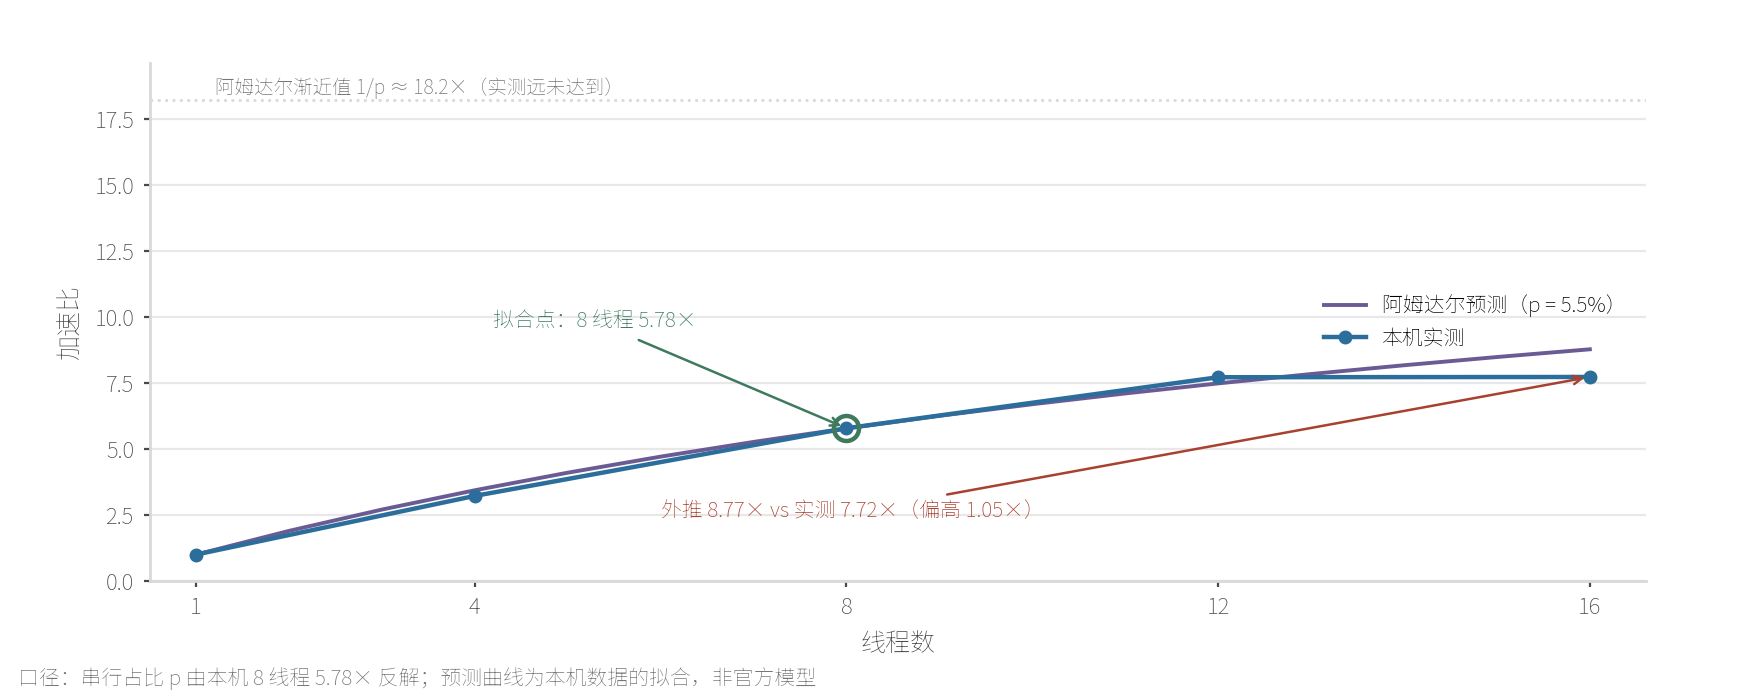
这 1.05 倍的缺口,就是"第三条原因"的量化证据。 阿姆达尔定律假设串行占比 $p$ 是常数,
但本机的火焰图告诉我们它不是:Executing Jobs 从 4 线程的 17.9% 涨到 16 线程的 24.4%。
并行度越高,"协调"本身越贵,等效于 $p$ 随 $N$ 上升,这正是实测会低于经典模型的原因。
所以更准确的说法是:Jolt 这条流水在 8 线程处的串行占比约 5.5%; 再往上加线程,串行占比会自己变大,把曲线提前压平。 这就是 8 线程拐点的完整解释。
要说明的是:这是一次单机型、单场景的拟合,$p \approx 0.055$ 只对本机这台 16 逻辑核、 Ragdoll 场景、Discrete 模式成立。它不是一个普适常数,换机器、换场景、换 LinearCast 都会变。 本系列给的是方法与落点,不是一个可以到处套用的数字。
6.5 顺带一个对照:切到 LinearCast 之后,流水没变
既然跑到了这一步,顺手做个对照实验:把运动质量(MotionQuality)
从 Discrete 换成 LinearCast(连续碰撞检测),看流水形状会不会变。8 线程下两组的读数如下:
| 段 | Discrete(8 线程) | LinearCast(8 线程) |
|---|---|---|
FindCollisions |
17.4% | 17.2% |
宽相 FindCollidingPairs |
12.0% | 11.7% |
Island(岛相关) |
5.7% | 5.9% |
SolveVelocityConstraints |
3.1% | 3.3% |
SolvePositionConstraints |
2.6% | 2.6% |
Executing Jobs(调度开销) |
22.3% | 22.3% |
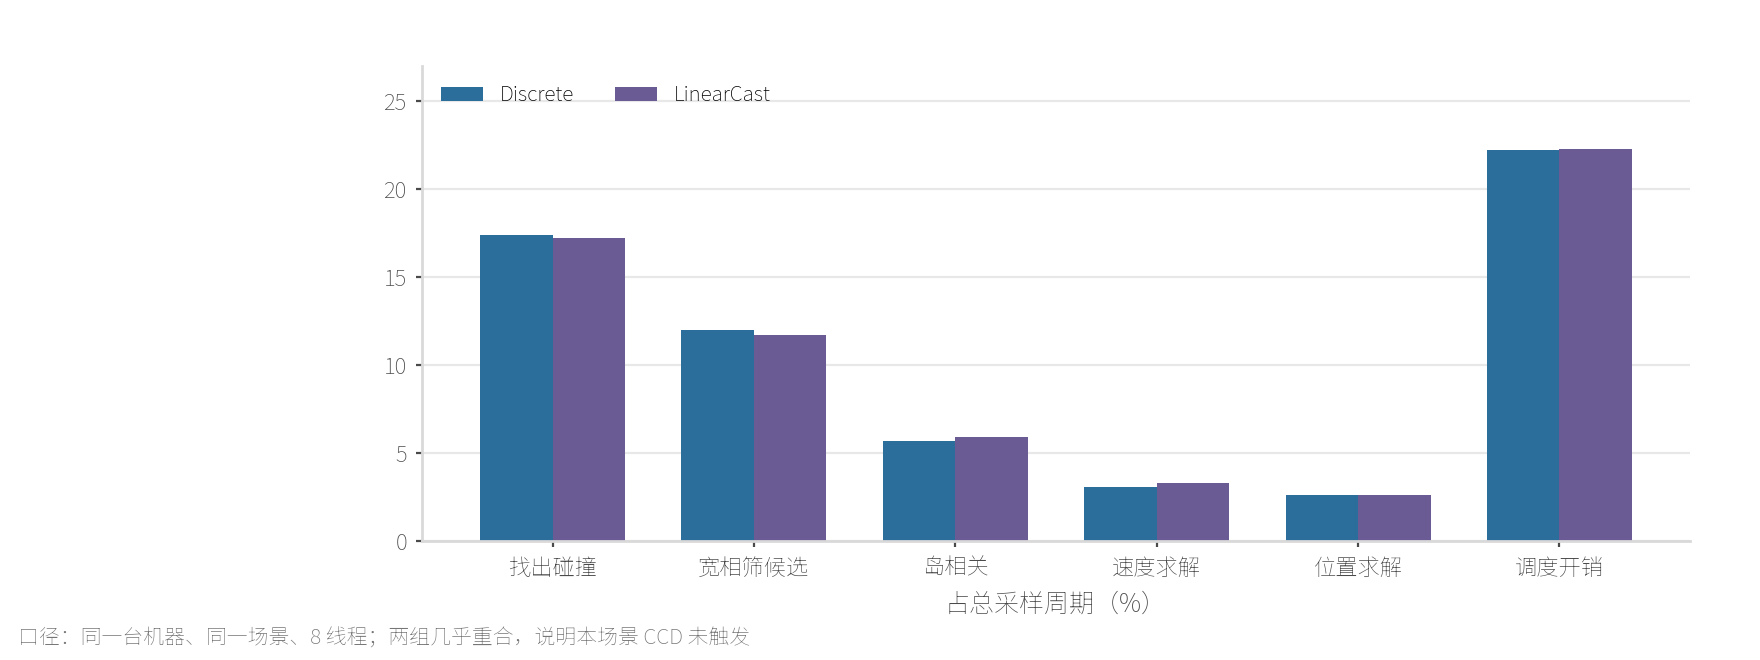
六项读数几乎重合。 原因在 §4.5 已经说过:Ragdoll 场景里没有高速穿透的物体,
mResolveCCDContacts 根本没被触发,所以切到 LinearCast 之后流水执行的东西几乎一样。
这也从侧面验证了一件事:流水图的形状是由场景的构成决定的,不是由开关决定的。
要看到 CCD 段真的出力,得换一个"子弹打薄墙"的场景,
那正是第十一篇要做的实验,本篇不越界。
七、自己跑一遍:把这些读数复现出来
7.1 构建:三条命令
OK,上面所有"本机"数字都来自同一个构建。复现它只需要三步:
#-----------------------------------【Jolt v5.6.0 本机构建】---------------------------------------
#------------------------------------------------------------------------------------------
#【1】生成构建树(VS2022 生成器,x64)
cmake -S <repo>\Build -B <repo>\Build\VS2022_CL_v2 -G "Visual Studio 17 2022" -A x64

#【2】编译目标
cmake --build <repo>\Build\VS2022_CL_v2 --config Release --target PerformanceTest

#【3】运行并导出 profile(-i 为迭代步数,-p 每 100 步输出一份快照)
cd <repo>\Build\VS2022_CL_v2\Release
.\PerformanceTest.exe -s=Ragdoll -i=50 -p
上面三步做完,命令行会打出"线程数 → 步/秒 → 哈希"三列,同时目录里会落下 32 个
profile_chart_*.html(1–16 线程 × Discrete/LinearCast)。
如果你只想先确认"库能跑起来",官方那个最小例子
HelloWorld.cpp
是更短的入口;想按本站色板重排题图的话,官方还提供了同名的
PhysicsSystemUpdate.drawio 源文件。
7.2 步频表怎么读
第三列步/秒就是本篇 §6.1 那张表的来源;最后一列的哈希是确定性校验位, 同一场景不同线程数跑出来的哈希必须一致,这就是 ep01 那条"十六个线程数、同一个哈希"的实验。 "-p" 同时给出两个维度:一个是吞吐(步/秒),一个是可复现性(哈希),两者互不替代。
7.3 火焰图怎么读
先来看看怎么读它。导出的 profile_chart_*.html 是可交互的:
横轴是采样时间、纵轴是调用栈深度、每一根方框的宽度就是该函数占的采样比例,
标在框上的文字就是 §1.6 说的作业名。要拿到本篇用的"分段占比",
需要把它的 aggregated.cycles_per_frame 按函数名聚合一次,
#-----------------------------------【分段占比提取】---------------------------------------
# 描述:从导出的火焰图 HTML 中聚合出各作业的时间占比
#------------------------------------------------------------------------------------------
#【1】火焰图数据以 JS 变量形式内嵌在 HTML 里,先取出 name 与 cycles_per_frame 两个数组
#【2】按 name 累加 cycles_per_frame
#【3】除以总和,得到各段的占比
这一步做完,FindCollisions 的 11.8%→19.3%、Executing Jobs 的 17.9%→24.4% 就直接读出来了。
注意口径:这是跨全部线程的采样占比,不是墙钟时间占比,线程越多,
同一个段可能被多个线程同时采到,占比会被放大,所以它只适合做段间比较。
7.4 三个容易踩的坑
坑一,别用 -i 极小的值。 物理有预热期,前几步的分布不代表稳态;
本篇取 50 步,是"预热已过、还没收敛"的一档。
坑二,别把 cMaxConcurrency 当成本机并发数。 它是编译期上限 32,
实际生效的是它与作业系统能力的较小值,本机是 16。
坑三,别在单场景上外推结论。 本篇全部读数出自 Ragdoll 一个场景,
FindCollisions 占大头是这个场景的特征(3680 个刚体堆在一起);
换成"子弹打薄墙"的场景,占比会明显偏向 CCD。给场景、给命令、给版本,结论才站得住。
八、关键路径与边界
8.1 关键路径:哪条链最长
好了,把依赖图当成一张有向图,从 mStepListeners 出发走到最后一个作业,能算出关键路径,
决定一帧最短耗时的那条链。按 §2.2 的四条主干拼起来,它长这样:
mStepListeners → mDetermineActiveConstraints → mFindCollisions → mFinalizeIslands →
mSolveVelocityConstraints → mPreIntegrateVelocity → mIntegrateVelocity →
mPostIntegrateVelocity → mResolveCCDContacts → mSolvePositionConstraints → mSoftBodyPrepare。
这条链上有三个单作业窄口(不是 JobHandleArray,只有一个实例):
mFinalizeIslands、mPreIntegrateVelocity、mPostIntegrateVelocity。
无论开多少线程,这三个作业都只能由一个线程跑。 它们是并行度的硬边界。
这条关键路径还能和 §6.4 的拟合对上。把路径上"不可并行"的部分估个量级:
三个单作业窄口加起来只占 0.07% 的直接耗时(单项 0.01%–0.17%),看起来微不足道;
但关键路径的代价不只是这些作业自己的耗时,还包括它们前后无法重叠的等待,
比如 mPreIntegrateVelocity 必须等到 mSolveVelocityConstraints 全部结束
(而不是等到最后一个岛解完)才能动,这中间就有一段"解完了但还没齐"的尾巴。
把这些等待累起来,量级正好落在 §6.4 反推出来的 5.5% 串行占比附近。
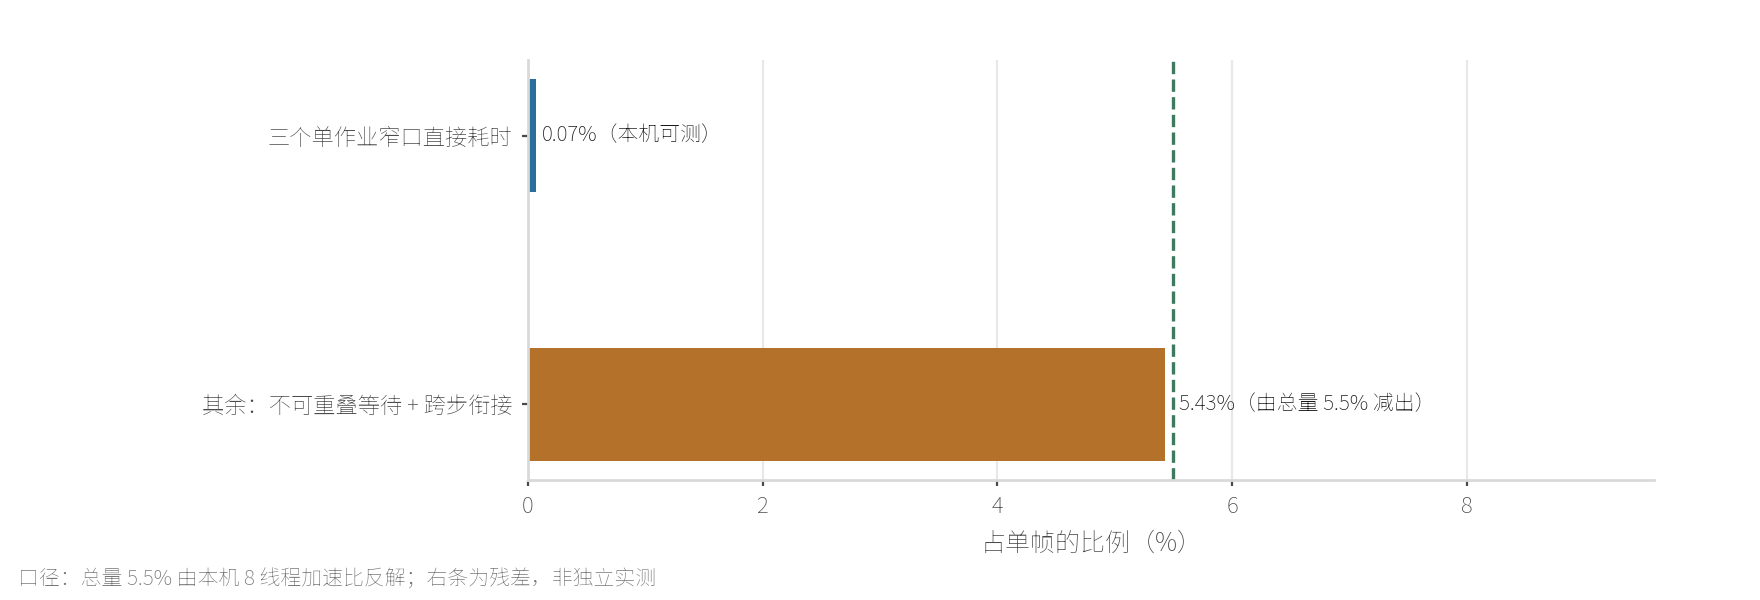
这也解释了一个常见困惑:为什么"把作业数开满"不等于"把并行度用满"。 因为并行度由关键路径决定,跟作业数没关系, 你可以在旁支上开 32 个作业,但只要关键路径上有一个单作业窄口,整条流水就得等它。
8.2 本篇不涉及什么(边界声明)
四条边界,各自归属已定。下表左边是"本篇只给了什么",右边是"深入要靠哪一篇":
| 本篇给出的 | 不展开的部分 | 归属篇目 |
|---|---|---|
| 宽相 Prepare/Finalize 两段的位置与动机 | QuadTree 双树怎么建、无锁扩张的数据结构 | 第四篇 |
| 碰撞检测是流水里最重的一段(含读数) | GJK、EPA、流形裁剪与三层过滤 | 第五、六篇 |
| 求解段的实例数与切法(按队列领) | 顺序冲量、暖启动、Baumgarte 稳定化 | 第九篇 |
| CCD 段的动态依赖与"本场景未触发" | LinearCast 怎么"偷时间"、状态回归怎么做 | 第十一篇 |
理由还是那句:本篇交付地图与因果,不打开任何一段算法。 提前打开,一是会让后面四篇无题可写,二是读者拿不到整体形状, 你不可能通过逐个门牌号来认识一座城市。
8.3 本篇的六条可检验命题
照例把本篇的结论写成可被别人检验的命题,每条都给出检验入口,不信的朋友可以自己跑。
| # | 命题 | 检验入口 |
|---|---|---|
| 1 | PhysicsUpdateContext::Step 有 22 个作业句柄,含 mStartNextStep |
读 PhysicsUpdateContext.h 的 Step 结构体 |
| 2 | 头注释写"in order of execution",但声明序与执行序在 6 处不一致 | 对比声明顺序与 CreateJob 的依赖计数 + RemoveDependency 调用 |
| 3 | 一帧最多 32 个并发作业、2048 个作业、8 个屏障 | PhysicsUpdateContext.h + PhysicsSettings.h 的常量 |
| 4 | 碰撞检测是四条主干里最重的一段(本机 11.8% → 19.3%) | PerformanceTest -p 导出火焰图,读 FindCollisions 占比 |
| 5 | 调度开销随线程数上升(17.9% → 24.4%),是拐点的成因之一 | 同一火焰图读 Executing Jobs 占比 |
| 6 | 8 线程处的串行占比约 5.5%;阿姆达尔外推 16 线程偏高约 1.05× | 用本机步频表代入 S(N) = 1/(p + (1-p)/N) 拟合 |
其中第 1、4、5、6 条是本篇新提出的,第 2、3 条是对上一篇与本篇阶段 1 的修正与确认 (句柄数从 21 修正为 22;常量口径确认不变)。把它们列出来的意思很直接: 这篇想说的不是"Jolt 大概是这样",是"你可以这样去查"。
8.4 下篇预告
下一篇我们离开流水,去看流水里最基本的那件事物:刚体(Body)本身。
Body 与 MotionProperties 为什么分成两个对象、BodyInterface 为什么有加锁与非加锁两副面孔、
批量增删刚体时 Jolt 是怎么避免"一边加一边算"的,
这些问题的答案,会解释本篇流水里那句"位置在宽相收尾前是冻结的"到底冻结的是什么。
PerformanceTest -p(原创)资源清单
本篇用到的官方一手材料与本机产物,一并列出,方便复核:
官方源码与文档(Jolt 仓库,MIT;以下均给出 v5.6.0 的 raw 地址,可直接点开核对)
- Jolt/Physics/PhysicsUpdateContext.h , 22 个作业句柄与 cMaxConcurrency 的定义处(本篇骨架依据)
- Jolt/Physics/PhysicsSystem.cpp , Update 的完整实现与全部依赖计数(§2 的推导依据)
- Jolt/Physics/PhysicsSystem.h , Update 的签名与语义注释(§0.1 的原文出处)
- Jolt/Physics/PhysicsSettings.h , cMaxPhysicsJobs / cMaxPhysicsBarriers
- Jolt/Core/JobSystem.h , 作业图与屏障的接口定义
- Jolt/Physics/IslandBuilder.h , 模拟岛构建段
- Jolt/Physics/LargeIslandSplitter.h , 大岛切分段(属第十篇)
- Jolt/Physics/Constraints/ContactConstraintManager.h , 求解段的相邻依据(属第九篇)
- Docs/PhysicsSystemUpdate.svg , 官方流程图(题图原图)
- Docs/Architecture.md , 含 Job Graph 章节的文字说明与宽相 lock-free 扩张的动机
- Docs/PerformanceTest.md , -p / -f / -r 等命令行开关的说明
- Docs/Samples.md , Samples 的按键与 Profile 导出说明
- Docs/ReleaseNotes.md , 版本变更记录
- 仓库主页与 v5.6.0 版本页 , 版本锚点
- Doxygen 架构与 API 文档 , 文件清单与类索引
- 官方多核 scaling 文档 , §6.3 的对账参照

对照参考(非 Jolt) - NVIDIA PhysX 仓库 , §1.5 路线对照的另一方
检索留痕(Wikimedia Commons,本篇六组关键词全部无对位素材) - Category:Physics engine - Category:Rigid body dynamics - Category:Collision detection - Category:Job scheduling
本机产物(原创)
- profile_chart_discrete_th{1,4,8,12,16}_it0.html , 五档线程的火焰图
- profile_chart_linearcast_th8_it0.html , LinearCast 对照件
- perf_ragdoll_ep02_20261001.txt , 步频原始输出
- profile_phase_share_20261001.csv , 分段占比提取表
- 命令:PerformanceTest.exe -s=Ragdoll -i=50 -p
本站自绘
- 全部 ep02_*.svg,走 styles/qianmo/palette.json 色板单源
相关链接 - 上一篇:【Jolt Physics 3D】(一) 全景与边界:它在物理引擎谱系里的第几格 https://yyy3d.online/blog/jolt-physics-ep01-landscape/ - 下一篇(预告):【Jolt Physics 3D】(三) Body 与 MotionProperties:三态、两副面孔的接口、批量增删 - Jolt Physics 仓库:https://github.com/jrouwe/JoltPhysics - 本机实测数据与火焰图:https://yyy3d.online/blog/jolt-physics-ep02-step-pipeline/
With Best Wishes.