本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
图 1 优化器边界总览——UB 契约/优化器自由度/向量化报告/别名规则/观测手段 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
本篇是第二波「编译器与链接器」的第二篇。 ep04 讲的是"编译器花了多少时间",这一篇讲"编译器把你的代码改成了什么"。
目录总览:本篇共十一章。零章划边界,一至二章讲 UB 的契约与优化器的自由度,三至四章用
/Qvec-report:2逐条对账向量化,五章讲严格别名(同一段代码两种结果),六章讲目标 ISA 档位,七章复盘 UB 案例,八章给合法的替代写法,九章算优化等级的代价,十章收束。
背景与边界
0.1 从"编译期的账"到"优化器的选择"
ep04 算的是编译器花了多少时间——前端还是后端、模板实例化还是头解析。那一篇的账记在"时间"上。
ep05 换一个账本。这一篇算的是编译器在你允许的范围内,把你的代码改成了什么。
这两个问题的性质完全不同。编译时间是一个可观测的标量:慢就是慢,跑几次就知道。而"优化器改了什么"是个语义问题——你写的循环变成了 SIMD 指令,你写的判空分支消失了,你写的溢出检查被删掉了。这些改动都有一个共同的前提:标准允许优化器假设这些事情不会发生。
这个前提就是未定义行为(undefined behavior, UB)。
0.2 本篇的边界(四条不写)
- 不逐模块讲任何具体引擎/库:渲染算法归《实时渲染管线探析》,抓帧工具归《图形性能剖析工具链》。本系列的工具是编译器与链接器。
- 不做 C++ 入门教学:不写"什么是 UB"的语法导览、不写"怎么开 -O3"的教程。
- 不做"最佳实践清单":无一手证据的泛泛总结违反站规。本篇的建议都附本机实测读数。
- 不碰 GPU 与 ISA 微架构深水区:SIMD 指令集只讲到"档位带来的指令差异"这一层,不做指令延迟/吞吐的微架构分析。
0.3 工具链声明(先说清楚什么能用、什么不能用)
这个题域的标准工具是 Clang 的 -Rpass=loop-vectorize(向量化成功报告)与 -Rpass-missed(失败报告)。本机没有 Clang,所以这一次的改道是系列配置里早就标明的:
| 用途 | 原计划(Clang) | 本机替代(MSVC) | 状态 |
|---|---|---|---|
| 向量化成功/失败报告 | -Rpass=loop-vectorize / -Rpass-missed |
/Qvec-report:2(成功 + 失败 + 原因码) |
✅ 实测可用 |
| 目标 ISA 档位 | -mavx2 / -mavx512f |
/arch:AVX2 / /arch:AVX512 |
✅ 实测可用 |
| 浮点重结合 | -ffast-math |
/fp:fast |
✅ 实测可用 |
| 类型双关对照 | -fstrict-aliasing / -fno-strict-aliasing |
g++ 16.2.0 同名选项 | ✅ 实测可用 |
| 溢出语义对照 | -fwrapv |
g++ 16.2.0 同名选项 | ✅ 实测可用 |
| 反汇编 | objdump -d |
dumpbin /disasm |
✅ 实测可用 |
改道之后反而更适合这个题域:Clang 的 pass 报告给的是"某条 pass 做了什么",而 /Qvec-report:2 给的是带原因码的判定——"这个循环没有向量化,原因是 1105"。原因码是可以逐条对账的,pass 报告不行。
本篇所有读数均为本机实测。编译器为 MSVC 19.44.35228(VS 2022 Community 17.14.35)与 g++ 16.2.0(MSYS2 ucrt64)。不同版本、不同目标平台的结论可能不同——方法比数字重要,本文给的是可复现的量化路径。
0.4 本篇的六个反直觉发现(先给结论)
这一篇的写法跟前面几篇一样:每个结论都配本机实测。 下面六条是"跟流行说法不太一样"的发现,先摆在这里,后面逐条给证据:
float求和的循环默认不会被向量化(原因码 1105),加/fp:fast才向量化——问题不在循环写法,在于浮点归约需要"重结合",而重结合默认被禁止。- 循环里有
if/else不代表不能向量化:只要分支能被"无分支化"成掩码选择,照样是C5001 已向量化。 __restrict不是向量化的开关:本机实测加与不加都向量化,运行时也没有差异(ns/elem 比值 0.98)。- 加对齐声明不一定换来更快的指令:加了"32 字节对齐"的断言之后,
vmovups从 4 条变成 5 条,vmovaps原地不动。 - GCC 在
-O0就把x+1>x折成真:UB 的风险不是从-O2开始的——那是前端的代数化简。 - 类型双关能被 TBAA 变成"每次运行结果不同":GCC
-O2下返回 132/165/193,-fno-strict-aliasing立刻修回 −1。
这六条的共同点是:它们都不是靠读文档能得到的,必须动手量。 而且其中三条(第 1、3、4 条)是"流行说法被实测推翻"——这也是本系列一直强调的方法论:机制靠原文,代价靠自跑。
一、一句话点题:优化器的边界就是 UB 的边界
先把这一篇的核心结论放在最前面:
优化器能做的所有"惊人"改写,都建立在一个前提上——标准说某些事情不会发生。而"标准说不会发生"的那些事情,就是未定义行为。
这句话可以换个更直白的说法:你不是在跟一个"忠实的翻译器"打交道,你是在跟一个"基于假设做推理的证明器"打交道。 你写的每一行代码,优化器都会问一句"我能不能假设它满足标准的所有要求",然后在这个假设下做数学化简。
这个性质带来三个后果,正好构成这一篇的三条主线:
第一条:向量化报告会告诉你"为什么没向量化",而原因往往不是你不懂 SIMD。 本机用 /Qvec-report:2 测了 16 个循环,结论里最扎眼的一条是——一个再普通不过的 float 求和循环,默认选项下不会被向量化,原因码是 1105。工作一点点没做错,只是浮点归约需要重结合,而重结合默认被禁止。
第二条:别名规则不是"建议",它能让同一段代码给出不同结果。 本机实测:同一份类型双关的 C 代码,GCC -O2 下返回 132 / 165 / 193(每次运行都不一样),加 -fno-strict-aliasing 立刻变回正确的 −1;而 MSVC 在 /O2 和 /Od 下都给 −1。
第三条:UB 的"惩罚"来得比你想的早,也比你想的晚。 本机实测:GCC 在 -O0 就把 x + 1 > x 折成"恒真"(mov eax, 1; ret)——不是开了 -O2 才有风险;而 MSVC 在 /O2 和 /Od 下都给出补码回绕的 0。同一段 UB,两个编译器在两个不同的时间点给出了答案。
1.1 为什么这道边界值得单独写一篇
因为它是"代码看起来对、跑起来不对"这类问题最大的单一来源,而这类问题用调试器查不出来——调试器看的是优化后的行为,而"为什么变成了这样"是编译期的决定。
本篇的写法跟前面几篇一致:每个结论都配本机实测。下面四条是"跟流行说法不太一样"的发现,先摆在这里:
float归约默认不被向量化(原因码 1105),加/fp:fast才向量化。- GCC 在
-O0就把x+1>x折成真——UB 风险不是从-O2才开始的。 - 同一段类型双关代码,GCC
-O2给出每次运行都不同的垃圾值;MSVC 两侧都正确。 - 加
__restrict在这个 saxpy 上既没让更多循环向量化、也没让程序更快——"必须加 restrict 才能向量化"在本机 MSVC 上不成立。
这四条都不是靠读文档能得到的,必须动手量。
二、UB 的契约本质:标准不要求,优化器就可以任意推理
要理解优化器的行为,先得看清它手里那份"合同"。
2.1 标准怎么定义 UB
C++ 标准把 UB 定义为"本文档不施加任何要求的行为"(ISO/IEC 14882)。标准在 [ub](https://eel.is/c++draft/ub)里明确了这一点:程序含有 UB 时,标准对它没有任何要求——从"完全忽略"到"终止编译"都算合规。
这句话的杀伤力在于"任何要求"这四个字。它意味着优化器可以:
- 假设 UB 不会发生,然后据此推导别的结论;
- 在推导过程中,删掉依赖"UB 会发生"的代码;
- 甚至删掉 UB 之前的代码——因为如果前面的代码会对后面产生影响,那也只是 UB 的性质之一。
注意这里的逻辑方向:不是"优化器发现 UB 然后删代码",而是"优化器假设 UB 不存在,于是某些代码变得没有意义了"。 前者是被动检测,后者是主动推理。
2.2 优化器手里的三张牌
具体到实现,优化器主要靠三类推理来"越界":
第一张牌:代数恒等式。 在"有符号溢出是 UB"的前提下,x + 1 > x 恒为真。它可以被直接折成 true。这不是"优化",这是在 UB 前提下正确的数学化简。
第二张牌:类型不别名(type-based alias analysis, TBAA)。 标准在 [basic.lval](https://eel.is/c++draft/basic.lval)里规定了什么类型的泛左值可以访问哪个对象。优化器据此假设"不同类型的指针不指向同一块内存",于是可以缓存到寄存器、跨存储重排、跳过重复加载。
第三张牌:无副作用推理。 一个没有可观测副作用的循环可以被整个删掉;一个"不可达"的分支可以被移除。
2.3 这三张牌的共同点:都建立在"你保证了 X"之上
关键认识在这里:这三张牌没有一张是"编译器 bug"。 它们全部是标准授权的推理。
所以真正的工程问题是:你怎么知道自己有没有在无意中给出错误的保证? 这就是后面几章要解决的事——用 /Qvec-report:2 看向量化的判定,用双编译器对照看别名的边界,用反汇编看折叠的实际结果。
2.4 边界声明:本篇不涉及
- 不分析具体的 UB 检测工具(UBSan/ASan/MSan 的原理与用法)——那属于工具链专题。
- 不讨论编译器 bug 与标准缺陷的具体争议案例——聚焦"标准授权的行为"。
- 不覆盖多线程数据竞争(那是内存序专题,规划在 ep10)。
2.5 优化器"看得见"的范围有多远
上面三张牌都建立在一个前提上:优化器对一段代码的推理,只覆盖它同时看得见的那些定义。
这句话解释了很多"为什么优化没生效"的困惑:
- 定义在另一个
.cpp里、没开 LTO 的函数:编译器只看到声明,不知道函数体里做了什么,于是"假设它可能读写任何内存、可能有任何副作用"。这是 4.4 节"函数调用阻碍向量化"的根源。 - 通过头文件内联进来的函数:编译器看得见完整函数体,可以穿透分析、可以重排内存访问。
- 虚函数调用:除非能证明动态类型(去虚化,devirtualization),否则编译器必须假设任意派生类的实现都可能被执行。
所以"优化器没做好"这个抱怨,很多时候要翻译成"优化器没看见"。 而让它看见的手段,从"把函数放进头文件内联"到"开 LTO 跨 TU 分析",本质都是同一件事:扩大它的视野(LTO 是 ep07 的主题)。
这里有一个很实际的推论:/Qvec-report:2 报"未向量化"时,原因码可能会指向"看起来很无辜"的代码。 本机实测里,循环内调用 std::sin 拿到的是原因码 1200(循环携带数据依赖)而不是"函数调用"——因为优化器无法确定这次调用会不会改写 a、b,只能保守地把它建模成一个依赖。
2.6 三张牌各自的"开关"
对应到实际选项,这三张牌都有可以被关掉的开关——这一点对排查很关键,因为当优化行为不符合预期时,逐个关掉假设是最快的定位手段:
| 推理类型 | 对应优化 | 关掉它的开关 |
|---|---|---|
| 代数恒等式(依赖 UB) | 常量折叠、表达式化简 | -fwrapv(把有符号溢出定义成回绕) |
| 类型不别名(TBAA) | 载入提升、跨存储重排 | -fno-strict-aliasing |
| 无副作用 | 死代码消除、循环删除 | 很少能单独关;volatile 是局部手段 |
第五章和第七章会分别用实测展示前两个开关的效果——-fno-strict-aliasing 把一段"每次运行结果都不同"的代码救回确定行为,-fwrapv 让被折叠成常量的表达式回到"按机器算"。
相关标准:ub(UB 定义)、basic.lval(类型可访问性)、basic.life(对象生命周期)、dcl.type(cv 限定符)、expr.pre(求值前提)。
三、向量化报告实战:16 个循环逐条对账
这一章是篇实操:用 /Qvec-report:2 把 16 个循环的向量化判定逐条拍出来,看看优化器到底在什么条件下点头、什么条件下摇头。
3.1 /Qvec-report:2 怎么用
/Qvec-report:1 只报成功向量化的循环,/Qvec-report:2 连失败的一起报——失败的那一半才是笔记的主角。用法就一行:
cl /c /O2 /Qvec-report:2 my.cpp
输出长这样(本机实测,saxpy 循环):
正在分析函数: void __cdecl saxpy(float * __restrict, float const * __restrict, float const * __restrict, float, unsigned __int64)
my.cpp(3) : info C5001: 循环已向量化
C5001 = 已向量化,C5002 = 未向量化(后面跟原因码)。
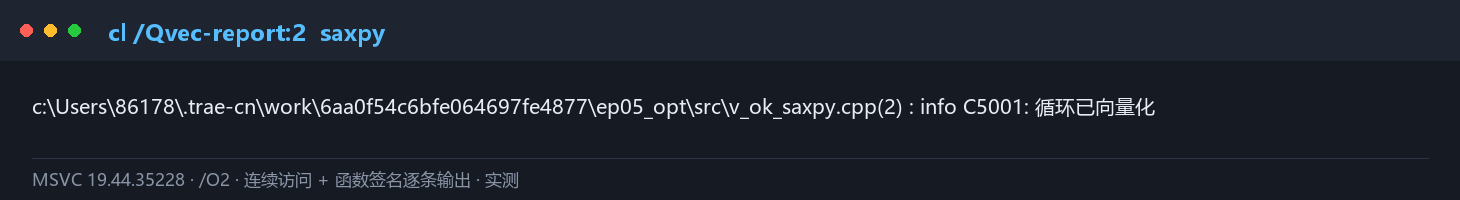
cl /Qvec-report:2 对 saxpy 循环的判定:C5001 已向量化@ MSVC 19.44 实测读这份输出有个容易踩的坑:一条 C5001 只代表"某个循环被向量化了",不代表"你关心的那个循环被向量化了"。 一个函数里可能有多个循环,报告会逐条打印。所以看报告时要对着行号找自己那个循环,别看到 C5001 就以为万事大吉——也别看到 C5002 就以为自己写错了循环。
3.2 16 个用例的总账
把 16 个循环的判定汇总成一张表——这张表就是本篇的证据主体:
| 用例 | 判定 | 原因码 |
|---|---|---|
saxpy(连续访问 + __restrict) |
C5001 已向量化 | — |
saxpy(去掉 __restrict) |
C5001 已向量化 | — |
int 归约(s += p[i]) |
C5001 已向量化 | — |
float 归约(默认选项) |
C5002 未向量化 | 1105 |
float 归约 + /fp:fast |
C5001 已向量化 | — |
float 归约且模式为 s += p[i] + s + /fp:fast |
C5002 未向量化 | 1105 |
循环携带依赖 a[i] = a[i-1] + 1 |
C5002 未向量化 | 1200 |
跨步访问 p[i*3] |
C5002 未向量化 | 1203 |
循环内调用 std::sin |
C5002 未向量化 | 1200 |
循环内 if/else(数据相关分支) |
C5001 已向量化 | — |
while(a[i] != 0)(次数不可知) |
C5002 未向量化 | 500 |
间接索引 p[idx[i]] |
C5002 未向量化 | 1300 |
结构体 short 字段访问 |
C5002 未向量化 | 1300 |
| 标量在循环外被使用 | C5002 未向量化 | 1104 |
int → double 隐式转换 |
C5001 已向量化 | — |
float → int 截断 |
C5001 已向量化 | — |
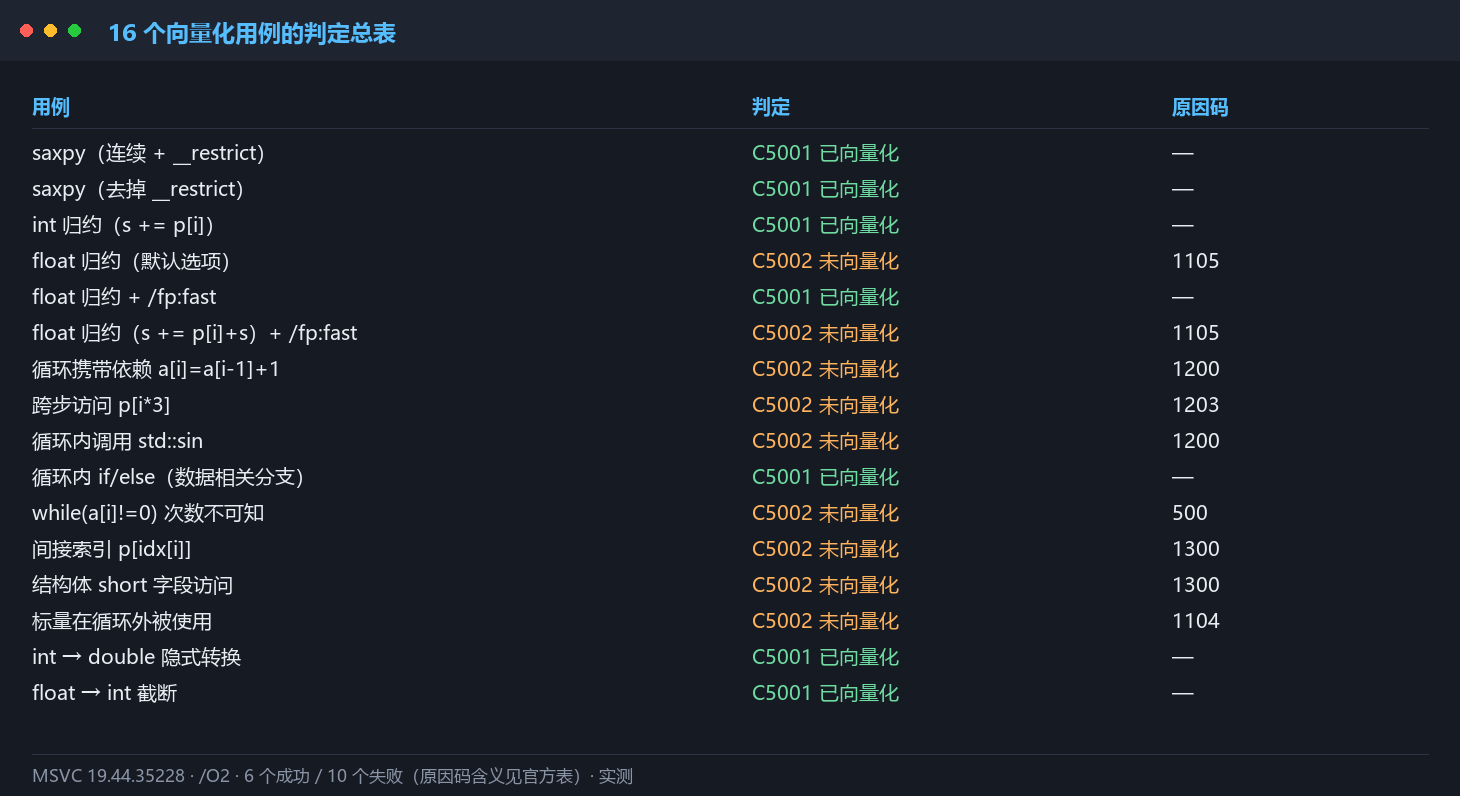
先给这张表一个整体印象:16 个用例里 6 个向量化成功、10 个失败。成功的那些有一个共同特征——循环体是"一路直线的数组读写";失败的那些则各自撞上了不同的阻碍。换句话说,向量化不是"编译器愿不愿意帮忙"的问题,而是"循环形态是否落在它认得的模板里"的问题。
这也解释了为什么"我把 -O3 打开就好了"这种经验不牢靠:优化等级只影响它尝试的力度,不影响循环形态是否匹配。形态不对,-O3 也报 C5002。
先看三条"打破了直觉"的条目。
3.3 反直觉一:float 求和默认不向量化,原因是 1105
一个再普通不过的浮点求和,默认选项下不会被向量化:
float sum(const float* __restrict p, size_t n){
  float s = 0;
  for (size_t i = 0; i < n; i++) s += p[i];
  return s;
}
/Qvec-report:2 的判定是 C5002: 由于"1105",循环未向量化。
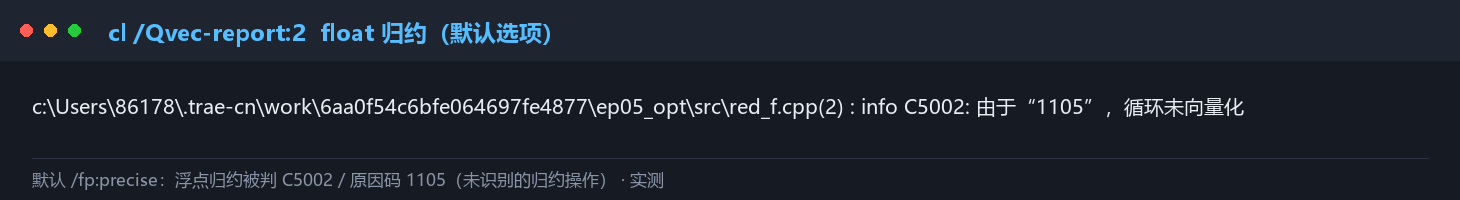
float 归约在默认选项下的判定:C5002 未向量化,原因码 1105@ MSVC 19.44 实测原因码 1105 的官方含义是"循环包含一个未被识别的归约操作"(见 MSVC 原因码表)。而那份文档里紧跟着一句更关键的话:
归约优化用了"浮点重结合"(floating point reassociation)。只有当
/fp:fast被启用时,重结合才被允许。
所以问题不在"归约写得对不对",而在"浮点运算能不能被重排"。 浮点加法不满足结合律((a+b)+c 与 a+(b+c) 在有限精度下结果可能不同),所以默认的严格浮点模型禁止编译器重排它。向量化一个归约,本质上就是要把 s += p[i] 拆成若干条部分和再合并——那就是重结合。
验证一下:加上 /fp:fast,同一个循环立刻变成 C5001 已向量化。
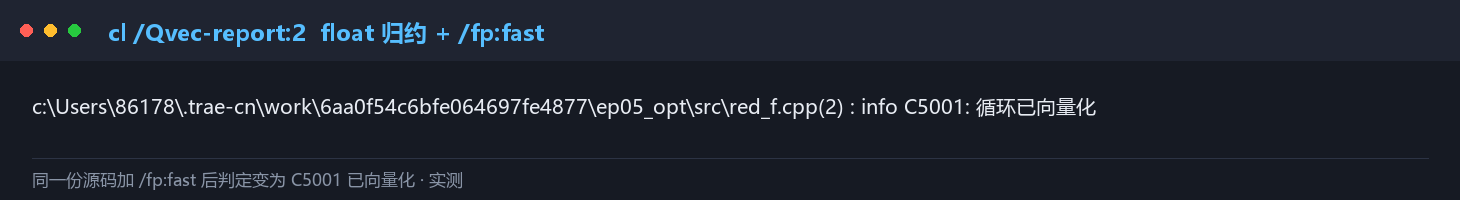
float 归约循环,加 /fp:fast 后判定变为 C5001 已向量化@ MSVC 19.44 实测这条实测的实用含义很直接:如果你发现自己的浮点求和/求平均循环没有被向量化,第一件事不是去改循环写法,而是检查 /fp 选项。而且要注意——/fp:fast 是一份"可以改变浮点结果"的授权,开了它,你的浮点结果就不再保证与严格模型逐位一致。
顺带说一句整数侧:同样的归约,int 版本默认就是 C5001。因为整数加法满足结合律(在无 UB 前提下),重排不需要任何额外授权。同一段结构的循环,只因为元素类型是 float 还是 int,优化器的判定就相反。
3.4 反直觉二:if/else 也能向量化
直觉上,"循环体里有分支"应该是最典型的向量化阻碍——毕竟 SIMD 指令是"一条指令动四个数",遇到分支怎么办?
实测结果:这个循环向量化了。
void absify(float* __restrict a, const float* __restrict b, size_t n){
  for (size_t i = 0; i < n; ++i){
    if (b[i] > 0) a[i] = b[i];
    else          a[i] = -b[i];
  }
}
判定是 C5001 已向量化。
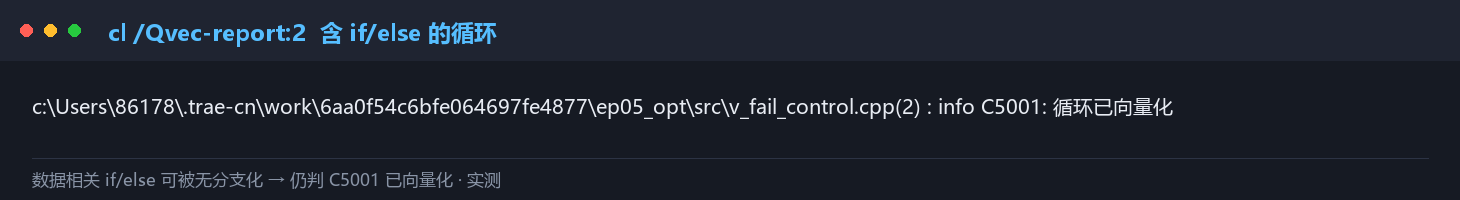
原因是这个分支可以被"无条件化":if (b[i] > 0) b[i] else -b[i] 等价于 b[i] 的绝对值,而绝对值可以用位运算或 select(掩码选择)实现——没有真正的控制流,只有数据选择。向量化的并不是"分支",而是"分支两侧可以合并成一个无分支表达式"。
这条有个重要的推论:"有分支"不是判据,"分支是否能被无分支化"才是判据。 这一点在下一章讲五大阻碍时还要用到。
3.5 反直觉三:去掉 __restrict 照样向量化
__restrict 常被当成"向量化的开关"。实测的判定是:
- saxpy 加
__restrict:C5001 已向量化 - saxpy 去掉
__restrict:C5001 已向量化
两者都向量化了。 而且运行时的读数也几乎一样(第九章给数字:中位值 0.1434 ns/elem vs 0.1409 ns/elem,比值 0.98)。
这条的准确表述应该是:MSVC 在这个用例上不需要 __restrict 就能向量化——它要么能证明两个指针不别名,要么用别的方式(如运行时检查或标量尾部)保证了正确性。第五章会用"重叠数组"的正确性测试来验证后者。
需要说明:这不代表
__restrict没用。它是一份语言层的显式承诺,在循环形态更复杂、编译器无法自行证明时,它能决定向量化的成败。但它不是"加了才向量化"的开关——这一点跟很多教程的说法不一样。
3.6 那些确实没向量化的循环
失败案例同样有教学价值。以下是本机实测的 8 类失败及其原因码:
| 写法 | 原因码 | 官方含义 |
|---|---|---|
循环携带依赖 a[i] = a[i-1] + 1 |
1200 | 循环携带数据依赖 |
跨步访问 p[i*3] |
1203 | 非连续访问 |
循环内调用 std::sin |
1200 | 循环携带数据依赖(函数调用阻碍) |
while(a[i] != 0)(次数不可知) |
500 | 归纳变量发现/递推失败 |
间接索引 p[idx[i]] |
1300 | 非连续/不可识别的访问模式 |
结构体 short 字段访问 |
1300 | 同上(字段宽度问题) |
| 标量在循环外被使用 | 1104 | 循环体含标量变量 |
volatile 写 |
503 | 循环含不可接受的操作 |
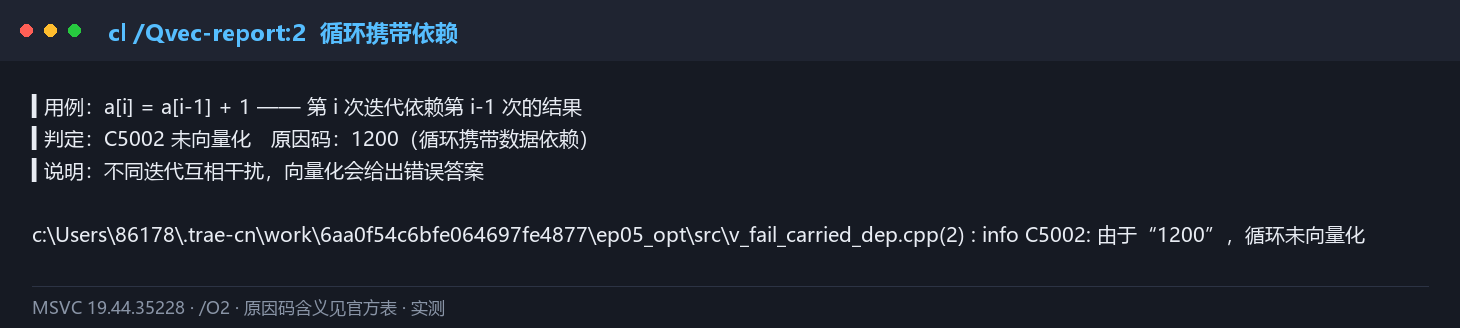
a[i]=a[i-1]+1 的判定:C5002 未向量化,原因码 1200@ MSVC 19.44 实测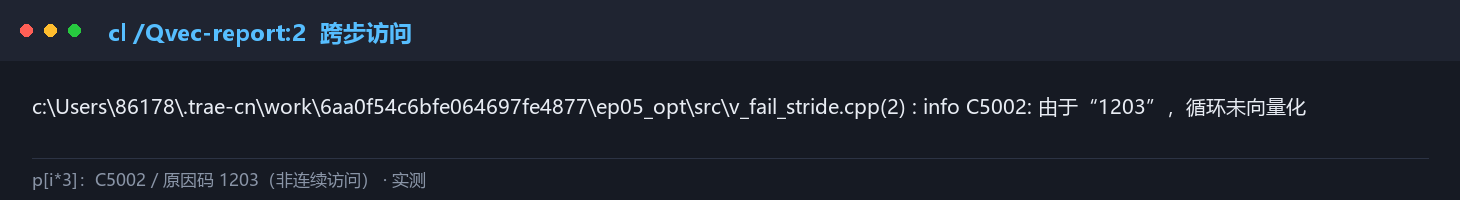
p[i*3] 的判定:C5002 未向量化,原因码 1203@ MSVC 19.44 实测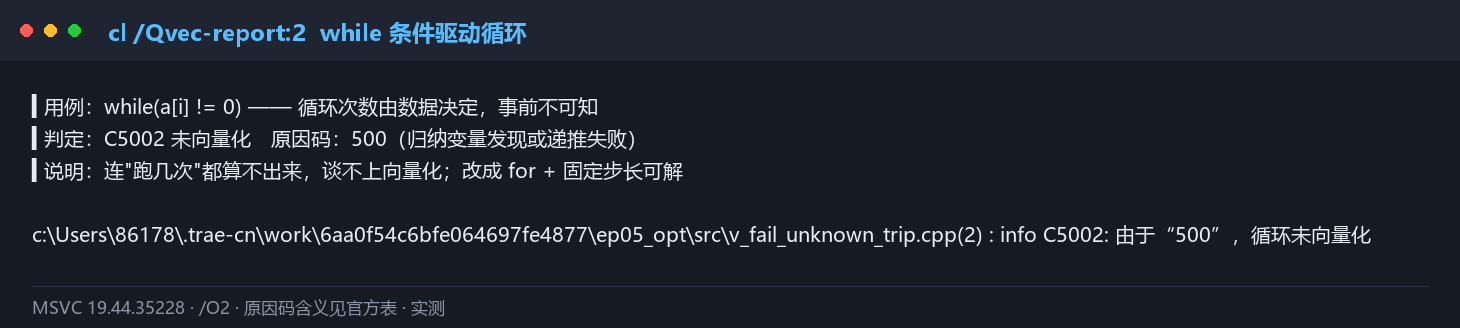
while 条件驱动、次数不可知的循环:C5002 未向量化,原因码 500@ MSVC 19.44 实测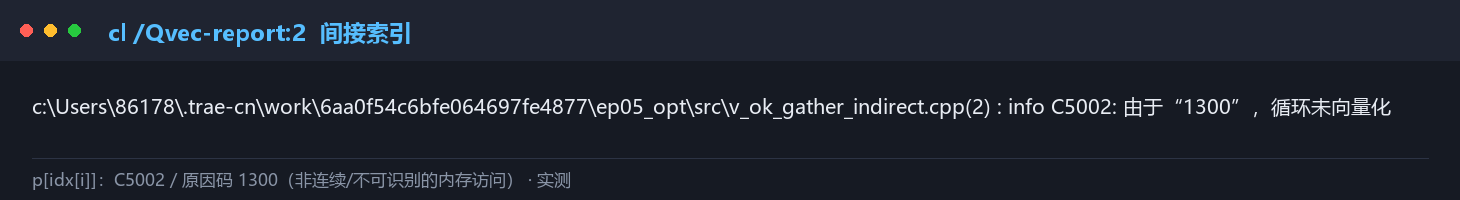
p[idx[i]] 的判定:C5002 未向量化,原因码 1300@ MSVC 19.44 实测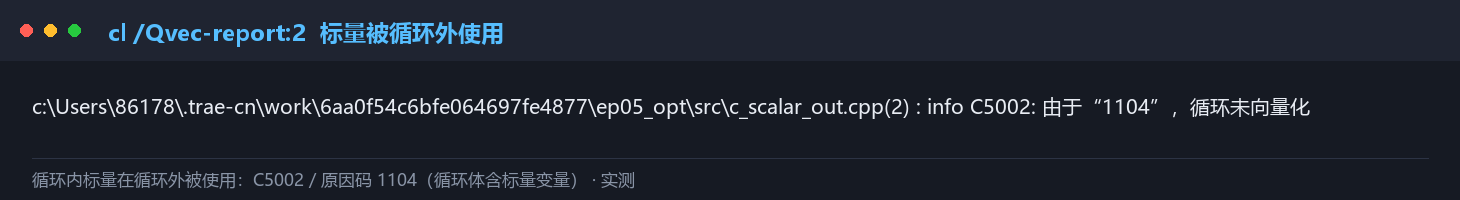
注意 1300 这一条会让人意外:AVX2 明明有 gather 指令,为什么 MSVC 在 AVX2 档位下仍然不向量化 p[idx[i]]?答案是 gather 是"收集"——它按索引从内存里一个个抓元素,吞吐远低于连续载入,编译器判定"向量化反而不划算"。优化器不只看"能不能做",还看"值不值得做"。
3.7 一次完整的排查演练
把这一章的方法串成一条可照抄的流程。假设你有一个热点循环,想知道它为什么没有变快。
第一步:先要判定,不要猜。
cl /c /O2 /Qvec-report:2 hot.cpp
看输出里这个循环是 C5001 还是 C5002。
- 如果是
C5001(已向量化):问题不在向量化,去看内存访问模式、分支预测、数据布局。 - 如果是
C5002:记下原因码,进第二步。
第二步:用原因码查含义,不要猜。
拿原因码去官方表里查(本篇 4.6 节整理了常用项)。这一步能把"感觉是别名问题"变成"确认是 1200 循环携带依赖"。
第三步:按原因码对症改。
| 原因码 | 对症改法 |
|---|---|
| 1105(归约) | 浮点归约评估 /fp:fast;或改成整数累加 |
| 1200(携带依赖) | 检查循环是否真的按 a[i] 依赖 a[i-1];函数调用试内联 |
| 1203(非连续) | 改数据布局(连续化),或接受不向量化 |
| 500(非规范循环) | 把 while 改写成 for + 固定步长 |
| 1300(不可识别访问) | 间接索引试着改成连续;或接受(gather 常不划算) |
| 1104(标量) | 把循环外使用的标量改为循环内局部量 |
第四步:改完必须重跑报告 + 验结果。
重跑 /Qvec-report:2 确认判定变了;再用标量参考实现验一遍数值(本篇 5.4 节的做法)。没有第二步验证的"优化"是危险的——向量化会改变浮点求值顺序,可能悄悄改变结果。
这条流程最后一步的纪律,跟 ep04 的"改完再量一遍"是同一条:优化这件事,只有量过才算数。
四、向量化的五大阻碍
上一章给了 16 个用例的判定。把它们按"为什么失败"归一下类,会得到五类阻碍——这五类跟 Intel 官方向量化指南里列的完全一致(见 Intel 向量化建议)。
4.1 阻碍一:别名(aliasing)
判据不是"有没有 restrict",而是"优化器能不能证明两个指针不重叠"。
a[i] = b[i] + k*c[i] 这个循环里,如果 a 与 b 指向同一块内存,那么"先读 b[i]、后写 a[i]"的顺序就不能改——改了就出错。优化器只有两条路:证明不重叠(于是可以放心并行读),或者加运行时检查(versioning)。
本机实测的结果是:简单形态下 MSVC 两条路都不走也照向量化(3.5 节),且结果正确(5.4 节验证)。而 GCC 在类型双关场景下走的是更激进的路(5.3 节)——这正是第五章要展开的核心。
4.2 阻碍二:对齐(alignment)
SIMD 指令分"对齐载入"(vmovaps,要求 32 字节对齐)与"非对齐载入"(vmovups,无对齐要求)。理论上,告诉编译器"指针是对齐的"应该能让它用上更快的对齐指令。
实测把这个理论推翻了。 同一个 saxpy 函数,一份原样、一份加两行 __assume 声明两个指针 32 字节对齐,都用 /O2 /arch:AVX2 编译,然后数反汇编里的载入指令:
| 版本 | vmovups(非对齐) |
vmovaps(对齐) |
|---|---|---|
| 原样 | 4 | 2 |
加 __assume 对齐声明 |
5 | 2 |
指令构成没有变好。 加了"我保证对齐"的声明之后,vmovups 不但没减少,还多了一条;vmovaps 的数量原地不动。
为什么会这样? 因为 MSVC 在这个循环上本来就在混用两者——它把数组尾部/未对齐的头部用非对齐指令处理,把主体循环用对齐指令处理。__assume 声明的是"起点对齐",但循环体中间的访问位置是否对齐,还取决于向量宽度与步长的配合。一行断言改变不了这层安排。
所以这一条的准确表述是:"加对齐声明就能换来更快的指令"是一个需要验证的假设,不是一条规律。 本机这个用例里它不成立。真正需要对齐优化时,请照本篇 10.6 节的四步流程,用
dumpbin /disasm自己数一遍。
4.3 阻碍三:控制流(control flow)
上一章已经给了一个反例:简单的 if/else 是可以向量化的——只要它能被"无条件化"成掩码选择。真正阻碍向量化的是无法无分支化的控制流:
- 循环里有
break/continue(迭代次数不确定); - 循环里有
switch(分支数太多,掩码代价超过收益); - 循环里有异常处理或需要析构的 C++ 对象(原因码 503 / 504)。
本机实测里,while(a[i] != 0) 这种"条件驱动、次数不可知"的循环拿到了原因码 500(归纳变量发现失败)——它连"循环跑几次"都算不出来,自然谈不上向量化。
4.4 阻碍四:函数调用(function calls)
循环体内调用一个编译器看不见定义的函数,会直接杀死向量化:编译器无法知道这个函数会不会读写 a、b,也无法知道它有没有副作用。
本机实测:循环里调用 std::sin,判定是 C5002 原因 1200(循环携带数据依赖)。注意原因码给的是 1200 而不是"函数调用"——因为编译器把"调用可能读写内存"建模成了依赖。这也解释了为什么把函数标成 inline 或 __forceinline 常常能让循环突然向量化:不是"内联"本身有用,而是内联之后编译器终于看得见循环体了。
4.5 阻碍五:归约(reduction)
第三章已经讲过 float 归约需要 /fp:fast 这件事。这里补两个细节:
第一,归约的"模式"要对得上。 官方文档给了一个具体的反例:s += p[i] 是标准归约模式,s += p[i] + s 则不是——本机实测这两种写法都必须靠 /fp:fast,但后者即使开了 /fp:fast 仍然是 1105。因为后者的递推结构不是"把数组元素累加到一个独立累加器上"。
第二,整数归约免费,浮点归约要买票。 本机实测:int 版本默认 C5001,float 版本默认 C5002/1105。区别只有一个字——元素类型。但代价是"/fp:fast 会改变浮点结果"。
4.6 原因码对照表(官方来源)
上面用到的原因码全部来自微软官方文档。把本篇涉及的那些整理成一张表——遇到 C5002 时,先在表里查原因码,比猜快得多。这张表值得抄进你的排查笔记:原因码是编译器给出的最直接的诊断,比任何"经验判断"都可靠。
| 原因码 | 官方含义 | 本机命中用例 |
|---|---|---|
| 500 | 归纳变量发现或递推失败 | while(a[i]!=0) |
| 503 | 循环含异常处理或 switch | volatile 写 |
| 1104 | 循环体含标量变量 | 标量被循环外使用 |
| 1105 | 未识别的归约操作 | float 归约(默认) |
| 1200 | 循环携带数据依赖 | a[i]=a[i-1]+1、std::sin |
| 1203 | 非连续访问 | p[i*3] |
| 1300 | 非连续/不可识别的内存访问 | p[idx[i]]、结构体短字段 |
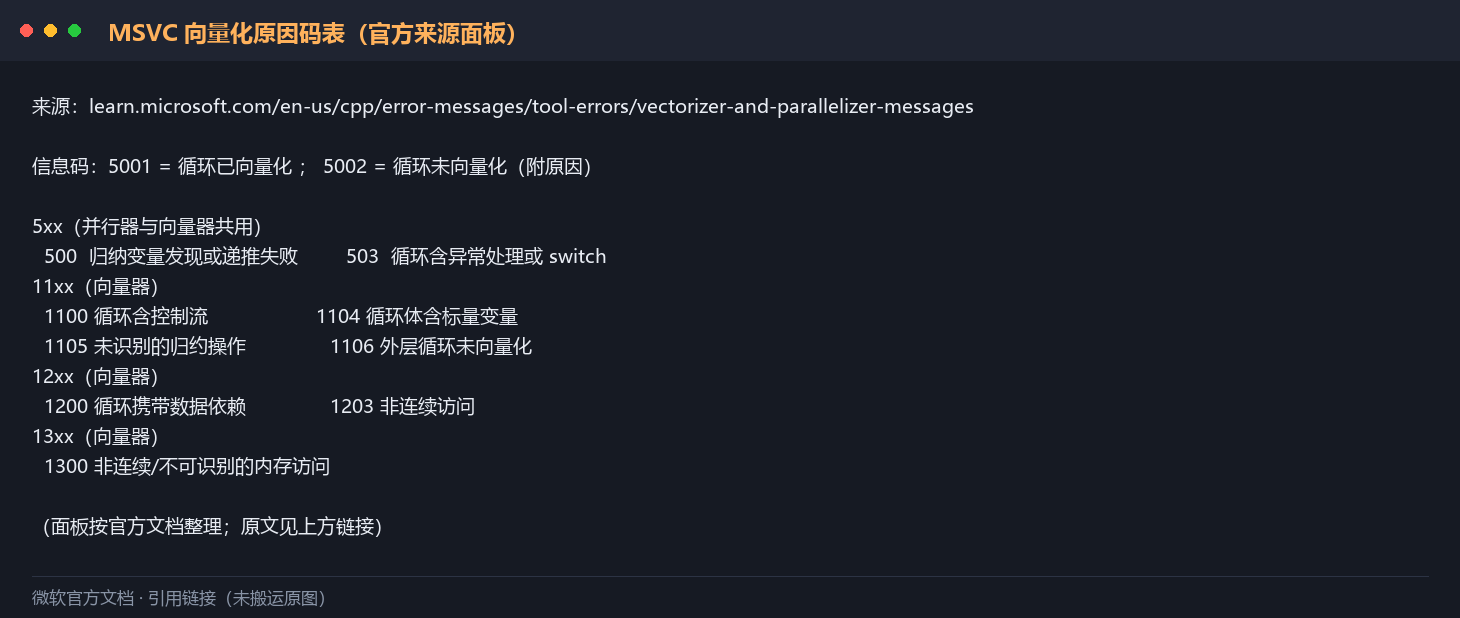
注意这张面板里的分类方式:5xx 是循环结构本身的问题(归纳变量、规范形式),11xx 是循环体内容的问题(控制流、转换、标量、归约),12xx 是数据依赖与访问模式的问题。知道原因码属于哪一类,就等于知道了该往哪个方向改——这也是 3.7 节那张"对症改法表"的分类依据。
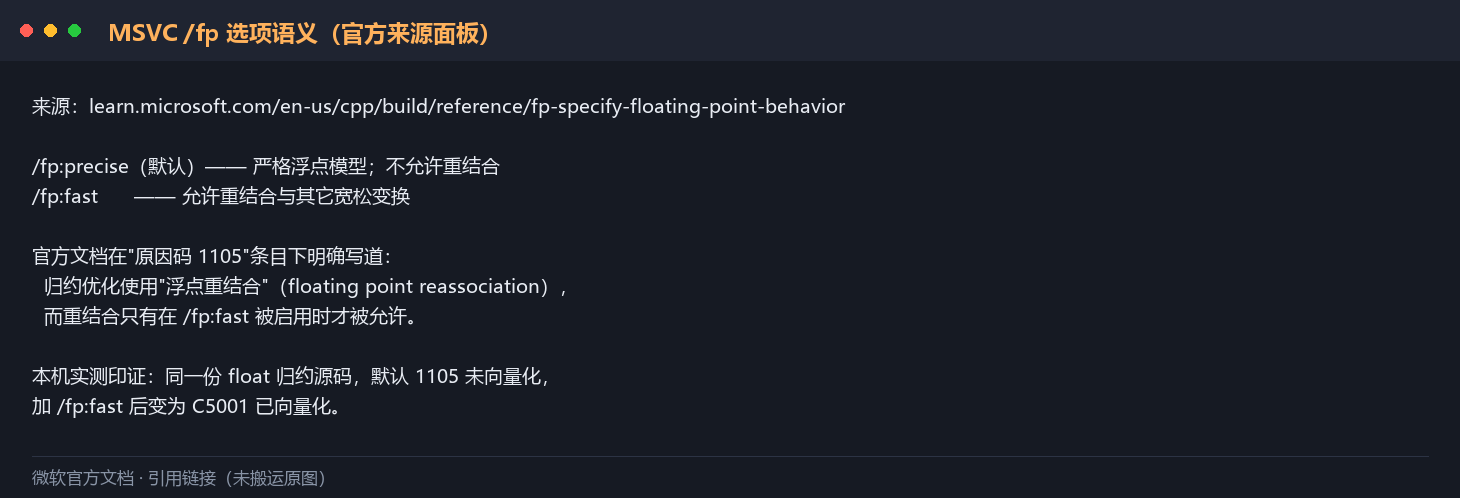
/fp:fast 语义——官方文档来源面板(浮点重结合仅在 fast 模式下允许)@ learn.microsoft.com这份面板解释了本篇最反直觉的那条实测:float 归约之所以默认不向量化,不是因为编译器"不会做",而是因为向量化一个浮点归约必然涉及重排求值顺序,而重排默认被禁止。/fp:fast 是唯一能解除这个禁止的开关——它同时也是"允许浮点结果与严格模型不同"的开关。
权威出处:Vectorizer and parallelizer messages(原因码逐条表)、自动并行化和自动矢量化(选项与
#pragma loop(no_vector))、/fp 选项。
4.7 小结:五大阻碍里哪几个是"能改的"
把五类阻碍按"改动成本"排一下,比按"重要性"排更实用:
| 阻碍 | 改动成本 | 手段 |
|---|---|---|
| 归约 | 低(一个编译选项) | /fp:fast(接受浮点语义变化) |
| 对齐 | 低(一行声明 + 对齐分配) | std::assume_aligned(但要先验证有效,见 4.2) |
| 别名 | 中(加 __restrict 或改接口) |
但实测显示简单用例本就不需要(3.5 节) |
| 控制流 | 中(改写循环结构) | 把"不可无分支化"改成"可无分支化" |
| 函数调用 | 中高(内联或重构) | 把热点函数移进头文件;或开 LTO |
最实用的信息是前两行:归约只差一个选项——如果你在做浮点求和/求平均的优化,先试 /fp:fast 可能一步到位。
五、严格别名与 TBAA:同一段代码两种结果
这一章是整篇最"硬"的一章。别名规则不是一条注释,它能直接改变程序的运行结果。
5.1 规则本身
标准在 [basic.lval](https://eel.is/c++draft/basic.lval)里规定了类型可访问性(type accessibility):一个对象的存储,只允许通过特定类型的泛左值去访问。简单说:int 对象只能通过 int(及其 cv/有符号无符号变体)访问,long 对象只能通过 long 访问。
优化器据此实现的优化叫 TBAA(type-based alias analysis):如果两个指针的类型不同,就假设它们不指向同一块内存。 一旦这个假设成立,优化器就可以:
- 把
*i的读取提前到*l的写入之前(因为"反正互不影响"); - 把重复的载入缓存到寄存器,不再重读;
- 把两次写入重排。
5.2 复现用例
用一个最小的类型双关场景——同一块内存,同时用 int* 和 long* 去访问:
__attribute__((noinline)) long f(int* i, long* l){ *l = -1; return *i; }

int main(){
  long v = 0;
  int r = (int)f((int*)&v, &v);   // 两个形参其实指向同一块内存
  printf("%d\n", r);
  return 0;
}
f 里先把 *l 写成 −1(8 字节全 0xFF),再读 *i(低 4 字节)。如果按"程序写的顺序"执行,*i 读到的必然是 0xFFFFFFFF,即 −1。
5.3 实测:GCC 给出每次运行都不同的值
| 编译器 / 选项 | 运行结果(各 3 次) |
|---|---|
GCC -O0 |
−1 / −1 / −1 |
GCC -O1 |
−1 / −1 / −1 |
GCC -O2(默认 -fstrict-aliasing) |
132 / 165 / 193 |
GCC -O2 -fno-strict-aliasing |
−1 / −1 / −1 |
MSVC /O2 |
−1 / −1 / −1 |
MSVC /Od |
−1 / −1 / −1 |
看第三行。 同一份源码,GCC -O2 下返回的既不是 −1,也不是 0,而是每次都不同的 132 / 165 / 193——*i 的读取被 TBAA 提到了写入之前,读到的是"写之前那块内存里碰巧是什么"。这就是"程序的行为不再由源码决定"的样子。
再看第四行:加一个 -fno-strict-aliasing,结果立刻回到 −1。没有改一行业务代码,只关掉了一个优化假设。
而 MSVC 在两边都给 −1——它在 -O2 下没有做这个假设(或做了但保守地保住了顺序)。
int* 与 long* 被判为不别名,*i 的读取被提到 *l 的写入之前@ 本系列绘制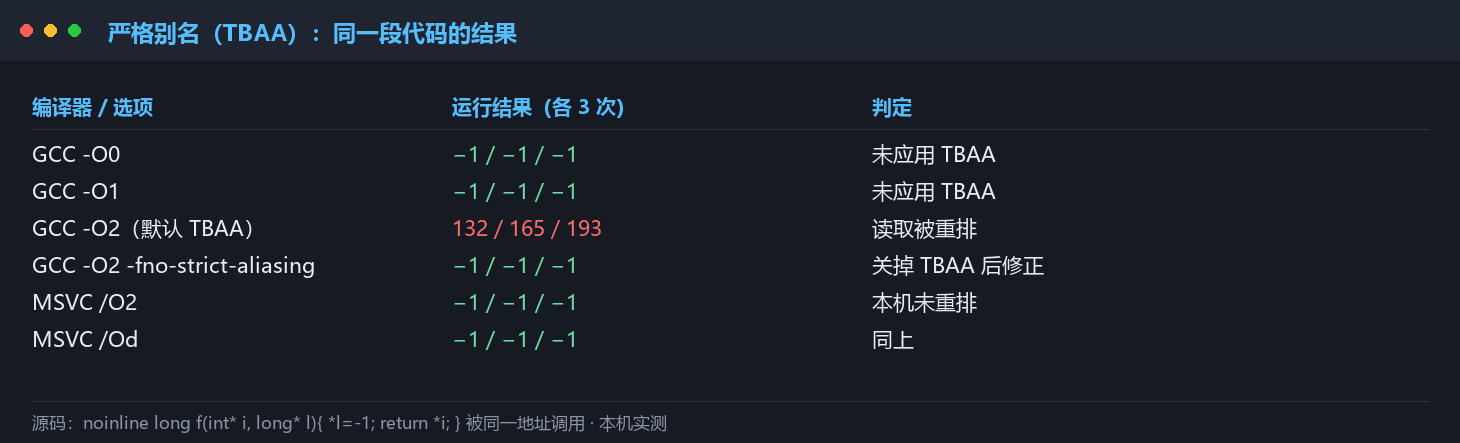
-O2 返回每次不同的 132/165/193,-fno-strict-aliasing 立刻修好;MSVC 两侧均为 −1@ 本机实测5.4 反过来:向量化并不等于"别名没管好就出错"
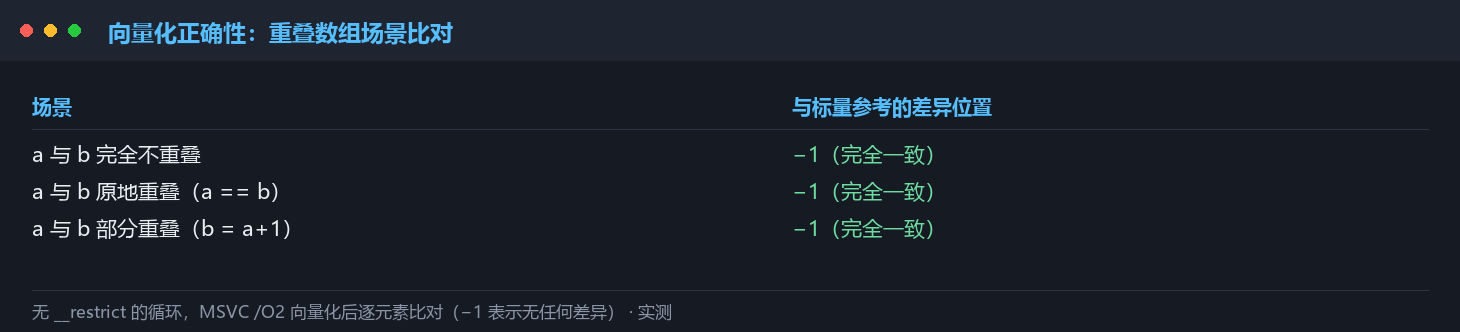
上面这个结果容易让人得出一个过度结论:"优化器一碰别名就出错。" 但事实不是这样。做一个反向验证——同一个简单循环(无 __restrict),在三种重叠场景下与标量参考实现逐元素比对:
| 场景 | 与标量参考的差异位置 |
|---|---|
a 与 b 完全不重叠 |
−1(完全一致) |
a 与 b 原地重叠(a == b) |
−1(完全一致) |
a 与 b 部分重叠(b = a+1) |
−1(完全一致) |
三种场景下,MSVC 向量化后的结果都与标量实现逐元素一致。 说明这个循环的向量化是安全的——编译器要么做了运行时检查,要么用尾部/版本化处理覆盖了重叠情况。
把第五章的两半合起来看,才是完整的图景:TBAA 是一份可以出错的风险(GCC 那个用例证明了),但优化器并不是"一有别名就出错"——真正决定后果的,是优化器在你这段代码上选择了多激进的假设。
5.5 工程结论
- 不要用类型双关(type punning)做低层访问。 一旦被 TBAA 抓住,结果是不可预测的——本机实测里它表现为"每次运行都不一样"。
-fno-strict-aliasing是急救药,不是长期方案。 它能让代码"变对",代价是关掉了整张 TBAA 优化牌(第九章给优化等级与开关的代价)。- MSVC 与 GCC 在这一条上行为不同。 跨平台项目不要假设两边一样——要在两边都测(这也正是本系列反复强调的方法论)。
5.6 为什么会有 std::launder 这种东西
理解了 TBAA,就能理解 std::launder 存在的必要性。
把 5.2 节的用例换一个形态——同一块存储上换了对象:
struct A { int x; };
struct B { int y; };
alignas(A) alignas(B) unsigned char buf[sizeof(A)];

A* a = new (buf) A{1};     // buf 上构造 A
B* b = new (buf) B{2};     // 同一地址上构造 B —— A 的生命周期结束
b->y = 3;                  // 合法:通过 B 访问
// int z = a->x;           // 非法:a 指向的对象已经不存在了
a 这个指针的值没变(还是那个地址),但它指向的对象换人了。 标准对"通过旧指针访问"有明确规定(basic.life)——在多数情况下这是 UB。std::launder 的作用就是把旧指针"洗"成指向新对象的指针:
A* a2 = std::launder(a); // 洗过之后,a2 才是指向"当前那个对象"的指针
它为什么要这么"绕"?因为优化器需要能基于对象的身份做推理(这个 int 和那个 int 是不是同一个对象)。如果语言允许"旧指针随便指向新对象",TBAA 那一整套优化就没有立足点了。std::launder 是把"对象身份变了"这件事显式告诉编译器的方式。
这也解释了它为什么不是"万能洗白器":它只解决"同一存储上有新对象"这一个场景。约束在 P2590R2 里有明确界定。
六、目标 ISA 档位:/arch 决定生成多宽的向量
前三章讲"能不能向量化",这一章讲"向量化之后生成多宽的指令"。
6.1 三个档位的实测差异
同一个 saxpy 函数,只改 /arch,反汇编里的 SIMD 指令数就变了:
| 档位 | SIMD 指令数 | 出现的指令种类 |
|---|---|---|
| 默认(SSE2) | 20 | addps / movups / mulps |
/arch:AVX2 |
16 | vaddps / vmovaps / vmovups / vmulps |
/arch:AVX512 |
12 | vaddps / vmovups / vmulps |
指令数递减,是因为每条指令处理的元素变多了——SSE2 一次处理 4 个 float(128 bit),AVX2 处理 8 个(256 bit),AVX-512 处理 16 个(512 bit)。同一个循环要处理的元素总数不变,宽度翻倍,指令数就减半。
还有一个细节值得注意:v 前缀说明了指令的编码族。 默认档位下是 addps/mulps/movups(SSE 编码,无前缀);AVX2 档位下变成 vaddps/vmulps/vmovaps(VEX 编码,带 v 前缀)。VEX 编码不只是"新写法"——它带来三操作数形式(dst = src1 op src2 不再破坏源操作数),这直接减少了寄存器搬运指令。这也是同为 128/256 bit 时,AVX 编码往往比 SSE 编码更快的原因之一。
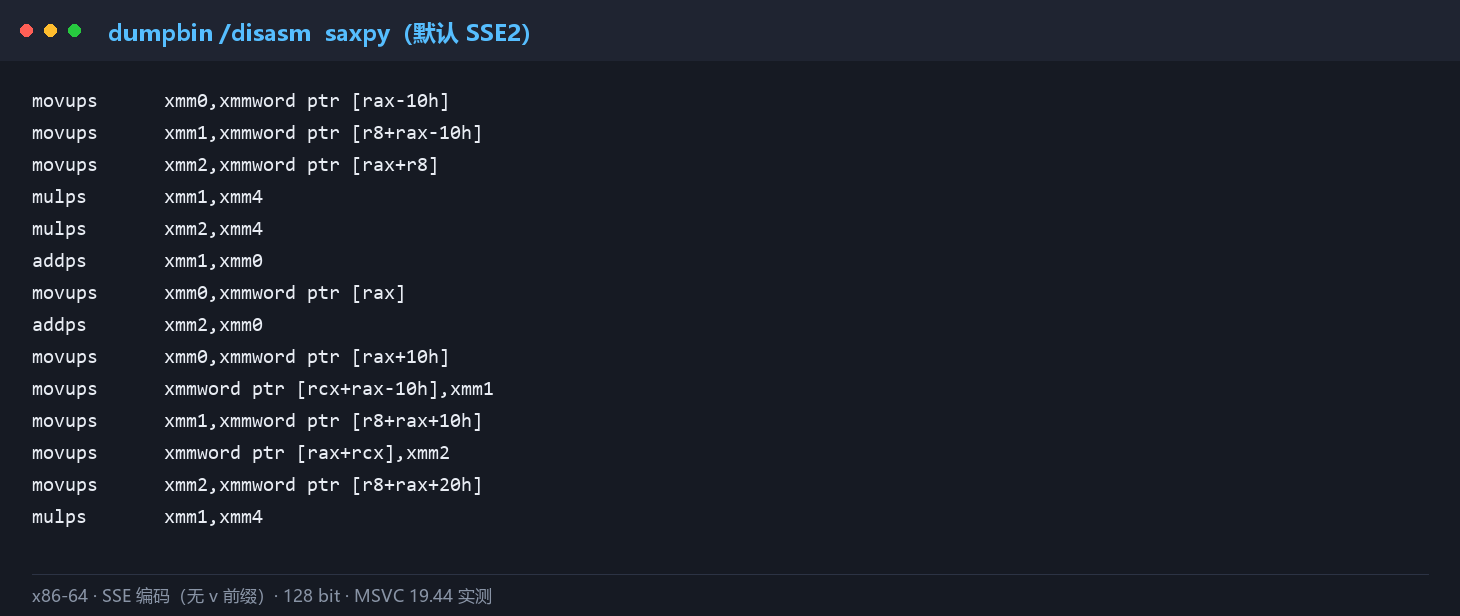
movups/mulps/addps(128 bit)@ MSVC 19.44 实测这张是"没有 AVX 时的样子":载入/存储用 movups,运算用 mulps/addps,一条指令动 4 个 float。注意指令名没有 v 前缀——这是 SSE 编码族的标志。
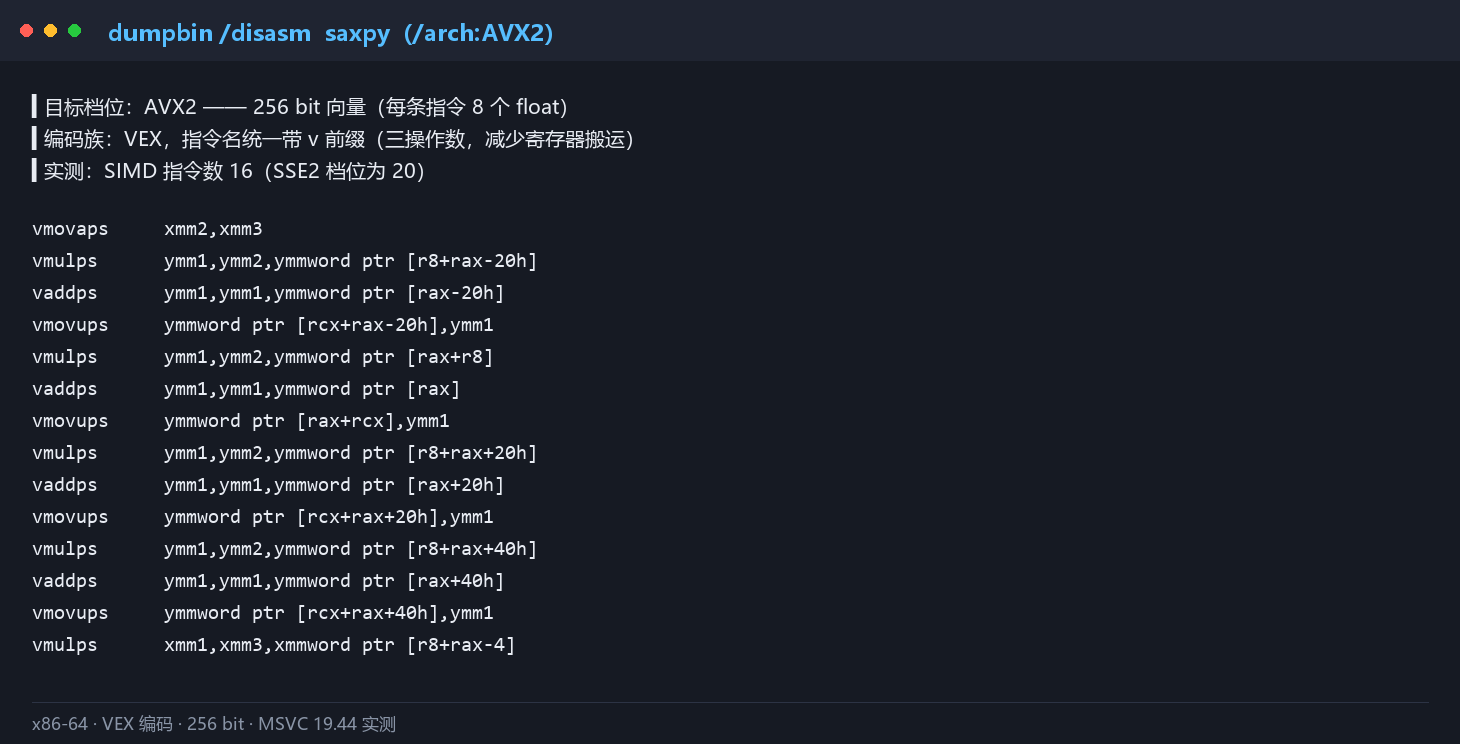
/arch:AVX2 档位下的 saxpy 反汇编——vmovaps/vmulps/vaddps(256 bit)@ MSVC 19.44 实测换成 AVX2 之后,指令名统一带上了 v 前缀(VEX 编码),一条指令动 8 个 float。指令数从 20 降到 16,就是因为每条指令干的活多了一倍。
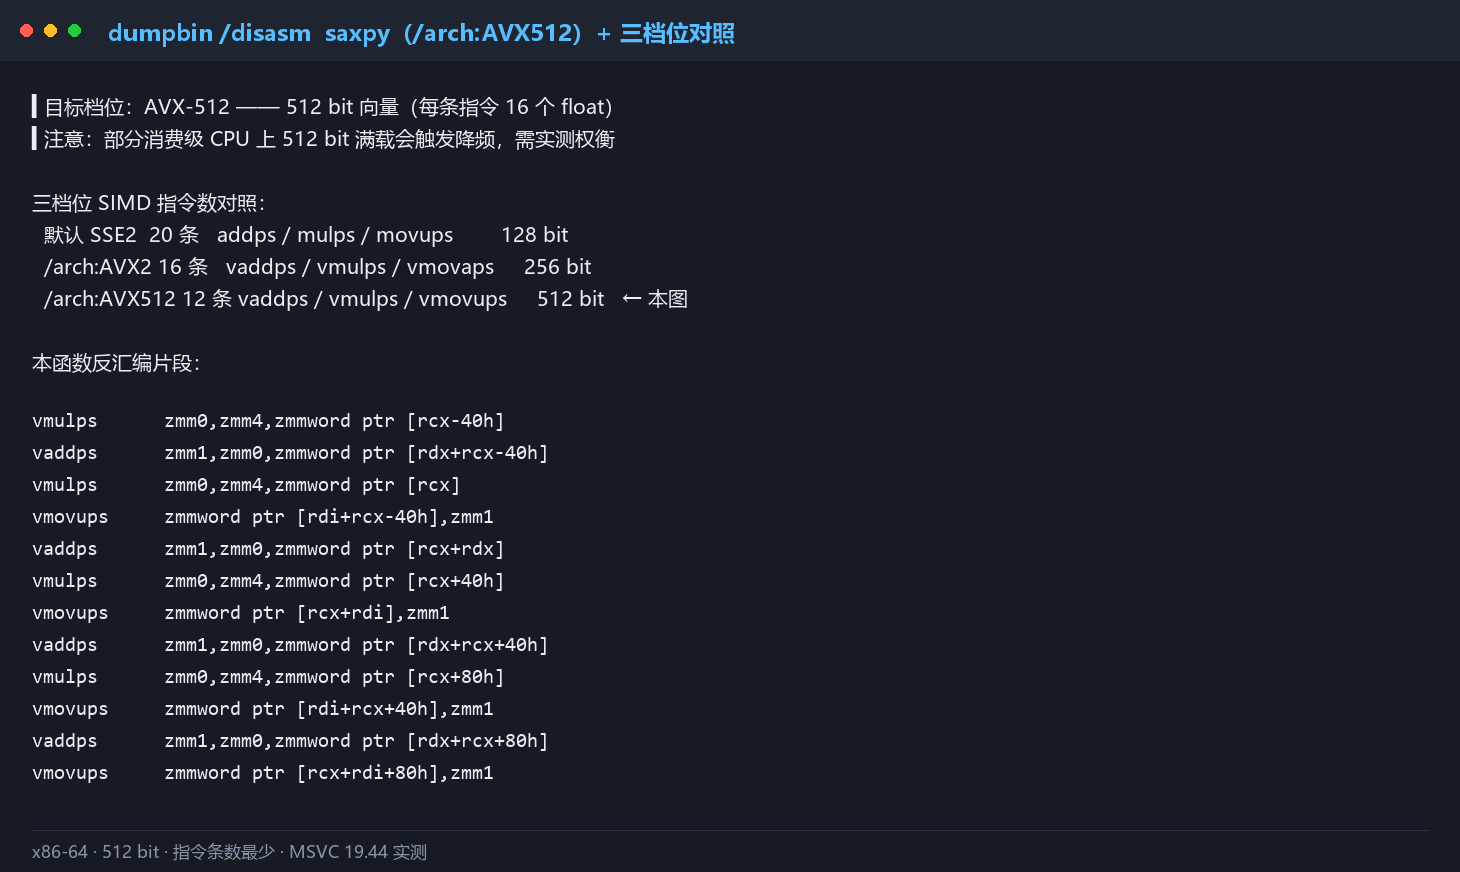
/arch:AVX512 档位下的 saxpy 反汇编——更少的指令条数(512 bit)@ MSVC 19.44 实测AVX-512 档位下指令数进一步降到 12——一条指令 16 个 float。三条曲线合起来看,指令数几乎与向量宽度成反比,这是"宽度换条数"的直接证据。
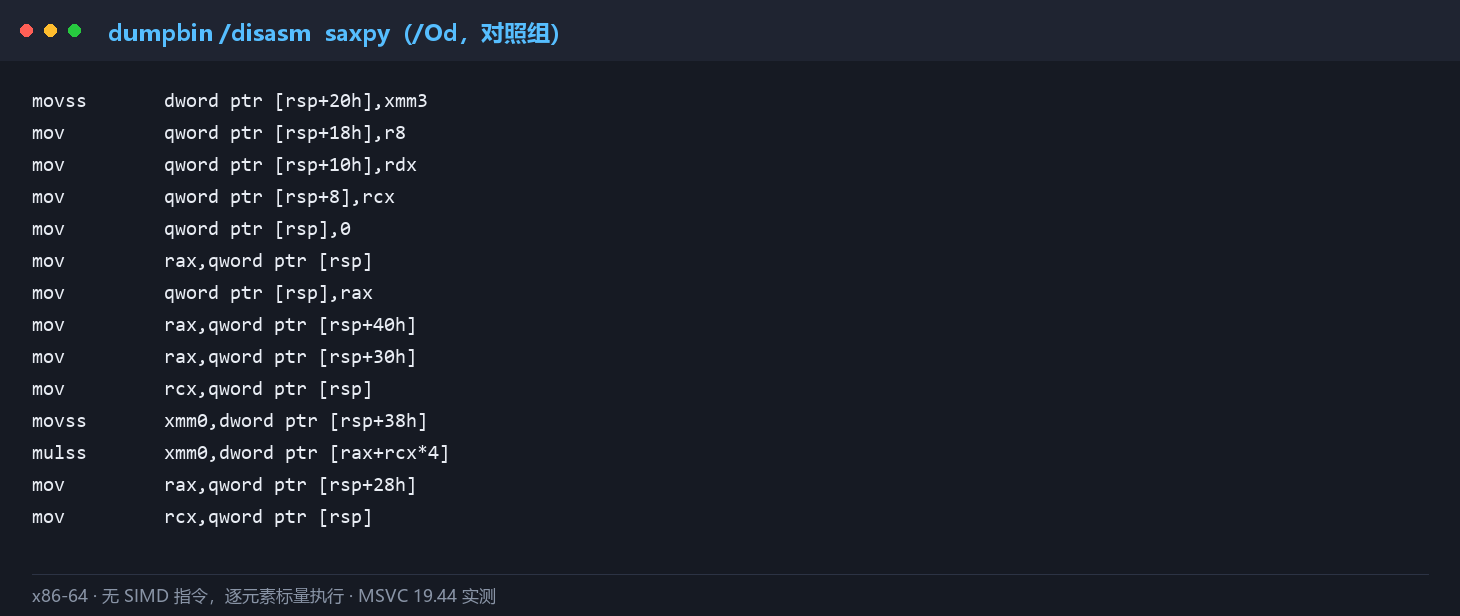
/Od 下的同一函数:没有 SIMD 指令,逐元素标量执行(对照组)@ MSVC 19.44 实测这一张是对照组:/Od 下同一份源码生成的是逐元素的标量代码,一条指令只处理一个 float。把它和最上面那张 SSE2 放在一起看,就能直观感受到"向量化"这三个字到底改变了什么——同样的循环,指令数与每次处理的数据量都完全不同。
把寄存器宽度和元素数画在一起,是为了说明一件事:宽度是硬约束。 128 bit 的寄存器装不下 8 个 float,这不是编译器"不想"用更宽的指令,而是目标平台根本不支持。
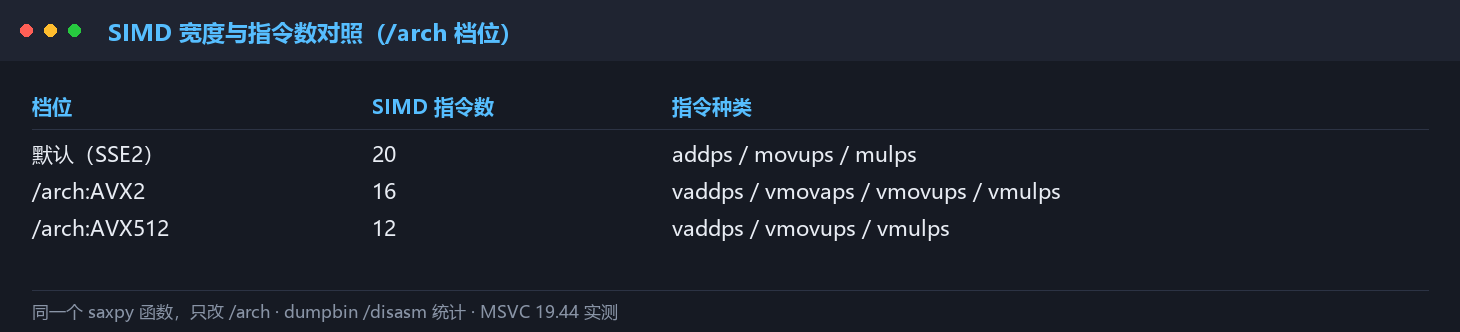
/arch 档位的 SIMD 指令数汇总:20 / 16 / 12@ MSVC 19.44 实测指令数 20 → 16 → 12,看起来像个"越大越好"的阶梯。但下一节要说的恰恰相反:这个阶梯不等于性能阶梯——档位选择要受部署目标的约束。
6.2 指令变少了,程序一定更快吗?
不一定,而且这一条值得单独说清楚:
- AVX-512 在部分消费级 CPU 上会降频。 512 bit 指令满载时会触发频率下调,吞吐收益可能被频率损失吃掉。
/arch:AVX2生成的二进制在只有 SSE2 的机器上会直接崩(非法指令)。 目标档位是运行时契约,不是"越大越好"的旋钮。- 指令数减少 ≠ 内存带宽减少。 对内存受限的循环(本机的 saxpy 只有 1M 元素,仍在缓存里),瓶颈往往是带宽而不是指令数。
结论:
/arch的选择应该由部署目标决定,而不是由"哪个档位指令少"决定。这一点跟 ep04 里"PCH 收益最大但要看场景"是同一类判断——收益有前提,前提在你手上。
6.4 指令变少了,为什么程序不一定变快
这一条值得单独讲,因为它是最容易"优化了半天没效果"的地方。
向量化改变的是指令数量,但一个循环的耗时取决于最慢的那一环。三种情况会让"指令变少"白费:
情况一:内存带宽受限。 如果循环要处理的数据远超缓存(比如百万级以上的浮点数组),瓶颈就在"从内存搬数据"上——SIMD 只是让你搬得更整齐,但总字节数没变。加宽向量不会让内存变宽。
情况二:乱序执行已经吃掉了指令数差异。 两条标量指令和一条 SIMD 指令,在超标量 CPU 上可能都在同一个周期内发射。当循环本身很轻(每次迭代只有一两次运算)时,指令数减少带来的收益会被流水线掩盖。
情况三:AVX-512 的频率下调。 如 6.2 节所述,512 bit 指令满载可能触发降频,把宽度收益吃掉。
判断方法:先量端到端时间,再看反汇编。如果时间没变,反汇编里却多了 SIMD 指令,那说明瓶颈不在指令数量上——去查内存访问、数据布局、cache 行为(后者是 ep11 的主题)。
本机这个 saxpy 用例(1M 个 float,约 4 MB,仍在 L3 范围内)拿到了 4.58× 的加速——这是一个"数据还在缓存里"的理想读数。真实工程里数据更大、访问更散,收益会明显下降。
6.3 对齐:让编译器少一次猜测
4.2 节的实测结论是:加对齐声明在本机这个用例上没有改善指令构成(vmovups 4→5,vmovaps 2→2)。所以不要把对齐声明当成"免费的加速"。
不过它仍然值得写——理由不是性能,而是可移植性与意图表达:C++20 有标准化的 std::assume_aligned<N>(ptr),它比 __assume 清楚得多,而且在能用标准的地方就不该用编译器扩展。
判断要不要写对齐声明的方法:先按 10.6 节的四步流程量一遍(判定 → 原因 → 反汇编 → 验证)。如果反汇编里看到大量 vmovups 且确认瓶颈在载入,再考虑对齐;否则它只是一行"看起来专业"的注释。
七、UB 案例复盘:常量折叠发生得比你想象的早
第五章讲的是"别名"这条推理线,这一章讲"代数化简"那条线。用一个最小的 UB 用例。
7.1 用例:有符号溢出
int add_wraps(int x){ return x + 1 > x; }
int main(){ int x = 2147483647; printf("%d\n", add_wraps(x)); return 0; }
x 是 INT_MAX。按补码语义,x + 1 回绕成 INT_MIN,而 INT_MIN > INT_MAX 为假——"按机器怎么算"的答案是 0。
但 C++ 标准说:有符号整数溢出是 UB(expr.pre 要求求值过程不出现 UB)。在"溢出不会发生"的前提下,x + 1 > x 数学上恒为真——因为如果它不溢出,加一个正数当然更大。
7.2 实测:两个编译器给出相反的答案
| 编译器 / 选项 | add_wraps(INT_MAX) 的结果 |
|---|---|
MSVC /O2 |
0 |
MSVC /Od |
0 |
GCC -O0 |
1 |
GCC -O1 |
1 |
GCC -O2 |
1 |
GCC 全部返回 1,MSVC 全部返回 0。 这个差异不是"哪个编译器更聪明",而是它们对同一段 UB 采取了不同的处理策略:GCC 在编译早期就应用了代数化简,MSVC 选择保留回绕语义。
注意最关键的一点:GCC 在 -O0 就返回 1。 这不是"开了高优化才有的风险"——它是前端(tree 层)的代数化简,不依赖优化等级。看一下 GCC -O2 下这个函数的反汇编:
"_Z9add_wrapsi":
    mov     eax, 1
    ret
整个函数被折成了一个常量 1。 没有任何比较、没有任何加法、没有任何分支——因为"在 UB 不会发生的前提下"这个表达式等价于 true。
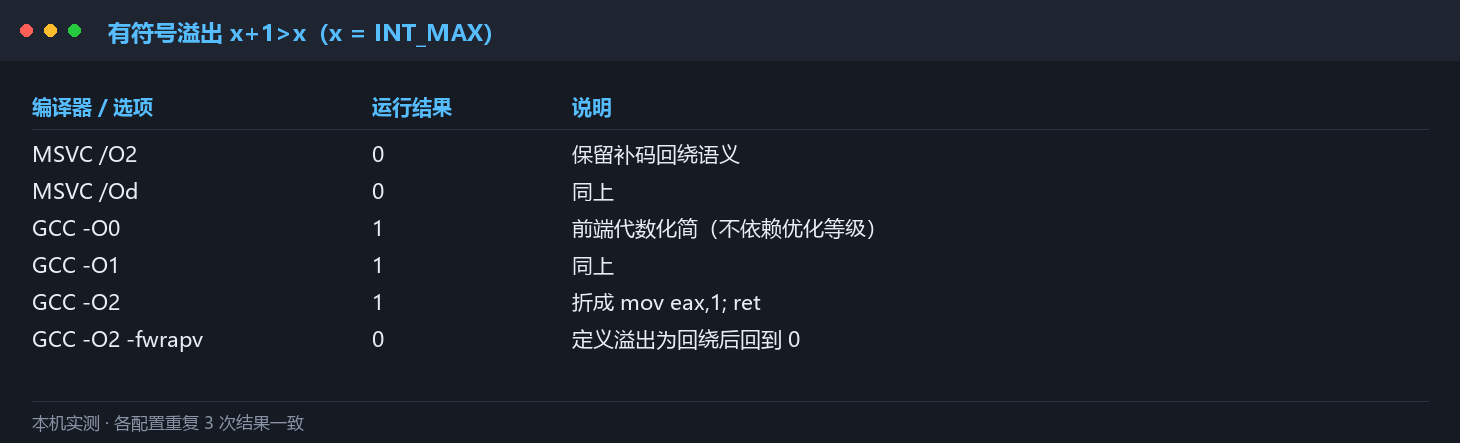
x+1>x(x=INT_MAX)的双编译器结果——MSVC 返回 0,GCC 返回 1@ 本机实测这张表的读法是"两列完全不同",而不是"其中一列是错的"。在标准眼里两列都合规——因为程序含 UB,标准对它没有任何要求。真正被这张表证伪的,是"这段代码的行为是确定的"这个想法。
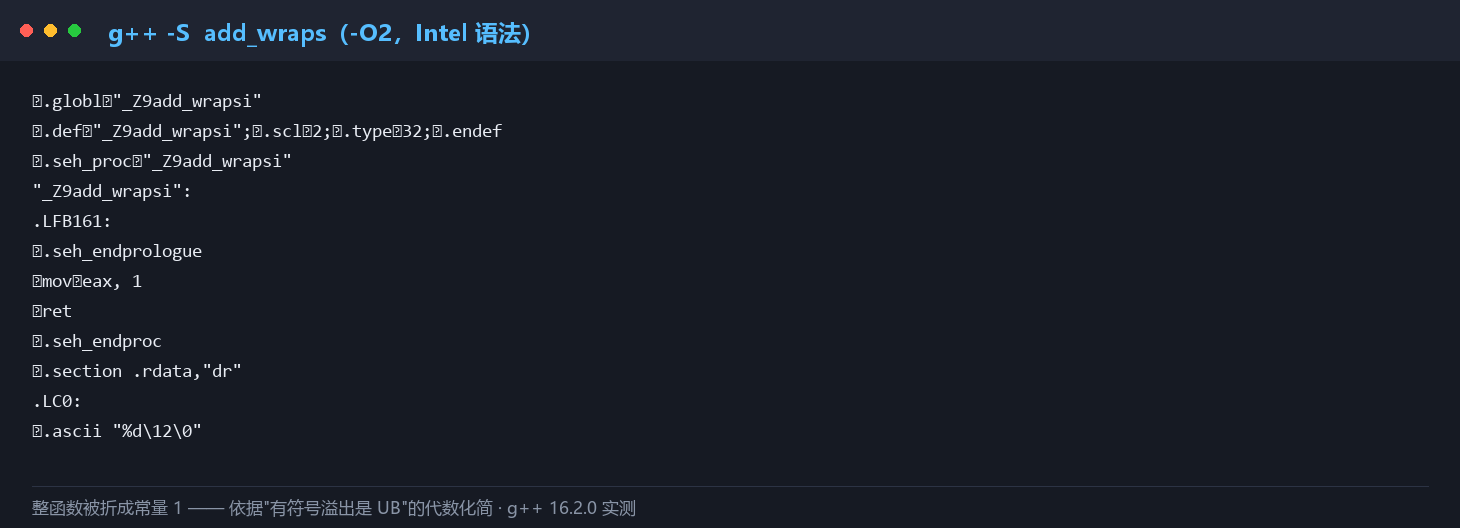
-O2 下 add_wraps 的反汇编:整函数被折成 mov eax,1; ret@ g++ 16.2.0 实测这张反汇编是整篇最有冲击力的一张图:三行源码变成一个常量返回。 没有任何比较、没有任何加法、没有任何分支。如果这段代码出现在一个真实的判空/边界检查里,那么"检查"这件事在机器码层面就彻底消失了——这不是 bug,是标准授权的推理结果。
x+1>x 恒真 → 折成常量 1@ 本系列绘制这张链式图值得顺着读一遍:起点是"标准说溢出不会发生"这个假设,终点是一个常量。 中间没有任何一步是"猜"的——每一步都是在这个假设下正确的数学推导。理解这条链,就理解了为什么"我明明写了检查"和"检查在机器码里不存在"可以同时为真。
7.3 为什么"两个编译器不一样"本身就是结论
这条实测最实用的价值不是"GCC 会折、MSVC 不会",而是:同一段含 UB 的代码,在不同编译器上可以有完全不同的可观测行为。
这意味着三件事:
- 在 GCC 上测试通过,不代表在 MSVC 上行为一致(反之亦然)。跨平台项目里,UB 是最难跨平台一致的那一类问题。
- 别指望用"实测"来给 UB 定行为。 上面那张表(0 和 1)看起来是个稳定结论,但那是"这两个版本在这两个选项下"的行为——它没有任何标准保证。换版本、换优化选项、甚至在同一个编译器里换个上下文,都可能变。
-fwrapv是把这个 UB 变成良定义的手段。 它告诉 GCC"有符号溢出按补码回绕处理",于是x+1>x回到"按机器算"的 0(见 GCC 代码生成选项)。Linux 内核历史上就用类似思路(-fno-strict-overflow)保住溢出检查——这一条有公开的案例记录(Wang 等的论文 分析了offset + len < 0这类检查被优化掉的漏洞)。
同类案例的公开讨论:Undefined Behavior: What Happened to My Code?(MIT)、UB is awesome(CppEurope 演讲)、CACM 的相关分析。
7.5 一次没复现成功的"检查被删"
文献里最常被引用的 UB 案例是"溢出边界检查被优化器删掉"。我照那个思路写了一个最小复现,想在本机看到同样的现象:
__attribute__((noinline)) int check(int offset, int len){
  if (offset + len < 0) return 0;   // 若 offset+len 溢出,这个检查本身就依赖 UB
  return 1;
}
int main(){ printf("%d
", check(2147483640, 100)); return 0; }
offset + len 会溢出(2147483640 + 100 > INT_MAX)。如果优化器"认为溢出是 UB",它就可以推出这个条件恒假,把检查删掉。
实测结果:没复现。 GCC 在 -O0、-O2 以及 -O2 -fwrapv 三种配置下,输出都是 0——也就是检查生效了,走了"溢出"那条分支。
这条"失败"的实测同样有信息量,它说明两件事:
- UB 的利用程度是编译器版本与写法相关的,不是"一句 UB 就一定被删"。 引用案例时要看清它对应的编译器版本与上下文,不能直接外推到自己的环境。
- "没复现"本身就是可报告的结果。 本系列的原则是:测到什么写什么——包括没测到的东西。把"我试了但没复现"写出来,比引用一个自己没验证的案例更诚实。
7.4 工程结论
"我没写 UB"这句话,最好由工具说,不由自己说。 三条可操作的:
- 跑 UBSan(Clang/GCC 的
-fsanitize=undefined):在运行时抓出实际的 UB 点,比读代码快。 - 关注编译器警告:
-Wall -Wextra之外,MSVC 的/W4与/analyze都会报一部分可疑写法。 - 对"依赖溢出回绕"的代码,显式写明语义:用
-fwrapv(GCC/Clang)或改成无符号运算(无符号溢出是良定义的)——把"碰巧能跑"变成"标准保证能跑"。
八、合法的替代写法:三条绕开别名规则的路
第五章讲了别名规则能造成什么后果。这一章给"合法的写法"——同样能实现低层访问,但不踩 UB。
8.1 第一条路:memcpy(最保守,全版本可用)
标准明确允许通过 memcpy 复制对象表示(object representation)。因为它被定义为"按字节拷贝",不涉及"用某类型去访问另一类型的对象",所以不违反类型可访问性。
float f;
std::memcpy(&f, &int_val, sizeof f);   // 合法:复制字节,不做类型双关访问
代价:编译器通常能把它优化成一条移动指令,但不保证(早期编译器会真的调库函数)。它是"最不容易出错"的一条路。
8.2 第二条路:std::bit_cast(C++20,语义最清晰)
C++20 引入了 std::bit_cast(P0476R2,经 P0593R6 补全隐式对象创建规则)。它在语言层面表达"按位重新解释":
float f = std::bit_cast<float>(int_val);
它的优点是语义写在类型系统里:不需要临时变量、不需要 memcpy、不能双关到有陷阱表示的类型(除非类型本身可平凡复制)。
一个 2026 年的提案值得关注:P3969R1 指出含 padding 的类型做
bit_cast时可能退化为unreachable,拟改为 ill-formed。也就是说:bit_cast也不是"任何类型都能随便转"。
8.3 第三条路:std::launder(解决"对象已换、指针还旧")
当一个对象的存储被复用(典型场景:placement new 在同一地址构造了不同类型的新对象),旧的指针仍然指向那块地址,但它指向的对象已经换人了。std::launder 的作用是把旧指针"洗"成指向新对象的指针:
T* p = new (buf) T{...};        // 在 buf 上构造 T(可能复用旧存储)
T* q = std::launder(p);         // 拿到指向"新对象"的可用指针
它的约束在 P2590R2 里有明确界定(不能用于函数类型或 void)。它不是"万能洗白器"——只在"同一存储上有新对象"这个特定场景成立。
memcpy(全版本、最保守)/std::bit_cast(C++20、语义清晰)/std::launder(存储复用场景)@ 本系列绘制8.4 三条路怎么选
| 场景 | 推荐 | 理由 |
|---|---|---|
| 需要 byte 级复制/解释 | memcpy |
全版本可用,语义最无争议 |
| 需要"按位重新解释"且能用 C++20 | std::bit_cast |
语义在类型系统里,无中间变量 |
| 同一存储上换了对象类型 | std::launder |
唯一能修正"旧指针指新对象"的工具 |
| 只是想读一个 float 的位模式 | 上面任一条 | 不要用 *(int*)&f |
相关标准与提案:basic.lval、P0476R2、P0593R6、P2590R2、P1839R7。
九、优化等级与开关的代价
前面几章都在讲"优化器能做什么"。这一章算一笔反向的账:优化等级和编译开关省下/付出了多少。
9.1 优化等级的演进脉络
各开关不是一开始就有的,-O 档位也一直在变:
| 年份 | 事件 | 来源 |
|---|---|---|
| 1990s | -O0/-O1/-O2 基本框架确立 |
GCC 早期手册 |
| 2000s | -O2 起启用类型别名优化(TBAA) |
GCC 4.1 Optimize Options |
| 2008 | -O3 额外启用 -ftree-vectorize 等 |
GCC 4.3.5 Optimize Options |
| 2011 | -fwrapv / -ftrapv 语义明确化 |
GCC 代码生成选项 |
| 2017 | -Ofast 明确"关闭严格合规" |
GCC 11.1 Optimize Options |
| 2020 | C++20 引入 std::assume_aligned / std::bit_cast |
P0476R2 / P1007R3 |
这条时间线里最值得记住的是"−O2 起开 TBAA"这一条:它意味着你不需要刻意追求最高的优化等级,就已经进入了别名假设生效的区间。 很多人以为"我只用 −O2,应该很安全"——本机第五章那个 TBAA 用例恰恰是在 −O2 下出问题的。
9.2 开优化的实际收益:4.58 倍
本机实测同一个 saxpy 循环(1M 个 float):
| 选项 | 读数 |
|---|---|
/O2 |
0.4074 ns/elem |
/Od |
1.8677 ns/elem |
| 加速比 | 4.58× |
这就是"开优化"这笔生意的实际规模——四倍多,不是"快一点点"。而代价是:你进入了 UB 与别名的推断生效区间(第五章、第七章的实测都在这个区间里)。
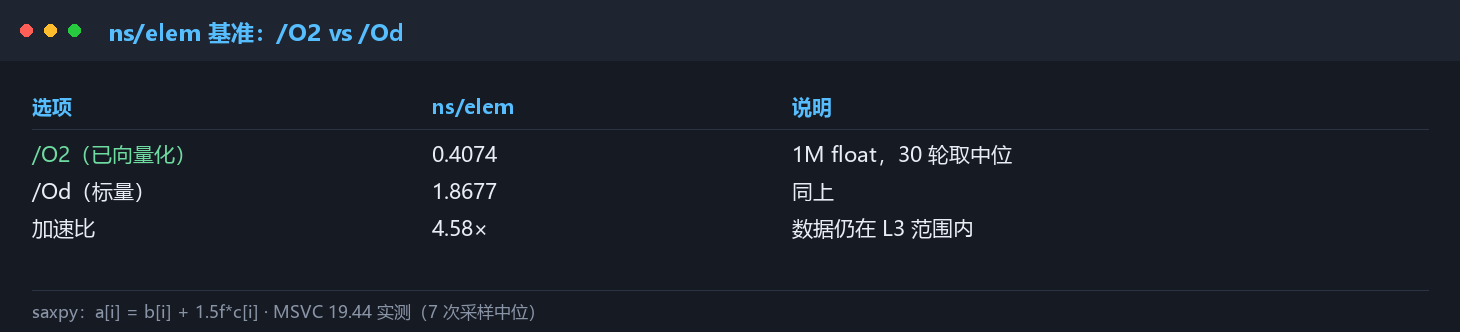
/O2 0.4074 vs /Od 1.8677(4.58×)@ MSVC 19.44 实测这个 4.58 倍的读数要连着它的前提一起记:这是一段"顺着内存走、数据在缓存里"的理想循环。 真实工程里的热点往往没有这么友好——数据更散、访问有分支、缓存反复失效。所以这个数字的意义不是"你也能快 4.58 倍",而是"关掉优化会付多大的代价"——这才是它的用途。
9.3 一个被推翻的常识:__restrict 不等于更快
第 3.5 节的判定层面结论是"加不加都向量化"。运行时层面也一样:
| 版本 | 中位 ns/elem(8 次采样,进程隔离、交替执行) |
|---|---|
加 __restrict |
0.1434 |
不加 __restrict |
0.1409 |
| 比值 | 0.98(无实质差异) |
两份代码都向量化了,跑得一样快。 这与"必须加 restrict 才有性能"的流行说法不符——至少在这个用例、这个编译器上不成立。
不过要说清楚边界:这不代表 restrict 没用。它的价值在于"编译器无法自行证明不别名"的场合(循环形态更复杂、指针来自不同层级)。而且它是语言层的承诺——你写了它,就要保证它成立;写错了(实际会重叠)反而会引入 UB。所以它更像一份"责任声明",不是一颗"性能药丸"。
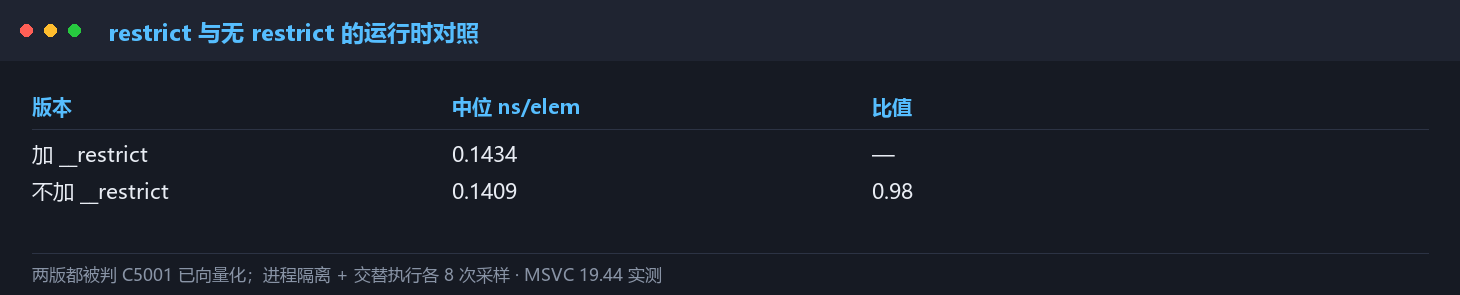
__restrict 与无 __restrict 的 ns/elem 对照:0.1434 vs 0.1409(比值 0.98)@ MSVC 19.44 实测9.4 开关的代价对照
| 开关 | 换来什么 | 付出什么 |
|---|---|---|
-O2 / /O2 |
TBAA 等优化生效(实测 4.58×) | 进入 UB 与别名的推断区间 |
-O3 |
额外启用 -ftree-vectorize |
代码体积、编译时间 |
/fp:fast / -ffast-math |
浮点归约可向量化(实测 1105 → C5001) | 浮点结果不再与严格模型一致 |
-fwrapv |
有符号溢出定义成回绕 | 失去基于溢出的代数化简 |
-fno-strict-aliasing |
类型双关代码"变对" | 关掉 TBAA 整张牌 |
这张表的核心意思是:每一个开关都是一份"权利交换",不是纯粹的增益。 知道自己换掉了什么,比记住"该开哪些"更重要。
相关文档:/fp 选项、/arch 选项、GCC Optimize Options、GCC Code Gen Options。
9.5 开关会互相影响
单独看每个开关还不够,它们之间还有交互。两条最容易踩的:
交互一:/fp:fast 是"浮点界的 -ffast-math",它会连带打开一串东西。 官方文档明确:/fp:fast 允许浮点重结合,而这正是向量化归约所需的前提(本机实测:1105 → C5001)。但它同时允许的还有:不保证 NaN/无穷的处理方式、可能改变 x != x 这类自比较的结果。这些副作用不会写在"我想让归约向量化"这个意图里。
交互二:-fno-strict-aliasing 关掉的不只是别名优化。 它关掉整张 TBAA 牌,于是"载入提升(把重复读取缓存到寄存器)""跨存储重排"这些优化会一起失效。第五章那个 TBAA 用例里它是"救命的";但在一个 TBAA 本来工作正常的工程里,它可能让性能整体下滑——而且不会有任何警告告诉你。
所以开关的正确用法是"一次只动一个,动完量一遍"。 这跟 ep04 里"extern template 要先用删除定义法验证是否生效"是同一种纪律:编译开关的效果是环境相关的,不能靠推理,只能靠测量。
十、收束与下一篇钩子
10.1 全篇读数总汇
| 实验 | 指标 | 读数 |
|---|---|---|
| 向量化用例(16 个) | 成功 / 失败 | 6 个 C5001 / 10 个 C5002 |
float 归约 |
判定 | 默认 C5002/1105 → 加 /fp:fast C5001 |
int 归约(同结构) |
判定 | C5001(默认即向量化) |
含 if/else 的循环 |
判定 | C5001(可无分支化) |
去掉 __restrict |
判定 | 仍 C5001 |
/arch SIMD 指令数 |
SSE2 / AVX2 / AVX512 | 20 / 16 / 12 |
有符号溢出 x+1>x |
MSVC / GCC | 0 / 1(GCC 折成 mov eax,1) |
| 类型双关(TBAA) | GCC /O2 |
132 / 165 / 193(每次不同) |
| 类型双关(TBAA) | GCC -O2 -fno-strict-aliasing |
−1 |
| 类型双关(TBAA) | MSVC /O2、/Od |
−1 |
| 重叠数组正确性 | 三种场景 | 差异位置均为 −1 |
| saxpy 运行时 | /O2 vs /Od |
0.4074 vs 1.8677 ns/elem(4.58×) |
__restrict 运行时 |
加 vs 不加 | 0.1434 vs 0.1409(0.98) |
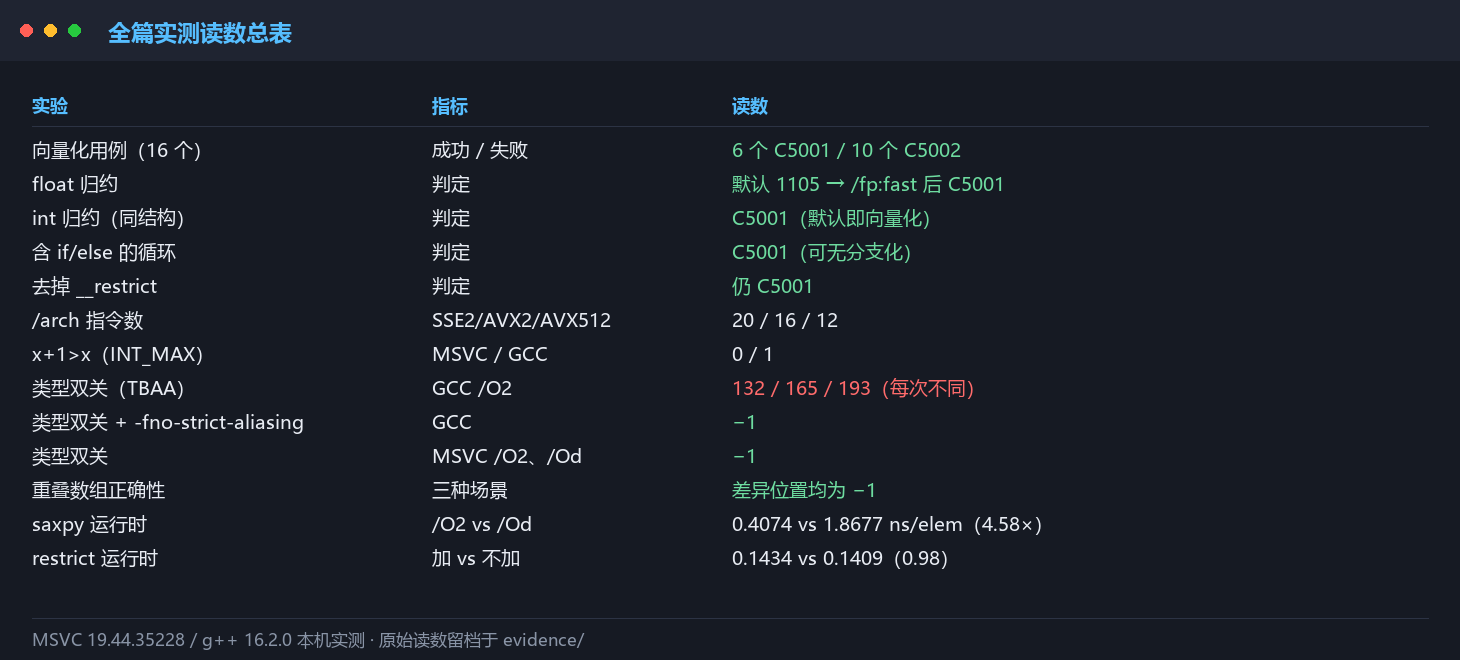
这张表值得竖着读一遍:上半部分是"优化器说了什么"(向量化判定、原因码),下半部分是"代码实际变成了什么"(汇编、运行结果、ns/elem)。两半合起来才是完整的账——只看判定容易停在"知道了但没验证",只看运行结果又不知道为什么会这样。
10.2 全量清单:本篇用到的观测手段
先把本篇出现过的观测与干预手段列全(全量清单),再在 10.3 做二次归类:
cl /Qvec-report:1——只报向量化成功的循环cl /Qvec-report:2——成功 + 失败 + 官方原因码cl /d2cgsummary——后端函数级代码生成明细dumpbin /disasm——反汇编(看实际生成的 SIMD 指令)g++ -S -masm=intel——GCC 汇编(看常量折叠)g++ -fstrict-aliasing/-fno-strict-aliasing——TBAA 开关对照g++ -fwrapv——把有符号溢出定义为回绕cl /arch:AVX2//arch:AVX512——目标 ISA 档位cl /fp:fast——允许浮点重结合cl /Odvs/O2——优化等级对照__restrict/restrict——别名承诺__assume/std::assume_aligned——对齐承诺#pragma loop(no_vector)——显式禁止向量化-fsanitize=undefined(UBSan)——运行时抓 UBstd::memcpy/std::bit_cast/std::launder——合法低层访问chrono采样——ns/elem 基准- 重叠场景正确性比对——验证向量化是否安全
10.3 二次归类:按"这是观测还是干预"分三档
上表 17 条不是同一个层面的东西。按"你用它做什么"二次归类:
| 档位 | 作用 | 包含手段 | 实测代表 |
|---|---|---|---|
| 观测档 | 看清优化器做了什么 | 1、2、3、4、5、16、17 | /Qvec-report:2 的 16 条判定 |
| 授权档 | 给优化器更多/更少的自由度 | 6、7、8、9、11、12、13 | /fp:fast 让 1105 → C5001 |
| 替代档 | 用良定义写法绕开 UB | 10、14、15 | bit_cast 替代类型双关 |
这一层归类带来一条行动顺序:
- 先观测——不要凭感觉判断"这段循环能不能向量化",跑
/Qvec-report:2看判定和原因码。 - 再决定授权——是"给编译器更多信息"(对齐、别名承诺)还是"给它更多自由"(
/fp:fast)?两者的代价完全不同。 - 最后才改写法——只有在观测确认"这个写法本身不可向量化"之后,才去重写循环或用良定义的替代实现。
10.4 六条可以带走的结论
float归约默认不向量化(1105):想向量化得开/fp:fast,但要接受浮点结果可能变化。if/else不一定是阻碍:能被无分支化的分支照样向量化。__restrict不是向量化的开关:本机实测加不加都向量化、跑得一样快(0.98)。- GCC 在
-O0就折x+1>x:UB 风险不是从-O2开始的。 - TBAA 能改变运行结果:GCC
/O2下类型双关返回每次不同的值;-fno-strict-aliasing立刻修好。 - 优化很值钱(4.58×),但代价是进入推断生效区间:知道换掉了什么,比记住"该开什么"更重要。
10.5 本篇边界
本篇只讲优化器对单线程代码做的语义改写。不涉及:
- 链接期优化(LTO/PGO 如何跨 TU 做推断):ep07 讲。
- 名字修饰、符号可见性与 ABI:ep06 讲。
- 多线程数据竞争与内存序:ep10 讲。
- 缓存行与伪共享(优化器管不了的那一半性能):ep11 讲。
10.6 怎么在自己工程里复现这套量法
把这一篇的方法整理成一条四步流程——每一步都只用一个工具,可以独立执行:
/Qvec-report:2)② 定原因(查官方原因码表)③ 看代码(dumpbin /disasm)④ 验结果(重叠/边界场景比对)@ 本系列绘制- 拿判定:对热点文件加
/Qvec-report:2,看哪些循环是C5001、哪些是C5002。 - 定原因:拿
C5002的原因码去官方表里查含义(本篇 4.6 节已整理常用项)。 - 看代码:对关键函数跑
dumpbin /disasm,确认生成的是 SIMD 还是标量。 - 验结果:这一步最容易被跳过,也最不该跳——构造重叠/边界场景,和标量参考实现逐元素比对(本篇 5.4 节的做法)。
10.7 一张决策表
把整篇的结论压成一张"遇到问题先查这里"的表:
| 你观察到的现象 | 最可能的原因 | 先做什么 |
|---|---|---|
| 浮点求和/求平均循环没向量化 | 浮点归约需要重结合 | 试 /fp:fast(接受浮点语义变化) |
| 循环里有分支,以为不能向量化 | 分支可能被无分支化 | 先跑 /Qvec-report:2 看判定,别猜 |
加了 __restrict 但没变快 |
本就不需要它就已向量化 | 查判定:若已是 C5001,restrict 无用 |
| 向量化后结果与预期不符 | 浮点求值顺序改变 | 用标量参考实现逐元素比对 |
| 类型双关代码行为不稳定 | TBAA 重排了内存访问 | 改用 memcpy/bit_cast,或临时 -fno-strict-aliasing |
| GCC 与 MSVC 行为不一致 | UB 或别名假设不同 | 两边都测;对依赖回绕的代码加 -fwrapv |
| 优化开了但没变快 | 瓶颈不在指令数 | 量端到端时间;查内存访问与数据布局 |
最后把这一篇聊到的所有开关汇成一张对照图——每个开关左边是它给你的东西,右边是它拿走的东西。 这张图建议和 10.7 的决策表放在一起看:决策表告诉你"遇到什么现象查哪个方向",这张图告诉你"动了那个开关会失去什么"。
10.8 与本系列前作的呼应
这一篇的四条主线,其实都能对应到前面几篇的伏笔:
| 前作 | 本篇的呼应 |
|---|---|
| ep01 对象布局 | 别名规则关心的是"同一块内存被谁访问"——布局是这件事的物理基础 |
| ep02 分配器 | 对齐分配(aligned_alloc)直接决定 4.2 节的对齐前提是否成立 |
| ep03 值语义 | 移动/拷贝的语义之所以能"零开销",前提也是编译器的推断生效 |
| ep04 编译期账本 | ep04 算的是"花多少时间",本篇算的是"改成了什么"——两笔账都在编译期 |
第二波「编译器与链接器」的路线到这里走了一半:ep04 看编译器花的时间,ep05 看编译器做的改写,ep06 转向链接器(名字与符号),ep07 收在跨 TU 的优化(LTO/PGO)。
资源清单
- 标准原文:ub(UB 定义)、basic.lval(类型可访问性)、basic.life(对象生命周期)、dcl.type(cv 限定符)、expr.pre(求值前提)
- 核心提案:P0476R2(bit_cast)、P0593R6(隐式对象创建)、P2590R2(launder 约束)、P1839R7(对象表示访问)、P3969R1(bit_cast 与 padding)
- MSVC 文档:向量化原因码表、自动并行化与自动矢量化、/Qvec-report、/fp 选项、/arch 选项
- GCC 文档:Optimize Options 4.1、Optimize Options 4.3.5、Optimize Options 11.1、Code Gen Options 12.5
- 论文与演讲:Undefined Behavior: What Happened to My Code?(MIT)、UB is awesome(CppEurope)、CACM: Undefined Behavior
- 实践参考:What is Strict Aliasing(Shafik)、Why Your Compiler Cannot Vectorize That Loop、HPC in 2026 · Vectorization、Intel 向量化建议
- 外部素材:MSVC 向量化原因码表界面(
learn.microsoft.com)、MSVC/fp选项语义(learn.microsoft.com),均按引用链接使用 - 本机实测源码与原始读数:随篇入库,路径
content/blog/cpp-language-foundations-ep05-optimizer-limits/evidence/
下篇预告
【C/C++ 现代语言与底层】(六)名字与符号:ABI、修饰、可见性、PLT 与 IAT——为什么 extern "C" 能解决链接问题?符号修饰(name mangling)到底在编什么信息?动态库里的函数调用为什么要绕 PLT/IAT 一圈?__declspec(dllexport) 与 -fvisibility=hidden 背后是同一件事吗?用 dumpbin /symbols、nm 与 readelf 把链接器的账本摊开来看。
希望能对大家有所帮助。下一篇见。
本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations