站点链接:技术博客页
【移动端图形与功耗】第 6 篇 | 系列共 7 篇
- 上一篇:【移动端图形与功耗】(五) 延迟着色在移动端:能做什么、不能做什么
- 下一篇(预告):【移动端图形与功耗】(七) 测量与调优:怎么证明你真的优化了
系列文章前言
1.1 一句话点题:第六篇要算什么
上一篇交棒时留下一句话:可变速率着色(Variable Rate Shading, VRS)改的是「每像素付多少着色」,网格着色(Mesh Shader)改的是「几何怎么提交」,硬件光线追踪(hardware ray tracing)改的是「每像素算多少射线」——三种改法落在同一本账上。本篇的命题只有一句:移动端的「现代特性」不是能不能开,是开了之后有没有真的生效。
判据也只有一条:有没有破坏片上流程。说白了,这一篇不做特性介绍,只把账面收益算成能判定的结论。
1.2 原理与概念:前五篇留下的三本账
下面我们开始对账。前五篇是三个账本逐层加厚的过程:第 2 篇拆开了分块这台机器,第 3 篇把「搬多少字节」算成与分辨率无关的单位 BU,第 4 篇划出每秒付得起多少焦耳的预算线,上一篇把中间物能不能留在片上钉在一条硬线上——128 bit/像素。
这张表是本篇的起跑线:三本账各有计量单位与预算上限,而本篇要审的三个特性,恰好各自动其中一本。
| 前置篇 | 交到本篇手里的东西 |
|---|---|
| 第 1 篇 物理约束 | 两条墙:带宽决定一帧能搬多少,功耗与散热决定能搬多久 |
| 第 2 篇 分块渲染 | 片上流程:几何 → bin → 逐 tile 着色 → 只写回最终像素 |
| 第 3 篇 带宽 | 「一个屏幕像素」这个计量单位与 BU 账本 |
| 第 4 篇 功耗与热 | 每秒付得起多少焦耳的预算观 |
| 第 5 篇 延迟着色 | 中间物落不落地决定成败;预算硬卡 128 bit/像素 |
先来看这个对应:VRS 动像素账,网格着色动几何账,光追动光照账。 三本账不是独立预算,它们会互相抵消——这正是第 1 章要把三者摆到同一页上算的原因。
1.3 原理与概念:全系列内容总览与阅读建议
系列七篇按「约束 → 机制 → 账本 → 代价 → 取舍 → 新特性 → 测量」推进,本篇正是第 6 篇,夹在「取舍」与「测量」中间——前五篇把约束、机制、三本账和取舍都审完了,这一篇轮到落地与验证新特性,为第 7 篇的测量方法预留好上下文。
阅读建议三条:只看结论的,翻到零章末那张总表;要复现的,跳到第十章拿配置清单与验收脚本骨架;只关心某一支的,VRS 走第二、三章,网格着色走第四、五章,光追走第六、七章。
范围上也要先说清:本篇不涉及虚拟几何与 Nanite、不涉及神经渲染与超分(DLSS/FSR/XeSS)、不涉及 PC 与主机端的光追实现对比——这三块各有独立的技术纵深,混进来会把账算糊。边界只画在移动端,只画在「特性有没有真的生效」这一个问题上。
1.4 原理与概念:本篇要回答的三个问题
本篇要回答三个问题,一个特性配一个:VRS 把着色率按下去了,画质与帧率的净效果是不是正的?网格着色把几何提交变简单了,为什么在被测平台上反而更慢?光追让射线算得动了,代价是不是从算力转移到了别的地方?
三个问题有先后:第一个不拆开,就看不出第二、三个坏掉的其实是同一件事。三问的答案方向倒是整齐,都反着直觉来——开了不等于生效,更简单不等于更快,算得动也不等于算得起。
1.5 原理与概念:边界声明
本篇不涉及四件事:纳米级虚拟几何(Nanite)这类虚拟几何流水线、神经渲染与超分辨率、PC 端光追的横向对比、主机端光追的实现细节——前两件属于另一条路线,后两件的约束条件与移动端差得太远。
另有三条口径:「移动端」指 Arm Mali / Immortalis、Qualcomm Adreno、Imagination PowerVR 与采用上述架构的 MediaTek 平台;性能以帧时间与功耗为主,不做跑分排名;厂商宣称的数字一律标明,与第三方实测分列。
1.6 原理与概念:本篇的因果链
把骨架先摆出来,后面每一章都在填其中一环。
VRS 改的是每像素付多少着色,但 Vulkan 规范写明:违反若干条属性限制(深度与模板写入、sample mask、保守光栅、片元着色器互锁、自定义采样位置等)时,实现会把着色率自动降为 (1,1),且不报错 Vulkan 指南。网格着色改的是几何怎么提交,可提交内容一变,驱动「依据提交内容预测所需资源」的能力就失效——Arm 与 Qualcomm 2026 年的联合实测里,网格着色路径 75.1 FPS / 3.77 W,传统索引路径 121.4 FPS / 2.02 W Arm 原文。光追改的是每像素算多少射线,但独立管线以射线生成取代光栅化,会丢掉帧缓冲压缩,而这条红利本是分块架构最大的一笔进项 Vulkan 原文。
三条路径的终点是同一个问题:这套片上流程有没有被破坏。 流程被破坏,收益就会换个形式还回去——还成功耗、还成带宽,或者干脆还成帧时间。
1.7 原理与概念:怎么读这一篇
读法很灵活:只想拿结论的,零章末的总表加第十章末的验收判定表,二十分钟读完;想复现的,第十章有配置清单、六个可观测信号与验收脚本骨架;要做选型判断的,第九章的决策树按画质目标、内容特征、目标设备三层给分支。
好了,言归正传,下面从「落地」的定义开始。
概念清理:什么叫「落地」
2.1 一句话点题:开了不等于生效
零章只做一件事:把「落地」定义清楚。先给三个反直觉的事实,各一句。VRS 开了之后可能被实现静默降回 1×1,而且不报错——这不是驱动偷懒,是规范为了跨设备可移植性刻意做的设计。网格着色在移动端实测比传统路径更慢,不是谁没优化好,是提交路径决定的。光追里最划算的那条路是嵌在片元阶段里的内联查询,独立管线排在它后面。
三句话各对应一种失效方式。所以这一章先把判据立起来再谈数字,否则后面每章的数字都会被读成没有前提的「快了几成」。
2.2 原理与概念:三条判据从哪来
先来看看它们的来历。三条判据不是本篇发明的,是从前五篇里继承的。
第一条来自第 2 篇的片上流程:几何 → bin → 逐 tile 着色 → 只写回最终像素——中间数据一旦离开片上再回来,收益就要打折Arm 原文。第二条来自第 3 篇的 BU 账:读一整屏算一趟,没记进账本的流量只是被藏起来了。第三条来自上一篇的片上预算:中间物落不落地决定成败,预算按 128 bit/像素硬卡。三条合起来只剩一句:特性必须待在片上流程里——进得去、留得住、算得清。
2.3 原理与概念:术语清理之一——三个「延迟」与三个「降频」
术语得先对齐。上一篇清掉了「三个延迟」:分块延迟渲染是硬件架构,延迟着色是渲染算法,帧缓冲延迟写回是内存行为——区别在「延迟什么」和「中间物归谁管」。
这一节的重点是三个「降频」,它们都主张「少算一点」,但谁定义、语义有多硬,两处不一样。可变速率着色(VRS)由 VK_KHR_fragment_shading_rate 定义,用整数块尺寸(1×1、2×2、4×4 等)规定一个屏幕区域里跑多少次片元着色 Vulkan 规范。注视点渲染(foveated rendering)是应用场景,不是 API:屏幕中心保持高密度、外围降密度。片段密度图(Fragment Density Map, FDM)由 VK_EXT_fragment_density_map 定义,用归一化浮点密度值 (0.0, 1.0] 表达密度,属提示语义,实现可以自行优化 Vulkan 规范。
这张表的结论只有一处:VRS 是硬约定,FDM 是软提示——两者都能降着色次数,但只有前者能当验收依据,因为它的执行结果可核对。
| 名称 | 谁定义 | 值的形式 | 语义硬度 |
|---|---|---|---|
| VRS | VK_KHR_fragment_shading_rate |
整数块尺寸(1×1、2×2、4×4…) | 强:实现需按规范执行 |
| 注视点渲染 | 应用 / 引擎 | 由实现决定 | 场景,不是 API |
| FDM | VK_EXT_fragment_density_map |
归一化浮点密度 (0.0, 1.0] | 弱:提示语义 |
2.4 原理与概念:术语清理之二——几何侧的三种提交
几何侧的三个名字经常混着用,区别在一件事上:谁知道要画什么,以及什么时候知道。传统索引化几何管线在提交那一刻,驱动就看见了全部索引与顶点属性,可以提前备好着色器与顶点缓存。GPU 驱动渲染(GPU-Driven Rendering)把剔除与提交挪到 GPU 侧,代价是「提交什么」要等运行时才知道。网格着色走得更远:VK_EXT_mesh_shader 用 task 与 mesh 两个 compute 风格的阶段整体替换前光栅化管线,几何与索引由着色器生成或从 buffer 读,连顶点输入接口都不用了 Vulkan 指南。
对照里最关键的一行是「驱动能否预取」:预取能力一丢,收益就不再由「提交方式先不先进」决定,而由「剔除做得够不够真」决定——第 5 章会用移动端的四方案实测把这句话坐实。
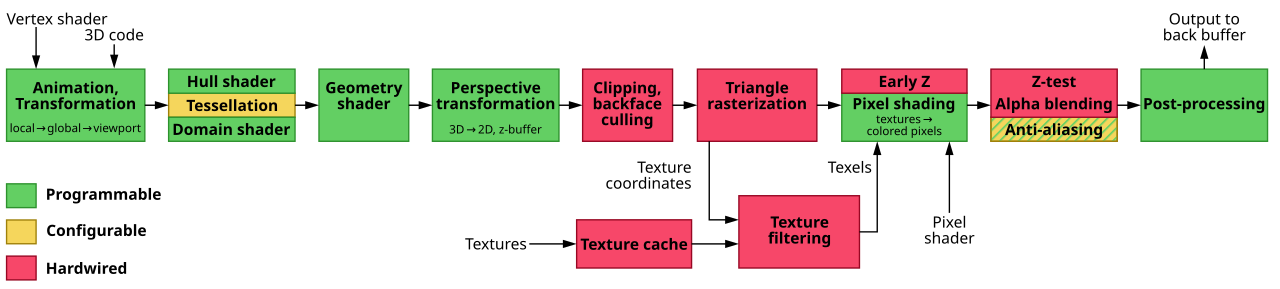
网格着色在移动端不是没生效,而是生效之后把驱动多年积累的预取红利交了回去。
2.5 原理与概念:术语清理之三——光追的两条路
光追在 Vulkan 里是两条完全不同的路,一句话能说清:一条在片元里问一次几何,另一条用射线把画面画出来。 前者是光线查询(ray query),在任意着色器阶段声明查询对象、用 OpRayQueryProceedKHR 推进求交,叠加在现有光栅管线之上 Vulkan 指南。后者是光追管线(ray tracing pipeline),一整套独立管线,用 OpTraceRayKHR 发射线、靠着色器绑定表(Shader Binding Table, SBT)组织命中着色器,以射线生成取代光栅化。Arm 的口径是两条路硬件都支持,但建议移动端从 ray query 起步:内联那条吃得到片上压缩,独立那条会丢掉帧缓冲压缩 Vulkan 原文。
顺带说一句:这两条路在移动端的收益方向是相反的,一个吃得到压缩、一个丢掉压缩。这件事第 6 章讲机制、第 7 章讲账。
2.6 原理与概念:三代特性的时间线
三个特性不是同一批出现的。把关键节点按时间排开,能看清一件事:移动端的支持总是晚于桌面,而且晚的方式各不相同——VRS 是芯片代际门槛,网格着色是先桌面后移动,光追则直接以移动为起点Arm 文档。
先来看这张时间线,它也是本篇后面所有「支持矩阵」的来源之一——节点只收公开文档里被明确表述过的能力,不按技术首次出现的年份算。
| 时间 | 节点 | 支 |
|---|---|---|
| 2018 | NVIDIA Turing 给出 meshlet 尺寸建议:≤64 顶点 / ≤126 图元 NVIDIA 文档 | 网格着色 |
| 2020 起 | Godot 文档口径:Snapdragon 888 及更新支持 VRS Godot 文档 | VRS |
| 2021 | 天玑 9000 及更新支持 VRS;收录进 KHR 的年份(待核实) | VRS |
| 2022 | Mali-G615 / G715 起支持 VRS;同代 Immortalis-G715 成为首款移动端硬件级光追 GPU Arm 原文 | VRS / 光追 |
| 2022 | VK_EXT_mesh_shader 取代 NV 私有扩展,成为跨厂商标准 |
网格着色 |
| 2025 | Snapdragon 8 Elite Gen 5 产品页列出 Mesh Shading 出处;天玑 9500 原生支持 Vulkan Raytracing Pipeline MediaTek | 网格着色 / 光追 |
| 2026 | Arm × Qualcomm 给出移动端网格着色的功耗实测:75.1 vs 121.4 FPS | 网格着色 |
年份口径:以该能力在公开技术文档中被明确表述的时间为准,不是技术首次出现的年份;2021 年那行已注明待核实。
2.7 原理与概念:静默失效的三种形态
三个特性的失效方式并不一样,但可以归成三类。分清楚这三类,后面每一章就知道该去找什么证据——不能笼统地问「这个特性有没有用」,得逐条对判据。
第一类是降级。 实现按规范把着色率压回 (1,1),不报错、不留痕——规范这么写是为了让同一套算法能跨设备发布,代价是「开了但没生效」不会被任何人发现,VRS 属于这一类。第二类是负收益。 特性打开了、也确实在跑,但账面是负的:移动端的网格着色并非没生效——它生效了,代价是把预取红利交了回去。第三类是红利流失。 特性本身有效,但它绕过了某条既有优化路径,把省下的又还了回去,独立光追管线丢掉帧缓冲压缩属于这一类。三类的共同点是:都不会在日志里留下痕迹。
2.8 实现与配置:本篇的验证方式
判据立起来了,接下来要有能观测的信号。本篇统一用六个,前三类证明「开了」,后三类证明「生效」——这六个信号串起来,就是第 10 章那份验收清单的骨架,也是我们判断一个特性有没有落地的最小证据集。
| # | 信号 | 怎么读 | 能证明什么 |
|---|---|---|---|
| 1 | 扩展与特性位 | vkGetPhysicalDeviceFeatures2 查特性位 |
设备声明支持(不等于生效) |
| 2 | 管线状态 | VRS 的 fragmentSize;新阶段位 0x40 / 0x80 |
确实设进去了 |
| 3 | 着色率图内容 | 逐帧导出着色率图附件 | VRS 有没有被静默压回 (1,1) |
| 4 | GPU 侧计数器 | 片元着色调用数、顶点吞吐、bin 数 | 着色次数与提交路径的实际变化 |
| 5 | 帧时间 | 分段计时,拆开主表面与后处理 | 净收益是正是负 |
| 6 | 功耗与频率 | GPU 频率与整机功耗,看稳态 | 收益是不是靠拉高频换来的 |
这张表的用法有顺序:信号 1 到 3 只能排除「根本没开」,信号 4 到 6 才回答「开了有没有用」。 工程上最常见的误判,恰恰是拿前三个信号当成了结论。
说白了,六个信号合起来是一条闭环:查特性位、回读管线状态、导出中间物、读计数器、分段计时、看稳态功耗——第 10 章会把它拆成三个特性各自的验收骨架,让大家在真机上照着跑一遍。
2.9 效果与量化:先给结论表
零章的最后一步,把三个特性乘三条判据压成一张表。后面九章都是这张表的展开:每一章负责填其中一格,填完之后再回到这里复核这张表有没有被推翻。
表里的数字分两列口径:厂商宣称值与第三方实测,不混着写。
| 特性 | 改的是什么 | 静默失效形态 | 关键证据(口径已标注) |
|---|---|---|---|
| 可变速率着色(VRS) | 每像素付多少着色 | 降级:违反属性限制即静默降为 (1,1) | 规范条款 Vulkan 指南;能效 >30% / 帧率 38%(厂商宣称)出处 |
| 网格着色 | 几何怎么提交 | 负收益:实测更慢、更费电 | Arm × Qualcomm 实测:75.1 vs 121.4 FPS、3.77 vs 2.02 W Arm 原文 |
| 移动光追 | 每像素算多少射线 | 红利流失:独立管线丢掉帧缓冲压缩 | Arm 口径;ACM 同行评审 实测:Bistro 286 vs 592 ms、Sponza 29 vs 466 ms 出处 |
表格里最关键的是第三列:三个特性坏的不是同一种东西。 所以修法也不同——降级要去查限制条件,负收益要去查提交路径,红利流失要去看压缩有没有被绕过。
2.10 源码与数据链接
依然是惯例,本章引用的规范条款、扩展说明与厂商口径,原始出处如下:
- Vulkan 规范·光栅化章节:https://docs.vulkan.org/spec/latest/chapters/primsrast.html
VK_KHR_fragment_shading_rate参考页:https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_fragment_shading_rate.htmlVK_EXT_fragment_density_map参考页:https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_fragment_density_map.htmlVK_EXT_mesh_shader扩展提案:https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_mesh_shader.html- Khronos 博客·网格着色:https://www.khronos.org/blog/mesh-shading-for-vulkan
- Vulkan 教程·光追总览:https://docs.vulkan.org/tutorial/latest/courses/18_Ray_tracing/00_Overview.html
- Qualcomm 博客·VRS 实测(厂商宣称):https://developer.qualcomm.com/blog/variable-rate-shading-has-arrived-mobile-impressive-results
- Arm 产品页 Mali-G715(厂商宣称):https://www.arm.com/zh-cn/products/silicon-ip-multimedia/gpu/mali-g715
- Arm Community·Immortalis-G715:https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/arm-immortalis-g715-developer-overview
- MediaTek 开发者中心·VRS:https://developer.mediatek.com/VariableRateShading/642428c3f55b040d6989a991.html
- Microsoft Learn·D3D12 的 VRS:https://learn.microsoft.com/windows/win32/direct3d12/vrs
- AMD GPUOpen·RDNA 性能指南:https://gpuopen.com/learn/rdna-performance-guide/
- Godot 文档·可变速率着色:https://docs.godotengine.org/en/latest/tutorials/3d/variable_rate_shading.html
- Qualcomm·Adreno 移动最佳实践:https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Arm × Qualcomm·GPU-Driven(实测):https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2026_2D00_mmg_2D00_rodrigo_2D00_gpu_2D00_driven.pdf.pdf
- NVIDIA·Turing 网格着色(meshlet 尺寸):https://developer.nvidia.com/blog/introduction-turing-mesh-shaders/
- Arm·Mobile Ray Tracing Demystified:https://www.vulkan.org/user/pages/09.events/vulkanised-2026/Mobile-Ray-Tracing-Demystified-Iago-CalvoLista-Arm.pptx.pdf
- ACM 论文·移动端光追帧时间:https://dl.acm.org/doi/pdf/10.1145/3721239.3734103
- Snapdragon 8 Elite Gen 5 产品页:https://www.qualcomm.com/products/mobile/snapdragon/smartphones/snapdragon-8-series-mobile-platforms/snapdragon-8-elite-gen-5
2.11 这一章留下的问题
好了,零章只解决了「怎么判」,还没解决「判出来是什么」:三个特性的证据链一条都没铺开,判据里的三条也还只是断言。下一章先把三本账摆上桌,算清每个特性要动的是哪一项账目——这一步不做,后面所有数字都会失去参照。然后我们会带着同样的六个信号回到每个特性,逐条验证它到底有没有真的生效。
一、先把三本账摆上桌
3.1 一句话点题:着色、几何、光照各付什么
第 3 篇把带宽算成了「一个屏幕像素」这个无量纲单位,第 4 篇划定了每秒付得起多少焦耳的预算,第 5 篇摆出了片上内存那条 128 bit/像素的硬线。三本账此前各算各的,从这一篇起要一起用。
本篇的三个特性正好各自动了一项:可变速率着色(Variable Rate Shading, VRS)动像素账里的「着色多少次」,网格着色(Mesh Shading)动几何账里的「几何怎么提交」,光线追踪(Ray Tracing)动光照账里的「每像素算多少射线」。
3.2 原理与概念:像素账——着色次数 × 每次的带宽
下面我们开始记账。像素账的算式很短:一帧的像素开销 ≈ 被着色的片元数 × 每次着色的代价Arm 原文。前半段是次数,后半段是每次要付的指令与采样字节,两端在移动端都在涨。
容易被忽略的是,它看的不是屏幕上有多少像素,而是着色器被调用多少次:同一像素可能被多个重叠图元重复调用,几个像素也可能在 VRS 之后被合并成一次调用Android 文档。
VRS 压的正是后一种:它在光栅化之后插一次降频,让一个区块里的若干像素共用一次着色,换来的是带宽与着色吞吐的下降 NVIDIA 文档。高通与网易的合作项目给出的实测是能效提升超过 30%、帧率提升 38%,属厂商实测 出处。说白了,像素账就是次数 × 单价。
3.3 原理与概念:几何账——提交路径决定可预取性
几何账看起来最好算,但移动端实测反复指出:决定几何开销的不是三角形数量,而是提交路径。
传统路径把「要画什么」写进绘制命令,驱动在命令到达前就能预取需要的着色器与顶点描述符;GPU-driven 与网格着色把它塞进间接缓冲(indirect buffer),内容要运行时才知道,这份预测能力就没了。Arm 与高通 2026 年的联合材料把这条列为移动端网格着色开销的三个来源之一 Arm 原文。
同一份材料还指出,GPU-driven 渲染的强制缓冲只有约 3 MB,真正吃流量的是顶点流式读取,量级在 400 MB 以上,几何账的大头在顶点数据本身。参照一个硬件尺度:NVIDIA 把 Turing 的网格簇(meshlet)尺寸卡在不超过 64 顶点、126 图元,因为首代硬件按 128 字节粒度分配 NVIDIA 文档;Khronos 也强调,网格着色换掉的是整段前光栅化管线 Khronos 规范。
3.4 原理与概念:光照账——采样数与能耗量级
光照账换了一把尺子:光栅化的光照是解析式的,算一次就是一次;光追的光照是采样式的,每像素的射线数直接决定噪声与成本arXiv。
求交能耗之所以是量级问题,是因为光线要在加速结构上反复访问内存。Arm 给出的量级是主存(RAM)约 100 pJ、片上二级缓存(SLC)约 10 pJ,差一个数量级 Arm 原文。这条账能直接接上 ep03 与 ep04 的结论。
另一把尺子是吞吐:Imagination 的 PowerVR Photon 里,IMG CXT-48-1536 RT3 核集成 3 个光线加速簇(Ray Acceleration Cluster, RAC),累计 1.3 GRay/s Imagination;Arm 在 Mali G1 Ultra 上引入 RTUv2,改善高光线发散场景,采用单光线模型 Vulkan 原文。两者都是厂商宣称值,只用来标注移动端硬件的量级位置。
3.5 原理与概念:三本账为什么必须一起算
三本账之所以不能分开算,是因为拧动一个旋钮会牵动另外两本。
先看最直接的一对:VRS 省的是像素账,但要想靠光追把光照账一起省下来,就得用内联式(ray query)让光线留在片元阶段、继续吃片上压缩;一旦切到独立光追管线,帧缓冲压缩丢掉,光照账省下的那点又被内存账吃回去Vulkan 规范。
再看一对更隐蔽的:延迟着色写几何缓冲(G-Buffer)时会做深度导出(depth export),而深度导出恰好是 VRS 的降级触发条件之一,AMD 的 RDNA 性能指南把它和 Post-depth coverage 一起列进了会削弱 VRS 的常见操作 GPUOpen。还有一对符号是反的:网格着色在移动端省不下几何账,反而抬高功耗账。
3.6 实现与配置:量这三本账要看的计数器
三本账各有仪表盘:像素账看 GPU 使用率与着色器调用数;几何账看指令总数与顶点流式读取流量;光照账兼看内存访问的能耗折算与每次求交的周期数Android 文档。
举个例子。Adreno 的离线编译器给出的芯片侧指令开销,在同一段场景的 Indexed 与 Indirect 两种提交下是 Total Instructions 1215 vs 1479、Cycles Text 12.1 vs 40.5 Qualcomm 文档——指令数只涨两成,纹理读周期却涨了两倍多,说明几何账的上涨主要落在读取侧。
Arm × 高通那份材料给的对照更直观:传统 Indexed 路径的 GPU 使用率是 82.8%、频率 656 MHz,GPU 网格着色是 98.7%、1012 MHz Arm 原文。
3.7 效果与量化:三本账的量级对照
把三把尺子并排放,量级差异就出来了:带宽用无量纲的 BU,功耗用每次访问的皮焦,指令用芯片侧计数。
| 账 | 尺子 | 参照值 | 出处与口径 |
|---|---|---|---|
| 带宽账 | BU(无量纲,归一化到一个屏幕像素) | 帧缓冲压缩 AFBC 约 2:1;AFRC 最高 4:1 | Arm 官方,厂商宣称 |
| 功耗账 | 每次访问的皮焦(pJ) | RAM 约 100 pJ、SLC 约 10 pJ | Arm 官方,量级值 |
| 指令账 | 芯片侧指令数 / 纹理读周期 | 1215 vs 1479;Cycles Text 12.1 vs 40.5 | Adreno 离线编译器,厂商工具实测 |
最该带走的是 pJ 那一行:搬一次付 100,算一次付 10,所以移动端优化往往是「把数据搬到离计算更近的地方」,而不是「算得更快」;换句话说,账本结构本身就在奖励「搬得近」这一侧Arm 文档。
3.8 效果与量化:一个具体的账本推演
拿一台旗舰机走一遍账:1080p、60fps,帧预算 16.7 ms。
像素账:开 VRS 的实测增益是帧率 38%、能效 >30%(厂商实测)出处,但同一条管线里若做了延迟着色的深度导出,这项收益要先打折。几何账:网格着色在 Ball Collision 基准上是 75.1 FPS / 3.77 W,传统 Indexed 路径是 121.4 FPS / 2.02 W Arm 原文,这一代硬件上是负收益。
光照账:按 1080p 约 2.07 M 像素、每像素 1 条射线、60fps 算,需要约 124 MRay/s,理论余量约 10 倍 Imagination。但这是峰值口径,落到实际帧里还要再扣掉光线相干性与遍历效率的折扣,所以余量只是上限,不是可以兑现的额度。
一句话收束:同一台机器上,三个旋钮的符号是 +、−、+,而末一个还只是峰值口径。
3.9 源码与数据链接
依然是惯例,本章用的原始出处按账目归类,便于逐项回溯;下表链接均为厂商官方文档、规范原文或工具文档,全部可以点开原文逐条核对,没有二手转述,便于日后复核,也用不着再去找二手整理。
| 账 | 来源 | 链接 |
|---|---|---|
| 像素账 | NVIDIA 官方博客《Advanced API Performance: Variable Rate Shading》 | https://developer.nvidia.com/blog/advanced-api-performance-variable-rate-shading/ |
| 像素账 | 高通开发者博客:VRS 在移动端的实测(与网易合作) | https://developer.qualcomm.com/blog/variable-rate-shading-has-arrived-mobile-impressive-results |
| 几何账 | Arm × 高通联合材料《State of GPU Driven Rendering on Mobile》(2026) | https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2026_2D00_mmg_2D00_rodrigo_2D00_gpu_2D00_driven.pdf.pdf |
| 几何账 | NVIDIA 官方博客《Introduction to Turing Mesh Shaders》 | https://developer.nvidia.com/blog/introduction-turing-mesh-shaders/ |
| 光照账 | Imagination PowerVR Photon 光线加速架构页 | https://www.imaginationtech.com/products/gpu/graphics-architecture/powervr-photon/ |
| 功耗账 | Arm Immortalis-G715 开发者概览(含内存能耗量级) | https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/arm-immortalis-g715-developer-overview |
| 指令账 | 高通官方文档《Adreno GPU on Mobile: Best Practices》 | https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html |
其中几何账那份 Arm × 高通材料,是本篇唯一给出移动端网格着色功耗实测的厂商级来源,第五章会反复用到它,其余来源会在对应章节再次引用,便于日后交叉引用。
3.10 这一章留下的问题
好了,账摆到这个份上,三个旋钮各自的调节范围还没量:VRS 能拧到多细、网格着色何时可能由负转正、光追的峰值余量能落进实际帧多少。这三个问题分别对应下面三章,本章只负责建账,不负责调账。
二、VRS 机制:三档与组合器
4.1 一句话点题:VRS 改的是「每像素付多少着色」
VRS 不减少像素、也不降低分辨率,它在光栅化之后、片元着色之前插一步,让一个区块内的若干像素共享同一次着色;这一步并不改变画面的几何数量与像素数量NVIDIA 文档。
所以它改的是「每像素付多少着色」,而不是「有多少像素」。这里要强调一句:降的是着色频率,不是光栅化精度——光栅化仍逐像素进行,这正是 VRS 能保住边缘几何清晰度的原因 Vulkan 指南。Vulkan 侧的载体是 VK_KHR_fragment_shading_rate(扩展 #227,已 Ratified)Vulkan 规范。
4.2 原理与概念:Per-Draw 档
先来看看最粗的那一档。第一档是逐次绘制(Per-Draw),也叫管线档:在图形管线创建时挂上 VkPipelineFragmentShadingRateStateCreateInfoKHR,或在命令缓冲里用动态调用 vkCmdSetFragmentShadingRateKHR,两者都只给一个 fragmentSize,粒度是整次绘制 Vulkan 规范。这是三档里最省事的一档,代价是粒度最粗。
它适合全屏后处理、半透明层这类「整批一起降」的场景,简单但不能细分GPUOpen。一批里既有要高精度的区域、又有可以省的区域时,Per-Draw 就无能为力了,要按内容细分得看下一档。
4.3 原理与概念:Per-Primitive 档
第二档是逐图元(Per-Primitive):让前光栅化阶段的最后一级着色器写一个内建变量 PrimitiveShadingRateKHR,光栅化器据此定这条图元覆盖区域的着色率 Vulkan 规范。它是三档里唯一由图元自身决定速率的一档。
粒度是图元,取值取自引发顶点(provoking vertex),可用标志位是 Vertical2Pixels、Horizontal4Pixels 这类方向性速率。有一条易踩的约束:同一图元不得同时带多个水平速率或多个垂直速率 Vulkan 指南,它适合按材质或距离区分。
4.4 原理与概念:Per-Tile 档与着色率图
第三档是逐区块(Per-Tile / Per-Attachment):用 VkAttachmentReference2 加 VkFragmentShadingRateAttachmentInfoKHR 绑一张低分辨率的着色率图,每个纹素(texel)对应屏幕上一块区域,纹素里的值就是那块区域的着色率 Vulkan 指南。这是三档里唯一以屏幕空间为单位的一档。
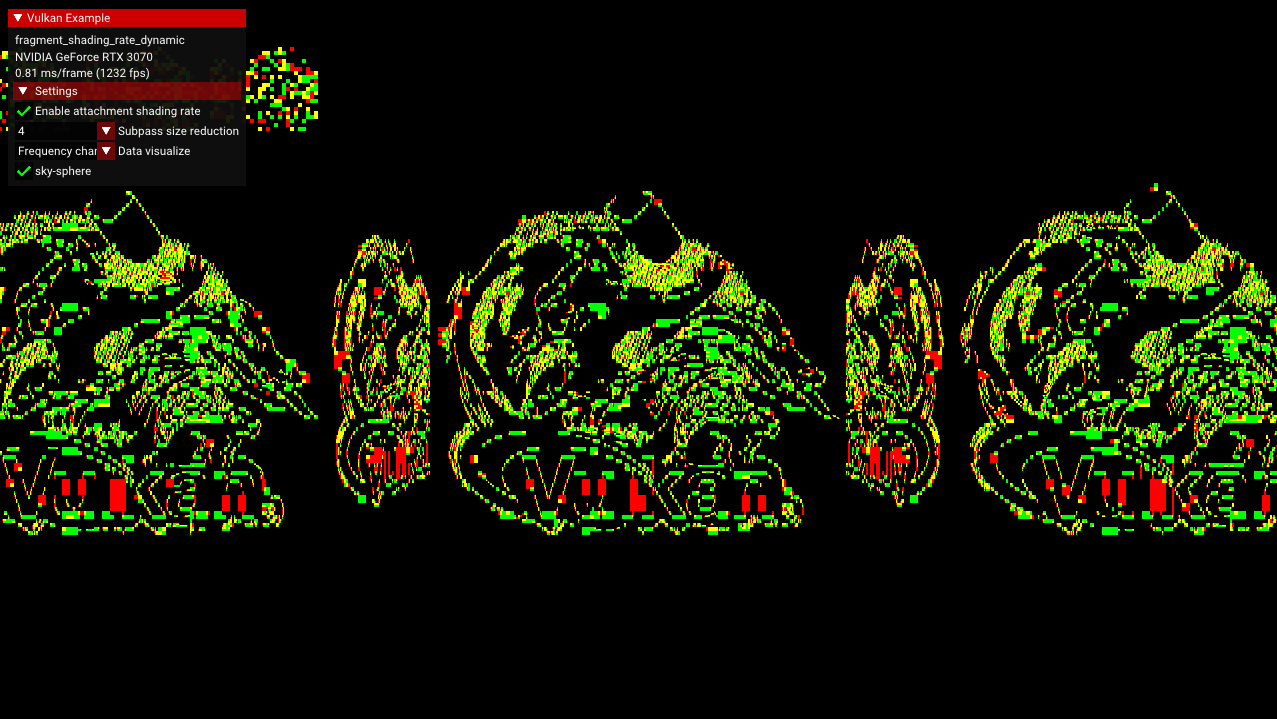
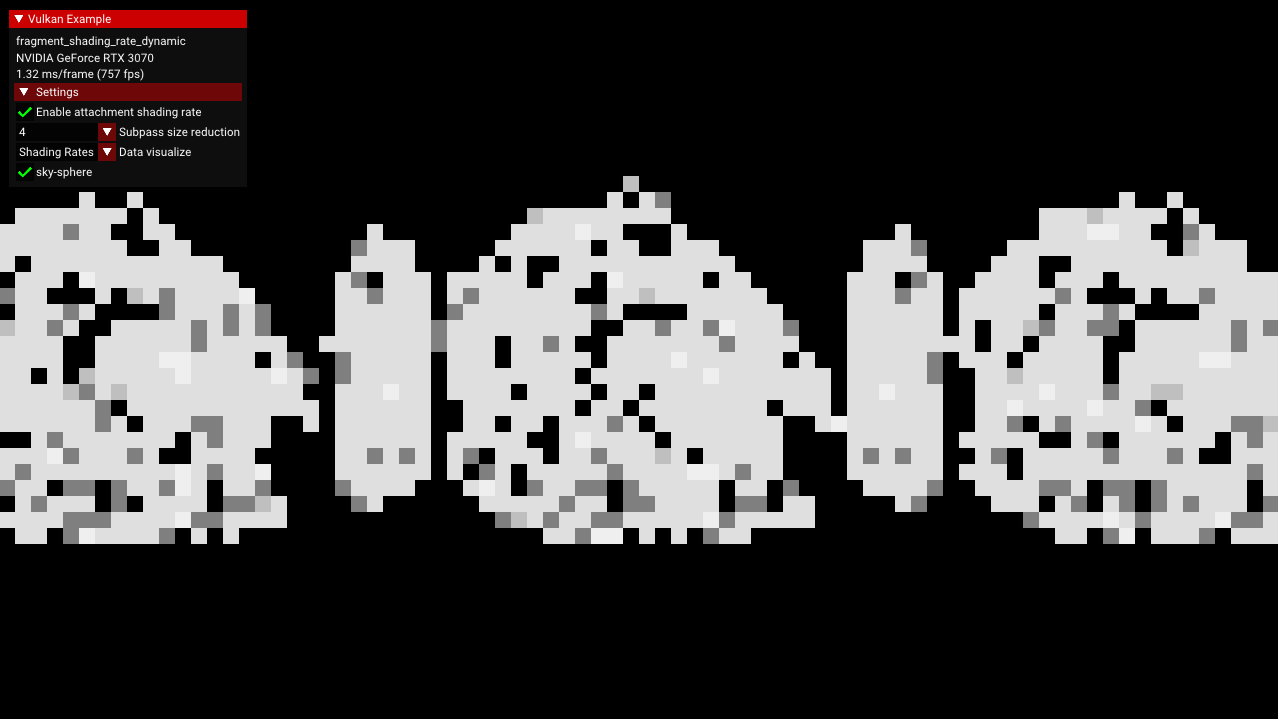
两条约束要记住:shadingRateAttachmentTexelSize 必须是 2 的幂;这张图每帧被读、要占带宽,分辨率不能随意堆大。官方的注视点渲染(foveated rendering)示例走的就是这条路——中央密、边缘疏 Vulkan 指南。三档不是三选一,它们可以同时存在。
4.5 原理与概念:组合器运算
三档能同时生效,是因为规范给了两级合并:先用 combinerOps[0] 把 per-draw 与 per-primitive 合并起来,再用 combinerOps[1] 与 per-region 的结果合并,运算符共五个 Vulkan 规范。这里的顺序不能颠倒:第一级只在管线级与图元级之间做,第二级才轮到屏幕空间。
这里有一个来历不太直观的兼容位:fragmentShadingRateStrictMultiplyCombiner。Vulkan 把着色率当作一对线性整数,两档相乘就是直接做乘法;D3D 把它表示为 log2 的位标志,两档「相乘」等于把位数相加 Microsoft Learn。这一点在跨平台移植时最容易被忽略。
两种语义多数组合下结果一致,唯独在 1+1 这一种组合上不同,所以规范单独给了一个布尔位来切换 Vulkan 指南。同一张着色率图配同一组管线状态,在 Vulkan 与 D3D 上可能在 1×1 区域产生不同结果。
4.6 实现与配置:Vulkan 侧的三个设置点
落到代码上只有三处要动:管线状态(VkPipelineFragmentShadingRateStateCreateInfoKHR 里的 fragmentSize 与两级 combinerOps)、命令缓冲(vkCmdSetFragmentShadingRateKHR)、渲染通道附件(把着色率图挂进动态渲染的 VkRenderingFragmentShadingRateAttachmentInfoKHR 或传统渲染通道的 VkAttachmentReference2)Vulkan 规范。三处可以混用,但同一次绘制只认一套。
三者需要的能力位不同:走管线与命令缓冲只需扩展的 feature,走着色率图还要额外的附件属性,并在使用前查询实现给出的最大速率与纹素尺寸限制。
4.7 实现与配置:FDM 与 VRS 的分工
另一条容易与 VRS 混起来的路是 VK_EXT_fragment_density_map(扩展 #219,Rev 3)。它也用一张低分辨率图,但语义完全不同:每个纹素存的是归一化浮点密度值,范围 (0.0, 1.0],而且是提示语义 Vulkan 规范。两者都靠一张低分辨率图,图的含义却完全不同。
配套的内建变量是 FragSizeEXT 与 FragInvocationCountEXT;它通常用于注视点渲染,后续还有 VK_EXT_fragment_density_map_offset(由高通的 VK_QCOM_fragment_density_map_offset 提升而来),用来偏移注视点区域而不重传整张图 Vulkan 规范,官方教程也把两者分开讲 Vulkan 指南,可以对照着一起读。
一句话分工:FDM 是「这里想算多密」的连续提示,VRS 是「这里必须按几档算」的离散承诺。
4.8 效果与量化:厂商实测数字
VRS 的公开数字不少,口径却混杂,必须分列;下表把厂商实测与厂商宣称分开标注。
| 数据 | 主体 | 口径 |
|---|---|---|
| 能效 >30%、帧率 38% | 高通 × 网易合作项目 | 厂商实测(A 级) |
| 平均帧率 24.55 → 27.62 fps(约 +12.5%);最低 20.87→22.36、最高 29.93→39.85 | 联发科天玑平台,VRS 开关对比 | 厂商实测(A 级) |
| 最高 +40% FPS 且降低功耗 | Arm Mali-G715 | 厂商宣称 |
| Tier 2 相比 Tier 1 再提升 14% | 微软 DirectX 博客,Gears Tactics | B 级(非移动端) |
联发科那一组值得多看一眼:平均值只涨约 12.5%,但最大值从 29.93 涨到 39.85 MediaTek。这说明 VRS 的收益在帧与帧之间并不均匀——它把最差的那几帧抬起来,而不是把每一帧均匀推进。
Arm 的 +40% 与微软的 +14% 分别标了「厂商宣称」与「非移动端」,不能与上面两组移动端实测直接相加;支持面口径可参考 Godot 的 VRS 文档,它按设备代次整理了各家的支持情况 Godot 文档。
4.9 效果与量化:收益递减的边界
VRS 省的是像素账里的「次数」,所以收益有明确上界:屏幕像素总数本身不大时,能省的绝对量就有限。微软在 Gears Tactics 的分析里给出的口径是「1080p 及以下收益递减」出处,这是三层边界里最容易被忽略的一层。
引擎侧还有一组可以直接查证的实测:Godot 官方文档在同一场景上跑了四档分辨率,1080p +10.7%、1440p +12.3%、4K +16.2%、8K +23.1%(GeForce RTX 4090、驱动 525.60.11,合成场景,密度图由中心到四角递减)Godot 文档。四档一起看,趋势与微软那句「1080p 及以下收益递减」是一致的:分辨率越高,能被省掉的绝对像素数越多,比例也就越大。 但要注意口径——合成场景与真实游戏的着色复杂度差得远,绝对值不能直接搬,能搬的是趋势。
第二个边界来自内容:AMD 的 RDNA 性能指南强调,收益取决于场景是否卡在着色吞吐或带宽上,瓶颈若在计算量或几何提交,降着色频率并不会让帧时间下降 GPUOpen。第三个边界才是本篇主线:一旦命中降级条件,收益会直接归零,而且不报错。
4.10 源码与数据链接
依然是惯例,本章原始出处按规范、厂商、引擎三类列出,便于按来源等级交叉核对,尤其是几处厂商宣称值的边界。
| 类别 | 来源 | 链接 |
|---|---|---|
| 规范 | Vulkan 规范 · 图元与光栅化章节 | https://docs.vulkan.org/spec/latest/chapters/primsrast.html |
| 规范 | VK_KHR_fragment_shading_rate 参考页 |
https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_fragment_shading_rate.html |
| 规范 | VK_KHR_fragment_shading_rate 提案(组合器与兼容位) |
https://github.khronos.org/Vulkan-Site/features/latest/features/proposals/VK_KHR_fragment_shading_rate.html |
| 规范 | VK_EXT_fragment_density_map 参考页 |
https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_fragment_density_map.html |
| 厂商 | 高通博客:VRS 移动端实测 | https://developer.qualcomm.com/blog/variable-rate-shading-has-arrived-mobile-impressive-results |
| 厂商 | 联发科开发者中心:VRS(Table 3-1) | https://developer.mediatek.com/VariableRateShading/642428c3f55b040d6989a991.html |
| 厂商 | Arm Mali-G715 产品页(厂商宣称 +40%) | https://www.arm.com/zh-cn/products/silicon-ip-multimedia/gpu/mali-g715 |
| 引擎 | Godot 文档:Variable Rate Shading | https://docs.godotengine.org/en/latest/tutorials/3d/variable_rate_shading.html |
需要核对术语的朋友,还可以从 Commons 上的 Vulkan 管线示意图入手,它把管线阶段与着色器阶段的关系画得很清楚 文件页,可以先看它建立整体印象,再回到本文的引用逐条对照。

4.11 这一章留下的问题
好了,三档都设得下去,组合器也写得出来,但「设下去」不等于「生效」——规范为跨设备发布留了后门,而它偏偏不会有任何报错,也不会在任何日志里留下痕迹D3D 规范。
下一章要处理规范里那份降级条件清单:哪些常见操作会让实现悄悄把着色率退回 (1,1),又为什么它不报错。这两件事其实是同一段规范条款的两面。
三、VRS 的静默失效:规范写明的降级条件
5.1 一句话点题:开了没生效,且不报错
下面我们开始拆它。上一章我们摆清了 VRS(Variable Rate Shading,可变速率着色)的三档与组合器:Per-Draw、Per-Primitive、Per-Tile,两级 combinerOps 合成一个最终着色率。那一章埋了个默认前提——设了速率,硬件就按这个速率着色。这一章要把它拆掉。
真相是:VRS 是本系列里最"安静"的特性。它有一整套写进规范的降级条件,一旦绘制踩中其中任何一条,实现会自动把着色率降回 (1,1),退回逐像素着色,而且不报错、不抛异常、不给提示。程序照常跑,画面照常出,只是参数白调了。Vulkan 指南
所以这一章要回答三件事:降级条件是哪几条、它们为什么存在、以及怎么在真机上确认自己有没有被降级。先看总览,把"设了三档、踩了限制、静默退回"这条路径画清楚。
原因不在硬件偷懒,而在规范给跨设备发布留的余地:同一套算法要在支持与不支持的设备上都跑得起来,唯一不破坏兼容性的办法就是"不合规就悄悄退回安全值"。代价是这件事除非主动验证,否则永远发现不了。
5.2 原理与概念:八项属性限制清单
好了,逐项过一遍。规范把降级条件拆成八项,前六项是布尔型能力位,后两项是数值上限。
前六项是:着色器写深度或模板时的着色率(fragmentShadingRateWithShaderDepthStencilWrites)、按像素的采样掩码(fragmentShadingRateWithSampleMask)、着色器写采样掩码(fragmentShadingRateWithShaderSampleMask)、保守光栅化(fragmentShadingRateWithConservativeRasterization)、片元着色器互锁(fragmentShadingRateWithFragmentShaderInterlock)、自定义采样位置(fragmentShadingRateWithCustomSampleLocations)。后两项是单次光栅化能覆盖的采样数上限(maxFragmentShadingRateRasterizationSamples)与覆盖率采样数上限(maxFragmentShadingRateCoverageSamples)。Vulkan 规范
这八项有个共同点:都要求"每个像素被独立、完整地处理"。只要绘制需要逐像素的采样掩码、逐像素的深度写入或精确的采样位置,把一块 2×2 的像素合并成一次着色就会改变语义,规范只好退回Vulkan 规范。
这八条在真实项目里对应的是这些操作:写深度/模板对应透明或自定义深度输出;采样掩码对应抗锯齿与覆盖率技巧;保守光栅化多用于体素化与阴影图;片元互锁常见于需要读写同一像素的算法Vulkan 规范Microsoft Learn。它们都是常规管线里很容易顺带打开的选项,谈不上冷门——这正是 VRS 容易"莫名失效"的原因。
5.3 原理与概念:sample shading 的硬互斥
除了上表那六项,规范还写了另一条更硬的规定:一旦启用 sample shading(逐采样着色),fragment shading rate 会被实质性禁用。Vulkan 规范
这条和"采样掩码"限制属于同一族逻辑。sample shading 要求"每个采样点都跑一次着色器",VRS 要求"一个块只跑一次",两者在定义上就冲突:一个要拆开采样点,一个要合并它们,硬件不可能同时满足。这已经越出性能问题,是语义层面的互斥。
这个坑最容易出现在画质档位切换上:为了在高端机开多重采样抗锯齿(Multisample Anti-Aliasing, MSAA)加 sample shading 提升边缘质量,顺手也开了 VRS,结果想省的地方一点没省,全部退回逐像素,还白付了着色率图的绑定开销Apple 文档。
5.4 原理与概念:深度导出与延迟着色的正面冲突
第三条冲突最要命,因为它不来自罕见选项,而来自延迟着色本身。AMD 在 RDNA 官方性能指南里列出一组常见触发条件:深度导出(depth export,着色器里写深度)、后深度覆盖率(post-depth coverage)、以及光栅顺序访问视图(Raster Ordered Access Views, ROV)。GPUOpen
深度导出恰好是延迟着色几何阶段(G-Buffer 写入)的常见操作。也就是说,VRS 和延迟着色一起开,很可能互相抵消:我们指望 VRS 降低每像素着色开销,延迟着色却因为要写深度把 VRS 打回逐像素。这一条把第三章和上一篇的结论直接钉在了一起。Vulkan 指南
回到上一篇:延迟着色能不能用,取决于几何缓冲(G-Buffer)落不落地;片上预算硬卡在 128 bit/像素Unity 文档Apple 文档。这一章要补的是同一张账的另一栏——就算把 G-Buffer 压进了片上,只要几何阶段需要导出深度,VRS 这一栏也可能是零。
好了,判断顺序因此很清楚:先问 G-Buffer 落不落地,再问几何阶段写不写深度,最后才轮到 VRS 有没有生效UE 文档NVIDIA 文档Unity 文档。跳过前两问直接去看 VRS 的开关键,基本等于没判断,这个顺序在后面写验收脚本时也要照搬。
5.5 原理与概念:光栅化仍按像素精度进行
这里要澄清一个常见误会。规范层面上,VRS 主要针对片元着色与带宽瓶颈,光栅化本身仍按像素精度进行。Vulkan 指南
这意味着:即使着色率设成 2×2 或 4×4,图元边缘的覆盖判定还是逐像素做的,边缘几何清晰度因此保留。很多人看到"边缘还是清楚的"就以为 VRS 生效了——其实两件事毫无关系。着色频率描述"每个像素跑几次着色器",光栅化精度描述"哪些像素算被覆盖",前者降了,后者没降。
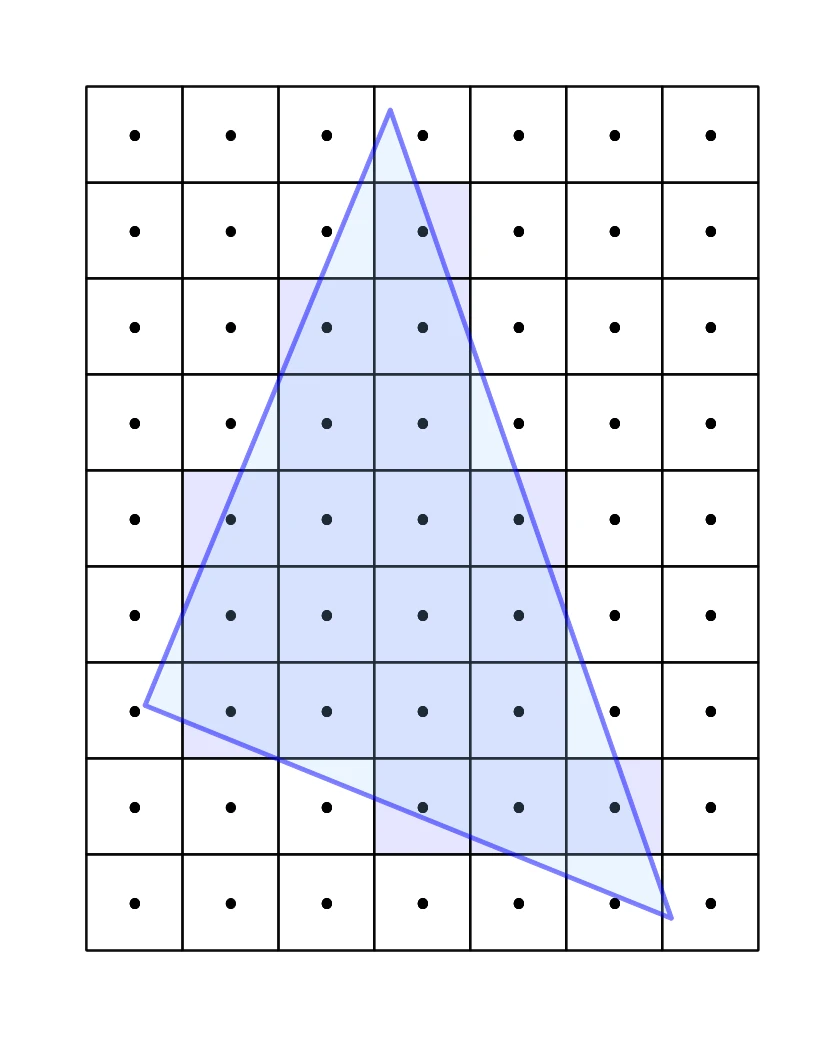
反过来说,"边缘仍然锐利"是个完全无效的验收证据。要确认 VRS 到底生效没有,必须去看着色次数或覆盖率计数器,而不是肉眼看边缘——眼睛能证明光栅化没变,证明不了着色率变了。
5.6 实现与配置:着色率图的绑定代价
Per-Tile 档要绑一张低分辨率的着色率图(shading rate image),它的 texel 尺寸必须满足 shadingRateAttachmentTexelSize 为 2 的幂。绑定不是一次性的——每次用到都要以附件形式挂上,用完再解绑。Vulkan 规范
AMD 的官方建议里有一条很实用:尽量减少每帧着色率图的绑定与解绑次数。因为每绑一次就多一次渲染通道切换,而移动端的通道切换本身就意味着一轮片上数据的落地与重载,这笔账和前几篇算过的带宽账是同一本。
再往下一层看,ROV(Raster Ordered Access Views)要求按光栅顺序、逐像素写入Vulkan 规范。VRS 把一块像素合并成一次着色,破坏了"逐像素、按顺序"这个前提,所以 ROV 也是降级触发条件之一;这一条不像采样掩码那样好绕开,往往要改整条数据流。
5.7 实现与配置:怎么确认真的生效
我们把可确认的信号按可信度从高到低排成三个。
第一个是着色器侧的内建变量。VRS 提供 FragSizeEXT 与 FragInvocationCountEXT,前者给出当前片元所属着色率块的尺寸,后者给出该块内被着色器调用覆盖的像素数。把它输出到调试纹理,就能直接看到实际生效的着色率是几乘几。Vulkan 规范
第二个是GPU 性能计数器:片元着色调用次数与像素数的比值最直接——如果开了 2×2 后这个比值没下降,大概率被降级了Vulkan 规范。第三个是截图覆盖率统计:跑一遍调试视图,统计实际以合并方式着色的像素占比。
这里有条边界要划清:三个信号里只有第一个是规范保证的语义,后两个依赖实现暴露的计数器,不同厂商的名字与口径可能不一致,只作交叉验证;正式验收时,我们以内建变量为准Apple 文档。
5.8 效果与量化:收益递减与失效叠加的净效果
把收益数据摆在一起,能看到一条清楚的分辨率边界。
微软 DirectX 官方博客给的是:Tier 2 相比 Tier 1 再提升 14%,且 1080p 及以下收益递减。出处 Microsoft Learn
联发科开发者中心的天玑平台开关对比是:平均帧率 24.55 → 27.62 fps(约 +12.5%),最低帧 20.87 → 22.36,最高帧 29.93 → 39.85。MediaTek
高通 × 网易《天谕》合作实测:能效提升 >30%、帧率提升 38%。出处
厂商宣称值与实测值要分列。Arm 对 Mali-G715 的说明是最高 +40% FPS 且降低功耗,这条属于厂商宣称值;把它和上面的实测放在一起看,规律很清楚——宣称值对应各自的最优场景,而 1080p 及以下这类边界恰恰是收益最容易缩水的地方。Arm 文档
这张曲线要连着看两件事:收益随分辨率下降而收窄,以及上一节的失效条件会让收益直接归零。两者叠起来,就解释了为什么很多项目"开了 VRS 但没什么感觉"。
5.9 效果与量化:一个反面推演
把失效条件叠加起来,做一次账面推演:一台旗舰机,同一帧同时开 VRS、延迟着色与 sample shading。
第一步,sample shading 触发硬互斥,着色率退回 1×1;第二步,就算软件层还标着"已开启",延迟着色的几何阶段导出深度,又命中 fragmentShadingRateWithShaderDepthStencilWrites,再退一次;第三步,着色率图依然每帧绑定与解绑,通道切换开销照付。Godot 文档
结果是:着色侧收益为零,绑定侧成本照收,净效果为负。这已经不是概率问题,是把这三个常见选项同时打开之后几乎必然出现的结果——它说明"开了三个加速开关"和"加速了三倍"之间,根本没有因果关系。
这张瀑布图的意思很直接:每个收益项都被一个抵消项吃掉,最后落到零以下。所以正确用法是先做失效条件检查,再谈提速——顺序反了,投入全是沉没成本。
5.10 源码与数据链接
依然是惯例,本章的材料分三层:规范原文决定失效条件,厂商实测的数字决定收益量级,引擎侧口径决定实际可用性。下面按这三层把权威来源列全,先给一张分层结构图。
- 规范降级条件与属性限制:https://docs.vulkan.org/spec/latest/chapters/primsrast.html
VK_KHR_fragment_shading_rate参考页与提案:https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_fragment_shading_rate.html 、https://github.khronos.org/Vulkan-Site/features/latest/features/proposals/VK_KHR_fragment_shading_rate.html- 渲染通道与附件绑定:https://docs.vulkan.org/spec/latest/chapters/renderpass.html
- AMD RDNA 性能指南(深度导出、后深度覆盖率、ROV):https://gpuopen.com/learn/rdna-performance-guide/
- 微软 DX12 VRS 与 Gears Tactics 实测:https://learn.microsoft.com/windows/win32/direct3d12/vrs 、https://devblogs.microsoft.com/directx/gears-vrs-tier2/
- 联发科与高通量化口径:https://developer.mediatek.com/VariableRateShading/642428c3f55b040d6989a991.html 、https://developer.qualcomm.com/blog/variable-rate-shading-has-arrived-mobile-impressive-results
- Arm Mali-G715(厂商宣称值):https://www.arm.com/zh-cn/products/silicon-ip-multimedia/gpu/mali-g715
- 密度图内建变量:https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_fragment_density_map.html
- 引擎侧口径:https://docs.godotengine.org/en/latest/tutorials/3d/variable_rate_shading.html
5.11 这一章留下的问题
好了,VRS 的失效条件全都"规范写明",理论上可以逐条自查;真正难判的是它与延迟着色的交叉限制,那要同时知道 G-Buffer 的落地方式与几何阶段的深度写入。这个交叉验证,我们留到第九章的选型决策里合并处理。
四、网格着色机制:task/mesh 两阶段与 meshlet
6.1 一句话点题:网格着色改的是「几何怎么提交」
OK,言归正传,换第二个旋钮。VRS 动的是"每像素付多少着色",网格着色(Mesh Shading)动的是另一件事:几何怎么提交到 GPU。它用 Task Shader + Mesh Shader 两个计算风格的阶段,整体替换传统"输入装配 → 顶点 → 曲面细分 → 几何"这条前光栅化管线。Khronos 规范
为什么要在讲收益之前先花一整章讲机制?因为网格着色在移动端的结论和桌面完全相反——桌面侧它常常更快,移动端却可能更慢。而解释这个反差的钥匙,全在提交路径的细节里。
这一章要让大家看清楚的是:网格着色换掉的不只是几个阶段的名字,而是驱动能不能提前知道"要准备多少资源"这件事。
6.2 原理与概念:Mesh Shader 的输出模型
下面我们开始拆它的输出模型。Mesh Shader 的调度单位是 workgroup(工作组),可以在内部使用共享内存(shared memory)与 barrier,形态上更接近计算着色器,而不是传统的逐顶点着色器。
它有三个关键约束。第一,不使用顶点输入接口——几何与索引必须由着色器自己生成或从缓冲区读取,没有"按顶点索引自动取属性"这一层。第二,输出拓扑仅支持列表(list),三角带(strip)与扇形(fan)需自行展开。第三,写出之前必须调用 OpSetMeshOutputsEXT,显式声明本次真正输出的顶点数与图元数。Vulkan 指南 Vulkan 规范
这个输出模型和 Direct3D 侧的 mesh shader 规格在语义上是对齐的,两边可以互相参照;区别主要在扩展的成熟度上——Vulkan 这边经历过私有与正式两版并存,D3D 那边则直接进了核心规格。对我们来说,这意味着同一套 meshlet 数据可以较容易地在两个 API 之间迁移,真正要重写的是剔除逻辑与调度参数。D3D 规范
先来看这两张图想强调什么:传统管线里硬件知道索引缓冲里有几个顶点、几个图元,可以据此预取;Mesh Shader 里,在着色器跑完之前没有任何人知道要输出多少几何——这个"未知"正是后面一切代价的源头Arm 文档。
6.3 原理与概念:Task Shader 与 payload
Task Shader 是可选的,作用是间接派发 Mesh Shader 的工作组。它通过 OpEmitMeshTasksEXT(count, payload) 发出新的工作组,把要派发的数量与数据交出去。Vulkan 指南
有两条语义要记牢:该指令每个 workgroup 只执行一次;payload 是 workgroup 级的,形态上类似共享内存;调用之后,该 workgroup 立即终止。这个设计的目的很明确——让一个工作组先用便宜的判断,决定下面哪些簇值得活着。出处
在 D3D 的语境里,Task Shader 对应的名字叫 Amplification Shader,两侧意图一致:做整簇级别的粗粒度剔除,或者按细节层次(Level of Detail, LOD)动态生成几何。两者的分工也是明确的:Task 阶段只看粗粒度的包围信息,不碰顶点,真正生成顶点与图元的活儿全部留给 Mesh 阶段。
payload 之所以定成 workgroup 级、而非全局共享,全局共享需要额外的同步与内存往返,而 workgroup 级可以直接待在片上——这正是它能把粗粒度剔除做得便宜的原因,也和前几篇反复讲的片上预算一脉相承。
6.4 原理与概念:meshlet 与尺寸约束
Task/Mesh 这套机制要落地,就得把几何切成小块,这个小块叫 meshlet(网格小块)。NVIDIA 在 Turing 上给出的一手推荐尺寸是:≤64 顶点 / ≤126 图元。NVIDIA 文档
126 这个数字看着奇怪,来历很清楚:首代硬件按 128 字节(B)的粒度分配空间,而 126 个图元加上计数刚好卡在边界内——3×126 + 4 ≤ 3×128。这里的 3 是每个图元的索引数,4 是末尾的图元计数。也就是说,126 是被 128 B 这个硬粒度倒推出来的,不是拍脑袋选的。NVIDIA 同时指出,这种 meshlet 结构通常能把索引缓冲压到原体积的约 75%。NVIDIA 文档
先来看这套约束在移动端意味着什么。约束越紧,切块就越多,Task Shader 要处理的簇数量也越大;而移动端的算力与带宽都有限,切块一多,"省下来的提交"很容易被"多出来的调度"吃掉arXiv。这是第五篇那条负收益结论的伏笔之一。
6.5 原理与概念:拓扑与输出顺序限制
Mesh Shader 在输出上还有两条容易忽略的限制。
第一条是拓扑仅支持列表。传统管线里的三角带与扇形必须由着色器自己展开成三角形列表,这带来额外的索引组织成本,但也换来了更自由的几何生成方式。Vulkan 规范
第二条是输出顺序被保留。这是 Vulkan 的 VK_EXT_mesh_shader 与早期 NVIDIA 私有 VK_NV_mesh_shader 在设计取舍上的明确差异:前者保证输出顺序与声明顺序一致,后者不保证。顺序可预期有利于确定性渲染与调试,但也少了让驱动重排优化的空间。Vulkan 指南
这两条落到工程上的影响是:想在移动端把 mesh shader 用顺手,几何数据的预处理(展开成 list、按 meshlet 重排索引)基本要从零做一遍,这部分前期投入在排期里常常被低估,最后变成上线前的返工。
6.6 实现与配置:三条派发命令与新阶段位
从 API 侧看,网格着色新增的东西不多,但都必须配对正确。
新阶段位是 VK_SHADER_STAGE_TASK_BIT = 0x40 与 VK_SHADER_STAGE_MESH_BIT = 0x80。同步阶段则是 VK_PIPELINE_STAGE_TASK_SHADER_BIT_EXT = 0x80000 与 VK_PIPELINE_STAGE_MESH_SHADER_BIT_EXT = 0x100000——它们在逻辑上与计算同类,位置在片元之前。派发命令有三条:vkCmdDrawMeshTasksEXT、vkCmdDrawMeshTasksIndirectEXT、vkCmdDrawMeshTasksIndirectCountEXT。Vulkan 规范
三条派发命令的差别只在参数来源:直接版把数量写在命令里,间接版从缓冲区读,带计数的间接版再用第二个缓冲区限制实际派发的工作组数Microsoft Learn。GPU 驱动的剔除结果正是靠后两者回填进命令的——这也是 Task Shader 与 GPU 驱动渲染能衔接起来的地方。
这几个位的编号有规律:0x40 与 0x80 是在原有着色阶段位序列上接着排的,而同步阶段位 0x80000 与 0x100000 走的是另一套更宽的位空间Vulkan 规范D3D 规范。同步写错是网格着色最常见的"能跑但结果不对"来源。
6.7 实现与配置:cluster 剔除与可见性缓冲的配合
网格着色真正的威力,来自簇级剔除(cluster culling)和可见性缓冲的配合。
做法是这样的:在 Task Shader 里,一个 workgroup 决定若干 meshlet 是否存活,把存活数量与索引写进 payload,再用 OpEmitMeshTasksEXT 只派发存活的部分。判定用的通常是一对保守量:包围球(bounding sphere)与法线锥(normal cone),前者做视锥剔除,后者做背面剔除。出处 出处
到了 Mesh Shader 内部,还可以逐三角形做廉价测试,用 SV_CullPrimitive 让光栅器直接跳过被剔除的图元。
引擎侧有个完整案例可参照:Capcom 的 RE Engine 在 Meshlet Rendering Pipeline 里做两级剔除——Instance Culling 用 32 位绘制标志位,Instance/Cluster Culling 用轴对齐包围盒(Axis-Aligned Bounding Box, AABB)加视锥判定,并对零面积三角形做数学处理;在可用时跑分层 Z 缓冲(Hierarchical Z, HiZ)剔除,如果剔除结果是可见性缓冲(visibility buffer),则设置 LOD bias,取值从 2×2、4×4 到 8× 等不同档。出处
这套配合只有一条硬要求:剔除必须在几何被提交之前完成,否则就退化成"先全部提交、再丢掉一部分",收益会大打折扣,这也是 Task 阶段存在的全部意义。
6.8 效果与量化:桌面侧的正收益
先看正面的证据。NVIDIA 用 Lucy 雕像的 2700 万(27M)三角形做实测:mesh shader 路径 0.9 ms,传统顶点着色路径 1.8 ms;在 16 位索引拆分的情况下是 0.8 ms 对 1.1 ms。NVIDIA 文档
这组数字是厂商实测口径,样本是桌面 GPU,测的是一个几何密度极高的模型。它能说明网格着色在高几何压力下的上限,但不能直接外推到移动端,因为移动端的瓶颈构成和桌面并不一样。
这里要强调的是"高几何密度":2× 的提升来自几何阶段被大幅压缩,一旦场景的几何量本身不大,可压缩的空间自然就小,剔除也就无从谈起。
6.9 效果与量化:收益全部来自剔除
再看反面。社区的对照实测(RTX 3080 mobile,作者 Kostas Anagnostou)给出了更细的结论。
第一,纯透传(不做任何 GPU 侧剔除)时,mesh shader 没有优势;而且 meshlet 越大反而越慢——128 顶点/256 三角形/128 线程组的配置是 3.43 ms,而传统顶点管线是 2.87 ms。
第二,加上逐 meshlet 的视锥剔除与遮挡剔除之后,某个视图的 G-Buffer 开销下降 44%,Bistro 场景从 1.06 ms 降到 0.74 ms(-30%)。第三,只做逐 mesh 的视锥剔除时,St Miguel 的 G-Buffer 从 3.11 ms 变成 2.86 ms(-8%)——剔除粒度越粗,收益越小,剔除做得越细,省下的帧时间越多。出处
先来看这三组数据的指向:网格着色的收益全部来自"真的做了簇级剔除",不来自它叫 mesh shader。 把这句话记住,后面在移动端看到负收益时就不会觉得意外。
6.10 源码与数据链接
依然是惯例,本章的材料分三层:扩展规范决定机制与约束,厂商实测给出收益量级,引擎案例展示工程落地形态。下面按这三层把权威来源列全,先给一张分层结构图。
- 扩展规范与提案:https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_mesh_shader.html 、https://registry.khronos.org/vulkan/specs/latest/man/html/VK_EXT_mesh_shader.html
- Khronos 官方机制说明:https://www.khronos.org/blog/mesh-shading-for-vulkan
- D3D 侧对照(Amplification Shader):https://microsoft.github.io/DirectX-Specs/d3d/MeshShader.html 、https://devblogs.microsoft.com/directx/coming-to-directx-12-mesh-shaders-and-amplification-shaders-reinventing-the-geometry-pipeline/
- meshlet 尺寸与索引压缩一手依据:https://developer.nvidia.com/blog/introduction-turing-mesh-shaders/
- 桌面正收益实测:https://developer.nvidia.com/blog/using-mesh-shaders-for-professional-graphics/
- 桌面反例与剔除收益实测:https://interplayoflight.wordpress.com/2025/05/05/meshlets-and-mesh-shaders/
- 剔除技术综述:https://www.tmarrec.dev/posts/mesh-shaders-and-meshlet-culling.html 、https://krupitskas.com/posts/modern_culling_techniques/
- 引擎侧案例(Capcom RE Engine):https://enginearchitecture.org/downloads/REAC_2025_Capcom.pdf
- 移动端最佳实践与支持边界:https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html 、https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_mesh_best_practices_2023.02.09-1.pdf
6.11 这一章留下的问题
好了,机制上讲,网格着色把"提交什么"的权力从固定功能单元交给了着色器;但这份自由也意味着驱动失去了提前预取的能力arXiv。这份失去在移动端到底值不值,就是第五篇要算的那笔账。
五、网格着色的移动端反直觉:实测负收益
7.1 一句话点题:移动端 mesh shader 反而更慢
上一章我们把网格着色的机制摆清了:任务着色器(Task Shader)做粗粒度的簇级剔除,网格着色器(Mesh Shader)生成几何,两者合起来替换传统管线里"输入装配 → 顶点 → 曲面细分 → 几何"那一段。那一章的正面证据全部来自桌面——NVIDIA 用 Lucy 雕像的 2700 万三角形测出 0.9 ms 对 1.8 ms,等于快一倍。NVIDIA 文档 读到那里,很容易顺手推出一句:移动端大概也能提速。
这一章要把这个推论拆掉。Arm 与高通 2026 年联合发布的 GPU 驱动渲染实测(Ball Collision / Occlusion 基准)给出的结果完全相反:GPU Mesh Shaders 路径 75.1 FPS / 3.77 W,传统 GPU Indexed 路径 121.4 FPS / 2.02 W——帧率低约 38%,功耗高约 87%。Arm 原文
同一台设备、同一个场景、同一套剔除逻辑,只把几何提交方式从索引绘制(Indexed Draw)换成网格着色,性能反而退了一大截。所以这一章不走"先讲机制再讲收益"的常规顺序,而是先把实测摆上桌,再逐层往下挖根因。
说白了,这一章要回答的问题是在移动端,把几何提交的权力从固定功能单元交给着色器,究竟换来了什么、又交回去了什么。这个问题顺带能解释另一件事:这条路线在移动端的采用率统计里,至今只有约 27%。Arm 原文
7.2 原理与概念:为什么去掉提交反而更慢
先来看看这条链断在哪里。要理解负收益,得先立一个前提:传统路径之所以快,有一半功劳不在硬件算得快,而在驱动提前知道要算多少NVIDIA 文档。
拿一次索引绘制来说,命令写明了索引缓冲(Index Buffer)、顶点缓冲(Vertex Buffer)与图元数量Microsoft Learn。驱动在提交那一刻就拿到完整信息:多少顶点、多少图元、需要哪些顶点属性。有了这些它才能提前做三件事——把着色器与常量送进片上、把顶点描述符取到近处、给分块器(tiler)安排负载。移动 GPU 是分块延迟渲染(Tile-Based Deferred Rendering, TBDR)架构,几何全部提交完之后才逐块着色,"提前知道几何规模"因此比对桌面更关键。
网格着色与间接绘制(Indirect Draw)做了什么?它们把"要画多少"从命令搬进了显存缓冲区,甚至改由上一阶段的计算着色器当场算出来。提交那一刻,命令还是个空壳。驱动失去的不是"提交"这个动作,而是依据提交内容预测所需资源的能力——这是本章所有反直觉现象的公共根因。Arm 原文
先来看这条链断在哪里。上一章的机制篇已经埋了伏笔:Mesh Shader 在着色器跑完之前,没有谁知道要输出多少几何,这是 Khronos 介绍网格着色时反复强调的输出模型特征。Khronos 规范 下面三节把开销拆成三个来源:预取不了着色器、预取不了顶点描述符、分块器被顶到计算之后。与其说它们是三个独立的毛病,不如说是同一件事在三个环节上的表现。
7.3 原理与概念:开销来源之一——无法预取 shader
第一条来自着色器侧。传统绘制里,驱动解析命令时就知道要用哪条管线、带哪些常量、要不要触发编译;这些准备能与 CPU 提交并行,甚至提前一帧做完。到了间接绘制或任务着色器派发,真正要用的着色器与参数取决于运行时才知道的数量,驱动没有名目去提前准备。Arm 原文
Arm 与高通把这条列在第一位。它的代价不体现在指令条数上,而体现在等待上:着色器要等到需要时才被取,取的时候 GPU 可能已经空转了好几个周期Vulkan 规范Vulkan 规范。这就解释了后面那张指令表为什么"总指令只涨两成、纹理周期数涨三倍多"——指令本身不多,错配在时间上的代价才是大头。
这一条在移动端格外贵,原因是移动 GPU 没有桌面那种够大的末级缓存去兜住取指延迟,一次取用没准备好,整条流水就多一段停顿;而这段停顿在功耗上同样要付,因为时钟还在跑。反过来说,若想缓解这一条,能做的也只有把状态切换与着色器变体的数量压下去,让驱动即使在运行时补准备,代价也可控Vulkan 规范Vulkan 规范。好了,下一条更直接。
7.4 原理与概念:开销来源之二——无法预取顶点描述符
第二条来自顶点属性的取法。传统顶点管线里硬件按索引自动取属性——顶点步长、各属性偏移与格式都是管线状态的一部分,驱动可以提前把描述符取到近处,硬件还能把取数合并成大块连续读取Vulkan 规范Microsoft LearnMicrosoft Learn。
Mesh Shader 没有顶点输入接口(上一章讲过),几何与索引必须由着色器自己生成或从缓冲区显式读取。Vulkan 规范 于是每个顶点属性都变成一次由着色器算地址的显式加载:地址要算、缓存要查、命中率还取决于索引重排得好不好。预取和合并这两个红利,一起没了。Vulkan 指南
它对预处理成本的影响是实打实的:桌面可以把索引重排整齐一点来补命中率,移动端带宽与缓存都小得多,重排跟不上就退化成随机读——NVIDIA 那种把索引缓冲压到约 75% 的做法,在移动端要付出更高的组织成本才可能兑现。NVIDIA 文档 换句话说,传统管线把"取顶点属性"做成了一条固定硬件通道,而 Mesh Shader 把这条通道拆掉,改由着色器自己走一遍:自由度上去了,代价是每一次访问都要自己付账。这也意味着,网格着色的前期投入里,索引与属性的重排不是可选项,而是必须项。
7.5 原理与概念:开销来源之三——binner 串行在 compute 之后
第三条来自分块架构本身。移动 GPU 的几何阶段要先跑完,把图元分进各个块(bin),再逐块着色Arm 原文Arm 原文。传统路径下这个过程在硬件内部是流水的:顶点处理、剔除、分块前后重叠,硬件持续有活干。
GPU 驱动渲染把剔除搬进了计算着色器,可见性计算(Visibility)、分层 Z 缓冲(Hierarchical Z, HiZ)测试、间接命令缓冲(Indirect Command Buffer, ICB)回填全是一串 dispatch。分块器只能等这串 dispatch 全部结束才能开工,因为在那之前没有任何人知道这一帧到底要画什么。Arm 原文
这就是第三条开销来源——分块器的序列化代价。它在数据上留下的痕迹很特别:GPU 使用率被拉到 98.7%,频率被顶到 1012 至 1044 MHz,可帧率反而更低。使用率与频率同升、吞吐却下降,说明流水被拉长了,时隙在等待中被消耗——这也顺带解释了功耗为什么同步涨上去。
好了,三个来源齐了:预取不了着色器、预取不了顶点描述符、分块器被顶到计算后面。它们指向同一处——几何提交从"硬件知道的固定流程"变成"着色器现场算出的未知量"。这三条共享同一前提,只要还走这条路,单独优化一条,另外两条照付。Vulkan 原文 下面把四套方案摆在一起,看这三种代价各占多大。
7.6 实现与配置:四方案对照的复现条件
在摆数据之前,先把口径交代清楚,否则同一组数字很容易被误读。下面这一节与 7.7、7.8 三节说的其实是同一批数字的三种切法:提交方案、帧率与功耗、帧时间。
这组实测来自 Arm 与高通 2026 年的联合材料,基准是 Ball Collision / Occlusion,即"球的碰撞与遮挡"这类几何规模中等、剔除需求明确的场景。记录四项指标:帧率、整机功耗、GPU 使用率、GPU 频率。对照四种提交方式:全 CPU(模拟、碰撞、剔除都在 CPU 做)、GPU Indexed(几何交给 GPU,走传统索引绘制,最佳传统路径)、GPU Indirect(GPU 侧剔除加分层 Z 缓冲,用间接绘制提交)、GPU Mesh Shaders(同一套剔除逻辑改用任务与网格着色器提交)。Arm 原文
有一处要交代:材料里没有列出被测设备的具体型号与驱动版本,若要作为选型依据,建议在同一台目标机上按四个方案各跑一遍,比对差距而非直接套数值。方法本身可靠——固定场景、只改提交方式,这正是隔离变量的标准做法,后面写验收脚本也要照搬。还有一点值得留意:GPU Indirect 与 GPU Mesh Shaders 共用同一套分层 Z 剔除逻辑,所以两者之间的差距只能归到提交方式上,而不是剔除算法本身。剔除前端一致这一点,让"提交方式才是变量"这个结论更硬。
7.7 效果与量化:四方案 FPS 与功耗全表
数据摆上桌。
| 方案 | FPS | 功耗 | GPU 使用率 | GPU 频率 |
|---|---|---|---|---|
| 全 CPU(模拟+碰撞+剔除) | 14.6 | 5.59 W | 82.3% | 815 MHz |
| GPU Indexed(最佳传统路径) | 121.4 | 2.02 W | 82.8% | 656 MHz |
| GPU Indirect(GPU 剔除 + HZB) | 84.4 | 3.84 W | 98.7% | 1044 MHz |
| GPU Mesh Shaders | 75.1 | 3.77 W | 98.7% | 1012 MHz |
表里有三个格子值得停下来看。第一,全 CPU 只有 14.6 FPS,说明把剔除搬到 GPU 侧确实有价值——从 14.6 到 84.4 FPS 这一段,是 GPU 驱动渲染真正的红利。第二,Mesh Shaders 与 Indirect 几乎并排(75.1 对 84.4 FPS,功耗 3.77 对 3.84 W),说明网格着色在移动端没能在这条链上再省出什么,反而略输。第三,Indexed 的 GPU 频率只有 656 MHz,另外两条路径都在 1000 MHz 以上,功耗也就跟着翻倍。
换句话说,收益的分布是这样的:剔除带来红利,但提交方式把红利又交回去了一部分。桌面的瓶颈更多压在几何吞吐上(NVIDIA 那组 0.9 对 1.8 ms 正是这种情形),移动端压在带宽、能耗与流水时隙上,交回去的那部分就格外显眼。NVIDIA 文档 另一层原因是两边的账本身不同:移动端要同时付带宽与能耗两份钱,交回去的那部分等于被扣了两次。
这张表的价值不在"Mesh 比 Indexed 慢"这个结论上,而在它把"GPU 剔除值不值得做"和"用哪种方式提交剔除结果"分开了——前者值得,后者在移动端是尽量别用计算着色器那一条路。桌面侧的对照实测同样显示:不加剔除的纯透传没有优势,加了剔除才有明显收益。出处
7.8 效果与量化:间接绘制 ON/OFF 的帧时间
帧率之外,Arm 与高通还给了间接绘制开与关的帧时间对比,这一组更能看清代价落在哪一段流水上。
同一场景下,一帧的 GPU 时间为 18.28 ms(间接开启)对 16.69 ms(关闭),差 1.59 ms,约 +9.5%;其中主表面(main surface)渲染时间为 11.50 ms 对 9.93 ms。Arm 原文
两个数字要分开放。整帧那 9.5% 看着不大,但它是净增开销——间接绘制本是为省时间才引入的,结果净账是负的。主表面那一段更值得注意:它属于逐块着色阶段,变慢说明代价渗透到了分块着色环节,而不只停在几何提交那里。这和 7.5 节的序列化代价对得上:分块器等到计算结束才开工,可重叠的时间被压缩,最终体现在主表面的耗时上。
先来看这组对比为什么比 FPS 更有说服力:FPS 会被降频、锁帧与调度抖动干扰,帧时间是 GPU 侧直接测出来的,误差小得多。反过来也提醒我们——验收时只看 FPS,很容易把"帧率掉了"归到热降频头上,而错过几何提交这一层。顺带一提,主表面那 1.57 ms 的增量,正好与后面要讲的顶点流式读取对得上:它是那笔带宽账在帧时间上的投影。换句话说,间接绘制的代价不止落在提交那一刻,也落在了它本不该影响的分块着色环节里。
7.9 效果与量化:芯片侧指令开销
再看一层更底层的证据:Adreno 离线编译器(Offline Compiler)给出的芯片侧指令开销对比Vulkan 规范。它把同一段逻辑在索引绘制与间接绘制两条路径上编译,数指令条数与关键资源的周期数。
总指令数为 1215(Indexed)对 1479(Indirect);内存写入为 16 对 42;纹理读取为 2 对 10;纹理相关的周期数为 12.1 对 40.5。Qualcomm 文档
这组数字的形状比绝对值更有信息量。指令总量涨了约两成(1215 → 1479),属于可接受的量级;但内存写入涨到约 2.6 倍,纹理周期数涨到约 3.3 倍。两件事叠起来,正是前面两条来源的量化表达:指令没涨多少,说明算法本身没变复杂;涨得凶的是访问类操作,说明代价集中在"取不到近处、只能往内存走"这件事上,与 7.3、7.4 两节的推论一致。顺带说,内存写入从 16 涨到 42,多数来自可见性结果与间接参数的写回——这是 GPU 驱动渲染额外引入的中间物,它们同样要过一遍内存。
顺带说一句口径:离线编译器数的是静态指令与估算周期,不代表真机的绝对时间,但它对"哪一类操作变重了"这类相对判断很可靠Arm 文档。所以这组数字我们拿来定性,不拿来当性能预测,只在做两版实现对比时拿来判方向。
7.10 效果与量化:真正的瓶颈是顶点流式读取
把上面几层拼起来,还剩一个问题没答:既然芯片侧只涨了两成指令,为什么实测会慢 9.5% 甚至更多?答案是带宽——具体说,是顶点数据的流式读取Arm 文档Android 文档。
移动端 GPU 驱动渲染游戏有一条共同的构成:预深度(PreZ)→ 分层 Z 缓冲 → 分层 Z 测试 → 可见性缓冲(Visibility Buffer)→ 间接命令缓冲 → 间接绘制。这套流程里,强制缓冲(feeding buffer)只有约 3 MB,属于低开销;真正的大头是顶点流式读取,规模在 400 MB 以上。Arm 原文
这就把前面的账接上了:去掉提交,省下的是那 3 MB 量级的强制缓冲;付出的却是顶点描述符无法预取、无法合并之后,顶点数据只能以更碎的方式流过。省的是一小笔,贵的是那一大笔。材料里也提到片内内存堆(tile memory heap)对这条链路有显著帮助——这又回到了整条系列反复出现的那条主线:能留在片上的,不要落到主存。Qualcomm 文档
这个结论对工程的含义很具体:想在这条路上省带宽,功夫不在剔除逻辑写得漂不漂亮,而在顶点数据的组织方式——索引是否重排得利于合并、属性是否拆到最少、片内内存能不能兜住热点Android 文档Arm 文档。这也正好解释了官方最佳实践里"优先逐顶点属性而非逐图元属性"那一条的来由。还有一点值得记住:这条瓶颈与"用不用网格着色"无关,它由顶点数据本身决定,因此无论走哪条提交路径,这笔流量都在那里,只是花法不同。
7.11 实现与配置:官方最佳实践里可用的部分
高通在 Adreno 的移动最佳实践文档里专门给了网格着色一节,要点有五条:避免使用放大(amplification,即 task)着色器;设置最优的波前(wave)数量;优先使用逐顶点属性而非逐图元属性;控制 task payload 不超过设备上限;可以用 LPAC 与图形管线(Graphics Pipe)做负载均衡。Qualcomm 文档
逐条看,它们都在回应前面那三个开销来源。避免 task 着色器,是因为多一层间接派发就多一段无法预取的等待;优先逐顶点属性,是因为逐图元属性会放大显式加载的次数(对应 7.4 节);控制 payload,是因为 payload 超限会溢出到主存,直接毁掉片上预算出处UE 文档。官方最佳实践与我们的根因分析指向同一处,这本身就是一条交叉验证。
不过清单之外还有一道硬门槛:支持现状。高通方面,Snapdragon 8 Elite Gen 5 的产品页明确写了支持网格着色,Adreno 800 系列(2025 年起)是真正可用的档位;出处 但 Vulkanised 2026 一份讲 Quest 2/3 上 GPU 驱动渲染的材料明确写着,其所用的 Adreno XR(600/700 架构)「Mesh shaders – Not available in our target hardware」——所以 Adreno 6xx/7xx 是反证,而不是支持证据。Vulkan 原文
Arm Mali 与 Immortalis 一侧,公开一手材料里未找到其声明支持 VK_EXT_mesh_shader 的证据,Arm 主打的是延迟顶点着色(Deferred Vertex Shading, DVS)与更大的图块,口径只能是「待官方确认」;Imagination PowerVR 同样未证实。这里我们把边界写准,不做任何超出一手材料的断言。Vulkan 指南 把这三条边界连起来看,网格着色在移动端目前的处境很清楚:机制已就绪、硬件刚铺开、收益还没被证明。
7.12 这一章留下的问题
好了,网格着色在移动端的账算是清楚了:剔除带来的红利是真的,但计算着色器式的提交方式会把这份红利连同预取能力一起交回去,净账为负。真正的问题因此变成:剔除该放在哪里、用什么方式提交,才能既不丢红利又不丢预取?这把钥匙在光追那一侧还有第二次用武之地——两条光追路线的差别,本质上也是"嵌在既有管线里"还是"另起一条管线",我们放到下一章去接D3D 规范。
六、光追的两条路:内联 vs 独立管线
8.1 一句话点题:光追改的是「每像素算多少射线」
下面我们开始换第三本账。这一章要换一本账,从光照切入。前两章的旋钮分别拧在着色与几何上:片段着色率(Variable Rate Shading, VRS)改的是每像素付多少着色,网格着色改的是几何怎么提交。光照这本账落在第三个旋钮上——每像素算多少条射线。这条数决定求交次数,求交次数决定加速结构被访问多少遍,而每一次内存访问都要按皮焦耳记账。所以移动端看光追,第一眼不该看画面有多真,要看这一栏。
先给两条路命名。内联式指 VK_KHR_ray_query 提供的光线查询(ray query);独立管线式指 VK_KHR_ray_tracing_pipelineVulkan 规范Vulkan 规范。两者都能算同一条射线,同一个效果也都能做,但在移动端的账是反的。
一句话收束本节:光追在移动端要解决的是"走哪条路算","能不能算"已经不是问题了。 这句是第六、七两章共同的题眼。
这两条路的名字先记住,后面每一节都会回到它们。回路本身是一样的,差别只在回路住在哪里。
8.2 原理与概念:光线追踪的基本回路
依然是惯例,先从回路本身说起。光追不是新东西。1525 年丢勒在《画家手册》里留下一幅木刻:画师把绳子一端固定在墙上一处,另一端穿过一块方格网,逐格去够物体上的位置——这其实就是"从视点经屏幕像素发射射线"最早的图解。五百年后硬件做的动作没变,只是把绳换成了射线,把手换成了加速结构。
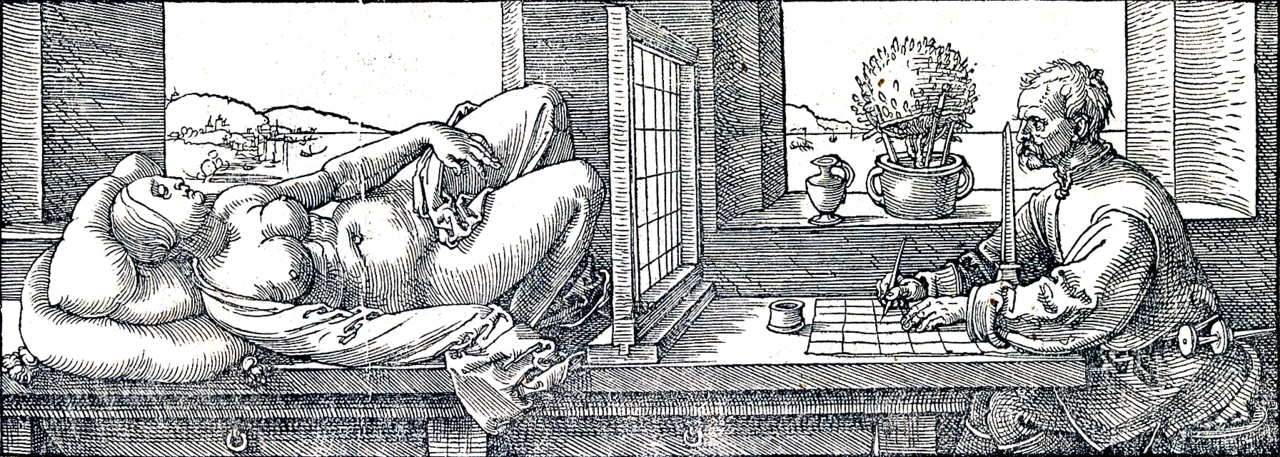
回路本身只有四步:从相机经像素发一条射线 → 与场景求交 → 取最近命中点的材质 → 着色或继续弹射。分歧不在回路,而在这段回路写在哪里。写在普通着色器里,就是内联式;写成一整组独立阶段,就是独立管线式arXiv。这个"写在哪里"的差别,会一路放大成下一章要算的那条 TBDR 收益差。
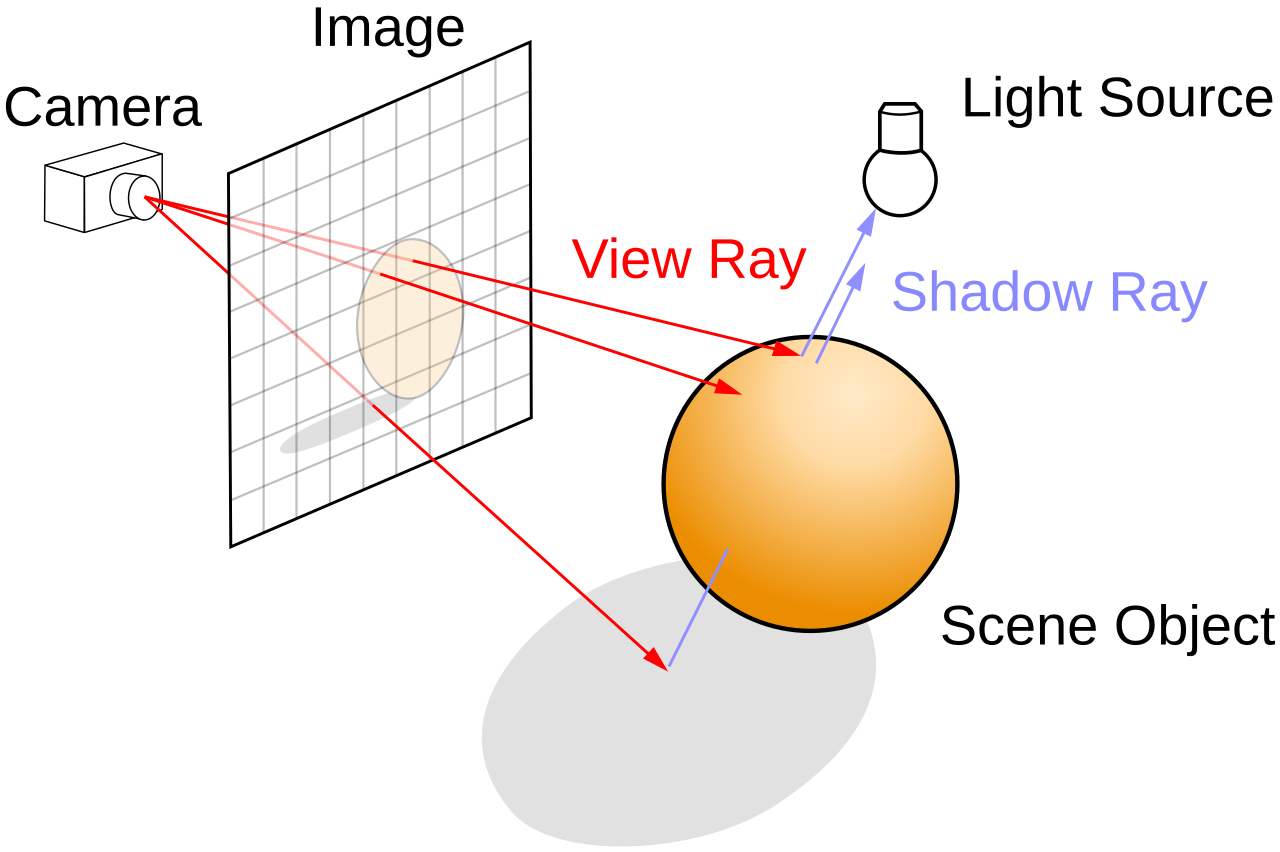
丢勒那张图还有一层用处:它提醒我们光追的核心动作是逐像素一条射线,不是"整屏一次"。射线条数是可数的,可数就能进账——这正是它比"画质好不好"更适合当移动端判据的原因。
8.3 原理与概念:Ray Query 内联式
内联式的关键词是"任意阶段"。VK_KHR_ray_query 允许在任意着色器阶段发起光线查询,核心指令是 OpRayQueryProceedKHR。写法是把遍历展开成一个循环:先用 rayQueryInitializeEXT 初始化一条查询,给定原点、方向、tMin/tMax 与标记位,再反复调用 rayQueryProceedEXT 推进遍历,命中后用 rayQueryGetIntersection* 取回距离、图元编号、实例编号等结果。Vulkan 指南
它最大的工程价值是不改管线。既然写在普通着色器里,就不需要新建光追管线对象,也不需要着色器绑定表(Shader Binding Table, SBT)Microsoft Learn。光栅路径与它是叠加关系:几何照常光栅化,几何缓冲照常写,只在片元里对"难题像素"多发一条射线。
先来看这条路的代价。它与主着色共享寄存器与占用率:遍历本身是同步点,射线一多,片元的占用率就被压下去Vulkan 规范。这不是致命的,但它说明内联式不是白捡的便宜。
8.4 原理与概念:RT Pipeline 独立管线式
独立管线式是另一套东西。VK_KHR_ray_tracing_pipeline 新增一组专用阶段:ray generation、intersection、any-hit、closest-hit、miss,以 OpTraceRayKHR 发起,用着色器绑定表(SBT)做分派——SBT 按"命中了什么"决定调用哪一段着色器。Vulkan 指南
它的结构与光栅是替换关系而不是叠加关系。ray generation 阶段生成的是光线,不是三角形;输入装配、顶点处理、光栅器这一趟全都不参与。代价也在这里:一旦绕过光栅器,下一章要算的那笔帧缓冲压缩红利就跟着一起没了。Vulkan 原文
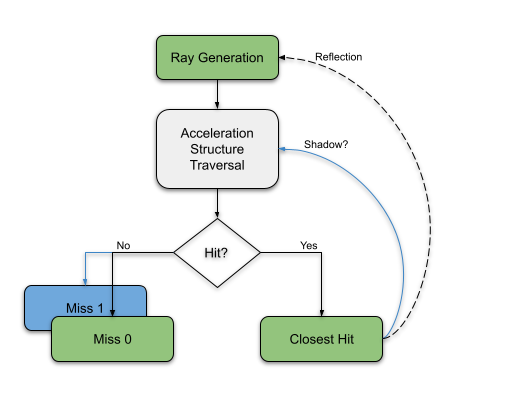
先来看两条路并排之后差在哪。六个维度里,真正决定移动端成败的是第三条——它是不是吃得到片上的压缩。
8.5 原理与概念:两条路的六维对照
把两条路并排放,六个维度就够看清。
| 维度 | 内联式 ray query | 独立管线 RT pipeline |
|---|---|---|
| 使用位置 | 任意 shader stage | 独立光追管线 + SBT |
| 与光栅的关系 | 嵌在片元里,叠加 | 以 ray generation 取代光栅化 |
| TBDR 交互 | 受益于片上压缩,少一次上下文切换 | 丢失帧缓冲压缩 |
| 移动端支持面 | 广得多,通常更高效 | 窄,驱动暴露不一致 |
| 适用 | 阴影/反射/AO/GI 等"难题" | 纯光追渲染器 |
| 代价 | 共享寄存器与占用率 | 换管线、换同步、丢掉压缩 |
Arm 的口径很明确:硬件同时支持两者,但早期驱动可能只暴露 ray query 扩展,移动端应从 ray query 起步。Vulkan 原文 硬件侧也有能全卸载的一条路线:Imagination 的 RAC(Ray Acceleration Cluster,光线加速簇)把 BVH 遍历与求交做进固定功能单元,IMG CXT-48-1536 RT3 核集成 3 个 RAC、累计 1.3 GRay/s(厂商宣称)。Imagination
这张分叉图先记着,下一章会把它换算成能耗。既然支持面与压缩都偏向内联,下面直接进实现细节。
8.6 实现与配置:Arm 的遍历最佳实践
如果只在移动端收一条建议,就是"保持 warp 内光线相干(coherent)"。理由和网格着色那一章同源:相干意味着同一 warp 的相邻线程走同一批 BVH 节点、命中缓存;一旦方向、起点、长度发散,遍历就退化成逐线程随机访存,能耗随之上去。所以发线时尽量让同一 warp 的光线方向、起点与长度相近。Vulkan 原文
第二条是每个 rayQueryInitialize() 只做一次 rayQueryProceed(),别把查询塞进循环或复杂分支里——遍历是同步点,循环里的查询会把占用率拖垮。第三条是尽早终止:阴影、遮蔽这类只需要"有没有被挡住"的测试,用 gl_RayFlagsTerminateOnFirstHit 命中即停;SkipAABB、Opaque 这类标记在编译期就能确定,能省掉不必要的相交阶段调用。Vulkan 指南
三条建议合起来是一句话:让遍历尽可能短、尽可能整齐。这条原则在加速结构的组织上还会再出现一次。
8.7 实现与配置:加速结构的构建与更新取舍
加速结构分两层:底层的 BLAS(Bottom-Level Acceleration Structure,底层加速结构) 装单个几何体或一组图元,顶层的 TLAS(Top-Level Acceleration Structure,顶层加速结构) 装实例与变换。构建很贵,更新便宜,但更新只吃得起"仅改变换"这一类变化Vulkan 规范Vulkan 规范。Vulkan 指南
Arm 给的调优方向有三条:缩小节点的包围盒、把含大空间空洞的 BLAS 拆开、用 BLAS transform 保证轴对齐。三条都指向同一件事——少遍历空节点。空洞越大,射线在空盒子里空转的步数越多,而每一步都是一次内存访问,也就都有 pJ 单价。Vulkan 原文
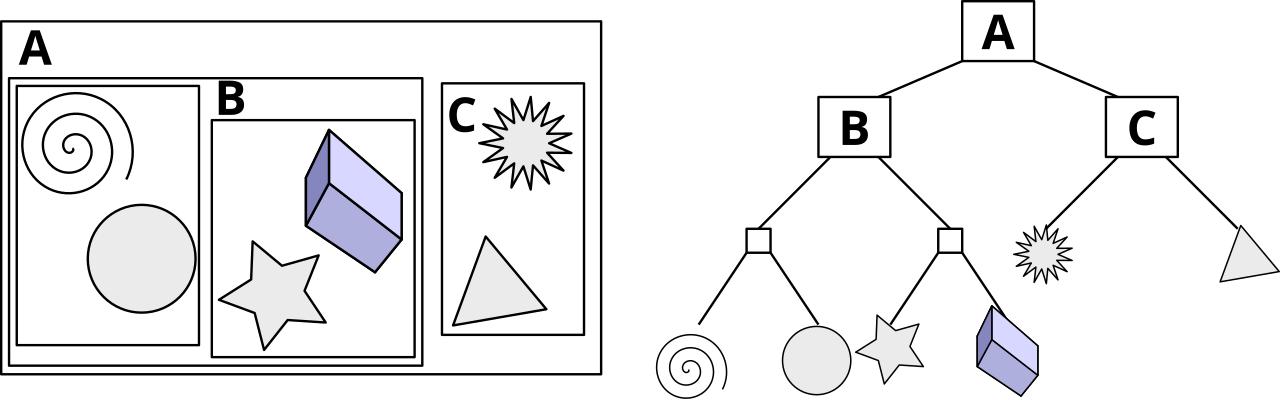
结构搭好之后,下一个问题就是"哪些效果值得发射线"。下面用一组对照图来回答。
8.8 效果与量化:反射与 GI 的做法对照
先看一张反射做法的对照图。它把同一场景的多种反射实现摆在一起,恰好说明"光追反射"是一族做法而非一种做法,观感与代价各不相同——这一点在选型时比"哪种更好看"重要得多。
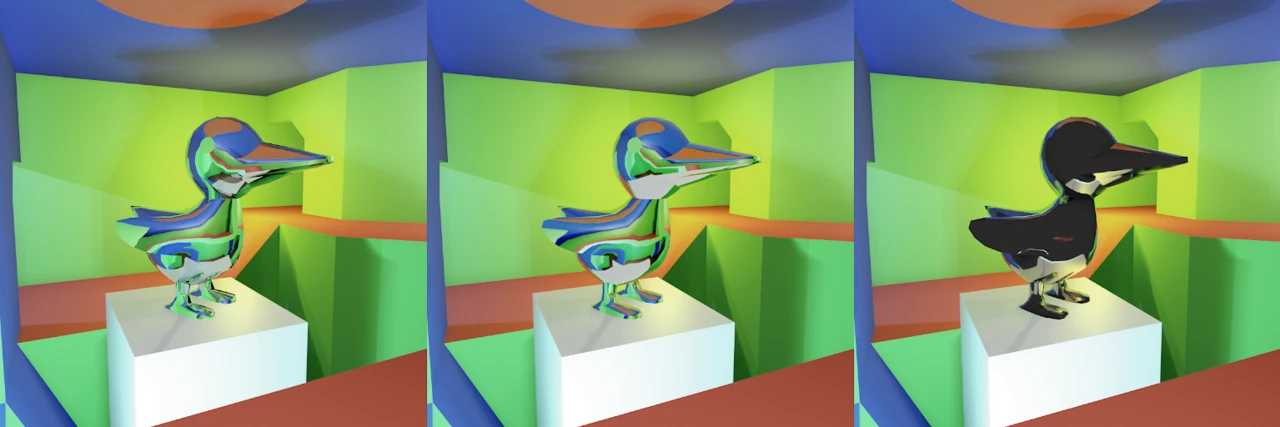
回到选型。反射最值得用内联:它在屏幕空间反射(SSR)失效的地方补一条射线,叠加在片元里,不碰压缩。光追阴影同样适合内联——只需要遮蔽测试,配终止标志即可,成本最低Vulkan 规范Vulkan 规范。环境光遮蔽(AO)与全局光照(GI)属于"难题里的难题",单帧一发不够、还要降噪,移动端一般只做低采样数的补充项。需要提醒的是,上图那种递归反射只是原理演示,真机上每一级弹射都要乘上射线条数——级数每加一,账就翻一倍,而观感收益是递减的。
这张表给出的不是"该不该做光追",而是"哪几个效果先用、每个像素发几条"。选完效果,还要知道算到什么程度算够。
8.9 效果与量化:算法收敛的参照系
判断一台设备"光追够不够用",还需要一个收敛参照系。经典的康奈尔盒(Cornell Box)就是干这个的:同一场景、同一组光源,路径追踪(Path Tracing)用蒙特卡洛采样逼近真实解,采样越多越干净;辐射度方法(Radiosity)只解漫反射的全局光照,收敛快,但看不到镜面与焦散。
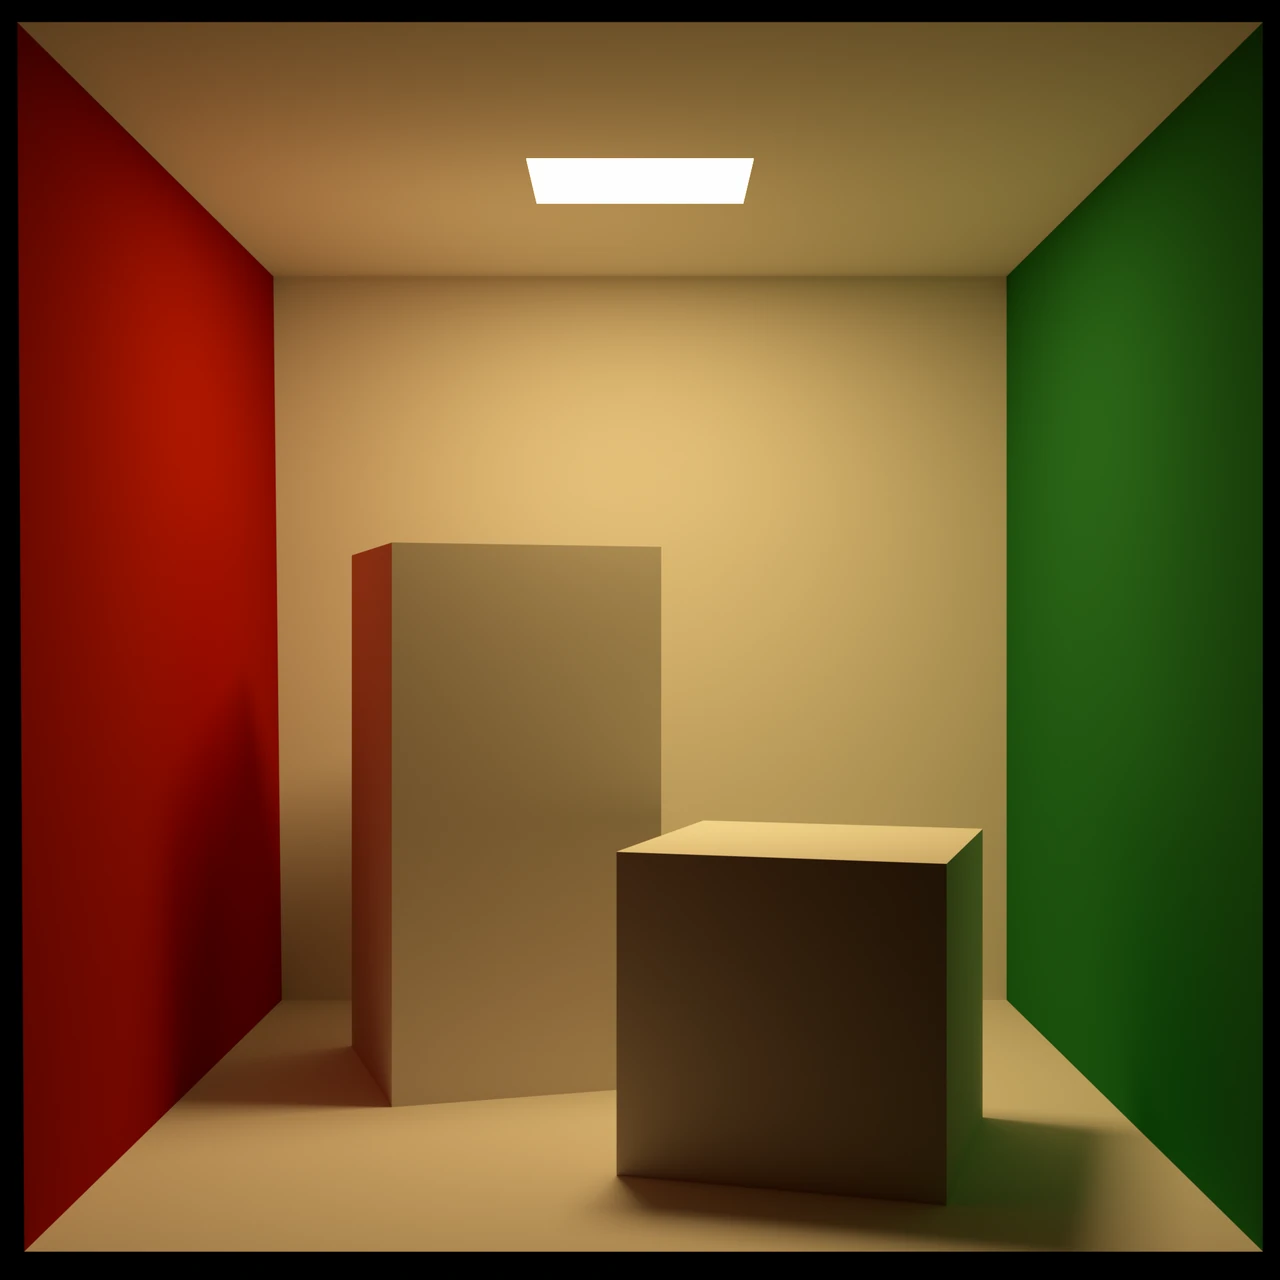
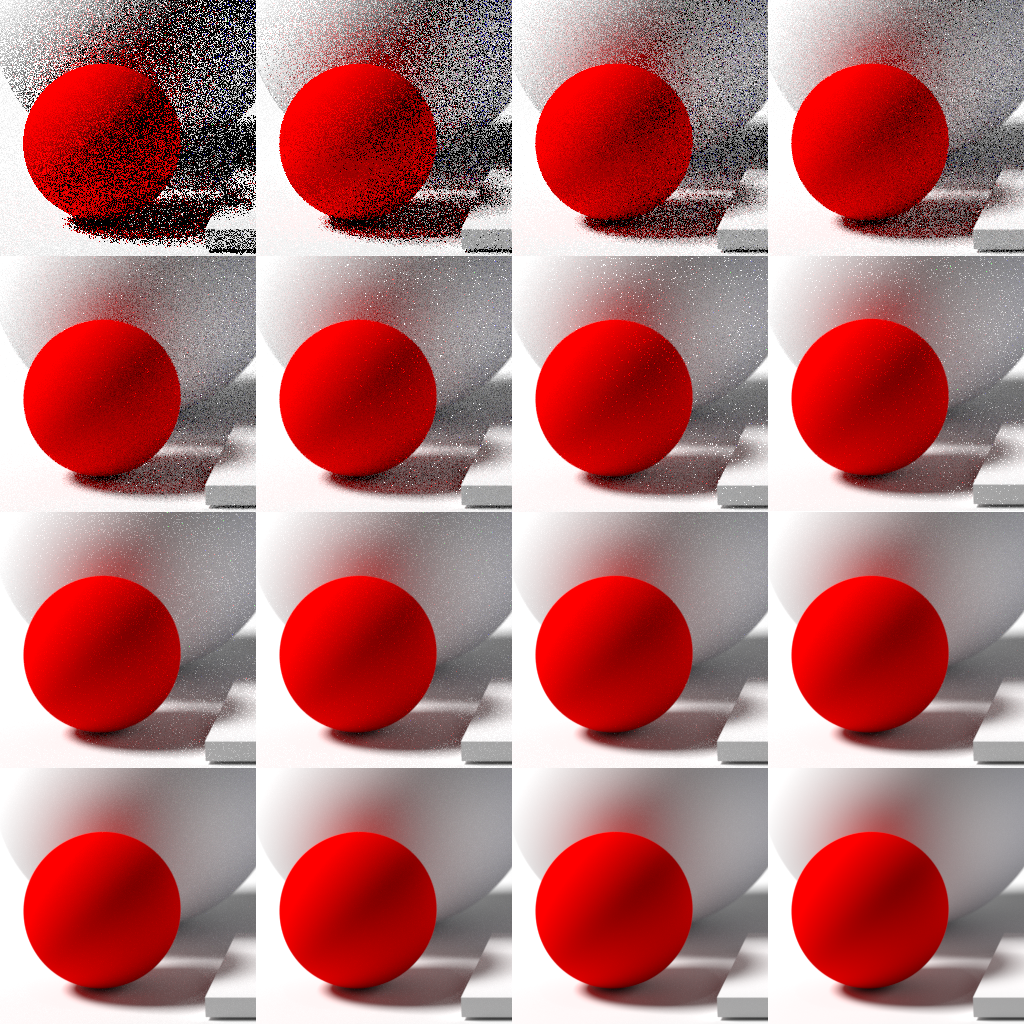
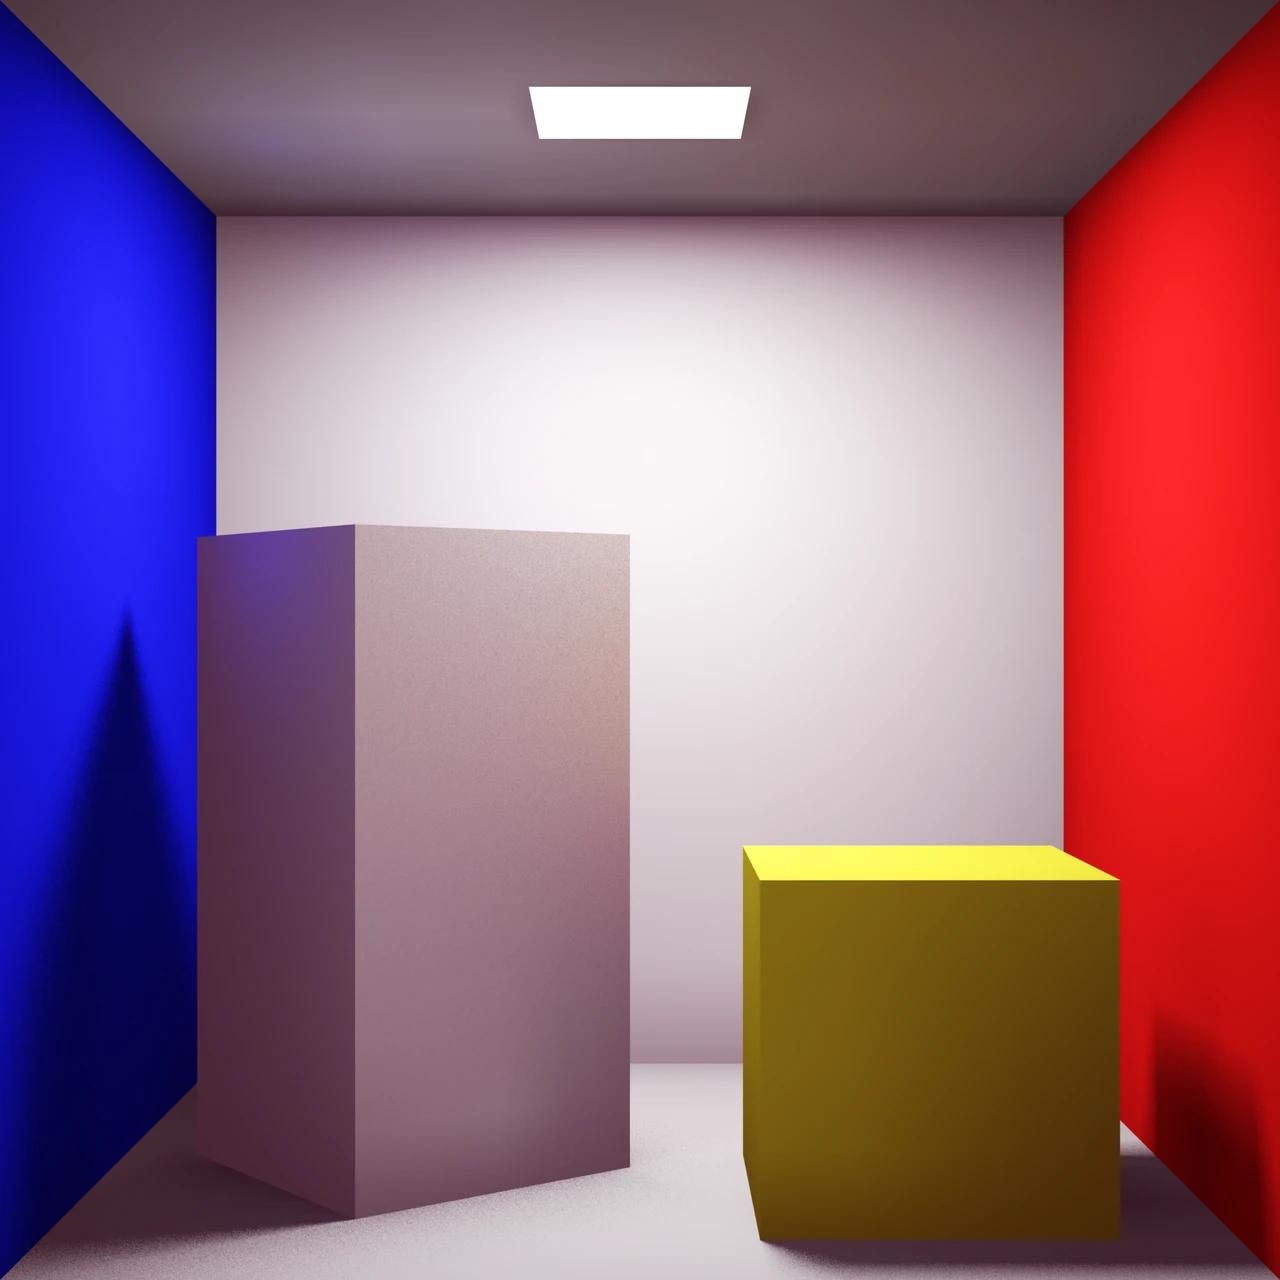
把这两张放一起看:路径追踪那张的光斑里还带着噪声,辐射度那张干净但缺镜面项。移动端的光追就夹在中间——采样数被功耗按住,只能靠降噪与分辨率折衷。算法收敛速度与硬件能负担的采样数,是两条独立的线,不能混着讲。
8.10 源码与数据链接
依然是惯例,本章材料分三层:规范原文定接口与遍历规则,厂商与学术材料定量级与实测,外部素材库供配图。先给一张分层结构图,再逐条列出全部出处,方便大家逐条核对。
- 光线遍历与 ray query:https://docs.vulkan.org/spec/latest/chapters/raytraversal.html
- Ray Tracing 概览与 SBT:https://docs.vulkan.org/tutorial/latest/courses/18_Ray_tracing/00_Overview.html
- Arm《Mobile Ray Tracing Demystified》:https://www.vulkan.org/user/pages/09.events/vulkanised-2026/Mobile-Ray-Tracing-Demystified-Iago-CalvoLista-Arm.pptx.pdf
- Arm 图形产品页(光追硬件与压缩规格):https://www.arm.com/zh-cn/products/silicon-ip-multimedia
- Imagination PowerVR Photon 与光追发布页:https://www.imaginationtech.com/products/gpu/graphics-architecture/powervr-photon/ 、https://www.imaginationtech.com/news/imagination-launches-the-most-advanced-ray-tracing-gpu/
- Imagination 光追白皮书:https://resources.imaginationtech.com/hubfs/gated-files/raytracing/raytracing-shininglight-whitepaper-en.pdf
- 高通 Adreno 产品页与骁龙 8 Gen 3:https://www.qualcomm.com/processors/adreno 、https://www.qualcomm.com/smartphones/products/8-series/snapdragon-8-gen-3-mobile-platform
- 联发科天玑 9500(原生支持 Vulkan Raytracing Pipeline):https://www.mediatek.com/products/smartphones/mediatek-dimensity-9500
- ACM 移动混合渲染与帧时间实测:https://dl.acm.org/doi/pdf/10.1145/2818427.2818442 、https://dl.acm.org/doi/pdf/10.1145/3721239.3734103
- Wikimedia Commons ·
Category:Ray tracing(本章外部素材来源):https://commons.wikimedia.org/wiki/Category:Ray_tracing
8.11 这一章留下的问题
好了,内联式先赢一局,但要记住这一局赢在哪:它赢在没有离开片元流程,因此吃到了 TBDR 的压缩红利。那份红利到底是什么、值多少皮焦耳?下一章把两样东西摆上同一张桌——压缩比与内存能耗的 pJ 账。
七、光追与 TBDR 的冲突:压缩红利与 pJ 账
9.1 一句话点题:吃掉压缩红利,光追才有账可算
好了,先把那份红利称一称。上一章的结论还悬在半空:内联式赢在"没离开片元流程"。这一章要把这份红利换算成具体的数——分块延迟渲染(Tile-Based Deferred Rendering, TBDR)到底送了移动端什么,独立管线又拿走了什么。 一句话:光追只有在吃到压缩红利之后,才有账可算。
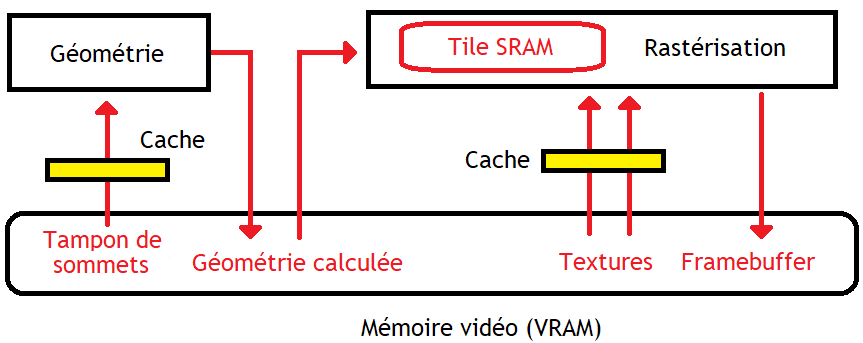
要算清这笔账,先把红利的来源拆开——它其实是两份互相叠加的收益,合起来才是一个数。
9.2 原理与概念:TBDR 的红利从哪来
下面我们开始算这笔红利。TBDR 的红利来自一件事:只把最终像素写回主存Arm 文档Qualcomm 文档。移动 GPU 把画面切成小块,几何先全部提交、逐块做隐面消除,最后只把可见像素的颜色写出去。中间过程——深度、模板、被覆盖掉的像素——都发生在片上,不产生主存往返。
这份红利是硬件白送的,不需要写一行代码。Imagination 的官方实测是典型帧里平均每屏幕像素提交了 4.7 个片段,实际着色只有 1.2 个;再叠加帧缓冲压缩,写回主存的字节还能再砍一档。Imagination
先来看这份红利为什么对光追格外重要。光追一旦进入片元,射线条数会随着画质目标成倍上涨,但可见性判定的收益仍在——被挡住的像素依旧不参与着色,也就不会发出射线arXiv。红利保住了,光追的成本才可能被压在功耗预算内。
9.3 原理与概念:RT Pipeline 为什么吃掉它
独立管线式把 ray generation 放在了光栅化前面,这一趟里没有"逐块收集几何再消除"的动作。帧缓冲压缩(framebuffer compression)在这条路径上失效:压缩的前提是写回的是连续的、有空间相关性的最终像素,而独立管线一帧逐像素地发线、写结果,像素之间不再有那种成块被剔除、成块被写回的模式Arm 文档。
Arm 的说法很直接:这条路径直接削弱了 TBDR 最大的优势。Vulkan 原文 结果就是本该压在片上的读写,被迫走到带宽受限的系统总线上,而这几笔账最后全部记在内存能耗上。
数据改道之后,多出来的往返要按什么单价记账?下面给出这条单价线。
9.4 原理与概念:内存能耗的 pJ 账
账要用能耗单位记。Arm 给的量级是:访问主存 RAM 约 100 pJ,访问系统级缓存 SLC 约 10 pJ——差整整十倍。Arm 文档 这个十倍不是理论值,它是移动端所有带宽优化最终要收敛到的那条线:把一次 RAM 访问换成一次缓存或片上访问,省下的是九成能耗。
把这条单价摆成表,三个落点的高低一目了然:
| 访问落点 | 单次能耗量级 | 相对代价 |
|---|---|---|
| 主存 RAM | 约 100 pJ | 10× |
| 系统级缓存 SLC | 约 10 pJ | 1× |
| 片上(tile memory / GMEM) | 低于 SLC | <1× |
好了,单价立住了,就能算一帧的账。一帧里每一次多余的 RAM 往返都按 100 pJ 计价,而压缩与 tile-local 读取做的正是把这类往返换成 10 pJ 甚至更低的片上访问——这就是"光追要留在片上"那句话的定量版本Arm 文档Microsoft LearnApple 文档。
9.5 原理与概念:压缩比与续航的关系
压缩比直接对应续航。Arm 的两套压缩:AFBC(Arm Frame Buffer Compression)无损,约 2:1;AFRC(Arm Fixed Rate Compression)有损固定码率,最高 4:1。Arm 文档 按上一节的单价换算:原本要写 4 份数据的动作,AFRC 4:1 下只需写 1 份,写回能耗直接降到四分之一。
要注意的是,这条链只在写回仍走片上的压缩路径时成立。独立管线让压缩失效,等于把 4:1 的红利原地退回 1:1——同一份画面,能耗差出好几倍Arm 文档。
9.6 实现与配置:dynamic_rendering_local_read
要在移动端做混合渲染,需要一条能在渲染过程中读回当前块已写出的像素的能力。VK_KHR_dynamic_rendering 加上 VK_KHR_dynamic_rendering_local_read 提供的正是这个:在动态渲染下实现类 subpass 的 tile-local 读取,读的还是片上那份数据,不落主存。Vulkan 指南
这条能力正好接上第五篇的结论:延迟着色在移动端成不成立,取决于几何缓冲落不落地。这里的落点一模一样——光追的中间结果如果能在块内被后续阶段读到,它就还在片上;一旦拆成两个 pass,压缩红利立刻作废Apple 文档Unity 文档Apple 文档。
这条取舍与第五篇的 subpass 结论是同一条:能在一个 pass 里读完的,就不要拆成两个Vulkan 规范NVIDIA 文档Arm 原文。分工原则也随之确定。
9.7 实现与配置:混合渲染的分工原则
分工原则一句话:光栅出几何缓冲与基础着色,ray query 只算难题Apple 文档Qualcomm 文档。几何与直接光照走成熟的光栅路径,保住隐面消除与压缩;阴影、反射、AO 这类"靠屏幕空间近似会出错的像素",再用内联射线补一刀。ACM 的研究结论同向:移动混合渲染的关键是把分块渲染的原理反映到加速结构的遍历里,带宽与能效才可能可接受。出处
分工定了,接下来看这套做法在真机上离目标还有多远。
9.8 效果与量化:移动端实测帧时间
第三方(ACM 同行评审)的帧时间把移动光追的现状钉住了:Samsung Xclipse 940 在 Bistro 场景平均帧时间 286 ms,同场 Mali-G715 是 592 ms;换到 Sponza,两者分别是 29 ms 与 466 ms。出处 注意口径:这是实测,不是厂商宣称值。
同一组材料里,两台的差距接近 2 倍与 16 倍两档,说明光追性能在移动端高度依赖硬件路线与驱动实现——同一句"支持光追",落在不同芯片上不是同一件事。
两组数字摆在一起,问题就变成一个很直接的算术题:还差几倍。
9.9 效果与量化:离可用还有多远
用帧时间反推差距。60 fps 的帧预算是 16.7 ms。Bistro 的 286 ms 要压到 16.7 ms,需要约 17 倍;Sponza 的 29 ms 只需约 1.7 倍。这两条线不能混着讲——"移动光追还不能用"是一句过于笼统的话,它只在重几何、强发散的场景里成立。
要走到可用,三条路并行:降分辨率或降采样、用降噪替代高采样、以及把难题交给内联式只算必要像素arXiv。三条都指向同一个方向——减少每帧真正发出的射线条数。
9.10 源码与数据链接
依然是惯例,本章的账本由两组硬来源支撑:压缩规格与内存能耗量级来自 Arm,帧时间与混合渲染结论来自 ACM 同行评审,另有厂商侧口径作为辅助。下面先给分层结构,再逐条列全出处。
- Arm 压缩规格与内存能耗量级:https://www.arm.com/zh-cn/products/silicon-ip-multimedia
- 渲染通道与类 subpass 的 tile-local 读取:https://docs.vulkan.org/spec/latest/chapters/renderpass.html
- Arm《Mobile Ray Tracing Demystified》:https://www.vulkan.org/user/pages/09.events/vulkanised-2026/Mobile-Ray-Tracing-Demystified-Iago-CalvoLista-Arm.pptx.pdf
- ACM 移动混合渲染的加速结构遍历:https://dl.acm.org/doi/pdf/10.1145/2818427.2818442
- ACM 移动光追帧时间实测:https://dl.acm.org/doi/pdf/10.1145/3721239.3734103
- 高通 Adreno TBDR 与 GMEM 说明:https://docs.qualcomm.com/bundle/publicresource/topics/80-78185-2/overview.html
- 高通 VRS × 光追配合口径:https://developer.qualcomm.com/blog/variable-rate-shading-has-arrived-mobile-impressive-results
- AMD RDNA 性能指南(帧缓冲压缩与深度导出):https://gpuopen.com/learn/rdna-performance-guide/
- 联发科天玑 9400(光追性能口径):https://www.mediatek.com/products/smartphones/mediatek-dimensity-9400
- Wikimedia Commons ·
Category:Ray tracing:https://commons.wikimedia.org/wiki/Category:Ray_tracing
9.11 这一章留下的问题
好了,压缩红利算清了:内联保得住,独立管线保不住;pJ 单价的十倍差,就是这条路的全部理由。但账本上的账不等于货架上的货——芯片支持矩阵、引擎开关、驱动暴露程度,每一层都可能再缩水一次。下一章去看这条链条从芯片到引擎到底剩多少。
八、厂商与引擎的现实:落地清单
10.1 一句话点题:从芯片到引擎,每一层都在缩水
上一章我们把光追与分块渲染(Tile-Based Deferred Rendering,TBDR)的冲突算成了一本 pJ 账,账算完还有个更现实的问题:这些特性在真机上到底有没有被做出来、被驱动暴露出来、被引擎认下来。
这条链路要走四道关口:硅片有没有硬件单元,驱动有没有以可用版本暴露扩展,引擎有没有对应渲染路径,项目有没有手段确认它生效。前两道是厂商的事,后两道是我们自己的事。
说白了,发布会讲的是第一层,开发者文档讲的是第二层,我们真正会踩坑的是后两层。这一章要把规格表上缺的那一列标出来,那一列的题目是"是否真的可用"。
10.2–10.3 原理与概念:光追硬件的三种路线与 RTUv1 → RTUv2 的演进
先来看看三者各自把线画在哪儿。移动端的光追硬件能数出三条路线。第一条是 Imagination PowerVR Photon 的光线加速簇(Ray Acceleration Cluster,RAC):由光线测试单元、硬件 BVH 遍历与包相干性聚集(RTLS Level 4)组成,把整段求交整块卸载出去。Imagination
第二条是 Arm Immortalis 的光线追踪单元(Ray Tracing Unit,RTU):Mali-G715 是首款移动端硬件级光追 GPU,Mali G1 Ultra 引入的 RTUv2 转向改善高光线发散场景,采用单光线模型。Vulkan 原文
第三条是高通 Adreno 的自研路线,官方措辞是它能处理"每秒数百亿次光线求交",并用后处理加速单元把后处理块效率最多提升 75%,三条路线里它最强调与自家分块架构配合。出处
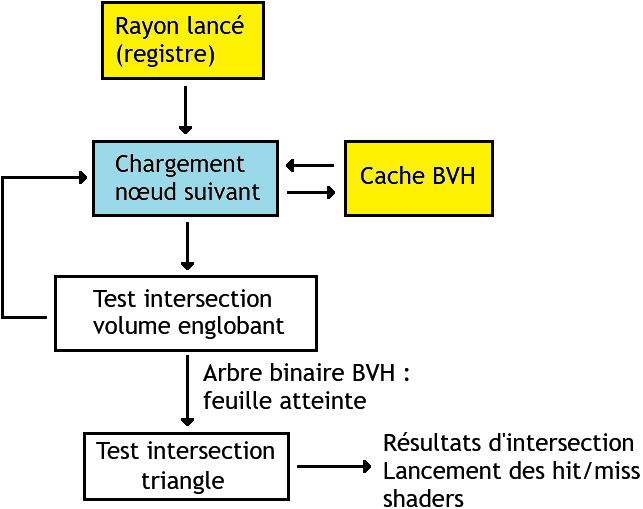
三者的分野在卸载粒度上:RAC 走整段卸载,RTU 与着色核心同层,Adreno 更贴近自家分块架构;同一段光追代码在三家的代价模型并不一样,不能拿一家的最佳实践去套另一家。出处
10.4 效果与量化:三家厂商的光追规格与宣称值
摆数字之前先把口径钉死:下面这一批数字全部是厂商宣称值,来自官方产品页或白皮书,不是第三方独立实测,不能当成工程可用性的证据。
Imagination 的口径是:IMG CXT-48-1536 RT3 核集成 3 个 RAC,累计 1.3 GRay/s;CXT 单核 RT3 的计算、纹理与几何较上代提升 50%。Imagination Imagination
Arm 更保守:G715 的新着色核心 128 个 fp32 FMA/时钟,性能较 Mali-G710 提升 15%。高通与联发科这边:Snapdragon 8 Gen 3 宣称 GPU 渲染与能效各 +25%;天玑 9300+ 宣称 60 帧光追加主机级全局光照(Global Illumination,GI)、同场景功耗省约 20%,这一列全部是厂商口径。Arm 原文 出处 MediaTek
先来看这张表最容易误导人的地方:这三家的数字单位根本不可比,排在同一列里做排名,等于把速度、里程和油价混在一起排序,得不出任何可靠结论。MediaTek
这也是后面只认第三方实测的原因:宣称值用来判断这笔投入有没有人认真在做,实测值用来判断现在能不能用,两者都要,不能互相替代,更不能混在一张榜上排名。
10.5 效果与量化:移动平台支持矩阵
支持面要按代次列成矩阵,并标出来源等级:A 级是官方一手材料,B 级是第三方整理Arm 文档Apple 文档。
Arm 一支:G715 起进入硬件光追(首款),G720 被用在多款旗舰 SoC 上,G925 与 G1 Ultra 继续演进,其中 G1 Ultra 带来 RTUv2,光追支持面因此覆盖了从 2022 年到 2026 年的整段旗舰。Imagination 一支:RT3 核(含 CXT 系列)是移动端光追的承载单元。Arm 文档 出处
第三方实测给的是另一面的数字,而且口径完全不同:ACM 的同行评审材料量的是帧时间——三星 Xclipse 940 在 Bistro 场景平均 286 ms、Mali-G715 为 592 ms,Sponza 场景分别是 29 ms 与 466 ms,这组落差本身就是结论,它就是移动光追目前的现实水位。出处
好了,矩阵要与规格表合起来看:规格表说有光追单元,实测表说有单元的机器跑一个中等场景要几百毫秒Microsoft Learn。
10.6 原理与概念:mesh shader 支持现状与未证实清单
网格着色(Mesh Shading)的现状最需要小心,因为一手证据分布极不均匀。证据最强的是高通 Adreno:Snapdragon 8 Elite Gen 5 的官方产品页明确写了「Support for Mesh Shading」。出处 Qualcomm 文档
但同一家厂商也有反向证据。Vulkanised 2026 的《GPU-Driven Rendering in the Quest 2 and 3》明确写着,Quest 2/3 所用的 Adreno 系列架构「Mesh shaders – Not available in our target hardware」,所以真正可用的范围是 Adreno 800 系列(2025 年起),这一点在中文资料里常被写成更早的代次,实际差了好几年。Vulkan 原文
Arm Mali / Immortalis:未证实。 公开一手来源中,我们没有找到 Arm 声明支持 VK_EXT_mesh_shader 的证据;Arm 官方主推的是延迟顶点着色(Deferred Vertex Shading,DVS)几何管线与更大的图块(G720 最高 64×64),与 mesh shader 不是一回事,这里必须写「未证实」,不得断言支持。Vulkan 指南
Imagination PowerVR:未证实。 官方对外主推 TBDR、HyperLane 与 AI Synergy,我们同样没有找到移动 PowerVR 支持 mesh shader 的一手证据,因此一样标注「未证实」,不得断言支持;这两处留白属于暂时没有答案,而不是答案是否。
这两处留白与桌面侧的坐标要分开看:第三方整理指出,截至 2024 年初代表低端支持卡是 GTX 1650、RX 6400(RDNA2)与 Intel Arc A370,苹果 Metal 3 在 2022 年引入该能力,硬件支持见于 M3 与 A17 一类的芯片,仅供参照。出处
10.7–10.8 实现与配置:引擎侧的双口径与 VRS 的芯片分代门槛
引擎侧最典型的是虚幻引擎(Unreal Engine,UE)的双口径,两套材料必须同时引用才算准确UE 文档。
第一套来自移动渲染路径:UE 的移动渲染器长期明确标注"硬件光追 = 否";Lumen 不支持移动平台,官方也写明没有为移动渲染器开发动态 GI 的计划。第二套来自 UE 5.3:自 5.3 起 Android 上加入实验性移动光追,但它走的是 Mobile Desktop Renderer,官方列出的支持 GPU 为 Adreno 740、Immortalis-G715 与三星 XClipse 系列。出处 UE 文档 UE 文档
两套合起来,准确的边界只有一句:UE 的移动光追是实验性的、绕过标准移动渲染路径、且需要落在官方 GPU 名单内UE 文档。 至于 Unity,本篇不为它的移动光追支持面下任何结论。
再看 VRS(Variable Rate Shading,可变速率着色)的芯片分代门槛:Arm 侧从 Immortalis-G715、Mali-G715 与 Mali-G615(第 4 代 Valhall)起支持,Godot 文档口径是 Mali-G615 及更新;高通侧是 Snapdragon 888 及更新;联发科侧是 Dimensity 9000 及更新。Godot 文档 Arm 原文 MediaTek
这三条门槛落到项目里却常被忽略:同一款游戏在 2021 年机型上开 VRS 可能是静默无效,在 2023 年机型上才是真开。
10.9 效果与量化:规格表上缺的那一列
把前面几节合起来就能说明白,为什么规格表在移动图形里几乎没用:它只填了硬件有没有,而真正决定成败的三列全是空的——扩展有没有被驱动暴露、引擎有没有对应渲染路径、项目有没有手段确认它生效。
先看两个现成的例子。网格着色那一列:硅片层写着有,但驱动与引擎层的成熟路径还很少,且第五章已实测出负收益,结论只能是有硬件、慎用。光追那一列:硅片层多家都有,驱动层可能只暴露 ray query 扩展,引擎层 UE 只有实验性路径。
10.10 源码与数据链接
依然是惯例,本章材料分四层:厂商产品页给规格与宣称值,厂商开发者文档给工程建议,引擎官方文档给可用性边界,学术与第三方材料给独立实测。下面按这四层把来源列全。
凡标注「厂商宣称」的条目都可回溯到对应产品页或白皮书;需要复核的同学可以从这里逐条查证,本节不引用任何无法回溯的二手数字,也不引用发布会口径。
- Imagination 光追架构、新闻与白皮书(厂商宣称):https://www.imaginationtech.com/products/gpu/graphics-architecture/powervr-photon/ 、https://www.imaginationtech.com/news/imagination-launches-the-most-advanced-ray-tracing-gpu/ 、https://resources.imaginationtech.com/hubfs/gated-files/raytracing/raytracing-shininglight-whitepaper-en.pdf
- Arm 移动光追一手材料(RTUv1 → RTUv2)与产品页:https://www.vulkan.org/user/pages/09.events/vulkanised-2026/Mobile-Ray-Tracing-Demystified-Iago-CalvoLista-Arm.pptx.pdf 、https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/arm-immortalis-g715-developer-overview 、https://www.arm.com/zh-cn/products/silicon-ip-multimedia
- 高通 Adreno 与 Snapdragon 产品页:https://www.qualcomm.com/processors/adreno 、https://www.qualcomm.com/smartphones/products/8-series/snapdragon-8-gen-3-mobile-platform 、https://www.qualcomm.com/products/mobile/snapdragon/smartphones/snapdragon-8-series-mobile-platforms/snapdragon-8-elite-gen-5
- 高通移动最佳实践(mesh shader 建议):https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- 联发科天玑平台光追口径:https://www.mediatek.com/zh-cn/products/smartphones/mediatek-dimensity-9300-plus 、https://www.mediatek.com/products/smartphones/mediatek-dimensity-9400 、https://www.mediatek.com/products/smartphones/mediatek-dimensity-9500
- mesh shader 扩展规范(用于标注未证实项)与横向参照:https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_mesh_shader.html 、https://linebender.org/wiki/gpu/mesh-shaders/
- Adreno 600/700 的反向证据:https://www.vulkan.org/user/pages/09.events/vulkanised-2026/1415-Lucas-Silva-DevshGraphicsProgramming.pptx.pdf
- 引擎侧边界(UE 与 Lumen):https://docs.unrealengine.com/5.2/en-US/rendering-features-for-mobile-games-in-unreal-engine/ 、https://dev.epicgames.com/documentation/en-us/unreal-engine/lumen-technical-details-in-unreal-engine/ 、https://dev.epicgames.com/documentation/en-us/unreal-engine/unreal-engine-5.3-release-notes
- VRS 芯片分代门槛(Arm / 高通 / 联发科):https://docs.godotengine.org/en/latest/tutorials/3d/variable_rate_shading.html 、https://developer.mediatek.com/VariableRateShading/642428c3f55b040d6989a991.html
- 第三方独立实测帧时间:https://dl.acm.org/doi/pdf/10.1145/3721239.3734103
- 代次对照(第三方,B 级):https://www.faceofit.com/immortalis-g1-ultra-vs-g925-vs-g720/
10.11 这一章留下的问题
好了,规格、宣称值、支持矩阵三层摆完之后,我们手上有了三张互不相同的清单:VRS 的门槛最清楚,光追的边界最模糊,网格着色则连"支持"都还没被普遍证实。
这三个特性放进同一个项目时该怎么排序、怎么取舍,以及顺序反了要付出什么代价,就是下一章要交的答卷,也是本篇最后一次把三个旋钮摆到同一张桌上。
九、三者的交汇与选型:同一本账上的三个旋钮
11.1 一句话点题:三个特性不是三次升级,是三个旋钮
下面我们开始合账。走完前八章,我们已经有三个独立结论:VRS 会被规范静默降回 1×1,网格着色在移动端实测是负收益,光追的独立管线会吃掉 TBDR 最大的红利。
这三个特性不是三次逐代升级,而是同一本账上的三个旋钮。它们之间是互相拉扯的关系——拧开一个,另一个的收益可能归零,配合得当也可能一起放大。
说白了,前八章验证的是每个旋钮能不能用,这一章验证的是它们能不能一起用;判据仍然只有一条,就是有没有破坏片上流程,这条判据不因为组合方式改变而改变。
11.2 原理与概念:VRS × 光追的配合
OK,言归正传,从第一对组合说起。这一对最顺:VRS 与光追在方向上一致。 光追把每像素的代价推高,VRS 正好把着色频率压下来,一个加成本、一个降成本。Arm 的口径是,其实现等价于 DirectX 的 Tier 2 语义,并建议着色率区域不超过 2×2。Vulkan 原文
为什么压到 2×2 而不是更激进?因为光追的输出通常是高频细节——反射、阴影边缘、GI 的间接光斑,对分辨率非常敏感;着色率一放大细节先糊掉,而糊掉的观感损失往往比省下的那点帧时间更贵arXiv。
先来看一个具体的分工建议:把反射缓冲这类低频大块的通道调得激进一些,把阴影与细节通道留在 1×1 或 2×2。但前提仍是第三章那套确认流程,顺序不能反。
11.3 原理与概念:光追 × 延迟着色的顺序
第二对组合是顺序问题。上一篇的结论是:延迟着色能不能用,取决于中间物落不落地;片上预算硬卡在 128 bit/像素。 这一章补的是同一张账的另一栏——光追若要吃到片上压缩,就必须留在片元阶段:内联式 ray query(VK_KHR_ray_query)嵌入在片元着色里,能受益于片上压缩;独立管线的 VK_KHR_ray_tracing_pipeline 以 ray generation 取代光栅化,会丢失帧缓冲压缩。Vulkan 指南 Vulkan 指南
细节上还有两个可用工具:VK_KHR_dynamic_rendering 配合 VK_KHR_dynamic_rendering_local_read,可以在动态渲染下实现类 subpass 的 tile-local 读取,Khronos 官方点名为移动端分块 GPU 省带宽的大件事,这条正好接上上一篇的 subpass 结论,两篇的账在这里合成一本。Vulkan 指南
11.4–11.5 原理与概念 与 实现:网格着色 × 可见性缓冲、三者的开启顺序与依赖
第三对组合最需要谨慎,因为它涉及全篇最反直觉的那条实测:网格着色在桌面侧的正收益全部来自簇级剔除(cluster culling);而在移动端,Arm × Qualcomm 的 Ball Collision 基准里,GPU Mesh Shaders 是 75.1 FPS / 3.77 W,传统 Indexed 路径是 121.4 FPS / 2.02 W。Arm 原文
那它和可见性缓冲(Visibility Buffer)的关系是什么?后者只记录哪个三角形覆盖了哪个像素、把着色推迟到后面,与 cluster 剔除天然合拍:剔除做在 task 阶段,可见性缓冲承接剔除结果。Capcom 的 RE Engine 就是完整样本,在可用时跑分层 Z 缓冲(Hierarchical Z,HiZ)剔除,命中可见性缓冲则设置 LOD bias。出处 Khronos 规范
但前提是:它的收益来自剔除,不来自 mesh shader 这个名字。 几何量不够大、剔除省不下多少,移动端那笔丢掉预取红利的成本就会原样落在账上,一分不少,这笔成本是刚性的。NVIDIA 文档
先来看开启顺序:第一步定引擎渲染路径(G-Buffer 落不落地);第二步定光追路线(ray query 起步);第三步才谈 VRS 的档位与区域大小;第四步才评估是否引入网格着色;这个顺序反了,返工量会翻倍Unity 文档Unity 文档。
11.6 效果与量化:组合效果表
组合关系要列成表,左边收益、右边抵消。VRS 配光追:收益是降低着色频率,抵消项是几何阶段写深度会触发静默降级。光追配延迟着色:收益是 ray query 能吃片上压缩,抵消项是 RT pipeline 会丢帧缓冲压缩。网格着色配可见性缓冲:收益来自簇级剔除,抵消项是移动端丢掉预取红利。三者同时开:抵消项会叠加。
这张表要传达的只有一句:收益可以叠加的部分很少,抵消却几乎总是叠加的。 判断一个组合值不值得,要看关掉它之后哪些抵消项会消失。
11.7 实现与配置:选型决策树
选型要按三个维度分叉:画质目标、内容特征、目标设备Unity 文档。画质目标是接近主机的观感时,光追必要性最高,VRS 要保守;画质目标是稳住 60 帧时顺序反过来。
内容特征这一维:几何密度高、剔除能做细的场景才有网格着色的讨论空间。目标设备这一维:只服务近两年的旗舰,还是必须覆盖 2021 年的中端机型,这一条直接决定 VRS 能不能用。
先来看这棵树怎么用:它是按先砍再选的顺序设计的,先用目标设备砍掉根本用不了的特性,再用内容特征砍掉收益上限低的特性。反过来按想要什么来选,一定会选到在自己设备上静默失效的那一项。
11.8 效果与量化:光追观感的参照基准
选型里最难量化的部分是观感,这里给一组可以对着看的参照基准,都来自公开的经典测试素材。
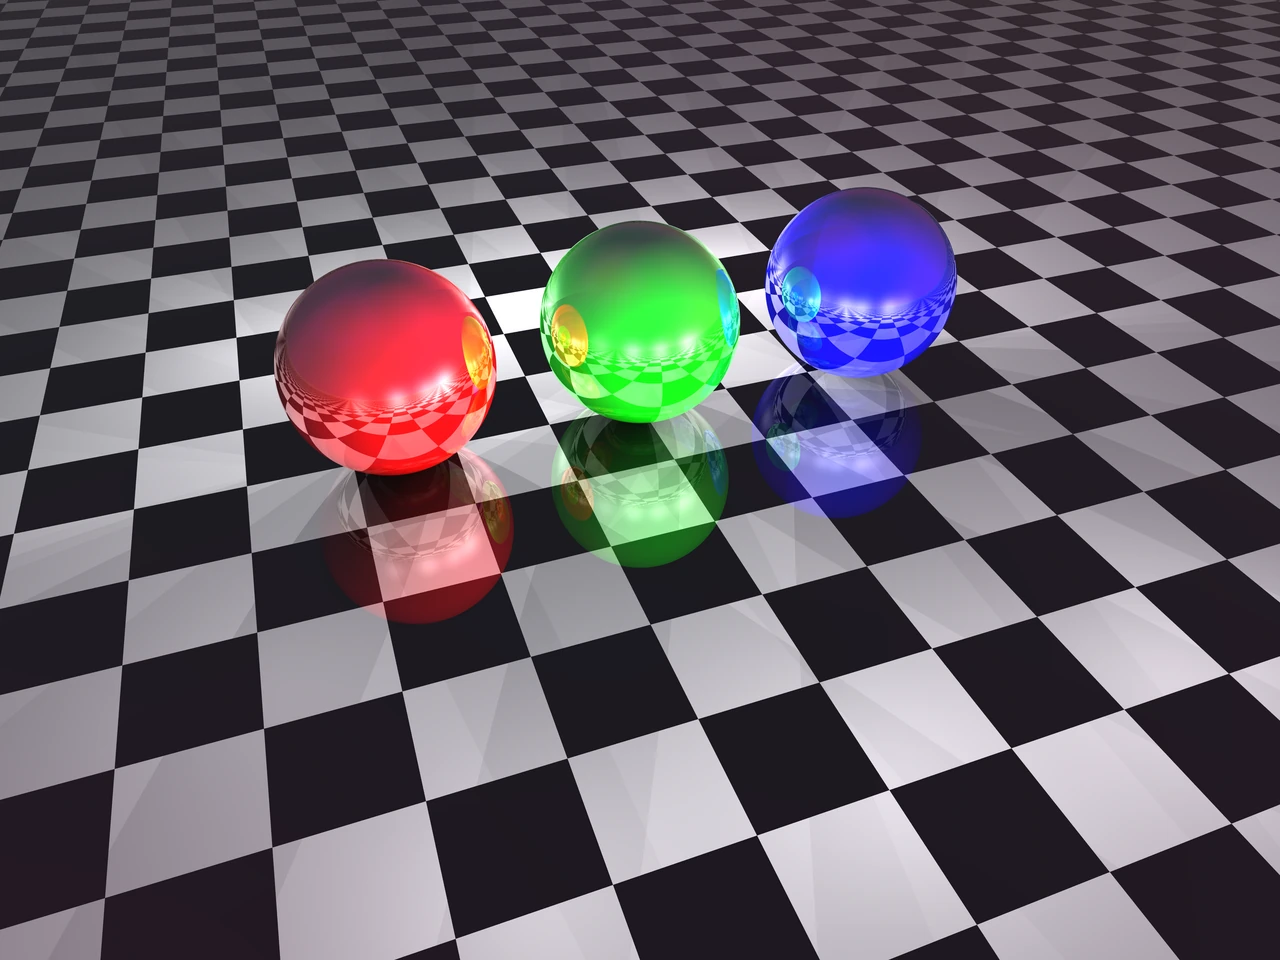
第一类是材质球测试:3chromeballs.png 那组三球图,用三种材质展示同一条反射算法在金属、玻璃与涂漆上的收敛情况,是判断反射到底做没做对最省事的一组。第二类是反射与焦散场景,用来判断反射与折射的能量走向对不对。文件页
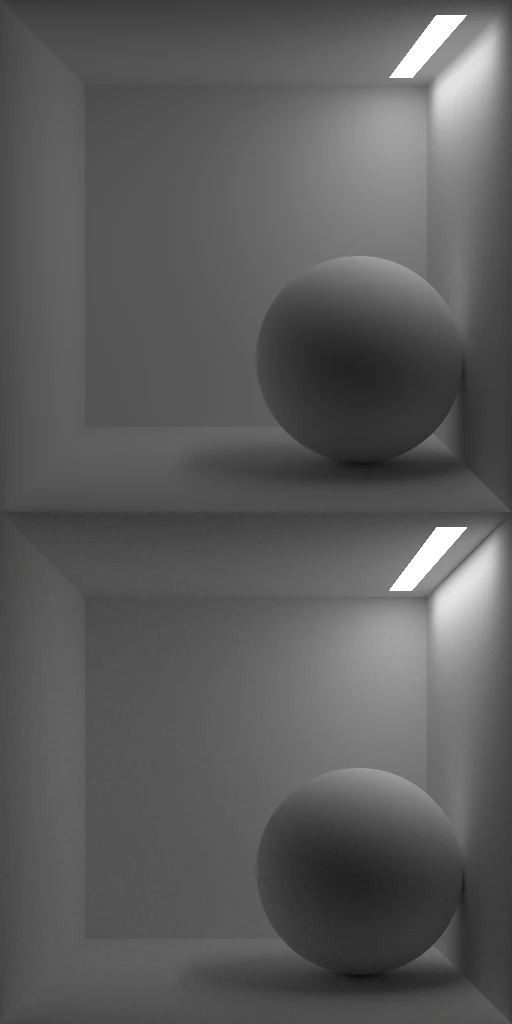
第三类是康奈尔盒(Cornell Box):路径追踪版与辐射度版的对照说明了一件事——同一个场景,两种算法的收敛形态完全不同,所以"和参照图长得像"并不等于"算法对了"。
说白了,这组基准是给验收一个锚点:移动端的光追不必和离线的路径追踪长得一样,但至少要能分出反射方向对错。
11.9 源码与数据链接
依然是惯例,本章材料分三层:规范与官方教程定路线边界,厂商与学术材料定实测量级,公开素材给观感基准。下面按这三层把来源列全,涉及数字的条目都能找到原始出处。
想自己复现的同学可以逐条回溯:本节只列一手材料与官方文档,二手转述一律不列,涉及数字的条目都能在原文里找到对应段落,方便独立复核与后续版本对照。
- 光追两条路的官方教程总览与遍历规范:https://docs.vulkan.org/tutorial/latest/courses/18_Ray_tracing/00_Overview.html 、https://docs.vulkan.org/spec/latest/chapters/raytraversal.html
- Arm 移动光追路线建议(ray query 起步、region ≤2×2):https://www.vulkan.org/user/pages/09.events/vulkanised-2026/Mobile-Ray-Tracing-Demystified-Iago-CalvoLista-Arm.pptx.pdf
- 渲染通道与 tile-local 读取(回指第 5 篇):https://docs.vulkan.org/spec/latest/chapters/renderpass.html
- VRS 光栅化与着色率语义、降级触发条件:https://docs.vulkan.org/spec/latest/chapters/primsrast.html 、https://gpuopen.com/learn/rdna-performance-guide/
- 网格着色机制与移动端负收益实测:https://www.khronos.org/blog/mesh-shading-for-vulkan 、https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2026_2D00_mmg_2D00_rodrigo_2D00_gpu_2D00_driven.pdf.pdf
- meshlet 尺寸约束一手依据与扩展规范:https://developer.nvidia.com/blog/introduction-turing-mesh-shaders/ 、https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_mesh_shader.html
- 引擎侧案例(HiZ 剔除与 visibility buffer 的 LOD bias):https://enginearchitecture.org/downloads/REAC_2025_Capcom.pdf
- 混合渲染与移动光追的学术结论:https://dl.acm.org/doi/pdf/10.1145/3721239.3734103 、https://dl.acm.org/doi/pdf/10.1145/2818427.2818442
- 公开观感参照素材:https://commons.wikimedia.org/wiki/Category:Ray_tracing
- 移动最佳实践(payload 与 wave count 约束):https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
11.10 效果与量化:三句话收束
这一篇的结论可以压成三句。第一句:VRS 的收益取决于有没有触发降级条件,而最常见的触发条件恰好来自延迟着色本身。 第二句:光追在移动端只有走内联 ray query 才吃得到片上压缩。 第三句:网格着色在移动端的收益全部来自簇级剔除,没有足够密的几何,这笔账就是负的。
这三句有一个共同前提,也就是全篇开头那条判据:有没有破坏片上流程。 判断任何一个新特性,先别问它是不是下一代技术,先问它有没有动到那本账。
11.11 这一章留下的问题
好了,选型给的是方向,不是证据。这三个特性在真机上到底生效没有——VRS 要看降级条件、光追要看压缩是否还在、网格着色要看剔除是否真的做了——三件事都需要可观测的信号来判定。
下一章要把这些信号做成可复现的配置与验收清单,让「我们开了」这句话变成能拿出来的证据,也让本篇的每个结论都能被独立复核,而不是只留下一句口头结论。
十、可复现配置与验收:怎么证明真的生效
12.1 一句话点题:验收闭环
好了,最后一章只问一件事。上一章把三个旋钮摆到了同一张桌上,也排定了开启顺序。顺序对了不等于结果对了,这一章要回答最后一个问题:怎么证明它真的生效。 前九章每条结论都来自别人的实测或规范原文,落到自己的项目里都得重新证一遍——我们这台机器、这条管线、这套内容,和材料里那台并不是同一个。
考核的终点是「我们能量出它带来的变化」,而不是停在「我们开了」。说白了,验收得闭环:一头是声明支持,另一头是稳态指标,中间必须有可观测的信号把两端连起来;三句口径也要分清——声明支持不等于设置成功,设置成功也不等于真的生效UE 文档。
这三句对应三层证据,缺一层就换不回一句能写进结论的话。下面先把要检查的东西列成清单,一份给 Vulkan 侧、一份给引擎侧,逐项对着实现核;这份清单决定后面每个信号能不能采到、每个结论能不能复核Arm 原文Unity 文档。
12.2 实现与配置:Vulkan 侧配置清单
Vulkan 侧的检查从设备能力开始,三个特性各有一组特性位与属性限制,声明支持只是第一道门。可变速率着色(Variable Rate Shading, VRS)要查 VkPhysicalDeviceFragmentShadingRateFeaturesKHR 里的三个布尔位,它们分别对应管线档、图元档与附件档。Vulkan 规范
只看布尔位还不够,真正的限制藏在属性结构 VkPhysicalDeviceFragmentShadingRatePropertiesKHR 里:前六个 fragmentShadingRateWith* 布尔位说明哪些操作会把着色率压回 (1,1),后两个是覆盖率采样数上限,另有 shadingRateAttachmentTexelSize,它必须是 2 的幂,尺寸越大省下的带宽越有限。Vulkan 指南
落到管线与命令缓冲上要核对三处:VkPipelineFragmentShadingRateStateCreateInfoKHR 里的 fragmentSize 与两级 combinerOps、动态命令 vkCmdSetFragmentShadingRateKHR、以及把着色率图挂进渲染通道的附件结构;另有兼容位 fragmentShadingRateStrictMultiplyCombiner,它决定 1×1 组合的结果,跨平台移植时属必查项。Vulkan 规范
网格着色侧要查 VkPhysicalDeviceMeshShaderFeaturesEXT(task 与 mesh 阶段位)与 VkPhysicalDeviceMeshShaderPropertiesEXT(输出与 payload 上限),并核对阶段位 0x40、0x80 与同步阶段位 0x80000、0x100000,同步写错是「能跑但结果不对」的常见来源。Vulkan 指南 光追侧按路分查:内联式确认 VK_KHR_ray_query,独立管线还要 VK_KHR_ray_tracing_pipeline 与 VK_KHR_acceleration_structure;混合渲染再加 dynamic_rendering 与 dynamic_rendering_local_read,后者提供类 subpass 的 tile-local 读取。Vulkan 指南 Vulkan 规范
12.3 实现与配置:引擎侧配置清单
引擎侧的清单要把上一章那张支持矩阵翻译成开关,逐层核对,顺序不能反。虚幻引擎(Unreal Engine, UE)分两套口径:标准移动渲染路径里硬件光追与 Lumen 都不可用,要开只能走 5.3 起的实验性移动光追(Mobile Desktop Renderer),且必须落在官方 GPU 名单内。出处 所以第一项检查看的是「走的是哪条渲染路径」,「开关在哪」反倒其次。UE 文档
Godot 侧的门槛是代次:文档口径是 Mali-G615 及更新、Snapdragon 888 及更新、Dimensity 9000 及更新,低于这条线的机器上开 VRS 只会静默无效。Godot 文档 这一条最容易被忽略——同一个包在 2021 年机型上开与在 2023 年机型上开不是同一件事,而清单里写的「已开启」很可能是前者。
网格着色在引擎侧更保守,主要落在高通 Adreno 的官方最佳实践上:避免放大(amplification,即 task)着色器、设置最优的波前(wave)数量、优先逐顶点属性而非逐图元属性、控制 task payload 不超上限、用 LPAC 与图形管线做负载均衡。Qualcomm 文档 这五条属于配置约束,而不是可以随手拨的开关,任何一条没对上,第五章那笔负收益就会原样复现。
Unity 一侧我们仍然不下结论:在取得官方权威来源之前,任何写法都属于替它做判断,这一格先留空,等一手文档补齐再填,宁可少一列,也不写猜出来的结论。
12.4 实现与配置:六个可观测信号
零章列过六个信号,这一节给每个信号补上判读方法:用什么查、查到什么算通过、以及常见误读。前三个只能排除「根本没开」,后三个才回答「开了有没有用」,这个分界是整份验收流程的地基。Vulkan 指南
第一个是扩展与特性位:用 vkGetPhysicalDeviceFeatures2 查那几组特性位,它只能证明设备声明支持。第二个是管线状态回读:把 VRS 的 fragmentSize 与网格着色阶段位记进日志,它证明参数设进去了,但设进去与生效之间还隔着降级条件。出处
第三个是着色率图内容:逐帧导出着色率图附件,看 2×2 区块里是否真的出现大于 1 的值,整张图全是 1 就是被静默压回了 (1,1)。Vulkan 指南 第四个是 GPU 侧计数器:片元着色调用数与像素数的比值最直接,开了 2×2 后这个比值不降,大概率是没生效;几何侧看顶点吞吐与 bin 数。Android 文档
第五个是帧时间:分段计时,把主表面与后处理拆开;它由 GPU 侧直接给出,比帧率稳、也不吃锁帧与调度抖动。出处 第六个是功耗与频率,要看稳态而不是峰值——网格着色那条路上使用率与频率同升、吞吐反降,说明流水被拉长,这笔代价只在稳态里显形。Arm 文档
12.5 实现与配置:三个特性各自的验收脚本骨架
清单是静态的,脚本要把它们串成一次可重复的跑测;三个特性各给一套骨架,伪代码只写关键步骤。三段骨架共用一个约定:固定场景、只改一个变量、记录全部六项信号,这样出来的差异才归得进账。Vulkan 原文
VRS 骨架。 第一步,启动时枚举特性位与属性位并落盘;第二步,建两条管线,一条 1×1、一条 2×2,或给同一条管线挂一张 2×2 着色率图;第三步,用 FragSizeEXT 与 FragInvocationCountEXT 把实际生效的着色率写进一张调试纹理;第四步,跑同一段场景,比较片元着色调用数;第五步,若没生效,按属性位逐条二分——先关掉 sample shading,再关掉几何阶段的深度导出。Vulkan 规范
网格着色骨架。 第一步,记录 task/mesh 特性位与输出上限;第二步,若设备支持网格查询(mesh shader queries)就用它数生成的图元数 Vulkan 指南;第三步,对照跑 Indexed 与 Mesh 两条路径,记录帧时间、功耗与频率;第四步,若 Mesh 更慢,先确认剔除是否真的发生——存活簇比例接近全量即形同虚设;第五步,再看顶点流式读取的流量。Arm 原文 光追骨架同理:确认内联式还是独立管线,记录射线条数,比对写回量判断压缩是否还在,再分段计时拆开遍历与着色。Vulkan 指南
12.6 效果与量化:验收判定表
把特性、信号与判据放进同一张表,验收就有了统一口径。判据都是相对量:片元着色调用数的下降幅度、存活簇比例、写回量的变化,都要先测一遍基准——VRS 测 1×1、网格着色测 Indexed、光追测关闭压缩的对照帧——再拿出来比Unity 文档Apple 文档。
| 特性 | 信号 | 通过判据 | 不通过的典型含义 |
|---|---|---|---|
| VRS | 着色率图 / FragSizeEXT |
出现大于 1×1 的生效值 | 命中降级条件,被静默压回 (1,1) |
| VRS | 片元着色调用数 ÷ 像素数 | 相比 1×1 基准明显下降 | 设了但没生效,或瓶颈不在着色 |
| 网格着色 | 存活簇比例 | 明显小于全量 | 剔除没做真,收益无从谈起 |
| 网格着色 | 帧时间 / 功耗 / 频率 | 不低于 Indexed,且频率不飙升 | 提交方式把红利交了回去 |
| 光追 | 写回量 / 压缩状态 | 压缩仍在生效 | 独立管线吃掉了帧缓冲压缩 |
| 光追 | 每像素射线条数 | 落在预算内且能靠降噪收敛 | 采样数被功耗按住,画质对不上 |
用法是先横向再纵向:横向一行行对,找出哪一项不通过;纵向一列列看,判断问题出在「没开」还是「没用」;两侧同时不通过时,优先怀疑路线选错,而不是参数没调好。
判定表还有一层用处:它能直接当回归对比的模板Apple 文档。把每次跑测的六项信号按同一张表落盘,两次结果一叠,差异就自动归到某一行上,这条链就是回归自动化的雏形。
12.7 效果与量化:三个典型失败案例的排查顺序
失败案例有三种典型形态,各自对应一条固定顺序;顺序有讲究,反着查会把最常见的原因放到最后。案例一:边缘依然锐利,着色却没省。 这是 VRS 的降级,顺序是——先看信号三,着色率图是否全是 1;若是,再查有没有开 sample shading(语义互斥);再查几何阶段有没有写深度,或用了光栅顺序访问视图(Raster Ordered Access Views, ROV);最后才回到属性位逐条二分。GPUOpen
这样排的理由很清楚:最常见的触发条件恰好来自延迟着色本身,也就是最后才该被想到的那一层。Vulkan 指南 案例二:网格着色开了反而更慢。 顺序是——先看剔除是否真的发生(存活簇比例);再看帧时间增量落在哪一段,是几何提交还是主表面;最后回到顶点流式读取的流量。Arm 原文
案例三:画面对了,功耗却爆了。 顺序是——先确认光追走的哪条路;再看写回量与压缩状态;最后数每像素射线。若走的是独立管线,压缩这一栏几乎没有挽回余地,只能改路线。出处
三个案例的共同点值得单独说一句:它们都不会在日志里留下痕迹Apple 文档。 报错为零,画面正常,唯一能露馅的地方就是我们自己埋的那几个信号——这也是为什么验收要先埋信号、再谈优化。
12.8 效果与量化:交付前的自检清单
上线之前,把前面的清单压成一份可以逐条打勾的自检表,五组顺序固定,不能跳步。第一组能力确认:目标机型的最低代次是否过线,特性位是否声明支持,官方支持名单是否覆盖。第二组配置核对:三处 VRS 设置点、四位网格阶段码、光追两条路的扩展组合,逐项对照实现代码。第三组观测就位:六个信号里至少要能稳定采集到四个,否则验收没有证据。Vulkan 指南
第四组指标达标:帧时间、功耗与频率都要落在稳态区间,不能用峰值或首帧数据Unity 文档UE 文档Android 文档。第五组文档留存:把设备型号、驱动版本、场景与口径一并记录,它是下一次回归对比的基准。五组之间有序:能力没过线,后面四组就没有意义;观测没就位,指标达标也只是巧合。
说白了,这份清单解决的是同一个问题:让「我们优化过了」这句话可被复核。 少了任何一组,下一次换设备、换驱动、换场景,全都得从头再猜,代价会重复一遍。
12.9 源码与数据链接
依然是惯例,本章的材料分三层:规范与官方指南定检查项,性能分析工具定采集方式,厂商与学术材料定量级与判据Arm 原文出处。先把三层之间的关系摆清——规范层回答「该查什么」,工具层回答「怎么取到」,实测层回答「取到的数怎么读」。
三层各管一段、互相不可替代:规范不给采集手段,工具不判读口径,实测不替代条款;三者缺一,验收就会退化成凭感觉判断Apple 文档Apple 文档Android 文档。下面按这三层把来源列全,涉及数字与条款的条目都能回溯到原文。
- 规范与官方指南(检查项与限制条件):https://docs.vulkan.org/spec/latest/chapters/primsrast.html 、https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_fragment_shading_rate.html 、https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_mesh_shader.html 、https://docs.vulkan.org/spec/latest/chapters/raytraversal.html 、https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- 渲染通道与 tile-local 读取(回指第 5 篇):https://docs.vulkan.org/spec/latest/chapters/renderpass.html 、https://docs.vulkan.org/refpages/latest/refpages/source/VK_KHR_dynamic_rendering_local_read.html
- 性能分析工具(采集方式):https://developer.android.google.cn/agi/start 、https://renderdoc.org/docs/index.html 、https://docs.qualcomm.com/bundle/publicresource/topics/80-71528-1/snapdragon_profiler.html 、https://developer.arm.com/documentation/101897/latest 、https://docs.qualcomm.com/bundle/publicresource/80-80022-19/topics/graphics_developer_tools.md
- 厂商最佳实践与配置约束:https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html 、https://gpuopen.com/learn/rdna-performance-guide/
- 厂商与学术实测(判读口径):https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2026_2D00_mmg_2D00_rodrigo_2D00_gpu_2D00_driven.pdf.pdf 、https://www.vulkan.org/user/pages/09.events/vulkanised-2026/Mobile-Ray-Tracing-Demystified-Iago-CalvoLista-Arm.pptx.pdf 、https://dl.acm.org/doi/pdf/10.1145/3721239.3734103
- 引擎侧可用性边界:https://docs.unrealengine.com/5.2/en-US/rendering-features-for-mobile-games-in-unreal-engine/ 、https://docs.godotengine.org/en/latest/tutorials/3d/variable_rate_shading.html
12.10 效果与量化:交给第七篇的三件事
本篇到验收为止,把三个特性算成了能判定的结论;但判定用的是本篇自己定的口径,能不能跨项目、跨芯片复用,还是另一回事。这三件事都是本篇每一条结论的隐含前提,并不算新话题。Vulkan 指南
第一件事是统一计量口径:带宽用 BU、能耗用 pJ、性能用帧时间,三把尺子要能互相换算,否则同一份优化在不同团队手里会得出相反的结论。第二件事是稳态判据:功率与频率必须落在稳态区间,首帧、峰值与降频后的数据不是同一件事,混用会把热降频误读成特性负收益Android 文档Android 文档。第三件事是把信号做成可复现的采集流程:六个信号要能一键采集、带版本落盘,才谈得上回归对比Android 文档Apple 文档。
说白了,前九章答「能不能生效」,这一章答「怎么证明生效」,下一章要答「怎么持续守住」——同一条证据链,只是把时间尺度从一次跑测拉长到一整条产品周期。
12.11 这一章留下的问题
好了,验收让「生效」变成了可复核的结论,但它只针对一台机器、一个驱动版本、一段场景;跨设备的下限能不能守住、回归对比能不能自动化,这两件事本篇给不出答案Unity 文档。
下一篇要把测量本身做成方法:怎么定基准设备、怎么设计回归、怎么让一份优化结论在半年后依然站得住,也为跨设备下限与回归自动化这两件事各留出一条可执行的路。
参考资料
本篇正文在每处论点就近给出了出处;以下是完整来源清单,编号 1–84 为第一至九章正文引用去重后的条目(含研究笔记中未被正文引用但相关的条目),85 起为第十章新增引用与同源补充,115–218 为本次引用密度补强新增的条目(全部经 HTTP 可访问性校验、与该句技术断言逐条对应),便于逐条查证与延伸阅读。
一、规范与扩展说明(Vulkan / Khronos / Direct3D)
- https://docs.vulkan.org/spec/latest/chapters/primsrast.html
- https://docs.vulkan.org/spec/latest/chapters/renderpass.html
- https://docs.vulkan.org/spec/latest/chapters/raytraversal.html
- https://docs.vulkan.org/spec/latest/chapters/framebuffer.html
- https://docs.vulkan.org/spec/latest/chapters/fragops.html
- https://docs.vulkan.org/features/latest/features/proposals/VK_EXT_mesh_shader.html
- https://registry.khronos.org/vulkan/specs/latest/man/html/VK_EXT_mesh_shader.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_fragment_shading_rate.html
- https://github.khronos.org/Vulkan-Site/features/latest/features/proposals/VK_KHR_fragment_shading_rate.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_fragment_density_map.html
- https://github.khronos.org/Vulkan-Site/features/latest/features/proposals/VK_EXT_fragment_density_map_offset.html
- https://docs.vulkan.org/samples/latest/samples/extensions/fragment_density_map/README.html
- https://docs.vulkan.org/tutorial/latest/OpenXR_Vulkan_Spatial_Computing/10_Variable_Rate_Shading/02_fragment_density_control.html
- https://docs.vulkan.org/tutorial/latest/courses/18_Ray_tracing/00_Overview.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_KHR_dynamic_rendering.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_KHR_dynamic_rendering_local_read.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_EXT_shader_tile_image.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_QCOM_tile_memory_heap.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VK_EXT_subpass_merge_feedback.html
- https://docs.vulkan.org/refpages/latest/refpages/source/VkSubpassMergeStatusEXT.html
- https://docs.vulkan.org/guide/latest/tile_based_rendering_best_practices.html
- https://docs.vulkan.org/samples/latest/samples/performance/subpasses/README.html
- https://docs.vulkan.org/samples/latest/samples/performance/render_passes/README.html
- https://docs.vulkan.org/tutorial/latest/Building_a_Simple_Engine/Mobile_Development/04_rendering_approaches.html
- https://www.khronos.org/blog/mesh-shading-for-vulkan
- https://community.khronos.org/t/tile-based-rendering-best-practices/112538
- https://vulkan.lunarg.com/doc/view/1.4.328.1/windows/antora/features/latest/features/proposals/VK_QCOM_tile_shading.html
- https://learn.microsoft.com/windows/win32/direct3d12/vrs
- https://devblogs.microsoft.com/directx/gears-vrs-tier2/
- https://microsoft.github.io/DirectX-Specs/d3d/MeshShader.html
- https://devblogs.microsoft.com/directx/coming-to-directx-12-mesh-shaders-and-amplification-shaders-reinventing-the-geometry-pipeline/
二、厂商文档与产品页(Arm / Qualcomm / MediaTek / Imagination / NVIDIA)
- https://developer.qualcomm.com/blog/variable-rate-shading-has-arrived-mobile-impressive-results
- https://developer.qualcomm.com/blog/improving-foveated-rendering-fragment-density-map-offset-extension-vulkan
- https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- https://docs.qualcomm.com/bundle/publicresource/topics/80-78185-2/overview.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/vk_adreno_layer.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/sdp.html
- https://docs.qualcomm.com/doc/80-78185-2/topic/spec_sheets.html
- https://www.qualcomm.com/processors/adreno
- https://www.qualcomm.com/smartphones/products/8-series/snapdragon-8-gen-3-mobile-platform
- https://www.qualcomm.com/products/mobile/snapdragon/smartphones/snapdragon-8-series-mobile-platforms/snapdragon-8-elite-gen-5
- https://www.arm.com/zh-cn/products/silicon-ip-multimedia
- https://www.arm.com/zh-cn/products/silicon-ip-multimedia/gpu/mali-g715
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/arm-immortalis-g715-developer-overview
- https://community.arm.com/arm-community-blogs/b/announcements/posts/arm-gpus-built-on-new-fifth-gen-architecture
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2026_2D00_mmg_2D00_rodrigo_2D00_gpu_2D00_driven.pdf.pdf
- https://www.vulkan.org/user/pages/09.events/vulkanised-2026/Mobile-Ray-Tracing-Demystified-Iago-CalvoLista-Arm.pptx.pdf
- https://www.vulkan.org/user/pages/09.events/vulkanised-2026/1415-Lucas-Silva-DevshGraphicsProgramming.pptx.pdf
- https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_mesh_best_practices_2023.02.09-1.pdf
- https://developer.mediatek.com/VariableRateShading/642428c3f55b040d6989a991.html
- https://www.mediatek.com/zh-cn/products/smartphones/mediatek-dimensity-9300-plus
- https://www.mediatek.com/products/smartphones/mediatek-dimensity-9400
- https://www.mediatek.com/products/smartphones/mediatek-dimensity-9500
- https://www.mediatek.com/technology/hyperengine-6
- https://www.imaginationtech.com/products/gpu/graphics-architecture/powervr-photon/
- https://www.imaginationtech.com/news/imagination-launches-the-most-advanced-ray-tracing-gpu/
- https://resources.imaginationtech.com/hubfs/gated-files/raytracing/raytracing-shininglight-whitepaper-en.pdf
- https://resources.imaginationtech.com/hubfs/gated-files/gpu/powervr-dxt-whitepaper-en.pdf
- https://developer.nvidia.com/blog/advanced-api-performance-variable-rate-shading/
- https://developer.nvidia.com/blog/introduction-turing-mesh-shaders/
- https://developer.nvidia.com/blog/using-mesh-shaders-for-professional-graphics/
三、引擎与开源实现(Unreal / Godot / 开源资料)
- https://docs.unrealengine.com/5.2/en-US/rendering-features-for-mobile-games-in-unreal-engine/
- https://dev.epicgames.com/documentation/en-us/unreal-engine/lumen-technical-details-in-unreal-engine/
- https://dev.epicgames.com/documentation/en-us/unreal-engine/unreal-engine-5.3-release-notes
- https://dev.epicgames.com/documentation/en-us/unreal-engine/using-the-android-vulkan-mobile-renderer-in-unreal-engine
- https://dev.epicgames.com/documentation/en-us/unreal-engine/using-the-desktop-renderer-on-mobile-in-unreal-engine
- https://docs.godotengine.org/en/latest/tutorials/3d/variable_rate_shading.html
- https://docs.godotengine.org/en/stable/tutorials/rendering/renderers.html
- https://linebender.org/wiki/gpu/mesh-shaders/
- https://borisbat.github.io/dasVulkan/tutorials/13_mesh.html
四、学术论文与第三方实测
- https://dl.acm.org/doi/pdf/10.1145/3721239.3734103
- https://dl.acm.org/doi/pdf/10.1145/2818427.2818442
- https://scholar.smu.edu/cgi/viewcontent.cgi?article=1007&context=guildhall_programming_etds
- https://interplayoflight.wordpress.com/2025/05/05/meshlets-and-mesh-shaders/
- https://www.tmarrec.dev/posts/mesh-shaders-and-meshlet-culling.html
- https://krupitskas.com/posts/modern_culling_techniques/
- https://enginearchitecture.org/downloads/REAC_2025_Capcom.pdf
- https://gpuopen.com/learn/rdna-performance-guide/
- https://gpuopen.com/download/Mesh_Shaders_Work_Graphs-Perfect_Pair.pdf
- https://gpuopen.com/download/GDC2024_Mesh_Shaders_in_AMD_RDNA_3_Architecture.pdf
- https://www.faceofit.com/immortalis-g1-ultra-vs-g925-vs-g720/
- https://www.faceofit.com/immortalis-g1-ultra-vs-adreno-830/
- https://www.androidauthority.com/arm-mali-g715-immortalis-3179061/
- https://en.wikipedia.org/wiki/Variable_rate_shading
五、测量与验证工具(第十章验收用)
- https://developer.android.google.cn/agi/start
- https://developer.android.google.cn/agi/frame-trace/renderpasses
- https://developer.android.google.cn/agi/frame-trace/frame-profiler
- https://developer.android.google.cn/games/optimize
- https://developer.android.google.cn/games/optimize/vulkan-reduced-precision
- https://renderdoc.org/docs/index.html
- https://renderdoc.org/docs/window/performance_counter_viewer.html
- https://renderdoc.org/docs/window/event_browser.html
- https://docs.qualcomm.com/bundle/publicresource/topics/80-71528-1/snapdragon_profiler.html
- https://developer.qualcomm.com/software/adreno-gpu-sdk/tools
- https://docs.qualcomm.com/bundle/publicresource/80-80022-19/topics/graphics_developer_tools.md
- https://www.qualcomm.com/developer/snapdragon-game-toolkit/samples
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/mali-bifrost-family-performance-counters
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/accelerating-mali-gpu-analysis-using-arm-mobile-studio
- https://developer.arm.com/documentation/101897/latest
- https://community.arm.com/arm-community-blogs/b/mobile-graphics-and-gaming-blog/posts/vulkan-subpasses-the-good-the-bad-and-the-ugly
- https://vulkan.org/user/pages/09.events/vulkanised-2025/T18-Pete-Harris-Arm-MobileBestPractices.pdf
- https://vulkan.org/user/pages/09.events/vulkanised-2023/vulkanised_2023_battle_tested_optimisations_for_mobile_v2.pdf
- https://github.com/quic/adreno-gpu-vulkan-code-sample-framework/tree/main/samples/SubPass
- https://github.com/quic/adreno-gpu-vulkan-code-sample-framework/tree/main/samples/shaderResolveTonemap
- https://github.com/quic/adreno-gpu-opengl-es-code-sample-framework/tree/main/samples/avoid_gmem_loads
- https://github.com/quic/adreno-gpu-opengl-es-code-sample-framework/tree/main/samples/reduce_gmem_stores
六、素材检索来源(Wikimedia Commons)
- https://commons.wikimedia.org/wiki/Category:Ray_tracing
- https://commons.wikimedia.org/wiki/Category:Ray_traced_shadows
- https://commons.wikimedia.org/wiki/Category:Raytraced_cubes
- https://commons.wikimedia.org/wiki/Category:Ray_tracing_software
- https://commons.wikimedia.org/wiki/Category:Graphics_processing_units
- https://commons.wikimedia.org/wiki/Category:Computer_graphics
- https://commons.wikimedia.org/wiki/File:Vulkan_simplified_pipeline.svg
- https://commons.wikimedia.org/wiki/File:Pipeline_OpenGL.svg
七、本节新增:规范与官方 API 文档(Vulkan 扩展参考页 / Direct3D 规范 / 学术论文见第十组)
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_image_compression_control.html
- https://microsoft.github.io/DirectX-Specs/d3d/VariableRateShading.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_sample_locations.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_conservative_rasterization.html
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/conservative-rasterization
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_fragment_shader_interlock.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_performance_query.html
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/indirect-drawing
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_synchronization2.html
- https://microsoft.github.io/DirectX-Specs/d3d/D3D12EnhancedBarriers.html
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/resource-binding
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_pipeline_creation_cache_control.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_pipeline_binary.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_graphics_pipeline_library.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_shader_module_identifier.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_descriptor_buffer.html
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/descriptor-heaps
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/root-signatures
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_pipeline_executable_properties.html
- https://microsoft.github.io/DirectX-Specs/d3d/WorkGraphs.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_ray_query.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_ray_tracing_pipeline.html
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/direct3d-12-raytracing
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_subgroup_size_control.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_acceleration_structure.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_ray_tracing_maintenance1.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_KHR_shader_terminate_invocation.html
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_opacity_micromap.html
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/memory-management
- https://github.khronos.org/Vulkan-Site/refpages/latest/refpages/source/VK_EXT_attachment_feedback_loop_layout.html
- https://learn.microsoft.com/en-us/windows/win32/direct3d12/hardware-feature-levels
八、本节新增:厂商官方文档与白皮书(Arm / Qualcomm / Apple / NVIDIA / AMD)
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/1_2D00_mmg2020_2D00_mobile_2D00_graphics_2D00_101_2D00_jesse.pdf
- https://www.arm.com/products/silicon-ip-multimedia/gpu/mali-g715
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/siggraph_2D00_2018_2D00_mmg_2D00_5_2D00_felipe_2D00_rendering_2D00_efficiency.pdf
- https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/GDC2017/Achieving-Console-Quality-Games-on-Mobile.pdf
- https://developer.nvidia.com/vrworks/graphics/variablerateshading
- https://gpuopen.com/fidelityfx-variable-shading/
- https://developer.apple.com/documentation/metal/improving-edge-rendering-quality-with-multisample-antialiasing-msaa
- https://developer.apple.com/documentation/metal/rendering-a-scene-with-deferred-lighting-in-objective-c
- https://developer.nvidia.com/gpugems/gpugems3/part-iii-rendering/chapter-19-deferred-shading-tabula-rasa
- https://developer.apple.com/videos/play/wwdc2020/10603
- https://armkeil.blob.core.windows.net/developer/Arm%20Developer%20Community/PDF/Arm%20Mali%20GPU%20Best%20Practices.pdf
- https://developer.nvidia.com/blog/vulkan-dos-donts/
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2026_2D00_mmg_2D00_ralph_2D00_mobile_2D00_arch.pdf
- https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2066-00-00-00-00-58-55/New-Mali-Multimedia-System_5F00_final_5F00_rev2.pdf
- https://learn.arm.com/learning-paths/mobile-graphics-and-gaming/ams/malioc/
- https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Analyzing-Performance-of-Mobile-Games.pdf
- https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Performance%20Optimization%20and%20Debugging%20Mobile%20Games.pdf
- https://www.qualcomm.com/developer/blog/2025/08/optimize-performance-and-graphics-for-adreno-gpu-low-power-gaming
- https://www.arm.com/technologies/graphics-technologies/transaction-elimination
- https://docs.qualcomm.com/bundle/publicresource/topics/80-70020-19SC/graphics-overview.html
- https://www.arm.com/technologies/graphics-technologies/arm-frame-buffer-compression
- https://armkeil.blob.core.windows.net/developer/Files/pdf/graphics-and-multimedia/Advance_Uses_of_Pixel_Local_Storage.pdf
- https://developer.apple.com/documentation/metal/reducing-the-memory-footprint-of-metal-apps
- https://www.arm.com/technologies/graphics-technologies/adaptive-scalable-texture-compression
- https://developer.apple.com/documentation/metal/mtlresourceoptions/storagemodeMemoryless
- https://developer.apple.com/documentation/metal/choosing-a-resource-storage-mode-for-apple-gpus
- https://developer.nvidia.com/blog/advanced-api-performance-vulkan-clearing-and-presenting/
- https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2066-00-00-00-00-55-34/siggraph14_2D00_Bjorge_2D00_TLS_2D00_presentation.pdf
- https://developer.apple.com/videos/play/wwdc2020/10602
- https://docs.qualcomm.com/bundle/publicresource/80-71528-1/topics/remove_unused_render_targets.md
- https://www.arm.com/products/silicon-ip-multimedia
- https://developer.apple.com/documentation/metal/mtlgpufamily/apple4
- https://community.arm.com/cfs-file/__key/communityserver-blogs-components-weblogfiles/00-00-00-20-66/2_2D00_mmg2020_2D00_vulkan_2D00_emilio.pdf
- https://developer.apple.com/documentation/xcode/understanding-metal-performance-hud-metrics
- https://developer.apple.com/documentation/xcode/monitoring-your-metal-apps-graphics-performance/
- https://developer.apple.com/documentation/xcode/Analyzing-your-Metal-workload
- https://community.arm.com/cfs-file/__key/telligent-evolution-components-attachments/01-2066-00-00-00-00-47-97/Performance-Analysis-and-Debugging-with-Mali.pdf
- https://developer.qualcomm.com/qfile/71530/snapdragon_profiler_user_guide.pdf
- https://developer.apple.com/documentation/xcode/Metal-debugger
- https://developer.apple.com/videos/play/wwdc2020/10605
- https://developer.apple.com/documentation/xcode/Capturing-a-Metal-workload-in-Xcode
九、本节新增:引擎与平台官方文档(Unreal / Unity / Android)
- https://developer.android.google.cn/topic/performance/rendering/overdraw
- https://developer.android.google.cn/agi/sys-trace/counters
- https://docs.unity3d.com/6000.5/Documentation/Manual/urp/rendering/g-buffer-layout.html
- https://dev.epicgames.com/documentation/en-us/unreal-engine/using-the-mobile-deferred-shading-mode-in-unreal-engine
- https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@16.0/manual/rendering/deferred-rendering-path.html
- https://developer.android.google.cn/agi/sys-trace/texture-memory-bw
- https://developer.android.google.cn/games/optimize/optimization-tips
- https://dev.epicgames.com/documentation/en-us/unreal-engine/optimization-and-development-best-practices-for-mobile-projects-in-unreal-engine
- https://docs.unity3d.com/6000.5/Documentation/Manual/urp/rendering/render-passes-deferred.html
- https://dev.epicgames.com/documentation/en-us/unreal-engine/mobile-rendering-features-in-unreal-engine
- https://dev.epicgames.com/documentation/en-us/unreal-engine/ray-tracing-and-path-tracing-features-in-unreal-engine
- https://docs.unity3d.com/6000.0/Documentation/Manual/urp/rendering-paths-comparison.html
- https://docs.unity3d.com/Packages/com.unity.render-pipelines.universal@16.0/manual/rendering/forward-plus-rendering-path.html
- https://docs.unity3d.com/6000.0/Documentation/Manual/urp/rendering-paths-introduction-urp.html
- https://dev.epicgames.com/documentation/en-us/unreal-engine/mobile-feature-levels-and-rendering-modes-in-unreal-engine
- https://docs.unity3d.com/6000.5/Documentation/Manual/urp/urp-universal-renderer.html
- https://docs.unity3d.com/Packages/com.unity.profiling.systemmetrics.mali@1.1/manual/metrics-guide.html
- https://docs.unity3d.com/Manual/adaptive-performance/cpu-gpu-performance-control.html
- https://dev.epicgames.com/documentation/en-us/unreal-engine/performance-guidelines-for-mobile-devices-in-unreal-engine
- https://developer.android.google.cn/games/optimize/adpf
- https://developer.android.google.cn/agi/sys-trace/system-profiler
- https://developer.android.google.cn/bench
- https://developer.android.google.cn/games/optimize/adpf/thermal
- https://developer.android.google.cn/games/develop/vulkan/frame-pacing-extensions
- https://docs.unity3d.com/Packages/com.unity.adaptiveperformance@3.0/manual/user-guide.html
十、本节新增:学术论文(arXiv)
- https://arxiv.org/abs/2505.24653
- https://arxiv.org/abs/2404.06359
- https://arxiv.org/abs/2404.06156
- https://arxiv.org/abs/2305.07253
- https://arxiv.org/abs/1807.09449
- https://arxiv.org/abs/2210.05365
- https://arxiv.org/abs/2506.11546
图片版权
外部素材共 22 张,全部来自 Wikimedia Commons 与厂商官方示例(A 级源),许可已逐张核验;CC BY / CC BY-SA 系列按要求署名。逐条的 source_page 与许可链接见 image-credits.json。
| 源文件 | 作者 | 许可 | 本篇用途 |
|---|---|---|---|
BMRT - Cornell box radiosity.png |
Morn | CC0 | 同一康奈尔盒的辐射度方法结果,用于算法收敛对照 |
Raytracing Unit |
Mewtow | CC0 | 移动光追硬件的三条路线:PowerVR RAC 整段卸载、Arm RTU 与着色核心同层、Adreno 自研路线 |
3chromeballs.png |
User Martinkb on en.wikipedia | Public domain | 光追观感参照之一:三材质球测试图,判断反射在金属、玻璃与涂漆材质上的收敛 |
CG reflections comparison.png |
Drummyfish | CC0 | 同一场景多种反射做法的对照:屏幕空间反射、立方体贴图、光追反射的观感差异 |
Cornell Box Octane Render (2K, 8bit).png |
Czerniawskimc | CC0 | 康奈尔盒式场景的路径追踪参照结果(含降噪前的采样噪声;原上传者注明与标准 Cornell Box 仅相似) |
3D-Pipeline.svg |
Original: Martin Wantke Vector: AntiCompositeNumber | CC0 | 几何提交路径的新旧对照:输入装配退场,task / mesh 两阶段接管;标 kind=structural(跨篇复用豁免) |
3D-Hypercube (raytraced).png |
Robert Illes | CC BY-SA 3.0 | 递归反射的光追立方体:多级弹射的收敛过程 |
Classical radiosity comparison with path tracing, simple scene, interpolated.png |
KaiaVintr | CC BY-SA 4.0 | 光追观感参照之二:康奈尔盒路径追踪版与辐射度版对照,两种收敛形态的差异 |
Albrecht durer ray tracing.png |
Albrecht Dürer | Public domain | 丢勒绳网取形与现代逐像素投射的对照:同一几何原理的两种实现 |
Variable rate shading disabled in textured scene |
Juan Linietsky, Ariel Manzur and the Godot Engine community | CC BY 3.0 | 同一场景、VRS 关闭的全像素着色对照基准 |
Variable rate shading enabled in textured scene |
Juan Linietsky, Ariel Manzur and the Godot Engine community | CC BY 3.0 | 同一场景、VRS 开启(密度图由中心到四角递减)的着色密度变化 |
Mesh Shader Culling sample |
The Khronos Group Inc. | Apache-2.0 | cluster 剔除与可见性缓冲的配合:间接绘制下的剔除收益来源 |
Shading rate image (fragment_shading_rate_dynamic sample) |
The Khronos Group Inc. | Apache-2.0 | FDM 着色率图:屏幕空间分辨率分布的实际样例 |
Frequency information (fragment_shading_rate_dynamic sample) |
The Khronos Group Inc. | Apache-2.0 | 与着色率图配套的频率信息通道,FDM 分频的依据 |
Normals visualization (gshader_to_mshader sample) |
The Khronos Group Inc. | Apache-2.0 | Vulkan 官方示例:同一茶壶模型分别走几何着色器与 mesh shader,以法线可视化验证结果一致 |
Ray tracing pipeline diagram (ray_tracing_reflection sample) |
The Khronos Group Inc. | Apache-2.0 | RT pipeline 阶段结构:ray generation 发起光线,命中结果经 SBT 索引到 closest-hit / any-hit / miss |
Pixels covered by a triangle |
Martin Kraus | CC BY-SA 3.0 | 光栅化的像素覆盖判定:像素中心是否落在三角形内,与着色率无关 |
Carte graphique en rendu par tiles |
Mewtow | CC0 | 分块渲染的数据流:逐块收集几何再消除,TBDR 压缩红利的来源 |
Example of bounding volume hierarchy |
Schreiberx | CC BY-SA 3.0 | 包围体层次(BVH)加速结构:构建与更新取舍的参照 |
Ray trace diagram |
Henrik | CC BY-SA 4.0 | 光线追踪的基本回路示意:发射、求交、命中处理的循环 |
Deferred Shading FBOs.jpg |
McMalloc | CC BY-SA 3.0 | 延迟着色的多阶段 FBO 可视化:颜色/深度/法线/光照各落独立通道,几何阶段写深度是常态 |
Path tracing sampling values.png |
Qutorial | CC BY-SA 4.0 | 同一场景不同采样数(spp)的路径追踪渐进收敛:采样越多越干净的直观对比 |
内部示意图(ep06_* 系列)由本系列自绘,走色板单源;外部素材一律 ext_* 命名。自绘图共 222 张,规格见 figspec.json。
相关链接 - 上一篇:【移动端图形与功耗】(五) 延迟着色在移动端:能做什么、不能做什么 - 下一篇(预告):【移动端图形与功耗】(七) 测量与调优:怎么证明你真的优化了 - 参考资料:本篇引用的规范条款、厂商文档与量化材料见上文「参考资料」;图片素材的来源与许见图注与素材表 - 系列总览:移动端图形与功耗(全七篇)
With Best Wishes.