系列配套:GitHub 源码仓库(demo 代码与生成本文全部示意图的工具)|在线阅读入口(本站发布)
上一篇我们从命令前端一路走到了显存:命令包里的地址怎么被翻译、页表与 TLB 怎么工作、有效带宽为什么远低于标称。但账算到那里,还剩下一个悬着的问题:那些准备好的带宽,到底是谁去用?
按全系列知识地图定位:本篇(着色器核)正处在显存与地址空间之后、纹理采样器之前,是整个系列的第三站。
这一篇在系列里的位置,可以先看一眼上面这张全系列知识地图:从命令前端、显存与地址空间,走到着色器核,再往下是纹理采样器与光栅化。本篇是第三站,所以它只回答一件事——数据与命令都就绪之后,硬件靠什么让它们一直有活干。
先给一句会被反复引用的结论:显存的延迟压不低,GPU 的办法不是去压,而是用足够多的线程把等待盖住。 这件事在上一篇里只是一句对策,落到硬件上却是整个着色器核存在的理由,它就是那台「把成千上万个线程变成每个周期都有活干」的机器。
一句话点题:占用率是这本账的名字
先把这一篇要回答的问题串起来,一共三件:
第一,一个核里到底装了什么。 从 SIMD 与标量的历史分岔讲起,落到计算单元(Compute Unit, CU)与流多处理器(Streaming Multiprocessor, SM)的资源清单,寄存器文件有多大、共享内存算谁的、wave 槽有多少个。 出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》。
第二,占用率怎么算、被谁卡住。 这里会出现一个反直觉的结论:占用率的上限是平台相关的,根本不存在一个跨代通用的「多少算够」。同一句「占用率 50%」,在 Turing 上和 Hopper 上完全是两件事。 出处:NVIDIA Nsight Compute · Profiling Guide。 出处:AMD GPUOpen《Occupancy explained》。
第三,这笔账最后落在哪。 占用率不是计算侧的私事,它直接决定图形阶段效率(2×2 quad、微小三角形)。这一层因果链,中文写作里基本是空白。
边界先说死,免得牵扯不清:本篇不讲 ISA 指令编码,不列汇编指令表、不讲编码格式、也不做 CUDA/HIP 的 API 教程。本篇只讲机制与那笔账:硬件为什么长成这样、占用率被什么卡住、代价落在哪一层。具体的指令集细节留给各厂商的 ISA 手册,那是另一类文档。 出处:NVIDIA CUDA C++ Programming Guide。 出处:AMD RDNA 架构技术页。
为什么要啃这一篇:因为「占用率」大概是图形与计算里被误传最多的一个词。它经常被讲成「越高越好」,被当成一个可以无脑拉满的旋钮;也经常被当成纯计算侧的概念,好像跟图形管线没关系。这两件事都不对,而它们不对的原因,恰好都在硬件的形状里。 出处:ROCm · Device hardware 术语表。
下面依「核的构成 → 占用率 → 发射与隐藏」的路线往下展开。
一、SIMD 与标量的分岔:一段被跳过的历史
好了,我们正式开始。要理解今天的着色器核,得先回到它曾经想成为什么样子。
1.1 VLIW:把调度交给编译器
2000 年代中期,GPU 的可编程单元走的是一条叫超长指令字(VLIW, Very Long Instruction Word)的路。它的思路非常直接:一条很宽的指令里塞好几个并行操作,靠编译器在编译期就把它们打包好、排好序。硬件只管按槽位发射,不需要复杂的运行时调度逻辑,省下的晶体管全拿去堆执行单元。 出处:AMD《Graphics Core Next》架构白皮书。 出处:LLVM · User Guide for AMDGPU Backend。
这套设计在规则、可预测的着色器代码上表现不错,但它把风险押在了一个前提上:编译器得在编译期就知道数据依赖、知道延迟、知道访存会不会命中。而这些恰恰是运行时才知道的事。 出处:AMD《RDNA 1.0》Instruction Set Architecture Reference Guide。
值得说明的是,VLIW 并不是一个「错误的设计」。它在规则性极强的负载上有真实优势:省下的调度硬件面积可以全部换成执行单元,而着色器代码在早期确实比通用 CPU 代码规整得多。它输在了两件事上。着色器的分支与访存越来越不可预测,以及驱动要编译的 shader 变体呈爆炸式增长,而每一个变体都得由编译器在离线时刻做对一次调度决定。这两件事一起,把「编译期调度」的容错空间挤压到了零。
失败的形态是很具体的:一个操作数没就绪,整条宽指令的所有槽位一起等。编译器预测错一次,代价不是某一个 lane 空转,而是整条打包指令的并行度全部浪费。这也是为什么 AMD 在 Graphics Core Next(GCN,2012 年) 上彻底转向了 SIMD,把调度的活从编译器手里收回到硬件。 出处:AMD《Introducing CDNA Architecture》白皮书。
1.2 两条路:SIMD 与标量 SIMT
转向之后,两家厂商的选择并不一样,这个差别一直延续到今天。
AMD 走的是 SIMD。 一个计算单元里有四条向量流水线,每条 16 个元素宽,合起来一次处理 64 个元素,这就是一个 wavefront。AMD 官方的 CDNA 白皮书把这句话写得很直白:「向量流水线是 16-wide,每个 64-wide 的 wavefront 用四个周期执行完。」 出处:ROCm · AMD Instinct MI250 microarchitecture。
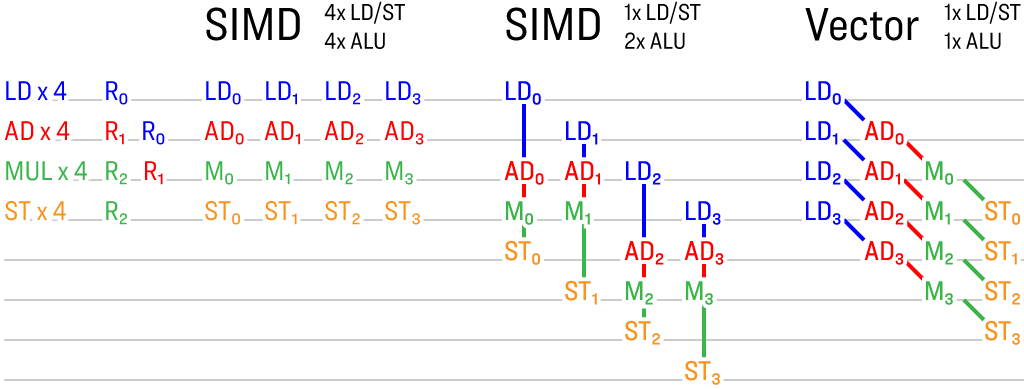
NVIDIA 走的是标量 SIMT。 每个线程有自己的标量指令流,硬件在发射时把 32 个线程聚合成一个 warp,让它们共享同一条指令。单指令多线程(SIMT, Single Instruction Multiple Threads)。 出处:CUDA Programming Guide · Warps and SIMT。 出处:CUDA Programming Guide · GPU Hardware Model。
这两条路的差别,官方文档里有一句很精到的定义,值得逐字读:
In SIMD, execution follows a single control flow path, while in SIMT, each thread is allowed to follow its own control flow path. Because of this, SIMT does not have a fixed data-width like SIMD. —— CUDA Programming Guide《Warps and SIMT》
翻一下就是:SIMD 是一条控制流管一批数据,数据宽度是硬件定死的;SIMT 名义上给每个线程自己的控制流,硬件只是「碰巧」把它们并行执行。这个「碰巧」很重要,它意味着 SIMT 可以做到 sub-warp 粒度的分歧处理,而经典 SIMD 不能。 出处:Intel Architecture Day 2021 演示稿。
1.3 统一着色器:真正被历史淘汰的是什么
这一段历史里最容易被讲错的地方,是以为「VLIW 输给了 SIMD」。真正被淘汰的是固定功能与可编程分离的老结构。 出处:Intel · Introduction to the Xe-HPG Architecture。 出处:AMD《RDNA4》Instruction Set Architecture Reference Guide。
早期 GPU 里,顶点着色器和像素着色器是两套物理上不同的硬件:顶点单元按三角形数量配、像素单元按像素吞吐配,两者的比例一焊死就改不了。一个场景如果几何重、像素轻,顶点单元排长队而像素单元闲着,反之亦然。 出处:AMD《RDNA3》Instruction Set Architecture Reference Guide。
统一着色器模型(Unified Shader Model) 把这两套硬件合成一套:同一批执行单元既能跑顶点着色器、也能跑像素着色器,还能跑计算着色器。负载比例变了,硬件不用改,调度器把工作分给它就行。 出处:Intel · GPU Architecture Terminology for Intel Xe。
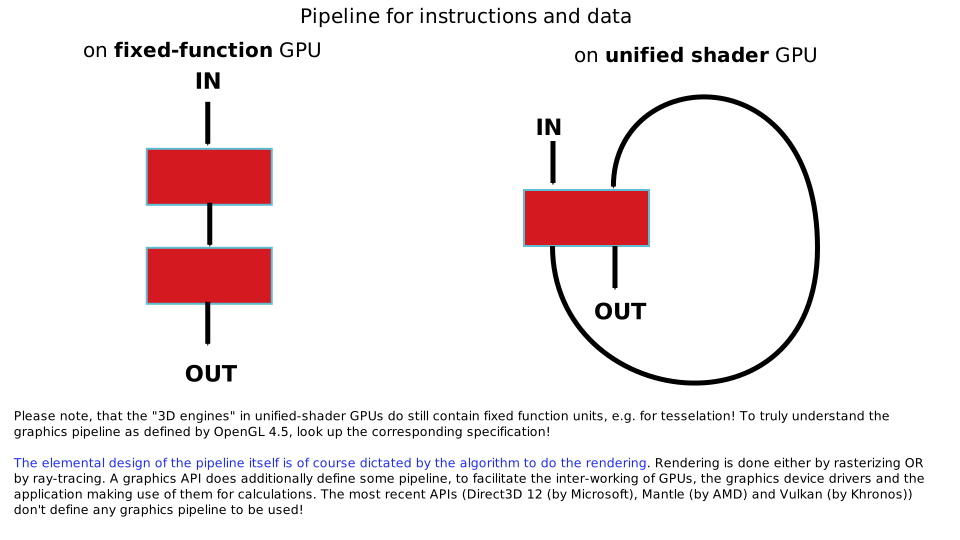
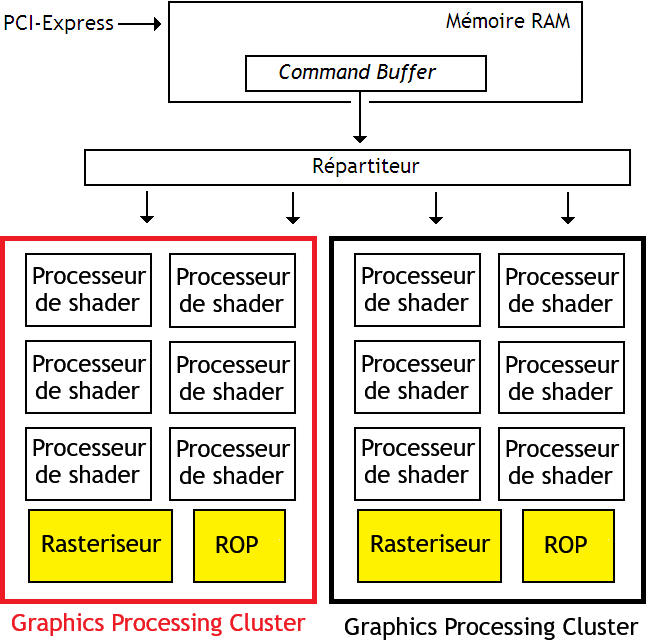
这件事对「占用率」的意义是根本性的:只有当执行单元是共享的,占用率才成为一个需要打理的量。 如果顶点和像素各有各的硬件,那各自的忙碌程度是结构决定的;统一之后,谁把执行单元占满、占得多满,才第一次变成设计者要回答的问题。 出处:Fabian Giesen · Part 3:3D pipeline overview, vertex processing。
还有一层更实际的缘由:占用率是少数几个能同时解释「计算慢」和「图形慢」的指标。 一个计算 kernel 掉了一半吞吐,看占用率;一段像素着色器在密集几何下变慢,最后也会落到占用率上,因为那时真正被浪费的不是算力,而是被无效像素占住的执行槽位。把这两件事连起来看,是本篇与其它中文材料最不一样的地方。
1.4 三家的术语映射
到这里必须先给一张映射表。同一个概念,三家叫法完全不同,中文写作里混用得非常厉害:
| 概念 | NVIDIA | AMD | Intel |
|---|---|---|---|
| 执行单元簇 | SM(Streaming Multiprocessor) | CU(Compute Unit)/WGP(Workgroup Processor,含 2 个 CU) | Xe-core |
| 线程束 | warp(32 线程) | wavefront(Instinct 64 / Radeon 32) | —— |
| 向量执行宽度 | 每分区 32 lane | 16-wide ×4 条流水线 | 16 个 vector engine |
Intel 的口径是 Xe-HPG 的一个 Xe-core 里含 16 个 vector engine 与 16 个 matrix engine,注意这里「engine」的粒度比 AMD 的「16-wide SIMD」还要细一层,所以数字不能跨厂商直接比,得先对齐「说的是哪一层」。 出处:AMD《GCN3》Instruction Set Architecture。
这一段收在一笔账上:这条路线的选择,本质是「谁来承担调度风险」的取舍。VLIW 把风险给了编译器(省硬件、赌预测),SIMD/SIMT 把风险收回到硬件(花面积、换确定性)。今天所有主流 GPU 都选了后者,这不是理论上更优,而是在真实着色器代码的不可预测性面前,编译器押不起这个注。 出处:NaviSim:面向 AMD RDNA 的 GPU 模拟器(ACM)。 出处:A Variable Warp Size Architecture(ISCA 2015)。
二、一个核的构成:三样东西与它们的量级
2.1 SM 里装了什么
下面我们进入这一层。NVIDIA 的官方文档用一句话就把结构说完了,而且这句话值得逐字读:
Each SM contains a local register file, a unified data cache, and a number of functional units that perform computations. The unified data cache provides the physical resources for shared memory and L1 cache. —— CUDA Programming Guide《GPU Hardware Model》
拆成三样:一块本地寄存器文件、一块统一数据缓存、一批算得动的功能单元。 注意第二样。共享内存和 L1 缓存不是两块东西,是同一块物理资源,只是可配置成不同比例。这一句解释了很多事,后面 §2.3 会专门算它的账。 出处:CUDA Programming Guide · Compute Capabilities(SM 信息表)。 出处:CUDA Programming Guide · Compute Capabilities(内存信息表)。
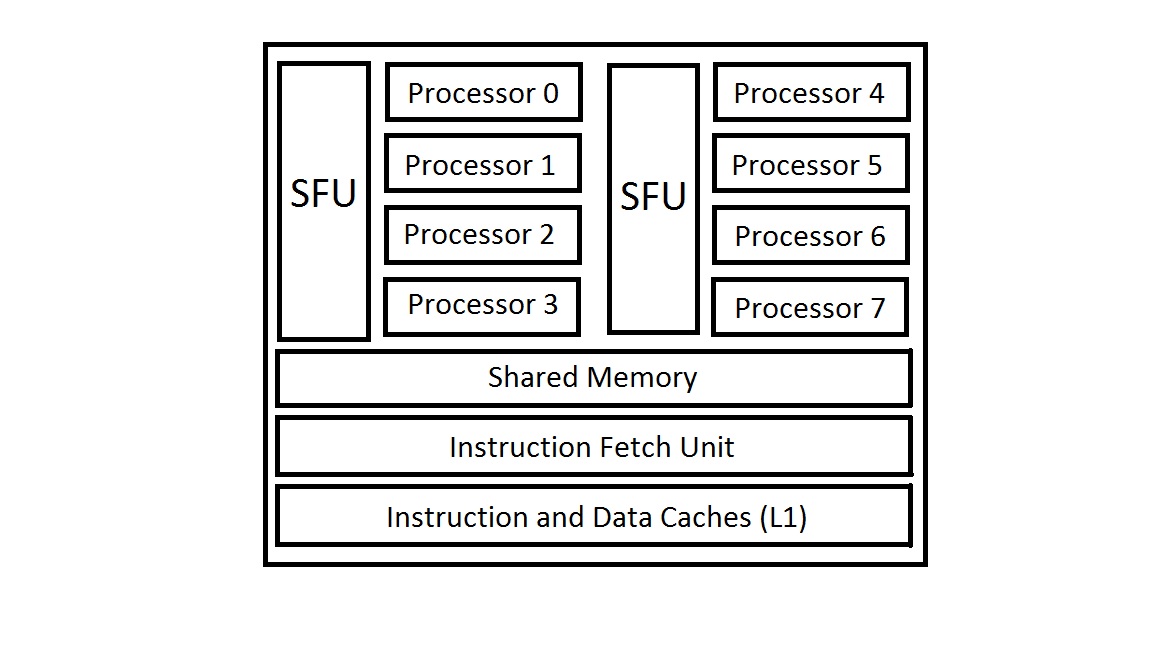
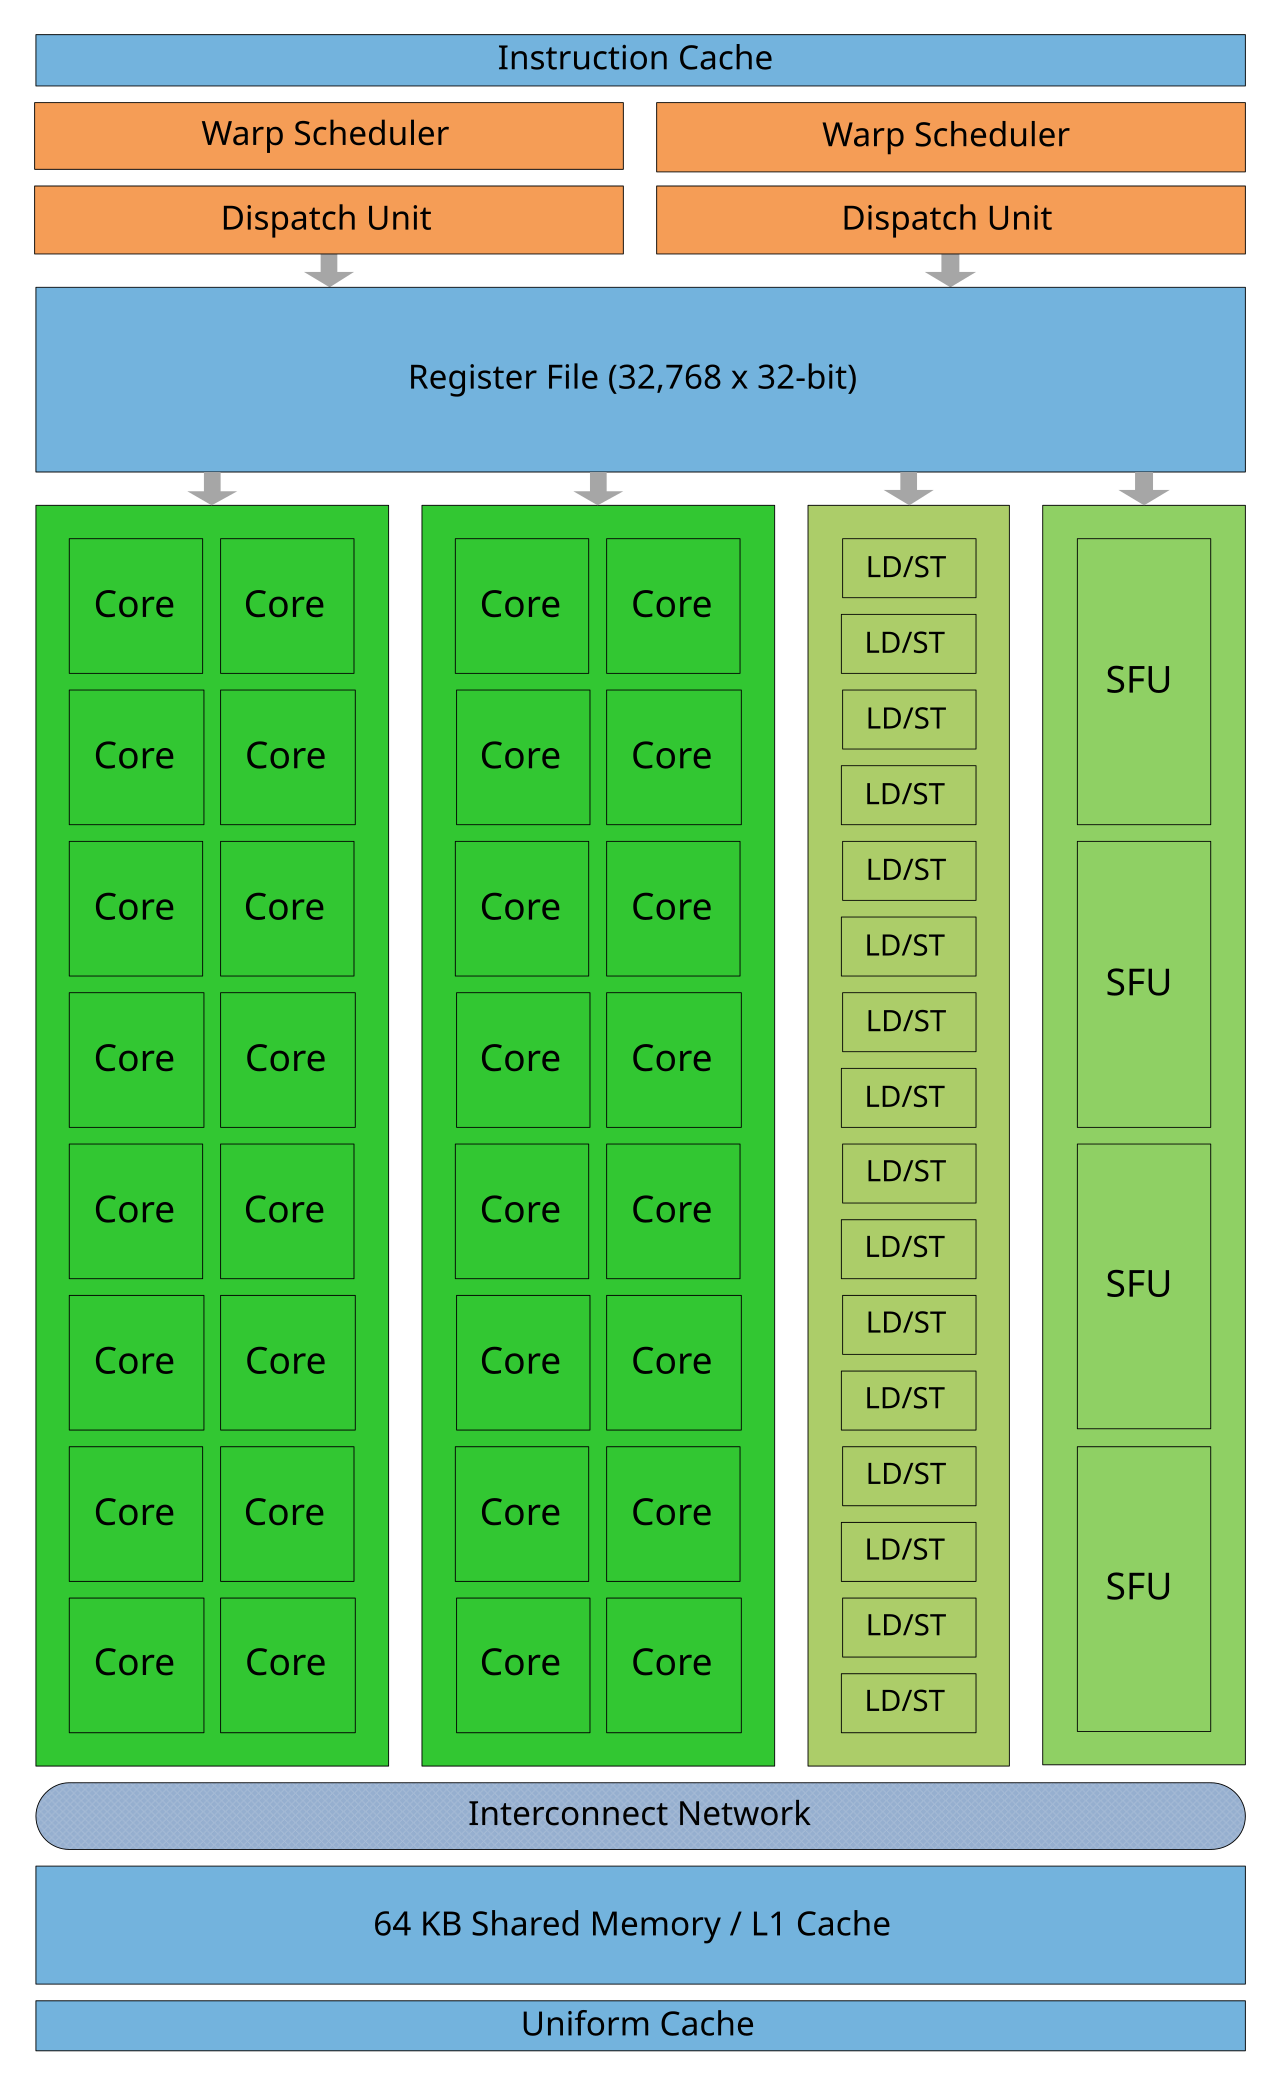
AMD 侧的结构要再多一层。一个 CU 里有四条 16-wide 的向量流水线(VALU),外加一条标量流水线(SALU)和一块局部数据共享(Local Data Share, LDS)。到了 RDNA 世代,AMD 又在 CU 之上加了一层 WGP(Workgroup Processor),一个 WGP 含两个 CU,LDS 归属 WGP 层,这个细节后面讲占用率时会变成一个硬约束。 出处:CUDA Programming Guide(分页版总入口)。 出处:GPUOpen《Optimizing GPU occupancy and resource usage with large thread groups》。
2.2 寄存器文件:核里最贵的那片地
寄存器文件是整个核里最占面积的一块。给几个可核对的数字:
| 平台 | 寄存器文件规模 | 说法出处 |
|---|---|---|
| NVIDIA(各代通用) | 64K × 32-bit / SM(= 256 KB) | CUDA Programming Guide · Memory Information 表 |
| AMD CDNA1(MI100) | 256 个 VGPR / 线程、800 个 SGPR | ROCm · MI100 microarchitecture |
| AMD CDNA3(MI300X) | VGPR 文件 512 KB | ROCm · GPU hardware specifications |
| AMD RDNA3(RX 7900 XTX) | VGPR 文件 768 KB | 同上 |
这里有个关键的不对称:NVIDIA 的寄存器属于「每个线程」,AMD 的 VGPR 属于「每个 wavefront 的每个 lane」。 换个说法,NVIDIA 按线程数算,AMD 按 wave 数 × 每 lane 数算。这两种记账方式正是下一章两套占用率口径的根源。 出处:ROCm · AMD Instinct MI100 microarchitecture。 出处:CUDA Pro Tip:Occupancy API 简化启动配置。
还有一个数字必须记住:每线程最多 255 个寄存器,这条上限在所有代际上都没变。它看起来只是个技术限制,实际上是一道很硬的天花板——当寄存器不够用时,编译器只能把变量溢出(spill)到本地内存,而那些访问会走显存。 出处:ROCm · GPU hardware specifications。 出处:NVCC 文档 · maxrregcount。
为什么寄存器不能干脆做成 512 个?因为寄存器文件是核里最贵的结构:它需要多端口访问(同一周期内多个 lane 同时读写),而多端口的 SRAM 面积随端口数快速增长。给每一个线程更多的寄存器,等于让整个 SM 的面积和功耗按比例上升。255 这个数字是面积、功耗与可表达性三者的一个折中点,而它十几年没变,本身就说明这个折中找得比较准。
至于「溢出」,它的代价容易被低估。被溢出的变量落在本地内存(local memory)里——名字叫 local,但它在显存上,只是被缓存着。所以一次溢出访问,代价与一次普通的显存访问同一量级(回看 ep02 的那笔延迟账),而且它还占用了带宽。一个为了抬高占用率而把寄存器从 128 压到 96 的改动,如果换来的是每个线程多十几次本地内存访问,那就是彻底的亏本买卖。
2.3 统一缓存:一次零和的配置
回到「共享内存与 L1 是同一块物理资源」这件事。它的直接后果是零和的:
Because shared memory and L1 cache share the same physical space, using shared memory reduces the size of the usable L1 cache for a kernel. —— CUDA Programming Guide《Writing CUDA SIMT Kernels》
你声明多少共享内存,就少多少 L1 缓存。 这个取舍在硬件上是按档位配置的,而且档位逐代在变宽:
| 平台 | 统一 L1/共享缓存总量 | 共享内存可用档位 |
|---|---|---|
| Turing(7.5) | 96 KB | 32 / 64 KB 两档 |
| Ampere(8.0 / 8.6) | 192 / 128 KB | 0…164 / 0…100 KB |
| Hopper(9.0) | 256 KB | 0, 8, 16, 32, 64, 100, 132, 164, 196, 228 KB |
| Blackwell(10.x) | 256 KB | 与 Hopper 同一组档位 |
以 256 KB 的统一缓存为例算一遍:共享内存取 100 KB,L1 就只剩约 156 KB;取到档位上限 228 KB,L1 只剩约 28 KB——只剩下一成出头。这就是「多给共享内存的每一 KB,都是从 L1 手里拿走的」的具体含义。
顺带一个很容易被忽略的细节:CUDA 每个线程块会固定保留 1 KB 共享内存(Hopper 与 Blackwell 官方文档都写了这句)。算占用率时漏掉这 1 KB,结果会差一档。 出处:CUDA C++ Best Practices Guide · Register Pressure。 出处:Tuning CUDA Applications for Blackwell。
这个 1 KB 在直觉上很小,但在小共享内存块的场景下会变成决定项。假设一个核打算用 8 KB 共享内存、指望靠小用量换来高并发,实际每个块要占 9 KB。并发块数从 8 掉到 7,占用率就少了一档。 这类误差在手工估算里非常常见,这也是为什么官方要把「用工具算,别手算」写在文档里。
2.4 资源是按线程块整体发放的
这一节要讲一个不如前面显眼、但同样决定占用率的机制:
GPUs allocate and release all resources for a thread group simultaneously. Registers, LDS and wave slots must all be allocated before group execution can start. —— GPUOpen《Optimizing GPU occupancy and resource usage with large thread groups》
翻译过来:寄存器、LDS、wave 槽三类资源,必须在该线程块开始执行之前全部备齐,一次发放、一次回收。
这条规则解释了一个常见困惑:为什么有时候明明还剩不少资源,新的线程块却起不来。因为剩下的资源凑不齐一个完整的块——寄存器够、LDS 不够,或者反过来。CPU 上可以逐个线程调度、资源慢慢凑;GPU 上不行,它按块结算。 出处:CUDA Programming Guide · Writing CUDA SIMT Kernels。 出处:Tuning CUDA Applications for Ampere。
这一段也收在一笔账上:一个核能同时装多少个线程块,不取决于总资源有多少,而取决于最紧的那一项资源够发几份。 出处:Tuning CUDA Applications for Hopper。 出处:Tuning CUDA Applications for Turing。
举一个具体的对照来体会这条规则。假设某个 SM 的寄存器够 6 个块、共享内存够 8 个块、块数上限是 32、warp 槽位也够。它能同时跑的就是 6 个块。 共享内存那多出来的 2 个份额完全用不上,因为寄存器先见底了。反过来,如果开发者为了「多塞几个块」去疯狂压缩共享内存用量,而瓶颈其实在寄存器上,那份努力一点收益都不会有——这正是 §11.3 那套「先确认限制项」的诊断流程要解决的问题。
三、wave 与 warp:为什么是 32 和 64
3.1 两个数字的由来
OK,言归正传。NVIDIA 的 warp 是 32 个线程,AMD 的 wavefront 在 Instinct 上是 64、在 Radeon 上是 32。为什么是这两个数,而不是 16 或 128?
先看硬件给出的约束条件。AMD 的向量流水线是 16-wide 的,所以 wave 宽度必须是 16 的整数倍才不浪费:32 = 2 条流水线并行,64 = 4 条流水线跑四拍。NVIDIA 的一个 SM 分区有 32 个 lane,warp 宽度对齐到 32 是最自然的选择。 出处:CUDA Programming Guide · Compute Capabilities。
再看取值背后的取舍。宽度越大,分摊到每线程的调度开销越小(一条指令管更多线程),但分歧时浪费的 lane 也越多——一个 if 分支只有 1 个线程走进去,宽度 32 就浪费 31 个 lane,宽度 64 浪费 63 个。 出处:CUDA C++ Best Practices Guide · Differences between Host and Device。 出处:ROCm · GPU architecture documentation(总入口)。
这就是为什么 AMD 从 GCN 的 wave64 一路走到 RDNA 的 Wave32/Wave64 双模式:图形负载(分支多、发散重)用 wave32 更划算,计算负载(分支少、向量密集)用 wave64 吞吐更好。RDNA 的 ISA 手册把两种模式并列写进规范,本身就是一个信号。没有一种宽度对所有人都是最优。 出处:ROCm HIP · C++ language extensions(warpSize 与 launch_bounds)。 出处:GPUOpen · RDNA Performance Guide。
3.2 一个 wave 在硬件上是几拍
「一个 wave 同时执行」这句话其实不准确。硬件是 16-wide 的,64 个 lane 的 wavefront 要拆成四个 16-lane 的组、跑四个连续周期。AMD 的官方文档把这件事讲得很清楚: 出处:GPUOpen · AMD GCN Assembly Cross-Lane Operations。 出处:AMD《Introducing CDNA 2 Architecture》白皮书。
The actual GCN hardware implements 16-wide SIMD, so wavefronts decompose into groups of 16 lanes called wavefront rows that are executed on 4 consecutive cycles. —— GPUOpen《AMD GCN Assembly Cross-Lane Operations》
把它摊开看就是:第 1 拍走 lane 0–15,第 2 拍走 16–31,第 3 拍走 32–47,第 4 拍走 48–63。一个 wavefront 的四拍,走的正是四个 16-lane 的「波前行」。
这个「四拍」有个容易被忽略的后果:跨 lane 的操作不能白拿。如果 shader 里要做 lane 之间的数据交换(shuffle、permute),数据得在四个 row 之间来回走,这类操作天然比逐 lane 运算贵。RDNA2 的 ISA 里甚至专门注明:wave64 模式下,permute 只在每个 32 lane 的半边内生效——「它的行为等同于两个独立的 wave32」。 出处:AMD《Introducing CDNA 3 Architecture》白皮书。
3.3 LDS 的周期账:一个能算清的例子
共享内存(AMD 叫 LDS)的访问代价,是这一章最适合拿来算账的地方,因为官方给了一组很干净的数字:
Due to the internal banked structure of LDS, operations can complete in as little as one cycle (for wave32, or 2 cycles for wave64), or take as many 64 cycles, depending upon the number of bank conflicts. —— AMD《RDNA 2》Instruction Set Architecture
最好情况 1 个周期(wave32)/2 个周期(wave64),最坏情况 64 个周期——差距是 64 倍,而变量只有一个:bank 冲突的数量。
LDS 被切成 32 个 bank,同一拍内不同 lane 访问同一 bank 的不同地址就会撞车、只能串行。这条账的意义在于:共享内存不是「用了就快」,它快不快取决于你访问它的方式。一个 64 拍的访问,比直读显存还慢。 出处:AMD《RDNA 2》Instruction Set Architecture。 出处:ROCm · AMD Instinct MI300 microarchitecture。
规避 bank 冲突的手法其实很朴素:让同一个 warp 里的 lane 访问连续、错开的地址,而不是全都指向同一个 bank。一个最典型的坏例子是「所有 lane 读同一个数组的第 0 列」——如果那个数组按列存储,32 个 lane 就会全部撞在同一个 bank 上;把布局改成按行存储,冲突立刻消失。
值得一提的是,硬件对同一地址的广播是友好的:如果所有 lane 读的完全是同一个地址,LDS 会做一次广播、一拍返回。真正贵的是「同一 bank 的不同地址」——所以判断一段共享内存访问是好是坏,问的不是「地址一样吗」,而是「bank 一样但地址不一样吗」。
3.4 零开销切换:延迟隐藏的物理前提
这一章最该记住的一句话,是 AMD 与 NVIDIA 都写进官方文档的同一件事:
The hardware can perform single-cycle context switching between warps with zero overhead, as all warp contexts remain resident on the CU. —— ROCm《Hardware implementation》
The execution context (program counters, registers, etc.) for each warp processed by an SM is maintained on-chip throughout the warp's lifetime. Therefore, switching between warps incurs no cost. —— CUDA Programming Guide《Hardware Multithreading》
所有 warp 的上下文(程序计数器、寄存器)在整个生命周期里都常驻片上,所以切换零开销。 这句话是整篇的地基:如果切换有成本,用并行盖延迟就是一笔亏本买卖。CPU 做线程切换要保存/恢复上下文、要刷 TLB、要污染缓存,所以它必须靠大缓存和乱序执行去压单次延迟;GPU 反过来,它让上下文永远待在原地,把「换一个线程接着干」变成零成本,于是延迟就可以用数量去磨。 出处:ROCm HIP · Hardware implementation。 出处:CUDA Programming Guide · Hardware Multithreading。
这条分野解释了两者在很多设计上的对称差异。CPU 有庞大的乱序窗口和分支预测器,为的是在一条指令流里提前做掉后面的工作;GPU 几乎没有这些,它把同样的面积花在同时存活的线程数上。CPU 的缓存要大、要智能(因为访存稀疏、每次都可能关键);GPU 的缓存可以小、可以简单(因为访存密集,命中率靠的是并行访问的空间局部性,而不是单线程的时间局部性)。同一个物理约束,长出了两套完全不同的硬件。
3.5 从线程块到 warp
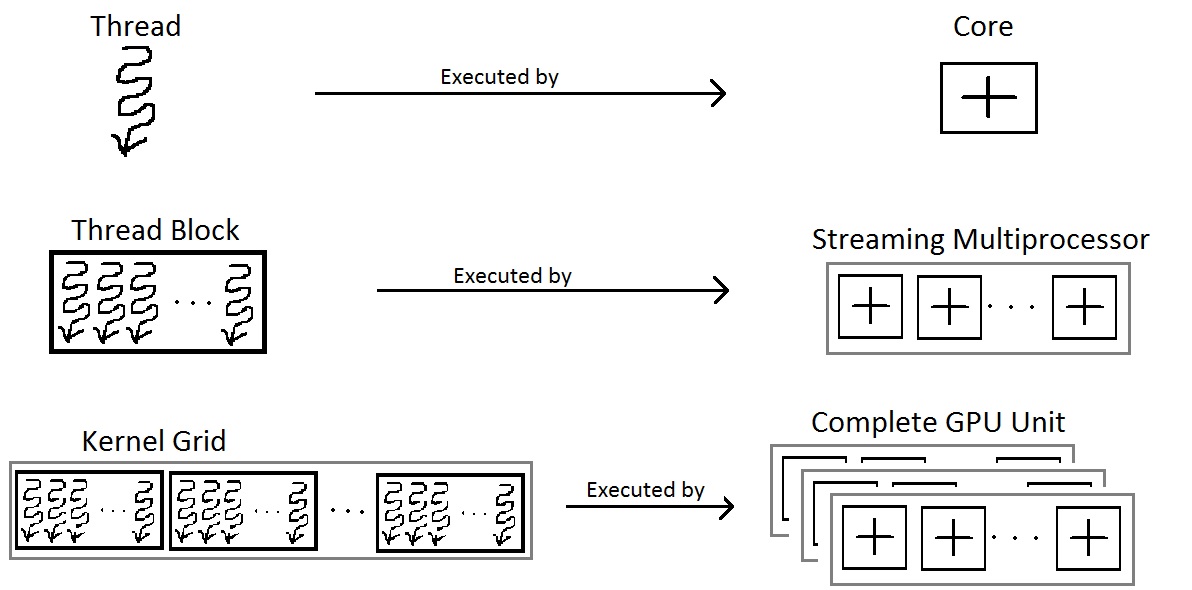
最后把三层的映射关系钉死。一个线程块(thread block / workgroup)里的线程,被硬件切成若干个 warp:warp 数 = ⌈线程数 ÷ warp 宽度⌉。如果线程数不是宽度的整数倍,最后一个 warp 会有一部分 lane 是空转的——这些 lane 照样占寄存器、照样占 wave 槽,只是不出活。 出处:GPUOpen · Radeon GPU Profiler 手册。 出处:AMD《"Vega" 7nm》Instruction Set Architecture Reference Guide。
所以「线程块大小取 32 或 64 的整数倍」不是玄学,而是避免为不存在的线程付资源。这条建议在 CUDA 与 HIP 的官方文档里都排在优化建议的前列。 出处:ANU COMP4300 · The NVIDIA Volta V100 GPU SM and Execution Model。
这笔浪费在小线程块上尤其明显。一个 33 线程的块,在 warp 宽度 32 下要开 2 个 warp。第二个 warp 只有 1 个 lane 有活,其余 31 个空转,而它们占用的寄存器与槽位一个不少。按 33 个线程算,warp 利用率只有 $33 \div 64 \approx 52\%$。
所以「块大小取 2 的幂」这条建议的正确表述应该是:块大小取 warp 宽度的整数倍(NVIDIA 上是 32 的倍数,AMD Instinct 上是 64 的倍数)。在 AMD 的 Wave32 模式下,32 的倍数同样成立。但如果我们要写的是跨两家的代码,取 64 的倍数最省心。
四、占用率的两套口径
4.1 定义:一个比值,两种记账
下面我们开始这一节。占用率(Occupancy) 的定义朴素得让人意外——它就是一个比值。NVIDIA 的官方定义:
The multiprocessor occupancy is the ratio of active warps to the maximum number of warps supported on a multiprocessor of the GPU. —— CUDA Occupancy Calculator
AMD 的口径略有不同,它是按每个 SIMD 的槽位算的:
Occupancy is the ratio of assigned wavefronts to the maximum available slots. In RDNA2 onwards, for a single SIMD, this means the number of assigned wavefronts divided by 16. Let's take an example, if a SIMD has 4 wavefronts in flight, the occupancy is 4 / 16 = 25%. —— GPUOpen《Occupancy explained》
注意这里已经埋了一个坑:NVIDIA 的分母是「每个 SM 能装多少 warp」,AMD 的分母是「每个 SIMD 能装多少 wave」。 一个是 SM 层,一个是 SIMD 层,两者差着四倍。所以你在 AMD 文档里看到「占用率 25%」,跟 NVIDIA 文档里的「25%」根本不是同一件事。 出处:NVIDIA CUDA Occupancy Calculator(官方页)。 出处:GPUOpen · Occupancy explained through the AMD RDNA architecture(GPC 2024)。
4.2 NVIDIA 侧:上限逐代在变
先把最容易做错的一件事摆出来:每 SM 能同时驻留多少 warp,不是一个常数。
| 架构 | 计算能力 | 每 SM 最大 warp | 每 SM 最大线程 | 每 SM 最大 block |
|---|---|---|---|---|
| Volta | 7.0 | 64 | 2048 | — |
| Turing | 7.5 | 32 | 1024 | 16 |
| Ampere | 8.0 / 8.6 | 64 / 48 | 2048 / 1536 | 32 / 16 |
| Ada | 8.9 | 48 | 1536 | 24 |
| Hopper | 9.0 | 64 | 2048 | 32 |
| Blackwell | 10.x | 64 | 2048 | 32 |
这张表值得盯着看一会儿。Turing 是个明显的洼地。32 个 warp,只有 Volta 和 Hopper 的一半。这不是笔误,官方 Turing 调优指南写得很清楚: 出处:CUDA Programming Guide · Compute Capabilities。 出处:NVIDIA Tesla V100 架构白皮书。
The maximum number of concurrent warps per SM is 32 on Turing (versus 64 on Volta). —— Turing Tuning Guide §1.4.1.3
这个洼地带来一个很实际的后果:「占用率 50%」在 Turing 上是 16 个 warp,在 Hopper 上是 32 个 warp。 同样是 50%,能拿来盖延迟的线程数整整差一倍。所以当有人拿一个占用率数字跨代比较时,第一件该问的事是:在哪个架构上? 出处:Tuning CUDA Applications for Turing · Occupancy。 出处:Tuning CUDA Applications for Hopper · Occupancy。
为什么这个上限会来回变?回到 §2 的资源清单就明白了:每 SM 的 warp 上限,本质上是「寄存器文件总量 ÷ 每 warp 的寄存器占用」与「硬件愿意为 warp 上下文花多少静态存储」这两件事的合力。 Turing 把 FP32 与 INT32 的数据通路合并(一条通路同时支持两种运算),单 SM 的执行效率上去了,但warp 上下文与调度的静态开销相对变重,于是上限从 64 降到 32;之后的 Ampere 与 Hopper 又把它拉回 48/64。
换句话说:上限是设计的副产品,不是设计的起点。 它随每一代在「执行效率」与「并发线程数」之间的取舍而移动——这也解释了为什么官方文档从不给一个「推荐占用率」的具体数字。
4.3 AMD 侧:按 SIMD 的槽位算
AMD 的口径更接近「座位数」的思路。每个 SIMD 有一定数量的 wave 槽(slot),占用率就是「坐了几个座位 ÷ 总座位数」:
| 架构 | 每 SIMD 的 wave 槽 | 每 CU 最大驻留 wavefront |
|---|---|---|
| RDNA1 | 20 | 40 |
| RDNA2 / RDNA3 | 16 | 32 |
| CDNA1 | —— | 32 |
| CDNA2 / CDNA3 | —— | 32 |
注意 RDNA1 到 RDNA2 槽位从 20 降到 16 。每 SIMD 能坐的 wave 又少了一档,但同期每 SIMD 的寄存器文件变大了。这又是一次「上限换别的资源」的取舍,跟 §4.2 那张表是同一个道理:上限从来不是单一目标,它是资源分配的结果。 出处:Tuning CUDA Applications for Ampere · Occupancy。 出处:GPUOpen · Occupancy explained(RDNA 槽位与实算)。
4.4 theoretical 与 achieved:上界不是实际值
这是全篇最重要的一处区分。官方文档写得很直白:
The theoretical occupancy or maximum achievable occupancy is only an upper bound of what we'll call now the measured occupancy. —— GPUOpen《Occupancy explained》
理论占用率只是上界,实测值总是更低。 三个原因:
- 资源分配粒度。寄存器不是按个发的,而是按最小粒度块发的。你声明 119 个寄存器,硬件可能按 120 或 128 发放——官方原文说得很清楚:「实际上 VGPR 的分配粒度大于 1」。 出处:NVIDIA Ada Lovelace Professional GPU 架构白皮书。 出处:GPUOpen · Live VGPR Analysis with Radeon GPU Analyzer。
- 块的整体发放(见 §2.4)。三类资源要同时备齐,剩下零碎资源用不上。
- 尾部效应。最后一个线程块可能只有零星几个线程,却占着一整套资源份额。
把这三个折损放在一起,就能理解一个很常见的现象:手工算出来的占用率总是比工具报的高。 手算时我们习惯用「总量 ÷ 单份用量」,而硬件实际做的是「按分配粒度取整 ÷ 按块整体发放 ÷ 处理尾部剩余」。三处各自损失一点,累积起来常常就是一整档。
这也是为什么「用工具算」不是懒惰,而是必要:官方提供 Occupancy Calculator 与 profiler 里的占用率视图,正是因为手工推导容易在多处取整上出错。本篇给出的所有算式,用途是建立直觉与量级判断,而不是替代工具。
所以工具才会专门给出「谁在限制占用率」。RGP 的口径是:它会告诉你当前的理论占用率、哪一项资源是限制项、以及需要把这项资源降到多少才能让占用率加 1。这句话本身就是最好的证据。如果只有一个答案,工具不必这么啰嗦。 出处:GPUOpen · Radeon GPU Profiler 手册 · Events Windows。 出处:AMD《How to accelerate AI applications on RDNA 3 using WMMA》。
五、谁把占用率卡住
5.1 四类资源,四个计数器
好了,接着往下看。AMD 的硬件里,有一个单元专门盯着四类资源的分配(官方称 SPI),四类资源里任何一类不够,新的 wave 就发不出去: 出处:ROCm · MI300 and MI200 Series performance counters and metrics。
| 资源 | 不足时的含义 | 对应官方计数器 |
|---|---|---|
| wave 槽 | SIMD 上的座位满了 | SPI_RA_WAVE_SIMD_FULL_CSN |
| VGPR | 向量寄存器文件满了 | SPI_RA_VGPR_SIMD_FULL_CSN |
| SGPR | 标量寄存器满了 | SPI_RA_SGPR_SIMD_FULL_CSN |
| LDS | 共享内存满了 | SPI_RA_LDS_CU_FULL_CSN |
这四个计数器是本篇最实用的一样东西:它们把「占用率低」从一个现象变成了一个可归因的结论——你不是笼统地知道占用率上不去,而是知道是哪一类资源把它顶住了。 出处:ROCm HIP · Hardware implementation(SPI 与发射仲裁)。
顺带排除一个常见嫌疑:在 RDNA 上,SGPR 几乎不会是瓶颈。官方的说法是每个 wavefront 分配固定数量的 SGPR,而这些量总是够填满 16 个槽位;GCN 时代的分析也给出同样结论(SGPR 不是 GCN 上的占用率限制项)。所以实操中真正要盯的是三项:wave 槽、VGPR、LDS。 出处:GPUOpen · AMD GCN Assembly Cross-Lane Operations(LDS 带宽算例)。
LDS 这一类有个别的资源没有的特点:它的分配粒度是块级的,而且位于 WGP 层。 AMD 官方特意指出「同一个线程组的线程必须执行在同一个 WGP 上」——这意味着共享内存的用量不仅限制单个 CU,还会把一个线程组锁在一对 CU 里。一个用了大量共享内存的块,即使寄存器很省,也很难在多个 CU 之间摊开,占用率的调节余地因此比表面上更小。
这也是移动端与桌面端在共享内存策略上分出差异的原因之一:共享内存能省访存,但它把执行单元的分配自由度一起收窄了。
5.2 实算一:119 个 VGPR 只能挂两个 wave
现在来算一笔真实的账。这是 ROCm 官方 MI100 微架构页给出的例子,值得逐句读:
A wavefront can occupy any number of VGPRs from 0 to 256, directly affecting occupancy; that is, the number of concurrently active wavefronts in the CU. For instance, with 119 VGPRs used, only two wavefronts can be active in the CU at the same time. —— ROCm · AMD Instinct MI100 microarchitecture
用 119 个 VGPR 时,同一个 CU 里只能同时有 2 个 wavefront。 而 MI100 的一个 CU 最多能装 10 个 wavefront。也就是说:
$$\text{占用率} = \frac{2}{10} = 20\%$$
这笔账可以写成一条通用的估算式(用惯例记号):
$$N_{\text{wave}} = \left\lfloor \frac{C_{\text{regfile}}}{R_{\text{per-thread}} \times W_{\text{wave}}} \right\rfloor$$
其中: - $N_{\text{wave}}$ 是一个 SIMD 上能同时驻留的 wave 数; - $C_{\text{regfile}}$ 是该 SIMD 的寄存器文件容量(以 32-bit 寄存器计); - $R_{\text{per-thread}}$ 是每线程声明的寄存器数; - $W_{\text{wave}}$ 是 wave 宽度(32 或 64)。
翻译一下:能挂多少 wave,取决于寄存器文件总容量除以「一个 wave 吃掉的寄存器数」;而一个 wave 吃掉的量 = 每线程寄存器数 × wave 宽度。所以寄存器用量翻一倍,能挂的 wave 数就掉一半——这就是占用率与寄存器压力之间的直接换算关系。 出处:ROCm · AMD Instinct MI100 microarchitecture(VGPR 与占用率)。
5.3 实算二:1024 个线程只有 40% 占用率
第二笔账来自 GPUOpen 的另一篇官方文章,它算的是 GCN 时代一个最典型的情形:
1024 threads will yield 16 waves of 64 threads, which are distributed equally among the SIMDs resulting in 4 waves per SIMD… optimal occupancy and latency hiding requires 10 waves, so 4 waves results in a mere 40% occupancy. —— GPUOpen《Optimizing GPU occupancy and resource usage with large thread groups》
拆开看:1024 个线程 = 16 个 64 线程的 wave,平均分到 4 个 SIMD 上,每个 SIMD 拿 4 个。 而一个 SIMD 想达到理想占用率需要 10 个。
$$\text{占用率} = \frac{4}{10} = 40\%$$
这笔账有个反直觉之处:1024 是个很「圆」的数字,但它并不优。 因为一个 CU 有 4 个 SIMD、每个 SIMD 要 10 个 wave 才满,理想线程数是 $4 \times 10 \times 64 = 2560$ 个线程对应的负载量——而这个量通常远超单块的线程上限,得靠多个线程块叠起来才能填满。这就是为什么「一个块写多大」和「同时起几个块」是同一个问题的两面。 出处:AMD《Introducing CDNA Architecture》白皮书(四条 16-wide 流水线)。 出处:GPUOpen《Optimizing GPU occupancy… large thread groups》(40% 算例)。
5.4 寄存器压力的两难
到这里,一个绕不开的取舍浮现出来了。编译器在分配寄存器时面对两个方向:
往上限走(多用寄存器):变量都留在寄存器里,指令快、不溢出;但每个线程占的资源多,能同时驻留的 warp 就少,占用率掉下去。 出处:CUDA Runtime API · Occupancy group。
往下压(少用寄存器):占用率上来了;但一旦压过头,变量被溢出(spill)到本地内存,而那些访问要走显存。你为了多几个 warp,把访存次数翻了几倍。 出处:CUDA C++ Best Practices Guide · Occupancy。
NVIDIA 的官方文档把这条线的两端都点到了:-maxrregcount 能压低寄存器用量、可能让更多块并发,但也可能导致 register spilling。所以「把占用率追上去」这件事有个明确的边界:当它开始以溢出为代价时,就该停手了。 出处:CUDA C++ Best Practices Guide · Arithmetic Instructions。
实操上有一条简单的判据:先看寄存器是不是真的限制项。 如果 SPI_RA_VGPR_SIMD_FULL_CSN 之类的计数并不高,那么压低寄存器用量对占用率毫无帮助,只会白白增加溢出风险;只有当寄存器确实是限制项、而且离下一个占用率档位只差几个寄存器时,动它才划算。
最后一种情况需要一点判断力:有时候从 128 个寄存器压到 120 个,刚好能让 SIMD 多挂一个 wave;而有时候压到 120 换不来任何东西,因为分配粒度会把 120 向上取整回 128。「差几个就够」这个判断,只能靠工具给出的分配后数值,不能靠声明的数值。
顺带说,这也是为什么__launch_bounds__ 这类工具要存在:它让开发者显式声明「我最多同时起 N 个块」,编译器据此反推每线程可用寄存器数。AMD 侧的官方表述很直接:「能用的最大寄存器数 = 可用寄存器 ÷ 最小 warp 数」。这行式子就是占用率与寄存器之间的兑换率。 出处:GTC 2025 · CUDA Techniques to Maximize Compute and Instruction Throughput。
5.5 为什么「把占用率拉满」是反模式
把前面几节连起来,可以给出这一章最实用的结论:占用率不是目标,它是达成延迟隐藏的手段;而延迟隐藏有饱和点。
官方文档里那句话点得很准:
low occupancy always reduces the ability to hide latencies, resulting in overall performance degradation. —— Nsight Compute Profiling Guide
注意它说的是「低的占用率总会削弱延迟隐藏能力」——这是一句单向论断:低一定不好。但反过来不成立:高占用率不等于高吞吐,因为占用率只是「有多少 warp 可选」,而不是「这些 warp 现在能不能发射」。 出处:ROCm HIP · Hardware features(资源上限表)。
这一点是下一章的引子,也是本篇第六章的全部内容。「装得多」和「发得出」是两件事——而后者才是性能的真正决定项。
六、从 occupancy 到 eligible warp
6.1 四个层级:把「忙碌」拆开看
下面我们进入下一层。要理解为什么占用率高不一定快,得先把「有活干」这件事拆成四级。NVIDIA 的性能分析工具给出的口径是一段很短但信息量极大的说明: 出处:D. Wong《Architectural Support for Address Translation on GPUs》。 出处:NVIDIA Nsight Compute · Profiling Guide(SchedulerStats 与 WarpStateStats)。
The upper bound of warps in the pool (Theoretical Warps) is limited by the launch configuration. On every cycle each scheduler checks the state of the allocated warps in the pool (Active Warps). Active warps that are not stalled (Eligible Warps) are ready to issue their next instruction. From the set of eligible warps, the scheduler selects a single warp from which to issue one or more instructions (Issued Warp). On cycles with no eligible warps, the issue slot is skipped… —— Nsight Compute Profiling Guide
把这段话拆成四级,就是一张很实用的诊断表:
| 层级 | 含义 | 由什么决定 | 低意味着 |
|---|---|---|---|
| Theoretical Warps | 理论上能驻留的最多 warp 数 | 启动配置、硬件上限 | 块大小/资源开销不合理 |
| Active Warps | 实际驻留在 SM 上的 warp 数 | 占用率(资源够不够) | 被寄存器/LDS/槽位卡住 |
| Eligible Warps | 当前没有停顿、可以发射的 warp | 数据依赖、访存等待 | 被内存延迟或依赖链卡住 |
| Issued Warp | 本周期真正发射的那一个 | 调度器选择 | —— |
这张表是本篇最值得带走的东西。占用率量的是第二级(active),而性能取决于第三级(eligible)。 两者之间隔着一道很宽的沟。一个 warp 可以既驻留在 SM 上、又完全不能发射,因为它正在等一次显存访问回头。 出处:NVIDIA Nsight Compute · User Manual。 出处:CUDA Programming Guide · SIMT Execution Model。
6.2 没有 eligible warp 的周期,发射槽被跳过
官方说明里那句「On cycles with no eligible warps, the issue slot is skipped」值得单独拎出来。它说的是:如果一个周期里没有任何一个 warp 处于可发射状态,那个周期的发射机会就白白丢掉了——不是攒起来、不是顺延,就是没了。 出处:NVIDIA 开发者论坛 · Independent Thread Scheduling 的重聚依据。
这就解释了那个最常见的困惑:为什么 profiler 里显示占用率不低、发射效率却很差。 因为占用率统计的是「驻留了几个 warp」,而发射看的是「这一拍有没有一个能不等待就发指令的 warp」。前者是静态的资源占用,后者是动态的就绪状态。 出处:CUDA Programming Guide · CUDA C++ Execution Model。 出处:AMD《RDNA 2》ISA(LDS bank 冲突周期)。
6.3 谁的停顿占了大头
warp 什么时候会「不能发射」?把常见的停顿来源排一遍,答案并不意外。排在首位的往往是访存:
- 长延迟访存等待:一次未命中的显存访问几百纳秒,期间该 warp 完全不可发射(这是上一篇算过的那笔账)。
- 依赖链:下一条指令的操作数还没算出来。FMA 的依赖延迟有几个周期(具体值见 §7.1)。
- 屏障与同步:等线程块内其它 warp 到齐。
- 资源冲突:共享内存 bank 冲突(见 §3.3)、或者指令队列拿不到发射端口。
顺带给出一个能自己量化的口径:NVIDIA 的工具里有一个指标叫 warp cycles per instruction,官方说明是「两条连续指令之间的延迟——这个值越高,就需要越多的 warp 并行度来盖住它」。这句话其实已经把下一章的公式说完了。 出处:Dissecting the NVIDIA Hopper Architecture through Microbenchmarking(arXiv)。
落到读表上,这四级口径给出的诊断路径其实很清晰:Theoretical 低说明启动配置就不合理(块太大、资源要得太多);Active 低说明资源不够(回第五章看是哪一项);Active 高而 Eligible 低说明 warp 在等(去看停顿原因,多半是访存);Eligible 有但 Issued 上不去才轮到怀疑调度器与发射端口。
四级里前三级的差别,恰好对应三类不同的病因。 这也是本篇反复强调「占用率只是一个中间量」的原因。它在漏斗的第二级,看得见问题的一半,看不见另一半。
七、延迟隐藏的定量:到底要多少个 warp
7.1 一个能算出具体数字的例子
OK,回到正题。这一章要兑现开篇的承诺——把「用并行盖延迟」从一句口号变成一笔能算的账。全篇最硬的一组数字来自 NVIDIA 的 Turing 调优指南: 出处:CUDA Volta Tuning Guide。 出处:NVIDIA A100 Tensor Core GPU 架构白皮书。
Each Turing SM includes 4 warp-scheduler units… Dependent instruction issue latency for core FMA math operations is four clock cycles, like Volta, compared to six cycles on Pascal. As a result, execution latencies of core math operations can be hidden by as few as 4 warps per SM, assuming 4-way instruction-level parallelism (ILP) per warp, or by 16 warps per SM without any instruction-level parallelism. —— Turing Tuning Guide §1.4.1.1
这段话给出了两个端点:每个 warp 有 4 路指令级并行(ILP, Instruction-Level Parallelism)时,4 个 warp 就够;完全没有 ILP 时,需要 16 个 warp。
数字之间的关系可以写成一条式子:
$$N_{\text{warp}} = N_{\text{sched}} \times \frac{L_{\text{dep}}}{\text{ILP}}$$
其中: - $N_{\text{warp}}$ 是盖住该延迟所需的 warp 总数; - $N_{\text{sched}}$ 是每个 SM 里的调度器数量(Turing 为 4 个); - $L_{\text{dep}}$ 是依赖指令的发射延迟(Turing 上核心 FMA 为 4 个周期); - $\text{ILP}$ 是每个 warp 内可独立发射的指令数。
翻译一下:每个调度器需要 $L_{\text{dep}} \div \text{ILP}$ 个 warp 才能把发射槽排满,再乘上调度器的数量,就是整个 SM 需要的 warp 数。代入 Turing 给出的两组数字:每 warp 4 路 ILP 时,$4 \times 4 \div 4 = 4$ 个 warp;没有 ILP 时,$4 \times 4 \div 1 = 16$ 个 warp。与官方给的两个端点完全对上。 出处:Tuning CUDA Applications for Turing · Instruction Scheduling。
7.2 关键在于 ILP 与 TLP 可以互相替代
这条式子最有用的一点,是它把两种资源摆成了可替换的关系:
| 手段 | 含义 | 代价 |
|---|---|---|
| TLP(线程级并行) | 多放几个 warp 轮转 | 占寄存器与槽位,挤占用率 |
| ILP(指令级并行) | 让一个 warp 内部有多条独立指令 | 需要指令重排、展开循环、占更多寄存器 |
两种手段干的是同一件事——把延迟的窟窿填上。 这解释了一个很实际的现象:一段指令重排良好的 shader(ILP 高),用较低的占用率也能跑满;而一段处处依赖、串行到底的 shader(ILP 低),就算把占用率堆上去,也未必填得住。 出处:Analyzing and Improving Hardware Modeling of Accel-Sim(arXiv)。 出处:Cache Interference-Aware Throughput-Oriented Architecture and Scheduling for GPUs(arXiv)。

ILP 从哪里来?它不是编译器的魔法,而是源码结构的直接结果。三条最常用的手段:
- 循环展开:把相邻迭代的独立计算排在一起,让它们在等待彼此之外互相填补。
- 拆分累加器:把一条依赖长链(如连续累加的归约)拆成几条互不依赖的短链,最后再合并。
- 重排无关运算:把不相关的取数与算术交错排布,避免同一条依赖链连续占满发射槽。
三者的共同点是:它们都靠「占用更多寄存器」换取「更多独立指令」。 这就是为什么 §5.4 那个两难会在这里再次出现。ILP 与占用率争的是同一份寄存器预算,一个要留寄存器放中间结果,一个要多开 warp。
7.3 与上一篇接上:带宽 × 延迟
现在把这一节的账和上一篇接起来。ep02 留下过一个「带宽 × 延迟乘积」的思路:要盖住一次远路访问,需要的并发访问数约等于带宽与延迟的乘积。换到本篇的语言,那笔账算的是需要多少个 warp 同时处于访存等待中。 出处:Investigating Machine Learning Warp Schedulers(UCLA CS259)。
两篇合起来看,延迟隐藏的完整条件其实是两句话:
第一,装得下。 有足够多的 warp 驻留在 SM 上(占用率,本篇前半)。 第二,到时候有得发。 在某个 warp 等待访存的那几百纳秒里,其它 warp 得处于可发射状态(eligible warp,本篇后半)。
7.4 饱和点:为什么堆到某个程度就没用了
最后要给这条曲线一个形状。延迟隐藏是有饱和点的:当 warp 数量已经足够把延迟填满,再增加不会带来任何收益。因为瓶颈已经转移了。 出处:Cache-Conscious Wavefront Scheduling(Communications of the ACM)。 出处:Buddy SM:共享流水线前端的 GPGPU 能效优化(ACM TACO)。
转移去哪?最常见的两个去处:
- 发射带宽。一个 SM 每周期能发射的指令数是有限的(AMD 侧的官方口径是发射仲裁理论上每周期最多 5 条指令)。warp 再多,发射端口就那么几个。 出处:Phase Aware Warp Scheduling。
- 访存带宽。这正是 ep02 的那堵墙——所有 warp 都在等访存,加 warp 只会让显存更堵。
这句话有一个很实用的推论:当性能不动时,先确认瓶颈在哪,再决定要不要继续加并行度。 如果瓶颈是访存带宽,加 warp 只会让显存更堵、延迟更长,占用率上去了而吞吐掉下来。这是「优化后反而更慢」最常见的一种成因。
判断方法就是上一章那套顺序:看 Active 与 Eligible 的差距。如果活跃 warp 已经很多、可用 warp 却很少,说明加并行度这个方向已经走到头了。
所以「占用率该追到多少」这个问题的完整答案是:追到延迟能被填满为止,再多就是浪费寄存器。而「延迟什么时候算填满」,取决于 ILP、停顿结构、以及下面第九章要讲的调度策略。它是一个需要测的量,不是可以预设的目标值。 出处:Fabian Giesen · Part 8:Pixel processing – fork phase。
八、分歧与重聚:warp 什么时候会分叉
8.1 分歧:一个 warp 里的两条路
好了,我们继续。前七章讲的都建立在同一个隐含前提上:一个 warp 里的 32(或 64)个线程,执行的是同一条指令。 一旦这个前提被打破,故事就变了。
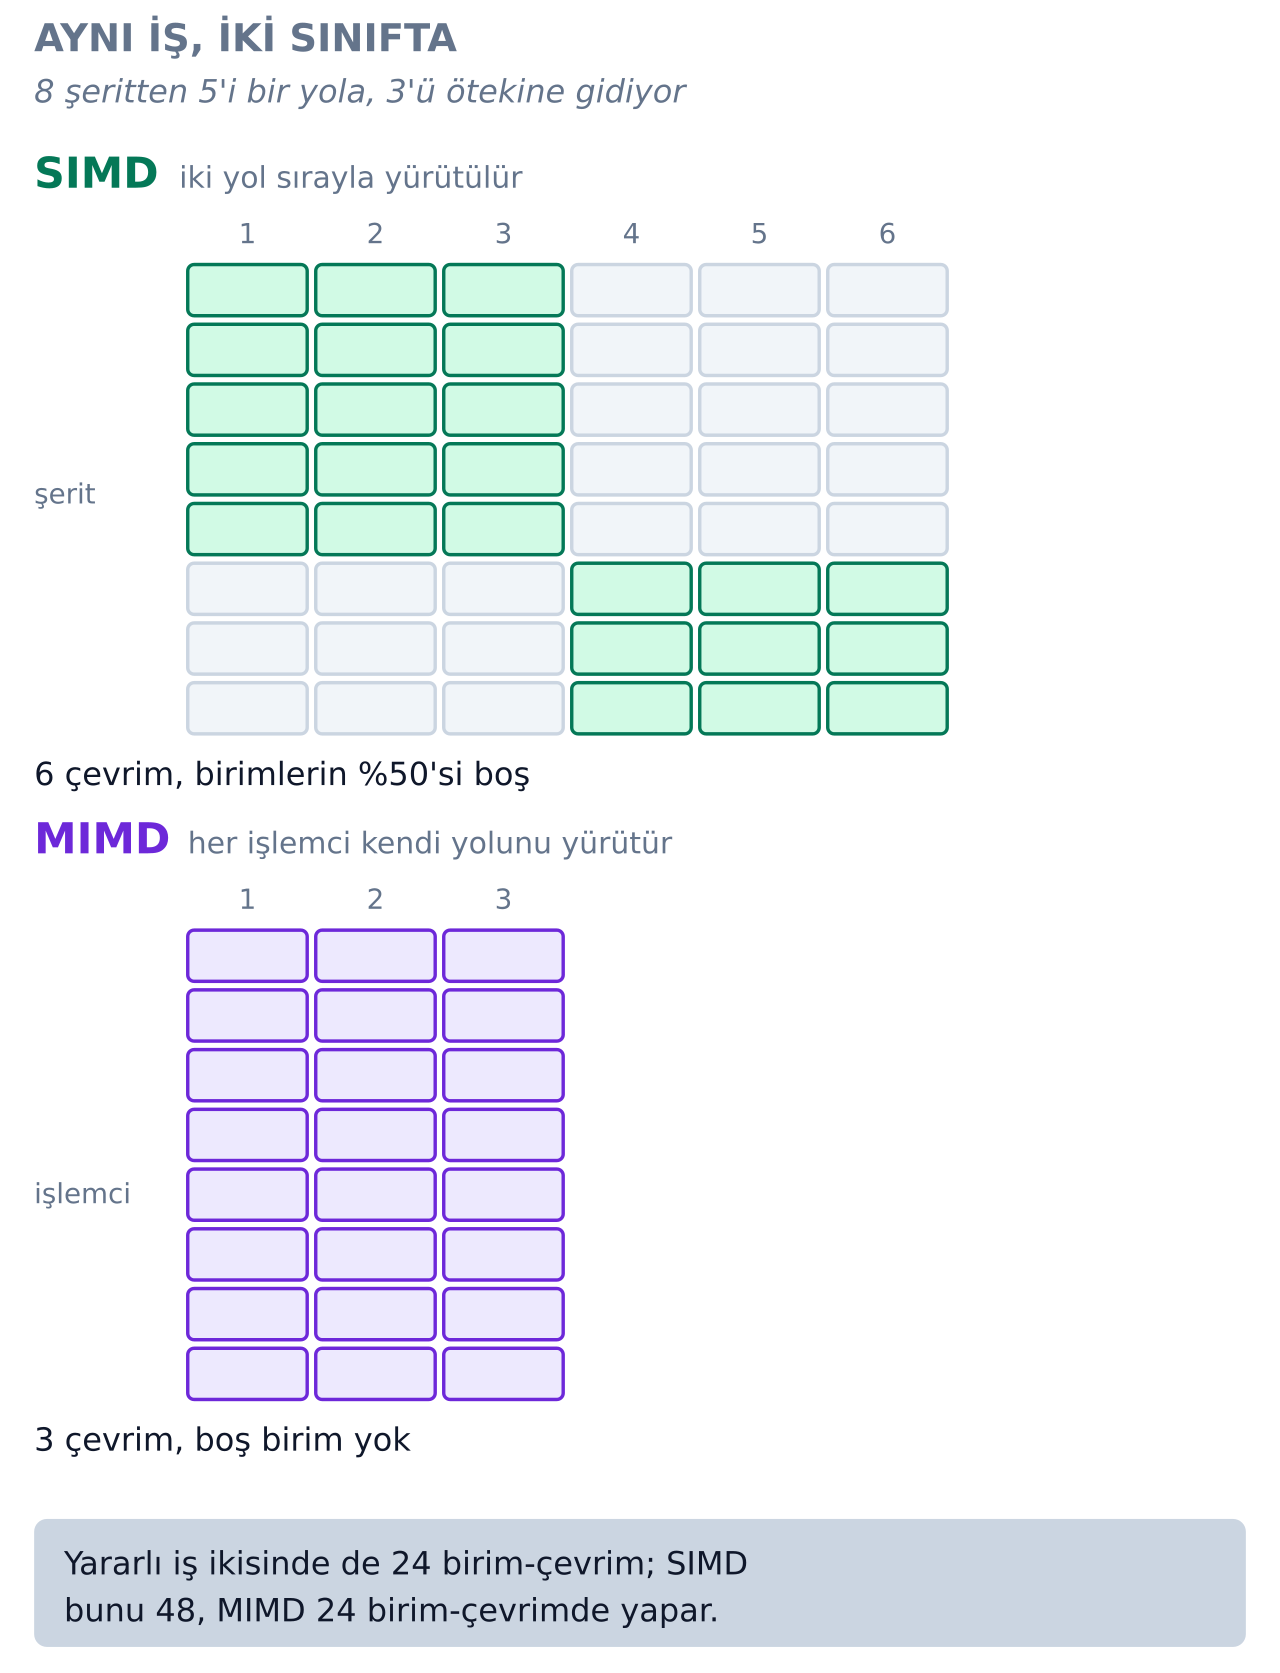
想象一个 warp 里 16 个线程走 if 分支、另外 16 个走 else。硬件手里只有一条指令流,它怎么办?。它把两条路串起来跑两遍:先跑 if 那半,走 else 的线程被掩码(mask)掉;再跑 else 那半,走 if 的线程被掩码。这就是分歧(divergence)。 出处:NVIDIA PTX ISA。
PTX 规范里的表述很直白:
the warp serially executes each branch path taken, disabling threads that are not on that path —— NVIDIA PTX ISA
注意「disabling」这个词。这些线程不是不执行,而是执行了但不生效。它们的 lane 照样占着、照样走流水线,只是结果被丢弃。这是分歧成本的第一层:多跑的那几趟,是纯粹的时间开销。 出处:CUDA Programming Guide · Warps and SIMT(分歧与掩码)。
8.2 重聚:什么时候能合回来
分歧不是永久的。两条分支执行完,硬件需要把 warp 重新合回一条指令流——这个动作叫重聚(reconvergence)。
实现这套机制的经典结构是SIMT 栈。学术综述把它描述得很清楚:
SIMT-Stack… enforce reconvergence at IPDom points… stores the next instruction's PC and the active mask ——《Control Flow Management in Modern GPUs》(arXiv 2407.02944)
两个关键词:IPDom(Immediate Post-Dominator,立即后支配点) 和活跃掩码。重聚发生在「两条分支必然汇合」的那个点上——编译器静态分析出这个点,硬件在进入分支时把「下一条该去哪儿」和「当前哪些 lane 是活的」压进栈里,出来时再弹回来。 出处:Control Flow Management in Modern GPUs(arXiv 2407.02944)。 出处:Benchmarking the cost of thread divergence in CUDA(arXiv)。
这里要标注一条边界:重聚的具体实现(栈的形态、硬件如何选择重聚点)出自研究界与专利文献的描述,厂商并未公开完整细节。本篇只讲机制层面「存在这样一个栈、它在汇合点强制重聚」,不把某一种具体实现当作定论。 出处:Turing Tuning Guide · Independent Thread Scheduling。
8.3 Volta 起:独立线程调度
分歧的故事在 Volta(2017 年)之后有了明显变化。官方的说法是:
the GPU maintains execution state per thread, including a program counter and call stack —— CUDA Programming Guide《SIMT Execution Model》
每个线程维护自己的执行状态,包括程序计数器与调用栈。 这意味着硬件可以做到 sub-warp 粒度的分歧与重聚——不再强制以一个 warp 为单位串行两条分支,而是让不同线程各自推进、需要时再合。 出处:NVIDIA Turing 架构白皮书。
但这次升级带来一个编程侧的代价,必须讲清楚:既然线程可以独立推进,那「同一个 warp 里的线程严格同步」就不再成立了。官方文档专门列了受影响的模式——__shfl* / __any / __all / __ballot 这类 warp 级原语必须换成带 _sync 的版本,还要显式插 __syncwarp()。 出处:TheRealMJP《To Early-Z, or Not To Early-Z》。
换句话说:warp-synchronous 的写法从「事实上成立」变成了「必须显式同步」。 这是本篇里少见的、由硬件升级反向要求软件改写的地方。
8.4 分歧的代价结构
把这一章收成一笔账。分歧的成本有两层,而且它们叠加:
| 层级 | 代价 | 与什么相关 |
|---|---|---|
| 多趟执行 | 两条分支串行跑,总时间翻倍 | 分支路径数 |
| 掩码浪费 | 每趟里有 lane 空转 | 分支的「倾斜程度」 |
第二层特别值得留意:它和一个均匀分配的分支完全不同。如果 32 个 lane 里有 16 个走 A、16 个走 B,那两趟各浪费一半,合计效率 50%;但如果 31 个走 A、1 个走 B,两趟下来仍然是 50% 的 lane 利用率。那个落单的线程,拖累了整个 warp。 出处:GPU Performance for Game Artists(80.lv)。 出处:CUDA Programming Guide · Programming Model。
这解释了为什么「按 lane 连续分组」的写法在 GPU 上特别重要:同一个 warp 里的线程访问模式越一致,分歧与掩码浪费就越少。 这条建议在上一篇讲合并访存时出现过一次,在这里以另一种机制再次出现。它们其实是同一个道理的两个侧面。
真实着色器里的分歧形态,比教科书上的 if-else 更琐碎也更值得留意:
- 边缘像素的 helper invocation:quad 里没被三角形覆盖的那些像素,走的是同一条 shader,但被标记为 helper(见第十章)。
- 材质分支:按材质类型分派到不同着色路径。一个 warp 里混着两三种材质时,代价就是把这几种路径全部走一遍。
- 循环退出条件:循环次数不一致的线程,会让还在循环内的 lane 陪着已经退出的 lane 一起走。
- 纹理采样的 LOD 分支:Mipmap 层级不同导致的访存路径分叉。
最后一类尤其值得记住,因为它是图形负载特有的。几何边缘天然带来分歧,这也是为什么 AMD 在 RDNA 上给出 Wave32 模式:图形负载的分歧倾向,值得为它专门准备一种更窄的波前。
九、调度的下一层:不只看有没有活干
9.1 从「有活干」到「先干哪个」
好了,我们正式开始。到这里,故事还差最后一块拼图。前八章一直在问「有多少 warp 可发射」,但硬件手里往往同时有好几个 eligible warp——那它选哪个?
最朴素的策略是轮转(Round-Robin),但研究界实测下来,一个叫 GTO(Greedy-Then-Oldest) 的策略表现更好:先在一个 warp 上连续发射直到它停顿,再换到等待最久的那个。 出处:GPGPU-Sim 的 GTO 调度讨论(Accel-Sim 社区)。 出处:Cache-Conscious Wavefront Scheduling(MICRO 2012)。
这个策略的直觉很有意思:「贪心」是为了吃满 ILP(同一个 warp 的独立指令连着发,延迟自然被填掉),「最久优先」是为了公平与延迟隐藏(不让某个 warp 饿死)。它是「ILP 与 TLP 两手都要」的调度侧实现。
9.2 缓存感知:调度器还有一个看不见的目标
GTO 只看 warp 的就绪状态,还有一类研究指出这不够。调度顺序会影响缓存命中率。
代表性工作 CCWS(Cache-Conscious Wavefront Scheduling) 的出发点是这样的:如果放任所有 warp 同时涌向内存,它们的工作集会互相挤掉缓存内容,命中率一掉,延迟立刻上去(这就是下一篇讲纹理采样器时会展开的那条链)。它的做法是主动节流:宁可让一部分 warp 缓一缓,也要保住缓存里的热点数据。 出处:Cache-Conscious Wavefront Scheduling(CACM 全文)。
这段给本篇一个重要的收敛点:调度器的目标不是单一的「别让发射槽空着」,而是「在保住访存效率的前提下别让发射槽空着」。 这就把 ep02 的带宽账与本篇的占用率账真正缝到了一起。两本账在调度器这一个点上交汇。 出处:DUCATI:扩展 GPU 加速系统的 TLB 覆盖(TACO 2019)。
十、这一切对图形意味着什么
下面我们进入这一层。前九章讲的是机制,这一章讲它落在哪。这也是中文写作里基本空白的一层。占用率看起来是纯计算侧的概念,但它直接决定图形阶段的效率。 出处:Wulf & McKee《Hitting the Memory Wall》(SIGARCH 1995)。
10.1 2×2 quad:像素着色的最小单位
第一个事实很硬:像素着色器不是按单个像素调度的,它的最小单位是一个 2×2 的像素方块,叫 quad。 NVIDIA 的官方材料把这件事写得很直接:
8 times 2x2 pixel quads, which is the smallest unit… gl_HelperInvocation —— NVIDIA Developer《Life of a Triangle》
也就是说:哪怕一个三角形只覆盖了 1 个像素,硬件也会为它启动一个完整的 quad。另外 3 个像素是「陪跑」的。这些陪跑的像素在 shader 里可以看到自己的处境(gl_HelperInvocation / SV_IsHelper),但它们的结果会被丢弃。 出处:NVIDIA Developer《Life of a Triangle》。
10.2 quad overshading:边缘的浪费
这个机制的直接后果叫 quad overshading(quad 过度着色):三角形的边缘像素所在的 quad,如果只有一部分被三角形覆盖,整个 quad 仍要完整执行。 出处:Stanford CS248A L19 · Parallelizing and Optimizing Rasterization。
浪费的比例是可以估的:一个 quad 有 4 个像素,边缘上的 quad 往往只有 1–2 个真正被覆盖。也就是说 50%–75% 的着色量花在了不输出的像素上。而且这个浪费与三角形的大小直接相关:三角形越小,边缘占的比例越大,浪费越严重。 出处:Roofline:一个直观的性能模型(CACM 2009)。
这个浪费是可以自己量出来的,而且方法不难:把像素着色器的输出与「实际可见像素」做对比。 只要在 shader 里判断 helper invocation 的比例、或者用工具统计「着色器调用数 ÷ 实际覆盖的像素数」,就能得到一个比值。这个比值就是 quad overshading 的直接度量。
它给优化指了一个方向:当这个比值很高时,减少四边形数量的收益,会比优化单个像素着色器更大。而减少四边形数量的手段是几何侧的。合理的 LOD、减少过密的细分、以及在几何前端就把不可见的图元剔掉。
10.3 微小三角形:几何密度与着色效率的冲突
这就把话题引到了微小三角形(tiny triangles)。当场景的几何密度极高(细分、LOD 细密、或者远处的密集网格),屏幕上会塞进大量只有几个像素甚至不到一个像素的三角形。这时: 出处:Fabian Giesen · Part 8(helper pixel 与 quad)。
- 每个三角形都要启动 quad,于是 quad 数量随三角形数量线性上升;
- 每个 quad 的有效像素却越来越少,浪费比例越来越高;
- 结果:着色器的执行次数与实际像素数严重脱节。
10.4 与本系列的接点
这一章的意义在于:它把「占用率」从一个计算指标,变成了一个图形指标的输入。 三处具体的接点:
第一,接 ep02。 quad 变多意味着着色器执行次数变多,而每一次执行都要访存、都要吃带宽。这里的浪费最终是以显存带宽的形式支付的。
第二,接 ep07。 early-Z 能省掉被遮挡像素的着色器调用,但它省不掉 quad 粒度:一个只被覆盖了 1/4 的 quad,即使 3 个像素最终被剔除,early-Z 也只能救回它们在着色之前的那部分。所以 early-Z 的收益上限,是被 quad 粒度卡住的。 出处:Microsoft Learn · Output Merger Stage。
第三,接本篇。 当有效着色比例低时,shader 的执行时长被浪费在无效像素上,而这部分执行会实实在在占用 warp 槽、占用发射带宽。它让占用率这个数字变得「虚高」:看起来 warp 都在忙,实际有效产出却少。 出处:CUDA C++ Best Practices Guide(占用率与吞吐的关系)。
十一、三厂商对照与测量
11.1 同概念的三种切法
OK,言归正传。前三章一直在三家之间来回跳,这里把映射关系一次钉死。
| 概念 | NVIDIA | AMD | Intel |
|---|---|---|---|
| 执行单元簇 | SM | CU(RDNA3 起以 WGP 为调度单位,含 2 个 CU) | Xe-core |
| 线程束粒度 | warp = 32 | wavefront:Instinct 64 / Radeon 32 | —— |
| 向量执行宽度 | 每分区 32 lane | 16-wide × 4 条 VALU | 16 个 vector engine |
| 寄存器归属 | 每线程(上限 255) | 每 wavefront × 每 lane(VGPR 0–256) | —— |
| 占用率分母 | 每 SM 最大 warp(32/48/64) | 每 SIMD 的 wave 槽(16 或 20) | —— |
这张表最该注意的还是最后一行:三家的「占用率」分母根本不在一个层级上。 所以跨厂商比占用率数字是无意义的。要比就比「能同时驻留多少线程」这个绝对量,它至少是同一把尺子。 出处:Intel · oneAPI GPU Optimization Guide(Xe Architecture)。 出处:ROCm · GPU hardware specifications(逐卡硬件表)。
11.2 两边各自该看什么
测量这一层,两家给的抓手不一样,但指向同一件事。
NVIDIA 侧看的是四级口径的分布:Theoretical / Active / Eligible / Issued warp 各是多少,以及 warp 的停顿原因分布。最关键的一对是 Active 与 Eligible 的比值。如果 active 很多、eligible 很少,说明 warp 都在等(多半在等访存),增加占用率没用。 出处:NVIDIA Nsight Compute · Profiling Guide(Occupancy 小节)。 出处:NVIDIA Nsight Graphics · User Guide。
AMD 侧看的是四类资源的「不足」计数器和在飞 wave 数。官方给了一组很直白的定义:
| 计数器 | 含义 |
|---|---|
SQ_LEVEL_WAVES |
在飞 wave 数(当前驻留多少) |
SPI_RA_WAVE_SIMD_FULL_CSN |
有多少个 SIMD 周期是被 wave 槽不足卡住的 |
SPI_RA_VGPR_SIMD_FULL_CSN |
被 VGPR 不足卡住的 |
SPI_RA_LDS_CU_FULL_CSN |
被 共享内存不足卡住的 |
这套计数器的价值在于它直接给出归因:如果 SPI_RA_VGPR_SIMD_FULL_CSN 很高,那就是寄存器在卡人,降寄存器用量或改块大小才有意义;如果它很低而 SQ_LEVEL_WAVES 也不低,那问题根本不在占用率上,去查停顿原因。 出处:AMD《RDNA Performance Guide》(占用率在优化链上的位置)。
需要提醒一点:三家的计数器名字不同、口径也不完全一致,但它们回答的是同一组问题——「有多少可发射的」「没发射是因为什么」。所以真正的技能不是记住计数器的名字,而是建立一张「现象 → 该问哪个问题 → 该看哪类计数」的映射。这张映射在上一节已经给出,它比任何一份计数器清单都更耐用。
11.3 一次完整的诊断流程
把前面几章串成一条可执行的流程。遇到「性能不达预期」时,顺序应该是这样:
第一步,先确认是不是占用率的问题。 看 Theoretical 与 Active 的差距——差距大说明资源卡住了,差距小说明资源够用、问题在别处。这一步能挡掉大量「无脑调占用率」的尝试。 出处:GPUOpen · Radeon GPU Profiler(工具本体)。
第二步,如果是资源卡住,看是哪一项。 用 11.2 的计数器或限制项视图,定位到槽位 / 寄存器 / 共享内存三者中的一个。 出处:NVIDIA Nsight Systems · User Guide。
第三步,如果不是占用率的问题,看 eligible。 Active 高而 Eligible 低,说明 warp 在等——多半是长延迟访存(回 ep02 查命中率)或者依赖链太长(回 §7 补 ILP)。 出处:AMD GPUOpen《Occupancy explained》(theoretical vs measured)。
第四步,才轮到动手。 调块大小、调寄存器上限、改访问模式、或者重排指令补 ILP。
11.4 三个最常见的误判
最后把本篇反复出现的三个错误集中列一遍,它们几乎覆盖了中文写作里关于占用率的全部误传: 出处:Intel · Graphics Performance Analyzers 总览。
| 误判 | 实际 | 依据 |
|---|---|---|
| 「占用率越高越好」 | 低一定不好,高不一定好;追过饱和点就是浪费寄存器 | Nsight 官方口径;§7.4 饱和点 |
| 「GPU Util 100% 就是打满了」 | 占用率只是驻留比值,还要看 eligible;被内存烫住的 warp 也是「占着」的 | §6.1 四级口径 |
| 「占用率跨代可以直接比」 | 上限逐代不同(Turing 32 vs Hopper 64),同一百分比对应完全不同的 warp 数 | §4.2 逐代表 |
第三条最容易被忽略,也最容易造成错误结论:在 Turing 上调到 100% 占用率,也就是 32 个 warp;在 Hopper 上这只是 50%。如果你拿两代硬件上「都是 100% 占用率」的运行结果做对比,你其实在比较两个完全不同的负载配置。 出处:Intel · Graphics Performance Analyzers 用户指南 2024.3。
还有一类更容易犯的错误,来自「占用率」与「利用率」的混用。这两个词在中文里常常被当成同义词,但硬件口径完全不同:占用率是「驻留了多少」,利用率通常指「发射了多少个周期」。一个 100% 占用率的 SM 完全可能只有 20% 的发射利用率(如果 warp 都在等访存)。
把这两个数字分开说、分开量,是本篇最想留下的一个习惯。
十二、这一篇留下的问题:交棒 ep04
下面我们开始这一节。把本篇的账收一下,然后交给下一篇。
12.1 三个结论
第一,显存延迟是物理给定,对策只有一个方向——把它藏起来。 而藏它的物理前提是零开销的上下文切换:所有 warp 的上下文常驻片上,所以「换一个线程接着干」不花钱。这是整篇的地基,也是 CPU 与 GPU 在延迟哲学上最根本的分野。 出处:NVIDIA Ampere GA102 GPU 架构白皮书。
第二,占用率是一个比值,不是目标。 它的分母逐代在变(NVIDIA 32/48/64、AMD 16 或 20 个槽),它的上界与实测值之间有三次折损(分配粒度、块整体发放、尾部效应),它被三类资源卡住(槽位、寄存器、共享内存)。追到延迟能被填满就该停手。 出处:Tuning CUDA Applications for Blackwell(与 Hopper 的上限一致性)。
第三,装得多不等于发得出。 占用率量的是 active warp,性能取决于 eligible warp。这两级之间隔着「访存等待」这条几百纳秒宽的沟。而这正是 ep02 那堵墙在本篇的回声。 出处:Dissecting the NVIDIA Blackwell Architecture with Microbenchmarks(arXiv)。
12.2 交棒:为什么下一篇更贵
下一篇要讲纹理采样器,而它在本系列里有个特殊的地位:它是整条管线里代价最高的单点之一。
原因不复杂。纹理采样要处理 LOD 计算、各向异性过滤、寻址模式、多级过滤——这些步骤串起来构成一条几百级深的流水线。而它深度大的理由,和我们这一篇讲的是同一件事:它也在用并行度去填延迟。 出处:Fabian Giesen · Part 4:Texture samplers。
也就是说,纹理采样器和着色器核解决的是同一类问题——只是前者填的是「滤波链的延迟」,后者填的是「线程的等待」。 理解了本篇的占用率与延迟隐藏,下一篇那条几百级的流水线就不会显得神秘:它只是把同一套思路,用在了另一条链上。 出处:Vulkan 规范 · Samplers。
十三、收尾
13.1 参考资料与可回溯出处
好了,接着往下看。本篇的关键数字全部来自厂商官方文档与规范,正文中的引用可直接回溯到出处。主要来源:
NVIDIA CUDA Programming Guide、
Turing 调优指南、
GPUOpen《Occupancy explained》、
ROCm《Hardware implementation》、
ROCm MI100 微架构、
AMD RDNA3 ISA 参考指南、
Nsight Compute Profiling Guide。
完整来源清单见阶段产物的 citations.json。
13.2 下篇预告
《GPU 架构剖析》系列进度:已完成【一】命令前端、【二】显存与地址空间、【三】着色器核。 下一篇《纹理采样器:一条几百级的流水线》,回答本篇留下的那个追问。同一套「用并行填延迟」的思路,在一条几百级的滤波链上是怎么落地的。 出处:Vulkan 规范 · Image Sampling(LOD 与 texel 坐标)。 出处:Fabian Giesen · Part 10:Geometry Shaders。
13.3 结语
写完这一篇,最想留下的是那句反直觉的话:占用率不是越高越好,它只是达成延迟隐藏的手段。
硬件给的是一条曲线而不是一个刻度。低了一定不好,高了未必有用,而最优点取决于你的指令依赖结构与访存模式,只能测、不能猜。 下一篇我们会看到,纹理采样器把同一件事做到极致:用几百级的流水线深度,换取每一级都能并行填满。 下篇再见。 出处:Fabian Giesen 系列索引(CC0 声明)。 出处:NVIDIA 架构速览 · Ada / Hopper / Blackwell 对照。
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在硅片到像素之间,继续挖下去。