本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
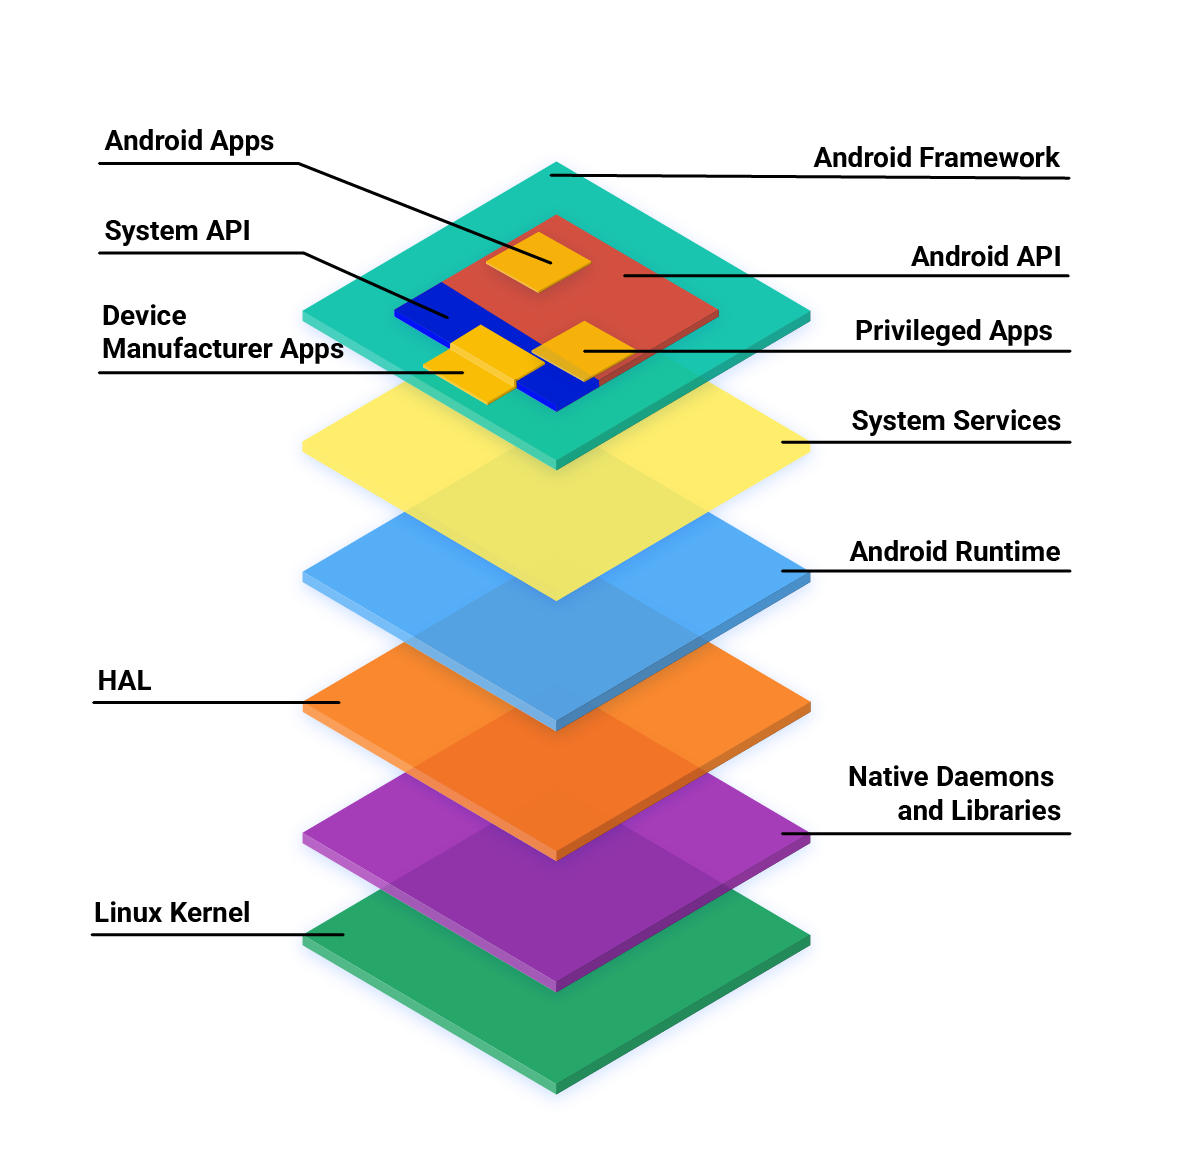
核心问题:一篇讲滑动卡顿的文章,如果只告诉你"渲染慢",那它没有回答任何问题。因为"渲染慢"至少是两件不同的事:UI 线程在等渲染线程交活,还是渲染线程在等一块可用的缓冲?
这两件事的成因相反、判据不同、修法也不同。前者多半是 UI 线程自己慢(或者被位图上传卡住),后者多半是 GPU 与合成侧消费不及时、空闲缓冲放不回来。中文侧的多数文章把它们合成一句"渲染慢"就收尾了,于是读者读完之后,仍然不知道该查哪一步。
这一篇把它们拆开,并且用本机实测的两组新读数把它量出来:一是逐帧的缓冲耗时四列,二是 Perfetto 上的双线程轨。
承接上一篇。ep02 讲的是谁把应用叫醒——一条从显示控制器到五档回调的"叫醒链",以及订阅为什么是一次性的。那是在讲"什么时候开始干活"。本篇讲的是醒来之后:UI 线程记录了什么、怎么把活交给另一个线程、渲染线程又从哪里拿到一块能画的缓冲。
两篇共用同一条链路,量的东西却完全不同:
| 维度 | ep02(上篇) | ep03(本篇) |
|---|---|---|
| 关心的对象 | 唤醒:节拍打在谁身上 | 交接:活与缓冲怎么交出去 |
| 量什么 | 订阅状态——枚举取值、连接条数 | 缓冲与时间——dequeue 耗时、GPU 执行时长、帧余量 |
| 主要命令 | dumpsys SurfaceFlinger 的连接段 |
gfxinfo framestats 的缓冲四列 + Perfetto 双线程轨 |
| 典型结论 | 静止时没有一条连接处于周期订阅 | dequeueBuffer 是中位瞬时、尾部几十毫秒的双峰 |
本篇也不涉及:渲染算法与画面技术(《实时渲染管线探析》《实时光线追踪与混合渲染》已写)、GPU 内部管线与硬件实现(《GPU 架构剖析》已写)、移动端功耗与带宽取舍(《移动端图形与功耗》已写)、Skia 内部的光栅化实现(《2D 矢量引擎深挖》已写)、BufferQueue 的四态迁移与队列深度(ep04 展开)、HWC 的叠加层决策(ep08 展开)、抓帧工具自身的设计原理(《图形性能剖析工具链》已写)。为什么不涉及:这些题域各有专门的篇目,混进来会让"交接"这个很窄的问题重新糊成一团——尤其 BufferQueue 的四态,本篇只从渲染线程视角看一次 dequeue/queue,四态迁移留给 ep04。完整边界见 §0.3。
系列文章写作风格说明(沿用前两篇,不再重复解释)
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、本机跑出来是什么——这三层分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、采样窗口);
- 实测优先:能用命令量出来的就不引用别人的结论;
- 模拟器与真机分开写:模拟器拿不到的东西(帧级时间线、自适应刷新率)如实标"需真机",绝不写成 Android 通例。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交(本篇)
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank
相关资源链接
- 官方一手来源:硬件加速 | 硬件加速(Views 版,含绘制模型) | Android 5.0 版本介绍 | 呈现速度缓慢
- 提交侧:BufferQueue 与 Gralloc | SurfaceFlinger 与 WindowManager | systrace(界面管道)
- 源码入口:
RenderThread.cpp|DrawFrameTask.cpp|CanvasContext.cpp|BLASTBufferQueue.cpp - 与本文强绑定的前置:ep01《总览》| ep02《Choreographer:谁在召唤 Vsync》
这一篇回答什么,不回答什么
OK,先把坐标系挪正。前两篇给了一张地图和一跟链条,这一篇要给的是一次交接:一个线程把手里的活交出去,另一个线程接过去,然后从某个地方拿到一块能画的缓冲。
0.0 内容总览:本篇知识地图
好了,先把十章各自回答的问题钉在一张表上。它同时也是本篇的目录总览,后面每一章都在展开其中的某一行。如果时间紧,第五章(缓冲从哪来)与第七章(实测:卡在哪一端)是这篇最不可替代的两章——前者讲清了那个最容易被误判的等待点,后者把"卡在哪一端"变成了可读的数。
| 章 | 回答的问题 | 关键结论 |
|---|---|---|
| 零 | 这一篇在整条链上补哪一段 | 交接链有四步:记录 → 交接 → 执行 → 出缓冲 |
| 一 | 为什么要有 RenderThread | 三个里程碑必须分开:硬件加速 2011、显示列表 4.x、独立线程 2014 |
| 二 | UI 线程到底干了什么 | 记录与重录:它产的是显示列表,不是像素 |
| 三 | 交接怎么发生 | postAndWait 是同步点,但"放开"要过 canUnblockUiThread |
| 四 | 渲染线程醒来后做什么 | 四个阶段,最后只做一件事:把命令发出去 |
| 五 | 缓冲从哪来 | dequeueBuffer 是中位瞬时、尾部几十毫秒的双峰 |
| 六 | 缓冲怎么送出去 | BLAST 把缓冲与图层属性一起提交,避免两次上屏不一致 |
| 七 | 实测:卡在 UI 线程还是卡在缓冲 | 两个等待点的判据完全不同,本机读到最大值 70.5% 的占比 |
| 八 | 四个最常见的误用与误解 | 其中一个是"把应用线程当成系统线程" |
| 九 | 三项可以立刻做的事 | 每条都给出命令与判定阈值 |
0.1 那条交接链:从显示列表到一块缓冲
OK,先看一段交接。它的起点是 UI 线程手里的一棵显示列表树,终点是一块被交给了合成侧、可以被扫到屏幕上的缓冲。中间有四步。
第一步,记录。 UI 线程不画像素,它把"这个界面该画成什么样"记成一棵树的显示列表(DisplayList),每个节点是一个 RenderNode(渲染节点)。这一步的产物是数据,不是图像。
第二步,交接。 UI 线程把"这一帧的记录"交给渲染线程,然后在需要它的时候等一等。注意"需要的时候"这四个字——交接不是无条件的同步,什么时候必须等,是第三章的正题。
第三步,执行。 渲染线程醒来,把显示列表变成真正的绘制命令,交给 GPU。它需要一块能往上画的缓冲(buffer),而这块缓冲不是随时都有的。
第四步,出缓冲。 画完把缓冲交出去(queueBuffer),让合成侧去取。到这里,一次交接完成。
言归正传,这四步里,有两个等待点,而且它们是本篇的核心。一个是第二步里 UI 线程的等(等渲染线程把活领走或干完),另一个是第三步里渲染线程的等(等一块可用的缓冲)。中文侧通常把它们合成一句"渲染慢",但它们的成因是相反的。
0.2 本篇与前两篇的分工
好了,三篇共用同一条链路,如果量的是同一批数字,那就不是三篇而是重复。所以把分工说清。
| 维度 | ep01《总览》 | ep02《Choreographer》 | ep03(本篇) |
|---|---|---|---|
| 关心的对象 | 六步生命周期与相位 | 唤醒:节拍打在谁身上 | 交接:活与缓冲怎么交出去 |
| 量什么 | 时长——相位偏移多少纳秒 | 状态——枚举取值、连接条数 | 时间与占比——dequeue 耗时、GPU 执行、帧余量 |
| 主要命令 | dumpsys SurfaceFlinger 的 DispSync 段 |
SurfaceFlinger 连接段 + gfxinfo |
gfxinfo framestats 缓冲四列 + Perfetto 双线程轨 |
| 结论形态 | 唤醒点被历史统计推早了多少 | 静止时没有周期订阅 | dequeueBuffer 的双峰与最高 70.5% 的占比 |
一句话概括:ep01 量"几点几分",ep02 量"谁在等这个点钟",本篇量"等的时候各花了多久"。
OK,下面这张表还有一层用处:它划定了本篇的范围。ep02 里已经讲透的东西——订阅的一次性、VSyncRequest 的枚举、五档回调的顺序——本篇一句都不重复。 本篇要补的是"醒来之后"的那一段。所以读本篇时如果觉得少了什么,先回头翻 ep02 的第五章;反过来,读 ep02 时如果觉得"知道谁被叫醒了,但还是不知道被叫醒之后忙了些什么",那正是本篇要接上的一段。两篇配合起来,才构成"被叫醒 → 去干活"的完整链条。
0.3 本文不涉及什么,为什么
本文不涉及:渲染算法与画面技术(延迟着色、阴影、光追混合等,已在《实时渲染管线探析》与《实时光线追踪与混合渲染》写透);GPU 内部管线与硬件实现(《GPU 架构剖析》写透);移动端功耗与带宽取舍(《移动端图形与功耗》写透);Skia 内部的光栅化实现与贝塞尔曲线处理(《2D 矢量引擎深挖》写透);BufferQueue 的四态迁移、队列深度与 slot 数组(ep04 展开);HWC 的叠加层决策与合成模式(ep08 展开);Vulkan 后端路径(ep05 展开);抓帧工具自身的设计原理(《图形性能剖析工具链》写透);厂商对渲染线程与合成过程的私有改造(未公开,如实标注)。
为什么不涉及:这九类问题各有专门的约束条件,混进来会让"交接"这个很窄的问题重新糊成一团。特别是BufferQueue 的四态那一条——本篇确实会讲 dequeueBuffer,但只讲从渲染线程视角看它在等什么,不讲四态怎么迁移、队列多深、slot 怎么分配。那三件事是 ep04 的正题。
好了,还有一处边界要提前说明:本篇讲的是 AOSP 通用链路。 厂商可以在渲染线程之上加自己的调度策略,也可以替换合成路径。这类改动没有公开文档,本篇一律不推测,只在必要处标注"这一段属厂商私有,未公开"。
0.4 本文的读数从哪来
OK,本篇所有真图都是本机实测。它同时也是这条交接链在软件侧能被观测到的全部入口——四类读数,三条命令,没有一项需要 root。
| 项 | 取值 | 获取方式 |
|---|---|---|
| Android 版本 / API | Android 16 / API 36 | getprop ro.build.version.release / ro.build.version.sdk |
| 渲染后端 | Pipeline=Skia (OpenGL) |
adb shell dumpsys gfxinfo <pkg> 包级段 |
| 缓冲四列(逐帧) | DequeueBufferDuration / QueueBufferDuration / GpuCompleted / CommandSubmissionCompleted |
adb shell dumpsys gfxinfo <pkg> framestats |
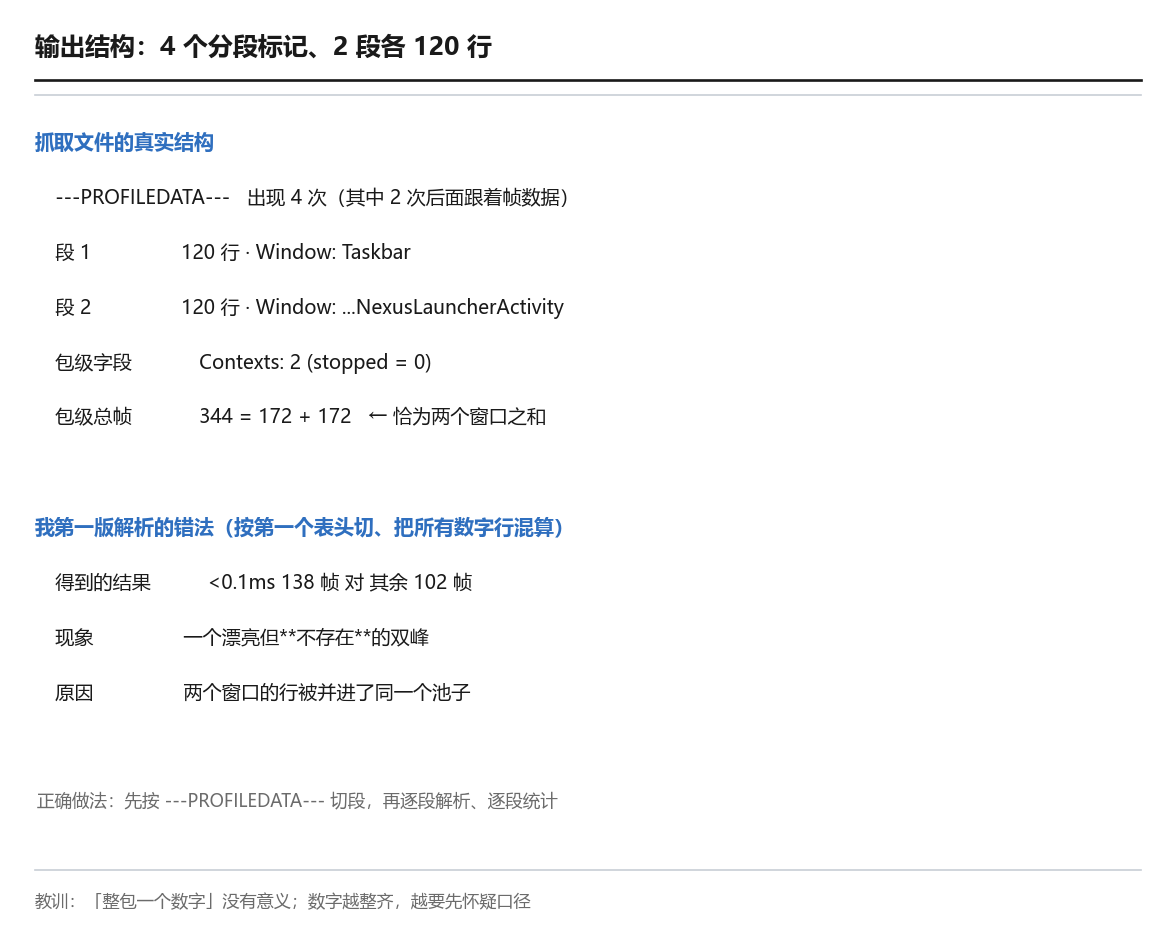
| 分段结构 | 4 个 ---PROFILEDATA--- 标记、2 段各 120 行;包级 Contexts: 2 |
同上(这是解析陷阱,见 §7.1) |
| 包级汇总 | 344 帧 / janky 227(65.99%)/ Slow UI thread 197 / Slow bitmap uploads 1 |
adb shell dumpsys gfxinfo <pkg> |
| 双线程轨 | 3,327,074 字节 trace,RenderThread ×135、dequeueBuffer ×287 |
perfetto --txt -c <cfg>(类别 gfx / view / sched / freq) |
| BLAST 事务 | BLAST ×1420、Transaction ×1936、setBuffer ×284 |
同上 |
| 被测应用 | com.google.android.apps.nexuslauncher |
系统桌面 + 任务栏,两个窗口各有一段 profile |
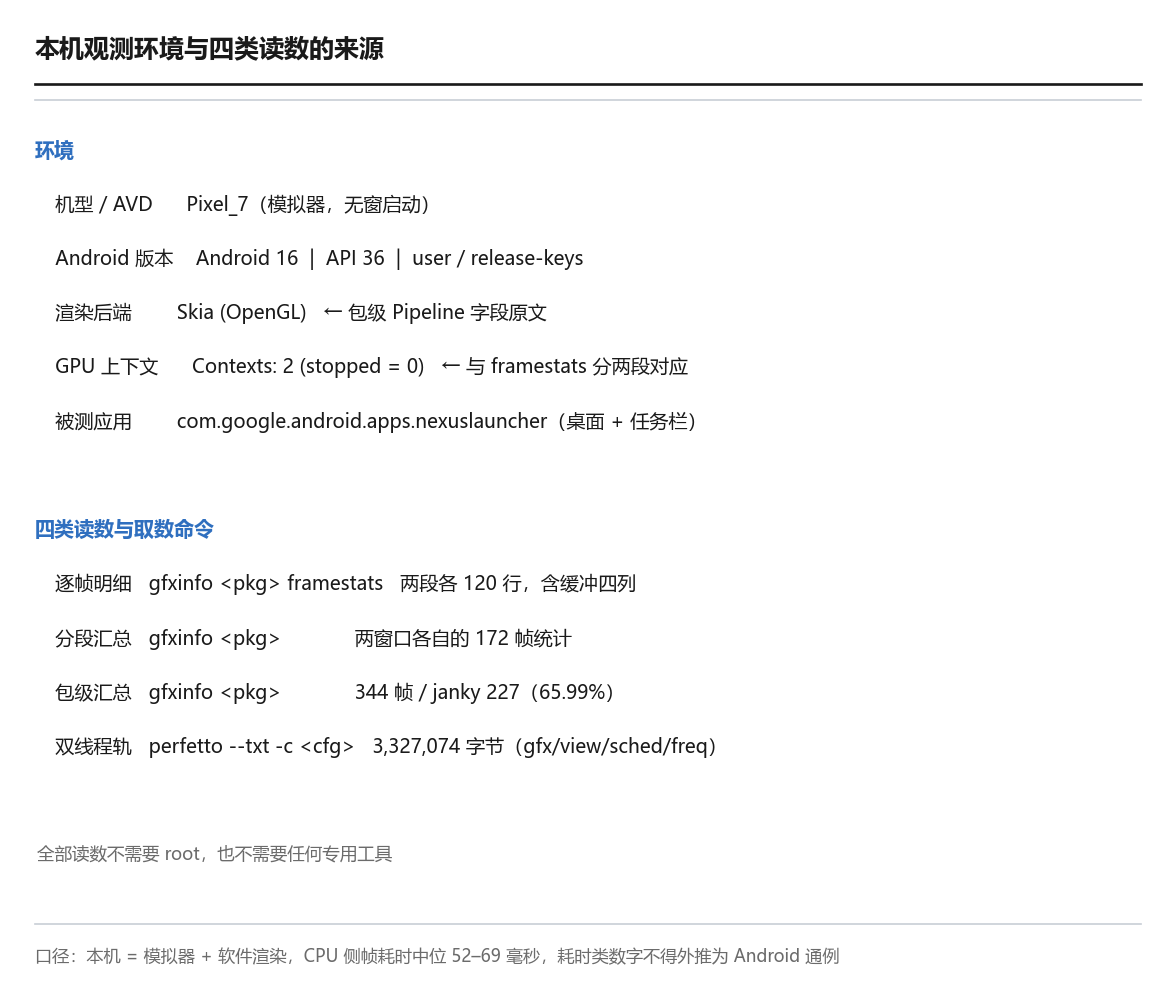
好了,两张必须提前说明的表外条件。第一,本机是模拟器(Pixel_7 AVD),渲染走 SwiftShader 软件光栅化,所以 CPU 侧帧耗时(中位 52–69 毫秒)远高于真机——本篇所有耗时类数字都标"本机 = 模拟器 + 软件渲染",不得当作 Android 通例。第二,包级那段汇总里出现过一个量级异常的读数(90th gpu percentile: 4950ms,与它自己的 50 分位 14–24 毫秒差两个数量级),疑为超时占位值,本篇引用它会明确标注、不据此下结论。
依然是国际惯例,再说两句本篇的图从哪来。11 张真图全部由上面那三条命令产出,脚本可复跑;2 张外部图来自 Wikimedia Commons 的类目枚举与关键词检索(Category:Android architecture 与关键词 triple buffering),检索留痕见 Commons 类目 API 与 关键词检索 API。其余 15 张是自绘结构图,因为 Commons 上没有任何 RenderThread / DrawFrameTask / BLAST 的对位图(下面第二章会给出检索结论)。
一、为什么要有 RenderThread
一.1 官方那句话,逐词拆
OK,关于 RenderThread 的由来,官方最直接的表述来自 Android 5.0 版本介绍页(原文原意):
系统管理的新处理线程(称为 RenderThread)可确保动画流畅,即使主界面线程出现延迟也不例外。
好了,这句话是"为什么要有它"最权威的答案,但四个短语里藏了四个判断,我们一个一个拆。在拆之前先给一个定义:本系列说的「渲染线程」,指的就是官方那句话里那条由系统管理的处理线程——它在 trace 上的名字是 RenderThread。后文一律用这个名字,不再换称。
"系统管理的新处理线程"——它是一个由框架创建与管理的线程,不是应用自己起的。 这句话划清了责任:应用不需要(也不能)自己创建它,但应用的每一次绘制都会用到它。
"处理线程"——它处理的是"记录",不是"画面"。 它拿到的是 UI 线程产出的显示列表,不是像素。这个区分在第 0.1 节已经给过,但它的重要性在这里才显出来:因为它处理的是记录,所以它可以和 UI 线程并行——UI 线程在继续记录下一帧时,它可以同时在把上一帧的记录变成命令。
"即使主界面线程出现延迟也不例外"——这才是它存在的全部理由。 在 Android 5.0 之前,主线程自己就是那个执行绘制命令的线程。这带来一个直接的后果:主线程上任何一次抖动,都会直接变成掉帧——哪怕抖动的来源跟绘制毫无关系(比如一次 JSON 解析、一次数据库查询)。把执行搬出去之后,UI 线程的抖动与输出帧之间不再是一一对应的关系。
"确保动画流畅"——它保障的是"动画",不是"这一帧一定会准时"。 这是一个很精细的措辞:搬走执行能让你在 UI 线程抖动时仍有帧输出,但不能让一个本就画不完的界面变快。RenderThread 解决的是"被别人拖累",不是"自己太慢"。
一.2 三个里程碑必须分开
这是本篇的第一处纠正,也是中文写法里最集中、最整齐的一处错配:把"硬件加速引入"当成"RenderThread 引入"。
它们是三个不同年份的里程碑,解决的问题完全不同:
| 里程碑 | 版本 / API | 年份 | 解决了什么 | 官方出处 |
|---|---|---|---|---|
| 硬件加速绘制 | Android 3.0 / API 11 | 2011 | 让绘制从 CPU 光栅化转向 GPU:记录显示列表,由 GPU 光栅化 | 硬件加速(Views 版) |
显示列表 / RenderNode 体系 |
Android 4.x 逐步成型 | 2011–2013 | 把"界面该画成什么样"固化成可复用、可局部重录的数据结构 | 同上页的"绘制模型"一节 |
| 独立渲染线程 | Android 5.0 / API 21 | 2014 | 把绘制命令的执行从 UI 线程搬走,让 UI 线程的抖动不再直接等于掉帧 | Android 5.0 版本介绍 |
错在哪。 2011 年那一步解决的是"怎么画得快"——把光栅化交给 GPU;2014 年那一步解决的是"画的时候别人能不能干别的"——把执行从 UI 线程搬走。它们回答的是两个不同的问题,只是都发生在"渲染"这条线上,所以很容易被并成一句"Android 从某个版本开始用 RenderThread 渲染"。
这处错配的后果不是学术性的。 如果你以为 RenderThread 是 2011 年就有的,那么在面对一台 Android 4.x 的老设备时,你会用一套不存在的并行假设去推测它的行为——而那个版本上,UI 线程就是绘制线程,两者是同一个东西。
好了,这个年份口径在中文侧有两条可交叉的来源:《Android 之旅(总结)》 与 《自上而下解读 Android 显示流程》 都写到"Android 5.0 之前主线程同时也是那个执行绘制命令的线程,引入渲染线程之后才分工",与官方版本页口径一致。另有一篇用一句话把分工概括得很干净(《Android 图形渲染框架》):UI 线程只生成显示列表,由渲染线程转成 GPU 指令。 三处互相独立、结论一致,可以放心引用。
OK,至于类名本身,还有一个容易忽略的细节:Java 侧的门面类历经改名(ThreadedRenderer → HardwareRenderer),改名的具体版本待核实(HardwareRenderer 参考页 本轮抓取只返回导航壳、未取到正文)。本篇统一用 trace 上的线程名 RenderThread 指代这条线程,首次出现处给类名,避免在文档与代码之间来回换算。
一.3 交接为什么能成立
好了,到这里可以给这一章收尾了:RenderThread 把执行从 UI 线程搬走,让记录的抖动与输出的帧解耦;而它能被搬走的前提,是记录与执行之间有一份只读的数据结构。
OK,但这里还留着一个没回答的问题:既然执行能搬到另一个线程,为什么记录不一起搬过去?答案在接口层,不在实现层——它是下一章的正题。
二、UI 线程到底干了什么:记录与重录
2.1 记录的那棵树长什么样
好了,先看清"记录"到底是什么。UI 线程在遍历阶段调用 View#draw,而硬件加速模式下 draw 做的事是往 RenderNode 里录指令,不是画像素。
//-----------------------------------【显示列表的记录(硬件加速模式)】-----------------------------------
// 文件:frameworks/base/core/java/android/view/ThreadedRenderer.java
//       frameworks/base/core/java/android/view/View.java
// 说明:硬件加速下 View#draw 不产生像素,只往 RenderNode 里追加绘制指令
//--------------------------------------------------------------------------------------------------------
// 【1】遍历阶段:ViewRootImpl 触发整棵树的重新记录
//      ThreadedRenderer.updateRootDisplayList()  →  updateViewTreeDisplayList()
// 【2】每个 View 把自己的绘制录进自己的 RenderNode
//      View#draw(Canvas) 收到的是一个 RecordingCanvas,不是真实画布
// 【3】整棵树录完,收口
//      ThreadedRenderer.updateRootDisplayList() 末尾调用 endRecording()
// 【4】由此得到一棵以 root RenderNode 为根的显示列表树 —— 它就是交给渲染线程的东西
下面对其中三处特别说明。
RecordingCanvas 是这套设计的关键道具。 它实现了 Canvas 的接口,但每一次 drawLine、drawRect 都不落像素,而是在当前 RenderNode 的显示列表里追加一条指令。所以 View#draw 的代码可以一个字不改地在软件模式与硬件模式之间切换——换掉的只是传进去的那个 Canvas 实现。
endRecording() 是这条记录的收口。 收口之后,这棵树在下次重录前是只读的——这正是它能被安全地交给另一个线程的前提。
每个节点是可以被单独重录的。 一个 View 属性变化时,不需要重录整棵树,只重录它自己与受影响的后代。这是 4.x 那一步"显示列表体系"带来的性能红利,也是它与 2011 年那一步的分工所在。
OK,显示列表的构建过程,中文侧有一篇按 Android 13 源码逐步走的笔记(《【Graphics & SF】【硬件加速】2、DisplayList 构建过程分析》),它把 updateRootDisplayList / updateViewTreeDisplayList / endRecording 的调用顺序交代得比本篇细;另一篇从 View 到 DrawOp 的映射讲得更直观(《Android 渲染 — 重温硬件加速(上)》)。两篇都值得在读完本节后翻一遍——本节只给形状,它们给的是逐行。
2.2 RenderNode 的线程约束:为什么记录必须在 UI 线程
好了,上一个自然的问题:既然执行搬到了另一个线程,为什么记录不一起搬过去?
OK,答案在接口层,不在实现层。官方 RenderNode 类参考 明确:每个节点持有显示列表与属性、默认被所有 View 内部使用,并且非线程安全,必须在同一线程使用。
这条约束看起来是限制,其实是一种分层设计:
- 记录侧与
View树强绑定——View的层级、属性、可见性都在 UI 线程上变,所以记录必须在 UI 线程; - 执行侧只依赖"记录"这份数据,与
View树无关,所以它可以搬到任何线程。
好了,换句话说:跨线程交接的边界,恰好落在"数据结构"与"使用数据结构"之间。 这条边界选得好,是因为它让两侧的耦合降到最低——UI 线程只需要产出一份不变的记录,渲染线程只需要消费它。这也解释了 ep02 里那句"UI 线程只做记录"的说法从何而来。
2.3 重录的触发条件
OK,那么,什么情况下会重录?三条常见路径:
- 属性变化:
View的可见性、透明度、位移、尺寸等变化会标记该节点需要重录; - 内容变化:自绘 View 调用
invalidate(),或在onDraw里改动了录进去的内容; View树结构变化:增删子 View、改变层级,会牵动父节点的录制。
好了,这里有一条实践上很容易被忽略的推论:invalidate() 的代价不是"重画一遍",而是"重录一遍"。 真正的光栅化发生在渲染线程,UI 线程付出的只是记录。这也解释了为什么"少 invalidate"这条优化建议在硬件加速下依然成立——它省的是 UI 线程的记录时间,而不是 GPU 的时间。
OK,顺带估一下重录的量级,因为它是"UI 线程慢"这一支的常见来源之一。本机包级汇总里 Number Slow UI thread 是 197(344 帧中),而 Number Slow issue draw commands 是 147——两者是同一个量级的。这说明在本机这套负载下,UI 线程侧与渲染线程侧的"慢"次数相当,没有哪一侧可以单独背下全部责任。而 Number Slow bitmap uploads 只有 1 次,又一次印证了"位图上传是罕见但存在的那一支"。
这个比例关系可以当作一条粗判据用:如果一侧的计数远高于另一侧,主战场就在那一侧;如果两者相当,就得继续往下分等待点。
到这里,"为什么要有 RenderThread"这件事可以给一个完整的回答了:它把执行从 UI 线程搬走,让记录的抖动与输出的帧解耦;而它能被搬走的前提,是记录与执行之间有一份只读的数据结构——显示列表树。 剩下的问题就变成了:这份数据结构是怎么交过去的?
三、交接怎么发生:一次同步点
3.1 交出去,然后等一等
好了,交接的核心是一个同步调用。UI 线程把显示列表树的根交出去,然后在需要结果的时候停下来等。这条调用链是本篇第一个要给全的东西:
//-----------------------------------【一帧的交接调用链】-----------------------------------
// 文件:frameworks/base/core/java/android/view/ThreadedRenderer.java(Java 侧)
//       frameworks/base/libs/hwui/renderthread/RenderProxy.cpp(native 侧)
//       frameworks/base/libs/hwui/renderthread/DrawFrameTask.cpp(任务与同步)
//------------------------------------------------------------------------------------------
// 【1】遍历阶段的最后一步:Java 侧门面
//      ThreadedRenderer.draw(...)  →  syncAndDrawFrame(frameTimeNanos)
// 【2】桥到 native:把根 RenderNode 交给渲染线程的代理
//      RenderProxy::syncAndDrawFrame(...)  →  DrawFrameTask::drawFrame()
// 【3】任务入队 + 同步等待(这一步是 UI 线程的等待点)
//      DrawFrameTask::postAndWait()   →  渲染线程 threadLoop 取走任务
// 【4】渲染线程执行完,唤醒 UI 线程
//      DrawFrameTask::run() 末尾  →  发信号唤醒 postAndWait 里的 mSignal.wait
// 【5】UI 线程继续往下走(继续下一帧的遍历)
下面对其中三处特别说明。
postAndWait 是 UI 线程唯一的等待点。 名字已经说明了它做两件事:把任务投递(post) 给渲染线程,然后等待(wait) 它完成。这一等,就是"UI 线程在等渲染线程交活"这句话的源码位置。
等的是"任务完成",不是"帧上屏"。 这一点极其重要:postAndWait 返回时,渲染线程已经把命令发出去了,但那一帧还没有上屏——上屏要经过合成与显示控制器,那是后面几篇的事。所以"UI 线程不卡"与"画面不卡"是两件事。
第三步到第四步之间有一次线程切换与两次信号。 这类同步点的代价不在"算",而在"切"——每次唤醒都要经过内核调度。所以 60 Hz 下每秒六十次的交接,本身就是一个可观的固定开销。这也是为什么"减少同步点"在渲染优化里是一条常被提到的方向。
OK,这条链路的逐步骤展开,中文侧有一篇抓得很细的笔记可作对照:《anr 你的 nSyncAndDrawFrame 到底卡在了哪里?》(它从 nSyncAndDrawFrame 一路给到 ThreadedRenderer.draw 与 ViewRootImpl.draw);覆盖最全的则是 Perfetto 系列里讲 MainThread 与 RenderThread 的那一篇,它把一帧拆成了十二步,并配了时间线截图。本篇与它们的分工在于:它们把"有这些步骤"讲全了,本篇要回答"你卡住时该查哪一步"。
3.2 但"等"不是无条件的:canUnblockUiThread
好了,如果 postAndWait 永远是"全等",那 UI 线程就被渲染线程彻底绑住了——渲染线程慢一点,UI 线程也就慢一点,那 RenderThread 的意义何在?
OK,所以交接里有一个提前放开的分支。这是本篇第二处必须讲清的纠正点,因为中文侧普遍写成"同步完就释放主线程",漏掉了它的条件。
//-----------------------------------【提前放开 UI 线程的判定】-----------------------------------
// 文件:frameworks/base/libs/hwui/renderthread/DrawFrameTask.cpp
// 说明:并非"同步完就放开"——是否放开由 canUnblockUiThread 决定
//--------------------------------------------------------------------------------------------
// 【1】UI 线程投递任务后,先做一次"同步帧状态"的尝试
//      syncFrameState(...)   // 把 UI 线程这边的树状态同步给渲染线程
// 【2】如果这次同步里不需要上传新的位图(Bitmap),UI 线程可以提前放开
//      if (canUnblockUiThread()) { unblockUiThread(); }   // 先走,不等了
// 【3】否则 UI 线程继续阻塞在 mSignal.wait 上,直到渲染线程把这一帧跑完
下面对其中两处特别说明。
"需要上传位图"是那条分界线。 位图(Bitmap)是 GPU 侧的资源,第一次被用到时必须从 CPU 内存传上去。这个上传动作要访问 UI 线程这边的数据,所以它在的时候,UI 线程不能被放开。官方 呈现速度缓慢 页也专门注明:syncFrameState 在需要上传位图时会阻塞 UI 线程。
这条分支解释了两种看起来矛盾的现场。 同样的界面,有时 UI 线程的帧图很"轻"(大部分时间不在这条链上),有时又整帧卡在 postAndWait 上——差别往往在于这一帧里有没有新的位图要上传。它也给了一条很实在的优化建议:在进入动画或滚动之前把位图先准备好(预热),让上传发生在不敏感的时机,而不是在每一帧的关键路径上。
3.3 实测:UI 线程侧一帧长什么样
好了,理论说完,看读数。本机用 Perfetto 抓了一段 8 秒的 trace(类别 gfx / view / sched / freq),抓取期间对桌面做连续滑动,产物 3,327,074 字节。
| 字符串 | 出现次数 | 含义 |
|---|---|---|
Choreographer#doFrame |
236 | UI 线程侧实际跑了 236 次 doFrame |
onVsync |
142 | 收到的脉冲回调次数 |
DrawFrames |
142 | 渲染线程侧形成并发出绘制命令的次数 |
prepareTree |
142 | 渲染线程准备绘制树的次数 |
flush |
458 | 命令提交相关的切片(含多个调用点) |
dequeueBuffer |
287 | 申请缓冲的次数(含重试) |
queueBuffer |
573 | 交出缓冲的次数(含多进程) |
doFrame(236)明显多于 DrawFrames(142) ——这说明 UI 线程跑的帧数比真正交给渲染线程的帧数多。差额来自两处:一是 ep02 讲过的"一拍里可能跑不止一次 doFrame",二是有些遍历跑完发现没有需要重绘的内容,于是根本不进入交接。这是好事:说明记录侧的"空转"没有变成渲染侧的开销。
prepareTree 与 DrawFrames 严格相等(142 / 142) ——每一个被发出的绘制帧都对应一次准备,说明这段抓取里没有出现"准备了但没发出去"的浪费。
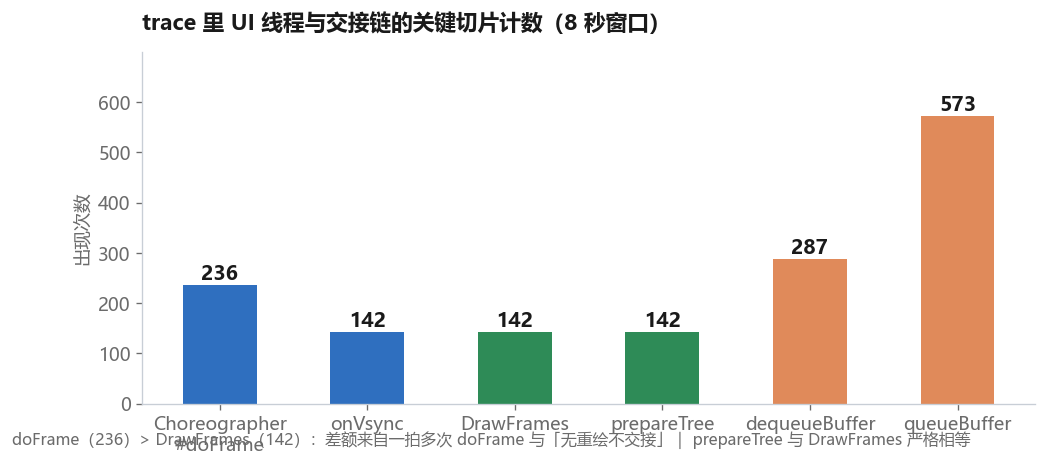
这三行数字连起来,正是交接链的形状:脉冲来 → UI 线程跑 doFrame → 决定要不要交接 → 交接后渲染线程 prepareTree + DrawFrames → 出缓冲(queueBuffer)。链上每一环都有一个可数的切片。
四、渲染线程醒来后做什么
4.1 四个阶段
OK,渲染线程被唤醒后,做四件事。这四件事的顺序是不能换的,因为后一件依赖前一件的产物。
第一阶段,同步帧状态(syncFrameState)。 把 UI 线程那边的树状态同步过来:哪些节点变了、有哪些新的位图要上传、这一帧的画布尺寸是多少。这是唯一会触及 UI 线程侧数据的阶段——也是 §3.2 那条"能不能提前放开"的分界线的所在。
第二阶段,准备绘制树(prepareTree)。 按显示列表树把这一帧要执行的东西整理成渲染侧可用的形态:更新被标记过的节点、准备图层与资源。
第三阶段,绘制(draw)。 真正把显示列表变成绘制命令。这一段的落点是渲染管线的 flush——注意"形成并发出命令"与"画完"是两件事,命令发出后 GPU 是异步执行的。
第四阶段,出缓冲(提交)。 把画好的缓冲交出去(queueBuffer),让合成侧去取。
4.2 它在哪儿等任务:threadLoop
好了,渲染线程的主体是一个循环。它平时挂在一个任务队列上,有活就取、取完继续等:
//-----------------------------------【渲染线程的主循环】-----------------------------------
// 文件:frameworks/base/libs/hwui/renderthread/RenderThread.cpp
//       frameworks/base/libs/hwui/renderthread/DrawFrameTask.cpp
//------------------------------------------------------------------------------------------
// 【1】线程入口:一个"取任务—执行"的循环
//      RenderThread::threadLoop()
//        → 在任务队列上等待(没有活时不占 CPU)
//        → 取到任务后调用 DrawFrameTask::run()
// 【2】run() 内部按四个阶段推进(见 §4.1)
// 【3】run() 结束时唤醒等待它的 UI 线程(对应 §3.1 第 4 步)
// 【4】除主线程外,渲染侧还有若干工作线程(trace 上表现为 hwuiTask0 / hwuiTask1)
下面对其中两处特别说明。
"没有活时不占 CPU"是本机 trace 能验证的性质。 如果渲染线程空转,它会以固定频率出现在 sched 轨上。本机抓取里 RenderThread 只出现 135 次、并与 142 次 DrawFrames 同量级,说明它是被事件驱动的,不是轮询的。
hwuiTask0 / hwuiTask1 是另外的线程,不是渲染线程本身。 本机 trace 里它们各出现 3 次与 2 次(合计 5 次),出现频率远低于渲染线程。这一点值得单独记一笔,因为它正是下一章那处误用的现场:trace 上名字里带 "hwui" 的不止一个线程,而它们与 RenderThread 分工不同、进程归属也不同。
OK,关于这个任务模型的中文侧解读有两篇可读:《android 硬件加速(二) — RenderThread 与 OpenGL GPU 渲染》(讲了 HardwareRenderer.draw 的入口与 UI 线程 / 渲染线程的任务切分)与腾讯云的同题版本(讲了渲染侧初始化、绘制、更新这三类任务是怎么被提交进去的)。它们对"任务队列"这件事的交代比本篇更细,本篇只需要它来支撑一件事:渲染线程是一个被任务驱动的循环,而不是一个"每帧自动跑一遍"的定时器。
4.3 实测:渲染线程侧的切片构成
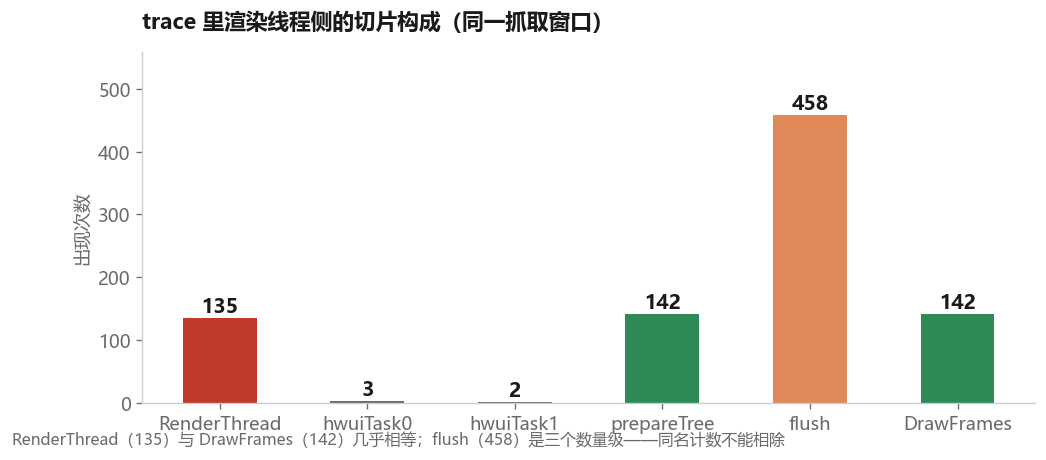
好了,同一个 trace,换个角度统计渲染线程侧:
| 字符串 | 出现次数 | 归属 |
|---|---|---|
RenderThread |
135 | 应用进程的渲染线程(本篇主角) |
hwuiTask0 |
3 | 渲染侧工作线程 |
hwuiTask1 |
2 | 渲染侧工作线程 |
prepareTree |
142 | 阶段二 |
flush |
458 | 阶段三(命令提交,多个调用点都会打这个点) |
DrawFrames |
142 | 阶段三的收口 |
RenderThread(135)与 DrawFrames(142)几乎相等 ——说明渲染线程的每次出现大致对应一次绘制帧,没有大面积"被唤醒但没活干"。
flush 的数量是 DrawFrames 的三倍多(458 对 142) ——这个比值不能读成"提交了三次"。flush 是一个会在多个调用点被记录的标签,它统计的是"提交相关动作发生了多少次",不是"提交了几帧"。同名计数不能直接相除,这一点与 ep01、ep02 遇到的是同一类陷阱。
OK,到这里可以回答"醒来之后做了什么"了:同步状态(可能顺带上传位图)→ 准备这棵树 → 把命令发出去 → 交缓冲。 四步里最后一步要一块缓冲,而那块缓冲不是想拿就能拿到的——这就是下一章,也是本篇的核心。
五、缓冲从哪来:dequeueBuffer 的三态
5.1 一次申请有三种结局
好了,渲染线程要往一块缓冲上画,第一步是申请一块(dequeueBuffer)。这个申请有三种结局,而三种结局的耗时相差三个数量级。
| 结局 | 触发条件 | 典型耗时 | 对帧的影响 |
|---|---|---|---|
| 拿到 | 队列里有空闲缓冲 | 微秒级(几十微秒) | 无影响,这是正常路径 |
| 等一会儿 | 没有空闲缓冲,但有正在显示的缓冲会被释放 | 毫秒到几十毫秒 | 直接叠加到这一帧的耗时上 |
| 等超时 | 长时间没有缓冲被释放 | 秒级(本机 GPU Context timeout: 10) |
大概率丢帧 |
关键在第二种结局。 它看起来像"生产者太慢",实际恰恰相反:缓冲不在应用手里,是因为它还在显示链路的下一环上——已经被交出去的缓冲需要等到被消费完、被释放回来,才能重新申请。
//-----------------------------------【渲染线程侧的一次缓冲循环】-----------------------------------
// 文件:frameworks/base/libs/hwui/renderthread/CanvasContext.cpp(绘制与缓冲获取)
//       frameworks/native/libs/gui/ 下的 BufferQueue 生产端接口
// 说明:三种结局的分界就在 dequeueBuffer 的返回值与耗时上
//------------------------------------------------------------------------------------------------
// 【1】申请一块缓冲:可能立刻返回,也可能阻塞
//      status = dequeueBuffer(&slot, &fence, w, h, format, usage);
//        → OK              队列里有空闲缓冲,微秒级返回(本机中位 26.9–158.6 µs)
//        → TIMED_OUT       等到超时也没有缓冲被归还(本机 GPU Context timeout = 10)
//        → 阻塞后 OK       等到某块缓冲被归还才返回(本机尾部 24.7–27.3 ms)
// 【2】拿到 slot 后往这块缓冲上画(第 4 章的四个阶段在这里发生)
// 【3】画完交回队列,让合成侧去取
//      queueBuffer(slot, ...);
// 【4】回到第 1 步 —— 循环的代价主要落在第 1 步上,而不是第 3 步
说白了,所以 dequeueBuffer 的等待不是应用算得不够快,而是下游还没把这批缓冲还回来。这一句话是整章的支点,也是它与"UI 线程等渲染线程"那个等待点的根本区别。
先把这一章要用到的四个列钉住,后面所有读数都从它们来:
| 列名 | 量的是什么 | 量纲 | 本篇怎么用 |
|---|---|---|---|
DequeueBufferDuration |
申请一块缓冲花了多久 | 纳秒 | 分位与分桶,本章的主角 |
QueueBufferDuration |
把缓冲交回队列花了多久 | 纳秒 | 与上一条对照,判断长尾在哪一侧 |
CommandSubmissionCompleted |
命令提交出去的时刻(与 SwapBuffers 逐行相同) |
绝对时间 | 与下一条相减 = GPU 执行时长 |
GpuCompleted |
GPU 完成这一帧的时刻 | 绝对时间 | 与上一条相减,判断压力是否在 GPU 侧 |
这四列的关系不都是"相减即所得"。 前两列是时长,直接读;后两列是时刻,必须配对相减才有意义——而且配错对象就会得到没有物理意义的差(§7.4 会给出一次真实的配错)。
5.2 实测:两段读数,两个窗口
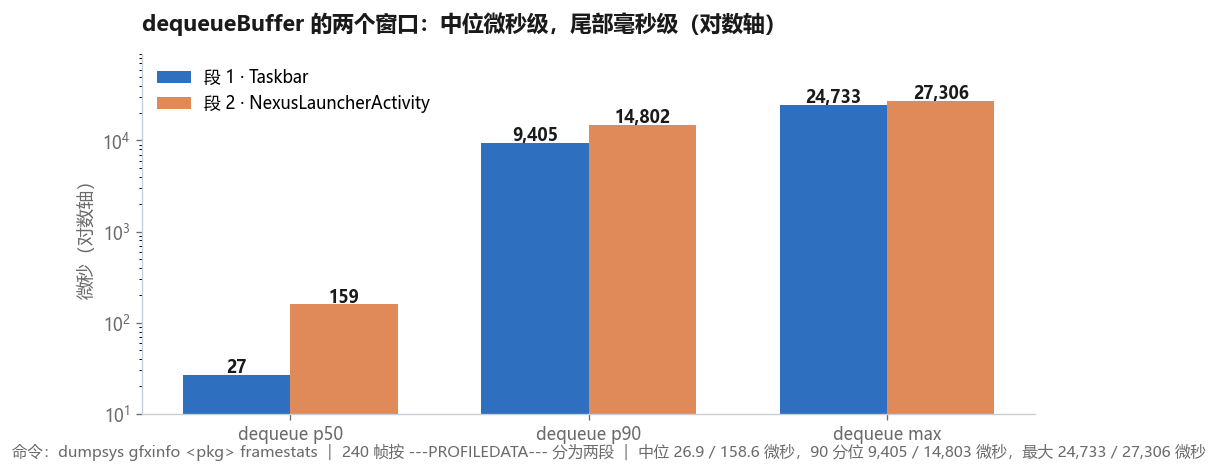
OK,现在把命令跑起来。dumpsys gfxinfo <pkg> framestats 给出逐帧明细,而本机的输出分两段(这一点本身是个坑,见 §7.1)——两段分属两个窗口:
| 段 | 窗口 | 有效帧 | dequeue p50 |
dequeue p90 |
dequeue max |
CPU 帧 p50 | GPU 执行 p50 |
|---|---|---|---|---|---|---|---|
| 1 | Taskbar |
120 | 26.9 µs | 9,405 µs | 24,733 µs | 52.1 ms | 3,873 µs |
| 2 | NexusLauncherActivity |
120 | 158.6 µs | 14,803 µs | 27,306 µs | 69.0 ms | 23,498 µs |
先看中位数。 两段的 dequeue 中位分别是 26.9 微秒与 158.6 微秒——都在百微秒量级,相对它们各自 52 毫秒与 69 毫秒的帧耗时,几乎可以忽略。这说明大多数帧里,申请缓冲是"立刻就有"的。
再看 90 分位。 9.4 毫秒与 14.8 毫秒——比中位高了两个数量级。最坏的两帧分别是 24.7 毫秒与 27.3 毫秒。
这一对比就是整章要讲的事:dequeueBuffer 的耗时不是一个"平均值"能描述的,它是双峰的——绝大多数帧根本不在这上面花时间,但一旦等了,就是十几毫秒量级。而 60 Hz 下一帧的预算是 16.7 毫秒,十几毫秒的等待足以单独吃掉一整帧。
两段之间的差异也值得看一眼。 Taskbar 的 dequeue 中位更低(26.9 对 158.6 微秒)、GPU 执行更短(3.9 对 23.5 毫秒);而 NexusLauncherActivity 因为是那个在滚动、在重绘的界面,两项都更重。这正是 §7.1 要讲的:把两个窗口的数字合成一个"整包"数字,就把这个差异抹掉了。
5.3 把分布摊开看:双峰长什么样
好了,分位点只给了两个截面。把 240 帧按 dequeueBuffer 耗时分桶,双峰的形态就出来了:
| 桶 | 帧数 | 占比 | 含义 |
|---|---|---|---|
| < 0.1 毫秒 | 138 | 57.5% | 有可用缓冲,立刻返回 |
| 0.1–1 毫秒 | 19 | 7.9% | 略等,仍在噪声量级 |
| 1–5 毫秒 | 12 | 5.0% | 开始侵蚀帧预算 |
| 5–15 毫秒 | 48 | 20.0% | 接近或超过半帧预算 |
| > 15 毫秒 | 17 | 7.1% | 单次等待就超过一整个帧周期 |
第二个峰(5 毫秒以上)合计 65 帧,占 27.1%。 也就是说,每四次申请里就有一次,光等缓冲就花掉 5 毫秒以上——而这还只是 dequeueBuffer 一个动作的花费,不含绘制、不含提交。
OK,再把占比算出来会更刺眼:dequeueBuffer 耗时 ÷ CPU 侧帧耗时,中位只有 0.06%–0.19%,但 90 分位是 20%–27%,单帧最大 70.5%。在最坏的那一帧上,四分之三的时间都在等一块缓冲。
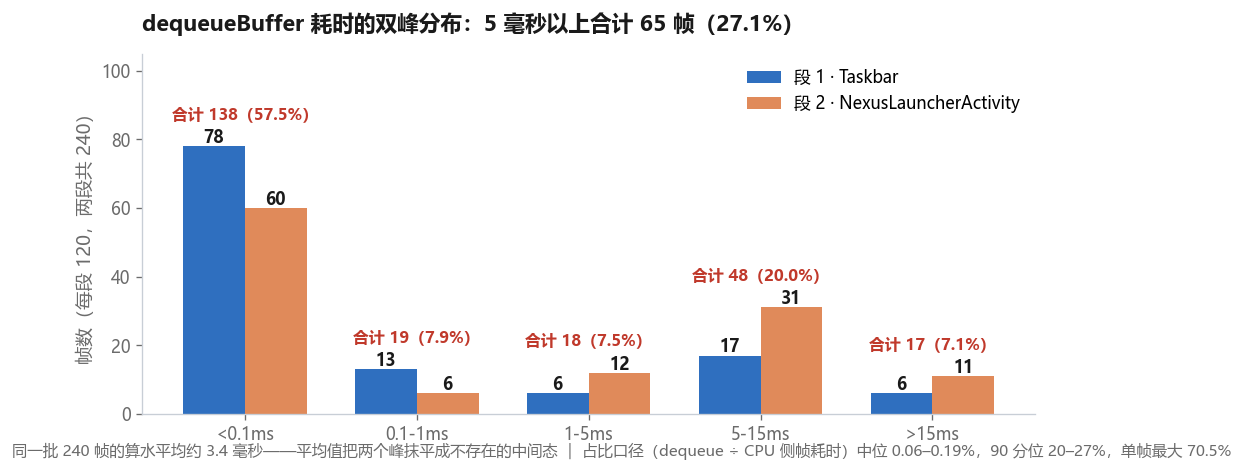
言归正传,这张图值得慢慢看一分钟,因为它示范了为什么"看分位数"比"看平均值"更接近真相。同一批数据,如果把 240 帧的 dequeue 耗时取一个平均值,得到的是 3.4 毫秒左右的"还不错"的数字——而实际上有 27.1% 的帧在这一项上花了 5 毫秒以上。 平均值把两个峰抹平成了一个不存在的中间态,这正是"平均帧耗时"这类指标最危险的地方。
更要紧的是第二个峰的位置。 5–15 毫秒这一档有 48 帧,它们恰好落在"半帧到一帧"的区间——意味着这些帧不像"偶发的长卡顿"那样显眼(不会触发掉帧日志,也不会让用户立刻察觉),但它们稳定地把帧率压在半速。本机 §7.3 那个余量分布(31.7% 的帧迟到一整个周期以上)就是这一档的直接后果。
5.4 为什么"等"的是下游:一条因果链
好了,双峰的成因,用一条因果链说清:
- 应用申请缓冲 → 拿到一块,画完,交出去(
queueBuffer); - 这块缓冲自此进入下一环节,被用来合成、上屏;
- 在它被消费完并归还之前,它不算"空闲";
- 如果应用手上的缓冲都用完了(比如双缓冲下只有两块),下一次申请就得等;
- 等的时长,等于"最快被归还的那一块还有多久回来"。
说白了,所以 dequeueBuffer 变长,通常意味着下游变慢了:GPU 绘制延后、或者合成侧没有及时把缓冲释放回来。中文侧有一篇一线实测把这个现象写得很具体(《从 dequeueBuffer 卡顿看一次 GPU 丢帧问题分析》):GPU 绘制延后 → 合成侧无法及时消费 → 空闲 buffer 释放不及时 → 应用后续 dequeueBuffer 被卡,trace 上表现为渲染线程的 dequeueBuffer 切片变长。
这条链有一个反直觉的推论:dequeueBuffer 卡住的时候,去优化应用的绘制代码往往没有用——因为瓶颈不在应用画得多快,而在下游还不还。修法方向应该是"让下游更快把缓冲还回来"(比如减少合成压力、调整缓冲数量),或者"让应用不必等这一块"。
好了,顺带说一句:这也是三缓冲、四缓冲这类方案的真正动机。多一块缓冲并不会让应用画得更快,它只是让应用在迟到时有地方放——队列里多一块空闲缓冲,dequeueBuffer 就不必等了。代价是延迟更高,这笔账 ep11 会算。
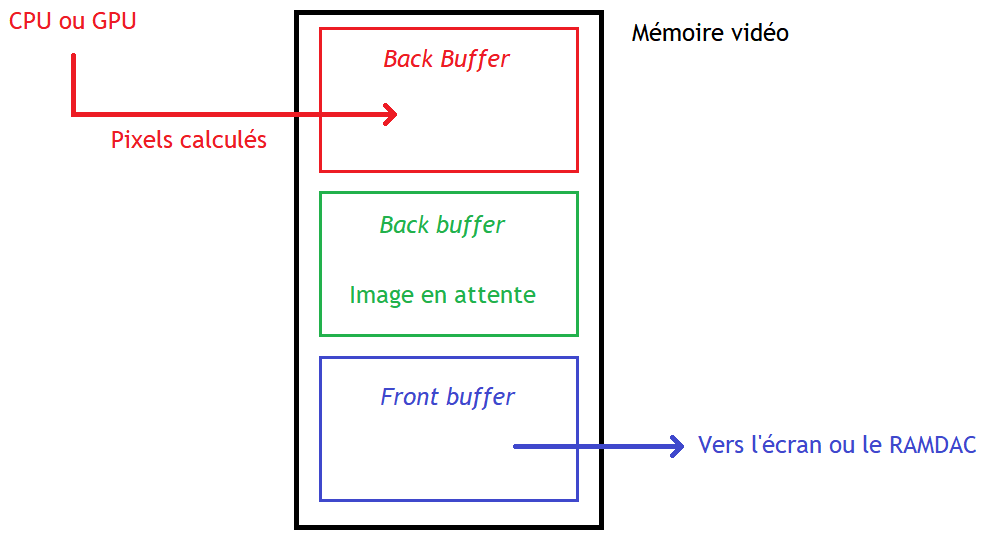
OK,关于 queueBuffer / acquireBuffer 这条生产者—消费者循环的完整流程,中文侧有几篇按源码走的笔记可读:《Surface 系统-5-BLASTBufferQueue 工作流程概览》、《从 VSync 心跳到 SurfaceFlinger 合成:拆解 Choreographer 与 Display 刷新流程》 与《案例分析 — 卡 GPU 丢帧分析》。它们讲的正是本篇克制没展开的那一段(队列内部到底怎么记账),留给 ep04。
六、缓冲怎么送出去
6.1 queueBuffer:交出去 ≠ 上屏
好了,画完以后,渲染线程把缓冲交回队列(queueBuffer)。这里有一个极易被混淆的区分:
- 交出缓冲只意味着"这块可以拿去用了";
- 上屏要经过合成(ep06)、硬件合成或 GPU 合成(ep08)、显示控制器的扫描(ep01)。
OK,所以"queueBuffer 很快"与"这一帧会准时亮起"是两件独立的事。queueBuffer 的耗时本身也印证了这一点:本机两段的 p50 分别是 337 微秒与 448 微秒,最大 2,473 微秒与 6,284 微秒——比 dequeueBuffer 的尾部稳定得多(后者的最大值是 24.7 / 27.3 毫秒)。
这个对比本身就是一条判据:如果你看到的是 dequeueBuffer 的长尾,问题在下游还不还缓冲;如果是 queueBuffer 的长尾,问题更可能在这一侧(提交动作本身被拖住)。两个同族的动作,长尾的含义完全不同。
6.2 BLAST:缓冲与图层属性一起提交
好了,缓冲交出去之后,还有一个容易被忽略的问题:只交缓冲够不够?
不够。因为一次上屏除了"这一帧的像素",还包括"这个图层的属性"——位置、大小、透明度、圆角、层级。如果缓冲与属性分两次提交,就可能出现缓冲已经换了、属性还没更新(或者反过来)的中间态:屏幕上一个图层短暂地出现在错误的位置上。
OK,这正是 BLAST(Buffer Layer Async Transaction BufferQueue)要解决的事。官方文档层没有单列 BLAST 页面,但它的语义体现在 SurfaceFlinger 与 WindowManager 的 ASurfaceControl 一节:把 Surface 与 SurfaceControl 组合进一个事务包(Transaction)提交给 SurfaceFlinger。缓冲与属性在同一个事务里,一次生效。
//-----------------------------------【BLAST 的一次提交序列】-----------------------------------
// 文件:frameworks/native/libs/gui/BLASTBufferQueue.cpp(事务化提交)
// 说明:缓冲与图层属性放进同一个事务包,一次生效
//--------------------------------------------------------------------------------------------
// 【1】应用侧画出这一帧,拿到一块缓冲,交回队列
//      queueBuffer(slot, ...);
// 【2】把缓冲设进事务
//      transaction->setBuffer(surfaceControl, buffer);   // 本机 trace: setBuffer ×284
// 【3】图层属性也放进同一个事务
//      transaction->setPosition / setAlpha / setLayer(...);
// 【4】一次提交,缓冲与属性同时生效
//      transaction->apply();            // 本机 trace: Transaction ×1936、BLAST ×1420
本机的 trace 里能看到这条路径的痕迹:
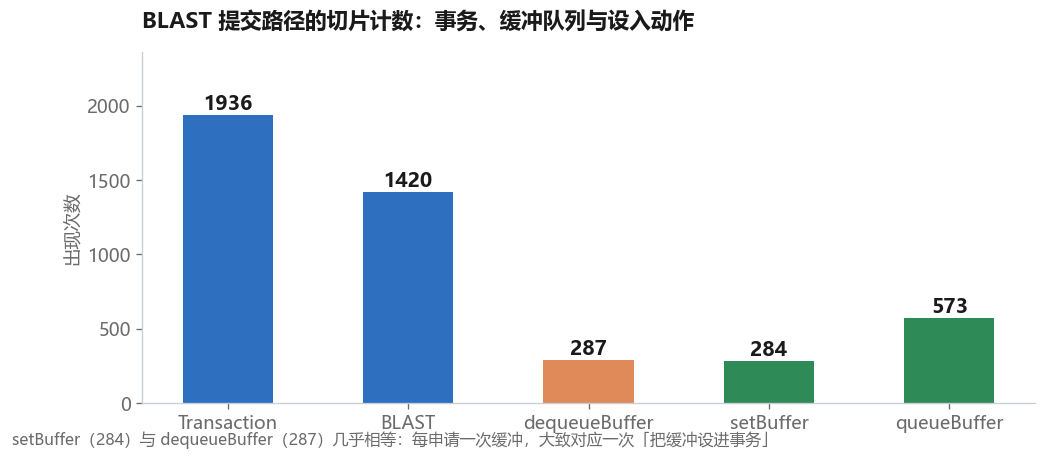
| 字符串 | 出现次数 | 含义 |
|---|---|---|
Transaction |
1936 | 事务相关的切片 |
BLAST |
1420 | BLAST 缓冲队列相关切片 |
setBuffer |
284 | 把缓冲设置进事务的动作 |
setBuffer(284)与 dequeueBuffer(287)几乎相等 ——这个数字关系很值得记:每申请一次缓冲,大致对应一次"把缓冲设置进事务"。 两者是同一个动作的两端:一头是应用从队列里取,另一头是应用把一个缓冲放进要提交的事务里。而 Transaction 的计数(1936)远高于它们,说明事务本身是一个被反复使用的机制,不只服务于换缓冲一件事。
一处边界:BLAST 默认启用的具体版本号需复核(社区说法集中在 Android 12 前后),官方文档层也没有以 BLAST 命名的专页。本篇只讲它的语义(缓冲与属性一起提交),不虚构官方条款、不写具体版本号。
好了,BLAST 的架构与它替代旧 BufferQueue 的动机,中文侧有三篇连读比较顺:架构概述(队列创建在业务进程、图层属性走 Transaction、事务可合并)、Android 16 显示系统 · BLASTBufferQueue(把它定位成 App 与 SurfaceFlinger 之间的桥)、BufferQueueConsumer 核心操作(消费侧如何取用并把缓冲设进事务)。把"为什么要换掉旧队列"这件事讲清楚的是第一篇,本篇不重复。
到这里,交接链的上半段就完整了:记录 → 交接 → 执行 → 出缓冲。而链上有两个等待点,一个在交接处(UI 线程),一个在执行末段(渲染线程)。下一章把这两个等待点摆在一起,用读数判断"卡在哪一端"。
七、实测:卡在 UI 线程还是卡在缓冲
7.1 第一件意外:这段汇总里不止一个窗口
OK,本篇的实测从一处陷阱开始。dumpsys gfxinfo <pkg> framestats 的输出,不是一段,而是多段。本机这次抓取里:
---PROFILEDATA---   出现 4 次
带帧数据的段         2 段,每段 120 行
包级段还写着         Contexts: 2 (stopped = 0)
好了,也就是说,同一个包在两段里各有一份逐帧明细,分属两个窗口:Taskbar 与 NexusLauncherActivity。每段还各有自己的汇总(总帧数、百分位、各类"慢"的计数)。
我第一版解析就把这个坑踩了。 当时的做法是"取第一个表头 + 把所有数字行都算进去",于是 240 行被混成一个池子,得到一个看起来很漂亮、其实不存在的双峰:138 帧"瞬时"对 102 帧"等待"。一查段结构才发现,那是两个窗口的行被并到了一起。分段之后才是真实分布(§5.2 那张表)。
这件事有三层教训:
- "整包一个数字"没有意义。 一个应用可以有多个窗口,每个窗口有自己的记录侧与自己的渲染侧;把它们的帧混在一起算分位数,量出来的是一个不存在的"平均窗口"。
- 段结构要先看清,再解析。
---PROFILEDATA---是这段输出的分段标记,必须先按它切段、再逐段解析。 - "数字好看"要警惕。 一个双峰分布如果刚好落在"一半瞬时、一半等待"这种整齐的比例上,先怀疑口径,再相信结论。
7.2 两个等待点,两张不同的判据
把 UI 线程侧的等待与渲染线程侧的等待摆在一起,它们的差别一目了然:
| 判据 | UI 线程等任务 | 渲染线程等缓冲 |
|---|---|---|
| 等待点 | postAndWait 里的信号等待 |
dequeueBuffer |
| 等的是 | 另一个线程把这一帧跑完 | 一块可用的缓冲被归还 |
| 常见成因 | UI 线程自己慢;或这一帧有新的位图要上传 | 下游(合成/显示)没有及时归还缓冲 |
| 观测手段 | trace 上 UI 线程的帧切片宽度 | framestats 的 DequeueBufferDuration 分桶 |
| 误判风险 | 以为是"渲染慢",其实是位图上传卡住 | 以为是"应用画得慢",其实是下游还不还 |
| 优化方向 | 预热位图、减少 UI 线程的无关工作 | 降低合成压力、调整缓冲数量、而不是改绘制代码 |
这张表是整篇的落点:同样一句"卡了",落在左列还是右列,要改的地方完全不同。而判定它落在哪一列,靠的是两组不同的读数。
7.3 帧余量:本机有多少帧赶上截止时间
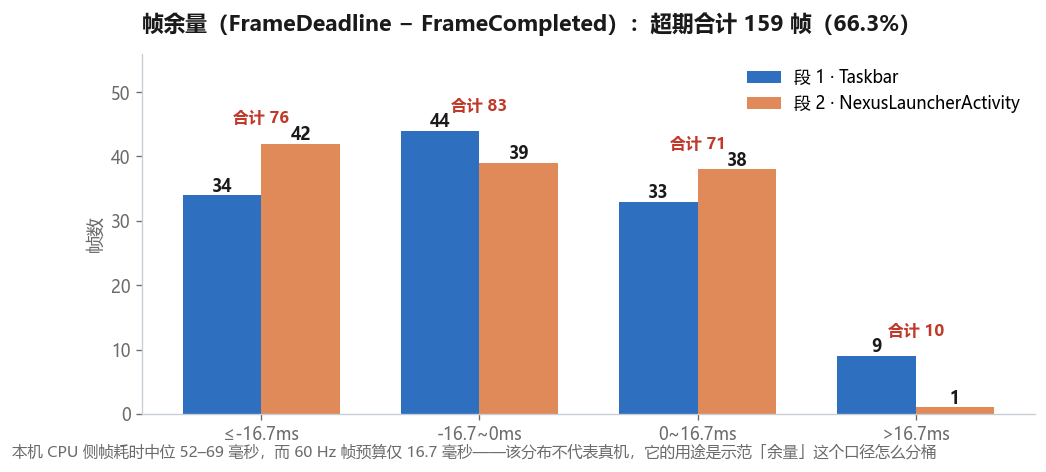
OK,先给一个"总体有多赶"的量。framestats 里的 FrameDeadline 是这一帧的截止时刻,与 FrameCompleted 相减就是余量:
| 余量区间 | 帧数 | 占比 | 含义 |
|---|---|---|---|
| ≤ −16.7 毫秒 | 76 | 31.7% | 迟到一整个帧周期以上 |
| −16.7 ~ 0 毫秒 | 83 | 34.6% | 已过截止,但没到一个周期 |
| 0 ~ 16.7 毫秒 | 71 | 29.6% | 赶上了,余量在一帧以内 |
| > 16.7 毫秒 | 10 | 4.2% | 余量充裕 |
中位余量是 −7.7 毫秒——也就是说,一半以上的帧在登记完成时已经过了截止时刻。
好了,这个结果不能读成"Android 很慢",因为本机是模拟器加软件渲染:CPU 侧帧耗时中位 52–69 毫秒,而 60 Hz 的帧预算只有 16.7 毫秒,本机的 CPU 侧根本不可能跟上节拍。这张图的用处不是给出性能数字,而是说明余量这个口径怎么用:它把"这一帧有没有赶上"变成一个可以分桶的数,而不是一句主观的"有点卡"。
OK,中文侧也有把"主线程 doFrame 看着正常、但渲染线程有长尾"这类现象单独拎出来讨论的文章(《Android 渲染机制深度解析:Choreographer 与 VSYNC 如何驱动每一帧》),它的落点与本篇"渲染线程在等缓冲"是同一个方向的观察——只是它停在现象,本篇往下量了一层。
好了,还有一处本篇没依赖的手段要交代清楚:帧级时间线切片(FrameTimeline 的 expected / actual 双轨)。官方对它的说明见 FrameTimeline 数据源,但本机这套模拟环境取不到(ep01 阶段 2 已两次实证:数据源在册、两次实抓均未产出切片)。所以本篇的帧数据全部改用 gfxinfo 的逐帧明细自写解析,该能力留给 ep13 并标注「需真机」。至于应用侧的同步屏障机制(ViewRootImpl.scheduleTraversals 先插屏障、再排遍历),ep02 已详述,本篇不重复,可参看 《深入理解 Android 卡顿 Choreographer:从 VSYNC 到掉帧》 作对照。
7.4 一处减法纠正:GPU 执行时长怎么算
OK,这一节是自我纠错,也是本篇第三个要交代的口径。
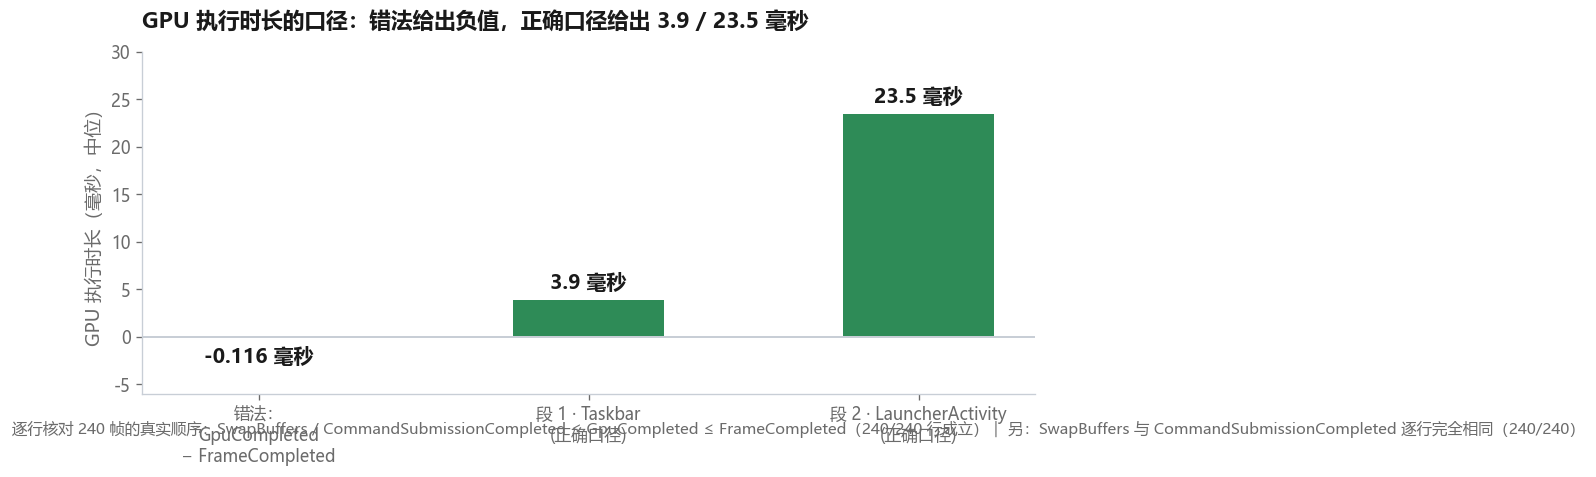
我想量"GPU 这一帧花了多久",第一版写的是:
GPU 长尾 = GpuCompleted − FrameCompleted ← 错
好了,跑出来中位是 −116 微秒——负的。GPU 不可能在帧完成之后"提前"完成,所以这个减法一定搞错了对象。逐行核对 240 帧之后,真实的时间顺序是:
SwapBuffers / CommandSubmissionCompleted ≤ GpuCompleted ≤ FrameCompleted
240/240 行成立。 而且顺带发现两条文档没明说的等式:SwapBuffers 与 CommandSubmissionCompleted 逐行完全相同(240/240);FrameCompleted 与 SwapBuffersCompleted 有 138/240 行相等。
所以正确的 GPU 执行时长是:
GPU 执行时长 = GpuCompleted − CommandSubmissionCompleted
OK,按这个口径算出来:Taskbar 段中位 3.9 毫秒、NexusLauncherActivity 段中位 23.5 毫秒,最大 129.2 毫秒。
这次纠错值得写出来,因为它示范了本系列一贯的那条纪律:列名看起来像什么,不等于它量的是什么。 GpuCompleted 与 FrameCompleted 都带 "Completed",但它们一个是 GPU 侧的时刻、一个是 CPU 侧登记完成的时刻;两个时刻相减得到的既不是 GPU 时长、也不是 CPU 时长,而是一个没有物理意义的差。
7.5 包级汇总里的三组计数
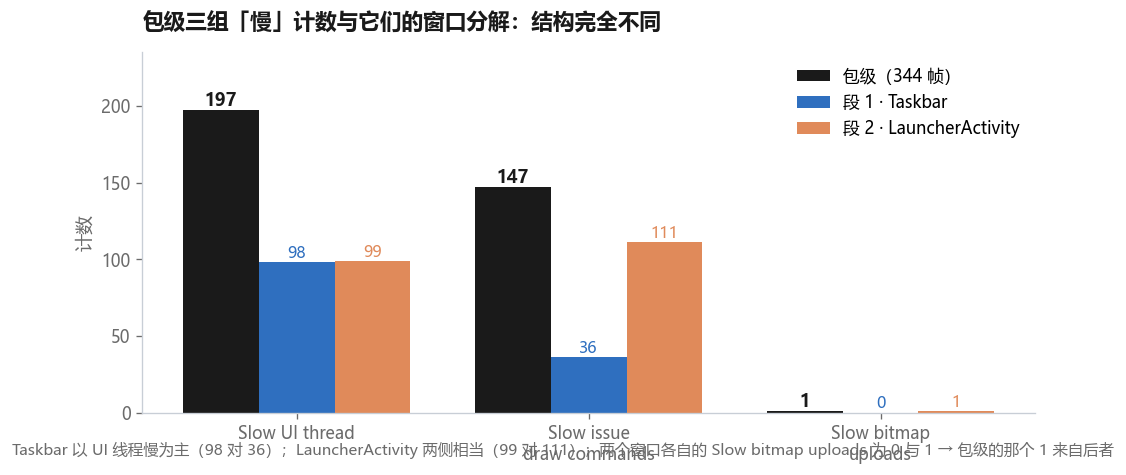
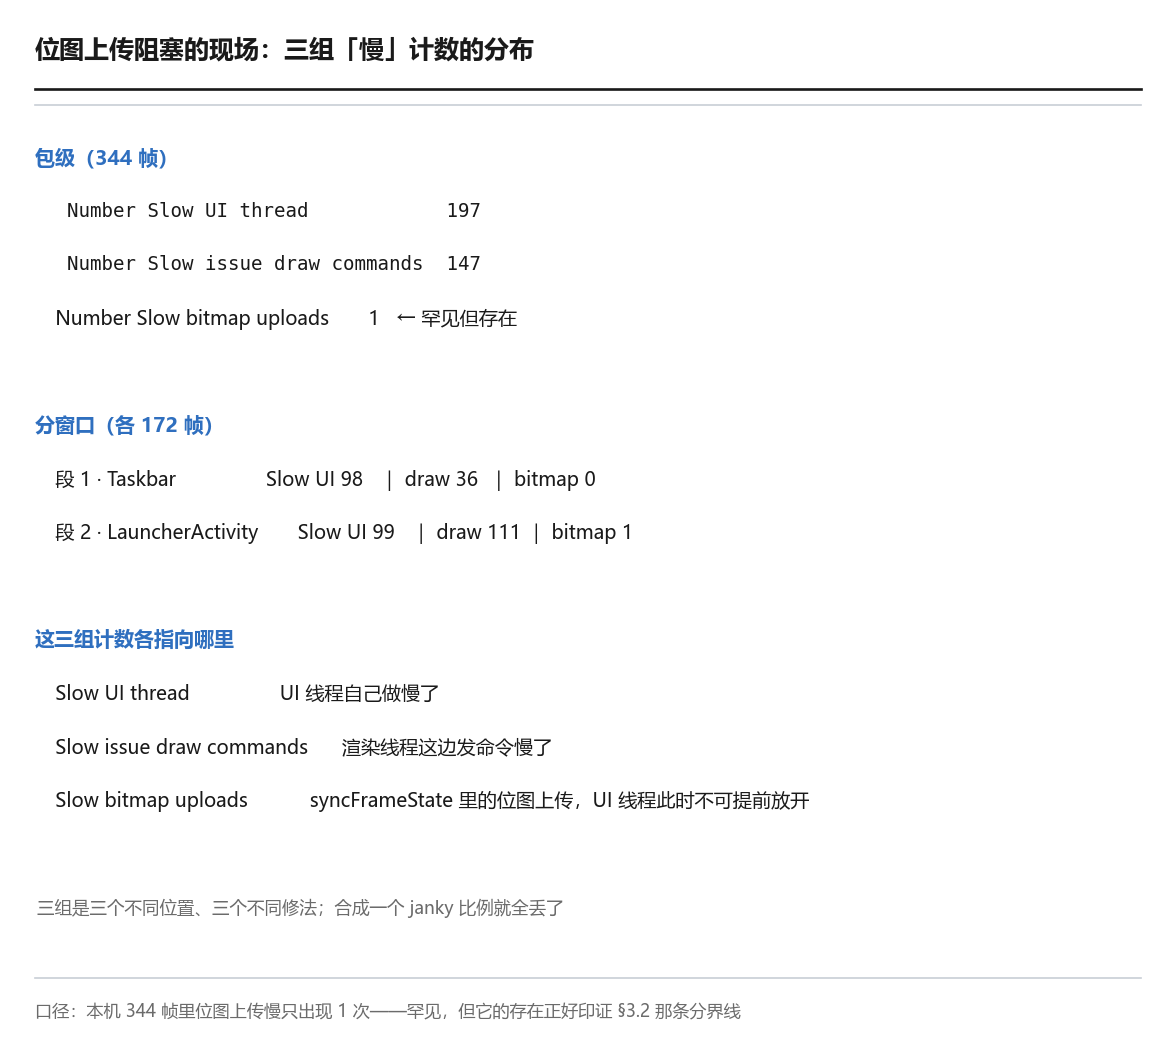
好了,最后看包级那一段的汇总。它给出一组很好用的计数,而且恰好对应三处不同的等待点:
| 计数 | 本机读数 | 指向哪里 |
|---|---|---|
Number Slow UI thread |
197 | UI 线程自己做慢了 |
Number Slow bitmap uploads |
1 | syncFrameState 里的位图上传(§3.2 那条分界线) |
Number Slow issue draw commands |
147 | 渲染线程这边发命令慢了 |
Number Missed Vsync |
142 | 错过了节拍(ep02 的量) |
Number Frame deadline missed |
227 | 超过截止(§7.3 的量) |
Number High input latency |
206 | 输入侧积压 |
| 包级总帧 / janky | 344 / 227(65.99%) | — |
这张表最有用的是它把"慢"拆成了三种:UI 线程慢(197)、位图上传慢(1)、发命令慢(147)。它们是三个不同的位置、三个不同的修法。 而中文侧常见的"janky 比例 66%"这种单一数字,只会把你引向"整包都在卡"这个没有信息量的结论。
把这三组计数按窗口拆开,会看到两种完全不同的结构。 Taskbar 是 Slow UI thread 98 对 Slow issue draw commands 36——UI 侧为主;而 NexusLauncherActivity 是 99 对 111——两侧相当。两者的 Slow bitmap uploads 分别是 0 与 1,也就是说,包级那个 1 完全来自后者。同一台机器、同一个进程、同一段时间,两个窗口的"慢"结构就不同;把它们合成一个包级数字,这两种结构会同时消失。
这也顺手解释了一条看起来矛盾的经验:为什么同一个应用"有时卡得能忍、有时卡得明显"——很可能你量的那个窗口/那段代码,恰好不在这次卡的那一侧。
顺带记一处异常:包级汇总里有一个 90th gpu percentile: 4950ms 的读数,与它自己的 50 分位(14–24 毫秒)差两个数量级。本篇引用这个值时会标注它可疑——它更像是一个超时占位值,而不是真实的 GPU 耗时分布。引用异常读数时要说明它异常,而不是拿它当结论。
八、四个常见的误用与误解
前七章把交接链讲完了。这一章把最容易踩的四处摊开——它们的共同点是:都会让你找错那一端。
8.1 把应用进程的渲染线程当成系统的合成线程
OK,这是最隐蔽、后果也最严重的一个。先把定义摆清:本篇说的「应用渲染线程」指应用进程里 libhwui 那条线程;而「系统合成线程」指 SurfaceFlinger 进程里做合成决策与执行的那一批线程。两者名字相近、职责不同、进程也不同。 trace 上会同时出现多个和"渲染"有关的线程,而它们分属不同进程、干不同的事:
| 线程名(trace 上的样子) | 进程归属 | 干什么 |
|---|---|---|
RenderThread |
应用进程(libhwui) |
本篇主角:把显示列表变成命令、出缓冲 |
hwuiTask0 / hwuiTask1 |
应用进程 | 渲染侧的工作线程,与 RenderThread 并列 |
| 合成侧的线程 | SurfaceFlinger 进程 | 合成决策与执行(ep06 / ep08 展开) |
中文侧有文章把"RenderThread(SF 内部)"描述成 GPU 合成的干活线程(例如这篇讲 SF 线程的延伸阅读),把两侧混成了一个名字。这在读 trace 时会直接把人带错方向:你在应用进程的轨上找一个名叫 RenderThread 的线程,然后拿它的耗时去解释合成侧的现象。
好了,判据很简单,而且只有一条:看进程。 同名的轨先按进程拆开,再谈它的耗时。
8.2 以为"同步完就释放主线程"
OK,这是 §3.2 讲过的条件的反面。流传的写法是"syncAndDrawFrame 一返回,主线程就解放了",漏掉了 canUnblockUiThread。
实际是:"不需要上传新位图"时才提前放开;需要上传时,UI 线程会一直阻塞到这一帧跑完。 官方 呈现速度缓慢 页也把这一点单独写了出去。本机的包级段给了这条分界线一个现场证据:Number Slow bitmap uploads: 1——本机确实出现过位图上传慢,只是频次很低(344 帧里 1 次)。它罕见,但存在;而罕见的东西最容易被写成"不存在"。
好了,关于这次握手的源码级细节——DrawFrameTask 的 postAndWait / run / unblockUiThread 与 TreeInfo——《anr 你的 nSyncAndDrawFrame 到底卡在了哪里?》 给得比我这一篇更细,值得一并读;ANR 栈停在 postAndWait 这件事本身就说明这个等待点是真实存在的。
8.3 以为 DrawFrames 出现就画完了
DrawFrames 这个名字很容易被读成"帧画好了"。官方 UI 卡顿检测 的口径是:它表示渲染线程形成并发出实际绘制命令。命令发出之后,GPU 是异步执行的。
OK,本篇 §7.4 那个派生量正好把这件事量了出来:命令提交(SwapBuffers)与 GPU 完成(GpuCompleted)之间隔着 3.9–23.5 毫秒(中位)。"发出命令"与"画完"之间隔着的,正是这个区间。
8.4 以为"整包一个 janky 比例"能定位问题
这是 §7.1 与 §7.5 两节合起来要破的误解。只拿一个包级 janky 比例(本机 65.99%)能得到什么?什么也定位不了——因为:
- 它不分窗口:本机两个窗口的读数差一倍以上(§5.2);
- 它不分等待点:UI 线程慢、位图上传慢、发命令慢是三个不同位置(§7.5);
- 它不含方向:余量超期(227)与错过节拍(142)是两个不同的量(§7.3)。
"一个比例"能回答的是"有没有问题",不能回答"问题在哪"。 要定位,必须往下拆两层:先分窗口,再分等待点。
8.5 四个坑收成一张表
| # | 误用 / 误解 | 你会怎么找错 | 判据 |
|---|---|---|---|
| ① | 把应用 RenderThread 当系统合成线程 | 在应用轨上找合成问题 | 先看进程归属 |
| ② | 以为同步完就释放主线程 | 漏掉位图上传这一支 | 看 Slow bitmap uploads 计数 |
| ③ | 以为 DrawFrames = 画完了 |
把"发出命令"当"已上屏" | 比较提交时刻与 GPU 完成时刻 |
| ④ | 用一个 janky 比例定位问题 | 停在"整包都在卡" | 先分窗口,再分等待点 |
四条判据有一个共同点:它们都不是"看代码",而是"看口径"。 这是本系列一直在说的那件事的又一次现身——先问这个数是谁在什么窗口里量的,再谈它说明什么。
九、三项可以立刻做的事
9.1 三条命令,三个判据
好了,前面八章的原理,落到操作上就是三条命令。每条都给出判据——不是"跑一下看看",而是"读到什么算有问题"。
第一件:看 dequeueBuffer 的尾部。
# 逐帧明细(注意:可能有多段,按 ---PROFILEDATA--- 切段后再统计)
adb shell dumpsys gfxinfo <包名> framestats
判据:算 DequeueBufferDuration 的分位数,重点看 p90 与 max,而不是平均值。 本机读数是中位 26.9–158.6 微秒、p90 9.4–14.8 毫秒、max 24.7–27.3 毫秒。若 p90 已经进入毫秒量级,说明多数帧在等缓冲;若 p90 仍是微秒级,这条不是你的瓶颈。
第二件:把 dequeue 与 queue 的尾部摆在一起看。
同上一条命令,换一列读。
判据:两者的尾部量级是否同阶。 本机 dequeue 尾部 24.7–27.3 毫秒、queue 尾部只有 2.5–6.3 毫秒——差了四倍以上。若你的 dequeue 尾部明显长于 queue 尾部,问题在"下游没归还缓冲";反过来则问题更可能在提交侧。命令的完整字段说明见 dumpsys 工具。
第三件:看包级汇总里的三组"慢"计数。
# 包级汇总:三组不同的"慢" + 掉帧与超期计数
adb shell dumpsys gfxinfo <包名>
判据:三组计数谁大。 本机读数是 Slow UI thread 197、Slow issue draw commands 147、Slow bitmap uploads 1。第一组最大 → 主战场在 UI 线程;若第三组不为零,去查位图预热。 注意这份汇总也是分段输出的,先确认你读的是包级那一段。
9.2 从「滑动卡顿」到定位结论:四步判读
OK,如果只有一个抱怨——"滑动的时候明显卡"——按下面四步走,每一步都把范围缩小一半。
第一步:先分窗口。 跑第一件命令,确认输出有几段 ---PROFILEDATA---。如果有多段,先挑出"那个在滚动的窗口"的那一段,其余段的数字与这个问题无关(§7.1)。
第二步:判定是"等缓冲"还是"自己慢"。 在那一段里算 DequeueBufferDuration 的分位。p90 进入毫秒级 → 走第三步;p90 仍是微秒级 → 跳到第四步。
第三步(等缓冲):往下游找。 看 GPU 执行时长(GpuCompleted − CommandSubmissionCompleted,见 §7.4)。若 GPU 时长本身就长,压力在 GPU 侧;若 GPU 很短而 dequeue 很长,压力在合成或缓冲数量上。这一步要改的不是绘制代码。
第四步(自己慢):看是哪一组慢。 回到包级汇总的三组计数(§9.1 第三件)。Slow UI thread 大 → 查 UI 线程的无关工作;Slow bitmap uploads 不为零 → 查位图预热;Slow issue draw commands 大 → 查绘制命令量。
这四步的顺序不能换。 先分窗口、再分等待点、再分责任方,最后才看代码。反过来做(一上来就去读 onDraw)几乎必然找错方向,因为前三步的结论会直接排除掉大部分嫌疑。
9.3 本篇留下的一句话,与下一篇
把全篇收成一句话:
"渲染慢"不是一个诊断,而是一个待分类的现象。 它至少包含两件成因相反的事:UI 线程在等渲染线程交活,渲染线程在等一块可用的缓冲。前者的修法在 UI 线程(含位图预热),后者的修法在下游(合成压力与缓冲数量)。分类的分类依据不是代码,是口径。
好了,这也顺带回答了开头那个问题:为什么"只要看渲染就知道卡在哪"是错的。因为"渲染"这个词本身横跨了两个进程、两种量纲、两个成因相反的等待点——它是一个范围,不是一个位置。
下一篇讲的是这块缓冲的完整生命周期:BufferQueue 的四态迁移、队列深度、slot 数组——也就是本篇只从渲染线程视角看了一次的那个 dequeue/queue,在队列内部到底改变了什么。
相关链接
- 上一篇:【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 下一篇(预告):【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 官方文档:硬件加速 | 硬件加速(Views 版) | Android 5.0 版本介绍 | 呈现速度缓慢 | UI 卡顿检测
- 源码入口:
RenderThread.cpp|SkiaPipeline.cpp|RenderNode.java|ThreadedRenderer.java - 提交侧:BufferQueue 与 Gralloc | SurfaceFlinger 与 WindowManager | systrace(界面管道) | BLASTBufferQueue 英文条目
- 素材来源:Wikimedia Commons(图注逐张标作者与许可);本机实测图版权自有
With Best Wishes.