站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:上一篇交了「什么时候算」,这一篇问「桌上那些东西从哪来」
上一篇我们跟着主循环这条线走到收口,末尾那个结论是「同一份先后顺序,什么时候被算出来、被哪个线程算出来」。那一篇把「资源」当成一个已经存在的东西来用——它讲了物理在前、逻辑在后、渲染最后,讲了累加器怎么攒出一帧里该跑几步物理,唯独没问一句:那些被画出来的东西,一开始是怎么进到引擎里的。
这一章问的就是这个。它看起来像「文件格式」的事,实际上是「一次绘制怎么落到 GPU 上」这句话里最靠前的一段:前面九篇都在讲「落到哪里、什么时候落」,这一篇要讲这条链的入口——盘上的一个字节,是怎么变成一块能被采样的显存的。
0.1 本系列的位置:从「什么时刻」往上游走一步
好了,前面九篇把落点链走完了大半:对象模型(第二篇)→ 服务层接口(第三篇)→ 画布剔除与排序(第四篇)→ 画布渲染抽象(第五篇)→ 批处理(第六篇)→ RenderingDevice 与渲染依赖图(第七篇)→ 后端分叉(第八篇)→ 主循环与多线程(第九篇)。本篇接在第九篇后面,换一个方向走:前九篇走的是「这份命令往哪里去」(空间)与「它按什么节拍被驱动」(时间),本篇走的是「这些命令要用的东西从哪来」。
整个系列按这两条轴铺开,目录如下(本篇即第十行):
| # | 篇目 | 它回答的问题 | 状态 |
|---|---|---|---|
| 01 | 全景与边界 | 四层架构是什么、一次 2D 绘制要经过谁 | 已发布 |
| 02 | 对象模型 | 谁在什么时候把命令层下发 | 已发布 |
| 03 | 服务层接口 | 命令长什么样、怎么被排队 | 已发布 |
| 04 | 画布剔除与排序 | 画什么、按什么顺序 | 已发布 |
| 05 | 画布渲染抽象 | 绘制项里存了什么、怎么被提交 | 已发布 |
| 06 | 批处理 | 一批能装多少、按什么切、代价在哪 | 已发布 |
| 07 | RenderingDevice 抽象 |
命令列表怎么变成一张依赖图 | 已发布 |
| 08 | 后端分叉 | 四条驱动怎么选、分叉长在哪几处 | 已发布 |
| 09 | 主循环与多线程 | 这套账在什么时刻、被哪个线程算出来 | 已发布 |
| 10 | 资源侧(本篇) | 一张纹理从盘上到显存 | 本篇 |
| 11 | 收官 | 这条链整体买到了什么 | 待写 |
其中:这张表要看的不是「进度」,而是本篇与相邻两篇的接缝——第九篇交出「什么时候算、谁来算」,第十一篇接手「这条链整体买到了什么」。夹在中间的这一篇,问的是那些被算出来的账,用的是从哪来的料。系列里好几位老朋友会在这里再出现一次:RenderingServer、WorkerThreadPool、ResourceLoader——但这一篇看的是它们的资源入口,不是它们的执行时机。
0.2 口径先对齐:三个名字,其中一个不是资源
好了,先把一个最容易混的地方钉死。在 Godot 工程目录里,同一张图会以三个身份同时存在,而很多人把它们当成一件事:
| 名字 | 它是什么 | 谁读它 |
|---|---|---|
tex_rgba.png |
人放的源文件。引擎不直接读它,读它的是导入器 | 导入器(编辑器侧) |
tex_rgba.png.import |
一份配置,不是资源。里面记着「这张图该导成什么格式、带不带 mipmaps」 | 编辑器;官方要求入库 |
.godot/imported/tex_rgba.png-4e33af38…ctex |
引擎真正读的那个文件。运行时 load() 拿到的就是它 |
ResourceLoader |
其中:这三个名字的分工不是「命名习惯」,而是职责切分:源文件给人看、.import 给编辑器看、.ctex 给运行时看。把 .import 叫成「资源」是第一个常见误读,它会导致后面「为什么改一个参数整张图就重导了」完全说不通。三者并列摆出来是这样(下表是本篇自己排的对应表,不是任何一份原文):
| 盘上的名字 | 它是谁 | 谁在读写它 |
|---|---|---|
res://tex_rgba.png |
源文件,你放进来的那张图 | 你;引擎只在导入时读一次 |
res://tex_rgba.png.import |
一份配置,不是资源。里面记着「这张图该导成什么格式、带不带 mipmaps」 | 编辑器;官方要求入库 |
res://.godot/imported/tex_rgba.png-4e33af38…ctex |
产物,引擎真正读的那个文件 | 编辑器写、ResourceLoader 读;官方要求不入库 |
下面对这三行特别说明:第三行的路径不是猜出来的,是第二行里 path= 那一项写死的。换句话说,「.png 怎么变成 .ctex」这件事对运行时是透明的——它只看配置,不看文件名。下图把这套对应关系与它上面的三条触发通路画在一起:
其中:图里三条触发通路里,前两条大家都会想到(改图、改参数),第三条最反直觉——编辑器自己也会去改那张 .import,而且改完立刻重导(第四章会给源码)。这也是为什么官方要强调那份文件必须进版本控制:它不是缓存,是被程序写过的一份声明。
0.3 本篇的边界:不涉及什么
OK,按本系列的惯例先把边界写清,免得后面读到别的意思:
| 不涉及 | 为什么 |
|---|---|
| 显存占用读数 | 本机没有显存侧读数工具。本篇凡涉及字节数,一律写「被上传的压缩块字节数」(.ctex 内容 / get_image() 返回的压缩块),不得当作显存读数值 |
| 跨平台对照 | 本机只有 Windows 一个平台,etc2_astc 那一支本机根本不产出 ⇒ 只写「源码有两条分支」,不推断移动端表现 |
| Detect 3D 回写的本机复现 | 回写由 MAKE_3D_FLAG 触发,需要编辑器 GUI 里把这张纹理实际用到 3D 场景/材质上;本机是 --headless --import 批处理,该 flag 不产生 ⇒ 只呈现源码与 .import 结构 |
| 矢量光栅算法 / 渲染 API 用法 / 硬件微架构 | 分别属 T03、T04/T09 与《GPU 架构剖析》题域(系列边界①②③),本篇不碰 |
0.4 盘上那份不是引擎读的那份
对齐完词,先看一件具体的事。造一个最小工程、放三张源图、跑一次导入,然后分别列出 res:// 与 res://.godot/imported/ 两处的内容——这是本篇最基础的一次对照,也是后面所有结论的地基:
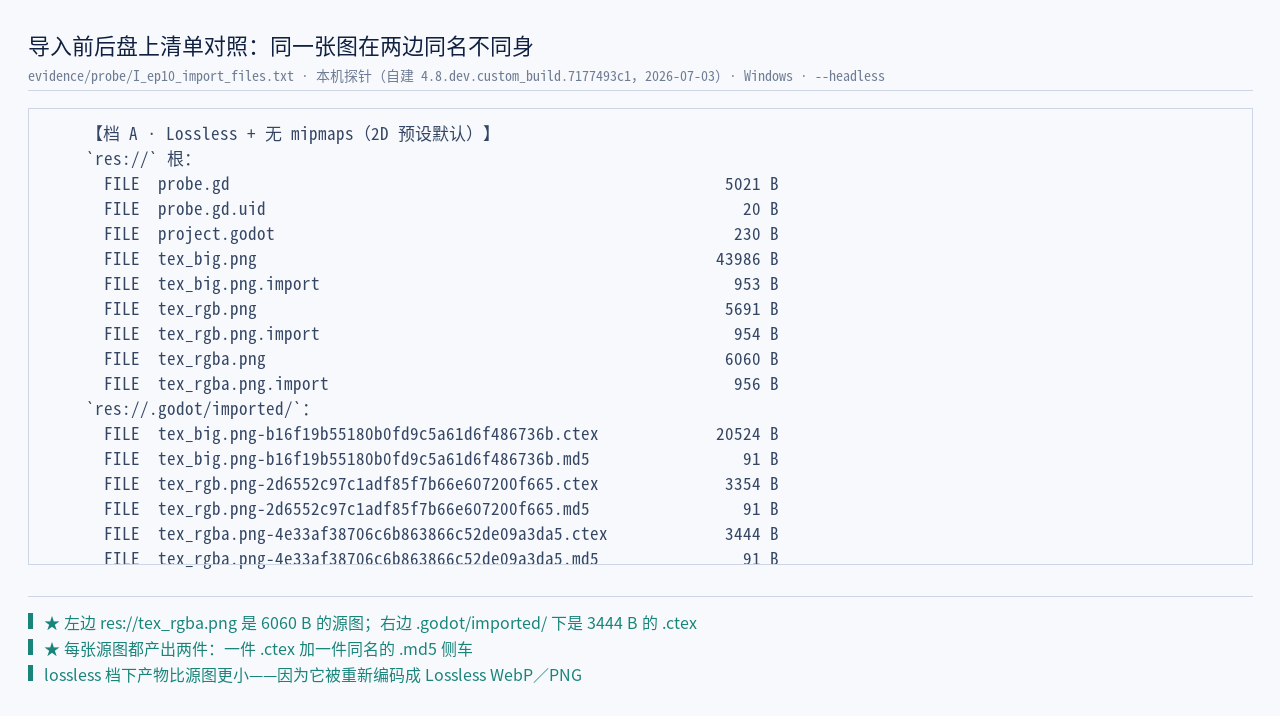
.ctex 与 .md5 两件@ 本机实测 · Godot 4.8.dev.custom_build.7177493c1(自建构建)其中:这张清单里有两个数字值得记一下:源图 6 060 B、产物 3 444 B——lossless 档下产物反而更小,因为它被重新编码过(官方文档写着「Lossless 是存成 Lossless WebP 或 PNG」)。但更重要的是右边那两件:一件 .ctex,一件同名的 .md5。后者是侧车文件,第一章会用它回答一个被误传很久的问题——文件名里那串十六进制到底是什么。
0.5 三个可检验命题
本篇只回答三个问题,每个都要能落到可核对的东西上。
先来看看第一个问题,盘上的源图和引擎读的那个文件是什么关系。答案不是「同一个文件的两种叫法」,而是「一次转换的两个端点」:中间那张 .import 是配置,.ctex 是产物,而产物的文件名里带着一串从路径算出来的哈希(第一章)。
再看第二个,同一张图,为什么换个压缩模式,代价会朝三个不同方向动。答案是它不是「压得好不好」一个问题,而是三笔账:磁盘、显存、加载时间。Lossless 在这三笔账上是「省磁盘 + 费显存 + 慢加载」,VRAM Compressed 三项全反。本机在 1024² 上实测到的加载差是 4.6 倍(第三章、第五章)。
最后看第三个,这张图最后落到谁手里。答案是一条可以被逐行读出来的链:.ctex → CompressedTexture2D::load() → RenderingServer::texture_2d_create() → TextureStorage::texture_2d_initialize() 的四件事 → RD::texture_create()(第八章、第九章)。而这条链上还坐着一位管账的——一份只有 19 行的缓存(第七章)。
0.6 四条读法约定
依然是惯例,四条读法约定也一并写清,请在读完全篇时记住:
| 约定 | 为什么 |
|---|---|
| 行号属于某个提交,不属于版本号 | 本篇所有行号按 master 快照 2026-10-09,逐条回本机文件复核,不做算术平移;本机自建构建的行号若与快照不同,会同时给出两个并注明 |
| 本机读数的前提 | 引擎为自建版本 4.8.dev.custom_build.7177493c1(2026-07-03 构建)、Windows、--headless 批处理导入;少了任一条读数就不可比 |
| 文档 / 源码 / 本机三层不能混说 | 文档说「设计上是这样」,源码说「代码里确实这样」,本机说「这台机器上跑出来是这样」。三层结论不一致时并列给读者,不替任何一层圆场 |
| 围栏里的「原文」边界 | 围栏内就是源码原文,一字未增删。只有三样东西是本篇加的:行首那条 // 文件路径:行号 定位注释、行尾方框里的 【1】 这类编号标签(含 【mipmaps】:278 这种只标区间的断点)、以及用 … 明写的省略。除此之外围栏内任何一个字符都来自源文件——这也是本篇的图与文能互相对上的前提 |
这里顺带把一个定义放在最前面,免得后面反复解释:本篇说的「导入」(import),指的是编辑器把一个源文件按一份配置转换成引擎资源的那一次动作——它不属于运行期,也不属于打包期,而属于你按下保存键前后的那几秒。
本章出处:官方文档 Import process(三件套的定义与两段 ls);官方类参考 CompressedTexture2D(.ctex 是引擎内部格式);本机实测 I_ep10_import_files.txt(content/blog/godot-engine-ep10-resource-pipeline/evidence/probe/)。
一、三件套与那串哈希:盘上到底留下了什么
这一章把零章那张图里的三个名字逐个拆开看:官方怎么规定这三件套、.import 里到底写了什么、以及旁边那件 .md5 侧车到底存了什么。
1.1 官方是怎么规定这三件套的
言归正传,先把官方的规矩抄清楚,后面所有尝试都落在它上面。官方文档《Import process》里有四段话直接管这件事:
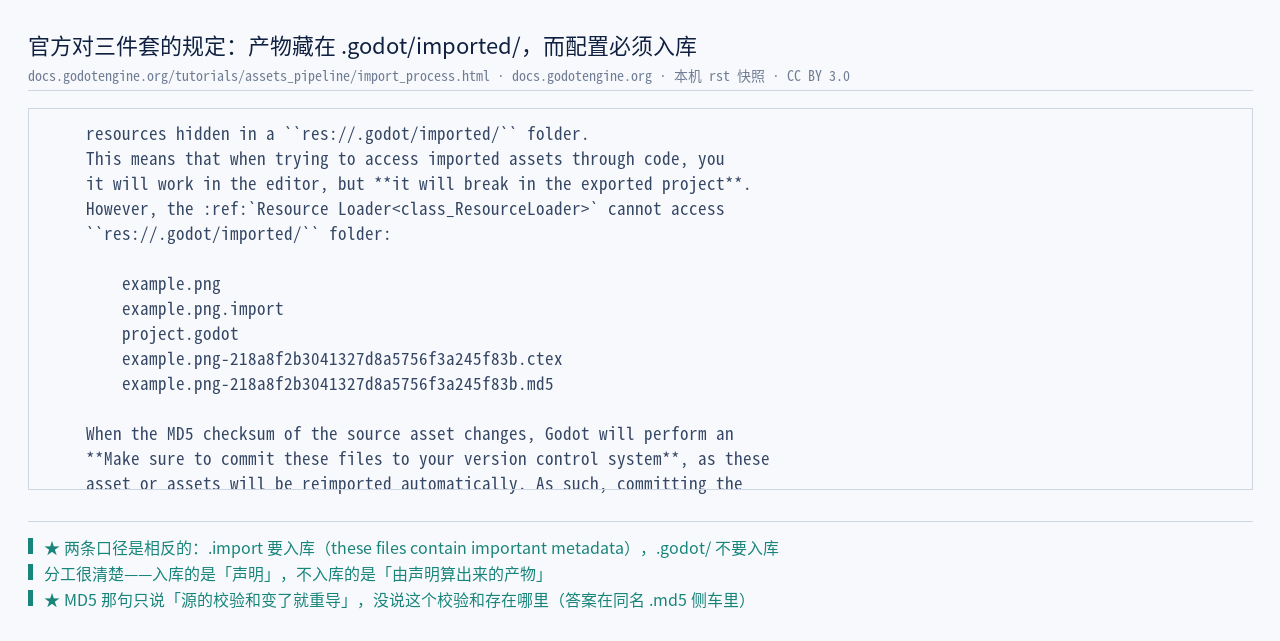
.godot/imported/,而配置必须入库@ godot-docs 官方文档(本机 rst 快照)· CC BY 3.0其中:这段里有两条口径是相反的,很容易被读成一条:.import 要入库(官方明写那句「these files contain important metadata」),而 .godot/ 不要入库(官方写「committing the .godot/ folder to the version control system is not recommended」)。初看像矛盾,其实分工很清楚——入库的是「声明」,不入库的是「由声明算出来的产物」。声明入库,别人 checkout 后能重算出一样的产物;产物入库只会白占空间与带宽。
官方还写了一条关于自动重导的规矩,它是本章后半段的引子:
When the MD5 checksum of the source asset changes, Godot will perform an automatic reimport of it, applying the preset configured for that specific asset.
其中:注意这句只说「源资源的 MD5 校验和变了就重导」,没说这个校验和存在哪里。这件事本轮实测有答案,但在那之前,先看看 .import 里究竟有什么。
1.2 .import 里到底写了什么
官方要求这份文件入库,那它里面理应装着「重新算出一样产物」所需的全部信息。让引擎自己生成一份(先不手写任何内容,跑一次导入)然后全文读出来:
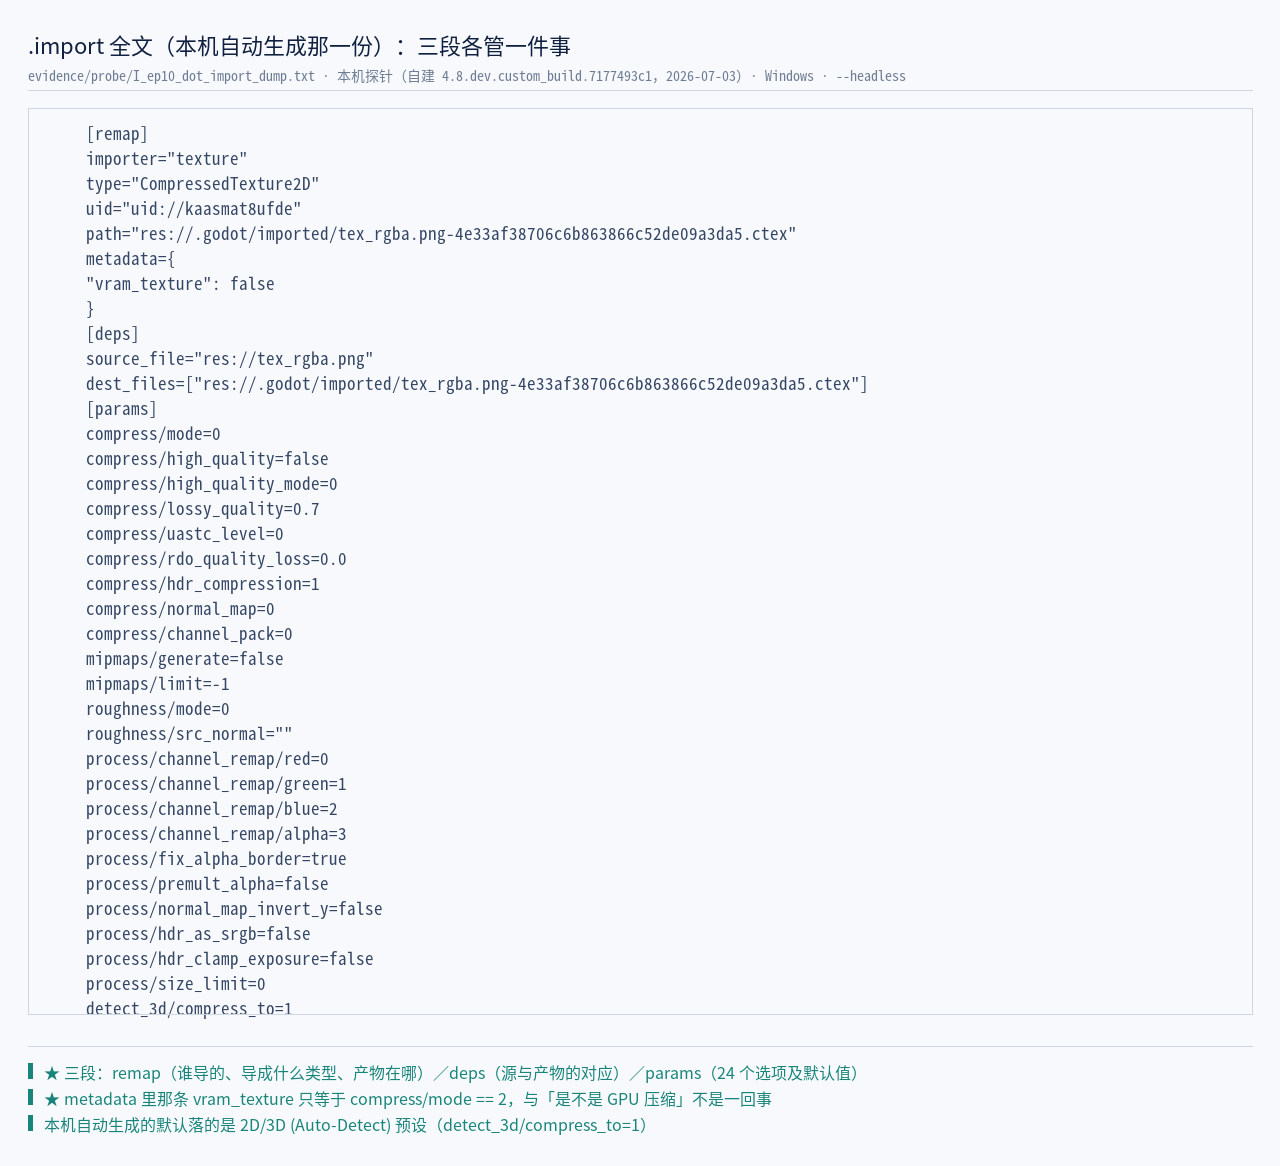
.import 全文:[remap] / [deps] / [params] 三段各管一件事@ 本机实测 · Godot 4.8.dev.custom_build.7177493c1(自建构建)其中:这份文件分三段,每段各管一件事,逐段对上源码里那三个取名字的方法就明白了。这里先给出三段的骨架(不是面板里那份全文,只保留结构与字段名):
; res://tex_rgba.png.import —— 三段结构

[remap]                                   ; 谁导的、导成什么类型、产物在哪
importer="texture"
type="CompressedTexture2D"
uid="uid://…"
path="res://.godot/imported/….ctex"       ; ← 运行时就是靠这一行找到产物的

[deps]                                    ; 源与产物的对应
source_file="res://tex_rgba.png"
dest_files=["res://.godot/imported/….ctex"]

[params]                                  ; 24 个导入选项(本节不展开,下一节讲)
compress/mode=0
mipmaps/generate=false
detect_3d/compress_to=1
…
下面对这三段特别说明:三个字段名恰好就是第二章要讲的那三个方法的产物——importer 来自 get_importer_name()、type 来自 get_resource_type()、path 的后缀来自 get_save_extension()。配置里的三个字符串,一一对应接口上的三个方法,这就是「名字由接口装配」的第一层证据。
| 段 | 内容 | 谁写的 |
|---|---|---|
[remap] |
importer="texture" / type="CompressedTexture2D" / uid= / path=…ctex |
ResourceImporter::get_importer_name() / get_resource_type() |
[deps] |
source_file= / dest_files=[…] |
导入器与文件系统的对接 |
[params] |
24 个选项及默认值 | get_import_options() |
其中:这里有个细节值得单独点出来:[remap] 里的 type="CompressedTexture2D"。它意味着「.png 进去、.ctex 出来」这件事在配置层就写明了——不是运行时猜的。这也解释了为什么 .png 能被 load() 直接当纹理用:ResourceLoader 读到这份 .import 的 remap,就知道该去加载那个 .ctex,而不是真去解析 PNG。
1.3 文件名里那串哈希是什么的哈希
现在回答本章开头留下的那个问题:产物名里那串十六进制,到底是路径哈希(path hash)还是内容哈希(content hash)?官方说「源的 MD5 校验和变了就重导」,而产物文件名里也有一串十六进制——它们是同一个东西吗?
本轮把同一张源图在三档压缩模式下各导一遍,逐档记下三样东西:文件名里的哈希、同名 .md5 侧车的内容、以及 .ctex 自己的哈希,再与本机自算的三种候选哈希比对:
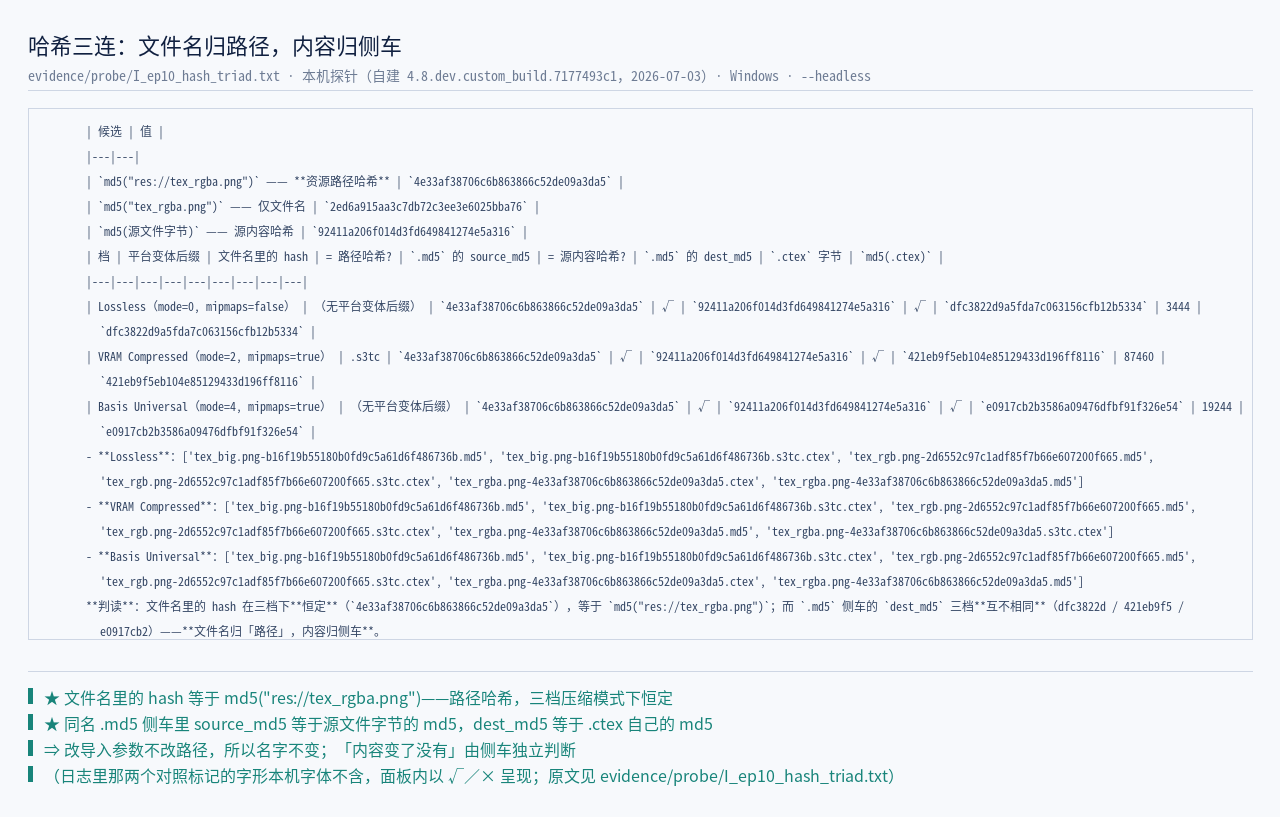
其中:这张对照表把一件事说清了:三个哈希管三件事,别混。
| 你看的那个哈希 | 它等于什么 | 用途 |
|---|---|---|
| 文件名里那串 | md5("res://tex_rgba.png")——路径哈希 |
让产物名与源路径一一对应且稳定 |
.md5 侧车的 source_md5 |
源文件字节的 md5 | 判断「源图内容变了没」,决定要不要重导 |
.md5 侧车的 dest_md5 |
产物 .ctex 字节的 md5 |
判断「产物本身完不完整」 |
其中:这里是本篇第一处「只看名字会读反」的地方。文件名里挂着哈希,直觉会认为「内容变了名字就变」——可实测是三档压缩模式下名字完全一样(都是 …4e33af38…)。原因就是它算的是路径:改导入参数不改路径,所以名字不变;只有改文件名或移动目录,名字才变。而「内容变了没有」这件事,由侧车里那个 source_md5 独立判断。
顺带解释了一个日常现象:为什么改一次导入参数后,.ctex 的文件名看起来没变,但内容确实换了。名字归路径,内容归侧车——你可以把 .md5 那件侧车看成产物的「双联单」:一边记源、一边记产物,两张单据各查各的。
本章出处:官方文档 Import process(res://.godot/imported/ 与两段 ls 原文);源码 resource_importer_texture.cpp(三个取名字的方法);本机实测 I_ep10_import_files.txt、I_ep10_dot_import_dump.txt、I_ep10_hash_triad.txt(content/blog/godot-engine-ep10-resource-pipeline/evidence/probe/)。
二、导入器对一张图做了什么:三个名字由接口装配
上一章看的是「盘上留下了什么」,这一章往上一层:是谁决定了留下这些东西。答案是 ResourceImporter 这个抽象类——它只有三个「取名字」的方法和一个干活的方法。
2.1 一个导入器的接口只有八个参数
把 ResourceImporter 的接口逐行读出来,会发现「源文件 → 中间扩展名 → 资源类型」这套命名不是惯例,是接口强制的:
其中:这个接口的入参里有两个是出参性质,值得单独看:
// core/io/resource_importer.h:157

virtual Error import(ResourceUID::ID p_source_id, const String &p_source_file,   【1】源
        const String &p_save_path, const HashMap<StringName, Variant> &p_options,  【2】产物落点 【3】选项
        List<String> *r_platform_variants, List<String> *r_gen_files = nullptr,    【4】平台变体 【5】生成文件
        Variant *r_metadata = nullptr) = 0;                                        【6】回写元数据
下面对第 4 与第 6 个参数特别说明。r_platform_variants 是平台变体的出口——第九章会看到,VRAM 压缩模式下同一张图可能按平台产出不同格式;r_metadata 是回写元数据的出口——它会落到 .import 的 metadata 那一段(上一章那张全文里就有 vram_texture 一项)。
其中:所以「一次导入可以产出多个文件」这件事在接口层就是允许的,不是实现层的特例。这一点在第九章会变成一句具体的话:某些压缩模式下,一次导入确实会写不只一个 .ctex。
2.2 那 24 个默认值是谁定的
[params] 那 24 行不是随手写的默认值,它们由预设决定。引擎给纹理导入器准备了三个预设,名字与三处关键默认值如下:
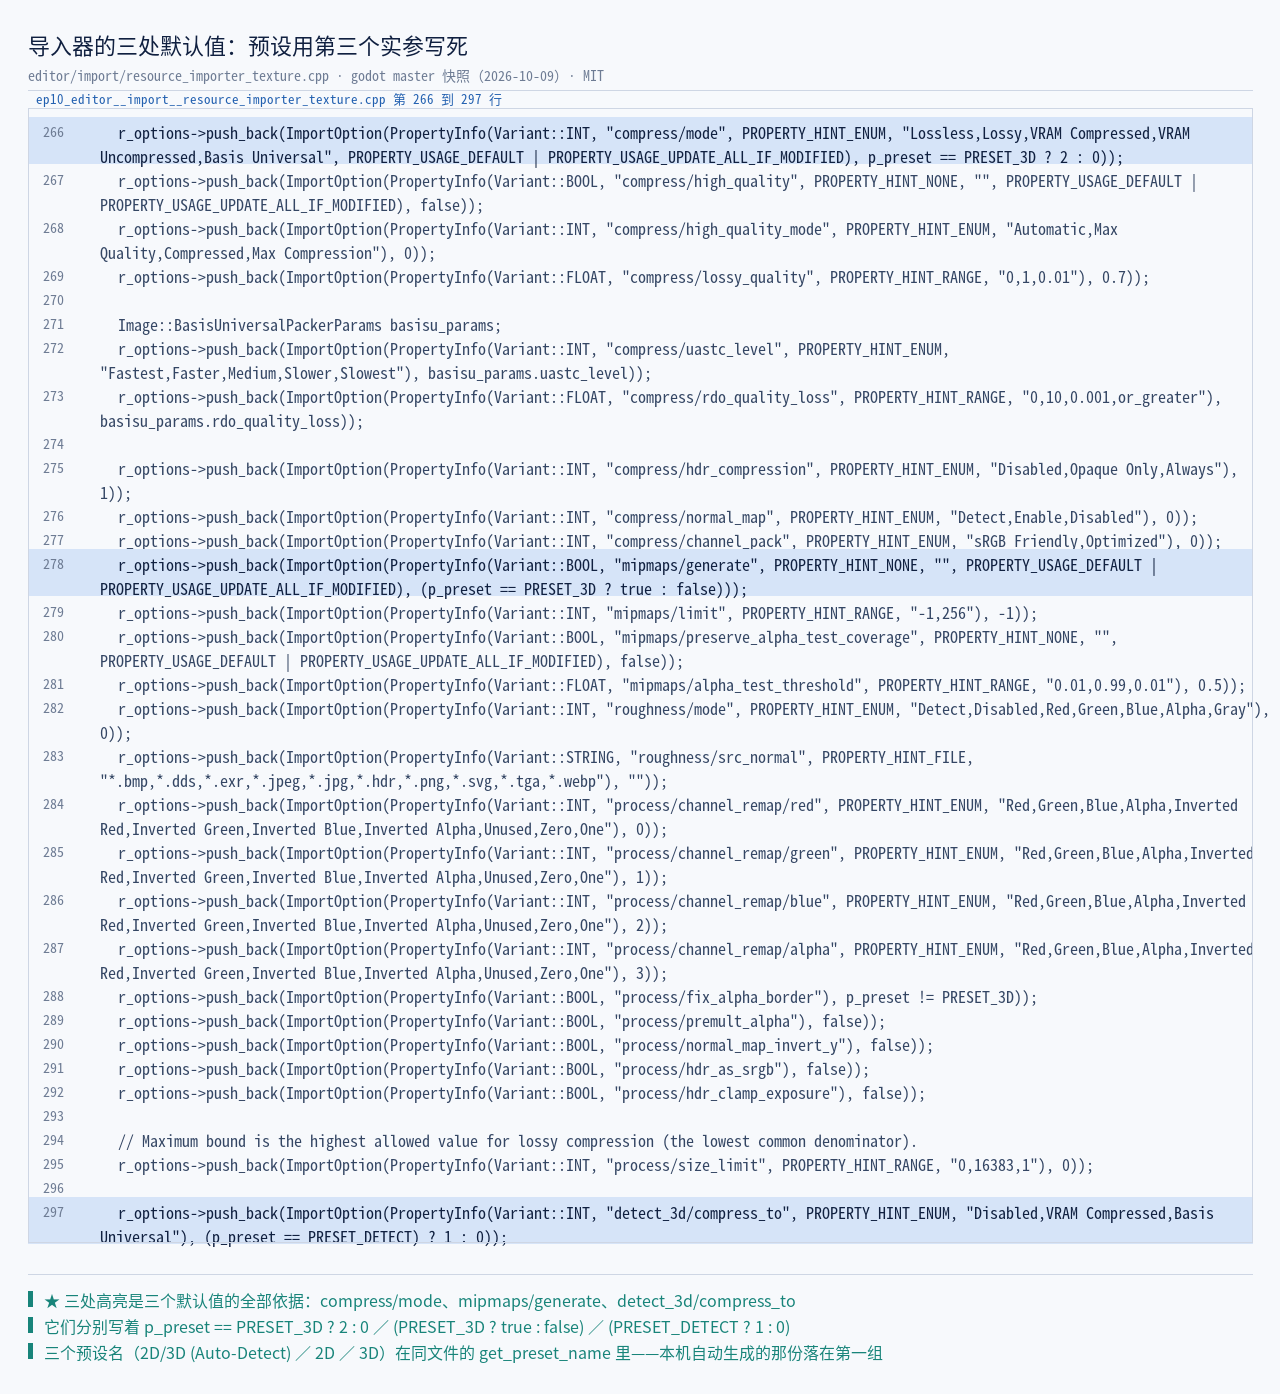
compress/mode、mipmaps/generate、detect_3d/compress_to,各由预设的第三个实参写死@ godot master 快照(2026-10-09)原文截取 · MIT其中:三处第三个实参就是三个默认值的全部依据,一字不改抄下来是这样:
// editor/import/resource_importer_texture.cpp

【压缩模式】:266
r_options->push_back(ImportOption(PropertyInfo(Variant::INT, "compress/mode", PROPERTY_HINT_ENUM,
        "Lossless,Lossy,VRAM Compressed,VRAM Uncompressed,Basis Universal", …),
        p_preset == PRESET_3D ? 2 : 0));            // ← 3D 预设给 2,其余给 0

【mipmaps】:278
r_options->push_back(ImportOption(PropertyInfo(Variant::BOOL, "mipmaps/generate", …),
        (p_preset == PRESET_3D ? true : false)));   // ← 只有 3D 预设才开

【Detect 3D】:297
r_options->push_back(ImportOption(PropertyInfo(Variant::INT, "detect_3d/compress_to", PROPERTY_HINT_ENUM,
        "Disabled,VRAM Compressed,Basis Universal"), (p_preset == PRESET_DETECT) ? 1 : 0));
下面对这三行特别说明。第一行的 ? 2 : 0 把「2D 用 Lossless(枚举值 0)、3D 用 VRAM Compressed(枚举值 2)」写死在预设里;第二行的 ? true : false 把「3D 才开 mipmaps」也写死;第三行是三个预设里只有 Auto-Detect 才给 1。
其中:这里有一个能纠正常见说法的实测结论:本机让引擎自动生成 .import,拿到的 detect_3d/compress_to=1 + compress/mode=0 + mipmaps/generate=false——正好是 2D/3D (Auto-Detect) 那一组,不是「2D」。所以准确说法是「一张普通 png 进来先落在 Auto-Detect 预设上」,它同时具备 Lossless 的当前值与「被用到 3D 就改」的开关。
2.3 size_limit 那三段硬编码的兜底
接着看它是怎么干活的。import() 一开头读了一大堆选项(压缩 7 个、mipmaps 4 个、粗糙度 2 个、处理 8 个),但在真正动手之前,先处理了一个没人在意、但一定生效的参数:process/size_limit。
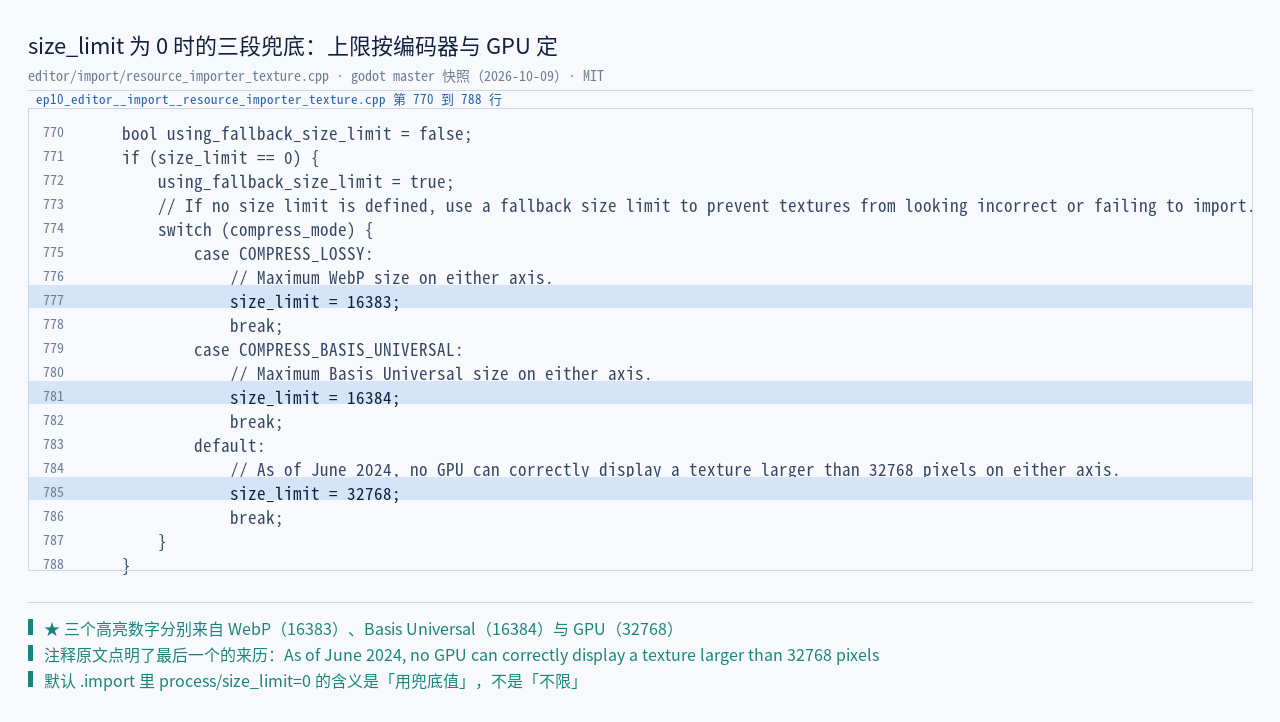
size_limit 为 0 时的三段兜底:16383 / 16384 / 32768——上限由编码器与 GPU 决定,不是由用户定@ godot master 快照(2026-10-09)原文截取 · MIT其中:这段代码的注释本身就值得引用一次,因为它是把「硬件事实」写进代码的典型:
// editor/import/resource_importer_texture.cpp:770–788

if (size_limit == 0) {
        using_fallback_size_limit = true;
        // If no size limit is defined, use a fallback size limit to prevent textures from looking incorrect or failing to import.
        switch (compress_mode) {
                case COMPRESS_LOSSY:
                        // Maximum WebP size on either axis.
                        size_limit = 16383;
                        break;
                case COMPRESS_BASIS_UNIVERSAL:
                        // Maximum Basis Universal size on either axis.
                        size_limit = 16384;
                        break;
                default:
                        // As of June 2024, no GPU can correctly display a texture larger than 32768 pixels on either axis.
                        size_limit = 32768;
                        break;
        }
}
下面对这三档特别说明:它不是按「用户想要多大」定的,而是按「编码器与 GPU 各能吃到多大」定的。Lossy 那一档的上限来自 WebP(16383),Basis Universal 来自 Basis(16384),其余来自 GPU(32768)。三个数字里只有中间那个是 2 的整数次方,其余两个都是「差一点」。
其中:这段还顺带解释了一个观察:为什么默认 .import 里 process/size_limit=0 却从没见过「超大图没被裁」——因为 0 的含义是「用兜底值」,真正的上限一直在生效。
2.4 导入是逐文件的,而且会报耗时
导入器干完活之后,编辑器会留下一串日志。本机用 --verbose 跑一次,日志里能读到逐文件的耗时:
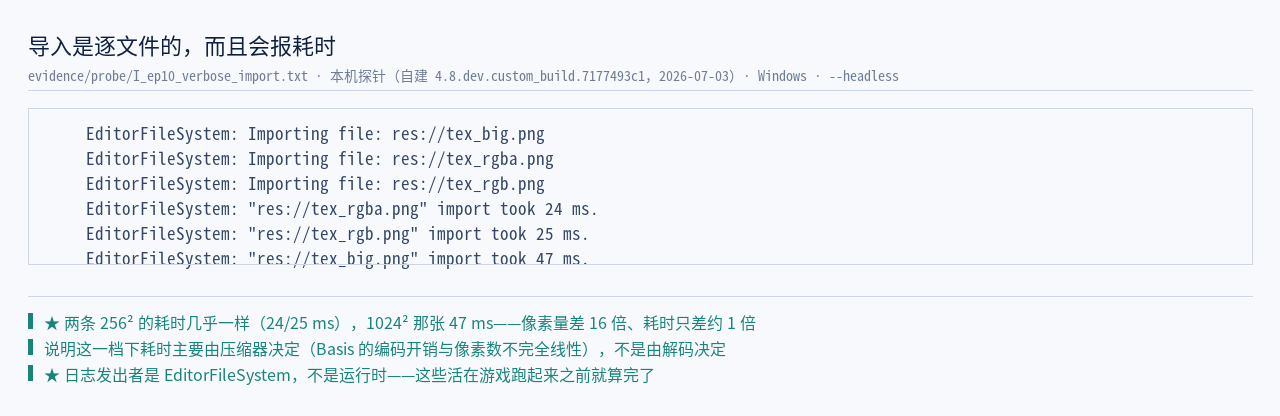
其中:三条日志里有两条 256² 的耗时几乎一样(24 / 25 ms),而 1024² 那张是 47 ms——像素量差了 16 倍,耗时只差了约 1 倍。这不是矛盾,而是说明这一档下耗时主要由压缩器决定(Basis Universal 的编码开销与像素数不完全线性),不是由解码决定。第五章的加载耗时表会从另一个方向印证这件事。
这段日志还有一层用处:它是「导入是编辑器行为」的物证。日志的发出者是 EditorFileSystem,不是运行时——这些东西在游戏跑起来之前就已经算完了。
2.5 预设 → 选项 → 格式:一条会回环的链
到此可以把第二章的认识收成一张图。这张图里有一条回环,是第四章的主角:
其中:这条回环的意思是:选项不是只读的。用户改它、预设给它默认值,此外编辑器也会在某些条件下改写它。这就是「我明明选了 Lossless,为什么最后是 VRAM Compressed」这个问题的形状——答案不在用户这边,在第四章那段源码里。
本章出处:源码 resource_importer.h(:110–157)与 resource_importer_texture.cpp(:186–204 三个取名字的方法、:266–297 预设与选项、:770–788 兜底);本机日志 I_ep10_verbose_import.txt、I_ep10_dot_import_dump.txt。
三、一个数字管三种代价:五档压缩模式
前两章讲的是「导入这件事怎么发生」,从这一章开始讲它做的那个最重要的决定:把这张图压成什么。这个决定看着只有一个数字(compress/mode),实际同时改变三笔账。
3.1 官方的六行对照表
官方把五档压缩模式放在一张表里对照,六行看下来,会发现「内存」与「加载时间」两行才是真正分家的地方:
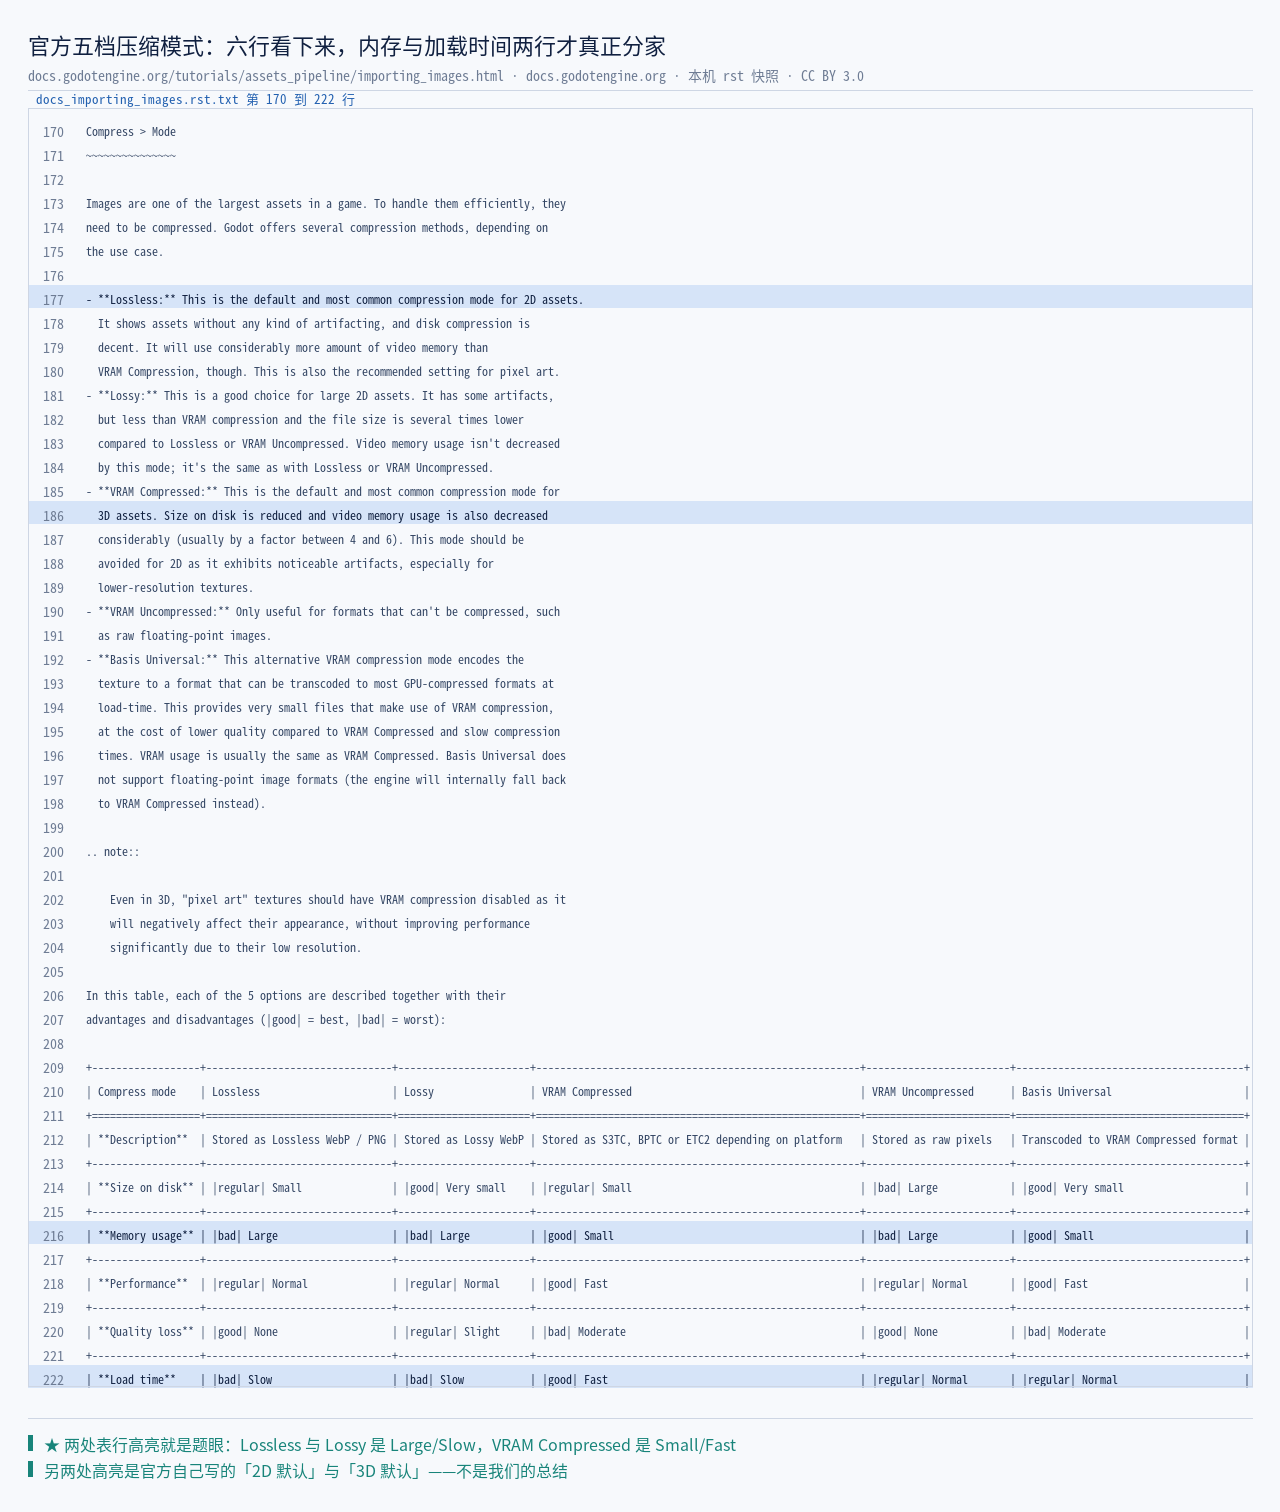
其中:把六行压成一句话,五档可以按「代价往哪个方向走」归类成三组:省磁盘组(Lossy、Basis Universal)、省显存组(VRAM Compressed、Basis Universal)、两不省组(VRAM Uncompressed);而 Lossless 单独站在「省磁盘、不省显存」这一格上。归类的目的不是给它们排名,而是看清换一档到底换掉了哪笔账:
| 档 | 磁盘 | 内存 | 加载时间 | 质量损失 |
|---|---|---|---|---|
| Lossless | Small | Large | Slow | None |
| Lossy | Very small | Large | Slow | Slight |
| VRAM Compressed | Small | Small | Fast | Moderate |
| VRAM Uncompressed | Large | Large | Normal | None |
| Basis Universal | Very small | Small | Normal | Moderate |
其中:这张表里最该记住的是没有一档是三项全优的——VRAM Compressed 三个方向里赢两个、赔一个质量;Lossless 赢磁盘与质量、赔内存与加载。而 2D 默认选 Lossless、3D 默认选 VRAM Compressed,依据就是「2D 图通常小且要精确、3D 贴图通常大且看远近」这两句常识(下一节会用实测数把它们量化)。
这五档在源码里的定义就是导入选项上的一个枚举,五个值按顺序排开:
// editor/import/resource_importer_texture.cpp:266(枚举字符串原文)

"compress/mode", PROPERTY_HINT_ENUM,
        "Lossless,Lossy,VRAM Compressed,VRAM Uncompressed,Basis Universal"
//        ↑0       ↑1      ↑2                ↑3                 ↑4
下面对这五个取值特别说明:它们的顺序就是取值。所以后面看到 .import 里写 compress/mode=2,指的就是 VRAM Compressed;写 =0 就是 Lossless。三个预设各自的默认值(2D 给 0、3D 给 2)也正是用这个序号表达出来的。
3.2 官方给的内存表,以及它的两条脚注
官方在对照表下面还给了一张具体数字的表(单个 RGBA8 纹理、开 mipmaps),这张表是「同一张图显存差 4 倍」这句话的唯一权威来源:
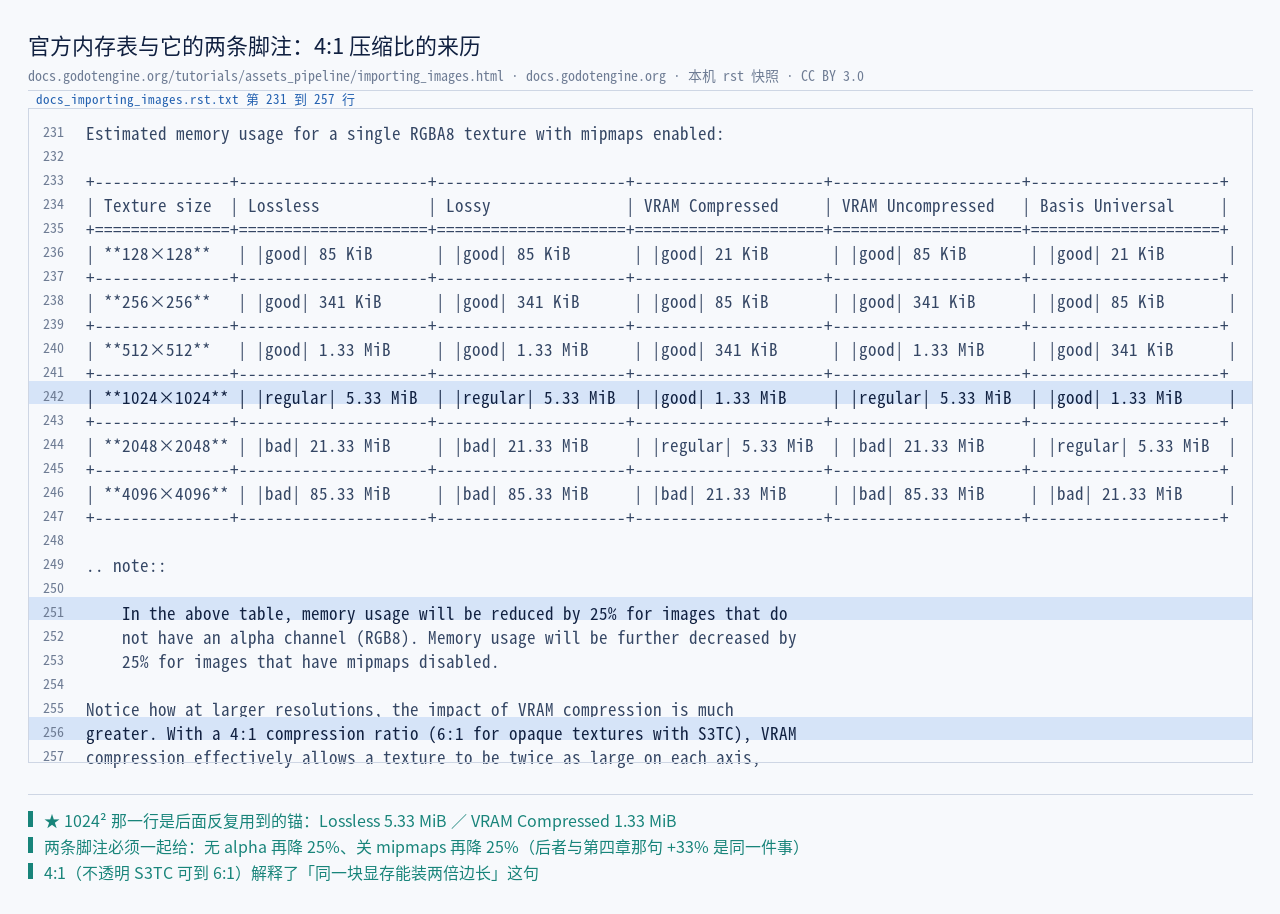
其中:这张表里 1024² 那一行是后面反复会用到的锚:Lossless 5.33 MiB、VRAM Compressed 1.33 MiB。而它的两条脚注是必须一起给的,否则数字会被误读:
- 没有 alpha 通道(RGB8)时,内存再降 25%;
- 关掉 mipmaps 时,内存再降 25%。
其中:第二条脚注与第四章官方那句「mipmaps 让内存多约 33%」是同一件事的两种说法(1 ÷ 1.3333 ≈ 0.75)。本篇会把这两句对齐后再用,避免出现「一边说 +33%、一边说 -25%」看起来自相矛盾的情况。
3.3 本机在盘上量到的字节数
说白了,官方那张内存表讲的是显存。本机没有显存侧读数工具,但有一件能直接量的东西:.godot/imported/ 里 .ctex 的字节数。同一批源图,只改 .import,三档各导一遍:
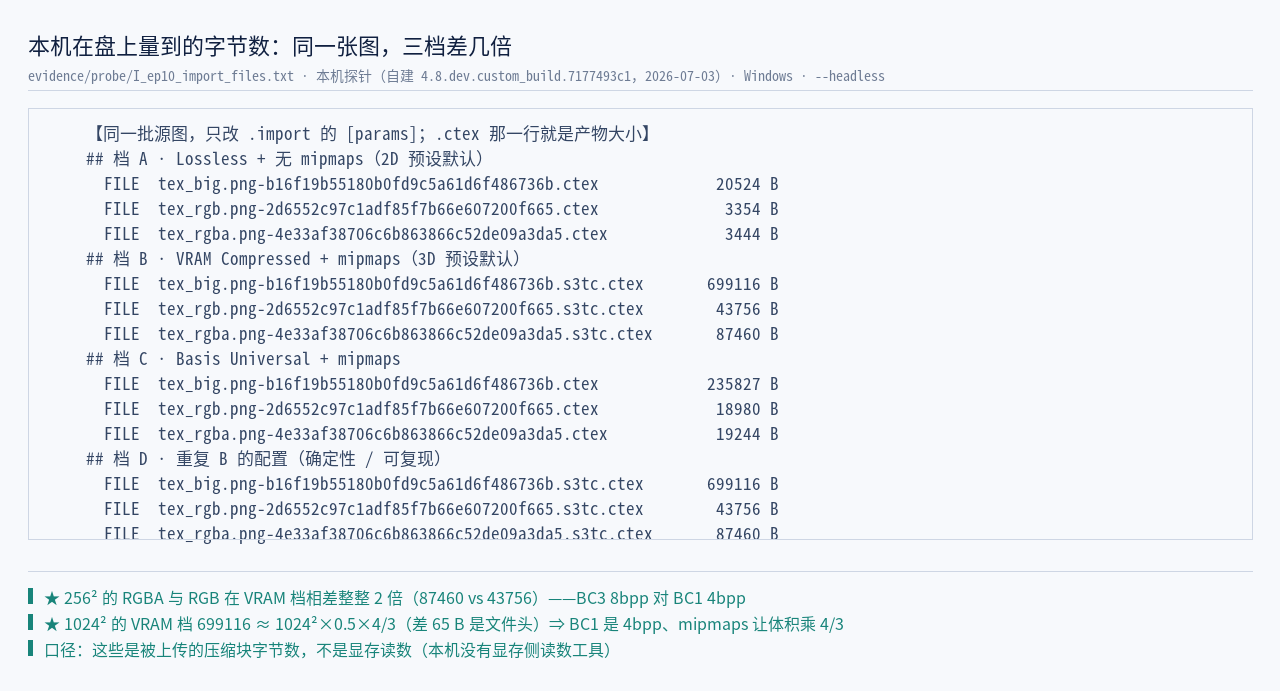
.import,三档相差数倍@ 本机实测 · Godot 4.8.dev.custom_build.7177493c1(自建构建)其中:这张表有两条关系是可以自己动手对上的,它们把官方的抽象数字与盘上的具体字节接了起来。
第一条:256² 的 RGBA 与 RGB 在 VRAM 档相差正好 2 倍(87 460 与 43 756)。这是因为不透明 RGB 被压成了 BC1(4 bpp),而带 alpha 的被压成 BC3(8 bpp)——每像素 1 字节对 0.5 字节,正好一倍。官方那条「无 alpha 再降 25%」讲的是未压缩的 RGB8 相对 RGBA8(3 字节对 4 字节),而在压缩后,这个差距被放大到了一半。
第二条:1024² 的 VRAM 档是 699 116 B,而 1024² × 0.5 B/px × 4/3 ≈ 699 051 B——差的 65 B 是文件头。这意味着「BC1 是 4 bpp」与「mipmaps 让体积乘 4/3」这两个认识,在盘上能一次性同时验证(第四章会把 4/3 那部分单独量出来)。
其中:这里要重复一次口径:这些是被上传的压缩块字节数,与显存里那份同源但不等于显存读数值。本机拿不到显存侧的数字,所以全篇凡涉字节,一律按这个口径写。
3.4 三根轴摆到一起
好了,把官方那三行与本机这两张表合成一张图,五档压缩的取舍就一目了然了:
其中:这张图想说的不是「哪一档最好」,而是这三根轴不能互相换算。如果只看磁盘,Lossless 与 VRAM Compressed 都是 Small,看不出差别;只看显存,Lossless 与 VRAM Uncompressed 一样大;而加载时间那一根轴上,只有 VRAM Compressed 与 Basis Universal 站在 Fast 侧。
其中:这也顺带回答了一个常见的追问问法:「我 2D 项目能不能改用 VRAM Compressed 省显存?」技术上能,代价写在官方表里那一格:Quality loss: Moderate。官方在类参考里把这句话说得更直接——VRAM compression can exhibit noticeable artifacts and is intended to be used for 3D rendering, not 2D。所以 2D 默认不选它,不是因为省不了,是因为画面上看得出来。
本章出处:官方文档 Importing images(五档对照表、内存表与两条脚注、4:1/6:1 那句);官方类参考 CompressedTexture2D(Only VRAM Compressed actually reduces the memory usage on the GPU);本机实测 I_ep10_import_files.txt、I_ep10_manifest.json。
四、mipmaps 那 33%,以及一个会改你配置的检测器
上一章讲的是「压缩成什么」,这一章讲两件与它紧邻的事:要不要生成 mipmaps(一个纯加法),以及编辑器凭什么能推翻你已经做好的选择(一个回环)。
4.1 「缩小到远处就闪」这件事有名字
先来看看现象。一张纹理被贴到远处、或者被缩到很小时,如果只用原分辨率去采样,画面会开始闪动、出现细密的噪点。这不是显卡坏了,而是采样点太稀造成的走样:
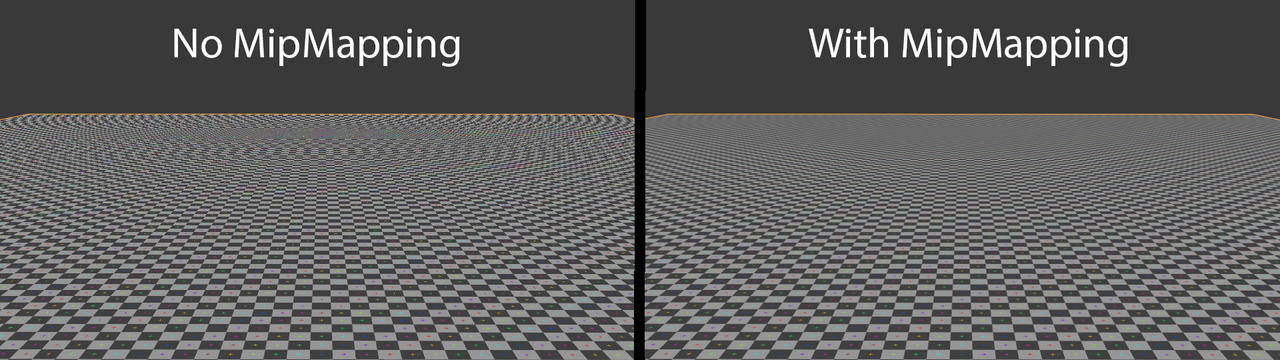
其中:这件事在 Godot 里的解法就是 mipmaps:在导入时预先算出一串逐级减半的小图,采样时按距离选合适的那一级。官方文档写得很直白:
If enabled, smaller versions of the texture are generated on import. For example, a 64×64 texture will generate 6 mipmaps (32×32, 16×16, 8×8, 4×4, 2×2, 1×1)…
其中:注意「6 层」这个数字:64 是 2 的 6 次方,所以能减半 6 次到 1×1。mipmap 层数由尺寸的 2 的幂次决定,不是固定值——这条在后面量体积时会用上。
4.2 那 33% 是怎么来的、又是怎么量的
mipmaps 不是免费的。官方给的代价是一句话:
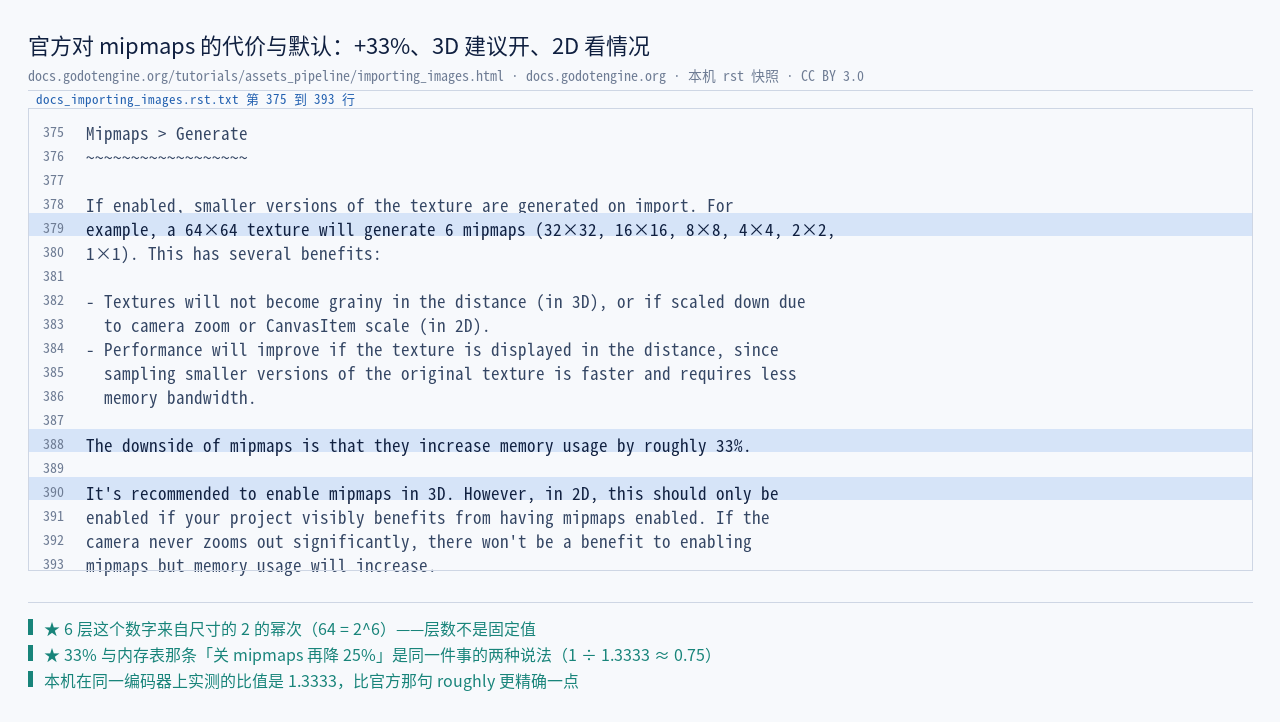
其中:「roughly 33%」这个数字的来源很好推:每加一层,面积是上一层的一半,所以总量 = 1 + 1/4 + 1/16 + … = 4/3,也就是多出 1/3。但推出来的数与量出来的数不是一回事——官方也说了是「roughly」。本机把它直接量了一遍:同一张图、同一个编码器,只切 mipmaps/generate 一个开关:
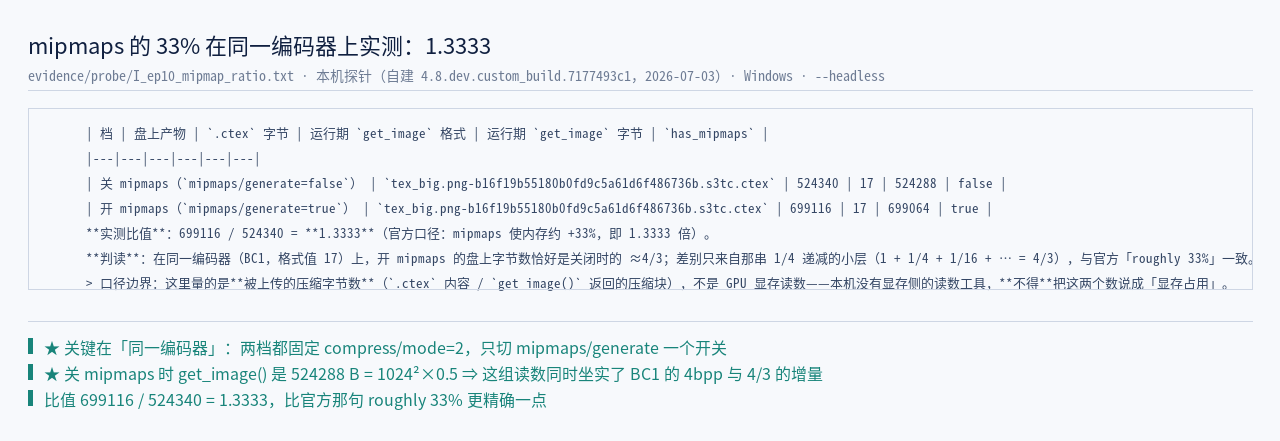
其中:实测比值是 1.3333——比官方那句「roughly」更精确一点。而这张表里还有一个顺带被坐实的数字:关掉 mipmaps 时 get_image() 的字节数是 524 288,正好等于 1024 × 1024 × 0.5。这个 0.5 B/px 就是 BC1 的压缩率(4 bpp),它把上一章那条「1024² 的 VRAM 档 ≈ 1024²×0.5×4/3」也补完了:两个认识在同一组读数里各归各位。
其中:这里要重复一次那三个字:同编码器。如果拿 Lossless 档(20 524 B)和 VRAM 档(699 116 B)去比「开不开 mipmaps 差多少」,比出来的会是压缩方式的差异,不是 mipmaps 的差异。这一类「换一个变量只能测一个变量」的纪律,本篇在第五章的加载耗时表上也用了一次。
4.3 一个会改你配置的检测器
OK,前面三章都默认「.import 里的参数是用户定的」。现在要打破这个默认——编辑器自己也会去改它。这段源码是本篇第二处「只看表面会读反」的地方:
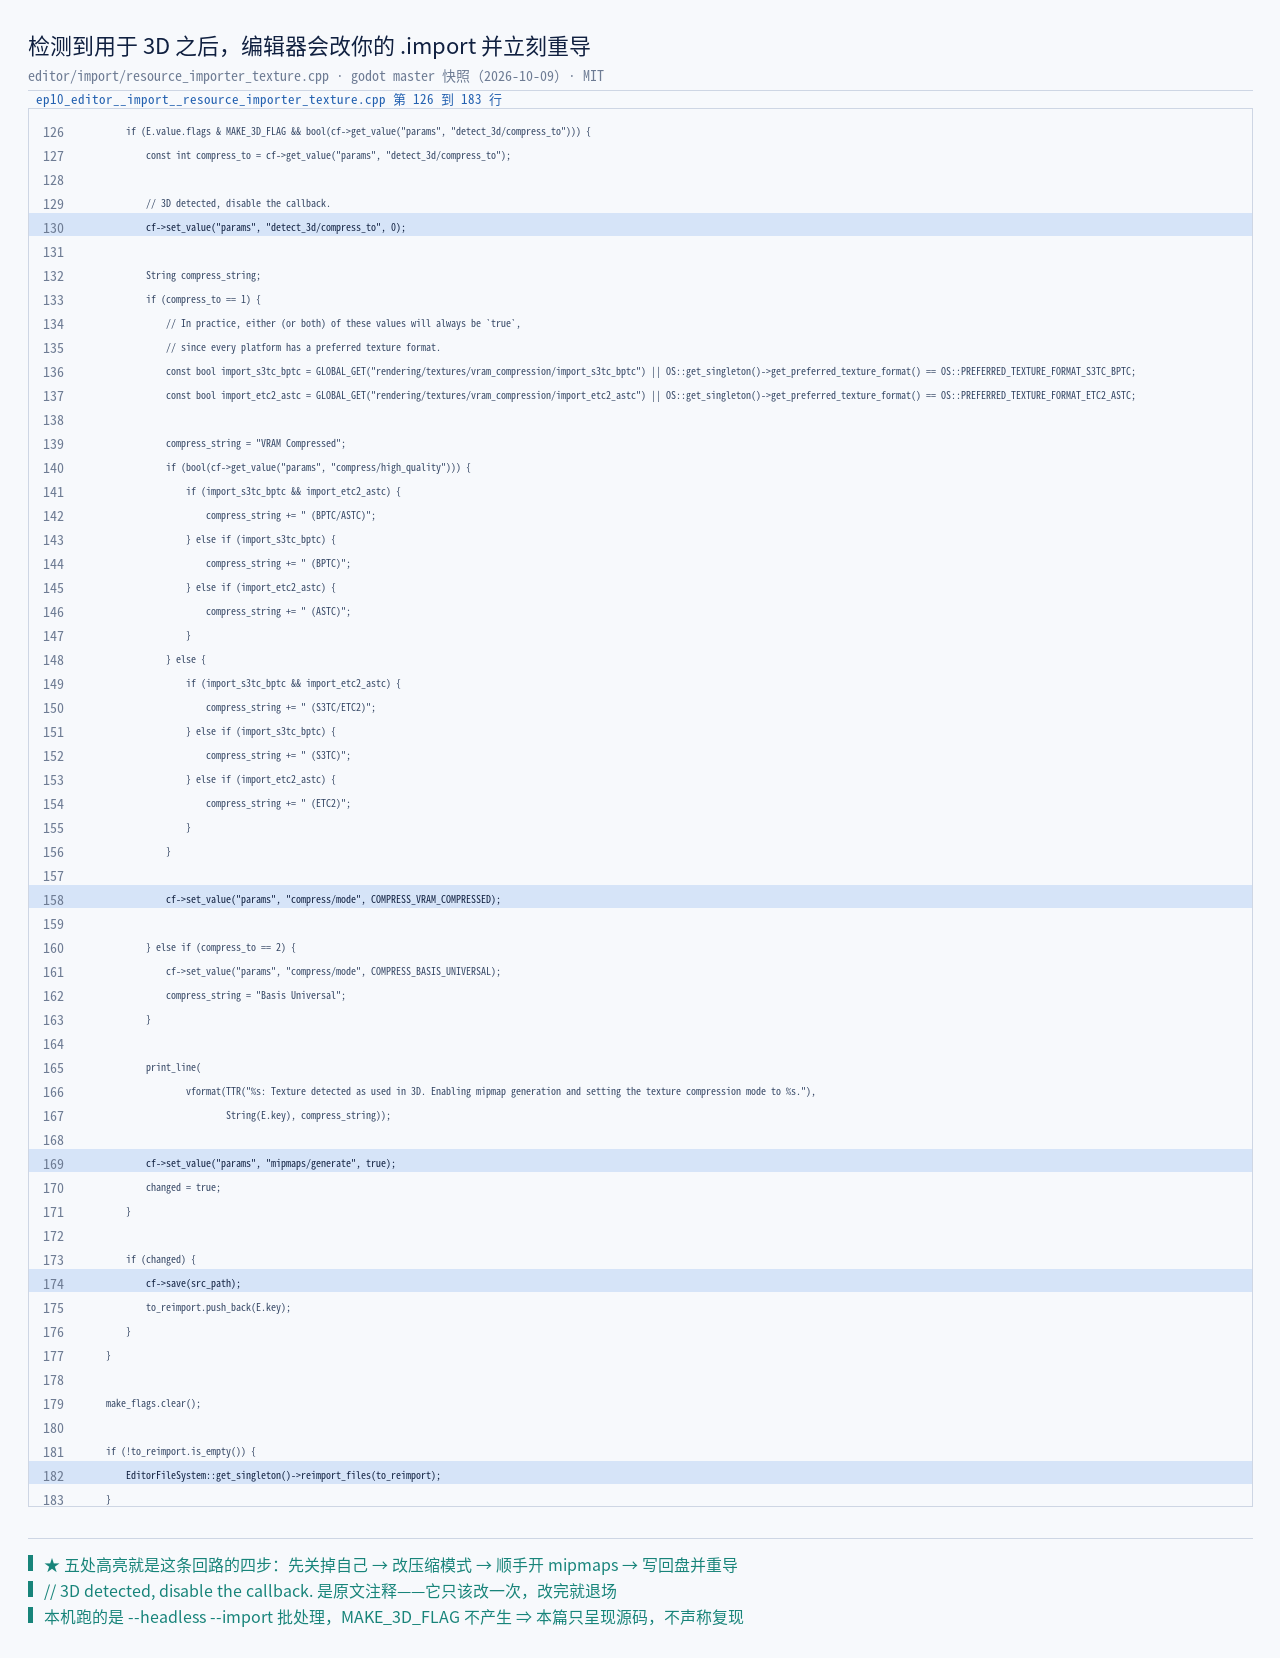
.import 并立刻重导@ godot master 快照(2026-10-09)原文截取 · MIT其中:把这段的因果链抄清楚,它一共四步:
// editor/import/resource_importer_texture.cpp:126–183(节选)

if (E.value.flags & MAKE_3D_FLAG && bool(cf->get_value("params", "detect_3d/compress_to"))) {
        const int compress_to = cf->get_value("params", "detect_3d/compress_to");

        // 3D detected, disable the callback.
        cf->set_value("params", "detect_3d/compress_to", 0);                    【1】先把开关关掉
        …
        cf->set_value("params", "compress/mode", COMPRESS_VRAM_COMPRESSED);     【2】改压缩模式
        …
        cf->set_value("params", "mipmaps/generate", true);                      【3】顺手开 mipmaps
        changed = true;
}

if (changed) {
        cf->save(src_path);                                                     【4】把配置写回盘
        to_reimport.push_back(E.key);
}
…
EditorFileSystem::get_singleton()->reimport_files(to_reimport);                 【4'】立刻重导
下面对这四步特别说明。第【1】步最有意思——检测器会先把自己关掉(detect_3d/compress_to 置 0)。官方在这行旁边留的注释是 // 3D detected, disable the callback.:因为它只该改一次,改完就退场,否则用户手动改回去又会被它改回来。
其中:第【4】步是整件事的关键:cf->save(src_path) 加 reimport_files(...)——它不只是内存里改了一下,而是把配置写回了盘上那个 .import,然后立刻重导。所以第二天你打开工程,看到 .import 里 compress/mode 已经不是自己选的那个值,这件事有明确出处。
而官方给用户看的那句提示(就在同一个函数里):
%s: Texture detected as used in 3D. Enabling mipmap generation and setting the texture compression mode to %s.
其中:这句话解释了这条路的准入条件:MAKE_3D_FLAG。本机要复现它,得在编辑器 GUI 里把这张纹理实际用到 3D 场景或材质上——本轮的 --headless --import 批处理走不到这条路径,所以本篇只呈现源码,不声称复现。这一点在第十二章会作为「没做的事」再列一次。
4.4 同族的另外两处回写
顺带说清一件事:Detect 3D 不是唯一一处回写。同一个函数里还有两处,机制完全一样:
| 触发条件 | 回写什么 | 源码位置 |
|---|---|---|
| 被当作法线图使用 | compress/normal_map 置 1,并提示「red-green texture compression to reduce memory usage (blue channel is discarded)」 |
:107–114 |
| 被当作粗糙度图使用 | roughness/mode 置成对应通道,并记下 roughness/src_normal 指向的法线图 |
:116–124 |
其中:三处合起来说明一件事:Godot 的导入参数里有几个是「可被推断」的——法线图一定只需要 RG、粗糙度图一定有对应的法线图、用于 3D 的图一定需要 mipmaps。引擎把这个推断做进了检测器,代价就是它会动你的配置。这是一条设计取舍,不是 bug:官方在文档里也写了「If you run into quality issues when a texture is detected to be used in 3D… change compress/mode back to Lossless after using the texture in 3D. This is preferable to disabling Detect 3D, as mipmap generation remains enabled」。
本章出处:官方文档 Importing images(mipmaps 段与 Detect 3D 段);源码 resource_importer_texture.cpp(:107–124 两处同族回写、:126–183 检测与写回、:165–167 提示文本);本机实测 I_ep10_mipmap_ratio.txt。
五、运行时三路:一个同步入口加三个线程入口
前四章讲的是「盘上发生了什么」,从这一章开始进入运行时。第一件事是:同一份 .ctex,运行时可以用几种方式把它读进来。
5.1 四个入口,五个状态
下面进入运行时这一侧。ResourceLoader 的接口里,管加载的一共四个方法——一个同步、三个线程:
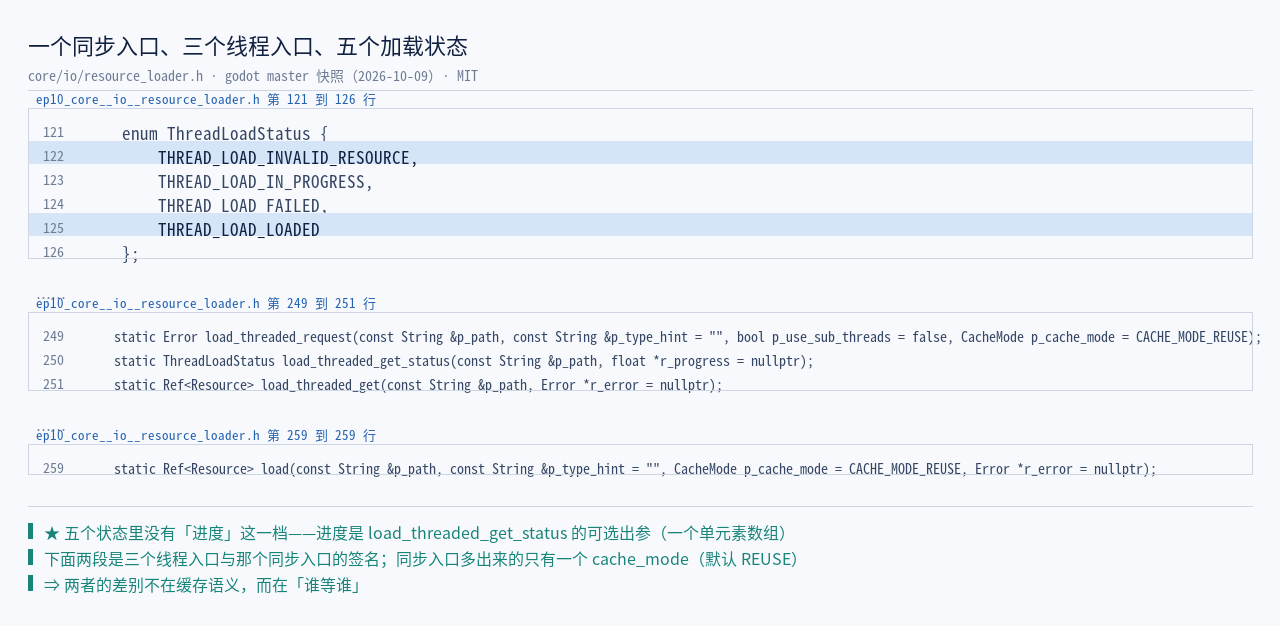
cache_mode@ godot master 快照(2026-10-09)原文截取 · MIT其中:这四个方法的签名里有几个默认值值得记住:
// core/io/resource_loader.h

【线程状态】:121–126
enum ThreadLoadStatus {
        THREAD_LOAD_INVALID_RESOURCE,   // 无效,或没请求过
        THREAD_LOAD_IN_PROGRESS,        // 还在加载
        THREAD_LOAD_FAILED,             // 失败
        THREAD_LOAD_LOADED,             // 加载完成,可取
};

【三个线程入口】:249–251
static Error load_threaded_request(const String &p_path, const String &p_type_hint = "",
        bool p_use_sub_threads = false, CacheMode p_cache_mode = CACHE_MODE_REUSE);
static ThreadLoadStatus load_threaded_get_status(const String &p_path, float *r_progress = nullptr);
static Ref<Resource> load_threaded_get(const String &p_path, Error *r_error = nullptr);

【同步入口】:259
static Ref<Resource> load(const String &p_path, const String &p_type_hint = "",
        CacheMode p_cache_mode = CACHE_MODE_REUSE, Error *r_error = nullptr);
下面对这四行特别说明。线程那三个是一个状态机:request 排队、get_status 查状态(顺带拿进度)、get 取结果。而同步的那个 load() 只有一个参数多出来——cache_mode,默认是 CACHE_MODE_REUSE。这说明两者共享同一套缓存语义,差别不在这里。
其中:四个 ThreadLoadStatus 里没有「进度」这一档——进度是 get_status 的一个可选出参(一个单元素数组)。官方对它的用法给了一条很具体的建议:
Note: The recommended way of using this method is to call it during different frames (e.g., in
Node._process, instead of a loop).
5.2 状态机在本机跑起来是什么样
官方既然说「要在不同帧里调」,那实际跑起来每帧长什么样就有意义了。本机对一个 1024×1024 的纹理发起线程加载,然后在每一帧查一次状态:
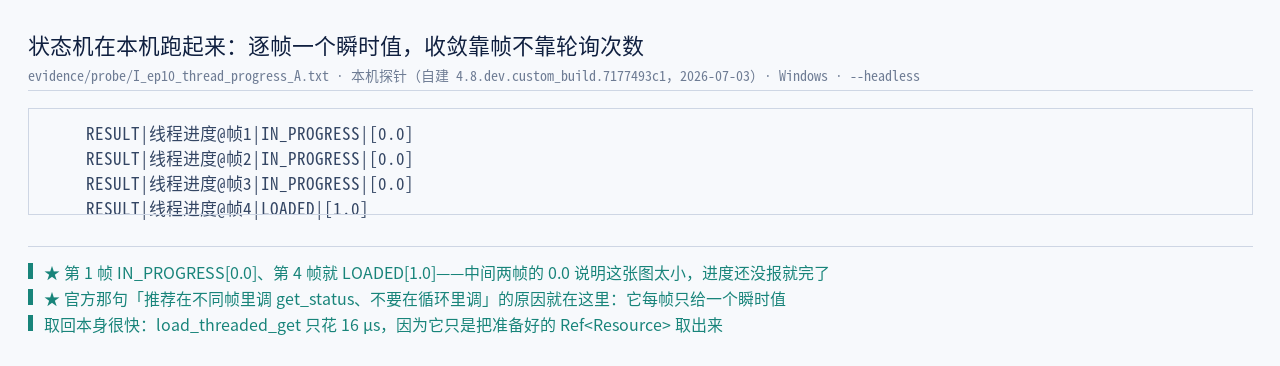
IN_PROGRESS[0.0],第 4 帧 LOADED[1.0]@ 本机实测 · Godot 4.8.dev.custom_build.7177493c1(自建构建)其中:这三个读数把官方那句 Note 的原因摆出来了:get_status 每帧只给你一个瞬时值,它不会帮你等到好。第 1 帧读到 IN_PROGRESS 且进度 0.0,第 4 帧就跳到 LOADED 且进度 1.0——中间那两帧的 0.0 说明这张图太小,进度还没来得及报就已经完了。真正要控制的是「什么时候去取」,而不是「查几次」。
同一份读数里还有一条容易被忽略的效率证据:状态收敛到 LOADED 之后,load_threaded_get 只花了 16 µs——因为它此时只是从任务里把准备好的 Ref<Resource> 取出来,没有解码、没有上传。所以官方那句「load_threaded_get 会阻塞」的真正含义是「它会阻塞在还没加载完的时候」,而不是「它本身很慢」。
5.3 同一张图,三档压缩模式的加载耗时
说白了,上一章量的是盘上字节数,这一章量加载耗时。同一张图、同样只改 .import,三种压缩模式下各冷加载 5 次取中位,外加一次 1024² 大图的冷加载:
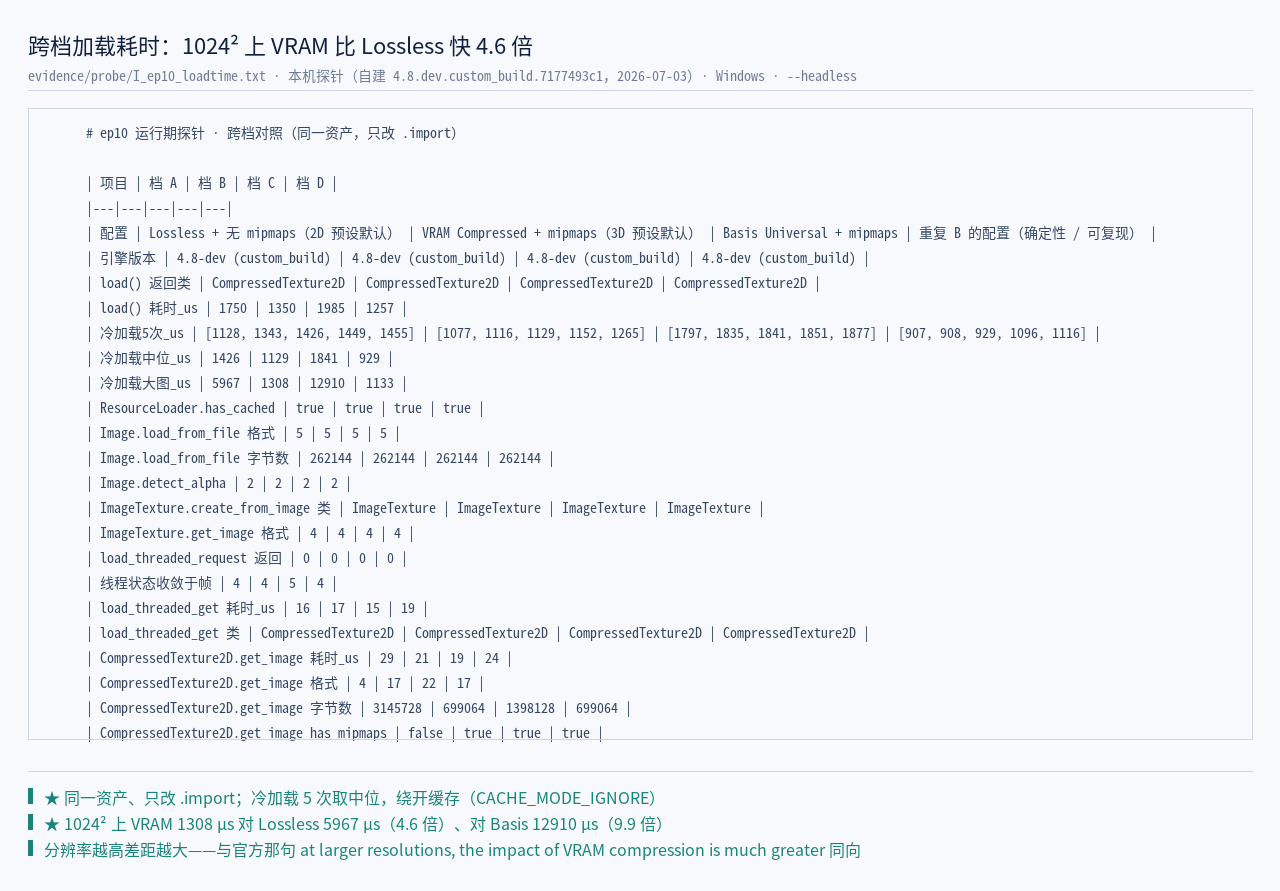
其中:这张表把官方那句「Load time: Lossless Slow / VRAM Compressed Fast」量化了:256² 上 VRAM 档比 Lossless 快约 21%,而到 1024² 上差距拉到 4.6 倍(1 308 µs 对 5 967 µs)。分辨率越高,差距越大——这正是官方在内存表下面那句「at larger resolutions, the impact of VRAM compression is much greater」在加载侧的同构现象。
其中:Basis Universal 那一列是最意外的:1024² 上它要 12 910 µs,比 Lossless 还慢一倍多。但它盘上只有 235 827 B——磁盘最省的那一档,加载最慢。这正好说明第五章这张表与第三章那张表为什么不能互相换算:一个是「存的时候花多大代价」,一个是「读的时候花多大代价」,两条曲线在三档之间是交叉的。
5.4 三条路其实是同一个任务体
知道耗时之后,还剩下一个结构问题:同步 load() 与三个线程入口,是不是两套实现?把它们接到源码上看:
其中:这张图的落点是:两者走的是同一个任务体,差别只在调用方要不要等。第六章会把这个任务体逐行读一遍——它里面有一个主动让出线程的动作,那是这套东西能在多线程下不忙等的关键。
本章出处:源码 resource_loader.h(:121–126 状态枚举、:249–251 三个线程 API、:259 同步 API);官方文档 Background loading(load_threaded_get 会阻塞那段);官方类参考 ResourceLoader(跨帧调用那条 Note);本机实测 I_ep10_thread_progress_A.txt、I_ep10_loadtime.txt。
六、线程加载落在谁身上
上一章说「两者走同一个任务体」。这一章把那个任务体读一遍,看它到底是谁的线程在跑、以及遇到依赖时它怎么办。
6.1 任务体与它的投递方式
先来看看这个任务体是谁、怎么被投出去的:
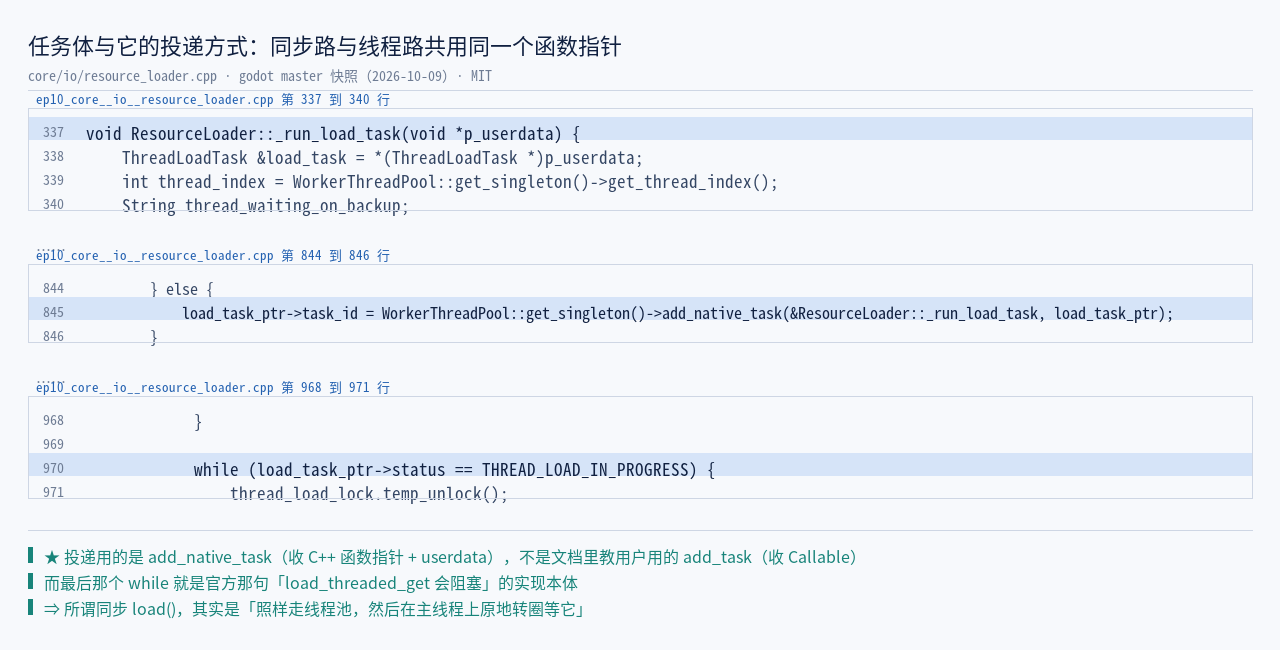
add_native_task)与那个 while:官方「会阻塞」的实现本体@ godot master 快照(2026-10-09)原文截取 · MIT其中:这里有三行是这套机制的骨架,逐行抄下来:
// core/io/resource_loader.cpp

【任务体】:337–339
void ResourceLoader::_run_load_task(void *p_userdata) {
        int thread_index = WorkerThreadPool::get_singleton()->get_thread_index();

【投递】:845
load_task_ptr->task_id = WorkerThreadPool::get_singleton()->add_native_task(&ResourceLoader::_run_load_task, load_task_ptr);

【唯一阻塞点】:970
while (load_task_ptr->status == THREAD_LOAD_IN_PROGRESS) {
下面对第 845 行特别说明:它用的是 add_native_task,不是 WorkerThreadPool 文档里教用户用的 add_task。区别在于 add_task 收的是 Callable(脚本可调用对象),而 add_native_task 收的是一个 C++ 函数指针加一段 userdata。前者要过一层脚本调用机制,后者不用——引擎内部的批量加载不需要为脚本接口付这个成本。这也是为什么第九章能说「同步路和线程路共享一个任务体」:两条路投递的是同一个函数指针。
其中:而第 970 行就是官方那句「会阻塞」的实现本体:整个「等」就是一个 while 轮询任务状态。这也说明了一件事——同步路看起来像「不排队直接调」,其实是「照样走线程池,然后在这里原地转圈等它」。第五节那条 load() 与 load_threaded_request 走同一任务体的结论,落到这里就是这三行。
6.2 依赖没就绪时它主动让出
言归正传,接着看任务体内部。加载一个资源往往要牵出别的资源(比如场景里引用着纹理),而 WorkerThreadPool 的线程数是有限的。这两件事碰在一起就有风险:如果 B 任务在等 A 任务、而 A 任务排在 B 后面,线程就会被占死。引擎的解法是让出去:
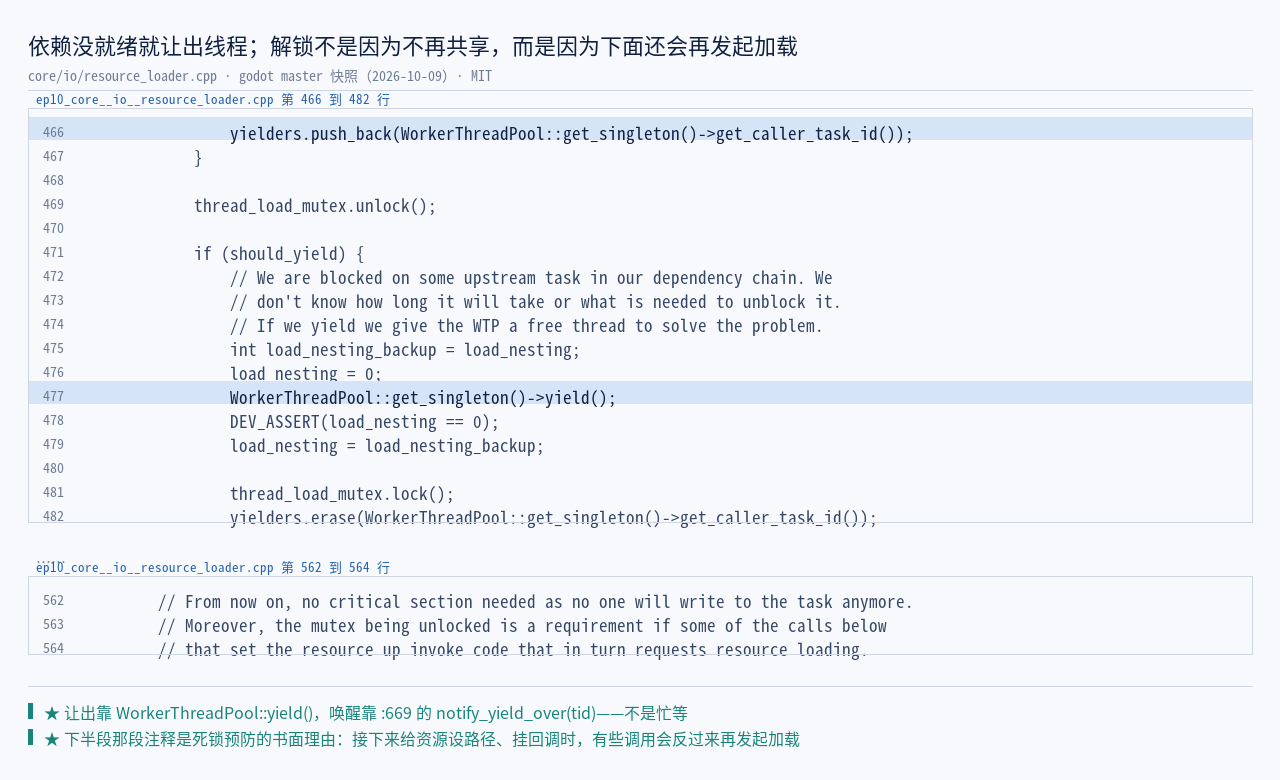
yield() 让出;下半段那段注释是死锁预防的书面理由@ godot master 快照(2026-10-09)原文截取 · MIT其中:两段原文各自对应一件事,分开看更清楚。
第一段(:466 / :477 / :482)是让出:把「谁在等我」记进 yielders,然后 WorkerThreadPool::get_singleton()->yield()——把当前线程交还出去,让别人先跑。等依赖加载完,再靠 notify_yield_over(tid)(:669)把等的人叫醒。这不是忙等,是真正的让出。
第二段(:562–564)是一段注释,讲的是一个反直觉的解锁:
// core/io/resource_loader.cpp:562–564

// From now on, no critical section needed as no one will write to the task anymore.
// Moreover, the mutex being unlocked is a requirement if some of the calls below
// that set the resource up invoke code that in turn requests resource loading.
下面对这段特别说明:它的意思不是「不再共享了所以解锁」,而是——接下来那几步(给资源设置路径、挂回调)里,有些调用会反过来再发起资源加载。如果此时还握着加载锁,就会自己锁死自己。所以这里必须先解锁再干。这段话是死锁预防的书面理由,它出现在源码里,等于作者把这段设计意图钉在了代码上。
6.3 一次线程加载的完整长相
把上一节那两块拼起来,就是一次线程加载的形状:
其中:这张图里有两条对读起来才有意思:一条是让出(依赖没就绪时把线程交出去),一条是抢锁(装配阶段把结果原子地写进缓存)。两者不是竞态关系,而是分工——让出发生在「还没东西可写」的阶段,抢锁发生在「东西已经做好、只差登记」的阶段。下一章把后一半单独拆开看:被抢的那把锁保护的到底是什么。
本章出处:源码 resource_loader.cpp(:337–340 任务体开头、:466/:477/:482 让出、:562–564 解锁注释、:669 唤醒、:845 投递、:970 阻塞点)。
七、谁在记账:一把锁与一张表
上一章末尾说到「抢锁登记」。这一章把那把锁与它保护的东西拆开——这是本篇最短、也最出乎意料的一节。
7.1 缓存的全部本体是 19 行
OK,先看看这个类有多大。在「一个引擎会有一大堆资源、还要跨线程加载」的印象下,缓存的实现理应很复杂。实际是:
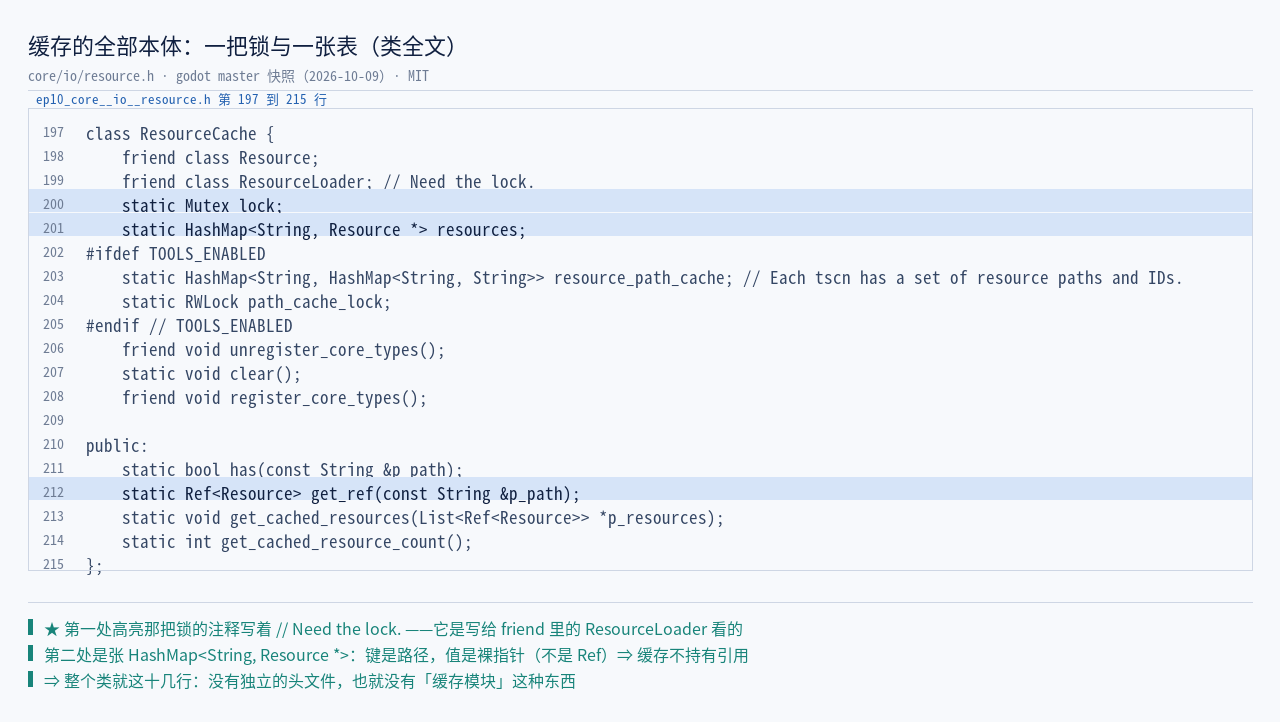
Mutex 加一张 HashMap<String, Resource *>@ godot master 快照(2026-10-09)原文截取 · MIT其中:这 19 行里,真正干活的数据结构只有两行,逐字抄下来:
// core/io/resource.h:197–215(全文 19 行,节选关键两行)

class ResourceCache {
        friend class Resource;
        friend class ResourceLoader; // Need the lock.
        static Mutex lock;                              【1】一把锁
        static HashMap<String, Resource *> resources;   【2】一张表:路径 → 资源裸指针
        …
public:
        static bool has(const String &p_path);
        static Ref<Resource> get_ref(const String &p_path);
        static void get_cached_resources(List<Ref<Resource>> *p_resources);
        static int get_cached_resource_count();
};
下面对这两行特别说明。第【1】行的注释 // Need the lock. 是写给 ResourceLoader 这个 friend 看的——它表示「你可以直接用我这把锁」。这就是上一章那段 ResourceCache::lock.lock(); // Check and operations must happen atomically. 的来源:加载任务在装配阶段要做的「查表 + 写表」必须原子,而它用的就是缓存自己的这把锁。
第【2】行是张 HashMap<String, Resource *>——键是路径,值是裸指针,不是 Ref。这一点很重要:缓存不持有引用,它只是一张索引。真正决定资源死活的是外面的 Ref 计数;计数归零时资源析构,顺手把自己从这张表里摘掉(resource.cpp:798–800)。
其中:「缓存引用路径、不引用对象」这个设计带来一个直接后果,官方在类参考里写得比源码更清楚:
The engine keeps a global cache of all loaded resources, referenced by paths (see
ResourceLoader.has_cached). A resource will be cached when loaded for the first time and removed from cache once all references are released. When a resource is cached, subsequent loads using its path will return the cached reference.
7.2 谁往这张表里写
好了,表的读取方有四个(上面那四个方法),写入方只有一处:
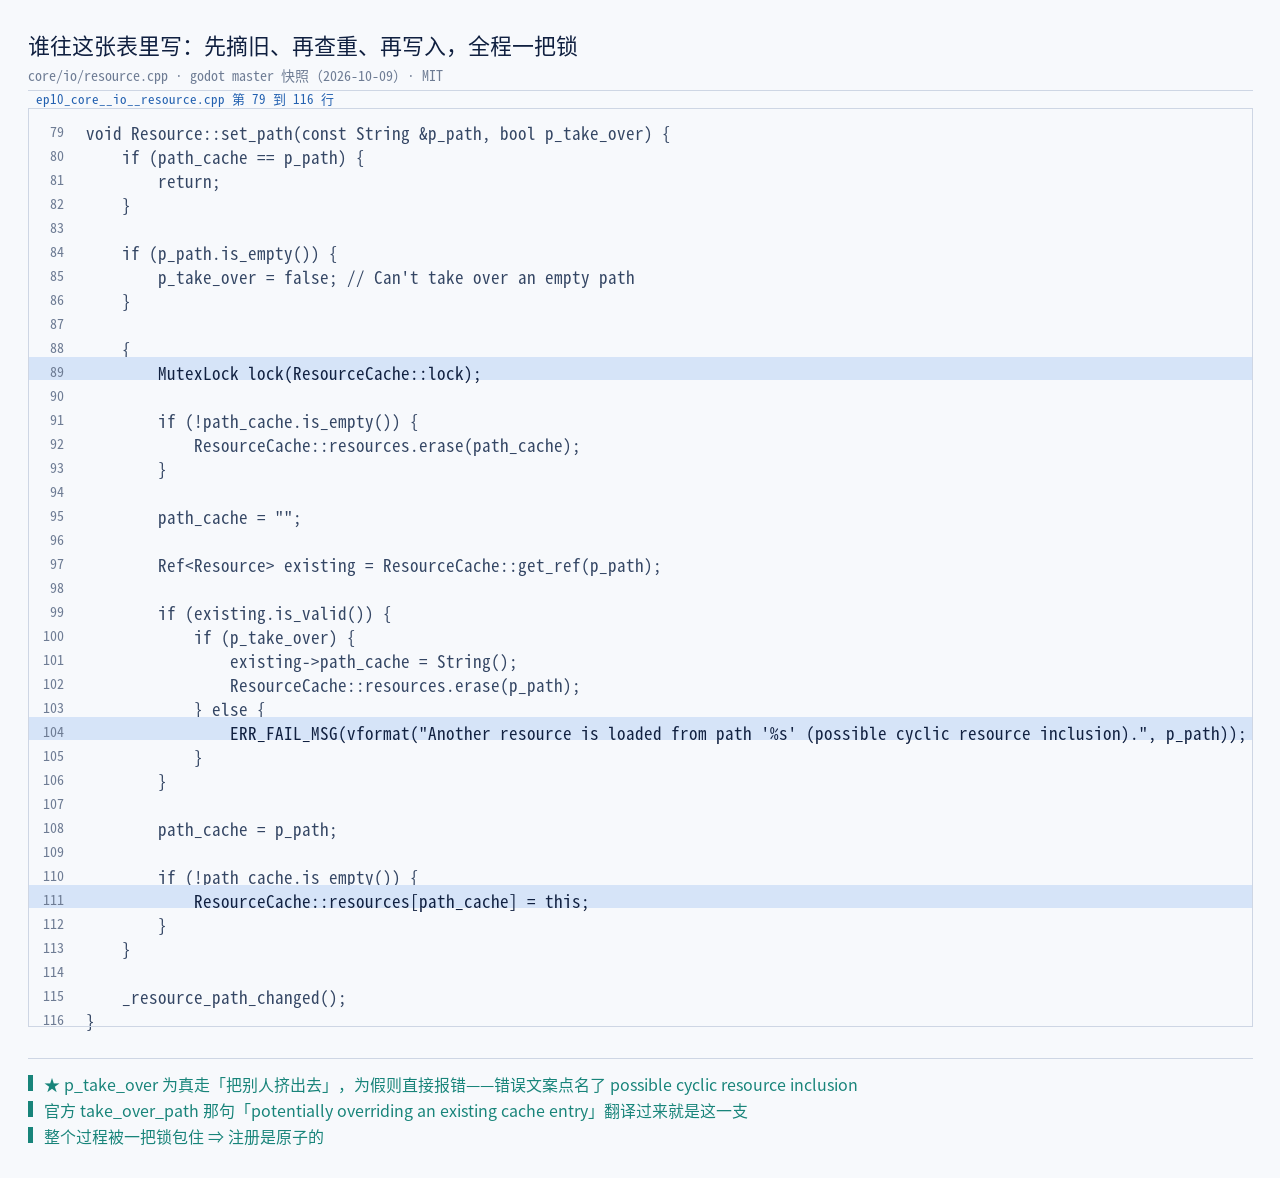
Resource::set_path():先摘旧、再查重、再写入,全程一把锁@ godot master 快照(2026-10-09)原文截取 · MIT其中:这段代码里「先摘旧、再查重、再写入」三步被一把锁包住,次序是有讲究的:
// core/io/resource.cpp:79–116(节选)

void Resource::set_path(const String &p_path, bool p_take_over) {
        …
        {
                MutexLock lock(ResourceCache::lock);
                if (!path_cache.is_empty()) { ResourceCache::resources.erase(path_cache); }   【1】摘掉自己旧的位置
                path_cache = "";
                Ref<Resource> existing = ResourceCache::get_ref(p_path);                      【2】这个位置有人吗
                if (existing.is_valid()) {
                        if (p_take_over) {
                                existing->path_cache = String();
                                ResourceCache::resources.erase(p_path);                   【3a】抢:把别人挤出去
                        } else {
                                ERR_FAIL_MSG(vformat("Another resource is loaded from path '%s' (possible cyclic resource inclusion).", p_path));    【3b】不抢就报错
                        }
                }
                path_cache = p_path;
                if (!path_cache.is_empty()) { ResourceCache::resources[path_cache] = this; }  【4】登记
        }
        _resource_path_changed();
}
下面对第【3a】与【3b】特别说明:这两支正是官方 take_over_path 那句话的落点。类参考写着「Sets the resource_path to path, potentially overriding an existing cache entry for this path. Further attempts to load an overridden resource by path will instead return this resource.」——翻译成这段代码就是:p_take_over 为真时走【3a】(把原主从表里挤掉),为假时走【3b】(直接报错,且错误文案点名了「possible cyclic resource inclusion」)。
其中:第【3b】这条报错文案本身就是一条经验:同一路径上出现两个资源,最常见的原因是循环引用——A 加载时拉起 B,B 又回头拉起 A。所以引擎在这里不是静默覆盖,而是让这次加载失败。而要走「我就是要换掉它」的意图,唯一合法的口子是 take_over_path。
7.3 那个「正在被删」的判断出现了两次
读这段源码时会注意到一个细节:同一个判断在两处重复出现。它不是冗余,而是一个真实的时序窗口:
其中:两处的原文几乎一样,都在锁内做这一件事:
// core/io/resource.cpp

【第一处】:837–842(has)
if (res && (*res)->get_reference_count() == 0) {
        // This resource is in the process of being deleted, ignore its existence.
        (*res)->path_cache = String();
        resources.erase(p_path);
        res = nullptr;
}

【第二处】:862–867(get_ref)
if (res && ref.is_null()) {
        // This resource is in the process of being deleted, ignore its existence
        (*res)->path_cache = String();
        resources.erase(p_path);
        res = nullptr;
}
下面对这处重复特别说明:它说明的是「表里有」与「对象还在」是两件事。资源引用计数归零时会析构,而析构时会把 path_cache 清空并尝试从表里摘掉自己——但如果恰好在这两步之间有人来查表,就会读到一条指向正在析构对象的记录。两处判断就是给这个窗口兜底:看到引用计数已归零,就顺手把这条记录清掉并当作不存在。
其中:这也是本篇第四节所讲的那条纪律在源码里的一个具体落点:「缓存里有一条记录」并不等于「资源可用」。所以判断一个路径能不能复用,正确做法是查 has_cached 或 get_ref(它们会做这个清理),而不是自己遍历 resources 表。
本章出处:源码 resource.h(:197–215 类全文)与 resource.cpp(:79–116 原子登记、:798–800 析构摘表、:804 表的唯一定义、:829–850 / :852–871 两处「正在被删」、:896–899 计数);官方类参考 Resource(全局缓存与 take_over_path 两句)。
八、.ctex 打开之后:从文件到四件事
到这里,盘上的东西讲完了、怎么读进来讲完了,剩下最后一段:读到的那些字节,是在哪一步变成一块能被采样的显存的。这一章顺着调用链走这一段。
8.1 .ctex 由谁认出来
言归正传,先补一个上一章跳过的环节:load("res://tex_rgba.png") 这条路径走到最后,真正被打开的文件是那个 .ctex。而 .ctex 并不是 ResourceLoader 天生认识的扩展名——它由一个专门的资源格式加载器认出来:
// scene/resources/compressed_texture_resource_format.cpp:35–62(节选)

Ref<Resource> ResourceFormatLoaderCompressedTexture2D::load(const String &p_path, …) {
        Ref<CompressedTexture2D> st;
        st.instantiate();
        Error err = st->load(p_path);      【1】真正干活的是它
        …
        return st;
}

void …::get_recognized_extensions(List<String> *p_extensions) const {
        p_extensions->push_back("ctex");   【2】认这个扩展名
}

bool …::handles_type(const String &p_type) const {
        return p_type == "CompressedTexture2D";      【3】认这个类型名
}

String …::get_resource_type(const String &p_path) const {
        if (p_path.has_extension("ctex")) { return "CompressedTexture2D"; }   【4】路径 → 类型
        return "";
}
下面对这四行特别说明:加载器本身是个薄壳。它只做三件事——认出 ctex 扩展名、把类型名映射成 CompressedTexture2D、然后 instantiate() 一个实例并把工作交给它。真正读字节、解格式、建纹理的,全在 CompressedTexture2D::load() 里。这个分工同族还有四兄弟:ctexarray / ccube / ccubearray / ctex3d,各自对应一类压缩纹理资源。
其中:注意第【3】与第【4】行是两回事:handles_type 回答「这个加载器能不能处理名为 X 的类型」,get_resource_type 回答「这个路径对应哪个类型」。第【4】行正是第一章那份 .import 里 type="CompressedTexture2D" 的另一半——一边是配置里写着类型,一边是加载器按扩展名报出类型,两者对上,这条路才通。
8.2 load() 里那两个动作
先来看看那个「真正干活的」函数。它的骨架很短,值得整段读:
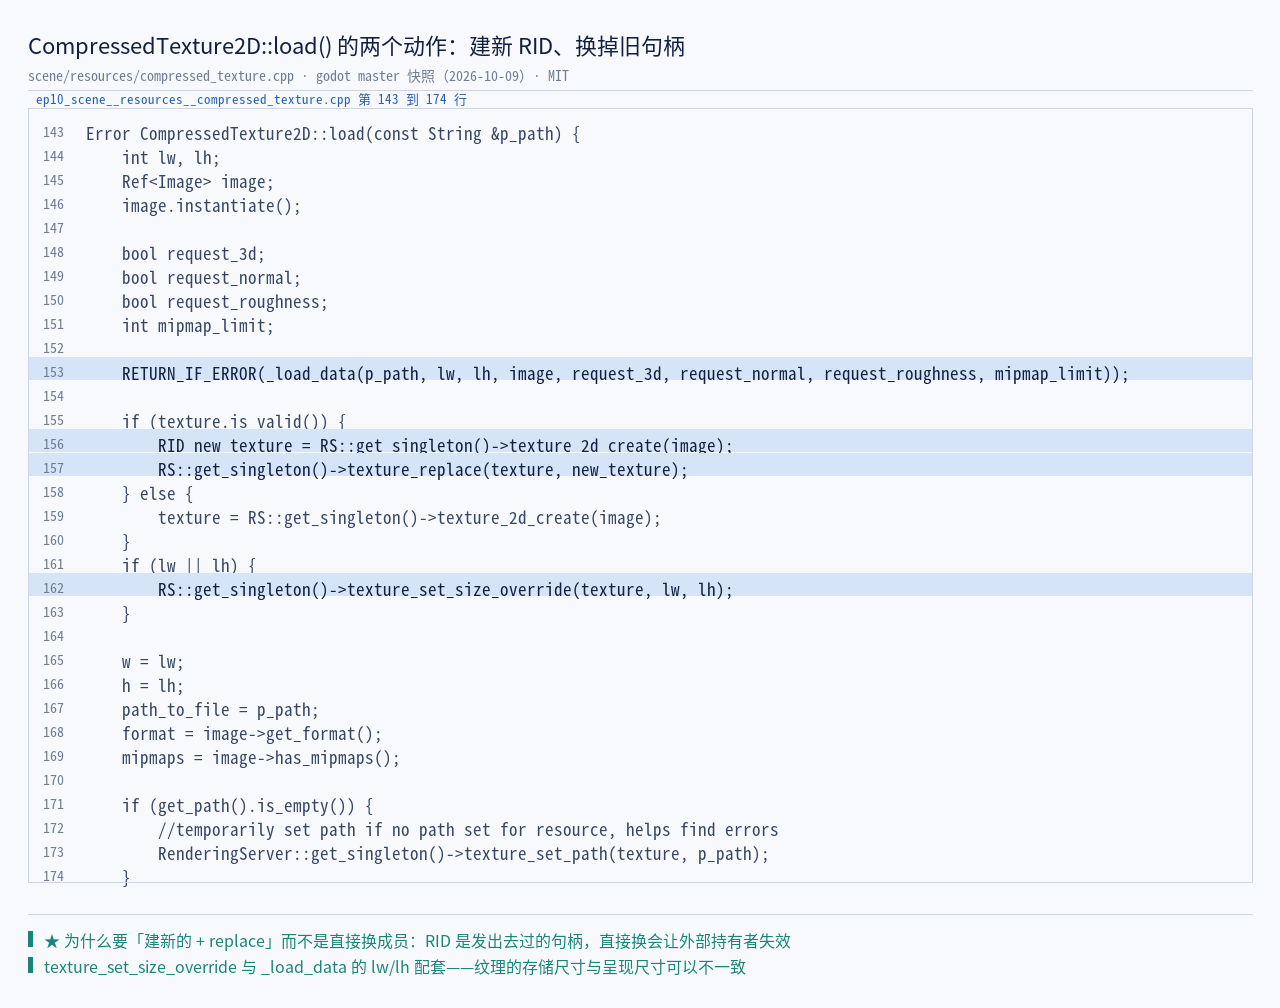
CompressedTexture2D::load():_load_data 读文件,texture_2d_create 建新 RID,texture_replace 换掉旧句柄@ godot master 快照(2026-10-09)原文截取 · MIT其中:把这段的骨架按顺序抄下来:
// scene/resources/compressed_texture.cpp:143–174(节选)

Error CompressedTexture2D::load(const String &p_path) {
        int lw, lh;
        Ref<Image> image;
        image.instantiate();

        bool request_3d;
        bool request_normal;
        bool request_roughness;
        int mipmap_limit;

        RETURN_IF_ERROR(_load_data(p_path, lw, lh, image, request_3d, request_normal, request_roughness, mipmap_limit));   【1】读文件

        if (texture.is_valid()) {
                RID new_texture = RS::get_singleton()->texture_2d_create(image);        【2a】建新 RID
                RS::get_singleton()->texture_replace(texture, new_texture);             【2b】换掉旧的
        } else {
                texture = RS::get_singleton()->texture_2d_create(image);                【2a'】第一次就直接建
        }
        if (lw || lh) {
                RS::get_singleton()->texture_set_size_override(texture, lw, lh);        【3】尺寸覆盖
        }

        format = image->get_format();
        mipmaps = image->has_mipmaps();
        …
}
下面对第【2】组特别说明:这里有一对容易混淆的动词。texture_2d_create 是新建一块,texture_replace 是把旧 RID 的内容换成新的那块。为什么要两步?因为 RenderingServer 的 RID 是对外发出去过的句柄——如果你直接把成员换成新 RID,别人手里那个旧句柄就废了。所以正确做法是「建新的 → 用 replace 让旧句柄指向新内容」,让外部持句柄的人无感。
其中:第【3】行的 texture_set_size_override 与第【1】行的 lw/lh 是配套的:.ctex 头里可能带一个尺寸覆盖值(导入时因为 size_limit 缩过图,或者编辑器缩放),此时纹理的实际存储尺寸与「对外呈现的尺寸」不一致。这两个数分家,就是「为什么这张图看着比文件里小」的答案。
8.3 那四个出参:.ctex 里除了像素还存了什么
上一节的第【1】行值得单开一节,因为它的签名里有四个出参,而它们不是像素:
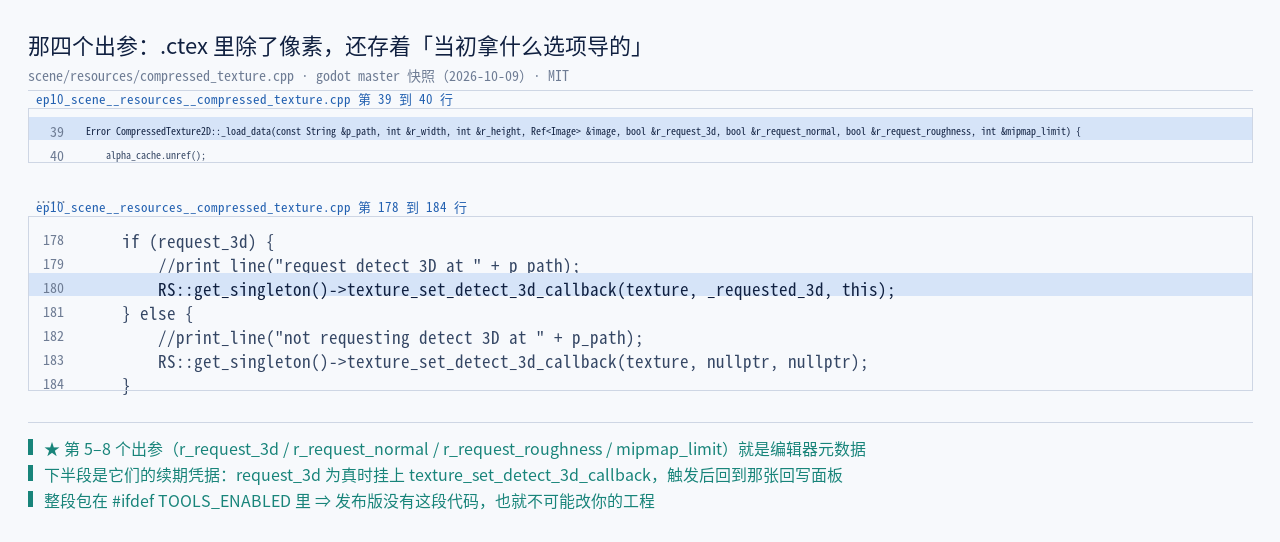
_load_data 的四个出参就是编辑器元数据;request_3d 为真时挂上检测回调@ godot master 快照(2026-10-09)原文截取 · MIT其中:把签名逐个数一遍就明白了——第 1 到第 4 个是常规输出(宽、高、Image),第 5 到第 8 个是编辑器元数据:
| 出参 | 它回答什么 |
|---|---|
r_request_3d |
这张图当初是不是挂过「检测 3D」(即是否还需要继续观察用途) |
r_request_normal |
是否还要检测它有没有被当法线图用 |
r_request_roughness |
是否还要检测它有没有被当粗糙度图用 |
mipmap_limit |
mipmaps 层数上限 |
其中:关键结论是:一次导入留在盘上的,除了像素,还有「当初拿什么选项导的」。这四个布尔/整数就是第四章那个检测器的「续期凭据」——request_3d 为真时,load() 会把一个回调挂到纹理上:
// scene/resources/compressed_texture.cpp:176–184(节选,仅编辑器构建)

#ifdef TOOLS_ENABLED
if (request_3d) {
        RS::get_singleton()->texture_set_detect_3d_callback(texture, _requested_3d, this);
} else {
        RS::get_singleton()->texture_set_detect_3d_callback(texture, nullptr, nullptr);
}
下面对这段特别说明:它把第四章与本章接了起来。第四章那个「检测到用于 3D 就回写 .import」的能力,起点在这里——导入时把 detect_3d/compress_to 记进 .ctex,加载时读出来,据此决定要不要挂回调;回调一旦触发,就回到第四章那段 cf->save(src_path)。整条链是:配置 → 产物头 → 运行时回调 → 改配置 → 重导。注意外面还套着 #ifdef TOOLS_ENABLED——这套能力只在编辑器构建里存在,发布版根本没有这段代码,也就不可能改你的工程。
8.4 上传那一步做的四件事
好了,现在到了最后一站。texture_2d_create() 在 RenderingServer 那一层只是接口,实现在 TextureStorage 里,而它的第一站是 texture_2d_initialize():
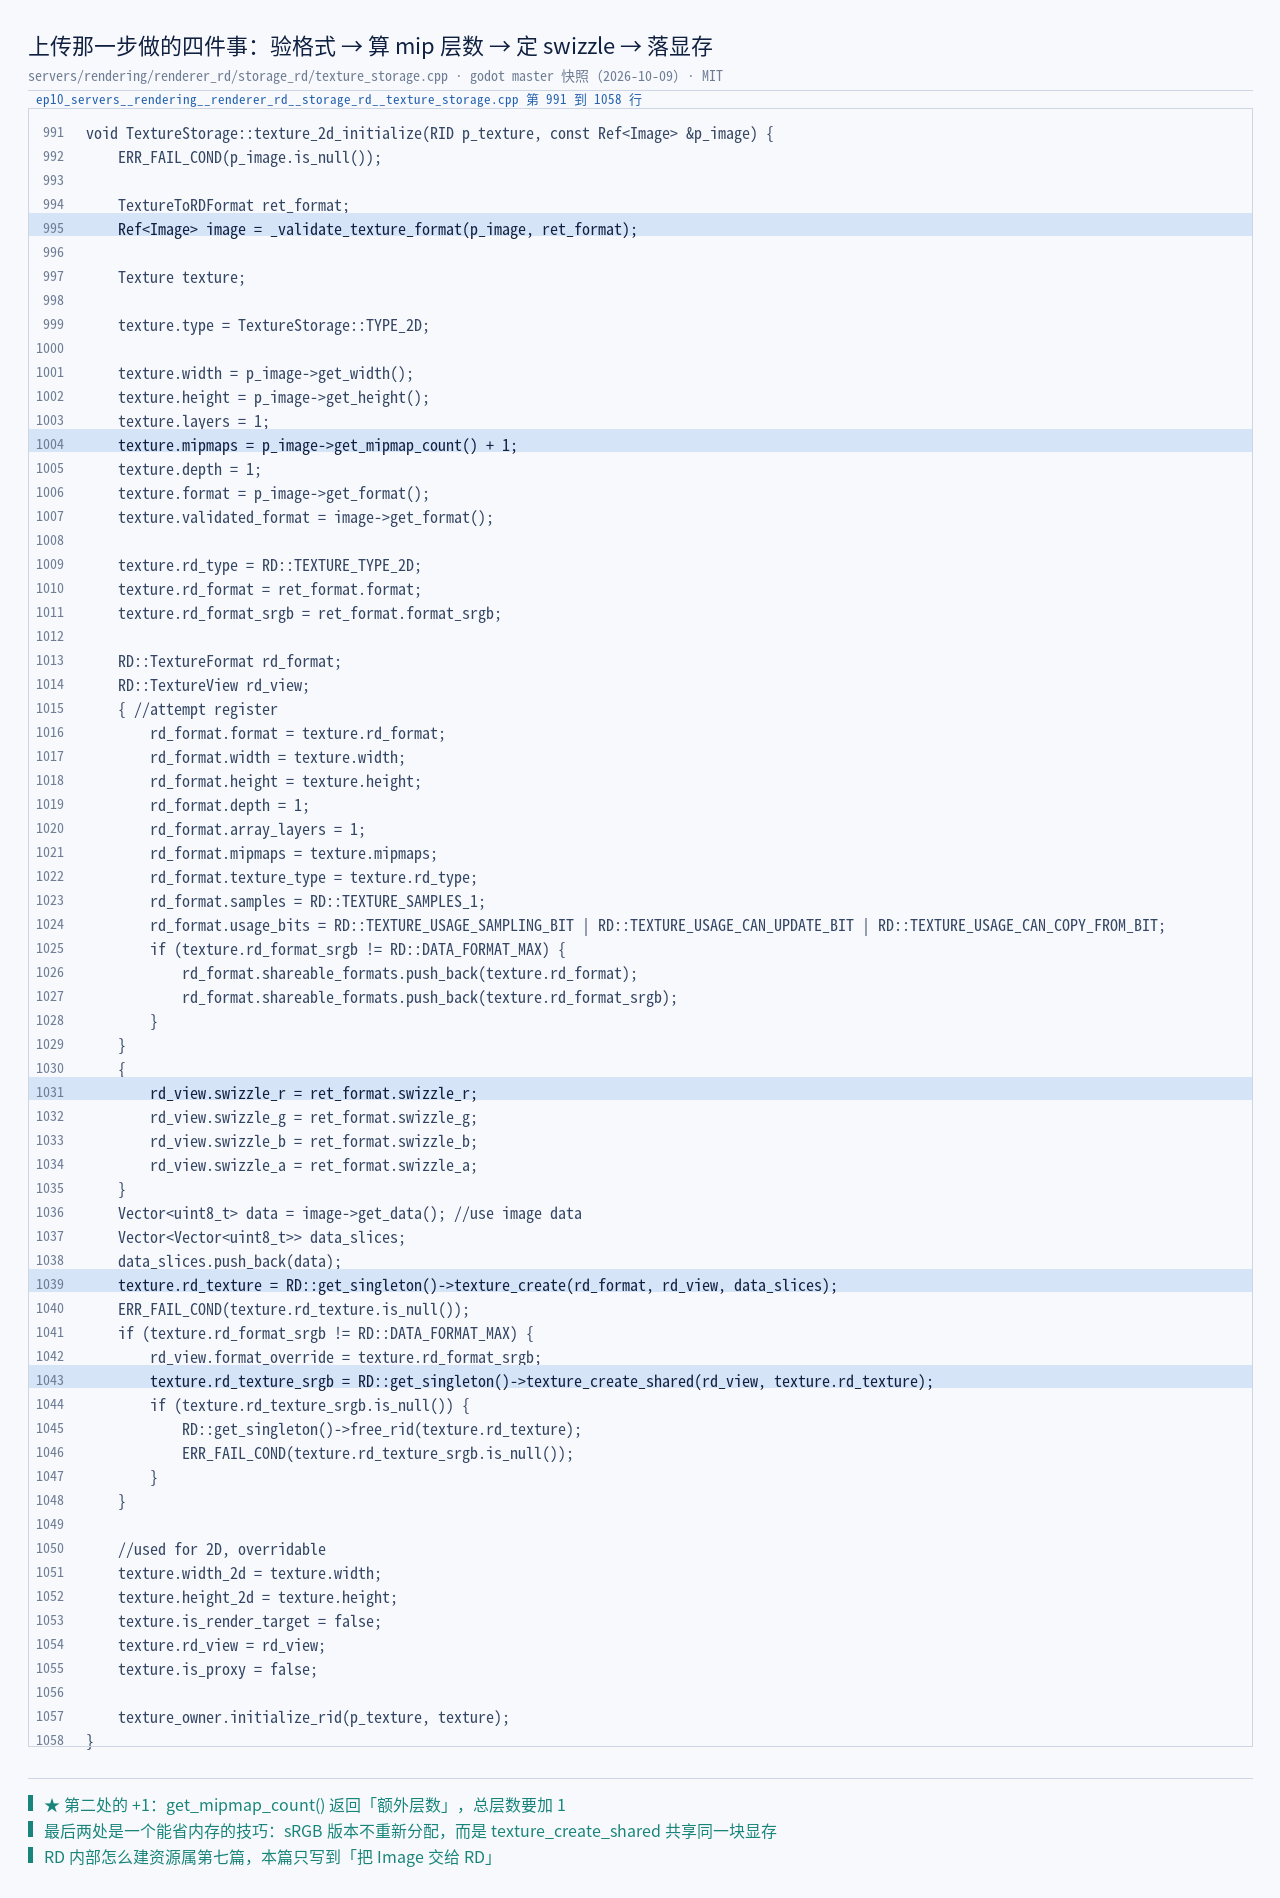
其中:这个函数从头到尾只做四件事,顺序固定:
// servers/rendering/renderer_rd/storage_rd/texture_storage.cpp:991–1058(节选)

void TextureStorage::texture_2d_initialize(RID p_texture, const Ref<Image> &p_image) {
        ERR_FAIL_COND(p_image.is_null());
        TextureToRDFormat ret_format;
        Ref<Image> image = _validate_texture_format(p_image, ret_format);      【1】验格式(可能换一份 image)

        Texture texture;
        texture.type = TextureStorage::TYPE_2D;
        texture.width = p_image->get_width();
        texture.height = p_image->get_height();
        texture.layers = 1;
        texture.mipmaps = p_image->get_mipmap_count() + 1;                     【2】mip 层数 = 计数 + 1
        …
        texture.rd_format = ret_format.format;
        texture.rd_format_srgb = ret_format.format_srgb;

        RD::TextureFormat rd_format;
        RD::TextureView rd_view;
        { //attempt register
                rd_format.format = texture.rd_format;
                rd_format.width = texture.width;
                rd_format.height = texture.height;
                rd_format.mipmaps = texture.mipmaps;
                rd_format.usage_bits = RD::TEXTURE_USAGE_SAMPLING_BIT
                        | RD::TEXTURE_USAGE_CAN_UPDATE_BIT | RD::TEXTURE_USAGE_CAN_COPY_FROM_BIT;
                …
        }
        {
                rd_view.swizzle_r = ret_format.swizzle_r;                      【3】通道重排
                …
        }
        Vector<uint8_t> data = image->get_data(); //use image data
        Vector<Vector<uint8_t>> data_slices;
        data_slices.push_back(data);
        texture.rd_texture = RD::get_singleton()->texture_create(               【4】落显存
                rd_format, rd_view, data_slices);
        …
        if (texture.rd_format_srgb != RD::DATA_FORMAT_MAX) {
                rd_view.format_override = texture.rd_format_srgb;
                texture.rd_texture_srgb = RD::get_singleton()->texture_create_shared(   【4'】sRGB 共享视图
                        rd_view, texture.rd_texture);
        }
        …
}
下面对第【2】与第【4'】两处特别说明。第【2】行的 + 1 是个小细节但很实在:get_mipmap_count() 返回的是「额外层数」,所以总层数要加 1。上一章那张 mipmap 对照表里 has_mipmaps 从 false 变 true,落到这里就是 1 变成 11(1024² 的 11 层)。
第【4'】处是个能省内存的技巧:sRGB 版本不重新分配,而是拿同一块显存建一个共享视图(texture_create_shared),只把格式覆盖成 sRGB 变体。这样「同一张图既要当 sRGB 采样、又要当线性数据」时,显存里只存一份。这一点属于 RenderingDevice 的能力范围,本篇只用一句带过——具体怎么建共享资源,见第七篇。
其中:第【3】行那个 swizzle 是下一章的引子:它意味着同一份字节,采样时按哪个通道读是可以被改的。下一章会看到它被真正改动的两个具体场合。
8.5 这一段链的边界
把第八章这条链画成一张落点图,顺便标清楚本篇到哪里为止:
.ctex 到 RID 的四次交接@ 本系列绘制其中:这张图上画了两条边界,它们是本篇的纪律而不是省略:① RD::texture_create() 内部怎么向驱动申请资源,属第七篇(本篇只写到「把 Image 交给 RD」);② RenderingServer 的接口怎么被排队与包裹,属第三篇(本篇只用它的四个接口名)。把边界画在图上而不是含糊带过,读的人才知道这一篇的结论落在哪一层。
本章出处:源码 compressed_texture_resource_format.cpp(:35–62 薄壳加载器、:95–99 与 :132–134 同族)、compressed_texture.cpp(:39 四个出参、:143–174 加载骨架、:176–184 检测回调)、texture_storage.cpp(:991–1058 四件事)。
九、那张图被改了格式与通道
OK,上一章第【1】步「验格式」与第【3】步「通道重排」都只是提了一句。这一章把它们拆开——顺便处理本篇第二处「只看表面会读反」的地方。
9.1 源码里有两支格式分支
VRAM Compressed 这一档在导入时做的事情比别的档多:它要按平台决定压成哪种 GPU 格式。源码里确实是按两支写的:
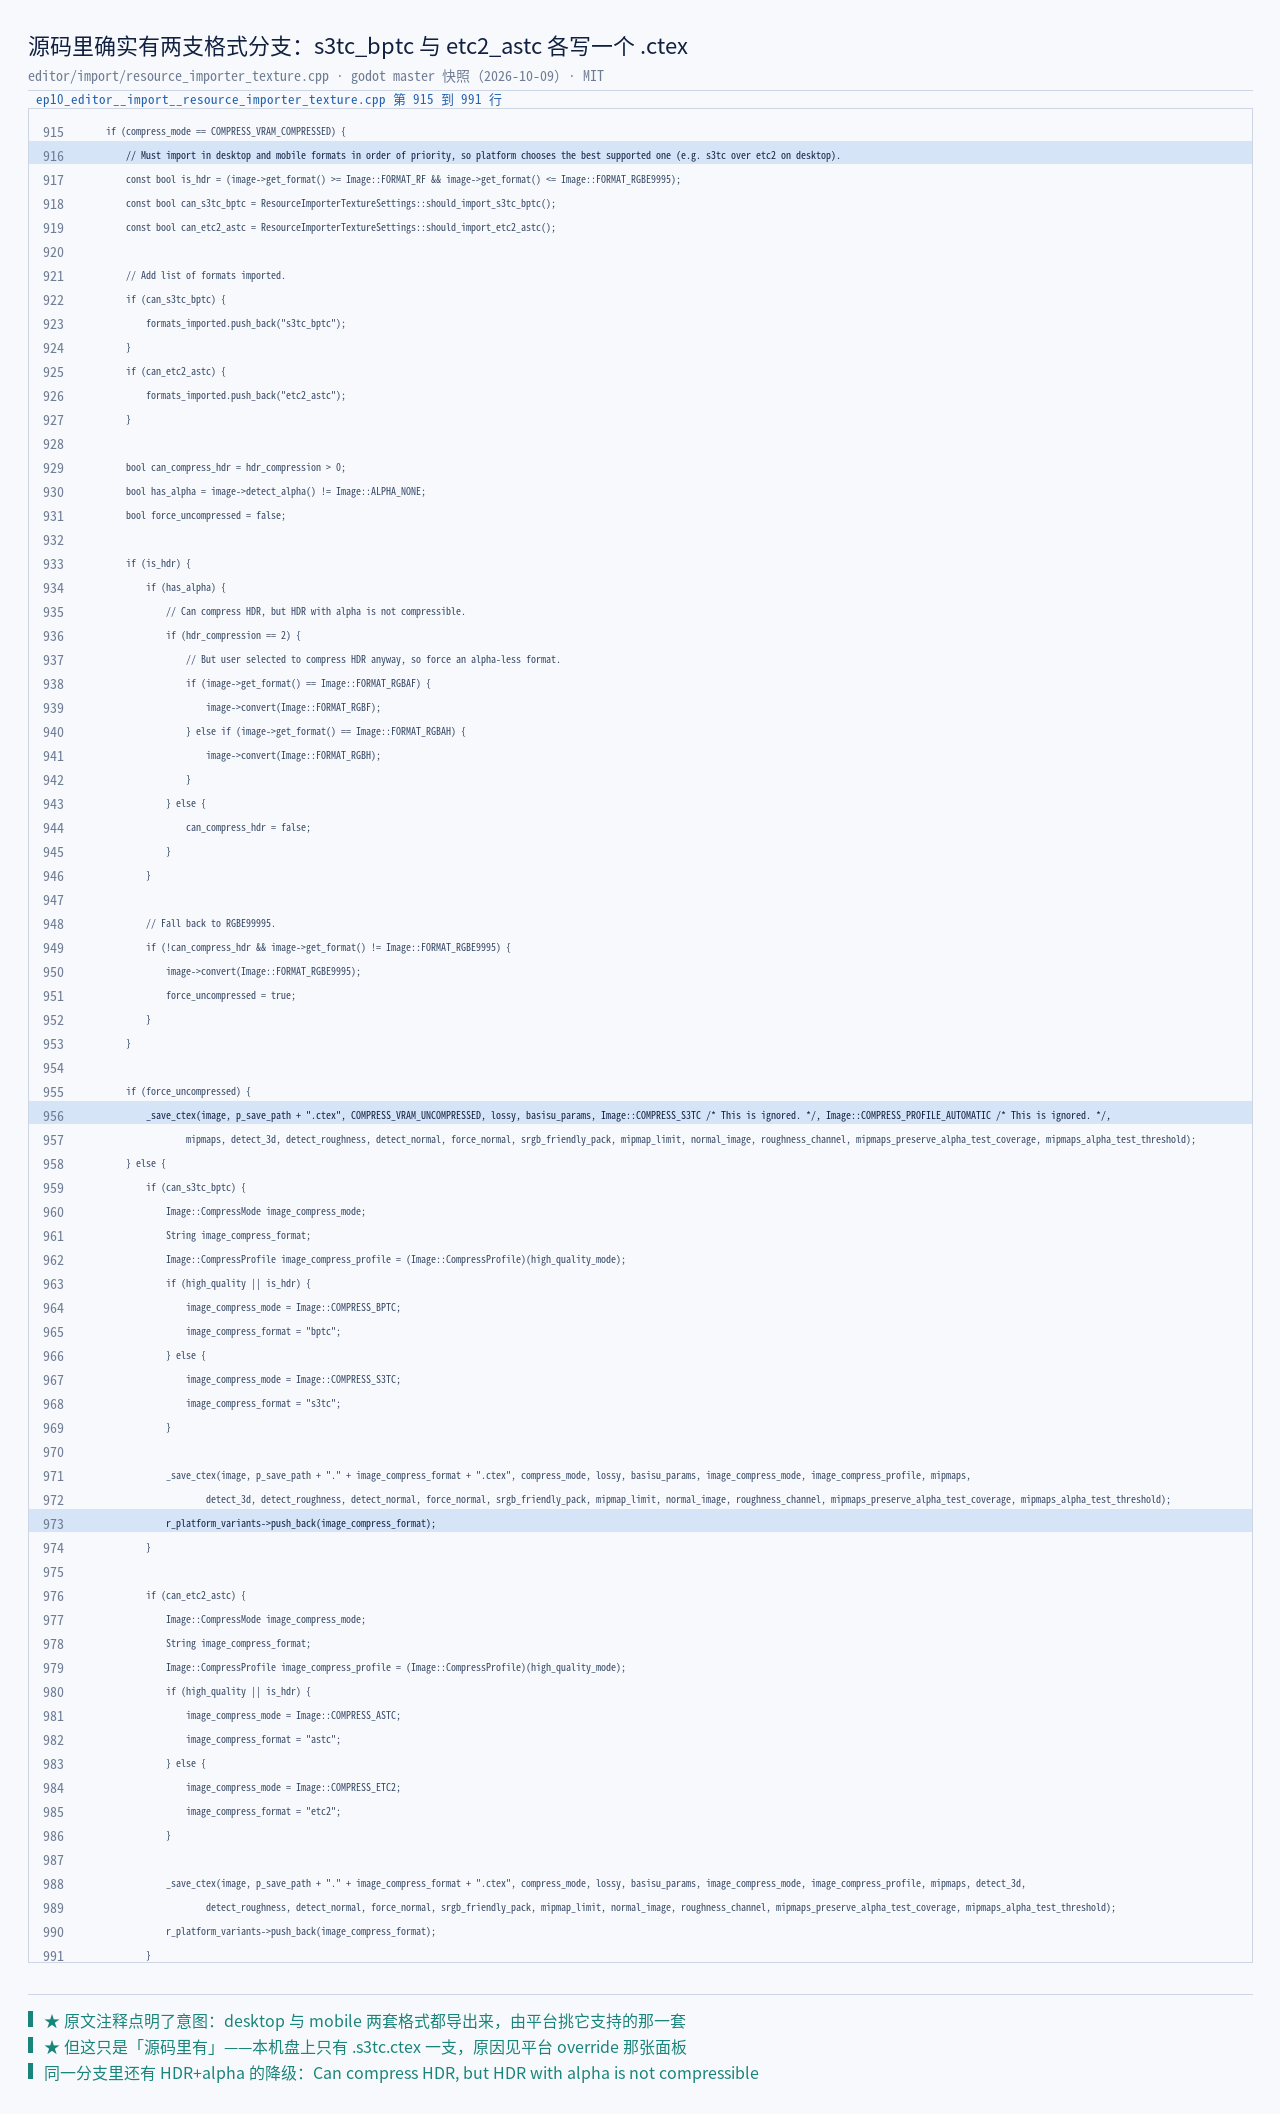
s3tc_bptc 与 etc2_astc 各写一个 .ctex@ godot master 快照(2026-10-09)原文截取 · MIT其中:两支分支的条件与写法是这样:
// editor/import/resource_importer_texture.cpp:915–991(节选)

if (compress_mode == COMPRESS_VRAM_COMPRESSED) {
        // Must import in desktop and mobile formats in order of priority, so platform chooses the best supported one (e.g. s3tc over etc2 on desktop).
        const bool can_s3tc_bptc = ResourceImporterTextureSettings::should_import_s3tc_bptc();   【1】
        const bool can_etc2_astc = ResourceImporterTextureSettings::should_import_etc2_astc();   【2】
        …
        if (can_s3tc_bptc) {
                …
                _save_ctex(image, p_save_path + "." + image_compress_format + ".ctex", …);       【3】
                r_platform_variants->push_back(image_compress_format);
        }
        if (can_etc2_astc) {
                …
                _save_ctex(image, p_save_path + "." + image_compress_format + ".ctex", …);       【3'】
                r_platform_variants->push_back(image_compress_format);
        }
        …
}
下面对这三处特别说明。第【3】与第【3'】处各写一个 .ctex,文件名里多一段平台格式后缀(.s3tc.ctex / .etc2.ctex),并把格式名推进 r_platform_variants——这正是第二章那个「平台变体出口」的第一个真实用户。
其中:同一个分支里还处理了一个特殊情况:HDR 带 alpha 的图压不了。源码原话是 // Can compress HDR, but HDR with alpha is not compressible.,此时它会退成 RGBE9995 并把 force_uncompressed 置真,最后走 _save_ctex(…, COMPRESS_VRAM_UNCOMPRESSED, …)。而那次调用的两个参数旁边写着 /* This is ignored. */——降级路径上的这两个参数已经没意义了,注释把这件事直接写在调用点上。
9.2 但本机盘上只有一支
如果只看上一节,会得到「一次导入会同时产出两套格式」的印象。本机盘上不是这样。这是本篇第二处必须靠产物纠正的地方:
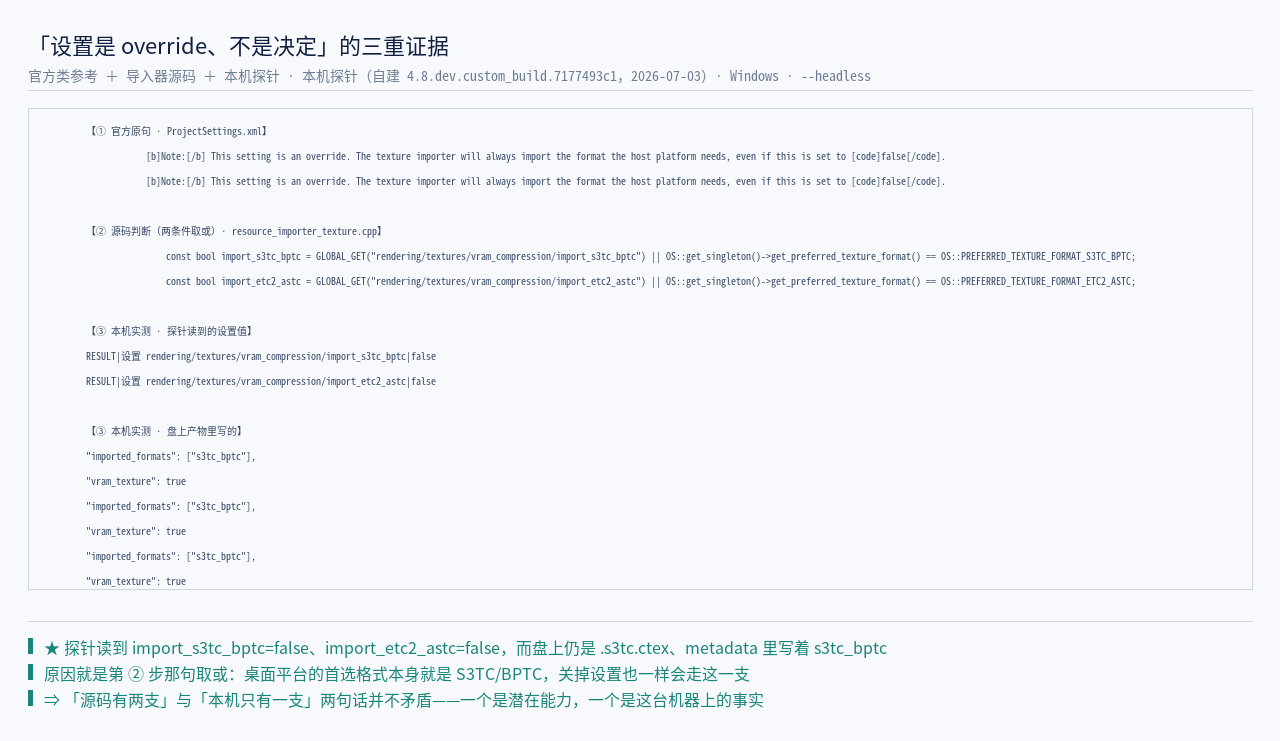
其中:三重证据的排布是这样,从上到下依次收紧:
| 证据 | 内容 |
|---|---|
| 官方原句 | Note: This setting is an override. The texture importer will always import the format the host platform needs, even if this is set to false. |
| 源码判断 | can_s3tc_bptc 的取值不只是读设置,还或上了一个平台偏好判断(:136 / :918) |
| 本机产物 | 探针读到 import_s3tc_bptc = false、import_etc2_astc = false,而 .import 的 metadata 写着 imported_formats 只有 s3tc_bptc 一项,落盘的是 …s3tc.ctex |
其中:这三条合起来回答了一个日常困惑:「我明明把 import_s3tc_bptc 关掉了,为什么产物还是 .s3tc.ctex?」答案是——这个设置是「override」,不是开关。它只在「平台偏好也说不清」的时候起作用;桌面平台的首选格式本身就是 S3TC/BPTC,所以关掉它也一样会走这一支。
其中:所以本节与上一节不矛盾,它们说的是两件事:源码里有两条路(上一节),这台机器上只走其中一条(本节)。本篇按这个写法落笔——不把源码的潜在能力写成本机事实。同理,etc2_astc 那一支在移动平台上长什么样,本机没有平台可测,正文也不推断。
9.3 「验格式」到底改了什么
说白了,回到第八章第【1】步。_validate_texture_format() 是一段很长的 switch,把每一种 Image::Format 映射成 RD::DATA_FORMAT_* 加一组 swizzle。它里面有两条能直接读懂动作的注释级事实:
其中:先把这段映射的规模说清楚:Image 的格式枚举有 40 项(core/io/image.h:74–113),而这段 switch 要为每一项给出「用哪个 RD 格式 + 四个通道怎么摆」。本机 get_image() 的实测值正好落在其中三项上,可以逐条对上:
| 档 | 实测格式值 | 枚举名 | 说明 |
|---|---|---|---|
| Lossless | 4 | FORMAT_RGB8 |
未压缩,3 字节/像素 |
| VRAM Compressed | 17 | FORMAT_DXT1(BC1) |
压缩块,4 bpp |
| Basis Universal | 22 | FORMAT_BPTC_RGBA(BC7) |
压缩块,8 bpp |
其中:这张表顺手澄清了一件事:get_image() 拿到的不是解压后的像素,而是压缩块本身。理由就在字节数上——1024² 的 BC1 应该是 524 288 B(上一章量到的正是这个值),BC7 应该是 1 398 000 B 上下(实测 1 398 128)。如果 get_image() 做了 CPU 解压,返回的会是 3 145 728 B(3 字节/像素的下采样结果)。这也解释了为什么 Basis Universal 的显存侧并不比 VRAM Compressed 省:本机它转出来是 BC7(8 bpp),而 VRAM Compressed 在不透明 RGB 上走的是 BC1(4 bpp)——官方那句「VRAM usage is usually the same as VRAM Compressed」在不透明 RGB 这一档上,与本机读数不同向。这一条本篇如实并列,不替官方圆场。
至于那段 switch 里两个具体动作,值得各记一句:FORMAT_RGBA4444 与 FORMAT_RGB565 这两支要把 R 与 B 的 swizzle 对调(因为它们映射到的 RD 格式是 B 在前);而 FORMAT_RGB8 那一支里的判断写着 if (false && …)——恒假,所以不透明 RGB 总会先被复制转换成 RGBA8。这两处都在说明同一件事:「通道顺序」在这一层是可改的元数据,不是必须与内存里一致的东西。
本章出处:源码 resource_importer_texture.cpp(:915–990 双支分支与 HDR 降级)、texture_storage.cpp(:2367–2482 格式校验与 swizzle)、image.h(:74–113 格式枚举);官方类参考 ProjectSettings(两条 override 说明);本机实测 I_ep10_loadtime.txt 与 .import 的 metadata 字段。
十、运行期造纹理的另一条路
下面进入第三条路。前面九章讲的都是「盘上的图怎么进来」。还有第三条路:图根本不在盘上,是运行期算出来的(程序化地形、截图、RenderTarget 数据转纹理)。这条路只有两个动词,但它们对应两次完全不同的显存动作。
10.1 两个动词:分配与重填
ImageTexture 是这个入口,它对外只暴露了三个方法(其中两个是关键):
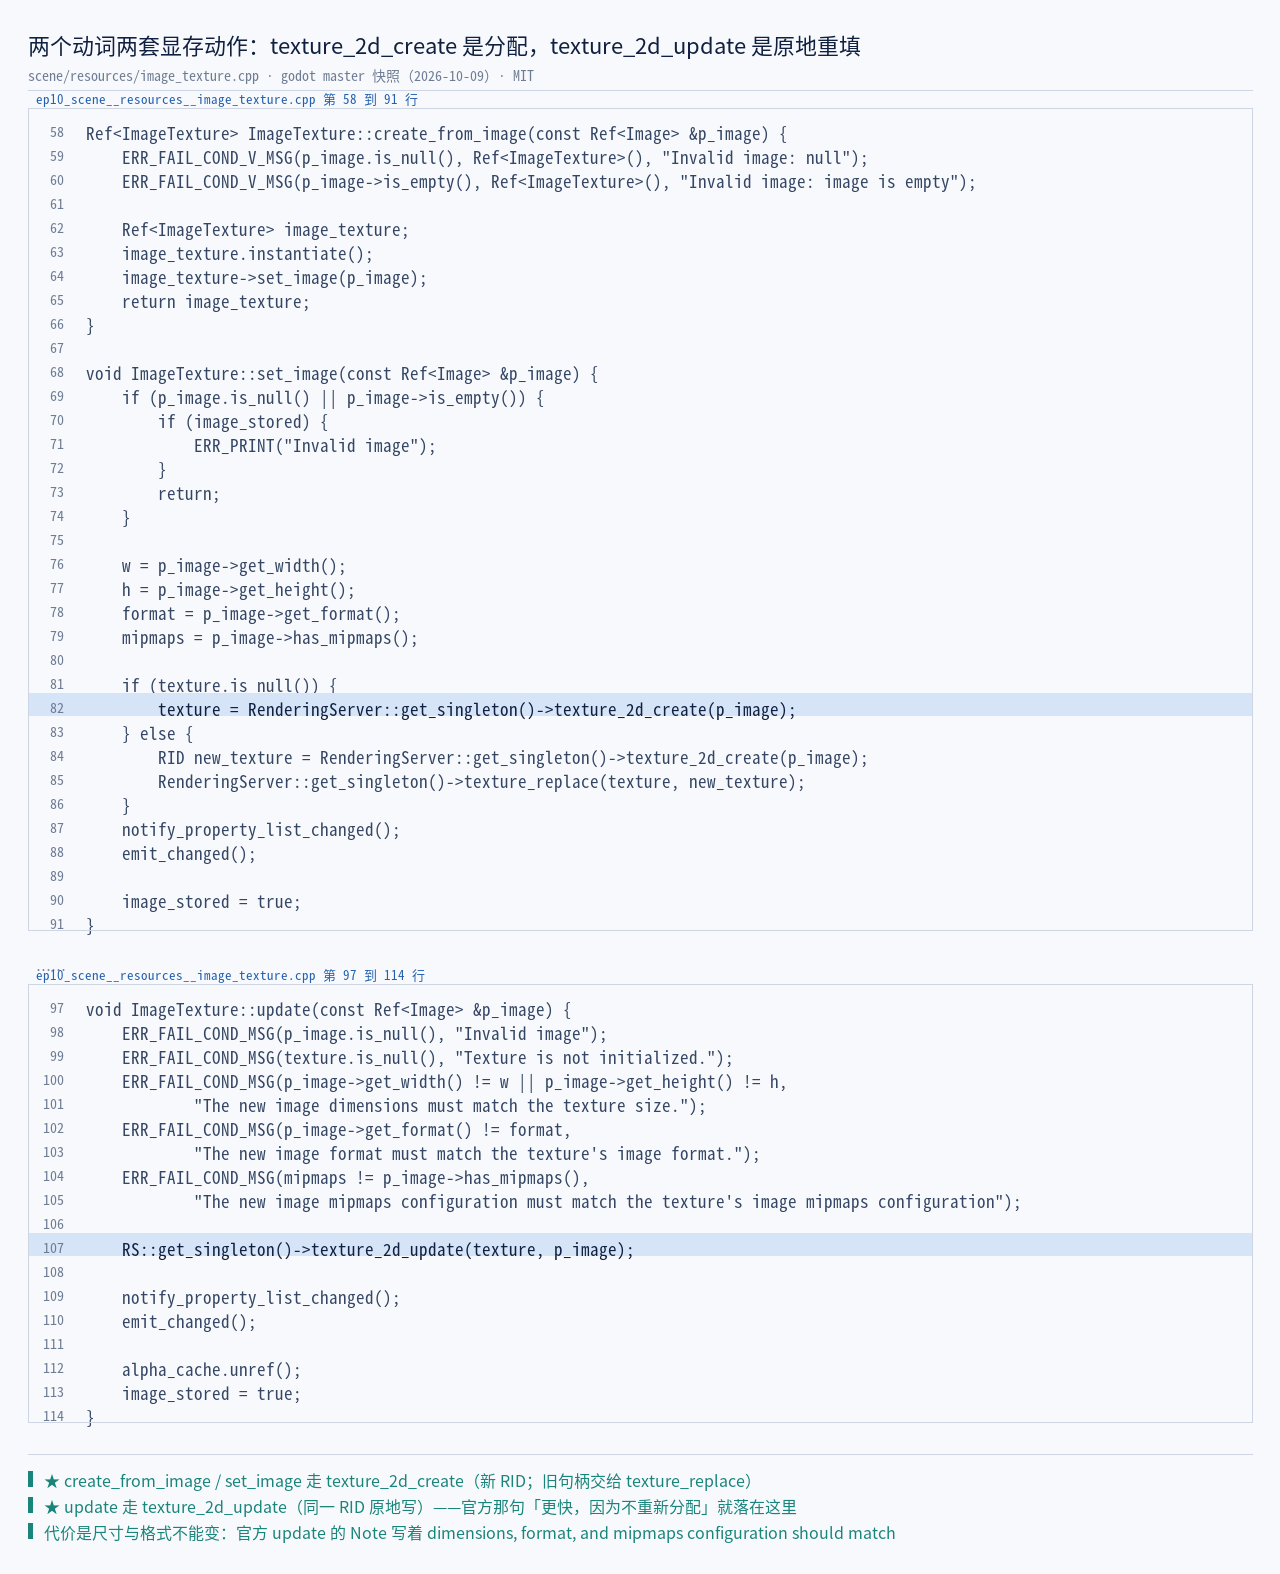
texture_2d_create 是分配,texture_2d_update 是原地重填@ godot master 快照(2026-10-09)原文截取 · MIT其中:把两个动词放在一起看,区别就清楚了:
// scene/resources/image_texture.cpp(节选)

【动词一:分配】:58–91
Ref<ImageTexture> ImageTexture::create_from_image(const Ref<Image> &p_image) {
        …
        image_texture->set_image(p_image);
}

void ImageTexture::set_image(const Ref<Image> &p_image) {
        …
        texture = RenderingServer::get_singleton()->texture_2d_create(p_image);       【新 RID】
        …
        RID new_texture = RenderingServer::get_singleton()->texture_2d_create(p_image);  【也是新建】
}

【动词二:重填】:97–114
void ImageTexture::update(const Ref<Image> &p_image) {
        …
        RS::get_singleton()->texture_2d_update(texture, p_image);                     【同一 RID,原地】
}
下面对这两个动词特别说明。它们调用的是 RenderingServer 上两个不同的接口——一个是 texture_2d_create(第八章见过),一个是 texture_2d_update。前者要分配一块新的显存,后者在已有的那块上原地写。这就是官方那句「update 比 set_image 快,因为不用重新分配内存」在代码层的落点。
其中:这两个动词不是可以随便换的。官方在 update 的说明里加了一条前置条件:纹理必须先用 create_from_image 建好,而且新图的数据要与旧的匹配——原话是「The new image dimensions, format, and mipmaps configuration should match the existing texture's image configuration」。翻译过来就是:update 省下了分配,代价是尺寸与格式不能变;要变尺寸就得走 set_image 重新分配。这个取舍与第五章那张加载耗时表是同一个道理:省下的永远是某一笔账,不是全部。
10.2 又一条官方的警告:源码 PNG 别在运行期读
言归正传,顺带说清一条与本章相邻的官方规矩:Image.load_from_file() 能不能在运行期用?官方答案是可以但不推荐:
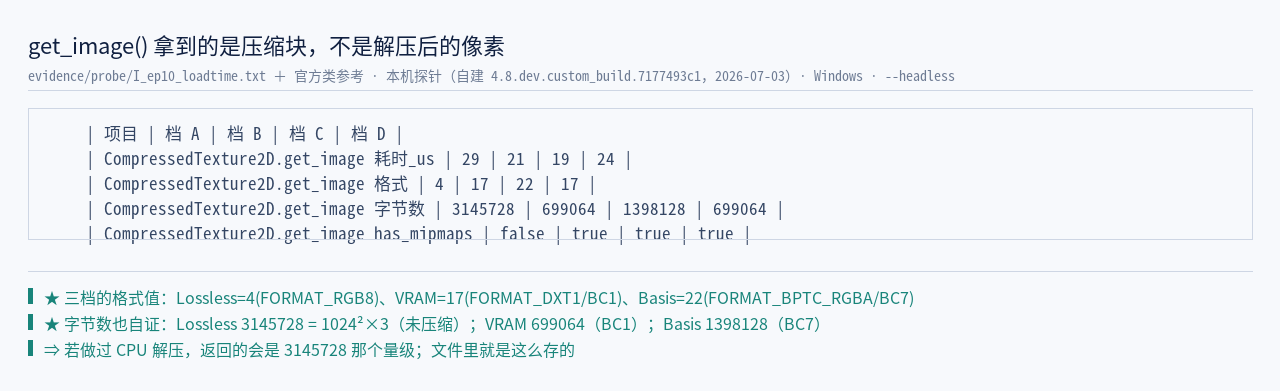
get_image() 返回的是压缩块:格式值 4 / 17 / 22,字节数与 GPU 侧同量级@ 本机实测 · Godot 4.8.dev.custom_build.7177493c1(自建构建)其中:这条警告在本机是跑得出来的——探针调用 Image.load_from_file("res://tex_rgba.png") 时,日志里确实打出了那句 Loaded resource as image file, this will not work on export。它的落点顺带留了个副产品:本机构建里这句警告在 core/io/image.cpp:2804,而 master 快照里同一句在 :2883——同一个提交之外的行号会漂移。这正是零章那条读法约定的实例:本篇引行号一律用 master 快照,本机行号只在与快照不同时另行注明。
其中:这条警告的真正含义值得说透:发布版工程里那个 res://tex_rgba.png 根本不在包里。打包时进包的是 .godot/imported/ 里那个 .ctex,源 PNG 未必被导出。所以「运行期直接读源图」在编辑器里能跑、在导出后崩——这就是官方为什么要你在编辑器里就用 load() 走资源系统。
10.3 两个动词两套动作
好了,把这一章收成一张对照图:
其中:图里画的差别对应两条 RenderingServer 接口,一句话概括:set_image / create_from_image 是「换一块」,update 是「就地擦一遍」。两者都合法,选择依据只有一条:尺寸与格式变不变。不变就用 update,变了就重新分配。
本章出处:源码 image_texture.cpp(:58–95 分配、:97–113 重填、:212 尺寸覆盖、:232 静态绑定)、image.cpp(:2880–2904 两条 Image.load_from_file 警告、:2906–2912 写侧的函数指针);官方类参考 ImageTexture(set_image 与 update 的分工原句、那条 Warning);本机实测 I_ep10_runtime_A.txt。
十一、版本节奏:导入速度是一条被单独推的线
先来看看这一章要讲的事,它容易被忽略:导入这条线在最近的版本里被专门优化过两次,而两次优化的方向不完全是同一个。
再说清这一章用的原理:版本节奏这一类结论只能取自官方发布说明,而且必须落到具体动作——「更快了」是结论,「改了什么」才是机制。所以下面每一格都尽量给出官方原句里的那个动词。
11.1 4.4 与 4.6 两次改动
官方发布说明里,这条线有两块独立的卡片:
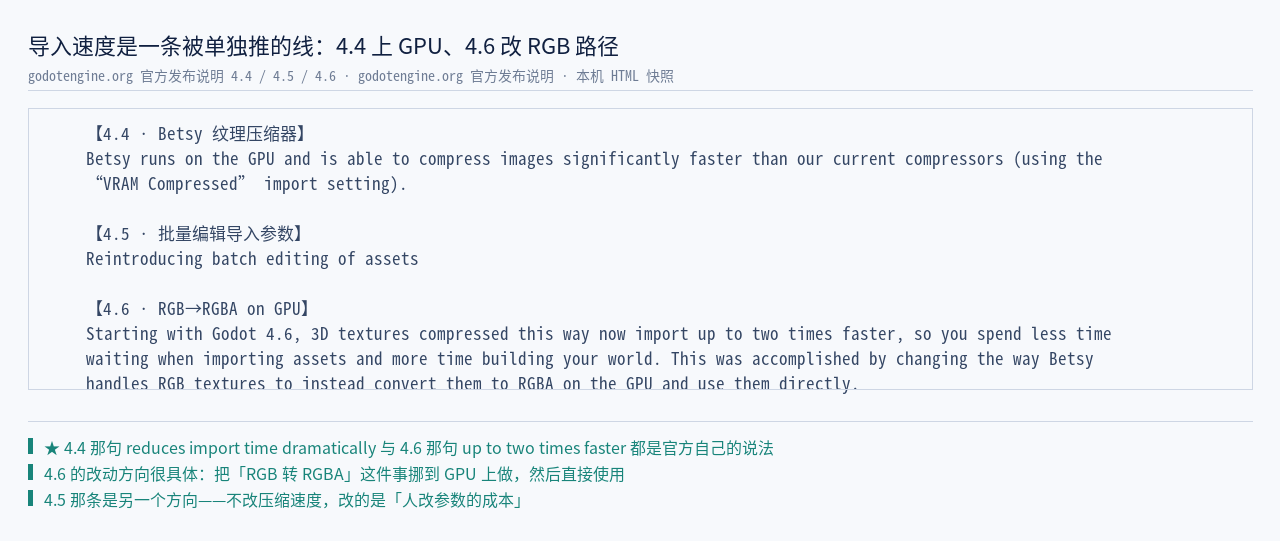
其中:把两段原文并排读,能看出一条清晰的走向:
| 版本 | 做了什么 | 官方原句里的关键 |
|---|---|---|
| 4.4 | 把 Betsy 纹理压缩器接进引擎 | Betsy runs on the GPU and is able to compress images significantly faster than our current compressors (using the “VRAM Compressed” import setting). This change reduces import time dramatically. |
| 4.5 | 重新引入批量编辑导入参数 | Reintroducing batch editing of assets(一次改多个文件的同一项) |
| 4.6 | 改 Betsy 处理 RGB 的方式 | Starting with Godot 4.6, 3D textures compressed this way now import up to two times faster… This was accomplished by changing the way Betsy handles RGB textures to instead convert them to RGBA on the GPU and use them directly.(PR 110060) |
其中:4.6 那条与第二章、第九章的内容正好接上:第二章看到 compress_with_gpu 这个设置默认是 true,而官方给它写的适用范围是「BC1, BC3, BC4, BC5, and BC6」这几个格式;第九章又看到 FORMAT_RGB8 那支的判断写着 if (false && …),不透明 RGB 总会先被转成 RGBA8。4.6 的改动正是把「转 RGBA」这件事挪到了 GPU 上做——于是它自然落在「Betsy 的路径」里,而不是在 CPU 侧先转一遍。
其中:4.5 那条是另一个方向:它不改压缩速度,改的是人改参数的成本。这条与第四章那节合起来看很有意思——一边是工具在替你改参数(检测器回写),一边是工具让你批量改参数(批量编辑),两件事都在处理同一个现实:一个工程里需要改导入参数的场合很多。
11.2 一条时间线,以及一个本机的版本缺口
OK,把上面三件事与上一节那些源码事实放到一条时间线上,同时把本机口径标在末尾:
其中:这张时间线上有一个必须写清楚的缺口:rendering/textures/streaming/* 这一组设置(按可见性动态装载/卸载 mipmap 来省显存)在 master 快照的文档里是有的(ProjectSettings.xml:3541–3563 一整套,含 enabled、inactivity_decay_rate_ms、max_ops_per_second),而本机探针去读时返回的全是 <null>——本机构建里这两个键不存在。
把它写出来是这样一组键,本机读到的值与文档写的值并排:
; 这一组键在文档里有、在本机构建里读不到

rendering/textures/streaming/enabled                    文档默认 false   本机读作 <null>
rendering/textures/streaming/inactivity_decay_rate_ms    文档默认 5000    本机读作 <null>
rendering/textures/streaming/max_ops_per_second          文档默认 200     本机读作 <null>
下面对这三行特别说明:「读不到」与「读到 false」是两件不同的事——探针拿到的是 <null>(键不存在),不是 false(键存在但关着)。这个区别是要紧的:如果它只是关着,那本篇可以写「本机默认不开」;而它根本不存在,本篇就只能写「本机构建里没有这一组键」。这两句话给读者的信息完全不同。
这不算矛盾,而是零章那条读法约定的第三个实例:文档取 stable(写的是最新稳定版的能力),源码取 master(含未进稳定版的新货),本机是 4.8-dev 自建构建(介于两者之间,但不完全等于任何一个)。所以本篇对 texture streaming 的处理是:只把它作为版本线上的一个观察写出来,并注明本机读不到;不给任何本机读数。
其中:这一节也顺带回答了这一章开头的那个观察:「导入快不快」在 Godot 里不是一条背景参数,而是一条被单独推的线。4.4 上 GPU、4.6 改 RGB 路径、4.5 改人的操作方式,三件事指向同一个现实——导入是编辑器里最频繁的动作之一,它的耗时直接决定开发时的手感。
本章出处:官方发布说明 4.4(Betsy 卡片)、4.5(批量编辑资产)、4.6(RGB→RGBA on GPU 与「up to two times faster」);4.6 beta 1 开发快照(GH-110060);官方类参考 ProjectSettings(compress_with_gpu 与 streaming/* 两处);本机实测 I_ep10_runtime_A.txt(streaming/* 读到 <null>)。
十二、收官:三件事对回机制
这一章把前面十一章收起来。它不做总结式复述,只做三件本篇该做的事:把调研期间反复出现的三个现象对回机制、把没做的事列出来、把证据分层说清,然后把接力棒交出去。
12.1 一遍走完的这条链
OK,先把整条链放到一张图上——它不是路线图,是一条有起点的调用链,每一格都能指回前面某一章的具体行:
其中:这张图想让人记住的不是「有七个格子」,而是这七个格子里的每一格都是可核对的:三个名字可以在盘上 ls 出来(第一章)、导入器的两个「名字」在接口签名里(第二章)、五档压缩的三根轴在官方表里(第三章)、三路加载与状态机在本机读数里(第五章)、一把锁一张表在 19 行源码里(第七章)、.ctex 到 RID 的四步在一个函数里(第八章)、两个动词对应两条接口(第十章)。
这里补一句本篇反复用到的定义:所谓「一条链的落点」,指的是它在源码里可以被指认的那一个函数或那一行。本篇全篇只在四个 RenderingServer 接口上落点,就是这条纪律的直接结果:
// servers/rendering/rendering_server.h:112–141(本篇用到的全部渲染层接口,仅四个)

virtual RID  texture_2d_create(const Ref<Image> &p_image) = 0;                  // 建纹理
virtual void texture_2d_update(RID p_texture, const Ref<Image> &p_image, …) = 0; // 原地更新
virtual void texture_replace(RID p_texture, RID p_by_texture) = 0;               // 换内容
virtual void texture_set_size_override(RID p_texture, int p_width, int p_height) = 0;
下面对这四行特别说明:它们不是「可能用到」,而是「本篇全部结论的落点边界」。超出这四个接口的部分(它们内部怎么排队、怎么下发给驱动),本篇一律交给第三篇与第七篇——把边界钉死在一张图上,比在一句话里含糊带过要诚实得多。
12.2 三个反复出现的现象,对到机制上
言归正传,调研期间在官方论坛、问答区与技术博客里反复出现的现象大致有三类。这里只做机制对应,不引用无法核对的原句、也不写热度数字——那些数据本轮没有证实过。
| 现象 | 对上的机制 | 在哪一章 |
|---|---|---|
| 切场景的时候卡住几百毫秒,播放中的 loading 界面也跟着停 | 用的是同步 load()。它会走同一个加载任务体,但调用方在 while 里原地等(第六章 6.1);官方给出的替代路径是 load_threaded_request + 跨帧查 load_threaded_get_status + load_threaded_get(第五章 5.1、5.2) |
第五章、第六章 |
「我明明用了 CACHE_MODE_IGNORE,为什么还是拿到了旧资源」 |
这个档位只管主资源与它自己的子资源,依赖(外部资源)仍按 CACHE_MODE_REUSE 走。官方常量说明原文是 Dependencies (external resources) are loaded with CACHE_MODE_REUSE。要连依赖一起绕开,得用 CACHE_MODE_IGNORE_DEEP |
第五章 5.1、第七章 |
| 像素画的边缘被压糊了、颜色也偏了 | 2D 预设默认是 Lossless,但第四章那个检测器会改它:一旦这张图被用到 3D 场景或材质上,compress/mode 会被回写成 VRAM Compressed(写回 .import 并自动重导)。官方类参考也承认 VRAM compression can exhibit noticeable artifacts and is intended to be used for 3D rendering, not 2D |
第四章 4.3、第三章 3.4 |
其中:这三行放在一起看,会看出它们不是三个不同的问题,而是同一条链上三个不同位置的摩擦:
- 第一行是在错误的位置等——等本身没错,错在让调用方在主线程上等;
- 第二行是对档位的范围想错了——把一个「只管自己」的选项当成了「管全局」;
- 第三行是配置被工具改过而人不知道——问题不在压缩模式好不好,在于它是谁定的。
其中:所以对应的三类解法也完全不同:第一类靠换调用方式(不改成线程加载,就是把该等的地方从主线程挪走);第二类靠看清档位的作用域(换 _DEEP 或改用 CACHE_MODE_REPLACE);第三类靠知道谁在写你的配置(要么接受检测器的判断并手动改回,要么在 .import 里把 detect_3d/compress_to 关掉)。把三类混成一类,就会出现「给像素画加锁」或者「为了防检测器而禁用整个导入流程」这种不对症的处置。
12.3 本篇没做的四件事
按本系列的惯例,边界也写出来——这四件本篇没有做,读者别从本篇里读出它们:
| 没答的问题 | 为什么没答 |
|---|---|
| 显存占用的真实读数 | 本机没有显存侧读数工具。本篇所有字节数都是被上传的压缩块字节数(.ctex 内容 / get_image() 返回的压缩块)。要拿显存真值得用 GPU 侧工具,本轮没做 |
Detect 3D 回写的本机复现 |
回写由 MAKE_3D_FLAG 触发,需要在编辑器 GUI 里把这张纹理实际用到 3D 场景/材质上;本机跑的是 --headless --import 批处理,走不到这条路径。所以第四章只呈现源码与 .import 结构,不声称复现 |
| 跨平台产物差异的实测 | 本机只有 Windows 一个平台,etc2_astc 那一支根本不产出。所以第九章只写「源码有两条分支、本机只落一支」,不推断移动端表现 |
| texture streaming 的行为 | 本机构建里 rendering/textures/streaming/* 这两个键不存在(探针读到 <null>),而 master 快照的文档里有一整套。所以第十一章只把它作为版本线上的一个观察,不给本机读数 |
其中:第三条与第四条是同一类:「源码/文档里有」不等于「本机测得到」。而第二条是另一类:「源码里读得到」不等于「本机能复现」。两类都统一按「看源码就写看源码、没测就说没测」处理,不把两者混成一句。
12.4 证据分层与下一步
好了,本篇的材料分三层,缺一层就会在结论上留缺口:官方文档与类参考定口径(三件套、五档压缩表与内存表、CacheMode 五档、ImageTexture 两动词)、源码定落点(三个取名字的方法、检测器回写、任务体与让出、19 行缓存、.ctex 到 RID 的四件事、格式校验的 swizzle)、本机定实况(盘上文件名与字节数、三个哈希、mipmaps 的 1.3333、三档加载耗时、状态机逐帧序列)。三层的分工是固定的:文档说「设计上是这样」,源码说「代码里确实这样」,本机说「这台机器上跑出来是这样」。
其中:这一篇比前几篇多出来的是中间那一层的一个新面:前九篇的「本机」大多是运行期读数(启动行、帧间隔、计数),这一篇的「本机」有一半是盘上产物——文件名、字节数、侧车内容。这不是换了个花招,而是因为这篇讲的对象的中间态就落在盘上:.ctex 既不是源也不是显存,它只存在于文件系统里。
关于第十一篇(收官篇):第九篇讲了「什么时候算、谁来算」,本篇讲了「那些料从哪来」,下一篇要回答的是「这条链走下来,整体买到了什么」——把落点、时序、资源三件事放回一张账上,看这套架构在什么场景下是划算的、在哪些地方是需要付代价的。本篇不做这个总结,因为它需要前十个部分的全部结论。
本章出处:本篇全部结论的取值口径见上文各章的「本章出处」;官方文档入口 Import process 与 Importing images;本机材料可复跑,入口是 content/blog/godot-engine-ep10-resource-pipeline/evidence/probe/(ep10_make_probe.py → ep10_run_probes.py → ep10_probe_hash_triad.py → ep10_probe_mipmaps.py),原始日志在 evidence/probe/I_ep10_*.txt。
相关链接
官方类参考
- ResourceLoader(三个线程 API、五个
CacheMode、跨帧调用的 Note) - Resource(全局缓存那段与
take_over_path) - CompressedTexture2D(四条压缩法与「只有 VRAM Compressed 真的省显存」)
- ImageTexture(
create_from_image/set_image/update的分工与那条 Warning) - Image(格式枚举与
load) - ProjectSettings(
vram_compression/*六条与lossless_compression/force_png) - ResourceImporterTexture(导入选项的官方说明)
- ResourceImporter / ResourceFormatLoader
官方教程与文档
- Import process(三件套与两段
ls、.import要入库那句) - Importing images(五档压缩对照表、内存表与两条脚注、mipmaps、Detect 3D)
- Background loading(
load_threaded_get会阻塞那段) - Resources(缓存与引用计数的用法基线)
- Internal rendering architecture(纹理与显存的上位视图)
官方发布说明
- Godot 4.4 发布说明(Betsy 纹理压缩器接入)
- Godot 4.5 发布说明(批量编辑导入参数重新引入)
- Godot 4.6 发布说明(RGB→RGBA on GPU,3D 导入最多快 2 倍)
- 4.6 beta 1 开发快照(
GH-110060)
源码入口(master 快照 2026-10-09)
- resource_importer_texture.cpp:三个取名字的方法(
:186–204)、预设与选项(:255–297)、检测器回写(:126–183)、size_limit兜底(:770–788)、双支格式分支(:915–991) - resource_importer.h:导入器接口(
:110–157) - resource_loader.h / resource_loader.cpp:四个加载入口(
:121–259)、任务体与让出(:337–482)、解锁注释(:562–564)、投递与阻塞(:845/:970) - resource.h / resource.cpp:
ResourceCache全文(:197–215)、原子登记set_path(:79–116) - compressed_texture.cpp / compressed_texture_resource_format.cpp:
.ctex的加载器薄壳与_load_data四个出参 - image_texture.cpp:两个动词(
:58–113) - image.h / image.cpp:格式枚举(
:74–113)、两条load_from_file警告(:2880–2904)、一族load_*_from_buffer - image_loader.h / image_loader.cpp:插件式解码派发与
add_image_format_loader - texture_storage.cpp:
texture_2d_initialize四件事(:991–1058)、_validate_texture_format(:2367起) - rendering_server.h:
texture_2d_create/texture_2d_update/texture_replace/texture_set_size_override(:112–141)
本机材料(可复跑)
- 探针工程与复跑脚本:
content/blog/godot-engine-ep10-resource-pipeline/evidence/probe/(ep10_make_probe.py、ep10_run_probes.py、ep10_probe_hash_triad.py、ep10_probe_mipmaps.py) - 原始日志:
I_ep10_A_default.txt…I_ep10_D_repeat.txt、I_ep10_import_files.txt、I_ep10_dot_import_dump.txt、I_ep10_hash_triad.txt、I_ep10_mipmap_ratio.txt、I_ep10_loadtime.txt、I_ep10_thread_progress_A.txt、I_ep10_verbose_import.txt、I_ep10_manifest.json - 被导入的产物本体(连同
.import与.md5侧车):evidence/probe/godot_import_probe/
社区与同类文章(仅作现象与竞品来源,本篇未引用其原句与热度)
- Godot 源码分析(十一):resource_loader.h & resource_saver.h(中文侧最接近的源码级文章,只覆盖两个头文件)
- Resource Management and Saving(由官方文档生成的索引,非源码)
- How to Fix Godot ResourceLoader Blocking the Game(症状层)
外部素材来源
- 题图:
Godot-3-theme-editor.png@ L10nM4st3r / Wikimedia Commons / CC BY-SA 4.0 - mipmap 走样对照:
Mipmap Aliasing Comparison.png@ BillyBob CornCob / Wikimedia Commons / CC0


系列前篇
- 第九篇 主循环与多线程:这套账在什么时刻、被哪个线程算出来|第八篇 后端分叉:Vulkan / Direct3D 12 / Metal / OpenGL|第七篇
RenderingDevice抽象与渲染依赖图|第六篇 批处理|第五篇 画布渲染抽象|第四篇 画布剔除与排序|第三篇 服务层接口|第二篇 对象模型|第一篇 全景与边界
下篇预告(第十一篇 · 收官):下一篇要问的是「这条链整体买到了什么」——把落点、时序、资源三件事并回一张账,看这套分层在什么场景下划算、在哪些地方必须付代价,以及「四层架构」这个说法至此能不能被完整回答。
以上。本篇所有源码行号一律按 godot master 快照(2026-10-09),逐条回本机文件复核,不做算术平移;本机读数一律写明引擎为自建版本 4.8.dev.custom_build.7177493c1(2026-07-03 构建)、Windows、--headless 批处理导入;凡涉及字节数一律指被上传的压缩块字节数,不是显存读数。希望能对大家有所帮助。
With Best Wishes.