站点链接:技术博客页
系列文章前言
系列定位
这个系列只回答一个问题:同样是「把矢量变成像素」,为什么市面上会同时活着五套做法完全不同的引擎,而它们各自还都活得挺好?
它面向的是已经写过两三年渲染、能看懂管线,但没有把「矢量光栅化」当成一条独立技术线去追过的图形程序员。Skia 大家天天在用却未必读过它的分层;Cairo 大家以为它死了;Vello 大家在新闻里见过但说不清它现在走到哪;Godot-2D 与 Rive 则常被当成「游戏里那点 2D 的事」一笔带过。所以我们不复述 API 教程,也不写「十大 2D 库推荐」——我们要算的是:每一款引擎为什么长成现在这个样子,它的生态位换回去要付什么代价。
系列文章写作风格说明
- 篇幅规划:每篇约 16,000 汉字、10 章左右,每章 1,400 到 2,300 字。
- 写作顺序:先立坐标系(本篇),再沿 Skia 主线走机制(ep02 到 ep06),中间穿插三次自跑(ep07、ep08、ep10),最后与 Vello 前沿和 Godot-2D、Cairo、Rive 三个对照项合流(ep09、ep11)。
- 每篇都给可核对的量化结论与出处;用「本机实测」与「官方原文」两条腿站住,凡是二手转述一律标注口径。
- 本系列不搬运厂商官方配图(Skia、Vello、Rive、Godot 的官方图示受项目方或厂商版权约束)。需要图示时,我们用自己跑、自己算、自己画的图;外部示意图只取自 Wikimedia Commons 的通用概念图。
- 凡是前序系列已经占领的题域,本篇只引用、不复述——边界见 0.3 节。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主线 API 面(Skia 官方,本系列第二到第六篇的依据):https://skia.org/docs/user/api/
- 前沿对照(Linebender 官方季度进展,第九篇的依据):https://linebender.org/blog/tmil-25/
- 本系列使用的自跑工具链:https://pypi.org/project/skia-python/
本篇总览与边界:只回答三件事,不复述什么
这一篇要干的事只有一件。它是整个系列的坐标系,不是某一款引擎的介绍。 十一篇里它排第一,因为后面十篇都会回指它——每一篇开头都要写一句「本篇在坐标系里占哪一格」,用的就是这里钉死的两根轴。
0.1 全篇知识地图:十章的顺序与产出
先来看看这张表。它不是并列的知识点,而是一条从抽象到具体的动线——顺序不能颠倒:先立词汇,才谈得上比较;先比较完五款引擎的生态位,才谈得上给它们排格子。
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 零、总览与边界 | 本篇只回答哪三件事、不复述什么? | 三件题域 + 五块让出去的题域 + 术语双语对照 |
| 一、矢量到像素 | 从一条路径到一屏像素,中间有哪几步? | 图元与状态的分工 + 贝塞尔细分 + 覆盖判定 + 扫描线 |
| 二、抗锯齿与覆盖 | 为什么讲矢量一定要讲抗锯齿? | 走样的本质 + 位图与矢量之别 + 两族 AA + 术语路线归属 |
| 三、Skia | 它为什么能同时长在 Chrome、Android、Flutter 里? | SkCanvas 分层 + Raster 与 GPU 双后端真图 + 耗时读数 |
| 四、Vello | 它的 GPU compute 路线现在走到哪一步? | 三条分支现状 + sparse strips + 抽象层易主 + 版本时间线 |
| 五、Cairo | 这条跨平台 CPU 通用 2D 的老路还在被谁用? | source 与 mask 与 destination 绘制模型 + surface 后端分叉 |
| 六、Godot-2D | 游戏引擎里的 2D 渲染,边界划在哪? | CanvasItem 与 RenderingServer 的解耦边界 |
| 七、Rive | 矢量动画运行时与渲染器为什么必须解耦? | 内容侧与渲染侧的互不知情 + 后端清单 |
| 八、横向对照 | 五款引擎在同一张坐标系上各占哪一格? | 五维对照矩阵 + 交付格式边界 + 本机 GPU 读数 |
| 九、回指与预告 | 接下来 10 篇各回答什么? | 坐标系回指图 + 11 篇索引表 + 下篇口径 |
这张表里最先要记住的是第一章。 多数中文教程讲 Skia 直接从 SkCanvas 开始,读者于是记住了 API,却说不清「光栅化」这三个字具体是哪一步在动几何、哪一步在算颜色。本篇不惜篇幅,把这条链路拆到能看出「后续哪一篇展开哪一段」为止。
0.2 本篇只回答三件事
第一件:五款引擎各自在什么生态、被谁用、解决什么问题。 这里要克制「比性能」的冲动——本篇不给任何跨引擎性能排名。理由是 3.6 节会讲清的一条纪律:不同调用栈的耗时数字放在一起比,得到的结论是假的。
第二件:它们与「2D 矢量引擎」这个概念象限的边界。 「2D 矢量引擎」听起来是一个东西,其实是三类东西:通用 2D 图形库(Skia、Cairo、Vello)、游戏引擎里的 2D 渲染(Godot-2D)、矢量动画运行时(Rive)。它们共享「矢量变像素」这段技术,却对「谁来管场景」有完全不同的答案。
第三件:给 11 篇立共同词汇表与图序。 后面的每一篇都会回指本篇的两根轴,而回指要成立,前提是词汇先统一。0.5 节会把 path、tessellation、coverage 这类词一次钉死。
0.3 本篇不复述什么:五块已经占领的题域
既然三件事说清了,边界也得说清。开篇篇最容易翻的车,就是写成前序系列的复述或导读。 所以下面这张表把五块题域显式让出去:
| 已被占领的题域 | 属哪个系列 | 本篇只用它做什么 |
|---|---|---|
| 抓帧、回放、Event Browser、Perfetto trace 与 FrameTimeline | T01 性能剖析工具链(已完结 13 篇) | 只在讲「实测」时引用其方法论,不重讲任何工具用法 |
| Godot 引擎整体架构(场景树、服务器架构、渲染器组织) | T02 Godot 4 引擎架构 | 只借 CanvasItem 与 RenderingServer 这条边界,讲游戏引擎 2D 的分界 |
| App 到 Choreographer 到 SurfaceFlinger 到 HWC 的上屏系统栈 | T05 Android 图形显示系统 | 讲引擎内部如何把矢量变像素,sink 侧只引用不展开 |
| 粒子、程序化特效、后处理 | T16 实时 GPU VFX | 本篇讲图形引擎算法,不是特效 |
| GLSL、HLSL、WGSL 写法与 SPIR-V、DXIL、DXC 编译链 | T14 与 T15 着色器语言与 IR | 只在 Graphite 与 Vello 需要时引用 compute shader 概念,不教程化 |
一句话说清本篇与它们的关系: 前序系列在讲「怎么验」「引擎整体长什么样」「像素怎么上屏」,本篇讲的是「矢量这一路本身有哪些做法,各自的生态位在哪」。
0.4 边界声明与量化锚点
边界在开篇说一次,九章 9.4 节再确认一次:
- 不涉及任何一款引擎的内部机制实现:SkCanvas 的绘制路径、sparse strips 的段结构、Rive 的状态机求值,这些分别属 ep02、ep09、ep11,本篇只给「它在坐标系里的位置」;
- 不给跨引擎性能排名,也不做跨栈耗时对比:理由见 3.6 节;
- 不把本机自跑读数当作引擎的普适指标:本机读的是绑定层版本(skia-python 对应 Skia m144),与主线源码不是同一份,凡断言「Skia 现在怎么做」都会同时给实测与官方文档两条依据;
- 不预测 Vello 与 Graphite 的路线胜负:两者都在快速迭代,本篇只记录到本轮实测的原点;
- 本机可用面:
skia-python 144.0.post2(Skia m144)、pycairo 1.29.1(底层 libcairo 1.18.4)、Playwright 1.63.0 驱动 Edge(Chromium 153);rustc、cargo、godot、clang均不在位。
本篇要拿下的可核对数字有六个,全部来自本机实测或官方原文:本机 Skia 为 m144;同场景 drawPath 跑 50 次共 13.29 ms,即 0.2657 ms 每帧,非白像素 59,531;同场景 pycairo 为 0.0821 ms 每帧、非白像素 59,573;Edge 侧 canvas 非白像素 66,762,GPU 读数为 ANGLE 加 D3D11 下的 RTX 3060 Laptop;Vello 版本时间线为 0.6.0 到 0.10.0(2025 年 10 月到 2026 年 8 月)。
先来看看本篇与其余三个系列、以及后续十篇的题域切分图。它决定了后面每一章能讲多深:
被划掉的那五块都不是本篇的题域。 本篇占的是最下面那条细线——「矢量变像素」本身有哪几种做法。正因为它是「做法」,它才能不带任何一款引擎的实现细节独立成篇。
0.5 术语双语对照(先备着)
后面几章会密集出现官方术语原名,中文侧译法并不统一,这里一次钉死:
| 中文 | English | 一句话 |
|---|---|---|
| 路径 | path | 由直线段与曲线段构成的图元,可开放可闭合 |
| 细分 | tessellation | 把曲线拆成可光栅化的直线段的前置步骤 |
| 光栅化 | rasterization | 把几何变成像素覆盖的过程 |
| 覆盖 | coverage | 一个像素被几何盖住的比例,取 0 到 1 之间 |
| 解析式抗锯齿 | analytic AA | 逐像素精确算覆盖,而非按样本二值判定 |
| 多重采样抗锯齿 | MSAA | 每像素放 N 个样本,按样本二值覆盖后 resolve |
| 稀疏条带 | sparse strips | Vello CPU 与 Hybrid 共享的段式几何核心 |
| 计算着色器光栅化 | compute rasterization | 用 GPU 通用计算代替固定功能光栅的阶段 |
| 绘制调用 | draw call | 一次「图元加状态」的下发,引擎调度的最小单位 |
| 后端 | backend | 真正把像素写出去的那一层:Raster、Ganesh、Graphite 等都是 |
一句话记住本篇的方法:先分清「几何在哪算、像素怎么合」,再问「谁管场景」;这两个问题的答案组合起来,五款引擎的位置就唯一确定了。
一、从「矢量」到「像素」,中间有哪几步?
下面我们开始第一阶段。 这一章要回答的问题看起来最基础,却恰恰是中文资料最含糊的一段:一条路径从「数学上存在的曲线」变成「屏幕上亮起来的像素」,中间到底经过了哪些步骤?把这五步拆清楚,后面四章才有共同的语言。
1.1 一次绘制调用的三个要素:图元、状态、目标面
先从这条链路最上面那一层看起。任何一个 2D 矢量引擎,对外暴露的最小动作都能写成一句话:一次绘制调用,等于「一个图元」加「一组状态」,落到「一个目标面」上。
图元(primitive)在 2D 矢量世界里通常就是路径(path):一串直线段与曲线段,可以开放(只描边)也可以闭合(可填充)。官方 API 页把 Skia 的组织方式讲得很直接——「Skia is organized around the SkCanvas object. It is the host for the "draw" calls」,所有绘制都是往 SkCanvas 上发的,而 SkCanvas 本身「holds relatively little state」,只持有矩阵与裁剪栈,其余样式全在 SkPaint 里。这条「几何与样式分离」的切分,是理解后面所有引擎的一把钥匙(ep02 会展开)。
状态(state)指颜色、线宽、渐变、混合模式、抗锯齿开关这一整套;目标面(target)则是像素最终落在哪里——内存里的位图、窗口的绘图表面、或者一张 GPU 纹理。三者当中,只有「图元」是矢量的,另外两个都是光栅世界的概念。
先来看看 2D 路径本身长什么样。它是产业链最上游的那份数据:
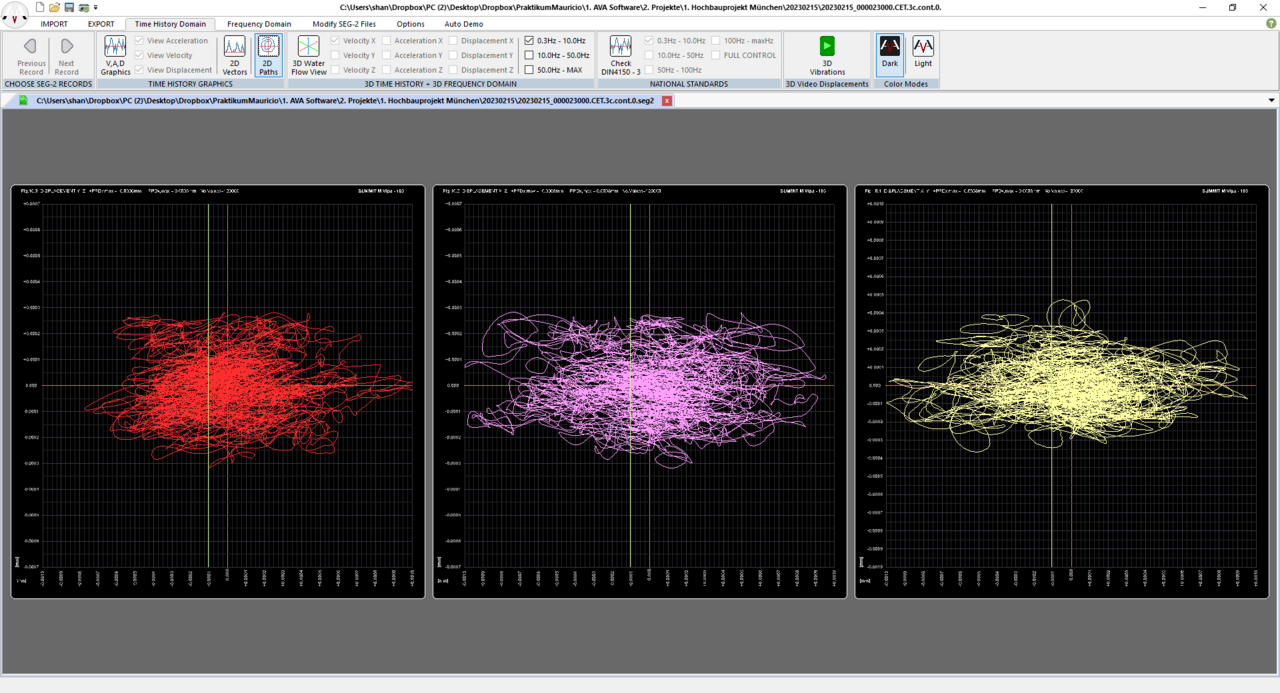
「填充」与「描边」这两个动词要分开看。 它们不是两种图元,而是同一份路径数据的两种渲染方式——描边要在原路径两侧「长」出宽度(还可能涉及连接处与端点样式),填充则要做非零环绕或奇偶规则判定。两者走的不是同一段光栅化代码,这是后面讲覆盖时会再遇到的一个岔路口。
1.2 曲线段为什么用贝塞尔:控制点决定曲率
路径里既有直线段又有曲线段,那个「曲线段」为什么不干脆用圆弧或多项式? 答案是工程妥协:贝塞尔只有两项好处,而两项都无法替代——第一,它能用固定数量的控制点表达任意光滑曲线,且求值稳定;第二,它能被拆成任意精度的直线段,因为细分这一步是纯代数运算。
曲线的控制点直接决定曲率分布。 以三次贝塞尔为例,它是四个点的加权平均:
-----------------------------------【三次贝塞尔曲线的参数式】------------------------------------
# 描述:四个控制点 P0、P1、P2、P3 加权求和,参数 t 从 0 走到 1
# 权重:三个权重项构成 Bernstein 基,和为 1,因此曲线必定落在四点的凸包内
#------------------------------------------------------------------------------------------------
B(t) = (1 - t)^3 * P0  +  3 * (1 - t)^2 * t * P1  +  3 * (1 - t) * t^2 * P2  +  t^3 * P3
其中:
- P0 与 P3 是端点,曲线必然穿过它们,所以相邻路径段可以无缝衔接;
- P1 与 P2 是控制点,曲线一般不穿过它们,它们只负责「把曲线往哪个方向拉」;
- 凸包性质:因为四个权重都非负且和为 1,曲线永远落在 P0、P1、P2、P3 构成的凸包内——这条性质是后面做包围盒裁剪与覆盖判定的几何前提。
字体格式正好是这条性质的两个活例。 TrueType 用二次贝塞尔(一个控制点),OpenType 的 CFF 轮廓用三次贝塞尔(两个控制点)——同一款字体换格式,曲线段数量与细分代价都会变,这是 ep04 讲 CJK 字形时的一个关键变量。
先来看看贝塞尔曲线的控制点与曲率关系:
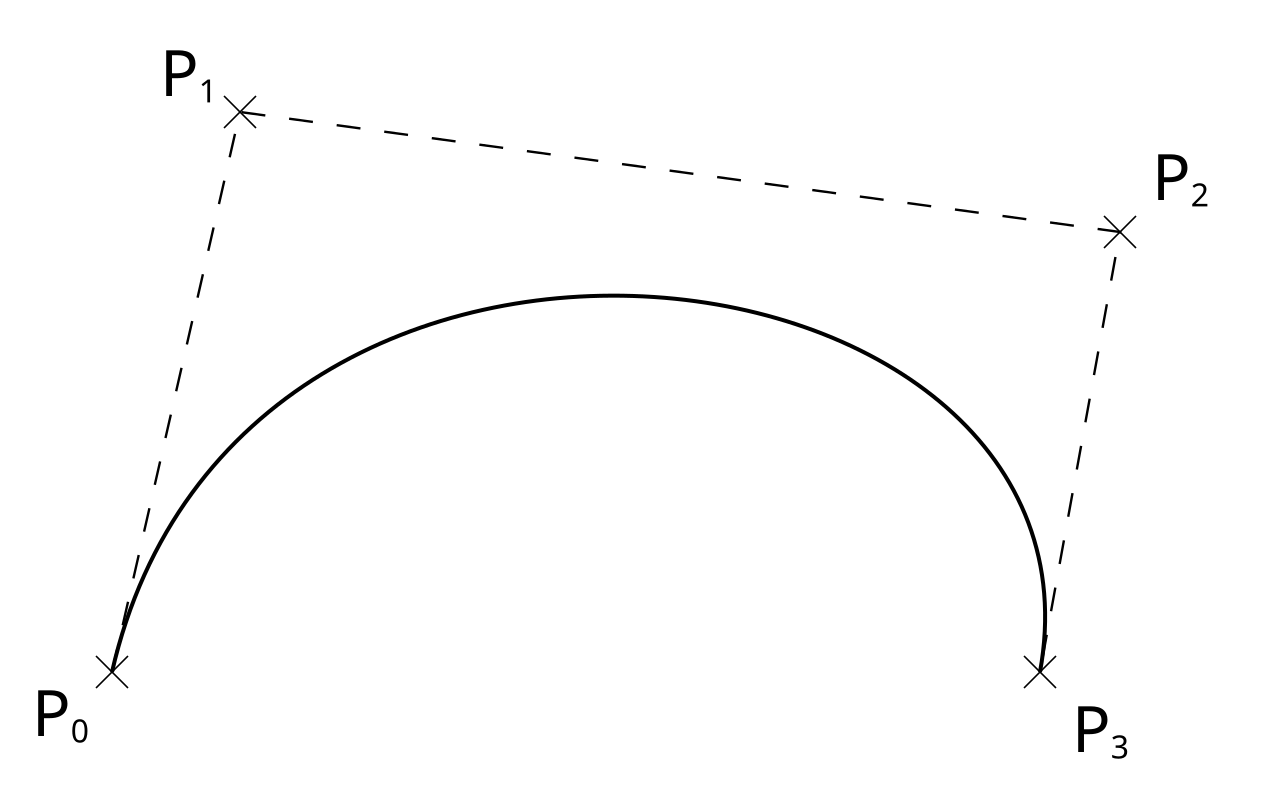
控制点挪一点,曲线整段都跟着变,这条特征在图上很直白。 正因为曲线不能直接光栅化,细分(tessellation)才是必需的中间步骤:按曲率自适应地把曲线拆成足够短的直线段,短到「线段与像素格的关系」可以被稳定判定为止。细分粒度定在哪,是 ep03 的核心权衡。
1.3 总链路:路径到像素的五段与各自的下游篇章
把 1.1 与 1.2 拼起来,就得到本篇的骨架图。 这条链路上有五个环节,每一段都有明显不同的技术内容,也正好对应本系列后面的某一篇:
每一段右侧挂的篇号,就是本系列后面九篇的分工。 这不是事后贴标签,而是排期时就定下来的:细分与覆盖率归 ep03,字形归 ep04,GPU 覆盖归 ep05,Graphite 归 ep06,Vello 归 ep09。本篇只负责把这条线画出来,让后面每一篇都知道自己站在第几段。
| 链路环节 | 输入 | 输出 | 关键问题 | 展开于 |
|---|---|---|---|---|
| 曲线细分 | 路径(含曲线段) | 折线(直线段序列) | 粒度怎么定、误差怎么控 | ep03 |
| 光栅化 | 折线 | 每个像素的覆盖值 | 覆盖怎么算得又准又快 | ep03 |
| 抗锯齿与覆盖合成 | 覆盖值 | 带 alpha 的颜色 | 按样本还是按解析式 | ep03 与 ep05 |
| 混合上屏 | 带 alpha 的颜色 | 目标面像素 | 混合模式与图层合成 | ep05 与 ep06 |
| 字形旁路 | 字体轮廓 | 覆盖位图(带缓存) | 缓存怎么管、CJK 怎么办 | ep04 |
1.4 覆盖判定:光栅化的核心动作
先来看看这条链路里最容易被一句话带过、却最关键的那一步。光栅化的核心动作,是拿几何与像素格的关系,定下每个像素被盖住多少。 官方在讨论抗锯齿时把它归纳得很清楚:要么在像素内放若干个样本、按样本是否被盖住做二值判断(这是多重采样那一族),要么逐像素精确算出被盖住的面积比例(这是解析式那一族)。两条路的差别是「逼近」与「精确」之别,代价则反过来。
先来看看三角形光栅化加抗锯齿的样子。它把「几何压到像素格上」这件事画得很直观:
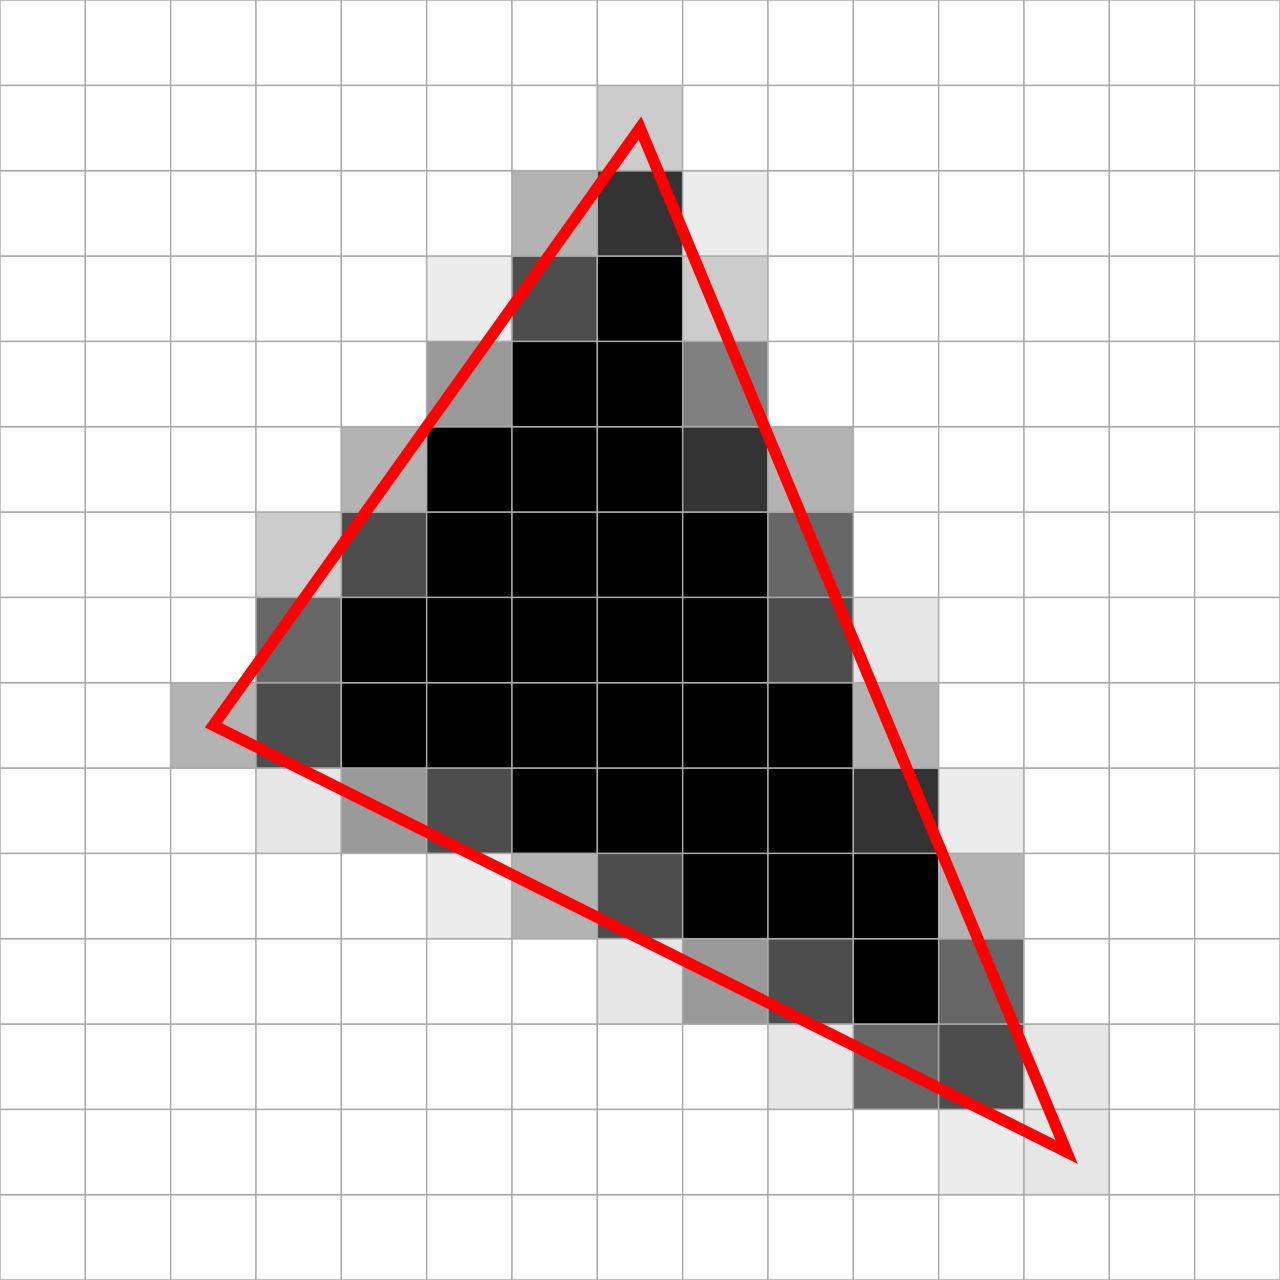
那些灰阶边缘就是「覆盖」的可视化。 内部像素的覆盖值是 1,外部是 0,只有边界像素取中间值——抗锯齿做的就是把这个连续量还原出来。 而判定的最小单位很关键:如果只判「像素中心是否被盖住」,那么一条几乎水平的细线会整条断掉;按覆盖面积算,才能得到图中的灰阶过渡。
1.5 另一条经典路径:扫描线算法
覆盖判定还有另一条更老的经典做法。 它不逐个三角形遍历,而是按行求交、逐行填充:对每一条扫描线,算出它与多边形各边的交点,排序后成对填充。这条路径在 CPU 光栅化时代是主流,因为它天然兼容「任意复杂度的多边形」且不需要三角形化。
先来看看扫描线算法的形态:
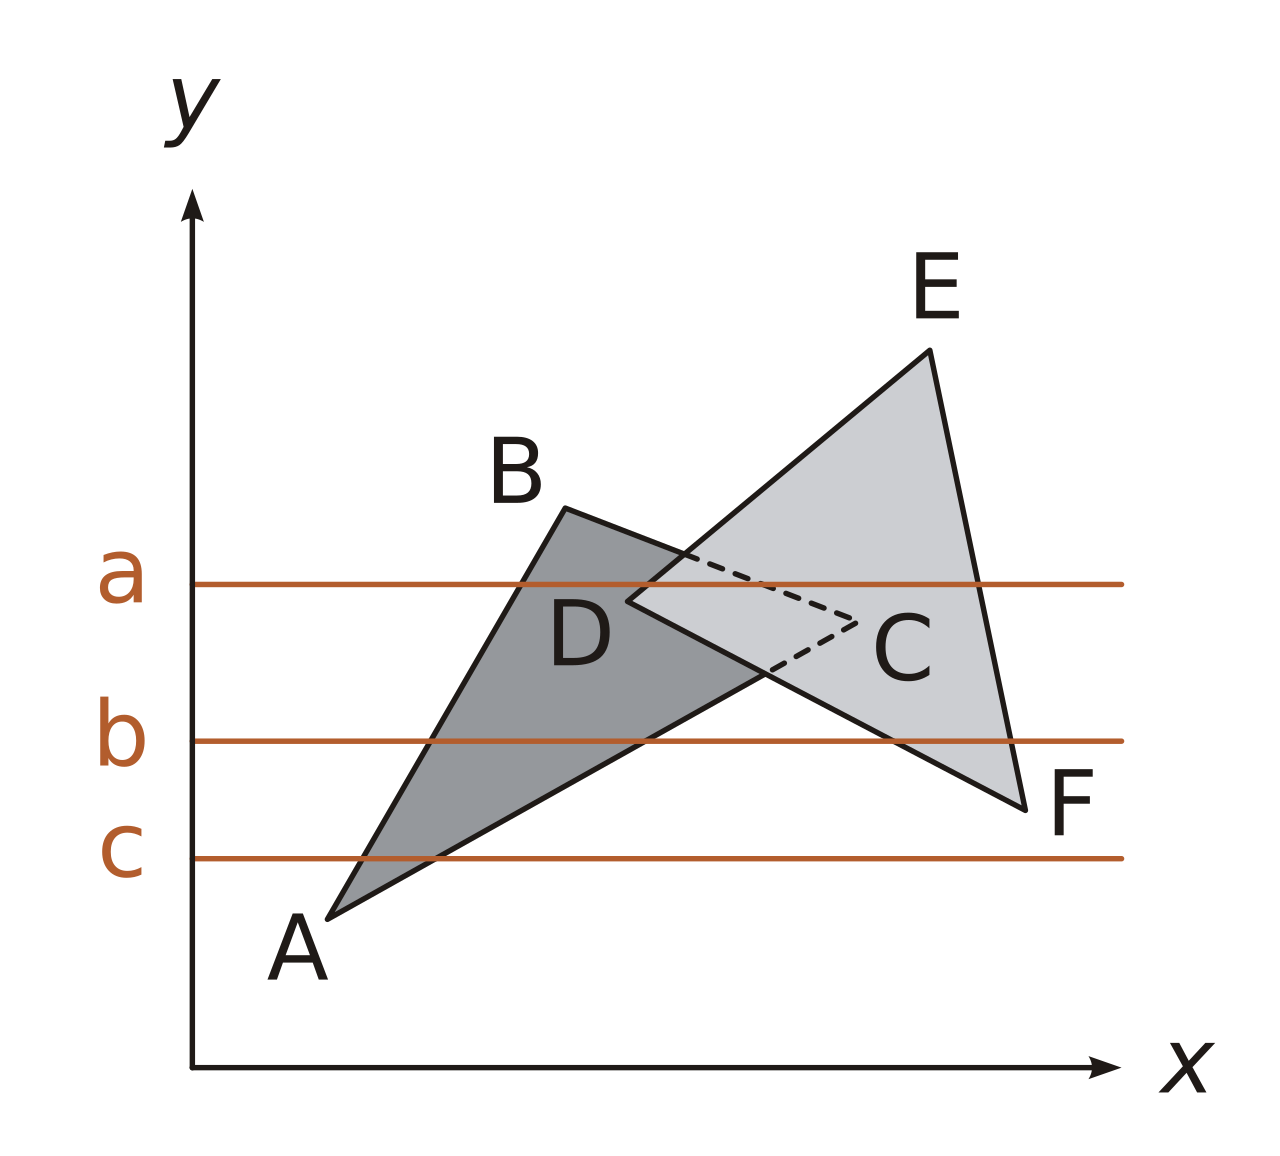
它与 1.4 的三角形遍历同属扫描转换(scan conversion),代价结构却完全不同。 扫描线的成本与「边数乘以覆盖行数」相关,三角形遍历的成本与「三角形数乘以覆盖像素数」相关——同一份几何,哪条路径更省,取决于它的复杂度分布。 本篇只立这条分岔,具体取舍留给 ep03。
1.6 本章收在哪里
第一章走完,手里该有四件东西:一句「一次绘制调用等于图元加状态加目标面」的共同词汇、一条从路径到上屏的五段链路、一个「覆盖」的概念、一条扫描线分岔。下一章要回答的是:为什么讲矢量绕不开抗锯齿。
把本章的链路压成一段伪代码,它长这样:
-----------------------------------【矢量到像素的五段流水线】--------------------------------------
# 描述:引擎内部一条路径的完整旅程,对应 1.3 节骨架图的五段
# 说明:括号里标注的是本系列的展开篇号;本段代码是结构示意,不是任何引擎的真实实现
#------------------------------------------------------------------------------------------------
1. path       <- 图元:直线段与曲线段序列          # 几何与样式分离(ep02)
2. segments   <- tessellate(path, tol)            # 细分粒度 tol 决定质量与代价(ep03)
3. coverage   <- scan_convert(segments)           # 覆盖判定:按样本还是按解析式(ep03 / ep05)
4. color      <- composite(paint, coverage)       # 抗锯齿与覆盖合成(ep05)
5. target     <- blend(color, target, mode)       # 混合上屏(ep05 / ep06)
其中:
tol(细分容差) 是这段流水线里唯一由使用者直接决定的质量旋钮,容差越小折线越密;coverage的取值范围在 0 到 1 之间,是「连续几何」与「离散像素」之间唯一的桥梁;- 第 3 步与第 4 步的顺序在 GPU 后端上可能被重排(覆盖先算还是先着色),这是 ep05 的话题。
本章对应的官方依据:绘制调用的组织与
SkCanvas的职责切分见 Skia 官方 API 总览 与 SkPath 概览;像素与位图侧的定义见 SkBitmap 与像素;抗锯齿两族划分的官方口径见 skia-discuss 讨论帖;贝塞尔与填充描边的规范侧说明见 MDN 的 SVG 填充与描边教程。
二、为什么讲矢量一定要讲抗锯齿与覆盖?
下面我们开始第二阶段。 上一章把链路拆成了五段,其中第 3、4 段都挂着「覆盖」这个词。这一章要回答的是:为什么这两段值得单独讲一章,而不是当成一个细节? 因为它们决定了「矢量」这个象限到底有没有存在的意义。
2.1 走样不是模糊,是采样频率不足产生的假结构
先说一个常见的误解。 走样(aliasing)经常被说成「边缘有锯齿」,听起来像是画质不够好。其实它不是模糊,而是采样频率不足时产生的假结构——屏幕上出现的那些条纹、波纹、闪动,是真实几何里根本不存在的东西。
先来看看走样最直观的一种形态。两个已经光栅化好的方阵按不同角度叠加,就产生了本不存在的环状条纹:
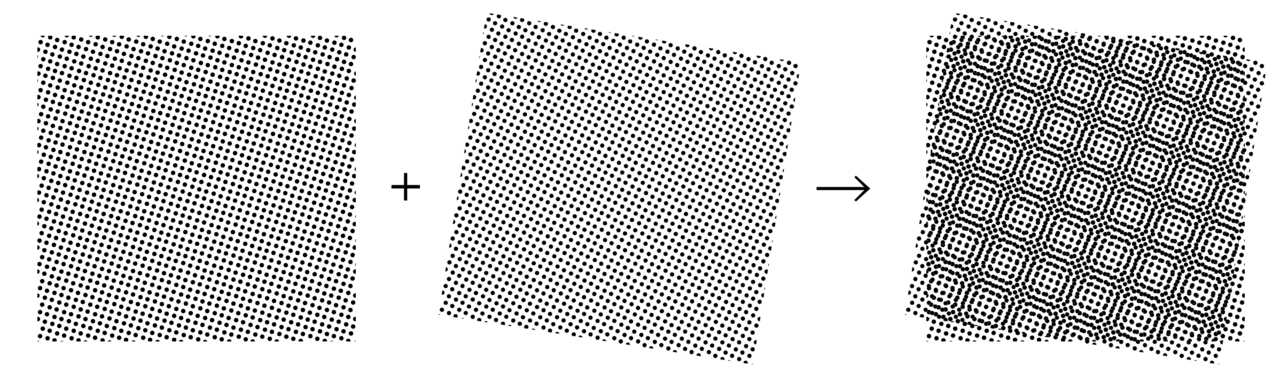
这些环是「假的」。 参与叠加的两张方阵本身都很规整,环状条纹全是采样与重构过程造出来的。所以抗锯齿不能靠后期模糊解决:模糊只能把假结构抹淡,不能把它去掉;抹淡的同时,真实的高频细节也一起没了。
2.2 位图与矢量之别:这笔账算在分辨率上
走样引出的第二个问题是:为什么要用矢量这个表示法? 同一个字母「A」,用位图存和用轮廓存,差别不只在文件大小,而在「放大」这一步的成本结构上。
先来看看同一个字母在两种表示下的对照:
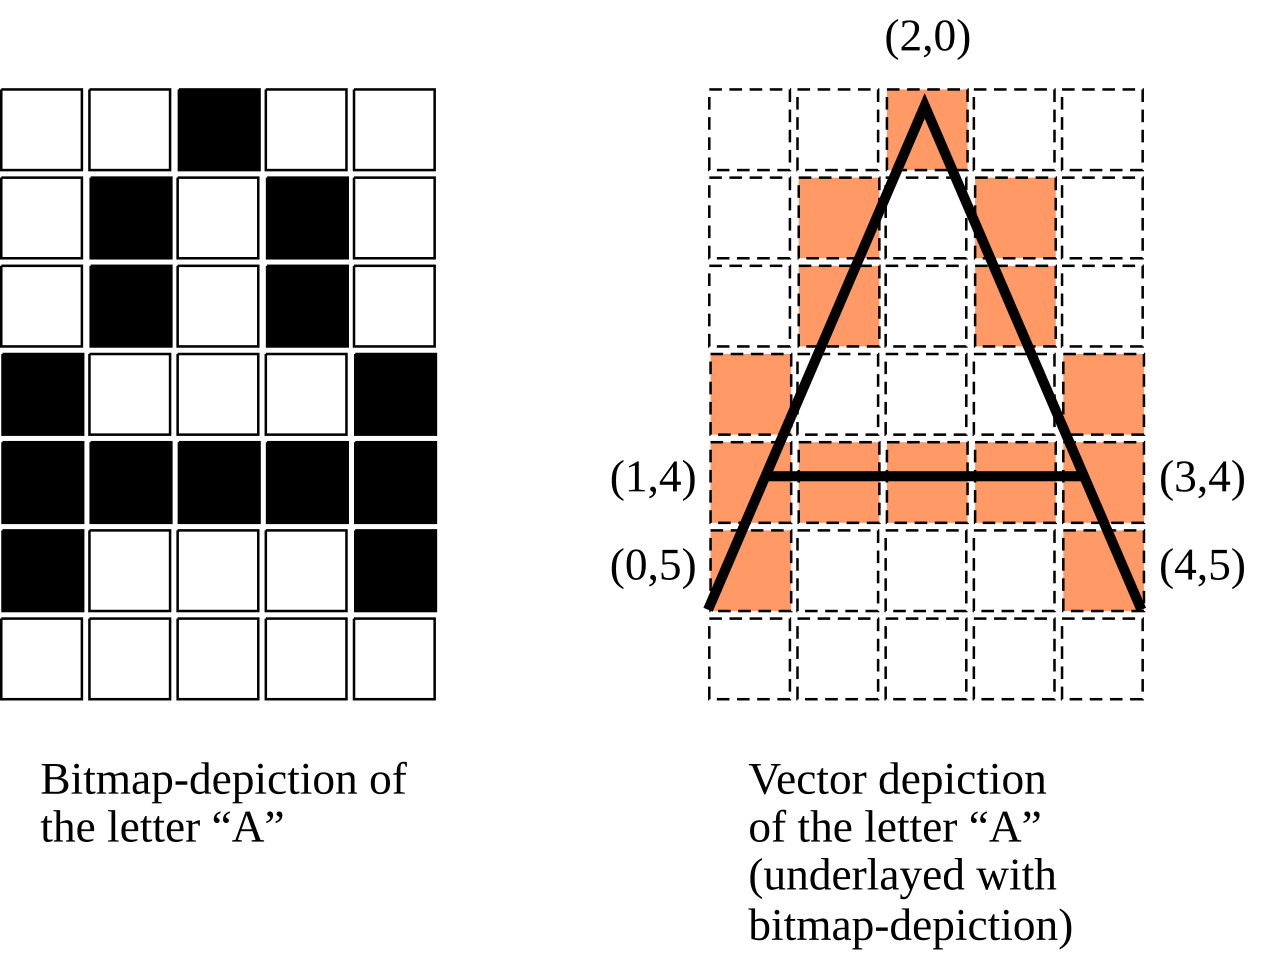
这正说明了「矢量」这个象限为什么必须存在。 位图的成本是「一次光栅化,之后零成本显示」;矢量的成本是「每次显示都要重新光栅化,但分辨率任意」。后者的代价正是本篇要讲的那五段链路——矢量引擎这门手艺的价值,就是把这五段的成本压到能接受。
2.3 两族抗锯齿:按样本二值覆盖,还是逐像素解析覆盖
既然成本压在这五段上,那么第 4 段「抗锯齿与覆盖合成」就成了主战场。 官方维护者讨论 Skia 的 GPU 抗锯齿实现时,把路线归成两族:一族是多重采样(MSAA),在像素内放若干个样本、按样本是否被覆盖做二值判定,最后 resolve 成一个平均覆盖;另一族是几何或解析式(analytic AA),逐像素把被盖住的面积精确算出来。
两者的差别可以用覆盖率这一个量说清:
-----------------------------------【覆盖率与合成】----------------------------------------------
# 描述:覆盖率 coverage 的两种求法与它对最终颜色的作用
# 口径:coverage 在 0 与 1 之间;解析式求的是面积比,MSAA 求的是被覆盖样本数占样本总数的比
#------------------------------------------------------------------------------------------------
解析式:  coverage = area(几何 交 像素格) / area(像素格)
多重采样:coverage = count(被覆盖样本) / count(全部样本)
合成:    color_out = color_src * coverage + color_dst * (1 - coverage)
其中:
- 解析式的
coverage是连续值,理论上可以任意精确,代价是边界像素要单独走一条昂贵的路径; - MSAA 的
coverage是离散值,只可能取 N 分之一,代价与样本数成正比,但可以直接用硬件固定功能完成; - 合成那一步是把覆盖折算成颜色,它也是「图层混合」与「透明合成」的同一个算式——这就是为什么覆盖这一章必须排在讲混合之前。
两族各有官方说法里的适用面。 官方口径提到解析式一族在客户端里更常见,并且对圆与圆角矩形有专门的着色器处理:把包围盒向外扩一个像素,再在片元位置算覆盖。这条细节说明:解析式抗锯齿不是「更贵一点」,而是「要针对图元形状写特化路径」,工程成本落在引擎侧,不在硬件侧。
2.4 共同词汇的路线归属
先来看看本章最后一张图。前四章反复要用的词汇,到这里该钉死了:每个词归哪条路线,决定了后续哪一篇展开它。
值得多看一眼的一格是 sparse strips。 它同时出现在 Vello CPU 与 Vello Hybrid 两条分支上——这是本篇前半段唯一的「前沿信号」:新生代引擎没有把 CPU 路线丢掉,而是把它当成了共享核心(第四章展开)。
本章的术语在正文里的用法,也压成一段对照代码:
-----------------------------------【术语的路线归属】--------------------------------------------
# 描述:把术语按「几何在哪算 / 覆盖怎么合」两根轴分开,避免后文混用
# 说明:同一行内的词在同一根轴上才可比较;跨轴比较必须显式声明
#------------------------------------------------------------------------------------------------
CPU 几何侧:  path  tessellation  sparse strips(CPU)         # 几何在 CPU 上算
GPU 几何侧:  compute rasterization  sparse strips(Hybrid 的像素合)  # 几何或覆盖在 GPU 上算
两者共有:    coverage  MSAA  analytic AA  draw call          # 覆盖与调度与实现无关
其中:
draw call归「两者共有」,因为它是调度单位,不涉及几何在哪算;analytic AA归「两者共有」,因为它是算法而非实现——CPU 与 GPU 都能做,只是特化方式不同;sparse strips被拆成两行,正是因为它在 CPU 与 Hybrid 两条分支上承担的角色不同。
本章对应的官方依据:走样与抗锯齿的通用说明见 Skia 官方 API 总览;两族抗锯齿的维护者口径见 skia-discuss 讨论帖;SkPaint 与混合模式的入口见 SkPaint 概览;浏览器内 Skia 所处层次见 Chromium 图形与 Skia 设计文档。
三、Skia 为什么能同时长在 Chrome、Android、Flutter 里?
下面我们开始第三阶段。 前面两章立了词汇与链路,从这一章起进入具体引擎。Skia 是系列主线,也是本篇唯一能拿到双后端真图的一款——所以它放在第一篇讲机制的位置上。这一章要回答的是它的「通用性」从哪来:凭什么同一份代码可以同时活在浏览器、手机系统与跨平台 UI 框架里?
3.1 官方分层原话:Canvas 管几何与裁剪栈,样式全在 Paint
先来看看 Skia 官方对自身职责切分的两句原话。这两句话是整章的地基:
「The canvas holds relatively little state. It points to the actual pixels being drawn, and it maintains a stack of matrices and clips.」
「All other stylistic attributes of the drawing are controlled by the paint.」
翻成工程语言就是:SkCanvas 只持有两样东西——矩阵栈与裁剪栈;颜色、线宽、渐变、混合模式、抗锯齿开关全部在 SkPaint 里。 像素本身则落在 SkSurface 或 SkBitmap 上。而 SkCanvas 被官方称为「It is the host for the "draw" calls」,也就是所有绘制动作的宿主(定义与入口见 Skia 官方 API 总览)。
这条切分有三个直接后果。 一是状态切换被限制在「换一个 Paint」上,而矩阵与裁剪是栈式管理,代价可控。二是图层合成可以独立于绘制发生——这正是 saveLayer() 语义的来源。三是同一套绘制描述可以发给不同的后端,因为「怎么画」与「画到哪」被彻底分开了。
3.2 三条后端线:Raster、Ganesh、Graphite
「画到哪」这一侧,Skia 历史上长出过三条后端线。 先是纯 CPU 的 Raster,然后是 GPU 侧的 Ganesh,最新一代是面向现代图形 API 的 Graphite:
中间那条「后端」横带是最关键的一层。 上层绘制描述与下层后端之间是解耦的,这就是 Skia 通用性的来源。三条后端线里,Ganesh 有一个被官方点名的历史包袱:它「never utilized the depth testing capabilities」,因为严格遵守画家顺序,于是「suffers from overdraw」——同一像素被反复着色,这是排序换来的代价,也是 Graphite 存在的理由(官方因果见 Chrome 官方博客,机制展开留给 ep06)。
| 后端 | 计算位置 | 时代与定位 | 已知边界 |
|---|---|---|---|
| Raster | CPU | 最早、最通用的软件光栅 | 性能受编译器与 CPU 影响大 |
| Ganesh | GPU | GPU 加速的第一代 | 严守画家顺序,存在 overdraw |
| Graphite | GPU | 新一代,给绘制赋 z 值以启用深度测试 | 先在部分平台的 Chrome 默认启用,非全平台 |
3.3 本机 Raster 现场渲染:同场景真图
讲到这里该上真图了。 本机装了 skia-python 144.0.post2——它内置的是真实的 Skia 二进制,版本对应 Skia m144。我们用同一个场景(512 乘 512 画布、抗锯齿填充的三次贝塞尔闭合路径,加描边、线性渐变与 multiply 混合)在 Raster 后端现场出图:
-----------------------------------【skia-python Raster 现场渲染】--------------------------------
# 描述:m144 真实二进制、Raster 后端、512x512 画布
# 场景:AA 填充的三次贝塞尔闭合路径 + 描边 + 线性渐变 + multiply 混合
# 实测:drawPath 连跑 50 次共 13.29 ms,折合 0.2657 ms 每帧;非白像素 59,531
#------------------------------------------------------------------------------------------------
import skia, time
surface = skia.Surface(512, 512)                  # Raster 后端
canvas  = surface.getCanvas()
paint   = skia.Paint(AntiAlias=True)              # 样式全在 Paint 里
path    = build_cubic_path()                      # 图元:三次贝塞尔闭合路径
paint.setShader(skia.Shader.MakeLinearGradient(...))
paint.setBlendMode(skia.BlendMode.kMultiply)
canvas.drawPath(path, paint)                      # 一次绘制调用
其中:
AntiAlias=True打开的就是解析式那一族抗锯齿的入口(具体走哪条实现由后端决定);setBlendMode与setShader都属于 Paint,印证了 3.1 节的职责切分;- 非白像素 59,531(占 512 乘 512 的 22.7%)是「确实发生了真实光栅」的证据,不是空图。
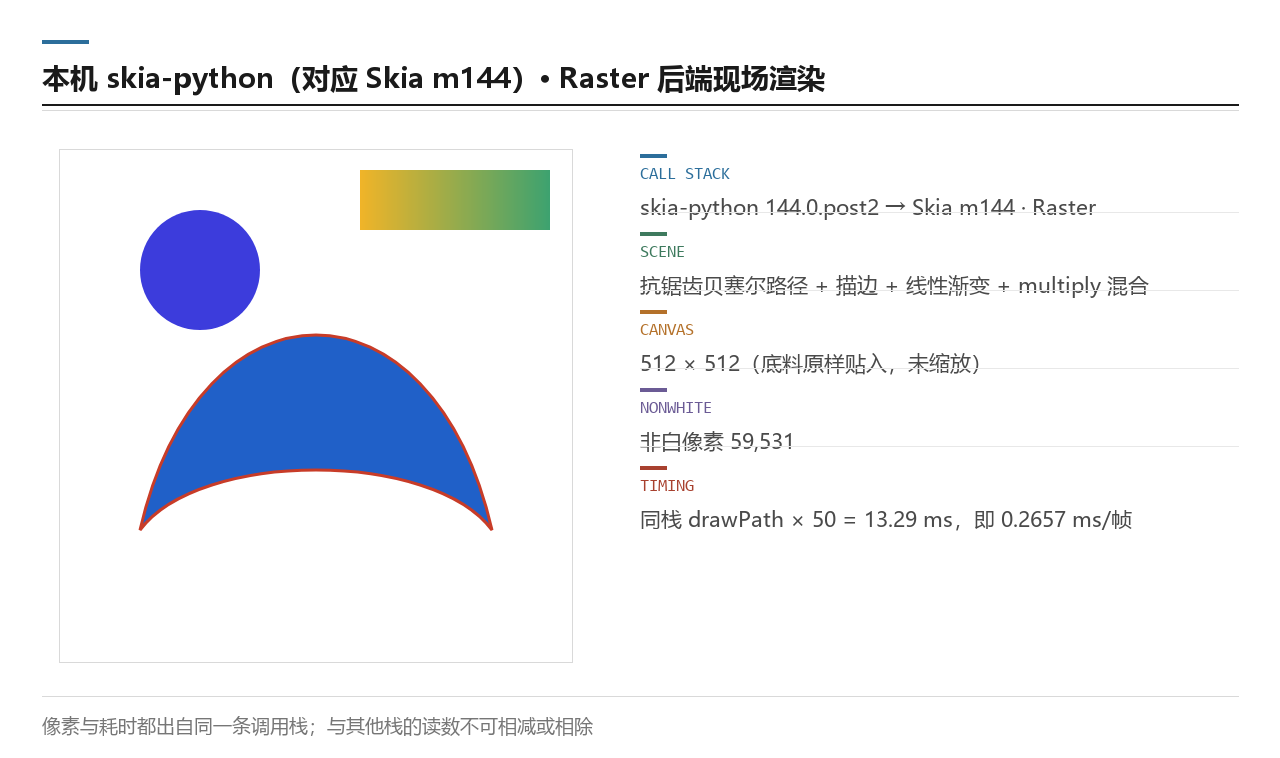
它最要紧的地方是「真的」这一条。 它不是截图,也不是示意图,而是本机跑出来的像素矩阵,可以逐像素复核。这也是本系列从这一篇起的纪律:凡说「某引擎会这样画」,最好能附一张自己跑出来的图。
3.4 字形光栅是另一条链路
但「路径光栅」和「字形光栅」不是同一段代码。 这一点容易被忽略:文字走的是 SkTextBlob,背后是字形缓存到覆盖到位图的链路,不是路径细分那一套。同一款引擎里,文字与图形走的是两条并行的光栅路径。
先来看看本机跑出的字形光栅真图:
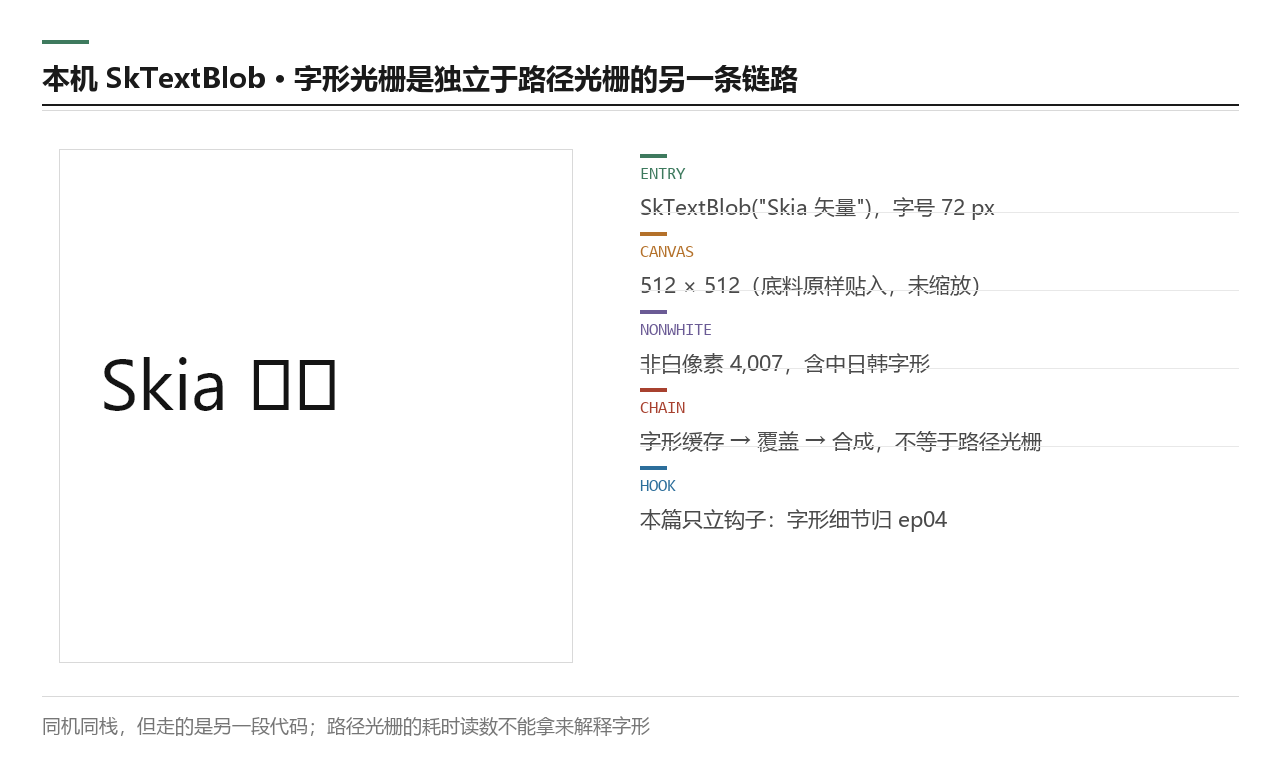
这行字与 3.3 那张路径图来自同一台机器、同一个库,走的却是完全不同的链路。 非白像素只有 4,007,量级差异本身就说明两者在覆盖计算上的成本结构不同。这条旁路就是 ep04 的全部题域,本篇只在这里挂一个钩子。顺带补一条官方事实:在 Windows 上,最终文本光栅是由 Skia 直接处理的,系统文本栈只负责字体查找(见 Chromium 官方博客)。
3.5 同一台机器上的另一条真实光栅路径:Edge 与 Chromium
Raster 只是 Skia 的一半。 另一半长在 GPU 上——本机没装 Chrome,装的是 Edge。Edge 的内核是 Chromium,Chromium 的 2D 光栅用的正是 Skia,所以同一个场景可以通过 Edge 渲染 canvas 再读回像素,拿到同一台机器上的 GPU 侧像素:
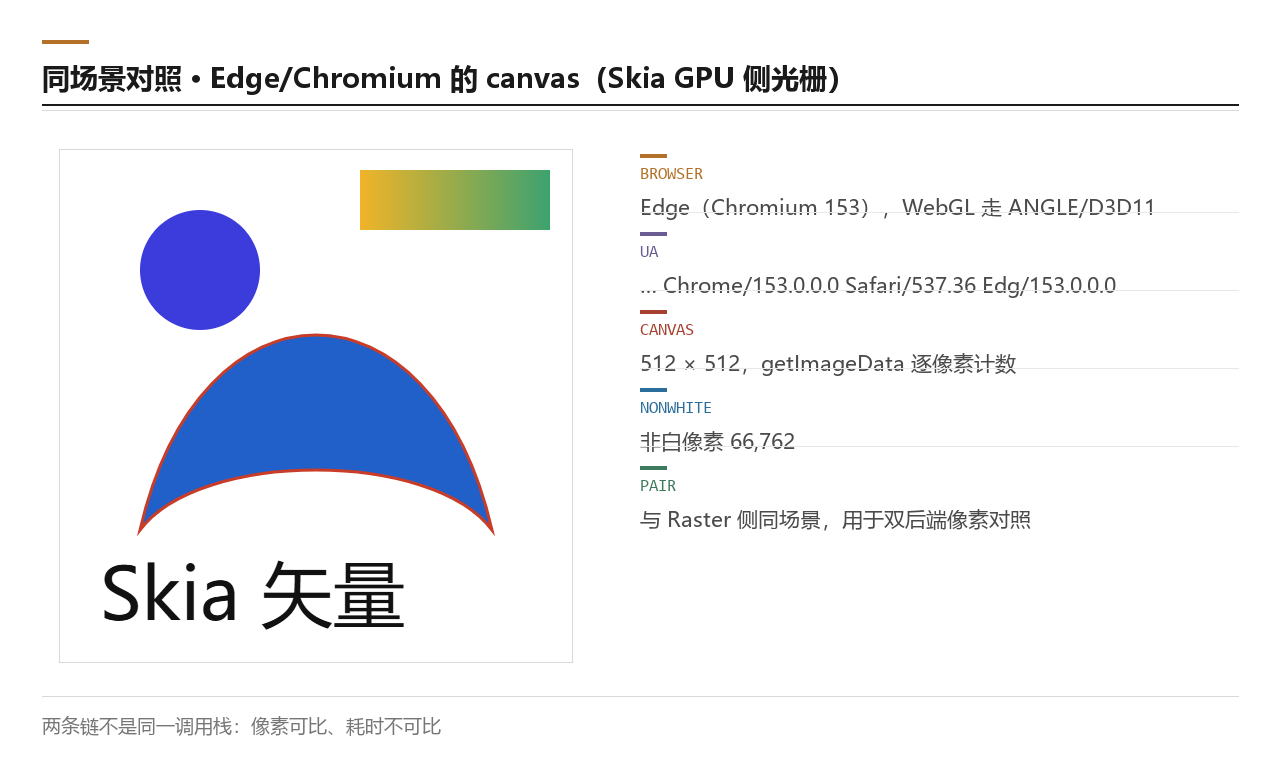
它与 3.3 那张并排看,才是「双后端对照」的完整形态。 两张都是本机跑出来的真实像素,比较像素结果是成立的(非白像素 59,531 与 66,762,差约 12%,来自浏览器 canvas 侧另一套抗锯齿实现);但要比耗时,就得先看下一节。
3.6 耗时读数必须先说清是哪条调用栈
这是本篇最想让读者带走的一条纪律。 先把三条链的读数并排放出来:
| 链 | 入口 | 场景 | 单帧耗时 | 非白像素 | 能否与别列比耗时 |
|---|---|---|---|---|---|
| A | skia-python,Raster 后端 | 贝塞尔路径加描边加渐变 | 0.2657 ms | 59,531 | 不可 |
| B | pycairo,底层 libcairo 1.18.4 | 同场景 | 0.0821 ms | 59,573 | 不可 |
| C | Playwright 驱动 Edge,Chromium 153 | 同场景 canvas | 未计时 | 66,762 | 不可 |
先来看看这份读数的记录方式。A 与 B 的像素数几乎一致(59,531 与 59,573,相对差 0.07%),C 则高出一档(66,762,比 A 多约 12%)——C 走的是浏览器 canvas 的 GPU 侧光栅,抗锯齿实现与软件光栅不同,像素数有差是预期的;无论像素数怎样,耗时那一列一律不可跨行比较:
-----------------------------------【跨栈耗时的三条禁则】------------------------------------------
# 描述:为什么上表第四列不可跨行比较
# 口径:像素结果可比,耗时不可比;如需比较必须先统一调用栈、编译器与计时口径
#------------------------------------------------------------------------------------------------
禁则一:不同调用栈不可比   # A 是绑定层原生 Raster,C 是浏览器合成栈,二者不是同一条链
禁则二:不同编译器不可比   # Skia 官方称软件光栅在非 Clang 下性能会 dramatically worse
禁则三:不同计时口径不可比 # 是否含上屏、是否含缓存预热,都会改变量级
其中:
- 禁则二的官方出处是 Skia 构建文档:官方明说「a number of routines in Skia's software backend have been written to run fastest when compiled with Clang」,非 Clang 会「dramatically worse performance」(见 Skia 官方构建文档);
- 禁则三对应本机读数的事实:A 链的 13.29 ms 是纯
drawPath循环,不含任何上屏或合成; - 一条可比的替代做法是在同一条链内换参数(例如同一后端内换细分容差),这也是 ep07 自跑篇要走的路。
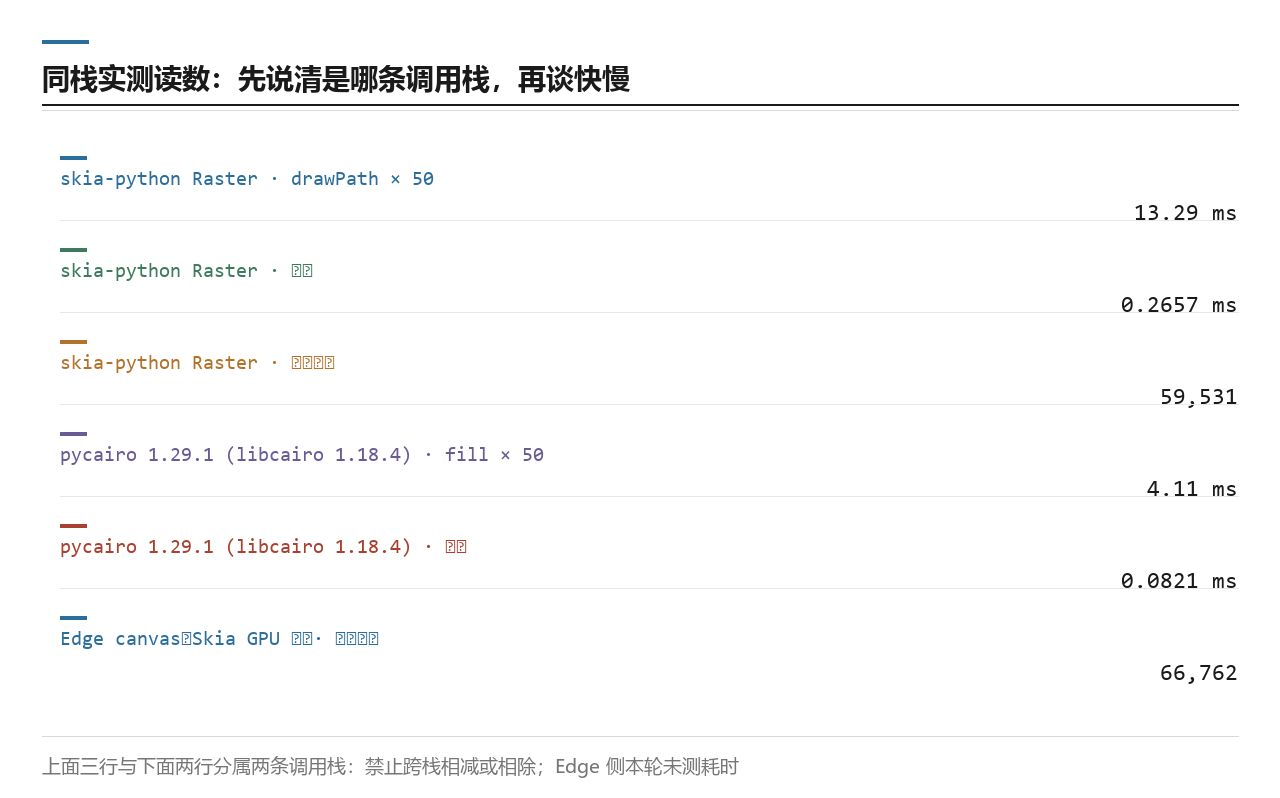
「不得跨栈对比」那句是这张图的重点,不是免责声明。 中文社区里大量「CPU 比 GPU 慢几倍」的结论,问题就出在把两条不同调用栈的数字放进了同一张表。本篇把它钉在这一章,是因为后面几章还要反复用到这三条链的读数。
本章对应的官方依据:分层与职责切分见 Skia 官方 API 总览;构建与 Clang 性能口径见 Skia 官方构建文档;Graphite 与 overdraw 因果见 Chrome 官方博客;浏览器内分层见 Chromium 图形与 Skia 设计文档;Windows 文本光栅归属见 Chromium 官方博客;Fiddle 与调试器入口见 Skia Fiddle 与 Skia WASM Debugger。
四、Vello 的 GPU compute 路线现在走到哪一步?
下面我们开始第四阶段。 上一章的 Skia 是本系列的主线,这一章进入前沿对照。Vello 常被中文资料说成「Skia 的替代者」,这句话在本篇至少有两处需要更正——更正它的最好材料,就是项目方自己的季度进展。
4.1 官方口径的现状:Classic 与 CPU 与 Hybrid,其中两支共享核心
先来看看项目方在最新一份季度进展里给出的现状。它不是三条并列的分支,而是「一条 GPU compute 主线,加一条共享核心的 CPU 系」。
把 CPU 与 Hybrid 连起来的那层共享核心就是关键。 据项目方在 tmil-25 季报里的原文,该季报时点最近一次发布的是「most recently sparse strips 0.0.7(encompassing both Vello CPU and Vello Hybrid)and Vello 0.8.0」——也就是说 CPU 与 Hybrid 共享同一个段式几何核心,不是两条独立实现(见 Linebender 季度进展;本轮从发布记录读到的最新版本已是 0.10.0,见 4.3 节时间线)。而 Hybrid 的机制被官方一句话说清:「uses the GPU to do pixel compositing, but SIMD-accelerated geometry processing on the CPU」,成熟度是「roughly beta quality」。
| 分支 | 几何在哪算 | 像素在哪合 | 成熟度 |
|---|---|---|---|
| Vello Classic | GPU compute | GPU | 主线,动态与矢量密集型负载最强 |
| Vello CPU | CPU(sparse strips 核心) | CPU | 面向更广应用的第一个版本 |
| Vello Hybrid | CPU(SIMD 加速) | GPU | 官方自述 roughly beta quality |
第三行最值得记住。 它打破了「前沿一定是全 GPU」这个直觉:Hybrid 的卖点恰恰是把几何留在 CPU 上,因为段式计算在 CPU 的 SIMD 上更划算。这也是本系列要用一整篇(ep09)讲 sparse strips 的原因。
4.2 抽象层易主:AnyRender 与 imaging 同时服务 Vello 与 Skia
比分支现状更有信息量的,是围绕它长出来的抽象层。 项目方原本计划的「Vello API」没成型,接替它的是两个第三方抽象层:
「同时服务 Vello 与 Skia」这几个字,是本篇最有力的生态信号。 官方原文的表述是这两个抽象层「both Vello and other renderers including Skia」。它意味着前沿与主流第一次被放进了同一个抽象层——这比任何「谁替代谁」的说法都更接近事实。 一个应用可以今天把渲染器接上 Skia,明天换到 Vello,上层代码不用改;这种可替换性本身就是对「两者属于同一类东西」的官方确认。
4.3 版本时间线、负载判据与本节收口
一个还在快速迭代的项目,最缺的不是评价,而是时间坐标。 把版本号排成一条线,结论比任何形容词都清楚:
-----------------------------------【Vello 版本时间线】--------------------------------------------
# 描述:从 crate 发布记录里读出的版本节奏(本轮实测检索所得)
# 口径:时间取自发布页;本机无 Rust 工具链,故未在本机复跑,属引用而非实测
#------------------------------------------------------------------------------------------------
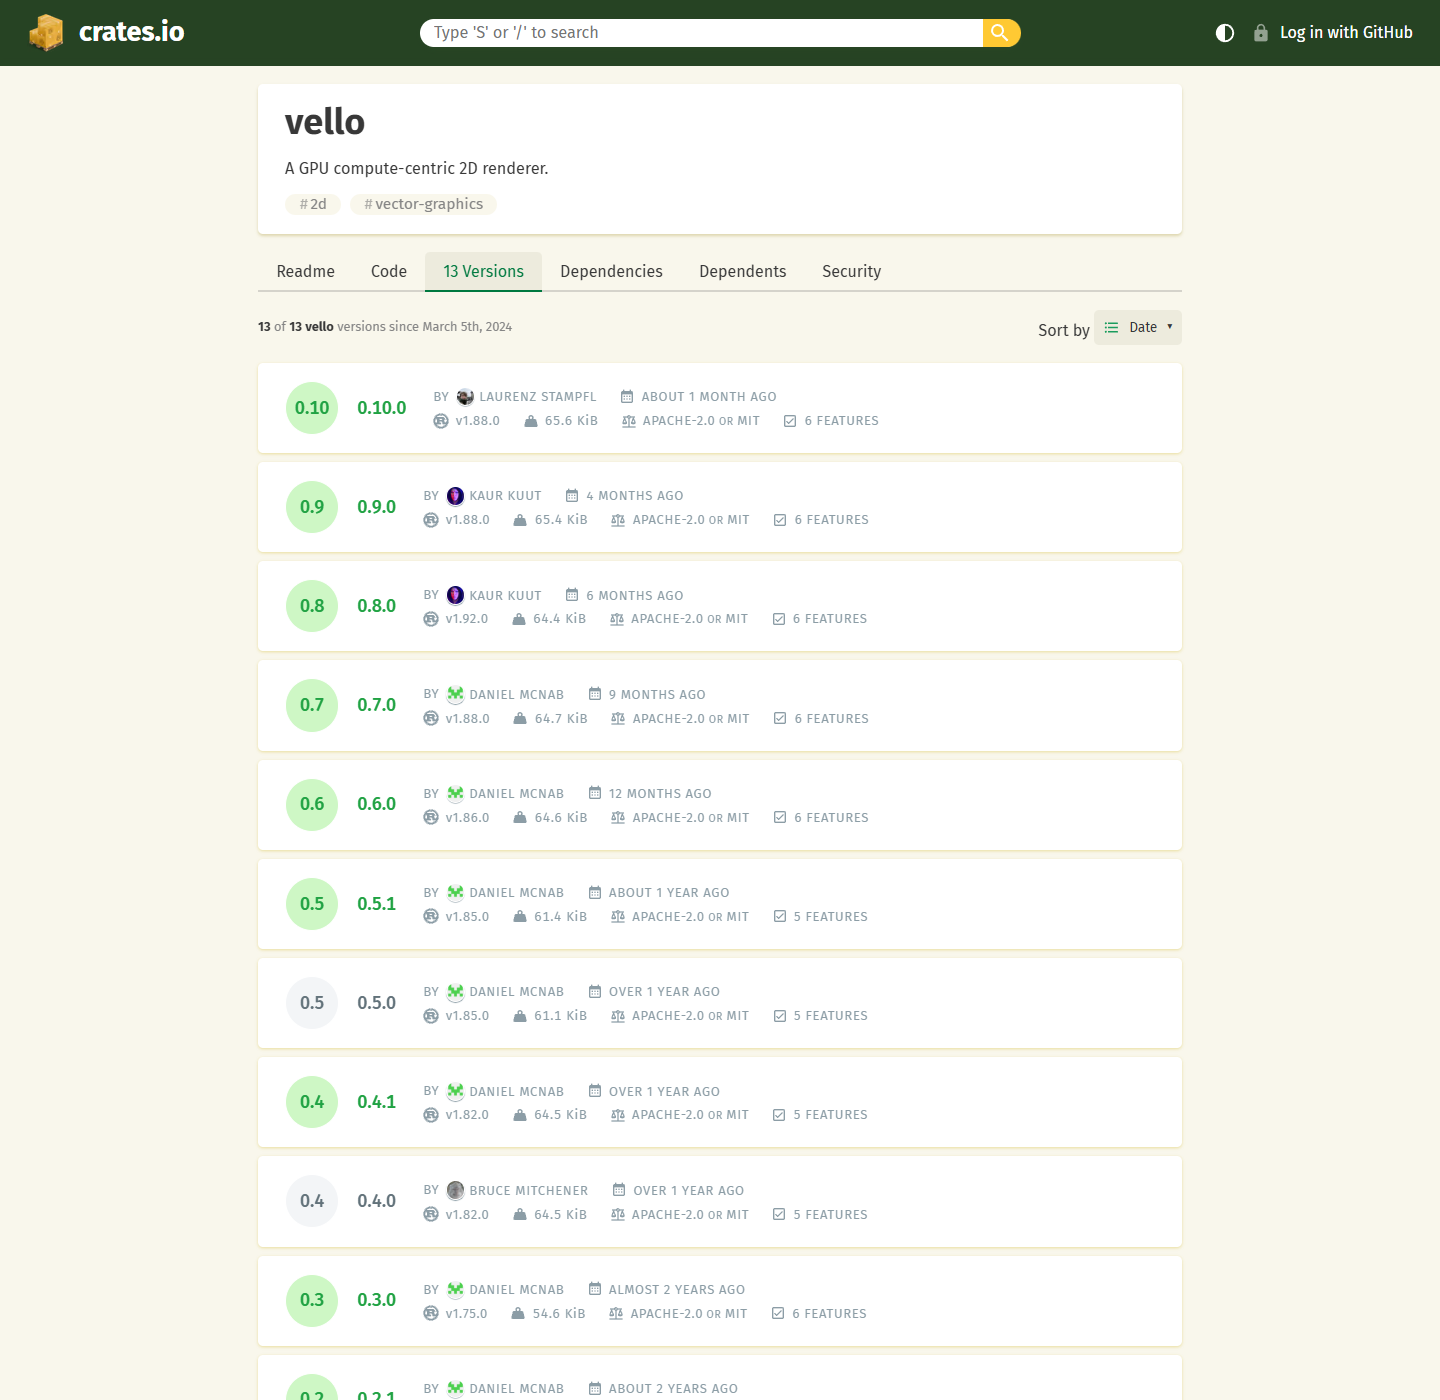
0.6.0  2025-10-03    # Vello CPU 首个面向更广应用的版本;Hybrid 首次发布
0.8.0  2026-03-20    # sparse strips 0.0.7 同期,CPU 与 Hybrid 共享核心
0.9.0  2026-05-15    # 中间版本
0.10.0 2026-08-14    # 本轮最新
其中:
- 从 0.6.0 到 0.8.0 是 5 个多月,从 0.8.0 到 0.10.0 又是 5 个月——半年两个小版本,这是「还在快速迭代」的客观依据,不是印象(记录见 crates.io 的 vello 页 与 lib.rs 的 vello 页);
- 版本号本身不能说明能力,所以还要配一条官方给的负载判据;
- 负载判据来自 Hybrid 的 crate 文档:它「does not match Vello Classic's raw performance on dynamic and vector-heavy workloads」,但在「images, gradients, and filters」这类能从 GPU 加速中获益的负载上「excellent performance」(见 vello_hybrid 官方文档)。
把这两条合起来,就是「什么负载该用哪条分支」的官方判据。 这也解释了本篇为什么把它放在「全景」里讲,而不留到 ep10:选分支的依据是负载类型,而负载类型的判断属于生态位认知,不属于调优技巧。
本节最后钉一条边界:本机没有 Rust 工具链(rustc、cargo、rustup 均不在位),本章全部结论都来自官方原文与发布记录,没有一条是本机实测。 这条区分很重要——ep09 与 ep10 要么先装工具链,要么沿用同样的「引用加自绘」口径(更早的两份季度进展见 tmil-22 与 tmil-19,仓库见 linebender/vello)。
本章对应的官方依据:分支现状与 Hybrid 机制见 Linebender 季度进展 tmil-25;更早的两次进展见 tmil-22 与 tmil-19;Hybrid 的负载判据见 vello_hybrid 官方文档;版本记录见 crates.io 与 lib.rs;源码见 linebender/vello。
五、Cairo 这条「跨平台 CPU 通用 2D」的老路还在被谁用?
下面我们开始第五阶段。 上一章是前沿,这一章往回看一位「老将」。Cairo 常被当成已经退场的技术,这是本篇要更正的第二处印象——它还活着,而且活在一个很具体的位置上:它把「同一份绘制代码输出到屏幕与输出到文件」这件事做得比谁都早。 官方对它的自述是「2D graphics library with support for multiple output devices」(见 Cairo 官方文档入口)。
5.1 绘制模型:source、mask、destination 三要素
先来看看 Cairo 的绘制模型。它不讲「图层」,也不讲「渲染目标」,讲的是三个更朴素的东西:源、遮罩、目标。
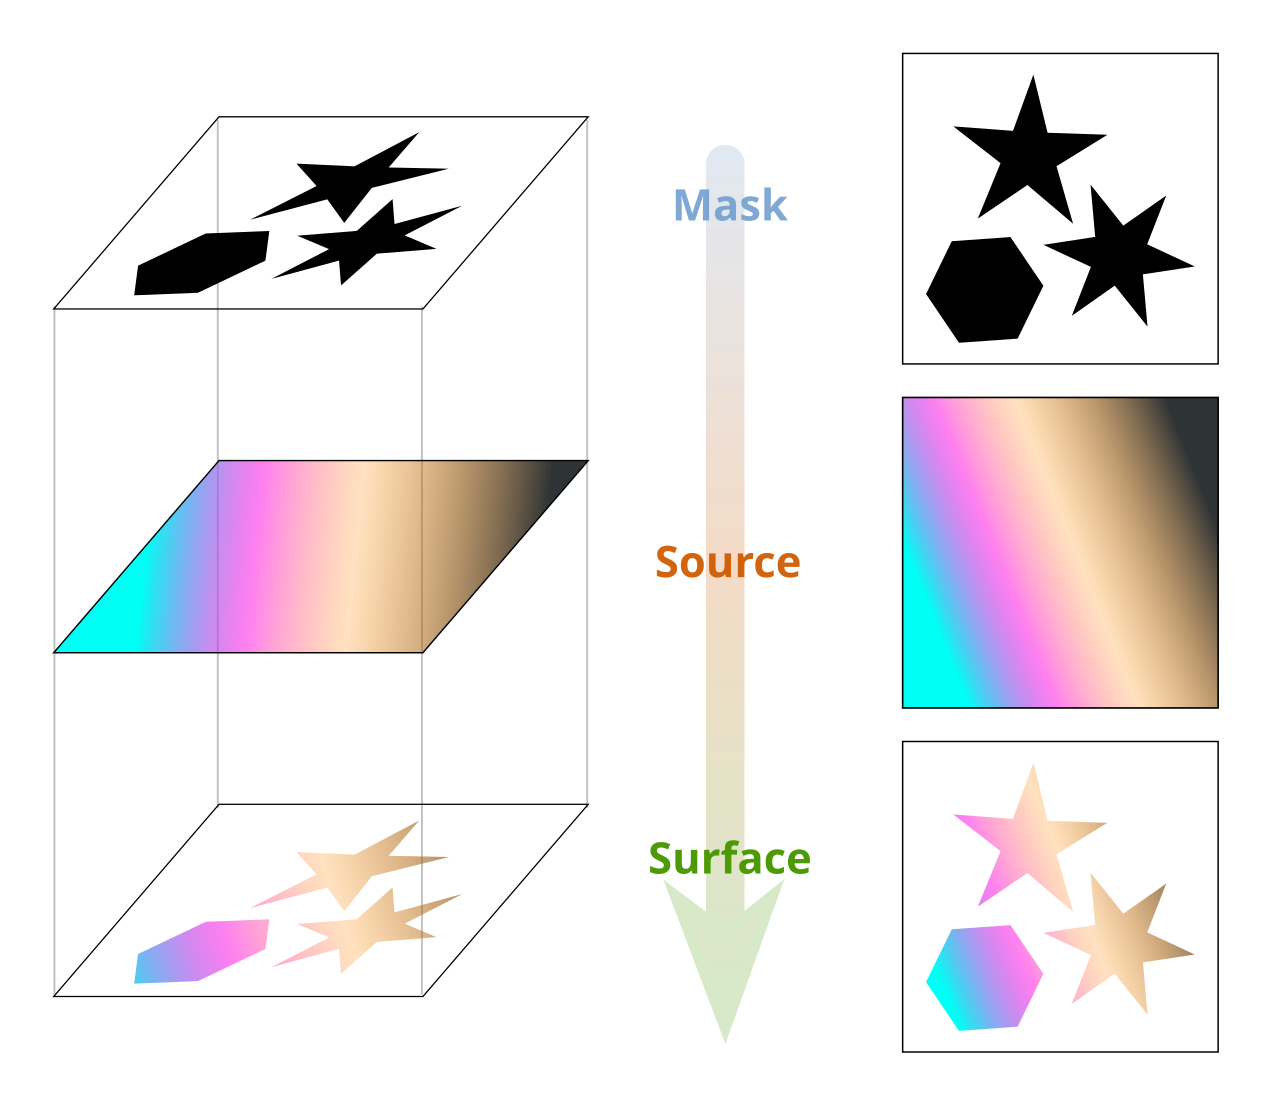
它把「覆盖」摆到了与「颜色」并列的位置,这一点很关键。 在 Cairo 的模型里,形状控制是通过遮罩(mask)表达的——而遮罩本身就携带着覆盖信息。于是第一章讲的覆盖判定,在这里成了模型的一部分,不是实现细节。 这张图还有一条额外优势:官方在描述里自述它是「a language neutral diagram(using the terms which are used in the Cairo graphics library)」——也就是说它用的就是库自己的术语,没有任何自然语言标注,这在外部素材里是语言风险最低的一类。
5.2 后端分叉:一份绘制代码输出到哪
如果说 5.1 讲的是「怎么画」,这一节讲的是「画到哪」。 Cairo 的跨平台具体跨在哪,答案就写在后端类型的枚举里:
这棵树的形状就解释了 Cairo 的生态位。 它把「设备后端」与「文件后端」放在同一个抽象下——同一个 cairo_surface_t 家族,既能指向窗口,也能指向 PDF 或 SVG 文件。所以大量图表工具与排版系统至今仍用 Cairo:它们要的不是最快的像素,而是「屏幕所见即文件所出」的可靠性。
| 后端类别 | 具体后端 | 用途 | 成熟度 |
|---|---|---|---|
| 文件侧 | image、PDF、PS、SVG | 导出与打印 | 稳定,长期主力 |
| 窗口侧 | Xlib、XCB、quartz、win32 | 直接在系统窗口上绘制 | 稳定,覆盖主流桌面平台 |
| 实验性 | GL、DRM、SKIA、VG | 尝试接入 GPU 或其它光栅器 | 实验性,不可当作生产依据 |
最后那一行要单独说。 后端清单里出现 GL、DRM、SKIA 这些名字,很容易被读成「Cairo 也能跑 GPU」。但官方把它们归在实验性一侧——本机也没有可用的 GL 上下文可以验证,所以本篇不写「Cairo 能跑 GPU」这类结论(后端清单见 Cairo 官方手册)。
5.3 本机 pycairo 同场景真图与交叉验证
既然 Cairo 是「CPU 通用 2D」的代表,它就该能和 3.3 节的 Raster 做一次同场景交叉验证。 本机装了 pycairo 1.29.1,底层是 libcairo 1.18.4——这里有两个版本号,绑定版本与底层库版本要分清:
-----------------------------------【pycairo 同场景交叉验证】--------------------------------------
# 描述:与 3.3 节 skia-python 完全相同的场景,改由 Cairo 绘制
# 版本:发行版 pycairo 1.29.1,底层 cairo_version_string() = 1.18.4(两个版本号须分开写)
# 实测:fill 连跑 50 次共 4.11 ms,折合 0.0821 ms 每帧;非白像素 59,573
#------------------------------------------------------------------------------------------------
import cairo
surface = cairo.ImageSurface(cairo.FORMAT_ARGB32, 512, 512)   # 目标面
ctx     = cairo.Context(surface)
ctx.set_source_rgba(r, g, b, a)                                # 源:颜色
ctx.append_path(build_cubic_path())                            # 形状:进入遮罩
ctx.fill()                                                     # 源经遮罩合成到目标
其中:
set_source_rgba对应「源」,append_path加fill对应「遮罩」,ImageSurface对应「目标」——三要素在代码里一一就位;0.0821 ms与 3.3 节的0.2657 ms不可直接比:两者是不同实现、不同编译器产物的软件光栅,理由见 3.6 节的三条禁则;- 非白像素 59,573 与 Skia 的 59,531 只差 42 个像素(相对差 0.07%)——这个接近程度才是交叉验证的正经结论:同一份几何,两个引擎给出的覆盖率像素基本一致。
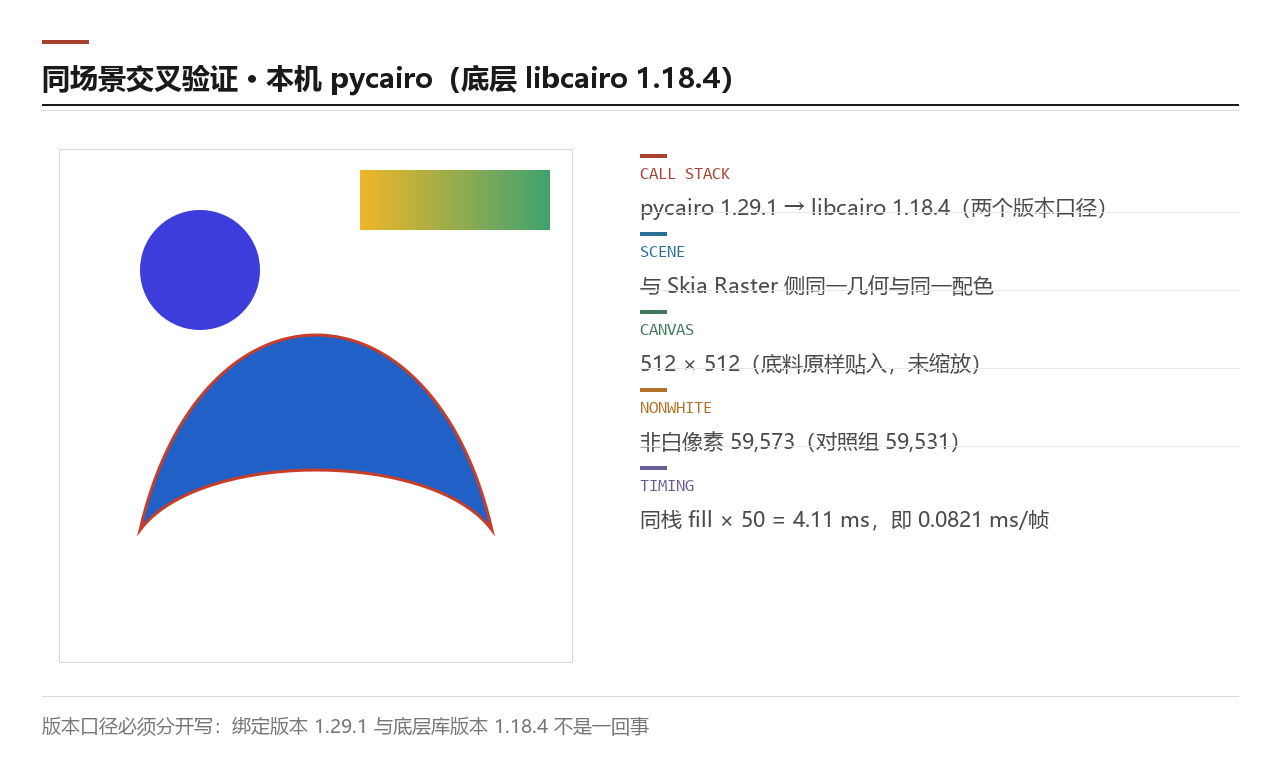
它要证明的就是「可交叉验证」这四个字。 覆盖判定这一步在不同实现之间可以对齐——而这正是本篇敢于把「覆盖」当成共同词汇的实证基础,不是靠定义推出来的。
本章对应的官方依据:绘制模型与三要素见 Cairo 官方文档入口;surface 后端清单与实验性后端见 Cairo 官方手册;本机绑定的发行页见 pycairo 项目页。
六、游戏引擎里的 2D 渲染,边界划在哪?
下面我们开始第六阶段。 从这一章起进入三个「对照项」。它们各自只有一章的篇幅,不是不重要,而是本篇只需要它们的边界:游戏引擎 2D 渲染与矢量动画运行时,这两类东西与「通用 2D 库」的分界线,恰恰是理解生态位的关键。
6.1 CanvasItem 与 RenderingServer:节点树与提交侧的解耦
Godot 的 2D 渲染一句话就能说清它和通用库的差别:它是「节点树加层级」,不是「一次绘制调用加状态」。 官方类文档把职责划得很清楚:CanvasItem 负责 2D 绘制单元与层级关系,而真正把绘制提交出去的是 RenderingServer——两者解耦(见 Godot 官方 CanvasItem 类文档)。
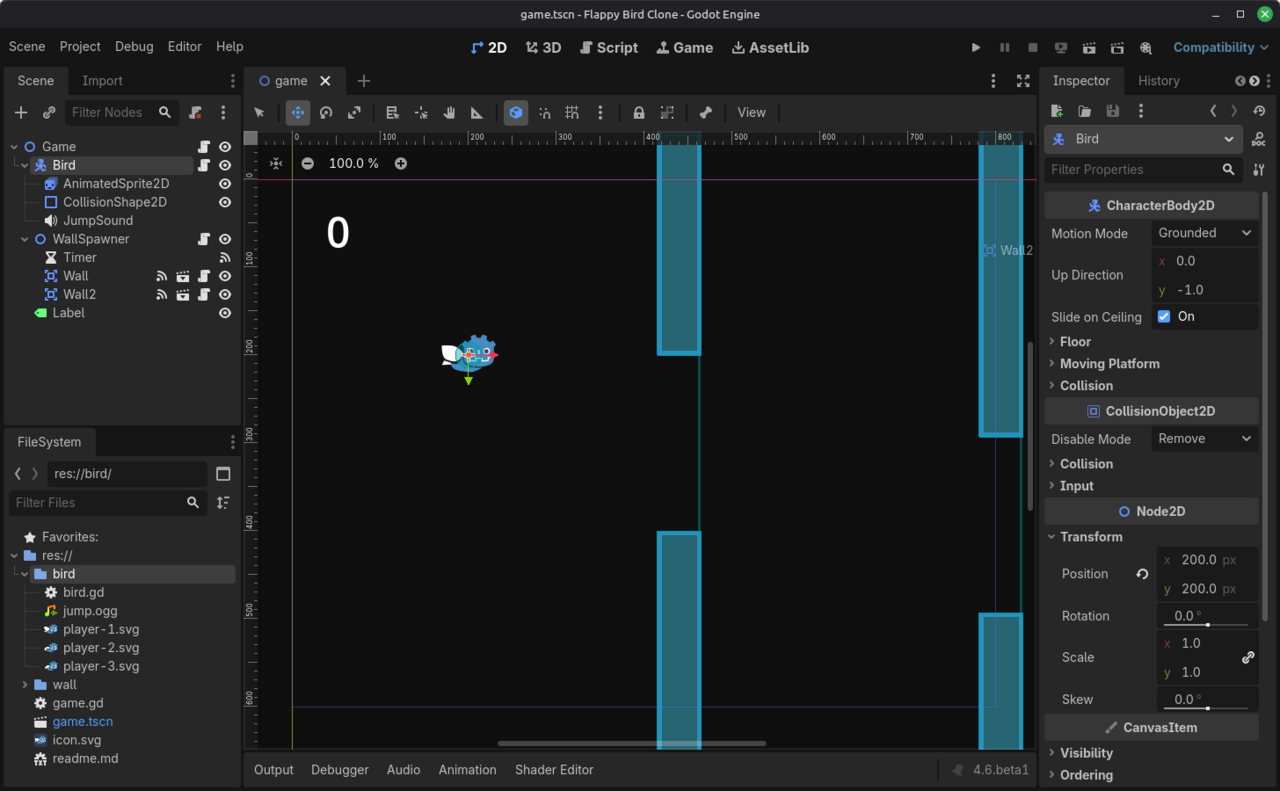
这条职责切分就是本篇要的那条边界。 在通用 2D 库里,「谁管场景」这个问题根本不成立——引擎只管把这一批绘制画出来,场景结构是调用方的事。而在游戏引擎里,「谁在谁的上面、谁跟着谁移动」必须由引擎自己维护,这就是节点树存在的理由。
6.2 这条边界为什么必须存在
这条边界的代价结构可以直接算出来。 游戏引擎每一帧都要重新决定「画什么、按什么顺序画」,而这个决定依赖场景树的状态:
-----------------------------------【游戏引擎 2D 的每帧开销结构】----------------------------------
# 描述:通用 2D 库与游戏引擎 2D 的职责差,落在每帧要做的事上
# 口径:本表是结构对照,不是任何一方的性能测量;Godot 未在本机安装,故无实测
#------------------------------------------------------------------------------------------------
通用 2D 库:   每帧 = 调用方给出的绘制列表            # 场景结构不在引擎内
游戏引擎 2D:  每帧 = 遍历节点树 -> 求可见性与层级 -> 提交到 RenderingServer
其中:
- 左列的输入是「绘制列表」,引擎不关心列表怎么来的;
- 右列多出的两步(遍历与求层级)就是节点树的成本,也正是游戏引擎 2D 无法退化成通用库的原因;
- 本机没有安装 Godot,所以本章不给任何 Godot 的性能数字,只引边界(
where godot与常见安装目录均已确认不在位)。
本章压成一句:通用 2D 库回答「怎么画」,游戏引擎 2D 还要回答「画什么、按什么顺序画」。 前者是渲染问题,后者是场景问题——两者题域不重叠,这就是边界。 引擎整体架构属 T02 的题域,本篇只取这条线(另一份官方入口见 Godot 4.5 版本文档)。
这条边界还解释了一个常见的困惑:为什么游戏引擎不干脆把通用 2D 库整个塞进去? 答案在「层级」这个词上。通用库的世界里,绘制顺序由调用方一次性给出,画完这一批就结束;游戏引擎的每一帧里,层级都会变——节点被添加、被隐藏、被换父节点、被换渲染层级。这意味着「画什么」这份清单是每帧重新算出来的,不可能由调用方预先给定。 于是引擎必须在内部维护一幅可查询的层级结构,再把它翻译成提交侧的绘制指令;这一步翻译就是 CanvasItem 到 RenderingServer 之间那段代码的职责。
再往下追一层,还能看出为什么 2D 与 3D 在引擎里常常共享同一套提交侧。 无论是 2D 的节点还是 3D 的网格,最终都要变成「提交一批绘制」这个动作;差别只在「求层级与可见性」那一步用的是二维还是三维的判据。所以 Godot-2D 的边界不是「二维与三维的边界」,而是「场景求解与渲染提交之间的边界」——这也是本篇把它归到「谁管场景」这根轴、而不归到几何那根轴的原因。
本章对应的官方依据:CanvasItem 的职责与层级见 Godot 官方 CanvasItem 类文档;同一条目在 4.5 版本的确切措辞见 Godot 4.5 类文档。
七、矢量动画运行时与渲染器为什么必须解耦?
下面我们开始第七阶段。 上一章讲的是「场景归谁管」,这一章讲的是另一类东西:矢量动画运行时。它既不是通用库也不是游戏引擎,它的核心问题只有一个——怎么让一份矢量动画资产,在换掉底层渲染器之后还能一模一样地播出来。
7.1 官方原文:内容侧与渲染侧的互不知情
Rive 的官方文档把这件事写成了两句对称的话,这是本篇能找到的最干净的例证。 内容侧——File、Artboard、StateMachineInstance——know nothing about the GPU;渲染侧——Renderer、RenderContext——know nothing about Rive content(见 Rive C++ 运行时总览)。
左右两侧「互不知情」,这就是全部要点。 内容侧只负责「这一帧的图形状态是什么」,渲染侧只负责「把这些图形画出去」——两者的接口里没有一个字段提到对方的技术。 于是同一份动画资产可以配 D3D11、D3D12、Metal、Vulkan、GL 五套后端,资产文件不用改一个字节(另有外部渲染器接口见 Rive 外部渲染器文档)。
7.2 解耦带来的两个能力,以及它的边界
这种彻底的解耦换来两件事。 一是资产可移植:动画的播放结果不依赖宿主平台。二是渲染器可替换:宿主可以把 Rive 的画指令接到自己已有的渲染管线上,不必为它单开一条路。
-----------------------------------【解耦的两个方向】----------------------------------------------
# 描述:内容侧与渲染侧各自只依赖中间接口,两侧的替换互不影响
# 口径:后端清单取自 Rive 官方文档;本机未安装任何 Rive 运行时,无实测
#------------------------------------------------------------------------------------------------
内容侧可替换:  换一份 File / Artboard / 状态机  ->  渲染侧不用改
渲染侧可替换:  换 D3D11 / D3D12 / Metal / Vulkan / GL  ->  资产文件不用改
其中:
- 「两侧同时可替换」才是解耦的严格含义——只做到一侧可换,那只是适配器,不是解耦;
- 它和第六章的边界刚好互补:Godot 把「场景」收进引擎,Rive 把「场景时间轴」也收进内容侧,只是内容侧完全不碰渲染;
- 边界:Rive 的运行时是闭源产品的 SDK,本篇只引用其公开文档所述的接口划分,不评价其实现。
本章压成一句:矢量动画运行时要回答的是第三类问题——不是「怎么画」,也不是「画什么」,而是「画出来的东西怎么跟着时间走、换平台还不走形」。 三个问题对上三类引擎,坐标系的三格到这里就都有了。
这套解耦不是没有代价,代价正好落在本篇讲的那条链路上。 渲染侧既然「不知道 Rive 内容」,就只能接收一份与内容无关的画指令序列:画这条路径、填这个渐变、裁剪到这块区域。内容侧必须自己在 CPU 上把动画求值到「可以下发」的粒度,再把结果交给渲染侧。 这与 4.1 节 Vello Hybrid 的做法在结构上完全一致——几何与内容在一侧算,像素在另一侧合;差别只在于 Rive 把「算几何」交回给了宿主。
这条代价还能解释一个工程现象:为什么矢量动画运行时特别在意「画指令的条数」。 因为指令条数直接决定宿主渲染器的负担,而运行时又不知道宿主会怎么批处理它们。于是「把动画资产做得更省指令」成了运行时侧的核心优化方向——这与第一章讲的「细分粒度决定折线密度、折线密度决定覆盖判定成本」是同一笔账,只是算在另一层。
本章对应的官方依据:内容侧与渲染侧的职责划分见 Rive C++ 运行时总览;接入自定义渲染器的接口见 Rive 外部渲染器文档。
八、五款引擎在同一张坐标系上各自占哪一格?
下面我们开始第八阶段。 前七章把五款引擎挨个走了一遍,这一章把它们放回同一张表。「全景」的落点就在这一章——前面每一章只回答了一款引擎的问题,只有并排看,才能看出「为什么五套做法能同时活着」。
8.1 五维对照矩阵
先来看看本篇的主表。它不能只有一个维度,因为五款引擎的差别不在「好坏」,而在五个互不相同的坐标上:
最该横向读的是「成熟度」那一行。 单独抽出来看,五个格子的差异比任何形容词都直白:
| 引擎 | 生态位 | 几何在哪算 | 后端 | 典型负载 | 成熟度 |
|---|---|---|---|---|---|
| Skia | 通用 2D 图形库(浏览器、移动系统、跨平台 UI) | CPU 与 GPU 都有 | Raster、Ganesh、Graphite | 界面、文字、图形混合的通用绘制 | 生产级,多平台默认启用 |
| Vello | 通用 2D 渲染器(Rust 生态前沿) | Classic 在 GPU,CPU 与 Hybrid 在 CPU 侧算几何 | GPU compute、CPU SIMD、Hybrid | 动态与矢量密集型、以及图像与渐变与滤镜 | 快速迭代,官方自述 Hybrid 约 beta |
| Cairo | 跨平台 CPU 通用 2D(含文件输出) | CPU | image 与 PDF 与 PS 与 SVG 与窗口后端 | 需要屏幕与文件一致的图表与排版 | 稳定,但以 CPU 为主 |
| Godot-2D | 游戏引擎内置的 2D 渲染 | 随引擎后端 | 随引擎发行 | 场景化的 2D 游戏与工具界面 | 随引擎版本发行 |
| Rive | 矢量动画运行时 | 随宿主渲染器 | D3D11、D3D12、Metal、Vulkan、GL | 交互动画资产 | 运行时可替换 |
这张表每一格都有可核对依据: Skia 的分层与后端来自官方 API 与构建文档;Vello 的三条分支来自项目方季度进展与 crate 文档;Cairo 的后端清单来自官方手册的枚举;Godot-2D 的边界来自官方类文档;Rive 的后端清单来自官方运行时总览。凡是没有官方依据、也没有本机实测的格子,本篇一律不填。
8.2 「矢量」也是一类交付格式
在收起这张表之前,还有一层容易被忽略的边界:「矢量」不只是一种画法,也是一类交付格式。 同一个内容用位图交付还是用矢量交付,差的不是画质,而是「在哪个阶段定型」:
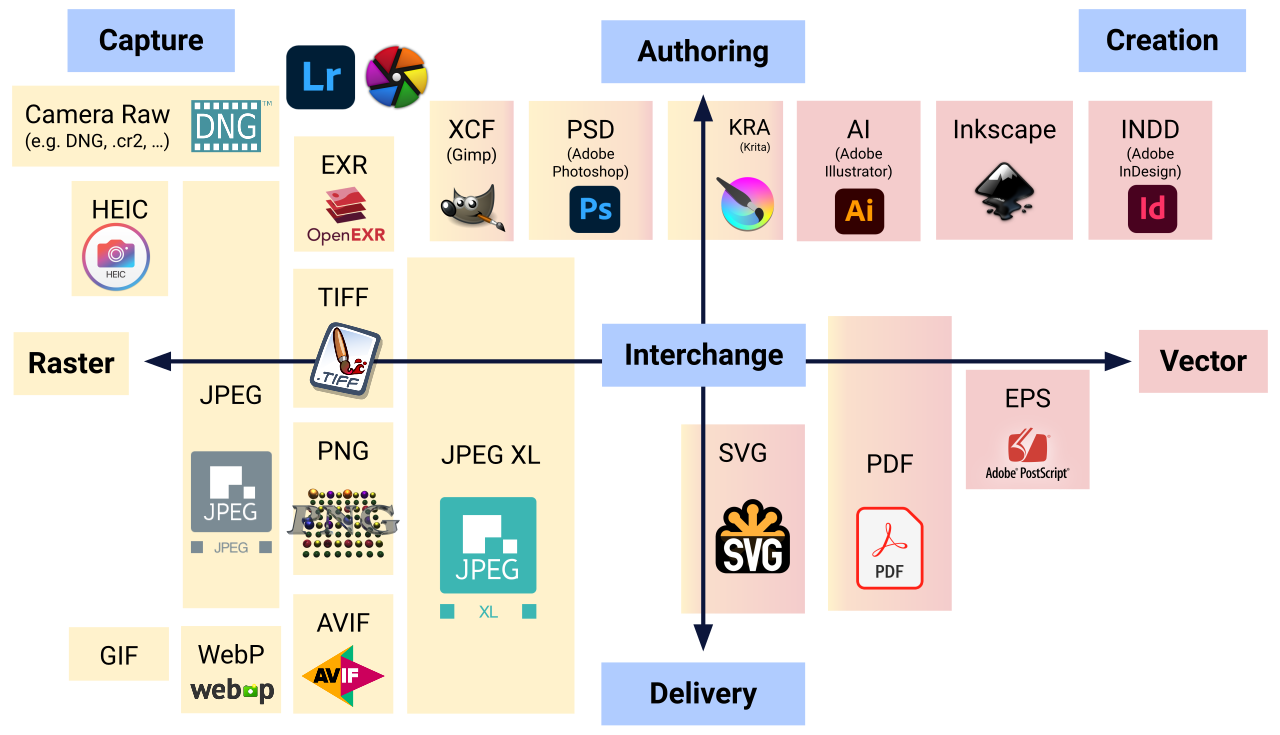
这两根轴解释了本篇为什么要讲「交付」这一层。 一个以矢量创作的资产,可以在交付时被光栅化(比如导出成位图纹理)——这一步就是第一章那五段链路的「一次性执行」;反过来,位图内容无法在交付时变成矢量。所以矢量引擎的生态位,本质上是「把定型时刻往后推」的能力。
8.3 本机 GPU 侧读数:前沿后端在本机到底能不能跑
最后补一条本机的客观证据。 前面几章反复提到 GPU 侧与前沿路线,那么「本机的硬件与驱动条件到底够不够」就该有个读数,不靠猜:
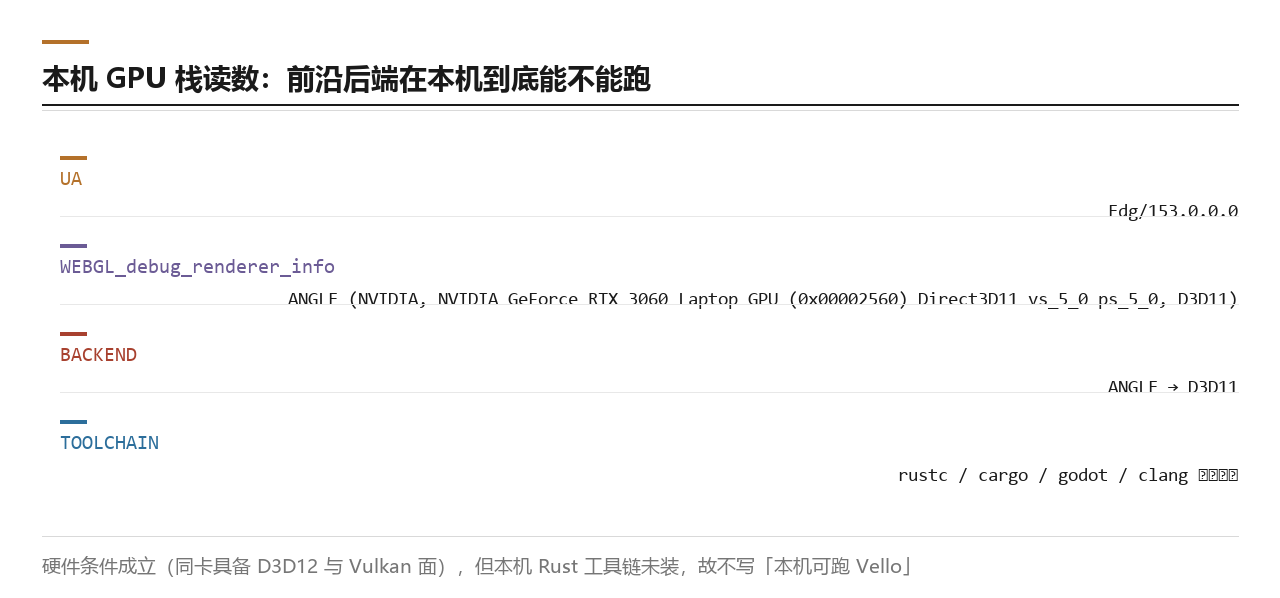
这条读数的完整原文是「ANGLE (NVIDIA, NVIDIA GeForce RTX 3060 Laptop GPU (0x00002560) Direct3D11 vs_5_0 ps_5_0, D3D11)」,浏览器 UA 为 Edg/153.0.0.0。它能证明的是硬件条件成立:Vello 与 wgpu 所依赖的 D3D12 与 Vulkan 路径,这块卡在硬件层面是支持的,本机的 Vulkan 运行时也在位(C:\Windows\System32\vulkaninfo.exe 存在)。它不能证明「能跑」——因为本机的 Rust 工具链(rustc、cargo、rustup)全不在位,Skia 全量自建所需的 gn、ninja、clang 也不在位。硬件条件与工具链条件,是两件必须分开说的事。
8.4 三根轴上的落格
把三根轴叠起来,五款引擎的位置就唯一确定了。 三根轴分别是:几何在哪算、谁管场景、内容与渲染是否解耦:
-----------------------------------【三根轴上的落格】----------------------------------------------
# 描述:把本篇的三根轴叠起来,每款引擎得到一个三元组
# 口径:轴一取几何位置,轴二取场景归属,轴三取内容与渲染是否解耦
#------------------------------------------------------------------------------------------------
Skia      : 几何 = CPU 或 GPU | 场景 = 调用方 | 解耦 = 不涉及(库不含内容概念)
Cairo     : 几何 = CPU        | 场景 = 调用方 | 解耦 = 不涉及(库不含内容概念)
Vello     : 几何 = GPU 或 CPU | 场景 = 调用方 | 解耦 = 不涉及(渲染器,不含内容)
Godot-2D  : 几何 = 随后端     | 场景 = 引擎   | 解耦 = 节点树与提交侧解耦
Rive      : 几何 = 随宿主     | 场景 = 内容侧 | 解耦 = 内容与渲染彻底解耦
其中:
- 前四行的差别集中在第二根轴:Skia 与 Cairo 与 Vello 都只管渲染,场景归调用方;Godot-2D 把场景收进引擎;
- 第五行的差别在第三根轴:Rive 连「场景时间轴」都归内容侧,渲染侧完全不知情;
- 第一根轴上只有 Cairo 是纯 CPU,而 Vello 恰好证明「前沿也未必全上 GPU」——两根轴都不成立「越新越靠 GPU」,这是本篇最重要的一条反直觉结论。
如果嫌三根轴太细,只按第二根轴再归类一次,五款引擎立刻收敛成两类。 第一类是场景归调用方的通用渲染库:Skia、Cairo、Vello——它们只回答「怎么画」,画什么由调用方给。第二类是场景归引擎或内容侧的运行时:Godot-2D、Rive——它们各自把「画什么」也纳入了职责。两类之间没有优劣,只有职责范围的差别;本篇要立的坐标系,正是为了让「某款引擎该归哪一类」有可核对的判据,而不是靠流派印象去归类。
本章对应的官方依据:Skia 的分层与后端见 Skia 官方 API 总览 与 Skia 官方构建文档;Vello 分支见 Linebender 季度进展;Cairo 后端枚举见 Cairo 官方手册;Godot-2D 边界见 Godot 官方 CanvasItem 类文档;Rive 后端清单见 Rive C++ 运行时总览;本机 Vulkan 运行时可自
vulkaninfo.exe复核。
九、接下来 10 篇各回答什么、本篇坐标系怎么被回指?
下面我们开始第九阶段。 这是本篇的收口章,要做的事只有一件:把本篇立的坐标系,交到后面十篇手里。
9.1 坐标系回指:后续各篇的技术块落在哪
回指不是「再列一遍目录」,而是把后续各篇要展开的技术块,按本篇的两根轴标位置。 这样每个技术块都能回答「它为什么在这条链路上、为什么归这篇」:
每个技术块都带着它所属的篇号,这就是「回指」的具体含义。 后面每一篇开头都要写一句「本篇在坐标系里占哪一格」,用的就是这张图立的两根轴。注意轴只定位置关系、不定阅读顺序——目录功能由 9.2 节的表承载。
9.2 11 篇知识地图
下面这张表只用文字承载,不做成图——它是「找篇号用」的索引,不是本篇论点:
| 篇号 | 回答什么 | 在本篇坐标系里的位置 |
|---|---|---|
| ep01 全景(本篇) | 五款引擎各在哪个生态、边界在哪 | 全图 |
| ep02 Skia 架构 | SkCanvas API 分层,CPU 与 GPU 后端分工 | 三根轴的「几何在哪算」轴上 |
| ep03 矢量核心 | 贝塞尔细分、tessellation、analytic AA、coverage | 第一章链路的第二与第三段 |
| ep04 字形光栅化 | 字形数据组织、blob、CJK | 第一章链路的「字形旁路」 |
| ep05 Skia GPU backend | 覆盖 approach、instanced tessellation | 第一章链路的第三段,GPU 侧 |
| ep06 Graphite | 新一代 compute 后端:z 值与降 overdraw | 第一章链路的第四与第五段 |
| ep07 自跑一 | Skia 路径 CPU 与 GPU 对照、overdraw 可视化 | 双后端对照的执行篇 |
| ep08 自跑二 | SKP 回放与字体渲染差异 | 「字形旁路」的实测篇 |
| ep09 Vello | sparse strips 与 prefix-scan | 第四章的机制展开 |
| ep10 自跑三 | Vello 三条分支对照 | 第四章的执行篇 |
| ep11 对照与索引 | Godot 2D 与 Cairo 与 Rive 对照,交叉索引 | 第六与第七章的展开 |
9.3 下篇口径钉死
下篇的题域在本篇就要钉死,免得临场改题。 ep02 的口径是:Skia 架构——SkCanvas API 分层,加 CPU 的 Raster 后端与 GPU 后端的分工。 入口正是本篇 3.1 与 3.2 两节留的那条线:
-----------------------------------【ep02 的入口与本篇的交接点】-----------------------------------
# 描述:ep02 从本篇哪几处接着走,以及本篇哪些话不得在 ep02 重复
# 口径:本篇只给位置与官方原话,分层细节与后端实现归 ep02
#------------------------------------------------------------------------------------------------
ep02 接走: 3.1 节的职责切分原话      -> 展开 SkCanvas 与 SkPaint 与 SkSurface 的实现分层
ep02 接走: 3.2 节的三条后端线        -> 展开 Raster 与 GPU 后端的具体分工
逐篇共用:   3.3 到 3.6 节的三条链读数 -> ep07 复用,但必须同时复用「不得跨栈对比」这条口径
其中:
- 本篇 3.3 到 3.6 节的三条链读数与三条禁则,是 ep07 的共用资产,可以直接复用;
- 本篇不复述任何一款引擎的内部机制,这是 0.3 节就声明的边界,ep02 起才展开;
- 凡后续篇目与本篇结论冲突,以「有官方依据或本机实测」的那一方为准,并回写本篇。
9.4 本篇的边界再确认
最后把边界再确认一遍,与 0.4 节首尾呼应。 本篇不涉及任何一款引擎的内部机制实现,不覆盖跨引擎性能排名,不讨论 Vello 与 Graphite 的路线胜负,不做跨栈耗时对比。
本篇交付的是坐标系,不是结论。 它的正确性不取决于某一款引擎未来怎么演化,而取决于那两根轴——「几何在哪算」与「像素怎么合」——够不够区分所有的做法。如果后面某一篇发现三根轴不够用,那说明本系列的坐标系需要一次版本升级;这正是 9.1 节那张图要反复被回指的原因。
本章对应的官方依据:本篇引用的全部官方页面已在各章末逐条列出;11 篇骨架与各篇自跑可得性见 Skia 官方 API 总览 与 Linebender 季度进展 所代表的四类 A 级源,完整清单见文末参考资料。
相关链接
- 下一篇(预告):【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 相关系列(方法底座):T01 性能剖析工具链,13 篇已完结
- 相关系列(硬件侧):GPU 架构剖析
- 本系列使用的自跑工具链:skia-python 发行页 | Skia Fiddle | Skia WASM Debugger
参考资料
- Skia 官方 API 总览
- Skia 官方构建文档
- SkCanvas 概览
- SkPath 概览
- SkPaint 概览
- Skia Doxygen 全量 API
- Skia 源码仓
- Skia 的 GitHub 镜像
- Chrome 官方博客:Graphite 发布
- Chromium 图形与 Skia 设计文档
- skia-discuss:GPU 抗锯齿实现讨论
- Windows 文本渲染归属说明
- Linebender 季度进展 tmil-25
- Linebender 季度进展 tmil-22
- Linebender 季度进展 tmil-19
- vello_hybrid crate 文档
- vello crate 发布记录
- vello crate 索引
- linebender/vello 仓库
- Cairo 官方文档入口
- Cairo 官方手册
- Godot CanvasItem 类文档
- Rive C++ 运行时总览
- Rive 外部渲染器接口
- Flutter Impeller 性能文档
- Android 硬件加速说明
外部示意图出处
- 2D Paths.png | Bezier curve.svg | Rasterisation-triangle example.svg | Scan-line algorithm.svg
- Moir%C3%A92.png | Bitmap vs vector.svg | Cairo's drawing model.svg | Image formats by scope.svg


With Best Wishes.