本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
题图 「免费」要分 load、store、RMW 三类操作来问:前两类在 x86 上免费,store 不免费 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
- ep05 优化器的边界:UB、严格别名与向量化报告——第二波·编译器与链接器
- ep06 名字与符号:ABI、修饰、可见性、PLT 与 IAT——第二波·编译器与链接器
- ep07 链在一起:LTO 与 PGO 的收益从哪来——第二波·编译器与链接器
- ep08 分发的代价:虚函数、模板、variant 与类型擦除——第三波·运行时代价
- ep09 异常与 RTTI:零成本到底成不成立——第三波·运行时代价
背景与边界
好了,上一篇算的是"语言替你留下的痕迹"里异常与类型信息那两笔。这一篇算第三笔,也是最少被量化的一笔:内存序。
std::atomic 的默认内存序是 seq_cst(sequentially consistent,顺序一致)。它承诺的是一个单一全序——所有 seq_cst 操作在全局有一个一致的先后。这句承诺的代价是多少?在 x86 上,流传最广的回答是"免费",依据是那句被反复引用的表述:强序机器上 release-acquire 是自动的,不产生额外指令。
这一篇要把「免费」这个判断按操作类型拆开,因为答案不是一句话:有的操作确实免费,有的不免费。
0.1 一句话结论先放这里
- 免费与否取决于操作类型。按本机实测:load 免费(各档都是单条
mov)、RMW 免费(fetch_add与 CAS 五个内存序档位生成的指令逐字节相同),但 store 不免费——seq_cststore 在 x86 上是xchg(隐含锁),实测约 6 至 8 倍。 - 「x86 是强内存模型」这句话只对了一半。它放松的恰恰是 StoreLoad:本机千万轮 store-buffering 里 relaxed 稳定命中 2.62%(MSVC)/ 3.07%(GCC),而
seq_cst命中 0 次。 - 两套工具链的原子操作里没有一条
mfence。而seq_cstfence 也不是mfence——GCC 生成lock or QWORD PTR [rsp],0x0,MSVC 生成lock inc DWORD PTR [rsp+8],后者改写的是调用者的影子空间。
0.2 实测环境
| 项 | 值 |
|---|---|
| MSVC | cl / dumpbin 19.44.35228,/std:c++17 /O2 /EHsc |
| GCC | MSYS2 ucrt64 g++ 16.2.0 + binutils objdump 2.47,-std=c++17 -O2 -pthread |
| 平台 | Windows x86-64 |
| 计时 | 被测进程内 std::chrono::steady_clock,每档多轮 |
| 计数口径 | 反汇编表只统计核心指令,剔除对齐填充 nop 与函数尾 ret |
| 负载 | 单线程 5,000 万次;竞争 2,000 万次总操作;store-buffering 1,000 万轮 |
0.3 本篇不涉及什么(边界声明)
- 不做 ARM / PowerPC 的本机实测。本机是 x86-64,ARM 的
ldar/stlr/dmb只引官方表述作对照。"免费"是机器给的,不是语言给的,这一点靠 ARM 的表述来突显,而不是靠本机读数。 - 不做硬件性能计数器的实测。本机无
perf、无 VTune。所以本篇给不出 cache-miss 事件计数,缓存行争抢只能从端到端时间间接观察。这条限制也会直接影响下一篇(ep11 缓存与布局)。 - 不做 TSan 与形式化模型的机器检验。本机无 TSan、无
herd7。StoreLoad 重排只做统计式实证(千万轮命中率),不声称复现了 x86-TSO 的形式化模型。 - 不涉及
atomic_ref与atomic<shared_ptr>的实现细节,只引其语义。 - 不给"无锁一定更快"或"处处
seq_cst"的立场建议,只给判据与读数。
0.4 按需跳读
本篇 11 章,三条路线:
- 只想知道"我该写哪个内存序":读 §一(三个词)、§四(时间侧三类操作)、§九(判据)——三章,约 2,600 字。
- 正在写无锁结构:加读 §五(StoreLoad 重排的实证)与 §八(竞争下的账)。这两章的读数决定你的取舍。
- 想学方法(怎么自己看):读 §三(全档位反汇编表)、§六(fence 的真相)、§七(volatile 的边界)、§十(证据形态与复现)。
0.5 这一篇与系列其他篇的接续
- 接 ep09:两篇合起来是"语言机制留下的痕迹"三笔账——异常、类型信息、内存序。ep09 量的是"语言替你留了什么",本篇量的是"语言向你承诺了什么、机器实际给了什么"。
- 接 ep01:
atomic<T>的大小与对齐(§八)接着 ep01 的布局话题——实测除atomic_flag外无额外包装开销。 - 接 ep05:本篇 §六 要观察编译器重排,与 ep05 的 UB / 优化器边界同族——编译器屏障与硬件屏障是两件事。
0.6 为什么这一篇要按"操作类型"拆
「seq_cst 在 x86 上免费吗」这个问题,多数文章给的是一个单词的答案。但把这个答案按操作拆开之后,情况是这样的:
| 操作类型 | 典型指令 | x86 上 seq_cst 的额外代价 |
|---|---|---|
| load | mov |
无(各档同指令) |
| store(relaxed / release) | mov |
— |
| store(seq_cst) | xchg |
有(实测约 6 至 8 倍) |
| fetch_add / CAS | lock xadd / lock cmpxchg |
无(各档同指令) |
原因不难理解:load 需要的 acquire 语义与 store 需要的 release 语义,x86 的硬件本来就免费给你(它不允许 LoadLoad 与 StoreStore 重排);lock 前缀本身就带全序,所以 RMW 的各档没有差别。唯一漏网的是 seq_cst 的 store——它需要的"全局可见顺序"在 x86 上要靠一条带锁的指令来实现。
这正是本篇要讲清楚的那一笔账。
0.7 证据形态与读法
本篇的证据有三类,读的时候要分清它们各自能证什么。
第一类是标准与厂商规范:C++ 标准的两页([intro.races]、[atomics.order])、Intel SDM 的第 9 章、Arm 的官方表述。它们能证明"承诺了什么""硬件允许什么",不能证明"某个操作在你机器上花多少时间"。
第二类是本机实测:反汇编、指令计数、单线程与竞争读数、重排命中率、布局转储。它们能证明"在这套工具链的这个版本上,代价是这个数",不能证明"别的架构也一样"。
第三类最特殊:本机拿不到的那部分。ARM 的屏障行为、PMU 事件计数、TSan 的检测结果都属于这一类。对这一类,本篇只引官方表述并明确声明没有实测,不做推断性结论。
三类证据混着读,最容易犯两个错:
- 把一家的读数当通例。本篇里 MSVC 与 GCC 在反汇编层面高度一致(这本身是个发现),但在读数上有量级相同的抖动差异,把任何一家的单个数字当结论都会过读。
- 把"可能"当"经常"。StoreLoad 重排确实"可能"发生,但实测命中率是 2.6% 至 3.1%(relaxed),既不是零也不是常态。报"可能"不报频率,读者就无法判断该不该为它花钱。
下面这张表把本篇的六处反直觉先集中放一次,方便回头对照(细节在各章):
| # | 反直觉 | 小节 |
|---|---|---|
| 1 | seq_cst 的免费与否取决于是 load、store 还是 RMW |
§四 |
| 2 | 两套工具链的原子操作没有一条 mfence |
§三、§六 |
| 3 | seq_cst fence 不是 mfence,MSVC 版还改写调用者的影子空间 |
§六 |
| 4 | volatile store 与 relaxed atomic store 逐字节相同 |
§七 |
| 5 | x86 上 relaxed 稳定复现 StoreLoad 重排(2.6% 至 3.1%) | §五 |
| 6 | atomic_flag 的 ABI 两家不同(4 字节 / 1 字节) |
§八 |
一、三个词:happens-before、synchronizes-with、单一全序
言归正传,先把标准里的三个词说清楚,后面的读数才有地方落。
1.1 happens-before:标准唯一认可的"先后"
OK,C++ 标准不谈"指令的执行顺序",它谈的是 happens-before 这个关系:
An evaluation A happens before an evaluation B (or, equivalently, B happens after A) if either — A is sequenced before B, or A synchronizes with B, or A happens before X and X happens before B.
拆开看,只有三条构造路径:同一线程内的顺序(sequenced before)、跨线程的同步(synchronizes with)、以及传递闭包。第三条是前两条能不能串起来的关键——一次同步不只是让两个操作有先后,它会把两个线程里各自之前的所有操作都连上。
1.2 synchronizes-with:release 与 acquire 的配对
说白了,这对配对关系值得在动手写代码前先想清楚:release 只负责把本线程之前的一切托付出去,acquire 只负责把对方托付过来的一切接住。两句话各说一半,合起来才是一份完整的保证;只写其中一半,编译器不会报错,运行期也不会立刻出事,但那份保证其实并不存在。
那条"跨线程的同步"来自哪?标准给了原子操作这一条最常用的来源:
Certain library calls synchronize with other library calls performed by another thread. For example, an atomic store-release synchronizes with a load-acquire that takes its value from the store.
—— 同上
这一句就是"发布-订阅"模式的全部机制:线程 A 用 release 写一个标志,线程 B 用 acquire 读到同一个标志,于是 A 在 release 之前写的一切,对 B 在 acquire 之后可见。
注意配对关系:release 与 acquire 是成对的,单独一个没有意义。这与 ep09 里 noexcept 的语义承诺同构——承诺本身不产生效果,配对使用才产生 happens-before。
1.3 单一全序 S:seq_cst 独有,但有一条限制
好了,seq_cst 比 acquire/release 多给的东西,是一个跨越所有 seq_cst 操作的单一全序:
There is a single total order S on all
memory_order::seq_cstoperations, including fences, that satisfies the following constraints. First, if A and B arememory_order::seq_cstoperations and A strongly happens before B, then A precedes B in S.
这个全序是 seq_cst 的全部价值所在:它让所有线程对"这些操作谁先谁后"有同一个答案。acquire/release 给不了这个——两个线程可能对同一对操作的先后有不同看法。
但同页还有一条限制,本篇要单独讲:
memory_order::seq_cstensures sequential consistency only for a program that is free of data races and uses exclusivelymemory_order::seq_cstatomic operations. Any use of weaker ordering will invalidate this guarantee unless extreme care is used.—— 同上
"only for ... uses exclusively seq_cst" ——这句把"我用了 seq_cst 就安全了"这个想法直接否掉了。你的程序里只要有一处弱内存序,全局的顺序一致承诺就不再成立。这条限制解释了为什么工程里"混用内存序"是无锁代码最容易出错的地方。
1.4 修改顺序:第四个词
言归正传,除了前面三个词,还有一个词在无锁代码里几乎每天都会用到,但标准把它和 happens-before 放得同样正式:修改顺序(modification order)。
All modifications to a particular atomic object M occur in some particular total order, called the modification order of M.
它管的是同一个原子变量上的写入顺序:所有线程对这个变量的写,构成一个所有线程都同意的全序。注意它只保证"次序一致",不保证"谁看到了谁"——一个 relaxed 的读看到的是修改顺序里的某个位置,但它可能看到的是较早的那个写。这正是 relaxed 缺的那一环:修改顺序给你"先后",synchronizes-with 才给你"可见性"。
四个词的分工摆在一起就清楚了:
| 词 | 管什么 | 谁提供 |
|---|---|---|
| sequenced-before | 同一线程内的顺序 | 语言本身 |
| synchronizes-with | 跨线程的"我之前的都对你可见" | release / acquire 配对 |
| happens-before | 前两者的传递闭包 | 语言本身(由前两者推出) |
| modification order | 同一个原子变量上的写入全序 | 原子变量本身 |
实践含义:一个原子变量即使全是 relaxed 操作,它的修改顺序仍然存在——所以"永远不会读到一个中间态"这类性质由它保证;但"读到了新值就一定读到了配套的普通变量"这类性质,只有 happens-before 能保证。
1.5 官方口径对得上
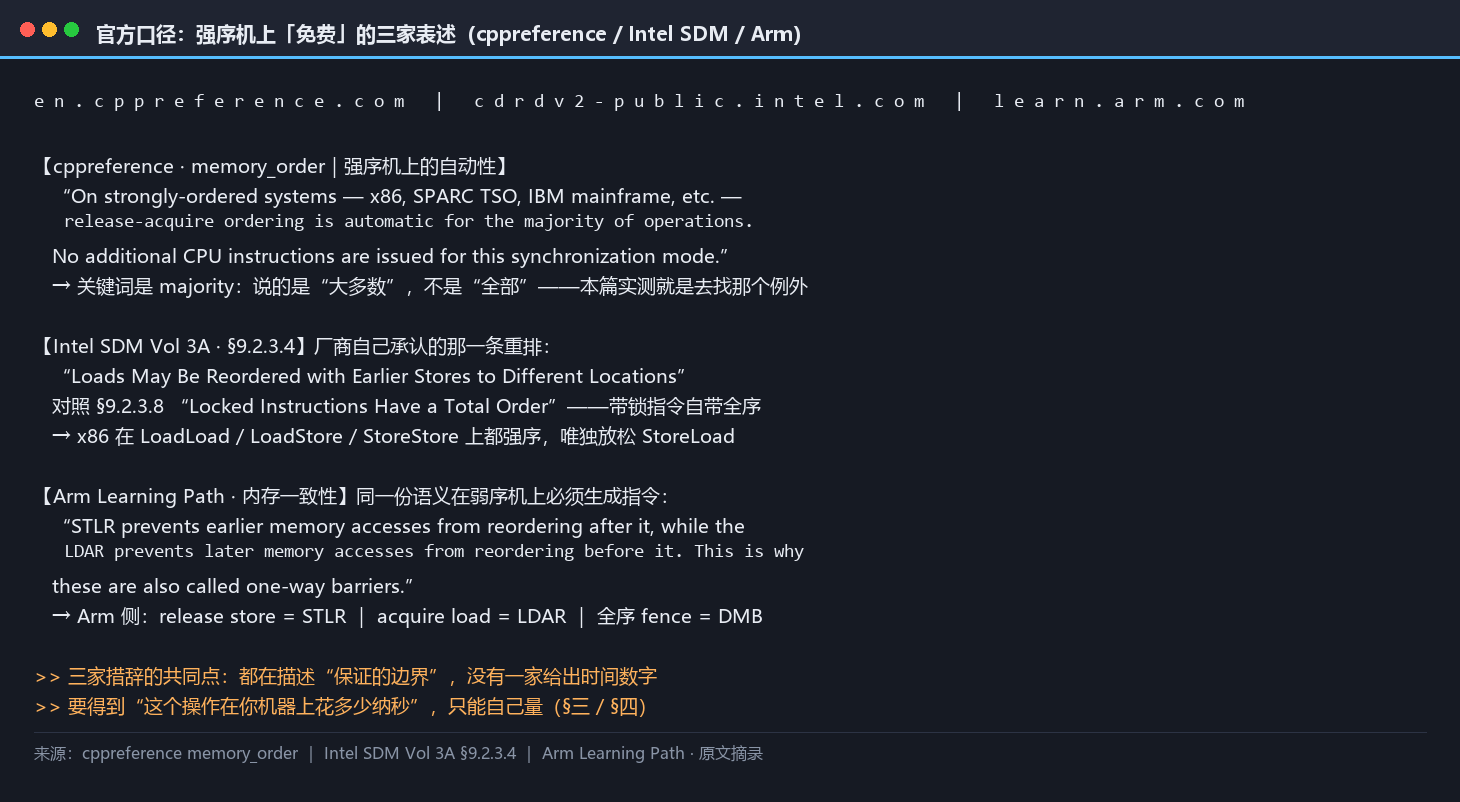
说白了,把三段原文摆在一起,"x86 免费"这件事的官方依据就成形了:
| 工具链 / 来源 | 官方表述 | 出处 |
|---|---|---|
| cppreference | On strongly-ordered systems — x86, SPARC TSO, IBM mainframe, etc. — release-acquire ordering is automatic for the majority of operations. No additional CPU instructions are issued | memory_order |
| Intel SDM | §9.2.3.4 Loads May Be Reordered with Earlier Stores to Different Locations | SDM Vol 3A |
| Arm | STLR prevents earlier memory accesses from reordering after it, while the LDAR prevents later memory accesses from reordering before it | Arm Learning Path |
三家措辞的共同点与分歧点:cppreference 那句是"大多数操作免费"(majority,不是全部——§四的实测就是去找出那个例外);Intel 的小节标题是厂商自己承认允许一种重排;Arm 的表述说明同样的语义在弱序机器上必须生成指令。
⇒ "免费"是机器给的,不是语言给的。 这句话是本篇的第二个题眼。
把这三段并排放,还能看出一个共同的处理方式:三方都在描述保证的边界,而不是给出"快不快"的结论。cppreference 说"不产生额外指令"说的是指令生成,Intel 说的是允许什么重排,Arm 说的是哪些访问不能越过哪些访问——三者都不等于"这个操作花多少纳秒"。要得到后者,只能自己量。
二、x86 到底承诺了什么
2.1 SDM 的七条:厂商自己列的"允许与不允许"
OK,Intel SDM 卷 3 第 9 章把内存序规则逐条列了出来。这份清单比任何二手解读都清楚,因为它是厂商对"我的 CPU 会做什么"的公开声明:
| SDM 小节 | 标题(逐字) | 含义 |
|---|---|---|
| §9.2.3.2 | Neither Loads Nor Stores Are Reordered with Like Operations | 同类操作之间不重排(LoadLoad、StoreStore 有序) |
| §9.2.3.3 | Stores Are Not Reordered With Earlier Loads | Store 不越过更早的 Load(LoadStore 有序) |
| §9.2.3.4 | Loads May Be Reordered with Earlier Stores to Different Locations | Load 可以越过更早的、不同地址的 Store(StoreLoad 可重排) |
| §9.2.3.5 | Intra-Processor Forwarding is Allowed | 允许处理器内部转发(读到自己缓冲里的写) |
| §9.2.3.7 | Stores Are Seen in a Consistent Order by Other Processors | 其他处理器看到的 store 顺序一致 |
| §9.2.3.8 | Locked Instructions Have a Total Order | 带锁指令有全序 |
| §9.2.3.9 | Loads and Stores Are Not Reordered with Locked Instructions | Load/Store 不越过带锁指令 |
这七条里,§9.2.3.4 是一切的根源。 前三条都在说"x86 很强"(同类有序、LoadStore 有序),第四条则给出了例外:唯一被放松的是 StoreLoad。而顺序一致(SC)恰恰不允许这种重排。
⇒ "x86 是强内存模型"这句话对了一半:它对 LoadLoad、LoadStore、StoreStore 都是强序,唯独在 StoreLoad 上是弱序。
2.2 为什么允许:store buffer
好了,允许 StoreLoad 重排的物理原因是写缓冲(store buffer)。x86-TSO 模型把这件事写成了三条规则:
The store buffers are FIFO and a reading thread must read its most recent buffered write, if there is one, to that address; otherwise reads are satisfied from shared memory. An MFENCE instruction flushes the store buffer of that thread. To execute a LOCK'd instruction, a thread must first obtain the global lock. At the end of the instruction, it flushes its store buffer and relinquishes the [lock].
这三条规则解释了三件事:
- 为什么 StoreLoad 可以重排:store 写完先进缓冲,还没到共享内存;后面的 load 从共享内存读,可能读到旧值。于是从"其他线程看到的顺序"看,像是 load 越过了 store。
- 为什么
mfence有效:它把本线程的 store buffer 刷干净。 - 为什么带锁指令有全序:它要取一个全局锁,取之前刷缓冲、放锁时也刷——这正好解释了 §6 那个反直觉读数:既然带锁指令本身就有全序,
seq_cstfence 用一条带锁指令实现就够了,不必用mfence。
而 StoreLoad 重排有一个经典的可观测后果,论文里的表述是:
given two distinct memory locations x and y (initially holding 0), if two processors respectively write 1 to x and y and then read from y and x ... it is possible for both to read 0 in the same execution.
两个线程都读到 0 —— 这在顺序一致下不可能发生(总有一方的写先可见)。§五会拿这个预测去对本机读数。
2.3 硬件有序不等于编译器有序
言归正传,SDM 那七条规则管的是 CPU。但 C++ 程序还有第二个会重排的角色:编译器。
这一点在 relaxed 上最容易踩:relaxed 对编译器几乎等于"没有约束"——它只要求"这次访问不被消除",不要求它与相邻的普通访问保持顺序。所以:
std::atomic<bool> ready{false};
int payload = 0;

// 【1】发布者:这两行的顺序在 relaxed 下不受保护
payload = 42;                              // 普通变量写
ready.store(true, std::memory_order_relaxed);   // relaxed 发布

// 【2】订阅者:同样不成立
while (!ready.load(std::memory_order_relaxed)) { /* spin */ }
use(payload);                              // 不保证看到 42
两处都不成立的原因不同:payload = 42 可能被编译器挪到 store 之后(编译器重排);即使编译顺序正确,CPU 也可能让这两次写对别的核呈现为乱序(硬件重排,§2.2 的 store buffer)。
因此"硬件强序所以不用管内存序"这句话有两个漏:一是它只覆盖硬件那一半,编译器那一半不在范围内;二是它只覆盖 StoreLoad 之外的三类重排,而 §2.2 那 2.6% 恰好落在 StoreLoad 上。
正确的写法是把两个角色一次说清:release/acquire 的价值不在于它生成了什么指令(在 x86 上什么都不生成),而在于它同时约束了编译器和硬件——前者由语言的抽象机规则保证,后者由硬件的内存模型保证。
2.4 缓存一致 ≠ 顺序一致
说白了,这里有一处最容易混淆的地方:缓存一致性(cache coherence)与内存一致性(memory consistency)是两个不同层次的承诺。
| 管什么 | x86 给不给 | |
|---|---|---|
| 缓存一致性 | 同一个地址的读写,所有核看到同一个顺序(per-location) | 给(这是 MESI 一类协议负责的) |
| 内存一致性 | 不同地址的读写,跨核看到的顺序关系(across locations) | 不完全给(§9.2.3.4 就是例外) |
MESI 保证了"每个缓存行内部"的一致,但从不承诺"不同缓存行之间"的顺序。 这正是为什么一台拥有一致缓存的机器仍然可以有 StoreLoad 重排——两条规则管的是两件事。
把这两条规则的物理载体放上来看一眼:下面这张是 Commons 上的多核处理器照片(CC BY-SA 2.0)——一颗封装里就有多个核心,每个核心带自己的私有缓存,一致性协议要维持的那份“同一地址的单一视图”,就发生在这些私有缓存之间:
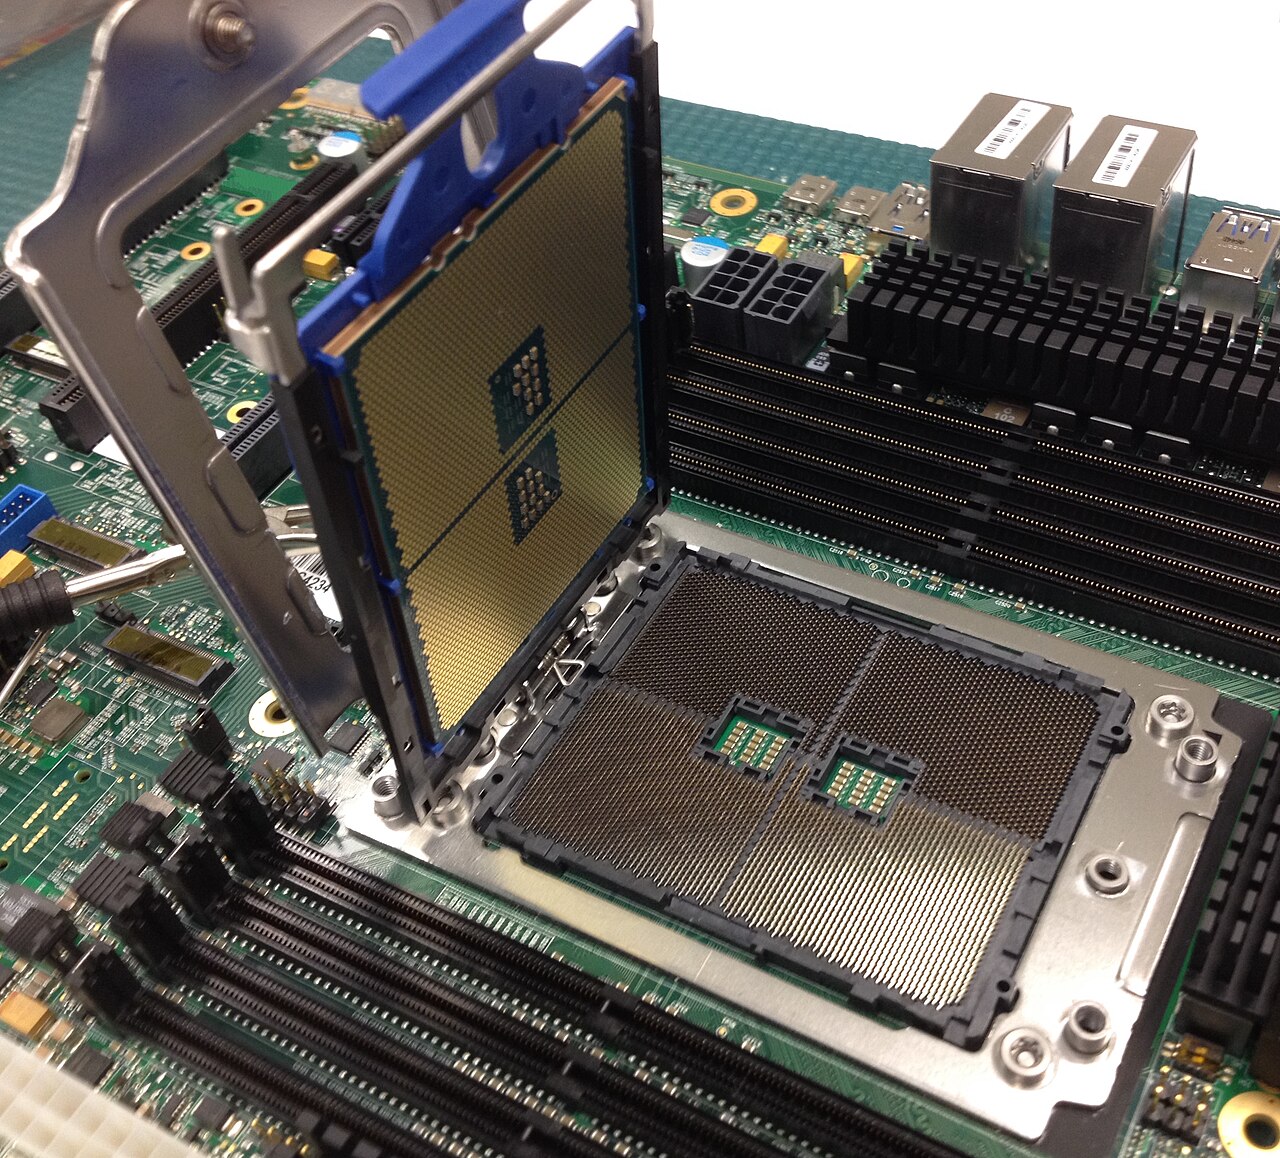
看这张照片要想的是它照不到什么:MESI 这类协议描述的只是一个缓存行在多个核之间的状态迁移,全程不涉及“不同地址之间的顺序”。这正是 §2.3 那张分工表想说的——把这类协议的规则讲完,仍然得不出“不会发生 StoreLoad 重排”的结论。
三、全档位反汇编:谁带锁、谁用 xchg、谁什么都不加
机制说完,开始看指令。这是本篇证据最硬的一章——内存序最终要落到指令上,而指令是可以逐条数的。
3.1 被测对象:每个"档位"都是一个独立函数
OK,把每个组合写成独立函数还有一个不显眼的好处:它让反汇编的输出可以直接对照。如果一个函数里塞了多个档位,编译器可能把共同的部分提取出来,或者因为上下文而改变某一档的生成结果,读数就不再是这个档位本身的代价,而那恰恰是本节的测量对象。
要看清内存序对应什么指令,最干净的做法是把每个组合写成一个独立函数,让编译器只编译这一个组合:
// 【1】load 的三档(store 只有两档,RMW 五档齐全)
int ld_relaxed(std::atomic<int>* p) { return p->load(std::memory_order_relaxed); }
int ld_acquire(std::atomic<int>* p) { return p->load(std::memory_order_acquire); }
int ld_seq_cst(std::atomic<int>* p) { return p->load(std::memory_order_seq_cst); }

// 【2】store 的三档
void st_relaxed(std::atomic<int>* p, int v) { p->store(v, std::memory_order_relaxed); }
void st_release(std::atomic<int>* p, int v) { p->store(v, std::memory_order_release); }
void st_seq_cst(std::atomic<int>* p, int v) { p->store(v, std::memory_order_seq_cst); }

// 【3】RMW:fetch_add 与 CAS,各自五档
int fa_relaxed(std::atomic<int>* p) { return p->fetch_add(1, std::memory_order_relaxed); }
bool cas_acq_rel(std::atomic<int>* p, int& e, int d) {
  return p->compare_exchange_strong(e, d, std::memory_order_acq_rel);
}
下面对这段代码特别说明三点。
第一,这些函数必须 noinline(或干脆各自独立编译)。一旦被内联进调用者,上下文会改变编译器的选择,读数就不再是"这个档位本身"的代价。
第二,load 只有三档、store 只有三档。这不是笔误:std::atomic::load 接受 relaxed / acquire / seq_cst,传入 release 是未定义行为;store 同理。语言层面就已经规定了哪些组合合法。
第三,RMW 是五档齐全的(relaxed / acquire / release / acq_rel / seq_cst),因为一次 RMW 既包含读也包含写。
3.2 全档位反汇编对照表
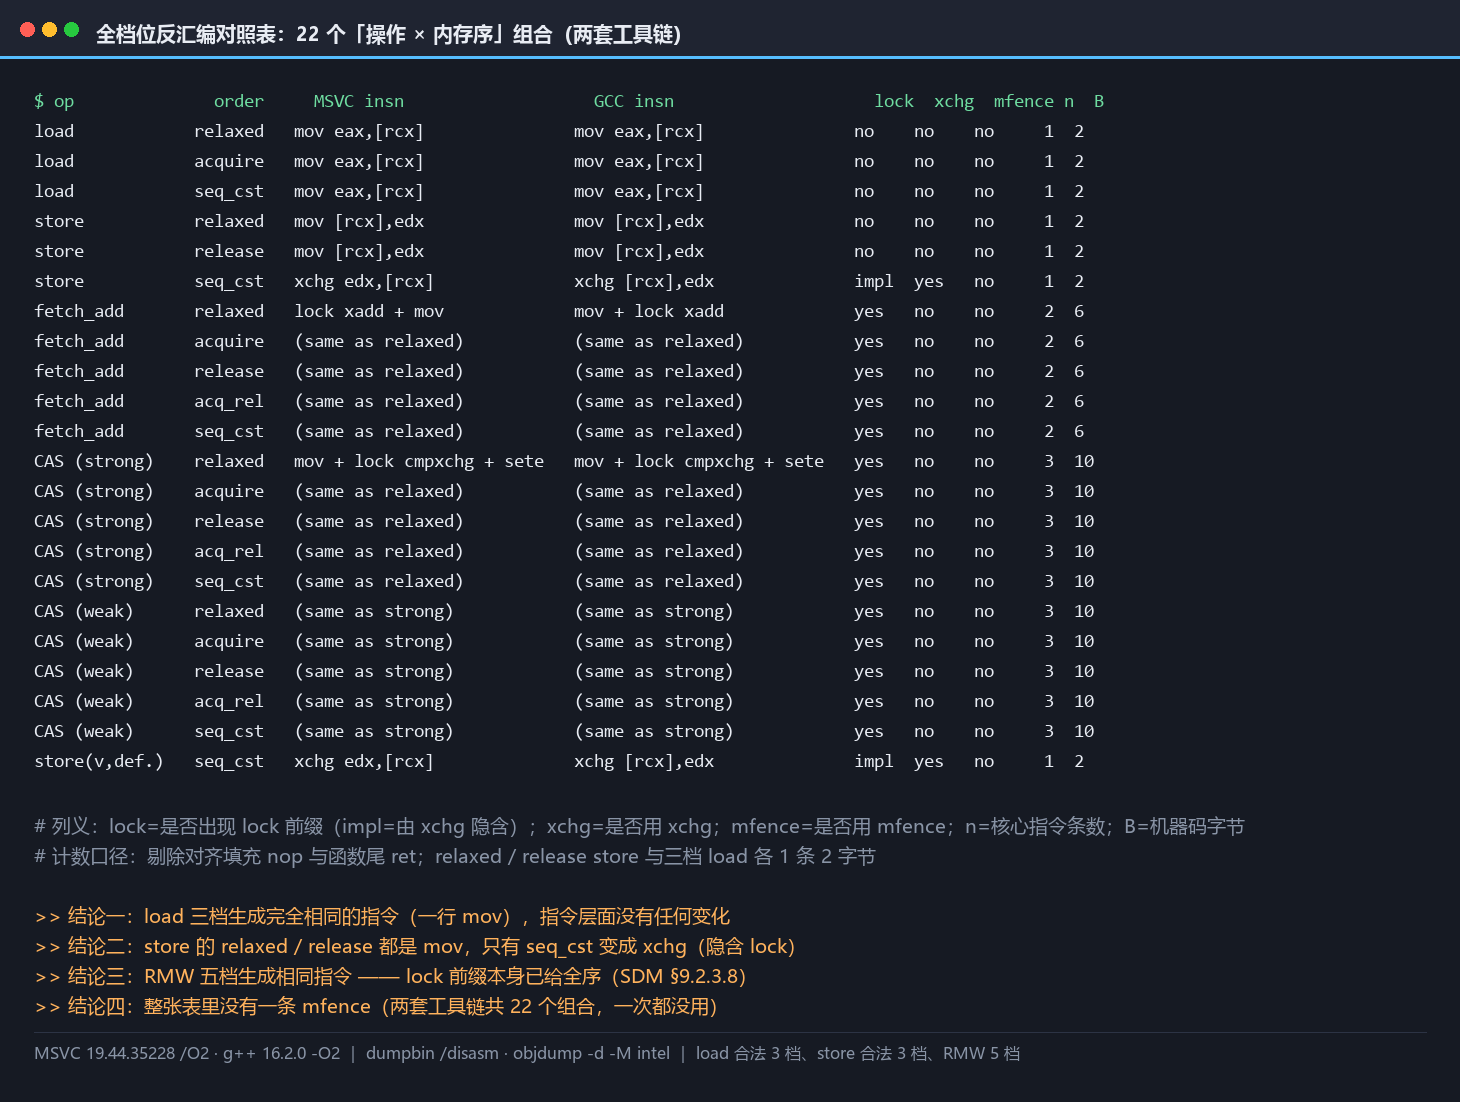
好了,两套工具链的实测结果如下(lock 列表示是否出现 lock 前缀;xchg 列表示是否使用了 xchg):
| 操作 | 内存序 | MSVC | GCC | lock |
xchg |
mfence |
条数 | 字节 |
|---|---|---|---|---|---|---|---|---|
| load | relaxed / acquire / seq_cst | mov eax,[rcx] |
mov eax,[rcx] |
否 | 否 | 否 | 1 | 2 |
| store | relaxed / release | mov [rcx],edx |
mov [rcx],edx |
否 | 否 | 否 | 1 | 2 |
| store | seq_cst | xchg edx,[rcx] |
xchg [rcx],edx |
隐含 | 是 | 否 | 1 | 2 |
| fetch_add | 全 5 档 | lock xadd + mov |
mov + lock xadd |
是 | 否 | 否 | 2 | 6 |
| CAS(strong / weak) | 全 5 档 | mov + lock cmpxchg + sete |
同左 | 是 | 否 | 否 | 3 | 10 |
这张表里有四个结论,每一个都能单独拿出来讲。
结论一:load 的三个档位生成完全相同的指令。 一行 mov。在 x86 上把 load(acquire) 换成 load(relaxed),指令层面没有任何变化——省不下东西,也不会变慢。
结论二:store 的 relaxed 与 release 都是 mov,只有 seq_cst 变成 xchg。 这是本篇的核心发现:seq_cst 的免费与否,取决于它出现在 load 还是 store 上。
结论三:RMW 的五个档位生成完全相同的指令。 fetch_add 不论 relaxed 还是 seq_cst,都是 lock xadd;CAS 不论哪一档,都是 lock cmpxchg。因为 lock 前缀本身就已经提供了全序(SDM §9.2.3.8:Locked Instructions Have a Total Order),所以再往上加内存序不需要额外指令。
结论四:整张表里没有一条 mfence。 这不是遗漏——两套工具链的全部原子操作(共 22 个组合)都没有生成 mfence。屏障效果全部由 lock 前缀与 xchg 的隐含锁提供。
3.3 load:三档一行
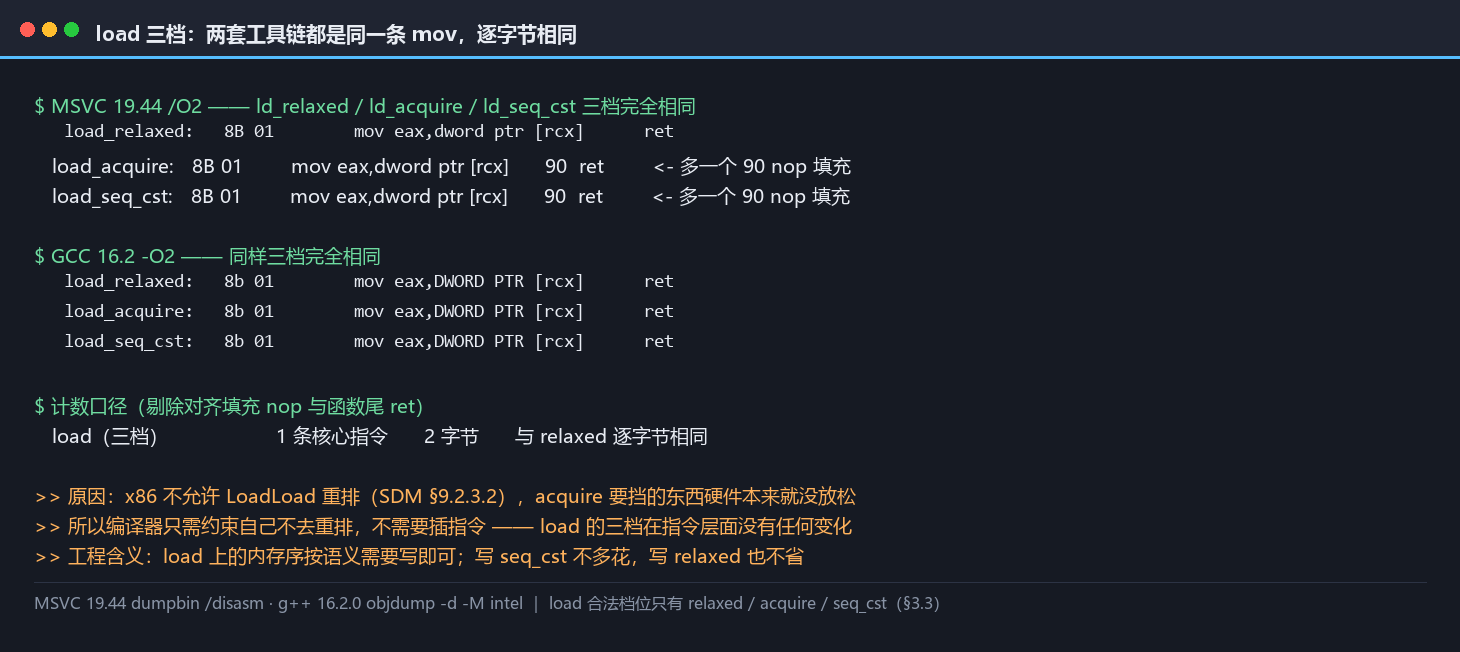
言归正传,单独把 load 的三档放出来,因为它是最容易被过度设计的地方:
; MSVC 19.44 /O2 —— 三档完全相同
ld_relaxed  PROC    mov eax, DWORD PTR [rcx]    ret
ld_acquire  PROC    mov eax, DWORD PTR [rcx]    ret
ld_seq_cst  PROC    mov eax, DWORD PTR [rcx]    ret

; GCC 16.2 -O2 —— 同样三档完全相同
ld_relaxed: mov eax, DWORD PTR [rcx]    ret
ld_acquire: mov eax, DWORD PTR [rcx]    ret
ld_seq_cst: mov eax, DWORD PTR [rcx]    ret
为什么这样是对的? 因为 x86 不允许 LoadLoad 重排(SDM §9.2.3.2),也不允许后面的 load 越过更早的 load。所以 acquire 语义所要求的"我之后的读写不能提到我前面",x86 硬件本来就保证。编译器只需要防止自己重排,不需要插指令。
seq_cst 的 load 也没什么可加——全序的约束主要体现在 store 侧:所有 seq_cst 操作要在同一个全序里,而 load 只要"看到最后那个写"就自然满足。
3.4 store:mov 与 xchg 的分野
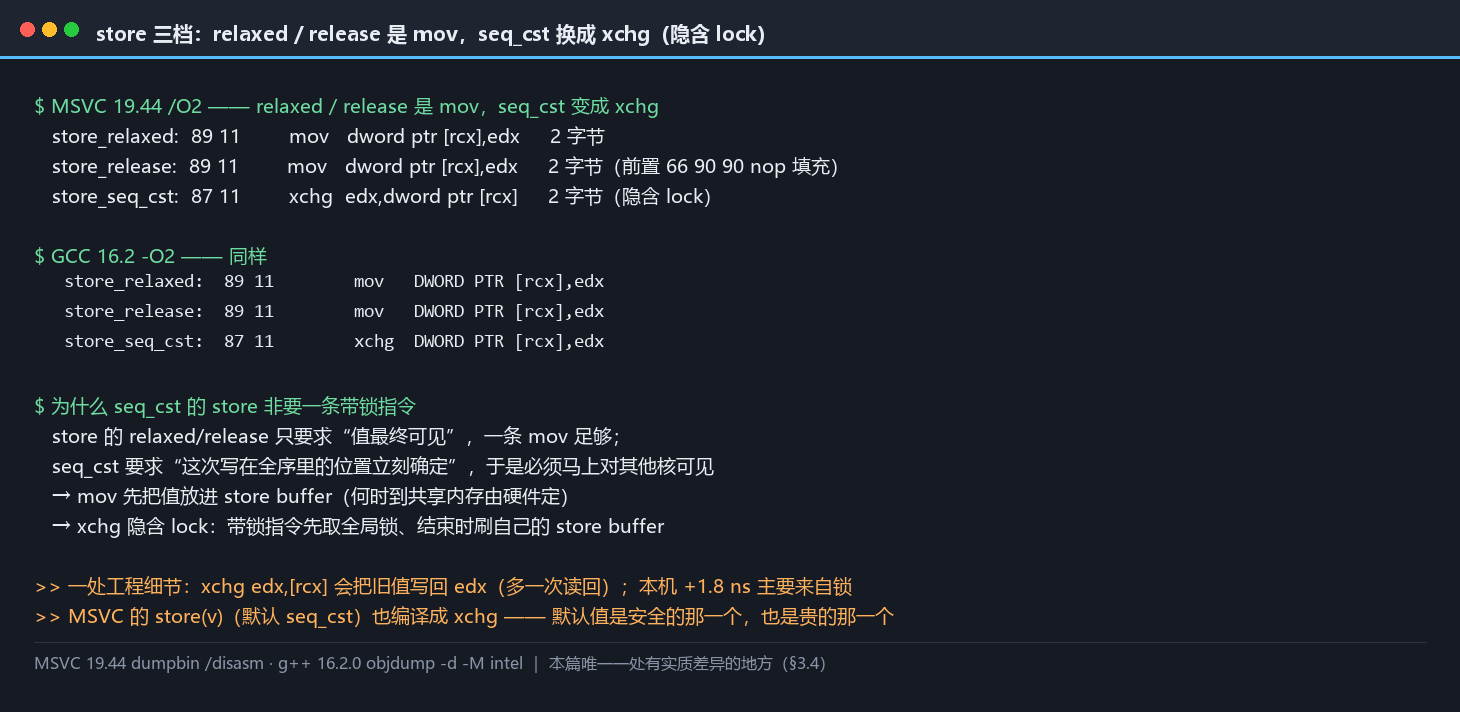
说白了,这是本篇唯一一处有实质差异的地方:
; MSVC —— relaxed / release 是 mov,seq_cst 变成 xchg
st_relaxed:  mov DWORD PTR [rcx], edx      ; 2 字节
st_release:  mov DWORD PTR [rcx], edx      ; 2 字节
st_seq_cst:  xchg edx, DWORD PTR [rcx]     ; 2 字节(隐含 lock)

; GCC —— 同样
st_relaxed:  mov DWORD PTR [rcx], edx
st_release:  mov DWORD PTR [rcx], edx
st_seq_cst:  xchg DWORD PTR [rcx], edx
为什么 seq_cst 的 store 非要一条带锁的指令? 回到全序的定义:所有 seq_cst 操作必须在一个全局顺序里。对 store 来说,"我这次写在全局顺序里的位置"必须马上确定下来——而这要求这次写立刻对其他核可见。普通的 mov 做不到这一点:它把值放进 store buffer,什么时候到共享内存由硬件决定。所以编译器换成了 xchg——xchg 隐含 lock,而带锁指令会先取全局锁、结束时刷自己的 store buffer(§2.2 的第三条规则)。
一处工程上的细节:xchg edx, [rcx] 会写回 edx(交换是把旧值取回来)。这也让这次 store 多了一个"读回旧值"的动作——虽然本机读数(+1.8 ns)显示代价主要来自锁而不是这次读回。
⚠️ 还有一处必须点明:MSVC 的 store(v) 默认就编译成 xchg。因为 std::atomic::store 的默认参数是 seq_cst。这一点与 ep09 的"默认 potentially-throwing"同构——语言的默认值是安全的那一个,也就是贵的那一个。
3.5 RMW:五档一行,因为 lock 已经给了全序
; MSVC —— fetch_add 五档完全相同
fetch_add:   lock xadd DWORD PTR [rcx], edx     ; 隐含 lock,6 字节
             mov eax, edx

; MSVC —— CAS 五档完全相同
cas:         mov eax, edx
             lock cmpxchg DWORD PTR [rcx], r8d
             sete al
RMW 的五个档位生成同一段指令,理由是 SDM §9.2.3.8 那条:带锁指令本身有全序。既然 lock xadd 已经把这次操作放进了某个全局顺序,那么再声明 seq_cst 也不会让它更"全序"——编译器自然什么都不用加。
这条推论在工程上很有用:如果你的原子变量只做 fetch_add 或 CAS,那么把它从 seq_cst 改成 relaxed 不会省下任何指令,也不会变快。 §四的读数会证实这一点。
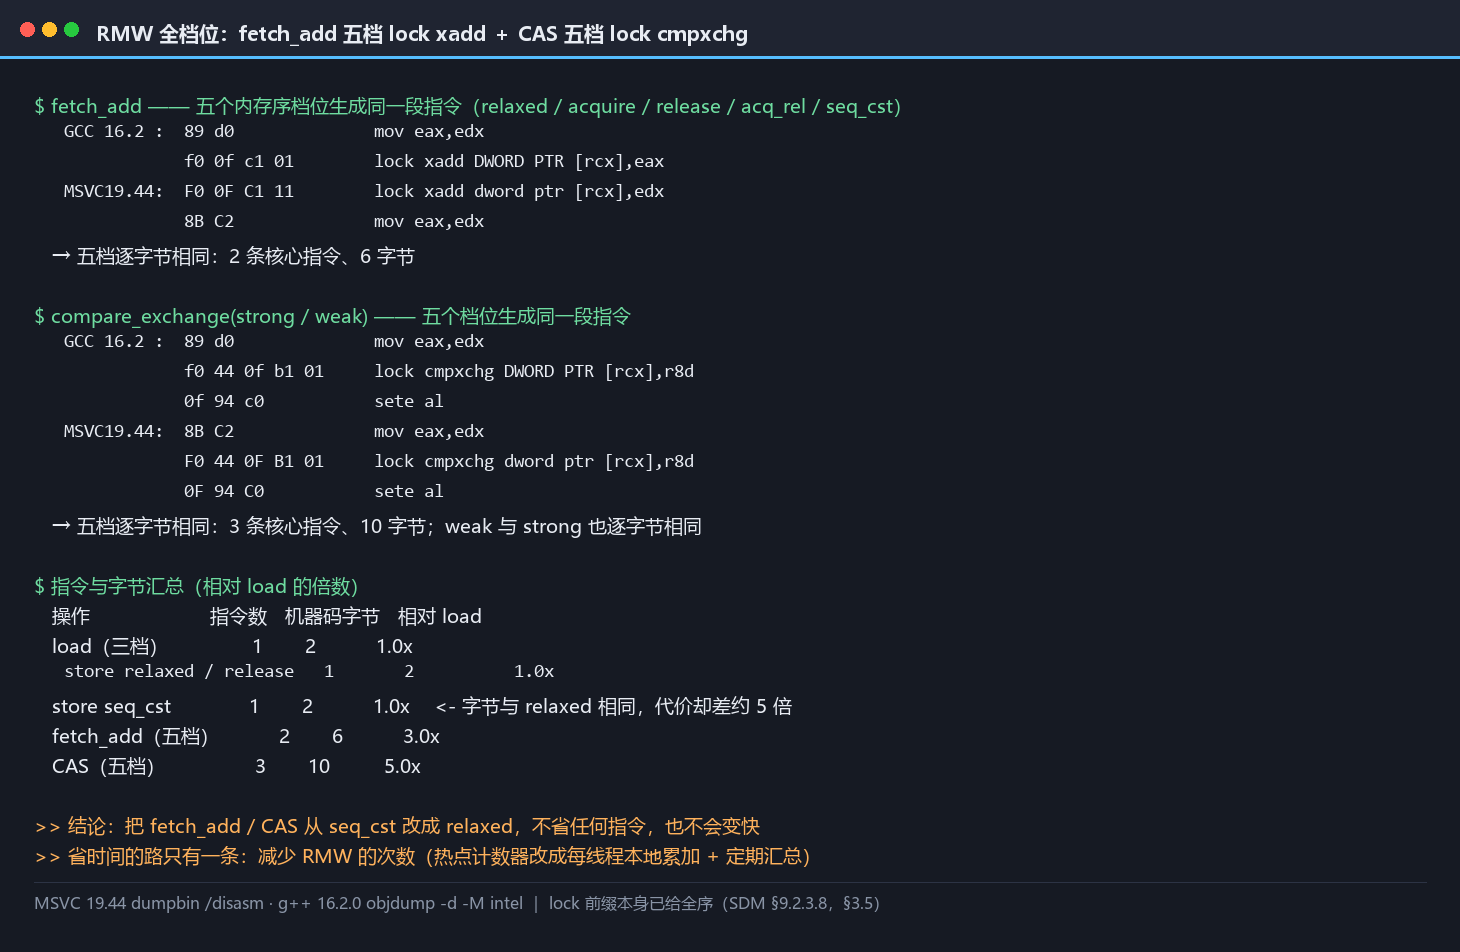
顺带把指令与字节数汇总一下:
| 操作 | 指令数 | 机器码字节 | 相对 load 的倍数(字节) |
|---|---|---|---|
| load(三档) | 1 | 2 | 1.0× |
| store relaxed / release | 1 | 2 | 1.0× |
| store seq_cst | 1 | 2 | 1.0× |
| fetch_add(五档) | 2 | 6 | 3.0× |
| CAS(五档) | 3 | 10 | 5.0× |
注意这一列"字节数":seq_cst 的 store 与 relaxed 的 store 字节数相同(都是 2)。 差异不在长度上,在这条指令做了什么上——xchg 与 mov 的编码长度一样,微架构行为完全不同。这也是"看代码大小判断开销"会失效的一个例子。
3.6 同一份代码在 ARM 上长什么样(无本机实测)
OK,前一节那张全档位表是 x86 的答案。把同一批函数换到 ARM 上,结果完全不同——这一节只引官方表述,本机无 ARM(§0.3 已声明)。
| 语义需求 | x86-64 实测 | Arm 的官方表述 |
|---|---|---|
| release store | mov |
STLR —— "prevents earlier memory accesses from reordering after it" |
| acquire load | mov |
LDAR —— "prevents later memory accesses from reordering before it" |
| 全序 fence | 1 条带锁指令 | DMB —— "DMB instructions are Sequentially Consistent with respect to other DMB instructions" |
STLR prevents earlier memory accesses from reordering after it, while the LDAR prevents later memory accesses from reordering before it. This is why these are also called one-way barriers ... LDAR and STLR instructions are Sequentially Consistent with respect to other LDAR and STLR instructions, while ordinary LDR and STR are not.
这张对照表解释了"免费"这个词的归属:x86 给的是硬件级的免费——它不允许大多数重排,所以编译器不必插指令;Arm 给的是指令级的支持——用 ldar/stlr 这种单向屏障把需要的顺序补上。同一份 C++ 代码,在 x86 上编译成 mov、在 Arm 上编译成 ldar/stlr,而两边都符合标准。
实践含义有两条:一是在 x86 上调好的无锁代码,换到 Arm 上"变慢"是正常的(多出了屏障指令),不要以为编译器变笨了;二是在 x86 上"看起来能用"的代码,换到 Arm 上可能直接错——因为 x86 免费给的那部分保证,Arm 要靠指令来给,而如果你的代码里根本没有 release/acquire 的标注,编译器就不会生成那些指令。
四、时间侧实测
:只有 store 付钱
4.1 单线程读数
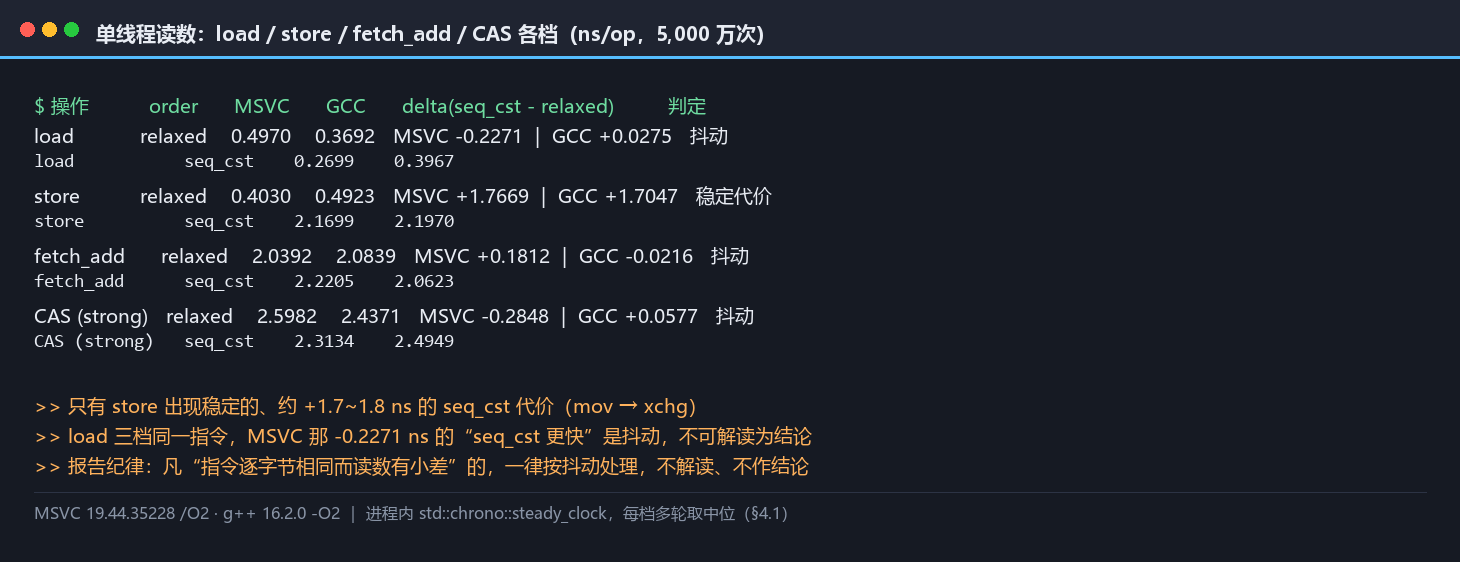
好了,单线程、无竞争、5,000 万次,单位 ns/op:
| 操作 | 内存序 | MSVC | GCC |
|---|---|---|---|
| load | relaxed | 0.4970 | 0.3692 |
| load | seq_cst | 0.2699 | 0.3967 |
| store | relaxed | 0.4030 | 0.4923 |
| store | seq_cst | 2.1699 | 2.1970 |
| fetch_add | relaxed | 2.0392 | 2.0839 |
| fetch_add | seq_cst | 2.2205 | 2.0623 |
| CAS(strong) | relaxed | 2.5982 | 2.4371 |
| CAS(strong) | seq_cst | 2.3134 | 2.4949 |
读数与反汇编完全对得上:
- load:两档指令相同,读数差(MSVC 那 0.27 ns 的"seq_cst 更快")是抖动,不可解读。
- store:
relaxed是 0.40 / 0.49,seq_cst是 2.17 / 2.20,稳定的 5 倍左右。这一档的差异在两套工具链上一致,而且与前一场的编译结果一致,可以当结论。 - fetch_add 与 CAS:两档各自相差 0.1 至 0.3 ns,且方向不一致(MSVC 上是 relaxed 更快,GCC 上是 seq_cst 更快)。指令既然逐字节相同,这点差异就是抖动。
一条报告纪律:凡是"指令逐字节相同而读数有小差"的情况,一律按抖动处理,不解读、不作为结论。本篇有四处属于这一类(load 两档、fetch_add 两档、CAS 两档、以及 §八的 weak/strong)。
4.2 把三类操作分开看
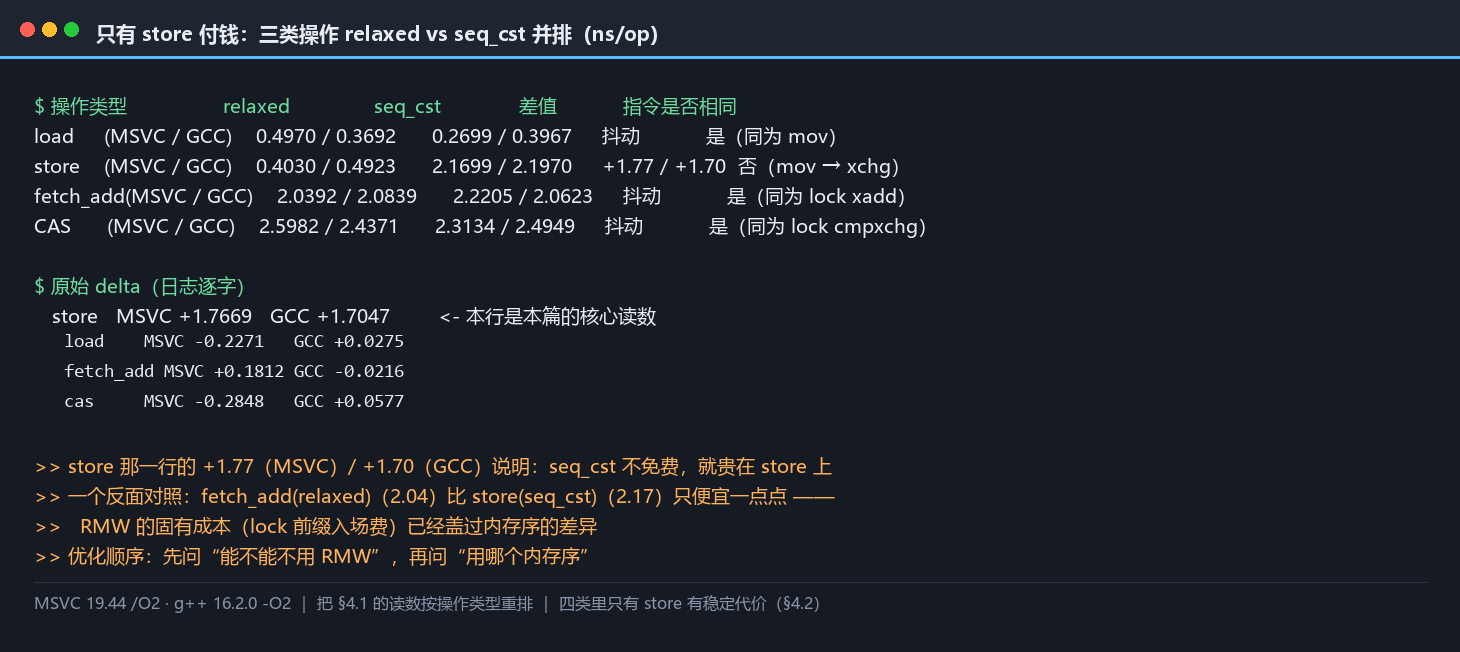
言归正传,把 §4.1 的读数按操作类型重排,"免费"这件事就清楚了:
| 操作类型 | relaxed | seq_cst | 差值 | 指令是否相同 |
|---|---|---|---|---|
| load(MSVC / GCC) | 0.4970 / 0.3692 | 0.2699 / 0.3967 | 抖动 | 是 |
| store(MSVC / GCC) | 0.4030 / 0.4923 | 2.1699 / 2.1970 | +1.77 / +1.70 | 否(mov → xchg) |
| fetch_add(MSVC / GCC) | 2.0392 / 2.0839 | 2.2205 / 2.0623 | 抖动 | 是 |
| CAS(MSVC / GCC) | 2.5982 / 2.4371 | 2.3134 / 2.4949 | 抖动 | 是 |
四类里只有 store 有稳定代价。 这就是 §0.1 那句结论的完整依据。
再看一个反面的对照:load 与 store 的 relaxed 档都只要 0.4 ns 左右,而 fetch_add 无论哪一档都要 2.0 ns 以上。RMW 的固有成本(lock 前缀)已经盖过了内存序的差异——一个 fetch_add(relaxed) 比一个 store(seq_cst) 还要贵一点点。这条对照说明:优化原子操作时,先问"能不能不用 RMW",再问"用哪个内存序"。
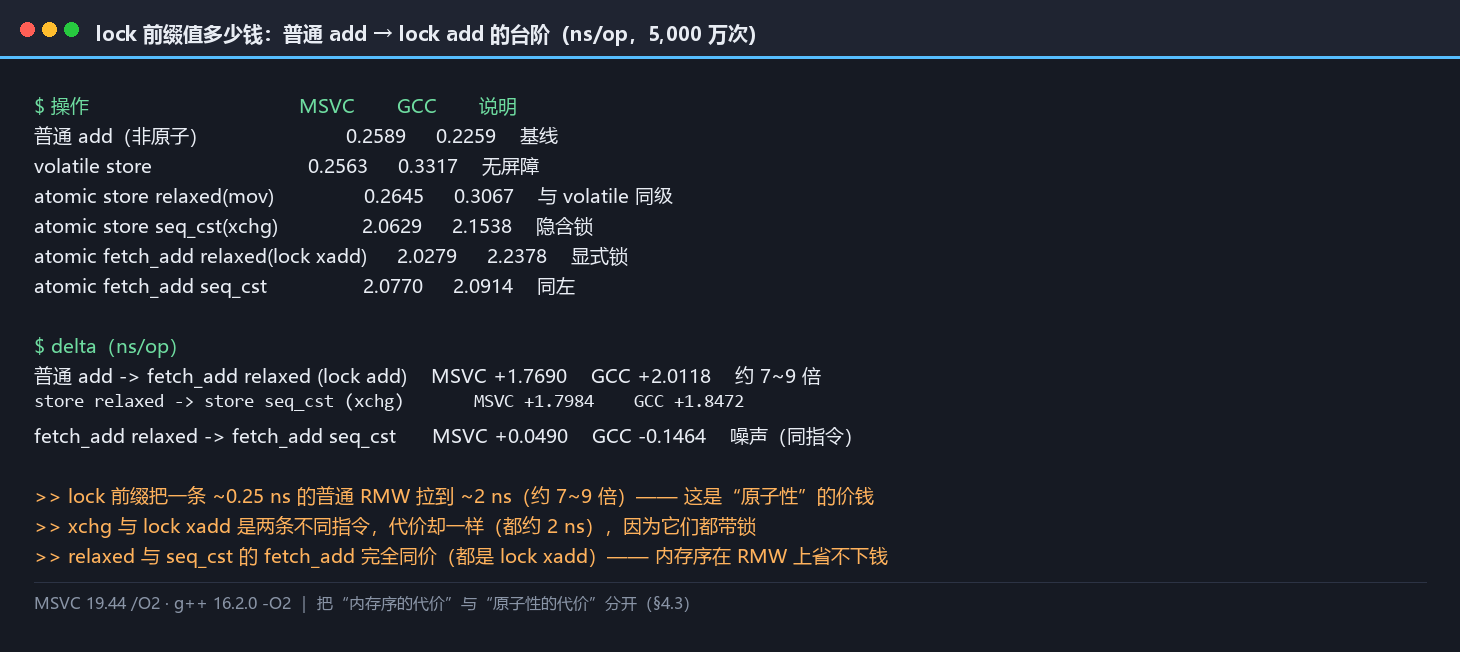
4.3 lock 前缀到底值多少钱
说白了,既然 lock 是成本的主因,单独量一次它:
| 操作 | MSVC | GCC | 说明 |
|---|---|---|---|
普通 add(非原子) |
0.2589 | 0.2259 | 基线 |
volatile store |
0.2563 | 0.3317 | 无屏障 |
atomic store relaxed(mov) |
0.2645 | 0.3067 | 与 volatile 同级 |
atomic store seq_cst(xchg) |
2.0629 | 2.1538 | 隐含锁 |
atomic fetch_add relaxed(lock xadd) |
2.0279 | 2.2378 | 显式锁 |
atomic fetch_add seq_cst |
2.0770 | 2.0914 | 同左 |
结论很干净:
- 从普通
add到lock add,代价是 +1.77 ns(MSVC)/ +2.01 ns(GCC),约 7 至 9 倍。这是"原子性"本身的价钱。 lock xadd的 relaxed 与 seq_cst 完全同价(2.0279 对 2.0770;2.2378 对 2.0914)——再次印证 §3.5。xchg的代价落在同一档(2.0629 / 2.1538),与lock xadd基本同价。两个不同的指令,代价却一样,因为它们都带锁。
⇒ 这张表把"内存序的代价"与"原子性的代价"分开了:前者只在 seq_cst 的 store 上出现;后者是 RMW 的入场费,与内存序无关。
4.4 因果链:为什么偏偏是 store
OK,把这一章串起来,seq_cst store 那条 +1.8 ns 的因果链是完整的:
seq_cst要求所有seq_cst操作在一个单一全序里(§1.3 的标准原句);- 对 load 来说,满足这个要求不需要额外动作(x86 不允许 LoadLoad 重排,load 自动看到最新值);
- 对 store 来说,要"立刻确定自己在全序里的位置",就必须让这次写马上对其他核可见;
- 普通
mov做不到——它先把值放进 store buffer(§2.2 的第一条规则); - 于是编译器换成
xchg(隐含lock),带锁指令会取全局锁并刷新自己的 store buffer(§2.2 的第三条规则); - 这条锁就是那 1.8 ns。
4.5 release / acquire 在 x86 上同样是免费的
好了,这一节的结论对写代码的人有直接影响:在 x86 上按语义需求写 release 与 acquire 是零成本的,所以没有理由为了省一点而把它们降成 relaxed。降级只会丢掉 happens-before 这份保证,不会省下任何指令,也不会让这段代码变快哪怕一点。
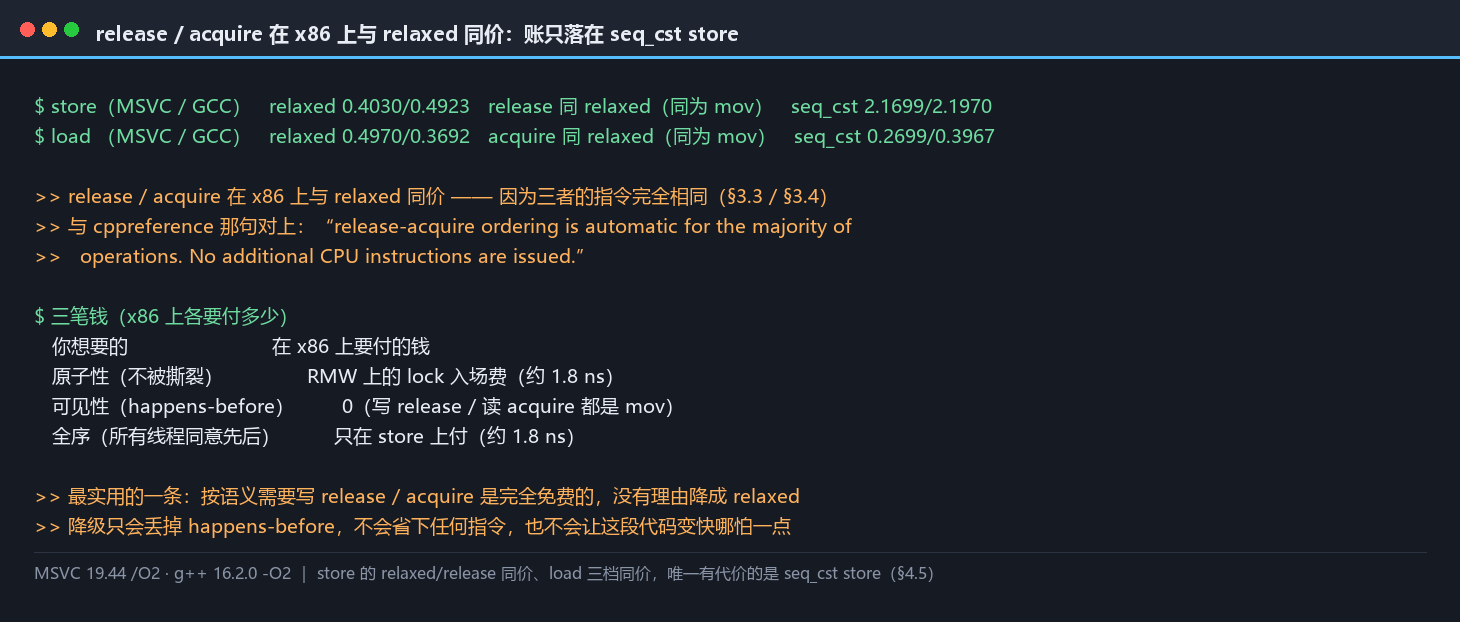
§4.2 那张表按"操作类型"分组,但还有一处值得单独确认:同一种操作里,release 与 acquire 与 relaxed 是否同价? 实测的答案是与反汇编一致的:
| 操作 | relaxed | release / acquire | seq_cst |
|---|---|---|---|
| store(MSVC / GCC) | 0.4030 / 0.4923 | 同 relaxed(同为 mov) |
2.1699 / 2.1970 |
| load(MSVC / GCC) | 0.4970 / 0.3692 | 同 relaxed(同为 mov) |
0.2699 / 0.3967 |
release / acquire 在 x86 上与 relaxed 同价——因为三者的指令完全相同(§3.3 / §3.4)。这也与 cppreference 那句"release-acquire ordering is automatic for the majority of operations. No additional CPU instructions are issued"完全对上。
⇒ 这是本篇最实用的一条结论:在 x86 上,按语义需要写 release / acquire 是完全免费的。既然免费,就没有理由为了"省一点"而降成 relaxed——降级只会丢掉 happens-before,不会省下任何东西。
这条与 §4.2 的结论合起来,构成一个清晰的取舍:
| 你想要的 | 在 x86 上要付的钱 |
|---|---|
| 原子性(不被撕裂) | RMW 上的 lock 入场费(约 1.8 ns) |
| 可见性(happens-before) | 0(写 release / 读 acquire 都是 mov) |
| 全序(所有线程同意先后) | 只在 store 上付(约 1.8 ns) |
4.6 判据(第三条之外的第四条)
判据一(时间侧):先问操作类型,再问内存序:
- 只做
load→ 三档随便挑,指令与时间都一样; - 只做
store→relaxed/release免费,seq_cst要付约 1.8 ns(5 至 8 倍); - 做 RMW(
fetch_add/ CAS)→ 五个档位同价,内存序不影响时间,按语义需求挑即可。
判据二(默认值):std::atomic 的默认是 seq_cst。如果这个原子变量在热路径上且只做 store,把默认值改成 release 是一处真实的收益(约 5 倍);但改之前要确认这次 store 之后的可见性需求(§五会讲哪些场景必须付这笔钱)。
五、StoreLoad 重排的实证:千万轮里的 2.6% 与 0%
言归正传,§2.1 说 SDM 承认 StoreLoad 可以重排,§2.2 说原因是 store buffer。这一章去量它到底发不发生、多频繁。
5.1 实验设计:两个线程,两个变量,各写各读
说白了,这个测试在文献里叫 store-buffering(SB)litmus 测试。构造极简:
// 【1】两个原子变量,初值都是 0
std::atomic<int> X{0}, Y{0};

// 【2】线程 A:先写 X,再读 Y
void writer_a(int *r1) {
  X.store(1, ORDER);           // 写自己的
  *r1 = Y.load(ORDER);         // 读对方的
}

// 【3】线程 B:先写 Y,再读 X(与 A 完全对称)
void writer_b(int *r2) {
  Y.store(1, ORDER);
  *r2 = X.load(ORDER);
}

// 【4】主控:反复跑这对线程,统计"两边都读到 0"的次数
for (long round = 0; round < 10'000'000; ++round) {
  X.store(0, std::memory_order_relaxed);
  Y.store(0, std::memory_order_relaxed);
  int r1 = -1, r2 = -1;
  std::thread ta(writer_a, &r1), tb(writer_b, &r2);
  ta.join(); tb.join();
  if (r1 == 0 && r2 == 0) ++hit;    // 顺序一致下这不该发生
}
下面对这段代码特别说明三点。
第一,ORDER 是被测变量。整组实验跑两遍:一遍填 relaxed,一遍填 seq_cst,其余代码完全相同。
第二,判定条件是 r1 == 0 && r2 == 0。按顺序一致(SC),两个线程的四个操作存在某个全局顺序,无论怎么排,至少有一方会读到对方的写(1)。所以"两边都读到 0"在 SC 下不可能发生。x86-TSO 的预测是它可能发生(§2.2 的 SB 引文)。
第三,每轮都重建线程。这样做的代价是启动开销大(每轮约 3 微秒),但保证两个线程真的在不同的时间片上跑;如果复用线程 + 循环内同步,测量本身就会引入屏障。
⚠️ 一处必须标注的边界:这个实验只能证明"允许发生"和"实际发生了多少次",不能证明"一定发生"。它是统计式实证,不是形式化检验(本机无 herd7,§0.3 已声明)。
5.2 读数:relaxed 稳定命中,seq_cst 一次不中
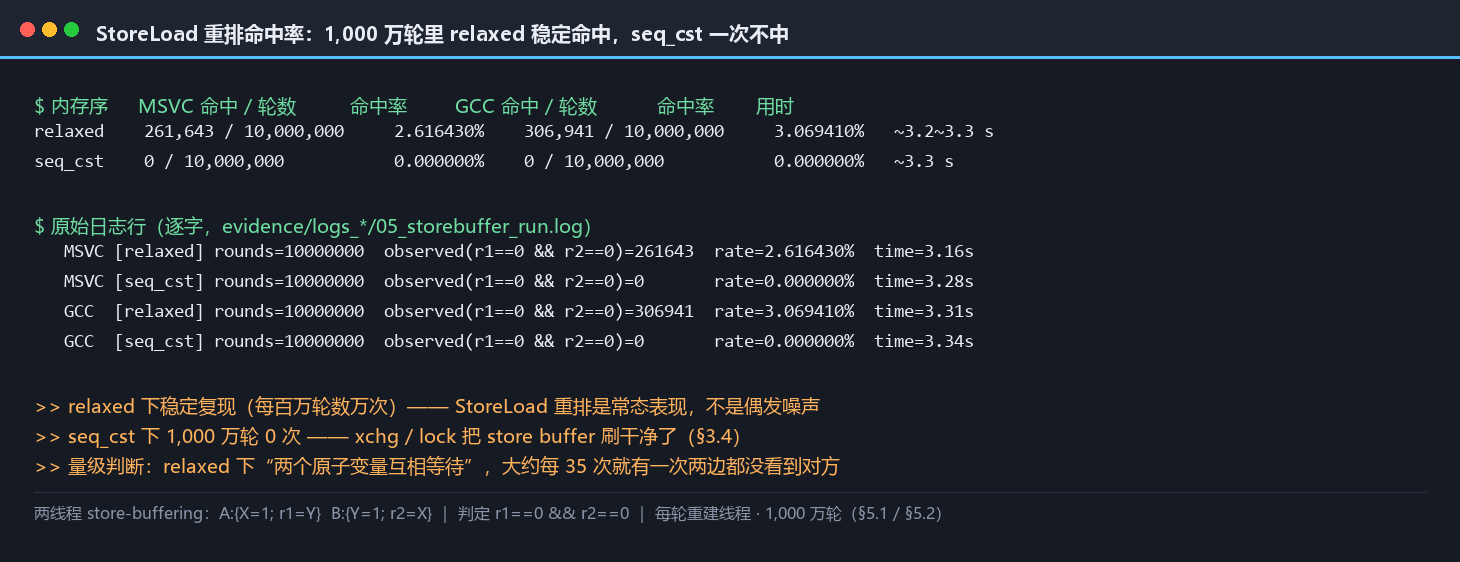
OK,1,000 万轮,两套工具链各跑一遍:
| 内存序 | MSVC 命中 r1==0 && r2==0 |
GCC 命中 |
|---|---|---|
| relaxed | 261,643(2.616430%) | 306,941(3.069410%) |
| seq_cst | 0(0.000000%) | 0(0.000000%) |
两套工具链的结论一致,而且极其干净:
- relaxed 下稳定复现,命中率 2.6% 至 3.1%——这个量级说明它不是偶发噪声,而是 StoreLoad 重排的常态表现;
- seq_cst 下 1,000 万轮一次不中——
xchg与lock把 store buffer 刷干净了(§3.4)。
这条读数把"可能"变成了一个频率。 中文侧的同类文章大多停在"StoreLoad 重排是可能的",读了之后读者无法判断该不该为它花钱。2.6% 与 3.1% 这两个数字才是可决策的依据:如果你的程序在 relaxed 下靠 X、Y 两个标志互相等待,大约每 35 次就会有一次两边都没看到对方。
5.3 重排的物理载体
好了,重排这个概念容易停在抽象的可能性上,但它在硬件里对应一个具体的结构:写先进缓冲,读从缓冲或共享内存取值。理解了这个结构,前两节那些规则就不再是一份清单,而是一台机器正在做的事;也才能解释为什么某些屏障指令是必需的,另一些则是多余的。
重排不是一个抽象概念,它需要硬件里的一个具体结构来支撑。x86 的这个结构就是 load/store 队列——写先进队列(store buffer),读可以从队列转发、也可以直接去共享内存。
下面这张是 Commons 上的 load/store 队列图,公共域:
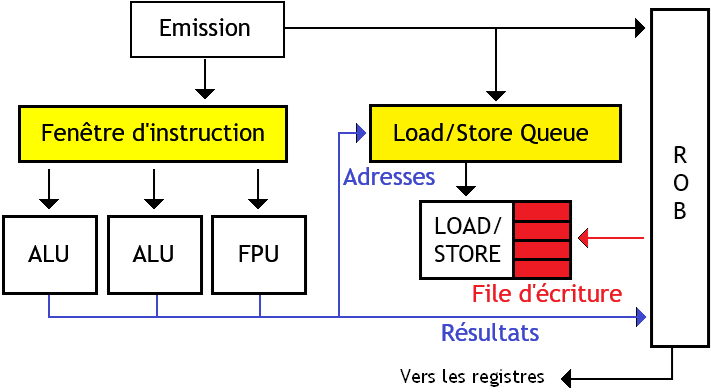
这张图给出了 §2.2 那三条规则的物理落点:store buffer is FIFO 对应队列的先进先出;"reading thread must read its most recent buffered write" 对应队列转发;"MFENCE flushes the store buffer" 对应把队列排空。
⚠️ 一处尺寸说明:这张图只有 711×392,属原理小图,正文里按小图排版,不放大到全宽。
5.4 理论预测与实测对照
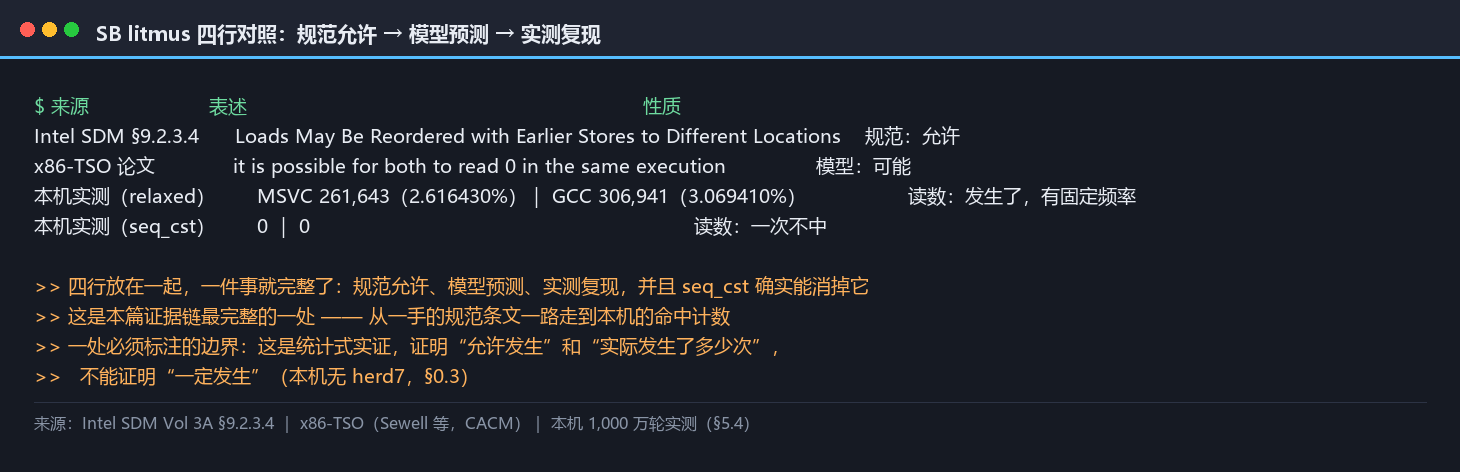
言归正传,把 §2.2 的论文预测、§2.1 的 SDM 规则、与 §5.2 的实测放在一起:
| 来源 | 表述 | 性质 |
|---|---|---|
| Intel SDM §9.2.3.4 | Loads May Be Reordered with Earlier Stores to Different Locations | 规范:允许 |
| x86-TSO 论文 | it is possible for both to read 0 in the same execution | 模型:可能 |
| 本机实测(relaxed) | MSVC 2.616430% | GCC 3.069410% | 读数:发生了,而且有固定频率 |
| 本机实测(seq_cst) | 0 | 0 | 读数:一次不中 |
四行放在一起,一件事就完整了:规范允许、模型预测、实测复现、并且 seq_cst 确实能消掉它。这是本篇证据链最完整的一处——从一手的规范条文一路走到本机的命中计数。
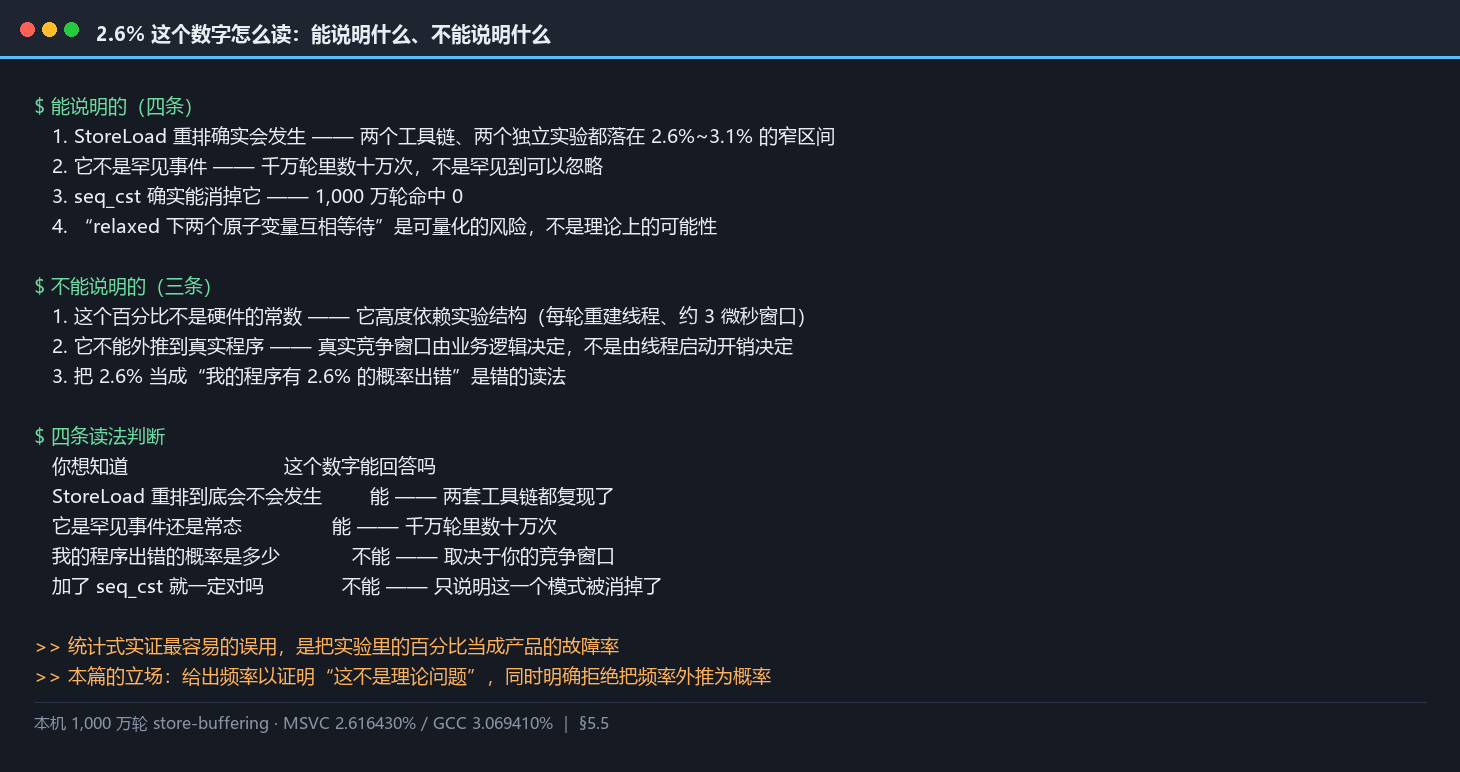
5.5 2.6% 这个数字怎么读(以及不该怎么读)
说白了,§5.2 那两个数字(2.616430% 与 3.069410%)很具体,但它们的解释空间比看上去大。先说清楚它能说明什么与不能说明什么。
能说明的:
- StoreLoad 重排确实会发生,而且有固定量级的频率——两个工具链、两个独立实验都落在 2.6% 至 3.1% 这个窄区间里;
seq_cst确实能消掉它(1,000 万轮命中 0);- 因此"relaxed 下两个原子变量互相等待"是一个可量化的风险,而不是理论上的可能性。
不能说明的:
- 这个百分比不是硬件的一个常数。 它高度依赖实验结构:每轮都重建线程,于是两个线程的启动与执行有一个约 3 微秒的窗口;两者的写落在窗口的不同位置时,重排才可观测。换一个线程复用、加一轮同步、或者把循环次数改掉,百分比都会变。
- 它不能外推到真实程序。 真实程序里的竞争窗口由业务逻辑决定,不是由线程启动开销决定。把 2.6% 当成"我的程序有 2.6% 的概率出错"是错的读法。
正确的读法是把它当成一个量级判断:
| 你想知道 | 这个数字能回答吗 |
|---|---|
| StoreLoad 重排到底会不会发生 | 能,两套工具链都复现了 |
| 它是罕见事件还是常态 | 能,千万轮里数十万次,不是罕见到可以忽略 |
| 我的程序出错的概率是多少 | 不能,那取决于你的竞争窗口 |
加了 seq_cst 就一定对吗 |
不能,这只说明这一个模式被消掉了 |
为什么要专门写这一节:统计式实证最容易的误用就是"把实验里的百分比当成产品的故障率"。
本篇的立场是:给出频率以证明"这不是理论问题",同时明确拒绝把频率外推为概率。
5.6 判据:什么时候必须付这笔钱
判据三(StoreLoad):按这个顺序问。
- 这段代码有没有"两个原子变量互相等待"的形态? 有 → 这是一处 SB 结构,relaxed 下每几十次就可能失效一次,必须用
seq_cst或显式的释放-获取配对。 - 只有单个原子变量的读改写? 那么 StoreLoad 重排影响不到你,按 §4.5 的判据一挑即可。
- release/acquire 配对够不够? 多数"发布-订阅"场景够——release store 与 acquire load 的配对能建立 happens-before(§1.2),不需要
seq_cst的全序。 - 什么时候才真的需要全序? 需要多个线程对多个原子操作的先后有一致看法时。典型是"多个标志位之间的相对顺序要被所有线程同意"这类场景。
- 不确定就先用
seq_cst,热点再降。 这是默认值存在的理由——先证明确实是热点,再为它付设计的复杂度。
一条反向提醒:seq_cst 的代价只出现在 store 上(§4.2)。所以"我要全序,所以哪里都得写 seq_cst"是过度设计——load 与 RMW 上写 relaxed 省不下东西,但写 seq_cst 也不多花东西。真正的取舍点在 store。
六、fence 的真相:为什么一条 mfence 都没有
6.1 三类 fence 的指令现场
OK,std::atomic_thread_fence 可以带不同内存序。本机实测的结果出乎意料:
| fence 内存序 | MSVC | GCC | 指令数 |
|---|---|---|---|
acquire |
(函数体只剩 ret) |
(只剩 ret) |
0 |
release |
(只剩 ret) |
(只剩 ret) |
0 |
seq_cst |
lock inc DWORD PTR [rsp+8] |
lock or QWORD PTR [rsp],0x0 |
1 |
两条结论,每一条都反直觉。
第一,acquire 与 release fence 在 x86 上是空操作。 编译器完全不生成指令——函数体里只有一条 ret。理由与 §3.3 相同:x86 不允许 LoadLoad 与 StoreStore 重排,这两类 fence 要挡的东西硬件本来就挡住了,编译器只需要约束自己的重排,不需要插指令。
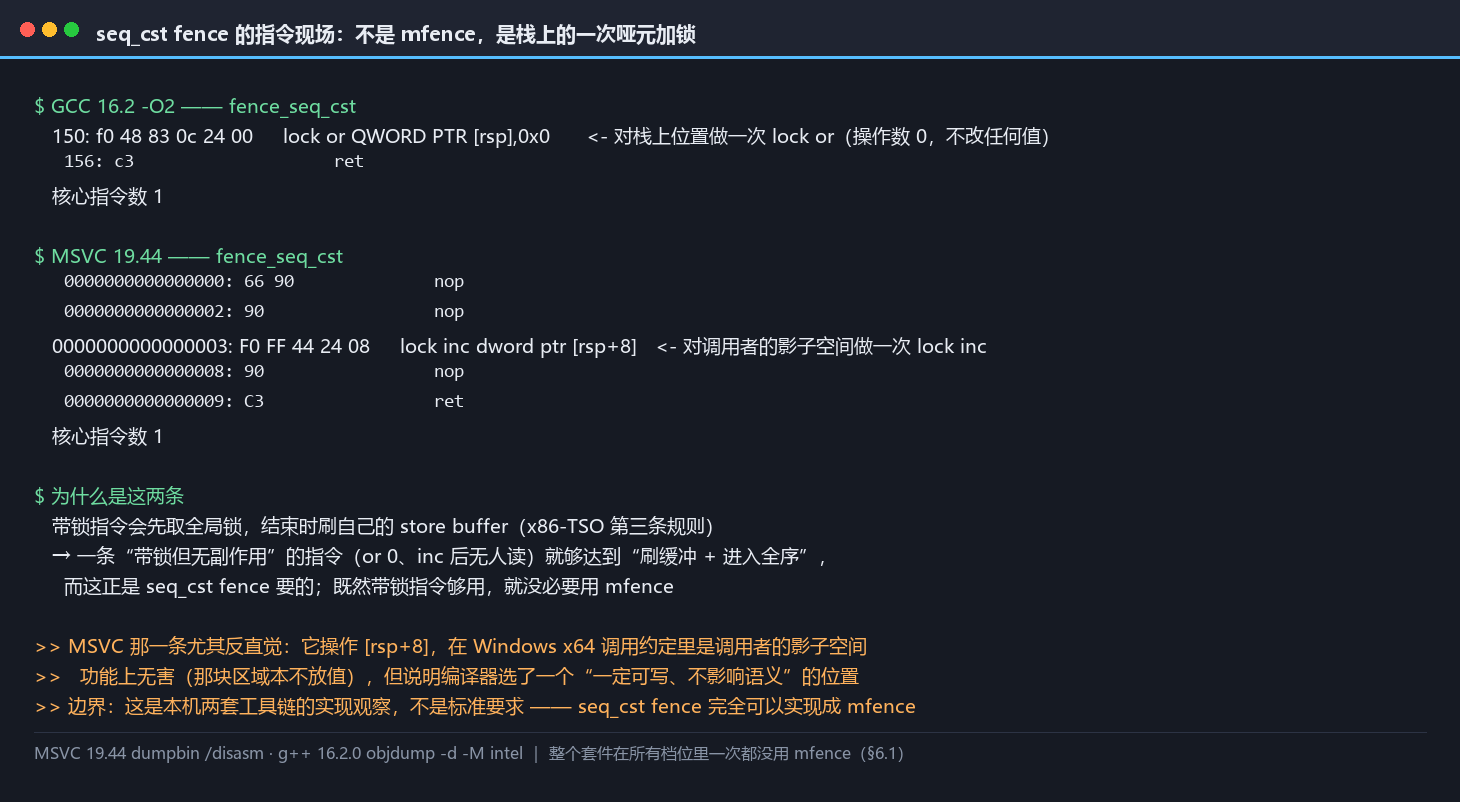
第二,seq_cst fence 不是 mfence。 这一点最值得单独讲:两套工具链都用了"在栈上做一个哑元加锁操作"的办法——
; GCC 16.2 —— 对栈上的任意位置做一次 lock or,操作数是 0(不改变任何值)
lock or QWORD PTR [rsp], 0x0

; MSVC 19.44 —— 对调用者的影子空间做一次 lock inc
lock inc DWORD PTR [rsp+8]
为什么是这两条? 回到 §2.2 的第三条规则:带锁指令会先取全局锁、结束时刷自己的 store buffer。一条带锁但无副作用的指令(or 0、inc 之后没人读)就能达到"刷新 store buffer + 进入全序"的效果,而这正是 seq_cst fence 要的。既然带锁指令够用,就没必要用 mfence。
MSVC 那一条尤其反直觉:它操作的是 [rsp+8],在 Windows x64 的调用约定里这是调用者的影子空间(shadow space)——也就是它改写了调用者栈帧里的一块保留区域。功能上无害(那块区域本来就不放值),但它说明编译器选择了一个"一定可写、且不会影响程序语义"的位置。
⚠️ 一处必须标注的边界:以上是本机两套工具链的实现观察,不是标准要求。seq_cst fence 完全可以实现成 mfence——事实上在较早的编译器版本上就是这样。本篇只声明"当前这两个版本选择了带锁指令",不声明"一定如此"。
6.2 三类 fence 的对照
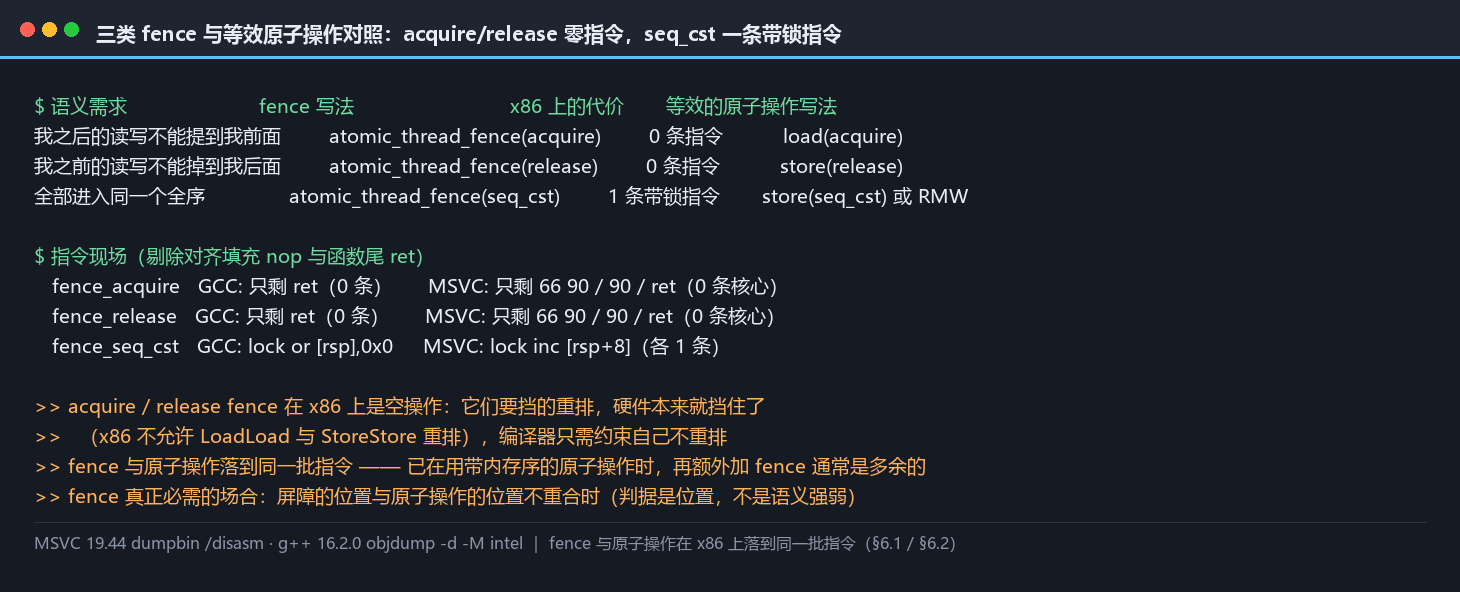
好了,把三类 fence 与对应的原子操作放在一起看,规律就出来了:
| 想表达的语义 | fence 写法 | x86 上的代价 | 等效的原子操作写法 |
|---|---|---|---|
| 我之后的读写不能提到我前面 | atomic_thread_fence(acquire) |
0 条指令 | load(acquire) |
| 我之前的读写不能掉到我后面 | atomic_thread_fence(release) |
0 条指令 | store(release) |
| 全部进入同一个全序 | atomic_thread_fence(seq_cst) |
1 条带锁指令 | store(seq_cst) 或 RMW |
这张表的最右一列是关键:fence 与原子操作在 x86 上落到同一批指令。已经在用带内存序的原子操作,再额外加 fence 通常是多余的——两套写法表达同一件事,只是写法不同。
什么时候 fence 才是必需的? 当屏障的位置与原子操作的位置不重合时。典型场景是"先写一批普通变量,再一次性发布"——此时如果发布用的是已有的原子变量、而你想让屏障落在它前面某处,就需要 fence。判据是位置,不是语义强弱。
6.3 为什么"没有 mfence"值得单独写一节
言归正传,回到 §3.1 那张全档位表:22 个组合,一条 mfence 都没有。这不是偶然,而是两套工具链共同的取舍,原因有三层:
- 能用更便宜的东西就不上
mfence。mfence是通用屏障,会序列化本线程所有先前的 load 与 store;而大多数场景只需要更窄的屏障。 - 带锁指令已经给了全序。 SDM §9.2.3.8 那条"Locked Instructions Have a Total Order"让
lock前缀成了一个"顺便免费"的全序来源——xchg、lock xadd、lock cmpxchg都在提供它。 mfence只在"既不能带锁、又需要全序"时才划算。 本机这 22 个组合里没有这种情形。
这一节的价值在于破除一个常见印象:很多讲内存序的材料把 mfence 当成 x86 上"全序的代价"的代名词。本机实测表明,当前两套工具链在原子操作层面一次都没用它。
但也别反向过读:没有 mfence 不等于没有代价。§4.4 那条 1.8 ns 的因果链说明,代价换了一个形式存在——落在了 xchg 与 lock 前缀上。"没有某条指令"与"没有开销"是两件事。
七、volatile 的边界:逐字节等于 relaxed
7.1 逐字节对照
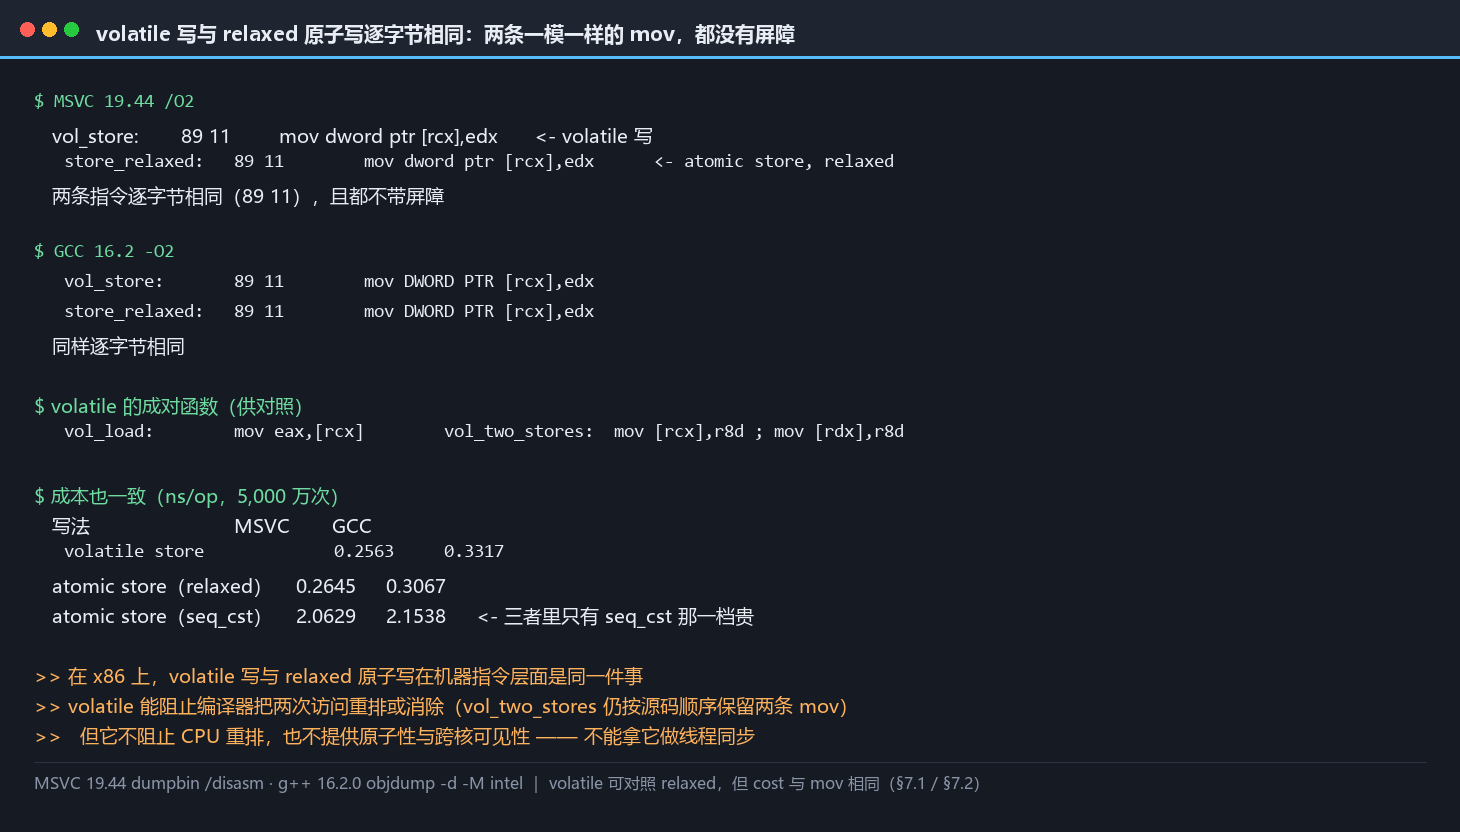
说白了,volatile 在 C++ 里常被当成"轻量版原子"。本机实测给出了一个非常干净的对照:
; MSVC —— volatile store 与 relaxed atomic store 完全相同
vol_store:        mov DWORD PTR [rcx], edx      ; volatile
st_relaxed_impl:  mov DWORD PTR [rcx], edx      ; atomic store, relaxed

; GCC —— 同样相同
vol_store:        mov DWORD PTR [rcx], edx
st_relaxed_impl:  mov DWORD PTR [rcx], edx
两条指令逐字节相同,而且都没有屏障——在 x86 上,volatile 写与 relaxed 原子写在机器指令层面是同一件事。
成本也一致:
| 写法 | MSVC | GCC |
|---|---|---|
volatile store |
0.2563 | 0.3317 |
| atomic store(relaxed) | 0.2645 | 0.3067 |
| atomic store(seq_cst) | 2.0629 | 2.1538 |
三者里只有 seq_cst 那一档贵,volatile 与 relaxed 同级——这符合 §4.3 那张 lock 成本表的结论。
7.2 volatile 唯一可靠的作用:挡编译器
OK,volatile 不是完全没用。本机实测里它确实做了一件事:
| 函数 | MSVC | GCC | 说明 |
|---|---|---|---|
两个 volatile store(先后写不同变量) |
mov; mov |
mov; mov |
保持源码顺序 |
两个 relaxed 原子 store |
mov; mov |
mov; mov |
本例也保持顺序 |
两个 seq_cst 原子 store |
mov eax,r8d; xchg; xchg |
同左 | 两条 xchg 强制固定顺序 |
volatile 能阻止编译器把两次访问重排或消除——这是它与普通变量的最大区别,也是它真正的用途(内存映射 I/O、信号处理器里的标志)。但它不阻止 CPU 重排,也不提供原子性与跨核可见性。
⚠️ 一处诚实标注:本例里 relaxed 原子 store 也保持了源码顺序——这不代表 relaxed 有顺序保证,只代表"在这个简单例子里,编译器没有动机去重排"。要观察编译器在 relaxed 下的重排,需要构造更复杂的上下文(例如让两个 store 之间存在可能影响结果的读),那属于另一组实验。本篇不据此声明 relaxed 有顺序。
7.3 两家的官方口径:MSVC 的 volatile 默认带屏障
好了,有一处平台差异必须写明。MSVC 的 volatile 有两套语义,由开关选择:
/volatile:iso— Selects strict volatile semantics as defined by the ISO-standard C++ language. Acquire/release semantics are not guaranteed on volatile accesses.
/volatile:ms— Selects Microsoft extended volatile semantics, which add memory ordering guarantees beyond the ISO-standard C++ language. Acquire/release semantics are guaranteed on volatile accesses. However, this option also forces the compiler to generate hardware memory barriers, which might add significant overhead on ARM and other weak memory-ordering architectures.
非 ARM 平台默认是 /volatile:ms。 这句话解释了一件很容易被误读的事:同一份用 volatile 写的代码,在 MSVC 上"看起来能用"、在 GCC 上可能直接失效——因为 MSVC 的默认语义额外加了顺序保证,而 GCC 按标准只给"不被优化掉"。
⚠️ 但本机实测里 MSVC 的 volatile store 并没有生成屏障指令(§7.1 逐字节对照)。这两件事不矛盾:/volatile:ms 承诺的是"语义上有顺序保证",而在 x86 这个强序目标上,这份保证不需要额外指令(与 §3.3 的 acquire fence 同理)。接口上的保证一样,落到机器码上因为平台而不同。
7.4 判据:什么时候用 volatile
判据四(volatile):只有两类场景该用。
- 内存映射 I/O:硬件寄存器的读写必须每次真的发生,不能被优化掉或被合并。
- 信号处理器里的标志:
volatile sig_atomic_t这类类型,要求访问不被优化掉。
除此之外一律用 std::atomic。 理由很直接:
- 想让别的线程看到 → 需要跨核可见性,
volatile不给(本机实测:无屏障指令); - 想保证读改写不丢更新 → 需要原子性,
volatile不给(x++会编成三条指令); - 想建立 happens-before → 需要 release/acquire,
volatile不给(没有语义)。
一条最容易踩的坑:用 volatile bool 当"就绪标志"、用普通变量传数据。这在 x86 上可能看起来能用(因为硬件强序),但编译器可以重排那批普通变量的写——而那正是 volatile 挡不住的地方。"在我的机器上跑了三年没问题"不是证据。
八、竞争下的账:内存序的差 vs 缓存行争抢的差
言归正传,前面七章都是单线程读数。但原子操作在真实程序里几乎总在竞争——这一章去量竞争本身,并把它与内存序的代价放在同一个尺度上。
8.1 竞争发生在哪里
多个线程对同一个原子变量做 RMW 时,争抢的对象是这个变量所在的缓存行。下面这张是 Commons 上的 SMP(Symmetric Multiprocessor,对称多处理器)示意图,公共域,给出了这个场景的物理图景:
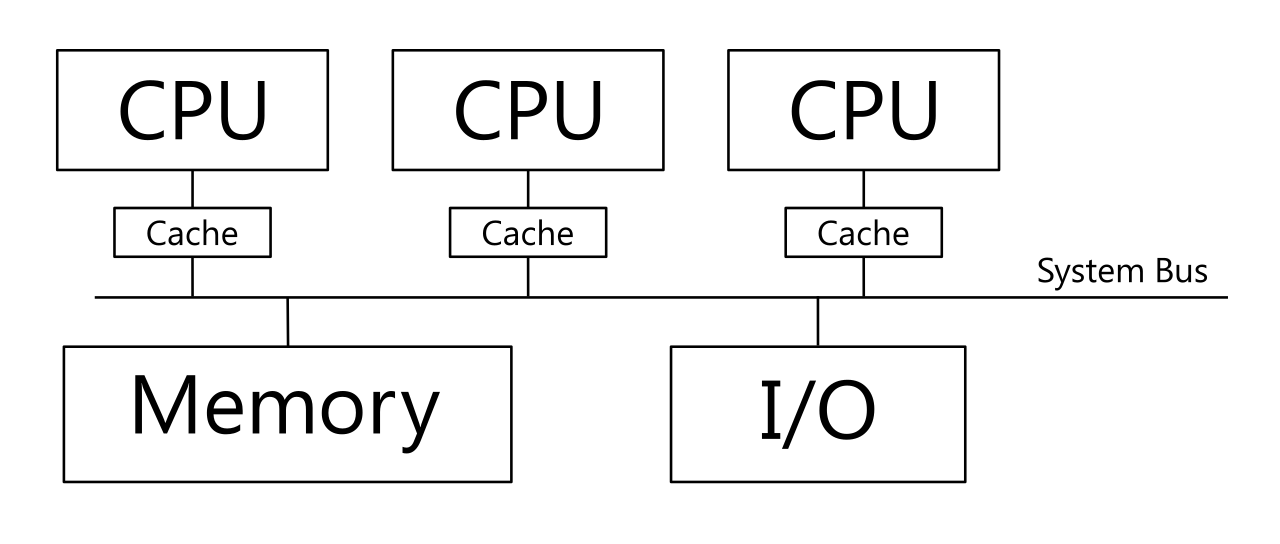
这张图补上了 §2.3 那张分工表缺的一角:缓存层次的共享结构,正是"同一个地址的读写会被所有核以同一顺序看到"(缓存一致性)得以成立的物理前提;而 §五 那个 2.6% 的重排,发生在不同地址之间——这一层不在图里。
8.2 竞争下的读数
说白了,竞争读数里最容易被误读的是线程越多越慢这个印象。慢下来的原因不是线程本身,而是它们争抢同一个缓存行时产生的来回协商;把变量拆开,或者让每个线程先在自己的副本上累加,读数会回到单线程那一档附近。下一节的对照表把这件事量化。
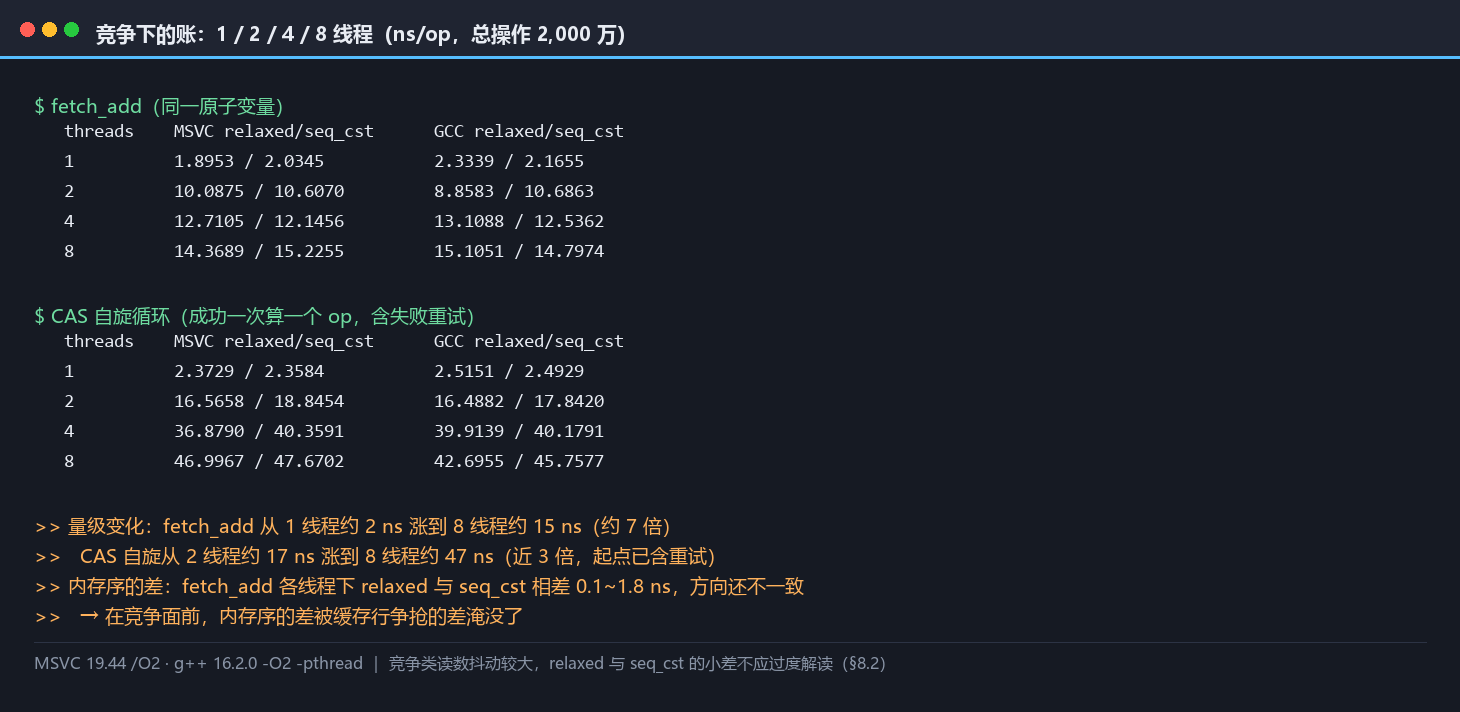
总操作数 2,000 万,线程数从 1 到 8,单位 ns/op:
| 操作 | 线程 | MSVC relaxed / seq_cst | GCC relaxed / seq_cst |
|---|---|---|---|
fetch_add |
1 | 1.8953 / 2.0345 | 2.3339 / 2.1655 |
fetch_add |
2 | 10.0875 / 10.6070 | 8.8583 / 10.6863 |
fetch_add |
8 | 14.3689 / 15.2255 | 15.1051 / 14.7974 |
| CAS 自旋 | 2 | 16.5658 / 18.8454 | 16.4882 / 17.8420 |
| CAS 自旋 | 4 | 36.8790 / 40.3591 | 39.9139 / 40.1791 |
| CAS 自旋 | 8 | 46.9967 / 47.6702 | 42.6955 / 45.7577 |
这张表最值得看的是量级变化:
fetch_add从 1 线程的约 2 ns,涨到 8 线程的约 15 ns——7 倍;- CAS 自旋从 2 线程的约 17 ns,涨到 8 线程的约 47 ns——近 3 倍(且 CAS 自旋本身就含失败重试,起点就高)。
而内存序带来的差:fetch_add 各线程数下 relaxed 与 seq_cst 相差 0.1 至 1.8 ns,方向还不一致;CAS 自旋相差 1 至 2 ns,方向同样不一致。
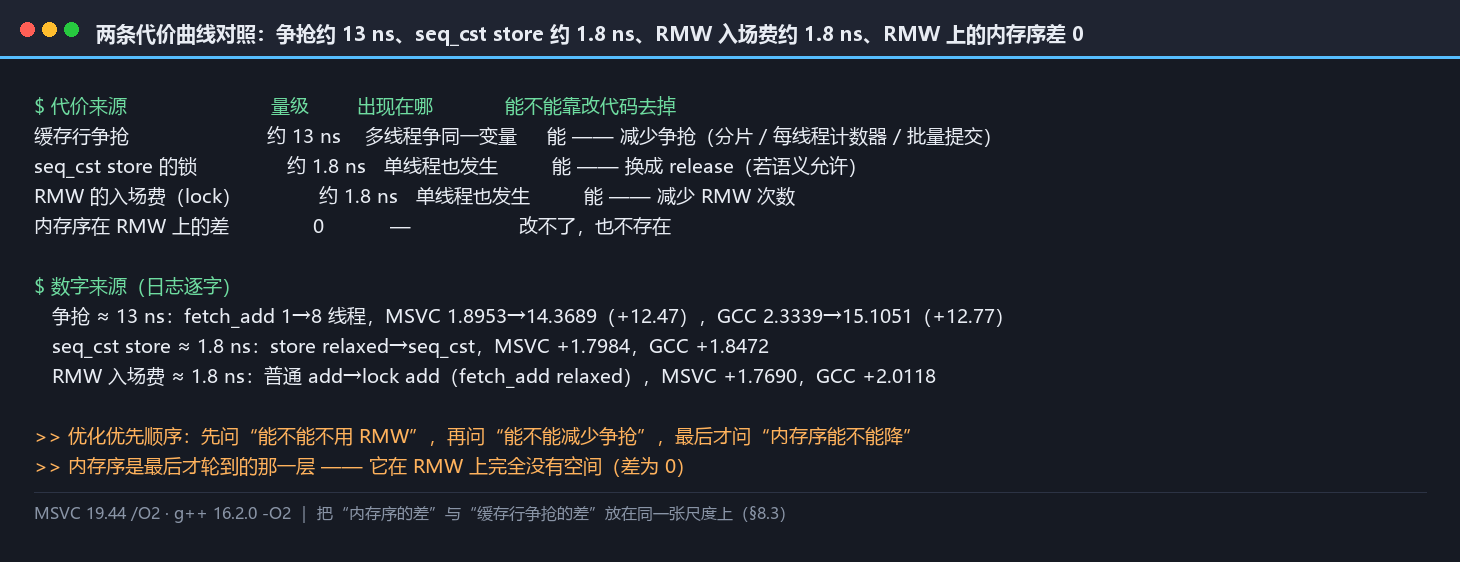
⇒ 一句话结论:在竞争面前,内存序的差被缓存行争抢的差淹没了。 fetch_add 单线程时两类内存序都是 2 ns,8 线程时都变成 15 ns;而这 13 ns 的增量与内存序无关。
8.3 两条代价曲线的对照
OK,把两条"代价"放在同一张尺度上:
| 来源 | 量级 | 出现在哪 | 能不能靠改代码去掉 |
|---|---|---|---|
| 缓存行争抢 | 约 13 ns(fetch_add,1→8 线程) |
多线程争同一变量 | 能——减少争抢(分片、每线程计数器、批量提交) |
seq_cst store 的锁 |
约 1.8 ns | 单线程也发生 | 能——换成 release(若语义允许) |
RMW 的入场费(lock) |
约 1.8 ns | 单线程也发生 | 能——减少 RMW 次数 |
| 内存序在 RMW 上的差 | 0 | — | 改不了,也不存在 |
这张表给出了优化的优先顺序:
- 先问"能不能不用 RMW"。
fetch_add比store(seq_cst)还贵(§4.2),所以把热点计数器改成"每线程本地累加、定期汇总"通常收益最大。 - 再问"能不能减少争抢"。8 线程争一个变量比 1 线程贵 7 倍,这是最大的一笔。
- 最后才问"内存序能不能降"。它只在
seq_cst的 store 上有约 1.8 ns,且在 RMW 上完全没有空间。
这与 ep08 那条结论同族:先看"是不是在热路径上",再看"能不能换个结构",最后才谈开关。内存序是最后才轮到的那一层。
8.4 布局:atomic<T> 有没有额外开销
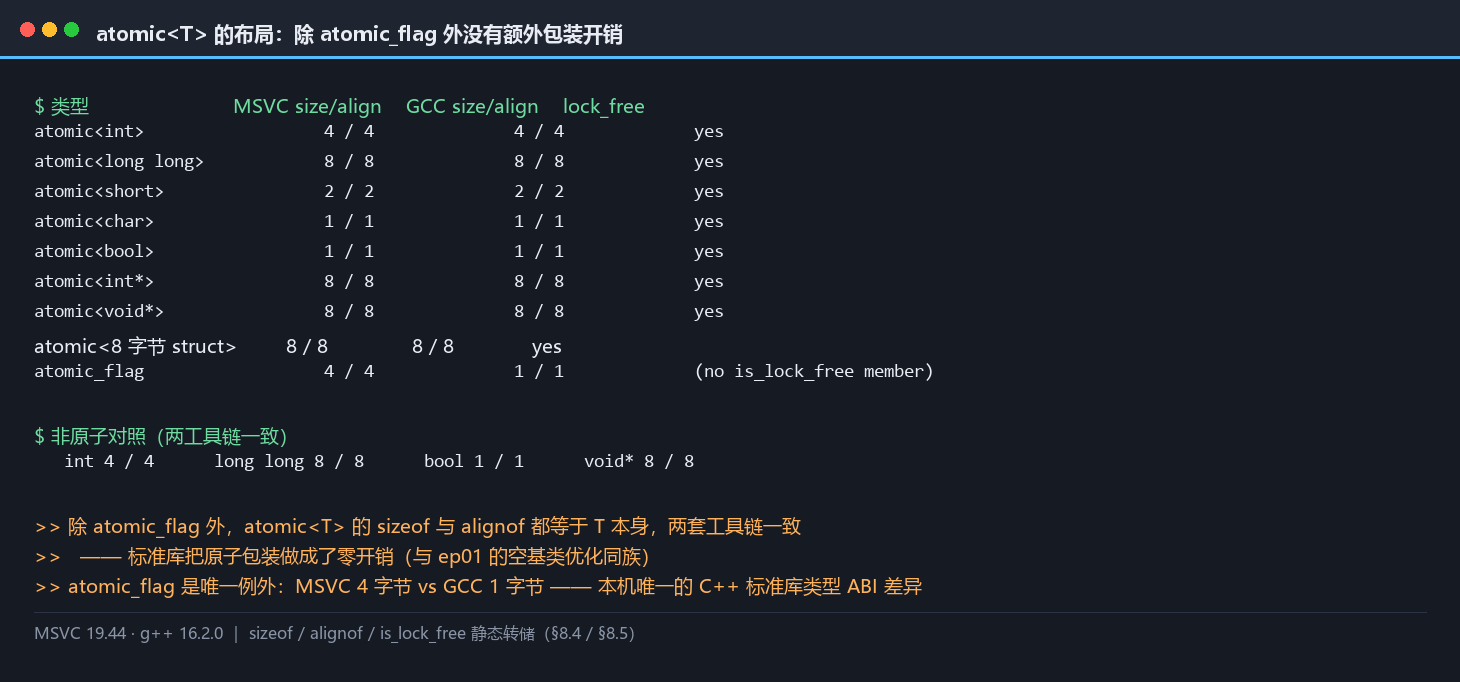
好了,按 ep01 的口径,把大小与对齐也量一遍:
| 类型 | MSVC sizeof / alignof | GCC sizeof / alignof | lock_free |
|---|---|---|---|
atomic<int> |
4 / 4 | 4 / 4 | 是 |
atomic<long long> |
8 / 8 | 8 / 8 | 是 |
atomic<short> |
2 / 2 | 2 / 2 | 是 |
atomic<char> |
1 / 1 | 1 / 1 | 是 |
atomic<bool> |
1 / 1 | 1 / 1 | 是 |
atomic<int*> / atomic<void*> |
8 / 8 | 8 / 8 | 是 |
atomic_flag |
4 / 4 | 1 / 1 | — |
结论:除 atomic_flag 外,atomic<T> 没有任何额外包装开销——sizeof 与 alignof 都等于 T 本身,两套工具链一致。这与 ep01 讲过的"空基类优化"是同一件事的两面:标准库把原子包装做成了零开销。
而 atomic_flag 是一个例外:MSVC 是 4 字节,GCC 是 1 字节。 这是本机实测里唯一一处 C++ 标准库类型的 ABI 差异。实践含义:atomic_flag 不要跨编译器边界的二进制接口使用;同一个结构体里混放 atomic_flag 与其它字段时,两套工具链编出的布局会不同。
8.5 atomic_flag 与 is_lock_free
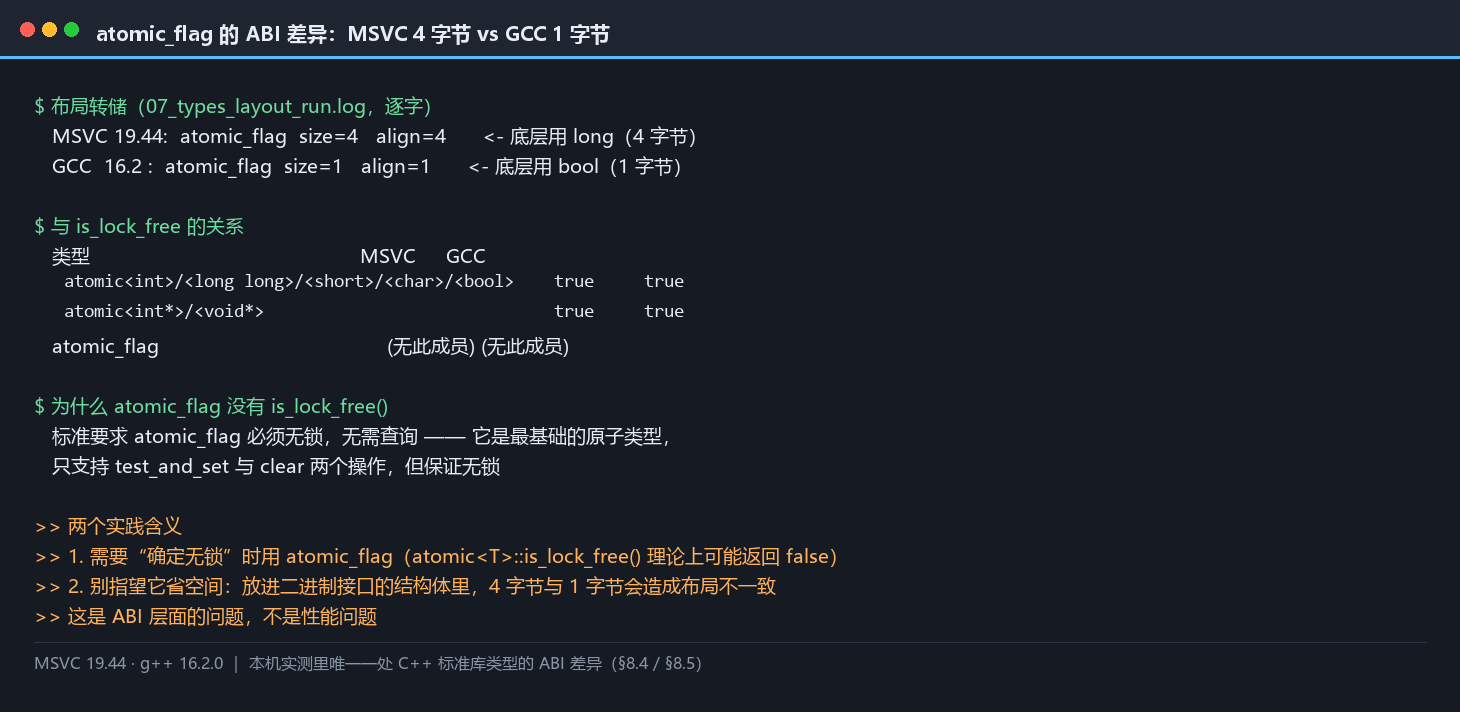
§8.4 那张布局表里,atomic_flag 是唯一的例外(MSVC 4 字节 / GCC 1 字节)。值得单独看一下它与 is_lock_free 的关系。
标准给了 is_lock_free() 成员,用来查询"这个原子类型在这个平台上是不是真原子的"(不借助锁)。本机实测:
| 类型 | MSVC | GCC |
|---|---|---|
atomic<int> / <long long> / <short> / <char> / <bool> |
true |
true |
atomic<int*> / <void*> |
true |
true |
atomic_flag |
(无此成员) | (无此成员) |
注意最后一行的括号:atomic_flag 没有 is_lock_free() 成员——因为标准要求它必须是无锁的,无需查询。这也解释了它的语义定位:它是最基础的原子类型,只支持两个操作(test_and_set 与 clear),但保证无锁。
两个实践含义:
- 需要"确定无锁"时用
atomic_flag。atomic<T>的is_lock_free()理论上可能返回false(某些平台上大类型的原子操作要靠内部锁实现),而atomic_flag不可能。 - 但别指望它省空间:MSVC 上它是 4 字节、GCC 上 1 字节。要放进二进制接口的结构体里时,这个差异会造成布局不一致——这是 ABI 层面的问题,不是性能问题。
顺带一条与 ep01 的连接:atomic<T> 在没有额外开销这件事上,与本系列 ep01 讲过的"空基类优化"是同一类做法的两面——标准库把包装做到零开销,代价是全靠编译器的类型系统而不是运行期结构。
九、选型判据与工程建议
言归正传,判据的顺序本身就是结论的一部分:只有前一条不构成瓶颈,后面的权衡才有意义。把它们倒过来问,先去挑内存序,再回头看这个变量是否真的被多线程访问,通常会得出一组互相矛盾的答案,也会让本来免费的那部分被当成瓶颈去优化。
前面八章都在量代价,这一章把它们收成一组可以直接在代码评审里用的判据。
判据按顺序问,不按重要性排——因为前一条的答案会决定后一条要不要问。
9.1 六条判据,按顺序问
判据一(要不要原子):这个变量真的会被多个线程同时访问吗?
- 不会 → 别用
atomic。普通变量更快,而且不需要任何内存序推理; - 会,但只在锁保护下 → 也用普通变量。锁已经提供了同步,锁内的原子操作是多余的一层。
判据二(要不要 RMW):能不能不用 fetch_add / CAS?
- 能(比如每线程本地计数器 + 定期汇总)→ 这是收益最大的一步(§8.3);
- 不能 → 接受约 2 ns 的入场费,并且不要在内存序上找收益(RMW 五档同价)。
判据三(哪一类操作):这个原子变量的热点操作是 load、store 还是 RMW?
load→ 三档随便挑,指令与时间都一样(§3.3);按语义需要写,不用为性能纠结;store→ 这是唯一有代价的一档:relaxed/release约 0.4 ns,seq_cst约 2.2 ns(§4.2);- RMW → 五档同价(§3.5)。
判据四(要不要全序):需要"多个线程对多个原子操作的先后有一致看法"吗?
- 不需要 →
release/acquire配对就够(发布-订阅的标准写法); - 需要 →
seq_cst。而且代价只出现在 store 上,load 与 RMW 上写seq_cst不多花东西; - 注意标准的限制(§1.3):
seq_cst的顺序一致承诺只在全程都用seq_cst时成立。混用弱序会让这个承诺失效——这是无锁代码最容易出错的地方。
判据五(要不要 fence):屏障的位置与原子操作的位置重合吗?
- 重合 → 不要额外写 fence,两者在 x86 上落到同一批指令(§6.2);
- 不重合(需要在原子操作之外的位置插屏障)→ 用
atomic_thread_fence; - 只在信号处理器、内存映射 I/O 这类场景 → 才考虑
volatile(§7.4)。
判据六(怎么验证):写完怎么知道对不对?
- 不能靠"跑了很多次没出问题"。§5.2 那个 2.6% 的重排命中率说明:relaxed 下的错误大约每 35 次出现一次,但只在特定交错下出现——"跑了三年"完全可能是运气;
- 本机无 TSan(§0.3),所以本篇给的是一份手工核对清单(§9.3),不是自动检测方案。
9.2 常见误用清单
说白了,把本篇实测能直接支持的五条误用列出来,按代价的来源归类,每条配一句"该怎么做":
| 误用 | 为什么是误用 | 该怎么做 |
|---|---|---|
用 volatile 做线程同步 |
实测它不生成任何屏障指令(§7.1),不保证原子性、不建立 happens-before | 用 std::atomic |
在 fetch_add 上把 seq_cst 改成 relaxed 求性能 |
RMW 五档生成的指令逐字节相同(§3.5),时间也相同(§4.2) | 按语义需求写,别指望省时间;要省就减少 RMW 次数 |
以为"用了 seq_cst 就顺序一致" |
标准明确:只有全程都用 seq_cst 才保证(§1.3) |
混用弱序时要逐个同步点验证 happens-before |
在 store 上无脑用默认的 seq_cst |
这是唯一有代价的一档,实测约 5 至 8 倍(§4.2) | 确认后续可见性需求;只用 release 语义时写 release |
| 把"x86 上 barrier 都是空操作"当通例 | acquire/release fence 确实是空操作,但 seq_cst fence 是一条带锁指令(§6.1) |
按操作类型分别判断,不要一句话概括 |
9.3 手工核对清单(无 TSan 时的替代)
判据六提到本机没有 TSan。下面这份清单是按本篇读数整理的手工核对步骤,用它可以查出一类最常见的错误:
- 列出所有共享变量,逐个标注:普通变量 /
atomic/ 锁保护。 - 给每个共享变量画出读写它的线程(哪几个线程写、哪几个线程读)。
- 对每个"一个线程写、另一个线程读"的变量,找出它们之间的同步点(哪个 release 配哪个 acquire,或哪把锁)。
- 检查是不是"两个原子变量互相等待"的形态(SB 结构)——是的话,§5.2 的 2.6% 就在你头上。
- 检查有没有"用
volatile当同步"——有就改掉。 - 检查
relaxed的用法:每次都问"这条relaxed需要和谁建立 happening-before 吗",需要就换成 release/acquire。 - 最后看反汇编:把你以为"应该带屏障"的位置编译一遍,看指令里有没有
lock或xchg。这是本机唯一可用的自动检查——它不能证明对,但能证明"这里根本没同步"。
十、收束与下一篇钩子
10.1 全篇读数汇总
OK,把本篇测出的全部读数集中在一张表里,便于对照与复核。每一档的原始日志都随篇留档在 evidence/ 下,表里任何一个数字都可以逐字回溯到某一行的日志。
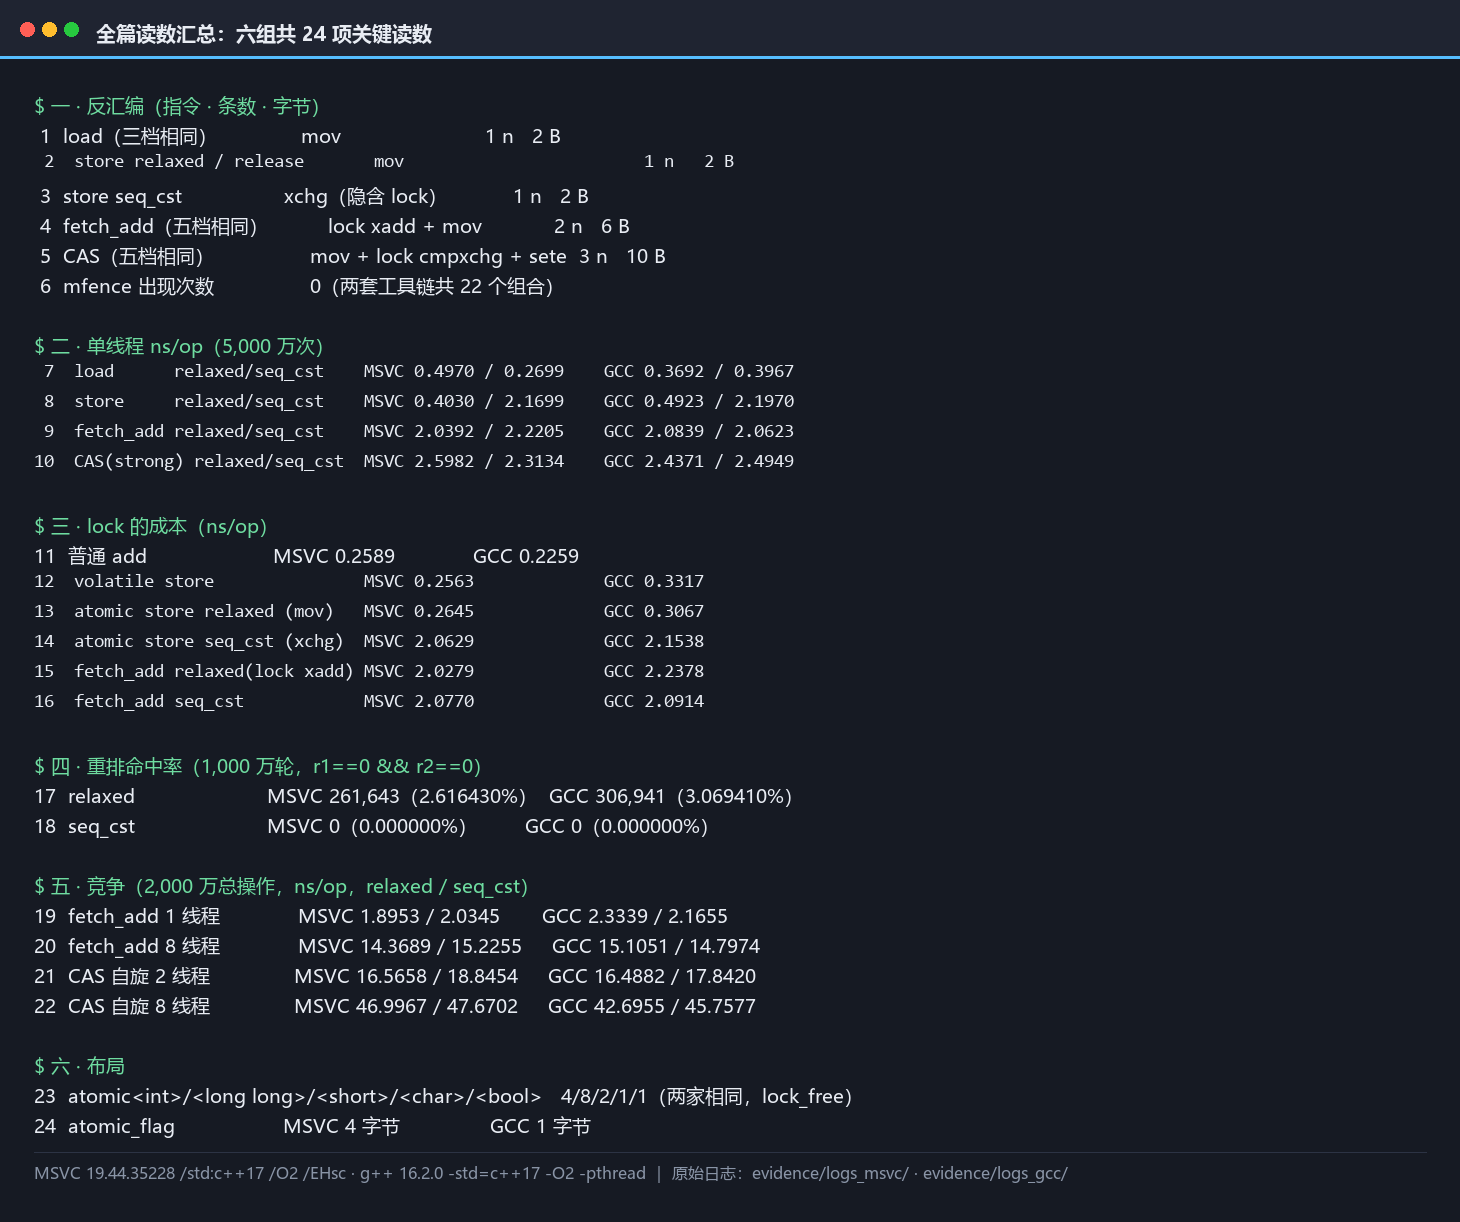
反汇编(指令 · 条数 · 字节)
load(三档相同)              mov                        1  2
store relaxed / release       mov                        1  2
store seq_cst                 xchg(隐含 lock)           1  2
fetch_add(五档相同)          lock xadd + mov            2  6
CAS(五档相同)                mov + lock cmpxchg + sete  3  10
mfence 出现次数                0(两套工具链共 22 个组合)

单线程 ns/op(5,000 万次)
                            MSVC            GCC
load relaxed / seq_cst      0.4970 / 0.2699  0.3692 / 0.3967
store relaxed / seq_cst     0.4030 / 2.1699  0.4923 / 2.1970
fetch_add relaxed / seq_cst 2.0392 / 2.2205  2.0839 / 2.0623
CAS relaxed / seq_cst       2.5982 / 2.3134  2.4371 / 2.4949

lock 的成本(ns/op)
普通 add                    0.2589          0.2259
atomic store relaxed        0.2645          0.3067
atomic store seq_cst        2.0629          2.1538
fetch_add relaxed           2.0279          2.2378

重排命中率(1,000 万轮,r1==0 && r2==0)
relaxed                     261,643(2.616430%)  306,941(3.069410%)
seq_cst                     0                    0

竞争(2,000 万总操作,ns/op)
fetch_add 1 / 8 线程        1.90→14.37       2.33→15.11
CAS 自旋 2 / 8 线程         16.57→47.00      16.49→42.70

布局
atomic<int>/<long long>/<short>/<char>/<bool>  4/8/2/1/1(两家相同)
atomic_flag                 MSVC 4 B         GCC 1 B
10.2 两套工具链的证据形态
本篇的结论敢把两套工具链并列,靠的是每一处判断都有不依赖时间的证据兜底。
| 证据形态 | MSVC 侧 | GCC 侧 |
|---|---|---|
| 反汇编转储 | dumpbin /disasm(另用 /FAcs 取机器码字节) |
objdump -d -M intel |
| 指令与字节计数 | 从 .asm 的机器码列统计 |
从 objdump 编码列统计(均可剔除 nop 与 ret) |
| 计时 | 进程内 steady_clock,多轮 |
同左 |
| 重排统计 | 两线程 store-buffering,计数命中 | 同左 |
| 布局转储 | sizeof / alignof 静态断言 |
同左 |
10.3 复现流程
好了,复现这一篇不需要任何私有环境:两条工具链(MSVC 19.44 与 g++ 16.2,都要 C++17)、一组"操作 × 内存序"的独立函数、以及 dumpbin / objdump。全部原始日志与反汇编转储随篇留档于 evidence/。
三个提醒:GCC 侧必须显式加 -pthread(ucrt64 用 winpthreads);计数时必须剔除对齐填充的 nop 与函数尾 ret;重排统计每轮要重建线程,复用线程会把测量本身变成一次同步。
10.4 自检清单
- [ ] 确认这个变量真的被多个线程访问(不是就别用
atomic) - [ ] 确认能不能不用 RMW(本地累加 + 定期汇总,收益最大)
- [ ] 确认热点操作是 load / store / RMW 里的哪一类
- [ ]
store上没有无脑用默认的seq_cst(这是唯一有代价的一档) - [ ]
fetch_add/ CAS 上没有为了性能改内存序(五档同价) - [ ] 检查有没有"两个原子变量互相等待"的形态(SB 结构)
- [ ] 混用弱序时逐个同步点验证 happens-before(全序承诺会失效)
- [ ] 没有用
volatile做线程同步 - [ ] 需要屏障的位置先确认它是一个原子操作(重合就不要写 fence)
- [ ] 编译后看反汇编确认有
lock或xchg(这是本机唯一可用的自动检查) - [ ] 全部原始输出留档(否则前面十条都只是"相信")
10.5 与系列其他篇目的交叉点
言归正传,这篇不是孤立的,它与系列里四篇有直接接口:
- 与 ep01《对象布局、对齐与 padding》:§8.4 那张布局表接着 ep01 的话题——除
atomic_flag外没有额外开销,说明标准库把原子包装做成了零开销;而atomic_flag的 ABI 差异属于 ep01 讲的对齐与填充问题。 - 与 ep05《优化器的边界》:§7.2 观察编译器重排与 ep05 的 UB 边界同族。编译器屏障(
asm volatile("" ::: "memory")一类)与硬件屏障是两件事——前者是给编译器的,后者是给 CPU 的,volatile只做前者。 - 与 ep09《异常与 RTTI》:两篇合起来是"语言机制留下的痕迹"三笔账。ep09 量的是"语言替你留了什么",本篇量的是"语言向你承诺了什么、机器实际给了什么"。两篇里都出现了"默认值是安全的那一个、也是贵的那一个"(
noexcept的默认、seq_cst的默认)。 - 与 ep08《分发的代价》:ep08 §6.5 量过
typeid比较 0.76 ns。本篇的load(relaxed)是 0.37 至 0.50 ns——同量级。这说明"一次原子读"并不比"一次类型比较"贵,贵的是 RMW 与带锁的 store。
10.6 一条可以搬走的方法
说白了,把本篇的做法抽象成三步:
- 先把一个单词的答案拆成可分类的问题。 「seq_cst 免费吗」拆成 load / store / RMW 三类;不拆开,就只能得到一个适用于三分之一情况的答案。
- 把"可能"变成"频率"。 StoreLoad 重排"可能发生"是共识,但只有 2.6% 这个数字能支持判断;统计式实证的成本很低(千万轮几秒钟),收益是让读者可以做决定。
- 读指令时要问"这条指令做了什么",不只是"有几条"。 本篇 §3.5 那处最典型:
seq_cststore 与relaxedstore 字节数相同、条数相同,代价却差 5 倍——只看长度会得出"没差别"的错误结论。
这三步与 ep07、ep08、ep09 的方法论是同一条。这一篇多了两种结构证据:指令的编码与语义对照,以及统计式实证的命中率。
10.7 参考资料(含源码与证据)
- 标准与官方文档:C++ working draft([intro.races]、[atomics.order])|cppreference 内存序|Intel SDM Vol 3A|GCC
__atomic内建|MSVC/volatile开关|LLVM AtomicOrdering - 形式化与体系结构:x86-TSO(Sewell 等,CACM)|Arm 内存一致性|Arm Load-Acquire/Store-Release|Linux memory-barriers.txt|Arm Synchronization Overview
- 中文对照:C++ 原子序与 x86-TSO|内存序长文|内存序与屏障|volatile 与内存序|原子指令含屏障|无锁队列与 x86-TSO 反汇编
- 外部示意图:多核处理器(AMD Threadripper)(CC BY-SA 2.0,Bill Abbott)|load/store 队列(CC0)|SMP 多处理器(CC0)
- 本篇证据:全档位源文件 + 两套工具链的原始日志、反汇编转储、读数与重排统计,见本篇目录
evidence/


10.8 下一篇:缓存与布局
这一篇算完了语言与机器之间那份契约的第三笔账。第三波到此收官。
下一篇原本属于第四波,也是全系列里证据通道最难的一篇:缓存与布局——AoS/SoA、伪共享与 cache line 的账。
难在哪里,本篇其实已经把话说了一半:§0.3 声明了本机无 perf、无 VTune,所以给不出 cache-miss 事件计数;§8.3 那张表里"缓存行争抢约 13 ns"是从端到端时间间接观察到的,不是从 PMU 计数器读出来的。下一篇要讲伪共享,而伪共享的教科书证据恰恰是 perf c2c 的 HITM 计数——本机拿不到。
所以下一篇的边界会比这一篇更硬:能测的是内存布局对时间的影响(AoS 与 SoA 的对照、填充对齐前后的对照),测不了的是产生这个影响的那次 cache miss。这两件事必须分开说清楚,否则又是一篇"引用别人的 PMU 数字"的文章。
以上。希望能对大家有所帮助。下一篇见。