本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
图 1 编译期账本总览——实例化机制/前端时间/二进制体积/跨编译器差异/构建层优化五层脉络 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
本篇是第二波「编译器与链接器」的开篇。 第一波讲的是"编译器给你的对象和值做了什么",第二波换一个方向——讲"编译器自己花了多少时间"。
目录总览:本篇共十一章。零章划边界,一至四章拆实例化机制与代价,五章讲 MSVC 侧观测工具链,六章给一个跨编译器的实测差异,七至九章讲三类优化手段(约束方式/模块/构建系统),十章收束。
背景与边界
0.1 从"值语义的账"到"编译期的账"
ep01 算的是对象布局的账——sizeof 里每一字节从哪来。ep02 算的是内存分配的账——malloc 背后是谁在管。ep03 算的是值语义的账——move、拷贝、SSO、emplace_back 各要多少钱。
这三篇有一个共同点:账都记在运行时。程序跑起来,你才能用探针数出构造了几次、分配了几次、拷贝了几字节。
从 ep04 开始换账本。这一篇算的是编译期的账——你的代码从 .cpp 变成 .obj,编译器自己花了多少时间、花在了哪一步、哪些写法让这笔账变大。
这笔账之所以值得单独算,是因为它有个要命的性质:它不显示在任何运行时指标里,却实实在在拖慢你的每一次构建。 一个"运行时零开销"的模板抽象,可能在编译期让你多等 30 秒——而且是每天、每次改代码都多等。
0.2 本篇的边界(四条不写)
- 不逐模块讲任何具体库:Godot 引擎架构归 T02《Godot 4 引擎架构》,Jolt 物理归 T06《Jolt Physics 3D》。本系列只讲语言与工具链那一层——同一段 C++,那两卷讲"它实现的机制",本系列讲"编译器与链接器对它做了什么"。
- 不做 C++ 入门教学:不写模板语法教程、不写 SFINAE 教程。中文侧同题竞争激烈(cppreference 中文、CSDN/知乎/掘金),没有差异度。
- 不做"面试题/最佳实践清单":无一手证据的泛泛总结违反站规。
- 不碰图形算法与 GPU 硬件:本系列的工具是编译器与链接器,不是抓帧器。
0.3 工具链声明(先说清楚什么能用、什么不能用)
这一篇的题眼里带着 -ftime-trace,但我必须先声明一件事:本机没有 Clang,-ftime-trace 用不了。
-ftime-trace 是 Clang 独有的编译时间追踪特性,它生成 JSON 格式的时间线,可以在 chrome://tracing 或 Perfetto 里看(见 Clang 官方文档)。本机装的是 Visual Studio 2022 Community 17.14.35,自带的 LLVM 只有 clang-format 和 clang-tidy,没有 clang 编译器本身。
g++ 也不行。 实测:
$ g++ --version
g++.exe (Rev3, Built by MSYS2 project) 16.2.0
$ g++ -ftime-trace -o test.exe test.cpp
g++.exe: error: unrecognized command-line option '-ftime-trace'
GCC 至今没有实现 -ftime-trace。所以本篇的编译时间证据全部来自 MSVC 侧的替代三件套:
| 工具 | 版本 | 用途 | 本机状态 |
|---|---|---|---|
cl /Bt+ |
MSVC 19.44.35228 | 编译各阶段(前端 c1xx.dll/后端 c2.dll/链接器)时间 | ✅ 实测可用 |
vcperf |
14.44.35207 | 采集 C++ 构建的 ETW 追踪,用 WPA 查看 | ⚠️ 存在,但采集需管理员权限(本机受拒) |
MSBuild /bl |
MSBuild 17.14.40 | 生成结构化二进制日志(binlog) | ✅ 实测可用 |
/d2cgsummary |
MSVC 19.44 | 后端函数级代码生成明细 | ✅ 实测可用 |
dumpbin |
14.44.35228.0 | 段尺寸、符号表(数实例化) | ✅ 实测可用 |
g++ |
16.2.0 (MSYS2 ucrt64) | 第二条工具链,用于跨编译器对照 | ✅ 可用(但无 -ftime-trace) |
本篇所有时间读数均为本机实测,标注 cl /Bt+、/O2、5 轮取中位数。不同机器、不同版本会有差异,你的环境请自己量——本文给的是方法与口径,不是绝对基准。
这一条边界很重要:如果你在找"
-ftime-trace怎么用",本篇给不了本机示范,只能引官方文档(Clang 文档)。但如果你在 MSVC 上想知道"编译时间花在哪",本篇的cl /Bt+路线是完整可跑的。
0.4 本篇的四个反直觉发现(先给结论)
这一篇的写法跟前面几篇一样:每个结论都要有本机实测撑着。 下面是四个"跟流行说法不太一样"的发现,先摆在这里,后面逐条给证据:
- 模板实例化是"惰性"的——编译器不为你写的模板付费,只为你用到的成员付费。 同一份 100 成员模板,只用 2 个成员生成的
.obj是 2,913 字节(3 个符号),用全部 100 个是 65,361 字节(101 个符号)——差 22 倍。 extern template不是万能药——实测在 MSVC 19.44 上没生效,在 GCC 16.2 上生效。 这个结论直接推翻了我原本打算写的"省 10 倍"教程。- "新机制更快"是错觉——实测
if constexpr比 concepts 更快。 200 类型下if constexpr比 SFINAE 快约 24%,concepts 快约 16%——if constexpr仍领先 concepts 约 9%。 - Unity Build 是双刃剑——全量构建快 9.7 倍,但增量构建反而变慢。 改一个文件就要重编整个超级 TU。
这四条的共同点是:它们都不是靠"读文档"能得到的,必须动手量。 这正是本系列的方法论——机制靠原文,代价靠自跑。如果你只想要结论,上面四条就够了;如果你想知道这些数字是怎么量出来的、以及怎么在自己工程里复现,往下看。
一、一句话点题:模板实例化是编译时间的隐形成本
先把这一篇的核心结论放在最前面:
模板实例化(template instantiation)是 C++ 编译时间的主要驱动因素之一,而它的成本结构是"惰性"的——不看你写了多少模板代码,只看你实际触发了多少实例化。
这句话里有两个反直觉点。
第一,成本不看"代码量",看"实例化量"。你可以在头文件里写一个 500 行的模板,只要没人用它的成员函数,编译器几乎不花时间——因为隐式实例化是按需、按成员触发的。反过来,一个 20 行的模板,如果被 200 种类型各用一遍、每种用了全部成员,它能吃掉几秒钟。
第二,"模板实例化很贵"这个说法,只在特定条件下成立。本机实测(cl /Bt+,/O2):
| 程序 | 前端时间 c1xx.dll | 后端时间 c2.dll | 总墙钟 |
|---|---|---|---|
空程序 int main(){} |
0.0142 s | 0.0078 s | 0.0814 s |
| 带头文件与容器模板的程序 | 0.7755 s | 0.3864 s | 1.2245 s |
同样一个 main,只因为 #include 了 <vector>/<string>/<map>/<algorithm> 并实际用了几次,前端时间涨了约 55 倍(0.0142 → 0.7755)。而后端时间也涨了约 50 倍。
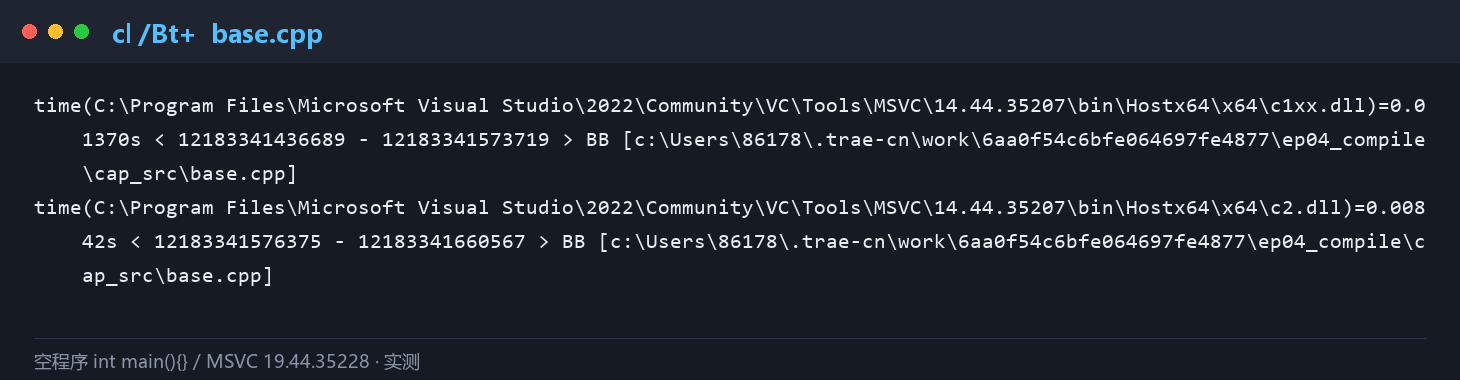
int main(){} 的 cl /Bt+ 输出——前端 c1xx 仅 14.2 ms@ MSVC 19.44 实测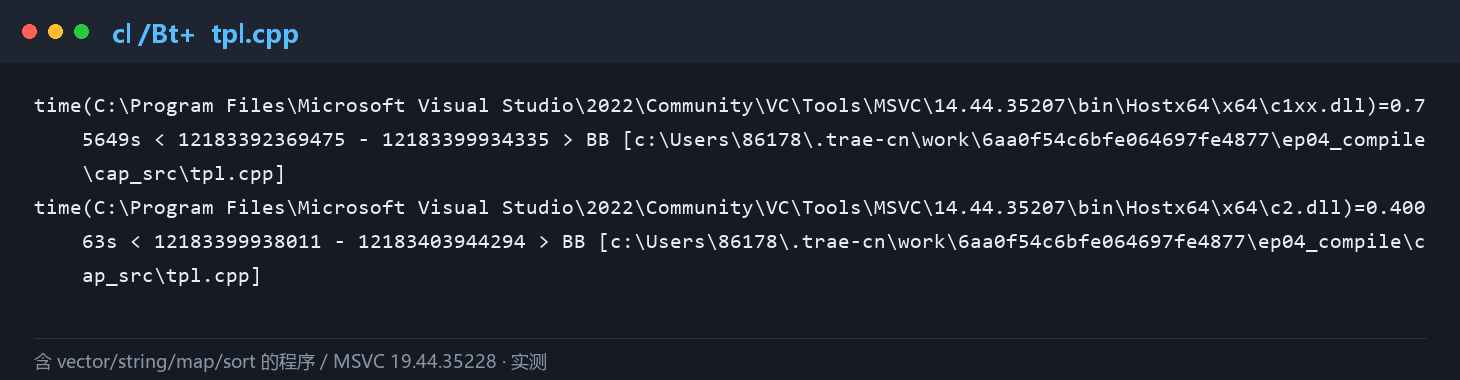
cl /Bt+ 输出——前端 c1xx 涨到 776 ms@ MSVC 19.44 实测这就是编译期账本的第一笔:涨的是"前端",不是"后端"。 前端(c1xx.dll)负责预处理、词法/语法/语义分析、模板实例化;后端(c2.dll)负责优化与代码生成。模板实例化发生在前端——所以当你的编译时间失控时,先看前端时间;如果 c1xx 比 c2 大一个数量级,八成是模板撑的。
1.1 为什么这笔账值得单独算
编译期成本最阴的地方在于它的复利效应:
- 本地开发循环:改一行代码 → 增量编译 → 跑测试。如果增量编译从 2 秒涨到 20 秒,一次调试要迭代 20 次,就是 6 分钟的额外等待。一天下来是小时级。
- CI 流水线:全量构建从 8 分钟涨到 40 分钟,等于每天少跑好几轮合并验证。团队越大,这笔账越贵。
- 它不会自己变好:模板相关的编译时间增长,通常是"每加一个类型/每多一个参数组合就多一份实例"的累积过程。没人会在加第 200 个类型时立刻察觉——直到某天构建崩了。
而且这笔账有个反直觉的特点:它跟"代码质量"没有正相关。 写得最抽象、最"现代"、模板用得最花的那部分代码,往往正是编译时间的大头。本篇要做的就是把这些"看不见的开销"变成可测、可复现、可定位的数字。
机制类引用:隐式实例化的触发条件写在标准 [temp.inst](https://timsong-cpp.github.io/cppwp/temp.inst)里,部分特化的选择规则写在 [temp.spec.partial](https://eel.is/c++draft/temp.spec.partial)。本篇不逐条抄标准,只在需要时给稳定标签的链接。
二、模板实例化机制:隐式、显式与"按成员惰性"
先来看看这套机制到底是怎么运转的——要把账算清楚,先得知道实例化在哪触发、按什么粒度触发、什么时候不触发。
2.1 隐式实例化(implicit instantiation):用到才生成
C++ 标准在 [temp.inst](https://timsong-cpp.github.io/cppwp/temp.inst)里规定了隐式实例化的触发条件:当某个模板特化的完整定义被需要时。比如你声明了一个 std::vector<int> 变量,编译器需要它的完整定义才知道对象多大;你调用了它的 push_back,编译器需要生成那个函数的实例才能生成调用代码。
关键细节,也是很多人不知道的一条:隐式实例化是"按成员"(per-member)的,不是"整个类一次性生成"。你用了 vector<int> 的构造函数,但没调用 push_back,那么 push_back 不会被实例化。类模板的成员函数定义只在被用到(odr-used)时才实例化。
这条"惰性"性质是本篇后续很多结论的根。用实测量化它最直观——我写了一个 Big<T> 模板,包含 100 个成员函数 m000()…m099(),然后对比两种用法:
| 用法 | 单个 .obj 体积 |
Big<int> 相关符号数 |
|---|---|---|
只用 2 个成员(m000、m099) |
2,913 字节 | 3 |
| 用全部 100 个成员 | 65,361 字节 | 101 |
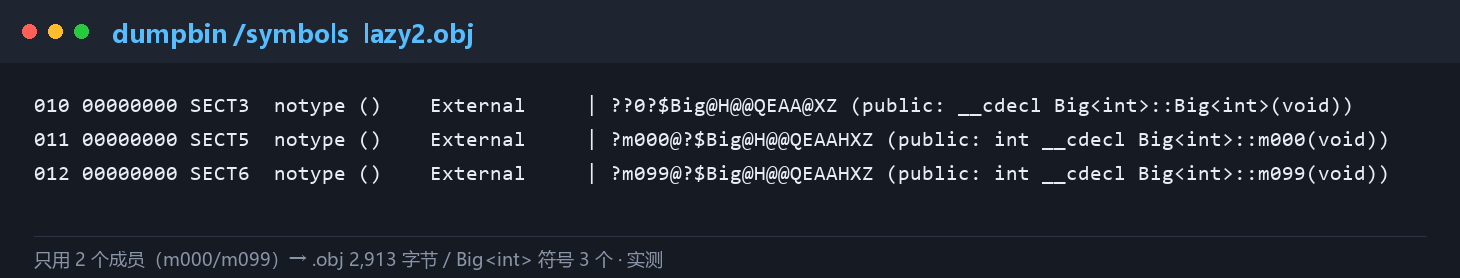
lazy2.obj 的符号表——只有 3 个 Big<int> 符号@ MSVC 19.44 实测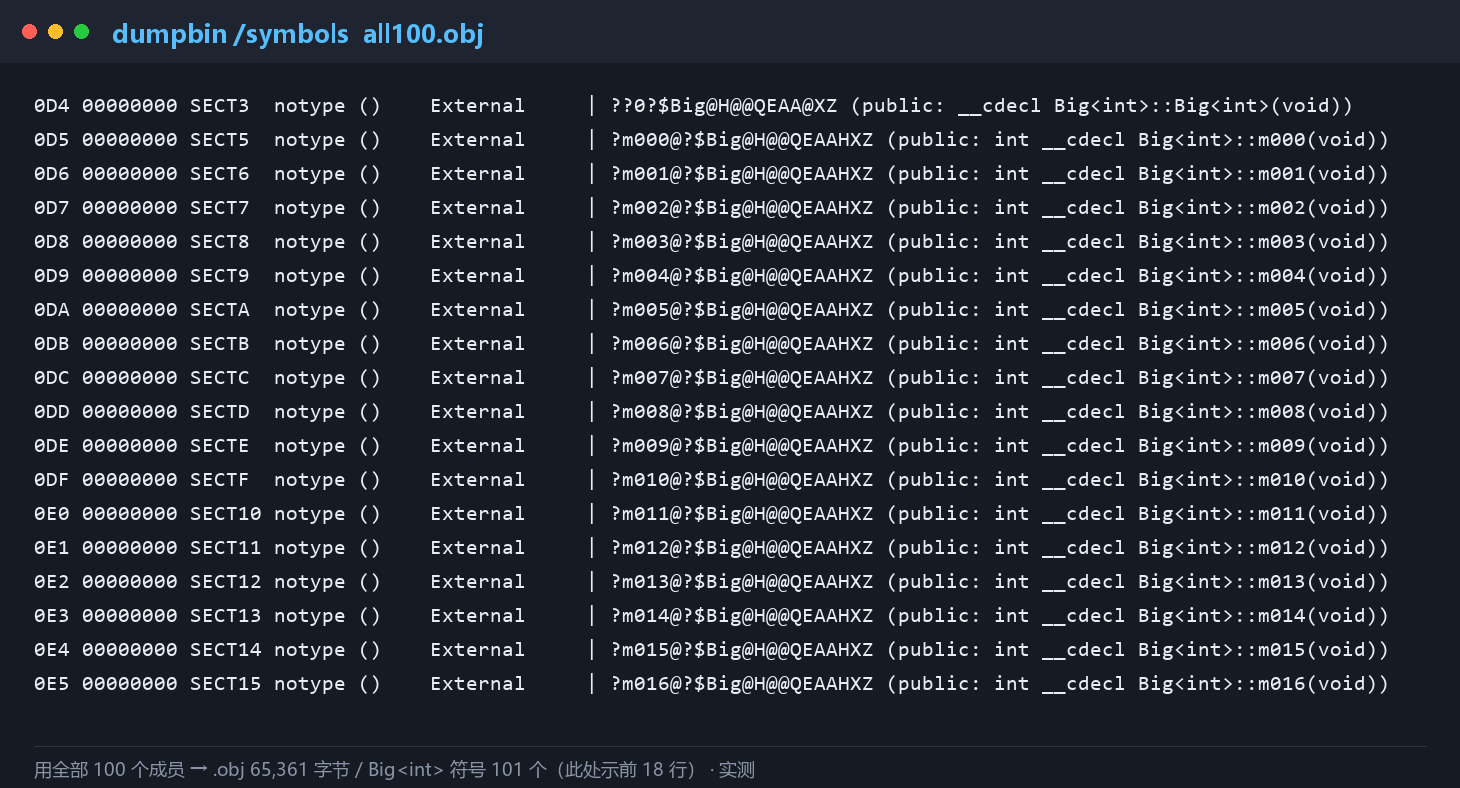
all100.obj 的符号表——101 个 Big<int> 符号@ MSVC 19.44 实测同一份模板定义、同一份头文件,只因为调用面不同,生成的代码量差了 22 倍(2,913 → 65,361 字节)。这是"惰性实例化"最直接的证据:编译器不为你写下的模板付费,只为你用到的成员付费。
2.2 显式实例化(explicit instantiation):强制全量生成
如果你想主动控制实例化时机,用 template 关键字做显式实例化:
// big.h —— 模板定义
template <typename T>
struct Big { /* 100 个成员函数 */ };

// use.cpp —— 显式实例化定义:把这个类的所有成员都生成出来
template struct Big<int>;
这一行 template struct Big<int>; 的含义是:"在这个翻译单元(translation unit, TU)里,把 Big<int> 的所有成员都实例化出来。"注意与隐式实例化的对比——显式实例化是全量的,不看调用面。
实测同一个 Big<int>:
| 实例化方式 | .obj 里的 Big<int> 符号 |
|---|---|
| 隐式(只用 2 个成员) | 3 |
显式实例化定义 template struct Big<int>; |
101 |
.obj 体积对比@ 本系列绘制这条差异有个直接后果:显式实例化既是"加速"手段,也是"增重"手段。它把实例化集中到一个 TU(利好其他 TU),但那个倒霉的 TU 要生成全部成员(自伤)。所以在"每个 TU 只用少量成员"的工程里,显式实例化可能得不偿失。
2.3 部分特化(partial specialization):只改"用哪个定义",不改时机
类模板可以有部分特化。标准在 [temp.spec.partial](https://eel.is/c++draft/temp.spec.partial)里规定了选择规则:多个匹配时按偏序(partial ordering)选最特化的那个;一个都不比其他更特化则程序 ill-formed;都不匹配则用主模板。
template <typename T> struct Trait;            // 主模板
template <typename T> struct Trait<T*>;        // 部分特化:指针
template <typename T> struct Trait<const T*>;  // 部分特化:const 指针

Trait<const int*> t;   // 两个都匹配 → 偏序选出 Trait<const T*>
从编译时间角度看,部分特化不改变实例化的时机和粒度,只改变"实例化时用哪份定义"。特化分支多会略微增加匹配计算,但本机实测里它从来不是瓶颈——真正的成本在"实例化了几份"和"每份多大"。
2.4 模板参数推导(template argument deduction)
推导规则在 [temp.deduct](https://eel.is/c++draft/temp.deduct)。单次推导本身很便宜。贵的是推导的"次数"——当你有一堆重载的函数模板,编译器要逐个尝试推导(overload resolution),这就是前端时间的主要来源之一。
反直觉发现一:编译时间不一定由
#include数量主导。 WG21 提案 P2172R0(https://www.open-std.org/JTC1/sc22/WG21/docs/papers/2020/p2172r0.pdf)指出,C++ 编译时间常由重载解析(overload resolution)驱动,而不是单纯的"解析了多少头文件"。一个巨大的模板重载集合会显著拉长前端时间——哪怕你只#include了一个头。
2.5 两阶段名字查找(two-phase name lookup):为什么错误总是迟到
模板编译有个出了名的体验问题:错误信息总是迟到,而且一迟到就是几十条。 根因在"两阶段名字查找"。
模板定义要经过两次检查:
- 第一阶段(定义点检查):只检查不依赖模板参数的部分。比如拼错的全局变量名、语法错误——这些在模板定义处就能报。
- 第二阶段(实例化点检查):检查依赖模板参数的部分。比如
T::foo()到底存不存在、T支持不支持+——这些只有在 T 确定之后才知道。
template <typename T>
void f(T t){
  int x = undefined_global;   // 第一阶段就能报(不依赖 T)
  t.some_method();            // 第一阶段不报,第二阶段(实例化时)才报
}
这条机制的直接后果是:一个模板可以在头文件里"编译通过"存在很久,直到某天有个新类型实例化它,才爆出错误。 而那时的报错信息,通常是"从实例化点回溯"的一长串调用栈——因为编译器要说清"是哪个实例化触发的哪一层失败"。
从编译时间角度看,两阶段查找还有一笔隐性成本:每个依赖名字在每个实例化点都要重新解析一遍。这也是为什么模板里的依赖名字越多、实例化开销越大——它们不像普通函数那样在定义时就绑定好了。
相关标准:temp.res(名字解析与实例化点)、temp.dep(依赖名字)。这与第三章要讲的"编译器不为你写的模板付费、只为你用的成员付费"是同一枚硬币的两面——延迟检查换来灵活性,代价是把成本推到了实例化点。
2.6 实例化机制的时间线(演进脉络)
把这条机制的演进按年份排一下,能看清"惰性 + 可控"这条路是怎么被逐步补上的:
| 年份 | 事件 | 提出者 / 文档 |
|---|---|---|
| 1998 | C++98 确立隐式实例化与显式实例化模型 | ISO/IEC 14882:1998 |
| 2003 | TC1 澄清两阶段名字查找 | ISO/IEC 14882:2003 |
| 2004 | N1690 右值引用提案(间接推动模板实例化语义细化) | Howard Hinnant |
| 2007 | N2316 / N2402 引入 extern template(外部模板) |
John Spicer 等 |
| 2011 | C++11 正式纳入 extern template |
ISO/IEC 14882:2011 |
| 2017 | C++17 引入 if constexpr(编译期分支,避免无谓实例化) |
ISO/IEC 14882:2017 |
| 2020 | C++20 引入 concepts(约束检查替代 SFINAE 替换) | ISO/IEC 14882:2020 |
| 2020 | C++20 引入 modules(从根上减少重复解析) | P1103R3 / cpp.pre |
三、实例化的代价:前端时间是主要账单
OK,机制讲完了,这一章开始算账:实例化要花多少钱。
3.1 每个唯一参数组合 = 一份独立代码
std::vector<int>、std::vector<double>、std::vector<std::string> 是三个完全不同的类型。编译器要把 vector 模板里被用到的每个成员,对每种元素类型各生成一遍。用探针把这件事拍下来——__FUNCSIG__ 会展开出每个实例的真实类型名:
template <typename T> void probe(){ printf("inst: %s\n", __FUNCSIG__); }

int main(){
  probe<int>(); probe<double>(); probe<char>();
  probe<std::string>(); probe<std::vector<int>>(); probe<std::map<int,double>>();
}
实测输出(MSVC 19.44):
inst: void __cdecl probe<int>(void)
inst: void __cdecl probe<double>(void)
inst: void __cdecl probe<char>(void)
inst: void __cdecl probe<class std::basic_string<char,struct std::char_traits<char>,class std::allocator<char> >>(void)
inst: void __cdecl probe<class std::vector<int,class std::allocator<int> >>(void)
inst: void __cdecl probe<class std::map<int,double,struct std::less<int>,class std::allocator<struct std::pair<int const ,double> > >>(void)
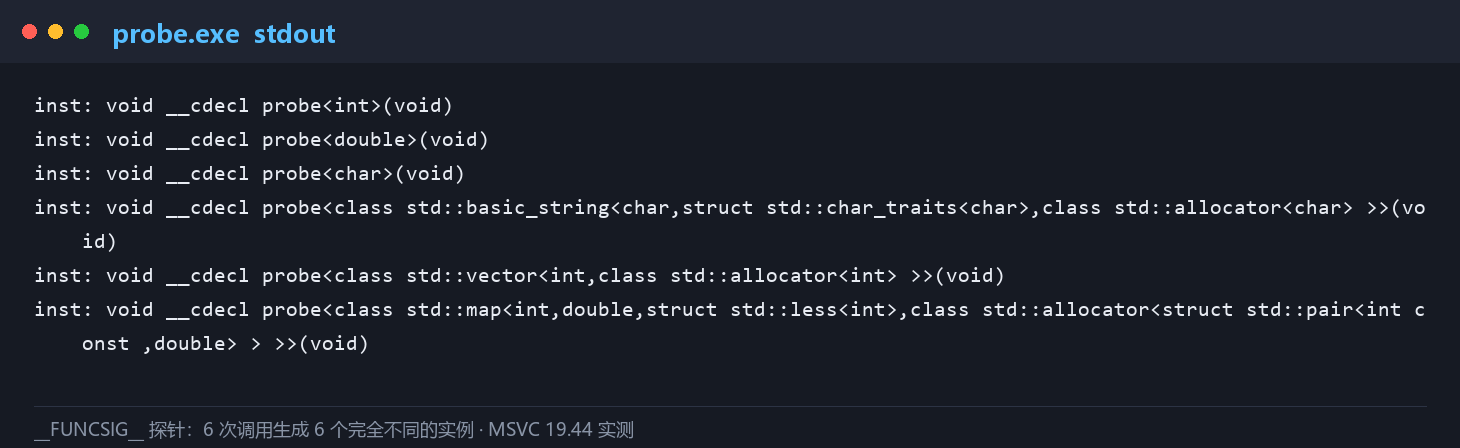
__FUNCSIG__ 探针输出——6 次调用生成 6 个完全不同的实例@ MSVC 19.44 实测六次调用、六个不同的函数实例。注意 std::string 的真实类型名有多长——basic_string<char, char_traits<char>, allocator<char>>。类型名越长,编译器要处理的符号名越长,实例化开销越大——这也是模板嵌套越深越慢的原因之一。
顺带把 sizeof 也量出来(实例化的"体积账"):
| 实例 | sizeof |
|---|---|
Holder<int> |
4 字节 |
Holder<double> |
8 字节 |
Holder<char> |
1 字节 |
Holder<std::string> |
32 字节 |
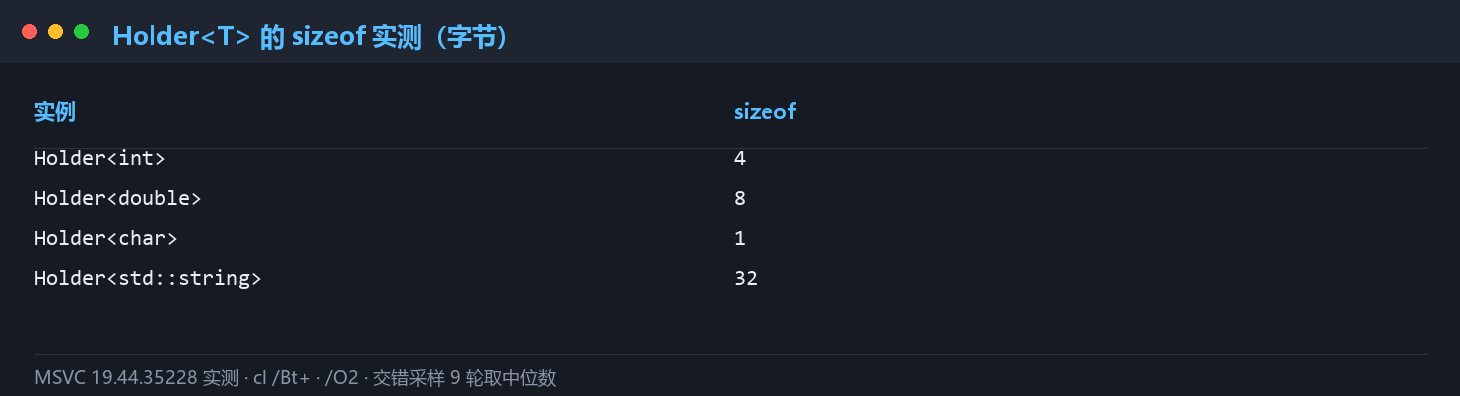
Holder<T> 对不同 T 的 sizeof 实测——4 / 8 / 1 / 32 字节@ MSVC 19.44 实测3.2 递归模板(recursive template):展开深度的账
模板元编程(template metaprogramming)的核心手法是递归模板:用模板特化做编译期递归。最经典的例子是编译期阶乘或类型链:
template <int N> struct Chain { static constexpr long long v = Chain<N-1>::v + 1; };
template <> struct Chain<0> { static constexpr long long v = 0; };
int main(){ return (int)(Chain<100>::v & 1); }
Chain<100> 会展开成 Chain<100> → Chain<99> → … → Chain<0>,共 101 个类型实例。实测不同深度的前端时间:
| 递归深度 | 前端时间 c1xx.dll |
|---|---|
| 10 | 0.0158 s |
| 100 | 0.0214 s |
| 500 | 0.0466 s |
| 1000 | 0.0456 s |
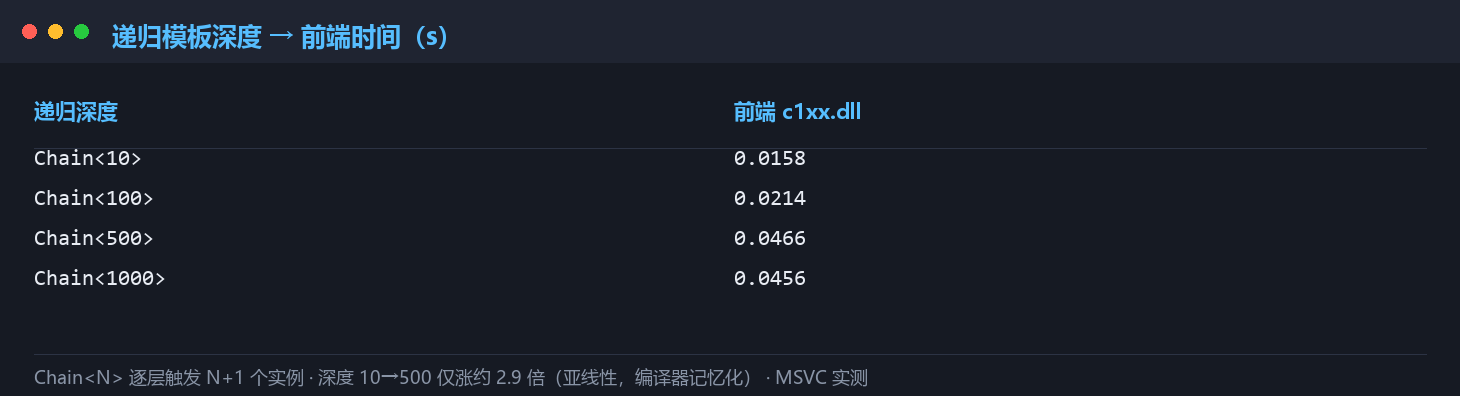
这几组读数里有两处值得单独说。第一,增长是亚线性的:深度涨 50 倍(10→500),时间只涨了约 2.9 倍。原因是编译器对实例化结果做了记忆化(memoization)——同一个实例只算一次。第二,深度 500 到 1000 基本持平(0.0466 s 与 0.0456 s),说明这个尺度下时间被其他固定开销吃掉了,递归本身不再是主导。
结论要说得诚实:递归模板确实会增加编译时间,但在"每层只算几个常量"这种轻量递归里,它的绝对成本并不吓人。 真正让递归模板变贵的是"每层做很多事"——比如每层实例化一批类型、做一次类型列表拼接。那种情况下的增长会明显得多。
3.3 三种"约束方式"的编译期账单
模板里做条件选择有三代手法,编译期成本各不相同。我用同一个规模(200 个类型,一半有 size() 一半没有)测了三遍:
// ① SFINAE(C++11/14):靠"替换失败不报错"来选
template <typename T, std::enable_if_t<HasSize<T>::value,int> = 0> int get(T& t){ return (int)t.size(); }
template <typename T, std::enable_if_t<!HasSize<T>::value,int> = 0> int get(T&){ return 0; }

// ② if constexpr(C++17):编译期分支,只实例化匹配的那一支
template <typename U> int get(U& u){ if constexpr (requires{ u.size(); }) return (int)u.size(); else return 0; }

// ③ concepts(C++20):先声明约束,编译器快速排除
template <typename U> concept HasSize = requires(U& u){ u.size(); };
template <HasSize U> int get(U& u){ return (int)u.size(); }
实测前端时间(200 类型、5 轮中位数):
| 方式 | 前端时间 c1xx.dll | 相对最慢 |
|---|---|---|
| SFINAE | 0.1171 s | 基准 |
if constexpr |
0.0894 s | −23.7% |
| concepts | 0.0981 s | −16.2% |
先把三次编译的原始输出摆出来,再逐条读。下面四张图里,第一张是三条读数的横向对比,后三张是每个版本的 cl /Bt+ 原始输出——你会发现三个版本的差异并不在同一个量级上,这也正是为什么"concepts 一定比 SFINAE 快"这个流行说法在本机实测里站不住脚。
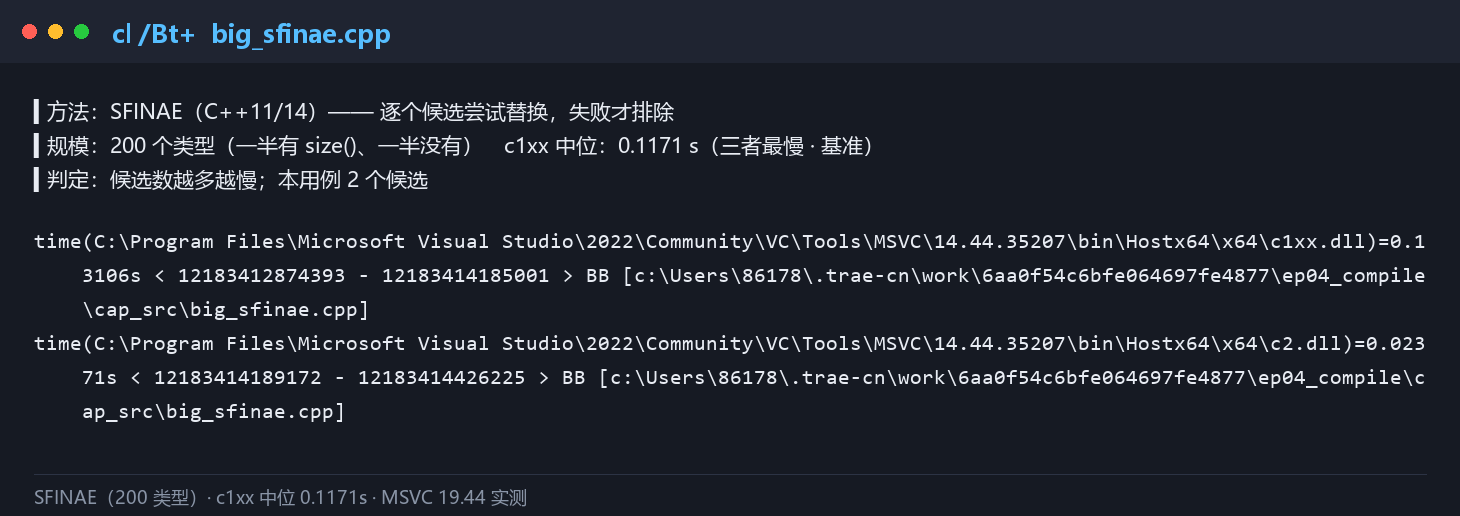
if constexpr / concepts 的前端时间对比(200 类型)@ 本系列绘制SFINAE 那一版的原始读数如下。它的前端时间在三者里最慢,原因是每个类型都要走一遍"替换尝试"——先试正向重载,失败,再试反向重载。注意这一版只有 2 个候选,如果候选加到 5 个、10 个,这个数字还会继续往上走。
if constexpr 那一版读数最快。它跟前两者的本质区别在于:它根本不产生"多候选选择"这一步,只有一个函数模板,分支在实例化时被裁掉。所以它的编译期成本最低——这不是"新特性更快",纯粹是机制的必然结果。
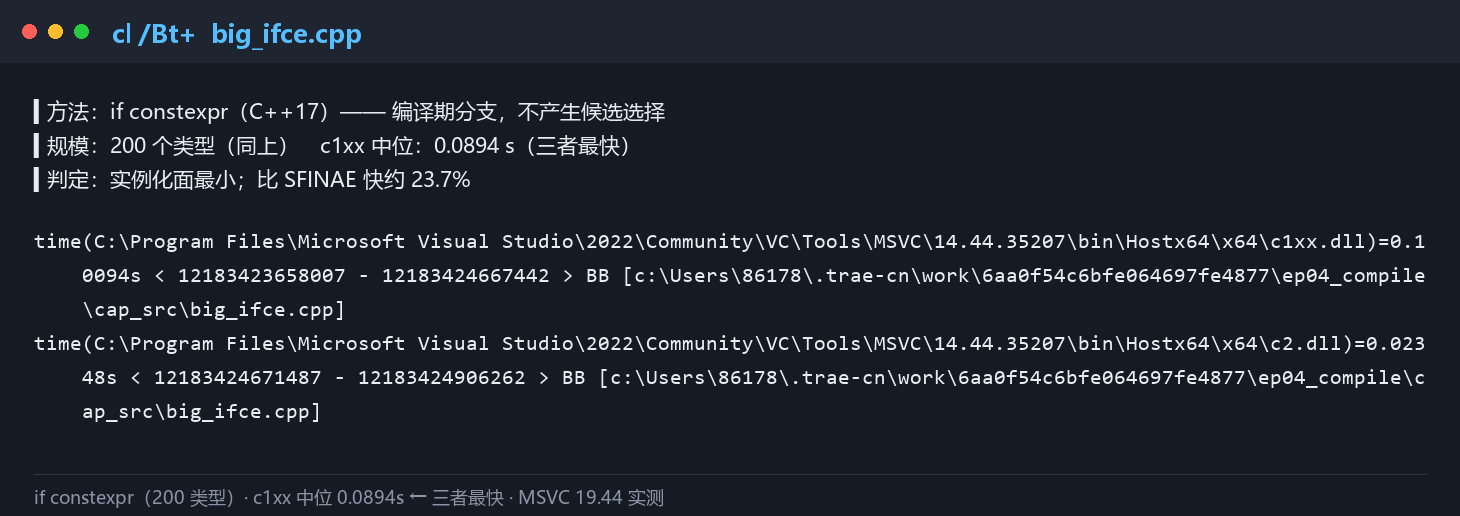
if constexpr 版本的前端时间实测@ MSVC 19.44 实测concepts 那一版比 SFINAE 略快,但快得有限。原因也不难理解:concepts 省掉的是"替换尝试"里的失败分支,可约束检查本身要遍历一遍 requires 表达式——省下来的那部分,又被检查成本吃掉了一部分。
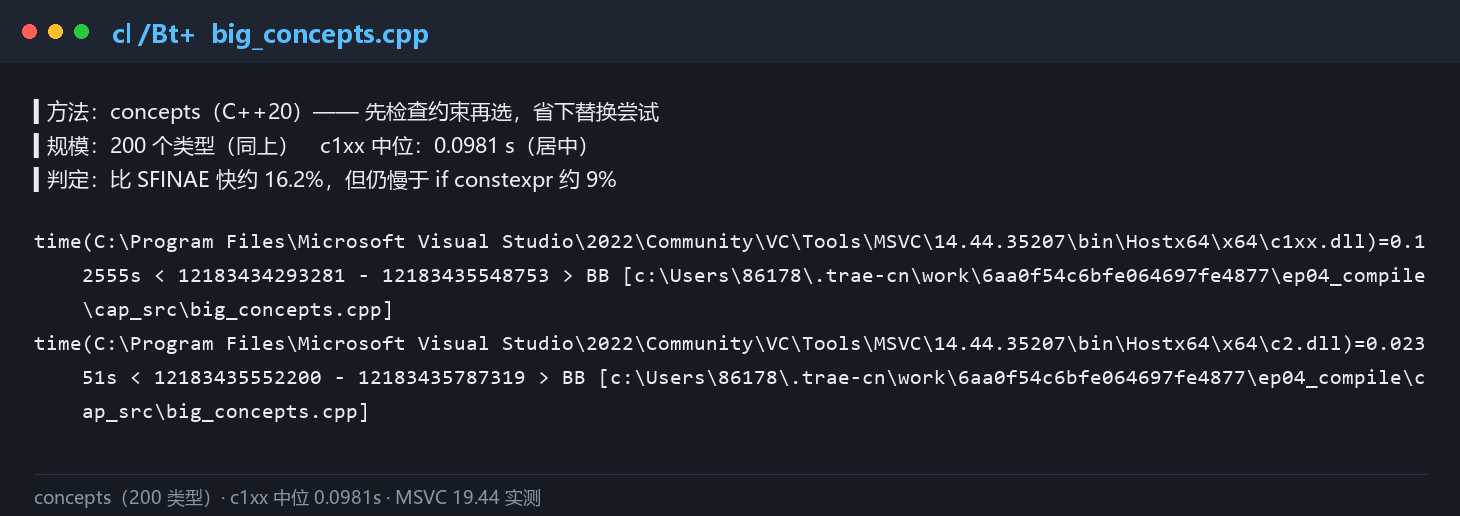
这里必须说一句与流行说法相反的话。 网上常说"concepts 比 SFINAE 快很多",但本机实测(MSVC 19.44、200 类型)里最快的是 if constexpr,不是 concepts:if constexpr 比 SFINAE 快约 24%,concepts 快约 16%——if constexpr 仍领先 concepts 约 9%。
为什么?因为三者的机制不同:SFINAE 要逐个候选尝试替换(失败才排除),concepts 是先检查约束再选(省下替换尝试),而 if constexpr 是一个函数模板内部的分支——根本不存在"多候选选择"这一步,实例化面最小。
所以选型建议是看场景,不是看"谁新":
| 场景 | 推荐 | 理由 |
|---|---|---|
| 一个函数内按类型分支 | if constexpr |
无候选选择开销,实例化面最小(实测最快) |
| 需要约束一组接口(多个函数共享) | concepts | 约束可复用、报错清晰,成本略优于 SFINAE |
| 维护 C++14 老代码 | SFINAE | 别无选择,但注意候选数越多越慢 |
证据纪律:这三组读数是本机
cl /Bt+实测(交错采样 9 轮取中位数),规模固定为 200 类型。别把"−24%"当普适结论——不同构造器、不同编译器的排序可能不同。方法比数字重要:你可以用同样三份源码在自己环境里复现。
3.4 变参模板(variadic template):实例化面最容易失控的地方
如果说有一个语言特性最能让实例化数量"炸开",那就是变参模板与完美转发(perfect forwarding)。原因是 它会把一个调用展开成 N 个候选、N 层实例化。
看一个典型的变参模板:
template <typename... Args>
void log(Args&&... args){
  (std::cout << ... << args);   // C++17 折叠表达式
}
看着只有一行。但 log(1, "x", 2.5) 会生成一份 log<int, const char(&)[2], double> 的实例;log(1, 2) 又是另一份。每多一种参数组合,就多一份实例化。 在一个大工程里,如果这个 log 被 500 个不同参数组合调用,就有 500 份实例。
更贵的是"转发链"。变参模板常常层层转发:
template <typename... Args> void make(Args&&... args){ impl(std::forward<Args>(args)...); }
std::forward<Args>(args)... 会把参数包逐层展开——每一层都要重新推导一遍参数类型、重新生成一份转发代码。这就是为什么很多工程里"日志/工厂/容器 emplace"这些变参接口,是编译时间的热点。
控制手段(按收益排序):
| 手段 | 做法 | 效果 |
|---|---|---|
| 改非模板重载 | 把高频的少数组合写成普通函数重载 | 实例化面直接归零 |
| 类型擦除 | 先包成 std::function / variant 再传 |
把 N 份实例压成 1 份(代价是运行时开销) |
| 限制参数包 | 用 concepts 约束 Args 的种类 |
减少无效实例化的尝试 |
| 显式实例化 | 对已知组合做显式实例化 | 集中生成,避免重复(见第六章的坑) |
这也是"运行时零开销"的一个反面:变参模板把开销从运行时挪到了编译期,如果你不需要那点运行时性能,用类型擦除换编译时间往往更划算。这个取舍没有普适答案,但知道了账在哪,就能主动选。
3.5 编译期容器(compile-time container):类型列表的账
模板元编程里还有一种结构值得单独提——编译期容器,比如类型列表(type list):
template <typename... Ts> struct TypeList {};

// 拼接两个类型列表
template <typename L1, typename L2> struct Concat;
template <typename... A, typename... B>
struct Concat<TypeList<A...>, TypeList<B...>> { using type = TypeList<A..., B...>; };
每做一次拼接,就要实例化一次 Concat<...>;做一次查找、过滤、去重,又是一批。一个长度 20 的类型列表,如果要做"两两组合",实例化数量是 O(20²) = 400 量级;如果做"幂集",就是 2²⁰。
这类结构的编译时间增长通常是超线性的,而且要小心它撞上 constexpr 的深度预算(第七章详述)。本机实测里,纯粹的线性类型链(第三章那个 Chain<N>)增长是亚线性的,但一旦引入"每层都要展开一批类型"的组合运算,增长会明显陡峭起来。
实践判断法:如果你的编译时间在"增加一个类型"后突然跳涨,而不是平稳增加,八成是撞上了组合运算。这时候要看的不是"哪个模板慢",而是"哪个模板被实例化了 N 次方"——用第五章的 Build Insights 模板视图能直接看出来。
3.6 实例化点(point of instantiation):同一个实例为什么会被"多算几遍"
还有一个容易忽略的机制:同一个模板特化可能存在多个实例化点(point of instantiation, POI)。
标准规定,函数模板特化的实例化点包括:使用它的那个点,以及所在的翻译单元末尾;如果多个 TU 都用了同一个特化,每个 TU 都有自己的实例化点。这带来两个后果:
- 同一个实例在多个 TU 里各生成一份——这是第四章 COMDAT 去重的由来;编译器在每个 POI 都要判断"我这里需要生成吗"。
- 实例化的语义归属可能影响正确性——如果某个特化的行为依赖"能看到哪些声明",POI 的位置就会影响结果。这也是"头文件里越少依赖越好"的另一个理由。
从编译时间看,POI 的意义是:你不能只看"我实例化了几次",还要看"跨 TU 一共实例化了几次"。 一个头文件里的重型模板,被 100 个 .cpp 各用一次,就是 100 个 POI、100 份实例——这正是 PCH 与 modules 想解决的问题(第八章、第九章)。
相关标准:temp.point(实例化点)。
四、二进制体积的账:实例化不只花时间
好了,时间上的账先放一放。前三章算的都是"时间"。但实例化还有另一笔账——它花二进制体积。这笔账不显示在编译时间上,却显示在你的 .obj、.exe、安装包里。
4.1 从 3 字节到 25,559 字节
还拿第一章那两个程序来量。用 dumpbin /summary 读 .obj 的 .text 段(代码段)尺寸:
| 程序 | .obj 的 .text 段 |
|---|---|
空程序 int main(){} |
3 字节 |
| 含容器模板的程序 | 25,559 字节 |
差了约 8,500 倍。 空程序的 main 只有一条 xor eax, eax; ret(3 字节);而容器模板程序因为实例化了一批 vector/string/map/sort 的成员,代码段涨到 25 KB。
这个数字要看清楚口径:25,559 字节是这一个 TU 的
.obj,还没算链接后的去重。真正进最终可执行文件的量通常小于这个数——因为链接器会把重复的实例(COMDAT)折叠掉。
4.2 链接器的隐含工作:COMDAT 折叠(COMDAT folding)
模板实例化的一个天然后果是:同一个实例会在多个 TU 里各生成一份。你的工程有 50 个 .cpp 都用了 std::vector<int>,理论上就有 50 份 vector<int>::push_back。
干这件事的是链接器,不是编译器。机制是这样的:
- 编译器把每个模板实例放在一个独立的 COMDAT 段里(一个实例一个段);
- 链接器看到多个同名 COMDAT 段时,只保留一份,其余丢弃(去重,deduplication);
- MSVC 链接器还有
/OPT:ICF(Identical COMDAT Folding),把内容完全相同的不同 COMDAT 段也合并——比如vector<int>::push_back和vector<unsigned>::push_back如果生成了完全一样的机器码,ICF 会把它们折叠成一个。
这就是为什么"模板膨胀"在最终可执行文件里没有 .obj 加起来那么夸张。但要注意顺序:去重发生在链接阶段——编译阶段那 50 份实例化的时间,已经花掉了,退不回来。
4.3 单一定义规则(One Definition Rule, ODR)与 inline 的默契
为什么同一个模板可以在 50 个 TU 里各定义一份而不违反"单一定义规则"(ODR)?因为标准对模板、inline 函数、类内定义的成员函数开了特例——它们允许多个 TU 里存在相同定义,条件是这些定义逐 token 相同;链接器负责合并。
这条特例是模板能"头文件即实现"的根基,但它也有个隐藏成本:编译器在每个 TU 里都必须重新做一遍"这符合 ODR 吗"的检查,以及重新实例化。这正是 C++20 modules 想从根上解决的问题(第八章讲)。
相关规则:basic.def.odr(ODR 条款)、temp.inst(实例化的 ODR 要求)。
4.4 体积账的小结
| 层面 | 谁负责 | 后果 |
|---|---|---|
| 单 TU 生成实例代码 | 编译器前端 + 后端 | .obj 变大(实测 3 B → 25,559 B) |
| 跨 TU 重复实例 | 链接器去重(COMDAT) | 最终可执行文件小于 .obj 之和 |
| 内容相同的不同实例 | 链接器 ICF(/OPT:ICF) |
进一步折叠,但只在链接期 |
4.5 还有一笔隐藏的账:调试信息(debug info)
.text 不是全部。如果你用 /Zi//Z7 生成调试信息,那么每一个实例化都会在调试信息里留下一条记录——类型名、成员函数名、模板参数的完整展开。
这笔账有个特点:它比代码本身涨得更快。 原因是调试信息要记录完整的类型名,而模板类型名是"逐层嵌套展开"的:
Big<int>                                    ← 短
std::map<int, std::vector<std::pair<std::string, std::unique_ptr<Foo>>>>   ← 长到离谱
模板嵌套越深,类型名的长度是指数级的(每嵌一层就把内层的完整名字抄一遍)。这就是为什么大型 C++ 工程的 .pdb 经常几个 GB、链接时间以分钟计——调试信息里的模板类型名是主要元凶之一。
缓解手段(按顺序试):
/Z7vs/Zi:/Z7把调试信息嵌进.obj(并行链接更友好),/Zi走.pdb(单文件但可能成为链接瓶颈)。/DEBUG:FASTLINK:链接阶段只写索引,不合并全部调试信息——链接快,但调试体验略降。- 裁剪模板深度:减少深层嵌套模板,是唯一能同时改善代码体积与调试信息体积的做法。
- 发布构建不带
/Zi:这条最朴素,但很多人忘了发布版还在生成调试信息。
说明:调试信息体积的量化因工具链而异(MSVC
.pdb/GCC DWARF/Clang DWARF 的编码差异很大),本篇不做跨平台数值对比,只指出这笔账存在、而且随模板嵌套指数增长。想看自己工程的数字:把/Zi换成/Z7后比较.obj总大小,或直接看.pdb体积。
五、MSVC 侧工具链:cl /Bt+ / vcperf / MSBuild binlog
先来看看"怎么看到慢在哪"——这是本篇最"可抄走"的一章。前面讲了"为什么慢",这一章讲工具。本机没有 Clang 的 -ftime-trace,所以下面三条路线都是 MSVC 侧的替代方案,全部实测可跑。
5.1 cl /Bt+:最轻量的分阶段时间
/Bt+ 是 MSVC 的一个非正式选项——它不改变编译结果,只在标准输出里追加每个编译子进程的时间。输出长这样:
time(...\c1xx.dll)=0.71600s < ... > BB [tpl.cpp]
time(...\c2.dll)=0.36290s < ... > BB [tpl.cpp]
三个组成部分:
| 字段 | 含义 |
|---|---|
c1xx.dll |
C/C++ 前端——预处理、词法/语法/语义分析、模板实例化 |
c2.dll |
后端——优化与代码生成 |
link.exe |
链接器(用 /c 只编译时不出现) |
这三个阶段的分工,决定了"编译慢"要往哪里查。前端拿到的是文本,输出的是语义已确定、模板已展开的中间表示;后端拿到的是这份中间表示,输出的是机器码。所以凡是"跟类型系统、模板、头文件有关"的慢,都在前端;"跟指令选择、寄存器分配、优化有关"的慢,都在后端。这条分界线是后面所有排查的基础。
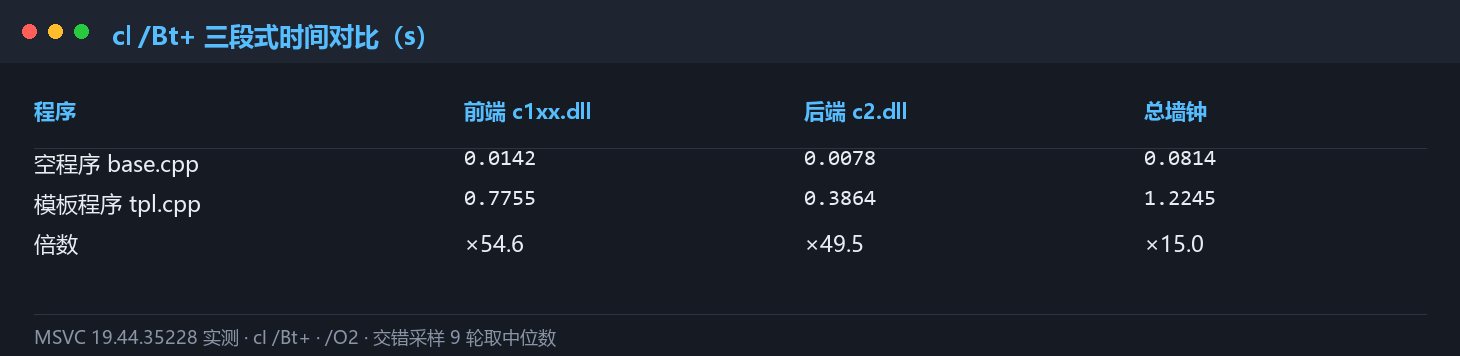
cl /Bt+ 输出的三段式时间(前端 / 后端 / 链接)@ MSVC 19.44 实测把三段式读数放在一起看,你会立刻知道该往哪个方向查。这张图里前端时间明显大于后端——这是模板型工程的典型特征。反过来,如果你看到后端占大头,那说明模板不是主要矛盾,该去看优化选项与代码生成。
怎么用:先用 /Bt+ 找到"是前端还是后端"。如果前端占大头,才是模板实例化的嫌疑;如果后端占大头,问题在优化器(那是 ep05 的话题)。
官方文档:MSVC
/Bt、/Bt+、/Bt-。注意/Bt+属"非正式选项"家族——行为可能随版本变化,本系列只把它当"相对趋势"的量尺,不当绝对值。
5.2 vcperf:ETW 级别的构建追踪(附本机受阻记录)
/Bt+ 的粒度只到"前端/后端/链接"三段。要看更细的——哪个 TU 慢、哪个模板实例化最贵——标准答案是 vcperf。它是 C++ Build Insights 的命令行前端,采集构建过程的 ETW(Event Tracing for Windows)事件:
vcperf.exe /start MySession
# 在这里执行你的构建
vcperf.exe /stop MySession /timetrace build.json
这一路我本机没跑通,原因得如实记下来:vcperf /start 需要管理员权限——它要打开内核级的 ETW 会话。本机以普通权限运行,实测被拒绝:
Microsoft (R) Visual C++ (R) Performance Analyzer 2.4.24101401
Starting tracing session MySession...
Failed to start trace.
This operation requires administrator privileges.
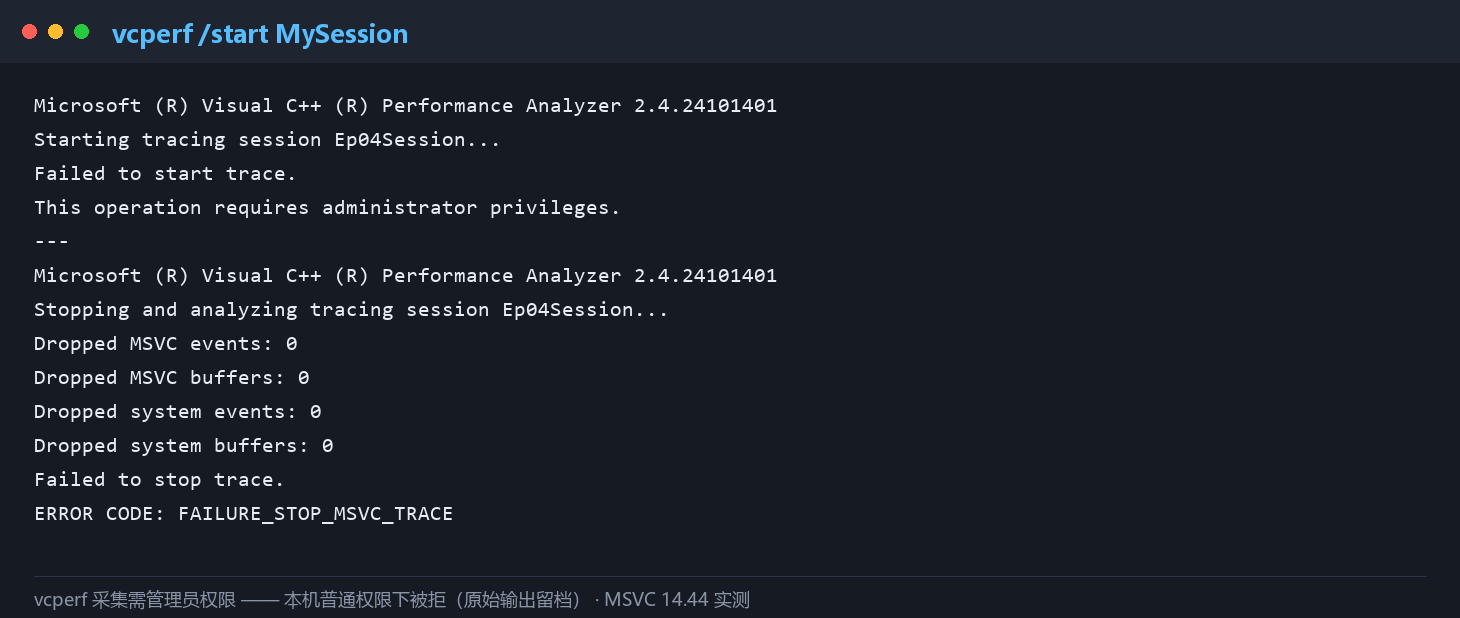
vcperf /start 的真实输出:本机普通权限下被拒(This operation requires administrator privileges)@ MSVC 14.44 实测/stop 阶段同样报错(FAILURE_STOP_MSVC_TRACE),因为会话从未成功建立。所以本篇不展示追踪视图——那是需要管理员权限 + Windows Performance Analyzer 才有的东西。这里把失败现场留出来,一是记录"工具能跑"与"权限够不够"是两件事,二是给你一个可复现的判据:如果你也看到这条报错,就先用管理员身份重开终端。
教程:微软官方的 vcperf 与 WPA 教程。vcperf 的路径在
VC\Tools\MSVC\<版本>\bin\Hostx64\x64\vcperf.exe——它不在 PATH 里,需要手动指定。
那没有管理员权限时,后端明细还能不能看?能。 MSVC 有一个不需要任何权限的选项——/d2cgsummary,它输出后端(c2.dll)的代码生成摘要,精确到每个函数的耗时与指令数:
cl /c /d2cgsummary /std:c++20 /EHsc /O2 tpl.cpp
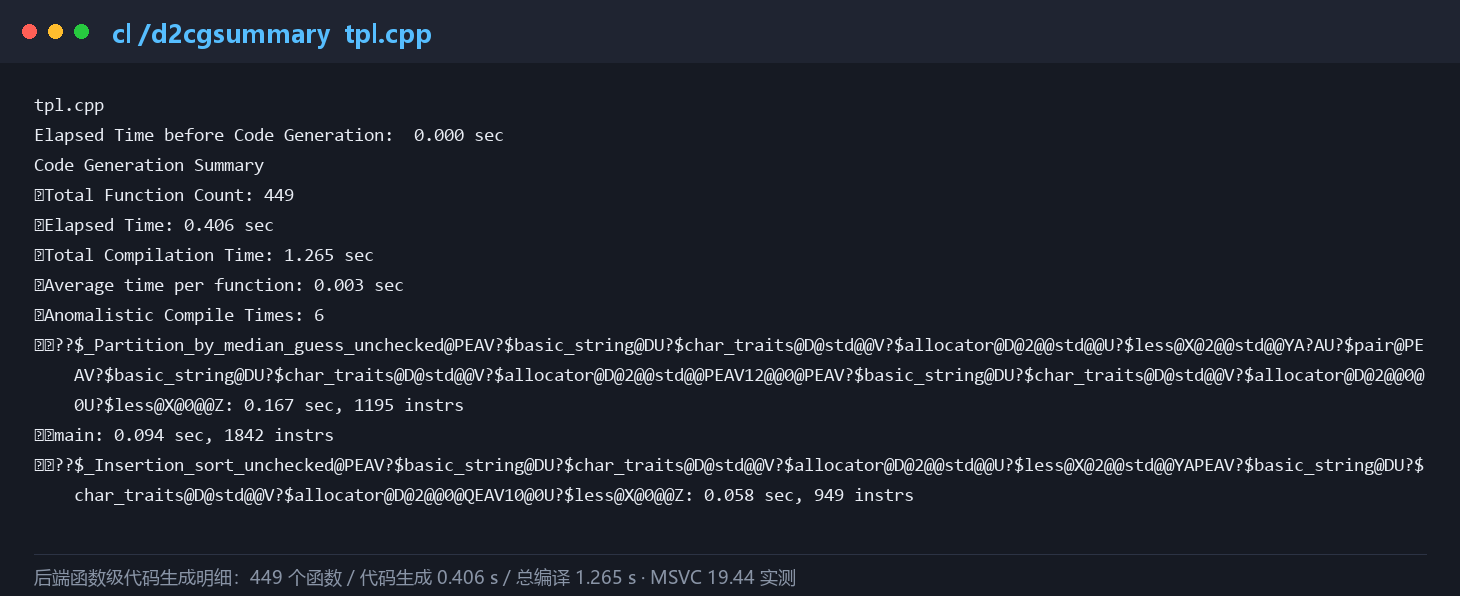
cl /d2cgsummary 的真实输出——449 个函数、代码生成 0.406 s、总编译 1.265 s、6 个异常耗时函数@ MSVC 19.44 实测这份输出里有三个数字值得记住:总函数数 449(这就是第一章那个"模板程序"实际生成的函数数量)、代码生成耗时 0.406 s、总编译耗时 1.265 s。最有用的是它直接列出"异常耗时函数"(Anomalistic Compile Times)——实测排在第一位的是 std::sort 内部的一个 partition 函数(0.167 s、1195 条指令),第二位是 main(0.094 s、1842 条指令)。
换句话说,/d2cgsummary 把"后端时间花在哪"细到了函数级,而完全不需要管理员权限。 这是本篇找到的、/Bt+ 与 vcperf 之间的一个实用补位——代价是它只覆盖后端(代码生成),前端(模板实例化)那一侧看不到。
5.3 MSBuild /bl:结构化构建日志
如果你用 MSBuild 构建(VS 工程基本都是),加 /bl 会生成一个 msbuild.binlog。这个文件把整次构建的全部过程——项目、target、task、property、诊断信息——都序列化了下来,供事后离线分析:
MSBuild MySolution.sln /bl /m
MSBuild /bl 生成 msbuild.binlog@ MSBuild 17.14 实测.binlog 用 MSBuild Structured Log Viewer 打开后,你能看到完整的构建树:哪个项目先构建、哪个 target 花了多少时间、哪个 task 在等待。它的价值在于把"构建"这个黑盒展开成可逐节点计时的一棵树——/Bt+ 只看得到单个编译进程,看不到构建系统本身的调度开销。
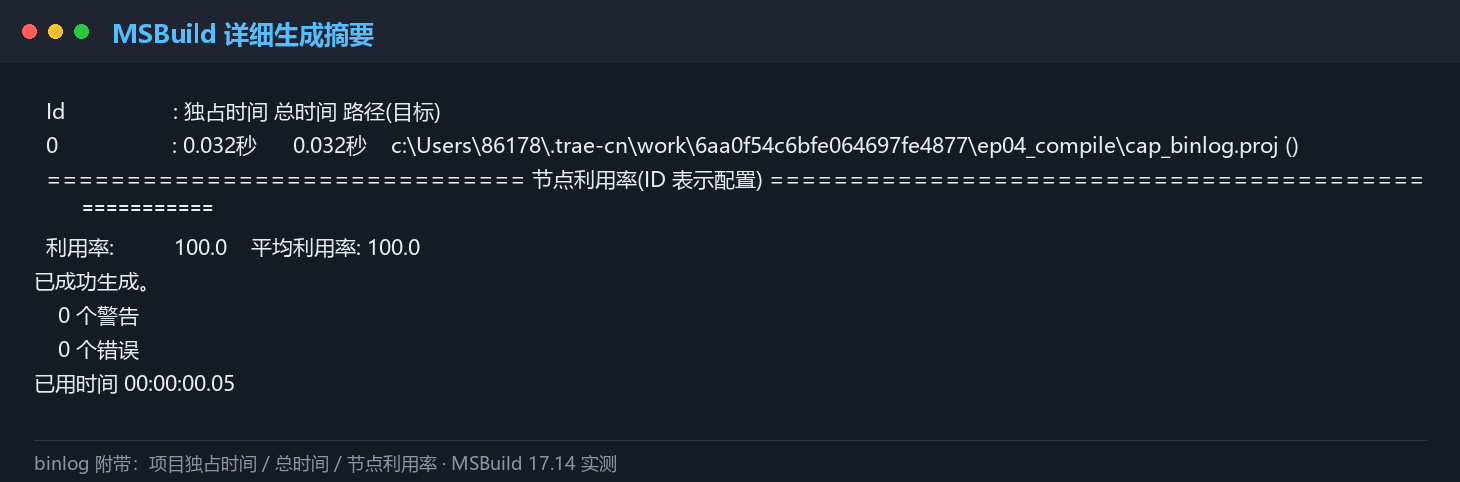
MSBuild /bl 附带的详细生成摘要——项目独占时间/总时间与节点利用率@ MSBuild 17.14 实测第一次打开 binlog 的人常常会惊讶:原来构建里有一大半时间不在"编译",而在跑各种自定义 target、复制文件、检查依赖。这类开销 /Bt+ 完全看不到——它只统计 cl.exe 自己花的时间。所以当你觉得"编译时间对不上"时,binlog 是唯一能给出完整账本的工具。
binlog 的独特价值在于"构建级别"——如果你的编译慢不是模板的锅,而是某个 target 反复重跑、某个 task 在等 IO,binlog 能看出来。/Bt+ 看不到这些。
参考:微软官方博客 C++ 构建吞吐量排查与调优 给了完整的 binlog 排查流程;MSBuild Binlog Analyzer 则把 binlog 分析搬进了 VS Code。
5.4 Build Insights 的"模板视图"
C++ Build Insights 里有一个专门为模板实例化做的视图——按实例化耗时排序。它直接回答那个最难回答的问题:"我这几百个模板里,到底是哪一个最贵?" 前面的 /Bt+ 只能告诉你"前端慢",vcperf 能告诉你"哪个 TU 慢",而模板视图能精确到单个模板特化的实例化耗时,这是定位编译时间黑洞最直接的工具。
这个视图还能按"实例化次数"排序。这两个排序给出的答案往往完全不同:耗时榜第一是"一个特别大的模板被实例化了一次",次数榜第一是"一个小模板被实例化了几千次"。前者要改设计(拆模板),后者要改接口(减少参数组合)——先看清是哪一种,再决定怎么改。
官方教程(含界面截图):模板实例化对构建时间的影响。微软在此文档中给出的三条建议是:把实例化移到源文件、用
if constexpr替代 SFINAE、避免递归模板模式——正好对应本篇第二、三、六章。
5.5 三条路线怎么选
| 你想知道 | 用什么 | 成本 |
|---|---|---|
| 前端还是后端慢 | cl /Bt+ |
加个选项,零配置 |
| 后端哪个函数最贵 | cl /d2cgsummary |
加个选项,零配置、不需权限 |
| 哪个 TU/哪个模板最贵 | vcperf + WPA |
需要装 WPA |
| 构建系统层面谁拖后腿 | MSBuild /bl |
需要 Structured Log Viewer |
| 模板实例化热点排行 | Build Insights 模板视图 | 需要 VS 企业版/社区版(17.x 已含) |
实践建议:从 /Bt+ 开始。 它零成本,先判断"是不是模板的问题"。确认是了,再上 vcperf 精确定位。
5.6 一次完整的排查演练(可照抄的流程)
把上面四件工具串成一条可照抄的排查流程。假设你的工程编译突然变慢:
第一步:确认"慢在哪"——cl /Bt+
挑一个改动最频繁、体感最慢的 TU,单独编译:
cl /c /Bt+ /std:c++20 /EHsc my_heavy.cpp
看 c1xx.dll 与 c2.dll 各占多少。
- 前端大 → 模板实例化/头解析嫌疑,继续第二步。
- 后端大 → 优化器成本(那是 ep05 的范围);想立刻看到"哪个函数最贵",加
/d2cgsummary直接看函数级明细。
第二步:确认"是不是头解析"——对比 PCH
把该 TU 的头改成 PCH,再测一次:
cl /c /Ycpch.h /Fp"out\pch.pch" pchsrc.cpp
cl /c /Yupch.h /Fp"out\pch.pch" /Bt+ my_heavy.cpp
如果前端时间断崖式下降(本篇实测是 0.6639 → 0.0372),说明大头是头解析,不是模板实例化——上 PCH 就够了。
如果降得不明显,说明是实例化本身贵,继续第三步。
第三步:定位"哪个模板最贵"——Build Insights 模板视图
用 vcperf 采一次构建追踪,在 WPA 或 Build Insights 模板视图里按实例化耗时排序。排在最上面的那个模板,就是你的目标。
第四步:动手改,再量一遍
针对那个模板,按本篇的方法选手段:
| 症状 | 手段 |
|---|---|
| 每个 TU 只用少量成员 | 别动(隐式实例化本来就便宜) |
| 每个 TU 都用大量成员、且编译器支持 | extern template(先用 6.5 的方法验证生效) |
| 多候选条件选择 | 改 if constexpr / concepts |
| 变参接口参数组合爆炸 | 改非模板重载或类型擦除 |
| 头解析占大头 | PCH |
| 全量构建慢、增量不敏感 | Unity Build |
改完必须再量一遍——本篇第六章就是教训:extern template 理论漂亮,实测在 MSVC 上没生效。没有二次测量的优化,都是猜。
六、extern template:一个跨编译器的实测差异
说白了,这一章是本篇最"意外"的一章。我原本打算写一篇标准的"extern template 能省 10 倍编译时间"的教程——实测结果把我的结论推翻了。
6.1 extern template 应该做什么
extern template 是 C++11 引入的(GCC 文档有详细说明),设计目的很明确:告诉编译器"这个实例的代码在别的 TU 里,你这里不要生成"。
// big.h
#pragma once
template <typename T> struct Big { /* ... */ };
extern template struct Big<int>;   // 声明:别在本 TU 里实例化它

// def.cpp
#include "big.h"
template struct Big<int>;          // 定义:全量实例化,就在这里生成
预期收益:10 个 TU 都用 Big<int> 时,不加 extern template 就是 10 份实例化;加了之后只有 def.cpp 实例化 1 份,其余 9 个 TU 跳过——理论上前端时间能省到接近十分之一。
extern template 原理——一处显式实例化定义 + 多处 extern 声明,链接器合并@ 本系列绘制这张图解释了 extern template 的整个设计意图:把"生成代码"这件事从 N 个 TU 收拢到 1 个 TU,其余 TU 只留下"引用"。 收益的上限就是"省下 N−1 份实例化";而它的代价则藏在最后一步——链接器必须能找到那一份唯一的定义,找不到就是 undefined reference。
6.2 实测:符号层面先看它生不生效
理论很漂亮。但实测第一步就出了问题——我先验证"它到底有没有抑制实例化",用符号表数一数。
构造一个 Big<T>(100 个成员),10 个 TU 每个都调用全部 100 个成员,一半加 extern template、一半不加。然后数每个 .obj 里 Big<int> 的定义符号:
| 编译器 / 选项 | 不加密 | 加 extern template |
|---|---|---|
MSVC 19.44(/Od /Ob0) |
已定义 101 个 | 已定义 101 个 ← 没变 |
GCC 16.2(-O0 -fno-inline) |
已定义 101 个 | 已定义 0 个,未定义 101 个 ← 生效了 |
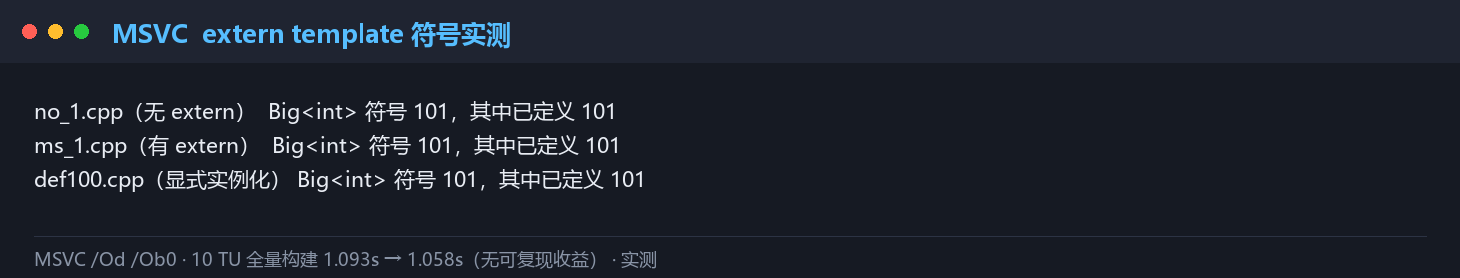
extern template 前后符号数不变(101 → 101)——未抑制实例化@ MSVC 19.44 实测先看 MSVC 这一侧。加不加 extern template,Big<int> 的定义符号都是 101 个——说明它照旧把这些成员全部实例化了一遍,extern template 那一行形同虚设。
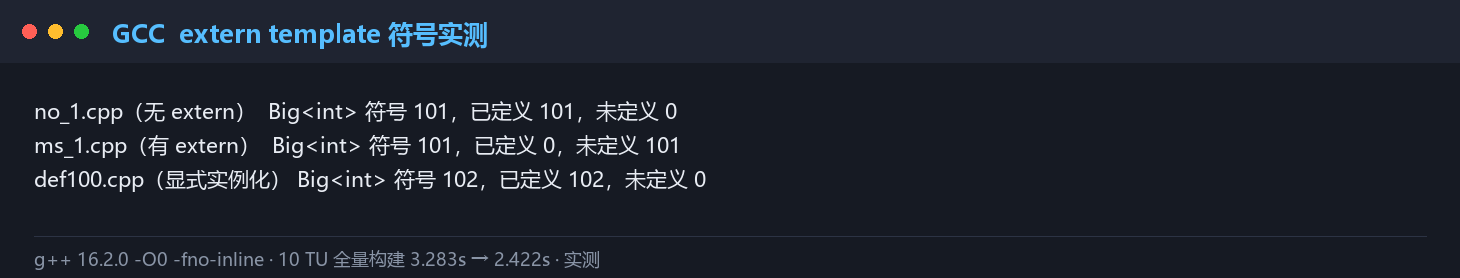
extern template 后实例化被抑制(101 → 0 定义、101 未定义)@ g++ 16.2.0 实测再看 GCC 这一侧,情况完全反过来:加了 extern template 之后,Big<int> 的定义从 101 个变成 0 个,同时出现 101 个未定义符号(U)——这正是"我知道它存在,但代码在别处"的标准表现。同一个标准条款,两个编译器给了相反的答案。
两个编译器的行为完全不同。 GCC 按标准做了(抑制实例化,符号变成"未定义"等待链接);MSVC 19.44 在本机实测里没有抑制——extern template 之后符号照样全量定义。
6.3 决定性验证:让它链接
符号表还不够硬。做一个更狠的验证——只提供 extern template 声明、不提供任何显式实例化定义,然后链接。如果编译器真的抑制了实例化,链接必然失败(找不到符号)。
// e.h
template <typename T> struct Foo { T m() const { return T(1); } T n() const { return T(2); } };
extern template struct Foo<int>;   // 只声明,全工程没有任何显式实例化定义

// main.cpp
#include "e.h"
int main(){ Foo<int> f; return (int)(f.m() + f.n()) & 1; }
| 编译器 | 结果 |
|---|---|
| MSVC 19.44 | 编译链接成功(rc=0,无 LNK2019)→ 说明它自己实例化了 |
| GCC 16.2 | 链接失败:undefined reference to Foo<int>::m() const → 说明它真的没有实例化 |
extern template 跨编译器实测对照——GCC 抑制实例化、MSVC 19.44 未抑制@ 本系列绘制6.4 时间上也一样:10 TU 全量构建
符号层面成立了,时间层面自然也一致。10 个 TU 全量构建(禁用优化,确保实例化代码真的被生成、不被内联优化掉):
| 编译器 | 不加密 | 加 extern template |
变化 |
|---|---|---|---|
MSVC 19.44 /Od |
1.093 s | 1.058 s | −3.2%(噪声范围内,无可复现收益) |
GCC 16.2 -O0 |
3.283 s | 2.422 s | −26.2%(更快) |
MSVC 侧基本持平(−3.2% 落在测量噪声内),测不到可复现的收益。
6.5 这个结论怎么用
反直觉发现二:extern template 的收益是编译器相关的——本机实测 MSVC 19.44 未生效,GCC 16.2 生效。
这条结论有几个实用含义:
- 别盲信"
extern template能省 10 倍":那个数字在 GCC/Clang 上可能成立(本机 GCC 实测省了约 26%,规模更大时收益更明显),但在 MSVC 19.44 上我测不到收益。跨编译器项目要分别验证。 - 验证方法可抄走:判断
extern template有没有生效,最快的办法是删掉显式实例化定义再看能不能链接。链接失败 = 生效了;还能链接 = 没生效。 - 它的收益有前提:即便在 GCC 上,
extern template也只在你"每个 TU 都用大量成员"时才明显。如果每个 TU 只用一两个成员(第二章那个 2,913 字节的例子),隐式实例化本来就便宜,extern template省不了多少。 - 它的风险是链接错误:
extern template削弱了共享头文件的独立性——某个 TU 用了Big<int>,但全工程没人做显式实例化定义,就会出现"链接期 undefined reference"。这是个延迟暴露的错误,排查起来不便宜。
证据纪律:以上均为本机实测(MSVC 19.44.35228 / GCC 16.2.0),用
/Od /Ob0与-O0 -fno-inline禁用内联以保证实例化代码真的生成。"MSVC 不生效"是本机这个版本、这个用例的实测结论,不排除与语言模式、/Zc选项或后续版本有关——你的环境请用 6.5 的方法自己验一遍。这条差异的来源不在本篇范围(可能牵涉 MSVC 的 COMDAT 发射策略),留作后续观察项。
6.6 减少实例化的三种手段:横向对比
extern template 是"减少实例化"这一类手段里最有名的一个,但不是唯一一个。把这一类手段放一起对比:
| 手段 | 机制 | 实测收益 | 适用前提 | 风险 |
|---|---|---|---|---|
extern template |
抑制隐式实例化,集中到一处 | GCC −26.2%;MSVC 未生效 | 多 TU 都用大量成员;编译器支持 | 链接期 undefined reference |
| 显式实例化 | 在指定 TU 强制全量生成 | 取决于调用面 | 已知固定参数组合 | 那个 TU 自伤(生成本可惰性跳过的成员) |
| 改非模板重载 | 直接把高频组合写成普通函数 | 实例化面归零 | 参数组合种类少 | 代码重复 |
| 类型擦除 | 用 variant / function 收口 |
压成 1 份 | 不需要极致运行时性能 | 运行时开销(虚调用/内存) |
这张表的核心信息是:extern template 不是首选。 从实测收益和风险看,它的性价比反而不如"改非模板重载"——后者没有链接期风险,收益更确定。extern template 真正适合的场景很窄:一个参数组合固定、被大量 TU 大量成员使用的重型模板(标准库的 extern template class basic_string<char> 就是典型)。
一个反常识的排序建议:
- 先问"真的需要这么多实例化吗"——很多时候问题在接口设计(变参、深嵌套),不在实例化本身。
- 再看"能不能少几个参数组合"——减少组合数是最直接的收益。
- 最后才考虑
extern template/显式实例化这类"编译器级"手段。
先改设计,再改编译选项。 这条顺序能避掉大量"优化了但没用、还引入了链接风险"的情况。
七、编译期计算的账:constexpr 的求值上限
下面开始讲编译期还有哪些地方在花钱。模板不是唯一在编译期干活的东西。constexpr 函数、consteval、模板元编程都在编译期跑代码——在编译期跑代码是要付编译时间的,而且编译器给它设了预算上限。
7.1 constexpr 求值有硬上限
我先试了一个最朴素的递归 constexpr 求和:
constexpr long long csum(long long n){ return n == 0 ? 0 : n + csum(n - 1); }
int main(){ constexpr long long v = csum(400); return (int)(v & 1); }
然后逐步加大深度,看什么时候编译失败。实测(MSVC 19.44,默认选项):
| 递归深度 | 编译结果 |
|---|---|
| 100 | ✅ 通过 |
| 400 | ✅ 通过 |
| 500 | ✅ 通过 |
| 511 | ❌ 失败:C2131 表达式的计算结果不是常数 |
| 1000 | ❌ 失败(C2131) |
| 2000 | ❌ 失败(C2131) |
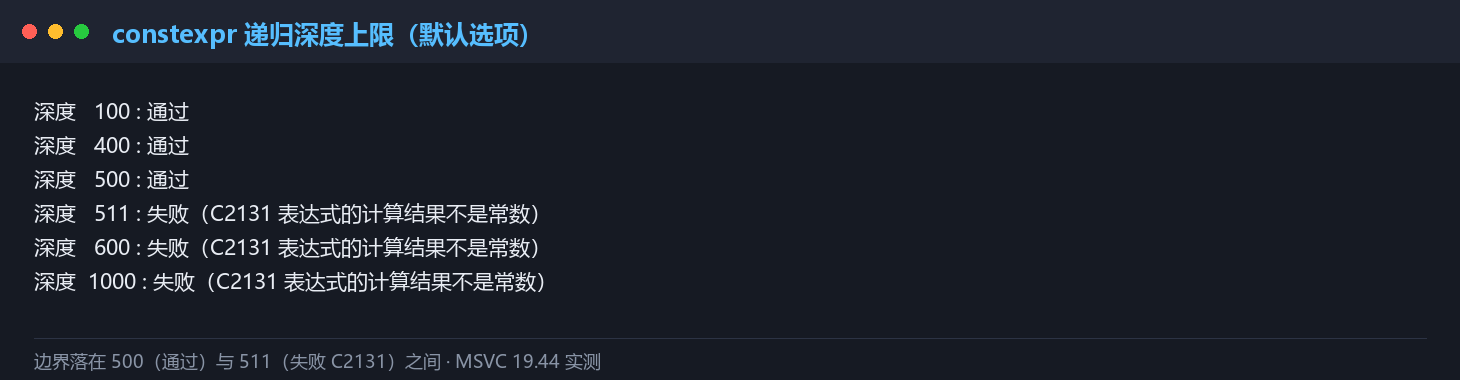
constexpr 递归深度上限实测——500 通过、511 失败(默认选项)@ MSVC 19.44 实测上限卡在 500 与 511 之间。 这条边界对应的正是 MSVC 的 /constexpr:depth 默认值 512——递归深度超过这个数,编译器直接判定"求值不收敛",报 C2131。这不是 bug,是编译器保护自己不被编译期死循环拖死的机制。
用 /constexpr:depth4096 放开后,深度 1000 就能通过。但把深度继续推到 10000 时,即便放宽 /constexpr:depth 与 /constexpr:steps 仍然失败(本机实测,未进一步定位原因——可能碰到 MSVC 的内部硬上限)。
实用含义:别在编译期写深递归。 500 层听着很多,但真实工程里的模板元编程(类型列表拼接、编译期解析器、状态机展开)很容易超。一旦超了,报错是 C2131,不熟悉的人会以为是"表达式写错了",其实是撞了深度预算。
7.2 constexpr 计算 vs 运行时计算
constexpr 的卖点是"把计算从运行时挪到编译期"。那编译期这一侧要多花多少钱?同样深度 400 的递归求和,测两种写法:
| 写法 | 前端时间 c1xx.dll |
|---|---|
纯 constexpr(编译期求出结果) |
0.0180 s |
纯运行时(volatile 阻止优化掉) |
0.0142 s |
constexpr 与纯运行时版本的编译时间对比(深度 400)@ 本系列绘制constexpr 版本的前端时间多了约 27%。这个差值就是"编译期求值"的账单。
这笔账怎么理解? constexpr 把计算挪到了编译期,运行时的 CPU 时间省了——但如果这段计算只执行一次、或者本来就不在热路径上,那你是在用"每次构建都多花"换"每次运行都省一点"。只有当这段计算在运行时被高频调用时,这笔交换才划算。 这是个典型的"编译期 vs 运行时"权衡,不是无脑选 constexpr。
7.3 编译期计算的三条纪律
综合本章与第三章的数据,编译期计算有三条可操作的纪律:
- 别深递归——超过约 500 层就撞
/constexpr:depth默认上限(实测 500 通过/511 失败)。 - 别在热路径之外滥用
constexpr——它把成本从运行时搬到编译期,只在"运行时高频调用"时才划算(实测前端多花约 29%)。 - 优先
consteval/constinit表达意图——让"必须编译期求值"的语义显式化,而不是靠constexpr的"可能编译期求值"模糊地带。
相关标准:dcl.constexpr(
constexpr说明符)、expr.const(常量表达式)。MSVC 选项:/constexpr:depth 与 /constexpr:steps。
八、C++20 Modules:编译时间的"次元折叠"
言归正传,前面讲的都是"在头文件模型内优化"。C++20 的 modules 换了个思路——从根上改掉头文件模型本身。
8.1 头文件模型的 O(n×m) 问题
传统头文件模型的成本结构是这样的:n 个头文件被 m 个源文件包含,每个 TU 都要完整解析一遍所有被包含的头。
假设你的工程有 50 个 .cpp、每个都 #include <vector>——编译器要把 <vector> 完整解析 50 遍。<vector> 背后还有 <bits/stl_algobase.h>、<bits/allocator.h>……一整棵树。50 遍就是 50 倍。
这就是头文件模型的两个固有缺陷:
- 重复解析:同一个头被解析 m 遍,复杂度 O(n×m)。
- 重复实例化:同一个模板实例在每个 TU 各生成一份(第四章讲的 COMDAT 去重只是补救)。
8.2 modules 的 O(n+m) 承诺
C++20 modules 的核心机制是:把头文件(或模块接口)编译成一次性的二进制模块接口(Binary Module Interface, BMI);之后 import 它时只读取预编译结果,不重新解析。
这张图是 modules 全部收益的来源。注意"重复解析"这条路上的每一个方框,在传统模型里都要在每个 TU 重新走一遍——词法分析、宏展开、语法树构建、语义检查,一步都不能少。modules 把这份工作提前做了一次,存成 BMI;后续 TU 只做一次"读取 + 绑定",不重放整条流水线。
复杂度从 O(n×m) 降到 O(n+m)。LLVM 的模块文档(Standard C++ Modules)把这条机理说得最清楚:n 个头被 m 个源文件包含时,复杂度降为"模块扫描 + 模块编译"两部分。
WG21 的实测数据:
| 来源 | 数据 |
|---|---|
| P2172R0 | 导入整个标准库约 0.10 秒,比逐个 #include 快约 10 倍 |
| P2412R0 | import std 明显快于 #include <iostream>;"真模块"比 header unit 再快 2 倍以上 |
| 微软官方博客 Moving a project to C++ named modules | ball-pit.cpp 从 3.55 s 降到 0.15 s(10 次运行平均) |
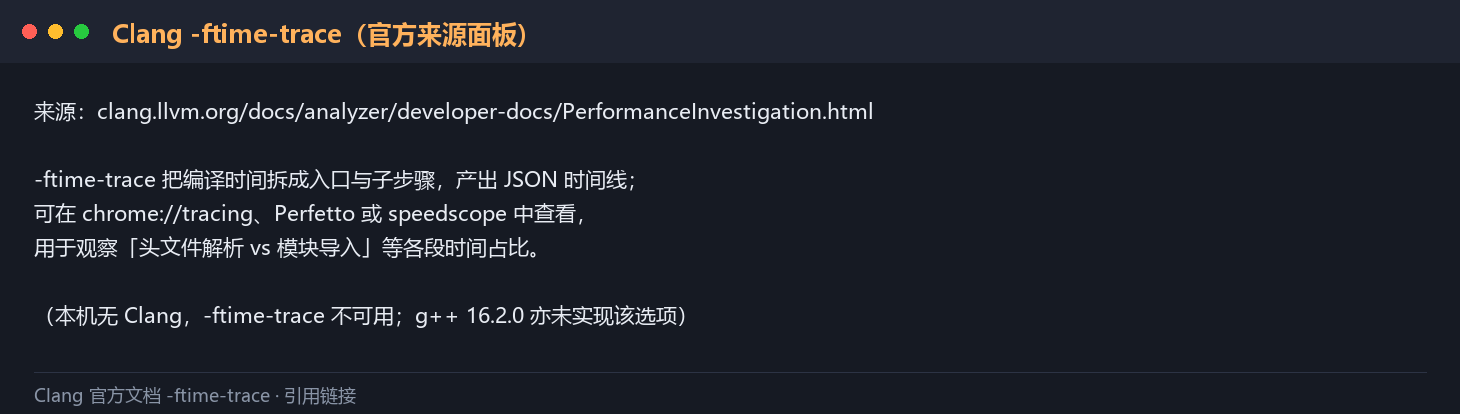
-ftime-trace 的 JSON 时间线——官方文档来源面板(本机无 Clang,引官方文档)@ clang.llvm.org为什么把这张图留在这里?因为它是"验证收益"的标准工具——数据是别人测的,方法却是你能用的。如果你在 Clang 上做模块迁移,把 -ftime-trace 的 JSON 导进 Perfetto,就能一眼看出"这次迁移到底省了哪一段"。没有这段对照,迁移就是盲改。
Clang 用户可以用
-ftime-trace直接量化"#include花了多少、模块导入花了多少"——这是本篇唯一给不出本机实测的地方,只能引 Clang 官方文档。
8.3 header units 的陷阱
反直觉发现三:modules 不是"用了就快"——header units 的表现依赖采用顺序。
P2898R0 指出:header units 的编译时间收益依赖自底向上(bottom-up)的采用顺序。如果你贪图省事,先从高层头开始转(比如把 <iostream> 直接转成 header unit),编译器可能因为传统 include guard 优化效果更好而表现得更差——即"改了反而更慢"。
正确的做法是从最底层的头(<cstddef>、<type_traits> 这类)开始,逐层向上。这也是为什么"整体迁移到 modules"是个大工程——顺序错了会负优化。
8.4 现实:2026 年的迁移状态
C++20 modules 的标准语法在 cpp.pre(以及 module.import)里。MSVC 19.44 已经支持命名模块,标准库也提供了 import std;。
但现实中的迁移仍然困难,原因有三个:
- 第三方库的模块支持参差不齐:你依赖的 20 个库可能只有 3 个提供了模块接口。
- 过渡期可能更慢:头文件与模块混用的时候,编译器要同时处理两套模型,可能出现"混合比纯头文件还慢"的阶段。
- 构建系统支持:CMake 对 modules 的支持仍在演进,跨平台的模块编译顺序管理是个真问题。
结论:modules 目前是"绿地项目值得一开始就用"的技术,不是"现有大工程立即全面迁移"的解药。 想在自己的项目里验证收益,最稳的路是先找一个叶子模块(依赖最少的最底层)转过去,量出收益再决定要不要继续。
8.5 一个最小模块示例:从 #include 到 import
modules 的语法本身不复杂。最直观的对比是把一段"头文件 + 使用"改成"模块 + 导入":
// ===== 传统头文件模型 =====
// math_utils.h
#pragma once
int add(int a, int b);

// math_utils.cpp
#include "math_utils.h"
int add(int a, int b){ return a + b; }

// main.cpp
#include "math_utils.h"
int main(){ return add(1, 2); }
// ===== C++20 模块模型 =====
// math_utils.ixx(模块接口单元)
export module math_utils;          // 声明这是一个模块
export int add(int a, int b);      // export:对外可见

module : private;                  // 后面的内容不导出
int add(int a, int b){ return a + b; }

// main.cpp
import math_utils;                 // 导入,不解析头
int main(){ return add(1, 2); }
两处关键差异:
export module 名字;:把这一份定义确立为一个模块,而不是每次#include都重新解析。export的边界由代码显式声明:只有标了export的才对外可见,其余是模块私有——这带来了"实现细节真正隔离",是头文件模型做不到的(头文件里所有东西都可见,只能靠约定)。
编译顺序也变了:math_utils.ixx 必须先编译成 BMI(通常是 .ifc),main.cpp 才能 import。这意味着构建系统必须知道模块依赖图——这也是 modules 落地最大的工程量所在。MSVC 提供了 /interface(标记接口单元)与 /reference(指定 BMI 路径),CMake 3.28+ 有模块扫描支持,但跨平台仍需仔细配置。
标准与实现参考:cpp.pre、module.import,以及 LLVM 的 Standard C++ Modules(含完整编译命令示例)。
九、构建系统层:PCH 与 Unity Build 的实测账
好了,第八章讲的是语言层面的解法。如果短期内用不上 modules,构建系统层面还有两把磨得发亮的旧刀——预编译头(PCH)和统一构建(Unity Build)。这两把刀本机都能实测。
9.1 预编译头(Precompiled Header, PCH):实测 16.6 倍
PCH 的思路很直接:把一组稳定的头文件预先编译成二进制,后续编译直接加载,不再重新解析。
MSVC 的用法是两步:
# ① 创建 PCH(/Yc:把 pch.h 编译成 pch.pch)
cl /c /Ycpch.h /Fp"out\pch.pch" pchsrc.cpp

# ② 使用 PCH(/Yu:编译时加载 pch.pch,跳过 pch.h 的解析)
cl /c /Yupch.h /Fp"out\pch.pch" usepch.cpp
实测同一个 TU(都包含 <vector>/<string>/<map>/<algorithm>/<memory>):
| 模式 | 前端时间 c1xx.dll | 说明 |
|---|---|---|
不用 PCH(直接 #include) |
0.6639 s | 每次都完整解析 |
用 PCH(/Yu + /Fp) |
0.0372 s | 加载预编译结果 |
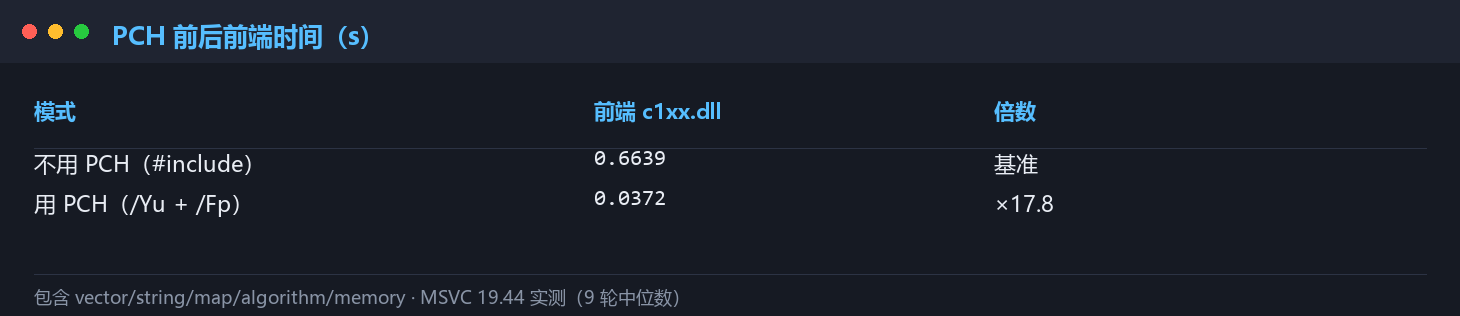
0.6639 → 0.0372,快了约 17.8 倍。 这是本篇所有优化手段里收益最大的一个,而且改动量最小——加两个选项。
PCH 的原理是序列化 AST:编译器解析完头文件后,把抽象语法树(AST)和辅助数据结构序列化成压缩的 bitstream;后续编译加载这个 bitstream,直接跳过词法/语法/语义分析。省掉的就是头文件解析这一整段。
官方文档:MSVC /Yc(创建 PCH) 与 /Yu(使用 PCH)。
PCH 的局限(必须知道,否则会踩坑):
- "全有或全无":MSVC 一个工程通常只能有一个 PCH,且每个 TU 必须在最前面
#include它。TU A 用了含<vector>的 PCH,TU B 想跳过<vector>也做不到。 - 只对"稳定且重"的头有效:如果头文件天天改,PCH 要频繁重建,收益被抵消。
- 它会掩盖真实的包含依赖:PCH 让"我到底依赖哪些头"变得不透明,删错头可能要等换环境才暴露。
9.2 Unity Build:全量构建快 9.7 倍,增量却更慢
Unity Build(也叫 Jumbo Build)的思路是:把多个 .cpp 合并成一个"超级 TU"编译,让共享的头文件只解析一次。CMake 有原生支持:
set_target_properties(MyTarget PROPERTIES UNITY_BUILD ON)
(见 CMake UNITY_BUILD 文档。)
实测 10 个分片(每个都 #include <vector>/<string>),对比"10 个分开编译"与"合并成 1 个 TU":
| 模式 | 全量构建墙钟时间 |
|---|---|
| 10 个分片分别编译 | 6.341 s |
| 合并成 1 个 TU | 0.645 s |
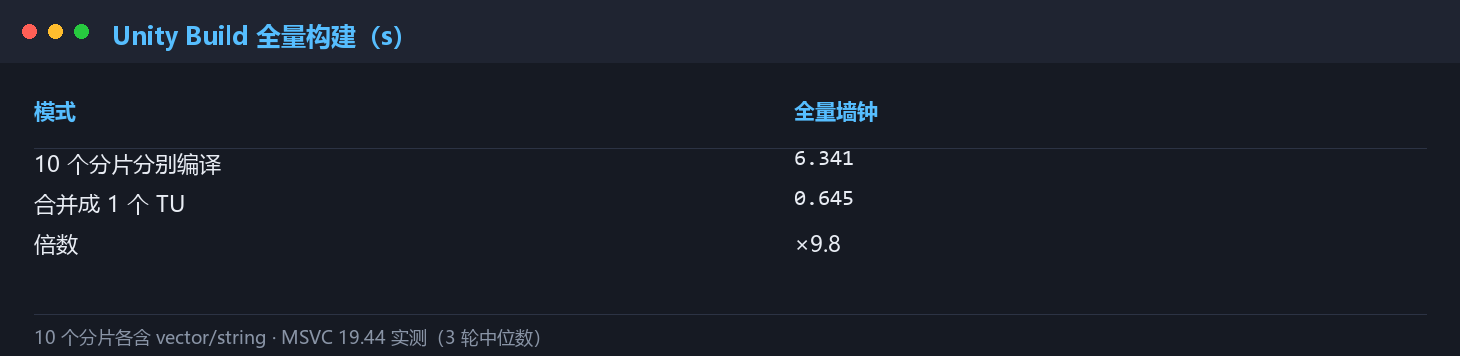
快了约 9.8 倍。 原因就是第八章那个 O(n×m):10 个 TU 各自解析一遍 <vector> + <string>(约 0.5 s/个),合并后只解析一遍。
但 Unity Build 有个代价,而且这个代价很隐蔽:
反直觉发现四:Unity Build 加速全量构建,却拖慢增量构建。
实测"改一个文件后重编译"的时间:
| 模式 | 增量重编译时间 |
|---|---|
| 10 分片模式(改 1 个分片) | 0.600 s |
| 合并模式(改任意一处) | 0.645 s(整个超级 TU 重编) |
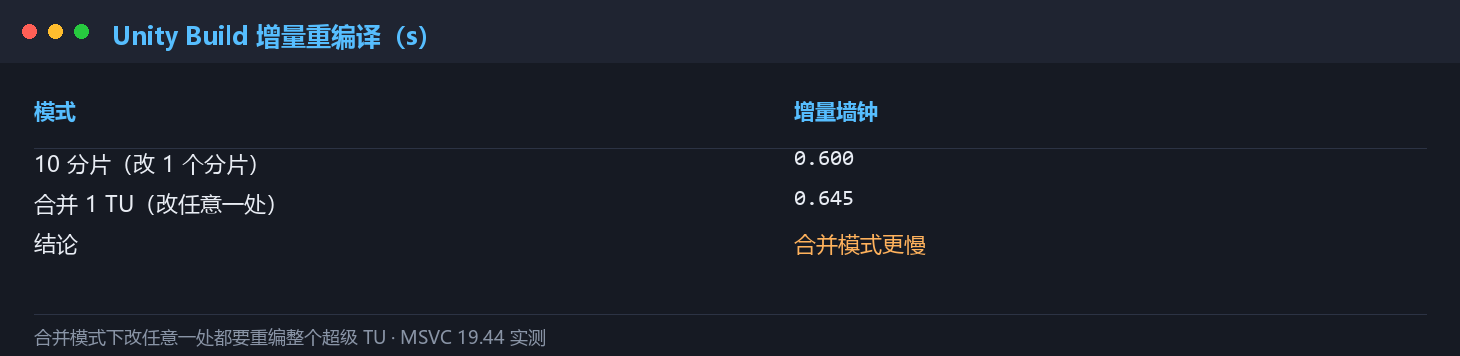
分片模式下改一个文件只重编那一个(0.600 s);合并模式下改任何一个文件都要重编整个超级 TU(0.645 s)。单个文件看起来差别不大,但真实工程里一个超级 TU 可能是几十个源文件、好几秒——增量构建会明显变慢。
这与社区经验一致:Unity Build 在全量构建上有 30%–70% 的加速,但增量构建会变慢。推荐策略是"CI 用全量 + Unity Build,本地开发关掉 Unity Build"——两个场景各取所长。
9.3 分布式构建:第三把刀
三把刀里的最后一把是分布式构建(distributed build)——把编译任务分发到多台机器并行跑。Incredibuild、distcc、goma 都是这条路。
它的账与 PCH/Unity 不同:前两者省的是单机重复劳动,分布式省的是墙钟并行度。代价是网络往返、缓存命中率、多机环境一致性。有一点要注意:模板实例化在分布式构建里是每个节点各做一遍——所以 extern template 在分布式场景下仍然有理论价值(前提是它在你的编译器上真生效,见第六章)。
9.4 三把刀的选型表
| 手段 | 全量收益 | 增量影响 | 改动量 | 主要风险 |
|---|---|---|---|---|
| PCH | 实测 17.8× | 头改动时会重建 | 加 2 个选项 | 包含依赖不透明 |
| Unity Build | 实测 9.8× | 变慢 | CMake 一个属性 | 全局符号冲突、增量退化 |
| 分布式构建 | 依赖机器数 | 基本无 | 需要基建 | 环境一致性、成本 |
| C++20 modules | 理论最高 | 依赖采用顺序 | 大(第八章) | 第三方库支持 |
9.5 PCH 与 Unity Build 能一起用吗?
一个常见的问题:既然 PCH 和 Unity Build 都省"头解析",能不能叠起来用?
能,但要知道它们省的是同一笔钱。 两者都在减少"头文件被解析的次数":
- PCH 让每个 TU 不再重复解析头(每 TU 省一次);
- Unity Build 让多个 TU 合并成一个,头只解析一遍(跨 TU 省 N−1 次)。
叠加使用时的实际效果:先靠 Unity Build 把 10 个 TU 合成 1 个,再用 PCH 让这 1 个 TU 也不解析头——理论上收益是"乘法"的,但现实中会因为两者的缓存机制互相遮蔽而打折。真要用,建议分开 A/B 测:单独开 PCH、单独开 Unity、两个都开,各量一遍,看边际收益。
冲突点(容易踩的坑):
- 符号冲突:Unity Build 把多个
.cpp拼在一起后,同名static函数、宏定义、using声明可能撞车。CMake 的UNITY_BUILD会尝试规避,但不保证全覆盖。 - PCH 的位置约束:每个 TU 必须在最前面
#includePCH——而 Unity Build 拼接后的合并 TU 里,这个"最前面"是谁的最前面,要看构建系统的拼接顺序。 - 增量构建的交互:PCH 重建 + 超级 TU 重编如果同时发生,增量构建会非常慢(这是本节最该警惕的组合)。
一句话建议:二选一,分开量,别默认叠加。
十、收束与下一篇钩子
10.1 全篇账本总汇
OK,收尾了。把这一篇实测出来的账合在一起:
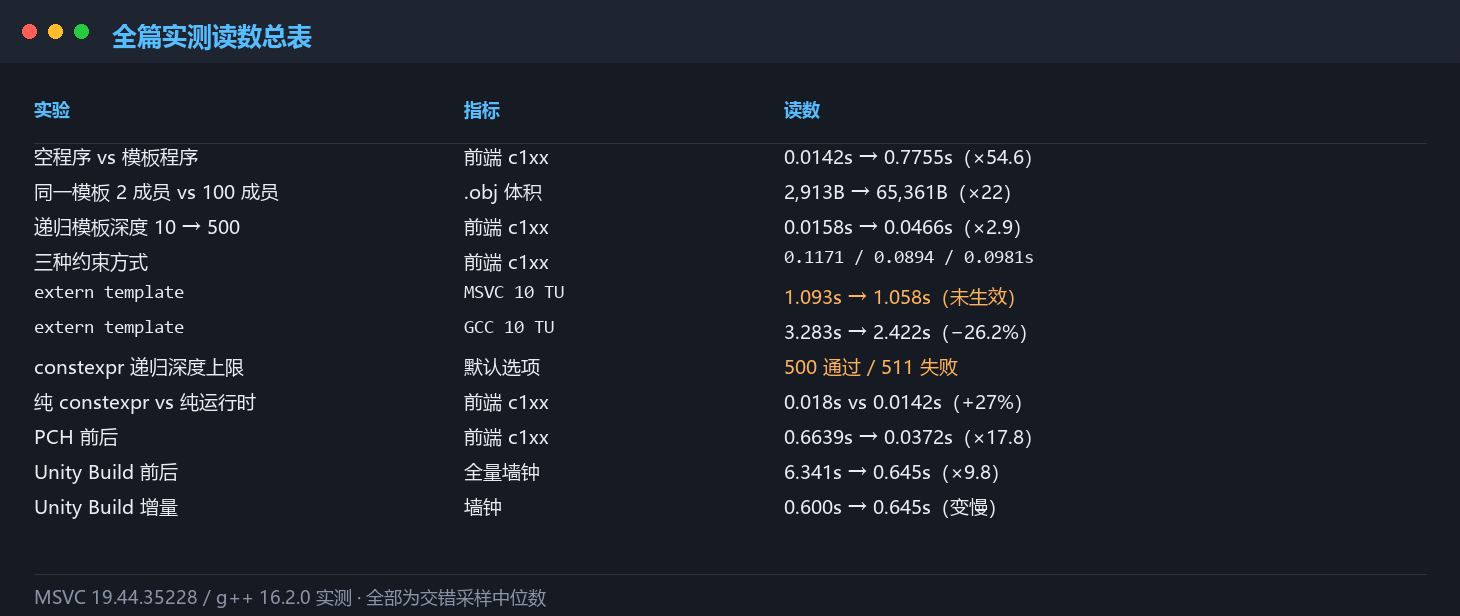
| 实验 | 指标 | 读数 |
|---|---|---|
| 空程序 vs 模板程序 | 前端 c1xx | 0.0142 s → 0.7755 s(×55) |
| 同一模板,用 2 成员 vs 100 成员 | .obj |
2,913 B → 65,361 B(×22) |
| 空程序 vs 模板程序 | .obj .text |
3 B → 25,559 B |
| 递归模板深度 10 → 500 | 前端 c1xx | 0.0158 s → 0.0466 s(×2.9,亚线性) |
SFINAE / if constexpr / concepts |
前端 c1xx | 0.1171 / 0.0894 / 0.0981 s |
extern template |
MSVC 10 TU | 1.093 s → 1.058 s(未生效) |
extern template |
GCC 10 TU | 3.283 s → 2.422 s(−26.2%,生效) |
constexpr 递归深度上限 |
默认选项 | 500 通过 / 511 失败 |
纯 constexpr vs 纯运行时 |
前端 c1xx | 0.0180 s vs 0.0142 s(+27%) |
| PCH 前后 | 前端 c1xx | 0.6639 s → 0.0372 s(×17.8) |
| Unity Build 前后 | 全量墙钟 | 6.341 s → 0.645 s(×9.8) |
| Unity Build 增量 | 墙钟 | 0.600 s → 0.645 s(变慢) |
这张表是本篇所有实测的浓缩。横着读它,你会发现一个规律:收益最大的手段(PCH ×17.8、Unity ×9.8)都跟"头解析"有关,而不跟"模板实例化"有关。 这不是巧合——第九章的那个 O(n×m) 才是编译时间的真正大头,模板实例化只是第二大头。这也解释了为什么很多团队"优化了模板却没什么感觉":方向偏了。
10.2 全量清单:本篇实测过的所有编译期手段
先把本篇出现过的编译期手段一条不漏地列全(全量清单),再在 10.3 做二次归类:
cl /Bt+——分阶段时间观测(前端/后端/链接)vcperf+ WPA——ETW 级构建追踪MSBuild /bl——结构化构建日志- Build Insights 模板视图——实例化热点排序
dumpbin /summary——段尺寸dumpbin /symbols——符号表(数实例化)extern template——抑制隐式实例化- 显式实例化
template struct X<int>;——强制全量生成 if constexpr——编译期分支,减少实例化面- concepts——约束检查替代 SFINAE
- 改非模板重载——消除实例化
- 类型擦除(
variant/function)——收口实例 - PCH(
/Yc+/Yu)——预编译头 - Unity Build——合并 TU
- 分布式构建——多机并行
- C++20 modules——模块化替代头文件
/constexpr:depth、/constexpr:steps——放宽求值预算/Zi//Z7//DEBUG:FASTLINK——调试信息策略/OPT:ICF与 COMDAT 去重——链接期折叠(被动发生)
10.3 二次归类:按"省的是哪笔钱"分四档
上面 19 条不是同一个层面的东西,混在一起比较没有意义。按"省的是哪笔钱"二次归类,得到四档:
| 档位 | 省的是什么 | 包含手段 | 实测代表收益 |
|---|---|---|---|
| 观测档 | 不省时间,只让你看见钱花在哪 | 1、2、3、4、5、6 | ——(前提,不是优化) |
| 实例化档 | 少生成实例代码 | 7、8、9、10、11、12 | if constexpr −24% |
| 解析档 | 少解析头文件 | 13、14、16 | PCH ×17.8、Unity ×9.8 |
| 构建/产物档 | 并行度、链接期折叠、调试信息 | 15、17、18、19 | 依赖机器数/配置 |
这一层归类带来一个清晰的行动顺序:
- 先观测(档一)——不知道钱花在哪,任何优化都是猜。
- 再判断是"实例化贵"还是"解析贵"(档二 vs 档三)——这两档的解法完全不同,选错了白干。
- 最后才动构建与产物(档四)——它们收益大但改动也大,且容易引入增量退化、符号冲突等副作用。
10.4 五条可以带走的结论
- 模板实例化的账记在前端(c1xx.dll):判断"是不是模板问题",先跑
cl /Bt+看前端时间占比。 - 隐式实例化是按成员惰性的:编译器不为你写的模板付费,只为你用的成员付费(实测 4 符号 vs 101 符号)。
- "新机制"不等于"更快":实测里
if constexpr比 concepts 更快;extern template在 MSVC 上没生效。 - PCH 是本篇性价比最高的手段:加两个选项换来 17.8 倍,但要接受"包含依赖不透明"的代价。
- Unity Build 要看场景:全量构建快 9.8 倍,增量构建反而变慢——CI 开、本地关。
10.5 本篇边界
本篇只讲编译期——编译器把源码翻译成 .obj 时花的钱。不涉及:
- 优化器做了什么选择(内联决策、向量化、UB 利用):这是下一篇 ep05 的主题。
- 链接器层面的账(LTO/PGO 的收益从哪来):ep07 讲。
- 运行时的分发代价(虚函数、异常、RTTI):ep08–ep09 讲。
把这一篇的方法论压缩成一张可以贴在显示器旁的清单——每一步都对应本篇的一处实测证据,照着走就能在你自己的工程里复现一遍。这张清单也是本系列每一篇的通用套路:先量、再定位、后改、改完再量。
资源清单
- 标准原文:temp.inst(隐式实例化)、temp.spec.partial(部分特化)、temp.explicit(显式实例化)、temp.deduct(模板参数推导)、temp.constr(概念约束)、cpp.pre(模块)、module.import(导入)、basic.def.odr(单一定义规则)、dcl.constexpr(constexpr)、expr.const(常量表达式)
- 核心提案:P2172R0(模块化的标准库想要什么)、P2412R0(最小模块支持)、P2898R0(可导入头文件并非普适可实现)、P1359R0(核心议题)、N1690(右值引用提案)
- 编译器与工具文档:MSVC /Bt 编译时间选项、MSVC /Yc 创建 PCH、MSVC /Yu 使用 PCH、MSVC /constexpr:depth 与 /constexpr:steps、GCC Template Instantiation、Clang -ftime-trace 性能调查、LLVM Standard C++ Modules、CMake UNITY_BUILD
- MS 官方博客与教程:vcperf 与 WPA 教程、Build Insights 模板视图、构建吞吐量排查与调优、迁移到 C++ 命名模块、MSBuild Binlog Analyzer
- 工具站点:MSBuild Structured Log Viewer、Perfetto
- 外部素材:MS Build Insights 模板视图界面截图(
learn.microsoft.com)、Clang-ftime-trace示例(clang.llvm.org),均按引用链接使用 - 本机实测源码与原始读数:随篇入库,路径
content/blog/cpp-language-foundations-ep04-compile-budget/evidence/
下篇预告
【C/C++ 现代语言与底层】(五)优化器的边界:UB、严格别名与向量化报告——编译器为什么能把你写的循环变成一条 SIMD 指令?-ffast-math 省下的那些时间是从哪"偷"来的?未定义行为(undefined behavior)到底给了优化器多大的自由?用 /Qvec-report 与反汇编把优化器的每一次决策摊开来看。
希望能对大家有所帮助。下一篇见。
本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations