站点链接:技术博客页 | 公众号:溯光的图形笔记
Hair Strand - PMG.jpg(CC BY-SA 4.0,ConformationXII)入口:一句话该怎么说
本篇要拆的那句话里,藏着三个定义不同的东西:一条计算着色器(compute shader)接口、一套跑在显卡上的物理求解器、以及能被显卡求解的刚体;它们在 v5.6.0 里各处于什么状态,是后面各节要逐项核的。本篇的目录也按三条主线排:零到三讲柔体的机制,四到六讲它的读数与缺口,七到九把显卡那条线与三家路线收口。
一句话说清这一节:把「Jolt 到底有没有 GPU 物理」这个被反复转述的问题,压成一句能站得住的答案,并交代本篇三条线索各管哪一段、证据分几层。
0.1 一句话的答案
下面开始,把这个问题压成一句话,答案是:v5.6.0 交付了一条通用的计算着色器(compute shader)接口,而这套接口在库内的唯一内建消费者是毛发(hair);柔体(SoftBody)、布料、刚体(body)、角色与载具依旧全部跑在 CPU 上。这句话有三层要拆开。接口通用是设计意图,当前只有毛发在用是实现状态,CPU 实现长期保留是作者本人在讨论区写下的立场。收官篇要做的,是把这三层分别落到官方原文与本机读数上,让读者自己能复核。
先来看看,顺手把两条流行误引先钉住,它们在社区里被转得比原文还响。第一条「Jolt 有 GPU 物理」,它把「库内有一条计算接口」读成了「物理计算跑在显卡上」。第二条是讨论区里被反复引用的那句「强烈反对把物理库放到 GPU 上跑」,作者 jrouwe 没有说过这句话,原话出自贡献者 Jan Krassnigg,而作者在同一讨论里的表态方向恰好相反。这两条误引各自对应不同的证据面:第一条要靠全库检索与源码原文去核,第二条要靠时间戳与发言人身份去核,归档与清算留在本篇第三部分。
0.2 三条线各管什么
言归正传,柔体、毛发、GPU 这三条线,在本篇里各有明确分工,边界要先划清,后面的读数才有归属。柔体线回答的是「一个顶点网格怎样被约束成有形状的软物体」,它的证据主体是 XPBD 迭代与六类约束。毛发线回答的是「一束头发怎样在 GPU 上按科瑟拉杆(Cosserat rod)被模拟」,它的证据主体是十三组计算着色器与三级 GPU 管线。GPU 线回答的是「这条 compute 接口到底是什么、谁在用、作者怎么想」,它的证据主体是全库检索结果与作者原话。
好了,三条线也各自画了「不写」的边界。柔体线不写渲染,测试框架里的 DX12 与 Vulkan 管线细节只在「物理与渲染共用图形设备」这一层出现一次;毛发线不写美术制作,发束资产与发片贴图都不在讨论范围,只写模拟侧;GPU 线不替任何一家引擎补实现,路线对照止于「官方文档怎么写」这一层。划出这三条边界,是为了让每一条论断都能在正文里指出落点,也为了让图位只承载有信息量的对照,不去占位那些靠行内文字就能说清的导览与预告。
还要交代一句收官篇的特殊风险。本篇是系列第十三篇,前十二篇已经建立过的跨篇素材,例如第一篇的多核扩展曲线与同一台机器的硬件口径,本轮优先复用并在正文标明取自第几篇,这类复用图不计入本篇的新交付素材。柔体与毛发两节里那些看起来「新」的阅读器,多数是同一台机器上新跑的本机复现,它们的机器口径与第一篇完全一致,读者可以把它们与第一篇的读数放在同一个坐标系里看。
0.3 三层证据与版本口径
OK,本篇的读数分三种来源,混在一起就会出问题。第一种是官方文档,路径在 Docs/*.md;第二种是官方源码原文,路径在 Jolt/**;第三种是本机实测,来自 evidence/bench_softbody_hair.cpp 的 E0 到 E5 九组。凡写数字,都要注明它是「官方数值」还是「本机复现」。官方数值指头文件里写死的默认值与官方文档里写明的规矩,本机复现指在本机检出上跑出来的读数。两类来源一旦混用,读者就无法判断某个数字是引擎承诺的,还是这台机器偶然量到的。
版本口径也要交代清楚。官方源码与文档一律按 v5.6.0,链接里的 raw 路径都带 v5.6.0。本机检出的仓库是 v5.5.0-183-g765845d6,它和 v5.6.0 标签只差两个提交,改动文件只有 Build/CMakeLists.txt、Docs/APIChanges.md、Docs/ReleaseNotes.md 与 Jolt/Core/Core.h 里的版本宏。柔体、毛发与 Compute 相关源码在两版之间逐字节一致,本机行号就是 v5.6.0 行号,正文里所有行号都按这个口径读。这条口径在第一节的量规模与第三节的作业编排里各会用到一次,它保证了本机同行的行号可以对照官方 raw 文件逐字核。
本机的编译开关沿用前几篇的同一套:/DJPH_USE_DX12、/DJPH_USE_VK 与 /DJPH_USE_CPU_COMPUTE,与官方 Build/CMakeLists.txt:121–131 的默认一致;JPH_USE_MTL 在 Windows 构建里不存在,它是 macOS 专用。本机是 8 物理核加超线程,任何耗时类读数只报比值,不报绝对毫秒,也不跨机器比。这套口径贯穿全篇,柔体与毛发都按它跑。
源码落点:本篇的版本与证据口径,对应官方发布页 https://github.com/jrouwe/JoltPhysics/releases/tag/v5.6.0 与仓库主页 https://github.com/jrouwe/JoltPhysics ,三层证据的原始出处见 Docs/Architecture.md 与 Docs/ReleaseNotes.md。其中: 柔体与毛发的「仍在开发」标注都写在各自的头文件里,后面每一节会给出对应行号,读者可对照 raw 文件逐字核;本机检出与 v5.6.0 只差两个提交的结论,也是按这四份文件核对得到。
一、柔体是什么:一个仍在开发中的 Body
柔体的定义只落在 Body 这一个类上:它与刚体共用同一个 Body 接口,靠 Body::IsSoftBody 区分,靠把 GetMotionProperties() 转成 SoftBodyMotionProperties 才拿到粒子级的状态。
一句话说清这一节:柔体到底是引擎里的哪一类对象,官方在把它交出来之前先声明了什么,它默认有多大、放开之后怎么落,又缺了哪几件事。
1.1 官方自己先声明「仍在开发」
依然是惯例,柔体在交付时仍带着一份「开发中」的标注,官方在头文件的第一屏就写明了这一点。Jolt/Physics/SoftBody/SoftBodyCreationSettings.h 的类注释只有两行,第一行说这个类保存创建柔体所需的信息,第二行直接给出警告:柔体仍在开发中,并带有若干注意事项。这两行是整节的总纲,后面所有缺口都能在这里找到伏笔,也是官方把「当前状态」写在接口入口处的一种做法。
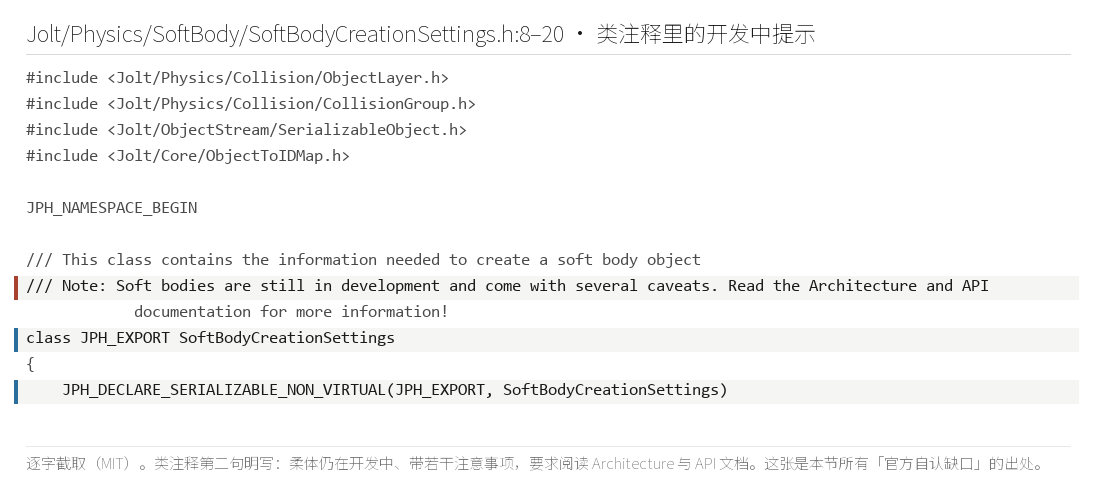
SoftBodyCreationSettings.h:11–12):Note: Soft bodies are still in development and come with several caveats.。「仍在开发」是官方自己写的,不是外界的评价@ Jolt Physics v5.6.0 源码原文截取(MIT)这段注释的口径要点在于「still in development」与「several caveats」两个短语。它指向 Docs/Architecture.md 里那张五条的缺口清单,也指向头文件自身那组为「开发中」状态服务的默认值。官方没有把这段警告藏在文档深处,它就在创建对象要读到的第一个头文件里。1.4 会把那五条逐一列出,本篇第二部分还会逐条复现。
这段注释没有给出任何时间表。官方既没有写「将在某版本完成」,也没有写「不打算完成」,它只标注当前状态。对使用者来说,这条口径的实际含义是:可以把柔体用起来,但要为它在某些方向上的缺失准备退路,例如柔体之间不互撞,需要自己在应用层补一层碰撞处理。
1.2 三步创建与「简化版」
Docs/Architecture.md 第 427 到 433 行给出柔体的创建流程与实现口径。官方把创建拆成三步:先建 SoftBodySharedSettings,再把顶点与约束灌进去,最后交给 PhysicsSystem;同时说明柔体的 Body 实现「尽量实现接口,但那是现实的简化版」。三步创建这套流程决定了柔体的数据在创建期就已经定型,顶点、面与约束在运行期不再增删,这是柔体与刚体在架构上的第一处分歧。
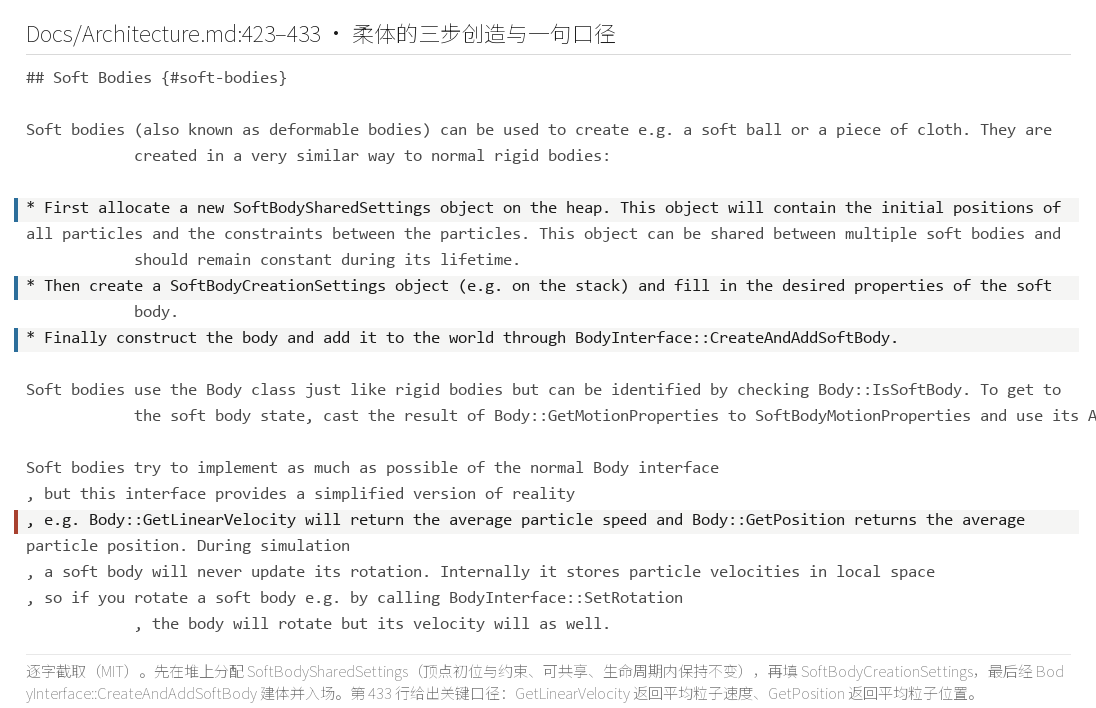
Architecture.md:427–433):先进 SoftBodySharedSettings、再填 SoftBodyCreationSettings、最后经 BodyInterface::CreateAndAddSoftBody 入世界;Body::GetPosition 与 GetLinearVelocity 返回的是粒子平均位置与平均速度@ Jolt Physics v5.6.0 官方文档原文(MIT)下面开始,「简化版」具体简化在哪里,官方写得很直白。Body::GetLinearVelocity 返回的是粒子平均速度,Body::GetPosition 返回的是平均粒子位置,而模拟过程中柔体从不更新自身的旋转。这三句是理解后面所有读数的钥匙。速度按粒子存这条尤其关键,它直接解释了为什么 SetLinearVelocity 对柔体不生效,也解释了为什么会有一处默认值叫「不更新 body 位置」。
后面会量到一处偏差。Body::GetPosition 在本机返回的正是顶点包围盒的中心,与文档写的「平均粒子位置」不相等,1.3 那张表的两列正是这个差。本篇的读法是把文档原文与本机读数并排摆出,让读者看到概括与实现之间那点缝隙。
三步创建还有一个容易被忽略的后果:柔体的形状完全由创建时的共享设置决定。顶点怎么连边、哪些三角围成一个四面体、要不要加弯曲约束,都在 SoftBodySharedSettings 里定死。运行期能改的只有少数整体量,例如整体的阻尼、压力与重力倍率,单根边或单个顶点的约束关系不在运行期调整。这条性质塑造了整个柔体模块的能力边界。
1.3 默认规模与落地轨迹:E0 的读数
先来看看,一个柔体默认有多大、放开之后怎么落,用官方样例函数量一次最清楚。本机用 sCreateCube(5, 0.5f) 造出一个立方体柔体,两个参数的含义是 5 段细分、边长 0.5 m。规模读数如下:顶点 125、面 192、边约束 300、体积约束 384、二面角(dihedral)弯曲 0、长程附着(Long Range Attachment, LRA)0;GetNumIterations() 读到 5,GetPressure() 读到 0.000000;包围盒 2000×2000×2000 mm,顶点质心初始 y 为 4000.0000 mm,自算体积 8.0000e9 mm³(本机复现)。
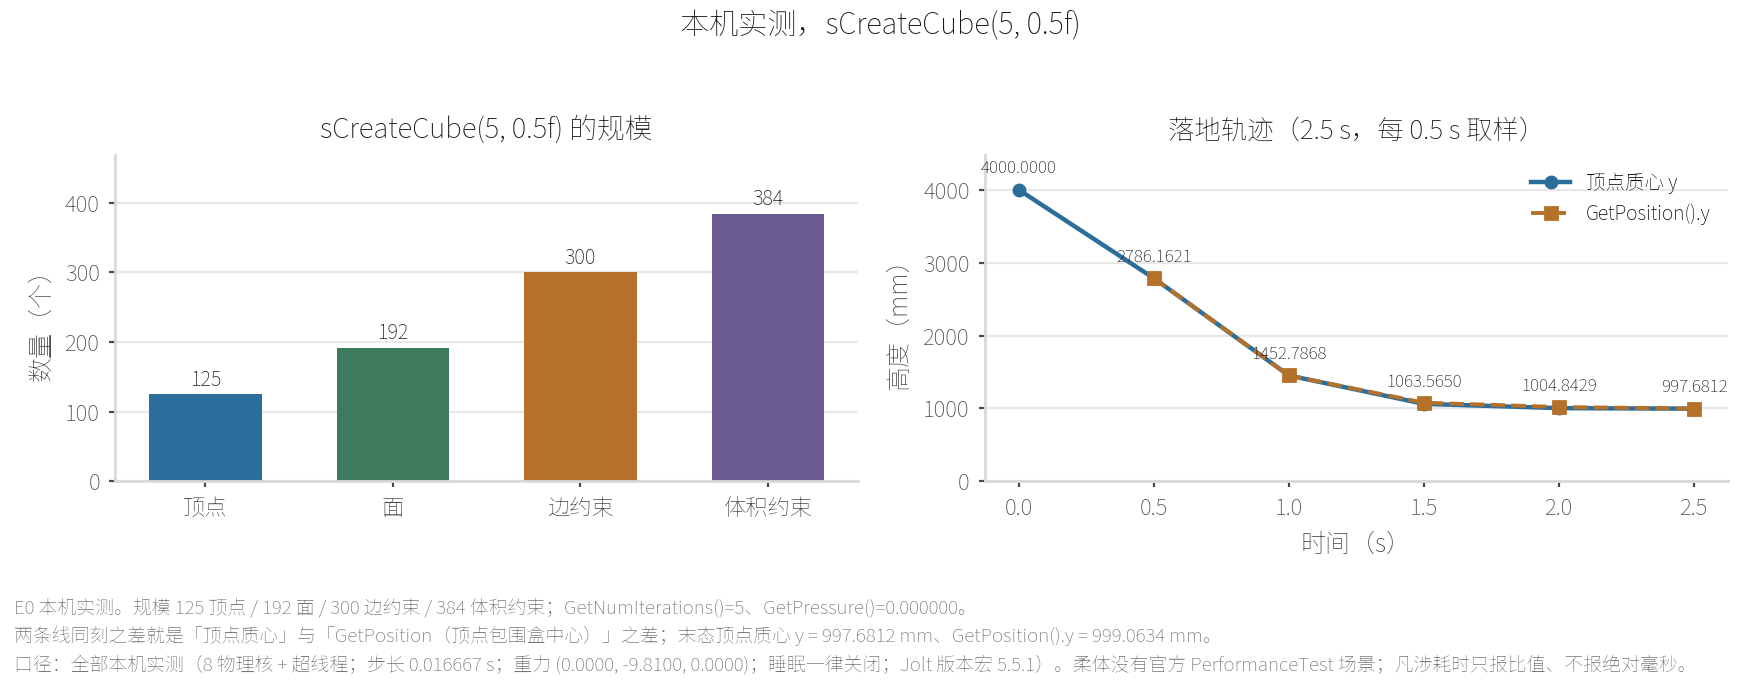
sCreateCube(5, 0.5f) 造出的柔体是 125 粒子、192 面、300 条边约束、384 条体积约束,默认求解迭代 5 次;从 y = 4 m 落到 2.5 s 时顶点质心 y 为 997.6812 mm,同刻 GetPosition().y 为 999.0634 mm@ 本机基准实测(原创)这组数里有两类来源要分清。顶点、面与三类约束的条数是本机复现,它们由 sCreateCube 的拓扑决定;求解迭代 5 次与压力 0 是官方数值,mNumIterations 的默认值就是 5,mPressure 的默认值就是 0.0。125 与 192 这两个数还有一层几何含义:一个 5 段细分的立方体每条棱被切成 5 段,顶点落在表面与内部的规则网格上,192 个面围成封闭外壳,体内的四面体则贡献了 384 条体积约束。体积约束的条数比边约束还多,原因在于每一条内部三角与一个顶点都能配出一个四面体。
E0 还留了一列落地读数。把柔体从 y=4 m 放开,重力开、有地板,每 0.5 s 记一次顶点质心 y:4000.0000 → 2786.1621 → 1452.7868 → 1063.5650 → 1004.8429 → 997.6812 mm,最后收在 997.6812 mm。同一时刻的 GetPosition().y 读到的却是 2786.1619、1452.9649、1079.8384、1020.2339、999.0634 mm(本机复现)。两列并不相等,越到后段差得越明显,1.2 那段「简化版」口径在这里拿到了现场证据。
体积那一列也值得看一眼。柔体从 8.0000e9 mm³ 出发,落地后自算体积约 7.9906e9 mm³,收缩不到千分之一。落地过程里柔体被地板顶着,体积几乎不变,这一档默认约束把形状守得相当稳。落定高度 997.6812 mm 与边长 500 mm 的关系也对得上:柔体底部触地后,质心停在接近边长两倍的量级,因为立方体在落定后略有摊开。
1.4 五条缺口清单
言归正传,柔体「仍在开发」到底缺什么,官方在 Docs/Architecture.md 第 455 到 463 行列了五条。逐字读:柔体只能与刚体碰撞,柔体之间的碰撞尚未实现。AddTorque、SetLinearVelocity 这类接口对柔体无效,因为速度按粒子存、不按 body 存。浮力(buoyancy)计算尚未实现。约束(constraint)不能作用在柔体上,要把某个粒子的逆质量(inverse mass)设为零、再靠给速度来把柔体钉住。计算摩擦与弹性时传给接触约束管理器的子形状 ID(SubShapeID)是空的,因为该回调按 body 对调用。这五条是整节的缺口索引。
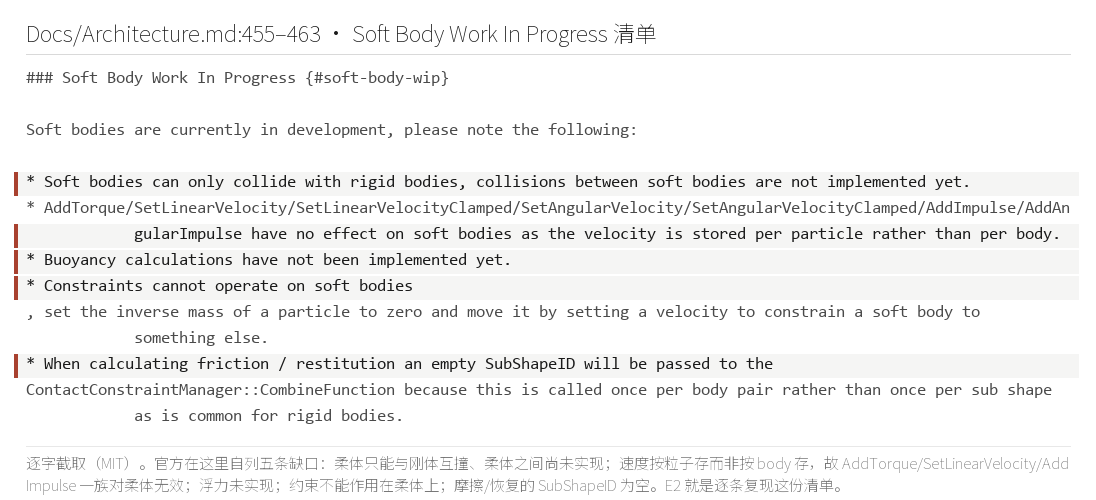
Architecture.md:455–463):柔体只与刚体碰撞、速度类接口对柔体无效、浮力尚未实现、约束不能作用到柔体、摩擦与弹性的合成回调拿到的是空的 SubShapeID@ Jolt Physics v5.6.0 官方文档原文(MIT)这五条里有四条在本篇第二部分有对应的本机复现:两个柔体对穿验证第一条,给柔体设线速度再读回验证第二条,调用浮力接口读返回值验证第三条,第四条「约束不能作用到柔体」在官方样例里有正面替代方案,即把粒子逆质量设零。第五条只在接触回调的参数层面可见,测试侧用一个空的子形状 ID 就能触发。先把它们列全,是为了让后面每一处「官方说缺」都能回到这张清单上对号。
把五条并排看,会发现它们指向同一个根因:柔体没有把自己当作一个整体的刚体来暴露接口。速度按粒子存、子形状 ID 为空、约束作用在粒子而非 body 上,都是「体」与「粒子」两层没有完全对齐的表现。理解这条根因,就能预判还有哪些刚体接口在柔体上会失灵,例如整体的角速度与旋转。
源码落点:本节「仍在开发」标注与创建口径,对应 SoftBodyCreationSettings.h 与 Docs/Architecture.md,柔体样例目录见 SoftBodyCosseratRodConstraintTest.cpp。其中: 三步创建、五条缺口与「简化版」三处原文都在 Architecture.md,行号按本机口径即 v5.6.0 行号;E0 的规模、落地与体积读数由 evidence/bench_softbody_hair.cpp 产出,属本机复现。
二、六类约束:柔体的形状由什么维持
一句话说清这一节:柔体看上去是一团会变形的顶点,它的每一处形状都由一类约束在维持,这一节把六类约束逐类拆开,给出各自的官方原文行号与它维持的那个量。
2.1 六类约束全景
好了,柔体的形状由六类约束叠出来,它们分别是边约束、二面角弯曲、体积约束、长程附着、科瑟拉杆与蒙皮。它们的共同点在「保持」二字:边约束保持相邻两顶点距离等于静止长度,二面角弯曲保持两个三角面沿共享边的夹角,体积约束保持四面体体积。长程附着限制动点到最近动学点的距离,科瑟拉杆保持一段杆的长、惯性与朝向,蒙皮(skinning)把顶点绑到关节上。理解柔体,先理解这六类各维持什么,再看它们如何被默认开关点亮或关闭。
这六类并非每类都在 sCreateCube 里出现。1.3 的读数显示,那个立方体用了边约束 300、体积约束 384,二面角弯曲与长程附着都是 0,科瑟拉杆与蒙皮也都不涉及。不同构造路径点亮不同约束:CreateConstraints(...) 只铺边与弯曲,体积与压力要另外开关,科瑟拉杆由专门样例处理,蒙皮则在 SkinnedConstraintTest 这类场景里出现。约束之间还有成本差异,越靠几何的越便宜,越靠夹角与朝向的越贵。下面三节按「几何距离、面与体、杆与附件」的顺序展开。
柔体的约束还有个统一接口,就是柔度(compliance)。所有柔性约束都带一个 mCompliance 字段,它是刚度的倒数,值越大越软。把刚度写成柔度,是为了让求解器在迭代里用同一套乘子处理量纲不同的约束。边约束的量纲是长度差,体积约束的量纲是体积差,二面角的量纲是角度差,它们本不能直接相加,XPBD 靠柔度与时间步的归一化把它们放进同一个迭代框架。这条口径是第三节的前提。
2.2 几何距离:边约束与二面角弯曲
OK,边约束是柔体最基础的一类。SoftBodySharedSettings.h 第 156 到 171 行的 Edge 结构注释写明:它保持 |x1 - x2| 等于静止长度(rest length),静止长度由 CalculateEdgeLengths 算出;关键字段 mCompliance 是刚度的倒数,值越大越软。边约束的数量与网格拓扑挂钩,一个顶点连的邻居越多,参与的边约束越多,局部也越硬。
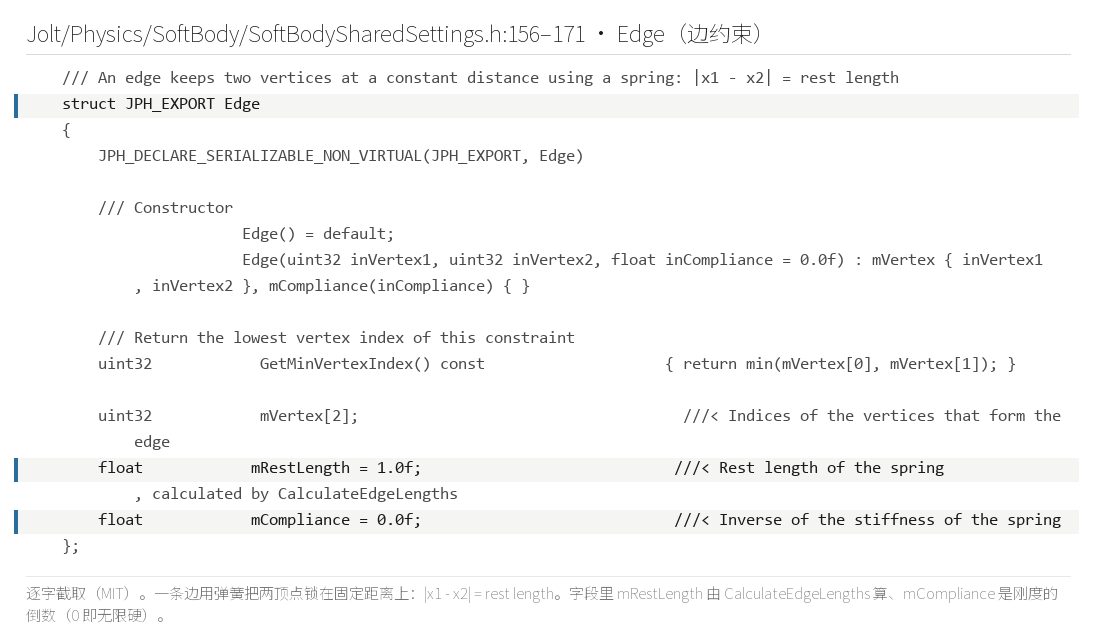
SoftBodySharedSettings.h:156–171):它把两个顶点的距离保持在静止长度上,mRestLength 由 CalculateEdgeLengths 算出,mCompliance 是刚度的倒数@ Jolt Physics v5.6.0 源码原文截取(MIT)二面角弯曲(DihedralBend)比边约束贵一档,它沿共享边保持两个三角面之间的夹角。同一文件第 173 到 205 行给出该结构的注释,并列了三篇文献出处:Müller 的「Position Based Dynamics」、Müller 的「Strain Based Dynamics」与 Bridson 的「Simulation of Clothing with Folds and Wrinkles」。官方在枚举 EBendType 里把弯曲分成三档,Dihedral 最贵,好处是能处理初始就不共面的三角。
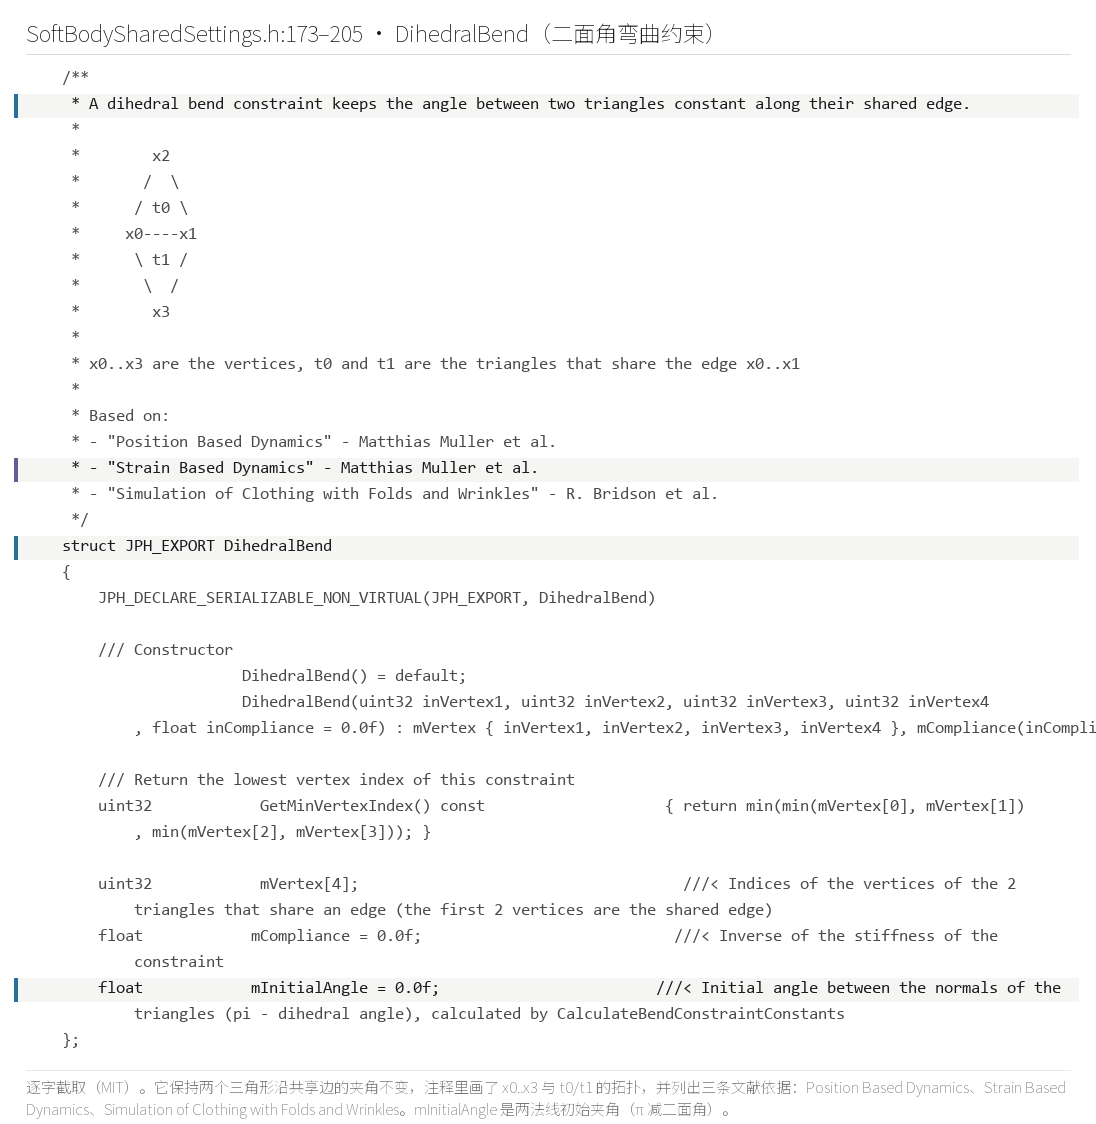
SoftBodySharedSettings.h:173–205):保持共享一条边的两个三角面之间的夹角,注释里画了 ASCII 示意图并给出三篇文献(Position Based Dynamics、Strain Based Dynamics、Simulation of Clothing with Folds and Wrinkles)@ Jolt Physics v5.6.0 源码原文截取(MIT)本机那一组读数里二面角弯曲为 0,说明 sCreateCube 这条路径只铺了边约束。要用弯曲约束,得在创建共享设置时按 EBendType 指定档位,代价会在迭代里按约束条数放大。对同一拓扑,边约束数与弯曲约束数往往不成一比一,弯曲约束的条数常按共享边数计,而一条共享边两侧各有一个三角面,运算里要读四个顶点。一个管长度,一个管夹角,两类几何约束合起来,决定了柔体在拉伸与弯折两个方向上的手感。
弯曲约束还有一处默认细节。CreateConstraints(...) 把夹角容差取为 DegreesToRadians(8.0f),也就是 8 度。这个容差决定多小的角度偏差会被当作已满足,容差越大,弯曲越松。对软布料这类场景,8 度是个偏松但不至于塌的值;要更挺括的面料感,就得把它调小并承担更多迭代。
2.3 面与体:体积约束与长程附着
依然是惯例,体积约束把一对三角面与一个内部顶点构成的四面体拴住。SoftBodySharedSettings.h 第 207 到 222 行的 Volume 注释写的是保持四面体体积不变,字段 mSixRestVolume 存的是静止体积的六倍。用六倍而非一倍,是为了让体积公式少一个常数因子,四面体体积公式里本就带一个六分之一,预先乘六可以把除法挪出迭代循环。那个立方体用了 384 条体积约束,远多于 300 条边约束,这些四面体共同围出封闭的表面。
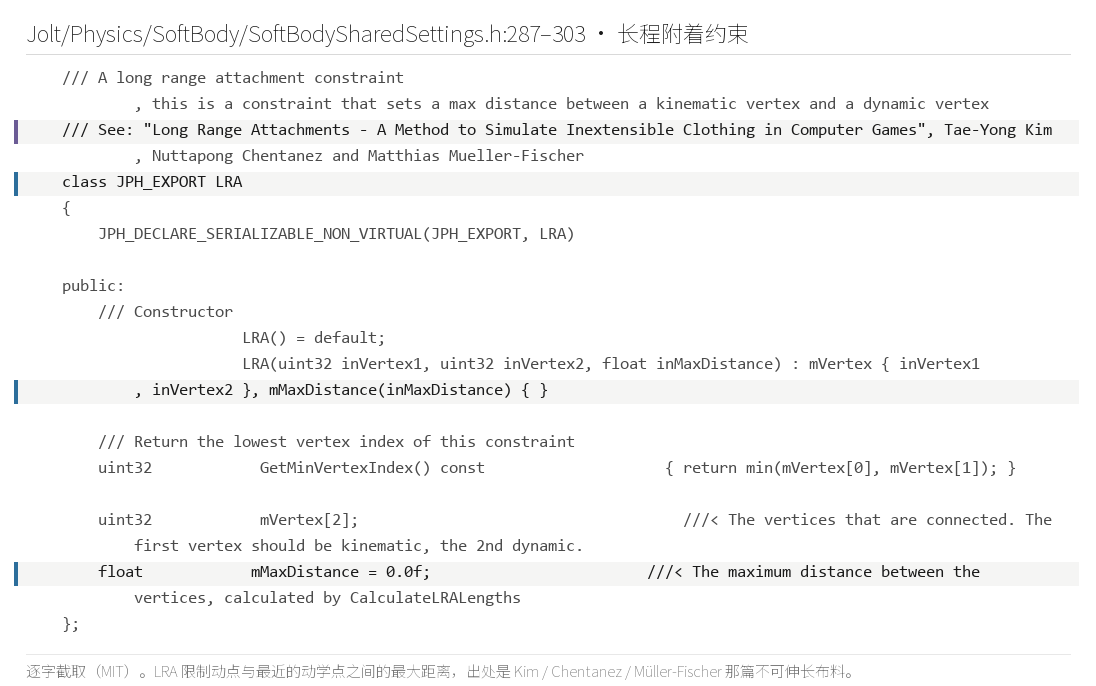
SoftBodySharedSettings.h:287–303):它限制一个动点与最近的动学点之间的最大距离,出处是 Kim、Chentanez 与 Müller-Fischer 那篇不可伸长布料@ Jolt Physics v5.6.0 源码原文截取(MIT)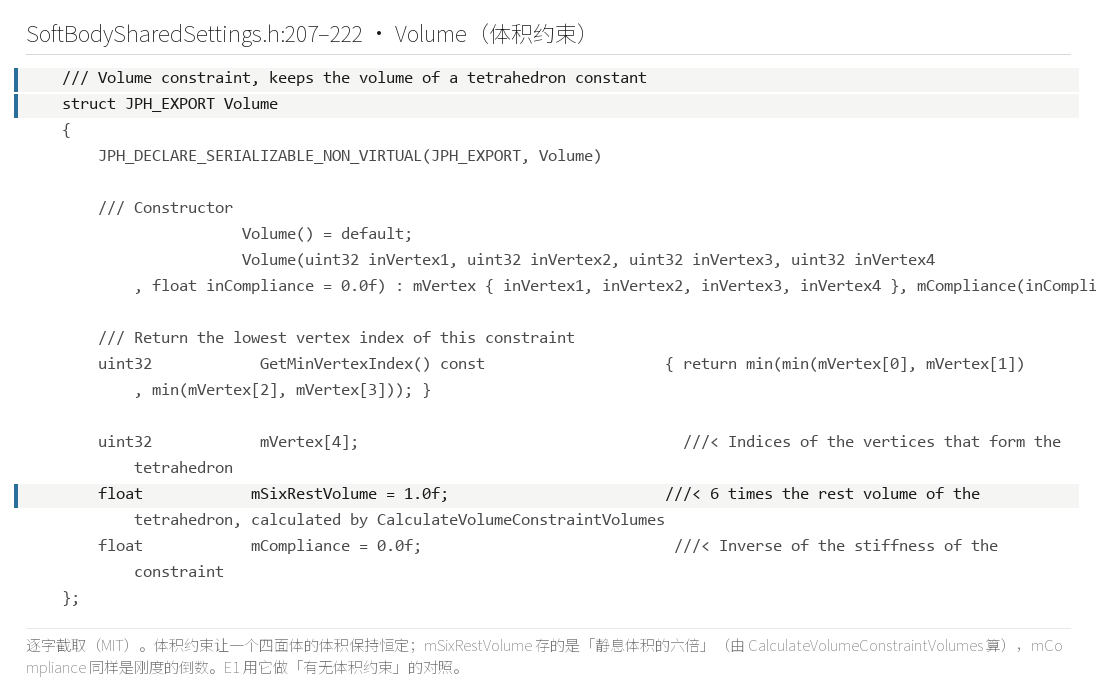
SoftBodySharedSettings.h:207–222):保持一个四面体的体积不变,mSixRestVolume 是静止体积的六倍(省掉一次除法)@ Jolt Physics v5.6.0 源码原文截取(MIT)体积约束的分量在本篇第二部分会有一处对照读数。E1 用零重力、无地面把压力项隔离出来,量到有体积约束时压力 5000 只让体积变 −0.028%,去掉体积约束后同样压力让体积变 +0.598%(本机复现)。同一档压力,体积约束在不在,结果差约二十倍。这条对照留到第二部分展开,此处先记住体积约束是「压力能不能推动体积」的那个开关。若把体积约束当作柔体的骨架,压力就是往骨架里充气的手。
长程附着(Long Range Attachment, LRA)是六类里的附件类约束,官方注释说它限制动点与最近动学点之间的最大距离,出处是 Kim、Chentanez 与 Müller-Fischer 的工作。这个立方体里 LRA 为 0,因为 sCreateCube 不铺它;它在需要把柔体挂到某个可动锚点的场景里才点亮,例如一件悬在衣架上的布,锚点动了,远处的顶点也不会被甩得过远。LRA 的价值在于抑制长距离的过度拉伸,而边约束只约束相邻顶点,管不到隔了很远的两个点。
那一组零点几到二十几的角速度对照与体积约束没有关系,它量的是科瑟拉杆的朝向稳定性,放在下一节交代。这里把面与体两类约束收齐,也给附件类里最轻的 LRA 留了位置,柔体的约束族到此已列出五类,剩下最重的一类科瑟拉杆单独讲。
2.4 杆与附件:科瑟拉杆与两个枚举
下面开始,科瑟拉杆(Cosserat rod)是柔体里最特别的一类约束,它把一根杆当成同时有长度、有惯性和有朝向的刚杆。SoftBodySharedSettings.h 第 305 到 342 行给出两件套:RodStretchShear 连接两个粒子、定长、带惯性,mBishop 存的是杆的 Bishop 框架;RodBendTwist 连接两根相邻杆,限制弯曲与扭转。官方在这段注释里有一句警告:每根杆至少要有一根 RodBendTwist 约束来定住朝向,否则杆的取向会绕杆轴以恒定角速度自转。出处是 Kugelstadt 与 Schoemer 的「Position and Orientation Based Cosserat Rods」。
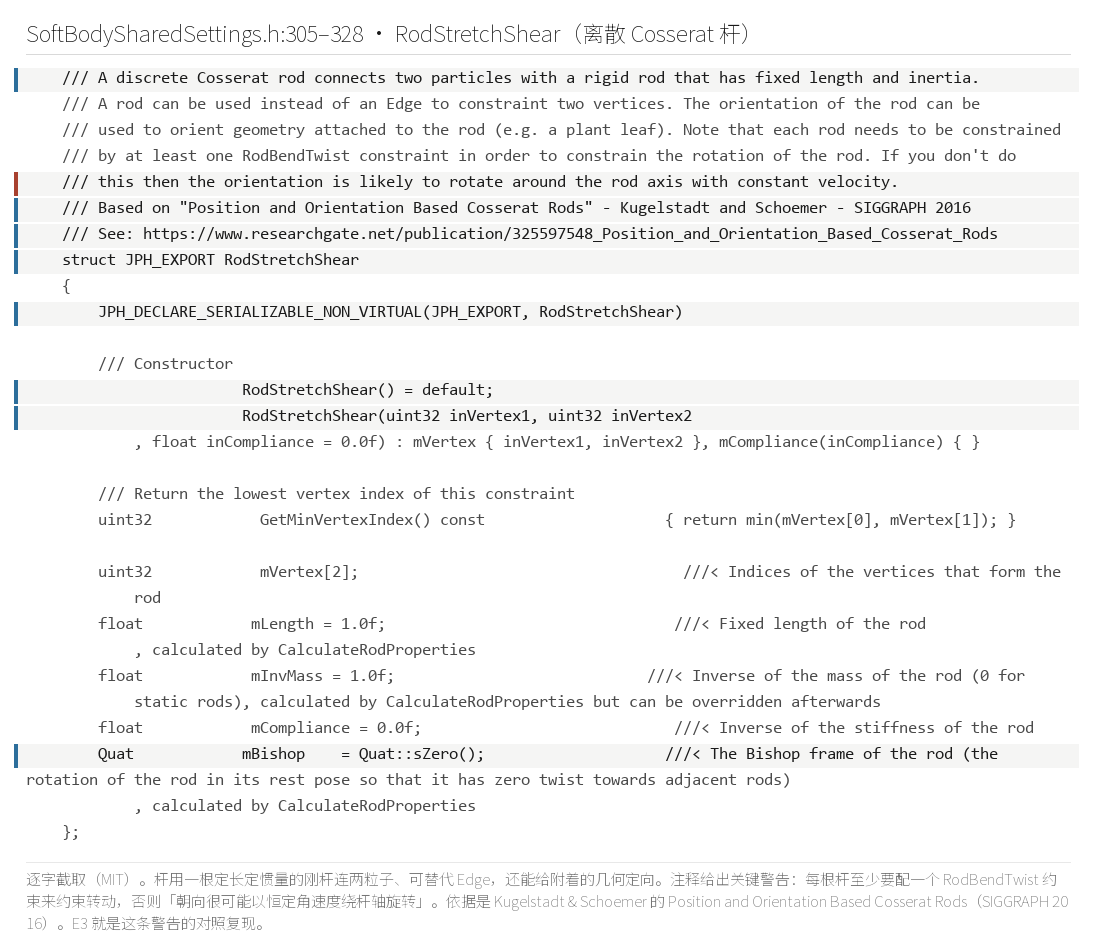
SoftBodySharedSettings.h:305–328):RodStretchShear 连接两粒子并给定长度与惯性,RodBendTwist 限制两根杆之间的弯曲与扭转;注释里那句警告写明「若没有至少一条 RodBendTwist 约束,杆的朝向会绕杆轴以恒定角速度旋转」@ Jolt Physics v5.6.0 源码原文截取(MIT)这处警告在本篇第二部分有对照复现。本机量到有 RodBendTwist 时,末态各杆角速度之和是 0.028656 rad/s;去掉它之后升到 24.686938 rad/s(本机复现)。两个数差三个数量级,正好印证「不计扭转会绕杆轴自转」这句。更细的数列也一致:有约束时第一根杆的角速度从 0.1890 一路衰减到 0.0022 rad/s,没有约束时它在 5.0125 与 5.1399 之间来回摆动,末态不收敛。
同一文件第 21 到 34 行给出两个枚举,它们决定约束族里的可选档位。EBendType 有三种弯曲类型:None、Distance 与 Dihedral,其中 Dihedral 最贵但支持初始不共面的三角;ELRAType 有两种长程附着类型:EuclideanDistance 与 GeodesicDistance。CreateConstraints(...) 的默认是 EBendType::Distance,夹角容差取 DegreesToRadians(8.0f)。
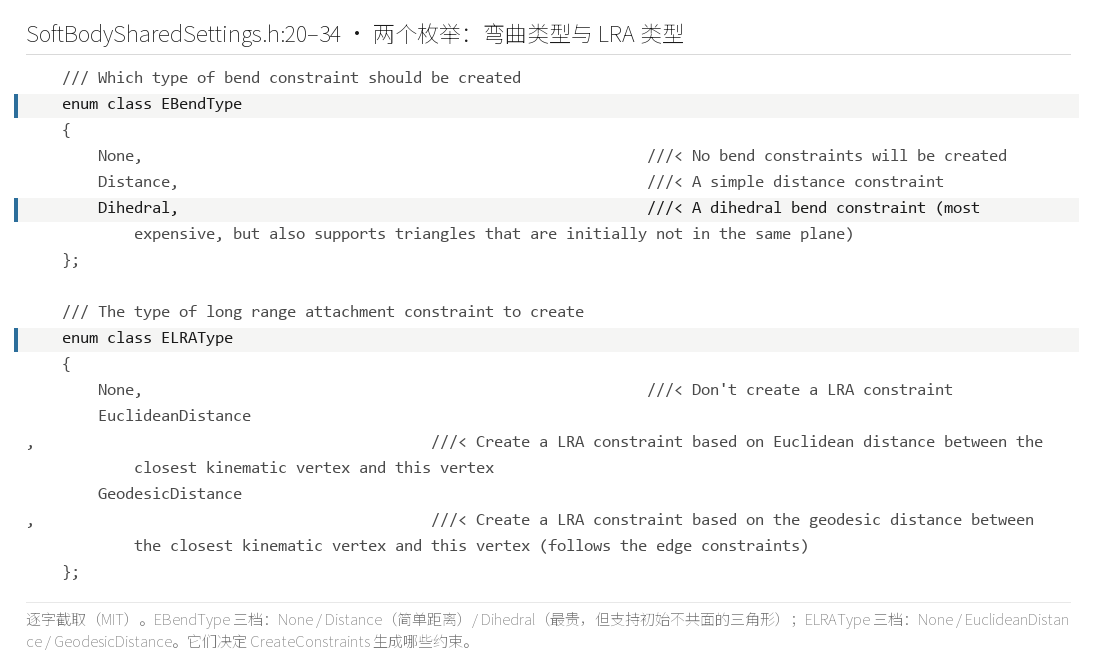
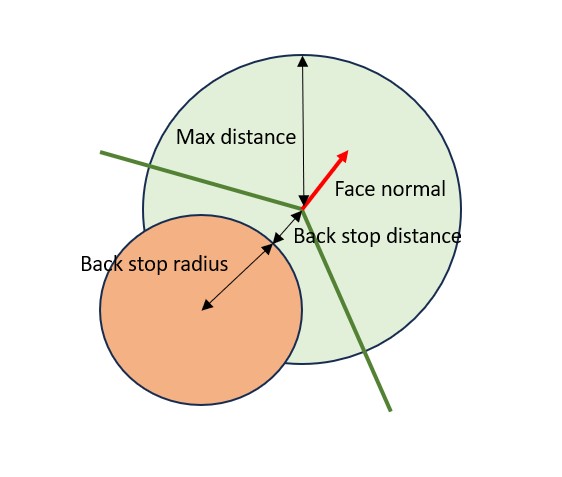
SoftBodySharedSettings.h:21–34):EBendType 取 None / Distance / Dihedral(Dihedral 最贵,但支持初始不共面的三角),ELRAType 取 None / EuclideanDistance / GeodesicDistance@ Jolt Physics v5.6.0 源码原文截取(MIT)把两个枚举与前面的六类约束对齐,可以看到官方的默认取向:几何上先用便宜的 Distance 弯曲,附件上默认不铺 LRA,需要更准的夹角再手动切到 Dihedral。蒙皮族则另有 InvBind、SkinWeight 与 Skinned 三件套,把顶点绑到关节,并带 mMaxDistance 与背面停止的距离与半径。官方唯一一张柔体机制配图 SoftBodySkinnedConstraint.jpg 画的就是这套球与背面停止球,它是官方 Docs/Images 里十四张图中唯一与柔体相关的一张。
源码落点:本节六类约束的原文都在 SoftBodySharedSettings.h,蒙皮机制配图见官方 Docs/Images/SoftBodySkinnedConstraint.jpg,科瑟拉杆的用例见官方样例 SoftBodyCosseratRodConstraintTest.cpp。其中: Edge、DihedralBend、Volume、LRA 与科瑟拉杆两件套的行号按本机口径即 v5.6.0 行号;E1 与 E3 的对照读数为本机复现,完整数列在正式档里。
三、XPBD 与四段 job:柔体怎么被算出来
XPBD 的原理与刚体那套顺序冲量求解不是一回事:它把每个约束写成一个带柔度(compliance)的投影,迭代里反复把约束误差投影回位置,再把位置的变化折成速度。
一句话说清这一节:上一节讲了柔体由哪六类约束维持形状,这一节讲这些约束在每一步里按什么算法被求解,以及求解过程被切成了哪四段作业。
3.1 XPBD 是什么
先来看看,柔体的求解器走的是 XPBD,全称扩展位置约束动力学(XPBD, Extended Position Based Dynamics)。SoftBodyMotionProperties.h 第 32 行给出出处:基于 Matthias Müller 的 Ten Minute Physics 系列。位置约束动力学(Position Based Dynamics, PBD)的思路是先按下落速度积分出新位置,再按各类约束把位置拉回可行域,拉回的动作直接改位置,不修改速度,最后再由位置差反推速度。XPBD 在 PBD 之上加了柔度与时间步的归一化,让同一套约束在不同步长下表现出接近的刚度。
SoftBodyMotionProperties.h:32):Based on: XPBD, Extended Position Based Dynamics, Matthias Muller, Ten Minute Physics。柔体走的是 XPBD,与刚体那套顺序冲量不是同一套迭代@ Jolt Physics v5.6.0 源码原文截取(MIT)2.1 提到的 mCompliance 是刚度的倒数,正是这套口径的接口。在 XPBD 里,约束被满足的程度由一个乘子决定,乘子的大小与柔度、时间步有关;柔度越大,同样一次迭代能把约束修正到位的幅度越小。柔体与刚体在这里分道扬镳:刚体走顺序冲量法,用速度层面的冲量来解约束;柔体走 XPBD,用位置层面的投影来解约束。第九篇写过的接触求解那套顺序冲量,不适用于柔体,两套迭代的思路并不相同。
PBD 与 XPBD 还有一处工程上的好处:约束是局部可并行的。一条边约束只读两个顶点,一条体积约束只读四个顶点,只要两个约束不共享顶点,它们就能同时算。柔体的顶点以百计、约束以百计,约束间的依赖是稀疏的,这为后面四段作业里的并行切分提供了空间。本机在单线程下量到柔体每步耗时约是同等规模刚体的 8.55 倍(本机复现,只报比值),这个倍数里既有约束数量,也有 XPBD 迭代本身的开销。
3.2 四段 job 的编排
言归正传,柔体的模拟被切成四段作业(job),排列在 PhysicsUpdateContext.h 第 142 到 145 行:mSoftBodyPrepare、mSoftBodyCollide、mSoftBodySimulate、mSoftBodyFinalize。前三段里碰撞与模拟是数组,准备与收尾各是一个。四段的名字直接对应职责,Docs/Architecture.md 第 1022 到 1036 行给出逐段说明,这四段是最能说明「柔体怎样嵌进主循环」的一处。
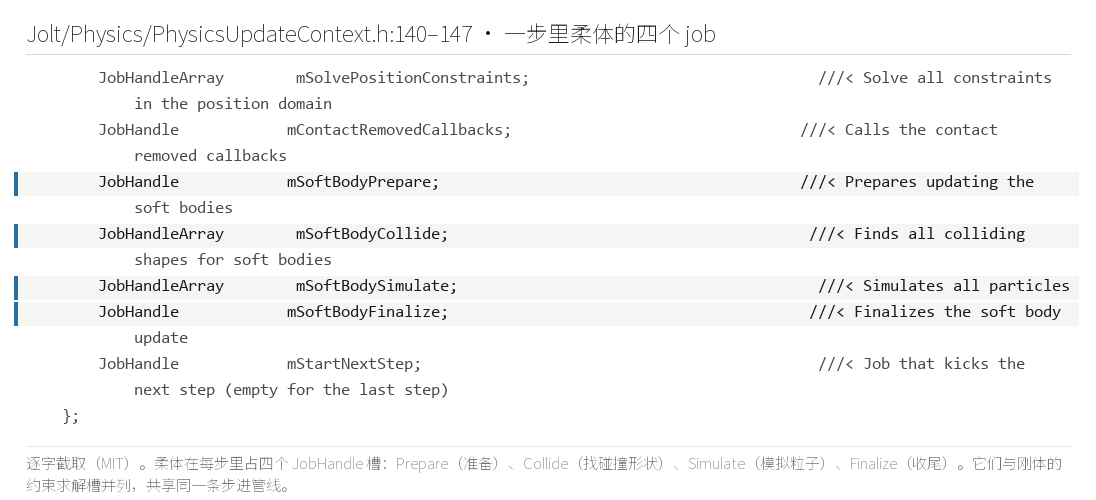
PhysicsUpdateContext.h:142–145):mSoftBodyPrepare、mSoftBodyCollide、mSoftBodySimulate、mSoftBodyFinalize,前三段是 job 数组、收尾段是单个 job@ Jolt Physics v5.6.0 源码原文截取(MIT)准备段负责建上下文。官方原文说它创建碰撞、模拟与收尾三段作业,并生成一张排好序的 SoftBodyUpdateContext 列表。碰撞段做宽相(broadphase),一个线程领走一个柔体,用它的包围盒去找相交的刚体。模拟段做真正的计算,先让多个线程分工处理柔体的顶点批次与刚体的碰撞,再用 XPBD 迭代。收尾段把刚体的速度改动写回,并更新柔体的位置与速度。四段串起来,柔体就完成了与主循环的一次交互。
SoftBodyUpdateContext 的顺序;碰撞段对每个柔体做宽相、找出相交的刚体;模拟段先把顶点批与刚体碰撞、再按 XPBD 模拟,一个柔体也能被多线程切分;收尾段写回刚体的速度变化并更新柔体状态@ 本系列绘制四段作业是插在全库主循环里的一小块。前几篇写过 PhysicsSystem 的更新流程,柔体这四段就挂在其中的软体专用分支上,名字里的 mSoftBody 前缀把它们与刚体的岛并行、接触求解等作业区分开。柔体在同一套作业系统里占了几格,它没有一个独立的主循环,这也是它能在开启柔体而关闭其它系统时仍被单独调度的原因。
3.3 一个柔体也能被多线程切分
好了,四段里最该留意的是模拟段的并行粒度。官方明写「多个线程可以同时处理同一个柔体」,也就是单个柔体内部也能被切开分摊到多个线程;刚体的并行通常停在岛这一级,一个刚体不会被拆到多个线程。柔体的顶点数以百计,切分空间比刚体大得多,这正是一个大柔体也能吃满多核的原因。
这条粒度差异有它的物理来源。刚体的每一块都是一个不可分的整体,它的位置与旋转不参与约束间的并行;柔体由一堆粒子和约束组成,约束之间只要不共享顶点就能并行施加,于是「一个体」这一层就被打开了。3.1 说过约束依赖是稀疏的,稀疏性让切分成为可能,而模拟段的顶点批次划分把这层可能性落成了具体的作业分派。
四段作业也解释了为什么柔体的准备段与收尾段只用一个作业:它们的活儿是编排与汇总,本身不重。真正吃算力的是中间两段,碰撞段按柔体的个数摊开,模拟段按顶点批次摊开,前者依赖场景里有多少个柔体,后者依赖单个柔体有多大。
3.4 一次迭代里的施加顺序
OK,四段作业之外,一次 XPBD 迭代内部还有固定的施加顺序,落在 SoftBodyMotionProperties.h 第 257 到 300 行。这段代码按次序处理各类约束:先施加压力项,再做位置积分,随后依次施加边、弯曲、体积、长程附着与科瑟拉类约束,最后处理碰撞约束。顺序固定意味着同一场景在同一机器上可复现,这也是本篇所有 E 组读数能在三次复跑里逐行一致的前提。
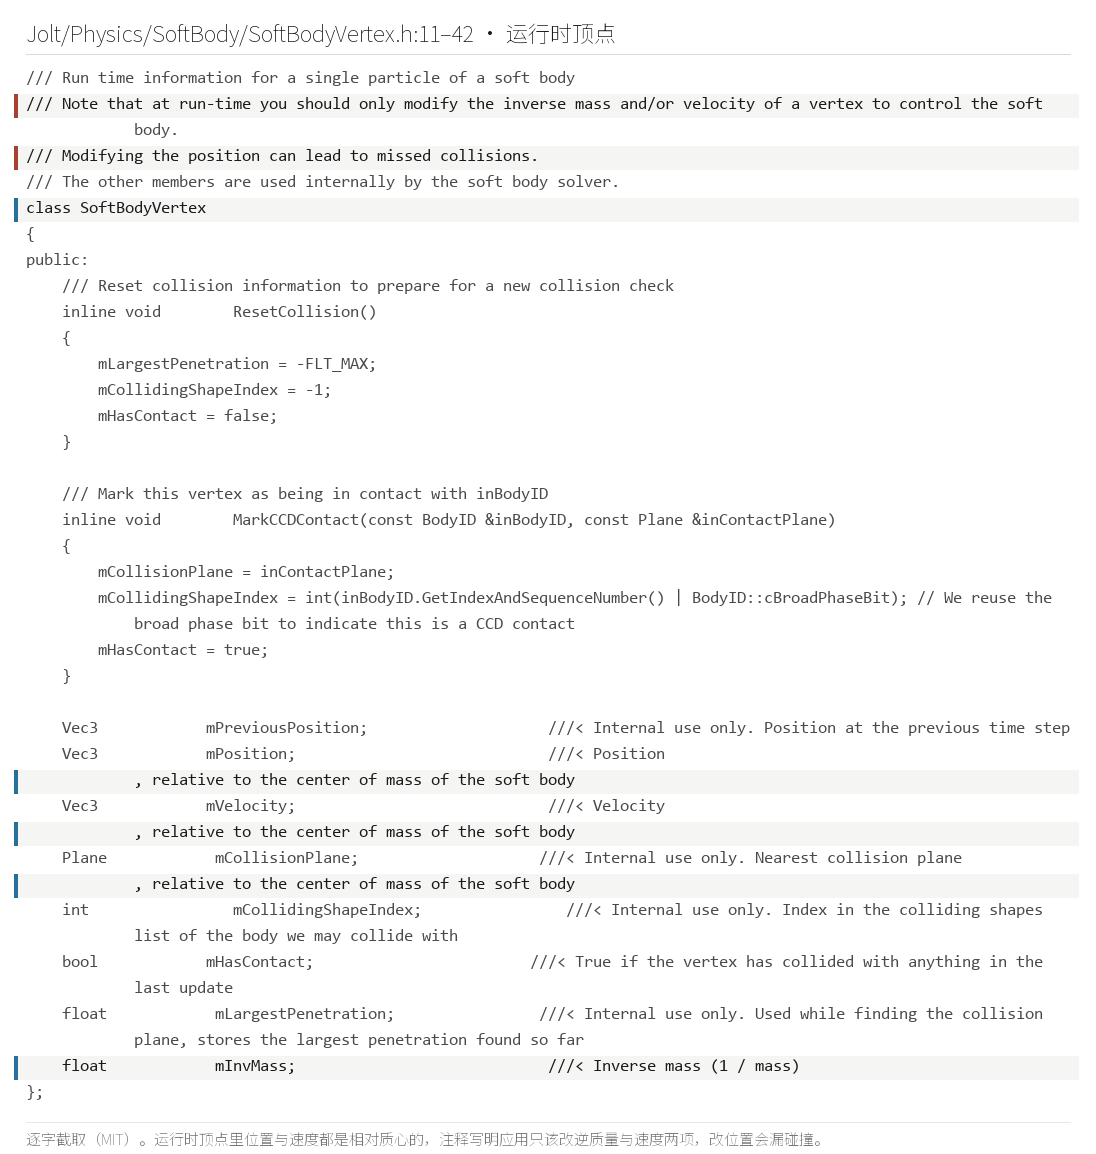
SoftBodyVertex.h:11–42):位置与速度都是相对质心的,注释写明应用只该改逆质量与速度两项,改位置会漏碰撞@ Jolt Physics v5.6.0 源码原文截取(MIT)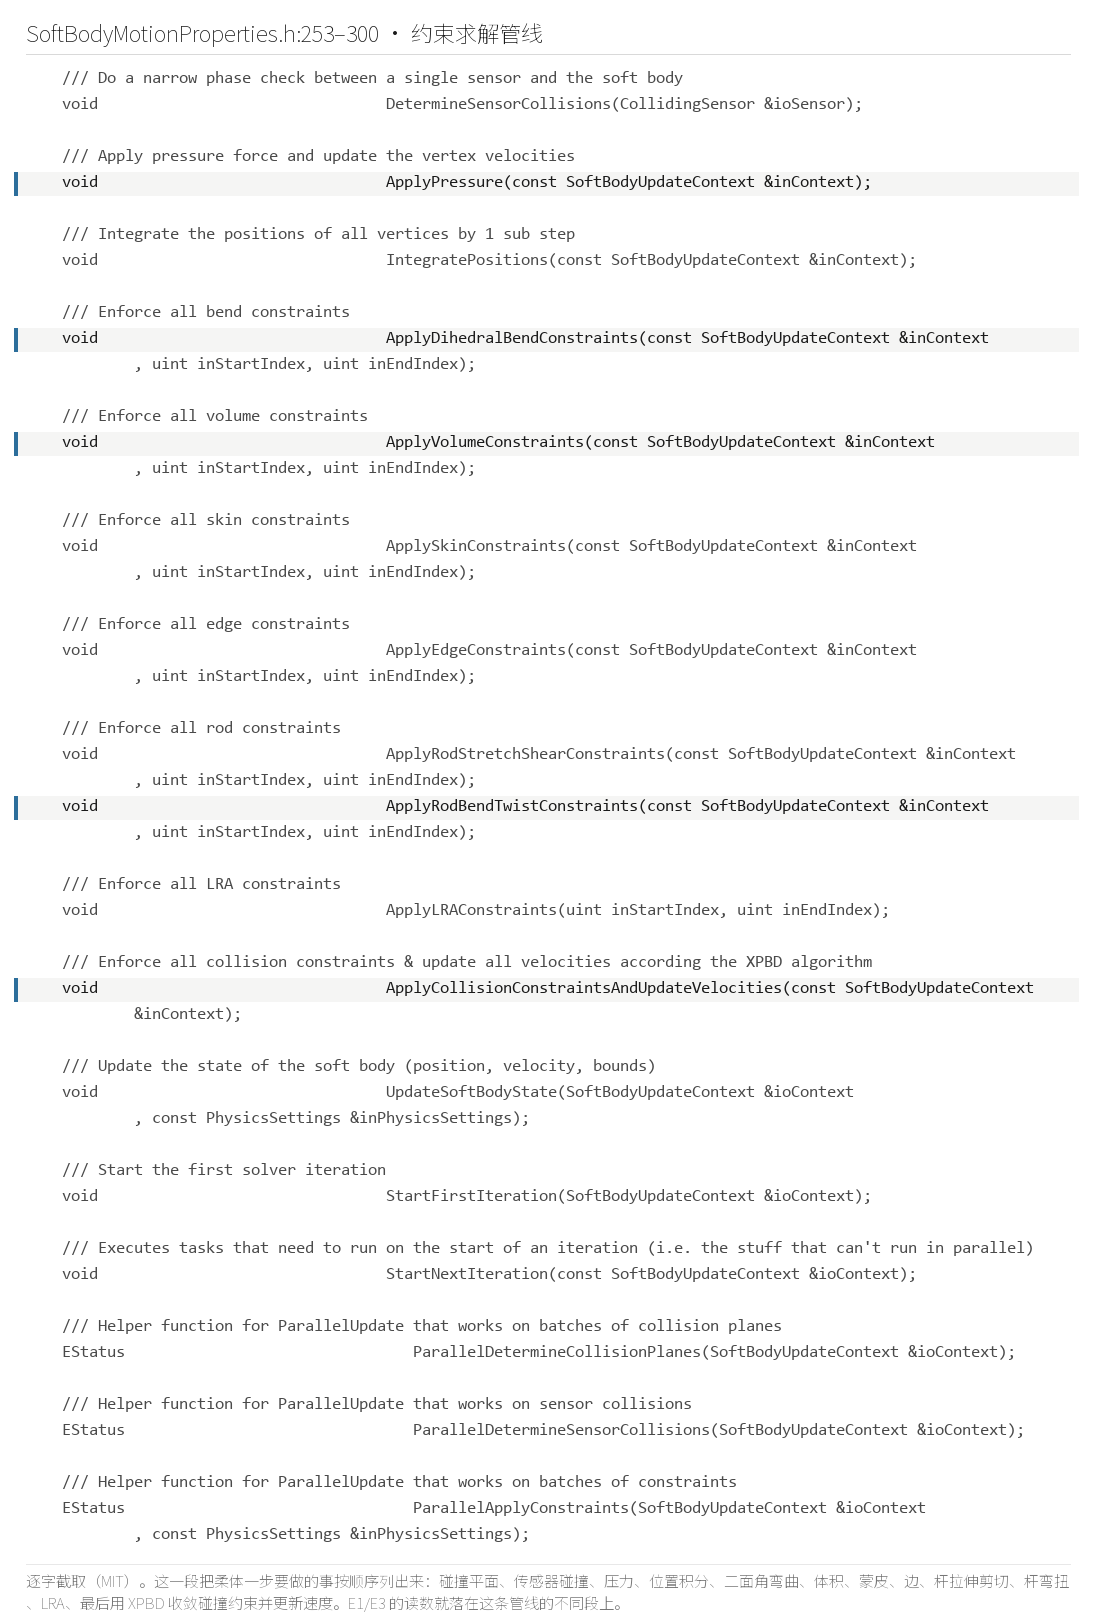
SoftBodyMotionProperties.h:257–300):先施压力、再积分位置,随后依次施二面角弯曲、体积、蒙皮、边、杆拉伸剪切与杆弯曲扭转约束,最后施加碰撞约束并按 XPBD 更新速度@ Jolt Physics v5.6.0 源码原文截取(MIT)顺序要固定,原因在于 XPBD 的投影是串行修正。每一类约束读的是上一步修正后的位置,所以先算谁后算谁会影响结果,把顺序钉死才能让结果可重复。顺序本身也透露了优先级:压力与积分排在最先,碰撞约束排在最后,等于让形状约束先塑形、再由碰撞约束把顶点推出刚体表面。碰撞放最后,能让穿模在每次迭代的末尾被纠正。
迭代次数由 mNumIterations 决定,默认 5。1.3 读到 GetNumIterations() 等于 5(官方数值),配合落地读数可以看到:柔体在 1.0 s 时顶点质心落到 1452.7868 mm,2.5 s 收在 997.6812 mm(本机复现),5 次迭代给出的是一组够用但偏软的稳定落点。迭代次数越高,约束越接近硬约束,代价也按次数放大。这一档默认值在本篇第二部分会与阻尼、摩擦那几项并排再核一次。
源码落点:本节的求解器与作业编排,对应 SoftBodyMotionProperties.h、PhysicsUpdateContext.h 与 Docs/Architecture.md。其中: XPBD 出处、四段 job 与迭代内施加顺序三处行号均按本机口径即 v5.6.0 行号;E0 的迭代与落地读数、E4 的成本比值均为本机复现,正式档里有完整数列。
四、默认值与压力项:开箱即用的那一组数
这一节要回答一个具体问题:创建一个柔体时如果什么都不填,官方替你选的那一组默认值分别是什么,它们各自管哪一件事,以及压力(pressure)与体积约束(volume constraint)之间那处互相牵制究竟该怎么量。
4.1 十二个默认值逐项读
SoftBodyCreationSettings.h 第 61 到 72 行是柔体的默认值面板,一共十二项,八项数值、四项布尔。数值项是:求解迭代次数 mNumIterations = 5,注释写着 Number of solver iterations;线性阻尼 mLinearDamping = 0.1f,注释给出的公式是 dv/dt = -mLinearDamping * v,并提示这个值应当非负且通常很接近零;单个顶点能到达的最大线速度 mMaxLinearVelocity = 500.0f,单位 m/s;碰撞弹性 mRestitution = 0.0f;碰撞摩擦系数 mFriction = 0.2f;压力 mPressure = 0.0f,注释把它定义成 n * R * T,也就是物质的量乘理想气体常数再乘绝对温度;重力倍率 mGravityFactor = 1.0f;粒子(particle)半径 mVertexRadius = 0.0f,注释说它能把顶点从别的物体表面推远一点以避免深度冲突(z-fighting)。布尔项是:模拟时是否更新 body 位置 mUpdatePosition = true,挂到静态世界的东西要设成 false;是否把指定的初始旋转烘进顶点 mMakeRotationIdentity = true,注释说让柔体旋转保持单位四元数会让模拟稍微更准;能否睡眠 mAllowSleeping = true;面是否按双面参与查询 mFacesDoubleSided = false,这一项是 v5.4.0 新增的,只影响射线与形状查询。
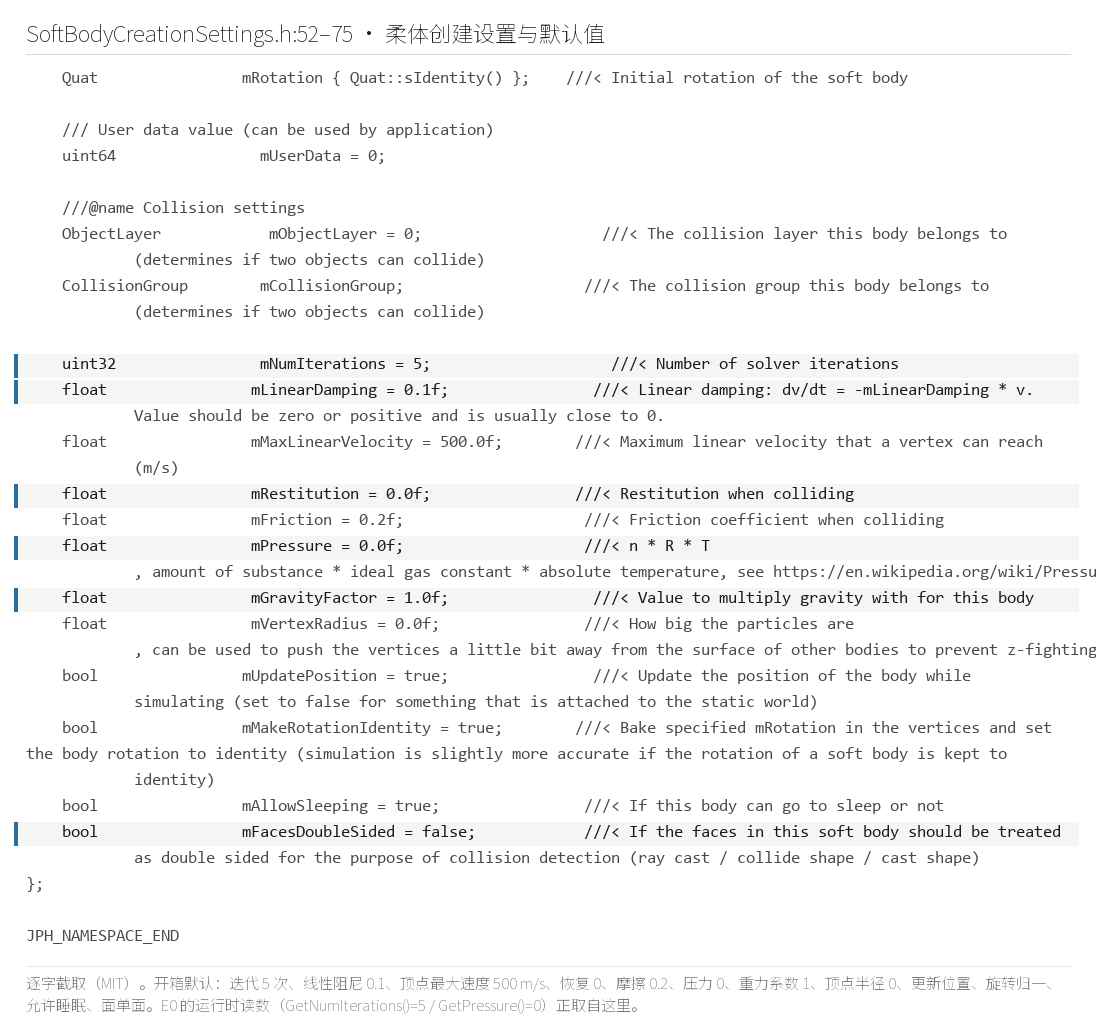
SoftBodyCreationSettings.h:52–75):求解迭代 5 次、线性阻尼 0.1、最大线速度 500 m/s、弹性 0、摩擦 0.2、压力 0(n * R * T)、重力倍率 1、粒子半径 0、更新位置开、旋转烘为单位、允许睡眠、面不双面@ Jolt Physics v5.6.0 源码原文截取(MIT)说白了,这十二项里,有三项在本机 E0 里直接读到了。sCreateCube(5, 0.5f) 造出的柔体,GetNumIterations() 返回 5,GetPressure() 返回 0.000000,粒子数 125(本机复现)。迭代与压力两项是官方数值,与头文件里的默认值逐字吻合;粒子数由拓扑决定,属本机复现。把这三项对上,就说明默认值在运行时确实生效,不是纸面数字。
先来看看,还有几项默认值值得单独说一句。mMaxLinearVelocity = 500 是一个很大的上限,它约束的是单个粒子而不是整具柔体,500 m/s 在 0.016667 s 的步长下对应每步约 8.3 m 的位移,正常场景碰不到它,它的作用是在数值失控时兜底。mLinearDamping = 0.1 对应一个每秒衰减到原来百分之九十几的阻尼,量级很轻,官方注释也强调它通常接近零。mUpdatePosition 默认为 true,意味着柔体在模拟时会把自己算出来的包围盒中心写回 body 位置,这一项与 4.4 的位置口径直接相关。mMakeRotationIdentity 默认也为 true,它把创建时指定的旋转直接烘进顶点,让运行期的 body 旋转保持单位四元数,这与文档里「模拟过程中柔体从不更新自身旋转」这句话彼此呼应。
言归正传,碰撞相关的三项默认值也各有取向。mRestitution = 0.0f 表示默认不带弹性,柔体砸在刚性表面上不反弹;mFriction = 0.2f 是一个偏小的摩擦系数,柔体贴着斜面时更容易滑;mVertexRadius = 0.0f 把粒子当成没有半径的点,柔体与刚体接触时是顶点直接落在外表面上。这三项合在一起,给出的是一具「软、滑、无弹」的默认柔体。mAllowSleeping = true 让柔体在静止后可以入睡,mFacesDoubleSided = false 让面只按单面参与射线与形状查询,这两项都偏向省算力的一侧。把这些布尔项与数值项放在一起看,官方的默认取向是「先让它动起来、把开销压住」,精细的手感交给使用者去调。
4.2 压力项的定义与量纲
好了,压力项的默认值是 0,官方注释把它定义成 n * R * T,这是理想气体状态方程 pV = nRT 里的那一项。把物质的量、气体常数与绝对温度三项乘在一起,得到的量纲与压强一致。这段定义写在 SoftBodyCreationSettings.h 第 66 行,它解释了为什么这个字段在零重力下也能单独把体积撑开:压力与重力无关,它是一股从内部往外推的力。
OK,本机 E1 专门把压力这一个变量隔出来。做法是把重力和地面都关掉,只留柔体自己,再分别在有体积约束与无体积约束两种几何上各跑压力 0 与压力 5000 两档。四组读数的体积比分别是:有体积约束压力 0 时 +0.000%,有体积约束压力 5000 时 −0.028%,无体积约束压力 0 时 +0.000%,无体积约束压力 5000 时 +0.598%(本机复现)。这四个数里,两个压力 0 的格子都是 0,说明在没有压力也没有重力时体积不动;另外两个格子才是压力项的现场。
官方对压力这一族参数有正面用例。Samples/Tests/SoftBody/SoftBodyPressureTest.cpp 第 25 到 28 行用的是 1000 乘 i(i 取 0 到 10)这一族取值,几何取自样例侧的 SoftBodyCreator::CreateSphere,那个球是工具函数造的,不属于库本身,所以它的拓扑与 E1 的立方体不同。把官方用例的取值族和本机的 5000 放在一起看,5000 落在这一族的中段,量级合理。E1 的价值落在它把这一个变量从重力、地面、碰撞里切了出来。
依然是惯例,顺带说清 n * R * T 这个定义带来的一个后果:压力带温度,它不只是一个纯几何量。使用者给 mPressure 填的数,被解释成物质的量与绝对温度之积,填 5000 相当于把某个内压水平换算成气体状态量。官方在样例里以 1000 为一档往上加,是把它当参数扫描,而不是当物理上的气压去标定。本机 E1 取 5000,只是取在扫描区间的中段,目的是让体积变化足够可读,不代表这个值有任何标准含义。
4.3 压力与体积约束的对抗
下面开始,把 E1 四个格子按「体积约束在不在」两两对照,就能看到一场局部的对抗。同样的压力 5000,有体积约束时体积只变了 −0.028%,去掉体积约束后同样压力让体积变了 +0.598%(本机复现)。两个数的符号相反,量级差了约二十倍:有体积约束的那一格甚至略微收缩,没有体积约束的那一格被压力撑大。
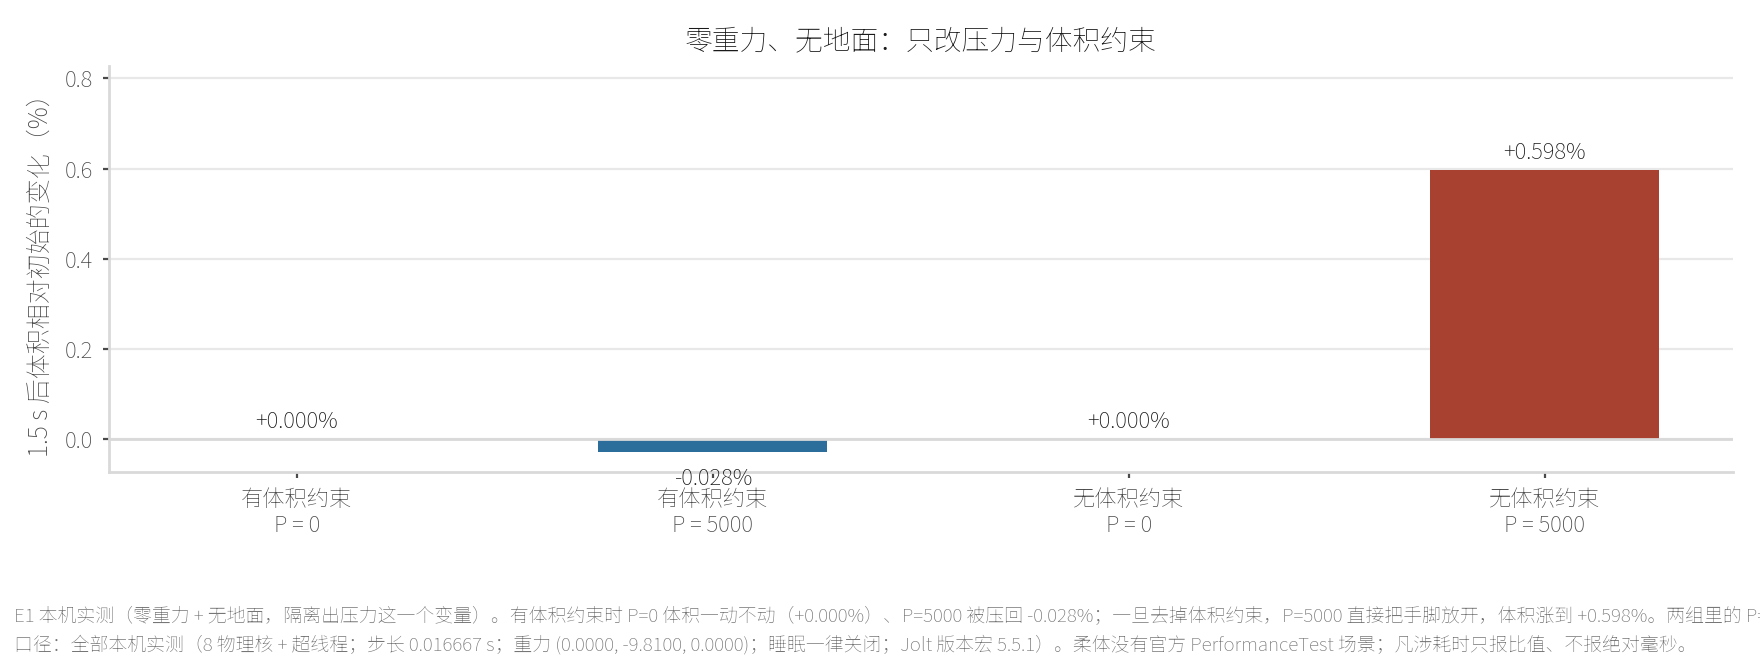
先来看看,怎么读这场对抗。体积约束把一对三角面与一个内部顶点构成的四面体(tetrahedron)拴在静止体积上,它像一层绷紧的膜,外部怎么推都要把每个四面体拉回原位;压力项则从内部往外顶,想让体积变大。两个力方向相反,谁强谁说了算。有体积约束时,约束把压力的效果压到千分之零点几的收缩;去掉体积约束后,压力失去对手,直接把体积顶大了千分之六。这就是「压力能不能改变体积,取决于体积约束在不在」的现场证据。
还要把口径写清:−0.028% 与 +0.598% 这两个数是本机复现,不是官方承诺值;官方只给了压力字段的定义与样例取值,没有给出「压力 5000 会改变多少体积」这种数。E1 的两次压力 0 对照(+0.000%)是这条结论的锚点,它说明体积的变化确实来自压力而不是别处。把这两个方向相反的百分数并排看,读者就能自己判断体积约束在这场对抗里的分量。体积约束的取值口径也要交代:sCreateCube(5, 0.5f) 默认铺了 384 条体积约束,有体积约束的那两格用的是满配的 384 条,无体积约束的那两格把这 384 条全部去掉,其余约束与拓扑保持不变。
4.4 位置口径的两副面孔
言归正传,柔体的「位置」在本机有两条互不相等的路径,这一段要把它讲清。一条是文档口径:Docs/Architecture.md 第 433 行说柔体尽量实现 Body 接口但那只是现实的简化版,并写明 Body::GetPosition 返回的是平均粒子位置(average particle position)。另一条是实现口径:SoftBodyMotionProperties.cpp 第 884 行的注释写着 Shift the body so that the position is the center of the local bounds,也就是把 body 位置设成局部包围盒(bounding box)的中心。包围盒的中心与粒子的平均位置在一般情况下并不相等。
Body::GetPosition 返回的是平均粒子位置,而源码里做的是把 body 位置写成顶点包围盒的中心(SoftBodyMotionProperties.cpp:884)。本机 E0 两列读数因此不相等:落定后差约 1.4 mm,摆动过程中最大差到 16.3 mm@ 本系列绘制本机 E0 落地那组读数把这两列并排量了出来。同一时刻,顶点质心 y 与 GetPosition().y 分别是:0.5 s 时 2786.1621 与 2786.1619 mm;1.0 s 时 1452.7868 与 1452.9649 mm;1.5 s 时 1063.5650 与 1079.8384 mm;2.0 s 时 1004.8429 与 1020.2339 mm;2.5 s 时 997.6812 与 999.0634 mm(本机复现)。两列在同一时刻不相等,差值从亚毫米一路到 16.2734 mm;落定附近最后两次的差是 15.3910 mm 与 1.3822 mm,整段的峰值就出现在 1.5 s。
这处口径差该怎么写才不失真。文档写「平均粒子位置」是概括性描述,源码写「包围盒中心」是具体实现,两者口径不同,也说不上谁写错。本机的两列数就是这句话的现场:物理上真正有意义的量是顶点质心,接口返回的 GetPosition() 走的是包围盒中心那条路径,所以两者会分叉。写读者报告时,凡是引用 GetPosition() 的读数都要带上「本机口径」;凡是引用顶点质心的读数要说清是自算的。这条纪律在 4.1 的 mUpdatePosition 那一项上也成立:位置默认每步回写,回写的正是包围盒中心,而不是顶点质心。理解了这一点,就能明白为什么 E0 落地那一列顶点质心与 GetPosition() 会越到后段差得越明显:柔体落地后略有摊开,包围盒中心与粒子平均位置的重合度随之下降。
源码落点:本章十二个默认值与位置口径,对应 SoftBodyCreationSettings.h https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/SoftBody/SoftBodyCreationSettings.h 、SoftBodyMotionProperties.cpp https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/SoftBody/SoftBodyMotionProperties.cpp 与 Docs/Architecture.md https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Docs/Architecture.md ,压力用例见官方样例 https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Samples/Tests/SoftBody/SoftBodyPressureTest.cpp 。其中: 十二个默认值的行号按本机口径即 v5.6.0 行号,第 61 至 72 行;位置实现口径的落点是 SoftBodyMotionProperties.cpp:884;体积约束的定义在 SoftBodySharedSettings.h 第 207 至 222 行,E1 四格与 E0 两列均出自 evidence/bench_softbody_hair.cpp,属本机复现。
五、官方自列的缺口:逐条复现
三条缺口的定义都写在官方文档的同一节里,措辞很短:柔体只与刚体碰撞、速度类接口对柔体无效、浮力尚未实现。本节把这三句逐个量成读数,并额外给一组与刚体的对照。
这一节要回答的是:官方自己列在 Docs/Architecture.md 第 455 到 463 行的那几条缺口,能不能在本机一条条量出来,量出来的数又长什么样。
5.1 缺口一:柔体之间不互撞
好了,官方五条缺口的头一条是:柔体只能与刚体碰撞,柔体之间的碰撞尚未实现。本机 E2a 用两个同几何的柔体各给 ±4 m/s 的顶点初速,让它们在零重力、无地面下相向而行,看它们会不会互相挡住。读数按时间排:初始 A(从 −4000 mm 出发)与 B(从 +4000 mm 出发)的顶点最小间距是 6000.0000 mm;0.5 s 时 A 到 −2049.4969、B 到 +2049.4854,最小间距 2098.9537 mm;1.0 s 时 A 到 −194.1128、B 到 +194.0986,最小间距收到 111.6084 mm;1.5 s 时 A 到 +1570.7710、B 到 −1570.7775,次序交换;2.5 s 时 A 到 +4846.3764、B 到 −4846.4794 mm(本机复现)。两个质心在 1.5 s 前后互换了左右,等于从彼此体内穿了过去,全程顶点最小间距 111.6084 mm。
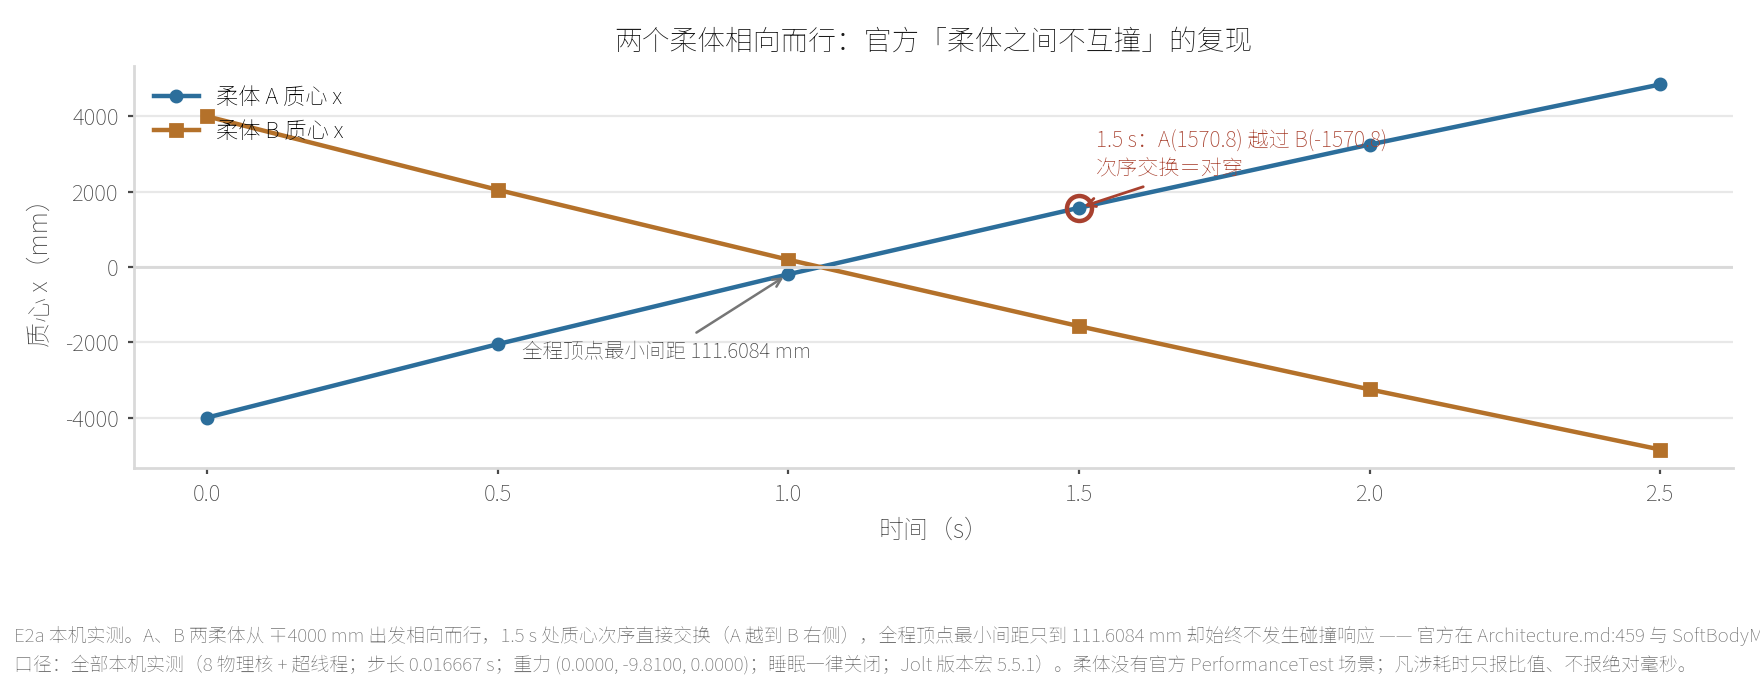
111.6084 mm 这个最小值要单独读。如果柔体真的互撞,两个 500 mm 见方的物体正面相遇时最小间距不会小到这个数,甚至可能贴住;量到 111.6 mm,说明它们在 1.0 s 前后已经互相插进对方体内,只是刚好错开了顶点。这是「柔体之间不互撞」最直观的一个数,也是本机五条缺口复现里判定最干脆的一条。
为什么是「不互撞」,源码给了落点。SoftBodyMotionProperties.cpp 第 147 行在碰撞收集处写着一行判断:if (body.IsRigidBody() // TODO: We should support soft body vs soft body。后半句那条待办注释直接承认了该支持柔体对柔体却还没做。也就是说,宽相(broadphase)确实把另一个柔体找了出来,进了这段收集逻辑,却在 IsRigidBody 这一关被筛掉,于是两个柔体在模拟里彼此透明。
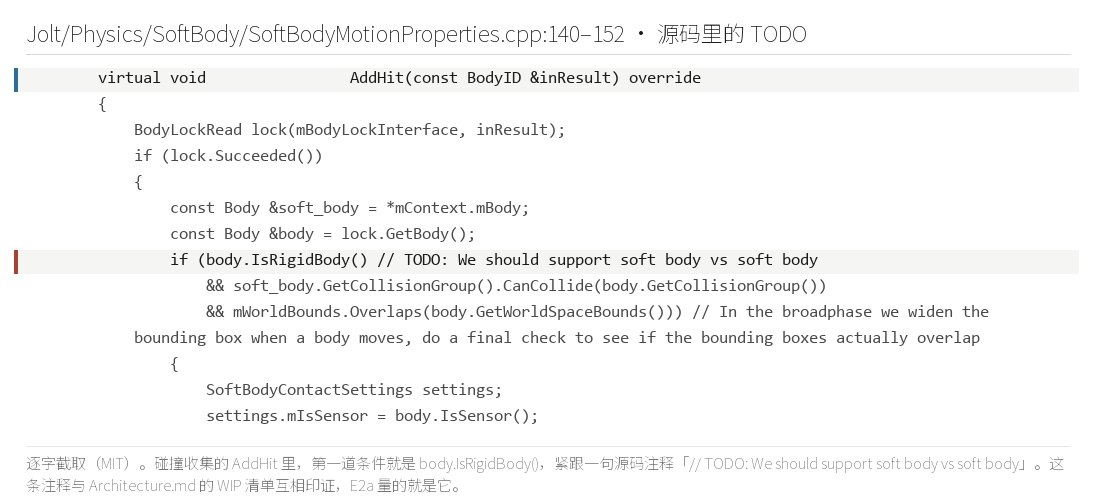
SoftBodyMotionProperties.cpp:147):收集碰撞体时的判断写着 body.IsRigidBody(),后面还跟一句待办注释 // TODO: We should support soft body vs soft body,官方把这件事明确标成了未做@ Jolt Physics v5.6.0 源码原文截取(MIT)这处落点把缺口从文档一句话变成了代码一行。理解它的写法还要知道后半段:这一句下面还串了碰撞组(collision group)的 CanCollide 检查与世界包围盒的最终重叠检查。IsRigidBody 在最前,柔体对柔体的配对被它提前挡掉,后面两道检查根本没机会跑。这条因果链是本机 E2a 读数与源码原文对上的地方,也是本章后续几节共用的读法:先在文档里找到缺口,再到源码里找到那一行判断,最后用本机读数把结果量出来。
还要补一句宽相的细节。AddHit 这段逻辑是宽相回调,BodyLockRead 已经先按 body ID 上了读锁,说明被找出来的那个 body 确实是宽相阶段登记在案的候选。柔体对柔体在宽相里能被找到,问题只出在这道 IsRigidBody 过滤,这解释了后面几节为什么都拿接触计数当探针:宽相找到没有、接触形成没有,两者会分别落在 Validate 与 Added 两个计数上。
5.2 对照组:柔体与刚体会互撞
OK,缺口的反面是对照:如果柔体只与刚体碰撞,那柔体撞刚体就该正常发生。E2b 把 E2a 的几何换成柔体对盒,只改盒的运动类型(motion type),其余几何、初速、步长完全一致,并且把盒的重力关掉。三档读数分别是:静态盒那一档,接触监听器(contact listener)读到的 OnSoftBodyContactValidate 命中 15 次、OnSoftBodyContactAdded 命中 14 次,柔体末位 x = 725.8810 mm,被盒挡住;动态盒那一档,计数 2 与 1,柔体末位 x = 2987.2482 mm,盒被推走(1.5 s 时盒 x = 3788.2993 mm、vx = 5.2378 m/s),柔体仍没过盒的右缘;让柔体自由下落砸到盒上那一档,计数 97 与 93,柔体末位 x = 2935.7259 mm(本机复现)。
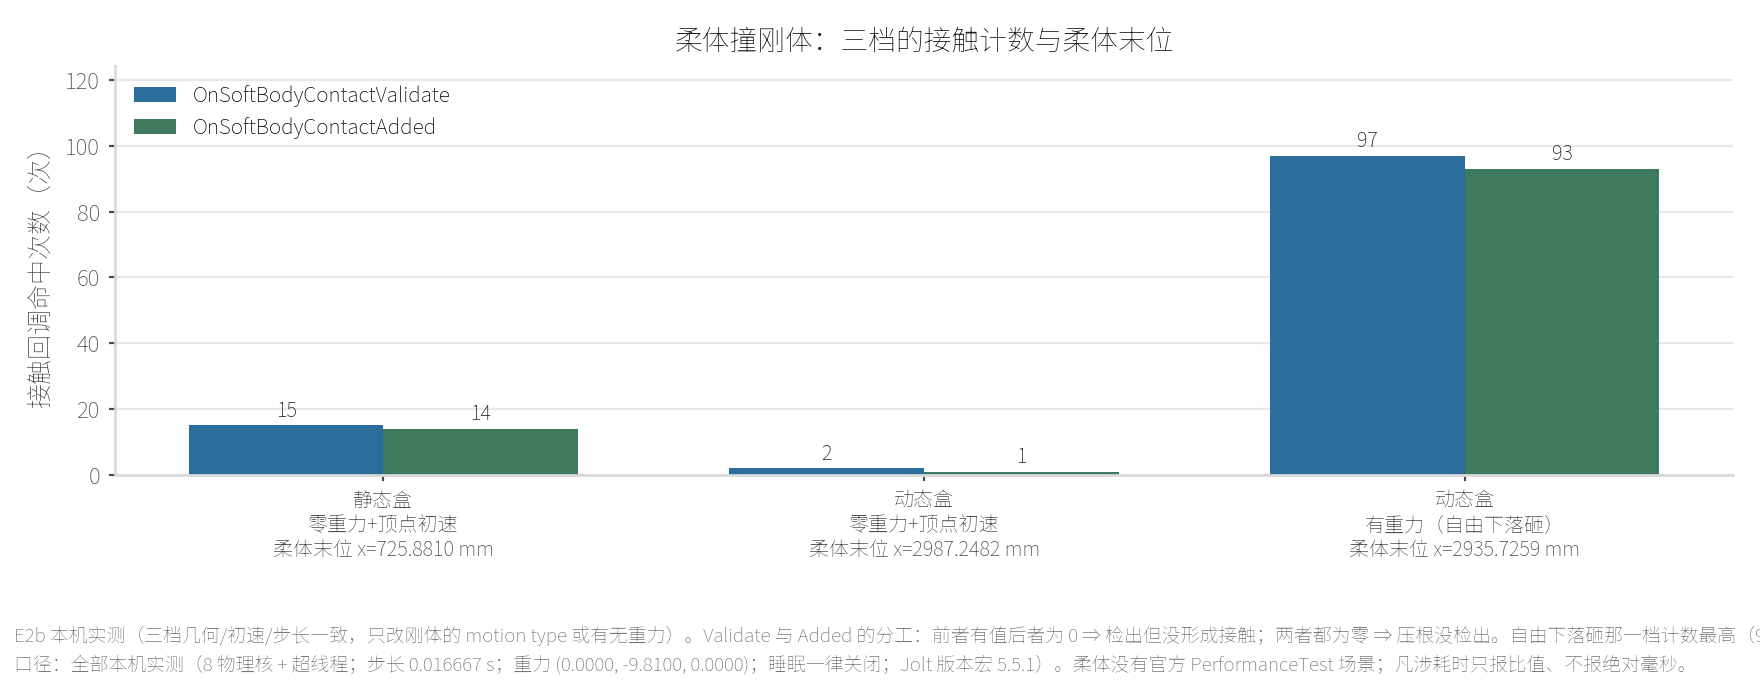
两个计数器的分工要交代。Validate 有值而 Added 为 0,表示检出了接触但没形成接触;两者都 0,表示压根没检出;两者都有值,表示检出并形成了接触。三档里 Validate 与 Added 都非零,说明柔体对刚体这条路径是通的,与 E2a 的柔体对柔体形成对照。动态盒那一档计数只有 2 与 1,是因为盒被推开后很快就离开了柔体,接触时间很短;静态盒 15 与 14、自由下落砸 97 与 93,分别对应持续压住与高速砸下的接触次数差异。
这组对照还把「一门一变量」这条纪律落到了实处。E2b 的两档与 E2a 的几何、初速、步长一致,动的只有盒的运动类型这一项。对照结果说明:同一具柔体、同一条初速,撞刚体会被挡住,撞柔体会穿过,差别来自配对两方的类型不同。这条读法为 5.4 那处装置坑埋了伏笔,因为它恰好演示了「动一个变量、看一个结果」的正确姿势。
5.3 两处接口级缺口:速度无效与浮力未实现
依然是惯例,官方五条缺口的第二、三条落在接口层:速度按粒子存不按 body 存,于是 SetLinearVelocity 这类接口对柔体无效;浮力(buoyancy)计算尚未实现。E2c 量的是前者:给柔体调用 SetLinearVelocity(5, 0, 0),调用前 GetLinearVelocity() 是 (0, 0, 0),调用后立刻读回 (5.0000, 0, 0),看起来生效了,再跑 0.5 s 后读回 (0, 0, 0),而顶点质心 x 全程 0.0000 mm(本机复现)。速度接口当场被读回一个数、下一步就被清零,整具柔体一动不动。
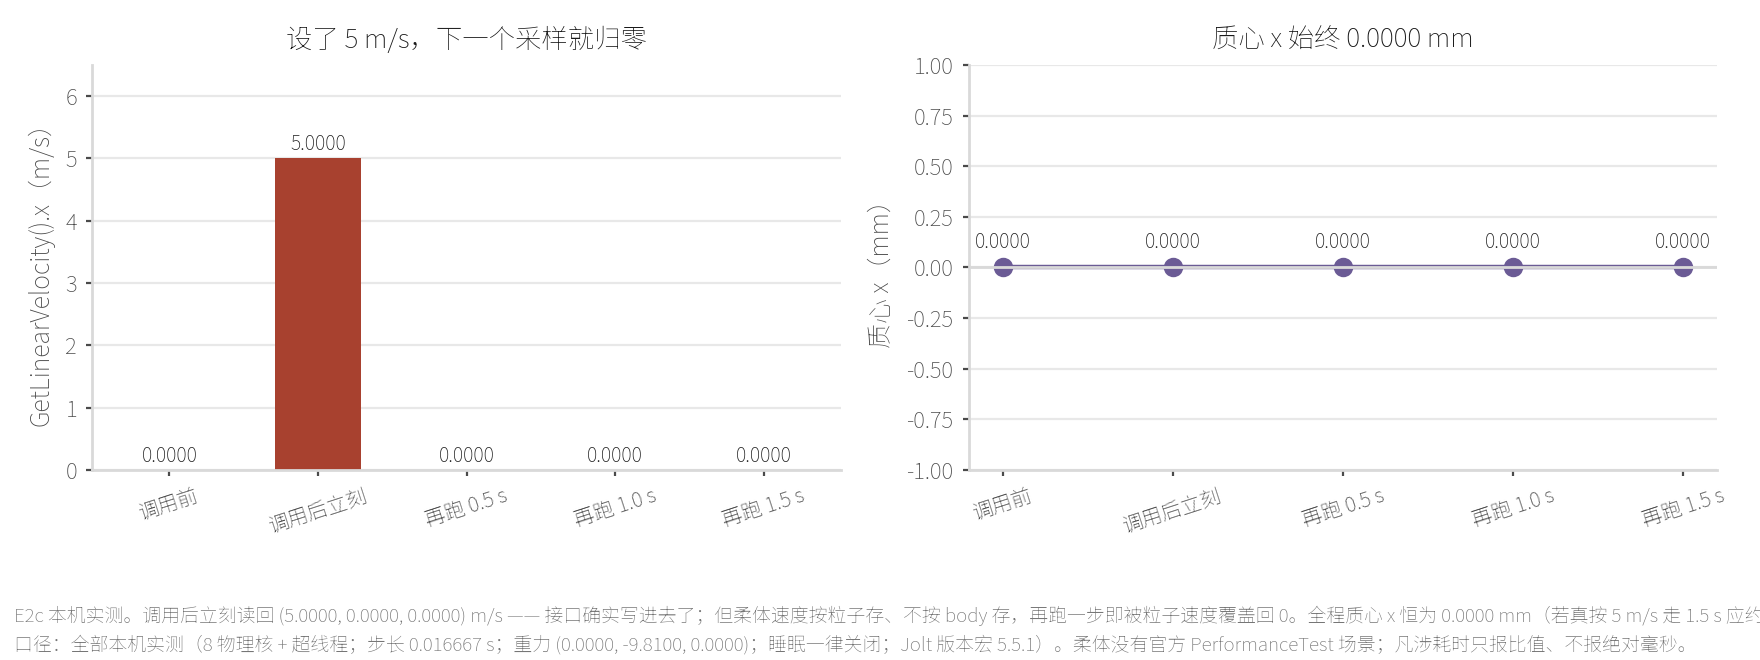
SetLinearVelocity(5, 0, 0),读回来确实是 5.0000 m/s,但再跑 0.5 s 就回到 0.0000,质心 x 自始至终是 0.0000 mm,速度是按粒子存的,body 级的接口对柔体不生效@ 本机基准实测(原创)E2d 量的是后者:对柔体调用 ApplyBuoyancyImpulse(浮力冲量),返回值是 false,调用前后的线速度都是 (0.000000, 0.000000, 0.000000),差 0.000000 m/s;再跑 0.5 s 后线速度仍是零,相对调用前的净变化 0.000000 m/s(本机复现)。返回值 false 与速度差为零两个信号一致,都指向同一个结论:这条接口对柔体没有实现。
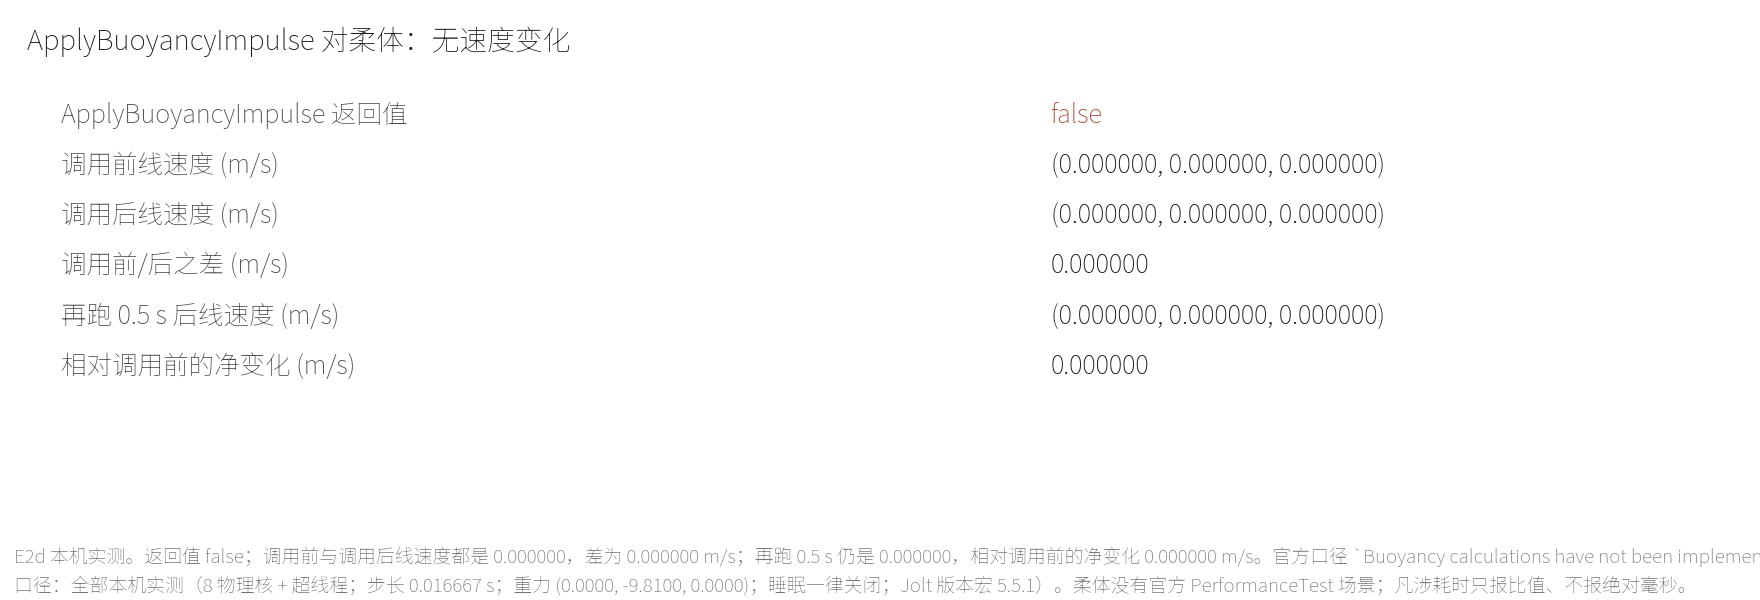
ApplyBuoyancyImpulse 直接返回 false,调用前、调用后、再跑 0.5 s 之后的线速度都是 0.000000,净变化 0.000000 m/s,对应官方那句「浮力计算尚未实现」@ 本机基准实测(原创)两处缺口的根因是同一个。柔体的速度按粒子存,body 这一层没有一份自己的速度,所以 SetLinearVelocity 写进去的数在下一次积分里就被粒子速度覆盖掉;而 GetLinearVelocity 读回的是粒子平均速度,调用瞬间读到 5.0000 只是那一刻的平均值。浮力冲量走的也是 body 级接口,柔体这一层没实现,直接返回 false。官方在这两条上的措辞分别是 have no effect on soft bodies as the velocity is stored per particle rather than per body 与 Buoyancy calculations have not been implemented yet,本机两组读数与这两句话逐字对应。缺口的第四条「约束不能作用到柔体」在官方样例里有正面替代方案,做法是把某个粒子的逆质量(inverse mass)设为零、再靠给速度来把柔体钉住,本机 E2 没有单独复现这一条,读法在下一章不涉及。
5.4 一处实验装置自身的坑
OK,这一节要讲的是首轮实验里我们自己踩的坑,它比缺口本身更值得写。E2b 的动态盒那一档,第一版做法只改了盒的运动类型,忘了把盒的重力关掉。盒一放开就自由落体往下掉,柔体从左边冲过来时盒早已掉走,柔体的 x 一路冲过盒原来的位置,看上去像是「柔体不与动态刚体互撞」。当时差点把这个结果写进正文,当成第二条缺口。
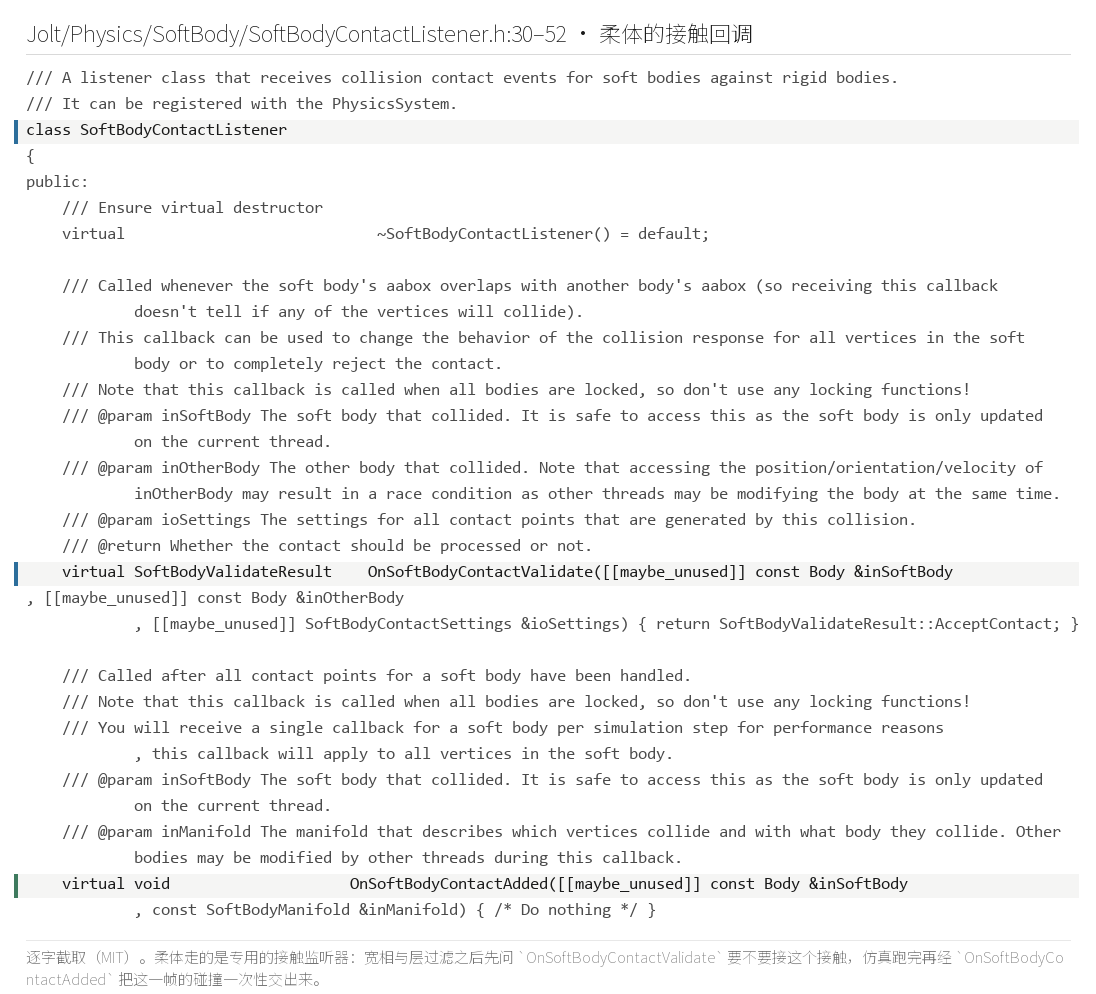
SoftBodyContactListener.h:30–52):宽相与层过滤之后先问 OnSoftBodyContactValidate 要不要接这个接触,仿真跑完再由 OnSoftBodyContactAdded 把这一帧的碰撞一次交出。§5.4 的诊断正是靠它@ Jolt Physics v5.6.0 源码原文截取(MIT)
把它定位出来的手段是装上接触监听器。首轮那一版里,OnSoftBodyContactValidate 与 OnSoftBodyContactAdded 两个计数都是 0,也就是压根没检出接触。这个 0 与 E2a 的最小间距对读之后,问题就清楚了:如果两方真的互不碰撞,应该像 E2a 那样有近距离的错身;这里连接触都没检出,说明盒根本不在柔体该遇到的位置上。回头查场景配置,才发现是盒的重力没关。
这条经验的写法是「先怀疑装置,再下结论」。柔体的缺口确实存在,官方也白纸黑字写了,但要用本机读数去复现一条缺口,首先要保证装置本身没在动别的变量。动态盒不关重力,等于同时动了「运动类型」与「重力」两个变量,这是一门一变量纪律的典型反例。修正之后,盒关重力,同一档的接触计数变成 2 与 1(本机复现),柔体被挡在 x = 2987.2482 mm,读数才与文档口径对上。凡遇到「本机量与官方不符」,先回到装置,检查是不是自己多动了一个旋钮,这一步比下结论重要。这套「装置自检」的思路与第九篇写过的接触诊断同源,区别只在对象从刚体换成了柔体。
源码落点:本章五条缺口与逐条复现,对应 Docs/Architecture.md https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Docs/Architecture.md 的「Soft Body Work In Progress」一节、SoftBodyMotionProperties.cpp https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/SoftBody/SoftBodyMotionProperties.cpp 与 SoftBodyContactListener.h https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/SoftBody/SoftBodyContactListener.h 。其中: 柔体对柔体的待办注释落点是 SoftBodyMotionProperties.cpp:147,五条缺口的原文行号是 Architecture.md:455–463,均按本机口径即 v5.6.0 行号;E2a 到 E2d 四组读数出自 evidence/bench_softbody_hair.cpp,属本机复现;ApplyBuoyancyImpulse 的原文在 Architecture.md:461。
六、毛发:Cosserat 杆与 GPU 上的发束
这一节要回答:一束头发在 GPU 上是怎么被算出来的,科瑟拉杆(Cosserat rod)在其中扮演什么角色,以及官方自己承认还差哪些东西。
6.1 一根发丝就是一串杆
先来看看,毛发这条线的几何基底与柔体的科瑟拉杆是同一件事。一根发丝在模拟里由一串离散的科瑟拉杆首尾相接组成,每根杆连接两个粒子、有固定长度与惯性,杆与杆之间靠弯曲扭转约束定住相互的朝向。把它和第二章写过的柔体科瑟拉杆两件套对上:RodStretchShear 管单根杆的长与惯性,RodBendTwist 管两根相邻杆之间的弯曲与扭转,发丝的这串杆用的就是这套两件套。
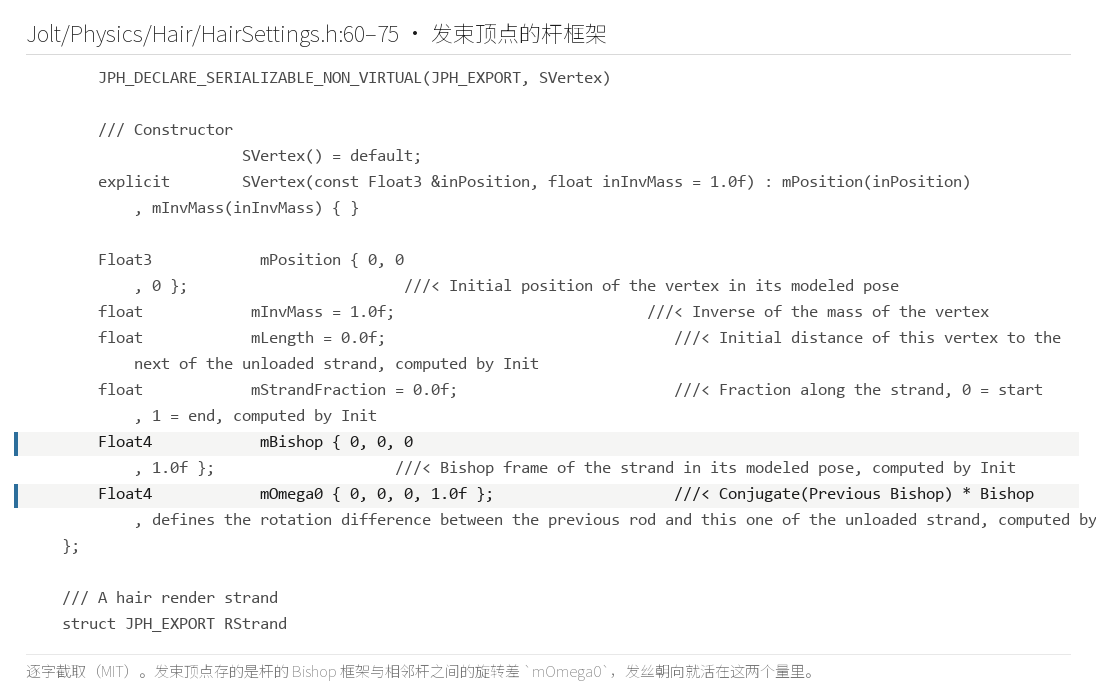
HairSettings.h:60–75):发束顶点存的是杆的 Bishop 框架与相邻杆之间的旋转差 mOmega0,发丝的朝向就活在这两个量里@ Jolt Physics v5.6.0 源码原文截取(MIT)
Acht haarvlechten van Prins Willem IV, NG-NM-1000.jpg(CC0,Rijksmuseum)E3 用一根 8 顶点、间距 0.25 m 的杆链量了朝向稳定性,只喂横向顶点初速,不喂任何杆朝向的初值。有 RodBendTwist 时,第一根杆的角速度 |w1| 从 0.5 s 的 0.1890 衰减到 0.0391、0.0031、0.0022 rad/s,末态各杆角速度之和 0.028656 rad/s;去掉 RodBendTwist 后,|w1| 在 5.0125 与 5.1399 之间来回摆,2.0 s 时到 4.5433 rad/s,末态各杆角速度之和 24.686938 rad/s(本机复现)。两个末态数差三个数量级。
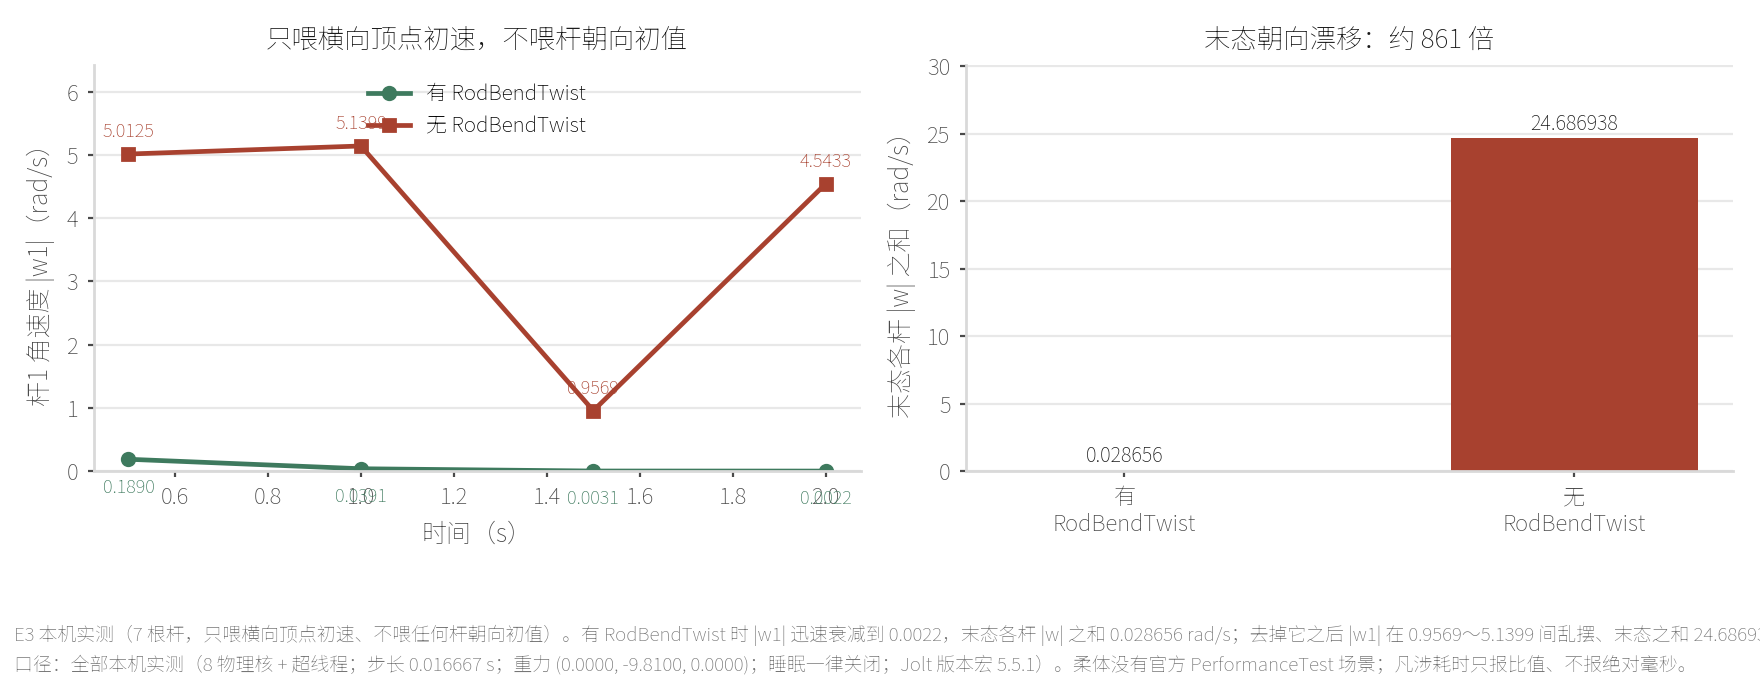
RodBendTwist 时杆 1 的角速度从 0.1890 衰减到 0.0022 rad/s,末态各杆角速度之和 0.028656;去掉它之后杆 1 的角速度在 5.0125 与 4.5433 之间大幅摆动,末态之和 24.686938 rad/s(约 861 倍)。官方那句警告被量成了数字@ 本机基准实测(原创)这组对照复现的是官方在 SoftBodySharedSettings.h 第 305 到 310 行的那句警告:每根杆至少要有一根 RodBendTwist 来约束它的旋转,不做这件事的话,杆的取向会绕杆轴以恒定角速度自转。无约束那一档的 |w1| 之所以在 5 rad/s 上下徘徊,就是这句自转。有约束那一档衰减到 0.0022 rad/s,说明扭转约束把它刹住了。发丝为什么要靠这套杆,原因也在这里:发丝细长,绕自身轴的旋转靠普通的位置约束管不住,必须显式约束朝向。官方样例 SoftBodyCosseratRodConstraintTest.cpp 就是这个机制的正面演示,毛发只是把它搬到了 GPU 上。
6.2 发束的 GPU 管线
言归正传,毛发的模拟整条放在计算着色器(compute shader)上跑,这是 Jolt 里唯一一条这样的内建管线。官方在 Jolt/Shaders/ 下为它准备了一组计算着色器,每支都带 HLSL 源码、预编译的 DXIL 与 SPV,以及一份 *Bindings.h。在 HairShaders::Init 里能数到十五支着色器的创建:十三支属于常规模拟流程,覆盖网格、蒙皮、发根发束、速度、积分与渲染位置;另外两支 HairTeleport 与 HairApplyDeltaTransform 只在传送与全局变换变化时出场。下面按这十三组的职责走一遍。
Jolt/Shaders/ 下 15 支计算着色器分四组:网格类(清零、累积、归一化)、发丝类(更新发束、积分、更新速度、速度积分、更新发根)、蒙皮与碰撞类(发根蒙皮、顶点蒙皮、碰撞平面、全局位姿)、渲染与事件类(计算渲染位置、瞬移、应用位移);另有 TestCompute 两支说明这套接口是通用的@ 本系列绘制网格(grid)那三支是发-发碰撞的前提。HairGridClear 按网格单元把速度与密度缓冲清零;HairGridAccumulate 按顶点把每根发丝的速度与密度累进网格;HairGridNormalize 按网格单元把累积值归一化成单元平均。这三步过后,网格里存的是一片空间上的平均速度场与密度场。
蒙皮(skinning)与姿态那几支负责把发丝挂到头皮上。HairSkinVertices 用关节矩阵蒙皮头皮网格,HairSkinRoots 把每根发丝的发根绑到头皮三角上,HairApplyGlobalPose 在存储的全局姿态与蒙皮得到的姿态之间插值。发根可蒙皮到头皮这一点是 v5.6.0 发布说明里明写的能力,与之配套的还有 HairApplyDeltaTransform 与 HairTeleport 两支事件用的着色器。
剩下的几支分成更新与积分两拨。HairCalculateCollisionPlanes 为环境碰撞算出碰撞平面;HairUpdateRoots 与 HairUpdateStrands 更新发根与发束的状态;HairUpdateVelocity 与 HairUpdateVelocityIntegrate 更新并积分速度;HairIntegrate 做发丝积分;HairCalculateRenderPositions 算出交给渲染的位置。碰撞平面那一支对应环境碰撞,v5.6.0 发布说明写了它只支持凸包(ConvexHullShape)与复合形状(CompoundShape),其余形状还没有,本章 6.3 会把这条并进待办。
这套着色器还有两处工程细节。每支都配了一份 *Bindings.h,用来在 HLSL 与各后端之间对齐缓冲区绑定的名字与位置;每支还预编译了 DXIL 与 SPV 两份中间产物,DX12 用前者、Vulkan 用后者。CPU 回退路径复用同一批 HLSL 源码,靠 Jolt/Compute/CPU/ 一侧的转换层把着色器翻成 C++ 执行,所以同一套着色器源码能在三条通道上跑出同一套逻辑。
把这条管线与 CPU 侧对照,能看出一个关键差别:柔体的四段 job 跑在 CPU 的作业系统里,毛发的这十三支计算着色器跑在 GPU(或 CPU 回退路径)上的同一套 ComputeSystem 里。两条路共用一套作业编排的思路,落点却不同。这也说明 Compute 接口本身是通用的,毛发只是它当前唯一的库内消费者,下一章要拆的「接口通用、消费者唯一」那句话,证据一半就落在这里。官方另外还留了 TestCompute 与 TestCompute2 两支通用示例着色器,用来证明这套接口不是为毛发专门做的。
6.3 官方自列的待办清单
好了,毛发和柔体一样,官方在头文件里自己标了「仍在开发」。Hair.h 第 23 到 33 行是这样一屏:开头一句 Note that this system is currently still in development, it is missing important features like:,后面按条列出还缺什么。清单包括缺少细节层次(Level of detail,LOD)、缺少风力(wind forces)、缺少网格速度场的平流(advection)步、除凸包以外的碰撞形状支持、Gradient 类太简陋将换成纹理查找、重力预载系数还没完全可用、内存浪费(CPU 与 GPU 各存一份)、只支持单一中立姿态作为驱动目标、还能再进一步优化。
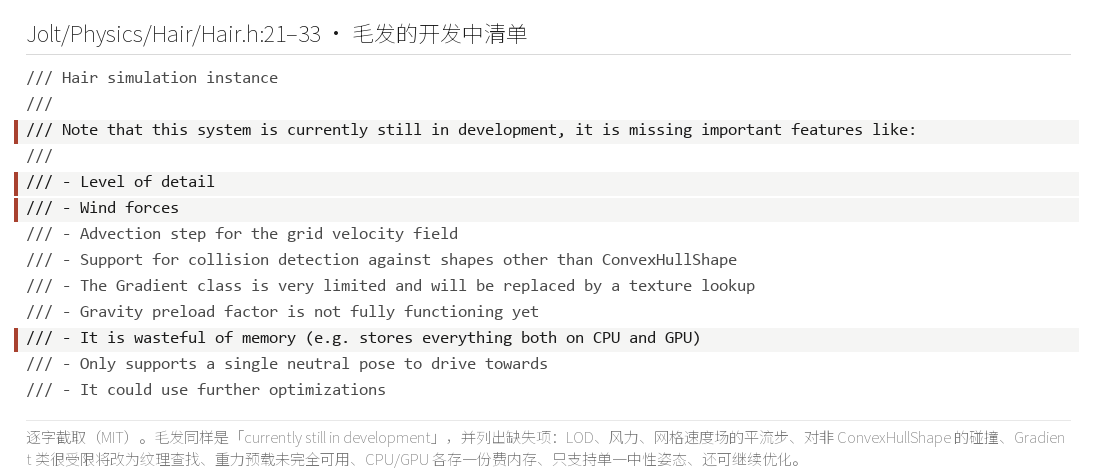
Hair.h:23–33):缺 LOD、缺风力、缺网格速度场的平流步、环境碰撞只支持凸包与复合形状、渐变类很有限、重力预载尚未完全生效、CPU 与 GPU 各存一份而浪费内存、只支持单一中性姿态@ Jolt Physics v5.6.0 源码原文截取(MIT)这一屏里有两条最值得展开。一条是「内存浪费(CPU 与 GPU 各存一份)」,它说明当前的实现把同一份数据在两侧都留了副本,这与 6.2 里那条通用 Compute 接口的定位有关:接口是通用的,实现还在早期,先把数据两边各放一份,换来的是路径简单。另一条是「缺少网格速度场的平流步」,它指向 6.4 要讲的网格平均速度场:场能累积与归一化,却还缺一步把速度场本身随时间搬运的平流,所以发-发碰撞目前用的是当场归一化的平均值。
发行说明也在同一处补了一句口径。Docs/ReleaseNotes.md 的 v5.6.0 条目在 Added a strand based hair simulation running on GPU 这条下写了七个子条,最后一条是 Note that this is still work in progress, some things that still need to be done are listed in Hair.h.,把「还在开发」这件事直接指回 Hair.h 这张清单。也就是说,Hair.h 第 23 到 33 行是官方认可的待办权威列表,本节读的就是它。把这张清单与柔体的五条缺口并排,可以看到两条线的状态标注都是写在各自头文件里的同一类做法:官方不藏着这些限制,恰恰相反,它把限制放在使用者最先读到的地方。
6.4 发-发碰撞用网格平均速度
OK,发丝之间的碰撞不走两两求交那条路,它靠一张网格上的平均速度场。做法是:先把每根发丝的速度按位置累进一张三维网格,归一化得到每个网格单元的平均速度;再让每根发丝向所在单元的平均速度靠拢,于是密集处的发丝会彼此带动,形成整体的发束感。这条路径省掉了发丝两两之间的成对检测,代价是精度只到网格单元这一级。
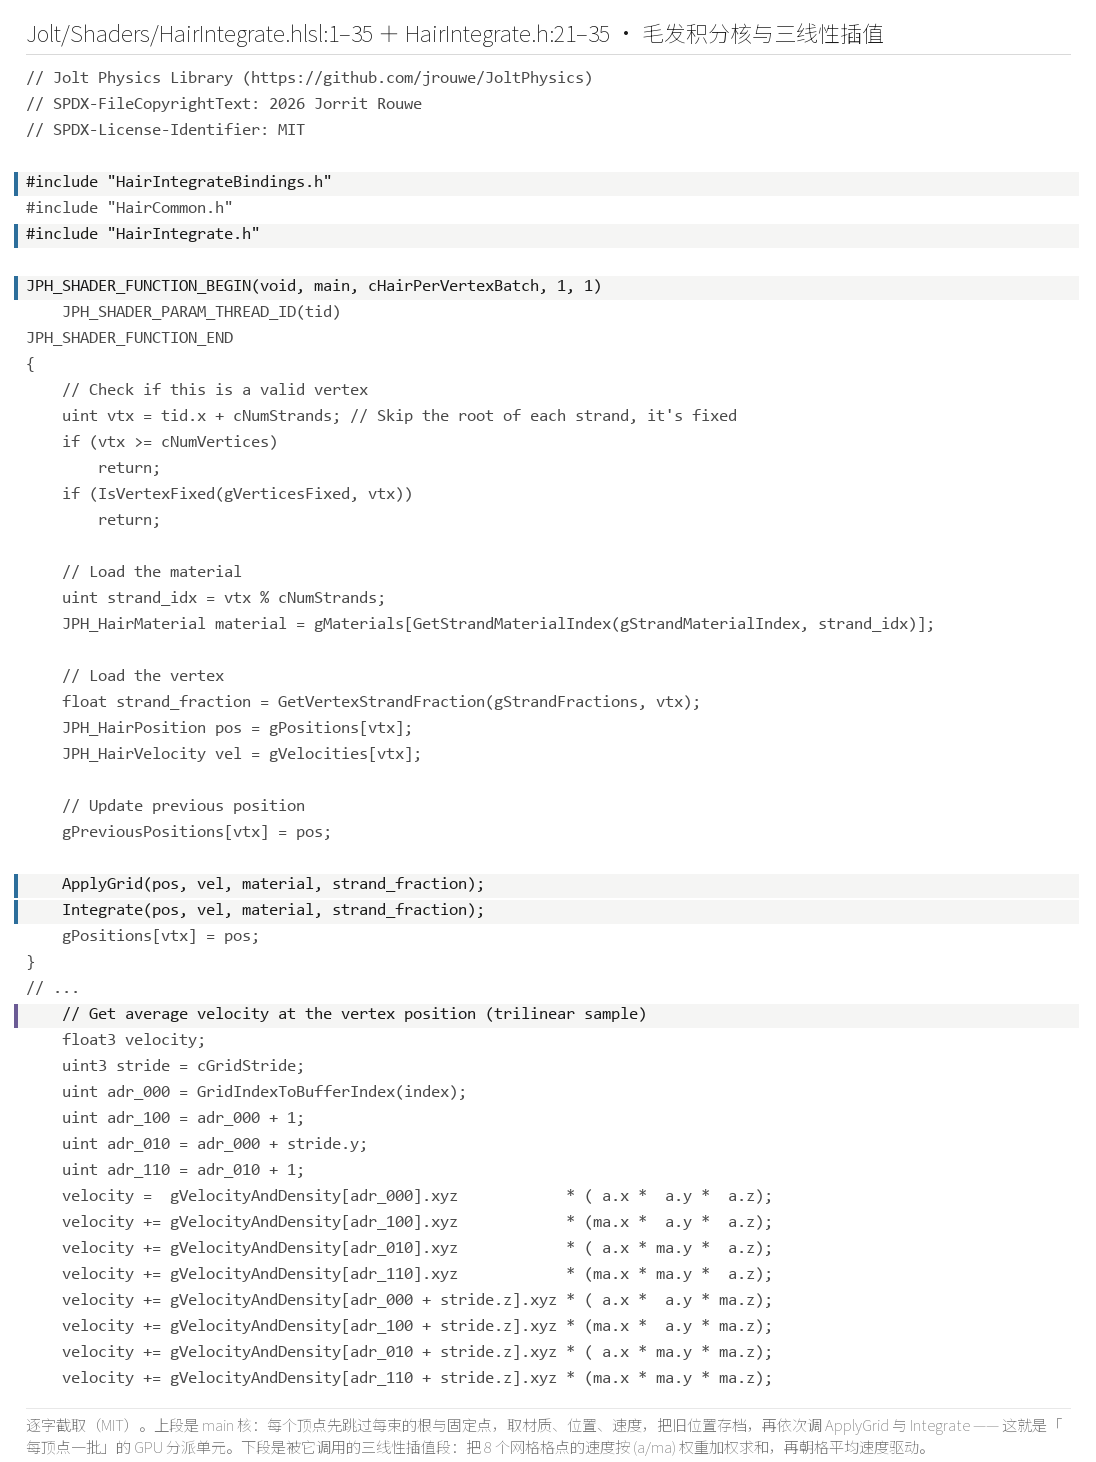
Jolt/Shaders/HairIntegrate.hlsl 与 HairIntegrate.h:21–35):发-发碰撞不走两两求交,而是先在三维网格里累积平均速度,再由每根发丝在所在单元上做一次三线性插值取用@ Jolt Physics v5.6.0 源码原文截取(MIT)取平均速度这一步用的是三线性插值(trilinear interpolation)。HairIntegrate.hlsl 里的发丝积分着色器调用 ApplyGrid,后者把顶点位置换算成网格单元索引与单元内的小数坐标,再用八个角点的速度按八个权重加权求和,权重由小数坐标的三个分量两两相乘得到,这正是三线性插值。算完把这个平均值按一个因子往发丝自身速度上带,发丝就被网格速度场轻轻拽住。这八个加权项写在 Jolt/Shaders/HairIntegrate.h 第 28 到 35 行,由 HairIntegrate.hlsl 第 32 行调用。
这里还有一股和平均速度并行的力。ApplyGrid 的后半段用网格里各单元的密度与中立密度之差,算出一股把发丝往中立密度推的力,注释标了它基于 Petrovic、Henne 与 Anderson 那篇《Volumetric Methods for Simulation and Rendering of Hair》的第三条公式。平均速度负责让发丝彼此带动,密度力负责把过密或过疏的地方拉回中立,两者合起来才是一张完整的网格速度场。
官方在讨论区确认过这条实现。作者 jrouwe 在 Discussion #2076 里写道,毛发目前是在着色器代码里手写三线性插值去取发丝顶点处的平均速度,并说这一步将来可以交给采样器(sampler)来做。本机能核到落点:三线性那八个加权项就写在 HairIntegrate.h 里,由 HairIntegrate.hlsl 调用。把它和 6.3 的待办对上,网格速度场这条线还缺平流步,而取平均速度这一步是已经跑起来的。发-发碰撞只到单元这一级精度,与官方「缺少网格速度场平流」这条待办连在一起读,就能明白为什么这套方案被标成仍在开发:它先用最省的一步做出了发束的整体感,精细的部分还在清单上等着补。
源码落点:本章的科瑟拉杆、GPU 管线与网格速度场,对应 Hair.h https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/Hair/Hair.h 、HairSettings.h https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/Hair/HairSettings.h 、HairIntegrate.hlsl https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Shaders/HairIntegrate.hlsl 与柔体侧的 SoftBodySharedSettings.h https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Jolt/Physics/SoftBody/SoftBodySharedSettings.h ,毛发用例见官方样例 https://raw.githubusercontent.com/jrouwe/JoltPhysics/v5.6.0/Samples/Tests/Hair/HairTest.cpp 。其中: Hair.h 第 23 至 33 行是官方待办清单,SoftBodySharedSettings.h 第 305 至 310 行是科瑟拉杆的朝向警告,均按本机口径即 v5.6.0 行号;E3 的杆链对照读数出自 evidence/bench_softbody_hair.cpp,属本机复现;十三支常规着色器的注册表在 Jolt/Shaders/HairWrapper.cpp:118–134。
七、GPU Compute 的真相:接口是通用的,消费者只有一个
本节要回答的是「Jolt 有 GPU 物理」这句话能不能成立,办法是把它拆成可以分别核对的三小句,再逐句去找落点。
7.1 发布说明里只有两句话,一句说接口,一句说发束
下面开始,v5.6.0 的发布说明(Release Notes)里,与显卡(GPU)相关的条目只有两处。第一处原文是 Added interface to run compute shaders on the GPU with implementations for DX12, Vulkan and Metal.,紧跟着一句补充说这些接口可以通过把 JPH_USE_DX12、JPH_USE_VK、JPH_USE_MTL 与 JPH_USE_CPU_COMPUTE 设为 OFF 来关闭。第二处原文是 Added a strand based hair simulation running on GPU,它下面挂着七条子项,讲的是基于科瑟拉杆(Cosserat rod)的发束、guide 与 follow 两级发束、发与发碰撞用网格平均速度驱动、环境碰撞只支持凸包(ConvexHullShape)与复合形状(CompoundShape),以及一句 Note that this is still work in progress。
这两条合起来能读出的东西很有限:这一版交付了一条在显卡上运行计算着色器(compute shader)的接口,以及这条接口上的第一个使用者。发布说明没有写「刚体求解改由显卡承担」,也没有写「接触求解搬到显卡」。发布说明的口径就是它列出的改动本身。
要把这一句读准,先把三个常被混用的词分开:显卡计算接口(GPU compute interface)、显卡物理(GPU physics)、显卡刚体(GPU rigid body)。发布说明覆盖的是第一个词,第二个与第三个词在发布说明里都没有对应的条目。本节后面三节按这三个词各自的证据面展开,接口看源码本体,消费者看全库检索,本机通道看编译期检查。
7.2 接口本体:四条创建通道加一条未实现回退
先来看看,接口的形状可以直接读头文件。Jolt/Compute/ComputeSystem.h 第 39 至 76 行把创建方式排成一串条件编译块,四条通道分别叫 CreateComputeSystemVK()、CreateComputeSystemCPU()、CreateComputeSystemDX12() 与 CreateComputeSystemMTL(),各自挂在一个编译宏之下,依次是 JPH_USE_VK、JPH_USE_CPU_COMPUTE、JPH_USE_DX12 与 JPH_USE_MTL。
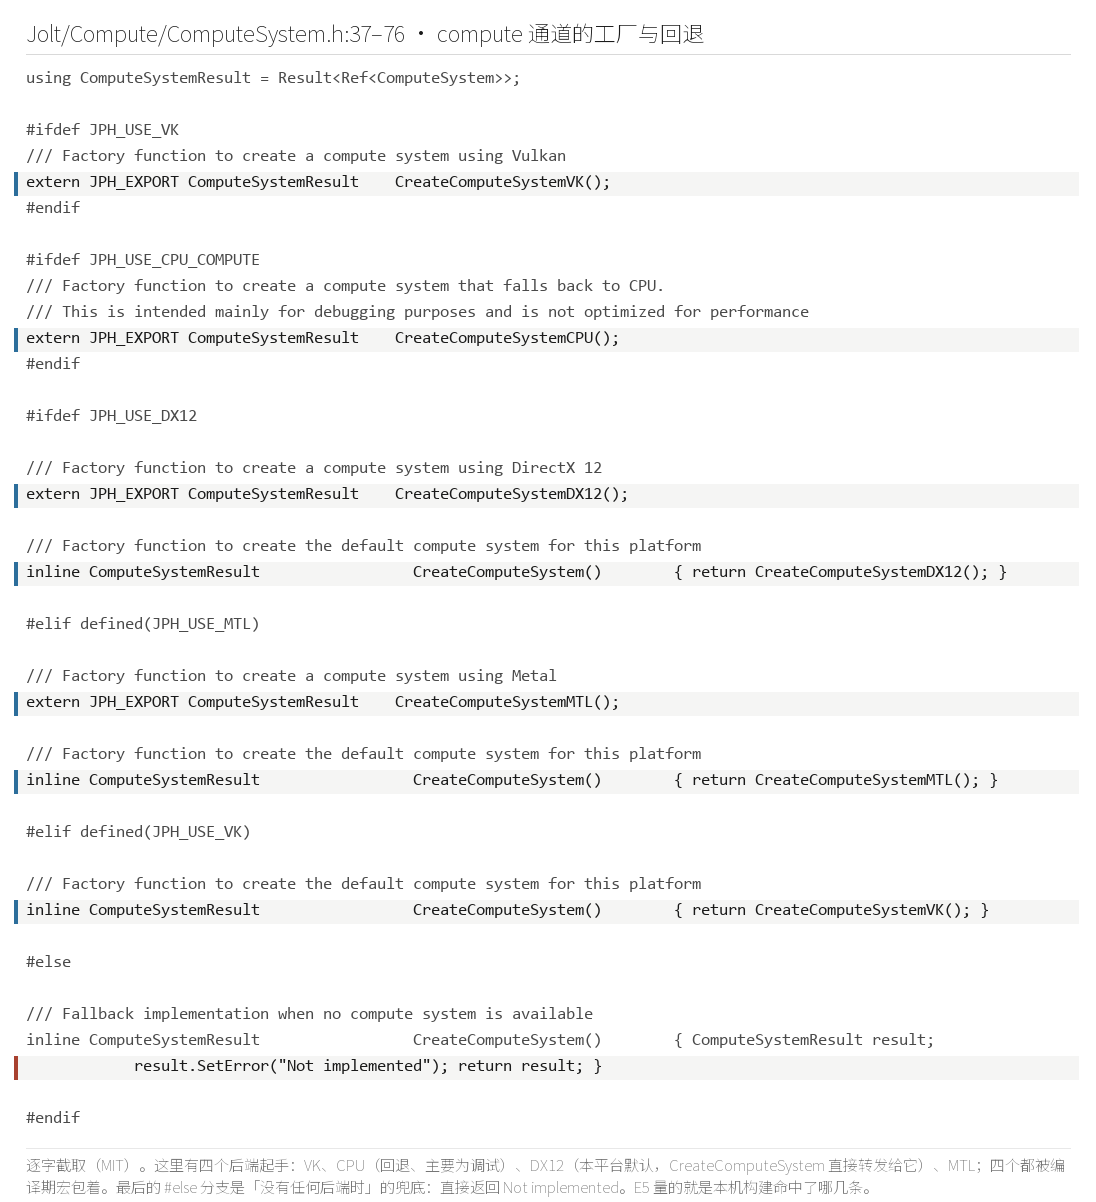
Jolt/Compute/ComputeSystem.h:39–76):CreateComputeSystemVK、CreateComputeSystemCPU、CreateComputeSystemDX12 各受一个编译开关保护,默认工厂按平台挑一条;一条都不满足时返回一个写着 Not implemented 的错误结果@ Jolt Physics v5.6.0 源码原文截取(MIT)言归正传,接口类本体在同一文件的前半段,三个纯虚函数分别是编译计算着色器、创建缓冲(buffer)与创建队列(queue),另有一个着色器加载回调(callback)。四条通道之外还留着一段 #else 分支,原文是 result.SetError("Not implemented"),也就是四种后端(backend)全部缺席时接口返回一个错误码,并未中止进程。这段回退(fallback)的定位写在两句注释里,CPU 通道的注释说它主要为调试目的准备、并未针对性能优化,原文是 This is intended mainly for debugging purposes and is not optimized for performance。
好了,同一段里还有一处细节值得单独指出,默认工厂 CreateComputeSystem() 的挑选顺序是 DX12、Metal、Vulkan,CPU 那一个不在这条默认链上,要由调用者显式点名。这一处安排说明 CPU 通道的位置是「可用但不走默认」,它是给调试与无显卡环境留的退路。接口目录下的实现面也能印证这条分工,Jolt/Compute/ 里除了接口头文件,还分列 CPU、DX12、VK、MTL 四个后端子目录,CPU 那一支带一个把着色器源码翻成 C++ 的转换头,它是这条回退路径真正被走通的地方。
四条通道加上那一段回退,构成了「Jolt 有显卡计算接口」这句话的全部含义。接口是抽象的,它不预设消费者是谁,也不预设被算的是什么。下一节要查的正是消费者。
7.3 全库检索:库内唯一的内建消费者是毛发
OK,接口看完了,下一步查谁在用它。在本机检出上对 ComputeSystem 与 ComputeQueue 两个符号做全库检索,先剔除 Jolt/Compute/ 目录本身,那里放的是接口与四个后端的实现,再剔除 Jolt/Physics/Hair/ 目录本身,那是毛发的模拟侧,剩下能在库内查到消费点的文件只有两个,Jolt/Shaders/HairWrapper.cpp 与 Jolt/Shaders/HairWrapper.h。
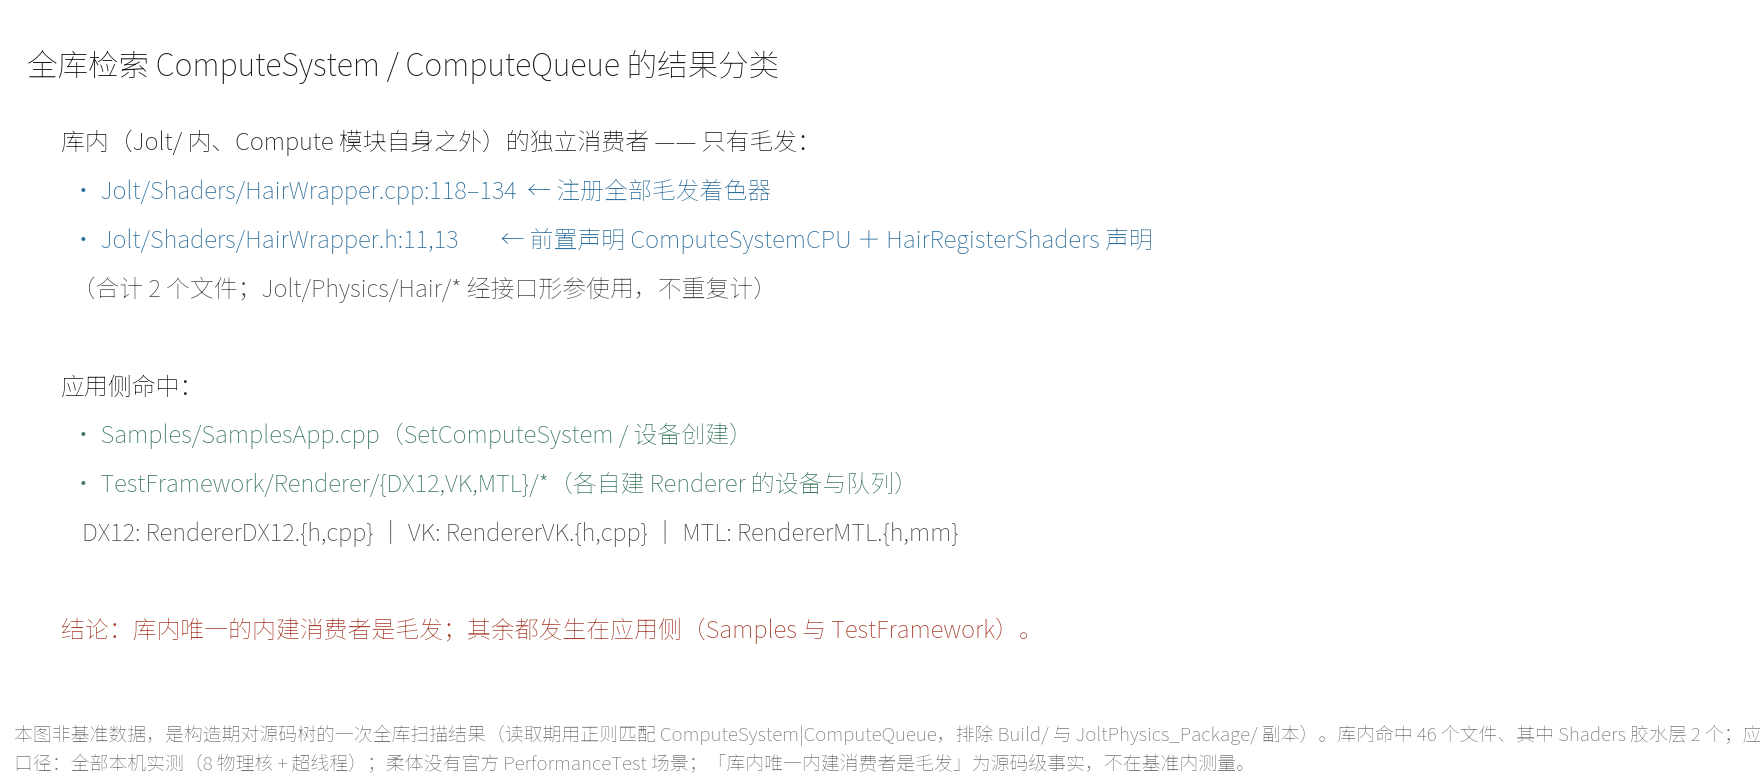
ComputeSystem / ComputeQueue 的引用全部列出并分类,库内只剩 Jolt/Shaders/HairWrapper.cpp:118–134 与 HairWrapper.h:11,13,其余命中都在应用侧的 Samples/SamplesApp.cpp 与 TestFramework/Renderer/{DX12,VK,MTL}/,那是渲染器与物理共用同一个图形设备,不是物理计算跑在显卡上@ 本机基准实测(原创)说白了,这次检索的口径要写清,否则结论会被读窄。检索范围是仓库全树,命中分三类。第一类是接口与实现自身,落在 Jolt/Compute/。第二类是毛发这一条模拟,落在 Jolt/Physics/Hair/ 与 Jolt/Shaders/HairWrapper.*。第三类落在应用侧,是 Samples/SamplesApp.cpp 与 TestFramework/Renderer/DX12、VK、MTL 几处,那几处的角色是渲染器与物理共用同一套图形设备,物理计算并没有因此被搬到显卡上。排除前两类之后,库内真正在用的消费点确实只有毛发。
Jolt/Shaders/HairWrapper.cpp 第 118 至 134 行的函数 HairRegisterShaders 把这件事写得最直白,它一口气向计算系统登记了 HairTeleport、HairGridClear、HairIntegrate、HairUpdateStrands 等十几个着色器,名字全部以 Hair 开头。同目录的 HairWrapper.h 第 11 行与第 13 行分别声明了持有计算系统与计算队列的成员,这两行是「谁持有这条接口」的字面证据。登记入口一共十三组计算着色器,全部围绕发束,没有一组服务刚体或柔体。
还有一件旁证恰好说明接口的通用性。Jolt/Shaders/ 里除了那十几组毛发着色器,还留了一个 TestCompute.hlsl,它做的是一次读写缓冲的通用计算,与毛发没有任何关系。这个示例着色器的存在说明接口本身并非为某一类模拟定制。接口是通用的、毛发只是它当前唯一的消费者,这两句话要一起说,只留一句都会把结论读偏。
7.4 本机的三条通道、三句话的口径,以及一处错挂
下面开始,再把本机构建的通道亮出来,把三个词的口径对齐,最后处理一处被安错人的话。E5 一组只做编译期检查,不创建设备。本机构建里 JPH_USE_DX12、JPH_USE_VK 与 JPH_USE_CPU_COMPUTE 三个宏都被定义,JPH_USE_MTL 未被定义,CreateComputeSystemCPU() 调用返回建成。这四个取值与官方 Build/CMakeLists.txt 第 121 至 131 行的默认开关一致,Metal 通道在 Windows 构建里不存在,它是 macOS 专用。
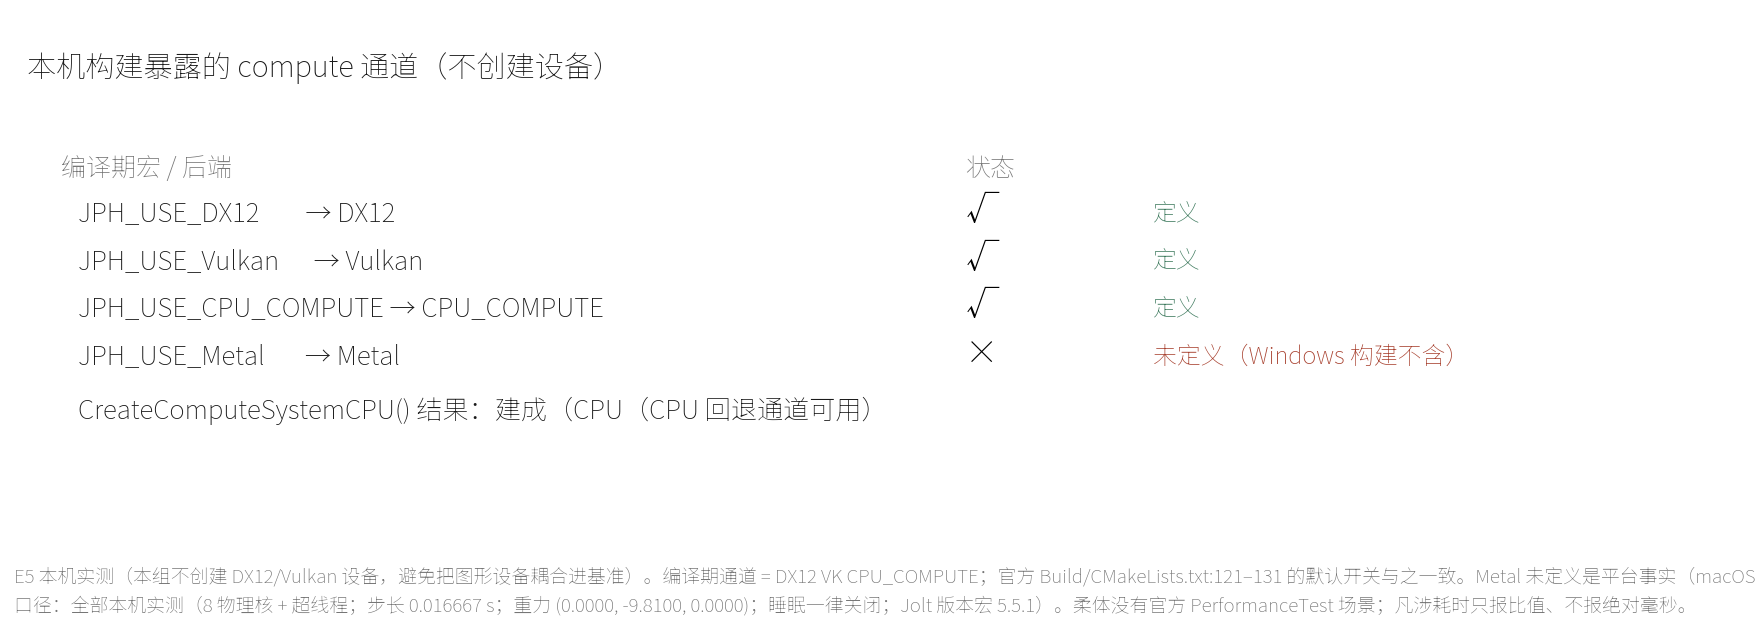
JPH_USE_DX12、JPH_USE_VK 与 JPH_USE_CPU_COMPUTE 三条通道,没有 JPH_USE_MTL(Metal 是 macOS 专用);CPU 回退通道能建成@ 本机基准实测(原创)把通道数与本机读数并排看:编译期可见的三条是 DX12、Vulkan 与 CPU 回退,Metal 这一格在 Windows 上为空。这里要留一句口径,通道存在与设备建成是两件事,本组只确认了前者,CreateComputeSystemCPU() 是唯一被真正调用并建成的一个。本机能验证的就是这两处。
三个词的口径到这一步可以对齐。
「Jolt 有显卡计算接口」这一句成立,证据是 ComputeSystem.h 的四条通道与本机 E5 的三条通道。「Jolt 有显卡物理」这一句目前不成立,因为库内消费这条接口的内建模块只有毛发,毛发是发束模拟,不在刚体与柔体的求解管线上。「Jolt 有显卡刚体」这一句同样不成立,刚体求解仍在 CPU 的多核作业(job)系统上用顺序冲量(sequential impulse)加岛(island)并行来跑,库内没有第二个消费者能改变这一定位。三句话里只有第一句能落到接口,后两句要等到接口长出新的消费者才谈得上。
三句话之外还有一处错挂要当场拆掉。社区里被引用最多的一句「强烈反对把物理库放到显卡上跑」,在转述时常被挂到作者 jrouwe 名下,这句话的实际出处是讨论区 jrouwe/JoltPhysics#501(标题是 GPU acceleration?)里贡献者 jankrassnigg(Jan Krassnigg)2024-10-25 的发言,原文是 As a user of a physics library, I am quite strongly against running it on the GPU.,同一段里他还提到 Havok also dabbled with GPU physics every once in a while, but AFAIK came to the conclusion that it is just not worth it。这一段是贡献者以使用者身份讲的观点,作者并没有替它背书。
作者本人在同一个讨论里的表态方向与之不同,也更能代表引擎的路线。他 2024-10-25 的原话是 If I add GPU support, it will be an optional feature. I'm well aware that callbacks are not practical on the GPU, so the existing CPU-only implementation will not go away.,紧接着列了三个首批用例:视觉特效(VFX)用的成千上万个简单刚体、快速射线投射、柔体模拟,并以 All of them would have CPU fallbacks. 收尾。再往前,作者 2023-04-11 就在同一讨论里写过显卡物理在他的愿望清单上,思路是先提供一套抽象的显卡接口、配 DirectX 与 Vulkan 实现,第一优先是把射线投射放到显卡上。
两段话摆在一起,作者对显卡的立场可以写成一句:可选特性,加上纯 CPU 实现永续保留,首批用例是海量简单刚体、射线与柔体。把「强烈反对」安到他头上是一处错挂,把「Jolt 的显卡只服务毛发」当成设计意图是另一处误读。v5.6.0 交付的是通用接口,毛发是它的第一个消费者,「只服务毛发」描述的是当前实现状态,设计层面并未划下这条边界。两处误读的根在同一个地方,接口、形变与物理解算这三件事各自落在不同的层上。
源码落点:接口本体、四条创建通道与未实现回退见 ComputeSystem.h,登记十几个毛发着色器的函数与持有接口的两个成员见 HairWrapper.cpp 与 HairWrapper.h,证明接口通用性的示例着色器见 TestCompute.hlsl,两条发布说明原文见 ReleaseNotes.md,作者与贡献者在 #501 的两种表态见 GPU acceleration? 讨论;其中:v5.6.0 只交付了一条通用计算接口与发束这一条模拟,库内消费 ComputeSystem 的内建模块只有毛发,本机构建可见 DX12、Vulkan 与 CPU 回退三条通道,Metal 通道在 Windows 上不存在。 再把两处官方口径补上:官方自认 compute 后端「still really early day」(讨论区 #2076),而运行时要探测 compute 系统是否存在、创建失败得由调用者处理(讨论区 #1903)。
八、三家路线对照:Jolt / PhysX 5 / Havok
对照之前先把三个概念分清:计算着色器接口是一条执行通道,形变是对网格顶点做位移,物理解算是求解器在解约束与接触。三者可以在同一台显卡上,也可以各走各的。
本节要回答的是三家引擎在「显卡该不该碰物理」这个问题上各走了哪条路,办法是分别读三家的官方原文,再落到一张四列对照表。
8.1 对照之前先分清三层:接口、形变、物理解算
先来看看,三家能在同一张表里排开,前提是先分清三个层次,否则一句话很容易把层次读串。第一层是计算接口,它回答的是「引擎有没有一条把通用计算送到显卡上的通道」,有没有实现与消费者是谁是两个独立的问题。第二层是形变(deformation),它回答的是「几何量在显卡上被搬运与插值的那一步」,处理的是顶点位置的迁移,不涉及质量、冲量或约束。第三层是物理解算,它回答的是「约束、冲量与求解迭代跑在哪里」。这三层里只有第三层决定一个引擎有没有显卡物理,前两层都不等价于显卡物理,也不互为证据。
把这条分界定下来,上一节那处错挂与本节要拆的第二处流传话就归到同一类问题:一处是把接口读成物理,一处是把形变读成物理解算。下面按 PhysX 5、Havok、Jolt 的顺序,各读一家的官方原文,最后落到一张四列对照表。每一家的写法都止于「官方怎么写」,不替任何一家补实现细节。
8.2 PhysX 5:显卡刚体是一条完整的管线
言归正传,对照的第一家是 PhysX 5,它这一侧真的把刚体求解搬到了显卡上,而且是一条完整管线。官方显卡刚体文档给出两个独立开关,一个是用 PxSceneFlag::eENABLE_GPU_DYNAMICS 打开显卡刚体动力学,另一个是把宽相(broadphase)类型设成 PxBroadPhaseType::eGPU 打开显卡宽相。
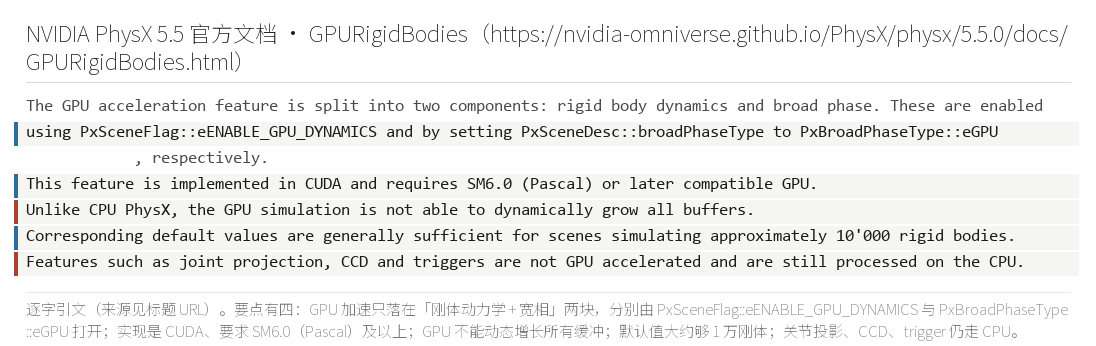
PxSceneFlag::eENABLE_GPU_DYNAMICS 与 PxBroadPhaseType::eGPU 打开;需要 CUDA 与 SM6.0(Pascal)以上;缓冲不能动态增长、必须预先分配;默认值大致够一万个刚体;关节投影、CCD 与触发器仍走 CPU@ NVIDIA 官方文档 PhysX 5.5「GPU Simulation」原文摘录官方列出的显卡加速范围是宽相、接触生成(contact generation)、形状与刚体管理与约束求解器(solver)四件,并写明其余特性仍在 CPU 上执行。边界也写在同一页:关节投影(joint projection)、连续碰撞检测(CCD)与触发器(trigger)都不做显卡加速,场景查询(scene query)在 CPU 上执行,也不与显卡独占的可变形体(deformable body)交互。这套东西用 CUDA 实现,要求 SM6.0(Pascal)及以上显卡,找不到兼容设备就退回 CPU;缓冲不能像 CPU 版那样动态增长,需要调用者预先分配,官方给的默认值大致够一万个刚体(approximately 10'000 rigid bodies)的场面。Isaac Sim 的文档把这条边界说成显卡独占与 CPU 独占两类特性互不交互,可变形体与粒子系统(particle system)都属于显卡独占那一侧。
PhysX 这一条路的形状可以概括成:显卡上跑整套刚体管线,代价是 CUDA 绑定、预先分配缓冲、以及显卡与 CPU 特性之间的互斥。它与 Jolt 的差别正落在这里,一边把管线整体搬到显卡,一边只交出一条接口。
8.3 Havok:显卡布料只做形变那一步
好了,对照的第二家是 Havok,这里要拆的是本篇第二处流传话。常听到的说法是「Havok 用显卡跑布料物理」,Havok 官方的原话把这件事按另一种方式切开了。
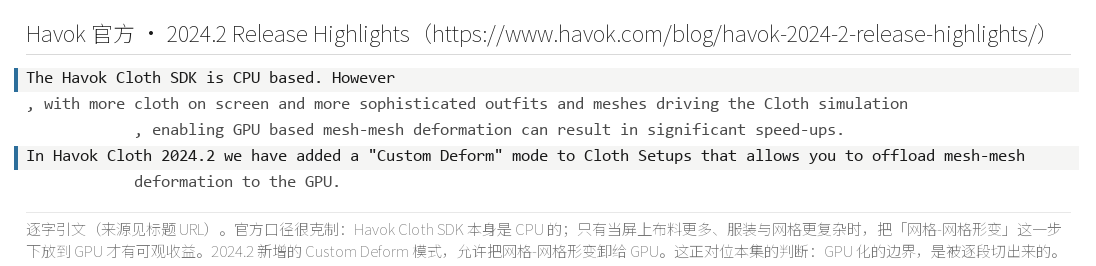
The Havok Cloth SDK is CPU based.,GPU 承担的是新增的 Custom Deform 模式,也就是把网格与网格之间的形变这一步挪到显卡上,形变与物理解算是两件事@ Havok 官方博客 2024.2 Release Highlights 原文摘录官方 2024.2 的发布亮点里写着 The Havok Cloth SDK is CPU based.,显卡承担的是网格与网格之间的形变(mesh-mesh deformation)这一步,对应新增的 Custom Deform 模式,把这一步卸载到显卡。原文接着解释,屏幕上布料越多,开启显卡形变带来的加速越明显。Unreal 集成侧给的数字是,新组件带来的形变性能提升最高约 3 倍(up to 3x compared to the CPU based mesh-mesh deformation);2026 年 1 月的季度亮点里还提到显卡形变与角色动画、渲染的同步问题被修掉,此前被显卡形变的布料会比角色动作慢一帧。这几条合起来指向同一件事:Havok 的布料解算在 CPU 上,显卡处理的是形变这一步,形变是几何量的搬运与插值,与物理解算分属两层。
源码开放度这一列也要写清。Unity 的 Havok Physics 手册写明这个包提供的是一个闭源物理后端,发行的是 Havok Physics 2021.2 的二进制版本,拿不到 C++ 源码。例外在工具链,Havok Cloth 的产品页写明客户可以拿到 Cloth Setup Tool 与运行时的全部源码。这一列与 Jolt 的 MIT 全开形成对照,一边是二进制与工具链源码,一边是整库开源。
三家在这一处各归各位:Havok 是形变在显卡、解算在 CPU,PhysX 是解算也搬到显卡、做成显卡独占的可变形体,Jolt 是布料用柔体近似、柔体仍在 CPU 的 XPBD 上开发。三家的差别落在「显卡管到哪一层」这一个问题上。
8.4 三家路线对照表
OK,把三家放同一张表里,按刚体求解、显卡接口、布料与柔体、源码开放度四个维度并排。
eENABLE_GPU_DYNAMICS 加 GPU 宽相;需 SM6.0 以上、预分配缓冲、约一万刚体的默认上限;GPU-only 与 CPU-only 特性互不作用)、Havok(Physics 是闭源 binary-only;Cloth SDK 官方明写是 CPU 的,GPU 只做网格与网格之间的形变)@ 本系列绘制| 维度 | Jolt v5.6.0 | PhysX 5.5 | Havok(2024.2 / UE 5.7) |
|---|---|---|---|
| 刚体求解 | CPU 多核(作业系统加岛并行) | CPU 或显卡二选一(eENABLE_GPU_DYNAMICS) |
CPU,官方未宣称显卡刚体解算 |
| 显卡接口 | 通用计算(DX12/Vulkan/Metal/CPU 回退),当前只有毛发在用 | CUDA 专用 | 未公开通用接口,Cloth 侧显卡只做形变 |
| 布料与柔体 | 柔体走 CPU 的 XPBD,仍在开发;布料用柔体近似 | 显卡独占的有限元(FEM)可变形体加 PBD 粒子 | Cloth SDK 在 CPU,显卡做网格形变(Unreal 约 3 倍) |
| 源码开放度 | MIT,全开 | 开源(BSD-3 起,新版朝 Apache 2.0) | Physics 闭源二进制;Cloth 工具链源码向客户开放 |
这张表能省掉的误判有两处。一处是把「有显卡接口」直接读成「有显卡物理」,PhysX 与 Jolt 的差别恰好落在这里,PhysX 把整套刚体管线放进显卡,Jolt 只交出一条接口。另一处是把「显卡布料」读成「显卡布料物理」,Havok 这一格给出的答案是形变在显卡、解算在 CPU。两处误判的根在同一个地方,接口、形变与物理解算这三件事各自落在不同的层上,读文档时要把层说清。
源码落点:作者与贡献者在 #501 的两种表态见 GPU acceleration? 讨论,PhysX 的显卡刚体开关与边界见 PhysX 5.5 显卡刚体文档、NVIDIA PhysX 发布博客 与 NVIDIA PhysX 产品页,显卡独占边界见 Isaac Sim 文档,Havok 的 Cloth CPU 口径见 Havok 2024.2 发布亮点 与 Havok Cloth 产品页,闭源口径见 Unity Havok Physics 手册,PhysX 源码见 NVIDIA-Omniverse/PhysX 仓库;其中:那句「强烈反对把物理放到显卡」出自贡献者 jankrassnigg,作者本人的立场是可选特性加纯 CPU 实现永续,Havok 的「显卡布料」把形变放在显卡、解算留在 CPU,PhysX 则把整套刚体管线放进显卡。
九、收官:十三篇的适用域与流传话清算
收官这一节用两张表收口,先给定义口径:流传话列的是可被引用的说法,官方原文列的是能逐字核的句子,第三列只回答一件事,本机能不能验。
本节要回答的是十三篇走完之后,哪些说法能落到可复核的证据上,以及各层模块分别跑在哪个处理器上。
9.1 流传话清算:一张三列表
依然是惯例,收尾的第一件事,是把十三篇里点过与没点过的流传话一次列清。表格三列分别是流传话、对应的官方原文、本机能否验证。列进去的每一条都是社区里被转得比较多、又在原文里有明确落点的说法,其中包括把 Jolt 的求解器叫成时间高斯赛德尔(TGS, Temporal Gauss-Seidel)的那一条。
| 流传话 | 官方原文 | 本机能否验证 |
|---|---|---|
| Jolt 有 GPU 刚体 | 发布说明只写计算着色器接口与发束两条;库内消费计算接口的内建模块只有毛发 | 能,全库检索加 E5 通道检查 |
| Jolt 的求解器叫 TGS / Solver | Docs/Architecture.md 第 731 行写的是 We use a Sequential Impulse solver with warm starting;Jolt/ 全目录检索 TGS 零命中,TGS 是 PhysX 的 PxSolverType 档位 |
能,源码检索零命中,官方点名顺序冲量 |
| Havok 用 GPU 跑布料物理 | Havok 官方写 The Havok Cloth SDK is CPU based,显卡只做网格形变 |
不能,Physics 闭源二进制,无源码可查 |
| 柔体之间会互撞 | SoftBodyCreationSettings.h 第 11 至 12 行与 Architecture.md 第 455 至 463 行写明仍在开发、柔体之间互撞尚未实现 |
能,E2a 两个柔体对穿,全程顶点最小间距 111.6084 mm |
| GPU Compute 只服务头发 | 发布说明写接口通用,TestCompute.hlsl 是通用示例;头发只是第一个消费者 |
能,全库检索加示例着色器,属当前实现状态而非设计意图 |
| 作者本人强烈反对把物理放到 GPU 上跑 | 该句出自贡献者 jankrassnigg 在 #501 的发言;作者的表态是可选特性加纯 CPU 实现永续 | 不能,属讨论区言论,源码不可验证 |
| 毛发已经是成品件 | Hair.h 第 23 至 33 行列出十条待办,含无 LOD、无风力、CPU 与显卡各存一份 |
能,源码面板逐条可核 |
表里「本机能否验证」这一列本身也带信息。能验证的五条都落在源码与读数上,不能验证的两条都落在讨论区言论与闭源产品上,两类证据的可复核程度不同,不能把讨论区里的表态当成源码事实。第三行还有一层口径要补,即便哪天 Havok 开放源码,显卡形变与显卡物理解算也是两件事,验证时要针对具体那一步,不能拿形变的证据去支持解算的结论。第五行说的是当前实现状态,设计意图与眼下的落点本就不在同一页上。
9.2 十三篇适用域总表
下面开始,收口的第二件事,是把十三篇覆盖过的层排成一张适用域表。表格回答三个问题,这一层跑在哪、依据落在哪一篇、状态是什么。
| 层 / 模块 | 跑在哪 | 依据 | 状态 |
|---|---|---|---|
| 刚体求解(顺序冲量) | CPU 多核(作业系统与岛并行) | 第 9 篇、第 10 篇 | 稳定 |
| 宽相(QuadTree)与窄相(GJK/EPA) | CPU | 第 4 篇、第 6 篇 | 稳定 |
| 三层过滤与形状路径 | CPU | 第 5 篇、第 7 篇 | 稳定 |
| 约束家族 | CPU | 第 8 篇 | 稳定 |
| 岛构建与睡眠 | CPU | 第 10 篇 | 稳定 |
| 连续碰撞检测与确定性 | CPU(同一二进制) | 第 11 篇 | 有边界 |
| 角色与载具成品件 | CPU | 第 12 篇 | 稳定 |
| 柔体(SoftBody / XPBD) | CPU 多线程(一个柔体可被多线程切分) | 本篇 §一至 §五 | 仍在开发,五条缺口 |
| 计算接口(ComputeSystem) | 可上 GPU,四条通道,含 CPU 回退 | 本篇 §七 | v5.6.0 新增,官方自认仍是很早期 |
| 发束模拟(Hair / strand) | 显卡计算,配 CPU 回退 | 本篇 §六、§七 | 仍在开发,十条待办 |
| 显卡刚体 | 库内不存在 | 本篇 §七、§八 | 未实现 |
读这张表要抓住三行。能上显卡的两行是计算接口与发束;标「仍在开发」的两行是发束与柔体,计算接口那一行标的是官方自认的「很早期」;其余各行都在 CPU。跨篇的咬合处也落在同一张表上:第 2 篇那次 step 的流水里,柔体的四段作业是插进那张总图的四格。第 9 篇的接触求解走顺序冲量,柔体走 XPBD,两条迭代各自独立,互不接管。第 11 篇的确定性与连续碰撞检测覆盖的是 CPU 刚体那一档,柔体与发束不在同一条命中范围内。
两张表都只收有落点的条目,凡查不到出处的说法一律不收。
9.3 「只服务头发」的当前与意图
先来看看,先把作者的原话再摆一次,作为上面两张表的收口。
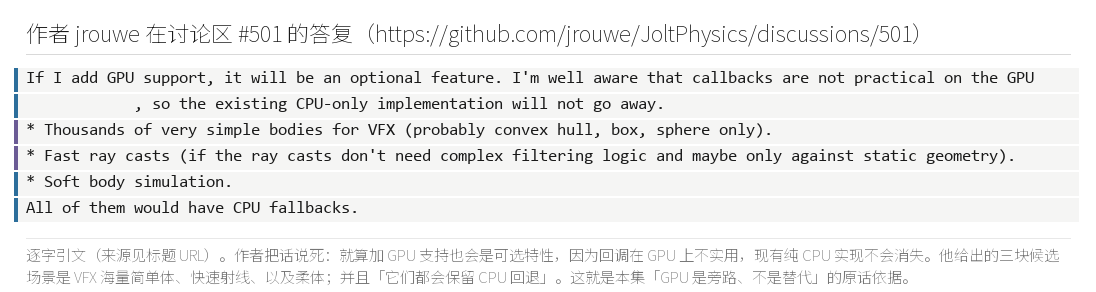
这段原文的三个要点与适用域总表正好对上。显卡支持是可选特性,对应表里「可上显卡」的两行都是可选项,尚未成为默认路径。纯 CPU 实现不会消失,对应表里那条 CPU 回退通道与全部 CPU 层。首批用例是海量简单刚体、射线与柔体,对应表里尚未出现的那三格,刚体、射线与柔体都还停在显卡那一列的空白处。讨论区另一条 #2076 里,作者在 v5.6.0 发布当天还写过计算后端现在仍在很早期(still really early day),并提到毛发的发与发之间的碰撞用的是着色器里手写的三线性插值(trilinear interpolation)取网格平均速度。#1903 那一条则说明计算系统在运行时创建、失败要由调用者处理,毛发的 CPU 回退路径正是这条纪律的落地。
「当前」与「意图」在这里分开说。当前实现里显卡只服务毛发,设计意图里的首批用例覆盖刚体、射线与柔体。两句都成立,用的时间点不同。把这一点想清,§七 的三句话与 §八 的两处流传话就合成了一条线:接口是通用的,消费者暂时只有一个,设计意图指向的范围比当前实现宽。
9.4 收官实证:取自第 1 篇的多核曲线
言归正传,收尾的实证不再重跑,直接用第 1 篇那组多核扩展(multicore scaling)读数。那组读数取自第 1 篇《全景与边界:它在物理引擎谱系里的第几格》的多核扩展实测(取自第 1 篇):本机 8 线程 6.44×,峰值落在 13 线程的 7.59×,9 线程起明显衰减、10 线程后进入噪声区,拐点在 9 到 10 线程之间。硬件口径是 8 物理核加超线程,与本篇前面几节的读数出自同一台机器。这组读数在本篇只作同机对照,不外推到其他线程数,也不外推到其他机器。
官方另有一份多核扩展论文,其场景与机器与本机不同,两份读数不放在一起比。本系列的纪律是把口径写进正文,读数贴在它自己的场景上。
把这条曲线放回收尾的位置,它回答的是「CPU 这条路还剩多少余量」。答案落在拐点 9 到 10 线程这一档,物理核用满之后,再加线程的收益转为噪声。这条余量与 §七、§八 那两个词的关系也清楚:Jolt 把更多算力押在 CPU 多核的调度上,显卡一侧先交出一条接口,把首位消费者留给毛发。十三篇走下来,适用域总表把边界摆在明处,流传话清算表把话说回原文,这两张表就是这一篇的收口。
源码落点:本篇适用域总表的接口依据见 ComputeSystem.h,毛发的待办清单见 Hair.h,柔体的官方缺口见 Architecture.md,发布说明与版本条目见 ReleaseNotes.md,作者与贡献者的表态见 GPU acceleration? 讨论、Metal 4 backend? 讨论 与 运行时探测 compute 系统讨论,多核曲线取自 第 1 篇 与官方 多核扩展论文;其中:流传话清算三列表把每条话对上官方原文与本机可验证性,适用域总表把十三篇覆盖的层分成 CPU、可上显卡与仍在开发三类,收官实证那条曲线取自第 1 篇,本机曲线与官方论文曲线不混比。
资源清单
官方源码与文档(v5.6.0 raw,行号口径见研究笔记,共 22 条):ComputeSystem.h、HairWrapper.cpp、HairWrapper.h、HairIntegrate.hlsl、TestCompute.hlsl、Hair.h、HairSettings.h、SoftBodyCreationSettings.h、SoftBodySharedSettings.h、SoftBodyMotionProperties.h、SoftBodyMotionProperties.cpp、SoftBodyShape.h、SoftBodyManifold.h、SoftBodyContactListener.h、PhysicsUpdateContext.h、Architecture.md、ReleaseNotes.md、Samples.md、PerformanceTest.md、SoftBodyVertex.h、ComputeQueue.h、SoftBodySkinnedConstraint.jpg。
官方样例与单元测试:柔体 Cosserat 杆用例、柔体压力用例、毛发用例、柔体单元测试。
相关链接(作者一手与竞品官方):官方仓库、v5.6.0 发布页、多核扩展论文、GPU acceleration? 讨论、Metal 4 backend? 讨论、运行时探测 compute 系统讨论、PhysX 5.5 显卡刚体文档、NVIDIA PhysX 发布博客、NVIDIA PhysX 产品页、PhysX 仓库、Isaac Sim 文档、Havok 2024.2 发布亮点、Havok Cloth 产品页、Unity Havok Physics 手册、官方全系列架构总图。

系列内:第 1 篇(多核 scaling 实测)、第 9 篇(接触求解)、第 11 篇(CCD 与确定性)、第 12 篇(角色与载具)。
把上面这些按来源归类,共四类,便于复查。官方源码:ComputeSystem.h、HairWrapper.*、Hair.h、HairSettings.h、SoftBody*、PhysicsUpdateContext.h 等。官方文档与样例:Architecture.md、ReleaseNotes.md、Samples.md、PerformanceTest.md、柔体与毛发样例、柔体单元测试。作者一手与竞品官方:多核扩展论文、#501/#2076/#1903 三条讨论、PhysX、Havok、Isaac Sim。本机实测档:bench_softbody_hair.cpp 与 bench_softbody_hair_run_20261007.txt,E0 至 E5 九组,三次复跑剔除耗时字段后逐行一致。四类里前三类指向官方仓库的 v5.6.0 标签,最后一类是本机读数,与本机口径绑定。
下篇预告
T06 系列十三篇到此收口,下一篇另起专题。
With Best Wishes.