本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
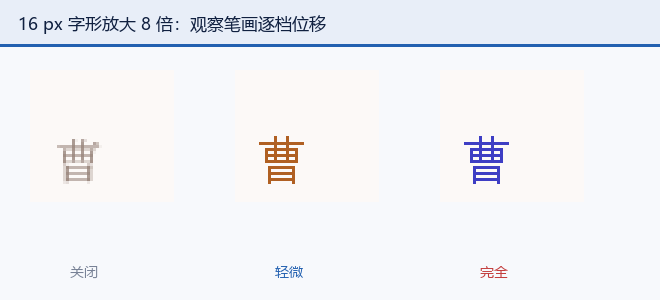
屏幕上的字,看起来和一条矢量路径没什么两样——都是轮廓,都要抗锯齿,都要变成像素。但从工程角度看,它们差得很远:一条路径是我们画出来的,一个字形是别人预先存在字体文件里、我们再取出来的。取出来的过程里有一整套数据组织、度量、缓存与平台分叉,而这些恰恰是「排版问题最后常常落在字体回退上」的根。这一篇就钻这一层。它接在上一篇(《矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage》)后面:上一篇讲的是「一条路径怎么变成像素」,这一篇换一种输入,讲字是怎么变成可绘制的东西的。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更快/更准」的说法,绑定本机实测数字或官方原文常量;
- 凡引必注:源码常量给文件与版本,官方文档给链接,本机实测给环境与命令;
- 本篇不涉及(边界见 0.3):曲线细分与覆盖率算法(上一篇已讲透)、GPU 后端的 op 组织与 paint 落地、Graphite 内部机制、Vello 的完整流水线、文本排版的完整规则(只讲到 shaping 边界为止);
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。为什么字形这一层值得单独开一篇。它是「图形」与「文字」两条线的交点,而这个交点上的知识两边都不完整:图形工程师懂扫描线与覆盖率,不清楚字形数据怎么组织;排版工程师熟 OpenType 表结构,不清楚数据进来之后怎么被缓存与光栅化。于是同一个问题常被两边推给对方——「显示不对」归排版,「字形太慢」归渲染。本篇把这条链一次走通。本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机自跑实截由
skia-python 144.0.post2生成;自绘图为本系列绘制,走styles/qianmo/palette.json色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(路径到像素):【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 本篇引用最密的两个源码文件:SkGlyph.h | SkScalerContext.cpp
- 本篇本机自跑用的绑定:skia-python 发行页
本篇只回答三件事
先来看看这一篇要回答的三个问题。
0.1 全篇知识地图:三个问题,一条动线
字形这一层的问题可以收成三句:第一件:字形从哪来。我们手上是字符(character),引擎要的是字形(glyph)。中间那次映射由 cmap 表完成,而映射失败时不会报错,只会给你一个 glyph 0——这个默认值的存在,解释了为什么缺字最终表现成「一个方框」而不是一段空白。第二件:字形长什么样。字形在字体文件里不是一条现成的路径,而是一串增量坐标加一串 flag 位:glyf 表里每个点的坐标是相对前一点的 delta,是否短、是否与上一点相同,全靠 flag 里的三个 bit 表达。二次曲线与三次曲线在同一个文件里可以共存,复合字形还能把别的字形拼起来用。第三件:怎么变成可绘制的东西。引擎算一个打包键(字形 ID 加子像素位置,共 20 位)去缓存里查;查不到才让平台后端光栅化,结果按五种形态之一存下来。
这条动线里有一个反复出现的结构:引擎把「难的部分」交给平台,自己只做编排与缓存。Skia 在这件事上非常坦白,我们第一节就来看它的原话。
0.2 一句话说清「字形不是路径」
好了,先把一句话的结论放在这里。一条路径是我们构造的:控制点、曲线段、填充规则,全在手里。一个字形是取来的:字符 → 字形 ID 是一次查表;字形 ID → 轮廓是一次解析;轮廓 → 位图是一次光栅化。三步里每一步都可能失败,而失败的方式都指向同一个入口——字体回退(font fallback)。这就是为什么「字显示不出来」这件事,在工程上很少是「渲染错了」,绝大多数是「根本没找到这个字形」。第 1 节先把这条链拆开。
0.3 边界:本篇不涉及什么
边界不是客套——它防的是两篇文章讲同一件事又都讲半截。前序篇目已经占了不少地,我们一块块让出去:
- 曲线细分、tessellation、覆盖率与解析 AA:属 ep03(上一篇),本篇只引用不复述。字形轮廓同样要吃那套算法,但那是上一篇的事。
- GPU 后端的 op 组织与 paint/surface 落地:属 ep05。
- Graphite 内部机制:属 ep06,本篇只在最后一句立它与 Ganesh 的分界。
- Vello 的完整流水线:属 ep09,本篇只用它的
glyph_run与 ImageCache 一句。 - 字形光栅化的数学内核(扫描线怎么放、覆盖率怎么算):属 ep03,本篇讲的是字形这一层特有的组织方式。
- 文本排版的完整规则:双向文本、断行、行内盒模型只讲到「shaping 的边界」为止,因为再往后是排版引擎的领地。
0.4 证据来源与可复现方式
本篇证据分两类。本机自跑:环境 skia-python 144.0.post2(对应 Skia m144),代码在 pixel-raster-dev 仓 exp/font/ 下,标「本机自跑」的图都附关键读数。可引用的源码常量与规范原文:格式为「文件路径 + 常量名或注释原文」,链接见文末参考资料。另有一条检索结论:Commons 上没有对位「引擎内部机制」的示意图(Category:TrueType、Category:Font rendering、Category:Vector fonts、Category:Signed distance field、Category:Font formats 均返回 0 个文件),故机制示意全部是本机实截或本系列自绘。
本章的术语定义与边界声明见 Skia — Tips & FAQ;让出的题域见 ep03 原文。
0.5 本章收在哪里
下面我们进入第一阶段。这一篇的线索是「取」:字符是索引,字形是数据,缓存是取的方式。
一、字符怎么变成字形
下面我们进入第一阶段:字符是怎么变成字形的。
1.1 第一步是一次查表
先来看看第一次查表发生在哪里。字符到字形的映射由字体文件的 cmap(character to glyph mapping)表完成。它把字符码映射到默认字形索引(glyph index),而这里有一句必须记住的规范原文:未映射的字符一律映射到 glyph 0,也就是 .notdef 那个「缺字方框」[17]。
Skia 侧的入口是 SkTypeface,它的类注释写着它「specifies the typeface and intrinsic style of a font」,并且不可变、可跨线程共享[2]。查表接口是:
// 【SkTypeface】字符到字形的三个入口(skia/include/core/SkTypeface.h)
sk_sp<SkTypeface> face = ...;

// 【1】单个字符查询:注释原文「If the unichar is not supported, returns 0.」
SkGlyphID g1 = face->unicharToGlyph(0x6C49);   // 汉

// 【2】批量查询:UTF-8/16/32 三种编码都可
SkGlyphID glyphs[8];
size_t n = face->textToGlyphs(text, bytes, SkTextEncoding::kUTF8, {glyphs, 8});

// 【3】批量 unichar 查询
face->unicharsToGlyphs({unis, unisLen}, {glyphs, 8});
下面对这三个入口特别说明:返回值 0 是正常返回值而不是错误码。「不支持就返回 0」这句注释的分量在于,调用方无法从返回值区分「这个字符的字形恰好是 0 号」与「这个字符根本没映射」——虽然按规范前者不会发生(glyph 0 按定义保留给 .notdef),但在写容错逻辑时这一点必须心里有数。字形的数量由 countGlyphs() 给出,坐标系统的尺度由 getUnitsPerEm() 给出——这两个数决定了后面所有的缩放计算。
1.2 字形不只有轮廓:度量也是字形的一部分
初学者容易把字形等同于轮廓,但一个字形实际上是轮廓加一整套度量:横向推进量(advance width)、左侧边距(left side bearing,lsb)、右侧边距(rsb)、以及包围盒。
hmtx 表存的就是这些。规范给了一条可核算的关系式:
rsb = aw − (lsb + xMax − xMin)
其中 aw 是 advance width,xMax/xMin 来自字形头部的包围盒。同一张表还定义了 phantom points(幽灵点)的初值:pp1 = xMin − lsb,pp2 = pp1 + aw [18]。
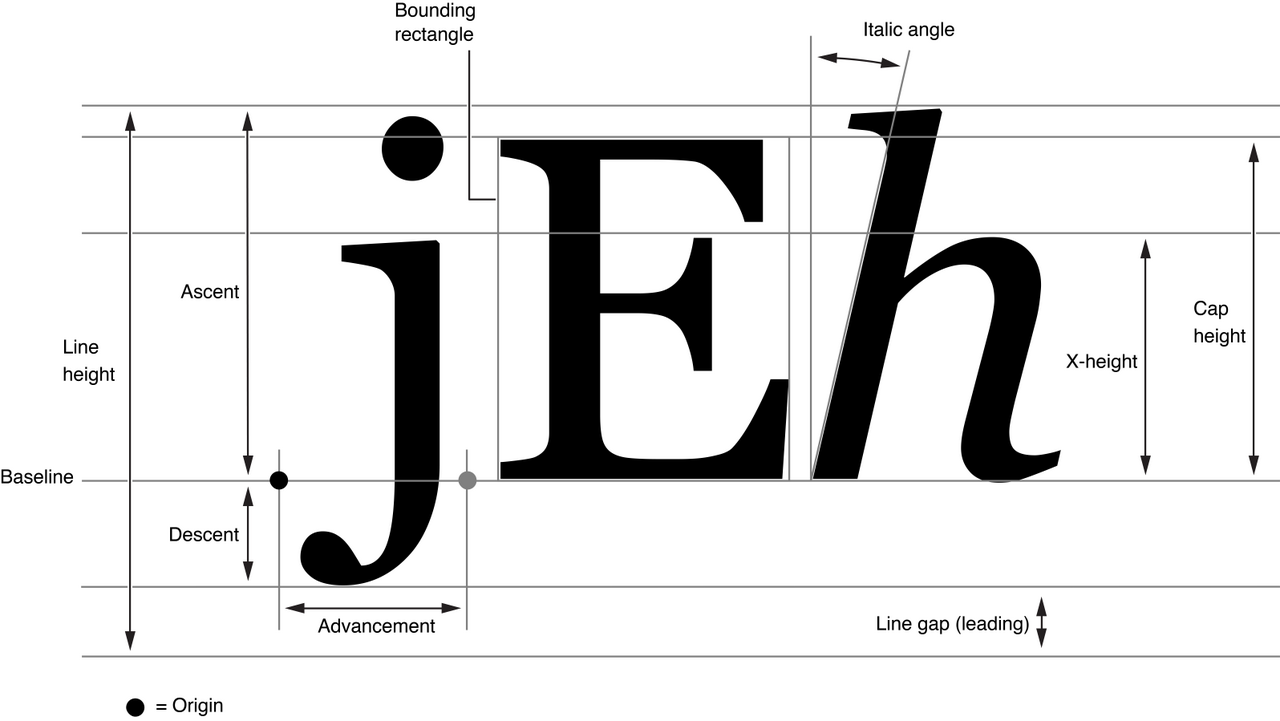
为什么这几个量值得单独画一张图:因为它们解释了「同样的字形,为什么不同字体排出来的行宽不一样」。光栅化只管把轮廓变成像素,行宽是度量算出来的——两者不共享同一套数据,这也是「看起来对齐了但间距不对」这类问题的来源。
1.3 字距是另一张表,而且引擎不替你做
字距调整(kerning)由 GPOS/kern 一类的表描述。Skia 不主动做复杂 shaping,SkTypeface 只提供了一个成对调整的接口:
// 【SkTypeface】成对字距:返回值语义为 false 时「no kerning should be applied」
bool ok = face->getKerningPairAdjustments(glyphIDs, adjustments);
下面对这句注释特别说明:它把「有没有字距」与「字距是多少」分开表达——返回 false 不表示失败,而是表示这一对字形之间没有调整。真正做 shaping 的是上层(通常是 HarfBuzz),我们第 8 节讲 blob 时会回到这条边界。
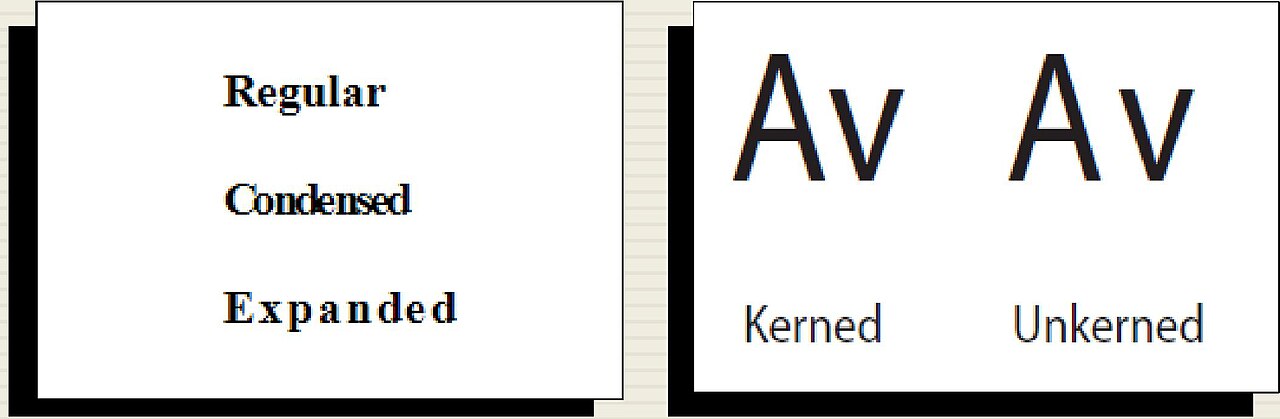
值得再看一眼这张表的归属:它既不在轮廓里,也不在 hmtx 的 advance width 里,而是一张独立的两两对照表。所以「两个字形摆到一起要挪多少」这件事,引擎必须先知道要把哪两个字形摆到一起——这正是它只能交给 shaper 的原因。
1.4 缺字:一次映射失败是怎么变成方框的
下面我们看一次映射失败是怎么发生的。把 1.1 的三条事实串起来:cmap 未映射落 glyph 0;unicharToGlyph 不支持返回 0;SkTextBlob::MakeFromText 明确不做字体回退(原文:「It does not perform typeface fallback」)[9]。三者叠加的结果就是:如果你用的字体没有这个字符,而你又没有手动准备回退链,那么你会看到一个 .notdef 方框,而不是一段空白。
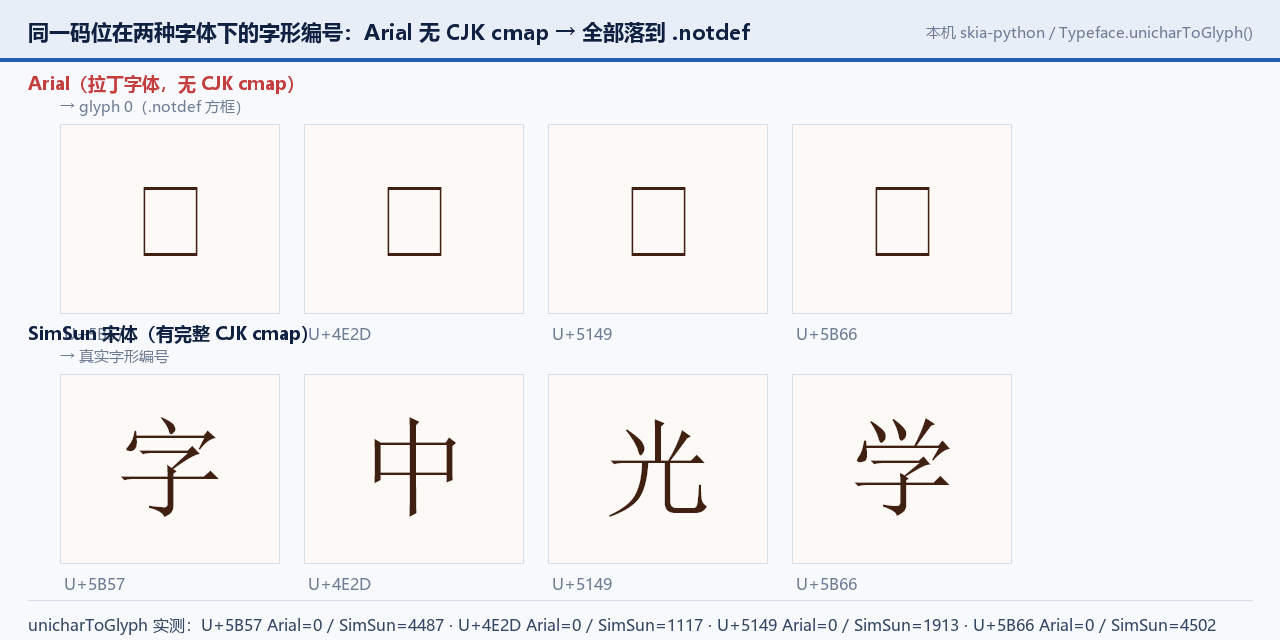
回退链必须由上层提供。Skia 的 Paragraph(skparagraph 模块)提供了两个查询接口来暴露这个问题:
// 【Paragraph】未解析字形的计数与码点集合(modules/skparagraph/include/Paragraph.h)
int32_t missing = paragraph->unresolvedGlyphs();          // -1 表示「尚未 shape,属合法情形」
std::unordered_set<SkUnichar> cps = paragraph->unresolvedCodepoints();
下面对 -1 这个返回值特别说明:注释写得很清楚——-1 表示「还没 shape,是合法情形」。把「没准备好」与「缺字」分开表达,这个设计正是为了让上层能区分「我需要再等等」和「我需要换字体」。
1.5 cmap 不只有一张表
cmap 表内部可以有多张子表,按平台与编码区分,读取方按优先级挑一张用 [17]:
| 子表格式 | 覆盖范围 | 何时用 |
|---|---|---|
| Format 4 | 仅 Unicode BMP(U+0000–U+FFFF) | 拉丁 + 基本汉字,最普遍 |
| Format 12 | Unicode 全范围(含 U+10000 以上) | 需要增补平面(emoji、罕用字) |
| Format 14 | 变体序列 | 与 Format 12 配对,处理异体字选择 |
| Format 2 | 双字节混合编码 | 专为日/中/韩的 8/16 位混合编码设计,今已少用 |
平台标识上,Platform 3(Windows)还定义了一套编码号:ShiftJIS(2)、PRC(3)、Big5(4)、Wansung(5)、Johab(6) [17]。这五个编号是 CJK 字体历史包袱的直接证据——它们是各自地区的旧编码体系,在没有 Unicode 统一之前,一个字体要为每种编码各带一张映射子表。一条可引用的规范要求:Encoding record 必须按 platformID → encodingID → language 排序,且三元组唯一 [17]。这个排序要求是为了让「按优先级挑一张」这件事能在不加载全部表的前提下完成——规范在这里考虑的是启动性能。
1.6 度量链的一个完整算例
把 1.2 的两条公式连着算一遍,就能看出度量链的完整形状。假设某个字形的设计数据是:xMin = 60、xMax = 900、lsb = 60、advanceWidth = 1000(单位是 design unit,unitsPerEm = 1000)。
【度量算例】unitsPerEm = 1000 的某字形
  rsb = aw − (lsb + xMax − xMin)
      = 1000 − (60 + 900 − 60) = 1000 − 900 = 100
  pp1 = xMin − lsb = 60 − 60 = 0          # 第一个 phantom point
  pp2 = pp1 + aw  = 0 + 1000 = 1000       # 第二个 phantom point
下面对这个算例特别说明三点:
rsb = 100是算出来的,不是存下来的。hmtx只存advanceWidth与lsb,右边界靠上面的公式反推 [18]。- 两个 phantom point 落在
0与1000——它们就是「这一格文字的左右边界」。hinting 指令可以修改它们,而 advance width 的最终值就是pp2 − pp1。 - 这里
lsb == xMin,符合 2.4 节说的「规范建议的性能友好情形」,此时pp1 = 0。
这三个数(aw、lsb、rsb)决定的是排版位置,不是像素形状。 光栅化只关心轮廓;一旦你发现「字排出来位置偏了」,该查的是这张表,不是渲染器。
官方依据:字符到字形的映射定义见 OpenType spec — cmap;度量与字距接口见 SkTypeface.h。
1.7 本章收在哪里
这一章只讲了一件事:字形是查出来的。未映射落 0、度量单独存、缺字要回退——这就是「中文没显示出来」的排查顺序。
二、字形数据在文件里长什么样
下面我们进入字形数据的存储层。
2.1 glyf 表:没有索引,靠 loca 算
先来看看 glyf 为什么不需要索引表。
TrueType 的字形数据放在 glyf 表里,而它的组织方式很不「现代」:没有表头、没有偏移记录,只是一串按字形 ID 顺序排列的数据块。怎么找到第 N 个字形?靠 loca 表——相邻两项之差就是第 N 块的偏移与长度,所以 loca 的元素数是 numGlyphs + 1 [16]。
loca 有两种格式,由 head 表的 indexToLocFormat 指定:Short 格式存的是实际偏移除以 2(所以最大可寻址约 128 KB),Long 格式存实际偏移 [16]。无轮廓字形(比如空格)的判定很简单:loca[n] == loca[n+1]。
2.2 坐标是增量,flag 是三态压缩
glyf 里最简单的一个字形长这样:一个 10 字节的头部(numberOfContours 加四个包围盒值),然后是端点索引、指令、flag 数组与两串坐标 [15]。关键在坐标的存法:每个点的坐标不是绝对值,而是相对前一点的增量(delta),第一点相对 (0,0)。而每个增量占几个字节,由 flag 里的 bit 决定,一共三态:
| flag 位 | 含义 | 坐标占用 |
|---|---|---|
0x02 X_SHORT_VECTOR |
x 是 1 字节短量 | 1 字节(符号由 0x10 给) |
0x02 未设、0x10 设 |
x 与上一点相同 | 0 字节 |
| 两者都未设 | x 是带符号 int16 增量 | 2 字节 |
这里最值得记住的是两个「省」:
- 省坐标:连续的相同坐标不占空间。横竖笔画多的字形(汉字尤其)受益明显。
- 省 flag:
0x08REPEAT_FLAG 让下一个字节表示「这个 flag 重复几次」,于是 flag 数组可以比点数短[15]。规范里还有一句工程味的取舍:更小的unitsPerEm让增量更容易落进 8 位(省一半坐标字节),代价是轮廓精度下降 [15]。这就是「小 em 值的字体更省,但放大后更糙」的规范级解释。
2.3 位图字体:另一种存在方式
前面讲的都是轮廓字体(outline font)。但字体还可以直接存位图——每个字号一套预先画好的点阵,渲染时不需要轮廓也不需要光栅化。
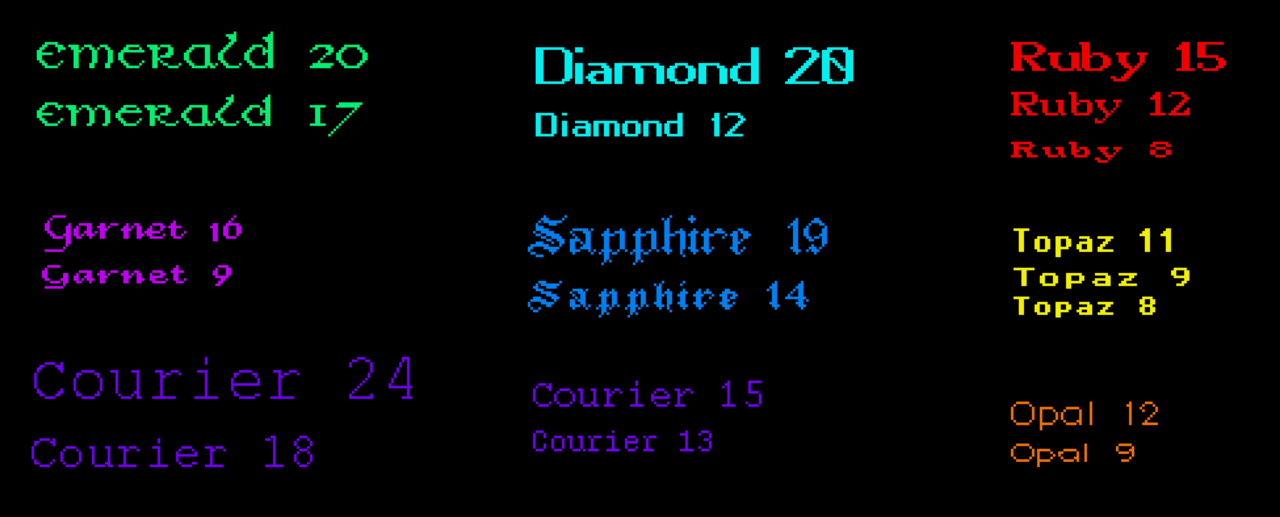
这条分界在今天仍有现实意义:小尺寸下的点阵字形有时比「光栅化出来的轮廓」更清晰,因为它在字体设计阶段就做过人工优化,而不是运行时算出来的。Skia 侧对应的是 kEmbeddedBitmapText_Flag(值 0x0004)与 isEmbeddedBitmaps()——是否使用字体内嵌位图,是一个显式开关[8][3]。
2.4 头部十个字节里有什么
glyf 的头部是固定 10 个字节 [15]:
| 字段 | 类型 | 含义 |
|---|---|---|
numberOfContours |
int16 | ≥0 为简单字形;负值(建议 −1)为复合字形 |
xMin / yMin |
int16 × 2 | 包围盒左下 |
xMax / yMax |
int16 × 2 | 包围盒右上 |
这四个包围盒值有一条容易忽略的性质:它们由控制点算出,保证包含轮廓但并不紧贴轮廓——也就是说,包围盒可能比实际形状大一点,因为贝塞尔控制点可以落在轮廓之外(这一点在 FreeType 文档里也有对应表述:cbox 始终包含 bbox)[15][22]。规范还给了两条与性能有关的备注:若 xMin == lsb,光栅器的性能会更好(此时应置 head.flags 的 bit 1);变量字体的 TrueType 轮廓里,lsb 必须等于 xMin[18]。「包围盒与边距对齐」这件事在规范层面被当成性能优化来写,因为它省掉了光栅器里的一次额外计算。
2.5 REPEAT flag 到底省了多少
0x08 REPEAT_FLAG 的效果可以算一下。一个汉字的某个横画由 8 个点构成,若这 8 个点都是「在曲线上、x 与上一点相同、y 走短量」——那么这 8 个点的 flag 完全一样。
【REPEAT 压缩算例】8 个 flag 相同的点
  不用 REPEAT:8 个 flag 字节 = 8 B
  用  REPEAT:1 个 flag 字节 + 1 个重复计数字节 = 2 B
  省下 6 B(75%)
下面对这个算例特别说明:REPEAT 的语义是「下一个字节是重复次数」,所以它能表达「这个 flag 连续出现 N 次」[15]。规范在这里做了一个很聪明的设计——把「相同的重复」与「不同的重复」用同一套机制表达:如果相邻两点的 flag 不同,那就不设 REPEAT,各写各的。两个必须注意的边界:REPEAT 不能跨轮廓(它只压缩同一个 flag 数组内的连续重复);以及坐标数组并不跟着压缩——REPEAT 只省 flag,坐标仍按各自的三态逐点写 [15]。所以「省」这件事在 glyf 里是三处独立的机制(短坐标、相同坐标不占字节、flag 重复),它们不互相替代。
官方依据:
glyf与loca的结构定义见 OpenType spec — glyf、loca。
2.6 本章收在哪里
这一章回答「字形存成什么样」。三态坐标、REPEAT、loca 相邻差都是压缩手段,位图字体是另一条不经过轮廓的路:格式设计的目标一直是「文件更小」,不是「解析更快」,缓存层由此而来。
三、二次、三次与复合字形
先来看看两种曲线在同一个文件里怎么共存。
3.1 两种曲线,两套规范
先来看看两种曲线在数据里各自长什么样。轮廓里的曲线有两种:二次(quadratic)与三次(cubic)。TrueType 用二次弧,PostScript Type 1、CFF、CFF2 用三次弧 [22]。它们在同一条轮廓里怎么表示?FreeType 的文档给了完整的分解规则 [22]:
| 相邻点的情况 | 分解结果 |
|---|---|
| 两个 on 点 | 直线段 |
| 两 on 之间一个 conic off 点 | 二次弧 |
| 两 on 之间恰好两个 cubic off 点 | 三次弧(单个 cubic off 点非法) |
| 两个连续的 conic off 点 | 光栅器必须在此插入一个虚拟 on 点 |
最后一行是这套设计里最容易踩的地方:二次弧的点序列本身不携带中点信息,所以遇到两个连续 off 点时,光栅器得自己补一个 on 点。这不是可选优化,而是规范要求的补全。另外两个可引用的实现细节:FreeType 的轮廓坐标是 26.6 定点(1/64 像素)[22];FT_Outline 的 contours[] 存各轮廓末点索引,合法时满足 n_points == contours[n_contours-1] + 1[22]。
3.2 CFF2 与可变字体:字形可以「连续变化」
CFF 的字形数据经 CharStrings INDEX 访问,Top DICT 里必须指定 CharstringType = 2,且 OpenType 的 glyph index 与 CFF 的 glyph index 必须相同[20]。
CFF2 是 CFF 的下一代,多了两件事:blend 运算(支持可变字体)与 hint 运算;而且它不含 advance width(与 CFF v1 不同),宽度必须去 hmtx 取,可变实例再用 hmtx 加 HVAR[21][18]。
【CFF2】数字编码速查(规范表格)
  b0 32..246   -> b0 - 139           # 单字节小整数
  247..250     -> 2 字节,108..1131
  251..254     -> 2 字节,-1131..-108
  28           -> int16
  255          -> 16.16 Fixed        # 仅 CharString
  29           -> int32              # 仅 DICT
  30           -> BCD 实数           # 仅 DICT
栈最大操作数 = 513;BCD 终止 nibble = 0xf
例:-2.25 编码为 30 E2 A2 5F
下面对 255 与 29 的分工特别说明:同一个「大数」在 CharString 与 DICT 里走了不同的编码路径。这不是冗余设计——DICT 是字体级配置、需要整数精度;CharString 是字形绘制、需要定点小数。栈上限 513 这个数也值得记一下:它决定了复杂字形能用多长的操作数序列。
3.3 复合字形:把别的字形拼起来用
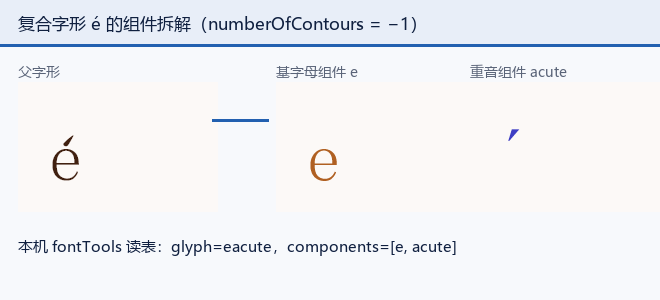
一个字形可以不画轮廓,而是引用若干别的字形——这就是复合字形(composite glyph)。头部里 numberOfContours 为负值(规范建议 -1)即表示复合 [15]。每个组件有自己的 flag,控制参数宽度、是否用 xy 偏移、是否带缩放或 2×2 变换:
| 组件 flag | 含义 |
|---|---|
0x0002 ARGS_ARE_XY_VALUES |
参数是 xy 偏移而非点编号 |
0x0004 ROUND_XY_TO_GRID |
偏移取整到网格 |
0x0008 / 0x0040 / 0x0080 |
带 scale / 带 xy 独立 scale / 带 2×2 变换 |
0x0200 USE_MY_METRICS |
用我的度量——对齐的关键 |
0x0400 OVERLAP_COMPOUND |
轮廓可能重叠 |
三个细节:
- 它是有向无环图,嵌套深度上限记在
maxp.maxComponentDepth;规范建议避免嵌套,因为部分 PostScript 设备渲染不了 [15]。 - 每个子组件在并入父级前会先执行自己的 hinting 指令,所以锚点对齐可以引用子组件的 phantom point [15]。
USE_MY_METRICS解决的是「带重音的字母该按谁算宽度」——用基字母的度量,否则行距会被重音撑开。
3.4 三次弧在 CFF2 里的表达
CFF2 的字形由三次贝塞尔曲线与直线构成,并且带 blend 与 hint 两类运算 [21]。它的布局被规范钉死:Header 在偏移 0,TopDICT 在偏移 5,GlobalSubrINDEX 在 5 + Header.topDICTSize,三者必须按此顺序开头 [21]。偏移 5 这个「奇怪」的起点来自于 CFF2 的 header 定长,好处是解析器不必先读长度再定位——规范在这里用一点空间浪费换了解析确定性。另一条硬约束是栈深度:CFF2 的最大操作数栈是 513[21]。这个数字决定了单个字形能用多长的操作数序列;超长的复杂字形(汉字里常见)需要借助子程序(subroutine)拆分。需要区分的是两条不同性质的曲线来源:TrueType 的 glyf 用二次弧;PostScript Type 1、CFF、CFF2 用三次弧 [22]。所以「同一个字形在两种格式下的点序列完全不同」是正常的——格式转换必然要做曲线阶数转换,而这一步会引入逼近误差。
3.5 格式转换的误差从哪里来
二次与三次弧的互相转换必然引入误差,来源有三处,都是规范级的:第一处是点数的改变。一段三次弧转成二次弧需要拆成两段或更多(因为二次弧只有两个控制点,无法精确表示一般三次弧)。这意味着转换后轮廓的点数会变多,文件变大。
第二处是 on/off 语义的差异。三次弧的「两个 off 点才算一段」与二次弧的「一个 off 点就算一段」在转换后需要重新分配 tag,而连续两个 conic off 点要插入虚拟 on 点这条规则在这个环节必须重新满足 [22]。第三处是可选的 hinting 程序失效。 TrueType 的 hinting 是一段逐点的 bytecode 程序,它绑定点编号;一旦点数变了,原程序要么失效、要么算错。所以「字体格式转换工具」通常会把原 hinting 一并丢弃——这就是「转格式之后小字号变糊」的规范级原因。
官方依据:二次与三次弧的定义见 OpenType spec — CFF、CFF2;轮廓曲线原理见 FreeType — Glyph Outlines。
3.6 本章收在哪里
这一章讲「轮廓的两种表达与一种复用」。二次弧插虚拟 on 点、CFF2 把连续变化写进规范、复合字形用引用换体积——取向仍是先省文件体积。
四、从字形 ID 到一个可绘制的键
下面我们进入缓存层的第一个问题:怎么寻址一个字形。
4.1 20 位打包键
引擎要缓存字形,就得先给每个「字号下的某个字形的某个子像素位置」造一个键。Skia 的做法是把这三样塞进一个整数:
// 【SkGlyph】SkPackedGlyphID 的位布局(src/core/SkGlyph.h)
kGlyphIDLen    = 16u;   // 字形 ID
kSubPixelPosLen =  2u;  // 子像素位置:x、y 各 2 位
kSubPixelX  = 0u;
kGlyphID    = kSubPixelPosLen;                    // 从第 2 位起
kSubPixelY  = kGlyphIDLen + kSubPixelPosLen;      // 从第 18 位起
kEndData    = kGlyphIDLen + 2 * kSubPixelPosLen;  // = 20
static_assert(SkPackedGlyphID::kEndData == 20);
下面对这 20 位特别说明:16 位给字形 ID,剩 4 位给子像素位置(x、y 各 2 位,即 4×4 个位置)。这个分配直接决定了两件事——
- 字形 ID 上限 65535。CJK 大字库要留意这个天花板。
- 子像素只有 4 档。8 个子像素位置?不,x 是 4 个位置(2 位),y 也是 4 个。规范侧另有
kSubpixelRound = 1/8这个常量,那是取整时的补偿量,不是档位数——两个数不要混。
4.2 五种承载形态
一个字形光栅化完之后,以什么形式存下来?Skia 把它分成了并列的五类(skglyph::ActionType)[4]:
| 值 | 形态 | 含义 |
|---|---|---|
0 |
kDirectMask |
直接掩码(无 padding) |
2 |
kDirectMaskCPU |
CPU 侧直接掩码 |
4 |
kMask |
掩码(带 padding,供插值) |
6 |
kSDFT |
距离场纹理 |
8 |
kPath |
路径 |
10 |
kDrawable |
可绘制对象 |
| 这张表还有一处值得停下来想:同一个字形在同一个字号下,可以同时存在多种承载形态。小字号用掩码最省,标题字号用路径最准,需要跨字号缩放时则用距离场——三者不是版本替代关系,而是并存选项。 |
这是本篇最重要的一张表:路径与距离场并列在同一层,意味着引擎运行时可选择——小字号用掩码,大字号或需缩放时用路径,需特效时用距离场。
4.3 什么时候不该用掩码
选形态的判据是显式的。SkStrikeSpec 里有一个函数就叫这个名字:
// 【SkStrikeSpec】显式判据:什么时候把字形当路径画
static bool ShouldDrawAsPath(const SkPaint& paint, const SkFont& font, const SkMatrix& matrix);
另有一个硬上限:能进图集的字形最大 256×256。源码常量与注释原文:
// 【SkGlyph】图集的尺寸硬上限
static constexpr uint16_t kSkSideTooBigForAtlas = 256;
// 注释原文:「A plot can be at least 256x256. This means that the maximum size
// a glyph can be is 256x256.」
// 可用插值(interpolated)的上限再紧 2 像素:
//   fitsInAtlasInterpolated() = maxDimension <= 256 - 2
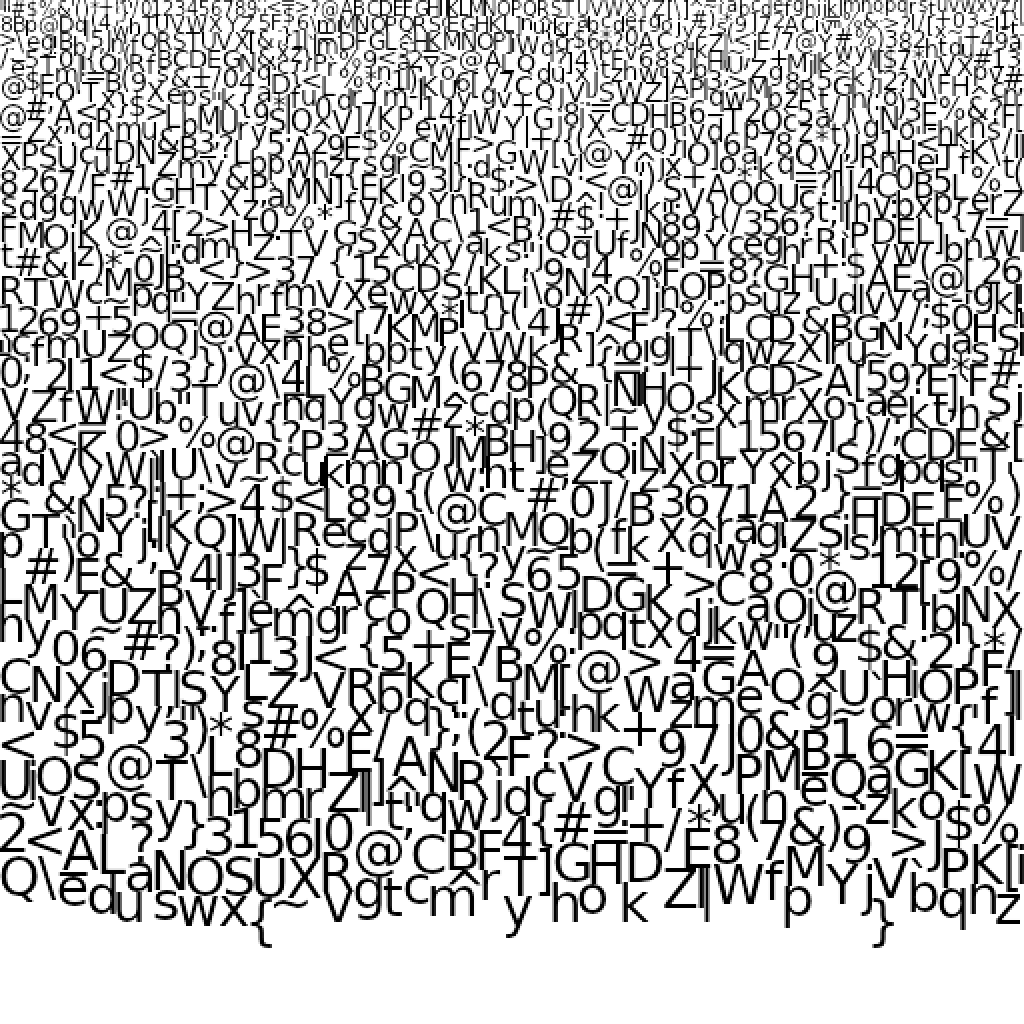
这张图还有一处值得留意:块与块之间的空隙就是给采样插值留的 padding。空隙不是浪费,而是「让双线性采样不会取到隔壁字形」的必要成本——它把 4.3 节那条 1 像素规则画了出来。下面对这个 256 特别说明:超出这个尺寸的字形进不了图集,只能走路径或可绘制对象——这正是 4.2 那张表里 kPath 与 kDrawable 存在的直接原因。
4.4 缓存的四种分类
同一个字形在不同用途下要不同的产物:画文本要掩码、取轮廓要路径、量尺寸只要度量。Skia 把这些需求拆成四种缓存分类,各自用不同的缓存键 [7]:
| 分类 | 入口 | 缓存什么 |
|---|---|---|
| 掩码 | MakeMask(...) |
位图(含子像素位置差异) |
| 变换掩码 | MakeTransformMask(...) |
带变换的位图 |
| 路径 | MakePath(...) |
轮廓路径(返回 SkScalar 缩放量) |
| 规范化 | MakeCanonicalized(...) |
与设备无关的规范形态 |
下面对这张表特别说明:「分类」本身就是一层缓存。如果只有一种缓存,那么取一次轮廓就会把掩码挤出去,反之亦然;分成四类之后,写入与逐出互不干扰。这类「按用途分池」的做法在系统软件里很常见,代价是管理复杂度上升。还有一个值得一提的接口:MakeWithNoDevice(...) 用于构造不依赖具体设备的 strike,这正是「同一个 blob 在不同 DPI 的屏幕上复用」的实现基础 [7]。
4.5 打包键怎么用:位运算速查
那 20 位不是抽象概念,它的用法就是几次位移与掩码 [4]:
// 【SkPackedGlyphID】打包与解包的等价写法(示意,与源码语义一致)
// 打包:字形 ID 左移 2 位放进高位区,子像素 x 与 y 各占 2 位
uint32_t packed = (uint32_t)glyphID << kSubPixelPosLen      // 字形 ID 进第 2..17 位
                | (uint32_t)subX                             // 低 2 位:子像素 x
                | ((uint32_t)subY << kSubPixelY);            // 第 18..19 位:子像素 y

// 子像素份数:由位移得到「视图坐标落在哪个 1/4 像素」
// 取整补偿:非子像素 1/2,子像素 1/8
//   subpixelOffset = (floor((pos + rounding) & mask) >> 14) & 3
下面对这两行特别说明:打包用的是「低位放子像素、中段放字形 ID」的布局,而不是直觉上的「高位放 ID」。这样做的好处是解包字形 ID 只要一次右移,而子像素位置可以用低位掩码直接取——两次操作就能拿到两个值。这种「让高频操作最便宜」的位布局,是缓存键设计里的常见取向。还要留意 kSubPixelPosLen 的取值是 2,所以子像素档位是 2² = 4 档而不是 8 档。这一点常被误解,因为同一个头文件里还有一个 1/8 的常量——那个是取整补偿量,不是档位数。
官方依据:打包键与五种承载形态的定义见 SkGlyph.h、SkStrike.h。
4.6 本章收在哪里
这一章讲「字形怎么被寻址与承载」。打包键管「怎么找到」,五种形态管「以什么形式存在」,256 上限管「何时换形式」——三者构成缓存层的数据模型。
五、字号与位置:缩放、子像素与吸附
先来看看字号与位置这两个变量是怎么进场的。
5.1 从 design unit 到像素
字形的坐标以 design unit 为单位,尺度由 head.unitsPerEm 定义;渲染时要乘上「每 em 多少像素」(ppem)。这一步看起来是纯乘法,但取整的位置不同会导致明显差异:先取整再缩放,还是先缩放再取整,结果可能差一个像素。
Skia 把这个选择做成了两个开关 [3][8]:
setLinearMetrics(bool):注释原文「For outline fonts 'true' means font and glyph metrics should ignore hinting and rounding」——线性度量。isBaselineSnap()/setBaselineSnap:轴对齐时基线吸附到像素。
5.2 子像素定位:为什么字会「不正」
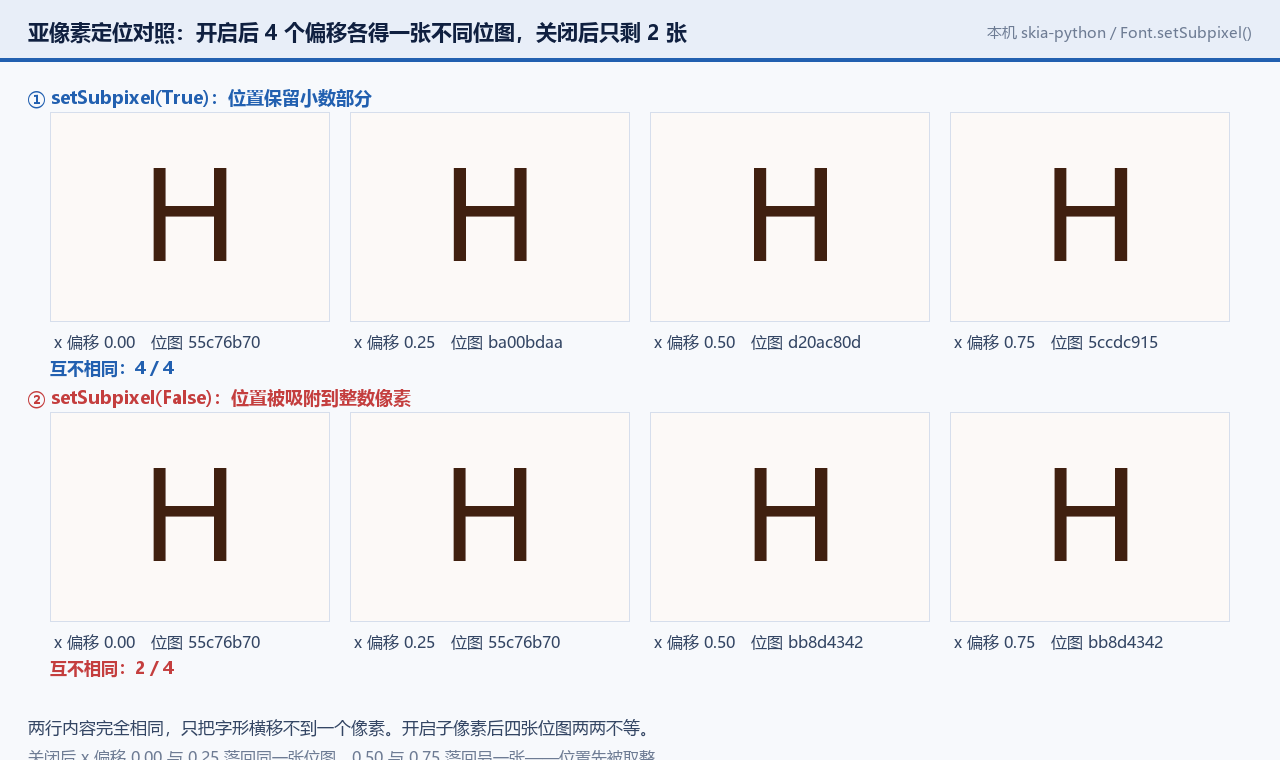
把每个字形的起点取整到整数像素,会得到一个整齐但字距忽宽忽窄的结果;不取整则字距均匀,但每个字形落在像素网格的不同偏移上,需要多套位图。
Skia 的表述很谨慎 [3]:
// 【SkFont】子像素定位是个「请求」而非「要求」
bool isSubpixel() const;      // 「Returns true if glyphs may be drawn at sub-pixel offsets.」
void setSubpixel(bool);       // 「Requests, but does not require, that glyphs respect
                              //  sub-pixel positioning.」
下面对「requests but does not require」特别说明:这是一个跨平台留白——Skia 只表达意图,具体怎么取整由平台后端决定。而取整的补偿量在 SkGlyph 里写着:
// 【SkGlyph】取整补偿与掩码:两种模式
// 非子像素:rounding = 1/2      子像素:rounding = 1/8
// subpixelOffset = (floor((viewportPosition + rounding) & mask) >> 14) & 3
kSubpixelRound = 1.f / (1u << (kSubPixelPosLen + 1));   // = 1/8
5.3 hinting:把轮廓往网格上「推」
hinting(字体微调)的目标是让小字号下的笔画落在像素网格上,代价是字形会被轻微改变。Skia 侧是一个两 bit 的枚举,编码在两个 flag 里 [8]:
// 【SkScalerContext】hinting 用两个 bit 表达,与 SkPaint::Hinting 枚举对齐
kHinting_Shift = 7;
kHintingBit1_Flag = 0x0080;
kHintingBit2_Flag = 0x0100;
kHinting_Mask = kHintingBit1_Flag | kHintingBit2_Flag;   // 两位 → 四档
kForceAutohinting_Flag = 0x0020;  // 「Use auto instead of bytcode hinting if hinting.」
另有 isForceAutoHinting(),注释写明「only meaningful if platform uses FreeType」[3]——这一个开关在不同平台上意义不同,又一次印证了「引擎只编排、平台才干活」的结构。这里还有一层含义值得点明:既然这个开关只在 FreeType 平台上有意义,那么同一份绘制代码在 macOS 与 Windows 上跑出的字形位置就可能不同——跨平台一致性问题从这一层就已经埋下了,不必等到排版层。
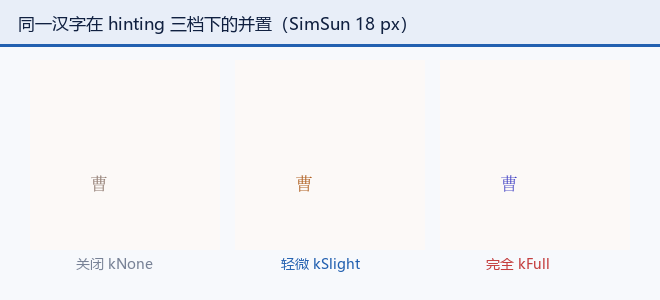
三档之间的差异在小字号下最明显;字号一大,轮廓自由度上升,三者的结果会迅速靠拢。所以「hinting 有没有用」这个问题必须先指定字号才谈得上。实践中的经验区间是:正文尺寸(约 12 到 16 像素)附近 hinting 的收益最明显,因为这时候一个像素的位移就足以让笔画看起来「虚」或「实」;而到了标题尺寸,位移量已经小于抗锯齿本身的宽容度,开与不开的区别基本看不出来。
5.4 两个容易被忽略的取整点
第一个是 ppem 的取整。原生 TrueType 的 bytecode hinting 引擎只支持整数 ppem,遇到小数 ppem 会取整 [28]。这意味着「13.5 pt」与「13 pt」在某些平台上会渲染成同一套位图——字号的可选档位其实比想象中少。第二个是基线的吸附。 isBaselineSnap() 控制轴对齐时基线是否吸附到像素。它影响的是整行文字的垂直位置:吸附后每行文字落在整数像素上,清晰但行距可能不严格;不吸附则行距精确但每行都要子像素采样。还有一个与缩放有关的开关值得单独提:PreMatrixScale 的三个取值——kFull、kVertical、kVerticalInteger[8]。它决定「先缩放再光栅化」还是「在垂直方向按整数倍处理」,是「请求尺寸」与「实际尺寸」不一致时的分叉点。这个不一致是正常的——请求 12.3 px 的字形,实际可能以 12 px 光栅化再缩放上去。
5.5 子像素定位在 CJK 上的成本
子像素定位对拉丁字体几乎免费(一段文字的字符种类少),但对 CJK 是显著的乘法项。把第 4 节的缓存键搬过来算一遍:
【缓存条目估算】假设一段文本用到 N 个不同字形
  拉丁:N ≈ 40,字号 3 档,子像素位置 4×4 → 上限 40 × 3 × 16 = 1,920 条
  CJK :N ≈ 800,字号 3 档,子像素位置 4×4 → 上限 800 × 3 × 16 = 38,400 条
两点说明:这只是上限,实际活跃的子像素位置远少于 16 个;但它说明了「2048 条对 CJK 偏紧」——只取 1/10 用例也已接近预算。工程上的缓解手段是关掉子像素定位(setSubpixel(false)),把 16 个位置压成 1 个,代价是字距不再均匀——这正是「中日韩界面字距看起来比西文松」的来源之一。
官方依据:子像素定位与 hinting 的定义见 SkFont.h;strike 规格见 SkStrikeSpec.h。
5.6 本章收在哪里
这一章讲「位置与形状的取整之争」。字距要均匀就得允许子像素,笔画要锐利就得往网格上推——这是同一对矛盾的两种解法,开关都在 SkFont 的 flag 上。
六、hinting 到底改了什么
下面我们进入 hinting——这一层最容易被误判。
6.1 三代解释器
先来看看这三代解释器分别在模拟什么。
TrueType 的 hinting 不是「一个算法」,而是一段跑在字体自带 bytecode 虚拟机里的程序。微软的解释器一代代升级,FreeType 用版本号来区分要模拟哪一代 [23]:
| FreeType 常量 | 值 | 近似对应 |
|---|---|---|
TT_INTERPRETER_VERSION_35 |
35 | MS rasterizer v1.7(Windows 98),仅支持灰度与黑白光栅化 |
TT_INTERPRETER_VERSION_38 |
38 | v1.9 ≈ DirectWrite ClearType(Win7),即 Infinality 子像素 hinting |
TT_INTERPRETER_VERSION_40 |
40 | v2.1 ≈ DirectWrite ClearType(Win10),即 minimal 版,Infinality 的精简高性能版 |
把这条时间线横着看,会发现一个清晰的迁移方向:目标从「把轮廓对齐到像素网格」转向「把轮廓对齐到屏幕的物理结构」。数字从 3 涨到 40,要解决的问题换了一代。这些常量值就是 GETINFO 指令返回的版本号[23]。可引用的完整对照表包括:3(GDI Win3.1 初版)、33(WinNT3.1)、34(Win95,新增 SCANTYPE)、35(Win98/2000)、36(WinCE2,经典 ClearType)、37(XP,GDI ClearType)、38(Vista/Win7)、39(DWrite Win8 前)、40(Win7 后 GDI+ 与 Win8 DWrite)[23]。有一句话必须单独引用:interpreter-version 只控制 bytecode interpreter 的 hinting 行为,不控制光栅化,也不控制子像素颜色滤波[23]。调它不会改变抗锯齿与 LCD 滤波——这是常见的误解。
6.2 那句自曝:v40 其实没在做子像素 hinting
FreeType 官方关于 v40 的说明页里有一句非常坦诚的话:
there actually is no subpixel hinting going on here... The code simply ignores all horizontal hinting instructions.
也就是说,v40 的做法是忽略所有水平方向的 hinting 指令,并防止 advance width 被改变 [24]。同页还给了几条结论:v35 按 90 年代规范做全像素网格吸附(面向 CRT 黑白位图);LCD 子像素把水平分辨率提高约 3 倍(因需模糊滤波,实际略低);v38(Infinality)因为慢且原作者停止维护,默认不编译;v40 的速度与 v35 相当[24]。这段历史解释了今天的一个现象:现代屏幕上「hinting 好像没起多大作用」,在水平方向上是真的没起作用——因为那一侧的解法替换成了子像素渲染。
6.3 另一条路:autohinter
不是所有字体都自带 hinting 程序。为此有 autohinter(自动微调器),它的设计目标在 2000 年的原始设计页里写得很清楚:专利无涉、对黑白与抗锯齿字形采用不同 hinting、实时执行、且能服务任何没有自有 hinting 的驱动(TrueType、Type 1、CFF/Type 2)[25]。引擎选择用 hinting-engine 属性:FT_HINTING_FREETYPE = 0 与 FT_HINTING_ADOBE = 1(用于 CFF/Type1/CID,默认 adobe 引擎)[23]。还有个容易忽略的接口细节:FT_LOAD_NO_RECURSE 对「把复合字形当独立元素加载」至关重要——autohinter 处理复合字形时要逐个组件处理 [25]。
6.4 stem darkening:hinting 的另一半
gamma 校正会让字变细(第 7 节细讲),而 stem darkening(笔画加粗)就是它的补偿。参数是分段的,单位千分之一像素 [23]:
| stem 宽度 | 加粗量 |
|---|---|
| ≤ 0.5 px | 0.4 px |
| = 1 px | 0.275 px |
| = 1.667 px | 0.275 px |
| ≥ 2.333 px | 0 px |
这条折线的形状本身就说明了问题:笔画越细,加粗越多。原因很直接——细笔画在 gamma 校正下更容易被抬没,需要更多补偿;而粗笔画的中间灰度本来就少,不需要额外加粗。约束是 y ≤ 500(半像素),且每段斜率须浅于 −1;FT_LOAD_NO_SCALE 时永不应用[23]。
6.5 回看:hinting 改了轮廓的哪里
收一下:hinting 会改变轮廓点的位置(网格吸附)、可能改变度量(advance width,v40 明确禁止这一项)、以及额外生成 phantom points 供指令引用 [15]。它不改变的是:轮廓的拓扑、曲线的阶数、以及光栅化算法本身。
6.6 那几个必须记住的加载标志
FT_LOAD_* 是一组位标志,其中几位对结果影响最大 [26]:
| 标志 | 值 | 影响 |
|---|---|---|
FT_LOAD_NO_HINTING |
1<<1 |
关闭 hinting;抗锯齿模式下位图更「糊」 |
FT_LOAD_RENDER |
1<<2 |
加载后自动调 FT_Render_Glyph(默认 NORMAL) |
FT_LOAD_NO_RECURSE |
1<<10 |
不递归加载复合字形,改为填充子字形信息 |
FT_LOAD_PEDANTIC |
1<<7 |
bytecode 引擎的错误才回传;默认会吞掉错误 |
FT_LOAD_MONOCHROME |
1<<12 |
强制单色位图 |
下面对 PEDANTIC 特别说明:注释里写明默认行为是「吞掉字节码引擎的错误」,而这可能造成「部分 hinting 或字形失真」[26]。也就是说,字体里的 hinting 程序如果写错了,默认模式下你看不到报错、只能看到一个略歪的字形。要排查这类问题,必须显式打开 PEDANTIC。
目标模式用高位表达:宏是 FT_LOAD_TARGET_(x) = (x & 15) << 16,反解用 FT_LOAD_TARGET_MODE(x) = (x >> 16) & 15;这几个值不能 OR 组合,只能选一个[26]。可用值有 TARGET_NORMAL / LIGHT / MONO / LCD / LCD_V。
6.7 bytecode 与 autohinter:什么时候用哪个
两条 hinting 路线各有一片适用地,可以按字体来源分 [25][23]:
| 场景 | 用哪条 | 原因 |
|---|---|---|
| 商业字体、自带 hinting 程序 | bytecode interpreter | 设计者在字体里逐字调过,质量最高 |
| 开源字体、无 hinting 程序 | autohinter | 有程序可依;覆盖 TrueType / Type 1 / CFF 全格式 |
| CFF / Type 1 / CID 轮廓 | adobe 引擎(FT_HINTING_ADOBE = 1,默认) |
针对三次弧优化 |
| 需要跨字体一致的外观 | autohinter | 不受各字体 hinting 质量差异影响 |
| 想要「原样呈现设计者意图」 | bytecode | autohinter 会按自己的目标改写 |
下面对第二行特别说明:autohinter 的设计目标之一就是「能服务任何没有自有 hinting 的驱动」[25],所以它是「没有选择时的选择」。而它的代价也在同一份文档里写着——它对黑白与抗锯齿字形采用不同的 hinting 策略,也就是说同一个字形在两种输出模式下的位置可能不同。还有一个工程细节值得记:autohinting 激活时,lsb_delta / rsb_delta 会表示「hinted 与 unhinted 侧边距之差」,而文档强调强 autohinting 必须应用这两个 delta,否则小字号下字距会过大 [26]。这是「hinting 改了度量」这件事在 API 上的暴露面。
官方依据:三代解释器的定义见 FreeType — Driver properties;子像素 hinting 原理见 Subpixel Hinting。
6.8 本章收在哪里
这一章回答「hinting 到底动了什么」。三代解释器差在「模拟哪一代真机」,v40 的真相是「忽略水平指令」,stem darkening 是 gamma 的对冲——调显示效果前,先分清调的是哪一层。
七、输出为什么是灰度,gamma 又在做什么
先来看看光栅化输出之后还剩下什么工序。
7.1 两种输出:1 位与 8 位
先来看看两种输出形态差在哪里。光栅化的输出形态由渲染模式决定。FreeType 的两个基础模式 [28][27]:
| 模式 | 值 | 输出 |
|---|---|---|
FT_RENDER_MODE_NORMAL |
0 | 256 级灰度的抗锯齿覆盖位图 |
FT_RENDER_MODE_MONO |
2 | 1 位单色位图 |
FT_RENDER_MODE_LIGHT |
1 | 更轻的 hinting(仅沿 Y 轴吸附),接近 ClearType 的做法 |
FT_RENDER_MODE_LCD |
3 | 水平子像素三通道 |
FT_RENDER_MODE_LCD_V |
4 | 垂直子像素三通道 |
下面对 LIGHT 特别说明:它的定义是「gray-level 模式下更轻的 hinting:仅沿 Y 轴吸附到像素网格,以保留水平字距」[26]。这是一个很聪明的折中——纵向对齐给出清晰的水平笔画,横向不动保住字距均匀性。
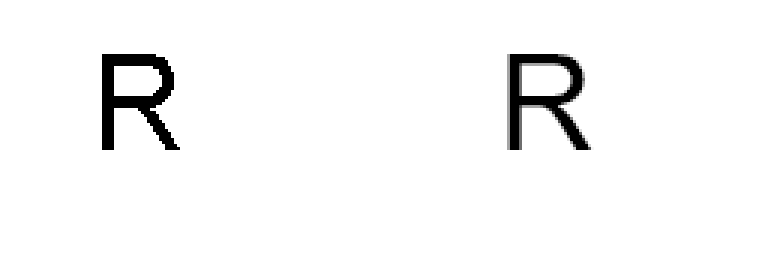
有两条实现侧的事实值得记:灰度光栅器固定使用 256 级;FT_Span 的 coverage 是 0(背景)到 255(前景)[29]。而原生 TrueType bytecode hinting 引擎只支持整数 ppem,小数 ppem 会被取整 [28]。
7.2 覆盖率位图是 alpha 通道
这一句是 FreeType 文档里最重要的操作口径:
For optimal rendering on a screen the bitmap should be used as an alpha channel in linear blending with gamma correction.
同页还强调覆盖率位图应被视为「无色 coverage 对象」[28][29]。理解这句话,就理解了为什么同一个字形在不同引擎里看起来会不一样——字形位图本身没错,错的是混合它的那一步。
7.3 LCD 子像素:把分辨率借来的三倍
LCD 像素由红绿蓝三个条带组成,ClearType 一类技术就利用这个物理结构,把条纹方向的可用分辨率提高约 3 倍[30]。代价是彩边,所以要滤波器。FreeType 文档给出的「均衡 5-tap FIR」有三个性质 [30]:
- 对称
{a, b, c, b, a}——避免视觉位移; - 色彩平衡
a + b = c——降低彩边; - 归一化
2a + 2b + c = 1.0——维持整体亮度。可引用的两组权重(1/256 单位)[30]:
【LCD 滤波器权重】5-tap,单位 1/256
  FT_LCD_FILTER_DEFAULT = [0x08 0x4D 0x56 0x4D 0x08]   # beveled,默认
  FT_LCD_FILTER_LIGHT   = [0x00 0x55 0x56 0x55 0x00]   # 盒式 3-tap,更锐利
  FT_LCD_FILTER_NONE / LEGACY1 / LEGACY = 0 / 3 / 16
下面对这两组权重特别说明:DEFAULT 的首尾是 0x08 而不是 0,这就是「beveled(斜边)」的含义——留一点点远端权重换取对 gamma 曲线不理想时的宽容度。文档的原话是:盒式 3-tap 更锐利但「对非理想 gamma 曲线更不宽容」[30]。
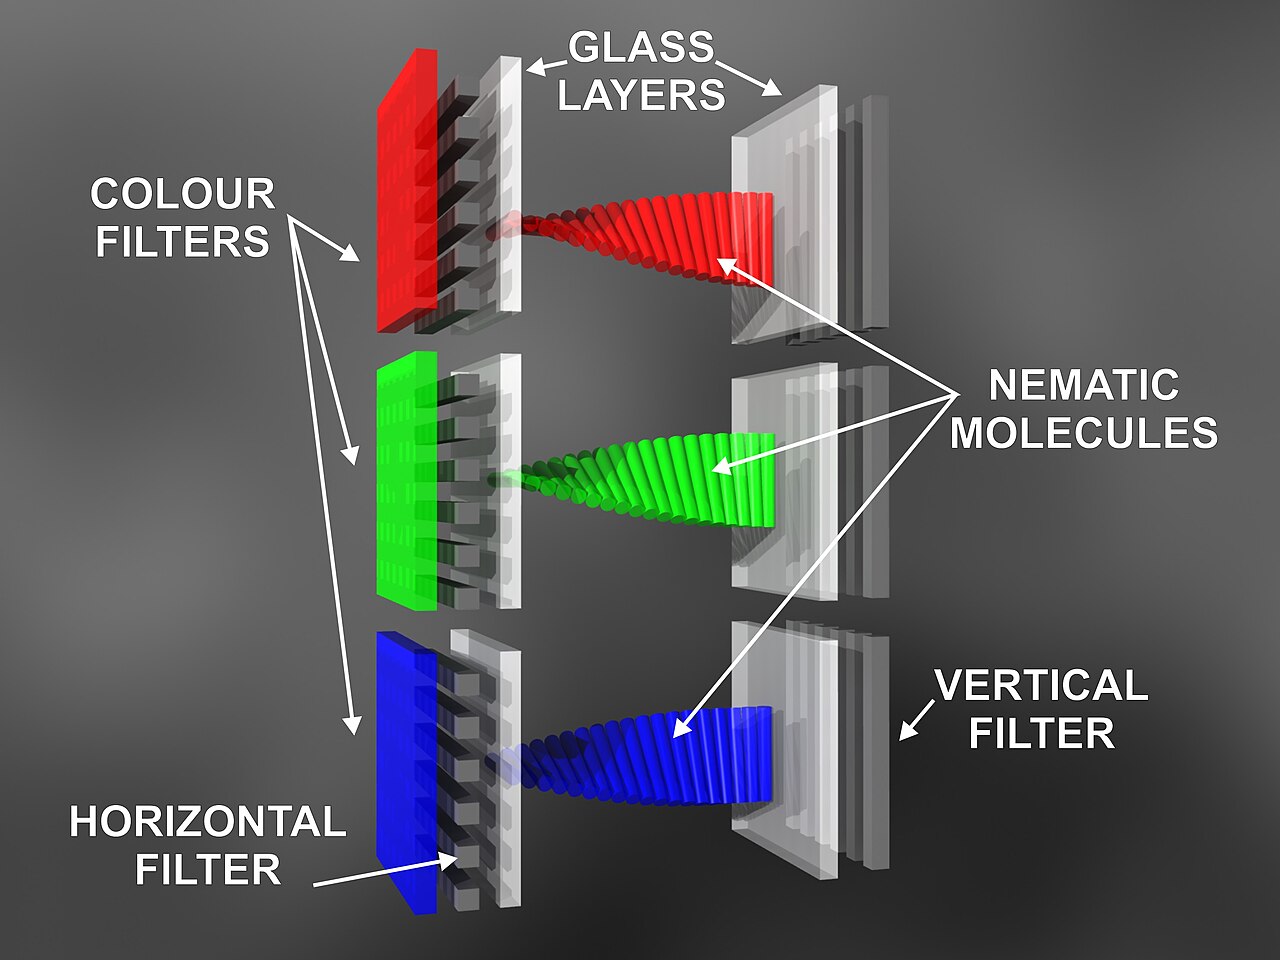
自 2.10.3 起 LCD 滤波默认就以 DEFAULT 启用,不必显式调用 FT_Library_SetLcdFilter[30]。几何方面,Harmony 的默认三通道位置是 {{-21, 0}, {0, 0}, {21, 0}}(26.6 定点,约 ±1/3 像素);BGR 面板取反;垂直面板把 ±21 放到 y 上 [30]。还有一个副作用要提前算进布局:FT_RENDER_MODE_LCD 下滤波器会在左右各多加 2 个 subpixel,位图偏移随之调整——但客户端不需要改布局代码[30]。
7.4 gamma 与 stem darkening 的因果链
最后把第 6 节与本节接上。这条链是 [23]:线性空间混合 + gamma 校正 → 灰色被推向更亮的像素值 → 字看起来变细 → 用 stem darkening 加粗补偿。原文的措辞是:「Gamma correction essentially lightens fonts since shades of grey are shifted to higher pixel values」,副作用是字重变细,Mac OS X 与 Adobe 都用 stem darkening 反制;而若不做线性混合与 gamma 校正,字形会显得又重又糊[23]。这两句话合起来说明了一件事:「字重」不是字体文件里的固定属性,它是渲染链的产物。同一个字重 400 的字体,在不同平台上可能被显示成 380 或 430 的观感,差别就来自 gamma 与 stem darkening 这两步的开关组合。
反过来说也成立:如果某个平台关掉了 gamma 校正,它就不需要 stem darkening。这两者的开关是成对的,只看到其中一个,就会把另一个当成「无关的额外处理」。反过来,如果某个平台既不校正 gamma 又打开了 stem darkening,字形就会明显偏粗——这类「两边都调」的 bug 最难查,因为每一处单独看都合理。
7.5 光栅器自己的开关
FT_Render_Mode 决定输出形态,而光栅器本身还有一组标志 [29]:
/* 【FT_Raster_Flags】光栅标志 */
FT_RASTER_FLAG_DEFAULT = 0x0
FT_RASTER_FLAG_AA      = 0x1   /* 抗锯齿覆盖率 */
FT_RASTER_FLAG_DIRECT  = 0x2   /* 直接回调 */
FT_RASTER_FLAG_CLIP    = 0x4   /* 带裁剪盒 */
FT_RASTER_FLAG_SDF     = 0x8   /* 生成距离场 */
FT_RASTER_FLAG_SDF 这一位对应 FT_RENDER_MODE_SDF:让光栅器直接产出签名距离场字形图像,输出格式是 FT_PIXEL_MODE_GRAY8[29]。这是第 4 节那张五形态表在 FreeType 侧的对应物——两个引擎都给了「距离场」一个正式位置,而不是把它当成外部后处理。
FT_Span 是光栅器的输出单元:{x, len, coverage},其中 coverage 从 0(背景)到 255(前景);灰度光栅器固定使用 256 级[29]。这个 256 不是可调参数——它是「8 位覆盖率」这个选择的直接后果,也解释了为什么第 7.4 节的 gamma 表要按这个量级设计。
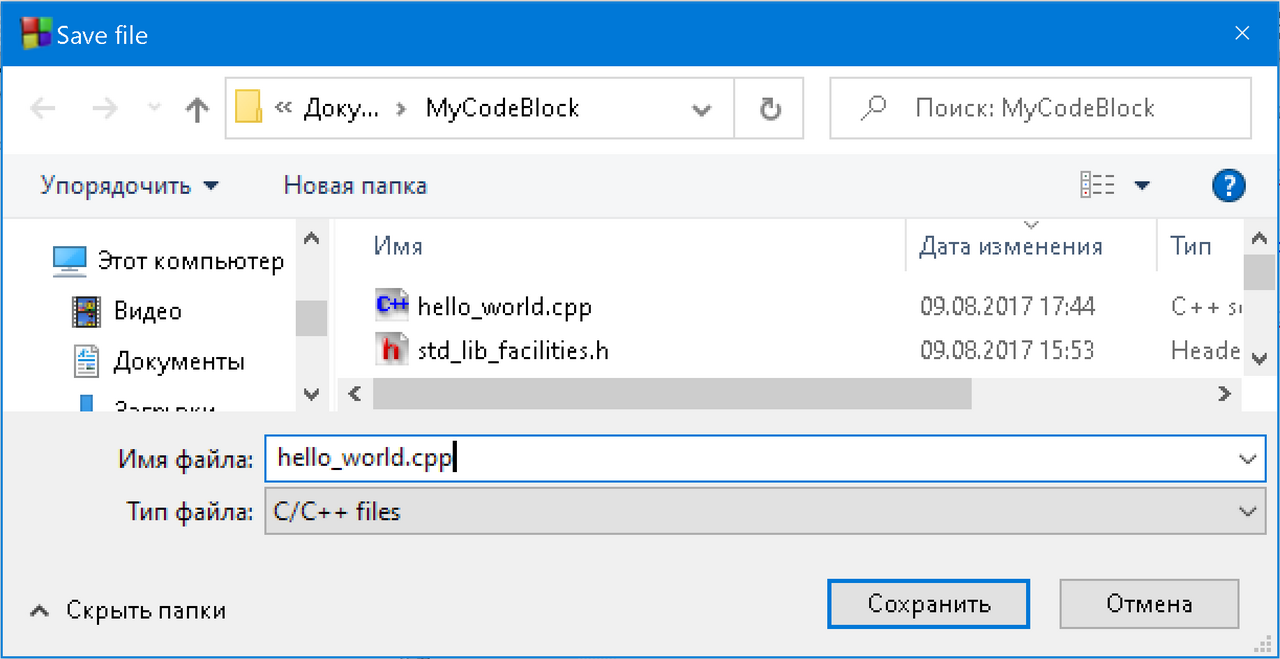
这张截图值得单独看:同一个开关在不同进程里生效情况并不一致,因为开关的归属层不同——系统的、应用的、以及旧 GDI 应用各自走各自的路。「我明明关了,为什么还是这样」这类问题,答案往往就是「你关的那一层不是它生效的那一层」。
官方依据:输出形态与光栅标志的定义见 FreeType — Scanline Converter、FT_Render_Mode 定义。
7.6 本章收在哪里
这一章讲「输出之后的两道工序」。覆盖率位图只是中间产物,要作 alpha 参与线性混合,混合前过 gamma、之后补 stem darkening——漏掉就会误判「这个引擎渲染得不好」。
八、blob 里装的是什么
下面我们进入引擎给字形准备的那个容器。
8.1 三层:字形、画笔、位置
下面我们进入 blob 的三层结构。单个字形画不了整句话——引擎需要容器把「一串字形 + 它们各自的画笔与位置」装起来。Skia 的容器是 SkTextBlob,类注释原文 [9]:
SkTextBlob combines multiple text runs into an immutable container. Each text run consists of glyphs, SkPaint, and position.
三层结构值得拆开看:blob 由 run 组成,run 由「字形数组 + 画笔 + 位置」组成。不可变(immutable)这一点很关键——它意味着 blob 可以安全地在多线程间共享,也可以被缓存起来复用。
8.2 三条否定式:blob 不做什么
MakeFromText 的注释里有三句连着说「不」的话,堪称全篇最该引的一段 [9]:
It does not perform typeface fallback... It does not perform kerning or other complex shaping; glyphs are positioned based on their default advances.
下面对这三条特别说明:
- 不做回退:缺字就是你的事(第 1 节)。
- 不做字距:字形位置按默认推进量摆。
- 不做复杂 shaping:连字、上下文替代、标记附着全都不管。那么谁来做?答案是 HarfBuzz。Skia 官方 FAQ 的原话是:「Skia does not shape text… Skia's clients often use HarfBuzz to generate the glyphs and their positions, including kerning.」[1]
8.3 shaping 的接口长什么样
需要 shaping 时走 SkShaper,它的 RunHandler::Buffer 把「输入文本」与「输出字形」的对应关系写得很清楚 [10]:
// 【SkShaper】RunHandler::Buffer 的字段(modules/skshaper/include/SkShaper.h)
SkGlyphID* glyphs;    // required
SkPoint*   positions; // required:positions[i] 是第 i 个字形的位置
SkPoint*   offsets;   // optional:最终位置 = positions[i] + offsets[i]
uint32_t*  clusters;  // optional:utf8 + clusters[i] 指向产生该字形的原文
SkPoint    point;     // 所有位置的公共偏移
下面对 clusters 特别说明:它是字形回到原文的指针。排版要做「点击文字跳到对应位置」或者「高亮某个词」时,靠的就是这个映射——shaping 会改变字形数量(连字、替代),所以文本与字形不是一一对应。
RunInfo 里还有两个字段值得记:fScript(注释写明「Should be iso15924 codes」)与 fBidiLevel[10]。中文场景下 script 是 Hani,这正是「同一段文字里中英混排要分段 shaping」的依据。
8.4 一个 run 里到底有几个字形
blob 的迭代器把结构暴露得很直接 [9]:
// 【SkTextBlob::Iter】遍历 run
SkTextBlob::Iter::Run run;
for (SkTextBlob::Iter iter(*blob); iter.next(&run);) {
    run.fTypeface;     // 这个 run 用的字体
    run.fGlyphCount;   // 这个 run 有几个字形
    run.fGlyphIndices; // 字形 ID 数组
}
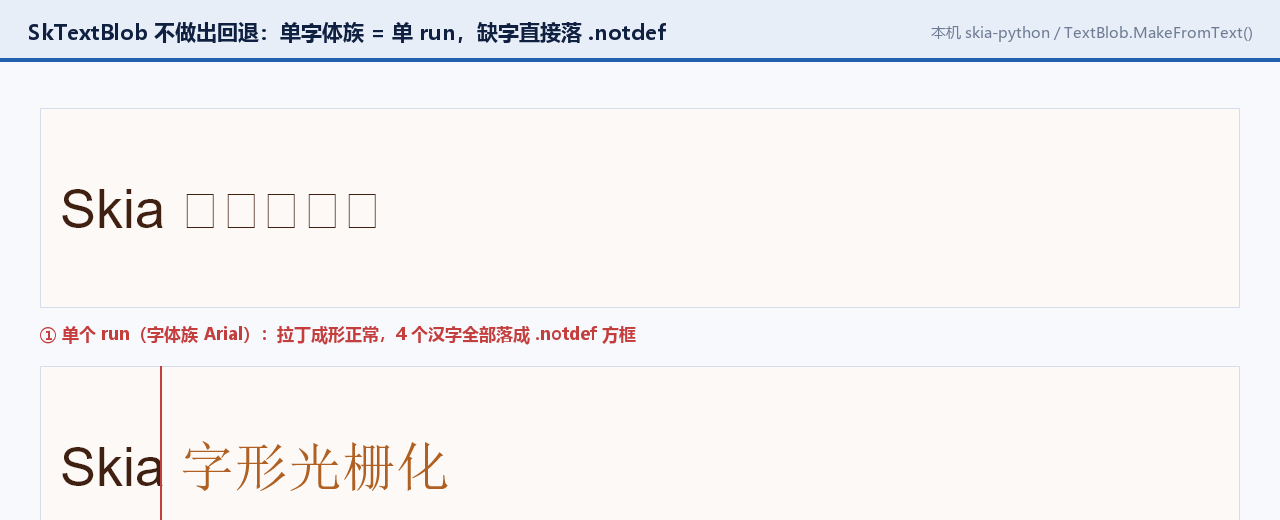
如果统计出来的 run 数比直觉得多,通常意味着回退链被触发了——每一段回退都要求「换一个字体」,而换字体就意味着切一个新 run。所以 run 数在这里同时也是一个回退诊断指标。
按字体切 run,这是 blob 的一个隐含约定:因为缺字与回退是按字体发生的,一个 run 只能用一个字体 [9][11]。
8.5 上层还能拿到什么
如果用 skparagraph 模块做排版,除了 blob,还能拿到三样东西 [11]:
// 【Paragraph】把布局结果转回可操作的几何与索引
int getPath(int lineNumber, SkPath* dest);     // 返回「无法转成路径的字形数」
static SkPath GetPath(SkTextBlob* textBlob);   // 整个 blob 的路径
bool containsColorFontOrBitmap(SkTextBlob*);   // 是否含彩色字形或位图字形
下面对 getPath 的返回值特别说明:它返回的是「有几个字形无法转成路径」,而不是成功数。彩色字形(COLR/CPAL)与位图字形天然没有单色轮廓,所以这个返回值实际上是「这段文字能否安全地走矢量导出」的探针——导出 SVG 或 PDF 时,它就是必须检查的那一项。另外两个访问器值得记:VisitorInfo 把每个字形的原点、推进量与 UTF-8 起点一起给出;GlyphClusterInfo 给出字形簇的包围盒与对应的文本范围 [11]。前者用于逐字绘制,后者用于交互命中测试——这也是「文本与字形不是一一对应」(8.3 节的 clusters)在 API 上的落地形态。
8.6 blob 什么时候真正省钱
不可变与可复用是 blob 的两个卖点,但要看清它们成立的场景:
| 场景 | blob 是否有优势 | 原因 |
|---|---|---|
| 同一段文字每帧重绘 | 有 | 构造一次、复用多帧;shaping 成本被摊平 |
| 文字内容频繁变化 | 无 | 每次都要重建 blob,不可变反而成了重分配 |
| 多线程并行绘制 | 有 | 不可变 ⇒ 无需加锁 |
| 需要逐字动画 | 无 | 位置被烘进 blob,改位置就得重建 |
下面对第一行特别说明:blob 真正省掉的是 shaping。HarfBuzz 做一次复杂文本的 shaping 是毫秒级的开销,静态界面上「每帧重新 shape」是纯浪费;把它烘成 blob 之后,每帧只剩「遍历 run 并绘制」。这是「不可变」这个设计最实际的回报。第二行的对照也值得记:正因为 blob 不可变,「文字变了要重建」这件事无法避免。所以高频更新的文本(比如实时计数器、逐帧变化的日志)通常不经过 blob,而是走更底层的字形绘制接口。
官方依据:blob 的定义与接口见 SkTextBlob.h、SkShaper.h。
8.7 本章收在哪里
这一章讲「引擎给字形准备的那个容器」。不可变、按字体切 run、不做 shaping 也不做回退,把复杂部分留给 HarfBuzz——这就是第 1 节那条边界的完整形态。
九、CJK 为什么是另一个量级
先来看看 CJK 这一侧的规模现实。
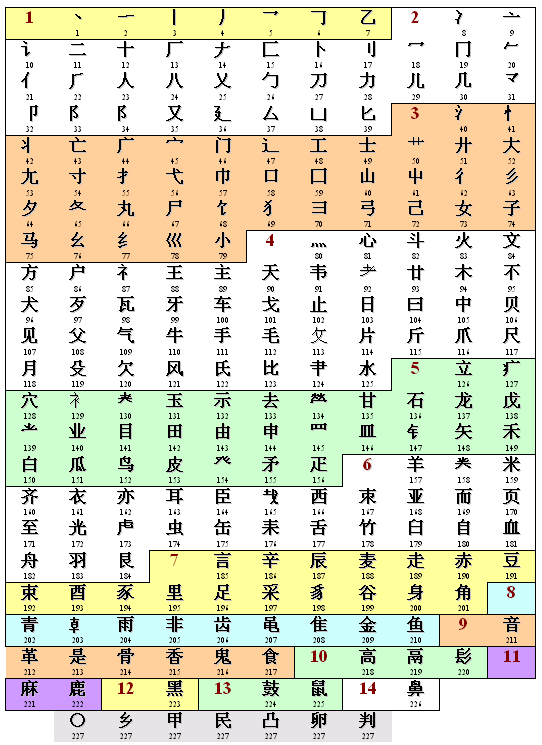
9.1 两个天花板:65535 与 256
先来看看汉字这一侧的两个天花板。回到第 4 节的打包键:字形 ID 只有 16 位,上限 65535[4]。这对拉丁字体绰绰有余(几百个字形),但对 CJK 是一个真实的天花板——中日韩统一的表意文字区块本身就有两万多个码位。另一个天花板是图集:能进图集的字形最大 256×256[4]。汉字在小字号下没问题,但一旦放大到标题尺寸,就容易越界。
9.2 从一个真实案例看数字
Excalidraw 团队为手绘风格接入中日韩字体时,公开了一组工程数字(2024-11)[31]:
| 项 | 数字 |
|---|---|
| 字体码位数 | 4 万+ |
| 未压缩 TTF 体积 | 约 22 MB(约同款拉丁字体的 5%) |
| 分包数 | 209 个 chunk,每块 50–70 kB |
| WOFF2 无损压缩 | 再省约 50% |
| 客户端按需 subset | 可再省 95% |
| 瓶颈在哪 | WOFF2 压解占约 80% 的计算,而不是 HarfBuzz subsetting |
| 放入 3 个 Web Worker 后 | 导出提速 3× |
这组数字里最反直觉的是第二行与第六行:大家都以为瓶颈在 shaping,实际在压缩。而「209 个 chunk」这个数量级说明,CJK 的问题从来不是「能不能解析」,而是「要处理的数据量比拉丁大两个数量级」。同一个案例里还提了两个 CJK 特有的麻烦:断行要重写换行算法(禁则处理),以及Unicode 里汉字与日文 Kanji 共用码位——同一个码位在不同语言下期望不同的字形,这是回退链最难处理的一类情况 [31]。
9.3 为 CJK 优化的新格式
规范侧也在回应这个问题。HarfBuzz 的发布说明里提到一个新机制 VARC(Variable Composites/Components):一种新的字形轮廓存储方式,通过形状复用大幅减小 CJK 字体的文件体积;其中一个测试字体(由 NotoSerifKR-VF 派生的约 7160 个 Hangul 音节)比对应的传统 OpenType 版本小 90% 以上[34]。
「形状复用」与第 3 节的复合字形是同一脉:复合字形引用别的字形,VARC 引用并参数化地组合,区别是后者进了可变字体的连续轴。
9.4 字形缓存为什么在 CJK 上更吃紧
把 9.1 与第 4 节的缓存键放在一起看:缓存键 = 字形 ID + 4 个子像素位置组合。拉丁字体下,一段文本用到的字形可能只有几十个;CJK 下同样长度的文本涉及的字形可能是几百到几千个,再乘上字号与子像素位置,条目数增长很快。下一节我们就来看这个缓存的具体预算。
9.5 一个字体扛多种语言的历史包袱
CJK 的特殊之处还在于同一个字形在不同地区可能期望不同写法。Unicode 把汉字与日文 Kanji 放在同一批码位上,但「月」「直」「骨」这些字在中日韩三地的标准字形并不完全一致——同一个码位,三种期望[31]。字体层面的历史解法是「一个大字体带多套区域子表」。前面 1.5 节提到的 Platform 3 编码号(ShiftJIS / PRC / Big5 / Wansung / Johab)就是那个时代的产物:一个 Pan-CJK 字体要为每个区域各带一张映射子表,读取方按当前语言环境挑一张 [17]。今天的解法转向「按语言选择局部字形」(OpenType 的 locl 特性一类),但回退链仍然要处理这个问题:当主字体缺字、回退到另一个字体时,回退的那个字体是否知道当前语言?这就是为什么 shaping 需要 fScript 与 fBidiLevel 两个字段[10]——script 是 Hani 只说明了文字种类,真正决定局部字形的是语言。
9.6 子集化与分块:三种时机的取舍
CJK 字体的工程解法可以按「什么时候做」分三类:
| 时机 | 做法 | 优点 | 代价 |
|---|---|---|---|
| 构建期 | 按常用字表(3500 / 7000 / 2 万)切成静态子集 | 运行时零成本 | 生僻字缺字 |
| 分发期 | 按 Unicode 区间切成 chunk(Excalidraw 用 209 块) | 按需加载,首屏小 | 需要 manifest 与调度逻辑 |
| 运行期 | 按实际出现字符做 subset | 体积最省(可再省 95%) | 占用 CPU,且要等 |
Excalidraw 的实测数据给出了这三者的性价比边界:WOFF2 解压/压缩占了约 80% 的计算量,而 HarfBuzz 的 subsetting 本身不是瓶颈;把工作放进 3 个 Web Worker 后导出提速 3×[31]。第一行要特别说明:「常用字表」是有风险的近似——出现人名、地名、专业术语就会缺字,而缺字的表现就是第 1 节那个 .notdef 方框。所以构建期子集化必须配回退链,否则省下的加载时间会以「用户看到方框」的形式还回去。
本章的规模数据出自 Excalidraw 官方博客;VARC 的定义见 HarfBuzz NEWS。
9.7 本章收在哪里
这一章讲「规模带来的性质变化」。 16 位 ID 与 256 图集是天花板,4 万码位、22 MB、209 个 chunk 是现实,CJK 不是「更难的拉丁」,是另一个量级。
十、字形缓存怎么管这几十万个形状
下面我们进入缓存层自己的预算问题。
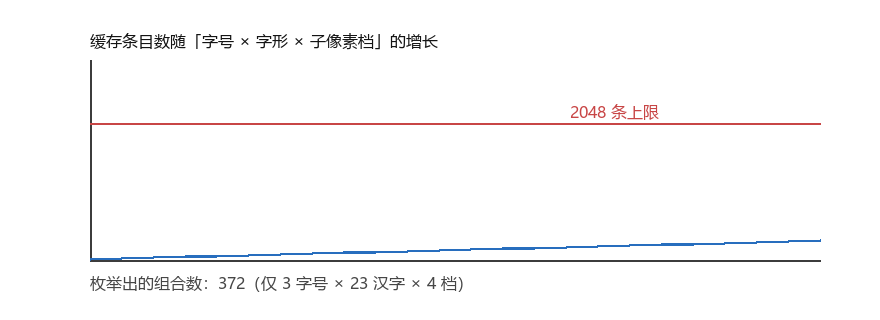
10.1 预算:2048 条与 2 MiB
下面我们进入缓存预算的那两个数。缓存的两个默认上限写在源码里,是可以直接引用的常量 [6]:
/* 【SkStrikeCache】两个默认预算 */
#define SK_DEFAULT_FONT_CACHE_COUNT_LIMIT   2048
#define SK_DEFAULT_FONT_CACHE_LIMIT    (2 * 1024 * 1024)   /* 2 MiB */
生命周期接口很完整:findStrike / createStrike / findOrCreateStrike 负责查找与创建,purgeAll 全清,setCacheCountLimit / setCacheSizeLimit 调上限,internalPurge 做实际回收——实现是链表式 LRU(fHead / fTail)[6]。
10.2 缓存键就是那个 20 位整数
缓存的粒度不是「字形」,而是「字形 + 子像素位置」。SkStrike 的注释原文写得很直白 [5]:
Maps from a combined GlyphID and sub-pixel position to a
SkGlyphDigest.
下面对「为什么连子像素位置都要进键」特别说明:因为不同子像素位置的位图是不同的(第 5 节那张图已经证明)。所以同一个字形在 4×4 个位置下最多产生 16 个缓存条目。这也解释了 2048 这个上限为什么不够大:CJK 文本下,几百个字形乘几个字号就可能把预算吃完。
10.3 怎么用这个缓存
从 SkFont 侧看,有一个专门为「重复查询同一个字形」设计的快捷对象 [3]:
// 【SkFont】避免每次查询都构造描述符、做哈希与全局缓存查找
SkStrikeRef makeStrikeRef() const;
// 注释原文:「An SkStrikeRef caches the resolved strike (font metrics engine),
// avoiding the overhead of descriptor construction, hashing, and global cache
// lookup on each glyph query.」
下面对这句注释特别说明:它点出了缓存的隐藏成本不在存储而在查找——构造描述符、算哈希、走全局缓存,这三步在「每个字形都要走一遍」时很可观。SkStrikeRef 就是把解析结果拿在手里。批量取「度量 + 路径」的公开入口是 SkBulkGlyphMetricsAndPaths,缓存里对应的是 prepareImages / preparePaths / glyphIDsToPaths 这组方法 [5][7]。
10.4 一个缓存失效的真实案例
Apple 平台上的 PingFang(苹方)在 iOS 18 之后改为私有格式 PingFangUI.ttc,是分层可变字体,字形被组织成「复合 → Parts → 嵌套树」。开发者论坛里有人做了剖析 [32]:
| 观察 | 数字 |
|---|---|
| 单个汉字触发的 part 加载次数 | 约 20 次 |
| part cache 被清空的频率 | 每 18 个字形一次 |
| 轮廓字典缓存 | FIFO,固定 512 容量 |
「每 18 个字形清一次」意味着一句话还没画完,缓存就开始丢了:分层字形的加载粒度比「字形」细,缓存策略必须跟着下移一层。
10.5 GPU 侧的图集管理
CPU 侧的缓存以字节为单位,GPU 侧则以纹理为单位。GrAtlasManager 的类注释写明它「manages the lifetime of and access to GrDrawOpAtlases」,并且给图集加字形的操作只在 flush 时可用[12]。图集按掩码格式分三类——源码里有个静态断言钉住了数量:static_assert(skgpu::kMaskFormatCount == 3);,对应 A8 / A565 / ARGB 各一个图集 [12]。另有一条 padding 规则值得记 [12]:
Bump direct mask glyphs (zero padding) up to 1px when the atlas can be bilerp'ed.
下面对这条特别说明:直接掩码本来是零 padding 的,但如果上层要用双线性插值(bilerp)采样,就必须补 1 像素,否则插值会取到隔壁字形的像素——采样方式反过来决定了存储布局。还有 atlasGeneration 这个计数器:它是「单调递增的数,每次从纹理后端移除东西就变」[12]。移除也要使版本号失效,这是 GPU 侧处理「图集被复用」时的常见坑。
10.6 缓存内部的三个小常量
除了总数与总容量两个上限,SkStrike 还定了三个与内存分配粒度有关的下限 [5]:
// 【SkStrike】最小分配量:避免为单个小字形反复申请小块内存
inline static constexpr size_t kMinGlyphCount     = 8;
inline static constexpr size_t kMinGlyphImageSize = 16 /* height */ * 8 /* width */;
inline static constexpr size_t kMinAllocAmount    = kMinGlyphImageSize * kMinGlyphCount;
下面对这三个数的关系特别说明:16 × 8 是「最小可用位图」的尺寸,8 是「最小批量」——合起来是一次分配的下限(1024 字节)。也就是说,缓存不会为「一个 8×6 的标点」单独申请内存,而是至少按这个量级切块。另一个设计细节是 SkGlyphDigest:注释写明「在 remote glyphs cache 里,只需存 digest 就够」[4]。把「完整字形数据」与「查找所需的摘要」分开,让缓存索引可以只装摘要——这是缓存系统里常见的「二级表示」手法,代价是命中的时候要多一次跳转。
官方依据:缓存预算常量的定义见 SkStrikeCache.h;
SkGlyphDigest原理见 SkGlyph.h。
10.7 本章收在哪里
这一章讲「缓存层怎么兜住前九章的约束」。 2048 条 / 2 MiB、键含子像素位置、查找比存储贵——上游每多一个自由度,下游缓存就被乘一次。
十一、GPU 那一侧与边界回指
好了,最后一章来看 GPU 那一侧。
11.1 距离场:把「形状」换成「距离」
先来看看距离场这条路线。第 4 节的五形态表里,kSDFT(距离场纹理)与 kPath 是并列的。距离场的思路是:不存「这个像素在不在字形里」,而存「这个像素到轮廓的距离」,采样时用一个阈值切出形状。
Skia 自己的实现常量可以直接引用 [13]:
/* 【SkDistanceFieldGen】常量与打包 */
#define SK_DistanceFieldMagnitude   4      /* 距离范围 (-4, 4] */
#define SK_DistanceFieldPad         4      /* 四周各留 4 像素 */
#define SK_DistanceFieldInset       2
#define SK_DistanceFieldMultiplier  "7.96875"       /* 4 * 255/128 */
#define SK_DistanceFieldThreshold   "0.50196078431" /* 128/255 */
注释把这几个数的来历解释得很清楚:距离场用无符号字节存,零值在 128 处,取值范围是 [-4 * 127/128, 4],所以乘数是 4 * 255/128、零阈值是 128/255[13]。打包函数(原样引用)[14]:
template <int distanceMagnitude>
static unsigned char pack_distance_field_val(float dist) {
    dist = SkTPin<float>(-dist, -distanceMagnitude, distanceMagnitude * 127.0f / 128.0f);
    return (unsigned char)SkScalarRoundToInt(dist / (2 * distanceMagnitude) * 256.0f);
}
下面对 127.0f / 128.0f 这个上界特别说明:它是防溢出的——如果直接夹到 distanceMagnitude,乘完 256 会超出字节范围。这类「差一点点」的常量在编解码里很常见,也最容易被抄错。算法血统也写在源码注释里:边距离依据边法向量与 alpha 计算,出自 Gustavson (2011);距离传播用 Danielsson 的 8SSEDT(四趟扫描 F1/F2/B1/B2)[14]。
11.2 Slug:把贝塞尔曲线直接交给 GPU
Slug 走的是另一条路:不预计算纹理、不做距离场,直接把二次贝塞尔轮廓送进 GPU,由像素着色器判断每个像素在不在字形内 [36]。它的数据组织是「每字形画一个覆盖包围盒的 quad,配两张纹理」:一张存全部贝塞尔曲线数据,一张存空间数据结构 [36]。学术出处是 Lengyel 的 JCGT 论文《GPU-Centered Font Rendering Directly from Glyph Outlines》——用等价类算法消除了参数区间判定的数值鲁棒性问题,同时避免着色器分支发散 [37]。一个值得注意的进展:Slug 的相关专利已到期(社区长文,2026-03)[38]。这对开源实现是实质利好。
11.3 HarfBuzz 的 blob:另一种「不透明」
HarfBuzz 自己的 GPU 模块给了第三种组织方式 [33]:字形在 CPU 侧被编码为不透明 blob(每 texel 8 字节 RGBA16I),上传到一个 GL_TEXTURE_BUFFER,由片段着色器直接解码光栅化——中间没有位图图集。Draw 路径实现的就是 Slug 算法,Paint 路径处理 COLRv0/v1 彩色字形 [33]。
「不透明 blob」这个设计与第 8 节的 SkTextBlob 是同一种思路的两个尺度:上层的 blob 装的是「字形 + 位置」,下层的 blob 装的是「解码字形所需的全部数据」。两者都把「怎么解释这段数据」交给了解释方——这是图形管线里一种很稳定的分工。
11.4 SDF 与 MSDF:单通道与三通道
单通道距离场(SDF)有一个众所周知的副作用:尖角会被磨圆。原因很直接——距离场记录的是「到最近轮廓的距离」,而一个尖角的两条边在角点附近距离值相同,插值之后自然变成圆角。多通道距离场(MSDF)的解法是把符号距离拆到多个通道分别计算,采样时取各通道的中值 [39]。「取中值」这个操作等价于取交集:只有在所有通道都判定「在内」时,该像素才被判为在内——尖角因此得以保留。
| 方案 | 通道数 | 放大质量 | 代价 |
|---|---|---|---|
| 位图图集 | 1(位图) | 放大即糊 | 最小 |
| SDF | 1(距离) | 放大平滑但圆角 | 小 |
| MSDF | 3(距离) | 放大平滑且保尖角 | 三倍数据 |
| Slug / 轮廓直算 | 0(不预计算) | 任意缩放无 artifact | 每像素求值开销 |
这张表解释了第 4 节五形态表里的 kSDFT 为什么是一个独立选项:它不是「更省」,而是「在有限数据里换到了可缩放」。而 Slug 一行说明这条谱系的另一端是彻底不预计算。
11.5 三条路线的选型判断
把 11.1 至 11.4 收成一张表:
| 你的约束 | 优先方案 | 原因 |
|---|---|---|
| 字号变化大、要能缩放 | SDF / MSDF | 一张纹理覆盖任意字号,代价是圆角或三倍通道 |
| 分辨率高(4K/Retina)+ 要锐 | MSDF 或 Slug | 单通道 SDF 在大字号下圆角明显 |
| 要任意缩放无 artifact | Slug(轮廓直算) | 不预计算、不插值,专利已到期 [38] |
| 字形种类多、纹理预算紧 | 距离场或 blob(hb-gpu 路线) | 编码进少量数据,不按字号膨胀 |
| CPU 侧已强、GPU 只做合成 | 传统位图图集 | 实现最简、兼容性最好 |
这张表里有一条容易被忽略的对称:「省纹理」和「能缩放」在距离场方案里是同一件事的两面。距离场之所以能省,是因为它把「形状」换成了「距离」——一个与分辨率无关的量。这也是为什么 kSDFT 会出现在第 4 节那张五形态表里,而不是被归成「一种特殊的位图」。
11.6 边界回指与预告
回到开头那条动线,现在可以把它说得更准了:字符经 cmap 变成字形 ID,字形 ID 与子像素位置打包成缓存键,未命中时由平台后端光栅化,结果按五种形态之一落进缓存,再由 blob 打包交给画布。
本篇到此为止。下一篇(ep05)进入 GPU 后端:同样是画一条路径、一个字形,GPU 侧那些绘制命令是怎么被组织起来的、paint 与 surface 在这一层怎样落地。ep03 讲清了「一笔怎么变成像素」,本篇讲清了「一个字怎么变成可绘制的数据」,下一篇接着讲「这些绘制命令怎么被批量送进 GPU」。
官方依据:距离场常量定义见 SkDistanceFieldGen.h;GPU 字形 blob 见 hb-gpu.cc。
参考资料
- Skia — Tips & FAQ
- SkTypeface.h
- SkFont.h
- SkGlyph.h
- SkStrike.h
- SkStrikeCache.h
- SkStrikeSpec.h
- SkScalerContext.h
- SkTextBlob.h
- SkShaper.h
- Paragraph.h(skparagraph)
- GrAtlasManager.h
- SkDistanceFieldGen.h
- SkDistanceFieldGen.cpp
- Microsoft OpenType spec — glyf
- Microsoft OpenType spec — loca
- Microsoft OpenType spec — cmap
- Microsoft OpenType spec — hmtx
- Apple TrueType Reference Manual — glyf
- Microsoft OpenType spec — CFF
- Microsoft OpenType spec — CFF2
- FreeType — Glyph Outlines(轮廓与曲线)
- FreeType — Driver properties(interpreter / autohinter / stem darkening)
- FreeType — Subpixel Hinting(v40 说明)
- FreeType — Auto-Hinter 设计页
- FreeType — Glyph Retrieval(FT_LOAD_* 标志)
- LSB 5.0 — FreeType 数据定义(FT_Render_Mode)
- FreeType Tutorial — Step 1
- FreeType — Scanline Converter
- FreeType — Subpixel Rendering(LCD 滤波)
- Excalidraw — Adding hand-drawn font for CJK
- Apple Developer Forums — PingFang 字形缓存剖析
- HarfBuzz — hb-gpu.cc(GPU 字形 blob)
- HarfBuzz — NEWS(VARC / 版本时间线)
- HarfBuzz — Shaping and shape plans
- Slug 官网
- JCGT — GPU-Centered Font Rendering Directly from Glyph Outlines
- Decade of Slug:专利到期与算法回顾
- redblobgames — Guide to SDF+MSDF Fonts
- Vello — Hybrid Rendering(glyph_run 与 ImageCache)
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机自跑实截由
skia-python 144.0.post2生成;自绘图为本系列绘制,走styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:下一篇进入 GPU 后端——同一笔绘制,GPU 侧怎么被组织成命令、paint 与 surface 在哪一层落地。本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.