本文由@溯光 出品,转载请注明出处。
本篇承接【一】《一次 Draw 走了多少路》。命令包里的那些地址,进了 GPU 之后到底是怎么被找到一排物理内存的? 这一篇把显存子系统、地址空间、页表与 TLB、页错误与有效带宽逐层拆开。
【GPU 架构剖析】(二)显存与地址空间:带宽极高,延迟也极高
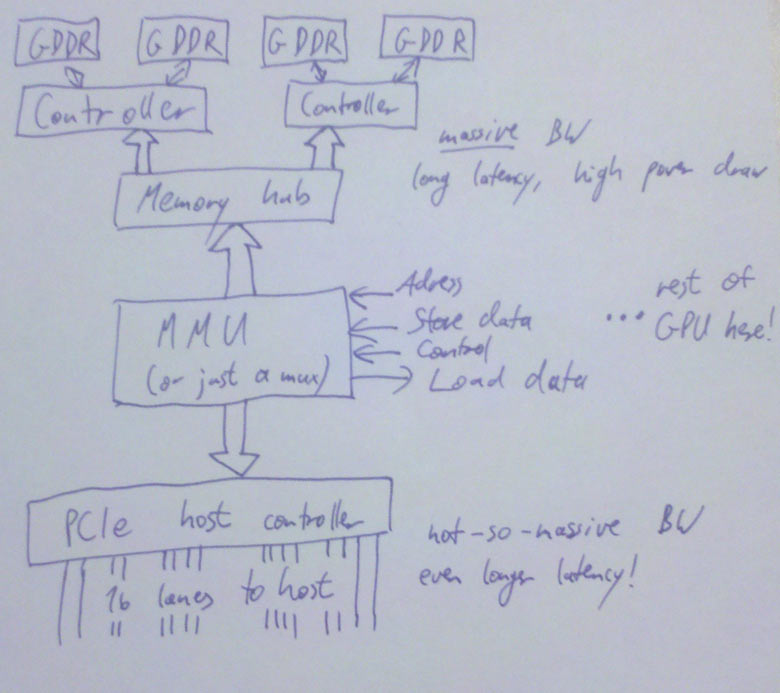
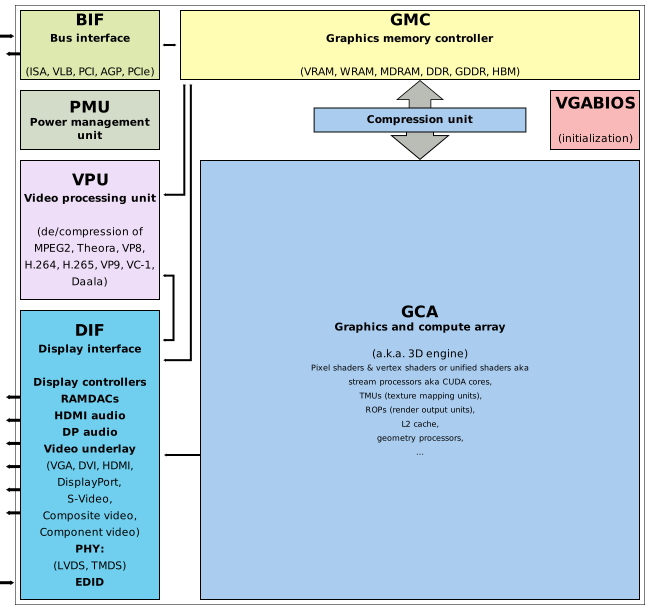
系列配套:GitHub 源码仓库(demo 代码与生成本次全部示意图的工具)|在线阅读入口(本站发布) 题图来自《A trip through the Graphics Pipeline 2011》(Fabian Giesen,CC0 1.0)。
一句话点题
0.1 为什么说显存"带宽极高,延迟也极高"
ep01 讲到命令处理器把一串命令包从环形缓冲里捞出来开工,但那条路我们只走了一半,命令包里的每一个地址,GPU 都还没有真正碰过。从这一篇开始,我们把目光从「命令怎么进去」移到「数据从哪里来」:显存(Video Memory / VRAM)、地址空间,以及那颗替所有线程翻译地址的显卡上的 MMU。
先抛一个看似矛盾的说法:显存是带宽极其充裕、延迟也极其高昂的一块存储。现代 GDDR 的带宽常年是几百 GB/s 起步,旗舰机可以做到 TB 级;可一次访问的延迟却动辄上百纳秒,比 CPU 的一级缓存慢了上百倍。一边是喂得饱画质的带宽,一边是藏不掉的延迟,这个矛盾贯穿本期全部主题。 把「带宽极高、延迟也极高」钉成一张定位图:横轴是延迟(低→高)、纵轴是带宽(低→高)。寄存器/L1 落在低延迟、低带宽一隅;片外显存落在高带宽、高延迟一角。整个 GPU 存储层次里,几乎找不到「既高带宽又低延迟」的相交点。这份没有免费交集,正是全篇反复咀嚼的那句物理。 出处:Fabian Giesen《GPU 内存架构与命令处理器》。
我们要回答的问题串起来就是一件事:显存为什么快、又为什么慢,GPU 靠什么把这种"快的带宽、慢的延迟"消化成能用的画质。理解它,你才会理解为何现代 GPU 要堆那么大一片片上缓存、为何地址翻译不能出错、为何「换一次驱动内存布局」能改变一整代产品的表现。
0.2 本篇在系列里的位置与边界
十二篇的骨架里,ep01 把命令送到前端,本期把它们接进存储器体系,下一站才是着色器核。《实时渲染管线探析》和《移动端图形与功耗》都在更靠概念的一侧讲过显存,本期从硅片侧把它落地:存储层次怎么排、地址怎么翻、页表占多少、页错误能不能等。 出处:系列总目录(13 篇,CC0)。
把它放回十二篇骨架:本期正卡在命令前端与会话着色器核之间——ep01 刚把命令送进前端,着色器核还等着读数据,显存就是夹在中间那层账。
边界先说死,免得牵扯不清:本篇不碰带宽账本的细节,那在《移动端图形与功耗》ep03 已经写透,本期只在必要处引用结论并注链接;也不去比较各家移动端 GPU 的内存压力策略。本期只讲桌面 GPU 侧那套通用机制,移动端差异留给对应篇目。
一句话把本篇点透:显存的昂贵与迟缓,被地址空间的高明翻译和一片片上缓存悄悄化解了,而这套机制,恰恰是理解占用率、理解 GPU 内存分配、理解"为什么显存不够用"的共同底座。
在展开正文前,先给一张全篇的"话术地图",方便你随时回看:本本能带走的四件事,一是存储层次的代价结构,二是地址翻译为什么必须存在、又怎么做到不慢,三是页错误在 GPU 上为什么是灾难,四是从分离到统一的内存演进里藏着哪些设计权衡。
这张地图对应正文的四个一级章节,也对应你读完后面该有的四根支柱,我把它们钉在版头上,之后任何一节都要能收回这张图里:
| 章节 | 核心要解决的问题 | 读完你该带走的判断 |
|---|---|---|
| 一、存储层次与 GDDR | 显存为何"带宽高、延迟也高" | 带宽靠并行位宽、延迟受物理下限约束 |
| 二、地址空间与 MMU | 地址翻译为什么必须存在、怎么做到不慢 | 隔离/按需/连续,靠 TLB 与多级页表把成本压低 |
| 三、页错误与有效带宽 | 页错误为何是灾难、带宽怎么真正兑现 | 级联雪崩 vs 有效带宽才是命 |
| 四、沿革与现代面貌 | 二十年内存机制怎么演化的 | 分离↔统一是带宽 vs 共享的两笔账在谈判 |
读完全篇再回头看这张表,我们会发现自己从"能复述"升级成了"能判断"。这正是前面每一节都在训练你的:不只是记住显存慢、地址靠翻,而是能在写代码时据此做取舍。
一、GPU 的存储层次:同样的层级,不同的取舍
好了,我们正式开始。先把全景铺开。GPU 的内存体系从离芯片最近到最远,大致是:着色器核里的寄存器 → 片上共享内存 / L1 → L2 → 显存控制器 → 显存颗粒。离核越远,容量越大、带宽越小、延迟越长。这条层次结构,和我们熟悉的 CPU 金字塔是同构的,但形态完全不同。 出处:Khronos Dev Day 2018 · Memory(内存模型总览)。
为什么 GPU 不干脆沿用 CPU 那一套大缓存体系?因为这两者的工作方式天生不同:CPU 的线程少而指令依赖强,指望缓存把局部性跑满;GPU 的行之有效的做法是用大规模并行去隐藏延迟,一个请求等得久,就同时发一堆请求,谁先回来谁先算。这就要求「从远处拿数据」这项能力带宽够大,而非等待够短。 出处:Ulrich Drepper《What Every Programmer Should Know About Memory》。 出处:TUM《Data Processing on Modern Hardware · Cache awareness》。 把「用并行藏延迟」这层再画透:一次显存访问要等上百纳秒,却正好可以同时发十几个 warp 的请求,谁先回来谁先算。
内存层次金字塔(Memory Hierarchy) 是教科书里最常见的总览图,它把寄存器、各级缓存、主存按「越靠上越快越贵越小」排成一座塔。GPU 的塔长得几乎一样,只是塔尖多了寄存器堆、塔身换成了显存。 出处:冯·诺依曼架构与存储分层。
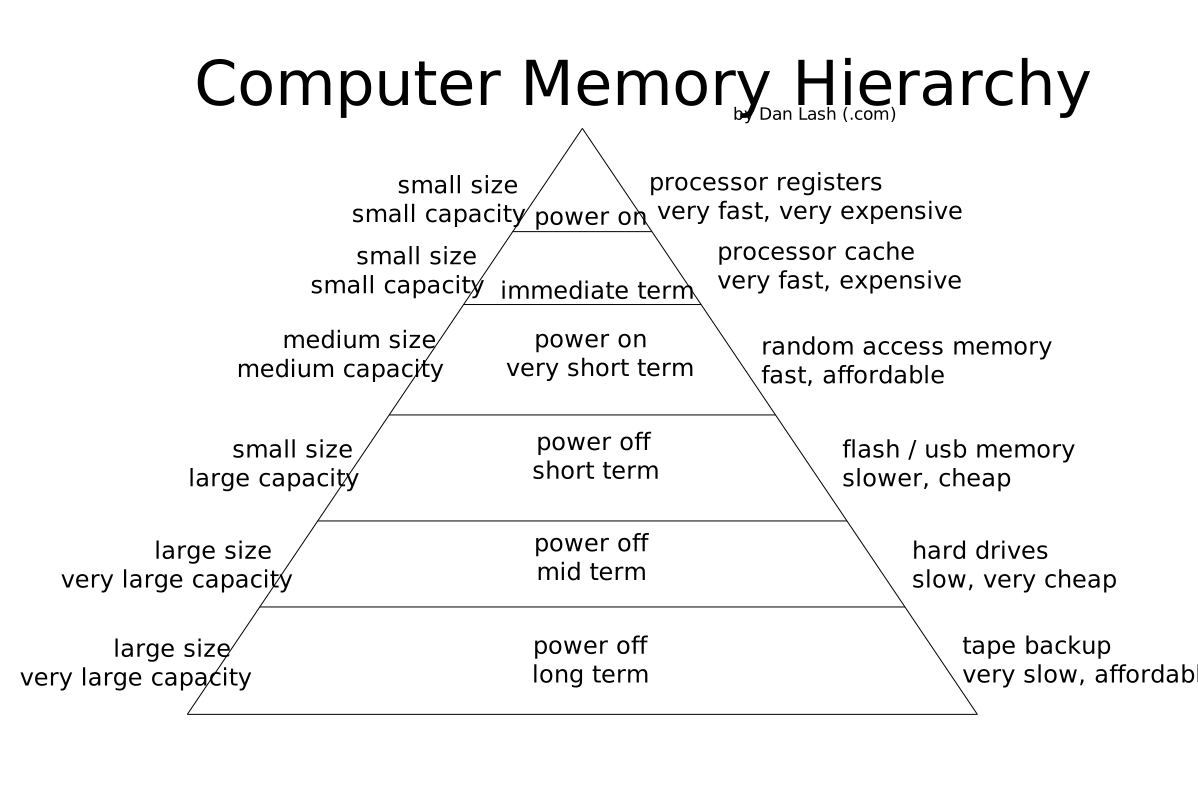
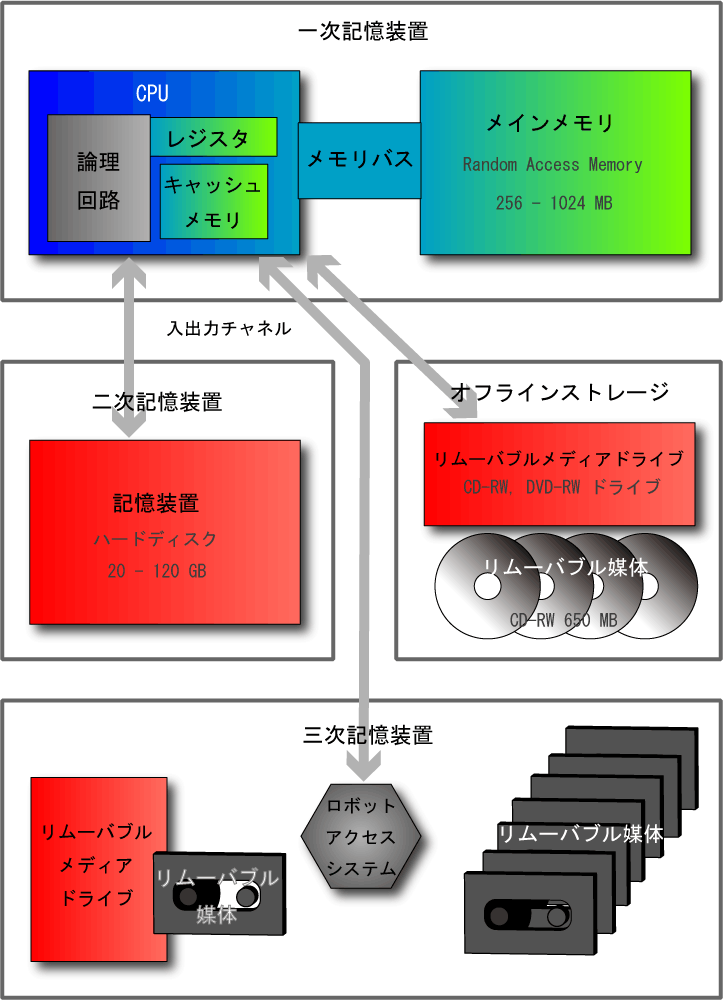
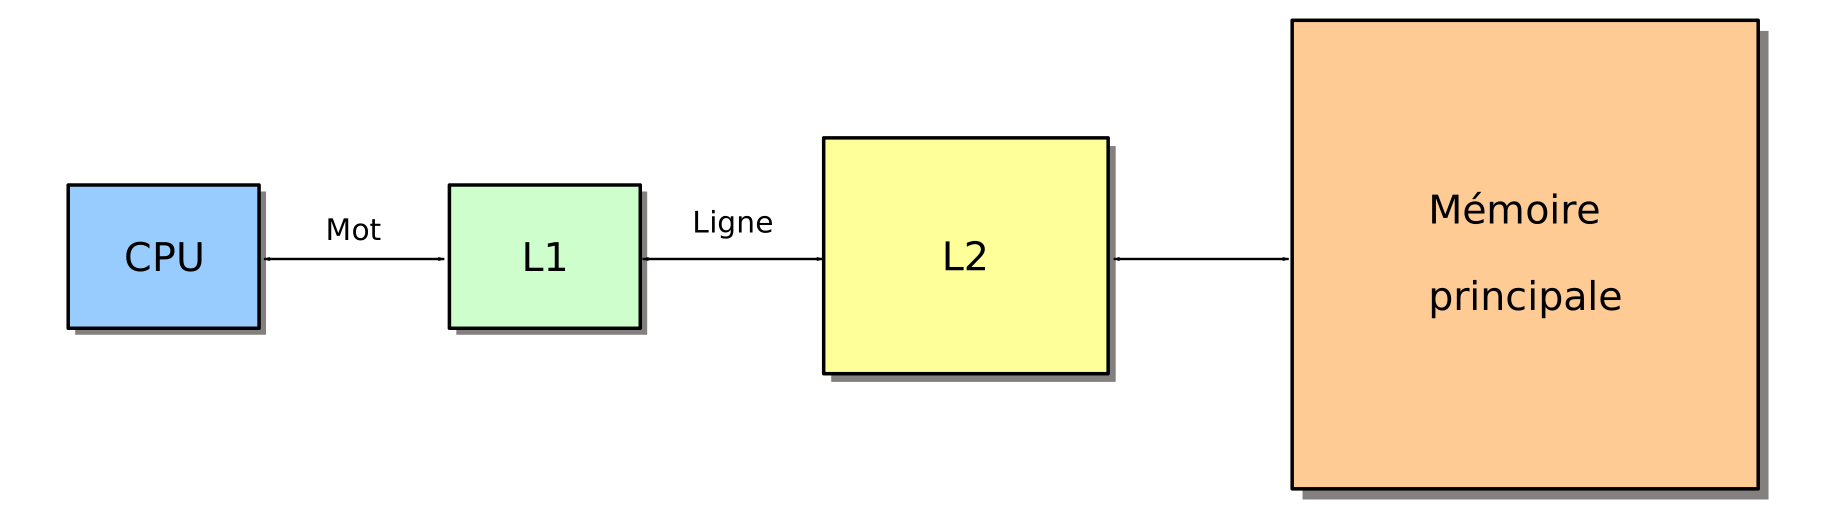
既然两者同构,区别到底在哪?一句要紧的:CPU 的每一级缓存都试图"命中即快",GPU 的片上缓存更多是"挡一眼就放行",它不是为了少跑内存,而是为了滤掉那一大堆先占带宽的重复访问,把宝贵的外带宽留给真正需要的数据移动。 出处:通用计算机内存层次(Commons《Computer Memory Hierarchy》)。

把这件事落成一张可核对的表,GPU 存储层次的每一级都有它要背的责任:
| 层级 | 典型容量 | 典型延迟 | 责任 |
|---|---|---|---|
| 寄存器堆 | 数百 KB(按核计) | ~1 个周期 | 正在执行的线程的临时变量,最快的存储 |
| 共享内存 / L1 | 数十–数百 KB | 十几–几十个周期 | 同一核内线程协作,等价于手动管理的快缓存 |
| L2 | 数 MB–数十 MB | 几十–上百个周期 | 全 GPU 共享的"大缓存",滤重复访问、挡远路 |
| 显存控制器 + GDDR | 数 GB–数十 GB | 上百纳秒 | 真正装载顶点、纹理、帧缓冲的地方 |
| 主机内存(可选) | 数十 GB | 微秒级 | 兜底,CPU/GPU 共享或仅 CPU 访问 |
这张表每一行的数字都是"量级"而非精确值,但它框住了问题的形状:层级越深,容量越大、延迟越陡、带宽越金贵。GPU 的设计目标从来不是"把最热的数据炒进 L1",而是"让尽可能多的访问停在 L2 以内,把最贵的显存带宽花在真正必须搬的数据上"。
要真正理解这张表,得先想通一条反复出现的暗线:在 GPU 里,越往下走的每一级,都不是"下一个快缓存",而是一道"去往更贵带宽的门槛"。寄存器和共享内存是线程自己掌管的"手边抽屉",几乎零成本;L1/L2 是该 SM / 全芯片共享的"橱柜",靠命中去省外访;再往下,每走一级都意味着多付一次"更慢 + 占带宽"的代价。所以 GPU 编程里最高级的一课不是"用好缓存",而是"把访问层次想成钱:能在一级内解决的,绝不往下漏"。 把「数据该住哪」落成一张可操作的小地图:共享变量与临时结果住寄存器/共享内存;被很多线程反复读的常量与纹理住 L2 甚至显存;每帧都在变的小参数住 HOST_VISIBLE 常驻缓冲。放数据不是越近越好,而是「它被怎么读,就住哪里」,这一页就把代价阶梯翻译成了能写进代码的直觉。 出处:缓存层次基础(容量/延迟/带宽对照)。
为了量化"停在 L2 以内"到底省了多少,记一个带宽公式:
$$ B_{eff} = B_{peak} \times \left( h + (1 - h) \cdot \frac{B_{peak}}{B_{DRAM}} \cdot \frac{1}{\cdots} \right) $$
其中有效带宽受命中率与两级带宽共同约束。更实用的近似是:等效内存带宽 ≈ 缓存命中率把每次远路访问"折算"回近处的带宽。换个直白的说法:如果 80% 的内存访问都能被 L2 拦下,那么等效于把显存带宽放大了约 5 倍。这就是现代 GPU 疯狂堆 L2 的动机,它不是防御性优化,而是物理上的带宽倍增器。 命中率说白了就是「带宽放大镜」。把命中率与等效带宽放大倍数排成一张表:命中率 0.8 时放大 5 倍,0.9 放大 10 倍,0.95 放大 20 倍,0.99 直接到 100 倍。只差几个百分点,等效带宽却能再翻一个数量级。
好,把层次讲清了,下一节看那两条"快与慢"的曲线怎么量化。
二、片上缓存与片外显存:延迟与带宽的分野
下面我们进入这一层。数字最有说服力。给一个粗略但可核对的起跑点:现代 CPU 一级缓存(SRAM)的访问延迟约 1ns 量级、带宽可达几百 GB/s;片外 GDDR 显存的访问延迟约 100–200ns、带宽同样在几百 GB/s 到 TB/s。延迟相差两个数量级,带宽却打平甚至反超,这就是开篇那个「矛盾」的全部来源。 出处:存储墙与 LLM 加速器综述(arXiv)。
把 bandwidth、延迟两条线放一起看,就能看到那个著名的 Memory Wall(存储墙):几十年里处理器算力按摩尔定律翻倍,而内存带宽爬升得慢得多、延迟几乎原地踏步。GPU 用并行度硬生生把它扛过去了,但代价是。我们没法指望单次访问变快,只能指望把访问甩成一片。 出处:Wulf & McKee《Hitting the Memory Wall》(SIGARCH 1995)。 出处:McKee《Reflections on the Memory Wall》(CF 2004)。
把「算力指数、带宽线性、延迟水平」三条线并排放,存储墙的成因就一目了然。值得留意的是带宽那条线并非完全躺平,HBM、多通道、堆叠这些年它也在缓慢上移,只是永远追不上算力翻倍的速度。所以「等内存变快」从来不是对策,对策只有「多线程把延迟盖住 + 缓存把弯路截住」。 出处:Vulkanised 2018 · Vulkan Memory Management(Steven Tovey)。
这句「把访问甩成一片」,落到硬件上就是两件事同时做:一是把带宽跑满(并行位宽、多通道),让同一时刻能装下最多正在进行的访问;二是有足够的并发 warp 把这些访问背后的等待叠起来,谁先回来谁先算。
为什么算力涨、带宽爬、延迟却几乎不动?因为三者受不同的物理约束:算力靠晶体管密度翻倍,带宽靠互联宽度与频率同步提升,而延迟受制于光速与电容充放电的物理下限,我们没法让一条几百纳秒的信号路径凭空变短。于是存储墙的形态是固定的:算力是指数,带宽是线性偏慢,延迟是几乎水平的线。这也是为什么所有「啊这代显存应该快了吧」的错觉都落空——他们在等延迟变短,可延迟天生就不肯挪。 出处:存储墙的历史与现状(综述)。 既然延迟压不下来,GPU 就把「压延迟」换成了「控期望」:只要平均延迟被并行度摊得很低,瞬时等待再高也不受影响。这带来一个反直觉的结论。对 GPU 而言,个别访问慢不可怕,可怕的是「同类的慢」扎堆撞上同一时刻的等待,那才是局部性断裂的信号。
习惯上我们用"每秒传输多少位"衡量带宽,但"访问一次要多久"是延迟。两者合起来决定一个访存的"吞吐",想问读写得多快,用带宽;想问单个线程等多久,用延迟。对以延迟隐藏为生的 GPU,等待本身并不可怕,可怕的是等待时没有别的活可干。 出处:Roofline 模型:算术强度与有效带宽(Williams et al., CACM 2009)。 出处:CUDA C++ Programming Guide · 占用率与延迟隐藏。
于是问题变成:既然带宽是命脉,那带宽的天花板在哪?在 DRAM 的物理上,一颗颗粒的位宽再宽也有限,想提高带宽只能把通道数、颗粒数堆上去;可颗粒越多、连线越长,延迟就越高。容量能翻倍,带宽慢涨,延迟几乎不动,这便是"带宽墙"。 出处:CUDA C++ Best Practices Guide · 占用率。
为了消化这个尴尬,GPU 的经典解是铺开一片片上缓存当缓冲池,再配一套地址翻译让「换页、搬数据」都发生在你看不见的地方。三种内存访问方式,命中缓存、未命中、直读显存——代价差异极大,值得单独给一张对照图。 出处:百度百科 · 动态随机存取存储器(DRAM 单元与刷新)。
三条路从快到慢拉开,给人一个直观的梯度: - 命中缓存(Cache Hit):数据就在片上,几个周期内拿回,带宽不占、延迟可忽略,这是所有优化的目标。 - 未命中缓存但页在(Cache Miss):要回显存读一次,一个 warp 就得等上百纳秒;好在延迟隐藏体系能让别的 warp 先顶上。 - 直读显存 / 翻译未命中:既没缓存、还得先翻页,最贵,命中这边一秒,它那边要多等一轮 DRAM + 一轮页表遍历。
给三条路配一道真实的数字,方便你心里有个锚点:L1/L2 命中约几个周期、显存读约一两百纳秒、缺页+翻译回显存约多一个量级。
三条路的代价差异,最终会以「占用率」的形式反映到性能上:命中缓存的访问几乎不占等待,未命中回显存那次会占用住一个 warp 直到数据回来,直读显存还要叠一轮页表翻译。
理解了梯度,你就明白为什么"减少未命中"和"提高命中率"几乎是同一句优化口号的两面。它们都在把访问从第三条路往第一条路上挪。
三、GDDR 为什么延迟高
OK,言归正传。先看这颗颗粒本身。GDDR(Graphics Double Data Rate)本质上是从 PC 的 DDR 内存演化出来、为显卡专门调校的产物:位宽更极端的版型、更高的时钟,但存储单元仍是那个 DRAM 电容阵列。

DRAM 的延迟高,根子不在布线,而在组织方式。一颗颗粒内部被切成了若干 bank,每个 bank 是一个行×列的二维电容阵。要读一个数,得先「激活行」把整行搬进感测放大器,再"列选择"取出一列,最后等数据从内部总线上吐回来。这一整套物理动作,决定了延迟的天花板。 出处:Memory Banks and Rows(行缓冲与 bank 交错)。 出处:Micron · 图形显存产品总览。
把一次读的路径拆开看就明白了:地址 → 内存控制器解码 → 激活行 → 选列 → 数据沿内部总线返回。每一步都是几十纳秒量级的物理开销,累加起来就是上百纳秒。这就是为什么再快的 GDDR,延迟也压不到 CPU 缓存的量级。 出处:JEDEC JESD239F《GDDR7 SGRAM》标准。 出处:JEDEC JESD250D《GDDR6 SGRAM》标准。 bank 的并发用不好,反过来会吃带宽。当连续两个访存落在同一个 bank 的不同行上,控制器得先「预充电」清空上一行、再激活新行,这行切换的时间里数据线是闲的,带宽被白白漏掉。对策是多 bank 交错(interleave):把物理地址的相邻段摊到不同 bank,让连续读时多 bank 并行,把行切换的开销抹去大半。 出处:Micron · 内存产品总览。
DRAM 的延迟可以写成一条和时序参数绑定的关系,我们用惯例记号量化它:
$$ t_{total} \approx t_{RCD} + t_{CL} + t_{BURST} $$
其中: - $t_{RCD}$(RAS-to-CAS Delay,行激活到列选择)。一行电容还没充满,命不了令的物理等待,是延迟的大头; - $t_{CL}$(CAS Latency,列访问延迟),选列到数据出现在引脚上的等待; - $t_{BURST}$,连续突发传输一段数据本身要花的周期,与要读的字节数成正比。
把数字套进去看量级:现代 GDDR 的 $t_{RCD}+t_{CL}$ 常在 20–40 个时钟周期,乘上 2–3GHz 的时钟就是几十纳秒,再加上寻址与走总线,单次读轻松上百纳秒。延迟骂的是物理,不是设计。 DRAM 还得为「会漏电」额外付账。电容里的电荷随时间泄漏,每隔一个刷新周期,内存控制器就得重写整片单元,这就是刷新(Refresh)。刷新占用的时间不能用于搬数据,对有效带宽和延迟都是一笔隐形税;颗粒越多、队列越满,这笔开销越大。这也是「单颗 GDDR 参数很漂亮、多颗粒整机却吃不下有效带宽」的隐藏原因之一。 出处:DDR 时序参数交互与刷新开销。 出处:Micron · DDR5 SDRAM。
为什么这么慢还不肯换别的存储?因为除了一颗电容、一个晶体管、一行电荷,DRAM 在"每比特成本"上没有对手。SRAM 快但占六个晶体管、贵到只能当缓存;DRAM 一个晶体管一电容,密度高到能廉价地装上几十 GB。 出处:Micron · DRAM 器件产品线。 把两种存储单元摆在一起,差距不是「贵一点」而是「贵一个数量级」:SRAM 一位要 6 个晶体管、速度极快;DRAM 一个晶体管加一个电容、密度高成本低。速度、密度、成本四项,两者几乎正负颠倒——GPU 就是在这条分界上决定哪一层用 SRAM 当缓存、哪一层用 DRAM 当海量。 出处:Micron · GDDR7(32 Gb/s,>1.5 TB/s 系统带宽)。

把「成本」也排成一根分层线,你就能理解存储层次的形状不是偶然:按每 bit 折算的原始成本,SRAM 比 DRAM 贵一到两个数量级、DRAM 又比 NAND/硬盘贵一个数量级。成本越往下越便宜、速度也越往下越慢,一进一出,系统只能把「最宠的少量数据」放最贵最快的层级。GPU 不上缓存不行、上了又贵,于是设计者永远在「抠硅片、只放最小够用的那一片」。GPU 和内存产业默契地接受了「慢而廉的海量」,再用并行与缓存去跟它相处。 出处:Micron · DDR4 SDRAM。
那极宽的带宽从哪来?答案在并行的位宽:一颗颗粒本身只有十几位数据线,GPU 吃过的是"多颗粒 × 多通道"拼出来的上千位总位宽——一读就是几十上百字节,吞吐自然上来。位宽换不来延迟,这正印证了第一章那笔取舍。 出处:JEDEC 新闻稿:GDDR7 标准发布。 把行冲突的代价量化来看:横轴是「连续访存落在同一 bank 同一行」的比例,纵轴是有效带宽相对峰值的占比。只要冲突率稍上来,有效带宽就肉眼可见地下掉。这正是「把不同资源摊到不同 bank 偏移」成为写高性能纹理常识的原因。多 bank 交错,就是把这条下坠的曲线重新掰平回去。 出处:Micron 技术博客 · DRAM。
GDDR 自己也有一部"物理上限下如何一点点挤"的演进史。把历代代际摆在一起,你会看到带宽怎么靠"频率 × 位宽"两条腿爬、而延迟始终被物理卡着:
| 代际 | 典型频率 | 每颗粒位宽 | 单颗粒带宽量级 | 一次访问延迟大趋势 |
|---|---|---|---|---|
| GDDR3 | ~2–2.5 Gbps | 较少 | 每颗粒数 GB/s | 基准 |
| GDDR5 | ~4–8 Gbps | 较多 | 每颗粒 4–8 GB/s | 略升(频率上、物理没变) |
| GDDR6 | ~10–16 Gbps | 如前 | 每颗粒 10–16+ GB/s | 基本持平 |
| GDDR7 | ~32+ Gbps | 如前 | 每颗粒 30+ GB/s | 依旧持平,物理是硬约束 |
这张表的读法很关键:带宽每隔一到两代就翻一番,延迟却几乎钉在原地——因为带宽来自"把频率和位宽堆上去"这种工程手段,而延迟受光速与电容充放电的物理下限约束,工程再堆也压不动。这正是本期开篇那句"带宽极高、延迟也极高"的字面来源:能拿设计冲上去的是带宽,拿物理垫底的是延迟。 把代际表的「带宽爬、延迟停」转成一条时间轴,视觉冲击更强:带宽一辈接一辈长高,延迟却几乎钉在地上。这条「一升一平」的剪刀差,就是你未来看到任何「新一代显存更快」广告时,该在心里亮起的那盏灯——它声明的是带宽,不是延迟。 出处:Micron · GDDR6X。
讲完颗粒,必须接上 ep01 留下的那句话:命令包里的地址,GPU 动手前要翻译成真实物理地址。命令处理器拿到的是虚拟地址,可显存里的页是物理页——这中间隔着一层翻译,就是下一章的主角。 出处:IIT Kanpur《DRAM Timing Constraints》讲义。
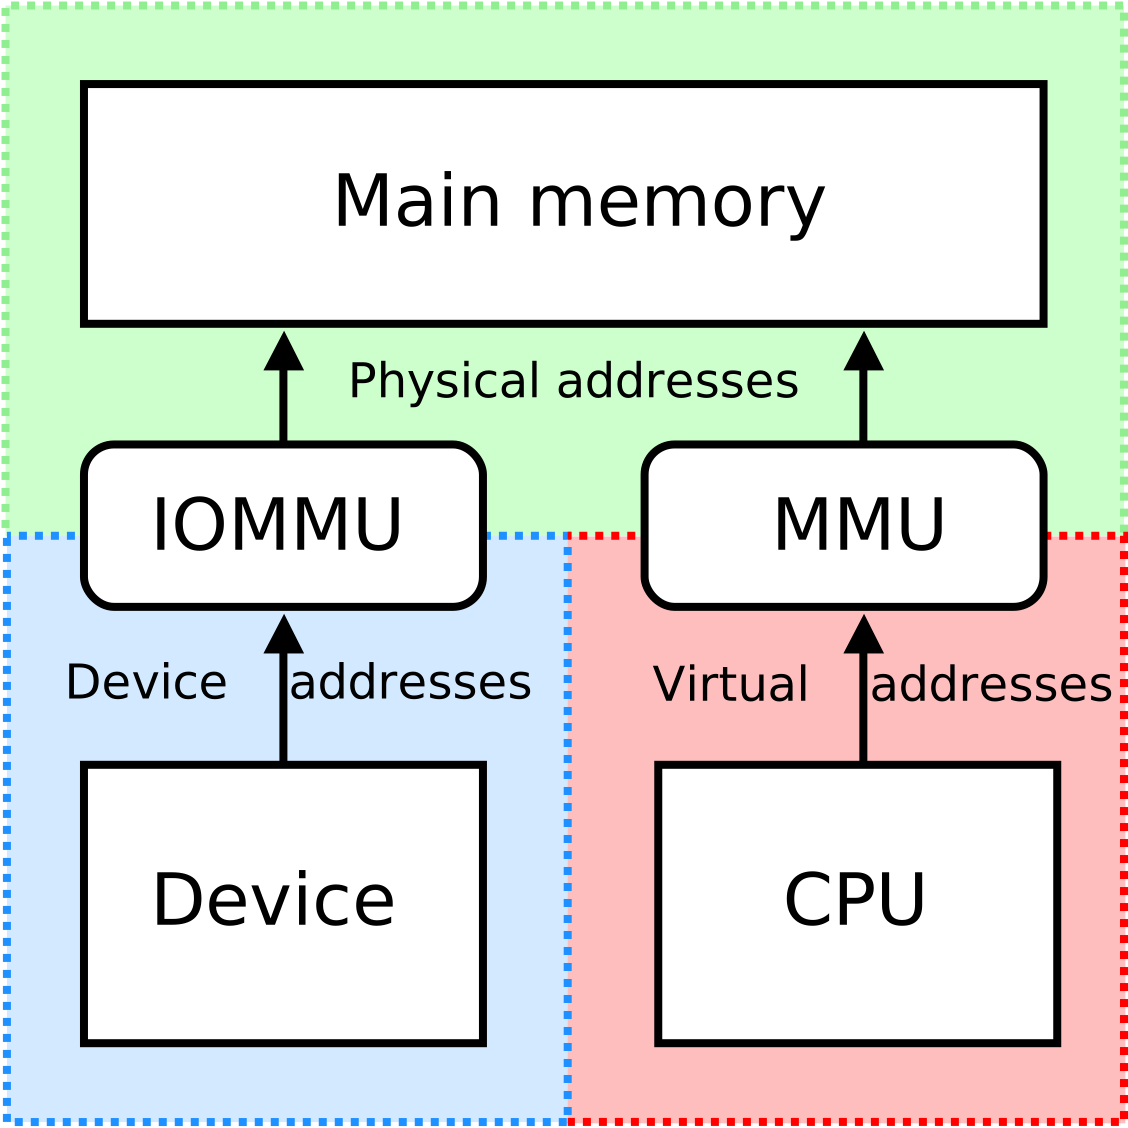
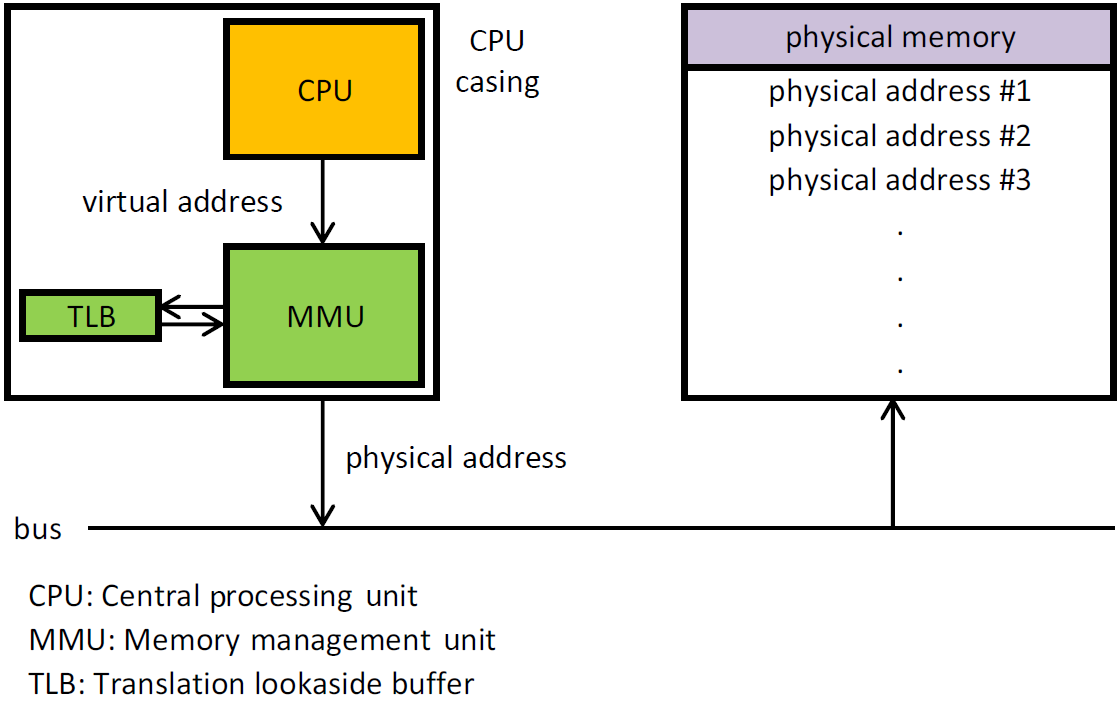
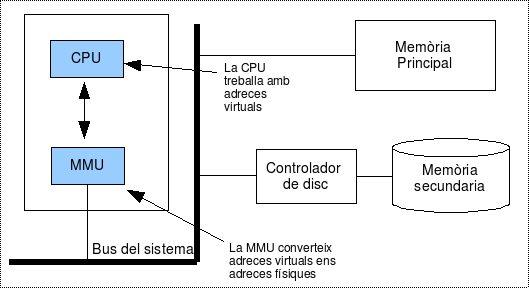
MMU(Memory Management Unit,内存管理单元) 是替一颗芯片(无论 CPU 还是 GPU)做地址翻译的硬件单元。CPU 侧它早就司空见惯;GPU 侧它同样必不可少,只是规模更极端。一次地址翻译的完整路径——从请求发出,到查页表、命中 TLB、返回物理地址——是理解后面所有内容的地基。
本章相关链接与数据出处: - 主参考:A trip through the Graphics Pipeline 2011 — Part 2(显存与命令处理器):https://fgiesen.wordpress.com/2011/07/09/a-trip-through-the-graphics-pipeline-2011-part-2/ - GDDR SDRAM 概述:https://en.wikipedia.org/wiki/GDDR_SDRAM - Memory wall(存储墙):https://en.wikipedia.org/wiki/Memory_wall - GPU 存储层次金字塔(Wikimedia Commons):https://commons.wikimedia.org/wiki/File:Computer_Memory_Hierarchy.svg - 《移动端图形与功耗》ep03 的带宽账(本篇只引结论):{移动端系列链接}
四、GPU 也有自己的 MMU
下面我们开始这一节。可能有人觉得:GPU 直接拿物理地址不就行了,干嘛多此一举搞地址翻译?答案很有分量:物理地址空间做不到两件事——按块隔离与按需映射。让每个应用、每段资源都舒舒服服地拥有一块"自己的连续地址",同时把物理内存自由地拼来拼去,非虚拟化不可。 出处:AMD-Vi IOMMU:PTE/PDE 位域与 IOTLB。 出处:内核文档 · x86 IOMMU 支持(DMAR/IVRS)。
这三件事,是 MMU 之所以存在的硬理由: - 隔离:应用 A 的地址,绝不允许坏了应用 B 的地址。页表把每一块的"能看不能看"写进页表项,天然堵死越界——比靠应用自觉靠谱太多。 - 按需映射:不必一口气把整块资源都搬进显存,可以先占虚拟地址、真正用到时再映射物理页。对动不动几十 GB 的工作集,这是省内存的关键。 - 连续幻觉:物理内存碎片化了也没关系,虚拟地址照样给你一段连续空间。 「连续幻觉」还顺带解释了内存池的兴起:因为虚拟地址连续、物理可以散,驱动才能维护一个「逻辑上像一大块」的分配池,把碎片和页表扫描这层脏活全藏在背后。你 API 里看到的"一整块显存",底层往往是一盘散沙的物理页拼出来的。 出处:Intel VT for Directed I/O 规范 Rev 5.0(ATS / Device-TLB / PASID)。 分配器不必去大海捞针凑一块大连续区。
隔离到底「隔」出什么?最直观的是,两个应用哪怕申请到地址相邻的两块虚拟区,背后的物理页也可能隔得极远、谁也碰不到谁。
要注意,这套机制的代价是:每次访存都要多一次翻译。GPU 用 TLB 把"多一次"压到可见成本之下,后面 2.3 我们再展开。这里先记住结论:MMU 是拿「一次的翻译成本」换「整个系统的隔离与柔韧性」,这笔账在 GPU 这种动辄千线程的设备上尤其划算。 出处:OSDev · Memory Management Unit。 隔离换来的安全性,在 GPU 上还是多进程隔离的前提:多个应用共享同一张卡,谁也不能读别人的显存。页表把每一块的可读可写写死,驱动按需给每个上下文分配独立页表。没有地址翻译,多租户 GPU 根本没有安全边界可言。 出处:OSDev · IOMMU。 出处:内核文档 · mmu_notifier 与二级 TLB 失效。
从体系结构看,现代 GPU 大致有两条路:分离地址空间(显存独立、CPU 世界与 GPU 世界分家)和统一内存(Unified Memory / UMA)(CPU 与 GPU 共享同一片物理内存与同一套地址)。Apple M 系列、集成显卡走统一路线,独显在更宏大尺度上做虚拟地址共享——两者都离不开 MMU。 出处:GPU MMU 设计:为数百条 GPU lane 提供 x86-64 地址翻译(HPCA'14 海报)。
两条路不是"谁强谁弱",而是方向相反的取舍。把它们放到一张表上对照,各自的代价与账单就清楚了:
| 维度 | 分离地址空间(独显) | 统一内存 / UMA |
|---|---|---|
| 物理内存 | 独立显存 + 主机内存两套 | CPU/GPU 共享同一片 RAM |
| 地址空间 | 设备地址与主机地址分开 | 一套虚拟地址 |
| 数据共享 | 要显式拷贝(upload/download) | 可 zero-copy 直读 |
| 带宽 | 显存带宽 100s GB/s | 受系统内存带宽与互联上限约束 |
| 一致性 | 靠 API 显式同步 | 靠硬件一致性协议或 API 同步 |
| 典型代表 | NVIDIA/AMD 独立显卡 | Apple M、Intel/AMD 集成图形 |
这张表想点破的,是"统一"和"分离"永远是一场带宽 vs 共享便利的交易:独显拿"显存带宽自由"换"得显式搬运、两套地址";UMA 拿"共享便利与省搬运"换"带宽被系统互联卡住"。没有免费的统一,只有你把哪笔账放在更优先的位置。 出处:D3D12 内存模型:committed / reserved / placed。
统一路线还有一个进阶形态:共享虚拟内存(SVM,Shared Virtual Memory)/ zero-copy。CPU 和 GPU 各持一个虚拟地址,指向同一段物理内存,于是一方改完另一方直接读到——少一次整块拷贝。这套能力是零拷贝技术在地图、帧缓冲、计算缓冲上跑得动的前提。共享的代价很诚实:一致性没兑现,就得让谁等谁。CPU 写完缓冲,GPU 若读了旧的数据,画面就错了。于是要么靠 API 显式同步(如 vkCmdPipelineBarrier 里刷一遍缓存、约定谁在什么时候看过),要么靠硬件一致性协议在后台悄悄对齐——后者省代码,但要扣一点性能。SVM 的核心,是拿"不拷贝"换"更操心谁先谁后"。
SVM 的「谁先谁后」有多要命,值得单独画个时序:CPU 写完一块共享缓冲,GPU 若在同步栅栏前就读,可能读到半新半旧的数据。SVM 的收益是省一次拷贝,代价是从此你得为「先后」买单。
别忘了,独显还有一根"通向 CPU 世界"的独木桥。PCIe 总线。当我们说"把数据上传给 GPU",走的往往不是 GPU 显存侧那条宽得多的主路,而是这根带宽有限、延迟也不低的 PCIe。于是现代独显的地址空间其实分两段:设备本地地址(GPU 手动、显存侧)和主机可见的 PCIe 段(CPU 侧,得借 PCIe 互通)。真正会"统一"的驱动,会在 API 层把这些地址拼成一张逻辑表,让应用以为"就一块显存",而实际上数据可能一半躺在显存、一半还挂在主机。 「上传到 GPU」的路径常被误解成主路,实则它是根独木桥。于是「上传一次大纹理」往往比「GPU 内部读十次同纹理」更贵——这解释了数据为何要上传一次、留在显存反复用。
把这张"地址空间地图"画全,你就能对上号每次读写到底砸在哪颗物理单元上:GPU 读显存侧走设备总线、快而宽;GPU 回访主机段走 PCIe、慢而挤;CPU 写显存往往走 PCIe 再被装进 device_local。三者代价量级差得极大,却经常在同一帧里出现。这就是为什么"把经常被 GPU 读的东西放在显存、把经常被 CPU 写的东西留在主机段各管各的"几乎总比"强行全塞显存"更快。 把独显这张「两段地址空间」的账算成一张量级表,你会对「每帧布局资源」更有体感:device-local 段带宽 TB/s 级、延迟上百纳秒;host(PCIe)段带宽只有几到几十 GB/s、延迟拉到微秒级。同一帧里,源码只写一句「上传纹理」,底下可能同时踩了两条价格差百倍的公路。
MMU 挂在哪个总线、跟缓存子系统怎么接,决定了翻译的性能代价。GPU 的 MMU 通常贴近 L2 与显存控制器之间的枢纽位置:着色器发出的访存请求先落到 L2,未命中再带着虚拟地址去找 MMU 翻译,翻完才真正去摸显存。
刚才说本质是"拿翻译成本换柔韧性",这里把它落到一个可核对的判断。MMU 放得越靠枢纽,翻译离数据越近、命中率越高;放得越靠边,路径越松但翻译可能绕远。设计者用"枢纽位置 + 大缓存 + 大页"三件套,把翻译的可见成本压到尘埃里。 MMU 的接入位置还决定了「翻译能不能也命中缓存」:当 MMU 紧贴 L2,页表 walk 本身能享受 L2 缓存,命中热路径的成本就低;若 MMU 挂在很远处,walk 次次去显存,翻译开销瞬间放大。这也是为何现代 GPU 把 MMU 摆在存储器枢纽、而不是总线边缘。
五、页表与地址翻译
好了,接着往下看。地址翻译的核心是分页(Paging)。物理内存被切成固定大小的页(通常 4KB 起),虚拟地址被切成同样长度的页号 + 页内偏移。要翻译,就查一张把「虚拟页 → 物理页」对应起来的表——页表(Page Table)。 出处:内核文档(中文)· 页表。
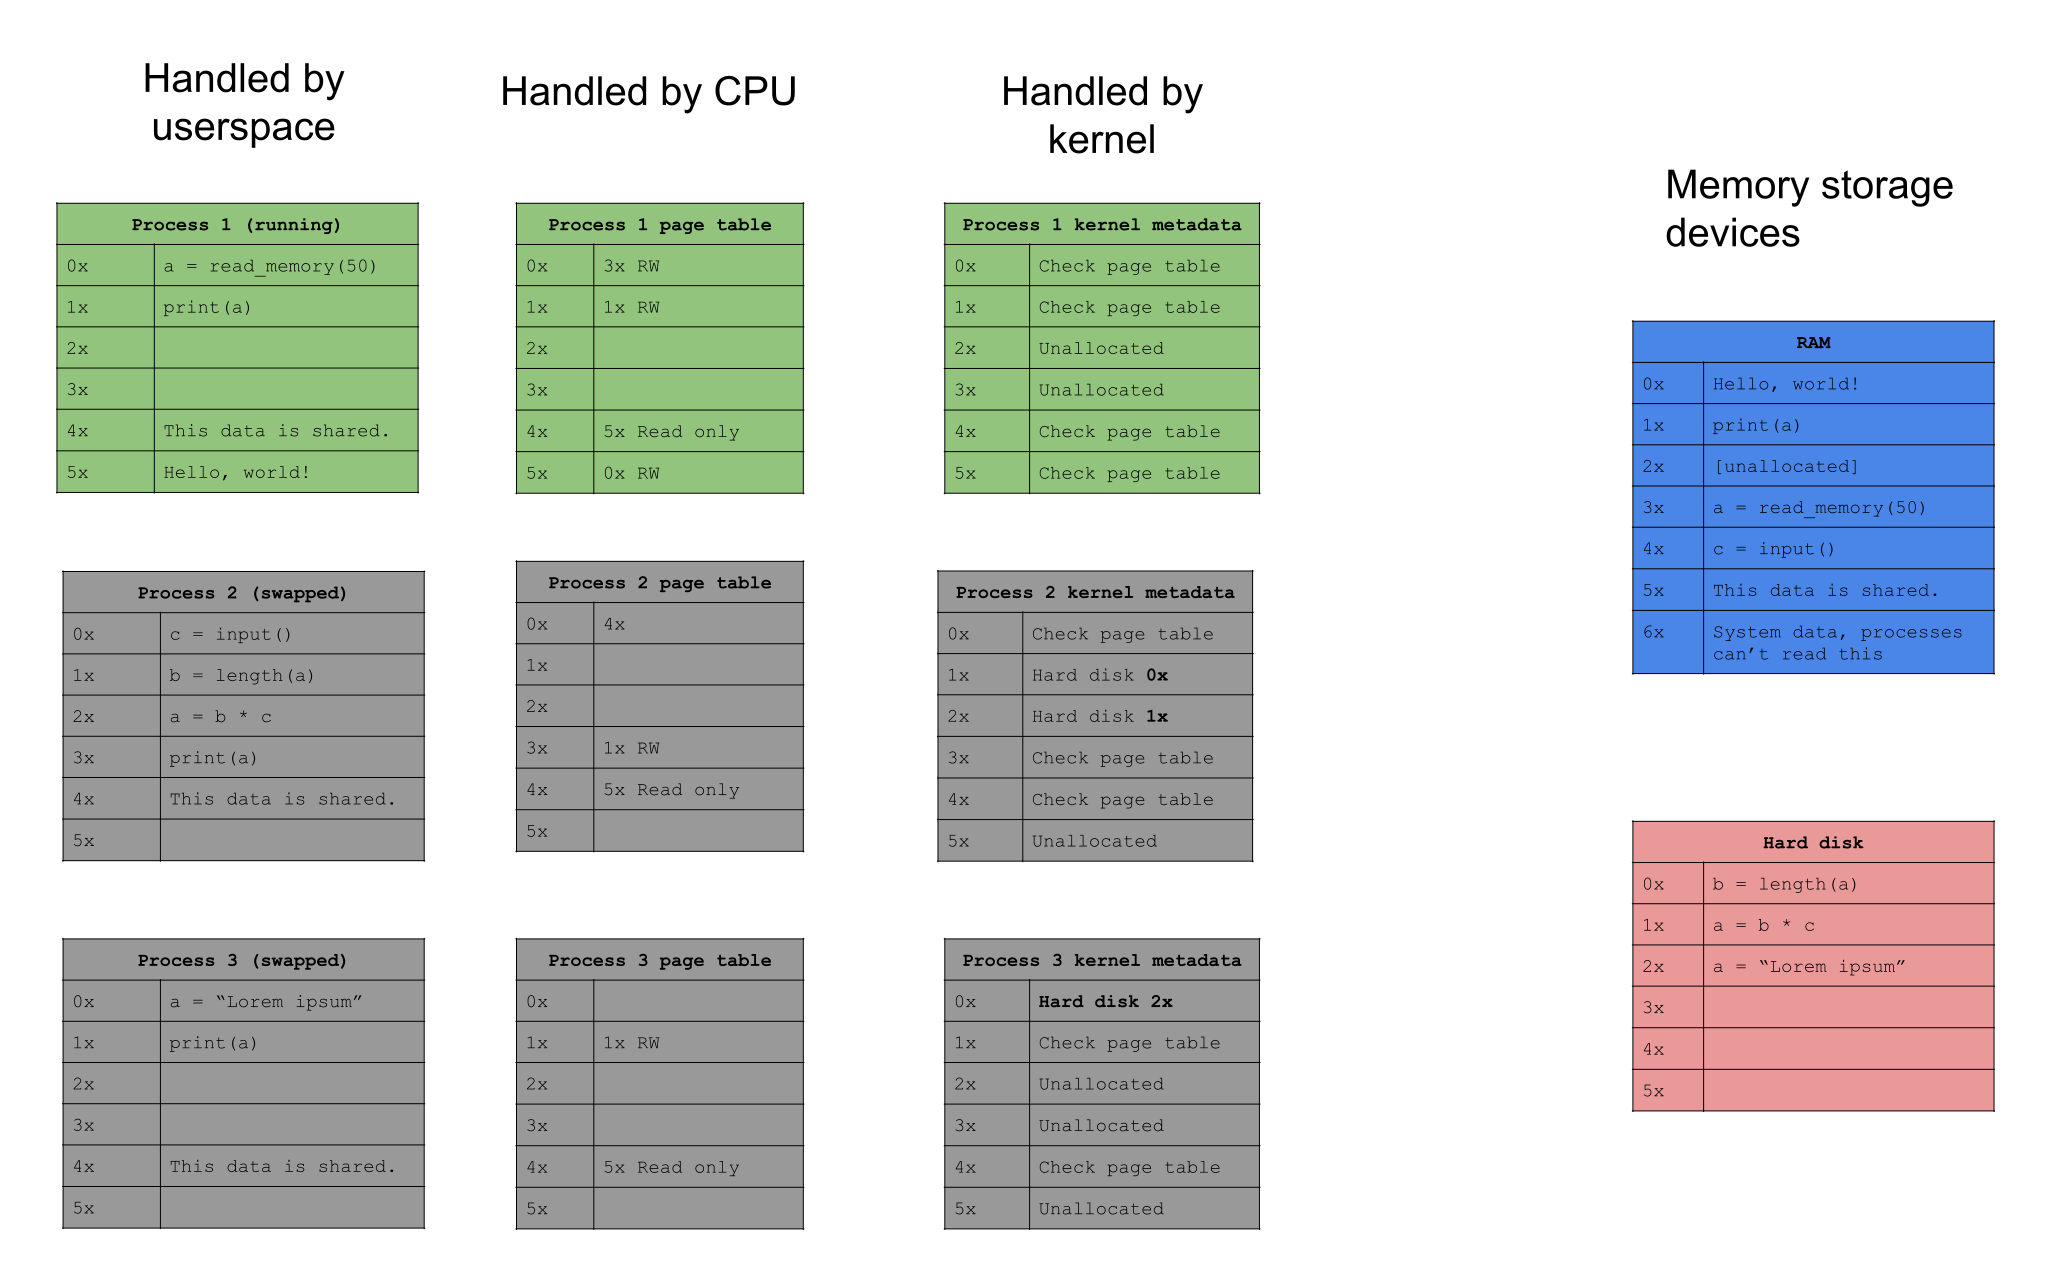
单张平铺的页表在地址空间一大时根本藏不住——4GB 地址空间直接平铺就要上百万项。怎么办?多级页表。把虚拟地址的高位拆成几段,每一段是"下一级页表的索引",逐级下钻最后一级才指向物理页。GPU 的地址空间往往比 CPU 更大,动辄几十 GB 显存 + 设备地址,三到四级页表是常态。 出处:内核文档 · Page Tables(PGD/P4D/PUD/PMD/PTE)。 为什么不是「多级就多级,越多越好」?因为每加一级,walk 就多一次访存。层数其实是一道权衡题:地址空间越大、页越小,要兜住它的级就越多;可级数越深、非命中 walk 越贵。把「地址空间位宽 × 页大小」与「需要几级页表」放一起看,我们会发现 4KB 页 + 48 位地址基本锁死在四级。再多一分是浪费,再少一分装不下。 出处:内核文档 · x86-64 虚拟地址布局。
多级带来的最大好处,是稀疏友好:不必为没被用到的区域白白建一张满表。比如一个进程只真的用了地址空间的头尾两小段,多级页表只在有映射的路径上开花结果,中间的未用段级级留白即可——省下的既是指向空页表的表项,更是"每次都要翻那一级"的时间。 出处:man7 · madvise(2)(MADV_HUGEPAGE / MADV_COLLAPSE)。 稀疏到什么程度才值得多级页表?省下的不只是内存,还有那一级的翻译跳数——留白的层级在 walk 时一级就判「无映射」,根本不用往下钻。
多级页表不只是"省空间的技巧",它把一次查找硬生生变成了一条"逐级取址"的流水,值得手动走一遍,因为这是理解 TLB 为什么存在的地基。以 4KB 页、48 位虚拟地址、四级页表为例,一次拒不命中的翻译大致是这样的四步: 出处:OSDev · Page Frame Allocation(buddy/bitmap)。
- 第 0 级:取虚拟地址的高 9 位,读第 0 级页表(通常只有一张根表,常驻换算),找到下一级页表的基址;
- 第 1–2 级:再各取 9 位,逐级下钻,每级都是一次访存,把"下一级的起点"往前推一层;
- 第 3 级:取最后 9 位落到叶子,叶子 PTE 里的物理页号 + 页内偏移(低 12 位)拼成最终物理地址;
- 合计:一条未命中的翻译 = 4 次额外访存(加上 PTE 本身还可能跨 cache)——这就是为什么 GPU/CPU 都要用 TLB 把它缓存下来,否则平均到每笔访存上都是 4 次的乘法代价。 把这「4 次访存」换算成另一种不耐烦:一次翻译若真要走 4 级×4 次,等于把一次正常的显存读放大成五次开销;而 GPU 上千线程同时翻译时,这个放大是并发的、瞬时的。于是 TLB 不只是一层缓存,而是把「翻译这笔乘法」降级成「加法」的关键开关。 出处:man7 · mmap(2)(MAP_HUGETLB / MAP_HUGE_2MB)。
把"4 次"这个数字记牢,你就明白 2.3 里"TLB 命中率决定一切"是什么意思:命中 = 1 拍,未命中 = 4 次访存叠加,两者可以差两个数量级。而 GPU 上千个线程同时 miss,等于把 4 次访存的洪峰同时压给页表与内存——这才是地址翻译在 GPU 上真正的瓶颈场景。 把这条「逐级取址」的流水换成时间轴看,你会更直白地感到 TLB 的珍贵:一次 4 级 walk,每一级都是一次访存,几乎线性拉长到「4 个 DRAM 往返」。若命中 TLB,这一整串立刻缩成一跳。TLB 的名义不是「快一点」,而是把这条 4 级流水整个拿掉。
页表里的每一项,即 PTE(Page Table Entry,页表项),除了物理页号,还装着一堆控制位:可读 / 可写 / 可执行、大小、缓存策略……翻译时把这些位一并取回,GPU 才能判定这次访问合不合法。 出处:OSDev · X86 Paging(PTE/PDE 位域)。 PTE 不只是「一个物理页号」,它是一串位拼成的:高位是物理页号,低位是一组标志位——有效位、读/写/执行权限、缓存策略、dirty、可迁移等。
解读 PTE 时最容易被忽略的,是那一串权限与缓存标志:它们让翻译从"找地址"升级成"顺带做了访问控制"。一个越界的读能被当场拦下,不是因为有人盯着,而是因为 PTE 里的"可读位=0"在翻译那一拍就把它筛掉了。权限检查被巧妙地埋进了地址翻译里,成本近乎为零。 权限检查被埋进翻译里,最生动的演示是一次「越界读」到底在哪一步被抓:在 walk 到叶子 PTE 的那一刻,硬件读到 valid 位 / 可读位为 0,直接就地抛一个权限错误,根本不用真的去碰物理内存。
这一套翻译的妙处在于——它顺手解决了显存碎片化。虚拟地址可以连续,物理地址不必连续,于是"8GB 地址空间"不必非要凑出一块 8GB 的连续物理区,散落的页拼起来就行。这对显存分配的意义,怎么强调都不为过。 出处:内核文档 · Architecture Page Table Helpers(young/dirty 位)。 下面我们进入下一层。把「虚拟连续 = 物理不连续」再推一步:它还让「按需增长」成为可能——程序先用 8GB 虚拟地址、真正用到哪段才映射哪段,不必预先把 8GB 物理页全部搬进来。这就是 GPU 大工作集内存不那么吃紧的原因:它从来没真把整块塞满,只是假装有这么大。 出处:Intel 64 与 IA-32 架构软件开发手册(卷 3 分页)。
页表不是免费的。它自己也要占显存。算一笔可核对的账:一个 8GB 的地址空间,若按 4KB 页 + 4 级页表,最底层就有约 200 万个页表项,每项 8 字节就是十几 MB——对显存是毛毛雨,可对"每次都要查"的翻译路径来说,是沉重的每一步。 出处:OSDev · Page Tables(各级尺寸与映射)。 页表住在哪,直接决定翻译快不快:GPU 的页表往往驻留在显存/系统内存里,下一次 walk 就得去显存捞一次。于是「页表入口热不热」甚至能反过来影响你该不该给这块区域开大页。让页表自己命中缓存,比让业务数据命中缓存更优先,因为一次 walk 要命中的是整条链。 出处:内核文档 · Transparent Hugepage Support。
把页表占用算成公式,好让你面对任何容量都能自己估:
$$ N_{entries} = \frac{PageSize \times 2^{nPages \cdot \log_2(X)}}{4KB} \qquad;\qquad Mem_{pt} = N_{entries} \times 8\text{B} $$
更直白的一条线是:页越小,条目越多,页表越大;地址空间越大,条目越多。整页映射(大页)能成数量级地砍掉条目,这正是现代 GPU 支持 2MB/1GB 大页映射的原因之一——页表瘦身,翻译压力也一起减小。 出处:内核文档 · Page Table Check。 把大页与普通页摊开对比,「省条目」有多省就一目了然:同样的 1GB 空间,4KB 页要 256K 条 PTE、2MB 页只要 512 条。同一个 TLB 表项,管小页只能管 4KB,管大页能管 2MB——页表瘦了 512 倍,TLB 能覆盖的地址范围却大了 512 倍。这也是 GPU 地址翻译特别迷信大页的原因:它天生偏爱「让一个大页管住一大段连续显存」。 出处:内核文档 · HugeTLB Pages(2M/1G 池与 demote)。
一个实操的启发:当显存告急时,第一反应不该是"换颗更大的显存",而该查查是不是页表、两套缓冲、预留的头尾把容量吃掉了——地址机制的隐性开销,往往比你以为的大得多。 出处:内核文档 · 5-level paging。
六、TLB 与地址翻译缓存
下面我们进入下一层。逐级查多级页表,一次翻译要好几趟内存访问,这在 GPU 上不可接受——于是有了缓存:TLB(Translation Lookaside Buffer,地址转换旁路缓存)。把最近翻译过的「虚拟页 → 物理页」结果存起来,命中就免去整趟页表遍历。GPU 上的 TLB 天然和 CPU 类似,可分 L1 / L2 两级。 出处:内核文档 · The TLB(i-TLB/d-TLB、多级、刷新)。
TLB 的命中决定翻译成本,而翻译成本叠加在每次访存上。记个直观式子:一次访存的平均翻译开销
$$ \overline{t_{xlate}} = h \cdot t_{L1} + (1-h) \cdot \left[ t_{L2} + (1 - h_{L2}) \cdot t_{walk} \right] $$
其中 $h$ 是 L1 TLB 命中率,$t_{walk}$ 是逐级走页表的代价。只要 $h$ 高,命中率 95% 以上,翻译平均开销就压到一两个周期——这是"多一次翻译"能贵价的根本原因。GPU 因为访存态势强并行,$h$ 往往要靠「大页 + 多级 TLB」共同抬起来。 出处:Pichai et al.《Architectural Support for Address Translation on GPUs》(ASPLOS'14)。 把这句话转成一条可核对的对应关系,你能亲眼看到「95% 的上方是最甜蜜的位置」:命中率从 80% 拉到 99%,平均翻译开销能掉一个数量级不止。所以两个 GPU 之间比 TLB,比的不是「有多少兆表项」,而是能否让热路径的命中率骑在曲线的右上段。
但 GPU 对 TLB 的伤害是"规模性"的:一个 warp 几十个线程、一个 GPU 上千个线程同时在做翻译,处女访存几乎全 miss,于是成千上万个 page table walker 一拥而上。TLB 的压力不是来自误用,而是来自并行的天性。 出处:GPU 系统调用与 UVM 背景(ISCA'18 讲稿)。
多级 TLB 的分工是:L1 TLB 小而快,管最热的少数页;L2 TLB 大而慢,兜住剩下的翻译并和页表对接。命中率上去了,翻译不再成为瓶颈——这是现代 GPU 能把 TB 级带宽喂给上千线程的前提。 出处:内核文档 · Cache and TLB Flushing Under Linux。 TLB 不只有容量之分,还有分工之分:不少 GPU 把指令访问与数据访问拆成两套 L1 TLB(i-TLB / d-TLB),让取指与读写互不挤占同一个热点的条目。这也解释了一个常被忽略的现象。同一段代码,取指走 i-TLB、读写走 d-TLB,二者命中率要分开看,混着读往往掩盖掉某一侧的瓶颈。
给几个真实 GPU 的 TLB 配置做量级参考(具体数值随架构与步进浮动,但数量级是稳定的)——我们会发现一个共性:L1 TLB 特意做成小表,靠写死的小容量去赌"最热那几十个页",把省出来的硅片让给数量庞大的 TLB 单元本身: 出处:DUCATI:扩展 GPU 加速系统的 TLB 覆盖(TACO 2019)。
| 架构 | L1 TLB(每多单元) | L2 TLB | 页大小支持 | 备注 |
|---|---|---|---|---|
| NVIDIA Volta (V100) | 每 SM 16 项 ×128 | 每分区页表缓存较大 | 4KB / 2MB / 1GB | SM 内 L1 极小,命中靠 L2 与超大页兜 |
| NVIDIA Turing | 每 SM 较低项数 | 较大容量 | 4KB / 2MB / 1GB | 强调大页命中,降低 translation 压力 |
| AMD RDNA 2/3 | 每 CU 数百项 | 每 RAC 大缓存 | 4KB / 大页 | 大页 + 缓存流水化降低有效开销 |
这张表要传达的,不是让你背型号,而是让你看到数量级的取舍:大部分 GPU 宁可把 L1 TLB 做小、把大页映射做宽,也不愿让 TLB 表本身吃掉太多硅片和功耗。因为对 GPU 而言,"要翻译的页绝大多数是连续的、可归纳成大页的"。大页命中一次,能顶得上小页命中 256 次(2MB/4KB)。 还差一层「大页到底省几拍」的细腻账:对小页,TLB 一条只盖 4KB;对 2MB 大页,同一条盖 512 个页。把「连续访问一段显存」翻译成 TLB 条目数,大页是近乎唯一能把「连续」喂饱 TLB 的姿势。
把"大页为啥省事"算成账,你就懂了为什么所有 GPU/OS 都在推广大页:
$$ \frac{Free_{small \to big}}{N_{entries}} = \frac{2\text{MB}}{4\text{KB}} = 512\times \Big| \; 每次大页命中 = 512 次小页命中 $$
一句话:TLB 的配方(小 L1 + 大 L2 + 大页)不是拍脑袋,是译对着 GPU「访存地址高度连续」这一特性设计出来的。 你写 cudaMallocPitch 拿到对齐缓冲、Vulkan 里用 bigPage 堆,都是在帮 TLB 命中这一前提成立。
分布式内存还有一个绕不开的痛:即使同一套虚拟地址,不同访存单元各自的 TLB 都要同步。一方改了页表,另一方的 TLB 里还躺着旧映射,就可能读到错误物理页。这套"通知各方作废 TLB 缓存"的机制,就是 TLB shootdown。 出处:SITE:用自失效 TLB 条目规避 shootdown(PACT'17)。
shootdown 的动作通常是:先把新映射写进页表 → 给所有持有旧缓存 TLB 的单元发作废指令 → 等它们确认 → 新映射才正式生效。那为什么不干脆"统一清空所有 TLB?"——因为 TLB 里多数条目还是有效的,真清空了,下一步访存全得重新一行行翻页表,白亏一堆翻译周期。精确作废只废掉受影响那几条,比无脑全清聪明得多——这就是留给你的问题 3 的答案思路。
shootdown 的代价有个特点:它贵在"跨所有单元的同步握手",而非单条作废本身。核越多、单元越多,等齐所有人确认就越久。这也就是为什么 GPU 上了几千线程、多 Die 之后,设计会尽量静态分配地址、减少运行时改映射——少触发一次 shootdown,比优化一次 shootdown 更快。 不过 shootdown 还有一条「省事」的替代路线:不少架构给每套页表绑定一个标识(ASID/NUMA 域/进程号),TLB 条目里记着它属于谁,切换上下文时按标识过滤、不该看的旧条目直接当没看见。
shootdown 落到 API 上是具体可见的吗?严格说,主机侧看不到手动的"作废指令"——它由驱动在后台串起映射变更时自动触发。但你能感受到它的存在。用 CUDA 的话,最常见的信号是:新分配一块 GPU 内存、再同步一次,某次 kernel 的第一发访存会莫名变慢。那不是你代码写坏了,是这一发恰好踩着"页表变更 + TLB 作废 + 重装载"的握手,把翻译成本原样暴露了出来。Vulkan 这边同理,vkMapMemory 首次写入一块新分配的内存,头几笔访问往往不是慢在"显存",而是慢在"建立映射 + 条目冷装载"这串一次性开销上。
于是驱动和库都在用同一个土办法躲它:分配器(VMA / CUDA 分配池)预先建立映射、之后长期复用同一段地址,让热路径上几乎不再发生"改映射 → shootdown → 重新翻译"这种三连。这也就是为什么你会看到 cudaMallocManaged、VMA 文档都反复叮嘱"分配一次、长期持有",而不是每帧现开一块。频繁分配等价于变相逼驱动反复做 TLB 的搬运工作。理解到这一层,你再读分配 API 的文档,就能读懂它每一条"别在热路径上分配"的告诫,背后绑着一整串外加的翻译开销。
七、Vulkan 里的内存类型与堆
OK,回到正题。从寄存器视角回到 API,A同学会问:这些底层机制,对上层的显存 API 意味着什么?Vulkan 把这个话题量化成了两级概念:VkMemoryHeap(内存堆) 是"到底由哪块物理内存出资",VkMemoryType(内存类型) 是"这块内存给不给你看、看不看得见、动不动得起"。 出处:Khronos 官方教程 · Advanced Memory Management。 出处:Vulkan 参考页 · VkMemoryHeap。
常见的三档类型,正好对应本期的三个层次: - DEVICE_LOCAL:在显存/板载内存上,GPU 访问最快、CPU 基本摸不到——对应"最贵的带宽、最远的 CPU"。 - HOST_VISIBLE:CPU 能写进来(往往映射到一段可访问的地址)——买的是"CPU 可控"。 - HOST_COHERENT:CPU 写完不用显式刷缓存,GPU 就能看到——买的是"一致性"。
性能上把这几类排个咱们能记住的顺序:DEVICE_LOCAL 读最快、但 CPU 摸不到;HOST_VISIBLE 给 CPU 开了一道门,代价是经常走系统内存或映射路径;HOST_COHERENT 再多买一道"自动同步"。凡是要每帧喂给 GPU 的小数据(Ubo、常驻 descriptor),最好落在既能被 GPU 高效读、CPU 又能写的位置;凡是大且读多写少的纹理,就该躺在 DEVICE_LOCAL。 出处:DirectX-Specs · Resource Heaps(tile pool 与保留资源)。 出处:DirectX-Specs · Sampler Feedback(稀疏流式与按需映射)。
落到代码上,Vulkan 里选内存的过程可以用一段伪代码说清(真正的 API 调用序列,写在注释里好对照):
//-----------------------------------【选择内存类型】---------------------------------------
// 描述:把"我要什么能力"翻译成一块具体的 VkMemoryType
//------------------------------------------------------------------------------------------
//【1】vkGetPhysicalDeviceMemoryProperties —— 拿到一堆 heap 与 type
//【2】按 bitmask 过滤出我想要的属性:DEVICE_LOCAL? HOST_VISIBLE? HOST_COHERENT?
//【3】从命中的 type 逐一带大小地试 vkAllocateMemory;命中率决定成本
VkMemoryPropertyFlags want = VK_MEMORY_PROPERTY_DEVICE_LOCAL_BIT
                         | VK_MEMORY_PROPERTY_HOST_COHERENT_BIT;
uint32_t typeIdx = find_matching_type(prop.memoryTypes, want);
VkDeviceMemory mem; vkAllocateMemory(dev, {size, typeIdx}, nullptr, &mem);
这段伪代码最值得注意的一行是 want:它同时要 DEVICE_LOCAL 与 HOST_COHERENT。这类"既要又不"的类型未必存在,find_matching_type 就会退而求其次——这正是"为什么我对的匀速型有时找不到、只能退一级"的答案。 出处:Vulkan 规范 · Sparse Resources(binding / residency / mip tail)。
want 那个 bitmask 背后,是驱动在一张「heap × type」的网格里挑一块能力全部满足的池。画成筛选表,每一列是一种属性、每一行是一种类型;挑内存就是逐列勾掉不满足、看哪一行剩下全对勾。你声明的「既要又要」越多,命中整行的概率越低,退而求其次的空间越小。 出处:Vulkan 规范 · Features(sparseBinding / sparseResidencyAliased)。
分配器还有一道数学题:碎片化。线性分配简单但会让大块内存越切越碎,分块(sub-allocation)能复用但引入管理成本。Vulkan 的分配器(如 VMA)会选择两者兼用的组合策略。 线性分配与分块分配各自的碎片长得不一样:线性分配是「割裂式」——用得多、释放不齐,可用区被切成一段段小洞;分块分配是「复用式」——把大块预切好、按需发放,小洞在内部消化,但多一层管理。三种形态摆一起,你才看得见 VMA 为何在两者之间取折中。 出处:Vulkan 规范 · Limits(maxMemoryAllocationCount)。 出处:GPUOpen Learn · Vulkan Device Memory(堆/类型/子分配)。
两类碎片的对策恰好对应两种分配策略:对付外部碎片要靠「复用与分块」,把零散小洞重新攒成可用大块;对付内部碎片要靠「按尺寸分级」,让每类请求都落在粒度相称的池子里。把碎片形态和分配策略对上号,再看下面这张对比表就不会只记住结论。 出处:Vulkan Guide · Memory Allocation(device-local / host-visible / UMA)。
一次资源的完整生命周期——分配 → 映射 → 刷写 → 回读——每一步的代价量级差异极大。理解这些数字,才能理解为什么"每帧 realloc 缓冲"是性能灾难,而"预先分池"是常识。 出处:Vulkan 参考页 · vkAllocateMemory(含可换出 device-local 语义)。 出处:VMA 源码仓库(子分配与池化实现)。
给这四步排个体感:分配是驱动层的记账,快,但会动分配器状态与碎片;映射把一块显存地址交给 CPU,快,但引入了"X 和内存到底是同一块还是两份"的语义;刷写(若不在同一块)要搬数据,慢——搬的字节越多越贵;回读从显存把结果搬回 CPU,往往最贵,因为它绕开了 GPU 的快速路径。凡是你在热路径上频繁做的分配/映射/回读,都值得被拉出来审一遍:能不能池化、能不能留在 DEVICE_LOCAL。 出处:GPUOpen · Vulkan Memory Allocator(VMA)。 把一次资源从出生到退休画成时间轴,你会看到最贵的一环几乎总在「上传/回读」这两笔跨设备搬运,而不是分配本身。这解释了一句 VMA 文档的劝告:宁可反复复用一块已分配好的缓冲,也别每帧新建一块再丢掉——新建本身很便宜,可伴随它的映射、搬运、回收,才是热路径上真正的杀手。 出处:Vulkan 规范 · Memory Aliasing。
一句话收束本节:Vulkan 让你显式选择内存类型,就是在让你替 GPU 决定"这块数据该住近屋还是远屋"。选对了,省掉的是看不见的搬运;选错了,赔掉的是每帧都在扣的带宽。 出处:Vulkan 规范 · Memory Allocation(设备内存属性/类型/堆)。 出处:Vulkan 参考页 · VkPhysicalDeviceMemoryProperties。
本章相关链接与数据出处: - Vulkan 规范《Memory Allocation》:https://docs.vulkan.org/spec/latest/chapters/memory.html - Vulkan 内存管理最佳实践(Khronos):https://github.com/KhronosGroup/VulkanMemoryAllocator - D. Wong《Architectural Support for Address Translation on GPUs》(GPU 页表/TLB 研究):http://danielwong.org/classes/_media/ee260_w17/addresstranslation.pdf - 分页(Paging)概述:https://en.wikipedia.org/wiki/Paging - 内存管理单元(MMU)概述:https://en.wikipedia.org/wiki/Memory_management_unit
八、页错误:能等与不能等
好了,我们正式开始。地址翻译出错了会怎样?在 CPU 上,那叫缺页,交给操作系统去换页,进程等得起。在 GPU 上,问题立刻尖锐:数千个线程还排着队等你翻译,你能让它们停下等换页吗?于是典型 GPU 设计了两种页错误。可排程(recoverable)与不可排程。 出处:CUDA 编程指南 · Unified Memory(页错误、页大小与 TLB 语义)。
这里先立一个口径:「可排程」不等于「常见」,更不等于「每次缺页都这样处理」。绝大部分走的是"别让它发生"的路线——驱动按需映射、把需要的页提前搬进来,尽量让 GPU 在纯命中状态下跑完。页错误是可观测的兜底,不是日常路径。能天天出错还好端端跑的,是"可排程"那一类;一旦跌进"不可排程",往往意味着驱动要重置上下文甚至整个设备。 出处:NVIDIA 博客 · Maximizing Unified Memory Performance。 正因为兜底不常走,可排程与不可排程的取舍才成立:如果缺页天天发生,任何优化都救不回来;正因为它是「罕见但可能」的尾部事件,硬件才舍得为「别让它频繁发生」投入按需映射,为「万一发生」留一条恢复窄路。罕见性是这套设计的先决条件。 出处:NVIDIA 博客 · Unified Memory for CUDA Beginners(Pascal 硬件缺页)。
这两种页错误的取舍,本质上是一场延迟的博弈: - 可排程(recoverable):缺页后,把受影响的工作暂停、排队、补齐映射、再恢复。对用户来说可能就一次卡顿,但至少没崩。它押注的是"缺页是少数、补一次能赢回后面几百上千次命中"。 - 不可排程/fatal:缺页直接导致上下文错误或设备复位。牺牲那次工作,换整体稳定与驱动设计简单。它押注的是"一旦不可收拾,早止损别连坐"。
为什么要顶上这么贵的取舍?因为它赌的就是别让它频繁发生。当一种错误既罕见又必然要处理时,设计会优先"发生的路径极省事、异常路径有兜底"——这正是 GPU 页错误处理的一贯哲学。 出处:ROCm 概念文档 · GPU memory(统一内存行为对照)。 把两种错误摆上同一张对赌表,赌注完全不同:可排程赌「缺页少、补一次能赢回几百次命中」,付出的是复杂的恢复硬件;不可排程赌「代价可控、早止损不连坐」,付出的是偶尔一次设备重启。
为什么 GPU 要极力避免页错误?因为代价是级联的:一个 warp 缺页,得把它从执行中摘下来挂起;挂起的线程还在占寄存器与调度席位;再多几个,占用率崩了,延迟隐藏体系瞬间失守。一个页错误,往往是整片性能雪崩的引信。 出处:NVIDIA 博客 · Beyond GPU Memory Limits with Unified Memory on Pascal。 挂起一条 warp 为什么这么疼?因为它占着的不只是「它自己」:还占着寄存器席、调度槽、共享内存的一角。等其中任何一份被一个离家出走的 warp 钉死,能并行推进的 warp 就永久少一个。缺页让 GPU 丢掉的不是一个 warp 的执行,而是一整套本可服务其他 warp 的资源。
把"级联"这件事讲透:GPU 靠高占用率来藏延迟——一堆 warp 轮流上,谁等访存谁就让位。可一旦某个 warp 因为缺页长期挂起,它就卡住了一整套调度席位,原本可以并行的其它 warp 进不来;占用率下降 → 藏延迟的能力下降 → 更多人开始等 → 占用率更低。这是个正反馈的恶性循环,一次缺页能引发整片卡顿,远超"这一次翻译"本身。 把「级联雪崩」画成一个环,你会看到它有自己的加速度:缺页把 warp 挂起 -> 占用的调度席位变多 -> 新 warp 进不来、占用率下降 -> 藏延迟能力变弱 -> 更多人等 -> 占用率更低。这个环一旦转起来,不是慢一点,而是滚雪球。这也是驱动宁可预先按需映射、也不愿在热帧里撞上一次缺页的原因。 出处:NVIDIA 驱动内核模块(nvidia-uvm 缺页处理落地)。
可排程路径的总思路是:检测到缺页 → 把受影响的执行暂停、排进一个队列 → 由软件或硬件拿到物理页 → 恢复执行。这要求 GPU 有能力"摘下一步正在执行的工作",而不是整个 GPU 自爆。 出处:ROCm HIP · Unified memory management(XNACK 与按需迁移)。 好了,接着往下看。「能把一条 warp 摘下来」听起来容易,实则在 GPU 上是奢侈的:warp 之间共享寄存器文件、L1、调度槽,摘一条不能挤了别人。于是可排程路径要求硬件在「摘下来的那部分」能独立保存现场,其他部分照常推进。这正是 GPU 缺页处理比 CPU 昂贵的根源。
实现上通常是一条"现场保全"的流水:检测到缺页 → 记下出错的 warp、虚拟地址与指令 → 暂停 w/让位 → 驱动把这个缺页请求交给主机侧 → 主机驱动走系统调用分配物理页、写入页表 → 返回后 GPU 恢复那条 warp 继续往后执行。关键在第一步与第三步:硬件必须具备"把一条正在执行的 warp 摘下来、存好现场、不破坏别的 warp"的能力——这是 GPU 与 CPU 缺页处理最大的不同,CPU 把整条线程停掉只伤一条,GPU 上千线程里摘一条要保证其他照跑。 把可排程路径的每一拍在时间轴上排开,损失的大头就清楚了:故障拍本身几乎瞬间;真正贵的是「把请求送回主机、走系统调用、分配物理页、写页表、等返回」——这是两次跨设备边界的往返,动辄几百微秒到毫秒。
而不可排程则走另一套退路:检测到致命缺页(访问了根本没有映射的地址、或权限非法)→ 直接把整个上下文标记为错误 → 触发一次设备复位 / 上下文重置(CUDA 里的 cudaError_t 之流,或 Vulkan 的 VK_ERROR_DEVICE_LOST)。极端情况下整个 GPU 驱动都要重起。这是"牺牲一次工作,换驱动模型简单与整体稳定"——代价是用户能体会到的掉帧或黑屏,但它避免了"一个坏页把整片并行单元拖进死锁"。 出处:NVIDIA 博客 · Inside Pascal(Page Migration Engine)。
不可排程路径在状态机里是一条「一票否决」的边:一旦致命缺页被判定,工作队列直接标错、上下文被标记 fatal,GPU 连安全退出的机会都不给就触发复位。
这里要给一个可核对的判断:可排程与不可排程的分界,本质是"这个缺页是合理的按需映射,还是程序真的撞了非法地址"。前者是 OS/驱动点头后耐心的流水,后者是硬件一眼判死的红线。设计上总期望绝大多数访问落在"别缺页"的命中路径,可排程只是兜底,不可排程是最后那道保险丝。 页错误对帧时间的伤害有多不对称?一个几乎「永不缺页」的渲染循环,帧时间稳定得很低;一旦踩中一次可排程缺页+恢复,那一帧的时间直接跳出近一个量级的尖峰,明明只多了一次错误。
九、命令处理器与显存的协同
下面我们进入这一层。回到 ep01 的主角:命令处理器要执行的命令包,其实就躺在显存里。于是出现了一个微妙的前后依赖。命令处理器自己要先访问显存,才能拿到要去访问显存地址的命令。它配了预取器(prefetch)去猜脚本的下一步,提前把命令包搬进片上。 出处:Fabian Giesen · Part 2:命令处理器如何通过显存取命令。
这个"先读命令、再执行命令"的往复,有个容易被忽略的推论:命令包的访存模式,直接决定命令处理器喂不喂得饱 GPU。如果命令流是线性的、连续的一块,预取器一路梭哈即可;可一旦命令里夹了大跳变(比如一次大资源拷贝、一次屏障),预取器就得回退、重新对齐——于是命令的组织方式(尽量连续、少大跳)成了性能的一部分。 出处:GPUOpen Learn · Vulkan Barriers Explained。
有效带宽 和峰值带宽是两回事:标称是理论极限,真正能吃到的是把行激活、多 bank 交错、缓存命中率都折算进去之后的数值。实测里这个数字往往只有标称的六到八成——不是厂商虚标,而是 DRAM 的物理特性使然。 出处:NVIDIA · Turing 架构详解(前端与缓存层级)。 把「有效带宽被谁吃掉」拆成一张账,你会看到峰值和有效之间那两成到四成的落差去哪了:一部分花在行切换(预充电/激活),一部分花在刷新,一部分是 bank 冲突的等待,还有一部分是地址翻译与 cache miss 的叠加。
把有效带宽写成公式,让你对"为什么会掉成这样"有数:
$$ B_{eff} = \frac{N_{accesses} \cdot Byte_{each}}{T_{busy}} \qquad,\qquad T_{busy} = \sum \big(t_{RCD} + t_{CL}\big) + N_{miss}\cdot t_{walk} + \cdots $$
更直白的说法是:任何"没在搬数据"的周期(行切换、bank 冲突、地址翻译、缓存未命中回访)都是带宽的漏损。多 bank 交错就是专门去抹平行切换的开销,命中率则决定有多少次访问根本不用碰外带宽。真正会写的人,会在 profile 里同时盯着命中率和有效带宽占比,而不是只看标称。
预取器在带宽与延迟之间做的博弈,本质是用带宽换延迟:宁可多读一点、别读漏了——因为读漏导致的二次重取,比多读一次的代价高得多。命中率高,预取就赢;命中率差,预取反而拖累带宽。 出处:Vulkan 规范 · Command Buffers。 预取器是双刃剑,值得一条对应关系说清:命令流越可预测,预取越能近乎免费地把命令/数据提前搬上片上、把有效带宽顶到上限;可预测性一差,预取读空、得清队列重来,反而吃掉本该属于正经数据的带宽。所以预取的收益,高度依赖驱动把命令排得多整齐。 出处:Microsoft Learn · D3D12 命令队列与命令列表。
命令预取器具体怎么"猜"?它不会傻等下一命令包从显存里排队出来,而是按一套预测策略把自己前方的路提前探明,把"下一步读哪里"提前排好。常见的打法有四种,正好对应命令流的四种形态: 出处:Vulkan 规范 · Synchronization。
- 顺序预取(Sequential):默认按地址连续步进、提前读下一块。命中的场景是"命令流是连续线性写出来"的最常见形态——驱动生成命令时本来就尽量排成连续的一串 buffer。
- 步长预测(Stride):发现地址按固定间隔跳动(比如每隔 256KB 一块命令),就按这个步长跳着预取。适合"每帧在固定偏移刷新 descriptor"的惯用打法。
- 分支 / 跳变处理:遇到跳跃(一次大资源拷贝、一次屏障、一个远跳转)就当"预取哨站"——清空当前预取队列、重设起点,避免在错误方向上白读。 预取器的「哨站」策略还负有安全职责:遇到屏障或远跳转,它不只在方向上跳回来,还会顺手把可能有错读的预取队列清掉,避免把脏数据顶进指令流。预取的每一分「提前」,都要靠「能随时回退」兜底,否则提前就变成了冒险。 出处:AMD · RDNA 2 指令集参考(含命令处理器语义)。 出处:AMD · RDNA 架构白皮书。
- 预取深度(prefetch depth):决定"同时追几拍"。追得越深,越能盖住 DRAM 延迟,但也越占片上缓冲、越可能读空。设计上通常取"能覆盖一次 DRAM 往返(上百纳秒)所需读量"的深度。
这套机制的调优点其实很朴素:预取深度与步长预测,是驱动可以告诉硬件的"线索"。一个把命令排得又线性又紧凑的驱动,能让预取器永远命中它预装的图景;一个随手乱排、中间到处插跳转的驱动,则让预取器反复清空重来。命令的组织方式,从"软件怎么排"一路传导成"硬件怎么读"。 出处:AMD · RDNA 3 指令集参考(命令处理器与调度)。
给一次典型场景算笔可核对的总账:从顶点缓冲、索引缓冲、纹理、帧缓冲到深度,一次帧渲染下来在显存上的读写量有多大。这笔账和《移动端图形与功耗》ep03 是同一本账,本期只引结论并注链接。在带宽有限的前提下,减少无意义访问就是最大的优化。 这句结论在不同层级有不同的抓手:在显存层,少的是一次次 DRAM 往返;在 TLB 层,少的是翻译条目;在 bus 层,少的是对带宽的争抢。同一句「少无意义访问」,落到每一级都是同一种优化、只是省的东西不同——把它分解到各级,才叫真正的定量。
用一个"帧内存预算"的口径框住量级(数值是单帧量级,随分辨率/几何/效果浮动):顶点与索引一是当次几何的入口,二是重绘时反复被读;纹理是采样的大头,Mipmap 多做一次常常能省下一大片带宽;帧缓冲的读写最反复。片元每写一次颜色,往往还要附带一次读改写。把这几项加总,我们会发现超过一半的显存流量其实来自"像素反复跑去读回写帧缓冲"。 给这笔帧内存预算配一张占比图,你会一眼看到大头在哪:颜色/深度缓冲的读写往往占比最高(片元每写一次还常带一次读改写),纹理采样次之,顶点与索引反而是小头。
十、带宽优化实践清单
OK,言归正传。讲透了原理,就该落到手上。这一节不是理论,是把前面几条物理规律翻译成你在代码里能逐条打勾的清单。每条后面都标注它到底动了本期的哪个机制,方便你回查: 出处:NVIDIA 博客 · 在 CUDA 中使用共享内存。 出处:Fabian Giesen · Part 7:Z/Stencil 的三种实现与带宽。
第一组:少跑远路(动的是"命中率"与"等效带宽") 第一组的第一条,往往是很多人没意识到就免费拿到的大项:warp 合并访存(coalescing)。一个 warp 里相邻线程若访问相邻地址,硬件能把这些散请求合并成一条总线事务;反之若各奔东西,一条访存就退化成几十条、把带宽白白撕碎。让相邻线程走相邻地址,是"少跑远路"最便宜也最有效的实现方式。 出处:NVIDIA 博客 · 如何高效访问 CUDA 全局内存。 出处:Khronos 官方 · 显存管理与别名复用实践。
- [ ] 原子化打包顶点/索引:一次 draw 的几何尽量塞进连续、对齐的 buffer,避免散落——既是预取器的线性线索,也让 TLB 大页命中更容易成立。
- [ ] 纹理用 Mipmap:
textureLod或者让采样器自动降级,一次高 mip 的大采样降成低 mip 的小采样,少读的字节数就是白赚的带宽。这是全部清单里性价比最高的一条。 - [ ] 多用顶点缓冲流、少更新:把"每帧都变"的小数据(变换矩阵、per-draw 参数)合进一块
HOST_VISIBLE的常驻缓冲,而不是每帧 realloc 一块新显存。
第二组:让翻译和搬移消失(动的是"页表 / 直达 / 上传路径")
- [ ] 预先分配、池化复用:避免热路径上 malloc 显存——分配本身不贵,贵的是伴随的映射、条目的 TLB 重载与碎片累积。
- [ ] 能直达就直达:CPU 与 GPU 共享的缓冲,优先走 zero-copy / SVM 路径,别绕一圈 map → 拷 → unmap。拷一次,等于把"省的搬运"又送回去了。
- [ ] 尽量用大页 / 对齐分配:大页命中一次顶 512 次小页,页表条目也少一个数量级——对 TLB 和页表占显存都是乘法级的节省。
第三组:别让像素来回折腾(动的是"帧缓冲读改写"这笔最大的账) - [ ] 用高速缓存命中的方式读写帧缓冲:能在一个 cache line 里解决的写入别拆成多次小写;能就地合并的片元写别分成读改写两拍。 - [ ] 尽早 occlude(遮挡剔除):被遮住的像素越快不写帧缓冲,那笔"读改写"就越早省下——这是减少"像素反复回读帧缓冲"最直接的手段。
这条清单的核心不是"背十条技巧",而是让你看到每一条都在回答同一个问题:这一次访存,能不能不跑显存? 命中率、大页、直接映射、少读改写——全是在把访问从"最贵的第三条路"往"最便宜的第一条路"上挪。写代码时每放一次 draw、每次布局一个 buffer,心里都过一遍这个问题,比背任何一种 API 的最佳实践都有用。 出处:Fabian Giesen · Part 4:纹理采样器与访存局部性。 出处:GPUOpen Learn · RDNA 性能指南(波前/内存排布建议)。
十一、怎么测:把带宽、延迟、命中率拿到手
下面我们开始这一节。光有清单还不够,得知道"我的程序到底漏到第几级"。GPU 侧该有一套把"看不见的漏"变成数字的工具——这在各厂商里都有对位物(NVIDIA 的 Nsight 系列、AMD 的 RGP、Vulkan 的 Profiler),它们能再给你三类关键的读取: 出处:NVIDIA 博客 · 用 Nsight Compute 定位访存瓶颈。 出处:GPUOpen · Radeon GPU Profiler(RGP 计数器与带宽分析)。
- 带宽读数:
L2 Read/Write Throughput、VRAM Throughput。直接告诉你"显存侧到底被喂得多满"。若已逼近VRAM Throughput的上限,说明你在撞带宽墙——下一步不是加大显存,而是降低远路访问。 - 命中率读数:
L1/L2 Hit Rate。当 L2 命中率低迷(比如远低于常见工作负载的 80–90%)而带宽又很高,通常意味着"访问不够局部、一直往下漏"——这是比"显存不够宽"更值得先动的地方。 - 延迟/等待读数:
Memory Throttling、DRAM Latency采样。告诉你"有没有线程在空等显存"——若大量 SM 在访存等待中空转,说明延迟隐藏被占用率不足给戳穿了,得回去加线程数或减每线程访存密度。 「占用率不够」长什么样?最直观是看一条时间线:带宽高、延迟长时,若占用率不足以盖住一次显存往返,就会出现大段空档——调度器等一个数据回头,手上却没了能立刻顶上的 warp。占用率不是越大越好,而是至少大到能盖住「延迟 × 带宽」这个乘积。 出处:Nsight Systems · User Guide(系统级时间线与传输分析)。 出处:NVIDIA 博客 · 如何优化 CUDA 主机-设备数据传输。
把这三类读数和本期第一性对齐,你就有了一套判断的顺序:先看有没有撞带宽墙(带宽读数),再看为什么撞(命中率 → 漏往哪级),最后看漏了之后有没有线程顶上(延迟/占用)。绝大多数的"显存慢",走到第三步才发现根子不在显存,而在"访问不局部 + 占用率不够"这对手拉手的元凶。 把「访问局部性」和「L2 命中率」的对应排成一张表,你会得到一个可复用的诊断标尺:局部性好(同一 cache line 反复读、相邻紧凑访问)-> 命中率能顶到 80-90% 以上;局部性差(大跨度、随机跳)-> 命中率垂直掉到一二十。所以 profile 里看到 L2 命中率低迷,第一反应不该是「缓存太小」,而是「访存扩得太散」。 出处:Nsight Compute · Profiling Guide(L1/L2 命中率与 DRAM 带宽指标)。
落到动作上,一条实际走得通的路是三步:
- 先开时间线看占用(NVIDIA Nsight Systems / 通用 profiler):跑一遍程序,盯 GPU 利用率 与 warp 占用率 两条带。若 GPU 有一段长时间空着等人,第一嫌疑就是访存延迟没被线程填满——值得回去核占用率。
- 再开计数器看命中(NVIDIA Nsight Compute 的 lts__t_bytes_sectors_sum 类计数):对热点 kernel 抓 L2 命中率,Memory 页签会把"DRAM 实际吞吐 / 峰值吞吐"的百分比直接报出来——这就是你 B_eff / B_peak 的实测值;命中率远低于该工作负载的常值时,先别怪显存,去查访问局部性。
- AMD 用 RGP(Radeon GPU Profiler)补曲线:时间线里盯内存控制器读写曲线,VRAM Throughput 一眼能看出撞没撞墙;再回到第一期看的 占用率,把"碰墙"还是"等人"分清楚。
把 3.4 那套「先时间、再计数器、再曲线」落成一张判读决策流,你会得到一份可复用的排障地图:先问带宽有没有撞墙(VRAM Throughput)-> 撞了,再问命中率为什么会漏(L2 Hit Rate)-> 还漏,最后问撞墙后线程有没有顶上(占用率)。三层问一遍,大多数「显存慢」的根子其实都藏在第二、三层。 出处:Nsight Graphics · User Guide(图形侧带宽/缓存计数器)。
这条路线的价值在于把三类读数落成"先时间、后计数器、再曲线"的三步,每步都能对应回本期的一个公式或概念。撞墙看 VRAM Throughput,无效瓶颈看 L2 Hit Rate,戳穿延迟隐藏看 占用率。 出处:Intel · GPA 图形帧分析器总览。
好,账算到这里,回到一句话:显存宽不宽是硬件,用不省是本事。理解存储层次、地址翻译与命中率,正是把"贵带宽"花到刀刃上的第一性原理——下一章,我们看看这套机制这二十多年是怎么演化的。 出处:Intel · Graphics Performance Analyzers 用户指南 2024.3。
十二、从分离显存到统一内存
好了,接着往下看。显存走过的路,是"从分离到统一、再从统一到混合"的一路反复。最早的图形卡共享系统内存;后来带宽压力逼出独立显存;到集成时代又回到统一内存(还靠 CPU 的地址总线借道);今天独显在最宏大尺度上重新做起了"大显存 + 主机内存"的分工。 出处:CUDA C++ Programming Guide · Unified Memory Programming。
这一段演进,可以用一条带年份的编年脉络串起来(年份是"这一代大约在此时定型",不是精确发布日):
- 1980s–1990s 初:图形卡直接画进系统内存,没有专属显存——简单,但一画就抢 CPU 的带宽。
- 1990s 中–2000s 初:带宽压力逼出独立显存(SDRAM→DDR→GDDR),GPU 有了自己的石板,但也和 CPU 世界彻底分家。
- 2000s 中–2010s:集成图形再度走向统一内存,CPU/GPU 共享同一片物理 RAM,省成本、省搬运,但共享带宽易抢。
- 2010s–今(标准 GPU):独显在"虚拟地址共享、物理独立"上做文章:共享寻址但保留高带宽显存,用 SVM/可共享内存把 CPU 与 GPU 的地址打通。就要"统一",又要"不抢带宽"。 「统一」和「分离」在延迟与带宽上差多少,值得画一张对照:统一内存要过系统总线与一致性协议,CPU 直读延迟可低、GPU 大规模访问却被系统带宽卡住;分离显存让 GPU 侧又宽又快,但 CPU 想碰得绕 PCIe。一句话:统一省的是「搬运与两套地址」,分离省的是「别被系统带宽拖住」——两者拿同一块带宽换不同的便利。 出处:ROCm OpenMP 支持(XNACK 与 USM)。
这一路的本质,是带宽、成本、共享三条线的反复谈判:独立显存买带宽、统一内存买共享与省事,而现代方案试图"两边都要"。 出处:CUDA 编程指南 · 统一寻址与系统内存(UVA/ATS/HMM)。 把「谁在什么年代、为什么换边」排成一条时间轴,你会看到它不是简单的前进,而是一次次「为带宽换边、为省事换回来」的来回摆动:早期为了共享省事 -> 统一;带宽不够 -> 分离;集成省成本 -> 又统一;追求极致 -> 虚拟地址共享、物理还是分离。每一次换边,都是同一组「带宽/成本/共享」三根线在重新出价。 出处:HMM-V:面向虚拟化的异构内存管理(arXiv:2209.13111)。
各家在同一目标(让 CPU/GPU 互相看得见地址)下的路径并不相同:NVIDIA 选择在设备与主机之间铺共享内存总线、做统一寻址;AMD 用自家的大带宽统一内存衔接 APU;Apple 则把内存直接焊在一起,用统一的 M 系列 SoC 设计彻底抹平 CPU/GPU 的存储鸿沟。 出处:CUDA 驱动 API · 虚拟内存管理与地址预留。
把三家摆在同一张评价表上,你会看到"统一"这件事的连续谱:左边是"最彻底统一"(Apple 的一体化),右边是"最保留物理分离"(NVIDIA 的独显 + 区分对待),AMD 落在中间偏 Apple 的 APU 路线。选择权不在这三家"谁更高明",而在于他们要服务的目标:Apple 的铁一哈希预算、NVIDIA 的超大参数模型、AMD 的 APU 一体机——三条路子各自匹配不同的形态。 出处:NVIDIA GPUDirect(设备直通 DMA 与地址映射)。 把三家「统一程度」摆到一根光谱上,最左是 Apple 的全 SoC 一体化(物理内存焊在一起、彻底统一),最右是 NVIDIA 的「虚拟共享、物理分离」,AMD 的 APU 落在中间。光谱上的任意一点都不存在「更先进」,只有「更适合它所服务的产品形态」——这正是上面那张对照表想逼你得到的判断力。 出处:内核文档 · CPUSETS(内存节点约束)。
一条更本质的线是:无论谁走哪条路,"让地址开放、让物理不同"都是当今高性能 GPU 的公约数。真正区分各家的是挂在地址之后的取舍——缓存大小、共享带宽的定价、是否允许 CPU/GPU 互相直读。理解到这个粒度,你读厂商白皮书时才会去看"它对共享与独立是怎么权衡的",而不是只记型号数字。 出处:内核文档 · Heterogeneous Memory Management(HMM)。 出处:内核文档(中文)· 异构内存管理(HMM)。
好了,我们继续。统一内存的实现,还有一个容易被忽略的引擎。页迁移(Page Migration / Demotion)。当 CPU 与 GPU 共享物理内存却各自有"就近的更快存储器"(GPU 的显存 vs CPU 的系统内存)时,OS/驱动会在幕后根据访问频率悄悄搬数据:哪个核最近老是碰某页,就把这页往离它近的存储迁移,并在出现访问切换时迁回去。GPU/CPU 各自的热点页迁到自己身边,冷页留在原地省带宽。 出处:NVIDIA GTC 2019 · Unified Memory and Page Migration(访问计数与迁移引擎)。 统一内存最微妙的一课,是「一块带宽,CPU 与 GPU 怎么分」。当两者都往同一片系统内存喂数据,谁抢得多谁就让对手变慢——这不只是慢一点,而是带宽是沉默的公共资源,先到先得、彼此拖累。所以统一内存的驱动常有「带宽份额」概念,按负载给 CPU/GPU 分时间片与访问优先级,避免一边把另一边的带宽挤崩。 出处:LPC 2018 · Heterogeneous Memory Management 讲义(Glisse)。
但这套机制要付出真金白银的代价。迁移本身也是搬数据,搬错了反而更贵。于是 OS 需要一套"谁在碰、碰多频、值不值得迁"的记账与决策:Linux 的 NUMA Balancing 就是干这个的,它周期性扫描页的访问记录(page fault 采样),达到阈值才触发迁移,避免在"来回踢皮球"的震荡里把带宽耗光。 出处:内核文档 · NUMA Memory Policy(MPOL_* 与页迁移策略)。
NUMA Balancing 是怎么「知道」热点在变的?不是一次性摸底,而是用硬件页表访问位周期性地扫一遍、配上一个滑动窗口,每轮重算热点。这个扫描周期就是它的反应速度:太短,疯狂来回迁、带宽被踢皮球耗光;太长,热点换了它还没跟上。找到「既跟得上又不震荡」的周期,正是这套引擎最难调的参数。 出处:man7 · mbind(2)(迁移范围与策略)。
页迁移的完整决策不是「谁近搬谁」一句话,而是一套「要不要搬」的门槛:先采样看这块页最近被哪个核碰得多(GPU 还是 CPU);GPU 显著超过 CPU 就往显存迁,CPU 反超再迁回来,两端都冷就留在原地。迁移只在「收益明显大于一次搬数据的代价」时才值得触发——这套记账,就是 NUMA Balancing 的核心。 出处:内核文档 · Page migration(迁移 PTE 与页表处理)。 这套参数——采样周期、迁移阈值、每页迁移的下限——就是本期"用软件兜硬件成本"精神的一个活例子:统一内存不是免费的,它是用一套精密的迁移会计在替我们说"这页到底该住哪"。 出处:CUDA 运行时 API · Memory Management。
十三、GPU 存储层次的现代面貌
下面我们进入下一层。把镜头拉回现在,现代 GPU 的存储层次已经是一张精打细算的图:大片的 L2、AMD 的 Infinity Cache、不断变大的片上缓存,都是为了挡住"远路"、榨干"近路"的带宽。片上缓存越大,等效带宽越高,越能掩盖显存的延迟。 出处:NVIDIA · Ampere GA102 架构白皮书(片上缓存与显存分层)。 出处:Micron · HBM2E。
把 GPU 存储层次的二十年演进排成时间线,主线清晰得吓人。远处的东西(显存)换代相对慢,近处的工具(L2、专用缓存、预取)一直在加码。从早期「几 MB L2 + 一枚显存控制器」,到现代「数十 MB L2 / Infinity Cache + 多通道交错 + 预取 + 多级 TLB」,GPU 用越来越多「离得近的聪明」去补贴「离得远的物理慢」。 出处:AMD CDNA 架构(各代 HBM 类型与峰值带宽)。 出处:AMD CDNA 4 架构白皮书(8 栈 12-Hi HBM3E 封装)。
现代显存还有另一条支线——HBM(高带宽内存)。它把 DRAM 颗粒立体堆叠、用穿硅通孔(TSV)连到 GPU 芯片,一举把位宽与带宽推到 GDDR 望尘莫及的 TB/s 级,代价是成本与散热扶摇直上。所以 HBM 只用于旗舰、专业与 AI 卡,游戏卡仍沿用 GDDR——又是一次「带宽 vs 成本」的经典分账。 出处:JEDEC JESD235D《HBM DRAM》标准。 出处:Micron · High-bandwidth memory(HBM 堆叠与硅通孔)。
把这批"近路"工具当一份清单过一遍,你就有了对号入座的能力: - 大 L2 / 共享环形总线:NVIDIA Ampere 之后 L2 可到 40–45MB,把大部分纹理与共享数据挡在片上。 - Infinity Cache(AMD):在显存前加一块大片 SRAM 缓存,专门抬升有效带宽、压低对 GDDR 的依赖。 - 纹理/常量专用缓存:管线里每一级都有一小段只服务某种访问的缓存,靠"有针对性"提高命中。 - 命令预取缓冲 / 顶点预取:命令处理器与几何前端各自的片上预取,让"读下一步命令/顶点"少踩显存。
这几类工具的共同逻辑,正是 1.1 那张表的精神:让访问尽量停留在片上,把最贵的体外带宽留给非搬不可的数据。 出处:NVIDIA Blackwell 架构技术简报(HBM3E 16 TB/s)。
三家桌面 GPU 厂商的近路策略,值得并排放在一起看——它们共享同样的物理定律(片上缓存挡远路),但"挡多少、挡在哪"各有各的账: 三家其实在回答同一个问题:有多少比例的非纹理访存应该停在片上、由缓存付费,又有多少比例必须放行、由显存带宽付费。答案的差异,本质是「SRAM 面积的单位成本」与「GDDR 带宽的单位成本」在每位厂商的 die 预算里如何权衡。 出处:Micron · HBM3E(>1.2 TB/s per stack)。 出处:NVIDIA Hopper 调优指南(SM 级占用率上限)。
| 厂商架构 | 片上大缓存 | 主打机制 | 设计取舍 |
|---|---|---|---|
| NVIDIA(Ampere→Ada) | L2 40–45MB+,HBM 或 GDDR | 超大 L2 兼作共享总线 | 缓存大,等效带宽高;牺牲一点面积换掩盖延迟的能力 |
| AMD(RDNA 2→3) | Infinity Cache 96–128MB | 显存前加一整块 SRAM 缓存 | 用一大片 SRAM 让"大多数访问不碰 GDDR",有效带宽直逼 HBM 观感 |
| Intel(Arc/Xe-HPG) | L2 数–十几 MB(较早架构) | 常规 L2 + 靠显存带宽硬顶 | 缓存相对小,更依赖显存侧带宽,成本与复杂度更低 |
| Intel 的「小缓存」路线另一个容易忽略的收益是更可预测:缓存小,命中率更依赖访问的绝对局部性,profile 里的一行数字更好解读;大缓存则把「到底被多少层拦下」藏得更深。小缓存不是性能更差,而是把性能取走的方式更透明。 出处:JEDEC JESD270-4A《HBM4 DRAM》标准。 出处:Micron · HBM4。 |
这张表想让你读出的,不是"谁缓存大谁强",而是一条共性 + 一条分叉:共性是三家都把"片上缓存"当成降带宽依赖的命根;分叉是对"缓存到底该堆多大、以什么为代价"的取舍不同。NVIDIA 用超大 L2 换高等效带宽、AMD 用 Infinity Cache 直接向带宽要价、Intel 早期押注"小缓存 + 大显存带宽"控制成本。在物理约束(SRAM 贵、GDDR 便宜)完全相同的前提下,他们押了不同的注。 出处:NVIDIA H100(显存带宽代际)。 出处:AMD CDNA 3 架构白皮书(MI300X HBM3 5.3 TB/s)。
把 Intel 单独放大看,更能看清"小缓存路线"不是偷懒,而是基于自家功耗与生态的刻意取舍。Arc(Xe-HPG)的 L2 只做到十几 MB 量级、并配一个相对紧凑的显存控制器,它没有像 AMD Infinity Cache 那样堆出近百 MB 的 SRAM——因为它要控成本、控 die 面积,还要让"独显—集显—移动端"尽量共享同一套架构设计,不得不把缓存规模压到可复用的范围。结果就是 Intel 更依赖显存侧原始带宽硬顶,早期性能提升全靠 GDDR 的频率与位宽。这一局提醒我们一个容易踩的坑:读厂商缓存数字时,一定要连它服务的形态(独立插卡 / 集成 SoC / 移动端)一起看,脱离形态比容量,等于拿"油箱多大"来比"一辆车好不好开"。 出处:NVIDIA H200(HBM3E 4.8 TB/s 与容量)。 出处:SK hynix 新闻室(HBM 代际与堆叠)。 各家缓存大到什么程度、换回多少带宽,画一张「缓存容量 -> 有效带宽收益」的对应,你会看到成本-收益的同一条曲线被三家踩在不同位置:Intel 踩在「小而便宜」、AMD 踩在「大而冲收益」、NVIDIA 用超大 L2 兼作共享总线踩在中间偏重。曲线本身在物理上是同一条,差异全在「愿意为带宽付多少面积」。 出处:SK hynix · HBM3E。
于是结论清晰了:峰值带宽吓人,有效带宽才是命。 缓存堆多大才算「够」,得看边际收益什么时候塌:缓存在前期每加 1MB 都拦下一大截远路访问、收益陡涨;到一定程度后,剩下的多是「冷而散」的访问,再堆收益骤降。设计者把缓存定在「边际收益开始塌」那一档附近——这既解释了 AMD 的 Infinity Cache 为何停在百 MB 级,也解释了为何游戏卡普遍「够用就好」、不学 HBM 一路堆到底。 出处:AMD Instinct MI300 系列(HBM3 与统一内存)。 一个应用能跑多快,不取决于显存多宽,而取决于有多少访问能命中那层"越来越大的片上缓存"。
把「有效带宽才是命」再落成一句可操作的检查:优化动作前先问「这次改动让多少访问变得更大概率命中缓存」。命中率每提升一点,等效带宽就放大一片;凡是能提高命中率的改动(改布局、加 mip、池化、大页),都是把「峰值数字」向「有效数字」收拢。 出处:Samsung Semiconductor · HBM 产品线。 出处:NVIDIA GB200 NVL72(单机架内存带宽)。
这里要给一条实操的启示:当你在 profile 里看到"内存带宽占用奇高",别急着怀疑显存不够宽,先看有多少访问是非命中、可避免的——把一个不该回显存的读挪进片上缓存,约等于白赚一块带宽。 出处:JEDEC JESD238B.01《HBM3 DRAM》标准。 出处:NVIDIA Blackwell 架构(B200 级带宽)。
十四、这一篇留下的问题
OK,回到正题。从显存与地址空间这道门出去,数据终于可以开工了——但真正的瓶颈来了:怎么让成千上万个线程去占用满那片昂贵的带宽? 占用率、波前调度、如何把延迟藏得更好——这些占满了着色器核那半边天。你会在下一期看到,GPU 是怎么把"慢的存储"用"多的线程"硬生生喂饱的。 出处:Fabian Giesen · Part 1:软件栈与提交路径。 出处:面向商用 GPU 的异构隔离执行(ASPLOS'19)。 延迟隐藏与带宽是同一枚硬币的两面:带宽保证「同时装得多」,延迟隐藏保证「等的时候不闲着」。缺任何一面,另一面也白搭——带宽再大、warp 不够多,一次访问还是卡住大批线程。理解存储其实是在理解这一个闭环。 出处:NVIDIA Nsight Compute 用户手册。 出处:AMD Instinct MI350 系列(288GB HBM3E、8 TB/s)。
在进下一章之前,先把"延迟隐藏"这枚种子埋下——它是上一篇《访问路径》的出口、也是下一篇《着色器核》的入口。显存延迟是物理下限,压不低;于是 GPU 的对策不是"少等",而是"装上足够多的线程同时等":当一个 warp 在等显存数据回头时,调度器立刻把另一波已经就绪的 warp 顶上去执行。用"并发线程数"去填平"固定的等待时间",这就是延迟隐藏的本质,也是 GPU 千核并行真正的意义所在。 但我们会发现下篇里它被一步步逼到极限:SIMD 一发射就绑死一组线程、寄存器预算限制你能驻留多少 warp、占用率太低时想藏也藏不住——这些约束会把"延迟隐藏"从一句口号变成一串权衡。而它和本期共享同一条物理账:带宽靠并行去喂,延迟靠并行去填。 出处:GPU 系统调用(ISCA'18 论文页)。 这句对策落到仿真里,就是「负荷 × 延迟乘积」:要盖住一次 300ns 的远路,需要的并发 warp 数约等于「带宽 × 延迟」的比值。显存延迟由物理钉死,那么唯一能掰的旋钮,就是把并发线程数撞到那个乘积之上。 出处:NVIDIA Blackwell Ultra 技术博客(288GB HBM3E @ 8TB/s)。
给读者留几个能自己动手核的问题: 1. 你的机器上,一块 4KB 页、8GB 地址空间的三级页表约占多少显存?(提示:逐级乘页表项数与项大小) 2. 为什么 Vulkan 要求 DEVICE_LOCAL 与 HOST_VISIBLE 往往不是同一块内存?(提示:回读要拷一份) 3. 一次 TLB shootdown,猜猜为什么比"直接清空所有 TLB"更高效? 4. Infinity Cache 和 CPU 的大缓存,"成功"的定义一样吗——一个靠命中率取胜,另一个靠什么?
本章相关链接与数据出处: - GPUOpen《RDNA 3: Beyond the current gen》(Infinity Cache 与有效带宽):https://gpuopen.com/download/RDNA3_Beyond-the-current-gen-v4.pdf - CUDA C Programming Guide《Memory Hierarchy》:https://docs.nvidia.com/cuda/cuda-c-programming-guide/ - 统一内存(Unified Memory)概述:https://en.wikipedia.org/wiki/Unified_memory - 移动端带宽账(本篇只引结论):{移动端系列链接}
以上。显存这道门,通了;下一站,把成千上万的线程赶进那片带宽里。《着色器核》见。
相关链接 - 上一篇:【GPU 架构剖析】(一)一次 Draw 走了多少路:从 API 到命令前端 - 下一篇(预告):【GPU 架构剖析】(三)着色器核:SIMD、波前与占用率 - GitHub 仓库:{url} - 主参考:A trip through the Graphics Pipeline 2011(Fabian Giesen,CC0 1.0):https://fgiesen.wordpress.com/2011/07/09/a-trip-through-the-graphics-pipeline-2011-index/
With Best Wishes.
十五、收尾
15.1 参考资料与可回溯出处
本篇的每一个量级与机制表述都留了出处,正文中的「出处:」链接可直接回溯。主要来源:Fabian Giesen《GPU 内存架构与命令处理器》 / Vulkan 规范 · Memory Allocation(设备内存属性/类型/堆) / JEDEC JESD239F《GDDR7 SGRAM》标准 / 内核文档 · Page Tables(PGD/P4D/PUD/PMD/PTE) / CUDA 编程指南 · Unified Memory(页错误、页大小与 TLB 语义) / ROCm 概念文档 · GPU memory(统一内存行为对照) / 内核文档 · Heterogeneous Memory Management(HMM) / NVIDIA · Ampere GA102 架构白皮书(片上缓存与显存分层)。 完整来源清单共 150 条,见正文各处内联链接。
15.2 下篇预告
《GPU 架构剖析》系列进度:已完成【一】从 API 到命令前端、【二】显存与地址空间。 下一篇《着色器核:SIMD、波前与占用率》将回答本篇留下的那句追问——带宽与地址空间都备好了, 着色器核究竟靠什么把成千上万个线程喂饱、又靠什么把显存的延迟藏住。
15.3 结语
存储这一层的道理其实很朴素:延迟改不了,只能藏;带宽是上限,用满才是本事。 下一篇我们走到着色器核,看这套「用并行换吞吐」的账在后端怎么继续算下去。
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在硅片到像素之间,继续挖下去。