本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
核心问题:上一篇讲了"事务改的是层树关系,不是像素"。可是改完关系之后,这一帧到底是谁画出来的?SurfaceFlinger 手里有一份可见层清单,它可以把这摞活全部交给 GPU 画,也可以交给显示控制器画,还可以一家一半。这个"判给谁"的决定是谁做的、凭什么做的、代价是什么?
一个具体的读数就能把它逼出来。在本机同一份
dumpsys输出里,两块屏的状态段并排摆着:物理屏写的是usesDeviceComposition=true、usesClientComposition=false;同一时刻用screenrecord拉起来的虚拟屏写的恰好相反——usesDeviceComposition=false、usesClientComposition=true。同一台设备、同一个合成器、同一瞬间,归属可以完全相反。 所以"合成归属"根本不是设备的属性,而是每块屏、每一帧的属性。
承接上一篇。ep06 讲的是"关口":一轮刷新里 SF 做了什么。ep07 讲的是"改动":应用想让屏幕上某个东西换个位置、换层、藏起来,这个意思怎么被打包成事务交出去。可这两篇都把"合成"当成了一个已经定好的结果——ep06 §1.1 把三段里的第三段列成"合成",只交代了一句"归属会被标成 device 或 client",然后就送屏了。这一篇就把它打开:那份归属是谁标的、标的依据是什么、标成客户端之后又贵了多少。
这件事在前几篇里也挂过账。ep06 §1.1 与 §9.3 都写明 HWC 的归属判定属于 ep08 的题域;ep07 §5.1 讲"事务的完成状态"时也只能一路回指 HWC 那一侧;系列 config 里 explicitly_out_of_scope 更是直接把"厂商 HWC 实现的私有逻辑"划了出去。所以这一篇是来还债的:把"层清单 → 归属判定 → 谁来画"这条链讲清。
三篇共用同一条链路,各篇量的东西仍然不同:
| 维度 | ep06《SurfaceFlinger》 | ep07《ASurfaceControl》 | ep08(本篇) |
|---|---|---|---|
| 关心的对象 | 关口:一轮刷新里 SF 做了什么 | 改动:层的属性是怎么被改的 | 归属:这一帧由谁去摞 |
| 量什么 | 送屏节拍与合成归属的结果 | 层树结构与属性 | 每层的合成类型与客户端合成的代价 |
| 主要命令 | --timestats + --latency |
--list + 层段 + gfxinfo framestats |
dumpsys SurfaceFlinger 的 HWC layers 段 + --timestats |
| 典型结论 | 静置 0 次 present;峰值 16 ms 对上 60 Hz | 一次下拉 = 一笔 reparent:parentId 110 → 115 |
7 层仍全 DEVICE(2);一旦退回客户端,RenderEngine 从 0.000 ms 变成 9.093 ms |
本篇也不涉及:Vsync 回调与虚拟显示路径的细节(ep09)、Vsync 偏移三步舞(ep10)、三缓冲与多刷新率 ARR(ep11,需支持 ARR 的真机)、虚拟显示与录屏自身的实现(ep12)、Perfetto FrameTimeline 抓 jank 的完整方法论(ep13 与《图形性能剖析工具链》已写)、事务与层树(ep06/ep07 已写,本篇只回指)、BufferQueue 的队列归属(ep04 已写)、渲染算法与画面技术(《实时渲染管线探析》已写)。为什么不涉及:这一篇的价值集中在"归属判定"这一个点,把凭什么接、凭什么不接、不接之后贵多少三样讲透,掺进别的题域,这件事就讲不透了。完整边界见 §0.3。
系列文章写作风格说明(沿用前七篇,不再重复解释)
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、设备上读出来是什么,这三层分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、采样时刻);
- 模拟器与真机分开写:本机 composer 是官方文档点名的模拟器参考实现,不是显示硬件的 HWC 实现;凡是硬件能力类结论一律不外推为真机,读不到的项一律如实标"需真机"。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交:从显示列表到一块缓冲
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加(本篇)
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank
相关资源链接
- 官方一手来源:实现硬件合成器 HAL | 硬件合成器 HAL | 硬件合成器 HAL 的 AIDL | SurfaceFlinger 和 WindowManager | Winscope · 分析 SurfaceFlinger
- 源码入口:
hardware/libhardware/include/hardware/hwcomposer2.h|graphics/composer/aidl/.../composer3/Composition.aidl|.../composer3/DisplayCommand.aidl|device/generic/goldfish-opengl/system/hwc3/(模拟器参考实现) - 与本文强绑定的前置:ep04《BufferQueue》| ep06《SurfaceFlinger》| ep07《ASurfaceControl》
这一篇回答什么,不回答什么
OK,先把坐标系挪正。前七篇给了地图、叫醒链、交接、账本、入口、关口、改动;这一篇要给的是归属——屏幕上这一帧到底由谁去摞,这个决定是谁下的、依据是什么、不算数的时候会怎样。
0.0 内容总览:本篇知识地图
好了,先把十章各自回答的问题钉在一张表上。它同时也是本篇的目录总览。如果时间紧,第三章(归属是谁定的)、第八章(一次归属阶梯实测)、第九章(客户端合成的代价)是这篇最不可替代的三章:第三章给机制,第八章给现场,第九章给价钱。
| 章 | 回答的问题 | 关键结论 |
|---|---|---|
| 零 | 这一篇补哪一段 | 一篇讲"归属"的文章;与 ep06/ep07/ep09 的分工 |
| 一 | 为什么要有一块专门的合成硬件 | 官方第一句:GPU 不是为合成优化的;GPU 去合成,应用自己的渲染就得排队 |
| 二 | 一帧有几种合出来 | GLES / MIXED / HWC 三种模式的定义;像素级的"合"到底在算什么 |
| 三 | 归属是谁定的 | validateDisplay → getChangedCompositionTypes → acceptDisplayChanges:HWC 先报"想改",SF 再决定接不接受 |
| 四 | 合成类型有几种 | hwc2_composition_t 六项,composer3 再加两项;DEVICE / CLIENT 只是其中两种 |
| 五 | 从 HWC2 到 composer3 变了什么 | Android 13 起改 AIDL;FMQ → parcelable;expectedPresentTime;模拟器含参考实现 |
| 六 | 归属的不确定性谁来兜 | setBuffer 的双用途标志:一个缓冲必须同时能被叠加直收、也能被 GPU 采样 |
| 七 | 在设备上怎么读出来 | composer3 v4、HWC layers 段、composition=DEVICE (2)、显示级 usesDevice / usesClientComposition |
| 八 | 一次归属阶梯实测 | 5/6/7 层全 DEVICE("超过 4 层就退"不成立);含缩小层的 7 层整屏 CLIENT |
| 九 | 客户端合成的代价 | clientCompositionFrames 0 → 204;RenderEngine 0.000 ms → 9.093 ms;帧时长 4.909 → 15.320 ms |
| 十 | 四处说法与四项动作 | 逐条核四种流传很广的说法,每条给一个可执行命令与判据 |
0.1 本篇那个"反直觉的现象"
好了,先把这个现象摆出来,因为它撑住了整篇的骨架。
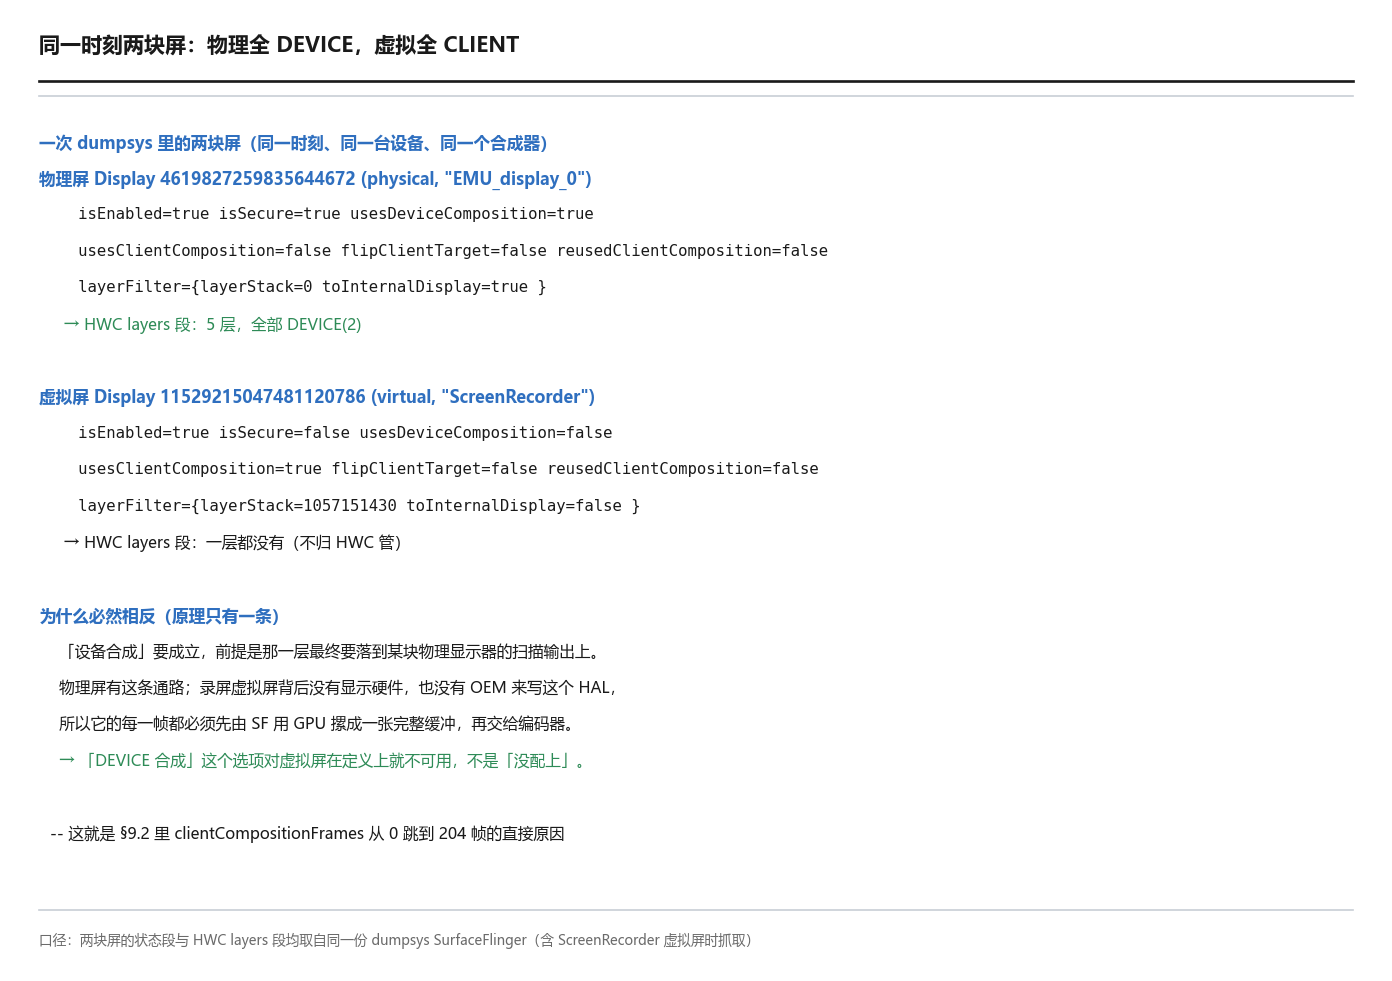
同一台设备、同一时刻,两块屏的合成归属恰好相反。 一次 dumpsys SurfaceFlinger 里同时读到两段:
Display 4619827259835644672 (physical, "EMU_display_0")
   Composition Display State:
   isEnabled=true isSecure=true usesDeviceComposition=true
   usesClientComposition=false flipClientTarget=false reusedClientComposition=false

Display 11529215047481120786 (virtual, "ScreenRecorder")
   Composition Display State:
   isEnabled=true isSecure=false usesDeviceComposition=false
   usesClientComposition=true flipClientTarget=false reusedClientComposition=false
物理屏那一侧,HWC layers 段里列着 5 个图层,每个都标着 DEVICE(2);虚拟屏那一侧,HWC layers 段里一层都没有——因为它压根不归 HWC 管。
所以"合成归属"不是设备的属性,而是每块屏、每一帧的属性。 同一台设备、同一个合成器、同一瞬间,一个全交给显示控制器、一个全交给 GPU。这句话听着平淡,但它推翻了一个很常见的默认认知:很多人把"这台机器有没有硬件合成"当成一个固定的能力开关,而实际上它是一个每帧都在重新做的判定。
下面这张图是本篇的角度:
这一章后面会一路用到它:归属判定的结果,决定了这一帧要不要动用 GPU,以及动用多少。
0.2 与相邻篇目的分工
言归正传。把"谁在画"这件事拆开看,会发现它跨了三个篇目,本篇只拿其中最核心的一段:
| 篇目 | 它管的那一段 | 本篇与它的接口 |
|---|---|---|
| ep06《SurfaceFlinger》 | 一轮刷新里 SF 做什么;把"合成"列为第三段 | 本篇从它那句"归属会被标成 device 或 client"接着往下讲 |
| ep07《ASurfaceControl》 | 事务改的是层树关系 | 事务改完关系之后,这一帧归谁画由本篇回答 |
| ep09《HWC2》 | Vsync 回调与虚拟显示路径 | 本篇只用到"虚拟屏必然走客户端合成"这一个结论当对照 |
| ep11《三缓冲与 ARR》 | 刷新率与缓冲数量的取舍 | 本篇不做刷新率实验,refreshRateSwitches 老老实实报 0 |
这里有一条必须说清的接口:归属判定发生在 SF 内部,但判定权在 HWC 那一侧。 SF 只负责把清单交出去并接受结果,能"拒绝"的只有 HWC。所以本篇的读数只能从 SF 的 dump 里看结果,看不到 HWC 内部的理由——这一点在 §7.5 会专门列一张表说明。
0.3 边界声明:本篇不涉及什么,以及关键参数
先把边界画出来,省得后面对不上账。
本篇展开:HWC 的定位与动机、一帧的三种合成模式、validateDisplay 三步的归属决策与"反悔权"、合成类型枚举、HWC2 → composer3 的代际切换、setBuffer 双用途标志这条对上层的不确定性、以及归属在设备上的可读面与它的时间代价。
本篇不涉及(越界内容只给指针,不配图):
| 不涉及的内容 | 已在何处 | 本篇的交代 |
|---|---|---|
| 厂商 HWC 实现的私有逻辑 | 未公开 | 只写 AOSP 通用链路与官方参考实现,厂商部分一律标"未公开" |
| 事务与层树 | ep06 / ep07 | 只回指,不重讲 |
| BufferQueue 的队列归属 | ep04 | 只取"缓冲交付"这一句接口关系 |
| Perfetto / RenderDoc 自身的方法论 | 《图形性能剖析工具链》 | 只当验证手段 |
| 渲染算法与画面技术 | 《实时渲染管线探析》 | 完全不碰 |
| 移动端功耗与带宽取舍 | 《移动端图形与功耗》 | 本篇只给时长与帧数,不给焦耳 |
关键参数取值范围(后面所有读数都落在这个区间内,超出即视为异常):
| 参数 | 本机实测值 | 说明 |
|---|---|---|
| 屏幕分辨率 | 1080x2400 |
activeMode 给出 |
| 刷新率 | 60.00 Hz |
renderRate 与 vsyncRate 一致 |
| 每帧时长(60 Hz) | 16,666,666 ns |
app duration / 系统周期 |
| 本机物理屏可见层数 | 4–7 | 场景相关,见 §8 |
本机 HWC layers 段列出的层数 |
0–7 | 虚拟屏为 0 |
本机单帧 RenderEngine 耗时 |
0.000 ms(纯 DEVICE)~ 9.093 ms(全 CLIENT) |
见 §9 |
边界之外的写法也定一条:凡是本篇从官方文档取的措辞,一律附原文与链接(如实现硬件合成器 HAL);凡是从 AOSP 源码取的字段,一律给出文件路径;凡是从设备读到的数字,一律标出命令与采样条件。三层不混写——这是本系列从 ep01 起就定下的规矩,本篇继续执行。
一、为什么要有一块专门的合成硬件
先看官方给 HWC 写的第一句定义——它把动机说得很直白,不需要额外解释:
"The Hardware Composer (HWC) HAL composites layers received from SurfaceFlinger, reducing the amount of composition OpenGL ES (GLES) and the GPU perform."
关键在 "reducing" 这个动词:HWC 的定位不是"更快的合成器",而是"把合成从 GPU 手里拿走的那条通路"。紧接着的一句把原因说透了:
"Most GPUs aren't optimized for composition, and when the GPU composes layers from SurfaceFlinger, apps can't use the GPU for their own rendering."
这句话有两层意思,第二层才是真正要命的。合成本质是"搬运 + 混合"的带宽活:把几块缓冲按位置贴到一张画布上,逐像素按 alpha 混合。GPU 的强项是着色与并行算力,让它去干搬运,等于拿高薪工程师做搬运工。但更麻烦的是第二层:GPU 一旦忙在合成上,应用自己那一帧的渲染就得排队——合成和应用渲染抢的是同一块硬件。
1.1 GPU 的强项与合成本质的错配
说白了,"让 GPU 去合成"这件事的问题不在速度,而在它把两件事压到了同一块硬件上:
| 维度 | 应用自己渲染 | GPU 合成 |
|---|---|---|
| 干什么 | 着色:跑顶点、片元、算光照 | 搬运:贴图、按 alpha 混合 |
| 强项匹配 | 高并行、算力密集 | 带宽密集、算力很轻 |
| 谁来发起 | 应用(RenderThread) | SurfaceFlinger |
| 与谁抢资源 | 只和自己抢 | 和所有应用抢 |
这张表里最后一行是重点。当合成也压在 GPU 上时,屏幕上任何一个应用刷新,都可能影响到另一个应用的渲染节奏。 而 HWC 要做的,就是把这个"抢"从 GPU 上挪走。
下面这张图就是那条错配:一条通路让 GPU 既画应用又摞应用,另一条通路把"摞"这件事交给显示控制器。
1.2 显示控制器自己有一整套部件,这不是新概念
"显示硬件自己会摞图"这件事,比 Android 早了几十年。下面这张图是 1980 年代 PC 上一颗显示控制器芯片的内部框图:
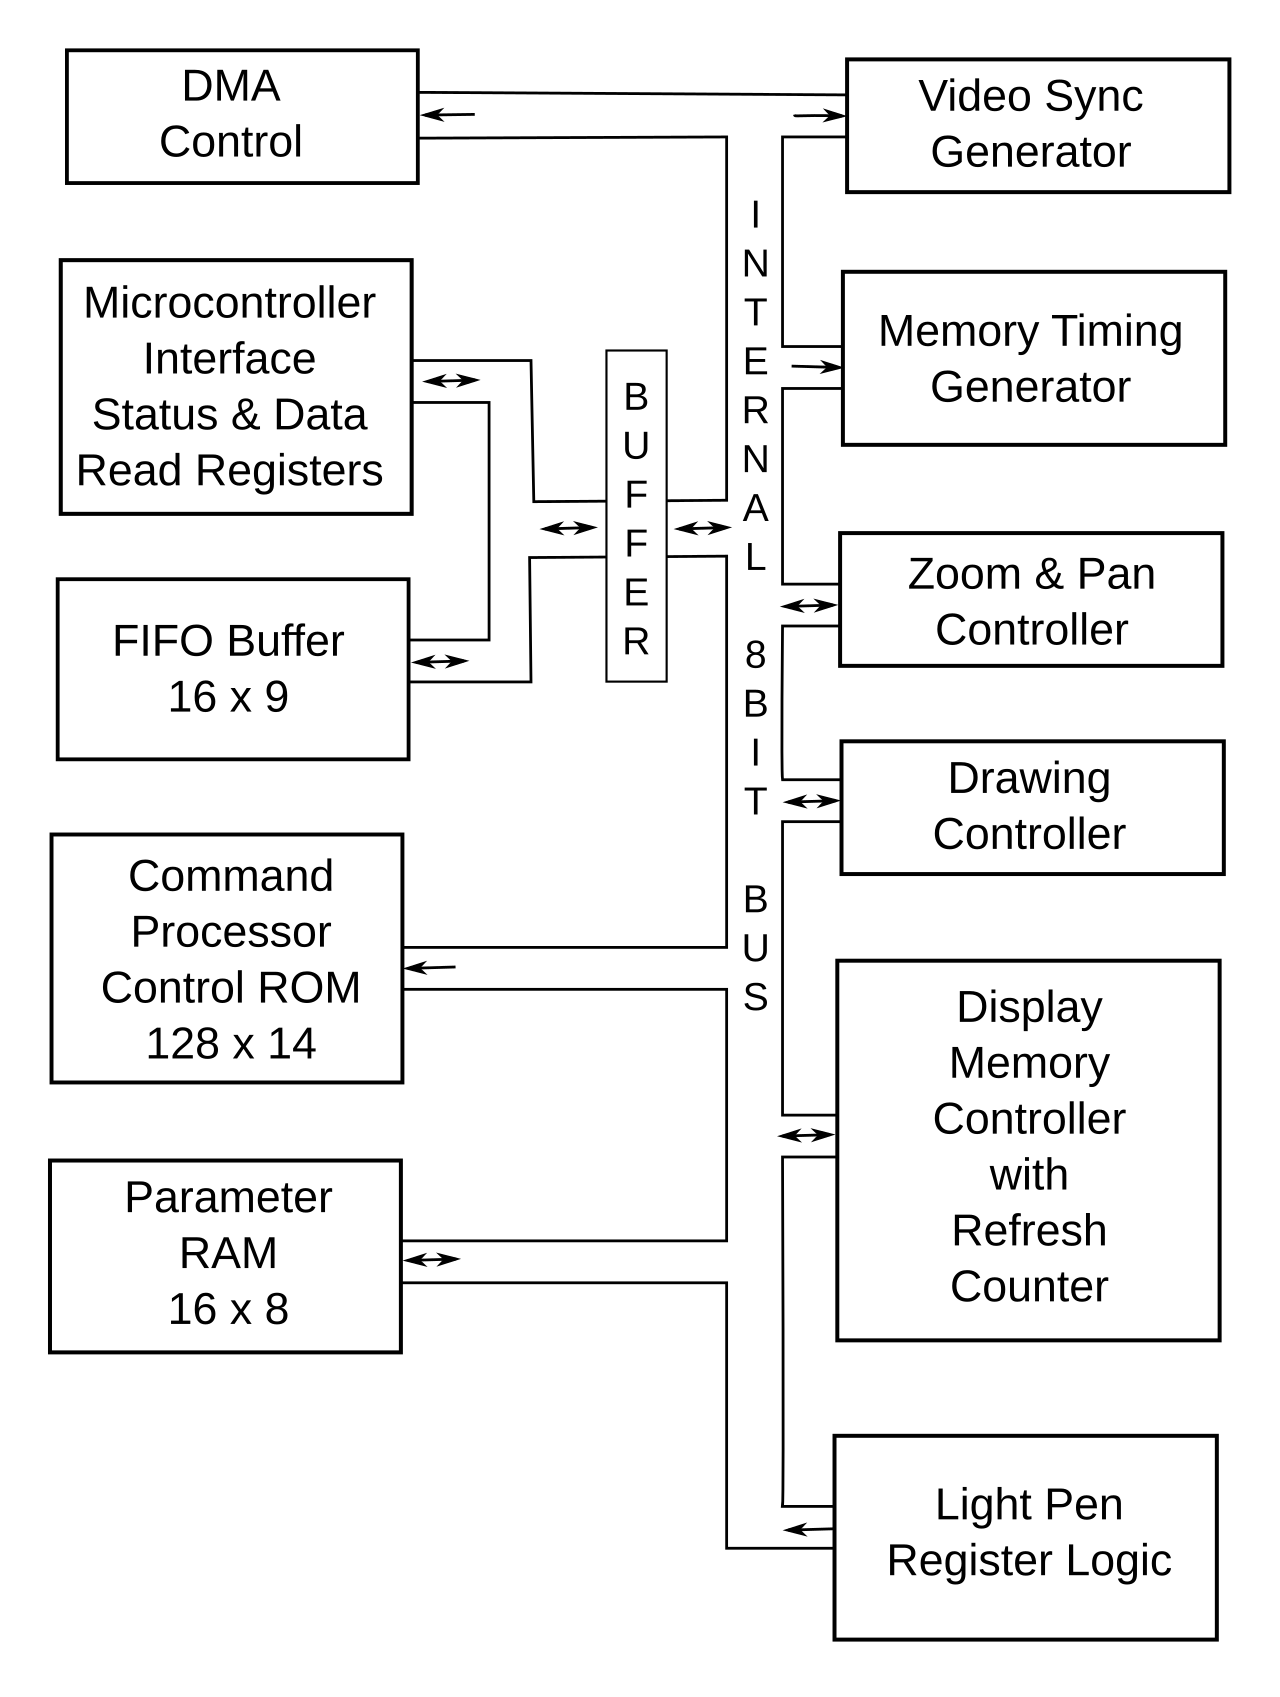
先把边界说清:这张图画的是1980 年代 PC 上的显示控制器芯片,不是 Android 的 HWC,也不是移动端 SoC 里的显示子系统,本篇只借它证明一件事——"显示硬件自己有一整套部件来处理画图与送显"是一个几十年的既成事实,不是 Android 发明的概念。
为什么值得借这一张:看它的块名就知道,一颗显示控制器里同时有时序(Video Sync Generator / Memory Timing Generator)、几何处理(Zoom & Pan Controller)、显示存储管理(Display Memory Controller with Refresh Counter)和命令通道(Command Processor Control ROM / Parameter RAM)。这正是 HWC 今天要做的事的同构版本:同步、几何、显存、命令四类活,硬件一直是自己干的。
1.3 角色分工:SF 出题,HWC 判卷
官方把这一层的关系写得很生动,两句原文可以直接当引子:
"SurfaceFlinger provides HWC with a full list of layers and asks, 'How do you want to handle this?'" "HWC responds by marking each layer as device or client composition."
注意官方用的动词是 "asks"——SurfaceFlinger 不是"下令"把某几层给显示控制器,而是把整份清单交出去问。这个措辞不是修辞,它对应着一个真实的接口约束:判定方案要由 HWC 给出,因为只有它知道自己那块硬件的限制。 SF 不可能预知某个设备能不能吃下一个带缩放的层、能不能处理某种数据空间——这些只有 HWC 自己清楚。
判完之后的分工也很明确:
"SurfaceFlinger takes care of any client, passing the output buffer to HWC, and lets HWC handle the rest."
说得直白些,判给 client 的那些层由 SF 先摞好(输出到客户端目标缓冲),再连同其余层一起交给 HWC。两条路最后汇到同一个出口。
下面这张图把"出题—判卷—汇总"三步画成一条链:
1.4 三层分开说:官方怎么写、源码怎么做、设备上读出来什么
本篇的行文纪律在这里第一次落地——同一个概念,三层口径要分开摆:
| 层 | 这一层说什么 | 本篇的证据 |
|---|---|---|
| 官方文档 | HWC 减少 GPU 合成量;SF 问、HWC 答 | 官方三页原文引句 |
| AOSP 源码 | 枚举与接口:hwc2_composition_t、composer3 Composition、IComposerClient.executeCommands |
头文件与 .aidl 原文 |
| 设备读数 | 判完之后结果长什么样 | HWC layers 段的 Comp Type、输出层的 composition=DEVICE (2) |
三层里的第三层是本篇的立足点:前两层到处都能查到,而"判完之后在设备上怎么读出来"这一段,中文侧几乎没有人写过完整的一遍。
下面这段命令就是第三层的入口,全篇会反复用到它:
# 一、看 HWC 的身份与版本(服务是否在、AIDL 还是 HIDL、版本号)
adb shell service list | grep -i composer
adb shell dumpsys SurfaceFlinger | grep -A4 "h/w composer state"

# 二、看每一层的归属结果(HWC layers 段的 Comp Type 列)
adb shell dumpsys SurfaceFlinger | awk '/HWC layers:/{f=1} f&&!NF{exit} f'

# 三、看显示级的整体状态(这一帧有没有用客户端合成)
adb shell dumpsys SurfaceFlinger | grep -E "usesDeviceComposition|usesClientComposition"

# 四、看客户端合成的时间成本(只在这一层能拿到毫秒读数)
adb shell dumpsys SurfaceFlinger --timestats -dump | grep -E "clientCompositionFrames|averageRenderEngineTiming"
这四组命令后面各有一节专门讲怎么读。先说清它们共同的边界:读到的都是 SF 视角的结果,不是 HWC 视角的理由——理由那一侧在本机拿不到,§7.5 会列清楚。
二、一帧有几种合出来
好了,概念清楚了,下一个问题很自然:这一帧合出来,一共几种可能? 官方给的答案只有三种,而且每种的边界都写得很死。
2.1 三种模式:GLES、MIXED、HWC
官方原文逐条列出(这三句可以直接当定义用):
| 模式 | 官方定义(原文) | 谁在干活 |
|---|---|---|
| GLES | "The GPU composites all layers, writing directly to the output buffer. The HWC isn't involved in composition." | 只有 GPU |
| MIXED | "The GPU composites some layers to the framebuffer and HWC composites the framebuffer and the remaining layers…" | GPU + HWC 一起 |
| HWC | "HWC composites all layers and writes directly to the output buffer." | 只有 HWC |
读完这三句,有两个容易踩的坑。
第一个坑:以为 MIXED 是过渡态。 不是。纯 GLES(一张图都不给硬件)和纯 HWC(一张图都不给 GPU)是两个端点,MIXED 才是工程上的常态——因为真实场景里总会有那么一两层硬件吃不下去(带缩放的、格式特殊的、需要额外效果的),界面又不可能为此只剩两层。所以正确的默认认知是:"默认混合,两端才是特例"。
第二个坑:以为 GLES 模式就是"没有 HWC"。 也不对。看官方对默认姿态的描述:
"By default, SurfaceFlinger attempts to configure every layer such that the layer is composited by the HWC; though in some circumstances, SurfaceFlinger composes layers through the GPU fallback."
"fallback" 这个词说明了方向性:GLES 不是一条平行的默认路径,而是默认路径失败之后的退路。SF 的起手动作永远是"尽量都交给 HWC",只有在 HWC 表示吃不下时才退回 GPU。
下面这张图把三种模式画成一条端点轴:
2.2 像素级的"合"到底在算什么
好了,"合成"这个词听起来抽象,落到像素上其实只有一件事:一块像素压在另一块像素上面,该显示成什么颜色。
官方对这个动作没有给公式(那是图形学教材的事),但 Android 自己把它实现成了一组具名的混合算子。下面这张图是按 Android 的实现跑出来的一组算子演示:
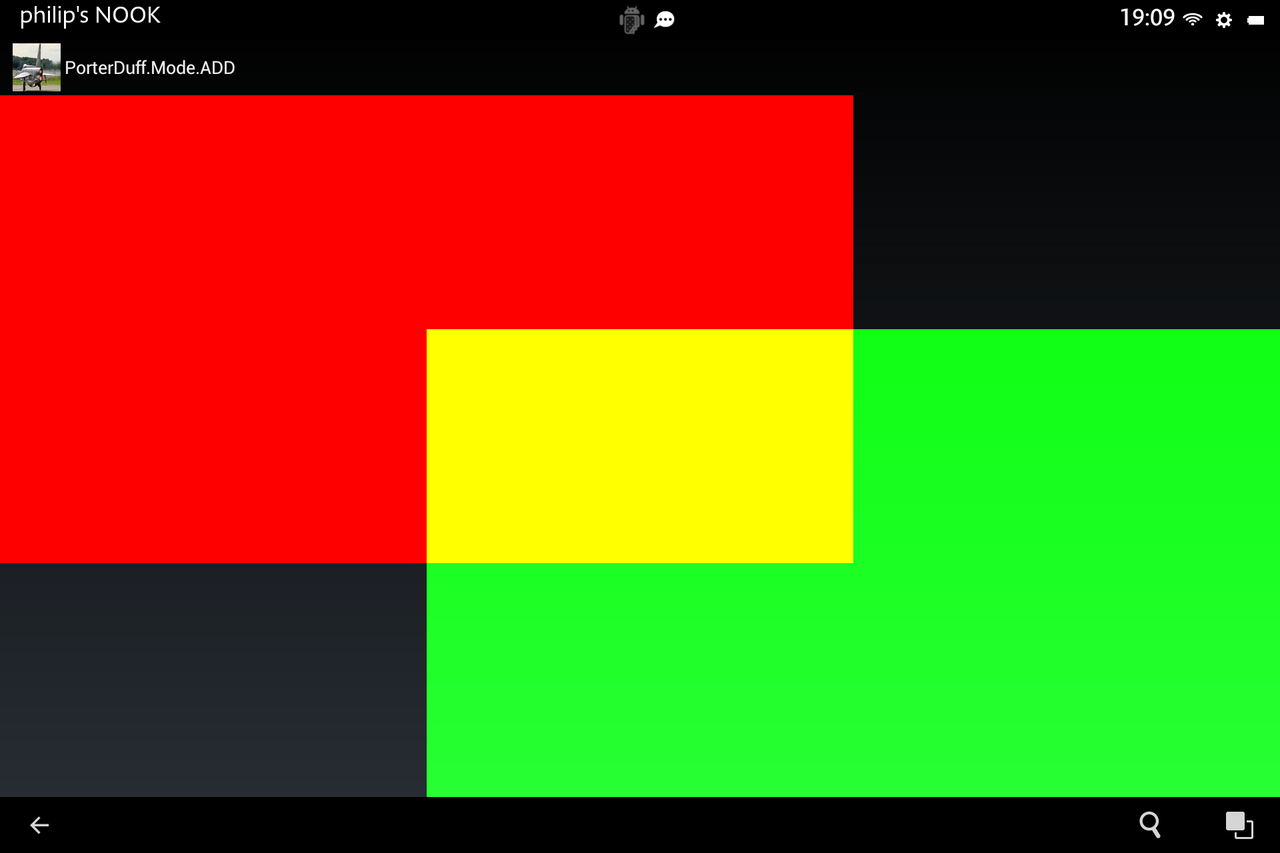
这张图的官方描述值得单独拎出来:它写的是 "as implemented by Android"——也就是说,这套算子在设备上的行为不是"某本教材的定义",而是 Android 自己实现出来的结果。Android 的 PorterDuff.Mode 与 BlendMode 就是这套东西的公开 API 面。
放到合成的语境里,最常用的那个算子是 source-over(源覆盖目标),它的定义可以直接写成公式:
输出的颜色         Co = Cs × αs + Cb × αb × (1 − αs)
输出的 alpha        αo = αs + αb × (1 − αs)
其中:
  Cs  = 上层(source)的颜色,Cb = 下层(buffer)的颜色
  αs  = 上层的 alpha,αb = 下层的 alpha
  (1 − αs) 这一项就是"下面还能露出来多少"
这三个参数就是合成归属的成本来源:αs 只要不是 0 或 1,就必须逐像素做一次混合——既不能简单跳过,也不能简单覆盖。合成之所以是带宽活,全在这个 (1 − αs) 上。
下面这张图是算子命名的通用对照,把同一组"源"与"目标"在不同算子下的关系摆在一起:
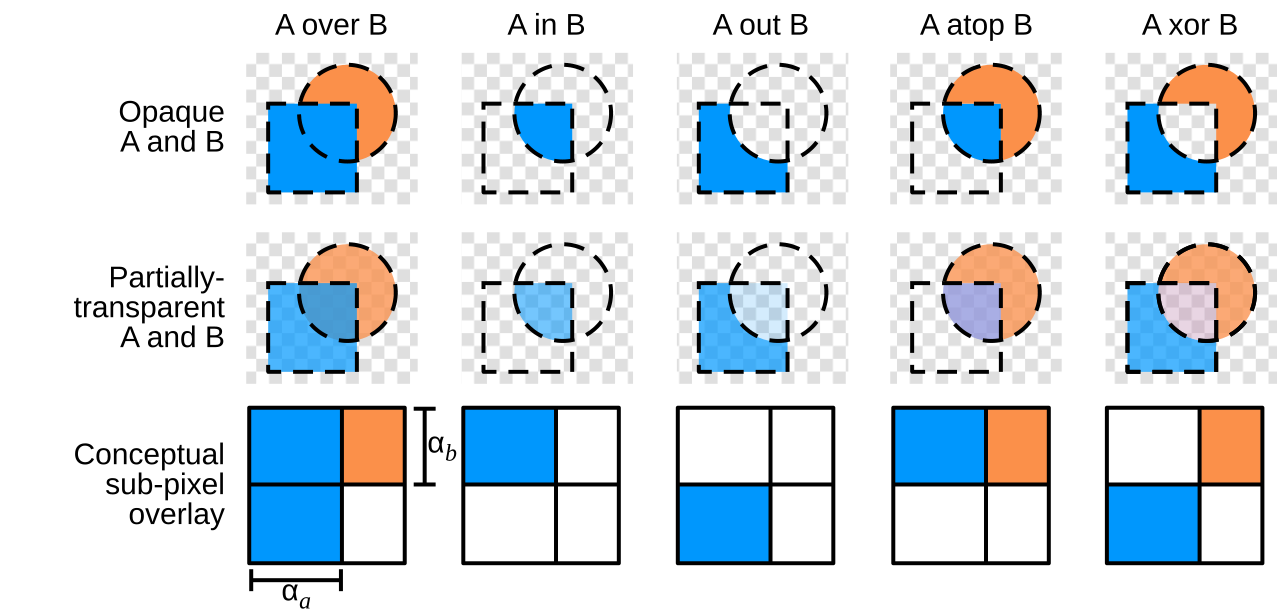
为什么要把这张图放在"一帧有几种合出来"这一章:因为它说明了一件事——"合成"不是一个固定动作,而是一族可选的像素运算。surface 上那个 setBlendMode(或 NDK 侧对应的设置)选的是哪一族里的哪一个,直接影响 HWC 敢不敢接这一层。硬件叠加单元能做的混合模式是有限的,选了它不支持的算子,这一层就只能退给 GPU。
2.3 三种模式在本机的对应读数
好了,"三种模式"在设备上怎么看得出来?本机的读面是显示级那两个布尔值:
# 本机样例:纯 DEVICE 侧
adb shell dumpsys SurfaceFlinger | grep -E "usesDeviceComposition|usesClientComposition"
isEnabled=true isSecure=true usesDeviceComposition=true
usesClientComposition=false flipClientTarget=false reusedClientComposition=false

# 本机样例:纯 CLIENT 侧(录屏虚拟屏)
isEnabled=true isSecure=false usesDeviceComposition=false
usesClientComposition=true flipClientTarget=false reusedClientComposition=false
两个布尔值的组合对应三种模式(这是本篇自己推出来的对照,不是官方措辞,标注一下):
usesDeviceComposition |
usesClientComposition |
对应的模式 |
|---|---|---|
| false | true | 接近 GLES(这一帧全是客户端合成) |
| true | true | MIXED(两边都有活) |
| true | false | HWC(这一帧显示控制器全包) |
| false | false | 该屏这一帧没有可合成的层 |
本机这两次观测一个落在第三行、一个落在第一行——同一份 dump 里同时看到了两个端点,这也是 §0.1 那个现象的完整解释。
三、归属是谁定的
这一章是全篇的机制核心。"谁在画"这件事,答案不是"SurfaceFlinger 决定的",也不是"HWC 决定的",而是三步之间商量出来的。
3.1 五步:一次 validate 换来一份归属
官方给出的合成流程是五步,原文如下:
validateDisplay:"informs HWC to examine the layer state and determine how composition will proceed";getChangedCompositionTypes:SurfaceFlinger 问 HWC"你想改哪些层的合成类型";acceptDisplayChanges:SurfaceFlinger 接受这些改动;setClientTarget:(当有客户端合成时)把客户端合成目标缓冲交给 HWC;presentDisplay:出屏。
第 2 步和第 3 步是本篇最值得写的一处,也是很多资料一笔带过的地方。 看这个顺序:HWC 先报"我想改",SurfaceFlinger 再决定接不接受。 这一来一回等于在接口上给 HWC 留了一次反悔权——它可以看完清单之后说"这几层我吃不下去,改成客户端吧"。
下面这张图把五步画成一条时序,重点标出第 2、3 步之间的那个往返:
3.2 反悔权为什么必须存在
为什么这个反悔权是必需而不是可选? 因为 SurfaceFlinger 不可能预知每个设备的限制。
举几个具体例子:某台设备的叠加单元不支持旋转(官方原文写得很清楚:"Many hardware overlays don't support rotation (and even if they do, it costs processing power)"),那么一个被旋转过的层就必须退给 GPU;某台设备的叠加单元只吃特定格式,那么一个用了新数据空间的层就得退;某台设备的叠加单元数量有限,多出来的层也得退。这些信息只存在于 HWC 那一侧,SF 手上只有层的属性清单。
所以接口只能是这个形状:SF 给出"我想要的",HWC 回答"我吃不下哪些",SF 再决定"那就算了"。
官方给这段分工的原话也很直:
"The Hardware Composer (HWC) HAL determines the most efficient way to composite buffers with the available hardware. As a HAL, its implementation is device-specific and usually done by the display hardware OEM."
"device-specific" 这个词就是反悔权的根据——判定逻辑是设备相关的,所以判定必须由设备侧做。
下面这张图把"为什么必须由 HWC 判"画成一张条件对照:
3.3 两种调用形状:分开调与合并调
AIDL 版比 HIDL 版多了一种调用形状。HIDL 时代是"验证"和"呈现"两次调用分开;AIDL 版里有一个 presentOrValidateDisplay,把两件事合成一次 IPC。
这个改动看着琐碎,其实对每帧的路径成本是有影响的:合成判定本来就在关键路径上,多一次跨进程往返就多一段延迟。把它合起来,等于每帧省下一次 binder 往返。
下面这段是本机读到的 HAL 身份,可以直接验证走的是 AIDL 版本:
adb shell service list | grep -i composer
31      android.hardware.graphics.composer3.IComposer/default: []

adb shell dumpsys SurfaceFlinger | grep -A4 "h/w composer state"
h/w composer state:
  h/w composer enabled
android.hardware.graphics.composer3.IComposer version:4 hash:aba56b3f763c2762a7929fe39b8c6b386b0ccb94TODOOverlayProperties:
supportMixedColorSpaces: 0
SupportedBufferCombinations(0 entries)
读法:服务名是 composer3(不是 composer@2.x),版本号是 4。这两条合起来说明本机走的是 AIDL 版 composer3 v4 这条路。
3.4 客户端合成不是"画完就算":栅栏约束
最后一件事必须说清:判给客户端之后,活不是"画完就完"。 官方给了这条约束:
"The HWC requires that the GPU finish writing buffers before buffers are displayed. Sync fences are passed through the graphics pipeline with buffers and signal when buffers are written."
落到缓冲上,客户端合成的那张客户端目标缓冲会挂一个同步栅栏(sync fence),HWC 必须等它 signal 之后才允许出屏。这条约束是"归属能变"的前提——如果客户端合成的结果可以没写完就出屏,那切换归属就等于切换撕裂。
在 AIDL 的 DisplayCommand.aidl 里,这条约束被写成了对客户端目标字段的一句注释:
"Layers marked as Composition.CLIENT must be composited into this buffer prior to the call to PRESENT_DISPLAY, and layers not marked as Composition.CLIENT must be composited with this buffer by the device."
这句话同时定义了两件事:CLIENT 层必须先被合成进客户端目标;非 CLIENT 层必须与这个目标一起由设备再合成一次。这就是 MIXED 模式的完整定义,比 §2.1 那句更精确。
下面这张图把这条约束画成时序:
四、合成类型有几种
OK,机制讲完,来收枚举。这是本篇最容易被讲错的一节——因为绝大多数资料只讲 DEVICE 和 CLIENT 两种,而实际上这两种只是八种里的两种。
4.1 HIDL 时代的六项
hardware/libhardware/include/hardware/hwcomposer2.h 里的 hwc2_composition_t 一共六项,每项都带官方注释:
| 成员 | 值 | 官方注释 |
|---|---|---|
HWC2_COMPOSITION_INVALID |
0 | — |
HWC2_COMPOSITION_CLIENT |
1 | "The client will composite this layer into the client target buffer (provided to the device through setClientTarget)." |
HWC2_COMPOSITION_DEVICE |
2 | "The device will handle the composition of this layer through a hardware overlay or other similar means." |
HWC2_COMPOSITION_SOLID_COLOR |
3 | 纯色,不占缓冲 |
HWC2_COMPOSITION_CURSOR |
4 | 光标层,可用 setCursorPosition 异步定位 |
HWC2_COMPOSITION_SIDEBAND |
5 | 边带流,需 SIDEBAND_STREAM 能力 |
4.2 composer3 又加了两项
AIDL 版的 Composition.aidl 前六项数值完全对齐,另加两项:
| 成员 | 值 | 含义 |
|---|---|---|
DISPLAY_DECORATION |
6 | 给挖孔/圆角抗锯齿用的显示装饰层,需 HWC 实现 getDisplayDecorationSupport |
REFRESH_RATE_INDICATOR |
7 | 声明"这次更新不算活动",不应重置省电切换计时器 |
来源:composer3 Composition.aidl、硬件合成器 HAL 的 AIDL(AOSP)
DISPLAY_DECORATION 这一项值得多写一句。 官方对它的说明是:某些设备有专门的硬件来优化"平滑屏幕圆角与挖孔的那张 alpha 遮罩"的绘制。有这块硬件的设备必须实现 getDisplayDecorationSupport 并返回一个 DisplayDecorationSupport 结构;实现之后,System UI 会把那张 alpha 遮罩层标成 DISPLAY_DECORATION,让这张遮罩走专门硬件而不是走普通图层。
下面这张图把八项画成一张对照表,标出各自的数值与"谁来画":
八项摆在面前,还得再归一次类,否则等于没读。 按"这一项到底是让谁去画"这个维度,它们其实是三族:
| 族 | 包含 | 共同点 |
|---|---|---|
| 要有人去画的那一族 | CLIENT |
由 SF 经 GPU 摞好再交出去 |
| 设备自己去画的那一族 | DEVICE、SOLID_COLOR、CURSOR、SIDEBAND、DISPLAY_DECORATION |
都不经 GPU;差别在"画什么"——普通层、纯色块、光标、边带流、装饰遮罩 |
| 根本不画东西的那一族 | REFRESH_RATE_INDICATOR、INVALID |
前者只传一个信号,后者是非法值 |
归类之后有两条推论:① "硬件合成"这个词其实覆盖了五项,它们各自走的是设备侧不同的部件,把它们一律叫"overlay"会丢掉很多信息;② 只有 CLIENT 这一项会把活推回 GPU,所以"这一帧要不要动 GPU"这个问题,等价于"有没有至少一层落在 CLIENT 这一族里"。
4.3 DEVICE 与 CLIENT:两条注释,两个数值
言归正传,回到最常用的那两项。它们各自的官方注释值得逐字读:
| 项 | 官方注释 | 谁在画 |
|---|---|---|
CLIENT(1) |
"The client will composite this layer into the client target buffer" | SurfaceFlinger 经 RenderEngine(GPU) |
DEVICE(2) |
"The device will handle the composition of this layer through a hardware overlay or other similar means" | 显示控制器(叠加单元) |
注意 DEVICE 的措辞里有 "or other similar means"——它没有把"硬件叠加"写死成一种实现方式。这一点在写正文时很容易被忽略:DEVICE 的含义是"由设备负责",具体是叠加单元、是专用混合器、还是别的部件,取决于厂商实现。 所以"DEVICE = 硬件叠加"是一个方便的简称,不是官方定义。
数值 1 与 2 这两条在设备上是可以直接交叉验证的(这是本篇实测里最让人踏实的一处):
# 本机输出层明细里直接打印了枚举名与数值
hwc: layer=0x0810 composition=DEVICE (2)

# 同一份 dump 的 HWC layers 段里,则是纯名字
  Layer name
            Z |  Window Type |  Comp Type |  Transform |   Disp Frame (LTRB) |          Source Crop (LTRB) | ...
 com.google.android.apps.nexuslaunche[...]uslauncher.NexusLauncherActivity#100
            4 |            1 |     DEVICE |          0 |    0    0 1080 2400 |    0.0    0.0 1080.0 2400.0 |
(2) 这个数字与头文件里的 HWC2_COMPOSITION_DEVICE = 2 对上了。 官方头文件里的枚举值,在设备上是可以直接读出来交叉验证的——这类"文档 ↔ 设备"能对上号的读数并不多见,值得记住。
下面这张图把"名字与数值"两个读面并置:
五、从 HWC2 到 composer3 变了什么
好了,上一节的枚举在两个时代有各自的版本。这一章把两个时代之间的那道坎说清——因为很多老资料还在按 HIDL 的写法讲,对着新设备会一路对不上号。
5.1 Android 13 起,HWC 的 HAL 定义改到了 AIDL
官方原文明明白白:
"Starting in Android 13, the Hardware Composer (HWC) HAL is defined in AIDL. The HIDL versions ranging from
android.hardware.graphics.composer@2.1toandroid.hardware.graphics.composer@2.4are deprecated."
新 HAL 的名字就叫 android.hardware.graphics.composer3。注意 "deprecated" 这个词——不是"并存",而是"这一代已经淘汰"。所以从 Android 13 起,讨论 HWC 的接口时应当以 composer3 为准。
5.2 四处具体变化
官方列出的差异里,四处对写代码与排查有直接影响:
| 变化 | 内容 | 影响 |
|---|---|---|
| FMQ 被去掉 | 改成强类型 parcelable 命令:CommandResultPayload[] executeCommands(in DisplayCommand[] commands); |
命令载荷有稳定接口、可读性更好;老资料里"往 FMQ 里塞序列化命令"的说法不再适用 |
新增 expectedPresentTime |
「lets SurfaceFlinger set the expected present time for when the current content must be displayed on screen」 | SF 提前把"这一帧什么时候要上屏"告诉 HAL,HAL 可以把合成活流水线化 |
新增 DISPLAY_DECORATION |
见 §4.2 | 圆角与挖孔的 alpha 遮罩可以走专门硬件 |
| 新增显示空闲计时器接口 | DISPLAY_IDLE_TIMER / setIdleTimerEnabled / onVsyncIdle 回调 |
空闲时由厂商侧降刷新率省电;回调用来通知平台"vsync 节奏变了" |
expectedPresentTime 这一项值得多说一句,因为它是"提前交卷换流水线"的典型:在 HIDL 时代,SF 只能"这一帧准备好了 → 交给 HAL → HAL 合成 → 出屏",HAL 只能在收到命令之后才开始干活。而有了 expectedPresentTime,SF 可以在内容还没完全就绪时先把呈现命令发出去,HAL 据此安排自己的时序。代价是 HAL 必须自己承担"按预测时间对齐"的责任。
下面这张图把两个时代的命令通道并置:
5.3 本篇的封条:模拟器里跑的是官方参考实现
这一段是整篇文章最重要的一条边界声明,它决定了本篇所有实测结论的适用半径。
官方在同一个页面里写了这一句:
"Android emulators include a reference implementation for the AIDL HWC HAL."
并给了源码路径:device/generic/goldfish-opengl/system/hwc3/。
这句话意味着什么? 意味着本篇在模拟器上读到的 composer,是官方为 AIDL HWC 写的参考实现,而不是任何一块真实显示硬件的 HWC 实现。所以:
- 读到的
composer3 version:4、HWC layers段、composition=DEVICE (2)、clientCompositionFrames这些读数本身是真实的(确实是这个 composer 在跑); - 但由这些读数推出的性质,只属于这个参考实现:它认哪些层、不认哪些层、退回客户端时是"部分退"还是"整屏退"——这些都不是 Android 的规定,更不是硬件的规矩;
- 因此本篇凡是出现"本机"二字的地方,一律是"本机这个参考实现",绝不写成"Android 会怎样"。
下面这张图把本篇的证据适用半径画出来:
5.4 怎么确认自己面对的是哪一代
这一节给一段可直接用的自检。换到任何一台设备上,先跑这三条,就能判断该按哪一代的写法去读它的 HWC。
# ① 看服务名:composer3(AIDL)还是 composer@2.x(HIDL)
adb shell service list | grep -i composer

# ② 看 SurfaceFlinger 认到的 HAL 版本
adb shell dumpsys SurfaceFlinger | grep -A2 "h/w composer state"

# ③ 看这个 HAL 是不是参考实现(真机不会出现 ranchu / goldfish 这类标识)
adb shell getprop | grep -E "ro.hardware|ro.product.board"
判据(按顺序看):
| 读数 | 说明 | 该怎么读 |
|---|---|---|
服务名含 composer3.IComposer |
AIDL 那一代 | 按 Composition.aidl 的八项枚举读,命令走 executeCommands |
服务名含 composer@2. |
HIDL 那一代(已废弃) | 按 hwcomposer2.h 的六项枚举读,命令走 FMQ |
ro.hardware = ranchu 或 ro.product.board = goldfish_* |
模拟器参考实现 | 本篇所有"本机"结论都在这一档,不得外推 |
h/w composer enabled |
HAL 已启用 | 若这里是 disabled,前面所有归属读数都不成立 |
为什么要把这段单独列出来:因为 §5.1 那句 "deprecated" 是有落地后果的——两代枚举的成员不同、命令通道不同、可读的字段也不同。一份按 HIDL 写的排查文档拿去看 Android 16 的设备,最容易踩的坑就是把 composer@2.4 的字段名当成现行字段名去 grep,然后得到一个空结果,误以为"这个设备没上报"。
这一段同时也是本篇自己的自检:本机三条读数的结果分别是"composer3.IComposer/default"、"version:4"、"ro.hardware = ranchu + ro.product.board = goldfish_x86_64"。按上表判,本机 = AIDL 代 + 参考实现。
六、归属的不确定性谁来兜
OK,前面五章讲的是"归属怎么定"。这一章换个位置问:如果归属是每帧现场决定的,那它的不确定性由谁来承担?
6.1 题眼:一个缓冲必须同时满足两条路
说白了,答案在 SurfaceControl.Transaction.setBuffer 的注释里,这是本篇最硬的一句官方条文:
"Note that the buffer must be allocated with
HardwareBuffer#USAGE_COMPOSER_OVERLAYas well asHardwareBuffer#USAGE_GPU_SAMPLED_IMAGEas the surface control might be composited using either an overlay or using the GPU."
这句话的因果关系要读得很仔细。 它不是"建议给缓冲多加两个标志",而是:
- 因为
might be composited using either an overlay or using the GPU(这一层可能走硬件叠加、也可能走 GPU), - 所以
must be allocated with ... as well as ...(缓冲分配时必须两条用途标志一起打上)。
换句话说:分配缓冲的人根本不知道这一帧会被谁画,所以只能两条路都准备好。
这句话的重量在于——它把"归属的不确定性"从合成阶段一路顶到了内存分配阶段。应用在 dequeueBuffer 那一刻做下的决定(这块缓冲怎么分配、用什么 usage),要一直兼容到合成那一刻才知道的归属结果。这中间隔着几十毫秒和好几层调用。
下面这张图把这条因果链画出来:
6.2 一条更隐蔽的开关:不透明
先看看另外一条:不那么显眼、但同样影响归属的——
setOpaque— "Indicates whether the surface must be considered opaque, even if its pixel format is set to translucent."
为什么它会影响到 HWC 能不能接? 因为一个"声明自己不透明"的层,在合成时可以直接覆盖下面的内容——底下的层被完全遮住,就不需要真的参与混合;反过来,一个半透明的层会让下面的层必须参与运算。对叠加单元来说,"能不能跳过混合"直接决定了这一层能不能被简单贴上去。
这就解释了 §2.2 那个公式里的 (1 − αs):它既是混合的数学来源,也是硬件叠加能不能省的判据。
6.3 不确定性的完整传导链
好了,把 §6.1 与 §6.2 接起来,就得到了一条自上而下的传导链。这一节是全篇概念上的收束:
| 环节 | 谁做决定 | 决定什么 | 不确定性怎么传下去 |
|---|---|---|---|
| 层属性 | 应用(经事务) | 位置、层序、alpha、是否不透明、混合模式 | 属性里带有"可能不被硬件接受"的部分 |
| 缓冲分配 | 应用(dequeueBuffer) |
usage 标志、格式、数据空间 | 必须双用途,为两种归属都留后路 |
| 归属判定 | HWC(validateDisplay 那一步) |
每层 DEVICE / CLIENT | 这一刻才知道结果 |
| 客户端合成 | SurfaceFlinger / RenderEngine | 把 CLIENT 层摞成客户端目标 | 增加 GPU 工作量(本篇 §9 量化) |
| 出屏 | HWC | 等 fence、合成全屏、出屏 | 归属的代价最终落在这一帧的时长上 |
这张图把上面那条链画成一条自上而下的传导,每一环都标出"此刻归属是否已知":层属性和缓冲分配这两环发生在应用侧,那时归属完全未知;归属判定这一环才第一次知道结果;客户端合成与出屏这两环则已经是"知道结果之后"的动作。
三个"未知"环就是成本所在:应用为了让同一块缓冲在两种归属下都能用,必须把用途标志打得比实际需要更宽;而这份"宽"不是免费的——它意味着缓冲区更可能落在能被 GPU 采样的内存类型上,而不是最适合叠加直读的类型。这条链解释了为什么"归属可以随便切"这个说法是错的:切换本身很便宜,为切换做的准备不便宜。
七、在设备上怎么读出来
好了,前三章讲的是机制,后面三章全部是实测。这一章先解决"读什么":把归属这件事在设备上能读到的四个面逐个交代清。
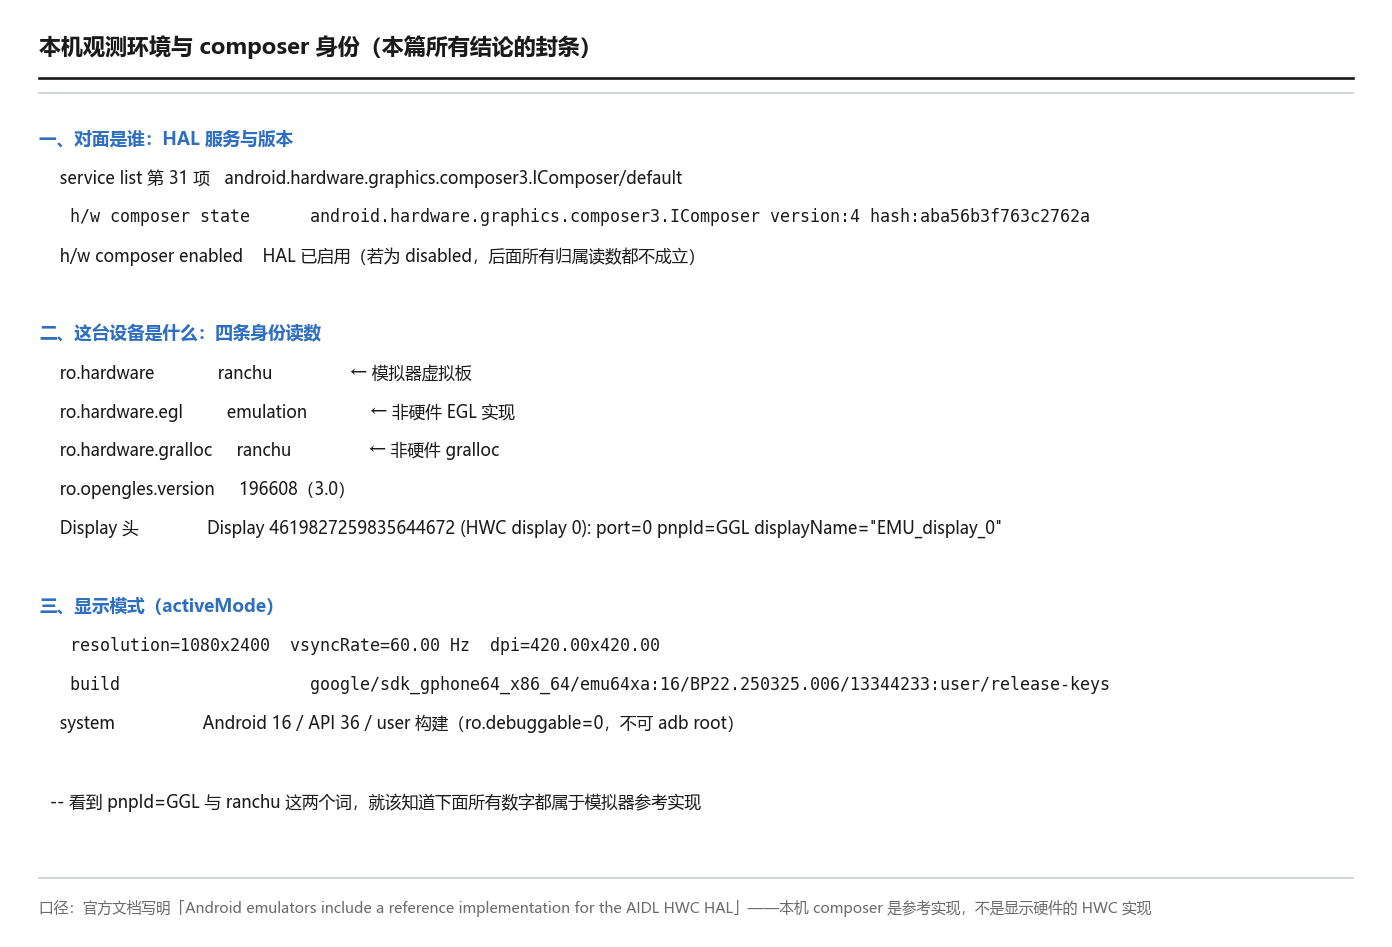
7.1 第一个面:composer 的身份
OK,读归属之前,先确认对面是谁。三条命令、三个读数:
adb shell service list | grep -i composer
31      android.hardware.graphics.composer3.IComposer/default: []

adb shell getprop | grep -E "ro.hardware|ro.opengles"
[ro.hardware.egl]: [emulation]
[ro.hardware.gralloc]: [ranchu]
[ro.opengles.version]: [196608]

adb shell dumpsys SurfaceFlinger | grep -E "HWC display|h/w composer"
Display 4619827259835644672 (HWC display 0): port=0 pnpId=GGL displayName="EMU_display_0"
h/w composer state:
  h/w composer enabled
android.hardware.graphics.composer3.IComposer version:4 hash:aba56b3f763c2762a7929fe39b8c6b386b0ccb94TODOOverlayProperties:
读法:服务名 composer3 说明走 AIDL;version:4 是 HAL 版本;ro.hardware.egl = emulation、ro.hardware.gralloc = ranchu、pnpId=GGL(Google 的虚拟标识)、displayName="EMU_display_0" 四条合起来,把这个 display 的身份钉死在"模拟器的虚拟显示"上。
这一段读数在本篇里承担一个特殊职责:它是后面所有结论的封条。看到 ranchu 与 EMU_display_0 这两个词,读者就该知道下面所有数字都属于模拟器。
先把"读归属"这件事的定义划清:本篇说的"读归属",读的是 SurfaceFlinger 记录下来的判定结果,不是 HWC 内部的判定过程。这个区别很重要——结果与过程是两份东西:结果一定能读到(SF 要拿它去合成),过程不一定读得到(那在 HAL 内部,取决于这个 HAL 愿不愿意说话)。§7.5 会把"读不到的过程"单独登记一遍。
下面这张图就是本机这一段原始输出的面板化呈现:
7.2 第二个面:HWC layers 段,一次列全每层的归属
先看看主力读面。dumpsys SurfaceFlinger 里有一段专门叫 HWC layers,它是本篇的主力读面:
adb shell dumpsys SurfaceFlinger | awk '/HWC layers:/{f=1} f&&!NF{exit} f'
Display 4619827259835644672 (active) HWC layers:
---------------------------------------------------------------------------------------------------
 Layer name
           Z |  Window Type |  Comp Type |  Transform |   Disp Frame (LTRB) |          Source Crop (LTRB) |     Frame Rate (Explicit) (Seamlessness) [Focused]
---------------------------------------------------------------------------------------------------
 Wallpaper BBQ wrapper#69
           1 |            0 |     DEVICE |          0 |    0    0 1080 2400 |   21.0   47.0  440.0  977.0 |
---------------------------------------------------------------------------------------------------
 com.google.android.apps.nexuslaunche[...]uslauncher.NexusLauncherActivity#279
           4 |            1 |     DEVICE |          0 |    0    0 1080 2400 |    0.0    0.0 1080.0 2400.0 |
---------------------------------------------------------------------------------------------------
 StatusBar#104
           9 |         2000 |     DEVICE |          0 |    0    0 1080  136 |    0.0    0.0 1080.0  136.0 |
---------------------------------------------------------------------------------------------------
 Taskbar#137
          10 |         2019 |     DEVICE |          0 |    0 2337 1080 2400 |    0.0    0.0 1080.0   63.0 |
---------------------------------------------------------------------------------------------------
 ScreenDecorOverlay#74
          14 |         2024 |     DEVICE |          0 |    0    0 1080  136 |    0.0    0.0 1080.0  136.0 |
---------------------------------------------------------------------------------------------------
 ScreenDecorOverlayBottom#77
          15 |         2024 |     DEVICE |          0 |    0 2326 1080 2400 |    0.0    0.0 1080.0   74.0 |
---------------------------------------------------------------------------------------------------
这一段的列语义(逐列交代,因为中文侧很少有人写全):
| 列 | 含义 | 本篇怎么用 |
|---|---|---|
Layer name |
层名,尾部的 #N 是层 ID |
认层用(注意:与层段的 [N] 不是同一套编号) |
Z |
相对同级层的层序 | 判断上下关系 |
Window Type |
窗口类型码(如 2000 = 状态栏、2019 = 任务栏、2024 = 屏幕装饰) | 认系统层 |
Comp Type |
合成类型:DEVICE / CLIENT | 本篇的主读数 |
Transform |
变换(本例全 0) | 判断是否旋转 |
Disp Frame (LTRB) |
在屏幕空间的落位 | 与下一列一起算缩放比 |
Source Crop (LTRB) |
从源缓冲取哪块 | 同上 |
Frame Rate (Explicit) |
显式帧率投票与类别 | 本篇只用来判断是否在动 |
下面这张图把这一段的本机原始输出做成可读面板:
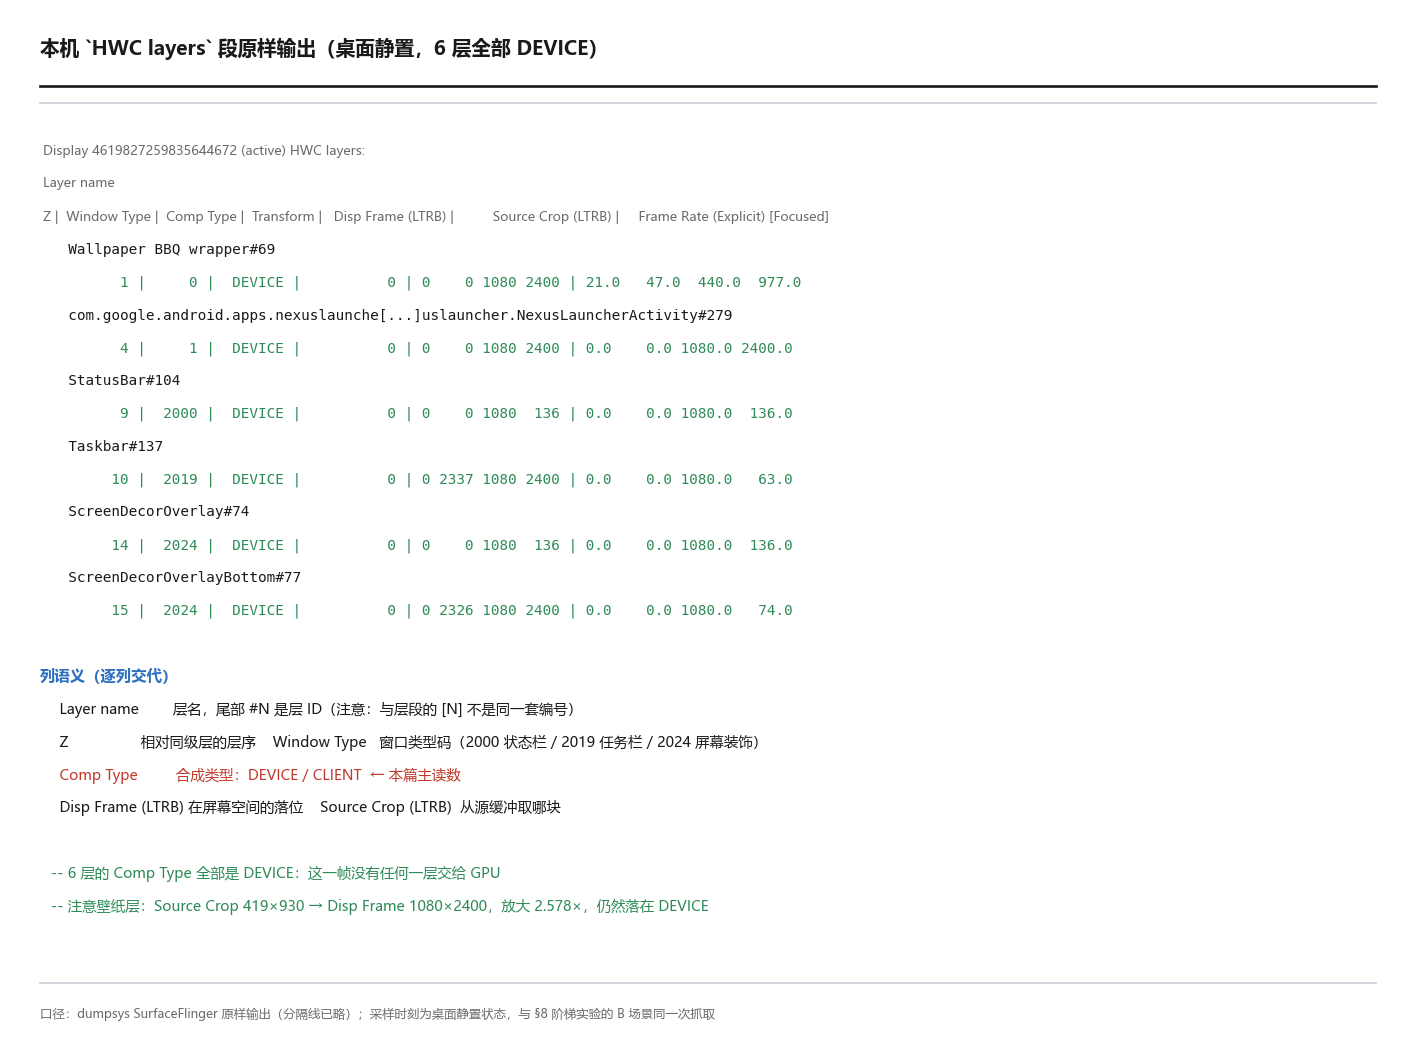
读到这一段的第一个印象往往是"怎么全是 DEVICE"——对,本机在桌面静置这个场景下,六层全部由显示控制器接走,一帧 GPU 合成都没有。这不是异常,是这台设备的常态(§8 会用一整个阶梯实验把这个常态的边界找出来)。
这一段还顺带给出一个后面要用的读数:壁纸层的 Source Crop 是 21,47 → 440,977(419×930),而 Disp Frame 是 0,0 → 1080,2400——它是被放大了 2.578 倍贴上屏幕的,却仍然落在 DEVICE。这一条在 §8.4 会算清楚,它是"缩放本身不是拒绝理由"的直接证据。
7.3 第三个面:composition= 带数值,可与官方枚举对上
好了,HWC layers 段给的是名字,而输出层明细里给的是名字加数值:
adb shell dumpsys SurfaceFlinger | grep "hwc: layer="
hwc: layer=0x0810 composition=DEVICE (2)
hwc: layer=0x08f composition=DEVICE (2)
hwc: layer=0x0811 composition=DEVICE (2)
hwc: layer=0x083 composition=DEVICE (2)
hwc: layer=0x085 composition=DEVICE (2)
每个数字都能在头文件里找到对应:DEVICE (2) ↔ HWC2_COMPOSITION_DEVICE = 2。这是本篇唯一一处能把"官方头文件"与"设备实际输出"直接并排对上的读数,也是 §4.3 那张对照图的数据来源。
同一屏的显示级状态则给出"这一帧整体是什么模式":
adb shell dumpsys SurfaceFlinger | grep -A4 "Composition Display State"
   Composition Display State:
   isEnabled=true isSecure=true usesDeviceComposition=true
   usesClientComposition=false flipClientTarget=false reusedClientComposition=false
   layerFilter={layerStack=0 toInternalDisplay=true }
   transform (ROT_0) (IDENTITY)
usesDeviceComposition=true 与 usesClientComposition=false 这一对,就是 §2.3 那张对照表里的第三行:这一帧显示控制器全包。
这一段要读的是两个不同粒度的东西:层级告诉你"哪一个层被怎么处理",屏级告诉你"这一帧整体落了哪种模式"。两者是同一份判定在不同尺度上的投影,层级是明细、屏级是汇总——明细里只要有一层被判成 CLIENT,屏级就一定不会出现"只用设备合成"的那种组合。
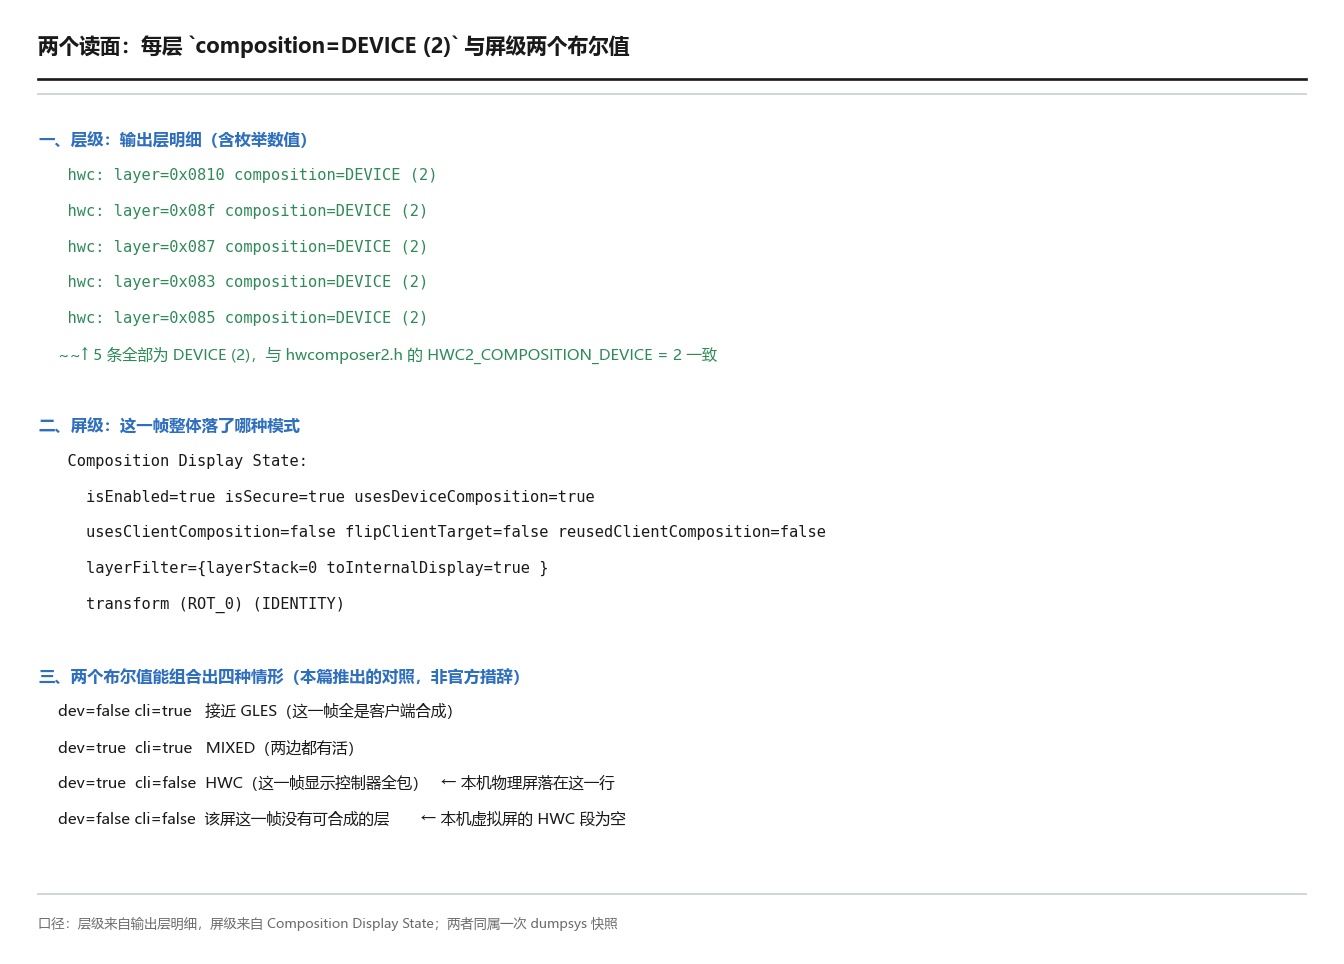
读的时候有个顺序建议:先看屏级那一对布尔值,判断"这一帧有没有用到 GPU";再看层级分布,数出"具体是哪几层"。反过来先看层级容易迷路——HWC layers 段一次可能列七八行,而屏级只有两个词,先看后者能立刻确定这一帧的性质,再看前者的明细才不会读成流水账。
7.4 第四个面:--timestats,把归属换算成时间
OK,前三个面读的是"归属是什么",第四个面读的是"归属有多贵":
adb shell dumpsys SurfaceFlinger --timestats -enable
adb shell dumpsys SurfaceFlinger --timestats -clear
adb shell dumpsys SurfaceFlinger --timestats -dump | head -17
SurfaceFlinger TimeStats:
Legacy stats are as follows:
statsStart = 1790673150
statsEnd = 1790673166
totalFrames = 33
missedFrames = 2
clientCompositionFrames = 0
clientCompositionReusedFrames = 0
refreshRateSwitches = 0
compositionStrategyChanges = 0
compositionStrategyPredicted = 0
compositionStrategyPredictionSucceeded = 0
compositionStrategyPredictionFailed = 0
displayOnTime = 16082 ms
displayConfigStats is as below:
60fps = 5172269ms
totalP2PTime = 1037 ms
averageFrameDuration = 4.909 ms
averageRenderEngineTiming = 0.000 ms
这一段里有两个字段是本章的关键:
clientCompositionFrames:窗口内有多少帧走了客户端合成。本机这个窗口是 0。averageRenderEngineTiming:窗口内RenderEngine(也就是那个"被 HWC 取代的 GPU 合成器")的平均耗时。本机这个窗口是 0.000 ms。
两个 0 放在一起,含义比单个 0 强得多:clientCompositionFrames = 0 只说明"没有客户端合成帧";averageRenderEngineTiming = 0.000 ms 进一步说明"RenderEngine 在这个窗口里一次都没跑过"。§9 会拿它跟另一个窗口做对照。
顺便记一个口径坑:--timestats 必须先 -enable 才有输出(-clear 只清计数)。本机第一次跑的时候 -clear 之后 -dump 是空的,加一步 -enable 才拿到数据。
7.5 读不到 / 做不到的清单(这一节比读数本身还重要)
这一篇的结论里,有一半是"读不到什么"。 单独列一张表:
| 想读什么 | 结果 | 原因 |
|---|---|---|
| HWC 自己的内部状态 | ❌ | adb shell dumpsys android.hardware.graphics.composer3.IComposer/default → FAILED_TRANSACTION。所以"HWC 认为有几块叠加层""为什么拒绝这一层"读不出来 |
| 叠加层属性与能力 | ❌ | 本机输出里是字面的 TODOOverlayProperties:,另有 SupportedBufferCombinations(0 entries)、supportMixedColorSpaces: 0——参考实现不上报 |
| "强制 GPU 合成"开关 | ❌ | 写入 settings put global disable_hw_overlays 1 后,12 秒窗口 totalFrames=1、clientCompositionFrames=0——该开关不改变归属(已复位为 null) |
lshal 里看 composer |
❌ | AIDL 服务不出现在 lshal 列表(那里只有 HIDL 项),只能从 service list 看到第 31 项 |
| 真实叠加层数量 / 拒绝理由 | ➖ | 需真机:getChangedCompositionTypes 的返回、getCapabilities 的平面数 |
| Cursor / Sideband / SolidColor / DISPLAY_DECORATION 的实际激活 | ➖ | 需真机 |
| 功耗与带宽 | ➖ | 需真机(--timestats 只给时长与计数,不给焦耳) |
下面这张图把这张表做成面板:
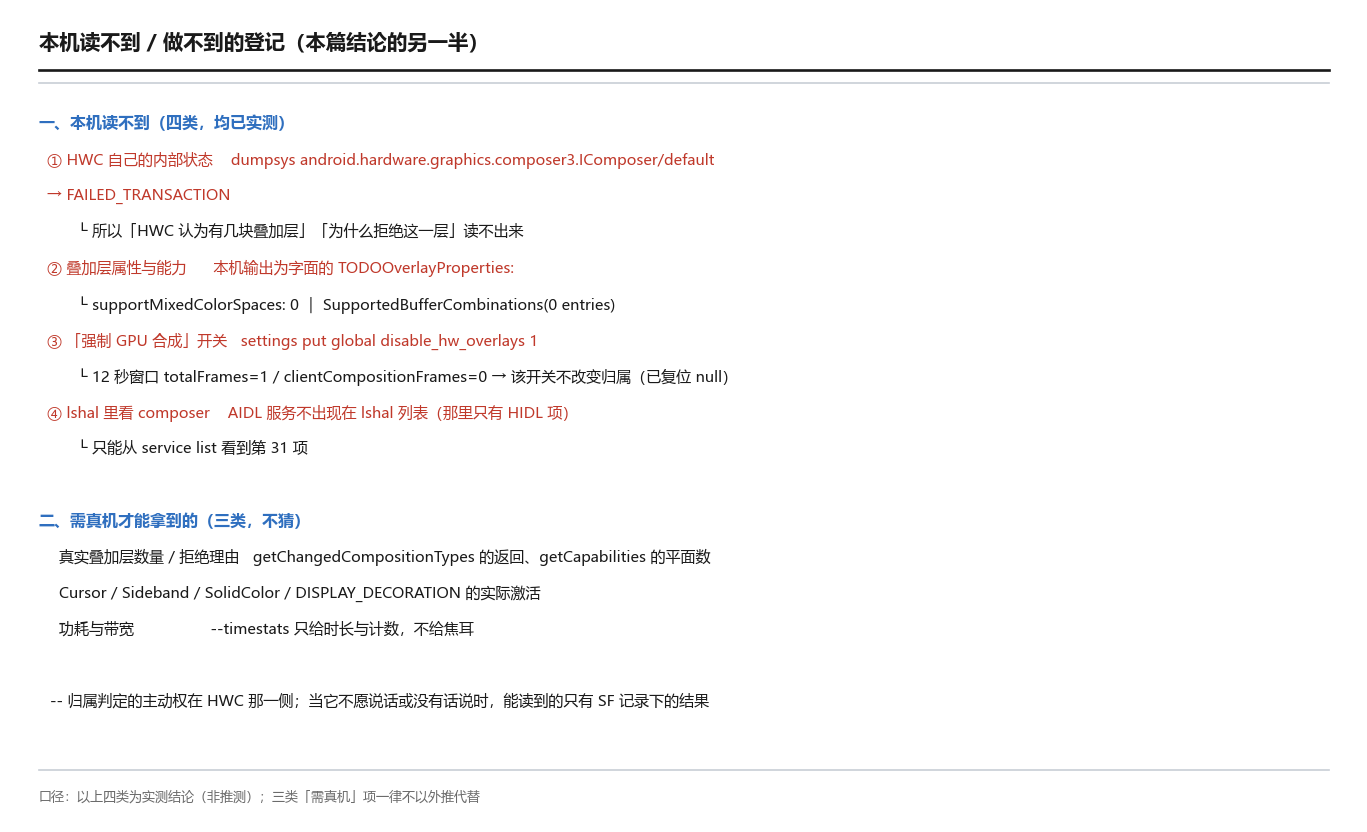
为什么要为"读不到"单开一节:因为这一篇写的是"归属判定",而归属判定的主动权在 HWC 那一侧。当 HWC 不愿说话(FAILED_TRANSACTION)或没有话说(TODOOverlayProperties:)时,能读到的就只有 SF 记录下来的结果。把这条边界说清,比多给三个漂亮的读数更有价值——它决定了本篇哪些结论可以被引用、哪些只能被当作一台模拟器的现场记录。
下面这段命令可以用来验证"停用叠加开关不生效"这条结论:
# 打开开关 → 清计数 → 静置 12 秒 → 取数
adb shell settings put global disable_hw_overlays 1
adb shell dumpsys SurfaceFlinger --timestats -clear
sleep 12
adb shell dumpsys SurfaceFlinger --timestats -dump | grep -E "^totalFrames|^clientCompositionFrames"
#   totalFrames = 1
#   clientCompositionFrames = 0        ← 开关打开后仍然是 0,说明它没起作用

# 用完复位,别留在系统里
adb shell settings delete global disable_hw_overlays
八、一次归属阶梯实测
好了,读数面交代完,正式做实验。这一章的目的是回答一个问题:归属到底在什么情况下会从 DEVICE 掉到 CLIENT?
8.1 实验设计:逐级加层,只看 Comp Type
思路很简单:从最少层的场景开始,一级一级往上加层,每一级抓一次 HWC layers 段的 Comp Type 分布。 如果"层数多就会被退回客户端"这个说法成立,就应该在某一级看到分布翻转。
# 每个场景:先归零,再造场景,再抓一次
adb shell input keyevent KEYCODE_HOME                 # 归零
# ...造场景(见下表每一行的"操作"列)...
adb shell dumpsys SurfaceFlinger > sf_<state>.txt     # 抓取
# 解析:只看 HWC layers 段的 Comp Type 列
grep -E "^\s+[0-9]+\s+\|\s+[0-9]+\s+\|\s+(DEVICE|CLIENT)\s+\|" sf_<state>.txt
判据:每次只数 Comp Type 列里的 DEVICE 与 CLIENT 各几个,不看别的。
8.2 结果:八个场景的归属分布
| 场景 | 操作 | 层数 | Comp Type 分布 |
|---|---|---|---|
| 设置前台 | am start -n com.android.settings/.Settings |
5 | DEVICE × 5 |
| 桌面静置 | KEYCODE_HOME |
6 | DEVICE × 6 |
| 桌面 + 音量面板 | 桌面 + KEYCODE_VOLUME_UP ×2 |
7 | DEVICE × 7 |
| 桌面 + 截屏预览 | 桌面 + KEYCODE_SYSRQ |
7 | DEVICE × 7 |
| 设置 + 下拉通知栏 | 设置 + cmd statusbar expand-notifications |
4 | DEVICE × 4 |
| 设置 + 最近任务 | 设置 + KEYCODE_APP_SWITCH |
7 | CLIENT × 7 |
| 同上,静置 4 秒 | 不再操作,等 4 秒再抓 | 7 | CLIENT × 7 |
| 回桌面收栏 | KEYCODE_HOME + cmd statusbar collapse |
6 | DEVICE × 6 |
先把这张表的读法交代清楚:每一行只回答两个问题——这个场景下屏幕上有几个可见层,以及每一层在 Comp Type 列里落的是 DEVICE 还是 CLIENT。层数那一列是"自变量",分布那一列是"结果",中间的"操作"列写清了这个场景怎么造出来,方便任何人照着复现。
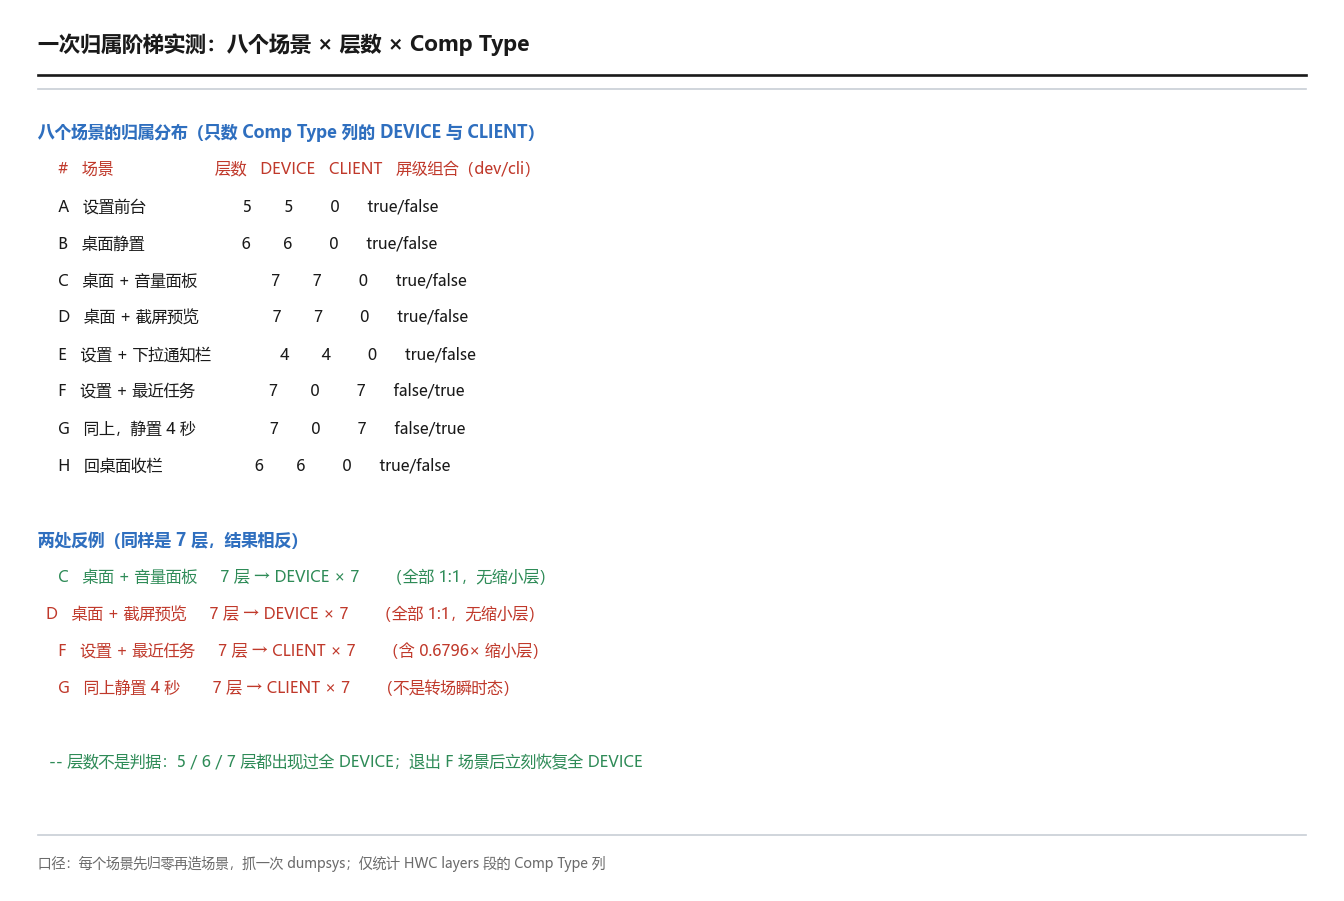
从这张表里能先读出两条:一是这批场景的层数从 4 层到 7 层,覆盖了"只有系统栏"到"应用 + 系统栏 + 装饰层"的常见组合;二是八个场景里没有出现 DEVICE 与 CLIENT 混杂的 MIXED 行——这一点本身就值得留意,说明这台参考实现在归属上倾向于"整屏站队",而不是按层挑。
8.3 两个反例:层数不是判据
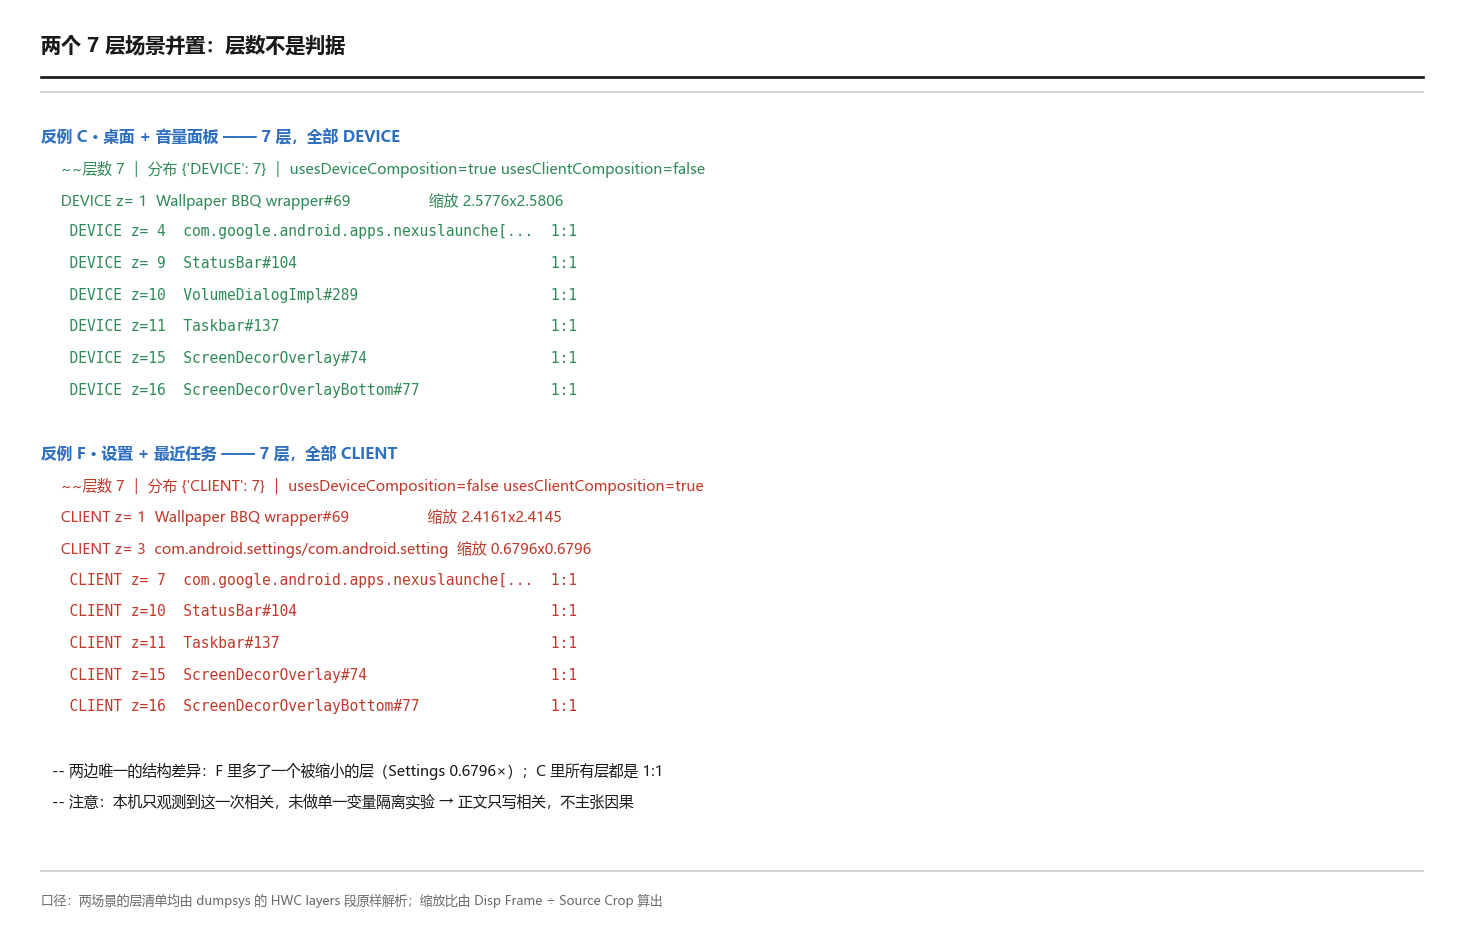
好了,这张表里最要紧的是两行。 把它们并排看:
场景 C:桌面 + 音量面板        7 层  →  DEVICE × 7
场景 F:设置 + 最近任务        7 层  →  CLIENT × 7
同样是 7 层,一个全给硬件、一个全给 GPU。 所以"层数超过某个数就会被退回软件合成"这个说法,在本机被证伪了——它既不是 5、也不是 6、也不是 7。
那就换个方向找:这两行还有什么不一样?把两边的层清单摆在一起看:
| 场景 C(7 层全 DEVICE) | 场景 F(7 层全 CLIENT) | |
|---|---|---|
| 壁纸 | 上采样 2.5776× | 上采样 2.4161× |
| 桌面层 | 1:1 | 1:1 |
| 设置页 | 无 | 缩小 0.6796× |
| 音量面板 | 1:1 | 无 |
| 状态栏 / 任务栏 / 屏幕装饰 ×2 | 1:1 | 1:1 |
两边都有被放大的壁纸层(2.5776× 与 2.4161×),所以"放大"显然不是判据。真正的差别只有一处:场景 F 里多了一个"被缩小的层"——最近任务转场里,设置页被缩到 0.6796 倍。
但这里我必须收住话头:我只观测到"含缩小层的那一次退回了客户端",没有把变量隔离到只剩"缩小"这一项——没有做"同样 7 层、只有这一个层的缩放不同"的对照实验。所以正文只写相关,不写因果。要拿到因果,得去读 HWC 拒绝这一层时给出的理由(getChangedCompositionTypes 的返回),而那个本机读不到(§7.5)。
下面这张图把两个反例并置:
8.4 几何读数:把一个层的缩放比算出来
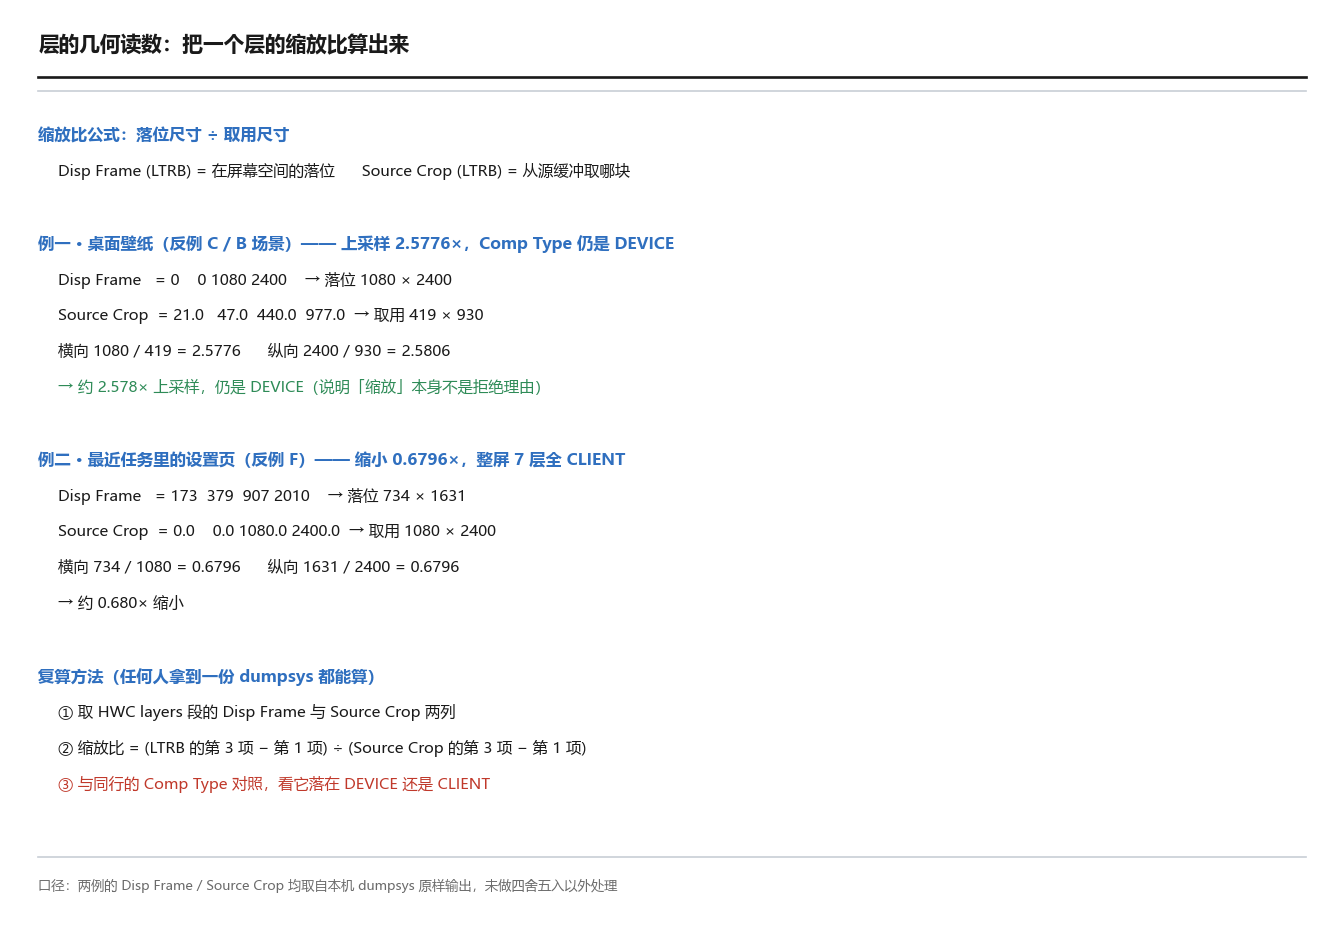
先看看那两个"缩放比"是怎么来的:它们不是明文写在 dump 里的,要从 Disp Frame (LTRB) 与 Source Crop (LTRB) 两列算出来:
缩放比 = 落位尺寸 ÷ 取用尺寸

例一 · 桌面静置里的壁纸层(六层全 DEVICE 的那个场景):
  Disp Frame   = 0 0 1080 2400        → 落位 1080 × 2400
  Source Crop  = 21.0 47.0 440.0 977.0 → 取用 419 × 930
  横向缩放 = 1080 / 419 = 2.5776
  纵向缩放 = 2400 / 930 = 2.5806
  → 约 2.578× 上采样,而它的 Comp Type 是 DEVICE

例二 · 最近任务里的设置页(七层全 CLIENT 的那个场景):
  Disp Frame   = 173 379 907 2010     → 落位 734 × 1631
  Source Crop  = 0.0 0.0 1080.0 2400.0 → 取用 1080 × 2400
  横向缩放 = 734 / 1080 = 0.6796
  纵向缩放 = 1631 / 2400 = 0.6796
  → 约 0.680× 缩小
这两行读数放在一起,就已经把"缩放 = 拒绝理由"这个想法挡掉了一半:例一是放大 2.578 倍,仍然 DEVICE;例二是缩小 0.680 倍,所在的那一帧整屏 CLIENT。同一种几何操作(缩放),方向相反,归属也相反——所以真正被拒的既不是"有缩放",也不是"缩了多少",而是别的什么。
而它的方法论价值在于:把一个"看着像玄学"的判定变成了可算的数。 任何人拿到一份 dumpsys,都能用同一个公式算出每一层的缩放比,然后自己去看它落在 DEVICE 还是 CLIENT——不需要猜 HWC 的心思,只需要比一行数字。
下面这张图把几何读数做成面板(含两处计算过程):
8.5 一条官方经验值被撞了一下
OK,官方给过一条经验值,这一段必须引原文:
"Android devices typically support four overlay planes. Attempting to composite more layers than overlays causes the system to use GLES composition for some of them, meaning the number of layers used by an app can have a measurable impact on power consumption and performance."
这句话里有两处限定,本机实测恰好各撞了一下。
第一处:typically 不是接口保证。 官方说的是"通常支持 4 个叠加层",而不是"必须正好 4 个"。本机在 5 层、6 层、7 层时都还是全 DEVICE——说明这台参考实现的判定跟"4"这个数字没有关系。"层数超过 4 就退"这条说法,在真机上有参考价值,在模拟器上直接不成立。
第二处:官方说的是 "some of them"(部分退回),本机观测到的是"整屏一起退回"。 官方那句描述的是 MIXED 式的回退——多出来的那几层退给 GPU,剩下的继续走硬件。而本机在那一行里,7 层全部变成了 CLIENT,连最上面那些完全 1:1、不透明的屏幕装饰层也一起进了客户端合成。
这两处偏离必须挂在"参考实现"名下,不能写成"Android 会这样"——这正是 §5.3 那条封条的用处。要判断真机上到底是"部分退"还是"整屏退"、平面数到底是不是 4,需要真机。
这一章的最后一句结论(同时也是本篇的第二个正面结论):
能不能用硬件叠加,取决于"这一层的几何与格式能不能被硬件直收",不取决于"一共有几层"。
九、客户端合成的代价
好了,上一章找到了"什么时候会退回客户端"。这一章回答"退回去要付多少钱"。
9.1 实验设计:同口径的两个窗口
做法:先把统计计数清零,然后在固定长度的窗口里造两种负载,最后取数对照。
# 窗口 A:只有物理屏
adb shell dumpsys SurfaceFlinger --timestats -enable
adb shell dumpsys SurfaceFlinger --timestats -clear
sleep 16
adb shell dumpsys SurfaceFlinger --timestats -dump > timestats_idle.txt

# 窗口 B:物理屏 + 录屏虚拟屏(并持续滑动制造帧)
adb shell dumpsys SurfaceFlinger --timestats -clear
adb shell screenrecord --time-limit 20 /sdcard/demo.mp4 &
sleep 4
for i in 1 2 3 4 5 6 7 8 9 10; do adb shell input swipe 540 1900 540 500 100; sleep 0.25; done
adb shell dumpsys SurfaceFlinger --timestats -dump > timestats_rec.txt
两个窗口的口径一致(都是十几秒、都是同一台设备、同一块屏、同一条命令),唯一的差别是有没有那块虚拟屏。
9.2 结果:两个窗口的对照
| 指标 | 窗口 A(只有物理屏,16 s) | 窗口 B(物理屏 + 录屏虚拟屏,14 s) | 变化 |
|---|---|---|---|
totalFrames |
33 | 206 | 6.2× |
clientCompositionFrames |
0 | 204 | 0 → 99.0% |
averageRenderEngineTiming |
0.000 ms | 9.093 ms | 从"没跑过"到"每帧 9 ms" |
averageFrameDuration |
4.909 ms | 15.320 ms | 3.1× |
totalP2PTime |
1,037 ms | 8,327 ms | 8.0× |
missedFrames |
2 / 33 | 109 / 206 | 丢帧率 6% → 53% |
refreshRateSwitches |
0 | 0 | 无变化(两款都锁 60 Hz) |
compositionStrategyChanges |
0 | 1 | 策略变了一次 |
下面这张图把两个窗口的七项读数并排:
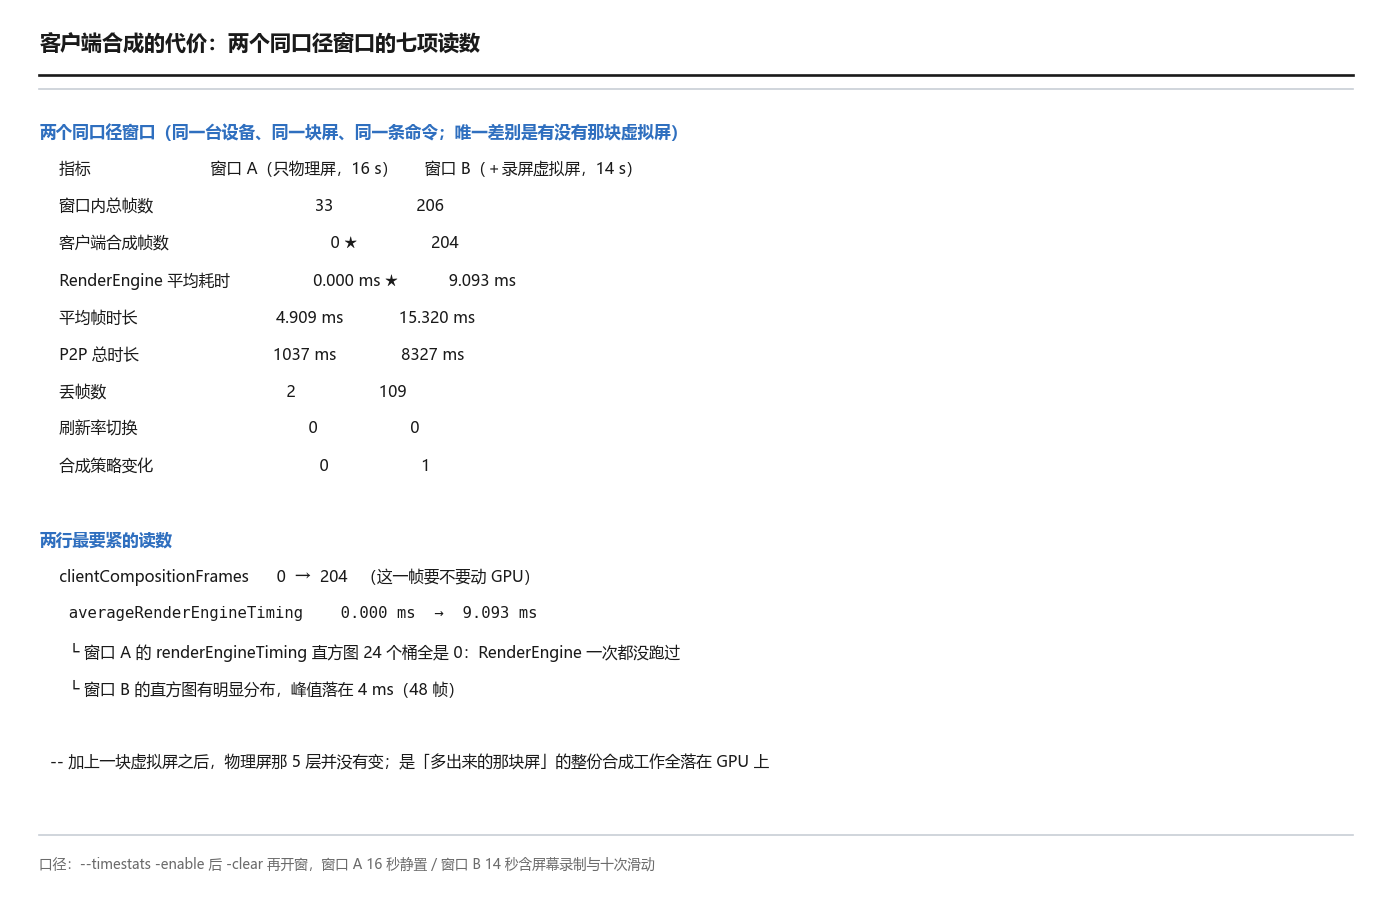
这张表最值钱的一行不是 clientCompositionFrames,是 averageRenderEngineTiming。
因为 clientCompositionFrames = 0 只说明"这个窗口里没有客户端合成帧";而 averageRenderEngineTiming = 0.000 ms 说明"RenderEngine 这个渲染器在这个窗口里一次都没被叫起来"。两行合起来才是完整的对照:在窗口 A 里,GPU 从头到尾没碰过合成这件事;在窗口 B 里,它每帧要花 9 ms。
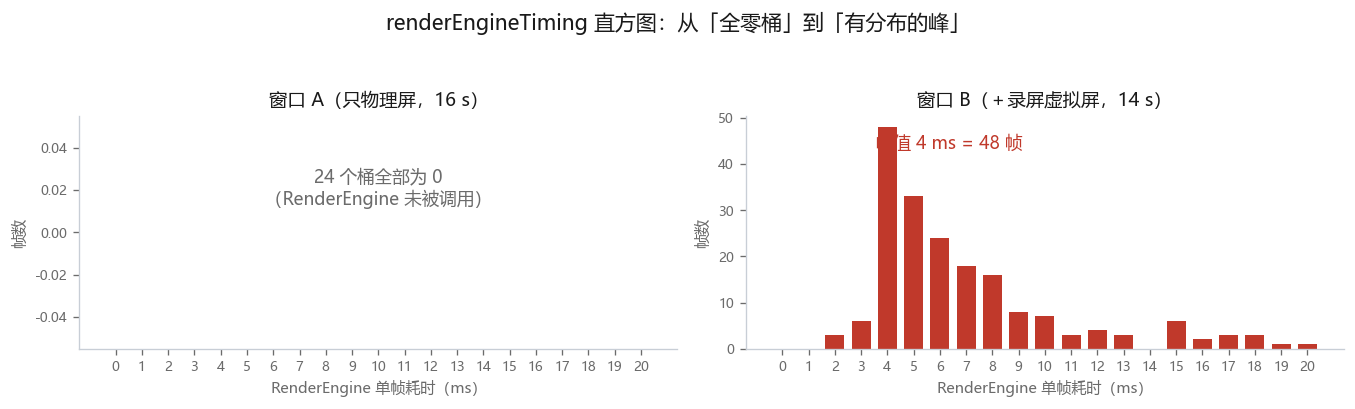
9.3 直方图:从"全零桶"到"峰值 4 ms"
好了,平均值还不能说明分布形状。下面这两个直方图是同一批次数据的另一个读面:
# 窗口 A:renderEngineTiming 直方图(24 个桶,全部为 0)
0ms=0 1ms=0 2ms=0 3ms=0 4ms=0 5ms=0 6ms=0 7ms=0 8ms=0 9ms=0 10ms=0 11ms=0
12ms=0 ... 1000ms=0

# 窗口 B:renderEngineTiming 直方图(分布明显,峰值在 4 ms)
2ms=3  3ms=6  4ms=48  5ms=33  6ms=24  7ms=18  8ms=16  9ms=8
10ms=7 11ms=3 12ms=4 ...
# 取直方图(只打印非零桶)
adb shell dumpsys SurfaceFlinger --timestats -dump \
  | grep -A1 "renderEngineTiming histogram" | tail -1 \
  | tr ' ' '\n' | grep -v '=0'
窗口 A 那一行是 24 个 =0——一个桶都不是非零,也就是说 RenderEngine 在这个窗口里完全没有工作记录。窗口 B 那一行则有一个明显的峰:4 ms 上落了 48 帧。
为什么分布形状比平均值更有说服力:平均值 9.093 ms 可以被"少数几帧特别慢"拉高,而直方图显示的是一条有峰有尾的分布——说明每帧都在稳定地花这笔钱,不是偶发。
下面这张图把两个直方图并置:
9.4 同一时刻的两块屏:一个最干净的对照
OK,前面两个实验都是"前后对照",还有一个更干净的同时对照:在同一份 dumpsys 里读两块屏。
Display 4619827259835644672 (physical, "EMU_display_0")
   isEnabled=true isSecure=true usesDeviceComposition=true
   usesClientComposition=false flipClientTarget=false reusedClientComposition=false
   → HWC layers 段:5 层,全部 DEVICE(2)

Display 11529215047481120786 (virtual, "ScreenRecorder")
   isEnabled=true isSecure=false usesDeviceComposition=false
   usesClientComposition=true flipClientTarget=false reusedClientComposition=false
   layerFilter={layerStack=1057151430 toInternalDisplay=false }
   → HWC layers 段:一层都没有
两块屏的差别用一句话概括:物理屏有"自己的显示控制器",所以它的层可以交给硬件直收;录屏虚拟屏没有对应的显示硬件,它的输出必须由 SF 先用 GPU 摞成一张缓冲,再送给编码器。同一台设备、同一个合成器、同一瞬间,两块屏的归属完全相反。
这也解释了 §9.2 里那个暴涨:加上一块虚拟屏之后,物理屏上那些本来走 DEVICE 的层并没有变,是多出来的那块屏的整份合成工作全落在了 GPU 上——所以 clientCompositionFrames 从 0 直接跳到 204 帧。
背后的原理其实只有一条:HWC 的"设备合成"要成立,前提是那一层最终要落到某块物理显示器的扫描输出上。物理屏有这条通路,虚拟屏没有——所以虚拟屏的每一帧都必须先由 SF 用 GPU 摞成一张完整缓冲,再交给消费端(录屏这里是编码器)。"DEVICE 合成"这个选项对虚拟屏在定义上就是不可用的,不是"没配上"。
官方对这条通路的描述可以回头对一遍:HWC 是"device-specific"的,也是"usually done by the display hardware OEM"的——虚拟屏背后没有 OEM 的显示硬件,所以没有谁来接这个活。 参考:硬件合成器 HAL(AOSP)
下面这张图把两块屏的读数并排:
9.5 这些代价数字的边界
必须说清三件事,否则上面那些数字会被误用。
- 这是参考实现的代价,不是真机的。 本机 composer 是模拟器的参考实现,
RenderEngine背后是 SwiftShader(软件光栅)——所以 9.093 ms 这个绝对值包含软件渲染的成分,真机上的数字会低得多。可以引用的是"从 0 到有"这个跃变,不是这个绝对值。 - 这不是"HWC 比 GPU 快"的证明。 两个窗口的负载不一样(窗口 B 多了一块屏、还多了一段滑动),所以不能把两个窗口的帧时长直接相减当作"GPU 合成的开销"。本文引用它只说明一件事:一旦走客户端合成,成本立刻从"没跑过"变成"每帧一笔"。
- 功耗与带宽一个数字都没有。
--timestats只给时长与计数,不给焦耳。官方那条"层数会明显影响功耗与性能"的结论,本篇只能用时长间接佐证,不能直接量化——功耗要真机加外设才能测,列入需真机项。
9.6 一个本机没打开的开关:合成策略预测
前面所有实验里,有一个字段一直在场,但一直是"关着"的:
adb shell dumpsys SurfaceFlinger | grep -E "compositionStrategy|Planner"
   compositionStrategyPredictionState=DISABLED
Planner is disabled
Planner is disabled
而同一批 --timestats 数据里,却又实实在在地印着这一族计数器:
compositionStrategyChanges = 0        ← 窗口 A
compositionStrategyPredicted = 0
compositionStrategyPredictionSucceeded = 0
compositionStrategyPredictionFailed = 0

compositionStrategyChanges = 1        ← 窗口 B
三件事要分开说:
- 计数器存在 ≠ 功能打开。本机是
DISABLED,所以那四个计数器全程读到的都是 0(窗口 B 那个 1 落在Changes上,是策略变化次数,不是预测次数)——不能因为看到这四个字段,就说这套机制在本机生效了。 - 这套机制的定位不难猜到:判定归属要花时间,而"下一帧的归属大概率和这一帧一样"是常见情形。如果能提前猜出下一帧的归属,就能把这段判定时间藏起来——
Predicted / Succeeded / Failed三个计数器正好对应"猜了几次、猜对几次、猜错几次"。 - 但它在本机是关的,而且官方文档里没有为它写过条目。所以本篇只把"能读到这三个计数器"和"状态是 DISABLED"这两件事实摆出来,不推测它的内部算法,也不承诺它的收益。
这条也顺手解释了一个常见的困惑:功能开关与计数器是两条独立的线——FeatureFlagManager 那一串(本机另读到 vulkan_renderengine: false、graphite_renderengine: false、protected_if_client: true 等几十项)决定"开不开",--timestats 那一串决定"记不记"。看到字段就先假定它开着,是最容易出错的一步。
十、四处说法与四项动作
10.1 四处流传很广的说法,逐条核
| 说法 | 核对结果 | 依据 |
|---|---|---|
| "可见层超过 4 层就会被退回 GPU 合成" | 不成立(至少不是通用规律) | 官方原文是 "typically four overlay planes",属经验值;本机在 5/6/7 层时全 DEVICE(§8.2) |
| "打开 Winscope 看每一层是不是 HWC,HWC 是硬件合成、GPU 是软件合成" | 已过时 | 官方明文:HWC / GPU 两个 chip "are deprecated since Android 15";改用 HWC layers 段的 Comp Type(§7.2) |
| "开发者选项里'停用 HW 叠加'能强制 GPU 合成" | 本机不成立 | 写入后 12 秒窗口 totalFrames=1、clientCompositionFrames=0(§7.5) |
| "判给客户端合成的层,应用侧不用管,SF 会处理" | 不成立 | setBuffer 明文要求缓冲同时带 USAGE_COMPOSER_OVERLAY 与 USAGE_GPU_SAMPLED_IMAGE(§6.1) |
第三条值得多说一句:那条说法在真机上通常成立——disable_hw_overlays 是 Android 的开发者选项之一。但本机的参考实现不认这个开关,所以它不能拿来当验证手段。这是一个很典型的坑:一个在真机上可用的排查手段,在模拟器上会静默失效,而且失效时不会报错,只会给你一个"看起来正常"的读数。
10.2 一条口径警示:三套丢帧计数不能互相代入
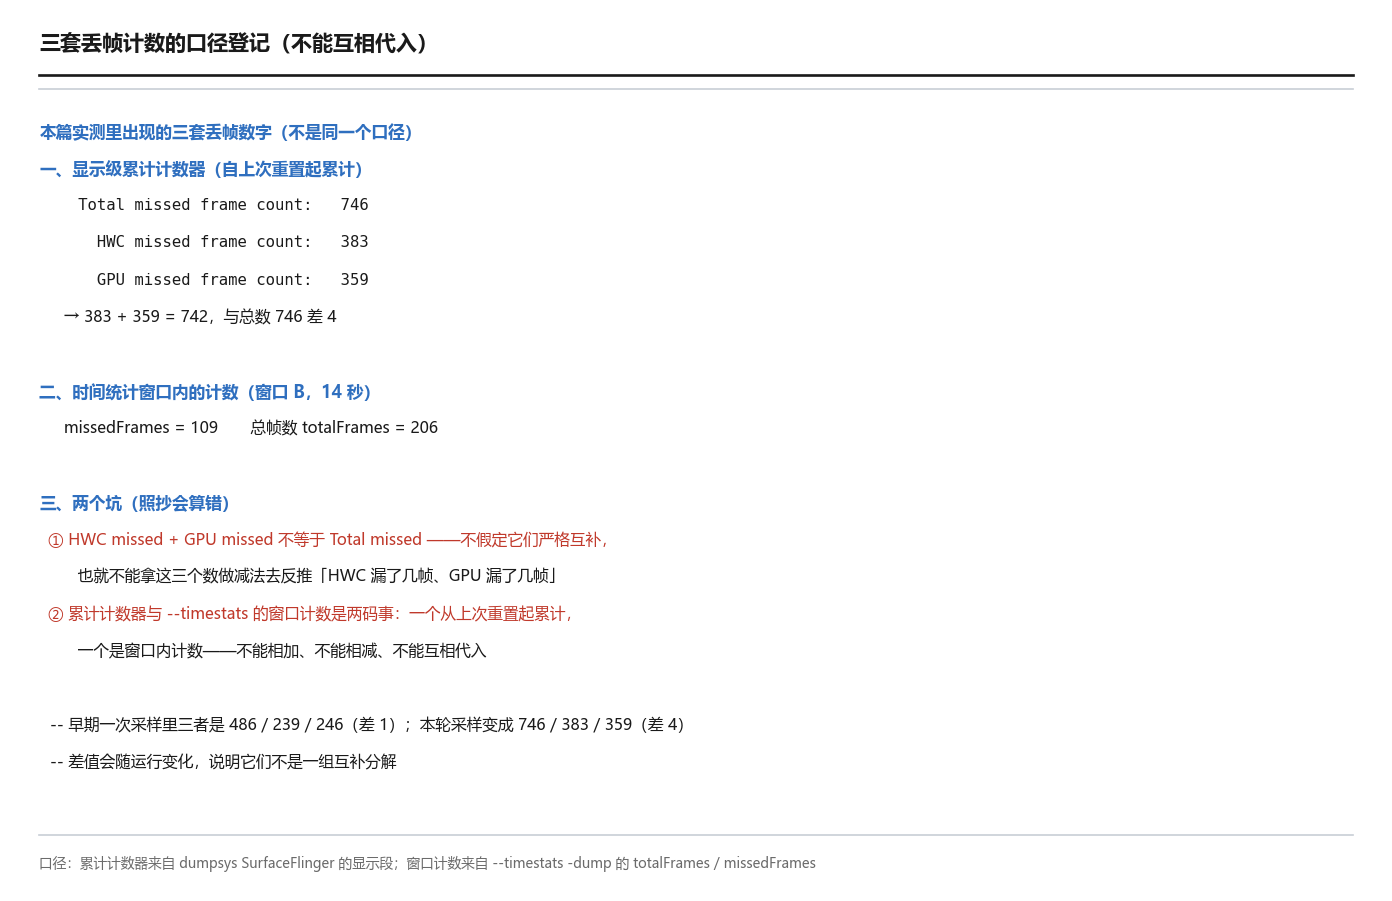
先看看一个坑:本篇实测里出现了三套丢帧数字,它们不是同一个口径:
# 一、显示级累计计数器(自上次重置起累计)
Total missed frame count: 746
  HWC missed frame count: 383
  GPU missed frame count: 359
  → 383 + 359 = 742,与总数 746 差 4
  (早前一次采样的同一组是 486 / 239 / 246,差 1——差值会随运行变化)

# 二、时间统计窗口内的计数
missedFrames = 109          ← 窗口 B(14 秒)
totalFrames = 206
两个坑:
HWC missed + GPU missed不等于Total missed(本轮实测差 4,早前一次差 1)。所以不要拿这三个数做减法去反推"HWC 漏了几帧、GPU 漏了几帧"——至少不能假定它们是严格互补的,差值本身还会跑。- 这套累计计数器与
--timestats的窗口计数是两码事。一个是从上次重置起累计,一个是窗口内计数,不能相加、不能相减、不能互相代入。
下面这张图把三套计数与它们的口径边界做成登记面板:
10.3 四项可执行动作与判据
好了,最后给四组命令,每组配一个判据。这四组覆盖了本篇从"确认对面是谁"到"量出代价"的完整路径。
# ① 确认对面是谁:走的是 AIDL composer3 还是 HIDL
adb shell service list | grep -i composer
# 判据:出现 android.hardware.graphics.composer3.IComposer 即为 AIDL 那一代

# ② 看这一帧每层的归属
adb shell dumpsys SurfaceFlinger | awk '/HWC layers:/{f=1} f&&!NF{exit} f'
# 判据:Comp Type 列里 DEVICE 与 CLIENT 各几个;CLIENT 数 = 这一帧要交给 GPU 的层数

# ③ 确认这一帧整体模式(层级与屏级两个粒度对得上)
adb shell dumpsys SurfaceFlinger | grep -E "composition=|usesDeviceComposition|usesClientComposition"
# 判据:屏级两个布尔值与层级 Comp Type 分布应当一致——
#       usesClientComposition=false 时,层级不应出现 CLIENT

# ④ 量出客户端合成的代价
adb shell dumpsys SurfaceFlinger --timestats -enable
adb shell dumpsys SurfaceFlinger --timestats -clear
sleep 10
adb shell dumpsys SurfaceFlinger --timestats -dump | grep -E "clientCompositionFrames|averageRenderEngineTiming"
# 判据:clientCompositionFrames 与 averageRenderEngineTiming 应当同向变化——
#       前者为 0 时后者通常也是 0.000 ms;前者不为 0 时后者会明显抬高
第 ③ 组是四组里最有用的一个自检:如果 usesClientComposition=false 而层级里出现了 CLIENT,说明读的不是同一帧的两段(dumpsys 是快照,屏级与层级来自同一次采样,但中间若有新帧提交,两者可能错位)。这种"两个粒度对不上"的情况本身就是一条值得记的诊断信号。
10.4 三句结论
OK,把这一篇收成三句话:
第一句:合成归属不是设备的属性,而是每块屏、每一帧、每个层的属性。 本机同一份 dump 里,物理屏全 DEVICE、虚拟屏全 CLIENT;同一个 7 层场景,一个全 DEVICE、一个全 CLIENT。
第二句:判定权在 HWC 那一侧,因为只有它知道自己吃不下什么。 SF 把清单交出去问(validateDisplay),HWC 报回"想改哪些"(getChangedCompositionTypes),SF 再决定接不接受(acceptDisplayChanges)——接口上的这次反悔权,是 DEVICE / CLIENT 能按设备而异的根本原因。
第三句:归属的不确定性,最终由缓冲区分配的人来兜。 因为这一层可能走叠加也可能走 GPU,所以 setBuffer 要求缓冲同时带 USAGE_COMPOSER_OVERLAY 与 USAGE_GPU_SAMPLED_IMAGE——每帧现场决定的归属,代价是每个缓冲都要为两条路做好准备。
10.5 下一篇预告
OK,下一篇接着讲 HWC 的另一半:既然归属是 HWC 判的,那 HWC 和 SurfaceFlinger 之间的消息是怎么传的? 尤其是 Vsync 回调——是谁在什么时候告诉 SF"该出下一帧了",以及虚拟显示那条路径在这一层是怎么走的。也就是本篇 §9.4 只用到一个结论、没打开看的那块地方。
相关链接 - 上一篇:【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务 - 下一篇(预告):【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径 - 相关系列:实时渲染管线探析 | 移动端图形与功耗 | GPU 架构剖析 | 图形性能剖析工具链 | 2D 矢量引擎深挖
With Best Wishes.
参考资料
- 实现硬件合成器 HAL(三种合成模式 / 五步流程 / 同步栅栏)
- 硬件合成器 HAL("SF 问 / HWC 答" / four overlay planes)
- 硬件合成器 HAL 的 AIDL(Android 13 起改 AIDL / composer3 / 模拟器含参考实现)
- SurfaceFlinger 和 WindowManager(旋转与硬件叠加 / layer 定义)
- Winscope · 分析 SurfaceFlinger(HWC/GPU chip 自 Android 15 废弃)
- Winscope · 用 adb 抓取
- Winscope · overview
- SurfaceControl.Transaction(setBuffer 双用途标志 / setOpaque)
- SurfaceControl(类定位)
- NDK · native-activity 参考(ASurfaceControl 三件套)
- Android · dumpsys 工具
- 减少图形内存占用(Composer HAL 3.2 与缓冲缓存)
hardware/libhardware/include/hardware/hwcomposer2.h(hwc2_composition_t)- composer3
IComposer.aidl - composer3
Composition.aidl(DISPLAY_DECORATION / REFRESH_RATE_INDICATOR) - composer3
DisplayCommand.aidl(clientTarget 语义 / validateDisplay) - composer3
LayerCommand.aidl(per-layer brightness 等) - composer3
IComposerClient.aidl(executeCommands 等接口全集) device/generic/goldfish-opengl/system/hwc3/(模拟器 AIDL HWC 参考实现,官方文档指名的路径)- Perfetto · FrameTimeline
- Perfetto · SQL tables(surfaceflinger_* 表)
- CSDN · surfaceflinger 与 HWC 的关系(validate 与三种合成方式)
- DeepWiki · SurfaceFlinger Configuration and Properties(predict_hwc_composition_strategy 等属性)
- AOSP changelog 13.0.0_r1→r9(可见 CSP 相关回滚提交标题)
- Android graphics - Hardware Composer HAL(AIDL vs HIDL 串讲)
- Wikimedia Commons · PorterDuffAdd
- Wikimedia Commons · Alpha compositing
- Wikimedia Commons · NEC µPD7220 Block Diagram


