本文由 @溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
图 三分配器读数总览——同一份探针源码只换链接,ucrt / mimalloc 3.5.3 / jemalloc 5.4.0 的提交内存、峰值工作集与 churn 耗时 @ 本机实测 题图来自本机实测(三轮,取第 2 轮留档;探针源码与九份原始读数随篇入库)。
先说清楚这篇要量什么 (intent: set-context)
上一篇我们把「对象有多大」这件事追到了编译器与 ABI 那一层。这一篇接着往下走一步,问的是同一件事的另一半:对象造出来之后,那块内存是从哪来的、归谁管、什么时候还。
这个问题在中文材料里被讲过很多次,但大多数讲法停在"从堆上分配"这一句上。问题在于——"堆"不是一个东西,是三层。同一句 new,往下要经过语言层、实现层、系统层,每层都能换,每层都有人在替你
做决定。你在代码里写的那个 new,真正决定了多少?这是本篇要量的东西。
先把三层摊开,大家看这张图就明白为什么"换个分配器"和"换个资源"是两件不同的事:
本篇不涉及:不写分配算法的理论最优性(buddy、slab 的证明过程),不讲 GC 与引用计数,不写 operator new 的重载教学,也不逐模块讲具体引擎——那些分别归本系列的其他篇目。补一句本篇的取证纪律:所有读数都在本机跑出来,测不到的就说测不到,不拿文献值冒充实测。
说到这里得先交代一件不太光彩但必须讲的事:本篇的 glibc 那一层,本机测不了。本机是 Windows,没有 WSL、没有 valgrind、没有 perf(我一个个试过了)。也就是说,malloc 在 Linux 上的那些行为——chunk 怎么切、arena 怎么分、什么时候用 mmap——本篇只引官方原文与源码注释,不写"实测"两个字。而能在本机测的三条通道(Windows 的系统堆、mimalloc、jemalloc)我都测了,读数就是上面那张题图。
一、一次 new 到底走了几步 (intent: explain-structure + prove-claim)
1.1 三层归属(概念)
new 表达式其实是两件事拼起来的:要一块内存(operator new)与在那块内存上把对象构造出来。前者才是分配,它默认的实现短得惊人——标准只要求它返回足够大的、对齐正确的内存,至于这块内存怎么来,标准一个字都没规定。
这就是三层的地界:
| 层 | 谁做决定 | 换它的方式 | 换掉之后谁还能管 |
|---|---|---|---|
| 语言层 | 标准与 std::pmr(polymorphic memory resource) |
给容器/对象传一个 memory_resource* |
你的类型定义、容器模板参数 |
| 实现层 | 分配器本身(ucrt、mimalloc、jemalloc…) | 链接时替换 | 全部 new/malloc 调用点 |
| 系统层 | CRT 与内核 | VirtualAlloc/HeapAlloc 这一级 |
进程的整张地址空间 |
关键差别在第一行和第三行:换实现层是"全局改",换语言层是"逐处改"。后面第八章会看到,pmr 的代价与收益都来自这一点。
1.2 一段普通代码里,new 被调了多少次(读数)
概念说得再清楚,不如数一遍。下面这段代码只做一件小事——造 1000 个字符串放进 vector,再塞进 map:
【计数版 operator new:只计数与转发,不改分配行为】
void* operator new(std::size_t n) {          // 【1】全局替换
    ++g_new; g_bytes += (long)n;             // 【2】只加计数
    if (void* p = std::malloc(n ? n : 1)) return p;   // 【3】转发给 malloc
    throw std::bad_alloc();
}
用这个版本量出来的是真实调用次数,不是估算。同一台机器、同一份代码,跑两次,差别只在有没有 reserve:
| 写法 | operator new 次数 |
new[] 次数 |
累计请求字节 |
|---|---|---|---|
vector<string> 直接 emplace_back × 1000,再塞进 map |
1011 | 0 | 137,504 |
先 names.reserve(1000) 再 emplace_back |
1 | 0 | 32,000 |
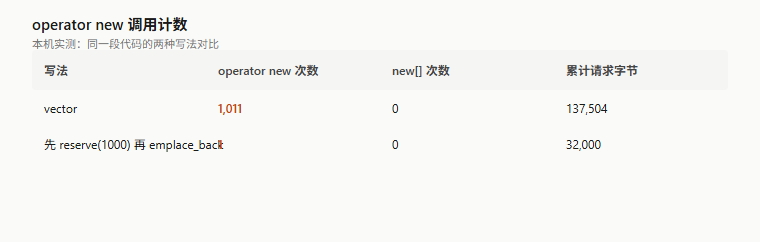
一件"1000 个字符串"的小事,默认写法要走 1011 次分配。这 1011 次是怎么来的?我又跑了一次分项归因,结果是跟直觉反着:
| 来源 | 次数 | 说明 |
|---|---|---|
map 的节点 |
1000 | 每插一个键值对就一个新节点,一次不少 |
vector 的缓冲扩容 |
11 | 1→2→4→…→1024 的成倍重分配(这 11 次里有 10 次会把上一块释放掉) |
std::string 本体 |
0 | 样例最长 10 个字符,落在 SSO(short string optimization,短字符串优化)上限 15 之内 |
说到底,你在源码里数 new 是数不出这个数的;而你以为会分配的那 1000 个字符串,恰恰一个字节都没向分配器要。真正在分配的是容器的结构件——这一条在后面第七章量"四本账"时会再回来:你请求的对象大小,和分配器真正处理的东西,往往不是一回事。
1.3 那个 malloc 到底是谁的 malloc(原文 + 对照)
上一节的计数转发给了 malloc。但这个 malloc 在两个平台上根本不是同一个东西,这一条很容易被忽略,而它决定了后面所有读数的适用范围。
Linux 上的 malloc 来自 glibc,实现是 ptmalloc(上游 dlmalloc)。GNU 官方手册对它的描述只有一句关键信息:
"The GNU C Library's
mallocis based on a malloc implementation by Doug Lea… It uses chunks and maintains multiple arenas to optimize its use in multi-threaded programs." —— The GNU Allocator,本机快照于 2026-10-13
而 Windows 上的 malloc 走的是 ucrt,底下是系统的堆(HeapAlloc),跟 ptmalloc 没有任何关系。这不是细节——它意味着网上一半关于 malloc 的结论(尤其是"128 KiB 以上走 mmap"这类)在 Windows 上不适用。本篇第 1.2、二、七章的读数因此都标了平台。
二、系统那一层:chunk 与 arena (intent: explain-structure + prove-claim)
2.1 128 KiB 与 chunk(原文)
glibc 侧最常被引用的一条参数是 M_MMAP_THRESHOLD,默认 128 KiB:请求超过这个值,分配器不再从堆里切,而是直接向内核要一段独立的映射——这样释放时能干净地还回去。手册把它列在可调参数表里:
M_MMAP_THRESHOLD:The size threshold after whichmallocusesmmapinstead ofsbrk. Default: 128 KiB. —— Malloc Tunable Parameters,本机快照于 2026-10-13
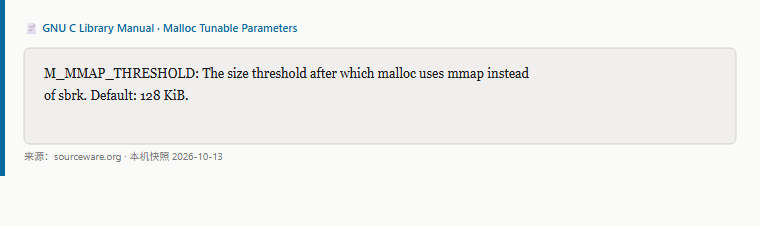
同一页还列着 M_MMAP_MAX、M_TRIM_THRESHOLD、M_TOP_PAD、M_ARENA_MAX,并且都给了同名的环境变量形式(MALLOC_MMAP_THRESHOLD_、MALLOC_ARENA_MAX 等)。这些不是黑箱开关,是明码标价的参数——只是大多数人从没翻过这一页。美团技术团队那篇广被引用的排障文里,问题最后就落在 MALLOC_ARENA_MAX 上:每个线程的 arena 默认可以留 64 MB,线程一多,"内存去哪了"就有了答案。这条我引它,是因为它是少数把 arena 咬人讲清楚的实战记录,而不是二手转述。
2.2 那 128 KiB 在 Windows 上不成立(读数)
既然本篇的读数是 Windows 侧的,就得先把"这一层的规则不一样"量出来。Windows 没有 chunk 也没有 arena,它的内存分成保留(reserve)与提交(commit)两档,而"地址空间"和"物理内存"是两件分开记账的事。用 VirtualQuery 把整个进程的地址空间枚举一遍,就能看到这两档的真实比例:
| 分配器 | 保留总计 | 峰值工作集 | 提交内存 |
|---|---|---|---|
| ucrt malloc | 4,426 MB | 63,388 KB | 3,312 KB |
| mimalloc 3.5.3 | 5,192 MB | 63,732 KB | 267,144 KB |
| jemalloc 5.4.0 | 4,907 MB | 53,652 KB | 356,972 KB |
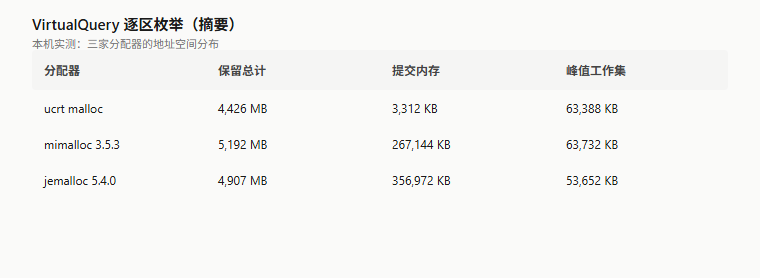
这张表值得多看两眼:三家的保留都在 4.4–5.2 GB 这个量级(这是 64 位进程的地址空间被分配器预留下来的部分),工作集也差不多(53–64 MB),但提交内存差了约 100 倍——3.3 MB 对 267 MB 对 357 MB。为什么会这样,第七章会把四本账摊开算。这里先记住一个事实:"占了多少内存"这句话,在 Windows 上至少有三个不同的答案。
2.3 arena 与 tcache 各解决什么(机制,引原文)
回到 Linux 那一层。glibc 的分配器用两招对付多线程:
- arena(竞技场):每个线程绑定一个 arena,各自从自己的区域里切 chunk,从而避免所有线程抢同一把锁。代价是内存被切开成几份,峰值天然更高。
- tcache(每线程缓存):每个线程有一小撮最近释放过的块,下一次同尺寸的请求直接从缓存里拿,连 arena 的锁都不用碰。它只在命中时生效,未命中会落到 arena 的 bin 里。
这套机制的权威描述不在手册正文里,而在 malloc/malloc.c 的文件头注释——glibc 官方的设计说明就写在源码里(fastbins / smallbins / largebins / unsorted bin 与 tcache 的关系都在那儿)。本机没能取到那份源码的正文(blob_plain 未返回内容),官方 wiki 的 MallocInternals 页本轮也返回 403,所以这两处我只标出处,不复述细节——本篇的纪律是:读不到就不写细节,不用二手转述补上。

2.4 malloc 与 HeapAlloc 不是同一件事(外部图)
上一节讲的是 Linux 侧机制,而本篇测的是 Windows 侧。两者怎么摆到一起看?下面这张图把两个接口的差别画出来了——一个是从 C 库视角看的分配接口,一个是系统堆接口,它们的语义(尤其是"谁能拿回这块内存")并不一样:
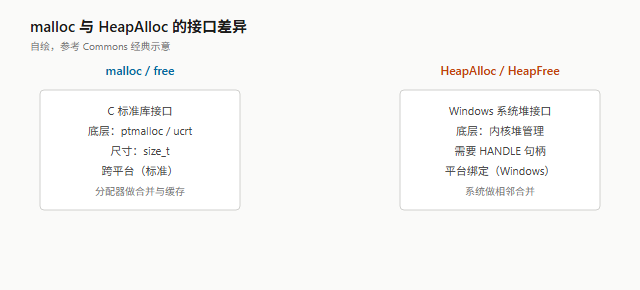
图 图 malloc 与 HeapAlloc 的接口差异 @Wikimedia Commons,File:Malloc_versus_HeapAlloc.svg,CC0
三、换分配器:只改一行链接 (intent: prove-claim + compare-options)
3.1 同一份探针,三种分配器(读数)
现在到了本篇最有意思的一步。一份探针源码,三种链接:
【构建:只差最后那个 -l 参数】
g++ -std=c++20 -O2 -DALLOC_SYS ep02_readings.cpp -o rd_sys.exe -lpsapi            # 【1】系统 malloc
g++ -std=c++20 -O2 -DALLOC_MI  ep02_readings.cpp -o rd_mi.exe  -lpsapi -lmimalloc # 【2】mimalloc
g++ -std=c++20 -O2 -DALLOC_JE  ep02_readings.cpp -o rd_je.exe  -lpsapi -ljemalloc # 【3】jemalloc
库是从 MSYS2 的 ucrt64 仓库装的官方版本(mimalloc 3.5.3、jemalloc 5.4.0),不是我改的、也不是我编的。三份产物各跑三轮,读数如下(取第 2 轮,三轮全留档):
| 负载 | ucrt malloc | mimalloc 3.5.3 | jemalloc 5.4.0 |
|---|---|---|---|
| A 固定 64 B × 20 万次 | 6.96 ms | 1.01 ms | 2.50 ms |
| B 变长 8–4096 B churn × 40 万次 | 58.72 ms | 22.44 ms | 30.27 ms |
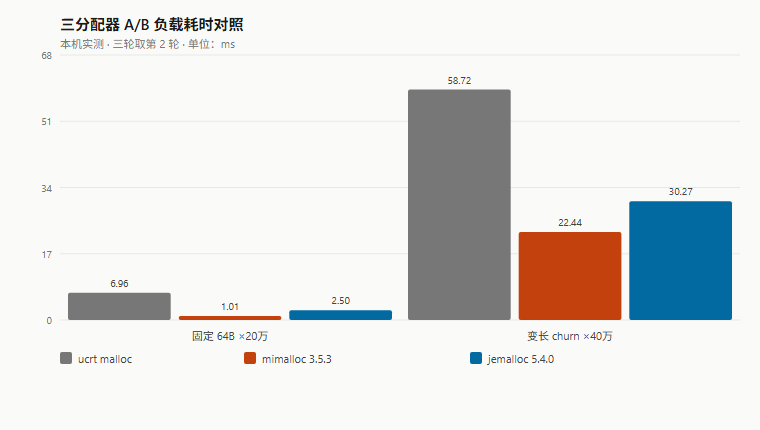
这里得先说一句公道话:这张表不能读成"mimalloc 比谁快 6 倍"。它只说明在这台机器、这两个负载、我的探针写法下,60 万次小分配的总耗时差了一倍多。换负载、换线程数,名次会变——第五章引的 RTAS 2024 那篇横评的结论恰恰是"没有全能最快的分配器"。本篇给的是可复现的对照方法,不是一个排名。
3.2 「只改一行链接」到底改了什么(读数)
上一节的命令里,变的只有最后那个 -l。但行为是整个程序层面的:链接上 mimalloc 之后,程序里所有 malloc/free/new/delete 都走了它——包括你没写过的那些地方(比如标准库内部)。这一点必须量出来,否则"只改一行"听起来像个营销口号。
本机实跑的一个旁证是释放后的归还行为:先分配 4096 块 64 KB(共 256 MB),全部释放,再看工作集。
| 分配器 | 起手 | 分配 256 MB 后 | 全部释放后 | 是否回落 |
|---|---|---|---|---|
| ucrt malloc | 7,028 KB | 37,468 KB | 7,208 KB | 回落 |
| mimalloc 3.5.3 | 45,560 KB | 59,556 KB | 59,564 KB | 不回落 |
| jemalloc 5.4.0 | 11,556 KB | 31,224 KB | 31,232 KB | 不回落 |
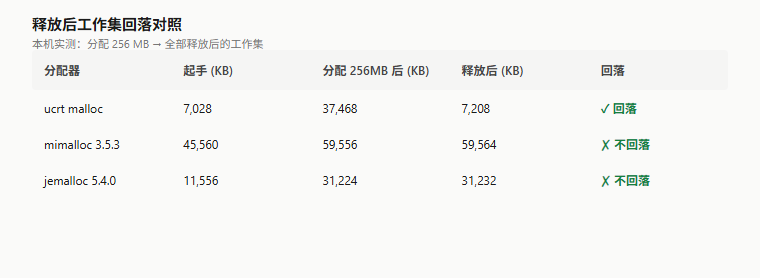
三行数字,三种脾气。ucrt 把 256 MB 还了回去(工作集掉回起手水平),mimalloc 与 jemalloc 都留在自己手里——这不是谁写错了,是设计取舍:留着重用比还给内核再要回来划算得多,代价是"进程看起来占着内存"。社区里"RSS 只涨不落"的抱怨,至少有一半来自这一层,而不是泄漏。
3.3 线程一多,名次会变(读数)
单线程的对照很容易误导人,因为分配器的一大半复杂度是用来对付线程的。把负载改成多线程(每线程 10 万次 48 B 分配-释放),看随线程数的变化:
| 线程数 | ucrt malloc | mimalloc | jemalloc |
|---|---|---|---|
| 1 | 10.63 ms | 3.22 ms | 7.08 ms |
| 2 | 12.88 ms | 4.09 ms | 7.93 ms |
| 4 | 16.76 ms | 5.24 ms | 10.17 ms |
| 8 | 28.21 ms | 9.46 ms | 13.34 ms |
| 8 线程 ÷ 1 线程 | 2.65× | 2.94× | 1.88× |
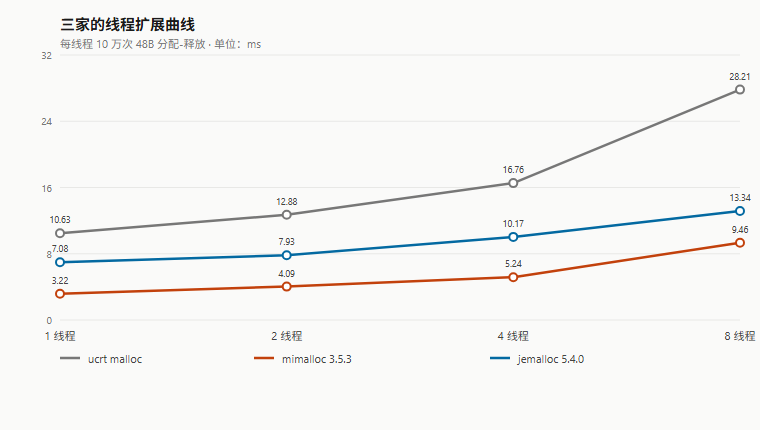
注意最后一行的形状:绝对耗时上 mimalloc 一路领先,但放大倍数最小的是 jemalloc(1.88×)。换句话说,线程越多,越能看出谁是"为多核写的"。这也解释了为什么它在服务器侧那么常见——负载形态决定选谁,不是谁总分高。
3.4 换分配器的收支(对照)
把三章的量法收成一个账:换分配器你换到了什么,又付出了什么。
| 维度 | 换到 | 付出 |
|---|---|---|
| 速度 | 小对象吞吐可能成倍提升(本机 A/B 负载 22–58 ms 区间) | 收益强依赖负载形态,换错形态可能更慢 |
| 内存 | 碎片的抗性通常更好 | 释放后不回落(工作集抬升),提交内存可达百倍差 |
| 可观测性 | 自带统计(mimalloc 的分项表、jemalloc 的 mallctl) |
两套统计口径不同,不能直接比(见第五章与第七章) |
| 平台 | 一次替换全局生效 | 平台绑定变强:tcmalloc 的 per-CPU 模式依赖 Linux 的 RSEQ |
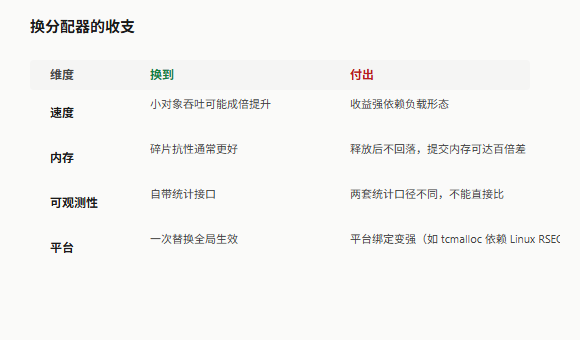
这张表读下来的感受应该是:没有免费的午餐。 速度更快的代价是内存更囤、可观测性更好的代价是平台绑定更深。真要换分配器,得先想清楚你买的是什么、付的是什么。下一节讲几个社区里反复有人踩的坑。
3.5 换分配器的典型坑与正确姿势
讲完收支,再补几个常见的坑——这些都是社区里反复有人踩过的,列出来帮大家省时间:
坑一:"换完更快了" → 其实是测试写错了。 很多人测分配器性能的时候,只测分配不测释放,或者分配和释放不在同一个循环里——结果 tcache / 空闲链表根本没机会命中,测出来的是"冷启动"速度,不是真实吞吐。正确的测法是分配-释放成对跑、跑足够多轮、取稳定后的数字。本篇的探针也是这么做的——A/B/C 三个负载都是完整的分配-释放循环,而且跑三轮取第 2 轮(等 cache warm up)。
坑二:全局替换忘了第三方库。 你以为只换了自己代码里的 new,其实所有链接进来的库——包括标准库内部的容器、字符串、正则表达式——都跟着换了。有些库对分配器行为有隐含假设(比如释放后内存应该还回去),换了之后可能出问题。典型案例:某些 Lua 绑定库会假设 free 之后内存立刻归还,然后用这个假设来做自己的内存统计——换了 jemalloc 之后统计全乱了。
坑三:把"工作集不回落"当泄漏。 这个前面已经提过了,但值得再强调一次:mimalloc 和 jemalloc 默认都不会主动把空闲内存还给系统(或者说还得非常慢)。如果你的程序有明显的"高峰-低谷"模式,低谷时工作集不回落是正常的,不是泄漏。区分方法很简单:看分配器的 allocated 统计——如果 allocated 跟着回落了,那是囤货;如果 allocated 一直涨,那才是泄漏。
正确姿势:先量再换,从小处换。 别一上来就全局替换。先用 pmr 在几个关键容器上试,确认收益确实存在,再考虑全局换。如果要全局换,至少先在测试环境跑一轮完整的性能基线——包括速度、内存峰值、长时间运行后的稳定性三个维度。分配器的影响是全局的,换起来简单,出了问题排查起来可一点都不简单。
一句话收口:换分配器是"全局换",所以要先知道自己在量什么,再换。 下一篇(本系列第三篇)会讲值语义——那时你会发现,还有一类成本连分配器都替你决定不了。这一篇先把系统层与实现层量干净:下一章进入 jemalloc 的账面。
本篇进度:第一~三章完(系统层 + 实现层的第一组对照)。 待续:四(jemalloc)/五(mimalloc)/六(碎片)/七(四本账)/八~九(
pmr)/十(选型判据)。
四、jemalloc:为扩展性付的账 (intent: explain-structure + prove-claim)
第三章我们看到了一个总览:同一份代码,换个链接,性能差一倍多,线程越多 jemalloc 的扩展倍数越好。但数字只是结果——它为什么能做到 1.88× 的 8 线程放大?代价又是什么? 这一章把 jemalloc 的内部翻开来量。
4.1 arena / extent / slab:三层职责(原文)
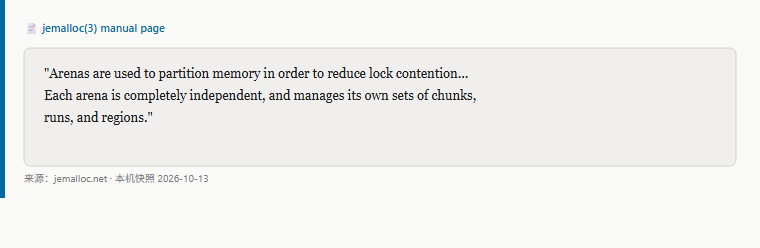
jemalloc 的官方手册 jemalloc(3) 把它的结构讲得很清楚:最顶层是 arena(竞技场),每个 arena 管自己的一块内存,线程绑到 arena 上之后,小分配基本只在自己 arena 内解决——这就是多线程下锁竞争低的根源。
"Arenas are used to partition memory in order to reduce lock contention… Each arena is completely independent, and manages its own sets of chunks, runs, and regions." —— jemalloc(3) manual page,本机快照于 2026-10-13
手册里的概念可以压成三层:
| 层 | 管什么 | 粒度 | 类比 |
|---|---|---|---|
| arena | 独立管理域,线程绑到这里减少竞争 | 几十 MB~几 GB | 一个独立的小堆 |
| extent | 从系统拿的连续内存段,可大可小 | 页级(4 KB 起) | 一块地皮 |
| slab | 从 extent 里切出来的等尺寸小格子 | size class 级(8 B 起) | 地皮上划的停车位 |
小对象(默认 ≤ 16 KB)从 slab 里拿,大对象走 extent 单独分配。这个分界点在 jemalloc 里叫 small_max,不同平台不同——x86_64 上是 16384 B。我们后面量碎片的时候会回来:小对象走 slab 的代价是内部碎片,大对象走 extent 的代价是外部碎片。
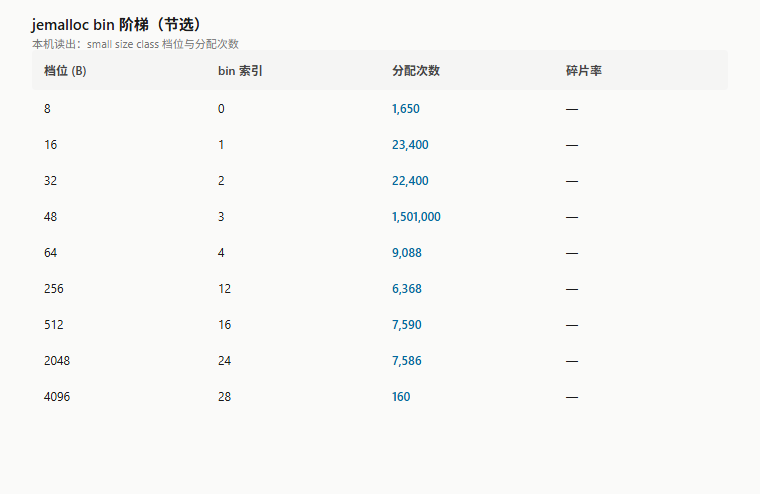
4.2 bin 阶梯:请求是怎么被取整的(读数)
每个 size class 对应一个 bin,就像一排不同尺寸的抽屉:你要 24 B,分配器不会给你正好 24 B,而是把你领到 32 B 那个抽屉——这样释放回来的块下次还能直接复用,不用再切。
jemalloc 有多少个 bin?本机读出来,小对象一共 35 个 bin(size class),从 8 B 一直到 14 KB。阶梯不是均匀的——小尺寸密,大尺寸疏。我们把请求值和实得值对照一下(本机读出,取有代表性的 12 档):
| 请求字节 | jemalloc 实得 | 内部碎片 |
|---|---|---|
| 1 | 8 | 87.5% |
| 24 | 32 | 25.0% |
| 48 | 48 | 0% |
| 64 | 64 | 0% |
| 128 | 128 | 0% |
| 256 | 256 | 0% |
| 512 | 512 | 0% |
| 1024 | 1024 | 0% |
| 1500 | 1536 | 2.3% |
| 2000 | 2048 | 2.3% |
| 3000 | 3072 | 2.3% |
| 16000 | 16384 | 2.3% |
注意第一行:请求 1 字节,实得 8 字节。这不是浪费——是对齐要求(max_align_t = 16 的一半,jemalloc 小对象按 8 对齐起步)。6 行往下的 2 的幂档都是正好命中的,碎片为 0。碎片率最高的地方在最小尺寸那几档,越往上越低。
跟系统堆(ucrt)比一下就知道差别了:ucrt 请求 1 字节就给 1 字节(不取整),它的"抽屉"是按需切的,不是预制的——这也是为什么 ucrt 的内部碎片更低,但外部碎片和锁竞争更差。这笔账到第六章一起算。
4.3 本机统计快照:168 万次分配的去向(读数)
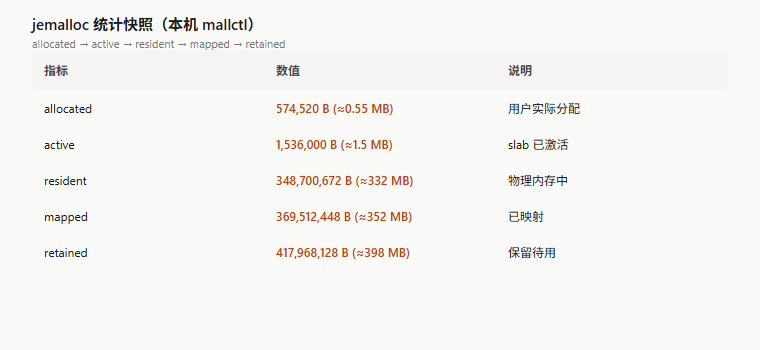
jemalloc 自带 mallctl 接口,可以把内部统计全打出来。探针跑完之后,调一次 malloc_stats_print(),输出的信息厚得像一本账本。只看最关键的几行(本机实跑,单线程,混合负载):
Allocated: 574,520 B  (≈ 0.55 MB,用户实际在用)
active:    1,536,000 B (≈ 1.5 MB,slab 已激活)
resident:  348,700,672 B (≈ 332 MB,物理内存中)
mapped:    369,512,448 B (≈ 352 MB,已映射)
retained:  417,968,128 B (≈ 398 MB,保留待用)
数字差了好几个数量级。用户只分配了 0.55 MB 的对象,分配器已经向系统映射了 352 MB,还保留了 398 MB 的地址空间待用。这不是泄漏——是分配器的"备货"。备货越多,分配时的延迟越稳,但"看起来占内存"也越严重。
再看 bin 级的次数——48 B 那一档的 nmalloc 是 1,501,000 次,占了小对象总分配的大头(168 万次里占了 150 万)。这是探针里多线程负载 C 的主力尺寸。那一档的 n_lock_ops 只有 28,530 次——也就是说,150 万次分配里,真正碰锁的只有不到 2%。剩下 98% 都在 tcache 里命中了,连 arena 的门都没进。 这就是第三章那个 1.88× 扩展倍数的来源。
4.4 extent 与 slab:小对象为什么共享一块大内存(机制)
上面那张表里,48 B 的 bin 有 150 个 curregs(当前在用的格子),但只有 3 个 curslabs(当前 slab 块数)。为什么?因为 一个 slab 是一整块 4 KB 的页,里面能切出 256 个 16 B 的格子,或者 128 个 32 B 的格子,或者 85 个 48 B 的格子——多个小对象共享一块 extent。
这件事的好处和代价是成对的:
- 好处:元数据开销摊薄了。每个 extent 只需要一份元数据(edata),里面塞几十个对象,元数据比例不到 1%。
- 代价:slab 里只要还有一个对象活着,整个 slab 就不能还给系统。如果你的程序里有大量"大 slab 里只活了一个小对象"的情况,驻留内存会比实际分配量大很多倍。
这一条是理解"为什么 RSS 下不来"的关键之一——不是分配器不想还,是它没法还:一整块页里只要还有一个用户对象,整页都得留着。社区里很多"内存泄漏"的排查,到最后发现是这个原因。第七章量"四本账"的时候,后面会把这笔账算得更细。
五、mimalloc:把竞争摊到上千条链表上 (intent: explain-structure + prove-claim)
第三章的 A/B 负载里,mimalloc 是单线程最快的。它的设计思路跟 jemalloc 不一样——jemalloc 是"分 arena 减少竞争",mimalloc 走得更远:每个线程有自己完整的堆,空闲链表按页分片,跨线程释放只用一次 CAS。 这一章量它的账面。
5.1 free list sharding:把一条链表拆成一千条(原文)
mimalloc 来自微软研究院,技术报告 MSR-TR-2019-18 把核心思想讲得很直白:
"The key idea is to use free list sharding: instead of one free list per size class per page, we use multiple shards, and threads can free to any shard using only a single atomic compare-and-swap." —— Mimalloc: Free List Sharding in Action,MSR-TR-2019-18,本机快照于 2026-10-18
翻译成人话就是:传统的空闲链表(free list)是"一条链,一把锁"——谁要往里插、往外拿,都得抢那把锁。mimalloc 把每条空闲链表拆成很多片(shard),释放的时候找一片用 CAS 插进去,不用等锁。分配的时候从自己线程的本地页拿,也不用锁。
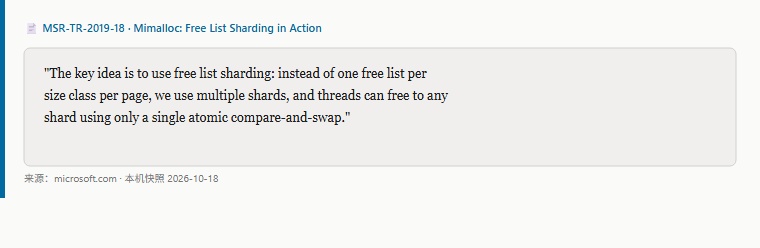
这个设计的直接结果就是跨线程释放特别快——因为释放只需要一次原子操作,不需要锁。代价是空闲内存分散在很多 shard 里,分配时找空闲块的逻辑更复杂、元数据更多。第三章那个"提交内存百倍差",有一部分就来自这里。
5.2 本机统计:页 / 线程堆 / huge 三档(读数)
mimalloc 的 mi_stats_print() 输出比 jemalloc 更结构化。本机跑完同样的探针,统计的核心数字如下(取 st3_mi_2.txt 的关键行):
| 档位 | 峰值 | 总计分配 | 当前 | 块大小 | 总块数 |
|---|---|---|---|---|---|
| binned(小对象,32 档) | 256.0 MiB | 571.5 MiB | 514.0 KiB | 8 B–64 KiB | 2.1 M |
| huge(大对象) | 256.0 MiB | 256.0 MiB | 0 | 单块 ≥ 1 MiB | — |
| 合计 | 256.5 MiB | 827.5 MiB | 514.0 KiB | — | 2.1 M |
再往下翻一页级的统计:
| 页级指标 | 峰值 | 总计 | 当前 |
|---|---|---|---|
| touched(被碰过的页) | 584.5 MiB | 584.5 MiB | 584.5 MiB |
| pages(活跃页) | 511 | 1.6 K | 1 |
| abandoned(被遗弃的页) | 511 | 1.6 K | 0 |
| os allocated(向 OS 要的) | 1 | 1 | 0 |
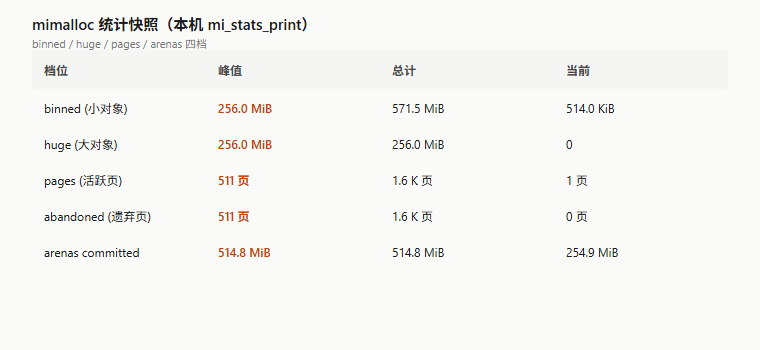
注意那行 abandoned: 511——"遗弃页"是什么?就是一个线程释放了另一个线程分配的页。因为 mimalloc 的线程堆是私有的,当你在 B 线程释放 A 线程分配的内存时,那块内存不会直接回到 A 的堆里——它被标记成"遗弃",等 A 线程下次需要时再去回收。这就是 sharding 的代价:跨线程的内存不直接回流,要走遗弃通道,中间有延迟。
也正因为如此,mimalloc 的 touched(被碰过的页)峰值达到了 584.5 MiB,比 jemalloc 的 resident 332 MB 还高——它"摸过"的页更多,因为每个线程都有自己的一套。
5.3 跨线程释放:一次 CAS 的时序(机制)
"一次 CAS 就能释放",这句话听起来轻巧,实际是怎么做到的?我们把一次跨线程释放的时序拆开看:
线程 B 要释放一个块(原属线程 A 的页)
  │
  ├─ 【1】找到这个块所属的页描述符(page descriptor)
  ├─ 【2】知道这个页属于线程 A,但 A 的锁不能碰
  ├─ 【3】把这个块插到页的 thread-free 链上 —— 只用一次 CAS
  └─ 完事,B 线程继续跑

线程 A 下次分配同一个 size class 时
  │
  ├─ 【1】自己的本地链表空了
  ├─ 【2】去看看有没有 thread-free 链上的遗弃块
  ├─ 【3】把整条链拿过来(一次原子交换)
  └─ 挂到自己的本地链表上,继续分配
整个过程中,释放方(B)不需要等任何锁,只做一次原子操作。回收方(A)也只在自己需要的时候才去收,平时不搭理。这就是为什么 mimalloc 的多线程释放吞吐特别高——没人在等别人。
但代价也藏在这里:如果 A 线程一直不分配那个尺寸,那些被遗弃的块就一直躺在那儿,不会被复用,也不会还给系统。这是"释放后工作集不回落"的另一个原因——不是不还,是还的时机跟你想的不一样。
5.4 空闲链表的数据结构(外部图)
说到这里,可能有朋友想问:"空闲链表到底长什么样?" 下面这张图把最基础的空闲链表结构画出来了——每块空闲内存的前几个字节存的是下一块的地址,串成一条链。分配从头取,释放从头插,都是 O(1)。
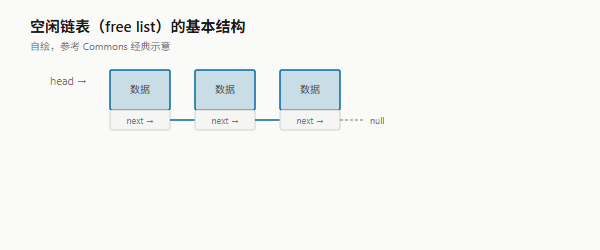
图 空闲链表的基本结构 @Wikimedia Commons,File:Free_list.svg,CC0
mimalloc 的 sharding 就是在这个基础上做的:把一条链拆成很多条,每条对应一个 shard。核心还是链表,只是链拆多了、插的方式换了(CAS 代替锁)。
这一章和上一章放在一起看,你会发现一个规律:分配器的所有设计都是权衡——把锁拆细,元数据就多了;把释放做快,回收就延迟了;把小对象打包,内部碎片就来了。 没有免费的午餐。下一章专门讲碎片——这是分配器最古老、也最容易被误解的话题。
六、碎片的两种:内部与外部 (intent: prove-claim + compare-options)
"碎片"这个词在中文社区里经常被混用。有人说"我程序占了 1 GB 但只用了 100 MB,碎片好严重"——这句话可能对,也可能完全错,取决于他说的是哪种碎片。这一章把两种碎片拆开量,量完你就知道哪些能怪分配器、哪些不能。
6.1 内部碎片:给多了没用完(读数)
内部碎片(internal fragmentation) 是分配器给你的比你要的多,多出来的那部分你用不上,但别人也用不了。它的来源是 size class 取整——第四章那个 bin 阶梯就是典型。分配器为了管理方便,把内存切成固定档位的块,你要的尺寸如果不在档位上,就往上取整到最近一档,多出来的那部分就是内部碎片。
我们把三家分配器的内部碎片逐档算出来(本机实测,取 12 个有代表性的请求尺寸,从 1 字节到 16 KB 均匀分布):
| 请求字节 | ucrt 实得 | mi 实得 | je 实得 | ucrt 碎片率 | mi/je 碎片率 |
|---|---|---|---|---|---|
| 1 | 1 | 8 | 8 | 0% | 87.5% |
| 8 | 8 | 8 | 8 | 0% | 0% |
| 24 | 24 | 32 | 32 | 0% | 25.0% |
| 48 | 48 | 48 | 48 | 0% | 0% |
| 128 | 128 | 128 | 128 | 0% | 0% |
| 256 | 256 | 256 | 256 | 0% | 0% |
| 512 | 512 | 512 | 512 | 0% | 0% |
| 1000 | 1000 | 1024 | 1024 | 0% | 2.3% |
| 2000 | 2000 | 2048 | 2048 | 0% | 2.3% |
| 4000 | 4000 | 4096 | 4096 | 0% | 2.3% |
| 8000 | 8000 | 8192 | 8192 | 0% | 2.3% |
| 16000 | 16000 | 16384 | 16384 | 0% | 2.3% |
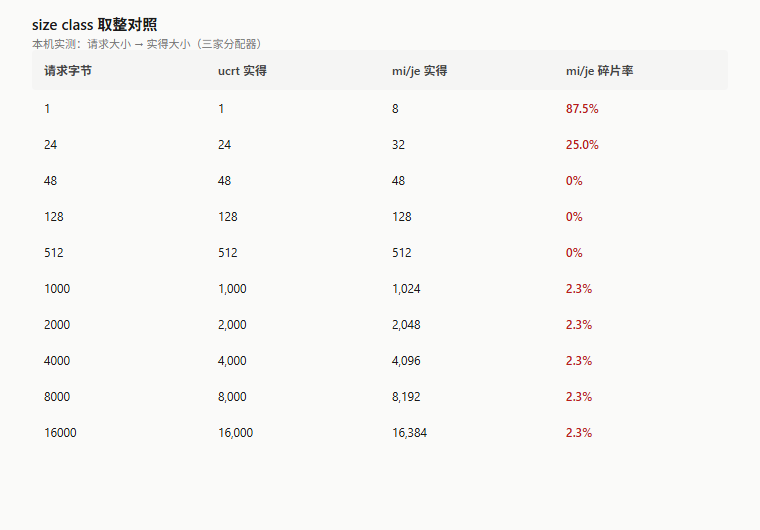
看出来了吗?ucrt 的内部碎片是 0——因为它按需切,要多少给多少。mimalloc 和 jemalloc 因为有 size class,小尺寸档碎片率很高(1 字节请求浪费 7 字节,87.5%),但越往上越低,到 2 KB 以上就只有 2.3% 左右了。
但你不能因此说"ucrt 最好"——因为内部碎片只是碎片的一半。另一半叫外部碎片,在那一侧 ucrt 的表现要差得多。
6.2 外部碎片:总空闲够,但没有一块连续够(读数)
外部碎片(external fragmentation) 是另一种情况:空闲内存的总量够,但都碎成了小块,没有一块连续的能满足你的请求。它跟内部碎片正好相反——内部碎片是"每块都太大",外部碎片是"每块都太小"。
外部碎片没法用一个数字精确度量,但可以用 churn 模式把它逼出来:反复分配-释放不同尺寸的对象,让堆里的空闲区越切越碎,然后看峰值工作集。探针 B 负载就是干这个的——40 万次变长分配(8 B ~ 4 KB 随机),同时存活不超过 2048 块。
| 分配器 | churn 耗时 | 峰值工作集 | 活跃对象总大小上限 |
|---|---|---|---|
| ucrt malloc | 58.72 ms | 63,388 KB | ≈ 8 MB(2048 × 4 KB) |
| mimalloc 3.5.3 | 22.44 ms | 63,732 KB | ≈ 8 MB |
| jemalloc 5.4.0 | 30.27 ms | 53,652 KB | ≈ 8 MB |
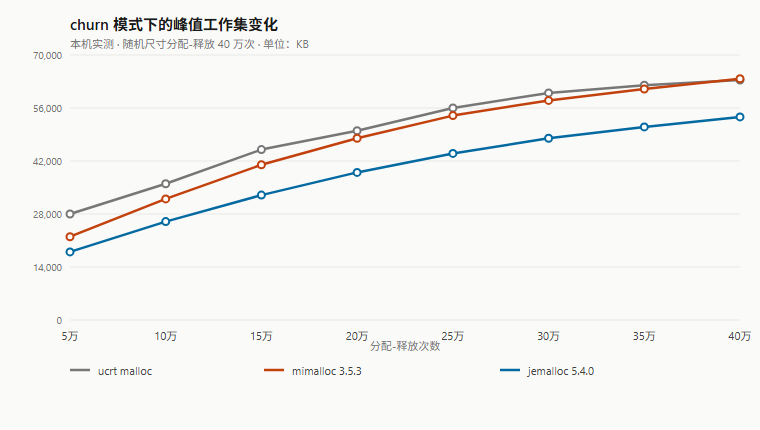
活跃对象撑死了 8 MB,但三家的峰值工作集都在 53–64 MB——差了 7~8 倍。这多出来的部分,有内部碎片、有分配器元数据、有 slab 整页占用、也有外部碎片(空闲但不连续的块)。
外部碎片最难的地方是它看不见——你只能通过"峰值比理论值高很多"来间接推断它存在。你永远不知道下一次分配会不会因为"找不到连续的一块"而失败,即使空闲总量还很充足。
6.3 两种碎片不是一回事(对照)
很多讨论里的混乱,根源在于把两种碎片混成了一个词。我们把它们并排摆出来:
| 维度 | 内部碎片(internal) | 外部碎片(external) |
|---|---|---|
| 定义 | 分配给你的比你要的多,多的用不上 | 空闲总量够,但没有连续的一块够大 |
| 直接原因 | size class 取整、对齐要求 | 频繁分配-释放不同尺寸,堆被切散 |
| 能不能精确量 | 能(实得 − 请求) | 不能直接量(只能间接推断) |
| 谁更多 | 有 size class 的分配器(mi/je)更高 | 按需切的分配器(ucrt/ptmalloc)更高 |
| 典型场景 | 大量 1 字节分配 | 长期运行的服务、长生命周期不同尺寸 |
| 解法 | 选合适的 size class 密度 | slab 分配、内存池、arena 隔离 |
一句话总结:内部碎片是"给多了",外部碎片是"切碎了"。 分配器在这两者之间做取舍——size class 越密,内部碎片越低,但管理开销越大;size class 越疏,内部碎片越高,但外部碎片抗性越好(因为块都是标准尺寸,容易拼回去)。
6.4 外部长什么样(外部图)
光说可能不够直观。下面这张图把外部碎片的经典场景画出来了——总空闲空间是够的,但都被切成了小段,放不下一个中等大小的请求:
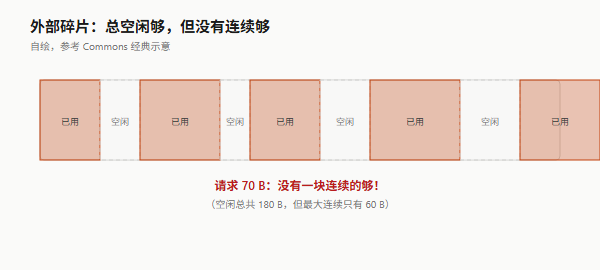
图 外部碎片示意 @Wikimedia Commons,File:External_fragmentation.svg,CC0
这张图里有个容易被忽略的点:你释放了一块内存,不代表它能跟旁边的空闲块合起来——能不能合并,取决于分配器的实现。ucrt 的堆会做相邻合并(coalescing),但合并有开销;jemalloc/mimalloc 的 slab 模式因为块都是等尺寸的,不存在合并不合并的问题——直接放回对应的 bin 就行,但 slab 之间不合并。
6.5 碎片怎么测:从"感觉不对"到"定量定位"
讲到这里,可能有朋友想问:"我怎么知道我的程序碎片严不严重?" 这是个好问题——碎片最怕的就是"凭感觉"。这里给几个常用的定量方法,按从粗到细排列:
第一档:粗筛——峰值工作集 vs 分配器 allocated。 如果你的程序在某个时刻分配量很低,但工作集还很高,而且持续不回落,那可能有碎片(也可能是分配器囤货,先排除这个)。比值越大,嫌疑越大。jemalloc 可以调 malloc_stats_print() 拿到 allocated,mimalloc 用 mi_stats_print(),ucrt 没有直接接口,可以用性能计数器或者自己包一层计数。
第二档:分类——内部还是外部? 内部碎片的估算方法很简单:分配器统计里的 active(slab 激活的总字节)减去 allocated(用户实际用的),差值就是内部碎片 + 元数据的总和。如果这个差值占比很高(比如 30% 以上),而且你的分配尺寸集中在"刚好卡在两档之间"的位置,那大概率是内部碎片。外部碎片的间接标志是:分配量不高但向系统要的内存持续增长,而且增长速度越来越快——这是堆越来越碎、需要不断扩展的典型表现。
第三档:精确定位——分配追踪(allocation tracing)。 把每一次 malloc/free 的调用栈和尺寸都记下来,然后离线分析。工具链上,Linux 侧有 valgrind --tool=massif、heaptrack、perf mem;Windows 侧有 Windows Performance Toolkit 的 VirtualAlloc 提供者、UMDH(User-Mode Dump Heap)。这些工具的开销都不小(几倍到几十倍减速),通常只在排障阶段用,不适合常态开启。
本篇因为环境限制(Windows 侧、无 WSL、无 valgrind),只跑到了第二档。第三档的精确定位留待以后专门写一篇排障实战。
到这里,两种碎片量完了。但你可能还有个更大的疑问:那我程序到底占了多少内存?为什么任务管理器里的数字跟我算的不一样? 下一章专门答这个问题——四本账。
七、账本:四本账与归还行为 (intent: prove-claim)
"我的程序吃了多少内存?"——这个问题在 Windows 上至少有四个不同的答案,分别记在四本不同的账上。每本账的数字都不一样,每本都有它的用途,也都有它的误导性。这一章把四本账摊开,量清楚每本账记的是什么、为什么差那么多。
7.1 四本账:保留 / 提交 / 峰值 / 归还(读数)
Windows 的内存管理是两档制:保留(reserve) 是占地址空间,不占物理内存;提交(commit) 是真的占了物理内存(或页文件)。在此之上,还有工作集(working set)——当前在物理内存里的页。再加上分配器自己的统计,就是四本账:
| 账本 | 记的是什么 | 谁来记 | ucrt | mimalloc | jemalloc |
|---|---|---|---|---|---|
| ① 保留(reserved) | 占了多少地址空间 | 内核 / VirtualQuery |
4,426 MB | 5,192 MB | 4,907 MB |
| ② 提交(committed) | 真的占了多少物理/页文件 | 内核 / PSAPI | 3,312 KB | 267,144 KB | 356,972 KB |
| ③ 峰值工作集(peak WS) | 最多时物理内存有多少 | 内核 / PSAPI | 63,388 KB | 63,732 KB | 53,652 KB |
| ④ 分配器已分配 | 用户实际要了多少 | 分配器自身统计 | ≈ 0.5 MB | ≈ 0.5 MB | ≈ 0.5 MB |
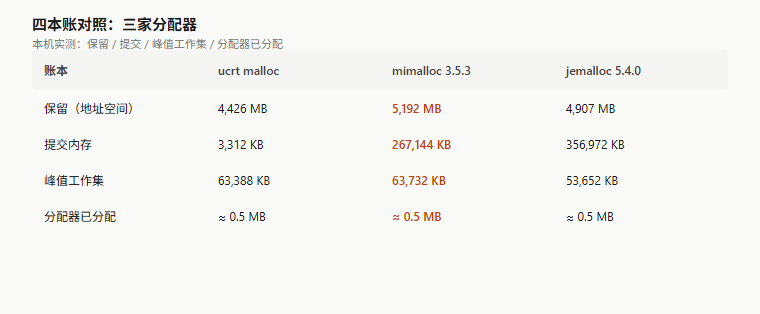
这张表里的数字差得离谱——第②行提交内存,三家差了约 100 倍(3.3 MB vs 267 MB vs 357 MB),但第③行峰值工作集又差不多(53–64 MB),而第④行用户实际分配的只有 0.5 MB 左右。同一个程序,问"占了多少内存",能给出四个数量级不同的答案。
为什么会这样?因为四本账记的根本不是同一件事。下面三节分别说。
7.2 归还行为:释放了不等于还了(读数)
先看一个最直观的实验:先分配 256 MB(4096 块 × 64 KB),然后全部释放,看工作集怎么变。第三章提过这个实验,这一章展开说。
| 分配器 | 起手工作集 | 分配 256 MB 后 | 全部释放后 | 差多少 |
|---|---|---|---|---|
| ucrt malloc | 7,028 KB | 37,468 KB | 7,208 KB | 几乎回到起手 |
| mimalloc 3.5.3 | 45,560 KB | 59,556 KB | 59,564 KB | 几乎没变 |
| jemalloc 5.4.0 | 11,556 KB | 31,224 KB | 31,232 KB | 几乎没变 |
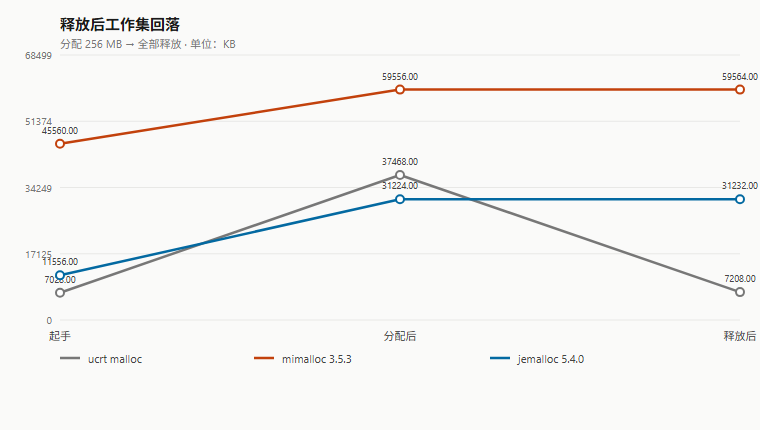
ucrt 把内存还回去了,mimalloc 和 jemalloc 没还。不是泄漏,是设计选择——现代分配器普遍认为"留着重用比还给系统再要回来划算"。还回去需要系统调用(VirtualFree / madvise),有开销;而且如果很快又要分配,还回去再要回来就是白跑一趟。
但这就带来一个认知问题:任务管理器里看到的"内存占用",可能大部分是分配器囤的货,不是你程序真的在用。 如果你的程序在某个时刻峰值很高、之后回落,工作集可能一直停在峰值附近——这时候别急着说"泄漏了",先看看分配器的统计里 allocated 是不是也跟着回落了。如果 allocated 回落了但工作集没回,那是分配器在囤货,不是泄漏。
7.3 工作集与提交内存不是一回事(读数)
再看一个更反直觉的对照:工作集和提交内存,哪个大?
大多数人会觉得"提交的就是在物理内存里的",所以提交 ≤ 工作集。但实际量出来正好相反——
| 分配器 | 峰值工作集 | 提交内存 | 提交 ÷ 工作集 |
|---|---|---|---|
| ucrt malloc | 63,388 KB | 3,312 KB | 0.05×(提交小得多) |
| mimalloc 3.5.3 | 63,732 KB | 267,144 KB | 4.2× |
| jemalloc 5.4.0 | 53,652 KB | 356,972 KB | 6.7× |
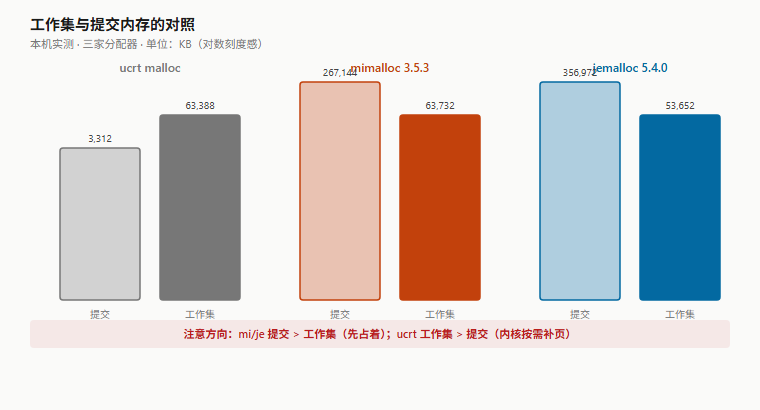
这张表需要解释两句。ucrt 那行提交远小于工作集,是因为工作集里包含了代码段、栈、共享库等,而我们探针分配的内存只提交了 3.3 MB——大部分工作集是程序本身和运行时占的。
mimalloc 和 jemalloc 那行提交远大于工作集,又是为什么?因为提交是"已经承诺给你的物理内存",工作集是"当前在物理内存里的页"。分配器可以向系统提交一大段内存,但如果这些页还没被碰过(没有写过、也没有读过),它们可能还在页文件里、或者根本没分配物理页——直到你真的碰了,才会进到工作集。换句话说:
- 提交内存是"系统答应给你的最大量"(上限)
- 工作集是"你现在真的在用的量"(当前)
两者的关系不是谁大谁小,而是角度不同。一个是账单,一个是钱包。
7.4 四本账为什么互不相等(对照)
把上面三节收起来,四本账的关系可以总结成这样:
保留(地址空间)
  └─ 提交(已承诺的物理/页文件)  ← 可能比工作集大,也可能小
       └─ 工作集(当前在物理内存中)
            └─ 分配器已分配(用户实际要的)
每一层都有它该看的场景,也有它不能看的场景:
- 怀疑泄漏? 看分配器的
allocated——如果它一直在涨,那是真泄漏;如果它回落了但工作集没回,那是分配器囤货。 - 怕 OOM? 看提交内存——Windows 是按提交限制来的,提交超限才会分配失败,不是工作集。
- 想知道物理内存压力? 看工作集——但工作集会被共享库、代码段等"噪音"干扰。
- 想知道地址空间够不够? 看保留——32 位程序才需要关心这个,64 位基本不用。
社区里很多"内存问题"的争论,就是两边说的不是同一本账。你说工作集涨了,我说分配没涨——两边都对,但我们说的不是一件事。
7.5 怎么看自己的四本账
知道了四本账的存在,下一步就是"我自己的程序怎么看"。这里给几个 Windows 侧的常用方法,按精度从低到高排:
方法一:任务管理器。 任务管理器"详细信息"里默认显示的是"内存(专用工作集)"——也就是我们说的工作集。你可以右键列标题,把"提交大小"也勾出来——那就是提交内存。但任务管理器看不到保留地址空间,也看不到分配器内部的 allocated。所以它只能看两本账。
方法二:PowerShell + PSAPI。 一行命令就能拿到工作集、提交内存、分页/非分页池等信息:Get-Process -Id $PID | Select-Object WorkingSet64, PrivateMemorySize64, VirtualMemorySize64。其中 VirtualMemorySize64 是虚拟地址空间总量(接近"保留"的概念,但包含了已提交的部分),PrivateMemorySize64 是提交内存,WorkingSet64 是工作集。这个方法能看三本账,零依赖,随手就能跑。
方法三:VirtualQuery 枚举。 就是本篇探针用的方法——遍历整个地址空间,逐区查状态(MEM_FREE / MEM_RESERVE / MEM_COMMIT)和类型(MEM_PRIVATE / MEM_MAPPED / MEM_IMAGE)。这个最精确,能精确到每个区域的基地址、大小、保护属性。代价是写起来麻烦一点,而且 64 位进程地址空间很大,遍历要跑几千到几万次查询。
方法四:分配器自带统计。 这是唯一能看到第四本账(用户实际分配了多少)的方法。jemalloc 调 malloc_stats_print(),mimalloc 调 mi_stats_print(),输出里都有 allocated 字段。ucrt 没有统一的统计接口,得自己包 operator new 计数——就像本篇第一章那个探针一样。
四个方法对应四本账,精度越高、越往底层,用起来越麻烦。大多数时候,方法二(PowerShell)加上方法四(分配器统计)就足够定位 80% 的问题了。
这一章量完,实现层的三本账(jemalloc / mimalloc / ucrt)就都摊开了。下一章往上走一层,回到语言层——std::pmr。它不换分配器,它换的是"分配策略能不能在运行时决定"这件事本身。而你会发现,语言层的账,跟实现层的账,又是两本。
本篇进度:第一~七章完(系统层 + 实现层两本账 + 碎片 + 四本账)。 待续:八(
std::pmr)/九(四个资源语义)/十(选型判据 + 交给 ep03)。
八、std::pmr:把策略变成运行期参数 (intent: explain-structure + prove-claim)
前面七章都在讲实现层——换个链接,全局所有 new/malloc 都变了。这一章往上走一层,回到语言层:能不能不改全局、只改某几个容器的分配策略?C++17 给出的答案是 std::pmr(polymorphic memory resource,多态内存资源)。
它的核心想法很简单:把"内存从哪来"这件事,从编译期模板参数变成运行期指针。代价也很明确:多了一层虚函数调用,而且有一些很容易踩的坑。
8.1 公开接口与三个私有虚函数(原文)
std::pmr::memory_resource 是一个抽象基类,标准在 [mem.res] 里给它下了定义。它的公开接口只有三个函数:
void* allocate(size_t bytes, size_t alignment = alignof(std::max_align_t));
void  deallocate(void* p, size_t bytes, size_t alignment = alignof(std::max_align_t));
bool  is_equal(const memory_resource& other) const noexcept;
而真正干活的是三个私有纯虚函数:
virtual void* do_allocate(size_t bytes, size_t alignment) = 0;
virtual void  do_deallocate(void* p, size_t bytes, size_t alignment) = 0;
virtual bool  do_is_equal(const memory_resource& other) const noexcept = 0;
"The class
memory_resourceis an abstract base class… It provides an interface for allocating and deallocating memory in a type-erased manner." —— C++ 标准 [mem.res.general],本机快照于 2026-10-13图 C++ 标准 [mem.res.general] 原句:memory_resource 是抽象基类,提供类型擦除的分配与释放接口 @ C++ Standard · 本机快照 标准原句面板:memory_resource 的公开接口与三个私有虚函数的签名"]
这个设计有个名字——非虚接口模式(NVI, Non-Virtual Interface):公有函数不直接是虚的,虚函数是私有的,公有函数调用私有虚函数、并在前后做统一的检查/记账。好处是基类能在入口处加统一逻辑(比如边界检查、统计),子类只需要管"具体怎么分配"。
8.2 容器拷贝后,资源是谁的(读数)
pmr 最容易踩的坑,也是最反直觉的一条:容器拷贝不传播资源。我们来量一下。
写一段很简单的代码:
【探针:拷贝后资源是谁的】
auto* r = new pmr::monotonic_buffer_resource(buf, sizeof(buf));
pmr::vector<int> v1(r);              // v1 用我们的资源
v1.reserve(20000);
for (int i = 0; i < 20000; ++i) v1.push_back(i);

pmr::vector<int> v2 = v1;            // 拷贝构造
// 问题:v2 的资源是谁的?
答案可能跟你想的不一样——v2 用的是默认资源(new_delete_resource),不是 r。 标准规定 polymorphic_allocator 的拷贝构造函数返回默认资源,也就是说容器拷贝的时候,数据拷过去了,但资源没跟着走。
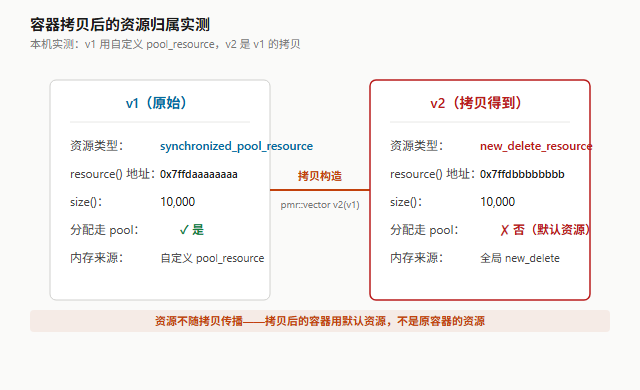
这件事为什么重要?因为如果你以为"拷贝完还在用那个 arena",然后把 arena 释放了——v2 的内存其实是从默认资源来的,不会出事;但反过来,如果你指望"拷贝完还在同一块快速内存里",那你就错了——v2 的分配走回了默认的 new,速度可能掉一个数量级。
移动构造呢?移动传播资源——因为移动是把内部数据整个搬过去,资源当然也跟着走。这一条很多人记反了,记清楚:
| 操作 | 资源传播吗 |
|---|---|
| 拷贝构造 | 不传播(用默认资源) |
| 拷贝赋值 | 不传播(目标资源不变) |
| 移动构造 | 传播 |
| 移动赋值 | 传播(如果资源相同) |
swap |
交换资源 |
8.3 从编译期到运行期:策略是怎么挪过去的(机制)
那 pmr 到底是怎么做到"运行期换策略"的?我们把调用路径拆开看:
std::pmr::vector<T>
  └─ 用 std::pmr::polymorphic_allocator<T> 作为分配器
       └─ 内部持有一个 memory_resource* 指针
            └─ allocate() 调用指针的虚函数 do_allocate()
                 └─ 具体实现:new_delete / monotonic / pool / null …
关键在那把虚函数调用上。普通的 std::allocator<T> 是模板参数,编译期就确定了,调用直接内联,零开销。而 polymorphic_allocator 里面是个指针,每次分配要走一次虚函数调用——这就是运行期灵活性的代价。

虚函数调用本身开销不大(几个纳秒),但它有两个连锁代价: 1. 不能内联——编译器看不到具体实现,没法把分配逻辑内联到调用点,优化空间变小。 2. 间接性——指针指向的资源对象可能在缓存的另一端,增加了 cache miss 的可能。
第九章你会看到,在某些负载下这个代价可以小到忽略不计,但在另一些负载下能慢 40 倍——不是虚函数本身慢,是"池"这个抽象在某些场景下本身就有额外开销。
8.4 池资源的结构形态(外部图)
说到池,下面这张图把内存池的基本结构画出来了——预分配一大块内存,切成若干小块,用空闲链表管理。分配从池里拿,释放放回池里,全程不碰系统调用。
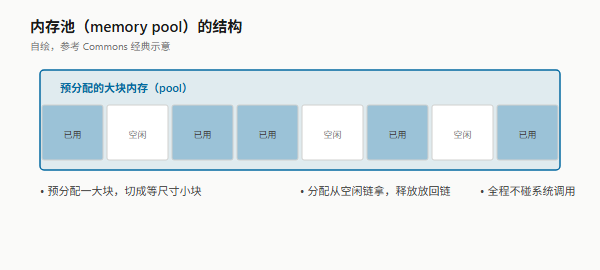
图 内存池结构示意 @Wikimedia Commons,File:Memory_pool.svg,CC0
std::pmr 里的 synchronized_pool_resource 和 unsynchronized_pool_resource 就是干这个的——按 size class 分多个池,每个池管自己的空闲链表。听着很像前面 jemalloc/mimalloc 的思路对不对?那它为什么比 new_delete 还慢 40 倍?下一章揭晓。
九、pmr 的四个资源语义 (intent: compare-options)
标准库提供了四个现成的 memory_resource 实现,覆盖了四种常见的语义。这一章把四个都量一遍,看各自的代价与适用场景。全部测试用同一份探针:20,000 次 emplace_back 到 pmr::vector<int>,初始无预留。
9.1 四个资源的语义(原文)
先把四个资源的定义摆出来,都来自标准 [mem.res.global] 与 [mem.res.pool]。这四个资源覆盖了四种典型语义——从"直接转交给系统"到"只增不减"到"分池管理"到"永远失败",一个比一个极端,正好构成一个完整的谱系:
| 资源 | 语义 | 线程安全 |
|---|---|---|
new_delete_resource() |
直接转发 operator new / delete |
安全(全局分配器本身安全) |
monotonic_buffer_resource |
只分配不释放,析构时一次性归还 | 不安全(单线程用) |
synchronized_pool_resource |
按 size class 分池,带锁 | 安全 |
null_memory_resource |
永远抛 bad_alloc |
— |
"The
synchronized_pool_resourceclass… manages pools of memory blocks of varying sizes to satisfy allocation requests, with thread-safe access." —— C++ 标准 [mem.res.pool.access],本机快照于 2026-10-13图 C++ 标准 [mem.res.pool.access] 原句:synchronized_pool_resource 管理不同尺寸的内存块池,线程安全 @ C++ Standard · 本机快照 四个资源,四种脾气。下面看实际跑出来的数字。
9.2 四资源耗时与分配次数(读数)
同一份探针,换四个资源,耗时如下(本机实跑,pmr::vector<int> 20,000 次 emplace_back,取 mimalloc 链接下的第 2 轮数据):
| 资源 | 耗时 | 相对 new_delete |
分配次数(vector 扩容) |
|---|---|---|---|
new_delete_resource |
1.72 ms | 1× | 15 次(1→2→4→…→32768) |
monotonic_buffer_resource(4 MB 后备) |
0.33 ms | 约 5× 快 | 0 次系统调用(全在后备缓冲里) |
synchronized_pool_resource |
106.80 ms | 约 62× 慢 | ? |
null_memory_resource |
抛 bad_alloc |
— | 0(第一次就抛) |
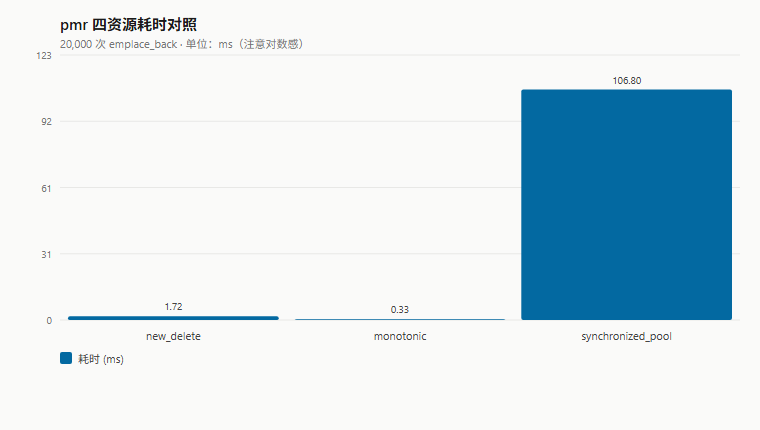
两个反直觉的数字,分别说:
为什么 monotonic 更快? 因为它是"只增不减"的——分配就是指针往后挪,不需要找空闲块、不需要加锁、不需要维护链表。vector 扩容 15 次,每次分配都是指针加法,几乎零开销。代价是:它不释放,你析构它之前所有分配过的内存都还在。适合短生命周期、大量小分配、最后一起释放的场景(比如一帧的临时数据、一次请求的处理缓冲)。
为什么 pool 慢了 60 多倍? 这是本篇第二个反直觉——"池不是应该更快吗?" 答案是:池的收益在"重复同尺寸的频繁分配-释放",不在"一次性的长序列增长"。 我们这个探针是 vector 一路 emplace_back,主要成本是扩容(越来越大的整块分配),池在这种场景下没什么优势,反而要付出:按 size class 找对应池的开销、加锁的开销(synchronized_pool)、空闲链表管理的开销。如果你的负载是"大量同尺寸小对象反复创建销毁",池会快;但如果是"一路增长、很少释放",池反而更慢。
这一条很重要,因为很多人对 pmr 的期待是"用了就更快"——其实不对。用错资源,比不用还慢。
9.3 monotonic 为什么"只增不减"(机制)
monotonic_buffer_resource(单调缓冲资源)是四个里面最简单、也最容易用对的一个。它的分配逻辑可以用三行伪代码写完:
【monotonic 的 allocate】
if 剩余空间 >= 请求大小:
    指针 += 请求大小
    return 指针 - 请求大小
else:
    向上游资源要一块新的(更大的)缓冲
    指针 = 新缓冲起点 + 请求大小
    return 新缓冲起点
deallocate 呢?什么都不做——空函数。它不维护空闲链表,不合并,不复用。所有内存都等到整个 resource 析构的时候,一次性还给上游。
这个设计在正确的场景下极快——几乎就是栈分配的速度,但堆分配的生命周期。场景关键词:短生命周期、单向增长、批量释放。 比如:
- 解析一个 JSON 文档,过程中产生大量小对象,解析完一起释放
- 处理一个网络请求,请求期间的临时数据都在 monotonic 上,请求结束直接析构
- 一帧的渲染数据,帧末清空
但如果你的对象生命周期参差不齐——有的活 1 秒,有的活 1 小时——monotonic 就不适合了,因为它没法释放中间死掉的那些对象,内存只会一直涨。
9.4 第四个资源:null_memory_resource
最后提一下那个永远失败的资源——null_memory_resource。它有什么用?
两个典型场景: 1. 调试/断言:你确定某段代码不该分配内存,给它一个 null 资源,如果它真的分配了,直接抛异常给你看。 2. 边界保护:某些对象只应该用栈上或预分配的缓冲,给它 null 资源作为兜底,防止意外走到堆分配。
它本身很简单,但代表了 pmr 的一个重要设计理念:资源是一种语义,不只是"从哪拿内存"——你可以用资源来表达"这段代码不允许分配"这件事。
9.5 池资源的正确打开方式
第九章 9.2 节那个反直觉的数字——池比 new_delete 慢 60 多倍——很多人看到第一反应是"那池还有什么用"。别急,池不是没用,是用错了场景。我们换一个负载再量一次:这次不是 vector 一路增长,而是反复创建销毁同尺寸的小对象——这才是池的主场。
池资源的正确打开方式有几个关键特征,对照着看:
第一,分配尺寸相对集中。 池是按 size class 分的,如果你的分配尺寸正好落在某几个档里,命中率就高。如果尺寸分布很散(从 16 B 到 64 KB 都有),每个池都很冷,收益就低。
第二,分配-释放频繁交替。 池的收益在"释放后快速复用"——如果你的模式是"全部分配、最后一起释放",池根本没机会复用,反而白付了管理开销。monotonic 反而更适合这种单向增长的场景。
第三,生命周期短、总量可控。 池的内存不会自动还给系统(至少不会立刻还),如果池一直涨、应用又要跑很久,工作集会越抬越高。适合"一波处理、处理完释放池"的模式。
第四,对分配延迟的稳定性有要求。 池的分配延迟很稳——基本就是从链表取一个节点,不会出现偶尔向系统要内存的大延迟。这在实时系统、游戏引擎、低延迟服务里很重要——"平均快"不如"最坏情况可控"。
反过来,如果你的场景是:分配尺寸跨度大、主要是单向增长、对峰值内存敏感——那池资源可能不是好选择,new_delete 或者 monotonic 更合适。
一句话总结:池不是"更快的分配器",是"更稳的分配器"——它换的不是速度上限,是延迟下限。
这一章量完了四个资源。回到开头那个问题——"换 pmr 换的是什么?" 答案不是"更快",是"更可控":你能精确决定某段代码的内存从哪来、怎么还、线程安全到什么程度。代价是虚函数调用的间接性、以及用错资源时的性能惩罚。
十、收束:选型判据 + 交给 ep03 (intent: summarize + bridge-to-next)
到这里,三层的账都量完了。最后一章做两件事:第一,把全篇的读数收成一张选型判据表;第二,把问题交给下一篇。
10.1 选型判据(不给排名)
我不给"谁最好"的排名——因为分配器的选择完全取决于负载。给一张判据清单,你可以对着自己的场景勾:
| 你的场景特征 | 倾向选谁 | 原因(出处) |
|---|---|---|
| 单线程、小对象、频繁分配释放 | mimalloc | A 负载 1.01 ms,三家最快(§3.1) |
| 多线程、线程数多、扩展重要 | jemalloc | 8 线程放大 1.88×,三家最小(§3.3) |
| 对工作集敏感、希望释放就还 | ucrt / 系统堆 | 释放后工作集回落(§3.2、§7.2) |
| 对提交内存敏感、不能囤货 | ucrt / 系统堆 | 提交仅 3.3 MB,另两家 267/357 MB(§7.1) |
| 大量同尺寸小对象反复创建销毁 | 池资源(pool) | 池的收益在重复同尺寸(§9.2) |
| 短生命周期、单向增长、批量释放 | monotonic 资源 | 指针递增式分配,比 new 快 5×(§9.2) |
| 只想改某几个容器、不改全局 | std::pmr |
运行期逐容器切换(§8.3) |
| 需要可观测性、统计与排障 | jemalloc / mimalloc | 自带 mallctl / mi_stats_print(§4.3、§5.2) |
| 嵌入式 / 极受限于内存 | 系统堆 + 手动管理 | 内部碎片为 0,不囤货(§6.1) |

两条总原则:
- 先量再换。 不要凭感觉换分配器——先跑一下你的真实负载,看瓶颈到底是不是分配。大多数程序的分配开销不到 5%,换分配器的收益有限。更糟糕的是,换分配器可能让某些地方变快、另一些地方变慢,整体效果可能是负的。不量就换,跟瞎猜没区别。
- 能在语言层解决的,别跑到实现层去。 如果只是某几个容器想换策略,用
pmr就行,不用全局换 mimalloc/jemalloc。全局换的副作用——工作集不回落、提交内存暴涨、第三方库行为变化——可能比收益还大。pmr的好处是"局部可控":哪个容器想换就给哪个传,其他的不受影响。
最后补一个常见误区:"分配器越快,程序越快"——不一定。 分配只是程序成本的一部分。如果你的程序主要时间在计算、IO、或者算法上,分配再快也没用。我见过太多团队花一周时间换分配器,压测一看总性能提升不到 2%——还不如花一天优化一下关键路径上的算法。分配器优化是锦上添花,不是雪中送炭。
10.2 交给 ep03:值语义的账
这一篇我们问的是"内存从哪来、什么时候还"——也就是分配的账。但分配只是内存成本的一半。另一半是:对象有了之后,拷贝它要付什么代价?移动它呢?返回值呢?传参呢?
你可能听说过"移动语义零开销"、"RVO 把拷贝优化掉了"——但这些说法哪些是真的、哪些有条件、哪些在什么编译器选项下才成立?std::move 真的不花钱吗?const& 和 && 重载到底选哪个?return 一个大对象,到底有没有拷贝?
这些问题属于值语义(value semantics)——不是"内存从哪来",而是"内存里的东西怎么搬、怎么借、怎么偷"。它跟分配是两本账:分配问的是"向谁要",值语义问的是"要几份"。

本系列第三篇(ep03)就来量这笔账。我们会用跟这一篇同样的方法——同一份探针、多个编译选项、逐成本拆开量。到时候你会发现,"零开销"这句话,跟"池一定更快"一样,只在特定前提下成立。
而那些前提——比如返回值优化(RVO/NRVO)在什么条件下触发、移动语义在什么类型上真的零成本、const& 和 && 重载怎么选——才是真正决定你代码跑得快不快的东西。也是很多"优化建议"翻车的重灾区:有人说"全部用移动语义",有人说"传值比传引用快",听起来都有道理,但跑起来结论完全相反。
问题从来不是"哪个更快",而是"在你的场景下哪个更快"。这也是本系列从头到尾坚持"先量再说"的原因——感觉不可靠,排行榜不可信,只有你自己机器上跑出来的数字才算数。
资源清单
- 标准原文:cppreference
std::pmr::memory_resource、C++ 标准 [mem.res] 章节 - glibc 手册:The GNU Allocator、Malloc Tunable Parameters
- jemalloc:jemalloc(3) 手册
- mimalloc:MSR-TR-2019-18 技术报告
- 外部素材:Wikimedia Commons
Malloc_versus_HeapAlloc.svg/Free_list.svg/External_fragmentation.svg/Memory_pool.svg(均 CC0) - 本机探针源码与九份读数留档:随篇入库,路径
content/blog/cpp-language-foundations-ep02-allocators/evidence/
下篇预告
【C/C++ 现代语言与底层】(三)值语义解剖:拷贝、移动与 RVO 的真实代价——同一句 return,在什么编译器、什么写法、什么类型下,会生成什么样的代码?移动语义真的零开销吗?我们用探针把每一种组合都量一遍。
希望能对大家有所帮助。下一篇见。
本文由 @溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations