系列配套:GitHub 源码仓库(demo 代码与生成本文全部示意图的工具)|在线阅读入口(本站发布)
上一篇我们拆完了着色器核:一个核里装了什么、占用率怎么算、GPU 靠什么让千个线程一直有活干。账算到那里,有一件事反复出现——访存要等很久,硬件靠并发把等待盖住。但显存那一层的账,落进像素着色的实际操作里,是靠一块我们还没拆的东西去取数的:纹理采样器。
这一篇在系列里的位置,可以再看一眼全系列知识地图:命令前端、显存、着色器核都到了,再往下就是纹理采样器与光栅化。本篇是第四站,它回答一个问题——shader 里写一句 texture(...),硬件到底在这一句后面走了一条多长的路。
先来看看,这一篇那句会反复被引用的结论是什么:采样不是一个「读像素」,而是一条几百级的深流水线。 坐标归一化、LOD 计算、cache line 对齐取数、滤波插值、写回寄存器,每一个步骤都在不同的硬件级里串行推进,延迟动辄几百周期。GPU 不试图压缩这条流水线,而是用足够多的并发采样请求把它的延迟盖住——这跟上一篇着色器核「用并行填延迟」是同一招,只是换了条链再用一次。
一句话点题:延迟藏在一句 texture 后面
先把这一篇要回答的问题串起来,一共四件:
第一,请求从哪进、到哪出。 一条采样指令从 warp 里发出来,坐标要经过哪些硬件级,中间有没有调度器、有没有缓存、有没有排队。出处:NVIDIA CUDA C++ Programming Guide · Texture Memory。
第二,坐标怎么变成一段颜色。 纹素坐标要先归一化,再按寻址模式换算,再按滤波模式做插值——每一步都是一类硬件逻辑。出处:Vulkan Specification · Textures。
第三,取数为什么要等那么久。 这里会出现一个反直觉的点:一次采样真正卡住的往往不是 ALU 算插值,而是 cache 没命中的那次内存访问。 先把这个模型立起来:假设一次采样的总延迟是 $L$,它大致由 $L = L_{算} + L_{等}$ 组成,其中 $L_{算}$(坐标换算、滤波的 ALU 部分)通常就几个周期,而 $L_{等}$(等数据到)在 L1 未命中时能到几十上百周期。几百周期的延迟,大部分花在等数据到,而不是算。出处:Fabian Giesen《A trip through the Graphics Pipeline 2011》Part 3。
第四,延迟怎么被盖住。 采样器比着色器核更极端——它把「用并行填延迟」这一招做到极致,用几百级的流水线深度,换每一级都能并行填满。这一层因果,跟上一篇的延迟隐藏完全同构。
好了,四个问题串起来了,动手之前先把这句边界声明码清楚:本篇不讲 UV 展开与美术流程,不教怎么烘焙纹理贴图,也不讲 Mipmap 是怎么生成出来的(那是离线和上传的活)。本篇只讲线上那一半:一条采样请求进了硬件之后,每一级在干什么、为什么慢、用什么盖住慢。 离线的纹理生成与压缩编码,留给纹理管线文档。出处:GPUOpen · GPU Image Operations。
为什么要啃这一篇:因为「纹理采样很快」大概是图形里最普遍的误解之一。它经常被当成一次便宜的内存读取,被当成 shader 里随手能写的东西;也经常在性能排查时成了一个「别动它」的黑盒。这两件事都不对——它不快,只是被并行盖住了;它也不黑,只是一条级数太多的流水线,一旦拆开,延迟和带宽的账都能算清楚。
下面依「请求路径 → 坐标换算 → 滤波与 LOD → 缓存与延迟账」的路线往下展开。
一、TMU 在 GPU 里的位置:warp 之后、取数回写
我们正式开始。要把采样讲清楚,先得把它放在芯片里。
1.1 一次采样指令发出了什么
当 warp 里的一条指令是纹理采样时,它实际上做了什么?先看软件侧。shader 里写 texture(sampler, uv),经编译器翻译后,通常变成一条纹理指令(如 TEX / TSAMPLE / IMAGE_SAMPLE):
vec4 color = texture(tex, uv);   // 你写的
// ↓ 编译后大概长这样(伪汇编)
TEX    R0.xy, R1.xyzw, R2, tex, sampler  // 坐标→结果寄存器
其中 R1 是 uv 所在的坐标寄存器,R2 是采样器绑定,R0 是结果写到哪。它带着三个东西:采样器绑定(sampler,或独立的 immutable sampler)、坐标寄存器(uv 所在的那组寄存器)、以及一个目标寄存器(结果写去哪)。
这里有一个多数人没注意的点:坐标是 per-lane 的,但 sampler 是整个 warp 共享的。 一个 warp 里的 32 条 lane,各自带着自己的 (u,v),共用同一套寻址与滤波参数。这很重要——它决定了采样硬件可以怎样分摊成本。出处:OpenGL Specification · Texture Sampling。 出处:Vulkan Specification · Programming Model。
1.2 指令去了哪:TMU 与统一缓存
纹理指令不会直接去读显存。它先进 TMU(Texture Mapping Unit,纹理映射单元)。TMU 是着色器核里的一块固定功能硬件,专门承接采样请求。它将算坐标换算、滤波、LOD 这些活;真正的数据在 TMU 背后的 texture cache 里查。
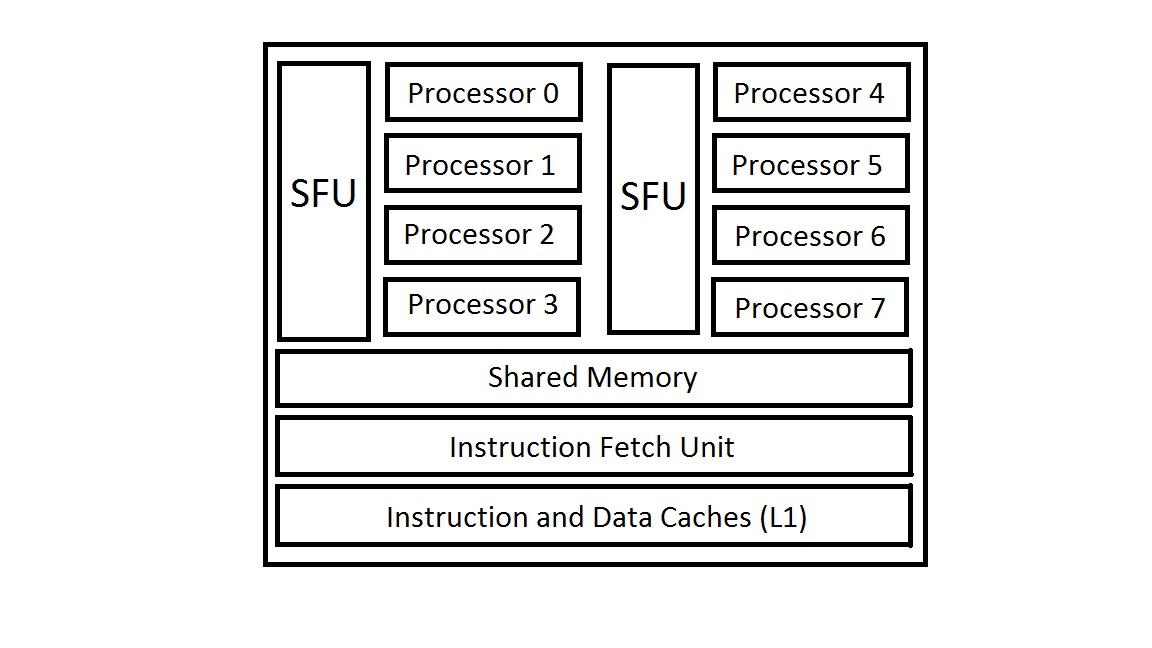
不同厂商给了不同的名字:NVIDIA 管它叫纹理单元或 TEX 单元;AMD 在 GCN 时代叫 TMU,RDNA 里把纹理与 L1 缓存合并得更紧。但机制一致:采样请求先进 TMU,TMU 算坐标,再去缓存取数。 出处:NVIDIA CUDA Programming Guide · Texture Memory。
1.3 shader 视角:一次指令,透明地完成
对 shader 程序来说,这一切是透明的——一条 texture(...) 就是一条指令。TMU 帮它处理了坐标换算、滤波、mipmap 选择、cache miss。这个「透明」是硬件设计的刻意选择:它把极深的内部流水线,抽象成一拍指令的语义。
但透明不等于便宜。正是这份透明,让无数性能问题被藏了起来:一条采样指令到底有多贵,取决于它背后的 cache miss 多不多、滤波开多高、坐标是否助长了 LOD 抖动。 这些全在 TMU 内部,shader 看不到,只能从延迟和带宽的账里反推。
二、采样输入:坐标、sampler 状态、LOD bias
进入内部之前,先把采样的「输入面」铺平。说白了,一次采样,硬件拿到的东西比 shader 写的那句多得多。
2.1 采样器状态位:把「怎么采样」钉死在对象里
现代 API(Vulkan / D3D12)把采样参数拆成了独立的 sampler 对象。它是一组状态位,不再随每次采样指令重复传递。这条设计很深:sampler 与纹理解耦后,同一个纹理可以用多套滤波/寻址策略采样,而纹理本身不带采样状态。 出处:Vulkan Specification · Samplers and Views。
具体到硬件,sampler 携带的大致是这些位: - 寻址模式(wrap / clamp / mirror / border 之一或分轴组合); - 放大滤镜(mag filter:nearest / linear); - 缩小滤镜(min filter:nearest / linear); - Mip 滤镜(mip filter:none / nearest(选层)/ linear(层间混合)); - LOD 钳制(min/max LOD)、LOD bias、各向异性级别。
一度这些状态是纹理对象的属性(如 OpenGL 时代的 GL_TEXTURE_MIN_FILTER 挂在纹理上)。Vulkan 把它拆出来,硬件采样时每次都要读 sampler 状态,但状态本身是常驻的、可被缓存。
2.2 坐标寄存器与 per-lane 的并行
坐标是 per-lane 的。32 条 lane 各带自己的 (u,v),可能还带 w(对 3D 纹理)和 dLod 等。硬件把这些坐标打包成一次 warp 级采样——32 个独立坐标,一次调度,共享同一组 TMU 逻辑。 这一点与 ALU 指令完全平行:采样器面对的不是 32 次独立调用,而是 32 份坐标同时喂进同一条采样流水线,固定开销(sampler 状态读取、流程分发)只摊一次,而不是铺开 32 遍。
这是「并行填延迟」的最底层形态:不是 32 条 lane 各跑一遍采样逻辑,而是一条 TMU 流水线同时吞吐 32 个请求的坐标换算。
把「分摊」再压实一点看:这 32 份坐标不是排队一份份算,而是打包成一次 warp 级采样请求,一起进 TMU。采样器面对的不是 32 次独立调用,而是 32 份坐标同时喂进同一条流水线——sampler 状态读取、流程分发这类固定开销只烧一次,而不是铺 32 遍。所以采样吞吐的账,单位从来是 warp,不是单条 lane。
2.3 LOD bias / explicit LOD:软件能干预的少数旋钮
采样器还接受一个 shader 可传入的 LOD bias,以及显式的 LOD(textureLod / textureGrad)。这给 shader 两个干预采样的旋钮。它们的共同点是直接改 LOD 计算:bias 是在硬件算出的 LOD 上加一个偏移,explicit LOD 则完全接管。出处:Vulkan Specification · Texture Operations。
多数情况我们用默认路径:硬件从屏幕坐标的梯度自动推出 LOD。但要知道这两个旋钮存在——当自动推导在边缘产生纹理抖动(texture swimming)时,textureGrad 是解决办法。
三、寻址模式在硬件里怎么落地:归一化的艺术
好了,坐标和 sampler 都在手上了,接下来看它们进了 TMU 之后第一拍干什么。坐标到了 TMU,第一件要做的,是把它变成「该读哪个纹素」的定位。这一步在硬件里分两拍:归一化,再按寻址模式换算。
3.1 归一化坐标到纹素坐标
纹理坐标是归一化的,范围大多落在 [0,1]。硬件拿到它时,先乘上纹理的分辨率 S×T,得到纹素坐标 (u·S, v·T)。一句话公式:$s=u \cdot S,\quad t=v \cdot T$,其中 $S,T$ 是纹理长宽(纹素为单位),$(u,v)$ 是归一化坐标,$(s,t)$ 是纹素坐标。这一步是所有寻址与滤波的前提,也是整数/定点运算要处理的第一站。出处:Vulkan Specification · Notation。
这步看起来简单,却暗含一个设计取向:硬件固定做定点/整数换算,而不是浮点。 一致、可预测、没有跨实现浮点误差——这也是为什么不同 GPU 之间采样结果能高度一致。
要建立「归一化坐标 → 纹素坐标」的空间感,最直观的是把表面看成一张展开的 UV 平面:物体被摊平成矩形坐标系,每个点拿到一个落在 [0,1] 的 (u,v)。贴图上各个位置在物体表面怎么分布,全由这张展开决定——而采样硬件根本不关心 3D 形状,它只认展开后这张平面上的坐标。
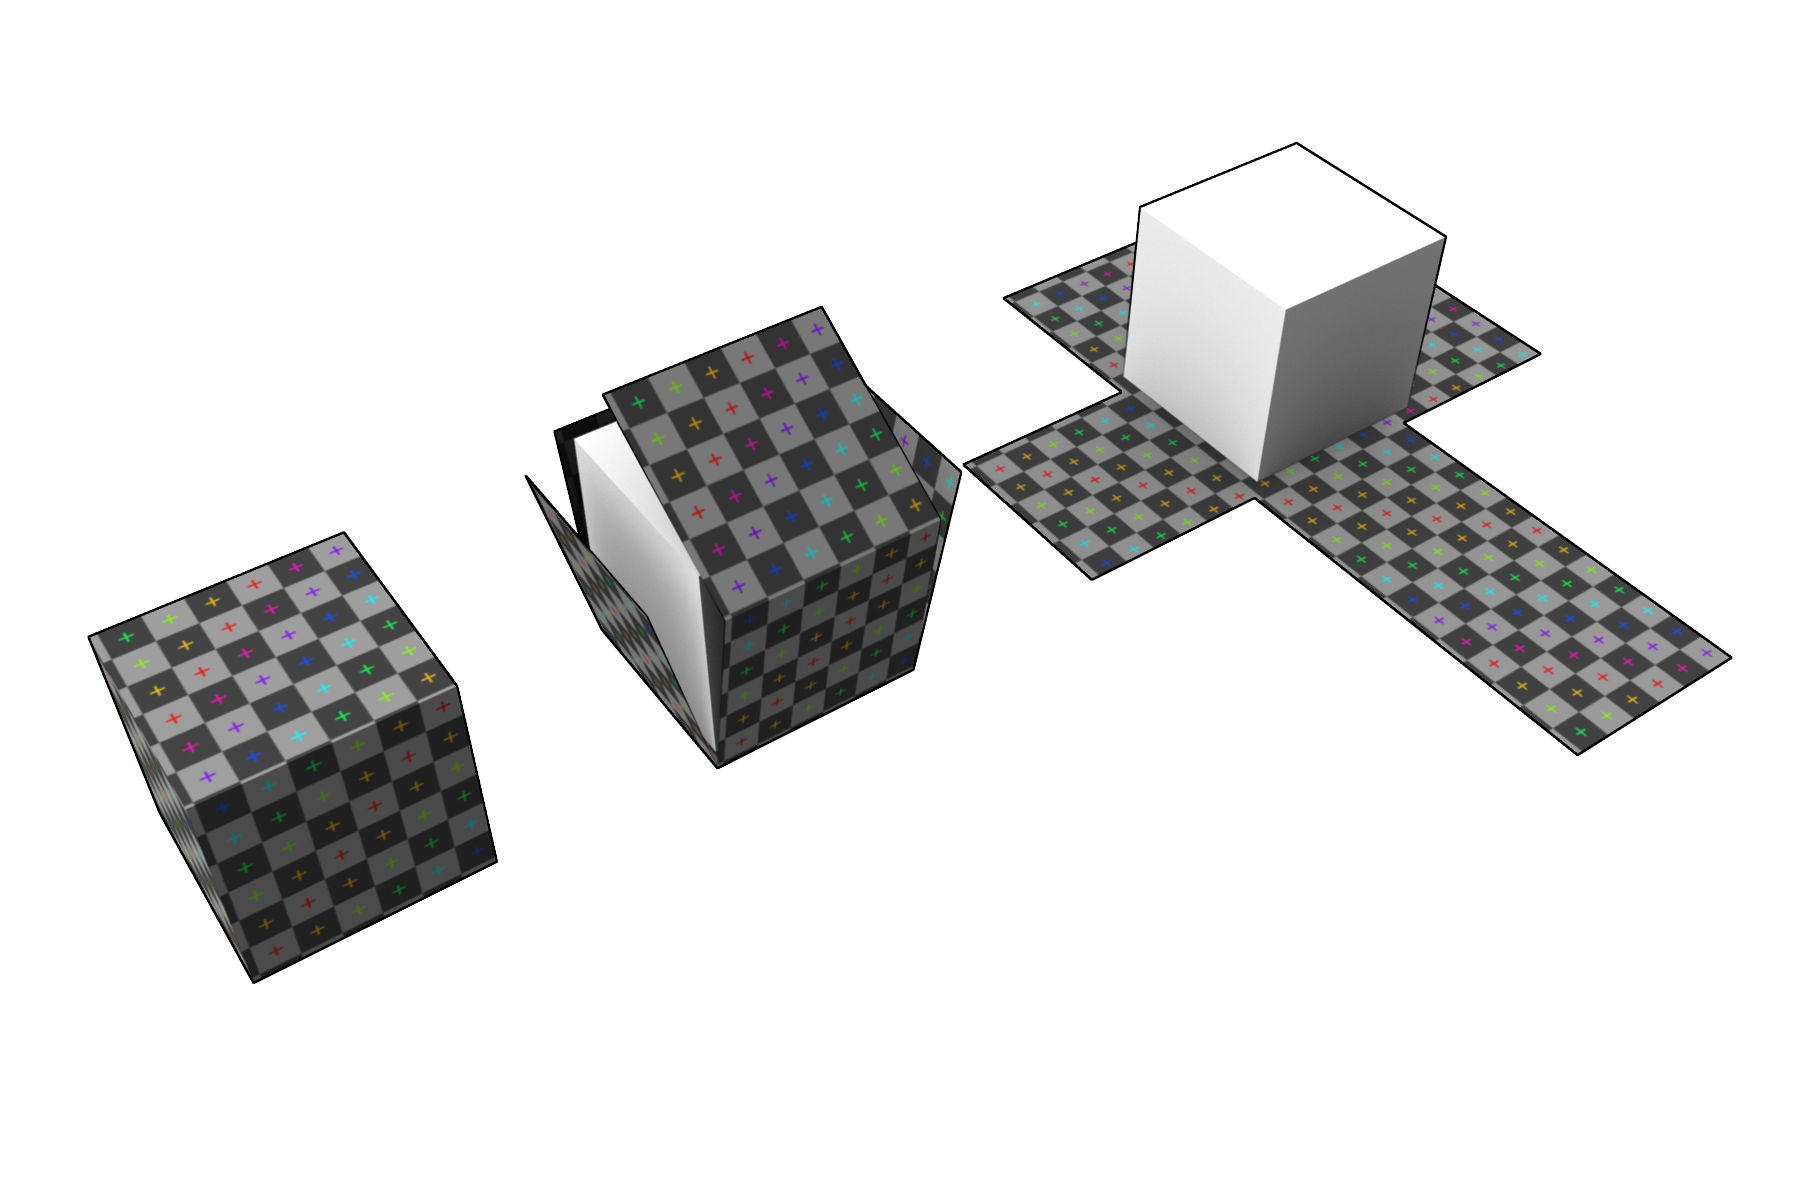
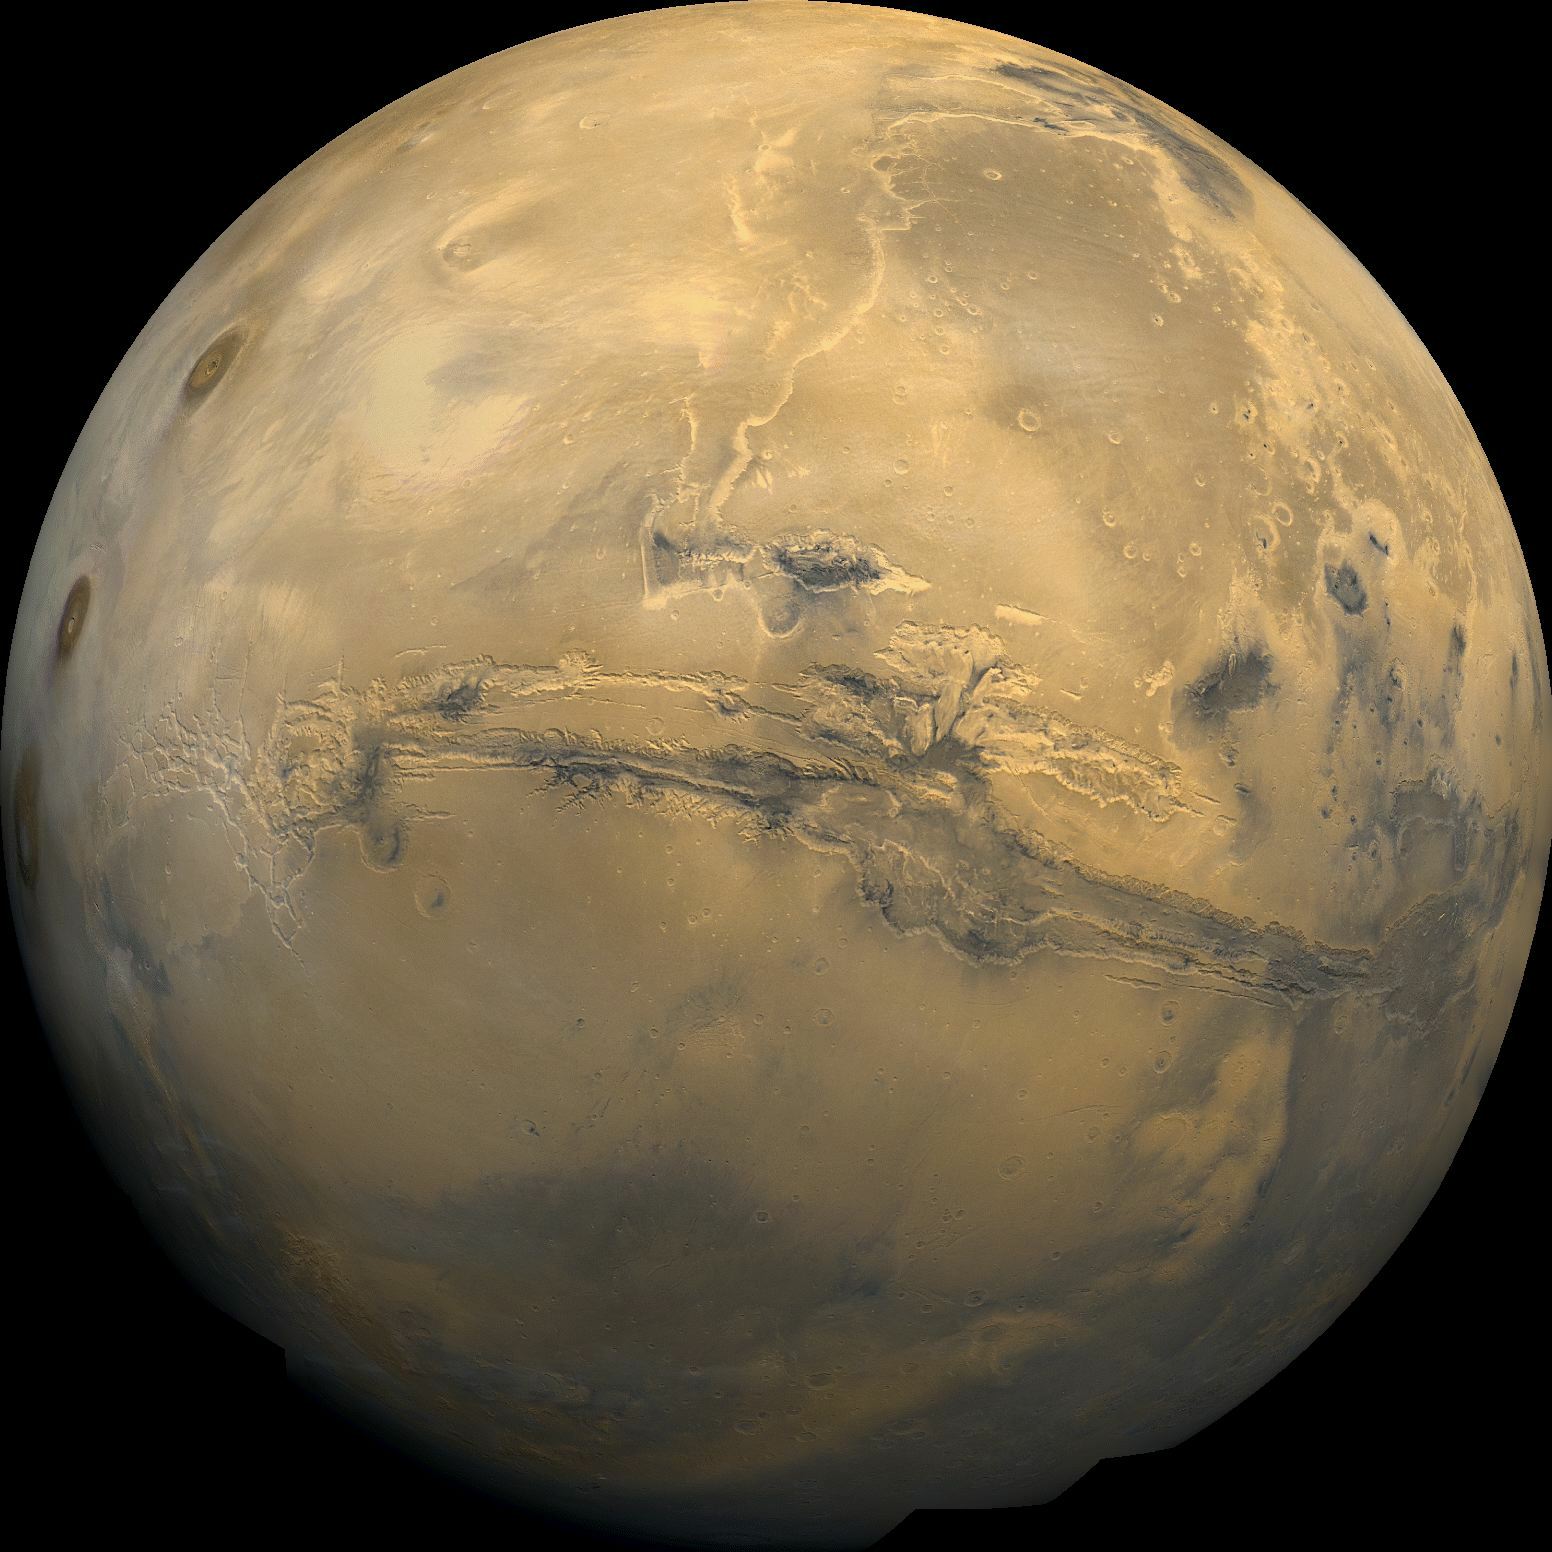
把这张平面再包回曲面,就是纹理映射的成果:一张平面影像被包裹到球面或地形之上,屏幕上每个像素沿着它所在处的 (u,v),回纹理平面里去取色。这印证了前面那句判断——硬件只管在平面坐标系里取数,3D 的形状和 UV 怎么分布都是贴图阶段定的,采样器只要坐标对就行。
3.2 四种寻址模式:wrap / clamp / mirror / border
先来看看坐标归一化之后发生了什么:麻烦在于——纹素坐标可能越界(小于 0 或大于 S)。越界之后怎么办,由寻址模式决定。四个标准模式,硬件各有实现:
- wrap(repeat):取模,
coord mod size,纹理会重复平铺。硬件实现最便宜——只需要一次与 size 的按位与(当 size 是 2 的幂时),或一次取模。 - clamp:钳到 [0, size],边缘纹素被拉伸填充。需要一次饱和运算(clamp 到合法范围)。
- mirror:把坐标在 [0,1] 往返反射,镜像重复。需要判断奇偶再取补。
- border:越界区域返回一个固定 border 颜色,不采样纹素。最贵——要判断越界并短路到常数区。
成本差异不大,但存在。这里是硬件语义在起作用:wrap 在 size 为 2 的幂时直接按位与,几乎零额外周期;clamp 和 mirror 各多一两条逻辑。这是为什么很多引擎对可平铺地板偏爱用 2 的幂尺寸——一半是历史惯性,一半是真有一点周期成本。
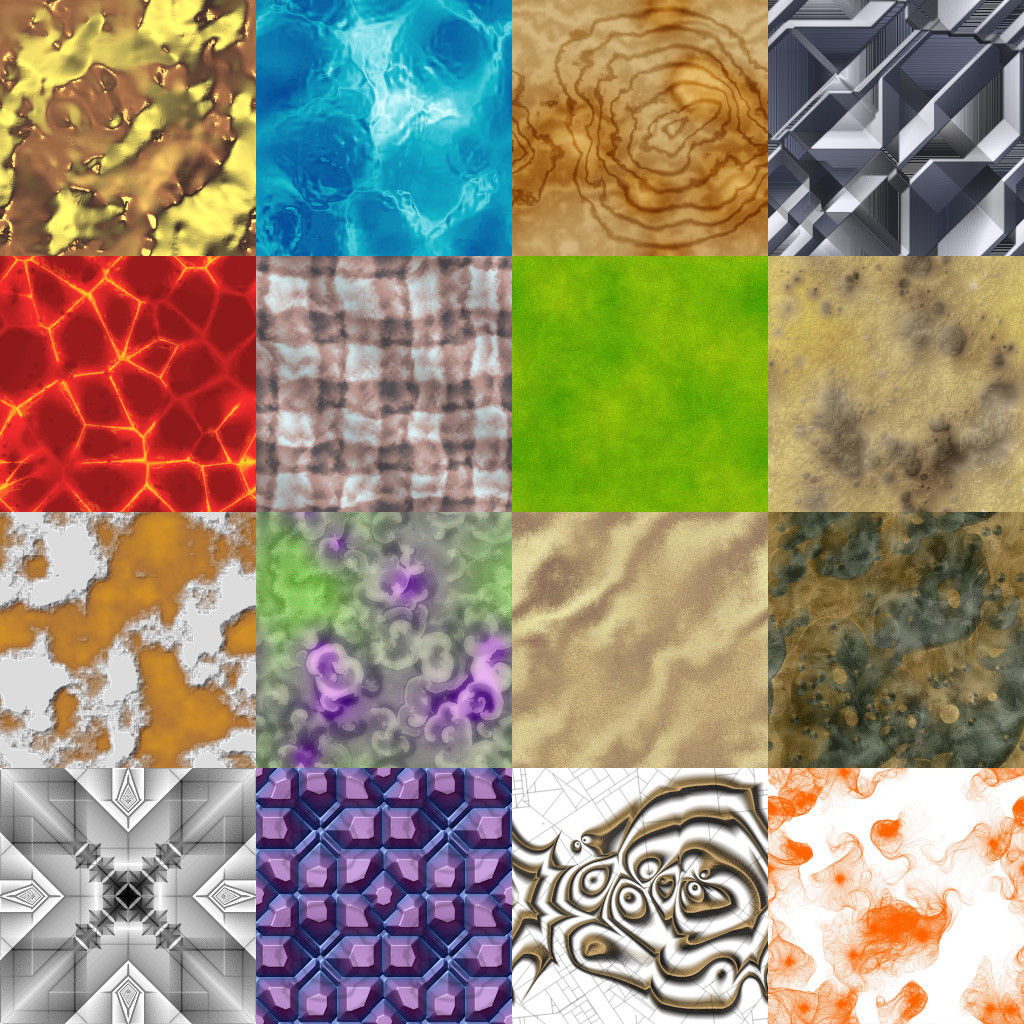
wrap 的「平铺」是引擎里最常见的地板手法:一张地板纹理 wrap 之后无缝重复,米数随便铺。可一旦放在图上看,它其实就是把同一张图按单位块四向贴满——这正是上一段说的取模地址换算的直观画面,也是透视近处清晰、越远越密的纹理重复感来源。
3.3 越界访问:clamp 的边界语义
值得单独提 clamp 的边界语义:clamp 到边界不是「复制最后一行纹素」那么简单,它与滤波叠加后会取到最外圈纹素带,在 minification(缩小)场景下会产生边缘特征。硬件处理 clamp+filter 的正确性,是材质边缘不糊的关键。出处:GPUOpen · GPU Image Operations。
这一层边界语义有个可操作结论:缩小场景里,clamp 模式会把最外圈纹素的颜色一路拖到边缘,形成一圈可见的「边框」。要避开它,要么换 wrap、要么在美术侧把边缘 mip 做干净,要么接受 minification 下一点边缘特征。硬件只负责按寻址语义取数,好不好看是参数的问题。
四、滤波在硬件里怎么落地:nearest → bilinear → trilinear → AF
言归正传,坐标定位搞定,接下来是采样流水线的核心:滤波。它决定了一组纹素怎么合并成一个采样结果。滤波的选择是 min filter / mag filter 与 mip 的组合,硬件按放大还是缩小分两条路走。
滤波不是控一个开关,而是一架从快到处、从省到省的阶梯:最近邻最快只取一个纹素,双线性读 2×2,三线性翻到两层 mip,各向异性则按投影拉长方向再多读整排。每上一档,读的纹素变多,画面更顺、带宽压力也更大。理解这张阶梯,这一章的四个小节就串起来了。
4.1 mag filter:放大时的插值
当采样点的投影纹素尺寸大于纹素本身(放大),用 magnification filter。两个选项:nearest(取最近的纹素,最便宜)或 linear(bilinear,取邻近 2×2 并双线性插值)。放大时采样点落在纹素网格的「内部」,nearest 直接取离该点最近的纹素,几乎不做运算;linear 则要读出包围该点的四个纹素做插值,成本高但结果平滑。
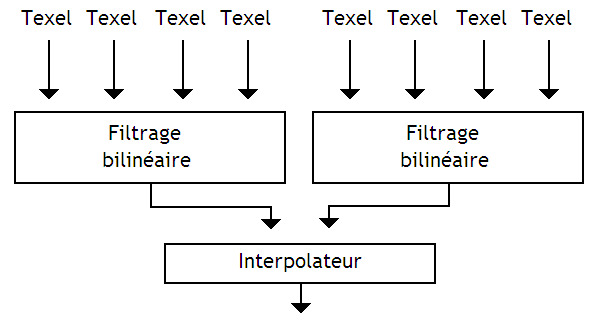
linear 是绝大多数写实渲染的选择,因为它把「像素感」抹掉,代价是读 4 个纹素(在单一 LOD 层)。这里的「4 个纹素」是关键数:bilinear = 2×2 纹素,两次线性插值。
4.2 双线性滤波阶段:两个 pass 的两次插值
先对 2×2 纹素围成的四方格做一次横向插值(两对相邻纹素各插一次,得两个中间值),再做一次纵向插值(沿另一条轴把这两个横向结果合成目标点的唯一颜色)。写成公式就是:先对每条边做 $p_{上}=T_{a0}(1-\alpha)+T_{a1}\alpha$、$p_{下}=T_{b0}(1-\alpha)+T_{b1}\alpha$,再沿另一轴合成 $p=p_{上}(1-\beta)+p_{下}\beta$。其中 $\alpha,\beta$ 是采样点在 2×2 格内的横向/纵向小数偏移。这就是「双线性」名字的来历:先在一条轴上做线性、再沿另一条轴做线性,两个 pass 共两次插值,本质是 2×2 双线性基函数的硬件落地。出处:Texturing and Modeling: A Procedural Approach。
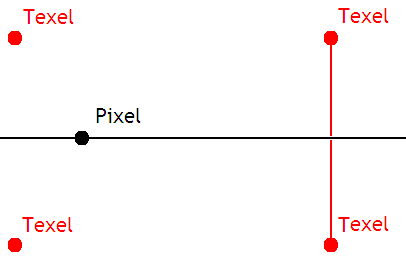
用定点还是浮点做这两次插值,取决于硬件世代;但结构不变:4 次读取(2×2 纹素),2 阶段线性混合,1 个输出。 它保证了放大时没有 nearest 那种生硬的块状感——代价是固定 4 次取数,无论采样点落在格的哪个角落都躲不掉。
把这两拍画出来更直观:pass 1 横向——对上下两条边,各在相邻两个纹素之间插一次,得到两个中间值;pass 2 纵向——再沿另一条轴把这两个中间值合成采样点的唯一颜色。两次都是单轴线性插值,叠起来才是「双线性」。
4.3 trilinear:跨 mip 层的混合
放大之外,多数实际场景是缩小(minification)——这时目标纹素比像素小、画面在往下缩,直接单层采样会出走样(闪烁、抖动),得靠 mipmap 预先生成的一串缩小副本。三线性(trilinear)取两层「最近」的 mip:先在每层上各做一次双线性,再按 LOD 小数部分的位置,把两个结果做层间线性混合,得到一个连续过渡的纹素。出处:Vulkan Specification · mipmap LOD。
三线性的纹素读取量从双线性的 4 个涨到 8 个(每层 4 个 × 2 层),取数多了一倍。它是最普通的滤镜——几乎默认开启——也因此成了带宽压力的第一个来源:一遍 trilinear 就是 8 次纹理访问,画面里动辄几百万个采样点,把这笔账乘上去,cache 在放大缩小交错的场景里很容易被顶满。
4.4 各向异性过滤(AF):不是魔法,是读更多纹素
三线性到此为止,但滤波还没讲完——还有一档更「重」的:各向异性过滤(Anisotropic Filtering, AF)。它是为了在很斜的表面上消除模糊。它的思路很直白:当纹素在屏幕的投影严重拉长时,按拉长的方向读一排纹素,而不是按 mip 取一层糊掉。 出处:Wikipedia · Anisotropic filtering。
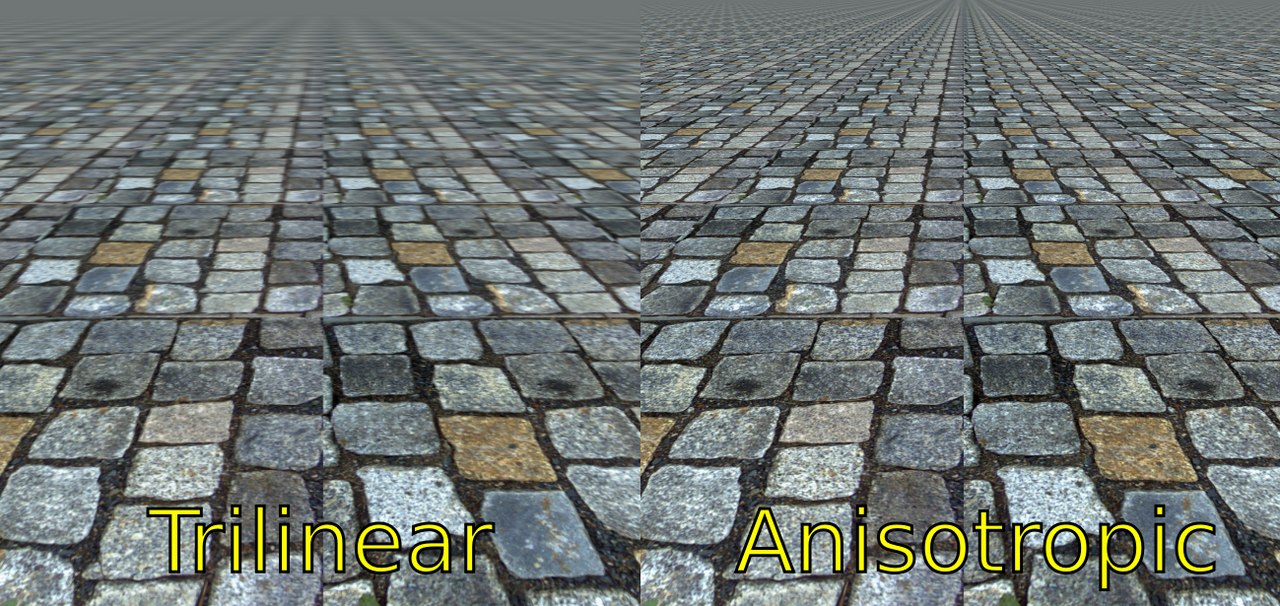
关键要打破一个流行的误解:AF 不是对每帧画面做更强的滤波,而是每多一个采样数量级就多读一批纹素。 4x AF 一次采样可能读 4 个双线性样本,8x 读 8 个,16x 读更多。
这不是一张帧渲染里的「逐像素扫描」——它是固定管线在采样器内做的,一次采样请求被拆成多次子采样,硬件自动完成。它不快,但被并行盖住。
把倍率落到「读多少」这一口上:1x 只在近邻方向采一次(4 纹素),2x 补第二个方向,到了 8x/16x,采样器沿投影最拉长的方向整排取数,单次采样请求的纹素读取量从 4 跳到 32~64。这就是为什么 AF 档位越高,纹理带宽计数器涨得越明显——插值 ALU 是复用的,涨的是读纹素的带宽开销。
4.5 AF ≠ n 倍 ALU
这里是拿来算账的一句:AF 的高倍率主要花在「读更多纹素」上,而不是更高的 ALU 插值算力。 插值逻辑是复用的——它只是把「读出 4 个还是 32 个纹素」不同。代价第一落在纹理带宽 / cache 压力上。
这让性能调优有个很实用的推论:把 AF 从 4x 提到 16x,帧率下降主要来自带宽,而不是 TMU 的算力。 想验证,看 cache miss 与纹理带宽计数器,而不是看 ALU 利用率。
五、LOD 与 mipmap:把「该看多大」算出来
滤波把「读哪几个纹素」定下来,但这些纹素来自哪一层 mip,由 LOD 决定。LOD 是本篇最容易出反直觉结论的地方。
5.1 LOD 从哪来:屏幕空间梯度
硬件从屏幕坐标推导 LOD——它算 uv 在屏幕空间(x、y 两个方向)上的差分(gradient)。粗略说:把 (dU/dX, dV/dX) 与 (dU/dY, dV/dY) 的模合成一个量,再映射成 mip 层级。 出处:Vulkan Specification · Gradients。
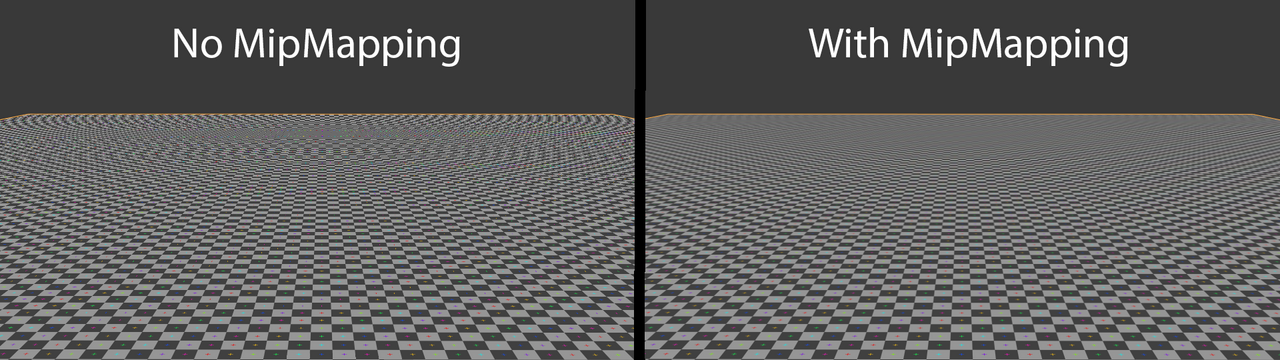
这是关键机制。它意味着 LOD 是每个像素独立算的(严格说是每 quad 用统一的微分),并且完全取决于这个像素在屏幕上对应的 uv 变化率——远景的平面 uv 变化慢→低 LOD(更糊的 mip),近景的平面 uv 变化快→高 LOD(更细的 mip)。
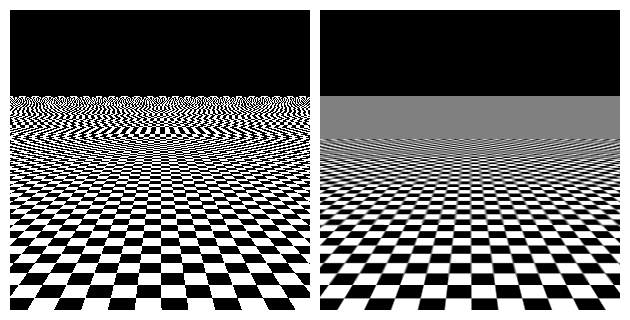
用一张真实示范图把这句话钉住:同一张棋盘格纹理,远处因采样点比纹素还稀而出现摩尔纹抖动,近处则清晰稳定。预先算好各级 mip、按 LOD 挑层后,远景也能停在「看得清却不闪烁」的那个模糊档,而不是在画面里剧烈闪烁。
拆开看,梯度就是一组差分:在屏幕的 x 方向测 uv 变了多少(dU/dX、dV/dX),在 y 方向又变了多少(dU/dY、dV/dY),把两方向的模合成一个标量,再映射成 mip 层级。uv 变化越剧烈,说明屏幕上这一小片覆盖的纹素越多,就越该用更细的层。
5.2 走样与 mipmap:为什么不能只采一层
还是那句老话,先看看不做 mipmap 会发生什么:如果不做 mipmap,缩小(minification)时单个像素会同时覆盖多个纹素,直接采样会欠采样→走样(aliasing)——远处出现闪烁、摩尔纹。mipmap 就是为此而设:提前把不同分辨率(每层减半)的版本算好,采样时按 LOD 挑一层或两层。出处:Wikipedia · Mipmap。
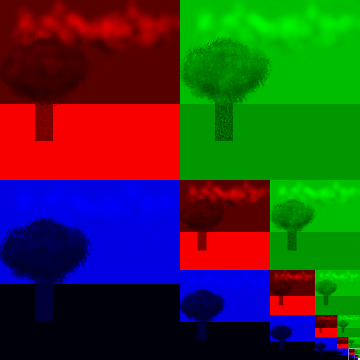
mipmap 是「提前多做一遍工作,换采样时少等」的经典硬件权衡:存储多花 33%,换采样在任何 LOD 下都只读固定几层。
把这份代价量化到存储上:只算比率,基图是 1,下一层是 1/4,再下面 1/16,无限递减——等比级数求和是 4/3,也就是比单张纹理只多 1/3 的存储。用这 33% 换来的,是任何 LOD 下都只读固定的几个层,不再被远景缩放反复触发整纹素扫描。
5.3 LOD 计算的粒度:2×2 quad 是根子
LOD 要算梯度,而梯度必须有两个相邻像素的 uv 做差分。因此 GPU 永远按 2×2 quad(四像素块)做像素着色,即使屏幕边上一个孤立的像素也会补一个 quad。这跟上一篇的 quad 机制是一回事——LOD 计算最小单位就是 quad。
这带来一个实际影响:边缘的孤立像素也会连带处理一个 quad 的采样,浪费的部分上次在着色器核章算过。这里只强调:LOD 的实现依赖 quad,是采样不像你想的那么便宜的原因之一。
5.4 LOD bias 与 mip filter:两个可调的档
说到旋钮,还差两个没展开。前面提过 LOD bias 与 explicit LOD,现在结合 mip filter 把它们一次说全:mip filter=none 时只采一层(LOD 四舍五入到最近的整数层,对应「只挑一张最像的 mip」);mip filter=linear 时采相邻两层并做层间混合(就是三线性)。而 bias 是在自动推导出的 LOD 上再做一个偏移量:负 bias 强制往更细的层走,正 bias 往更粗的层走,把「画面细节」和「带宽开销」的天平手动往一边扳。出处:Vulkan Specification · Levels of Detail。
工程上,负 bias(往更细层走)常用于让纹理看起来更锐、远景更清晰,但副作用是走样更明显、带宽只升不降;正 bias(往更粗层走)则是省带宽、减轻远景闪烁的常用手段,代价是纹理泛糊。这是一对「清晰 vs 带宽」的画质旋钮——比起调电源档位它更精确,也是高端渲染器里常开放给用户的两档预设(如「锐利」「省流」)的底层机制。
画成一左一右的对比更清楚:往细走,抓到的纹素更多、锐度和走样一起上来,带宽往上顶;往粗走,采的层更糊、带宽往下掉。调 bias 就跟拨天平,想要哪边,就承受另一边。
六、缓存层级与压缩:取数那一下才是大头
说白了,前面坐标换算和滤波都是纯计算,做得再深也快——真正慢的是取数。这一章讲的是不讨喜但决定帧率的那个部分:采样请求进了内存系统后,延迟和气被灌在哪。
6.1 采样请求的缓存查找路径
采样要的纹素数据不是直接去显存。它在层级里找:texture L1(TMU 旁)→ L2 → 显存(VRAM)→ 内存(对集显)。命中层级越低,延迟越小;落到显存/主存,延迟暴涨。出处:NVIDIA CUDA Programming Guide · Memory Hierarchy。
纹理采样的特殊之处是它有自己的专用缓存(tex L1 常常是独立于指令缓存的标记),并且缓存行的形状是针对纹素访问的。但要澄清:现代架构里 L1 多为统一缓存(unified / combined),分享给共享内存与纹理。
6.2 cache line 对齐与 miss 填充
一次滤波(双线性就要)读 4 个或更多纹素,这些纹素是否落在同一条 cache line 里,直接决定了这一拍要触发几次内存访问:同线就是一次取齐,跨线就得拆成多次。 粗算一下:设纹素一个占 $b$ 字节、缓存行是 $B$ 字节,那么一条 128B 的 miss 填充能装 $\lfloor B/b\rfloor$ 个纹素。若 4 个纹素恰好横跨两条 line,一次采样就从 1 次访问变成 2 次。硬件因此会尽量按 2×2 的纹素块对齐读取(quad 对齐),让一次 4 纹素的采样尽量只触碰一条 cache line、只触发一次 miss 填充。出处:FGiesen · Graphics Pipeline Part 3。
把「一个纹素占多少字节」也算进去,才能真正体会 cache line 的价值:RGBA8 每纹素 4 字节,一条 128B 的 line 能装 32 个;RGBA16f 每纹素 8 字节,只能装 16 个;BC/ASTC 压缩块用 8 字节就压掉了 4~16 个纹素,同样的一条 line 能装下成倍的邻域。纹素越紧凑,同一条缓存行盖住的邻居越多,后到的采样命中率越高——这也是压缩在带宽之外、对命中率的第二重贡献。
6.3 BC / ASTC 压缩:把 99% 的带宽省回去
缓存只解决「热点重复读」,真正把纹理带宽压下来的是压缩。把纹素按固定块压缩(Block Compression, BC / Adaptive Scalable Texture Compression, ASTC),是降低纹理带宽的杀手锏。它分块(如 4×4 texel 一块)压缩,让显存里的纹素以压缩存储、在取数路径内解压,节省的大头是带宽。出处:Wikipedia · S3 Texture Compression。 出处:Vulkan Specification · Block-Compressed。
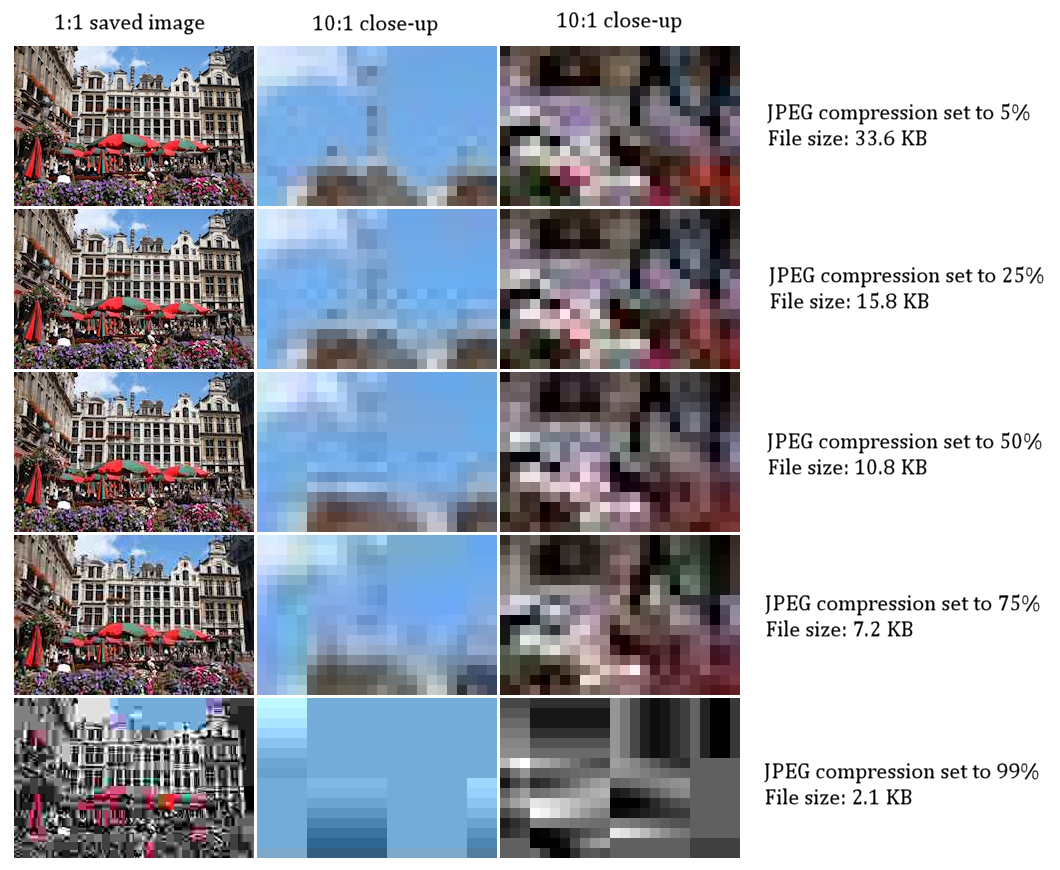
沿线数字看不出冲击力,放一张真实对比图:同一张照片,压缩质量档一路降下去,文件体积同时大幅变小——纹理压缩省带宽的代价就是质量档的取舍,只是 BC/ASTC 用的是固定的块压缩,质量档对应块的位深选择。
压缩比可到 4:1(BC1)乃至 8:1(ASTC),对带宽与显存是数量级节省。换算一下:同样一块 4KB 的纹素数据,不压缩要搬 $4\,\text{KB}$,用 4:1 的 BC1 只搬 $1\,\text{KB}$——省下来的就是取数路径上每一拍实打实的带宽。这是为什么现代引擎几乎只上传压缩纹理。
沿着取数路径标一遍更直白:压缩省的是「显存 → TMU」这一段。显存里躺的是小块压缩数据,取数路径上先把它搬进 TMU / 解码单元解压,之后才轮到滤波。真正省下的,是这段跨片传输上几十 GB 级的带宽——而解压要付的那点解码算力,放在省掉的带宽面前不值一提。
6.4 解压透明:在 TMU 内完成
关键机制:压缩纹理的解压发生在 TMU/tex 单元内部,对 shader 完全透明。 shader 拿到的始终是解压后的最终纹素,它既不知道那块纹素在显存里是不是压缩存储,也无需为此写一行额外指令——带宽省在「显存→TMU」这段路上,解压成本由固定的 TMU/解码硬件悄悄消化。这让压缩可以在不改任何应用代码的前提下普及。
代价呢?解压要用掉一点 ALU 算力和一点 L2/取数带宽,但这点开销和它省下的跨片传输带宽完全不在一个数量级——省的是每帧几十 GB 的读带宽,付的是一小块固定的解码逻辑。净收益巨大,这就是 BC/ASTC 在现代引擎里几乎被默认启用的原因:你不显式启用,采样路径上照样在替你省带宽。
七、延迟与吞吐:几百周期藏在哪、怎么盖住
好,现在把前面的都合起来,算总账。这也是本篇的落点。
7.1 一次采样延迟:几百周期 vs ALU 的一周期
把它量化:一次采样,从指令发出到结果就绪,延迟通常在几十到几百个周期,取决于 L1/L2/VRAM 命中情况。而一条 ALU 指令一个周期就出结果。差距是数量级的。用前几篇的口径写:延迟就是一个数 $L$,ALU 是 $L_{ALU}\approx 1$ 周期,采样是 $L_{tex}=10^1 \sim 10^2$ 周期,两者只差在「结果要等数据到」。出处:NVIDIA Hopper Architecture。
那"几百周期"到底在哪?把眼光从软件抬到硬件——一次采样要穿透的是一堆真实的硅片结构:TMU、各级缓存、显存控制器、跨片的传输线。这张真实 AMD GPU die(Radeon R9 290,28nm,显微摄影)里那些纵横交错的阵列,就是延迟和带宽赖以存在的物理本体;采样要等的数据,就趴在这些结构里,越深入 die / 远离着色器核,等待越久。
但 GPU 不在乎单次延迟。它要的是吞吐:同一时刻有几百个采样在流水线的不同级并行推进。延迟长,只在你需要它出结果的那一刻才变成停顿。
把这几百周期的成分拆开,会看到一个跟直觉相反的比例:真正拿来「算」的(坐标换算、滤波插值)只有几个周期,剩下的几乎全是「等数据到」——L1 命中就等 30 周期左右,一旦 miss 落到显存,就是几百周期。所以优化采样性能,砍的从来不是 ALU,而是让采样更常命中缓存、更少掉到慢的那一头。
7.2 用并行填延迟:与着色器核同一招
这正是上一篇的延迟隐藏。采样器不做别的,就是把深流水线的每一级都填满并发请求。一旦流水线装满,平均每个周期都能出一个采样结果,即使单个采样要等几百周期。出处:FGiesen · Part 3 · Latency。
这是整篇最核心的一笔账:流水线深度和并发度,一个负责藏延迟,一个负责填带宽。 它们共同让你感知不到采样慢。
把「单次慢」和「整体快」摆在一起算最直观:单次采样看得见的是几百周期的等待,落地到吞吐,平均每个周期照样能出一个结果——前提是流水线一直有活填。慢不在单次延迟,而在你让流水线空下来那一刻。这就是为什么采样密集的 shader 里,调度器会拼命塞无关指令把这一拍盖住。
7.3 从 shader 视角:一条指令,一次等待
对 shader,等待是有形的:如果一个 warp 发出一串依赖结果的采样(tex 后立刻用结果),它会在结果回来前停顿。这就要求编译器/warp 调度器在tex 后面安排不依赖结果的其他指令,保持流水线满载。出处:NVIDIA · Life of a Triangle。
这是程序员能影响的:提升 ILP(指令级并行)、把采样结果间的依赖摊开,是让采样延迟不卡帧的软件手段。
7.4 AF 高采样时的 cache 压力
最后再把 AF 拉回来连一次账:高倍 AF 一次采样读更多纹素,若它们跨多条 cache line 且未命中,会同时放大延迟与带宽。AF 的代价因此是「cache miss 概率 × 读纹素数」双重的。 牌桌上,把 AF 从 4x 拉到 16x,可能把原本命中的一批子采样推成 miss。
一个实用的检查:如果纹理带宽是瓶颈,先试降 AF,再试降 mip bias,很可能比降分辨率更划算。
八、结论:这条流水线是盖出来的
好了,账算到这,也该收尾了。把前面六个机制合起来,三个结论能带走。
8.1 三个结论
第一,采样是深流水线,不是一次读取。 坐标归一化、寻址、滤波、LOD、取数、回写,各在不同硬件级串行,延迟几百周期。第二,对 shader 透明。 你把一句 texture(...) 交给硬件,硬件把整条流水线背下来。第三,用并行盖延迟。 深流水线 + 高并发,让采样慢这件事对吞吐无感。
8.2 可带走的量化
几个能在排查时用上的数(都是本系列前几篇反复用到的口径): - 一次采样延迟:几十到几百周期,随 cache 命中下降而爆炸式增长;量化地看,$L = L_{L1命中} \ll L_{L2命中} \ll L_{VRAM}$,其中每跳一个层级,延迟约涨一个数量级; - bilinear 读 4 纹素,trilinear 读 8,AF 则更多; - 纹理压缩(BC/ASTC)在 TMU 内解压,省大量带宽; - LOD 由屏幕梯度推导,依赖 2×2 quad。
8.3 交棒:下一站是图元装配、裁剪与视口变换
采样把「读一段颜色」的问题解决了,读到的是片元着色的最终颜色。但这串颜色如何落到屏幕上——图元先要被装配、裁剪、变换进视口,再光栅化成像素——才是把「颜色放进屏幕」的完整链条。系列下一站【五】先把几何收尾的图元装配、裁剪与视口变换讲清。我们在硅片到像素之间,继续往下挖。
这一站的交棒关系值得定格一下:采样器产出的是一段已经滤波、按 LOD 选好层的颜色,它接下去是像素流水线的输入。要真正写进屏幕,还得补上几何段最后几环——图元从装配、裁剪到视口变换,之后才轮到光栅化决定覆盖哪些像素、要不要被更近的深度压掉。读颜色的这一大段至此结清,下一段是「把颜色放进屏幕」。

几何收尾——图元装配、裁剪与视口变换——留给下篇去补。
九、参考资料与可回溯出处
本篇的关键数字全部来自厂商官方文档与规范,正文中的引用可直接回溯到出处。主要来源:
- NVIDIA CUDA C++ Programming Guide · Texture Memory
- Vulkan Specification · Textures
- Vulkan Specification · Samplers and Views
- Fabian Giesen《A trip through the Graphics Pipeline 2011》
- GPUOpen · GPU Image Operations
- NVIDIA · Life of a Triangle
- Wikipedia · Mipmap
- Wikipedia · Anisotropic filtering
- Wikipedia · S3 Texture Compression
下篇预告:《GPU 架构剖析》系列进度:已完成【一】命令前端、【二】显存与地址空间、【三】着色器核、【四】纹理采样器,接下来是【五】图元装配、裁剪与视口变换。我们在硅片到像素之间,继续挖下去。
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在硅片到像素之间,继续挖下去。