本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
前八篇都在 Skia 里。从第二篇的 SkCanvas 分层,到第三篇的贝塞尔细分与解析式覆盖率,到第四篇的字形光栅化,到第五篇的 GPU backend 与实例化细分,到第六篇的 Graphite 录制模型;中间夹着三篇「把工具搬出来」的自跑——第七篇量两条后端的像素差与 overdraw,第八篇拆开 SKP 与字体开关。
先把坐标挪一下。
八篇下来,我们知道了 Skia 这一个引擎是怎么把矢量变成像素的。但 2D 矢量引擎不止一家。这一篇换引擎:
Vello——一个用 Rust 写的、把「矢量怎么变成像素」这件事重新设计了一遍的渲染器。它最出名的两件事,一件是 sparse strips(稀疏条带),一件是 prefix-scan(前缀扫描)。
言归正传,先说一处需要纠正的说法。
不过这一篇开篇就要先纠正一件事,而且这件事决定了整篇的结构。网上(包括本系列自己的规划稿)常用的说法是:
Vello = GPU compute + prefix-scan + sparse strips,三件事是一套东西。
这个说法在 2026 年 9 月之后不成立了。
先看看那次重构动了什么。
Vello 的仓库在那时做了一次重构:sparse strips 成了 vello_cpu 与 vello_gpu 这两个渲染器共享的架构,而重度的 compute 与 prefix-scan 属于被搬进 research/ 目录的那套实验渲染器。官方 ARCHITECTURE.md 现在的原话是:
"Vello contains two renderer families: 1.
vello_cpu, a CPU-only renderer, andvello_gpu, a GPU-accelerated renderer, both based on the Sparse Strips architecture. 2. The experimentalvellorenderer, which is based on compute shaders."
所以这一篇要做的第一件事,是把两代实现拆开讲;第二件事,是把「稀疏条带」这条数据流从一条路径一路串到一屏像素;第三件事,是把 prefix-scan 在其中的位置与代价量出来——代价那一段,本篇有一条本机真跑的读数,读出来的结论和「工作高效的算法更快」这个直觉相反。
OK,还有一件事要先说清。
还有一件事得提前说清,因为它决定了这一篇的诚实标准。本机跑不了 Vello 本体——它需要 Rust 工具链,而这台机器上没有。但本篇不是「只能读源码」:Vello 的 compute 版 shader 用的是 WGSL,而 WGSL 是 WebGPU 的标准着色语言,本机可以用 Python 的 WebGPU 绑定在真 GPU 上跑同一类算法。所以本篇的证据分两类,而且绝不混用:机制性结论全部来自源码与官方文档的逐字引用;可量化的代价来自本机真跑的算法级实现。
先看看这一篇要回答的三个问题。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更快/更省/更大」的说法,绑定本机读数或官方原文并写明口径;
- 凡引必注:官方定义给链接与逐字原句,本机读数给环境、命令与脚本口径;
- 本篇不涉及(边界见 0.3):Skia 侧的机制(前八篇已做完)、Vello 的三路性能对比(属 ep10)、 Vello 在具体应用里的接入(Xilem / Bevy 的用法)、GPU 驱动的底层细节;
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑/真算的读数图由本篇的测量脚本产出(图注写明口径);
自绘图为本系列绘制,走 styles/qianmo/palette.json 色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(自跑二:SKP 与字体):【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 本篇讲的主角:Vello 仓库 | 官方架构文档 ARCHITECTURE.md | vello crate 文档
- 与本篇对照的 Skia 侧机制:【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 本机跑算法用的绑定:wgpu-py(Python 的 WebGPU 绑定) | WGSL 规范
本篇只回答三件事
先从三个问题入手。它们不是三个并列的知识点,而是一条从「这个引擎是什么」到「它凭什么快」的动线:先看清它有几套实现,才知道要讲哪一套;先看清一条路径要过几站,才知道 prefix-scan 站在哪一站;最后才谈得上它的代价。
0.1 全篇知识地图:三个问题,一条动线
第一件:Vello 现在到底有几套渲染器? 这是本篇最容易被跳过、也最容易讲错的一步。2026 年 9 月的重构把仓库拆成了两族:一族是 vello_cpu 与 vello_gpu,共享 sparse strips 架构;另一族是被搬进 research/ 的那套 compute 实验渲染器。它们的硬件要求不同、成熟度不同,甚至不需要同一类 GPU 能力——vello_gpu 官方明说 "without requiring compute shaders"。把这件事讲清楚,后面两问才不会串线。
第二件:一条路径到一屏像素,中间过了几站? 官方的 ARCHITECTURE.md 用一句话把动线说完了:「Paths are flattened, binned into tiles, and represented as sparse horizontal strips.」——展平、分箱进 tile、表示成稀疏水平条带。这条动线上每一站都在干一件具体的事,也都有对应的源码文件。这一问要把这五站逐站拆开。
第三件:把串行变并行,代价是什么结构? prefix-scan 是这条动线上最「反直觉」的一站:它处理的不是像素,而是计数与位置。官方对它的解释只有一句——把「本来必须串行」的步骤并行化。但并行化本身有结构代价:要分几趟、要用多少加法、要付多少次屏障。这一问要把这个结构量出来,而本机真跑的结果是:少做 5 倍加法的那一版,实测反而慢 2.66 倍。
这三个问题说完了。
OK,把这套做法先定义清楚,再压成一句话。
0.2 一句话说清这一篇的做法
前八篇问「Skia 是怎么做的」,这一篇问「换一个引擎,同样的事有没有别的做法」。
好了,把做法压成一句话。
这句话不是修辞。Skia 与 Vello 面对的是同一个问题——把矢量描述变成一屏像素——但给出的答案在几个关键点上分道扬镳。最典型的一处:像素该不该有深度。Skia 的新一代后端 Graphite 引入了深度测试,给每个绘制一个 z 值,让不透明物体可以乱序画、靠深度决定谁赢;Vello 这侧没有深度缓冲,它靠的是「路径按序 + 每格的命令表按序播放 + 一个混合栈」。两条路都在回答「哪些像素要填」,但一个用深度、一个用覆盖率与顺序。
先看看诚实标准差在哪。
所以这一篇的诚实标准与前八篇有同有异。相同的是「凡引必注」;不同的在于证据的类型:前八篇(尤其第七、八篇)的读数来自「把 Skia 跑起来」,而这一篇跑不起来要讲的那个东西。这台机器没有 Rust 工具链,Vello 编译不了。于是本篇把证据切成两层:
- 机制层:Vello 的常量、阶段名、分工、原句——全部来自源码与官方文档,逐条给链接与逐字原句;
- 代价层:把 prefix-scan 这一类算法自己实现一遍,在真 GPU 上跑,与 numpy 逐元素对照。
第二层必须标明一句话:它是同一类算法在本机 GPU 上的形态与代价,不是 Vello 的读数。 语法同源不等于实现相同——这句界线本篇会反复回到。
先把不做的那部分定义清楚,直接让出去。
0.3 边界:本篇不涉及什么
把话说在前面,避免把精力花在别处:
- Skia 侧的机制:前八篇已做完,本篇只在需要对照时引用结论,不重复拆解;
- Vello 的三路性能对比:
vello_cpu/vello_gpu/ compute 版各跑一遍真实场景属 ep10; 本篇只讲它们为什么这么分,不讲它们谁快; - Vello 在应用里的接入:Xilem、Bevy 怎么用它,不在本篇题域;
- GPU 驱动与硬件细节:本机只有一块 NVIDIA 卡、一个 Vulkan 后端,跨后端结论不外推;
- 真机与移动端的 sparse strips 表现:本机没有 Apple 设备,Metal 相关的结论一律只引官方原句。
关键参数的取值范围(本篇反复用到的几个数,先立在这里):扫描实验的元素规模 1,024(单块) 与 1,048,576(1024 块 × 块长 1024);块内扫描的线程数 1024;时间读数取 预热 3 次、重复 20 次的最小值。 Vello 侧的常量则一律以 2026-09 的 main 分支为准。
0.4 证据口径与能力边界
这一节要放在最前面,因为它决定了大家怎么读后面的每一个数字与每一句引用。
先看第一类证据。
第一类:官方源码与文档。 本篇关于 Vello 的每一条机制性断言,都来自
github.com/linebender/vello 的 README、ARCHITECTURE.md、各 crate 的 README、Cargo.toml 与 shader 目录,
或作者本人(Raph Levien)与 Linebender 官方博客,或官方引用的论文(ETH 硕士论文)。
凡引用都给逐字原句与链接。
好了,再看第二类。
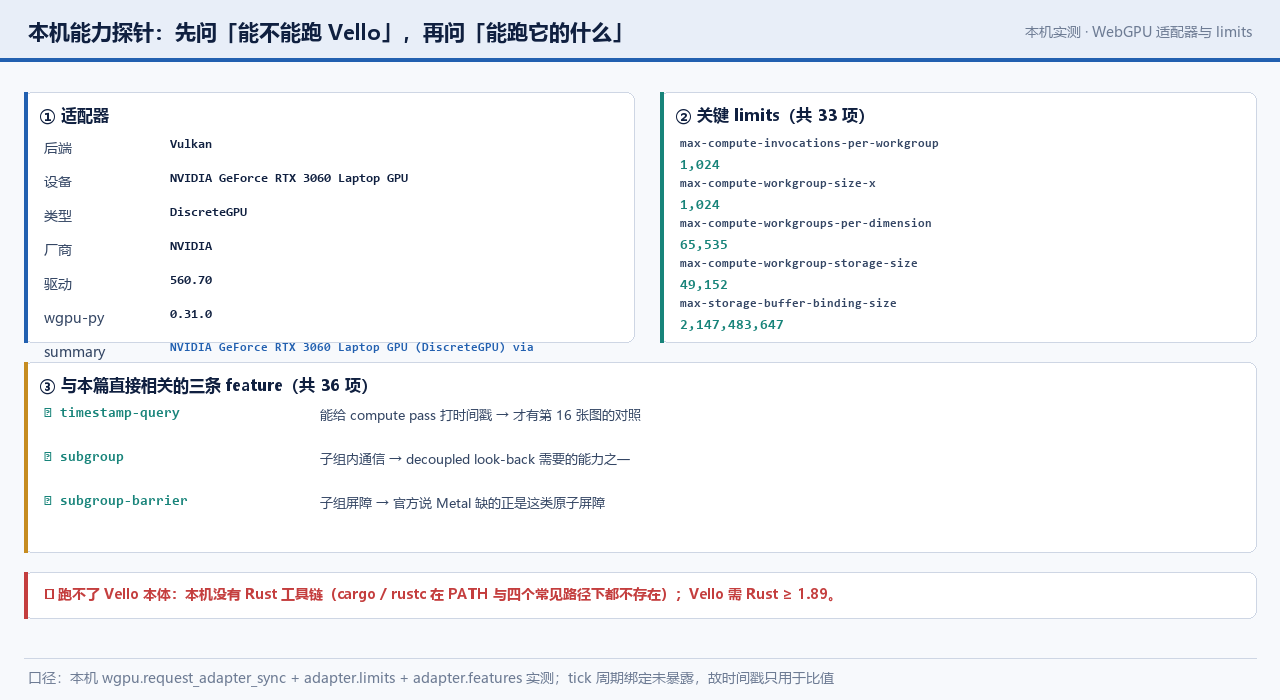
第二类:本机算法级真跑。 本机环境是:Windows 10.0.26200 | Python 3.10.11 | wgpu-py 0.31.0 |
后端 Vulkan | NVIDIA GeForce RTX 3060 Laptop GPU(DiscreteGPU)| 驱动 560.70。
适配器暴露 36 项 feature,其中与本篇直接相关的三条是 timestamp-query、subgroup、subgroup-barrier。
本机明确拿不到的东西(逐条给原因):
- Vello 本体的任何读数:本机没有 Rust 工具链(
cargo/rustc在 PATH 与四个常见安装路径下都不存在), 而 Vello 官方要求 Rust ≥ 1.89。编译不了,就跑不起来。 - sparse strips 的真实内存占用:要跑起来才能量;本篇只能引官方对它的描述,不给数字。
- 跨后端的差异:本机只有一个 Vulkan 后端可选,D3D12 与 WebGL2 路径未验证。
- Metal 上的行为:本机无 Apple 设备。本篇引用的那条 Metal 限制出自 2021 年的一篇博客, 且针对的是当年那套 compute 扫描算法——不得读成「Vello 现在在 Metal 上跑不了」。
三条自我约束:
- 算法级读数必须与 Vello 的读数分开标注。本机的 WGSL 扫描是自写实现, Vello 的 shader 是另一份实现;WGSL 同源只意味着语法可比,不意味着行为相同。
- 时间戳只用于比值。本机的
wgpu-py绑定没有暴露 tick 周期,所以时间戳(ticks)不能折算成绝对时间; 好在我们要比的是两个算法之间的比值,周期在比值里正好约掉。挂钟读数另报,且标明它含 CPU 提交与同步开销。 - 否定项不据记忆补。本篇有三处明确的「不存在」:
coat这个阶段不存在(源码与文档全无)、Potato设计文档抓取失败、官方没有一篇专门讲 draw order 的文档。三处都写进正文对应位置,不用记忆补。
0.5 本章收在哪里
下面我们进入第一阶段。 本篇的线索是「先拆血脉,再拆动线」:先看清 Vello 有几套实现,再从一条路径走到一屏像素。
官方依据:两族渲染器的原话见 Vello 官方架构文档; 「Paths are flattened, binned into tiles…」的定义同见该文件; 版本与工具链要求见 仓库 README 与 workspace Cargo.toml; 本篇的环境与脚本口径见参考资料第 26–28 条。
一、Vello 现在到底有几套渲染器
这一章不写测量,只做一件准备工作:把「Vello 是什么」这句话里的歧义清掉。因为如果这一步不清,后面每一句「Vello 怎么做」都会含混。
1.1 两族:Sparse Strips 家族与 compute 实验渲染器
先看官方 README 的总述:
"Vello is a project for high-performance 2D vector rendering. It contains three renderer implementations with different hardware requirements and maturity profiles."
三个实现,官方各自的定位是(逐字):
| 包 | 官方原话 | 要不要 compute shader |
|---|---|---|
vello_cpu |
"a CPU-only renderer optimized for multithreading and SIMD. It is the most mature choice when predictable CPU rendering, software rendering, or support for devices without a suitable GPU is required." | 否 |
vello_gpu |
"a renderer that preprocesses paths on the CPU and uses the GPU for rasterization and compositing. It supports a native WebGL2 backend and a wgpu backend without requiring compute shaders." | 否 |
vello(原 compute 版) |
"the original compute-centric renderer. It performs most rendering work in GPU compute shaders and remains an experimental implementation for compute-capable GPUs." | 是 |
而 ARCHITECTURE.md 把这三者收成两族(逐字):
"Vello contains two renderer families: 1.
vello_cpu, a CPU-only renderer, andvello_gpu, a GPU-accelerated renderer, both based on the Sparse Strips architecture. 2. The experimentalvellorenderer, which is based on compute shaders."
先看这两件事。
这张对照图看两件事就够了。
第一件:「Sparse Strips」与「compute」不是同一件事的两面,而是两族各自的路线。
Sparse Strips 是 vello_cpu 与 vello_gpu 共享的架构;compute 是实验渲染器走的路。
把它们讲成一套,就会得出一个错误结论——「Vello 需要一块支持 compute 的 GPU」。
对 vello_gpu 而言这不成立:它官方声明走的是 vertex / fragment,还专门支持 WebGL2 后端。
第二件:「CPU-only」不等于「另一套算法」。 vello_cpu 与 vello_gpu 共享同一套 CPU 侧预处理管线,
它们的差别在后半段在哪张硅片上跑,不在「怎么理解一条路径」。
仓库目录也印证了这次搬家:用户面只剩 vello_common/、vello_cpu/、vello_gpu/、vello_gpu_shaders/、
glifo/、vello_tests/、vello_bench/;compute 那套在 research/vello_research/、
research/vello_encoding/、research/vello_shaders/ 之下。
其中:glifo 这个包名值得单独看一眼——它是「字形」这一侧的公共部分。
这提示一件事:sparse strips 这套表示不只服务于路径,也服务于文字。这一点在第十一章会再回来。
1.2 版本、许可与依赖(可复核的硬信息)
言归正传,把常量摆出来。
这一节全是可复核的常量,写在一起便于读者自行核对:
| 项 | 值 |
|---|---|
vello / vello_encoding / vello_shaders 版本 |
0.10.0 |
vello_common / vello_cpu / vello_gpu / vello_gpu_shaders 版本 |
0.2.0 |
glifo 版本 |
0.3.0 |
| 许可 | Apache-2.0 OR MIT |
| Rust edition / 最低版本 | 2024 / 1.89 |
| 图形抽象层 | wgpu = "30.0.0"(features ["std", "wgsl"])、naga = "30.0.0" |
README 里还有一句可以直接引的编译要求:
"This version of Vello has been verified to compile with Rust 1.89 and later."
其中:这一行就是本篇「跑不了 Vello 本体」这条边界的直接依据—— 本机没有 Rust,而它要求 1.89 以上。把版本写在这里,是为了让「跑不了」这句话可核。
1.3 两次改名:piet-gpu → vello → 两族
先看看它改过几次名。
Vello 不是一开始就叫 Vello。compute 版的 README 里写着:
"Vello was previously known as
piet-gpu. This prior incarnation used a custom cross-API hardware abstraction layer, calledpiet-gpu-hal, instead of wgpu."
从 piet-gpu 到 vello 的这次变化,核心是把自建的跨 API 抽象层换成了 wgpu。
作者本人后来专门写过一篇《Requiem for piet-gpu-hal》来总结这件事。
第二次改名离我们更近。vello_gpu/README.md 里逐字写着:
"This package was previously named
vello_hybrid. New dependencies and Rust imports should usevello_gpu; no compatibility re-export package is provided in this repository."
注意最后半句:仓库不提供兼容再导出。也就是说,一个还在用 vello_hybrid 这个名字的项目,
升级时会直接编译不过——这不是「换了个名字」,而是一次硬切。
OK,看发布节奏。
发布节奏可以从官方博客读出来。2025 年 10 月的 Linebender 月报里写着:
"it is the initial release of Vello Hybrid, a newer approach that uses the GPU to do pixel compositing, but SIMD-accelerated geometry processing on the CPU."
到 2026 年一季度的月报里,口径变成了:
"Several releases, most recently sparse strips 0.0.7 (encompassing both Vello CPU and Vello Hybrid) and Vello 0.8.0."
外加一句质量定位:> "Vello Hybrid is currently at roughly beta quality."
其中:把这三条按时间排起来,能看出一条清楚的走向——Vello 的重心从「全 compute」往「CPU 预处理 + GPU 合成」挪了。
2025 年 10 月首发 Hybrid 时说它是 "a newer approach";到 2026 年一季度,发布说明里已经把 CPU 与 Hybrid
并称("encompassing both"),而 compute 版被移进 research/、官方称作 experimental。
这不是「谁替代谁」的结论,但至少能说明:本节开头那两族,不是并列的三个包,而是有主次的两个方向。
1.4 本章收在哪里
下面我们进入下一章。 血脉分清了,接下来把其中一族的动线摊开——从一条路径走到一屏像素,中间有几站。
官方依据:三个渲染器的定位见 仓库 README; 两族的表述、Sparse Strips 的定义见 ARCHITECTURE.md; 版本与许可见 workspace Cargo.toml; 改名留痕见 vello_gpu/README.md;
piet-gpu的历史见 research/vello_research/README.md。
二、一条路径到一屏像素,中间过了几站
上一章把血脉分开了。这一章把 Sparse Strips 这一族的动线摊开——因为它是主路径,也是后面每一章的地基。
2.1 五站动线:官方那一句话里的五个动作
ARCHITECTURE.md 里那段定义值得逐字再读一遍:
"Vello CPU and Vello GPU share a CPU-side pipeline implemented primarily in
vello_common. Paths are flattened, binned into tiles, and represented as sparse horizontal strips. Coverage data is retained where it is needed around path boundaries, while fully covered regions can be represented compactly. This limits intermediate work and memory to the parts of the scene that affect the final image."
这一句话里有五个动作,正好是五站:
- 展平(flatten):把曲线变成线段;
- 分箱进 tile(binned into tiles):把线段按它经过的格子归类;
- 表示成稀疏水平条带(sparse horizontal strips):把相邻格子并成条带;
- 只在边界保留覆盖率:条带内部不必逐像素记;
- 全覆区域压紧:整片覆盖的地方用一个紧凑表示带过。
官方对这五站的总目标是:把中间产物限制在「真正影响最终画面」的那部分场景上。
先看看这几站分别落在哪张硅片上。
前面四站在 CPU 侧,都由 vello_common 提供(所以 vello_cpu 与 vello_gpu 才能共享)。
第五站的归属取决于后端:vello_cpu 自己算(用 SIMD 与多线程),vello_gpu 把条带传上 GPU 算。
compute 版则有自己的另一套。
其中:这五站里有一站是「计数与位置」性质的,而不是「像素」性质的——第 2 站,分箱。 分箱要回答的是「这一条线段要落到哪几个格子里」,这既不是覆盖率的计算,也不是颜色的合成, 而是一次归类与记账。前缀和正是在这一站(以及相邻的几处)派上用场的(第五章)。
2.2 五站各自的源码落点
机制篇的规矩是「每句话都能落到一个文件上」。这一节的对照表全部来自官方 shader 目录的实际文件列表:
| 站 | 对应文件(源码目录实测存在) | 干什么 |
|---|---|---|
| 展平 | flatten.wgsl |
曲线 → 线段 |
| 计数 | path_count.wgsl / path_count_setup.wgsl |
数一数每条路径要多少段 |
| 分箱 | path_tiling.wgsl / path_tiling_setup.wgsl、binning.wgsl |
把线段接到格子上 |
| 归约与扫描 | pathtag_reduce*.wgsl / pathtag_scan*.wgsl、draw_reduce.wgsl、clip_reduce.wgsl |
前缀和家族 |
| 格子分配 | tile_alloc.wgsl |
给每条命令分配落位 |
| 粗光栅 | coarse.wgsl |
出每格的命令表 |
| 细光栅 | fine.wgsl |
逐像素出最终颜色 |
| 背景传播 | backdrop.wgsl / backdrop_dyn.wgsl |
跨行传播背景 |
| 边界清理 | bbox_clear.wgsl |
清包围盒 |
这份表里有两件事可以直接看出来,不需要额外解释:
第一,*_reduce 与 *_scan 成对出现(pathtag_reduce / pathtag_scan、
pathtag_reduce2 / pathtag_scan1、draw_reduce、clip_reduce)。
「reduce-then-scan」这个说法在源码层面就写成了文件名——先归约、再扫描(第六章)。
第二,*_setup 与主体也成对出现(path_count_setup / path_count、path_tiling_setup / path_tiling)。
这个命名模式对应的是「先数一遍、再按数分配一遍」——也就是前缀分配(第五章)。
⚠ 一条必须写死的否定项:本系列在规划阶段曾把「coat」当成 Vello 的一个阶段名。
本轮把源码 shader 目录、ARCHITECTURE.md、docs.rs 三处都查了一遍——没有 coat 这个东西。
它极可能是 coarse 的误记。本篇正文不使用该词,也提醒读者:看到别人这么写,可以直接去查源码目录。
2.3 本章收在哪里
下面我们进入下一章。 五站摊开了,最需要解释的是第 3 站——为什么是「条带」而不是「方块」,以及「稀疏」这两个字实际省掉了什么。
官方依据:五站动线的原句见 ARCHITECTURE.md; 阶段与文件名的对应见 vello shader 源码目录; 作者对粗光栅命名的解释见 A sort-middle architecture for 2D graphics。
三、为什么是「条带」而不是「方块」
第二章说第 3 站要把相邻的格子并成水平条带。这一章要回答的是两个问题:为什么并、以及并完以后那份数据结构长什么样。
3.1 从 4×4 的格子到一条水平条带
先说格子。这一族的实现里,参与判定的最小格子是 4×4 像素;粗光栅的输出单元更大一些,是 64×4 像素的「宽格子」。 两层粒度同时存在,各管一段:小的负责「谁跟谁相交」,大的负责「命令表按谁组织」。
好了,看合并规则。
合并的规则并不复杂。同一行里连续的、都被几何覆盖的格子并成一段;中间空掉的格子由一段「空隙」表示。 于是整个条带就变成了一个游程编码(run-length encoding)的序列:一段覆盖、一段空隙、再一段覆盖……
其中:为什么要按行并,而不是并成方块或竖条?因为光栅化是按扫描线走的。 一条水平线穿过图形时,覆盖状态只会在少数几个位置发生跳变;而在竖直方向上,覆盖状态是逐行变化的。 把不变化的方向(行内)压成一段,就能用最少的字符记下最多的信息——这正是游程编码擅长的事。
3.2 这份表示的三条设计取舍
ARCHITECTURE.md 里的定义句其实把三条取舍都写进去了,只是要拆开看。
第一条:覆盖率只在边界处保留。
"Coverage data is retained where it is needed around path boundaries"
这句话说的是:条带内部不需要逐像素记覆盖率。一片全覆的区域,它的覆盖率是多少? 是 1——所有像素都一样。既然都一样,就不必逐像素存。
第二条:全覆区域可以压紧。
"while fully covered regions can be represented compactly"
「压紧」的收益是可以算的。一片宽度为 W 的全覆区域,逐像素存要 W 份数据; 压成一段之后,只需要记「从哪到哪、覆盖率是满的」——常数份。 图形越是大块填充,这个比值越大。
第三条:目标是限制中间产物,不是限制最终精度。
"This limits intermediate work and memory to the parts of the scene that affect the final image."
注意主语是 "intermediate work and memory"——中间的工作量与内存。 最终那一屏像素该多少还是多少,稀疏的是中间。
其中:把这三条放在一起,就能回答「为什么是条带」。条带不是一种「更好看的格子」, 而是一种面向游程编码的数据结构:它的形状(长条)与它的表示(游程)是配套的。 如果只是把 4×4 换成 64×4,那只是换了个格子大小;真正改变性质的是把不变的区域压掉了。
3.3 本章收在哪里
下面我们进入下一章。 条带怎么来的说清了,接着把「稀疏」这两个字算成账——它到底省在哪、什么时候不省。
官方依据:4×4 与 64×4 两层的命名与尺寸见源码级索引(Sparse Strips 架构页); 覆盖率与压紧的原句见 ARCHITECTURE.md; 游程编码的学术表述见研究笔记引用的 ETH 硕士论文(参考资料第 20 条)。
四、「稀疏」省在哪里
第三章讲的是结构,这一章讲的是账。因为「稀疏」这个词很容易被读成一种修辞上的褒义——稀疏就是好的、省的。实际不是:它是一种代价交换,有明确的适用面。
4.1 省的是中间产物,不是最终像素
先把最容易搞混的一点说清:sparse strips 不改变最终画出来的那一屏像素。 它改变的是「从路径到像素」这段路上要搬多少数据、要跑多少趟。
先看看对照。
对照来看会更清楚。所谓密集光栅(dense rasterization),是「每个像素都过一遍」:画布多大, 中间产物就按画布面积算。空白区域也要记账——哪怕那片区域上什么都没有。
而稀疏条带这一侧的做法是:只处理有几何相交的格子,并且把其中的全覆区域压紧。 于是中间产物的规模取决于几何覆盖了多少,而不是画布多大。
这条替换并非总是划算。两组情况要分开看:
- 几何稀疏、画布大(典型的 UI、图表、文字排版):稀疏这一侧优势明显,因为大片区域压根不用记;
- 几何几乎铺满整屏(整屏渐变、全屏背景图):稀疏的优势会被吃掉—— 因为「没有空白可跳」了,压紧带来的收益只剩下全覆区域的常数化那段。
其中:这就是为什么「稀疏」不是一条普适的优势,而是一条与场景形状绑定的性质。 官方那句 "the parts of the scene that affect the final image" 里的 "parts" 是要紧的: 如果整个 scene 都是 "parts",这句话就没有省下任何东西。
4.2 「稀疏」的边界条件
言归正传,说边界。
一个更实际的问题是:这条路在什么情况下反而变慢?这一节给三条从结构上就能推出来的边界, 它们都不需要跑,只需要看数据流。
第一,格子粒度与几何尺寸不匹配。如果一条路径极短(短于一个 4×4 格子), 那么它仍然要占一个格子的记录量。细碎几何越多,格子数的浪费越大。
第二,条带的碎片化。如果几何的形状让「覆盖—空隙」频繁交替(例如一堆竖细线), 那么行内的游程数会急剧上升,「压紧」就压不动了。
第三,跨行的传播成本。有些量必须逐行往下传(例如背景 backdrop)。 行数越多、传播链越长,这部分固定成本占比就越高——而这部分成本与几何复杂度无关,只与画布高度有关。
其中:这三条不是我在替 Vello 说「它的弱点」。它们是数据结构的性质: 游程编码的压缩率取决于游程的平均长度,跨行传播的成本取决于行数。 把这三条写出来,是为了让「稀疏」这个词回到它本来的意思——一个与场景形状相关的取舍, 而不是一句笼统的赞美。
4.3 本章收在哪里
下面我们进入下一章。 稀疏省在哪说清了,接下来进入这条动线上最不直观的一站:分箱, 以及它为什么需要前缀和。
官方依据:稀疏的定义与「限制中间产物」的原句见 ARCHITECTURE.md; 「大多数绘制只碰到少数格子」的作者原话("bounding boxes exploit the fact that most 2D drawing is sparse")见 piet-gpu progress: clipping; 密集与稀疏的对照另见 Imagine 的 TBDR 文档(参考资料第 23 条)。
五、前缀和在前两站里干了什么
先换到第二条线。
第四章把动线走完了。这一章开始进入本篇的第二条线:prefix-scan(前缀和 / 扫描)。 它在 Vello 里到底干哪件事、为什么这件事需要它,是这一章要回答的。
5.1 前缀和是什么:一次「从串行到并行」的改造
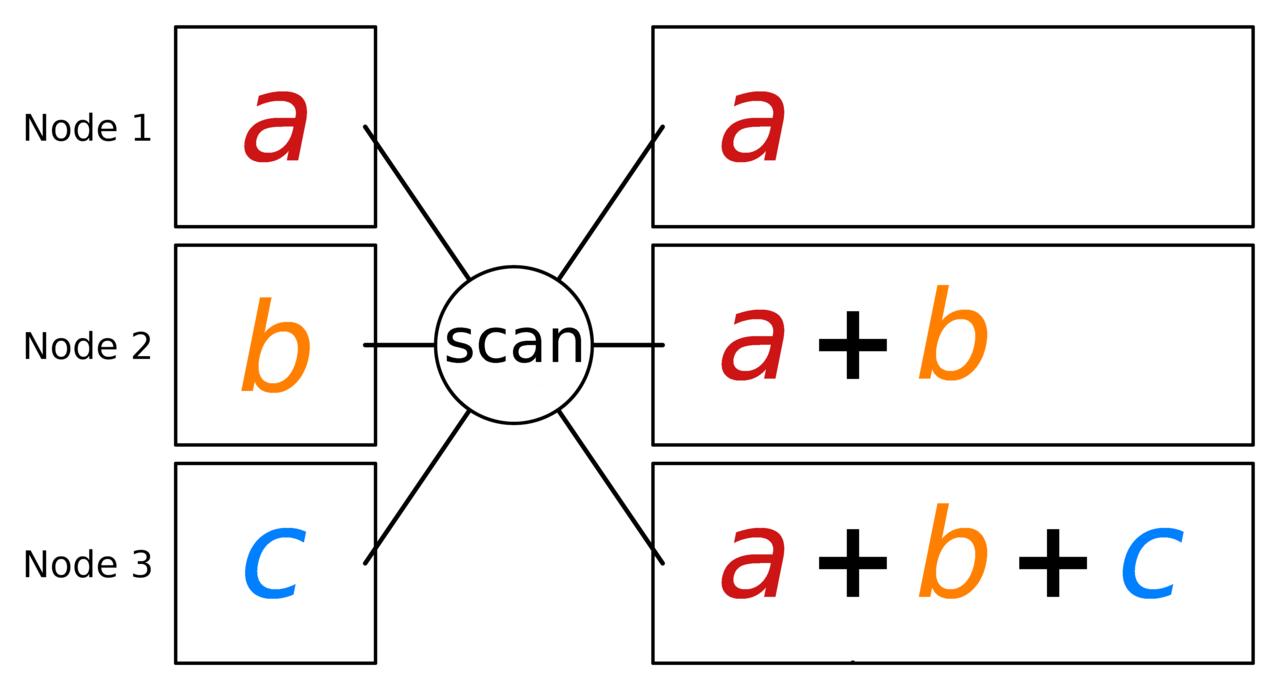
先定义清楚。前缀和(prefix sum),也叫扫描(scan):给定一个序列, 输出一个等长序列,其中第 i 个位置是原序列前 i 个元素的和(含前缀和),或是前 i−1 个的和(排他前缀和)。
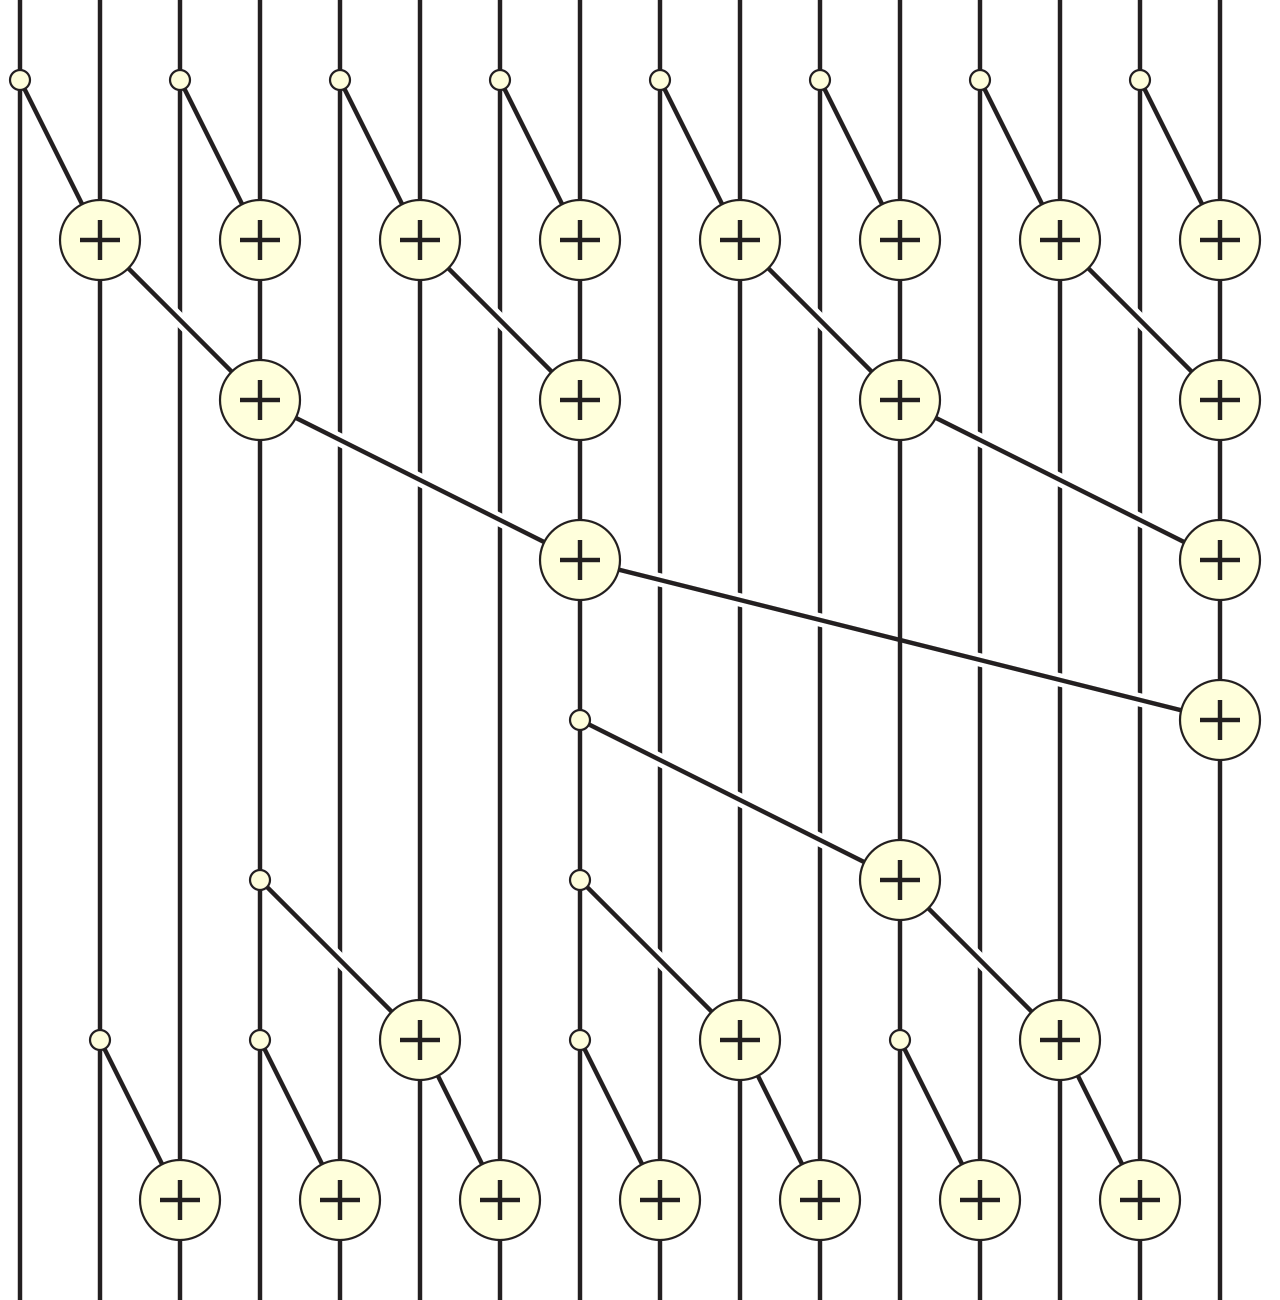
先看看它为什么难并行。
这个概念本身很朴素。朴素的部分不是它算的是什么,而是它「看起来」不能并行。 累加天然带着依赖:第 5 个位置的结果要知道第 4 个位置的结果。串行算一遍是 O(n),看起来没得优化。
但前缀和可以用并行算法做,而且是很成熟的一套。GPU Gems 3 第 39 章的开篇就写着:
"Blelloch (1990) describes all-prefix-sums as a good example of a computation that seems inherently sequential, but for which there is an efficient parallel algorithm."
这句话里的 "seems" 是要紧的:看起来串行,不等于必须串行。
5.2 官方怎么说 prefix-scan 在 Vello 里的用处
言归正传,引官方原话。
这是本篇最需要引准的一段。vello crate 的官方文档里逐字写着:
"In traditional PostScript-style renderers, some steps of the render process like sorting and clipping either need to be handled in the CPU or done through the use of intermediary textures. Vello avoids this by using prefix-sum algorithms to parallelize work that usually needs to happen in sequence, so that work can be offloaded to the GPU with minimal use of temporary buffers."
ARCHITECTURE.md 里的表述更短,意思一样:
"A Prefix-scan algorithms parallelize work that traditional renderers often perform sequentially."
其中:这两句都要读细一点。官方说的是「把本来必须串行的工作并行化」, 并举了 sorting 与 clipping 两个例子。它没有说 prefix-scan 用在曲线细分上—— 这一点必须写死,因为「扫描」这个词很容易被想当然地接到「把曲线打成线段」那一站上去。
那么在分箱这一站,具体是怎么用的?作者本人的一段描述给了最直接的画面:
"When backdrop is needed (a path segment crossing a horizontal tile boundary), there's just a simple
atomicAddof +1 or -1 to the backdrop for that tile. Then, another kernel performs a prefix sum across a scanline of tiles, propagating that backdrop to the right."
——先各自原子加,再用一次前缀和把整行的背景传播开。这就是「并行化本需串行的工作」的具体形态。
分箱这一步的完整动作是四拍:数(每格有多少片)→ 扫(对计数做前缀和)→ 写(按前缀位置落位)→ 得(每格的片清单)。 中间那一拍就是扫描。它的作用是把「逐个元素找位置」这件事,换成「一次前缀和算出所有人的位置」—— 所有人同时知道自己的位置,也就不需要排队。
5.3 先跟 numpy 对一遍
机制讲完,该上读数了。不过在拿它做性能对照之前,得先确认自己的实现是对的—— 这是自建量具的通行前置(口径注 ⑩ 第 ⑥ 条:已知答案反查)。
本机在真 GPU 上写了两种块内扫描的 WGSL 实现,输入取最朴素的一串数:1, 2, 3, …, 1024。
之所以挑这一串,是因为它的前缀和有已知闭式答案(第 i 个是 i×(i+1)/2),
而且用 numpy 的 cumsum 一行就能给出期望值——判定标准是逐元素全等,不是抽样。
两种实现:
- Hillis-Steele:每轮的比较距离翻倍(1、2、4、…、512),共 log₂1024 = 10 轮;
- Blelloch:先上扫归约、再下扫回填,共 10 + 10 轮,最后把自身值加回得到含前缀和。
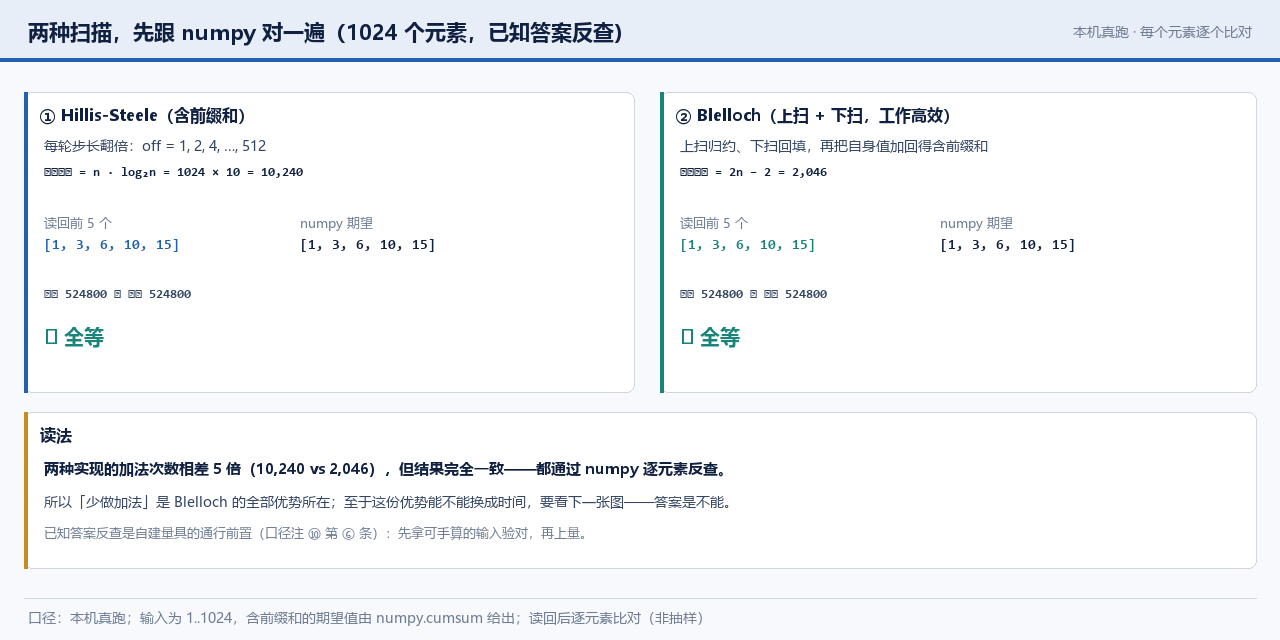
读数是:两种实现都与 numpy 全等。前 5 个元素是 1、3、6、10、15, 末位是 524,800(= 1024 × 1025 / 2),两者一致。
其中:把它们写在一起,是因为它们结果一样、代价差 5 倍: Hillis-Steele 单块要做 1024 × 10 = 10,240 次加法,Blelloch 只要 2n − 2 = 2,046 次。 按「工作高效(work-efficient)」的定义,Blelloch 才是那个「渐近加法次数不多于串行版」的实现。 直觉到这里就会给出一个预测:Blelloch 应该更快。下一章会拿本机读数把这个预测推翻。
5.4 本章收在哪里
下面我们进入下一章。 前缀和的位置与正确性都立住了,接下来是它真正的代价部分—— 既要讲清「reduce-then-scan」这条结构,也要把上面那个直觉预测的答案给出来。
官方依据:前缀和的定义与 Blelloch 的并行算法见 GPU Gems 3 第 39 章; Vello 对 prefix-scan 用处的两段原话见 vello crate 文档 与 ARCHITECTURE.md; backdrop 的传播见 Fast 2D rendering on GPU。
六、把串行变并行,代价是什么结构
先把那个悬念收掉。
第五章留了一个悬念:两种扫描结果一样、加法次数差 5 倍。这一章要把这个悬念收掉, 而收的方式是先讲清结构、再报读数——因为读数只有放进结构里才有意义。
6.1 三条历史路线与一条现代路线
先看「全局扫描」怎么做。NVIDIA 的技术报告把历史上的做法归成三类,逐字:
"Historically, GPU scan implementations have primarily embodied one of three radix-b strategies at the global level: scan-then-propagate, reduce-then-scan, or chained-scan."
三条路的问题也写在同一份报告里:
"the chained-scan GPU parallelization operates in a single pass, but is hindered by serial prefix dependences between adjacent processors that prevent memory I/O from fully saturating."
前两条(scan-then-propagate 与 reduce-then-scan)的共同点是把一次传播拆成多趟: 先在小范围内算好,再逐级往上归约。这条「从叶子往树根收」的结构,本质是一次树形归约: 每一层的通信轮次有限,代价随层数(也就是 log n)增长,而不随元素数增长。
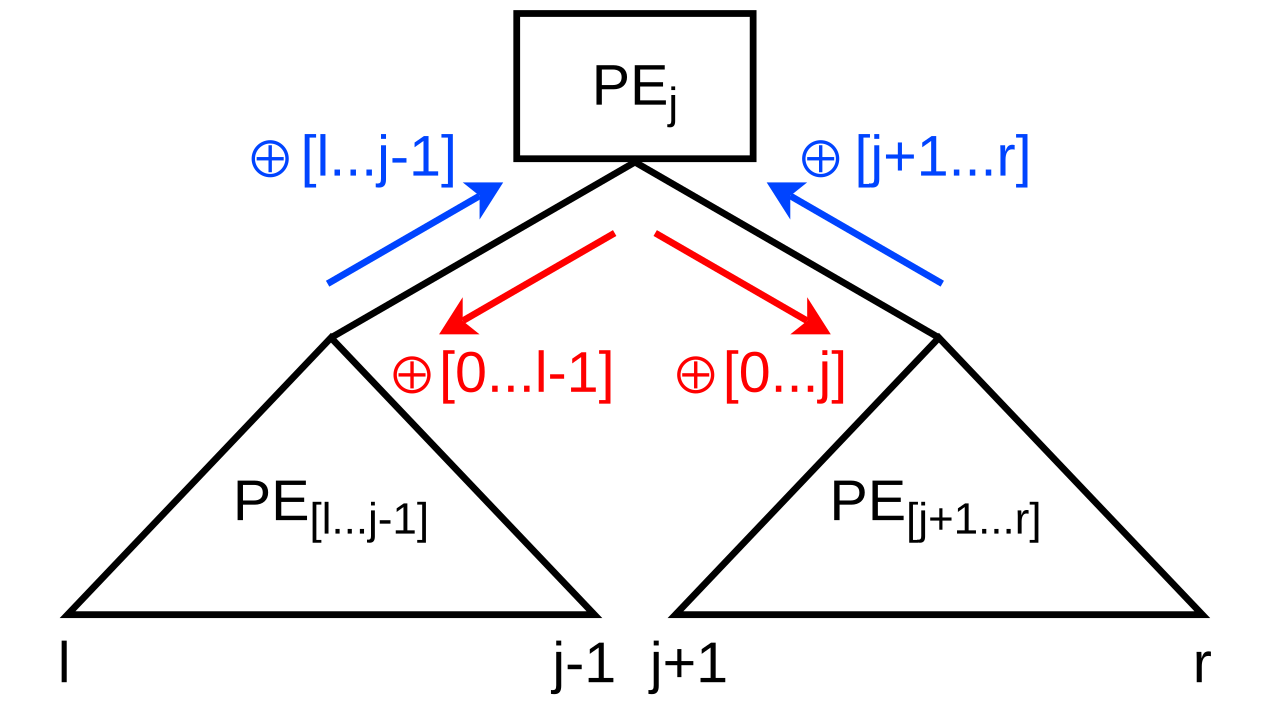
于是有了第四条:decoupled look-back(解耦回看)。
"We describe a work-efficient, communication-avoiding, single-pass method for the parallel computation of prefix scan. When consuming input from memory, our algorithm requires only ~2n data movement: n inputs are read, n outputs are written." "Our method embodies a decoupled look-back strategy that performs redundant work to dissociate local computation from the latencies of global prefix propagation."
其中:decoupled look-back 的思路可以一句话概括:每个块先把本地结果算好,再看左边的邻居「报到」了没有。 如果左边还没好,就等;为了不白等,它允许多做一点冗余工作。这样就把「必须严格依次传播」这条链拆松了。 代价是要在块之间同步——而这正是它在某些平台上卡住的原因(见 6.6)。
好了,补一句通信结构。
这条「块与块之间怎么通信」的问题,在并行计算里有一张经典的表:同样的前缀和, 在超立方体(hypercube)这类互联结构上,通信轮次与链路数的取舍是另一套算法。 它不直接对应 Vello 的实现,但能说明一件事——扫描的代价从来不只是加法次数,还包括通信结构。
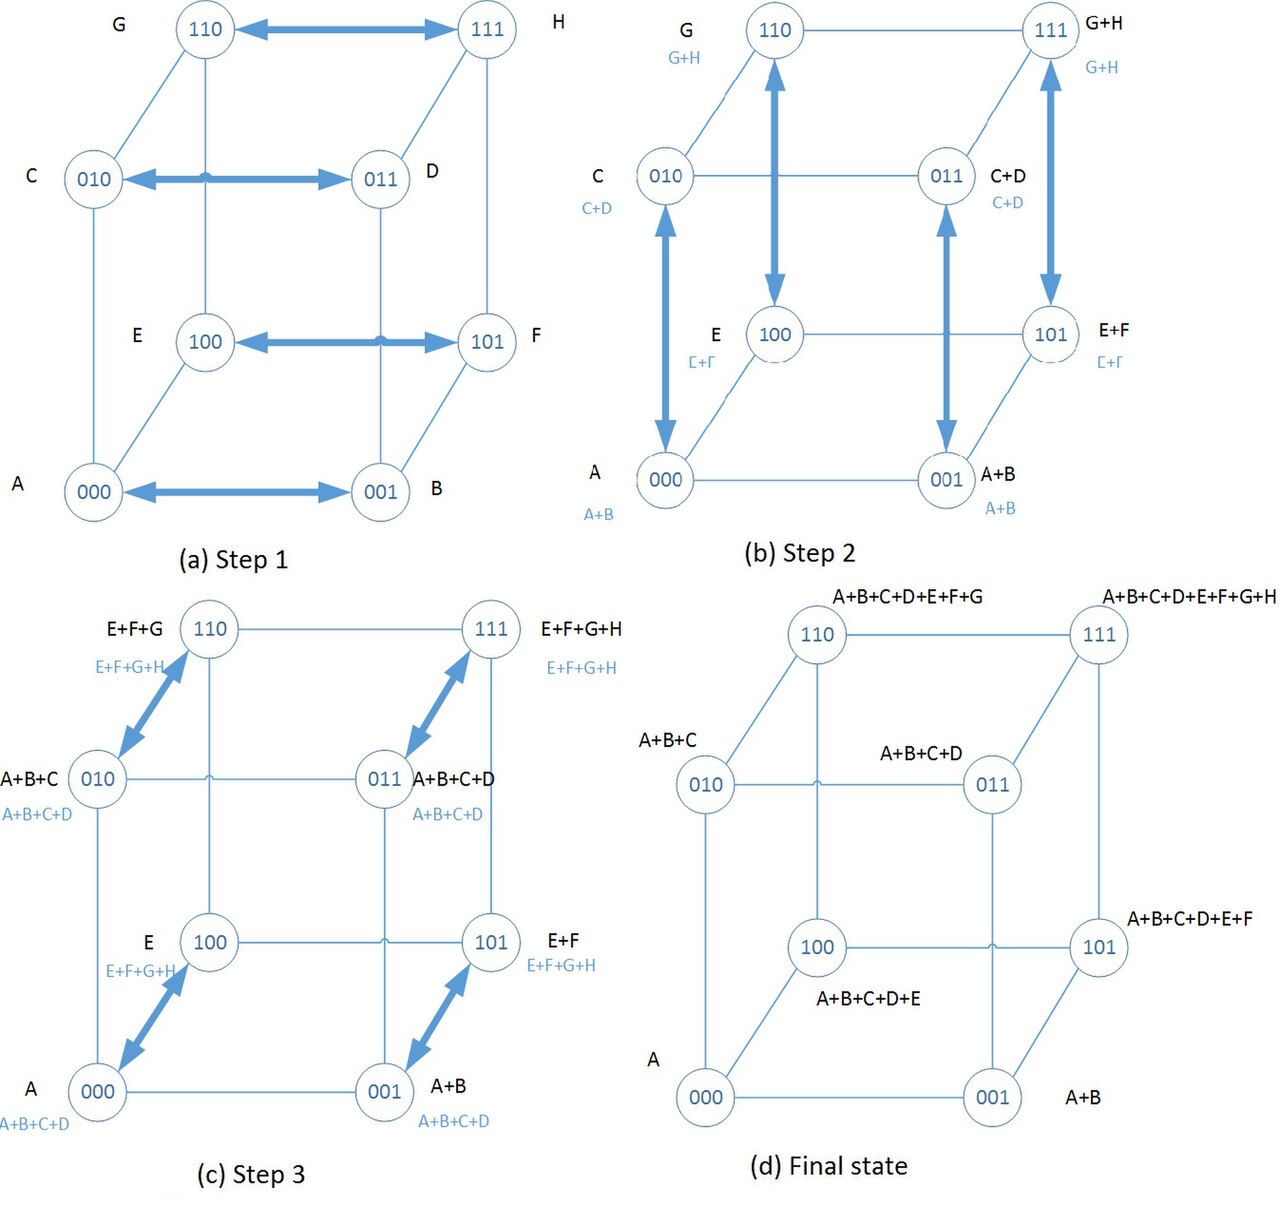
三条历史路线与它的区别也要说清:scan-then-propagate 与 reduce-then-scan 都要多趟, chained-scan 是单趟但被串行依赖卡住,decoupled look-back 是单趟且把依赖拆松。 本篇本机跑的是第二种(reduce-then-scan)——因为它的结构最清楚、最容易逐趟核对。
6.2 reduce-then-scan 的三趟
本机实现的三趟结构是这样的:
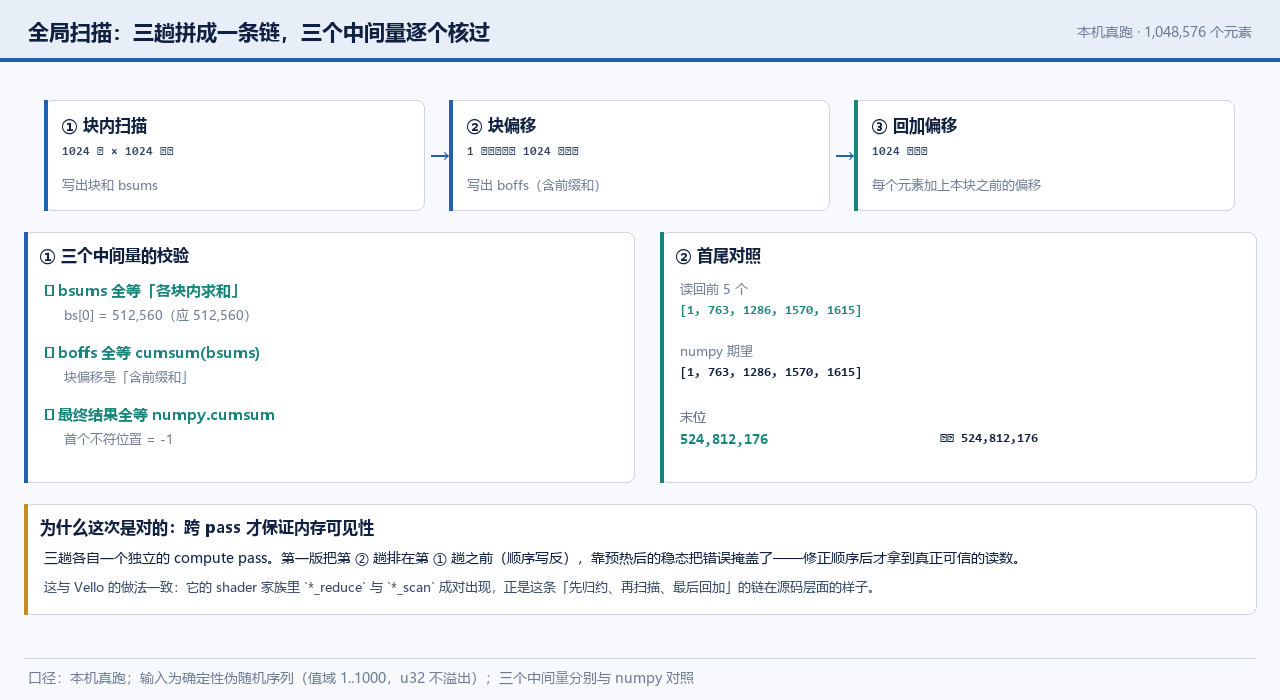
- ① 块内扫描:每个块(1024 个元素、1024 个线程)各自算含前缀和,同时写出本块的块和;
- ② 块偏移:把 1024 个块和收成一份 1024 长度的数组,做一次含前缀和,得到每个块的偏移量;
- ③ 回加偏移:每个元素加上「本块之前所有块的和」。
第 ② 趟只有 1024 个元素,正好一个工作组就能做完——这也是为什么块长要取 1024: 它同时满足「一个工作组的线程上限」与「块和的规模仍在单组可处理范围内」两个约束。 第三趟是第一趟的镜像:一趟加、一趟减,把块内的相对位置变成全局的绝对位置。
顺带一个可以从本机 limits 直接推出来的边界:本机 max-compute-workgroups-per-dimension 是 65,535,
块长取 1024,那么单级 dispatch 最多覆盖 65,535 × 1024 = 67,107,840 个元素(约 6,700 万);
再大就必须上第二级——也就是把「块和」本身再当成一个待扫描的数组递归处理。
这条是「本机 limits × 本机块长」的推论,不是通用常数,写在图注与本节一起标死。
其中:为什么要分三趟而不是一趟做完?因为工作组之间不能互相读写共享内存。 一个块看不到别的块的局部和,所以只能先把块和「交出来」(①),在全局面把它们扫一遍(②), 再把结果发回去(③)。这三趟不是实现上的偷懒,而是内存模型的硬约束推出来的结构。
6.3 两条路线各自的加法次数
先摆工作量。以块长 n = 1024、log₂n = 10 计:
| 算法 | 单块加法次数 | 形式 |
|---|---|---|
| Hillis-Steele | 10,240 | n · log₂n |
| Blelloch | 2,046 | 2n − 2 |
差 5 倍。 按 GPU Gems 3 对 work-efficiency 的定义——
"A parallel computation is work-efficient if it does asymptotically no more work (add operations, in this case) than the sequential version."
——Blelloch 是工作高效的那一个,Hillis-Steele 不是。直觉预测:Blelloch 更快。
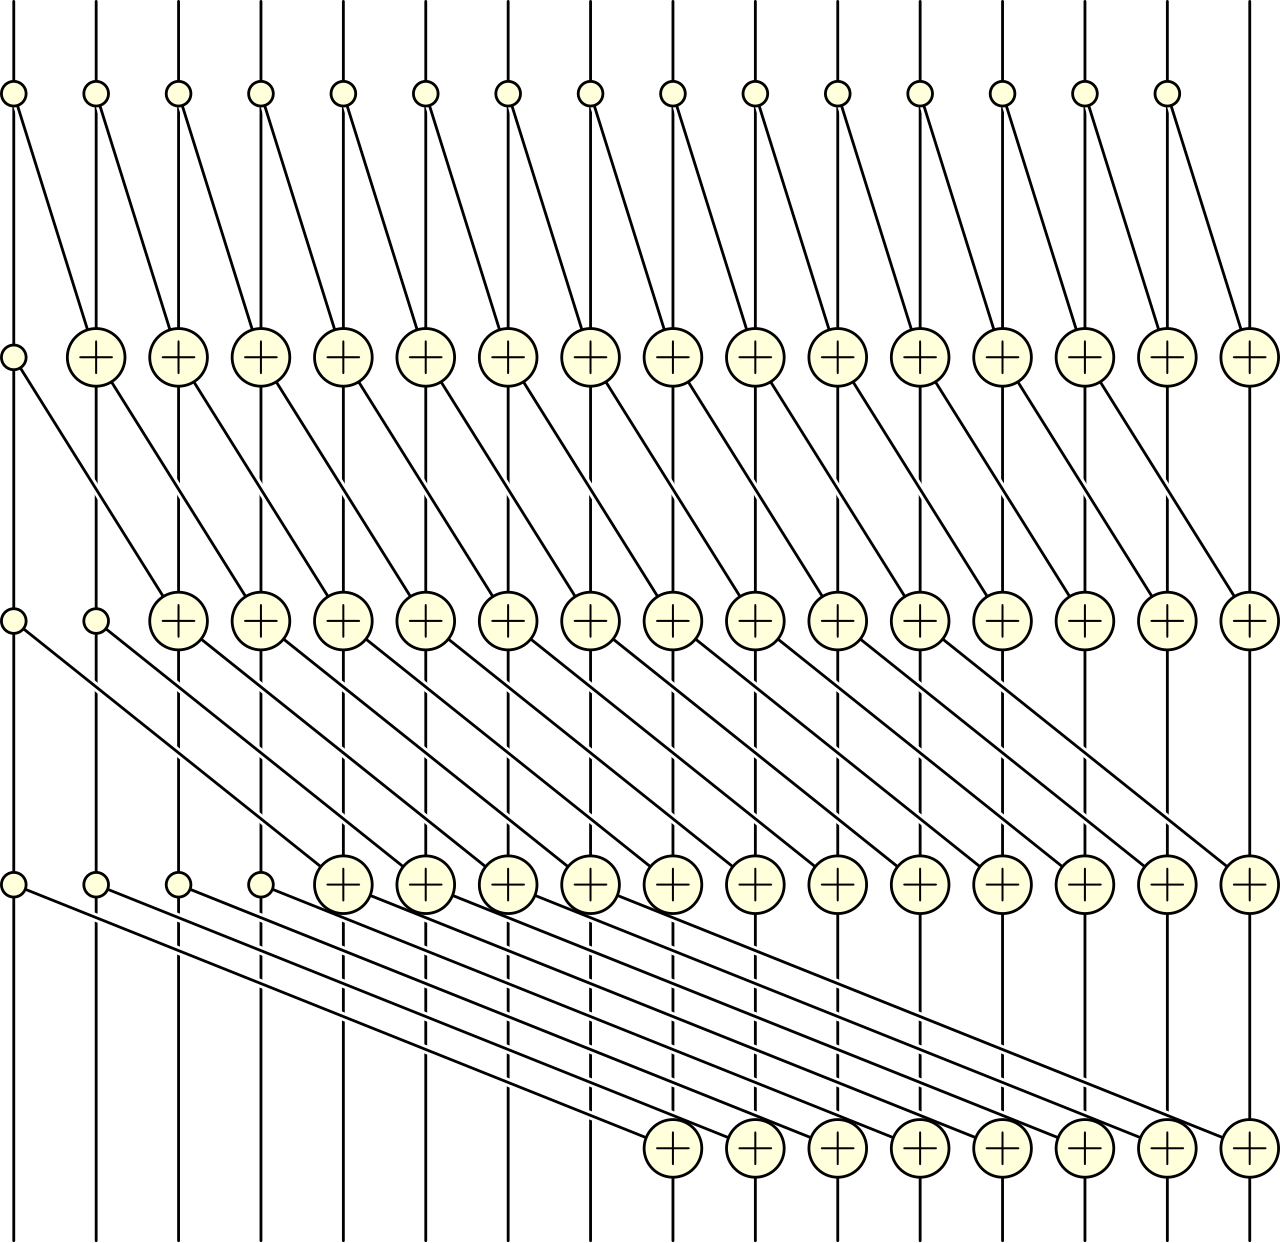
两者在并行形态上的差别,看一眼图就清楚:Hillis-Steele 是「每一轮全体线程一起读、一起写」, 轮数固定为 log₂n;Blelloch 是「一轮比一轮人少」的上下扫。这张图是理解后面读数为什么反直觉的关键。
6.4 本机读数:预测被推翻
把两种算法分别放进上面那条三趟链路里(只换第 ① 趟的块内扫描,其余完全不动),
在同一台 GPU、同一份 1,048,576 个元素的输入上跑,用 timestamp-query 在每个 compute pass 的起止打时间戳,
预热 3 次、重复 20 次取最小值:
| 算法 | 第 ① 趟(ticks) | 三趟合计(ticks) | 挂钟最小值 |
|---|---|---|---|
| Hillis-Steele | 130,464 | 182,240 | 1,362.9 µs |
| Blelloch | 347,168 | 404,224 | 1,517.8 µs |
| 比值 | 值 |
|---|---|
| 加法次数 hs / bl | 5.00×(Hillis-Steele 做得多) |
| 第 ① 趟 ticks 之比 hs / bl | 0.38× —— Blelloch 反而慢 2.66 倍 |
| 三趟合计 ticks 之比 hs / bl | 0.45× —— Blelloch 慢 2.2 倍 |
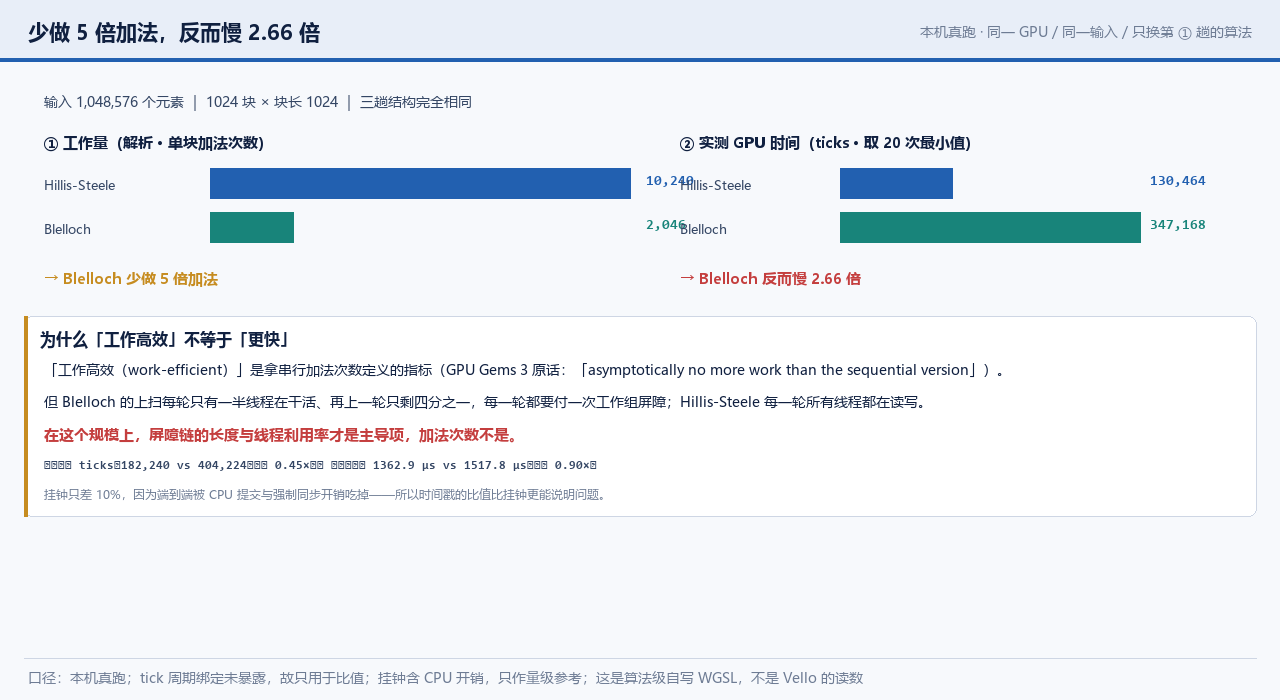
预测被推翻了,而且方向相反。 为什么?答案在两条算法每一轮里有多少线程在干活。
Hillis-Steele 的每一轮,所有 1024 个线程都要读一次、写一次;只有第一轮的判断会产生分歧, 之后的轮次里绝大多数线程都在做有效工作。Blelloch 相反:上扫的第一轮有 512 个线程在算, 第二轮 256 个,第三轮 128 个……到最后一轮只剩 1 个线程;下扫同理。 而每一轮都要付一次工作组屏障(workgroup barrier)的代价——屏障不关心有多少线程在做有效工作。
所以在「块长 1024」这个规模上:屏障链的长度是固定的(各 20 次), 而有效线程数在 Blelloch 里是指数衰减的。加法次数省下来的那部分, 被「大量线程空转但必须一起等屏障」吃掉了。
其中:这不是「Blelloch 不好」,而是「工作高效」这个指标的定义域的问题。 work-efficiency 只算渐近加法次数,它是一个串行计算模型下的指标; 把它直接搬到 GPU 上来预测时间,会漏掉两件事:屏障的代价与线程利用率。 这两件事在「工作总量小、但同步点密集」的小规模块内扫描上,恰恰是主导项。 ——一个算法在一个模型里更优,不等于它在另一台机器上更快。
三条必须写死的口径:
- 这是本机自写 WGSL 实现的读数,不是 Vello 的读数。Vello 本机跑不了(§0.4), 它自己的 shader 用的是另一份实现,块结构、线程组织、是否用 decoupled look-back 都可能不同;
- tick 周期绑定未暴露,所以时间戳只用于比值——好在周期在比值里正好约掉,这也是为什么上面报的是比例;
- 挂钟最小值之比是 0.90×(只差约 10%),因为端到端被 CPU 提交与强制同步的开销吃掉了。 挂钟只作量级参考,不当作 GPU 时间。
6.5 时间花在哪一趟
既然第 ① 趟是性能的主导项,那就该把它与其他两趟分开看。把同一批 dispatch 里三个 pass 的时间戳分别取出来:
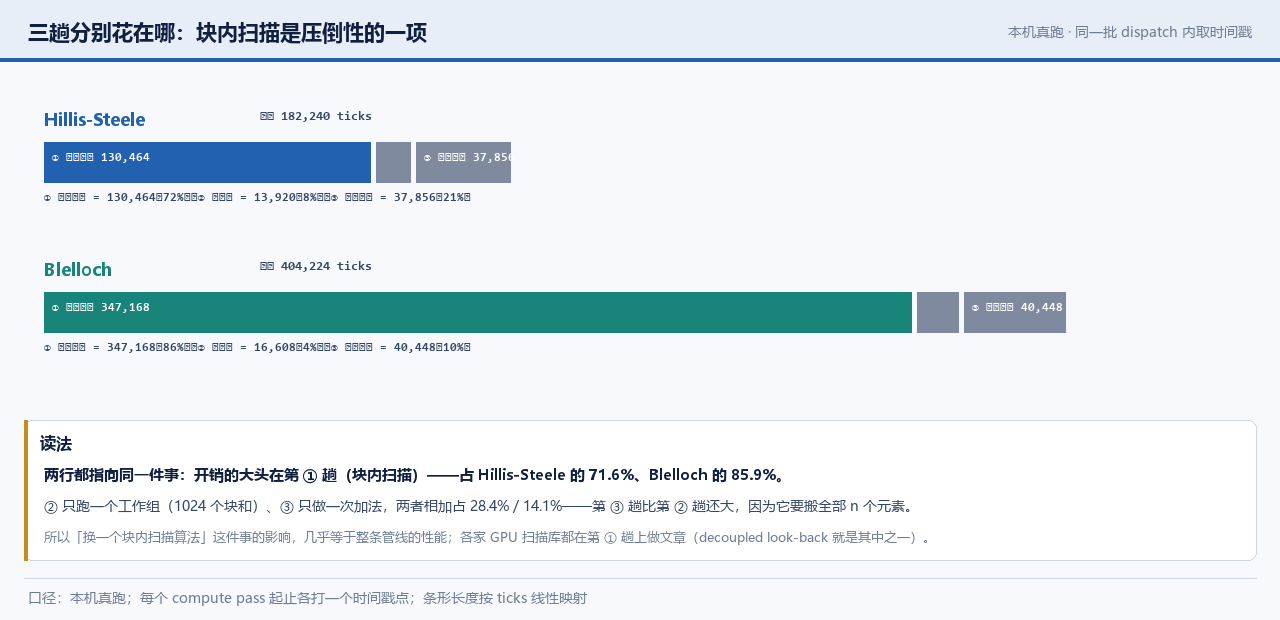
两行都指向同一件事:开销的大头在第 ① 趟(块内扫描)—— 占 Hillis-Steele 的 71.6%、Blelloch 的 85.9%。 第 ② 趟只跑一个工作组(1024 个块和的扫描),第 ③ 趟只做一次加法, 两者相加占 28.4% / 14.1%;其中第 ③ 趟比第 ② 趟还大(20.8% vs 7.6%), 因为它要搬全部 n 个元素。第 ② 趟的耗时几乎不随第 ① 趟换算法而变化(13,920 vs 16,608 ticks)。
其中:这个分解解释了一个工程上的取舍:为什么各家 GPU 扫描库都在第 ① 趟上下功夫。 第 ②③ 趟的规模由块数决定(这里有 1024 个块),与总元素数无关; 而第 ① 趟要处理的元素数是全部的 n。优化集中在这里,收益也集中在这里—— decoupled look-back 之所以值得为它付出「块间同步」的复杂度,原因就在这里。
6.6 一条不能读错的平台限制
讲 decoupled look-back 时,绕不开作者 2021 年那篇博客里的一段话:
"Metal is simply missing an atomic barrier type that is necessary to run the algorithm." "As far as I can tell, there is simply no way to run decoupled look-back on Metal..."
这段话很常被引用,但必须连时间与对象一起引:它是 2021 年、针对当年那套 compute 版扫描算法说的。
到 2026 年 9 月的重构之后,主路径 vello_gpu 走的是 vertex / fragment、官方明说 "without requiring compute shaders",
所以不能读成「Vello 现在在 Metal 上跑不了」。正确的读法是:
「某一类需要原子屏障的扫描算法,在某些图形 API 上缺能力」——这是一个算法与 API 的匹配问题,
不是某个引擎的可用性问题。
6.7 本章收在哪里
下面我们进入下一章。 结构讲完、读数报完,接下来回到像素那一侧: 粗光栅与细光栅各自算什么,以及本机那条三趟链路在更大规模上是不是还站得住。
官方依据:三条历史路线与 decoupled look-back 的原句见 NVIDIA 技术报告 Single-pass Parallel Prefix Scan with Decoupled Look-back; work-efficiency 的定义见 GPU Gems 3 第 39 章; Metal 的限制见 Prefix sum on portable compute shaders; 本机读数与脚本口径见参考资料第 26–28 条。
七、coarse 与 fine:两段光栅化
第六章把「计数与位置」那一侧讲完了。这一章回到像素那一侧,看这条动线的最后两站怎么分工。
7.1 两段的分界是「命令表」
官方对这两段的描述是:
"The GPU rendering pipeline consists of two major phases executed sequentially: 1. Coarse Rasterization Phase: Processes geometry, performs spatial binning, allocates tiles, and generates per-tile command lists. 2. Fine Rasterization Phase: Executes per-tile commands to produce final anti-aliased pixels."
两段的分工从输入输出上就能看清:粗吃的是几何(分箱后的路径段),吐的是命令表; 细吃的是命令表,吐的是像素。
「粗」这个字还得回到命名来历。作者在讲这段架构时写过:
"This is called 'coarse rasterization' because it is sensitive to the geometry of path segments. In particular, coverage of tiles by line segments is done with a 'fat line rasterization' algorithm."
——粗光栅对几何敏感:一条线段要判定它盖住了哪些格子,用的是「胖线」算法, 也就是把线段按它的覆盖宽度向外扩一圈再判定。而细光栅对像素敏感:它逐像素算最终的覆盖率与颜色。
其中:这个命名还带出一条架构血脉。同一篇文章里写着:
"The new architecture for piet-gpu draws heavily from the 2011 paper High-Performance Software Rasterization on GPUs by Laine and Karras."
也就是说,「粗/细」这套分法与「中间排序」这套骨架,源头是一篇 2011 年的 GPU 软件光栅化论文(常被称为 cudaraster)。Vello 的架构不是凭空设计的,它有一条可追的学术线索。
7.2 全局跑一遍:更大规模上还站不站得住
第六章的读数是块级的对照。为了确认整条三趟链路在更大规模上仍然正确, 本机又跑了一遍完整规模:1,048,576 个元素 = 1024 块 × 块长 1024,输入取确定性伪随机序列(值域 1..1000)。
这一轮不只核最终结果,三个中间量逐个核:
| 核什么 | 结果 | 说明 |
|---|---|---|
① 块和 bsums 全等「各块内求和」 |
True | bs[0] = 512,560 |
② 块偏移 boffs 全等 cumsum(bsums) |
True | 块偏移是「含前缀和」 |
③ 最终结果全等 numpy.cumsum |
True | 首个不符位置 = −1(即没有),末位 524,812,176 |
一条方法学记录(照实写):第一版的「① 块和校验」写错了——我拿块和去和
「到该块末的累计和」比,得到 False。查下来是校验写错了:块和是块内求和,不是累计。
改成与 reshape(1024, 1024).sum(axis=1) 比之后 True。
按口径注 ⑧ 的规矩:校验误报只改校验、不改内容——这次改的确实是校验。
还有一条同样照实写:第一版的三趟顺序写反了(把第 ② 趟排在第 ① 趟之前), 靠预热后的稳态把错误掩盖了——那时缓冲区里已经装着上一轮的正确块和。 修正顺序(①→②→③,且三趟各用一个独立的 compute pass)之后,才拿到真正可信的读数。 跨 pass 才保证内存可见性,这件事在 6.2 的结构里是硬约束,在自己的实现里同样是硬约束。
7.3 本章收在哪里
下面我们进入下一章。 动线走完了:从路径到条带、从计数到位置、从几何到像素。接下来把镜头对准那份命令表—— 细光栅到底在播放什么。
官方依据:粗/细两段的分工见源码级索引(GPU rendering pipeline); 「coarse rasterization」的命名来历与 cudaraster 出处见 A sort-middle architecture for 2D graphics; 本机全局读数见参考资料第 26–28 条。
八、每格一张命令表
第七章说粗光栅的输出是「每格一张命令表」。这一章把那张表打开看:它里面写什么、为什么需要它。
8.1 ptcl:细光栅到底在播放什么
这张表在官方与社区材料里有两个名字:per-tile command list(每格命令表),简称 ptcl; 作者在博客里也叫它 tape(磁带)。他的原话是:
"finally writing a per-tile command list (sometimes called 'tape') for each 16x16 tile in the target. The last stage is 'fine rasterization,' which plays these commands for all pixels in the tile."
「播放」这个词用得准:细光栅这一站不做判定,它只是按顺序把表里的命令执行一遍。 判定已经在粗光栅那一站做完了。
这张表里会出现的几类命令,各自对应一种实际情形:
- 填充:用某个 paint 把这片盖住;
- 纯色:这一格只有背景、没有几何——这是「稀疏」落到命令表上的样子(第四章说过的那类快路);
- 裁剪开始 / 结束:成对出现,负责压栈与出栈(第九章);
- 图像:贴一张图。
其中:命令表这个设计解决的是一个很具体的问题:判定与执行要分开。 粗光栅那一站知道几何、知道覆盖,但它不知道最终颜色;细光栅那一站知道怎么算颜色, 但它不该再去查几何。中间用一张表把两边的接口固定下来,两边就可以各自并行: 粗的那一侧按几何分派,细的那一侧按格子分派。这张表就是两段光栅化之间的 API。
8.2 本章收在哪里
下面我们进入下一章。 命令表打开了,里面有一对命令需要单独讲——裁剪的开始与结束。 它们背后是这套架构里最漂亮的一处设计:把裁剪当成一次混合。
官方依据:per-tile command list 与 "tape" 的说法见 piet-gpu progress: clipping; 命令类型的源码级索引见 GPU rendering pipeline。
九、裁剪与混合为什么能一起做
第八章的命令表里有一对命令是成对的:裁剪开始与裁剪结束。这一章讲它们背后的设计—— 这是本篇读下来最值得单独记一笔的一处。
9.1 裁剪不是开关,是一次混合
多数渲染器把裁剪(clip)实现成一个状态:进裁剪区、出裁剪区,中间画的东西被裁掉。 Vello 这边的做法不一样。作者的原话:
"Rather, we treat (antialiased) clipping as a blend operation – in fact, it is an instance of the Porter-Duff 'source in' composition operator."
裁剪被当成一次 Porter-Duff 的 source in 混合。 这个转换的收益是: 原本需要一套独立的裁剪逻辑(判区域、算遮罩、逐像素 mask),现在复用同一个混合器。
具体怎么跑?细光栅维护一份逐像素的状态,里面有一个 blend stack(混合栈):
"The fine rasterizer maintains a bunch of per-pixel state, notably a current pixel and a blend stack. ... A
BeginClipoperation pushes the current pixel on a blend stack. ... at a matchingEndClip, the clip mask is rendered into an alpha mask, that's composited with the current pixel using 'source in' ... and that result is composited (Porter-Duff 'over') with the top of the blend stack (which is popped), becoming the new current pixel."
把这段拆成动作:遇到裁剪开始 → 把当前像素压栈;遇到裁剪结束 → 算出遮罩、按 source in 合成、 再与栈顶按 over 合成、弹栈。裁剪的嵌套深度就是栈的深度。
9.2 三种格子状态:裁剪的「粗判定」
在粗光栅那一站,裁剪还要先做一次粗判定。官方给的是三种状态:
"a clip path may be in one of 3 states: zero coverage, partial coverage, or full coverage. Partial coverage only happens with the clip path intersects the tile. Full coverage is for tiles entirely within the clip path, and zero coverage is for tiles outside the clip path." "The mask computation and compositing only needs to happen for the partial coverage tiles... Zero coverage tiles suppress the rendering of child nodes... full coverage tiles are basically a no-op..."
三种状态的处置完全不同:
| 情形 | 处置 | 收益 |
|---|---|---|
| 完全在裁剪区内 | 无事发生,直接放行 | 省掉遮罩计算 |
| 完全在裁剪区外 | 抑制子节点,整片跳过 | 省掉整片的绘制 |
| 部分相交 | 真正算遮罩并合成 | 只有这一档要干活 |
其中:这一节与第四章的「稀疏」是同一个思路的两次应用: 先用粗粒度的判定把「不用干的活」划掉,再对剩下的小集合干精细活。 稀疏条带是在空间上划(只处理有几何的格子),裁剪三态是在覆盖关系上划(只处理部分相交的格子)。 两处都遵守同一条原则:粗判定要足够便宜,省下来的才划算。
9.3 裁剪栈也能并行:括号匹配
裁剪还有个看起来很难并行的地方:裁剪是嵌套的,而嵌套天然带着栈结构——栈又是串行的。 官方的解法是把它转成一次括号匹配:
"We use the result of parentheses matching for two things. First, each
EndClipis able to access the same path and bounding box data as the correspondingBeginClip." "the work of the clip stage is proportional to the number of clips in the scene, not to the total number of objects."
其中:留意后半句的收益:裁剪这一步的工作量正比于裁剪的数量,而不是场景里对象的数量。 一个场景里可能有一万个图形,但只有几十个裁剪区——这又是一个「把工作量从 n 降到 k」的例子, 和前缀和的精神是同一条:先把能省的省掉,再对省不掉的部分做精细计算。
9.4 本章收在哪里
下面我们进入下一章。 裁剪讲清了,接下来看「同一个算法怎么装进三种不同形态的机器」—— CPU、GPU、以及那条全 compute 的路。
官方依据:裁剪 = source in、blend stack、三种格子状态、括号匹配,四段原句均见 piet-gpu progress: clipping; PTCL 里的裁剪命令见源码级索引(参考资料第 30 条)。
十、三个后端怎么共享同一套数据
前面九章讲的是「一条路径怎么变成像素」。这一章换一个方向:同一套算法,怎么装进三种不同的机器。
10.1 切分点在哪
三个后端的官方分工是(逐字给出):
"vello_cpu rasterizes and composites the strips into a CPU pixmap. It uses SIMD and can use multiple threads, but requires no GPU." "vello_gpu performs the same broad preprocessing on the CPU, then uploads scheduled strips and paint data for GPU rasterization and compositing. Its wgpu and WebGL2 backends use vertex and fragment rendering rather than requiring compute shaders."
vello_gpu 的 README 把分工写成三条:
- "The CPU processes paths, tiles, and schedules sparse strips."
- "The GPU rasterizes those strips and performs compositing."
- "The compact strip representation limits data transfer between them."
把三条排起来看,切分点的位置就很清楚了:
| 后端 | CPU 做什么 | GPU 做什么 |
|---|---|---|
vello_cpu |
全部:光栅 + 合成 | 不用 GPU |
vello_gpu |
展平、分箱、调度条带 | 光栅化 + 合成 |
| compute 版 | 编码场景与资源 | 几乎全部在 compute 里 |
其中:切分点选在「条带」这一步,是有讲究的。往前切(把分箱也交给 GPU)需要 GPU 侧能处理 路径段的分类与记账,那是 compute 更擅长的活;往后切(把光栅也留在 CPU)就放弃了 GPU 的并行度。 选在条带,是因为条带正好是「已经整理好、体积又小」的那个中间产物—— 官方那句 "limits data transfer between them" 说的就是这一点:传输量由表示的紧凑程度决定。
10.2 为什么这件事对「CPU 也能跑」很重要
值得单独说一句的是 vello_cpu 的定位。官方 README:
"Vello CPU is a 2D graphics rendering engine written in Rust for devices with no or underpowered GPUs."
其中:这句话把 sparse strips 的价值从「性能技巧」提升到了「可移植性策略」。 如果一个引擎的核心资产是「一套紧凑的中间表示」,那么同一套表示可以喂给 CPU(用 SIMD 与多线程)、 可以喂给 GPU(用 vertex/fragment),也可以喂给 compute。 算法的价值不绑定在某一块硅片上——这在前几篇讲 Skia 的经历里是少见的: Skia 的两条后端(CPU 光栅与 GPU 后端)共享的是 API 层,而 Vello 这两族共享的是数据结构。 共享的层次不一样,可移植性的边界也就不一样。
10.3 本章收在哪里
下面我们进入下一章。 到这里,Vello 这一侧的机制基本讲完。最后一章正文要把镜头拉开, 把 Vello 与它最像的那个对手——Skia 的新一代后端 Graphite——放在一起看。
官方依据:三个后端的分工原句见 ARCHITECTURE.md; 三条分工与「限制传输量」见 vello_gpu/README.md; CPU 版的定位见 vello_cpu/README.md。
十一、与 Graphite、Cairo 的根本差异
前八篇讲 Skia,这一篇讲 Vello。最后一章正文把两家放在一起看——不是比快慢(那是 ep10 的事), 而是比它们各自选择了什么。
11.1 四种情形,两条路
Graphite 是 Skia 的新一代 GPU 后端,也是这一系列第六篇的主角。Google 官方在介绍它时, 把最核心的一处变化写得很直接:
"Graphite extends Skia's GPU rendering to take advantage of the depth test by assigning each 'draw' a z value defining its painter's ordering index. While transparent effects and images must still be drawn from back to front, opaque objects in the foreground can now automatically eliminate overdraw." "Ganesh never utilized the depth testing capabilities of graphics cards... Ganesh suffers from overdraw due to its reliance on adhering to strict painters order..."
而 Vello 这一侧,前面几章已经给足了依据:没有深度缓冲,靠的是路径按序、命令表按序播放、以及混合栈。
把它摊成四条并排看:
| 问题 | Graphite | Vello 这侧 |
|---|---|---|
| 谁赢 | 深度测试 + 画家序号(z) | 按序命令表 + 混合栈 |
| 抗锯齿 | 主要用 MSAA | 解析覆盖率 |
| 裁剪 | 当成只写深度的绘制 | 当成 source in 混合 |
| 空白区域 | 仍要过管线 | 直接跳过 |
其中:最后一行的差别值得停一下。Graphite 那条路给每个绘制一个 z 值, 靠深度测试在硬件里做「谁覆盖谁」;这对不透明物体是免费的胜利——先画后画都行,深度会摆平。 但透明物体不吃这一套,官方也明说 transparent effects 仍须 back-to-front。 Vello 那条路则相反:它从一开始就假设所有绘制都必须按序,于是不需要深度缓冲, 但需要一份能保证顺序的中间产物——这正是命令表存在的理由。 两条路各自解决了一类问题,也都为此付出了各自的结构成本。
11.2 与更传统的渲染器对照
把坐标系再拉远一层,还有第三个参照:像 Cairo 这类传统的 2D 渲染库。 它们的工作模型是「按顺序、逐个绘制对象地画到一张画布上」——一份命令、一次执行, 中间没有一份可复用的紧凑中间产物。
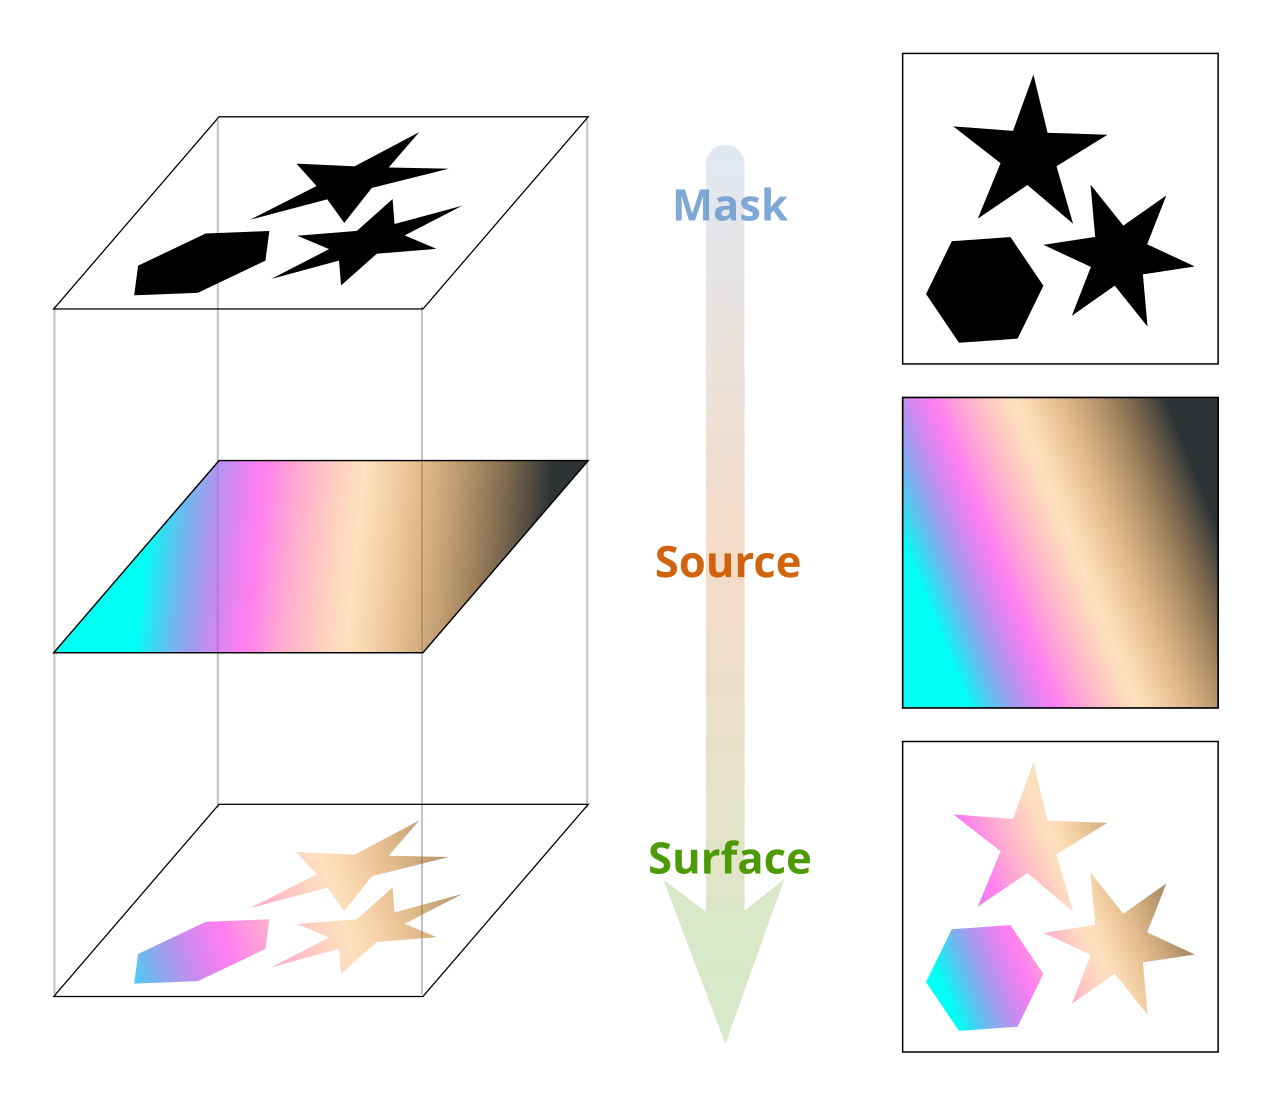
其中:这三者的差别可以用一个问题串起来:「中间产物」是什么? Cairo 这类的中间产物就是那张画布本身;Graphite 引入的是深度缓冲作为「谁赢」的中间记录; Vello 引入的是稀疏条带 + 命令表作为「哪些像素要填」的中间记录。 三种答案对应三种成本结构,也对应三种适用面。这也是为什么把引擎放在一起看时, 先看中间产物,比先看性能数字更有信息量——性能数字是结果,中间产物是原因。
顺带提一句两者都在意的同一件事:Google 那篇官方博文在讲 Graphite 时,也点了 Vello 的名字:
"GPU compute-based path rasterization is very much in vogue with recent implementations like Pathfinder and vello."
——两边都在看对方的做法。这句话本身也是一个可引的证据:这不是两条互不相干的路线。
11.3 本章收在哪里
下面我们进入下一章。 机制讲完了、对照做完了,最后一章要把这套方法测不了什么逐条交代。
官方依据:Graphite 的深度测试、z 值、overdraw 消除与对 vello 的点名,均见 Introducing Skia Graphite; Vello 侧的四条依据见前文各章的官方原句;Cairo 的画布模型见参考资料第 40 条。
十二、这套方法测不了什么
这一章是固定收尾:把给不出数字的量逐条列出来,并给原因。理由很简单—— 不把「我写的东西」当成「被讲的东西」,是这一篇唯一值得坚持的纪律。
12.1 能测与测不了
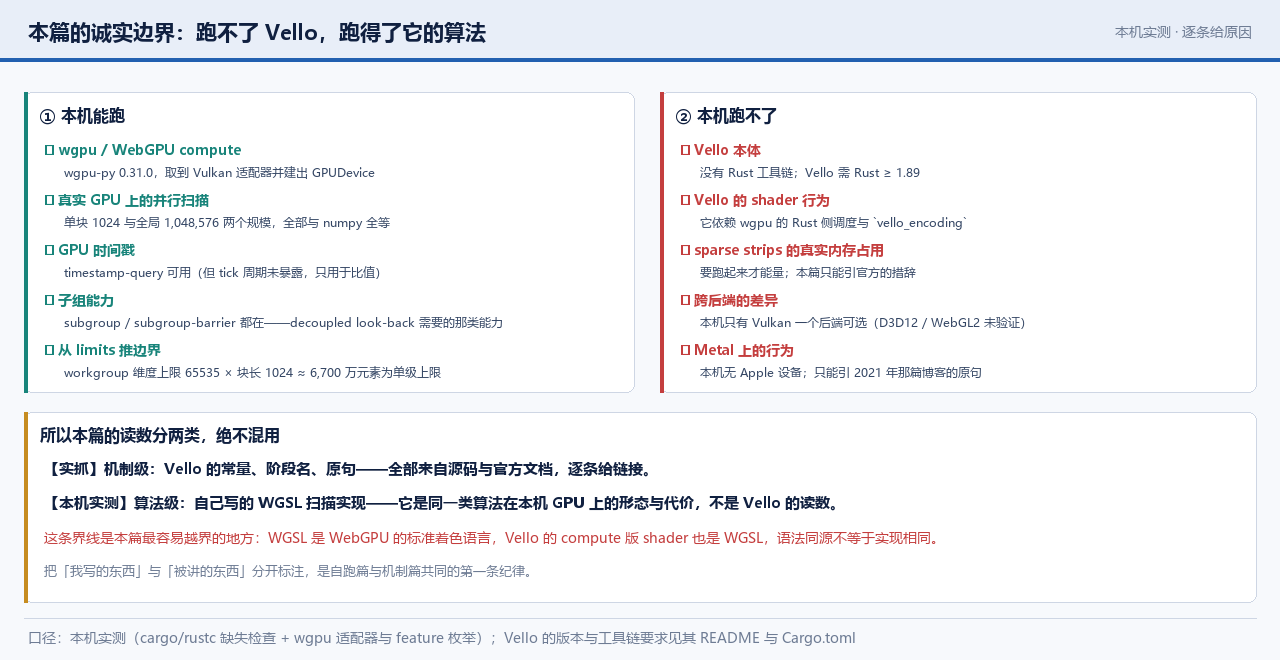
本机能测的:
- Vello 的机制:不是「测」,是「读」——常量、阶段名、分工、版本与工具链要求,全部逐字可核(§1、§2);
- 算法级的正确性:单块 1024 与全局 1,048,576 两个规模,与 numpy 逐元素全等(§5.3、§7.2);
- 算法级的代价:两种块内扫描的加法次数与 GPU 时间戳比值、三趟的分解(§6.3–6.4);
- 本机的能力边界:适配器与 36 项 feature、以及
cargo/rustc缺失这两条事实(§0.4)。
本机测不了的:
- Vello 本体的任何读数:没有 Rust 工具链,编不出来。官方要求 Rust ≥ 1.89;
- sparse strips 的真实内存占用:要跑起来才能量。本篇只能引官方对它的措辞,不给数字;
- Vello 自己那份扫描实现的性能:我跑的是自写 WGSL,不是它的 shader;
- 跨后端的差异:本机只有 Vulkan 一个后端可选;
- Metal 上的行为:本机无 Apple 设备,只能引 2021 年那篇博客的原句(且须连时间与对象一起引,见 §6.5);
- 真机与移动端的表现:本篇的 GPU 是一块桌面级独显,移动端的 TBDR 架构与这里不同。
其中:为什么第 1 条不设法绕过去?因为绕过去的代价是证据失真。 用 Python 的 WebGPU 绑定跑一段类似算法,得到的是「这类算法在这台机器上的样子」, 它回答不了任何关于 Vello 实现细节的问题——Vello 用几趟、块长取多少、有没有用 decoupled look-back, 这些都得读源码。把「可测的近似物」当成「测不了的原物」,是这一类文章最该防的错。 本篇的做法是把两者分层标注:机制层引原句,代价层标自写实现,中间不许跨层。
12.2 本章收在哪里
下面我们进入最后一章。 边界交代完了,最后用三句话把这一篇收住,再把题域让出去。
官方依据:工具链要求见 仓库 README; 本机的能力枚举与环境见参考资料第 26–28 条;Metal 限制的出处与读法见 §6.5。
十三、边界回指与预告
这一篇只做了三件事,用三句话收住。
第一句给「血脉」:Vello 不是一个渲染器,是两族。 一族走 sparse strips(vello_cpu / vello_gpu),
一族走 compute(被移进 research/ 的实验渲染器)。这句区分不是考古,
它直接改变了一个常见的结论——vello_gpu 不要求 compute shader,官方明说走 vertex / fragment。
看到「Vello 需要支持 compute 的 GPU」这句话时,要问清说的是哪一族。
第二句给「动线」:稀疏条带的价值在于把中间产物压小,而不在于改变最终像素。 一条路径要过展平、分箱、合并条带、粗光栅、细光栅五站;条带是「已经整理好、体积又小」的那个中间产物, 所以它既能喂给 CPU,也能喂给 GPU。共享的层次是数据结构,不是 API——这是它与 Skia 那类引擎最根本的不同。
第三句给「代价」:把串行变并行不是免费的,而且省下来的加法不等于省下来的时间。 本机那条读数是最直白的一次提醒:少做 5 倍加法的那一版,实测慢 2.66 倍。 原因不神秘——屏障链的长度与线程利用率才是这个规模下的主导项。 「工作高效」是一个串行模型下的指标,把它直接搬到 GPU 上预测时间,会漏掉这两件事。
把题域让出去之前,先标清这一篇的三条自我约束。其一,否定项不据记忆补:
coat 不存在、Potato 抓不到、没有专门的 draw order 文档,三处都写在正文里。
其二,算法级读数与官方原句分层标注、不许跨层:前者标「本机自写实现」,
后者给逐字原句与链接。其三,时间戳只报比值:绑定没暴露 tick 周期,报绝对时间就是编。
下面我们进入下一篇。
下篇预告:第十篇换回「自跑」——把 Vello 的三条路(GPU / CPU / Hybrid)在同一批场景上各跑一遍, 量出它们各自的耗时与输出差异。机制讲清了,三路对比才有意义:不然不知道自己在读什么。
官方依据:本篇所有机制性断言出自参考资料第 1–25 条;本机读数与口径见第 26–28 条; 外部示意图的来源与许可见第 35–40 条。
参考资料
- Vello 仓库 README(三个渲染器的定位)
- Vello 官方架构文档 ARCHITECTURE.md(两族与 Sparse Strips 定义)
- workspace Cargo.toml(版本、许可、wgpu 依赖、Rust 版本)
- vello_cpu/README.md(CPU 版定位)
- vello_gpu/README.md(改名留痕与三条分工)
- research/README.md(compute 实验渲染器定位)
- research/vello_research/README.md(piet-gpu 的历史与 wgpu 版本)
- research/doc/blogs.md(官方博客索引)
- vello_shaders/shader 目录(阶段文件名逐个核对)
- research/doc 目录(历史设计文档的实际清单)
- docs.rs · vello 0.10.0(prefix-scan 动机原句)
- crates.io · vello(发布版本)
- Fast 2D rendering on GPU(backdrop 的前缀和传播)
- A sort-middle architecture for 2D graphics(coarse/fine 命名与 cudaraster 出处)
- piet-gpu progress: clipping(source in、blend stack、三态、括号匹配)
- Prefix sum on portable compute shaders(Metal 缺原子屏障)
- Prefix sum on Vulkan(scan 的 Vulkan 实现与内存模型)
- Linebender 官方博客 · tmil-22(Hybrid 首发、ETH 论文)
- Linebender 官方博客 · tmil-25(sparse strips 0.0.7 与 Vello 0.8.0)
- ETH 硕士论文 · High-performance 2D graphics rendering on the CPU using sparse strips
- NVIDIA 技术报告 · Single-pass Parallel Prefix Scan with Decoupled Look-back
- GPU Gems 3 第 39 章 · Parallel Prefix Sum (Scan) with CUDA
- Imagination 官方 · Tile-Based Deferred Rendering(TBDR 定义)
- Vulkan 官方教程 · Mobile Development: Rendering Approaches(binning 阶段)
- Google 官方 · Introducing Skia Graphite(深度测试、z 值、点名 vello)
- wgpu-py 发行页(本篇本机跑用的绑定)
- W3C · WebGPU Shading Language 规范(本机 shader 用它)
- WebGPU 标准的社区门户(后端与能力对照)
- DeepWiki · Vello 总览(源码级索引)
- DeepWiki · GPU 渲染管线(coarse/fine/ptcl 命令)
- DeepWiki · Sparse Strips 架构(4×4 与 64×4 两层)
- Infinite Canvas · Lesson 35 Tile-based Rendering(三实现共享同一算法)
- kaelan.fyi · Vello:GPU Compute 2D Renderer(prefix sum 为核心创新)
- ginokent · SVG 动画渲染技术对比(横向对比里写到 Vello)
- Commons · Category:Sorting networks(本篇实测:该类目在本机渲染路径下不可用)
- Commons · Category:Parallel computing(通用并行计算素材)
- Commons · Prefix sum 16.svg(前缀和的定义图,CC0)
- Commons · Hillis-Steele Prefix Sum.svg(并行扫描的形态)
- Commons · Pipelined Binary Tree Prefix Sum Communication.svg(树形归约通信,CC0)
- Commons · Cairo's drawing model.svg(传统渲染器的画布模型)


本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑/真算的读数图由本篇测量脚本产出(图注写明口径); 自绘图为本系列绘制,走
styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:第十篇回到「自跑」——Vello 的 GPU / CPU / Hybrid 三条路在同一批场景上各跑一遍,量出各自的耗时与输出差异。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.