站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:上游交下来的是一条链,链上挂着什么
上一章我们跟着一条 2D 命令走完了剔除与排序,看到它从「一棵场景树」被筛成「一条 Item 链」。可那条链交出去之后呢?这一章要问的就是这个问题:下游收到的到底是什么东西,它又是怎么被变成一次真正的提交的。
0.1 全系列的目录:这一条链有五层,本篇落在第三与第四层之间
OK,先把整个系列按层摊开,大家好知道自己在哪一格。这套架构的主线是一次 2D 绘制的四层落点:从场景层的 CanvasItem(画布项)出发,经画布剔除(culling),落到画布渲染抽象层,再经 RenderingDevice(渲染设备)变成驱动能吃的命令缓冲。
| 层 | 谁在做 | 这一层回答什么 | 本系列哪一篇 |
|---|---|---|---|
| 场景层 | Node / SceneTree / CanvasItem |
谁在什么时候下发命令 | 第二篇 |
| 服务层 | RenderingServer 门面与其实现 |
命令怎么被接收、怎么被排队 | 第三篇 |
| 剔除与排序 | RendererCanvasCull |
画什么、按什么顺序 | 第四篇 |
| 画布渲染抽象 | RendererCanvasRender 与其 RD 实现 |
绘制项里存了什么、怎么被提交 | 本篇(第五篇) |
| 批处理与后端 | 攒批规则 + 四个后端分叉 | 一次绘制怎么变成一次 draw call | 第六、八篇 |
| 设备层 | RenderingDevice |
命令列表怎么排成依赖图 | 第七篇 |
| 横切 | 主循环与线程、资源导入 | 逻辑与渲染怎么错位、图从哪来 | 第九、十篇 |
好了,这套结构的原理很朴素,其中:先把「画什么」筛出来,再给筛出来的东西排位置,最后把排好的东西变成一批提交。前三步是上一篇的事,最后一步是这一篇的事。
这张表也顺带交代了本篇的边界:批处理的收益与四个后端的演进、RenderingDevice 的命令列表与依赖图、主循环与线程池的完整骨架、资源导入与显存路径,本篇都不展开——它们分别是第六、八、七、九、十篇的题目。本篇只走到「绘制项的中间表示」与「抽象层/实现层的分工」这道接缝上。
0.2 官方口径里,2D 是什么样的一种渲染
官方《内部渲染架构》一文里与 2D 有关的段落不长,但每一句都值得记下来,因为它们直接框定了本篇要讲的结构。
第一条是分离:2D 与 3D 渲染到不同的缓冲,2D 在 LDR 的 sRGB 空间里做,3D 在 HDR 线性空间里做。第二条是格式:2D 用的颜色格式是 RGB8(视口开 Transparent 时是 RGBA8),而且 2D 不使用深度缓冲。
第二条尤其重要。它意味着 2D 的先后只能靠画序——不能像 3D 那样把顺序交给深度测试去裁决。上一篇讲的 z 桶、层内序号、y 排序,之所以要那么费劲地摆位置,根子就在这里:没有一个硬件机制会在后面兜底。
第三条是单趟:2D 光照是单趟完成的,为的是在灯多的时候保持性能。第四条是批处理:所有渲染方式都支持 2D 批处理,屏幕上文字多的时候效果尤其明显——这条口径本身还有一个版本转折在里面(4.3 时代的文档写着「只有 Compatibility 有 2D 批处理」),那属于第六篇的题目,本篇只记结论。
OK,最后一条是 SDF 的生成时机:视口里代表 LightOccluder2D 节点的二维有符号距离场,在用户着色器请求它的时候才自动生成。这句话在源码里能找到确切的落点,我们在第九章会把它对上。
0.3 两段接力:一条链怎么变成一批提交
先来看看源码给的结构。本篇要讲的过程只有两段接力,值得先记住它们各自的入口。
第一段是「收」:剔除层把 Item 链交出来,渲染抽象层的实现第一件事是把链表收进一个定长数组——一次遍历、边走边收,同时判断「状态变了没有」,状态一变就切一批。第二段是「发」:一批一批地绑管线、绑缓冲、发绘制。
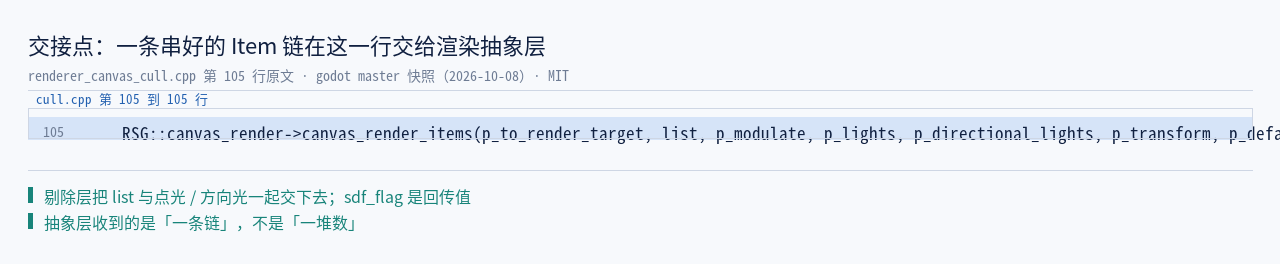
canvas_render_items 这一行换手@ godot master 快照(2026-10-08)原文截取 · MIT
第一条原文是两层的唯一交接点:RSG::canvas_render->canvas_render_items(...)。这里有一个细节值得留意——剔除层的 Item 是继承渲染层的 Item 的,也就是说两层用的不是两个对象、而是同一个对象的两副面孔:剔除层在上游给它填可见性、z、序号这些「位置」信息,渲染层在下游读它的命令链和累计态。
「什么顺序」由一次汇总回答,而「存了什么」由这条链自己回答。说白了,上一篇管的是「谁先进这条链」,本篇管的是「链节上挂着什么、以及怎么被装箱发走」。
0.4 本篇要留下的三个可检验命题
把话收一收,本篇想在读者心里留下三件可以自己去验的事:
- 一个绘制项的中间表示是一条命令链 + 一份累计态——不是「一堆绘制指令的数组」,也没有把最终变换、最终裁剪矩形算在每个命令上。
- 命令的内存是分块管理的,首条单独分配、其余进 4 KiB 的块,块只增不减;因此「一帧里反复重绘」的代价并不主要在内存分配上。
- 决定 draw call 数量的不是「画了多少东西」,而是「状态切换了几次」——这一点本机能直接测出来,我们在第七章给读数。
说白了,命题 1 与 2 的证据在源码里,命题 3 的证据在读数里。三层证据在这一篇里会分得很清楚:官方文档给口径、源码原文给结构、本机读数给行为。
0.5 边界声明:本章不涉及什么
承接系列边界(不写矢量光栅算法、不写渲染 API 教程、不写硬件微架构),本篇另有四条:
- 批处理的规则与收益只在「换批判据」这一层点到为止,攒批的完整策略与四个后端的演进留给第六篇与第八篇;
RenderingDevice的命令列表与依赖图只走到draw_list_begin那一行,留给第七篇;- 主循环与多线程不展开命令队列,留给第九篇;
- 资源导入与显存路径不展开,留给第十篇。
另外记一句口径:本篇所有本机读数都来自本机自建引擎 4.8.dev.custom_build.7177493c1(2026-07-03 构建,自定义构建),只在本机口径下成立,不跨机器外推;所有源码行号一律按 godotengine/godot 的 master 快照(2026-10-08)逐条实读,两者已漂移,不做算术平移。
// servers/rendering/renderer_canvas_cull.cpp:105(master 快照 2026-10-08)
RSG::canvas_render->canvas_render_items(p_to_render_target, list, p_modulate,
        p_lights, p_directional_lights, p_transform, p_default_filter,
        p_default_repeat, p_snap_2d_vertices_to_pixel, sdf_flag, r_render_info);
两条链在这里换手。其中:list 是剔除层一路串下来的那条 Item 链,sdf_flag 是回传值——它出去时代表「本轮要不要生成 SDF」。这条调用的原理很直白:上游把「决定」做完,下游只负责「兑现」。
本章出处:官方《内部渲染架构》master 原文(2D 与 3D 缓冲分离、2D 光照单趟、2D 批处理、SDF 生成时机)|CanvasItem 类参考|源码 renderer_canvas_cull.cpp。
一、抽象层:为什么这一层几乎全是虚函数
这一章先看这道接缝的上半截:RendererCanvasRender 这个类。它有个不太寻常的地方——几乎全是虚函数,几乎没有实现。这不是设计事故,而是这一层被刻意留成了一道「接口」。
1.1 一个几乎全是虚函数的类
言归正传,打开头文件,第一眼看到的是一个特别干净的定义。它没有构造函数里的复杂初始化,也没有成员数据,只有几样东西:一组 CanvasRectFlags 位常量、Item 与 Light 两个结构、以及一长串 = 0 的纯虚函数。
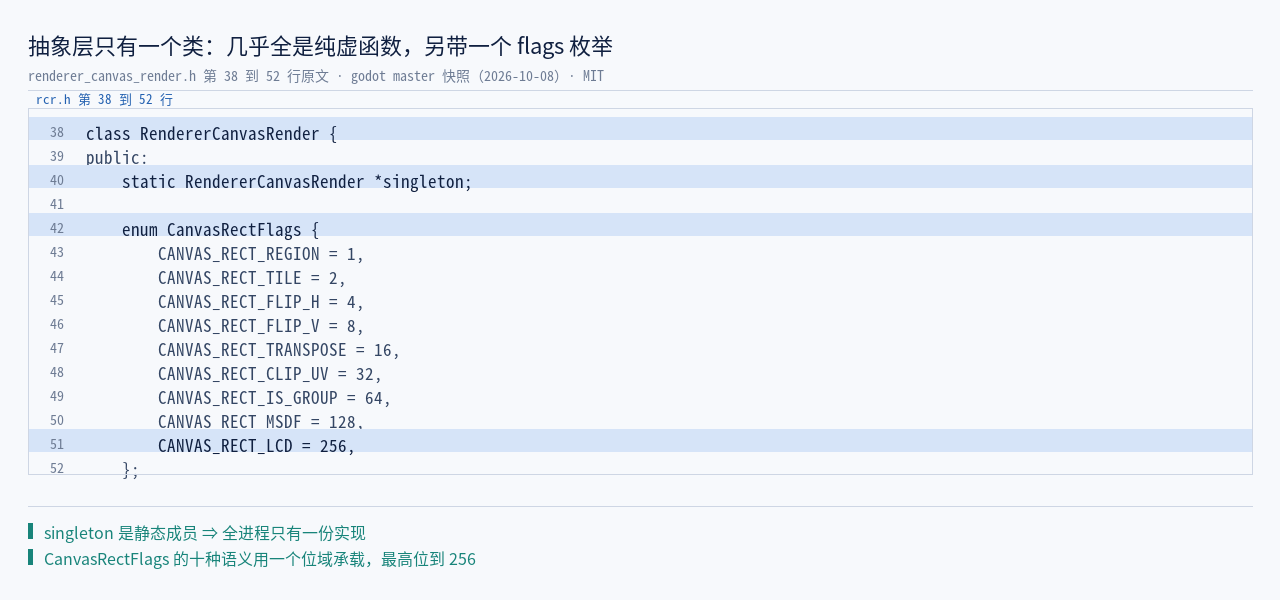
RendererCanvasRender 的类头与 CanvasRectFlags——一个类、几乎全是虚函数@ godot master 快照(2026-10-08)原文截取 · MIT那组 CanvasRectFlags 很能说明这一层的性格:CANVAS_RECT_REGION / TILE / FLIP_H / FLIP_V / TRANSPOSE / CLIP_UV / IS_GROUP / MSDF / LCD,九个语义塞进一个 uint16 的位里。抽象层只负责定义这些语义的编号,至于它们在具体后端里怎么落地,它一概不管。
1.2 只允许一个实现:单例断言
更值得留意的是它的构造与析构。抽象层里挂着一个静态指针 singleton,构造函数第一件事就是断言它必须为空——换个说法:全局只允许存在一个实现实例。
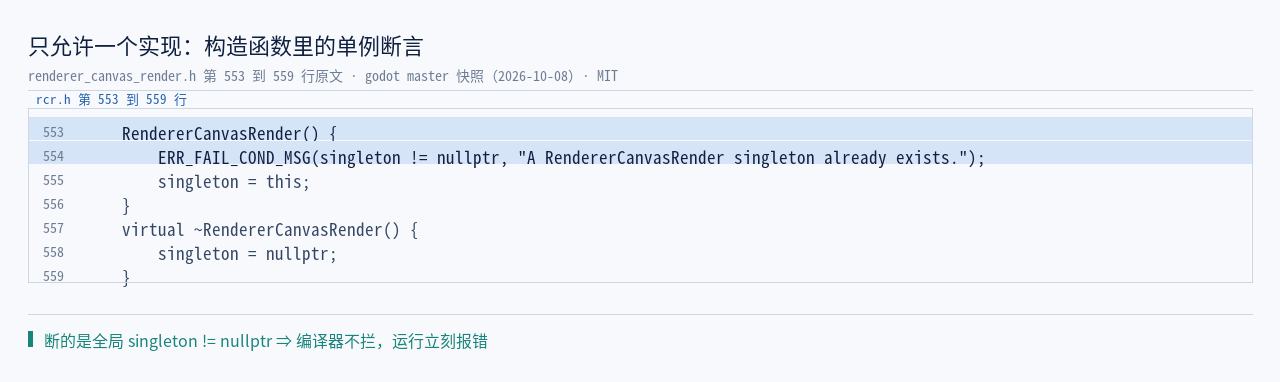
这条断言把一件事钉死了:抽象层与实现层是一对一的。不是「可以有多个 2D 后端互相竞争」,而是「这一层是一个接口,背后接的就是当前渲染方法的那一个实现」。这也解释了为什么剔除层与服务层都可以直接通过全局指针 RSG::canvas_render 拿它——它本来就是唯一的。
顺带说一句全局指针的事,因为它在这条链上出现过好几次:RenderingServerGlobals 里并排着两个指针,RSG::canvas 是剔除层、RSG::canvas_render 是渲染抽象层,它们是两个不同的对象。上一篇所有关于「画什么、什么顺序」的判断都在前者里,本篇所有关于「存什么、怎么发」的动作都在后者里。
1.3 抽象层定义「表示」,实现层负责「提交」
好了,上面这张图把分工画开了,用一句话说就是:抽象层定「表示」,实现层管「提交」。
具体到代码上,抽象层留下的东西有这几类:Item(绘制项)、Command 及其十个子类(命令)、Light(光)、LightOccluderInstance(遮挡体)、Polygon(多边形包装)。这些都是「数据长什么样」的定义,它们连内存怎么分配都写好了(内联的 alloc_command()),却不关心这些数据最终变成什么 API 调用。
而实现层要回答的是另一批问题:一个 Item 上的命令要变成几批、每批绑哪条管线、实例数据写进哪个缓冲、绘制列表什么时候开、什么时候关。这些问题的答案在 RendererCanvasRenderRD 里,也就是我们在第六章要展开的那个类。
1.4 抽象层里唯一的算法
抽象层里只留了一处真正的算法:Item::get_rect()——从命令链算出这个项的包围盒。它具体怎么算、什么时候算,是第五章的题目。
为什么唯独这个算法被留在抽象层?因为它算的是一个与后端无关的量:包围盒只跟「命令链上有什么」和「变换是什么」有关,跟用 Vulkan 还是 OpenGL 无关。凡是与后端无关的,就留在上面;凡是与后端有关的,就往下推。这条界线在后面几章会反复出现。
把虚函数清单按用途过一遍,就能看出这一层把哪些东西当作「契约」。它们大致分成四组:
| 组 | 典型成员 | 这一组管什么 |
|---|---|---|
| 多边形 | request_polygon / free_polygon |
把一组顶点交给实现层,换回一个 PolygonID |
| 光照 | light_create / light_set_texture / light_set_use_shadow / light_update_shadow / light_update_directional_shadow |
建光、给贴图、开关阴影、算阴影 |
| 遮挡与 SDF | render_sdf / occluder_polygon_create / occluder_polygon_set_shape / occluder_polygon_set_cull_mode |
建遮挡体、下发形状与剔除模式、生成距离场 |
| 杂项 | set_shadow_texture_size / set_debug_redraw / get_pipeline_compilations / update / free |
尺寸、调试、统计、每帧更新、释放 |
OK,四组里最能说明问题的是光照那一组:抽象层明确要求「阴影怎么算是实现层的事」——它只把「要算阴影的光 + 遮挡体链表 + 光矩形」打包递下去,至于用几次绘制、写成哪张纹理,抽象层一个字都不提。反过来,get_pipeline_compilations 这种只有 RD 类后端才有的概念也被放进了接口,只是让其它实现返回一个常数。接口的边界不是「能不能实现」,而是「这一层要不要知道」。
顺带记一处字段:抽象层自己还存着一份 default_filter 与 default_repeat——也就是全局默认的纹理过滤与重复模式。它们的作用在后面能看到:当某个项把自己的过滤模式设成 DEFAULT 时,就取这一份。
// servers/rendering/renderer_canvas_render.h:553–555(master 快照 2026-10-08)
RendererCanvasRender() {
    ERR_FAIL_COND_MSG(singleton != nullptr, "A RendererCanvasRender singleton already exists.");
    singleton = this;
}
这段构造只做一件事:登记唯一实例。其中:singleton 是静态成员,所以这条断言检查的是「全局」而不是「本对象」。它的定义就是「这一层只有一个实现」——谁想再建一个,编译能过、运行立刻报错。
本章出处:源码 renderer_canvas_render.h / renderer_canvas_render.cpp / rendering_server_globals.h(两枚全局指针)。
二、Item 的字段地图:命令/即位/累计态/插值
知道了这一层的性格,就可以看它的主角了。Item(绘制项)是本篇出现次数最多的名字,也是「中间表示」这四个字的具体所指。这一章把它摊开:一个绘制项到底存了哪些东西。
2.1 命令不是「一堆数据」,是一条链加一组块
先看 Item 的开头几行。那里有一段注释,把命令的存储策略直接写在了类型定义旁边:命令按 4 KiB 的块分配,为了性能和缓存一致性;块只会增长,从不收缩。这句话很短,却决定了后面两章要说的一切——分配是成批的,回收是几乎不做的。
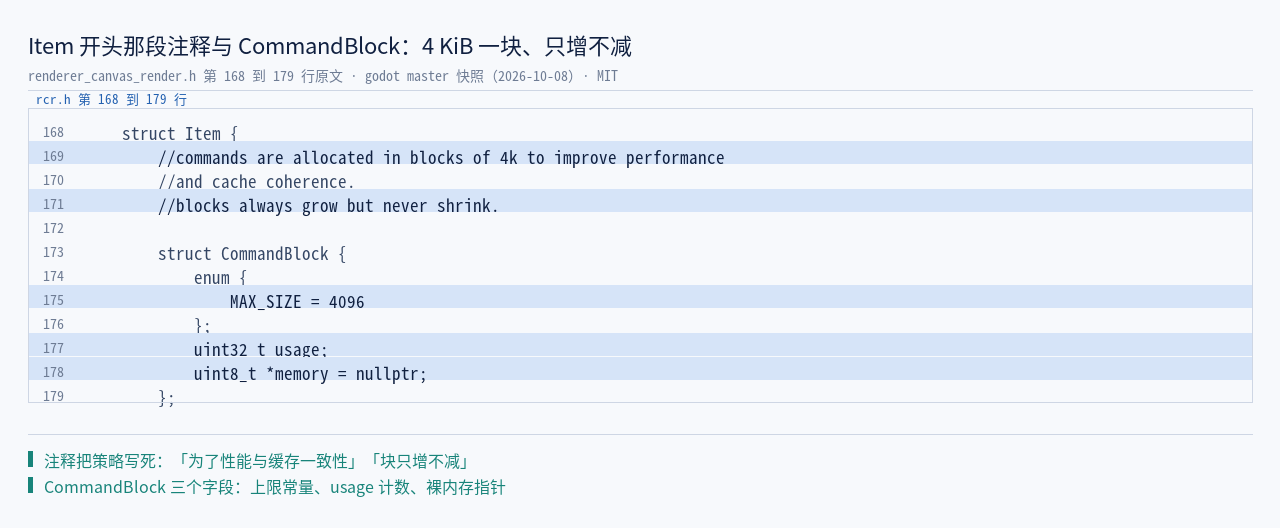
Item 开头的注释与 CommandBlock——4 KiB 一块、只增不减@ godot master 快照(2026-10-08)原文截取 · MITCommandBlock 本身只有三个字段:一个 MAX_SIZE = 4096 的编译期常量、一个 usage 计数、一个裸内存指针。这三样东西合起来就是一块「只往高处长」的小仓库。
命令链的头尾各留一个指针,再加上块数组与当前块下标,构成了四个字段:
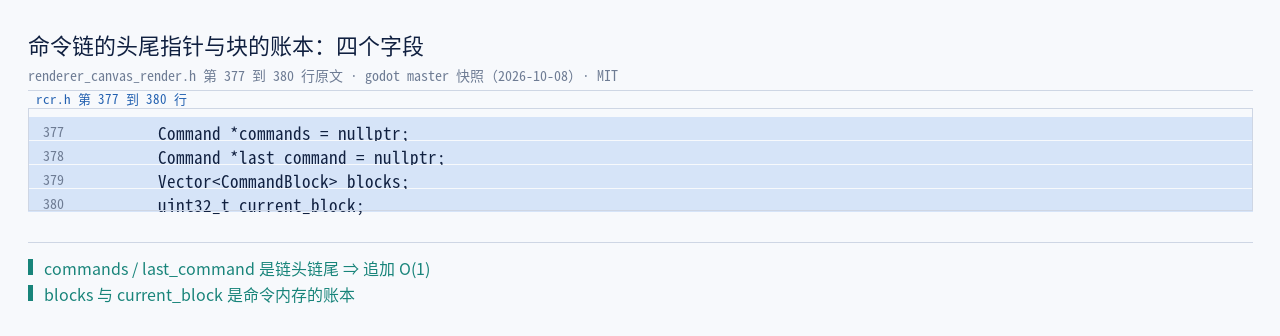
说白了,看到 last_command 就明白了一半:命令是追加式的,凭尾指针可以 O(1) 挂一条新命令上去。这跟上一篇桶内追加是同一个思路——能 O(1) 的地方就不做查找。
2.2 七个即位:一个项上的开关
Item 里有一片位域,一共七个 : 1 的布尔量:clip(本项是否参与裁剪)、visible、behind(画在父之下)、update_when_visible(可见时才重算矩形)、on_interpolate_transform_list、interpolated、use_identity_transform。
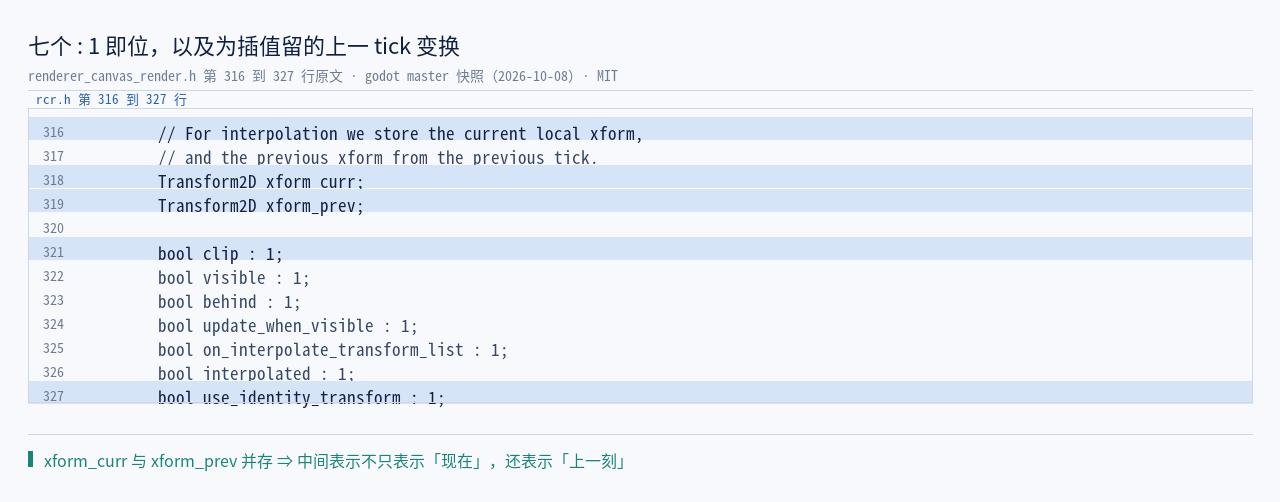
: 1 即位,以及为插值留的上一 tick 变换 xform_prev@ godot master 快照(2026-10-08)原文截取 · MIT有意思的是同一段里紧挨着两个 Transform2D:xform_curr 与 xform_prev。注释解释得很直白——为了插值,这里同时存着当前局部变换和上一个 tick 的变换。也就是说,这个「中间表示」不只表示「现在」,还表示「上一刻」,好让渲染可以和物理步长解耦。这一处是很多人第一次读源码时会忽略的设计。
2.3 累计态:父链算完的结果
再往下看,有一组字段的名字都带 final_ 前缀:final_modulate(累计调制色)、final_transform(累计变换)、final_clip_rect(累计裁剪矩形)、final_clip_owner、material_owner、canvas_group_owner,还有 global_rect_cache 与 z_final。
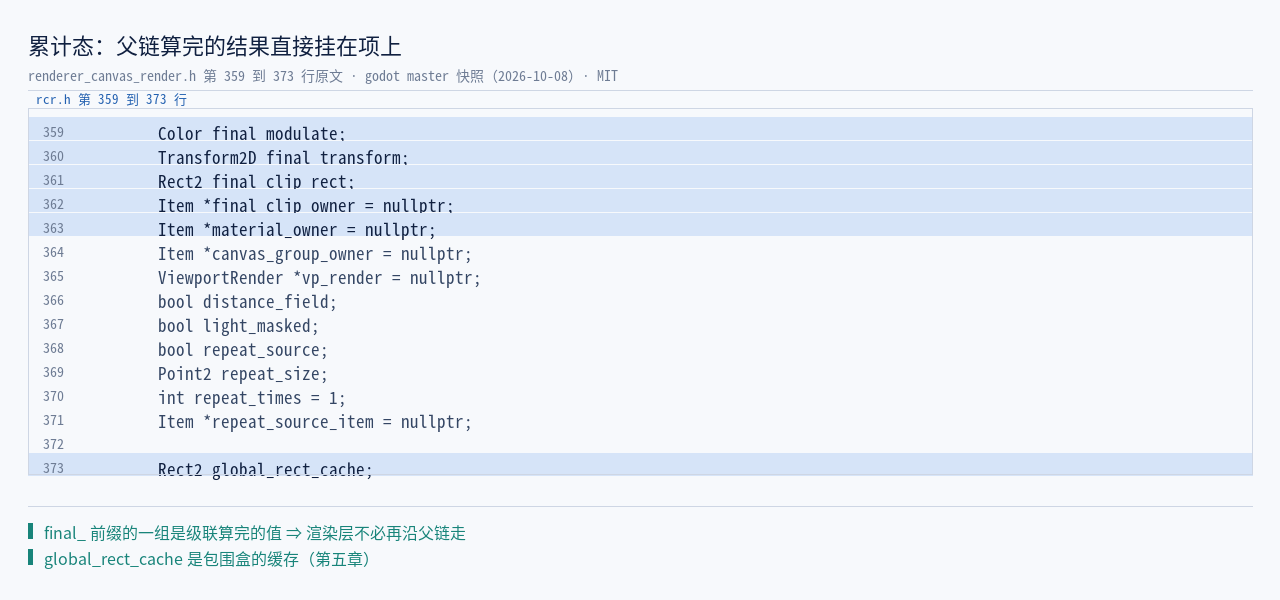
这组字段回答了本篇标题里的一个问题:「中间表示」到底中间在哪。答案是——它处在「场景层算完、后端还没用上」这个位置。父链上的调制色、变换、裁剪矩形都已经乘算、级联完毕,结果就挂在项上;渲染层拿到项之后不需要再沿父链走一遍。
这正好解释了上一篇里那条 Item 链为什么能直接交给下游:链上每一项都是自足的。
2.4 三处容易忽略的设计
字段地图里还有三个地方值得单独点出来,因为它们都属于「不写出来就想不到,但一看就懂」的那类。
言归正传,第一处是 mutable 矩形。custom_rect、rect_dirty、rect 三个字段都带 mutable,而且 get_rect() 不是普通的读取——它可能顺手算一次并把结果写回去。一个「取矩形」的动作带着副作用,这在 C++ 里通常是要避免的;这里之所以敢这么做,是因为算出来的结果与已有结果必然一致(只是补算),而且能省掉每个调用点的重复计算。
第二处是 instance_allocated_shader_uniforms_offset,初值是 -1。它是实例级 uniform 在缓冲里的偏移量——「同一材质、不同参数」靠这个下推,所以它必须挂在项上、跟着项走到实例数据里去。
第三处是一个请求:struct CopyBackBuffer { Rect2 rect; Rect2 screen_rect; bool full; } 与一个指向它的指针。也就是说,「请把背缓冲拷一份」这件事,是挂在某个项上被传递的,而不是走一条独立的命令队列。这条设计在第七章会看到一个具体后果:渲染层遍历到它的时候要「先把已攒的项冲掉」。
2.5 字段地图总图
Item 的字段地图四组:命令链 / 即位 / 累计态 / 插值@ 本系列绘制把四组字段与三处细节合到一张图上,就是上面这张。这张图也可以当成一条读源码的路线:先看命令链(它决定这个项画什么),再看累计态(它决定按什么参数画),最后看那几个「请求型」字段(它们决定渲染层的控制流怎么被拨动)。
2.6 这些字段放在一起有多大
顺着字段地图往下追问一句:一个 Item 大概占多少内存?这个问题不好给精确答案(有对齐与容器开销),但可以给量级:Item 里有两组 Transform2D(各 24 字节)、十来个 RID/指针(各 8 字节)、一批 int/bool、一个 Vector<CommandBlock>(24 字节的容器头,数据在堆上)、一个 mutable Rect2(16 字节级)。整体在几百字节量级——比一条命令大,比一棵子树小。
好了,这个量级解释了两件事。一件是「为什么剔除层可以在 Item 上挂那么多缓存字段」:加一个 int 对它的体积几乎没影响。另一件是「为什么命令不走同样的写法」:命令可能成千上万条,任何一条多一个字段都会被乘上去,所以它们被写得极紧凑(CommandRect 里那个 uint16 flags 就是例证)。
再补一个容易忽略的点:Item 里那两个 Transform2D(xform_curr 与 xform_prev)之所以要存两份,是因为逻辑帧与渲染帧不需要严格对齐——渲染可以在两次逻辑更新之间取一个中间值,从而在高刷新率屏幕上显得更顺。这件事的代价就是内存里多留一份变换。本机读不出「顺不顺」,但读得出它确实为这件事留了位置。
// servers/rendering/renderer_canvas_render.h:375–380(master 快照 2026-10-08)
const Rect2 &get_rect() const;
Command *commands = nullptr;
Command *last_command = nullptr;
Vector<CommandBlock> blocks;
uint32_t current_block;
五项声明把这一节的结论写在了一起。其中:commands 与 last_command 是链表的头尾,blocks 与 current_block 是命令内存的账本。这条设计的原理是把「找位置」的成本压到零:有了尾指针,追加一条命令不需要遍历。
本章出处:源码 renderer_canvas_render.h(Item 结构逐段)|CanvasItem 类参考(用户侧对应物)。
三、命令存储:首条 memnew、其余进 4 KiB 块
上一章看到命令是「一条链加一组块」。这一章把「块」这件事讲透:命令是怎么被分配出去的,又是怎么被回收的。这里的答案有点反直觉,因为回收那一半几乎是「不回收」。
3.1 为什么要块:一条命令的常见情况与非常见情况
alloc_command<T>() 的注释把设计动机交代得很清楚:画布项最常见的用法是只有一条命令,所以第一条用独立分配;其余的才进块。
OK,这句话背后是两份实测经验:一是绝大多数 CanvasItem(一个 Sprite2D、一个按钮、一段文字)确实只挂一两条命令;二是少数「画很多」的项(自绘图表、粒子示意、调试可视化)可能一次挂几十上百条。用一个策略同时照顾两头,就长成了现在这样:首条堆分配、其余块内 placement new。
3.2 alloc_command() 的两条路
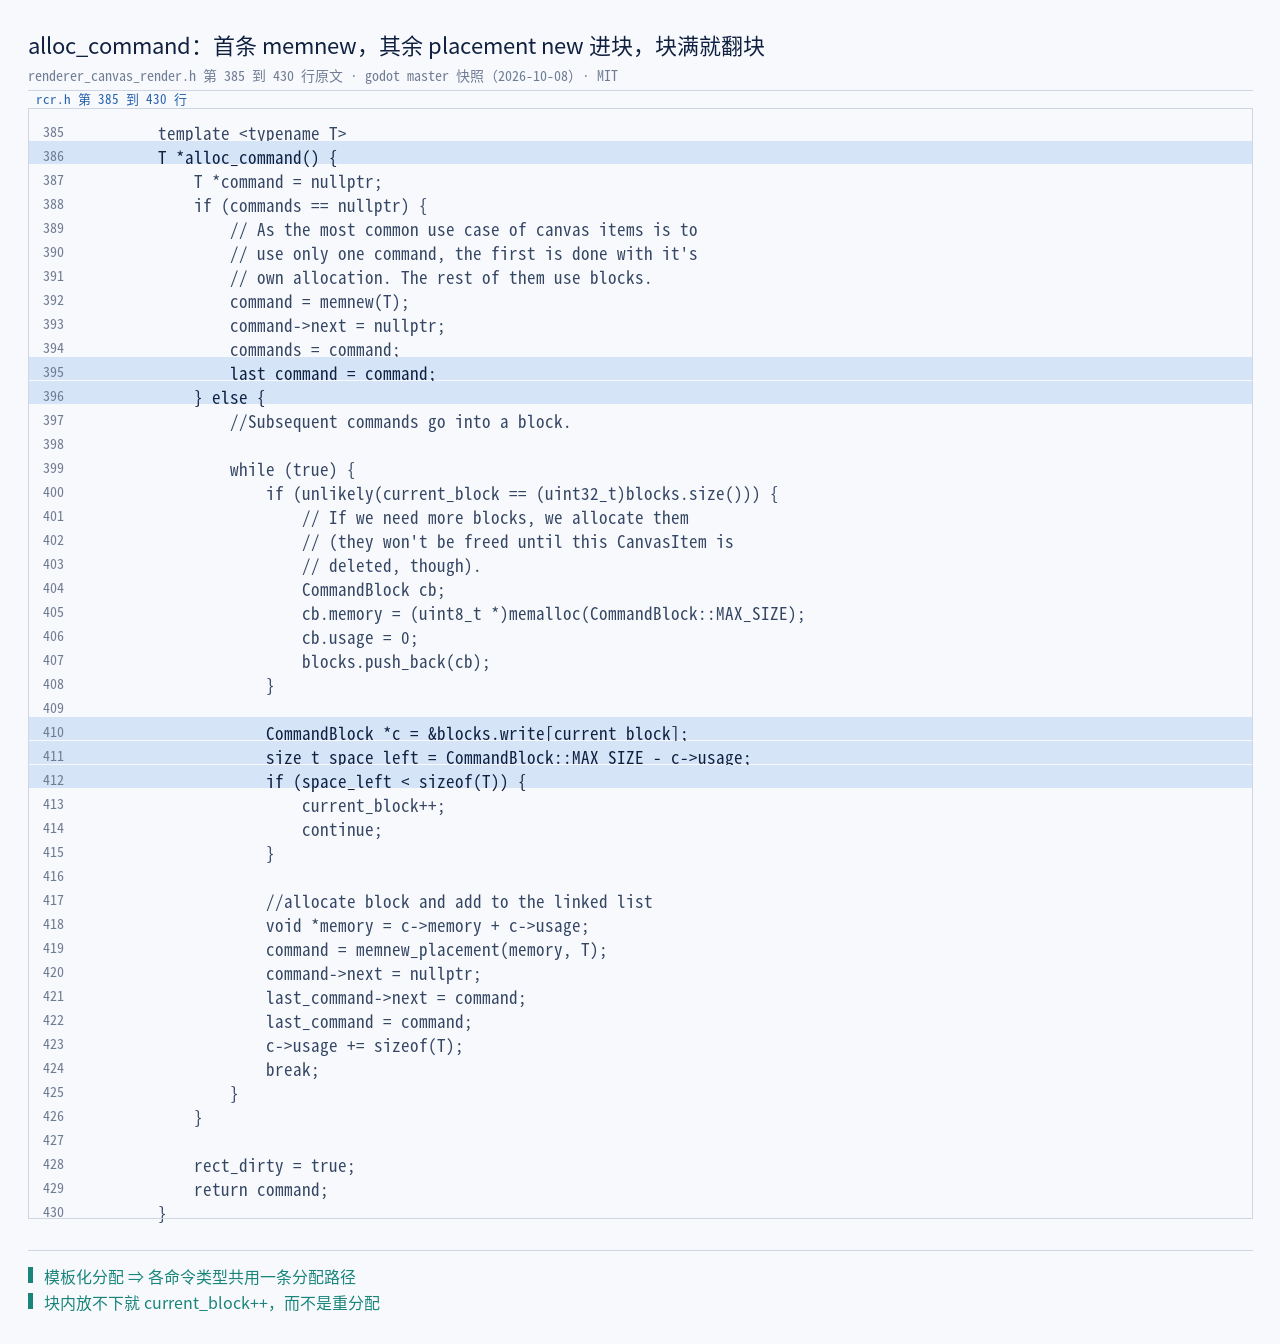
alloc_command()——首条 memnew,其余 placement new 进块,块满就翻块@ godot master 快照(2026-10-08)原文截取 · MIT读这段代码有两个地方要看仔细。第一处是块内放不下时的行为:它不去拆分一条命令,而是直接翻到下一块(space_left < sizeof(T) 就 current_block++ 继续找)。也就是说,块内可能留下一点用不掉的碎片——这是一个明确的取舍:宁可浪费几十字节,也不让一条命令跨块。
第二处是块的创建时机:只有在需要时才 memalloc 一块新内存,然后把 usage 归零。块一旦建出来就留在 blocks 数组里,不再释放。
3.3 clear() 只归零,不释放
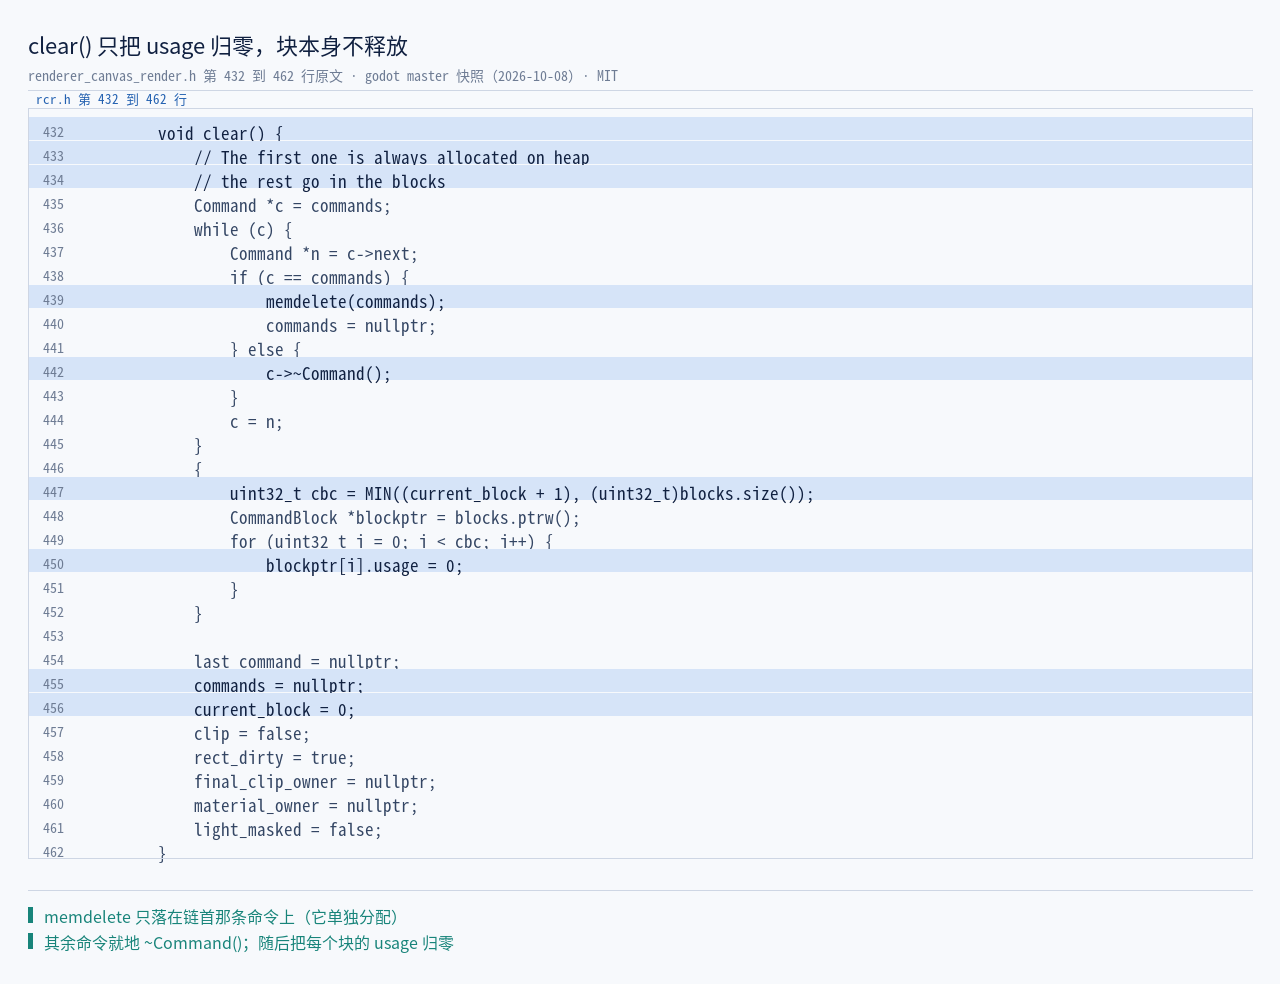
clear() 只把 usage 归零——memdelete 只落在链首那条命令上@ godot master 快照(2026-10-08)原文截取 · MITclear() 里有两种销毁:首条命令走 memdelete(它是独立堆分配),块内的命令只调一次析构函数 c->~Command()(它们的内存属于块)。然后——关键的一步——代码把块的 usage 全部归零,而没有 memfree。
换个说法:每一帧开始时,命令的「账」被清空,但「仓库」还在原地。下一帧再挂命令,直接从块的第一格开始摆。这也是为什么「2D 重绘频繁」这件事在实现侧不那么贵:真正贵的分配只发生在「第一次挂第二条命令」的时候。
clear() 之后命令链消失而块还在@ 本系列绘制3.4 一个本机读数:16,384 与 16,385 的分界
说白了,讲到这里,可以上一组本机读数了。不过要提前说明一句:这一组读数测的不是「块」,而是「块后面的那一层」——因为块本身在 CPU 内存里,外部看不到;能看到的只有它最终变成了几次提交。
先看一个粗测:在同一个 CanvasItem 的 _draw() 里画 200 个同色同纹理的矩形,整帧 draw call 数是 1。把数量提到 20,000 条,draw call 变成 2。这个「2」从哪来?回到源码里找,答案就在实现层的一个常量上:实例缓冲每批的容量是 16384。
于是补两组用例把这个分界钉死:16,384 条 ⇒ 1 个 draw call;16,385 条 ⇒ 2 个——只多出一条命令,draw call 就涨了 100%。
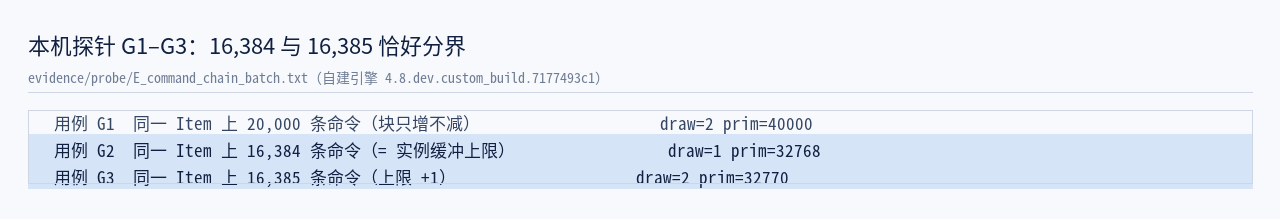
先算一笔账:按这个容量,16,384 条实例的实例数据是 16,384 × 128 B ≈ 2 MB。这条读数的价值在于它是双向对上的:源码里写着 16384,读数的分界恰好落在 16384 与 16385 之间。它不是「大致相符」,而是逐条对齐——多出一条就多一批。第六章我们会回到这个常量,看它在类定义里长什么样。
顺便把另外两组读数一并交代,它们说明「命令条数本身」不进 draw call:同一项上画 1 条、10 条、200 条命令,draw call 都是 1;200 个节点各画 1 条命令,也是 1(批是跨项合并的)。真正让 draw call 涨上去的是状态切换,那是第七章的内容。
3.5 一条命令的完整生命周期
把散在前面几节的东西按时间串起来,一条命令的一生是四步:
- 用户代码里发出绘制。在
_draw()里调一次draw_rect()、draw_texture_rect()之类的接口; - 场景层转成服务层调用。这一步的结果是往服务侧的项上加一条命令——接口的名字都长这样:
canvas_item_add_rect(...)。注意这次调用不产生任何 GPU 动作; - 实现层按类型分块装箱。命令落到
alloc_command<T>():第一条走独立分配,其余进当前块的下一格; - 清空时只归还账目。
clear()把块内usage归零、把首条命令真正delete,内存留在块里等下一帧。
言归正传,四步里只有第 2 步与第 4 步会动内存,而且第 4 步的「还」并不是真的还。这解释了为什么 2D 里频繁重绘是一件在实现侧被当作常态的事——它把分配成本压到了「第一次挂第二条命令」那一刻。
再补一句读数的细节,它让第三章那组数字更完整:在同一个项上画 200 条矩形命令时,整帧的图元数是 400——一条矩形命令等于两个三角形。到了 16,384 条那个用例,图元数是 32,768,正好是 16,384 × 2。也就是说,换批并没有改变「画了多少图元」,它改变的是「这些图元被分几次提交」。这两件事被分得很干净,也是这一篇与下一篇(攒批)之间的分界线。
3.6 块属于谁、什么时候还
「块只增不减」这句话容易被读成「内存泄漏」,所以要把归属讲清楚:块是 Item 的私有财产。Item 的析构函数里有一句 memfree(blocks[i].memory)——项被销毁时,它的块才会真正还给系统。
于是「块只增不减」的完整含义是:在同一个项的生命周期内,块不会缩;项消失时,整批块一起消失。这条规则对一个长期存在的项(一个常驻的 HUD 层、一个背景)意味着「峰值内存常驻」;对一个反复创建销毁的项(一屏列表滚过去)意味着「随对象一起回收」。
对照一下同一文件里的另一条规则就更能看清这个思路:块的首条命令是独立堆分配的,所以它每帧都要被 delete 一次,而块内的命令只调析构、不归还内存。同一份数据,两种生命周期——这正是那两行注释想说的事。
// servers/rendering/renderer_canvas_render.h:412–423(master 快照 2026-10-08)
if (space_left < sizeof(T)) {
    current_block++;
    continue;
}
void *memory = c->memory + c->usage;
command = memnew_placement(memory, T);
last_command->next = command;
last_command = command;
c->usage += sizeof(T);
好了,八行代码就是「块分配」的全部。其中:前三行是「翻块」,后四行是「装箱」。它的原理与一切池式分配器相同——把多次小块分配合并成一次大块申请,再用一个游标切分;代价是块内剩下的碎片不再利用。
本章出处:源码 renderer_canvas_render.h(alloc_command / clear)|renderer_canvas_render_rd.h(max_instances_per_buffer)|本机读数 evidence/probe/E_command_chain_batch.txt(A 组与 G 组)。
四、十种命令,两种是「改上下文」的
命令链的骨架讲完了,接下来看挂在链上的到底有哪些东西。源码给的答案是十种,而这十种并不平等——其中两种根本不画东西,它们改的是「后面那些命令所处的上下文」。
4.1 命令的共同形状
先把共同点说清楚,因为它比差异更重要。所有命令都继承自一个基类,基类只做两件事:声明一个 type 字段,以及提供 next 指针。
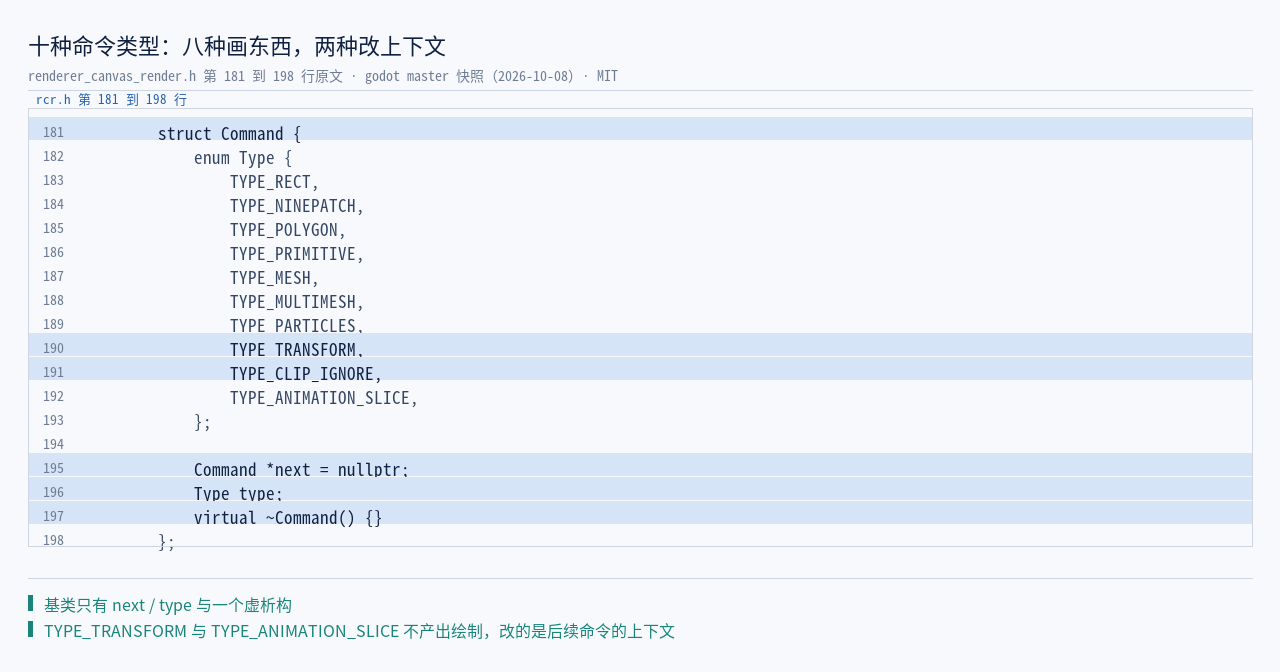
十个类型里,八个是「画」:矩形、九宫格、多边形、图元、网格、多网格、粒子。加上一个 CLIP_IGNORE(忽略裁剪)——它严格说不算「画」,但也确实影响一条命令的可见结果,所以归在「画」这一组里更顺。剩下两个是 TRANSFORM 与 ANIMATION_SLICE,我们放到最后一节讲。
4.2 矩形命令:一个 uint16 装下十种语义
矩形是最常用的一种命令,它的字段也最能体现这套表示的风格。
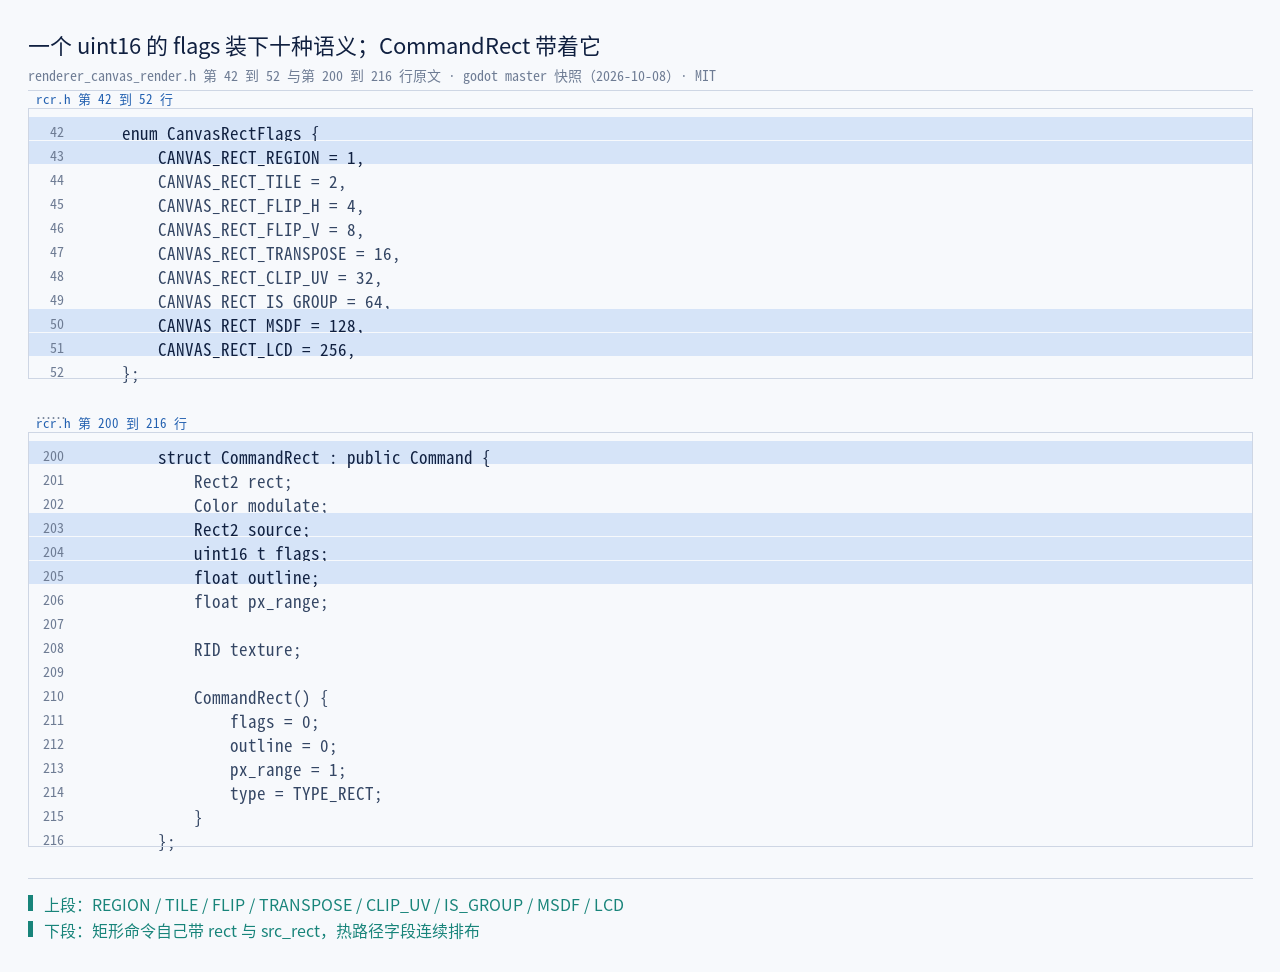
uint16 的 flags 装下十种语义;CommandRect 带着它与两个矩形@ godot master 快照(2026-10-08)原文截取 · MIT除了 rect(目标矩形)、source(源矩形)、modulate(调制色)、texture(纹理句柄)之外,真正有意思的是那个 uint16 flags:CANVAS_RECT_REGION(是一张图的一部分还是一整张)、CANVAS_RECT_TILE(平铺)、CANVAS_RECT_FLIP_H / FLIP_V(翻转)、CANVAS_RECT_TRANSPOSE(转置)、CANVAS_RECT_CLIP_UV、CANVAS_RECT_IS_GROUP(这是个画布组)、CANVAS_RECT_MSDF、CANVAS_RECT_LCD。
九个语义(加上默认态就是十种取值)压进 16 位,剩下两个字段 outline 与 px_range 专供 MSDF 字形使用。这就是「结构体即接口」的写法:后端拿到一个 CommandRect,需要的所有信息都在里面,不需要再去问别处。
好了,顺带记一笔:第七章会看到,flags 里的两个位——MSDF 与 LCD——是换批判据的一部分;而 TILE 位会改变纹理的重复模式,所以它也被算进「纹理状态」里。
4.3 图元命令:定长 4 点
另一种常用命令是「图元」——也就是自己给顶点画一个小多边形(三角形、四边形、线段的细分等等)。
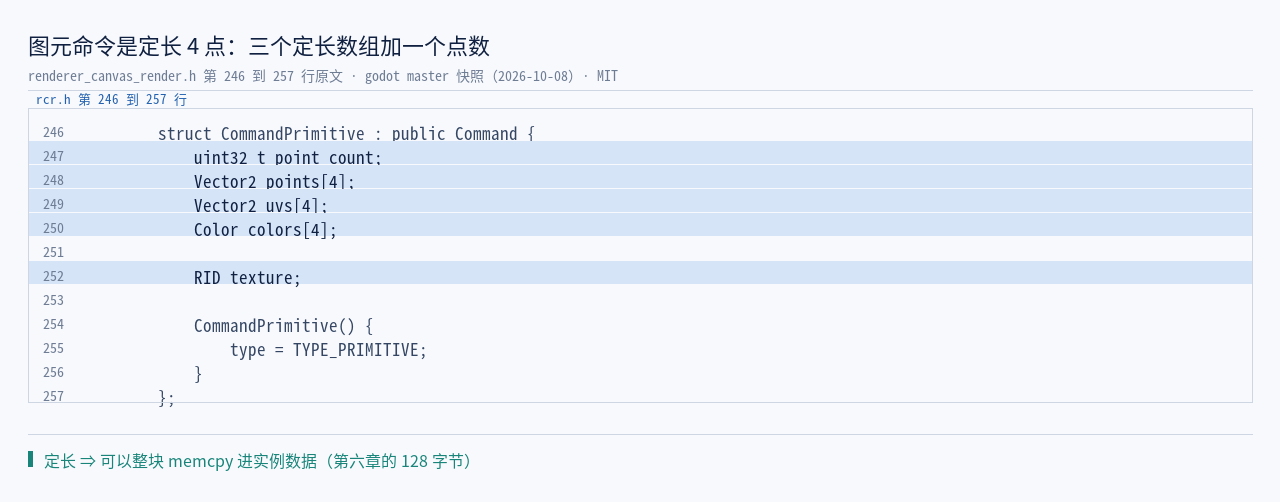
注意它是定长的:最多四个点,各自带 uv 与颜色,结构体里就是三个定长数组加一个点数。为什么不做成变长?因为这是最热的一条路——定位、定长、可以直接 memcpy 进实例数据(第六章会看到,InstanceData 里给图元留的正是 points[6]/uvs[6]/colors[6] 这一块 union)。
再看其余几种就很快了:CommandNinePatch 多一个 margin[4] 与 draw_center;CommandPolygon 通过一个 Polygon 包装类去引用真正存在实现层的顶点缓冲;CommandMesh / CommandMultiMesh / CommandParticles 各带一个 RID,真正的几何在存储层;CommandClipIgnore 只有一个布尔。
4.4 归类:八种画、两种改上下文
把十种命令按「画不画」分开看,结构就清楚了:八种负责产出绘制(其中 CLIP_IGNORE 影响的是可见结果),两种负责改变后面命令所处的上下文。这个「二八分」不是巧合,它对应的是数据的两种角色——一种是内容本身,一种是内容所处的环境;前者可合批,后者必须按序生效。
TYPE_TRANSFORM 携带一个 Transform2D。它不画任何东西,作用是声明「从这条命令之后,坐标系是另一个了」——第五章会看到,包围盒的计算对它要特殊处理。
TYPE_ANIMATION_SLICE 携带四个 double:动画总长、切片起点、切片终点、偏移。它也不画东西,改的是「时间域」——一条长动画只画其中一帧的一段,靠它来裁。
4.5 为什么值得为「两种不画东西的命令」单开一节
OK,因为它们改变了「命令链」这个词的含义。如果命令链只是「一串绘制指令」,那它顶多是个待办清单;而加上这两种命令之后,它就变成了一段有作用域的脚本:TRANSFORM 之后的矩形处在另一个坐标系里,ANIMATION_SLICE 之后的命令处在一个被裁过的时间窗里。
这也回答了「为什么同一批里的命令必须相邻」这个问题的一半:相邻意味着共享同一段上下文。第七章讲换批判据时会看到,use_lighting、纹理状态、MSDF 参数这些东西都是「段」级属性,它们一变就要切批——本质上和 TRANSFORM 划出的作用域是同一件事。
4.6 一张表看全十种命令的字段
把十种命令的关键字段列成一张表,读源码时可以当索引:
| 命令 | 关键字段 | 说明 |
|---|---|---|
CommandRect |
rect / source / modulate / flags / outline / px_range / texture |
最常用;flags 装十种语义,后两个字段专供 MSDF |
CommandNinePatch |
rect / source / margin[4] / draw_center / axis_x / axis_y |
四边留白 + 轴向模式,用于 UI 面板 |
CommandPolygon |
primitive / polygon / texture |
顶点在实现层的 Polygon 里,命令只持引用 |
CommandPrimitive |
point_count / points[4] / uvs[4] / colors[4] / texture |
定长 4 点,热路径 |
CommandMesh |
mesh / transform / modulate / mesh_instance / texture |
带一个网格实例句柄,析构要还 |
CommandMultiMesh |
multimesh / texture |
一个句柄画一批实例 |
CommandParticles |
particles / texture |
粒子的包围盒要向存储层问 |
CommandTransform |
xform |
不画,改后续命令的坐标系 |
CommandClipIgnore |
ignore |
影响可见结果(跳过裁剪) |
CommandAnimationSlice |
animation_length / slice_begin / slice_end / offset |
不画,改后续命令的时间域 |
看这张表会发现一个规律:八个「画」的命令都带一个 texture,两个「改上下文」的命令都不带。这不是巧合——纹理是「画」这件事的必要参数,而「改上下文」改的是坐标系与时间,跟纹理无关。第七章讲换批时,「纹理状态」之所以能成为一条独立判据,前提正是它只出现在「画」这一类命令上。
// servers/rendering/renderer_canvas_render.h:181–198(master 快照 2026-10-08)
struct Command {
    enum Type {
        TYPE_RECT, TYPE_NINEPATCH, TYPE_POLYGON, TYPE_PRIMITIVE,
        TYPE_MESH, TYPE_MULTIMESH, TYPE_PARTICLES, TYPE_TRANSFORM,
        TYPE_CLIP_IGNORE, TYPE_ANIMATION_SLICE,
    };
    Command *next = nullptr;
    Type type;
    virtual ~Command() {}
};
说白了,基类只有两个字段与一个虚析构。其中:type 决定实现层怎么解释这块内存,next 决定它在链上的位置。这条设计的原理是用类型标签代替虚函数分派:绝大部分处理都靠一个 switch (c->type) 一次跳到位。
本章出处:源码 renderer_canvas_render.h(十种命令与 CommandRect 的 flags)|CanvasItem 类参考(用户侧对应的 draw_* 方法)。
五、包围盒:get_rect() 怎么从命令链算出来
上一章的十种命令里,有两种「不画东西」;这一章要讲的那个算法,正是靠它们才能算对。Item::get_rect() 是抽象层里唯一的算法,也是这份中间表示唯一一处「有副作用」的读取。
5.1 三条早退判据
先看它什么时候不算。
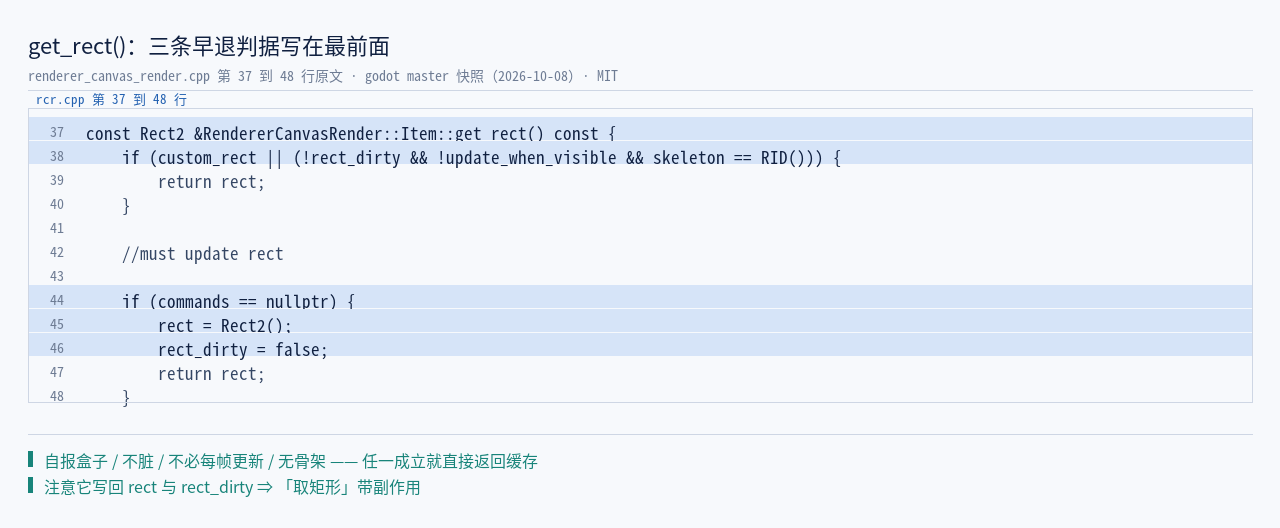
get_rect() 的三条早退判据写在最前面@ godot master 快照(2026-10-08)原文截取 · MIT三条判据合起来是一句:能不算就不算。custom_rect 表示调用方自己报了一个盒子,那就用它;rect_dirty 为假表示上次算完还没被弄脏;还有一条 update_when_visible 与 skeleton == RID()——前者是那个「可见时才重算」的即位,后者说明带骨骼的网格必须重算(顶点会被骨骼推动)。
5.2 逐条取局部矩形:各类型各取所需
真正算的时候,它做的是一件很朴素的事:沿命令链走一遍,每条命令给出它自己的矩形,最后取并集。
每种命令的矩形来源不同,这一点值得看代码原样:
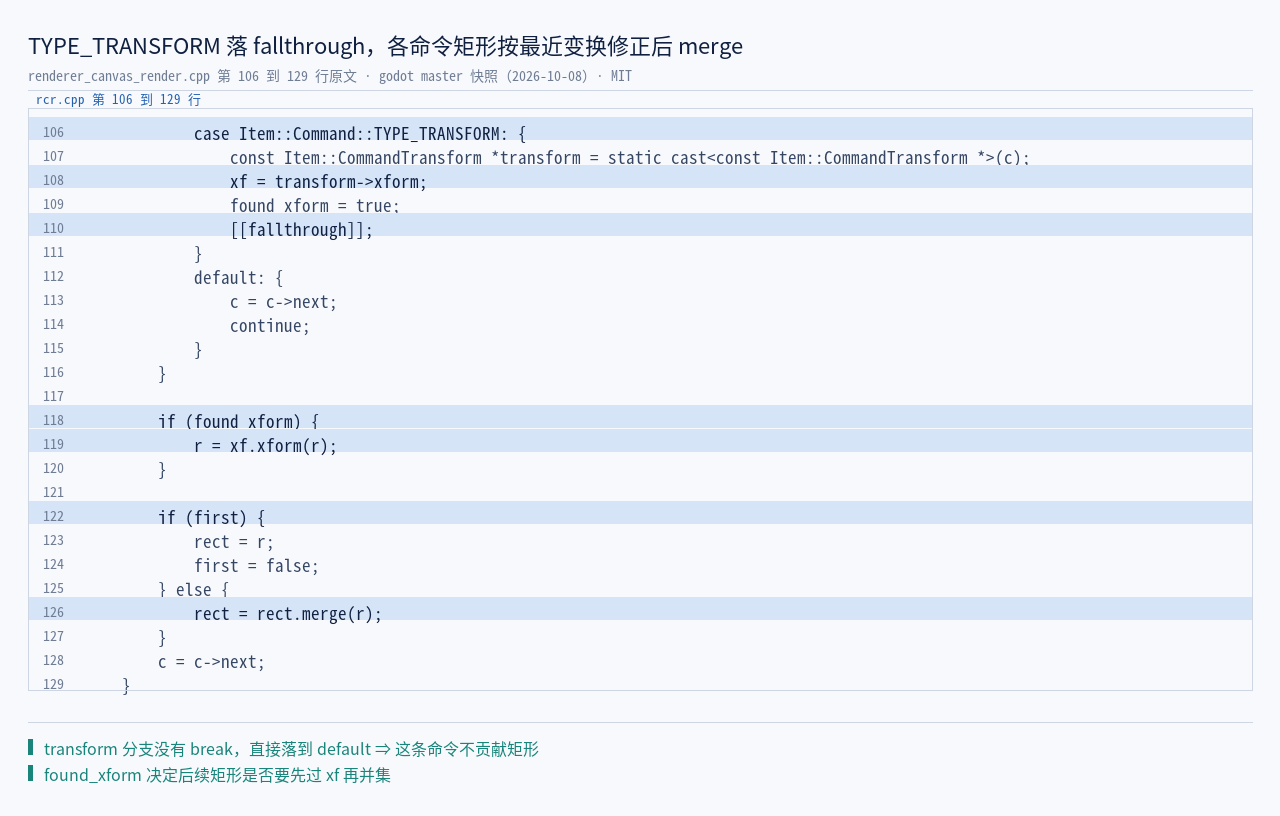
TYPE_TRANSFORM 落 fallthrough,各命令矩形修正后 merge 成并集@ godot master 快照(2026-10-08)原文截取 · MIT言归正传,矩形命令与九宫格命令直接用各自的 rect;多边形命令用它的 rect_cache(这个缓存是在创建多边形时顺手算出来的);图元命令把它的若干个点展开成矩形;而网格、多网格、粒子这三类命令要回头去问存储层——mesh_get_aabb、multimesh_get_aabb、particles_get_aabb。这一步是「表示层」向「存储层」借数据,也是抽象层里少数几处跨模块调用。
5.3 TYPE_TRANSFORM 的 [[fallthrough]]
前一条原文里有一处 C++ 的小技巧容易被忽略:TYPE_TRANSFORM 分支在记下变换之后,没有 break,而是 [[fallthrough]] 落到了 default 分支——也就是「这条命令不贡献矩形,直接下一条」。
但它的影响并没有消失:那个 found_xform 标记与 xf 变量留在循环里,后面每一条命令的矩形都要先用这个变换修正一次。所以 TRANSFORM 的语义在包围盒这里被精确地实现成了「它对后续命令生效」——与第四章说的一致。
5.4 并集、脏标记,以及它为什么带副作用
循环结束时的收尾只有两步:把算出来的矩形写回 rect,把 rect_dirty 置为假。这就是那个「副作用」的全部内容——一次补算加一次状态更新。
现在可以回答第二章留下的那个悬念了:为什么 rect 是 mutable、为什么这个「读取」允许改状态?因为包围盒是推导出来的缓存,不是原始数据;它的值只由命令链与变换决定,算一次与算十次结果相同。把它标成 mutable 并允许惰性计算,换来的是每个调用点都不必关心「算没算过」。
5.6 三种「矩形」不要混起来
读到这一章容易把几种矩形混为一谈,这里分清一下,因为后面两章都会用到:
| 名字 | 在哪 | 谁的坐标系 | 谁在用 |
|---|---|---|---|
命令自己的 rect / source |
命令结构体里 | 该项的局部坐标 | 实现层算实例数据 |
Item::rect(本地包围盒) |
项上,惰性计算 | 该项的局部坐标 | 组包围盒、快速判断 |
Item::global_rect_cache |
项上,剔除阶段填 | 画布全局坐标 | 第五道闸门、光照相交判据 |
裁剪矩形(final_clip_rect) |
项上,累计得到 | 画布全局坐标 | 实现层设裁剪 |
好了,关键区别在第三行:光照用的是全局包围盒,因为光是在画布坐标里定位的,两者必须处在同一个坐标系里才能判相交。这也是为什么「本地矩形算完还要换算一次」——不算这一步,光照的第四项判据就会在滚动、缩放之后失效。
顺带说一句口径:global_rect_cache 这个名字里带 cache,说明它同样是一份推导量——由本地包围盒与最终变换算出来,剔除阶段顺手填上。它不是第二个真相,只是同一个真相换了个坐标系。
5.5 这个包围盒被谁用
包围盒算出来了,谁在读它?顺着链路数,至少有四个消费者,而且它们分布在两层里:
- 剔除层的第五道闸门(上一篇讲过)。视口矩形与项的包围盒不相交,整个项就不进桶——这是唯一一道「只管自己」的闸门,而它判的就是这个矩形。
- 光照的第四项判据(第八章会展开)。一项要不要接受某盏光,条件之一是
global_rect_cache与光的rect_cache相交;用的是全局包围盒,因为光是在画布坐标里定位的。 - 画布组的包围盒。组主拿组内项包围盒的并集,再按
clear_margin外扩,得到要拷的背缓冲矩形。 - 背缓冲拷贝请求。请求里带的那个
rect是发起方自己算的,但「拷多大」这件事同样依赖包围盒口径。
四处消费者的共同点是:它们都在做「快速排除」——不相交就不做后面那些更贵的事。这也是为什么包围盒允许被惰性计算、允许带副作用:它本身就是个加速结构,不是「真相」。真相比它贵得多,而它只要能保守地圈住真实范围就够了。
OK,顺带说一句保守性:这个并集算法是保守的(宁可算大),因为它不理解绘制内容——它只知道命令给出的矩形。这与 GPU 侧那些按真实几何算出来的包围盒是两回事。
// servers/rendering/renderer_canvas_render.cpp:122–131(master 快照 2026-10-08)
if (first) {
    rect = r;
    first = false;
} else {
    rect = rect.merge(r);
}
c = c->next;
循环体的收尾只有这几行。其中:first 决定「初始化还是合并」,merge 就是把两个矩形撑成能同时装下它们的那一个。它的定义很朴素:包围盒是命令链上所有局部矩形的并集,不涉及任何几何求交。
本章出处:源码 renderer_canvas_render.cpp(get_rect 全段)|renderer_canvas_render.h(mutable 三字段)。
六、实现层入场:一个入口、四条上限、四组 uniform
从这一章开始,视角从「表示」切到「提交」。接手的是 RendererCanvasRenderRD——抽象层在 RD 路径上的那个实现。
6.1 继承关系与四组 uniform
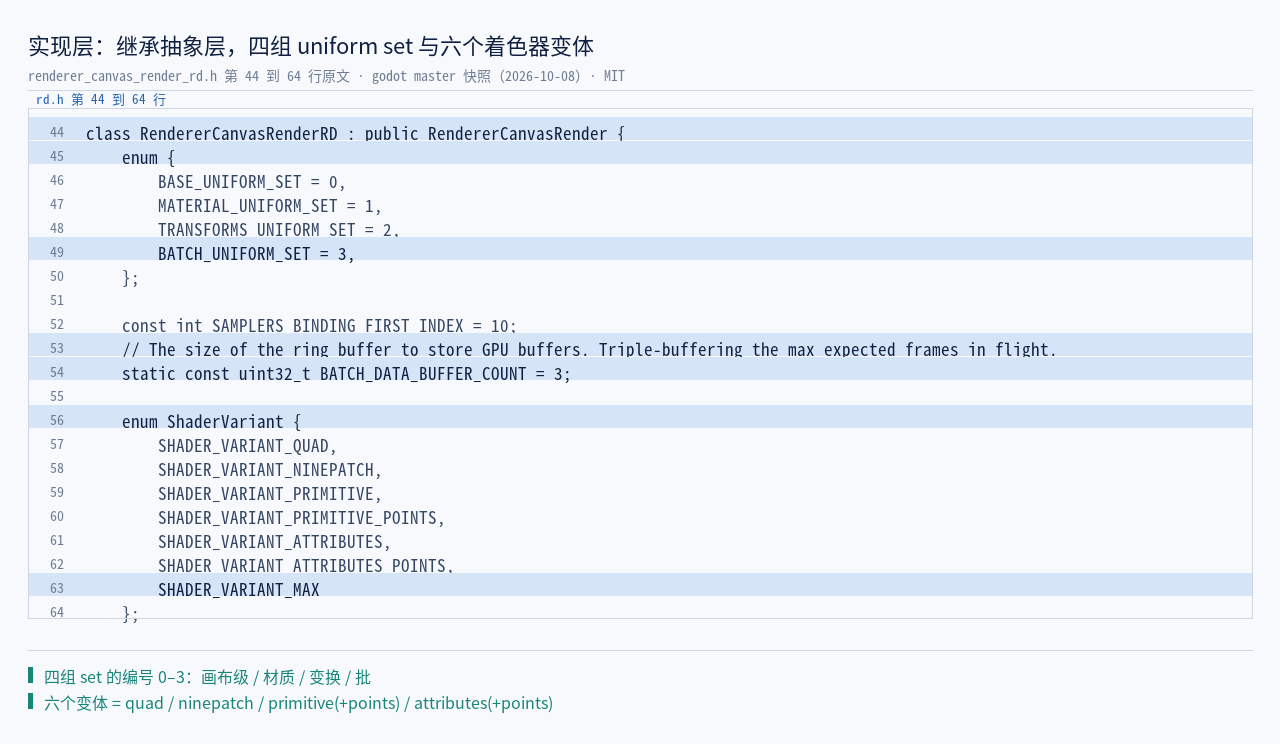
类定义的第一个枚举就把 GPU 侧的骨架交代了:BASE_UNIFORM_SET / MATERIAL_UNIFORM_SET / TRANSFORMS_UNIFORM_SET / BATCH_UNIFORM_SET——基础、材质、变换、批四组绑定。前三组是常规做法,第四组也就是「批」自成一组绑定,这是 2D 渲染的一个特点,第六章(下一篇)讲攒批时会展开。
紧接着是六个着色器变体:QUAD、NINEPATCH、PRIMITIVE、PRIMITIVE_POINTS、ATTRIBUTES、ATTRIBUTES_POINTS。注意它们与第四章的十种命令不是一一对应的:命令是「数据怎么组织」,变体是「顶点怎么进管线」——矩形与九宫格都走 QUAD(差别在实例数据),图元走 PRIMITIVE,而 ATTRIBUTES 那一支对应的是带顶点属性的路径(网格、自定义顶点)。
6.2 四条上限
这一层有四个硬上限,它们决定了「一次画布渲染」能装多少东西:
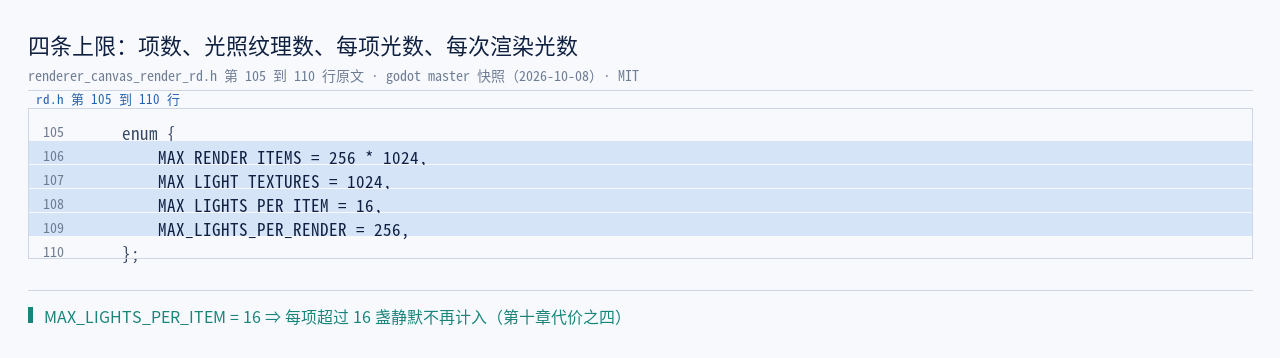
MAX_RENDER_ITEMS = 256 * 1024 是一次画布渲染最多容纳的项数(对应第七章那个定长数组的容量);MAX_LIGHTS_PER_ITEM = 16 是每一项最多接受多少盏光;MAX_LIGHTS_PER_RENDER = 256 是一次渲染的光总数上限;MAX_LIGHT_TEXTURES = 1024 是光照纹理的上限。
说白了,这四个数字里,第三章已经用过第二个——不是 16,而是我们当时找到的那个 max_instances_per_buffer = 16384(它在 State 里,是实例缓冲的容量)。两个常数容易被人混起来,但它们的角色完全不同:16384 是「一批装多少实例」,16 是「一项接受几盏光」。
6.3 InstanceData:128 字节,编译期钉死
把命令变成提交,中间要过一层「实例数据」。这一层的形状是这一篇最重要的一个结构。
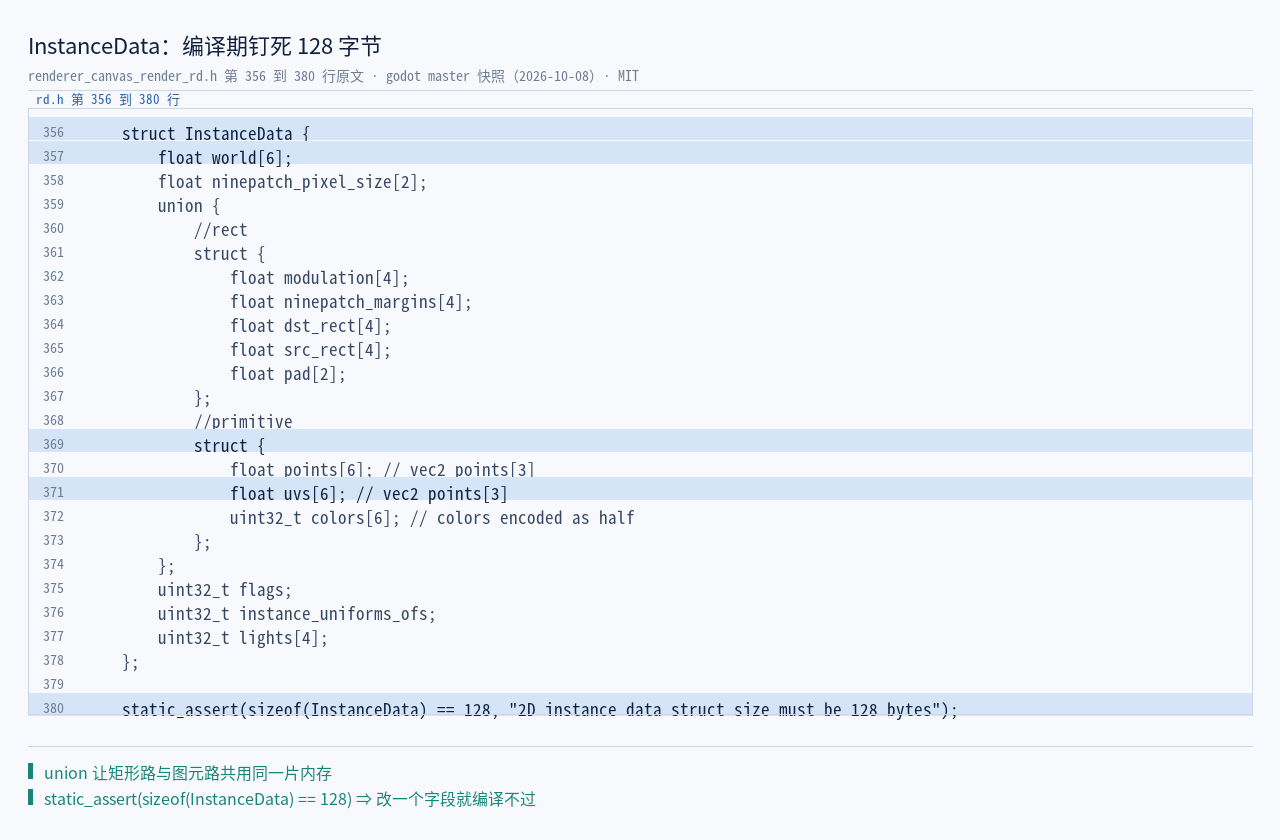
InstanceData 与编译期断言——一个 2D 实例在 GPU 侧就是 128 字节@ godot master 快照(2026-10-08)原文截取 · MITInstanceData 里有一个 float world[6](2×3 矩阵)、一个 union(矩形路用 modulation / ninepatch_margins / dst_rect / src_rect,图元路用 points[6] / uvs[6] / colors[6])、一个 flags、一个 instance_uniforms_ofs,以及 lights[4]。
而它最值得记的是最后那行断言:static_assert(sizeof(InstanceData) == 128, "2D instance data struct size must be 128 bytes");——在编译期就把这个结构钉死在 128 字节。为什么非要 128?因为着色器那边是按 8 条 vec4 来读它的:canvas.glsl 的实例路里有 attrib_A 到 attrib_H 八个 vec4 输入,位置从 8 排到 15。8 × 16 = 128。
这条对应关系值得单独说一句:CPU 侧的结构体大小与 GPU 侧的顶点属性条数是用一个断言连起来的。任何人改动这个结构(加一个字段、换一个类型)都会在编译期立刻失败,不会以「画面错位」的形式在运行时才暴露。
6.4 分区为什么这么分
回到 6.1 的四组 uniform,现在可以看得更清楚了:BASE 装的是画布级的量(画布变换、屏幕变换、光照数量、SDF 相关的映射);TRANSFORMS 装的是每一项的位置;BATCH 装的是每批共享的纹理与采样状态;MATERIAL 装材质参数。粒度从「画布」到「批」逐级收窄——这正是「一次遍历、边走边切批」这套做法在绑定侧的对应物。
6.5 Batch 里记了什么
「批」(batch)是本篇后半段的主角,它的字段值得逐项看一遍:
| 字段 | 作用 |
|---|---|
start / instance_count |
这一批在实例缓冲里的起点与条数(一批可能横跨多个项) |
instance_buffer |
这一批使用的那块 GPU 缓冲 |
push_data |
不用顶点数组那条路时的推送数据(InstanceData 的副本) |
tex_info |
按指针比的纹理信息,指针一变就换批 |
modulate |
批级的调制色(只在开了 LCD 混合时才参与判等) |
msdf_pix_range / msdf_outline |
字形渲染的两个参数 |
clip |
这一批的裁剪归属 |
material / material_data |
材质与其解析后的数据 |
command / command_type |
这一批「代表」的那条命令及其类型 |
shader_variant / render_primitive |
走哪个着色器变体、用哪种图元装配 |
use_lighting / use_msdf / use_lcd / has_blend |
四个布尔,决定着色器分支与批参数 |
flags |
批级标志位(与纹理信息里的标志或起来得到最终值) |
言归正传,把这张表与第七章那六条换批判据对着看,会发现它们一一对应:判据里的每一项,都是在问「这一批的这个字段需不需要变」。换句话说,Batch 就是那六条判据的状态载体——换批判据并不是一批独立的规则,而是「批这件事需要记什么」的自然结果。
再补一个细节:批最后要变成 GPU 侧的少量参数,这些参数被打包成 PushConstant(着色器特化、批标志、MSDF 的两个量、颜色纹理的像素尺寸)。所以「一批一次推送」这件事是真的——批级参数不写在实例里,而走推送常量,这也是为什么批的字段可以相对多,却不影响每个实例的 128 字节。
6.6 四组 uniform 各装什么
顺着「粒度逐级收窄」这条线,把四组绑定各自的载荷列出来,一张表就够:
| 组 | 载荷 | 变化频率 |
|---|---|---|
BASE(画布级) |
画布变换、屏幕变换、画布法线变换、画布调制色、屏幕像素尺寸、时间、是否像素对齐、SDF 的三组映射、方向光数量、一个线性色标志 | 一次画布渲染一次 |
MATERIAL(材质级) |
材质的参数与纹理(自定义 2D 着色器走这条路) | 换材质时 |
TRANSFORMS(项/实例级) |
每个实例的变换等 | 每实例 |
BATCH(批级) |
批共享的纹理与采样状态 | 每批 |
这张表把第六章开头那句话坐实了:从「画布」到「批」,绑定粒度一级比一级细。而每一级都恰好对应一个「多久变一次」的节奏——画布级的一整帧不变,批级的可能几十项就变,实例级的每条都不同。写渲染代码时把「变的东西放到合适的粒度上」这件事做对,后面就不需要在循环里反复绑资源。
好了,同一张表也能解释第七章那个读数为什么是那个形状:交替画两张纹理,等于在逼批级绑定每两条命令就重绑一次,所以 draw call 直接涨到 200。
// servers/rendering/renderer_rd/renderer_canvas_render_rd.h:356–380(master 快照 2026-10-08)
struct InstanceData {
    float world[6];
    union {
        struct { float modulation[4]; float ninepatch_margins[4];
                 float dst_rect[4]; float src_rect[4]; float pad[2]; };
        struct { float points[6]; float uvs[6]; uint32_t colors[6]; };
    };
    uint32_t flags;
    uint32_t instance_uniforms_ofs;
    uint32_t lights[4];
};
static_assert(sizeof(InstanceData) == 128, "2D instance data struct size must be 128 bytes");
这段定义把「一个实例带什么」摊平了。其中:union 是矩形路与图元路共用同一片内存,lights[4] 是 16 盏光的索引。这条设计的原理是让 CPU 结构体与着色器输入一一对应:着色器那边按 8 行 vec4 声明读它、共 128 字节,多一个字段就会在编译期被断言拦下。
本章出处:源码 renderer_canvas_render_rd.h(类定义、四条上限、InstanceData)|canvas.glsl(实例路的 8 条属性)|实现层同目录的其余文件(各类存储与着色器)见 renderer_rd 目录。
七、从链到数组到批:六条换批判据
这一章是本篇的重心:上游那条链,到底是怎么在实现层变成「几次提交」的。这一章的证据一半来自源码、一半来自读数,两者可以互相印证。
7.1 一次遍历:链表 → 定长数组
实现层的入口是 canvas_render_items(),它接的参数与抽象层声明的那个虚函数逐字一致:一个渲染目标、一条 Item 链、一串点光、一串方向光、画布变换、默认过滤与重复模式、是否像素对齐,以及两个回传值。
进来之后第一件事不是画,而是把链表收进数组:
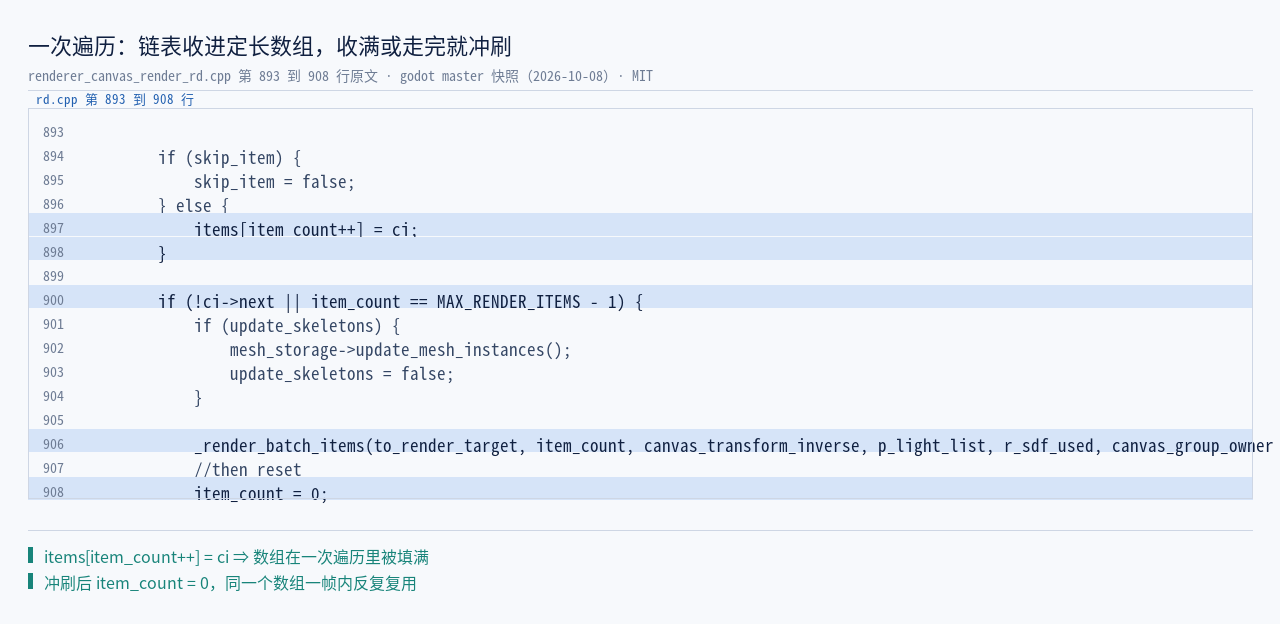
数组是类里的 Item *items[MAX_RENDER_ITEMS],容量 262144;每收一项,指针加一。收满或走到链尾就冲一次(_render_batch_items),然后把计数清零,数组继续用。同一个数组,一帧里被反复复用。
OK,为什么先收成数组、不直接顺着链表画?因为「切批」需要回看:要判断这一项和上一项的状态是否一致,就得先攒住一批。数组给了一个稳定的批边界,也让「一批有多少项」这个数字变成可数的。
7.2 三个中途冲刷点
除了「收满/走完」,还有三处会强制冲刷:遇到画布组的开始(组外的内容必须先画完,才能去拷背缓冲)、遇到组主本身(组内内容画完了,该把组当一项贴回去)、遇到背缓冲拷贝请求(拷之前必须把已攒的画掉)。
这三处的共同点是:它们都是「次序约束」而不是「状态变化」。也就是说,冲刷的触发条件有两类——状态不一致,和「必须在某个动作之前把欠账结清」。这一条在读代码时很容易漏。
7.3 六条换批判据
真正的换批判据在 _record_item_commands() 里,一共六条。它们集中在一段代码里,读起来像是「一份负面清单」——只要下面任何一条成立,就开一批新的:
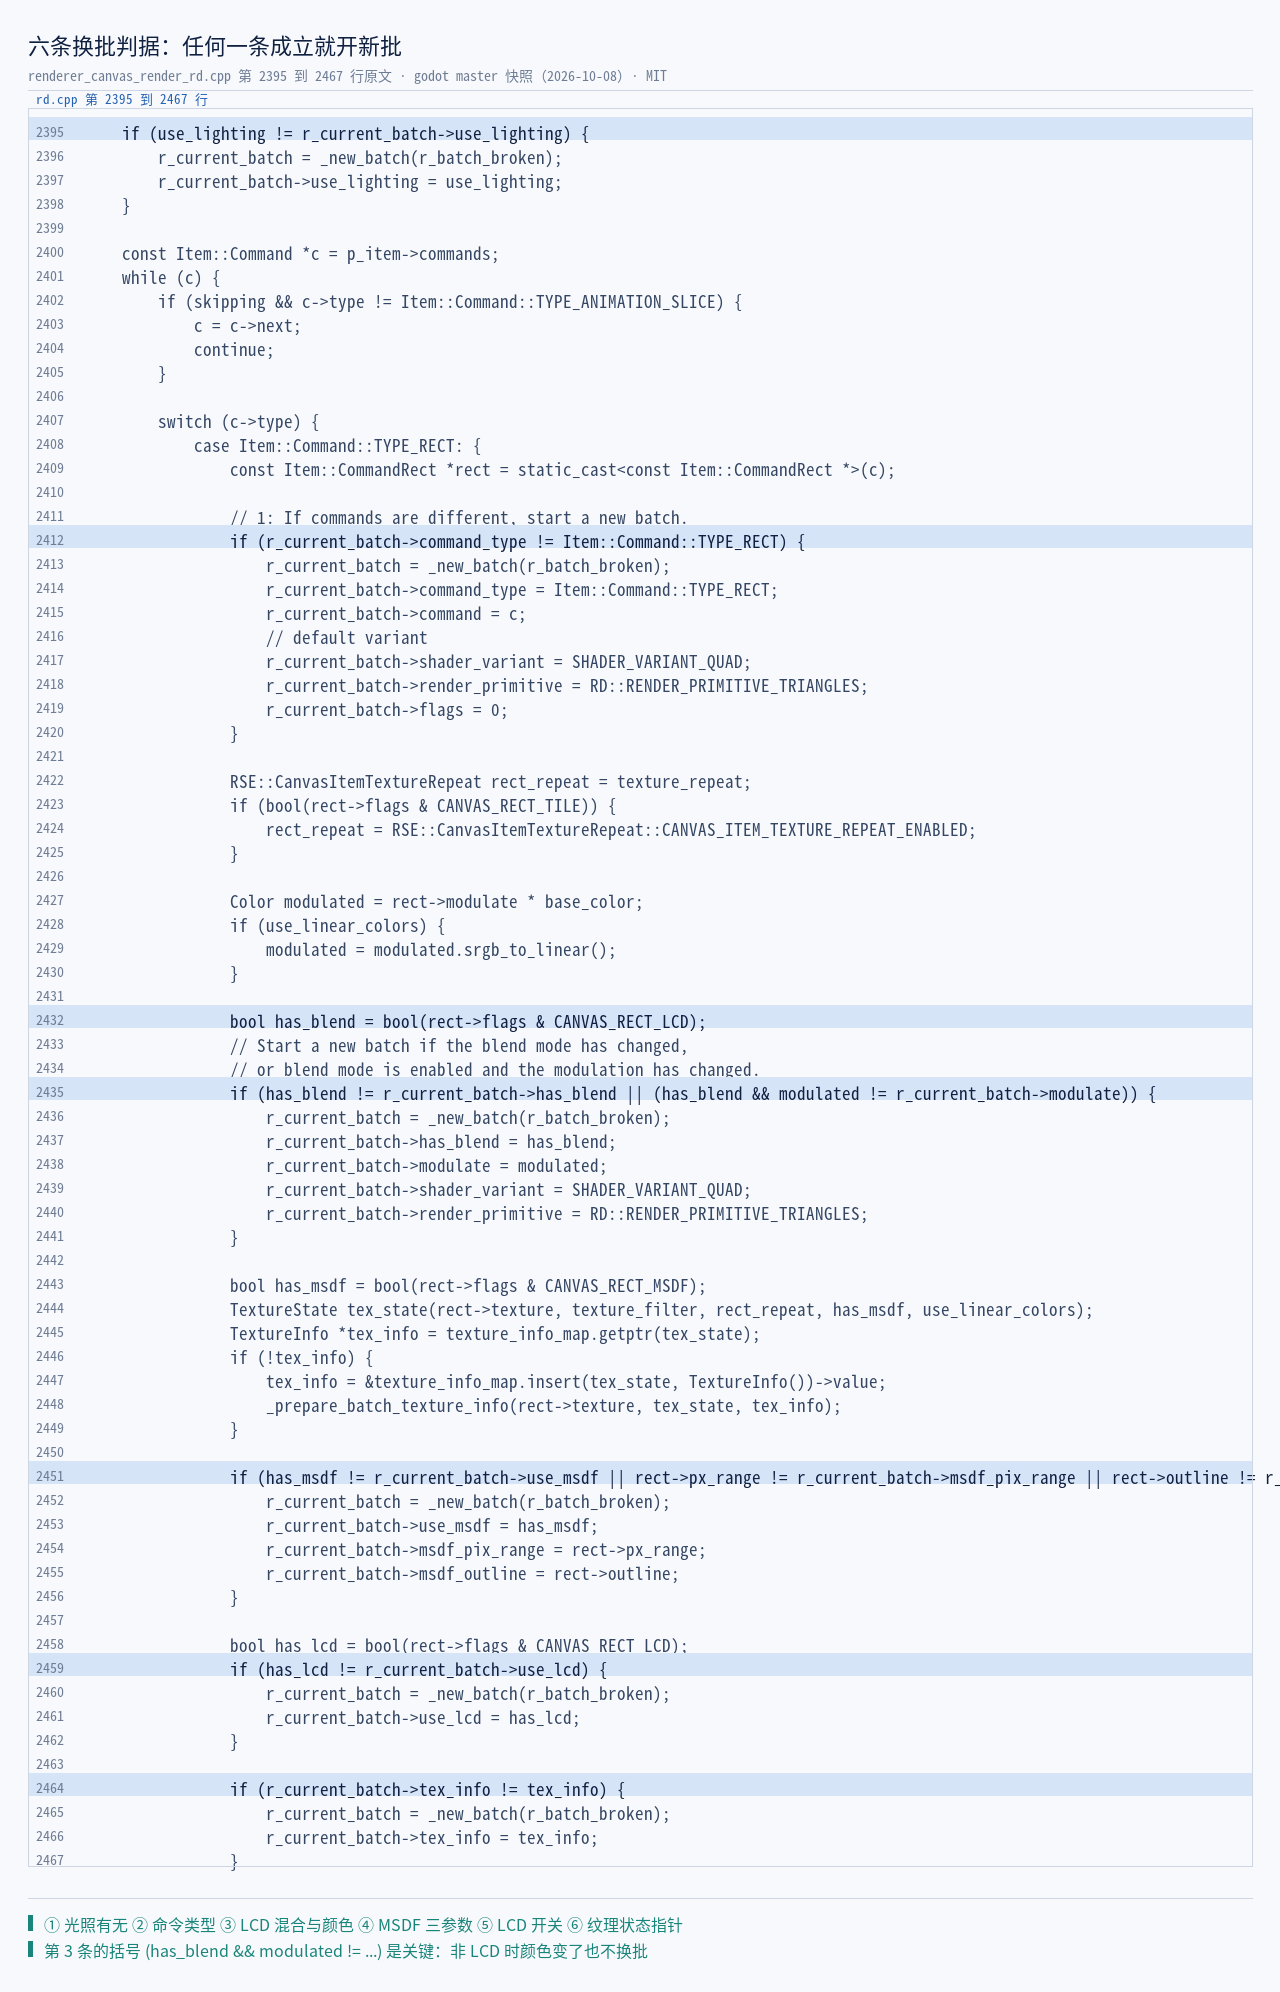
| # | 判据 | 为什么它会破坏合批 |
|---|---|---|
| 1 | use_lighting 变了 |
受光与不受光要走不同的着色器分支 |
| 2 | 命令类型变了 | 类型决定着色器变体与图元类型 |
| 3 | 开了 LCD 混合且颜色变了 | 次像素混合要把调制色烘进批参数 |
| 4 | MSDF 三参数(开关 / px_range / outline)变了 |
字形渲染需要每批固定的像素范围 |
| 5 | LCD 开关变了 | 同上,进批标志位 |
| 6 | 纹理状态指针变了 | 纹理与采样状态在批这一级绑定 |
说白了,第 3 条是最容易被误读的一条,值得单独说:它写的是 has_blend != r_current_batch->has_blend || (has_blend && modulated != r_current_batch->modulate)。颜色变了只有在「开了 LCD」时才换批。换句人话说:普通混合模式下,一整批可以用同一个颜色参数把千百个矩形画完;而 LCD 次像素模式下颜色得跟着走,所以颜色一变就得另起一批。
这条恰好是本机能测的——第三章那组 A 组用例里,同一个项上 200 个矩形、每两个换一次颜色,draw call 仍然是 1。读数与源码对上了。
再看一眼这六条在源码里的样子,挑两条最有代表性的(第一条与第三条):
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2395–2441(master 快照 2026-10-08)
if (use_lighting != r_current_batch->use_lighting) {
        r_current_batch = _new_batch(r_batch_broken);
        r_current_batch->use_lighting = use_lighting;
}
...
Color modulated = rect->modulate * base_color;
if (use_linear_colors) {
        modulated = modulated.srgb_to_linear();
}
bool has_blend = bool(rect->flags & CANVAS_RECT_LCD);
if (has_blend != r_current_batch->has_blend || (has_blend && modulated != r_current_batch->modulate)) {
        r_current_batch = _new_batch(r_batch_broken);
        r_current_batch->has_blend = has_blend;
        r_current_batch->modulate = modulated;
}
其中:_new_batch() 是唯一的「开新批」动作,六条判据每一条命中都落在这同一个调用上;has_blend、modulate 是批对象上记的状态字段。这段代码的原理是一次比较对应一个字段:判据之间互不覆盖,任何一条成立,就说明「这一批与上一批已经不是同一份状态」。
7.4 本机读数:交替与「只切一次」
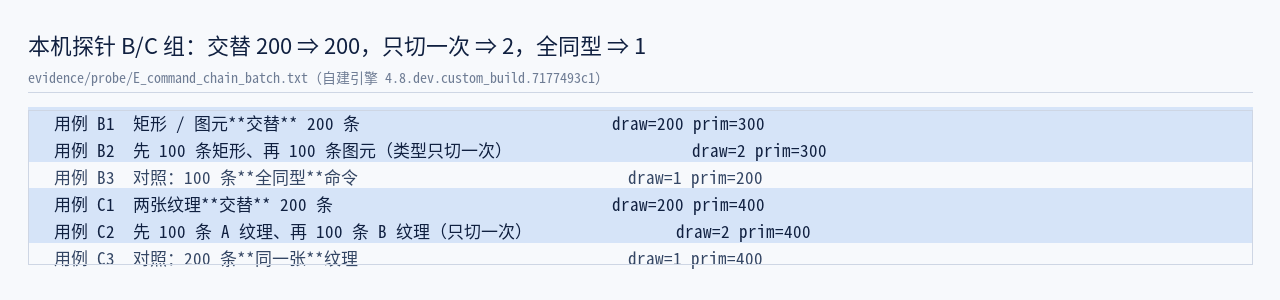
上面这张读数把第 2 条与第 6 条判据直接测了出来。交替(每画一个就换一次类型或纹理)⇒ 200 个 draw call;只切一次(前 100 个一种、后 100 个另一种)⇒ 2 个;全都一样 ⇒ 1 个。
换句话说:draw call 的数量取决于「状态切换了几次」,而不是「画了多少东西」。同一种组织方式下,交替与只切一次的差距是 100 倍(200 比 2)。这与很多人的直觉相反——直觉上「画得多就提交得多」,实测是「换得多才提交得多」。
7.5 批是跨项的
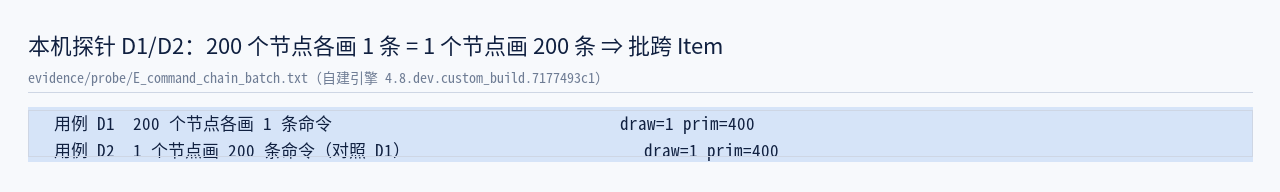
这组读数要表达的是:批的单位不是「项」,而是「连续的状态」。200 个节点各画一个矩形,与一个节点画 200 个矩形,得到的 draw call 数完全一样(都是 1)。上一章说的「上游交的是一条链」在这里得到了验证:链上相邻的项如果状态一致,就会被并进同一批。
7.6 切批之后是「加实例」,不是「再画一次」
言归正传,最后把这段流程画成一张图。注意第 5 步与第 6 步的区别:切批只是把「当前批」换成一个新对象,真正往 GPU 送数据的动作是「往当前批里加一条实例」(new_instance_data)。一批里的所有实例最终会被一次性发出去——这就是 6.3 里那 128 字节结构体的用武之地。
而这也解释了 max_instances_per_buffer = 16384 为什么会成为那个硬分界:它是一批能装下的实例数上限。第三章那组读数(16,384 ⇒ 1,16,385 ⇒ 2)说的就是这件事。
7.7 一批最后怎么发出去
切批讲完了,还得看「发」这一侧。一批真正落到 GPU 上,走的是一条固定的骨架:
- 取实例缓冲。从当前这一批记的
instance_buffer与start/instance_count知道要发多少条实例。 - 选管线。用批记的
shader_variant、渲染目标格式、顶点格式、图元类型、着色器特化这几项合成一个管线键,去查管线缓存(查不到才编译)。 - 绑资源。按四组 uniform 的顺序绑:画布级的、材质的、变换的、批自己的。
- 推常量。把批参数(特化位、批标志、MSDF 参数、像素尺寸)作为推送常量递进去。
- 发绘制。带上实例数发一次——一批就是一次。
这五步里,第 2 步是唯一可能「贵」的一步,因为它牵涉管线编译;而它被一个哈希键与缓存挡在前面。第 5 步则解释了前面所有读数的意义:一批一次,所以「批的数量」就是 draw call 的数量。
把第三章与第七章的读数并排看,一条链就闭合了:命令条数(16,384/16,385)决定批的数量,批的数量决定 draw call 的数量,而图元数(32,768 / 32,770)只跟画了多少条命令有关。三个量各管一段,互不代偿。
本章出处:源码 renderer_canvas_render_rd.cpp(canvas_render_items 与 _record_item_commands)|renderer_canvas_render_rd.h(Batch 与 max_instances_per_buffer)|批的绘制落到哪几个接口上,可对照官方 RenderingServer 类参考(canvas_item_* 一族);画布着色器的 uniform 布局见 canvas.glsl|本机读数 evidence/probe/E_command_chain_batch.txt(B/C/D 组)。
八、光照的中间表示:两条掩码、四项判据、16 盏上限
命令与批这条线讲完了,剩下两类东西:光与遮挡。它们在数据结构上是「旁挂」的——不在命令链里,却决定每一项最终长什么样。这一章先讲光。
8.1 光的中间表示
抽象层里定义了一个 Light 结构。它不算小,二十几个字段,但按角色一分就清楚了。
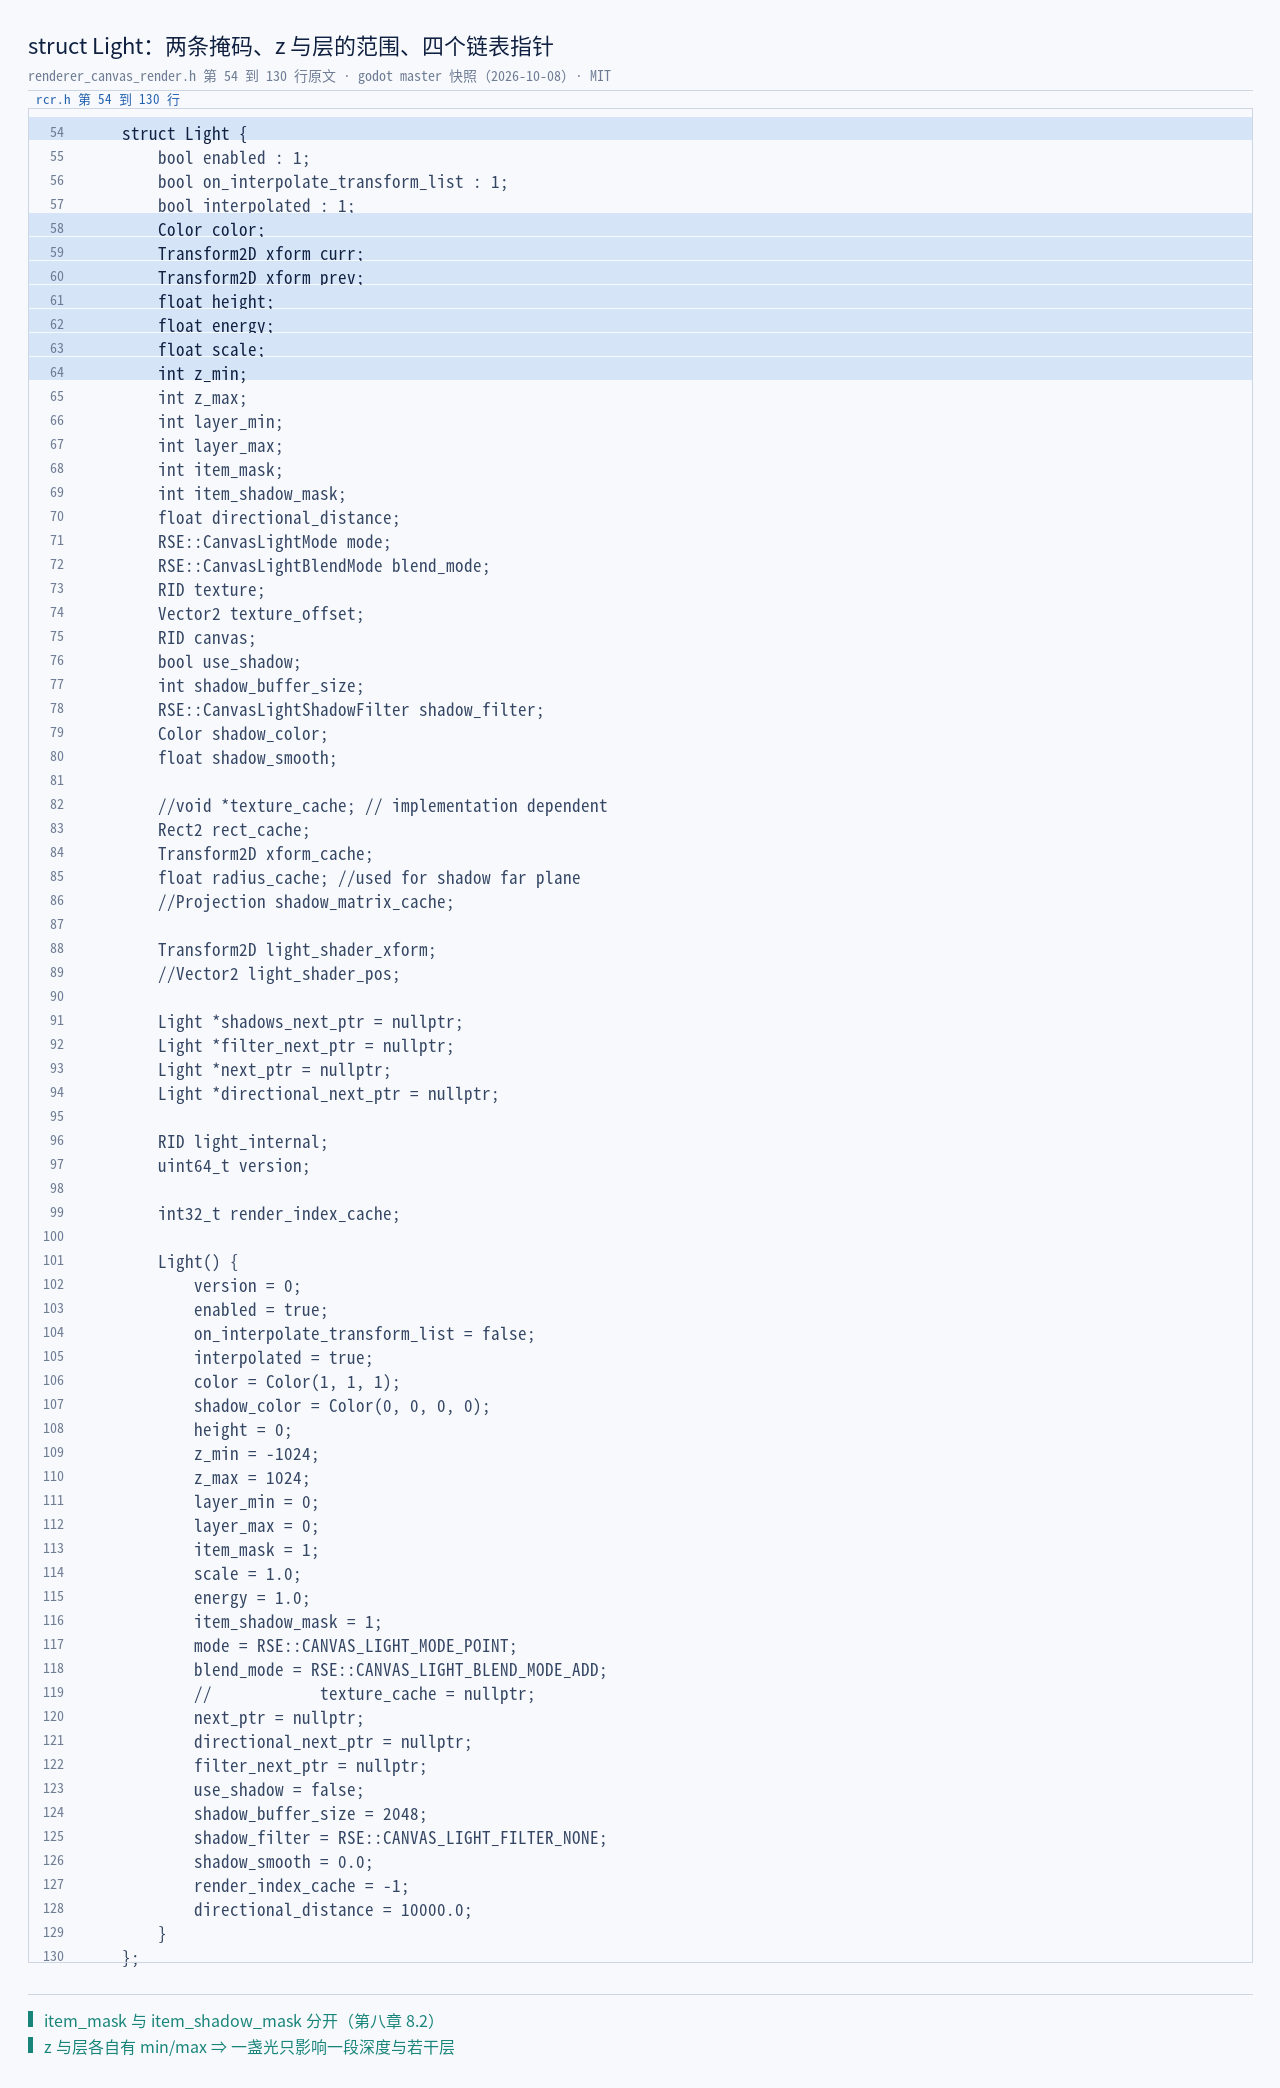
struct Light——两条掩码分开、z 与层各有范围、四个链表指针@ godot master 快照(2026-10-08)原文截取 · MIT先看作用范围这一组:z_min / z_max(默认 ±1024)管 z 方向,layer_min / layer_max 管画布层方向。再看过滤这一组:item_mask(默认 1)与 item_shadow_mask(默认 1)——两条掩码,一条管「谁接受这盏光」,另一条管「谁给这盏光投阴影」。还有一组是 CPU 侧的缓存:rect_cache(光的矩形)、radius_cache(用于阴影远平面)、render_index_cache(本帧在 uniform 数组里的下标)。
最后是四个链表指针:next_ptr、directional_next_ptr、shadows_next_ptr、filter_next_ptr。一盏光会同时出现在多条链上——因为「候选光」「方向光」「要算阴影的光」「要过滤的光」是四个不同的集合,各走各的链。这是这套实现惯用的手法:同一份数据,多根指针挂进不同的遍历顺序。
8.2 两条掩码为什么不能合成一条
好了,item_mask 与 item_shadow_mask 分开,是个很容易被忽略但很实用的设计。合起来看它的语义:一盏光可以「照亮某些东西」但「只被其中一部分遮挡」。举一个具体场景——2D 游戏里常见的「角色站在台灯下」:台灯(PointLight2D)照亮地面与角色,地面要投出角色的影子,但角色自己不该在墙上投出第二层影子。这时候两条掩码就能分开设。
场景侧的对应物也印证了这一点:Light2D 节点上有两个互不相干的属性 setter,一个设受光掩码、一个设投影掩码。它们不是同一个数的两个别名。
8.3 GPU 侧的光:LightUniform
CPU 侧有了 Light,GPU 侧还得有个能塞进存储缓冲的版本,那就是 LightUniform。
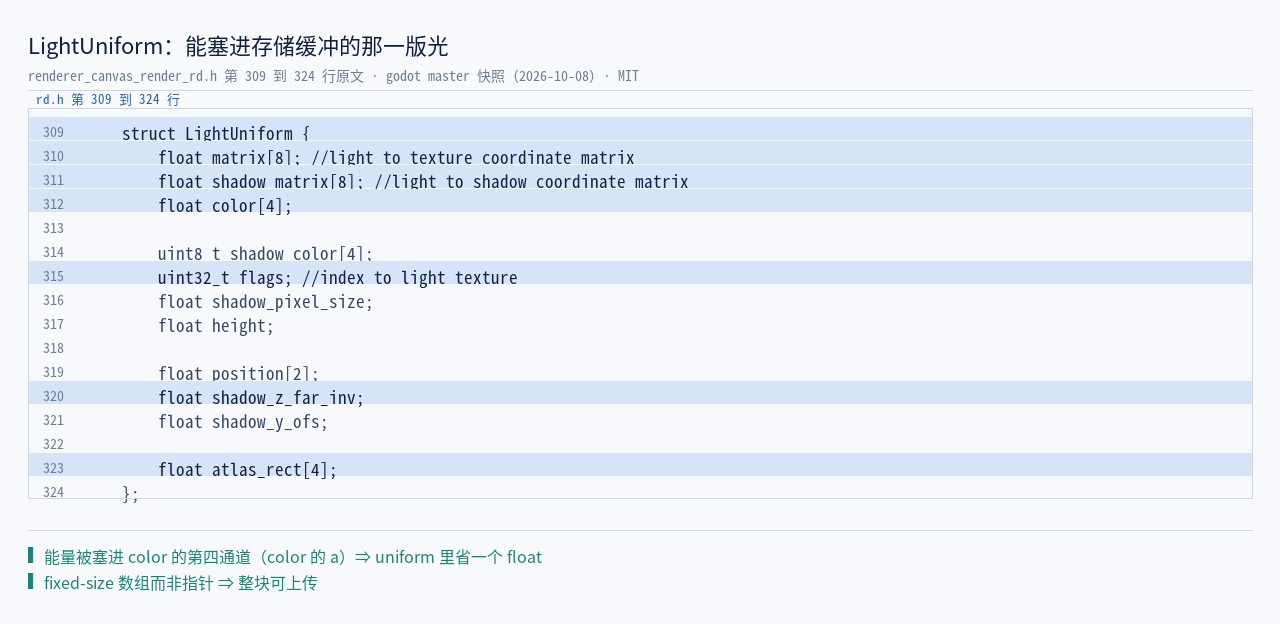
LightUniform——能量走 color 的第四通道@ godot master 快照(2026-10-08)原文截取 · MIT这份结构里有四组量:一组矩阵(光到纹理坐标的变换)、一组阴影量(阴影矩阵、像素尺寸、z_far 的倒数、y 偏移)、一组几何量(位置、高度、图集矩形)、一组打包标志位(flags 里塞着混合模式、阴影过滤方式、是否启用阴影)。
有一处小设计值得记:光的能量(energy)被塞进了颜色的 alpha 通道(color[3] *= l->energy)。这样基础颜色与强度可以分开调,而 uniform 里省下一个 float。这种「用满每一个通道」的写法在渲染代码里很常见,读的时候要留意——看到 color.a 不一定是透明度。
8.4 一束光怎么决定照到谁:四项判据
有了表示,就可以看判定。一项要不要接受某盏光,源码给的是一行同时成立的四个条件:
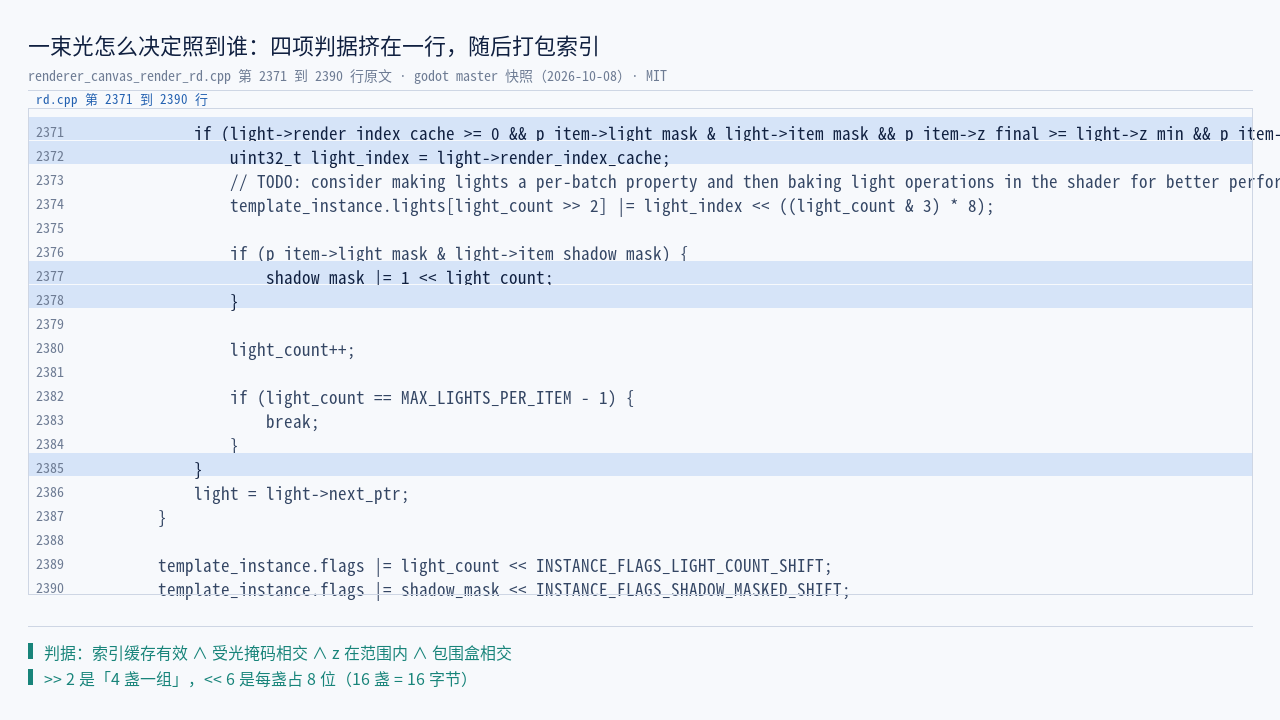
四项是:光在本轮有效(render_index_cache >= 0,也就是它没被上限截掉)、掩码相交(p_item->light_mask & light->item_mask,注意这里用的是项自己的 light_mask 而不是位域里那个)、z 在光的范围内(z_final 落在 z_min 与 z_max 之间)、包围盒与光的矩形相交(global_rect_cache.intersects(light->rect_cache))。
OK,这四项里,第二和第四项是最容易被忽视的性能开关:掩码把「不可能受光」的项一次排除,矩形相交把「光够不到」的项一次排除。而第三项说明 z 不只用于排序,还用于「光的分层」——同一盏光可以只照某个 z 区间里的东西。
判定通过之后,光的索引被按 8 位一格塞进 uint32 lights[4]:lights[light_count >> 2] |= light_index << ((light_count & 3) * 8)。四个 32 位数、每格 8 位,正好装 16 盏——这就是 MAX_LIGHTS_PER_ITEM = 16 的来历,也是 InstanceData 里那个 lights[4] 的用处。第 17 盏起直接 break,它不会再被算进这一项。
投影走的是另一条判据(受光掩码 ∩ 投影掩码),在同一个循环里用一个 shadow_mask 逐盏置位,最后并进实例标志里。
8.5 三张表与一组读数
把上面的判据画成图,就是「一束光的三张表」:一张管范围、一张管受光、一张管投影,三者都通过才落到项上,而落上去的方式是把索引压进 4 个字节的格里。
再补一组读数,它说明光不影响 submit 次数:本机探针在 200 个矩形上分别加 0 盏、1 盏、16 盏、20 盏 2D 光,draw call 全是 1。这与官方那句「2D 光照是单趟完成的」正好一致——光多光少,都是在这一趟里算完的,不会因为灯多就多几次提交。(口径照旧:本机自建引擎、自定义构建,只在本机成立。)
顺便记一处装置侧的事实:本机跑探针时发现 Godot 4 的 Light2D 是抽象类,不能直接构造;场景侧的实体是 PointLight2D 与 DirectionalLight2D。这与源码里 Light::mode 以及「点光链 + 方向光链」两套结构正好呼应。
8.6 struct Light 的字段分组
把 Light 的二十几个字段按角色分组,读起来会清楚很多:
| 组 | 字段 | 作用 |
|---|---|---|
| 类型与开关 | enabled / mode / blend_mode |
是否启用、点光还是方向光、加/减/混合 |
| 作用范围 | z_min / z_max / layer_min / layer_max |
只在某个 z 区间与层区间内生效 |
| 两条掩码 | item_mask / item_shadow_mask |
谁受光、谁投影 |
| 形态参数 | color / energy / height / scale / directional_distance |
颜色强度、光高(给法线用)、缩放、方向光距离 |
| 变换 | xform_curr / xform_prev / light_shader_xform / interpolated |
位置与插值 |
| 阴影 | use_shadow / shadow_buffer_size / shadow_filter / shadow_color / shadow_smooth |
阴影开关与三个参数 |
| 缓存 | rect_cache / xform_cache / radius_cache / render_index_cache |
本帧算出来的中间值 |
| 链指针 | next_ptr / directional_next_ptr / shadows_next_ptr / filter_next_ptr |
同一份数据挂进四条不同遍历 |
说白了,这张表里最值得回味的是最后一组:为什么一盏光要有四根指针?因为渲染流程里有四个不同的「需要按顺序过一遍光」的场合——候选光的顺序、方向光的顺序、要投阴影的光、要过滤的光。把四根指针挂在同一个对象上,比维护四个数组更省(不需要拷贝数据),代价是读代码时得记住「现在走的是哪条链」。
一处的量也值得记:shadow_buffer_size 默认 2048,directional_distance 默认 10000,而 z_min / z_max 的默认是 ±1024。都是「够用且不至于爆掉」的选择,不是算出来的最优值。
// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:2371–2374(master 快照 2026-10-08)
if (light->render_index_cache >= 0 && p_item->light_mask & light->item_mask &&
        p_item->z_final >= light->z_min && p_item->z_final <= light->z_max &&
        p_item->global_rect_cache.intersects(light->rect_cache)) {
    uint32_t light_index = light->render_index_cache;
    template_instance.lights[light_count >> 2] |= light_index << ((light_count & 3) * 8);
四项判据挤在一行里,判定完立刻打包索引。其中:>> 2 是「4 盏一组」,& 3 是组内位置,乘 8 是每组 8 位。这条编码的定义就是用 4 个 32 位数承载 16 个 8 位索引,一格对应一盏光。
本章出处:源码 renderer_canvas_render.h(struct Light)/renderer_canvas_render_rd.h(LightUniform)/renderer_canvas_render_rd.cpp(四项判据)|Light2D 类参考|材质的这类请求在用户侧怎么写、能读到哪些内置变量,见官方画布项着色器参考|本机读数 evidence/probe/E_command_chain_batch.txt(E 组)。
九、SDF:画占据图 + 后处理,闭合与不闭合两条路
光讲完了,还剩遮挡。这一章要讲的 SDF(signed distance field,有符号距离场)是 2D 光照里最容易被当成「黑盒」的一块——很多人以为它是一张算出来的距离图,实际做法比这朴素:先画一张占据图,再把距离场跑出来。
9.1 谁在请求 SDF
先从「什么时候会有这东西」说起。官方文档的说法是:视口里代表 LightOccluder2D 节点的二维有符号距离场(signed distance field),在用户着色器请求它的时候才自动生成。它的用途有两个:自定义着色器里的效果(比如 2D 全局光照),以及 2D 粒子碰撞。
源码里这句话有一个精确落点:渲染层遍历项的时候,若某项的材质声明了 uses_sdf,就把一个回传标记置为真(r_sdf_used = true)。这个标记会一路回到上游,由剔除层决定这一帧要不要跑一次 SDF 生成。
也就是说:SDF 不是每帧都有,不是有遮挡体就有,而是「有人要才做」。
9.2 形状下发:只有两个参数
言归正传,遮挡的形状是怎么进来的?看抽象层的声明就明白:occluder_polygon_set_shape(RID, const Vector<Vector2> &p_points, bool p_closed)——一个点集加一个「是否闭合」。
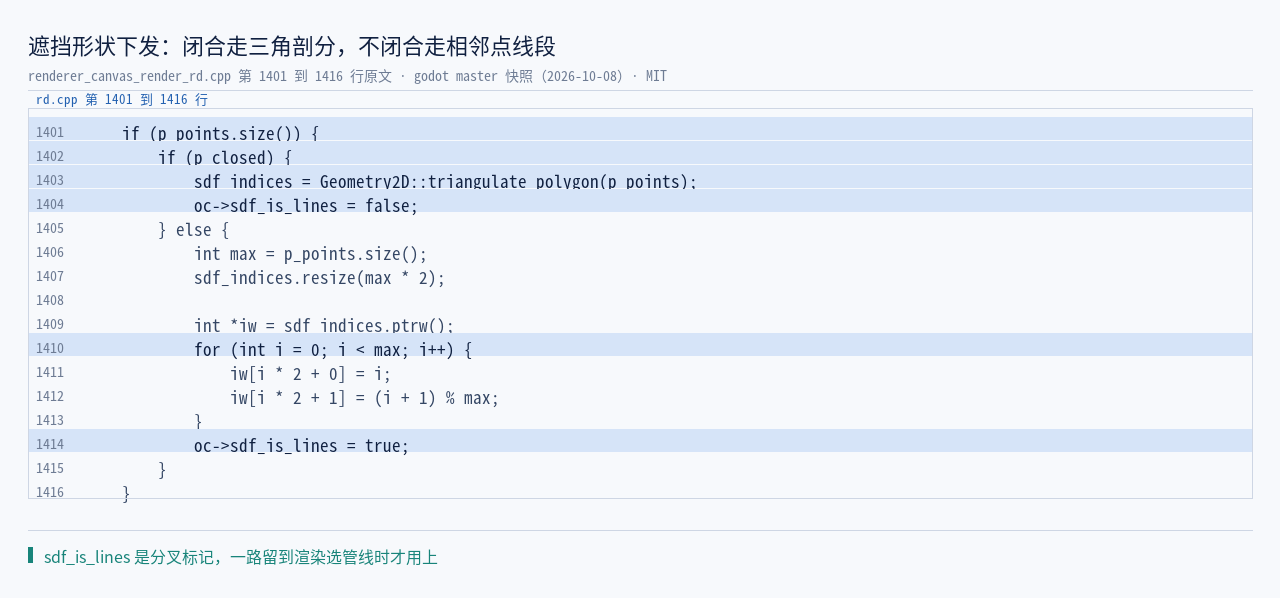
实现层拿到这两个参数之后,做的第一件事就是分叉:闭合的走 Geometry2D::triangulate_polygon(三角剖分,结果是一串三角形索引,sdf_is_lines = false);不闭合的按相邻点两两成对,生成一串线段索引(sdf_is_lines = true)。
这个标记一直留到最后——第九章最后一节会看到,它决定用哪条渲染管线。
9.3 同一个函数里还有第二套几何
值得单独提一句:这个函数里建了两套几何。一套是给阴影投射线用的(每条边拉成一个很高的四边形带,高度是一个写死的常数 POLY_HEIGHT = 16384),一套是给 SDF 用的(三角或线段)。两者的顶点缓冲、索引缓冲、顶点格式都不同。
为什么阴影要拉那么高?因为 2D 的「影子」在实现上是一种廉价近似:把边沿朝一个方向拉出一条很长的带子,靠高度换来「看起来像投影」的效果。这套几何不在本篇的范围内,但它与 SDF 共用一个函数、共用一份缓存策略,所以读的时候要分清哪几段属于哪一套。
9.4 渲染:清图 → 逐个画 → 后处理
到了真正生成的时候,做法极其直白:
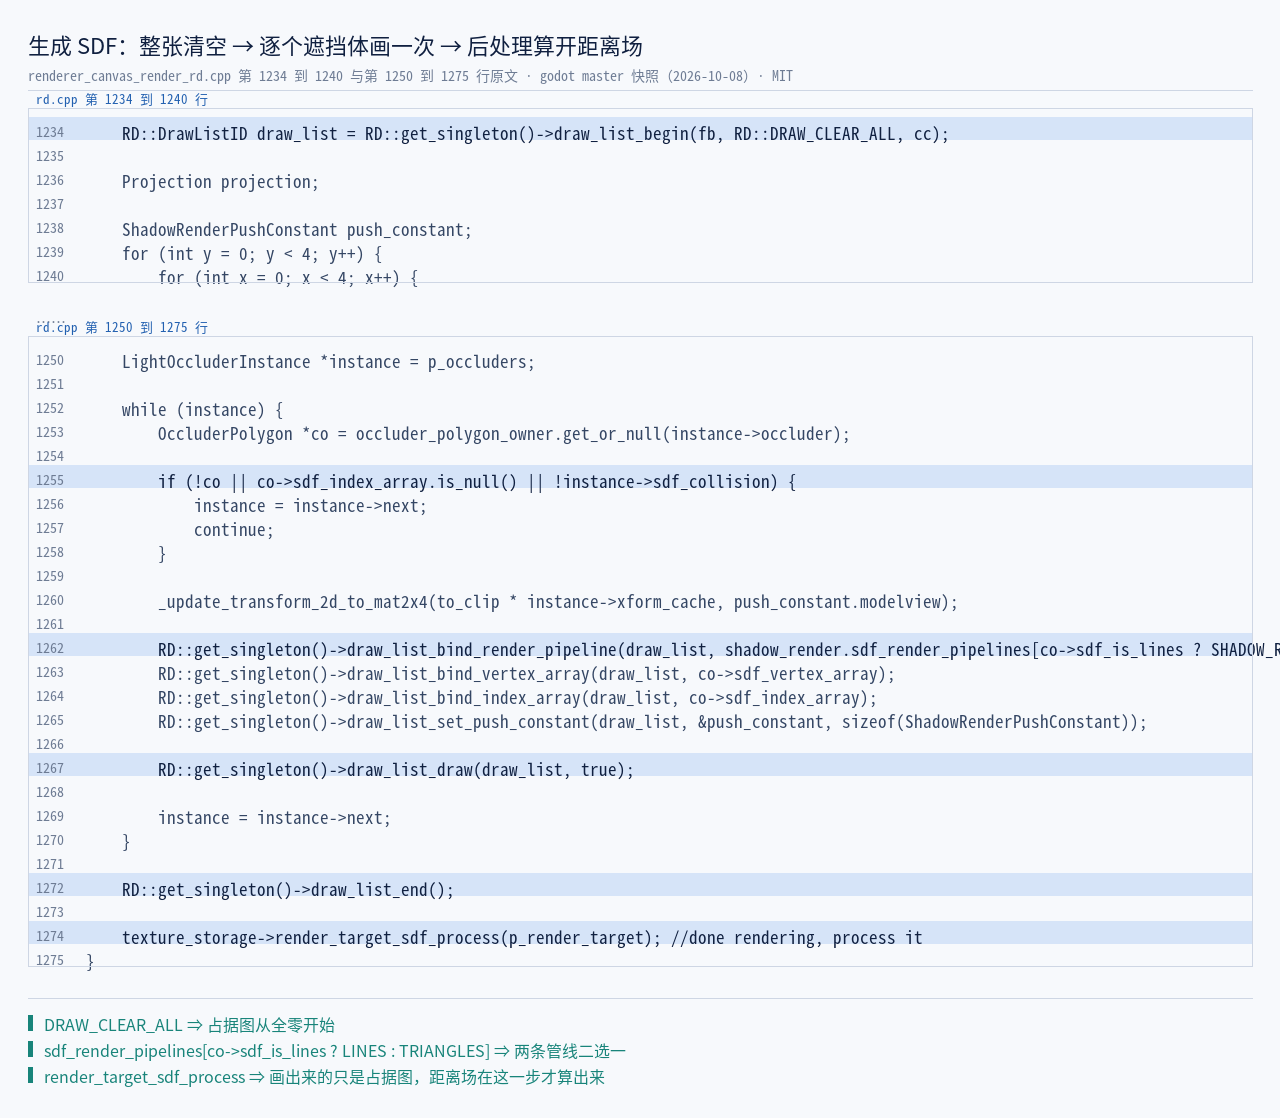
render_target_sdf_process 后处理@ godot master 快照(2026-10-08)原文截取 · MIT// servers/rendering/renderer_rd/renderer_canvas_render_rd.cpp:1234 / 1262 / 1274(master 快照 2026-10-08)
RD::DrawListID draw_list = RD::get_singleton()->draw_list_begin(fb, RD::DRAW_CLEAR_ALL, cc);
...
RD::get_singleton()->draw_list_bind_render_pipeline(draw_list,
shadow_render.sdf_render_pipelines[co->sdf_is_lines ? SHADOW_RENDER_SDF_LINES : SHADOW_RENDER_SDF_TRIANGLES]);
...
RD::get_singleton()->draw_list_end();
texture_storage->render_target_sdf_process(p_render_target); // done rendering, process it
其中:DRAW_CLEAR_ALL 就是第一步的整张清空;sdf_render_pipelines 是一个只有两根管线的数组,下标由 sdf_is_lines 决定——9.2 那个标记在这里用上;render_target_sdf_process() 是第三步的后处理。原理一句话:占据图是一次普通绘制,距离场是这一行调用的产物。
好了,三步:第一步取到 SDF 的帧缓冲并整张清掉(清成全零);第二步遍历遮挡体链表,每个遮挡体按它的 sdf_is_lines 选一条管线(三角或线段)、绑上自己的顶点与索引缓冲、发一次绘制;第三步——也是「距离场」真正诞生的地方——调 render_target_sdf_process() 做后处理。
第三步是这一章最想让大家记住的一点:画出来的那张图不是距离场,它只是一张「占据图」(哪块被挡、哪块没挡);距离场是后处理算开的。把这两步混为一谈,就很难理解为什么 SDF 的开销不像「画几张多边形」那么低。
9.5 SDF 的输入从哪儿来:场景侧的那两个字段
上面这张是编辑器里的两个落点:左边是节点树,右边是资源文件栏。场景侧这套分工与界面上这两栏一一对应:LightOccluder2D 作为节点挂在树里,它引用的 OccluderPolygon2D 是一份资源;多边形本身在资源里编辑,形状变化时经服务层下发到刚才那个 set_shape;而「参与不参与 SDF」是遮挡体实例上的一个开关字段(sdf_collision)——形状是资源、参与与否是实例,两者分开。
这里要如实交代一句口径:本节原本想要的是一张「检查器里能看清 LightOccluder2D 与 OccluderPolygon2D 字段」的截图,但 A 级源里没有这一类图——检索落空已留痕(见 search-log.jsonl)。按素材规范换成了同类真实界面图,因此本节不声称图内能读出那两个字段,只借它指出「节点树 / 资源栏」这两个落点。
这条分工也和 9.2 那段代码呼应:set_shape 只关心「点集与闭合」,至于这个形状要不要进 SDF,是在遍历遮挡体时按那个开关筛的。
9.6 这一章的一条口径提醒
本篇讲 SDF,只讲到「谁请求、形状怎么进、怎么画、距离场在哪一步算出来」为止。后处理那一步用到的着色器(官方文档点名了 canvas_sdf.glsl)本次没有取回,所以它的内部写法本篇不做任何描述——留到后续篇目补齐。这是有意为之:宁可不写,也不按印象补。
9.7 遮挡几何的缓冲是怎么复用的
OK,再补一处实现细节,它对性能的意义不小:遮挡多边形的缓冲不是每次下发都重建。
代码里有一道判断:只有在「索引数变了、或点数变了、或点集被清空」而且已经存在缓冲的时候,才去释放旧的顶点缓冲、索引缓冲与数组;否则走另一条路——直接 buffer_update 覆盖内容。
命令的内存是 4 KB 一块地要的,而遮挡几何的缓冲则相反——能更新就不重建。这个选择是为了避开「管线冲刷」:在图形 API 里,释放并重建缓冲往往意味着要等 GPU 用完,而原地更新只是往已有缓冲写数据。源码里那句注释写得很直白——同样的长度就只更新,避免一次管线冲刷。
有意思的是,SDF 那一套缓冲与描边那一套缓冲各自独立地做了同样的判断。也就是说,「变形状」这件事在两套几何上都被优化成了「尽量只改内容、不改结构」。对做 2D 光照效果的人来说,这条细节解释了为什么「每帧挪一下遮挡体」不会立刻掉帧——只要点数不变,代价就是一次缓冲写入。
本章出处:官方《内部渲染架构》master 原文(SDF 生成时机与用途)|2D 光照与阴影教程|LightOccluder2D 类参考|源码 renderer_canvas_render_rd.cpp(occluder_polygon_set_shape 与 render_sdf)。
十、收官:这套分工买到什么、代价是什么
十一章走下来,这条链的完整形状已经清楚了。最后一章把它收拢:这套分工到底买到了什么,又付出了哪些代价。
10.1 六条可以带走的结论
- 中间表示 = 一条命令链 + 一份累计态。绘制项不存「最终画出来的样子」,它存的是「怎么画」和「按什么参数画」;父链的调制色、变换、裁剪矩形在剔除阶段就已经乘算完毕,挂在项上。
- 命令的内存是分块的,块只增不减。首条命令单独分配、其余进 4 KiB 块;
clear()只归零usage,把仓库留给下一帧。这一条直接解释了「频繁重绘」为什么不等于「频繁分配」。
// servers/rendering/renderer_canvas_render.h:432–462(master 快照 2026-10-08)
void clear() {
        // The first one is always allocated on heap
        // the rest go in the blocks
        Command *c = commands;
        while (c) {
                Command *n = c->next;
                if (c == commands) {
                        memdelete(commands);
                        commands = nullptr;
                } else {
                        c->~Command();
                }
                c = n;
        }
        {
                uint32_t cbc = MIN((current_block + 1), (uint32_t)blocks.size());
                CommandBlock *blockptr = blocks.ptrw();
                for (uint32_t i = 0; i < cbc; i++) {
                        blockptr[i].usage = 0;
                }
        }
        last_command = nullptr;
        commands = nullptr;
        current_block = 0;
}
其中:memdelete 只出现在链首那条命令上(它单独分配在堆上),链上其余命令用 ~Command() 就地析构;随后把每个块的 usage 归零。原理一句话:清空被定义成「复位账本」而不是「归还内存」——块的地址与容量都不动,下一帧从零开始写。
3. 抽象层定表示、实现层管提交,界线画在「与后端有没有关系」上。抽象层里唯一的算法是包围盒,因为它是与后端无关的量。
4. draw call 的数量取决于状态切换的次数,不取决于画了多少东西。这一条是本机测出来的:200 条命令与 200 个节点都给 1 个 draw call,而「矩形/图元交替」给 200 个。
5. 一批的实例上限是 16384,本机读数在 16,384 与 16,385 之间恰好分界,与源码常量逐条对齐。
说白了,6. SDF 不是算出来的,是「画出来的图再后处理」;触发条件是材质声明 uses_sdf,闭合与不闭合走两条不同的管线。
10.2 代价:四处需要知道的成本
任何设计都有代价,这一层的代价有四处值得记:
第一处是时间依赖会强制整帧重绘。 遍历时若发现某项的材质用到 TIME,会直接调一次「请求重绘」。换句话说,一个用到时间的着色器会把整帧拉进每帧重绘——这在 2D 里通常没问题,但要知道它不是免费的。
第二处是命令块只增不减。 「峰值命令数」决定了内存上限,而且这块内存不会因为某一帧画得少而归还。对绝大多数场景这是划算的;对「偶尔一次性画十万条」的场景,就是一笔常驻开销。
第三处是纹理信息表每帧重建。 遍历结束时会把纹理信息表清空——它是一份「本帧用到的纹理状态 → 采样信息」的缓存,每帧重新填。这是「以每帧一次重建换掉跨帧失效判断」的取舍。
第四处是每项 16 盏光的上限。 超过就静默不再计入(代码里是 break)。它不报错、只是不照——所以「为什么第 17 盏灯没效果」这类问题,答案在源码里而不在文档里。
10.3 全篇链条回看
言归正传,上面这张图把本篇走过的路回看了一遍。如果只记一件事,那就记这条四层嵌套:一条项链(剔除层给的)→ 每条项上一条命令链(场景层挂的)→ 命令的内存成 4 KiB 的块(分配策略)→ 状态一致的那些项与命令合成一批(实现层切的)。四个层次各自解决一个问题,彼此之间只通过两个指针(Item::next 与 Command::next)相连。
10.4 后面各篇各看哪一层
到此为止,本篇把「表示」这一层讲完了。但它留下的问题还很具体:这些批最终是怎么变成 draw call 的、四个后端在这件事上有什么不同(第六、八篇);命令列表到了 RenderingDevice 之后怎么排成一张依赖图(第七篇)。再往后看:这一整套在什么时候被执行、逻辑与渲染怎么错位(第九篇);一张纹理从盘上到 §2.3 那个 RID 之间发生了什么(第十篇)。
延伸阅读:想对照「用户侧怎么设顺序与层」,可看官方 CanvasLayer 类参考 与Viewport 类参考; 它们讲的是接口,本篇讲的是这套接口背后的表示与提交。
10.5 与前三篇的对照
最后把本篇与系列前三篇摆在一起,看它们各自把「一次 2D 绘制」拆到了哪一段:
| 篇 | 入口 | 出口 | 它回答的问题 |
|---|---|---|---|
| 第二篇(对象模型) | _draw() 回调 |
服务层调用 | 谁在什么时候下发命令 |
| 第三篇(服务层接口) | 服务层调用 | RID 型命令入库 | 命令长什么样、怎么被排队 |
| 第四篇(剔除与排序) | 场景树 | 一条排好序的 Item 链 |
画什么、按什么顺序 |
| 第五篇(本篇) | 一条 Item 链 |
一批批的实例数据 | 绘制项里存了什么、怎么被提交 |
好了,四篇连起来看,有一个共同的写法值得点出:每一层都只把自己那一段讲清楚,接口两端的表示是同一份数据的不同视角。第三篇里命令是一种「可延迟的句柄型调用」,第四篇里它是「被排好序的一个项」,本篇里它变成「一条命令链上的一个节点」——对象没换,换的是谁在解释它。
这也是这套架构容易被误读的地方:读单篇时容易以为某一层「只是转发」,把四篇连起来才会看到,每一层都实实在在往这份数据上添了东西——第二篇添了命令,第三篇添了句柄与队列,第四篇添了位置,本篇添了「怎么把它变成提交」。
下篇预告:下一篇顺着「批」往下走,讲攒批的完整规则——为什么同一批能装下几百个矩形,以及官方文档里那句「所有渲染方式都支持 2D 批处理」是怎么从「只有 Compatibility 有」变过来的。
相关链接
源码落点:本篇共 280 处落点逐条实读(evidence/build/ep05_src_lines.txt,机器核对 0 FAIL),集中在
renderer_canvas_render.h、
renderer_canvas_render.cpp、
renderer_canvas_render_rd.h、
renderer_canvas_render_rd.cpp、
canvas.glsl、
renderer_canvas_cull.cpp、
canvas_item.cpp、
light_2d.cpp、
light_occluder_2d.cpp;
其中: CanvasKey 之外的接缝全在 renderer_canvas_cull.cpp:105 那一行,实例数据的大小由 renderer_canvas_render_rd.h:380 的编译期断言钉死,行号一律按 master(2026-10-08 快照)。
资源清单
官方文档(CC BY 3.0 Unported,署名 “Juan Linietsky, Ariel Manzur and the Godot Engine community”,引用须标注改动):
CanvasItem 类参考、
CanvasGroup 类参考、
Light2D 类参考、
LightOccluder2D 类参考、
OccluderPolygon2D 类参考、
内部渲染架构、
2D 光照与阴影、
Canvas layers、
用服务器优化、
RenderingDevice 类参考、
Viewport 类参考。
官方源码(godot 仓库 master raw;MIT,行号按 2026-10-08 快照):
renderer_canvas_render.h、
renderer_canvas_render.cpp、
renderer_canvas_cull.h、
renderer_canvas_cull.cpp、
rendering_server_globals.h、
rendering_server.h、
rendering_device.h、
renderer_canvas_render_rd.h、
renderer_canvas_render_rd.cpp。
许可与商标:引擎许可、官方美术与商标。Godot 名称与 Logo 属商标,配图与说明不得暗示官方背书。
官方素材(编辑器截图):Godot 截图类目。
言归正传,相关链接(站内与竞品口径):第四篇 画布剔除与排序、第三篇 服务层接口、caimouse《Godot 源码分析》专栏、graypigen1990《RenderingServer 总结》。
OK,本机一手产物:evidence/probe/E_command_chain_batch.txt(A–G 七组 21 条用例,一次窗口运行跑完),另有 evidence/build/ep05_src_lines.txt(280 处落点,机器核对 0 FAIL)。本机读数用的引擎版本为 4.8.dev.custom_build.7177493c1(2026-07-03 构建,自定义构建),只在本机口径下成立,不跨机器外推。
With Best Wishes.