核心问题:上一篇(ep06)把时域复用讲透了——用运动矢量把历史帧搬过来,1 spp 的噪声就能压到肉眼可接受,代价是 disocclusion 与鬼影。可时域那一套只解决"同一个像素在时间轴上抖不抖",它对单帧内部的空间相关性毫无办法:一个像素的估计误差和它邻居的估计误差是同源的,时域滤波不会让它们互相纠正。
时域之后剩下的残差是空间上的——低频块状噪声和高频斑点。要补上这一块,就得让邻居互相帮忙,而"邻居怎么加权"就成了整条降噪链上最容易调错、也最值得讲清的一环。
本篇来回答——空间滤波的邻居该按什么加权、à-trous 为什么要"打洞"、方差怎么就变成了驱动信号、三根 σ 调错了会看到什么、SVGF 的三个软肋在哪、A-SVGF 怎么把固定参数换成自适应、生产级的 ReBLUR/ReLAX 怎么选、TSR 与 DLSS 光线重建把这件事推进到了哪一步、以及神经降噪到底值不值。十件事合起来,才是"降噪(下)"的完整账。
本篇是降噪话题的下半篇,承接 ep06 的时域结论,只讲空间滤波与学习型重建;不重复展开时域复用的原理与失效模式(只在必要处引用 ep06 的结论)。本篇也不涉及:离线渲染的降噪(路径追踪器内部的样本累积与自适应采样)、视频编解码的降噪(时域/空域视频去噪)、摄影后期降噪、以及图像超分(仅涉及 DLSS 光线重建中与降噪融合的那部分)。这么切是因为这四类问题的约束条件与实时渲染完全不同——离线渲染有无限时间,视频编解码处理的是已有像素,摄影后期不关心延迟,硬凑在一起只会把"预算下的取舍"讲糊。
本系列(实时光线追踪与混合渲染,共 12 篇)的前置阅读:第一篇《分界线》给出了三类效果判据与三条成本模型;第二、三篇《加速结构工程账》上下给出了构建/更新/压缩与动态场景的账;第四篇《命中着色器与 SBT》讲了找到三角形之后该调用哪段着色器;第五篇《混合管线编排》讲了光栅化与光追怎么接力、性能预算怎么分;第六篇《降噪(上)》给出了时域复用的数学、运动矢量与重投影、六类失效模式。其余前置专题为算法层《实时渲染管线探析》5 篇、约束层《移动端图形与功耗》7 篇、硬件实现层《GPU 架构剖析》12 篇。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客:技术博客页。
点题:空间滤波补的是哪一块
0.0 内容总览:本篇知识地图
先放一张总表,把十章各自回答的问题钉在这里。后面每一章都在展开其中的某一行。大家可以先从这张表里找到自己最关心的问题,再跳到对应章节去看。
横向覆盖全篇十章,纵向给出每章的核心问题、结论与主要依据。第一章讲"邻居该怎么加权",第二章讲"半径怎么变大而不变贵",第三、四章讲"方差怎么驱动、三根 σ 怎么调";第五章讲"SVGF 哪里会坏",第六章讲"怎么自适应地修";第七章是生产级实现的两条路线,第八章是学习型重建,第九章是两边的工程账,第十章收束交棒。
| 章 | 回答的问题 | 核心结论 | 主要依据 |
|---|---|---|---|
| 一 | 邻居该按什么加权 | 联合双边滤波:空间距离 × 深度/法线/亮度三组边缘停权 | SVGF 论文 [Schied 2017] |
| 二 | 怎么把半径做大而不变贵 | à-trous 空洞卷积:步长翻倍、taps 不变;瓶颈在访存不在算术 | JCGT vol.15 no.1 [2026] |
| 三 | 方差怎么就驱动了整条链 | 一二阶矩 → 时域方差 → 同时决定 α 与滤波强度 | SVGF 论文 [Schied 2017] |
| 四 | 三根 σ 怎么调、错了什么样 | σz/σn/σl 各有"过小/过大/失配"三类可见症状 | 实作资料 + 社区实践 |
| 五 | SVGF 哪里会坏 | 鬼影残留、过模糊、高动态下方差估计失效 | Q2VKPT [GDC/GTC 2019] |
| 六 | 怎么自适应地修 | 逐像素 α + 自适应迭代数,平均 pass 数 5 → 2–3 | A-SVGF [Schied 2018] |
| 七 | 生产级怎么做 | ReBLUR 自稳定递归模糊(≤32 帧)/ ReLAX 球谐域拆分 | GTC 2020 · NRD 文档 |
| 八 | 学习型重建到哪一步了 | 单网络融合降噪+超分;2026 年的 4.5 版本已覆盖全部 RTX | DLSS 4.5 公告 [2026] |
| 九 | 神经降噪值不值 | 五维工程账:内存/延迟/可移植性/调参/失败模式,给判据不给结论 | 全篇汇总 |
| 十 | 边界与交棒 | 本篇不涉及什么;下一篇走向采样与重要性重采样 | 全篇总结 |
0.1 时域之后剩下的残差
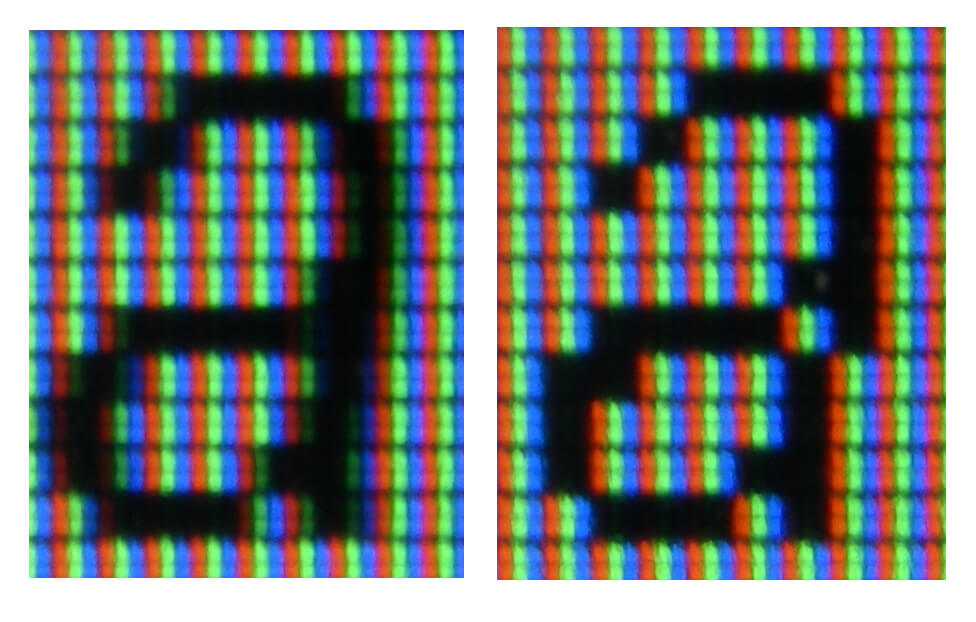
先来看看一张最朴素的证据。这张图把"有抗锯齿"与"无抗锯齿"两种画法摆在一起——左边是阶梯状的硬边,右边是过渡带。它说明的是一件很基础的事:当一个像素只取一个样本时,误差不是随机的白色噪声,而是有结构的——它会沿着几何边缘排成一条链,也会在细密纹理里结成块。
路径追踪里的噪声同样有结构。1 spp 时每条光线只随机挑一个方向、随机挑一个光源采样点,单条光线的辐射度估计方差极大;但相邻像素的随机数通常来自同一个低差异序列的相邻项,于是它们"错得相似"。这就解释了为什么降噪器不能只看自己——邻居的误差与你的误差是同源的,把它们平均起来,误差才会互相抵消。
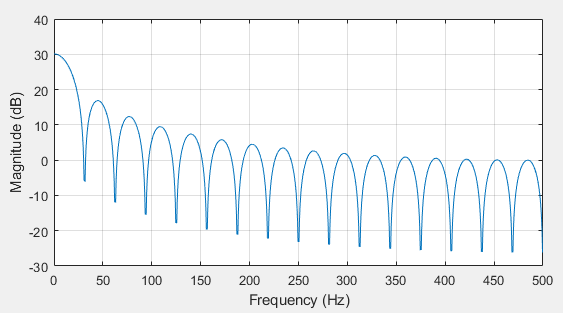
这件事有直接的量化证据。这张图是同一信号按 4 个样本与 32 个样本分组平均的结果:样本数从 4 涨到 32 只多了 8 倍,但方差的下降幅度远大于 8 倍观感上的改善——因为噪声的方差与样本数成反比,Var ≈ σ² / N,标准差只按 1/√N 下降。
把这套逻辑搬到实时渲染里就是一句话:时域复用是在时间轴上攒样本,空间滤波是在同一帧里借邻居的样本。前者受限于帧间连续性,后者受限于边缘——两者是互补的,谁也替代不了谁。
0.2 降噪器在整条管线里的位置
再定一次坐标。下面这张图把降噪器放回完整的混合管线里:左边是 G-buffer 与光追的原始输出(颜色、深度、法线、运动矢量、粗糙度),中间是降噪器内部的两段——时域累积与空间滤波,右边才是最终呈现。ep06 拆的是中间那段的前半,本篇拆它的后半。
值得先说清的是空间滤波阶段手里有哪些输入。这不是随便的加权平均,而是一组带语义的辅助缓冲(auxiliary buffers):
- 深度(depth):判断邻居在不在同一层表面上;
- 法线(normal):判断邻居的朝向是否一致,曲面折角与硬边在这里露馅;
- 亮度(luminance):判断邻居的颜色是否来自同一段光照与材质;
- 方差(variance):判断这一块到底有多脏,决定滤波强度与迭代层数。
少一个都会出问题:只用深度会在法线折角处渗色,只用亮度会把低对比度的真实纹理当成噪声抹掉。OK,言归正传,下面我们从最基本的一步开始——邻居该怎么加权。
0.3 口径声明
本篇的性能与内存数字基于以下口径,跨来源比较时请先对齐:
- 硬件:以 RTX 3080/4070 级别为参考(主流高端桌面 GPU),涉及内存的条目按 4K 分辨率计;
- 分辨率与帧率:1080p / 1440p(游戏常用),帧率目标 60 fps(16.67 ms 帧预算);
- 光追效果:以 1–2 spp 路径追踪为基准(最低有效采样率),GI/反射/阴影同开;
- 降噪器版本:SVGF 按原论文设定(固定 5 级 à-trous)、NRD 按 ReBLUR/ReLAX 默认、DLSS 光线重建按 2026 年 4.5 版本;
- 厂商宣传数字的处理:凡属厂商公布的相对倍数(如 NRD 相较 SVGF 的 +50%),一律保留其原口径并标注来源,不转述为跨项目定论。
一、联合双边滤波:为什么"邻居"不是随便加权的
1.1 朴素高斯模糊的代价:噪声和边缘一起没
OK,空间滤波的起点是高斯模糊(Gaussian Blur):离得近的邻居权重大,离得远的权重小,权重按高斯函数衰减。它的数学干净、可分离、实现简单,图像处理里用了半个世纪。
但它有一个致命问题:它不知道边缘的存在。这张图是 Canny 边缘检测流程的第一步——对原图做高斯模糊后的结果。大家注意看:噪声确实被压下去了,但物体轮廓也一起软掉了。原因很直白,高斯核的权重只看空间距离,不看内容;边缘两侧的两个像素在几何上是同一块砖,只是恰好被轮廓线分开了,高斯模糊照样把它们平均到一起。
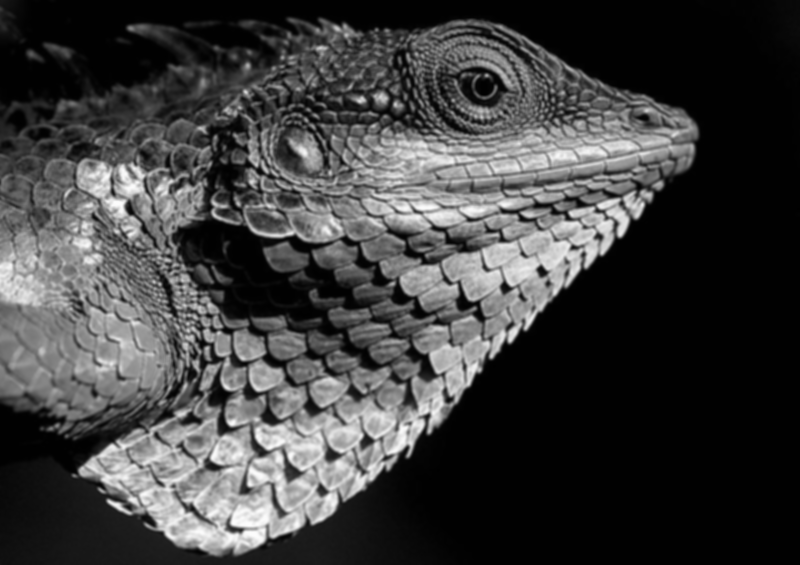
顺带说一句,Canny 流程本身要在模糊之后才算梯度,这个顺序不是随便定的——先模糊再求导,等于在求导前把高频噪声掐掉,否则梯度图上全是噪声引起的假边缘。这个"先抑制、再判边"的思路,和我们下面要讲的空间滤波是同一个道理。
1.2 保边平滑:第三条路
既然"只看距离"不行,"完全不看距离"也不行,好了,既然两头都不合适,那就有一条中间路:按内容决定要不要平滑。这类方法有个总称叫保边平滑(edge-preserving smoothing),最直观的一族是各向异性扩散(anisotropic diffusion,又称 Perona–Malik 扩散):它在平坦区域像热扩散一样把像素抹平,到了梯度大的地方就自动刹住,不让跨边缘的颜色通过。
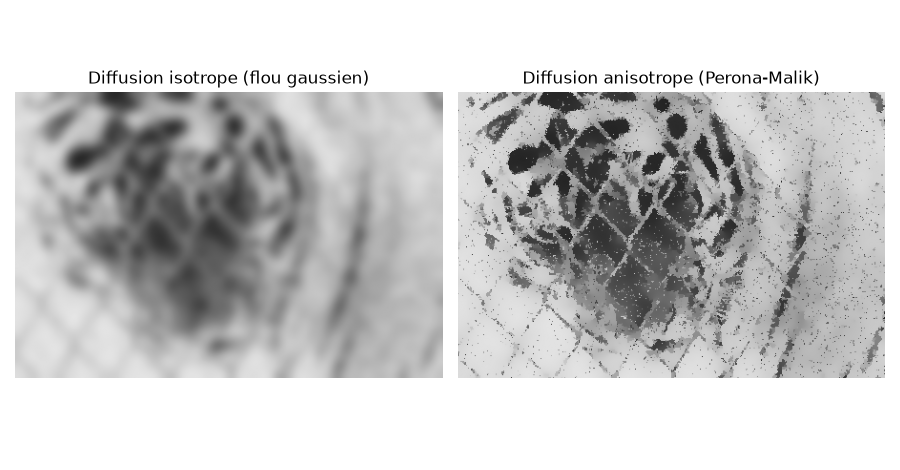
图里这张对照很能说明问题:各向同性(isotropic)那一版糊成一团,各向异性(anisotropic)那一版把纹理细节留住了。这条思路的直接后代就是双边滤波(bilateral filter)——把"内容"直接写进权重里:权重 = 空间距离项 × 亮度差项。
到这里轮廓就清楚了。先做一次二次归类:空间滤波这一族可以按"权重里放了什么"排成一条线:
| 方案 | 空间距离 | 亮度/颜色差 | 深度 | 法线 | 用在哪 |
|---|---|---|---|---|---|
| 高斯模糊 | ✅ | ❌ | ❌ | ❌ | 通用图像处理、Bloom 等 |
| 双边滤波 | ✅ | ✅ | ❌ | ❌ | 摄影后期、降噪预处理 |
| 各向异性扩散 | ✅(迭代) | ✅(梯度) | ❌ | ❌ | 医学影像、图像增强 |
| 联合双边滤波 | ✅ | ✅ | ✅ | ✅ | 实时光追降噪(本文主线) |
| à-trous 小波滤波 | ✅(多级) | ✅ | ✅ | ✅ | SVGF 的空间滤波阶段 |
"联合"(joint)二字的含义就在这里:除了当前颜色,它还吃别的缓冲——深度和法线来自 G-buffer,是几何侧给的"这块像素属不属于同一个表面"的判据。
1.3 卷积:邻居加权求和的标准形式
OK,讲具体权重之前,先把数学形式固定下来。空间滤波的本质是一次卷积(convolution):
I'(p) = Σ_{q ∈ Ω} w(p, q) · I(q) / Σ_{q ∈ Ω} w(p, q)
其中:
p是当前像素,q是邻域Ω里的某个邻居;I(q)是邻居的输入值(在光追降噪里通常是颜色,也可以对辐照度、方差等分别滤波);w(p, q)是权重,整个空间滤波的设计都在这一项里;- 分母是权重的归一化,保证滤波后整体亮度不漂移。
写成这样以后,"高斯模糊 vs 联合双边滤波"的区别就只剩 w 的写法了:
w_gauss(p, q)  = exp( -|p - q|² / (2σ_spatial²) )
w_joint(p, q)  = w_gauss(p, q) · exp( -|I(p) - I(q)|² / (2σ_l²) )
                            · exp( -|z(p) - z(q)|² / (2σ_z²) )
                            · max(0, dot(n(p), n(q)))^σ_n
四个因子相乘,各自管一件事:空间距离管"离得远不远",亮度管"颜色像不像",深度管"在不在同一层",法线管"朝向一致不一致"。任意一项趋近于零,w 就趋近于零,这个邻居直接被排除。
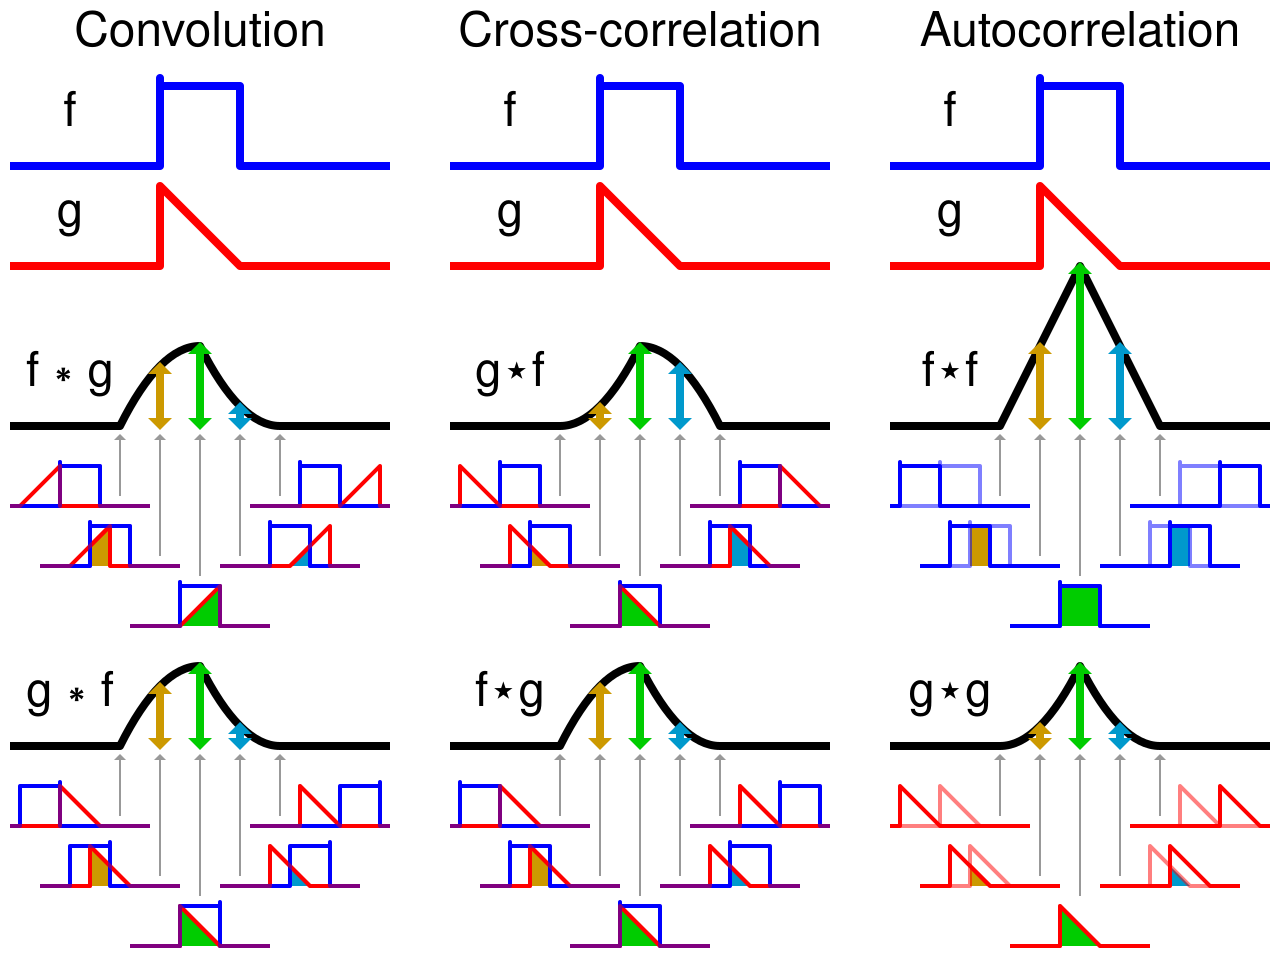
这里有个容易被忽略的实现细节:着色器里跑的多半是"相关"(correlation)而不是严格的卷积,差别只在核要不要翻转。因为我们的核是 w(p,q) 这种对称形式(|p-q| 用的是距离,dot(n(p), n(q)) 是对称的),翻转不翻转结果一样,所以工程上通常直接写成 Σ w · I,不再纠结定义。但如果哪天核变成非对称的(例如按梯度方向加权),这个差别就要回来了——而且回归时会表现为"图像被镜像"这种很难一眼看出的错误。
1.4 联合双边滤波核:一个像素的权重怎么算出来
下面我们开始算一像素的账。取当前像素 p 为中心,看它 3×3 邻域里的一个邻居 q,权重是四个因子的乘积:
这里要提醒一个实现上的坑:权重必须先算完再归一化,不能边算边累加。因为归一化分母 Σ w 在算完所有邻居之前是未知的;早期一些实现为了让循环更快,用固定分母(例如按 3×3 除以 9),结果在边缘密集处会整体偏暗——那不是算法错,是归一项错。
另一个坑是深度的写法。深度差可以直接比差值 |z(p) - z(q)|,也可以比"沿视线的相对深度",后者在掠射角与大面积斜面上明显更稳。工程上更常见的一招是把深度转成线性深度再比(透视投影后的非线性深度在远处极密,直接比会把远处的同一表面判成两层)。
1.5 三组边缘停权:为什么必须同时存在
这张图是本篇第一个"自家账本"——三组权重随差异的衰减曲线画在一起,横轴是差异量,纵轴是权重。曲线形状是一样的(都是高斯型),但横轴的量纲完全不同:深度差是距离量纲,法线差是夹角(弧度或余弦),亮度差是颜色量纲。
好了,三者为什么缺一不可——它们各自都在补别人的漏:
- 只有深度:斜面上深度梯度大,同一块地板被切成两半;法线折角处深度却是连续的,于是折角两侧互相渗色。
- 只有法线:法线对薄几何失效——一片薄墙的正反面法线几乎相反,但夹角判据在掠射时因为法线接近垂直视线而变得迟钝;同时法线对"同一平面上的两块材质"毫无分辨力。
- 只有亮度:低对比度的真实纹理(例如同一材质上的缓慢明暗过渡)会被当成噪声抹掉;反过来,噪声本身造成的亮度差又会被误判成"这里是边缘"。
这就是联合双边滤波的核心理念:判据要互补,因为没有任何单一物理量能同时刻画"是不是同一个表面、是不是同一段光照"。深度管空间上的层次,法线管朝向的一致性,亮度管辐射学上的相似性。三组一起用,才把"邻居"这两个字落到实处。
到这里第一章的闭环还剩最后一环——这一套东西在工业实现里怎么落地。SVGF 的参考实现公开在 NVIDIA Research 的论文页上,逐行代码级的讲解见 Jacques Pillet 的 SVGF 实作笔记,配套的矩与方差写法见 Adventures in Hybrid Rendering;UCSB 的 GAMES202 第 14 讲则把工业解法这一节讲成了可以直接照做的作业。这一章的公式在以上三处都能对上,感兴趣的朋友可以交叉核验。
二、à-trous:用"打洞"换半径
2.1 从"一个大核"到"多级小核"
第二章要解决的问题是:第一章定了权重的写法,但还有一个更实际的约束没解决:半径要多大。
降噪需要的往往不是 3×3 的邻域,而是几十个像素的跨度——因为残差是低频的块状噪声,半径不够大就压不下去。可如果真去做一个 33×33 的核,采样数就是 1089 次,每像素一千多次纹理读取,实时渲染的预算根本承受不起。
à-trous 小波滤波换了个思路:不在一次里做大核,而是分成多级做小核。每一级只用固定数量的采样点,但把采样点之间的间隔(步长)翻倍——第一级步长 1(就是普通 3×3/5×5),第二级步长 2,第三级步长 4,第四级步长 8,第五级步长 16。这样一来,5 级之后有效覆盖半径达到了几十个像素级别,而每级的采样数始终不变。
要理解它为什么合理,得先看它借用的工具——小波变换(wavelet transform)。下面这张图是二维离散小波分解(2D DWT)的结果:一次分解会把图像拆成四个子带——左上角的低频近似(approximation)与三个方向的细节(水平、垂直、对角)。
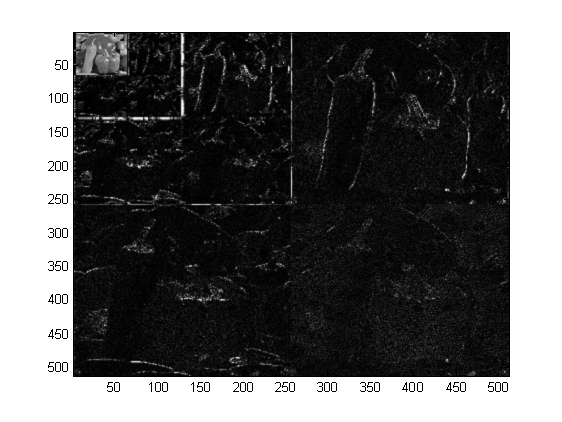
这张图解释了小波族的共同特点:它不是一次把图像换到频域,而是分层地换——每一层只在上一层留下的低频部分继续分解。这个"逐层递进"的结构正是 à-trous 的骨架:à-trous 的每一级也是在一个尺度上做一次加权平均,下一级在更大的尺度上继续。
2.2 名字的来历:为什么要"打洞",以及为什么是 B 样条
à-trous 是法语,直译是"带洞的"(with holes)。这个名字描述的就是它的做法:把上一级的核"插进空洞"再膨胀——原来相邻的两个采样点,现在中间塞进一个空洞,核的实际跨度变成原来的两倍,但采样点数量不变。
那这个核本身长什么样?经典 à-trous 小波变换用的尺度函数来自 B 样条(B-spline)族——它天然紧支撑、可分离、且不带负旁瓣,用它做加权平均不会引入振铃(ringing)。这张图是二阶 B 样条小波基函数的形状:
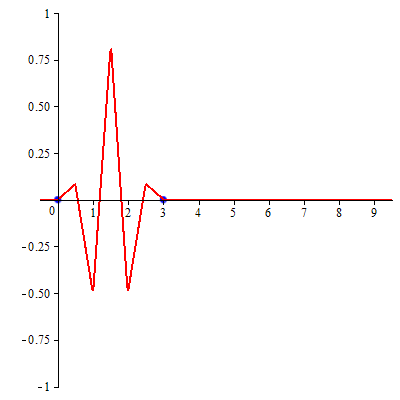
紧支撑这件事在工程上很值钱:核的支撑范围决定了"一个像素会读到多远的邻居"。支撑越紧,越容易放进缓存、越容易做波前式的并行;而 B 样条族在给定支撑宽度下能有最好的频率选择性——说白了就是在"该保留的细节"和"该压掉的噪声"之间划界划得最干净。
SVGF 的空间滤波阶段用的就是这个族里的核:5×5 大小、权重取自三次 B 样条(B3-spline)的一维权重序列,再按可分离性拆成横竖两趟。逐级的实现与核的写法在 SVGF 实作笔记里有完整对照。
2.3 五级结构:有效半径怎么算出来
先来看看每一级的采样点摆出来是什么样。这张图就是本篇第二个自家账本——五级 à-trous 的采样点分布,横轴是像素坐标,每一行是一级,步长分别是 1、2、4、8、16:
算一下覆盖半径:如果每级用的是 5×5(即每边 2 个采样点、间距为步长),那么第 i 级的覆盖半径是 2 · 2^{i-1} 像素。五级下来,最大一级的半径是 2 · 16 = 32 像素,单边直径 64 像素——而累计采样数只有 5 × 25 = 125 次,对比朴素大核的 1089 次,采样数降到约 1/9,覆盖范围反而更大。
这里有个值得单独说清的工程判断:为什么是 5 级,不是 3 级或 8 级?
- 级数太少(例如 2–3 级):最大半径只有 4–8 像素,低频块状噪声压不下去,画面会留下"脏底";
- 级数太多(例如 8 级):最大半径到 256 像素,这时跨区域采样不可避免——即使边缘停权在工作,几十像素外的邻居也很可能属于完全不同的光照条件,滤出来的颜色会脱离本地实际,表现为大范围的"糊"与光照渗漏;
- 而且每一级都是一次全屏 pass,多一级就多一次全屏读写,成本是线性增长的。
5 级是一个被工业界反复验证过的折中:半径够压住 1–2 spp 的块状噪声,又不会跨到大到失真的范围。这也是 SVGF 原论文的默认设定,后续实现基本沿用。
2.3.1 实现顺序:可分离性与两趟滤波
还有一个实现层的判断必须写下来,因为它直接决定了这笔账怎么算:B 样条核是可分离的(separable)。
一维的 B3 样条权重序列是 [1/16, 1/4, 3/8, 1/4, 1/16],二维核是这两个序列的外积。这意味着一个二维 5×5 滤波可以拆成"先水平一趟、再垂直一趟"两次一维滤波:每像素的采样数从 25 次降到 5 + 5 = 10 次。这不是优化技巧,而是这些核被选中的理由之一——不可分离的核(例如按梯度方向旋转的自适应核)就得老老实实付 O(r²) 的采样代价。
落到 à-trous 的每一级上,结构是这样的:
//--------------------------------【à-trous 单级滤波(可分离 · 横竖两趟)】--------------------------------
// 描述:第 level 级的空洞卷积,步长 step = 1 << level;辅助缓冲只读一次
//------------------------------------------------------------------------------------------
[numthreads(8, 8, 1)]
void AtrousLevel(uint3 id : SV_DispatchThreadID) {
    //【1】取本级需要的四类输入:颜色、深度、法线、时域方差
    //【2】横竖各采 5 个 tap,tap 间距 = step;权重 = B3 样条权重 × 三组边缘停权
    //【3】在同一趟内完成权重求和与归一化后写回;level+1 时 step 翻倍
}
下面对这段结构特别说明三点:
- 步长是本级唯一的变量。五级之间除了
step之外没有任何差别,所以实现上通常就是一个循环五次 dispatch,把step当参数传进去。这也解释了为什么"减级数"的收益是线性的——减的是 dispatch 次数,不是每级内部的计算量。 - 归一化必须在同一趟内完成。横竖两趟各做一次归一化,不能"横向只累不加权、纵向统一归一化",因为纵向无法知道横向跳过了哪些邻居。
- 辅助缓冲只读一次。这是 2.4 节那笔访存账的落点:每一级都要读颜色、深度、法线、方差,读的次数乘以级数就是总的读取量;把本级要用的 tap 邻域先搬到寄存器或共享内存,再在片内做加权,避免同一纹素被反复取——JCGT 2026 的优化正是沿这个方向做的。
2.4 那它为什么慢:JCGT 2026 给的量化答案
OK,那么一个自然的问题是:既然采样数已经降到 1/9,为什么 à-trous 还是被公认是降噪里最贵的一段?
JCGT(Journal of Computer Graphics Techniques)第 15 卷第 1 期在 2026 年 1 月专文优化了 SVGF 的 à-trous 阶段,给出的答案很明确:瓶颈不在算术量,而在访存模式。每个全屏 pass 都要读一遍颜色、深度、法线、方差,写一遍结果;5 级就是 5 遍"读一大把纹素、写一张全屏图"。滤波本身的计算(几次乘加)远不是问题,重复读取与缓存命中率才是。
该文针对现代 GPU 的内存访问特征重构了这一阶段,在滤波质量不变的前提下拿到 1.3–2.5× 的加速(原文口径,见 JCGT vol.15 no.1)。这篇文章的价值不只在这个倍数,更在于它把"à-trous 为什么慢"从经验判断变成了可复核的访存账——这也是本篇第一处需要给出数字的结论。
这笔账摊开是这样:每一级 pass 的读/写流量,以及优化前后在访存上的差别。
口径提醒:1.3–2.5× 是一个区间,不是一个定值——原文的加速比取决于场景与 GPU 架构(不同架构的缓存层次与带宽不同)。凡是看到"à-trous 加速 2.5 倍"这类被抹平口径的转述,都值得回去对一下原文的测试条件。
对做项目的朋友,这一节的实操含义是:调 à-trous 的级数是在拿画质换访存,而减级数的收益可能比想象中大——因为成本是每级的固定全屏开销,不是按有效半径平方涨的。反过来,如果降噪占了整个光追预算的一半以上,先查访存而不是先删 pass。
三、方差驱动:SVGF 真正的新意
3.1 从"攒样本"到"估方差"
前两章讲的是"怎么滤"。但还有一个更根本的问题没人回答:滤多狠?
OK,如果对整张图用同一套参数,结果一定是两头不讨好:平坦区域滤得不够(噪声残留),几何边缘滤得过狠(细节丢失)。要逐像素决定强度,就得知道"这个像素现在有多脏"——也就是噪声的方差。
SVGF 在时域累积时多存了一样东西:颜色的一阶矩与二阶矩。这件事在 ep06 里提过一句,这里把它展开,因为它是整条链的驱动信号。
矩(moment)的记法与更新:
m1_t = α · c_t + (1 - α) · m1_{t-1}          // 一阶矩:颜色的加权平均
m2_t = α · c_t² + (1 - α) · m2_{t-1}         // 二阶矩:颜色平方的加权平均
其中:
c_t是当前帧该像素的原始颜色(1 spp 的噪声值);m1_t是累积后的颜色,也就是最终要输出的值;m2_t是颜色的平方的累积值;α是时域混合系数(ep06 已详述,SVGF 默认取向是让历史占主导,常见取值在 0.05 量级)。
有了两个矩,方差就是一步减法:
σ²_t = m2_t - m1_t²
这个式子的物理含义很直白:如果颜色一直在稳定值附近小幅波动,m2 与 m1² 会非常接近,方差趋近于零——说明这个像素已经收敛、很干净;如果颜色方差很大(刚出现的新表面、快速运动的高光),m2 会明显大于 m1²,方差就大。
这里有一个必须点明的坑:用差值法算方差在浮点下是不稳定的。当 m2 与 m1² 都是大数而方差本身很小时,两者的差会被浮点精度吃掉,甚至算出负方差。工程上的标准做法有两条:一是按通道分开算,二是给方差设一个下限(clamp 到 0 或一个极小正值)。这一点在 Adventures in Hybrid Rendering里给了可核对的写法。
3.2 采样分布:方差从哪来
方差这个量,最终还是要回到采样本身。同一条光线打出去,落在哪、打中什么,全由采样决定。下面两张图是同一件事的两种样本分布:
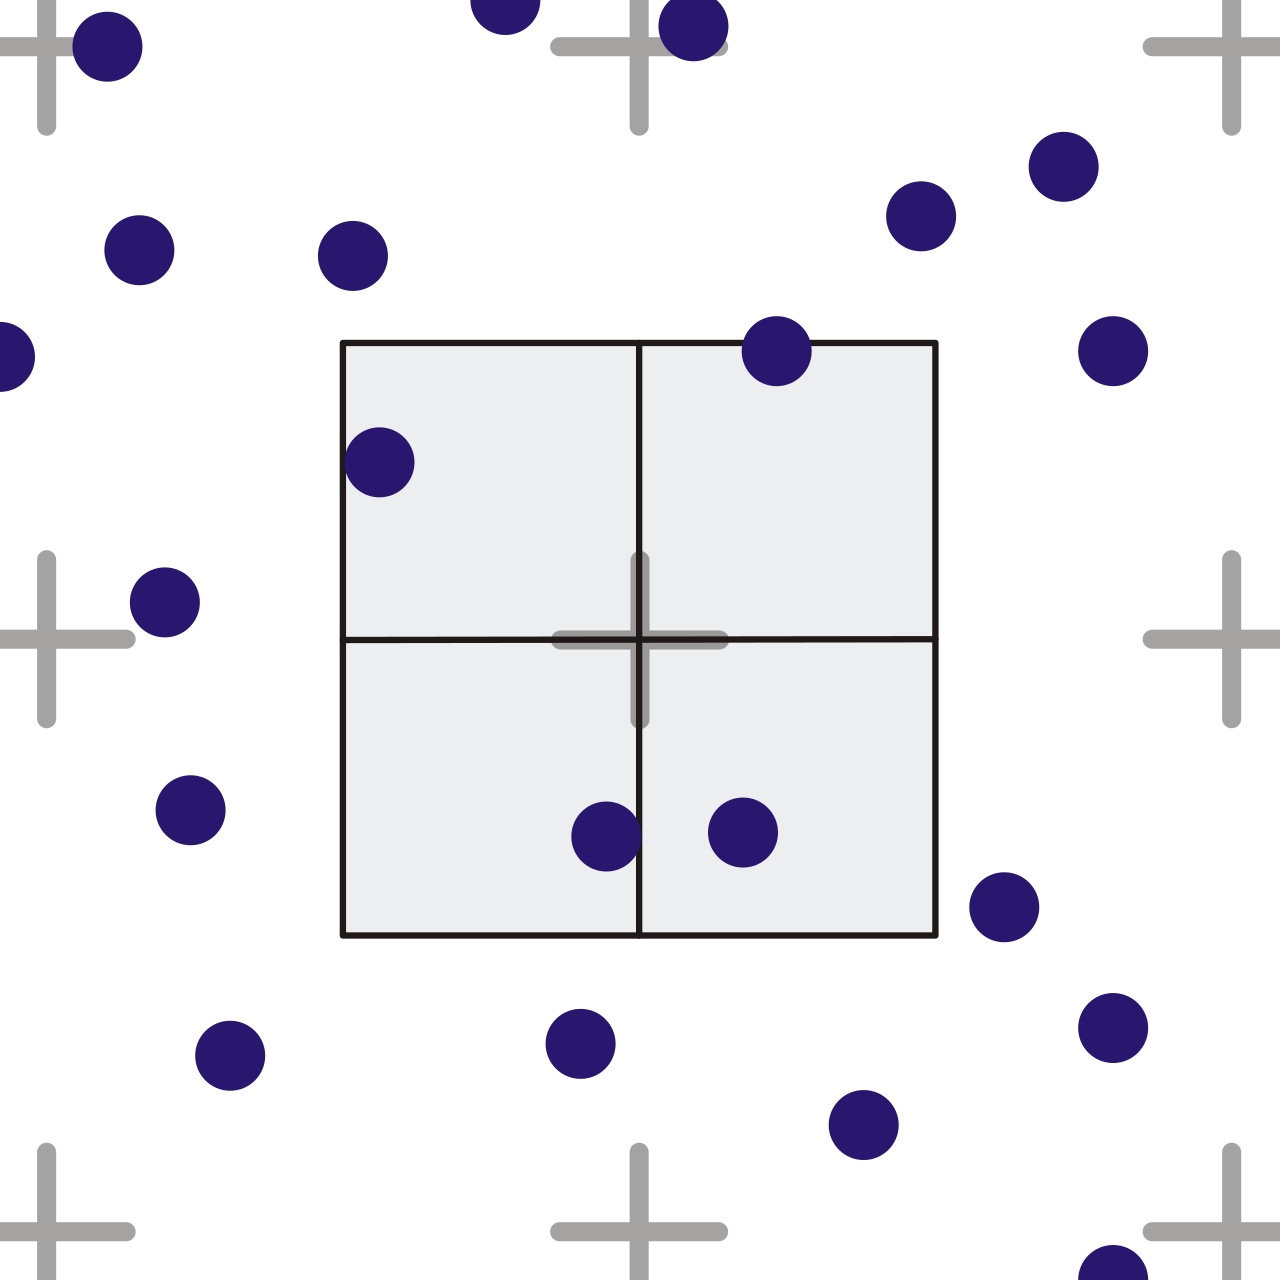
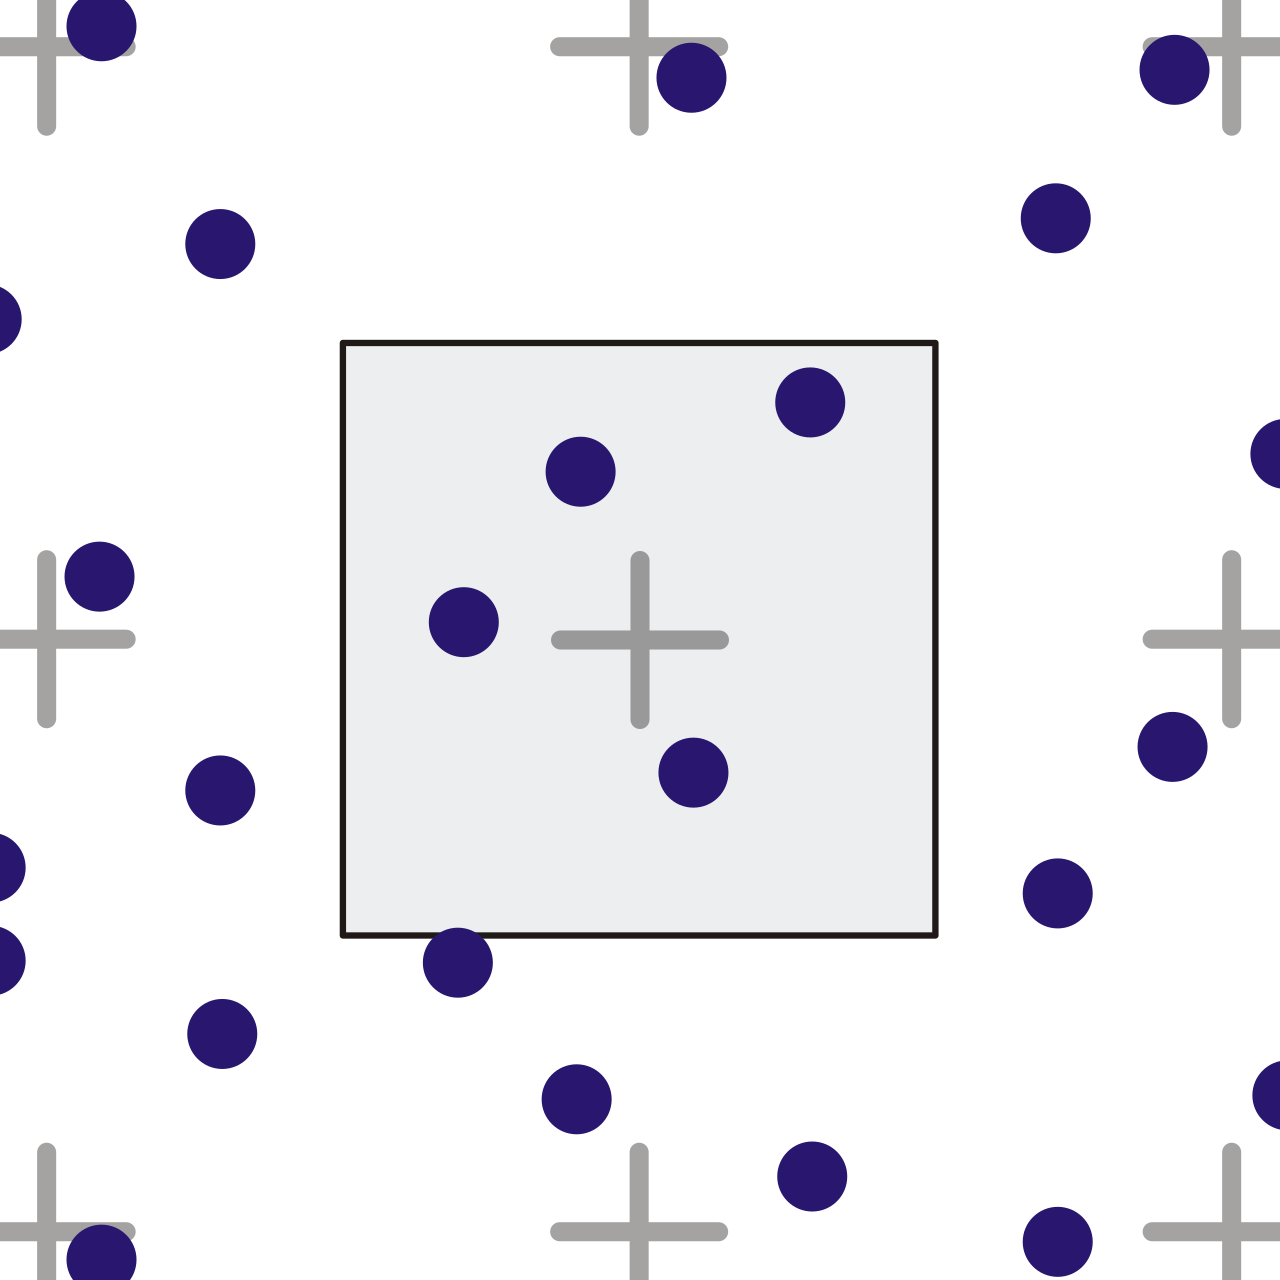
两张图的差别就是成簇(clumping)与空洞(gap):均匀随机的抖动采样会在某些区域挤成一团、另一些区域留白,这直接抬高了积分估计的方差;低差异序列(准蒙特卡洛,Quasi-Monte Carlo)让样本分布得更均匀,同样的样本数下方差更低。
这就解释了为什么工业光追管线几乎都用低差异序列(Halton、Sobol、蓝噪声)加子像素抖动:它不减小单样本的方差,但它让有限样本的分布更接近理想,把估计的方差压下来。ep06 里讲过的 Halton 序列抖动,正是为时域累积服务的同一件事——时域上每帧换一个抖动位置,帧间的样本合起来就覆盖了更多子像素位置。
还有一个实用推论:方差的估计质量直接决定了降噪的上限。如果采样分布本身很差(成簇严重),那么 σ² 这个信号就会失真,降噪器会把"采样太差"误判成"这里该狠滤",于是把细节一起抹掉。这也是第九章要算的账里的一项——采样与降噪不是两件事,是先后的同一笔预算。
3.3 一条链:方差同时驱动 α 与滤波强度
下面我们把它接回整条链。这是本篇最核心的一张结构图:
三个环节:
- 进:当前帧的 1 spp 颜色与上一帧的历史矩,来时域累积;
- 算:由两个矩得到时域方差
σ²,加上深度/法线的几何信息; - 出:方差去两个地方——一处决定
α(越脏越该信当帧,α越大、历史权重越低),一处决定空间滤波的强度(越脏越该多滤几级、权重放得越宽)。
这就是 SVGF 与它之前所有做法的分界。在此之前,"滤多狠"是人为设定的常数;在此之后,它是一个逐像素、逐帧变化的观测量。说白了,SVGF 真正的新意不是那 5 级 à-trous,而是让方差变成了整个算法的驱动信号。
代价也很清楚:多两个全屏缓冲(一阶矩、二阶矩),多一遍方差计算,多一倍的显存写入。对内存敏感的管线,这笔开销是要认真算的——到第七章讲 NRD 时我们会看到,生产级实现在这一点上做了非常不同的取舍。
这一章的公式与流程同样可以交叉核验:SVGF 原论文给了方差驱动的原始设定,GAMES202 第 14 讲给了作业级的实现骨架,SVGF 实作笔记给了可逐行对照的代码。三处的口径在"方差怎么算、算出来驱动谁"这一点上是一致的。
3.4 方差钳制:把离群值关在门外
第五章会说"方差估计会失效",但失效的机制在这里就该讲清,否则第五章的结论会显得突然。
OK,问题出在反馈环上:方差由历史矩算出来,而历史的长度又由方差决定——α 越小,历史越长,而 α 又受方差影响。这是一个闭环,闭环的系统最怕两件事:正反馈与离群值。
- 正反馈:如果某一帧因为一次离群采样(例如一条光线恰好打中高亮光源)把方差抬得很高,
α就会被迫抬高(弃用历史),历史变短 → 下一帧的方差估计样本更少 → 估计更不稳 → 方差继续偏高。于是画面在该区域反复"变脏—重滤—再变脏"。 - 离群值:
m2是平方的累积,对离群值极其敏感——一个比均值大 100 倍的样本对m2的贡献是100² = 10000倍。一阶矩m1会被它轻微拉动,但m2会被它彻底带偏。
工程上的标准对策是方差钳制(variance clamping):给 σ² 设一个上限,把估计值截断在合理范围内。
σ²_clamped = clamp( σ²_t , 0 , σ²_max )
σ²_max 的取值思路有两条,都在实践里用:
- 按当帧的统计量定:用当帧目标邻域的方差(或全局分位数)作参考上限,让钳制尺度随画面自适应;
- 按经验绝对量定:对归一化后的线性颜色,给一个固定上限,超出的部分一律按上限处理。
这里要区分两个容易混淆的"钳制":方差钳制管的是"滤波强度别失控",钳制对象是 σ²;而 NRD 里暴露给使用者的"噪声钳制"(noise clamp)管的是另一件事——把降噪结果往原始噪声图按比例拉回,避免降噪器产出"比真实信号还干净"的结果(第七章 7.4 提到的 blendFactor 就是这条)。两者的作用点完全不同,一个在估计环节,一个在输出环节。
顺手把这一章的一条实操推论写下来:如果你想验证自己的方差估计稳不稳,就去看"方差缓冲的可视化图"。健康的方差图应该只有几何边缘与运动区域亮,平坦静止区域应该是大片黑色;如果整屏都是灰的,说明钳制没做对,或者矩的更新用了错误的像素权重。
四、三根 σ 的实操:调错了会看到什么
4.1 先分清两种"边缘"
先来看看一个容易被跳过的事实:调 σ 之前必须先接受它——梯度图上的"边缘"有两种,而且降噪器必须区别对待。一种是几何与材质造成的真实边缘——物体轮廓、法线折角、纹理分界;另一种是噪声造成的假边缘——1 spp 的随机波动在梯度算子下同样会亮起来。
这张图是同一张图做过边缘/梯度检测的结果,大家可以直观看到边缘图的样貌:轮廓清晰,但纹理区域也出现了大量细碎响应——在实拍图里那是真纹理;在 1 spp 的光追输出里,那些细碎响应就有相当一部分是噪声。
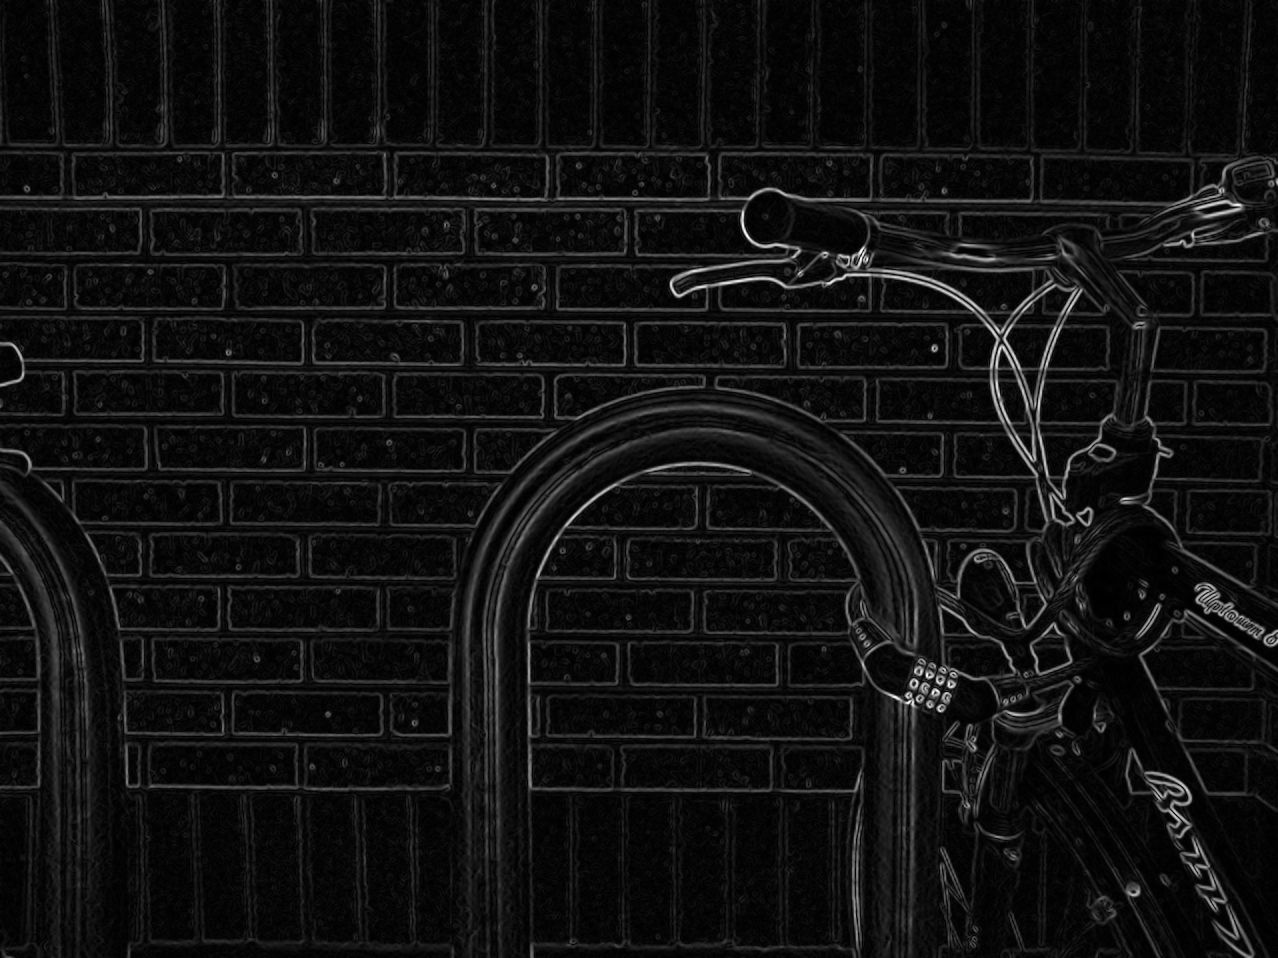
这件事和 σ 的关系在于:σl(亮度停权)本质上是在回答"多大的亮度差才算边缘"。设小了,噪声引起的假边缘也被当成真边缘保护起来,噪声就滤不掉;设大了,低对比度的真实纹理被当成噪声抹掉,画面像被磨皮过度。
4.2 σ 的数学形状:为什么它是"尺度"而不是"阈值"
三组权重都是高斯型,形式统一:
w_z(p, q) = exp( -|z(p) - z(q)|² / (2σz²) )
w_n(p, q) = max( 0, dot(n(p), n(q)) )^σn
w_l(p, q) = exp( -|l(p) - l(q)|² / (2σl²) )
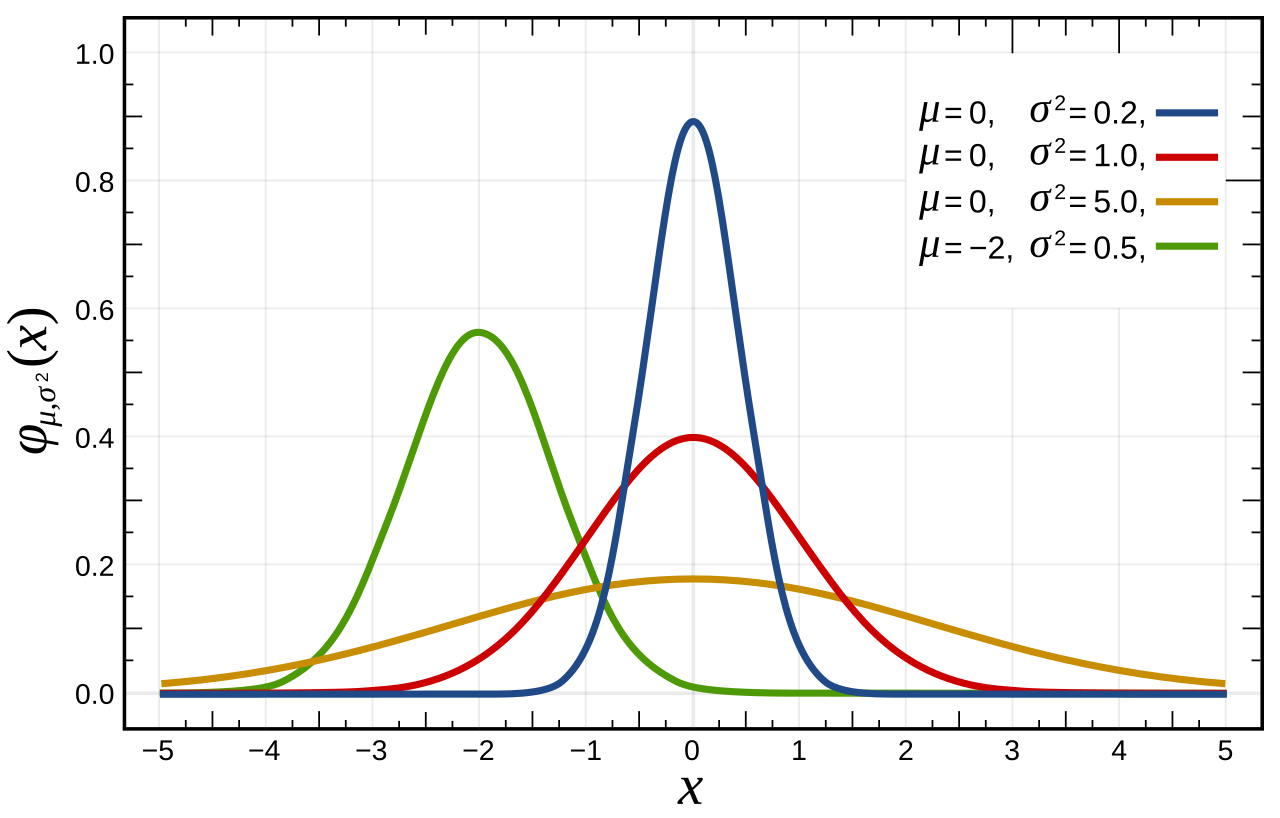
图上的 σ 变化说明了一个常被误解的点:σ 不是硬阈值,它是衰减尺度。权重不会在某个差值上突然从 1 跳到 0,而是随着差值增大逐渐衰减。这意味着:
- σ 稍小一点,远处的邻居权重变得很小但非零,仍会影响结果——"边缘两侧互相渗色"永远不会完全消失,只能被压到看不见;
- σ 稍大一点,权重曲线变平,滤波更像加权平均,细节会缓慢丢失而不是突然糊掉;
- 因此调 σ 看到的现象是"渐变"的,不是"开关"式的。这也是为什么调参必须靠"看到症状"来反推方向,而不是靠猜。
法线那一项形式不同——用 dot(n(p), n(q)) 的幂次。用点积而不是夹角差,是因为点积天然给出 [-1, 1],且 max(0, ·) 把背对背的邻居(点积为负)直接归零,正好对应"法线相反就不可能是同一表面"。幂次 σn 越大,衰减越陡:小的幂次(如 8)很宽松,大的幂次(如 128)非常严格。
4.3 调错了会看到什么:九种症状对照
下面这张图把三根 σ 的三种错法各画一行,每一格是对应的可见症状。这张表和图,是这一章最需要带走的实操内容:
| 旋钮 | 过小 | 过大 | 失配(取值与内容不匹配) |
|---|---|---|---|
| σz(深度) | 斜面上的同一表面被切成两半;掠射角看地面时出现明显的同心分层 | 前景与背景互相渗色,物体边缘"漏"出背景颜色(典型是头发丝、栏杆的镂空处糊在一起) | 场景尺度变化后没重调:近景合适的 σz 在几公里的大场景里等于"完全不判深度" |
| σn(法线) | 曲面细分密集处出现斑块状残留(相邻三角形的法线差被误判为不同表面) | 法线折角处拖出污迹,硬边物体像被水彩晕开 | 只对法线做了插值而没归一化,权重整体偏移 |
| σl(亮度) | 低对比度纹理(织物、木纹、缓慢明暗过渡)被抹平成塑料感 | 噪声被当成信号保留,画面留下一层细沙 | 在 HDR 线性空间与色调映射后的空间之间混用,σl 的实际含义差几个数量级 |
三种错法里,实战中最容易踩的是 σl 的失配:很多管线在色调映射之后的 LDR 图上看噪声做滤波,又在 HDR 线性空间里取 σl 的经验值,结果同一个数字在两种空间里的等效强度差出几个数量级——表现为"参数怎么调都不对",因为基准本身就错了。
判据给三条,方便自查:
- 看症状的位置:只有斜面上出问题 → σz;只在折角与硬边出问题 → σn;只在特定材质上出问题 → σl。
- 看症状的方向:细节被吃掉 → σ 偏大;噪声残留 → σ 偏小;斑块与条带 → 多半是空间尺度失配(σz 或 σn)。
- 做单旋钮实验:把另外两组 σ 调到极宽松(几乎不参与判断),只扫一根,看画面怎么变。一次只动一根,是调这三根旋钮唯一有效的办法。
这三根 σ 是工程上最常被调的旋钮,也是所有降噪教程都会提到、却很少讲清"调错什么样"的地方。社区里对这一点有第一手的抱怨——UE 用户最常讨论的两个问题就是"切了 ReBLUR/ReLAX 之后画面观感变化"和"噪声钳制该给多少",说明同一个降噪器在不同内容上需要的调参量并不小(见 NVIDIA 开发者论坛的实操帖)。
4.4 参数清单与取值带
按本系列的规矩,这一节给出可核对的参数清单,而不是停在"要调 σ"。下表是工业实现上常见的一组量级参考,不是标准答案——它的用途是让大家知道"大概从哪开始扫",以及"扫到哪个方向算离谱"。
| 参数 | 含义 | 常见取值带 | 取到带外会怎样 |
|---|---|---|---|
σz |
深度停权的尺度(相对深度口径) | 几十到几百(随场景尺度,按"相机到目标的距离"量级取) | 只有一个绝对值、不随场景尺度换算,等于没判深度 |
σn |
法线停权的幂次(dot(n_p, n_q)^σn) |
8–128 | 小于 8 几乎不拦法线差异;大于 128 会把曲面细分后的相邻三角形判成两个表面 |
σl |
亮度停权的尺度(线性 HDR 颜色) | 0.05–0.5(按归一化后的线性值) | 在色调映射后的 LDR 值上套这组数字,实际强度差几个数量级 |
α 下限 |
历史占比上限(越小平滑越强) | 0.02–0.1 | 过小会拖出长尾鬼影;过大则时域累积几乎不起作用 |
α 上限 |
剧变处的上限(AQ 自适应时) | 1.0(相当于弃用历史) | 设成 0.5 之类的中间值,会得到"既弃不干净、又留一点错历史"的最差组合 |
| 迭代层数 | à-trous 级数(或自适应上限) | 3–5(上限 5) | 见 2.3 节的半径推算 |
| 累积帧数 | 历史长度上限 | 8–32(ReBLUR 口径为 32) | 无上限会让鬼影变成"永久性错误" |
| 噪声钳制 | 输出向原始噪声图拉回的比例 | 按内容调,先从中等强度起扫 | 过强会把降噪结果拉回噪声态,等于白做 |
三条使用注意:
- 先定口径,再填数字。
σz依赖场景尺度、σl依赖颜色空间(线性还是色调映射后)、σn依赖法线的归一化方式。同一组数字换个口径就不是一个东西——这是横向对比时最容易出错的地方(本章开头提到的社区抱怨,一半来自这里)。 - 按内容而不是按显卡取值。同一台机器上,室内场景与几公里视野的开阔场景,
σz的量级能差出两个数量级。 - 一次只动一根。三根 σ 之间会互相掩盖症状(例如 σl 过小会掩盖 σz 过大造成的渗色),同时调等于把三个变量搅在一起,症状无法归因。
五、SVGF 的三个软肋
5.1 软肋一:鬼影残留
OK,ep06 已经把鬼影的机理讲透了——运动矢量不准导致历史颜色被错误复用。这里要看的是它在真实项目里的具体样子,因为这是判断"SVGF 够不够用"的关键证据。
Q2VKPT(Quake 2 的路径追踪版)在 GDC/GTC 2019 的材料里给了一个非常具体的观察:SVGF 的时域模糊会让光源已经关掉的画面里仍然残留光照,光滑的高光会拖出彩带(smearing)——材料里用第 412 帧的品红框标出了这个现象。他们的应对办法是估计并重建稀疏时域梯度,用它逐像素自适应 α——例如被闪烁蓝光照亮的区域在 406 帧附近 α 很大,等于主动放弃历史(见 Q2VKPT 的 GDC/GTC 2019 材料)。
这条证据的价值在于它不是实验室合成图,而是一个真实游戏里跑出来的、能指名到帧的失败案例。它同时也预告了第六章的内容:修鬼影的方向就是把 α 从常数变成逐像素量。
5.2 软肋二:过模糊
第二个软肋是本章最容易被忽视的:固定 5 级 à-trous 总是跑满。
第二章算过,5 级的最大半径是 32 像素。对平坦区域这是必要的;但对一块已经收敛、几乎没噪声的锐利区域(例如静止的镜面、干净的墙面),跑满 5 级就是在拿细节做无用功——边缘停权能保护硬边,却保护不了边缘附近的渐变与细节纹理,于是光滑表面会显得"发蜡"。
这个问题的本质是滤波强度与噪声水平没有耦合:SVGF 已经有方差这个观测量(第三章),但标准设定里 à-trous 的迭代层数是固定的——方差只用来调 α 与权重宽度,没有用来决定"跑几级"。这个缺口正是 A-SVGF 要补的。
5.3 软肋三:方差估计在高动态场景失效
好了,第三个软肋最隐蔽:方差估计本身会错。
第三章的公式 σ² = m2 - m1² 假设"历史与当帧来自同一个分布"。一旦这个假设破了,方差估计就失去了意义:
- 1 spp 的方差有离群值:单帧一条光线的结果可能恰好打到光源上、亮出几个数量级,
m2被一个离群值拉高,于是方差被高估,降噪器误以为"这里很脏"而重滤——明明只是采样运气差; - 当帧与历史不一致:镜头快速转动或光照突变时,
m1与m2混合的是两个不同分布的颜色,算出来的方差既不是旧的也不是新的,α与滤波强度就被同时带偏; - 高动态范围放大误差:亮度跨度大时,
m1²与m2都是大数,浮点精度损失更严重(3.1 节提过)。
三条合起来是这样:
到这一章为止,SVGF 的全貌就清楚了:它的框架是对的(方差驱动),但它的参数是固定的。下一个问题自然就是——能不能让参数跟着画面走?
5.4 这一章留下的问题
好了,三句话收一下这一章:
- 鬼影残留说明"历史信任度"不该是常数;
- 过模糊说明"滤波层数"不该是常数;
- 方差失效说明"方差本身"也该被估计得更稳。
三个"不该是常数",指向同一个方向:逐像素自适应。这就是下一章。
六、A-SVGF:把固定参数换成逐像素自适应
6.1 梯度估计器:先判断"变化有多大"
先来看看它怎么改——A-SVGF(Adaptive SVGF)针对第五章的三条软肋逐个改,而它的地基是一篇单独的论文——Schied 等人 2018 年的《Gradient Estimation for Real-Time Adaptive Temporal Filtering》,核心是估计时域梯度幅值:比较当帧亮度与历史亮度,判断画面在这里"变化得有多剧烈"。
逻辑很朴素:如果当帧与历史的亮度差很大,说明这里正在发生变化,历史已经不可信;差值小就说明画面稳定,历史可以多信一点。这个"亮度差"就是时域梯度的幅值,它比方差更容易算稳——因为它比的是一对值,而不是两个矩的差。
这张图把梯度估计器的判定链画出来。要注意它并不直接给出"要不要弃用历史"——它先给一个可比较的幅值,再由幅值去驱动后面两个决定(改 α、或钳制当帧输入)。
6.2 逐像素 α:剧变处直接弃用历史
有了梯度幅值,α 就不再是固定的 0.05,而是逐像素计算:
- 画面稳定处(梯度小):
α取小值,历史权重高,噪声被充分累积; - 画面剧变处(梯度大):
α直接推向 1——等于当场丢弃历史,只用当帧结果。
这一步解决的是鬼影:Q2VKPT 里那种"光源关了还亮着"的残留,本质上就是该弃用历史的地方没有弃用。把 α 推到 1 的瞬间,画面会短暂变脏(只剩 1 spp 噪声),但换来的是不会留下错误的历史。这是一个明确的取舍——用一瞬间的噪声换掉持续的鬼影。
6.3 自适应迭代数:平均 pass 数从 5 降到 2–3
好了,第二处改动直接用上了方差:由时空估计的方差决定 à-trous 跑几级(1–5)。低噪声的像素跳过深层,脏的像素才跑满。
这一步解决的是过模糊:已经干净的锐利区域不再被反复平滑。
两项改动叠加的实测效果是:平均 pass 数从 5 降到 2–3,镜面更锐、快移相机下更稳,而 GPU 成本相当(见 降噪方案综述中对 A-SVGF 与原版 SVGF 的对照;梯度估计的原始出处见 Schied 的论文主页)。
这里要提醒口径:"平均 pass 数 2–3"是一个统计量,不是每一帧的确定值。它意味着在全屏范围内平均跑了 2–3 级;局部看,静止的平坦区域可能跑满 5 级(因为方差大),而锐利的静止镜面只跑 1 级。做性能预估时按平均值算没问题,但如果要算最坏帧时间,得按 5 级算。
两项改动放在一起对照:
6.4 这一章留下的问题
OK,到这里 A-SVGF 已经把 SVGF 的三个常数换成了三个观测量,方向是对的。但它仍然是"手调降噪器"这一族:参数虽然自适应用了,可设计本身还是人定的——5×5 的核、5 级的上限、三组 σ 的形式、α 的上限。这些都是人在看画面、改代码、再测试的循环里定下来的。
那么问题来了:如果把这个循环交给一个能自己从数据里学的东西,会怎么样?以及——已经有一批跑了七八年的生产级手调实现(第七章要讲的 NRD),它们的账该怎么算?
这是第八、九章的事。
七、ReBLUR / ReLAX:生产级的两条路线
7.1 NRD:一个把降噪当工程题来做的集合
到这一步,我们讲的都是"论文里的降噪器"。但项目里真正跑起来的是实现——NVIDIA Real-Time Denoisers(NRD,NVIDIA 实时降噪器)是目前公开资料里最完整的一套生产级集合,包含两个主力:ReBLUR 与 ReLAX。选它作样本,是因为它的文档把设计判断写出来了,而不只是给结果。
先把两条路线的定位摊开:
| 维度 | ReBLUR | ReLAX |
|---|---|---|
| 核心表达 | 自稳定递归模糊(self-stabilizing recurrent blur) | 球谐(Spherical Harmonics, SH)域表达 |
| 处理对象 | 漫反射与镜面分别处理 | 漫反射与镜面拆成两套独立信号 |
| 累积策略 | 恒定半径 + 一趟额外 pass 修离群值;最多累积 32 帧 | 按信号分组,独立累积 |
| 权重 | 线性权重 | 与 SH 系数配套的重建 |
| 内存特征 | 相对紧凑 | 工作集大(见 7.3) |
7.2 ReBLUR 的四个设计判断
ReBLUR 值得单列,是因为它有四个不太一样的判断,每一个都能反过来解释我们前六章讲的机制:
判断一:恒定半径 + 一趟额外 pass 修离群值。 标准 à-trous 是"多级由小到大",ReBLUR 用恒定半径的递归模糊,再用一趟单独的 pass 处理离群值。这样做的好处是每一帧的滤波代价可预测——没有"这一帧跑了 5 级、下一帧跑了 2 级"的波动,对实时管线的预算管理更友好。
判断二:自适应半径随累积帧数变化。 累积帧数少时噪声大,半径放大;累积帧数多时画面已经稳定,半径收小。这实际上是把第六章"自适应迭代数"的思想换到了半径这个维度上,但实现代价更低——不用改 pass 数。
判断三:"时域稳定"不等于"时域累积"。 这是全篇最值得抄下来的一句话。两者的差别在于:
- 时域累积:把历史帧加权进来,等效采样数增加,噪声下降——代价是引入滞后(lag),因为历史占比高,画面反应慢;
- 时域稳定:不追求"多攒样本",只追求"少闪"——它更像一个设计得更好的 TAA 滤波器,不引入额外滞后,靠更宽的方差钳制把波动压住。
对项目来说这个区分很实际:如果目标是画质(静止画面要干净),选累积;如果目标是响应(快速运动不能拖),选稳定。很多团队抱怨"降噪一开手感就变粘",往往是因为在需要稳定性的场景里做了重累积。
判断四:累积速度是视差、NoV、粗糙度的函数。 这三者共同决定"这个像素的历史值不值得信":视差大(物体移动快)不信历史、NoV 小(掠射角,几何信息不可靠)不信历史、粗糙度高(本来就模糊,历史信息量低)少信历史。这套判据比单一的"亮度差"更全面,代价是要多读几个 G-buffer 通道。
ReBLUR 的设计讲解见 GTC 2020 的《Fast Denoising with Self-Stabilizing Recurrent Blurs》,落地案例分析见 NVIDIA 官方博文(Watch Dogs: Legion)。
7.3 内存账:低端卡开不开得起,由这个数决定
下面我们算本篇的第二笔硬账。社区的讨论里有一个很实在的观察:"能不能上降噪"的真实门槛是内存,不是算力。降噪器要维护工作集(working set)、常驻(persistent)与可混叠(aliasable)三类缓冲,4K 下部分配置的工作集是数百 MB 级——例如 ReLAX 的漫反射+镜面 SH 配置,工作集口径达 303.94 MB(数据源为 NRD 文档的内存表)。
这个数字的实操含义:显存紧张的卡(例如 8 GB 级)在 4K + 光追 + 高材质的情况下,降噪器很可能就是最后一根压垮的稻草。而降噪器又是不能关的——关掉画面上就是满屏噪点。于是现实里的取舍常常是降分辨率、降光追质量,或者换 ReBLUR。
这张账表把三级内存口径与两种路线的差别摆出来:
口径提醒:内存表随版本更新会变,且与分辨率、信号数量、是否开启可混叠强相关。凡是引用"某个降噪器占 XX MB"的说法,务必回去对口径——是工作集还是常驻?是 1080p 还是 4K?开了几个信号?这一条在横向对比时几乎每次都会踩到。
7.4 可调项:为什么"切一下"画面就变了
NRD 在运行时把这些选择暴露给了使用者:NRD 版本、ReBLUR/ReLAX 切换、噪声钳制强度等,在 Remix 的运行时面板里都能直接改(见 Remix 运行时文档 · 降噪页)。OptiX 侧的降噪器参数结构也说明了 blendFactor 的线性插值语义——它控制的是"把降噪结果与原始噪声图按什么比例混合"(见 OptiX 8 降噪器参数结构)。
这解释了一个反复出现的用户抱怨:同一台机器、同一个游戏,切了 ReBLUR/ReLAX 之后"画面观感变了"。这两条路线在处理漫反射与镜面的方式上根本不同,SH 域表达对低频光照更友好,递归模糊对高频细节更保真;再叠加噪声钳制这个"把结果往噪声图拉回多少"的旋钮,同一场景给出不同的观感是必然的,不是 bug。
对做项目的朋友,这一节的结论是:降噪器的参数不是"调一次就完"的配置项,而是随内容变化的运行参数。把 σz/σn/σl 与噪声钳制暴露给美术,让 TA 按场景微调,往往比在引擎代码里写死一套值更有效。
八、TSR 与 DLSS RR:从"调参"到"学习"
8.1 TSR:把降噪思路用在时域超分上
在讲学习型方案之前,先看一个"仍然是手调、但思路换了个对象"的例子——UE5 的时域超分(Temporal Super Resolution, TSR)。它做的是超分(把低分辨率渲到高分辨率),但用的机制和降噪是同一套。Epic 的文档把它的机制拆成几件可点名的事:
- 历史(History)的累积与复用:和 ep06 讲的时域累积同源,区别在于它复用的是渲染分辨率的历史;
- 视差启发法(Parallax Heuristics):用运动矢量重投影,并在解除遮挡(disocclusion)时保住画质——这正是 ep06 第三章的 disocclusion 问题;
- 着色拒绝(Shading Rejection):检测颜色变化与半透明,避免把已经变化的历史颜色带进来,同时还要和 Nanite 的细节量做平衡;
- 闪烁时域分析(Flickering Temporal Analysis):稳定画面,抑制摩尔纹与远景细节的抖动。
这四件事在实现里是有先后次序的,这张图把它们串成一条链——要留意的是最后那个"边界",它是 FAQ 自己承认管不到的部分:
机制名称见 UE5 官方中文文档(5.6),历史拒绝的两种累积策略对比见 5.2 版文档。
TSR 这一节最有价值的,其实是它的 FAQ 承认自己管不到所有闪烁:Lumen 在高强度色物体附近会失稳、Nanite 在几何边未焊接时远景会闪(见 Flickering Temporal Analysis 单篇 FAQ)。
这条"承认做不到"的证据,比任何成功案例都稀缺。它给我们的判据是:降噪/时域类方案的上限不由它自己决定,而由上游数据的质量决定——几何边没焊好、光照解算不稳,降噪器只会把这些错误忠实地传下去。
8.2 DLSS 光线重建:一个网络替掉一整排降噪器
先来看看学习型重建的代表——DLSS 光线重建(Ray Reconstruction, RR)。它的做法和前面所有方案都不同:用一个神经网络替掉手调的降噪器排布,并把降噪与超分融进同一个模型。
官方给出的关键信息有两条:它读取引擎提供的时间与空间数据(对应我们前面说的 G-buffer 与历史帧),重建采样光线之间的像素;训练数据是 DLSS 3 的 5 倍,且模型能识别不同的光追效果,据此决定如何使用时空数据、保留高频信息(见 DLSS 3.5 官方页,解读见 Kunal Ganglani 的拆解)。
"降噪 + 超分融合进同一个模型"这一点值得单独说:在手调方案里,降噪和超分是两段串联的全屏处理,中间有一次全屏写回;放进一个网络后,中间结果可以留在网络内部。这省下的不只是显存带宽,还有一段原本必然存在的量化与写回误差。
8.3 2026 的时间戳:4.5 版本已覆盖全部 RTX
关于"学习型降噪值不值",2026 年发生了一件让这个问题从预测变成事实的事:DLSS 4.5 光线重建在 Gamescom 2026 发布,并覆盖全部 GeForce RTX GPU;相较上一代模型算力 +35%、参数量 +20%,而官方称其性能影响可忽略(RTX 40/50 级)(见 NVIDIA 中文官方公告、覆盖范围的第三方报道、算力与参数增幅的报道)。
为什么这条时间戳对本篇关键:它把"神经降噪"从"未来的可能性"挪到了"现在的既成事实"。讨论它值不值,必须基于"它已经在所有 RTX 卡上跑起来了"这个前提,而不是复述 2023 年的预测。
把这一章的脉络按时间线钉一下(年份口径:论文按发表在 HPG/SIGGRAPH 的年份,产品按公开可用年份):
| 年份 | 事件 | 提出者 | 关键变化 |
|---|---|---|---|
| 2017 | SVGF:时域累积 + 方差估计 + à-trous 空间滤波 | Schied et al. | 降噪第一次成为"方差驱动的完整链" |
| 2018 | 时域梯度估计(A-SVGF 的地基) | Schied et al. | 参数从常数变成逐像素自适应 |
| 2020 | NRD/ReBLUR:自稳定递归模糊 | NVIDIA | 生产级实现,恒定半径 + ≤32 帧累积 |
| 2022 | UE5 TSR:时域超分 | Epic Games | 降噪思路用于超分,正式承认机制边界 |
| 2023 | DLSS 光线重建:单网络融合降噪 + 超分 | NVIDIA | 从"调参"转向"学习" |
| 2026 | DLSS 4.5 光线重建:覆盖全部 RTX | NVIDIA | 算力 +35%、参数 +20%,学习型方案进入普适期 |
九、神经降噪值不值:一笔工程账
9.1 五维对照
"哪个更好"是个伪问题——手调与会学习根本不是同一个维度上的东西:一个比的是"参数怎么定",一个比的是"参数从哪里来"。真正该算的,是它们在五个维度上各自付出的代价,而且这五个维度必须放进同一张表里看,单独拎出任何一个来比都不成立——只比内存会得出"手调更省",只比调参成本又会得出"学习型更省",两个结论都对,合起来才有用。
| 维度 | 手调降噪器(SVGF / A-SVGF / NRD) | 学习型重建(DLSS RR) |
|---|---|---|
| 内存 | 数百 MB 级工作集(ReLAX SH 配置 303.94 MB @4K,NRD 文档口径) | 网络权重 + 推理激活,与分辨率相关;权重部分固定 |
| 延迟 | 常数级全屏开销,随 pass 数线性(5 级 → A-SVGF 平均 2–3 级) | 推理有固定开销,与输出分辨率相关;官方称 4.5 在 RTX 40/50 上性能影响可忽略 |
| 可移植性 | 逐引擎、逐厂商调;同一套 σ 换项目常常要重调 | 一套权重跨引擎、跨项目;但依赖特定 GPU 厂商的加速单元 |
| 调参成本 | 高:三根 σ + 噪声钳制 + 迭代数 + 累积帧数,且随内容变 | 低:少数强度档;代价是无法手工兜底 |
| 失败模式 | 可解释、可局部修(哪个区域坏了就调哪根 σ) | 整模型级失败,且训练分布外的光照/材质更明显 |
9.2 判据,而不是结论
OK,把这张表翻译成可操作的判据:
选手调降噪器,当:项目要跨平台(含不支持推理加速的 GPU)、需要可解释与可局部调试、要对最坏帧时间负责、或者有大量非常规内容(自定义光照模型、特殊材质)需要手工兜底。
选学习型重建,当:目标平台固定且有对应加速单元、要的是最高画质与最低 CPU 侧调参成本、内容落在主流分布内(常规 PBR 材质与光照)、且能接受"失败时只能等模型更新"这一条。
两者可以共存:主流做法是把学习型方案作为高质量档,手调降噪器作为兼容档与兜底档。这不是骑墙——第五章和第八章给出的证据都指向同一件事:降噪器的上限由上游数据质量决定(几何是否干净、光照解算是否稳定、采样分布是否合理)。上游不修,两条路线都救不回来。
9.3 这一章留下的问题
本章给了判据但没给结论,因为结论取决于项目。但有一条可以确定:不管走哪条路,"降噪"这件事的性价比天花板正在下降——前面九章讲的都是"如何把已有的采样结果修得更好看",而真正决定信噪比的是发了多少条光线、发在哪。
修图修得再好,也不如一开始采得更聪明。这是下一篇的题目。
十、边界与交棒
本篇的边界前面已经声明过,这里再收一次:不涉及离线渲染的降噪(路径追踪器内部的样本累积与自适应采样)、视频编解码的降噪、摄影后期降噪、以及图像超分(只涉及 DLSS RR 中与降噪融合的部分)。此外,ep06 已讲透的时域复用原理与失效模式,本篇只做引用,不重复展开。
10.1 本篇三处量化结论的口径汇总
全篇引用的数字不少,但真正称得上"结论级"的只有三处。把它们与口径一起钉在这里,方便大家复核,也方便避免被抹平口径的转述带偏:
| 结论 | 数字 | 口径 | 出处 |
|---|---|---|---|
| à-trous 阶段针对访存优化后的加速 | 1.3–2.5×(区间) | 滤波质量不变;区间因 GPU 架构与场景而异 | JCGT vol.15 no.1(2026) |
| A-SVGF 自适应迭代数带来的平均 pass 数 | 5 → 2–3 | 平均值,非最坏帧;局部可跑满 5 级 | A-SVGF / 梯度估计论文 |
| NRD 中 ReLAX 漫反射+镜面 SH 的工作集 | 303.94 MB | 工作集口径,4K 分辨率,随版本更新 | NRD 文档内存表 |
三条口径提醒,值得单独记一下:
- 区间不是定值。1.3–2.5× 这种区间式表述在降噪领域很常见——不同分辨率、GPU、目标信号(阴影/反射/GI/AO)会给出不同的数。写"横向对比"前必须先声明口径,否则比较没有意义。
- 平均值不是最坏帧。做性能预算要按最坏帧算:如果平均 2–3 级,最坏帧仍可能跑满 5 级,帧时间预算是按后者准备的。
- 内存要看是三级中的哪一级。工作集、常驻、可混叠三者在不同实现里差别很大,引用任何单个数字都要问清是哪一列。
10.2 三句话收束
好了,三句话收束全篇:
- 空间滤波补的是时域补不上的那一块——邻居的误差与你的误差同源,只有互相平均才能抵消;
- 三根 σ 与方差是这套机制的两条命脉——前者决定"谁算邻居",后者决定"滤多狠",而它们都必须在正确的空间(线性 HDR、正确的尺度)里取值;
- 从 SVGF 到神经降噪,变的是参数怎么定,不变的是降噪的上限由上游数据质量决定。
交棒方向:降噪之后剩下的问题回到了几何与材质侧的采样预算——如何用更少的采样光线拿到同样的信噪比,也就是采样与重要性重采样(importance resampling)的题目。那正是【实时光线追踪与混合渲染】(八)《ReSTIR 与光照采样:小样本怎么骗过大方差》要回答的。
本篇作者:溯光 本系列(实时光线追踪与混合渲染,共 12 篇):分界线 → 加速结构工程账(上)→ 加速结构工程账(下)→ SBT → 混合管线编排 → 降噪(上)→ 降噪(下)→ ReSTIR → 光线预算表 → RT 资源生命周期 → 透明与体积 → 反射与阴影混合 → 跨平台差异 前置专题:《实时渲染管线探析》5 篇 · 《移动端图形与功耗》7 篇 · 《GPU 架构剖析》12 篇
相关链接 - 上一篇:【实时光线追踪与混合渲染】(六) 降噪(上):时域复用的原理与失效模式 - 下一篇(预告):【实时光线追踪与混合渲染】(八) ReSTIR 与光照采样:小样本怎么骗过大方差 - 参考资源:SVGF 论文 NVIDIA Research · JCGT vol.15 no.1 à-trous 优化 · NRD GitHub · UE5 TSR 文档
With Best Wishes.