本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
前面七个专题,我们一直在讲"画面怎么被算出来":算法层讲延迟着色与阴影怎么摆,约束层讲移动端能画多少、该省多少,硬件实现层讲 GPU 里的每一个单元在干什么,性能剖析工具链讲怎么把一帧拆开看,神经渲染讲神经网络怎么挤进渲染管线,光追讲混合渲染的取舍,2D 矢量引擎讲 Skia 与 Vello 怎么把路径变成像素。
这七个专题合起来,回答的是一个问题的前半句:一帧画面,是怎么被画出来的。
但画出来不等于看得见。应用在后台把一个缓冲区写满像素,这块像素要经过一串进程与硬件,才可能在某一块具体的屏幕上、在某一个具体的时刻亮起来。这中间会丢帧、会延迟、会在你没预料到的地方卡一下——而这些现象,前面七个专题一个都解释不了。
所以有了这个新专题:Android 图形显示系统。只讲后半句:画好的帧,怎么合得上、上得了屏。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、本机跑出来是什么——这三层在文中分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、时间);
- 实测优先:能用命令量出来的,就不引用别人的结论;本专题的图以本机抓帧与自绘链路图为主;
- 模拟器与真机分开写:模拟器拿不到的东西(真实叠加层决策、自适应刷新率)如实标"需真机",绝不写成 Android 通例;
-
篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,300 到 2,200 字。
-
本篇不涉及:渲染算法与画面技术(《实时渲染管线探析》《实时光线追踪与混合渲染》的题域)、移动端功耗与带宽取舍(《移动端图形与功耗》)、引擎渲染器内部实现(《2D 矢量引擎深挖》)、抓帧工具自身的原理(《图形性能剖析工具链》)、厂商私有的 HWC 实现。为什么不涉及:它们各自已有专门篇目,混进来会让「显示」与「渲染」两件事再次纠缠——这正是本专题要拆开的那对概念。完整边界见 §0.2。
本专题的配图分三类:本机实测真图(Perfetto 抓帧、dumpsys 面板,版权自有)、外部示意图(Wikimedia Commons,图注标作者与许可)、自绘链路图(走 styles/qianmo/palette.json 色板单源)。因为显示链路层在公共素材库里几乎不存在,自绘占比会明显高于前几个专题。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank
相关资源链接
- 本篇的证据工具:Perfetto 官方文档 | Winscope 总览
- 官方一手来源:图形架构总览 | BufferQueue 与 Gralloc | SurfaceFlinger 与 WindowManager | 实现 VSYNC | 实现 HWC HAL
- 与本文强绑定的前置专题:图形性能剖析工具链(Perfetto 方法论)
- 素材来源:Wikimedia Commons(图注逐张标作者与许可)
这一篇回答什么,不回答什么
OK,开篇先把坐标系挪正。这一篇是总览,它要给的是一张可以反复回来查的地图:一帧从应用的 doFrame 走到屏幕亮起,中间有哪几个站点、每个站点由谁负责、卡住时最可能停在哪一站。
0.1 本系列在这张图的哪一小块
官方对这条链路的完整阅读顺序,见 图形架构总览 与 Graphics 总览。
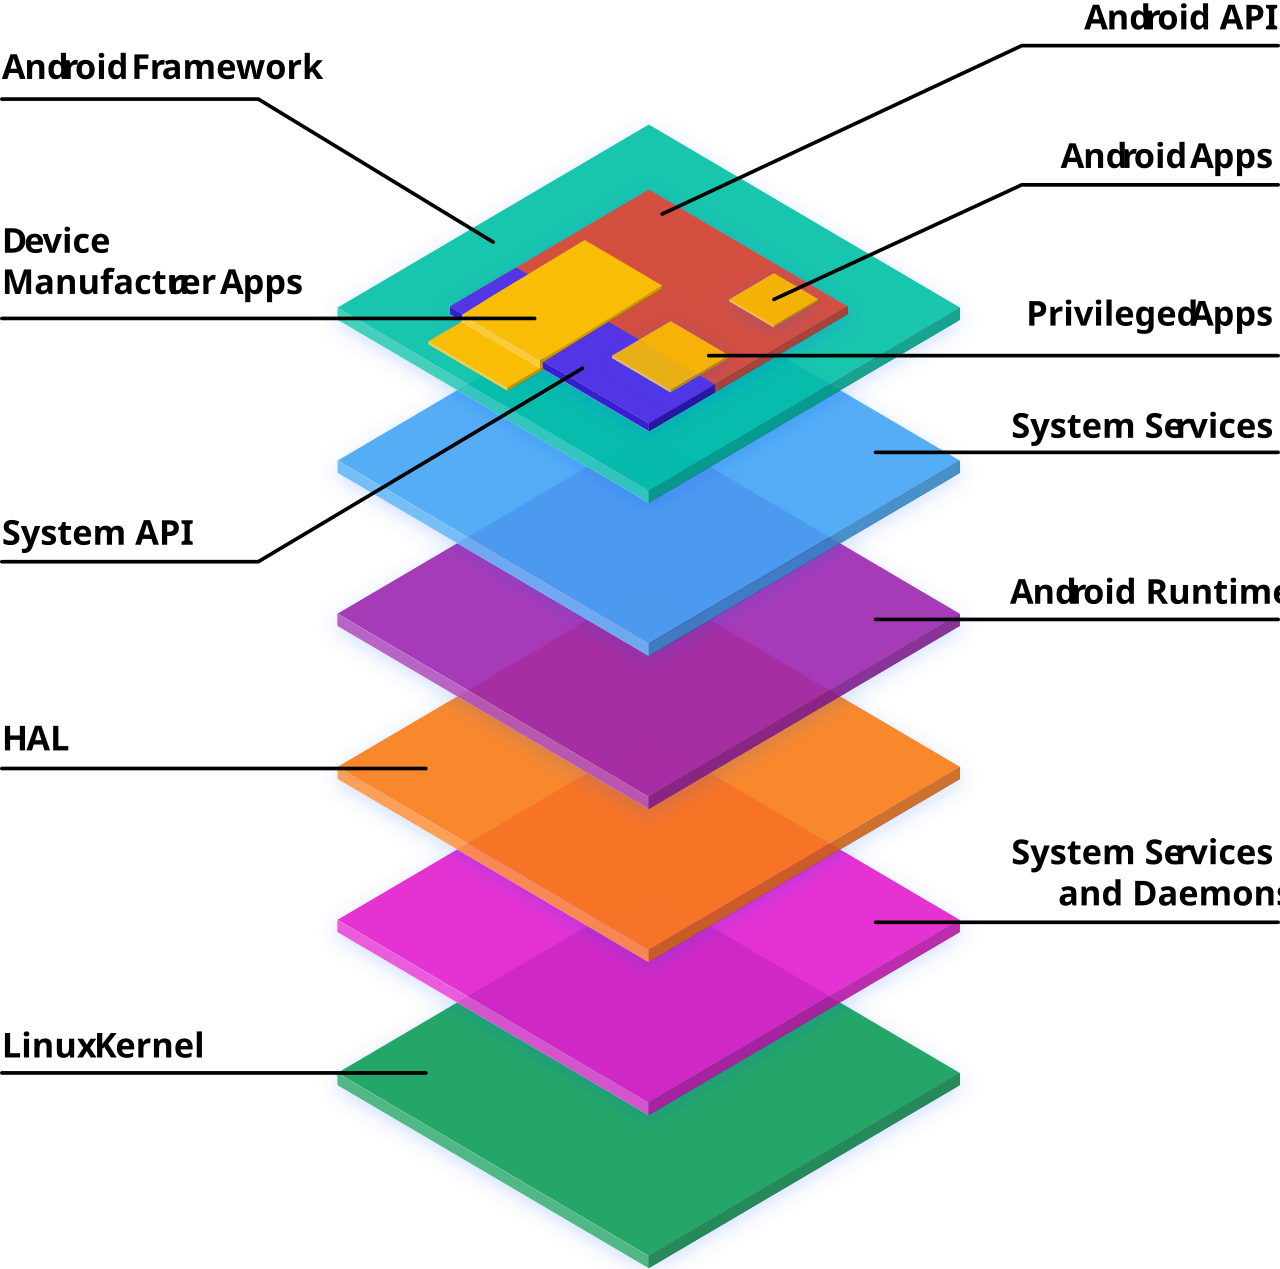
先看看坐标系。题图那张截图就是 Android 官方那张架构栈。
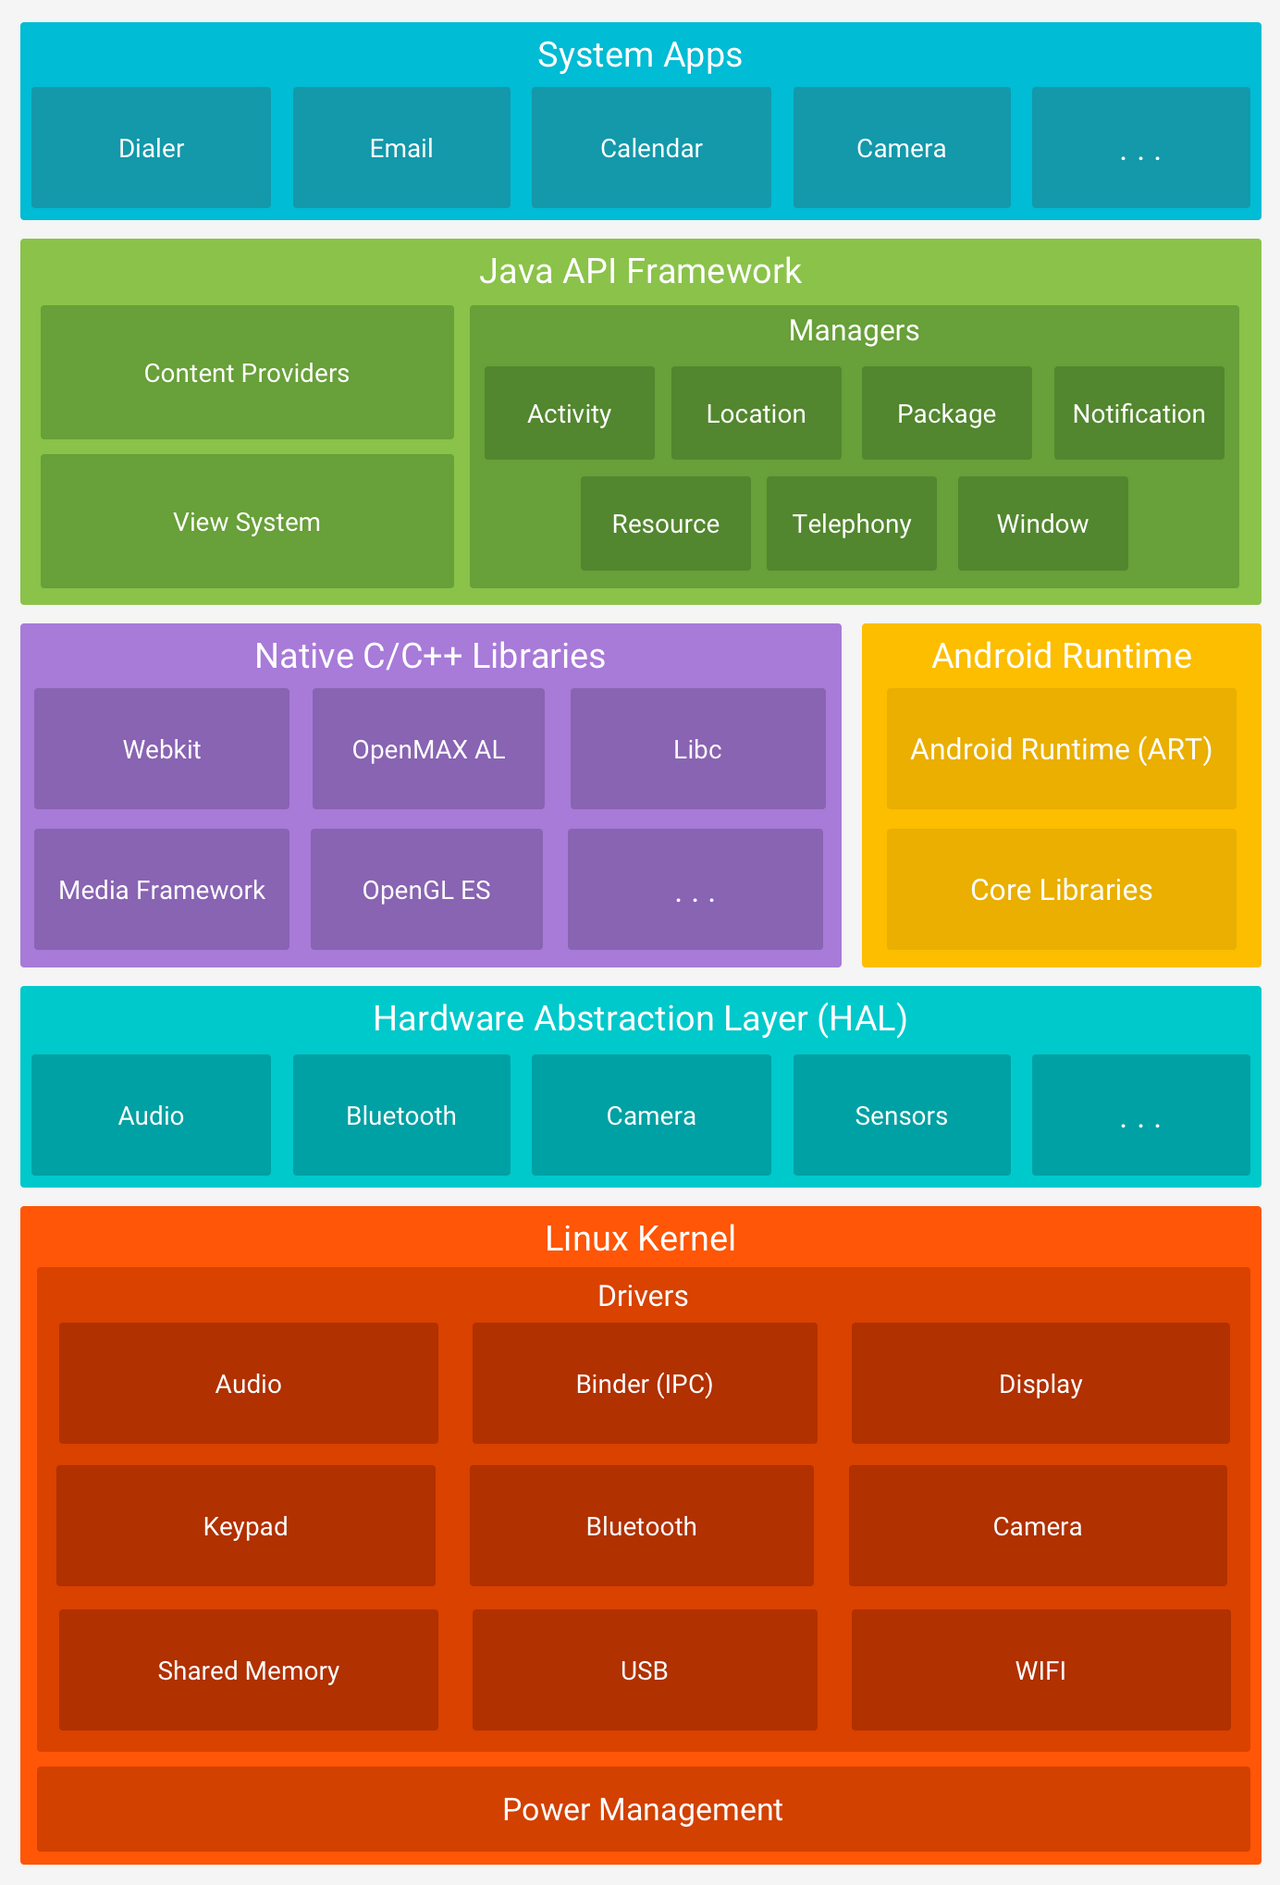
先看题图那张截图。它是 Android 官方那张"架构栈"图:从上到下是应用、Java API 框架、原生 C/C++ 库与 Android Runtime、硬件抽象层(HAL)、Linux 内核。绝大多数讲 Android 的文章,讲的是最上面那两层——应用怎么写。
我们要往下走到底。 从 Java API 框架里那个 Choreographer(编舞者)开始,穿过原生库里的 BufferQueue(缓冲区队列)与 libgui,下到 HAL 里的 Composer(合成器 HAL),最后落到内核的显示驱动与那块硬件屏幕。
这条链路的边界很窄:它只关心"像素从哪来、什么时候合、什么时候亮"。至于上面那两层里的业务逻辑、存储、网络、安全,一概不碰。
| 层(官方架构栈) | 本系列关心的部分 | 不关心的部分 |
|---|---|---|
| 应用 / Java API 框架 | Choreographer、View 的绘制触发、SurfaceControl |
业务逻辑、Compose/View 体系、存储网络 |
| 原生库与 ART | libgui(BufferQueue/BLASTBufferQueue)、libhwui(RenderThread)、EGL/Vulkan 加载器 |
媒体编解码、SQLite、WebKit |
| HAL | android.hardware.graphics.composer(HWC)、allocator(Gralloc) |
相机、音频、传感器 HAL |
| Linux 内核 | 显示控制器驱动、dma-buf(DMA 缓冲区)、fence(栅栏) |
文件系统、调度器内核策略、驱动私有实现 |
这张表本身就是本文的边界声明。题图在这里的作用只是定位——它不是机制论据,第二张定位图同理。
这四层里,前三层都有官方文档专门描述:图形架构总览讲了各层的职责与阅读顺序,BufferQueue 与 Gralloc 讲了缓冲的流转,SurfaceFlinger 与 WindowManager 讲了合成与图层控制。读完这三份,这一篇的机制部分就有了官方依据。
0.2 本文不涉及什么,为什么
好了,第二个问题是边界。
边界声明的作用是让这一篇可以被证伪:读者拿到清单,就能检查我有没有越界。
不讲渲染算法。 延迟着色、阴影、后处理、PBR 怎么算——那是《实时渲染管线探析》和《实时光线追踪与混合渲染》的题域。这一篇里出现的所有画面,都只是"某个缓冲区里的像素"。
不讲移动端功耗与带宽取舍。 TBR、TBDR、带宽预算、热管理怎么让应用少画一点——那是《移动端图形与功耗》的题域。我们要讲的是相反的半句:应用画了多少,系统怎么把它合上屏。
不讲引擎渲染器内部。 Skia 怎么光栅化一条路径、Vello 的 Sparse Strips 怎么分条——那是《2D 矢量引擎深挖》的题域。
不重复讲 Perfetto 与 RenderDoc 自身的原理。 抓帧工具怎么实现采样、trace 格式怎么组织,那是《图形性能剖析工具链》的题域。本专题只把 Perfetto 当验证手段用:给命令、给 SQL、给读数。
不讲厂商私有实现。 HWC 的厂商实现是闭源的,不同 SoC 的叠加层数量、回退策略、刷新率支持都不一样。本文只写 AOSP 通用链路;涉及厂商差异的地方,如实标注"未公开"或"需真机验证"。
三条边界里有两条特别容易失守:一是把"显示"写成"渲染",二是把"某一台设备上的行为"写成"Android 的行为"。前者的表现是讲着讲着开始讲光栅化,后者的表现是给出一条结论却不说是哪台机器。
这两条失守有各自的典型症状,可以拿来自查。
把显示写成渲染的症状是:文章里开始出现「填充率」「着色器分支」「过度绘制」这类词,却没有一处提到缓冲区、图层或合成。判据在主语——如果讨论的对象是「像素怎么被算出来」,那是渲染;只有讨论「算好的像素怎么被合上屏」,才是显示。这两件事在工程上常常同时被优化,但归因时不能混。
把单机行为写成通例的症状是:出现「Android 上某层的合成方式是 X」这种句式,却不带机型与版本。判据在条件——任何一句关于合成方式、刷新率、叠加层数量的结论,都必须能回答「在哪台机器上、哪个 Android 版本」。本专题的做法是把条件写进图注:每一张真图都标了设备、Android 版本与命令,读者可以直接看到这句结论的适用范围有多窄。
第三条边界(不重复讲抓帧工具)的失守更隐蔽:文章会花大段篇幅讲 Perfetto 的 trace 格式怎么组织、采样怎么触发。那属于工具专题。本专题提到工具时只给命令、SQL 与读数,不解释工具怎么实现。
0.3 本文的读数从哪来:本机环境与可复现性
OK,先把环境交代清楚,因为这一行很多结论是设备相关的。
这一篇的每一个实测数字,都来自下面这套环境。写清环境不是仪式,是因为这一行有大量结论是设备相关的。
| 项 | 值 | 获取方式 |
|---|---|---|
| Android 版本 | 16(API 36) | adb shell getprop ro.build.version.release / ro.build.version.sdk |
| 设备 | 模拟器 sdk_gphone64_x86_64(AVD Pixel_7) |
adb devices -l |
| 构建类型 | user / release-keys(生产构建) |
ro.build.type / ro.build.tags |
| 图形后端 | gfxstream + SwiftShader(ro.hardware.vulkan=ranchu,ro.hardware.egl=emulation) |
模拟器启动日志 + getprop |
| 屏幕 | 单显示器 EMU_display_0,1080×2400 @ 60 Hz,只有一个 displayMode |
dumpsys SurfaceFlinger --displays |
| 队列深度 | 2(NUM_FRAMEBUFFER_SURFACE_BUFFERS=2) |
dumpsys SurfaceFlinger 的 Build configuration |
| 抓帧工具 | Perfetto v49.0(设备端 /system/bin/perfetto) |
perfetto --query |
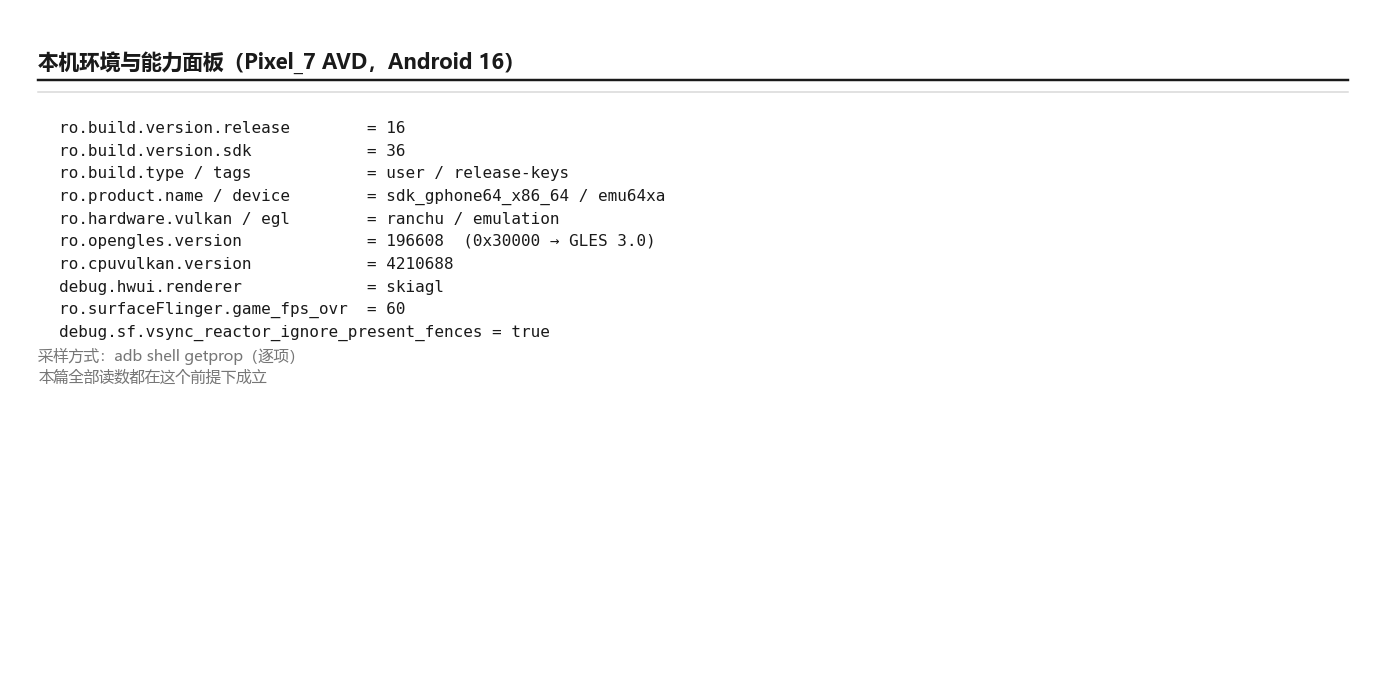
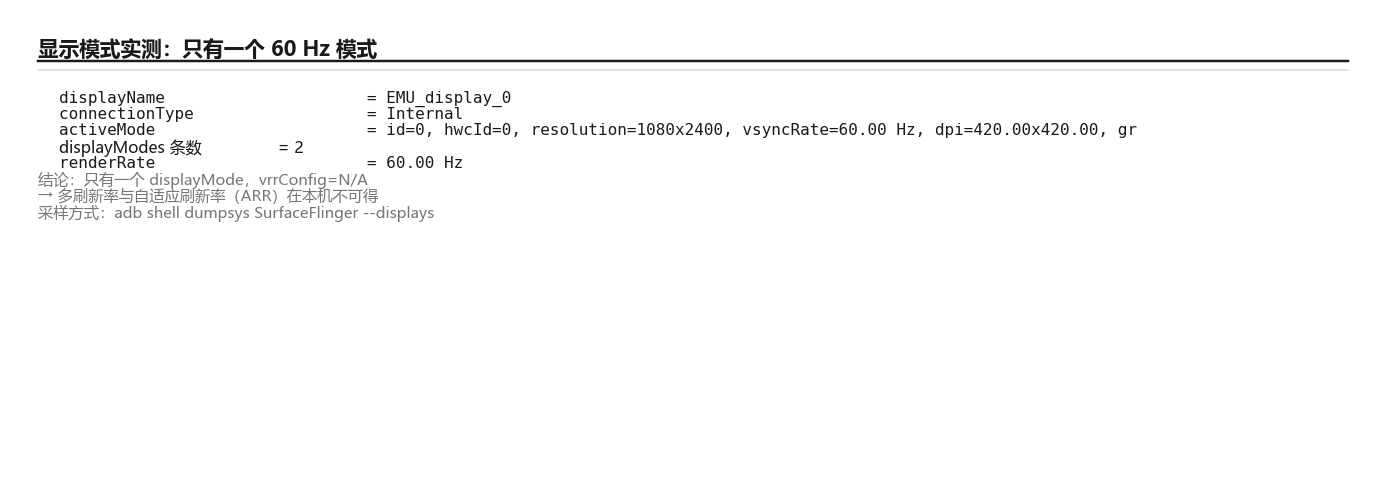
这张图值得单独看,因为它划出了本篇的能力上限:整台"设备"只有一个显示模式、只有一个刷新率。这意味着后面第十一篇要讲的多刷新率与 ARR,在本机连做实验的条件都没有——不是没测,是这台机器上不存在第二个刷新率可以切。
这里必须说清一件事:模拟器能做什么、不能做什么。 它跑的是 gfxstream 加 SwiftShader,图形调用被转发到宿主机执行,没有真实的显示控制器与物理叠加层。实测下来,能拿到的是时序层的证据(Perfetto trace、DispSync 参数、Vsync 请求、合成类型判定);拿不到的是物理显示层的证据。具体来说三件事在模拟器上做不到,本篇与后续篇目会如实标注:
- 自适应刷新率(ARR)与多刷新率:模拟器只有一个 60 Hz 模式,
vrrConfig=N/A,切不出第二个刷新率; - 帧时间线(FrameTimeline)的 jank 归因:数据源已在 Perfetto 里注册,但两次实抓(含一次滑动产帧负载、以及翻转
debug.sf.vsync_reactor_ignore_present_fences后重启 SurfaceFlinger 再抓)都没有产出帧时间线切片——这一项留到第十三篇,并需要真机; - 厂商物理叠加层的数量与回退路径:模拟器的合成器是模拟实现,能给"决策结果",给不了"真实叠加平面有几个"。
反过来它也有一件真机不好做的事:本机同时有默认镜像与 16 KB 页镜像两套系统镜像,可以做"同一台设备、两种页大小"的对照实验。这一条会在第六章用到。
OK,环境交代完了。下面从一帧本身开始。
一、一帧的六步生命周期
要讲清这条链路,先把"一帧"这个大词拆开。
1.1 六步:从一次触摸到屏幕亮起
六步里每一步的官方职责划分,见 图形架构总览 的分层说明。
先看看这一帧到底该怎么拆。
绝大多数人理解的"卡",是"应用画得慢"。但实测起来,一帧从触摸到上屏,中间有六个性质完全不同的阶段。
第一步:输入事件。 触摸事件由内核的输入子系统进来,交给应用进程。这一阶段的问题是分发延迟:事件什么时候被送到应用的主线程。
第二步:遍历与布局。 应用主线程(UI 线程)在这一帧要处理"界面变了吗":测量、布局、绘制指令的收集。如果界面结构复杂或者有同步 IO,这一步会超时。
第三步:记录绘制命令。 真正的绘制不发生在主线程,而在 RenderThread(渲染线程)。主线程把绘制任务同步给渲染线程,渲染线程把一个个绘制调用记录成一个显示列表(display list)。
第四步:提交缓冲区。 渲染线程把记录好的内容栅格化到一块图形缓冲区(GraphicBuffer)上,然后通过 BufferQueue(缓冲区队列) 把这块缓冲区交给系统。
第五步:合成。 SurfaceFlinger(SF,表面管理器) 在每次 Vsync 之后醒来,把所有可见图层的缓冲区收拢起来,问 HWC(Hardware Composer,硬件合成器):这些层该怎么合。HWC 逐层回答"硬件叠加"还是"留给你用 GPU 合成"。
第六步:上屏。 合成结果被送进显示控制器,在下一个 Vsync 到来时点亮像素。
六步里,应用能直接控制的只有第二、三步。 这是理解"卡"的第一把钥匙:一帧超时,可能是输入没送到、可能是布局太慢、可能是渲染线程在等 GPU、可能是 SF 没拿到缓冲区、也可能是合成器错过了一个 Vsync——而这五种原因的处置方式完全不同。
把六步各自的特征固定成一张表,后面每一章都会回到这张表上:
| 步 | 所属 | 典型耗时量级 | 超时时的表现 | 谁负责修 |
|---|---|---|---|---|
| 1 输入 | 系统 → 应用 | 亚毫秒到数毫秒 | 触摸延迟高,帧率却正常 | 减少主线程阻塞 |
| 2 遍历与布局 | 应用主线程 | 数毫秒 | 主线程单帧超过 16.67 ms | 应用侧 |
| 3 记录绘制命令 | 应用渲染线程 | 数毫秒 | 渲染线程被 GPU 栅栏拖住 | 应用侧 + 驱动 |
| 4 提交缓冲区 | 应用 → 系统 | 接近零(只传句柄) | 借不到空缓冲(在等消费者归还) | 应用侧 / 系统侧 |
| 5 合成 | 系统 | 数毫秒 | SF 没等到新缓冲 | 减少图层 / 改合成路径 |
| 6 上屏 | 硬件时序 | 由刷新率决定 | 错过 Vsync,等下一帧 | 刷新率策略 / 功耗协同 |
这张表里最反直觉的是第四步:它的耗时接近零,却是最常卡住的一步。原因在第二章——它卡的从来不是「传」,而是「等」。
六步的官方划分与每层的职责,见 图形架构总览;本节后面每一章对应哪一份官方文档,都在各章首段标出。
1.2 链路全景:进程、缓冲与同步对象
好了,六步是时间上的拆法,下面换成空间上的。
六步是时间上的拆解。要定位问题,还得知道这六步分别发生在哪个进程里——因为跨进程就意味着一次同步,而同步就意味着"等"。
这条链路上有四个执行体:
- 应用进程(主线程 +
RenderThread):产生缓冲区的一方,生产者; SurfaceFlinger进程(/system/bin/surfaceflinger):收缓冲区、决定怎么合的一方;Composer HAL服务(厂商实现,跑在独立进程):真正驱动显示硬件的抽象层;- 显示控制器与屏幕(内核与硬件):按时序把像素推出去。
四个执行体之间流动的东西只有两类:缓冲区(像素在哪)和同步对象(这块缓冲被谁占着、什么时候能用完)。这两类东西是本文的核心对象——后面第五章讲的 BufferQueue 四个动作,讲的就是缓冲区的流转;第四章讲的 Vsync 与栅栏,讲的就是同步。
1.3 用一次抓帧把全景坐实
OK,示意讲完了,来抓一次真的。
上面两张图都是自绘的示意。示意的问题在于:它看起来总是很有道理。所以这一节直接抓一次真帧。
在模拟器上启动一次抓帧,然后在设备上做持续的滑动操作,把整条链路跑起来:
# 推入抓帧配置(frametimeline + layers + ftrace + process_stats)
adb push t05_ep01_frames.cfg /data/misc/perfetto-configs/
# 抓 12 秒
adb shell perfetto --txt -c /data/misc/perfetto-configs/t05_ep01_frames.cfg `
  -o /data/misc/perfetto-traces/ep01_swipe.pftrace
# 取出
adb pull /data/misc/perfetto-traces/ep01_swipe.pftrace .
抓到的 trace 是 1,773,538 字节,里面出现的图层名形如 com.google.android.apps.nexuslauncher/com.android.launcher3.uioverrides.QuickstepLauncher#115——这串东西本身就说明了问题:每一层在 SurfaceFlinger 里都是一个带编号(#115)的实体,它的缓冲区、位置、合成方式都可以被逐帧查看。
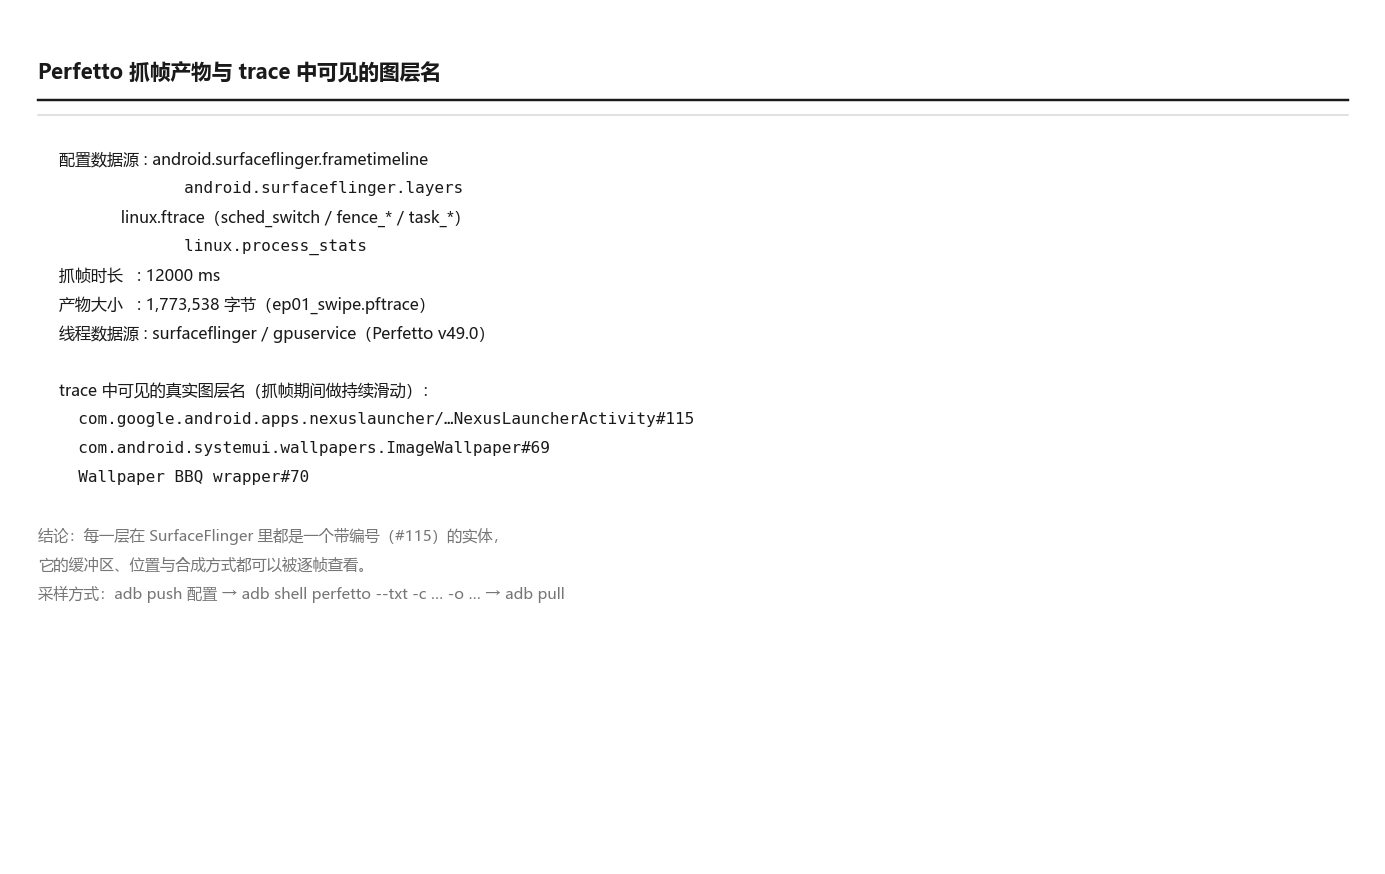
一条抓帧命令、一个 trace 文件,把前面两张自绘图里的所有实体变成了可以点开看的对象。这是本专题与前七个专题最大的方法论差别:前面几篇的机制靠读源码,这一篇的机制主要靠读时间轴。
1.4 六步里最容易误判的一步
先看看六步里最容易理解错的那一步。
六步之中,第三步与第四步的先后关系最容易被理解错,而它恰恰决定了一件事:「GPU 忙」和「应用卡」到底是不是一回事。
正确的顺序是:渲染线程先把绘制调用记录成显示列表,再把它栅格化进缓冲区;栅格化通过 GPU 执行完之后,栅栏就该绪了,这时才可以提交。也就是说,「记录」与「GPU 执行」之间存在一个真实的依赖:GPU 没干完,缓冲区就没法交出去。
这个依赖带来一个很有迷惑性的现象:应用主线程可能完全空闲,帧率却依然上不去。 打开 trace 会看到主线程上一片空白,渲染线程则在等栅栏。此时去读应用代码是找不到问题的——它是被 GPU 拖住的。
反过来的误判同样常见:把 GPU 当作瓶颈,实际瓶颈在绘制量。 一次绘制调用过多、状态切换频繁、或者纹理带宽吃紧,都会让 GPU 显得「慢」,而根因在应用提交的内容上。
区分这两者的判据只有一条:看 GPU 栅栏的就绪时刻相对 Vsync 的位置。 如果栅栏在 Vsync 之前很久就该绪了而帧依然晚,瓶颈在应用侧;如果栅栏就该在 Vsync 附近甚至之后,那瓶颈确实在 GPU 侧。
有了这张全景,下面三章把三个最关键的站点逐个拆开:缓冲区怎么传、合成怎么决定、上屏怎么对齐。
二、缓冲怎么传:BufferQueue 的四个动作
缓冲区是本文最核心的对象。而它在系统里不是一个"变量",是一套有状态的传递协议。
2.1 四个动作与四个状态
队列的状态机与四个动作的官方定义,见 BufferQueue 与 Gralloc。
先看看这套协议的动作与状态。
缓冲区队列(BufferQueue):生产者与消费者之间传递图形缓冲区的通道。它的官方文档把它描述成一套状态机,而状态机只有四个动作、四个状态。
四个动作按官方命名:
dequeueBuffer():生产者向队列"借"一块空缓冲。借的时候要说明尺寸与格式,队列返回一个 slot 号(槽位编号)与这块缓冲的句柄;queueBuffer():生产者画完之后把缓冲"还"回去,同时带上一个 fence(栅栏)——表示"这块像素什么时候真正写完";acquireBuffer():消费者向队列"取"一块已画好的缓冲;releaseBuffer():消费者用完"还"回来,队列把它标记为空闲。
四个动作串起来,就是下面这四个状态的循环。
官方文档里的状态名是 FREE、DEQUEUED、QUEUED、ACQUIRED。看清这张图的关键是"谁在动":前两个动作是生产者(应用侧)在动,后两个动作是消费者(SurfaceFlinger)在动。如果应用一直借不到空缓冲,说明四个状态全部卡在"消费者还没来得及还"上——这个判断在第五章会用到。
每个动作卡住时的表现都不一样,这张表可以当查表用:
| 动作 | 谁调用 | 卡住时看到什么 | 常见原因 |
|---|---|---|---|
dequeueBuffer() |
生产者(应用) | 应用侧阻塞在借缓冲上 | 消费者未归还;或所有 slot 都还压在队列里 |
queueBuffer() |
生产者(应用) | 提交时刻晚于本帧 Vsync | 绘制没画完(栅栏尚未就该) |
acquireBuffer() |
消费者(SF) | SF 这一帧拿不到新缓冲,沿用旧帧 | 应用交晚了 |
releaseBuffer() |
消费者(SF) | 可用 slot 数持续偏低 | SF 侧合成排队 |
注意第三行的措辞:SF 拿不到新缓冲时不是「卡住」,而是「沿用上一帧」。 这解释了一个现象——掉帧在视觉上表现为「画面停了一下」,而不是「画面撕裂」。撕裂是另一回事:它发生在缓冲区被换走时像素还没写完,也就是栅栏语义被破坏的时候,与「没等到缓冲」是两个不同的故障。
四个动作的官方定义与状态机描述,见 BufferQueue 与 Gralloc。
2.2 生产者与消费者各拿一个代理
好了,动作清楚了,下面看它是怎么跨进程的。
"应用进程把缓冲区交给 SurfaceFlinger 进程"这句话在实现上不是一次拷贝,而是一次句柄传递。
真正的队列对象(BufferQueueCore)活在 SurfaceFlinger 进程里,它持有一个 slot 数组。跨进程暴露出去的是两个代理接口:
- 生产者侧拿到
IGraphicBufferProducer,由应用进程的Surface持有; - 消费者侧拿到
IGraphicBufferConsumer,由SurfaceFlinger的Layer持有。
传过去的不是像素,是一个句柄:缓冲区背后的内存是 dma-buf(DMA 缓冲区),句柄里带着文件描述符,两个进程通过它共享同一块物理内存。这就是为什么传递一块 1080p 缓冲区几乎不花时间——花时间的从来不是传,是等。
理解这一点,就能理解一个常见困惑:为什么应用明明只画了一帧,SurfaceFlinger 却能看到好几层?因为每一层(Layer)背后都有独立的一套 BufferQueue,各自有独立的 slot 数组与状态。
顺着这条线再走一步,就能看清 fence(栅栏) 在里面扮演什么角色。
传句柄时,应用交出来的不只是一块内存,还附带一个 acquire fence——它的含义是「这块缓冲里的像素,要等到这个栅栏就该才算真的写完」。GPU 是异步执行的:应用发出绘制命令后立刻就返回了,像素可能还在排队。如果 SurfaceFlinger 不等这个栅栏就去合成,就会合到半成品。
所以跨进程流转的其实是两样东西:缓冲区句柄(像素在哪)和一对栅栏(什么时候能读、什么时候能再写)。合成完成之后,SurfaceFlinger 再交出一个 present fence 给显示侧,表示「这一帧什么时候真的推到了屏幕上」。
这一点解释了本专题后面反复出现的一个判读动作:看时间轴时不能只看「提交时刻」,还要看「栅栏就该时刻」。 提交只是一个记账动作,栅栏才是真正的时间边界。
2.3 队列深度实测:本机的默认值是 2
OK,接下来是这一章最容易被忽略的一个参数。
队列里到底放几块缓冲,是这一章最容易被忽略、也最容易出错的参数。它不是"越多越好",也不是固定值。
本机读到的值在 SurfaceFlinger 的构建配置里:
adb shell dumpsys SurfaceFlinger | Select-String "Build configuration"
输出里的这一段是关键:
Build configuration: [sf PRESENT_TIME_OFFSET=0 FORCE_HWC_FOR_RBG_TO_YUV=0 MAX_VIRT_DISPLAY_DIM=0
 RUNNING_WITHOUT_SYNCFRAMEWORK=0 NUM_FRAMEBUFFER_SURFACE_BUFFERS=2]
NUM_FRAMEBUFFER_SURFACE_BUFFERS=2——本机队列深度是 2,不是 3。 这一条值得停下来想一想:关于"Android 是三缓冲"的说法流传极广,但至少在这台设备上,默认值是 2。
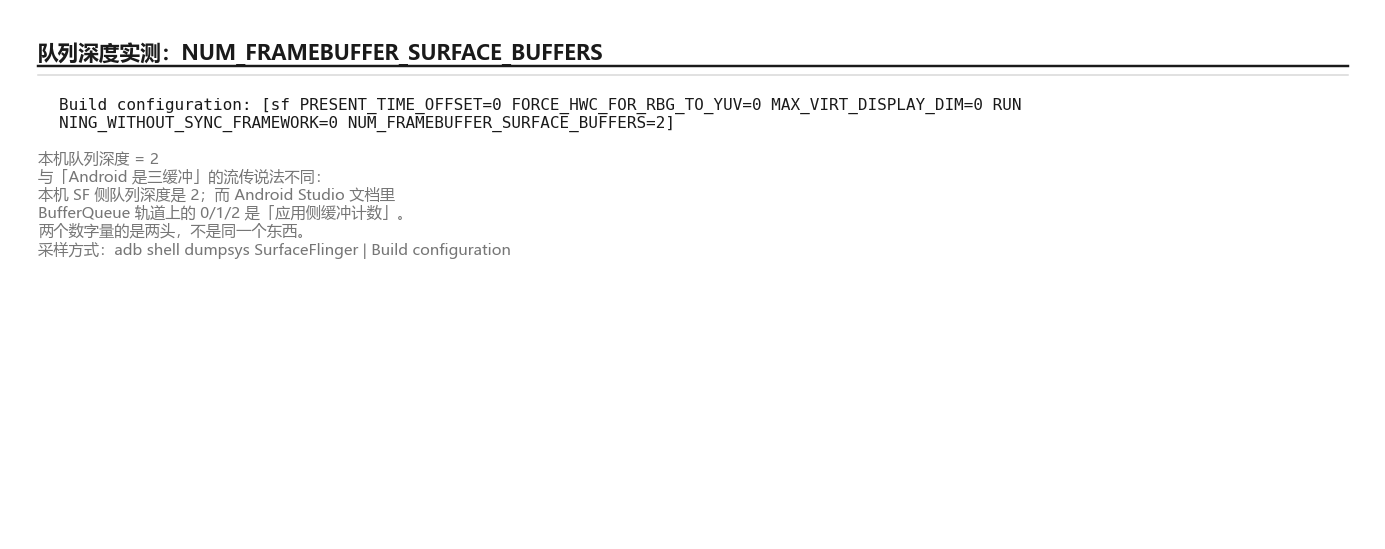
那"三缓冲"的说法从哪来?它是应用侧的缓冲计数,不是 SF 侧的队列深度。Android Studio 的官方卡顿检测文档在讲 BufferQueue 轨道时给过判据:轨道上显示的是应用表面的缓冲计数,取值 0/1/2,当值为 2 时表示应用处于三缓冲状态,会带来额外的输入延迟。两个数字量的是两头,不是同一个东西。
2.4 双缓冲与三缓冲:延迟与丢帧的取舍
好了,把两头分开之后,这个取舍就看清楚了。
把两头分开之后,这个取舍就看清楚了。
双缓冲只有两块缓冲:一块正在被显示,一块可以被应用填。 应用错过一次 Vsync,就只能等下一个——掉的这一帧没有挽回余地。
三缓冲给了一块额外的空地:当 SurfaceFlinger 还在用某一块时,应用可以有更多时间把下一块填好。代价是队列里积压的帧变多了,触摸到响应的延迟也变长。
所以正确的说法不是"三缓冲更好",而是:缓冲数是在"掉帧"和"延迟"之间选一个位置。追求帧率稳定的游戏会倾向多给一块;追求触控跟手的应用宁可掉帧也不要延迟。
2.5 队列深度不是「设了就完」:四个约束在互相拉扯
OK,既然深度可以选择,那它到底由什么决定?
既然深度可以选择,那它到底由什么决定?实际工程里有四个约束同时在拉扯。
第一个约束是输入延迟。 队列里每多积压一帧,手指到画面的延迟就多一个帧周期。这是深度不能无限加大的根本原因——它不是成本问题,是体验问题。
第二个约束是掉帧容忍度。 深度越浅,应用错过一次 Vsync 就越没有回旋余地。对于负载波动大的场景(比如列表滚动时突然要解码图片),浅队列会表现为帧率抖动。
第三个约束是内存。 每一块缓冲区都是实打实的内存占用。一块 1080×2400 的 32 位缓冲约 10.4 MB,多一块就是多 10.4 MB。在低内存设备上,多缓存的代价可以直接量出来。
第四个约束是 SF 侧的回收节奏。 前三个约束都作用在应用侧,而真正决定「应用能不能借到」的,是 SurfaceFlinger 什么时候把用过的缓冲还回去。如果 SF 侧自身合成排队,那么无论应用侧把队列加深到几,可用 slot 都还是不够用。
四个约束之后,可以给出一条实用判据:当应用表现为「偶发掉帧」时,加深队列有用;当应用表现为「稳定地借不到缓冲」时,加深队列没用,要去查 SF 侧的合成压力。 这两者的区分方法,就是第二章那张动作表里的第三行与第四行。
2.6 一个可以立刻验证的小实验
先看看一个十分钟就能自己验一遍的实验。
讲完机制,给一个十分钟就能自己验一遍的实验——它能把前三节的概念一次性坐实。
做法:在设备上打开一个会持续重绘的界面(比如系统设置的滚动列表),然后用两条命令分别读一次缓冲相关状态与合成状态,中间隔几秒。
# 连续两次采样,看同一批数字怎么变
adb shell dumpsys SurfaceFlinger | Select-String "Build configuration"
adb shell dumpsys SurfaceFlinger | Select-String "missed frame|Active Layers"
Start-Sleep -Seconds 10
adb shell dumpsys SurfaceFlinger | Select-String "missed frame|Active Layers"
要观察三件事。
第一,NUM_FRAMEBUFFER_SURFACE_BUFFERS 在这一段时间里没有变。 它是启动时定的,不会因为负载变化而变化——这说明队列深度是一个静态配置,选错了只能改配置,运行时挽救不了。
第二,missed frame 计数在变,而变的方式本身就是信息。 本机这一次采样窗口里(6.2 秒),HWC 侧从 19 涨到 34(+15),GPU 侧 325 保持不动,活跃层数稳定在 93。单次读数是快照,两次读数的差才是速率——而速率告诉你这段时间里压力落在哪一侧。
第三,Active Layers 的计数基本稳定,但会随界面切换跳一下。 跳上去之后如果不回落,说明有层没有被销毁(§5.3 讲的那个现象)。
实验的意义在于:它把「缓冲区」「合成」「图层」这三个抽象概念,变成了三个能看见变化的数字。后面每一篇讲到一个新站点时,都可以用同样的方法——先找那个站点的可观测数字,再去读它的机制。
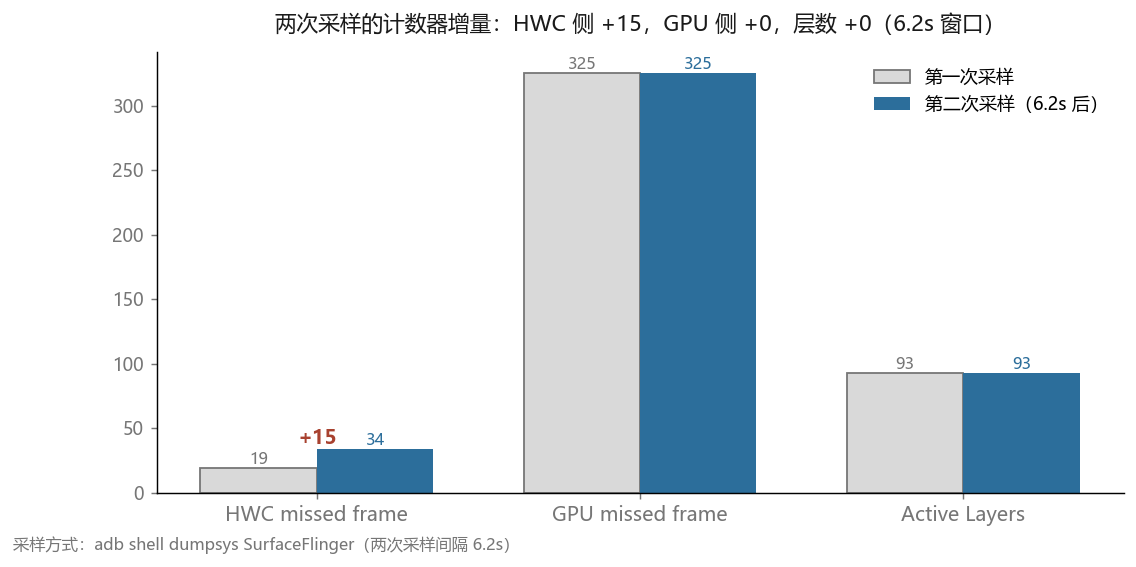
这张图也顺手证伪了一个想当然的读法:两个计数器的绝对值不能直接比大小。 GPU 侧的累计值(325)比 HWC 侧(34)大一个量级,但在这段窗口里真正在增长的是 HWC 侧。绝对值看总量,增量看当前——这也是 §5.4 那两条反例的来源。
三、合成怎么决定:SF 与 HWC 的两阶段与三模式
缓冲区到了 SurfaceFlinger 手上,下一件事是合成(composition):把多个图层的像素合成为一帧最终画面。这一章讲两个问题:谁来决定怎么合、以及"合"的三种模式怎么区分。
3.1 两阶段:先问,再合
两阶段的接口定义与三种合成模式,见 实现 HWC HAL 与 SF 与 HWC。
决策流程的另一份官方描述见 Hardware Composer HAL;新版 AIDL 化的 HWC 接口见 AIDL HWC。
先看看合成为什么是两次调用。
合成不是一次动作,而是两个阶段:
第一阶段是"问":SurfaceFlinger 收齐这一帧可见的所有图层,调用 HWC 的 validateDisplay()。这一步不产出画面,只做决策——HWC 逐层检查:这个层能不能走硬件叠加?能不能留在叠加平面(overlay)上?
第二阶段是"答":对于被判为"不能走硬件"的层,SurfaceFlinger 通过 getChangedCompositionTypes() 拿到变更结果,把这些层交给 GPU 合成,最后调用 presentDisplay() 提交。
两阶段之间,HWC 返回的是逐层的合成类型:DEVICE(走硬件叠加)或 CLIENT(交给客户端,也就是 GPU 合成)。合成的本质是一道分配题:有限的叠加平面怎么分给哪些层,剩下的谁来兜底。
这两个阶段的接口定义与三种合成模式,见 实现 HWC HAL。
3.2 决策结果实测:在真机上怎么看
好了,决策结果其实可以直接读出来。
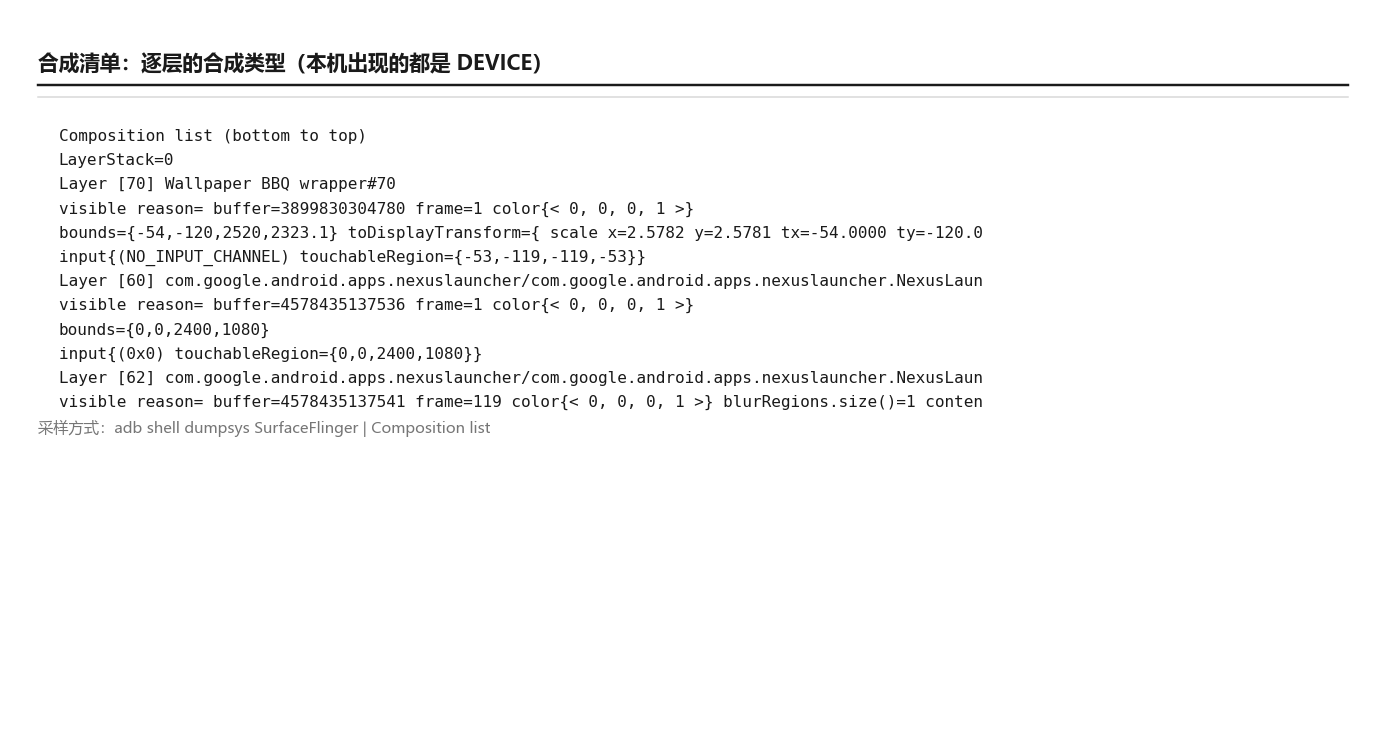
决策结果是可以直接读出来的。dumpsys SurfaceFlinger 会打印一份合成清单(Composition list),逐层列出合成类型。
本机读到的清单里,真实图层一行行排着,每行第三个字段就是合成类型——本机出现的都是 DEVICE:
Composition list (bottom to top)
           8 |         2040 |     DEVICE |          0 |    0    0 1080 2400 | ...
           9 |         2019 |     DEVICE |          0 |    0 2337 1080 2400 | ...
          13 |         2024 |     DEVICE |          0 |    0    0 1080  136 | ...
这一列的含义很直接:DEVICE 表示这一层被交给了硬件路径,CLIENT 表示它被交给了 GPU。数量上还有个隐含信息——能同时拿到 DEVICE 的层数是有限的,官方在 HWC HAL 的文档里给过一个下限要求(至少 4 个叠加平面),超出的层就只能走 CLIENT。
3.3 三种模式与两个开关
OK,逐层的结果汇总起来,就是三种模式。
逐层的 DEVICE/CLIENT 汇总起来,整个显示这一帧的合成模式落进三种之一:
HWC:所有层都走硬件叠加,GPU 不参与合成;GLES:所有层都交给 GPU 合成;MIXED(混合合成):一部分硬件、一部分 GPU。
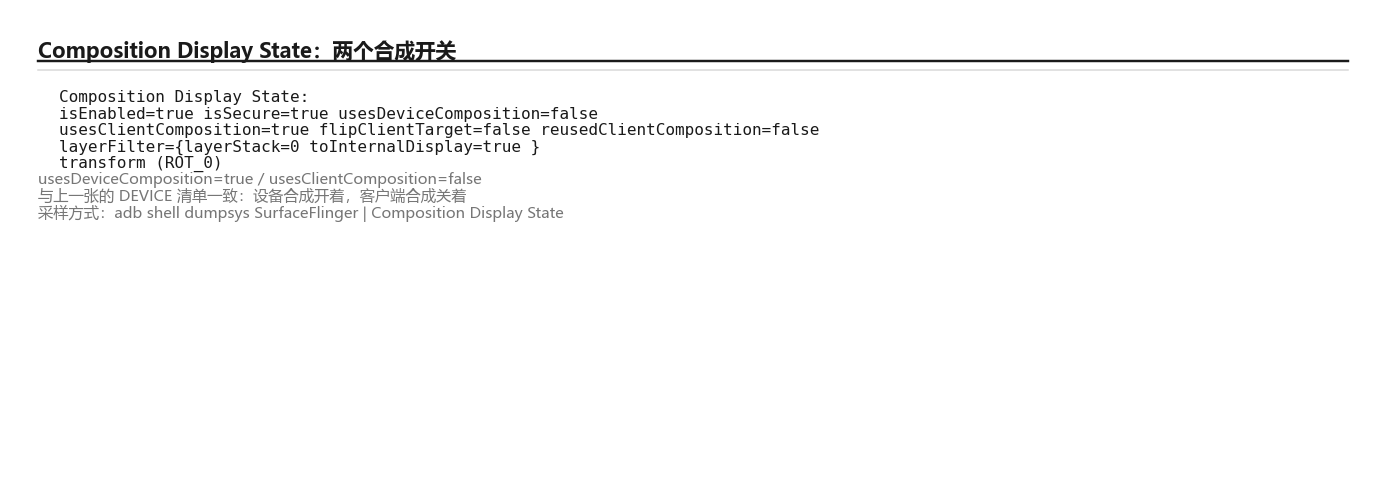
显示的状态则被两个布尔开关概括:
Composition Display State:
   isEnabled=true isSecure=true usesDeviceComposition=true
   usesClientComposition=false flipClientTarget=false reusedClientComposition=false
本机读到的 usesDeviceComposition=true / usesClientComposition=false,与前一张图的 DEVICE 清单一致——这就是 MIXED 之外的那两种状态在文本上的样子:设备合成开着,客户端合成关着。
官方文档里还有一个细节值得记住:硬件叠加在主线程上是阻塞调用,而 GPU 合成是并行执行的。这个差别直接决定了一帧超时该归到谁头上——后文第五章讲失败模式时会用到。
三种模式的代价可以用一张表对齐:
| 模式 | 谁来合成 | 功耗 | 主线程行为 | 什么时候出现 |
|---|---|---|---|---|
HWC |
硬件叠加 | 最低 | 阻塞 | 图层少、格式与缩放都符合叠加条件 |
GLES |
GPU(客户端) | 最高 | 并行 | 图层过多、格式不支持、需要复杂混合 |
MIXED |
两者分担 | 中 | 混合 | 最常见:能硬件叠加的走硬件,剩下的兜底 |
这张表说明了一个反直觉的结论:图层越多,功耗越高——不是因为「画得多」,而是因为「合成路径从硬件掉到了 GPU」。 一个只有三个简单图层的界面可能全程走硬件合成,而一个叠了十几层阴影与圆角的界面几乎必然触发 GPU 合成。这就是边界里「减少图层数」在工程上真正重要的原因。
3.5 合成失败的三种形态
OK,把两个计数器放进真实故障里看,一共三种形态。
合成这一站出错,表现出来是三种不同的形态,而它们的原因完全不同。
第一种:硬件路径接不住,悄悄掉到 GPU。 表现是功耗上升、发热增加,但帧率可能完全不掉——因为 GPU 合成虽然更贵,仍然是能按时完成的。这一种最容易被忽略,因为它不产生可见的卡顿,只产生电量的下降。判据是看合成模式是不是从 HWC 变成了 MIXED。
第二种:GPU 也接不住,帧就掉了。 表现是 GPU 侧的 missed frame 计数快速增长,同时用户能感知到画面停顿。这一种通常会伴随 GPU 占用率上升,比较容易归因。
第三种:合成按时完成了,但合成的内容是旧的。 这是最隐蔽的一种——SurfaceFlinger 这一帧拿不到新缓冲,只好沿用上一帧(§2.1 那张表的第三行)。此时所有计数器都可能是正常的:合成没超时、没有 missed frame、GPU 也不忙,唯一不对的是应用交晚了。判据只能回到时间轴上看 queueBuffer 的时刻。
三种形态里,第三种最值得记住。 因为它把"掉帧"这个词的两种含义分开了:一种是系统没跟上(前两种),一种是应用没交上来(第三种)。前者要去查合成路径与图层数,后者要去查应用自己的绘制耗时。归错方向,怎么优化都不会有效果。
3.4 失败时长什么样:两个丢帧计数
先看看合成这一站出错时长什么样。
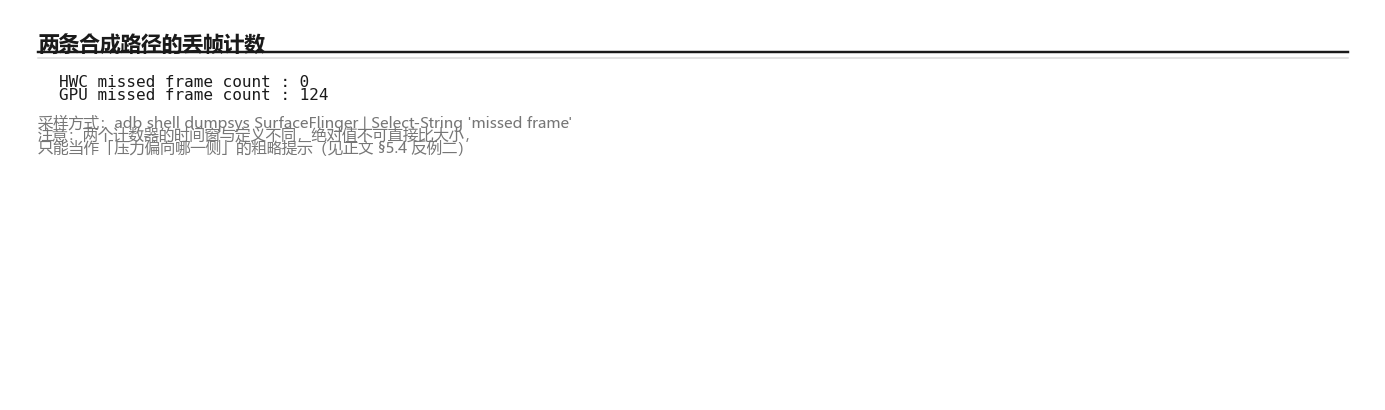
合成这一站的失败模式很具体:错过 Vsync。dumpsys 里有两个现成的计数器:
    HWC missed frame count: 158
    GPU missed frame count: 490
两个计数器的差别是谁错过了。HWC 少帧意味着硬件合成路径没能按时交付;GPU 少帧意味着客户端合成没赶上。本机这一次读到的两个数字是 HWC 侧 0、GPU 侧 124——这台模拟器的合成几乎全部由 GPU 承担,所以 GPU 侧的计数明显更高。注意这两个计数是自开机累计的:同一台机器另一次开机读到的是 HWC 侧 158、GPU 侧 490,绝对值完全不同——这也是为什么 §5.4 会把「比值」列为一条需要谨慎使用的线索。这两个计数的比值本身就是一条线索:它告诉你这一帧的合成压力落在硬件路径还是 GPU 路径上。
四、上屏怎么对齐:Vsync 的三个相位与 DispSync
合成完了,最后一个问题是什么时候亮。这一章讲时序。
4.1 三个相位:HW_VSYNC、VSYNC、SF_VSYNC
先看看这条节拍在系统里变成了几个。
垂直同步(VSYNC):显示控制器在画完一帧之后发出的一个节拍信号。它的原始形态来自硬件,但系统里流动的并不只这一个。
在 AOSP 的实现里,一条 Vsync 在到达应用之前会经过两次取舍,于是出现三个相位:
HW_VSYNC(硬件 Vsync):显示控制器真正发出的那个信号;VSYNC:SurfaceFlinger转发给应用的节拍,它与HW_VSYNC之间存在一个偏移;SF_VSYNC:SurfaceFlinger自己按这个节拍工作的时刻。
中间的偏移不是误差,是故意留的:应用需要在 Vsync 之前把它这一帧准备好,SurfaceFlinger 才能在 Vsync 之后立刻合成。所以应用拿到的"节拍"必须提前一点。
三个相位与 DispSync 的参数,见 实现 VSYNC。
三个相位的存在,解释了一个常见的不理解:为什么应用在 Vsync 回调里立刻开始绘制,仍然会错过这一帧? 因为应用订阅到的那个「Vsync」本来就不是硬件那个 Vsync——它被提前了一个偏移量。应用是在「预计显示时刻之前」被叫醒的,不是在「显示时刻」被叫醒的。错过它,意味着这一帧的截止线比你以为的更早。
4.2 DispSync:偏移量是怎么算出来的
相位偏移与 Vsync 参数,见 实现 VSYNC;多刷新率下的选率策略见 多刷新率。
好了,偏移从哪来,就是 DispSync 要回答的问题。
产生这个偏移的模块叫 DispSync(显示同步)。它要解决一个很实际的问题:显示器的 Vsync 是硬件给的,而应用需要提前被叫醒,那到底提前多少?
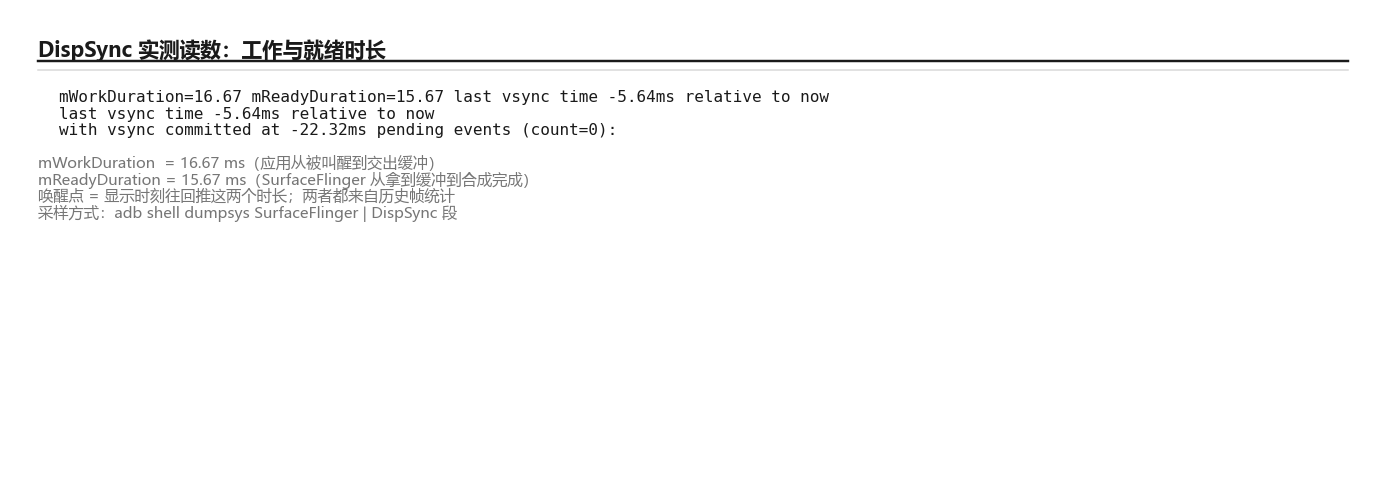
DispSync 的答案不是拍一个常数,而是维护两个时长:
mWorkDuration(工作时长):应用从被唤醒到把缓冲交出来,通常需要多久;mReadyDuration(就绪时长):SurfaceFlinger从拿到缓冲到合成完成,通常需要多久。
两个时长都来自对历史帧的统计。唤醒点 = 显示时刻往回推这两个时长。本机读到的值是:
mWorkDuration=16.67 mReadyDuration=15.67 last vsync time 11.76ms relative to now
 with vsync committed at 11.75ms
这里有一个反直觉的点:mWorkDuration 恰好是 16.67 毫秒,也就是 60 Hz 的整帧周期。这不是巧合——本机只有 60 Hz 一个模式,工作时长被统计到了一个整周期上,意味着唤醒点被推到了上一帧。真机上多刷新率设备的这两个值会随刷新率变化,这也是第十一篇要讲的内容。
4.3 VsyncSchedule:谁在等这个节拍
OK,偏移算出来了,下面看谁需要被叫醒。
偏移算出来之后,还有第二个问题:谁需要被叫醒?
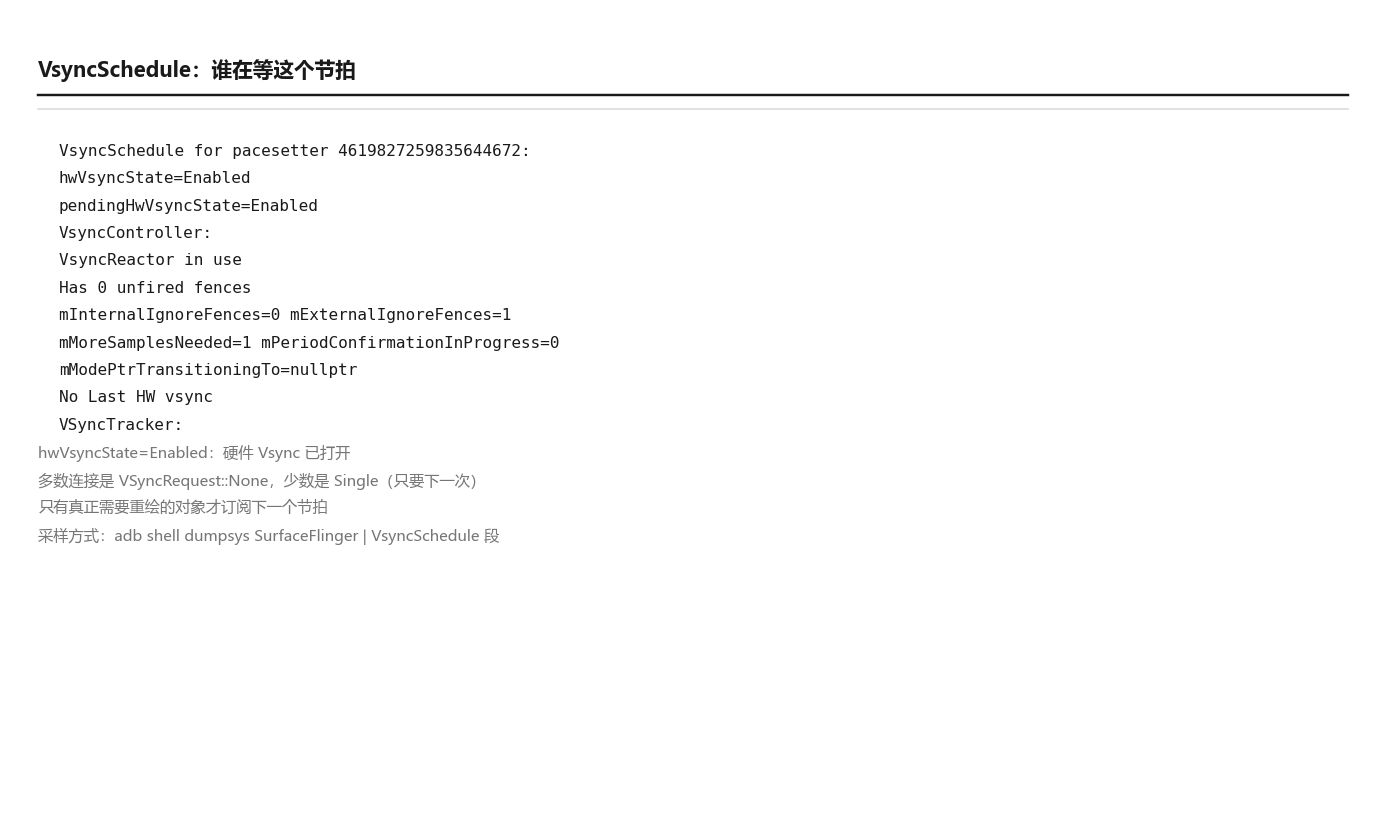
答案在 VsyncSchedule(Vsync 调度表)里。它维护一批连接(Connection),每个连接代表一个等待 Vsync 的对象——应用的主线程、RenderThread、其他系统服务。本机读到的这一段很能说明问题:
VsyncSchedule for pacesetter 4619827259835644672:
hwVsyncState=Enabled
pendingHwVsyncState=Enabled
...
    Connection{0x74d145456f50, VSyncRequest::None}
    Connection{0x74d14545b090, VSyncRequest::Single}
    Connection{0x74d14545b8d0, VSyncRequest::Single}
两件事可以直接读出来。一是 hwVsyncState=Enabled:硬件 Vsync 已经打开;如果这一项是 Disabled,那么整条链路的节拍其实是由软件模拟的——这在排查某些机型问题时是个关键判据。二是每个连接后面的 VSyncRequest 取值:多数是 None(这一帧不要),少数是 Single(只要这一次)。只有真正需要重绘的对象才会订阅下一个节拍,这是 Android 省电设计的一部分。
请求的形态不止「要一次」这一种。AOSP 的 EventThread.h 里,这个枚举的取值是:
VSyncRequest::None(−1):这一帧不需要,别叫我;VSyncRequest::Single(0):只要下一次;VSyncRequest::Periodic(1):按周期持续订阅;- 较新的版本里还追加了
Persistent与SingleSuppressCallback——用于「持续订阅」与「这一帧别叫、下一帧还要」这类更细的语义。
其中周期订阅那一档才是耗电的真正来源。 界面静止时,理想状态下所有连接都应该是 None,整条链路接近休眠。如果界面静止而 CPU 占用依然居高不下,第一件要查的就是有没有对象错误地长期订阅了周期请求。 本机读到的这一屏里绝大多数是 None、少数是 Single,一档周期订阅都没有——因为当时并没有持续动画在跑。
注:这一组的枚举名以 AOSP
EventThread.h为准。中文社区流传的写法常作「None / Single / Persistent」三档,把Periodic漏掉或与之混为一谈;而本机实测输出里也只出现了None与Single两种。「枚举有哪几档」与「这台机器上出现了哪几档」是两件事,别把它们并成一句。
4.4 相位偏移会漂移吗
先看看最后一个疑问。
到这里还剩一个必须回答的问题:DispSync 用的是统计出来的时长,而统计值会变。如果工作时长突然变长,唤醒点会不会来不及调整,导致成片掉帧?
答案是:这正是 DispSync 存在的理由。它与硬件的 Vsync 之间维持着一个反馈回路——每个周期都拿实际的就绪时刻去校正模型,偏移量随之缓慢调整。它不是一次性配置,而是一个持续收敛的控制环。
这个设计带来两个可观测的后果。
一是偏移量会随负载移动。 应用突然变重(比如开始解码大图),mWorkDuration 会跟着变长,唤醒点随之前移。所以在 trace 上看到的偏移不是一个固定常数——如果拿一台机器的偏移值去套另一台机器,结论必然是错的。
二是它需要时间收敛。 负载刚发生阶跃变化的那几帧,模型还停在旧值上,这几帧最容易掉。这也是为什么「刚打开应用的瞬间」往往比「稳定运行之后」更容易卡:它不是应用代码的问题,是控制环还在收敛。
理解了这一点,本章三张图就串成了一条链:三个相位决定了谁在什么时刻被叫醒,DispSync 决定唤醒点往前推多少,而这个推的量是一个持续校正的估计值。
三个站点讲完了:缓冲区在 BufferQueue 里流转,合成分两阶段分配硬件与 GPU,上屏由 DispSync 对齐节拍。下面把这三站串起来,看一次真实的滑动。
五、实测:一次滑动把整条链路走一遍
前三章是分站看的。这一章把站连起来,回答一个更实际的问题:卡住的时候,怎么知道停在哪一站。
5.1 把一张 trace 拆成六段
先看看判读的顺序。
抓帧之后,第一件事不是找红色,而是找到六个阶段各自的边界:它们在同一条时间轴上,但归属不同的进程与线程。
判读的顺序可以固定下来:
- 先看输入段:找
aq(应用队列)相关的事件,确认输入事件什么时候到达应用进程。这一段长,说明输入分发慢; - 再看主线程段:找应用主线程上的
Choreographer#doFrame。这一段长,说明测量/布局/绘制指令收集慢; - 然后看渲染线程段:找
RenderThread上的绘制活动,以及它到 GPU 的栅栏。这一段长,说明绘制命令记录或 GPU 执行慢; - 接着找提交点:
queueBuffer事件就是第四步的边界,它的时刻决定了这一帧能赶上哪一个 Vsync; - 再看合成段:
SurfaceFlinger线程上的合成活动,以及presentFence(呈现栅栏)。这一段长,说明合成压力大; - 最后对上屏时刻:显示侧的呈现时刻与 Vsync 序列对齐。
这六段的归属是排查的分水岭:前三段属于应用,第六段属于硬件时序,中间两段属于系统。一道常见的误判是把合成慢当成应用慢——它们的修法完全不同。
每一段在 trace 上要找的事件,可以固定下来:
| 段 | 找什么事件 | 判据 |
|---|---|---|
| 输入 | 应用队列(aq)相关事件 |
输入到达应用进程的时刻 |
| 遍历 | 主线程上的帧回调 | 从帧开始到绘制任务下发 |
| 记录 | 渲染线程上的绘制活动 + GPU 栅栏 | 从任务接收到栅栏就该 |
| 提交 | queueBuffer |
提交时刻相对本帧 Vsync |
| 合成 | SF 线程的合成活动 + presentFence |
从拿到缓冲到提交显示 |
| 上屏 | 显示侧呈现时刻 | 与 Vsync 序列的对齐 |
判读最容易踩的坑是「只盯最长的那一段」。 一帧超时的原因往往不在最长的一段,而在离 Vsync 最近的那一段——因为截止时间是固定的,谁离截止线近,谁就是瓶颈。长度是干扰项,位置才是判据。
Perfetto 官方的 trace 分析范例(含可直接套用的 SQL)见 Android trace analysis;Android Studio 侧的卡顿检测入口见 Jank detection。
5.2 一处实测限制:帧级时间戳为什么取不到
OK,这一节写的是一次失败。
这一节写的是一个失败,因为它的成因比结论更有用。
按常规做法,判读完六段之后下一步应该是把两个关键线程并排放:应用的 RenderThread 与 SurfaceFlinger 的主线程。它们在一帧里的关系不是接力而是竞速——RenderThread 要在 Vsync 之前交出缓冲,SurfaceFlinger 要在 Vsync 之后立刻合掉;交晚了,SF 这一帧就只能沿用旧帧。
要做到这一点,需要帧级时间戳。本篇尝试了两条取法,两条在本机都没有拿到数据:
第一条是 dumpsys SurfaceFlinger --latency。 官方把它当作帧延迟的查询入口,返回一个刷新周期加最多 128 行"期望呈现 / 实际呈现 / 帧就绪"的三元组。本机实测的是:
adb shell dumpsys SurfaceFlinger --latency
16666666
只有第一行:16666666 纳秒,也就是 60 Hz 的周期。三元组一行都没有——不管是无参(主显示)、指定显示 id、还是指定图层名,三次尝试都是同样的结果。这意味着这台设备上那条按层维护的延迟环形缓冲是空的。
第二条是 Perfetto 的 FrameTimeline 数据源。 它在 perfetto --query 里是注册状态(android.surfaceflinger.frametimeline,由 /system/bin/surfaceflinger 提供),但两次实抓都没有产出帧时间线切片——第二次还专门把 debug.sf.vsync_reactor_ignore_present_fences 置为 false 并重启了 SurfaceFlinger,结果一样。
两条路都指向同一个原因:这套模拟环境里的显示链路是被模拟出来的(gfxstream + SwiftShader,图形调用转发到宿主机),它不产生真实显示控制器那种"呈现语义"。而帧级时间戳恰恰依赖呈现语义——没有真实的呈现事件,就没有可记录的时间戳。
所以这一篇的时序证据只能来自另外两类观测量:一类是计数器(两次采样的增量,§2.6 那张图),一类是水位(DispSync 的两个时长、Vsync 的连接状态、活跃层数)。它们能回答"压力在哪一侧、节拍怎么算",但回答不了"这一帧的第 37 毫秒发生了什么"。
这条限制也解释了本专题的篇目安排:帧级归因(jank_type 那一套)被放到了第十三篇,并且标明需要真机。 不是因为它难,而是因为在这样的环境里它的输入数据根本不存在。
5.3 图层快照:94 层意味着什么
合成活动的逐帧查看入口见 Winscope 总览;dumpsys 的用法见 dumpsys。
好了,最后换一个维度——不看时间轴,看数量。
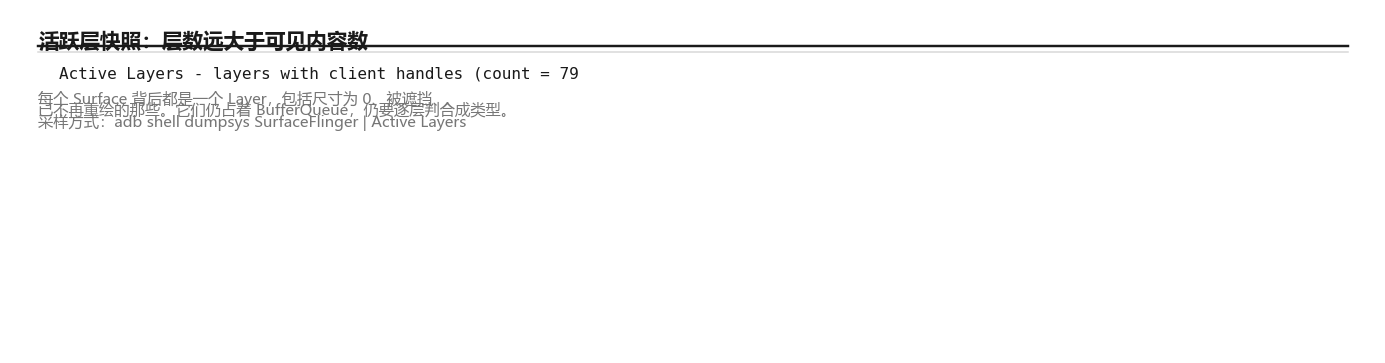
最后一个实测项不看时间轴,看数量。同一时刻,系统里有多少层在参与合成?
adb shell dumpsys SurfaceFlinger | Select-String "Active Layers"
本机读到的答案是 79:
Active Layers - layers with client handles (count = 94)
94 这个数字乍看夸张——屏幕上显然没有那么多个可见的东西。原因在于"层"不等于"可见内容":每个 Surface(表面)背后都是一个层,包括那些尺寸为 0、被遮挡、或者已经不再重绘的层。它们仍然占着 BufferQueue,仍然要在合成时被逐层判一遍合成类型。
这个数字会随设备状态浮动:本机在另外两次采样里读到过 93 与 94——刚开机、刚滑动过、刚退出应用都会改变它。但有一点稳定:它总是远大于屏幕上看得见的东西。 这一点也解释了一个常见现象:应用退出后帧率没有立刻恢复,往往是因为它的层还没有被真正销毁,合成器还在为它做无用功。
5.4 两个反例:看起来像结论,其实不是
先看看两个反例。
实测容易得出一些看起来很硬的结论,而它们大多带一个隐含条件。这里给两个本篇自己的反例,作为读后面十二篇的预防针。
反例一:「本机队列深度是 2,所以 Android 的默认队列深度是 2。」 前一半是实测,后一半是越界。队列深度可以被设备配置覆盖,本机读到 2 只能说明这台设备是 2。正确的表述是「本机 NUM_FRAMEBUFFER_SURFACE_BUFFERS=2」,而不是「Android 用双缓冲」。
反例二:「HWC 丢帧 158、GPU 丢帧 490,所以 GPU 是瓶颈。」 这个推论同样越界了。两个计数器统计的时间窗与定义都不同,绝对值不能直接比大小,比值只能当作「压力偏向哪一侧」的粗略提示。要判断真正的瓶颈,得回到时间轴上看栅栏的位置——也就是 §1.4 给出的那条判据。
这两个反例指向同一条纪律:实测给出的是「这台机器上的读数」,不是「系统的性质」。 把读数与性质分开陈述,是这一行最基本的要求,也是最容易在写作中被忽略的一步。
5.5 trace 之外:三条命令就够用
Perfetto 的入门与常规抓帧流程见 开始使用 Perfetto。
设备侧抓系统 trace 的官方步骤见 On-device tracing;SQL 表的字段定义见 Perfetto SQL tables。
OK,抓帧不是每次都需要。
Perfetto 很强,但它不是每次排查都需要。日常有三个问题,用 dumpsys 就足够回答,而且比打开 trace 快得多。
问题一:这台设备的显示链路在什么状态?
adb shell dumpsys SurfaceFlinger --displays
关注三个字段:activeMode 的分辨率与 vsyncRate(一个还是多个模式)、vrrConfig(是不是 N/A,即有没有自适应刷新率)、renderRate 与 activeMode.vsyncRate 是否一致(不一致说明发生了刷新率覆盖)。
问题二:合成压力在哪一侧?
adb shell dumpsys SurfaceFlinger | Select-String "missed frame"
两个计数的增速(不是绝对值)告诉你在这一段时间里压力偏向硬件路径还是 GPU 路径。
问题三:有没有层在漏?
adb shell dumpsys SurfaceFlinger | Select-String "Active Layers"
在同一个界面进出前后各读一次,看计数有没有回到原来的水平。
这三条命令的价值不在于给出答案,而在于决定"要不要上 trace"。 如果三条命令都正常,那么问题极可能在应用侧,直接去量应用的绘制耗时比抓整机 trace 更有效;如果三条命令里有一条异常,再针对那一侧抓 trace。先分流,再深挖——这是把工具用出效率的关键。更完整的抓帧与分析方法,见工具前置专题。
六、版本矩阵:Android 10→17 的六次演进
前五章讲的是现状。这一章把那套现状放回时间轴上——这条链路的每一次改动,都对应一个具体的生态事件。
6.1 六次演进
性能提示侧的官方说明见 ADPF 与慢会话 与 GAME 功耗模式。
Android 16 与 17 的完整变更清单见 Android 16 版本说明 与 Android 17 版本说明。
先看看时间轴上发生了什么。
从 Android 10 到 17,与显示链路直接相关的变动有六次:
| 版本 | 变动 | 对链路的影响 |
|---|---|---|
| 10 | ASurfaceControl 引入;HWC 虚拟显示路径 |
事务式的图层控制有了公开 API;虚拟屏成为一等公民 |
| 11 | 多刷新率;HAL composer@2.4 |
屏幕不再只有一个刷新率,config group 概念出现 |
| 12 | Perfetto FrameTimeline;GKI 2.0 用 dma-buf heaps 取代 ION |
卡顿第一次可以被"归因"而不只是"看到";缓冲区内存分配换了底座 |
| 14 | ADPF 的 GAME 功耗模式 | 性能提示从应用单方面请求变成系统协同 |
| 15 | 自适应刷新率(ARR) 引入;16 KB 页支持 | 刷新率从"选一个"变成"跟着内容变";页大小影响图形内存 |
| 16 | Vulkan 1.4 成为强制要求;16 KB 页兼容模式 | 图形 API 的下限被抬高 |
| 17 | ION 彻底弃用;图形类新增 WebGPU;官方明确转向以 Vulkan 作为主要低层 GPU API | 旧内存分配器退场;图形 API 的长期方向定调 |
六次演进可以压成一条主线:从"固定"走向"动态"。 Android 10 之前,刷新率是固定的、内存分配器是固定的、图层控制是一把梭;10 之后,图层可以事务式更新(10)、刷新率可以选(11)、可以自适应(15)、卡顿可以归因(12)、性能可以协同(14)。
本节七条变动的官方出处:Android 10–15 的图形侧变动见各版本 release notes 与 ARR 文档;Android 16 的 Vulkan 要求见 实现 Vulkan。
这七条变动按性质可以再分三类,分类的意义在于它们的失效方式完全不同:
- 接口层变动(10 的
ASurfaceControl、12 的FrameTimeline):改变了「能看到什么、能控制什么」; - 时序层变动(11 的多刷新率、15 的 ARR):改变了「一帧有多少时间」;
- 底座层变动(12 的
dma-bufheaps、15/16 的 16 KB 页、17 的 ION 弃用):不改变接口,只改变内存的样子。
三类里最容易被低估的是第三类。 接口层变动会立刻报错,时序层变动会在性能上体现,而底座层变动往往只在特定机型上才暴露——16 KB 页就是典型:在 4 KB 设备上一切正常,换到 16 KB 设备上才现原形。下一节就讲它。
6.2 一条被误传的硬要求:Vulkan 1.4
Vulkan 版本要求见 实现 Vulkan;Android 17 的图形侧方向见 Android 17 功能清单。
好了,这一章最容易传错的是 Vulkan 那条。
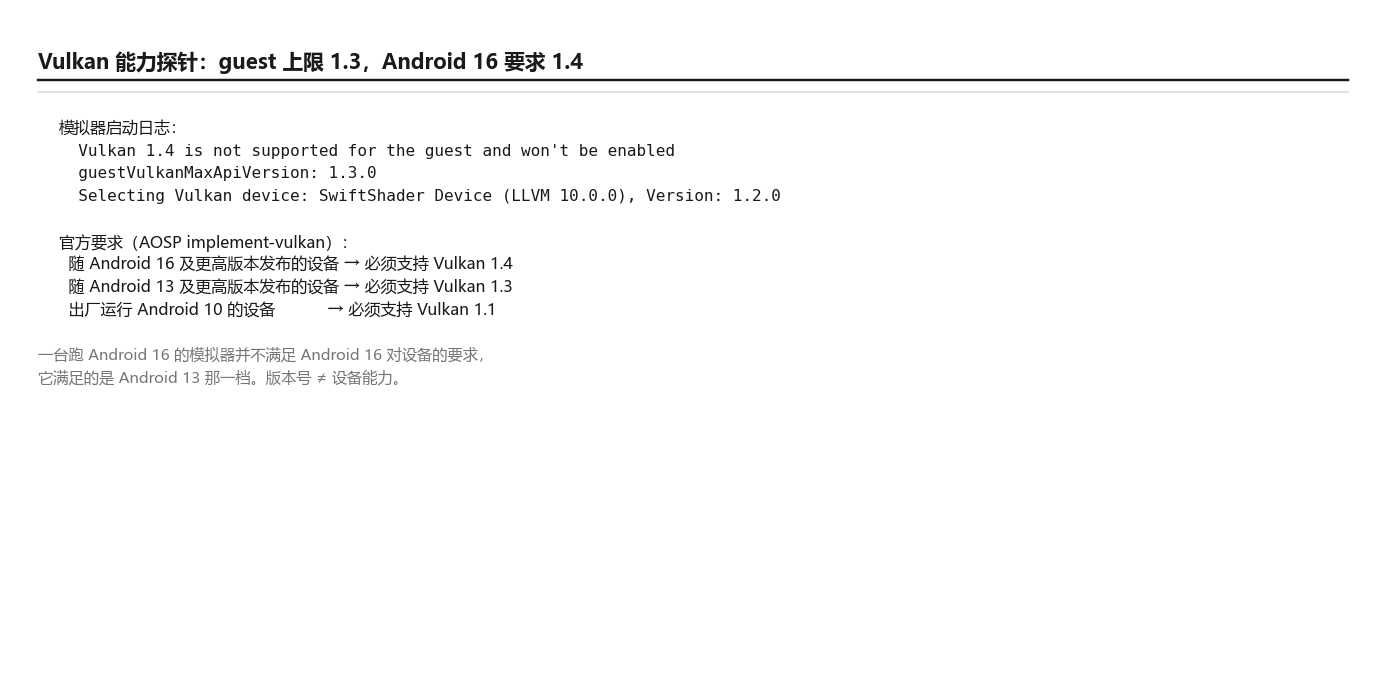
版本矩阵里最容易传错的是 Vulkan 那条。流传的说法是"Android 17 要求 Vulkan 1.4",这个归因是错的。
官方文档写得很清楚:随 Android 16 及更高版本发布的设备必须支持 Vulkan 1.4;随 Android 13 及更高版本发布的必须支持 Vulkan 1.3;出厂运行 Android 10 的设备必须支持 Vulkan 1.1。也就是说,1.4 这条线不是 17 才划的,是 16 就划了。Android 17 这一侧的新东西是"把 Vulkan 定位成主要的低层 GPU API"这个方向性表述。
这条差距在模拟器上看得特别直白。启动日志里有一行:
Vulkan 1.4 is not supported for the guest and won't be enabled
而同一份日志里的能力上限是 guestVulkanMaxApiVersion: 1.3.0。也就是说,一台跑 Android 16 的模拟器并不满足 Android 16 对设备的要求——它满足的是 Android 13 那一档。这条事实本身就是一个很好的提醒:Android 版本号不等于设备能力,版本只规定下限,不保证上限。
6.3 16 KB 页:本机唯一能做真机不好做的对照
16 KB 页的适配要求见 页大小指南;内存分配底座的迁移见 dma-buf heaps。
OK,最后一个演进点值得单独说。
最后一个演进点值得单独说,因为它涉及一个应用侧必须处理的硬期限。
Android 15 起,系统支持 16 KB 页大小;而 Google Play 的规则是:自 2025 年 11 月 1 日起,面向 Android 15 及更高版本的新应用与更新,必须在 64 位设备上支持 16 KB 页;自 2027 年 2 月 1 日起,不支持的更新将无法发布。 官方同时在 Android 16 里提供了兼容模式(android:pageSizeCompat)作为过渡。
对显示链路来说,页大小影响的是图形内存的对齐与碎片:缓冲区需要按页对齐,页变大之后,同样大小的缓冲占用的页数变少、页表项变少,但对齐造成的浪费可能变大。这不是"越大越好"的问题,是"必须适配"的问题。
16 KB 页的两道时间线与适配方式,见 Android 页大小指南 与 Android 16 的 行为变更。
本机恰好具备做这个对照的条件:系统镜像里同时存在默认镜像与 16 KB 页镜像(后者的 AVD 配置里 tag.id = page_size_16kb)。同一台"设备"、同一个 Android 版本、只换页大小——这种对照反而比在真机上做更干净,因为真机换页大小通常要重刷系统。
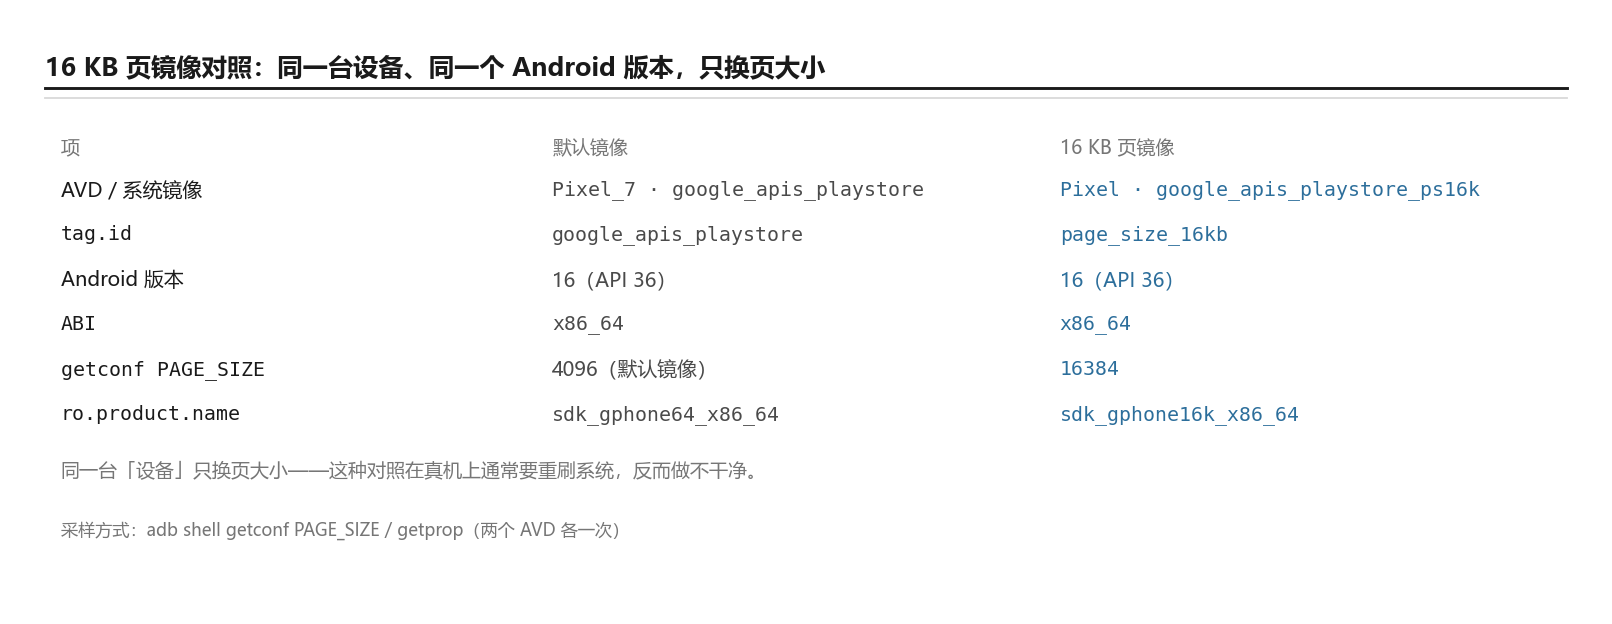
6.4 这张矩阵怎么用
先看看这张矩阵怎么用起来。
版本矩阵不是用来背诵的,它有三个具体用法。
用法一:给"这句结论最早什么时候成立"划一条线。 比如讲多刷新率时,要知道 setActiveConfigWithConstraints 是 Android 11 引入的;讲 jank 归因时,要知道 FrameTimeline 需要 Android 12 以上。不划线就会出现"在 Android 10 上讲 FrameTimeline"这种错。
用法二:判断一个现象的成因属于哪一层。 接口层、时序层、底座层三类变动的失效方式不同(§6.1 的三类划分)。遇到一个"在某批机型上才出现的怪现象",先看它落在哪一类:如果落在底座层,那大概率是内存布局问题,而不是逻辑错误。
用法三:给应用的兼容策略排序。 底座层的变动带硬期限(16 KB 页的两道时间线就在那里),时序层的变动影响体验(刷新率策略要适配),接口层的变动则要求改代码。按"有硬期限的先做"排序,比按"看起来重要的先做"更实际。
这三条用法有一个共同前提:版本矩阵里的每一条都得能回答"在哪份官方文档里"。 本节的七条变动、以及 §6.2 与 §6.3 的两处纠正,出处都在官方文档与 release notes 里,读者可以逐条复核。
七、读法:怎么用这套坐标系读后面十二篇
OK,地图画完了。这一章说清怎么用它。
7.1 三条读法
好了,地图画完了,下面说清怎么用它。
第一条:先问"这一段在哪个进程里"。 前面六章出现的所有实体——Choreographer、RenderThread、BufferQueue、SurfaceFlinger、HWC、显示控制器——分别属于应用进程、系统进程、HAL 进程和内核。任何一句"这里慢"如果没有指明进程,就还没有可操作性。 后面每一篇讲一个站点时,都会先把这个站点的归属写清。
第二条:分清"文档怎么写"和"这台机器跑出来是什么"。 这条链路的官方文档是可靠的,但它描述的是通用链路;而真机行为受 SoC、驱动、OEM 定制影响。本专题的每一处读数都会标机型与 Android 版本,读到不带条件的绝对结论时,应当警惕。
第三条:把"渲染"与"显示"分开。 这是最容易混的一对。渲染是"算出像素",显示是"把像素合上屏"。渲染慢的修法是减少绘制量、降低分辨率、优化着色器;显示慢的修法是减少图层数、避免遮挡、处理刷新率策略。混在一起讨论,就会得出"优化了渲染但卡顿没变好"这种结论。
这三条读法的原理是同一条:显示链路是一条有明确归属的流水线,任何结论都必须能落到三个坐标上——哪一段、哪个进程、什么条件。 缺任何一个,结论就不可验证。
其中: - 第一条(先问在哪个进程里)解决的是「出了事该找谁」; - 第二条(分清文档与实测)解决的是「这条结论能推广到多远」; - 第三条(把渲染与显示分开)解决的是「该优化哪一边」。
7.3 三个常见的错误推论
先看看三个最容易出现的错误推论。
把这条链路上最容易出现的错误推论列在这里,它们是后面十二篇反复要避开的坑。
错误推论一:「帧率高就没问题。」 帧率高说明平均吞吐够,但它不反映单帧的最坏情况。一个平均 60 帧、每秒掉两帧的界面,体验比稳定 55 帧更差——因为掉帧的分布比平均值更能被感知。要看的是分位数,不是平均数。
错误推论二:「CPU 没跑满就不该卡。」 §1.4 讲过这个反例:瓶颈可能在 GPU 侧,而 CPU 恰恰因为被栅栏挡住而显得空闲。"CPU 不忙"与"这一帧按时完成了"之间没有必然关系。
错误推论三:「减少绘制量就能解决显示侧的问题。」 绘制量与合成是两个站点。减少绘制量能降低第三步与第四步的耗时,但对第五步的合成压力几乎无能为力——合成压力的主要来源是图层数与合成路径。对症下药的前提是先确定病灶在哪一站。
7.2 本篇留下的三个问题
帧级归因机制(jank_type)的官方说明见 Perfetto FrameTimeline。
OK,这张地图能回答「在哪一站」,但还有三个问题没展开。
地图能回答"在哪一站",但有三件事这一篇只给了入口,没有展开:
- 缓冲区为什么会"借不到":四个状态全卡在消费者侧,具体是谁在压着不放?这是第四篇的主题;
- 合成决策到底按什么规则分配叠加平面:本篇只说了"有限平面怎么分",没说分配算法与回退顺序。这是第八篇的主题;
- 怎么把一次卡顿归因到具体某一方:本篇用的是"数计数器和看 trace",而系统其实提供了一套归因机制(
FrameTimeline的jank_type)。这是第十三篇的主题,也是唯一需要真机才能做透的一篇。
八、系列地图与边界
8.1 十三篇怎么排
先看看这十三篇怎么排。
十三篇分两类。机制篇十篇(二到十、十二),证据以 AOSP 官方文档与源码为主,每篇把一个站点拆到底。自跑篇三篇(十一、十三,以及本篇的实测部分),证据以本机抓帧读数为主。
这样排的原理不复杂:一篇能承载多少信息量,由它的证据类型决定。 机制篇的证据是文本(文档与源码),可以写得密;自跑篇的证据是读数,必须留出交代条件的篇幅——同一句话在机制篇里是一行,在自跑篇里可能要配机型、版本和命令。
其中: - 机制篇的每篇:一个站点,一条主线,证据以官方文档与源码为主; - 自跑篇的每篇:一个可复现的实验,读数与条件同时给; - 置后再做的两篇:第十一与第十三篇,都需要真机才能做透。
这个安排和前面的专题不太一样:前面几个专题通常是"机制篇在前、自跑篇在后",而这一篇把实测嵌在机制篇内部——因为这条链路的很多机制(DispSync 的相位偏移、合成类型判定)不跑一次根本看不见,只读文档会得到一个看起来正确但没有细节的印象。
8.2 与已交付七专题的边界
这一节的判断依据是各专题的官方入口与各自的题域声明,可对照 图形架构总览 的分层来看。
好了,还有一个必须划清的边界。
这个专题站在前七个专题的下游。它承接它们的结果,但不重复它们的机制。
三处需要特别说明的边界:
与《移动端图形与功耗》的关系最需要划清。 那个专题讲"应用能画多少、该省多少",是约束层;本专题讲"画出来的帧怎么合上屏",是链路层。两者的交界处是帧预算:约束层决定一帧有多少时间可用,链路层决定这些时间花在哪一站。
与《图形性能剖析工具链》是工具与用法的关系。 那个专题讲 Perfetto 与 RenderDoc 怎么工作;本专题只把它们当验证手段,给命令、给 SQL、给读数,不重复讲工具实现。
与《2D 矢量引擎深挖》是上下游关系。 那个专题的终点是"像素被写进缓冲区";本专题的起点恰好在那里。第十一篇讲缓冲区交接时,会引到那篇的结论,但不会往回讲光栅化。
九、小结与三项行动
9.1 三项可以立刻做的事
卡顿检测的官方入口见 Jank detection。
OK,最后把结论落成动作。
这一篇的结论可以落成三个动作,都不需要读源码、不需要刷机——只要一台 Android 12 以上的设备(真机或模拟器)和一条 adb 连接。
这三个动作的原理都一样:显示链路的绝大多数结论都能从外部观测到,所以不需要符号表、不需要调试版本,也不需要改代码就能验证。
其中: - 第一件(设备自查)量的是状态:队列深度、丢帧计数、活跃层数; - 第二件(抓一次 trace)量的是时间:主线程从帧开始到交出缓冲用了多久; - 第三件(查无用层)量的是浪费:层有没有被及时销毁。
第一件:把你手上的设备自查一遍。 三条命令拿到本篇的六个读数:
adb shell getprop ro.build.version.release
adb shell getprop ro.build.version.sdk
adb shell dumpsys SurfaceFlinger | Select-String "Build configuration|missed frame|Active Layers"
对照本篇的读数看三件事:队列深度是 2 还是 3、两个丢帧计数的比值、活跃层数是不是远大于可见内容。这三项就能告诉你这台设备的显示链路大致处在什么状态。
第二件:抓一次自己的 trace,只找一件事。 用第四章给的命令抓 10 秒,然后只看一个问题:你的应用主线程上,Choreographer#doFrame 到 queueBuffer 之间有多长。 这个长度决定你的应用能赶上哪一个 Vsync,比任何"优化建议"都直接。
第三件:检查你的应用有没有在制造无用层。 对照 Active Layers 的计数,看退出界面后这个数字有没有回落。如果没回落,说明有层没被销毁,合成器一直在为它们做无用功。这是最容易改、见效最快的一项。
这三件事有一个共同点:都不需要读源码。 原因在于显示链路有一个特性——它的很多结论可以从外部观测到。dumpsys 打印的是内部状态,Perfetto 抓的是时间轴,两者都不需要符号表,也不需要刷调试版本。这也是本专题能做到「每篇都有真图」的原因:与前几个专题不同,这一篇的证据主要来自观测,而不是阅读。
9.2 边界回指
好了,把边界再回指一遍,方便后文引用。
最后把边界再说一遍,方便后文引用。这一篇讲了显示链路的六个站点、两类流动对象(缓冲区与同步对象)、三条实测判据(队列深度、合成类型、相位偏移)。只给指针的是 ARR 的调度策略、FrameTimeline 的归因机制、厂商叠加层的实现差异。完全不碰的是渲染算法、移动端功耗取舍、引擎渲染器内部、抓帧工具本身的实现。
9.3 下一篇
OK,这一篇是地图,下一篇从第一站开始。
这一篇是地图,下一篇从第一站开始:应用是怎么被"叫醒"的。
Choreographer 这个名字听起来像个调度器,实际上它的正式身份是"按 Vsync 节拍分发的回调调度器"。它要处理的麻烦比想象中多:VSync 请求可以按需订阅也可以长期订阅;回调有优先级(输入、动画、遍历、提交四档);而在它之下,DisplayEventReceiver 还要处理一条从显示控制器一路传上来的信号。下一篇把这条"叫醒链"完整走一遍,并给出一个可以直接量出来的问题:为什么"界面不动的时候 CPU 占用应该降到接近零"。
相关链接
- 下一篇(预告):【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 本专题的工具前置:《图形性能剖析工具链》全十三篇
- 官方一手文档:图形架构总览 | BufferQueue 与 Gralloc | 实现 VSYNC | 实现 HWC HAL | 自适应刷新率 ARR | Perfetto FrameTimeline
- 相关系列:2D 矢量引擎深挖 | 移动端图形与功耗 | 图形性能剖析工具链
With Best Wishes.