本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
核心问题:前十篇讲完了链路、节拍与相位,但它们都默认了两件事——队列默认够深,屏幕默认只有一个档。
这一篇把这两个"默认"打开。开场先看两个同框的现场读数,第一个来自本机:
Build configuration: [sf PRESENT_TIME_OFFSET=0 ... NUM_FRAMEBUFFER_SURFACE_BUFFERS=2]
      Slots:
       >[01:0x7802ff32b050] state=ACQUIRED   frame=539 [1080x2400:   0,  1]
        [00:0x7802ff328020] state=FREE       frame=538 [1080x2400:   0,  1]
两格。 可官方文档里明明写着另一句话:
"Android apps are always triple buffered."——AOSP《了解 systrace》
同一件事,一处说"始终三缓冲",一处数出来只有两格,而这两句话都是对的。它们不矛盾的原因,正是本篇第一章要讲的东西。
第二个现场同样来自本机,换到屏幕那一侧:
hasArrSupport false
supportedRefreshRates [60.000004]
mRefreshRateChangeable: false
VoteSummary{ ... maxPhysicalRefreshRate=120.0, maxRenderFrameRate=60.0, requestRefreshRates=[], ... }
上限可以写成 120,而可用档位表里只有一个 60。 更妙的是,同一条日志里
requestRefreshRates=[]—— 没有任何一层为刷新率投过票。
承接上一篇。ep10 讲的是"三路节拍错开多少":VSYNC_EVENT_PHASE_OFFSET_NS 一族属性、updatePhaseOffsets() 的短路、两个窗口里"帧就绪 → 上屏"的 6.172 ms 与 15.963 ms。可那篇量的是时间差,没有问过"一帧能排几个队"——队列深一格还是两格,直接决定应用能不能连续产帧;也没有问过"屏幕能不能换档"——ep10 里那个 16.666 ms 的周期,是唯一的档给出来的。
这件事在前面几篇里都挂过账。ep04 讲了 BufferQueue 的四态迁移与 dequeueBuffer / queueBuffer / acquireBuffer / releaseBuffer,但没讲"到底有几个格子";ep09 结尾把"三档相位怎么随多刷新率走"明写留给 ep11;ep10 §0.3 又把"多刷新率与 ARR"和"三缓冲与 buffer stuffing"两笔账一起挂到了 ep11 名下。这一篇来还这三笔债。
三篇共用同一条链路,各篇量的东西仍然不同:
| 维度 | ep04《BufferQueue》 | ep09 / ep10《Vsync》 | ep11(本篇) |
|---|---|---|---|
| 关心的对象 | 缓冲区的流转:谁是生产者、谁是消费者 | 节拍的来源与相位差 | 队列有多深 × 屏幕有几个档 × 换档是"切档"还是"改步长" |
| 量什么 | 四态迁移与引用计数 | 派发对象、速率、三档相位 | 槽位数、BufferStuffing 计数、三个区间、投票汇总、零次切换 |
| 主要命令 | dumpsys SurfaceFlinger 的 Layer 段 |
Scheduler 相位段 / VsyncDispatch 段 |
Slots: 段 + --timestats + dumpsys display + DMD 日志 |
| 典型结论 | 四态迁移与 fence 语义 | 本机三档全 1 ms;就绪→上屏 6.17 / 15.96 ms | 槽位只有两格;appBufferStuffingJankyFrames 2326;refreshRateSwitches=0 |
本篇也不涉及:应用侧 Choreographer 的调度细节(ep02)、SF 合成归属与 HWC 判定(ep08)、逐帧 jank 时序与 Perfetto 用法本身(T01《图形性能剖析工具链》与本系列 ep13)、厂商私有的刷新率策略(LTPO 面板调参与厂商白名单,未公开)、功耗与带宽取舍(《移动端图形与功耗》专题)。为什么不涉及:这一篇的价值集中在"两个默认"这一个点上——把几格、谁定格数、几个档、档怎么被选出来这四问讲透,掺进别的题域就讲不透了。完整边界见 §0.3。
系列文章写作风格说明(沿用前十篇,不再重复解释)
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 三层分开说:官方文档怎么写、AOSP 源码怎么做、设备上读出来是什么,这三层分开陈述,不混成一句;
- 读数标口径:每一个数字都标来源与条件(机型、Android 版本、命令、采样时刻);
- "设备报的"与"人写的"分开读:这是本篇最要紧的一条纪律——可用档位表是设备报的,区间上限是人写的。凡涉及"能跑到多少"的结论,一律标明它是来自设备自报、来自平台配置,还是来自我们刚刚写进去的设置;
- 模拟器结论不外推:本篇所有读数来自一台 Android 16 模拟器,一个 60 Hz 单档的屏。凡是"多档设备会怎样"的话,本篇一律标为转述官方或标为待验证。
系列主要内容总览
- 【Android 图形显示系统】(一) 总览:从 App 到屏幕的图形管线
- 【Android 图形显示系统】(二) Choreographer:谁在召唤 Vsync
- 【Android 图形显示系统】(三) RenderThread 与帧提交:从显示模块到一块缓冲
- 【Android 图形显示系统】(四) BufferQueue:图形缓冲区的邮局
- 【Android 图形显示系统】(五) Vulkan on Android:低开销渲染入口
- 【Android 图形显示系统】(六) SurfaceFlinger:在 Vsync 之后做什么
- 【Android 图形显示系统】(七) ASurfaceControl:Android 10 的透明事务
- 【Android 图形显示系统】(八) HWC:GPU 合成之外的硬件叠加
- 【Android 图形显示系统】(九) HWC2:Vsync 回调和虚拟显示路径
- 【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞
- 【Android 图形显示系统】(十一) 三缓冲、多刷新率与 ARR(本篇)
- 【Android 图形显示系统】(十二) 虚拟显示与屏幕录制
- 【Android 图形显示系统】(十三) 剖帧实战:Perfetto FrameTimeline 抓 jank
相关资源链接
- 官方文档:Adaptive refresh rate (ARR)(AOSP) | Multiple refresh rate(AOSP) | BufferQueue and Gralloc(AOSP) | 了解 systrace(AOSP)
- 应用侧:Frame rate(Android Developers) | Optimize frame rate with adaptive refresh rate | 界面卡顿检测
- 量化定义:Android Jank detection with FrameTimeline(Perfetto)
- 源码:
frameworks/native/libs/gui/include/gui/下的BufferQueueCore.h、BufferQueueProducer.h、BufferQueueDefs.h、JankInfo.h
这一篇回答什么,不回答什么
OK,先把坐标系挪正。前十篇给了地图、叫醒链、交接、邮局、入口、关口、改动、归属、节拍、错开;这一篇要还的是"默认值"这笔账——队列默认够深、屏幕默认只有一个档,这两个默认各撑起了前文的一大片结论,而它们从来没被打开过。
先说清它跟前一篇的关系:ep10 量的是"错开多少",它给出的关键数字是 app phase: 1000000 ns、SF phase: 1000000 ns、app duration: 16666666 ns——注意最后那个数,16,666,666 纳秒正好是 60 Hz 的一个周期。这一个数就把 ep10 的计算前提露出来了:它所有关于相位的算式,分母都是那一档给出来的。换一档,分母就换了;而如果屏幕能每帧换一次步长,那连"分母"这个说法都要改。这就是本篇要接上的地方。
0.0 内容总览:本篇知识地图
好了,先把十一章各自回答的问题钉在一张表上。它同时也是本篇的目录总览。如果时间紧,第二章(五个成员怎么算出槽位数)、第七章(平台的投票汇总)、第九章(ARR 与 MRR 互斥)是这篇最不可替代的三章:第二章给"格数从哪来",第七章给"请求侧怎么被合并",第九章给"两种屏的分界"。
| 章 | 本章问句 | 关键读数或原文 |
|---|---|---|
| 零 | 这一篇回答什么、不回答什么 | NUM_FRAMEBUFFER_SURFACE_BUFFERS=2 / "Android apps are always triple buffered" |
| 一 | "三缓冲"到底指什么 | "SurfaceFlinger 中可能只有一个待处理帧在等待" |
| 二 | 槽位数是配的还是算的 | getMaxBufferCountLocked() 的五个成员 |
| 三 | 队列被塞满会怎样 | "more of a state than a jank";appBufferStuffingJankyFrames |
| 四 | 本机到底有几格 | Slots: 两行(1 ACQUIRED + 1 FREE) |
| 五 | 多刷新率的请求侧长什么样 | primary / appRequest × physical / render 六个边界 |
| 六 | 谁在为刷新率投票 | 五层 requestedFrameRate: {0.00 Hz ... NoPreference} |
| 七 | 平台怎么把票汇总成一个档 | VoteSummary{...};Found available modes=[{...60.000004}] |
| 八 | 改设置能改到什么 | maxPhysicalRefreshRate 90→120→∞,物理侧四项不动 |
| 九 | ARR 与多刷新率差在哪 | vrrConfig=N/A;"either MRR or ARR, but not both" |
| 十 | 哪些只能上真机 | refreshRateSwitches=0;833 ≠ 462+367 |
0.1 本篇那个"反直觉的对照"
好了,先把这个对照摆出来,因为它撑住了整篇的骨架。
第一件事:本机的队列只有两格,而且设备自己把格数写在了配置里。
Build configuration: [sf PRESENT_TIME_OFFSET=0 FORCE_HWC_FOR_RBG_TO_YUV=0 MAX_VIRT_DISPLAY_DIM=0 RUNNING_WITHOUT_SYNC_FRAMEWORK=0 NUM_FRAMEBUFFER_SURFACE_BUFFERS=2]
NUM_FRAMEBUFFER_SURFACE_BUFFERS=2 —— 这个 2 不是随便来的,它是 SurfaceFlinger 在 BoardConfig 层面记下来的"这块 framebuffer 几个槽"。而同一份 dump 往下翻,对应的那条队列把槽位一格一格地印了出来:
      Slots:
       >[01:0x7802ff32b050] state=ACQUIRED 0x78017f325580 frame=539 [1080x2400:   0,  1]
        [00:0x7802ff328020] state=FREE     0x78017f324390 frame=538 [1080x2400:   0,  1]
两行。一格正被下游持有(frame=539),一格空着(frame=538)。 而且两个帧号是连续的——538 与 539,就是相邻两帧。这就是题图上那两端里的左边那端:队列的格数。
第二件事:同样是"三格"这个说法,官方文档在另一处写得很不一样。
"Android apps are always triple buffered."——AOSP《了解 systrace》
一处数出来两格,一处说"始终三缓冲"。初看像打架,其实是两句话在说两个不同的队列。 准确地说,AOSP 那句话的完整版是这样的:
"……虽然应用始终会进行三重缓冲,但 SurfaceFlinger 中可能只有一个待处理帧在等待,这样它就看起来与双重缓冲一样。"
结论就是这一句:应用侧那条队列的格数,和 SurfaceFlinger 里那条队列的格数,不是同一件事。本机的 Slots: 段印出来的,恰好是后者——SF 喂给 HWC 的那一条。这个"看起来像双缓冲"的现场,就是本篇第一章要拆的第一个结。
第三件事:换到屏幕那一侧,同一份 dump 里还有一组更微妙的对照。
displayManagerPolicy={defaultModeId=0, allowGroupSwitching=false,
  primaryRanges={physical=[0.00 Hz, inf Hz], render=[0.00 Hz, 60.00 Hz]},
  appRequestRanges={physical=[0.00 Hz, inf Hz], render=[0.00 Hz, inf Hz]} idleScreenConfig=nullptr}
两个区间,每个区间又分 physical 与 render 两栏——一共六个边界。 而 primary 那一侧的 render 上界是 60.00 Hz,appRequest 那一侧却是 inf Hz:应用能请求的范围,比平台自己允许的更宽。
再看一句同一条日志里的东西:
VoteSummary{ minPhysicalRefreshRate=0.0, maxPhysicalRefreshRate=120.0, minRenderFrameRate=0.0,
  maxRenderFrameRate=60.0, ... requestRefreshRates=[], ... }
上限写着 120,可用档位表里只有一个 60,而 requestRefreshRates 是空的。 三个数字放在一起,问题就出来了:这个 120 是谁写的?为什么它带不动档位表?为什么没有一层投票?
这一篇就是回答这三个问题的。
承接上一篇。ep10 的结论是"相位是配出来的,不是量出来的"——那篇把三档相位的来源追到了 BoardConfig.mk。到这一篇,我们要换个对象接着追:格数是从哪来的,档位表是谁报的,而"我请求了"和"我能得到"之间的距离有多远。
0.2 与相邻篇目的分工
三篇都在讲"队列与节拍",但各篇量的东西不同,这里一次说清:
| 维度 | ep04《BufferQueue》 | ep09 / ep10《Vsync》 | ep11(本篇) |
|---|---|---|---|
| 关心的对象 | 缓冲区的流转:四态迁移、引用计数、fence | 节拍的来源、派发对象与相位差 | 格数、槽位占用、塞满的状态、档位表与请求侧 |
| 量什么 | 状态机与计数 | 派发速率、三档相位、上屏间隔 | Slots: 行数、mMaxDequeuedBufferCount、appBufferStuffingJankyFrames、refreshRateSwitches |
| 一句话结论 | 信封怎么传 | 节拍谁在派、错开多少 | 邮筒有几格,以及收信节奏能不能换 |
0.3 边界声明:本篇不涉及什么,以及关键参数
本篇展开:三缓冲这个说法到底指着什么(第一章);槽位数由哪些成员联合决定(第二章);队列被塞满是一种什么状态、它怎么被数出来(第三章);本机的槽位现场(第四章);多刷新率的三个区间与六个边界(第五章);谁在投票(第六章);平台怎么把票汇总成一个档(第七章);一次请求侧实验(第八章);ARR 与 MRR 的分界(第九章);只能上真机的四件事(第十章)。
本篇不涉及:Choreographer 的调度细节(ep02);SF 的合成归属与 HWC 判定(ep08);Perfetto / RenderDoc 的工具用法与逐帧时序(T01 与 ep13);虚拟显示与屏幕录制(ep12);厂商私有的刷新率策略(LTPO 面板调参、厂商白名单、游戏模式干预策略——未公开,本篇只写 AOSP 通用链路);功耗与带宽取舍(《移动端图形与功耗》)。
关键参数取值范围(本篇反复用到的几个数,先钉在这里):
| 参数 | 本机实测值 | 说明 |
|---|---|---|
NUM_FRAMEBUFFER_SURFACE_BUFFERS |
2 | SurfaceFlinger 的 framebuffer 槽数(构建期配置) |
mMaxDequeuedBufferCount / mMaxAcquiredBufferCount |
1 / 1 | 生产者一次最多 dequeue 数 / 消费者一次最多 acquire 数 |
default-size |
1080x2400 | 本条队列的默认缓冲尺寸 |
supportedRefreshRates |
[60.000004] | 设备自报的可用刷新率(只有一个) |
maxRenderFrameRate(默认态) |
60.0 | 渲染帧率上限 |
refreshRateSwitches |
0 | 统计窗内刷新率切换次数(约 4 小时 54 分) |
0.4 本篇怎么读:三条判据贯穿全篇
好了,这一篇的读法跟前一篇不同。ep10 的判据管的是"这个数是配的还是会量的",本篇管的是"这一层有没有权力"。三条判据:
- 判据一:档位表是设备报的,上限是人写的。 同一条日志里,
Found available modes=[{... fps=60.000004}]与maxPhysicalRefreshRate=120.0并列。前者来自设备自报,后者来自一份设置。写设置只能改后者——第八章会用一组实验把这件事钉死。 - 判据二:有没有人投票,是可读的。 请求侧不是黑盒:
Layer Hierarchy里每一层都带着一条requestedFrameRate,平台侧的VoteSummary里又有一个requestRefreshRates。两处独立印出同一件事,第六章与第七章会各读一次、然后交叉验证。 - 判据三:三缓冲不是开关,是一个"和"。 格数由若干个计数联合算出,而不是一个布尔量。所以"改一个开关就变成三缓冲"这种说法,从机制上就不成立。 第二章给公式,第四章给现场。
三条判据的性质也不一样,别混用:判据一管"谁能改",判据二管"谁在说话",判据三管"数从哪来"。它们各自解决的问题不同,所以下文的每一章都会先说明它落在哪一条判据上。
最后还有一条读法上的提醒:本篇的读数全部来自一台 Android 16 模拟器,它的屏只有一个 60 Hz 档。所以"多刷新率设备会怎样"这类话,本篇只做两件事——转述官方原文,或者标成待验证。模拟器上的结论,不得写成 Android 通例。
一、三缓冲:一个被读成"开关"的和
好了,上一章把那两句话摆在了一起:"应用始终三缓冲",而本机数出来两格。这一章先把这个结拆开,因为"三缓冲"这三个字在全网被用得最随意,也最容易把人带偏。
1.1 两句话在说两条队列
好了,先把两条队列分开。
第一条是应用侧的队列:应用在这里 dequeueBuffer() 拿到一块空闲缓冲,画完 queueBuffer() 还回去,SurfaceFlinger 再 acquireBuffer() 拿走、用完 releaseBuffer() 放回来。这条队列的格数,决定了应用能连着画几帧而不被挡住。
第二条是 SurfaceFlinger 自己的队列:它把合成结果交给 HWC 去送显,这一步也要一条队列——本机 Slots: 段印出来的正是这一条,因为它的生产者和消费者都是 SurfaceFlinger 自己:
(mConsumerName=unnamed-541-0, mConnectedApi=1, mConsumerUsageBits=6656, mId=21d00000000,
 producer=[541:/system/bin/surfaceflinger], consumer=[541:/system/bin/surfaceflinger])
看 producer 与 consumer 两栏:进程号 541 是同一个,都是 surfaceflinger。 这就说明了它是 SF 内部那条队列。所以"AOSP 说应用中始终三缓冲"与"本机这里只有两格"不矛盾——说的是两条不同的队列。
那 SF 为什么自己也要一条队列? 因为它把合成结果交出去之后,不能停下来等 HWC 送完——一旦同步等,SF 的下一轮合成就会被屏幕的节奏锁死。有了这条缓冲区队列(BufferQueue),SF 可以接着合成下一帧,把"送显"这一步交给屏幕的节奏去追。这条队列的作用,和第一章标题里那个"和"是同一个道理:用多出来的一格换取"上下游不必互相等"。
格数就是这条队列的"槽位(slot)数"。 本机那条队列里两格分别处于 ACQUIRED 与 FREE 两个状态,而这两个状态名正是 ep04 讲过的四态迁移里的两态——ep04 讲状态怎么走,本篇只问一共几个格子。
那为什么官方还要特意补一句"看起来与双重缓冲一样"?因为读者最容易犯的错,就是拿 SF 的槽位表去推应用的缓冲级数。这两条队列的格数由不同的地方决定,它们不是一回事,也不能互相代入。
1.2 三缓冲不是开关,是一个"和"
好了,第二个常见的误解,是把"三缓冲"当成一个布尔开关——好像有个 enableTripleBuffering 之类的东西,打开就三格、关掉就两格。机制上不是这样。
BufferQueue 的格数是算出来的。AOSP 的头文件里,这个函数自己的注释就列出了它依赖哪些成员:
// getMaxBufferCountLocked returns the maximum number of buffers that can be
// allocated at once. This value depends on the following member variables:
//     mMaxDequeuedBufferCount
//     mMaxAcquiredBufferCount
//     mMaxBufferCount
//     mAsyncMode
//     mDequeueBufferCannotBlock
五个成员,联合决定格数。 这里面没有任何一个叫"是否三缓冲"——三缓冲是这五项凑出来的结果,不是一项输入。
这个区别为什么重要? 因为它直接决定了排查方式。如果它是开关,那么"我的应用为什么只有两格"这个问题,答案会是"某个开关没打开";而既然是五个成员的和,答案就可能是任意一项变了——生产者调过 dequeue 数、消费者改过 acquire 数、或者走了异步模式多分一格。第二章把这五项逐项拆开。
再看一眼官方那句"看起来与双重缓冲一样",它的落点其实也是这个"和"字:SF 那条队列里可能只有一个待处理帧在等待,而"待处理帧数"和"格数"又是两个量——格数是容量,待处理帧数是当前占用。本机 Slots: 段给的正是这两件事的现场:容量两格,占用一格 ACQUIRED、一格 FREE。
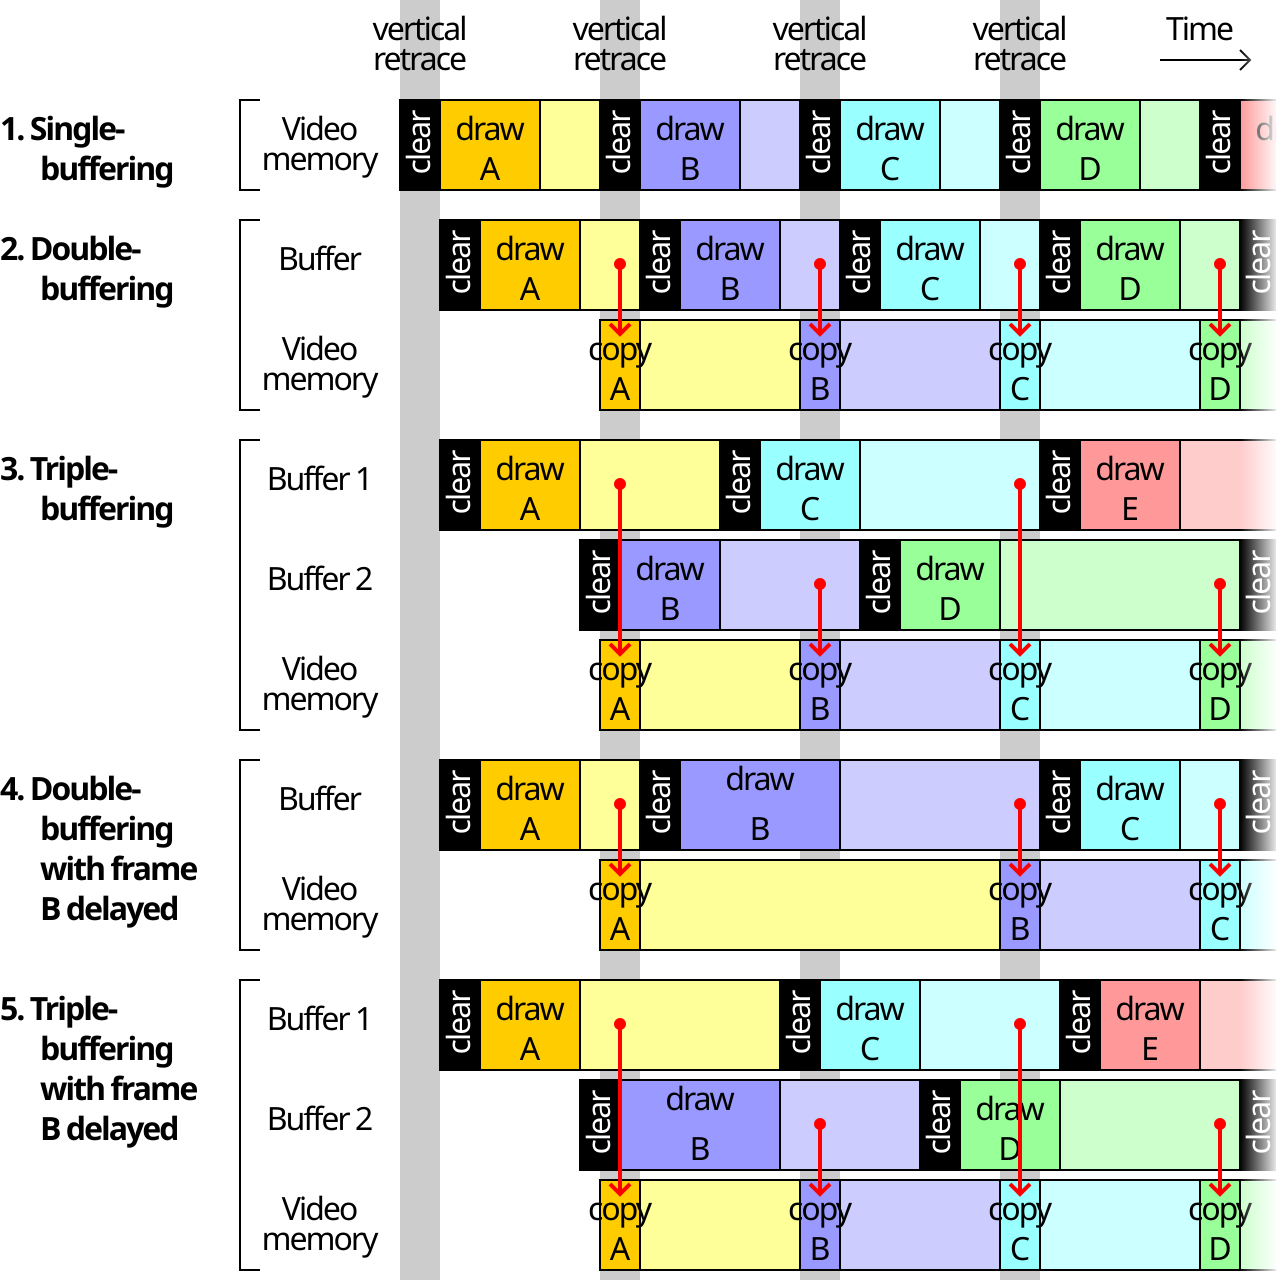
边界声明:这张图是一张通用图形学的双/三缓冲对比图,讲的是"交换缓冲"这个经典结构,它不是 Android 的 BufferQueue 实现图,也不含任何 Android 侧结论。本篇只借它说明"多一格换到的是什么"这层结构。
本章的源码与文档:AOSP 镜像 · BufferQueueCore.h | BufferQueue and Gralloc(AOSP)。这一章的定义可以收成一句:三缓冲指的是缓冲区队列里可同时存在的缓冲块数,而它的原理是"用一格换上下游不必互相等"。其中:格数是结果,五个成员是输入。
二、BufferQueue 的账本:五个成员怎么决定槽位数
好了,上一章说格数是算出来的。这一章就把那个算式拆开——逐项讲清五个成员各是什么、默认值是多少、谁能改。
2.1 五项分别是什么
先把五项的名字与含义列全(来源:AOSP frameworks/native/libs/gui/include/gui/BufferQueueCore.h 的成员注释)。
这一节先不动手,只做一件事:把这五项的名字、各自管什么、以及默认值是多少摆清楚。 为什么要专门开一节做这件事?因为下一节的现场读数全靠它们来解释——只有先知道哪几项会"白加一格"、哪几项只管"拿到格子的行为",才能看懂本机为什么是两格而不是三格,也才能在换一台设备、或换一个应用之后,判断出差异到底出在哪一项上。所以这一节虽短,却是后面所有格数讨论的解释框架:先有这张表,再看读数。
| 成员 | 含义(原文摘译) | 本机实测 |
|---|---|---|
mMaxDequeuedBufferCount |
生产者一次最多能 dequeue 几个;"It defaults to 1" | 1 |
mMaxAcquiredBufferCount |
消费者一次最多能 acquire 几个;"It defaults to 1" | 1 |
mMaxBufferCount |
允许分配的缓冲块数上限 | —(未单独印出) |
mAsyncMode |
是否异步模式;异步下"会多分配一块 buffer" | 0(非异步) |
mDequeueBufferCannotBlock |
dequeueBuffer 是否不允许阻塞 |
0(允许阻塞) |
getMaxBufferCountLocked(),输出可用格数@ 本系列绘制注意这五项里有两项是"钩子":mAsyncMode 一开,会白多一格;mDequeueBufferCannotBlock 一开,拿不到格子时不再等。这两项都直接改变了"格数"或"拿到格子的行为",却都不叫"三缓冲"。
2.2 两个计数的默认值都是 1,但改它们的权限不对称
好了,五个成员里最常被生产者碰的是前两个。这两个的默认值都是 1——出厂状态下,生产者一次只能拿着一格,消费者一次也只能拿一格。
但它们的修改权限很不对称——BufferQueueCore.h 里对 mMaxAcquiredBufferCount 写得很明确:
// ... it defaults to 1, and can be changed by the consumer via
// setMaxAcquiredBufferCount, but this may only be done while no
// producer is connected to the BufferQueue.
"may only be done while no producer is connected" —— 消费者想改这个数,必须趁生产者还没接上来的时候改。为什么要有这个限制?因为它改的是"消费者一次能扣住几格",而生产者已经在按当前格数产出节奏跑了;中途改,等于把生产者的假设悄悄掀掉。
这一条给排查带来一个很实际的推论:如果你在运行时从来没改过它,那它就是默认的 1——这一点比"某个开关没打开"更好核,因为它不需要猜,只需要看 getMaxAcquiredBufferCount 之类的读数。
2.3 拿不到格子时:两条路
好了,格数定完了,还有一个问题:格子用完的时候会怎样? 这里 dequeueBuffer 有两条完全不同的路,AOSP 的接口注释把契约写得很直白:
// If no slot is available then a status of -EBUSY is returned and buf is
// unmodified.
拿不到格子,就返回 -EBUSY,并且不动输出参数。 注意它的措辞是"返回",不是"等待"——dequeueBuffer 默认不是你想象中的那个阻塞调用。
那"阻塞"这条路在哪?在实现里的 waitForFreeSlotThenRelock,它的注释解释了两件事:
// It may block if there are no available slots and we are not in non-blocking
// mode (producer and consumer controlled by the application). If it blocks,
// it will release mCore->mMutex while blocked so that other operations on
// the BufferQueue may succeed.
两个条件同时成立才阻塞:没有可用格子,并且不在非阻塞模式。而一旦阻塞,它会把 mMutex 放开——否则整个 BufferQueue 就被这个等待卡死了。
dequeueBuffer 的两条路:返回 -EBUSY 还是阻塞等待,取决于模式@ 本系列绘制本章的源码与文档:BufferQueueCore.h | BufferQueueProducer.h。这一章的公式是那条函数:getMaxBufferCountLocked() 的输出格数由五个输入决定,其中:mMaxDequeuedBufferCount 与 mMaxAcquiredBufferCount 默认都是 1,mAsyncMode 一到 1 就白多一格。这条公式的原理很简单——格数要同时满足生产者与消费者各自"一次能拿几格"的要求。
这三节连起来回答了一个问题:格数不是配置项,是五项成员加两条分支凑出来的行为。九成的"我明明是三缓冲怎么还掉帧"疑问,症结就落在这里——他们说的"三缓冲"和我们数的"格数",根本不是同一个坐标系里的东西。
三、把队列塞满:BufferStuffing 到底是什么
好了,格数讲完了,接下来该问一个新问题:如果应用产帧比上屏快,多出来的帧去哪了? 这一章讲的就是这件事——它是三缓冲的"反面":多出的那一格本来是给你周转的,一旦变成"攒着的帧",缓冲就从帮手变成了累赘。
3.1 官方给它的定义:一种"状态",不是一次掉帧
好了,先看 Perfetto 官方文档对这个现象的原话。它在 FrameTimeline 里被称为 Buffer Stuffing(缓冲塞满):
"This is more of a state than a jank. This happens if the app keeps sending new frames to SurfaceFlinger before the previous frame was even presented. The internal Buffer Queue is stuffed with buffers that are yet to be presented, hence the name, Buffer Stuffing. These extra buffers in the queue are presented only one after the other thus resulting in extra latency. ... The actual duration of work performed by the app might still be within the deadline, but due to the stuffed nature, all the frames will be presented at least one vsync late no matter how quickly the app finishes its work."
这段话里有四个要点,每个都值得单独拎出来:
- "more of a state than a jank" —— 它是一种持续状态,不是一次性事件。所以你在帧率上看不出它:应用可能每一帧都在 deadline 之内完成了工作。
- 触发条件是"上一帧还没上屏" —— 注意,不是"应用太慢",而是应用太快、比上屏快。
- 后果是"每一帧都至少晚一个 vsync" —— 强调"no matter how quickly the app finishes its work"。应用再快也没用,因为瓶颈不在它的计算,而在队列的排队。
- 队列里的帧只能一个接一个上屏 —— 这就是"extra latency"的来源。
为什么它特别值得单独讲? 因为它会骗过最常见的排查方式。应用侧一量,"我的帧时间只有 6 毫秒,远小于 16.7 毫秒的预算,怎么会卡?"——因为卡的不是它。这正是 AOSP 那套 jank 分类要把 BufferStuffing 单列一类的原因:把它算进"应用慢",会让人去优化一个本来就没问题的东西。
这个"单列一类"不是修辞,它在本机的账本上是一个具体的计数。 dumpsys SurfaceFlinger --timestats -dump 会打出整套 jank 分类,其中就有这一项:
| 计数项 | 全局累计 | launcher 层 | 状态栏层 |
|---|---|---|---|
appBufferStuffingJankyFrames |
2326 | 944 | 151 |
sfPredictionErrorJankyFrames |
1501 | 435 | 524 |
appUnattributedJankyFrames |
1195 | 329 | 263 |
sfLongCpuJankyFrames |
886 | 305 | 155 |
sfLongGpuJankyFrames |
515 | 29 | 88 |
jankyFrames(总计) |
3183 | — | — |
看第一行:全局累计 2326 次"缓冲塞满"。这是个不小的数,而且它不是从"应用慢"里来的——它就是 §3.1 那段定义所描述的状态,被平台逐帧数了下来。"队列被塞满"这件事不需要你去推,设备自己有一本账。
顺带把这张表的一条口径钉在这里(第十章会再强调一次):七项 jank 分类不能相加。 886 + 515 + 4 + 1195 + 2 + 1501 + 2326 = 6429,而总计 jankyFrames 只有 3183——一个 jank 帧可以同时命中多类,所以只能逐类读,把它们当"占比"的分子分母会立刻算错。
# jank 类型的枚举定义处(AOSP)
frameworks/native/libs/gui/include/gui/JankInfo.h      # 含 BufferStuffing 等枚举
# 本机账本里的对应计数项(--timestats -dump)
appBufferStuffingJankyFrames = 2326
3.2 攒满之后:dequeue 阻塞等待
好了,那队列一直攒下去会怎样?官方文档接着说了下一幕:"This can also result in a stage where there are no more buffers for the app to use and it goes into a dequeue blocking wait."
格数用完,应用就在 dequeueBuffer 上等。 这一句和第二章 §2.3 那条"两条路"正好接上:waitForFreeSlotThenRelock 之所以存在,就是为了应对这个时刻。注意这个因果顺序——是先塞满,再阻塞,而不是先阻塞。
这个顺序为什么重要? 因为它解释了"为什么有些卡顿是从'应用很顺'突然变成'应用被卡住'":mDequeueBufferCannotBlock 那一项如果是 0(允许阻塞,本机正是 0),应用最终会被队列拦住;如果那一项是 1,它就会一直拿到 -EBUSY 而不是等——同一份格数配置下,两项设置给出两种完全不同的手感。
3.3 这笔交换:多一格买到吞吐,付出延迟
好了,把第一章和本章连起来看,会发现三缓冲其实是一笔明确的交换。多出的那一格,买到的是"应用不必等上一帧上屏就能接着画",也就是吞吐;付出的是"帧得在队列里排一次队",也就是延迟。
这一点 Khronos 的 Vulkan 官方示例文档讲得最直白(虽然它讲的是 swapchain 而不是 BufferQueue,但交换结构同源):
"Triple buffering ... there is always an image that has already been processed available for presentation, so the GPU does not have to wait ..."
"always ... available" 就是买到的东西;而"多一张图在流水线里"就是付出去的代价。在移动端,这个代价尤其贵——《移动端图形与功耗》那个专题讲的"多一帧延迟"的账,一部分就记在这里。
所以"三缓冲好不好"这个问题本身问错了。 它是一个在"吞吐"与"延迟"之间选的档位,不是一个好坏的开关。
本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | 界面卡顿检测(Android Developers)。这一章的定义来自官方那句 a state rather than a jank,而它的原理是:队列里的帧只能一个接一个上屏,其中:appBufferStuffingJankyFrames 是本机那一项计数,它不是应用慢的度量。下一章换到设备上,看看本机这个档位实际上是多少。
四、本机的槽位现场:两格,而不是三格
好了,前三章讲的是机制。这一章开始上设备——把"本机到底有几格"这件事查实。 这一章的三张面板,都来自同一条命令的输出:dumpsys SurfaceFlinger。
4.1 第一张:槽位表本身
好了,先看那条队列的完整现场。这一段是 4.1 到 4.3 三节共用的证据,我把它整块贴出来,然后逐行拆:
      - BufferQueue mMaxAcquiredBufferCount=1 mMaxDequeuedBufferCount=1
        mDequeueBufferCannotBlock=0 mAsyncMode=0
        mQueueBufferCanDrop=0 mLegacyBufferDrop=1
        default-size=[1080x2400] default-format=1         transform-hint=00 frame-counter=539
        mTransformHintInUse=00 mAutoPrerotation=0
      FIFO(0):
      (mConsumerName=unnamed-541-0, mConnectedApi=1, mConsumerUsageBits=6656, mId=21d00000000,
       producer=[541:/system/bin/surfaceflinger], consumer=[541:/system/bin/surfaceflinger])
      Slots:
       >[01:0x7802ff32b050] state=ACQUIRED 0x78017f325580 frame=539 [1080x2400:   0,  1]
        [00:0x7802ff328020] state=FREE     0x78017f324390 frame=538 [1080x2400:   0,  1]
这一屏里有五个可核的事实:
| 事实 | 读数 | 对应第二章的哪一项 |
|---|---|---|
| 槽位只有两行 | 01 与 00 |
——(这是"和"的结果) |
| 生产者一次最多拿一格 | mMaxDequeuedBufferCount=1 |
mMaxDequeuedBufferCount(默认值) |
| 消费者一次最多扣一格 | mMaxAcquiredBufferCount=1 |
mMaxAcquiredBufferCount(默认值) |
| 非异步模式 | mAsyncMode=0 |
mAsyncMode(所以没有白多一格) |
| 允许阻塞 | mDequeueBufferCannotBlock=0 |
mDequeueBufferCannotBlock(所以会走 §3.2 那条路) |
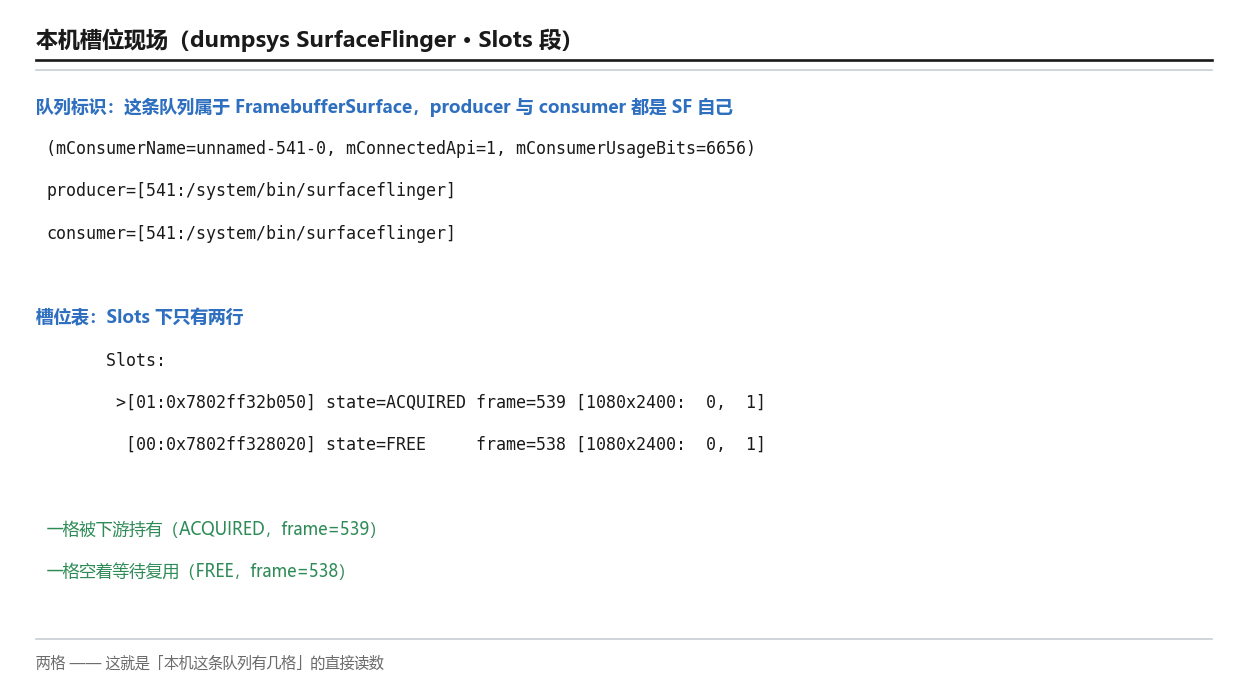
Slots: 下只有两行——一格被下游持有、一格空着(本机实测)@ 本系列绘制两格这个数字,正好对上了第二章那条推论:两个计数都是默认的 1,且没走异步模式——没有哪一项会额外加格。所以"AOSP 说应用始终三缓冲"和"本机这里两格"之间的落差,不能靠"某一项被调了"来解释。得换一个解释:这里印的本就不是应用那条队列。
4.2 第二张:格数被写进了构建配置
好了,第二张面板直接给出了那个 2 的出处:
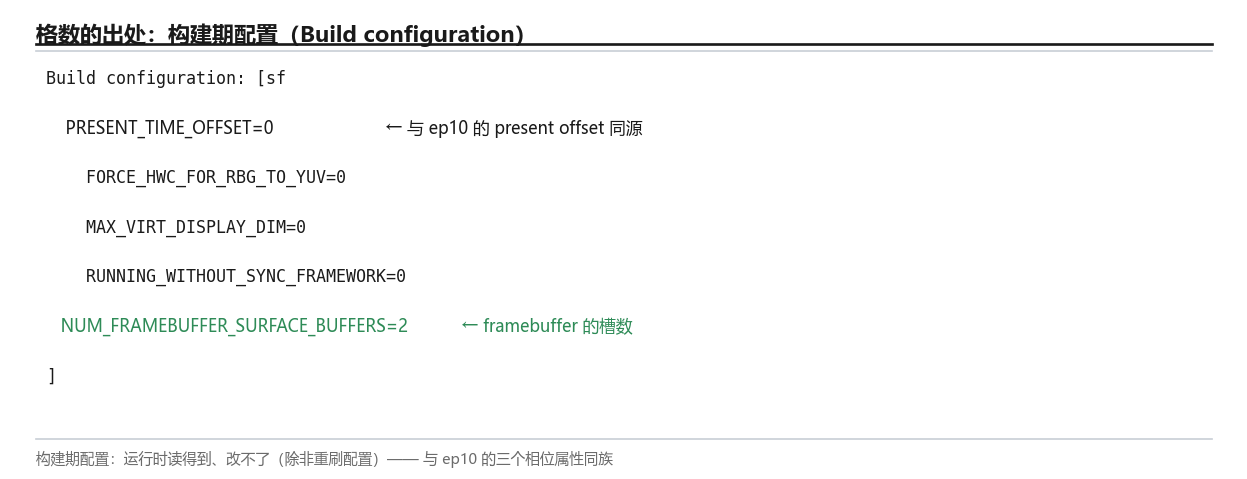
Build configuration: [sf PRESENT_TIME_OFFSET=0 FORCE_HWC_FOR_RBG_TO_YUV=0 MAX_VIRT_DISPLAY_DIM=0 RUNNING_WITHOUT_SYNC_FRAMEWORK=0 NUM_FRAMEBUFFER_SURFACE_BUFFERS=2]
Build configuration 这一行是 SurfaceFlinger 在启动时把一批构建期开关打出来的,本机一共五项。第五项 NUM_FRAMEBUFFER_SURFACE_BUFFERS=2 就是 framebuffer 的槽数。
这一项的性质值得说清:它是构建期配置,不是运行时参数——它和 ep10 里那三个相位偏移属性是同一类东西:写死在设备配置里,运行时读得到、改不了(除非重新刷配置)。判据一在这里第一次显形:格数这种量,来源是"设备报的",不是"我们量的"。
NUM_FRAMEBUFFER_SURFACE_BUFFERS=2 写在构建配置里(本机实测)@ 本系列绘制4.3 第三张:两格的帧号是连续的
好了,第三张面板回到槽位明细,但换一个看法——不看状态,看帧号。
        default-size=[1080x2400] default-format=1         transform-hint=00 frame-counter=539
      Slots:
       >[01:0x7802ff32b050] state=ACQUIRED 0x78017f325580 frame=539 [1080x2400:   0,  1]
        [00:0x7802ff328020] state=FREE     0x78017f324390 frame=538 [1080x2400:   0,  1]
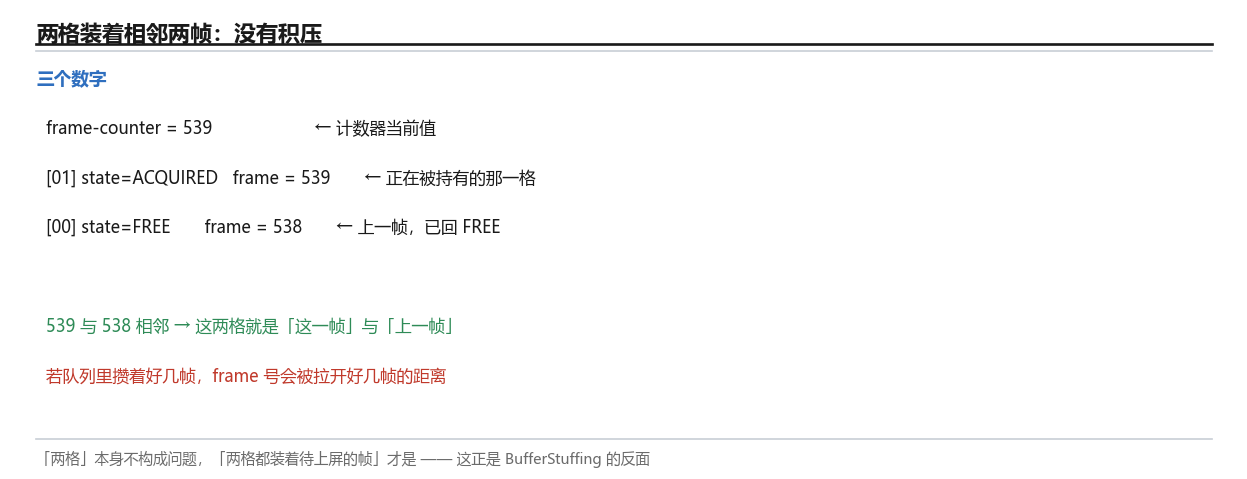
三个数字:frame-counter=539、ACQUIRED 那格 frame=539、FREE 那格 frame=538。
它们之间的关系是自洽的:计数器的当前值 539 就是正在被持有的那一格的帧号;另一格是 538,也就是上一帧——它已经被下游用完了,回到 FREE 状态等着被复用。这两格此刻分别装着"这一帧"和"上一帧"——这是从帧号直接读出来的。
这恰好是 BufferStuffing 的反面。 如果队列里攒着好几帧,我们会看到多格的 frame 号彼此拉开好几帧的距离;而这里两格紧挨着,说明没有积压。"两格"本身不构成问题,"两格都装着待上屏的帧"才是问题——这两件事的区分,正是 §3.1 那句"state 而不是 jank"的落点。
本章的源码与文档:了解 systrace(AOSP) | BufferQueue and Gralloc(AOSP)。这一章的判据定义是"容量与占用是两个量",其中:容量是 Slots: 的行数(本机 2),占用是其中处于 ACQUIRED 的行数(本机 1)。这条区分本身就是本章的原理——"看起来像双缓冲"说的是占用,不是容量。
第四章查实了一件事:本机这条队列是两格、且没积压。 到这里,队列那一侧的默认值算是打开了。下一章换到屏幕那一侧——那里有另一组默认值,而且它比格数更绕:因为它的读数是分层的。
五、多刷新率:三个区间、六个边界
好了,队列讲完了,现在换到屏幕。这一章先把"多刷新率"这东西的请求侧结构画出来。注意用词:是"请求侧"——因为本章不回答"最后选了哪一档"(那是第七章的事),只回答"这套机制长什么形状"。
5.1 三个区间、六个边界,在两处 dump 里各印一遍
好了,先看两份 dump 的并置。这两条读数来自两个不同的服务,说的是同一件事:
# dumpsys display
mDisplayModeSpecs={baseModeId=1 allowGroupSwitching=false
  primary=physical: (0.0 Infinity) render:  (0.0 60.0)
  appRequest=physical: (0.0 Infinity) render:  (0.0 Infinity)
  idleScreenRefreshRateConfig=null}

# dumpsys SurfaceFlinger
displayManagerPolicy={defaultModeId=0, allowGroupSwitching=false,
  primaryRanges={physical=[0.00 Hz, inf Hz], render=[0.00 Hz, 60.00 Hz]},
  appRequestRanges={physical=[0.00 Hz, inf Hz], render=[0.00 Hz, inf Hz]} idleScreenConfig=nullptr}
看结构,别看数值。 这里有三层结构,每一层都值得停一下:
第一层:两个区间。 primary 与 appRequest。前者是平台自己定的范围,后者是留给应用请求的范围。这不是"一个区间",是"两个来源的两个区间"。
第二层:每个区间又分两栏。 physical 与 render。物理刷新率与渲染帧率——同一台设备上,屏能跑多快、应用该按多快渲染,是两个可以分开约束的量。
第三层:两处 dump 用了两套名字。 primary ↔ primaryRanges、appRequest ↔ appRequestRanges、(0.0 60.0) ↔ [0.00 Hz, 60.00 Hz]。同一个结构,两处叫法不同。
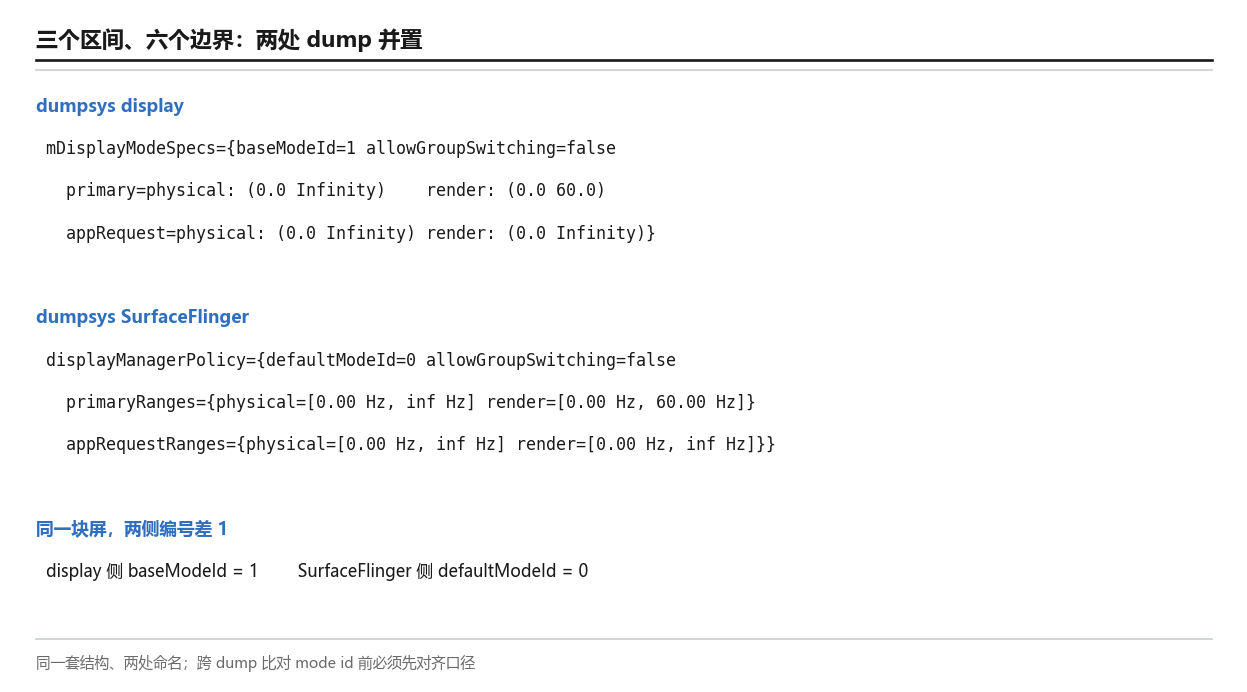
primary 与 appRequest 各分 physical 与 render(本机实测,两处 dump 并置)@ 本系列绘制还有一处更细的口径差,顺手记下。 两份 dump 里"当前档位"的编号不一样:
| 取值处 | 字段 | 值 |
|---|---|---|
dumpsys display |
baseModeId |
1 |
dumpsys display |
supportedModes[].id |
1 |
dumpsys SurfaceFlinger |
defaultModeId |
0 |
dumpsys SurfaceFlinger |
activeMode.id / hwcId |
0 |
同一块屏,display 侧叫 1,SF 侧叫 0。 这不是笔误,而是两层各自编号:SF 那边用的是 HWC 的 display mode id(从 0 起),display 服务那边用的是它自己维护的 DisplayModeRecord id(从 1 起)。所以任何"跨 dump 比对 mode id"的动作,都得先对齐口径——否则会把同一个档当成两个档来数。这条和 ep10 里"层名 / 请求侧字段"那类坑是同一族。
还有两个字段,读法也要顺手钉住。
第一个是 allowGroupSwitching=false。官方那句关于选档的话里提到过"config group"这个概念——同组的档之间切换代价低,跨组切换代价高,而 allowGroupSwitching 决定平台能不能跨组去选。本机它是 false,也就是不许跨组。这一条在单档设备上无所谓,但在多档设备上它直接决定了"选档的自由度"——如果档位分布在不同的 config group 里,而这一项又是 false,那平台就只能在当前组里挑。
第二个是 idleScreenRefreshRateConfig=nullptr(display 侧写作 idleScreenRefreshRateConfig=null)。这是"空闲时降到哪一档"的那份配置,本机是空的。 空不等于"降到最低档"——它意味着这份策略没有配。配合官方那个 set_idle_timer_ms 属性一起看:"多久算空闲"与"空闲后去哪一档"是两份配置,本机后者为空。
这两项的性质与本章开头那句判据一致:它们都属于"平台配置",读得到、改不了,而且在单档设备上体现不出差别。之所以仍要在这里登记,是因为到了多档设备上,它们会变成决定行为的两个关键开关——本篇把它们标在这里,供真机复核时对照。
5.2 内容帧率 ≠ 刷新率
好了,第二个要钉死的区分,是内容帧率与刷新率。这两个词在日常对话里常被混着用:"我这段是 24 帧的电影"、"我这台是 120 赫兹的屏"——它们说的是两个不同的东西,而且官方文档专门写过当它们不一致时会发生什么:
"if two active layers set their frame rate to 24 and 60, SurfaceFlinger will pick 120Hz if it is available. If such refresh rate is not available ... it will try to pick the refresh rate which has the minimal error for the frame rate."
读这句要抓两点:一是平台可以把刷新率选成内容帧率的整数倍(24 与 60 的最小公倍数附近,于是 120);二是当没有合适档位时,它会退而求其次选"误差最小"的那个——也就是允许不整除。
这两点合起来说明一件事:内容帧率和刷新率不是必须相等的关系,而是"被平台撮合"的关系。"24 帧的内容在 60 赫兹屏上就该显示成 24 帧"这种想法,与平台的撮合逻辑是两回事。
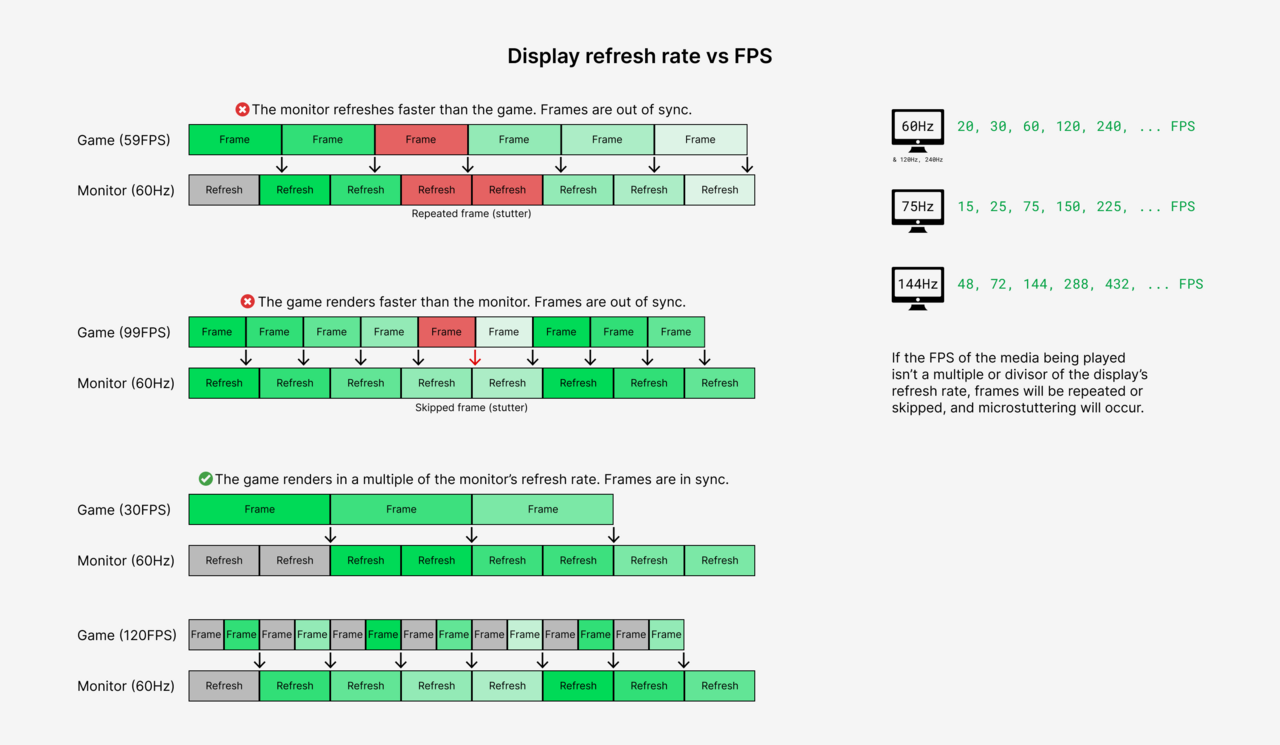
边界声明:这张图来自 Commons,讲的是"显示刷新率 vs 视频帧率"这个通用关系(位图,图内文字语言已在阶段 4 逐字核对),不是 Android 侧的实现图,也不含任何 AOSP 结论。
5.3 一张"类别表"与一张"档位表",不是一回事
好了,第三个坑更隐蔽。本机的档位面里,同时印着这两样东西:
frameRateCategoryRate FrameRateCategoryRate {normal=60.0, high=90.0}
supportedRefreshRates [60.000004]
左边那张表说:normal 类映射到 60.0、high 类映射到 90.0。右边那张说:这台设备支持的刷新率只有 60.000004。 一台只有 60 Hz 一档的屏,印着一张写着 90的类别映射表。
为什么会有这个落差? 因为"类别 → 帧率"这张表来自平台配置(它是 FrameRateCategory 这套应用侧 API 的落地依据),而"支持列表"来自设备自报。前者是承诺,后者是能力。 一台设备完全可能在"承诺表"里写着 90,而实际硬件只报得出 60。
判据一在这里第二次显形,而且比 §4.2 那次更清楚:同一屏数据里,一个数来自"人写的表",一个数来自"设备报的表"。 读的时候必须分清——否则你会以为这台设备能跑 90。
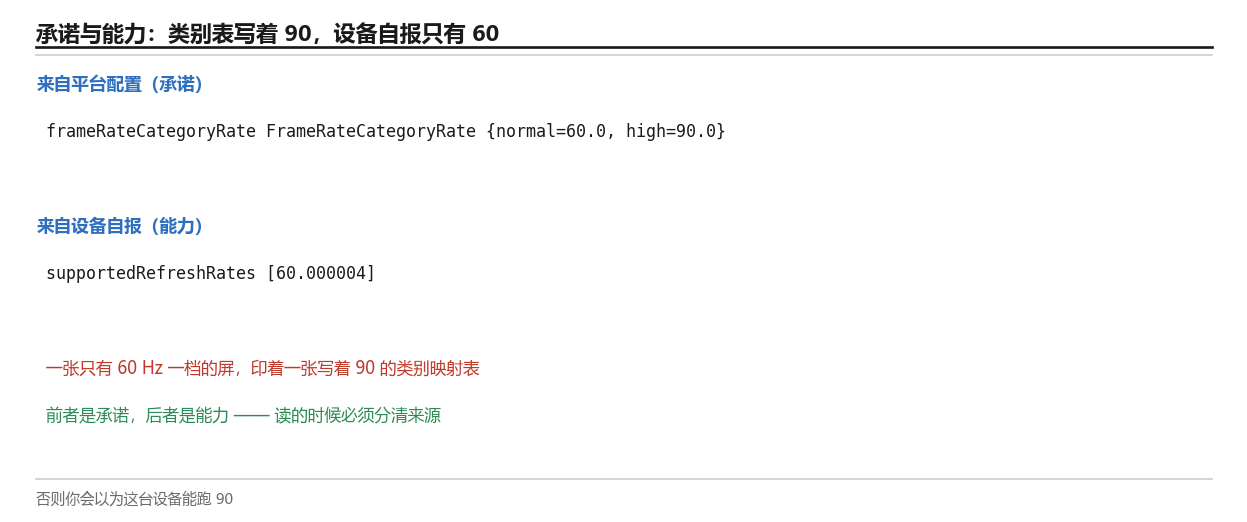
本章的源码与文档:Multiple refresh rate(AOSP) | Frame rate(Android Developers)。这一章的公式是一对区间:primary 与 appRequest 各自给出 physical 与 render 的上下界,其中:本机 primary.render 是 (0.0 60.0)、而 appRequest.render 是 (0.0 Infinity)。这条落差的原理是——平台自己受档位表约束,而应用请求的范围可以更宽。
第五章把请求侧的形状画完了:两个区间、六个边界、一套会换名的结构、一张不保证能兑现的类别表。但还有一个关键问题没碰——这些范围是谁在往里填数?下一章去读"票"。
六、谁在投票:五层各一条票
好了,上一章读的是"范围",这一章读"范围里的内容"——谁来请求、请求了什么。 这一章的落点就是判据二:"有没有人投票"在设备上是可读的。
6.1 五层,五条票,全是"无偏好"
dumpsys SurfaceFlinger 的 好了,Layer Hierarchy 段会把整棵层树打出来,而带 client handle 的每一层会额外带一段请求信息。本机这一次,带请求的层有五条:
| 层 | pid / uid | requestedFrameRate |
|---|---|---|
...NexusLauncherActivity#329 |
5196 / 10180 | {0.00 Hz FrameRateCompatibility::Default FrameRateCategory::NoPreference} |
StatusBar#104 |
917 / 10185 | {0.00 Hz FrameRateCompatibility::Default FrameRateCategory::NoPreference} |
Taskbar#137 |
5196 / 10180 | {0.00 Hz FrameRateCompatibility::Default FrameRateCategory::NoPreference} |
ScreenDecorOverlay#74 |
917 / 10185 | {0.00 Hz FrameRateCompatibility::Default FrameRateCategory::NoPreference} |
ScreenDecorOverlayBottom#77 |
917 / 10185 | {0.00 Hz FrameRateCompatibility::Default FrameRateCategory::NoPreference} |
五层、五个 0.00 Hz、五个 NoPreference。 这一段里还顺带印出了两个枚举:
FrameRateCompatibility::Default—— 帧率兼容性。这个枚举决定"平台能否把刷新率选成该帧率的整数倍"这类行为,官方建议视频类应用用FRAME_RATE_COMPATIBILITY_FIXED_SOURCE;FrameRateCategory::NoPreference—— 这正是 Android 15 ARR 那套类别枚举里的一员(NoPreference/Normal/High)。应用侧对应的 API 是View.setRequestedFrameRate()。
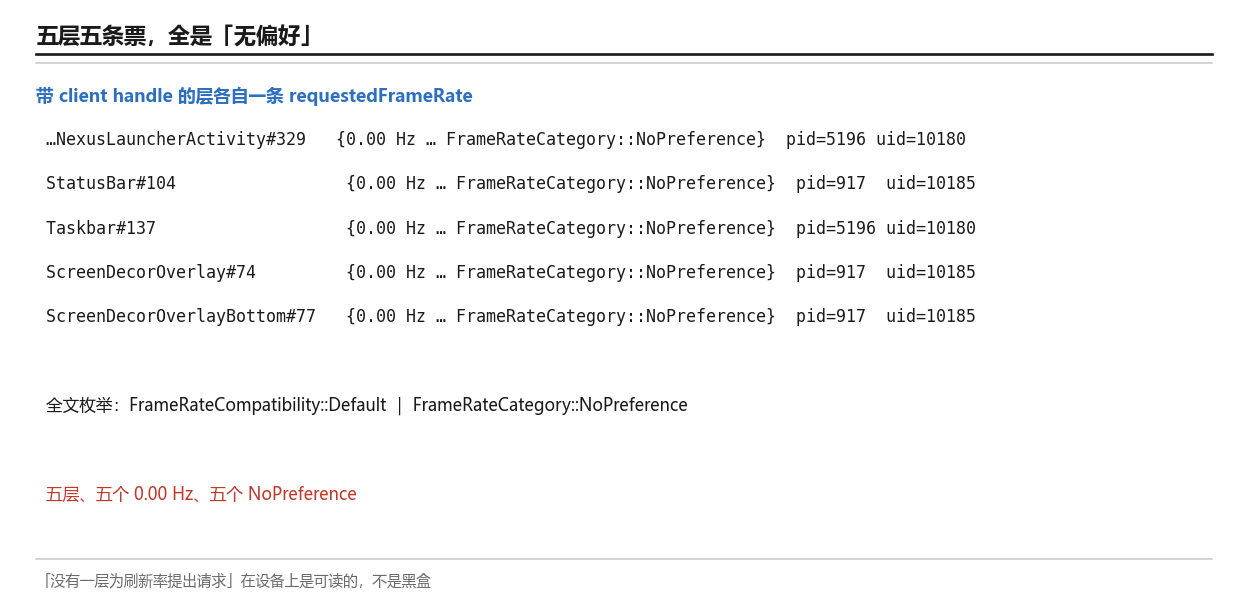
这份读数为什么值钱? 因为它把"应用没提要求"从推断变成了读数。以前只能说"我们的应用没调过 setFrameRate,所以大概没请求";现在可以直接指出设备上印着 NoPreference。这就是判据二要说的事:请求侧不是黑盒。
# 层树里每一层的请求(本机 · 摘录一行)
com.google.android.apps.nexuslaunche[...]uslauncher.NexusLauncherActivity#329
    requestedFrameRate: {0.00 Hz FrameRateCompatibility::Default FrameRateCategory::NoPreference} pid=5196 uid=10180
6.2 从"票"到"汇总":一条单向的路
好了,那这些票接下来会去哪?它们会被合并成一份汇总——第七章那张 VoteSummary。这一节的图只做一件事:把这条单向关系画清楚,因为"票"和"汇总"是两个不同的读数,混起来就会出错。
这条路上有三个容易混的点:
- 票是"每层一条",汇总是"全场一份"。 所以"我那层请求了 120"不等于"平台会给我 120"——中间要过合并;
- 合并的规则不是简单取最大。 官方文档里那个"24 与 60 合并成 120"的例子已经说明:合并的产物可能是谁都没请求过的第三个值;
- 没人投票本身是一种合法状态。 本机五层全是
NoPreference,平台就会落到默认档——这不是"机制坏了",而是"机制正常地收到了空输入"。
本章的源码与文档:Optimize frame rate with adaptive refresh rate(Android Developers) | Multiple refresh rate(AOSP)。这一章的定义是"票(request)"与"汇总(summary)"的分野,其中:票按层计(每层一条),汇总按场计(全场一份)。这条不对称的原理是——多个请求必须被合并成一个可执行的档位。
第六章查实了一件事:本机没有任何一层为刷新率请求过。 那么问题马上就来了——没有票的汇总长什么样? 下一章去读平台自己印出来的那份账。
七、平台自己的账:VoteSummary 逐字段
好了,上一章读的是"输入",这一章读"输出"——平台把票合并之后得出的那份结论。 这一章的三张面板全部来自同一个开关,先说这个开关。
7.1 先把平台的日志打开
cmd display 里有一个子命令:dmd-logging-enable。dmd 是显示模式主管(Display Mode Director)的缩写——它就是那套区间/投票逻辑的宿主。打开它之后,logcat -s DisplayModeDirector 会把每一次决策的输入与结论都打出来。
本机在这一段里印出的原话是这样的(下图是四态对照,先看其中一态):
Found available modes=[{id=1, width=1080, height=2400, fps=60.000004, vsync=60.000004,
  synthetic=false, alternativeRefreshRates=[], supportedHdrTypes=[]}]
  with lowest priority considered PRIORITY_DEFAULT_REFRESH_RATE and summary:
VoteSummary{ minPhysicalRefreshRate=0.0, maxPhysicalRefreshRate=120.0,
  minRenderFrameRate=0.0, maxRenderFrameRate=60.0,
  width=1080, height=2400, minWidth=0, minHeight=0,
  disableRefreshRateSwitching=false, appRequestBaseModeRefreshRate=0.0,
  requestRefreshRates=[], supportedRefreshRates=null, supportedModeIds=null,
  rejectedModeIds=[], mIsDisplayResolutionRangeVotingEnabled=true,
  mSupportedModesVoteEnabled=false, mSupportsFrameRateOverride=true }
一句话里有三样东西:① 有哪些档可选(Found available modes);② 汇总出来的六个边界与若干开关(VoteSummary{...});③ 最后落到哪个优先级去选(considered PRIORITY_DEFAULT_REFRESH_RATE)。
这就相当于把上一章"从票到汇总"那条黑线拆开摆在了桌上。 我们不用去猜合并规则,设备自己把输入与输出都印了。
7.2 四态对照:只有一项在动
好了,现在把四个状态并排看。做法很简单:改一个设置值,看这条日志里哪些字段跟着动。
| 状态 | maxPhysicalRefreshRate |
maxRenderFrameRate |
minPhysicalRefreshRate |
minRenderFrameRate |
requestRefreshRates |
可用档位 | 生效优先级 |
|---|---|---|---|---|---|---|---|
peak 未设 |
Infinity |
60.0 |
0.0 |
0.0 |
[] |
[{id=1, fps=60.000004}] |
PRIORITY_DEFAULT_REFRESH_RATE |
peak=90 |
90.0 |
60.0 |
0.0 |
0.0 |
[] |
同上(一档) | 同上 |
peak=120 |
120.0 |
60.0 |
0.0 |
0.0 |
[] |
同上(一档) | 同上 |
删掉 peak |
Infinity |
60.0 |
0.0 |
0.0 |
[] |
同上(一档) | 同上 |
四行里只有一列在变:maxPhysicalRefreshRate(Infinity → 90 → 120 → Infinity)。其余七列一字不差。
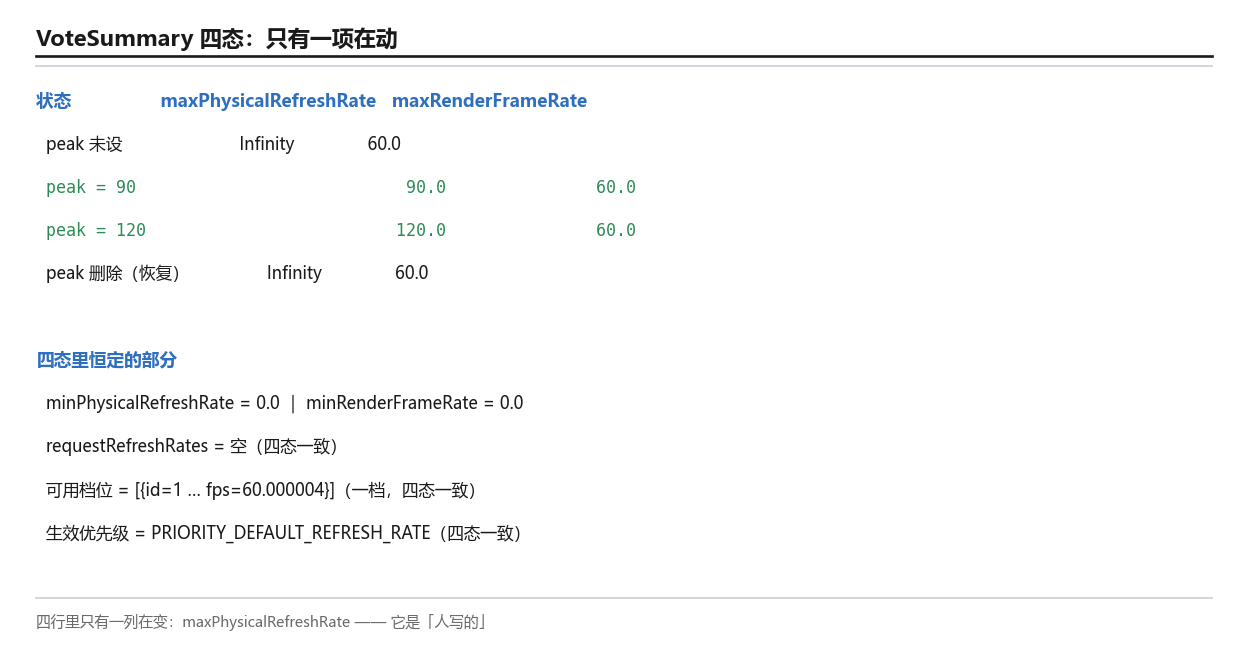
VoteSummary 四态:只有 maxPhysicalRefreshRate 跟着设置走,其余一字不差(本机实测)@ 本系列绘制这张表的读法就是判据一。 maxPhysicalRefreshRate 是"人写的"那一类——它就是被设置值直接推上去的;而 maxRenderFrameRate=60.0 是"设备报的"那一类——它与档位表绑在一起,写设置改不动它。两边并列在同一行里,谁有权力、谁没权力,一眼就看出来了。
7.3 Found available modes 四态一字不差
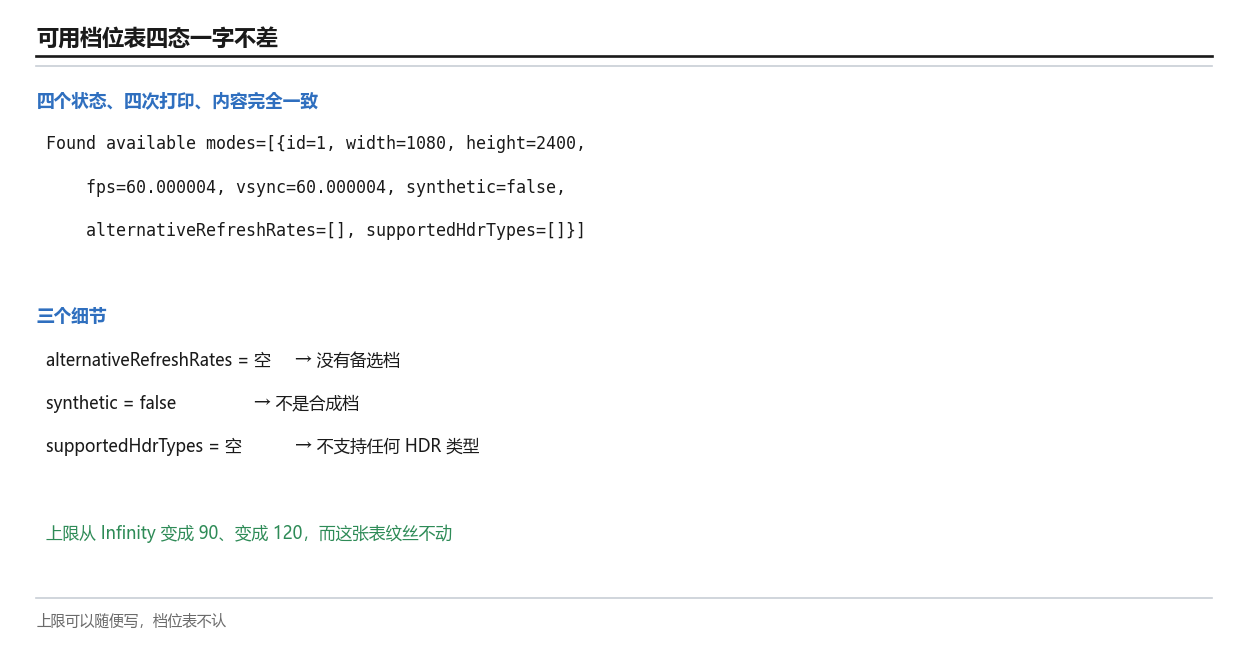
好了,再单独看一眼第二样东西,因为它比上一张表更干净——它是设备的"能力清单",而它在四个状态里完全没动:
Found available modes=[{id=1, width=1080, height=2400, fps=60.000004, vsync=60.000004,
  synthetic=false, alternativeRefreshRates=[], supportedHdrTypes=[]}]
四个状态、四次打印、一字不差。 里面还带着三个细节:alternativeRefreshRates=[](没有备选档)、synthetic=false(不是合成档)、supportedHdrTypes=[](不支持任何 HDR 类型)。这三项其实在说同一件事:这台设备的能力清单非常“素”——没有备选档、没有合成档、连 HDR 类型都是空的。而这恰好是一台模拟器该有的样子:它不需要真去驱动一块面板,只需要把一份最小可用的能力描述报给上层。所以这一段的读法不是“这台设备能力弱”,而是“这四行字描述的是设备自报,不是我们的配置”——它与 §7.2 那张会跟着设置变的表,正好构成一组对照。
把 §7.2 与 §7.3 合起来读,就是判据一的完整版:同一份日志里,"上限"从无穷变成 90、变成 120,而"可用档位"始终只有那一档。 上限可以随便写,档位表不认。
7.4 落到哪个优先级去选
好了,最后看第三样东西:considered PRIORITY_DEFAULT_REFRESH_RATE。这一句说的是最终按哪个优先级的票去定档。
为什么是"默认档"这个最低的优先级? 因为没有更高的票——requestRefreshRates=[],没有应用层请求。平台的逻辑是"按优先级从高到低找,谁有票听谁的";本机最高只收到默认档那一层,所以结论就是它。
这就把判据二补完了:不但"有没有人投票"可读,"最终听了谁"也可读。而且这两个读数来源不同——一个在 Layer Hierarchy(层侧原始票),一个在 DMD 日志(平台侧汇总),互相印证。
VoteSummary 里还有三个布尔开关,值同样值得读一遍。 它们不参与"边界"的计算,但描述的是"这套机制此刻被允许做什么":
| 开关 | 本机值 | 读法 |
|---|---|---|
mSupportsFrameRateOverride |
true |
支持"逐应用帧率覆盖" |
mSupportedModesVoteEnabled |
false |
"按支持的档位投票"这条路没开 |
mIsDisplayResolutionRangeVotingEnabled |
true |
分辨率范围的投票是开的 |
disableRefreshRateSwitching |
false |
没有禁掉刷新率切换(false = 允许) |
第二行与第四行放在一起看,会得出一个反直觉的组合:"允许切档"是 true,而"支持按档位投票"是 false。 这套机制此刻的状态是"切档没有被禁掉,但没有一个能投出档位的票源"——这与 §6.1 那五条 NoPreference、§7.3 那张只有一档的列表完全自洽。
再补一个同族的读数(在另一处 dump 里):frameRateOverrideConfig=Enabled,而同时印着的 FrameRateOverrides=none、GameFrameRateOverrides=(空)。又一次"功能开着、却一条生效的都没有"——判据二在这里有了第二个侧面:不但"有没有票"可读,"有没有生效的覆盖"也可读。
本章的源码与文档:Adaptive refresh rate (ARR)(AOSP) | Display(Android Developers)。这一章的公式是一份汇总:VoteSummary 的六个边界由各路票合并而来,其中:本机只有 maxPhysicalRefreshRate 随设置变化,maxRenderFrameRate 恒为 60.0。这条不对称的原理是——上限可以被请求抬高,而渲染上限受设备能力约束。
第七章把平台那份账读完了:输入为空、上限可写、档位不动、结论落到默认档。但"上限可以写"这件事,我们只是"读"到了——下一步该动手验一遍。
八、一次请求侧实验:只动了一个数
好了,前十篇里我们做过不少"只读"的实测,这一章换一种:动手改,看谁跟着动。 这一章的三次实验全部围绕同一组设置项,而且每次都把改前改后各抓一遍。
8.1 三个实验,三次前后对照
好了,三次实验都做同一件事:改一个设置值,然后重新读两处 dump 的区间。
| # | 操作 | 命令返回 | primary.render 区间 |
说明 |
|---|---|---|---|---|
| 一 | cmd display set-user-preferred-display-mode 1080 2400 90 |
异常 | 未变 | 见下文 |
| 二 | settings put system peak_refresh_rate 90 |
无输出 | (0.0 60.0) → (0.0 60.0)(未变);而 primary.physical 与 appRequest.* 的上限都变成 90 |
上限跟着走 |
| 三 | settings put system min_refresh_rate 90 |
无输出 | (0.0 60.0) → (0.0 Infinity) |
下界丢掉了 |
先说实验一那一次异常。官方给的"用户首选显示模式"这条路径(对应 WindowManager.LayoutParams.preferredDisplayModeId 那一族的底层设置)在本机的返回是:
Exception occurred while executing 'set-user-preferred-display-mode':
java.lang.SecurityException: Package android does not belong to 2000
    at com.android.server.display.DisplayManagerService.setUserPreferredDisplayModeInternal(...)
does not belong to 2000 —— 2000 是 shell 的 uid,而这条路径要写的是 Global settings。这条请求路径在 user 构建上被权限挡住了,而不是"设备不支持"。 这两个结论完全不同:一个是"能力没有",一个是"权限没有"。按本系列的纪律,"做不到"必须分档记——这里是"权限挡住",不是"设备做不到"。
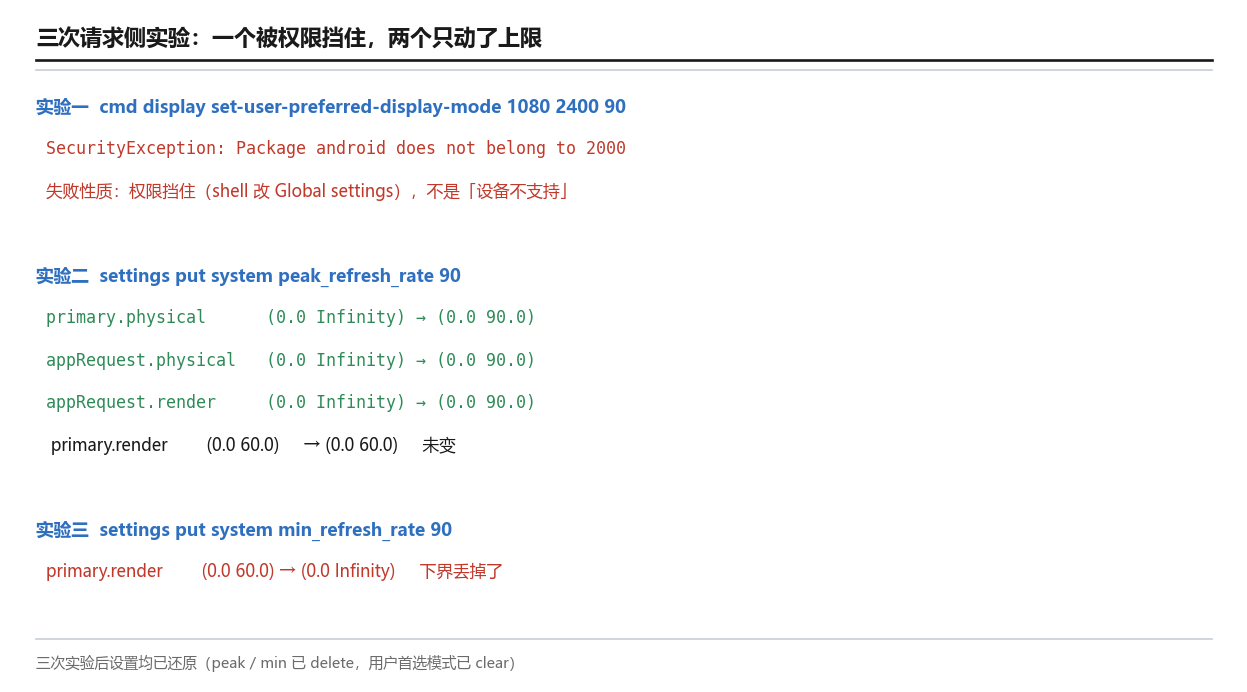
再说实验二那一次成功。peak_refresh_rate=90 之后,两处 dump 的区间都动了——但动的只有上限:
| 字段 | 改前 | 改后 |
|---|---|---|
primary.physical |
(0.0 Infinity) |
(0.0 90.0) |
appRequest.physical |
(0.0 Infinity) |
(0.0 90.0) |
appRequest.render |
(0.0 Infinity) |
(0.0 90.0) |
primary.render |
(0.0 60.0) |
(0.0 60.0)(未变) |
注意最后一行:primary.render 的上界本来就是 60,它来自设备支持的档位,没被设置改。而 appRequest 那两栏本来是 Infinity,被压到了 90。同一份结构里,"能改的"与"改不动的"并排躺着。
8.2 四个恒定量:物理侧全程没动
好了,上面那张表说的是"区间"。这一节换一个角度看物理侧——也就是"这台设备实际上能做什么"。三次实验、六次读取,下面四个量一次都没变:
| 恒定量 | 六次读取的值 | 含义 |
|---|---|---|
mSupportedRefreshRates |
[60.000004] |
设备自报的可用刷新率列表 |
mActiveRenderFrameRate |
60.000004 |
当前实际的渲染帧率 |
renderRate(SF 侧) |
60.00 Hz |
SF 侧记的渲染速率 |
peak-refresh-rate(SF 侧) |
60.00 Hz |
SF 侧读到的峰值刷新率 |
四个量 + 六次读取 = 二十四个读数,无一变化。 而与此同时,区间上限从 Infinity 变成 90、变成 120、又变回 Infinity。
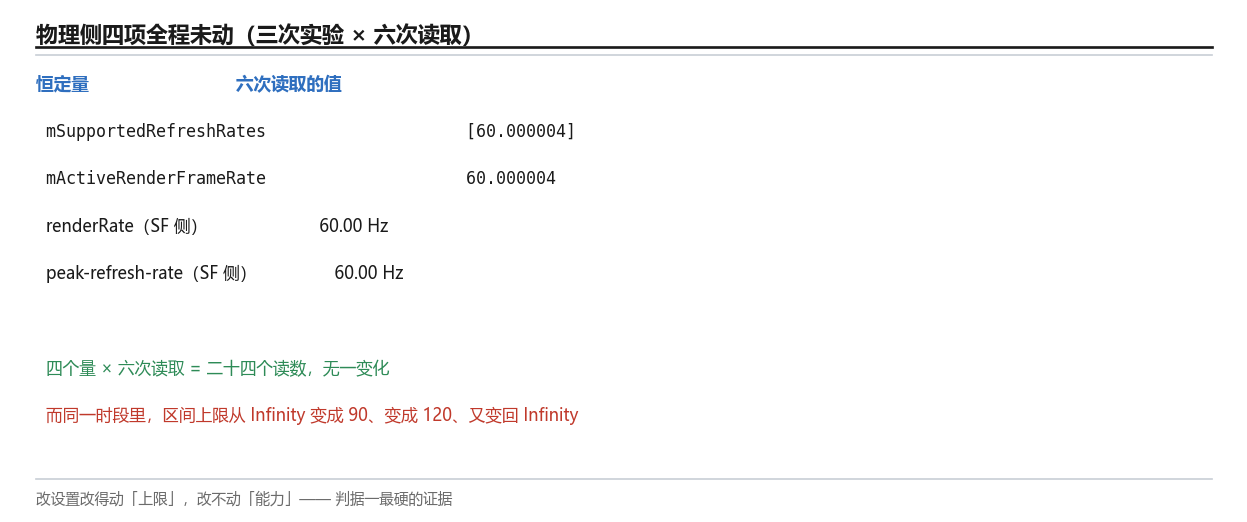
这张面板是判据一最硬的证据。 到这一步,"档位表是设备报的、上限是人写的"这句话,已经不再是读文档得出的印象,而是一组受控实验的结论。
顺手记一个细节:SF 侧那个 peak-refresh-rate 印的是 60.00 Hz,而我们在 settings 里写的是 90。两个"峰值刷新率"——一个来自设置、一个来自 SF 侧的计算——名字一样、值不一样。这一条归到 §10.1 那类"同名两数"里去。
8.3 实验三留下的一个悬置点
好了,第三次实验的结果最反直觉:min_refresh_rate=90 之后,primary.render 从 (0.0 60.0) 变成了 (0.0 Infinity)。
为什么反直觉? 因为如果你先看了实验二,会自然得出一个模型:"上限 = peak 的值,下限 = min 的值"。按这个模型,min=90 应该得到 [90, 60] 或者某种被夹住的区间。可实际得到的是 (0, ∞)——下界完全丢掉了,一点约束都没留下。
这一行读数直接证伪了"区间是设置的直接映射"这个模型。 两个实验不可能同时是直接映射:peak=90 看着像映射,min=90 就完全不像。所以区间只能是"投票 + 求解"的产物——这与第七章那张 VoteSummary 的形态是一致的。
peak=90 像直接映射,min=90 却给出 (0, ∞)——两者不可能同时成立@ 本系列绘制一处诚实的悬置:min_refresh_rate=90 为什么会得到 (0.0 Infinity),dump 与日志都没有给出解释。本篇不猜原因,把它登记为需真机复核项(§10.1 会一并列出)。
本章的源码与文档:Frame rate(Android Developers) | Android 12 行为变更。这一章的判据定义是"变的那一项是谁写的",其中:primary.physical 的上限跟着 peak_refresh_rate 走,mSupportedRefreshRates 不动。这条判据的原理是——设置与能力是两本账,改一本不会改另一本。
所以"我设了 90 它就一定按 90 来"这个想法,在请求侧就已经不成立了。 更别说上面还有一层"档位表"——下一章去看与它完全不同的另一种屏。
九、ARR:另一种屏
好了,第八章做的是多刷新率(MRR)的请求侧实验。这一章要讲的是一件更需要分清的事:"能换档"和"能每帧换步长"是两种屏。 前八章讲的全是前者。
9.1 设备自报:本机是 MRR,不是 ARR
好了,先把本机的自报读数摆齐。这是一组互相独立的四个读数,全部指向同一个结论:
| 读数 | 值 | 出处 |
|---|---|---|
hasArrSupport |
false |
dumpsys display |
activeMode.vrrConfig |
N/A |
dumpsys SurfaceFlinger |
supportedRefreshRates |
[60.000004] |
dumpsys display |
mRefreshRateChangeable |
false |
dumpsys display |
注意第一项与第二项的性质:hasArrSupport false 是 display 服务直接回答"这台设备支不支持 ARR";vrrConfig=N/A 是 SF 侧在当前档位的描述里给出的。
为什么这两个数一起出现就能定案? 因为官方对这两者的关系有一句非常明确的表述:
"With this attribute, a display can be configured as either MRR or ARR, but not both."——AOSP《Adaptive refresh rate (ARR)》
"either ... or ... but not both" —— 一个屏要么按 MRR 配,要么按 ARR 配,不能同时是两者。而官方的判据就是 vrrConfig:vrrConfig=null 即为 MRR。本机印的是 N/A。
所以本机不是"我们没测到 ARR",而是"设备自报是 MRR 屏"。 这两句话的分量完全不同:前者是测量的缺口,后者是设备属性——它是一条读数,不是一个遗憾。这里值得停一下,因为这正是本系列一路在做的那件事:把一个"做不到"尽量翻译成一条"读数"。 "我们测不到 ARR 的相位切换"是一句无法核验的陈述,别人没法在同一台机器上重跑;而 hasArrSupport false 与 vrrConfig=N/A 是设备自己印出来的两行字,任何人都能在同一台设备上复现。前者是遗憾,后者是证据——这也是本篇所有"需真机"条目都坚持给出具体字段名与取值的原因。
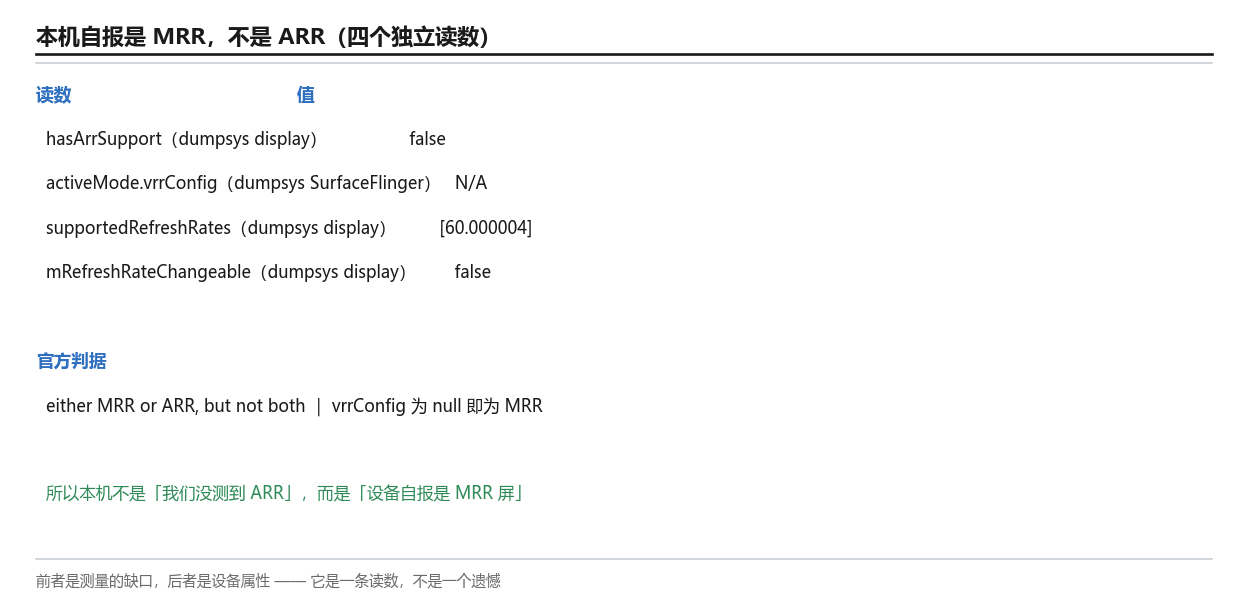
这一条把 ep09 与 ep10 挂的那笔债结清了——那两篇写"ARR 需真机",本篇给出的不是"还是没测到",而是"本机在设备属性上就不是 ARR 屏"。
# 本机对 ARR 的两条自报读数
hasArrSupport false
activeMode={id=0, hwcId=0, resolution=1080x2400, vsyncRate=60.00 Hz, dpi=420.00x420.00, group=0, vrrConfig=N/A, supportedHdrTypes=SYSTEM}
9.2 相位与节拍不对时,现场是什么样
好了,那 ARR 与 MRR 的差别,在视觉上到底意味着什么?这一节用一张现场图把"后果"具象出来。
撕裂(tearing) 是显示链路里最经典的一种"时间对不齐"的现场:屏幕正在读一块缓冲、而这块缓冲的内容在中途被换了,于是同一屏画面上出现上下两半来自不同帧的错位。
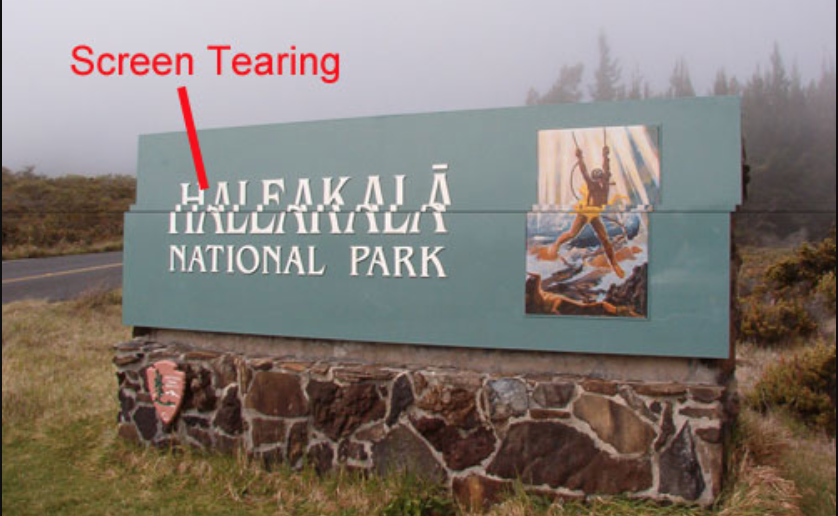
边界声明:这张图是一张通用的撕裂现象实拍,用来把"时间对不齐会看到什么"具象化,它不是 Android 设备的截图,也不含任何 AOSP 结论。而且它长边只有 838 像素,本篇按 1:1 落位、不放大。
为什么在这一章用它? 因为 ARR 要解决的正是这类"对齐"问题的下一层:MRR 时代,平台靠切档去让刷新率贴近内容;而切档这个动作本身会带来抖动——官方那句话说得直白:
"Reducing jank: ARR eliminates the need for mode switching, which is a known cause for jank."
"mode switching is a known cause for jank" —— 换档这件事本身就会造成 jank。所以 ARR 的思路不是"换得更快",而是不换。
9.3 切档与改步长:两件事
好了,这一节把两种机制摆在一起,因为这是本篇最需要分清的一对概念。
MRR(多刷新率) 的做法是切档:设备预先声明若干"档"(本机的档位表里只有一个 60),平台在这几档之间选一个,选中的那一档决定了一段时间内所有 vsync 的节奏。它的粒度是"档",切换有代价(mode switching)。
自适应刷新率(ARR, Adaptive Refresh Rate) 的做法是改步长:官方原话说,ARR 让显示刷新率"using discrete VSync steps"适配内容帧率,并且——
"On non-ARR panels, the display refreshes at a fixed cadence determined by the active display mode. On ARR panels, the display VSync rate and refresh rate are decoupled ..."
"the display VSync rate and refresh rate are decoupled" —— 在 ARR 屏上,vsync 的速率与刷新率被解耦了。这正好解释了为什么它不需要切档:它换的不是"档",是"每帧之间的那一步有多长"。
这对概念一分开,前面几章的读数就都能归位了:第八章那三个实验改的是请求侧的范围,它们最终仍要在有限的档位表里落一个结果(本机只有一个可选);而 ARR 屏上根本不存在"从档位表里挑"这一步。本篇第八章讲的那套逻辑,是 MRR 的逻辑。
本章的源码与文档:Adaptive refresh rate (ARR)(AOSP) | Optimize frame rate with adaptive refresh rate。这一章的定义落在官方那句 either MRR or ARR, but not both 上,其中:判据字段是 vrrConfig(为 null 即 MRR),本机印的是 N/A。这条互斥的原理是——两种机制对 vsync 速率的假设不同,不能并存。
再补一句版本门槛(这也解释了为什么它很新):ARR 需要 Android 15 且设备需 15-QPR1 及以上、HWC HAL 需 composer3 version 3;应用侧则通过 Display.hasArrSupport() 检测、用 View.setRequestedFrameRate() 请求、用 Window.setFrameRateBoostOnTouchEnabled() 这类窗口级开关微调。本机印的正是那个检测的结果:hasArrSupport false。
十、真机才能做的四件事
好了,上一篇的收尾章列了"需真机的四类"。这一章做同样的事,但多给一样东西——一处口径警示,它比缺口本身更重要。
10.1 先看一处"同名两数"
好了,本机的读数里,有两组数字名字几乎一样、值不一样。这一节把它们摆出来,因为读错它们会直接得出错误结论。
第一组:掉帧计数。
Total missed frame count: 833
HWC missed frame count: 462
GPU missed frame count: 367
三个数放在一起,第一个问题就来了:462 + 367 = 829,可 833 − 829 = 4。总数比两项之和大 4。 那这 4 去哪了?dump 里没有说明。可能还有第三类未列出的来源,也可能是统计口径不同——本篇不猜,如实登记。
第二组:missedFrames 在两个地方是两个数。
| 出处 | 字段 | 值 |
|---|---|---|
--timestats(Legacy 段) |
missedFrames |
336 |
Pacesetter 段 |
Total missed frame count |
833 |
同一个名字、同一台设备、几乎同一个时刻,两个数差了 2.5 倍。 原因同样未在 dump 中说明(两个统计的窗口口径与来源很可能不同——timestats 那段自己带 statsStart 与 statsEnd,而 Pacesetter 那段没印窗口)。
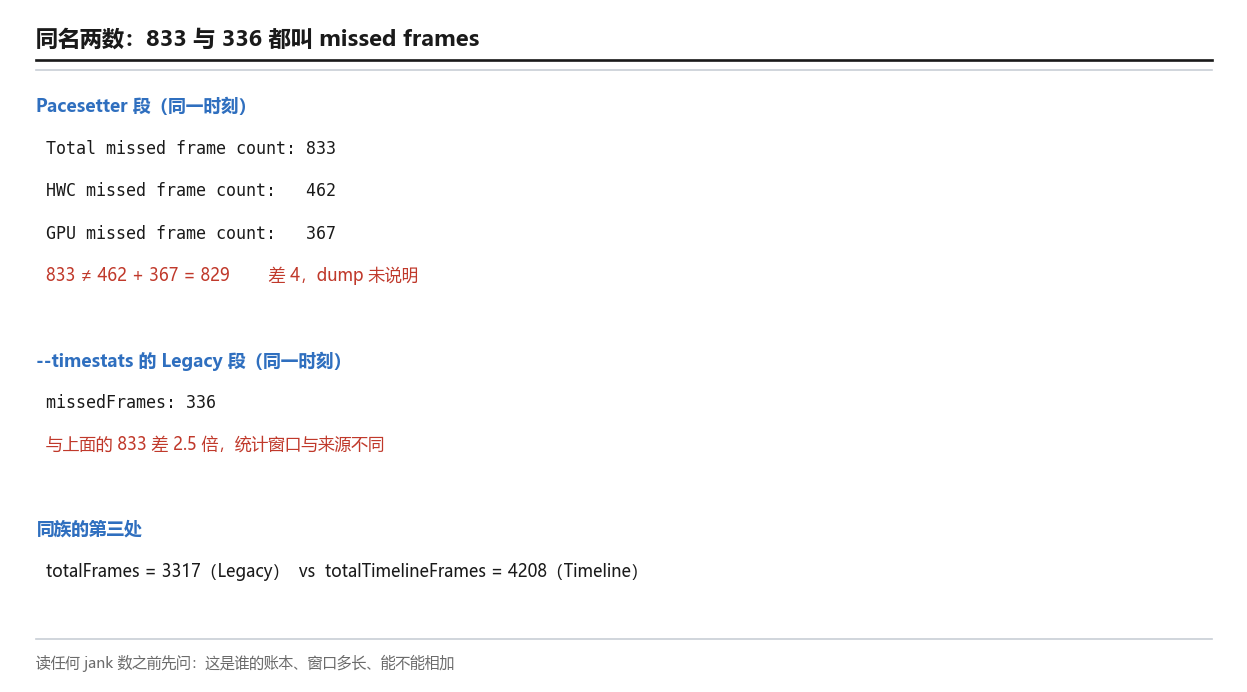
再加一条同族的:totalFrames 在 Legacy 段是 3317,而 Timeline 段是 totalTimelineFrames 4208——同一份 dump 里两套帧计数。
所以本篇给读者加一条口径警示:读任何 jank 或掉帧数之前,先问三件事——这是谁的账本(哪个段)、统计窗口是什么、它和别的同类数字能不能相加。 顺手把 §3.1 那条也并进来:七类 jank 之和 6429 远大于 jankyFrames 3183,所以 jank 分类不可相加(一个帧可以同时命中多类)。
10.2 零次切换的账
好了,第二个要登记的,是这台屏的完整历史。--timestats 给了一段带统计窗口的账本,statsStart=1790673193 到 statsEnd=1790690837,跨度约 4 小时 54 分。在这段窗口里:
refreshRateSwitches = 0
displayConfigStats is as below:
60fps = 17650263ms
再看刷新率直方图那一段,只有两行:
ScreenOff: 0d00:00:00.011
60.00 Hz: 0d06:29:20.250
四小时五十四分钟的窗口里,刷新率切换 0 次;配置统计里只有一个档位名(60fps);直方图只有"熄屏"与"60.00 Hz"两行。 这三条读数说的是同一件事,但它们来自三个不同的统计口径——一个计数器、一份配置时长表、一份状态直方图。三条独立读数一起为零,比任何单条都硬。
这就是"多刷新率"在这台设备上的全部历史:它不是"我们没测到切换",而是"从未发生过切换"。 而原因在前面的章节已经给全了:档位表里只有一个 60(§7.3)、没有一层投过票(§6.1)、两档同值也就无从谈起切换(这一点与 ep10 的"两档配成同值、切档被短路"是同一族现象)。
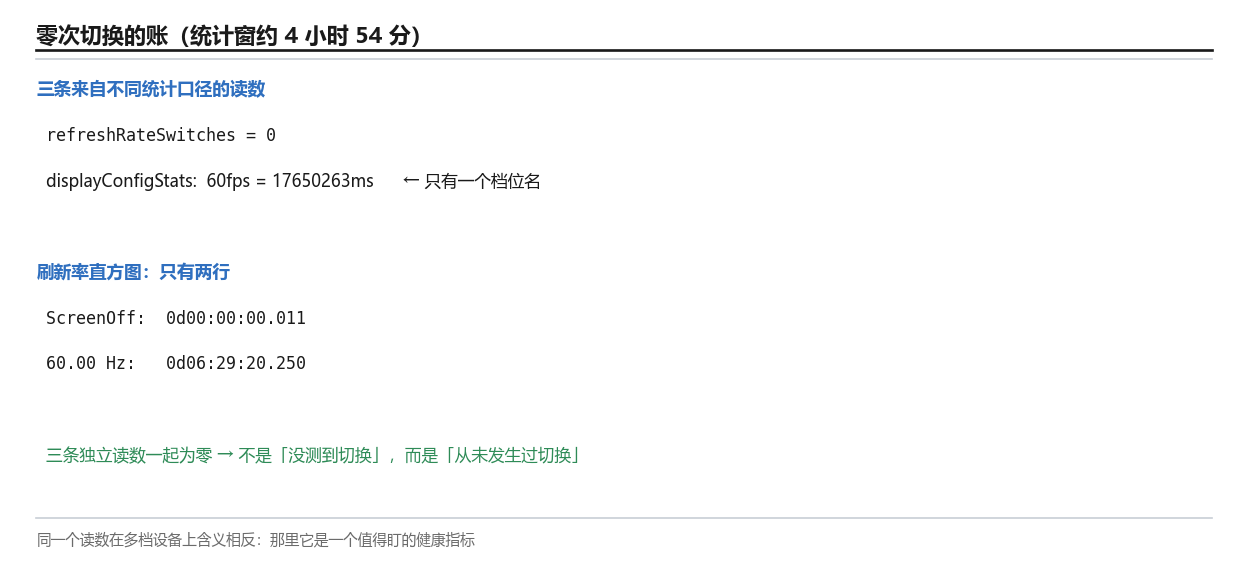
顺手说清一个容易被误读的点:refreshRateSwitches=0 不等于"性能好"。它只是说这台设备没有可切的档。在一台多档设备上,这个数反而是个值得盯的健康指标——切得太频繁会带来 mode switching 造成的 jank(§9.2),一次都不切则可能意味着刷新率策略根本没在按内容走。同一个读数,在两类屏上含义完全相反。
10.3 四项动作与判据
好了,前面九章讲的都是"读",这一章给四组可执行的动作——每组配一个判据。注意每组的判据都必须能被证伪:跑完之后要能明确地说"是"或"不是"。
① 确认"这块屏到底报了几个档"
# 取设备自报的可用刷新率列表与档位明细
adb shell dumpsys display | grep -E 'supportedRefreshRates|supportedModes|mRefreshRateChangeable|hasArrSupport'
# 判据:supportedRefreshRates 只有一个值 → 这台设备在切换层面"无档可切"
#       hasArrSupport=false → 它也不走 ARR 那条路
# 本机:supportedRefreshRates [60.000004]、hasArrSupport false、mRefreshRateChangeable false
② 确认"队列有几格、有没有积压"
# 取 framebuffer 那条队列的槽位表与构建期槽数
adb shell dumpsys SurfaceFlinger | grep -E -A3 'NUM_FRAMEBUFFER_SURFACE_BUFFERS|Slots:'
# 判据一:Slots: 下有几行 = 这条队列此刻有几格
# 判据二:若多格的 frame 号被拉开好几帧 → 有积压(Buffer Stuffing 的形态)
# 本机:2 行;frame=539 与 538,紧挨着 → 无积压
③ 确认"有没有层在为刷新率投票"
# 打开显示模式主管的日志,再取层树里的请求
adb shell cmd display dmd-logging-enable
adb shell "dumpsys SurfaceFlinger | grep -E 'requestedFrameRate|Layer Hierarchy'"
adb shell "logcat -d -s DisplayModeDirector | grep -E 'VoteSummary|Found available modes'"
adb shell cmd display dmd-logging-disable
# 判据:两处都印着"没有请求"才是真的没有——层侧看 NoPreference,平台侧看 requestRefreshRates=[]
# 本机:5 层全 NoPreference;requestRefreshRates=[]
④ 确认"改设置到底改动了什么"
# 改前取一份,改后取一份,逐项比
adb shell "dumpsys display | grep -m1 mDisplayModeSpecs"
adb shell settings put system peak_refresh_rate 90
adb shell "dumpsys display | grep -m1 mDisplayModeSpecs"
adb shell settings delete system peak_refresh_rate   # 记得还原
# 判据:变的那一项属于"人写的",不变的那几项属于"设备报的"
# 本机:primary.physical 与 appRequest 的上限变成 90;mSupportedRefreshRates / mActiveRenderFrameRate / renderRate 不变
第 ④ 组是四组里最有用的一个自检:它把"档位表是设备报的、上限是人写的"这句判据从印象变成可复现的对照。而且它有两条独立判据(区间变了几项、物理侧变了几项)——如果物理侧也跟着变了,那说明你读错了字段,或者这台设备的平台配置被改过。
本章的源码与文档:Android Jank detection with FrameTimeline(Perfetto) | FPS throttling(Android Developers)。这一章的判据定义是"先问这是谁的账本",其中:missedFrames(336)来自 --timestats 的 Legacy 段,Total missed frame count(833)来自 Pacesetter 段。这条警示的原理是——同一台设备上可以有多个互不相同的统计口径。
跑完这四组,还有一步口径核对别省掉:如果顺手取了 --timestats,别把里面的 jank 分类相加。本机那七项加起来是 6429,而总计是 3183——差了一倍有余,因为它们不是一个划分,而是一组可以同时命中的标签。同理,missedFrames(336)与 Total missed frame count(833)虽然名字像,但它们的统计窗口与来源不同,直接比大小会得出错误的结论。这两条合起来就是本篇的第一条口径纪律:先确认"这是谁的账本、窗口多长、能不能相加",再去算任何比例。
还有一条边界要说清:上面四组动作在本机都是只读的——除了第 ④ 组那一次"改了又还原"的设置实验。这不是保守,而是本机条件的限制:三个偏移属性与档位表都是 ro.* 级别或平台配置,运行时改不动(ep10 已经讲过这一族属性);而 ARR 那条路在本机的设备属性里就是不通的(§9.1)。所以本机的定位是"把可读的面读透、把读不到的面分档记清",而不是"造出一个多档环境"。
10.4 三句结论
好了,把这一篇收成三句话:
第一句:档位表是设备报的,上限是人写的。 同一份日志里,Found available modes=[{... fps=60.000004}] 四态一字不差,而 maxPhysicalRefreshRate 从 Infinity 变成 90、变成 120。写设置只能改后者——这也是为什么"我设了 120 它就该跑 120"这个直觉会落空。
第二句:有没有人投票,是可读的。 五层各带一条 requestedFrameRate、全是 NoPreference;平台侧的 VoteSummary 里 requestRefreshRates=[];最终 considered PRIORITY_DEFAULT_REFRESH_RATE。两处独立读出同一件事,所以"应用没提要求"从推断变成了读数。
第三句:三缓冲不是开关,是一个"和"。 getMaxBufferCountLocked() 依赖五个成员,本机两项计数都是默认的 1、且非异步模式——于是两格;而 AOSP 说"应用始终三缓冲"与"SF 里可能只有一个待处理帧"两句话合起来正好解释它。"改一个开关变成三缓冲"这种说法,从机制上就不成立。
10.5 下一篇预告
OK,下一篇换个方向:前面十一篇一直在讲"设备上这帧怎么走",下一篇讲"怎么把它录下来"——虚拟显示到底是什么、屏幕录制为什么拿不到真 vsync、以及录屏这件事为什么会让帧率读数集体失真。也就是 ep09 §9 里那段"虚拟屏没有自己的 vsync、它借主屏的节拍"没展开的那一块。
相关链接 - 上一篇:【Android 图形显示系统】(十) Vsync 偏移:应用、SF、屏幕的三步舞 - 下一篇(预告):【Android 图形显示系统】(十二) 虚拟显示与屏幕录制 - 相关系列:实时渲染管线探析 | 移动端图形与功耗 | GPU 架构剖析 | 图形性能剖析工具链 | 2D 矢量引擎深挖
With Best Wishes.
参考资料
- Adaptive refresh rate (ARR)(定义 / discrete VSync steps / vsync 与刷新率解耦 / "either MRR or ARR, but not both" / composer3 v3)
- Multiple refresh rate(Android 11 引入 / composer@2.4 / DisplayManager 定策略、SF 选档 / 24 与 60 合并成 120 / minimal error / 队列里已有 buffer 时切档)
- BufferQueue and Gralloc(dequeueBuffer / queueBuffer / acquireBuffer / releaseBuffer 四步与 fence 语义)
- 图形概览(类同步模式与非阻塞模式)
- 了解 systrace("Android apps are always triple buffered" 与"SF 中可能只有一个待处理帧")
- Frame rate(Frame Rate API 自 Android 11 起 / 建议用 setFrameRate 而非 preferredDisplayModeId / 平台可切到帧率的倍数)
- Optimize frame rate with adaptive refresh rate(View 投票机制 / FrameRateCategory / setRequestedFrameRate / setFrameRateBoostOnTouchEnabled / Android 15 与 Compose 1.9 门槛)
- 界面卡顿检测(BufferQueue 值 2 = 三重缓冲)
- Android 12 行为变更(setFrameRate 在非无缝切换屏上也可用)
- FPS throttling(Game Mode 的帧率干预,仅能下调)
- Display(getRefreshRate 与显示能力查询)
- Android Jank detection with FrameTimeline(Buffer Stuffing 的定义:"more of a state than a jank" / "at least one vsync late")
BufferQueueCore.h("reserve two slots ..." / 五个成员的定义与默认值 / mMaxAcquiredBufferCount 的修改限制 / 异步模式多加一格)BufferQueueProducer.h(dequeueBuffer 的 -EBUSY 契约 / waitForFreeSlotThenRelock 放开 mMutex)RefreshRateConfigs.java(规范路径,正文未取到;本篇不据此引用)DisplayModeDirector.java(规范路径,正文未取到;本篇的决策面结论改用设备上的 VoteSummary)- Frame rate override(AOSP 页面,取到的是占位页;本篇对该机制的结论只依据设备读数)
- Android14 显示系统剖析 6(BufferQueueProducer 与 setMaxDequeuedBufferCount(2))
- BufferQueue 学习总结(五态与引用计数 mSlots = mFreeSlots + mFreeBuffers + mActiveBuffers + mUnusedSlots)
- 又卡了~从王者荣耀看 Android 屏幕刷新机制(Project Butter 与三缓冲的动机)
- Android Surfaceflinger Service (i) — bufferqueue analysis(英文对照读法)
- Choosing the right number of swapchain images(Khronos:三缓冲"总有一张已处理好的图像可供呈现",及 FIFO / MAILBOX 的差异)
- Android Framework 之 Vsync(native 侧 RefreshRateConfigs::Config 的第三方复现,非官方)
- Smooth, Stutter-Free Animation with Vulkan(Tom Murphy / Google:FRR、VRR、ARR 的定义片段)
- Android 15 game default frame rate override(旁证 ro.surface_flinger.game_default_frame_rate_override,非官方)
- Wikimedia Commons|Comparison double triple buffering(本篇图 11-2 来源)
- Wikimedia Commons|Display refresh rate vs video FPS(本篇图 11-13 来源)
- Wikimedia Commons|Captura de Pantalla 2020-12-10(本篇图 11-24 撕裂实拍来源)
- Wikimedia Commons|Triple buffering(备选,与图 11-2 同题,本篇未用)
- Wikimedia Commons|Vertical Synchronize(备选,讲回扫、与本篇论点不对位,本篇未用)
- Wikimedia Commons|Category:Screen tearing(类目枚举结果,仅 1 个文件)


