站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:它到底是不是"HLSL 的一个子集"
好了,上一篇我们把"一次调用怎么被接过去"讲完了:代理库靠文件名被加载器选中,挂钩靠导出表求交集接住那几个关键点。接住之后跑的那个东西,就是用这一篇的语言写的。
而关于这门语言,中文技术圈流传最广的一句话是"ReShade FX 就是 HLSL 的一个子集"。这句话看着无害,实际上会把人带进三个坑:以为可以拿现成的 HLSL 教程照抄、以为可以用微软的编译器编、以为它只能写像素着色器。
说白了,它是一个方言,而且是一个"加了东西"的方言。这一篇要回答三件事:
- 它的血统到底是什么——官方把它的语法底子钉在哪个年代?为什么是这个年代?(第一章)
- 它比 HLSL 多了哪几类东西——多出来的部分为什么必须由它自己的编译器来吃?(第二章到第四章)
- "自带编译器"这四个字意味着什么——它能不能单独拿出去用?"能独立"与"真的被独立使用"是不是一回事?(第五章、第六章)
第七章做一件前两篇没做过的事:自己写一个最小的 .fx,把它编一遍,把中间产物抓下来看。第八章讲那些编不过的东西,第九章把三条流传较广的误说法逐条对着官方原文核一遍。
上面这张对照图是这一篇的地图:左边那栏是 HLSL 与 GLSL 都有的——变量、函数、内建数学函数、纹理采样;右边那栏是它们都没有的四类东西。后面四章就是逐类拆这四栏。判断一门语言是不是"子集",最省事的办法就是看它有没有对方表达不了的东西——有,就不是子集。
这张图同时是全篇的知识地图:左边那栏决定了"能不能用现成的 HLSL 知识接着写"(能,但不能只会那些),右边四栏决定了"为什么它必须自带编译器"。读这张图的正确姿势是自右向左:先看它多出来的东西,再回头看哪些是老底子。只看左边会得出"这不就是 HLSL"的结论,只看右边会以为它是一门全新的语言——两个方向都是错的。
0.1 全系列目录总览(十一篇)
依然是惯例,先给系列地图。本系列沿"一个外部注入的运行时"从入口一路拆到效果生态,十一篇的落点如下(本篇即第三行):
| # | 篇目 | 这一篇要回答的那一问 |
|---|---|---|
| 一 | 总论:注入式后处理与管线内后处理的边界 | 它到底动的是哪一段?和引擎自带的后处理差在哪? |
| 二 | 代理 DLL、加载顺序与导出表挂钩 | 它凭什么进得来?进来之后怎么把调用接过去? |
| 三 | 本篇:ReShade FX——语言血统、独立编译器与纹理语义 | 效果是拿什么写的?编译器为什么能单独拿出去用? |
| 四 | effect runtime:technique / pass 图、render state 与运行时数据源 | 一个 effect 从源码到画面,中间过了几道? |
| 五 | 跨 API 抽象:D3D9/10/11/12、OpenGL、Vulkan 的差异与统一 | 同一套东西怎么盖住六种图形 API? |
| 六 | Add-on API:事件模型、跨 API 资源交换与两种构建的分野 | 想在运行时插手更深的事,接口长什么样? |
| 七 | 深度缓冲的工程学:自动关闭、MSAA、UI 缺失与子矩形错位 | 为什么深度类效果时灵时不灵? |
| 八 | 效果生态与许可地图:同一份清单里的 MIT 与"禁止再分发" | 那些效果到底能不能用、能不能转? |
| 九 | 自跑一:注入本地 D3D11 demo——逐效果前后对比 | 真跑一遍是什么样子? |
| 十 | 自跑二:效果栈与帧耗账,外加自写一个小 .fx | 代价是多少?自己写一个要几步? |
| 十一 | 合规与工程取舍的合集:把十一篇的账并到一处 | 这条路线值不值得用、边界在哪? |
阅读路径:只想弄清"这门语言能不能用现成的 HLSL 知识接着写"的朋友,读第零章与第九章就够;要搞明白它多出来的那几类东西为什么必须有,第二章到第五章是主线;关心"能不能把它的编译器拿出去用"的,直接跳第六章。
0.2 本篇的三层证据
好了,按本站惯例把证据分层,免得把不同来源的话混着说:
- 官方文字(带版本号与出处):ReShade 自带的语言参考(
REFERENCE.md)、官网首页的定性、仓库 README、示例工具tools/fxc.cpp的用法串、作者本人在官方论坛的回复、各版本的发布说明。凡引原话一律给英文逐字; - 本机实测:复用第一篇那个自建的 D3D11 场景,新加一个自己写的最小
.fx,把它交给 ReShade 的运行时编一遍,然后把编译器落盘的中间产物(预处理展开、编译后对象、反汇编)逐个取回来看。本篇的证明类图位全部来自这里; - 既有结论:只在前两篇已经核过的位置上引用(例如"官方明令不得分发二进制与着色器文件"),不重复取证。
0.3 本篇不涉及什么(边界声明)
第一,不讲后处理算法本身。 Bloom、色调映射、环境光遮蔽这些算法的实现归《实时渲染管线探析》第三篇,本篇只把它们当"用这门语言写出来的东西"举例。
第二,不讲 effect runtime 怎么调度。 一个 .fx 被编译出来之后,谁决定哪个 pass 在哪一帧跑、渲染状态怎么落到 API 上——那是第四篇。本篇只讲到"语言交出去的产物是什么形状"。
第三,不讲跨 API 差异的细节。 __RENDERER__ 的取值表会出现在第一章(因为它是语言的内建宏),但"同一段代码在六个 API 上各自怎么被翻译"是第五篇。
第四,不拆编译产物的二进制格式。 DXBC、DXIL、SPIR-V 各自的容器结构是另一条线,本篇只关心"能产出哪几种"。
第五,不提供任何官方二进制与着色器文件的再分发。 官方明文写着 "Do NOT share the binaries or shader files. Link users to this website instead.",所以本篇的效果源码只截自己写的那一份,其余一律只给官网链接。
0.4 四条读法约定(沿用本系列体例)
- 官方文字优先,二手转述只作线索。 本篇有多处正面对上:一处是"它到底基于哪一代 HLSL"(第一章),一处是"独立编译器现在有没有被启用"(第六章),另一处是"纹理声明是不是 HLSL 也有的东西"(第二章)。三处都按官方可核的文字写,并说明流传说法为什么不准确。
- 数字一律带来源。 本篇的量化结论只出现在两处:内建宏的取值(官方原文)与编译产物的体积(本机实测)。
- 参数口径:所有本机读数都来自同一台机器(Windows 11 build 26200、RTX 3060 Laptop);全部实验在自有开源 demo 与自写
.fx上做,一个商业游戏都不碰。 - 落空照实写。 本机没能拿到的读数会明确写"测不了",不用估算值凑——本篇就有一处:编译器自报的是单件编译耗时,"一整批效果首次启动一共停多久"没有可靠统计(见 11.1)。
一、血统:底子为什么是那个年代的 HLSL
1.1 官方唯一一句定义
言归正传,先看原话。ReShade 自带的语言参考(crosire/reshade-shaders 仓库的 REFERENCE.md,官网首页直接链接)开头第一句就是血统声明:
"The ReShade FX shading language is heavily based on the DX9-style HLSL syntax, with a few extensions."
同一份文档紧接着自述了它的写作范围:
"This document will instead primarily focus on syntax and features that are unique to ReShade FX."
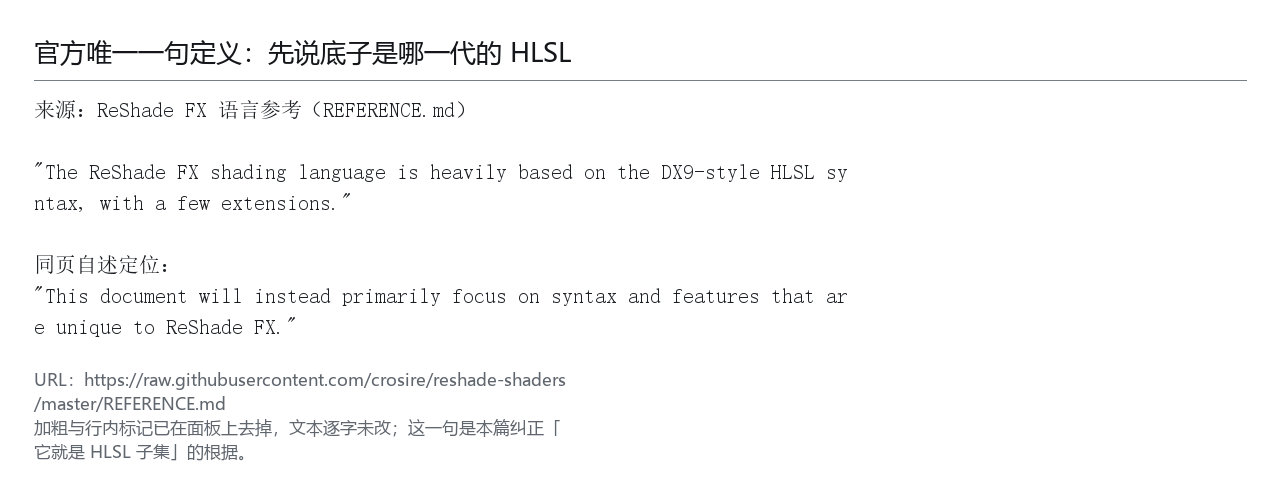
上面这张面板是原句的实物:注意 "DX9-style" 这个限定词。它不是「基于 HLSL」这么宽的一个说法——它把底子钉在了 Direct3D 9 那个年代的 HLSL 语法上。这句话后面会反复用到:为什么它没有常量缓冲的概念、为什么它的纹理声明长得像全局变量、为什么它对"结构体"这件事态度暧昧,答案都在这四个字里。
1.2 家谱里它站哪一格
说白了,要想把"血统"这件事看清楚,光有一句定性的自述不够,得有坐标。这门语言在编程语言的谱系里并不孤单——它属于"为某个图形 API 或某个引擎造出来的着色器语言"这一支。
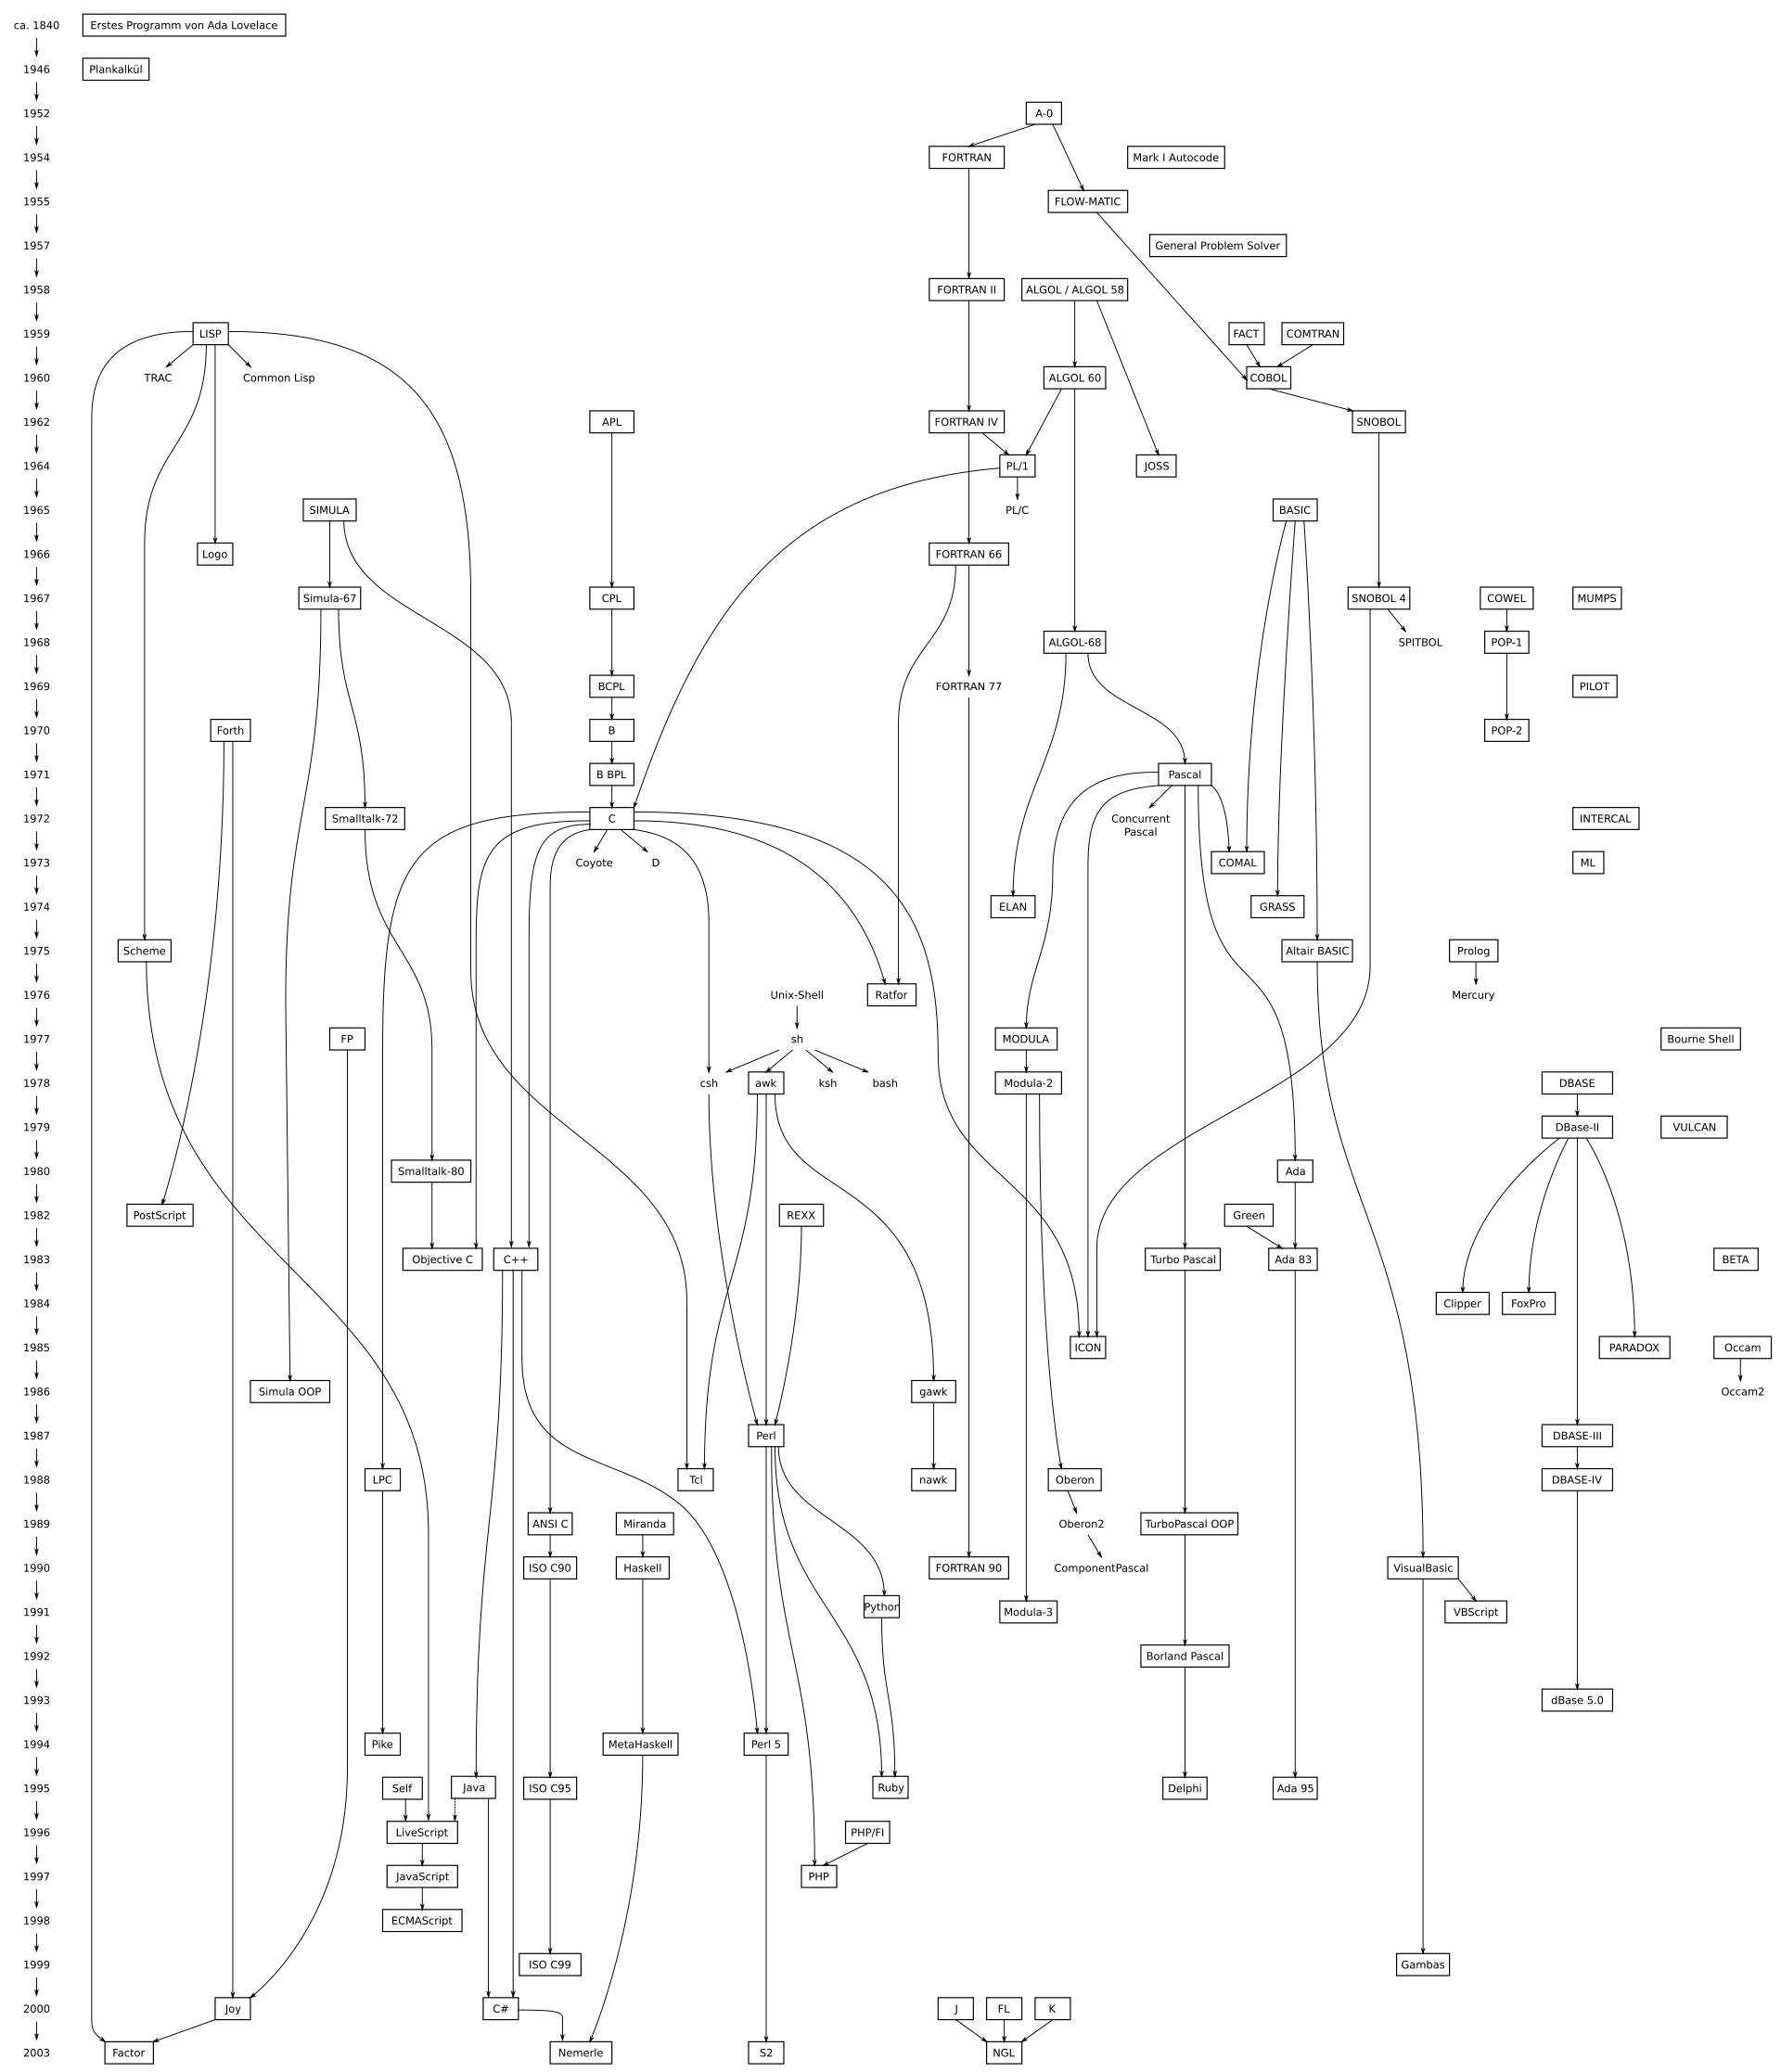
这张家谱树(Commons,CC BY-SA 3.0,原图 2020×2350)是给"血统"提供一个坐标系的:着色器语言不是从通用编程语言长出来的,而是从图形 API 的需求里长出来的。同一棵树上,GLSL 与 HLSL 是两条主干的产物,而 ReShade FX 是站在 HLSL 那条枝上的一个分支——分支的理由,就是它多出来的那几类扩展。
说白了,按出身把这门语言归类,着色器语言大致有四种。 第一种是图形 API 自带的——GLSL 与 HLSL,它们服务的是"任何宿主程序",所以必须通用,也因此不能把宿主的职责收进自己的语法;第二种是引擎自有的——材质定义与那个引擎的渲染管线绑死,出了这个引擎就没意义;第三种是翻译层的——输入一套调用、输出另一套,本身不产生新语义(第二篇提到的 DXVK 属于这一类);第四种是注入式的——它的宿主是唯一的,就是那个注入器,所以它敢把宿主该管的事收进语言里。
ReShade FX 属于第四种,而它的语法底子借的是第一种里 HLSL 那一支。 这个双重身份解释了后面所有的"为什么":为什么它有 technique(因为它有一个确定的宿主)、为什么它的纹理能带语义(因为数据由那个宿主提供)、为什么它不必考虑通用性(因为它只服务一个程序)。
1.3 SweetFX 被"完全重写"这件事说明了什么
OK,血统这件事还有一条旁证,而且这条旁证比定义更有说服力。ReShade 早期与 SweetFX 的关系常被写成"ReShade 把 SweetFX 收编了",但作者本人在官方论坛的说法是另一回事:
"ReShade has its own shader language (based on HLSL, so it looks similar, but still works different). This means SweetFX had to be completely rewritten for ReShade, thus 2.0." —— 作者在官方论坛的回复
"不得不完全重写"——如果两者只是同一门语言的两个版本,就不需要重写。作者在同一帖里给了具体后果:旧版 SweetFX 的预设会直接撞上编译错误,例如 error X3000: syntax error、error X3004: undeclared identifier 'Chromatic_shift'。
同一件事在 1.0 的发布帖里还有一句注脚,说明当时的分工:
"People still prefering the standalone SweetFX or MasterEffect packages are of course free to remove the shader files from that download and use core ReShade with their own files: CeeJay's SweetFX 2.0 for instance continues to exist seperatly, only using the ReShade injector DLLs" —— ReShade 1.0 发布帖
注入器可以共用,着色器文件不能。这条分界线本身就把"语言"从"注入"里切了出来——这也是为什么本系列要把它们分成两篇讲。
这条分界线还有一个更实际的推论。 如果两门语言只是"像",那么旧的文件通常能凑合跑;而这里是直接编不过,说明差异发生在语法与语义层,不是几个函数的改名。ReShade 与 SweetFX 共用的那一层是注入机制(怎么进到进程里、怎么把呈现调用接过来),而换掉的那一层是效果怎么写。这两层可以独立演进——这也预告了第二篇与第三篇的分工。
1.4 时间线:只写能核到的那几个点
OK,上面这条时间线只给了两个能核到日期的节点,其余节点一律留空。这里必须说明一处纠正:本站第一篇的正文与它的时间线图里写的是"2015-08 首个 Windows 版",本轮重新检索没有找到支持"到日"的官方原文——检索过「ReShade original release date August 2015」「crosire ReShade 2015-08-07」等措辞,能核到的只有两条:
- ReShade Framework 首版 2015-03-29——出自社区 FAQ(作者之一 Ganossa 撰写、发布在官方论坛,属二手但可追溯):> "The first version was released on March 29th 2015." —— 官方论坛 FAQ
- 1.0 结束公测于 2015 年——出自作者的 1.0 发布帖(一手,但页面只显示相对时间,没有绝对日期)。
所以本篇按"2015 年"这个粒度写,不写具体到日的日期。第一篇的那处标注与那张图,记在待订正清单里。
1.5 内建宏:它怎么知道自己在哪跑
血统的最后一块拼图是"它怎么知道自己的处境"。这门语言有一组内建宏,把"我在哪、我是谁、缓冲区多大"这类信息直接交给着色器作者。官方参考把它们逐条列了出来:
__RESHADE__——"Version of the injector"(官方给的算法是MAJOR * 10000 + MINOR * 100 + REVISION)__RENDERER__——"Graphics API used to render effects"__VENDOR__——显卡厂商(0x10deNVIDIA、0x1002AMD、0x8086Intel)BUFFER_WIDTH/BUFFER_HEIGHT——背缓冲宽高;配套还有BUFFER_RCP_WIDTH/BUFFER_RCP_HEIGHT(宽高的倒数)
其中 __RENDERER__ 值得整张抄下来,因为它是"同一份源码、六个后端"这件事在语言层留下的接口:
| 图形 API | __RENDERER__ 取值 |
|---|---|
| Direct3D 9 | 0x9000 |
| Direct3D 10 | 0xa000 起 |
| Direct3D 11 | 0xb000 起(如 D3D11.1 为 0xb100) |
| Direct3D 12 | 0xc000 起 |
| OpenGL | 0x10000 起(如 OpenGL 4.3 为 0x14300) |
| Vulkan | 0x20000 起(如 Vulkan 1.1 为 0x21100) |
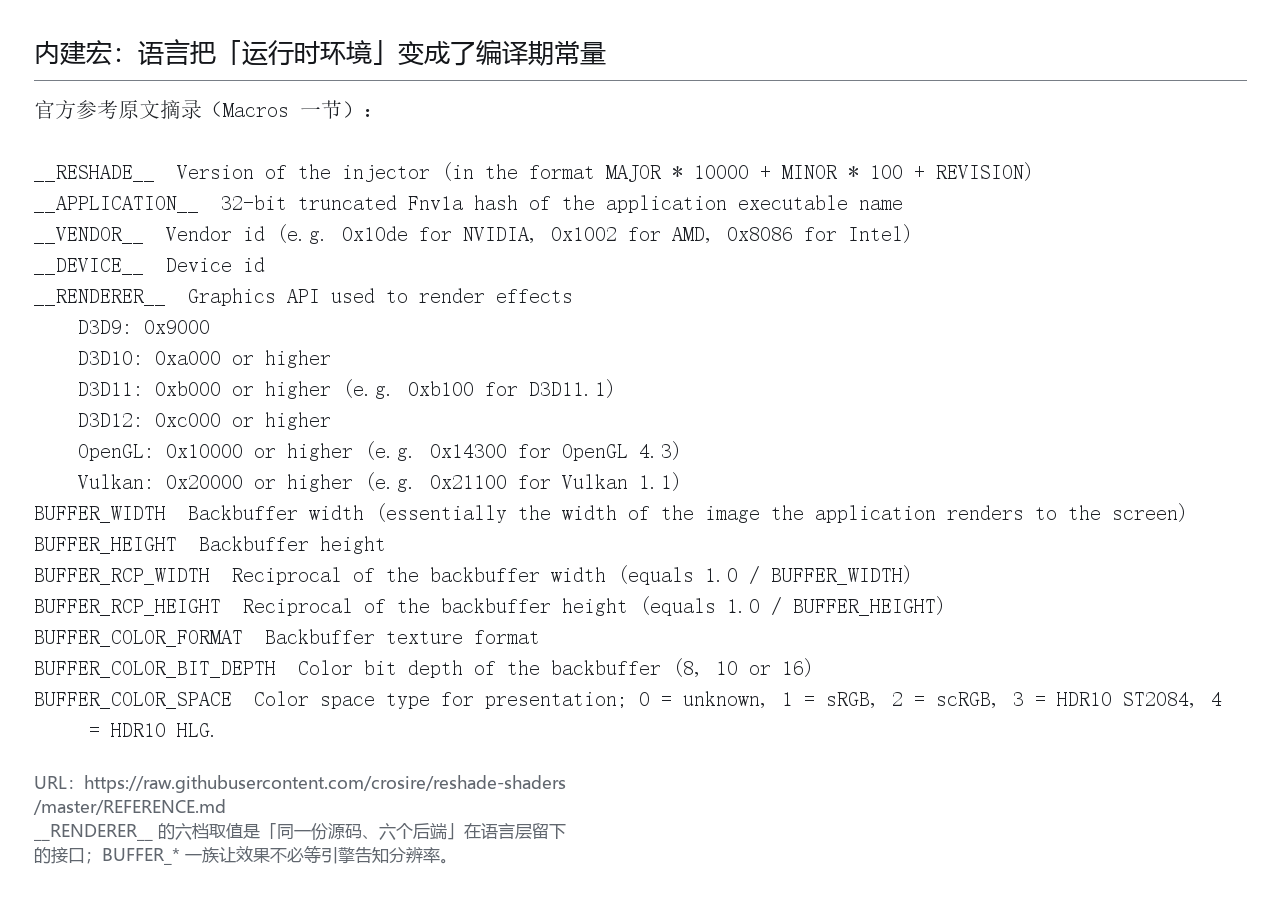
这张面板还带上了 BUFFER_COLOR_BIT_DEPTH(8/10/16)与 BUFFER_COLOR_SPACE(0 未知、1 sRGB、2 scRGB、3 HDR10 ST2084、4 HDR10 HLG)这类和输出相关的宏。
读法:这一组宏不是装饰。有了 __RENDERER__,一个效果文件可以在一段代码里分叉处理六个后端;有了 BUFFER_*,它不需要引擎告诉它分辨率。语言把"运行时环境"变成了编译期常量——这是它能做到"一次编写、到处编译"的下半句(上半句在第五章讲)。
顺带看一眼底子当年能做到什么,有个直观印象:
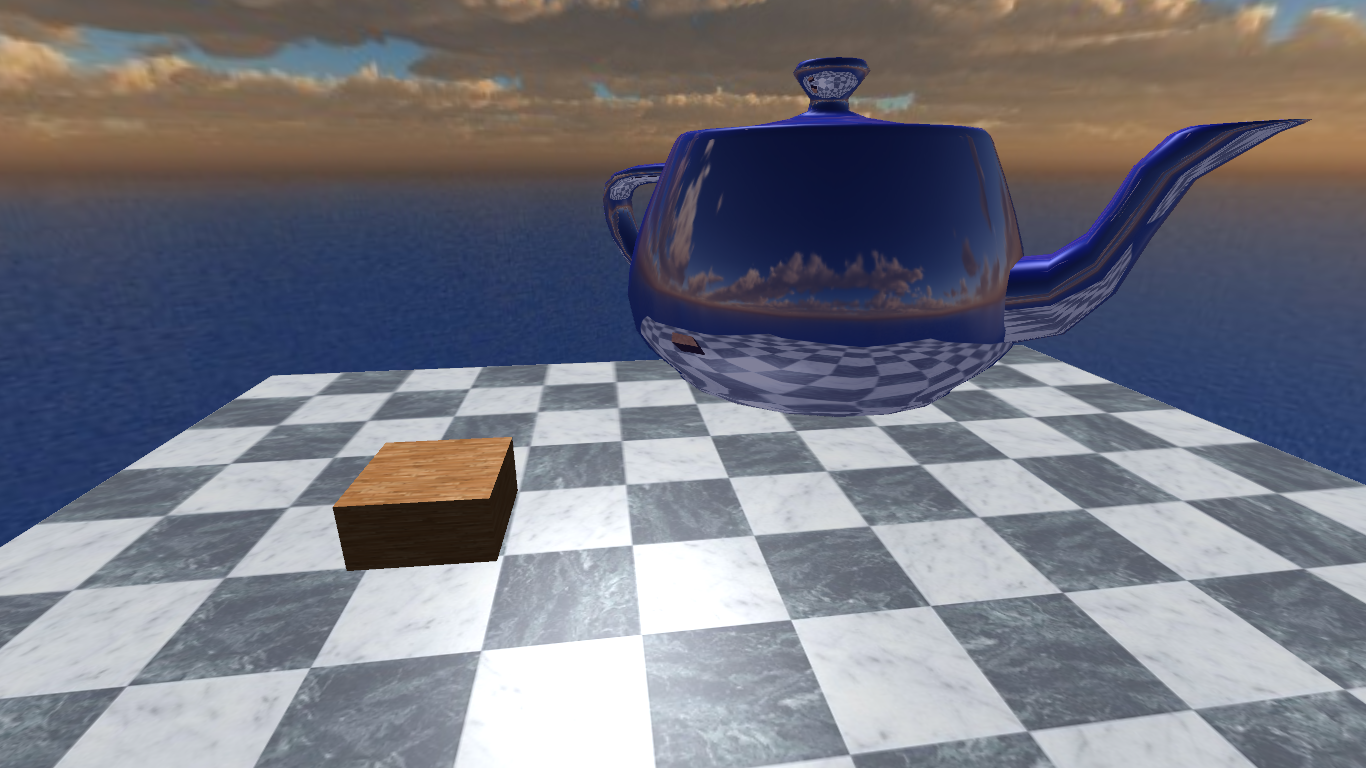
这是 DX9 时代 HLSL 的环境映射实拍(Commons,CC BY-SA 3.0):茶壶上的反射是把一张立方体贴图按反射向量采样出来的。这类效果在 ReShade FX 里照样能写——它的内建函数清单就是标准 HLSL 内建函数加一小批扩展。底子决定了它能写什么,扩展决定了它多能写什么。
二、它多出来的东西(一):纹理不是变量,是对象
2.1 三类对象,各管一段
言归正传,从这一章开始逐类拆"多出来的东西"。第一类是纹理——而且准确地说,是"纹理相关的三种对象"。
在 HLSL 里,纹理与采样器通常是"声明 + 采样"两件事:声明一个 Texture2D,声明一个 SamplerState,然后调 Sample。ReShade FX 把这件事拆成了三类对象,官方参考的说法是:
"Storage objects define how a texture should be written to from compute shaders."
三类对象的分工是这样的:
texture——数据容器。它定义一块纹理的尺寸、层级、格式,是"被读的东西";sampler——采样状态。寻址方式、过滤方式、是否按 sRGB 解释,都挂在这里;storage——计算的写入端。它把一个纹理接到计算着色器的写路径上。
为什么分成三类? 因为这三件事的生命周期不一样:数据容器会跨 pass 复用,采样状态跟着使用方式走,写入端只在计算管线里有意义。混成一件事写,就表达不出"同一块数据换一种采样方式被读两次"这种常见需求。
举个具体的例子就清楚了。 一个做锐化的效果想同时读到"清晰版"与"模糊版"同一块纹理:数据容器只有一个(那张纹理),但采样状态要两套——一套线性过滤做出模糊,一套点采样保持锐利;两个 sampler 都指向同一个 texture,谁也不必多占一份显存。在把纹理与采样器绑成一体的写法里,这个需求要靠两块纹理来实现:先各存一份,再分别采样。三分的写法省下的不是几个字节,而是"同一份数据被几种方式使用"这件事的表达能力。
2.2 语义:COLOR 与 DEPTH 是内建的两个
第二类扩展是语义(semantic)。这是本篇的题眼,也是"它不是 HLSL 子集"最硬的一条证据。官方参考写得很直接:
"ReShade FX allows semantics to be used on texture declarations. This is used to request special textures:"
texture2D texColor : COLOR;——"Receives the backbuffer contents (read-only)."texture2D texDepth : DEPTH;——"Receives the game's depth information (read-only)."
看语法:在纹理声明后面加一个冒号和一个语义名。这个冒号后面写什么,决定了这块纹理由谁填。目前在官方文档里被明确定义的内建语义只有两个:COLOR(背缓冲内容,只读)与 DEPTH(游戏的深度信息,只读)。
注意 read-only 这两处限定。 它们不是文档作者的修辞——这是这个运行时对语言下的硬约束:效果可以读背缓冲与深度,但不能写进游戏真正的那块缓冲;想写,得声明自己的 RenderTarget。
好了,这条约束的后果值得说透。 因为它读的是游戏的背缓冲、写的是自己的目标,所以一个效果不可能"就地修改"画面——它只能先把结果写到自己的目标上,再由呈现环节把它交出去。这就是为什么后处理链上的多个效果天然是串联的:每一个的输出是下一个的输入,最后一个才回到屏幕上。第四篇讲 technique 与 pass 的顺序时,源头就在这里。
上面这条链就是那句 read-only 的后果:输入是只读的,输出只能落到自己的目标上,于是每个效果都不可能跟别人同时改同一块画面,只能一个接一个地传下去。
2.3 语义还可以是别人给的
好了,COLOR 与 DEPTH 只是两个内建的。真正让这个机制"活"起来的是第三层:语义名可以由 add-on 自己注册。作者在官方论坛解释这个机制时写得很清楚:
"Textures are handled a bit different, since ReShade FX has explicit language syntax to specify that a texture should come from an external source (via
texture MyVarName : MY_TEXTURE_SEMANTIC;, whereMY_TEXTURE_SEMANTICdescribes what that texture should be filled with, similar toCOLORandDEPTHReShade already provides)." "The string you pass toupdate_texture_bindingsis the semantic by which you would reference the texture in an effect. E.g.update_texture_bindings("BLUB", ...)in add-on ⇒texture WhatEverVariableNameYouWant : BLUB;in ReShade FX." —— 作者在官方论坛的说明
这段话值得逐句读。 它说的是:add-on 那一边调 update_texture_bindings("BLUB", ...) 注册一个名字,语言这一边就能写 texture Whatever : BLUB; 把数据取过来——名字是字符串,两边靠约定对齐。
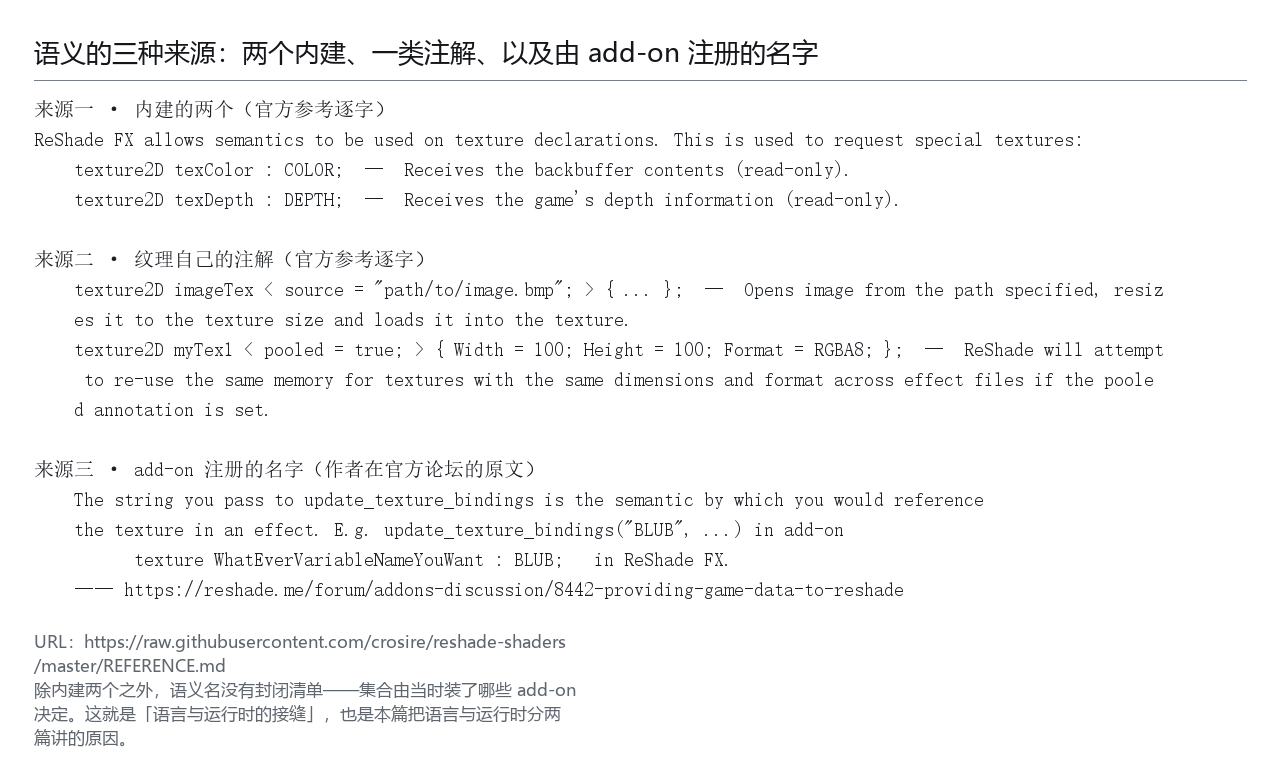
上面这张面板把语义的三种来源并置在一起:内建的两个、纹理自带的注解、以及 add-on 注册的名字。
读法(本篇最重要的一处):这里就是语言与运行时的接缝。语义不是语言自己实现的,而是语言留了一个"插槽",运行时往里塞数据。所以官方没有、也不可能有一份封闭的"合法语义清单"——除了内建那两个,其余语义名的集合由当时装了哪些 add-on 决定。
这也直接解释了本系列为什么要把"语言"与"运行时"分成两篇。 一个效果的输入,一半写在语言里(声明与语义名),另一半在运行时(谁注册了那个名字、什么时候把数据塞进去)。只看语言,读不出完整的故事。
2.4 采样状态也是语言的一部分
言归正传,第三层扩展是采样状态。先说一个反直觉的事实:在 HLSL 里,过滤方式这类状态通常由 CPU 侧的采样器描述决定;而在 ReShade FX 里,它被写进了语言——sampler 对象的定义体里直接列出这些成员。官方参考给的取值是:
- 寻址方式:
CLAMP/MIRROR/WRAP(或REPEAT)/BORDER - 过滤方式:
POINT/LINEAR/ANISOTROPIC
这不是抽象名词,它在画面上差别很大:
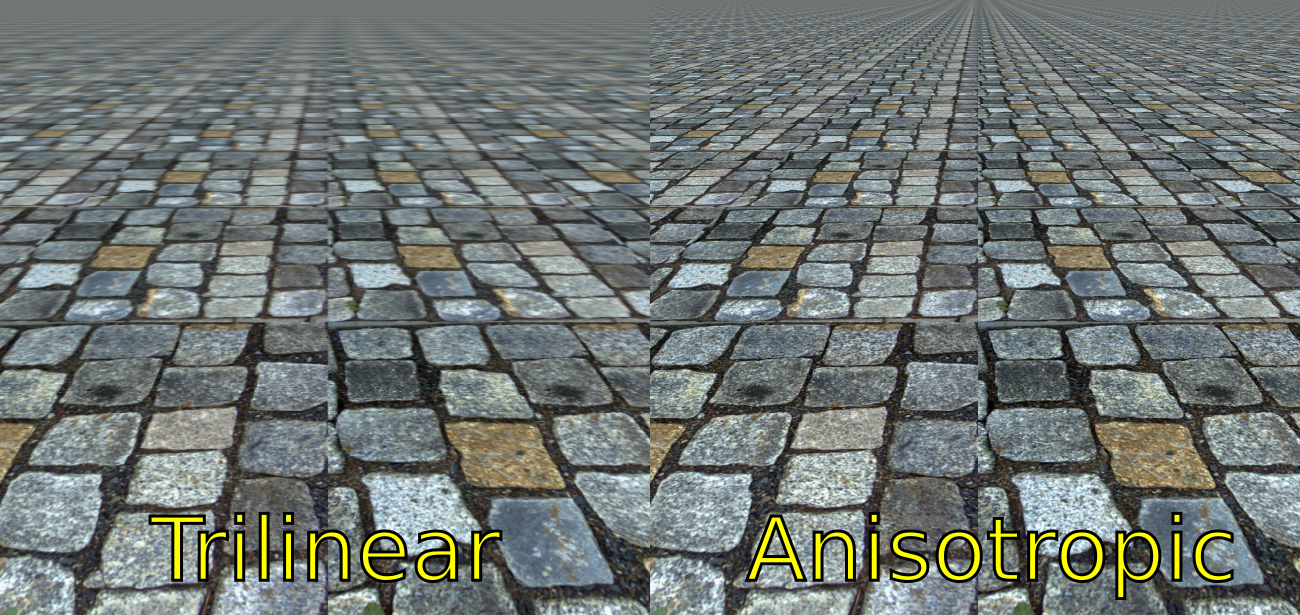
这是各向异性过滤与三线性过滤的对照(Commons,CC BY-SA 3.0,原图 1300×615)。同一块地面,越往远处越斜着看;只按三线性过滤采样,远处会糊成一片,各向异性过滤能把那个方向上的细节捡回来。
上面这张对照图把取值列成两栏:一边是取值名与它们的语义,一边是"什么场景下该选哪个"。
为什么把状态写进语言? 因为对效果作者来说,这个状态是效果定义的一部分——一个做锐化的效果与一个做模糊的效果,对采样的要求本来就不一样。把状态放回引擎侧,效果就不再是"一个自包含的文件"了。这一点在第三章会看得更清楚:这门语言连渲染状态都写进文件。
2.5 采样层级选错会怎样
依然是惯例,纹理这一块还有一件小事值得单列:层级。当一块纹理有多种分辨率版本(mipmap)时,采样器要决定读哪一层。选错了就是另一种难看:
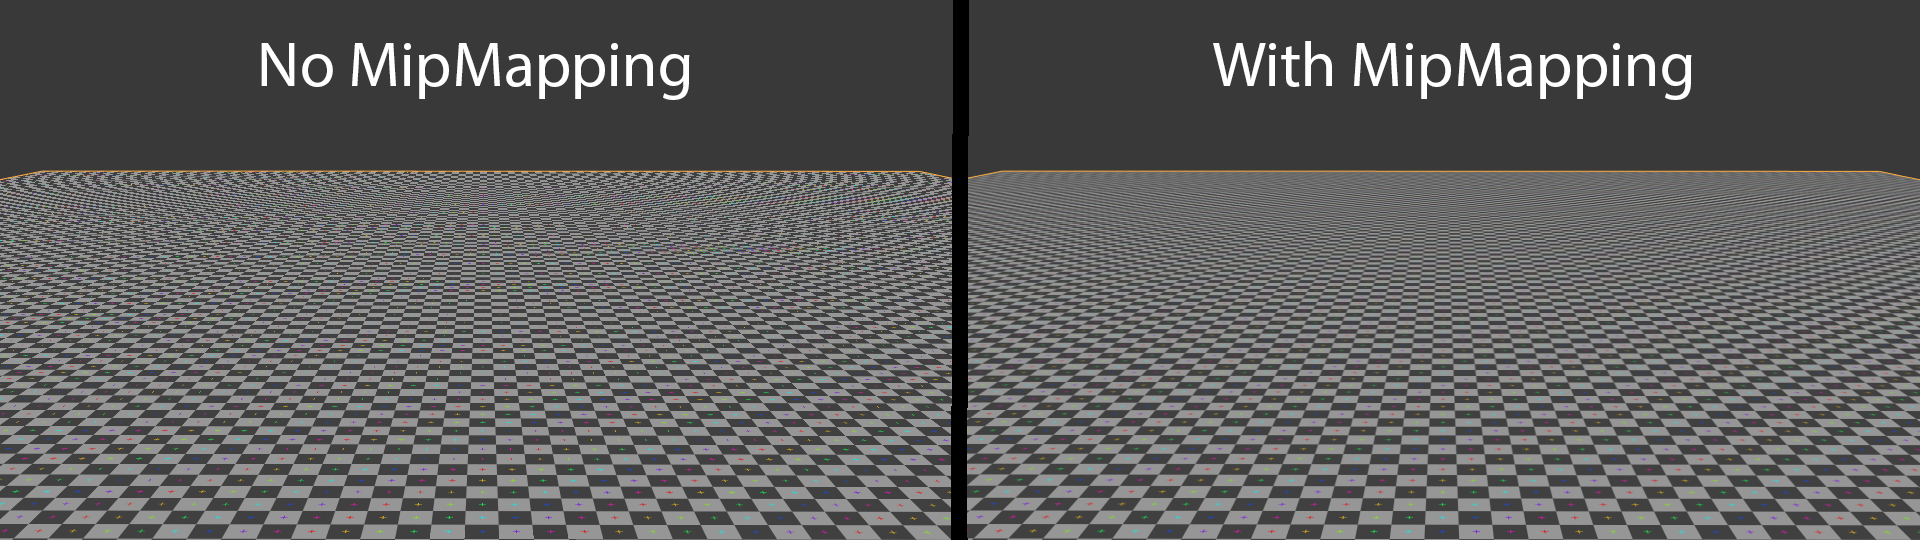
这张对照(Commons,CC0,原图 1920×540)把"层级选错"的两种典型后果并排放:一种是远处纹理闪烁(采得太细),一种是近处糊成一团(采得太粗)。它在语言里对应的是采样状态里的层级偏置与过滤方式——参数只有几个,后果写在画面上。
第二章收束:纹理在这门语言里不是"一个变量",而是"三类对象 + 一个语义插槽 + 一组状态"。这三样东西 HLSL 与 GLSL 都没有等价的写法,这就是第一章那句"它不是子集"的第一块证据。
三、它多出来的东西(二):渲染状态写在 shader 文件里
3.1 technique 与 pass 是语言一级的构造
依然是惯例,第二类扩展比第一类更"出格"。在 HLSL 与 GLSL 里,着色器文件就是一段可编译的代码:谁调用、用什么状态调用、画几个顶点,全是宿主程序的事。ReShade FX 把这件事翻了过来——官方参考原文:
"An effect file can have multiple techniques, each representing a full render pipeline... A technique is made up of one or more passes which contain info about which render states to set and what shaders to execute. They are run sequentially starting with the top most declared. A name is optional."
这张图把从属关系画出来了:一个效果文件可以有多个 technique,每个 technique 由若干 pass 组成,而渲染状态直接写在 pass 里。官方给的例子把这句话坐实了(逐字摘录,为了看清而拆了行):
technique Example < ui_tooltip = "This is an example!"; >
{
    pass p0
    {
        PrimitiveTopology = TRIANGLELIST;
        VertexCount = 3;
        VertexShader = ExampleVS;
        PixelShader = ExamplePS0;
        RenderTarget = texTarget;
        ClearRenderTargets = false;
        GenerateMipMaps = true;
        RenderTargetWriteMask = 0xF;
        SRGBWriteEnable = false;
        ...
    }
}
逐条看这几个键:图元拓扑与顶点数(画什么)、顶点与像素着色器(谁来算)、渲染目标(往哪写)、要不要先清屏、要不要生成 mipmap、写掩码、是否按 sRGB 写。这些在别的语言里都属于"宿主程序的职责",在这里是着色器文件的一部分。 把这些键按用途归一下类,能看出它到底把多少东西收进了语言:
| 用途 | 典型键 | 在别的语言里归谁管 |
|---|---|---|
| 画什么 | 图元拓扑、顶点数 | 宿主程序 |
| 谁来算 | 顶点着色器、像素着色器 | 宿主程序(语言只知道有这么几个阶段) |
| 往哪写 | 渲染目标、写掩码、是否先清屏、是否生成 mipmap | 宿主程序 |
| 怎么写 | sRGB 写开关、混合与深度模板一类状态 | 宿主程序 |
四栏里没有一栏属于"计算",全是"组织"的职责——这是这门语言最出格的地方:它交给运行时的不是"一段代码",而是一份可以照着执行的渲染配方。
3.2 一段真的 technique 长什么样
上面是官方示例。本机这一篇自己写了一个最小的 .fx,第七章会讲它怎么被编的;这里先看它长什么样——因为结构决定了编译产物:
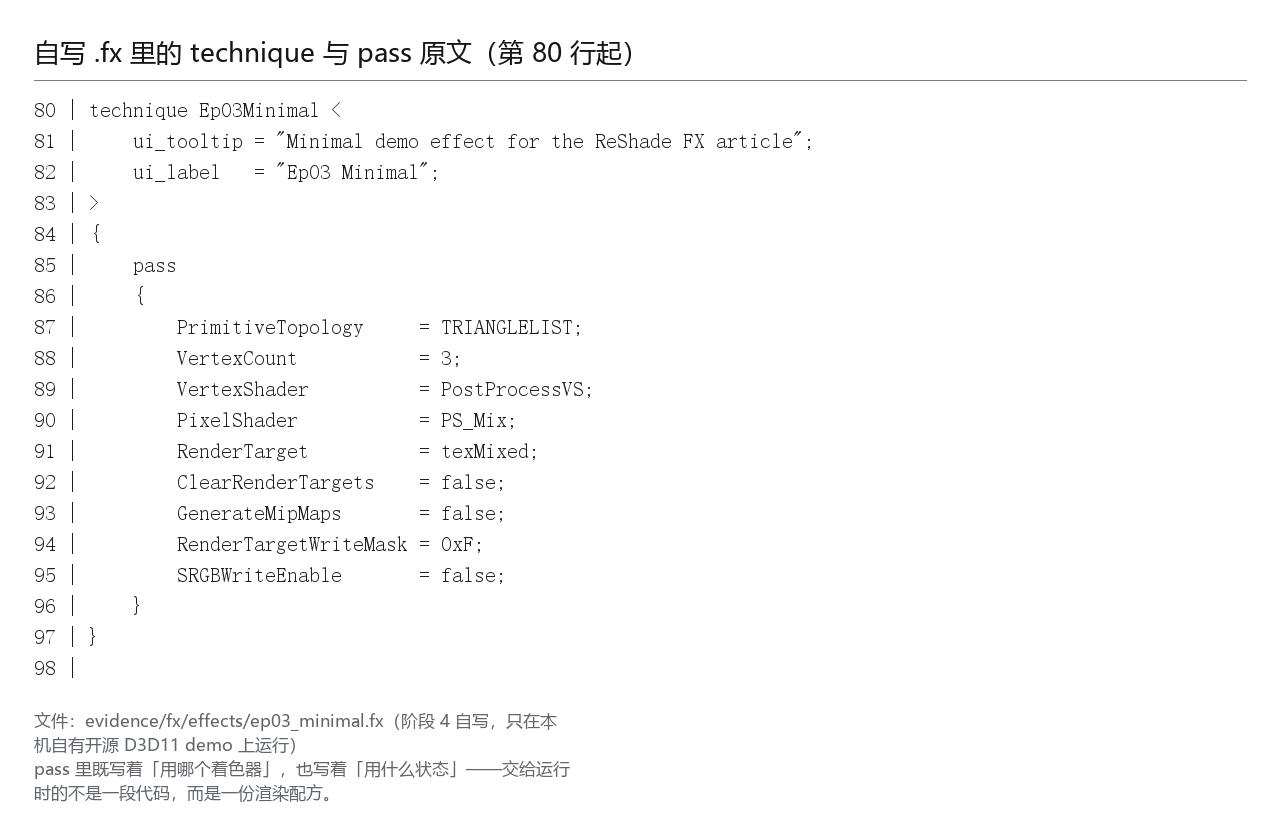
这张面板是自写 .fx 里那段 technique 与 pass 的原文。对照上一张图看,能读出一个关键点:pass 里既写着"用哪个着色器",也写着"用什么状态"。所以一个效果文件交给运行时的,不是"一段代码",而是"一份可以执行的渲染配方"。
这件事直接决定了第四篇的题目。 运行时要做的事,就是读这份配方、按谱做:设状态、绑资源、发射绘制。所以第四篇讲的不是"怎么编译",而是"怎么按谱办事"。
3.3 为什么 HLSL 与 GLSL 做不到这件事
依然是惯例,一个自然的疑问是:既然"多写点状态"是好事,为什么 HLSL 与 GLSL 不这么干?
因为它们的位置不同。 HLSL 与 GLSL 是图形 API 的着色器语言——它们要服务的是"任何宿主程序",而宿主程序可能是引擎、可能是工具、可能是别的什么东西。把渲染状态写进着色器文件,等于要求语言知道"这次绘制用几个顶点、往哪个目标写",而这件事在通用场景下根本不该由着色器决定。
ReShade FX 不需要背这个包袱:它唯一的宿主就是 ReShade 自己。作者在论坛里说过一句更狠的话,用来解释这类差异的根源:
"This particular feature is not possible with HLSL alone. It's a unique feature to ReShade which allows to define textures in shader code that does exist in neither HLSL, nor GLSL." —— 作者在官方论坛的回复
这句话原本说的是纹理声明,但同一逻辑完全适用于 technique / pass:有一个确定的宿主,语言才敢把宿主该管的事收进自己的语法里。这是"方言"的代价与红利:它不能通用,但它能把自己那件专用的事做得干净。
四、它多出来的东西(三):注解与运行时数据源
4.1 注解语法族
言归正传,第三类扩展是注解(annotation)——一套"给声明挂元数据"的写法。官方参考给的形式是:声明后面接一对尖括号,里面写一组键值,分号结尾;而函数用的是方括号属性。两种写法各管一类东西:
// 声明后尖括号:给声明挂元数据
technique Name < enabled = true; ui_label = "My Effect Name"; >

// 函数前方括号:标注它是什么阶段的着色器、以什么线程组大小跑
[numthreads(8, 8, 1)]
[shader("compute")]
void CSMain(...) { ... }
这张表把注解族分了两栏:一栏是"能挂哪些键",一栏是"各自管什么"。官方对 technique 注解给出的取值里,值得记住的几个是 enabled(默认开不开)、enabled_in_screenshot(截图时是否参与)、timeout(启用后多少毫秒自动关掉)、hidden(是否在界面上隐藏)、ui_label(界面上显示的名字)、ui_tooltip(鼠标停在界面上时显示的那段说明)。注意后三个:它们不是给编译器看的,而是给界面看的——这门语言把"界面上怎么显示"也当成了语言的一部分。
官方给出的 technique 注解取值一共六个,逐条都有明确用途:
enabled——这个 technique 默认开不开;enabled_in_screenshot——截图时是否参与(截图常常要一张"干净画面",这一键就是为此准备的);timeout——启用之后过多少毫秒自动关掉(timeout = 1就是"只跑一次",用来做一次性的初始化);hidden——是否在界面上隐藏(一些内部 technique 不该被用户看到);ui_label——界面上显示的名字;ui_tooltip——鼠标停在界面上时显示的那段说明。
六个里有三个是纯界面的(hidden、ui_label、ui_tooltip),另外三个(enabled、enabled_in_screenshot、timeout)管的是行为开关。前者在通用着色器语言里完全不存在:那些语言的"使用者"是宿主程序的作者,而这里的"使用者"是拿着预设调参数的玩家。
4.2 十六个运行时数据源
OK,注解里最实用的一类,是给 uniform 变量标"我的值从哪来"。官方参考列出这份取值清单,一共十六个名字,按用途分四组:
| 分组 | 取值名 |
|---|---|
| 时间类 | frametime、framecount、timer、date |
| 输入类 | key、mousebutton、mousepoint、mousedelta、mousewheel |
| 界面状态类 | overlay_open、overlay_active、overlay_hovered |
| 其他 | pingpong、random、screenshot、bufready_depth |
上图把这份清单与它们各自的附加参数(min/max/step/smoothing/keycode/mode)放在一起。
这里有一处最容易误读的地方。 看到 frametime 与 key 这两个名字,很多人会以为"效果可以自己读键盘、自己计时"。不是。 准确的说法是:效果声明它想要哪一个运行时数据,值由运行时按帧填进来。用作者自己的话讲,这类声明的作用是"request special runtime values"——请求,不是读取。
这条与第二章的语义是同一个机制的两半:纹理语义是"请求一块数据",uniform 数据源是"请求一个标量或向量"。两边都靠运行时兑现。把这两半放在一起,就能看出这门语言的边界在哪——它不自己产生数据,它声明想要什么。
这十六个数据源还能带附加参数。 官方参考在取值名旁边跟着列了一串:min / max / step(界面上滑块的取值范围与步进)、smoothing(变化时的平滑程度)、keycode(绑定哪个按键)、mode(取值模式)。这一串参数的存在说明它们不只是"数据源",还是"界面控件声明"——一个 uniform 声明了 frametime 作为来源、再给出 min 与 max,运行时就会在界面上给它一个受控的滑块。同一套语法同时服务编译期与界面期,这正是第四章开头那句"注解不是给编译器看的"的另一面。
4.3 纹理自己的两类注解
好了,除了给 uniform 用的,纹理声明也有自己的注解。官方参考列了两个,各解决一个问题:
texture2D imageTex < source = "path/to/image.bmp"; > { ... };——"Opens image from the path specified..."texture2D myTex1 < pooled = true; > { ... };——"ReShade will attempt to re-use the same memory for textures with the same dimensions and format across effect files if thepooledannotation is set."
第一个是"静态贴图":从文件读一张图,支持 .bmp/.png/.jpg/.tga/.cube(3D 查找表)/.dds。本系列第八篇要讲的"效果生态"里,那些查找表(LUT)类效果走的就是这条路。
第二个是"内存池":尺寸与格式相同的纹理会跨效果文件复用同一块显存。这是个很务实的开关——后处理效果经常各自声明一块全屏纹理,不池化的话显存会白白多占好几份。
注意这两个注解的性质不同:source= 是"我要读一个外部文件",pooled= 是"这块纹理的内存可以跟别人共用"。同一个语法位,能表达的资源语义完全不同——注解这套机制的价值就在这里:它不改变语言的计算能力,但它让声明更完整。
五、自带编译器:为什么它必须有
5.1 一次编写的四种产物
说白了,前四章讲的四类扩展,合起来就把"自带编译器"变成了必然:语法里有一大半东西是 HLSL 编译器不认识的。所以这门语言必须有自己的编译器,把带扩展的源码吃进来、把扩展落成各 API 能接受的东西。
官网首页对这个编译器的目标说得很清楚:
"Write your shaders just once, they'll work everywhere, regardless of your target being Direct3D, OpenGL or Vulkan: ReShade takes care of compiling them to the right shader model and language (HLSL, GLSL or SPIR-V)." —— reshade.me 首页
加上官方示例工具 tools/fxc.cpp 里能选的四个目标,这门语言实际能产出四种东西:
| 产物 | 对应目标 | 官方选项 |
|---|---|---|
| HLSL 源码 | 交给 D3D 编译器再编 | --hlsl(默认) |
| DXBC 字节码 | D3D9/D3D10/D3D11 | --dxbc |
| GLSL 源码 | OpenGL | --glsl |
| SPIR-V 字节码 | Vulkan | --spirv |
这张表值得记住,因为它是"跨六个图形 API"这件事在编译层面的全貌——不是六个后端,而是"四种产物 + 目标侧再加工"。第五篇会接着讲后半截。
为什么不做成六个后端? 因为其中三个目标已经有人把活干完了:D3D9 与 D3D11 都在等 HLSL 或 DXBC,而 HLSL 那一路交给系统自带的编译器就够了(第六章 fxc.cpp 用「像 fxc 一样」来类比,就是这个原因)。真正需要自己做的,是把带扩展的语法落到两份"标准产物"上:一份给 D3D 系(HLSL/DXBC),一份给 OpenGL(GLSL)、一份给 Vulkan(SPIR-V)。
这个取舍带来一个可验证的后果:产物里有 HLSL 与 GLSL 两种源码形态,说明它并不总是自己包办到最后一步——把源码交出去,由目标侧的编译器做最终优化,是更省事的做法。--shader-model 那一串版本号(30/40/41/50)为之存在:同一个效果要给老 D3D9 编,也要给 D3D11 编,由使用者挑一个版本号。
5.2 编译流水线:0.15 那次换心
上图是这条流水线:词法分析 → 预处理 → 语法分析 → 代码生成(四个后端)。其中语法分析那一步换过一次心,是这门语言历史上比较硬的一次改动。0.15.0 的发布说明原文:
"Replaced the entire effect parser + compiler and changed algorithm from a generated LALR parser to a fully handwritten recursive decent parser." —— 0.15 发布帖
为什么这一句值得停一下? 因为它对应着一个很实际的取舍:LALR 是"用生成器造出来的解析器",手写递归下降是"人一行行写出来的解析器"。前者写起来快、报错信息往往晦涩;后者写起来慢,但报错可以写得像人话。第八章那两条编译报错,读起来之所以还算清楚,源头就在这次换心。
顺带把语言能力的两条时间线也落在图上:4.8 加了计算着色器支持("Added compute shader support to ReShade FX shader language, supported in D3D11, D3D12, OpenGL and Vulkan.",见发布帖),6.1 加了 [shader] 与 [numthreads] 函数属性(见6.1 发布说明)。所以现在这门语言不只写像素着色器——这一点第九章会再回来用一次。
5.3 本机的那一堆编译产物
OK,讲完了设计,来看实物。本机装了 ReShade 官方构建,并且确实跑过效果编译——缓存目录里躺着三类中间产物:
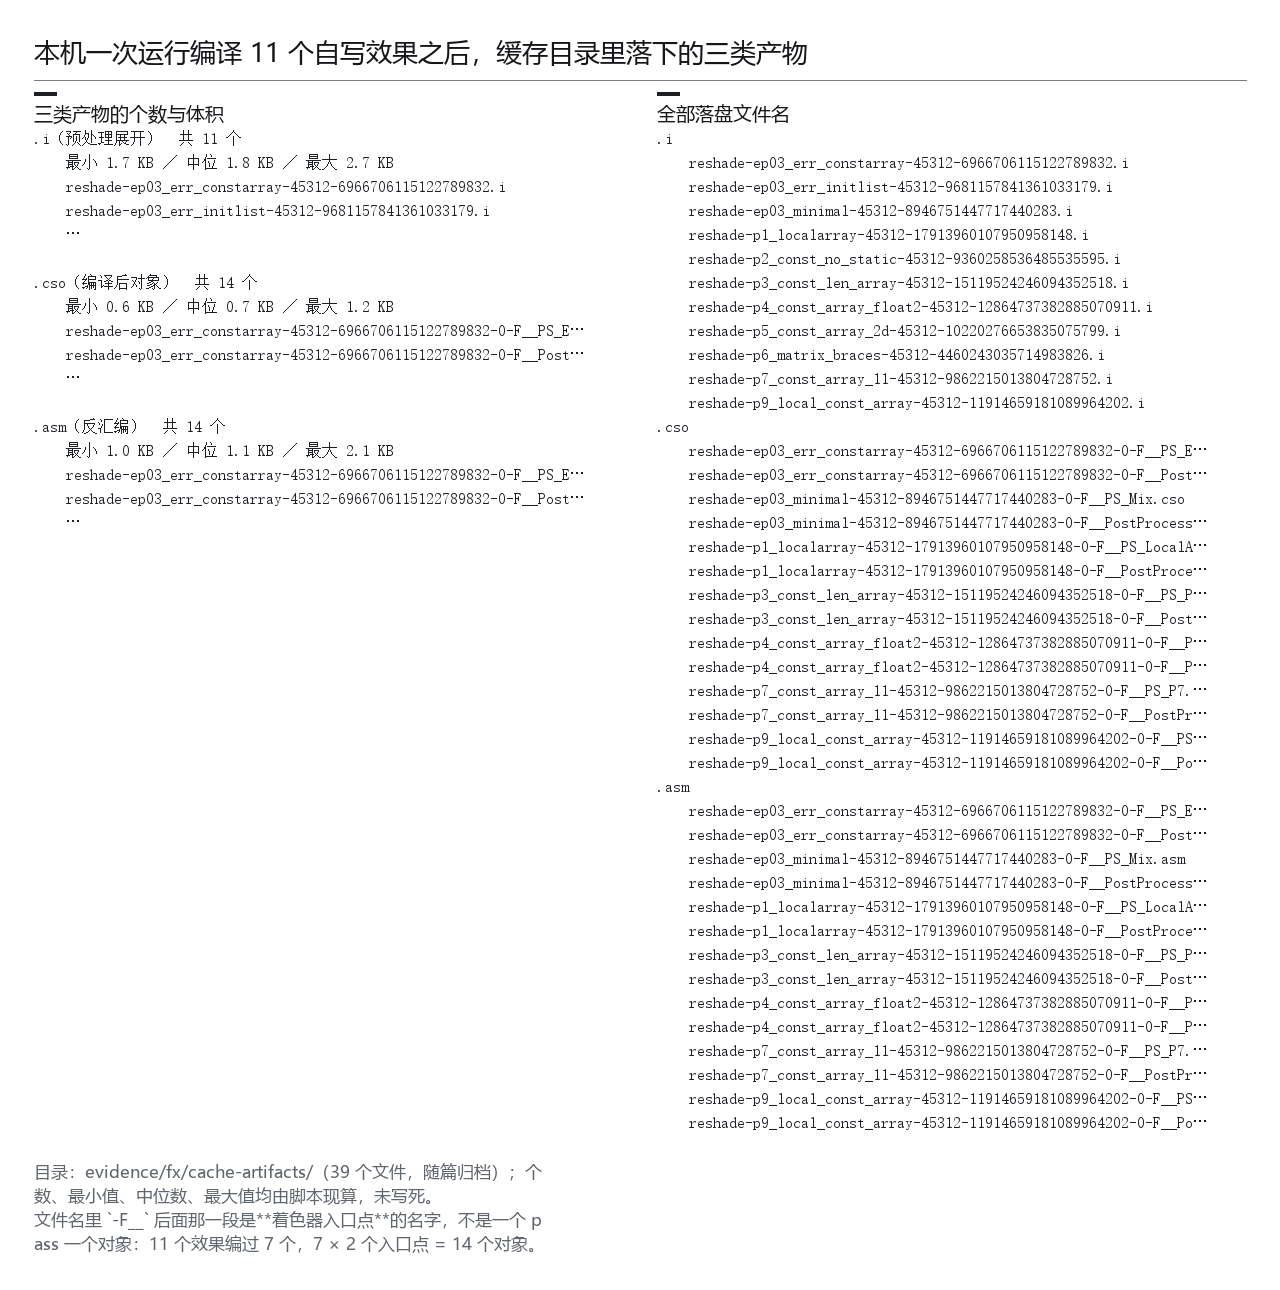
这张面板列的是本机缓存目录里的文件:.i 是预处理展开(头文件与宏都被摊平之后的样子)、.cso 是编译后的着色器对象、.asm 是反汇编。文件名形如 reshade-<效果名>-…-F__<入口点>.cso,那一段是着色器入口点的名字(PostProcessVS、PS_Mix 这种)。
这里要纠正一个想当然的说法:编译对象的粒度不是按 pass 计的。 本机那批既有效果里就有反例——PD80_02_Bloom 有 13 个 pass,其中 13 处写的都是同一个 VertexShader = PostProcessVS;,而缓存里的 PostProcessVS 对象只有 1 个。反过来,本篇第七章自写的那个效果只有 1 个 pass,却落了 2 个对象(顶点与像素两个入口点各一个)。
所以粒度是跟着「入口点」走的:一个入口点被几个 pass 引用,仍然只编一份;一个 pass 里用了几个入口点,就落几个对象。对象数 = 被用到的入口点数(再扣掉被 #if 预处理掉的那些)。第三章讲的 pass 结构当然还在,只是它决定的是"配方怎么排",不是"编几份"。
这里有一个必须说清楚的口径:这些产物是本机既有的,说明"运行时编译链路在本机真能跑通";但它们是既有缓存,不能当作"本次实测生成"。要拿到新鲜产物,得自己写一个 .fx 再跑一次——那就是第七章做的事。
既然口径说清了,就把这批既有产物的体积量一遍(只读统计,不删不改):
| 产物 | 个数 | 最小 | 中位 | 最大 |
|---|---|---|---|---|
.i 预处理展开 |
142 | 2.1 KB | 7.3 KB | 44.0 KB |
.cso 编译后对象 |
571 | 0.6 KB | 1.1 KB | 97.8 KB |
.asm 反汇编 |
571 | 1.0 KB | 2.0 KB | 119.3 KB |
三类合计 1,284 个文件。 里面有两处比例值得看一眼:
- 编译对象与反汇编一一对应(都是 571 个),而预处理产物只有 142 个——三者不是一对一的关系。这也解释了缓存目录里为什么会有上千个文件;
- 反汇编的中位体积(2.0 KB)是编译对象(1.1 KB)的 1.8 倍——反汇编是给人读的,它比机器码多出来的那部分就是可读性本身的成本。
源文件那一侧也量一下:效果目录里一共 69 个 .fx,行数从 15 行到 1,332 行,中位 240 行。这个分布说明"效果"这个词的跨度有多大:既有十几行的小工具,也有一千多行的完整后处理链。第七篇那个"最小可验证集"就是往 15 行那一端靠的。
5.4 编译器有旋钮
依然是惯例,最后补一块工程上的常识:这门编译器是运行时跑的,所以它的代价与开关都写在配置里。作者在官方论坛逐条列过 ReShade 的 ini 设置,其中与编译直接相关的是这几条:
NoEffectCache=<0/1>——"When one, disable caching of compiled effects entirely (the default is zero). This is not recommended."NoDebugInfo=<0/1>——"When one (the default), do not add file and line information to the code the effect compiler generates. This reduces the size of the generated code and makes it cache better, but may produce more cryptic error messages if compilation fails."IntermediateCachePath=<path>——"Path to a directory that ReShade should store the effect cache in."PerformanceMode=<0/1>——"Performance mode compiles effects with a higher optimization level and replaces all uniform variables with constants (based on the values in the preset) to further increase optimization potential."SkipLoadingDisabledEffects=<0/1>——"avoid loading any effects that are not present in the current preset, to speed up initialization time." —— 官方 ini 设置说明
这五条合起来讲了一件很实际的事:编译是运行时做的,所以它必须能缓存、能跳过、能调优化档。NoDebugInfo 那条尤其值得留意——它默认开着,代价是报错信息会变难读。第八章那两条报错之所以还能看,是因为本机那次没有关掉调试信息(或者说是源码直接在报错里指出来的位置)。
另有一个写在效果文件里的开关,官方参考里的一句话:
"You can disable optimization during shader compilation by adding this line to an effect file:
#pragma reshade skipoptimization"
所以这门语言带着自己的编译指示(pragma)。 在有宿主的同时还带着编译器,好处就是这些细节都归它自己管——第五篇讲跨 API 时还会用到这个性质。
这几条配置合起来有三个很实际的后果,值得一并说清:
- 首次启动会慢。 编译是运行时做的,所以第一次加载一批新效果时会有一段停顿。本机量到的是编译器自报的单件耗时(那一轮 7 件成功编译的样本落在 0.031 ∼ 0.034 秒)——但那是几十行的小文件;缓存里既有的效果展开后
.i中位 7.3 KB、反汇编最大 119.3 KB,量级差着好几倍。编过一次之后有缓存,后续启动就快,这就是NoEffectCache那条为什么标着"不推荐"。 - 报错可读性是一个可调项。
NoDebugInfo默认开着(生成的代码更小、缓存更有效),代价是报错更晦涩;调试效果时把它关掉,报错里就会带上文件与行号。 - 性能模式会改语义。
PerformanceMode不只是"更用力优化"——它还会把 uniform 替换成常量(按预设里的值)。这意味着改参数要重新编译:它是"参数能在界面上实时拖"与"优化到底"之间的一个取舍点。
六、独立编译器的两层含义
6.1 官方原话:它是 standalone 的
第五章说"它必须有自己的编译器",这一章要往前一步问:这个编译器能不能单独拿出去用? 官方仓库 README 的回答很明确:
"The ReShade FX shader compiler contained in this repository is standalone, so can be integrated into other projects as well. Simply add all
source/effect_*.*files to your project and use it similar to the fxc example." —— crosire/reshade 仓库 README
"standalone"这个词是有具体所指的:编译器是仓库里的一组 source/effect_*.* 源文件,你可以把它们加进自己的工程,不必拖进整个 ReShade。官方甚至给了一个现成的用法样例——tools/fxc.cpp,一个照着微软 fxc 的使用习惯写的命令行工具。
OK,既然有样例,就把它的用法抄下来看:
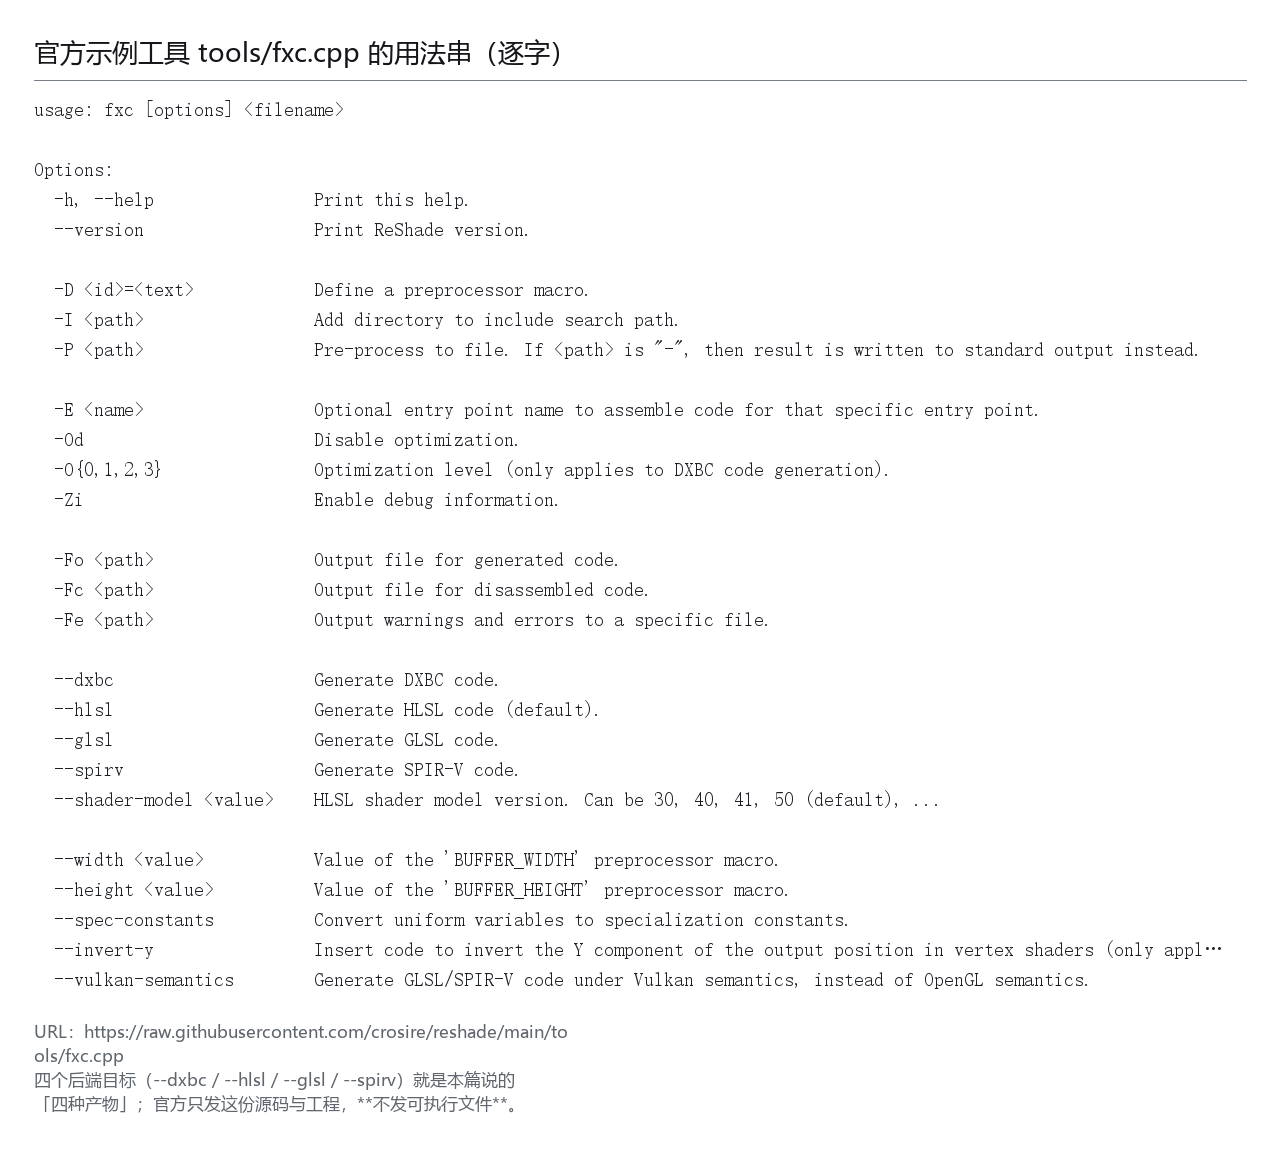
这张面板是 tools/fxc.cpp 的用法串原文。四行关键信息是:四个后端目标(--dxbc / --hlsl / --glsl / --spirv)、着色器模型版本(--shader-model,可取 30/40/41/50 等)、背缓冲宽高(--width / --height,用来给 BUFFER_WIDTH 这类宏定值)、以及预处理与优化开关(-D / -I / -P / -E / -Od / -O{0,1,2,3} / -Zi)。另外还有两个容易被忽略的:--spec-constants(把 uniform 转成特化常量)与 --vulkan-semantics(按 Vulkan 而不是 OpenGL 的语义生成 GLSL / SPIR-V)。
读法:这份用法串本身就是一份"编译器有多完整"的证据——它不是"能把 .fx 吐成 HLSL"那么简单,而是带预处理、带优化档、带多后端语义选择的完整前端加后端。
6.2 能力上独立,不等于产品上独立
言归正传,这里有一处必须讲清楚的区别,也是本篇最值得写的一处反直觉:
上图把"独立"这件事拆成两层:左边是能力上独立——源码可以拿走、可以集成、四个后端都在;右边是产品上独立——官方有没有给你一个能直接双击运行的可执行文件。
右半边是要打问号的。 本轮把能查的地方都查了:官网下载页只提供安装器(ReShade_Setup_6.8.0.exe 与带 add-on 的版本),没有单独分发这个命令行工具;检索过「reshade-fx standalone compiler CLI」「fxcompiler reshade download」等措辞,也没有找到官方发布的二进制。仓库里能看到的只有 ReShadeFX.vcxproj(编译器库)与 ReShadeFXC.vcxproj(命令行工具)这两个工程——要它,得自己编。
而作者的这段话把右半边的情况说得更直接。有用户在论坛里问 __RESHADE_FXC__ 这个宏是干什么的,作者回答:
"It's for a standalone compiler, where the BUFFER_WIDTH and BUFFER_HEIGHT defines are not actual defines, but uniform variables. This is not currently in-use by ReShade itself." —— 作者在官方论坛的回复
最后那半句是关键:这个宏是为独立编译器准备的,而ReShade 自己现在并不走这条路。也就是说,"独立编译器"这条通道在代码里是存在的、被维护的,但在产品形态上没被激活。
所以"独立编译器"这四个字的准确含义是:它是一个可嵌入式的前端加多后端——能力上随时可以拿走,产品上官方没打算把它做成一个你自己能下的工具。说它"能独立"没错,说它"可以像 fxc 那样随便用"就过头了。
6.3 那社区实际在做什么
好了,既然官方不发工具,社区怎么用这门语言?答案是手工移植。有一条可追溯的实践记录:有人把 SweetFX/ReShade 体系里的 LiftGammaGain.fx 搬到另一个引擎,做法是逐处改写——删掉 #include "ReShade.fxh" 这类头文件引用、把 technique{pass{VertexShader = PostProcessVS; …}} 换成目标引擎要求的 compile vs_3_0 形式、把 uniform 上的注解换成引擎自己的变量系统。原文给了一句很实在的评价:ReShade 比那个引擎"not quite as pick-up-and-go"。
—— NVR 的着色器移植教程
这条实录值得细看,因为它把"移植"的具体形状写出来了:删掉 #include "ReShade.fxh"(那个头文件里是运行时提供的接口)、把 technique / pass 换成目标引擎认的 compile 形式(渲染状态的表示法整个换掉)、把 uniform 上的注解换成引擎自己的变量系统(数据源机制整个换掉)。
三步改写,与本篇第二、三、四章讲的那三类扩展一一对应——要搬走的东西就是那些"多出来的",而能原样搬走的,只有第一章那句"DX9 风格的 HLSL"覆盖的部分。
上面这张图把三步与三章对照起来:每一处改写,动的都是"多出来的那几类"里的一类。
这个现象印证了 6.2 的结论:产物绑着运行时语义。ReShade FX 编出来的 HLSL 里带的那些东西(纹理语义、pass 状态、运行时数据源),一旦离开 ReShade 的运行时就没有兑现者——所以真要搬,搬的不是编译产物,而是算法本身。这也从反面说明:这门语言的"独立"是编译器的独立,不是产物的可移植。
6.4 后端会做的那些变换
OK,最后补一块:这个编译器在后端不是"原样翻译",它会做优化。官方在 fxc.cpp 里给了四个优化档(-O{0,1,2,3}),而 PerformanceMode 那条配置说明里直接写着"compiles effects with a higher optimization level"。
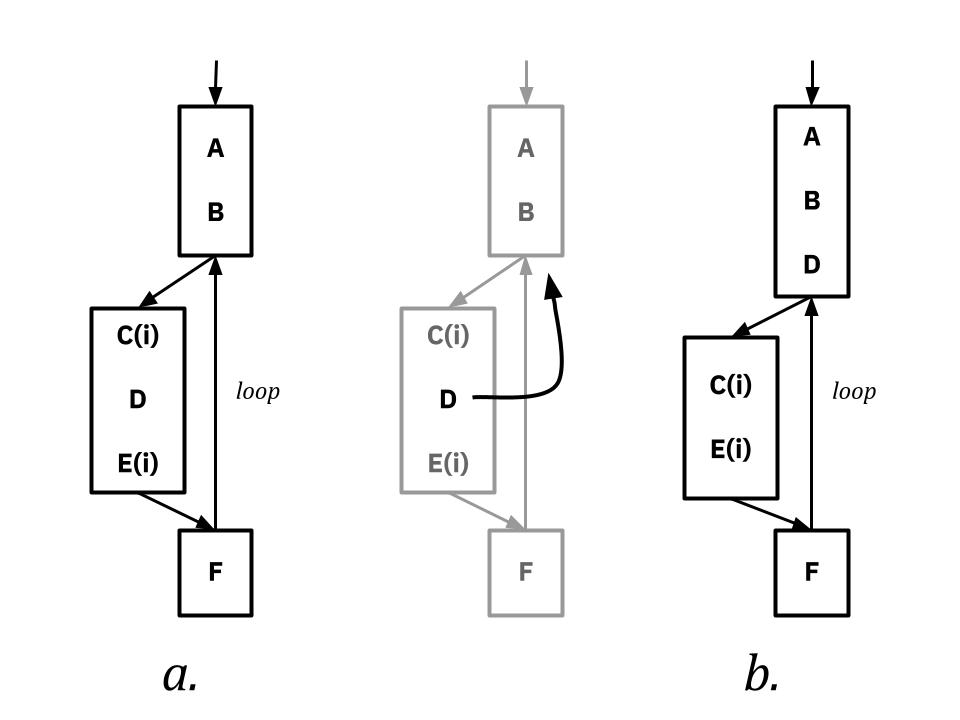
这张示意(Commons,CC0,原图 960×720)画的是编译器优化里最经典的一类:把循环里不随迭代变化的计算挪到循环外。它在后处理里很常见——例如一个按像素循环的计算里,某些量在整帧内是常量,编译器可以只算一次。
这里要老实说一句边界:这是通用编译器优化的示意,不是从 ReShade FX 的反汇编里逐条对比出来的。本机这一篇拿到了反汇编产物(第五章那张面板里的 .asm),但没有做"开优化 vs 关优化"的逐指令对照——那需要把同一个效果编两遍再逐条比汇编,属于第十篇"自跑二"的范围。所以这张图在这里只承担"后端会做变换"这一层意思,不作为 ReShade FX 优化能力的证据。
七、本机实测:编一次 .fx 会发生什么
7.1 我写的那个最小 .fx
好了,前面六章讲的全是"官方怎么说"。这一章往下走一步:自己写一个,编一遍,把中间产物抓下来看。
OK,写什么?越小越好,但要覆盖前四章讲的关键语法——不然编出来的东西看不出东西。所以这个最小文件里必须包含:一个带语义的纹理声明(第二章)、一个 sampler 对象(第二章)、一个带注解的 uniform(第四章)、以及一段 technique 与 pass(第三章)。
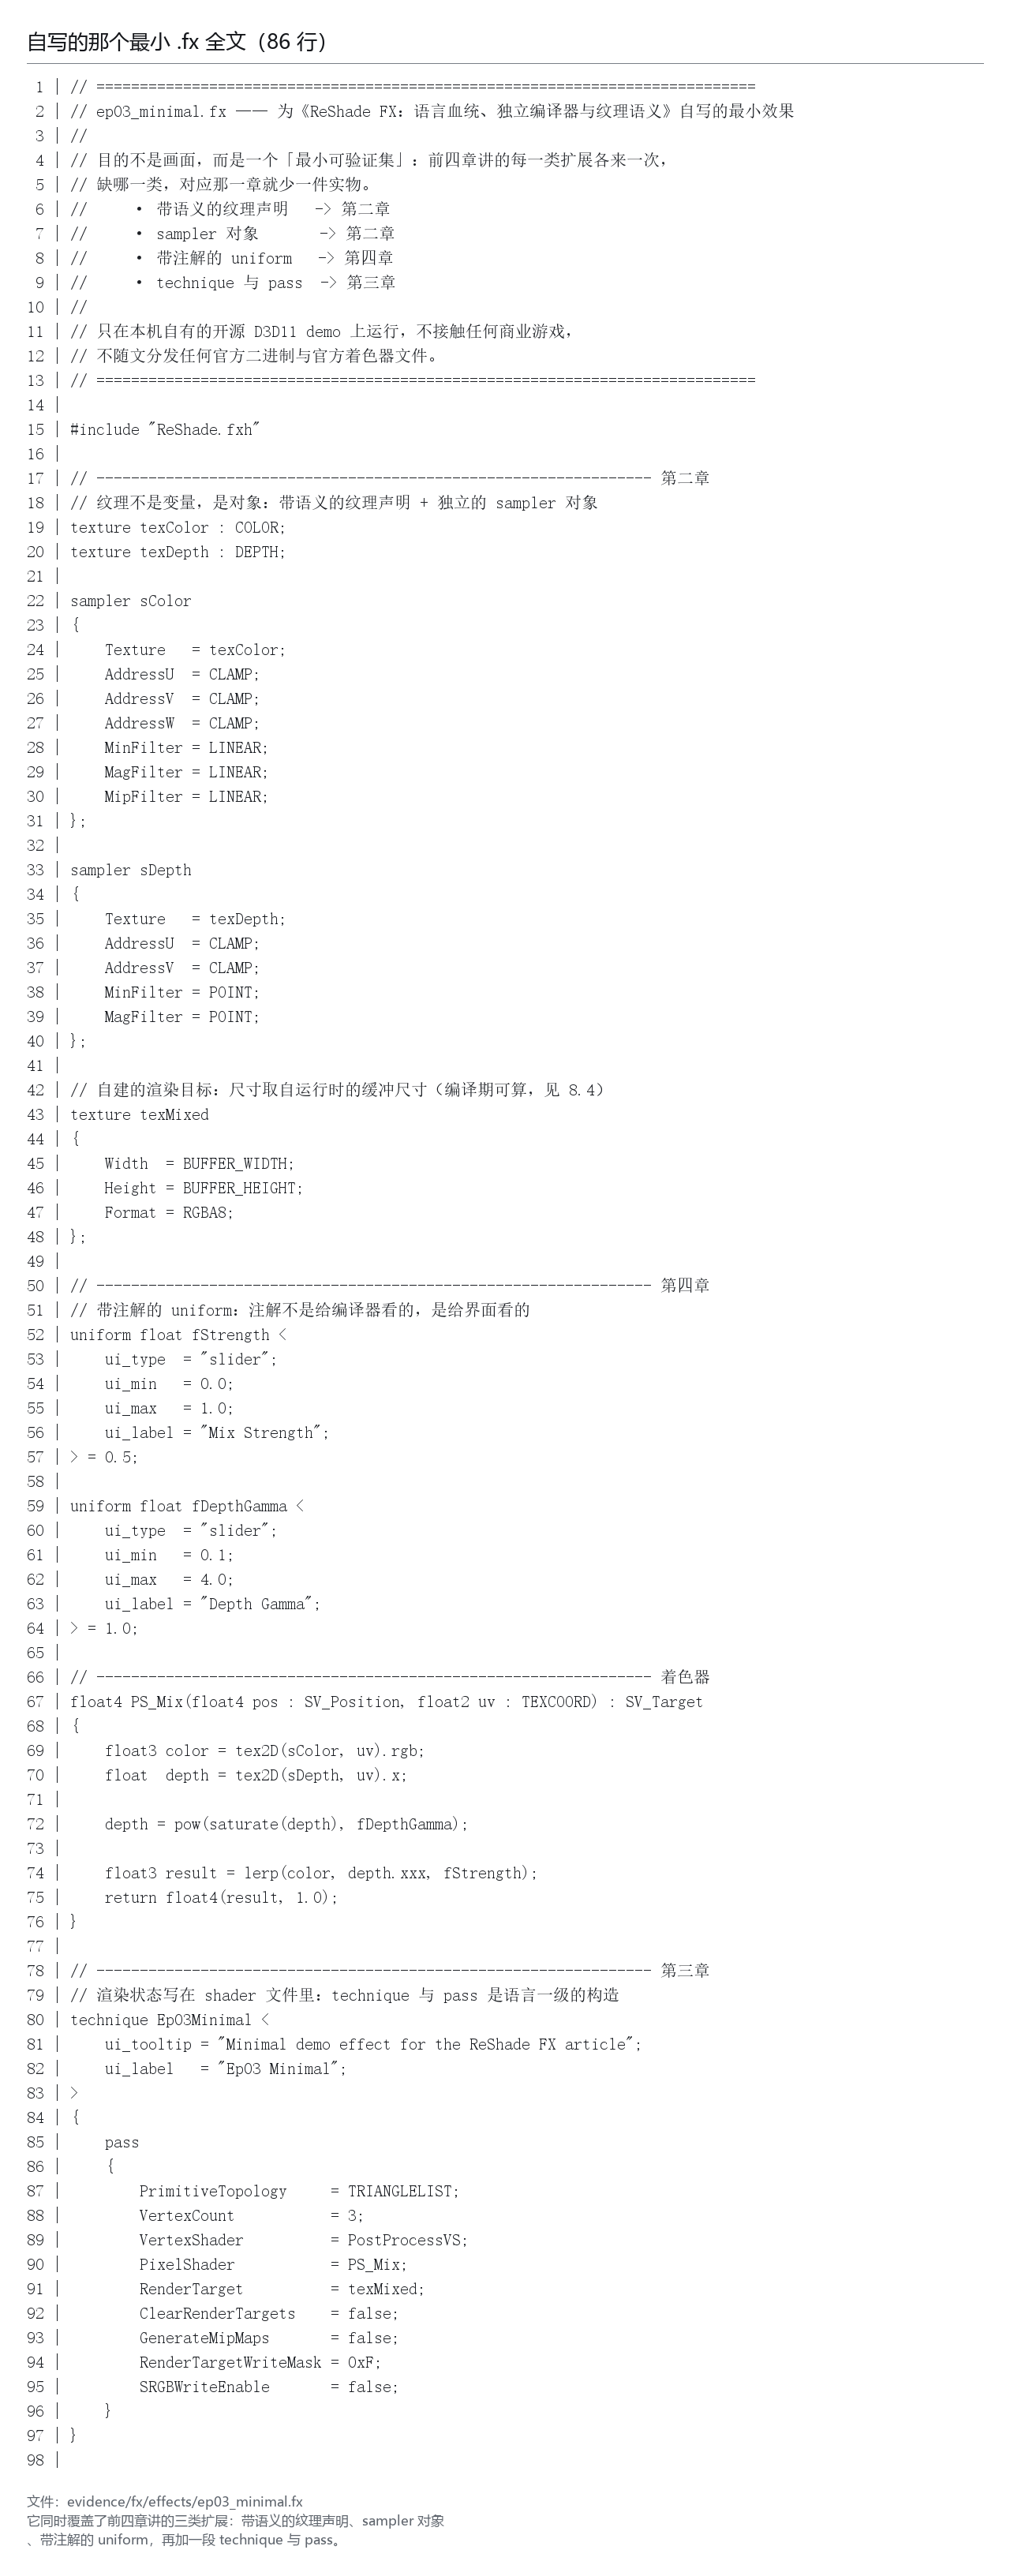
上面这张面板就是它的源码原文。要留意的是它有多短:一个能编过、能在画面上产生可见变化的效果,核心部分只有几十行。这本身是个值得记下来的事实——这门语言的"入门门槛"低到可以手写,而它的扩展又足够表达一套完整的渲染配方。
这几十行是有意挑的,它同时覆盖了本篇前面四章讲的每一类扩展:
- 一个带语义的纹理声明(第二章:
COLOR或DEPTH)——验证「语义能要到数据」; - 一个 sampler 对象(第二章:过滤与寻址写在定义体里)——验证「状态在语言里」;
- 一个带注解的 uniform(第四章:
< source = …; >)——验证「运行时数据源是请求出来的」; - 一段 technique 与 pass(第三章:渲染状态写在 pass 里)——验证「配方在文件里」。
所以这个文件不是"随便写个能编过的",而是一个最小可验证集:每一类扩展各来一次,缺哪一类,对应的那一章就少一件实物。
7.2 预处理展开:编译器真正读到的东西
好了,第一个产物是最容易被忽略的一步:预处理。.fx 里通常会有 #include,会有条件编译,会有宏。编译器在后端之前,先把这些摊平成一个大的中间文件——扩展名是 .i。
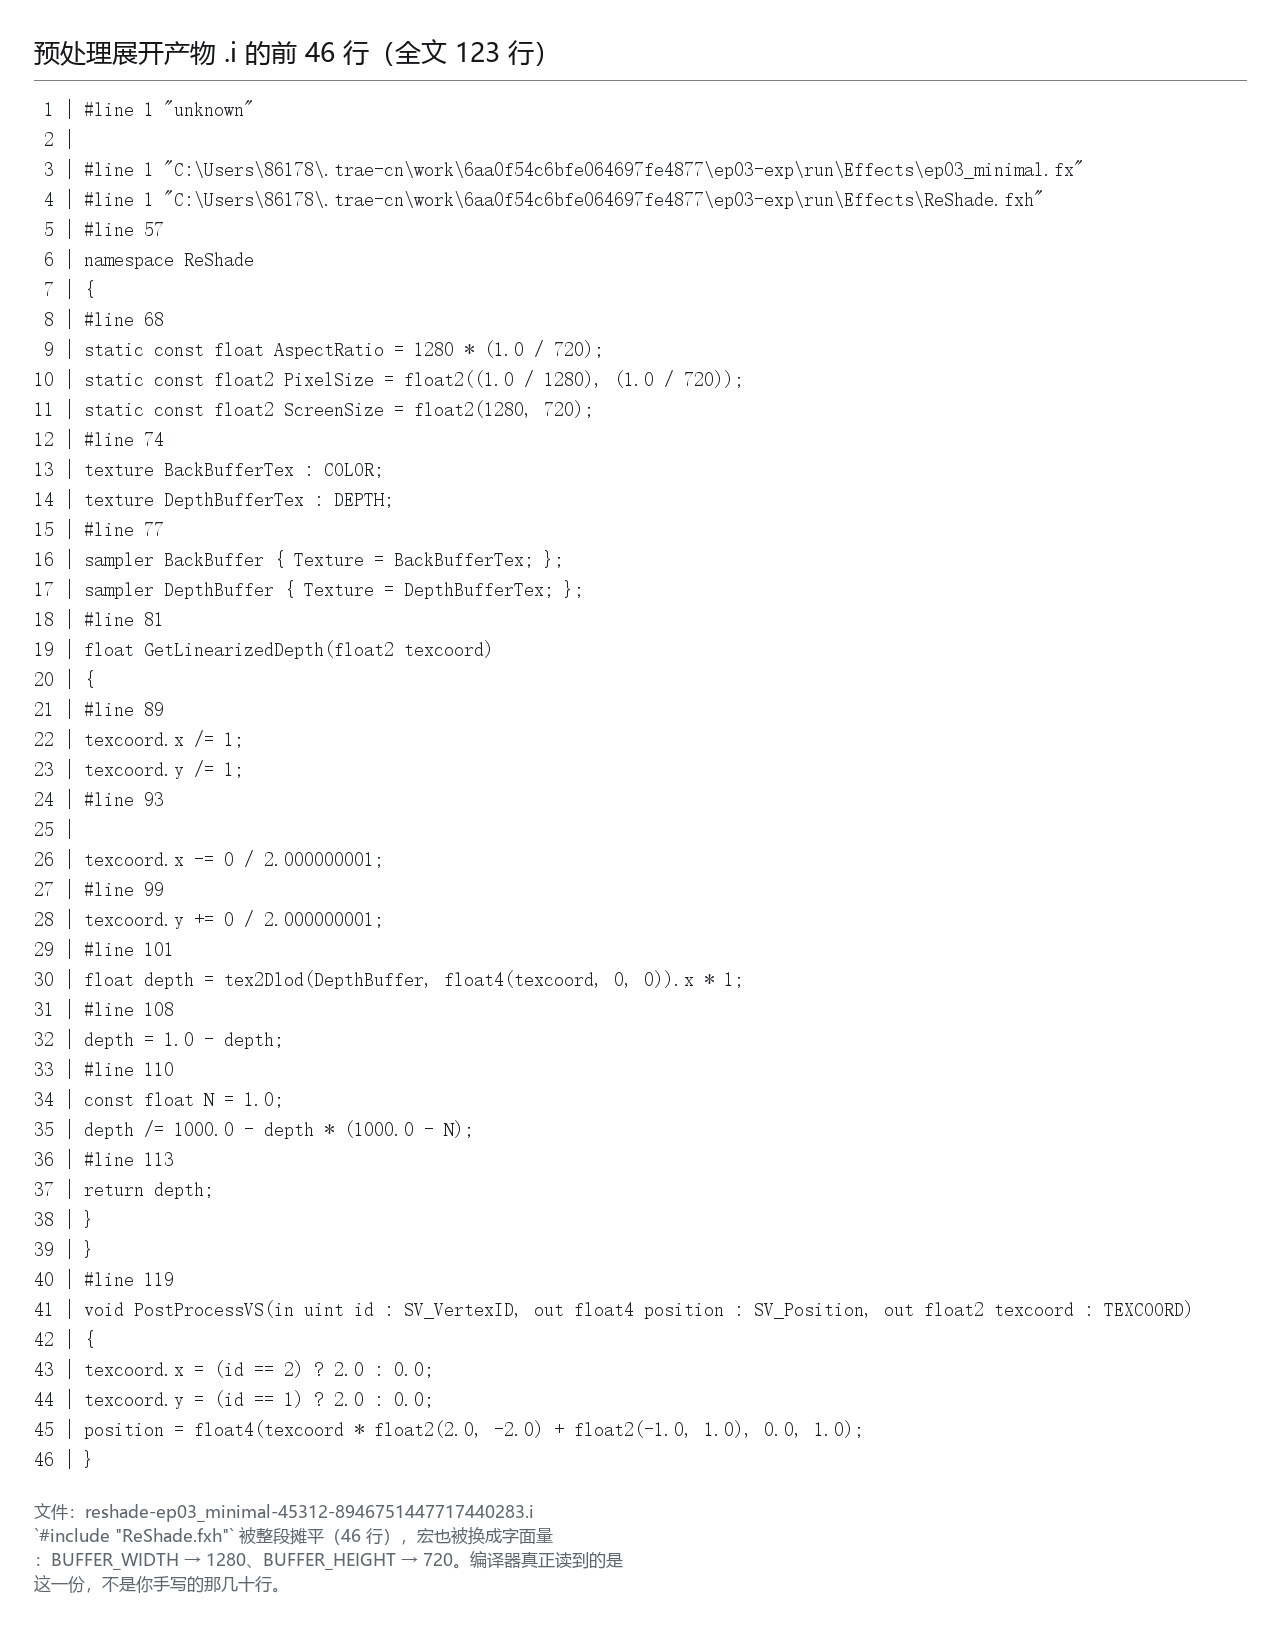
这张面板是预处理产物的片段。它的意义在于:如果你不看清这一步,你会以为编译器吃的是你写的那几十行;实际上它吃的是展开之后的几百上千行。官方参考里那句 "ReShade FX supports most of the standard HLSL intrinsics" 之所以不是空话,就是因为内建函数在预处理之后就是普通的函数声明与实现。
顺带解释了一个常见困惑:为什么有些效果文件在编辑器里看着只有几十行、编起来却很慢?因为那几十行展开之后可能很长——本机缓存里那些 .i 文件的体积就说明了这一点(见第五章那张面板)。
7.3 编译与反汇编:落到 .cso 与 .asm
言归正传,预处理之后是真正的编译:生成目标代码(.cso),以及配套的反汇编(.asm)。前者是给 GPU 吃的,后者是给人看的。
这两个产物对读者的价值不同:.cso 证明"它真的编译了",.asm 让你能看见编译器做了什么决定——比如 sampler 被分到了哪个槽位、常量被放进了哪一段、循环有没有被展开。
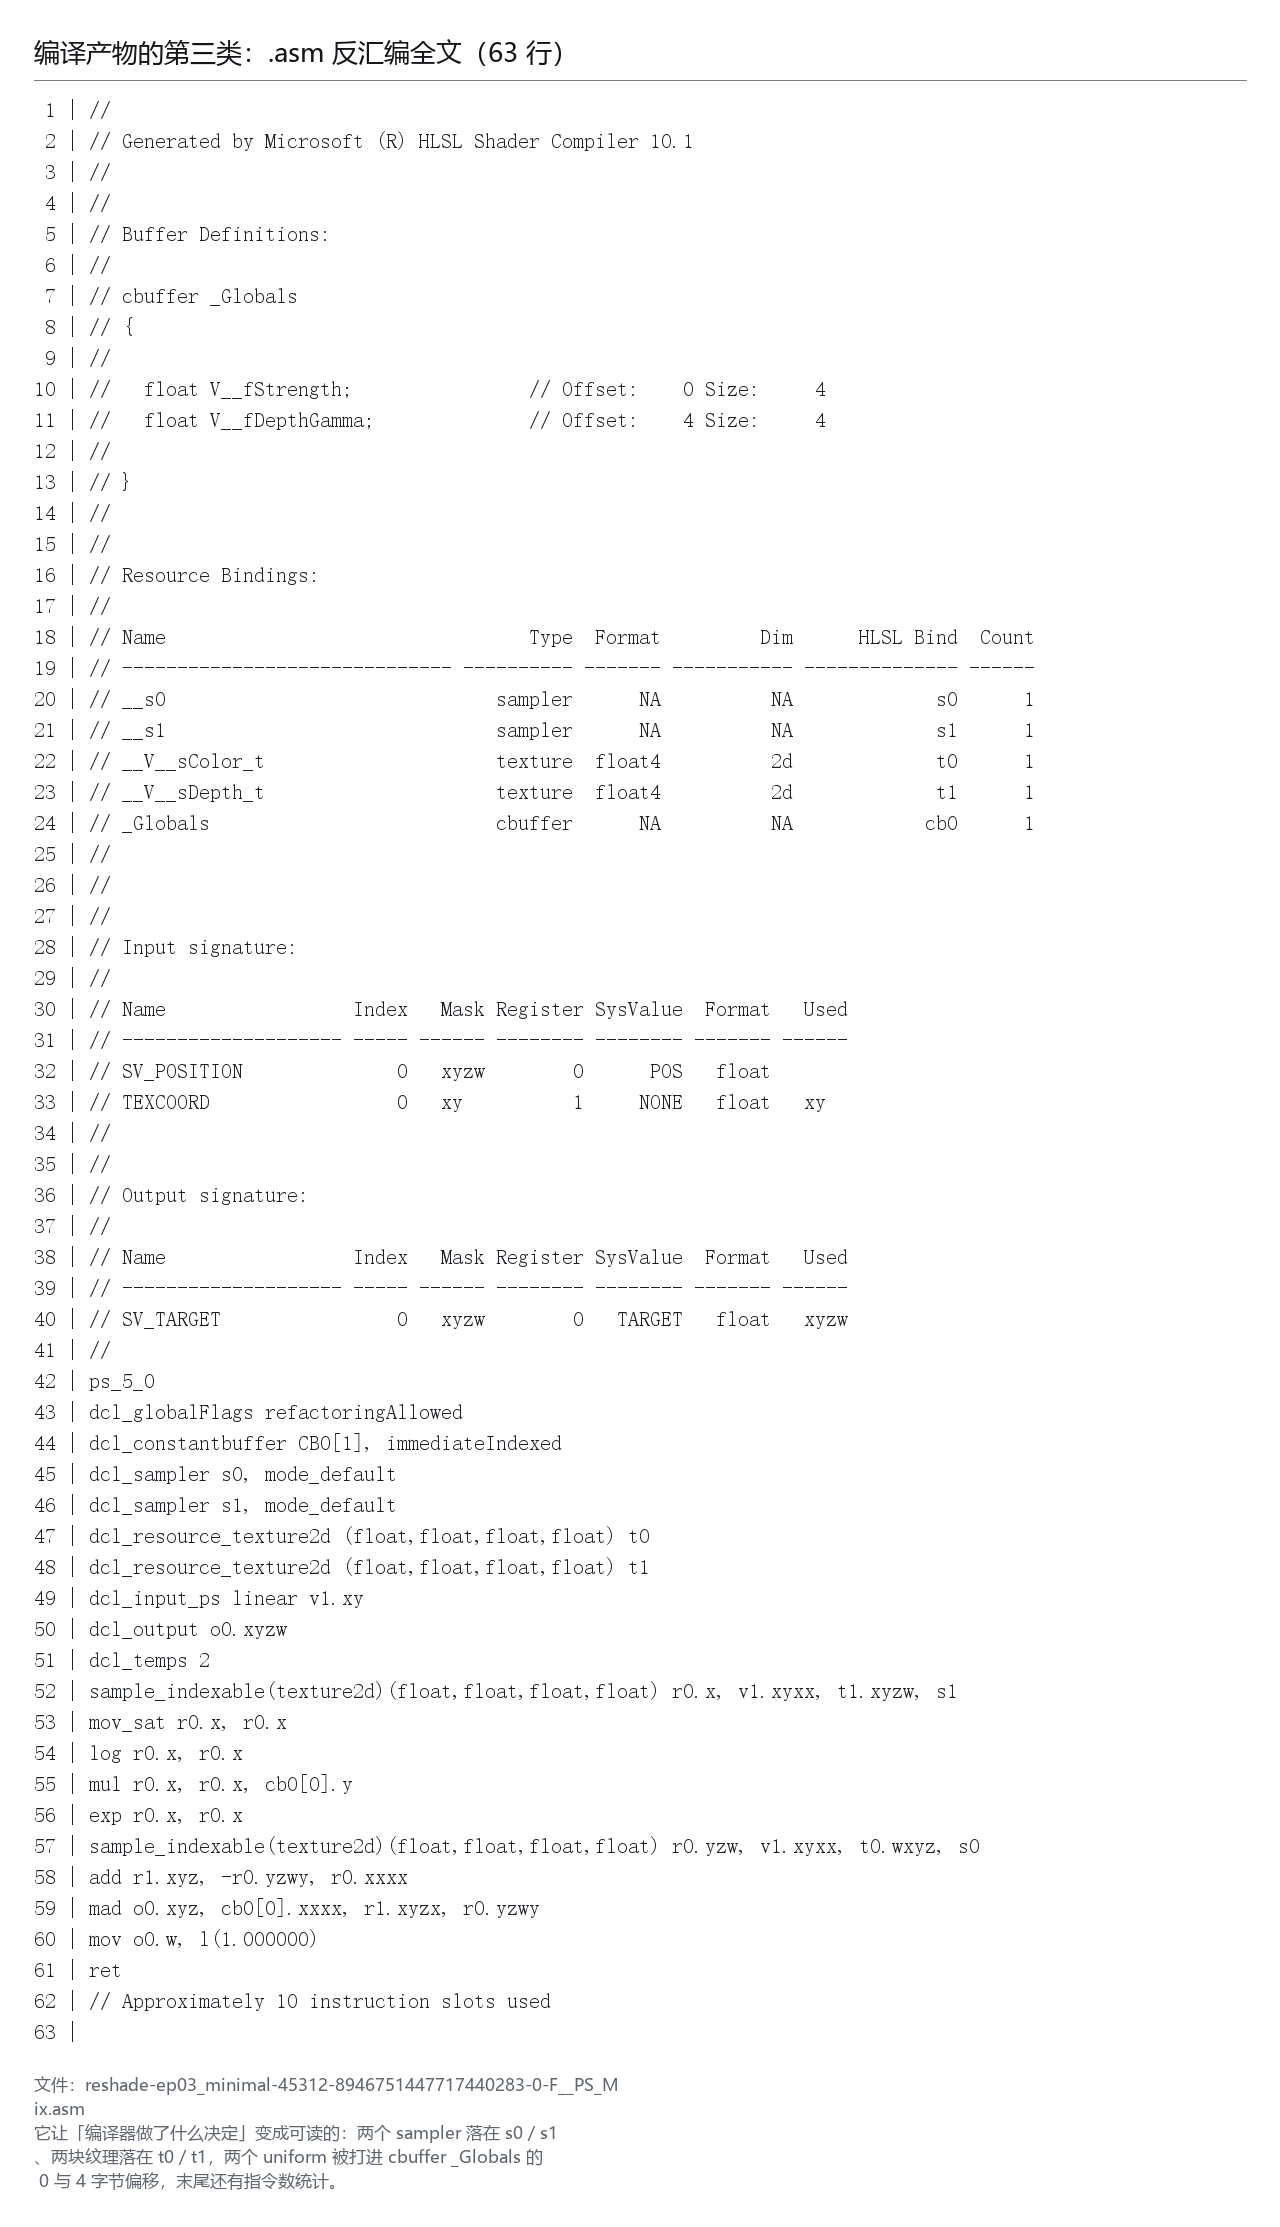
上面这张就是那段反汇编的全文。它把「编译器做了什么决定」从断言变成一份可读的账:两个 sampler 分别落在 s0 与 s1、两块纹理落在 t0 与 t1、两个 uniform 被打进同一个常量缓冲的 0 与 4 字节偏移,末行还给了指令数统计。
回头看第五章那张缓存产物面板:第一次看它,重点在"有哪些文件";现在再看,重点在文件名里的那一段——reshade-<效果名>-…-F__<入口点>.cso。而入口点正是第三章讲的那个东西:pass 里 VertexShader / PixelShader 指向的函数。
本篇自写的那一件就是最小的例子:它只有 1 个 pass,缓存里却落了 2 个对象——F__PostProcessVS.cso 与 F__PS_Mix.cso,对应它用到的两个入口点。对象是跟着入口点走的,这就是第三章那句"渲染配方"落在磁盘上的样子。
7.4 题图:日志里的那一行
题图的左半边是本机运行日志里的效果编译段——它是第七章全部结论的一手凭据:编译发生在运行时、发生在你按下启动之后,而编译器会把自己的工作过程逐条写进日志。右半边是官方语言参考的首句原文。
把第七章 7.1 那张源码面板与题图放在一起看,就能读懂"heavily based on the DX9-style HLSL syntax, with a few extensions"这句话的分量:左边是这门语言实际吃进去的东西(我写的几十行),右边是它对这份底子的自我描述。
7.5 这一章的方法与边界
方法:同一台机器、同一个自有开源 D3D11 场景、同一份自写 .fx,只改"编哪个效果"这一个变量。所有产物从缓存目录原样取回,不做二次加工。
边界(三处要说清的):
- 没有商业游戏。全部实验在自有开源 demo 上做,符合本系列红线。
- 没有逐指令对照。开优化与关优化的反汇编差异没做(理由见 6.4)。
- 没有把编译耗时做成可靠统计。日志里有时间戳,但一次编译的耗时受磁盘、首次缓存等因素影响,本机样本也不足——这一项如实写"测不了",不用估算值凑。
八、那些编不过的东西
8.1 不支持初始化列表
说白了,第一章说它是"方言",方言的意思不只是"多了一些词",还包括少了一些。第一类"少"来自作者的直接回答:
"ReShade FX does not support the initializer list syntax." —— 作者在官方论坛的回复(帖子发于 2017 年,回复的是一位想用嵌套花括号初始化 3×3 矩阵的读者)
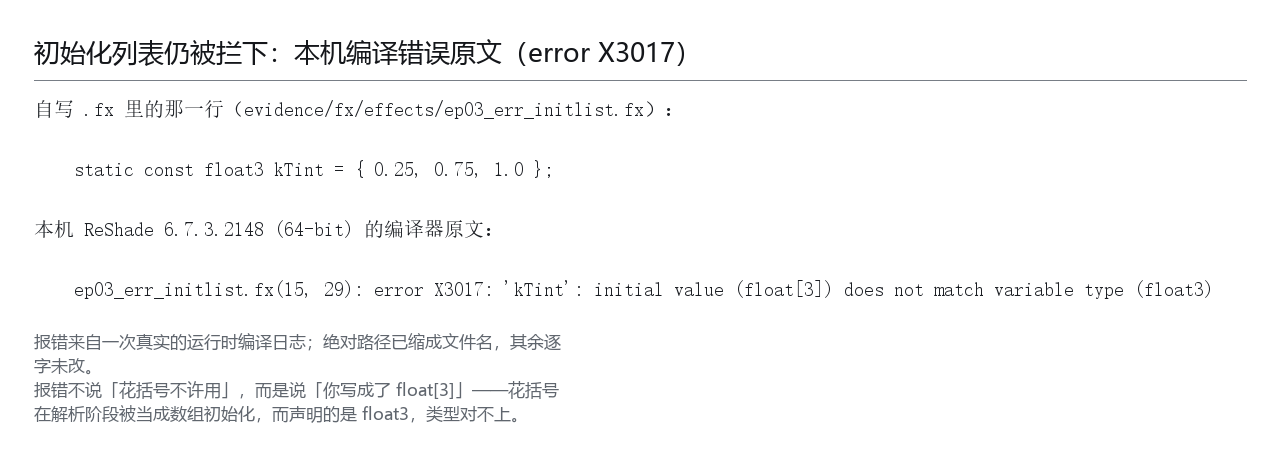
八年后这台机器上的结果与当年一致。 把同一形态的写法(static const float3 kTint = { 0.25, 0.75, 1.0 };)丢给本机的 6.7.3,编译器停在这里:
error X3017: 'kTint': initial value (float[3]) does not match variable type (float3)
这条报错本身就把机制说透了:花括号在解析阶段被当成数组初始化(括号里那三个数被读成 float[3]),而声明的是一个 float3——类型对不上,于是停住。嵌套花括号在矩阵上会被读成"数组的数组",另报一条 error X3119: arrays cannot be multi-dimensional。两条报错都不说"花括号不许用",而是说"你写成了数组"——这就是"不支持初始化列表"在这门语法里的实际形状。
为什么会少这个? 作者没有在这一帖里给理由。但他在谈另一处同类让步(结构体)时讲过共同的缘由:这门语言要能落到 D3D9,而那一代没有常量缓冲这套东西(详见 9.4)。为兼容最老的那个后端,语言在声明形式上做了让步——这就是"DX9-style"这个限定词的实际代价。
8.2 一条已经变了的结论:常量全局数组
好了,第二类"少"更隐蔽,而且它的下文比结论有意思得多。同一个帖子里,另一位读者追问"数组能不能也这么写"(他贴的是一段 11 个权重的常量全局数组),作者的回答是:
"Nope. The constant folder doesn't understand arrays right now, so constant global arrays are not possible. You can however define a constant array locally inside a function scope (drop the
statickeyword in that case too)." —— 同一帖
先看措辞:他说的是"常量折叠器现在不理解数组",不是"语言不支持数组"。这是一个实现状态,不是一个设计禁令——前者将来可能变,后者不会。
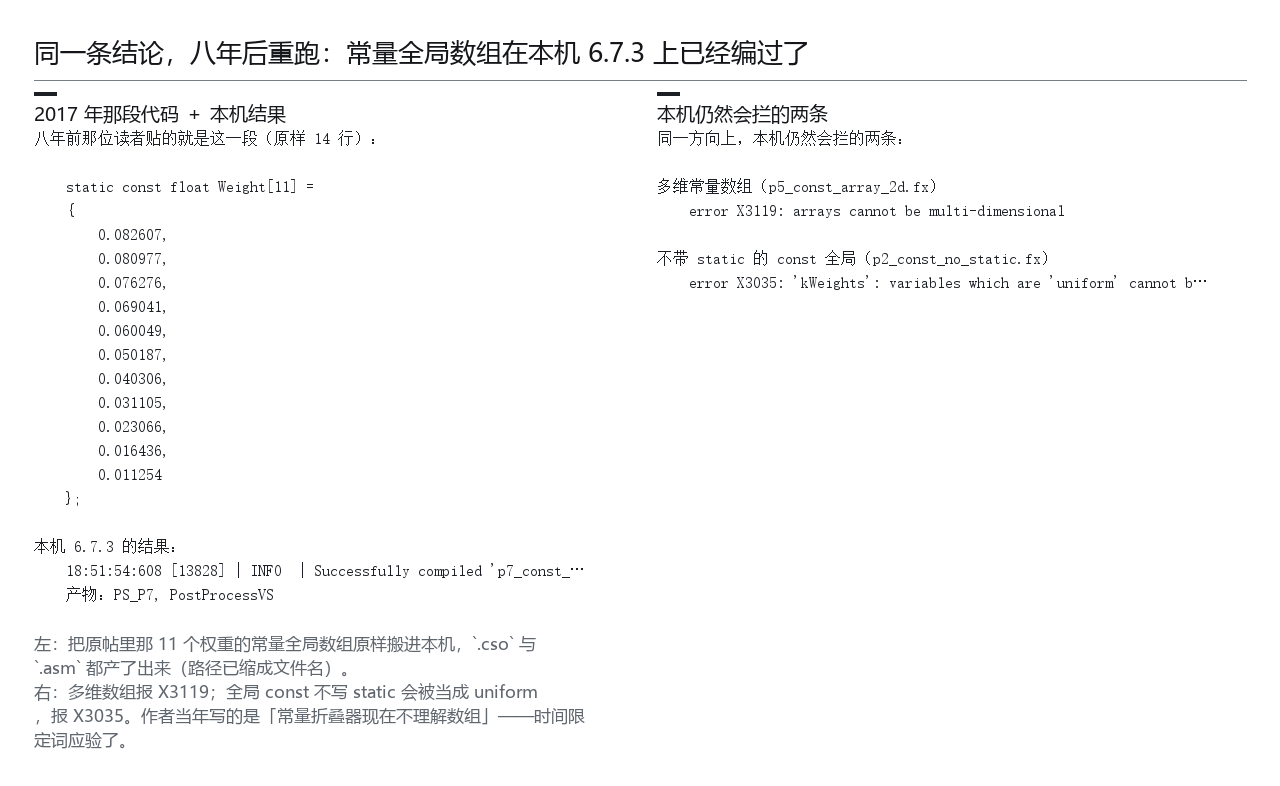
于是本篇在这里多做了一次对照:把八年前的结论原样搬回来,看它今天还成不成立。 把那位读者当年贴的、一模一样的 11 个权重常量全局数组放进本机 6.7.3 编一遍——它编过了,.cso 与 .asm 都产了出来。那句 "right now" 里的时间限定词,现在应验了:这条限制已经不属于这个版本。
同一个方向上还有两条本机仍然会拦的(都在那张面板里):把常量数组写成多维的,报 error X3119: arrays cannot be multi-dimensional;全局 const 之前不写 static,会被当成 uniform,报 error X3035: variables which are 'uniform' cannot be declared 'const'(前面还跟一条 warning X5000: global variables are considered 'uniform' by default——这条警告正是原因)。
这件事对写作与使用都更有用:遇到这类限制,先分清它是"语言不能"还是"实现还没做"——前者要绕道,后者可能已经在你看的那份文档写完之后被改掉了。作者当年给的那条变通写法(把常量数组搬进函数体、同时去掉 static)在本机仍然有效,本篇的对照件里也放了一份。拿八年前的回帖当现行规格用,这一节就是一个现成的教训。
8.3 DX9 与 DX10/11 的行为差异
OK,第三类"编不过"不是语言的问题,而是后端的问题。有一类报错只在 D3D10/11 上出现:
error X4014: cannot have gradient operations inside loops with divergent flow control—— 社区在官方论坛贴出的可复现报错,见该帖
读法:同一个效果文件在 D3D9 上能编、在 D3D11 上编不过——这不是 ReShade 的编译器不一致,而是底层编译器对"发散控制流里做梯度运算"这件事的态度不同。梯度运算需要知道相邻像素在做什么,而在一个分支里,相邻像素可能走了另一条路。
还有一条更细的差异与采样器有关。有用户在 4.0 之后撞上:
error X4509: maximum sampler register index exceeded, target has 16 slots
作者的解释是:ReShade 4 为每个效果单独分配采样器绑定(3 那代是复用),于是效果一多就把槽位用光了;这个问题在 D3D10/11 上修了,但——
"It will continue to not work in D3D9." —— 该帖
这一组差异说明"一次编写、到处编译"不是免费的:语言层做到了统一,但目标 API 的硬约束还在。第五篇要讲的跨 API 抽象,本质上就是在这些硬约束之间做取舍。
8.4 纹理宽高必须是字面量
言归正传,第四类限制是最容易被忽视、也最容易踩的:声明纹理时,宽高不能用任意表达式。社区有帖子记录,某些着色器在某个版本上突然编不过,原因是它们"declare a texture and don't use a literal expression for the width and height values"。 —— 该帖
为什么会这样? 因为纹理的尺寸决定了它的内存布局,而布局必须在编译期定下来(官方参考里写着 "Declared textures are created at runtime with the parameters specified in their definition body.")。能出现在定义体里的尺寸,只能是编译期能算出来的量——比如 BUFFER_WIDTH 的一半、或者一个常量。
把这一章四条归一下类,它们的性质并不相同:
| 限制 | 性质 | 原因 |
|---|---|---|
| 不支持初始化列表 | 语言层的设计让步 | 要兼容 D3D9(那一代没有常量缓冲) |
| 不支持常量全局数组 | 实现层的旧状态(已改变) | 当年常量折叠器还不处理数组;本机 6.7.3 上已能编过(8.2) |
| X4014:发散流里的梯度运算 | 后端层的硬约束 | 底层编译器对分支内梯度运算的态度 |
| sampler 槽位用尽 | 后端层的硬约束(且 D3D9 至今未修) | 每个效果独立分配采样器绑定 |
| 纹理宽高须为字面量 | 语言层的必然要求 | 纹理的内存布局必须在编译期定下来 |
分清这三层很有用:语言层的限制要绕道(改写代码结构)、实现层的可以等(8.2 那条就是活例——等了八年,它真的变了)、后端层的只能按目标分别处理(同一段代码在不同 API 上结果不同)。这三层再加上一遍,就是第五篇"跨 API 抽象"要面对的真实材料。
九、三条流传较广的误说法
9.1 误说法一:它就是 HLSL 的一个子集
判定:假。 第一章的官方原话是 "heavily based on...with a few extensions"——它是方言加扩展。更要紧的是第二章到第四章列的四类东西:纹理语义、technique/pass 里的渲染状态、注解族、运行时数据源——作者的原话说这些"exist in neither HLSL, nor GLSL"。有对方表达不了的东西,就不是子集。
9.2 误说法二:就是标准 HLSL,能直接丢给 fxc 编
判定:假,而且有两层错。 第一层是语法:texture2D texColor : COLOR; 这种写法,微软的编译器不认识。第二层是就算编过了也没有意义——编出来的东西带着纹理语义与 pass 状态,离开 ReShade 的运行时就没有兑现者(6.3 那条手工移植的记录就是证据)。作者自己那句 "based on HLSL, so it looks similar, but still works different" 说的正是这件事。
9.3 误说法三:它只能写后处理
判定:假。 4.8 的发布说明写着 "Added compute shader support to ReShade FX shader language, supported in D3D11, D3D12, OpenGL and Vulkan.",6.1 又补了 [shader] 与 [numthreads] 两个函数属性。有计算着色器、有 storage 对象(第二章讲的三类对象之一)、有 groupshared 与线程组语义——它能写的东西远不止一个像素着色器。
9.4 一处必须带语境的引文
好了,最后这条不是误说法,而是一处容易被单独引用而失真的材料。有读者在论坛问"能不能用结构体直接提供常量",作者的回答是:
"ReShade FX does not support structs, because it has to support D3D9, where the concept of a constant buffer does not exist. So it's invidiual variables only (which ReShade will put into a constant buffer for you behind the scenes in case of D3D11)."
但现行官方参考(REFERENCE.md)里明确有一节叫 Structs,写着 "Structs are user defined data types that can be used as types for variables. These behave the same as in HLSL."
两处并不矛盾,但必须带语境引用:作者那段话说的是uniform/常量缓冲层面——不能用一个结构体当整块常量缓冲的载体;而语言本身是支持结构体这个类型的。把前半句单独摘出来写成"ReShade FX 不支持结构体",就是错的。
9.5 这一章的方法
三条误说法各有官方反证,来源全部标注到具体帖子或文档;第四处是"引文必须带语境"的一个例子——它的价值不在于纠正谁,而在于提醒:这门语言有很多"听起来像"的说法,越像越要回去看原文。
把这一章的做法提到方法层,有两条可以带走的:
- 判断一个说法真假,先找它有没有"对方表达不了"的反证。 说"是子集",就用纹理语义与 technique 去顶;说"能随便编",就问产物离开运行时有没有兑现者。反证比正面解释有力。
- 引用一个人的话,先看他是在回答什么问题、在讲哪一层。 第 9.4 节那条就是典型:同一位作者在不同场合说的话看着冲突,读回原帖才发现一个是在讲常量缓冲、一个是在讲类型系统。语境不是修辞,是引用的一部分。
十、本篇的量化小结与方法学小结
10.1 量化小结
依然是惯例,把本篇出现的数字收在一处(全部可核,出处在对应小节):
| 项 | 值 | 出处 |
|---|---|---|
| 语言底子的年代 | DX9 风格的 HLSL 语法 | 官方 REFERENCE.md 首句 |
| 能产出的目标产物 | 4 种(HLSL / DXBC / GLSL / SPIR-V) | 官方 tools/fxc.cpp 用法串 |
__RENDERER__ 的 API 取值档 |
6 档(D3D9/10/11/12、OpenGL、Vulkan) | 官方 REFERENCE.md |
| uniform 的运行时数据源 | 16 个 | 官方 REFERENCE.md |
| 初始化列表在本机的状态 | 仍被拦(error X3017) |
本机实测(8.1) |
| 常量全局数组在本机的状态 | 已能编过(2017 年那条限制不复现) | 本机实测(8.2) |
| 本机那一轮的效果文件 | 11 个(1 个主件 + 10 个对照件) | 本机实验(第七、八章) |
| 本机落盘的编译产物 | 11 个 .i + 14 个 .cso + 14 个 .asm(编过 7 件、被拦 4 件) |
本机缓存目录 |
| 单件编译耗时 | 0.031 ∼ 0.034 秒(7 件样本) | 本机日志自报 |
| 一个效果落几个编译对象 | 跟着着色器入口点数走,与 pass 数无关 | 本机实测(5.3) |
| 内建纹理语义 | 2 个(COLOR、DEPTH,均只读) |
官方 REFERENCE.md |
| 语言核心对象 | 3 类(texture / sampler / storage) | 官方 REFERENCE.md |
| 编译器重写节点的版本 | 0.15.0(LALR → 手写递归下降) | 官方 0.15 发布帖 |
| 计算着色器支持的引入版本 | 4.8 | 官方 4.8 发布帖 |
| 函数属性的引入版本 | 6.1([shader]、[numthreads]) |
官方 6.1 发布说明 |
| 官方是否分发独立编译器二进制 | 没有(只有源码与示例工具工程) | 官网下载页 + 仓库 tools/ 目录 |
一句话:这一篇的每一个"结论"后面都跟着一个可核的数或一句可查的原话,而不是一个形容词。
10.2 方法学小结
本篇一共做了三类核查,每一类都遵守同一条约定:只改一个变量,并给出反向对照。
| 核查 | 变量 | 正向结果 | 反向对照 |
|---|---|---|---|
| 官方定义 | 引用来源 | 官网、仓库 README、语言参考三处互相印证 | 与中文转述对照,指出后者把血统压缩成了"基于 HLSL" |
| 独立编译器 | 能力 vs 产品 | 能力侧:README 明说 standalone + 四个后端 | 产品侧:官网无二进制 + 作者说那条路径"当前未启用" |
| 本机编译 | 编哪个效果 | 11 件里 7 件编过,落出 11 个 .i/14 个 .cso/14 个 .asm |
故意写错 4 处:一条仍被拦(初始化列表,X3017),一条已经不再被拦(常量全局数组,第八章) |
| 引文核实 | 引文所处的语境 | 四处引文全部读回原帖、找到问答现场 | 与"单独摘出来的半句话"对照,说明 §9.4 那条为什么必须带语境 |
为什么要给反向对照:正向结果单独看,永远可能被别的解释吃掉——"README 说 standalone"可能只是作者的良好愿望(于是要去官网看有没有二进制);"我写的效果编过了"可能只是它太简单(于是要故意写错,看它到底会不会拦)。第八章 8.2 那条还给出了更少见的第三种:把八年前的结论原样搬回来再跑一遍,看它今天还成不成立。只有把变量去掉、结果随之变化,才能把结论钉住。
十一、与后续各篇的接口
- 本篇讲语言与编译器,不展开"一个 effect 从源码到画面中间过了几道"——那是第四篇(effect runtime);
- 本篇只点名"多后端"这一个角(四种产物),完整的六 API 对照是第五篇;
- 本篇提到的"运行时数据源由 add-on 注册"这一处接缝,第六篇会从 add-on 那一侧接上;
- 本篇的实测基础是第二篇那个自建场景与自写
.fx,第九、十篇的自跑会回到同一套构件上,届时读数可直接对比。
一句话:这一篇把"效果是拿什么写的、编译器为什么长这样"讲完,从第四篇开始讲"这些东西是怎么被跑到画面上的"。
11.1 三处本篇没能回答的
按本系列惯例,把做不到的也摆出来:
第一,编译耗时只有"单件"这一层。 日志里其实逐条给了每个效果的编译耗时——本机那一轮 7 件成功编译的样本落在 0.031 ∼ 0.034 秒。但这个数只覆盖"编译"这一步,不含前面的文件读取,样本也只有 7 件、且都是几十行的小文件。所以"单件几十毫秒"给得出,"一整批效果首次启动一共停多久"给不出——后者如实写"测不了",不拿估算值凑。
第二,开优化与关优化的差异没做逐指令对照。 本章只能给出"后端会做这类变换"的示意(6.4 那张图),它不是 ReShade FX 优化能力的证据;要做逐条对比,得有第十篇那样的对照实验。
第三,独立编译器那条路没有亲手跑通。 本机没有官方分发的命令行工具,从源码自建一个 CLI 需要拉源码、写工程、调构建——本篇只把"这条路存在但未启用"这件事核清(6.2),没有声称自己跑过它。
资源清单
官方一手
- ReShade FX 语言参考(REFERENCE.md):血统声明、三类对象、纹理语义、注解族、内建宏、16 个运行时数据源
- ReShade 官网首页:语言与编译器的定位、"一次编写到处编译";当前版本 6.8.0(2026-08-02)
- crosire/reshade 仓库:README 的 standalone 自述
- 仓库 tools/ 目录:ReShadeFX.vcxproj(编译器库)与 ReShadeFXC.vcxproj(命令行工具)两个工程
- tools/fxc.cpp 源码:本篇那张用法串面板逐字引用的就是这一份
- crosire/reshade-shaders 仓库:语言参考 REFERENCE.md 所在的仓库
- 官方 API 文档站:add-on 与运行时接口
- 官方 ini 设置说明:
NoEffectCache/NoDebugInfo/PerformanceMode/SkipLoadingDisabledEffects/IntermediateCachePath
官方发布说明与作者原话
- 0.15 发布帖:解析器改为手写递归下降
- 4.8 发布帖:计算着色器支持
- 6.1 发布说明:
shader/numthreads函数属性 - 1.0 发布帖:与 SweetFX 的分界线
- 作者谈 SweetFX 必须重写
- 作者谈纹理声明是 ReShade 独有
- 作者谈自定义纹理语义与
update_texture_bindings - 作者谈
__RESHADE_FXC__与独立编译器 - 作者谈不支持初始化列表与常量全局数组
- 社区 FAQ(Framework 首版日期)
可复现的报错与差异
- DX10/11 专有报错 X4014
- 纹理宽高须为字面量
- 一套第三方结构化学习路径(英文):着色器手工移植的实录
图片素材(Wikimedia Commons,逐张核过许可)
- File:Genealogical tree of programming languages.svg(CC BY-SA 3.0)
- File:Anisotropic filtering en.png(CC BY-SA 3.0)
- File:Mipmap Aliasing Comparison.png(CC0)
- File:Environment mapping.png(CC BY-SA 3.0)
- File:Loop invariant code motion.jpg(CC0)


下篇预告
下一篇是《effect runtime:technique / pass 图、render state 与运行时数据源》。前两篇走的是"它怎么进来、怎么接住",这一篇走的是"它用什么写";下一篇回到运行时的账上:一个 effect 从源码到画面中间过了几道、pass 之间的依赖怎么排、那些写在文件里的渲染状态最后落到 API 的哪几个调用上,以及运行时数据源到底是谁在什么时候填进去的。
落款
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号「溯光的图形笔记」与个人博客 yyy3d.online。
这一篇把"这门语言从哪来、多了什么、谁在编"讲完了;希望能对大家有所帮助——尤其是那三条误说法和第四章那条"请求而不是读取",它们比语法本身更容易被记错。