本文由@溯光 出品,转载请注明出处 站点链接:技术博客页 | 公众号:溯光的图形笔记
第九篇的结尾留了一句话,说 Vello 本体在这台机器上跑不了——因为它需要 Rust 工具链,而这台机器上没有。
这句话现在作废了。
工具链装上了。E:\rust,rustup 1.98.1,走的是 TUNA 镜像;探针工程 200 行 Rust,cargo build --release 一次过。第九篇只能靠源码逐字引用加上「算法级自写实现」的读数,这一篇可以把 Vello 的三条路线在同一台机器、同一个场景、同一套计时口径下真跑一遍。
但真跑之后发现的第一件事,是这趟水比想象的深:官方文档说的是「三条路」,而在这台机器上你得先把它拆成四条,否则你测的是配置,不是渲染器。这件事值得单独一章。
先说清楚三件事:这一篇跑的是什么、量了什么、以及量出来的东西有多可信——第三条是这一篇真正的主线。
系列文章写作风格说明
- 术语双语:首次出现的核心术语写成「中文(English)」,后文可只用英文;
- 结论带读数:凡是「更快/更省/更大」的说法,绑定本机读数或官方原文并写明口径;
- 凡引必注:官方定义给链接与逐字原句,本机读数给环境、命令与统计口径;
- 本篇不涉及(边界见 9.1):能效(瓦特)与功耗、与 Skia / resvg / CanvasKit 的跨引擎对比(属 ep05–ep08 与 ep11)、Vello 在具体应用里的接入(Xilem / Bevy)、移动端 GPU 的表现;
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑的读数图由本篇的探针产出(图注写明口径);自绘图为本系列绘制,走 styles/qianmo/palette.json 色板单源。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(Vello 机制):【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 本篇讲的主角:Vello 仓库 | 官方架构文档 ARCHITECTURE.md | vello crate 文档
- 两条 Sparse Strips 路线:vello_cpu 0.2.0 | vello_hybrid 0.2.0
- 官方 benchmark 与论文:Vello CPU benchmark 图表 | Sparse Strips 硕士论文(Stampfl 2025)
- 场外实锤(GPU 反而更慢):linebender/vello issue #1380
本篇只回答三件事
这一篇不是第九篇的续集,而是它的对照组。第九篇讲的是「Vello 是怎么设计的」;这一篇要回答的是设计落到硅片上之后,时间花在哪。
先看看这一篇的动线。
0.1 全篇知识地图:三个问题,一条动线
第一件:为什么官方说三路,这里却要拆成四路? 官方 vello_gpu 的 README 把 Sparse Strips 的分工写得很清楚:「The CPU processes paths, tiles, and schedules sparse strips. The GPU rasterizes those strips and performs compositing.」CPU 做路径处理、分格、排布条带,GPU 光栅化条带并合成。问题是:CPU 那一半到底是单线程还是多线程? 这是 vello_cpu 的一个可选特性(feature),不在默认集合里。不打开它,你测出来的「CPU 路线」其实是「单线程 CPU 路线」,而你拿它去和 GPU 比,比的是配置差距,不是架构差距。本篇第一件要做的事,就是把这层说清并给出实测。
第二件:构建和渲染,时间分别花在哪? 一条路径变成像素要过两段:一段在 CPU 上做几何(扁平化、分条),一段在目标设备上填像素。四路的分工不同,所以两段的配比也不同。本篇把这两段分开计时,因为合起来看会把结论看反——8000 图元时 hybrid 的合计耗时里,有 81.4% 花在 CPU 侧那一段。
第三件:这些单帧数字有多可信? 这一问是这一篇真正的主线,也是三条路线里最容易被写成「大概更快」的地方。实测发现:compute 路线的单帧耗时在同一个配置上能出现三到七倍的摆动,而且在 CPU 基准路径里多写一次文件,它的读数就被抬高 2.30 倍,另外三条路线只变动 1.10 倍以内。所以这一篇对 compute 路线只给区间、不给单点。
这三个问题说完了。
好了,把做法压成一句话。
0.2 一句话说清这一篇的做法
场景是程序生成的:固定种子的 xorshift 伪随机数,产出 100 / 500 / 2000 / 8000 个圆和矩形,位置铺满画布、半径 3 到 25 像素、旋转角随机、颜色随机、透明度 160 到 255。同一份图元列表喂给四条路线,唯一的变量是渲染器。
每档跑 18 次:前 3 次是暖机(不计时),后 15 次计时,取中位数。整个探针跑 5 轮独立运行,最终取 5 轮的中位数。凡是正文里出现的「占比、倍数、之和」这类由读数派生的数,都由一个独立脚本从原始日志重算,不手工转录——这是第九篇留下的纪律。
跑的地方是本机:NVIDIA GeForce RTX 3060 Laptop GPU,Vulkan 后端,驱动 560.70;wgpu 大版本 29;渲染器版本 vello 0.10.0、vello_cpu 0.2.0、vello_hybrid 0.2.0;工具链 Rust 1.98.1,--release。CPU 是 16 逻辑核。
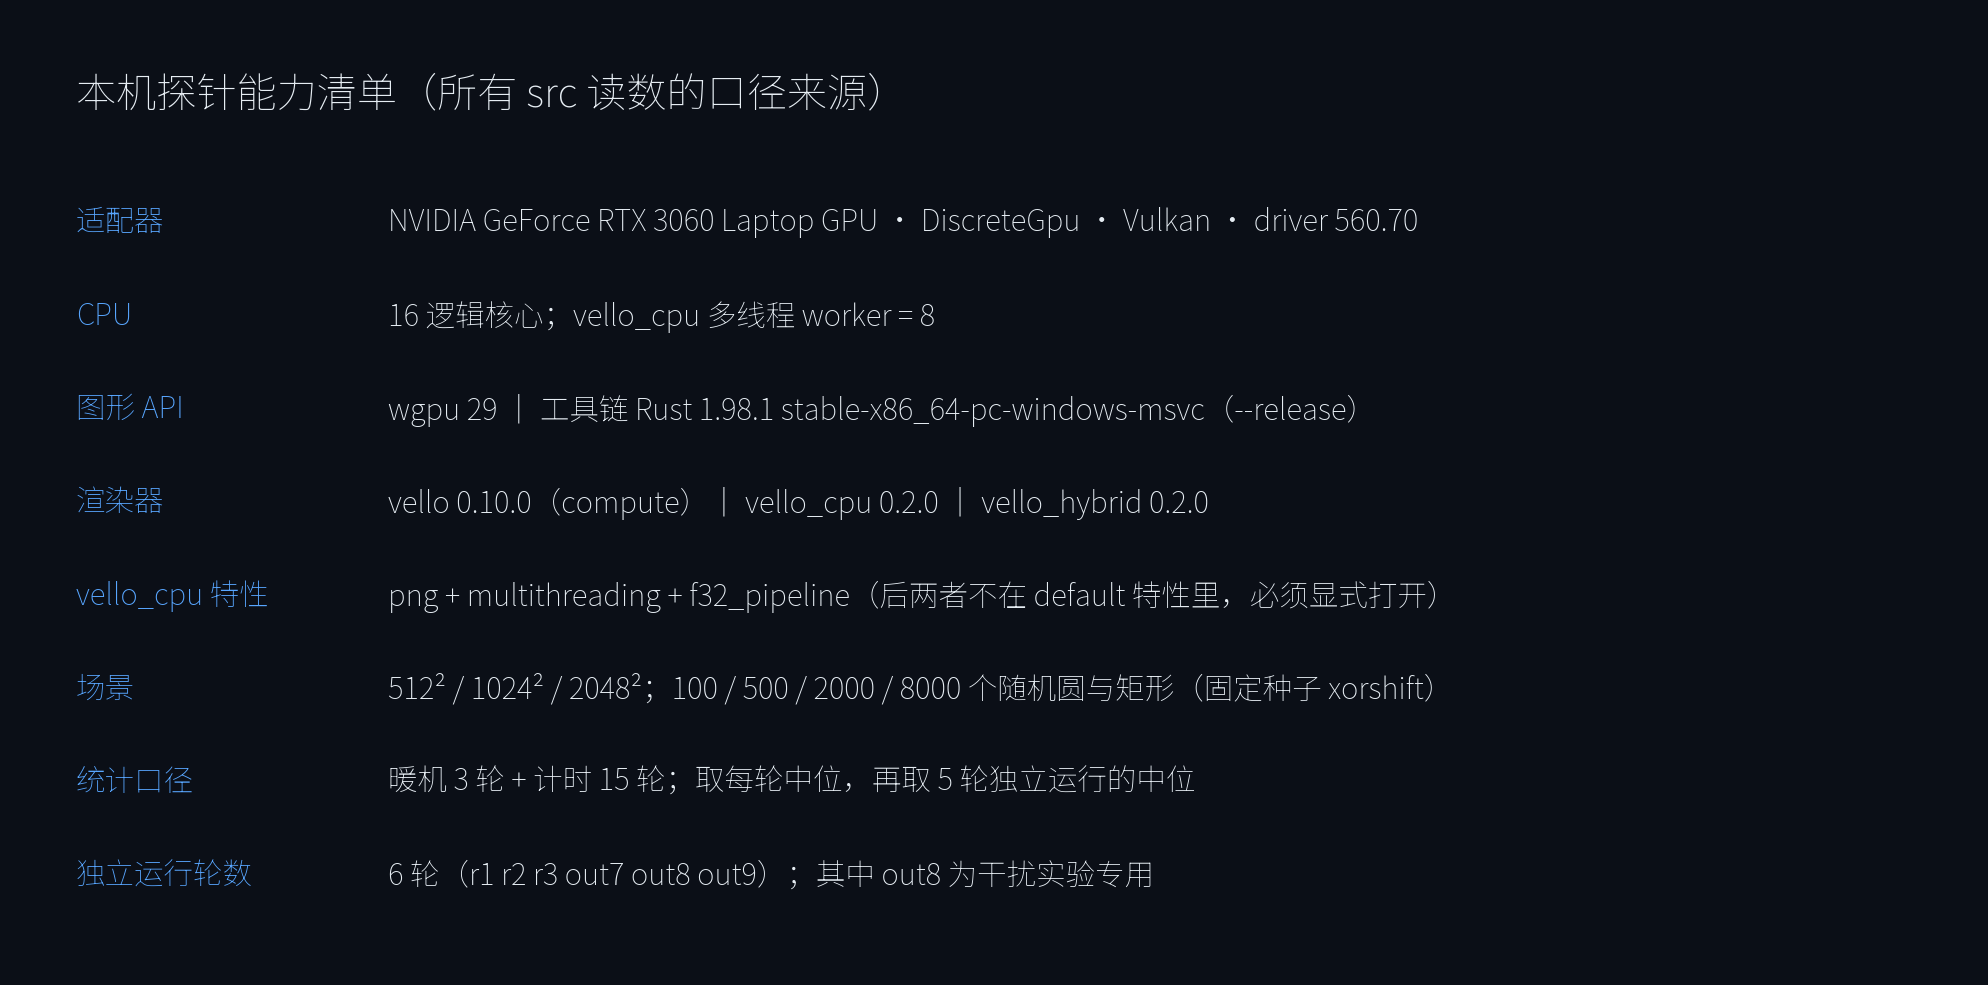
adapter.get_info() + available_parallelism() 输出|本机单机读数先把三条边界划出来。
0.3 三条不让渡的边界
第一,时间数字只在同机同版本内可比。 vello 0.10.0 是 2026-08-14 发布的,vello_cpu / vello_hybrid 0.2.0 是 2026-08-07 发布的;换一块 GPU、换一个驱动版本,绝对数字都会变。所以这一篇给的所有数字都只用来做同一台机器上的相对比较,不作跨硬件外推。
第二,只测时间不测能效。 Avalonia 与 Flutter 团队合作接入 Impeller时公布过一组第三方实测:同样的帧率下 Vello 的功耗约为 Impeller 的 12 倍。能效是 CPU 与 GPU 路线决策的另一条独立轴,本篇完全不涉及。
第三,不做跨引擎对比。 与 Skia、Graphite、resvg、CanvasKit 的横向对比不在本篇范围——Skia 侧已经在第五到第八篇做完,跨引擎对照留给第十一篇。
0.4 本篇的证据分三层,绝不混用
第九篇给了一个「机制靠源码、代价靠自跑」的两层结构;这一篇的层次要再细一层,因为它的主语变了——这一篇的主语就是读数本身。
第一层是官方一手材料,用来定义「跑的是谁、能跑在哪、默认怎么配」。这一层给的是逐字引用的原文与链接:ARCHITECTURE.md 的两族划分、vello_gpu README 的 CPU/GPU 分工、docs.rs 上 features 页的默认特性集合、RenderMode 的默认值、vello_cpu 源码里 num_threads == 0 那一行判断。凡是「机制性断言」,只认这一层。
第二层是本机真跑,用来回答「时间花在哪」。16 张读数图全部出自这一层,口径统一写在每张图的图注里:硬件、驱动、版本、图元数、画布尺寸、暖机与计时轮数、跨轮取值方式。凡是「性能性断言」,只认这一层,且只在同机同版本内比。
第三层是场外旁证,用来判断本机读数有没有系统性跑偏。比如仓库 issue #1380 里「Hybrid 约 110 毫秒 / CPU 约 36 毫秒 / Classic 约 18 毫秒 / Skia 约 6 毫秒」这组实测,和本篇「小场景上 compute 反而最慢」的形态一致;再比如 Trueno 文档里「单次 GPU 操作约 3.5 毫秒固定开销」的分解,和本篇「100 图元时 compute 的渲染段 0.973 毫秒」在量级上对得上。这一层只用来做形态比对,绝不把别人的数字写成本篇的结论。
三层的边界在正文里有明确的标记方式:提到官方材料一定给链接与英文原句;提到本机读数一定带环境与统计口径;提到场外数据一定会写「只作背景,不作对照」。
先把口径分层说清,是因为这一篇最容易出的错不是算错,而是把不同层的数字混在一起比。
边界说完了,回到第一章要回答的问题。
OK,先把坐标挪一下。要跑对比,先得确认跑的是谁。
一、Vello 现在有几条路
要跑对比,先得确认跑的是谁。第九篇讲过仓库在 2026 年 9 月的那次重构,这一篇要把它落成一张能对照的清单。
先看看官方的两族划分。
1.1 两族实现与三条路线
官方 ARCHITECTURE.md 的原话是:「Vello contains two renderer families: 1. vello_cpu …/ vello_gpu …, both based on the Sparse Strips architecture. 2. The experimental vello renderer, which is based on compute shaders.」
两族,两个思路完全不同的组织方式。
Sparse Strips 族走的是「CPU 侧把几何算完,目标设备只填像素」。这一族的两个成员分工点不同:vello_cpu 的目标设备就是 CPU 内存,官方描述是 "rasterizes and composites the strips into a CPU pixmap. It uses SIMD and can use multiple threads, but requires no GPU";vello_gpu(本篇实测时还叫 vello_hybrid)把条带和绘制数据上传,由 GPU 完成 "rasterization and compositing",官方特意注明它的 wgpu 与 WebGL2 后端 "use vertex and fragment rendering rather than requiring compute shaders"——也就是说它只要一条普通的图形管线就能跑,不需要计算着色器。
compute 实验族走的是另一条路:把分格与裁剪这些原本必须串行的步骤,用前缀扫描(prefix-scan)并行化,然后把绝大部分工作交给 GPU 的计算着色器。官方 README 对它的定位是 "remains an experimental implementation for compute-capable GPUs",并明确「需要支持计算着色器的 GPU」。
下面我们先看一处与时间有关的坑。
1.2 版本与命名:一次改名,一次搬家
对照之前先把命名理清,因为 2026 年这套东西改过名。
vello_hybrid 这个名字现在已经不用了。上游 main 分支的 README 里写着:「This package was previously named vello_hybrid… Existing crates.io releases under vello_hybrid remain available, and publication under the new name may lag behind the repository rename.」新名字是 vello_gpu,而 crates.io 上的 vello_gpu 目前还只是一个占位 crate,描述是 "Reserving the name for a future crate in the Vello ecosystem."。
同时,compute 那套渲染器被搬进了 research/ 目录——包名还叫 vello,但位置变了。所以这篇实测锁定的组合是:vello 0.10.0(crates.io 上最后一版 compute 渲染器)+ vello_cpu 0.2.0 + vello_hybrid 0.2.0,三者的 wgpu 大版本都是 29。这是 2026-08-07 到 2026-08-14 那一周里能同时拿到的组合。
research/@ 本系列绘制顺带说一句官方对成熟度的排序,它和后面的实测结果对得上。main 分支 README 的「Choose a renderer」一节里,vello_cpu 被称为 "the most mature choice",而 vello_gpu "is intended to become the primary renderer for production GPU use cases as it matures";docs.rs 上 vello_hybrid 0.2.0 的文档写得更直白:「Although it does not match Vello Classic's raw performance on dynamic and vector-heavy workloads, it provides excellent performance on workloads that benefit from GPU acceleration, such as images, gradients, and filters. Overall, we still consider it to be slightly less mature than its CPU-only counterpart Vello CPU.」
「在动态与矢量密集的负载上不如 compute 版」——本篇的 8000 图元场景正好是「矢量密集」,这一句可以作为后面读数的对照基线。
下面我们看看入口这一层。
1.3 三条路线的入口 API 不一样
命名理清了,还有一层实际影响更大的差别要交代:三条路线的入口 API 不是同一套。这决定了你不能只改一个 use 就换路线,也决定了「同一份场景代码跑三条路线」这件事必须由探针自己抹平。
vello_cpu 是一条同步的 CPU 管线:先建一个 RenderContext(构造时给宽高与 RenderSettings),再用 set_paint / set_transform / fill_path 往里面画,最后 render_with(&mut pixmap, &mut resources, rasterizer_settings) 把结果 rasterize 进一块 Pixmap。整条链路上没有异步、没有提交、没有等待——这也是它「单帧延迟最确定」的来源。
vello_hybrid 的接口形态介于两者之间:Scene::new(width, height) 建场景,set_transform / set_paint / fill_path 往里画,然后把场景、资源池、设备、队列、命令编码器一起交给 Renderer::render(...)。注意它需要一个 wgpu 设备与命令编码器,但不需要计算管线——官方对它的描述是「CPU 预处理 + GPU 片元光栅」。
compute 那一条最不一样:Scene::new() 不带宽高(画布尺寸是渲染时给的),scene.fill(fill_rule, transform, color, brush, shape) 一次调用完成「画笔 + 变换 + 形状」,然后 render_to_texture(device, queue, scene, view, params) 把结果直接写进一张 GPU 纹理。它的 Scene 构造不需要知道画布多大——因为画布尺寸这件事对它的编码阶段没有影响,分格是渲染时才做的。
这一点差别带来的直接后果,是四路的输出载体不同:vello_cpu 天然产出 Pixmap(可以直接 into_png()),另外两条产出 GPU 纹理,必须自己 copy_texture_to_buffer 回读才能比对。本篇的差异分析(第八章)在回读这一步上统一了字节行对齐(bytes_per_row 按 256 对齐)与通道顺序,这是三条路线能逐像素比的前提。
1.4 依赖与门槛:三条路线不是「快慢三档」
再补一层和选型直接相关的差别:三条路线对宿主平台的要求不同。
compute 那一条要求 GPU 支持计算着色器,官方 README 的原话是「This means that Vello needs a GPU with support for compute shaders to run.」——这是它最硬的门槛。vello_gpu(原 hybrid)明确绕开了这道门槛:「Its wgpu and WebGL2 backends use vertex and fragment rendering rather than requiring compute shaders.」也就是说,一块只支持 WebGL2 的设备就能跑。vello_cpu 干脆不要 GPU。
这三句官方描述拼起来,正好解释了三条路线为什么会同时存在:它们不是「快慢三档」,而是「设备能力三档」。第九篇讲过 Sparse Strips 的切分点选在「条带」这一层,好处之一就是让同一个数据结构能同时喂给 CPU 光栅器、GPU 图形管线和 GPU 计算管线——本篇的四路对比,本质上是在验证这个「同一个中间产物、三种消费方式」的设计到底成不成立。
从结果看,是成立的:第八章会给出三条路线的输出差异,在完全覆盖的 75.6% 像素上,CPU 与 hybrid 的 RGB 最大差只有 2。
还有一条没写进上面这段对照的差别,是依赖体积。vello_cpu 不依赖 wgpu(crates.io 上它的依赖列表里没有这一项),而另外两条都依赖 wgpu 29。对嵌入式或服务端无 GPU 的场景,这不只是「能不能跑」的问题,还是「要不要把一整套图形 API 抽象带进来」的问题。
版本理清了,现在可以动第一刀:为什么三路要拆成四路。
言归正传,这一章是整篇实验设计的关口。
二、为什么「三路」必须是「四路」
这一章是整篇实验设计的关口。它讲的是:在不改一行渲染代码的前提下,光靠改依赖声明,你能让同一条路线的实测性能差出四倍。
下面我们从一行依赖声明说起。
2.1 特性集决定你比的是什么
vello_cpu 0.2.0 有 7 个特性开关,其中:4 个默认打开。docs.rs 的 features 页写得很清楚,默认集合是 ["std", "png", "text", "u8_pipeline"]——multithreading 和 f32_pipeline 都不在里面。
multithreading 的官方说明是 "Enable multi-threaded rendering. Implies std."。而更能说明问题的是源码里的那一行判断:
// vello_cpu 0.2.0 · src/render.rs
if settings.num_threads == 0 {
    Box::new(SingleThreadedDispatcher::new(width, height, settings.level))
} else {
    Box::new(MultiThreadedDispatcher::new(width, height, settings.num_threads, settings.level))
}
num_threads = 0 就是单线程。而 RenderSettings::default() 取的是 (available_parallelism - 1).min(8),也就是这台机器的 8 个 worker。
于是问题来了:探针的第一版用的是默认特性集,还显式写了 num_threads: 0。它测出来的「CPU 路线」是单线程 CPU,而它拿去比的对象是 GPU。跑出来的第一版结论是「CPU 慢 GPU 6 倍」——这个数字不算错,但它测的是一台只用了一个核的 CPU,而不是「vello_cpu 这条路线」。同一份渲染代码、同一个场景,把特性打开、worker 设成 8,8000 图元时的合计耗时从 31.201 毫秒掉到 9.054 毫秒。
所以这一篇的对数从三变成四:CPU1(vello_cpu 单线程)、CPUn(vello_cpu 8 worker)、CMP(compute)、HYB(vello_hybrid)。
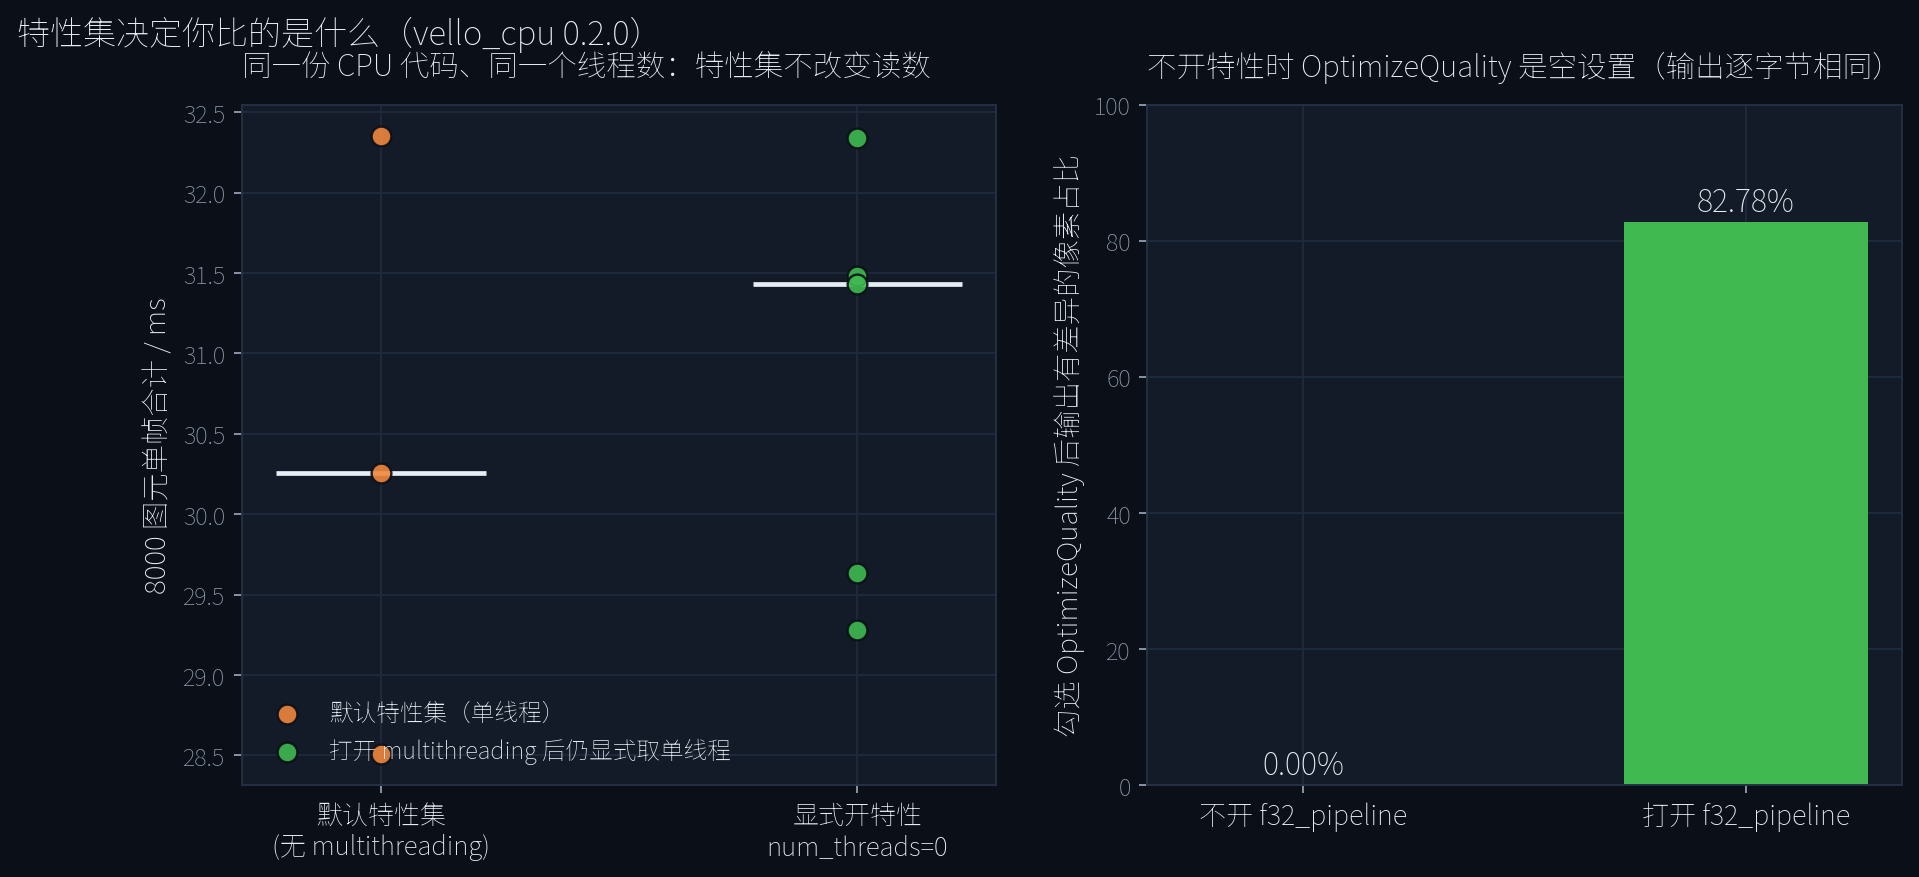
f32_pipeline 时勾选 OptimizeQuality,输出与原图逐字节相同,说明那一档是空设置@ 本机真跑 · 512×512,8000 / 2000 图元|本机单机读数左边这张图有个反直觉之处值得说一句:默认特性集下的读数,与显式打开 multithreading 但把 num_threads 设成 0 的读数,是同一件事(两组分别为 28.507 / 30.256 / 32.355 与 29.279 / 32.341 / 31.484 / 29.635 / 31.432,中位 31.432)。特性集不改变任何计算,它只决定你有没有第二个选项。
好了,同一个坑里还埋着第二个。
2.2 顺手抓到的第二个空设置
同一个坑还埋着第二个。vello_cpu 的 RenderMode 有两个值:OptimizeSpeed(用 u8/u16 算)和 OptimizeQuality(用 f32 算)。文档里有一句容易被跳过的话:「For using RenderMode::OptimizeQuality you also need to enable f32_pipeline feature.」
第一版探针勾了 OptimizeQuality,但没开 f32_pipeline,于是拿到一张与原图逐字节完全相同的对照图——任意通道有差的像素占比 0.00%,最大色差 0,平均色差 0.0000。也就是说,那一档是空设置。
打开 f32_pipeline 之后,同一对照变成:82.78% 的像素有差异,平均通道色差 0.3926。耗时上,2000 图元 / 512² 下 u8 合计 2.447 毫秒,f32 合计 2.747 毫秒,慢 12.3%(其中渲染段 1.289 → 1.562 毫秒,慢 21.2%)。
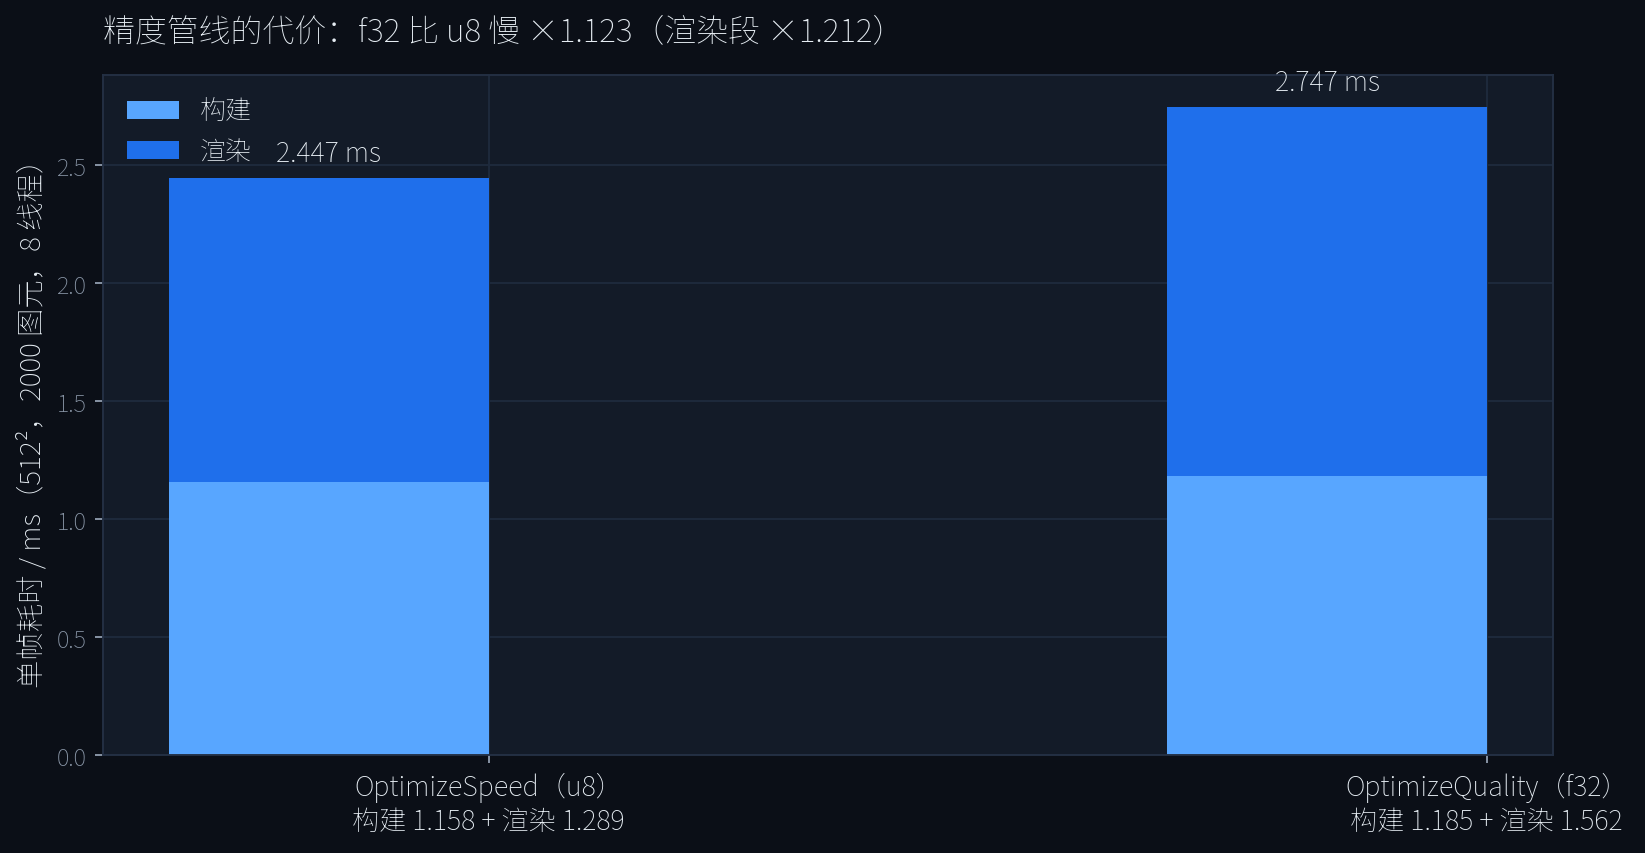
这个 12.3% 很值得留意,因为下一章会看到:CPU 路线与 compute 路线之间的输出差异(平均 0.3926 / 0.4133)和这两条 CPU 精度管线之间的差异(0.3926)是同一量级。换句话说,前面几章会反复出现的「CPU 和 GPU 画出来不一样」,其中相当一部分只是 u8 与 f32 的差别,不是「谁画错了」。
关口过了。后面三章进入正题:把时间拆成两段,看看四路各自花在哪。
先把两段拆开看。
三、构建阶段:谁在做扁平化与分条
一条路径到像素,前面有一段纯 CPU 的活:把曲线展平成折线、把折线分进格子、把格子整理成条带。这一段四路都要做,但做法与并行度不同。这一章只看这一段。
先看看两段各自的读数。
3.1 构建与渲染的耗时结构
先把两段分开计时的读数摆出来。构建(build)指把图元写进场景对象并完成 CPU 侧几何处理;渲染(render)指从场景对象产出像素。
| 图元 | 路 | 构建 | 渲染 | 合计 |
|---|---|---|---|---|
| 100 | CPU1 | 0.213 | 0.211 | 0.424 |
| 100 | CPUn | 0.206 | 0.146 | 0.352 |
| 100 | CMP | 0.019 | 0.973 | 0.992 |
| 100 | HYB | 0.222 | 0.372 | 0.594 |
| 500 | CPU1 | 1.112 | 0.759 | 1.871 |
| 500 | CPUn | 0.382 | 0.288 | 0.670 |
| 500 | CMP | 0.077 | 1.109 | 1.186 |
| 500 | HYB | 1.154 | 0.706 | 1.860 |
| 2000 | CPU1 | 4.303 | 2.959 | 7.262 |
| 2000 | CPUn | 1.158 | 1.289 | 2.447 |
| 2000 | CMP | 0.327 | 1.552 | 1.879 |
| 2000 | HYB | 4.547 | 1.660 | 6.207 |
| 8000 | CPU1 | 18.485 | 12.716 | 31.201 |
| 8000 | CPUn | 4.053 | 5.001 | 9.054 |
| 8000 | CMP | 1.636 | 3.691 | 5.327 |
| 8000 | HYB | 21.468 | 4.908 | 26.376 |
单位毫秒。全部是本机实测,口径同上。把这两列画成堆叠柱状图,四路在四个规模上的时间去向一眼可见——同一个「单帧耗时」,内部构成可以完全不同。
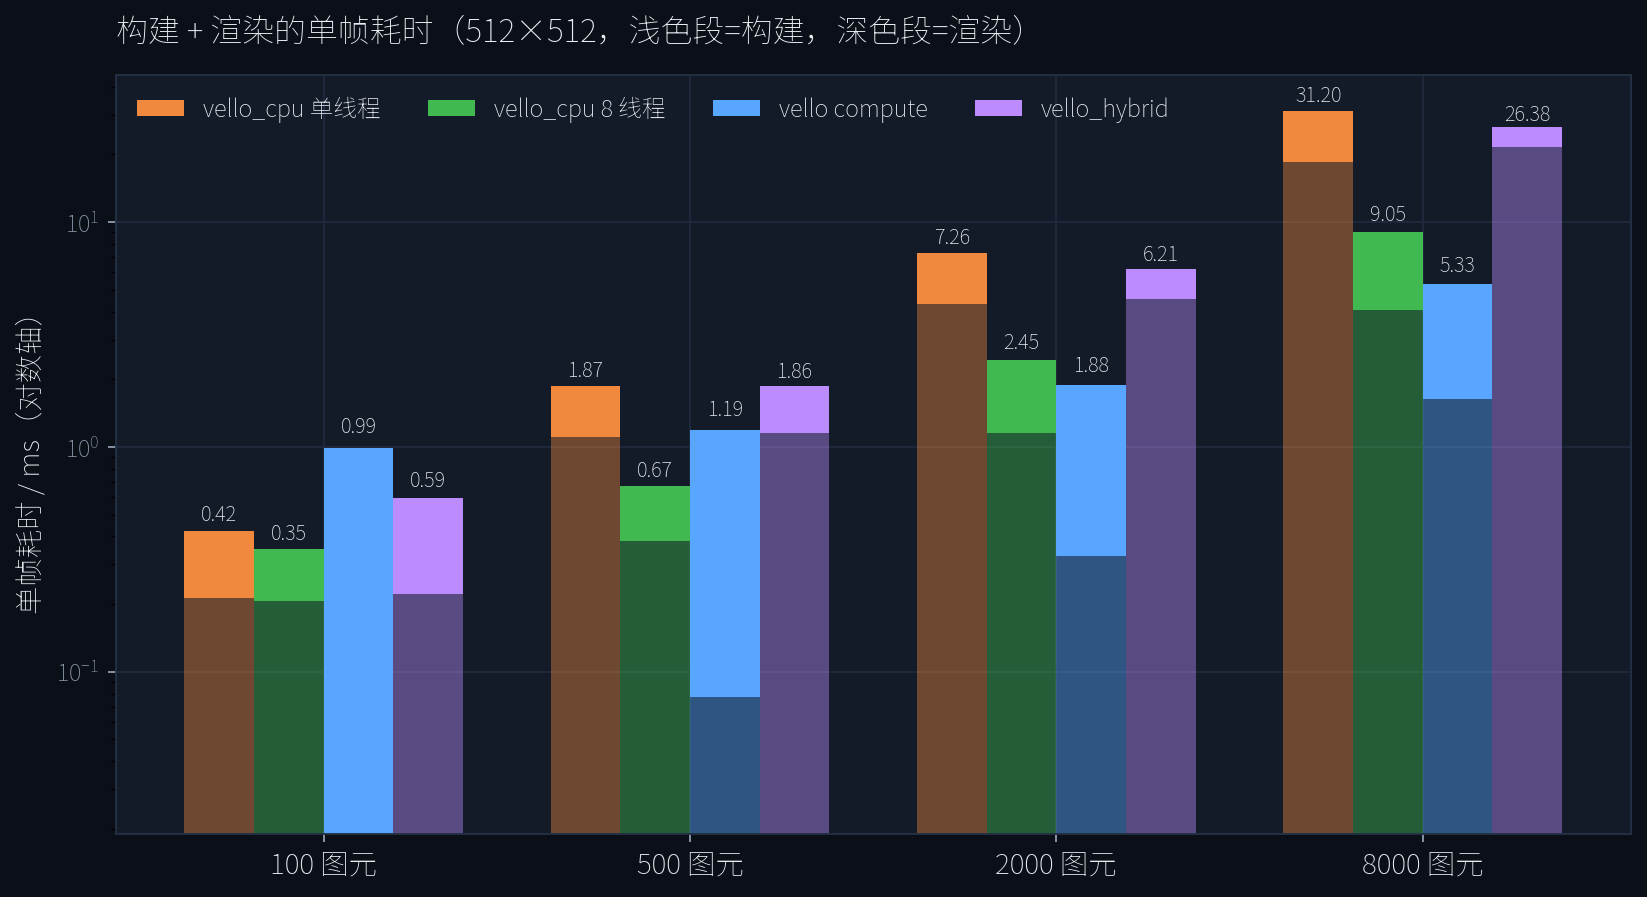
8000 图元那一列是这张图最有信息量的地方。看构建段:CPU1 18.485、HYB 21.468、CPUn 4.053、CMP 1.636。再看这两条的比值:hybrid 的构建成本是 8 线程 CPU 构建的 5.399 倍,而 compute 的构建成本只有 hybrid 的 7.5%。
下面我们换个角度,看这四路在构建段各自干了什么。
3.2 四路在构建段的分工
这三组数字指向的是同一件事:Sparse Strips 家族的「CPU 侧粗活」在 hybrid 那里没有并行。
vello_cpu 与 vello_hybrid 用的是同一套 Sparse Strips 数据结构,扁平化与分条这步活是一样的。区别只在于 vello_cpu 可以把这一步铺到 8 个 worker 上,而 vello_hybrid 的场景构建路径是单线程的——它的构建成本(21.468)与 vello_cpu 单线程的构建成本(18.485)是同一量级,而不是与 8 线程的那个(4.053)同量级。
compute 那一侧是另一个极端。它的构建只有 1.636 毫秒,是四路里最低的,而且随规模的增长最慢——从 100 图元到 8000 图元(80 倍),它的合计耗时只涨了 5.37 倍,而另外三路分别是 73.59 倍(CPU1)、44.40 倍(HYB)、25.72 倍(CPUn)。
原因在官方的分工描述里:compute 渲染器的 Scene::fill 只做编码,把路径命令序列化进一块缓冲区,真正的展平、分格、条带生成都推到 GPU 侧。所以它的「构建」几乎不花 CPU 时间——代价是这些活全都要在渲染段还回来,这也解释了为什么它在 100 图元时的渲染段要 0.973 毫秒,比 8 线程 CPU 的整个单帧(0.352 毫秒)还贵。
下面我们算一笔账。
3.3 多线程到底吃到了多少
把 CPU1 与 CPUn 相除,得到的是 vello_cpu 自己的并行效率。构建段的加速比随规模上升:100 图元 1.010 倍、500 图元 2.911 倍、2000 图元 3.910 倍、8000 图元 4.498 倍。渲染段差一些:1.366 / 2.472 / 2.460 / 2.434 倍。
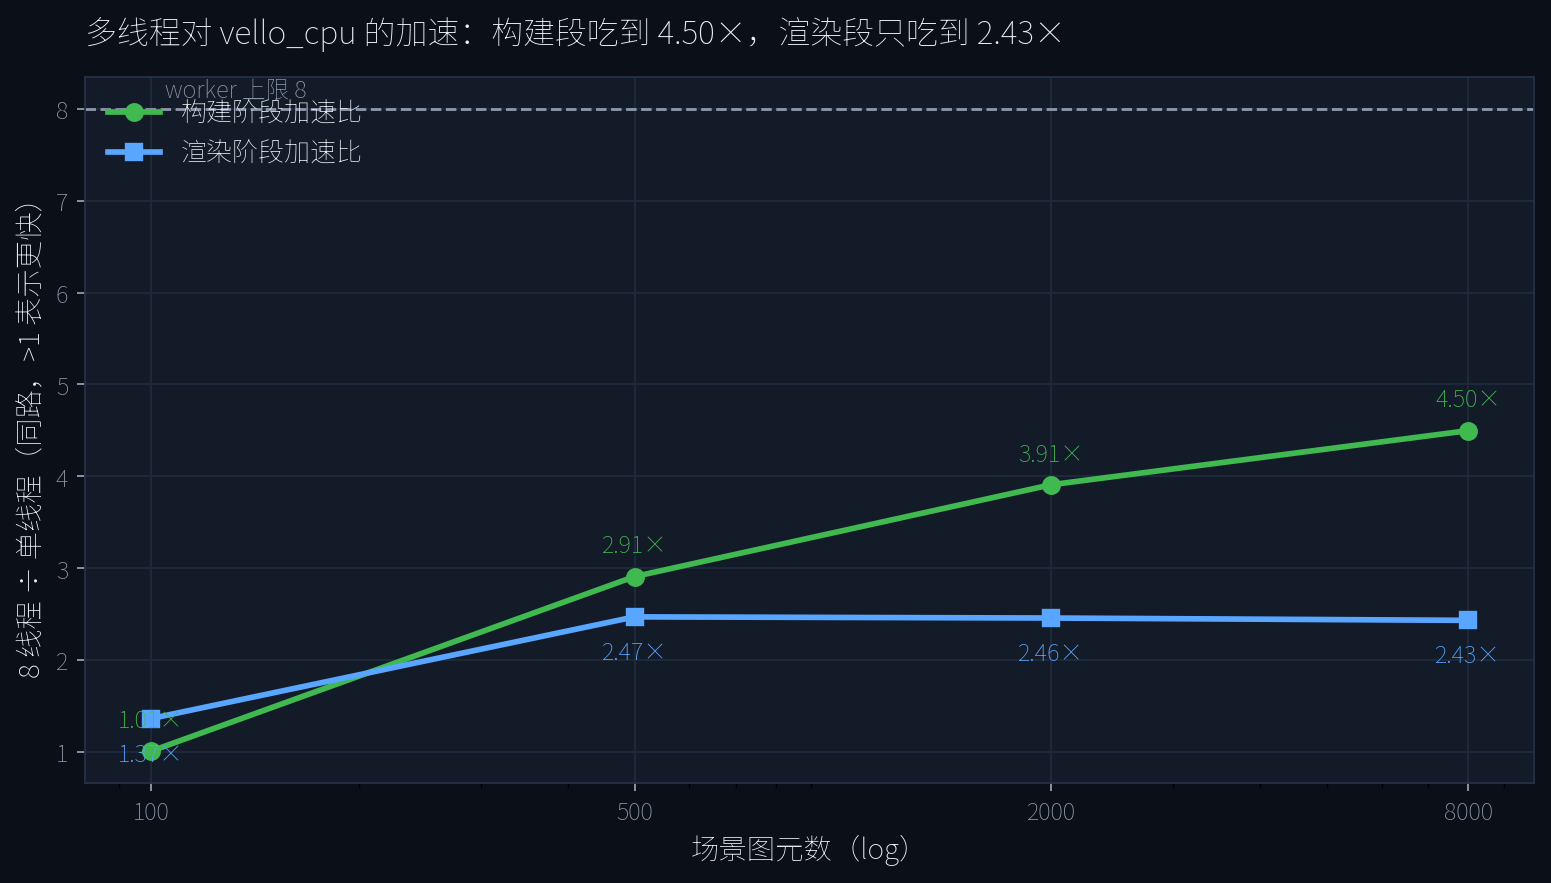
vello_cpu 8 worker 相对单线程的加速比随规模变化:构建段最高 4.50 倍,渲染段稳定在 2.43 倍附近;worker 上限为 8@ 本机真跑 · 512×512,5 轮运行取中位|本机单机读数8 个 worker,构建段拿到 4.50 倍,渲染段只有 2.43 倍。两条曲线都没有到 8,这很正常——小规模时任务本身不够切,大规模时切分与合并本身有开销。但有一个细节值得记一下:渲染段的加速比在 500 图元之后基本不再上升(2.472 → 2.460 → 2.434),说明渲染段的并行度在 500 图元左右就已经饱和了,而不是规模越大越吃得到核。
还有一条零结果的读数,按纪律照实写:把 CPU1 与 CPUn 的输出逐像素比对,α 通道最大差 0、RGB 最大差 0,即两条路线的输出逐字节完全相同。多线程不改变任何可见结果,它只是更快。
3.4 这一段的输入是曲线
最后补一个通用概念的锚点。上面说的「扁平化」,输入是贝塞尔曲线——矢量引擎里所有非直线的形状最终都要展开成折线,再进光栅化。
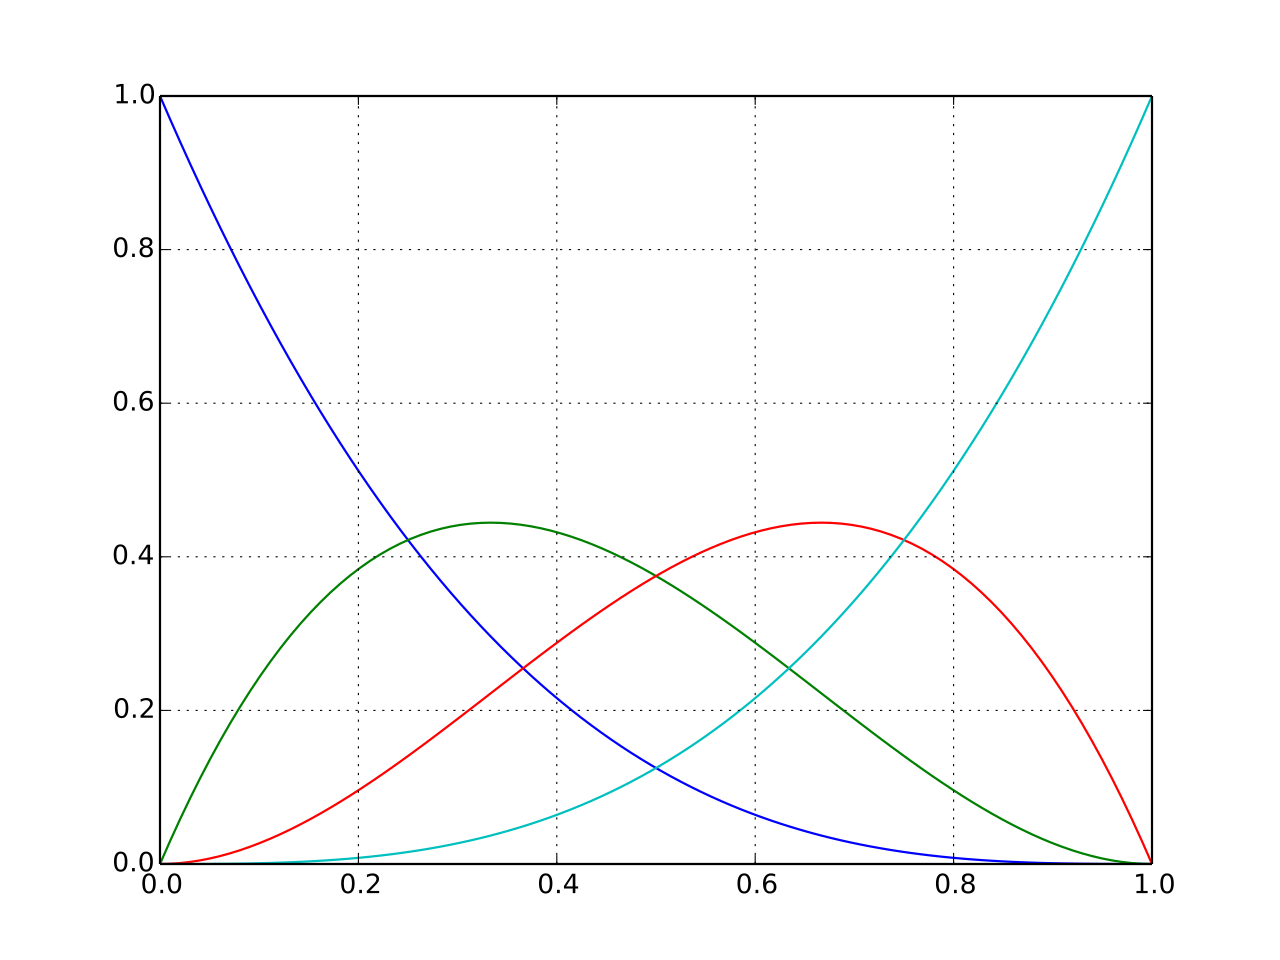
第九篇讲过 Vello 的扁平化容差与分段策略,这一篇不再重述。这里只要记住一件事:这一段只在 CPU 上做,GPU 的两条路线里,一条(hybrid)也必须自己做,另一条(compute)把这活推给了 GPU 的计算着色器。这就是构建段那张图里 1.636 与 21.468 的来由。
先看看这三段代码各自落在哪个函数上。
3.5 构建段的源码落点
上面说的「构建段」在三条路线里落在不同的函数上,这一点值得记下来,因为它决定了你用哪个 API 会付出什么代价。
vello_cpu 的构建段发生在 RenderContext::fill_path / fill_rect 里:每调用一次,路径就会被展平、分进格子、整理成条带,写进内部的场景缓冲。也正因为这样,vello_cpu 的构建耗时与图元数量是严格的线性关系——8000 图元 18.485 毫秒、2000 图元 4.303 毫秒、500 图元 1.112 毫秒,四点几乎落在一条过原点的直线上(每图元约 2.3 微秒)。
vello_hybrid 的构建段发生在 Scene::fill_path 里,官方文档 把它描述为「CPU 预处理 + GPU 片元光栅」,其中:CPU 那一半只走单线程。它的量和 vello_cpu 同一量级(8000 图元 21.468 毫秒对 18.485 毫秒,贵 16%),差别在于它没有多线程这条路可走——省不下来的部分就真是省不下来。
compute 那一条的构建段落在 Scene::fill 里,但那段代码只做编码:把填充规则、变换矩阵、颜色和路径命令按固定格式序列化进一块字节缓冲。它不做展平、不做分格、不做条带——那些活全在 render_to_texture 里由 GPU 侧的着色器趟数完成。这就是为什么它的构建只有 1.636 毫秒,比另外两路低一个数量级。
这三段实现合起来解释了本篇最重要的一条结构性结论:「构建 + 渲染」这个分法对三条路线的含义并不一样。 对 CPU 路线,它是「CPU 几何 + CPU 像素」;对 hybrid,它是「CPU 几何 + GPU 像素」;对 compute,它是「CPU 编码 + GPU 全流程」。同一张柱状图,三条路线读出来的是三件事。
3.6 一条不稳定的加速比
再记一个负面观察,免得把「多线程加速 4.50 倍」当成一个可以放心引用的常数。
把 5 轮独立运行里 CPU1 ÷ CPUn 的构建加速比逐轮列出来(8000 图元):4.631 / 4.209 / 4.080 / 4.498 / 4.618。极差是 0.551,相对中位 12.3%。看起来还行。但同一批运行里,2000 图元那一档的加速比是 4.034 / 3.586 / 4.167 / 3.617 / 3.910,极差 0.581,相对中位 14.9%;500 图元那一档是 3.013 / 3.015 / 2.911 / 2.841 / 2.725,相对中位 10.1%。
也就是说,加速比本身的噪声就有 10% 到 15%。这决定了你可以说「多线程把构建段加速到 4.5 倍左右」,但不可以说「加速比是 4.498」——小数点后三位在这里是没有意义的。本篇凡涉及加速比的表述,都用一位有效数字加「约」字。
顺带说一句为什么这条噪声比单路的耗时噪声更大:加速比是两个各自带噪声的量相除,噪声会被放大而不是抵消。这也是为什么本篇的派生量全部由脚本从每轮的原始读数独立算出比值、再取中位,而不是拿两个中位直接相除——后者会把噪声和系统性偏差一起抹平(第九篇留下的那条纪律,就是被这类错误逼出来的)。
构建段落定,接下来看后一段:同样是「填像素」,三种做法差在哪。
构建段说完了,下面进入后一段。
四、渲染阶段:三种「画」的法子
构建段产出的是「哪些格子、哪些条带、什么颜色」;渲染段要把它变成像素。三条路线在这一段的分工完全不同。
4.1 三种画法
vello_cpu 是在内存里画。它拿到的是一串条带,每条带着覆盖率和画笔信息,然后在 CPU 上逐条 rasterize 进一块 Pixmap。它的并行单位是条带与像素块,所以这一段也能铺到多线程上,只是饱和得更早(上一章那条 2.43 倍的曲线)。
vello_hybrid 是把条带上传给 GPU,用一次普通的图形管线(vertex/fragment)画出来。官方明说它的后端 "use vertex and fragment rendering rather than requiring compute shaders",这条路线的意义在于兼容性:只要一块支持 WebGL2 的 GPU 就能跑,不需要计算着色器。
compute 那条是另一套:它没有「条带」这个概念进入渲染段,而是把分格、排序、裁剪、覆盖率这些都做成计算着色器的多趟 dispatch,用前缀扫描把串行依赖解开。这就是第九篇讲的那套 prefix-scan 结构,它的代价是趟数多、屏障多、单帧延迟不稳定——第七章会把这件事量出来。
4.2 三条路线共同的输入
不管怎么画,输入是一样的:一组带填充色与变换的路径。这也是为什么本篇的对比能成立——同一份图元列表喂给四条路线,唯一的变量是渲染器。
这一点看着是废话,但它决定了实验的合法性:三条路线的差异只能来自渲染器,不能来自场景。第九篇讲 Sparse Strips 时提过「同一个中间产物、三种消费方式」,本篇就是把这个说法放到实测里验证一次。
OK,把渲染段单独拉出来比一比。
4.3 渲染段的对照
把渲染段单独拉出来,四路在 8000 图元时是:CPU1 12.716、CPUn 5.001、CMP 3.691、HYB 4.908 毫秒。
单看这一列,GPU 两条路线的优势是存在的但不大:compute 比 8 线程 CPU 快 1.36 倍,hybrid 只快 1.02 倍。真正拉开差距的地方在小规模——100 图元时 hybrid 的渲染段是 0.372 毫秒,是 8 线程 CPU(0.146 毫秒)的 2.618 倍;也就是说,场景越小,GPU 的固定开销越显眼。这与通用经验一致:一次 GPU 操作的固定开销在毫秒量级(有公开文档给出过约 3.5 毫秒的分解:缓冲创建 0.5 + 上传 1.5 + 派发 0.3 + 回读 1.2),场景越轻,这笔固定开销摊得越不划算。
这里还有一条容易被忽略的反转。把 hybrid 的渲染段除以 8 线程 CPU 的渲染段,随规模的变化是:100 图元 2.618 倍、500 图元 2.375 倍、2000 图元 1.328 倍、8000 图元 0.892 倍。也就是说,到了 8000 图元,8 线程 CPU 的渲染段已经比 hybrid 更快了(5.001 对 4.908 毫秒)。hybrid 的渲染段省下的时间,早就被它单线程的构建段吃掉——这正是下面第五章那条合计曲线要讲的。
4.4 GPU 光栅化路线的上下文
给 hybrid 那条路线补一个通用概念的锚点:它走的就是最传统的图形管线,只是几何处理在 CPU 侧提前做完了。
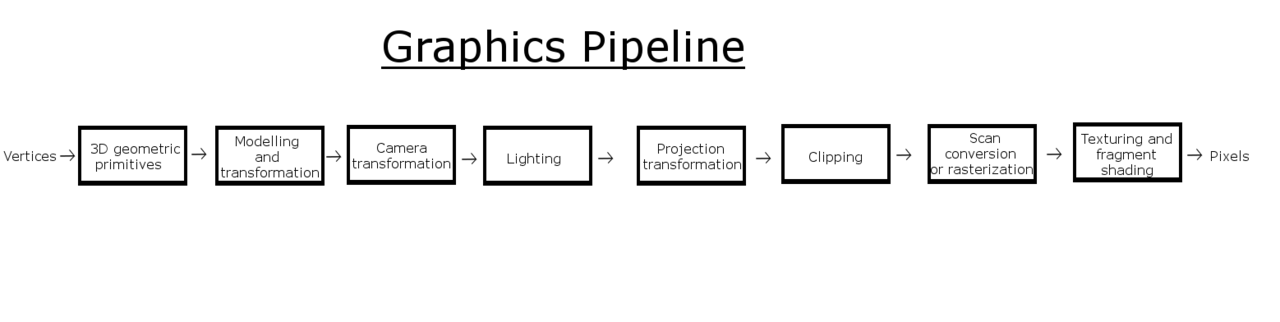
这张图的作用是定位:hybrid 在这条管线里跳过的是「用几何图元描述形状」这一整段,把它换成了「用稀疏条带描述覆盖率」。换句话说,它的着色器代码处理的不再是三角形与顶点属性,而是一条条带着覆盖率区间的水平条带——这也是为什么它不需要计算着色器,却仍能复用整套图形管线。
先看看那条比值曲线的另一面。
4.5 为什么 hybrid 的渲染段对规模最不敏感
上面那条「hybrid 渲染段 ÷ 8 线程 CPU 渲染段」的比值曲线(2.618 → 2.375 → 1.328 → 0.892)值得再拆一句,因为它容易被读成「hybrid 变快了」,而实际情况是「CPU 那边变慢了」。
两个绝对数摆出来就清楚了:从 100 图元到 8000 图元(80 倍),hybrid 的渲染段从 0.372 涨到 4.908 毫秒(13.2 倍),8 线程 CPU 的渲染段从 0.146 涨到 5.001 毫秒(34.3 倍)。hybrid 的渲染段涨得更慢,这才是比值的来源。原因不复杂:hybrid 的渲染段是 GPU 在做,而 GPU 的并行度远高于这台机器的 8 个 worker;图元数涨 80 倍时,GPU 侧的工作量虽然也涨,但它有更多的并行单元可以吸收。
反过来说,CPU 路线的渲染段斜率最陡(单线程 60.3 倍、8 线程 34.3 倍),这才是「CPU 在大场景上吃亏」的直接原因——它吃亏的不是固定开销,是每图元都要付出更多的像素填充时间(图元越多,重叠越多,同一个像素被填的次数越多)。
把两条曲线放一起看,可以得到一个对工程有用的判断:如果你的场景图元数会长期增长,那么 CPU 路线的性能会随场景变差,而 GPU 路线的性能会随场景变好(相对而言)。这正好解释了为什么两条曲线会在 1800 到 2000 图元之间交叉。
一句话收一下这一章:三段分工的差别,不在于「谁快」,而在于「固定开销」与「随规模增长的部分」配比不同。CPU 路线固定开销最低但斜率最陡,GPU 路线固定开销最高但斜率最平。两条曲线交叉的地方,就是选型的分水岭——下一章就去找这个点。
下面我们换一个维度。
五、规模涨 80 倍,四条曲线怎么走
把四个规模连起来看,四路的行为差异才完整。
先看看四条曲线摆在一起的样子。四条路的固定开销与斜率都不同,其中:compute 的斜率最平。
5.1 四条曲线
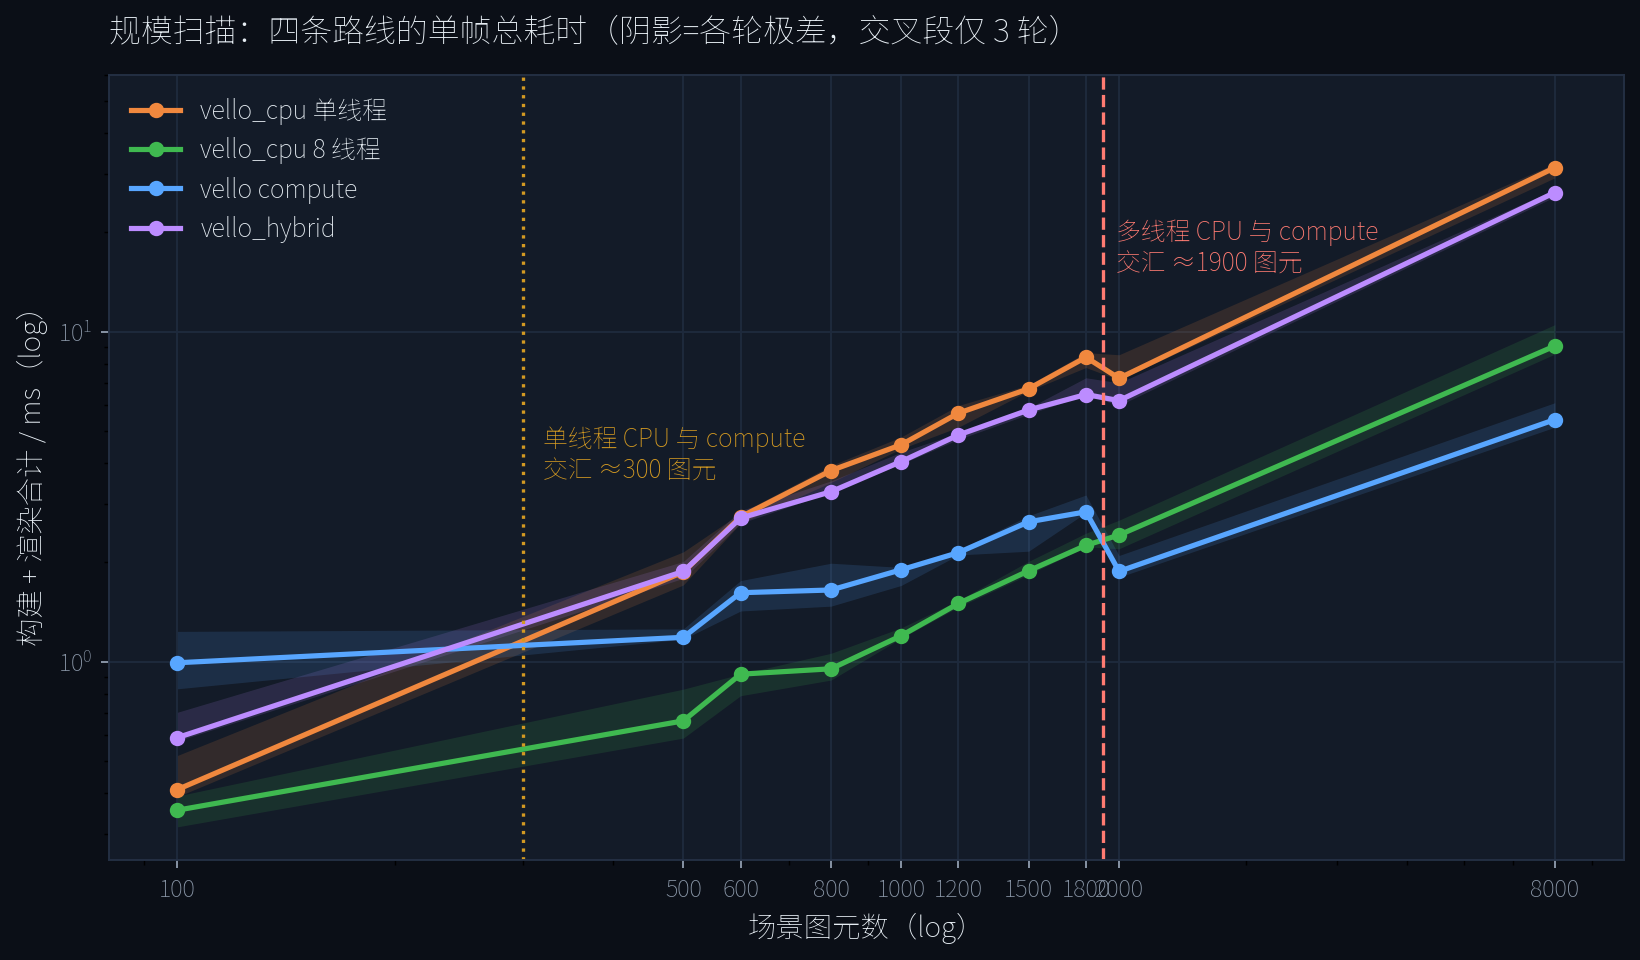
四条曲线在 100 图元处的排序是:CPUn 0.352 < CPU1 0.424 < HYB 0.594 < CMP 0.992 毫秒。最小的场景上,两条 CPU 路线最快,compute 最慢——compute 比 8 线程 CPU 慢了 2.645 倍,甚至比单线程 CPU 还慢 2.246 倍。这一条和场外的实测对得上:Vello 仓库的 issue #1380 里,有人拿 old.reddit.com 这个「文字与小图元密集」的页面测过,帧时间是 Hybrid 约 110 毫秒、Vello CPU 约 36 毫秒、Vello Classic 约 18 毫秒、Skia 约 6 毫秒。小场景上「上了 GPU 反而慢」不是个例。
到 500 图元,排序变成 CPUn 0.670 < CMP 1.186 < CPU1 1.871 < HYB 1.860。CMP 已经反超单线程 CPU,而 hybrid 仍落在最后。
到 2000 图元:CMP 1.879 < CPUn 2.447 < HYB 6.207 < CPU1 7.262。compute 登顶。
到 8000 图元:CMP 5.327 < CPUn 9.054 < HYB 26.376 < CPU1 31.201。此时的倍数关系是:compute 是单线程 CPU 的 17.8%(快 5.6 倍)、8 线程 CPU 的 59.1%(快 1.69 倍)、hybrid 的 20.6%(快 4.85 倍)。
另一组更能说明问题的数是增长率。以 100 图元为 1.00,图元数涨 80 倍后:
| 路 | 100 → 8000 的合计倍数 | 8000 图元合计 |
|---|---|---|
| CPU1 | 73.59× | 31.201 ms |
| HYB | 44.40× | 26.376 ms |
| CPUn | 25.72× | 9.054 ms |
| CMP | 5.37× | 5.327 ms |
这张表解释了两件事。第一,为什么 hybrid 明明渲染段最快,合计却排在 CPU 后面——它的构建段(单线程几何处理)斜率太陡,把渲染段的优势吃光了。第二,为什么 compute 在小场景反而最慢——它的斜率最平(只有 5.37 倍),说明它绝大部分开销是与规模无关的固定开销;场景轻的时候,固定开销就成了主体。
言归正传,既然曲线会交叉,就值得把交叉点找出来。
5.2 交叉点在哪
既然有多条曲线交叉,就值得把交叉点找出来。在 600 / 800 / 1000 / 1200 / 1500 / 1800 这六个规模上各跑一轮细扫(每档 3 轮运行取中位),得到:
| 图元 | CPU1 | CPUn | CMP | HYB | 最快 |
|---|---|---|---|---|---|
| 600 | 2.746 | 0.917 | 1.619 | 2.726 | CPUn |
| 800 | 3.797 | 0.952 | 1.650 | 3.276 | CPUn |
| 1000 | 4.546 | 1.199 | 1.900 | 4.043 | CPUn |
| 1200 | 5.669 | 1.502 | 2.142 | 4.867 | CPUn |
| 1500 | 6.717 | 1.886 | 2.655 | 5.794 | CPUn |
| 1800 | 8.372 | 2.253 | 2.847 | 6.455 | CPUn |
| 2000 | 7.262 | 2.447 | 1.879 | 6.207 | CMP |
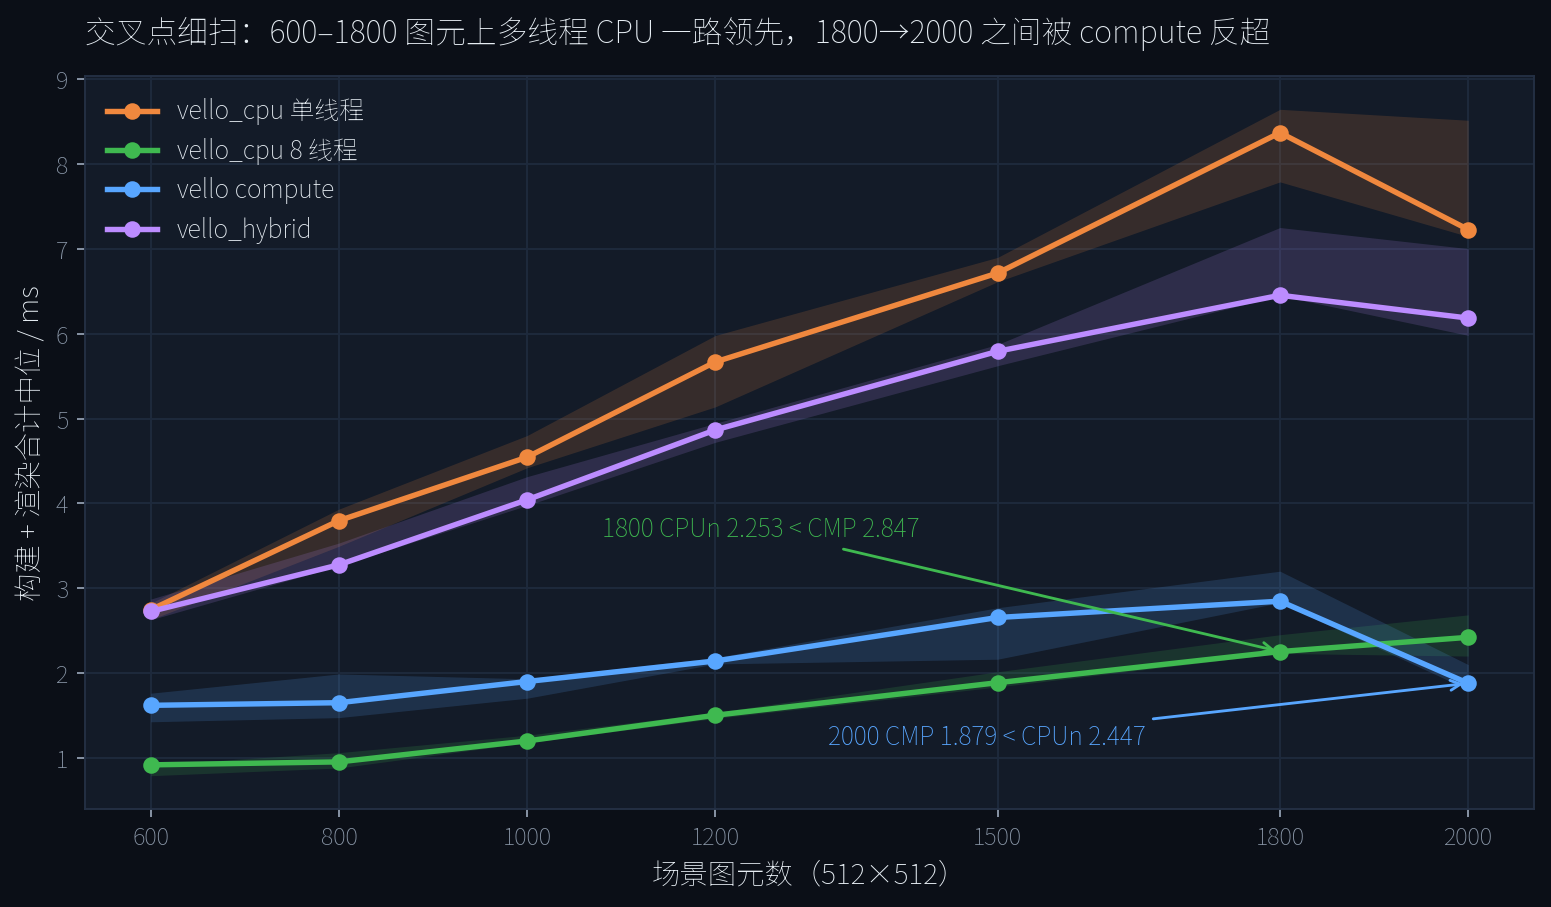
读这张表要克制。1800 图元时 CPUn 是 2.253、CMP 是 2.847,CPUn 领先 26%;到 2000 图元时 CPUn 是 2.447、CMP 是 1.879,CMP 反超 30%。 两点之间隔了 200 个图元,而这两点的读数本身带 20% 量级的轮间波动(见第七章)——所以能说的是「交叉点落在 1800 到 2000 图元之间」,不能说「1900 图元」这样的精确阈值。这是本篇刻意保留的模糊:把噪声当成信号,就会写出一个看着很精确、实际不可复现的数。
跨过这一段之后,答案就清晰了:在 512×512 这个画布上,单线程 CPU 与 compute 的交汇发生在 500 图元之前,8 线程 CPU 与 compute 的交汇发生在 1800 到 2000 图元之间。
先看看「顺手外推一下」这个诱惑有多大。
5.3 为什么不外推到没测过的规模
既然四条曲线在双对数坐标上接近直线,就有一个很自然的冲动:把线延长,预测 50000 图元或 32000 图元时谁赢。
本篇不做这件事,理由有三条,都来自前面量到的噪声结构。
第一,斜率本身带噪声。 上面那张增长率表里,CMP 的 5.37 倍是四路里最不平滑的一个数——它在四档上的比值分别是 1.00 / 1.20 / 1.89 / 5.37,而从 2000 到 8000 这一段(4 倍图元)涨了 2.84 倍,斜率明显比前一段陡。也就是说它也不是严格的直线,用两点外推会系统性高估它的优势。
第二,固定开销那一段会被外推吃掉。 compute 在 100 图元时最慢(0.992 毫秒,是 8 线程 CPU 的 2.645 倍),这个「慢」几乎全是固定开销。外推时如果把这段当成噪声丢掉,就会得到一个「compute 永远更快」的结论——而它在 100 图元上实测是四路最慢,这不是噪声,是结构。
第三,也是最重要的一条:这台机器上真正限制大规模测试的不是时间,是显存与内存带宽。 8000 图元、2048² 时的像素缓冲是 16 MiB(RGBA8 × 2048 × 2048),CPU 路线的 Pixmap 与 GPU 路线的纹理各一份,加上条带数据、覆盖率数据、回读缓冲,峰值占用已经进入百 MiB 量级。再往上加图元,测出来的会先是内存子系统的行为,而不是渲染器的行为。
所以这一章的结论只覆盖 100 到 8000 图元、512² 到 2048² 这个范围,一个字都不外推。这也是自跑篇该有的规矩:读数覆盖到哪里,话就说到哪里。
顺带补一个可以拿来对标的官方数字,但只作背景,不作对照。vello 0.10.0 的 README 里写着:「We've observed 177 fps for the paris-30k test scene on an M1 Max, at a resolution of 1600 pixels square, which is excellent performance… More formal benchmarks are on their way.」177 fps 对应单帧 5.65 毫秒,场景是 30000 个路径、1600×1600 画布,机器是 M1 Max(一块统一内存的 SoC,不是独显)。把它和本篇的 8000 图元 / 5.327 毫秒放在一起看很容易得出「本机更快」的错觉——但两者场景复杂度差近 4 倍、硬件代数差两代、平台完全不同,这组数字不可比。列在这里只是为了说明一件事:官方那个数字的位阶,和本篇的位阶是同一量级,说明本机没有测出一个离群的系统偏差。
规模这一维看完了。但规模不是唯一的变量——同样 2000 个图元,画布放大四倍,四条曲线会重新排一次队。
好了,下一个变量是像素数。
六、分辨率涨 16 倍,谁最不敏感
先看看渲染耗时的中位数。这一维改了两个量,其中:像素数从 26 万涨到 419 万。
6.1 分辨率敏感度
固定 2000 个图元,把画布从 512² 放大到 1024²、2048²(像素数 16 倍)。注意场景里的半径也按画布短边等比放大了,所以曲线段的扁平化成本会同步上升——这一维改的是两个量:像素数,以及几何的绝对尺寸。
渲染耗时的中位:
| 边长 | CPU1 | CPUn | CMP | HYB |
|---|---|---|---|---|
| 512² | 3.741 | 1.394 | 2.229 | 1.860 |
| 1024² | 7.859 | 3.107 | 9.806 | 2.680 |
| 2048² | 17.626 | 6.748 | 6.757 | 6.364 |
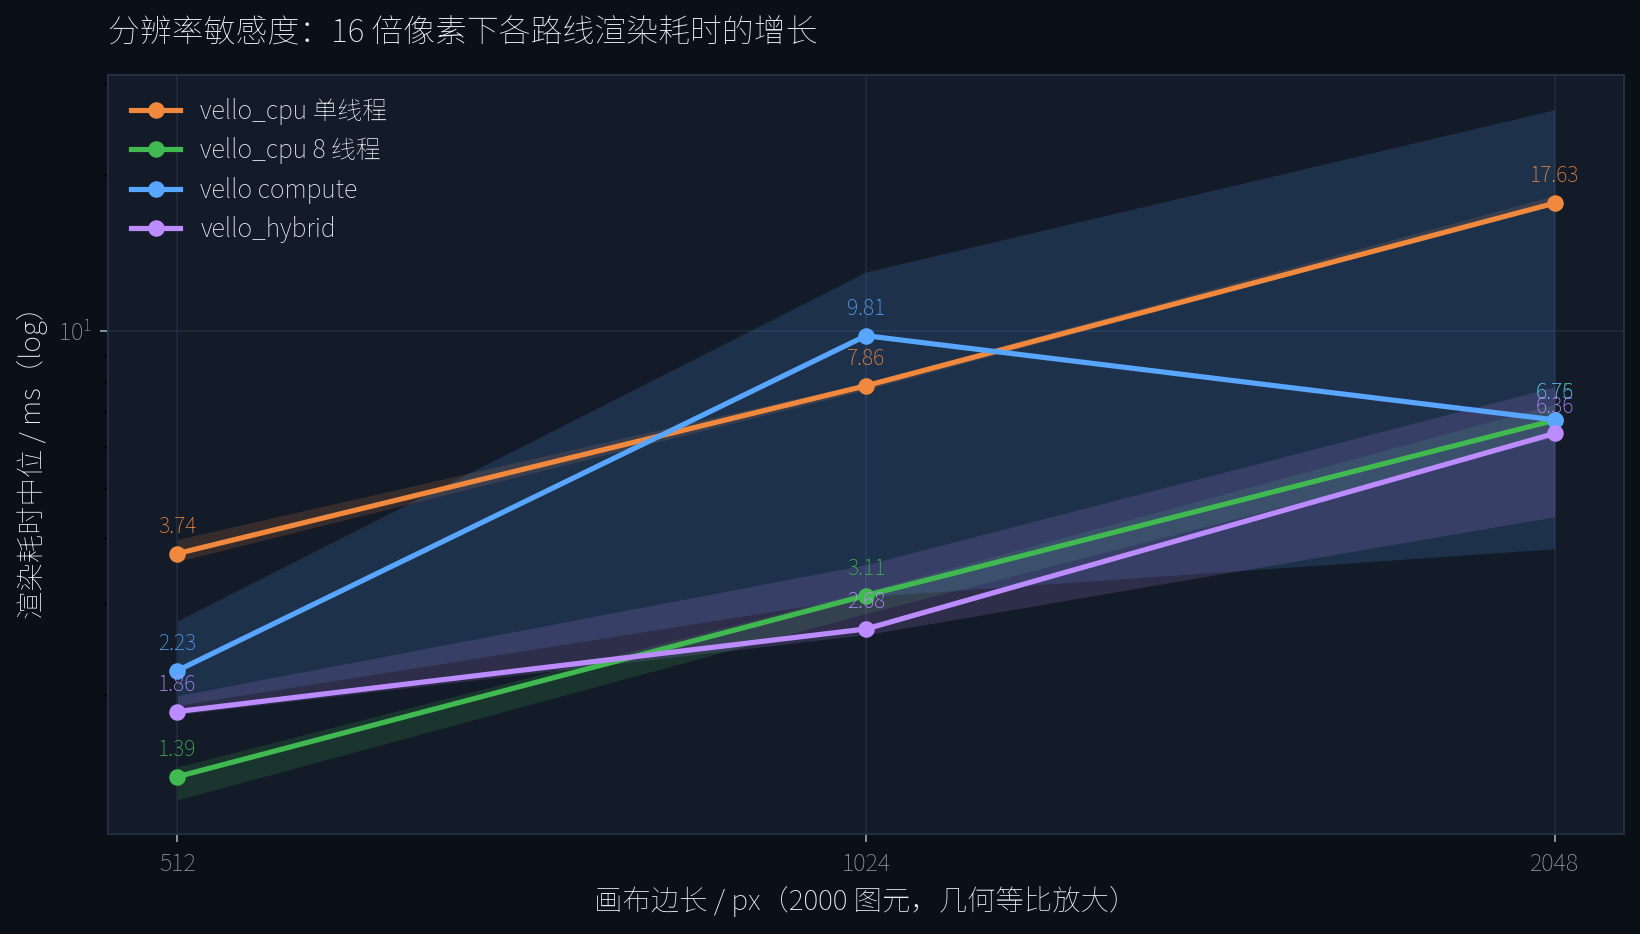
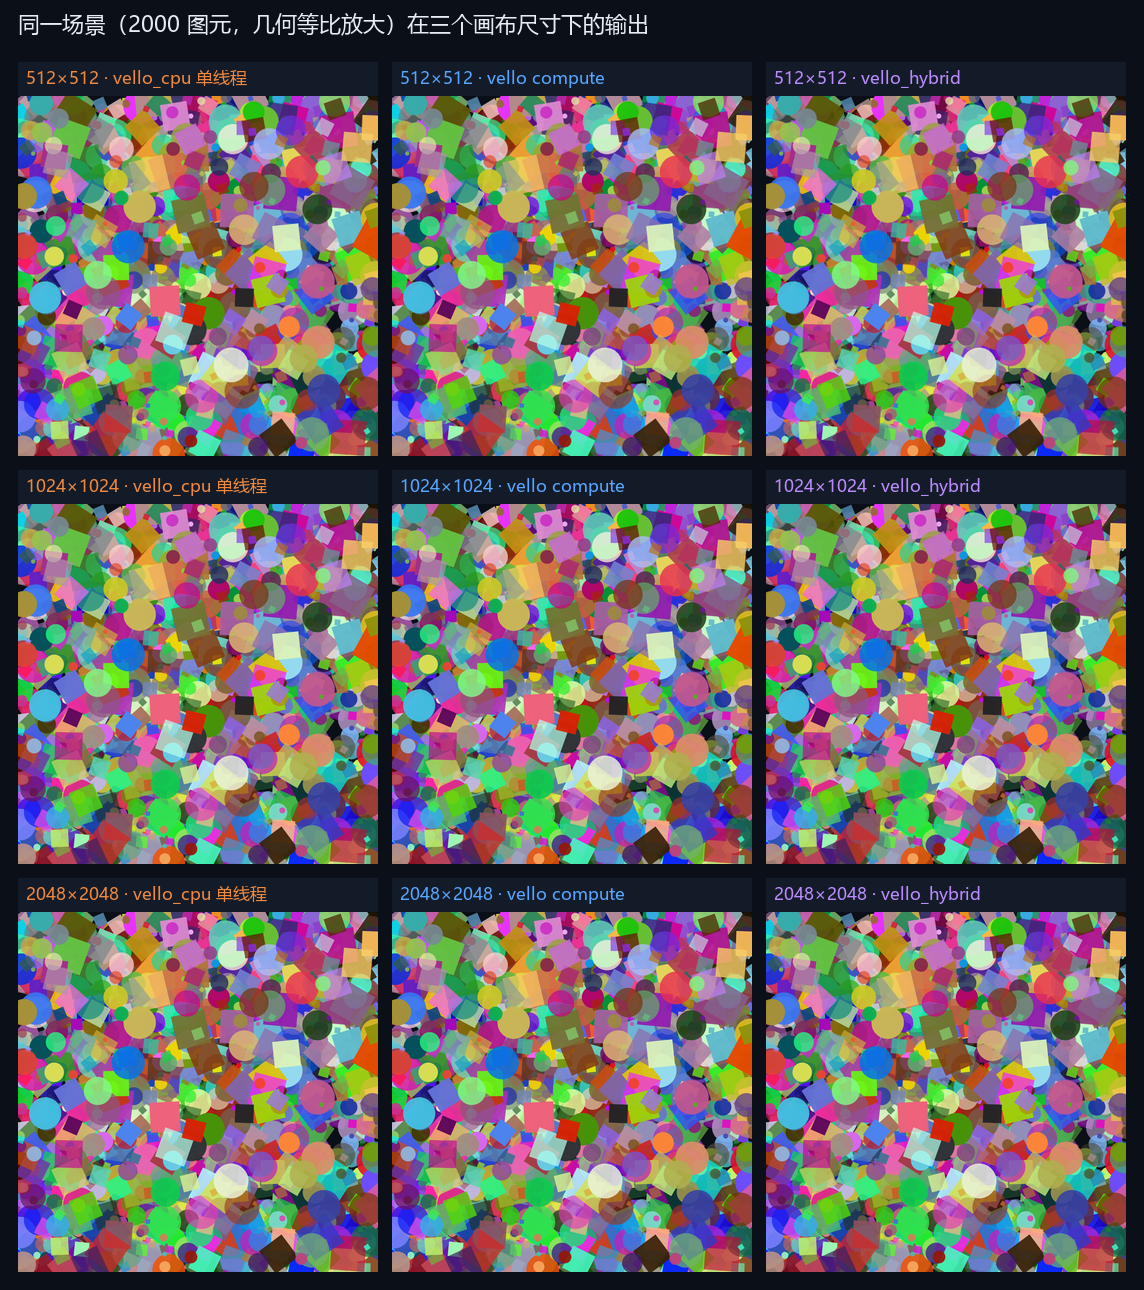
16 倍像素,CPU 两条路线的渲染耗时涨了 4.71 与 4.84 倍,hybrid 只涨 3.42 倍。 也就是说 hybrid 是四条路线里对分辨率最不敏感的——这与它的机制一致:像素的活全在 GPU 上,而 GPU 对像素的并行度远高于 CPU 对像素的并行度。
合计耗时的敏感度要低得多:CPU1 3.39 倍、CPUn 3.51 倍、HYB 2.68 倍。因为合计里有一大块(构建段)跟像素数基本无关,只有几何尺寸相关。
先看看一处必须如实登记的异常。
6.2 一个必须如实登记的异常
上表里 compute 那一列(2.229 → 9.806 → 6.757)不是笔误,也不是单调性错误,而是不可复现。把 5 轮独立运行在 2048² 上的渲染中位全部列出来:3.822 / 6.644 / 6.757 / 7.561 / 26.648 毫秒;1024² 上是 3.092 / 9.422 / 9.806 / 11.582 / 13.002 毫秒。
同一个配置、同一份代码,5 轮之间能出现 3.8 与 26.6 两种模式,相差近 7 倍。所以本篇对 compute 路线在这一档上只给区间不给单点:2048² 渲染中位的跨轮范围是 3.82–26.65 毫秒,1024² 是 3.09–13.00 毫秒。这也意味着「谁的渲染段更快」这个问题在 2048² 上没有答案——compute 的中位(6.757)与 hybrid 的中位(6.364)落在彼此的波动范围内。
下面我们补一张直观的对照。
6.3 图元数才是更重的那一维
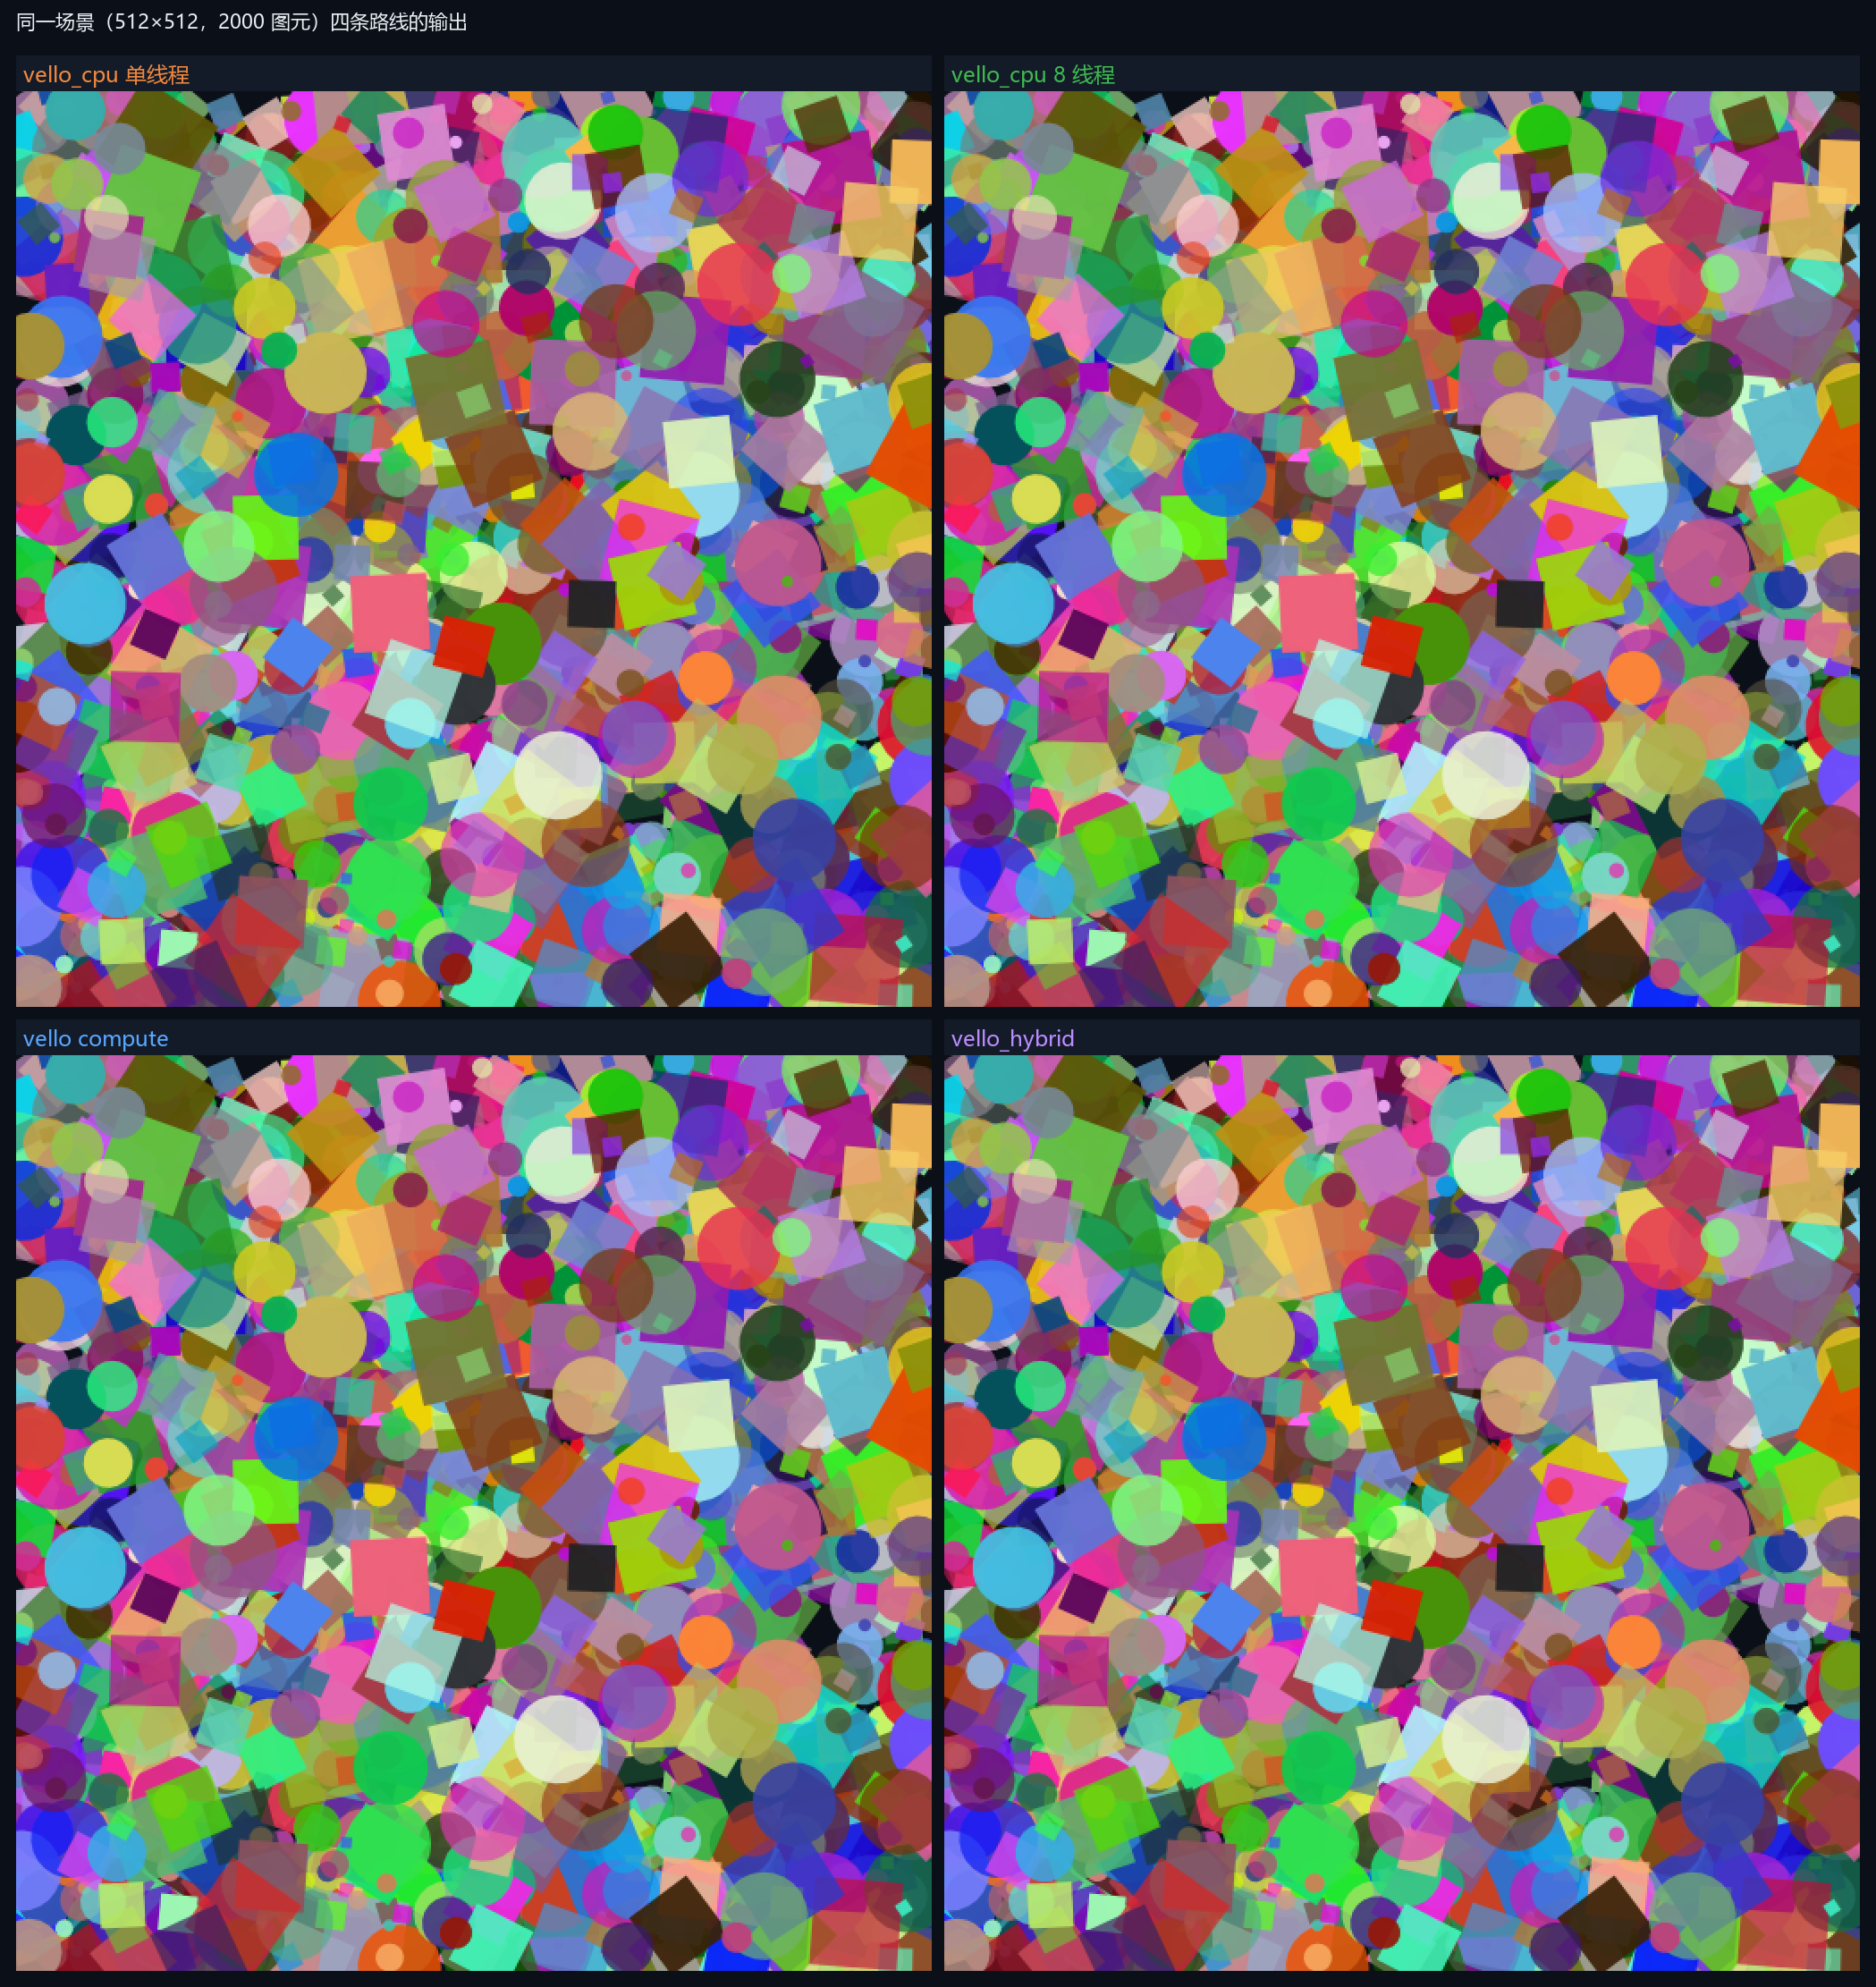
最后补一张 8000 图元的四路输出,作为「规模」这一维的直观对照:160 倍于 100 图元的场景下,四条路线画出来的仍然是同一幅图。
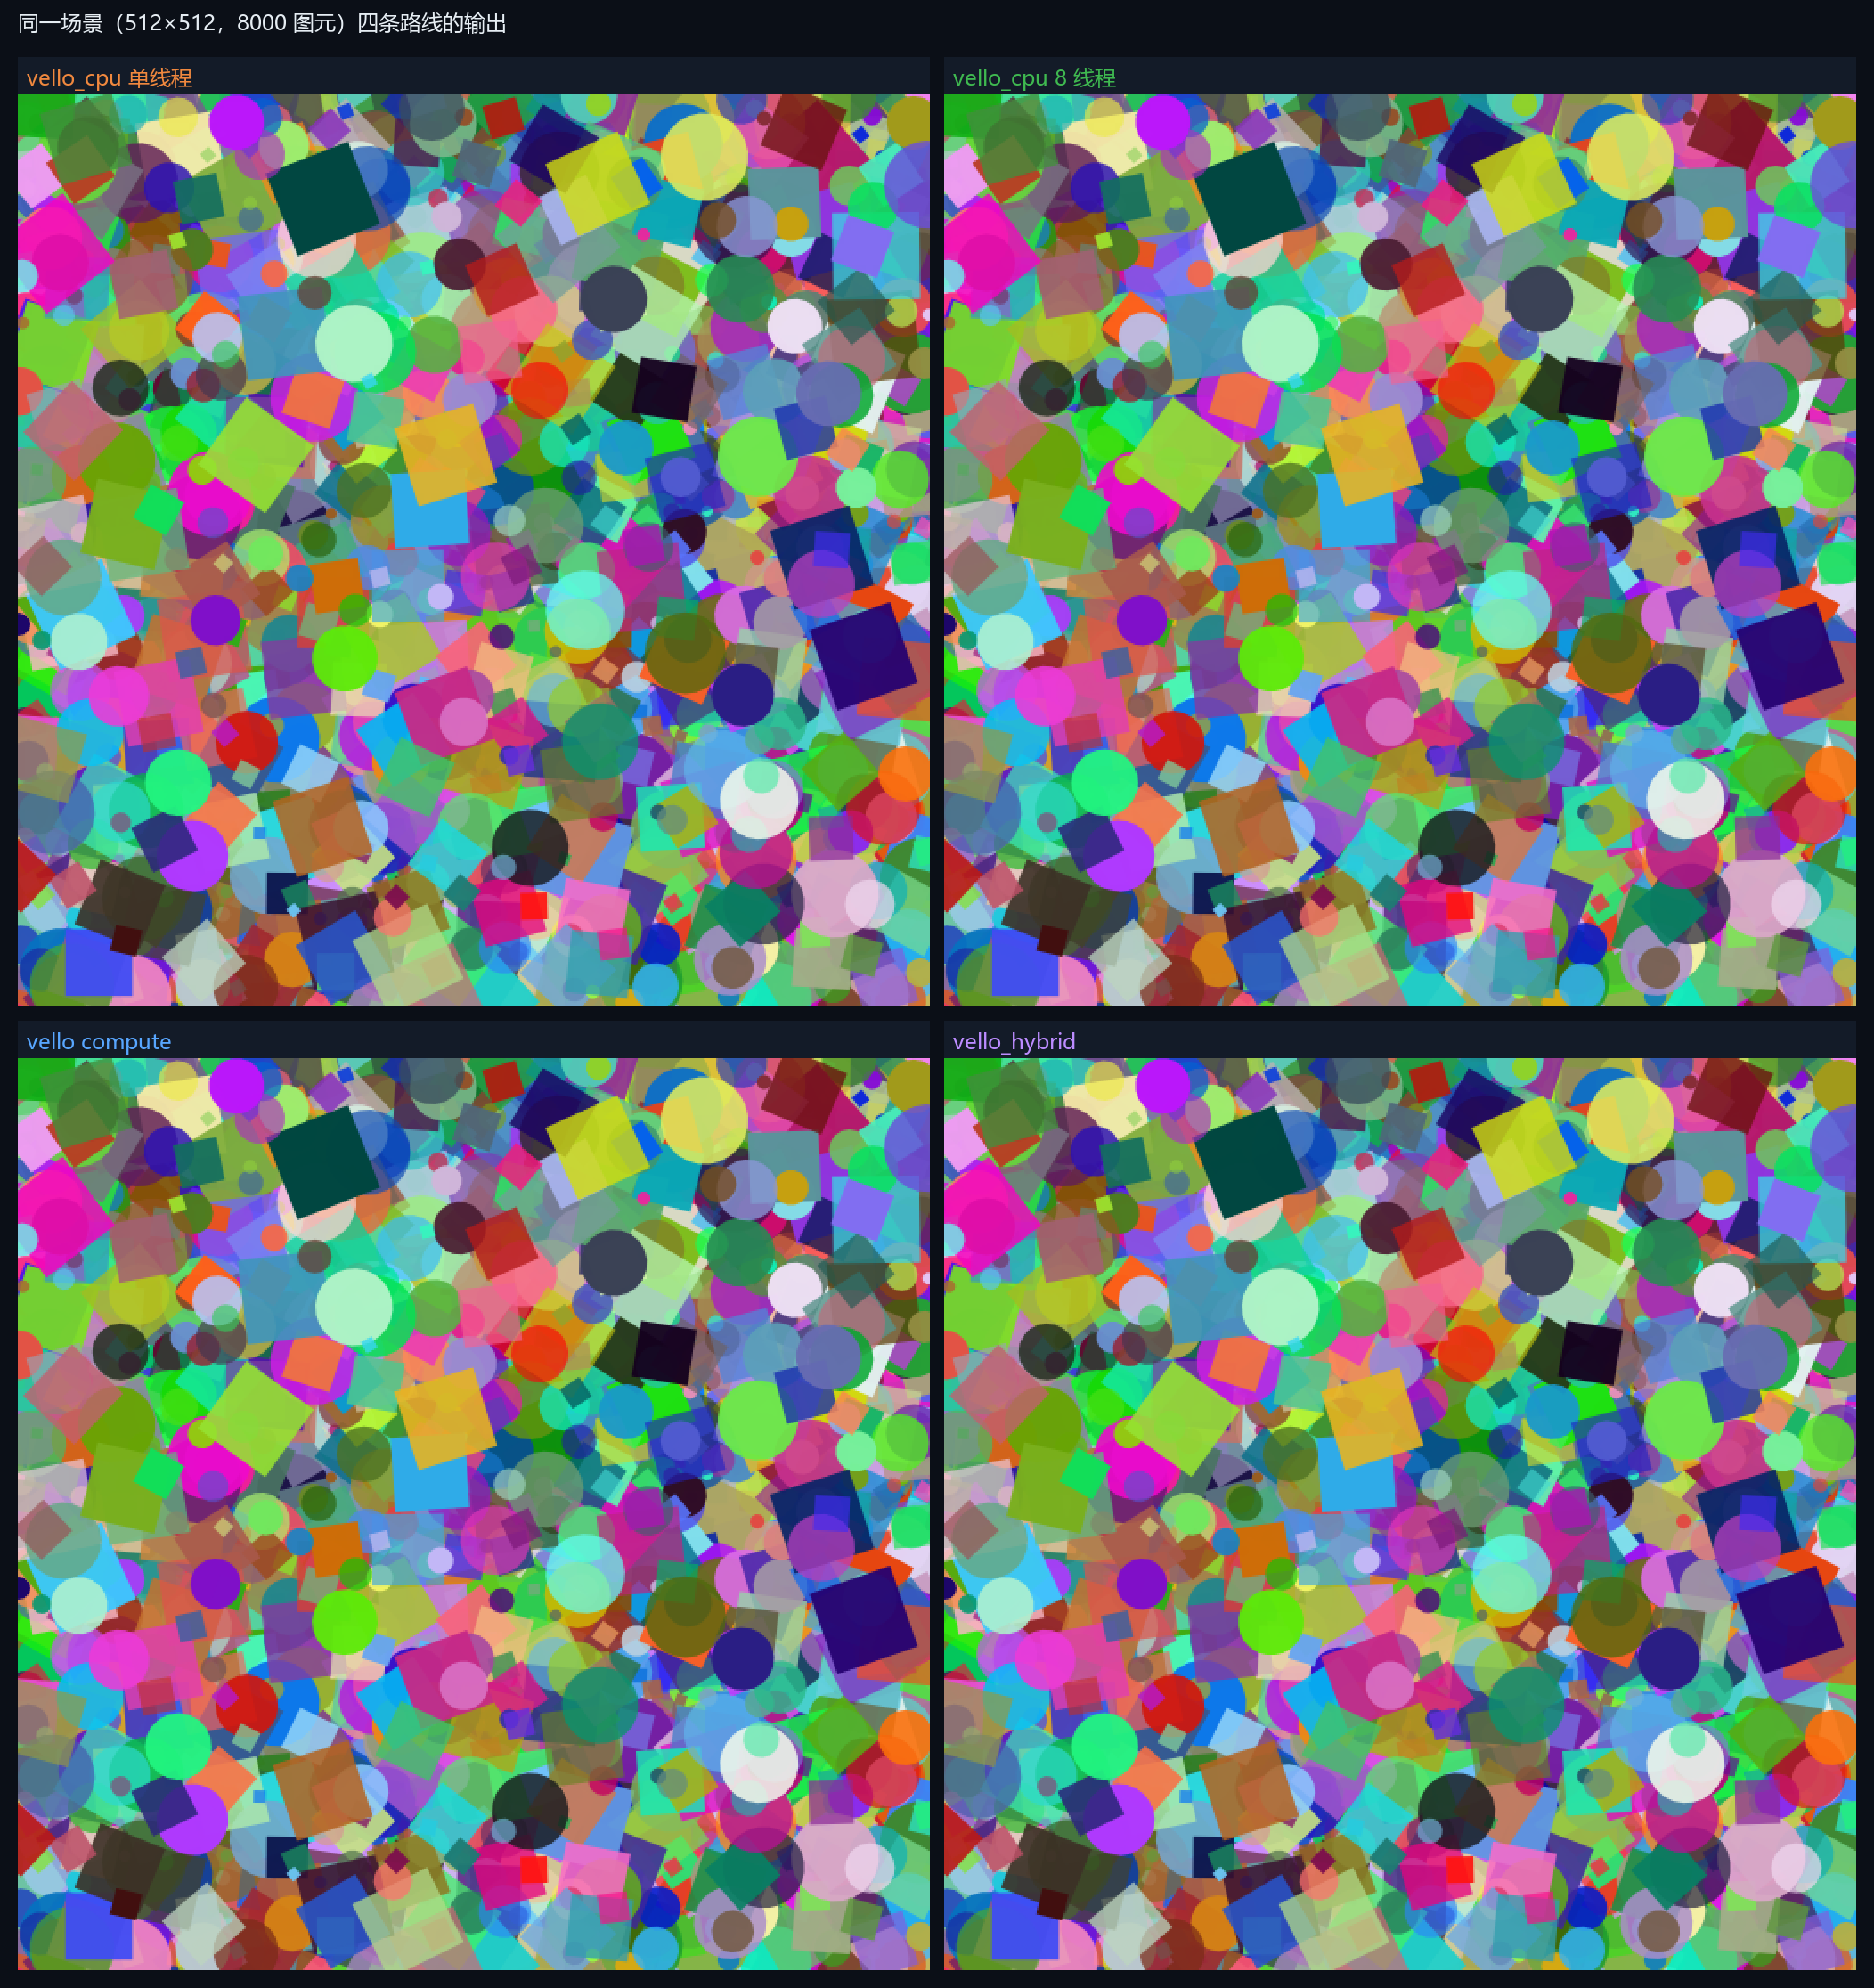
把这两章合起来看,能得到一条对工程更实用的结论:在 512×512 到 2048²、100 到 8000 图元这个范围内,决定性能的主要变量是图元数而不是分辨率。分辨率翻 4 倍(16 倍像素),hybrid 的合计只涨 2.68 倍;而图元数翻 4 倍(2000 → 8000),它的合计涨了 4.25 倍。
不过上面这些结论,全部建立在「这些数字本身可信」这个前提上。第七章就来拆这个前提。
下面这一章,是整篇最想写的一章。
七、这些单帧数字有多可信
这是本篇最想写的一章。前面所有数字都带小数点后三位,但小数点后的第三位没有意义——有意义的是:这些数字的波动有多大,以及什么样的干扰能改变它们。
先看看五轮样本摊开之后是什么样。
7.1 五轮之间的波动
把 5 轮独立运行的全部样本摊开看。以 8000 图元那一档的合计中位为例,四路的极差(最大值减最小值除以中位)是:HYB 5.1%、CPU1 9.7%、CMP 17.7%、CPUn 21.6%。
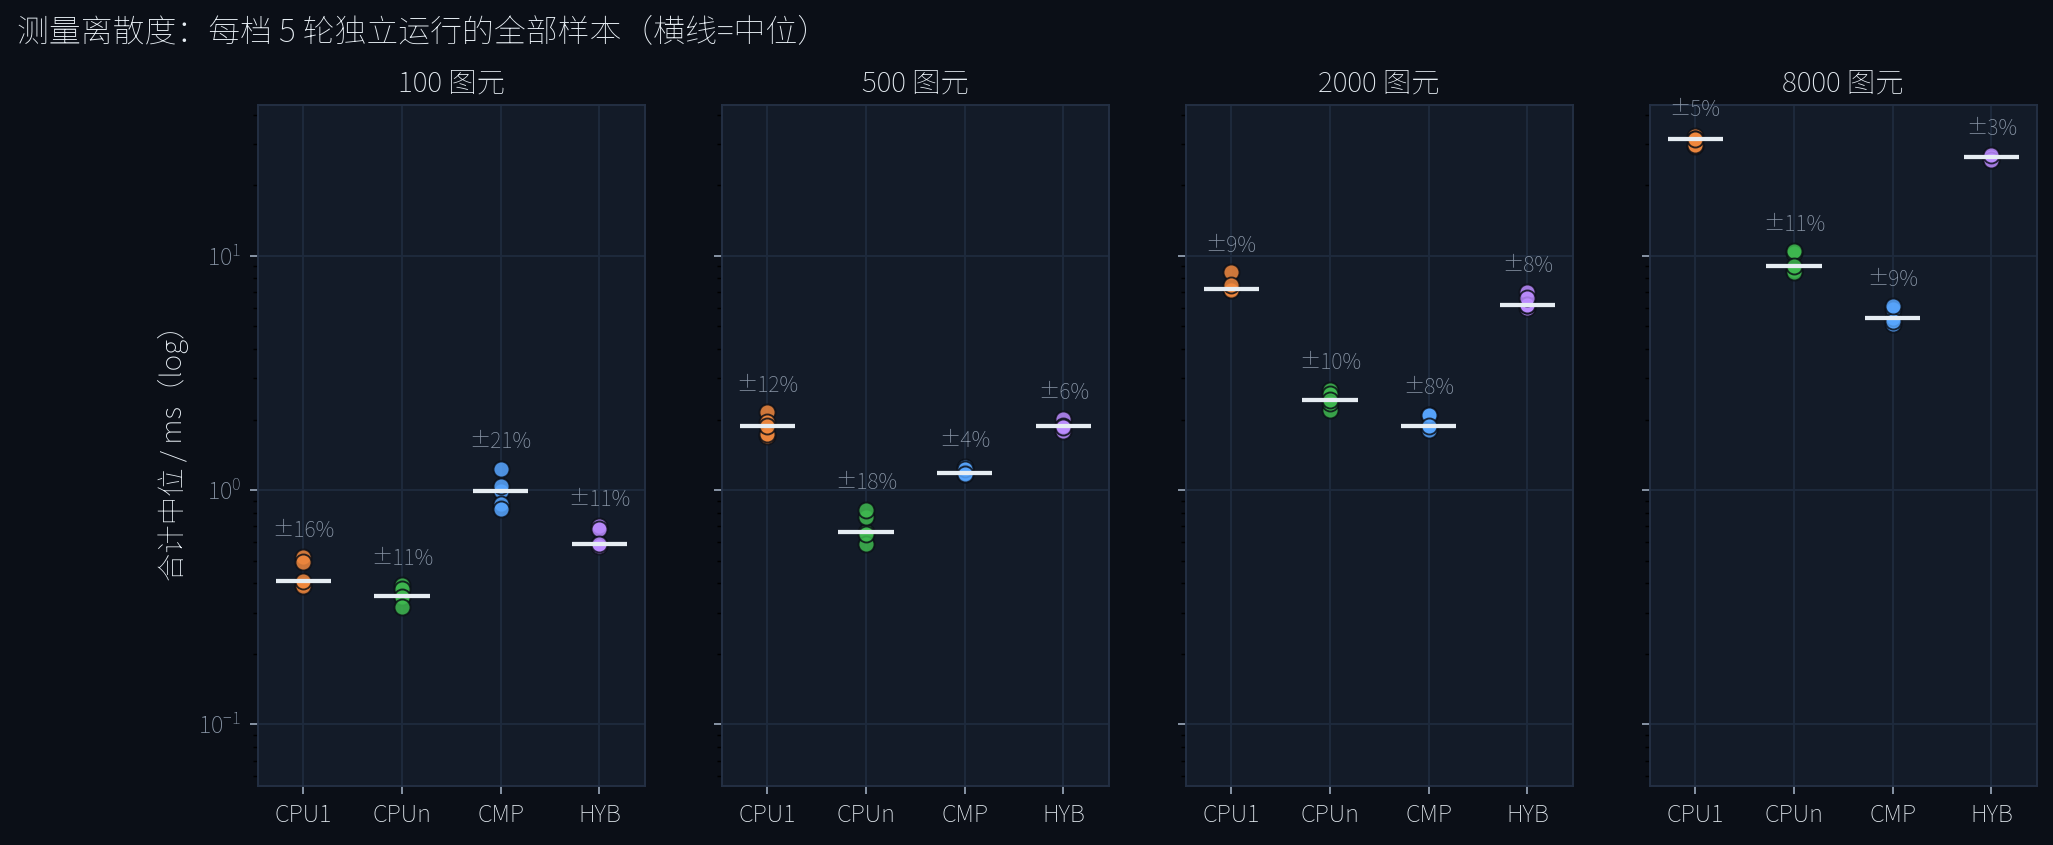
hybrid 的 5.1% 是四条路线里最稳的(说明它的渲染段确实是确定性的 GPU 工作),8 线程 CPU 的 21.6% 最大(多线程调度本身带抖动)。但真正的问题不在这 5% 到 22% 这一档——那是「正常的测量噪声」,多跑几轮取中位就能压住。真正的问题在下面。
先看看那个后来被删掉的写法闯了多大的祸。
7.2 干扰实验:一个文件写入,把 compute 的单帧抬高 2.30 倍
第一版探针里有一个后来被删掉的写法:在 CPU 基准循环里,每次渲染后把结果写成一张 512×512 的 PNG(这属于被测路径之外的动作,计时本身没有包住这个写入)。
删掉它之后,compute 路线在 8000 图元上的合计从 12.454 毫秒掉到 5.417 毫秒。为了确认这不是巧合,把两种写法做成一个开关(环境变量 PROBE_PNG),在完全相同的代码上各跑一遍:
| 路 | 基准循环不落盘(5 轮中位) | 循环内写 PNG | 倍数 |
|---|---|---|---|
| CMP | 5.417 ms | 12.454 ms | ×2.30 |
| CPU1 | 31.432 ms | 34.599 ms | ×1.10 |
| CPUn | 9.054 ms | 9.523 ms | ×1.05 |
| HYB | 26.422 ms | 25.574 ms | ×0.97 |
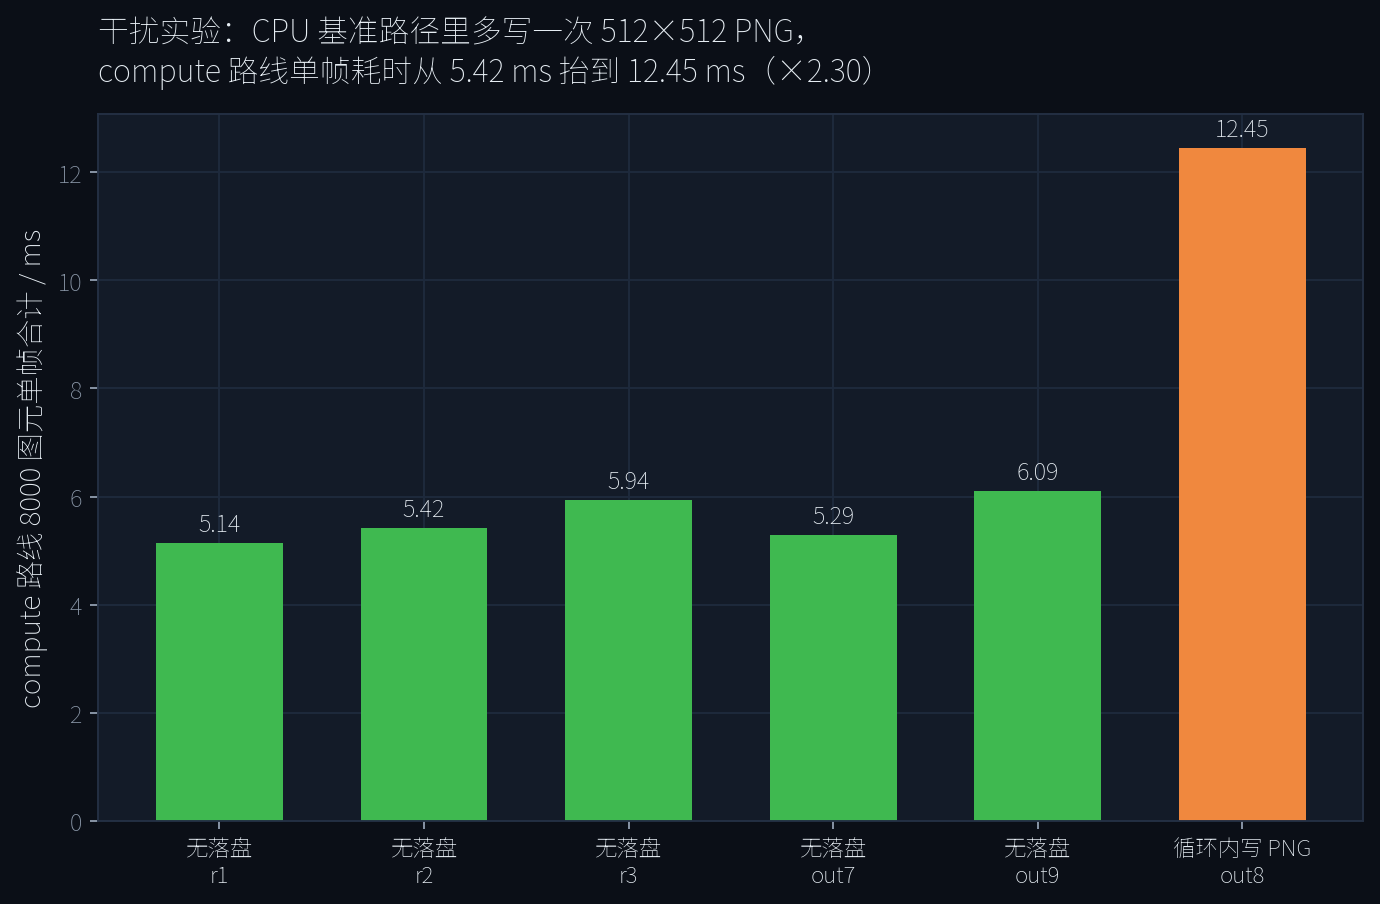
同一份渲染代码,唯一差别是 CPU 那条路径里多了一次文件写入,compute 路线的单帧耗时就被抬高了 2.30 倍。 另外三条路线的同口径变动分别是 1.10、1.05、0.97 倍——也就是说,这个干扰是 compute 路线特有的。
原因在源码里能找到。vello::Renderer::render_to_texture 内部走的 run_recording 只做 queue.submit,不做 poll:
// vello 0.10.0 · src/wgpu_engine.rs(run_recording 末尾)
queue.submit(Some(encoder.finish()));
// ……之后只回收缓冲与图像,没有 device.poll
所以单帧的结束点必须由调用方自己等:探针里写的是 device.poll(wgpu::PollType::wait_indefinitely())。这句等的是驱动与操作系统的唤醒延迟,而不是纯 GPU 计算时间。当系统里还有别的活动(哪怕只是文件写完成中断)时,这个等待就会被拉长。而 vello_cpu 的耗时是纯 CPU 计算(不受影响),hybrid 走一次普通 render pass(受影响远小于 compute 的多趟 compute dispatch)。
这一条不是「本机不行」的抱怨,而是一个可复现的方法学结论:对 compute 路线做单帧计时,必须把「被测路径之外的系统活动」也控制住,否则测出来的不是渲染器,是系统调度。
它同时也是对第九篇那条纪律的二次验证。第九篇总结过:耗时类读数必须拆「提交 / 完成」。这一章给出的是为什么——因为「完成」那一段的耗时,主要不在 GPU 里。
所以本篇的结论一律按这个标准写:能复现的(构建段、规模斜率、分辨率敏感度、输出差异)给单点值;不可复现的(compute 在 1024²/2048² 的渲染段)给区间;差异只有 5% 到 20% 量级的排序(1800 与 2000 图元之间那两点的先后)给「无法判定」。
下面我们从「哪里不干净」翻到「怎么才干净」。
7.3 三条能让读数更干净的做法
这一章只讲了「哪里不干净」,还欠一句「怎么才干净」。按成本从低到高排:
第一,把被测路径之外的 I/O 全部移出基准循环。 这一条本篇已经做到(第一版没做到),代价是零,收益是把 compute 的读数从 12.454 毫秒降回 5.417 毫秒。任何在计时循环里写日志、写截图、打印进度的做法,都会污染 GPU 路线的读数。规矩很简单:基准循环里只允许出现被测的那一件事。
第二,提高重复次数并报分布,而不是报单点。 本篇每档 18 次(3 暖机 + 15 计时),并且把 5 轮独立运行的结果都留着。这个做法抓到了 compute 在 1024²/2048² 上的双峰分布——如果只跑 15 次报一个中位数,那个 26.648 毫秒的慢模式就永远不会被发现。
第三,用 GPU 自身的时间戳查询(timestamp query)取代 CPU 侧的 poll 等待。 本机探针用的是 device.poll(wait_indefinitely),它把「驱动唤醒 + 系统调度 + GPU 执行」三段混在一起。wgpu 支持计算与渲染通道上的时间戳写入,能把 GPU 内的纯执行时间单独量出来。本篇没有用这条路——不是不知道,而是它测的是另一件事(GPU 内部耗时),与「应用侧要等多久」不是同一个量。两套口径都有用,但不能混着比。这是本篇明确留下的一处未做项。
7.4 本篇没做到的三件事
自跑篇的纪律是「落空要登记」。这一篇有三处明知可做但没做的事,列在这里:
其一,没有用 GPU 时间戳查询。 原因见上。后果是第七章关于 compute 单帧不可复现的结论,只在「CPU 侧等待」这个口径下成立;换口径后它是否仍然双峰,本篇无法回答。
其二,没有控制系统电源状态。 这台机器是笔记本,GPU 的时钟会随功耗墙变化。NVIDIA 的性能测量环境说明明确提到功耗墙导致的时钟变频会让短时测量不稳定。本篇对此没有任何控制手段(没有锁频、没有读到实时的时钟频率),只能靠多轮取中位来对冲。这也是为什么 compute 的 2048² 读数会出现 3.8 与 26.6 两种模式——它可能在反映机器的电源状态,而不是渲染器。这一点无法从本篇的数据里排除。
其三,没有在第二条 GPU 上复现。 结论里的所有 GPU 侧数字都来自 RTX 3060 Laptop 这一块卡。官方 issue #83 里那种「移动 GPU 上 fine 光栅化异常慢」的情况,本篇没有能力验证或排除。
把这三条写出来,是为了让读者知道这份读数的边界在哪。它们不影响本篇的主要结论(构建段的归属、规模斜率、分辨率敏感度、输出差异的通道归属——这四条在 5 轮之间都稳定复现),但影响「compute 路线到底有多快」这一个问题的精确答案。
还剩一件事要交代:这三条路线画出来的东西,到底一样不一样。
OK,回到最后一个问题。
八、三路画出来一样不一样
下面我们看最直接的一组数。
8.1 逐像素差异统计
拿同一个场景(512×512、2000 图元)四路的输出逐像素比:
| 对比 | 任一通道有差 | 色差 ≥8 | 色差 ≥32 | 最大色差 | 平均通道色差 |
|---|---|---|---|---|---|
| CPU 单线程 vs 8 线程 | 0.00% | 0.00% | 0.00% | 0 | 0.0000 |
| CPU8 vs compute | 80.47% | 0.38% | 0.02%(64 像素) | 254 | 0.4133 |
| CPU8 vs hybrid | 82.25% | 3.46% | 1.22%(3189 像素) | 255 | 1.0217 |
| compute vs hybrid | 34.31% | 3.70% | 1.22%(3210 像素) | 254 | 0.7551 |
| CPU u8 vs f32 | 82.78% | 0.04% | 0.02%(42 像素) | 255 | 0.3926 |
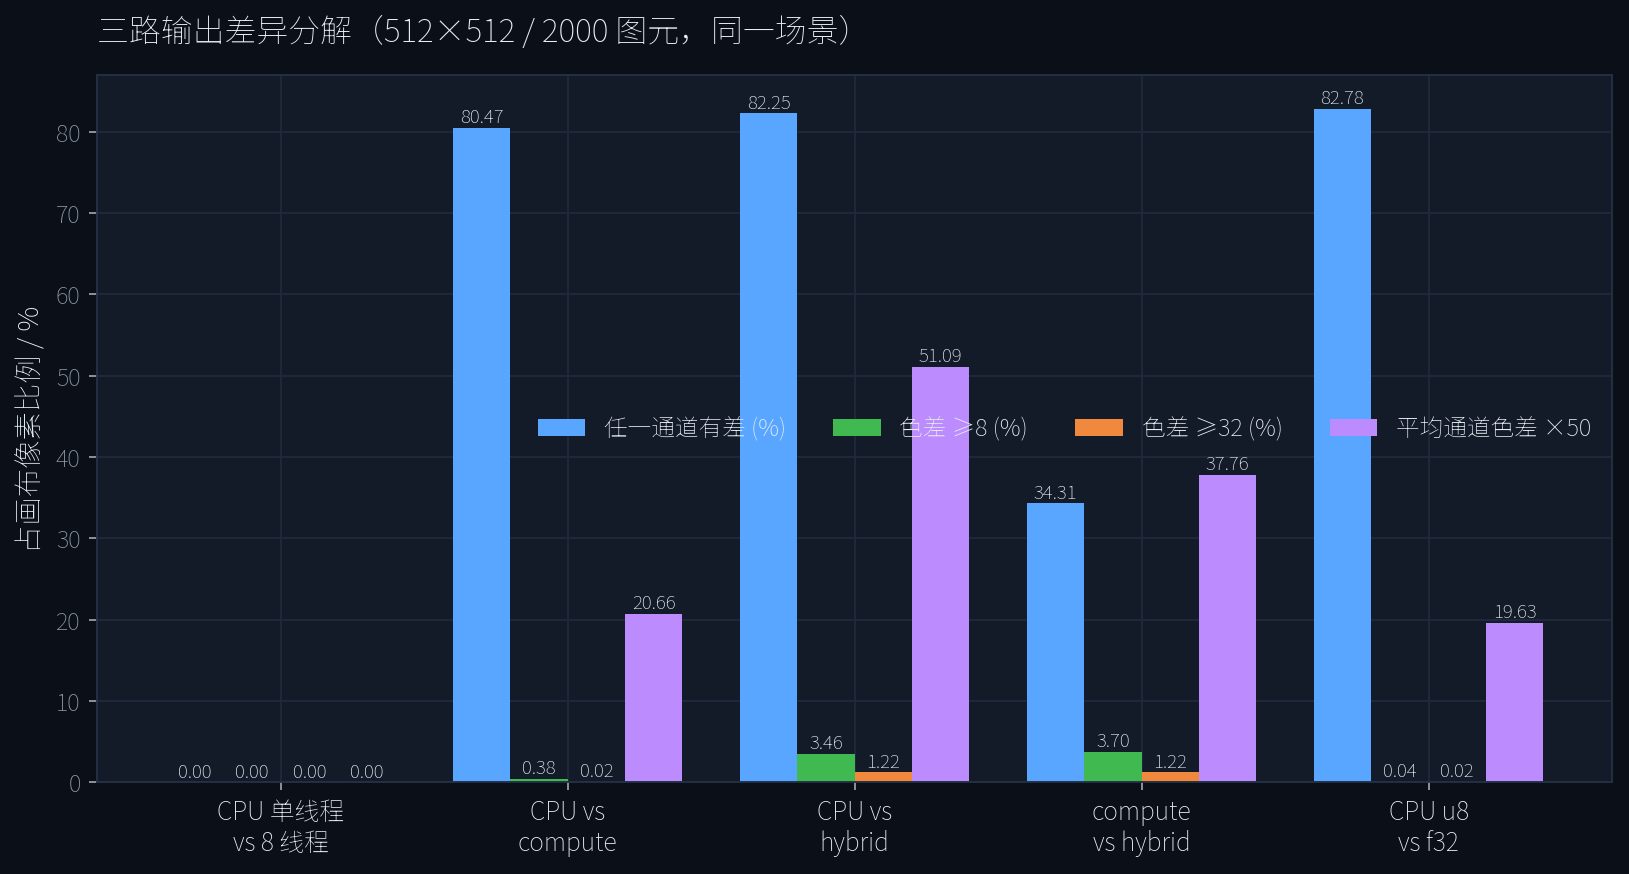
这张表有三处值得停一下。
第一行是零结果:同一路线的单线程与 8 线程输出逐字节相同,最大色差 0。它在统计上没有意义,但在工程上是个好消息——并行不改变结果。
后面几行的「任一通道有差」都在 34% 到 82% 之间,看着很吓人;但把阈值提到 ≥32,就只剩 0.02% 到 1.22%。也就是说,绝大部分差异是低幅度的(平均通道色差 0.41 到 1.02,相当于一个 u8 码值的零点几个)。真正肉眼可见的差异,是那 0.02% 到 1.22%。
而这张表的末行给了整张表一个参照系:CPU 自己的两条精度管线(u8 与 f32)之间的差异,平均通道色差是 0.3926,与「CPU vs compute」的 0.4133 几乎相同。 换句话说,CPU 与 compute 之间的那点差异里,主要成分是 u8 与 f32 的舍入差别,而不是某一方画错了。
换个切法再比一次。
8.2 差异落在哪些像素上
把差异拆到通道维度,结论会更清楚。
先看覆盖率(α 通道)。三路的不透明像素占比不一样:vello_cpu 有 22.51% 的像素是半透明的,而 compute 只有 14.07%、hybrid 14.20%。也就是说 CPU 路线的抗锯齿边缘带更宽——这本身就意味着两边的边缘像素不可能逐个对上。
再看「色差 ≥32」的那些像素到底是谁的错:CPU 与 compute 之间,其中 93.8% 是只有 RGB 超阈、α 没超;CPU 与 hybrid 之间是 100% 只有 RGB 超阈。所以色差不是覆盖率不同造成的。
最有力的一组对比,是把像素按「双方是否完全不透明」切开:
- 三路都是完全不透明(α=255)的像素占 75.6%。在这些像素上,CPU 与 hybrid 的 RGB 最大差只有 2,≥8 的占 0.00%;CPU 与 compute 的最大差 38,≥8 的占 0.13%。
- 三路都是半透明的像素占 12.6%。在这些像素上,CPU 与 hybrid 的 RGB 平均差 10.1506,≥32 的占 9.61%;CPU 与 compute 的平均差 0.9879,≥32 的只占 0.11%。
按透明度分档看得更彻底(CPU 与 hybrid 的 RGB 平均差):α 小于 32 时 23.17;α 在 32 到 95 之间时 136.17;96 到 159 时 89.63;160 到 223 时 43.20;224 到 254 时 2.79;α=255 时 0.78。
翻译一下:在完全覆盖的区域,hybrid 与 CPU 几乎逐像素一致;差异全部集中在覆盖率不足的边缘像素上,而且覆盖率越低差得越多。 这与「抗锯齿的覆盖率估计方式不同」完全吻合——不同实现对外缘那几个采样点的处理,本来就不该期望逐位相同。
把这块区域放大来看。
8.3 放大看这些像素
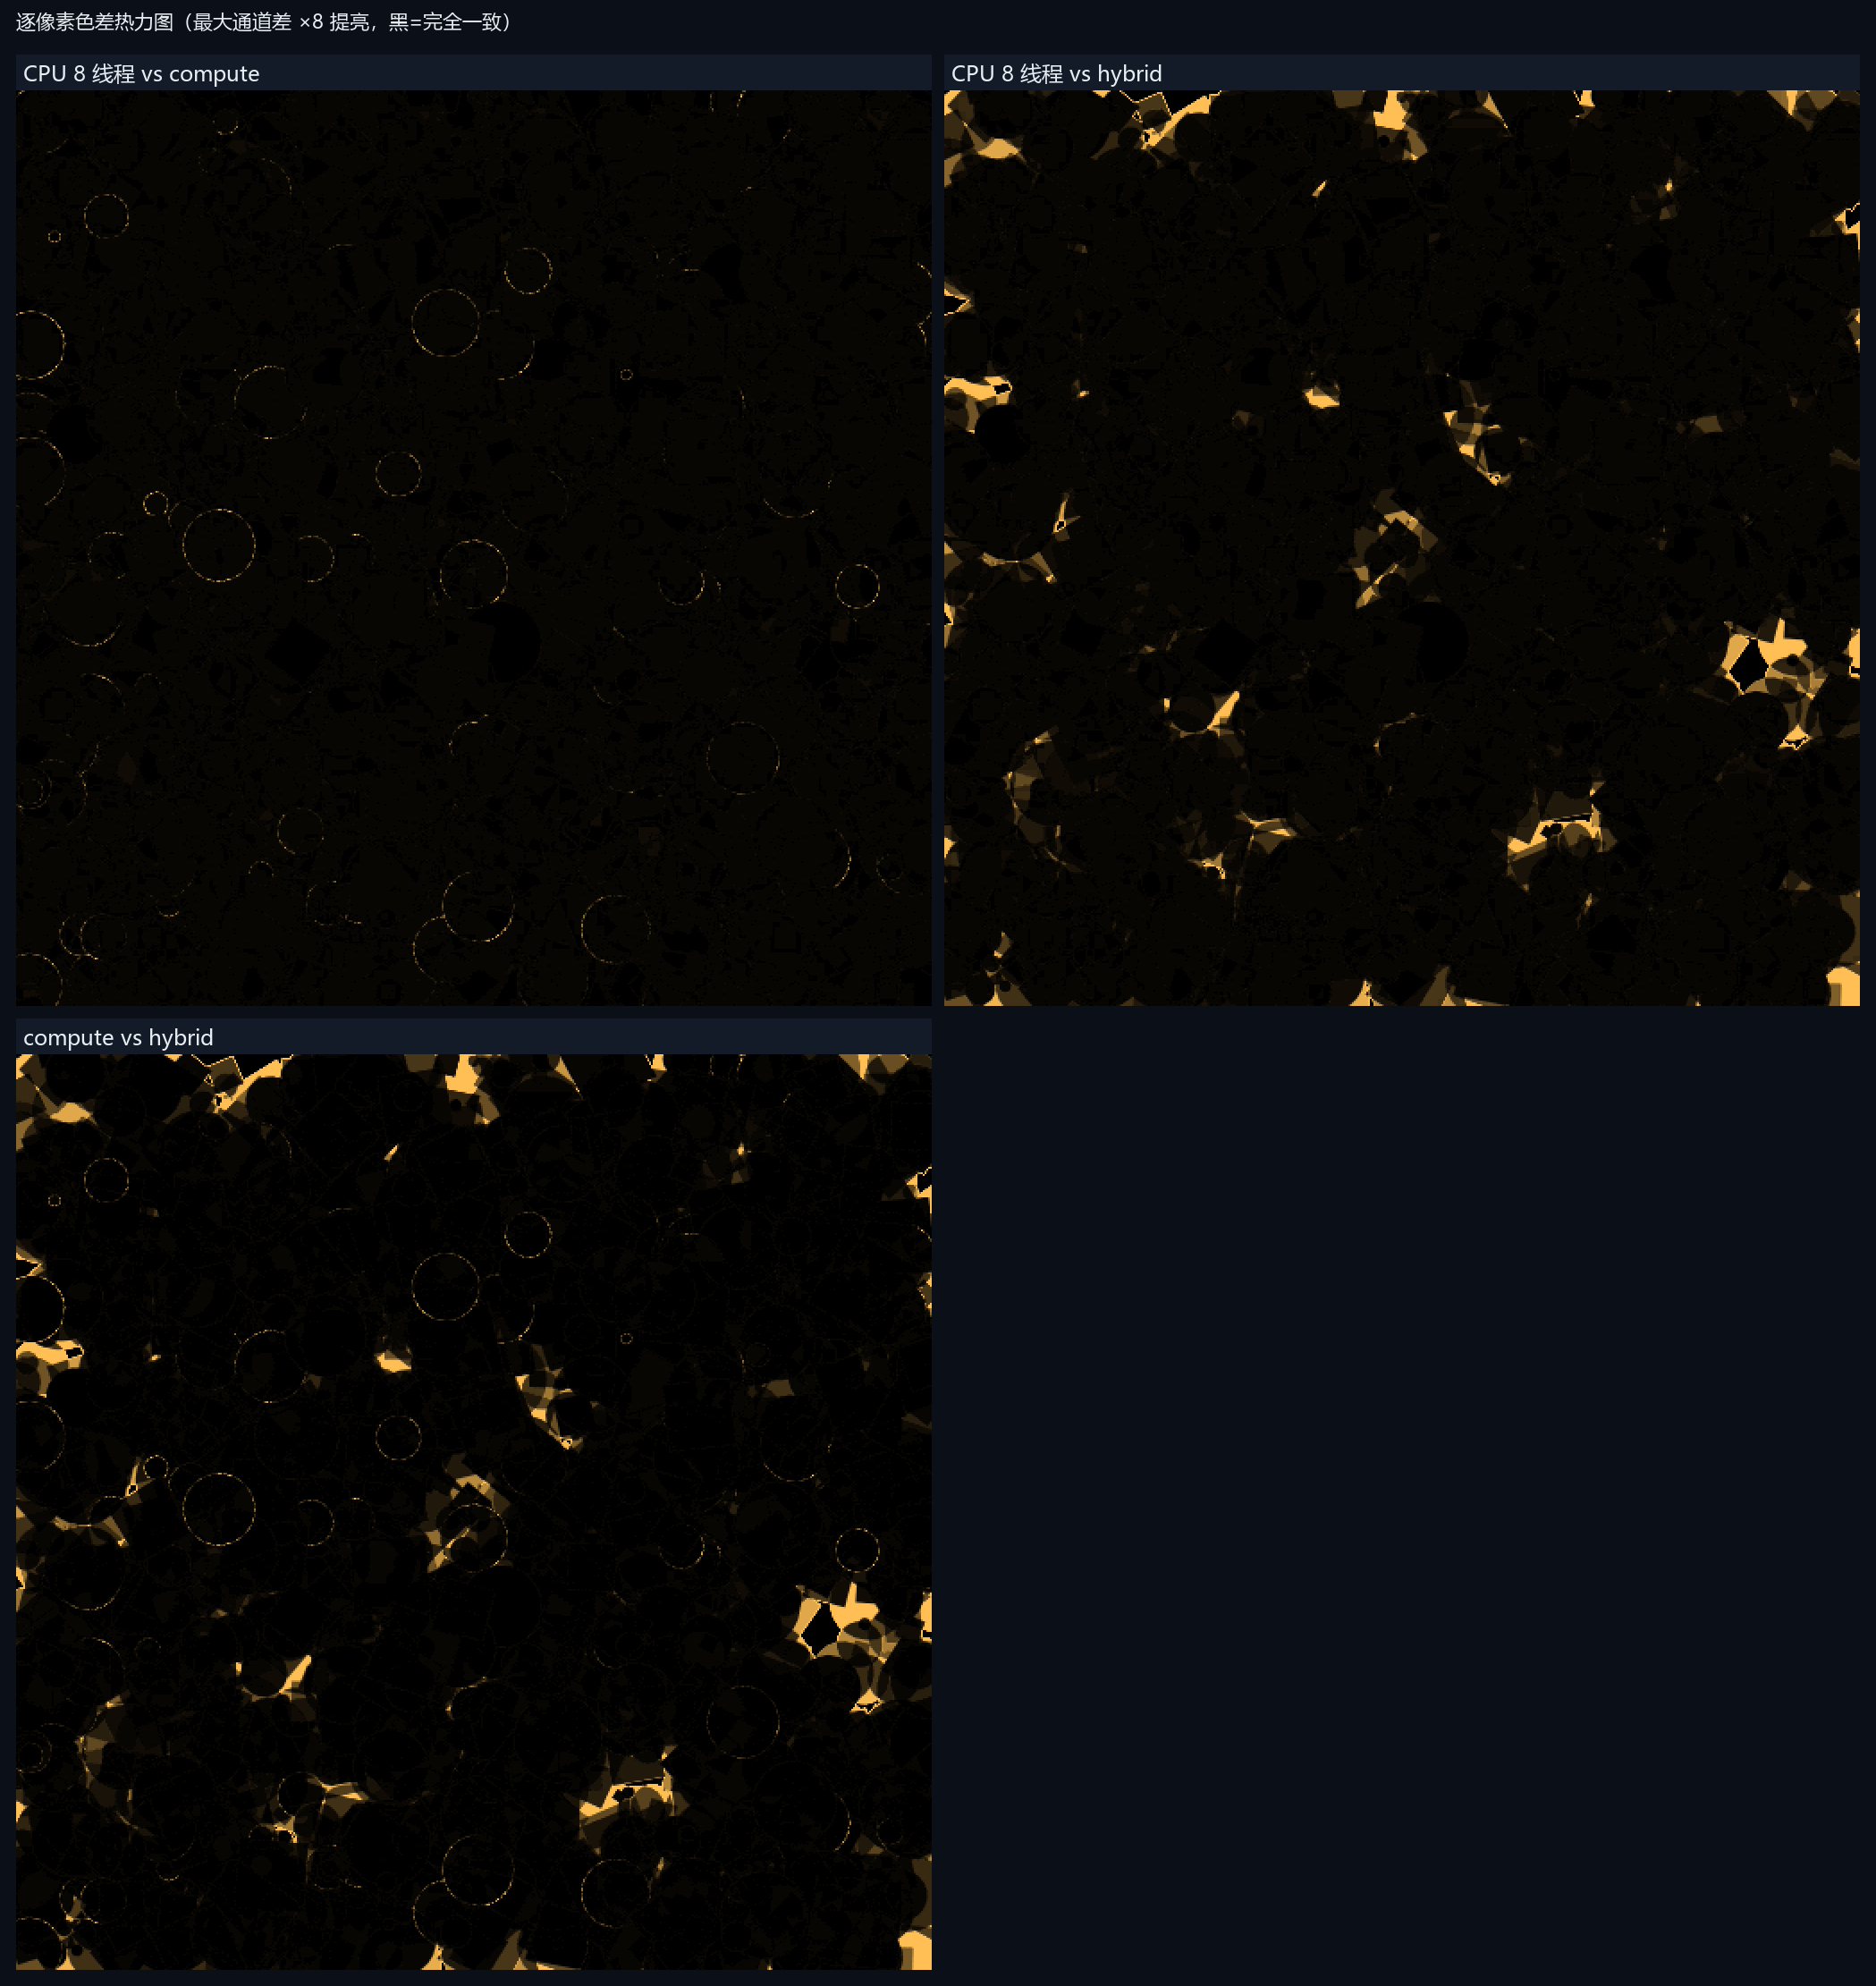
前两节的统计说了「差多少」,这一节要看「差在哪」。把三路的输出叠在一起,取色差最密集的区域放大,形态差别就出来了。
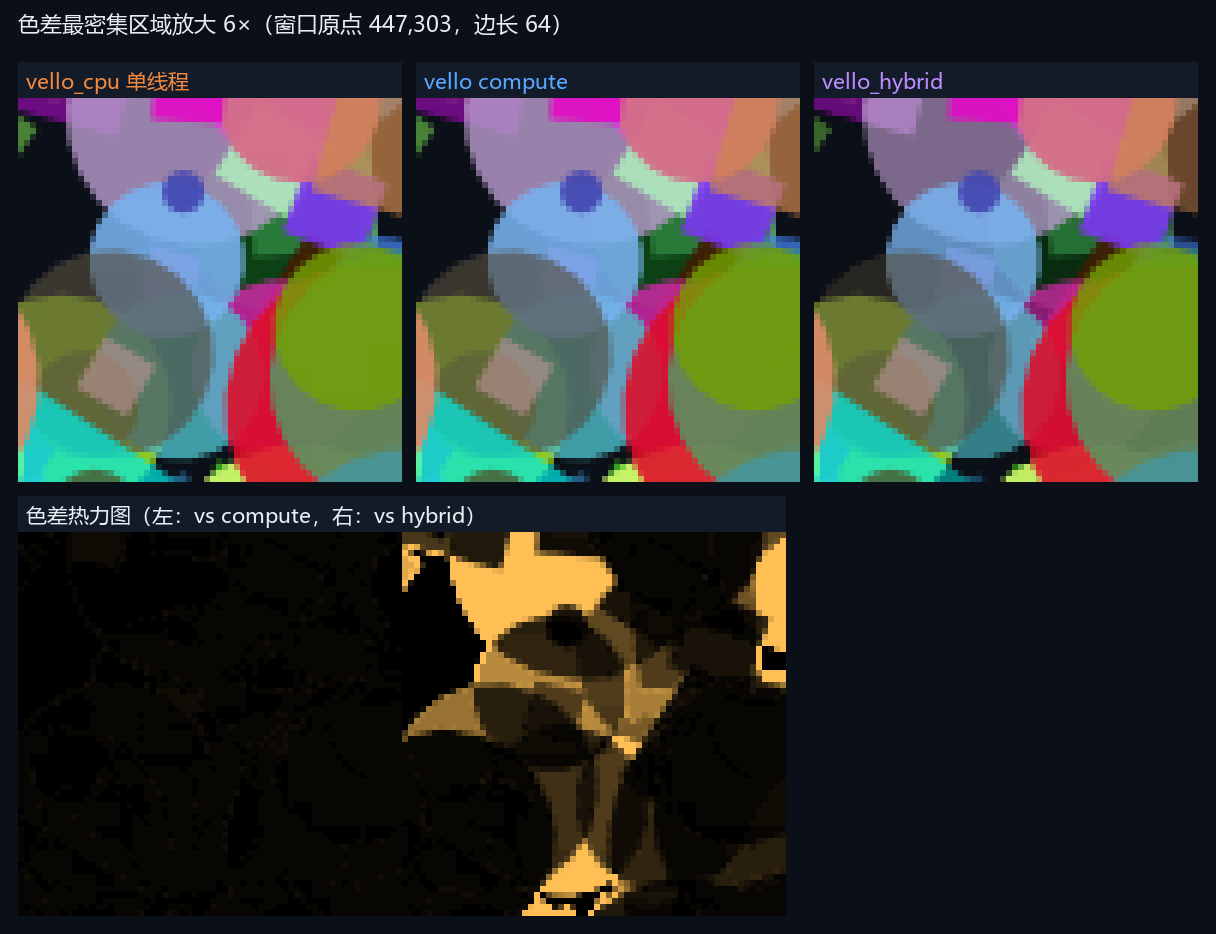
顺带把「差异是否集中在轮廓边缘」做了个定量。以「相邻像素亮度差 ≥12」定义边缘带,它占全图 12.0%。那么:
- CPU vs compute 的 ≥8 色差像素里,66.0% 落在边缘带——相对富集 5.5 倍。
- CPU vs hybrid 的 ≥8 色差像素里,只有 29.7% 落在边缘带——富集 2.5 倍,但七成落在平滑区域。
两条路线的差异形态确实不同:compute 与 CPU 的差别是「边缘抗锯齿的细节不同」,量级很小(≥8 只占 0.38%);hybrid 与 CPU 的差别则沿着轮廓铺成了带状(≥32 占 1.22%),量级更大。
差异形态之所以重要,是因为它指向不同的修法。compute 那一侧的差异是「边缘细节级别」的,通常改一个抗锯齿配置就能对齐;hybrid 那一侧是「轮廓带」级别的,要动的是覆盖率的生成与累积方式——这两件事在工程量上不是一个数量级。下面这张通用图就是这两侧差异的共同来源。
一句话概括这一节:同样是「画同一条边」,CPU 铺了 22.51% 的过渡像素,另两路只铺了约 14%,而这个差别在三路两两比对里都是最大的单一来源。
先看看这个数为什么容易被误读。
8.4 覆盖率分布差异怎么读
前面那条「CPU 的透明像素占 22.51%,另外两路只占 14.07% / 14.20%」是个容易被误读的数,值得单独交代一句。
先说它不是什么。它不是「CPU 画错了」——CPU 的半透明像素占比高,说明它的边缘带更宽,而更宽的边缘带意味着更保守的抗锯齿(在轮廓内外各覆盖若干像素做渐变),这在视觉上通常更平滑。反过来,compute 与 hybrid 的边缘带更窄,说明它们的覆盖率估计更「锐」。两种策略都在各自的设计取舍里,不是正确与错误。
再说它是什么。它是一个解释项:CPU 与另外两路在「任一通道有差」这一栏都超过 80%(80.47% / 82.25%),这个高比例的主要来源就是这 8.4 个百分点的半透明像素差异——CPU 认为半透明的那些像素,另外两路认为要么全透明、要么不透明,于是逐像素比就必然对不上。
再看它的实际后果。按前一节的分档数据,这些差异的幅度很小:α 在 224 到 254 之间的像素(也就是「接近全不透明」的那一档),CPU 与 hybrid 的 RGB 平均差只有 2.79;真正大的差异集中在 α 小于 96 的极低覆盖率像素上(平均差 89 到 136)。而这些像素在视觉上几乎是透明的——把它们合成到任何背景上,得到的颜色差别都很小。这就是为什么第四章那张四路并排图上,你看不出四条路线的区别。
一个可以拿来核对的量:把三路都判定为完全不透明的 75.6% 像素单独拿出来比,CPU 与 hybrid 的 RGB 最大差只有 2。占了画布四分之三的面积上,两条完全不同实现的渲染器给出了几乎逐位相同的结果。 剩下的四分之一里,差异也只在低覆盖率的边缘带上才达到肉眼可辨的量级。
8.5 一个好的意外
这里必须补一句官方原话,因为它和实测对上了。docs.rs 上 vello_hybrid 0.2.0 的文档写着:「Although it does not match Vello Classic's raw performance on dynamic and vector-heavy workloads, it provides excellent performance on workloads that benefit from GPU acceleration, such as images, gradients, and filters.」
「在动态与矢量密集的负载上不如 compute 版」——本篇的 8000 图元场景正是「矢量密集」,实测 hybrid 的合计是 compute 的 4.85 倍。官方对自家路线的定位描述,与本机实测在数量级上吻合。 这一条值得单独记下来:它不是「发现官方没说的事」,而是「实测验证了官方说的事」——在自跑篇里,后者同样是有价值的结论。
差异这一章说完,最后收边界与选型。
好了,最后收边界与选型。
九、边界声明与选型建议
9.1 本篇不涉及的
- 能效:本篇只测时间,不测功耗。公开数据里有「同帧率下 Vello 功耗约为 Impeller 的 12 倍」这样的第三方实测,说明能效是独立于时间的一条轴,本篇不涉及。
- 跨引擎对比:与 Skia、Graphite、resvg、CanvasKit 的对比不在本篇范围(Skia 侧见第五到第八篇)。
- 移动端与低端 GPU:本篇是 RTX 3060 Laptop + Vulkan 的单机读数,不外推到集显、移动 GPU 或软件光栅。
- 接入方式:Vello 在 Xilem / Bevy 等具体应用里的接入方式不在本篇范围。
- GPU 时间戳查询:本机探针用的是 CPU 侧
device.poll等待,不是 GPU 自身的时间戳查询。第七章那条「compute 单帧不可复现」的结论,是在这个测量方式下得出的;换用时间戳查询应当能拿到更干净的 GPU 内耗时,但那是另一套口径。
把这些读数压成一张表。
9.2 一张选型表
把这一篇的读数压成一张表,供选型时对照。前提固定在「512×512 到 2048²、100 到 8000 图元、单帧延时敏感」这个场景里。
| 场景 | 建议 | 依据 |
|---|---|---|
| 图元数 < 500 | 多线程 vello_cpu | 600–1800 图元上四路最快;100 图元时 0.352 ms,是 compute 的 37.8% |
| 图元数 500–1800 | 多线程 vello_cpu | 500 / 1000 / 1800 图元上均为四路最快 |
| 图元数 > 2000,且只要 GPU 兼容性 | vello_hybrid | 8000 图元合计 26.376 ms,是单线程 CPU 的 84.5%;不需要计算着色器 |
| 图元数 > 2000,且能保证有计算着色器 | compute | 8000 图元合计 5.327 ms,四路最快;但单帧延迟不可复现,需按区间规划 |
| 无 GPU 环境 | 多线程 vello_cpu | 唯一不依赖 GPU 的路线;8 worker 下 8000 图元构建加速 4.50 倍 |
| 需要确定性单帧延迟 | 避 compute | 1024²/2048² 上 5 轮内出现 3.8 与 26.6 毫秒两种模式 |
还有两条落在表外的实践经验:
第一,先把特性集写死再报数。 vello_cpu 的 multithreading 与 f32_pipeline 都不在默认集合里,num_threads = 0 是单线程。任何拿 vello_cpu 与 GPU 比性能的结论,都应该先声明这两项是怎么设的——否则比的是配置。
第二,报 GPU 路线的单帧耗时,要写明「有没有把系统活动控制住」。 本篇那个 ×2.30 的干扰实验说明,这个前提不写清,数字就没法复现。
把它变成三个能立刻照做的动作。
9.3 三个可以立刻照做的检查
这一篇的读数能变成三个动作,都是在没有专业工具的情况下就能做的。
第一个动作:跑之前先打印特性集与线程数。 vello_cpu 的默认特性集合里没有 multithreading,num_threads = 0 是单线程。在报告任何「CPU 与 GPU 对比」之前,把这两项打印出来。这一步的成本是两行代码,收益是避免一个数量级以上的误判——本篇第一版探针正是在这里错了:它报出「CPU 比 GPU 慢 6 倍」,而那个数字实际是「一个核的 CPU 比 GPU 慢 6 倍」。
第二个动作:把计时循环里的副作用全清掉。 写日志、存截图、打印进度、更新 UI,任何一件都会污染 GPU 路线的读数。本篇实测的代价是 2.30 倍。这一条不需要任何工具,只需要在自己代码里搜一遍「计时开始到计时结束之间还做了什么」。
第三个动作:报 GPU 的单帧耗时,一定同时报分布。 至少要给最小值、中位数、最大值三个数。本篇 compute 在 2048² 上的三个数分别是 3.82 / 6.76 / 26.65 毫秒——只报中位数会把「有三分之一的帧慢了四倍」这件事完全藏起来,而这对交互式应用是致命的。反过来,如果三个数挤在一起(像 hybrid 在 8000 图元上那样极差只有 5.1%),你就可以放心地把中位数当成代表值用。
这三个动作合起来,其实是在做同一件事:把「测的是什么」和「测到什么」之间的那层模糊去掉。这也是自跑篇相对于源码阅读篇的最大价值——源码不会骗你,但测量会。
9.4 边界回指
这一篇推翻的是第九篇的一句自述:「本机跑不了 Vello 本体」。现在能跑了,而且跑出来的东西推翻了我自己对它的两个想象——一是「GPU 一定更快」(小场景上不是),二是「实测总能给个准数」(compute 路线的单帧给不了)。
第九篇给的机制、这一篇给的读数,合起来才是 Vello 在 2026 年 9 月的完整样子。下一句要接的,是把这个坐标系铺开:Vello 只是 2D 矢量引擎里的一支,第十一篇会把它与 Godot 2D、Cairo、Rive 放在一起对照,并补上 Android 显示栈与 VFX 的交叉索引。
一句话收住这一篇:在 512×512 到 2048²、100 到 8000 图元这个范围内,决定性能的主要变量是图元数;三路的分水岭在 1800 到 2000 图元之间;而 compute 路线的单帧数字,必须先控制住被测路径之外的系统活动,才谈得上可信。
参考资料
- Vello 仓库 README(v0.10.0 与 main 两版)— https://github.com/linebender/vello/blob/v0.10.0/README.md | https://github.com/linebender/vello/blob/main/README.md
- Vello 官方架构文档 ARCHITECTURE.md — https://github.com/linebender/vello/blob/main/ARCHITECTURE.md
- vello_gpu(原 vello_hybrid)README — https://github.com/linebender/vello/blob/main/vello_gpu/README.md
- vello_cpu README 与特性说明 — https://github.com/linebender/vello/blob/main/vello_cpu/README.md | https://docs.rs/crate/vello_cpu/0.2.0/features
- RenderMode 语义与默认值 — https://docs.rs/vello_cpu/0.2.0/vello_cpu/enum.RenderMode.html
- vello_hybrid 0.2.0 文档(性能定位原话)— https://docs.rs/vello_hybrid/0.2.0/vello_hybrid/
- crates.io 版本页 — https://crates.io/crates/vello/0.10.0 | https://crates.io/crates/vello_cpu/0.2.0 | https://crates.io/crates/vello_hybrid/0.2.0 | https://crates.io/crates/vello_gpu/0.1.0
- Vello CHANGELOG(vello / vello_cpu / vello_gpu)— https://github.com/linebender/vello/blob/v0.10.0/CHANGELOG.md | https://github.com/linebender/vello/blob/main/vello_cpu/CHANGELOG.md
- linebender/vello issue #1380(Hybrid 慢于 CPU 的场外实测)— https://github.com/linebender/vello/issues/1380
- linebender/vello PR #1584(维护者对 hybrid CPU 侧开销的说明)— https://github.com/linebender/vello/pull/1584
- Vello CPU 官方 benchmark 图表 — https://laurenzv.github.io/vello_chart/
- Sparse Strips 硕士论文(Laurenz Stampfl, 2025)— https://ethz.ch/content/dam/ethz/special-interest/infk/inst-pls/plf-dam/documents/StudentProjects/MasterTheses/2025-Laurenz-Thesis.pdf
- Linebender 月报 tmil-19 / tmil-22 / tmil-25 — https://linebender.org/blog/tmil-19/ | https://linebender.org/blog/tmil-22/ | https://linebender.org/blog/tmil-25/
- Trueno GPU backend 固定开销分解 — https://paiml.github.io/trueno/architecture/gpu-backend.html
- NVIDIA TensorRT 性能测量环境(阻塞同步与时钟变频)— https://docs.nvidia.com/deeplearning/tensorrt/10.x.x/performance/hw-sw-environment.html
- NVIDIA Peak-Performance-Percentage 方法学(fence 等待受调度影响)— https://developer.nvidia.com/blog/the-peak-performance-analysis-method-for-optimizing-any-gpu-workload/
- LearnWebGPU 时间戳查询 — https://eliemichel.github.io/LearnWebGPU/advanced-techniques/benchmarking/time.html
- Avalonia × Flutter Impeller 公告(Vello 功耗第三方实测)— https://avaloniaui.net/blog/avalonia-partners-with-google-s-flutter-t-eam-to-bring-impeller-rendering-to-net/
- 素材来源:Wikimedia Commons 五张外部示意图(见各图图注署名与许可)
- 本机探针源码与原始日志:
E:\rust\vello-probe\(九次运行的probe.log、analysis.json、图表生成脚本)
本篇配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机真跑的读数图由本篇探针产出(图注写明口径); 自绘图为本系列绘制,走
styles/qianmo/palette.json色板单源。站点链接:技术博客页
下篇预告:第十一篇把坐标系铺开——Vello 只是 2D 矢量引擎里的一支,下一篇把它与 Godot 2D、Cairo、Rive 放在一起对照,并补上 Android 显示栈与 VFX 的交叉索引。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.