站点链接:技术博客页 | 公众号:溯光的图形笔记

Godot 4.6.png(CC0,Godot Engine 贡献者)入口:为什么从「一次 2D 绘制」切进去
0.1 分层标签解决不了的问题
这一节要回答的是:把引擎分成四层之后,为什么还必须追一次具体的绘制。
官方 Godot's architecture overview 把引擎拆成 Scene layer、Server layer 与 Drivers & Platform interface 三块,另外把 Core 与 Main 并列出来,于是通常说的「四层」就有了骨架。Core 提供 Object 基类、ClassDB、RID 与各类容器,被上面所有层依赖;Scene layer 是 Node、SceneTree、CanvasItem、Viewport 这一组;Server layer 是 RenderingServer 门面(facade)往下的一串实现;Drivers & Platform interface 是 drivers/vulkan、drivers/d3d12、drivers/metal、drivers/gles3 这些真正与图形 API 说话的代码。四层标签给的是一张地图,地图不等于路。真正的问题是:按下 queue_redraw 之后,那一串命令在这四层里各自被谁碰过。分层名词谁都能背,落点必须一层层指出来,指不出来就还是标签。
本系列要划的边界,正好也摆在这里。矢量光栅那一类专题回答的是「一段贝塞尔曲线怎么被算成像素」。渲染 API 那一类专题回答的是「Vulkan 或 D3D12 的接口按什么语义执行」。GPU 硬件微架构那一类回答的是「流处理器、缓存与显存带宽怎么组织」。系统合成那一类回答的是「窗口系统怎么把最终画面送进显示链路」。本系列只回答中间那一段:引擎内部怎么把一次绘制组织起来,交给驱动,再由驱动交给硬件。四类相邻问题各有专门篇目,这里不越界。
OK,本系列十一篇的目录可以按四层摊开:零与一给全景与三件事的计数口径;二到四是 Scene 层与服务层这条命令链怎么走;五与六是抽象层与命令录制;七讲 2D 与 3D 为什么分家;八讲版本转折怎么读;九收口并给出后十篇的映射表。全系列只拆这一条链上的层,本篇把链先走通。
把这张边界图读给读者听:横向四栏,左边一栏是矢量光栅,右边三栏依次是渲染 API、GPU 硬件微架构、系统合成,中间那条竖线就是本篇的题域。矢量光栅的输出是一张像素图,渲染 API 的输入是一串绘制命令,GPU 微架构的输入已经是机器指令,系统合成接的是已经上屏的缓冲。本篇要讲的那串命令,正好落在「像素图」与「绘制命令」之间那一段缝里。
为什么挑一次 2D 绘制当主线,而不是挑一次 3D 绘制或一次资源加载。理由是 2D 这条路的层数最少、旁支最少:它不牵出阴影与后处理,命令从场景层(scene layer)到驱动层的每一跳都能落到一个具体函数上。把 2D 走通,等于先把四层的接口形状认全,后面每一篇再往自己那一层加深。
0.2 四层与 Main 的位置
这一节要回答:这四层之间谁依赖谁,Main 又插在哪一处。
依赖关系可以用一句话概括:Core 被所有层依赖,Main 与所有层交互。Core 在最底下,谁都可以往下拿;Main 不在层内部,它是一条主循环,每一帧把 Scene layer、Server layer 与 Drivers 各推一把。这条关系解释了两件事:为什么 Object 与 RID 几乎在每个文件里都能见到,也为什么改一次主循环的节奏就能影响全局。
OK,读图:Core 画成底座,Scene、Server、Drivers 三层叠在底座上,箭头从每一层指向底座;Main 画成一条竖直的循环,箭头与三层双向相连。看图就能明白,Main 不出现在任何一层的内部,却是每帧驱动三层的那只手。后面要讲的 Main::iteration() 与 RenderingServer::sync(),都落在这条线上。
Core 里值得点名的几样东西后面都会反复出现:Object 是可脚本化类型的根,ClassDB 管注册与反射,RID 是跨系统句柄,容器与数学库供所有层取用。Main 画在旁边,因为它既不属于场景也不属于服务,它只拥有时间:每一帧轮到谁、跑多久、何时把命令交出去,都由这条循环说了算。
0.3 三层证据与本篇的版本口径
OK,这一节要交代两件事:证据分成几层,版本怎么标。
三层证据分开陈述是硬规矩。第一层是官方文档,落在 docs.godotengine.org 与 godot-docs 仓库,回答的是官方想让引擎怎么工作。第二层是官方源码原文,落在 godot 仓库的 master 分支,回答的是代码实际上怎么组织。第三层是本机实测,落在 evidence/ 里的三份启动日志,回答的是这台机器上实际跑了什么。凡读数都注明口径与来源,凡论断都要能在正文里指出落点。
版本口径有两版并存,别写混。官方稳定版是 4.7.2(2026-08-18),开发版是 4.8-dev7(2026-09-29)。本机实测用的是 4.8.dev.custom_build.7177493c1(2026-07-03 构建),它不是官方 stable,正文引用本机读数时会写明版本与「自定义构建」字样。本机另装 4.5.stable.official.876b29033 可作版本对照,它是非 console 构建,stdout 不落管道,本次没有拿到它的日志。源码行号一律按 master 快照(2026-10-08)读,文档里的源码链接部分仍指向 4.2 分支,正文不照抄那些链接。
OK,这张对照把三层证据并排:第一栏官方文档给设计意图,第二栏源码原文给代码组织,第三栏本机日志给这台机器上的实况。三栏的强弱不一样,官方文档适合讲「为什么这样设计」,源码原文适合讲「代码放在哪一行」,本机日志适合讲「拨到哪个驱动时谁被选中」。三栏混成一句就会出问题,本篇把它们分开摆。
三层证据的强弱不同,用法也跟着变。官方文档给得出「设计意图」与「命名约定」,对实现细节常常只给概述,且链接有时滞后。源码原文给得出确切行号与确切写法,它不解释为什么这样写。本机日志给得出这台机器上的实况,它只是一个样本。本系列的分工是:机制用源码原文,意图用官方文档,实况用本机日志。
源码落点:分层口径见官方 Godot 引擎架构总览,渲染内部结构见 Internal rendering architecture,版本与许可见 下载归档。其中: 前者给出 Scene、Server、Drivers 三层与 Core、Main 并列的关系,后者给出渲染侧的类名与流程命名,两者都属官方文档口径;源码落点从下一节开始逐条给出。
一、先说清三件事:三种渲染方法、四种驱动、七种组合
这一章要把三个最容易被搅混的名词钉住:渲染方法是几档、驱动有几种、两者能配出多少种组合。它们之所以值得先讲,是因为后面每一次「同一份工程在不同机器上表现不一样」的疑问,答案多半就落在这一章里。
1.1 三种渲染方法与四种驱动的可用组合
这一节要回答:同一份工程为什么在不同机器上会跑在不同的渲染方法上。
先把两组名词分开。渲染方法(rendering method)是引擎给项目选的工作模式,官方 renderers.html 的原句是 “Godot 4 includes three renderers”,一共三种:Forward+、Mobile 与 Compatibility。驱动(driver)是与图形 API 对接的那一层,一共四种:Vulkan、Direct3D 12、Metal 与 OpenGL。可用组合是七种,因为 OpenGL 只能配 Compatibility,其余三种驱动可以配 Forward+ 与 Mobile。
OK,三种方法的差别落在特性与目标平台上。Forward+ 面向桌面,特性最全,聚簇光照走计算着色器(compute shader);Mobile 面向移动端,特性较少,简单场景更快,采用纯光栅着色,没有 SDFGI 与体积雾;Compatibility 特性最少,是唯一使用 OpenGL 驱动的方法,也是 Web 与旧设备的首选。四种驱动的差别落在成熟度与平台上:Vulkan 是主驱动,开发重点在此,基线是 Vulkan 1.0,可选 1.1 与 1.2,用 volk 加载并用 VMA 管内存;Direct3D 12 是实验性的,4.3 起引入,与 Vulkan 共享 core shaders,经 SPIR-V 转 DXIL;Metal 也是实验性的,4.4 起引入,4.7 起在支持的设备上使用 Metal 4;OpenGL 覆盖 ES 3.0、桌面 3.3 Core 与 WebGL 2.0。
读矩阵:三行是渲染方法,四列是驱动,一共十二格里只有七格打得开。OpenGL 那一列只在 Compatibility 行留了一个入口,其余三列在 Forward+ 与 Mobile 两行各留一个入口。矩阵里空着的五格就是官方没有提供的组合,工程里一旦选了 Compatibility,驱动就被钉死在 OpenGL 上。这一章后面的本机读数,正是把这七格里的三格按出来看。
七种组合这个数字容易被记成「三加四」,真正值得记的是它背后的约束:RenderingDevice 不覆盖 OpenGL,于是 OpenGL 只能落在 Compatibility 那一格。这条约束把四种驱动劈成两组,一组三种走抽象层,一组一种直连驱动。后面遇到「为什么某个特性在某些后端没有」,先回这条分组找答案。
1.2 官方渲染分层图:谁跑在 RenderingDevice 上
这一节要回答:三种方法与驱动之间隔着的那个抽象层到底是什么。
官方的渲染分层图把这条缝画得很清楚:Compatibility 直接跑在 OpenGL 驱动上,Forward+ 与 Mobile 跑在 RenderingDevice 上。RenderingDevice 是官方为降低现代低层 API 复杂度而自建的抽象,写现代渲染代码时不直接调 Vulkan、D3D12 或 Metal;官方的定位是它不像 Vulkan 与 D3D12 那么细粒度,也不像 OpenGL 那么「有状态」,抽象层级接近 Metal 与 WebGPU。这套抽象不适用于 OpenGL 驱动,这正是 Compatibility 走另一条路的根由,也是后面那条本机读数被自动标成 Compatibility 的原因。
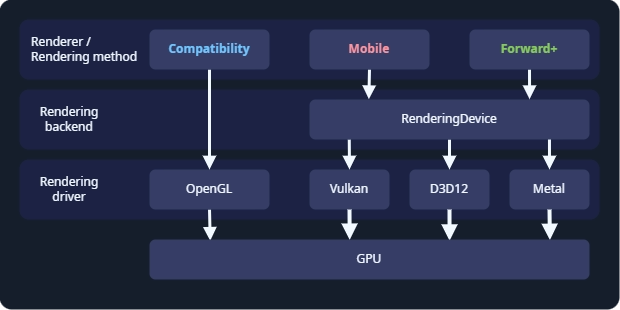
好了,读图:上层是三种渲染方法,中间只有 Forward+ 与 Mobile 经过 RenderingDevice 这一格,Compatibility 从旁边直接连到 OpenGL 驱动。这张图解释了为什么 OpenGL 那条路上看不到 RenderingDevice 的身影,也解释了 Compatibility 为什么迟迟拿不到一些只在 RenderingDevice 上实现的能力。四种驱动里有三种经过同一层抽象,一种不走,这条分叉会一路影响到后面的批次与命令录制。
再看抽象层级这条线。官方把 RenderingDevice 描述成接近 Metal 与 WebGPU:它比 Vulkan 与 D3D12 粗,比 OpenGL 细。这条线画在哪里,决定了引擎能在多后端之上复用多少渲染代码。走同一层抽象的两个方法可以共享大部分实现,直连驱动的那一个只能另起一套。
1.3 本机三后端启动识别行
这一节要回答:把驱动开关逐个拨过去,本机读到什么。
本机实测的命令是 godot.windows.editor.x86_64.console.exe --path <最小工程> --rendering-driver <d> --quit --verbose,同一二进制、同一台机器、只改 --rendering-driver 一个量。三行识别行分别是:Vulkan 那一行读到 Vulkan 1.3.280 - Forward+ - Using Device #0: NVIDIA - NVIDIA GeForce RTX 3060 Laptop GPU;D3D12 那一行读到 D3D12 12_0 - Forward+ - Using Device #0: NVIDIA - NVIDIA GeForce RTX 3060 Laptop GPU;OpenGL 那一行读到 OpenGL API 3.3.0 NVIDIA 560.70 - Compatibility - Using Device: NVIDIA - NVIDIA GeForce RTX 3060 Laptop GPU。三行中段那个字段,就是引擎最终选中的渲染方法。
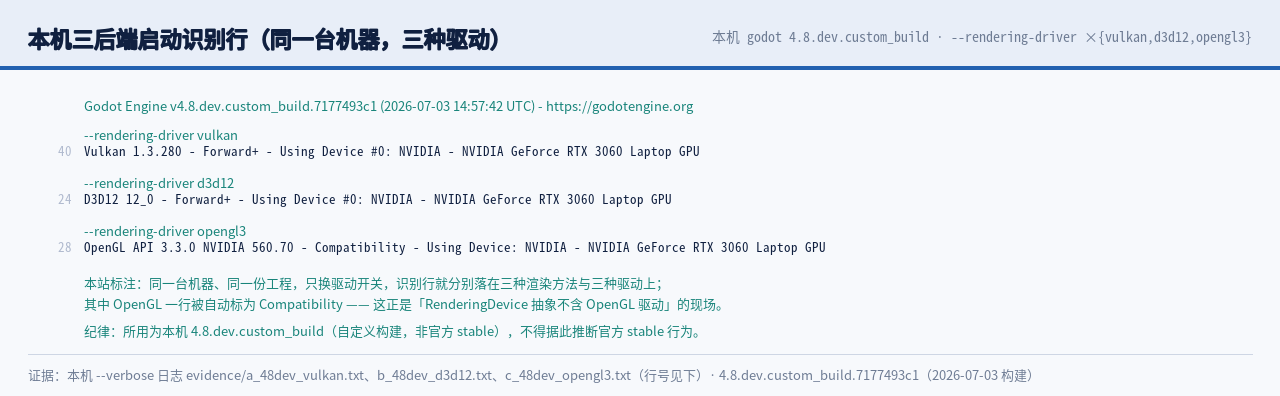
读这三行:前两行的中段字段都是 Forward+,第三行的中段字段是 Compatibility。三条读数来自同一份二进制(4.8.dev.custom_build.7177493c1),换的只是驱动开关,于是「三种方法乘四种驱动等于七种组合」这句话在本机被直接演了一遍。D3D12 那一行还附带报出 Shader model: 6.6、D3D12 Variable Rate Shading supported 与 D3D12: Device supports GPU UPLOAD heap.;OpenGL 那一行附带 NVAPI: Init OK! 与一个 CanvasSdfShaderGLES3 的 SHA256,后者说明 2D 的 SDF 光照在 OpenGL 路径上确实启用了。必须写明:这是自定义构建上的读数,不代表官方 stable 版本的行为。
好了,三行读数还有一个共同点:它们都在同一份启动日志里以固定格式出现,字段顺序是「API 与版本、选中的渲染方法、使用的设备」。这种固定格式本身就是可复核性,谁都能用同一份二进制、同一条命令,在各自的机器上读出同样的三段。本机这三行属单机样本,注明版本与构建来源后可作对照。
1.4 回退链,与本机的设备与版本口径
这一节要回答:驱动不可用时引擎退到哪里,以及本机这批读数是在什么设备与版本上得到的。
回退链从 4.4 起生效。在 Forward+ 与 Mobile 下,Vulkan 不可用就回退 Direct3D 12,两者互相回退;两个都不行,再退到 Compatibility。这条链有一个开关,在项目设置的 Rendering > Rendering Device > Fallback to OpenGL 3,关掉它引擎就停在失败上,不再往下退。回退只发生在启动阶段,一旦选中某个后端,运行期不会中途切换,这一点让「这一帧用谁」的问题退化成「这一次启动用谁」的问题。
读这条链:Vulkan 与 D3D12 是一对双向箭头,指向同一条备用出口;两个都断了,箭头才转向 Compatibility。链的末端是 OpenGL,也就是 Compatibility 唯一能站的那一列。把这条链与 1.1 的组合矩阵叠起来看,七种组合里真正会在启动时被自动挑中的,只是其中一小段。
本机的设备与版本一并交代,后面每一处读数都回到这张面板。机器是 RTX 3060 Laptop GPU,驱动 560.70;WorkerThreadPool 报 16 threads、4 max low-priority。版本方面,4.8.dev.custom_build.7177493c1 与 4.5.stable.official.876b29033 两版并存,本次三后端读数全部来自前者。设备列表里 #0 NVIDIA … Supported, Discrete 说明选中的是独显。这里只做单机陈述,不跨机器比,也不给绝对性能承诺。
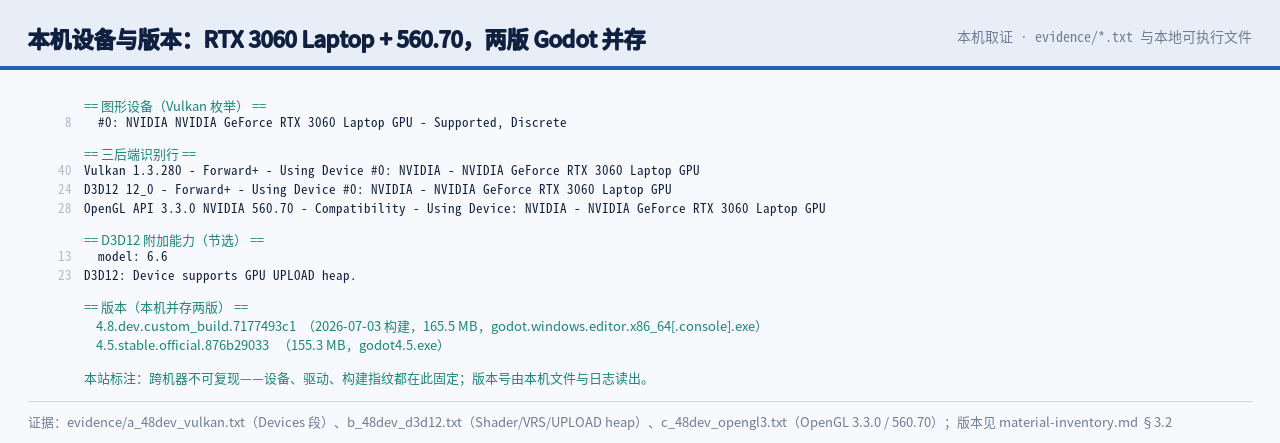
好了,读面板:设备一栏是 RTX 3060 Laptop GPU,驱动一栏是 560.70,线程一栏是 16。版本一栏两支并存,前者是本次取证用的自定义构建,后者是官方 stable 对照;后者的非 console 构建让 stdout 不落管道,日志为 0 字节,这一点在 evidence/d_45stable_vulkan.txt 里能直接看到。正因为这一处日志为空,本篇的版本对照只用于说明「两版并存」这个事实,不用于取行为读数。
把回退链与本机读数接起来看,会看到一个值得记的顺序:引擎先试请求的驱动,再试成对的备用驱动,最后才落到 Compatibility。这解释了为什么同时支持 Vulkan 与 D3D12 的机器,请求 Vulkan 时不会跑到 D3D12 上;也解释了驱动缺失时用户看到的未必是报错,而是一个被悄悄换上的能跑的后端。回退是启动期的一次性决策,运行期不重选。
源码落点:渲染方法的口径见官方 渲染方法(4.4),回退链与 2D/3D 分家的口径见 Internal rendering architecture,版本对照见 下载归档。其中: renderers.html 给出三种方法与四种驱动的对应关系,internal rendering architecture 给出回退链与 RenderingDevice 的适用边界,两者都属官方文档口径;三后端识别行与设备面板属本机口径,两类在正文里不混写。
二、Scene 层:按一下 queue_redraw 之后发生了什么
这一章把镜头压到场景层,只追一个动作:按下 queue_redraw 的那一刻到帧末之间,命令走了哪几步。场景层是四层里唯一由用户代码直接触碰的一层,也最容易被人想当然。
2.1 Object 到 CanvasItem 的继承,与两层分工
这一节要回答:场景层里发起重绘的是谁,命令又交给谁执行。
场景层的根是 Object,往上是 Node,再往上才是 CanvasItem。CanvasItem 是所有 2D 可绘制对象的基类,Node 提供进入场景树的能力,Object 提供 ClassDB 注册与信号机制。这条继承线决定了 2D 绘制的最小单位是什么:一个进了场景树、又派生自 CanvasItem 的对象。分工上,场景层发命令,服务层执行命令;场景层只描述「画什么」,服务层决定「什么时候画、怎么画、画在谁上面」。
说白了,读图:继承线从 Object 到 Node 到 CanvasItem 单线向下;旁边一条横线把场景层与服务层(server layer)分开,CanvasItem 把命令递给服务层,服务层回一个 RID。图里没有出现任何绘制细节,因为细节全在服务层那一侧,场景层这一侧只有一个「发起者」的身份。把这条边界记住,后面 queue_redraw 的语义就不会被读成「立刻画」。
继承线还有一个副作用:因为 CanvasItem 同时具备进场景树与可绘制两种能力,2D 绘制的最小单位天然带上层级关系。一个 CanvasItem 可以有父有子,它的变换会叠加到子节点上。服务层遍历时见到的是一棵带变换的树,不是一张扁平列表。这条性质决定了后面剔除层(culling layer)必须按树走。
2.2 queue_redraw 的真实语义
这一节要回答:调用 queue_redraw 的那一刻,绘制到底有没有发生。
答案是没有。queue_redraw 做的是两件事:把当前项标成「脏」,以及排一个延迟回调。绘制发生在帧末,发生在那个延迟回调被调度的时候,不发生在你调用它的那一行。这条语义有个直观后果:在同一个函数里连续调十次 queue_redraw,帧末只重绘一次;在一帧之内改了十次绘制内容,读者看到的也是最后一次提交的结果。
读这条时序:左边是调用点,queue_redraw 只打一个脏标记,排一个 call_deferred;中间是消息队列,回调被压进去等着;右边是帧末,回调被执行,绘制才真正派发出去。三点一线,绘制的位置在右端,不在左端。这条时序是理解后面两处源码原文的前提,也是「为什么改完属性不用手动重绘」这类常见疑问的答案。
说白了,延迟回调这套做法在实时程序里很常见,好处是同一帧里的多次修改会被合并。代价是调用点与生效点在时间上分开了,读代码时容易误判因果。判断某个改动会不会立刻反映到画面,只须问一句:它有没有绕开那条延迟回调直接提交。绝大多数绘制相关的改动都绕不开。
2.3 两处源码原文:排程与派发
这一节要回答:上面那条时序在源码里落在哪几行。
第一处是排程。scene/main/canvas_item.cpp 第 541 行是 CanvasItem::queue_redraw(),第 552 行用 callable_mp(this, &CanvasItem::_redraw_callback).call_deferred() 把回调排进延迟队列。这两行合起来就是「标脏加延迟」的机器可读写法。第二处是派发。同文件第 144 行是 _redraw_callback(),第 173 行调用 notification(NOTIFICATION_DRAW)。旧资料里常见的 _update_callback 这个名字在现 master 已不存在,现行名字是 _redraw_callback,写错就是硬错。
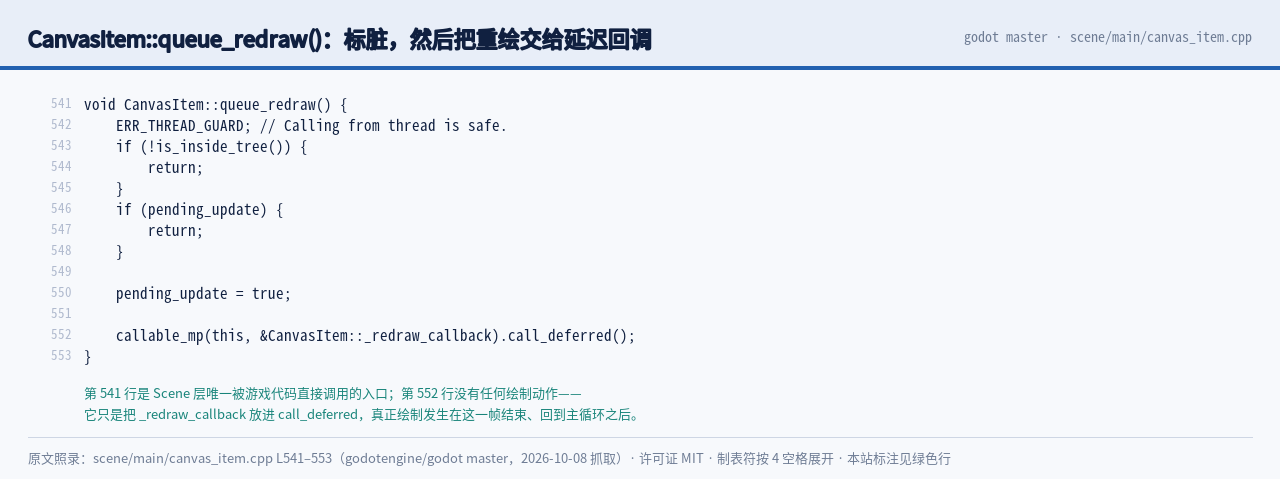
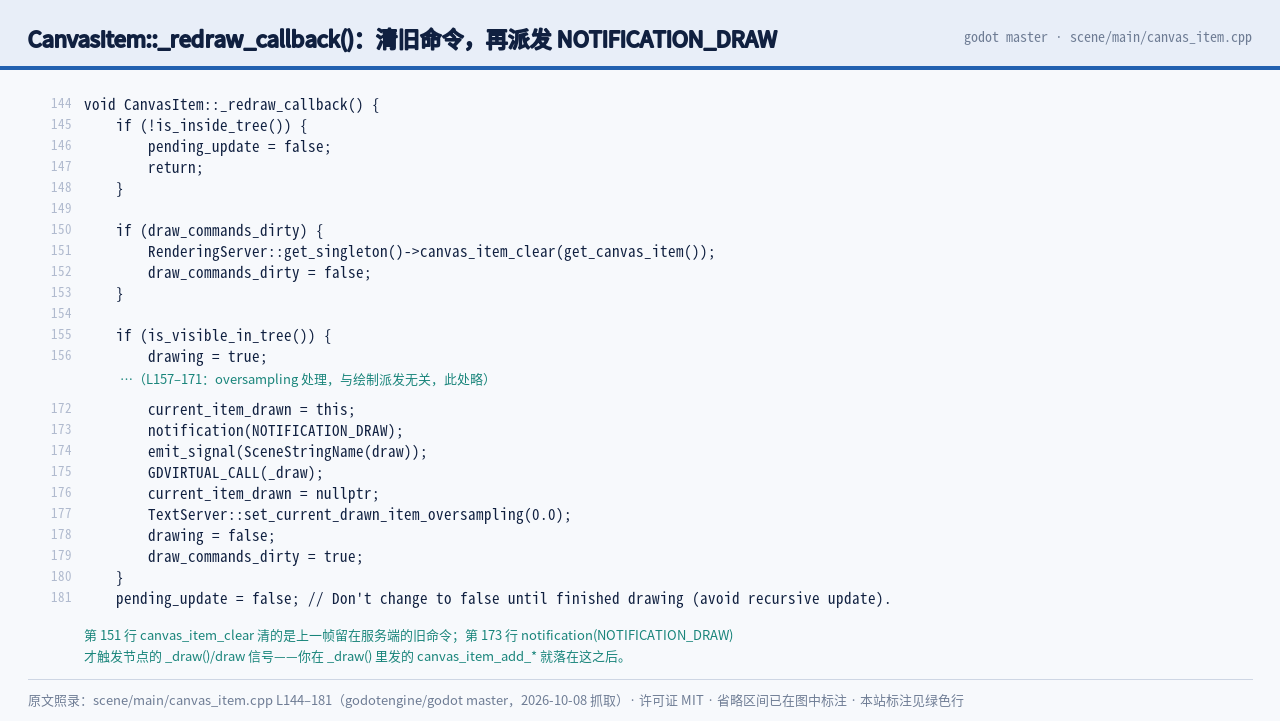
读这两处原文:541 与 552 行是一对,说明调用点只负责排程;144 与 173 行是一对,说明回调里先清掉旧的绘制命令,再把 NOTIFICATION_DRAW 派发出去。清旧命令这一步很关键,它保证每一帧重新提交的是当帧的完整命令集,不把上一帧的命令累加进去。NOTIFICATION_DRAW 一旦到达用户脚本的 _draw(),脚本里那一串 draw_* 调用才被写进服务层,也就到了下一章的门口。
两处原文合起来还说明一件事:命令的提交时机由引擎掌握,用户脚本只负责描述当帧的画法。用户在 _draw() 里写的每一条 draw_*,都是在清空之后重写一遍,引擎不假设上一帧的命令还能用。这条设计让状态管理变简单,也让每一帧的命令集合天然完整。行号与名称都以 master 快照为准。
2.4 编辑器里的场景树实拍
这一节要回答:编辑器面板上看到的那棵树,与服务端遍历的那棵树是什么关系。
说白了,关系是同一棵。编辑器里的场景树面板显示的节点层级,就是运行时服务端每帧要遍历的那棵树;检查器面板显示的属性,就是这些节点上被读写的字段。面板出自同一份数据,它是同一份数据的一个视图,不是另一份副本。这条对应关系让「编辑器里看到的树」可以直接当证据用。
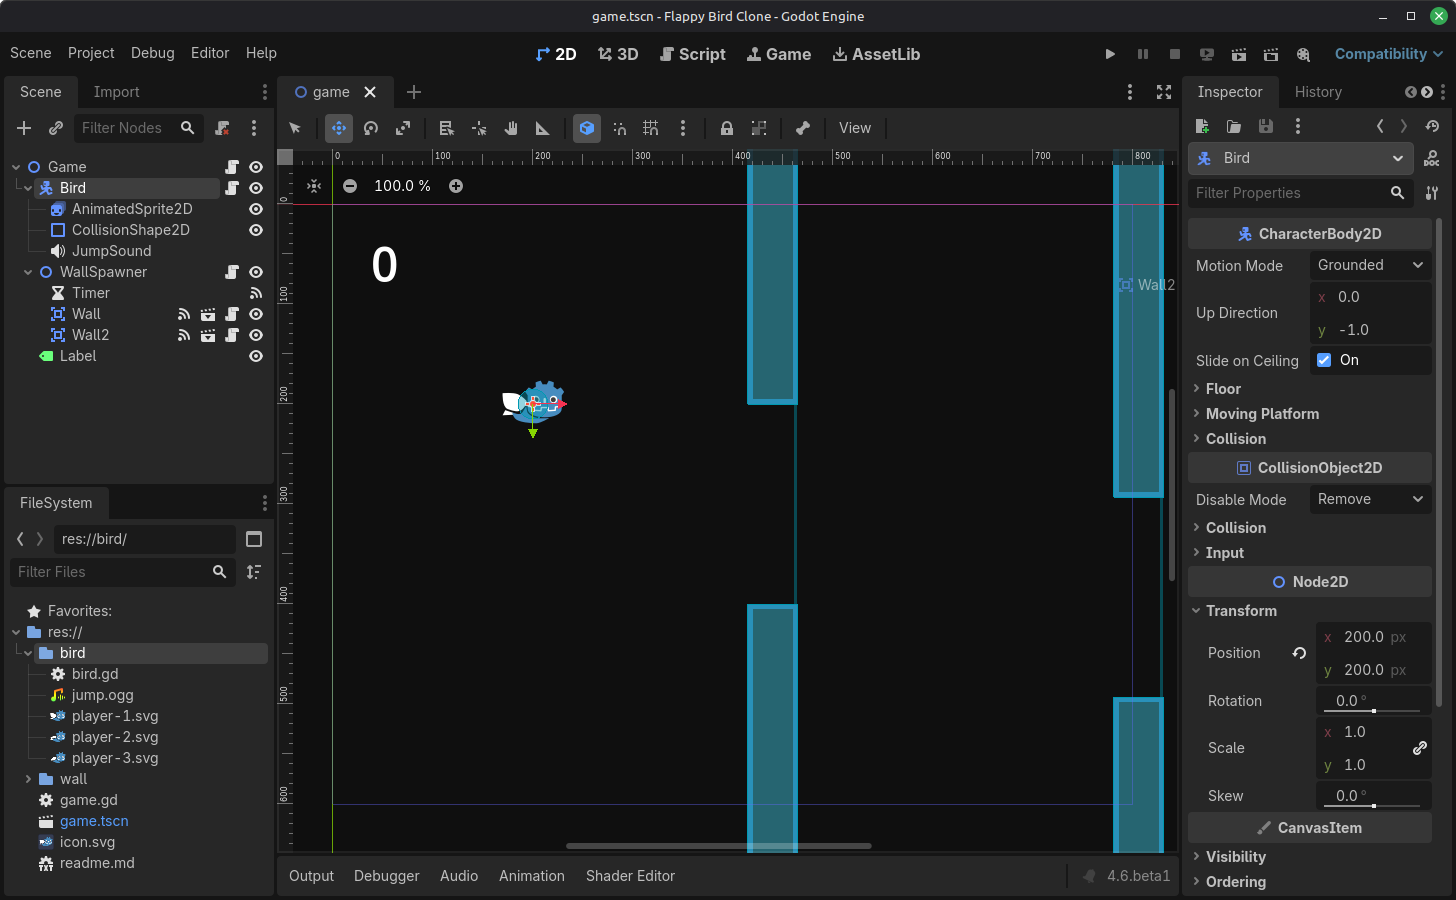
读这张实拍:左栏是场景树,节点按父子缩进;右栏是检查器,列着选中节点的属性。把左栏的缩进层级记下来,下一章里剔除层遍历的顺序就与它一一对应。父节点的可见性会影响子节点,这条在面板上只是勾选框的规则,最终要在剔除层那一侧兑现成一段真实的裁掉逻辑。
面板与运行时的同一性还解释了一条调试经验:在场景树里选中某个节点,看它的可见性与变换,就能预判它这一帧会不会进入后续的剔除与绘制。面板不是示意图,它读的就是运行时那份数据。把这一层的树记住,下一章讲剔除时就能把「谁被遍历、谁被裁掉」对到具体节点上。
源码落点:排程与派发的原文见 canvas_item.cpp。其中: 第 541 行是 queue_redraw() 的定义,第 552 行排下延迟回调,第 144 行是 _redraw_callback(),第 173 行派发 NOTIFICATION_DRAW,四处行号均按 master 快照(2026-10-08)实读,_update_callback 这一旧名在现 master 已无对应函数。
三、Server 门面:为什么是一组 RID 型命令
这一章要回答门面层的一个结构问题:场景层递出去的命令,为什么长成一组句柄号码,而不是一串对象调用。把门面的形状看清,后面剔除层与绘制层才能接得上。
3.1 门面调用的三段跳
这一节要回答:场景层递出去的那条命令,中间要经过几道手。
言归正传,三道。第一段是 RenderingServer 的虚接口,场景层调的是这个基类上的方法;第二段是 rendering_server_default.h 里的宏转发,RenderingServerDefault 把调用转给具体实现;第三段是 RSG 的 canvas 实现,也就是 RendererCanvasCull 那一侧。三段合起来把「谁调用」与「谁执行」彻底拆开,场景层只认第一段的签名,不认后面两段是谁。
读这条路径:最左边是场景层的调用点,中间是两个转发层,最右边是剔除层与绘制层。三段跳的代价是多了一层间接调用,收益是场景层与实现层可以各自演化,后端换一个,第一段的签名不用动。这也是为什么 RenderingServer 上几百个方法能长期保持一个统一形状。
三段跳里需要留意的是虚接口与宏转发之间那层。虚接口定义「有哪些命令」,宏转发定义「命令怎么落到实现上」。两者分开写,好处是新增一条命令时改动集中,坏处是调用链被拆成三处,顺着一步一跳才找得到实现。本篇把这三处都点出行号,正是为了让这条链在纸面上可走。
3.2 门面头文件里的 RID 型虚接口
这一节要回答:门面把哪些东西定义成命令。
servers/rendering/rendering_server.h 第 814 行是 canvas_item_create,第 836 行是 canvas_item_add_line,第 864 行是 canvas_item_clear。这三个声明摆在一起,能看出一条统一的形状:创建类接口返回一个 RID,添加类接口接收一个 RID,清理类接口也接收一个 RID。命令的参数不是对象指针,是句柄号码。
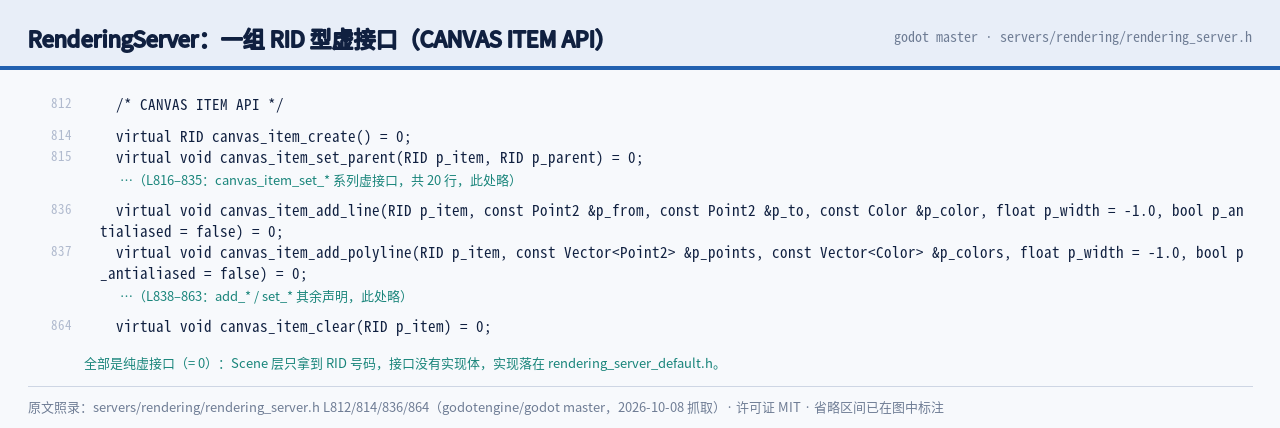
读这三行:814 行返回 RID,836 行收 RID 加一串绘制参数,864 行只收 RID。同一段里还有 canvas_item_set_parent(第 815 行)这样的接口,形状也一样。门面上大量方法都按这个形状铺开,RID 成了它们的共同货币。看懂这三行的形状,再去看别的方法,只剩参数长短的差别。
言归正传,把这三个接口与场景层那一章接起来看:canvas_item_create 返回的 RID,正是 CanvasItem 手里握着的东西;canvas_item_add_line 收下的 RID,正是 _draw() 里画线时填进来的号码。门面这一层不存对象,只存号码与号码到结构的对应关系,这份对应关系由服务层维护。
3.3 宏转发:FUNCRIDSPLIT 与 FUNCn
这一节要回答:虚接口上的调用怎么落到具体实现上。
servers/rendering/rendering_server_default.h 用宏来做这件事。第 1016 行是 FUNCRIDSPLIT(canvas_item),第 1039 到 1058 行是一串 FUNCn(canvas_item_add_*)。两个宏的分工是:FUNCRIDSPLIT 处理创建类接口,把返回值与实现体分开;FUNCn 处理添加类接口,把参数原样转发给 RSG::canvas。宏的意义在于一次书写、几百个方法复用,代价是读代码时看不到逐方法的实现体。
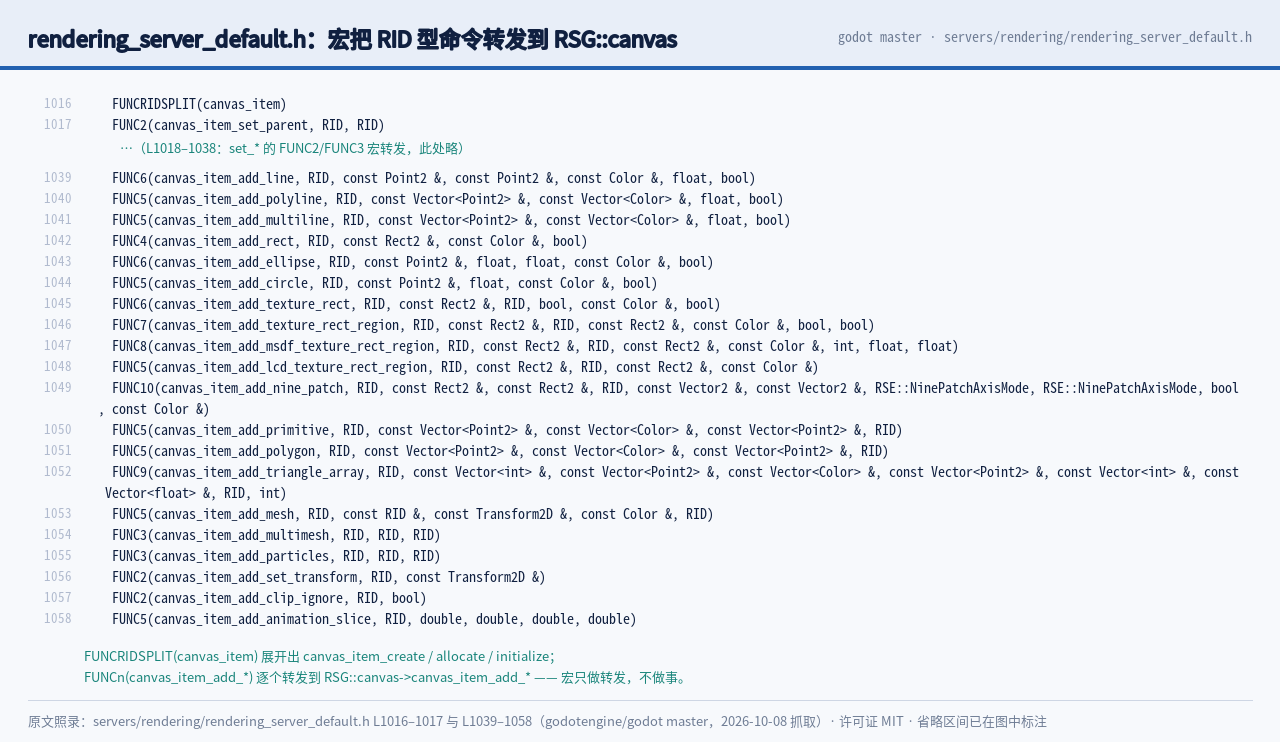
读这两处原文:1016 行的 FUNCRIDSPLIT(canvas_item) 展开后既声明又转发,1039 行往下的 FUNCn(canvas_item_add_line) 一类把绘制命令直接递给 RSG。这一段还有一处容易被照抄错的落点:旧资料写的 servers/rendering_server.cpp 在现 master 已不存在,实际路径是 servers/rendering/rendering_server.cpp,头文件也在 servers/rendering/ 下。照抄旧路径,行号就会全错。
宏在这里扮演的角色是省掉几百份重复样板。同一个形状写成一次宏,几百个方法共用一份展开结果,源码体积与出错面都小。代价是可读性:宏展开之后才是真正的方法体,直接读头文件看不到逐方法的实现。读这一层的正确姿势是先看宏的定义,再把宏名逐个代入。
3.4 RID 是跨系统句柄
这一节要回答:为什么门面用号码而不是指针来标识对象。
因为号码可以跨系统传递。RID 是一个跨系统的句柄(handle),场景层只持有号码,服务层负责解释号码与管生命周期。CanvasItem 手里那个 RID 只是一个整数,它不知道背后的画布项在哪、有多大;服务层拿这个整数去 RID_Owner 里查真正的结构。这样做的收益是场景层不必持有服务层的内部结构,代价是号码一旦被释放就失效,用错号不会有编译期报错。
说白了,读这张图:左边场景层画成一个持有 RID 的方框,右边服务层画成一张号码到结构的映射表,中间一条箭头只传整数。号码的生命周期由服务层管,场景层只管发号与用号。这条分工在门面的每一个创建类接口上都成立,第 814 行的 canvas_item_create 就是发号的那一个。号码与结构的这种分离,是四层能各自独立演化的结构前提。
最后一个与后面几章有关的观察:RID 这套句柄风格不只用在画布项上,纹理、着色器、渲染管线都用同一种风格。门面把创建、使用、释放拆成三段,三段都靠号码串起来。带来的直接后果是,命令在层与层之间传递时从不带指针,只带整数。下一章讲剔除层时,它产出给绘制层的那份中间表示,也沿用这种只传号码与轻量结构的做法。
源码落点:门面与转发见 rendering_server.h、rendering_server_default.h 与 rendering_server.cpp。其中: rendering_server.h 第 814、815、836、864 行给出 RID 型虚接口的声明,rendering_server_default.h 第 1016 行与第 1039 至 1058 行给出宏转发,rendering_server.cpp 第 3330 行与第 3350 至 3369 行是 ClassDB 绑定,不是实现体,三处行号均按 master 快照(2026-10-08)实读。
四、剔除层:RendererCanvasCull 每帧做什么
4.1 一帧里剔除层只做四件事
这一节回答一个具体问题:Scene 层把绘制命令交下来之后,画布剔除器(RendererCanvasCull)在一帧里到底跑了哪几步。
Scene 层提交的 canvas_item_add_* 命令不会当场变成 GPU 绘制,它们先被收进剔除层,按画布项记账保管,等帧末统一处理。命令挂在画布项对象自己的命令队列上,一次重绘开始时由 canvas_item_clear() 成批清掉,因此每帧处理的是这一帧的现场,与上一帧的命令累加无关。帧末引擎对每个需要更新的视口跑一次 render_canvas(),这一步把整棵画布树走一遍,判定哪些项落在可见区域里,把可见的那些挂进一条按 z 排好的列表,最后把这条列表移交给绘制层。四件事的顺序固定:遍历、判定、挂表、移交。
好了,读这张图要盯住一处时序:遍历发生在帧末,标脏发生在 queue_redraw 被调用的那一刻,两者之间隔着整整一帧。剔除层接收的正是上一章那批延迟回调(deferred callback)排好队的请求。命令在 Scene 层产生,在剔除层被筛选,在绘制层被翻译,在 RD 后端被录成 GPU 命令,一条链路四段职责,而剔除层做的是最省钱的那段:把不该画的先扔掉。视口的处理逐个进行,主视口加若干子视口各自跑一遍,剔除层按视口维护自己的空间,互不串号。这一层完全不碰 GPU,产出全在内存里,读它的代价与画布项数量同阶。
剔除层单独存在还有一个理由:把可见性判断从绘制动作里拿出来。绘制层因此永远只看到要画的那一批,不用在同一个循环里既判断又画。判断逻辑归一处,绘制逻辑归一处,两者各自演进,兼容性后端与 RD 后端共享同一份判断结果,这也是后面讲后端分叉时能并行比较的前提。
源码落点:类声明见 renderer_canvas_cull.h,帧入口与内部函数见 renderer_canvas_cull.cpp。其中:class RendererCanvasCull 在 renderer_canvas_cull.h:40,render_canvas() 在 renderer_canvas_cull.cpp:495,_render_canvas_item_tree() 与 _cull_canvas_item() 分别在 :71 与 :304,命令的清理入口 canvas_item_clear() 在 rendering_server.h:864,行号口径为 master 快照 2026-10-08。
4.2 render_canvas 是每帧唯一的总入口
这一节回答 render_canvas() 在链路里的位置,以及它靠什么完成一次剔除。
render_canvas() 是剔除层对外的唯一大门,一帧之内每个需要重绘的视口从这里进一次。它收下视口句柄、画布变换、目标矩形以及光照相关的掩码,本身不做数据返回,作用全部落在副作用上:内部那条命令列表被填满,绘制层的入口被呼叫一次。这种传入状态、改写内部、外呼下游的写法,把一个本该暴露返回值的过程收进一次函数调用里,调用方不必关心中间产生了哪些中间结构。
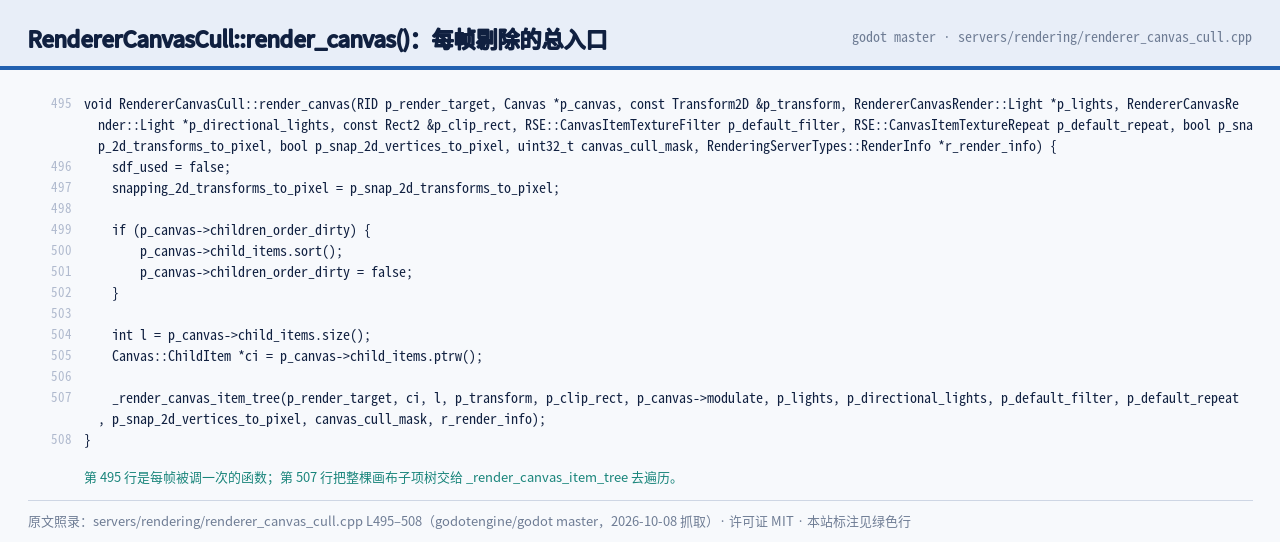
官方文档在画布剔除一节里把这一层的职责写成按可见性与顺序整理画布项、再交给渲染后端,与源码结构对得上:剔除层只做整理,不做绘制。口径要交代清楚:本机没有为 render_canvas 做计时读数,本节只陈述源码结构与官方文档表述,不给任何性能数字,免得拿结构去外推性能。剔除层的输入是 Scene 层在帧内攒下的命令,输出是一张待绘制的表,两头都在内存里,整层与驱动无关,四种驱动下面跑的是同一套剔除逻辑。
说白了,调用它的时机由主循环给定。Main::iteration() 在 main.cpp:4948 推进一帧,帧末调 RenderingServer::sync()(main.cpp:5104),紧接着走 draw(...)(main.cpp:5120/5124)。剔除与提交都挂在这条线上,render_canvas() 只是其中一个具体动作。把这个时序记住,后面看本机日志里帧末才出现的绘制痕迹就不会觉得意外。
源码落点:render_canvas() 的完整签名见 renderer_canvas_cull.cpp,职责表述见 官方内部渲染架构。其中:帧入口落在 renderer_canvas_cull.cpp:495,它内部先调 _render_canvas_item_tree()(:71)再向绘制层转交,两处共同构成一帧的剔除动作。
4.3 树遍历与单项裁剪的分工
这一节回答 _render_canvas_item_tree() 与 _cull_canvas_item() 各管什么。
_render_canvas_item_tree() 负责递归:从根画布项出发,沿孩子列表往下走,边下潜边累积变换与可见性。_cull_canvas_item() 负责单个节点的判定:自身可见标志、从祖先继承下来的可见性、父级裁剪矩形是否把这一项挡在外面。前者负责到达,后者负责筛选,两者合起来构成一次完整的剔除遍历。递归结构决定复杂度与节点数同阶,这是剔除层最容易被读错的一处:它没有空间加速结构,靠的就是按照场景树的形状走一遍。
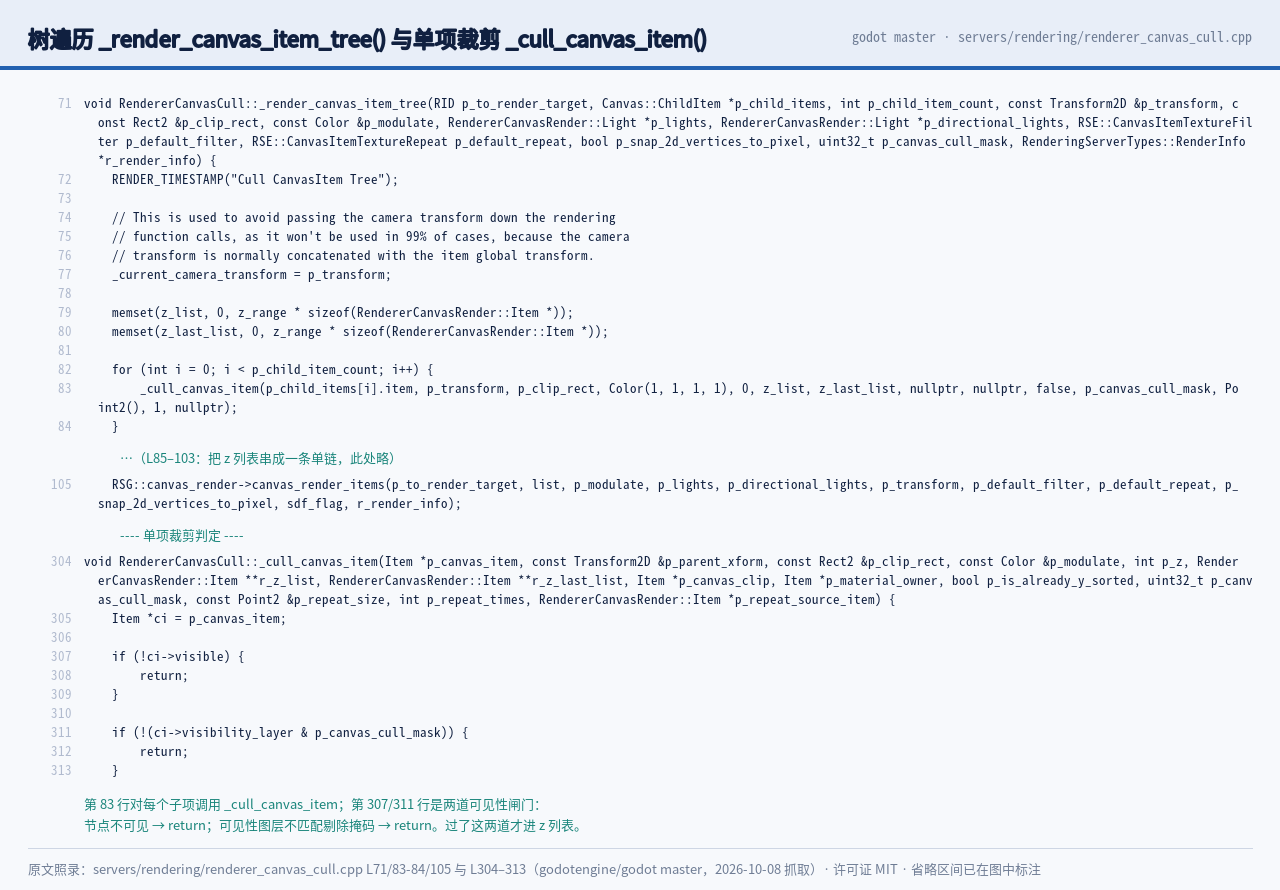
机制上,可见性判定并不只看一个 visible 布尔量。父级不可见会向下传染,CanvasItem 的裁剪模式(clip mode)会限制子树,一个子节点自身可见也可能因为祖先的裁剪矩形被排除在外。绘制顺序同样在这一次遍历里定下来,同一画布层内按 z_index 与树内次序排,跨画布层则按层号分层处理,需要按 y 轴排序的场景还要额外重排。这一层只读不改,判定结果以进不进列表的形式表达,所以它可以在帧末被反复安全地跑,也方便将来挪进多线程。
判定与遍历拆成两个函数,好处是判定可以单独替换。将来若要在同一棵树上补范围裁剪或遮挡判定,改动会集中在 _cull_canvas_item(),递归骨架不必动。把怎么走与怎么判分开,是引擎里常见的分工方式,剔除层之外的其他遍历器也照这个思路组织。
源码落点:遍历与裁剪两个函数见 renderer_canvas_cull.cpp,类的另一面见 renderer_canvas_cull.h。其中:树遍历落在 renderer_canvas_cull.cpp:71,单项裁剪落在 :304,画布项的分配与初始化已拆成 canvas_item_allocate()(:567)与 canvas_item_initialize()(:570)两个函数,取代了更早的单一创建入口。
4.4 交出去的中间表示
这一节回答剔除层最终递给绘制层的到底是什么。
OK,剔除层交出去的是一份中间表示(intermediate representation):一批可渲染项(item)的指针,按 z 排好序,每一项身上还挂着自己的命令队列。它交出去的内容以内存结构为主,GPU 命令在这一刻还不存在。z 顺序由 z_index 与树内次序共同决定,同一 z 下按稳定次序排列,保证每帧结果可复现,也让上层调试时看到的顺序与屏幕一致。
这份中间表示是四层里最关键的接口契约。剔除层只保证这些项、这个顺序,绘制层只管把它们变成 GPU 能吃的命令。两层之间没有反向依赖,绘制层不认识 CanvasItem,只认识 renderer_canvas_render.h 里的 Item 结构。边界划得干净,替换后端时前半条链不用动,这也是后面讲 2D 与 3D 分家时能各自演进的前提。把命令的载体与执行者拆开还有一处直接收益:同一份剔除结果可以被不同后端消费,兼容性后端与 RD 后端因此能共用前半条链。
这份表的形状还决定了调试体验。编辑器里看到的节点层级与绘制先后,对应的就是这份中间表示的内容;屏幕上顺序错乱时,问题多半出在 z 序号或画布层,落在前半条链上。把定位范围压回内存结构这一侧,比重读一遍 GPU 命令快得多。
源码落点:中间表示的定义见 renderer_canvas_render.h,转交动作见 renderer_canvas_cull.cpp。其中:struct Item 在 renderer_canvas_render.h:168,剔除层在 render_canvas()(renderer_canvas_cull.cpp:495)末尾调用 RSG::canvas_render->canvas_render_items() 完成移交。
五、绘制抽象层:一次绘制在中间表示里长什么样
5.1 五种命令各自承载什么
这一节回答绘制抽象层里那套命令家族由哪五类组成,各自管什么形态的绘制。
OK,绘制抽象层(renderer canvas render)夹在剔除层与 RD 后端之间,它定义一次绘制在内存里长什么样。剔除层交来的每一项都带着一串命令,命令按形状分成五类:矩形、多边形、网格、多网格、动画切片。这五类覆盖了 2D 最常见的绘制形态,矩形对应 draw_rect 与精灵这类方形区域,多边形对应 draw_polygon 的自定义路径填充,网格与多网格对应 draw_mesh 与 draw_multimesh,动画切片把逐帧动画压进图集的一段区域,省掉逐帧切纹理的开销。
这五类都是薄壳,字段只够描述一次绘制所需的顶点、纹理、颜色与调制参数,怎么送到 GPU 完全由后端决定。把它们放在抽象层,是为了让剔除层与后端之间有一份双方都懂的共同语言,上层不必知道底层用的是 Vulkan 还是 OpenGL。命令的生成时机也要说清:它们由 Scene 层在 NOTIFICATION_DRAW 里调用 draw_* 时写入,剔除层只负责搬运,抽象层只负责容纳与分类。
命令是逐项生成的,一项可以带多条命令,排列顺序就是绘制顺序。抗锯齿这类细节散落在各命令里,Line2D 与部分 draw_* 调用自带抗锯齿,不需要后端额外补处理。五个命令类的字段都贴着 2D 的实际需求来定,没有替 3D 预留位置,这也是抽象层能保持薄的直接原因之一。
这五类之上的状态并不在命令里。材质、混合模式、光照这些跨多项共享的东西,由批次组织阶段统一决定,命令只描述几何与外观。状态与几何分开存放,是抽象层能保持薄的具体表现,也让后端在攒批时有自由重排的余地。
源码落点:五个命令类见 renderer_canvas_render.h。其中:CommandRect/Polygon/Mesh/MultiMesh/AnimationSlice 依次声明在 renderer_canvas_render.h:200/235/259/271/299,头文件口径为 master 快照 2026-10-08。
5.2 抽象类、Item 与纯虚函数
这一节回答抽象层由哪三样东西构成,接口点落在哪一行。
OK,抽象层由三样东西撑起来:一个抽象类 RendererCanvasRender、一个承载数据与命令的 Item 结构、一个纯虚(pure virtual)入口 canvas_render_items()。抽象类规定形状,Item 承担数据,纯虚函数是唯一的接口点,三者合起来就是一条链上最小可用的抽象。Item 上除了命令队列,还挂着变换、z 序号、可见标志与它所属的父项,剔除层遍历时读的就是这些字段。
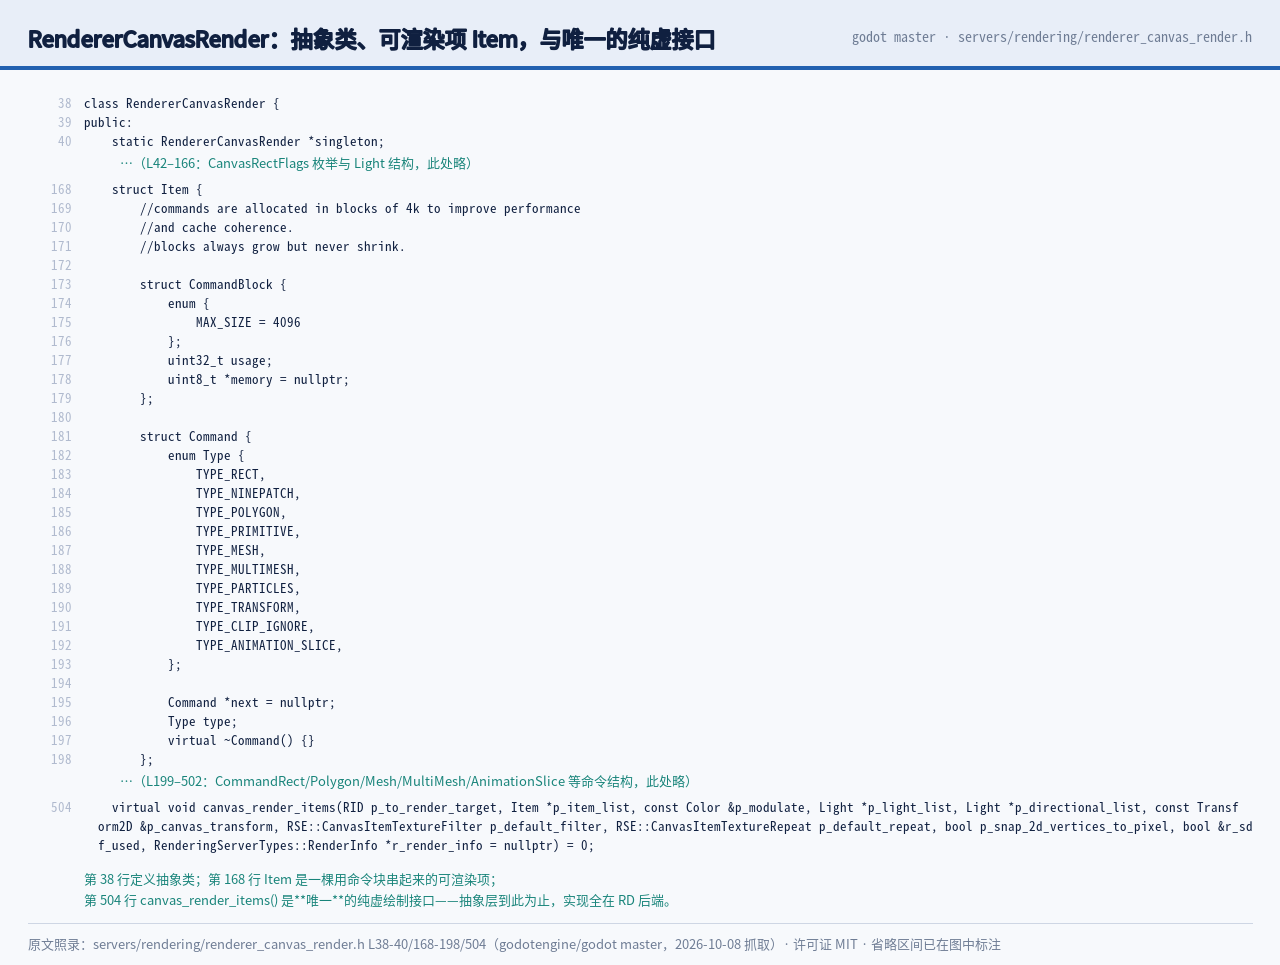
canvas_render_items() 是这条链上真正的接缝(seam):剔除层不认识任何具体后端,只认识这一个纯虚函数;RD 后端实现它,RendererCanvasRenderRD 因此可以整块替换而不触动上层。这是标准的多态(polymorphism)写法,上层持基类指针,下层给实现,接口稳定与实现自由同时成立,代价是接口一旦定错,整条链都要迁就它。抽象类里同时放着若干带默认实现的辅助函数,后端只挑需要覆盖的实现,其余沿用基类版本。
Item 与场景层的 CanvasItem 靠一个 RID 对上号:场景层持号码,服务层持对象,两边通过号码互相找到对方。号码是整数,复制与比较都很便宜,命令队列挂在对象一侧,场景层不必碰到底层结构。这层间接也解释了门面接口为什么清一色返回 RID。
源码落点:抽象类、数据结构与纯虚入口见 renderer_canvas_render.h,实现方见 renderer_canvas_render_rd.cpp。其中:class RendererCanvasRender 在 renderer_canvas_render.h:38,struct Item 在 :168,纯虚 canvas_render_items() 在 :504,实现落在 renderer_canvas_render_rd.cpp:509。
5.3 抽象层只有 140 行
这一节回答抽象层到底有多薄,薄在哪里。
renderer_canvas_render.cpp 全文只有 140 行,内容集中在三处:单例(singleton)、Item::get_rect()、以及 CommandMesh 的析构函数。其余函数体几乎都是空的默认实现,或者直接声明为纯虚留给后端。
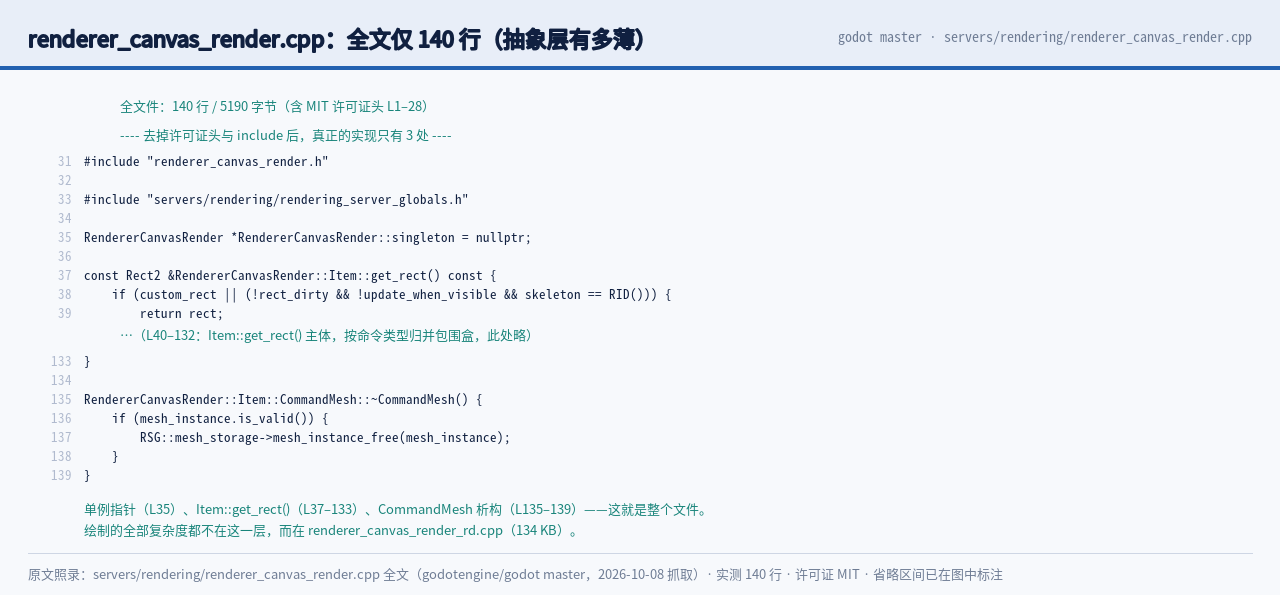
140 行这个数的口径要写清楚:它来自 master 快照 2026-10-08 的源文件行数,官方文档并未给出这一数字。把它和后端文件并排看更直观,后端同名文件的行数已经超过三千行,批次绘制这一路一直排到第 3008 行。抽象层刻意做薄,接口与数据留在头文件,行为全部下沉到 RenderingDevice 后端。薄的好处是替换成本低,代价是所有后端共享的复杂逻辑无处安放,只能在每个后端里各自实现一遍。
这一取舍在版本演进里会被反复验证。渲染后端后来做过一次大规模重构,抽象层的形状几乎没有动,改的全在后端内部,接口薄的收益就此兑现。反过来也有代价:任何想改进全后端共同行为的想法,都得在每个后端里各改一遍,抽象层帮不上忙。
140 行与三千行的落差来自分层本身。薄的接口换来后端各自优化的自由,代价是共同逻辑反复实现,这一点在版本演进里会反复出现。
源码落点:抽象层实现见 renderer_canvas_render.cpp,承接方见 renderer_canvas_render_rd.cpp。其中:singleton 在 renderer_canvas_render.cpp:35,Item::get_rect() 在 :37,CommandMesh::~CommandMesh 在 :135。
5.4 官方唯一给的那张类结构图
这一节回答官方的图形证据在这一点上给到了什么程度。
OK,官方文档在内部渲染架构一节里给出了一张核心渲染类结构图,画的是抽象层与服务层之间的类关系,这是该文档里唯一一张覆盖这一层的结构图。其余部分以文字与源码链接为主,图形证据的密度很低,2D 在里面只占很小篇幅。
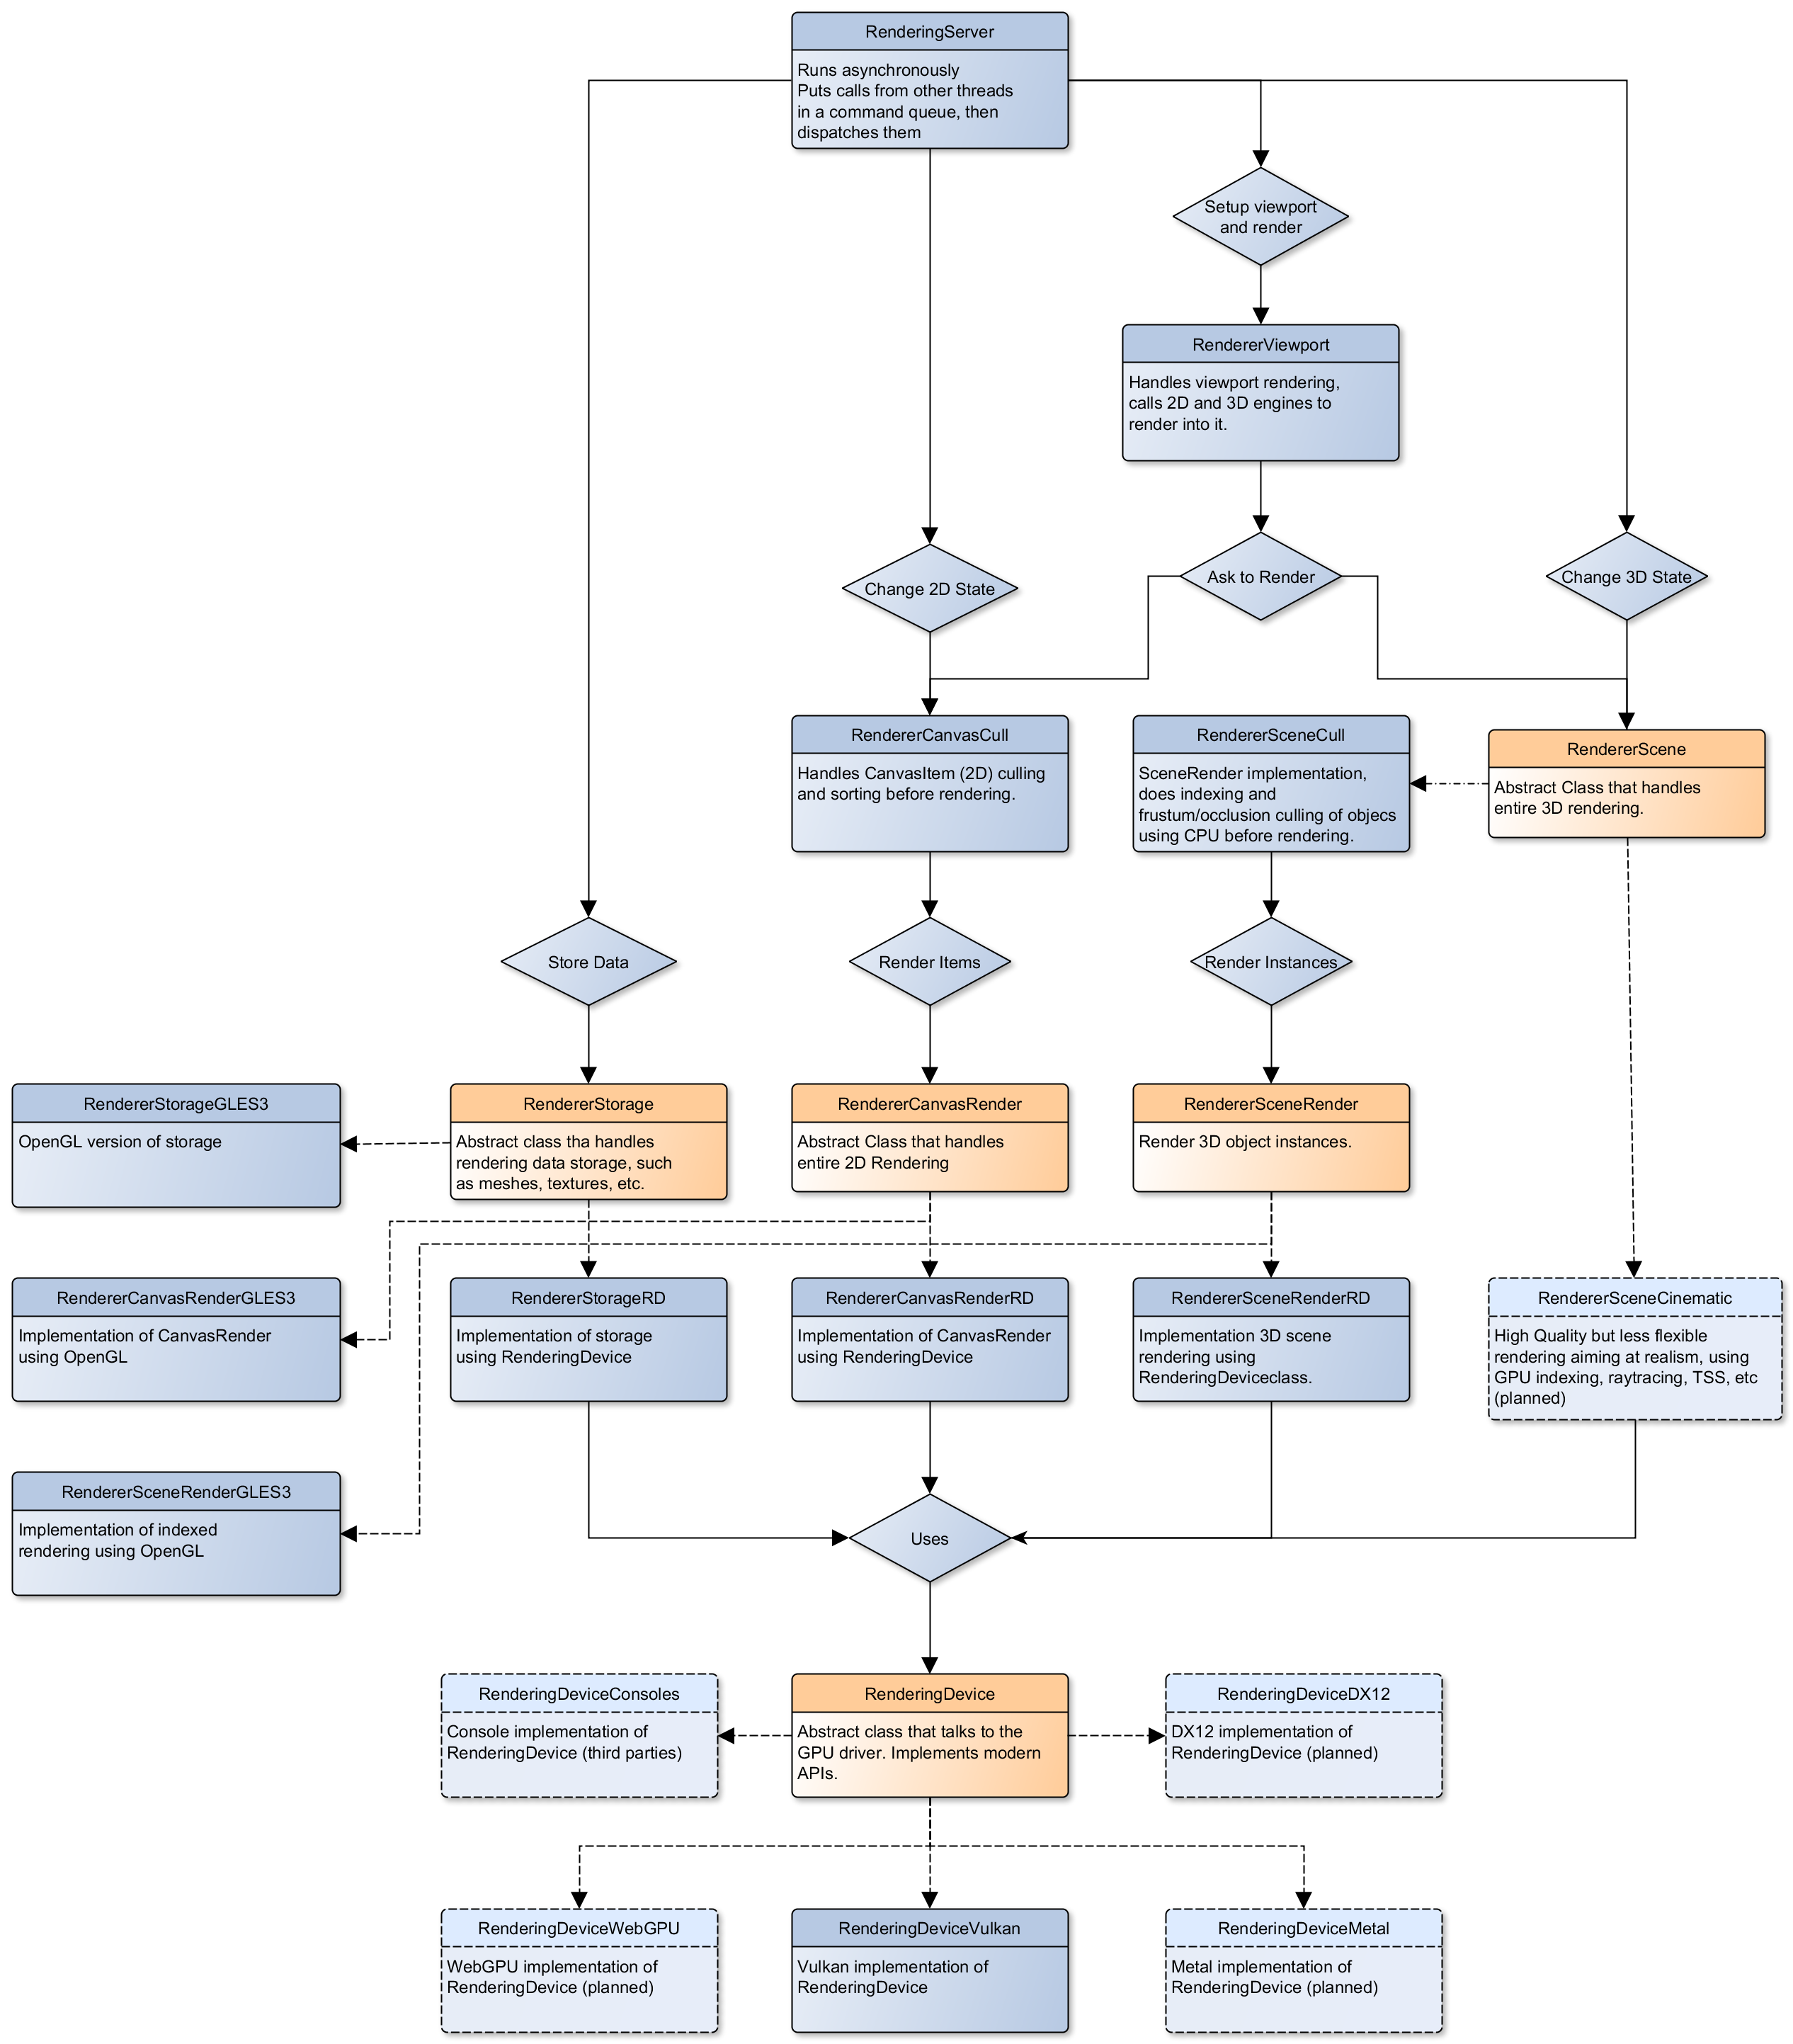
这张图出自 godot-docs 仓库,按仓库 README 的许可表述应受 CC BY 3.0 覆盖,可转载也可改绘;图本身没有逐图许可标注,是否另有第三方版权尚未核实,引用时按官方要求署名(Juan Linietsky, Ariel Manzur and the Godot community)并标注改动。图上读得到的关系与源码一致:剔除层持有一个抽象层基类指针,指针具体指向哪个派生类由后端决定,这也正是 5.2 里那处接缝的可视化版本。
官方的图形证据不止这一张。渲染方法页另有一张分层图,画的是 Compatibility 与 RenderingDevice 两条路各自压在哪层驱动上,两张图合起来才覆盖本篇这条链的前半段。两张图都出自 godot-docs 仓库,引用口径一致,使用时仍要逐张核许可状态,核完再定转载方式。
源码落点:类关系图出处见 官方内部渲染架构 与 4.6 版同页。其中:图中 RendererCanvasCull 与 RendererCanvasRender 的关系,在源码里对应 renderer_canvas_cull.h:40 的类声明与 renderer_canvas_render.h:38 的抽象类声明。
六、RD 后端:从 canvas_render_items 到 draw_list
6.1 从抽象调用到命令录制
这一节回答抽象层的纯虚调用之后,控制权如何一路走到 GPU 命令录制。
抽象层的纯虚函数一旦被调用,控制权就进了 RenderingDevice 后端。RendererCanvasRenderRD::canvas_render_items() 收下剔除层交来的表,按状态把可渲染项攒成批,交给批次绘制函数,批次绘制再把每一批翻译成一串 draw_list_* 命令,由 RenderingDevice 录进命令缓冲(command buffer)。走到这一步,一次 2D 绘制才第一次具备 GPU 能识别的形状。
好了,这条路径的关键词是攒批(batching):一次绘制不会直接变成一次 GPU 绘制,中间先按状态分组,同一状态的项合进一批,状态一变才结批。批次数决定 GPU 侧的状态切换次数,这是 2D 性能里最敏感的一个量,攒得好坏全看状态键怎么归类。把这一步放在后端而非抽象层,是因为每种渲染方法可用的状态与资源组布局并不相同,攒批规则只能跟着后端走。
从抽象层跨到后端这一步本身很轻,只是若干次虚函数分派加几层循环,真正的工作量都压在后面的循环体里。也正因为它轻,替换后端时上层几乎无感。代价是每一次绘制都要走这层间接,抽象带来的红利与开销就此同时计入。
源码落点:后端入口见 renderer_canvas_render_rd.cpp,录制侧见 rendering_device.cpp。其中:canvas_render_items() 在 renderer_canvas_render_rd.cpp:509,批次铺设在 :2187,批次绘制在 :3008,录制序列从 rendering_device.cpp:5641 起。
6.2 攒批与批次绘制的落点
这一节回答第 509、2187、3008 三行各承担什么职责。
canvas_render_items() 在 renderer_canvas_render_rd.cpp:509,是 RD 后端的总入口;_render_batch_items() 在 :2187,把一个批次里的项铺成顶点与索引;_render_batch() 在 :3008,把一批真正画出去。三个落点连成一条从表到命令的流水线,前面管攒,中间管铺,后面管画,职责分得相当干净。
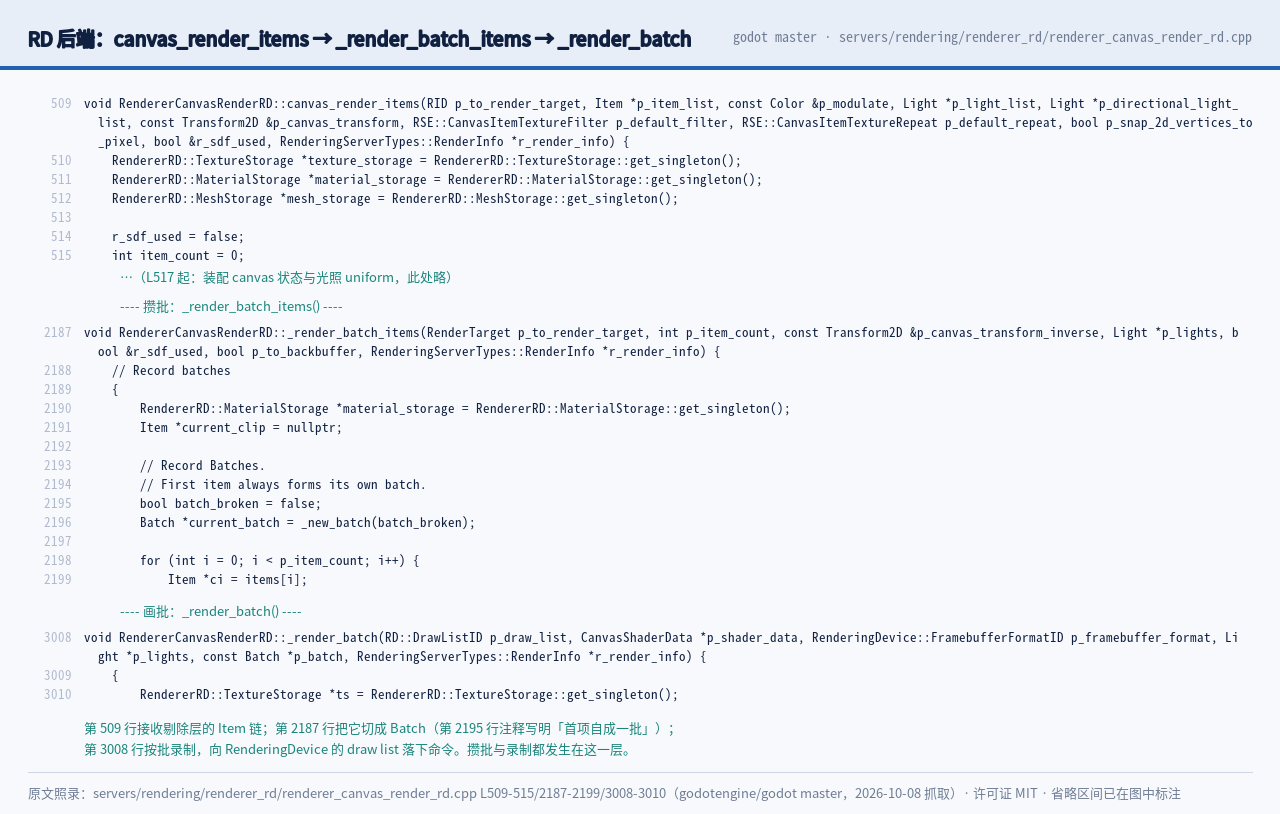
攒批的判据是状态键(state key):材质、混合模式、纹理、光照掩码、变换类型任意一项变化,当前批次就得结束,新批次开始。同一纹理与同一材质的连续项最容易被合进一批,屏幕上文字多的时候收益尤其明显,这与官方 2D 渲染技术一节里所有渲染方法都支持批处理的表述一致。这套做法在业界叫批处理(batching),Godot 到 4.4 才把它带到 Forward+ 与 Mobile 两种方法上,这条版本线留到讲版本转折的章节展开,届时会看到同一件事在三个版本里被判断过三次。
批次铺出来的顶点与索引最终要落到 GPU 侧的缓冲,实例数据缓冲是其中一个去处。攒批做得细,批次数就少,状态切换也随之变少;规则若把不该合的合到一起,后续的排序与遮挡又容易出错。这一层的取舍始终在性能与正确之间来回摆。
好了,这条流水线的三段里,最容易出问题的是第一段。状态键取得太细,批次数暴涨,绘制调用随之变多;取得太粗,错误的状态会被带进同一批,视觉上表现为颜色或混合异常。查这一类问题,GPU 计数器只能给出信号,真正要读的往往是批次划分的代码与状态键的构成。
源码落点:攒批与批次绘制见 renderer_canvas_render_rd.cpp。其中:总入口在 renderer_canvas_render_rd.cpp:509,批次铺设在 :2187,批次绘制在 :3008,三者共同构成后端里 2D 绘制的主动线。
6.3 draw_list 的录制序列
这一节回答 draw_list_* 这一串调用到底在录制什么。
RD 的命令录制是一条线性序列:先开录制,再绑渲染管线(render pipeline),再绑统一集(uniform set,也就是资源组),然后发绘制,最后结束录制。这几个动作在 rendering_device.cpp 里各有一个落点,串起来就是一批怎么变成 GPU 命令的全部内容,顺序写错任何一步,GPU 都会拒绝执行。
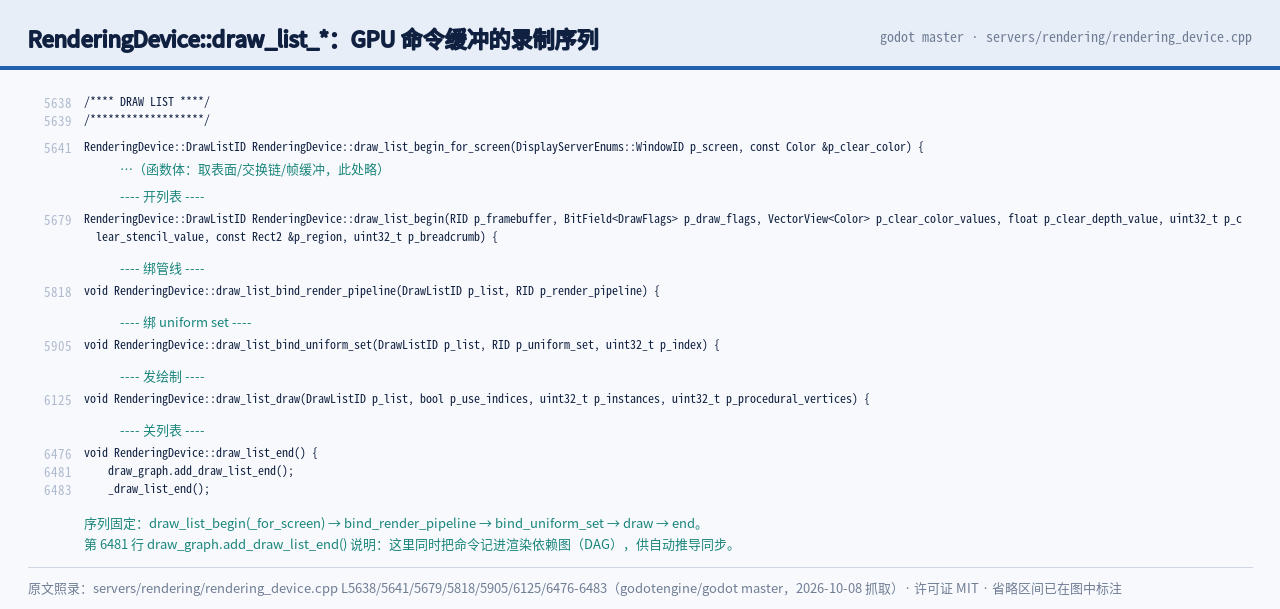
起点分两种:draw_list_begin_for_screen(:5641)直接对屏幕目标开录制,draw_list_begin(:5679)开的是普通录制。中间的绑定是 draw_list_bind_render_pipeline(:5818)与 draw_list_bind_uniform_set(:5905),发出绘制的是 draw_list_draw(:6125),收尾的是 draw_list_end(:6476)。这一段是命令录制(command recording)这一抽象在 Godot 里的具体形状,也是「一次 2D 绘制」在引擎里最靠底的一处落点。它与官方的定位吻合:这一层不像 Vulkan 那样细粒度,也不像 OpenGL 那样有状态,抽象层级接近 Metal 与 WebGPU。
开录制的两个起点对应两种目标。对屏幕直接开录制,服务于最终呈现;对离屏纹理开录制,服务于视口与后处理。两者的后续步骤一致,绑定、绘制、结束都照同一条序列走,差别只在目标怎么指定。
源码落点:录制序列见 rendering_device.cpp。其中:draw_list_begin_for_screen 在 rendering_device.cpp:5641,draw_list_begin 在 :5679,绑定与绘制在 :5818、:5905、:6125,结束在 :6476,行号口径为 master 快照 2026-10-08。
6.4 本机日志里的实例数据缓冲
这一节回答本机实测能否在日志里看到 2D 路径的 GPU 侧缓冲。
好了,本机在 RTX 3060 Laptop GPU 与驱动 560.70 上跑了一次退出转储,日志里出现 MultiUmaBuffer 'CANVAS_INSTANCE_DATA' used a total of 0 buffers… 这一条。这个条目名对应 2D 实例数据(instance data)在 GPU 侧的缓冲池,说明 2D 路径确实有一条实例数据上传通道,多个精灵可以共用一份实例数据,不必各自占一次独立绘制。
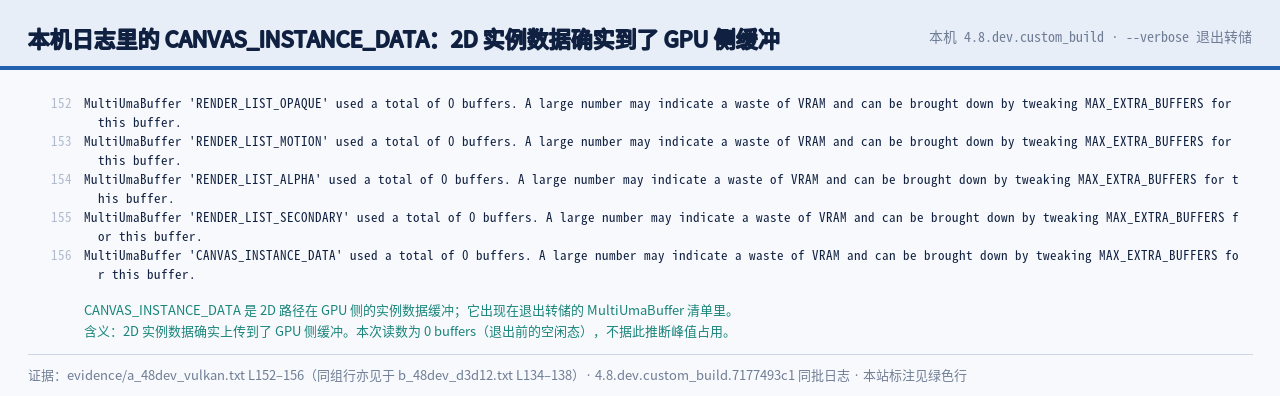
读数口径要先交代:本次实测用的引擎版本是 4.8.dev.custom_build.7177493c1(2026-07-03 构建),属于本机自定义构建,不等于官方稳定版 4.7.2;used a total of 0 buffers 表示退出时该缓冲池空闲、没有残留占用,不能据此推断缓冲容量或帧内使用量。这一段只陈述本机现场,不给跨机器结论,也不替引擎下判断。本机另装的 4.5.stable.official.876b29033 是非 console 构建,标准输出不落管道,本次没有拿到它的日志,版本对照这一格暂时空着。
同一次转储里还列出 RENDER_LIST_OPAQUE、RENDER_LIST_MOTION、RENDER_LIST_ALPHA 等条目,名字对应 3D 的渲染列表;2D 一侧只出现 CANVAS_INSTANCE_DATA 一个,并且只在 vulkan 与 d3d12 两次转储里出现,opengl3 那次转储里没有这一组条目。把这几条并排看,2D 与 3D 在缓冲上的分家也就有了现场的注脚。
本条读数与前面几节的源码落点串起来,正好覆盖「一次 2D 绘制」后半条链的末端:抽象调用进了后端,后端攒了批,批次录成命令,命令最终指向 GPU 侧的实例数据缓冲。
源码落点:缓冲池与录制逻辑见 rendering_device.cpp,现场读数为本机 evidence/a_48dev_vulkan.txt 与 evidence/b_48dev_d3d12.txt。其中:CANVAS_INSTANCE_DATA 一行来自 --rendering-driver vulkan 与 --rendering-driver d3d12 两次退出转储,两次命令只改了 --rendering-driver 一个量。
七、2D 与 3D 为什么要分家
本节要回答的是:Godot 4 把 2D 与 3D 拆成两套缓冲、两套格式与两套深度策略,这条分界压在哪些量上,又在哪一种渲染方法里成立。
7.1 两套缓冲的物理隔离
说白了,官方 Internal rendering architecture 的「2D and 3D rendering separation」一节把这条分界写成一句直白的话:2D 与 3D 渲染到不同 buffer。先给这条分界的定义,2D 那一侧走低动态范围(LDR)的 sRGB,3D 那一侧走高动态范围(HDR)的线性空间,两边的中间结果各自留在一份自己的缓冲里,互不借道。
把这张对照读给读者听,差别落在三处。第一处是动态范围,2D 停在 LDR,3D 走 HDR 线性,后者的光照与混合在更宽的区间里算,最后才压回显示范围。第二处是深度,2D 不使用深度缓冲(depth buffer),前后顺序由绘制顺序与 z 值在 CPU 侧排定;3D 用 24 位 UNORM 深度做遮挡判定。第三处是缓冲归属,两边各自持有一份,谁都不去读对方的中间结果。这三处合起来才是「分家」的完整含义,只拆其中一处会把结论读偏。
这条分界有一个前提要先钉住:它只对 Forward+ 与 Mobile 两种渲染方法成立,Compatibility 不使用这套分离。官方在同一页写明了适用范围,落到读者手里就是一句可操作的判断,同一个缓冲,在 Forward+ 上分家,在 Compatibility 上不分。这也就解释了为什么 2D 与 3D 的缓冲话题总是和渲染方法的选择绑在一起。
7.2 格式与色彩空间的字面证据
把这条分离往下一层,就落到颜色格式(color format)。官方给出的数字是 2D 颜色格式为 RGB8,每通道 8 位、不带透明度通道;当某个视口(viewport)打开 Transparent 时,格式换成 RGBA8,多出来的那一个通道用来承载透明度。这个切换按视口生效,同一帧里可以同时存在用 RGB8 的普通视口和用 RGBA8 的透明视口,两种格式各画各的。
说白了,两种格式的取舍可以这样读:RGB8 省下约 25% 的带宽,代价是画布不能携带逐像素透明度;RGBA8 把通道补回来,多出来的带宽换到合成阶段的正确性。分辨率缩放另有一条口径,官方写明缓冲由 RenderSceneBuffersRD::configure() 在尺寸变化时重分配,动态分辨率缩放(dynamic resolution scaling)尚未支持、仍在计划中,这一项在本篇只作边界登记。
这里要分清两层证据。上面这些格式与缩放口径来自官方文档,属于设计意图层的读数。本机跑的三后端日志里能读到的是 2D 路径在 GPU 侧确有实例数据缓冲,退出转储里那一行 MultiUmaBuffer 'CANVAS_INSTANCE_DATA' used a total of 0 buffers 就是这条路径的现场,它说明 2D 实例数据上了 GPU 侧缓冲。本机读数出自 4.8.dev.custom_build.7177493c1(2026-07-03 构建)这一自定义构建,与官方稳定版 4.7.2(2026-08-18)、开发版 4.8-dev7(2026-09-29)都不等同,正文只按本机口径陈述,不外推到其他版本与其他机器。本机三后端的那组读数出自同一二进制、同一台机器,对照时只改了 --rendering-driver 一个量。
7.3 官方 2D rendering techniques 的四点
官方 internal_rendering_architecture 的「2D rendering techniques」一节给了四点机制,它们是本节之后所有 2D 讨论的底稿。第一点是 2D 光照按单 pass(single pass)渲染,多个光源在一次遍历里算完,光源数量上升时开销比多 pass 更稳。第二点是所有渲染方法都支持 2D 批处理(batching),屏幕上文字与精灵密集时收益尤其明显。第三点是 2D 可以开多重采样抗锯齿(MSAA),而快速近似抗锯齿(FXAA)对 2D 不起作用,因为它在 2D 开始渲染之前就已经算完;Line2D 与部分 CanvasItem.draw_*() 另有自带抗锯齿。第四点是有用户着色器请求时,引擎会按需生成视口内 LightOccluder2D 的有符号距离场(SDF),实现文件是 canvas_sdf.glsl,这份距离场既服务自定义 2D 光照,也服务 2D 粒子碰撞。
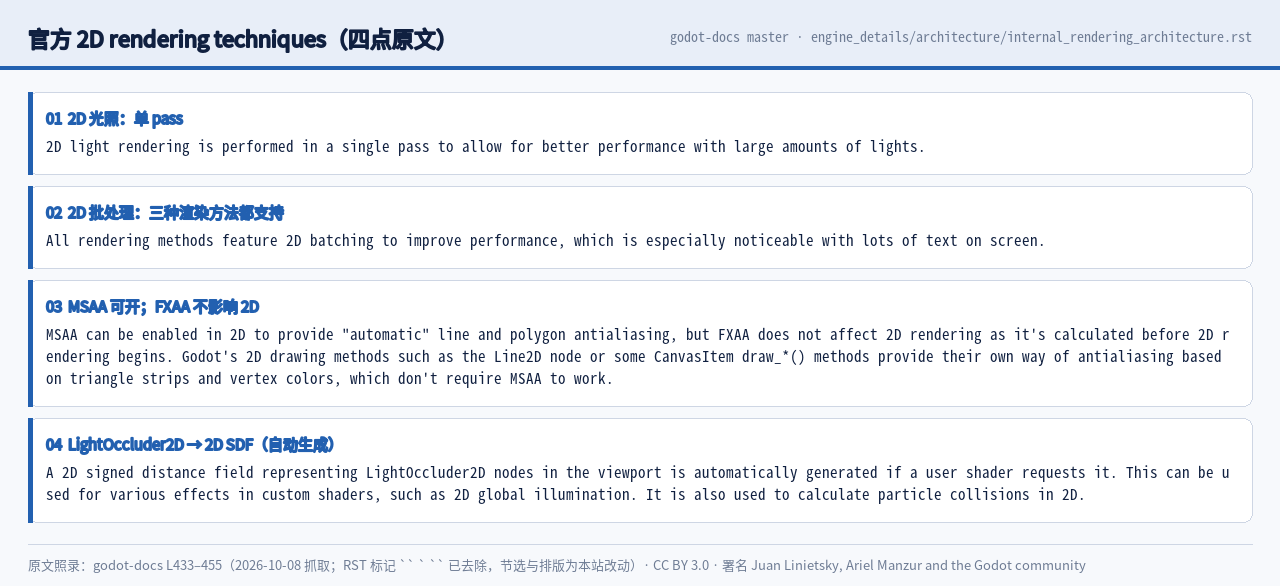
说白了,这四点里第二点要单独标出来,它与 4.3 版官方文档的旧口径相反。旧文档写的是 Forward+ 与 Mobile 还没有 2D 批处理,只有 Compatibility 后端有;新页面改成所有渲染方法都支持。同一件事在文档里前后不一,这正是下一节要顺着版本逐个拆的那条线。第四点则给出一个源码落点,2D 的距离场不常驻,它由需求触发、按视口生成,这份按需生成也是「2D 与 3D 分家」的一种体现。
源码落点:2D 与 3D 分离、2D 颜色格式与分辨率缩放的官方口径见 4.6 版内部渲染架构 与 稳定版同页,2D 距离场的实现文件见 canvas_sdf.glsl,本机 2D 实例数据缓冲的现场见本机退出转储(evidence/a_48dev_vulkan.txt 与 evidence/b_48dev_d3d12.txt);其中: 2D 在 LDR sRGB 且无深度缓冲、3D 在 HDR 线性且用 24 位 UNORM 深度,这条分离只对 Forward+ 与 Mobile 成立,2D 颜色格式为 RGB8、透明视口时换 RGBA8,本机只验到 GPU 侧存在 2D 实例数据缓冲这一层。
八、边界与版本转折:同一件事的三次判断
本节要回答的是:2D 批处理这一件事,官方为什么在 4.3、4.4、4.6 三个版本里做了三次方向不同的判断,以及每一次判断各出自哪一层证据。
8.1 三个版本节点
这三个节点排成一条时间线,先给这条时间线的定义:每个节点是一次判断,判断的口径各出自一层证据。4.3 的判断写在文档里,结论是 2D 批处理只在 Compatibility 后端存在。4.4 的判断写在发布说明里,结论是把批处理带到其他渲染后端。4.6 的判断写在开发快照里,结论是回过头对 2D 渲染器做一次大规模优化。三个节点都围绕同一件事,方向却两度翻转,先铺开,再收回其中一部分。
读这条时间线要带上口径。三个节点读的是三份不同来源,4.3 是官方文档,4.4 是发布说明,4.6 是开发快照,它们并非同机对照,也不代表同一版引擎的三种输出。把它们并排,得到的是官方在不同时间点对同一个问题的判断记录,这一点在下面三小节里逐条落实。
8.2 4.3 的口径:只有 Compatibility 有批处理
言归正传,4.3 版官方文档在 internal_rendering_architecture 里写下当时的结论,原文的意思是:Forward+ 与 Mobile 两种渲染方法还没有 2D 批处理,这一点在未来版本里有计划;Compatibility 后端有 2D 批处理。这份口径把「有批处理」这件事单独挂在 OpenGL 驱动程序所在的 Compatibility 上,等于给当时的批处理能力划了一条方法边界。
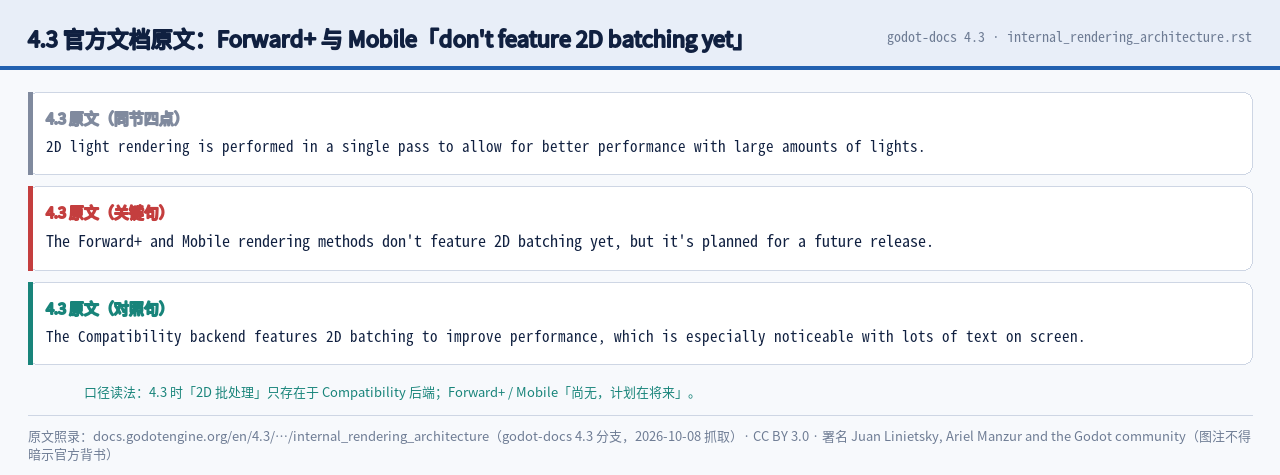
这条口径值得单列,原因是它限定了当时的适用面。按 4.3 的说法,一台桌面机器默认落在 Forward+,2D 精灵再多也走不到批处理这条路上,只有退回 Compatibility 才有。当时社区里有一类反馈正是沿着这条边界来的,比如 Godot 官方论坛那个标题为《Vulkan Fails to Batch 2D Sprites into a Single Draw Call》的帖子,以及引擎使用者提到的适配预期。这里引用的是社区口径,与官方文档口径分开陈述,社区反馈描述的是现象,官方文档给出的是当时的能力边界。
8.3 4.4 的口径:把批处理带到其他后端
4.4 版把这条边界改了。对应的源码变更是 PR #92797(Add batching to RendererCanvasRenderRD),作者是 Stuart Carnie;发布说明在 2D Batching 一节点出这次改动的跨度,原文的意思是:此前这项优化只在 Compatibility 渲染器里可用,这次发布把批处理带到了其他渲染后端。
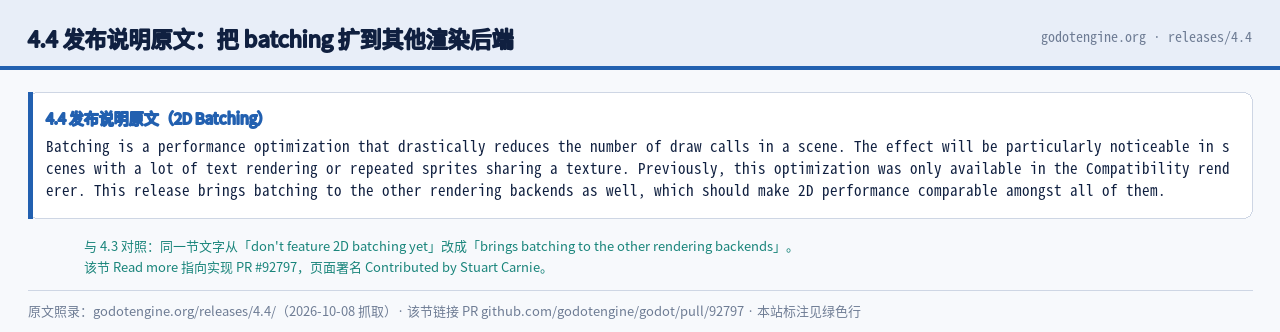
这次改动把批处理从单一后端扩到 Forward+ 与 Mobile,落点在 renderer_canvas_render_rd.cpp。它与 4.3 的口径正好接上,4.3 说「还没有、计划中」,4.4 兑现了那个计划。论坛那个帖子里,作者在 2024-09-13 的回复把提问者指向 PR #92797,这一条与发布说明互为独立佐证,一条来自代码变更记录,一条来自发布记录。
8.4 4.6 的口径:因 GPU 成本再重构
言归正传,4.4 的这次扩展省下了 CPU 侧的提交开销,代价出在 GPU 侧。4.4 之后,社区里低端移动设备的反馈集中到一处:在 GPU 瓶颈的场景下,4.4 的表现反而不如 4.3。这条反馈促成了 4.6 对 2D 渲染器的重构,官方在 4.6 开发快照里把这次改动写成对 2D 渲染器的大规模优化,用于 GPU 瓶颈场景的提升幅度落在 1.1 到 7 倍这个区间,对应的源码变更是 PR #112481。
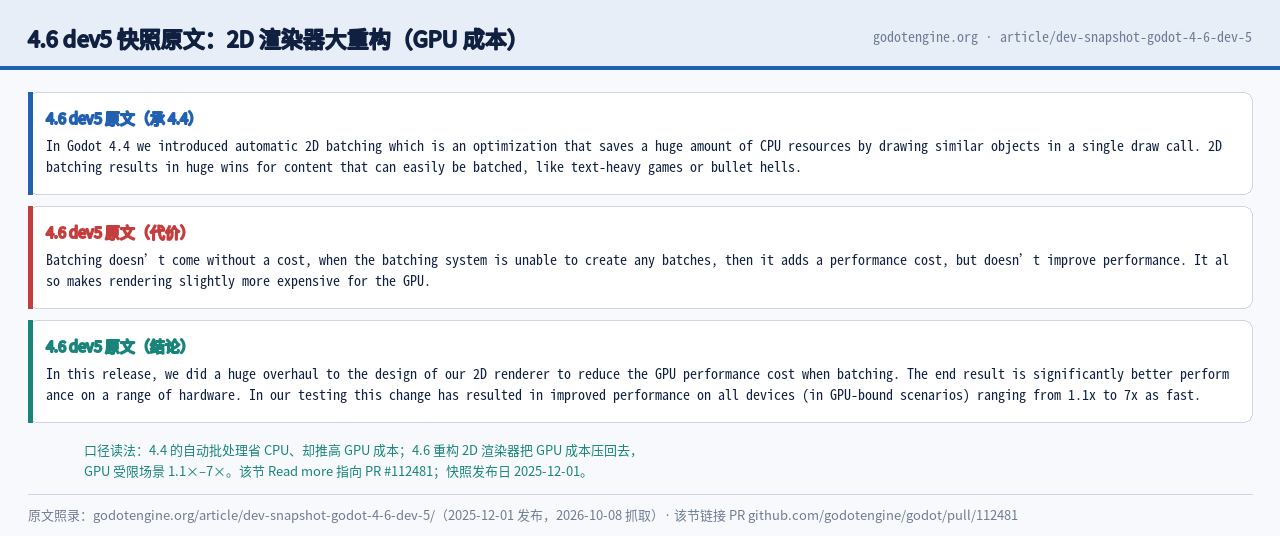
这里要把两层证据分开。官方快照给的是改动方向与提升区间,社区反馈给的是现象,两者都指向同一个点,4.4 那次省 CPU 的账在 GPU 一侧被补了回来,4.6 那轮重构处理的就是这笔账。三段连起来看,同一件 2D 批处理,官方先因缺功能而补上,再因 GPU 成本而重做,判断方向两度变化,判据始终是当时最紧的那个瓶颈。这里不写「引擎有 bug」,官方快照里的原话就是对 2D 渲染器做优化,社区反馈描述的是具体场景下的现象,两处各有出处,各自贴着它自己的口径。
源码落点:4.3 的旧口径见 4.3 版内部渲染架构,4.4 的跨越见 4.4 发布说明 与 4.4 dev3 快照,4.6 的重构口径见 4.6 dev5 快照,两次代码变更见 PR #92797 与 PR #112481,批处理的实现落点见 renderer_canvas_render_rd.cpp,同期 RenderingDevice 架构重构的背景见 4.3 发布说明,社区现象见 官方论坛 2D 批处理讨论;其中: 2D 批处理在 4.3 只存在于 Compatibility,4.4 由 PR #92797 扩到 Forward+ 与 Mobile,4.6 因 GPU 成本由 PR #112481 再重构、GPU 瓶颈场景提升 1.1 到 7 倍,三个节点分别取自官方文档、发布说明与开发快照,并非同机对照。
九、收官:这套架构的取舍,与后十篇各看哪一层
本节要回答两件事:一次 2D 绘制穿过四层的六跳落点合起来是什么形状、这套分层换来什么又付出什么,以及后面十篇各看哪一层。
9.1 四层落点链总图
先来看看先给这条链的定义,把前面八章串成一条链,六跳每一跳都能指到一个源码落点。第一跳在场景层,CanvasItem::queue_redraw() 于 scene/main/canvas_item.cpp:541 标脏,并在 :552 用 call_deferred 排下一个延迟回调。第二跳是那个回调本身,_redraw_callback() 在 canvas_item.cpp:144 清掉旧命令、在 :173 派发 NOTIFICATION_DRAW,让 _draw() 把这一帧的 canvas_item_add_* 命令交上去。第三跳是服务门面,servers/rendering/rendering_server.h 在 :814 声明 canvas_item_create()、在 :836 声明 canvas_item_add_line()、在 :864 声明 canvas_item_clear() 这些 RID 型虚接口,rendering_server_default.h 在 :1016 与 :1039–1058 用宏把它们转给画布实现。第四跳是剔除层,renderer_canvas_cull.cpp:495 的 render_canvas() 是每帧总入口,:71 的 _render_canvas_item_tree() 遍历画布项树,:304 的 _cull_canvas_item() 判定单个项的可见性。第五跳是绘制抽象与后端,renderer_canvas_render.h:504 的纯虚 canvas_render_items() 由 renderer_canvas_render_rd.cpp:509 实现,攒批落在 :2187 与 :3008。第六跳是命令录制,rendering_device.cpp 从 :5641 的 draw_list_begin_for_screen 一路到 :6476 的 draw_list_end,把这一帧录成 GPU 命令缓冲。整条链由 main/main.cpp:4948 的 Main::iteration() 驱动,帧末在 :5104 同步、:5120 与 :5124 提交。
这条链的取舍可以分两面说。换来的是解耦,四层各有明确的输入输出,绘制抽象层薄到 renderer_canvas_render.cpp 全文只有 140 行,真正干活的全在 RenderingDevice 后端,换一个后端不用动场景层与门面。付出的是间接,一次绘制要穿六跳,中间隔着 RID 句柄与多组虚调用,剔除层每帧都要把那棵画布项树走一遍。这套结构把「可替换」放在「最短路径」之前,2D 与 3D 分家、抽象层之薄、剔除与排序每帧重做,都是同一个取向的落点。
9.2 后十篇各看哪一层
第一到第八篇把这条链拆开,第九到第十一篇补上两个横切面。这张表只回答每篇看哪一层,各篇的标题不在本篇给出。
| 篇 | 看哪一层 | 这一层在链上的位置 |
|---|---|---|
| 第二篇 | Scene 层 | CanvasItem 与 Viewport 的真实约束,对应第一跳与第二跳 |
| 第三篇 | Core 层 | RID 句柄与服务层接口,第三跳的载体 |
| 第四篇 | Server 层·剔除 | RendererCanvasCull 决定画什么、按什么顺序,第四跳 |
| 第五篇 | Server 层·抽象 | 一次绘制的中间表示与命令家族,第五跳的接口面 |
| 第六篇 | Server 层·攒批 | 从 CanvasItem 到一次 draw call 的攒批规则与后端演进,第五跳的内部 |
| 第七篇 | Server 层·RD | RenderingDevice 抽象与渲染依赖图,第六跳 |
| 第八篇 | Drivers 层 | 四个后端的分叉与运行时选择,第六跳之下 |
| 第九篇 | Main | 引擎主循环与多线程命令队列,驱动整条链 |
| 第十篇 | Core·资源 | 导入器、PCK 与一张纹理进显存的路 |
| 第十一篇 | 全链收官 | 这套架构的取舍,与 2D 为什么也吃 GPU |
这张表里后十篇与第一篇的关系是同一条链的两端,第一篇给全景与边界,第二到第十篇逐层拆开。到这里,四层、六跳、三次版本判断收在同一条线上:分层给了可替换,六跳是它的账单,版本转折是官方在不同瓶颈下对账单的反复重算。
源码落点:六跳的落点依次见 canvas_item.cpp、rendering_server.h 与 rendering_server_default.h、renderer_canvas_cull.cpp、renderer_canvas_render.h 与 renderer_canvas_render_rd.cpp、rendering_device.cpp 与 main.cpp,抽象层之薄见 renderer_canvas_render.cpp,行号一律按 master 快照(2026-10-08);其中: 六跳从 queue_redraw 到 draw_list_end 每一跳都有落点,rendering_server.cpp 的现行路径在 servers/rendering/ 目录下、常被误记的 _update_callback 现名 _redraw_callback,分层换来可替换的后端,代价是六跳的间接与每帧遍历画布项树。
资源清单
官方文档(godot-docs 仓库,CC BY 3.0 Unported,署名 “Juan Linietsky, Ariel Manzur and the Godot Engine community”,引用须标注改动):4.6 版内部渲染架构、稳定版内部渲染架构、4.3 版内部渲染架构、引擎架构总览、渲染方法(4.4)。文档许可见 godot-docs LICENSE。
官方源码(godot 仓库 master raw;MIT,行号按 2026-10-08 快照):canvas_item.cpp、rendering_server.h、rendering_server.cpp、rendering_server_default.h、renderer_canvas_cull.cpp、renderer_canvas_render.h、renderer_canvas_render.cpp、renderer_canvas_render_rd.cpp、rendering_device.cpp、main.cpp、canvas.glsl、canvas_sdf.glsl。
说白了,官方发布与设计文章:4.4 发布说明、4.3 发布说明、渲染依赖图、4.4 dev3 快照、4.6 dev5 快照、PR #92797、PR #112481。
官方样例与素材(编辑器截图与美术):godot-design 仓库(4K 编辑器截图,CC BY 4.0)、Godot 4.6.png(CC0,2559×1369)、官方截图类目、Godot 主类目。许可与出处:官方许可页、官方美术与商标、下载归档(版本核对)。Godot 名称与 Logo 属商标,配图与说明不得暗示官方背书。

相关链接(社区与竞品口径):官方论坛 2D 批处理讨论、caimouse《Godot 源码分析(四)》。
本机一手产物:evidence/a_48dev_vulkan.txt、evidence/b_48dev_d3d12.txt、evidence/c_48dev_opengl3.txt 三份 --verbose 启动日志,出自同一二进制、同一台机器、只改 --rendering-driver 一个量;另有 0 字节的 evidence/d_45stable_vulkan.txt,对应 4.5.stable.official.876b29033 非 console 构建、stdout 不落管道。本机读数用的引擎版本为 4.8.dev.custom_build.7177493c1(2026-07-03 构建),设备为 RTX 3060 Laptop GPU 与驱动 560.70,与官方稳定版 4.7.2(2026-08-18)、开发版 4.8-dev7(2026-09-29)都不等同,本机读数只在「本机」口径下成立。
本清单的原则与前几章一致:每条结论都指到它那一层的原始出处,官方文档与源码里查不到对应命名的说法,本清单不收。
下篇预告
下一篇把镜头压到 Scene 层,专讲 CanvasItem 与 Viewport 的真实约束:第二篇。
With Best Wishes.