实时渲染管线探析
从 G-Buffer 讲到 GPU-Driven,一条管线走完。按「这一章要解决什么 → 怎么解 → 代价是什么」的顺序写。
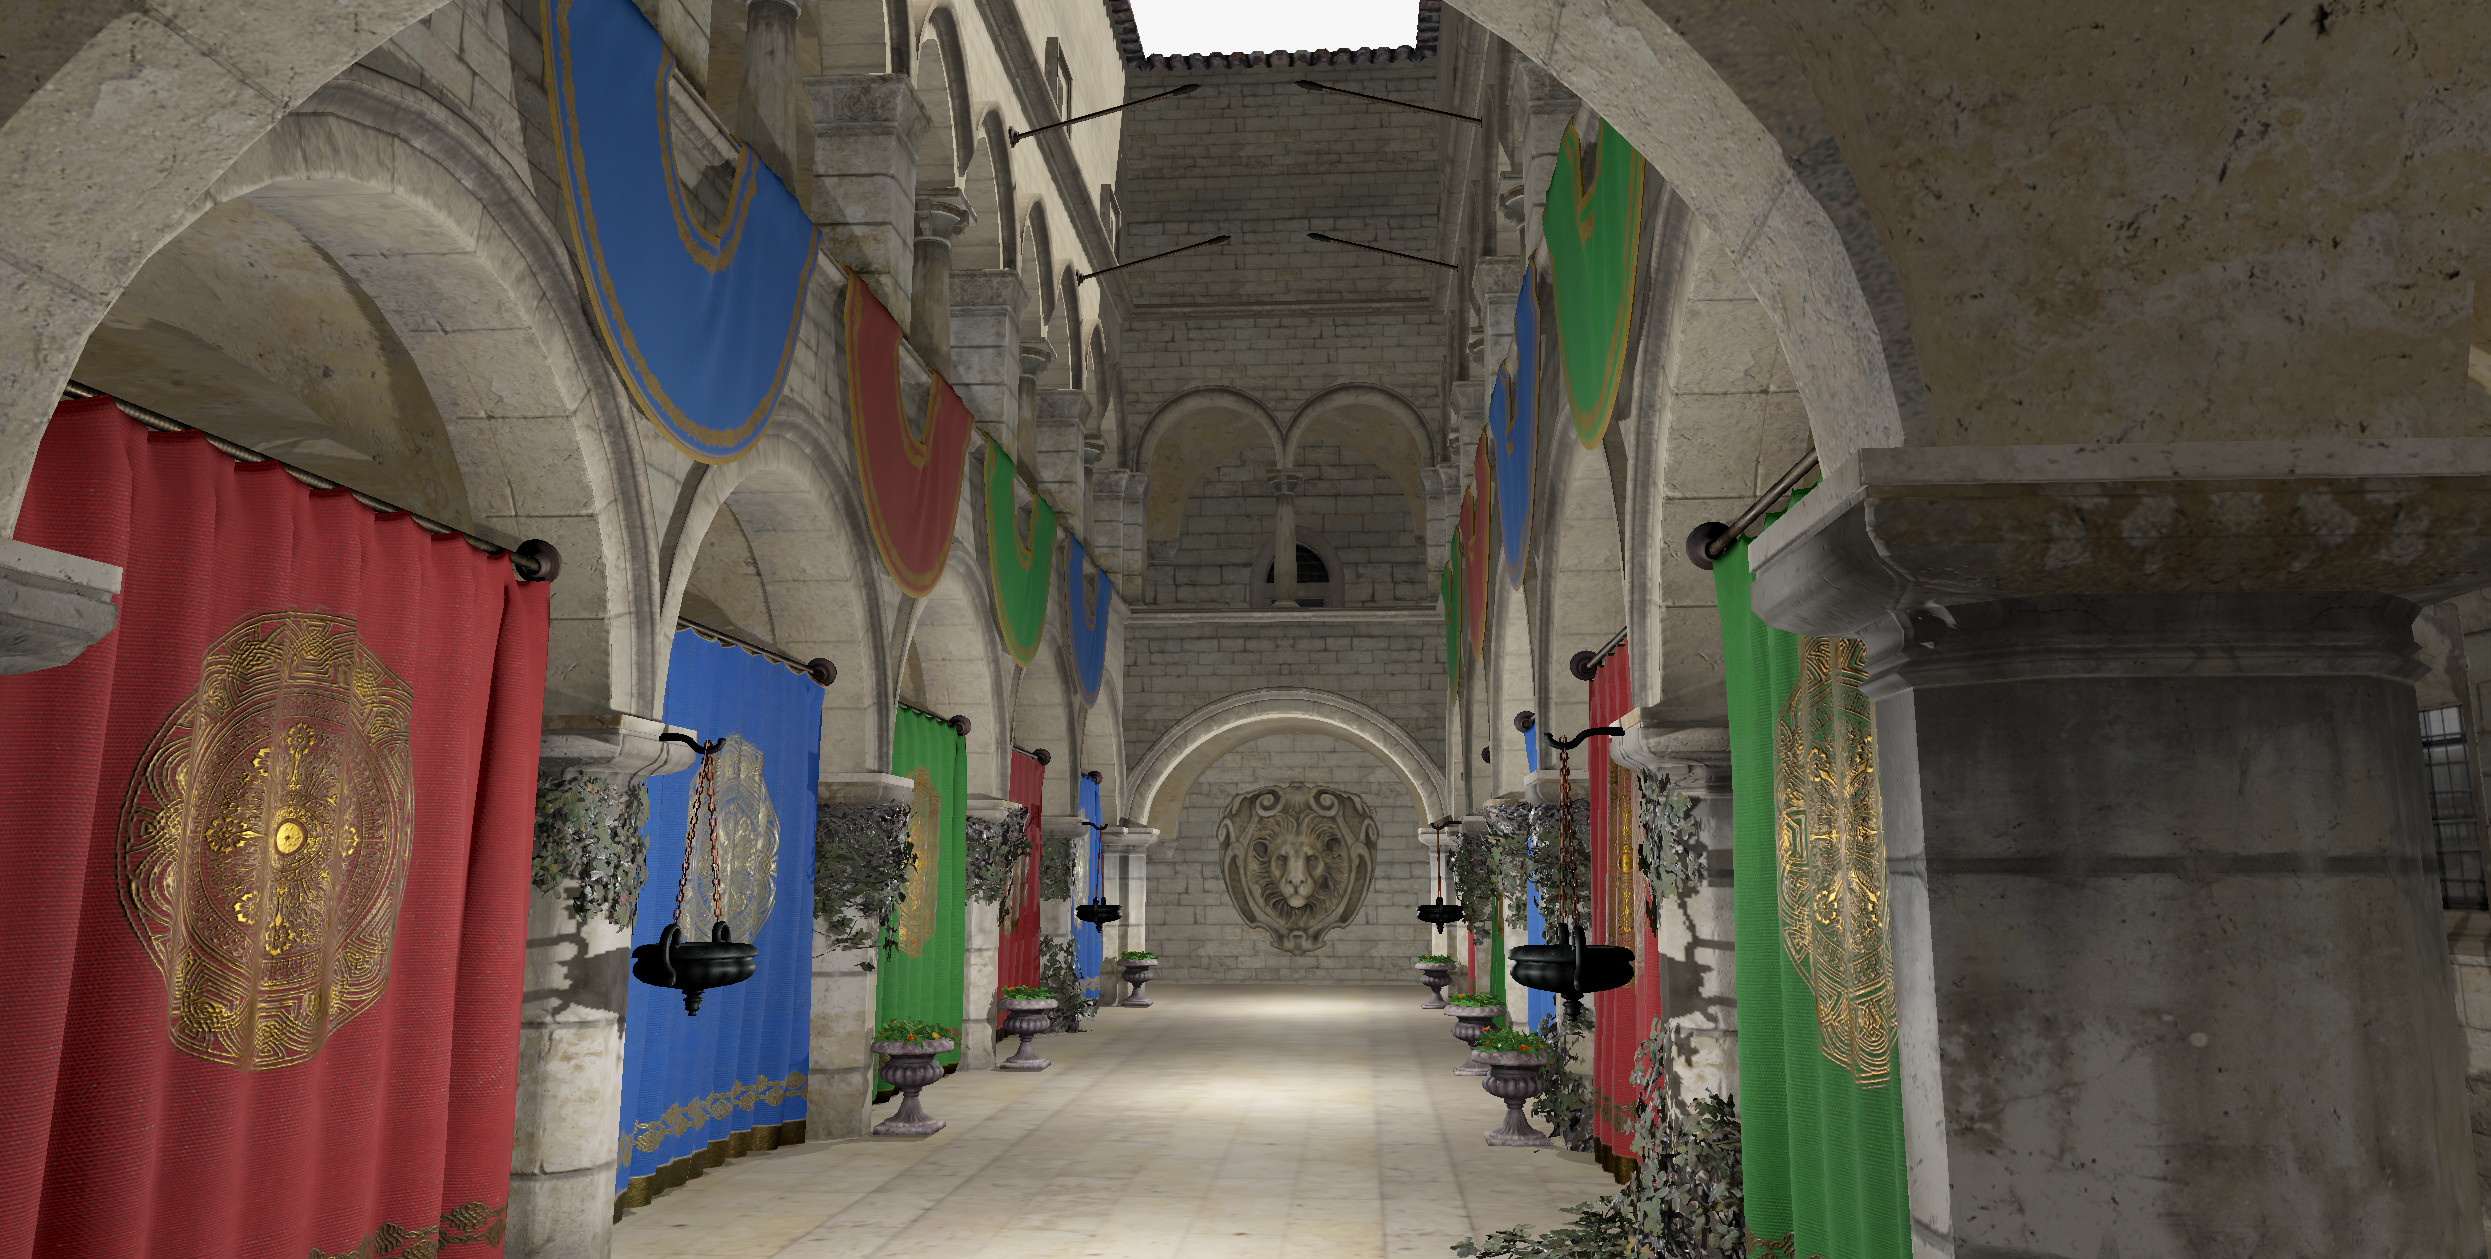
延迟渲染:从原理到实现的性能权衡
从 G-Buffer 的通道布局讲到光照被推迟到屏幕空间之后付出的带宽代价,逐项拆开延迟渲染这笔性能账。
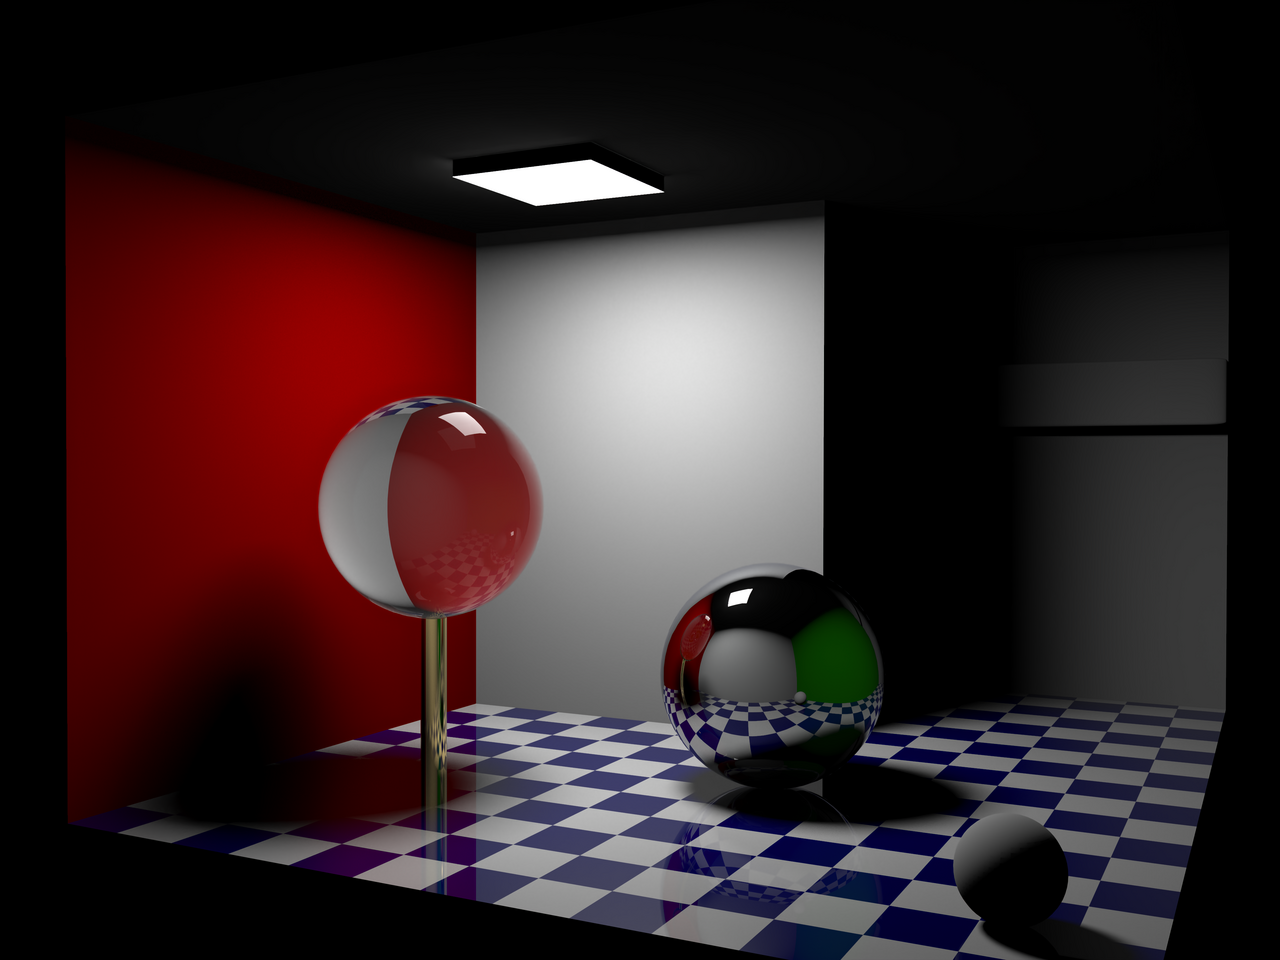
阴影贴图:从 PCF 到 VSM 的演进
从 PCF 的采样数一路推到 VSM 的矩估计,把阴影贴图这条演进线里每一步近似和它的失效条件讲清楚。
后处理链:Bloom、色调映射与抗锯齿
从 Bloom 的降采样链讲到色调映射的算子谱系与 TAA 的时间累积,把每一步近似和它糊掉或闪起来的代价讲清楚。
基于物理的渲染:从渲染方程到工业实践
从渲染方程的积分讲到 IBL 的预滤波与 BRDF LUT,逐项拆开 PBR 每个近似项、以及工业界两套工作流怎么取值。
可见性与剔除:从视锥到 GPU-Driven
从视锥剔除的六个平面一路推到 GPU-Driven 与 meshlet 提交,算清「宁可多画,不可漏画」这条规矩下每一步剔除的收益与代价。
移动端图形与功耗
从分块架构、带宽与功耗墙出发,讲清移动端图形为什么必须在约束里做取舍。
两台不同的机器:移动 GPU 的物理约束
从「同一份渲染代码,桌面流畅、手机烫手」出发,讲清移动 GPU 与桌面 GPU 是两台被不同物理约束塑造的机器,并把后续六篇要展开的两道墙(带宽与功耗)先立成前提。
分块渲染:binning、片上内存与它的代价
从「把 framebuffer 搬到片上」这条主线出发,拆开 TBR 与 TBDR 的两阶段机制,把 binning 开销、片上内存溢出与 resolve 三笔账逐项算清。
带宽:移动端最硬的那道墙
把一帧的字节账从头算到尾:附件、纹理、几何与隐式流量各占多少,四类降带宽手段各自能省下多少,以及省下的字节怎么折算成毫瓦。
功耗与热:帧率为什么会掉下去
把"为什么会掉帧"从温度阈值换成一本预算账:整机每秒付得起多少焦耳、一帧要花多少焦耳,两者相除得到可持续帧率;再讲清热惯性滞后、预测式控温与测量口径这三个中文资料普遍没讲透的环节。
延迟着色在移动端:能做什么、不能做什么
把延迟着色从"移动端不适合"这句话里救出来:G-Buffer 落在主存就是约 10 BU 的账,留在片上就是 1 BU,而片上预算硬卡在 128 bit/像素。三章讲清"能做什么",三章讲清"不能做什么",再给出三家引擎的官方硬约束与可复现配置清单。
现代特性落地:VRS、网格着色与移动光追
把三个"现代特性"放在同一本账上算:VRS 会被实现按规范静默降回 1×1,网格着色在移动端因提交侧开销反而更慢,光追的独立管线会丢掉帧缓冲压缩。共同判据只有一条——有没有破坏片上流程。
测量与调优:怎么证明你真的优化了
「优化生效了」是一个可证伪的测量命题,不是一个感觉命题。三条线缺一不可:口径线管读数怎么来(1% low 的两种算法能对同一份数据给出相反结论)、噪声线管差值能不能信(峰值不等于持续)、统计线管差值算不算成立(同机交替切片 + 配对差值 + 差值置信区间)。终篇回收前六篇的量化结论,并如实标出哪些在现有工具下证明不了。
GPU 架构剖析
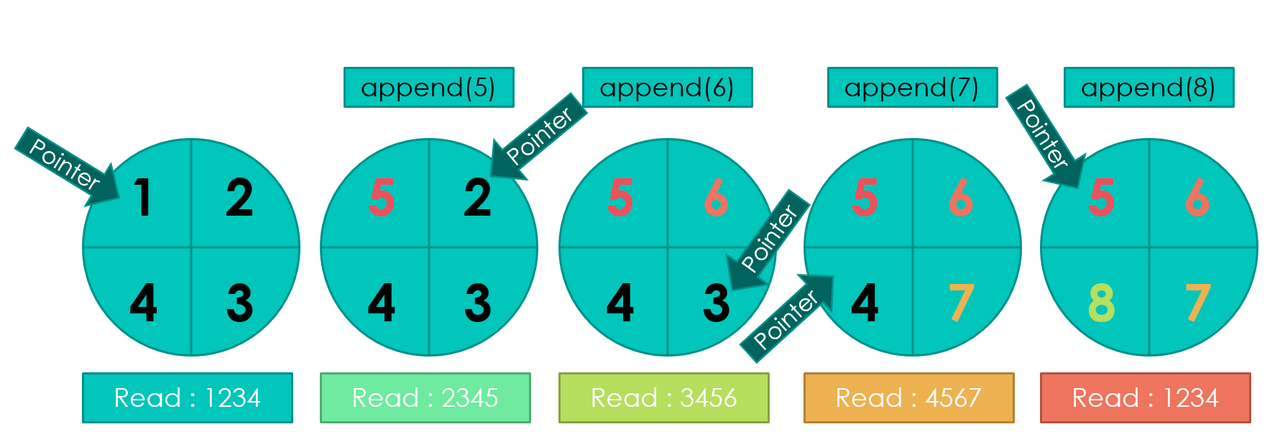
从一行 API 调用返回,到命令处理器把它捞出来,看见 CPU 与 GPU 之间那层决定无数性能问题的协议。
一次 Draw 走了多少路:从 API 到命令前端
从一行 API 调用返回,到命令处理器把它捞出来,中间隔着五层软件栈、一块环形缓冲与一颗专用状态机。本篇把这次 Draw 提交的完整路径逐段拆开,讲清楚 CPU 与 GPU 之间这层薄薄的、却决定了无数性能问题的协议。
显存与地址空间:带宽极高,延迟也极高
显存的带宽常年是几百 GB/s 起步,可一次访问的延迟却比一级缓存慢上百倍 —— 同一块存储的两副面孔。本篇把存储层次、地址空间、页表与 TLB、页错误与有效带宽逐层拆开,讲清 GPU 到底靠什么把「快的带宽、慢的延迟」消化成能用的画质。
着色器核:SIMD、波前与占用率
显存的延迟压不低,GPU 的办法不是去压,而是用足够多的线程把等待盖住。本篇把着色器核拆开:一个核里装了什么、占用率的两套口径、谁把占用率卡住、从「装得多」到「发得出」,最后落到占用率对图形阶段效率的影响。
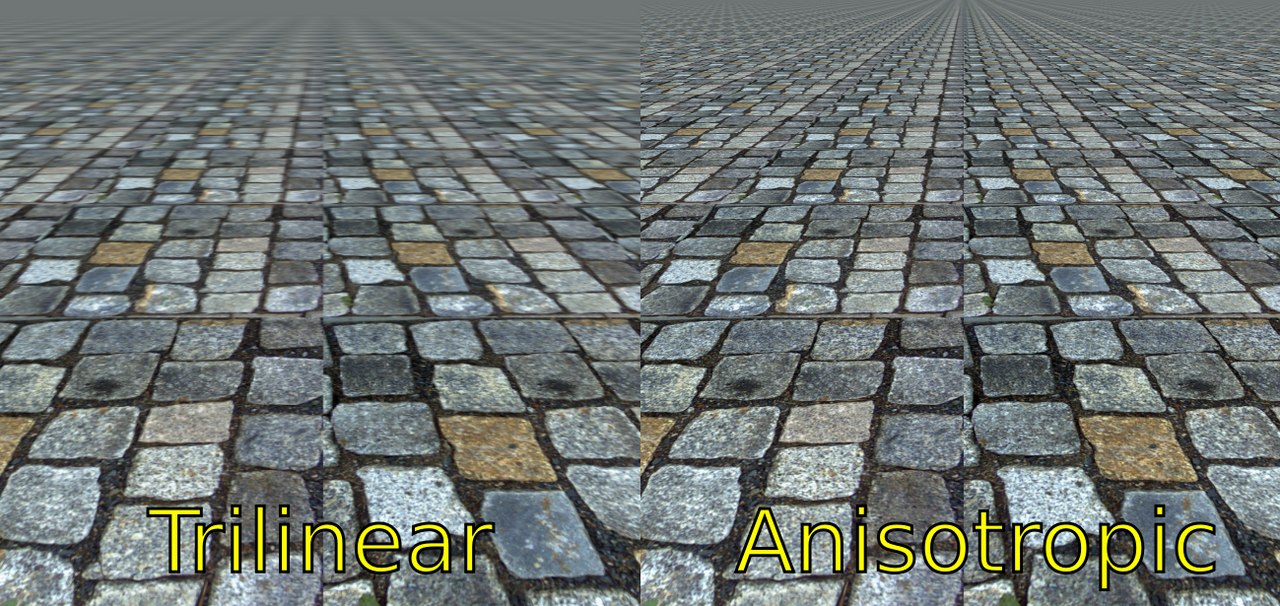
纹理采样器:一条几百级的流水线
一句 texture(...) 背后是一条几百级的深流水线。本篇把纹理采样器拆开:采样请求怎么进 TMU、坐标怎么换算、滤波(bilinear/trilinear/AF)怎么落地、LOD 从哪来、缓存与压缩怎么把取数那一头省下来,最后算清「几百周期延迟怎么被并行盖住」。
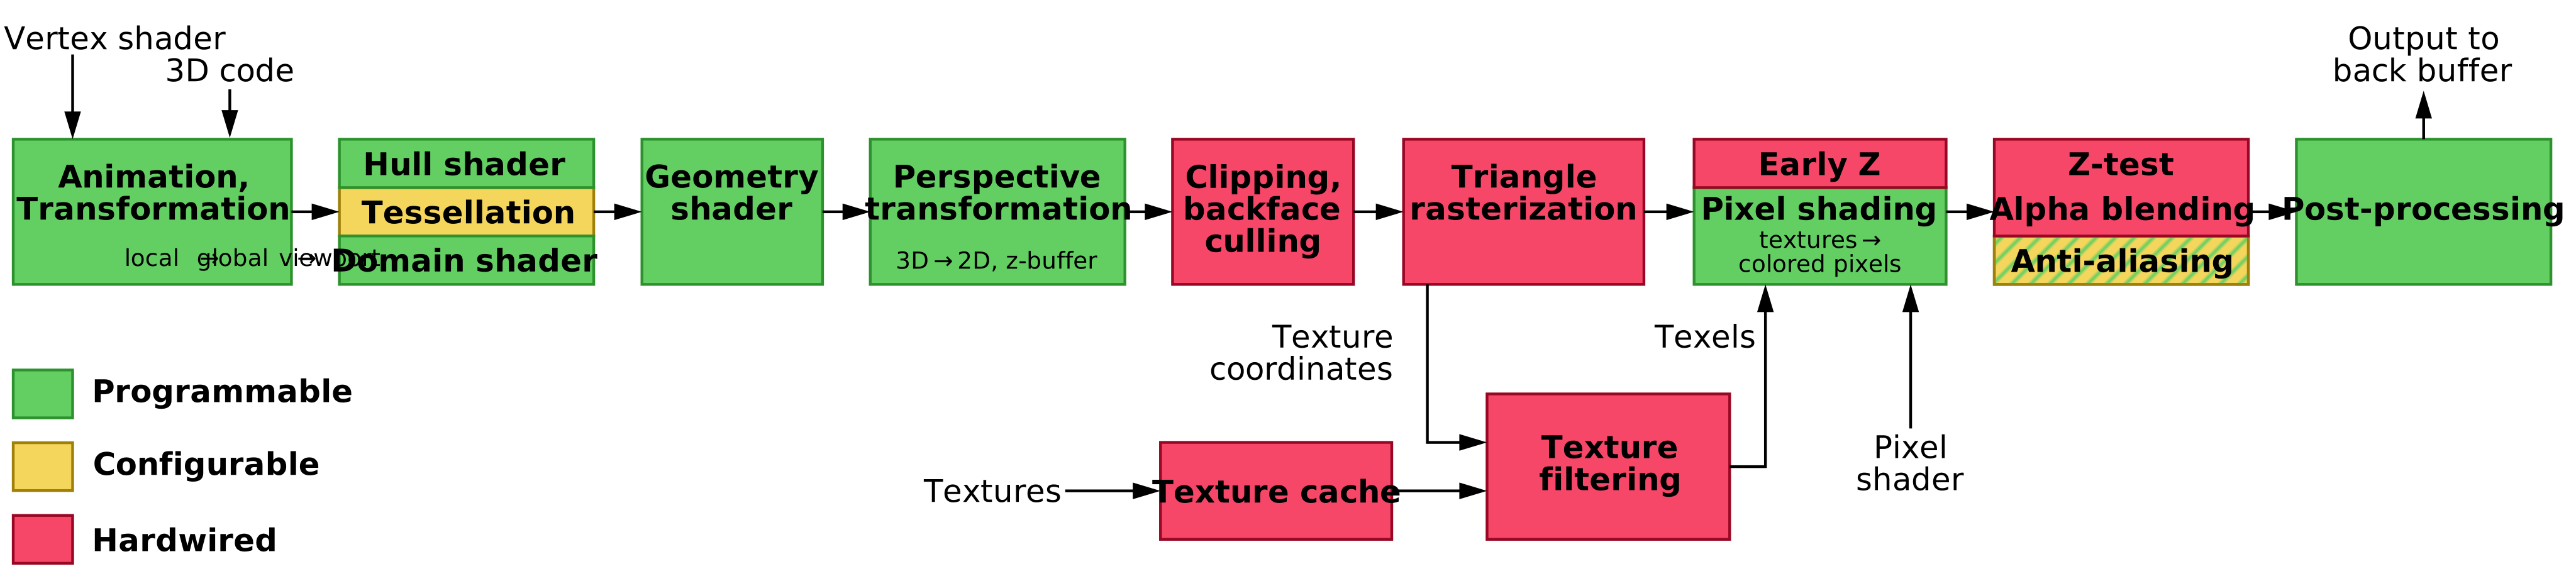
图元装配、裁剪与视口变换:屏幕坐标是怎么定下来的
顶点着色器算完 clip 坐标,屏幕上的像素位置不是它定的——中间还压着一整段固定功能。本篇把装配、透视除法与视口、裁剪与 guard band、背面与退化剔除、前端几何引擎逐层拆开:离散顶点怎么被捆成图元、clip 坐标怎么变窗口坐标、硬件为什么用护栏区兜底而很少真正逐元裁剪,最后落到可核对的账与实战排雷。
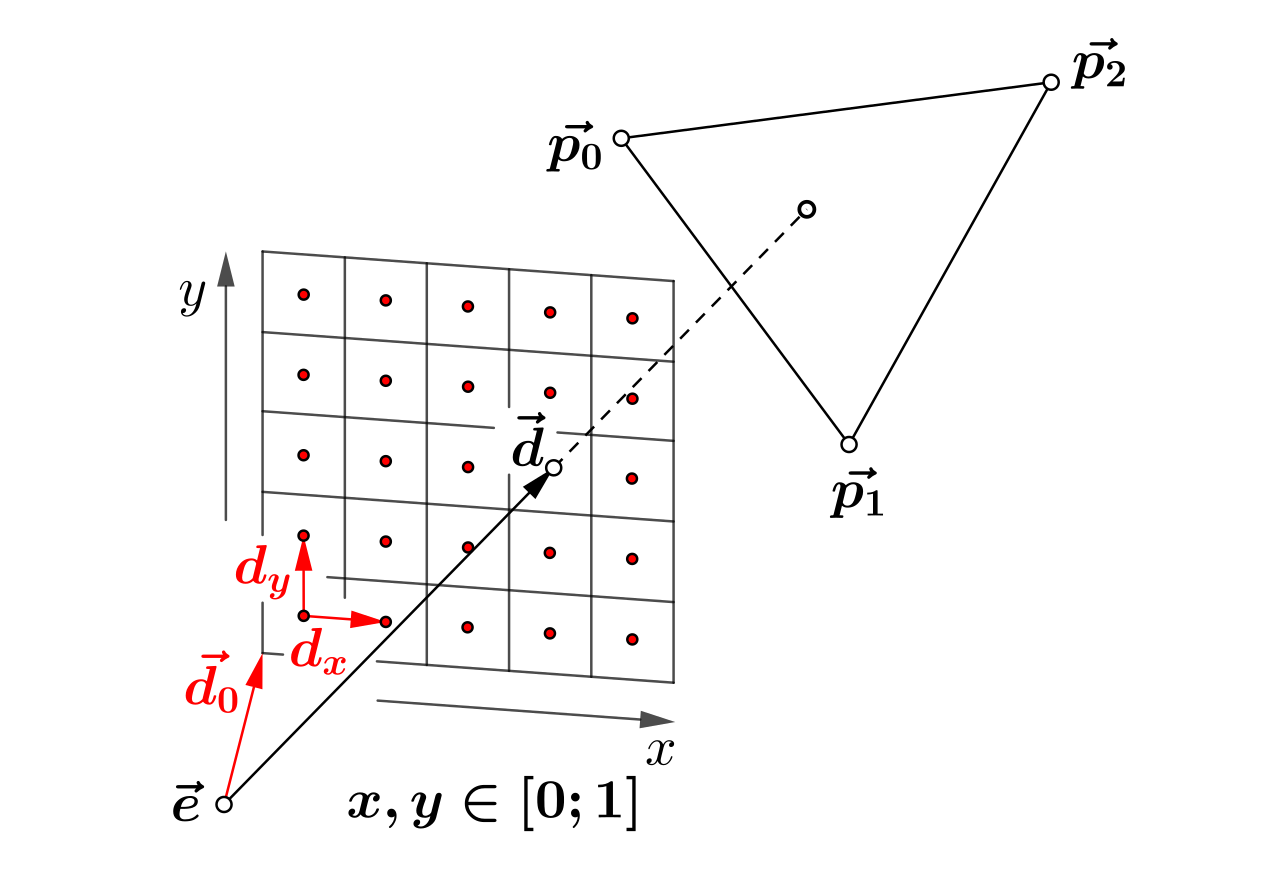
光栅化与三角形建立:边函数、填充规则与小三角形
顶点进了光栅化,屏幕上的像素到底由谁、按什么规则被三角形填上色?本篇把硬件实现层逐层拆开:setup 阶段的一笔账、Pineda 边函数怎么在硅片上算、bounding box 与扫描转换、顶左规则为什么保证共享边只画一次、重心坐标与透视校正插值,最后落到小三角形为什么那么贵、三角形怎么被分块 dispatch 到多光栅引擎。
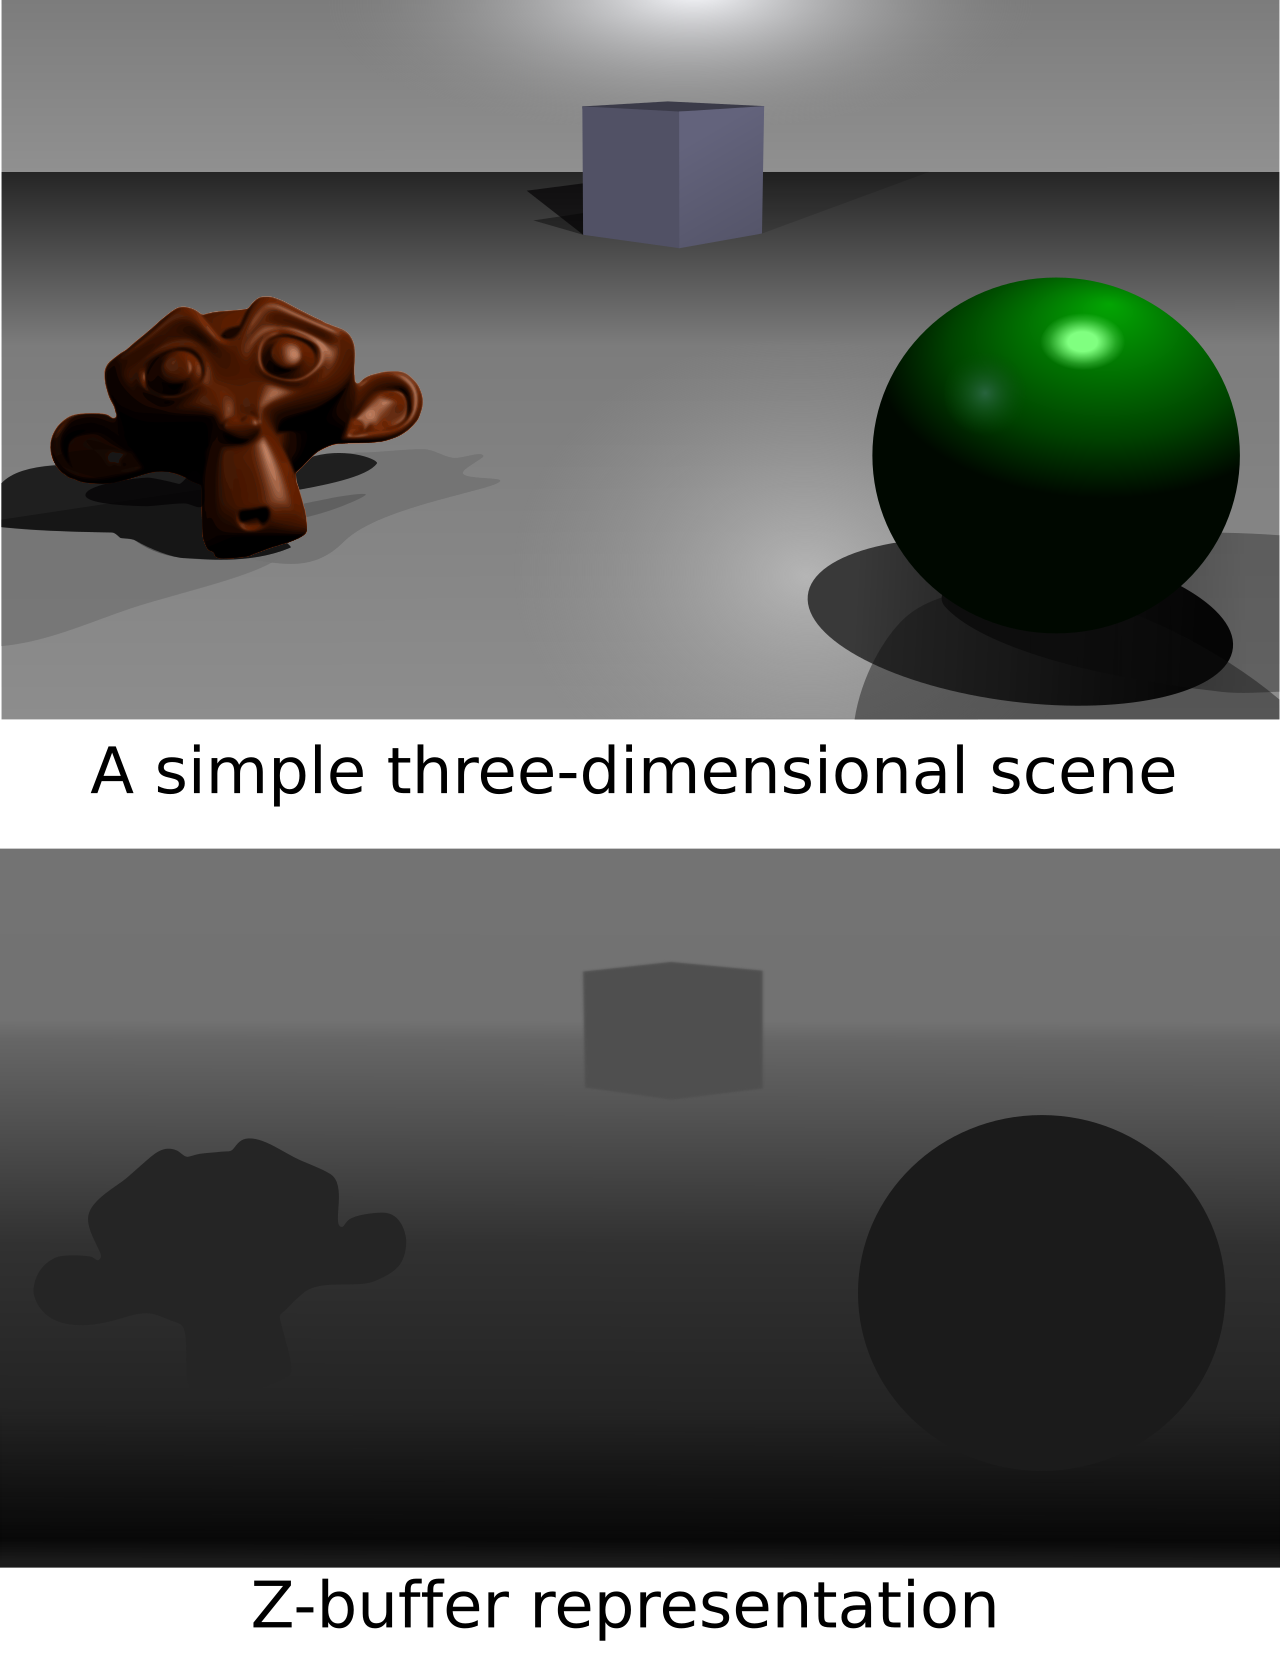
Z 缓冲与隐藏面消除:early-Z 到底什么时候生效
光栅化把每个三角形变成了带插值 z 的像素流,屏幕上一个不透明物体怎么保证"后画的盖住先画的"?本篇把深度缓冲当作管线里的"第三张图像"来读——深度写、深度读、early-Z 什么时候能提前、什么时候必须退到 late-Z,再到 stencil 这个附在深度上的通道,最后落到 TBDR 把整条 hidden-surface 换成另一个算法。全篇收在"early-Z 省的是着色、HSR 省的是着色加纹理、Z 压缩省的是带宽"这笔可核对的账上。
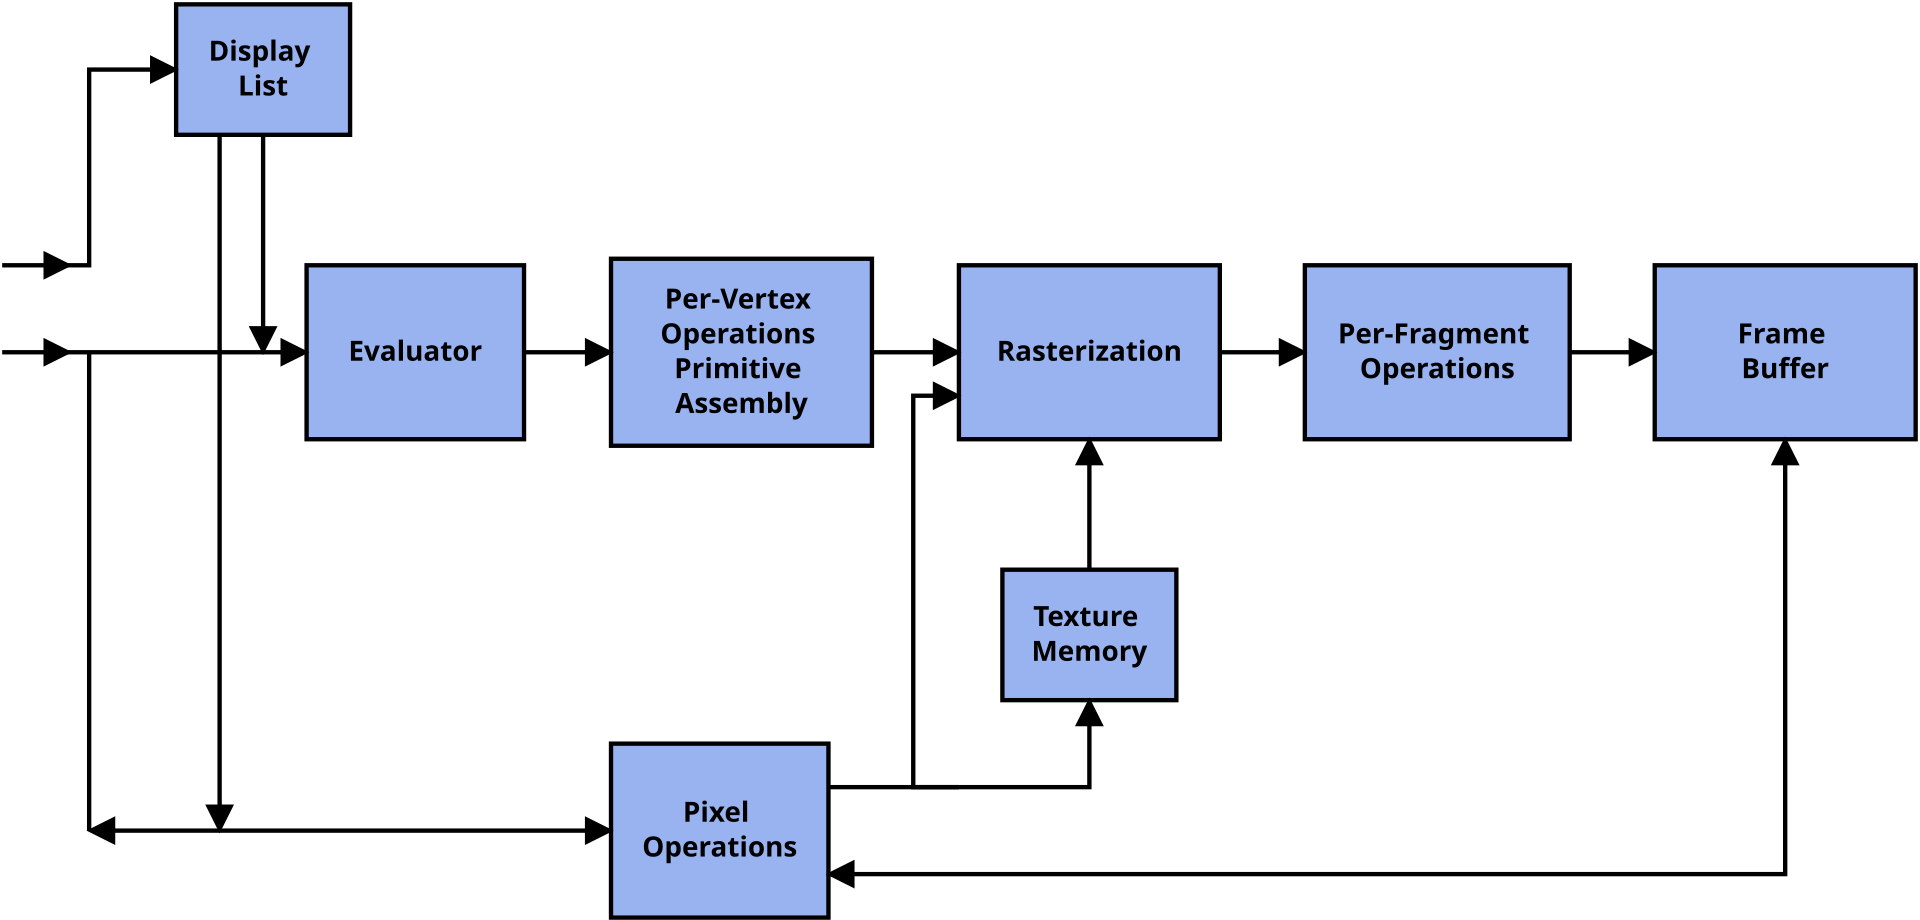
像素后端:fork/join、ROP 与那笔带宽账
光栅化把三角形倒成海量像素流之后,这些颜色、深度、模板、覆盖信息要怎样真正"落"进显存里那两块缓冲?本篇把像素后端当作整条管线唯一一个汇合点来读:光栅厂 fork 派发 quad、着色之后 join 回 render target,ROP/Output Merger 怎么在最后一站做深度/模板测试、混合、格式转换与写回——再到 overdraw、颜色/深度压缩、MSAA resolve、TBDR 的 HSR 这些带宽账在同一个地方结算。全篇收在"为什么像素越少,像素后端的工作未必越少"这句反直觉的话上。
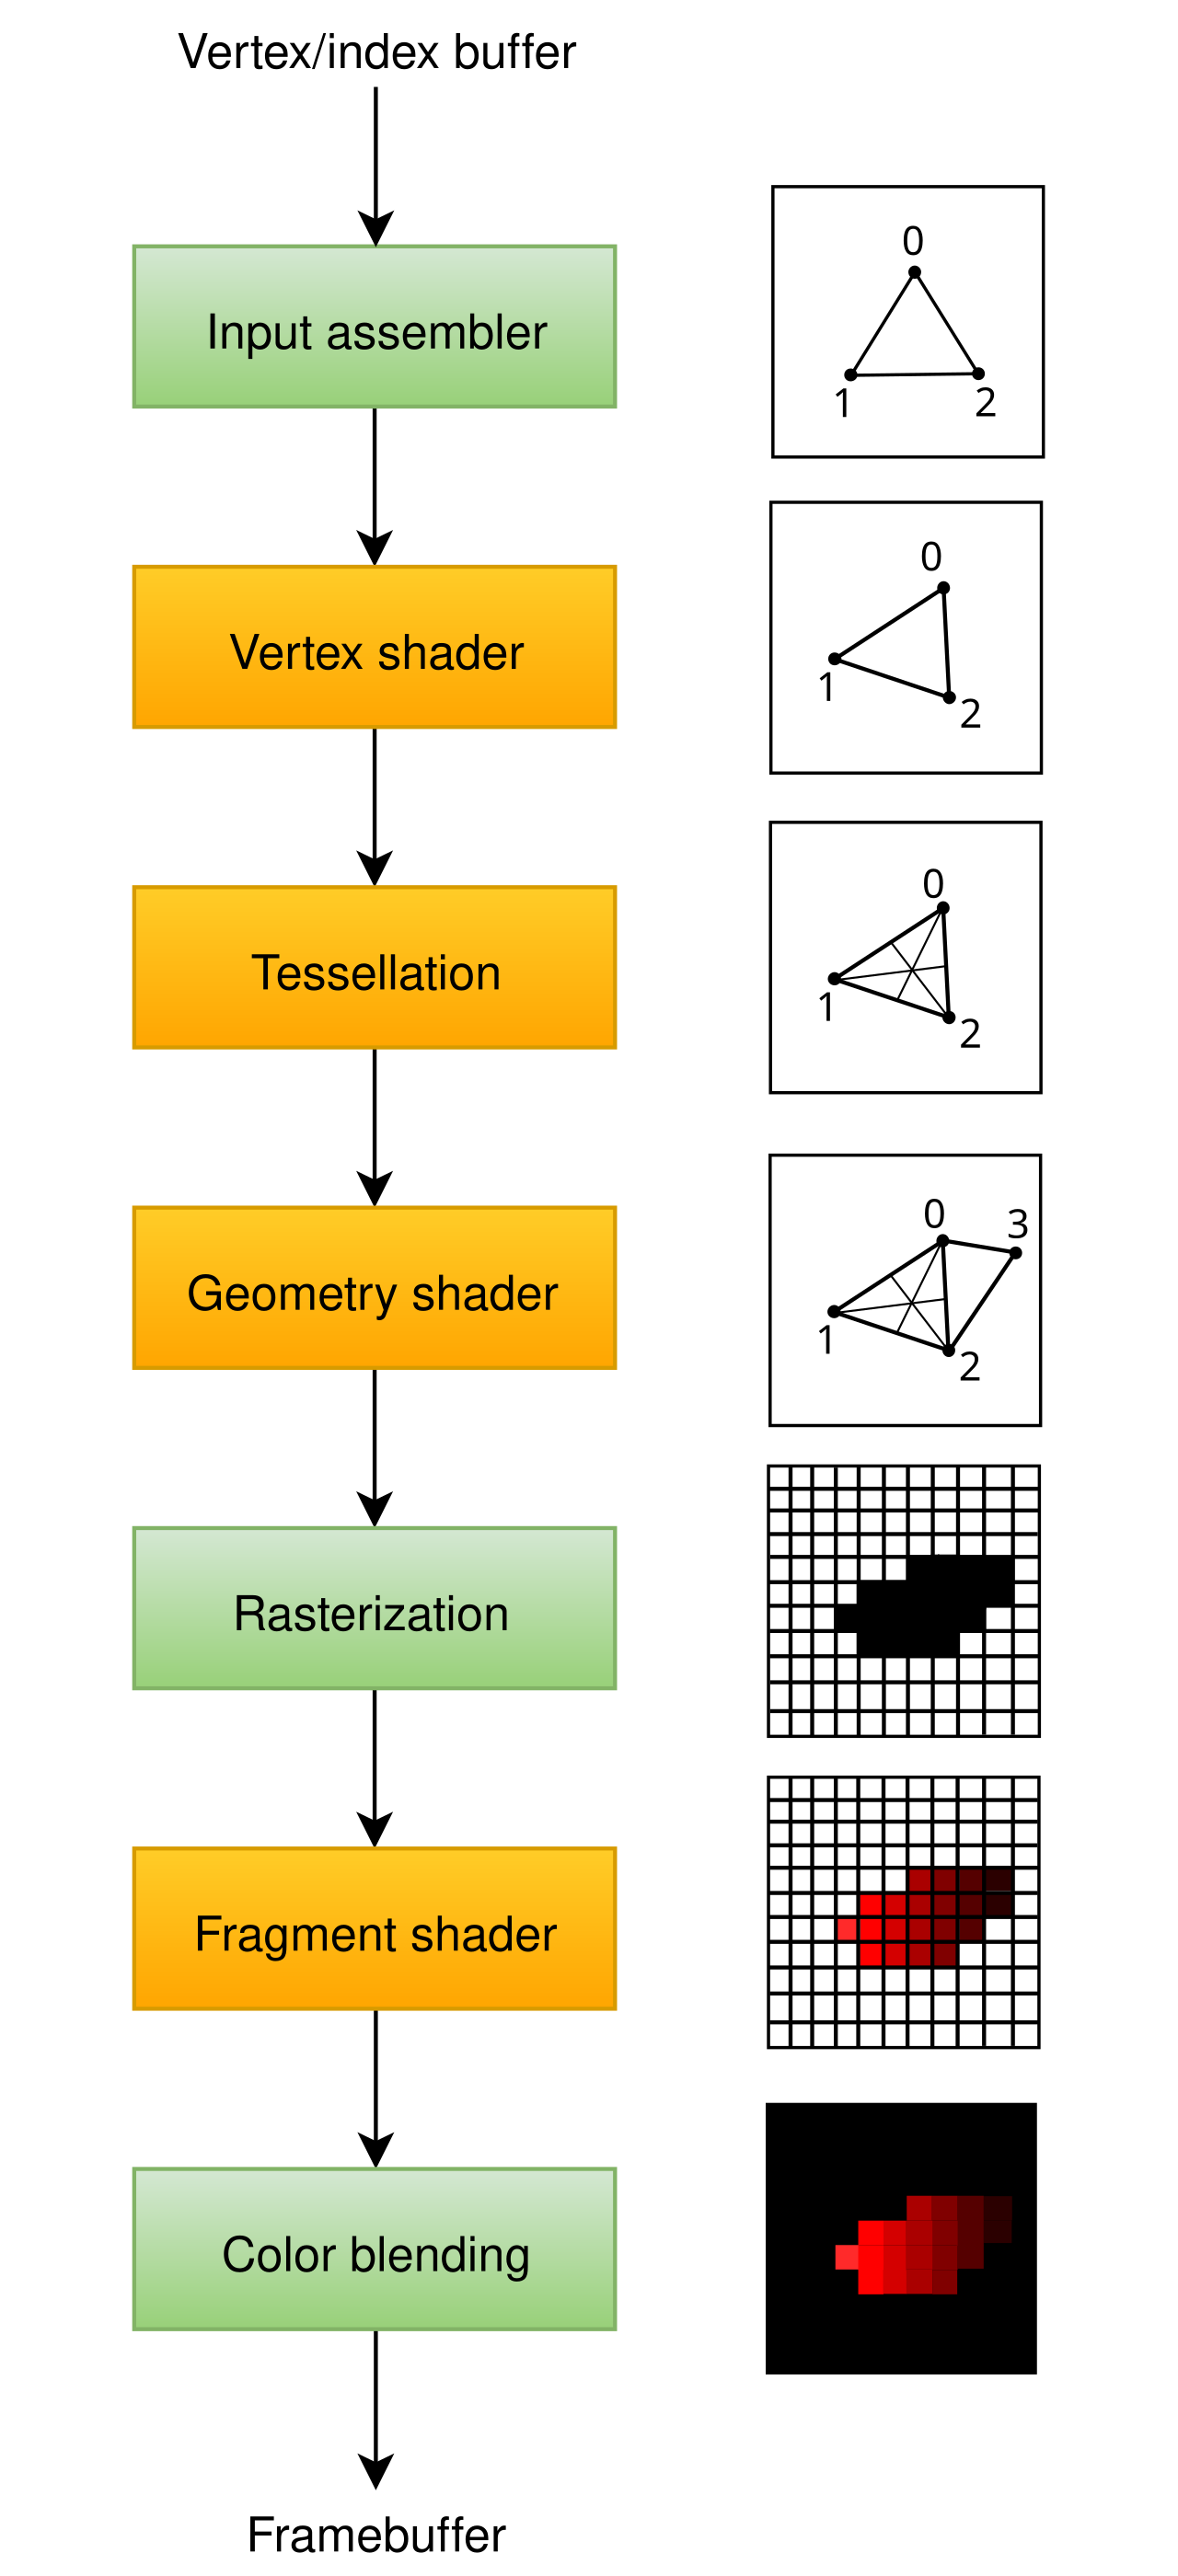
几何前端:几何着色器、流输出与细分
图元装配把顶点连成三角形之后、光栅化把三角形倒成像素之前,GPU 上还有一段能改变图元命运的"几何前端":几何着色器按图元改/生成图元、流输出把顶点旁路写回内存、细分把低位图元按 patch 铺细。本篇把这三件事当作同一条几何前端来读——二次装配、不可预知的输出规模、成倍增长的顶点流,每一笔都是改变图元形态的量价账。全篇收在"GS 的能力常被计算着色器与 mesh shader 取代"这句对几何前端的告别上。
计算着色器:波前、共享内存与三种屏障
上一期告别了几何着色器(GS)之后,"按图元改几何"这件事被迁移到一整套更通用的模型里——计算着色器(compute shader,CS)。它不把线程当作 OS 线程,而是当作一个只有 32 条 lane 一起前进的执行单元原子(波前/wavefront);它自带一块能协作的共享内存(shared memory / LDS);它用屏障(barrier)在不同层级间建立可见性。本篇把 CS 当作"GPU 上的并行计算模型"来读:波前怎么被调度进执行槽、共享内存的 bank 化排布与冲突代价、三种屏障各自贵在哪里、occupancy 的"占得高不等于快",最后算清 CS 为什么成了 GS 之后新的几何引擎。全篇收在交棒 ep11 同步与资源生命周期、ep12 mesh shader 的预告上。
同步与资源生命周期:为什么「看起来没画出来」
前面九期我们把 GPU 的硬件环节一个个拆完了。可很多第一次写完一帧的人都会撞上同一个怪现象:命令明明提交了、API 也没报错,屏幕上却「看起来没画出来」。这不是渲染错,而是同步与资源生命周期的问题——CPU 和 GPU 之间隔着一个巨大的异步鸿沟,资源从「被上一个用途用」切到「被下一个用途用」,中间那道转换没被正确声明。本篇把「规范怎么写」和「硬件实际怎么做」分开讲:fence、semaphore、barrier、event 这些同步对象只是正确性规则的「遥控器」,硬件真正执行的是 cache flush、pipeline drain、fence register 写标记、跨队列一致性切换。全篇把提交、可见、资源身份三笔账摊开,用四段误用代码+修复收拢,落到「范围与对象」的判据上,最终交棒给 ep12 的 2011 之后的机制变化。
2011 之后:哪些机制变了,哪些没有
十一期把 GPU 的硬件环节一个个拆完之后,这一期回答收官问题:从 2011 到 2026,那张硬件地图上哪些位置被改写了、哪些一动没动。全篇走判定式而不是编年史——每条机制都落到三个问题:它替代了 2011 年的哪个环节、代价转移到哪一侧、哪条原本由硬件兜底的保证被降级了。变的三处是几何前端被搬进可编程阶段、绑定模型换成 bindless、工作发起改成节点图;另有专用单元(求交硬件化)、固定功能按需降级(VRS/FDM/SER)、渲染目标与片上内存显式化、硬件形态(chiplet/HBM)四条横向演化。没变的四处是 SIMT 波前、固定功能光栅与 ROP、纹理采样器、以及留在应用侧的同步职责。所有性能数字按规范事实、厂商宣传、第三方实测三档标注。
2D 矢量引擎深挖
同样是把矢量变成像素,为什么五套做法完全不同的引擎能同时活着?这一系列先立坐标系(通用 2D 与领域专用 × CPU 几何与 GPU 几何),再沿 Skia 主线把机制走完,中间穿插三次本机自跑,最后与 Vello 前沿和 Godot-2D、Cairo、Rive 三个对照项合流。每篇结论都要求可复现的读数;不搬运厂商官方配图。
2D 矢量引擎全景:五款引擎各在哪个生态
同样是"把矢量变成像素",为什么五套做法完全不同的引擎能同时活着?本篇先把坐标系钉死——横轴「通用 2D 到领域专用」、纵轴「CPU 几何到 GPU 几何」,Skia、Vello、Cairo、Godot-2D、Rive 各占一格;再用一张五维对照表(生态位 / 几何在哪算 / 后端 / 典型负载 / 成熟度)把"谁在什么位置上"落成可核对的一行行,并为后续十篇立共同词汇与图序。最硬的证据是本机自跑的三组真实像素:同场景 Skia Raster 非白像素 59,531(drawPath 连跑 50 次 13.29 ms,折合 0.2657 ms 每帧)、pycairo 59,573(4.11 ms,0.0821 ms 每帧)、Edge canvas 66,762——两个软件光栅的像素数相对差只有 0.07%,而耗时一律不可跨栈比较;Vello 侧按项目方季度进展更正两处常见说法:Classic 之外是 CPU 与 Hybrid 共享 sparse strips 核心,beta 只落在 Hybrid 一支,且 AnyRender 与 imaging 已把前沿与主流放进同一抽象层。全部读数来自官方原文或本机实测,可复现。
Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
这篇钻入主线引擎 Skia,把「一次 draw」从 API 面拆到像素:SkCanvas 收下命令与状态,交给 SkDevice 这道抽象,再由它把同一条命令路由到 CPU Raster 或 GPU 后端(Ganesh 与 Graphite),三条路的像素产出物相同、代价结构不同。用本机 Skia m144(skia-python 144.0.post2)跑出可核对读数:Raster 侧同场景 drawPath 连跑 50 次共 254.02 ms(折合 5.0803 ms 每帧)、非白像素 88,771;同几何同尺寸下 Edge 的 Skia GPU 侧与之做像素并置差分,通道均差 0.083、最大差 3,两条实现路径在像素结果上高度一致;但 Raster 的 5.0803 ms 每帧与 Edge 的 GPU 栈读数(ANGLE + D3D11 + RTX 3060 Laptop,UA Edg 153)非同一条调用栈,任何拿它们直接比大小的结论都是假的。全篇 26 图位里,PictureRecorder 记录与 128→256 多尺寸回放、Canvas 四态、Paint 四态都是本机逐像素实截;唯一的边界是 Graphite 本篇只立与 Ganesh 的「即时 vs 延迟」分界线,内部机制留给下一系列。全部结论来自官方原文或本机实测,可复现。
矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
这篇把镜头再往前推一格:曲线在变成像素之前,先要变成什么。全篇沿「曲线→线段→覆盖率→灰度」一条动线走。几何侧:Skia 的扫描转换器只认直线段(源码原句),一条曲线最多折 2⁶ = 64 段、细分一次误差降为 1/4、目标精度 1/8 像素;Skia 特有的 conic 按 0.25 像素容差折成 1..32 条二次曲线;GPU 侧由 Wang 公式按 1/precision 像素反算段数,而 conic 的变体出自 Zheng-Sederberg 的有理版本——实现里多一个权重变化项 dw,这正是它无法照搬 Wang 公式的原因。覆盖率侧:Skia 的解析 AA 把扫描线放在三类几何变化点上,再用「排除面积」把复杂的交集算成两个三角形,于是三角路径只要约 3 + H 条扫描线,而 16 倍超采样要 4H 条。本机实测给出三组读数:H = 340 时解析 AA 340 条对超采样 1,360 条、H = 1000 时 1,003 对 4,000(比值 3.99);AA 开关的边缘像素 alpha 分布(关闭时中灰像素 0 个、开启后 882 个);解析覆盖率与 16 倍超采样的逐像素差(271 个边缘像素上最大差 0.0976、平均 0.0232,超采样只有 17 个档位)。三套工业实现——Skia AAA、FreeType ftgrays(8 位子像素、单遍扫描)、Cairo tor(逐行在解析与超采样之间二选一)——并置一张表对照,结论是数学内核一致、分歧全在「为谁优化」。前沿收在两条分界线上:Vello 的 4×4 tile 与 Graphite 把 painter's order 编码成 z 值降 overdraw。全部结论来自官方原文或本机实测,可复现。
字形光栅化:字形数据组织、blob 与 CJK
这篇接着上一篇往下钻:路径怎么变成像素已经讲完,这一篇换一种输入,讲「字」是怎么变成可绘制的东西的。全篇沿「字符→字形 ID→轮廓与度量→位图→缓存」一条动线走。引擎侧:Skia 自己不光栅化字形,它把难的部分交给平台后端,自己只做编排与缓存——`SkTypeface::unicharToGlyph` 遇到缺字返回 0 而不是报错,`cmap` 未映射一律落 glyph 0(.notdef),所以缺字最终表现成方框而不是空白。数据侧:`glyf` 表没有索引,靠 `loca` 相邻两项之差定位,坐标是增量、flag 用三态压缩;二次弧与三次弧(CFF/CFF2)在同一文件里共存,复合字形用引用换体积——这些设计的目标都是「文件更小」。缓存侧:字形 ID 加子像素位置打包成 20 位键(低 2 位子像素 x、16 位字形 ID、第 18 位起子像素 y),`kSkSideTooBigForAtlas = 256` 决定何时换承载形态,默认预算 2048 条 / 2 MiB,而本机枚举 3 字号 × 23 汉字 × 4 子像素档就已产生 372 个不同键。本机实测给出可核对读数:Arial 对四个汉字全部返回 glyph 0、宋体返回 4487/1117/1913/4502;同一字形在 4 个子像素档下得到 4 张互不相同的位图,关闭子像素后只剩 2 张(0.00 与 0.25 落回同一张);MONO 输出只有 0 与 255 两级、coverage 输出出现 160 个中间灰度;汉字墨迹 91×44 对拉丁 69×35。CJK 侧用一组公开工程数字把「难在哪」量化:4 万+ 码位、未压缩 TTF 约 22 MB、209 个 chunk,而瓶颈在 WOFF2 压解(约 80% 的计算)而不是 shaping。边界:本篇只讲到 shaping 的接口为止,GPU 后端的 op 组织留给下一篇。全部结论来自官方原文或本机实测,可复现。
Skia GPU backend:覆盖 approach 与 instanced tessellation
这一篇把前四篇一直没检验的前提拿掉:那些工作都由 CPU 干。同一条路径、同一个字形交到 GPU 手上之后,引擎的第一性问题不再是「怎么算准覆盖率」,而是「怎么把一次 draw 变成一串 GPU 愿意接受的指令」。全篇沿「draw → op → render pass → 实例化绘制」一条动线走,并把 GPU 侧的全部数字逐字落到官方源码常量上:管线阶段定位、四条画路径的路(模板两步法 / 覆盖式 AA / 固定次数实例化细分 / CCPR)与三条分法、覆盖式 AA 的裙边插值与「一次主绘制 + 一次四顶点裙边绘制」的两段结构,以及实例化细分的核心数:**每实例基座四个控制点**(`PatchStride = 4*sizeof(SkPoint) + PatchAttribsStride()`),曲线类型靠 `p3.y` 是否为无穷来区分,`PatchAttribs` 八个位逐位释义;段数由 Wang 公式算出(精度常量 4 即 1/4 像素,单曲线上限 32 段,超 1024 段先 `PreChopPathCurves`),三角形按 middle-out 拓扑排、段数是 2 的幂、简单曲线靠退化三角形提前停下;描边则靠多带一个控制点换切线、join 固定 3 或 4 条边。上限落在索引位宽上(16383 条边;无顶点 ID 时回退 1024),撞上限不是失败而是分块,于是「上限 → 分块 → 绘制次数」成了 GPU 侧效率问题真正的形状。本机实测给出可核对读数:同路径抗锯齿开/关逐像素不同 1,603 个、覆盖率分布关闭时中间灰度 0 个而开启后 1,137 个、三个真实汉字轮廓的曲线构成为直线 115 段对二次 50 段(conic 与三次为 0)、弦高误差 4→32 段从 5.63 降到 0.09 像素。本篇还主动纠了两个流传说法:「每实例 5 条二次曲线 / 10 个控制点」源码不支持(那是属性条数上限),以及「Skia 用覆盖式 AA」不是全局结论(Graphite 这一代默认是 MSAA,官方承认它常被限到每像素 4 采样)。一条能力边界写在最前面:本机没有 GPU 抓帧环境,故 GPU 侧不写任何「本机实测」,只能用官方常量逐字引用。
Graphite:Skia 新一代 compute 后端
上一篇讲的是 Ganesh 这一代的答案,这一篇问「为什么把这一代整体换掉,以及换成了什么」。Graphite 换掉的不是某个算法的常数,而是录制与回放的边界——官方把它定位成「少而清晰的代码路径」并「默认多线程」。全篇按「谁在记 → 多线程边界画在哪 → 按什么顺序摊到 GPU 上」一条动线走:`Recorder` 产出 `Recording`、`Context` 负责插入与提交,一份录制只能 snap 一次、录制期有线程守卫与 256 MB 默认预算;Chromium 里实际开两个 Recorder(内容线在主线程、合成线在合成线程),`insertRecording` 有六种返回状态、「按录制顺序插入」是一条可以显式关掉的性能契约;抽象层复用 Dawn,代价是采样只到 4 倍(上层枚举能到 16 倍)、只支持 optimal tiling、绑定组布局被写成常量。绘制侧的关键是把画家顺序交给深度值:`SortKey` 用 16/16/2/30 四段位域拼成 64 位,命令按 sort z 递增排序后相邻同管线合并,没有着色描述的一律转成只写深度的绘制——裁剪因此不再需要裁剪栈,而是「裁剪 atlas 优先、只写深度次之、最后退让到直接绘制」三档。路径光栅化这一篇必须写准:源码里已经有 CPU 光栅与compute 着色器两条受限的 atlas 路线(`transient`、不支持就返回 nullptr),而官方博客用将来式谈的是不受 atlas 限制的通用 compute 路线,两者不矛盾但混成一层就是错。**一条能力边界写在最前面:本机既没有 Graphite 运行环境、也没有抓帧工具**,所以全篇 `src_*` 只做两件事——按官方常量与位域本机重算、把源码摘录并置,图注逐张写明口径,不冒充实测与抓帧;唯一的性能数字是官方自测的 MotionMark 1.3 约 +15%(MacBook Pro M3),并注明没有第三方独立复测。
自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
这是「自跑」系列的第一篇,也是本系列第一次把工具搬出来:同一段场景代码,分别交给 Skia 的 CPU 光栅与 GPU 后端各跑一遍,再把三件事量出来——两条路的输出差在哪些像素、耗时的量级差多少、以及同一条绘制命令到底碰了多少像素(overdraw)。前提先解决:Skia 官方文档写得很清楚「Skia does not create a OpenGL context or Vulkan device for you」,所以先用 GLFW 建一个隐藏窗口的 GL 上下文,`GrDirectContext.MakeGL()` 才会从 None 变成真对象;但 Python 绑定里缺了四样——官方的 overdraw 三件套(`SkOverdrawCanvas`、`SkOverdrawColorFilter`、`SkNWayCanvas`)与 `MakeMetal` / `MakeDawn`,于是 Graphite 在本机仍跑不起来。读数部分:同一场景两条后端逐像素比对,68.42% 完全相同、82,775 个像素有差(平均差 0.41、最大 57),差异集中在边缘——因为一侧算距离、一侧数采样;耗时拆成三列,CPU 随像素数近似线性增长(512²→1024² 约 3.9 倍),而 GPU 那一列只是提交时间,要等它画完必须再做一次同步。overdraw 这一侧只能自建:照 `SkOverdrawCanvas` 的语义逐条绘制取覆盖率掩码再累加,先用已知答案做 4/4 校验,再上三个场景——三层半透明叠层的全域平均触达 0.843、裁剪让被触达像素少了 50.1% 但命令数一条不减、画家顺序用错则有 30.3% 的触达是白做的。一条边界写在最前面:本机拿不到 GPU 片元着色调用数,所以本篇给的是「绘制触达计数」,是上界而不是等同。
自跑二:SKP 回放与字体渲染差异
这是「自跑」系列的第二篇:上一篇换的是后端,这一篇换的是**输入**——一份录好的绘制内容(SKP)与一批当场排的字。第一件事是把 SKP 拆开看:它录的是命令不是像素,所以体积跟画面复杂度无关、跟画面里有没有字高度相关——只有矩形的 SKP 是 173 字节,同一张 256×256 画四个中文字是 19,704,677 字节,与系统里那份字体文件(msyh.ttc,19,704,352 字节)只差 325 字节;同一串字改成轮廓路径再画,只剩 2,521 字节,差 7,816 倍。第二件事是回放:同一份 picture 序列化再读回来,像素误差为 0;交给 CPU 光栅与 GPU(GL/Ganesh)两条路,131,072 个像素里有 2,070 个不同(1.58%),差异全部压在字形边缘与圆弧描边上——差别来自后端,不来自文件。第三件事把镜头推到字体本身:hinting 改的是轮廓,kNone 落墨 1,062 像素、kFull 951,两者差 521 个像素、最大通道差 148;亚像素开关关掉时把八个位置压成三种栅格(最大通道差 231 的整格跳),打开时八档各不相同(每档都在 100 以内小步挪);打开它的代价在缓存键上——`SkPackedGlyphID` 每轴 2 位,一个字形最多 16 种键,对着 2048 条的缓存上限只够 128 个不同字形。两处零结果照实写:本机 kSlight / kNormal / kFull 三档落在同一张图上,`setLinearMetrics` 对像素影响是 0。
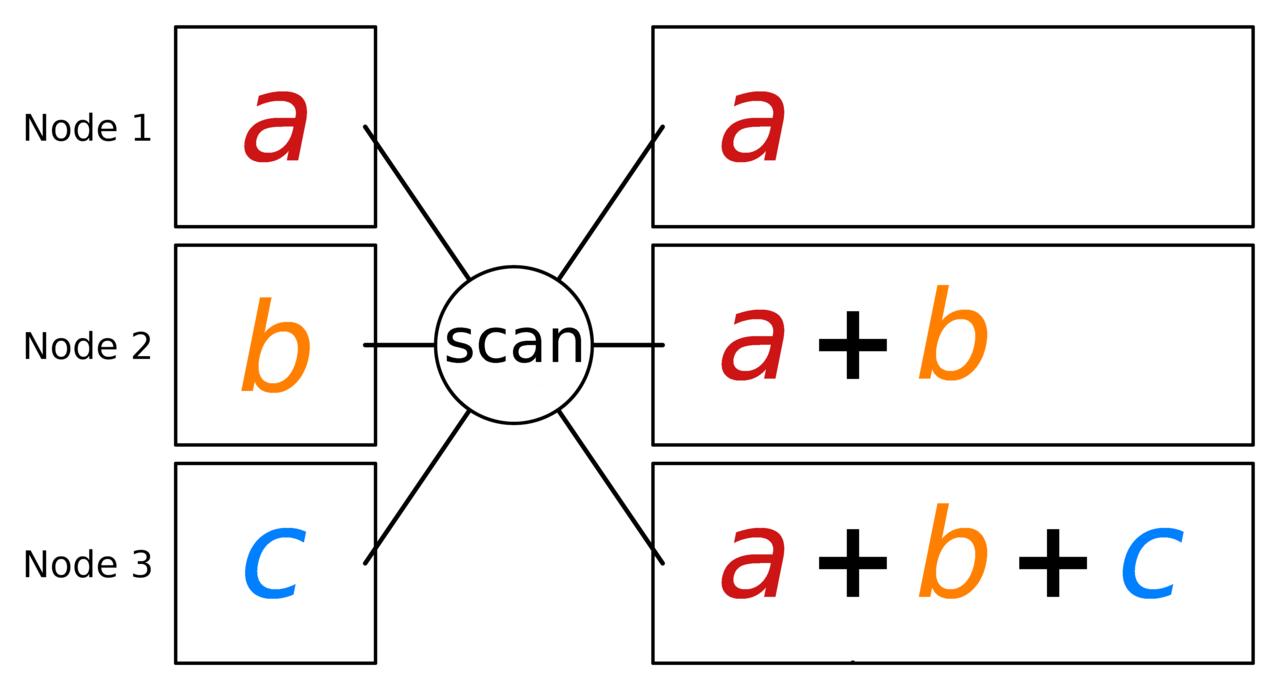
Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
前八篇都在 Skia 里,这一篇换引擎:Vello。开篇先纠正一处流传的说法——「Vello = GPU compute + prefix-scan + sparse strips」在 2026 年 9 月的仓库重构之后不成立了。官方架构文档现在写的是「two renderer families」:sparse strips 是 vello_cpu 与 vello_gpu 共享的架构,而重度的 compute 属于被搬进 research/ 的实验渲染器;最要紧的推论是 vello_gpu 并不要求 compute shader。机制部分把一条路径到一屏像素的动线拆成五站:展平、分箱进 tile、合并成稀疏水平条带、粗光栅出命令表、细光栅逐像素;并逐条引官方原句说清 prefix-scan 的位置(官方口径是排序、裁剪、分配与背景传播,不是曲线细分)。代价部分不是读来的,是本机在真 GPU 上跑出来的:用 wgpu-py + Vulkan(RTX 3060)写了两种 WGSL 块内扫描,单块 1024 与全局 1,048,576 两个规模都与 numpy 逐元素全等;把两种算法放进同一条三趟链路后,少做 5 倍加法的那一版(Blelloch,2,046 vs 10,240 次加法)实测反而慢 2.66 倍——原因是它的上下扫每一轮有效线程数指数衰减,而屏障次数固定。这条读数说明「工作高效」是串行模型下的指标,搬到 GPU 上预测时间会漏掉屏障与线程利用率。三条边界写在最前面:本机跑不了 Vello 本体(没有 Rust 工具链),所有算法级读数都标注「自写实现、非 Vello 读数」;时间戳只报比值(绑定未暴露 tick 周期);coat 这个阶段不存在、Potato 设计文档抓不到、官方没有专门的 draw order 文档——三处否定项不据记忆补。
自跑三:Vello GPU、CPU、Hybrid 三路对比
第九篇结尾写过一句「本机跑不了 Vello 本体」——因为没有 Rust 工具链。这一篇把这句话作废:装上 rustup 1.98.1 之后,Vello 的三条路线第一次在同一台机器、同一个场景、同一套计时口径下真跑了一遍。开篇先纠正一处实验设计错误:官方文档说「三条路」,但这台机器上必须拆成「四条」——vello_cpu 的 multithreading 与 f32_pipeline 都不在默认特性集合里,num_threads = 0 就是单线程,漏开这两项,你比的是配置而不是渲染器。四条路跑完的结论分三层:构建段上 hybrid 的 81.4% 时间花在单线程的 CPU 侧分条上,而 compute 的构建只有它的 7.5%;规模维度上,80 倍图元让四路的合计耗时分别涨 73.59 / 44.40 / 25.72 / 5.37 倍,多线程 CPU 与 compute 的分水岭落在 1800 到 2000 图元之间(受噪声影响,只给区间不给阈值);分辨率维度上,16 倍像素让 CPU 涨 4.7 到 4.8 倍,hybrid 只涨 3.42 倍。但这一篇最想写的是可信度:同一个配置下 compute 的单帧耗时能出现 3.8 与 26.6 毫秒两种模式,而在 CPU 基准路径里多写一次 PNG,它的读数就被抬高 2.30 倍——源码里的原因是 vello 的 run_recording 只提交不等待。输出侧另有一条让人安心的读数:在三条路线都判定为完全不透明的 75.6% 像素上,CPU 与 hybrid 的 RGB 最大差只有 2。
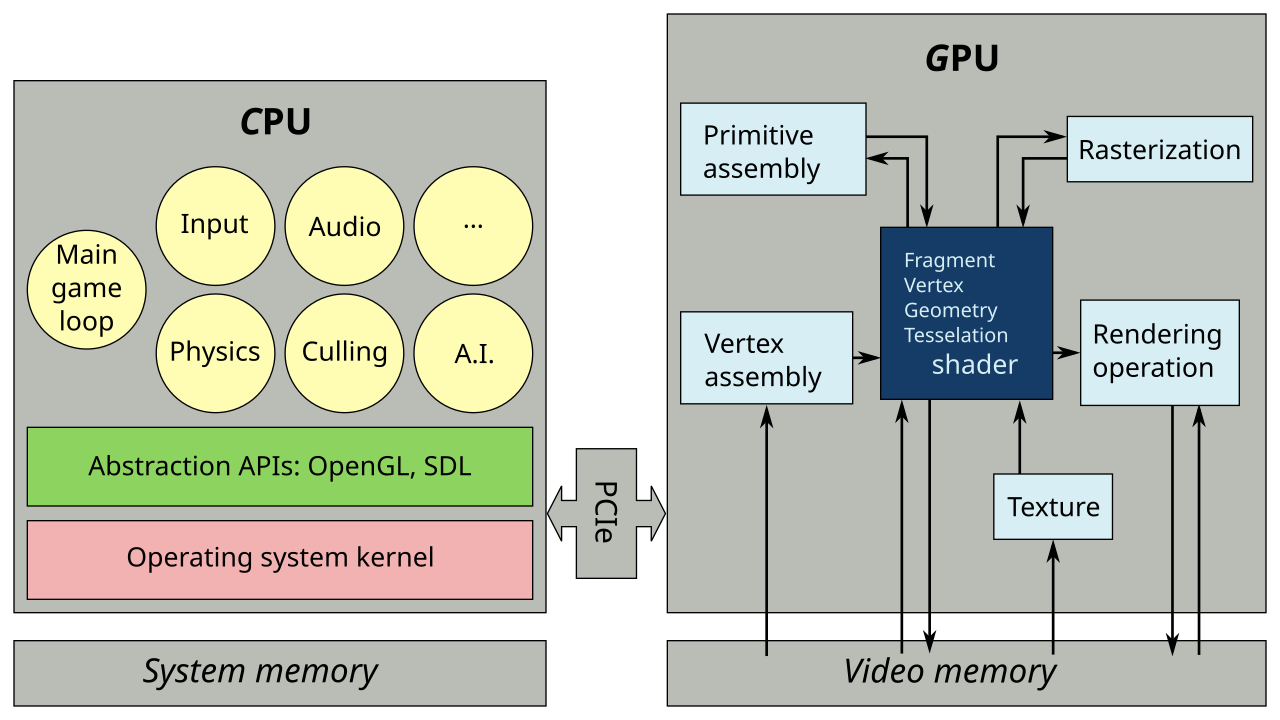
收官:与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
十一篇收官。前九篇每一篇内部都自洽,但篇与篇之间没有共同的度量——这一篇要补的就是坐标系。它只回答三个问题。第一,这五款引擎到底分几层?Skia 是图形库、Godot 2D 是游戏引擎里的一个子系统、Rive 是矢量动画运行时、Vello 是渲染器实现、Impeller 是 Flutter 的渲染运行时;把它们排成一行做表格看着整齐,其实是量纲错误——拿 Cairo 的「一次 fill 的耗时」去比 Rive 的「一次状态机切换的耗时」,分子分母完全不同。判据只有一条:它自己决定要画什么吗?第二,像素到底从哪来?只有三条路:CPU 光栅化、GPU 图形管线光栅化、GPU 计算。三条路决定了硬件门槛、单帧延迟特征与失败模式,也解释了为什么图形管线里没有「按几何求覆盖率」这一步,第三条路才会存在。第三,边界在哪?Android 图形栈内部、VFX 与粒子实现、跨引擎性能对比,全部只给指针不给机制——本篇一个跨引擎的性能数字都不引,因为那三套基准口径不可比。素材侧还有一条意外收获:Commons 上 Skia、Rive、Impeller 三个类目都不存在,而同批检索里 Godot、Cairo、Flutter、Vulkan、OpenGL 都有官方 logo。这条检索落空被写成了正文里的生态位证据——没有公共形象的技术,用户大概率也不直接与它打交道。Cairo 那一节给出了一个可迁移的判断:它在 2026-09-20 仍在发稳定版,同时被 WebKitGTK 换掉,两句都是真的,但说的是「项目还在维护」与「下游不打算再等」两件事。收官篇最容易失守的地方,是把十篇读下来的感觉写成结论;所以凡是没有出处的比较句,一律删掉。
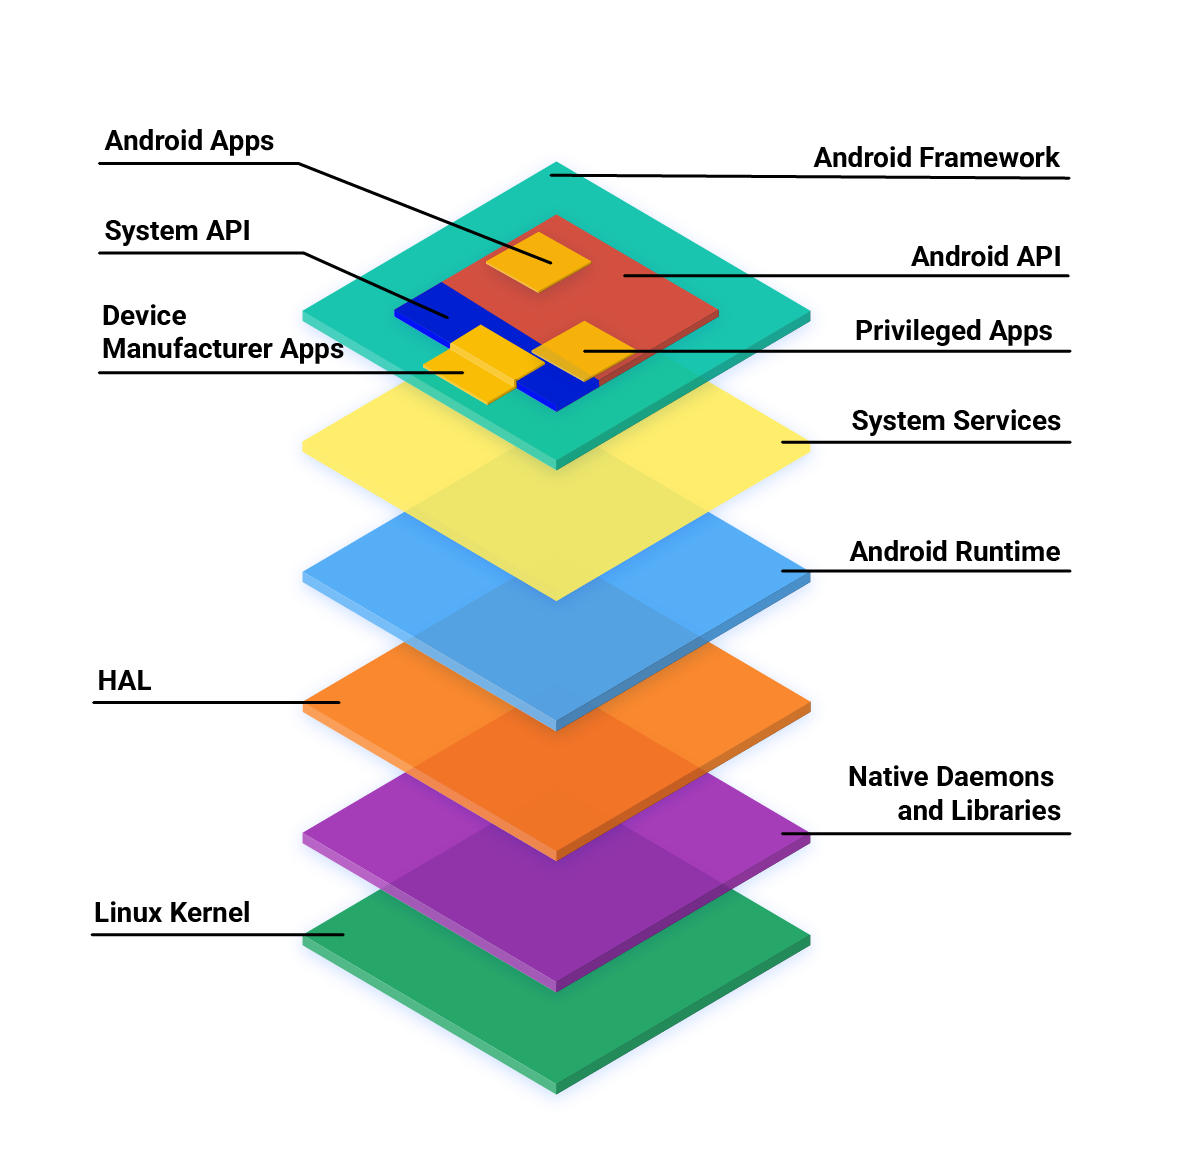
Android 图形显示系统
画出来不等于看得见。前七个专题讲的是「画面怎么被算出来」,这一系列只讲后半句:一帧从应用交出缓冲区,到屏幕亮起,中间经过谁的合成、谁的节拍、谁的叠加平面。以 AOSP 官方文档为主轴,把 Perfetto、Winscope 与 dumpsys 拿来做逐站取证;模拟器拿不到的那几件(真实叠加层决策、自适应刷新率、帧级时间戳)如实标注需要真机,绝不写成 Android 通例。
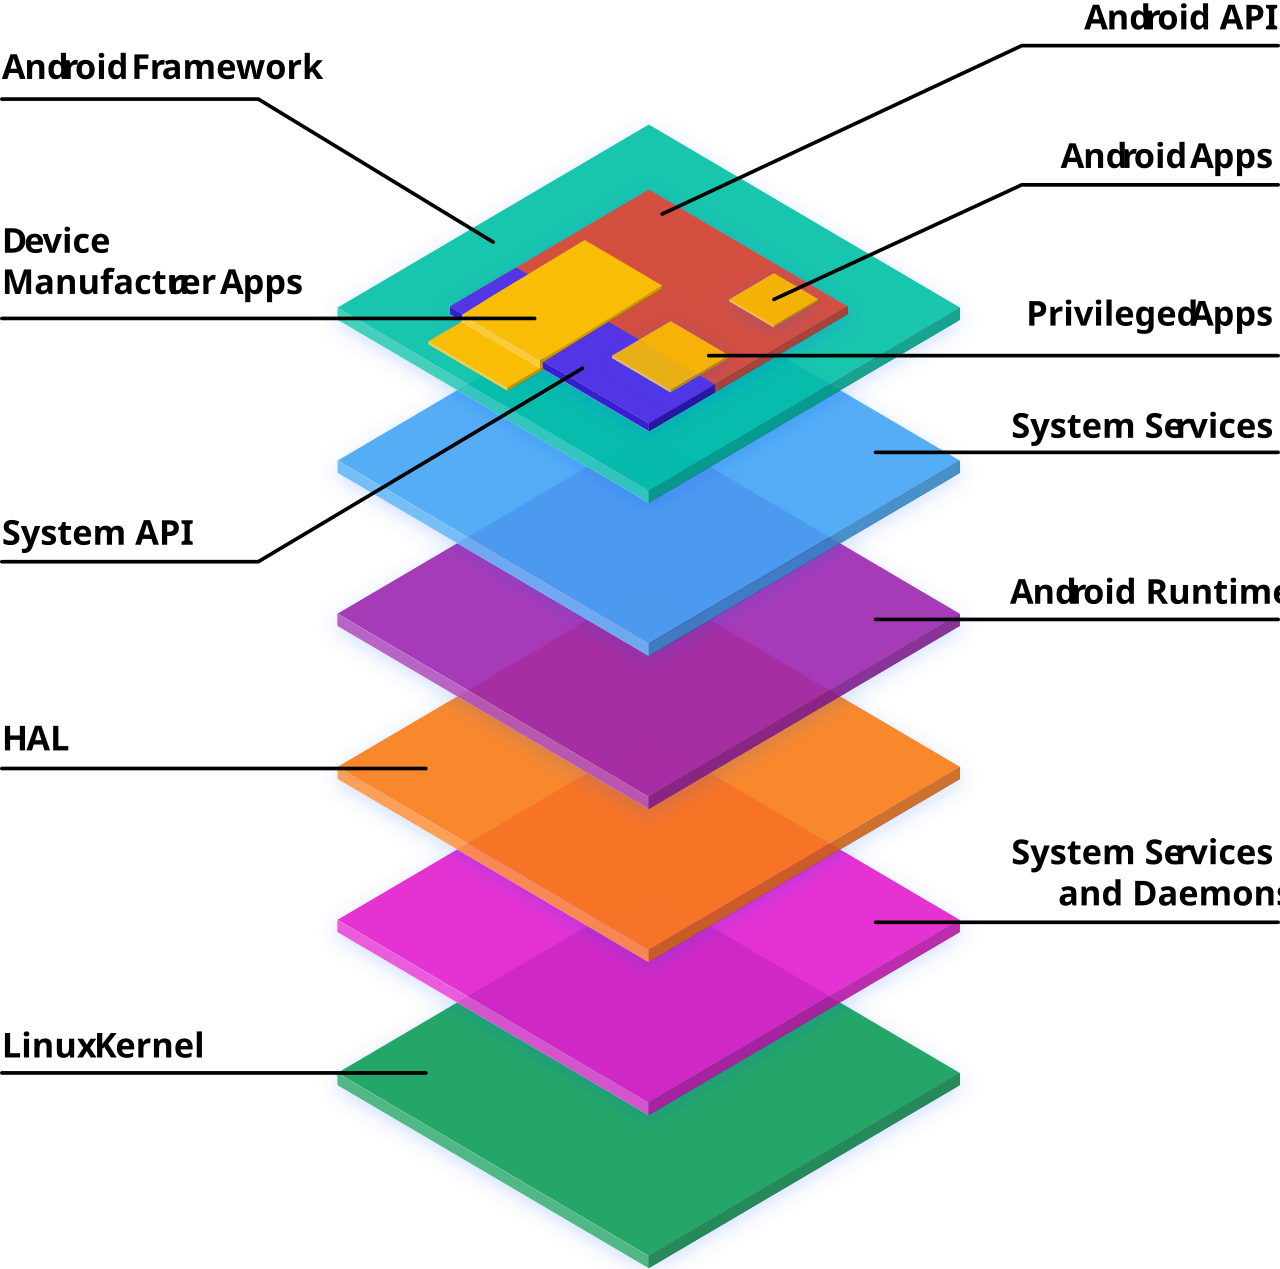
总览:从 App 到屏幕的图形管线
前面七个专题讲的都是「画面怎么被算出来」。这一篇换后半句:画好的帧,怎么合得上、上得了屏。一帧从触摸到亮起有六个阶段——输入、遍历、记录绘制命令、提交缓冲区、合成、上屏——分属应用进程、SurfaceFlinger 进程、Composer HAL 服务与显示控制器四个执行体,应用能直接控制的只有第二、三步。本文给出一张可以反复回来查的地图,并把它坐实到本机读数上:队列深度实测是 2 而不是流传的 3(Android Studio 文档里那个 0/1/2 是应用侧缓冲计数,两个数字量的是两头);合成本质是一道分配题,有限的叠加平面分给哪些层、剩下的交给 GPU 兜底,所以图层越多功耗越高——不是画得多,而是合成路径从硬件掉到了 GPU;那个刻意留出的 Vsync 相位偏移由 DispSync 从历史帧统计出来,是一个持续收敛的控制环,不是固定常数。顺带纠正两处流传甚广的归因:Vulkan 1.4 的强制要求来自 Android 16 起而非 17,16 KB 页的硬期限是 Google Play 的 2025-11-01。最后有一处失败值得知道:帧级时间戳在这套模拟环境里根本取不到,成因写进了正文,也正是第十三篇必须等真机的理由。
Choreographer:谁在召唤 Vsync
屏幕静止不动时,为什么 CPU 不归零?这一篇只盯住显示链路最靠前的一站。它给出一条「叫醒链」的四跳——显示控制器产生硬件脉冲、SurfaceFlinger 侧的 DispSync 分出两路软件脉冲、EventThread 按连接表分发、应用的 Looper 收到异步消息并进入五档回调。链条上没有任何一个应用在「召唤」Vsync,应用真正能决定的只有一件事:要不要继续订阅,而订阅是一次性的,不重订就没有下一拍。本篇用同一台机器、同一个应用、同一条命令的两个状态把它坐实:静止时 17 条连接全部是 VSyncRequest::None、reset 之后 framestats 是 0 行;连续滑动时变成 16 条 None 加 1 条 SingleSuppressCallback、帧数据 127 行。两次读数里 Periodic 恒为 0——这台机器上没有任何订阅者用过周期订阅,连正在高速滚动的那个也没有。顺带核清两处流传很广的枚举错误:回调是五档不是四档(Android 10 插入了 CALLBACK_INSETS_ANIMATION,TRAVERSAL 与 COMMIT 各后移一位);VSyncRequest 的核心三档是 None(−1)、Single(0)、Periodic(1),Persistent 是较新版本追加的而不是三档之一——后者正是本系列上一篇上线时踩过的坑,本篇把那次修正写进正文,作为「先核枚举名」这条纪律的实证。还交代了三层口径:官方文档里没有「空闲应停止请求 Vsync」的逐字表述,它是 AOSP 的源码实现语义;framestats 本机是 24 列驼峰式而文档是 14 列下划线大写;汇总段 p50 46 毫秒与逐行中位 85 毫秒其实量的是两个不同窗口。哪些是文档说的、哪些是源码做的、哪些是这台机器跑出来的,三层分开写。
RenderThread 与帧提交:从显示列表到一块缓冲
滑动卡顿到底是卡在哪一步?中文侧最常见的答案是「渲染慢」——但这句话没有回答任何问题,因为「渲染慢」至少是两件成因相反的事:UI 线程在等渲染线程交活,还是渲染线程在等一块可用的缓冲?前者多半是 UI 线程自己慢(或被位图上传卡住),后者多半是下游没把缓冲还回来。这一篇把这两件事拆开,并用本机实测的两组新读数把它量出来。第一组是逐帧的缓冲四列:dequeueBuffer 的中位数只有 26.9 到 158.6 微秒,但 90 分位跳到 9.4 到 14.8 毫秒、最坏 27.3 毫秒——240 帧里 5 毫秒以上的占 27.1%,而在最坏的那一帧上,等一块缓冲吃掉了 70.5% 的 CPU 侧帧时间;同一批数据取平均只有 3.4 毫秒,平均值把两个峰抹平了。第二组是 Perfetto 上的双线程轨:RenderThread 出现 135 次、hwuiTask0/1 共 5 次、dequeueBuffer 287 次、queueBuffer 573 次、BLAST 1420 次、Transaction 1936 次。过程中核清了四处流传很广的说法:把 2011 年的硬件加速说成 2014 年的渲染线程引入;把应用进程的 RenderThread 当成 SurfaceFlinger 的合成线程;以为「同步完就释放主线程」(漏掉 syncFrameState 需要上传位图时 UI 线程会被阻塞);以为 DrawFrames 出现就画完了。另外公开了两处我自己的口径错误:GPU 执行时长用错了减法(跑出负值),以及把 framestats 的两段当成一段、算出了一个并不存在的双峰。
BufferQueue:图形缓冲区的邮局
「三缓冲」到底指什么?是指队列里有三个位置,还是指分配了三块内存,还是指这一时刻有三块在流转?这一篇的答案是:这是三个不同的问题——在同一台设备上,读到的三个数分别是 64、2、3。这一篇讲的是 BufferQueue 这本账。它最重要的设定是使用方创建并拥有队列,因为使用方要按自己的节拍取用,所以必须由它掌控可用位置与能否丢帧。四个动作各改动一格状态:dequeueBuffer 让 FREE 变成 DEQUEUED、queueBuffer 让 DEQUEUED 变成 QUEUED、acquireBuffer 让 QUEUED 变成 ACQUIRED、releaseBuffer 让 ACQUIRED 回到 FREE,四条迁移围成一个环,环上任一格停住就会积压。最硬的一处证据是计数公式在设备上对上了:mMaxAcquiredBufferCount 的 1 加 mMaxDequeuedBufferCount 的 1 再加额外项 0 等于 2,而 dump 里恰好打出 2 个位置。顺着 ClientCache 段与层的绑定,还读出桌面进程两个表面各 3 块缓冲;两个客户端按表面均摊分别是每表面 3 块与 2 块。官方自己也给了一条可读判据:实测缓冲计数为 2 表示处于三重缓冲状态,会带来额外的输入延迟——也就是说,上限从 2 提到 3,换来抗抖动、付出约一帧的延迟。过程中核清三处中文侧的混淆:固定 3 个 slot、最多 32 个 slot、以及三缓冲等于分配三块 HardwareBuffer(官方原文明说队列中可能只有两个分配的缓冲区)。也如实登记了三处本机读不到:等待的那个函数不是 trace 切片、每层的队列账本读不到、--latency 不可用。
Vulkan on Android:低开销渲染入口
上一篇结尾欠的是「缓冲传往哪、谁来决定」,这一篇要问的更靠前:在 Android 上,一个应用到底走哪条「入口」接上 GPU?入口这件事拆开是三层坐标——谁加载它、谁被选中、谁在跑,本篇就翻这三个问题。加载链上,应用链接的 `libvulkan.so` 是加载器,它按 `ro.hardware.vulkan` 拼出并打开 ICD,再经 HAL 用 `HWVULKAN_DEVICE_0` 封装;本机读到的是 `/system/lib64/libvulkan.so`(223,616 B)与 `/vendor/lib64/hw/vulkan.ranchu.so`(1,373,184 B),后者里的 ranchu 正是模拟器代号。最硬的一处证据来自一次亲手做的后端切换实验:把 HWUI 后端从 `skiagl` 切到 `skiavk`,判据是 `dumpsys gfxinfo` 的 `Pipeline=` 那一行——切换前读到 `Skia (OpenGL)`(gfxinfo 12,398 字节),切换后连这一行都不存在(只剩 146 字节)。但结论不是「切换失败」:同窗口的 `dumpsys gpu` 显示 `app_createdVulkanDevice` 从 0 变成 1、`vkLoadingCount` 从 0 到 33,说明属性写进去了、Vulkan 设备也真的建起来了,只是应用在启动那一瞬崩溃,25 秒窗口里崩溃重启 74 轮。这条五层因果链每一层都有句子作证:取图失败 -30001、surface 包装失败、`Bitmap.getHeight()` 于 null、`DotRenderer` 构造抛空指针、进程被 signal 9 杀掉。版本一侧同样值得警惕:同一台机器在一次冷启动内能同时读出六个 Vulkan 版本号(1.4.0 出现三次、1.3.0、1.2.0,外加宿主日志一句「1.4 不启用」),它们不是互相矛盾,而是六个组件各报各的;编码规则 major<<22|minor<<12|patch 三次验算都成立。本机默认后端是 GL,但根因不在 Android 而在宿主启动参数 `androidboot.debug.hwui.renderer=skiagl`——所以「通用默认」与「本机默认」是两件事,本篇分开写。全篇还核了五处流传很广的说法,并如实登记四处本机读不到的东西(真机厂商 ICD 名、Vulkan APEX、验证层被加载的演示、合成侧的 Vulkan 路径),模拟器结论一条都不外推。
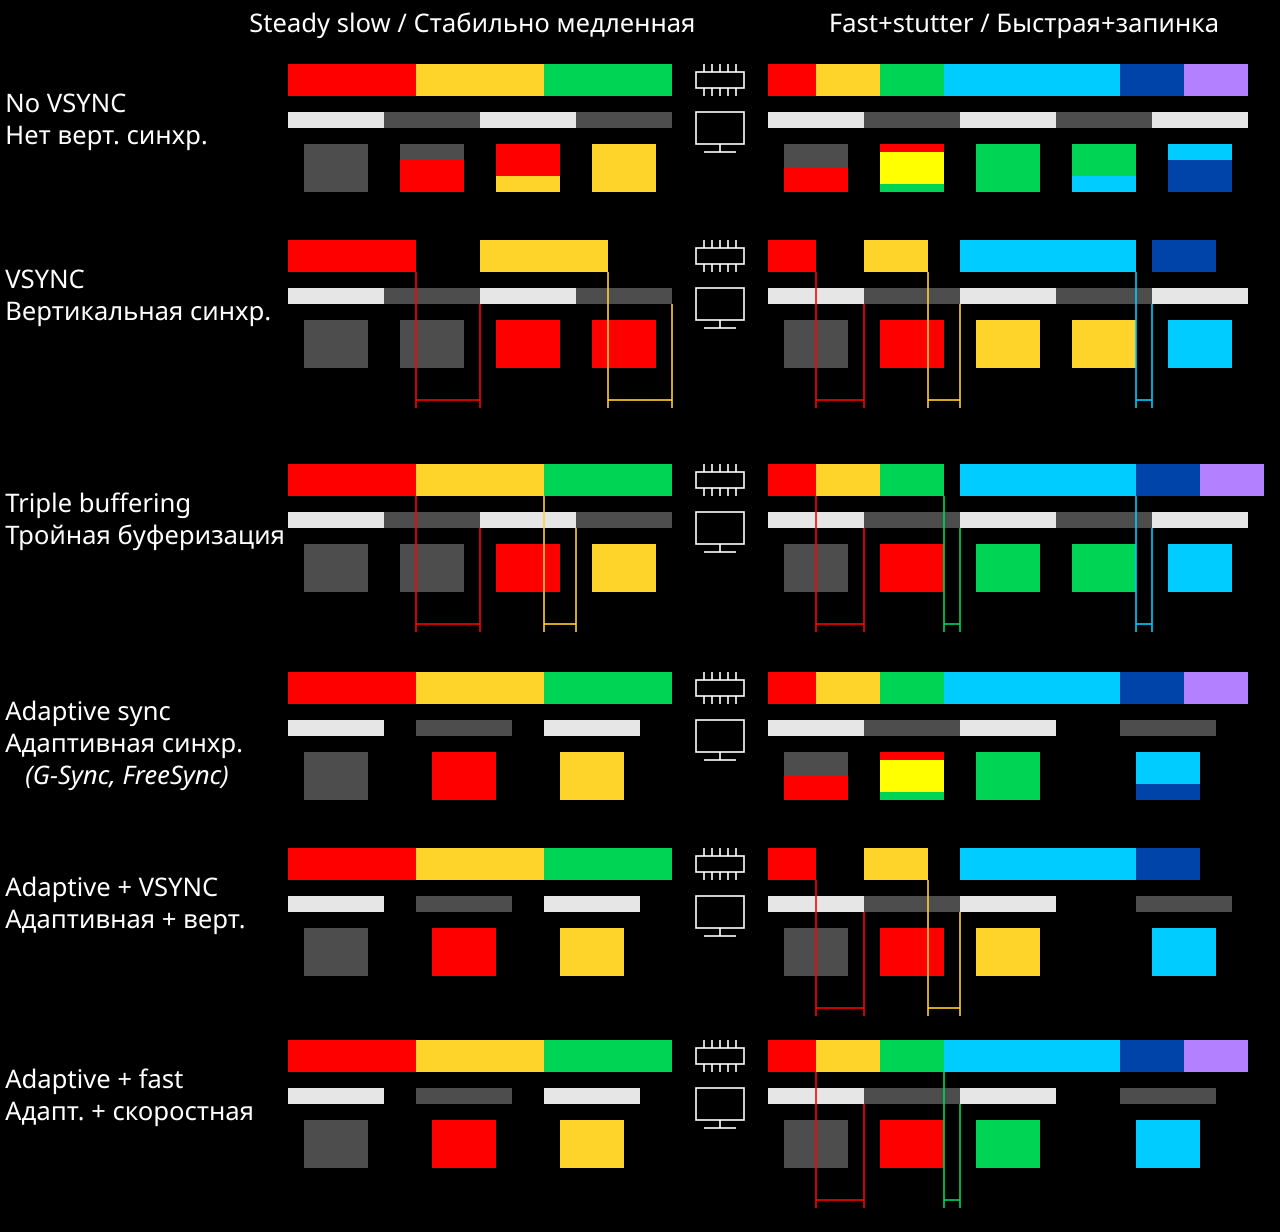
SurfaceFlinger:在 Vsync 之后做什么
上一篇结尾欠的是「命令从哪条门进 GPU」,这一篇要问的是:缓冲交出去之后,系统侧在 Vsync 之后到底做了什么?全文从一个反差现象切入——在一块静止的屏幕上,SurfaceFlinger 一帧都不合成。这不是推测,是两个窗口的对照读数:11 秒无输入的窗口里 presentToPresent 直方图 0 个样本、totalFrames = 1;而同机 11 秒滑动窗口有 375 个样本、totalFrames = 377。官方那句「只有事务或 latch 改变了显示内容才会做新的合成」,在这里变成了两个可以直接并排看的数。骨架来自官方对一轮的定义:Vsync 之后 SF 依次做三件事——处理事务、latch 新图形缓冲、以及带条件的一次新合成;其中第三段的前置条件正是那个 0 的来源。合成决策这一章讲的是决定权的分配:SF 把完整层清单交给 HWC,由 HWC 逐层标注 device 或 client,SF 只处理被标为 client 的部分。本机读到 6 层全 composition=DEVICE、usesClientComposition=false,这与 RenderEngine 在同一窗口里只有 4 个时间量样本完全吻合——被标为 device 的层根本不经过它,因此样本数说明的是「频次」而不是「速度」。送屏与刷新周期对齐这件事有两个互相独立又一致的读数:presentToPresent 直方图的峰值落在 16 ms(42 次),而 --latency 的首行是 16,666,666 ns,两者指向同一个 60 Hz 周期。第六章把这五个时间量逐段拆开(desired → latch → acquire → post → present)并给出本机 P50/P90/P99,再用三个互不相同的口径自洽核对一遍:报告的 averageFPS 34.122 与由帧数除显示时间推出的 34.47 fps 相差约 1%,说明解析口径没问题。全篇登记了四处流传很广的说法逐条核对、两次「搜不到」在性质上的分野(缩写撞词的噪声 vs 真的没有),并如实交代本机做不到的那件事:官方那条强制 GPU 合成的调试命令被 SELinux 拒绝,只能改用只读证据组合来论证——「做不了对照实验」不等于「得不出结论」,只等于「要换一组证据」。
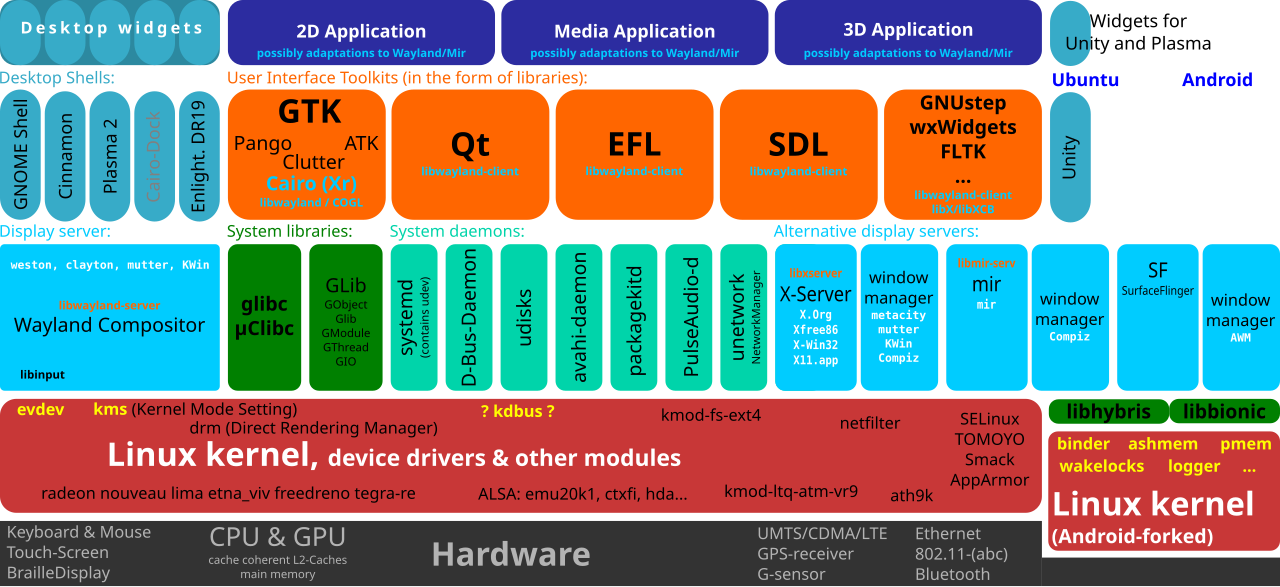
ASurfaceControl:Android 10 的透明事务
上一篇把「Vsync 之后」讲成三段,第一段「处理事务」当时只占一句话;这一篇就把它打开。全文从一个现象切入:下拉通知栏时,状态栏和任务栏会一起做同一段插入动画——可它们是不相干的两层,凭什么一起动?答案在层的清单里:同一个 StatusBar#87 的 parentId 从 110 变成 115、Taskbar#80 从 109 变成 114,而新增的 #115 名字里写着 animation-leash of insets_animation。也就是说,系统给它们各挂了一个「动画牵引层」再重挂上去——改的不是像素,是层树的结构。这一篇要讲的就是改动的语义:官方对事务的定义是一句「An atomic set of changes to a set of SurfaceControl」,三个词分别对应可批量、改的是层句柄、以及原子;原子性保证的是「一组改动在同一生效点落地、中间态不可见」,而不是「立刻生效」(apply 是异步应用的,官方在 OnComplete 里写明了这一点),也不保证跨层之间的先后。Android 10 把这套事务搬到了 NDK,ASurfaceControl、ASurfaceTransaction、ASurfaceTransactionStats 三件套里,第三个组件通过回调把 latch 时刻与 present fence 送回应用——而 Java 侧与 NDK 侧通过 fromJava 互转,说明底层是同一个事务对象,不是两套实现。设备侧的证据同样给足:--list 一次列出 94 个层,其中 33 个带 z、只有 1 个带相对父级;同一次 dump 里三个层的 frame 序号是 163 / 19 / 15,说明事务不是全局事件。全篇还核了四处流传很广的说法(含「apply 之后立即生效」「Winscope 随时能抓」),把两次检索撞词与一次真稀缺分开写,并如实交代两处做不到:Winscope 的逐事务抓取需要 adb root,本机 user 构建拿不到;旋转实验写入成功但没有生效。于是本篇把结论限定在「改了什么」这一层分辨率上——「怎么改的」如实标需 userdebug 或真机。
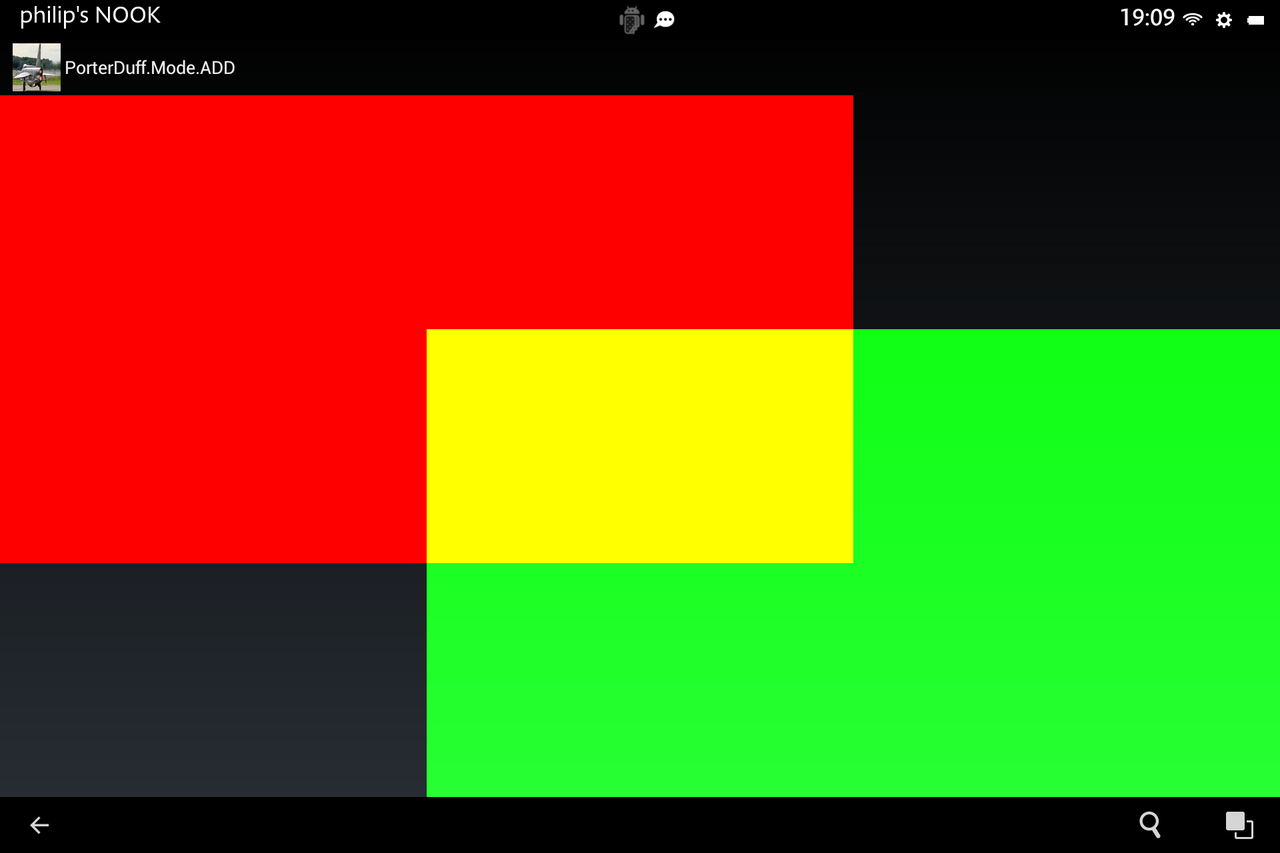
HWC:GPU 合成之外的硬件叠加
ep06 讲「Vsync 之后 SF 做了什么」,把「合成」当成三段里的第三段一句带过,只说归属会被标成 device 或 client;这一篇把那段打开,回答一个更硬的问题:屏幕上这一帧到底由谁去摞,这个决定是谁下的、凭什么下的、不接的时候又贵多少。开场就是一个反直觉的读数——同一份 dumpsys 里,物理屏写的是 usesDeviceComposition=true、usesClientComposition=false,而同一时刻录屏虚拟屏写的恰好相反;也就是说合成归属根本不是设备的属性,而是每块屏、每一帧、每个层的属性。机制部分给出官方原话与 AOSP 枚举:一帧只有 GLES、MIXED、HWC 三种可能,默认姿态是尽量交给 HWC,靠不住时才向 GPU 退;归属由 validateDisplay → getChangedCompositionTypes → acceptDisplayChanges 三步定下来,接口上给 HWC 留了一次反悔权(这也是「同样的层在不同设备上结局不同」的根据);合成类型一共八项,DEVICE 与 CLIENT 只是其中两种,官方注释里 DEVICE 写的是「由设备通过硬件叠加或其他同类方式处理」。全篇最值钱的一段是本机实测:把可见层从 5 层加到 7 层,屏幕仍然全是 DEVICE——「超过 4 层就退 GLES 合成」这条流传很广的经验值被证伪;而含一个 0.6796 倍缩小层的那个七层场景,整屏七层一起退回 CLIENT,静置四秒仍是。代价也用同口径窗口量了出来:客户端合成帧数从 0 变成 204,RenderEngine 平均每帧从 0.000 ms 变成 9.093 ms(它的直方图从「24 个桶全是 0」变成「峰值落在 4 ms、48 帧」),帧时长从 4.909 ms 涨到 15.320 ms。文中还核了四处流传很广的说法,并把三套丢帧计数的口径冲突摆出来——HWC 加 GPU 不等于 Total,而累计计数与窗口计数是两码事。最后如实交代读不到的东西:composer HAL 自己的状态 dump 返回 FAILED_TRANSACTION、叠加层属性输出成字面的 TODO、「停用 HW 叠加」这个开关在模拟器上压根不生效,真实叠加层数量与功耗带宽一律标需真机。
HWC2:Vsync 回调和虚拟显示路径
前两篇把 vsync 当成了既定条件——ep06 讲「Vsync 之后 SF 做了什么」,起手就是「等 vsync」;ep08 讲「这一帧归谁画」,量的是归属结果。可这个节拍本身从哪来、谁在派、派给谁,一直没打开。这一篇把它打开。开场是一个反直觉的读数:本机 dumpsys SurfaceFlinger 的 VsyncDispatch 段里印着三条回调条目 sf: / app: / appSf:,而静置时它们对应的计数几乎不动(0.65 Hz)、停录静置时mLastDispatchTime 涨到 8756 毫秒前——vsync 不是一块永远在滴答的钟,而是一份按需排的班。机制部分给出官方原文与 AOSP 头文件注释:三路信号同周期、只差相位(设备上印着的两条 workDuration 分别是 15.67 ms 与 16.67 ms,应用比 SF 早叫 1 毫秒,与 SF 的预算少 1 毫秒互为交叉验证);相位偏移是按最坏情况留的余量而不是最优值;HWC 侧有五个回调,其中 onVsync 必须先被 setVsyncEnabled 要求才会触发、onVsyncIdle 会让平台把整个 vsync 模型推翻重置;DispSync 是字面意义上的软件锁相环。全篇最值钱的一段是本机实测:同一台设备上只改「有没有人在动」这一个变量,量出四个窗口的速率——静置 0.65 Hz、连续滑动 57.57 Hz、录屏中 0.0 Hz、停录后 0.0 Hz;滑动时上一次派发落在 13 毫秒前。最后一章回答 ep08 留下的坑:虚拟屏没有自己的 vsync,它借的是主屏的节拍——但「借节拍」不等于「主屏那个应用侧计数会替它涨」,两个读面量的不是同一件事。全篇封条:本机 No Last HW vsync,硬件时间戳一次都没拿到,present fence 退路也被显式关闭,所以本篇的周期读数是软件算的,硬件 vsync 的真实抖动要真机。
Vsync 偏移:应用、SF、屏幕的三步舞
上一篇把 vsync 这条链打开了一半——节拍从哪来、谁在派、派给谁都回答了,但留下一个词没拆:那几条回调的相位到底错开了多少。这一篇从一个反直觉的对照切入。同一段 dumpsys 的 Scheduler 相位段,本机(模拟器 · Android 16)三档 regular / early / GL early 的 app 与 SF 相位「六个全是 1,000,000 ns」;而一份公开的真机 dump(Pixel 6 · Android 12 · 90 Hz)三档各不相同,early 档的 SF 相位甚至是个负值——−5,488,889 ns。这两个数不是「量」出来的,是「配」出来的:它们真正的身份是设备配置里写进去的纳秒值,dumpsys 只是把配置念了一遍。所以「偏移是多少」这个问题的答案不在屏幕里,在 BoardConfig.mk 里。机制部分给出官方映射与一段 AOSP 源码:两个相位属性分别管应用那一路与 SF 那一路的排班,第三个 present offset 管的是 retire fence 的对齐——它是对表,不是排班;而切档之所以在本机从不发生,是因为 `VSyncModulator::updatePhaseOffsets()` 第一句就是「两档相等则直接返回」,本机正好被配成了同值。全篇最值钱的一段是一次单变量实测:同一台设备、同一条命令,只改「有没有人在动」这一个变量,量出「帧做好之后还要等多久」——静置窗口就绪到上屏中位 6.172 ms、连续滑动窗口 15.963 ms,后者约等于一个整周期;而相邻帧的上屏间隔中位 19.869 ms,比周期慢约 19%。最后一章把四处流传很广的说法逐条核过(它们只犯两种错:把配的当成量的、把登记当成行为),给出四组可执行命令与判据,并把 ep09 两处口径错误的修正过程本身写进正文当论据:登记值不等于行为值,认不出来也不等于没在动。
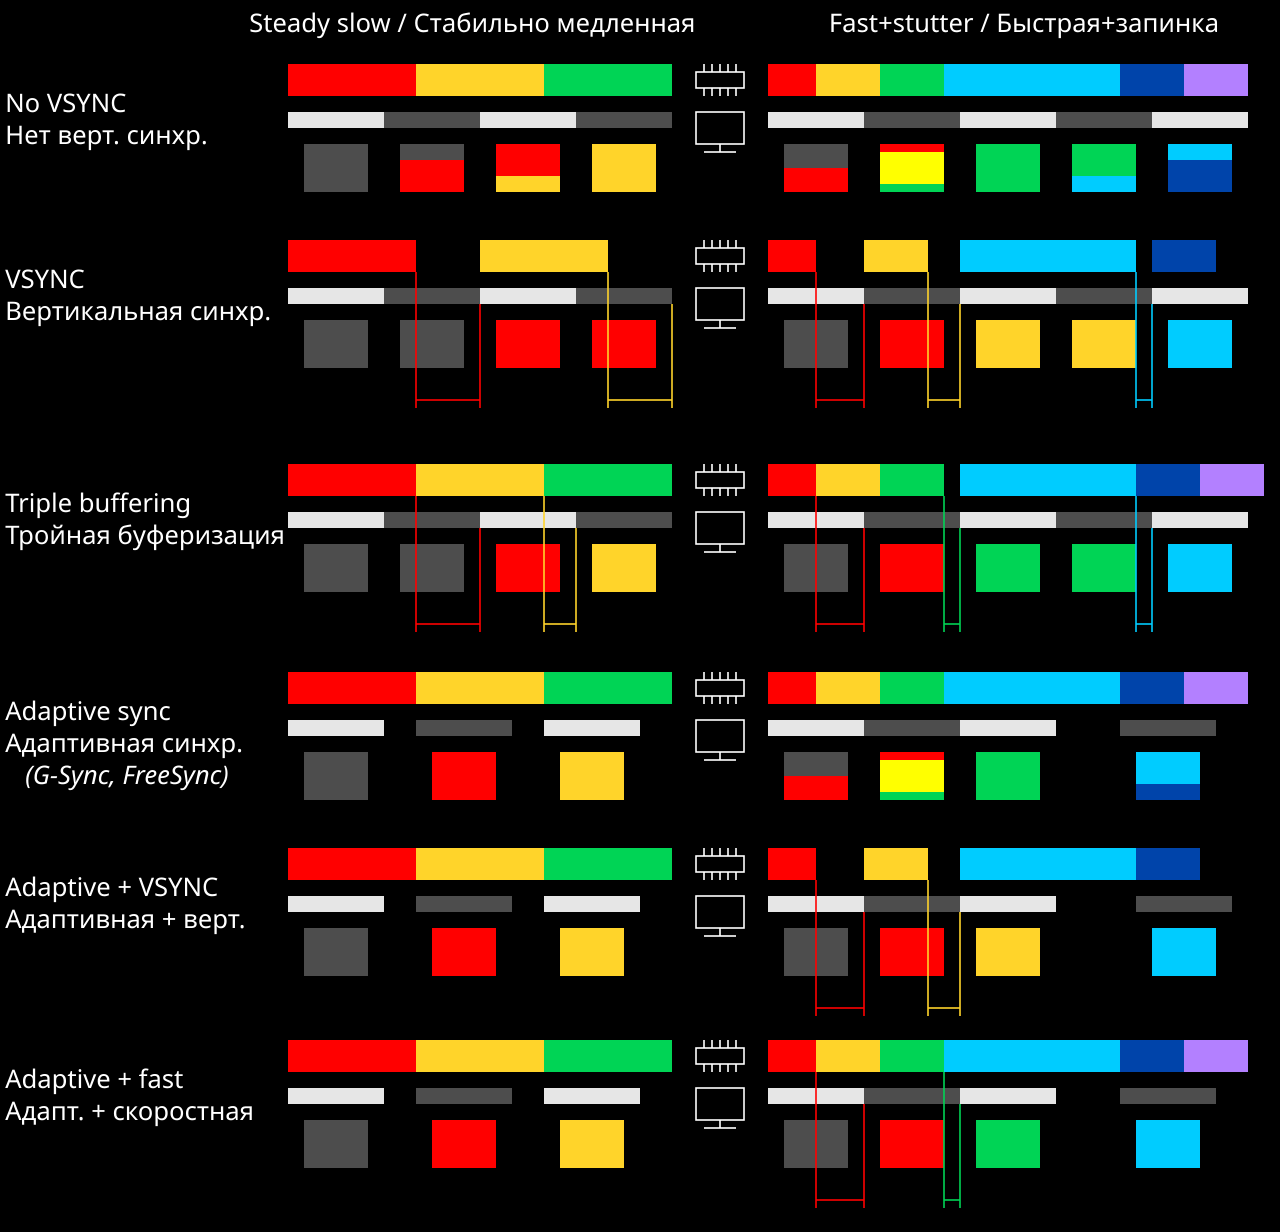
三缓冲、多刷新率与 ARR:队列有多深,屏幕有几个档
前十一篇把链路、节拍与相位都拆过了,但它们都默认了两件事——队列默认够深、屏幕默认只有一个档。这一篇把这两个默认打开。开场是两个同框的现场读数:本机那条队列的槽位表里只有两格,而官方文档却写着「Android 应用始终三缓冲」;另一份 dump 里,刷新率上限可以写进 120,可用档位表里却只有一个 60 Hz。本篇要回答的是:格数是谁定的、档位表是谁报的、而「我请求了」和「我能得到」之间究竟隔了多远。机制部分给出 AOSP 头文件的原话:格数由五个成员联合算出,没有任何一项叫「是否三缓冲」——所以「改一个开关变成三缓冲」这句话从机制上就不成立;而「应用始终三缓冲」与「SF 里可能只有一个待处理帧」两句官方话合起来,正好解释本机为什么只看到两格。中间几章把请求侧整个打开:三个区间、六个边界、五层各一条 requestedFrameRate(全是「无偏好」),以及平台自己打印出来的 VoteSummary——四态对照下只有上限跟着设置走,可用档位表一字不差。一次受控实验把这件事钉死:改设置改得动「上限」,改不动「能力」,物理侧四项在三次实验六次读取里无一变化。最后一章讲 ARR 与多刷新率是两类屏(官方判据是 either MRR or ARR, but not both),并把一处同名两数的口径陷阱与四组可执行命令一并交出。
虚拟显示与屏幕录制:一块不存在的屏,凭什么也算一块屏
前面十一篇里,「屏」这个字一直默认成立——它在那儿,有刷新率、有 vsync、有一棵挂在它下面的层树。这一篇问一个更基础的事:如果一块屏根本就不存在呢?开场是两个同框的现场读数:同一次录屏里,SurfaceFlinger 的显示清单多出一行标着 Virtual display 的 ScreenRecorder,而 MediaProjection 服务的账本上,录前、录中、录后全是 null——两本账记同一件事,却各记了一半。本篇先立「它不是一块屏却被当成一块屏」:它的完整档案只有六行,其中 isGpu=true 落在官方三种合成模式的 GLES 一支,而物理屏走的是 HWC;再拆「它借谁的节拍」:官方原话说虚拟显示没有自己的 vsync,本机 screenrecord 拿到的也是内屏的 60.00 fps;最后落到「录制到底录了什么」——收尾日志写着 14 秒只录到 2 帧,两轮相差 10 秒而文件只差 566 字节,因为录制记的是「变化」而不是「节拍」。中间几章把镜像在 SurfaceFlinger 里留下的三处标记逐条读出来,并用「多出来的第 105 行就是镜像根」把层数 104→105→104 那笔账收口;也把「同名两数」「谁的账本」这类读数的口径陷阱讲清。
剖帧实战:Perfetto FrameTimeline 抓 jank
前面十二篇每一篇都是取快照——一个时刻一个值。这一篇第一次取过程:哪一帧晚了、晚了多少、算谁的。一上来就撞见两个数:同一台设备、同一段窗口,Legacy 段说 6% 的帧有问题,Timeline 那本账说 78%——而到了应用侧,同一对名字给出的方向**反过来**。所以本篇要回答的不是「jank 率是多少」,而是「你读的是谁的账、用哪一对口径」。正文先把判据钉死:jank 是「实际上屏时刻与预测时刻不匹配」,不是「耗时超过某个阈值」;再拆八类归因,用两段受控窗口量出静止窗口零帧、负载窗口 93.8%,并把账落到层上——状态栏那层 86.8% 是预测错误,launcher 那层 92.1% 是缓冲堆积,两层的动手方向完全相反。另一条链走应用侧:gfxinfo framestats 的逐列时间戳,设备实际印的是 24 列而不是官方文档写的 14 列,其中 FrameTimelineVsyncId 正是两条证据链的接口。最后两章交代两件常被跳过的事:采一条含 FrameTimeline 的 trace 不需要 root(一条命令、6.6 MB 落盘),但把它剖开需要 trace_processor——本环境三条获取路径全部受阻,而本篇的全部结论不依赖它。作为系列收官篇,末章还给 T05 十三篇做了一次回望与边界声明。
C/C++ 现代语言与底层
同一段 C/C++,编译器和链接器到底对它做了什么、代价落在哪。这一卷不写语法,也不写面试题速查——它把已有几卷里天天出现的 `sizeof`、对齐、虚表、异常、内存序、编译时间接过来,专讲这些东西是怎么被决定的。取材只有两种:机制引原文(标准条款、Itanium ABI、官方文档快照),代价靠自跑(两套工具链的布局转储与读数;探针源码、编译命令、原始输出随篇入库)。十二篇分四波:布局与内存 → 编译器与链接器 → 运行时代价 → 跨平台专项。
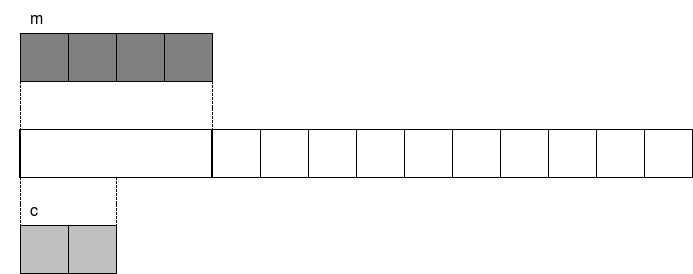
对象布局、对齐与 padding:sizeof 的真相
同一个结构体,字段一样、只换个声明顺序,一个 12 字节、一个 8 字节——差出来的全是编译器塞的填充,没有一个是你写的。本篇把这个数字拆到不能再拆:先把规则摊开(对齐要求定起点、声明顺序定中间、尾填充定收尾),再手算一个五字段结构体,然后拿本机两套工具链的转储逐行对上去——MSVC 会把填充显式标成 alignment member 一行,这正是本篇把转储当主力证据的原因。手算、转储、双编译器对照走完一遍之后,答案里的分工就清楚了:**布局规则两家同源,真正分叉的只有一处**——加了 [[no_unique_address]] 的同一个结构体,g++ 省下 4 个字节、MSVC 一个字节没省,而两家都没有违规,因为标准只「许可」这种重叠、不「要求」它。本篇还实测推翻了中文材料里常见的一个说法:g++ 的 -Wpadded 只报尾部对齐填充,对成员间填充一声不吭——所以「编译没报警」推不出「没有填充」。三十九张图里,二十七张是本机跑出来的真实输出与官方原文(转储、读数、条款、ABI 原句),另有外部对照图三张、自绘机制图九张;全部证据(探针源码、编译命令、原始输出、官方快照)随篇入库。
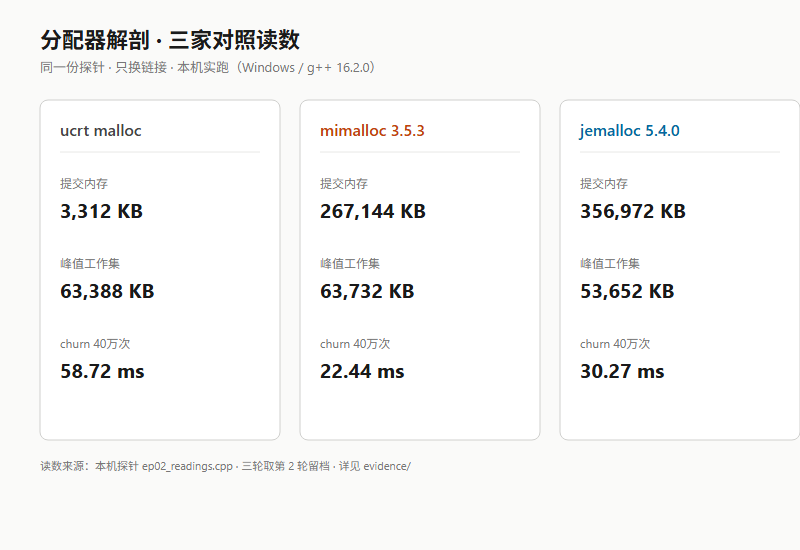
分配器解剖:malloc → jemalloc/mimalloc → pmr arena
同一句 new,往下要经过语言层、实现层、系统层,每层都能换——换分配器和换资源是两件事。本篇把"内存从哪来、归谁管、什么时候还"这件事拆到不能再拆:先把三层归属摊开(语言层 std::pmr / 实现层 ucrt+jemalloc+mimalloc / 系统层 CRT+内核),再拿本机三条通道的实跑读数逐一量上去——同一段代码,只改一行链接,行为就是不一样。两个反直觉的结论值得提前说:第一,池资源不一定更快——synchronized_pool_resource 在一次性长序列上比 new_delete 慢约 60 倍,因为池的收益在"重复同尺寸 + 批量归还",不在"第一次分配";第二,"内存"有四本账——三家分配器的峰值工作集差不多(53–64 MB),但提交内存能差出 100 倍(3.3 MB vs 267 MB vs 357 MB),因为 mimalloc 和 jemalloc 选择"囤着复用",而 ucrt 选择"用完就还"。三十七张图里,二十八张是本机跑出来的读数面板与官方原文(探针输出、统计快照、手册原句、标准条款),另有四张外部示意图、十一张自绘结构图;全部证据(探针源码、编译命令、原始读数、官方快照)随篇入库。
值语义的账:move/拷贝/SSO/emplace_back
同一个 string,传值和传引用差在哪?emplace_back 是不是一定比 push_back 快?std::move 到底搬了什么东西?值语义不是语法糖,是一份性能契约——每一次拷贝、每一次移动、每一次消除,都有明确的代价。本篇把这笔账拆到不能再拆:先把拷贝三板斧(构造/赋值/析构)的计数拍出来,再拆 move 语义的真相(std::move 就是个 static_cast,真正偷资源的是移动构造),然后讲编译器替你免单的 copy elision(RVO/NRVO,C++17 起部分变成保证),再到 SSO 三家对账(libstdc++ / libc++ / MSVC 各有各的缓冲策略,短字符串 move = copy),再到 emplace_back 的真实收益(不是万能的,传对象时和 push_back 一样快),最后落到 trivial 谱系和值语义的两个暗坑(noexcept 白写 / 自赋值安全)。五个反直觉结论全部有本机实测支撑:构造计数探针、反汇编片段、sizeof 对照表、benchmark 面板、地址同一性实测。三十七张图里,三十一张是本机跑出来的真实输出与官方原文(探针、反汇编、读数、标准原句、官方博客),另有九张自绘结构图;全部证据(探针源码、编译命令、原始输出、官方快照)随篇入库。
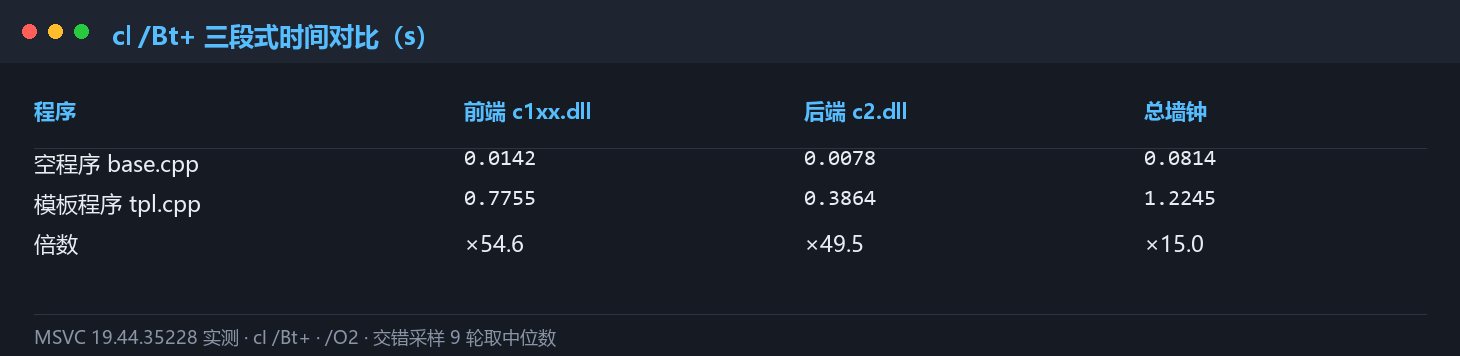
编译期账本:模板实例化与 -ftime-trace
编译慢到底慢在哪一步?模板实例化是"免费抽象"还是隐形成本?extern template 真的能省十倍编译时间吗?本篇把编译期的账拆到不能再拆:先讲清模板实例化的三种触发方式(隐式按成员惰性、显式全量、部分特化只改匹配),再用 cl /Bt+ 把前端与后端时间分开量——同一份 main,仅因包含并使用容器模板,前端 c1xx.dll 就从 0.0142 s 涨到 0.7755 s(55 倍);接着算二进制体积的账(同一模板只用 2 个成员 2,913 字节,用满 100 个 65,361 字节,差 22 倍),然后给出 MSVC 侧的观测三件套(cl /Bt+ 分阶段、vcperf 追踪、MSBuild binlog),并如实记录 vcperf 因管理员权限未采到的现场,补上不需要权限的 /d2cgsummary 函数级明细。第六章是全篇最意外的一章:extern template 在 GCC 16.2 上按标准生效(10 个 TU 全量构建 −26.2%),在 MSVC 19.44 上实测未生效(符号 101 → 101,删掉显式实例化定义照样能链接)——原本准备的"省十倍教程"被自己的实测推翻。最后落到三类可操作手段的实测账:constexpr 的求值上限(递归深度 500 通过 / 511 失败)、PCH(前端时间 0.6639 → 0.0372,17.8 倍)、Unity Build(全量 9.8 倍但增量变慢)。三十六个图位里,二十四张是本机跑出来的真实输出与官方来源面板,另有十二张自绘机制图;全部证据(探针源码、编译命令、原始读数、符号表)随篇入库。
优化器的边界:UB、严格别名与向量化报告
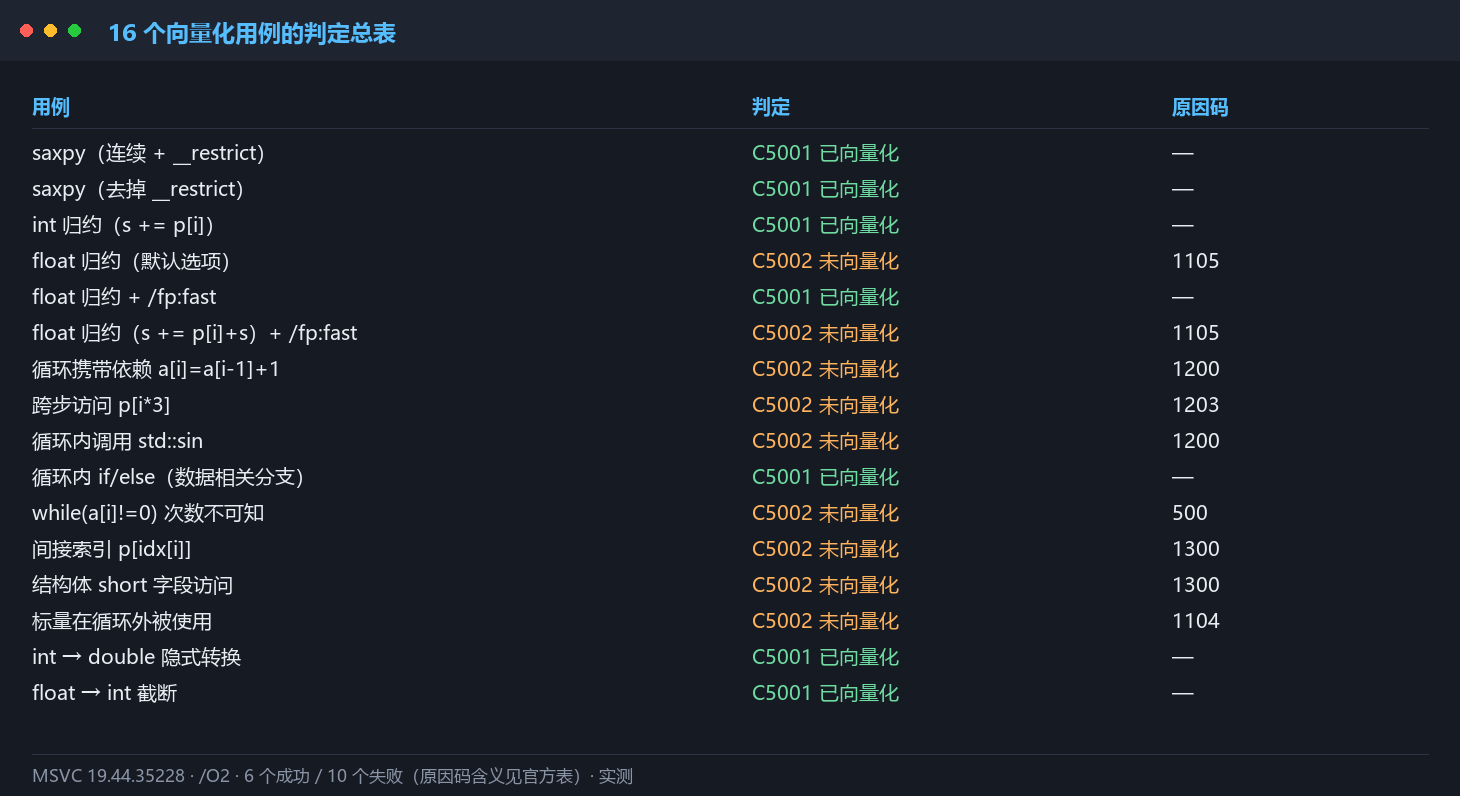
同一个循环为什么有时向量化、有时不?加 __restrict 到底有没有用?一段能跑的代码为什么换编译器就出错?本篇算的是"优化器的边界"这笔账——而这条边界,就是未定义行为(UB)的边界。先用 MSVC 的 /Qvec-report:2 把 16 个循环的向量化判定逐条拍出来(成功 6 / 失败 10,每条都带官方原因码):最反直觉的一条是"一个再普通不过的 float 求和循环默认不会被向量化",原因码 1105——因为浮点归约需要重结合,而重结合默认被禁止,加 /fp:fast 才变成 C5001;同样反直觉的还有"含 if/else 的循环照样向量化"(只要分支能被无分支化成掩码选择)和"加不加 __restrict 都向量化、跑得一样快"(ns/elem 比值 0.98)。第五章是全篇最硬的一章:同一份类型双关代码,GCC -O2 下返回 132/165/193(每次运行都不一样,因为 int* 与 long* 被 TBAA 判为不别名、读取被重排),加 -fno-strict-aliasing 立刻修回 -1,而 MSVC 两侧都正确;同时用三种重叠场景验证"向量化不一定算错",结果与标量实现逐元素一致。第七章用 x+1>x 演示 UB 的代数化简——GCC 在 -O0 就把它折成 mov eax,1; ret,MSVC 则返回补码回绕的 0。最后算优化等级与开关的代价:/O2 换来 4.58 倍,代价是进入 UB 与别名的推断生效区间。三十六个图位里,二十四张是本机跑出来的真实输出与官方来源面板(向量化报告、反汇编、双编译器运行结果、基准读数),另有十二张自绘机制图;全部证据(源码、编译命令、原始输出)随篇入库。
名字与符号:ABI、修饰、可见性、PLT 与 IAT
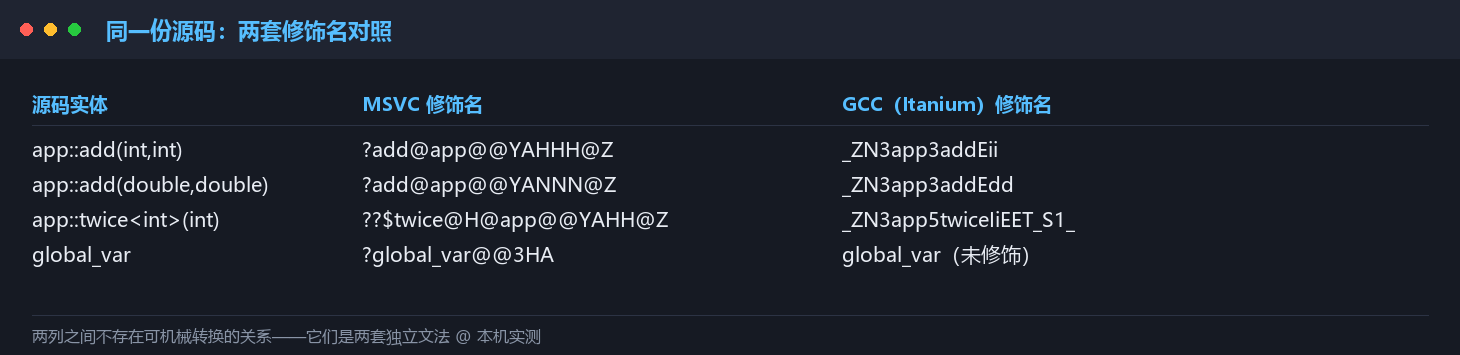
为什么 undefined reference 里那串字符完全看不懂?为什么同一份源码在 MSVC 和 GCC 下会编出毫无共同点的符号名?extern "C" 到底做了什么?dllexport 写了为什么还是没导出?本篇算的是「符号层」这笔账——而链接器只认符号名,不认你的类型与重载。先用本机实测把两套修饰文法并排摊开:源码里同一个 `app::add(int,int)`,MSVC 编出 `?add@app@@YAHHH@Z`,GCC 编出 `_ZN3app3addEii`,两列之间不存在任何可以机械转换的关系;然后用 undname 与 c++filt 把机器名读成人话。第五章补一个 x86 时代经验的失效点:x64 下 `__cdecl`/`__stdcall`/`__fastcall` 产出的符号名完全相同,约定被忽略。第六章是全篇的决定性实验:mingw 的 main 链接 MSVC 编出的 .obj——走 C 符号成功(rc=0),走 C++ 符号失败(rc=1),同一份 provider 只因名字有没有被修饰而结果相反。第七章实测出两条反直觉结论:`__declspec(dllexport)` 写在 class 前面只导出 1 条、写在 class 后面导出 5 条,而且连带导出了编译器隐式生成的拷贝/移动赋值运算符(你从没写过);同时如实记录 -fvisibility=hidden 在 PE 目标上不生效。第八章解剖符号表:静态库只是「.obj 归档 + 符号索引」,模板实例各占独立符号,vtable/RTTI 在两套工具链下命名完全不同。第九章走完动态链接链路:DLL 导出表 → EXE 导入表 → PE 数据目录里的 IAT(实测 RVA 16000 / 0x278),并说明延迟加载与 ELF 的 PLT/GOT、RELRO 是同一个取舍的两种实现,最后用 libstdc++ Dual ABI 收束「C++ 没有可移植 ABI」这一结论。需要说明边界:本机无 WSL、MSYS2 产出 PE/COFF,因此 PLT/GOT 与 RELRO 只引权威原文、不做本机实测,实测全部集中在 PE/COFF 侧。三十六个图位里,二十一张是本机跑出来的真实输出、三张是官方规范来源面板,另有十二张自绘机制图;全部证据(符号表、导出表、导入表、PE 头、链接报错原文)随篇入库。
链在一起:LTO 与 PGO 的收益从哪来
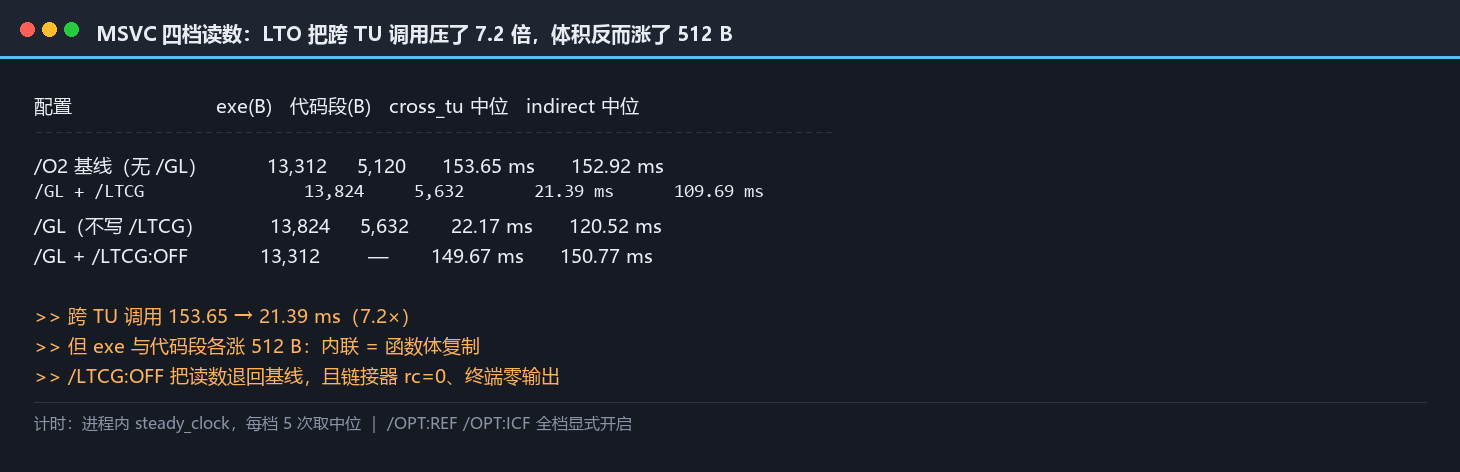
为什么两个被并列成"高级优化开关"的选项,动的东西完全不一样?LTO 拆的是翻译单元边界,PGO 拆的是类型与分支边界——本篇用同一份四文件源码、两个独立靶子,在 MSVC 19.44 与 GCC 16.2 上把两种收益分别量到各自的循环上。跨 TU 小函数 step(定义在 a.cpp、被 b.cpp 的 run 逐元素调用)在 MSVC 上从 153.65 ms 降到 21.39 ms(7.2 倍),exe 反而涨了 512 字节;决定性对照是把 step 手工搬进 run 同一个 TU、完全不开 LTO,得 19.73 ms,与 LTO 档同量级,说明书里的收益全部来自跨 TU 内联、没有第二个来源。PGO 侧换成虚拟调用:MSVC 的 PGO 版把 drive 循环体里的 call 清零,改成"预载 AddOp::apply 地址 + cmp + jne 冷路径 + 内联 x+1",间接循环 152.92 → 53.47 ms;GCC 更清楚,基线 -O2 本来就会做"三目标全枚举",但命中路径上仍是一条 call *%r8,PGO 换成单目标比较后命中路径再无 call,同一循环 43.66 → 10.45 ms(4.2 倍)。两列数字各归各的开关:GCC 的 PGO 对跨 TU 调用只差 0.08 ms(0.07%)。本篇还量了三处"安静的失效":/GL 不写 /LTCG 照样做 LTO,而 /GL + /LTCG:OFF 会真把 LTO 关掉、链接器却 rc=0 零输出;插桩 exe 在裸环境里因缺 pgort140.dll 直接退出 0xC0000135、不打印任何输出;GCC 的 .gcda 名字跟着 -o 走,改个输出名就让整份 profile 静默失配。最后一处最值得记:改掉热路径后不重训,MSVC 一边用过时 profile 一边报告 86 of 86、100.0% 命中,GCC 在没有数据时反而慢 2.5 倍。另外,被广泛流传的"LTO 静态库必须用 gcc-ar"在本机 binutils 上实测不成立。需要说明边界:本机无 Clang、无 WSL,LLVM 侧(ThinLTO/BOLT/AutoFDO)与 ELF 侧(链接器插件、PLT/GOT)只引权威原文、不做实测;全部证据(反汇编转储、链接器原话、计时与体积读数)随篇留档。
分发的代价:虚函数、模板、variant 与类型擦除
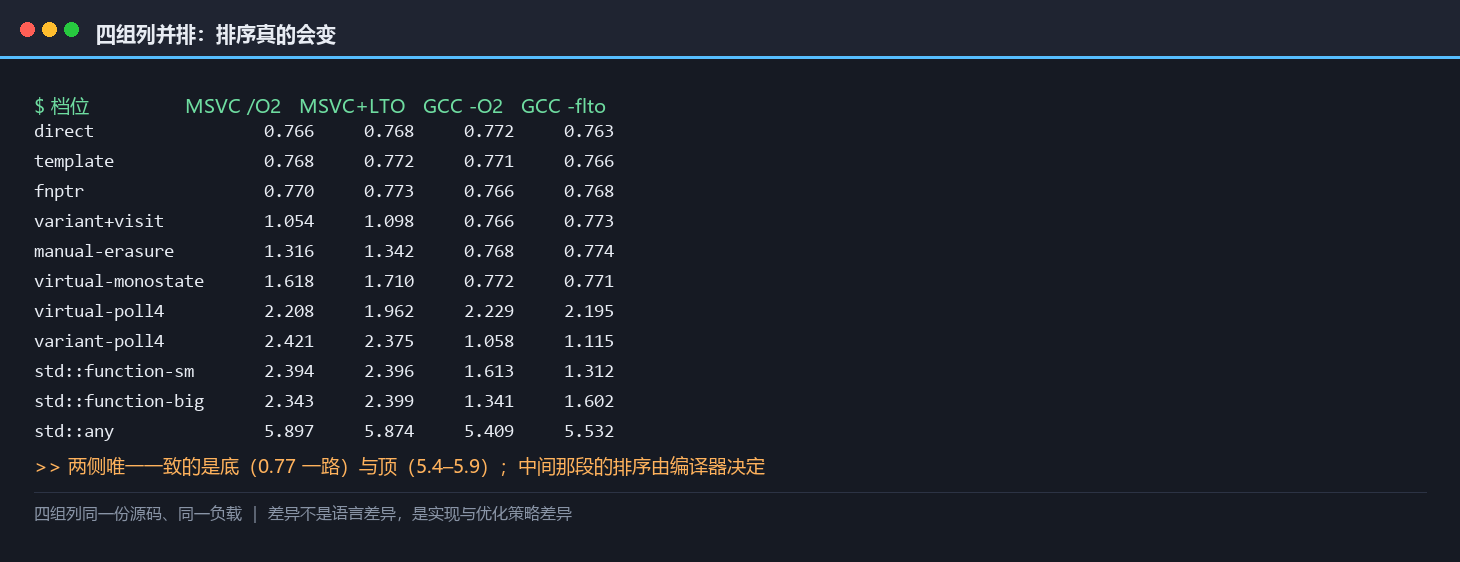
同一段"把类型藏起来"的代码,代价到底落在哪?本篇把模板、虚函数、std::variant、类型擦除四种办法编成 11 档分发阶梯——从直调、裸函数指针一直搭到 std::function 与 std::any——让被分发的操作缩小到只剩三条指令,再在两套工具链各两档开关下把每一档量到纳秒(8,192 万次分发,每档 5 次取中位)。结论是排序会变:MSVC /O2 与 GCC -O2 的四列排序互不相同。最刺眼的一处是同一份单态虚调用——GCC -O2 把它划掉(0.772 ns/op,与直调 0.772 同量级),MSVC /O2 没划掉(1.618,是直调 0.766 的 2.11 倍),反汇编里 GCC 的命中路径已经没有任何 call。第二处直接推翻了流行建议:variant-poll4 在 MSVC 上 2.421 ns/op,比 virtual-poll4 的 2.208 更慢,而在 GCC 上反过来是 1.058 对 2.229——同一行数字两侧结论相反。类型擦除一侧量到 std::function 的 SBO 阈值 MSVC 49 字节、GCC 24 字节,超过阈值换成一次堆分配;实测零分配那一档并不更快,所以它的瓶颈通常不是堆。std::any 是整条阶梯的底(5.897 / 5.409 ns/op,7 倍量级),且本篇实测踩到它的一次硬崩:按不匹配的类型取会抛 bad_any_cast,退出码 0xC0000409。体积方向也相反:同一批改动让 MSVC 的 exe 涨 512 字节、GCC 反而降 10,668 字节;模板从 8 个实例化加到 16 个,代码段只涨 1.6%。全篇把这笔账拆成四层——间接调用、分支预测、堆分配、类型检查——四种办法各踩其中几层,不是一条统一的账单。最后收成一组按顺序问的判据,与三条可操作建议:给不会再被继承的类写 final、别把 std::any 放进热路径、要优化 std::function 就去减少它在热路径上的出现次数。需要说明边界:本机无 Clang、无 WSL,LLVM 的 WholeProgramDevirt 与 ThinLTO 只引官方原文;四个源文件与两套工具链的全部原始日志、反汇编转储、读数 JSON 随篇留档在 evidence/。
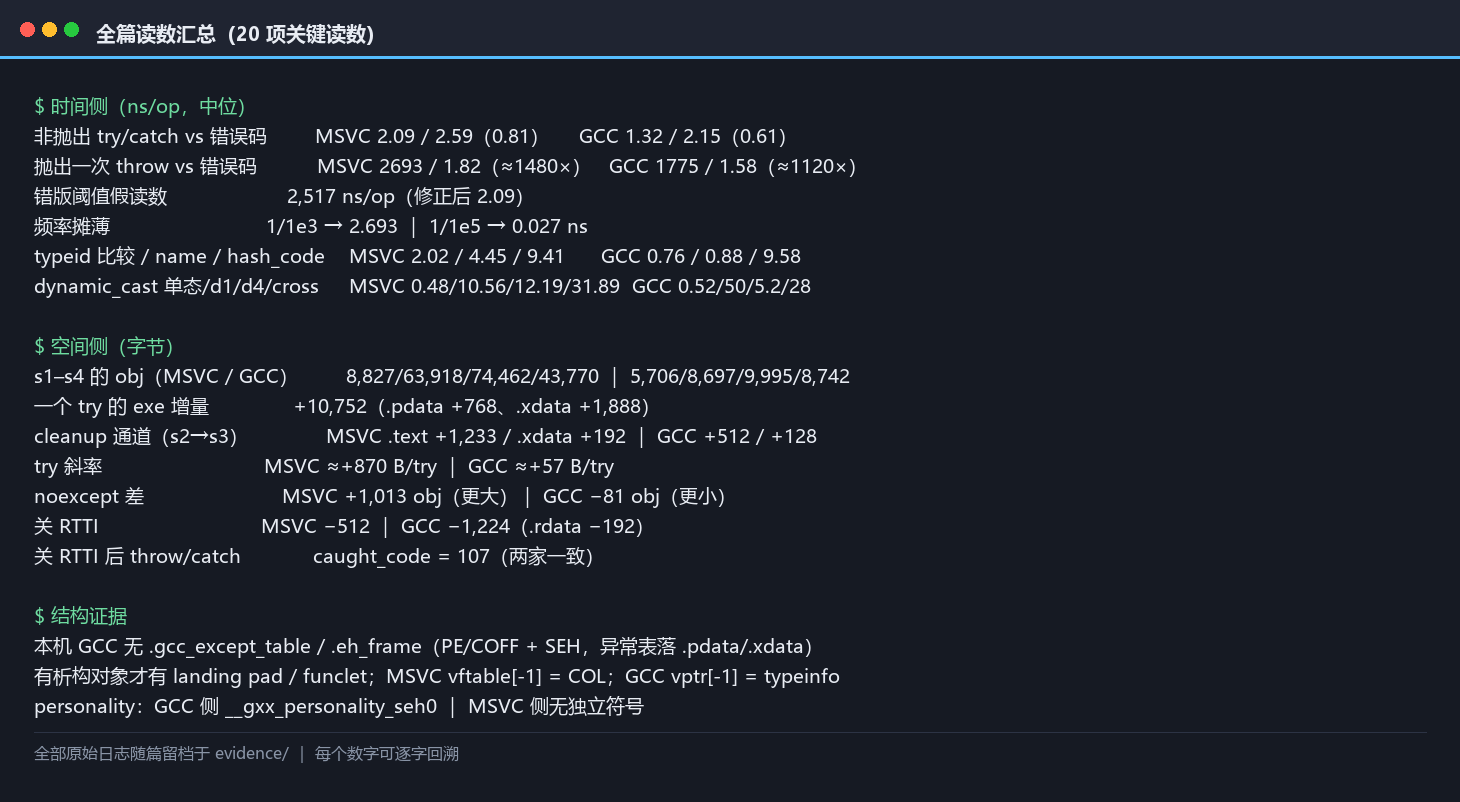
异常与 RTTI:零成本到底成不成立
「零成本」这句宣传语到底 claim 的是什么?本篇把它拆成时间与空间两笔账,用 MSVC 19.44 与 GCC 16.2 双工具链分别量。时间侧基本成立:不抛异常时 try/catch 与返回错误码同速(2.09 对 2.59 ns/op),差值是噪声;但一旦真抛,一次就是 2,693 ns(MSVC)与 1,775 ns(GCC),是错误码的千倍量级,与官方那句「与函数调用开销大致相当」不在同一口径上。空间侧不免费:只加一个 try 块,MSVC 的 exe 涨 10,752 字节,带析构的局部对象再拉进一条 cleanup 通道(.text +1,233);而 noexcept 在 MSVC 上反而更大、在 GCC 上更小。本机还有两处与流传说法不符:MSYS2 的 GCC 产出 PE/COFF,段表里既没有 .gcc_except_table 也没有 .eh_frame,personality 是 __gxx_personality_seh0;RTTI 那一侧,dynamic_cast 的真正变量不是继承深度,而是「目标是不是最派生类型」——GCC 上转到更深的派生类反而快一个量级(5.2 对 50 ns)。关掉 RTTI 只省 512 字节(MSVC)与 1,224 字节(GCC),与「直降 40%」的传说差三个数量级,而且关掉之后异常捕获照常工作(两家 caught_code 都是 107)。全篇 38 张图里 22 张是本机实测输出与官方原文面板,全部原始日志、段尺寸、反汇编与槽位转储随篇留档。
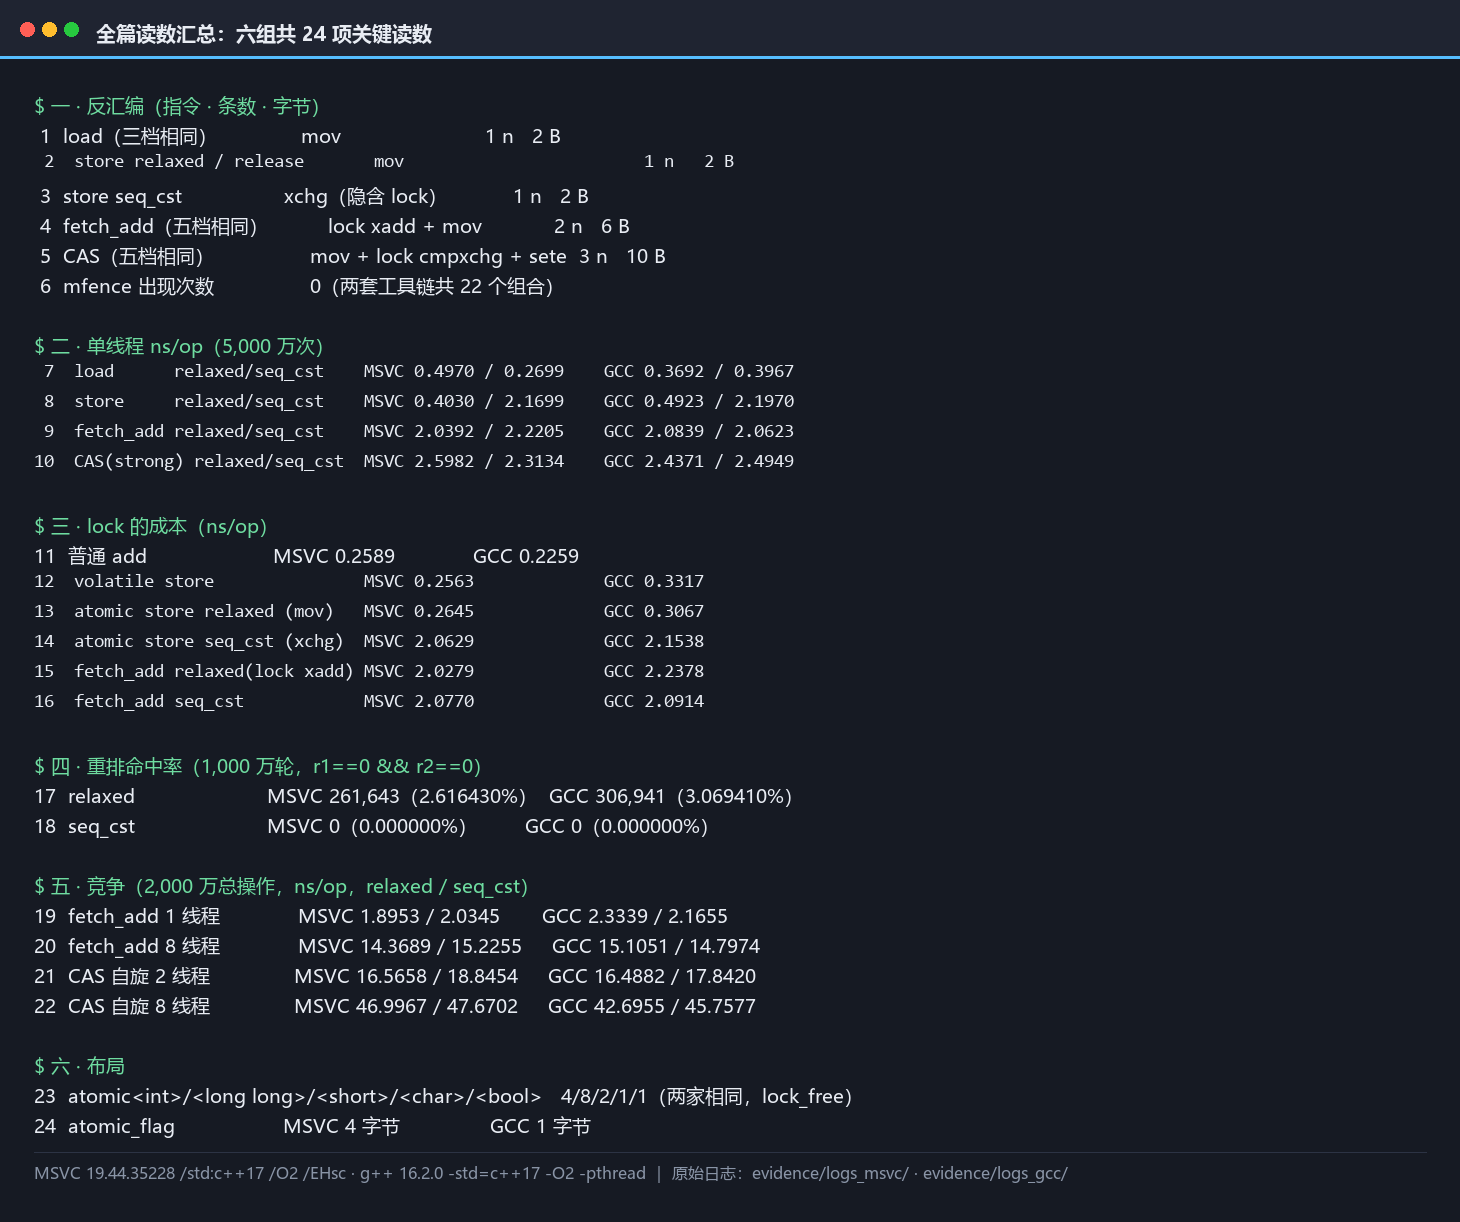
内存序与原子:seq_cst 在 x86 上免费吗
「seq_cst 在 x86 上免费吗」这个问题,多数文章给的是一个单词的答案。本篇把它拆成 load / store / RMW 三类操作,用 MSVC 19.44 与 GCC 16.2 双工具链各量一遍:**load 免费**(relaxed / acquire / seq_cst 三档都是同一条 mov),**fetch_add 与 CAS 也免费**(五档都是同一条 lock xadd / lock cmpxchg),只有 **seq_cst 的 store 不免费**——从 mov 换成隐含 lock 的 xchg,单线程 0.40 ns 变 2.17 ns,约 5 到 8 倍。更反直觉的是 22 个「操作 × 内存序」组合里**一条 mfence 都没有**:seq_cst fence 落到栈上一个哑元位置的 lock or 0(GCC)与 lock inc(MSVC),机器码逐字节留档。本篇还把「可能发生」变成了频率:1,000 万轮 store-buffering 实测,relaxed 命中 2.616430%(MSVC)与 3.069410%(GCC),seq_cst 一次不中;并且实测 volatile 写与 relaxed 原子写是同一串 `89 11`,atomic_flag 的 ABI 在两家一个是 4 字节、一个是 1 字节。四十个图位里二十张是本机实测输出与官方原文面板,原始日志、反汇编转储与统计脚本随篇留档。
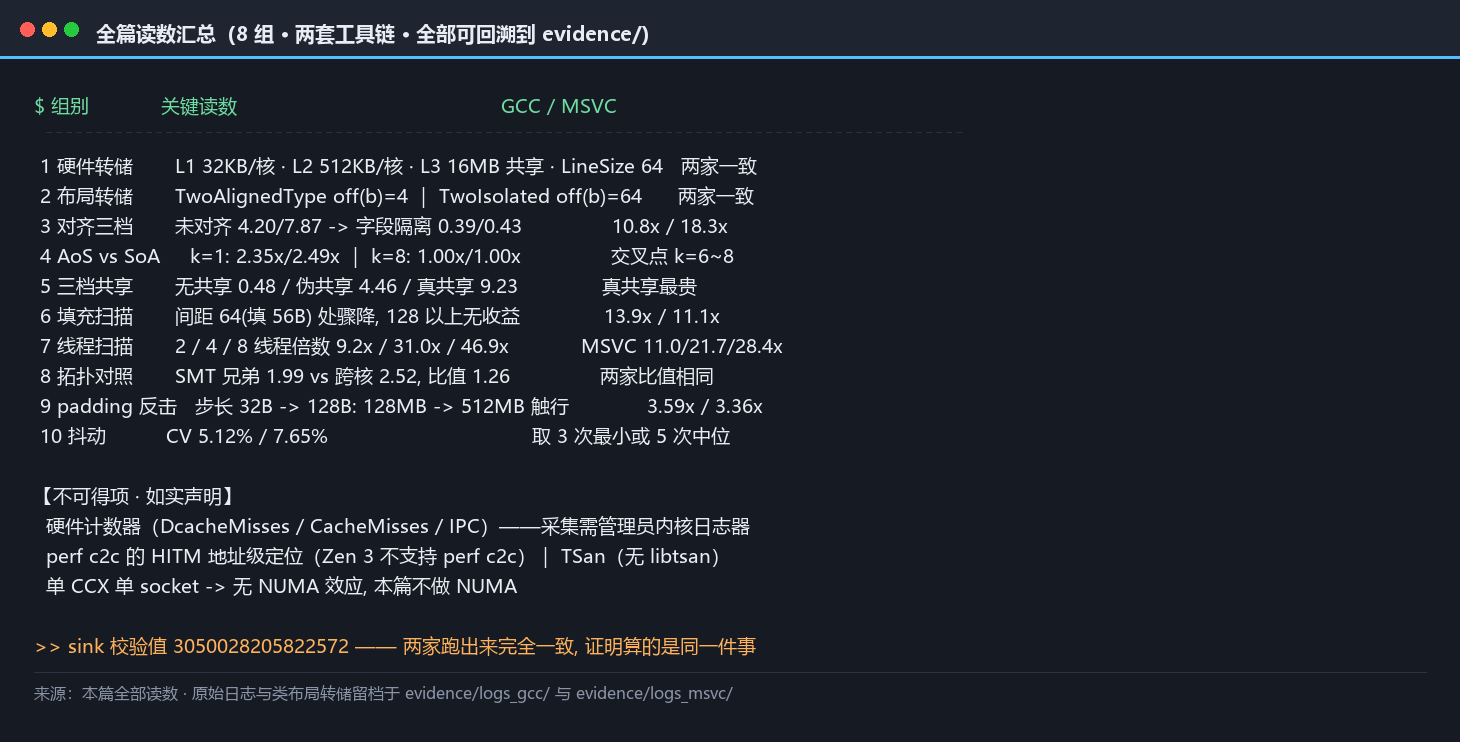
缓存与布局:AoS/SoA、伪共享与 cache line 的账
「SoA 比 AoS 快」与「填 64 字节」这两句流传最广的口号,本篇都用本机读数拆开。伪共享与对齐的关系比想象中细:**alignas(64) 加在类型上,与完全不加对齐一样慢**(4.20 对 4.61 ns/op,GCC),只有加到**每个字段**上才掉到 0.3902 ns/op,差 10.8 倍(MSVC 侧 16.9 倍);间距从 32 跨到 **64** 的那一步骤降 11 到 14 倍,再往上(128/256/512)没有任何进一步收益——这是本机行宽 64 的时间侧实证。AoS/SoA 的答案是「看 k」:只读 1 个字段 SoA 快 2.35×,读满 8 个字段两家完全打平(比值 1.000),数据装得下 L2 时布局根本不影响速度。而 padding 不是免费的:把步长从 32 抬到 128,单线程遍历慢 3.59×,触及字节从 128 MB 涨到 512 MB——它买的是并行正确性,付的是单线程容量。45 个图位里 20 张是本机实测输出与外部权威图示,两套工具链的原始日志与类布局转储随篇留档;硬件计数器因权限不可得,这条边界在正文里写明了。
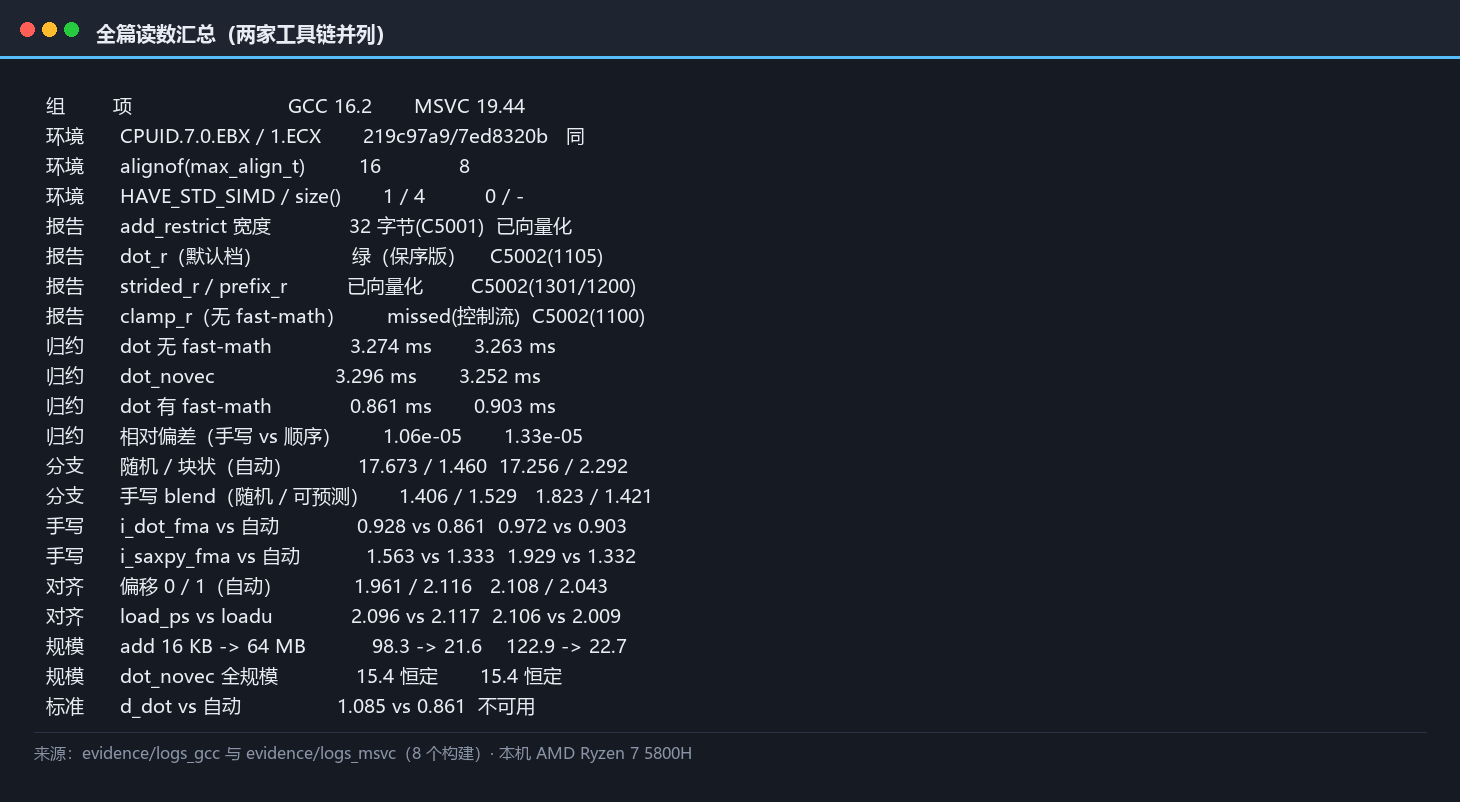
SIMD:自动向量化与手写 intrinsic 的分界
「加 `-O3` 就会自动向量化」这句话,本篇用 8 个构建(MSVC 3 + GCC 5)逐个拆。第一个反直觉来自**报告与读数不一致**:GCC 对那个浮点归约循环报 `loop vectorized using 32 byte vectors`,而把同一个循环关掉向量化之后是 **3.296 ms 对 3.274 ms**——收益是 0;反汇编给出了机器码解释:乘法已经向量化(`vmulps`/`vfmadd`),累加仍是 12 条串行 `addss`。第二个是**语义开关**:加上 `-ffast-math` / `/fp:fast`,点积从 3.274 掉到 **0.861 ms**(GCC)与 3.263 掉到 **0.903 ms**(MSVC),而这两档的 `-O3` 与 `/arch:AVX2` 早就开了。第三个是**数据**:同一份二进制上,随机符号的分支循环 17.256 ms、块状符号 2.292 ms(7.53 倍),手写无分支版的优势随之从 9.47 倍缩到 1.61 倍。第四个与流行说法相反:**开了 fast-math 之后编译器赢了手写 intrinsic**(点积自动快 7%,saxpy 快 31%)。54 个图位里 21 张是本机实测输出,原始日志、向量化报告与反汇编摘要随篇留档。
Godot 4 引擎架构
引擎是想法与 GPU 之间那座中间层。这一系列不写「引擎有哪些模块」,而是追一条链:按下 `queue_redraw` 之后,那一串命令在场景层、服务层、剔除层、绘制抽象层与 RenderingDevice 上各自被谁碰过,最后怎么变成 GPU 命令缓冲。以官方源码原文与本机三后端实测互相校验;同一件事被官方在 4.3 / 4.4 / 4.6 判断过三次,这一系列把版本转折也当证据读。

全景与边界:Godot 4 的四层架构,以及一次 2D 绘制要经过谁
前九个专题都在讲画面与物理怎么被算出来,这一个换到引擎内部:把一次 2D 绘制拆成四层落点,逐层给出源码坐标。按下 `queue_redraw` 之后,命令先在场景层标脏并排进延迟回调,再由服务层门面用 RID 型句柄收下、经宏转发交给实现;剔除层每帧遍历画布项、判定可见性并按 z 序挂进列表;绘制抽象层把一次绘制变成五种命令,攒批后由 RenderingDevice 录成 GPU 命令缓冲。本机只改一个 `--rendering-driver` 开关,三后端分别落到 Forward+、Forward+ 与 Compatibility,把「三种渲染方法 × 四种驱动 = 七种组合」现场演示出来。结尾用同一件事被官方在 4.3 / 4.4 / 4.6 判断过三次,示范版本转折该怎么读。
对象模型:Node、SceneTree、CanvasItem 为什么分成三层,以及一次绘制命令交给谁
上一篇把四层落点链走通了一遍,这一篇把镜头压到场景层这一侧:一条绘制命令到底是谁、在什么时候下发的。Node 管树,入树与就绪沿树传播;SceneTree 管节奏,物理帧与 idle 帧是两条入口;CanvasItem 管脏,queue_redraw 里有一道幂等闸与一个延迟回调。本篇用四个本机探针把三件事测出来:同一帧连调 23 次只画 4 次且落点同帧、改 modulate 根本不产生绘制、以及同一节点改挂父级后画布归属会跟着变。最后指出门面那一跳的真相:canvas_item_create 在实现层查不到,它是宏拼出来的两步。凡读数一律写明版本与「自定义构建」,不谈跨机器结论。
服务层接口:RenderingServer 为什么是一组 RID 型命令
上一篇把场景层讲透,这一篇进服务层,讲 RenderingServer 的接口为什么长成一组 RID 型命令。句柄本体只是一个 64 位数,高 32 位代际、低 32 位槽位;is_valid 只判这个数是不是 0,要问「它指的东西还活着吗」得去持有它的那一侧。三段本机探针把三件事测出来:槽位按栈复用(释放槽位 1 与 3 之后,新拿到的依次是 3、1、6)、同一张已释放的句柄用起来会报错而释放起来毫无声响、以及「要不要入队」那条判据在两种线程模式下各走一支。最后纠正两处旧印象:创建入口不是 create_default,日志里那行 RenderingServerWrapMT 只是没跟着改的旧类名。凡读数一律写明版本与「自定义构建」,不谈跨机器结论。
画布剔除与排序:RendererCanvasCull 决定画什么、按什么顺序
上一篇进服务层,讲 RenderingServer 的接口为什么长成一组 RID 型命令;这一篇接着往下走一层,看 RendererCanvasCull 怎么决定画什么、按什么顺序画。顺序被拆成三层箱位:画布层的 layer 先压一切,层内按树序取号,最后按 z_index 落进 8193 个桶、从低到高串成一条链。画什么由四道闸门在递归之前拦下,过不了的连同它整棵子树一起出局,第五道只管自己进不进桶。五组本机探针把几件事测出来:layer 能压过两百点 z 差、可见层必须整条链都匹配、y 排序会被 z 反压、同一批两百个方块套上画布组之后 draw call 从一变成二。最后纠正两处旧印象:画布组买到的是整体合成而不是省 draw call,可见层的默认值在场景侧与服务侧并不相同。凡读数一律写明版本与自定义构建,不谈跨机器结论。
画布渲染抽象:RendererCanvasRender 与一次绘制的中间表示
上一篇讲画布剔除与排序,停在一条排好序的 Item 链交给下游;这一篇接着往下一层,看那条链交出去之后长什么样、又是怎么变成一次真正的提交。主线是四层嵌套:一条项链、每条项上一条命令链、命令内存成 4 KiB 的块、状态一致的那些合成一批。分工界线画在与后端有没有关系上——抽象层定义表示,实现层负责提交,128 字节的实例数据由编译期断言钉死。七组本机探针把最硬的一条测出来:draw call 的数量取决于状态切换了几次,而不是画了多少东西——交替两百条给两百个 draw call,只切一次给两个,全同型给一个;两百个节点各画一条与一个节点画两百条,都只有一个,说明批能跨 Item。实例缓冲的分界也逐条对上:16,384 条给一个、16,385 条给两个。最后把六条换批判据、光照的两条掩码与四项判据、SDF 的两条路与后处理一并讲清,并写明四处代价。凡读数一律写明版本与自定义构建,不谈跨机器结论。
批处理:从 CanvasItem 到一次 draw call 的攒批规则,与四个后端的演进
上一篇停在链表收进数组、状态一致的那些合成一批;这一篇接着问,那批到底是怎么切出来的。容量来自两个项目设置,字节数等于实例上限乘以一条实例的 128 字节;切批分三层:第一批自成一派,然后项级看裁剪与材质,命令级看六条判据。新批只是上一批的副本改三处,上限一到就冲刷缓冲并强制换批。本篇还有上一篇没有的一手材料:4.3 的官方文档写着只有 Compatibility 有 2D 批处理,master 同一位置改成了所有渲染方式都有;4.4 的发布说明给出署名,4.6 的博客给出返工与量化收益,并写明批不出来时成本照付。最硬的一条是两档本机探针:默认档一万六千三百八十四条给一个 draw call,多一条就给两个;把设置改成五百一十二之后,分界跟着挪到五百一十二与五百一十三——分界真的跟着设置走。凡读数一律写明版本与自定义构建,不谈跨机器结论。
RenderingDevice 抽象:从命令列表到渲染依赖图,以及 4.3 那次同步返工
上一篇停在「一批一次发出去」;这一篇接着问:那批发到哪个对象上、谁替它排序、顺序乱了会怎样。渲染设备是引擎自己的抽象,抽象层级接近 Metal 或 WebGPU,但并不是所有后端都走它——Compatibility 那条 OpenGL 的路根本不经过。4.3 把同步责任从它挪进一张独立的有向无环图:依赖记进邻接表,收口时跑一次拓扑排序,同层再按命令类型优先级挑一个更好的顺序;屏障要不要发,先问驱动报的能力位。两个开关的默认值就是结论:重排默认开、全屏障默认关。本机对照只换一个后端参数:走图那条路五个 draw call、二点八五毫秒,不走的那条八千个、六点六毫秒——但这是两条后端路的合并读数,不能归因到图本身;「关掉重排会慢多少」本机测不了,也如实写明。凡读数一律写明版本与自定义构建,不谈跨机器结论。
后端分叉:Vulkan / Direct3D 12 / Metal / OpenGL,怎么选、分叉在哪
上一篇把顺序算完了;这一篇接着问:同一份顺序落到四张不同的桌子上会变成什么。分叉长在三处——编译期用宏拼出可用驱动、工程设置里七个平台键与三个回退开关、运行期由命令行与各后端自己的环境变量决定。引擎用两张能力表向四个后端要答案:一张有默认值、一张没有,连保守方向都相反。「默认」这件事还分三层:引擎内置的仍是 Vulkan,新工程模板写的是 Direct3D 12。Compatibility 差的不是实现而是层数——那条路上连渲染设备这个名字都不出现。最硬的一条是本机对照,其中 Direct3D 12 那一档根本起不来,如实入表、不用别的数据填空;三档的绘制调用数也不能横向比,因为它们计的本来就不是同一种东西。凡读数一律写明版本与自定义构建,不谈跨机器结论。
主循环与多线程:这套账在什么时刻、被哪个线程算出来
上一篇让同一份顺序落到四张桌子上;这一篇换到时间轴:这套账在什么时刻、被哪个线程算出来。三个节拍其实不是同一件事——物理步是定步长、idle 帧跑多快算多快、渲染帧还要过一道开关,而顺序(物理在前、逻辑在后、渲染最后)是硬编码的,没有开关可调。一帧跑几次物理由累加器攒出来:攒、取整、扣回,余数留下;插值分数就是那个余数。MainLoop 的钩子还有两张口径:头文件六个,脚本与文档侧只有四个。多线程这条线上,引擎内置默认是 Safe 而不是 Separate,后者官方标了实验性。跨线程的边界分三档:可直接跨、要开开关才可跨、完全不可跨。最反直觉的一格是本机默认档 180 个 idle 帧里 178 帧一个物理步都没跑;两个帧率口径也不得混用,凡读数一律写明版本与自定义构建。
资源侧:一张纹理从盘上到显存
前九篇走的是命令往哪里去、按什么节拍被驱动;这一篇换一个方向,问桌上那些东西从哪来。同一张图在盘上有三个身份:源文件给人看,点 import 文件是给编辑器看的配置且必须入库,ctex 产物才是运行时真正读的那个——而产物名里那串哈希只跟路径有关,跟内容无关,内容哈希在同名侧车里。导入器的三个关键默认值由预设的第三个实参写死,压缩那五档在磁盘、显存、加载时间三根轴上并不通向同一处,同编码器下 mipmaps 的增量本机实测是 1.3333 倍,1024 见方那张用 VRAM 档冷加载比无损快 4.6 倍。检测到用于 3D 时编辑器会回写配置并自动重导。运行时是一个同步入口加三个线程入口,而两条路共用一个任务体,差别只在谁等谁。缓存的本体只有一把锁和一张表;上传那一步依次验格式、算 mip 层数、定通道重排、落显存。显存侧读数本机拿不到,所以全篇凡涉字节一律写明是被上传的压缩块字节数。
收官:这套架构的取舍,以及 Godot 为什么让 2D 也吃 GPU
前九篇走的是命令往哪里去、按什么节拍被驱动,第十篇走这些东西从哪来;收官这一篇不再往下游走,而是把整条链翻过来看一遍。题眼是一条三段弧:同一件事官方先后给过三种口径——4.0 因绘制调用变便宜而判定 2D 不太需要批处理,4.4 又把批处理铺到所有后端,4.6 再回头重写 2D 渲染器把批的 GPU 代价压回去。本机新跑的一次对照给了量化的底账:同类精灵在三档渲染方法上都是 1 个绘制调用,断批后直接等于精灵数,代价是两千倍而不是两倍;同一份断批在低层接口上贵约 2.5 倍、在兼容档上贵约 8.5 倍。两处未被本机证实的说法、一处素材落空、一处本系列旧说法的更新,都逐条留在正文里。
Jolt Physics 3D
本站第一次把镜头转向渲染之外:物理引擎。Jolt 是把「多核扩展性」与「确定性」押在最前的 3D 刚体库——MIT 许可、v5.6.0、11,630 星,刚体求
全景与边界:它在物理引擎谱系里的第几格
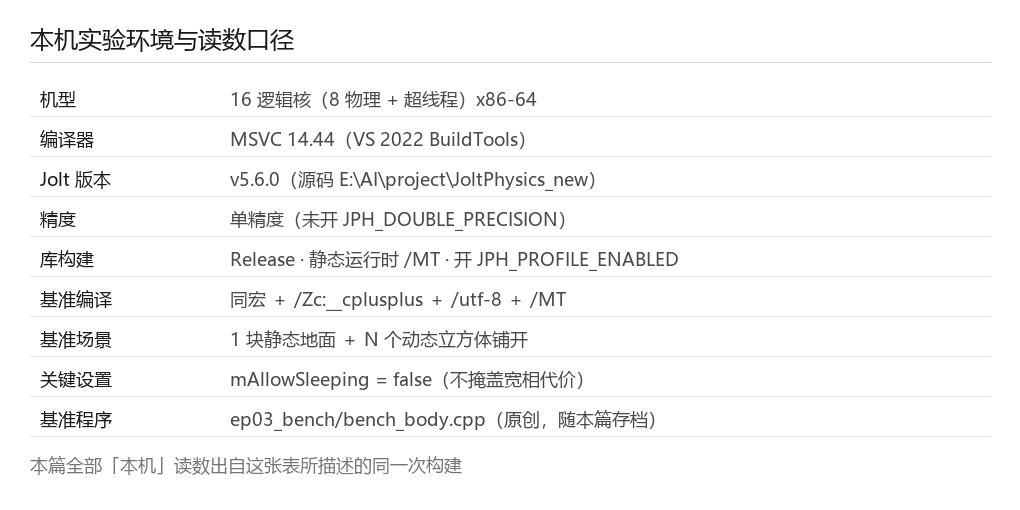
本站第一次把镜头转向渲染之外:物理引擎。Jolt 是把「多核扩展性」与「确定性」押在最前的 3D 刚体库——MIT 许可、v5.6.0、11,630 星,刚体求解全部在 CPU 作业系统上。本篇先立坐标系(与 PhysX 5 / Bullet / Box2D / Havok 各站哪一格),再用本机实测把它的两条自称量到底:8 线程加速 6.44×(官方论文同档 4.9×)、峰值 13 线程 7.59×,而拐点落在 9 到 10 线程(本机 16 逻辑核约等于 8 物理核加超线程),不是官方那句「约 16 核」;确定性侧,1 至 16 线程下终态哈希全同 0xcc61333c4bfb0fad,并行度变 16 倍而结果一位没变。两处流传很广的说法也在这里被钉死:v5.6 的 GPU Compute 只服务发束头发、不是 GPU 刚体;官方文档与源码里查无 Solver / TGS 命名。全部读数给出命令与条件,可复现。
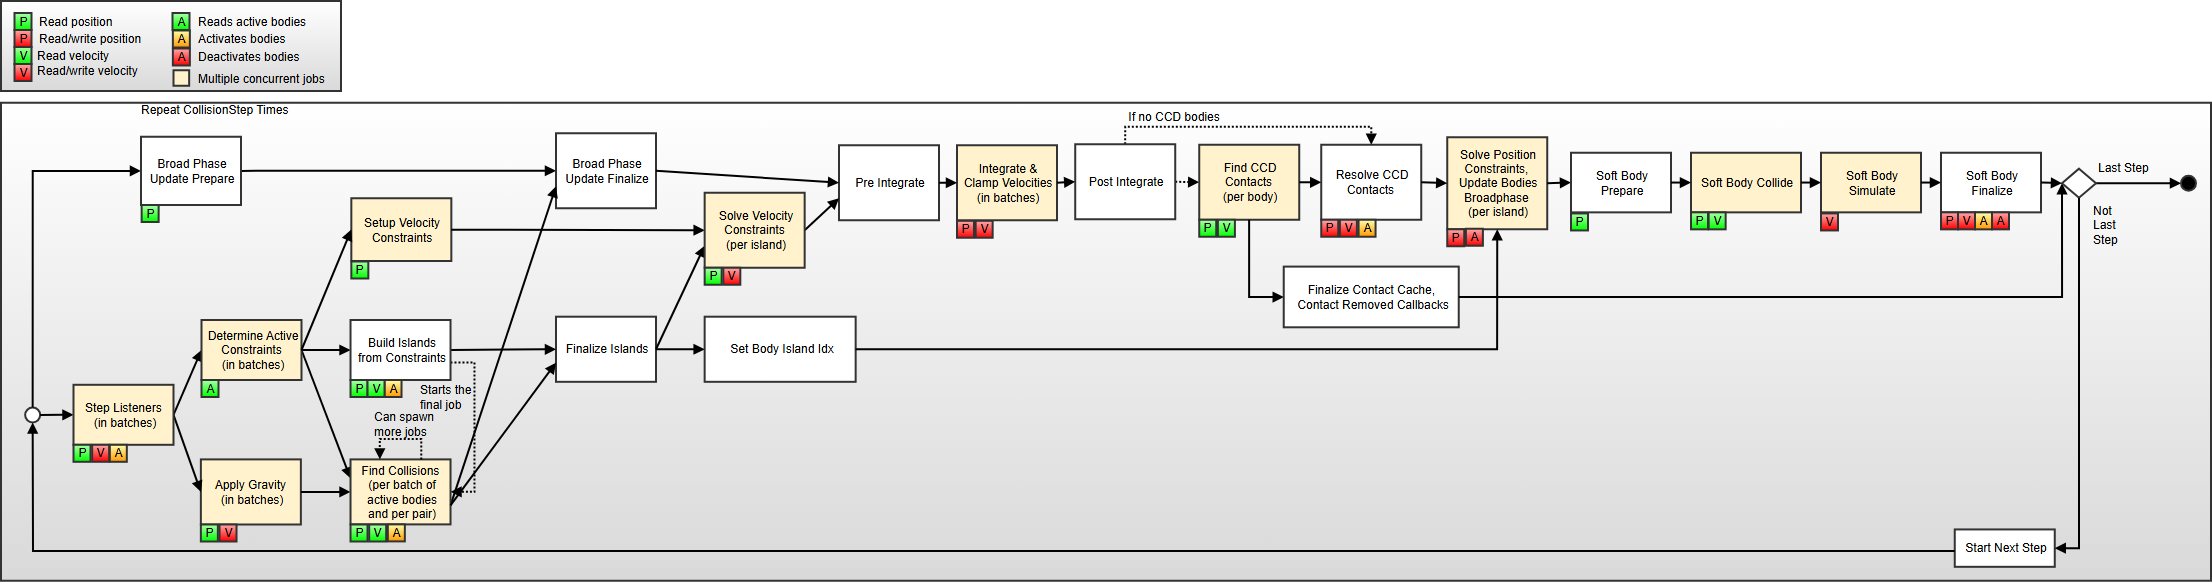
一次 step 的流水:Update 里到底排了哪些活
上一篇立好了坐标系,这一篇去拆最核心的那一个动作:一次 PhysicsSystem::Update 里到底排了哪些活。Jolt 把一帧切成 22 个作业句柄、四条主干链,靠依赖计数的加减法决定先后——头注释写「按执行顺序排列」,但声明顺序并不等于执行顺序,两者在 6 处不一致。本机火焰图给出的分段占比很反直觉:最重的不是求解,而是碰撞检测(FindCollisions 从 1 线程 11.8% 升到 16 线程 19.3%),两个求解段各只占约 2%。本篇还用阿姆达尔定律把上一篇留下的「8 线程后为什么掉速」算了一遍:反推串行占比约 5.5%,外推 16 线程应得 8.77×、实测只有 7.72×,这 1.05 倍的缺口正是「并行度越高、协调越贵」。全部读数给出命令、场景与版本,可复现。
Body 与 MotionProperties:三态、两副面孔的接口、批量增删
前两篇把物理世界和一次 step 的流水读开了,这一篇拆最底下那层:对象。刚体在 Jolt 里不是一个孤立的堆对象——只有会动的刚体才带一个 MotionProperties,静态体不分配(本机 sizeof 实测 Body 128 字节、MotionProperties 192 字节,静态体每体省下 60%);它的身份是一个 32 位的 BodyID,低 23 位索引配 8 位序号,序号位挡的正是「对象已销毁、索引被复用」的悬垂引用。官方规定的四步生命周期一步都不能少,不能 new、也不能 delete;访问接口还有加锁与非加锁两副面孔,锁不是每体一把而是固定数组加哈希(本机 32 把,上限来自 MutexMask 的位宽)。官方那句「必须批量添加」是定性的——本篇把它量出来:首次 Update 逐个比批量慢 25× / 89× / 185×,而插入本身批量反而更慢;补一次 OptimizeBroadPhase 只要 25.2 毫秒,就能抹平 3.8 秒的代价。全部读数给出命令、场景与版本,可复现。
宽相:QuadTree 的无锁双树
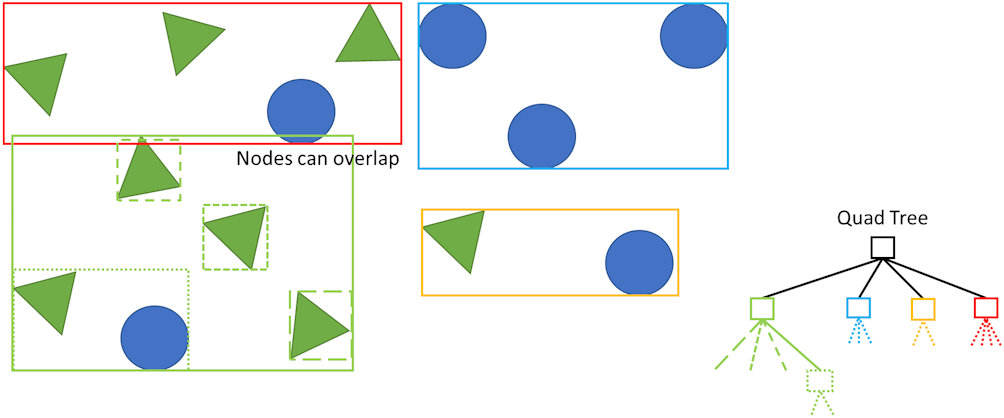
前三篇把物理世界、一次 step 的流水和最底下的对象层读完了。这一篇往上一层:刚体进世界之后,先要有人把「不可能相撞的配对」扔掉,那一层叫宽相。Jolt 的宽相是一棵四叉 AABB 树,而且做了两件不太常见的事——树是无锁的,同一时刻还存在两棵树(新树在后台建好、旧树等旧查询锁释放才丢)。无锁靠的是「放宽父节点路径」:不动结构,只把路径上的包围盒撑大,撑久了再整棵重建;重建也不是全量重算,只重算被标脏的那条路径、往下五层,更深的子树整块搬。官方只给了一句定性的警告——「逐个添加刚体会让宽相变得非常低效」——本篇把它量出来:10 万体逐个插入后,树被撑成一条 667 层、667 个节点的链(批量插入只有深 7 层),同一个查询要访问 33,333 个节点而不是 63 个,两者上报的刚体数却完全一样;补一次 OptimizeBroadPhase 花 18.24 毫秒,换回首次 Update 少花 3.2 秒。官方那句「宽相查询不确定」也做成了一个可数的实验:假阳性 1 个。全部读数给出命令、场景与版本,可复现。
三层过滤:谁能撞谁
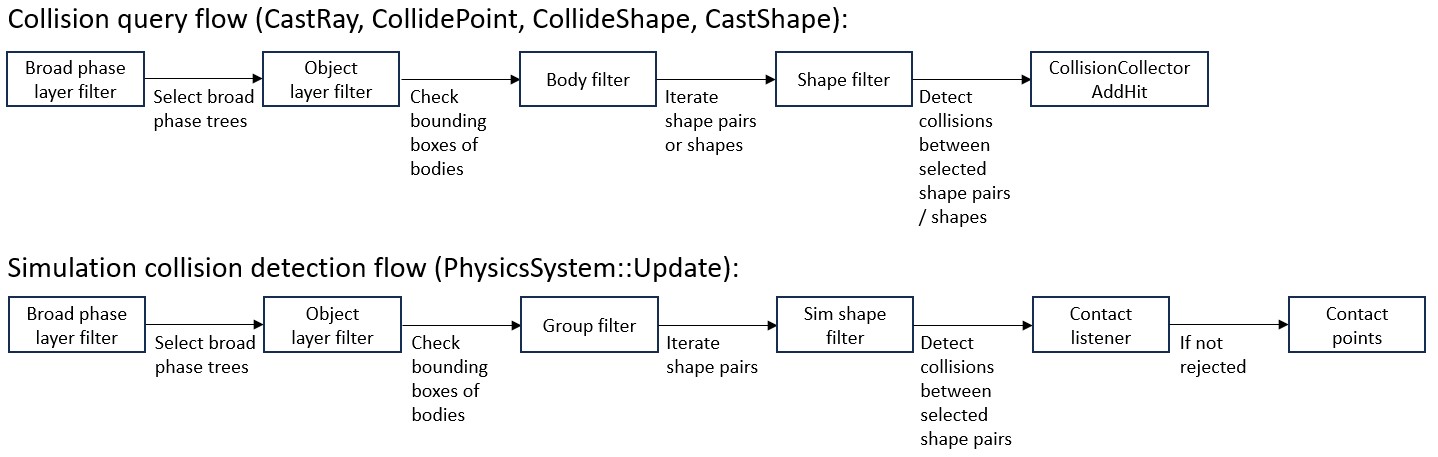
前四篇把物理世界、一次 step 的流水、对象层和宽相那棵树都读完了。这一篇问的是:树里到底该放谁。物理引擎里没有「碰不碰」这一个开关,只有一条从「还没配对」走到「已经算出接触点」的漏斗——宽相层、对象层、碰撞组、体过滤器、形状过滤器、接触监听器,六级越往下越贵,写贵一级的代价是先做完活再扔掉。Jolt 的做法是三个必需的 Init 参数:一个把对象层映射到宽相树,两个回答「这两个层该不该碰」。本机把代价量了出来:同一个探针查询、同样的结果,两个对象层共享一棵宽相树要多走一倍的节点(20000 对 10000)、多访问一倍的刚体,其中 2310 个是无关的;而只改一行映射返回,稳态每步快 1.62 倍(19.51 对 12.01 毫秒)。另一条线上,表驱动与掩码两条落地路线表达规则的能力等价,但掩码路线的最后一层是兜底层,两者在层序设计上不等价。七家引擎的横向对照、十条反模式与三条处方都在篇尾。全部读数给出命令、场景与版本,可复现。
窄相:GJK、EPA 与流形裁剪
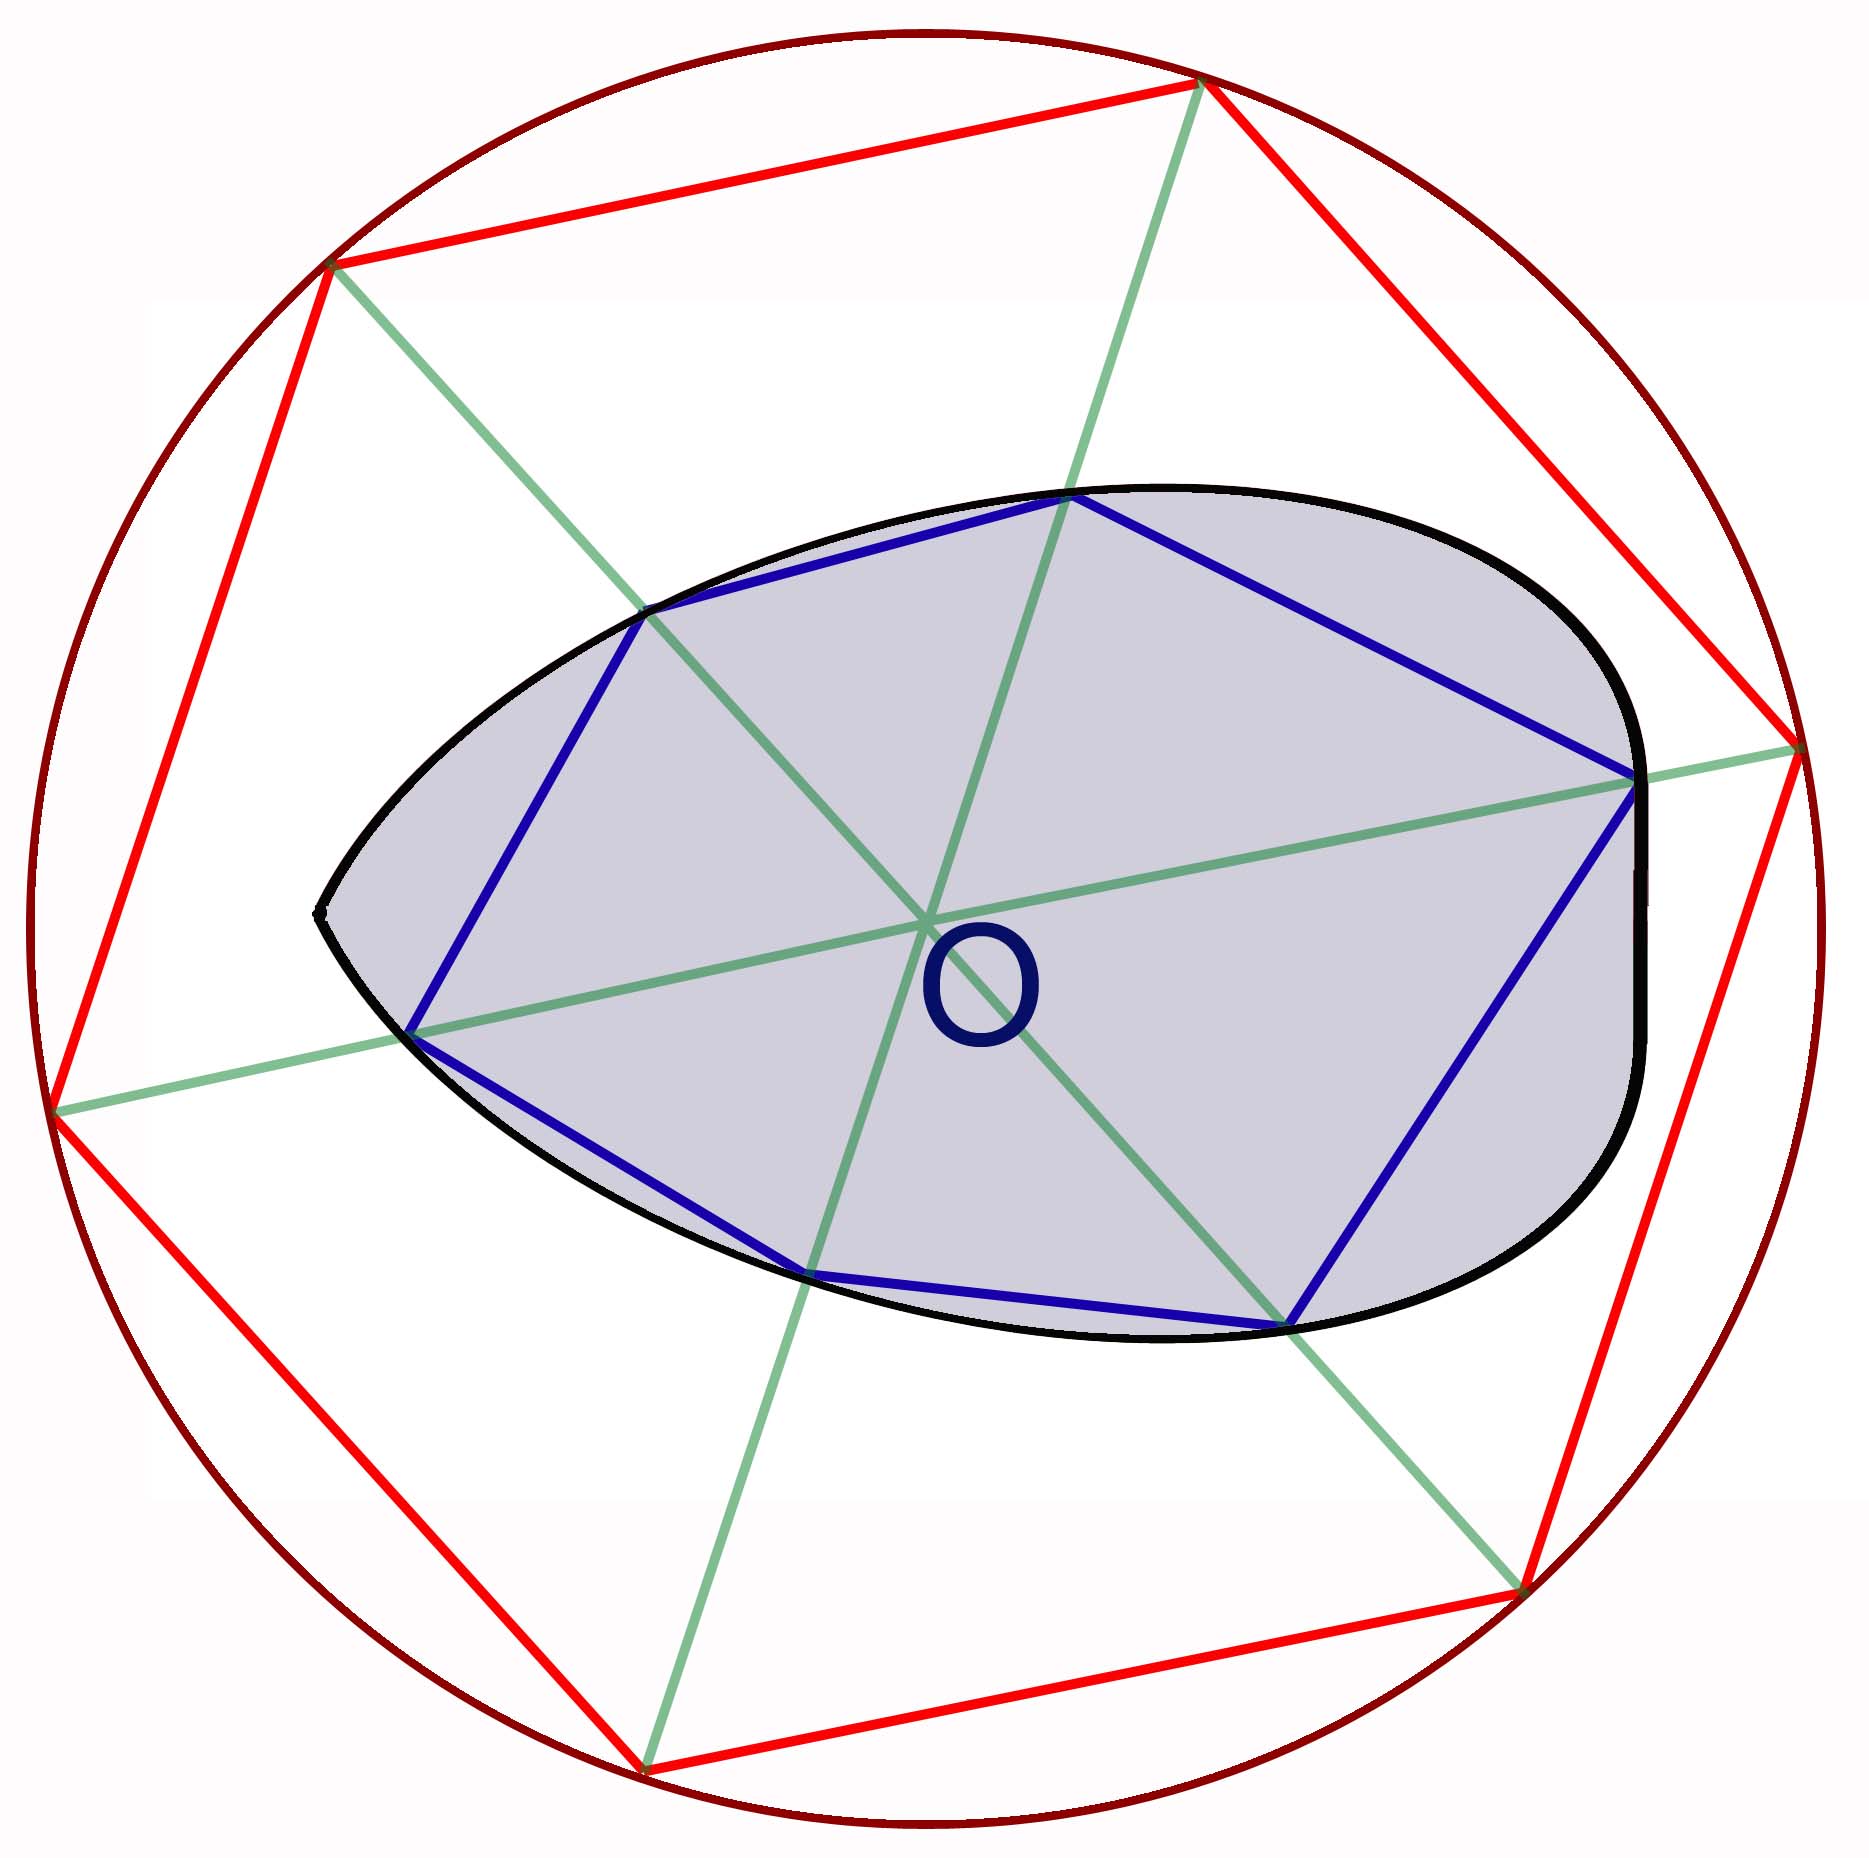
上一篇把「谁能撞谁」讲完了:宽相层、对象层、碰撞组、六级漏斗,那一篇从头到尾都在处理配对。这一篇回答配对之后的那个问题:两个体既然被允许碰,到底碰上了没有、碰得有多深、接触面在哪。官方文档的「窄相」一节只有 8 行,一半在讲锁——先在 body lock 里造一份形状快照,主要计算放到锁外做。剩下的事分成两半:GJK 一边判相交、一边给出最近距离;EPA 只在两个形状减掉凸半径后的核心真的重叠时才跑。本机把这条分工量了出来:静止堆叠场景 EPA 触发率 0%,高速下落场景 15.38%,而每次 EPA 的调用都能对上它那四类出口中的一类。接触点的容量是 64 不是 4:球堆 14346 个流形百分之百报 1 个点,箱堆 14000 个百分之百报 4 个点,一个例外都没有。缓存那一段的账也很直白:同一场景 420 步,体对缓存开关之间的 GJK 调用数差 123.2 倍。至于最常被当成「精度旋钮」的凸半径,本机把它扫了一遍——它不改变碰得准不准,只决定边咬不咬得住,分界线正好落在默认的 0.05 上,位移能差 154 倍。逐形状对的耗时差 53.5 倍、十条反模式与三条处方都在篇尾。全部读数给出命令、场景与版本,可复现。
形状谱系:34 个形状类型与 32 位路径
上一篇把窄相拆完了:GJK 判相交、EPA 算穿透深度、面-面裁剪出接触流形。那一篇从头到尾都把形状当成一个支持函数提供者,好像它天生就存在。这一篇就把形状本身拆开:球、盒、胶囊、圆柱、锥形胶囊、锥形圆柱、凸包、三角形、平面、空形状、三角网格、高度场,外加三种复合形状与三种装饰器,一张表是 12 个类型、另一张是 34 个子类型,而两张表的顺序都是追加演进的化石层——重排它会让统计表的坐标整体错位,且不报错。复杂度的分层也很直白:解析式形状的体积是零成本,凸包要额外存一个浮点数,网格与高度场连存都不存,直接承认自己没有定值;「必须 static」则是一条契约,源码里没有任何运行期校验点。第二件事是「打中了哪一块」:Jolt 的答案不是序号,而是把整条路径压进 32 位——位从最低位起逐层压入、根级不占位、没用到的高位一律补 1。本机做了双向验证,引擎回报的四个 ID 与预测逐位一致,手工构造的 ID 也能被重新解析回原叶子。32 位是总预算:一层平铺能装 42.9 亿个子形状,而二元嵌套链只能装 33 片叶子,深度一过 32 就构造失败。最后用官方 instrumentation 量了 18 格形状阶梯,最贵与最便宜差 11.61 倍;同一份读数连跑三次,查询数三次完全一致。全部读数给出命令、场景与版本,可复现。
约束家族:13 类约束与可复用的求解原语
上一篇把形状谱系拆完了:12 个类型、34 个子类型,回答的是「几何是什么」。这一篇换一个问题——两个体之间被允许怎么动。约束这一层用两张枚举描述,细的那张有 13 个内置类型加 4 个用户槽,一个显式赋值都没有,序号全靠写入顺序得到;而官方文档的列举顺序与源码的声明顺序只有 5 项同位,机器逐项比出来的位次差合计 8,根源在序列化只认序号。求解被抽成 14 个可复用的原语,一个具体约束只是把其中几个装配起来,GetTotalLambda 的转发实现就是这层装配的机器可读证据。参数侧有一处容易踩的量纲:弹簧的频率写法与质量无关,纯刚度写法在 100 kg 下 901 步仍未收敛、稳态误差 17.4344 mm;位置马达配频率 0 会一步不动。可断裂约束那半页官方文档还留了一个陷阱——GetTotalLambda 读的是本步冲量,阈值除以时间步才等价于力上限,本机测出的分界正好落在 2τ/dt。全部读数给出命令、场景与版本,可复现。
接触求解:sequential impulse、暖启动与 Baumgarte
上一篇把约束这一层拆完了:13 类约束、14 个可复用原语,回答的是「两个体之间被允许怎么动」。这一篇把镜头推到最底层——求解本身。Jolt 的求解器没有对应的类:它在官方文档里被点名为顺序冲量加暖启动,落到代码上是两个 job、两个循环,都带按需提前退出。一次迭代只算四个量,迭代次数是最直接的精度旋钮,但它买不到暖启动买的东西——关掉暖启动,十层塔的最大穿透从27.90 mm 跳到 4571.98 mm,把迭代从 2 加到 30 也救不回来。摩擦在第一次迭代里完全失效,因为它的预算取自上一轮的穿透冲量;位置侧不追求零穿透,slop 就是它的目标,本机量到的稳态穿透与设定值逐位吻合。全部读数给出命令、场景与版本,可复现。
岛、并行与睡眠:IslandBuilder、LargeIslandSplitter 与三判据
上一篇把一次冲击拆到了底:接触与约束共享同一个求解循环。这一篇把镜头往后拉一格,问两个新问题——一步里谁跟谁可以同时解、什么东西可以根本不参与。前者的答案是仿真岛:岛就是接触图上的连通分量,Jolt 每一步都从头重建,靠一套无锁并查集在 O(N) 里跑完;超过 128 项的岛再被切成 32 组并行推进,末组单线程兜底。后者的答案是睡眠:判据盯三个点、按整岛结算。本机九组读数给出两处头条——切分带来的差异在自由落体期恒为零,落地成坨后放大到 1545.305176 mm 并稳定,而小岛对照恒为零;睡眠把每步成本压到约六分之一,但线程从 1 加到 8 几乎无收益。全部读数给出命令、场景与版本,可复现。
CCD 与确定性:LinearCast 的「偷时间」与状态回归
上一篇把「谁跟谁可以同时解」讲完,这一篇回到一帧之内问两件事:又小又快的东西为什么没穿过去,以及同一份输入凭什么跑出同一份世界。前者的答案是连续碰撞检测:触发判据只有一行平方比较,命中之后靠一套「偷时间」的折算把体停在允许的穿透里,而允许多少由两个旋钮取小决定——固定穿透上限时翻转点在内半径 0.08 m,这是本篇唯一一处由源码推出、又被本机实测钉住的定量预测。后者的答案是两条前提加一套录放校验回路;本机读数里最直白的一组是:打开确定性开关,三次复跑得到同一个末态哈希,关掉之后三次三个,而每步耗时在本机这个规模上量不出差。另有几处「例外」被当作机制写清:命中落在步边界会被丢掉、投机接触会先一步把体停住、只转不飞与越墙后改档都不由 CCD 兜住。全部读数给出命令、场景与版本,可复现。
角色与载具成品件:CharacterVirtual 的三件套与 VehicleConstraint 的四个部件
前十一篇把一帧之内的零件逐个讲完,这一篇换一个问法:引擎已经把哪些东西做成了可以直接接入的成品件。角色侧是两条路——把角色做成配了滑动的刚体,或只用碰撞查询把它挪动;差别落在谁进宽相、谁能被射线打到、谁决定它什么时候动。三件套的编排写在 ExtendedUpdate 里:主更新无条件跑,下坡贴地与上台阶各压着一句条件;四把旋钮里,贴墙留白逐位等于角色留白这一把,穿透恢复速度决定起步就重叠时几步能出来。虚拟角色默认不在世界里,要让射线打到它得设内层刚体,要让两个角色互撞得应用自己接接口,要存它的状态得用它自己的录放接口——这三件事本机都用读数钉住了,其中 PhysicsSystem 快照往返后角色漂移 999.999084 mm、动态刚体 0.000000 mm,正是类注释那句「不保存它」的数字形态。载具侧是一个约束加每轮一份碰撞测试再挂四个部件;三个探测器几何不同,同一辆车跑同一段搓板路,换探测器改的不是精度而是接触点落在轮子下面的位置。悬挂三长度里藏着一条公式:自然长度等于最大长度加预压长度。摩托控制器的平滑系数官方明写帧率相关、且自认仍在开发,履带的默认摩擦值官方写明照 M1 Abrams 配。全部读数给出命令、场景与版本,可复现。
柔体、毛发与 GPU Compute 的真相:SoftBody 的 XPBD、发束的 Cosserat 杆,以及「Jolt 有 GPU 物理」这句话该怎么读
前十二篇把刚体侧逐个讲完,收官这一篇换三个问法:一个顶点网格怎样被约束成有形状的软物体、一束头发怎样在显卡上被模拟、以及「Jolt 有 GPU 物理」这句话到底该怎么读。柔体侧的证据主体是XPBD 迭代与六类约束,官方 sCreateCube(5, 0.5) 给出 125 粒子、192 面、300 边约束与 384 体积约束;本机把压力项单独隔出来量了一遍:有体积约束时压力取 5000 只让体积变 −0.028%,去掉体积约束后同样的压力让体积变 +0.598%,说明体积约束把压力挡在了外面。官方自列的缺口也逐条复现:柔体之间不互撞、SetLinearVelocity 对柔体无效、浮力尚未实现,而柔体与刚体那条路径是通的。其中一处坑值得单独写:动态盒忘关重力时柔体看起来穿了过去,装上接触监听器才定位到是装置问题——先怀疑装置,再下结论。毛发侧清点出 15 支计算着色器与九条待办。GPU 那条线用全库检索给出一个事实:库内唯一内建消费 compute 接口的模块就是毛发;PhysX 走的是另一条路,而 Havok 官方明写布料 SDK 是 CPU 的。那条流传很广的「强烈反对 GPU 物理」也在此更正归属:说这话的是贡献者,不是作者。全部读数给出命令、场景与版本,可复现。
ReShade 注入式后处理
本站第一次把镜头转向「从进程外面挤进来」的那类工具。注入式后处理不是后处理的一种实现,而是后处理的一种位置——引擎自己的后处理链跑完之后、交换链呈现之前,那一段
总论:什么是注入式后处理——它与管线内后处理的边界
本站第一次把镜头转向「从进程外面挤进来」的那类工具。注入式后处理不是后处理的一种实现,而是后处理的一种位置——引擎自己的后处理链跑完之后、交换链呈现之前,那一段原本没人的缺口。位置一变,能拿到什么、要付什么代价全都跟着变:它手里只有成品帧与条件满足时的深度,没有几何缓冲,所以只能做屏幕空间近似;换来的是不挑引擎、零侵入。本机在自有开源场景上把这句话量了一遍:对照组前后两帧逐字节相同,六组效果的平均绝对差从 15.9 到 63.2 不等;而深度这一类在本机没能拿到(四种设置口径输出一致),这一组就没做——四处素材落空全部走改写文案这条路,不拿示意图顶替。
代理 DLL 与导出表挂钩:一次调用是怎么被接过去的
上一篇讲清了「站在哪个位置」,这一篇往下一步:一次调用到底怎么被接过去。答案分两半——凭什么轮到你被加载,以及同一批导出函数有哪三种接法。前半段的依据是官方那张十二步清单里第 7 条排在系统目录之前,真正的风险在三条例外(安全模式挪的是「当前目录」、系统保留库不听程序目录、重定向靠文件名本身);后半段从源码里的一个三值枚举出发,讲清按导出表重定向、按函数体跳转、改虚表各自在动什么。本机把这两件事都量了一遍:探针用对名字时被加载、用错名字时连加载都没发生;注入日志逐模块宣布挂了 21/3/2/5 处,而末行报告卸载 40 处——两个数不是同一件事。四组实验都是单变量加反向对照,读数与日志随篇留档、可复跑。
ReShade FX:语言血统、独立编译器与纹理语义
前两篇走的是「它怎么进来、怎么接住」,这一篇往语言这层走:ReShade FX 到底是什么。官方只给了一句定性——它以 DX9 风格的 HLSL 语法为底子、另加少量扩展。本篇把「少量扩展」拆成四章:纹理语义(COLOR 与 DEPTH 内建,其余名字由 add-on 注册,所以没有封闭清单)、technique 与 pass 把渲染状态写进 shader 文件、注解族连界面怎么显示都管、以及十六个运行时数据源。这四类东西 HLSL 与 GLSL 都没有,于是「自带编译器」就是必然。「独立编译器」那句话被拆成两层:能力上独立(源码可拿走、四个后端)与产品上独立(官方不发命令行工具)——这是中文侧没人讲过的一处。第七章自己写一个最小 .fx 编一遍,把预处理展开、编译对象、反汇编逐个抓下来;第八章还把八年前那条「常量全局数组不可能」搬回本机重跑,6.7.3 上它已经编过了。
effect runtime:technique / pass 图、render state 与运行时数据源
前三篇走的是「怎么进来、用什么写」,这一篇回到运行时的账上:一个 effect 从源码到画面过了几道。第一件事最反直觉——没有依赖图。执行顺序只有两个来源:效果文件里的声明顺序,与预设里那行 TechniqueSorting 的一次稳定排序;pass 严格按数组下标走,依赖靠共享纹理与一次状态转换隐式维系,所以想调效果先后不是写代码而是改一行配置。第二件事是状态的两段式:pass 里写的渲染状态在装载期就被折进一个不可分割的管线对象,运行期只剩下换目标、绑管线、绑资源、发射。第三件事是十六个运行时数据源的分工——十五个由 core 按帧填,第十六个「深度就绪」由官方深度 add-on 从外面塞进来,而它的判定是「有没有选中可用的深度资源」,不是「深度图里有没有东西」。本篇全部读数来自对 69 个效果源与 12 个预设的只读解析,以及逐行引用的官方源码。第五章还解释了那个老问题:为什么开了性能模式之后,变量就调不动了。九张面板把官方源码原文、本机读数与本机预设原文逐行摊开,可复核。
跨 API 抽象:D3D9/10/11/12、OpenGL、Vulkan 的差异与统一
前四篇把「怎么进来、用什么写、每帧怎么跑」讲完了,这一篇回答那个最朴素的问题:同一行 add-on 代码,凭什么能在 D3D9 与 Vulkan 上都跑。答案不是「抹平差异」,而是先选坐标系——官方自己写着 modeled after the Direct3D 12 and Vulkan APIs,另外四个后端是被翻译进来的那一侧。所以差异没被消灭,只是被收走了:收进了六个不透明句柄的注释里,收进了四个后端的四份状态块里(83/77/174/244 行),也收进了九处 present 入口与六份格式转换器里。而最硬的一条痕迹是「谁需要状态块」——状态归设备管就要快照,归命令列表管就不需要,于是 D3D12 与 Vulkan 干脆没有这个文件。本篇进一步把三件事分开说:抽象住了、翻译了、没抽。第四、五、七章各给一处对照。全部读数来自对随篇归档的 35 份官方原件的离线解析与清单级核对,逐行可复核。
Add-on API:事件模型、跨 API 资源交换与两种构建的分野
前五篇把「怎么进来、用什么写、每帧怎么跑、怎么盖住六种 API」讲完了,这一篇回答往里更进一步的那个问题:想插手更深的事,接口长什么样。答案是一句反常识的官方定义——add-on 不导出函数、也不链接库;它靠三样东西站着:一张 100 个格子的事件表(取值 0–100,值 7 空白,末尾哨兵 max = 101)、18 个跨 DLL 边界的 C 导出,以及一个三档取值的构建开关(RESHADE_ADDON = 未定义 / 1 / 2)。最硬的两处痕迹:编号是「只增不废」的——23 个显式锚点把值钉死,值 7 报废后不回收,于是 100 个成员铺在 101 个槽位上;而签名版在编译期就摘掉了 30 个事件,手段是两处 static_assert(13 + 17),不是运行期拒绝。全部读数来自对随篇归档的 11 份官方原件逐行现读,以及 219/228 份原件的仓库级计数,逐条可复核。
深度缓冲的工程学:自动关闭、MSAA、UI 缺失与子矩形错位
前六篇把「怎么进来、用什么写、每帧怎么跑、怎么盖住六种 API、接口面长什么样」讲完了,这一篇回答中文圈里最深的那条经验:深度类效果为什么时灵时不灵。答案不是「修不好的 bug」,而是四道各自独立的工程条件叠在一起——关掉它的那一手根本不在深度模块里(网络一有流量,61 帧一个窗口、≥10 帧就把 add-ons 整体停掉,且只有签名版这么做);MSAA 下能不能用深度取决于设备能力位 resolve_depth_stencil;界面在深度写入之后才画,所以深度里本就没有它;而同一张深度缓冲可能服务多种分辨率,「该取哪一次」只能靠启发式。最硬的一处痕迹是签名版编译期禁掉的 30 个事件与这个检测器注册的 27 个事件的交集为空——这正是官方那句 just enough 的机制含义。全部读数来自对随篇归档的 8 份官方原件逐行现读,逐条可复核。
效果生态与许可地图:同一份清单里的 MIT 与"禁止再分发"
前七篇把「怎么进来、用什么写、每帧怎么跑、怎么盖住六种 API、接口面长什么样、深度为什么时灵时不灵」讲完了,这一篇换到生态这一层:那些 effect 到底能不能用、能不能转。答案不在许可条款的比较表里,而在「这份清单有没有托管任何东西」这个形态问题上——官方安装器读的三份清单里,45 个包全部是指针,下载地址一条不差地指向作者自己的仓库,官方一个字节都不托管。于是同一份清单里才能并存七种许可状态:MIT 15 个、BSD-3 3 个、CC0 2 个、GPL 家族 3 个、有文件却认不出的 6 个、只在 README 声明的 3 个,以及最大的一格——既无许可文件也无声明的 10 个。装哪些由 499 条白名单点名,不装哪些由 8 个包 20 个文件的黑名单决定,而且黑名单优先级更高(三个包实测重叠)。付费档连指针都不给:五个付费文件名在 499 条里零命中。全部读数来自对随篇归档的三份官方清单与 44 个仓库许可探针逐行现读,逐条可复核。
自跑一:注入本地 D3D11 demo——逐效果前后对比
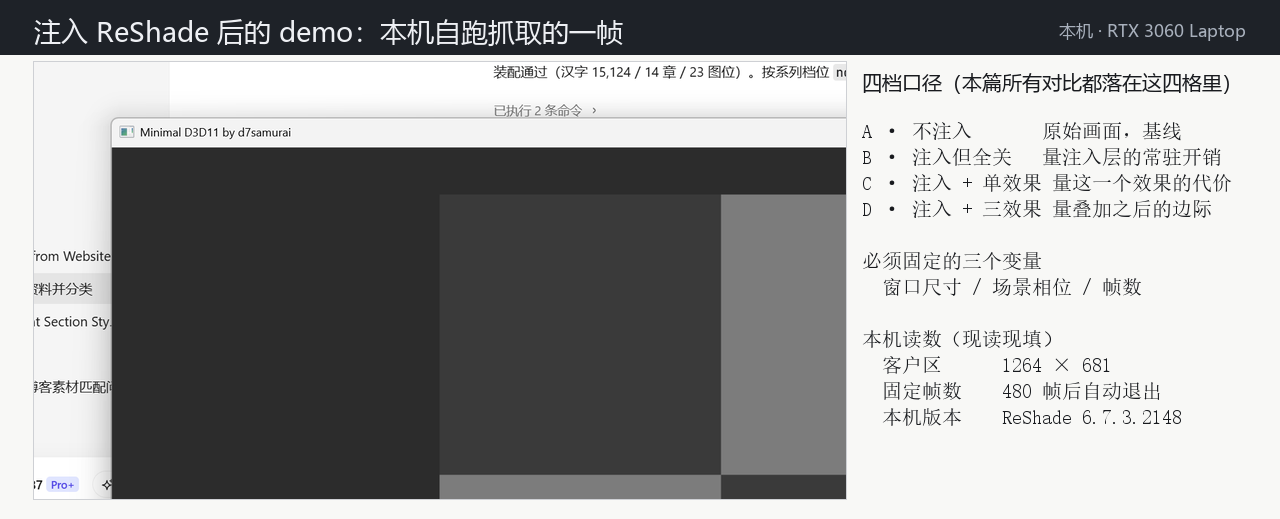
前八篇把「怎么进来、用什么写、每帧怎么跑、怎么盖住六种 API、接口面长什么样、深度为什么时灵时不灵、那份清单里的东西能不能转」讲完了,这一篇第一次真的把它装上去:在一个自有的极简 D3D11 demo 上布线、注入、逐档抓图。做法是把「开与不开差多少」拆成四档口径——不注入、注入但效果全关、注入加单个效果、注入加三效果叠加——每一档单独启动靶子、固定停在第 200 帧、窗口固定屏幕同一处后抓客户区,跨次启动的重复性残差实测 0.00。结果里最有意思的一处是:同一台机器、同一个靶子上,深度探针与色调映射是一眼可见(逐像素平均差 112.0 与 108.8/255),色差、查表调色与 CRT 看得出但轻(48.8/36.4/33.9),而景深几乎看不出(10.5)——因为靶子太简单、深度跨度太小。另一处是注入层本身可以小到测不出来:不注入与注入但全关的画面逐像素完全一致。全部画面来自本机自跑,逐张给出抓图口径与差异读数,抓图脚手架在同一份源码上的四处最小改动随篇归档。
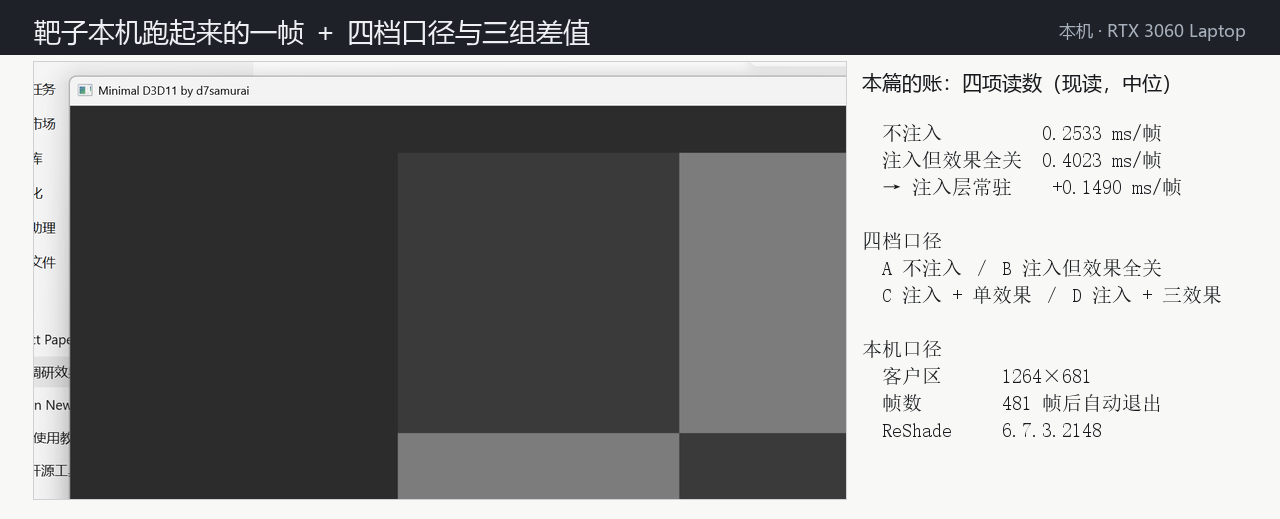
自跑二:效果栈与帧耗账,外加自写一个小 .fx
前九篇把「怎么进来、用什么写、每帧怎么跑、怎么盖住六种 API、接口面长什么样、深度为什么时灵时不灵、那份清单里的东西能不能转、画面到底长什么样」讲完了,这一篇第一次把账算出来:把「多花多少」定义成毫秒每帧,再把开销拆成三笔分开记。量下来三笔的性质完全不同——注入层常驻约 0.15 毫秒每帧(两场独立复跑一致);而八个单效果里有五个同口径档全部低于「注入但效果全关」档,三效果叠加的边际约 0.03 毫秒每帧、并不等于三个单效果之和;分辨率这条乘数也不线性(像素涨 1.584 倍,三档分别 +3.3%/+15.0%/−3.4%)。测量过程中订正了三处口径:逐帧日志不是每帧必写、Windows 上 sleep(1ms) 实际睡 15.6 毫秒、窗口起点会被停写顺移。最后一节自写一个小 .fx 走通整条链,并在它身上暴露出一处代码级自相矛盾(一个 pass 既读又写同一块后备缓冲,实测画面整体偏移 48.58/255),改成干净的两 pass 后开与不开差 8.29/255。全部读数来自本机自跑,测量脚本与原始日志随篇归档。
Vulkan 官方最佳实践
「官方最佳实践」这五个字,在 Vulkan 这边找不到对应的那一份文档——它散在四套体系里(Guide 的 74 页、Tutorial 的 18 章加 10 门进阶课、Samples 的 25 个 Performance 样本、以及验证层里一个开关),而其中最关键的那个开关**默认是关的**。这一系列不写 API 教程,只回答两件事:官方那条建议原本是什么形态、连同它的硬件前提;以及搬到这台机器上,它到底值多少。取材以自写最小用例的自跑读数为主,官方 Samples / Guide / Validation 只作 Do/Don't 的文本来源与对照,十篇按「2026 新范式 → 同步 → 管线缓存 → render pass → 命令缓冲 → 描述符 → layout transition → swapchain → 验证层闭环」推进。
官方最佳实践到底在哪:四套体系的边界与本机能力实勘
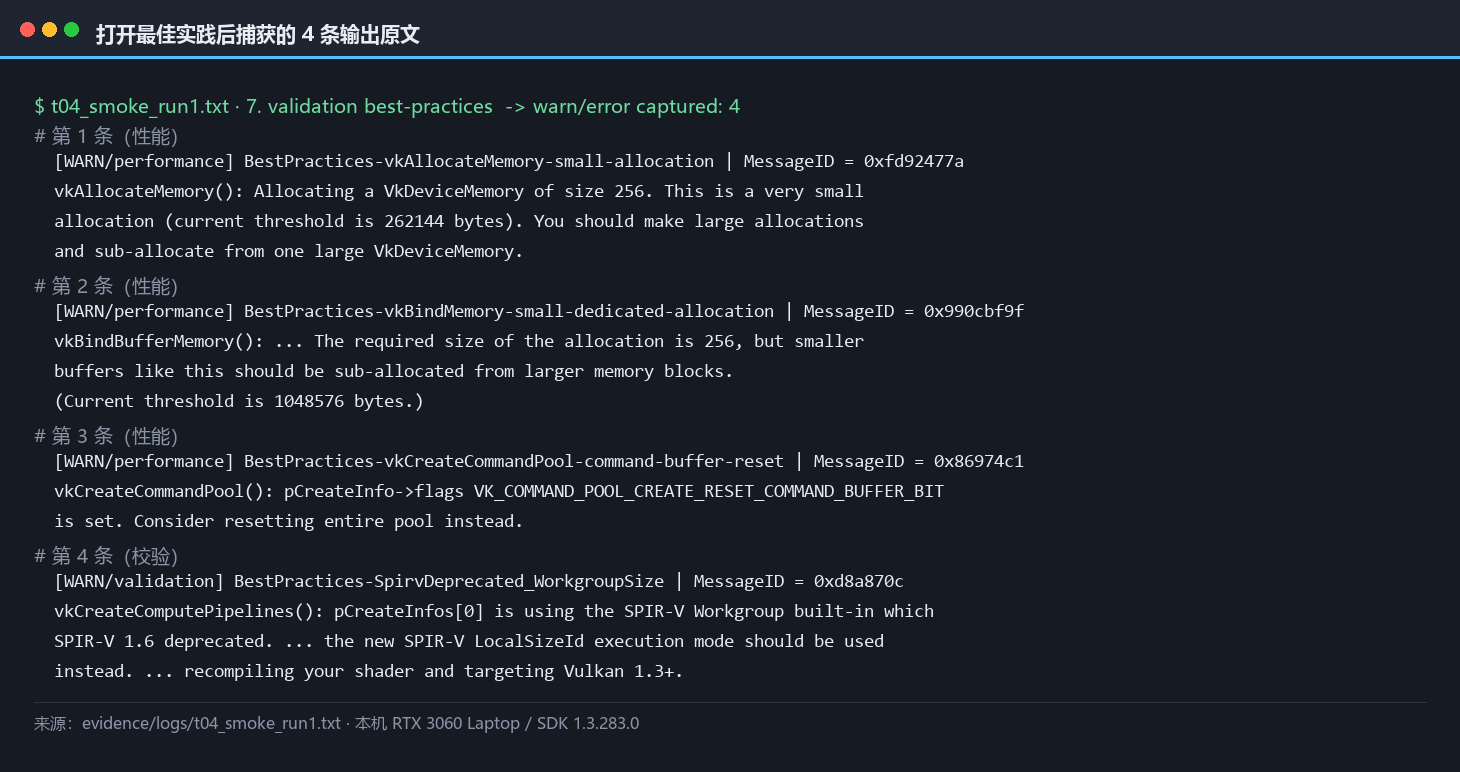
「Vulkan 官方最佳实践」这件事,第一篇先把地图和量尺立起来,因为后面九篇的读数都要挂在这上面。第一个结论与常识相反:**官方并没有一份叫这个名字的白皮书**——它散在四套体系里(Guide 的 74 页、Tutorial 的 18 章加 10 门进阶课、Samples 的 25 个 Performance 样本、以及验证层里的一个开关),而那个开关**官方默认值写的是 `false`**。本机把这句话量了一遍:同一份**没有在代码里请求最佳实践特性**的构建,默认配置路径捕获 **0 条**告警,走环境变量或 `vk_layer_settings.txt` 各捕获 **4 条**——两条内存分配阈值、一条命令池重置、一条 SPIR-V 弃用提示。第二个是量尺本身:本机 `timestampPeriod = 1.0`(一个 tick 就是一纳秒)、223 项设备扩展、apiVersion 1.3.280;100 次派发在五次复跑下从 20,992 ns 到 27,424 ns,**极差 30.6%**——单次读数不可靠,这条纪律后面每篇都守。另有两处如实标出边界:RenderDoc 注入成功,但纯计算用例**没有帧边界**,本篇抓不出 `.rdc`;引用官方数字时连它的硬件前提一起引(管线缓存那组 24.4 对 50.4 ms 是 Mali-G76 移动端的账)。
2026 新范式:Vulkan 1.4 基线、Dynamic Rendering 与 Shader Objects
第二篇把官方在 SIGGRAPH 2026 给出的那套「2026 写法」逐条搬到本机:**shader objects + dynamic rendering + descriptor heap** 三件套里,**两件有扩展、可以实测,一件(descriptor heap)与 unified_image_layouts 是 0 命中**——不是我们查漏了,是这台设备的**能力表里就没有**。能跑的那两件,用「一个二进制、五条路径、只改 API 形态」的方式量了一遍:单帧录制 **45.3 → 56.2 → 74.6 µs**(换 dynamic rendering 贵 **24%**、换 shader objects 贵 **65%**),而整帧只有个位数百分比变化——**成本全都落在 CPU 侧的命令录制上**。更有价值的是两处「读数被自己作废」:起步用 FIFO,垂直同步把差异整个盖住(归档复现 **5,764.1 µs**);shader object 路径漏设 18 项动态状态,**一万多条验证层报错被算进了被测对象**(归档复现 **1,956.4 µs**)。两条都不是删掉就算,而是做成了**可以随时重跑**的诊断路径。另外三件:时间线信号量与栅栏三档相差 **3.5% 以内、且并不更低**(「可以替代」不等于「更快」);交换链 acquire 不接受它,**运行时不一定拦你、验证层拦你**;两份 `.rdc` 的缩略图**逐像素 0/230,400 差异**——性能差异必须有「结果没变」这条配套证据。
同步最佳实践:barrier 精细化、sync2 与时间线信号量
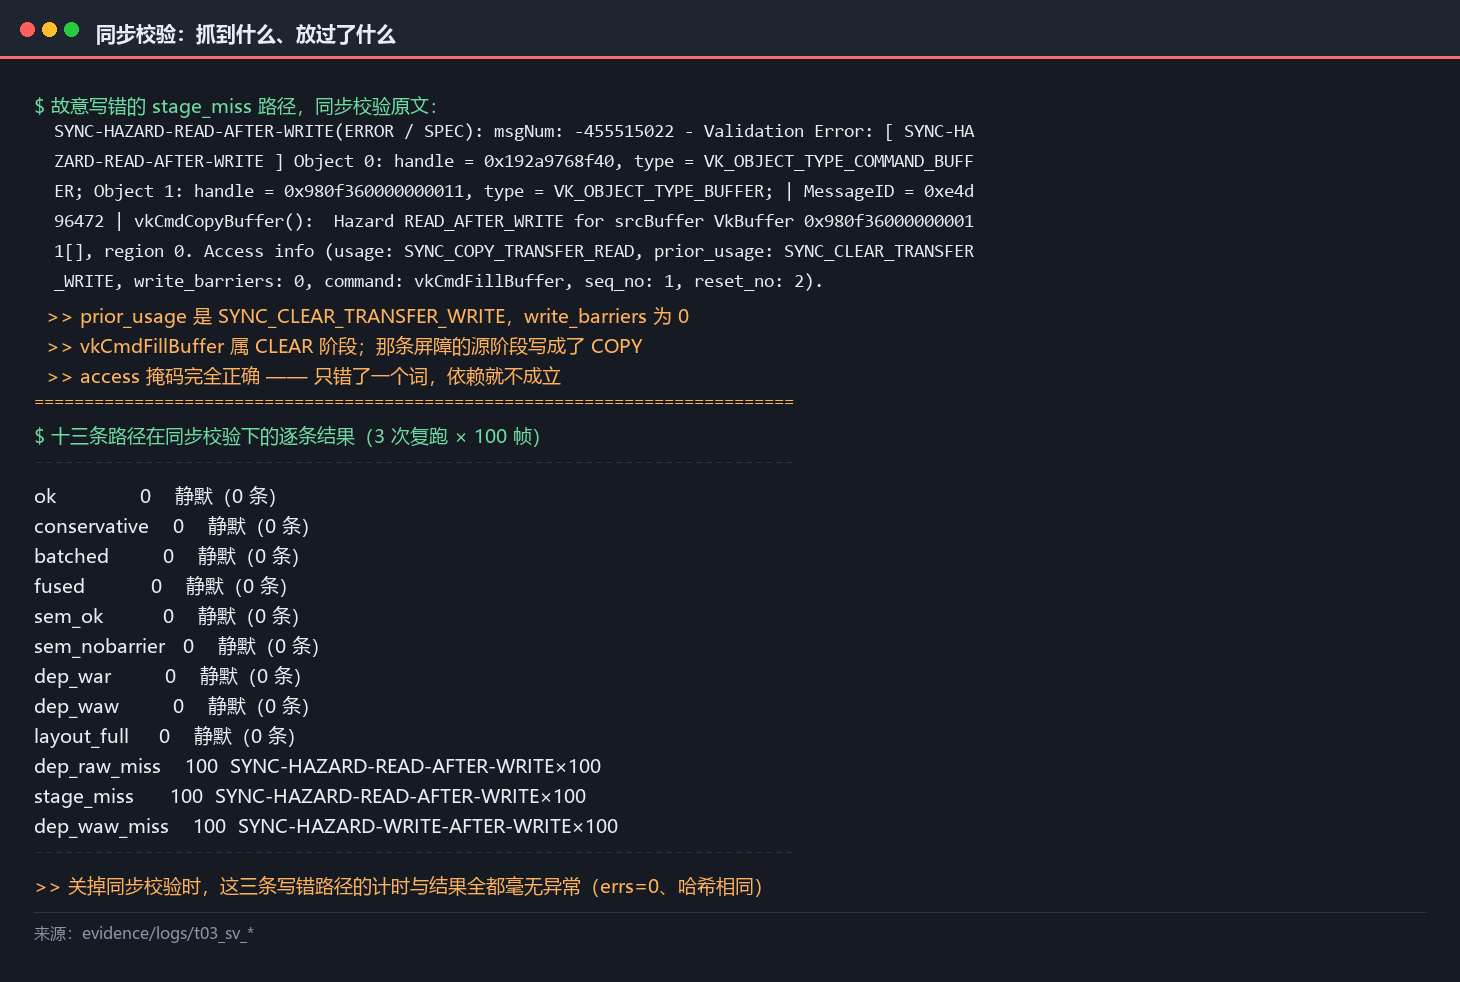
第三篇量的是**屏障怎么写**。官方四个体系里,Guide 给九条可执行的 Do/Don't、Tutorial 讲清 sync2 的动机、Samples 给方向、Validation 给工具,**四者共同缺的那一样是数字**——本篇补的就是这一格。做法是「一个二进制、十三条路径、唯一变量是屏障写法」,每帧内容完全相同(2 次填充 + 2 次拷贝 + 256 次 draw + 1 次布局转换),每条路径 ×5 次复跑并**报区间不报单次**。结果有两层:**第一层是好消息**,65 次运行读回缓冲的 FNV-1a **全为 `373aea8d1e1b3b83`**——删掉屏障、合并屏障、把掩码写成 `ALL_COMMANDS`,结果字节完全一样;**第二层是冷水**,唯一区间不相交的一对只有被判据明令禁止的全掩码写法(录制 **+2.8%**),而「合并调用」「合并掩码」「删掉官方点名可删的那条屏障」三项差异**全部落在复跑噪声里**——官方那句 *creating a bottleneck* 在这台机器这个用例上**量不到**,如实写出,不迁就措辞。真正抓到东西的是验证层:三条故意写错的路径在**同步校验关闭**时计时正常、结果正确、**验证层一条错都不报**;打开校验后各报满 **100/100 帧**。其中一条是可复现的 sync2 阶段粒度陷阱——`vkCmdFillBuffer` 属 **CLEAR** 阶段,屏障的源阶段写成 `COPY` 则依赖不成立,**access 掩码完全正确,只错一个词**。顺带把官方说的 non-trivial 开销量成了数:录制 **+40.6%**、整帧 **+26.4%**。最后一条延续 ep02 的结论:那条可删的屏障确实能删,但删掉它**不会带来收益**(GPU 335.4 vs 336.3 µs)——**可删 ≠ 删了更快**。
图形性能剖析工具链
会渲染,不等于会验证。以 RenderDoc 量 API 层的一帧、Perfetto 量系统层的整条路径,交叉出一张「画错 / 画慢 / 卡 / 迟延」各归其位的决策地图;再以「自跑 → 真图 → 归因 → 结论」这条可复现证据链,把图形性能验证做成方法论底座。全系列 13 篇都在这张图上走。
如何验证的全景图:从 API 层到系统层的剖析坐标系
会渲染,不等于会验证。本文先把图形性能验证立成一套坐标系——RenderDoc 量 API 层的一帧(帧级),Perfetto 量系统层的整条路径(系统级),两轴交叉出「画错 / 画慢 / 卡 / 迟延」四类症状各归其位的决策地图;再落地「自跑 → 真图 → 归因 → 结论」这条可复现的证据链,并把开源、可重放、可进 CI 作为不可妥协的选择红线。全系列 13 篇都将在这张图上走。
一帧是怎么被抓下来的:RenderDoc 抓帧机制解剖
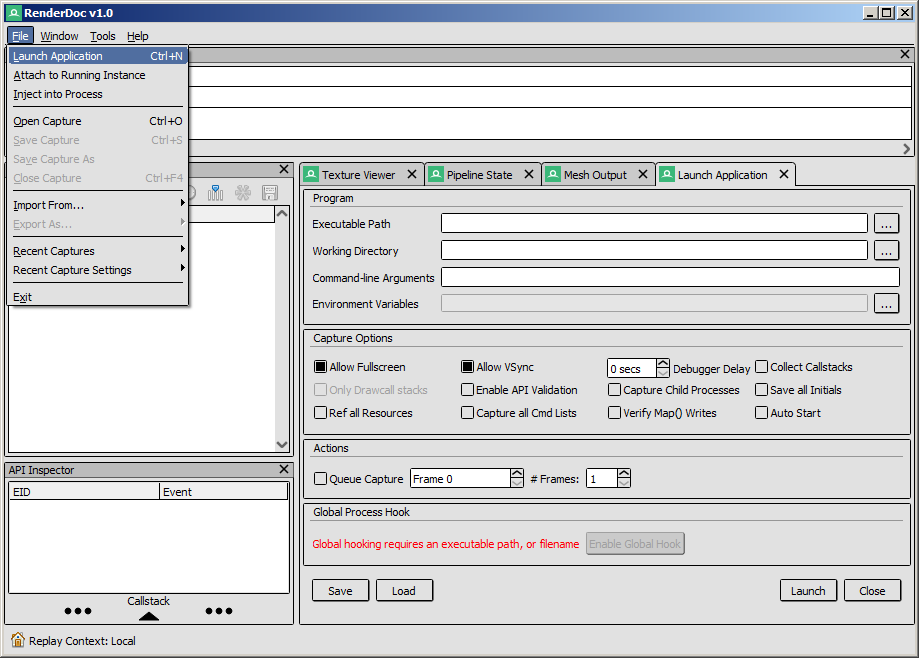
会抓帧,要知道抓帧本身发生了什么。本篇把 RenderDoc 前端从「你按下抓帧」到「一帧完整落到盘中」的机制链剖开:三种注入路径怎么进进程、Vulkan 的 implicit layer 与 D3D/GL 的 GetProcAddress hook 两套拦截机制的差异、帧边界怎么用 vkQueuePresentKHR 卡出一帧的起止、抓帧窗口内命令外发与资源快照分别在干什么,最后落到 .rdc 文件里到底是什么、怎么回到前端展示。让你用工具前先看穿工具。
一帧被抓下来之后:.rdc 如何被回放引擎重放与分析
会抓帧只是前半程,这一篇走后半程:.rdc 文件如何被回放引擎再次打开,并在回放设备上一点一点重建出当初那一帧的中间状态。我们从 .rdc 不是 zip 而是一个自描述二进制容器讲起,看文件头校验、Section 布局、序列化版本;再走到打开的本质——校验、探 API、建回放上下文;然后是 ReplayController 的三步帧事件推进,chunk-based 序列化与懒加载如何恢复资源状态,远程回放三种模式如何让 GPU 不在本机也能分析,最后落到"分析面板依赖的中间状态从哪来"。让你从会用回放,到看得懂回放在干什么。
事件浏览器:一帧 draw-call 列表到底怎么读
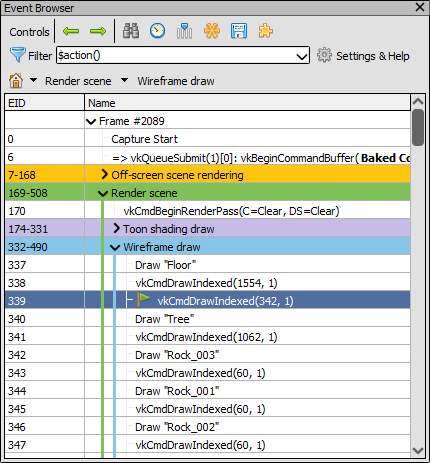
拿到一份单帧,如何把事件浏览器里那一长串 draw-call 列表读成一帧的结构化索引。我们从 action 与 draw 的术语辨析讲起,看 marker 如何把平铺调用链织成可折叠树、EID 为什么老是不连续且能当稳定句柄、点选一个 draw 如何把回放状态设到该命令结束的瞬时、三档显示开关与过滤表达式怎么从几千条命令里筛出关心的十几条、Timeline 如何鸟瞰整帧并联动资源与 Pixel History、时长列怎么把"哪个最贵"变成可排序的数字,最后落到书签查找与复制组成的逐 action 验证台。让你既是读图,又是排障。
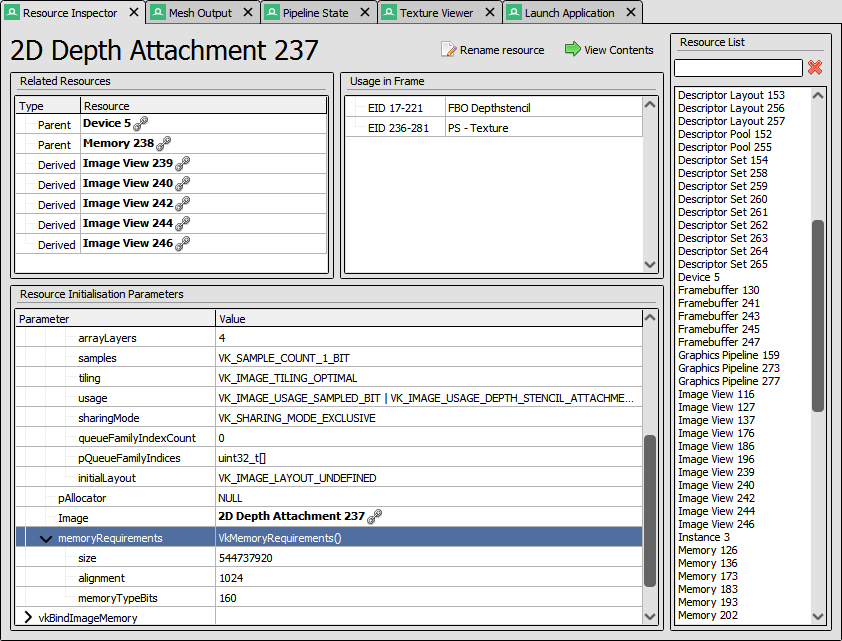
资源与描述符:一帧里那几百个 buffer 和纹理,怎么和 draw 对得上
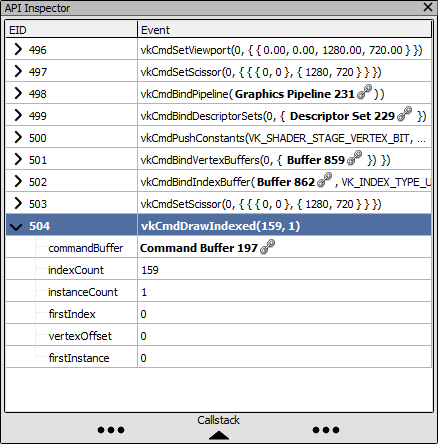
拿到一份单帧,如何把资源清单里那几百个 buffer 和纹理,与命令流里的 draw 一一对起来。我们从 Resource Inspector 的全量总账讲起,看资源的父子关系、创建细节与 usage 时间线如何按 EID 区间证明"这块资源被哪些 draw 用过";再进 Pipeline State 这条"接线总板",读绑定槽、descriptor、shader reflection 过滤与 bindless 推断,把"用什么画的"看成 action 之后的快照;接着用 Texture/Buffer Viewer 看资源真身,TexList 与 Locked Tab 双开联动,AoS/SoA 排布与自定义格式解释让 buffer 字节变成可读字段;最后以 DX view 与 Vulkan descriptor 的术语映射收齐口径,用"命令×资源"双闭环把 Timeline usage、CSV/raw 导出与自算归因串成一张可验证的工作台,衔接下一站的 Mesh Viewer 与反汇编。
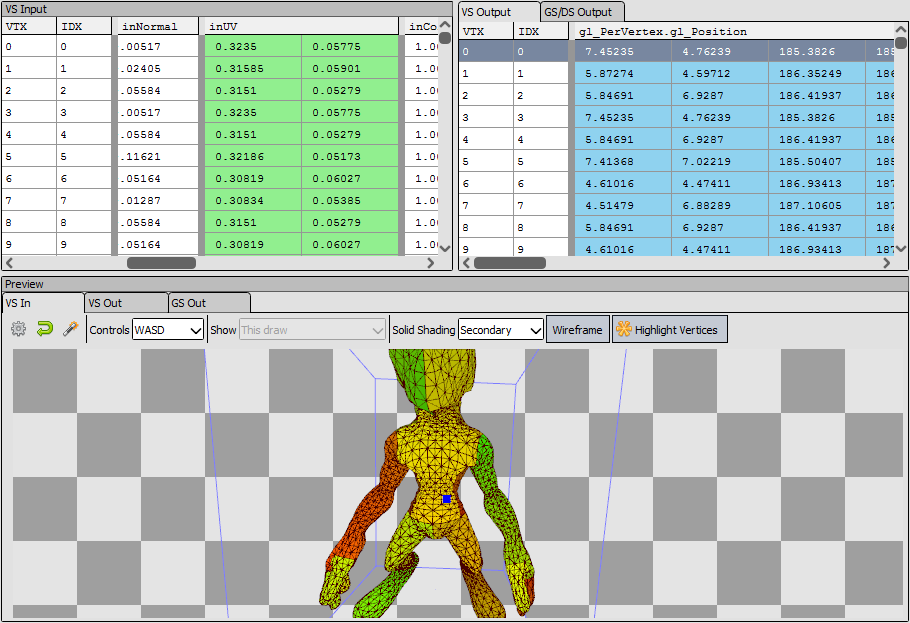
Mesh Viewer 与反汇编:读懂 GPU 在顶点与像素级到底算了什么
上一站 ep04 把事件浏览器读成 draw-call 的结构化索引,ep05 把资源与描述符绑上命令流。这一站把"GPU 在顶点与像素级到底算了什么"摊开:从 Mesh Viewer 这个窗口讲起,数据表加 3D 视图双形态,VS Input / VS Output 两档阶段差帮你在模型空间与裁剪空间之间一层层对账;再钻进顶点数据表,读 shader 签名驱动的字段来源、实例选择与 tessellation 特例;四章过一遍 Solid Color / Flat Shaded / Exploded / UV 重投影的排查价值;接着切到 Shader Viewer,找到反汇编入口,讲清 bytecode IR 出身与可配置反汇编器;六章是题眼,把 dp4 点积逐条映射回 HLSL/GLSL 源码,回答 GPU 到底算了什么;七章讲 Shader Debugger 逐行步进与调试符号这道入场券;八章划清工具边界,列出 mesh shader 缺陷、版本 clamping 与跨 API 差异;最后收束成"顶点像素双向验证台"。
trace 即 protobuf:.pftrace 内部长这样
上一站 ep06 把 RenderDoc 这条线收在 shader 反汇编上,那是 API 层的答案。这一站换到 Perfetto,问系统层的同一个问题:一条 trace 到底是一坨什么东西。我们从最外层讲起,说明一份 .pftrace 是 Trace{ repeated TracePacket } 的线性序列、schema 是 import 合并的结果;再逐字节手解一份真实 17 字节的 trace,把 varint、length-delimited、field tag = (field_number<<3)|wire_type 从概念变成摸得到的字节,并补上 ZigZag、packed repeated、proto3 默认值不下发三个坑;三章讲时钟域与 ClockSnapshot 对齐、interned 字符串去重(iid 按 sequence 隔离)与多写者分片、丢包 bitmask;四章拆 TraceProcessor 的六段流水(Tokenizer 先、Parser 后)与列式 TraceStorage,破除「列由 field_number 自动推导」的误解;五章区分静态表 / 视图 / 自定义表,给出核心表家族列对照与 arg_set_id 那扇窗;六章自跑验证台,用真实字节兑现承诺(hexdump、Protoscope 二重校核、blackbox 盲解、SQL 列血缘反查);七章反向验证,用 experimental_proto_path / content / flattened_args 把 proto 结构从 SQL 侧舀回来互证。核心结论:每一列都能沿血缘链追到字节,没有哪一列是凭空出现的。
data-source 全景:谁来画这些火焰图
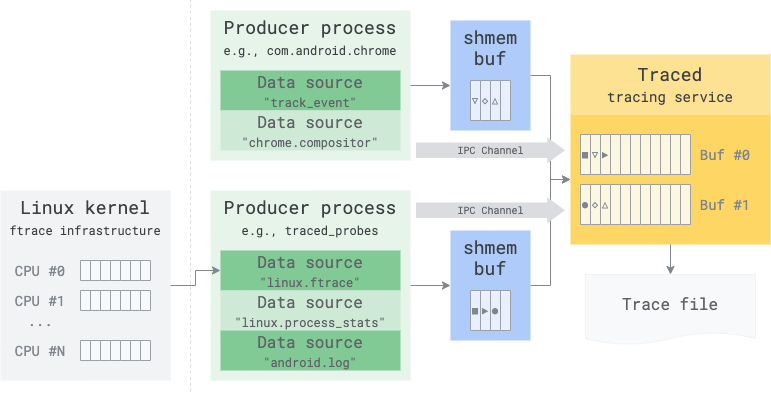
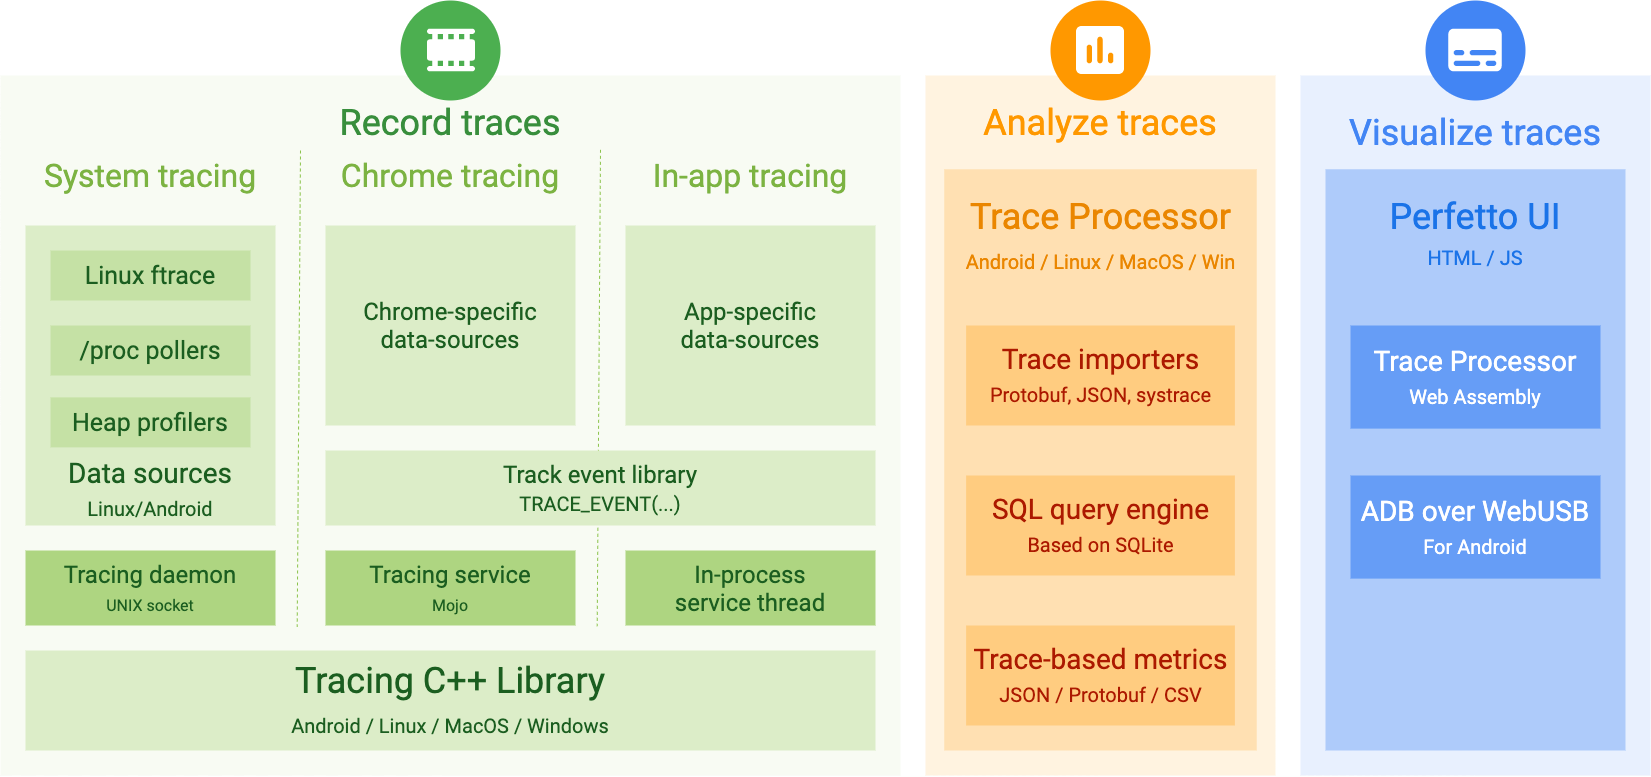
上一站 ep07 把 .pftrace 拆到字节与 SQL 表,回答「文件里有什么」;这一站翻个面,回答「这些数据是谁写进去的」。全篇用四方模型立骨:Service(traced) 是唯一中枢,Producer 是进程级宿主,Data source 才是干活的最小单位,Consumer 读走结果;控制面走 socket、数据面走共享内存两条通道分开讲。接着讲一次会话的生命:TraceConfig 的 data_sources{} 块如何按 name 声明与分发,target_buffer 如何把高频源与低频源分到不同 buffer,[lazy=true] 与「配置原样透传」如何让 service 对源的具体内容保持无知。第三到六章按四类生产者铺开:内核侧其实只有 linux.ftrace 一个宿主(atrace 经 trace_marker、GPU 频率与内存也都是 ftrace 事件);应用侧用 TrackEvent SDK 注册一个源,categories 与 tags 是运行期过滤而非编译期开关;专业采集器 heapprofd / java_hprof / perf 各有各的开销模型与产物形态;GPU 与功耗四个专门源之外,还要认得出「其实是 ftrace 事件」的那两个。第七章把源名 ↔ 谁在采 ↔ 产出 packet ↔ 落到哪张 SQL 表四轴一次对齐,与 ep07 的从表追字节反向咬合。
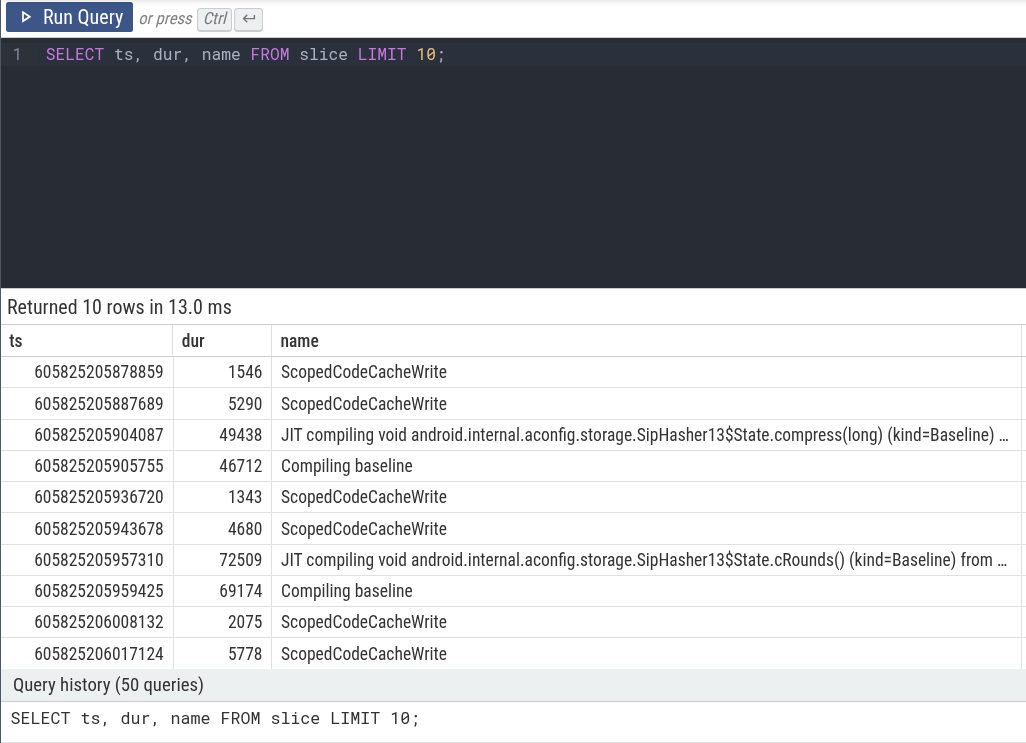
SQL 调优:把"能查"变成"查得快、算得对"
ep07 讲完「文件里有什么」、ep08 讲完「这些数据谁写的」,这一站轮到你自己动手:数据已经在库里了,该怎么把它们问对、问快。全篇分三层推进。第一层先算对——纳秒单位与时钟域、`dur` 的三种状态(正常 / 瞬时 0 / 未结束 -1)、嵌套切片如何变成 `depth` 与 `parent_id`、`arg_set_id → args` 这条唯一的附加参数通道,口径错了后面全白干。第二层该物化就物化——`CREATE PERFETTO TABLE` 为什么比视图快、`CREATE PERFETTO INDEX` 的适用面与两条禁令、增量物化不是建完就一劳永逸。第三层别重写标准库——`INCLUDE PERFETTO MODULE` 是 `#include` 而不是 `import`,`slices.*` 家族五个成员各管一件事。第四章是本篇的转折:官方说 filter early,但谓词落在封装外还是封装内,差的是口径还是量级,只能由 `EXPLAIN` 告诉你——本机实测给出 27 / 54 / 40 条计划指令与 627 vs 656 行的真实对照。第五章换尺度:批处理内存公式 `2 × S × N`、GB 级 trace 走原生 server、`-m` 元追踪,以及一次 `frame_id = -1` 引发的笛卡尔积 OOM 复盘。第六章把调优固化成一条可重放的命令,第七章用症状到处的矩阵收口,并与 ep08 的源到表对照反向咬合成追责链。

FrameTimeline:一帧到底有没有掉
ep07 讲文件里有什么、ep08 讲数据谁写的、ep09 讲表怎么问,这一站只回答一个问题:这一帧到底掉没掉。全篇先立坐标系——一帧有三个可测区间(应用侧 doFrame、渲染线程 DrawFrame、合成侧 SurfaceFlinger 合成与上屏),跨进程的接缝只有一处,两轨靠 frame token 对齐;再给判据——overrun 只有为正才算卡顿(值等于两条时间线的终点之差),四档严重度 20 / 50 / 200 ms 与 present_type 的取值面都不是恒定值;然后是归因——官方 8 个条目(含 None)× 判据 × 责任方矩阵,而源码 GLOB 判据比官方文档多出 3 个取值,真数据里确实出现。全篇最硬的两节是「文档与实现不一致」与「静默失效的路径」:was_jank 在三份真 trace 上少报一个数量级(236→13 / 149→0 / 42→1),根因是 android_frame_stats 的三段裸内连接把 1395 行削到 792 行;webview_jank.pb 有 1031 条 actual 帧却 doFrame / DrawFrame 切片全为 0——FrameTimeline 与 atrace 本来就是两路独立数据。所有帧级数字均为本机 trace_processor_shell v58.2 实跑,可复现。
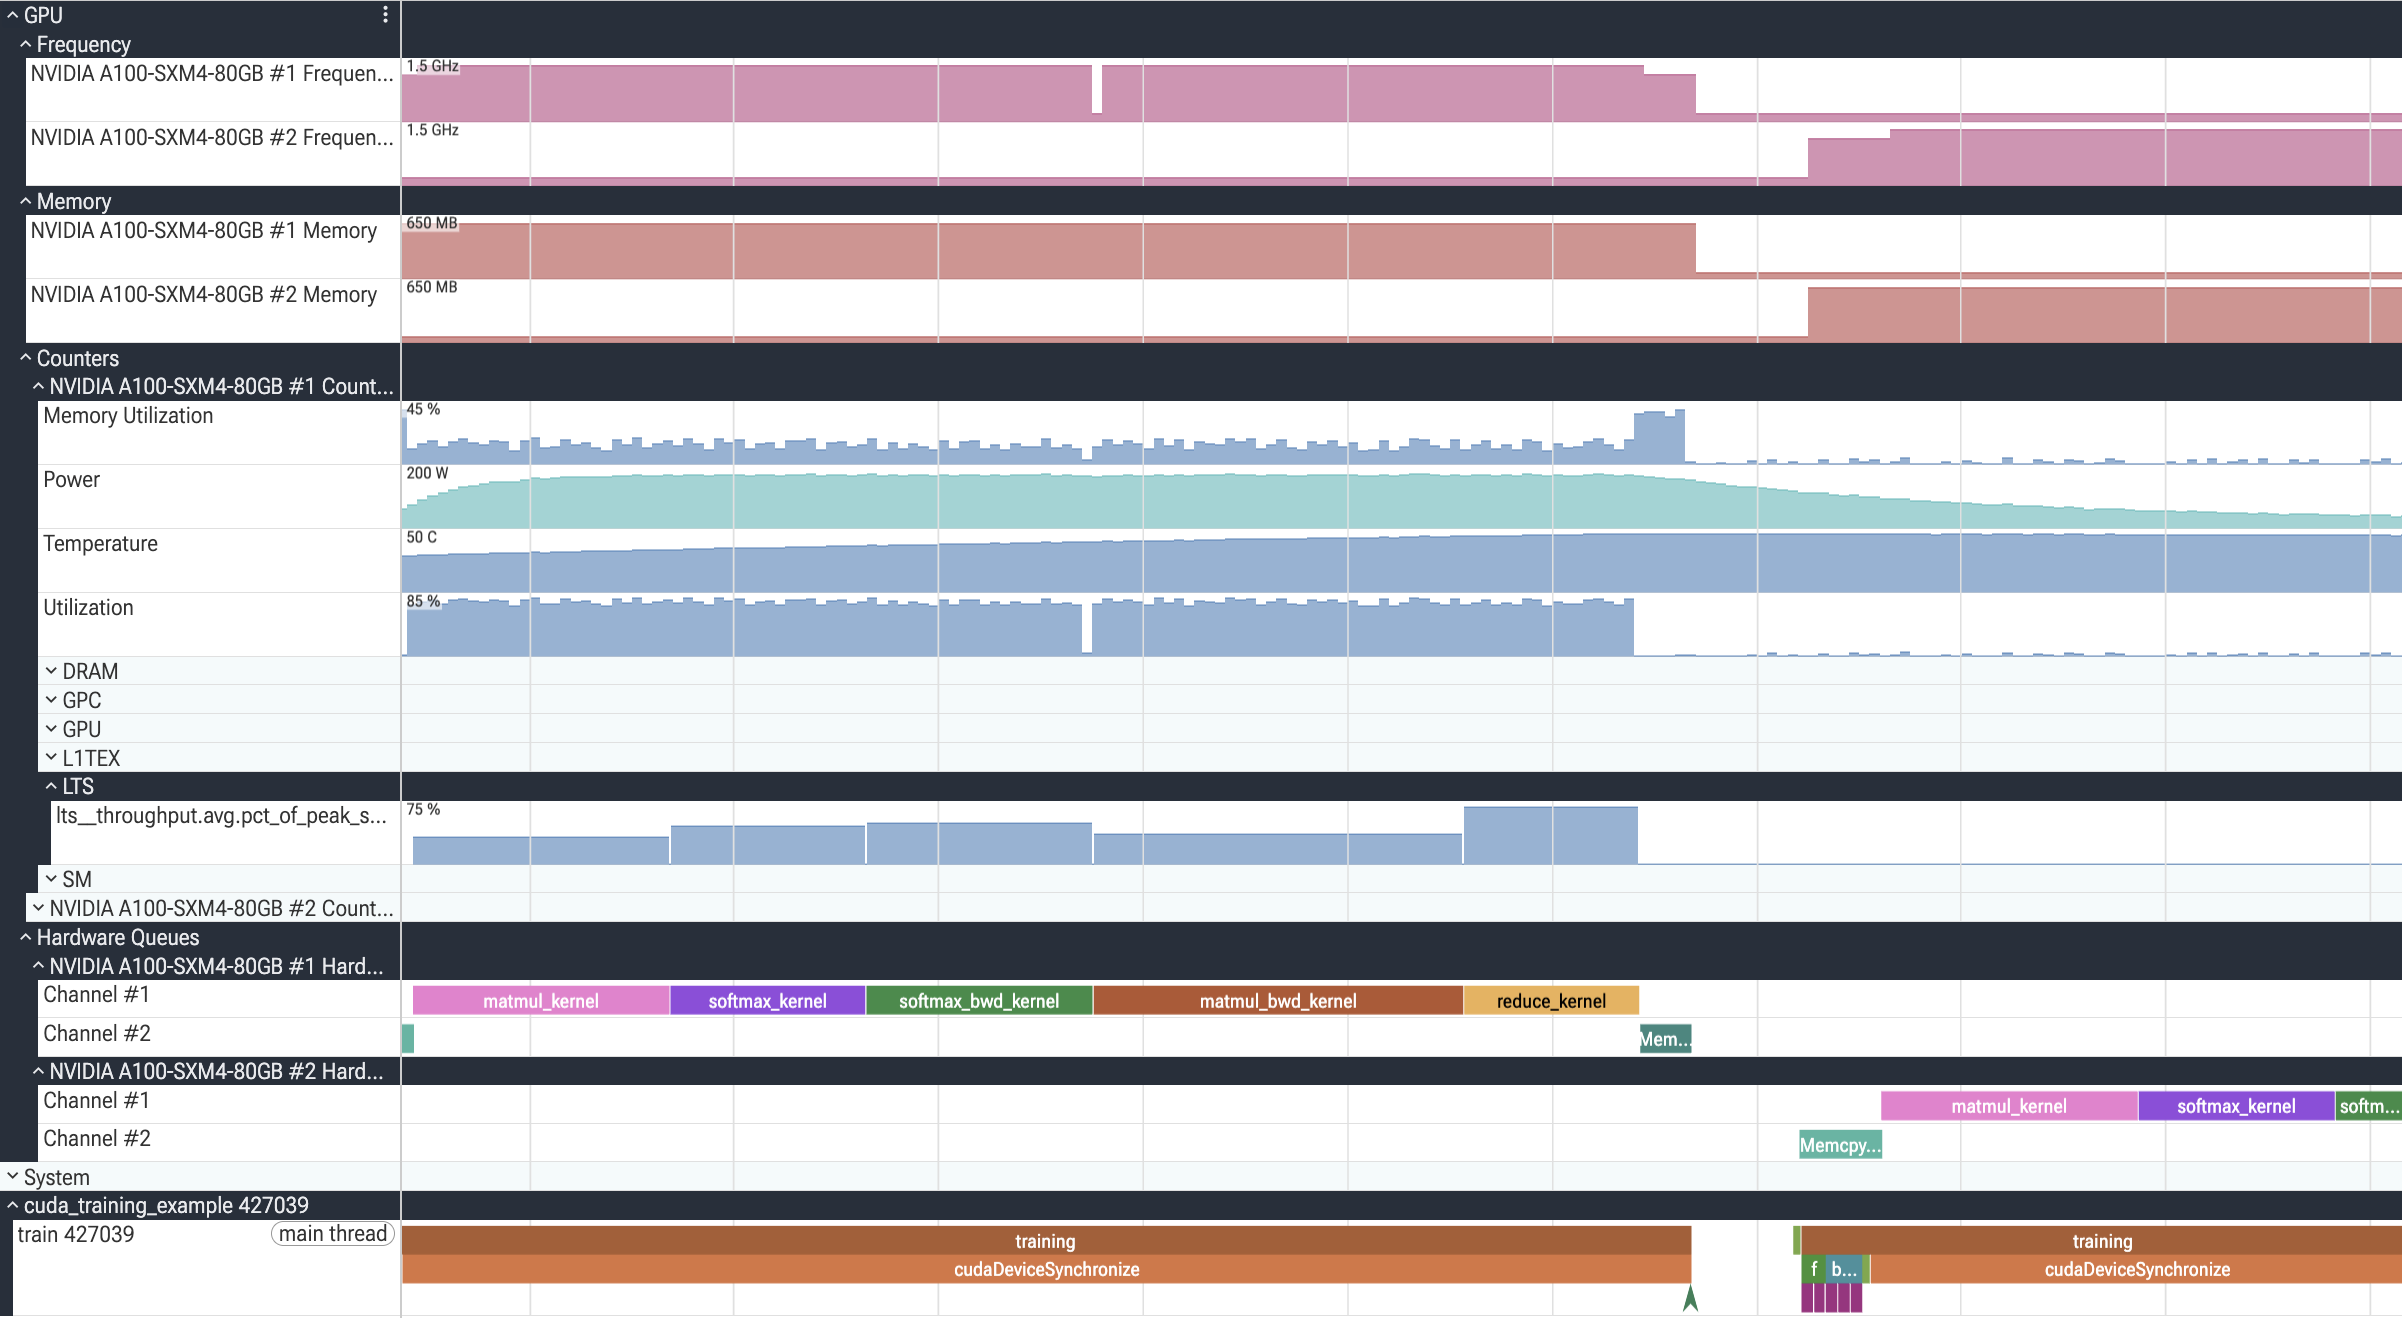
实战一:一条链路揪 GPU 瓶颈
前面十篇在装零件,这一篇开始装机器:一个症状进来——帧率上不去,问题出在哪。全篇把 RenderDoc(API 层)与 Perfetto(系统层)串成一条可跑的排查链路:先判方向(GPU 忙、GPU 等、还是帧里根本没活,三分支判定树;阈值分语境,移动游戏语境的 25 ms 与桌面 60 FPS 的 16.67 ms 不能互换),再定 API 层的量级(convert / thumb / --python 三件套取帧内统计与 Top API 真值),然后系统层拿两条硬证据(gpufreq 与 GPU Memory,厂商后缀写错即静默收不到),最后让两条腿互证。本篇据实守住两条边界:交叉印证只做到「方向一致」而非「同一帧」(三条本机实测加一条官方自陈),桌面 gpu_util_pct 来自 nvidia-smi 的 utilization.gpu 0.5 s 轮询,不等于 SM 占用率,全篇不简写成「GPU 利用率」。四、六两章是最硬的地方:本机 RenderDoc v1.29 对硬件计数器实测「枚举 14 条(13 个通用计数器 + 1 条厂商占位报错)」——菜单里有不等于采得到;把「同帧对不上」拆成三个可检查的条件之后,只剩方向级印证可用。收口压成四个动作:先判方向再深挖、左侧除预算、0 行与 0 值分开写、同帧对不上就只比方向。API 层与系统层的数字均为本机自跑(RenderDoc v1.29 / trace_processor_shell v58.2-add693d8b),可复现。
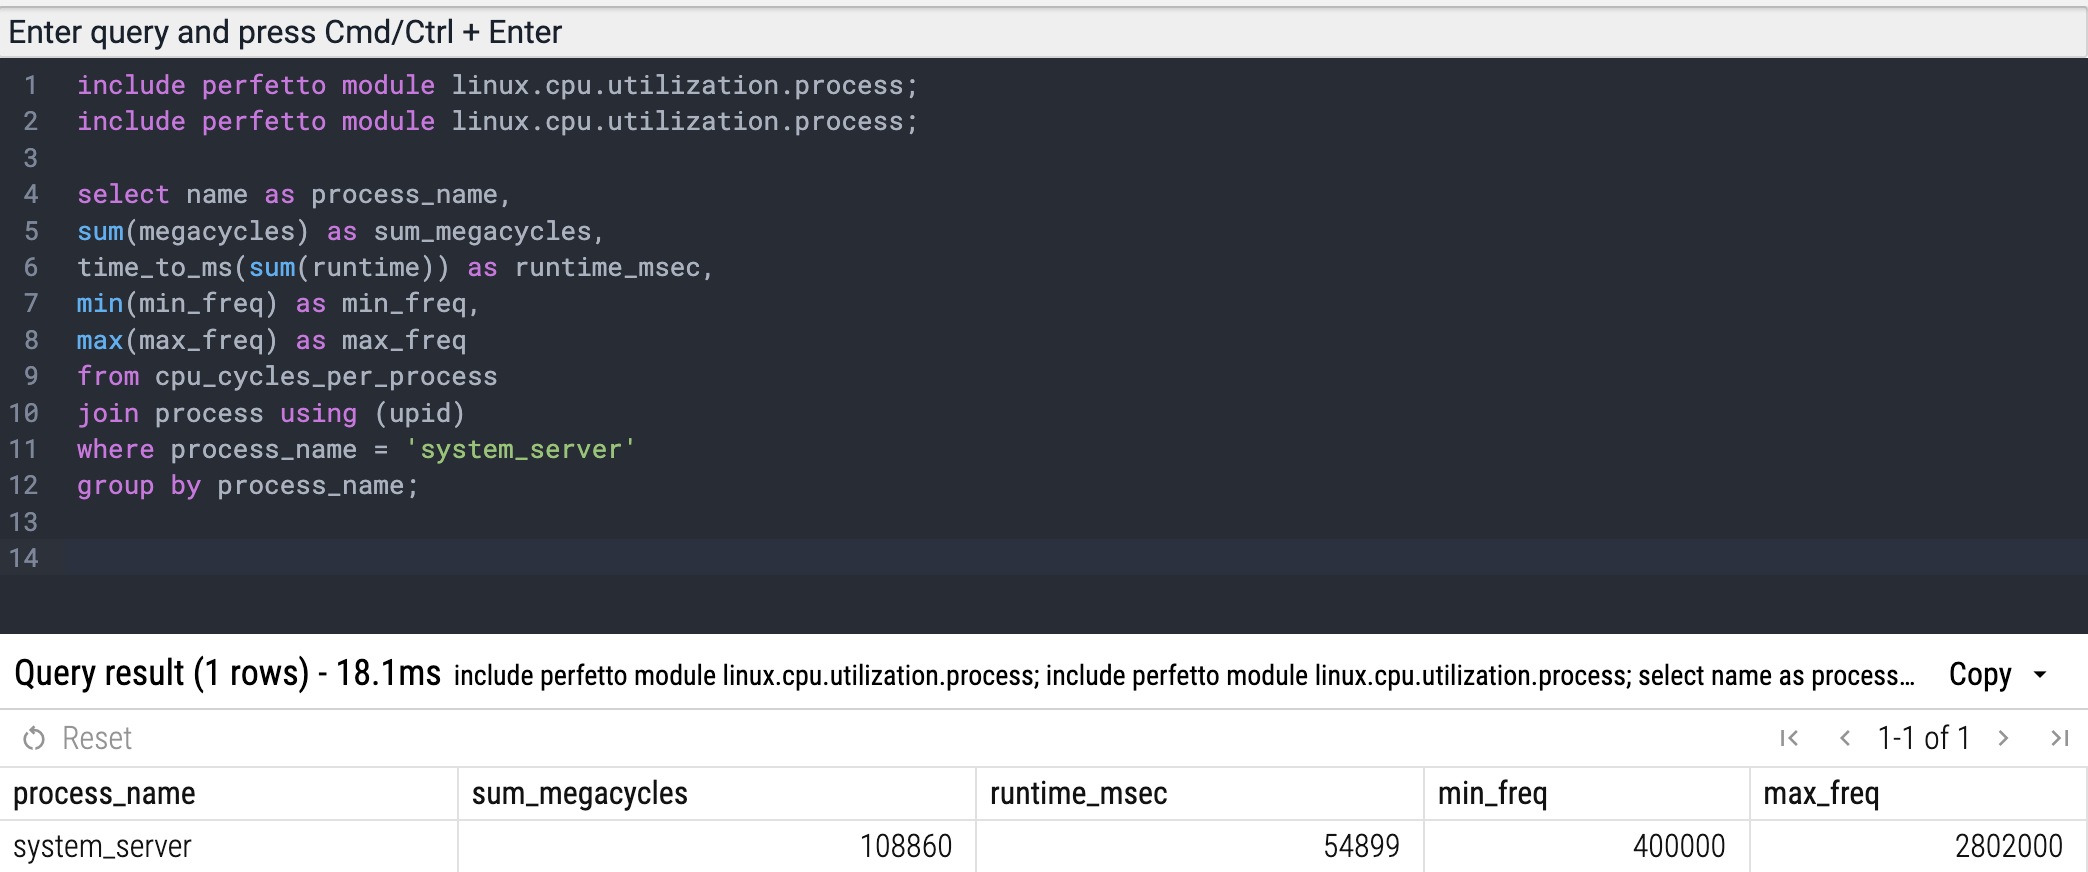
实战二:掉帧,到底是 jank 还是 shader
前十篇装零件、第十一篇串链路,这一篇只判一个分叉:某一帧确确实实超期了,这个「掉」该记在谁头上——是 jank(应用、调度、合成侧的时序问题),还是 shader 太重(GPU 执行、像素、带宽的成本)。两支嫌疑分住两层工具,全篇把两条路都走到头。系统层用 Perfetto 的 FrameTimeline 做责任方分流:jank_type / jank_tag 真值里唯一带 GPU 名字的条目偏偏属于合成器 SurfaceFlinger,六份官方 trace 上 jank_type GLOB '*GPU*' 恒为 0 行;再用四档严重度与 cpu_time 拆解看是哪条线程吃了时间(487 个正超期帧里只有 16 个、即 3.3% 能挂上线程切片)。API 层换腿到 RenderDoc,用 qrenderdoc --python 探针取绘制量与管线状态真值(2 个 draw / 294 个索引 / RT 1264×681 / cb0 144 B),并把反汇编当排除性证据用(VS 32 条、PS 3 条,无循环、无动态分支)。两条腿合起来只到「分层 + 方向 + 量级自洽」,做不到同一帧的因果链,7.2 节给三条本机实测加一条官方自陈。收口压成三档结论——可排除 / 不能排除 / 数据不足,并给出「症状 / 系统层 / API 层 / 印证点 / 边界」五列清单。系统层真值取自本机对六份官方 Android 测试 trace 的实跑(trace_processor_shell v58.2-add693d8b),API 层真值取自本机自跑(RenderDoc v1.29 内嵌 Python 探针,桌面 D3D11),可复现。
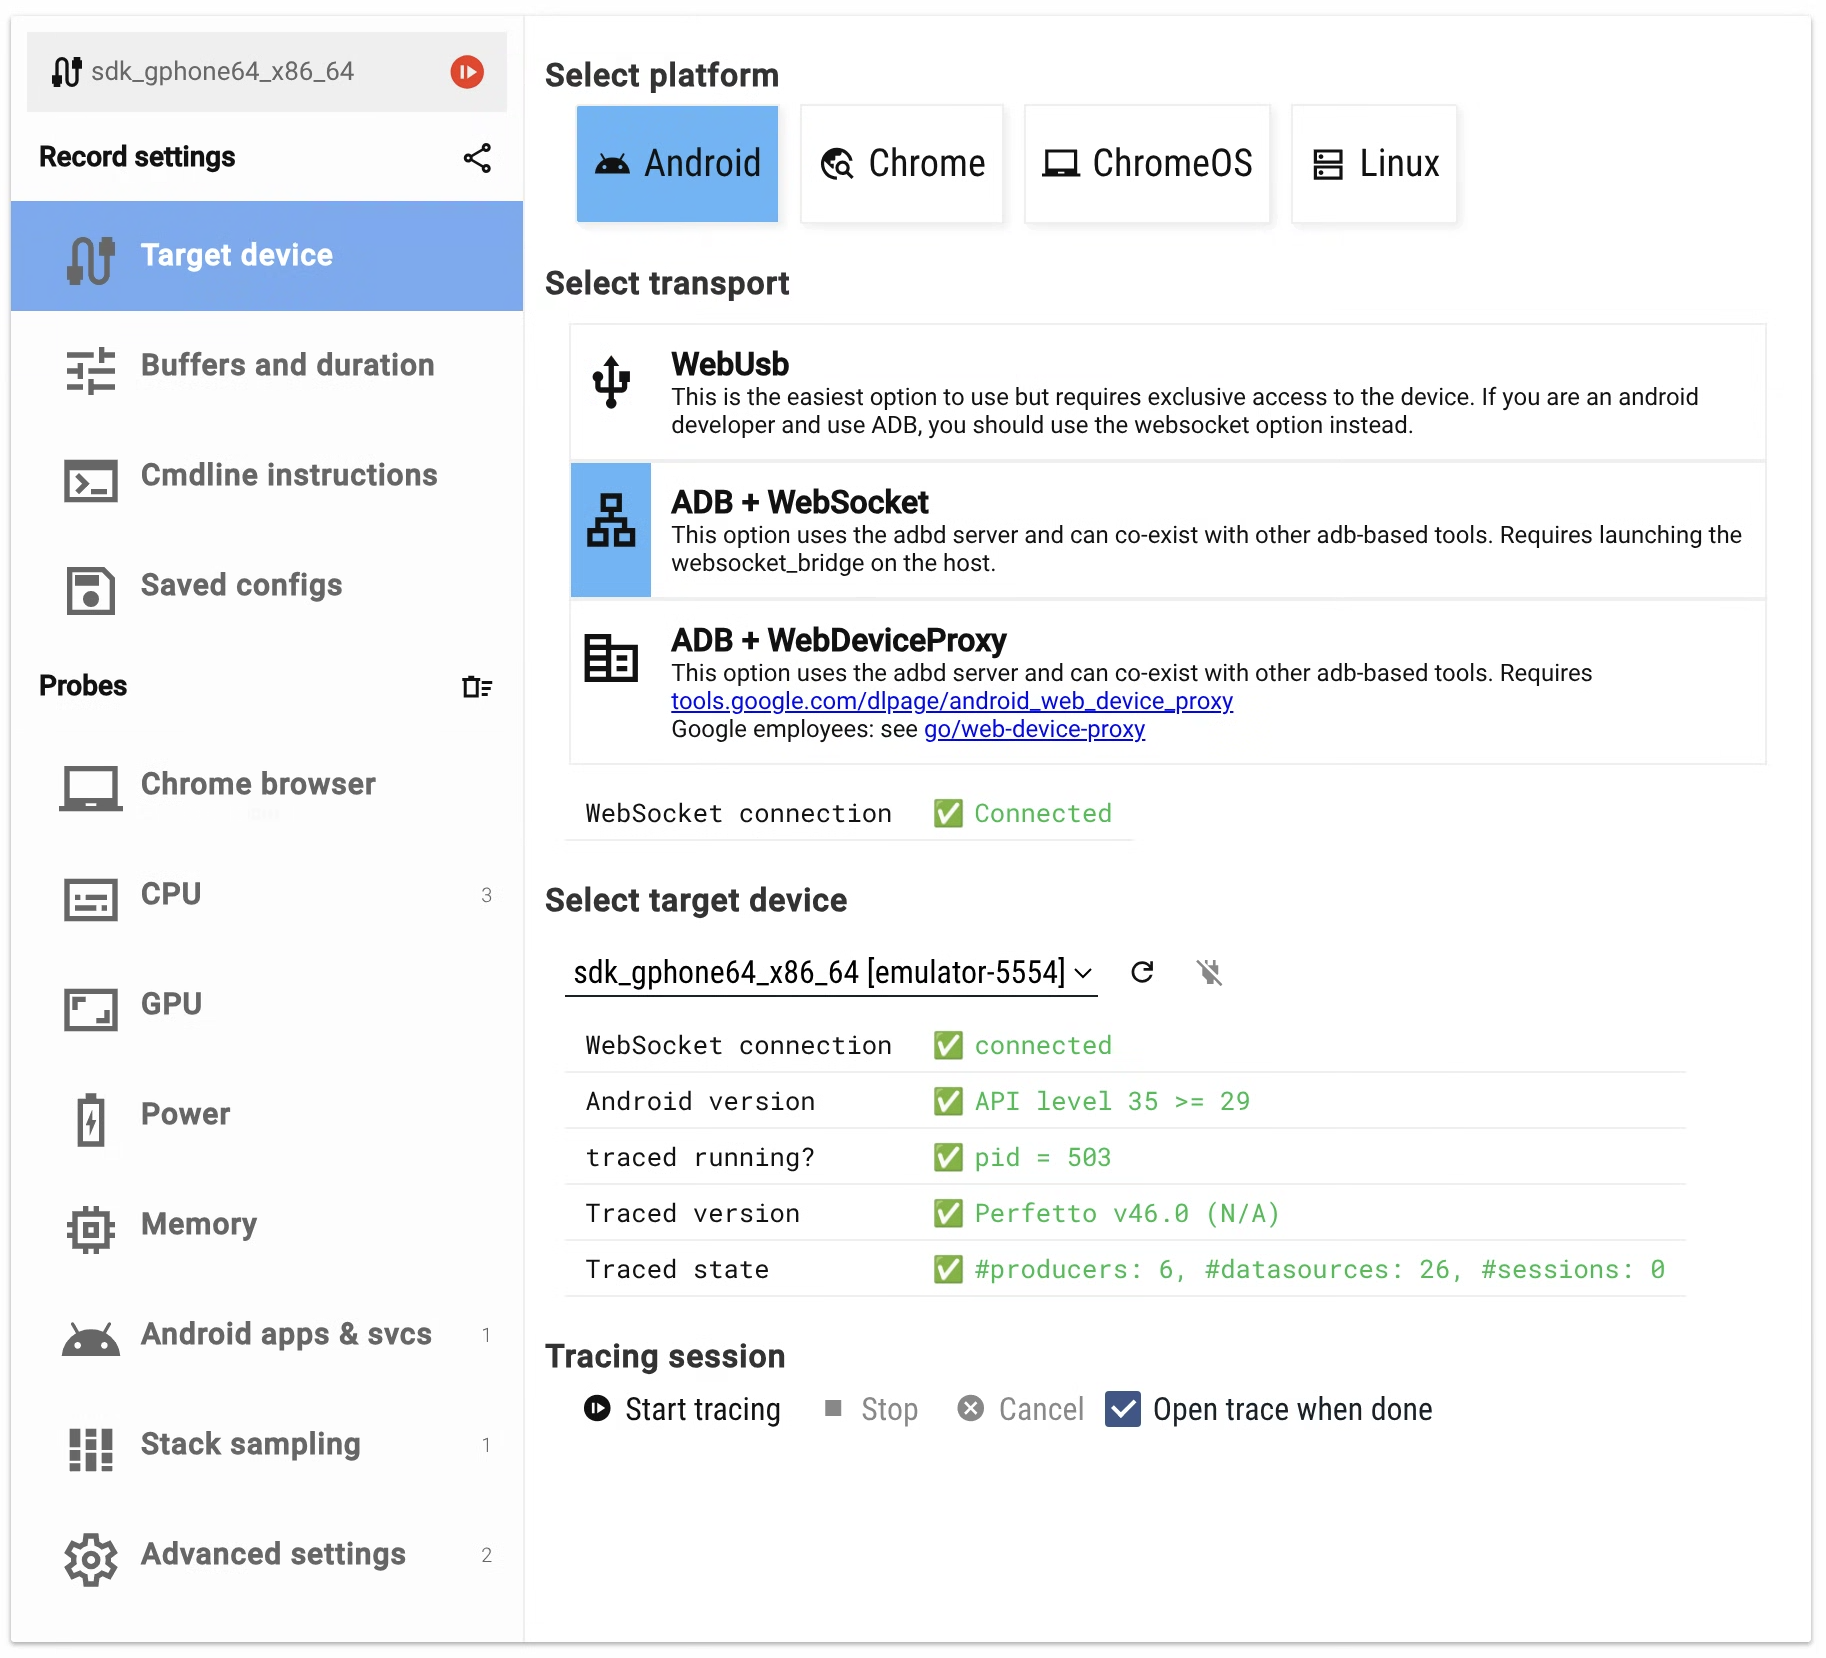
实战三:"如何验证"闭环手册
前十二篇装判据,这末篇只交付顺序:把散在前十二篇里的「判据 / 边界 / 工具能力与缺口」收成一套可复用的 SOP——验证阶梯。骨架是一条常被跳过的第 0 条(先确认文档对应哪一代实现),加六步(0 定症状与帧预算 → 1 分责任方 → 2 取 API 层证据 → 3 交叉印证能到什么粒度 → 4 落基线防回归 → 5 四类必须停手),再加一个「数据不够」也能正常走的出口;凡前面讲过的机制只引用不重讲,每处引用都带篇号。全篇最硬的证据是本仓库那套真在跑的验证工具链:audit_site.py --no-net 一轮扫 105 个 HTML / 3,828 条图片引用 / 硬失败 0 / 退出码 0,故障注入后硬失败 2 项、退出码 1,且 deploy_site.ps1 在「建立 SSH 会话」之前就中止;旧实现漏报 223 条 = 5.8%(历史口径 231 条 = 6.1%)。四步各有真值:第 0 步把一句抱怨换成 1000 ÷ 目标 FPS 的帧预算(60 FPS = 16.67 ms);第 1 步给 app / 合成侧 / HAL / 预测漂移 / 未定 五个出口,六份 trace 上 jank_type 里带 GPU 名字的条目恒为 0 行,487 个正超期帧里只有 16 个(3.3%)能挂上线程切片;第 2 步用三条取数路径拿到 2 个 draw / 294 索引 / RT 1264×681 / VB stride 44 的真值,反汇编 VS 32 条、PS 3 条且无循环无动态分支,但只许当排除性证据;第 3 步把印证口径钉死为「分层 + 方向 + 量级自洽」,并给出六级证据可信度表;第 5 步把「数据不够」拆成四类可判定条件,再把系列十三条款欠账按可收口 6 / 只能留档 4 / 存疑 2 / 已裁定 1 逐条结案。本机实测(trace_processor_shell v58.2-add693d8b、RenderDoc v1.29),可复现。
实时光线追踪与混合渲染
给定硬件能力与引擎约束,一个混合渲染管线该怎么组织、代价落在哪里、哪些常见做法其实不划算。从「什么时候该从光栅切到光线」这条分界线出发,一路算到加速结构、降噪、采样与跨平台差异。
分界线:什么时候该从光栅切到光线
前三专题写完了算法层、约束层与硬件实现层,这一篇起进入工程取舍层。首篇回答这条线的起点问题:哪些效果该走光线、哪些继续用光栅与屏幕空间近似?判据不是「哪个更先进」,而是三道可核对的问题——屏幕空间近似在什么硬条件下会失效(不是质量差一点,而是直接错)、走光追的成本与什么成正比(采样数、低粗糙度像素占比,还是 instance 数)、这次切换把代价转移到了哪里(显存、带宽、还是降噪器的时空稳定性预算)。全篇按这三道判据推进:从 SSAO/SSR/SDFGI 的失效清单,到三条成本模型与一页六类效果速查表,再到两条接口路线(inline ray query 与 SBT 派发)的能力差别、预算怎么摊开、代价如何转移到降噪器,最后把「光追=更快更真」拆成十条逐条检查。所有数字按规范事实、引擎官方口径、论文设定、第三方实测四档标注;论文里的毫秒数不换算成项目结论。
加速结构工程账(上):构建、更新与压缩
加速结构的本质是一笔预付:花一次构建的钱,买下之后每一次遍历的便宜。但场景会动、几何会变、显存有限,这笔账要分三科记——构建(一次要花多少、标志怎么选、建树器怎么挑)、更新(什么能改、什么不能改、改完之后遍历会变成什么样)、压缩(能省多少、省下来的钱要不要还回去)。本篇从 Vulkan 规范的三个尺寸与五个标志出发,给出构建前检查清单、更新三问决策树、压缩收益三档口径,以及一张可以直接套用的内存预算表。所有数字按规范事实、厂商口径、论文实测、第三方经验四档标注,不拿上限当常态。
加速结构工程账(下):动态场景与内存开销
上一篇我们算完了加速结构的"静态账"——构建花多少、更新改什么、压缩省多少。但那笔账有个前提:场景基本不动,或者动得很温和。一旦场景里有大量动态物体、蒙皮角色、粒子特效、植被摇曳,那笔预付账的算法就完全不一样了。TLAS 每帧重建会不会成为瓶颈?BLAS 是 refit 还是 rebuild?三角形簇结构和 Opacity Micromap 这些新东西值不值得上?显存里到底多了哪些开销?这一篇就来算"动态场景"这本账——**TLAS 的分区更新、BLAS 的动态策略、CLAS 的速度交换、OMM 的透明解放、内存账的拆解与预算**,五件事合起来,才是"动态场景下加速结构到底亏不亏"的完整答案。

命中着色器与 SBT:别被自己的表绊倒
ep03 讲完了加速结构——BVH 怎么建、怎么更新、怎么省内存。但加速结构只回答了一个问题:光线该往哪儿走、在哪个三角形面前停。光线停下来了,接下来呢?一个场景里有金属、玻璃、木头、皮肤、植被,每个三角形都"找到了",但每条光线该执行哪段着色器代码?找到之后算什么?算出来的结果怎么拼回最终画面?这一篇就来回答这些问题——**SBT 是什么、hit group 由哪三种着色器组成、closest-hit 算什么、any-hit 为什么贵、intersection 留给谁、材质系统怎么组织 SBT、以及 SBT 的 stride/offset/对齐能踩多少坑**。八件事合起来,才是"找到三...
混合管线编排:光栅化与光追的接力赛
光追管线不是独立运行的——它和光栅化是一条接力赛的两棒。这一篇讲清这条赛道怎么排:从 G-buffer 这个数据接口出发(六个通道各存什么、光追从哪读、读写一遍要多少带宽、布局怎么省),到光追侧的两种工作模式(完整管线与光线查询的能力边界与选型依据);然后把一帧拆开看 Pass 顺序、同步点与两个队列的重叠空间,再算一笔 16.67 ms 的账——光栅化占六成、光追两成、降噪一成半,并给出预算超支时的砍伐顺序与一套可复用的估算流程;接着展开降噪器(SVGF 三步、2.5 ms 花在哪、与 TAA/TSR 的分工)与 ReSTIR(蓄水池采样与时空复用的工程代价);最后给出阴影/AO/反射/GI 四类效果的混合档位矩阵、组合落地顺序与五个最常见的结构性坑。
降噪(上):时域复用的原理与失效模式
ep05 把混合管线的编排讲完之后,预算表上还剩一块最贵的支出没展开——降噪。这一篇只切降噪器内部最要命的那一环:时域复用。全篇按「先讲清楚为什么能用、再讲透什么时候会坏」推进:从 EMA 的数学与 α 的取值带、history length 与等效采样数,到 back projection 的映射链与运动矢量的三种算法(含阴影/反射/透明场景的 TRMV 变体);接着是时域复用的第一道坎 disocclusion——深度与法线一致性检测的阈值口径、四种处理策略与颜色裁剪的数学;然后是失效模式清单:鬼影的六种触发场景与两类根因,以及时域滞后、闪烁/沸腾、模糊、动画伪影四种额外失效,配上三种调试案例的排查实录。工业侧对比 NRD REBLUR 的自稳定递归模糊、SVGF 的方差驱动 α、UE5 TSR 的历史复活与 AMD FSR 的深度不连续检测,并给出 1080p 下缓冲区的显存账。最后收在 lag 与 blur 这对根本权衡上,给出可操作的调优清单。
降噪(下):从 SVGF 到神经降噪的取舍
ep06 把时域复用讲透之后,降噪链上还剩另一半没展开:时域只能压掉同一个像素在时间轴上的抖动,对单帧内部的空间相关性束手无策。这一篇接着往下切空间滤波与学习型重建。全篇按「先讲清邻居该怎么加权、再讲透参数调错会看到什么」推进:从朴素高斯模糊的代价讲到联合双边滤波的四因子权重,说明深度/法线/亮度三组边缘停权为什么缺一不可;接着是 à-trous 的「打洞」结构——五级步长翻倍如何用 125 次采样换到 32 像素半径,以及 JCGT 2026 给出的访存瓶颈量化答案(1.3–2.5×);然后是 SVGF 真正的新意:一二阶矩估出的时域方差同时驱动 α 与滤波强度,配上方差钳制处理离群值。实操部分是本篇重点:三根 σ 的九种可见症状与三条自查判据,以及一份可核对的参数取值带。工业侧对比 NRD 的两条路线(ReBLUR 自稳定递归模糊的四个设计判断、ReLAX 的球谐域拆分),并把 NRD 内存三级账当成一等证据——4K 下 ReLAX 漫反射+镜面 SH 的工作集 303.94 MB,决定低端卡开不开得起的是内存而不是算力。最后把 TSR 的四段机制与 DLSS 光线重建放在一起,按 2026 年 4.5 版本已覆盖全部 RTX 的事实算一笔五维工程账,给判据不给结论。
ReSTIR 与光照采样:小样本怎么骗过大方差
上一篇把降噪讲到了参数怎么定,但降噪只能修、不能造:一个像素一帧只发一两条阴影光线,挑错了地方,任何后处理都救不回来。这一篇转到采样侧,讲 ReSTIR 这条线——不是把光线发得更多,而是让每条光线更值钱。全篇按「先把两个地基铺好、再讲复用怎么放大、最后算清复用的代价」推进:RIS 用便宜分布抽候选再按分数筛,把贵操作(追光线)推到只剩一次;WRS 的蓄水池常数内存且可合并,这是复用能成立的前提。然后是一帧四段——初始采样、时域复用、空间复用、着色,以及 history length、邻居选择与 MIS 权重三处最容易出错的细节。第四章是本篇重点:复用的偏有三条来源(随机数共享造成相关性、支持集不匹配造成能量错配、条件概率造成系统性偏移),三条都要显式补偿,否则误差不随帧收敛——RTXDI 官方文档自己写明「ReSTIR PT 的空间 pass 有一些偏」。之后把复用推到路径(GI 与 GRIS 的偏移映射与雅可比行列式)、全路径(ReSTIR PT 的成对 MIS 与已知偏差),并算清工程账:1080p 下蓄水池常驻约 132 MB、单帧复用访存约 800 MB、60 Hz 折合约 48 GB/s——限制这类方法的是带宽而不是算力。生产侧对照 Cyberpunk 2077(GI)、Portal RTX(重制)与 UE5 Lumen(Gather 常规管线),最后落在 2025–2026 仍在被修的三条边界:运动下的蓄水池投递与置信度上限、多层投递治去遮挡、LOD 复用与兼容性引导的邻居选择。
光线预算表:反射、阴影、全局光怎么分钱
前面八篇各算了一笔账,但它们有一个共同的分母从未被摆到台面上:光线。一帧里能发出的光线总数是有限的,反射多要一条,阴影就少一条。本篇把这条预算线摊开——先给光线定价(遍历、命中着色、降噪是三项独立支出),再逐格拆账:反射凭什么 8 到 22 条、阴影凭什么只要 1 到 2 条、全局光为什么连花钱单位都跟别人不一样(每探针几条 × 每帧更新几个探针)。之后是三种分配策略(固定配额、按需裁剪、感知加权)各自的代价、预算不够时误差的三种暴露形式(过遮蔽、偷样本、降噪兜底失效),以及一张从帧时间倒推的可自己填的预算表。生产侧对照三款作品的分法,最后落在 2025–2026 年固定配额、神经降噪与亚 1 spp 自适应采样正在改写的三个格子。
RT 资源的生命周期:加速结构的可见性与同步
前面九篇各算了一笔账,但它们有一个共同的隐含前提:加速结构已经在那里了,着色器只管用。本篇翻过来看这个前提——AS 在每一帧里都经历构建、对 GPU 可见、被着色器读取、最终退役的完整生命周期。先建四态心智模型(build→visible→trace→retire),再讲 Build 到 Trace 之间那道屏障的 Vulkan/D3D12 具体写法,之后是双缓冲与延迟一帧的权衡、AS 压缩的五态生命周期与 RTXMU 的子分配、SBT 与 AS 的绑定关系和更新策略、compute build + graphics trace 的跨队列同步(Timeline Semaphore vs Fence+Binary Sem)、scratch buffer 回收与 AS 池化三池结构,最后对照 UE5/RTX SDK/Vulkan-Samples 三种生产方案,落在 2025–2026 年 Mesh Shader + GPU driven BLAS、Streaming AS、神经降噪三个方向正在改写的 AS 管理格局。
RT 资源的流式加载:大世界的 AS 管理
ep10 讲了 AS 在单帧内的四态流转与同步,本篇把时间轴拉长——当世界大到 AS 装不进显存时,BLAS 怎么序列化到磁盘、怎么按 tile 流式加载、怎么用 LOD 控制远近精度、加载卸载时怎么不让画面闪。从 Vulkan/D3D12 的序列化 API 讲起,经过 tile 生命周期状态机、BLAS LOD 与 CLAS、时域过渡方案、UE5 的 World Partition+Nanite+Lumen 三件套、显存预算的 bytes/triangle 实测、P0-P4 优先级队列、GPU-driven multi-indirect build,最后落在跨厂商兼容性与 streaming AS 标准化的演进方向上。
透明、半透明与体积:光追里最难盈利的部分
透明、体积和 SSS 是光追管线里的利润黑洞——每像素光线数从 1 条暴涨到 N 条、128 步或 16-64 次采样,而视觉收益却非线性递减。本篇从 alpha 合成操作符和 OIT 方案谱系出发,拆解光追透明的三条路径,用 Indiana Jones 实测数据证明 OMM 的工程价值;再讲体积渲染和 SSS 的代价差异;最后用三家引擎的跳过降级统一策略对比,论证把光花在利润最高的地方才是混合渲染的工程智慧。
混合渲染决策地图:十二篇系列总结与未来展望
十二篇各算了一笔账,但它们必须同时成立、且互相抢资源。收官篇把 ep01–ep12 的结论合成一张可查的决策地图:按几何与加速结构、着色与采样、降噪与合成三段给出三棵决策树,用四张总账表把每个数字的口径与成立边界摊开,再以四个真实项目形态(主机 60fps / 高端 PC 路径追踪常开 / 大世界开放世界 / 移动与低端回退)走查验证;随后回答下一代硬件会改写哪几条(Mega Geometry 与分区 TLAS、SER 与 2-state OMM、ML 光照缓存)、标准化两条线各自落地到哪一步,以及哪四条判据不随硬件改变。
神经渲染与神经着色器
把渲染管线里的某一环,它的先验从「人手写的启发式」换成「训练出来的网络」——代价到底转移到了哪里。先把四类替换的落点与三道判据立起分界线,再把已经进入生产管线的落地讲透(降噪、纹理、外观);更前沿的着色器内推理等篇目因缺乏可真实实验的环境而暂缓,系列止步于这五篇。

神经渲染的分界线:哪一环该换成网络
"神经渲染"这个词把四件完全不同的事混成了一件。本篇先把它们拆开——替换着色计算、替换表示、替换采样分布、替换时间轴,四类替换在管线上的落点与代价结构各不相同;再给三道可核对的判据:粒度看能不能让每次调用独立算,数据看输入分布是否由自己控制,开销看代价落在算力、带宽还是显存哪一本账。从手写先验的能力上限切入,用自算的对照实验与自由许可真图逐条落地,最后用五类一线踩坑记录说明哪些格子换了不划算,并收成一页可直接查的四类替换 × 三道判据速查矩阵。

神经降噪(上):当先验从人手写变成学出来
手写降噪的先验是「人定的形状 + 可调的参数」——SVGF 的方差引导、BMFR 的分块回归都属这一族。本篇写清把这一环的先验换成学出来的之后,账本如何变化:先沿着 2017–2019 四个节点看清先验是怎么一步步从人手交到网络手里的;再把最常被混为一谈的「鬼影」拆成三类(历史污染 / 去遮挡 / 噪声拖尾误读),给出三道看图就能用的判别问题,因为这三类修法互不通用、调错方向会越调越远;然后逐条列出换过去以后新增的三项成本(引导缓冲从可选变成必需、逐像素推理开销、把前提不成立的部分喂进网络);最后用 NRD 官方实测与学习式方案的公开数字算一笔同口径的账,并给出两条反例——什么情况下这一环换成网络不划算。
神经降噪(下):数据从哪来,以及它在哪里失效
上篇把先验从人手写换成学出来,算的是「换过去多了什么」;这一篇算的是那笔账背后真正稀缺的东西——数据。能把训练数据拿到手只有三条通道(离线渲染自产、公开数据集、自建自训),而它们的差别不只是成本:公开数据集要看许可(最常用的几套恰恰不可商用),自产要自己有渲染器,自建要自己标。NVIDIA 官方自述里有一句比收益更值得记的话——为了提升泛化去扩大训练集,先撞上的是新的失效模式(鬼影、油画感、时域不一致)。本篇由此建立一套归因框架:把失效压成输入锅、数据锅、容量锅三类,并给出按修法成本排序的判别顺序(先排输入、再看覆盖、最后才怀疑容量),明确标注为本文归纳而非厂商标准;再把「怎么知道它失效了」讲透——PSNR 在压缩这条直线上表现得完全正确,所以它最有欺骗性,而换一种误差分布它就开始失灵。最后给出三条反例与一条边界:有一条路根本不用训练数据,有一条路不需要监督对,还有一家完全不披露数据因而无法评估。
神经纹理压缩:把纹理解码交给网络
把纹理解码交给网络,这一环表面上是纯粹的显存问题,“省 8 倍”听起来不需要权衡;但把三种模式摊开看,权衡一直都在,只是藏在“省的是什么存储器”上。本篇先立口径纪律:同一件事官方到媒体有五个数字(磁盘 8×、显存与系统内存 7×、on-Load 一分不省、官方 2K 表 on-Sample 约 5×、中媒 96%),没有一个错,错的是把它们当同一个数用;再解释纹理为什么不能照图片那套压——随机访问把绝大部分现成压缩方案挡在门外;随后拆开 NTC 的做法(特征金字塔 + 量化隐向量 + 每材质小 MLP),算清 on-Load/on-Sample/on-Feedback 三笔账,并把最硬的一环“过滤”讲透(为何要换成随机纹理过滤 STF);出货路径上它不是取代 BC、而是把 BC 当载体。最后给出反证与边界(mip 2/3 略差 PSNR、各向异性是否保留的不同来源)、门槛与许可,以及一组“什么时候不值得换”的决策表。
神经外观:从解析 BRDF 到学习式材质
把材质这一环的反射函数也交给网络,是从解析 BRDF 到学习式材质的一次拼接。本篇不重复降噪与纹理压缩的账本,而是算清楚“外观表达力 + 显存/算力/训练/画质”四元账:先铺现状(材质 = 纹理 + 解析 BRDF)与解析模型的表达能力上限,再讲神经材质的框架与工程细节(latent 解码、自解码到逐采样解码),随后摊开工程账(显存/算力/训练/画质四元),处理过滤困境与 STF,落到材质重建这条生产路径,最后给一张反例决策表。凡是倍数一律标注口径,不做没有出处的转述。