站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:一次 2D 绘制里,「画什么」和「什么顺序」是两件事
这一章要把本篇的位置说清楚:第三篇我们走完了一条命令从门面到执行的全程,可那条命令只是一次绘制的内容。它有没有被画出来、在别人前面还是后面,是另外两个问题。
0.1 全系列的目录:这一条链有四层,本篇落在第三层
OK,先把整个系列按层摊开,大家好知道自己在哪一格。这套架构的主线是一次 2D 绘制的四层落点:从场景层的 CanvasItem(画布项)出发,经画布剔除(canvas culling),落到画布渲染抽象层,再经 RenderingDevice(渲染设备)变成驱动能吃的命令缓冲。
| 层 | 谁在做 | 这一层回答什么 | 本系列哪一篇 |
|---|---|---|---|
| 场景层 | Node / SceneTree / CanvasItem |
谁在什么时候下发命令 | 第二篇 |
| 服务层 | RenderingServer 门面与其实现 |
命令怎么被接收、怎么被排队 | 第三篇 |
| 剔除与排序 | RendererCanvasCull |
画什么、按什么顺序 | 本篇(第四篇) |
| 画布渲染抽象 | RendererCanvasRender |
一个绘制项里到底存了什么 | 第五篇 |
| 批处理与后端 | 攒批规则 + 四个后端分叉 | 一次绘制怎么变成一次 draw call | 第六、八篇 |
| 设备层 | RenderingDevice |
命令列表怎么排成依赖图 | 第七篇 |
| 横切 | 主循环与线程、资源导入 | 逻辑与渲染怎么错位、图从哪来 | 第九、十篇 |
这套结构的原理很朴素,其中:先把「画什么」筛出来,再给筛出来的东西排位置,两者共用同一次遍历。
这张表也顺带交代了本篇的边界:批处理规则、后端分叉、RenderingDevice 的命令列表与依赖图、主循环与线程池的完整骨架、资源导入与显存路径,本篇都不涉及——它们分别是第六、八、七、九、十篇的题目。画布渲染抽象层的内部结构也不展开,本篇只走到它与剔除层共用同一个 Item 这一个接缝上。
0.2 两个问题的官方口径
官方文档把「顺序」讲得很直白,只是分散在三处。CanvasItem 类参考的开篇写着:
"Canvas items are drawn in tree order on their canvas layer. By default, children are on top of their parents, so a root CanvasItem will be drawn behind everything. This behavior can be changed on a per-item basis."
CanvasLayer(画布层)类参考把层级与 z 的优先关系写死了:
"The layer is a numeric index that defines the draw order. The default 2D scene renders with index
0, so a CanvasLayer with index-1will be drawn below, and a CanvasLayer with index1will be drawn above. This order will hold regardless of theCanvasItem.z_indexof the nodes within each layer."
CanvasItem.y_sort_enabled 的说明则把 y 排序的作用域限定了:
"If
true, child nodes with the lowest Y position are drawn before those with a higher Y position. Iffalse, Y-sorting is disabled. Y-sorting only affects children that inherit from CanvasItem. You can nest nodes with Y-sorting. Child Y-sorted nodes are sorted in the same space as the parent Y-sorted node."
三句合起来是用户口径的三层箱位:CanvasLayer.layer 管画布级、z_index 管项级、树序兜底。可它没回答我们真正关心的问题——这三层在实现上是怎么落成一次遍历的,以及「画什么」是在遍历的第几步被判掉的。这些问题要回源码。
0.3 两件事:一个递归、一个汇总
先来看看源码给的结构。整条链只有两个入口值得记:RendererCanvasCull::render_canvas()(剔除器对外的入口)与它内部的 _render_canvas_item_tree()(真正干活的那一层)。
「画什么」由递归回答:_cull_canvas_item()(一个递归函数)从画布根开始往下走,每一项先过几道判据,过不了的连同它的整棵子树一起出局。「什么顺序」由一次汇总回答:所有活下来的项被塞进一排「桶」里,遍历结束之后再从低到高把桶串成一条链,交给下游。说白了,前者是筛,后者是排,它们在同一次遍历的头尾两端,中间没有第三次遍历。
这也是本篇敢把「剔除与排序」放在一篇里的原因:它们在源码里本来就是同一件事的两半。
0.4 本篇要留下的三个可检验命题
好了,写到这里,本篇的骨架可以压成三句话,后面每一章都是在给其中一句找证据:
- 顺序是三层箱位,不是一次排序:
CanvasLayer.layer→ 项内序号 →z_index,三层依次生效;z不是「比较大小后重排」,而是装箱。 - 剔除是五道闸门:其中四道一旦不过就是整棵子树出局,第五道只决定这一项自己进不进桶。
- 两个例外:y 排序会把子树拍平后按最终 y 重排;
CanvasGroup(画布组)会把子项先挪进背缓冲,因此它的 alpha 与clip_children行为都跟普通父节点不同。
0.5 三层证据与本篇的口径
本文的每一个论断都标清它站在哪一层证据上,三层分开陈述,不混着说:
| 层 | 来源 | 本篇承担什么 | 不可用它做什么 |
|---|---|---|---|
| 官方文档 | docs.godotengine.org 的类参考与教程 |
用户口径(谁在上谁在下) | 不回答实现怎么做 |
| 官方源码原文 | godotengine/godot master 快照 2026-10-08(MIT) |
机制层:判据、结构、字段 | 不当作运行结果 |
| 本机探针实测 | 自建引擎 4.8.dev.custom_build.7177493c1(2026-07-03 提交) | 可观测事实:像素读数、计数 | 不给跨机器、跨版本结论 |
三条纪律,后面每章都会用到:
- 行号属于提交,不属于版本号。本机 clone 是 2026-07-03 的提交,与 master 快照已漂移,且漂移量逐文件不同——所以本文不做算术平移:引用快照行号就标快照日,引用本机读数就带那个版本串,两者绝不互相换算。
- 本机读数一律带版本串与「自定义构建」四个字。这不是客套:同一个
z_index的边界行为、CanvasGroup的 alpha 语义,都可能在版本之间变。 - 探针必须带窗口跑。
--headless用的是 dummy 渲染器(空实现),get_viewport().get_texture()读回来全是黑的——本篇的判定全部基于像素读回,headless 下会整体失真。这一点在第二篇的探针里已经用 draw call 恒为 0 的现象验证过。
另外交代一句为什么本篇的本机探针这么多:剔除与排序是看不见的一层,它不像界面或实拍那样有现成的外部图可用(阶段 2 的检索实测里,与本题域相关的关键词组有六组是零命中)。所以本篇的证据重心只能是源码原文加上本机对照。
0.6 怎么读这篇
给三条阅读建议,省些来回翻的力气:
- 想先弄懂「顺序」:读第一到第四章(三层箱位),第五章是这条主路上唯一的例外。
- 想先排查问题:直接跳到第六章的 §6.6「排查手册」,那份表是本章倒过来用的版本;再回来看判据的来处。
- 想弄清一个具体结论有没有依据:每章末都有「本章出处」一行,列出该章引用的源码文件与官方页面;本机读数一律带版本串。
本章出处:三层落点链的分层依据见官方 2D 坐标与变换说明;场景层那一跳的完整走法在第二篇,服务层那一跳在第三篇。
一、第一层箱位:CanvasLayer.layer 与它的 64 位打包
这一章回答:CanvasLayer.layer 为什么不用一个整数直接比大小,而要打包成一个 64 位数;以及视口的画布表为什么自己存的时候是无序的。
1.1 排序键:一个字段扛下 layer 与 sublayer
先来看看排序键本身。RendererCanvasCull 的兄弟模块 RenderererViewport(渲染视口)里有个小结构,它是整条顺序链的第一层:它把「这块画布排第几层」压成一个可直接比大小的整数,后面所有跨画布的先后关系都从它开始。换句话说,谁在谁前面,第一个判据落在这个结构上,而不是落在任何节点的属性上。
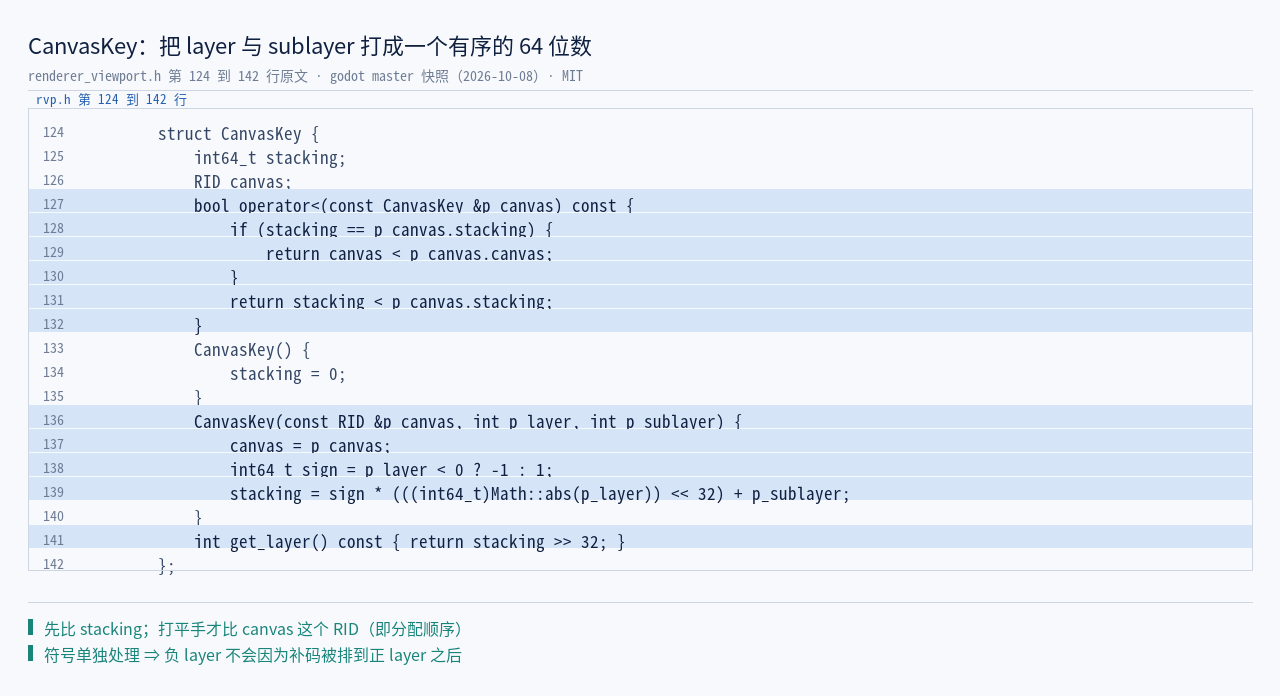
它只有一个用于排序的字段 stacking,另有一个 canvas 句柄用于打平手时的比较:
// renderer_viewport.h:124–142(master 快照 2026-10-08)
struct CanvasKey {
    int64_t stacking;
    RID canvas;
    bool operator<(const CanvasKey &p_canvas) const {
        if (stacking == p_canvas.stacking) {
            return canvas < p_canvas.canvas;
        }
        return stacking < p_canvas.stacking;
    }
    CanvasKey() {
        stacking = 0;
    }
    CanvasKey(const RID &p_canvas, int p_layer, int p_sublayer) {
        canvas = p_canvas;
        int64_t sign = p_layer < 0 ? -1 : 1;
        stacking = sign * (((int64_t)Math::abs(p_layer)) << 32) + p_sublayer;
    }
    int get_layer() const { return stacking >> 32; }
};
其中:layer 被搬到高 32 位,sublayer(子层)留在低位,两者合成一个有序的 64 位数。
1.2 为什么负 layer 要单独取符号
先来看看最容易被写错的那一行:sign * (abs(layer) << 32) + sublayer。如果偷懒写成「layer 左移 32 位再或上 sublayer」,负数的补码会把高 32 位全填成 1,比较结果立刻乱套——layer = -1 会被排到 layer = 0 的后面。
sign × (abs(layer) << 32) + sublayer 的位图与符号位处理@ 本系列绘制官方文档说「-1 的层画在 0 层之下、1 层画在其上」,这句用户口径能成立,靠的就是这行显式的符号处理。这是本篇第一处「文档说得简单、实现并不简单」的地方。
1.3 视口自己有表,但那张表是无序的
下面进入调用侧。视口里确实存了一张画布表,但它是个 HashMap:
// renderer_viewport.h:151–155(master 快照 2026-10-08)
    Transform2D global_transform;

    HashMap<RID, CanvasData> canvas_map;

    RenderingServerTypes::RenderInfo render_info;
哈希表没有顺序可言。顺序是在绘制那一刻才建立的:RenderererViewport::draw_viewports() 里另建一棵按 CanvasKey 排序的红黑树(RBMap),把画布逐个塞进去,再顺序遍历。
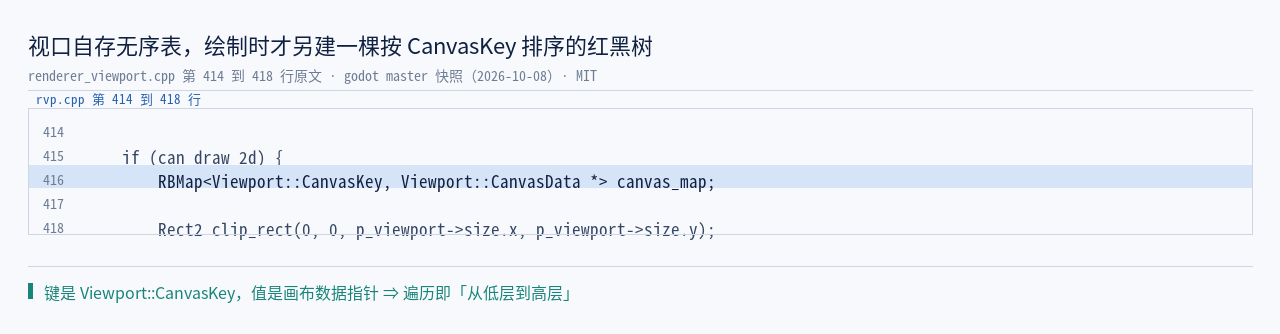
按 key 顺序遍历这棵树,就得到了「从低层到高层」的画布顺序;每遍历到一个画布,就把它的变换、光照、裁剪矩形连同视口的剔除掩码一起交给剔除器。也就是说,第一层箱位在进入剔除器之前就已经定好了。
1.4 本机对照:layer 压 z
言归正传,口说无凭。本篇的探针工程放了两块互相重叠的方块,一块放进 layer = 1 的画布层并给它 z_index = -100,另一块留在默认层并给它 z_index = +100:
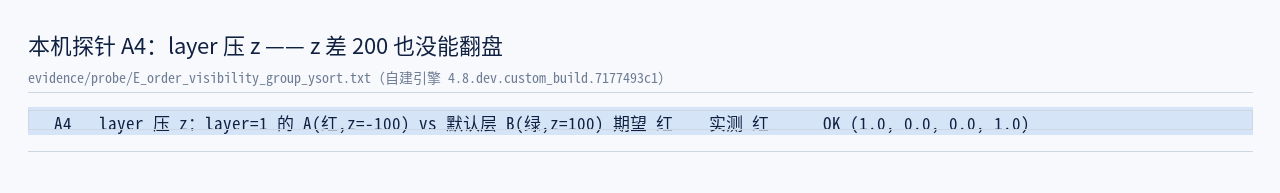
中心那一点最终是 (1.0, 0.0, 0.0, 1.0),也就是 layer = 1 的那块红。z 差了 200,也没能翻盘——这正是官方那句 "regardless of" 的实测版。注意:本机引擎是自建版本 4.8.dev.custom_build.7177493c1(2026-07-03 提交),下面的本机读数都带这个版本串,不给跨机器结论。
1.5 打包式的预算:31 位给 layer,32 位给 sublayer
依然是惯例,按上面那行式子拆开算一遍,stacking 这个 64 位整数是这样分配的:
| 位段 | 装什么 | 依据 |
|---|---|---|
| 最高 1 位 | 符号(由 layer 的正负决定) |
int64_t sign = p_layer < 0 ? -1 : 1; |
| 高 32 位里的低 31 位 | abs(layer) |
((int64_t)Math::abs(p_layer)) << 32 |
| 低 32 位 | sublayer |
+ p_sublayer |
也就是说:layer 的可表达范围被限制在 31 位以内,sublayer 独占低 32 位。打平手时(stacking 完全相等)才比 canvas 这个 RID——而 RID 的比较是拿句柄本体比大小,也就是分配顺序。⇒ 同一层同一子层下,先创建的画布排在前面。
这里有个容易误解的地方:sublayer 不是一个「微调优先级」的浮点数,它是个整数,且只在同一 layer 内参与比较。跨 layer 时高 32 位已经分出胜负,低位是什么都不影响。
本章出处:renderer_viewport.h 与 renderer_viewport.cpp(master 快照 2026-10-08,MIT)。本机读数来自探针 A4(evidence/probe/E_order_visibility_group_ysort.txt)。
二、第二层箱位:树序 → draw_index
这一章回答一个很容易被当成小事的问题:层内的先后到底由谁给号。答案不止一个,而是三套来源。不过先来看看这些属性在编辑器里长什么样——它们是这一章所有结论的入口。
排序与可见性相关的属性大多挤在检查器的同一栏里,界面上它们平铺在一起,看不出谁压谁:z_index 与 z_as_relative 决定这一项最终进哪个桶,y_sort_enabled 是第五章的主角,show_behind_parent 决定它画在父项之前还是之后。优先关系只能从源码里读。注意:这张截图的界面是英语、版本是 Godot 3.1,与本文引用的 master 版本不同——它只用来指出「这些字段在编辑器里的位置」,字段名与取值一律以正文的源码口径为准。
2.1 序号不是树序,是从树序算出来的一个整数
CanvasItem 的树序(谁在父节点里排第几)不会直接被剔除器读。场景层会把树序转成一个整数下发;剔除器那边收下的就是 Item::index 这一个 int。它按这个值给子项排序:
// renderer_canvas_cull.cpp:315–318(master 快照 2026-10-08)
    if (ci->children_order_dirty) {
        ci->child_items.sort_custom<ItemIndexSort>();
        ci->children_order_dirty = false;
    }
而 ItemIndexSort(renderer_canvas_cull.h:111–115)只有一行:return p_left->index < p_right->index;。
2.2 三套来源:谁给谁取号
先来看看这个接口。canvas_item_set_draw_index() 这个接口名看着平常,但它在场景层有两个调用点,而取号对象取决于节点处在什么位置:
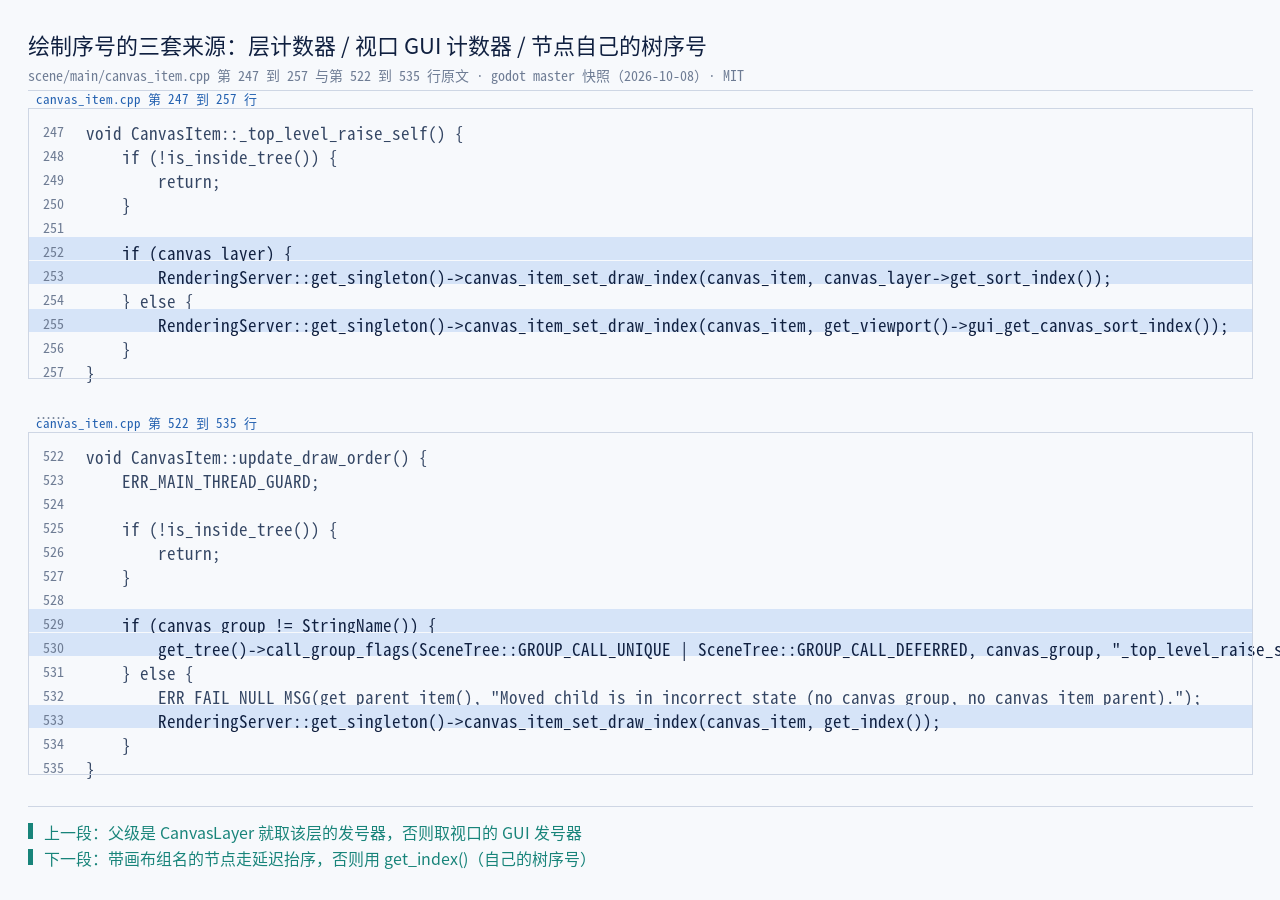
// scene/main/canvas_item.cpp:247–257(master 快照 2026-10-08)
void CanvasItem::_top_level_raise_self() {
    if (!is_inside_tree()) {
        return;
    }

    if (canvas_layer) {
        RenderingServer::get_singleton()->canvas_item_set_draw_index(canvas_item, canvas_layer->get_sort_index());
    } else {
        RenderingServer::get_singleton()->canvas_item_set_draw_index(canvas_item, get_viewport()->gui_get_canvas_sort_index());
    }
}
| 谁在取号 | 取的是什么 | 落点 |
|---|---|---|
父级是 CanvasLayer 的画布项 |
该 CanvasLayer 自己的一个计数器 | canvas_item.cpp:253 |
| 其余画布项(这一支) | 视口的 GUI 绘制计数器 | canvas_item.cpp:255 |
| 需要改序的普通画布项 | 自己在父节点里的序号 | canvas_item.cpp:533 |
第三支在另一个函数里,它顺便交代了一个容易混的邻居——canvas_group 这个名字看着像「画布组」,实际是组名字符串:
// scene/main/canvas_item.cpp:522–535(master 快照 2026-10-08)
void CanvasItem::update_draw_order() {
    ERR_MAIN_THREAD_GUARD;

    if (!is_inside_tree()) {
        return;
    }

    if (canvas_group != StringName()) {
        get_tree()->call_group_flags(SceneTree::GROUP_CALL_UNIQUE | SceneTree::GROUP_CALL_DEFERRED, canvas_group, "_top_level_raise_self");
    } else {
        ERR_FAIL_NULL_MSG(get_parent_item(), "Moved child is in incorrect state (no canvas group, no canvas item parent).");
        RenderingServer::get_singleton()->canvas_item_set_draw_index(canvas_item, get_index());
    }
}
也就是说:带画布组名的节点改序时,走的是「延迟调用整组的 _top_level_raise_self」,而不是自己设一个序号。注意:这里的 canvas_group 与第八篇要讲的 CanvasGroup 节点不是一回事:前者是场景层的一个组名(用来把一组顶层节点一起抬序),后者是服务层那个会动用背缓冲的隔离机制。
2.3 layer 与层内序号是两个数
OK,这里最容易搞混:CanvasLayer.layer 是层与层之间的顺序,而层内部的先后用的是另一个数,它的来源是一个计数器:
// scene/main/canvas_layer.cpp:264–269(master 快照 2026-10-08)
void CanvasLayer::reset_sort_index() {
    sort_index = 0;
}

int CanvasLayer::get_sort_index() {
    return sort_index++;
}
注意 return sort_index++; —— 这是个读一次、自增一次的计数器。视口侧那个 GUI 计数器写法一模一样:
// scene/main/viewport.cpp:3811–3813(master 快照 2026-10-08)
int Viewport::gui_get_canvas_sort_index() {
    return gui.canvas_sort_index++;
}
为什么这样写? 因为「谁先来谁拿小号」这件事,只能在进画布的顺序里确定,不能在事后补算。于是序号不是查出来的,而是发号发出来的。
注意:这里有一处旧印象要纠正:包括我在内的不少人会把「层内序号」直接等同于 layer,或者等同于节点在场景面板里的位置。按源码看,层内序号是发号器发出来的——CanvasLayer 下的项拿的是该层计数器的值,其余项拿的是视口 GUI 计数器的值,需要改序的普通节点才用自己的树序号。三套来源混在一起,才构成了「树序」这层箱位。
2.4 序号只置脏,不立刻重排
还有一个设计细节值得记:改序号、挂载节点这些动作不会当场触发排序,它们只是把标记置脏。
// renderer_canvas_cull.cpp:1966 与 :1972(master 快照 2026-10-08)
    canvas_item_parent->children_order_dirty = true;
    ...
    canvas->children_order_dirty = true;
排序发生在下一次剔除走到这一项的时候(cull.cpp:315–318),画布级同理(cull.cpp:499–502)。说白了,顺序是「用到才算」的,这也解释了后文那个桶模型为什么能这么省。
2.5 本机对照:同 z 时后加者在上
好了,把两块重叠的方块放进同一层、同为 z_index = 0,先加绿、后加红:
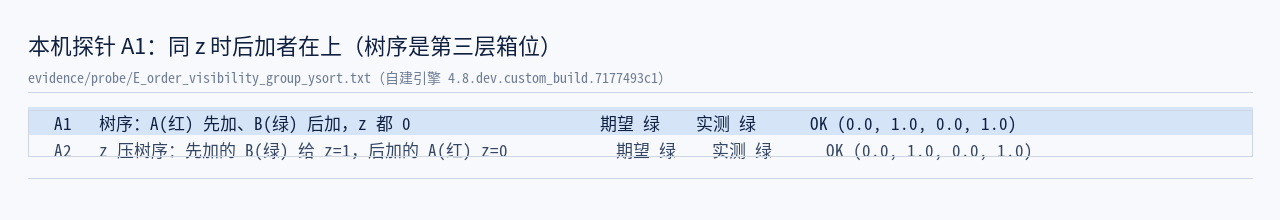
中心点是 (0.0, 1.0, 0.0, 1.0)——后加的绿在上。这与官方那句「children are on top of their parents... the topmost nodes in the scene panel are drawn on behind lower ones」对得上:场景面板里越靠上、画得越靠后(这里容易反直觉,所以官方在教程里特意加了提醒)。
再补一条本机读数:给先加的那块 z_index = 1、后加的那块保持 0,中心点立刻变成先加的那一块。⇒ z 压树序成立,这是第三层箱位与第二层箱位的先后关系,下一章从实现上看它为什么必然如此。
2.6 一张全量清单:影响顺序与可见性的属性都在这儿
OK,写到这里,可以把散在前两章的属性归齐了。下面这张表按功能分了三类——注意这三类的边界,它就是本篇的目录:
第一类 · 决定顺序的(谁先画)
CanvasLayer.layer:层与层之间,压过一切项内属性。CanvasLayer的层内发号器(get_sort_index()):只决定同层内的先后。Viewport的 GUI 发号器(gui_get_canvas_sort_index()):第二、三套序号来源里的另一套。CanvasItem.z_index:进入 z 桶的偏移量。CanvasItem.z_as_relative:决定 z 是累加还是取绝对值。CanvasItem.y_sort_enabled:把子树拍平后按最终 y 重排。CanvasItem.show_behind_parent:把这一项挪到父项之前画。CanvasItem.top_level:断开父链变换。CanvasItem.canvas_group:一个组名字符串,带它的节点改序时走延迟抬序。
第二类 · 决定去留的(到底画不画)
CanvasItem.visible:最外层开关。CanvasItem.visibility_layer与Viewport.canvas_cull_mask:按位与决定整条链的可见性。CanvasItem.modulate/self_modulate:累加后小于 0.007 就不画。CanvasItem.clip_children:裁剪区域退化到 0 就不画。
第三类 · 改变「怎么合成」的(画出来之后算什么)
CanvasItem.clip_children(在组外时)与CanvasGroup:都要动背缓冲,二者互斥。CanvasGroup.fit_margin/clear_margin/use_mipmaps:决定背缓冲多大、要不要 mipmap。CanvasItem.material/use_parent_material:决定这一项能不能和邻居合并(下一篇的主题)。
二次归类:这三类恰好对应三个不同的问题——「排」问的是遍历顺序,「筛」问的是判据,「合」问的是中间表示。本篇只讲前两类,第三类里唯一要讲的是它与前两类的冲突点:CanvasGroup 一旦动用背缓冲,clip_children 就失效(第八章)。
这张清单还有个实际用法:排查「我的节点不见了」,按第二类从上往下查;排查「我的节点压错人了」,按第一类从上往下查。顺序是从外到内、从大到小。
本章出处:canvas_item.cpp、canvas_item.h、canvas_layer.cpp、viewport.cpp(均为 master 快照 2026-10-08)。本机读数来自探针 A1 与 A5。
三、第三层箱位:z_index 与 8193 个桶
下面进入顺序链的最后一层。这一章要拆掉一个流传很广的说法:z_index 不是「排序依据」,它是装箱依据。
3.1 z 有硬边界,不是想给多大给多大
下面进入正题。先把值域钉住——CanvasItem 的 z_index 上下限写在 rendering_server_enums.h 的枚举里。这两个常量不只是「合法范围」的声明:它们直接决定了后面那排桶一共有多少格,也决定了越界时程序是夹一下还是明确拒绝。先看边界、再看结构,这个顺序不能反过来读。
// servers/rendering/rendering_server_enums.h:37–42(master 快照 2026-10-08)
enum {
    NO_INDEX_ARRAY = -1,
    ARRAY_WEIGHTS_SIZE = 4,
    CANVAS_ITEM_Z_MIN = -4096,
    CANVAS_ITEM_Z_MAX = 4096,
越界会被直接拒绝,不是夹一下就算了事的:
// renderer_canvas_cull.cpp:1883–1885(master 快照 2026-10-08)
void RendererCanvasCull::canvas_item_set_z_index(RID p_item, int p_z) {
    ERR_FAIL_COND(p_z < RSE::CANVAS_ITEM_Z_MIN || p_z > RSE::CANVAS_ITEM_Z_MAX);
为什么要有边界? 因为 z 要变成一个数组下标。有了 -4096 到 4096,桶的个数就是固定的:
// renderer_canvas_cull.h:216–219(master 快照 2026-10-08)
    static constexpr int z_range = RSE::CANVAS_ITEM_Z_MAX - RSE::CANVAS_ITEM_Z_MIN + 1;

    RendererCanvasRender::Item **z_list;
    RendererCanvasRender::Item **z_last_list;
z_range 等于 4096 - (-4096) + 1,也就是 8193。
3.2 桶是「数组 + 链表」,而且只分配一次
两个数组的长度都是 z_range,而且它们在构造期就分配好,不是每帧申请。这一点值得单独说:分配只做一次,意味着每帧的固定开销里只剩「清零」这一项,没有申请与释放;而清零是可以一次 memset 做完的连续操作,比逐个节点重建要稳定得多。
// renderer_canvas_cull.cpp:2828–2831(master 快照 2026-10-08)
RendererCanvasCull::RendererCanvasCull() {
    ...
    z_list = (RendererCanvasRender::Item **)memalloc(z_range * sizeof(RendererCanvasRender::Item *));
    z_last_list = (RendererCanvasRender::Item **)memalloc(z_range * sizeof(RendererCanvasRender::Item *));
按 64 位机器算,两个数组一共 8193 × 8 × 2 ≈ 128 KiB。每帧把这 128 KiB 清零,就是从零重建一次顺序表。
3.3 一次遍历:先装箱,再串链
好了,进入本篇最核心的一段代码。_render_canvas_item_tree() 的骨架只有三件事:
// renderer_canvas_cull.cpp:71–108(节选;master 快照 2026-10-08)
    RENDER_TIMESTAMP("Cull CanvasItem Tree");
    ...
    memset(z_list, 0, z_range * sizeof(RendererCanvasRender::Item *));
    memset(z_last_list, 0, z_range * sizeof(RendererCanvasRender::Item *));

    for (int i = 0; i < p_child_item_count; i++) {
        _cull_canvas_item(p_child_items[i].item, p_transform, p_clip_rect, Color(1, 1, 1, 1), 0, z_list, z_last_list, nullptr, nullptr, false, p_canvas_cull_mask, Point2(), 1, nullptr);
    }

    RendererCanvasRender::Item *list = nullptr;
    RendererCanvasRender::Item *list_end = nullptr;

    for (int i = 0; i < z_range; i++) {
        if (!z_list[i]) {
            continue;
        }
        if (!list) {
            list = z_list[i];
            list_end = z_last_list[i];
        } else {
            list_end->next = z_list[i];
            list_end = z_last_list[i];
        }
    }
三步就位:清桶 → 递归装箱 → 从低到高串链。第二步把每一项按它的绝对 z 放进对应的桶,第三步把 8193 个桶按 z 从小到大接成一条单链表。所以「z 小的画在前面」不是比较出来的,是桶的下标顺序天然给出的。
那每一项是怎么进桶的?往回看 _attach_canvas_item_for_draw():
// renderer_canvas_cull.cpp:274–287(master 快照 2026-10-08)
            int zidx = p_z - RSE::CANVAS_ITEM_Z_MIN;

            if (r_z_last_list[zidx]) {
                r_z_last_list[zidx]->next = ci;
                r_z_last_list[zidx] = ci;

            } else {
                r_z_list[zidx] = ci;
                r_z_last_list[zidx] = ci;
            }

            ci->z_final = p_z;

            ci->next = nullptr;
入桶下标 = 绝对 z − CANVAS_ITEM_Z_MIN。桶内是一条单链表,z_last_list 存尾指针,所以追加是 O(1):往尾巴上一挂就行。
3.4 桶模型的完整样子
好了,这个模型的代价与收益可以算清:
| 项 | 值 |
|---|---|
| 桶数 | 8193(z_range) |
| 每帧清零 | ≈128 KiB(两个指针数组:8193 × 8 × 2) |
| 每项入桶 | O(1)(尾指针追加) |
| 汇总一次完成 | O(8193) 扫描 + 每桶 O(1) 接链 |
| 排序比较次数 | 0(没有任何比较) |
结论落到量化上:这篇的「排序」实际做的是装箱。全局排序要做 O(n log n) 次比较,而桶模型把顺序外包给了下标——顺序信息被事先编码进数组位置,运行时只剩加法与指针接续。这也解释了为什么 z 必须有硬边界:没有边界就没有下标。
3.5 一处容易误读的地方:z 只在必要时才累加
z_index 默认是相对父项的(z_as_relative = true),所以绝对 z 是累加并夹紧出来的:
// renderer_canvas_cull.cpp:431–436(master 快照 2026-10-08)
    int parent_z = p_z;
    if (ci->z_relative) {
        p_z = CLAMP(p_z + ci->z_index, RSE::CANVAS_ITEM_Z_MIN, RSE::CANVAS_ITEM_Z_MAX);
    } else {
        p_z = ci->z_index;
    }
注意这里夹的是累加结果,不是 z_index 本身。⇒ 一个深层节点即使自己只写了 z_index = 3,也可能因为父链累加而顶到 4096;反过来,CLAMP 之后桶下标永远落在 [0, 8192] 里,越界在那里是数学上不可能的。
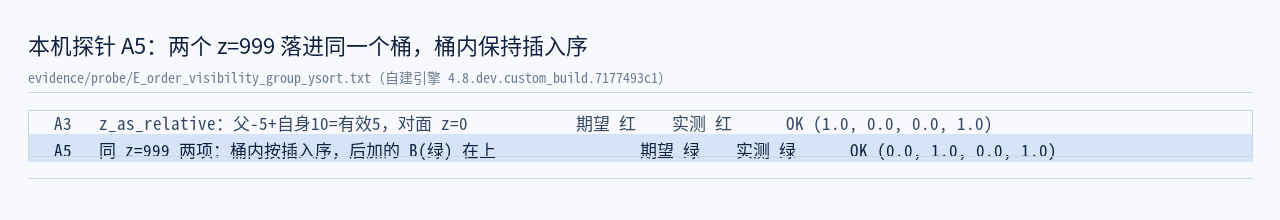
本机读数给了这条模型一个侧面证据:两个 z_index = 999 的重叠方块落在同一个桶里,结果是后加者在上——桶内没有再做任何排序,谁先被挂上谁就在前面。
另补一条本机读数:把父项设成 z_index = -5、子项自己设 z_index = 10,最终压在 z_index = 0 的对照块之上。-5 + 10 = 5 > 0,与上面那段 CLAMP 的累加式对得上。
3.6 三种「排序」的横向对比
OK,把桶模型和它的两个常见替代摆在一起,用一个统一维度表来看,才看得出它到底买到了什么:
| 维度 | 桶装箱(本篇实现) | 全局比较排序 | 每帧重建整棵有序树 |
|---|---|---|---|
| 每帧比较次数 | 0 | O(n log n) | O(n log n) |
| 每帧固定开销 | ≈128 KiB 清零 | 无 | 无 |
| 每项入列代价 | O(1)(尾指针追加) | — | 取决于树结构 |
| 结构变化代价 | 只置脏,下次用到才重排 | 每帧都付 | 每帧都付 |
| 可表达的 z 范围 | 受限于 8193 个桶 | 不受限 | 不受限 |
| 顺序信息的存放处 | 数组下标 | 比较函数 | 树结构 |
评价标准说明:这里的「代价」只看每帧的确定性开销与结构变化时的增量开销两项——因为剔除与排序是在渲染流程里每帧都要跑的东西,短突发的高开销比稳定的低开销更难接受。
对比的结论落在两句话上:顺序信息被事先编码进数组下标,运行时只剩加法与指针接续;代价是 z 必须有硬边界。为了避开比较排序而接受一个 8193 格的数组,这个取舍只有在「每帧都要重排」的前提下才划算——而 2D 场景恰好就是每帧都要重排。
本章出处:rendering_server_enums.h、renderer_canvas_cull.h、renderer_canvas_cull.cpp(均为 master 快照 2026-10-08,MIT)。本机读数来自探针 A5。
四、同一个桶里谁先谁后
这一章短,但它解释了「为什么每帧清空 128 KiB 也不心疼」。
4.1 桶内保持插入序,因为插入序就是正确顺序
说白了,在同一层、同一个 z 上,谁先画谁后画?答案在遍历里:子项是按序号从小到大被访问的,而访问到就往后追加,所以桶内链表天然按序号有序。这意味着「同一桶内再排一次序」是多余的——顺序信息在被访问的那一刻就已经确定,追加这个动作本身就在维护它。
// renderer_canvas_cull.h:111–115 与 :148–153(master 快照 2026-10-08)
    struct ItemIndexSort {
        _FORCE_INLINE_ bool operator()(const Item *p_left, const Item *p_right) const {
            return p_left->index < p_right->index;
        }
    };
    ...
        struct ChildItem {
            Item *item = nullptr;
            bool operator<(const ChildItem &p_item) const {
                return item->index < p_item.item->index;
            }
        };
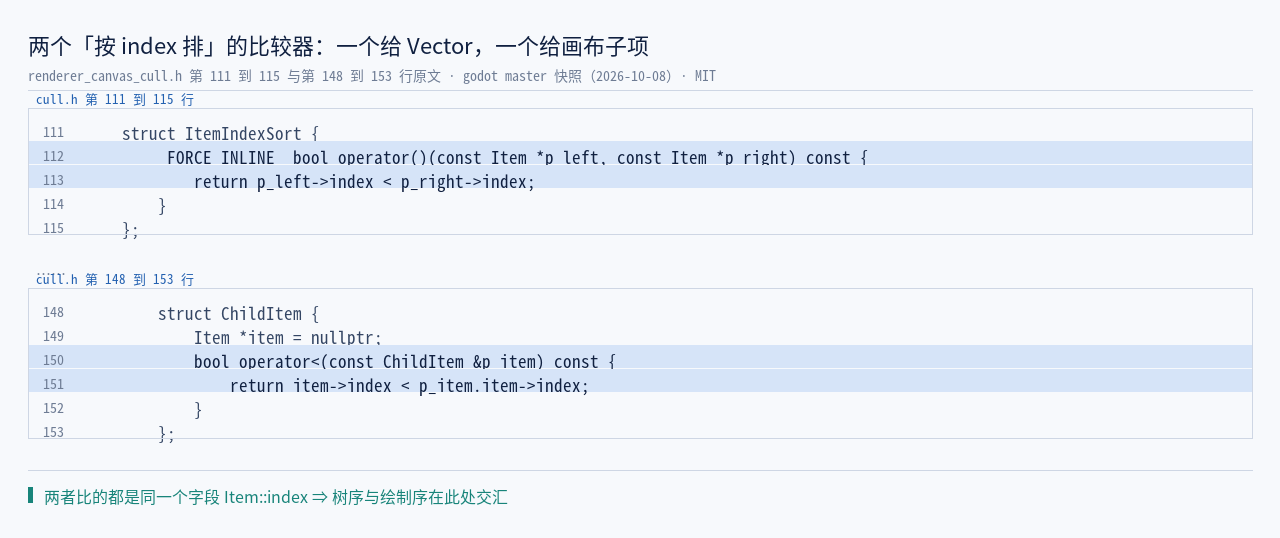
一个给 Vector 用(sort_custom),一个给画布的子项数组用(直接 sort())。两者比较的都是同一个字段:index。
4.2 代价落在「只在脏的时候排」
// renderer_canvas_cull.cpp:315–318 与 :499–502(master 快照 2026-10-08)
    if (ci->children_order_dirty) {
        ci->child_items.sort_custom<ItemIndexSort>();
        ci->children_order_dirty = false;
    }
    ...
    if (p_canvas->children_order_dirty) {
        p_canvas->child_items.sort();
        p_canvas->children_order_dirty = false;
    }
言归正传,回到那个「128 KiB 清零便不便宜」的问题。清零是线性的(8193 次),排序是只在结构变化时才做的(children_order_dirty),入桶是 O(1)——三者叠起来,才是「顺序可以每帧重建却不贵」的完整解释。如果每帧都做一次全局比较排序,这套设计立刻站不住。
4.3 一次结构变化的完整回路
OK,把「改一个属性」到「画面顺序变化」的整条回路走一遍,前面几段代码就串起来了。假设我们给一个已经进树的节点设 z_index = 3:
- 场景层:
CanvasItem::set_z_index()里把值存下,然后只调一句canvas_item_set_z_index(canvas_item, z_index)(canvas_item.cpp:757–761)。 - 服务层门面:这条命令经宏生成的转发(
FUNCRIDSPLIT(canvas_item)把这一段的实现层指定为RendererCanvasCull,rendering_server_default.h:1016),落到剔除器。 - 剔除器:
canvas_item_set_z_index()先做越界检查(cull.cpp:1884),再写字段。注意它没有触发任何排序——z 只影响入桶的下标,不影响子项次序。 - 下一帧剔除:这一项按新 z 落进另一个桶;汇总时桶的顺序自然给出新位置。
如果改的是顺序类属性(比如插入了兄弟节点),回路就多一步:
canvas_item_set_parent()(cull.cpp:576起)把子项挂进新父项,并置脏(cull.cpp:1966 / 1972)。- 下一帧
_cull_canvas_item()走到这一项,发现children_order_dirty,做一次sort_custom<ItemIndexSort>()(cull.cpp:315–318)。 - 排序之后子项按
index升序被访问,于是桶内的追加顺序随之改变。
这里的原理与第三章是同一处,其中:桶内先后不需要比较,只需要保证追加顺序正确,而追加顺序由序号排序保证。
⇒ 两条回路的差别值得记:改 z 不需要排序,改结构需要一次排序,而那次排序只发生一次(置脏后立刻清脏)。这就是「脏标记」在这里的全部作用——把排序从每帧摊到「真的变了」的那一帧。
本章出处:脏标记与比较器同见 renderer_canvas_cull.h;转发链的宏展开另见 server_wrap_mt_common.h(master 快照 2026-10-08)。
五、y 排序:把子树拍平,再按最终 y 排
前面四章讲的是「z 桶」这条主路。这一章讲例外一:y_sort_enabled 会绕过主路的一半。
5.1 y 排序比较的不是本地 y,而是最终位置的 y
这一节先看判据本身。y 排序的比较器只有几行,但它比的是哪一个 y,直接决定排序结果对不对:比本地坐标还是比最终位置,在父链带着变换的时候会给出完全不同的先后,而且错得很安静。
// renderer_canvas_cull.h:117–127(master 快照 2026-10-08)
    struct ItemYSort {
        _FORCE_INLINE_ bool operator()(const Item *p_left, const Item *p_right) const {
            const real_t left_y = p_left->ysort_xform.columns[2].y;
            const real_t right_y = p_right->ysort_xform.columns[2].y;
            if (Math::is_equal_approx(left_y, right_y)) {
                return p_left->ysort_index < p_right->ysort_index;
            }

            return left_y < right_y;
        }
    };
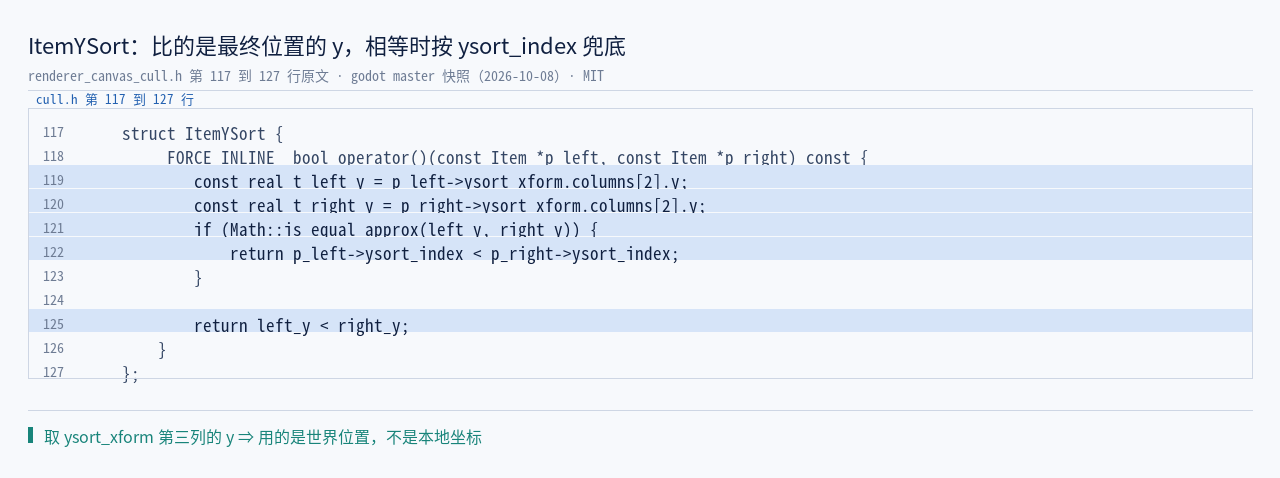
ysort_xform.columns[2].y 是这项在世界里的最终 y。取最终位置而不是本地坐标,是因为父链的变换会把局部位置挪走——官方那句 "Child Y-sorted nodes are sorted in the same space as the parent Y-sorted node" 说的就是这个口径。
第二条判据 ysort_index 是稳定排序的兜底:y 完全相等时,按收集顺序决定,不引入随机性。
5.2 为什么必须先拍平
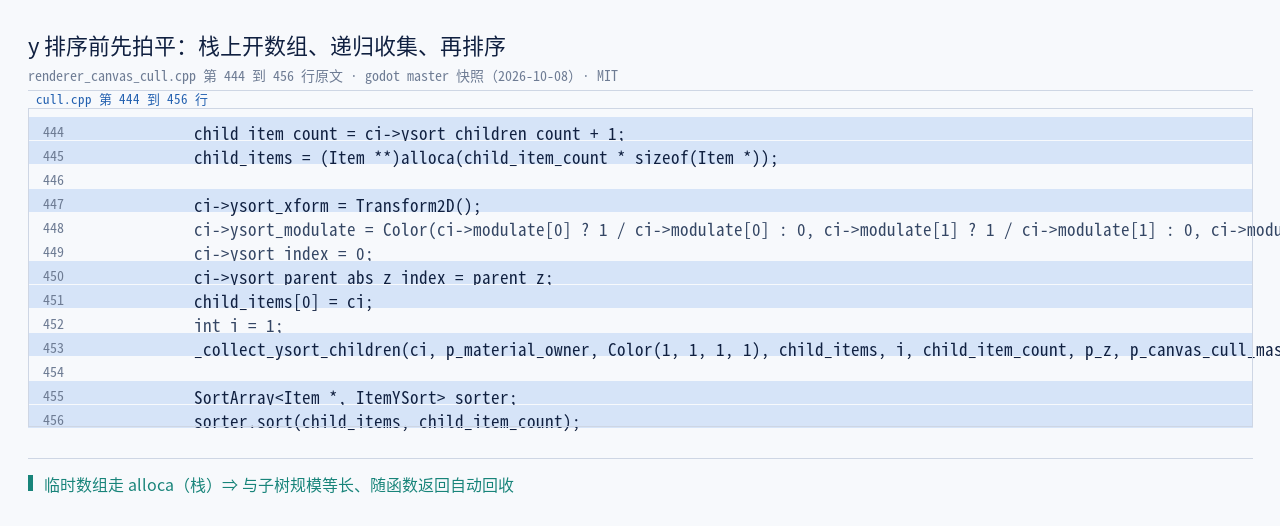
说白了,y 排序不能就地两两交换,因为它要跨层级比较。实现的做法是:把 y-sorted 这颗子树整体摊成一维数组,排完序之后再逐个送进剔除。
// renderer_canvas_cull.cpp:440–460(节选;master 快照 2026-10-08)
            if (ci->ysort_children_count == -1) {
                ci->ysort_children_count = _count_ysort_children(ci);
            }

            child_item_count = ci->ysort_children_count + 1;
            child_items = (Item **)alloca(child_item_count * sizeof(Item *));

            ci->ysort_xform = Transform2D();
            ci->ysort_modulate = Color(...);
            ci->ysort_index = 0;
            ci->ysort_parent_abs_z_index = parent_z;
            child_items[0] = ci;
            int i = 1;
            _collect_ysort_children(ci, p_material_owner, Color(1, 1, 1, 1), child_items, i, child_item_count, p_z, p_canvas_cull_mask);

            SortArray<Item *, ItemYSort> sorter;
            sorter.sort(child_items, child_item_count);
三处细节值得停下来看一眼:
- 临时数组走的是
alloca(栈),不是堆——一次用量与子树规模成正比,用完随函数返回自动回收。 - 拍平前要数一遍:
_count_ysort_children()递归数出可见子孙的数量,结果缓存在ysort_children_count上,-1表示「还没算」。 - 每个成员都要带上「父的绝对 z」:拍平之后它们会被逐个送回剔除,
ysort_parent_abs_z_index就是那时候用的。
5.3 缓存怎么失效
ysort_children_count 是缓存,于是就有失效问题。失效的做法是沿父链往上清,只清到最近的 y-sort 祖先——再往上那一层不受影响,所以循环会停在那里,而不是一路清到根。这种「只清受影响的最近一层」的写法,和前面脏标记的思路是同一个路子。
// renderer_canvas_cull.cpp:185–190(master 快照 2026-10-08)
void RendererCanvasCull::_mark_ysort_dirty(RendererCanvasCull::Item *ysort_owner) {
    do {
        ysort_owner->ysort_children_count = -1;
        ysort_owner = canvas_item_owner.owns(ysort_owner->parent) ? canvas_item_owner.get_or_null(ysort_owner->parent) : nullptr;
    } while (ysort_owner && ysort_owner->sort_y);
}
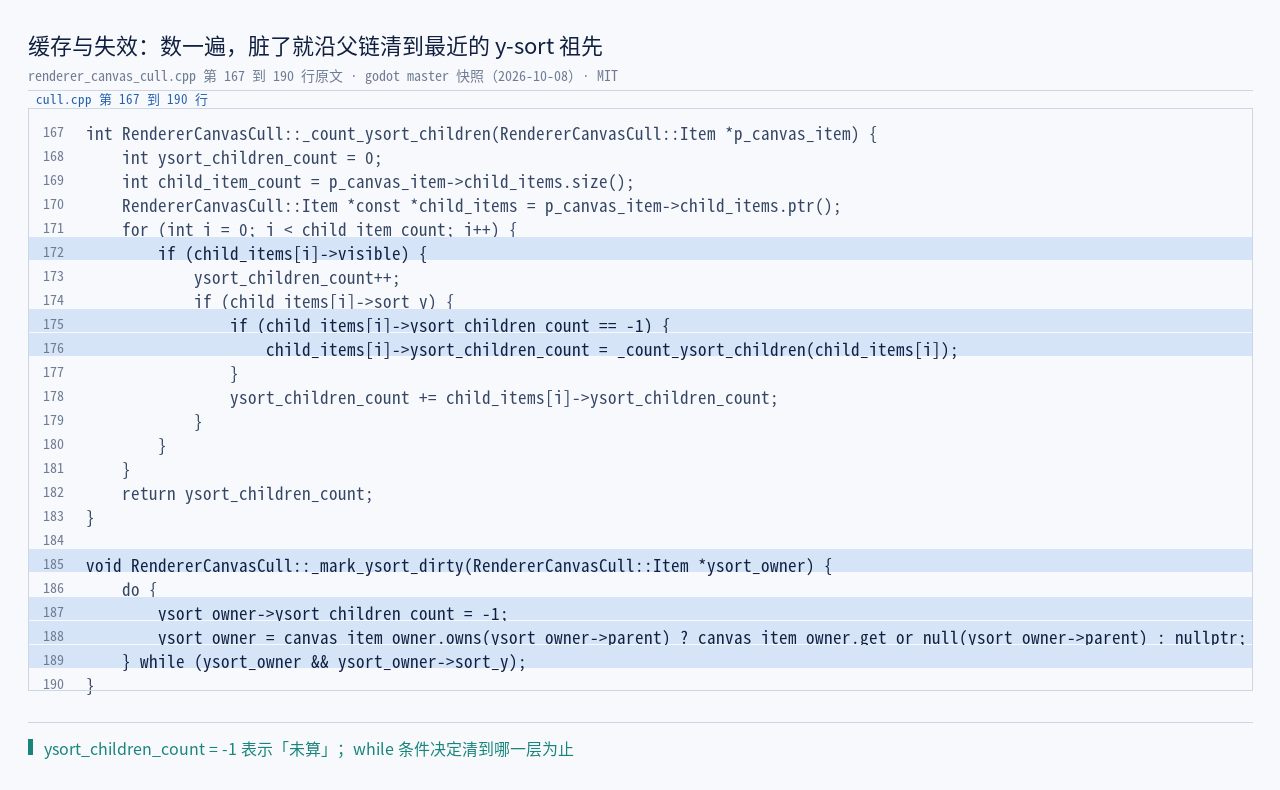
那个 while (ysort_owner && ysort_owner->sort_y) 就是「只清到最近的 y-sort 祖先」:再往上那一层不受影响,所以不必继续清。
5.4 例外里的例外:z 会静默压过 y 排序
言归正传,社区里流传一句结论:「y 排序只对 z 相同的项生效」。这句话我们需要实测而不是照抄,因为它是第三方(一位开发者在 4.7 上跑了逐像素断言)的结论。
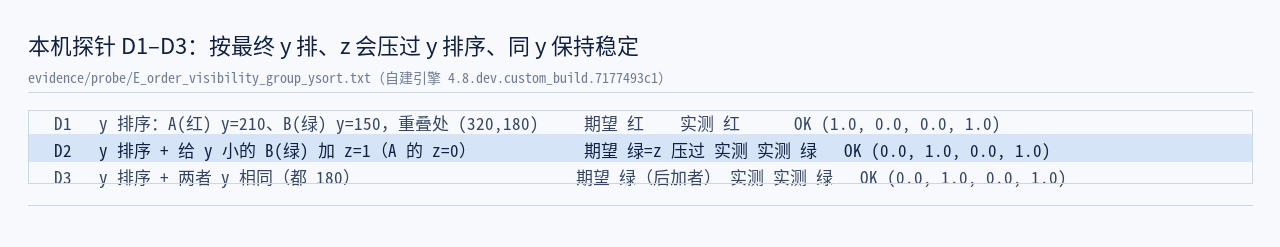
本机三组读数是这样的:
| 例 | 设置 | 中心点结果 |
|---|---|---|
| D1 | 父开 y 排序;红 y = 210、绿 y = 150 |
红(y 大者后画、在上) |
| D2 | 同上,另给绿加 z_index = 1(红为 0) |
绿(z 压过了 y 排序) |
| D3 | 父开 y 排序;两者 y 都是 180 |
绿(后加者在上,稳定) |
⇒ 「z 会压过 y 排序」在本机复现成立,D3 也印证了同 y 的稳定性。按源码看这也说得通:拍平之后每个成员仍然带着自己的绝对 z 回去装箱,而装箱发生在排序之后——y 只决定同一批项的收集顺序,z 才决定它们落在哪个桶。
注意:一处口径要写清:那条第三方结论来自 4.7,本篇只把它当作待验问题,结论以本机 D2 为准;不给跨版本结论。
5.5 y 排序的开销口径:贵在哪、便宜在哪
好了,把前面几段串起来,y 排序的代价可以拆成四项:
| 项 | 代价 | 何时付 |
|---|---|---|
| 数一遍子孙数 | O(子树规模) 递归 | 只在缓存失效后付一次 |
| 拍平收集 | O(子树规模) | 每次都要(数组走栈上 alloca) |
| 排序 | O(k log k),k 为拍平后成员数 | 每次都要 |
| 清缓存 | 沿父链走到最近的 y-sort 祖先 | 只在结构变化时付 |
⇒ 与 z 桶那条主路对比:z 桶是零比较,y 排序是每次都要排一次。这就是为什么 y 排序只在真的需要「按前后遮挡」时才该开——它换掉的正是主路最擅长的东西。
这里还有一条不能省略的历史背景。官方在 2020 年那篇《Godot's 2D engine gets several improvements for upcoming 4.0》里同时宣布了两件事:新增 CanvasGroup("merges the draw calls of its children nodes"),以及 clip children 的成本几乎为零("happens at literally no cost")。但y 排序的性能问题是后来才修的:2022 年前后(4.0 开发期)它在大图块地图上一直很贵,直到 2023 年 4.2 的一条改动——
"2D: Greatly improve Y-sort performance on TileMaps (GH-73813)."
才把 TileMap(瓦片地图)上的 y 排序开销压下来。社区里能查到的另一组实测来自更早的 3.x 时代:纯 TileMap 在 100×100 时约 50 fps、512×512 时直接崩,且「512 图块的地图不开 YSort 占 170 MB,468 图块开 YSort 逼近 400 MB」。
注意:那组数字是3.x 口径,本篇只作前后景引用,不当 4.x 的性能结论;它与上面那条 4.2 的修补连起来,只说明一件事:「y 排序便宜」不是天生成立的,是被修出来的。
本章出处:实现同见 renderer_canvas_cull.cpp;三条外部依据分别是 4.2 开发快照的发行说明(y 排序性能修补那条)、修复它的 GH-73813,以及社区那组 TileMap 实测(3.x 口径,仅作前后景)。本机读数来自探针 D1–D3。
六、「画什么」的五道闸门
前面五章讲的是「什么顺序」。从这一章起换到另一个问题:哪些东西根本不会进入那条链。先来看看编辑器里与可见性相关的那一节长什么样。
Visibility 一节(OCR 可读出 Visibility 与 Inspector)@ Wikimedia Commons(作者见 image-credits.json;CC BY 3.0,署名要求;原图未改动)这一节里的开关对应本章前面的两道闸门:Visible 与可见层(后者在 4.x 里是那组 32 位复选框)。而本章最容易被忽略的第三道闸门——累计透明度——在编辑器里根本没有专门的字段,它是父链 modulate 一路乘下来的结果;第四道(裁剪退化)也不在这一节。注意:同样是版本披露:这张图是 Godot 3.4 的界面。
6.1 两道在递归之前就拦下的闸门
_cull_canvas_item() 是个递归函数(cull.cpp:304 起),它从画布根往下走,每一项都要先过判据、再决定要不要继续看子项。而在它开头的十几行里,就连着过了两道门——这两道门的位置很关键,因为它们的 return 都写在递归调用之前。
// renderer_canvas_cull.cpp:305–313(master 快照 2026-10-08)
    Item *ci = p_canvas_item;

    if (!ci->visible) {
        return;
    }

    if (!(ci->visibility_layer & p_canvas_cull_mask)) {
        return;
    }
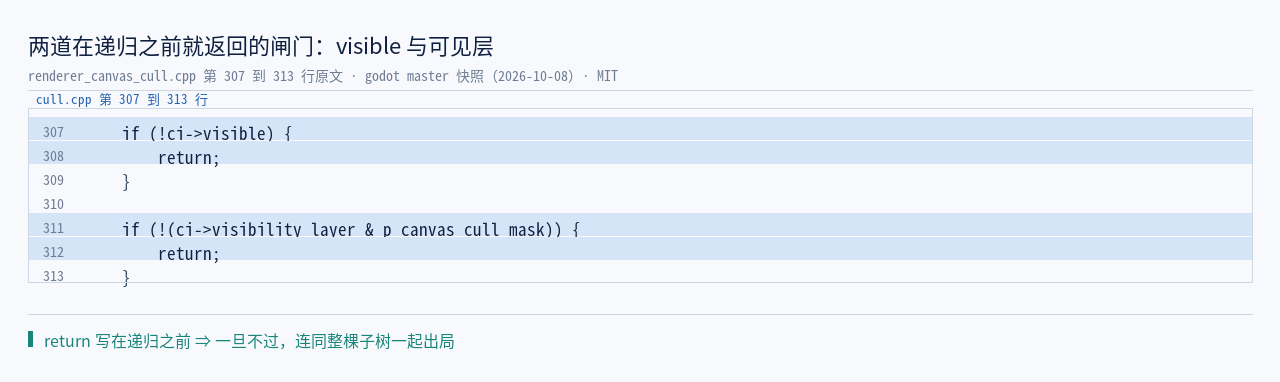
注意两处 return 的位置:它们在递归之前。所以这两道门一旦不过,出去的不是「这一项不画」,而是这一项连同它的整棵子树一起出局。
第二道门的判据是按位与:visibility_layer 是节点上的一个位域,p_canvas_cull_mask 是视口上的一个位域(Viewport.canvas_cull_mask,默认 0xffffffff,见 renderer_viewport.h:122),两者只要有一位重合就放行。
官方类参考的原句是这样的:
"A Viewport will render a CanvasItem if it and all its parents share a layer with the Viewport's canvas cull mask."
「and all its parents」这四个字是这一节的重点,下一小节用探针把它钉住。
6.2 另外两道:全透明与退化裁剪
OK,再往下走,还有两道同样会连坐整棵子树的门:
// renderer_canvas_cull.cpp:327–331 与 :419–422(master 快照 2026-10-08)
    Color modulate = ci->modulate * p_modulate;

    if (modulate.a < 0.007) {
        return;
    }
    ...
        if (ci->final_clip_rect.size.width < 0.5 || ci->final_clip_rect.size.height < 0.5) {
            // The clip rect area is 0, so don't draw the item.
            return;
        }
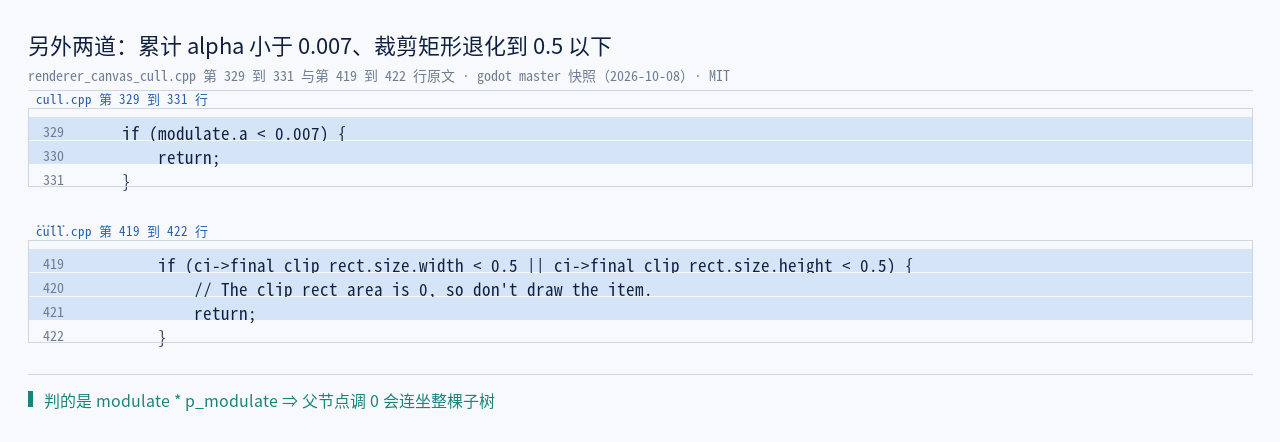
第三条门最容易被忽略:判的是累加后的 modulate.a,也就是「父链一路乘下来」的透明度。⇒ 一个父节点把 modulate.a 调成 0,它的整棵子树都会消失,哪怕子节点自己的 alpha 还是 1。这不是 bug,是递归的自然结果。
第四条门说的是一种很常见的情形:clip_children 开了、但可裁剪区域退化到 0(例如父项自身没有任何可见内容)。这时候同样整棵子树不画。
6.3 第五条:只管自己进不进桶
第五条门不在上面那个位置,而在装箱那一步(_attach_canvas_item_for_draw()):
// renderer_canvas_cull.cpp:260(master 快照 2026-10-08)
    if (((ci->commands != nullptr || ci->visibility_notifier) && p_clip_rect.intersects(p_global_rect, true)) || ci->vp_render || ci->copy_back_buffer) {
判据是视口裁剪矩形与这一项的包围盒是否相交,用的是 Rect2::intersects(..., true)(第二个参数包含边界)。不过它只决定这一项自己进不进桶——因为在这一步之前,它的子项已经被处理过了。
注意:这里要澄清一个很常见的误读:2D 剔除不是视锥剔除。本篇的 165 处源码落点里没有任何相机视锥或平面,与「画什么」相关的几何判据只有这一条矩形相交;z 只决定顺序,不决定去留。
6.4 五道闸门的全貌
| # | 闸门 | 落点 | 出局范围 |
|---|---|---|---|
| ① | visible 为假 |
cull.cpp:307 |
整棵子树 |
| ② | 可见层与视口掩码按位与为 0 | cull.cpp:311 |
整棵子树 |
| ③ | 累计 alpha < 0.007 | cull.cpp:329 |
整棵子树 |
| ④ | 裁剪矩形退化(宽或高 < 0.5) | cull.cpp:419 |
整棵子树 |
| ⑤ | 与视口裁剪矩形不相交 | cull.cpp:260 |
只影响自己进不进桶 |
依然是惯例,这张表建议对照源码各读一遍。它不是「性能优化清单」,而是「为什么我的节点不见了」的排查顺序:前四道门一旦不过,出局的是整棵子树,所以一旦发现某个父节点下面的子项集体消失,就该从这四道门里找原因,而不是逐个去检查子项自己的属性。
6.5 本机对照:链上任一环不匹配,整棵出局
OK,这一节的实测证据来得有点曲折:首跑时它判我错。
探针里有一例:视口掩码设成 0b10,父项 visibility_layer = 0b11、子项 = 0b10,按「按位与非零」的规则,父与子都该放行。可中心点读回来是背景色——什么都没画。查下去才发现根因不在被测节点上,而在探针自己的场景根节点:它的 visibility_layer 是默认值 1(canvas_item.h:108),而掩码 0b10 里没有第 0 位——于是整个场景在根那一层就被拦掉了。
这正好把「and all its parents」演成了实例。修掉装置(把装置自身的层放开)之后,又补了两例专门钉住它:
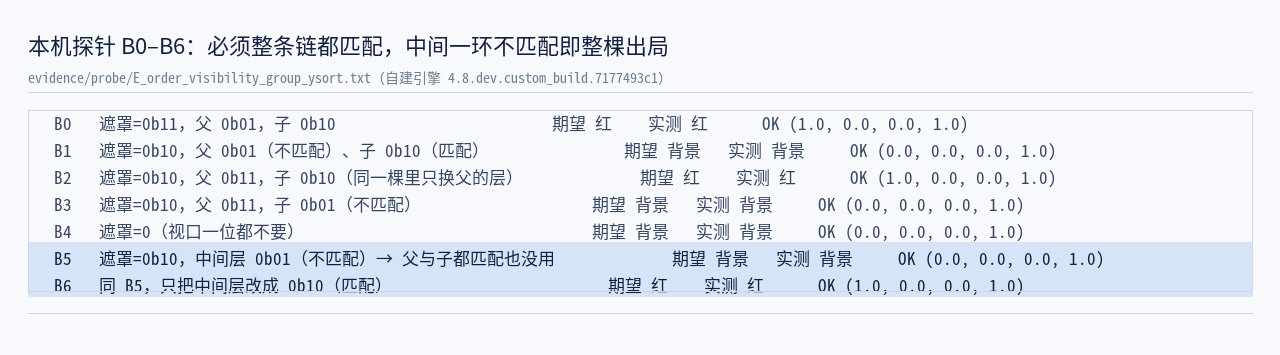
| 例 | 遮罩 | 链上各层的位 | 结果 |
|---|---|---|---|
| B0 | 0b11 |
父 0b01、子 0b10 |
画出(各有重合位) |
| B1 | 0b10 |
父 0b01(不匹配)、子 0b10 |
整棵出局 |
| B2 | 0b10 |
父 0b11、子 0b10 |
画出 |
| B3 | 0b10 |
父 0b11、子 0b01(不匹配) |
整棵出局 |
| B4 | 0 |
父与子都匹配 | 整棵出局(视口一位都不要) |
| B5 | 0b10 |
中间层 0b01(不匹配)、父 0b11、子 0b10 |
整棵出局 |
| B6 | 0b10 |
中间层 0b10、父 0b11、子 0b10 |
画出 |
B5 与 B6 只差中间层的一个位,结果一个全遮、一个正常。⇒ 「可见层必须整条链匹配」在本机成立。
还有一处旧印象要一并纠正:visibility_layer 的默认值两侧并不一样——场景侧是 1(只开第 1 位),服务侧 Item 的默认是 0xffffffff(全开)。这不是笔误:节点进画布时会把自己那一位下发下去(canvas_item.cpp:270 / :295),所以服务侧的默认值只对「没被场景层管过的项」生效。我最初就是按「两侧都是全开」的旧印象设计装置的,才踩了上面那个坑。
6.6 排查手册:节点不见了,按这五道门逐条查
好了,把上面那张表倒过来用,就是一份能对着敲的排查清单。顺序不要打乱——从整棵出局的门往后查,比从「样式对不对」查起快得多:
| 步 | 先看什么 | 怎么确认 | 典型现象 |
|---|---|---|---|
| 1 | 自己或任一祖先的 visible |
编辑器的可见性眼睛图标会连坐 | 整棵子树都不见 |
| 2 | 自己与整条父链的 visibility_layer,以及视口的 canvas_cull_mask |
两者按位与,任一环为 0 就出局 | 只有某个子视口里看不到 |
| 3 | 父链累加的 modulate.a |
逐级相乘,注意父节点设了 0 或者极小值 | 子节点明明 alpha 是 1 也不见 |
| 4 | 祖先里的 clip_children 与它自身的可见区域 |
裁剪区域退化成 0 就整棵不画 | 只有开了裁剪的那一支不见 |
| 5 | 该项自己的包围盒与视口裁剪矩形 | 第 5 道门只管自己 | 只有超出某一范围的那几个不见 |
这五步里,前三步都是「整棵出局」,这一点是排查效率的关键:如果问题是「整棵子树都不见」,就从第 1 步开始;如果只有个别节点不见,直接跳到第 5 步。回头看,本篇探针首跑那次误判(0b10 掩码下场景整棵消失),根因正是第 2 步里我没查链条最外层的那一环。
本章出处:五道闸门同见 renderer_canvas_cull.cpp。可见层与画布变换的关系见官方 2D 变换说明;2D 光照里那套同样按掩码选对象的写法见官方 2D 光照与阴影。本机读数来自探针 B0–B6。
七、两级结构:先剔完整棵,再把桶串成一条链交出去
OK,这一章把整条链收口:剔除器对外只有一个入口,出口只有一条链。入口是 render_canvas(),出口是那条把 8193 个桶串起来的链表;把这两个端点看住,也就看住了这一层与上下游之间的全部契约。
7.1 入口与出口
// renderer_canvas_cull.cpp:495–508(master 快照 2026-10-08)
void RendererCanvasCull::render_canvas(RID p_render_target, Canvas *p_canvas, const Transform2D &p_transform, ...) {
    sdf_used = false;
    snapping_2d_transforms_to_pixel = p_snap_2d_transforms_to_pixel;

    if (p_canvas->children_order_dirty) {
        p_canvas->child_items.sort();
        p_canvas->children_order_dirty = false;
    }

    int l = p_canvas->child_items.size();
    Canvas::ChildItem *ci = p_canvas->child_items.ptrw();

    _render_canvas_item_tree(p_render_target, ci, l, p_transform, p_clip_rect, p_canvas->modulate, ...);
}
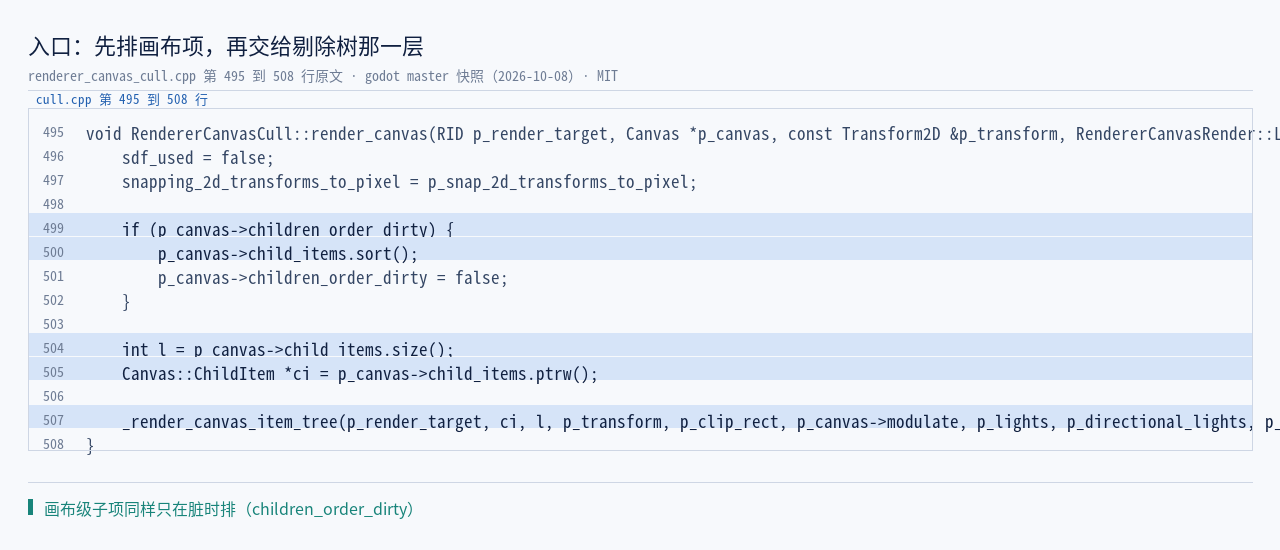
出口在 _render_canvas_item_tree() 的最后一行:
// renderer_canvas_cull.cpp:104–105(master 快照 2026-10-08)
    RSG::canvas_render->canvas_render_items(p_to_render_target, list, p_modulate, p_lights, p_directional_lights, p_transform, p_default_filter, p_default_repeat, p_snap_2d_vertices_to_pixel, sdf_flag, r_render_info);
第二个参数就是那条链的表头 list。下游拿到的不是数组,是一条单链表——这一条决定了后续所有消费方的写法:它们只能顺着 next 顺序遍历,不能按下标随机取用;而顺序恰好就是上游刚刚排好的那个顺序,不需要再解释一次。
7.2 交接面:一个 Item,两个模块共用
这条链的节点类型值得单独说一句。剔除层的 Item 继承了渲染层的 Item:
// renderer_canvas_cull.h:45(master 快照 2026-10-08)
    struct Item : public RendererCanvasRender::Item {
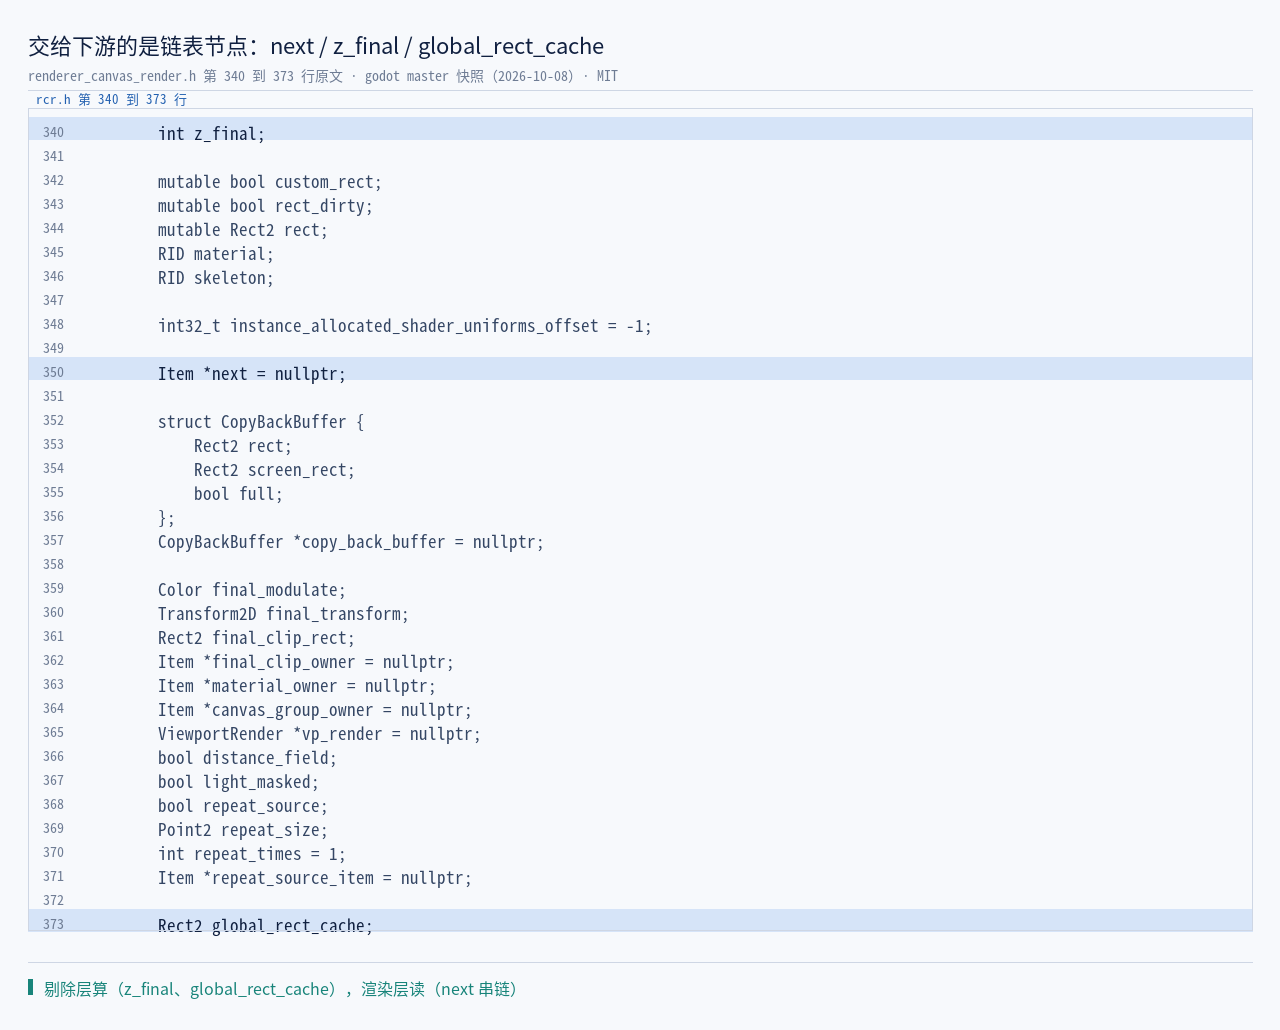
所以下游读的是同一块内存,只是字段的口径不同:next 是桶内链表指针(renderer_canvas_render.h:350),z_final 是剔除算出的最终 z(:340),global_rect_cache 是这一项的全局矩形(:373)。剔除层负责算,渲染层负责读——这就是两篇之间的接缝。
顺带记一个容易混淆的命名:RSG 是宏别名(#define RSG RenderingServerGlobals),它下面挂着两个不同的单例——RSG::canvas 是剔除器,RSG::canvas_render 是渲染抽象层(rendering_server_globals.h:62 / :65)。名字差一个后缀,职责差一层。
7.3 两级结构的代价与收益
把前面两小节拼起来看,剔除这一层实际做了两件性质不同的事,它们各自有独立的代价与收益。分开算,才能看清哪一部分是固定的、哪一部分随场景规模增长。
| 项 | 做法 | 收益 |
|---|---|---|
| 第一级:递归剔除 | 一个函数自递归,逐项过五道门 | 判据集中,出局即剪枝 |
| 第二级:桶汇总 | 一次 8193 桶扫描,串链 | 顺序零比较,O(1) 入桶 |
| 交接 | 一条单链表 | 下游顺序读,不必关心层级 |
| 每帧固定开销 | 两次 memset(≈128 KiB) |
与场景规模无关 |
7.4 本机对照:同内容三种组织方式的读数
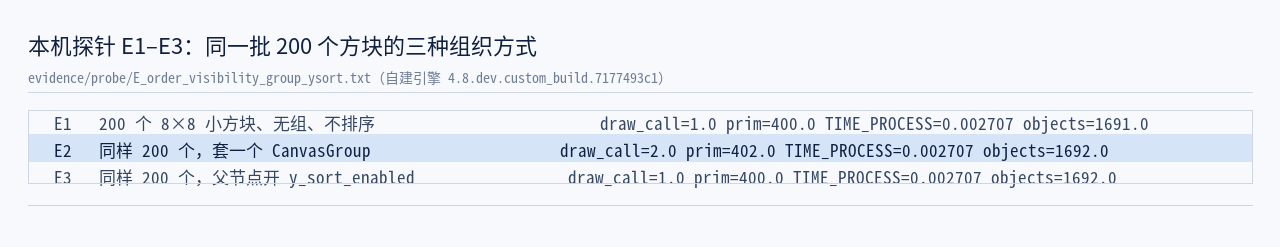
| 例 | 组织方式 | draw call | primitives | objects |
|---|---|---|---|---|
| E1 | 200 个小方块,无组、不排序 | 1 | 400 | 1691 |
| E2 | 同样 200 个,套一个 CanvasGroup | 2 | 402 | 1692 |
| E3 | 同样 200 个,父节点开 y 排序 | 1 | 400 | 1692 |
注意:这张表里藏着本篇的第三处口径纠正:CanvasGroup 并不省 draw call。200 个同材质方块本来就被批成 1 个 draw call,套上组反而变成 2 个(组要多一次背缓冲拷贝)。下一章按「代价」而不是「好处」来讲它。
7.5 为什么交给下游的是链表,不是数组
交接面的形状不是随手定的,三个理由都在源码里留着痕迹:
- 顺序已经编码在链里了。桶汇总做的事就是「把非空桶按 z 从小到大接起来」,接完之后顺序只体现在
next指针上——再转成数组等于把这份信息重新编码一次,纯属浪费。 - 下游是流式消费的。渲染抽象层拿到链头之后顺序读下去即可,它不需要按下标随机访问;而链表天然支持「遍历途中再插一项」(后面讲组与背缓冲时就会用到这个能力)。
- 桶内本来就是链。入桶用的是尾指针追加(
cull.cpp:276–283),所以桶里的项天生就是链表节点;汇总只是把这些小链接成大链,零拷贝。
⇒ 这条接缝一句话就能说清:上游负责「排序」,下游负责「消费」,中间用一条链传递,谁也不多做一次转换。这也是为什么本篇的边界停在 Item 这个类型上——它是两层共用的那一块内存。
本章出处:renderer_canvas_render.h、rendering_server_globals.h、rendering_server_default.h(均为 master 快照 2026-10-08)。本机读数来自探针 E1–E3。
八、CanvasGroup 的隔离要付什么
这一章讲例外二。CanvasGroup 的官方定义只有一句:"Merges several 2D nodes into a single draw operation."——「把若干 2D 节点合并成一次绘制操作」。可它买到的到底是什么、代价落在那儿,要一行行看。先看它在编辑器里是什么样子。
CanvasGroup 在里面只是一个普通节点@ Wikimedia Commons(作者见 image-credits.json;CC BY 4.0,署名要求;原图未改动)注意:这里有一处取图的如实交代:阶段 2 计划里,这一位想找一张「界面上能看清 Fit Margin / Clear Margin / Use Mipmaps」的截图,但整池 OCR 逐张查过之后没有一张能确认这些字段可见(本机也没有可用的 Godot 4 截图环境出图)。所以这一位按 §1.10 的处置办法换成了同类的真实界面图(如实标注为「组在场景树里只是个普通节点」),没有用自绘顶替;那三个字段的语义以正文的源码与官方类参考口径为准。
8.1 组什么时候启用
// renderer_canvas_cull.cpp:471–477(master 快照 2026-10-08)
    } else {
        RendererCanvasRender::Item *canvas_group_from = nullptr;
        bool use_canvas_group = ci->canvas_group != nullptr && (ci->canvas_group->fit_empty || ci->commands != nullptr);
        if (use_canvas_group) {
            int zidx = p_z - RSE::CANVAS_ITEM_Z_MIN;
            canvas_group_from = r_z_last_list[zidx];
        }
依然是惯例,先看第一道判据:组自己得有绘制内容,或者允许「空组也报一份尺寸」(fit_empty)。一个既没有绘制命令、又不允许空组自适应的 CanvasGroup,走的是普通路径——这一条解释了为什么「空的组什么也不做」。
8.2 组的包围盒是算出来的
组的可见区域不是用户设的,是由组内成员并出来的:
// renderer_canvas_cull.cpp:209–221(master 快照 2026-10-08)
            Rect2 rect_accum;
            RendererCanvasRender::Item *c = r_canvas_group_from;
            while (c) {
                if (c == r_canvas_group_from) {
                    rect_accum = c->global_rect_cache;
                } else {
                    rect_accum = rect_accum.merge(c->global_rect_cache);
                }

                c = c->next;
            }
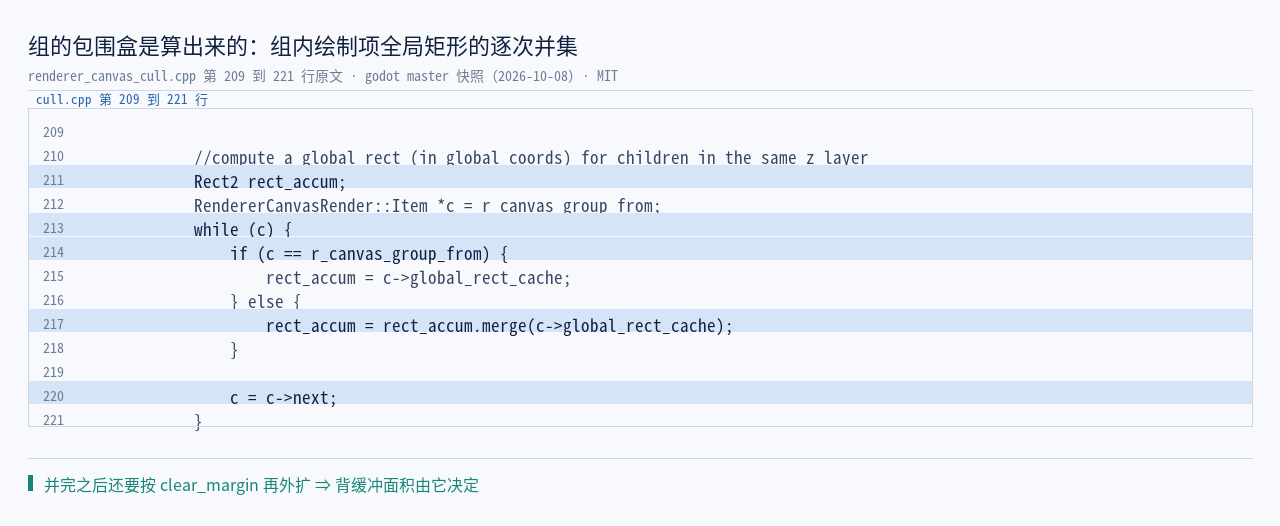
并完之后还要按 clear_margin 再外扩一圈,那是留给滤波与半透明边缘的余量(cull.cpp:243 / :249)。⇒ 组越大、余量越大,占用的背缓冲就越大。官方类参考里的两句提醒正是冲这个来的:fit_margin "increases both the backbuffer area used and the area covered by the CanvasGroup both of which can reduce performance",clear_margin 则相反——"A smaller margin will reduce the area of the backbuffer used which can increase performance"。
8.3 组的 α 与普通父节点的 α 不是一回事
好了,这是本篇最反直觉的一条实测。构造两组对比:都是「两个重叠的红块」,区别只在父节点是普通的 Node2D 还是 CanvasGroup,且父节点的 modulate.a 都设成 0.5。
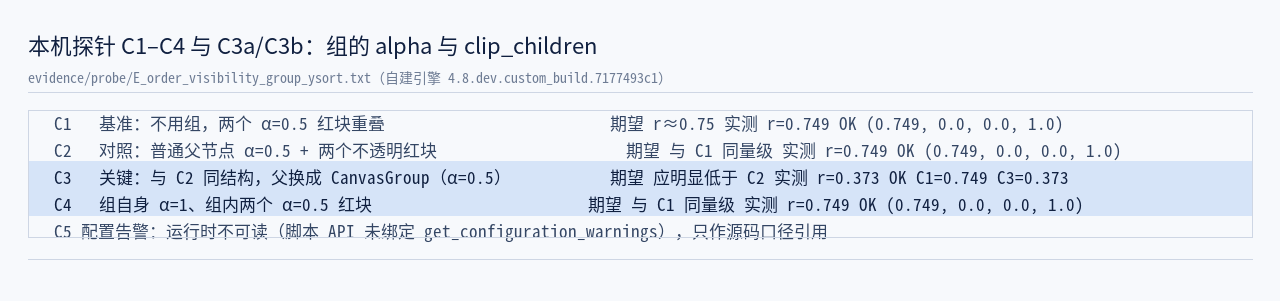
| 例 | 结构 | 中心点红分量 | 说明 |
|---|---|---|---|
| C1 | 不用组,两个 α = 0.5 红块重叠 |
0.749 | 基准 |
| C2 | 普通父节点 α = 0.5,两个不透明红块 |
0.749 | 与 C1 同值 |
| C3 | CanvasGroup α = 0.5,两个不透明红块 |
0.373 | ≈ 0.749 × 0.5 |
| C4 | CanvasGroup α = 1,组内两个 α = 0.5 红块 |
0.749 | 与 C1 同值 |
C2 与 C3 的差别只在「父是普通节点还是组」,结果却从 0.749 掉到 0.373。⇒ 组的 α 施加在「组内已经合成好的结果」之上再作用一次:子项先按继承来的 α 合成到背缓冲(得到 0.749),组主再把这份结果整体贴回父画布(再乘 0.5)。
这说明「整体合成」是真的:C4 里组自身 α 为 1 时,组内合成与无组完全一致(都是 0.749);一旦组自身要半透明,那一次透明就落在整份结果上,而不是落在每个子项上。注意:这也是本篇要改的口径——社区常说「组会合并 draw call」,本机读数(E2)恰恰相反:它买到的是「一次整体合成」,不是省 draw call。
8.4 clip_children 在组内会失效
同一批探针里还有一组对照:一个 20×20 的遮罩节点开 clip_children,它下面挂一个 120×120 的子项。
| 例 | 结构 | 遮罩外的采样点 |
|---|---|---|
| C3a | 组外,遮罩开 CLIP_CHILDREN_AND_DRAW |
背景色(被裁掉了) |
| C3b | 同样结构放进 CanvasGroup | 蓝(120×120 的子项整块露出来) |
⇒ clip_children 在组外生效、在组内失效。这不是实现漏洞,而是背缓冲只有一份的必然结果,源码里那条注释把话说明白了:
// renderer_canvas_cull.cpp:254–256(master 快照 2026-10-08)
            // Very important that this is cleared after used in RendererCanvasRender to avoid
            // potential crashes.
            r_canvas_group_from->canvas_group_owner = ci;
8.5 两条「不会正常工作」的告警
再看两条告警。CanvasGroup 节点自己会报两条配置告警:
// scene/2d/canvas_group.cpp:78–88(master 快照 2026-10-08)
            if (!warned_about_ancestor_clipping && as_canvas_item && as_canvas_item->get_clip_children_mode() != CLIP_CHILDREN_DISABLED) {
                warnings.push_back(vformat(RTR("Ancestor \"%s\" clips its children, so this CanvasGroup will not function properly."), as_canvas_item->get_name()));
                warned_about_ancestor_clipping = true;
            }

            CanvasGroup *as_canvas_group = Object::cast_to<CanvasGroup>(n);
            if (!warned_about_canvasgroup_ancestor && as_canvas_group) {
                warnings.push_back(vformat(RTR("Ancestor \"%s\" is a CanvasGroup, so this CanvasGroup will not function properly."), as_canvas_group->get_name()));
                warned_about_canvasgroup_ancestor = true;
            }
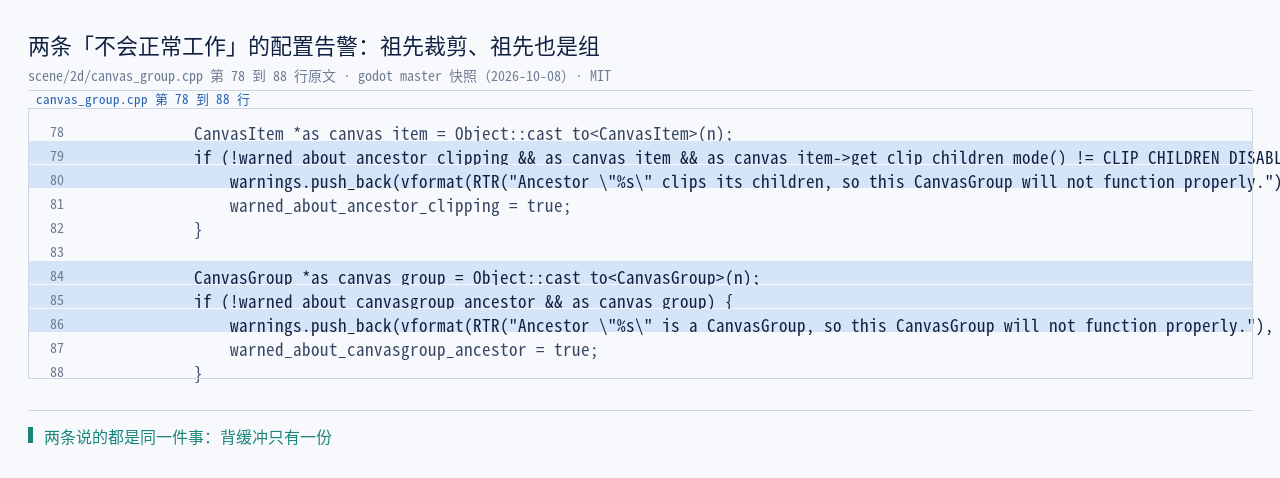
两条告警与官方类参考那句 "Since CanvasGroup and CanvasItem.clip_children both utilize the backbuffer... will not function correctly" 指的是同一件事:背缓冲只有一份。
注意:一处负结果要如实记下:这两条告警在运行时读不到。本篇探针原本想直接读出告警字符串,实测报 Nonexistent function 'get_configuration_warnings' ——该虚函数没有绑定到脚本 API,只有编辑器会去调它。所以这一节的口径只作源码引用,不声称「本机验过告警」。
8.6 组的节点侧默认值
最后补两条节点侧的事实:CanvasGroup 构造时把 fit_margin 设成 10 px(canvas_group.cpp:119),并且它实际下发的是透明模式加空组自适应——CANVAS_GROUP_MODE_TRANSPARENT 配 fit_empty = true(canvas_group.cpp:40 / :53 / :64),析构时再关成 CANVAS_GROUP_MODE_DISABLED(:122)。枚举里一共四种模式(rendering_server_enums.h:847–851):DISABLED / CLIP_ONLY / CLIP_AND_DRAW / TRANSPARENT,而 CanvasGroup 节点只用了最后一种。
8.7 按代价推出来的四条使用建议
把前面六小节的结论换算成可执行的建议,四条都是从代价推出来的,不是手感:
- 只在「需要整体施加效果」时用组。组的价值是一次整体合成(C3 的 0.373 就是它的指纹),而不是省 draw call(E2 实测 1 → 2)。如果只是想省绘制开销,组不是工具。
- 余量按需要给,别按习惯给。
fit_margin与clear_margin默认都是 10 px,它们直接决定背缓冲多大;官方类参考的原话是fit_margin"should be kept as small as possible"。 - 组内不要再开
clip_children。两条机制抢同一份背缓冲,实测结果是组内那一侧的裁剪彻底失效(C3a 对 C3b)。 - 不要嵌套组、也不要把组放进开了裁剪的祖先里。这两种情况节点自己会报配置告警——虽然那两条告警在运行时读不到,但编辑器里看得到。
注意:补一句关于第 4 条的口径:本篇没有用探针验证「告警会不会出现」,因为实测发现那个查询函数没有绑定到脚本 API(get_configuration_warnings() 报 Nonexistent function)。所以这一条的依据是源码里的告警分支,不是本机实测——证据层级要说清。
本章出处:canvas_group.cpp(master 快照 2026-10-08);组的立项动机见官方 2020 年那篇 4.0 二维引擎改进公告。本机读数来自探针 C1–C4 与 C3a/C3b。
九、收官:这套剔除与排序买到什么、代价是什么
OK,把九个章节的东西压成一张图,再看两处我们纠正过的旧印象。这一章不再引入新机制,只做三件事:把可量化的结论收拢成三条,把过程中纠正过的旧印象摆出来,以及把这条链往下交棒的位置指清楚。
9.1 三条量化结论
- 顺序零比较:8193 个桶、每帧 ≈128 KiB 清零、每项入桶 O(1)、汇总扫一遍 8193 个槽位——排序比较次数是 0。代价是 z 必须有硬边界(
-4096到4096),因为没有边界就没有下标。 - 剔除是五道闸门,四道连坐整棵子树:
visible、可见层、累计 alpha 小于 0.007、裁剪退化,四条都在递归之前return;第五条(矩形相交)只管自己。 CanvasGroup买到的是整体合成,不是省 draw call:本机 200 个方块,无组 1 个 draw call、套组 2 个;组内合成的 α 施加位置与普通父节点不同(0.373 对 0.749)。
9.2 两处旧印象纠正
- 「2D 剔除也有视锥剔除」——错。 本篇 165 处落点里没有任何相机视锥;几何判据只有视口裁剪矩形与包围盒的相交测试。2D 的「画什么」靠的是可见层掩码、透明度与矩形相交这三类判据。
- 「层内绘制序号就是
layer、或者就是场景树里的位置」——错。 层内序号是三套来源:CanvasLayer下的项取该层的发号器(return sort_index++)、其余项取视口的 GUI 发号器、需要改序的普通节点才用自己的树序。
还有一条口径值得留在结尾:本机的三条反直觉读数(组内 clip_children 失效、组的 α 二次作用、可见层必须整条链匹配)都来自 4.8.dev.custom_build.7177493c1 这个自定义构建,而源码行号取自 master 快照 2026-10-08。两者已漂移且漂移量逐文件不同,所以本文从不把本机行号当快照行号用,也不做算术平移。
9.3 这一层之后,链交给谁
剔除器的出口是一条链,下游接住它的是画布渲染抽象层。从 2020 年 4.0 的 2D 大改(CanvasGroup 就是那一批加的),到 2022 年前后 2D 光照与批处理的调整,再到 2023 年 4.2 对 TileMap y 排序性能的修补(GH-73813),这条链的形状一直在动,但「先剔完整棵、再把桶串成一条链」这个骨架没动过——它就是我们这一篇留下来的东西。
9.4 一条时间线:2D 剔除与排序被改过的几次
下面进入时间线:把散在各章的年份收拢起来,这条链的演进大致是这样(年份口径:以官方博客或发行说明的发布年为准,不按提交时间):
| 年份 | 变化 | 与本篇的关系 |
|---|---|---|
| 2020 | 官方博客宣布 4.0 的 2D 大改:新增 CanvasGroup、clip children |
第八章那个「整体合成」机制的来历 |
| 2020 | 同一篇里 2D 光照改为单 pass,并给出可见上限(屏幕内 256 盏灯、每节点 16 盏) | 剔除的「按掩码选谁受光」是同一套位域思路 |
| 2021 | 官方批处理文档给出把画家序打碎的三种原因(换纹理、换材质、换图元类型) | 下一篇的入口 |
| 2022 | 4.0 正式版与 4.2 开发期,y 排序在大图块地图上的开销问题被持续报告 | 第五章 §5.5 的前后景 |
| 2023 | 4.2 修补 y 排序在 TileMap 上的性能(GH-73813) | 「y 排序便宜」是被修出来的 |
| 2024 | 4.3 引入无环渲染图与 GPU 同步(官方博客) | 第七篇的题目,本篇只到「交给下游一条链」 |
| 2026 | 本篇使用的 master 快照(2026-10-08)与自建引擎(7177493,2026-07-03) |
所有行号与读数的时点 |
⇒ 时间线给出的结论是:这条链的骨架(先剔完整棵、再把桶串成一条链)从 4.0 到 4.6 没有变过,被反复调整的是外围——y 排序的性能、后端的批处理、设备层的同步方式。
回头看,这套设计的原理可以概括成一句,其中:结构承担了顺序,判据集中在了一处。
本章出处:时间线的依据依次是官方 2020 年 4.0 二维引擎改进公告、官方 3.x 批处理文档(画家序被打碎的三种原因)、4.2 开发快照发行说明与 4.2 beta 1 发行说明,以及官方 4.3 GPU 同步与无环渲染图那篇。另外两条社区线索只作前后景:论坛那条「同 z 看树序」的问答与那份 4.7 上的 y 排序断言套件。
9.5 术语对照
本篇出现的主要术语,中英并列,便于对照源码:
| 中文 | English | 在本篇指什么 |
|---|---|---|
| 剔除 | culling | 决定「画什么」的那一层(本篇) |
| 剔除器 | canvas culler | RendererCanvasCull 这个实现类 |
| 可见层 | visibility layer | CanvasItem 上的 32 位位域 |
| 剔除掩码 | canvas cull mask | 视口上与可见层按位与的那个位域 |
| 绘制序号 | draw index | 决定的层内先后,来源有三套 |
| z 桶 | z bucket | 按绝对 z 分箱的那 8193 个槽位 |
| 拍平 | flatten | y 排序前把子树摊成一维数组 |
| 背缓冲 | backbuffer | CanvasGroup 与 clip_children 争抢的那份缓冲 |
| 画布层 | canvas layer | CanvasLayer,层与层之间比 layer |
相关链接与出处
本站与后续篇目:上一篇 服务层接口:RenderingServer 为什么是一组 RID 型命令;下一篇(第五篇)是画布渲染抽象:RendererCanvasRender 与一次绘制的中间表示——那条链交下去之后,绘制项里到底存了什么;本系列 T02《Godot 4 引擎架构》全 11 篇(一次 2D 绘制的四层落点)的目录见技术博客页。
出处与文档:正文引用的源码是 godotengine/godot master 快照(2026-10-08)原文,许可 MIT,核对脚本与输出现已随本篇归档;本机探针输出见 evidence/probe/E_order_visibility_group_ysort.txt(A–E 五组 21 条用例,一次窗口运行跑完)。官方文档:Canvas layers、CanvasItem、CanvasLayer、CanvasGroup、Viewport。
With Best Wishes.