站点链接:技术博客页
本文是《实时光线追踪与混合渲染》系列第十二篇。全系列目录:ep01 画了光栅与光追的分界线,ep02-03 讲加速结构的构建与动态更新,ep04 拆解 Hit Shaders 与 SBT 组织,ep05 串联混合管线,ep06-07 覆盖时域降噪,ep08 讲 ReSTIR 采样,ep09 做光线预算分配,ep10-11 讨论 RT 资源的生命周期与流式加载。本篇接续 ep09 的预算视角,聚焦透明、体积和 SSS 三个"亏损区"。本文不涉及离线渲染器的透明/体积方案(如 Arnold 的 ray march、RenderMan 的 volumetric baking),所有性能数据和工程取舍均以实时渲染(≤16.6ms 帧预算)为前提。
为什么透明是光追的"利润黑洞"
在前面的十一篇里,我们花了大量篇幅讨论加速结构的构建与压缩、降噪器的时域复用、ReSTIR 的采样策略、光线预算的分配。这些话题有一个共同的前提:光线打到一个不透明表面,反弹一次或几次,然后返回相机。但真实场景里充斥着不满足这个假设的物体——玻璃窗、水面、树叶、火焰、雾气、皮肤。它们要么让光线穿过(透明/半透明),要么让光线在介质内部散射(体积),要么让光线进入表面下方后再渗出来(次表面散射)。
这些效果在光栅管线里已经有成熟的近似方案——alpha blending、froxel volumetric fog、屏幕空间 SSS blur。问题是,当我们把光线追踪引入混合管线后,这些效果突然变成了"利润黑洞":每像素需要的光线数成倍增加,而视觉收益却呈非线性递减。一位 UE 开发者在论坛上反馈,光追半透明在 Stat GPU 里显示约 8ms UE Forum,几乎吃掉了一帧 16.6ms 预算的一半。NVIDIA 在 Indiana Jones 中的实测数据更直观:alpha 测试对象(植被、铁丝网)的光追 GPU 时间从 7.90ms 降到 3.58ms,靠的是 Opacity Micromap 硬件加速 NVIDIA Indiana Jones Blog——也就是说,在 OMM 出现之前,仅"叶子上的透明"一项就花掉了将近 8ms。
这张图把两组数据放在一起:左边是 UE Forum 开发者反馈的光追半透明代价(约 8ms),右边是 NVIDIA 在 Indiana Jones 中用 OMM 优化前后的 alpha 测试对象 GPU 时间(7.90ms → 3.58ms)。两组数据指向同一个事实——透明效果在光追管线里的代价远超直觉。
问题的根源在于:不透明表面只需要一条光线就能确定像素颜色,而透明效果需要光线穿过表面继续前进,每穿过一层就多一次 BVH 遍历、多一次着色器调用。如果场景中有 N 层半透明表面,光线追踪在最坏情况下需要 N 倍的计算量。体积渲染更极端:沿光线方向每一步采样都需要积分消光和散射,一个 128 步的 ray march 相当于 128 次 BVH 遍历的开销。用公式表达:
$$ \text{Cost}_{\text{transparent}} = N \times \text{Cost}_{\text{opaque}}, \quad \text{Cost}_{\text{volume}} = M_{\text{step}} \times \text{Cost}_{\text{opaque}} $$
其中 $N$ 是透明层数,$M_{\text{step}}$ 是 ray march 步数。当 $N = 8$、$M_{\text{step}} = 128$ 时,透明和体积的代价分别是不透明表面的 8 倍和 128 倍。
// 不透明:1 条光线 → 1 次 BVH 遍历 → 1 次着色
traceRay(scene, ray); // 1x

// 透明(8 层):最坏 8 条光线 → 8 次遍历 → 8 次着色
for (int layer = 0; layer < N; ++layer)
    traceRay(scene, ray); // 8x

// 体积(128 步):128 次采样 → 128 次密度查询 + 光照
for (int step = 0; step < 128; ++step)
    integrate(sample(scene, ray, step)); // 128x
说白了,这些效果之所以"最难盈利",是因为它们打破了光追管线的基本假设——"一条光线 = 一次 BVH 遍历 = 一次着色"。透明让一条光线变成 N 条,体积让一条光线变成 128 次采样,SSS 让一条光线变成 16-64 次反弹。而每多一次遍历、每多一次采样,都需要从光线预算里扣钱。
OK,言归正传。下面我们从透明渲染的基础工具箱出发,逐层拆解光追管线下这些效果为什么"最难盈利",以及业界目前给出的工程解法。和前面的篇章一样,每条结论都会落到"代价换到了哪里"——显存、带宽、CPU、还是画质。
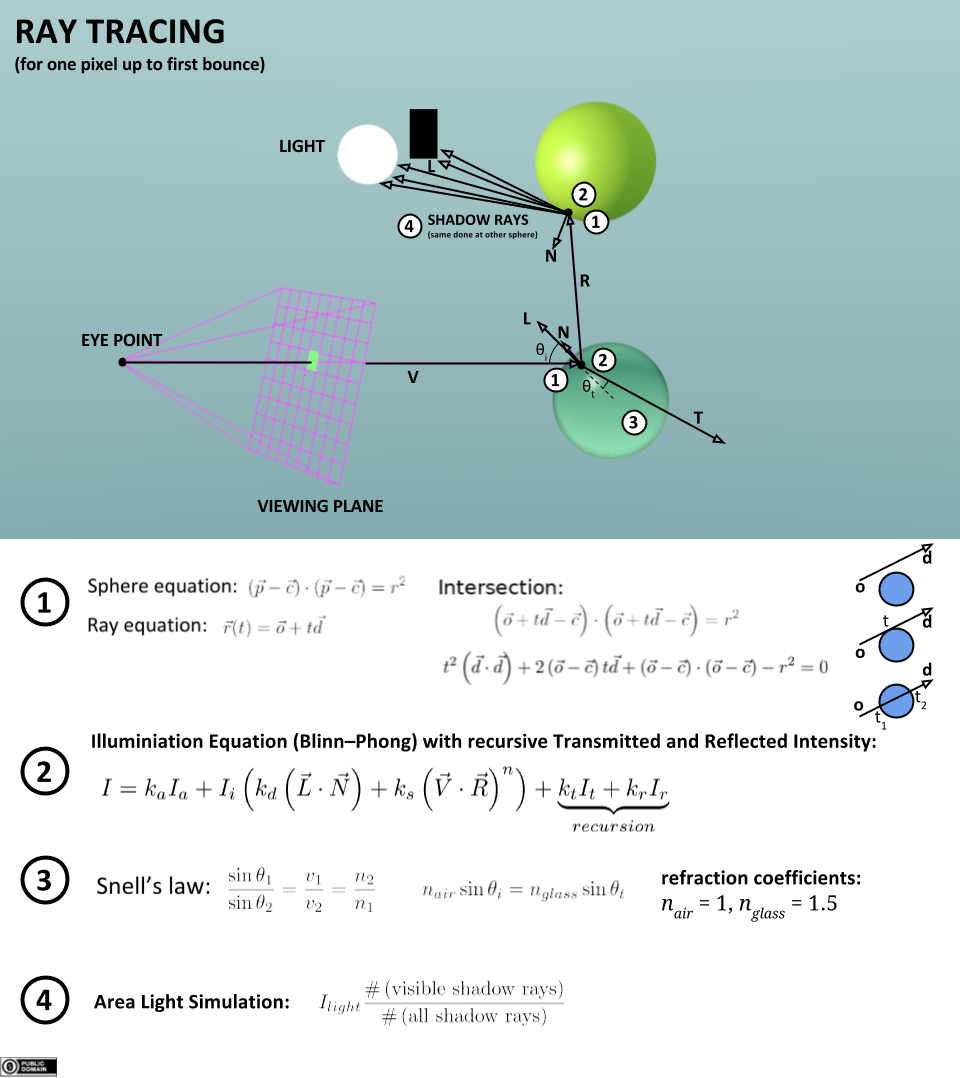
这张图展示了光线追踪的基本原理——从相机出发的射线穿过像素网格,在场景中与物体相交并反弹。对于不透明表面,一条光线打到表面就返回了;但对于透明表面,光线需要穿过表面继续前进,这就是"利润黑洞"的起点。
在深入光追之前,先把光栅化时代的透明工具箱摊开看——理解了它们的局限,才能理解光追为何被寄予厚望。
一、透明渲染的基础工具箱
1.1 Alpha 合成与混合操作符
透明渲染的核心是 alpha 合成(Alpha Compositing)——把半透明前景与不透明背景混合成最终像素颜色。这个操作由两个基础操作符组成:OVER 和 UNDER。
OVER 操作符(back-to-front):先画背景,再从后往前逐层叠加前景。对于前景色 $C_f$ 和 alpha 值 $\alpha_f$,背景色 $C_b$:
$$ C_{out} = C_f \cdot \alpha_f + C_b \cdot (1 - \alpha_f) $$
其中: - $C_{out}$ 是合成后的输出颜色。 - $C_f$ 是前景色,$\alpha_f$ 是前景的不透明度(1.0 = 完全不透明,0.0 = 完全透明)。 - $C_b$ 是背景色,$(1 - \alpha_f)$ 是背景的透过率。
UNDER 操作符(front-to-back):从前往后画,先画前景再叠加背景。公式形式相同,但累积方式不同——UNDER 在遍历完所有层后做一次合成,而非每层都做。
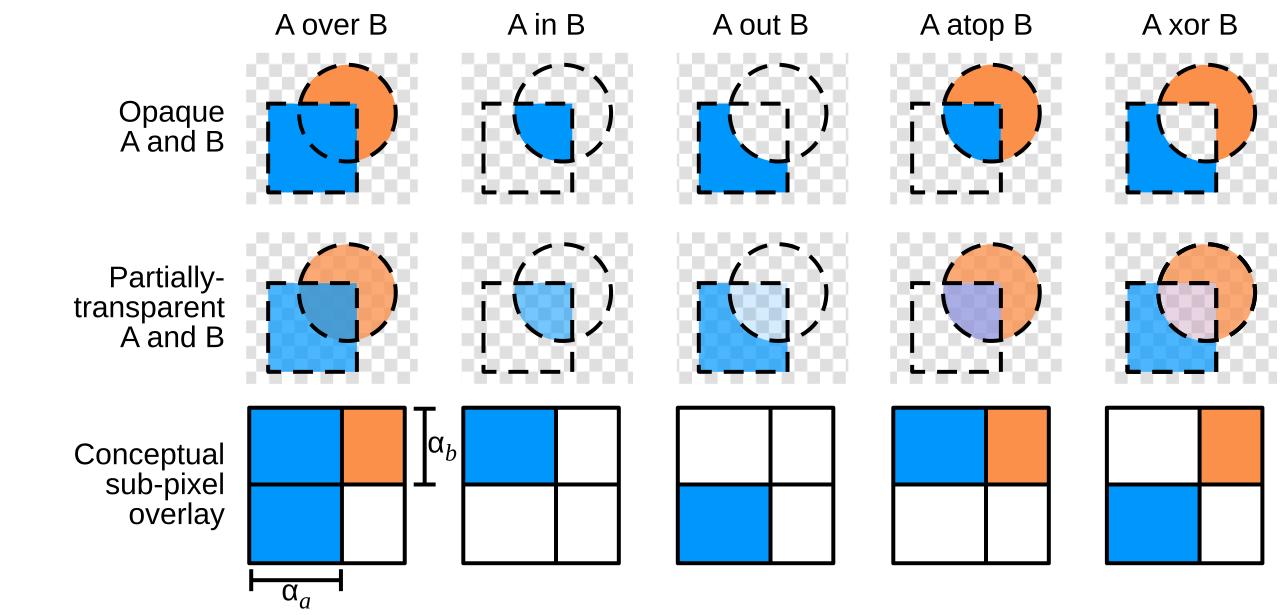
上图是 Wikimedia Commons 上的 alpha 合成示意 Alpha Compositing,展示了 OVER 操作符的混合过程:前景色的 alpha 决定了它对最终像素的贡献比例,剩余部分由背景色填充。这个看似简单的公式有一个致命的工程约束——它是顺序依赖的。

顺序依赖性是透明渲染一切麻烦的起点,下面进入顺序依赖性的分析。
1.2 顺序依赖性问题
OVER 操作符要求严格按从后到前的顺序绘制。如果顺序错了,结果就错了——半透明红色画在半透明绿色前面,和绿色画在红色前面,出来的颜色不同。这就是"顺序依赖性"(Order Dependence)。
在光栅化管线里,这个问题用两步解决:先用 Z-pre-pass 排好不透明物体的深度,再对半透明物体按距离排序后绘制。但排序是 O(N log N) 的 CPU 操作,而且当半透明物体互相穿插时(比如两个交叠的玻璃杯),任何排序都无法保证正确。这就是为什么业界花了二十年研究顺序无关透明(OIT)——我们稍后在第二节展开。
流程图对比了两种操作符的执行路径。OVER 在每一层都做一次混合(读写颜色缓冲),UNDER 则在前向遍历时累积颜色和透射率,最后一次合成。UNDER 的优势在于可以做"提前剔除"(Early Termination)——当累积的 alpha 达到 1.0 时,后面的层不再贡献,可以跳过。这个优化在植被渲染中非常有效——一排树叶中,前几层就把 alpha 累积到接近 1,后面被遮挡的叶子直接跳过。
好了,顺序依赖性的根源清楚了,下面进入工程优化环节。
1.3 Pre-multiplied alpha 与 DISCARD 优化
NVIDIA 的透明渲染指南 NVIDIA Transparency 介绍了两个常用的工程优化:
预乘 alpha(Pre-multiplied Alpha):在纹理加载时就把 RGB 通道乘以 alpha,这样 OVER 公式简化为 $C_{out} = C_f + C_b \cdot (1 - \alpha_f)$,省去运行时一次乘法。更重要的是,预乘 alpha 天然支持 additive blending($\alpha = 0$ 时颜色仍有贡献),适合粒子效果。
DISCARD 优化:在像素着色器中用 discard(HLSL)或 clip()(GLSL)丢弃 alpha 低于阈值的片元。这样虽然破坏了深度缓冲的早裁剪(Early-Z),但避免了半透明混合对不透明物体的干扰。在光栅管线里,alpha test 就是 DISCARD 的标准实现——纹理 alpha < 0.5 的像素直接丢弃,按不透明物体处理。
典型的 alpha test 着色器代码如下:
//-----------------------------------【Alpha Test (HLSL)】---------------------------------------
// 描述:光栅化管线中的alpha test,低于阈值的片元被丢弃
//------------------------------------------------------------------------------------------
//【1】采样baseColor纹理
//【2】提取alpha通道
//【3】alpha < 阈值 → discard,该片元不写入帧缓冲
//【4】alpha >= 阈值 → 继续正常着色
float4 baseColor = baseColorTexture.Sample(sampler, uv);
//【2】
if (baseColor.a < alphaCutoff) {
    //【3】
    discard;
}
//【4】继续不透明着色管线
下面对这段代码特别说明:discard 会禁用 Early-Z 优化——GPU 无法在该像素上做深度提前裁剪,因为着色器需要执行后才知道片元是否被丢弃。这是光栅化 alpha test 的隐性代价。在光追管线中,对应的机制是 any-hit shader——我们在第三节详细展开。
NVIDIA 的透明渲染指南还介绍了两个更高级的优化方案:
Reduced Rate Blending(半分辨率混合):把半透明物体渲染到半分辨率缓冲,再 upscale 回全分辨率。代价是半透明边缘的画质损失(边缘像素只有一半的采样密度),但带宽节省 75%。在 4K 分辨率下这个优化尤其有效——半透明通常是大面积低频效果(雾、玻璃),半分辨率的画质损失几乎不可见。
Transmittance Thresholding:当累积透射率 $T$ 低于某个阈值(如 0.01)时,后续层的贡献可以忽略不计——因为 $T = 0.01$ 意味着只有 1% 的背景光能透过,再加更多层也不会有明显差异。这个优化在植被渲染中非常有效——前几层树叶就累积到 $T < 0.01$,后面的叶子直接跳过。
好了,基础工具箱就介绍到这里。下面进入 OIT 方案谱系——这是理解光追透明为什么"难盈利"的背景知识。
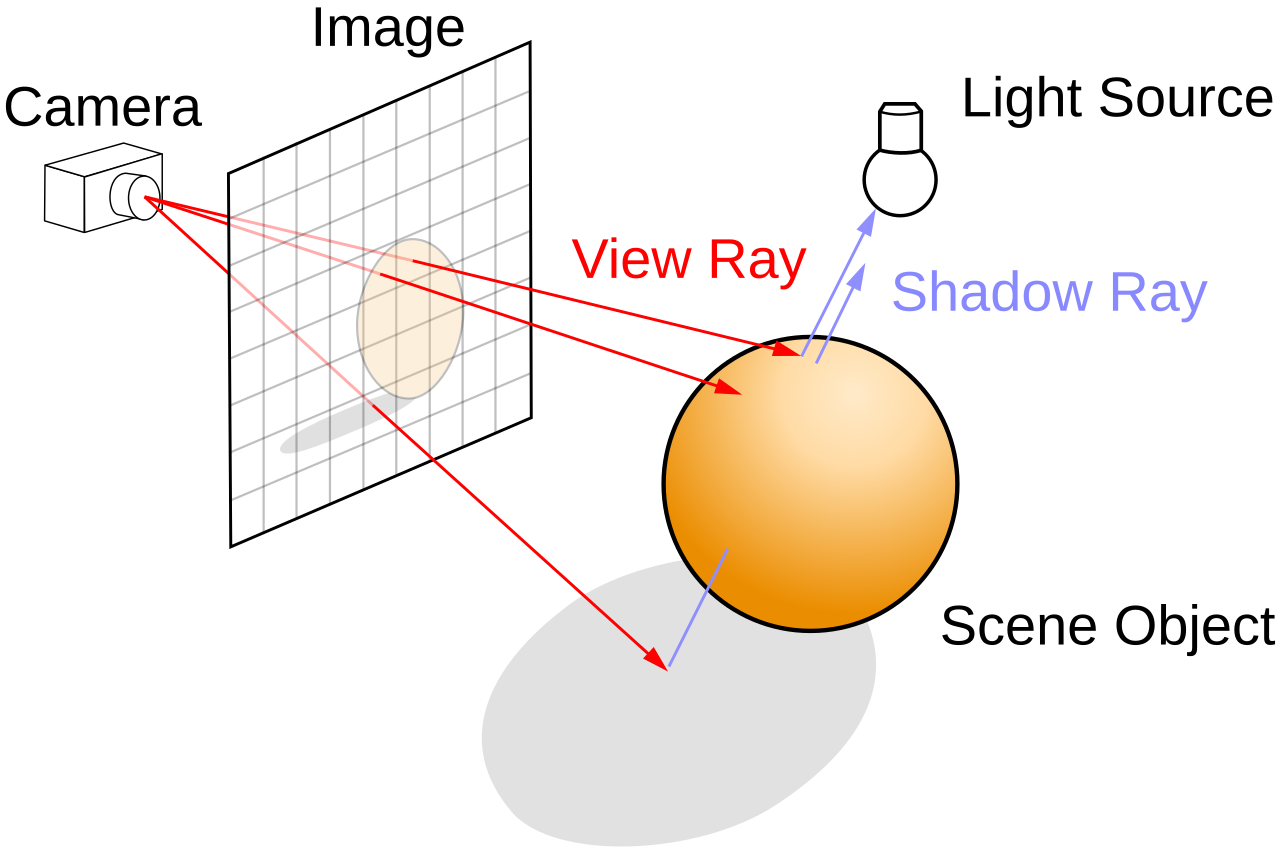
上面是 Wikimedia Commons 上经典的光线追踪示意图 Ray Trace Diagram。光追管线的优势在于:它天然处理反射和折射——光线碰到透明表面后可以分裂成反射光线和折射光线,递归追踪。但这也意味着每层透明表面都引入分支,光线数量指数级增长。

光追虽好,但光栅化时代积累的 OIT 方案谱系依然是实时渲染的主力——先看看这些方案的天花板在哪里。
二、光栅化 OIT 方案谱系
2.1 为什么需要顺序无关透明
顺序依赖性是光栅化半透明渲染的根本痛点。当场景中有大量半透明物体互相穿插时,CPU 排序既不正确也不高效。顺序无关透明(Order-Independent Transparency,OIT)的目标是:无论绘制顺序如何,结果都正确。
OIT 方案可以分为两大类:精确方案(结果与顺序无关且物理正确)和近似方案(结果与顺序无关但有误差)。AVBOIT 在 SIGGRAPH 2025 AVBOIT SIG2025 的课程中对所有方案做了系统梳理,下面我们按这个分类逐一拆解。
OIT 的发展脉络本身就反映了实时渲染"在精度和性能之间反复拉锯"的历史。2001 年 Everitt 提出深度剥离时,GPU 还没有 MRT(Multiple Render Targets)支持,每层需要一个完整的 pass。2010 年前后 A-buffer 方案在 GDC 上被多次讨论,但内存不可预测的问题始终没有好的工程解。2013 年 McGuire 和 Bavoil 发表 WBOIT,第一次把 OIT 的代价压到 1.2x 以内——这是一个里程碑,因为它让 OIT 在 60fps 预算下变得可用。2014 年 MLAB 把内存固定化,2017 年 Moment-based OIT 用信号处理的思路把精度和内存的权衡空间又扩大了一档。这条演进线的方向很清晰:从"精确但贵"走向"近似但便宜",每一步近似都在赌"人眼看不出差异"。
这张图展示了 alpha blending 的基本效果:两个半透明三角形叠加时,颜色根据 alpha 值混合。这正是 OIT 要解决的问题——如果绘制顺序改变,叠加结果也会不同。OIT 的目标就是消除这种顺序依赖。
先从精确方案看起,理解了"贵在哪里",才能体会后面近似方案的价值。
2.2 精确方案:深度剥离与 A-buffer
深度剥离(Depth Peeling)[Everitt 2001]:每"剥"一层,记录该层所有像素的最小深度,下一遍只画比这层更远的像素。N 层半透明需要 N 个 pass,每个 pass 一次全屏渲染。性能开销是 $O(N \times \text{fragment count})$,在 1080p 下 8 层剥离就是 8 次全屏绘制。
深度剥离的核心公式是逐层最小深度选择:
$$ d_i(p) = \min \{ d(p') : d(p') > d_{i-1}(p) \} $$
其中: - $d_i(p)$ 是像素 $p$ 在第 $i$ 层的深度。 - $d_{i-1}(p)$ 是上一层的深度,作为本轮的深度下界。 - 每层只保留比上一层更远的最近片元。
深度剥离的伪代码如下:
//-----------------------------------【Depth Peeling】---------------------------------------
// 描述:N层深度剥离,每层剥去最前表面
//------------------------------------------------------------------------------------------
//【1】第0层:正常渲染,记录最小深度
//【2】第i层:只渲染深度 > d_{i-1} 的片元,记录最小深度
//【3】合成:按back-to-front顺序混合N层颜色
//【1】
renderScene(depthBuffer_0);
//【2】
for (int i = 1; i < N; ++i) {
    setDepthTest(GREATER_THAN, depthBuffer_{i-1});
    renderScene(depthBuffer_i);
}
//【3】
compositeLayers(colorBuffer_0..N);
下面对这段代码特别说明:深度剥离的 pass 数与层数线性增长——8 层透明需要 9 次 full-screen rendering pass。完整实现见 LucidRaster 2024 论文的 Section 4。
示意图展示了深度剥离的迭代过程:每个 pass 先读上一层的深度缓冲,只渲染比上一层更远的片元,同时写本层的深度。N 层半透明需要 N+1 个 pass(N 个剥离 pass + 1 个合成 pass)。深度剥离的问题是 pass 数与层数线性增长——8 层透明就要 9 次全屏渲染,在 4K 分辨率下几乎不可用。
A-buffer / K-buffer:用每个像素一个链表存储所有半透明片元,最后按深度排序合成。问题是内存不可预测——一个像素可能叠了 50 层树叶,另一个像素只有 1 层。LucidRaster 论文 LucidRaster 2024 给出的实测数据是:4 层 MLAB(一种内存受限的 A-buffer 变体)比硬件 alpha blending 慢 4.75 倍。
2.3 近似方案:Weighted Blended OIT
Weighted Blended OIT(WBOIT)McGuire & Bavoil 2013, JCGT:通过修改合成操作符使其与顺序无关。核心思想是用一个随深度递减的权重函数对颜色加权,再用加法混合累积。单个 geometry pass 即可完成,无需排序。
WBOIT 的权重函数定义如下:
$$ w(z, \alpha) = \frac{\alpha}{\max(\epsilon, \alpha) \cdot (z_0 + z_1 \cdot z)} $$
其中: - $z$ 是片元的线性深度(view-space distance)。 - $\alpha$ 是片元的不透明度。 - $z_0$ 和 $z_1$ 是可调参数,控制近处和远处片元的权重衰减速度。 - $\epsilon$ 是防止除零的小常数(通常取 0.00001)。
图中是 WBOIT 的 MRT 流程。它需要 3 个 Render Target:RT0 存 $C \cdot w(\alpha, z)$(颜色乘权重),RT1 存 $\alpha \cdot w(\alpha, z)$(alpha 乘权重),RT2 存透射率累积 $\prod (1 - \alpha_i)$。最后在合成 pass 中用加法混合的结果除以权重和,得到近似正确的混合颜色。WBOIT 的关键是所有 RT 都用加法混合(GL_BLEND_FUNC 设为 additive),因此绘制顺序无关。
WBOIT 的代价是"近似正确"——它无法处理颜色突变(比如半透明红绿色交替),但对于烟雾、玻璃等渐变场景效果足够好。McGuire 在原始论文中报告:比硬件 alpha blending 仅慢约 20%。

不同着色器的渲染成本差异巨大:不透明金属只需一次 BRDF 求值,玻璃需要折射+反射+色散,肥皂泡需要薄膜干涉。OIT 方案的选择直接决定了这些着色器能否正确叠加——WBOIT 能处理烟雾但无法正确渲染玻璃叠玻璃,精确 OIT 可以但代价是 10 倍。依然是先来看看性能数据的横向对比,再继续展开近似方案。
2.4 性能横向对比
LucidRaster 论文给出了目前最完整的 OIT 方案性能基准数据:
| 方案 | 相对耗时(alpha blending = 1.00x) | 内存/像素 | 精确性 |
|---|---|---|---|
| 硬件 alpha blending | 1.00x | 0 | 顺序依赖 |
| Weighted Blended OIT | 1.17x | 3 RT | 近似 |
| MLAB 2 层 | 2.78x | 2 层 | 近似 |
| Moment-based OIT 4 矩 | 2.64x | 4 float | 近似 |
| MLAB 4 层 | 4.75x | 4 层 | 近似 |
| 精确 OIT | ~10x | 链表 | 精确 |
柱状图把六种方案的相对耗时可视化。数据来源是 LucidRaster 论文的性能基准表,测试平台为 1080p 分辨率。关键结论:WBOIT 是唯一代价低于 1.2x 的方案,而精确 OIT 的代价是 alpha blending 的 10 倍。这意味着在 60fps 预算下,精确 OIT 几乎不可用——16.6ms 的帧预算里,仅透明渲染就要吃掉 5-8ms。
MLAB(Multi-Layer Alpha Blending)[Salvi & Vaidyanathan 2014]:对 A-buffer 做内存受限的改进——固定存储 K 层片元(通常 2-4 层),当超过 K 层时用一个"合并"操作把最远的两层混合成一层。这牺牲了精度(合并引入误差),但换来了可预测的内存(每像素 K 层 × 片元大小)。LucidRaster 的数据显示 MLAB 2 层比 alpha blending 慢 2.78 倍,4 层慢 4.75 倍——代价随层数线性增长。
Moment-based OIT[Münstermann et al. 2017]:用前 M 阶矩(通常 4 阶或 6 阶)近似透射率函数 $T(z)$,而不是逐层存储。矩展开是信号处理中的经典技巧——用有限个矩恢复一个分布函数的近似。4 矩方案的代价是 2.64 倍 alpha blending,介于 MLAB-2 和 MLAB-4 之间,但精度不同——矩方案在平滑透射率变化时表现好,在突变场景(如半透明棋盘格)下会出现颜色泄漏。
矩方案的核心数学原理如下。定义归一化深度 $z \in [0,1]$,透射率函数 $T(z)$ 描述在深度 $z$ 处的累积透射率。Moment-based OIT 存储前 $M$ 阶矩:
$$ b_k = \int_0^1 z^k \cdot (-T'(z)) \, dz, \quad k = 0, 1, \ldots, M-1 $$
其中 $-T'(z)$ 是透射率的负导数,物理含义是"在深度 $z$ 处被消光的概率密度"。$b_0$ 恰好等于 $1 - T(1)$(总消光比例)。在 GPU 实现中,每像素存储 $M$ 个 float(4 矩方案 = 16 bytes),用 additive blending 累积——因此也是顺序无关的。
重建透射率时,4 矩方案使用 Chebyshev 多项式构造一个分段常数近似 $\tilde{T}(z)$。关键公式是求解一个 $M/2$ 次的多项式,使其在透射率为 0 和 1 之间取值。具体地,4 矩方案需要解一个二次方程来找到透射率从 1 降到 0 的两个"过渡点":
//-----------------------------------【Moment-based OIT Resolve】-----------------------------
// 描述:从4个矩重建透射率函数T(z),做最终合成
//----------------------------------------------------------------------------------------------
//【1】从G-buffer读取4个矩 b0, b1, b2, b3
//【2】计算归一化矩和功率矩
//【3】解二次方程找到两个过渡点 z0, z1
//【4】用过渡点构造分段常数透射率近似
//【5】合成颜色:sum(C_i * alpha_i * T(z_i)) + T(1) * backgroundColor
//【1】
float4 moments = momentsTexture.Load(pixel);
float b0 = moments.x, b1 = moments.y, b2 = moments.z, b3 = moments.w;
//【2】
float2 z = solvePolynomial(b0, b1, b2, b3); // 解二次方程
//【3】
float T_at_z0 = computeTransmittance(z.x, moments);
float T_at_z1 = computeTransmittance(z.y, moments);
//【4】
float T_final = 1.0 - b0; // b0 = 1 - T(1)
//【5】
float3 finalColor = accumulatedColor * T_at_z0 + backgroundColor * T_final;
下面对这段代码特别说明:solvePolynomial 是矩方案的核心——它从 4 个矩反推出透射率函数的形状。Münstermann 等人的原始论文给出了基于 Chebyshev 多项式的闭式解,避免了迭代求解。4 矩方案在大多数场景下的误差小于 5%,但在高对比度半透明边界处会出现"颜色泄漏"(color bleeding)——相邻像素的矩差异导致重建的透射率在边界处振荡。6 矩方案可以缓解这个问题,但代价从 2.64x 升到 3.5x。
AVBOIT 课程进一步给出了 transmittance integral 的数学公式:
$$ T = \prod_{i=1}^{N} (1 - \alpha_i) $$
其中 $T$ 是累积透射率,$\alpha_i$ 是第 $i$ 层的不透明度。精确 OIT 需要逐层计算这个连乘,而近似方案用不同的策略压缩这个计算——WBOIT 用加权平均,MLAB 限制层数,Moment-based 用矩展开。核心结论是:Weighted Blended 方案的误差在高对比度场景下不可忽视,但在游戏场景中通常可以接受。
换句话说,光栅 OIT 的方案谱系已经相当成熟,从 1.17x 代价的 WBOIT 到 10x 代价的精确 OIT,开发者可以根据帧预算选择合适的精度档位。但问题来了——当光追管线接管后,这些光栅 OIT 方案还能用吗?答案是:能用,但光追引入了新的透明处理路径,而且代价更高。正餐开始,下面进入光追管线的透明处理。
三、光追透明的三种路径
3.1 路径 A:any-hit shader 做 alpha test
光追管线中最自然的透明处理方式是利用 any-hit shader。在 Vulkan/D3D12 光追管线中,光线与三角形相交时,RT Core 会调用 any-hit shader 来决定是否接受这次命中。对于 alpha 测试纹理(如树叶),着色器采样纹理 alpha,低于阈值则调用 ignoreHitAndProceed()(Vulkan)或 AcceptHitAndEndSearch() 的反面——继续遍历 BVH 找下一个三角形。
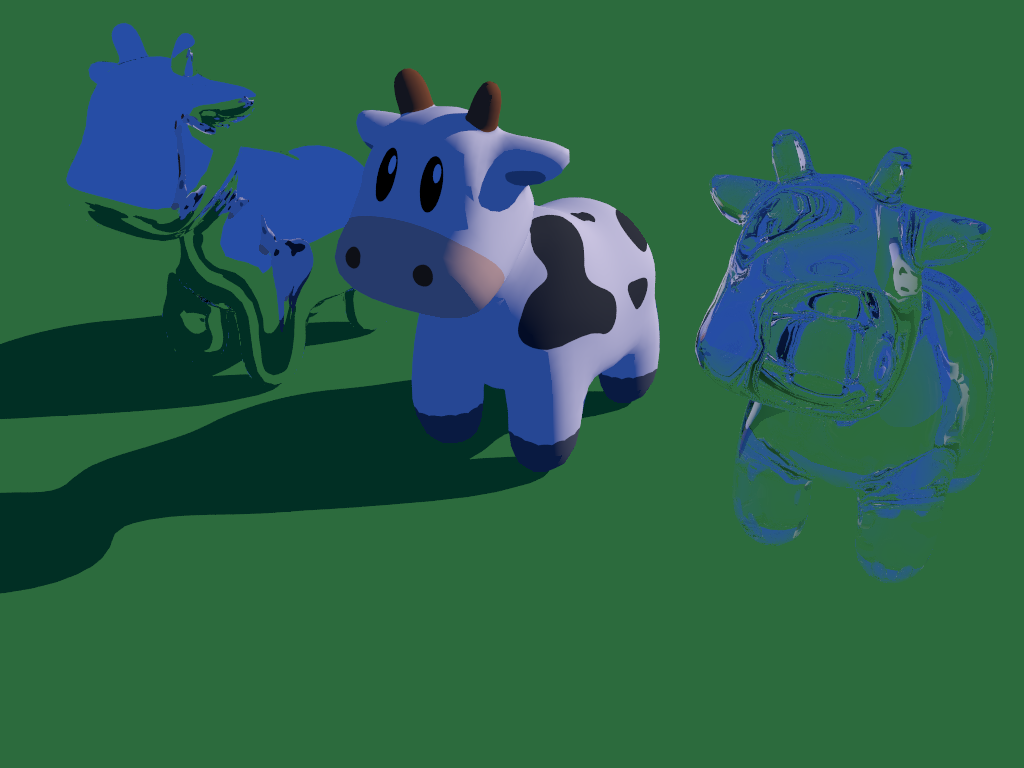
这张图展示了基础光线追踪对透明物体的渲染效果:玻璃牛的折射和反射都准确,但可以看到透明物体后面没有焦散,阴影也是硬阴影——这正是"基础光追透明"的典型表现。任何比这更复杂的效果(多层透明、体积散射)都需要额外光线。
Khronos 官方 Vulkan 教程 Vulkan Shadow Transparency 给出了核心代码:
//-----------------------------------【Alpha Test Any-Hit】---------------------------------------
// 描述:光追管线中的alpha test,低于阈值的片元被忽略
//------------------------------------------------------------------------------------------
//【1】从实例查找表获取纹理索引
//【2】采样baseColor alpha
//【3】alpha < 阈值 → 忽略命中,继续遍历BVH
//【4】alpha >= 阈值 → 接受命中,进入closest-hit
hitObjectAVS main(inout hitInfoAVS hitInfo) {
    //【1】获取纹理索引
    uint textureIdx = instanceTextureIndex[hitInfo.instanceID];
    //【2】采样alpha
    float alpha = texture(baseColorTextures[textureIdx],
                          hitInfo.barycentricCoords.xy).a;
    //【3】低于阈值则忽略
    if (alpha < alphaCutoff) {
        ignoreHitAVS();
        return;
    }
    //【4】接受命中 → 继续进入closest-hit shader
}
下面对这段代码特别说明:ignoreHitAVS() 不会终止光线遍历,而是告诉 RT Core"这次命中不算,继续找下一个"。这意味着每碰到一片透明的叶子,RT Core 都要继续遍历 BVH——如果场景中有 50 层叶子叠在一起,光线需要遍历 50 次 any-hit shader 才能找到一个不透明命中。完整源码和编译说明见 Vulkan Ray Query。
流程图展示了 any-hit shader 的执行路径。关键代价点在于:每次 ignoreHit 都触发一次 BVH 继续遍历,而不是像光栅 alpha test 那样在光栅化阶段就丢弃片元。在植被密集的场景中,这种"遍历-测试-继续遍历"的循环会导致 BVH 遍历时间成倍增长。
Interplay of Light 博客 Interplay of Light 2023 的实测数据证实了这一点:在 RTX 3080 笔记本上,1080p 分辨率下光栅化 MLAB 4 片段耗时 2.02ms,而光追 MLAB 更贵——因为光追方案需要从 TLAS 顶部重新遍历 BVH 来找下一层透明表面。
这里有一个关键的架构差异值得展开。光栅化管线的透明渲染是"像素级"的——GPU 的光栅化器逐像素处理半透明片元,排序和混合都在 ROP(Render Output Unit)层面完成,带宽开销可预测。光追管线的透明渲染则是"光线级"的——每条光线在 BVH 中独立遍历,碰到透明三角形后需要决定"穿过还是反弹",这个决策发生在 ray traversal 的内循环里。问题在于,BVH 的遍历是一个 stack-based 的过程,每次 ignoreHit 都意味着"从当前节点继续向下遍历",而不是像光栅化那样直接丢弃片元。在极端情况下(一片密集植被中 50+ 层叶子叠在一起),一条光线可能在 BVH 中遍历数百个节点,每个节点都触发一次 any-hit shader 调用——这种"遍历-调用-继续遍历"的循环是 OMM 出现前光追植被性能灾难的根本原因。
路径 A 的问题是"逐次遍历太贵",那能不能在着色器里自己做 OIT?这就是路径 B。
3.2 路径 B:closest-hit 逐次追踪实现 OIT
另一种方案是在 closest-hit shader 中手动实现 OIT:光线命中透明表面后,在着色器内发射一条新光线继续追踪,把结果累积到 per-pixel linked list 中。这本质上是在 GPU 着色器里做递归光线追踪。
问题是 DXR 不支持 BVH 距离排序遍历——你无法预先知道哪层透明表面最近。Interplay of Light 博客的初版方案就是每次从 TLAS 顶部遍历,效率极低。改进方案使用 any-hit shader 处理所有交叉点,配合 per-pixel linked list 存储结果,但性能依然不理想。
对比表从四个维度比较了光追透明和光栅 OIT 的代价。光追透明的优势是正确处理折射和反射(光栅 OIT 做不到),代价是光线数随透明层数线性增长。在 4 层透明表面的场景中,光追方案的 GPU 时间约为光栅 WBOIT 的 5-8 倍。
这张图展示了路径 B 的理想效果:光线在玻璃内部多次反弹(追踪深度 9),正确折射并形成焦散花纹。但要达到这个效果,每条光线需要递归追踪 9 层——在实时渲染中,这意味着每像素 9 条以上的光线,远超帧预算。
说白了,路径 B 的根本问题是递归——每次命中透明表面后发射新光线,光线数量按层数指数增长。如果限制最大递归深度(比如 3 层),又会导致深层透明表面被忽略,视觉上表现为"透明物体后面是黑的"。
Khronos 官方还提供了 ray query 方案 Vulkan Ray Query,在传统光栅化着色器内发射光线来处理透明效果。ray query 的优势是不需要完整的光追管线(no-hit/miss/closest-hit/any-hit 着色器),可以在像素着色器或计算着色器中按需发射。alpha masking 通过控制哪些候选交叉点被 commit 实现:允许 non-opaque 候选,对每个候选三角形计算 UV、采样 baseColor alpha、仅当 alpha >= alphaCutoff 时 accept。这相当于把光追的 any-hit 逻辑搬进了光栅化管线,代价是每条 ray query 的遍历开销仍然随透明层数线性增长。
3.3 路径 C:Opacity Micromap 硬件加速
NVIDIA Ada Lovelace 架构(RTX 40 系列)引入了 Opacity Micromap(OMM)Engine NVIDIA Ada Whitepaper,这是目前最有希望的"透明加速"硬件方案。

这张真实照片展示了 OMM 要解决的挑战:玻璃杯中每一根茶袋的光线路径都不同,折射角度随玻璃曲率变化,桌面上的焦散花纹是光线经过多次折射后汇聚的结果。如果用 alpha test 处理这种几何体,每个像素的 alpha 值在不同位置变化剧烈——这正是 OMM 预烘焙不透明度信息的用武之地。
OMM 的核心思想是:预先将三角形的不透明度信息烘焙到 GPU 加速结构中。具体来说,把每个三角形细分为微三角形(micro-triangle)网格,每个微三角形有一个 opacity 状态。Vulkan 官方教程 Vulkan OMM 详细介绍了 VK_KHR_opacity_micromap 扩展的使用方法。
示意图展示了 OMM 的细分过程。一个原始三角形被细分为多个微三角形(subdivision level 越高,细分越细),每个微三角形预先计算好不透明度状态。这样 RT Core 在遍历时不需要调用 any-hit shader 来逐个测试——它直接查 OMM 表,跳过标记为 transparent 的微三角形,只对标记为 unknown 的才调用 any-hit shader。
Vulkan 规范 Vulkan Ray Traversal 定义了三种 OMM 特殊索引值:
VK_OPACITY_MICROMAP_SPECIAL_INDEX_FULLY_TRANSPARENT_KHR:完全透明,RT Core 直接跳过,不调用 any-hit shaderVK_OPACITY_MICROMAP_SPECIAL_INDEX_FULLY_OPAQUE_KHR:完全不透明,RT Core 直接接受命中VK_OPACITY_MICROMAP_SPECIAL_INDEX_FULLY_UNKNOWN_TRANSPARENT_KHR:状态未知,需要调用 any-hit shader 判定
OMM 的加速效率可以用以下公式估算:
$$ \text{加速比} = \frac{1}{1 - p_{\text{opaque}} - p_{\text{transparent}}} $$
其中: - $p_{\text{opaque}}$ 是微三角形中被预分类为 opaque 的比例。 - $p_{\text{transparent}}$ 是被预分类为 transparent 的比例。 - 剩余 $1 - p_{\text{opaque}} - p_{\text{transparent}}$ 是 unknown 比例,需要回退到 any-hit shader。
公式说明:当 80% 的微三角形被预分类(opaque + transparent),只有 20% 回退到 any-hit shader,加速比为 5 倍——这与 Indiana Jones 实测的 2.2 倍加速在同一量级(实际加速比还受 BVH 遍历其他开销的限制)。
图中是 OMM 状态机的处理路径。关键收益在于 transparent 和 opaque 两种状态——它们完全绕过了 any-hit shader,RT Core 直接做决策。只有 unknown 状态才回退到传统的 any-hit shader 路径。在实际植被场景中,大部分微三角形可以被预分类为 opaque 或 transparent,只有边缘过渡区是 unknown。
OMM baking 的核心代码思路如下(基于 Microsoft D3D12 OMM 库 Microsoft D3D12 OMM):
//-----------------------------------【OMM Baking】---------------------------------------
// 描述:在CPU/GPU上预烘焙opacity micromap数据
//------------------------------------------------------------------------------------------
//【1】对每个三角形,采样alpha纹理
//【2】按subdivision level细分微三角形
//【3】每个微三角形分类为opaque/transparent/unknown
//【4】将OMM数据附加到BLAS
//【1】
for (auto& tri : triangles) {
    //【2】
    for (int microTri = 0; microTri < microTriCount; ++microTri) {
        float alpha = sampleAlpha(tri, microTriUV);
        //【3】
        if (alpha > 0.5f + threshold)
            state = OMM_OPAQUE;
        else if (alpha < 0.5f - threshold)
            state = OMM_TRANSPARENT;
        else
            state = OMM_UNKNOWN;
    }
}
//【4】 AttachOMMToBLAS(blas, ommData);
下面对这段代码特别说明:threshold 参数控制 unknown 区域的宽度——阈值越大,unknown 区域越窄(更多微三角形被明确分类),但误分类风险也越高。NVIDIA 推荐从 0.1 开始调参,在植被场景中通常能覆盖 80% 以上的微三角形。完整 baking 库和示例见 Microsoft D3D12 OMM。
3.4 OMM 实测性能数据
NVIDIA 在 Indiana Jones 中的实测给出了目前最有说服力的 OMM 性能数据:
- 测试平台:GeForce RTX 5080
- 测试对象:alpha 测试几何体(植被、铁丝网、粒子)
- 不使用 OMM:GPU 时间 7.90ms
- 使用 OMM:GPU 时间 3.58ms
- 性能提升:2.2 倍加速,节省 4.32ms
柱状图直接对比了 OMM 开启前后的 GPU 时间。4.32ms 的节省在一个 16.6ms 的帧预算里是决定性的——它意味着从"透明效果吃掉一半帧预算"变成"透明效果只占五分之一"。
同一篇博客还报告了 BLAS 压缩的效果:将动态植被模型的 BLAS 压缩后,所有 BLAS 所需 VRAM 从 1027MB 降低。这对显存预算紧张的场景(尤其是 8GB 显存的 RTX 4060 级别显卡)意义重大。NVIDIA Ada 架构白皮书进一步指出,OMM Engine 和 DMM Engine(Displaced Micro-Mesh)配合,后者提供最高 10 倍 BVH 构建速度和 20 倍存储减少——我们在第五篇讨论过 DMM 对加速结构的影响,这里不重复。还有一个数据点:Indiana Jones 的 OMM baking 在构建时离线完成,运行时开销几乎为零。对于动态植被(风吹树叶导致 alpha mask 变化),NVIDIA 建议用低分辨率 OMM 重新烘焙而非全量重建,这个增量更新路径正是 Mega Geometry 技术要解决的问题。
好了,光追透明的三种路径就讲完了。下面进入体积渲染——另一个"利润黑洞"。
四、体积渲染在光追管线中的代价
4.1 参与介质的物理基础
体积渲染处理的不是表面,而是参与介质(Participating Medium)——雾、烟、云、大气。光在介质中传播时发生四种相互作用:
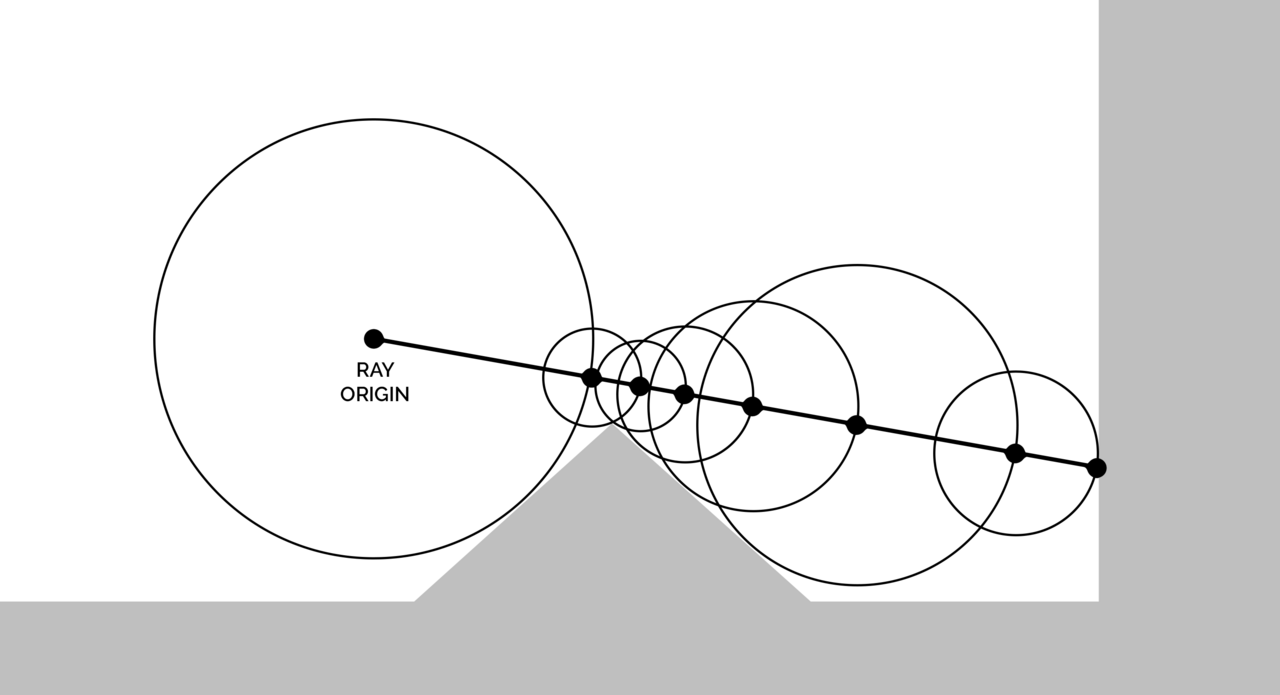
这张图展示了 ray marching 的核心思想——沿光线方向逐步前进,每一步采样介质的密度和光照。体积渲染的 ray marching 与此类似,但每步采样的是消光系数和散射系数,而不是到表面的距离。
- 吸收(Absorption):光被介质吸收,能量转化为热。吸收系数 $\sigma_a$ 表示单位距离的吸收概率。
- 外散射(Out-scattering):光被介质粒子偏转方向,离开光线路径。散射系数 $\sigma_s$ 表示单位距离的散射概率。
- 消光(Extinction):吸收加外散射的总效果。$\sigma_t = \sigma_a + \sigma_s$。
- 内散射(In-scattering):来自其他方向的光被散射进入光线路径。由相位函数 $p(\omega_i, \omega_o)$ 描述方向分布。
体积渲染方程的核心是光线穿过距离 $d$ 后的透射率(Transmittance):
$$ T(d) = e^{-\int_0^d \sigma_t(s) \, ds} $$
其中: - $T(d)$ 是光线穿过距离 $d$ 后未被消光的比例。 - $\sigma_t(s)$ 是位置 $s$ 处的消光系数。 - 积分路径沿光线方向。
光路示意图展示了参与介质中的四种物理过程。关键量是光学厚度(Optical Depth)$\tau = \int_0^d \sigma_t(s) ds$,它决定了透射率 $T = e^{-\tau}$。Frostbite 引擎在 SIGGRAPH 2016 Frostbite 2016 的演讲中给出了完整的参与介质渲染框架,包括天空查找表参数化、云的噪声生成、多散射近似等。Smolder SIGGRAPH 2026 进一步指出:体积雾与透明度面临相同问题——都需要处理光在介质中的透射与散射,但目前引擎的雾透射率只应用于透明层而非反过来,两者的集成仍需解决。
相位函数 $p(\omega_i, \omega_o)$ 描述了光被散射后方向分布的概率密度。实时渲染中最常用的是 Henyey-Greenstein(HG)相位函数:
$$ p(\theta) = \frac{1 - g^2}{4\pi (1 + g^2 - 2g\cos\theta)^{3/2}} $$
其中 $g \in [-1, 1]$ 是不对称因子(anisotropy parameter)。$g = 0$ 表示各向同性散射(光均匀散射到所有方向),$g > 0$ 表示前向散射(光倾向于沿原方向继续传播),$g < 0$ 表示后向散射。大气雾气的典型 $g$ 值约 0.5-0.8(强前向散射),皮肤内部散射的 $g$ 值约 0.9-0.95。HG 相位函数的优势是只需一个参数 $g$ 就能控制整个方向分布——但 Smolder 在 SIGGRAPH 2026 指出,真实的体积雾需要入射辐射度的完整球面积分,如果不用各向同性相位函数($g = 0$)就必须在运行时做积分,代价非常高。这就是为什么很多引擎在体积雾中用 $g = 0$ 近似——牺牲方向精度换取积分简化。
物理基础讲清楚了,下面进入工程实现——ray marching 和 froxel grid 两条路线。
4.2 Ray Marching 与 Froxel Grid
体积渲染有两种主流实现路径:
Ray Marching:从相机沿像素方向逐步前进,每一步采样介质密度并积分消光与散射。Scratchapixel 教程 Scratchapixel 指出,ray marching 曾是生产渲染软件的事实标准,现已逐步被 delta tracking 方法取代。但在实时渲染中,ray march 仍是主流——因为它的步数可控、易于 GPU 并行化。
ray marching 的离散积分公式如下:
$$ L_{out} = \sum_{i=0}^{N-1} T_i \cdot \sigma_s(x_i) \cdot L_{in}(x_i) \cdot \Delta x + T_N \cdot L_{background} $$
其中: - $T_i = e^{-\sum_{j=0}^{i-1} \sigma_t(x_j) \Delta x}$ 是从相机到第 $i$ 步的累积透射率。 - $\sigma_s(x_i)$ 是第 $i$ 步的散射系数。 - $L_{in}(x_i)$ 是第 $i$ 步位置的入射光亮度(需要阴影光线计算)。 - $\Delta x$ 是步长,$N$ 是步数。
ray marching 的核心循环伪代码如下:
//-----------------------------------【Ray Marching】---------------------------------------
// 描述:沿光线方向逐步积分消光与散射
//------------------------------------------------------------------------------------------
//【1】初始化累积透射率和输出颜色
//【2】每步采样密度场、计算消光、累积散射
//【3】根据透射率衰减背景光
//【1】
float T = 1.0;           // 累积透射率
float3 L_out = 0;        // 输出辐射度
//【2】
for (int i = 0; i < N; ++i) {
    float3 pos = rayOrigin + rayDir * (i * stepSize);
    float density = sampleDensity3D(pos);
    float sigma_t = density * extinctionCoeff;
    float sigma_s = density * scatterCoeff;
    // 累积散射光(需要阴影光线计算入射光)
    float3 L_in = computeLighting(pos);
    L_out += T * sigma_s * L_in * stepSize;
    // 更新透射率
    T *= exp(-sigma_t * stepSize);
    if (T < 0.01) break; // 透射率阈值提前剔除
}
//【3】
L_out += T * backgroundColor;
下面对这段代码特别说明:computeLighting(pos) 是最昂贵的部分——它需要为每个步进位置发射阴影光线来计算光照。如果场景中有动态光源,这部分的开销会随步数和光源数线性增长。完整实现参考 Scratchapixel 教程。
图中是 ray marching 的步进示意。每一步需要采样 3D 纹理(密度场)、计算光照(包括阴影光线)、积分消光。128 步的 ray march 意味着 128 次纹理采样和 128 次光照计算——如果每步都要发射阴影光线,就还需要 128 条额外的 BVH 遍历。这比一次不透明命中贵 100 倍以上。

医学 CT 体积渲染是 ray marching 最早的成功应用:每条光线穿过 3D 标量场(CT 密度数据),沿路径采样并按转移函数映射为颜色和不透明度。实时游戏中的体积雾采用完全相同的积分框架,只是把 CT 密度换成雾密度场——但游戏场景的体素数远大于医学数据,且需要每帧更新。
Froxel Grid:Frostbite 引擎推广的方案,将相机视锥对齐切分为 3D 体素网格(Froxel = Frustum + Voxel),每帧填充密度、散射和透射率,然后前向到后向积分。
图中是 froxel grid 的示意。它的优势是分辨率固定(不随分辨率线性增长),且可以用计算着色器批量处理。Euclidean Dreams 博客 Euclidean Dreams 给出了完整的 froxel volume 实现:相机对齐 3D 网格存储密度、散射和透射率,每帧填充体积→光照→前向到后向积分→合成到场景。Volumetric Lighting Explained Game Developers 进一步指出,Frostbite 的统一体积渲染系统支持多重散射近似、阴影传播和时间复用,但主要挑战是内存和更新策略。
froxel grid 的前向到后向积分是整个流程的核心。与 ray marching 沿像素方向步进不同,froxel 沿相机 Z 轴逐层积分,每一层内的 X-Y 平面并行处理。伪代码如下:
//-----------------------------------【Froxel Grid Integration】------------------------------
// 描述:沿相机Z轴逐层积分froxel grid,计算每个像素的体积雾颜色与透射率
//----------------------------------------------------------------------------------------------
//【1】将相机视锥切分为 3D froxel 网格(如 160×90×64)
//【2】计算着色器:填充每个 froxel 的密度、散射系数、消光系数
//【3】光照 pass:为每个 froxel 计算入射光照(含阴影)
//【4】积分 pass:沿 Z 轴前向到后向积分透射率和散射
//【5】合成 pass:将体积雾叠加到不透明场景
//【2】
void fillFroxel(uint3 froxelIdx) {
    float3 worldPos = froxelToWorld(froxelIdx);
    float density = sampleNoise3D(worldPos);
    froxelDensity[froxelIdx] = density * densityScale;
    froxelExtinction[froxelIdx] = density * extinctionCoeff;
    froxelScattering[froxelIdx] = density * scatterCoeff;
}
//【3】
void lightFroxel(uint3 froxelIdx) {
    float3 worldPos = froxelToWorld(froxelIdx);
    float3 L = 0;
    for (int i = 0; i < numLights; ++i) {
        float shadowAttenuation = sampleShadowMap(i, worldPos);
        L += lightColor[i] * shadowAttenuation * lightIntensity[i];
    }
    froxelInscattering[froxelIdx] = froxelScattering[froxelIdx] * L;
}
//【4】
void integrateFroxel(uint2 pixelIdx) {
    float T = 1.0;
    float3 L_vol = 0;
    for (int z = 0; z < numFroxelSlices; ++z) {
        float sigma_t = froxelExtinction[pixelIdx, z];
        float3 L_in = froxelInscattering[pixelIdx, z];
        L_vol += T * L_in * froxelSliceThickness;
        T *= exp(-sigma_t * froxelSliceThickness);
        if (T < 0.01) break;
    }
    volumetricColor[pixelIdx] = float4(L_vol, T);
}
下面对这段代码特别说明:froxel 积分和 ray marching 的关键区别在于,froxel 的步数固定(如 64 层),不随分辨率变化——4K 和 1080p 用同样大小的 froxel grid,只是合成时采样方式不同。froxel 的典型配置是 160×90×64(约 92 万个体素),总内存约 8-12MB(每体素存密度+散射+消光+光照,共 4 个 float)。光照 pass(步骤 3)是最昂贵的部分——每个体素都要对所有光源做阴影查询,这正是 Frostbite 用级联阴影贴图(CSM)和体素化光照来加速的原因。时间复用把光照 pass 的更新分摊到 4 帧,等效步数提升 4 倍——这意味着 64 层 froxel 可以达到等效 256 步 ray march 的画质。
依然是先来看合成顺序问题——这是体积渲染在工程取舍上的核心难题。
4.3 体积雾与透明层的合成顺序
体积渲染和透明渲染在管线末端都面临同一个问题:它们都需要和不透明场景合成,且合成顺序影响结果。
Frostbite 的方案是先渲染不透明场景,然后做体积雾积分,最后叠加半透明层。但 Smolder 指出:体积雾的透射率应该应用于透明层(雾应该在透明物体前面),而不是反过来(透明物体在雾前面)。目前大多数引擎的做法是"先体积雾、后透明层"——这在物理上是近似的,因为雾和透明物体的正确合成需要知道透明物体后面的雾密度分布,而这在实时管线中几乎不可能精确计算。
流程图标注了合成顺序和近似代价。关键权衡是:如果把体积雾放在透明层后面(先透明、后雾),雾会错误地遮挡透明物体后面的内容;如果把体积雾放在前面(先雾、后透明),透明物体看起来像"浮在雾上面"而非"浸在雾里"。两种方案都有可见的 artifacts,业界没有完美解。Frostbite 在 Siggraph 2015 的演讲中承认了这个近似——他们的做法是先体积雾后透明层,并在透明着色器里手动采样 froxel 的透射率来做"雾穿透"补偿。这虽然不物理正确,但在大多数场景下视觉差异很小,而性能收益(不需要二次体积积分)非常显著。
Smolder 在 SIGGRAPH 2026 的演讲中提到一个关键洞察:体积雾需要入射辐射度的完整球面积分,如果不使用各向同性相位函数就必须在运行时做。双重 raymarch pass(矩生成 + 散射解析)太昂贵,透明和雾的集成仍需解决。这从侧面说明,体积雾的"正确做法"在实时预算下目前不可行——所有引擎都在用不同方式的近似来回避这个完整积分。
说到近似,froxel 方案还有一个重要的工程优化:时间复用(Temporal Reprojection)。Frostbite 和 Unity 的体积雾都使用了时间复用——每帧只更新 froxel grid 的一部分(比如 1/4),其余部分从上一帧重投影获得。这相当于把 4 帧的采样量分摊到 4 帧里完成,等效步数提升 4 倍。但时间复用有一个我们在第六篇讨论过的老问题——鬼影(Ghosting)。当场景中体积效果快速变化时(比如爆炸产生的烟雾扩散),重投影的旧数据会导致拖尾。Frostbite 用指数衰减加权混合新旧数据来缓解,但无法完全消除。这个权衡在体积雾上比在 GI 上更敏感——因为雾的变化速度通常比间接光快。
换言之,体积渲染在实时管线里几乎处处是近似:ray march 步数砍半、froxel 分辨率降低、时间复用分摊、各向同性相位函数简化。每一步近似都省了算力,也丢了画质——但业界的一致判断是:这些画质损失在动态场景中几乎不可见,而算力省下来分给反射和 GI 的收益更大。
体积渲染讲完了,下面进入透明渲染家族的第三个"利润黑洞"——次表面散射。
五、次表面散射的混合管线处理
5.1 BSSRDF 与扩散剖面
次表面散射(Subsurface Scattering,SSS)描述的是光进入半透明材质表面、在内部散射后从邻近点出射的现象。皮肤、大理石、蜡烛、玉石都是典型的 SSS 材质。GPU Gems GPU Gems Ch16 指出,SSS 会柔化整体光照效果,使光照从一个区域渗透到相邻区域,皮肤散射还会导致朝红色的色偏。
从数学上讲,SSS 用 BSSRDF(Bidirectional Scattering Surface Reflectance Distribution Function)描述——它是 BRDF 的推广。BRDF 只关心"光从方向 $\omega_i$ 入射、从方向 $\omega_o$ 出射"的反射比例,而 BSSRDF 还需要考虑入射点和出射点之间的距离 $||x_i - x_o||$:
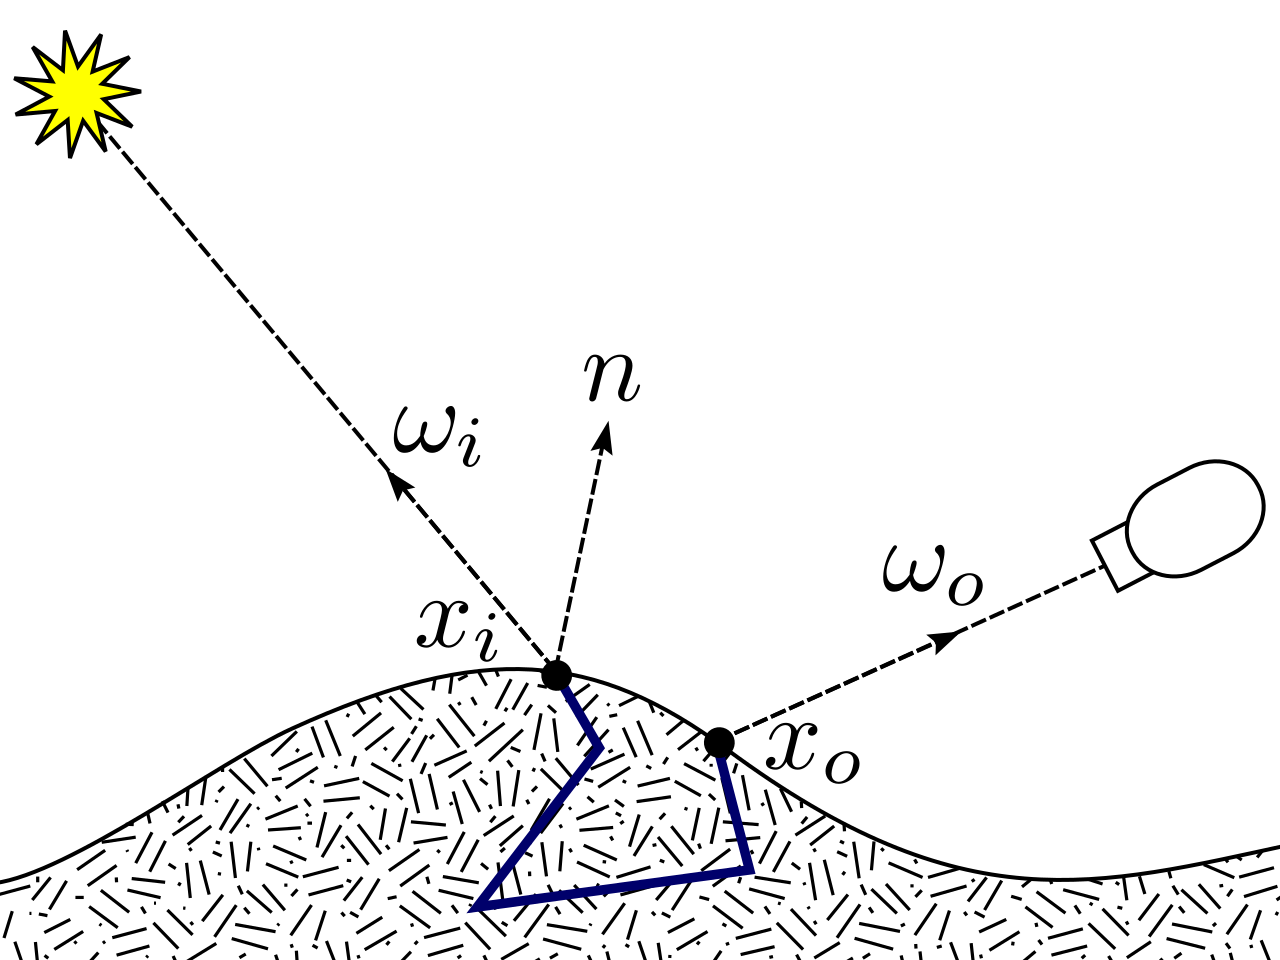
这张图说明了 BSSRDF 的核心——光不是在同一个点反射,而是进入表面后在介质内部多次散射,最终从附近的另一个点渗出。入射点和出射点之间的距离决定了扩散剖面的形状。
$$ S(x_i, \omega_i; x_o, \omega_o) $$
扩散剖面(Diffusion Profile)是预计算的 BSSRDF 类型——它假设光在介质内部经历了多次散射后呈高斯衰减分布,用一个或多个高斯函数的叠加来近似 $S$ 关于 $r = ||x_i - x_o||$ 的径向分布:
$$ R(r) = \sum_{i=1}^{K} w_i \cdot \frac{1}{2\pi\sigma_i^2} \cdot e^{-\frac{r^2}{2\sigma_i^2}} $$
其中: - $R(r)$ 是扩散剖面,描述距离 $r$ 处的出射光强度。 - $K$ 是高斯核数量(通常 3-6 个)。 - $w_i$ 和 $\sigma_i$ 是第 $i$ 个高斯核的权重和标准差,由材质参数(散射系数、吸收系数、折射率)预计算。 - $r$ 是入射点与出射点之间的表面距离。
示意图展示了 BSSRDF 的光路:光从 $x_i$ 进入表面,在内部经历多次散射后从 $x_o$ 出射。扩散剖面 $R(r)$ 描述了出射光强度随 $r = ||x_i - x_o||$ 的衰减——$r$ 越大,光在内部传播的路径越长,衰减越多。不同材质的扩散剖面不同:皮肤的散射距离约 1-3mm,大理石约 5-10mm,蜡烛约 2-5mm。
下面是 Wikimedia Commons 上的几张 SSS 相关图示,帮助大家直观理解 SSS 的视觉效果:
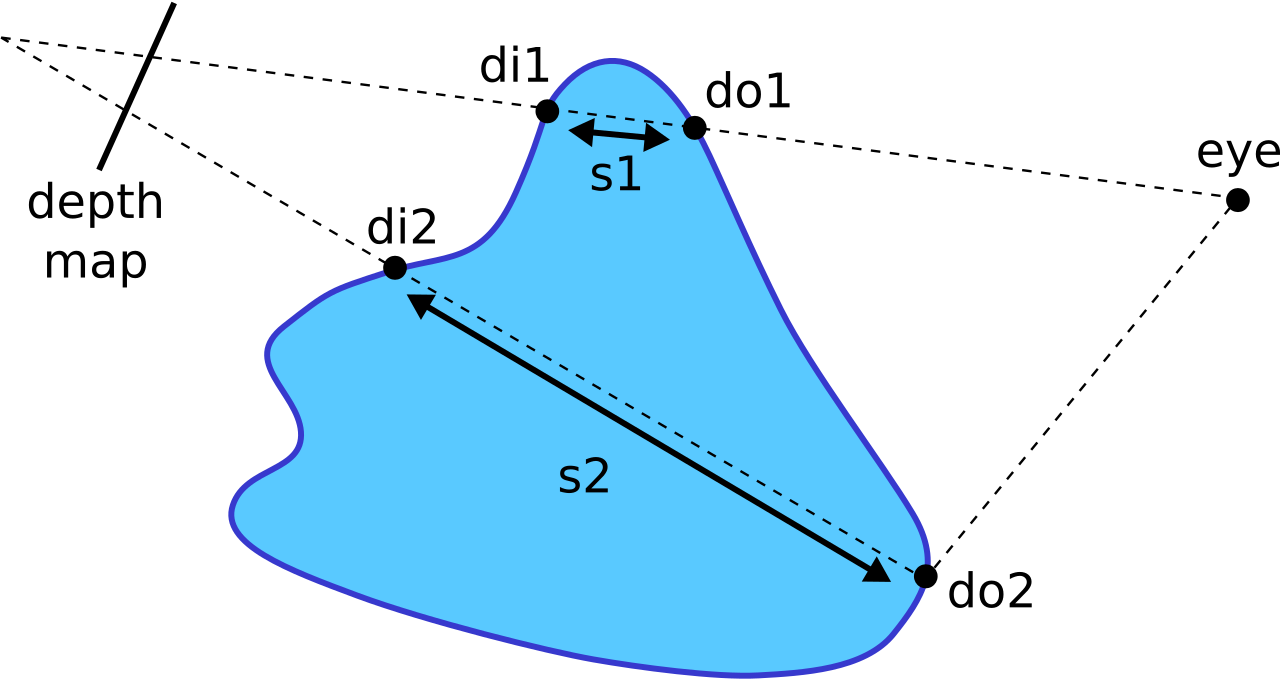
这张示意图来自 Wikimedia Commons(Public Domain)SSS Depth Map,展示了 SSS 的深度估算方法——光在介质内部的传播深度决定了散射范围。

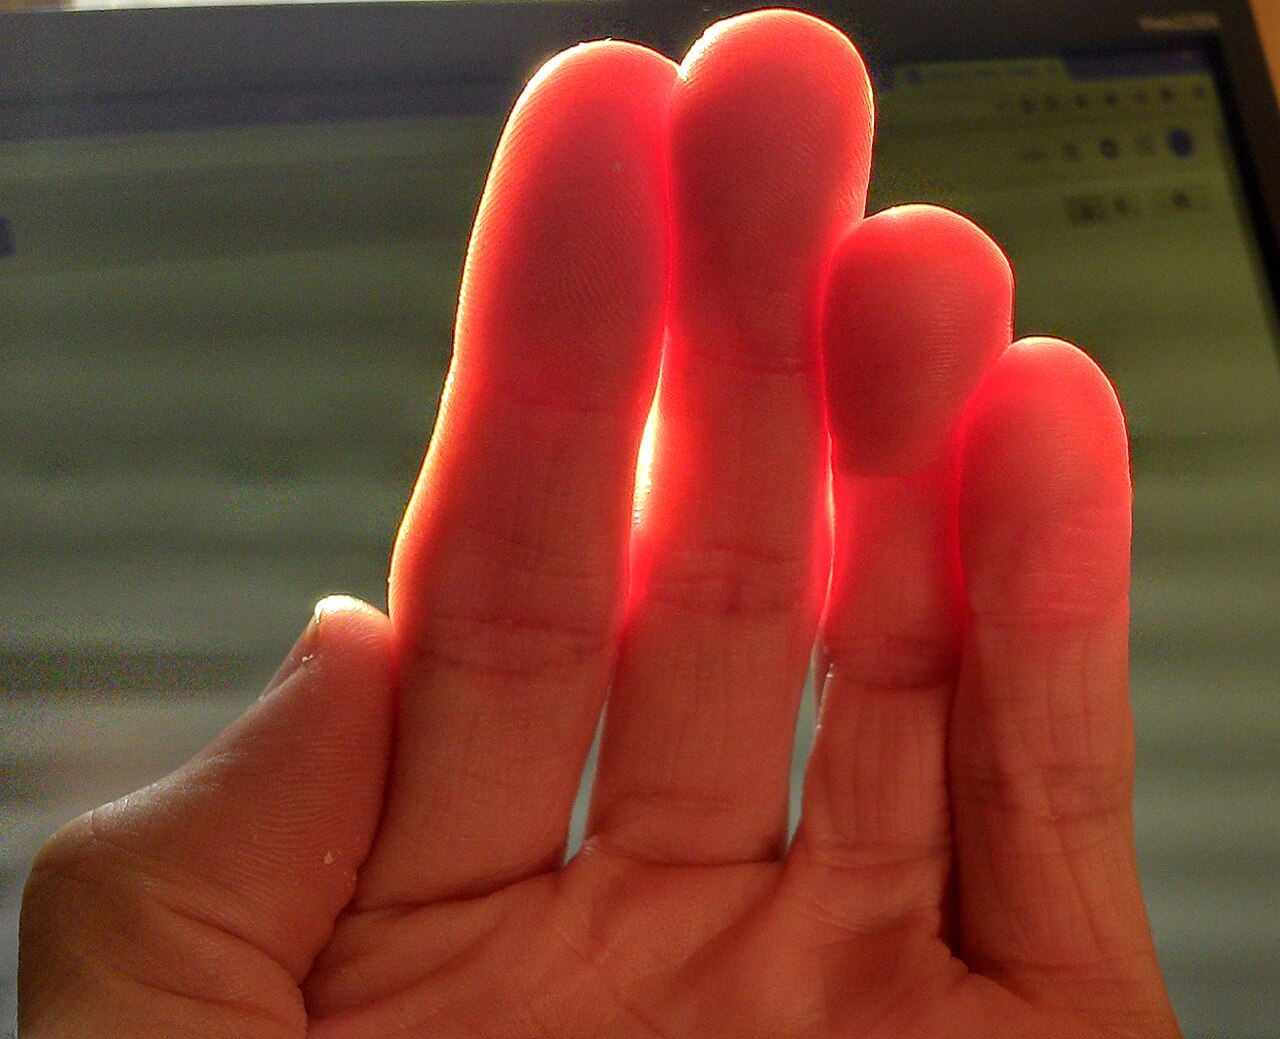
这张照片 Skin SSS 展示了真实的皮肤 SSS 效果——手指间透出的红光就是光在皮肤内部散射后从另一侧出射的结果。注意红色色调偏移——GPU Gems 指出,皮肤的散射会导致朝红色的色偏,因为红色光在皮肤组织中的穿透深度比绿色和蓝色更深。

不同材质的次表面散射参数差异很大。下表列出了几种常见 SSS 材质的物理参数:
| 材质 | 散射系数 $\sigma_s$ (1/mm) | 吸收系数 $\sigma_a$ (1/mm) | 散射距离 (mm) | 视觉特征 |
|---|---|---|---|---|
| 皮肤(表皮) | 0.74 | 0.026 | 1-3 | 红色色偏,柔化阴影 |
| 大理石 | 1.75 | 0.002 | 5-10 | 强透光,柔和光泽 |
| 蜡烛 | 0.9 | 0.03 | 2-5 | 暖色透光,模糊边缘 |
| 玉石 | 1.2 | 0.008 | 3-8 | 冷色透光,内部光晕 |
| 牛奶 | 0.7 | 0.001 | 8-15 | 白色弥漫,强散射 |
表中的数据来自 Jensen 等人的 BSSRDF 测量论文和 GPU Gems 的汇总。关键观察是:散射距离(大致等于 $1/\sigma_t$)决定了"光能传多远"——皮肤的散射距离只有 1-3mm,所以屏幕空间模糊半径可以很小(几像素);牛奶的散射距离 8-15mm,在屏幕上需要大半径模糊。散射距离越长,路径追踪的方差越大、需要的采样数越多——这就是 SSS"越透明越难"的物理根源。
有了物理基础,下面进入实时近似方案的讨论。
5.2 屏幕空间 SSS 近似
NVIDIA GPU Gems 介绍了实时 SSS 的多种近似方法,其中最实用的是屏幕空间模糊(Screen-Space Blur)。这个方案的核心思想是:把 BSSRDF 的空间扩散近似为屏幕空间的高斯模糊,用扩散剖面控制模糊半径和权重。这个方案的优势在于不需要额外渲染 pass,只需要在屏幕空间做后处理。
- 正常渲染漫反射颜色(不考虑 SSS)
- 根据扩散剖面,在屏幕空间对颜色做高斯模糊
- 把模糊后的颜色叠加回原始颜色
Burley 在 SIGGRAPH 2018 Burley 2018 提出了归一化扩散模型,用单一参数控制散射范围,比多高斯叠加更简洁。Unity HDRP 和 UE5 都采用了类似的屏幕空间方案。
图中是屏幕空间 SSS 的流程。它的优势是性能可控(一次全屏模糊),劣势是丢失了视角依赖性——从侧面看皮肤时,SSS 的散射距离应该在屏幕上变长,但屏幕空间方案无法感知这一点。
屏幕空间 SSS 的核心着色器逻辑如下:
//-----------------------------------【Screen-Space SSS Blur】---------------------------------------
// 描述:按扩散剖面在屏幕空间做高斯模糊,近似次表面散射
//------------------------------------------------------------------------------------------
//【1】采样当前像素的漫反射颜色和深度
//【2】按扩散剖面的多个高斯核做径向模糊
//【3】根据深度调整模糊半径(远距离物体模糊半径减小)
//【4】合成原始颜色与模糊颜色
//【1】
float3 baseDiffuse = diffuseTexture.Sample(sampler, uv).rgb;
float depth = depthTexture.Sample(sampler, uv).r;
//【2】
float3 blurred = 0;
for (int i = 0; i < KERNEL_SIZE; ++i) {
    float2 offset = kernelOffsets[i] * blurRadius;
    //【3】
    float sampleDepth = depthTexture.Sample(sampler, uv + offset).r;
    float weight = weights[i] * depthWeight(depth, sampleDepth);
    blurred += diffuseTexture.Sample(sampler, uv + offset).rgb * weight;
}
//【4】
float3 result = lerp(baseDiffuse, blurred, sssIntensity);
下面对这段代码特别说明:depthWeight 函数根据当前像素和采样像素的深度差调整权重——如果深度差过大(说明采样点不属于同一表面),权重降低,避免跨物体模糊。blurRadius 由材质的 SSS 参数控制——皮肤的散射距离短(约 1-3mm),大理石的散射距离长(约 5-10mm)。完整实现见 Burley 2018。
屏幕空间方案够快但不够准,那能不能把路径追踪的精度和扩散剖面的效率结合起来?这就是混合方案的思路。
好了,屏幕空间近似讲完了,下面进入更精确的混合方案。
5.3 混合 ReSTIR 路径追踪方案
NVIDIA 在 SIGGRAPH 2025 ReSTIR SSS SIG2025 提出了一种混合方案,把路径追踪光传输与扩散剖面结合,在 Omniverse RTX 渲染器中实现实时 SSS。
方案的核心思想是:用路径追踪准确捕获零次和单次散射(光进入表面后的第一次反弹),用扩散剖面近似多次散射(光在内部经历很多次反弹后的行为)。这比纯扩散剖面方法更接近离线路径追踪的地面真值,展示效果包括石狮、大理石棋子、蜡烛、皮肤等材质。
KIT 的 ReSTIR SSS 论文 ReSTIR SSS KIT 2024 进一步将 ReSTIR 采样策略应用于次表面光传输路径。关键技术挑战是 BSSRDF 的重要性采样——采样点需要按扩散剖面分布,但 ReSTIR 的时空重用需要在 BSSRDF 域和 BRDF 域之间移动路径(shift mapping)。论文提出了 sequential shift 组合多种 shift 映射来解决跨域重用问题。
图中是混合管线的流程图。左路是路径追踪:从相机发射光线,命中 SSS 表面后发射 BSSRDF 采样光线,用 ReSTIR 做时空重用。右路是扩散剖面:根据预计算的 $R(r)$ 在屏幕空间做模糊。最后两路结果合成——路径追踪负责近距离散射的细节,扩散剖面负责远距离散射的柔和光晕。
ReSTIR SSS 的核心难题在于 shift mapping——把一个像素的 BSSRDF 采样路径"搬"到相邻像素时,两个像素的散射参数可能完全不同。KIT 论文提出了 sequential shift 策略:先用 reconnection shift 在 BRDF 域做空间重用(和标准 ReSTIR GI 一样),再用 perturbation shift 在 BSSRDF 域做局部扰动——保持散射距离和方向,只移动出射点。两种 shift 的组合通过 MIS(Multiple Importance Sampling)加权混合。论文报告的收敛速度比纯路径追踪快 4-8 倍,但 4-8 倍仍然不够——纯路径追踪需要 4096 spp 才能收敛,4-8 倍加速后仍需 512-1024 spp,远超实时预算。
这引出了一个关键的降噪问题。SSS 的噪声模式和 GI 不同——GI 的噪声是低频的空间变化,降噪器可以用大核平滑;SSS 的噪声是高频的散射斑点,降噪器如果平滑过度会丢失 SSS 的"柔光感"。NVIDIA 在 Omniverse 中用了专门的 SSS 降噪器,基于路径空间回归(path-space regression),但这是离线方案,实时版本仍在研究中。
好了,三种 SSS 方案讲完了,下面来看看 SSS 为什么也属于"最难盈利"的行列。
5.4 SSS 为什么"最难盈利"
SSS 在光追管线中的代价模式很特殊:它不像透明渲染那样需要光线穿过表面继续前进,而是需要光线进入表面后在内部"反弹"多次。每次反弹都是一次 BVH 遍历 + 着色器调用。如果用纯路径追踪做 SSS,一个像素可能需要 16-64 次路径采样才能收敛——因为 SSS 的方差极高,尤其在散射距离大的区域(如耳垂、鼻尖)。
方差高的物理原因可以用辐射度的信噪比公式解释。路径追踪的方差 $\sigma^2$ 与样本数的反比关系为 $\text{SNR} \propto \sqrt{N}$——但如果单次采样的贡献值 $f(x)$ 的方差极大(BSSRDF 在散射距离长时分布很宽),需要的 $N$ 就成倍增加。具体地,如果 BRDF 场景需要 4 spp 收敛,BSSRDF 场景的散射距离是 BRDF 的 10 倍,方差大约是 100 倍(方差与散射距离的平方成正比),需要 400 spp 才能达到同样的 SNR。这就是为什么离线渲染器的 SSS 通道通常需要几百到几千 spp。
Unity HDRP Unity HDRP 17.3 的路径追踪支持 SSS(与 HDRP 材质相同设置)和 path-traced fog(各向异性雾吸收),但官方文档承认主要缺点是噪声——随采样增加才消失。在实时预算下(每帧 16.6ms),通常只能做 1-2 spp,噪声远超可接受范围。混合方案(路径追踪 + 扩散剖面)是目前最可行的折中,但它的实现复杂度远高于屏幕空间模糊。
Burley 的归一化扩散模型 Burley 2018 用单一公式替代了多高斯叠加:
$$ R_d(r) = \frac{e^{-r/s} + e^{-r/(3s)}}{8\pi s r} $$
其中 $s$ 是材质的散射半径参数,$r$ 是入射点到出射点的距离。这个公式的好处是只需一个参数 $s$ 就能控制整个散射行为,比多高斯叠加(需要 3-6 组权重和标准差)简洁得多。Disney 的 diffuse BRDF 就是这个公式的远场近似——当 $r \to 0$ 时,$R_d$ 退化为标准漫反射项。UE5 和 Unity HDRP 都采用了类似的单参数模型,使得美术调节更直观。
依然是先来看看跨引擎对比——不同引擎如何应对 SSS 和透明效果的"利润黑洞"。
六、跨引擎方案对比
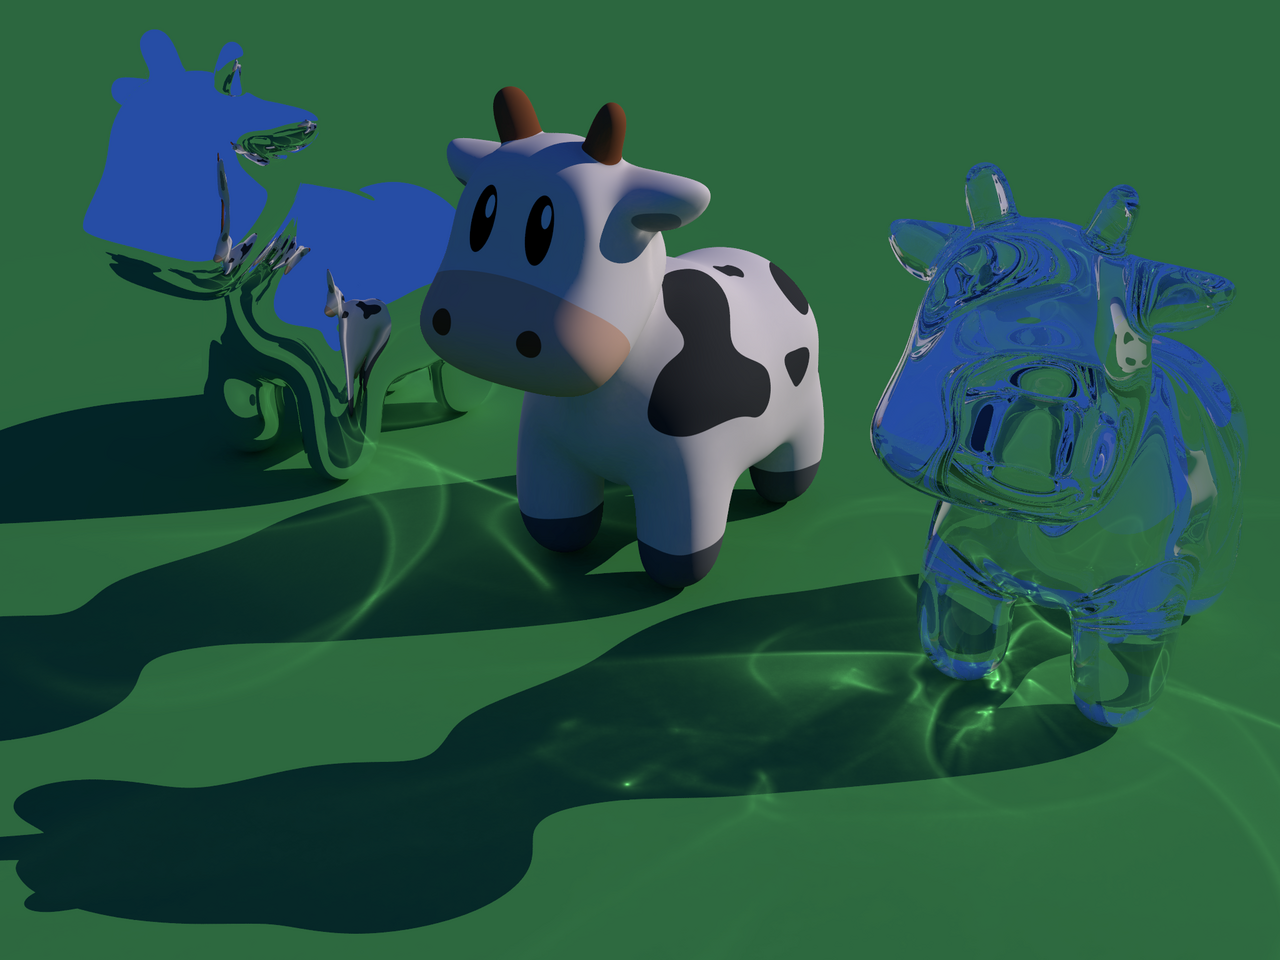
这张图展示了"理想透明渲染"的标杆——光线追踪 + 辐射度 + 光子映射的组合能正确渲染焦散、间接光照和透明阴影。但这是离线渲染,一帧需要数分钟。实时引擎的目标是在 16ms 内逼近这个效果,策略各有不同。
6.1 UE5 Lumen:跳过与降级
UE5 的 Lumen Lumen Technical Details 对透明和体积效果采取了明确的"降级"策略:
- 透明网格(Translucent):被 distance fields 忽略,不参与 Surface Cache 和软件光追
- Masked 材质(alpha-tested):视为 Opaque,但 alpha 值低于 50% 的网格被跳过
- 半透明反射:High Quality Translucency Reflections 选项在前层使用高质量镜面反射,其他层使用低质量的 Radiance Cache Lumen GI 5.4
- 体积雾 GI:Lumen 也解决体积雾上的全局光照,但质量较低
机核的中文解读 机核 Lumen 补充了细节:Surface Cache 对透光材质完全跳过,对 alpha-masked 材质计算表面缓存的不透明度并跳过值在 50% 以下的网格。这意味着 Lumen 的 GI 在透明场景下会"缺失"——透明的玻璃窗不会接收和传播间接光。
图中是 Lumen 透明处理流程。关键设计决策是"跳过而非处理"——Lumen 选择不把透明物体纳入 GI 计算,而不是投入大量算力去追踪透明表面的间接光。这是一个明确的工程取舍:接受透明物体上的 GI 缺失,换取其他场景的 GI 性能。Lumen Tech Blog UE5 Lumen Blog 也承认,发光材质的 GI 比手动放置光源更难解决。
UE5 选择"跳过",那 Frostbite 呢?它走的是另一条路——统一。
6.2 Frostbite:froxel 体积雾统一渲染
Frostbite 选择了另一条路:用 froxel grid 统一处理所有体积效果(雾、云、大气透视),而不是为每种效果单独实现一套管线。云的渲染使用参与介质材质模型,支持 ambient lighting、improved scattering、multiple scattering 三层近似。
Frostbite 的设计哲学是"统一介质"——所有体积效果共享同一套 froxel 积分管线,只是密度场和散射参数不同。这降低了管线复杂度,但代价是某些效果的精度受限——比如云的细节边缘无法用低分辨率 froxel grid 精确捕捉。
UE5 跳过,Frostbite 统一,Unity 则选择了第三条路——一切交给路径追踪。
6.3 Unity HDRP:路径追踪统一
Unity HDRP 的路径追踪 Unity HDRP Path Tracing 在统一过程中计算硬/软阴影、镜面/光泽反射和折射、间接光照,同时支持 SSS 和 path-traced fog。这是"用路径追踪统一所有效果"的思路——不区分透明、体积、SSS,全部用光线追踪解决。
问题是噪声。Unity 官方文档承认路径追踪从相机发射光线,遇到反射或折射表面时递归直到到达光源,主要缺点是噪声,随采样增加消失。在实时预算下,通常只能做 1-2 spp,需要配合降噪器——但降噪器在半透明边缘和体积内部的失效模式(我们在第六篇和第七篇讨论过)恰好最严重。
三种引擎的做法看似不同,但底层的取舍逻辑惊人地一致——来看看为什么。
6.4 引擎策略的深层逻辑
三家引擎的做法虽然不同,但底层逻辑是一致的:在帧预算固定的情况下,优先保证不透明场景的画质,透明和体积效果接受降级。这不是技术不够好——而是"利润率"的理性计算。用公式表达:
$$ R_{\text{profit}} = \frac{\Delta Q_{\text{visible}}}{\Delta \text{Cost}_{\text{GPU}}} $$
其中 $R_{\text{profit}}$ 是利润率,$\Delta Q_{\text{visible}}$ 是可感知的画质增量,$\Delta \text{Cost}_{\text{GPU}}$ 是 GPU 时间增量。把 4ms 花在反射上,玩家看得到;把 4ms 花在第 5 层透明上,玩家看不到区别——前者的 $R_{\text{profit}}$ 远高于后者。
UE5 选择"跳过"是因为 Lumen 的 Surface Cache 架构天然不适合处理透明——Surface Cache 需要参数化表面来缓存间接光,而透明表面无法被正确参数化。Frostbite 选择"统一"是因为它的 froxel 管线已经为体积效果建好,顺带处理雾的成本最低。Unity 选择"路径追踪统一"是因为 HDRP 的设计哲学是一切走物理正确路线,代价是实时性能不够好。
更深层看,三种策略反映了三种不同的工程哲学。UE5 的"跳过"是实用主义——承认"做不到就不做",把精力集中在收益最高的地方。Frostbite 的"统一介质"是系统思维——用一套管线覆盖多种效果,牺牲单点精度换取整体一致性。Unity 的"路径追踪统一"是理想主义——追求物理正确,用降噪器掩盖实时预算下的采样不足。三种哲学没有绝对优劣,但从"产品能按时发布"的角度看,UE5 的实用主义在当前硬件代际下胜出最多。
好了,三家引擎的做法拆解完毕,先来看看横向对比。
6.5 横向对比
对比表总结了三种引擎的策略差异。共性是:所有引擎都在"跳过/降级"透明和体积效果。UE5 跳过透明网格的 GI,Frostbite 用低分辨率 froxel 近似,Unity 用低 spp 路径追踪 + 降噪。没有一家引擎在实时预算下实现了"精确透明 + 精确体积 + 精确 SSS"——这从侧面验证了"最难盈利"的判断。
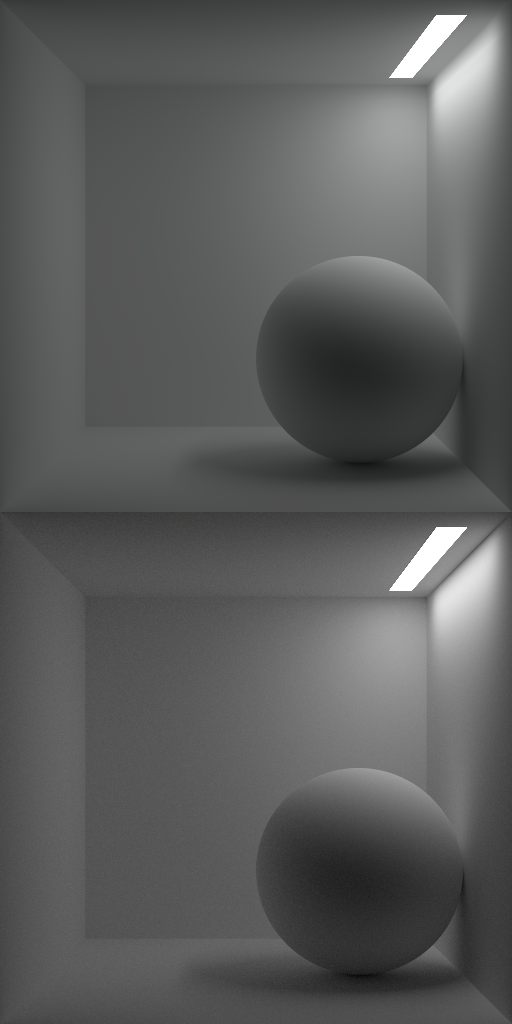
图中对比了两种全局光照方案的视觉差异。辐射度方法(上图)只处理漫反射到漫反射的传输,无法正确渲染焦散和透明折射——这正是 UE5 Lumen 的 Surface Cache 架构所采用的近似思路。路径追踪(下图)能统一处理所有光传输,但需要大量采样才能收敛——这正是 Unity HDRP 面临的噪声问题。实时引擎在透明效果上的取舍,本质上是选择"哪种近似方案能接受"。
概括来说,如果把三家引擎的做法翻译成一句话,那就是:能用光栅近似的就用光栅近似,实在要用光追的就降级处理。这不是偷懒,而是在 16.6ms 帧预算下的理性选择。
好了,对比完了三家引擎的做法,下面我们用光线预算的视角来量化"为什么这些效果最难盈利"。这个分析框架我们在 ep09《光线预算表》里已经建立过,这里把它扩展到透明、体积和 SSS 三个新维度。
七、为什么这些效果"最难盈利"
7.1 每像素光线数分析
让我们用光线预算的视角来分析为什么透明、体积和 SSS 是"利润黑洞"。在 ep09《光线预算表》中,我们讨论了反射、阴影、全局光如何分配光线预算。当时的前提是每像素 0.5-2 条光线。现在可以看到:透明效果把这个数字推高到 N(层数),体积推高到 128(步数),SSS 推高到 16-64(采样数)。
图按效果类型列出了每像素需要的光线数:
| 效果类型 | 每像素光线数 | 说明 |
|---|---|---|
| 不透明表面 | 1 条 | 一次 BVH 遍历 + 一次 closest-hit |
| 透明表面(N 层) | N 条 | 每层一次 any-hit + 最终一次 closest-hit |
| 体积(ray march 128 步) | 128 次采样 | 每步一次密度采样 + 一次光照计算 |
| SSS(路径追踪) | 16-64 条 | 高方差,需要多次路径采样才能收敛 |
| SSS(混合方案) | 4-8 条 + blur | 路径追踪 4-8 spp + 扩散剖面模糊 |
帧预算的光线分配可以用一个简单的公式估算:
$$ \text{可用光线数} = \frac{\text{帧预算}(16.6ms) - \text{不透明开销} - \text{透明开销} - \text{体积开销} - \text{SSS开销}}{\text{每条光线成本}} $$
其中每条光线的成本取决于 BVH 遍历深度和着色器复杂度。在 1080p 分辨率下,典型值约 2-5 微秒/千像素。如果透明和体积各花 3ms,SSS 花 1ms,不透明花 5ms,那么留给反射和 GI 的预算只有 4.6ms——约 1-2 条/像素的光线。
在总预算不变的情况下,这些效果必然会挤占反射和 GI 的光线份额。如果帧预算是 2 条/像素,一个 4 层透明的像素就用掉了全部预算,没有余量做反射和 GI。这就是为什么 UE5 选择跳过透明网格的 GI——不是做不到,而是做了就得从别处扣预算,而别处的预算花在反射和 GI 上利润更高。
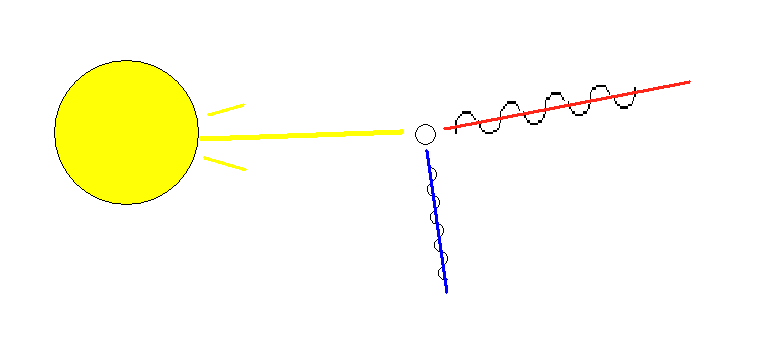
这张图展示了散射的物理本质——不同波长的光在介质中有不同的散射行为。体积渲染的消光系数和 SSS 的扩散剖面,本质上都是对这个散射过程的数学近似。理解了散射的物理基础,就能理解为什么这些效果的代价如此之高——每一次散射都是一次独立的光线计算。
我们再来看视觉收益的曲线。先来看看代价和收益的不对称,这是理解"最难盈利"的另一半。
7.2 视觉收益的非线性
更关键的问题是:光线数增加了,视觉收益却没有线性增长。
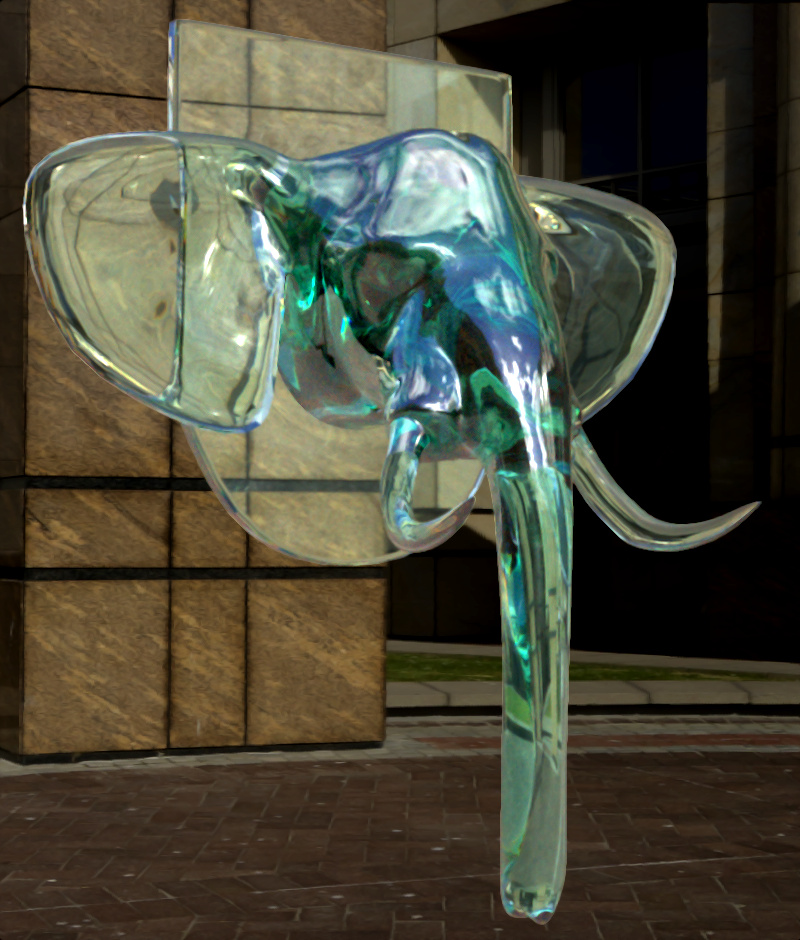
这张图是"完美透明渲染"的标杆:光谱色散(玻璃边缘的彩色条纹)、偏振效应、全内反射都正确模拟。但每条光线需要追踪数十次反弹才能收敛——在实时渲染中,这意味着每像素数十条光线,远超帧预算。问题不在于"能不能做到",而在于"做到之后还有多少预算留给其他效果"。
图展示了代价与收益的不对称。以透明渲染为例:
- 第 1 层透明:贡献了约 60% 的视觉差异(从"没有透明"到"有透明")
- 第 2 层透明:贡献了约 25% 的视觉差异
- 第 3-4 层透明:贡献了约 10% 的视觉差异
- 第 5+ 层透明:贡献了约 5% 的视觉差异
但代价是线性的——每多一层透明,就多一次 BVH 遍历和 any-hit shader 调用。这意味着前 2 层透明是"高利润"的(代价低、收益高),第 3-4 层是"微利"的,第 5+ 层是"亏本"的。
体积渲染的曲线更极端:128 步 ray march 的前 32 步贡献了 80% 的视觉效果,后 96 步只贡献 20%——但代价是线性增长的。这就是为什么很多引擎用 32-64 步而非 128 步:接受 10-15% 的画质损失,换取 50-75% 的性能节省。SSS 也类似——屏幕空间模糊贡献了 80% 的视觉差异,路径追踪只多贡献 15-20%,但代价是 10 倍以上的计算量。
我们可以用一个简单的利润率公式来量化这种不对称。定义"视觉利润率"为视觉收益增量与代价增量的比值:
$$ \text{利润率}(k) = \frac{\Delta \text{Visual}(k)}{\Delta \text{Cost}(k)} $$
由于代价是线性的($\Delta \text{Cost} = c$,常数),而视觉收益呈指数衰减($\Delta \text{Visual}(k) \approx A \cdot e^{-\lambda k}$),利润率随层数 $k$ 指数衰减。当利润率降到 1 以下时($\Delta \text{Visual} < \Delta \text{Cost}$),继续增加层数就是"亏本"——这就是"利润拐点"。对透明渲染,拐点大约在第 2-3 层;对体积渲染,拐点在 32 步左右;对 SSS,屏幕空间模糊本身就是拐点选择。
OK,把代价和收益放在一起看,结论就很清楚了:透明、体积、SSS 三个领域都存在"前几步高利润、后续亏本"的边际收益递减曲线。理性的工程策略是在"利润拐点"处停下——透明做到 2-3 层、体积做到 32-64 步、SSS 用屏幕空间模糊——然后把省下来的预算分给利润更高的反射和 GI。
7.3 硬件演进方向
NVIDIA Ada Lovelace 架构 NVIDIA Ada 引入了两个和透明直接相关的硬件单元:
- OMM Engine:加速 alpha 测试几何体的光追遍历,将 any-hit shader 的调用频率降低到只在 unknown 状态触发
- DMM Engine(Displaced Micro-Mesh):提供最高 10 倍 BVH 构建速度和 20 倍 BVH 存储空间减少,间接降低透明场景的 AS 构建开销
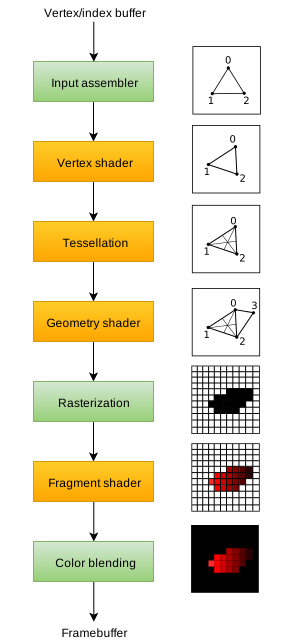
渲染管线的每个阶段都可能成为透明效果的瓶颈:顶点着色器需要处理变形动画的 alpha、光栅化器需要处理 alpha-to-coverage、片元着色器需要处理 alpha test、输出合并阶段需要处理混合。光追管线在此基础上还增加了 BVH 遍历和 any-hit/closest-hit 着色器调用——每一次额外调用都直接消耗帧预算。
OMM Engine 解决的是"透明遍历慢"的问题,DMM Engine 解决的是"AS 构建贵"的问题。两者配合,在植被密集场景中的效果最为显著——Indiana Jones 的实测已经证明了 2.2 倍加速。
但 OMM 和 DMM 都不解决体积渲染和 SSS 的问题。体积渲染的瓶颈不在 BVH 遍历,而在每步采样的光照计算(需要阴影光线)。SSS 的瓶颈不在遍历,而在高方差导致的多采样需求。这些效果的加速需要的是"更多光线并行度"或"更智能的采样策略"——前者依赖 GPU 的总体吞吐量提升,后者依赖 ReSTIR 类算法的进步。
换句话说,硬件演进正在拉大"能盈利"和"不能盈利"效果之间的差距。OMM 让透明从"几乎不可用"变成"勉强可用",但体积和 SSS 依然停留在"光栅近似 + 降级"的阶段。下一代 RT Core 如果能在硬件层面支持体积积分(比如硬件 ray march 加速),这个局面才可能改变。
值得关注的另一个硬件方向是 NVIDIA 的 Mega Geometry 技术 NVIDIA Mega Geometry——它允许在单帧内构建和更新大量 BLAS,对动态透明场景(如风吹植被)的 AS 更新开销有显著降低。Mega Geometry 与 OMM 配合时,OMM 数据可以增量更新而非全量重建,这对 Indiana Jones 这种植被密集场景尤其有效——植被的 alpha mask 在风中变化时,只有变化区域的微三角形需要重新分类。但这仍然只解决透明遍历和 AS 构建的问题,对体积渲染和 SSS 的核心瓶颈(光照采样和高方差)没有帮助。
基于以上分析,我们来总结工程取舍建议。依然是先来看量化的结论,再给出落地建议。
7.4 工程取舍建议
基于以上分析,我们给出以下工程取舍建议:
- 透明渲染:优先用光栅 OIT(WBOIT 或 MLAB-2),只在需要折射/反射时用光追。OMM 在 RTX 40+ 上几乎免费,应该默认开启。NVIDIA 在 UE4 光追介绍 NVIDIA UE4 RT 中也把 Ray tracing translucency 标为 Raster translucency 的等价物,说明厂商自己也知道光追透明不是必须的。
- 体积渲染:用 froxel grid(32-64 步),不用光追 ray march。体积雾的 GI 用 Lumen 类方案降级处理,不追求精确。
- SSS:用屏幕空间模糊 + 扩散剖面,路径追踪只在离线或高预算场景使用。混合 ReSTIR 方案是未来方向,但当前工程成熟度不足。
- 光线预算分配:把省下来的光线预算(不花在透明/体积/SSS 上的)分给反射和 GI——这些效果的视觉收益更高,每条光线的"利润率"更好。
- 降噪器配合:透明和体积效果的降噪器需要特殊处理——在 alpha 边缘和体积边界禁用大核模糊,改用小核边缘感知滤波。SSS 则不需要额外降噪器——扩散剖面本身就是低通滤波。
归根结底,这套建议的核心逻辑就是"把光花在利润最高的地方"。光追不是万能的——它在硬阴影、镜面反射、GI 上有明确的画质优势(我们在 ep01 的分界线就讨论过),在透明、体积、SSS 上则代价远超收益。理性地承认这一点,把光追用在对的地方,才是混合渲染的工程智慧。
实际工程中还有一条容易踩的坑:半透明物体的排序与合批。即使使用 OIT 方案,半透明物体的 draw call 仍然需要按深度排序才能保证 WBOIT 的权重函数正确工作。如果场景中有数百个半透明粒子(如火花、碎片),排序本身的 CPU 开销不可忽视。UE5 的方案是把半透明物体分成"前景层"和"背景层"两个 batch,层间排序但层内不排序——牺牲精度换 CPU 时间。Frostbite 更进一步,用 compute shader 在 GPU 端做排序,完全消除 CPU 端的排序开销。这些工程细节在学术论文里几乎不会讨论,但在实际项目中往往是决定帧率能否稳住 60fps 的关键因素。
另一个值得关注的实践问题是半透明边缘的 MSAA 兼容性。光栅管线的 MSAA 在几何边缘采样覆盖率,但半透明物体的边缘(alpha 渐变区域)不受 MSAA 保护——因为 MSAA 只在几何覆盖率的边界做子像素采样,alpha 渐变是着色器内部的连续变化,不在 MSAA 的处理范围内。这意味着 4x MSAA 的场景里,不透明物体的边缘很干净,但半透明物体的边缘可能有锯齿。光追管线的透明处理(any-hit shader + alpha test)天然支持每子像素采样不同 alpha 值,因此在 MSAA 场景下半透明边缘更干净——这算是光追透明为数不多的"画质优势"之一,但代价是否值得取决于具体场景。
讲完了透明、体积、SSS 三大"利润黑洞"的物理基础、工程方案和引擎取舍,最后留下几个值得继续思考的问题。
八、这一章留下的问题
到这里,我们已经把光追管线下"最难盈利"的三个领域——透明、体积、SSS——拆解完毕。结论是清晰的:在当前硬件和算法水平下,这三个效果都不适合在实时预算下做精确光追,业界的一致选择是"跳过、降级、近似"。
回看本系列十二篇的脉络,我们可以把光追的"盈利地图"画出来:
- 高利润区(光追有明确画质优势、代价可控):硬阴影(ep06-07 的降噪保证了时域稳定性)、镜面反射(ep04 的 SBT 组织)、GI(ep08 的 ReSTIR 采样)。这些效果每条光线的视觉收益高,且降噪器能有效压制方差。
- 微利区(光追有优势但代价偏高):软阴影、光泽反射、多次反弹 GI。这些效果需要更多采样或更复杂的着色器,但视觉收益仍然可见。
- 亏损区(光追代价远超收益):透明(N 倍 BVH 遍历)、体积(128 次采样)、SSS(16-64 次路径采样)。这些效果的每像素光线数远超帧预算允许,且降噪器在半透明边缘和体积内部失效最严重。
这个分界线不是静态的——OMM 硬件加速正在把透明从"亏损区"拉向"微利区"。如果未来的 RT Core 能在硬件层面加速体积积分或 SSS 路径采样,这些效果也可能跨越分界线。判断某个效果是否跨越了分界线,可以用一个简单的定义:
$$ \text{Profit}_{\text{RT}} = \frac{Q_{\text{RT}} - Q_{\text{raster}}}{T_{\text{RT}} - T_{\text{raster}}} $$
其中 $Q$ 是画质评分,$T$ 是 GPU 时间(ms)。当 $\text{Profit}_{\text{RT}} > 0$ 且足够大时,光追在该效果上"盈利";当 $\text{Profit}_{\text{RT}} \leq 0$ 时,光追"亏损"。OMM 把 $T_{\text{RT}}$ 从 7.90ms 降到 3.58ms,就是在把 $\text{Profit}_{\text{RT}}$ 从负拉向正。但在当前这一代硬件上,混合渲染的理性策略依然是:光追用在高利润区,光栅负责亏损区。
// 光追盈利判定:画质增量 vs 时间增量
float profit_rt = (quality_rt - quality_raster) / (time_rt - time_raster);
if (profit_rt > threshold)
    use_ray_tracing();   // 高利润区:硬阴影、反射、GI
else
    use_rasterizer();    // 亏损区:透明、体积、SSS
NVIDIA 在 Indiana Jones 的路径追踪优化分享 NVIDIA Indiana Jones Blog 中也验证了这个分界线:OMM 把透明从亏损区拉向微利区,但体积和 SSS 仍需下一代硬件的算法突破。
还有一个容易被忽视的维度:降噪器的有效范围。我们在第六篇和第七篇讨论过 SVGF 和 ReBLUR 的工作原理,它们在纯不透明场景下的方差压制效果非常好。但降噪器的假设前提是"邻域像素的光照条件相似"——这个假设在透明边缘(alpha 突变)和体积内部(深度方向变化)都不成立。这就是为什么透明和体积效果不仅光线数贵,降噪器的辅助也打折——双重"利润压低"让这些效果更加不划算。SSS 的情况更微妙:扩散剖面本身就是一种"物理正确的模糊",额外加降噪器反而可能过度平滑,丢失 SSS 的特征光晕。
但这个结论留下了一个更深层的问题:如果光追在透明/体积/SSS 上不划算,那光追的"盈利边界"到底在哪里?在系列开篇(ep01),我们画了一条"什么时候该从光栅切到光线"的分界线。经过十二篇的讨论,这条线已经越来越清晰——光追在硬阴影、镜面反射、GI 方面有明确的画质优势,在透明、体积、SSS 方面则代价远超收益。
还有一个实践层面的观察值得记录:在项目开发中,透明和体积效果的"降级策略"往往不是技术决策而是产品决策。美术团队希望玻璃有真实折射、雾有正确的散射、皮肤有柔软的次表面渗色——这些是画面品质的直观感知点。工程团队则在帧预算的压力下不得不降级。最终的方案通常是"分层降级":近景的透明物体用高精度方案(WBOIT + 光追折射),中景用半精度方案(MLAB-2),远景直接跳过光追只用光栅 alpha blending。这种分层策略在 UE5 的 LOD 系统中有原生支持——Lumen 的透明处理就按距离分档,近处的高品质 translucency reflections 只在前几层启用。Frostbite 的 froxel grid 也按距离调整分辨率——近处用高分辨率 froxel,远处用低分辨率。这些工程上的"妥协艺术"才是实时渲染的日常,也是本系列反复强调的"代价换到了哪里"的具象体现。
下一篇(也是系列的最后一篇)将做两件事:一是回顾整个系列的关键取舍决策,把十二篇里散落的工程经验串成一张"混合渲染决策地图";二是展望下一代硬件(RTX 50 系列的 Mega Geometry、Path Tracing 硬件加速)可能如何改变这条"盈利边界"。十二篇的旅程即将收束,但光追和光栅的混合之道才刚刚开始。
相关链接 - 上一篇:RT 资源的流式加载:大世界的 AS 管理 - 下一篇(预告):混合渲染决策地图:十二篇系列总结与未来展望 - 系列总览:实时光线追踪与混合渲染
With Best Wishes.