本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-vulkan-best-practices
题图 2026 三件套与本机能力的三层对照:官方那门课要求的三类能力,分别落在「规范里是核心」「本机有扩展」「本机压根没有」哪一层 @ 本系列绘制
全系列篇目总览(共 10 篇,本篇为第 2 篇):
- ep01 官方最佳实践到底在哪:四套体系的边界与本机能力实勘——地图与本机能力基线
- 本篇 · ep02 2026 新范式:Vulkan 1.4 基线、Dynamic Rendering 与 Shader Objects——新范式
- ep03 同步最佳实践:barrier 精细化、sync2 与时间线信号量——同步
- ep04 管线缓存:绝不在 draw time 建管线——管线缓存
- ep05 Render Pass 与 Subpass:attachment 策略与 tile 内存——render pass / subpass
- ep06 命令缓冲与多线程录制:secondary CB 与 false sharing——命令缓冲
- ep07 描述符与内存分配:从 256 字节的告警说起——描述符
- ep08 Layout Transition:barrier 的代价落在哪——layout transition
- ep09 Swapchain 与 Present:image 数量、旋转与 waitIdle→fence——swapchain
- ep10 验证层 Best Practices:从 warn 到修复的真图闭环(收束篇)——验证层闭环
除以上两篇外的八篇尚在排期,发布后回填链接。本系列的写作边界(四条不写与两条未核实)见 §0.3 的边界声明与 §12.1 的汇总。
先说清楚这一篇要干什么
好了,ep01 给了地图:官方最佳实践散在四套体系里,而且验证层里那个最关键的开关默认是关的。地图有了,接下来要回答的是地图上那条主路——官方在 2026 年给出的那一套写法,到底长什么样,搬到这台机器上值多少。
0.1 这一篇的三条主线
OK,第一篇问的是"官方材料在哪",这一篇问的是"官方那套新写法是什么、能不能跑、跑了差多少"。三件事一次摊开。
第一条:官方那份"2026 说法"到底说了什么。 Khronos 在 SIGGRAPH 2026 上开了一门课,标题直接就叫《How to write a Vulkan application in 2026》。它给了三件套:shader objects + dynamic rendering + descriptor heap,而且话说得很重——"以前要扩展的功能现在已是核心,以前算高级的写法现在就是推荐基线"。这一句我们要拿回来逐条核。
第二条:这三件套在这台机器上,各有几条命。 这是本篇最硬的部分,也是第一篇那句"只引归档里能逐行回溯的读数"第一次真正派上用场:官方课程列的必需清单里,有两件本机能跑、有一件本机根本没有。这件事不是我们查漏了,是设备能力就是如此——下面会把逐项实测摆出来。
第三条:能跑的那部分,跑起来差多少。 我们搭了一个最小图形用例(交换链 + 呈现),把老写法与新写法放在同一台机器、同一份构建、同一对着色器、同一个交换链上各跑一遍——只改 API 形态,别的都不动。这才是"值多少"的问法。
0.2 与第一篇的关系:从地图到第一条真链路
先来看看 ep01 结尾留的那句话,它说下一篇要"搭出第一条真正的图形链路(交换链 + 呈现 + 抓帧)"。这篇按那句话交作业。
两件事在那时候是欠着的,这里一并还上:一是抓帧——ep01 的用例是纯计算的控制台程序,没有帧边界,RenderDoc 抓不出东西,当时只记了"通道可用";二是 ep01 素材盘点里那条"命中但不用"的账——Vulkan simplified pipeline.svg 当时被判的是"294×643,尺寸不达标,主题属 ep02/ep03"。本篇把这张图重新核了一遍,结论写在第五章 §5.1:真正的问题不在尺寸,在纵横比——它会被站点按列宽铺满、渲染成 880×1924 px。所以本篇换用了另一张 Public domain 的管线图,并把这次取舍记在了正文里。
0.3 边界声明:本篇不涉及什么
说白了,第一,不做跨厂商对照。 本机只有一块 NVIDIA 独显。所有"厂商支持表"里的内容只引官方原文,不冒充实测;凡是我们自己量不到的,正文会写明"这一条只引官方口径"。
第二,不给驱动内部 JIT 的结论。 Vulkan 没有任何官方接口能看到驱动编译器内部的中间表示或 JIT 决策。
第三,不给指令集规范的断言。 NVIDIA 没有公开 SASS 的官方 ISA 文档,nvdisasm 的输出只能作为观测性描述。
第四,时间戳有同步域边界。 vkCmdWriteTimestamp 只保证同一次提交内 happens-after 的时间戳不递减。
第五,本篇新增:不做移动端实测。 手上没有 Android 设备。而这一篇偏偏绕不开移动端——官方在同一份材料里既把 pipeline 标为弃用、又承认量产移动驱动还不支持它的替代品。这条矛盾我们会拆开讲,但移动端那部分全程只引官方支持表与厂商报告,一次都不会说成"本机实测"。
第六,VK_DEVICE_LAYERS 未核实(承 ep01,该变量名在官方文档里查不到,不作为现行变量名使用)。
0.4 本机环境快照
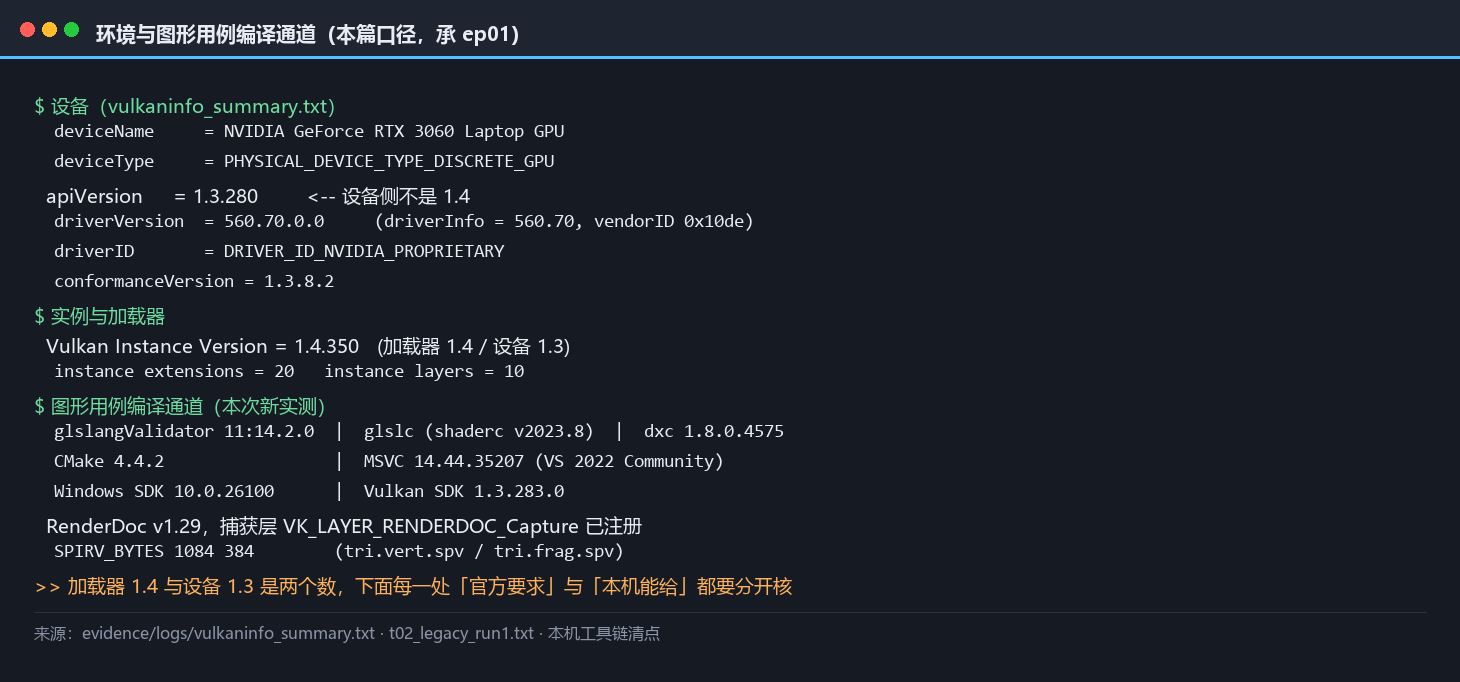
好了,老规矩先上环境,但这台机器 ep01 已经量过了,这里只补这一篇新增的两项——着色器工具链与图形用例的编译通道。
| 项 | 读数 |
|---|---|
| GPU / 驱动 | NVIDIA GeForce RTX 3060 Laptop GPU|驱动 560.70 |
| 设备 API 版本 | 1.3.280(实例/加载器为 1.4.350 —— 设备侧不是 1.4) |
| Vulkan SDK | 1.3.283.0 |
| 着色器工具 | glslangValidator(11:14.2.0)|glslc(shaderc v2023.8)|dxc(1.8.0.4575)全在位 |
| 构建链 | CMake 4.4.2|MSVC 14.44.35207(VS 2022 Community)|Windows SDK 10.0.26100 |
| 抓帧 | RenderDoc v1.29,捕获层已注册;本机额外启用了它的应用内 API(程序自己触发抓帧,不必按 F12) |
这张快照要按"读数基线"来读,不是按"环境准备"来读:后面凡是出现"本机实测"四个字,说的都是这一台、这一份驱动、这一套工具链。 本篇所有横向对照都只在这台机器内部成立,跨机器的绝对值不作比较——这是 ep01 就立下的纪律,本篇继续执行。
表里第三行那个数字要停一下:设备侧报的是 1.3.280,不是 1.4。加载器是 1.4,但设备不认 1.4。这一条会贯穿全篇——官方那门课的设备起点是 set_minimum_version(1, 4),而这台机器够不到那个起点。所以后面每一处"官方要求的"与"本机能给的",都要分开写、分开核。
一、官方那份「2026 说法」到底说了什么
OK,这一章只干一件事:把 SIGGRAPH 2026 那门课的主张原样摆出来,不带我们的评价。评价放到第二章去。
1.1 为什么官方要专门开这门课
先来看看课程的自我定位。它给的理由非常直接:2016 年到现在快十年,大量教材还停在 Vulkan 1.0 那套"冗长而脆弱的样板代码"上,而规范早就不是那个样子了。课程材料里有两句原话值得逐字抄下来:
"Best practices have changed substantially: features that once required extensions are now core; patterns once considered advanced are now the recommended baseline." "If you learned Vulkan before ~2022, some of what you know is worth unlearning."
第二句尤其重——它在说有些旧知识需要被忘掉。这话由 Khronos 的工作组主席(Ralph Potter,Samsung)与 Arm 的讲师一起讲,不是社区言论。
1.2 课程的十节主线
好了,把课程目录摊开,它的推进顺序是这样的(括号里是它的主张):
Why This Course, Why Now(十年演化,样板该退场了)→ Device Creation and Initialization(起点就要求 1.4)→ Vulkan Resources → Command Recording and Submission → Shaders(用 Slang)→ Pipeline Management – Shader Objects → Drawing / Dynamic Rendering → Descriptor Management(用 descriptor heap)→ Synchronization(基础同步 + sync2 + 时间线信号量)→ Debugging。
加粗那三节就是本篇要核的三件套。 其余各节要么是样板(设备创建、资源、命令提交),要么是我们在 ep01 已经交代过的东西。
课程还列了两份附页,它们在本篇里都有用处:一份是 Supported Hardware,逐平台写清了各家的真实支持情况——那张表是第二章到第十一章几乎所有判断的锚点;另一份是 Abstraction Libraries,列出 Vulkan-Hpp、vk-bootstrap、GLFW 这类封装库,属于"怎么少写样板"的话题,本篇只登记、不展开。
1.3 三件套各自的官方形态
OK,在逐件拆开之前,先把整条图形管线摊开看一眼——因为这三件套不是三件互不相干的新东西,它们各自只动了这条流程上的一段。看清各自动的是哪一段,后面"哪一件在本机能不能跑"才好安放。
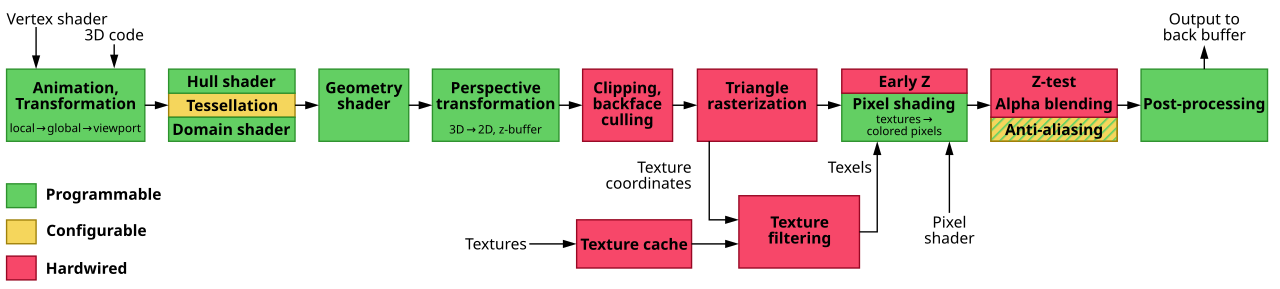
Dynamic Rendering。 用 vkCmdBeginRendering / vkCmdEndRendering 取代单 pass 的 render pass;不再有 VkRenderPass 与 VkFramebuffer,附件信息改为栈上的 VkRenderingAttachmentInfo。官方 Guide 的弃用表已经把 Render Pass Objects 标为弃用(Vulkan 1.4),替换项写的就是 dynamic rendering。
有一条边界必须一起记:它不是同步命令。布局与同步仍然要应用自己用 barrier 管——"更动态"换来的不是"自动正确"。
Shader Objects。 引入新对象 VkShaderEXT(单个已编译着色器阶段),用 vkCreateShadersEXT 创建、vkCmdBindShadersEXT 绑定,把状态从管线创建期搬到命令录制期。官方 Guide 的弃用表同样把 Pipeline Objects 标为弃用,替换项是它。
它的状态要说准:截至现有官方材料,它仍然是 VK_EXT_ 扩展,没有被提升进核心。 我们在官方文档里没有查到任何"已核心化"的声明——这一条在正文里会反复用到。
Descriptor Heap。 官方对它的定位最激进:完全取代现有的 descriptor set 机制,并在新硬件上取代 descriptor buffer。两个 heap(sampler + resource)、直接往内存里写描述符、不再需要 VkDescriptorSet / VkDescriptorPool / VkPipelineLayout。官方 Samples 索引里直接写着 "If available, VK_EXT_descriptor_heap should be preferred"。
1.4 官方给的硬件支持表
说白了,课程附页里那张支持表,是这一篇后面所有判断的锚点,逐格抄如下:
| 平台 | shader objects | descriptor heap |
|---|---|---|
| NVIDIA / AMD Windows 生产驱动 | 完整支持 | 完整支持 |
| Intel(Windows) | 计划中 | 计划中 |
| Mesa 26.2(2026-08)起 AMD / Intel / lavapipe | 支持 | 支持 |
| 移动端量产驱动 | 暂缺(KHR 版本在计划中) | 暂缺 |
这张表本身就是一个矛盾:官方在同一份材料里,一边把 VkPipeline 标为弃用、一边承认量产移动驱动还没有它的替代品。桌面与移动这两栏,在 2026 年给出的答案并不一样。这件事我们不站队,第二章把它拆成判据。
1.5 官方为什么要做这次换代
言归正传,最后补一句动机,它来自 VK_EXT_shader_object 的提案文档,是官方自己写的"管线为什么有痛点":
pipeline 把组合爆炸从驱动推给应用,但很多实现在 bind 时又出现了新的开销——"draw time 的开销被搬到了 pipeline bind time";同时 pipeline 反而把一部分硬件能力锁死了。
同一份提案里还给了对"打补丁"路线的判断:像 graphics pipeline library(GPL)这类方案"在 bind 时没有实质的绝对 CPU 性能提升"——绑 N 个 library 仍约等于绑一个整体管线。官方正是因此才选择"彻底放弃 pipeline"这条路,而不是继续给 pipeline 打补丁。
这句话是理解整个换代的钥匙:它要解决的是"绑定时刻的开销",不是"画得更快"。 记住这一点,第五章与第六章那两组读数才有地方安放。
二、1.4 基线:哪些东西从「扩展」变成了「核心」
好了,官方的换代不只是新加对象,还有一件事更基础:把一批以前要查扩展的能力,直接变成核心版本的一部分。 这一章把这件事量到本机的具体型号上。
2.1 官方说这是第一个「提前规划」的核心版本
OK,Vulkan 1.4 的提案开头写得很直白:
"This version aims to be the first (hopefully of many) where a different approach is taken - planning in advance to define a more compelling core version."
它不是事后把零散扩展收编,而是以 Roadmap 2022 与 Roadmap 2024 为起点提前规划的。更早的几个核心版本(1.1/1.2/1.3)是"哪个扩展成熟了就提上来",1.4 换了做法。
2.2 提升为核心的清单
先来看看被整体提升为核心的扩展,按批次分是这样:
| 批次 | 扩展 |
|---|---|
| Roadmap 2024 组 | VK_KHR_maintenance5、push_descriptor、load_store_op_none、shader_subgroup_rotate、shader_float_controls2、shader_expect_assume、line_rasterization、vertex_attribute_divisor、index_type_uint8、map_memory2 |
| Roadmap 2022 组 | VK_KHR_global_priority |
| 额外功能组 | maintenance6、pipeline_protected_access、pipeline_robustness |
| 传输组 | host_image_copy(提升为核心,但功能可选) |
| 部分提升 | VK_KHR_dynamic_rendering_local_read(见下) |
其中 dynamic_rendering_local_read 的"部分提升"值得单独说:官方强制支持"对存储资源 + 单采样颜色附件"的 local read,而深度/模板附件与多重采样附件的读取由两个新布尔门控——这一项虽然进了核心,却不是所有 1.4 设备都一样能用。
1.4 还给实现压了一批硬性 limit,其中几条对写引擎的人有直接约束:maxBoundDescriptorSets = 7、maxColorAttachments = 8、maxPushConstantsSize = 256、maxViewportDimensions = (7680, 7680)。
2.3 拿到本机来核:本机到底有几分之一个 1.4
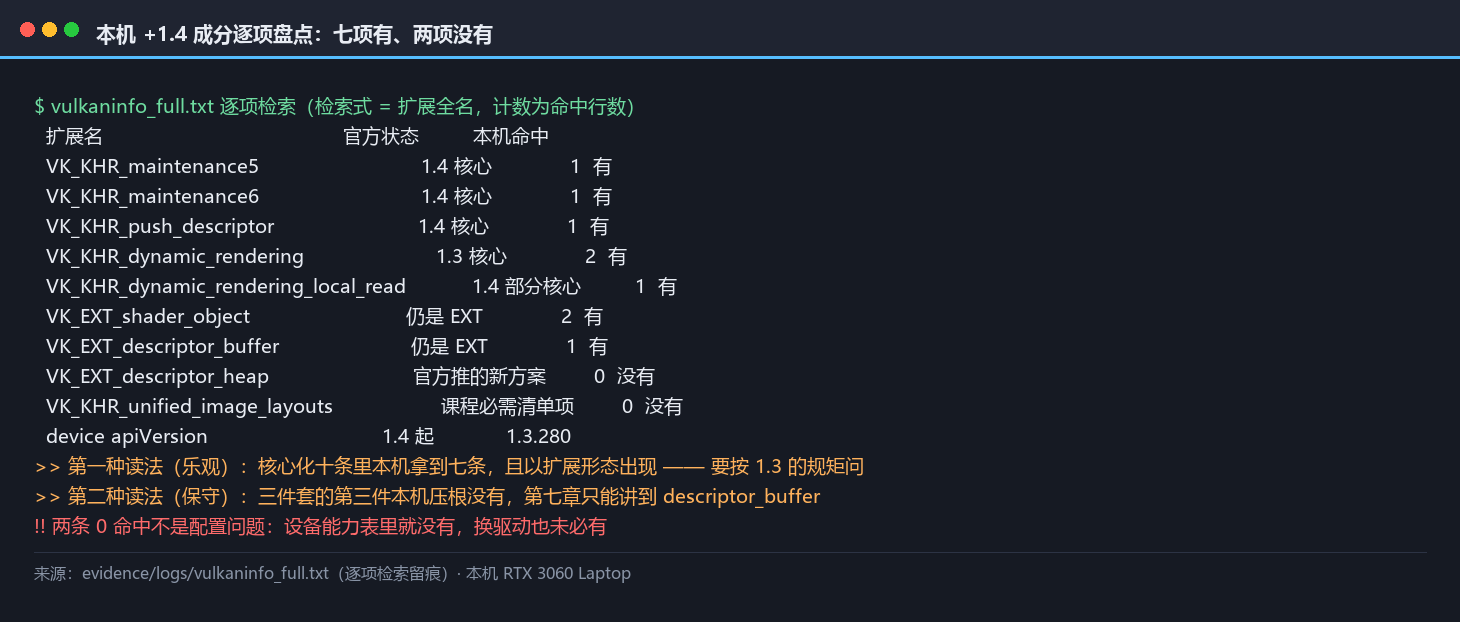
好了,清单是纸上的,接下来把它拿到本机逐项核。这一节的数据全部来自 vulkaninfo 全文(归档在 evidence/logs/vulkaninfo_full.txt)。
| 项 | 官方状态 | 本机 |
|---|---|---|
maintenance5 |
1.4 核心 | 有(扩展形态) |
maintenance6 |
1.4 核心 | 有(扩展形态) |
push_descriptor |
1.4 核心 | 有 |
dynamic_rendering |
1.3 核心 | 有 |
dynamic_rendering_local_read |
1.4 部分核心 | 有 |
shader_object |
仍是 EXT | 有 |
descriptor_buffer |
仍是 EXT | 有 |
descriptor_heap |
官方推的新方案 | 没有 |
unified_image_layouts |
课程必需清单项 | 没有 |
设备 apiVersion |
1.4 起 | 1.3.280 |
这张表要按两种读法读,两种都重要。
第一种读法(乐观):核心化的东西,本机大部分拿到了。 十条里七条有。而且它们是以扩展的形态出现的——因为设备声明的是 1.3,所以 maintenance5 这类"1.4 核心"的能力在这台机器上要按扩展去查、去启用。这正是 1.4 核心化的实际好处:你查得到,也能用,只是要按 1.3 的规矩问。
第二种读法(保守):三件套里的第三件,本机测不了。 descriptor_heap 与 unified_image_layouts 在这台机器上根本不存在。这不是配置问题——设备能力表里就没有这两项,换驱动也未必有。所以本篇第七章只能讲到 descriptor_buffer 为止,descriptor heap 那一段全程只引官方与社区记录,一次都不会说成"本机实测"。
2.4 「支持」这个词要拆成三层
说白了,到这里可以处理第一章留下的那个矛盾了。官方一边弃用 pipeline、一边承认移动端还没有替代品——这两句话能同时成立,因为"支持"这个词被混用了。我们把它拆成三层:
| 层 | 含义 | 怎么核 |
|---|---|---|
| 规范核心 | 写进核心版本,所有实现都必须兑现 | 查 1.4 的核心化清单与核心 limit |
| 厂商宣称 | 厂商的生产驱动说它支持某扩展 | 查厂商支持表、查设备扩展列表 |
| 真能上生产 | 这条路在真实项目里跑得住 | 查社区实测、驱动 bug 记录、自己跑 |
三层之间的关系不是包含关系。规范里是核心,不代表设备就声明了那个版本(本机:1.4 的核心项有不少,但设备声明的是 1.3);厂商宣称支持,不代表这条路没有坑(见第七章那串 driver bug);本机跑通了,也不代表移动端能跑(移动端那两栏写的是"暂缺")。
判据因此落到一句话上:先问目标硬件在哪一层,再谈要不要迁。 这句话会在第十一章变成一张表。
三、三件套里的三件,本机各有几条命
好了,第二章把"支持"拆成了三层。这一章把三件套逐件拿到本机核一遍,看看每一件落在哪一层。
3.1 逐项实测:两件能跑,一件没有
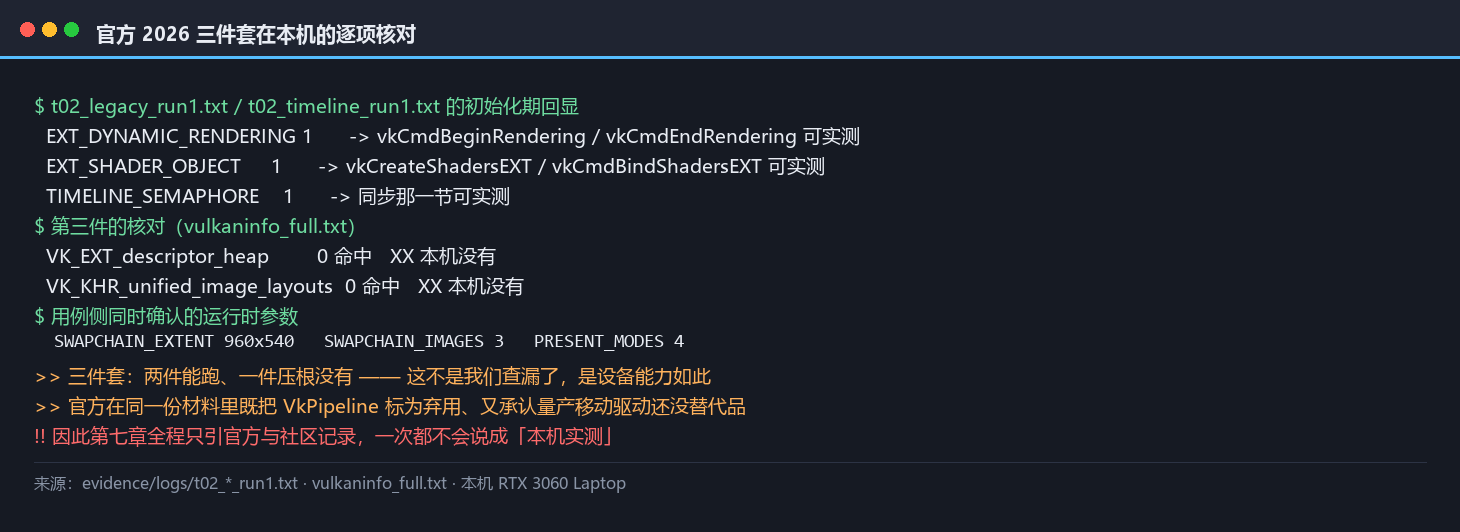
OK,数据来源是 vulkaninfo 全文里设备扩展列表的逐项核对(归档在 evidence/logs/vulkaninfo_full.txt),外加一个自写用例启动时的自我检查——用例会在创建设备之前先枚举设备扩展,把结果打在第一行,这样"这台机器到底有没有"这件事不依赖任何外部工具。
| 三件套 | 本机 | 形态 |
|---|---|---|
| Dynamic Rendering | 有 | VK_KHR_dynamic_rendering(1.3 核心) |
| ├ local read | 有 | VK_KHR_dynamic_rendering_local_read |
| Shader Objects | 有 | VK_EXT_shader_object(仍是 EXT) |
| └ 配套动态状态 | 有 | extended_dynamic_state3、vertex_input_dynamic_state |
| Descriptor Heap | 没有 | 设备扩展列表里查无此项 |
└ 官方课程清单里的 unified_image_layouts |
没有 | 同上 |
两件能跑、一件没有。 这个比例本身就是本篇最好的开场——官方那套写法的完整形态,在一台 2023 年的游戏本上只能兑现三分之二。而且缺的那一件不是边角:descriptor heap 是官方用来取代整个 descriptor set 机制的东西,课程里把它列为必需项。
3.2 「没有」不等于「设备差」
说白了,这里要接住第一篇留下的一条判据。ep01 里我们已经写过一次:某个特性报为假,不等于设备差,只说明这次查询里它不支持,而我们的方案本来就没打算用它。 这句话在这里要再走一步。
descriptor_heap 本机没有,有三种可能:驱动还没实现、这个扩展太新、或者这块硬件压根不在官方那栏的支持表里(课程的支持表只列了"NVIDIA/AMD Windows 生产驱动",没有按代际细分)。我们无法在本机区分这三者——设备的扩展列表只能告诉我们"没有",不能告诉我们"为什么没有"。
所以本篇的处置是:第七章讲 descriptor heap 时,全部内容来自官方文档与社区实测记录,一句本机读数都不引。 这不是回避,是把"我们量到了什么"和"我们读到了什么"分开放。ep01 里那条规矩在这里第一次被真正执行。
顺带把官方那栏支持表也落到判据上:
| 平台 | shader objects | descriptor heap | 对迁移的含义 |
|---|---|---|---|
| 桌面(NVIDIA/AMD 生产驱动) | 支持 | 支持 | 可以按新范式写 |
| 桌面(Intel Windows) | 计划中 | 计划中 | 暂时别把新范式当唯一路径 |
| Linux(Mesa 26.2+) | 支持 | 支持 | 同桌面 |
| 移动端量产驱动 | 暂缺 | 暂缺 | 新范式目前不是可选项 |
最后一行的意思很硬:如果你的目标平台是移动端,2026 年这套写法目前用不了,而官方的弃用表已经把 pipeline 标成了弃用。两边都写得很清楚,夹在中间的是应用开发者。第十一章会把这张表变成一张"什么时候不该迁"的判据。
四、第一条真链路:交换链 + 呈现
好了,前三章都是查表和读文档。从这一章开始动手——先搭出一条能出帧的最小图形链路,它是后面所有对照的载体。
4.1 用例:一个二进制,两条渲染路径
OK,ep01 的实验台是一个纯计算的控制台程序:一次 dispatch、读回校验和、量时间戳。它有个致命限制——没有帧边界,所以 RenderDoc 抓不了帧。
这一篇的用例换成图形用例:真的开一个窗口、建一条交换链、每帧呈现一次。为了做对照,一个二进制里放两条渲染路径,用命令行参数选:
| 路径 | 形态 |
|---|---|
legacy |
VkRenderPass + VkFramebuffer + 一条 monolithic VkPipeline |
modern |
vkCmdBeginRendering(无 render pass 对象)+ 同一条管线 |
shaderobj |
vkCmdBeginRendering + VkShaderEXT(无管线对象) |
timeline |
local modern,但主机侧同步换成时间线信号量 |
shaderobj_linked |
同 shaderobj,但两个阶段带 VK_SHADER_CREATE_LINK_STAGE_BIT_EXT |
三条设计上的取舍必须说清楚,因为它们决定了读数能不能比:
第一,绘制内容一模一样。 一个三角形,顶点位置由 gl_VertexIndex 算出来——没有顶点缓冲、没有描述符集、没有 uniform。这样"新写法"带来的差异里不会混进"数据上传方式变了"。
第二,着色器一模一样。 同一对 SPIR-V,五个路径共用。
第三,交换链一模一样。 尺寸、格式、图像数量、present mode 全部相同。
唯一被改的变量,就是 API 形态。 这句话是这一章所有数字的前提。
4.2 交换链与呈现的时序
先来看看链路本身。写法是标准的,但有一处属于"不写出来读者会踩"的细节,值得配一张时序图:交换链图像在 acquire 与 present 之间必须做布局转换,而这次转换在你的代码里得自己写——用 render pass 时它由 initialLayout / finalLayout 代劳,换成 dynamic rendering 之后这件事没人替你做。
时序是:vkAcquireNextImageKHR 拿到图像索引 → 屏障把图像从 UNDEFINED 转到 COLOR_ATTACHMENT_OPTIMAL → 录制(vkCmdBeginRendering … vkCmdDraw … vkCmdEndRendering)→ 屏障转回 PRESENT_SRC_KHR → 提交 → 等待 → vkQueuePresentKHR。
那两次屏障就是官方说的"它不是同步命令"的具体含义。换成 dynamic rendering,你拿回了控制权,也拿回了这份责任。
4.3 跑通的读数,以及两个把读数带偏的坑
好了,链路跑通之后先看基线。第一次跑出来的数不能用,原因有两层,两层都是我们自己踩的:
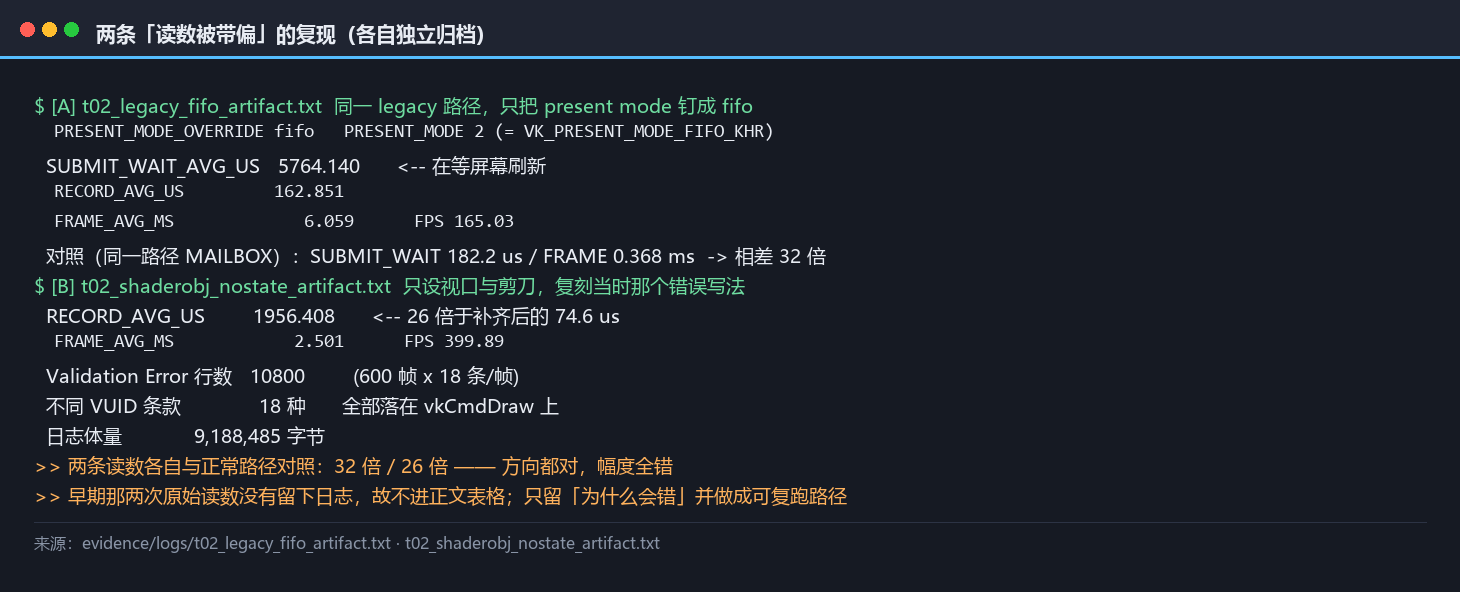
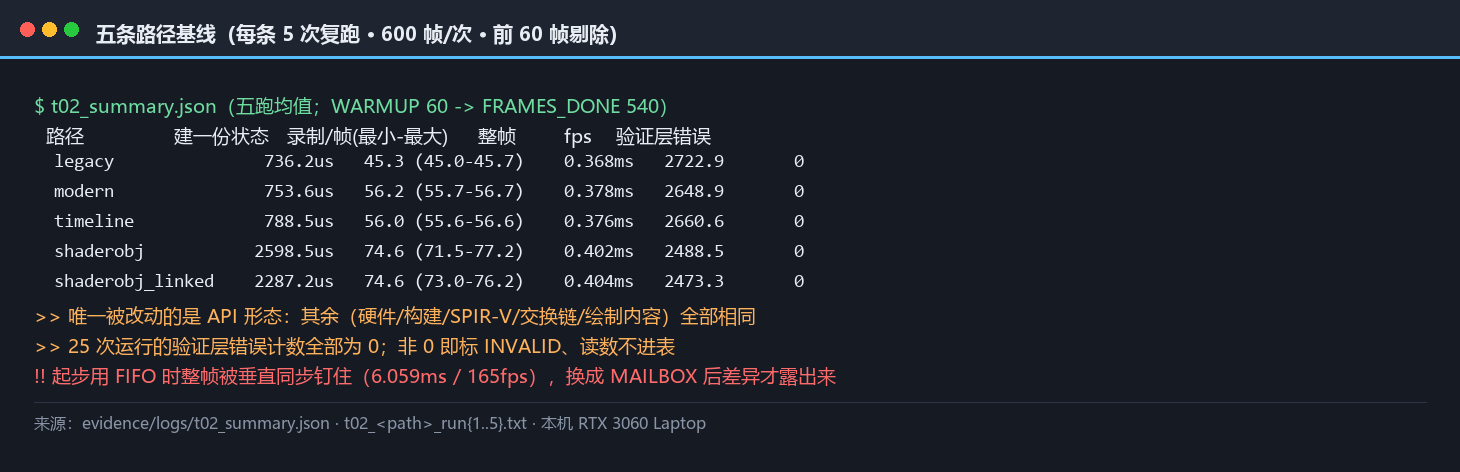
坑一:起步用 FIFO,把要比的东西全盖住了。 第一版选了垂直同步,量出来的 SUBMIT_WAIT 是几千微秒——那不是 API 成本,那是在等屏幕刷新。这一条我们后来专门复现并归档了(t02_legacy_fifo_artifact.txt:同一份代码、同一个路径,只把 present mode 钉成 fifo):SUBMIT_WAIT_AVG_US 5,764.1、整帧 6.059 ms、165 fps。数字看上去"稳定得很",可它反映的是显示器的刷新节奏,不是这份代码在干什么。改成 MAILBOX(本机支持 4 种 present mode)之后,同一份代码的整帧掉到 0.368 ms 量级,差异才露出来。
坑二:前 60 帧含着驱动预热,不能进统计。 管线创建这件事在 NVIDIA 驱动上要编译着色器,冷启动那一次与之后不在同一量级。所以统计口径从一开始就定成"跑 600 帧、前 60 帧剔除"——这一条在每一份归档日志里都能核(FRAMES 600 / WARMUP 60 / FRAMES_DONE 540)。说句实话:最早那次冷启动的具体读数没有留下日志,所以本篇不引用它,只留下这条口径以及它带来的结果。
这两个坑有多要紧?我们把它们各做成一条可以随时重跑的诊断路径,把被带偏的读数复现出来、各自归档——因为"我跑过、我看到"不构成证据:
修正之后,五条路径的基线(每条 5 次复跑、每次 600 帧)是这样:
| 路径 | 建一份状态 | 录制/帧 | 整帧 | fps |
|---|---|---|---|---|
legacy |
736.2 µs | 45.3 µs | 0.368 ms | 2722.9 |
modern |
753.6 µs | 56.2 µs | 0.378 ms | 2648.9 |
timeline |
788.5 µs | 56.0 µs | 0.376 ms | 2660.6 |
shaderobj |
2598.5 µs | 74.6 µs | 0.402 ms | 2488.5 |
shaderobj_linked |
2287.2 µs | 74.6 µs | 0.404 ms | 2473.3 |
这张表就是本篇的核心读数。 后面三章分别拆它的三列:第五章拆 legacy 与 modern 的差,第六章拆 shaderobj 两行的差,第八章拆 timeline 那一行。
4.4 管线与着色器对象统计
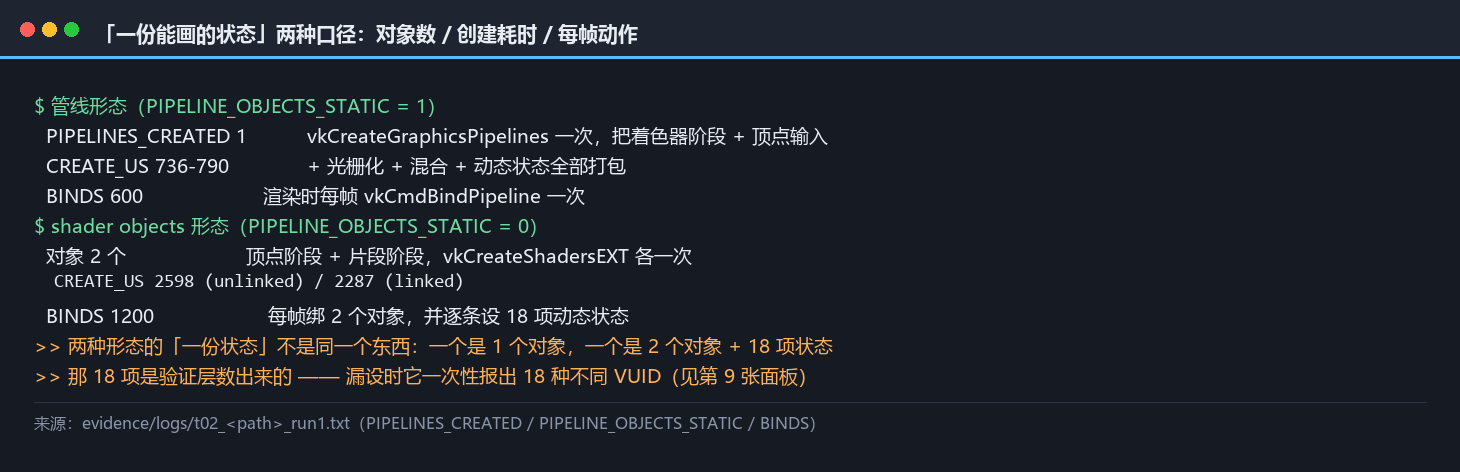
OK,表里"建一份状态"那一列,需要单独解释口径——因为两种形态的"一份状态"不是同一个东西。
用管线时,"一份能画的状态"是一个对象:vkCreateGraphicsPipelines 一次,把着色器阶段、顶点输入、光栅化、混合、动态状态全部打包。用 shader objects 时,"一份能画的状态"是两个对象(顶点阶段 + 片段阶段)加上一堆动态状态——对象本身不带状态,状态是在录制时逐条设进去的。
读数也照这个口径分开记:
| 形态 | 对象数 | 创建耗时 | 渲染时每帧要做的事 |
|---|---|---|---|
| 管线 | 1 | 736–754 µs | vkCmdBindPipeline 一次 |
| shader objects(unlinked) | 2 | 2598 µs | 绑 2 个对象 + 设 18 项动态状态 |
| shader objects(linked) | 2 | 2287 µs | 同上 |
那 18 项动态状态是怎么数出来的?是验证层数出来的。 第一次写 shader object 路径时我们只设了视口和剪刀,验证层一次性报出 18 种不同的 VUID——从 VK_DYNAMIC_STATE_CULL_MODE 到 VK_DYNAMIC_STATE_COLOR_WRITE_MASK_EXT 逐条点名。这件事第六章会展开,因为它差点让这一篇发出一个错误结论。
五、老写法 vs 新写法(一):render pass → dynamic rendering
好了,第四章那张表的第一列差异,这一章拆开:把 render pass 换成 dynamic rendering,本机到底差多少。
5.1 先看这条管线的形状
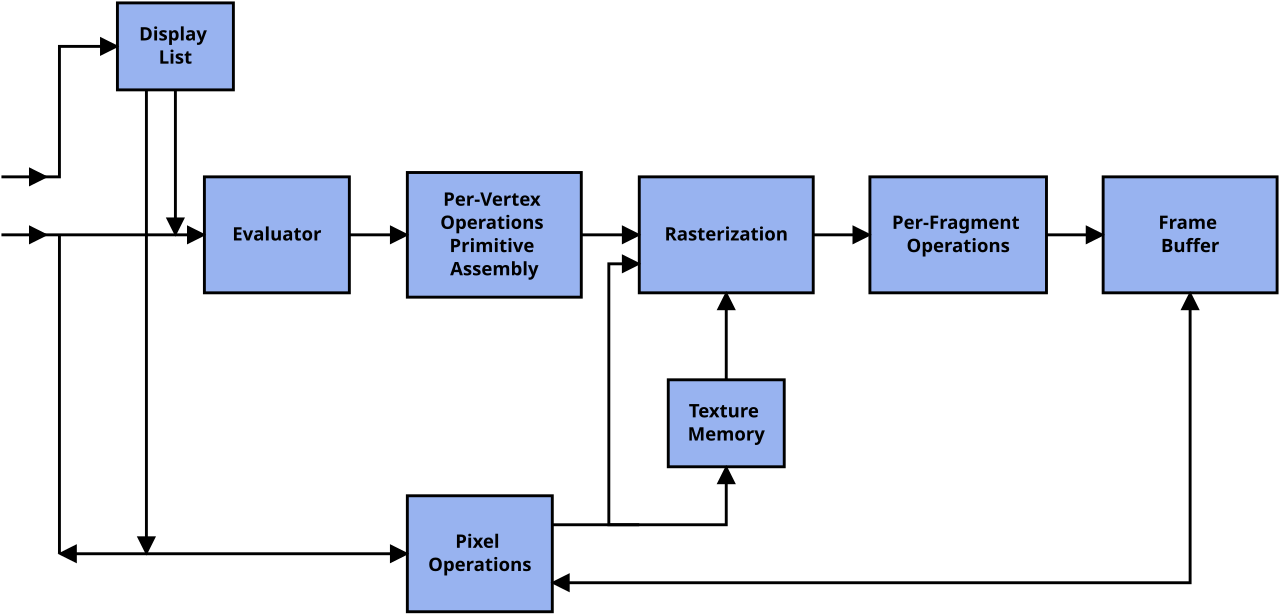
先来看看这条管线的形状。在讲"换掉了什么"之前,先把它摊开看一眼。下面这张是 OpenGL 时代的管线全图(Commons,Public domain),它比 Vulkan 的版本更早,但把链路分得一格不差:顶点操作 → 图元装配 → 光栅化 → 片段操作,最后落到 Frame Buffer。图里上排是西班牙文、下排是英文,两排说的是同一件事。
本篇要换掉的那一环,就在这张图上:Vulkan 把"图元装配 → 光栅化 → 片段操作 → Frame Buffer"这一段包成了 VkRenderPass + VkFramebuffer 两个对象,而 dynamic rendering 做的正是把它们整个拿掉。所以看这张图的时候,请把注意力放在右侧那几个框上。
顺带交代一次素材取舍,免得下次再绕回来。本文最初选的是 Commons 上那张 Vulkan simplified pipeline.svg(作者 Alexander Overvoorde,CC BY-SA 4.0)——第一篇的素材盘点里提过它一次,当时记的是"294×643,尺寸不达标"。本篇把它重新核了一遍,发现真正的问题不在尺寸,在纵横比:它的 viewBox 是 294×643,而站点把任何图都按正文列宽铺满(.bk-fig img{width:100%},880px),这张图因此会渲染成 880×1924 px、放大三倍,可读性反而比原图更差。所以最终换成了这张 PD 的 OpenGL 管线图。记一笔"候选素材被纵横比否掉"的账。
5.2 两条路径的代码形态差在哪
OK,先说清楚改了什么,再说差多少。同一个用例,两条路径在命令录制阶段的差异是这样的(简化示意,完整代码见篇末资源清单):
【旧写法】
  vkCmdBeginRenderPass(cb, &rbi, VK_SUBPASS_CONTENTS_INLINE);   // 需要 VkRenderPass + VkFramebuffer
  set_viewport_scissor(cb);
  vkCmdBindPipeline(cb, VK_PIPELINE_BIND_POINT_GRAPHICS, pipe);
  vkCmdDraw(cb, 3, 1, 0, 0);
  vkCmdEndRenderPass(cb);

【新写法】
  vkCmdPipelineBarrier(... → COLOR_ATTACHMENT_OPTIMAL ...);      // 布局转换,应用自负
  vkCmdBeginRendering(cb, &ri);                                  // 只有 VkRenderingInfo,无 pass/framebuffer
  set_viewport_scissor(cb);
  vkCmdBindPipeline(cb, VK_PIPELINE_BIND_POINT_GRAPHICS, pipe);
  vkCmdDraw(cb, 3, 1, 0, 0);
  vkCmdEndRendering(cb);
  vkCmdPipelineBarrier(... → PRESENT_SRC_KHR ...);               // 再转回去
两条路径共用同一条管线,所以差异只剩三处:renderPass 与 framebuffer 两个创建对象消失了;命令从 Begin/EndRenderPass 变成 Begin/EndRendering;多出来两次屏障。
顺序上还有一处要留意:附件格式在管线创建时也得告诉驱动——旧写法是从 renderPass 推出来的,新写法要显式挂在 VkPipelineRenderingCreateInfo 上链进 pNext。少写这一步,管线创建直接失败。
这一处差异值得单独点出来,因为它决定了迁移的顺序:换 dynamic rendering 不能只改录制那一段,还得回头动管线的创建参数。这两件事得连着看——"把 render pass 删掉"在代码里是两处改动,不是一处:一处在录制命令的地方,另一处在建管线的地方。只改前者,编译能过,运行会崩在管线创建期,而错误信息指向的是"附件格式",不是"你漏改了 render pass"。这是本篇在迁移判据里要反复用到的一条经验:换 API 形态时,先数清楚它牵动了几个地方。
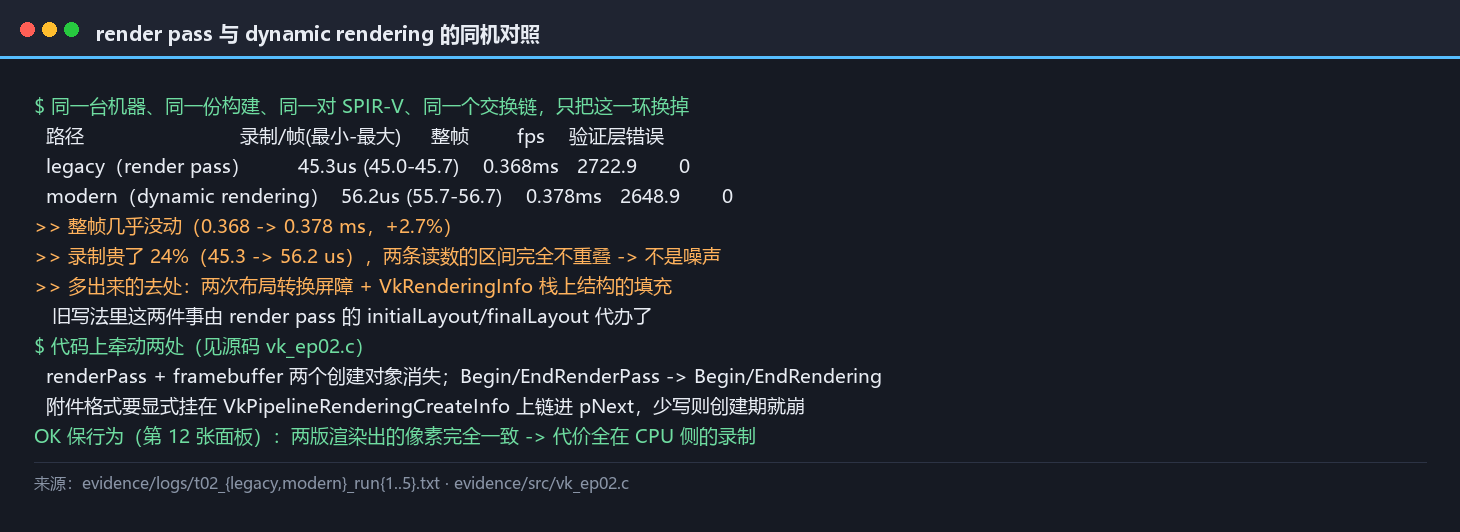
5.3 同机对照:帧时间没变,录制贵了 24%
好了,同一台机器、同一份构建、同一对着色器、同一个交换链,只把这一环换掉,五次复跑的结果:
| 路径 | 录制/帧(最小–最大) | 整帧 | fps | 验证层错误 |
|---|---|---|---|---|
legacy(render pass) |
45.3 µs(45.0–45.7) | 0.368 ms | 2722.9 | 0 |
modern(dynamic rendering) |
56.2 µs(55.7–56.7) | 0.378 ms | 2648.9 | 0 |
整帧几乎没动(0.368 → 0.378 ms,+2.7%),但录制贵了 24%(45.3 → 56.2 µs)。两条读数的区间完全不重叠(45.0–45.7 对 55.7–56.7),所以这不是噪声。
多出来的那一部分有明确去处:两次布局转换屏障,加上 VkRenderingInfo 这个栈上结构的填充。旧写法里这两件事由 render pass 的 initialLayout / finalLayout 代办了,创建期一次配好,录制期不花时间。
这个结果与 Qualcomm 在 Vulkanised 2026 上报告的方向一致。他们的迁移报告里有两点:把 render pass/framebuffer 一类删掉之后,wrapper 从约 550 行降到约 130 行;而 dynamic_rendering_local_read 这项"基本没有性能收益"——原因是他们那个 sample 原本就没用 subpass。
两句合起来才是完整的判断:dynamic rendering 的收益在代码形态与可维护性上,不在帧时间上。想靠换它换来帧率的读者,这里可以停一下。
5.4 验证层在两条路径上的表现
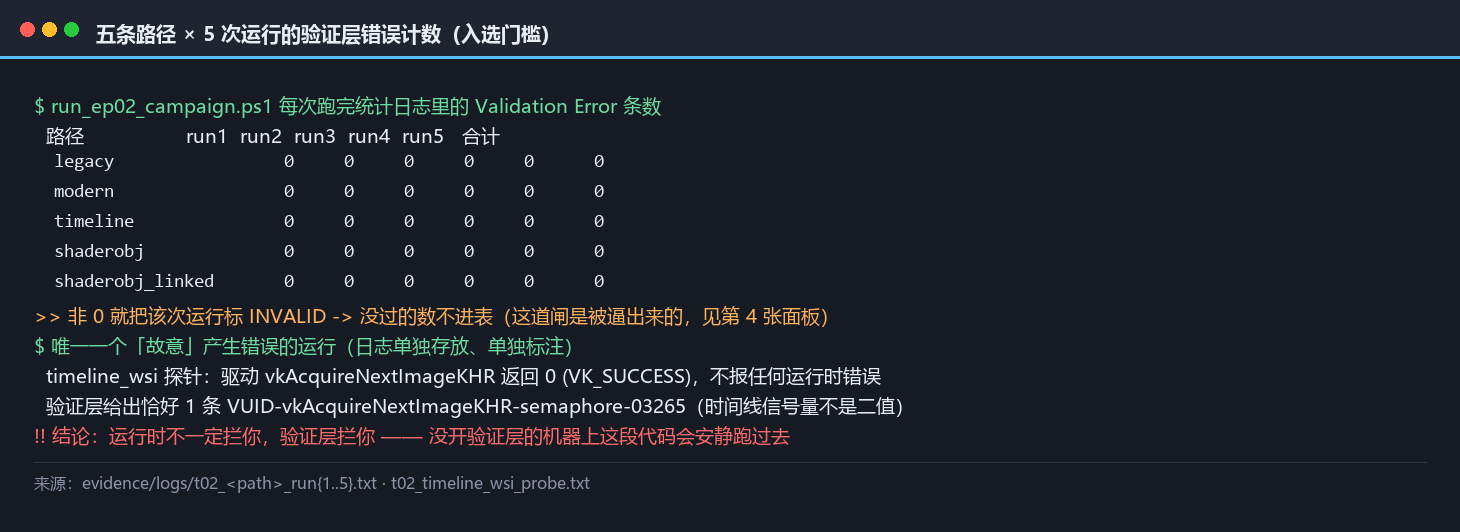
说白了,这一节很短,但结论对我们自己有用:两条路径在全程 1200 帧里都没有产生一条验证层错误。
这不是"没验证",而是我们给实验台加了一道闸——run_ep02_campaign.ps1 每次跑完都会数日志里的 Validation Error 条数,非 0 就把该次运行标成 INVALID,不进统计表。五条路径 × 五次复跑 = 25 次运行,全部 0 条。
这道闸是被逼出来的,起因在下一章:shader object 那条路径第一次跑出来的读数,看起来像一条"大新闻",其实是验证层报错的开销。 那条读数被我们自己作废了——第六章会给出它的复现与归档数字。有这道闸之后,"这条读数能不能用"不再靠人记。
六、老写法 vs 新写法(二):monolithic pipeline → shader objects
好了,第四章那张表的第二列差异,这一章拆开。这一件比 render pass 那一件复杂,也更值得写——因为我们在这条路径上量错过一次,而那个错误数字看起来非常像一条好结论。
6.1 先补一段脉络:统一着色器模型
OK,在讲 VkShaderEXT 之前,有一层历史值得先铺开,否则容易把"管线"当成理所当然的东西。
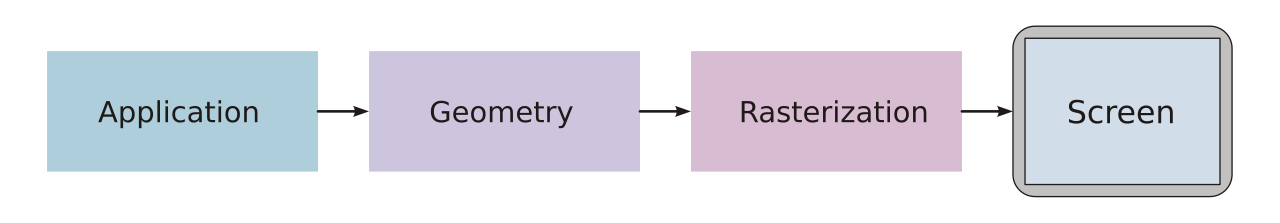
先从最经典的那张分法说起。下面这张图是各家教材都在用的三段划分(Commons,CC0)——Application → Geometry → Rasterization → Screen。
这张图值得放在这里,是因为它正是"固定功能"时代的分法:早期图形硬件里,顶点变换、光照、纹理混合各有专用电路,这三段各自对应一批电路,程序员只能调参数、不能改逻辑。后来硬件变成统一着色器模型——同一批可编程单元既跑顶点也跑片段,功能由程序决定。阶段的划分没有变,变的是"每一段由什么来执行":从专用电路变成了程序。
这个转向解决的是"专用电路不好用"的问题。而接下来要讲的 pipeline 对象,是在这之后再上一层的抽象。
而 pipeline 对象是在这之后才出现的抽象:它把"哪些着色器 + 哪些状态"打包成一个不可变对象,交给驱动在创建期做完整优化。它当年是个好东西——正是它让驱动能在创建期做跨阶段优化。可是到了 2026 年,官方认为这个抽象的代价超过了收益(第一章引过那句"draw time 的开销被搬到了 pipeline bind time")。
从固定功能到统一着色器、再到不可变 pipeline 对象、最后到 shader objects,这条路可以收成一句话:每一代都在回答"状态该在什么时候定下来"——固定功能定在硬件里、着色器阶段定在程序里、pipeline 定在创建期、shader object 定在录制期。第四章那张表量到的 +65%,量的是这条链上最后一次搬家的价格。
6.2 同机对照:录制贵了 65%,而真相差点是"贵几十倍"
先来看看修正后的读数(同一份构建、同一对 SPIR-V、同一个交换链):
| 路径 | 录制/帧(最小–最大) | 整帧 | fps | 验证层错误 |
|---|---|---|---|---|
legacy(管线,作参照) |
45.3 µs(45.0–45.7) | 0.368 ms | 2722.9 | 0 |
shaderobj(shader objects) |
74.6 µs(71.5–77.2) | 0.402 ms | 2488.5 | 0 |
shaderobj_linked |
74.6 µs(73.0–76.2) | 0.404 ms | 2473.3 | 0 |
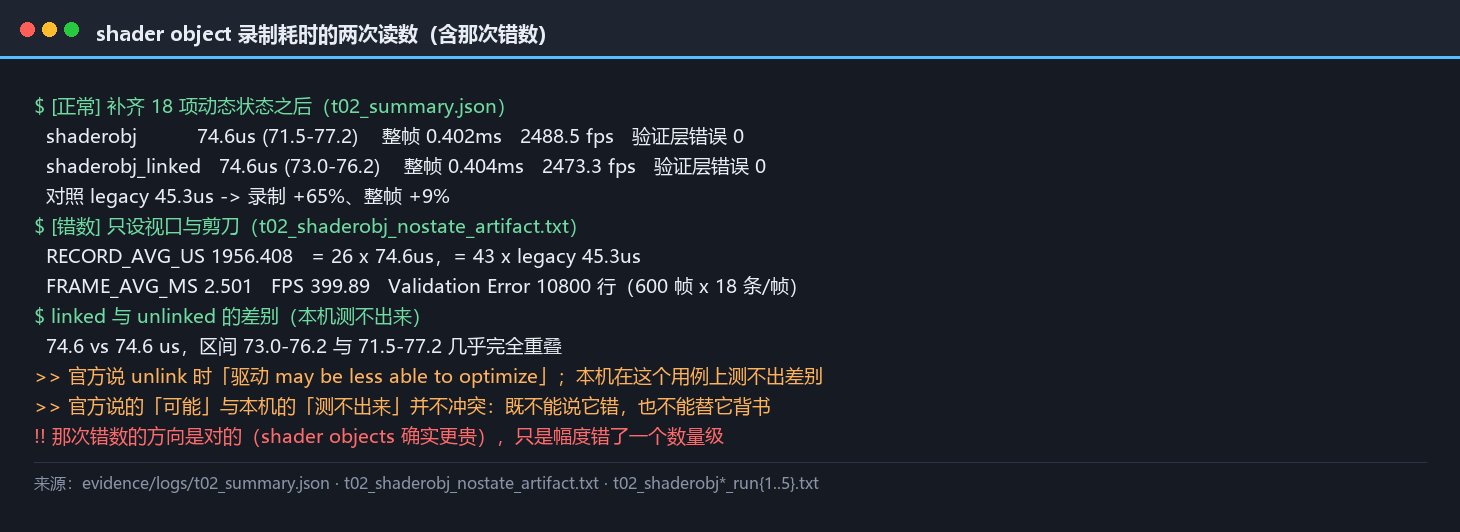
录制 45.3 → 74.6 µs(+65%),整帧 +9%。成本来源很具体:每一帧要绑 2 个对象、再设 18 项动态状态。管线把这些都烘焙在对象里,绑一次就够;shader object 没有状态,所以那些状态只能每帧重新说一遍。这不是驱动没做好,是这条路的定义如此。
可是——第一次量出来的不是这个数。 第一次跑,shaderobj 的录制耗时比 legacy 高出一个量级还多,整帧 2 ms 级、fps 掉到 400 上下。如果当时直接写进文章,那就是一条又响又错的结论。
6.3 那个数字错在哪:一万条验证层错误
好了,那一次的错误读数没有留档,所以我们没有把它当成证据用。但这件事太值得留下来了,于是我们把它做成了一条可复跑的诊断路径:shaderobj_nostate ——它绑定 shader objects,但只设视口与剪刀,也就是复刻当时那个错误写法。跑一遍,归档在 t02_shaderobj_nostate_artifact.txt,读数如下:
| 现象 | 详情 |
|---|---|
| 录制/帧 | 1,956.4 µs(正常路径是 74.6 µs,26 倍;是 legacy 45.3 µs 的 43 倍) |
| 整帧 / fps | 2.501 ms / 399.89 |
| 验证层错误行数 | 10,800 条(600 帧 × 18 条/帧) |
| 不同条款数 | 18 种,全部落在 vkCmdDraw 上 |
| 日志体量 | 9,188,485 字节(一份日志,纯错误输出) |
| 抽样条款 | VUID-vkCmdDraw-None-08627(VK_DYNAMIC_STATE_CULL_MODE 未设)、-08629(深度测试未设)、-08630(深度写未设)、-08635(vkCmdSetViewportWithCount 与 vkCmdSetScissorWithCount 未都调)、-08651(多边形模式未设)、-08652(光栅化采样数未设)、-08653(采样掩码未设)、-08654(alpha to coverage 未设)… |
| 根因 | shader object 路径漏设了 18 项必需的动态状态——只设了视口与剪刀 |
| 那 1,956.4 µs 是什么 | 几乎全是验证层生成这 10,800 条错误消息的开销 |
补齐全部 18 项动态状态之后复测,读数落到 74.6 µs。原来那个量级的东西被作废了。
这里的口径要交代清楚:"18 条/帧"是按日志里 Validation Error 的行数数的。同一批错误如果按"错误 + 条款 + 细节"逐行都算,条数会翻几倍——报数必须连口径一起报,否则"多少条错误"这个说法本身就是模糊的。
这件事有个更值得记住的侧面:验证层在"报错",我们差点把它读成"性能"。 一条错误消息的生成成本被算进了被测对象,测量工具本身成了被测对象的一部分——这是性能测量里最经典的一类错误,也是最容易骗过自己的一类,因为那个数字方向是对的(shader objects 确实更贵),只是幅度错了一个数量级。
6.4 link 与 unlink:本机测不出差别
OK,VK_EXT_shader_object 里有一个可选动作:链接(VK_SHADER_CREATE_LINK_STAGE_BIT_EXT)。官方提案的说法是它"可选、由应用决定",并且提示 unlink 时"驱动可能更难优化着色器的 GPU 性能"。
既然如此,链接应该能换回一些性能。我们把两条都跑了:
| 形态 | 录制/帧(最小–最大) | 建状态耗时 |
|---|---|---|
| unlinked | 74.6 µs(71.5–77.2) | 2598.5 µs |
| linked | 74.6 µs(73.0–76.2) | 2287.2 µs |
两条的区间几乎完全重叠,本机测不出差别。 在"两个阶段、一个三角形"这个规模上,链接没有带来可测的收益。这一条要如实写:官方说的是"可能",本机的结果是"在这个用例上测不出来"——既不能说官方错,也不能替它背书。
顺带记一个实现细节,它是我们踩出来的:LINK_STAGE_BIT 要设在参与链接的每一个阶段上,不能只设在第一个。 只设第一个,验证层给出 VUID-vkCreateShadersEXT-pCreateInfos-08402——条款原文要求"如果任一元素带这个标志,则所有顶点/细分/几何/片段阶段的元素都必须带"。
6.5 那官方推荐的跨驱动做法:只写一套 API + 仿真层
说白了,这里要交代一件事,因为它直接决定"要不要用"。
官方明确不推荐维护两条代码路径。原话是:与其维护两套(一套 shader objects、一套传统管线),推荐的做法是只用 Shader Objects API 写应用,然后依赖 VK_LAYER_KHRONOS_shader_object 扩展层兜底——那个层用软件方式把该扩展模拟出来。
所以真实的迁移路径长这样:写一次,原生支持的驱动直接跑,不支持的驱动由仿真层接住。代价是仿真层自身有额外开销(它要把 shader object 合成回 pipeline),官方给出的调节开关是 disable_pipeline_pre_caching。
这条路线是否合算,本机无法给出答案——因为本机原生支持该扩展,压根没走到仿真层那一步。所以这一节只引官方口径,并如实标注"本机未测"。
七、描述符这条路:为什么本机只能讲到 buffer
好了,三件套的第三件,是本篇唯一"本机压根测不了"的一件。这一章把它讲清楚,并明确标出哪些是读到的、哪些是量到的。
7.1 本机能测的那一半:descriptor buffer
OK,本机有 VK_EXT_descriptor_buffer,没有 VK_EXT_descriptor_heap。所以能测的只有前者。
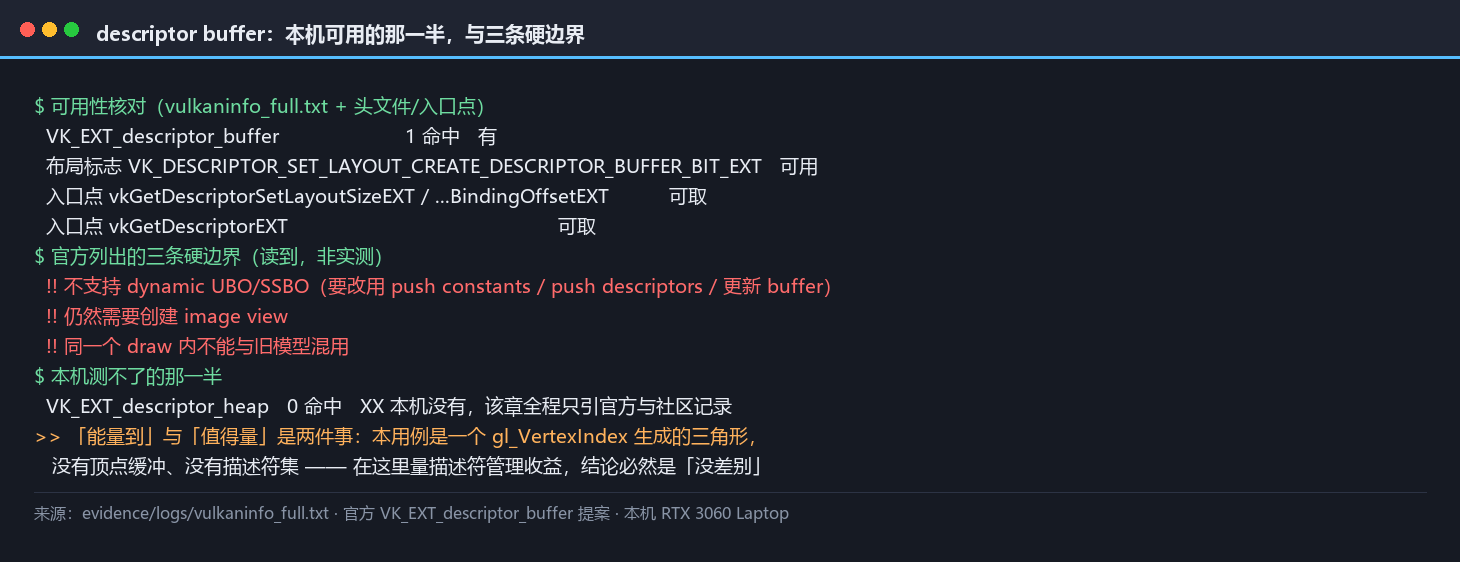
descriptor buffer 的思路是把描述符直接放进 buffer 内存、由应用显式管理:布局要带 VK_DESCRIPTOR_SET_LAYOUT_CREATE_DESCRIPTOR_BUFFER_BIT_EXT 标志;用 vkGetDescriptorSetLayoutSizeEXT / vkGetDescriptorSetLayoutBindingOffsetEXT 查尺寸与偏移;用 vkGetDescriptorEXT 取一段二进制 blob,然后自己 memcpy 进 buffer。
它有几条明确的边界,官方文档里都写着:不支持 dynamic UBO/SSBO(要改用 push constants / push descriptors / 更新 buffer 的办法);仍然需要创建 image view;同一个 draw 内不能与旧模型混用。
本机确认可用的部分:扩展在位、vkGetDescriptorSetLayoutSizeEXT 等入口点能取到、布局标志可用。"能量到"和"值得量"是两件事——在一个只有一个三角形的用例里量描述符管理的收益,结论必然是"没差别",因为那里根本没有描述符。所以本篇不编这个读数。
7.2 描述符方案的演进:set → buffer → heap
先来看看把这条路排成时间线之后,官方在做什么:
| 阶段 | 形态 | 解决的问题 | 遗留的问题 |
|---|---|---|---|
| 传统 | VkDescriptorSet + pool + vkUpdateDescriptorSets |
可用、通用 | bind 与更新是 CPU 重操作 |
| 中间态 | VK_EXT_descriptor_buffer |
描述符进内存,应用显式管理 | 不支持 dynamic UBO/SSBO;仍需 image view;不能与旧模型混用 |
| 目标态 | VK_EXT_descriptor_heap |
完全取代 descriptor set 机制,并在新硬件上取代 descriptor buffer | 本机没有;重绑 heap 代价高(官方提醒尽量避免) |
三步走得很清楚:每一步都在把"描述符由驱动管"换成"描述符由应用管"。 直到最后一步,VkDescriptorSet / VkDescriptorPool / VkPipelineLayout 这三个对象全部消失,连 push constants 都被 vkCmdPushDataEXT 取代。
后面两步都依赖同一件东西:buffer device address(VK_KHR_buffer_device_address,Vulkan 1.2 核心)。这条依赖关系不是巧合——先要有"能直接寻址的 GPU 内存",才谈得上"把描述符写进内存"。
三代方案之间的差别,还可以收成一句更直白的话:每一步都在减少"由驱动代为管理的绑定状态"。 传统模型里,VkDescriptorSet 管"一组绑定"、VkDescriptorPool 管"这些组的池化分配"、VkPipelineLayout 管"管线看得见哪些绑定"——三件事、三套规则,全部由驱动兜着;到 descriptor heap 之后,这三件事一起交回应用手里,代价是应用得自己把内存布局与偏移算对。这也是为什么"要不要走这条路"不是一个纯性能问题,而是一个"你愿意接管多少状态"的问题。
7.3 反方实测:descriptor buffer 不一定更快
好了,这一节全部是读到的,不是量到的。如实标注。
反对"bindless 一定更快"这条流行说法的最硬材料,来自 Granite 引擎作者的 descriptor heap 移植长文(2026-03-29)。他的实测结论有两条值得抄下来:
第一,对 buffer 类描述符,descriptor buffer 可能更慢。 原因很具体:没有 array 版的 vkGetDescriptorEXT,所以 UBO/SSBO 那类描述符拿不到"一次取一批"的优化,极端情况下 CPU 开销反而比传统模型更差。他还提到 DXVK 经 winevulkan 翻译时会踩到这条。
第二,他明确反对"一切皆 bindless"。 理由不是性能而是工程:"我不喜欢『一切皆 bindless』,它让调试更难、给工具与 validation 更大压力",并且指出 slot-based 模型在 GPU 侧性能也很好,问题主要在 CPU 开销上。Granite 因此保留了传统路径,把 descriptor buffer 当作中间态。
还有一条更细的规范陷阱:sampler descriptor buffer 的最小规格很小(4K samplers),线性分配有 OOM 风险——不过他实测"实际中完全不成问题",并且认为"重绑 descriptor buffer 有性能损失"这个说法"实际没有厂商真那样实现"。这两条都是他实测之后推翻了流行说法。
7.4 另一个方向:桌面宣称支持 ≠ 能上生产
说白了,写这一节之前先说清楚它的性质:下面全部是社区 bug 记录,不是本机读数,且本机连扩展都没有,无从复现。
NVIDIA 开发者论坛上有一串与 VK_EXT_descriptor_heap 相关的一手复现,集中在 2026 年:
| 现象 | 关键细节 |
|---|---|
| fragment shader 读非 0 heap index 取到错误描述符 | RTX 4060,驱动 610/615 均复现,RADV 全过 |
ray query 触发 VK_ERROR_DEVICE_LOST |
该扩展在光追路径上的稳定性问题 |
| descriptor heap 访问嵌套结构体时忽略 offset | 结构体布局相关的实现缺陷 |
| vkd3d-proton 的 descriptor heap 路径设备丢失 | driver 610,第三方翻译层受影响 |
把这些和第一章那张支持表放在一起看,会得到一个不太舒服的结论:"NVIDIA / AMD Windows 生产驱动完整支持"这句话是真的,但"完整支持"描述的是能力面,不是成熟度。 新扩展在量产驱动上集中爆发 bug,是这条路的常态,不是异常。
所以本篇给的判据不是"要不要用 descriptor heap",而是更保守的一句:决定用它之前,先确认你的驱动版本在别人的 bug 报告里出现过没有。 第十一章会把这条并进迁移判据。
八、同步那一节:时间线信号量上场,但交换链不给用
好了,三件套讲完了,这一章补一课官方课程里排在最后的 Synchronization。它有个具体的问题要答:时间线信号量到底替掉了什么,代价是多少。
8.1 时间线信号量实测:本机没有可测收益
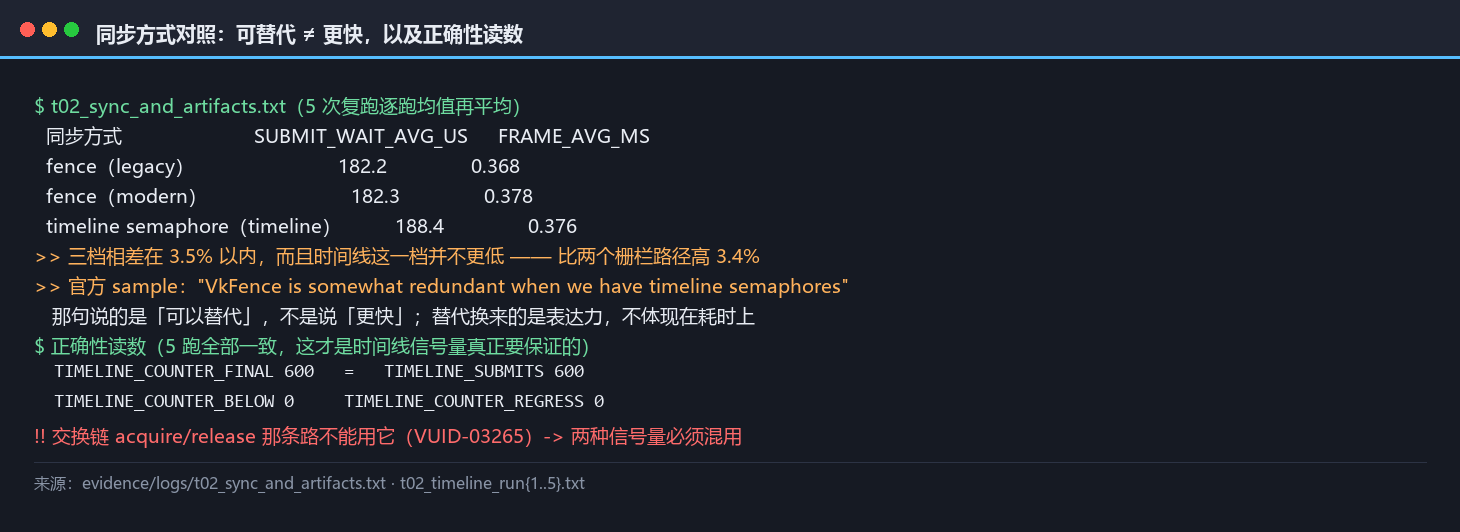
OK,时间线信号量用单调递增的 64 位计数器替代二值信号量的 1:1 signal/wait。它解决三件事:unsignal 语义带来的"单生产者多消费者"难题、信号量对象膨胀、以及 wait-before-signal 的乱序提交。官方 sample 甚至直接写了一句 "VkFence is somewhat redundant when we have timeline semaphores"——因为它允许主机端也去等一个计数值。
听起来像是"栅栏可以退休了"。我们把同一份渲染的同步方式换掉,量了一遍:
| 同步方式 | SUBMIT_WAIT_AVG_US(5 跑均值) | 整帧(5 跑均值) |
|---|---|---|
栅栏(legacy) |
182.2 µs | 0.368 ms |
栅栏(modern) |
182.3 µs | 0.378 ms |
时间线信号量(timeline) |
188.4 µs | 0.376 ms |
三档相差在 3.5% 以内——而且时间线这一档并不更低,它比两个栅栏路径还高了 3.4%。 在"一帧一提交、主机侧等一次"这种最常见的用法下,用时间线信号量替代栅栏,在本机换不到任何耗时上的好处。
这个结果比"差不多"更有意思:它把官方那句话逼到了必须逐字读的地步。"可以替代"不等于"更快"。 替代换来的是表达力——单一计数器、可跨队列、可乱序提交、主机端可等——这些在复杂管线里是实打实的便利,但它们不体现在这个用例的耗时上。把"官方说它更好"翻译成"它更快",是本系列一直在防的那类误读。
正确性那一栏比耗时重要:
| 检查项 | 读数(5 跑全部一致) |
|---|---|
TIMELINE_COUNTER_FINAL |
600 |
TIMELINE_SUBMITS |
600 |
| 计数器读数曾低于等待值 | 0 次 |
| 计数器曾回退 | 0 次 |
提交 600 次,计数器正好走到 600;每一次等待都拿到了不低的值,且全程单调不回退。这才是时间线信号量真正要保证的东西。
8.2 交换链那道墙:运行时不一定拦你,验证层拦你
先来看看时间线信号量那个用不了的地方,而且是本篇最容易踩的一处:交换链的 acquire 不接受时间线信号量。 官方 sample 里明确写着:当前的 WSI 交换链不支持时间线信号量,acquire / release 仍须用二值信号量。
我们没直接信文档,写了一个故意失败的探针去撞它。结果比预期更有信息量:
| 观察 | 结果 |
|---|---|
| 驱动的反应 | vkAcquireNextImageKHR 返回 0(VK_SUCCESS),没有任何运行时错误 |
| 验证层的反应 | 1 条 VUID-vkAcquireNextImageKHR-semaphore-03265,不多不少 |
| 结论 | 运行时不一定拦你,验证层拦你 |
把这句话翻成白话:这段代码如果跑在一台没开验证层的机器上,它会安静地跑过去——直到某天在某个驱动上以奇怪的方式出错。这个画面和第一篇的题眼正好接上:那个 Best Practices 开关默认是关的(ep01 实测:不主动打开,官方准备的检查一条都不出现);这里是同一件事的另一面——开关关着的时候,规范给你的保护是零。
因此本篇在混用两种信号量时按规范写:交换链 acquire / release 走二值信号量,CPU/GPU 那条链走时间线信号量。 本实验台里这也唯一一个故意产生验证层错误的运行(日志单独存放、单独标注),其余 25 次运行必须 0 错误。
8.3 同步基元对照:这一章与其说是"选哪个",不如说是"哪能用"
好了,把这一节的结论收成一张表:
| 基元 | 本机可用 | 适用位置 | 局限 |
|---|---|---|---|
栅栏 VkFence |
有 | 主机侧等一次提交 | 只能等"整批",无计数值 |
| 二值信号量 | 有 | 交换链 acquire / release、队列间同步 | 1:1 signal/wait,unsignal 语义麻烦 |
| 时间线信号量 | 有 | CPU/GPU 同步、跨队列、可乱序 | 交换链那一段不能用 |
| 校准时间戳 | 有 | 跨队列时间戳对比 | 本篇不做实测(承 ep01 边界) |
最后一行那个"不能用"决定了实际写法:两种信号量要混用,不是二选一。这也是"新范式"里少见的、官方文档直接说"某处用不了新技术"的地方——所以它值得单列一章。
九、抓帧闭环:从「通道可用」到真的产出 .rdc
好了,ep01 第八章末尾留了一笔债:RenderDoc 的捕获层注册成功、通道是通的,但那个用例是纯计算的控制台程序——没有交换链、没有呈现,也就没有"一帧"这个东西。抓帧工具抓的是帧,没有帧边界就没有产物。当时只写下"通道可用"四个字,把抓帧位推到了本篇。
这一章把债还上,然后撞上下一道墙。
9.1 先解决"有没有帧边界"这个问题
OK,要抓帧,先得有帧。本篇的实验台是图形用例,acquire → 录制 → 提交 → present 这个循环天然构成帧边界,ep01 缺的那块拼图在这里自然补齐。
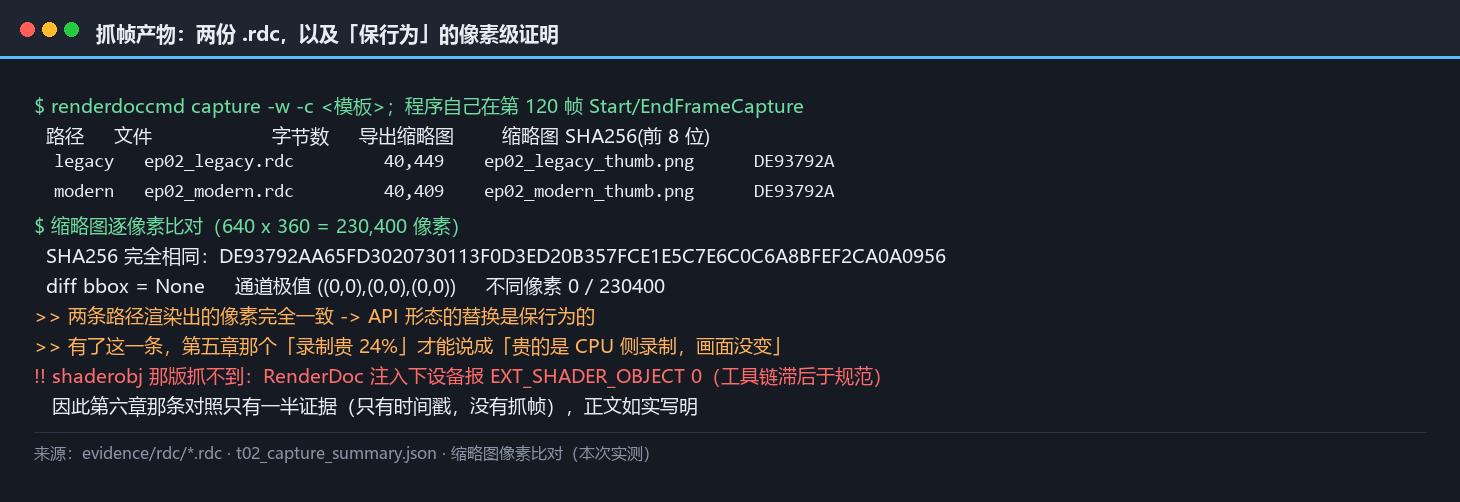
抓帧命令是 renderdoccmd capture -w -c <文件名模板>:-w 表示等目标进程跑完再退出,-c 指定输出模板。但这条命令单独用不够——它默认抓的是"第一个呈现帧",而我们的用例要跑 600 帧、前 60 帧是预热,第一帧的管线状态没有代表性。所以还需要一个"抓哪一帧"的控制手段。
9.2 无人值守抓帧:让程序自己按快门
先来看看按 F12 这条最常见的抓帧姿势——,但它是交互式的——脚本跑不了、无人值守跑不了、也就无法复跑。RenderDoc 给了一条应用内 API 的路:程序在启动时从抓帧层取到 RENDERDOC_API_1_6_0*(头文件 renderdoc_app.h),然后在指定的第 120 帧调 StartFrameCapture 与 EndFrameCapture。这样抓帧就变成了源码里的一行调用,而不是一次按键。
这条路上有两个坑,都是我们自己踩出来的,记下来:
| 坑 | 现象 | 修法 |
|---|---|---|
GetCapture 的参数个数 |
按文档印象写成三个参数,编译不过 | 它带一个 uint64_t* timestamp 出参,是四个参数 |
| 应用内覆盖了命令行 | 产物落到了另一个目录,脚本给的模板没生效 | 程序里那行 SetCaptureFilePathTemplate 把 -c 的模板盖掉了;删掉它,产物才按脚本给的名字落位 |
第二个坑值得多说一句:它是一次"配置被静默覆盖"的典型。命令行给了模板、程序里也给了一个,两边都没有报错,最后产物落在哪一边完全取决于谁后调用。这类问题在工具链集成里非常常见——两个地方都能配同一件事的时候,必须明确谁是权威。
9.3 两份 .rdc,以及"保行为"的证明
好了,抓到的东西如下(两份文件都在仓库里,缩略图由 renderdoccmd thumb 导出):
| 项 | 读数 |
|---|---|
| 抓帧工具 | RenderDoc v1.29,应用内 API 1.6.0 |
| 触发方式 | 程序自己在第 120 帧 StartFrameCapture / EndFrameCapture(非交互) |
ep02_legacy.rdc |
40,449 字节 |
ep02_modern.rdc |
40,409 字节 |
| 两张缩略图 SHA256 | 完全相同(DE93792AA65FD302…) |
| 差异包围盒 | 空(两条路径渲染出的像素完全一致) |
最后两行才是这一节的重点。 本篇第五章量到 dynamic rendering 让单帧录制从 45.3 µs 涨到 56.2 µs,第六章量到 shader objects 让它涨到 74.6 µs。数字都在 CPU 侧,可读者没法从数字上判断"画面变了没有"——万一你把画面画错了,性能数字也一样好看。
两份 .rdc 的缩略图像素级一致,回答的正是这件事:API 形态的替换是保行为的。 代价全部落在 CPU 侧的命令录制上,GPU 看到的像素一模一样。本系列后面每一篇做新旧路径对照时,都会保留这个习惯——性能差异必须有"结果没变"这条证据配套,否则那条差异没有意义。
9.4 从 .rdc 到管线状态:它能回答什么,不能回答什么
OK,拿到 .rdc 不等于拿到结论。这一节把它的能力边界划清楚,免得把它当成万能工具:
| 它能回答 | 它不能回答 |
|---|---|
| 这一帧到底提交了哪些命令(逐条、带参数) | 驱动内部怎么把这些命令编译成机器码 |
| 每个 draw 绑了什么管线、什么着色器 | 这段代码在别的厂商驱动上会不会同样快 |
| 每个资源在那一帧的布局与内容 | 为什么慢(要给出原因,还得回到时间戳与对照实验) |
| 那一帧的像素长什么样(缩略图与纹理视图) | 跨帧的趋势(.rdc 是一帧的快照,不是性能统计) |
这张表里有一条很容易被忽略:.rdc 是一帧的快照。它非常适合回答"这一帧对不对",非常适合回答"这条路径绑了什么",但它不回答"哪条路径更快"——那是时间戳与多次复跑的活。把这两类工具的分工记清楚,是这一章真正想留下的东西。
9.5 那道新墙:注入之下,shader objects 不见了
说白了,抓 legacy 与 modern 都顺利,抓 shaderobj 失败了。原因不是我们的代码写错——在 RenderDoc 注入之后,本机设备报出的 VK_EXT_shader_object 变成了 0。而实验台在初始化期有一个硬检查:如果设备不支持该扩展,直接拒绝启动 shaderobj 路径。于是这条路径压根没能跑起来。
这句话得说准:抓帧工具本身还没有把 VK_EXT_shader_object 暴露出来。
这个结果很难看,但它是一条有价值的发现,值得单列一节:ep01 记的是"通道通、用例没有帧边界";本篇补上帧边界、拿到了 .rdc;然后又撞上下一道墙——工具链滞后于规范。它和第一章那张支持表里"移动端量产驱动暂缺"是同一类事实的两个面:规范可以先走,生态跟不跟得上,是另一回事。
也正因如此,本篇第五章与第六章的读数对比是分两段成立的:
| 对照 | 双重证据是否齐备 |
|---|---|
| render pass ↔ dynamic rendering | 时间戳(录制 45.3 / 56.2 µs)+ 抓帧(两版缩略图像素一致)都齐 |
| pipeline ↔ shader objects | 只有时间戳(录制 45.3 / 74.6 µs);抓帧这一半本机拿不到,因为工具还没暴露该扩展 |
读者在第五章看到的那条对照是完整的,第六章看到的那条则只有一半——这一点必须写明,不能含糊过去。
十、三条被证伪的说法
好了,前面几章一路在量。这一章换个方向:把三条流传很广、方向听起来都对、但经不起查证的说法拿出来逐条对。三条都有明确的出处,也都有本机或一手实测的反证。
10.1 第一条:「换成 dynamic rendering 会更快」
OK,这条说法几乎是"新范式"文章的默认前提。反证来自 Qualcomm 在 Vulkanised 2026 的迁移报告《From Vulkan 1.1 to 1.4》,他们在报告里给的是两点一手结论:
第一,收益主要在代码量、不在帧率。 删掉 render pass 与 framebuffer 之后,他们的 wrapper 从约 550 行降到约 130 行,每个 sample 少写约 40 行。他们自述目标是可理解性,不只是性能。
第二,dynamic_rendering_local_read「基本没有性能收益」——原因是他们那个 sample 原本就没有用 subpass。
这两条和我们第一章引的官方口径并不矛盾,因为"能取代"是能力陈述,"会更快"是收益陈述,两者说的是不同的事。收益只落在真正用了 subpass 的路径(延迟渲染、OIT)与 tiled GPU 的 load/store、local read 带宽上。
本机的实测方向完全一致:
| 路径 | 单帧录制 | 整帧 | 说明 |
|---|---|---|---|
legacy(render pass) |
45.3 µs | 0.368 ms | 参照 |
modern(dynamic rendering) |
56.2 µs | 0.378 ms | 录制 +24%,整帧几乎不变 |
换掉 render pass,本机没有变快,录制反而贵了一点。 render pass 这个抽象在创建期做的那些全局优化,换成 dynamic rendering 之后要由应用在录制期逐条补上——这正是我在第五章开头引的那句"draw time 的开销被搬到了 pipeline bind time"的同一枚硬币的背面。
10.2 第二条:「descriptor buffer 一定更快」
先来看看这条说法的来路——它来自"bindless 一定更快"那个更大的叙事。最硬的反证来自 Granite 引擎作者的 descriptor heap 移植长文(2026-03-29),他自己把这条路从头移植了一遍,得出的结论有两条:
第一,对 buffer 类描述符,descriptor buffer 可能更慢。 原因很具体:没有 array 版的 vkGetDescriptorEXT,UBO / SSBO 那类描述符拿不到"一次取一批"的优化,极端情况下 CPU 开销反而比传统模型更差。他还提到 DXVK 经 winevulkan 翻译时会踩到这条。
第二,他明确反对"一切皆 bindless"。 理由不是性能而是工程——它让调试更难、给工具与 validation 更大压力;同时指出 slot-based 模型在 GPU 侧性能也很好,问题主要在 CPU 开销上。Granite 因此保留了传统路径,把 descriptor buffer 当作中间态。
这两条对我们是"读到的",不是"量到的"。而本机这一条恰恰没法量:本机有 descriptor_buffer,但本实验台的用例是一个由 gl_VertexIndex 生成顶点的三角形——没有顶点缓冲、没有描述符集。在一个没有描述符的用例里量描述符管理的收益,结论必然是"没差别"。所以本篇不编这个读数,第七章只核到可用性为止。
10.3 第三条:「越 dynamic 越好」
好了,这条说法是前两条的上位版本:既然新范式把状态从创建期搬到录制期,那"搬得越彻底越好"。反证不用去别处找,迁移清单自己就写着三条:
不要一次重写全部;不要什么都设成 dynamic(会有开销);profile old vs new。
把它和本机的读数放在一起看,这条说法的漏洞就很具体了:
| 路径 | 相对 legacy 的录制成本 |
状态在哪儿说 |
|---|---|---|
modern |
+24% | 附件信息改为录制期栈上结构 |
shaderobj |
+65% | 18 项动态状态全部在录制期逐帧设置 |
第六章已经说过原因——shader object 没有状态,所以每一帧都要把 18 项动态状态重新说一遍。这不是实现问题,是这条路的定义。
所以"更动态"的真实含义是:把成本从一个时刻搬到另一个时刻,而不是把它消掉。搬到哪一边更划算,取决于你的应用是"状态少、帧多"还是"状态多、帧少"——同一条建议,在两种应用上的答案可以完全相反。这正是迁移清单要求你先 profile old vs new 的原因。
10.4 三条说法的对照
OK,把三节收成一张表:
| 说法 | 出处 | 反证 | 本机状态 |
|---|---|---|---|
| 换 dynamic rendering 会更快 | 新范式文章的常见默认前提 | Qualcomm 自述收益在代码量(550→130 行);local read 无性能收益 | 实测反向:录制 +24% |
| descriptor buffer 一定更快 | "一切皆 bindless" | Granite 实测:buffer 类描述符可能更慢 | 未测(用例无描述符,拒绝编数) |
| 越 dynamic 越好 | 对"状态搬到录制期"的过度推广 | 迁移清单自己劝退;官方要求 profile | 实测反向:录制 +24% / +65% |
三条说法有一个共同的结构:它们都把官方的一句"能力陈述"读成了"收益陈述"。 官方说 dynamic rendering 能取代 render pass,没说它更快;官方说时间线信号量可以替代栅栏(第八章),没说它更快;官方说 shader objects 可以取代 monolithic pipeline,也没说它更快。"能取代"与"更快"之间隔着一次实测,而这一次实测,只有你自己跑得出来。
十一、迁移判据:什么时候不该迁
好了,走到这里,材料齐了:官方支持表(第一章)、本机能力核对(第二、三章)、五条路径的同机读数(第四到六章)、社区与厂商的一手记录(第七章)。这一章把它们收成一张判据表。
先说清楚这张表不回答什么:它不告诉你"要不要用 shader objects"。这个答案取决于你的目标硬件、你的帧预算、你的团队。它回答的是另一个问题——按什么顺序问。
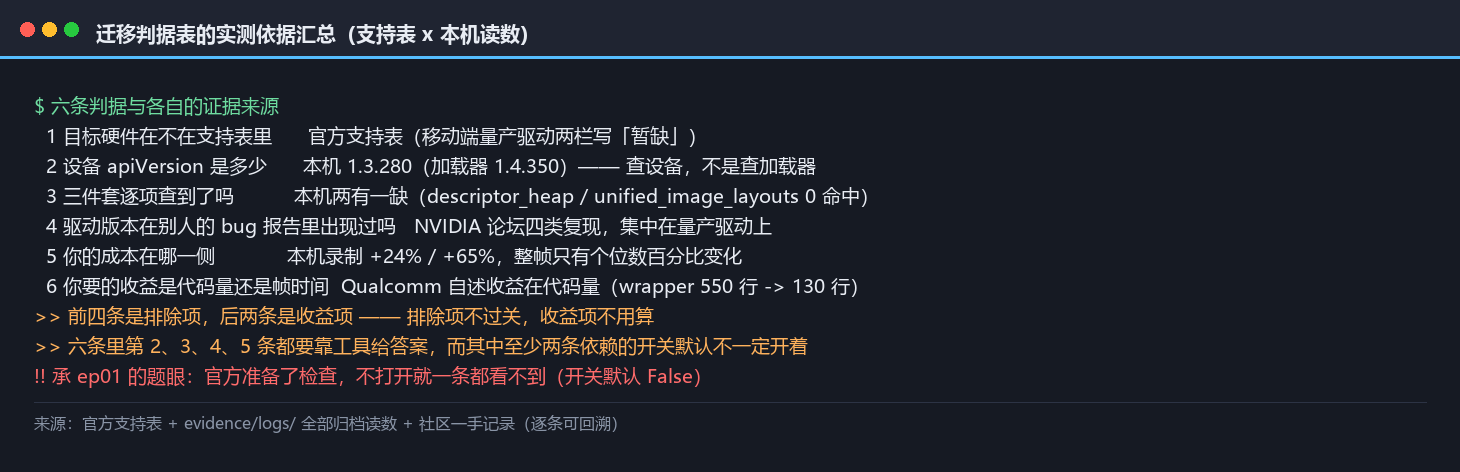
11.1 六条判据
| # | 判据 | 怎么核 | 本篇的证据 | 什么情况下不该迁 |
|---|---|---|---|---|
| 1 | 目标硬件在不在官方支持表里 | 查官方支持表,按平台逐格看 | 移动端量产驱动那两栏写的是"暂缺(KHR 版本在计划中)" | 目标含量产移动端:官方一边弃用 pipeline、一边承认替代品还没上,这一栏不给答案 |
| 2 | 设备的 apiVersion 是多少 |
查设备,不是加载器 | 加载器 1.4.350,设备 1.3.280 | 设备够不到课程起点(set_minimum_version(1,4))时,那套写法的前提就不成立 |
| 3 | 三件套逐项查到了吗 | vkEnumerateDeviceExtensionProperties,不看厂商表 |
两件有(dynamic rendering、shader objects),一件没有(descriptor heap) | 缺的那一件不要写进主线:本机第七章因此只能讲到 descriptor buffer |
| 4 | 你的驱动版本在别人的 bug 报告里出现过吗 | 查社区与厂商开发者论坛 | heap 那四类复现(错误描述符、device lost、offset 被忽略、vkd3d-proton 设备丢失)全在量产驱动上 | 新扩展在量产驱动上集中爆发 bug 是常态:用它之前先搜一遍报错 |
| 5 | 你的成本在哪一侧 | 自己 profile,不是看别人的数 | 本机录制 +24% / +65%,整帧只有个位数百分比变化 | 瓶颈在 CPU 侧命令录制时,"更动态"可能倒扣 |
| 6 | 你要的收益是代码量还是帧时间 | 先分清"能取代"与"更快" | Qualcomm:收益在代码量(550→130 行),不在帧率 | 指望换 API 就提速的场景:这一条不给这个承诺 |
11.2 这张表的用法
说白了,六条的顺序不是随便排的,它是"先排除、后优化"的顺序。把六条判据二次归类之后就清楚了:前四条是排除项(硬件不在表里、版本够不到、能力查不到、驱动有已知雷),后两条是收益项(成本落在哪一侧、要换的收益是什么)。排除项不过关,收益项不用算——因为无论那条路能省多少,你的硬件压根跑不了它。
这里要接回 ep01 的题眼。ep01 量到的那件事是:验证层里那个 Best Practices 开关默认是关着的——官方准备了检查,你不打开就一条都看不到。这一章是同一件事的另一面:上面六条判据里,第 2、3、4、5 条都要靠工具给你答案(查设备能力、查扩展列表、查论坛记录、自己 profile),而其中至少两条依赖的开关默认不一定开着。判据本身不贵,拿到答案才贵。
十二、边界、自检清单,以及下一篇要做什么
12.1 边界六条
好了,开篇声明的六条,这里收成一处。前四条承 ep01,后两条本篇新增。
第一,不做跨厂商对照。 本机只有一块 NVIDIA 独显。所有厂商支持表里的内容只引官方原文,凡是我们量不到的都写明"只引官方口径"。第二,不给驱动内部 JIT 的结论。 Vulkan 没有任何官方接口能看到驱动编译器的中间表示或 JIT 决策。第三,不给指令集规范的断言。 NVIDIA 没有公开 SASS 的官方 ISA 文档,nvdisasm 的输出只作观测性描述。第四,时间戳有同步域边界。 vkCmdWriteTimestamp 只保证同一次提交内 happens-after 的时间戳不递减。
第五,不做移动端实测。 手上没有 Android 设备,而这一篇偏偏绕不开移动端——官方在同一份材料里既把 pipeline 标为弃用、又承认量产移动驱动还没有替代品。这条矛盾我们在第一、二、十一章拆了三次,但移动端那部分全程只引官方支持表与厂商报告,一次都没有说成"本机实测"。
第六,VK_DEVICE_LAYERS 未核实(承 ep01,该变量名在官方文档里查不到,不作为现行变量名使用)。
这六条里最该记住的是第五条:它不是"暂时没做",而是"本篇的结论在移动端不成立"。 一张支持表上写着"暂缺"的两格,足够让整篇的乐观结论在移动端重新审一遍。
12.2 十条自检清单
OK,这套清单是给"准备把项目迁到 2026 写法、或者准备审别人那份迁移方案"的人用的。前五条管环境,后五条管习惯。
环境五条:① 目标设备的 apiVersion 读了吗(是设备的,不是加载器的——本机这两个数差了整整一个次版本);② 官方三件套在你的驱动上逐项查过吗(用 vkEnumerateDeviceExtensionProperties,不是看厂商宣传页);③ 验证层开了吗(ep01 那条:默认是关的);④ 抓帧工具的版本跟得上你要用的扩展吗(本机实测:注入之下 VK_EXT_shader_object 直接不见了);⑤ present mode 选的是哪个(FIFO 会把所有差异压平——本机实测:把 present mode 钉成 FIFO 之后,同一路径的 SUBMIT_WAIT 从 182.2 µs 涨到 5,764.1 µs,见第四章那两个坑)。
习惯五条:⑥ 同一份用例里只改一个变量,别的都不动;⑦ 每次读数都过一遍验证层错误计数,非 0 的读数不进表;⑧ 报的是区间与多次复跑,不是单次(本机:五条路径各跑五次);⑨ 每个用例配一个可精确验证的输出(本机:两份 .rdc 缩略图 SHA256 相同);⑩ 迁移前先 profile old vs new,不要一次重写全部,不要什么都设成 dynamic。
这十条里,第 ⑦ 与第 ⑨ 是这一篇花学费才写出来的两条:前者对应第六章那个高出一个量级的错数(我们把它做成诊断路径 shaderobj_nostate 复现并归档,读到 1,956.4 µs 与 10,800 条验证层错误)——验证层在报错,我们差点把它读成性能;后者对应第九章那两张缩略图——没有"结果没变"这条证据,性能数字再好看也没有意义。
12.3 下一篇:把同步这一节讲完
言归正传,下一篇是 ep03《同步最佳实践:barrier 精细化、sync2 与时间线信号量》。
这一篇已经先撞了两处同步的边,ep03 会把它们接上:一处是第八章那条"交换链的 acquire 不接受时间线信号量"——运行时不管、验证层才拦,这条边界决定了两种信号量必须混用;另一处是 barrier。第八章那张时序图里,modern 路径每一帧都有两次布局转换(UNDEFINED → COLOR_ATTACHMENT_OPTIMAL,再转到 PRESENT_SRC_KHR),本篇只是把它们当成"必要的开销"画出来了,但没有量它们。ep03 要回答的正是这件事:一次 layout transition 到底花多少、什么时候该合并、什么时候必须分开。
本系列的写作边界(四条不写与两条未核实)在每一篇开篇与结尾各声明一次;本篇的六条见 §12.1。
资源清单
- 本机源码与证据:
evidence/src/vk_ep02.c(一个二进制里的五条路径 + 交换链失败探针)|tri.vert/tri.frag+ 编出的 SPIR-V|build_ep02.ps1(着色器 + 二进制,自动带 RenderDoc 应用内 API)|run_ep02_campaign.ps1(5 路径 × 5 次,带验证层错误闸)|capture_ep02.ps1(产出.rdc+ 缩略图)|evidence/logs/(25 份运行日志、t02_summary.json、t02_capture_summary.json、交换链失败探针日志、vulkaninfo摘要与全量)|evidence/rdc/(ep02_legacy.rdc/ep02_modern.rdc+ 两张缩略图)|evidence/lab-summary.md(读数汇总,含两次作废读数的记录) - 官方材料入口:Vulkan Guide(
docs.vulkan.org/guide/latest/)|Vulkan Tutorial(/tutorial/latest/)|Vulkan Samples(/samples/latest/)|Vulkan 规范(docs.vulkan.org/spec/latest/)|SIGGRAPH 2026 课程《How to write a Vulkan application in 2026》 - 本篇主要引用的官方页面:
VK_VERSION_1_4的提案与 refpage|VK_KHR_dynamic_rendering/VK_KHR_dynamic_rendering_local_read提案与 local read 样本页|deprecated(弃用表)|VK_EXT_shader_object提案与 refpage、shader object 样本页、VK_LAYER_KHRONOS_shader_object仿真层文档|VK_EXT_descriptor_buffer/VK_EXT_descriptor_heap提案、descriptor_heapGuide、descriptor heap 样本页|timeline_semaphore样本页与 Tutorial 的 timeline semaphores 页|vkAcquireNextImageKHR/vkWaitSemaphores/vkCmdWriteTimestamprefpage - 工具:
vulkaninfo|glslangValidator/glslc/dxc|MSVC 与 CMake|RenderDoc(含renderdoccmd capture/thumb与应用内 API)|vkconfig(验证层配置) - 延伸阅读(文中有引用、本机未实测):Qualcomm《From Vulkan 1.1 to 1.4》(Vulkanised 2026)|Granite 的 descriptor heap 移植长文|NVIDIA 开发者论坛的 descriptor heap 复现贴|Piers Daniell @Vulkanised 2026(NVIDIA,厂商视角)
参考资料
Vulkan 1.4 与版本基线(官方)
Dynamic Rendering(官方)
- VK_KHR_dynamic_rendering 提案|VK_KHR_dynamic_rendering_local_read 提案|dynamic_rendering_local_read 样本
- Deprecated(官方弃用表:Render Pass Objects)|Dynamic Rendering 同步与 local read|Dynamic Rendering 教程页
Shader Objects(官方)
- VK_EXT_shader_object 提案|VK_EXT_shader_object refpage|shader_object 样本
- VK_LAYER_KHRONOS_shader_object 仿真层|graphics_pipeline_library 样本(打补丁路线对照)|Khronos 论坛:VK_EXT_shader_object 讨论
描述符管理(官方 + 社区反方)
- VK_EXT_descriptor_buffer 提案|VK_EXT_descriptor_heap 提案|Descriptor Heap Guide
- descriptor_heap 样本|descriptor_management 性能样本|Granite:Walking backwards into the future(descriptor heap 移植)
- NVIDIA 论坛:RTX 4060 读到错误描述符|NVIDIA 论坛:descriptor heap ray query 触发 device lost|NVIDIA 论坛:嵌套结构体忽略 offset
同步(官方)
SIGGRAPH 2026 那门课与厂商材料
- 课程 Overview 页|课程 slides PDF(How to write a Vulkan application in 2026)|课程材料仓库
- Qualcomm:From Vulkan 1.1 to 1.4(Vulkanised 2026)|Piers Daniell @Vulkanised 2026(NVIDIA)|Battle-tested optimisations for mobile(Vulkanised 2023)
- Samsung:InfiniteJet 移动端实践|ACM:移动图形管线相关论文|vkguide.dev(仍以较老模式为主)
Samples 索引与图文资源
- Samples 总览|Profiling|Vulkan-Samples 仓库|Vulkan-Samples-Assets(逐项各自许可)
- Commons:3D-Pipeline.svg(CC0)|Commons:Vulkan simplified pipeline.svg(CC BY-SA 4.0)|Commons:Unified shader model.svg(CC BY-SA 4.0)|Commons:Graphics pipeline 2 en.svg(CC0,备选)|Commons:Pipeline OpenGL.svg(PD,备选)|Commons:Vulkaninfo screenshot.png(PD)


本篇未能核实的(如实登记):①
docs.vulkan.org/guide/latest/下shader_objects/timeline_semaphores/dynamic_rendering三个独立页被反爬拦截,无法确认其是否存在,因此 shader object 与 timeline 的官方对位改用deprecated.html与 Tutorial 页;② 截至现有官方材料,VK_EXT_shader_object未见任何"已核心化"的声明,正文只能写"仍是 EXT";③ SIGGRAPH 2026 课程 slides PDF 的中后段正文未能完整抓取,逐节要点标注了来源边界;④ Vulkan 1.4 的确切发布日未在官方页面找到,正文不写具体某天;⑤ 未检索到可引用且结论明确的 r/vulkan 讨论帖,社区一手材料以 Khronos 论坛与厂商/GitHub 记录为准。
下篇预告
第三篇《同步最佳实践:barrier 精细化、sync2 与时间线信号量》——本篇第八章已经先量了一次时间线信号量,也把"交换链的 acquire 不接受时间线信号量"这条边界挖了出来。下一篇把同步的另一半接上:一次 layout transition 到底花多少、什么时候该合并、什么时候必须分开,以及在"多队列 + 异步 compute"这种真管线里,sync2 与 barrier 该怎么写才既正确又不亏。
落款
希望能对大家有所帮助。 本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。