CSDN 版文章链接:待发布 知乎专栏版文章链接:待发布

点题、总览与边界:掉帧不是感觉,是一个时间差
先说清一件事:本篇只回答一个问题——这一帧,到底掉没掉。这话听着像句废话,因为"卡"的感受我们都有;可要把它写成能复现、能追责的数字,问题就不平凡了:一帧的预算多少、晚多少才算晚、"晚"是应用侧还是合成侧、晚的那一帧在数据里能不能被看见——这四问串起来,才是 FrameTimeline(帧时间线)的全部内容。
本篇的边界也画在这一句话上:不涉及 trace 文件的内部结构(那是本系列的 ep07),不涉及数据源怎么采集与注册(那是 ep08),不复述 SQL 语法与调优(那是 ep09)。本篇是《图形性能剖析工具链》的第 10 篇,只讲帧这一题域的判据与归属:什么算掉帧、掉了多少、怪谁。
这条链路是这样接上的:ep07 讲"文件里有什么",ep08 讲"这些内容谁写进去的",ep09 讲"表该怎么问才既快又对";到本篇,数据与问法都已就位,剩下的问题只有一个:这一帧有没有按时上屏;如果没有,怪谁。
官方对卡顿(jank)的定义,把这个问题钉得更精确:当一个帧实际上屏的时间与调度器预测的上屏时间不一致时,这一帧就是卡顿帧。请注意两处细节:它谈的是"上屏"不是"画完",谈的是"与预测不一致"而不是"超过 16.7 毫秒"。这两个细节决定了本篇后面所有判据的形状。
下面我们先把地图铺好。
0.1 三种"看起来没问题"的错法
先来看看三种最容易发生的错法。 共同特征是:SQL 不报错,结果也不离谱,于是没有人会怀疑它。
第一种是把颜色当成判据。UI 上红色就是卡顿、绿色就是好帧,于是有人直接在截图里数红块。可颜色是给人看的,官方一共给了五种(3.5 节有对照表)。其中"浅绿色"与"黄色",用"数红块"永远数不出来——而它们恰恰最该看:一个是"帧没掉但手感变差",另一个是"帧掉了但锅不在你的代码里"。
第二种是用一个指标替代全部指标。android_frame_stats 里有个 was_jank 列,名字取得太好,于是很多人拿它数掉帧。实测很刺眼:在 android_startup_real.perfetto_trace 上,真正超期的帧(overrun > 0)有 236 帧,was_jank 只报 13 帧;webview_jank.pb 上是 149 对 0;wattson_jank_cuj.pb 上是 42 对 1。同一份数据,换个列名,答案少一个数量级。
第三种是把两路数据当成一路。webview_jank.pb 里有 1031 条 actual 帧、851 条 expected 帧,但你查 Choreographer#doFrame 是 0 条、查 DrawFrame 是 0 条、查 android_frames 是 0 行。这不是语法错,而是FrameTimeline 与 atrace 应用侧切片本来就是两路独立采集的数据:缺了后者,前者照样完整。不知道这件事的人,会把"表空"当成自己的查询问题。
把这三件事并成一句题眼:掉帧不是感觉,是一个可判定、可归因、也会被数错的时间差。 九章顺着它排开:零章立边界,一、二章建坐标系,三章给判据,四章给归因,五章讲标准库算了什么,六章讲怎么问,七章讲哪里取不到、哪里取错,八章收口。
0.2 全篇知识地图
下面这张表是后面九章的顺序与产出。它不是并列的知识点,而是一条坡道——顺序不能颠倒。
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 零、点题与边界 | 这一篇讲什么? | 知识地图 + 版本门槛 + 术语双语表 + 边界声明 |
| 一、一帧的生命周期 | 一帧由哪几段构成? | vsync → doFrame → DrawFrame → SF 合成 → 上屏 的分段 + token |
| 二、两条时间线 | "应该"与"实际"各指什么? | expected / actual 的定义差、取 max 的终点、Flow events |
| 三、判据 | 晚了多少才算掉? | overrun 公式与正负、四档严重度、present_type 取值面 |
| 四、归因 | 掉在谁身上? | 8 条目 × 判据 × 责任方矩阵、分流树、文档与实现的不一致 |
| 五、标准库替你算 | 官方已写好什么? | 四模块分工、android_frames 列结构、SDK 28 分水岭 |
| 六、把一帧查出来 | 该问哪些问题、答案在哪列? | 三段可直接跑的查询 + 列选择速查 |
| 七、边界与陷阱 | 哪里会取不到、哪里会取错? | 陷阱矩阵:was_jank 少报、两路数据、内置视图为空 |
| 八、收口清单与结语 | 下次遇到同类问题怎么办? | 判据 / 归因 / 查询 三列矩阵 + 下一站方向 |
这九章里,第一、二章最要紧。 后面的判据都建立在"一帧由哪几段构成"这个坐标系上——overrun 是两个时间点相减,present_type 描述终点落在哪。坐标系画错,后面每一步都在错地基上算。
0.3 这道题有版本门槛:FrameTimeline 的演进脉络
先说年份口径:下表年份以该能力进入 AOSP 主线或官方文档体系的可考时间为准,取"面向开发者的公开时间",不是内部提交时间。
| 阶段 | 时间 | 关键变化 | 留下来的痕迹 |
|---|---|---|---|
| 帧指标前史 | Android 9(SDK 28)及之前 | 只有 Choreographer#doFrame / DrawFrame 切片,帧要靠时间窗自己拼 |
今天 timeline_maxsdk28 的老路径 |
| 平台侧帧指标 | Android 7.0(API 24,FrameMetrics) |
应用侧可自己拿到一段帧的耗时分解 | android_cpu_time_per_frame 的按帧聚合思路(源码标注 Availability: from N (API 24)) |
| FrameTimeline 落进 SF | Android 12(S) | 官方明说 需要 Android 12(S)或更高;它是 SurfaceFlinger 内部模块,检测 jank 并报告来源 | 原生表 expected_frame_timeline_slice / actual_frame_timeline_slice |
| 标准库把它包起来 | 2024 年(android/frames/*.sql 版权头) |
四个模块把"拼帧 / 算超期 / 归类责任方"全部封装 | 今天你在 SQL 里用的 android_frames / android_frame_stats |
| 文档与实现不再同步 | 近年 | 官方页给 8 个条目,jank_type.sql 的 GLOB 判据已多出三个取值,且真数据里已出现 |
本篇第四章的核心论据 |
年份口径与出处(本轮逐行复核,不留未证年份):三处此前没取到一手依据的时间,本轮这样落定——① Android 7.0 与 FrameMetrics:官方 android.view.FrameMetrics 参考页对每个常量逐条标注 Added in API level 24(即 Android 7.0),且 per_frame_metrics.sql 对 android_cpu_time_per_frame 明写 Availability: from N (API 24)——官方页与源码一致,故写作 Android 7.0(API 24),来源 developer.android.google.cn/reference/android/view/FrameMetrics(镜像站,.com 直链本机不可达)。② "前史"一行:原写"Android 6.0 到 9"无一手可考,改用有源码依据的下界——标准库给老路径的模块名是 android/frames/timeline_maxsdk28.sql,而 timeline.sql 的分叉判据是 iif((SELECT count(1) FROM actual_frame_timeline_slice) > 0, "after_28", "maxsdk28"),即没有 FrameTimeline 数据时走 maxsdk28,故写作 Android 9(SDK 28)及之前。③ "标准库把它包起来"一行:原写"2020 年以后"同样无一手依据,改用该目录源码的版权头(Copyright 2024 The Android Open Source Project,见 android/frames/timeline.sql / per_frame_metrics.sql / jank_type.sql 四文件的文件头),来源 raw.githubusercontent.com/google/perfetto/main/.../android/frames/。"FrameTimeline 落进 SF"一行(Android 12/S)有官方一手页原文(Perfetto frametimeline 页:NOTE: FrameTimeline requires Android 12(S) or higher),末行有本轮实测支撑。
最后一行值得单独说一句:文档与实现不一致,而实现才准。 官方页写明 jank 类型定义出自 JankInfo.h,列了 8 个条目;而本机读到的源码里,判断"这算不算应用侧 jank"用的是 GLOB 模式,其中 App Resynced Jitter、SurfaceFlinger Scheduling、Dropped Frame 都不在那 8 条清单里。更关键的是,在 android_startup_real.perfetto_trace 上真实取到了 SurfaceFlinger Scheduling 3 次、Dropped Frame 2 次——这不是理论上的额外值,是真数据里就会出现的取值。
0.4 术语双语对照(先备着)
先来看看这套术语的双语对照。 后面几章会密集出现官方术语原名:
| 中文 | English | 一句话 |
|---|---|---|
| 期望时间线 | expected FrameTimeline | 调度器给出的"这一帧该在什么时间窗内完成" |
| 实际时间线 | actual FrameTimeline | 应用这一帧实际花掉的时间窗 |
| 上屏时刻 | present time | 帧真正出现在屏幕上的时刻 |
| 卡顿类型 | jank type | 这一帧被判为卡顿后,官方给出的原因归类 |
| 垂直同步 | vsync | 显示刷新与绘制对齐的心跳信号 |
| 合成器 | SurfaceFlinger | Android 里把各层合成为一屏的系统进程 |
| 编舞者 | Choreographer | 应用侧接收 vsync、驱动一次绘制的调度入口 |
| 超期 | overrun | 实际完成时刻减去期望完成时刻的差值 |
| 帧标识 | frame token | 贯穿应用、渲染线程与合成器的同帧对齐标识 |
| 预测类型 | prediction type | 调度器这次预测是否仍然有效 |
一句话记住方法:先看这一帧属于哪两条轨道,再问它超了多少,最后问超在了谁身上。
0.5 边界声明与量化锚点
边界在本篇开篇说一次,第八章会再确认一次:
- 不涉及 trace 文件的内部结构。 帧数据以哪种 packet、哪些字段写下来,是 ep07 的全部内容。
- 不涉及数据来源与采集配置。 哪个源、怎么配、谁写进 ring buffer,是 ep08 的全部内容。
- 不复述 SQL 语法与调优。
CREATE PERFETTO TABLE/INDEX的判据、slices.*家族、SPAN_JOIN、2 × S × N内存模型、命令行四模式,ep09 已讲透,本篇只讲"帧该问哪些问题、答案在哪一列"。 - 不涉及下一篇的题域。 ep11 即第 十一 篇《实战一:一条链路揪 GPU 瓶颈》,本篇不做标题级预告。
- 只讲帧这一题域的判据与归属,不讲这套判据怎么被上层业务指标消费(那是 cujs / startup 的事)。
本篇要拿下的量化锚点有六个,后文逐一对上:60 Hz 下一帧预算 16.7 ms(官方语境常以 16 ms 作红线);官方示例里应用侧 expected 的 dur 是 20.5 ms、SF 侧是 10.5 ms——期望窗口不是恒定值;官方 jank 条目 8 个(None + 7 类);严酷度四档阈值 20 / 50 / 200 ms;在 wattson_jank_cuj.pb 实测 overrun 区间 −13.87 ms 到 +2.08 ms;本机 trace_processor_shell 版本 v58.2-add693d8b。最后两个是"这确实是真跑出来的"的证据。
最后提一句题图:它截的就是官方文档里那个"每个上过屏的应用都会多出两条轨道"的画面[^ext1]。后面每章讲的,都是这两条轨道上的事。
一、一帧的生命周期:把"卡"切成可测量的段
下面我们开始拆第一层。 这一章不讲判据,只做一件事:把"一帧"切成能分别计时、分别追责的几段。后面的"晚了",都得先知道"晚在哪一段"。
1.1 心跳从哪里来:vsync 与应用的接收点
屏幕按固定节奏刷新,垂直同步(vsync)就是这条节奏线。显示端每个刷新周期发一次 vsync,应用侧收到后准备下一帧,合成器在下一个刷新点把准备好的内容推上屏。60 Hz 屏上这条线每 16.7 ms 走一次,90 Hz 与 120 Hz 更短——这就是"目标帧率要随刷新率调整"的由来,也是用固定 16.7 ms 去衡量 120 Hz 设备必然出错的原因。
应用侧接住心跳的入口是编舞者(Choreographer),它收到 vsync 后回调应用,这条回调用切片记下来就是 Choreographer#doFrame;较新的实现里还有一条等价入口 AChoreographer_vsyncCallback——两者在帧的语义上是同一段,只是调用形态不同。这一段的开始时刻很关键:官方对"实际时间线"起点的定义,正是"Choreographer#doFrame 或 AChoreographer_vsyncCallback 开始运行的时刻"。
1.2 第二段:渲染线程里的 DrawFrame
言归正传,接着看渲染线程(RenderThread)。真正向 GPU 提交绘制指令的是它,切片名是 DrawFrame。这里有个易漏的官方提示:一个 vsync 可能对应多个 DrawFrame——比如同时绘制状态栏与通知栏。这一点后面会在真数据上看到(wattson_jank_cuj.pb 上有 32 帧 draw_frame_count = 2)。
DrawFrame 这一段包含 GPU 的工作。官方对"实际时间线"的定义特意强调:应用"实际完成该帧"的时间是含 GPU work 的。所以 DrawFrame 很长时,可能不是 CPU 在忙,是 GPU 还没交活。
1.3 第三段:合成与上屏
帧画完要被交给合成器(SurfaceFlinger)合成,再推给显示硬件。官方对 SF 侧轨道的描述是:SF 的 slice 代表从 SurfaceFlinger 主线程开始,到屏幕上完成一次更新的区间,同时涵盖 Composer 与 DisplayHAL。这一段最容易出"看起来与应用无关、实际影响上屏"的问题——颜色码里的黄色(帧卡了但应用不是主因)指的就是这类。
把三段合起来,就是本章的坐标系:
这张图要留意的是"分界线不是进程边界"。 三个区间里跨进程的接缝只有一处:应用侧 doFrame 与渲染线程 DrawFrame 都在应用进程内,应用把帧交出去(post)之后,工作才转到 SurfaceFlinger 进程,合成与上屏都在那一侧。所以跨进程归因必须把合成侧那一轨拉进来对照——这也是 actual_frame_timeline_slice 里会有 layer_name 与 upid 的原因。
1.4 两条轨靠什么对齐:同一个 token
应用侧那么多帧、合成侧也那么多帧,凭什么知道哪个应用帧对应哪个合成帧?答案是帧标识(frame token)。官方机制是:期望/实际时间线里每一段的切片名就是从 Choreographer 拿到的那个 token;同一个 token 还会被加到应用侧的 doFrame 与渲染线程的切片上;而在合成器那一侧,你会在 onMessageReceived 上看到同名 token。
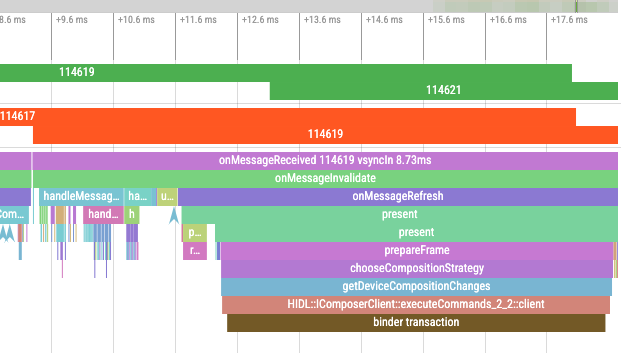
上面这张官方实景图(原图长边 621 px,按原理小图处理)来自 FrameTimeline 数据源文档页[^ext2]。没有 token,两轨就只能靠时间戳硬凑;有了 token,同帧的关联是一个等值条件。
1.5 用一条查询把分段读出来
概念讲完,落到一次真实查询上。下面这段 SQL 把某个进程的三段切片并排拉出来,它是本章的落地动作,不是判据:
-------------------------------------【帧的三段切片:先看清原料】-----------------------------------
-- 描述:按切片名把一帧的三段素材捞出来,确认这份 trace 里到底有哪些帧原料
-- 依据:perfetto.dev/docs/data-sources/frametimeline 与 perfetto.dev/docs/analysis/sql-tables
--------------------------------------------------------------------------------------------------
SELECT
  s.ts,
  time_to_ms(s.dur) AS dur_ms,                       --【1】统一换算成毫秒,避免手写零的个数
  s.name,
  t.name AS thread_name                              --【2】带上线程名,一眼看出是主线程还是渲染线程
FROM slice AS s
JOIN thread_track AS tt ON s.track_id = tt.id
JOIN thread AS t USING (utid)
WHERE s.name GLOB 'Choreographer#doFrame*'            --【3】应用侧的第一段
   OR s.name GLOB 'DrawFrame*'                        --【4】渲染线程的一段,注意可能一帧多条
   OR s.name GLOB 'AChoreographer_vsyncCallback*'
ORDER BY s.ts
LIMIT 50;
下面对【1】【3】【4】特别说明。【1】是 ep09 反复强调的纪律:时间单位是纳秒,手写换算迟早多写或少写一个零。【3】与【4】是本章最容易误判的地方——这两个模式串匹配的条数不能直接当帧数用。本机实测 wattson_jank_cuj.pb:Choreographer#doFrame* 有 466 条、DrawFrame* 有 252 条,而真正的帧数是 android_frames 的 220 行。条数比帧数多,因为"一个 vsync 可能有多个 DrawFrame",也因为同名模式会捞到变体切片。想要"帧"这个粒度,就得交给标准库去拼(第五章)。
这一章收在这里。 第一章走完,手里该有三件事:一帧有三个可测区间(应用侧、渲染线程、合成侧)、跨进程的接缝只有一处、靠 token 对齐、切片条数不等于帧数。
本章对应的源码:帧归属与 token 解析在
android/frames/timeline.sql,其中_get_frame_table_with_id()用STR_SPLIT(name, ' ', 1)从切片名里抠出帧标识,并显式过滤掉frame_id != 0与frame_id != -1两种无效值——这是"为什么有些帧你永远查不到"的第一个伏笔。
二、两条时间线:一条写"应该",一条写"实际"
好了,坐标系有了,我们来看系统为每一帧准备的两把尺子。 FrameTimeline 不满足于记录"这一帧花了多久",而是同时记录两个时间窗:调度器认为它该在什么窗口里完成,以及它实际在什么窗口里完成。两把尺子一减,就有了判据。
2.1 官方定义:两轨的起点与语义
期望时间线(expected FrameTimeline):每一段代表给应用渲染这一帧的时间;它的开始时刻是 Choreographer 回调被调度运行的时间。也就是说,expected 的起点不是"应用开始干活",是"系统打算让应用开始干活"——它由调度器给出,是一份计划。
实际时间线(actual FrameTimeline):每一段代表应用实际完成这一帧(含 GPU work)并交给合成器的时间;它的开始时刻是 Choreographer#doFrame 或 AChoreographer_vsyncCallback 开始运行的时间。
两条定义摆在一起,差别就出来了:两轨的起点口径不同。一旦系统忙、线程没被及时唤醒,这两个时刻就会分开——分开多少本身就是一条信息(第五章会看到标准库为此造的 android_app_vsync_delay_per_frame 视图)。
2.2 expected 不是一个固定的 16.7 毫秒
先看看 expected 的长度。不少人第一次听说 FrameTimeline,会默认"expected 就是 16.7 毫秒"——这个默认是错的,而且错得很自然:16.7 ms 是"屏幕刷新间隔",不是"系统分配给某个应用完成一帧的时间窗"。
官方示例给了两个真实取值:应用侧 expected 的 dur 是 20500000 ns,也就是 20.5 ms;同一时刻合成器侧的是 10500000 ns,也就是 10.5 ms(示例时间戳从 60230453475 起算,单位纳秒)。两个都不是 16.7 ms:应用侧比一个刷新周期长,合成侧比一个刷新周期短。
后果很直接:判据不能写成"dur > 16.7 ms 就是掉帧"。 正确的判据不是比长度,是比两个窗口谁更靠后——第三章的 overrun 就是这么定义的。调度器之所以能给应用一个 20.5 ms 的窗口,是因为它在按当前刷新率、当前负载与预测的呈现时刻动态分配;这也是 prediction type 单列成一栏的原因。
2.3 actual 的终点:为什么要取 max
接下来是本章最容易算错的一处:actual 的终点不是 DrawFrame 的结束时刻。
官方的写法是:actual 的 end time = max(gpu time, post time),其中 post time 是应用把帧 post 给 SurfaceFlinger 的时刻。为什么取大者?因为帧真正"完成"的标志是两件事都做完:GPU 画完了,应用也把这一帧交出去了。
两种典型反例,各记一笔:
- CPU 早交出去了,GPU 还在跑:post time 小、gpu time 大,取 max 后 actual 被拉长——只看
DrawFrame耗时,会得出"这帧很快"的错误结论。 - GPU 早画完了,应用迟迟不 post:gpu time 小、post time 大,对应的是"UI 线程状态更新没及时推给渲染线程",也就是颜色码里应用侧那个蓝色(Dropped Frame)描述的场景。
一句话记住这一节:actual 的终点是帧"具备被合成条件"的时刻。
2.4 token 在两轨上的落点
原生两张表各有一对 token 列:
| 表 | 应用侧标识 | 合成侧标识 |
|---|---|---|
expected_frame_timeline_slice |
surface_frame_token |
display_frame_token |
actual_frame_timeline_slice |
surface_frame_token |
display_frame_token |
也就是说,同一个 token 会同时出现在多处:期望轨与实际轨的同一行上;在应用侧 doFrame 与渲染线程的切片名里;在合成器那一侧,它出现在 onMessageReceived 上。把这四处置于同一张图上,就能"顺着一个 token 横穿三段"。
2.5 跨进程那一跳:Flow events 是怎么画出来的
下面我们开始看跨进程那一跳。UI 上怎么知道应用侧这一段对应合成侧那一段?答案是 Flow events(流事件),官方给了两条方向相反的机制:选中应用侧的 actual slice,UI 会画出连线指向对应的合成器切片;选中合成侧的 DisplayFrame,UI 会画出箭头指向被一起合成的所有帧(可跨进程)。
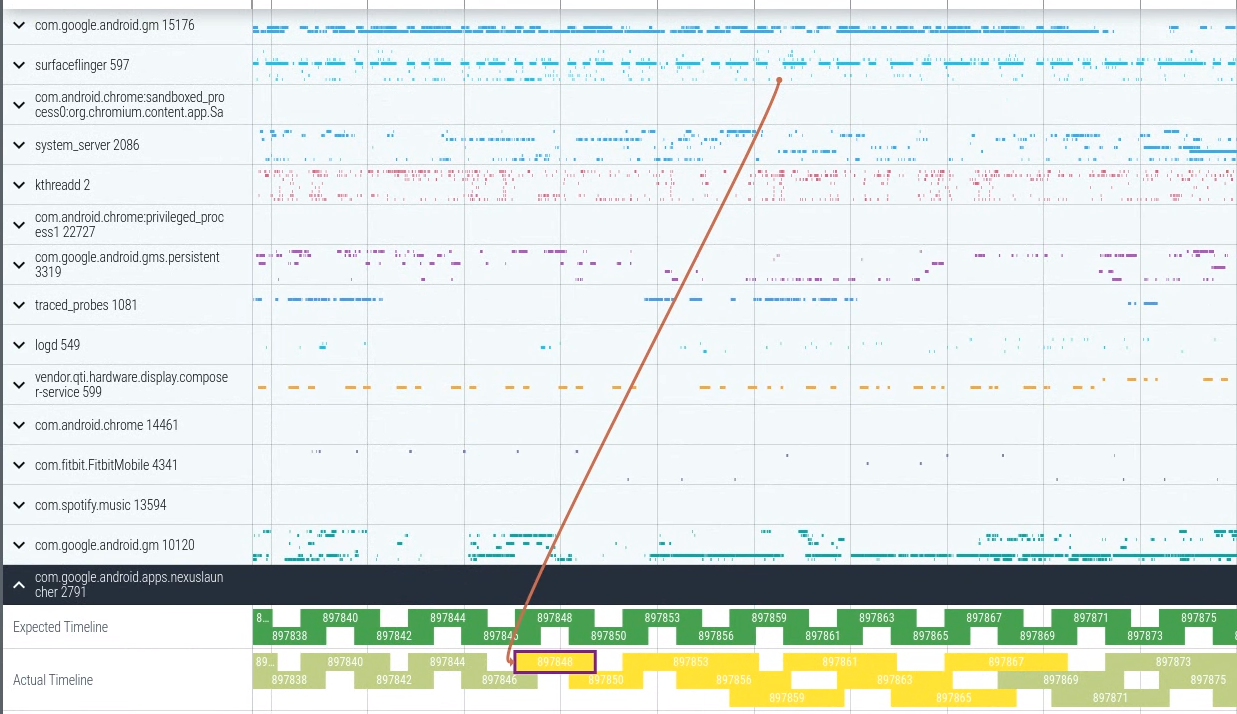
这张官方实景图(原图 1237×714)[^ext3] 证明了一句常被当成"玄学"的话:"这一帧到底怪谁"在 UI 上是有可视证据的。箭头从应用侧出发落到合成侧;红色落在应用那侧,锅在应用;落在合成侧,锅在系统。
2.6 一次把两轨并排捞出来
落到查询上:下面这段 SQL 把应用侧两轨并排放在一张结果表里,回答"两轨窗口分别多长、错开多少",不是"掉没掉":
-------------------------------------【两轨并排:看窗口长度与错位量】---------------------------------
-- 描述:应用侧的期望窗口 vs 实际窗口逐帧对照,错位量即 app_vsync_delay 的来源
-- 依据:perfetto.dev/docs/data-sources/frametimeline 的官方示例(两表 LEFT JOIN process 取进程名)
----------------------------------------------------------------------------------------------------
SELECT
  exp.ts                                   AS exp_start,
  time_to_ms(exp.dur)                      AS exp_ms,          --【1】期望窗口长度(官方示例里是 20.5 ms 量级)
  act.ts                                   AS act_start,
  time_to_ms(act.dur)                      AS act_ms,          --【2】实际窗口长度
  time_to_ms(act.ts - exp.ts)              AS start_delay_ms,  --【3】两轨起点错位量
  p.name                                   AS process_name
FROM expected_frame_timeline_slice AS exp
JOIN actual_frame_timeline_slice  AS act
  ON exp.surface_frame_token = act.surface_frame_token            --【4】按应用侧 token 对齐,而不是按时间戳
LEFT JOIN process AS p USING (upid)
ORDER BY exp.ts
LIMIT 20;
下面对【3】【4】特别说明。【3】是 2.1 节"起点口径不同"的可观测形态:两者相减就是被耽搁的时间;标准库有一个视图专干这件事,但它的注释与实现并不一致,这个矛盾留到 5.4 节说。【4】是重点:对齐要用 token,不要用时间戳。用时间戳去凑("起点差 1 ms 内就算同一帧")不忙时看着能用,一忙就张冠李戴;token 是等值条件,不存在"凑"。
这一章收在这里。 四个结论:expected 起点是"被调度"、actual 起点是"真开始";expected 的长度不是恒定的 16.7 ms;actual 的终点要取 GPU 与 post 的较大者;两轨靠 token 对齐,跨进程那一跳靠 Flow events 显示。
本章对应的官方依据:两轨语义与 Flow events 见 FrameTimeline 数据源页,两表列定义见 SQL 表参考。
三、判据:超了多少才算掉
下面我们进入本篇的核心。 这一章回答三个问题:掉了多少(overrun)、掉了算多严重(四档阈值)、这一帧的终点落在哪一档(present_type 与它的同伴列)。
3.1 overrun:一个减法,两种符号
判据只有一行减法,定义在 android_frames_overrun 视图里:
overrun = (actual.ts + actual.dur) − (expected.ts + expected.dur)
其中 actual.ts + actual.dur 是 actual 轨的终点,expected.ts + expected.dur 是 expected 轨的终点。两条终点一减,符号即结论。源码注释很直白:这个值为负表示没有错过截止时间;只有当 overrun 为正时,这一帧才被认为是卡顿帧。
这张图要挡住一个常见的误读:把"负的 overrun"当异常值。 它不是异常,是"提前完成"。在 wattson_jank_cuj.pb 上的完整分布是:215 帧有 overrun 值,其中 > 0 的 42 帧、≤ 0 的 173 帧;最小值 −13,873,287 ns(−13.87 ms),最大值 +2,078,702 ns(+2.08 ms)。负到 −13.87 ms 说明相当一部分帧是提前完成的——若用"绝对值大于某阈值"筛异常,这 173 帧会被全部误判。
说白了,判据就是两个终点相减。
3.2 四档严重度:别把阈值写进自己的 SQL
判据不止"掉没掉"一档。另三档阈值都写在 android_frame_stats 里:
| 列 | 判据(源码原文) | 含义 |
|---|---|---|
was_jank |
overrun > 0 |
错过了截止时间 |
was_slow_frame |
cpu_time > 20 ms |
帧的 CPU 时间超过 20 毫秒 |
was_big_jank |
cpu_time > 50 ms |
超过 50 毫秒 |
was_huge_jank |
cpu_time > 200 ms |
超过 200 毫秒 |
这张表有两个陷阱。 一是量纲:第一档判的是 overrun(与截止时间比),后三档判的是 cpu_time(CPU 耗时)——两把不同的尺子,不能混着读成"四档超期"。二是阈值别手写:官方源码用的是函数式毫秒换算,照抄"200"或"200000000"这样的裸数字,单位口径一变就是静默错误。顺带把原生表上那列 jank_severity_type 也盘了一遍(本篇不用它,但要知道它跟上面四档不是一回事):本机在 android_startup_real.perfetto_trace 的 2028 条 actual 帧上取到 4 个取值——None 1921、Partial 92、Full 11、Unknown 4;它判的是"这一帧该不该算严重 jank"的平台侧档位,与 android_frame_stats 里那四个基于 overrun / cpu_time 的布尔列不是同一套口径,别混用。
cpu_time 本身还有一层估算:算不出精确 CPU 时间时,标准库退回一个估值,规则是 ui_time + 5 ms(UI 时间加 5 毫秒),用在一个叫 _estimated_cpu_time_per_frame 的内部表上。意义在于:was_slow_frame 这类判据在回退帧上不是严格测量值,是估值。 写结论时说清这一点,比报一个漂亮数字更重要。
3.3 present_type 与它的两个同伴列
overrun 回答"超了多少",present_type 回答"这一帧落在哪一档"。官方详情面板里这一栏的常见取值是三个:Early Present(早于预测呈现)、On-time Present(按时呈现)、Late Present(晚于预测呈现)。它与另两列配合使用:
on_time_finish:应用是否按时完成了这一帧的工作——它判的是"应用的工作完成时刻",与present_type判的"上屏时刻"是两件事;prediction_type:调度器这次的预测是否仍然有效,取值是 Valid Prediction(预测有效) 与 Expired Prediction(预测已过期)。
这一栏的组合才是归因的入口。 在 wattson_jank_cuj.pb 的 217 条 actual 帧上取到:present_type 是 On-time Present 216 条 + Late Present 1 条;on_time_finish 是 1 出现 216 次、0 出现 1 次;prediction_type 全部是 Valid Prediction。也就是说这份 trace 的预测没有漂移,唯一那条晚呈现的帧,应用侧也确实没按时完成——两列的信息是对上的。
但取值面并不干净。官方页只给了 Early / On-time / Late 三态,而在最大样本 android_startup_real.perfetto_trace(2028 条 actual 帧)上把 present_type 分组统计,得到 4 个取值:On-time Present 1921、Late Present 103、Unspecified Present 2、Dropped Frame 2——后两个都不在官方三态里(Early Present 在这三份 trace 上一条都没出现,说明"官方列了"与"真数据会有"是两件事)。交叉表看得更清楚:Late Present 那 103 条对应的是 Buffer Stuffing / App Deadline Missed / SurfaceFlinger Scheduling;Unspecified Present 的两条恰好都带 Expired Prediction;而 Dropped Frame 那两条的 jank_type 与 jank_tag 也同为 Dropped Frame。这就是本篇反复出现的同一种现象:文档列的是"常见值",不是"完备枚举"。 用等值比较去圈这几个取值,会漏掉未列出的形态。
3.4 官方详情面板:这一章的字段全在上面
官方给了一张详情面板截图,上面就是本章这几列在界面上的样子:Present Type(呈现类型)、On time finish(是否按时完成)、Jank Type(卡顿类型)、Prediction type(预测类型)、GPU Composition(是否 GPU 合成)、Layer Name(层名)。
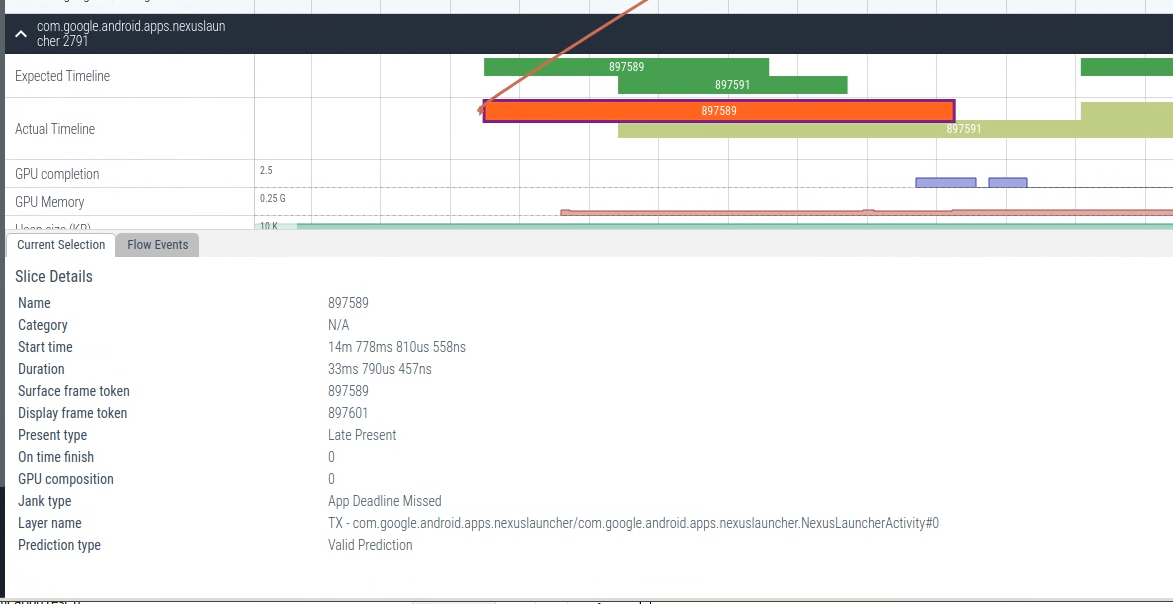
这张详情面板(原图 1173×604,按原理小图处理)[^ext4] 值得与 3.1 节的公式对着看。 面板上有的字段,SQL 里都有对应列,这就是"UI 与命令行问的是同一份数据"的证据(actual_frame_timeline_slice 共 25 列,与判据相关的有 present_type、on_time_finish、gpu_composition、jank_type、prediction_type、jank_tag 等)。
3.5 颜色码:给眼睛看的版本
| 颜色 | 含义 |
|---|---|
| 绿色 | 好帧,无 jank |
| 浅绿色 | 高延迟状态:帧率顺滑,但呈现偏晚,输入延迟变大 |
| 红色 | 卡顿,且该 slice 所属进程是这次卡顿的主因 |
| 黄色 | 帧卡了,但应用不是主因(合成侧造成)——只用于应用侧 |
| 蓝色 | 丢帧:合成侧指"主动跳过该帧、优先更新的帧";应用侧指"UI 线程的状态更新没及时推给渲染线程" |
最该记住的是"红与黄的分工":颜色本身就是责任方。 红与黄的区别不在"卡得多严重",在"怪谁";浅绿与绿色同理,区别不在"顺不顺",在"手感好不好"。颜色是给人扫一眼的,判据是给机器算的——对应关系成立,但推导方向不能反。
3.6 把判据跑出来
下面这段 SQL 一次把三件事都算出来,而且不自己写阈值:
-------------------------------------【判据一次到位:超期、严重度、呈现档位】-----------------------
-- 描述:用标准库的视图取判据,不在自己的 SQL 里重现阈值与公式
-- 依据:stdlib/android/frames/per_frame_metrics.sql(raw 全文)与 stdlib/android/frames/jank_type.sql
----------------------------------------------------------------------------------------------------
INCLUDE PERFETTO MODULE android.frames.timeline;          --【1】先引入帧归属,后面所有帧表都建立其上
INCLUDE PERFETTO MODULE android.frames.per_frame_metrics; --【2】再引入判据视图

SELECT
  count()                                            AS frames,
  sum(iif(overrun > 0, 1, 0))                        AS overrun_positive,  --【3】这才是"掉了多少帧"
  min(overrun)                                       AS min_overrun,
  max(overrun)                                       AS max_overrun,
  sum(CASE WHEN was_slow_frame = 1 THEN 1 ELSE 0 END) AS slow_frames
FROM android_frame_stats;                             --【4】四档判据都在这个视图里
下面对【3】【4】特别说明。【3】是本篇最想让人记住的一行:数掉帧要数 overrun > 0,不要数 was_jank。 两者语义上是一件事,但真数据上答案差一个数量级(0.1 节给过三组:236→13、149→0、42→1)。成因不是"哪列更权威",而是能不能算出来——was_jank 所在视图要做帧级 CPU 时间聚合,依赖应用侧切片;切片缺失时,那一帧即使超期也进不了统计(第七章拆开)。【4】是"别重写标准库"的再次体现:阈值、回退估值、聚合口径全在视图里,你只用列名。
这一章收在这里。 overrun 是两轨终点之差,只有为正才算卡顿;严重度另有四档、判的是 CPU 时间;呈现档位看 present_type,配合是否按时完成与预测是否有效;颜色是判据的界面版本。
本章对应的源码:公式、四档阈值与 CPU 时间回退估值都在
android/frames/per_frame_metrics.sql。
四、归因:这一帧掉在了谁身上
好了,判据有了,接下来是它真正的用武之地。 官方把 jank 检测做进 SurfaceFlinger,目的不只是"标出卡顿",而是报告 jank 的来源。这一章把"来源"拆成三件事:官方列了哪些条目、每条的判据是什么、以及文档与实现不一致时该信谁。
4.1 官方条目清单:8 个条目,不是 8 类 jank
这里第一个坑是计数口径:8 个条目里有 1 个是 None(无 jank),剩下 7 个才是真正的 jank 类型。把它们并列成"8 类 jank"是常见口误,这个口误会变成实际错误——None 不该被算进"卡顿帧分类统计"的分母。
| 条目 | 一句话判据(官方口径) |
|---|---|
None |
无 jank |
App Deadline Missed |
应用自己跑超时:起点是 Choreographer 被唤醒,终点是 GPU 与 post 的较大者 |
Buffer Stuffing |
应用在前一帧尚未呈现时继续送新帧,导致队列积压、至少晚一个 vsync |
SurfaceFlinger CPU Deadline Missed |
合成器主线程超时:设备合成时含整段合成时间;GPU 合成时含写 draw call 与交 fence |
SurfaceFlinger GPU Deadline Missed |
CPU 时间没超,但 GPU 没按时完成,于是被推到下一个 vsync |
Display HAL |
合成器按时交给了硬件抽象层,但没能在该 vsync 上屏 |
Prediction Error |
调度器预测漂移(例如预测 20 毫秒、实际 23 毫秒);调度器会自我纠正,孤立漂移几乎感知不到 |
Unknown |
未知原因,例如"超时了但帧仍提前呈现",官方说这种概率极低 |
最反直觉的一行是 Buffer Stuffing。 官方对它的描述里有一句关键话:它更像一种状态,不是一次 jank。原因是队列积压会让帧继续顺畅地出来(帧率看着没问题),代价是输入延迟变大——手指点下去,屏幕晚一拍才有反应。这就是颜色码里"浅绿色"对应的状态:帧率顺滑、手感变差。只看帧率的看板上,这种劣化完全隐形。
4.2 归因矩阵:条目 × 判据 × 责任方
把 8 个条目按"谁造成的"重排,就是本篇的中心图。判据列取自官方页与 JankInfo.h 的口径,责任方列取自 jank_type.sql 里三个分类函数的实现:
这张矩阵要按住一个观念:判据与责任方是两列,不是一列。 不少人把"卡得多严重"与"怪谁"混成一个判断,看到红帧就认定是应用的问题。读法应该是:先由判据确定"哪一类",再由分类函数确定"记在谁头上"。
4.3 责任方分流:从字符串到归属
先看看三个分类函数。官方 stdlib 文档页给了它们各自的一句话:android_is_sf_jank_type 判断这次卡顿是否由合成器造成;android_is_app_jank_type 判断是否由应用造成;android_is_missed_frame_type 判断该算在合成器、应用,还是 Dropped Frame。
三个函数都不建表,也不依赖具体数据——它们纯粹是字符串分类器。实跑确认了这一点:引入 android.frames.jank_type 后,用 sqlite_master 枚举不到任何新表或新视图,函数调用本身却可用。
这棵树上两处容易走反。 一是 Display HAL 与 SurfaceFlinger CPU / GPU 的区别:前者是"合成器按时交出去了,硬件没按时上屏",后者是"合成器自己就没按时"——同样表现为上屏晚,责任方一个在系统硬件链路,一个在合成器进程。二是预测漂移:官方明确说调度器会自我纠正、孤立漂移几乎感知不到,所以单列一类,不当成"应用或系统的锅"。看到 Prediction Error 就去找应用代码,是白费力气。
4.4 文档与实现不一致:这一节是本篇最硬的地方
下面我们进入本篇最值得单独拎出来的一节。 官方页给的条目是 8 个,而读到的 jank_type.sql 里,三个分类函数用的是 GLOB 模式匹配,模式里多出了三个官方清单没有的取值。
| 分类函数 | 源码里的 GLOB 判据 | 官方 8 条目清单里有没有 |
|---|---|---|
android_is_sf_jank_type |
*SurfaceFlinger CPU Deadline Missed*、*SurfaceFlinger GPU Deadline Missed*、*SurfaceFlinger Scheduling*、*Prediction Error*、*Display HAL* |
前两个有,SurfaceFlinger Scheduling 没有 |
android_is_app_jank_type |
*App Deadline Missed*、*App Resynced Jitter* |
前者有,App Resynced Jitter 没有 |
android_is_missed_frame_type |
前两个函数的结果,或 *Dropped Frame* |
Dropped Frame 没有 |
关键不是"文档漏了三个词条",而是这三个词条在真数据里真的会来。 在 android_startup_real.perfetto_trace 的 2028 条 actual 帧上统计 jank_type 真值:
jank_type 真值 |
条数 | 在官方 8 条目清单里 |
|---|---|---|
None |
1921 | 在 |
Buffer Stuffing |
89 | 在 |
App Deadline Missed |
12 | 在 |
SurfaceFlinger Scheduling |
3 | 不在 |
Dropped Frame |
2 | 不在 |
App Deadline Missed, Buffer Stuffing |
1 | 两值各自在,但这是逗号拼接的多值形态 |
这张表一口气钉住三件事。 第一,SurfaceFlinger Scheduling 与 Dropped Frame 各出现 3 次与 2 次——实现侧多出的取值不是理论可能,是实拍;这也解释了那三个 GLOB 的来历:实现比文档更新,而实现才准。 第二,同一个 jank_type 可以是逗号拼接的多值,于是等值比较会漏——WHERE jank_type = 'App Deadline Missed' 会漏掉那 1 条多值帧,而 GLOB '*App Deadline Missed*' 才能命中。第三,权威枚举源 JankInfo.h 本轮不可达,本篇只给"截至官方页列为 8 个条目"这一口径,并把真数据反例并排列出——这不是含糊,是把不确定性写在明处。
4.5 函数怎么用:入参是显示形,不是驼峰形
还有一个纯操作层面的坑:这三个函数的入参必须是带空格的显示形态。实跑:android_is_app_jank_type('App Deadline Missed') 返回 1,android_is_sf_jank_type('SurfaceFlinger CPU Deadline Missed') 返回 1;把合成器类判给应用侧返回 0——分类是互斥的,没有"两边都算"的情况。
三函数的真值本轮一次性跑全(android_startup_real.perfetto_trace,v58.2):android_is_app_jank_type('App Deadline Missed')=1、android_is_app_jank_type('SurfaceFlinger CPU Deadline Missed')=0、android_is_sf_jank_type('SurfaceFlinger CPU Deadline Missed')=1、android_is_sf_jank_type('App Deadline Missed')=0、android_is_missed_frame_type('App Deadline Missed')=1、android_is_missed_frame_type('Dropped Frame')=1、android_is_missed_frame_type('Buffer Stuffing')=0、android_is_missed_frame_type('None')=0、android_is_app_jank_type('App Resynced Jitter')=1、android_is_sf_jank_type('SurfaceFlinger Scheduling')=1。其中 android_is_missed_frame_type('App Deadline Missed')=1 一项,是为消除两份记录的自相矛盾而专门复跑的(研究笔记与素材清单曾分别记 0 与 1);实跑定论为 1,且这个结果在实现上是必然的——is_missed 的定义就是 is_sf($x) OR is_app($x) OR $x GLOB '*Dropped Frame*',App Deadline Missed 会先被 is_app 命中。后两项(App Resynced Jitter、SurfaceFlinger Scheduling)则再次坐实 4.4 节:官方清单外的取值不只存在于 GLOB 模式里,函数对它们就是返回真。
-------------------------------------【责任方分类:入参必须带空格】-----------------------------------
-- 描述:三个分类函数是纯字符串分类器,不建表、不依赖数据;入参用显示形
-- 依据:stdlib/android/frames/jank_type.sql(raw 全文,本轮已读到)
----------------------------------------------------------------------------------------------------
INCLUDE PERFETTO MODULE android.frames.jank_type;                    --【1】只说 3 个函数,没有表

SELECT
  android_is_app_jank_type('App Deadline Missed')                  AS a1, --【2】应用侧类 → 1
  android_is_app_jank_type('SurfaceFlinger CPU Deadline Missed')   AS a2, --【3】合成器类不该判给应用 → 0
  android_is_sf_jank_type('SurfaceFlinger CPU Deadline Missed')    AS a3, --【4】合成器类 → 1
  android_is_missed_frame_type('Dropped Frame')                    AS a4, --【5】官方清单外,但算 missed frame → 1
  android_is_missed_frame_type('Buffer Stuffing')                  AS a5, --【6】状态而非 jank,不算 missed → 0
  android_is_missed_frame_type('None')                             AS a6  --【7】无 jank,不算 missed → 0
下面对【2】【5】特别说明。【2】的重点是形态:'App Deadline Missed' 带空格才对,写成 'AppDeadlineMissed' 不匹配——因为源码用的是 GLOB 模式 *App Deadline Missed*,模式里的空格是字面量。这个坑很隐蔽:你会先看到"函数返回 0"而怀疑逻辑,其实只是字符串没写对;而 jank type 往往是从列里读出来的,一旦 SQL 中间做过字符串加工(去空格、转驼峰),分类就静默失效。【5】再一次印证 4.4 节:Dropped Frame 不在官方清单里,却在 android_is_missed_frame_type 的判据里,真数据里出现 2 次——要数"丢帧",就得把它算进去。
4.6 合成器侧的跨进程箭头
官方给了一张实景图:选中 DisplayFrame 之后,UI 会画出箭头指向被一起合成的所有帧——可以跨进程、可以来自不同应用。
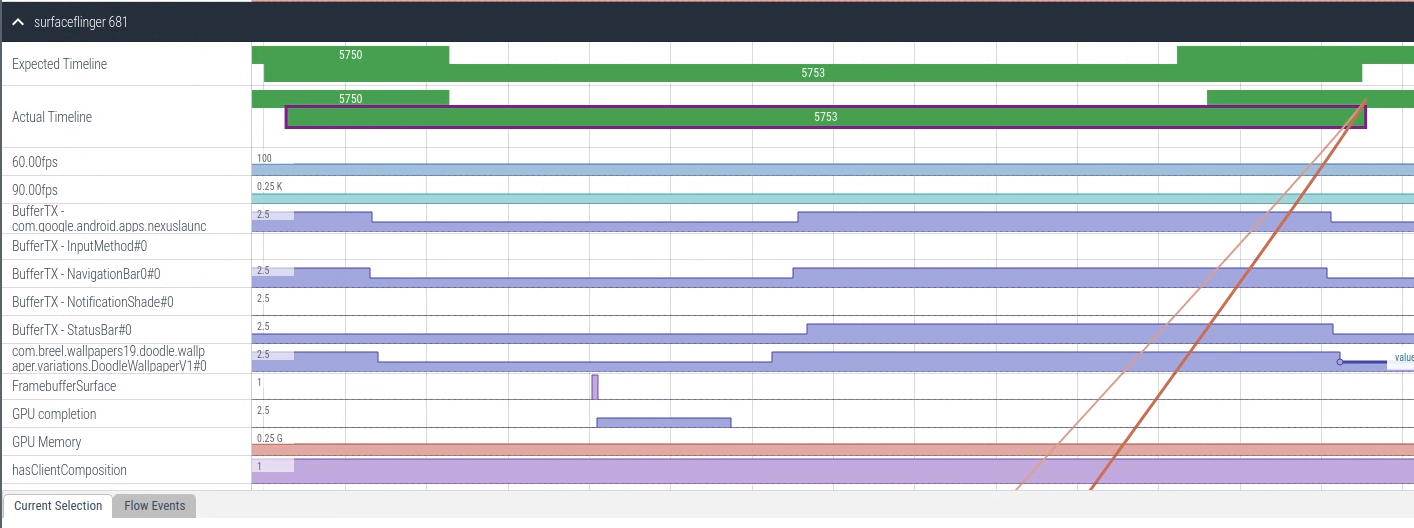
这张图(原图 1414×528,长边达标)[^ext5] 补上了分流树的另一半。 树告诉你"锅在合成侧",它告诉你"合成侧那一帧同时拖累了哪些应用帧"——一屏合成迟到,往往是多个应用帧一起受影响。这也是颜色码把"黄色"单列的原因:帧卡了但应用不是主因。
这一章收在这里。 四条:官方清单 8 个条目(含一个 None);判据与责任方是分开的两列,桥是 jank type 字符串;Buffer Stuffing 是状态不是 jank,伤的是输入延迟而不是帧率;文档与实现不一致时以实现为准。
本章对应的官方依据:条目清单与判据见 FrameTimeline 数据源页;三个分类函数见 标准库文档索引。
五、标准库替你算:四个模块与一道分水岭
下面我们来看看这套判据背后的工程量。 帧要拼、token 要解析、多 layer 要归并、SDK 版本要分叉——这些活都由 android.frames.* 包了。本章回答:它们分了几个模块、各自管什么、为什么你不该自己从 slice 表里手抠帧号。
5.1 四个模块的分工(本机实跑枚举)
帧题域不是"一个 timeline.sql",而是一个目录、四个功能模块加一个构建文件:
| 模块 | 本机实跑新增对象数 | 管什么 |
|---|---|---|
android.frames.timeline |
7 个 | 帧归属:把三段切片拼成"帧",并给出 android_frames 等表 |
android.frames.per_frame_metrics |
9 个 | 判据:overrun、ui_time、cpu_time、四档严重度 |
android.frames.jank_type |
3 个(且全是函数,无表) | 责任方分类 |
android.frames.timeline_maxsdk28 |
供回退路径使用 | 没有 FrameTimeline 数据时,按老办法拼帧 |
最值得记的是第二列。 第一行引入的 7 个对象里,4 个是能直接用的表(android_frames、android_frames_layers、android_frames_choreographer_do_frame、android_frames_draw_frame),2 个是内部表与内部函数,1 个是函数式入口(android_first_frame_after)。第二行的 9 个对象里有 4 个内部表。第三行最干净:引入 android.frames.jank_type 后,sqlite_master 里查不到任何新表或新视图——它只提供函数,与官方文档页"该模块只有 3 个函数、没有表"一致。这是"文档与实现一致"的正例,可与 4.4 节的反例并置。
android.frames.* 四模块的分工与依赖:帧归属 → 判据 → 责任方分类,外加一条 SDK 28 之前的回退路径@ 本系列绘制5.2 android_frames 的 14 列:帧的"全息档案"
下面我们进入 14 列。本机实跑的 android_frames 是 14 列:frame_id、ts、dur、do_frame_id、draw_frame_id、actual_frame_timeline_id、expected_frame_timeline_id、render_thread_utid、ui_thread_utid、actual_frame_timeline_count、expected_frame_timeline_count、draw_frame_count、upid、process_name。
其中四个 count 类字段是"体检指标":
expected_frame_timeline_count恒为 1。源码注释的原因:"一个frame_id的 expected 永远只有一条"。在wattson_jank_cuj.pb上验证:220 行全部等于 1。如果哪天它不等于 1,那不是数据有惊喜,是口径搞错了。actual_frame_timeline_count会取到 0、1、2:分布是 0 出现 103 行、1 出现 115 行、2 出现 2 行。"一帧"并不保证"一定有一条 actual",也不保证"只有一条"。draw_frame_count会取到 2:分布是 1 出现 188 行、2 出现 32 行,印证官方注释"一个 vsync 可能有多个 DrawFrame"。- 同一
frame_id会落在多个 layer 上:android_frames220 行 vsandroid_frames_layers256 行,差 36 行,而frame_id去重计数仍是 220——多出来的全是同一帧的不同 layer。所以"一帧一行"这个直觉是个假象。
5.3 SDK 28 分水岭:两套口径在同一个表名下
这是本篇最关键的一处机制。 标准库的 all_frames 不是一张表,是两条路的并集:一条用 FrameTimeline 数据(Android 12/S 之后),一条用老办法拼帧(SDK 28 及之前)。选哪条由标准库自己判断:
WHERE sdk = iif((SELECT count(1) FROM actual_frame_timeline_slice) > 0, "after_28", "maxsdk28")
意思是:标准库先看"这份 trace 里有没有 FrameTimeline 数据",没有就自动回退到老路径。 善意在于写 SELECT * FROM android_frames 时不必先判断 Android 版本;代价是,同一个表名下面,两条路的 frame_id 口径不一样。
说白了,SDK 分水岭的价值是"让你不必自己判断版本",代价是口径被藏了起来。老路径的 frame_id 是现造的:源码注释写明它用 row_number() OVER () 从 0 开始编号;而 FrameTimeline 路径的 frame_id 来自系统 token,是真实标识符(真数据上是五位以上的大数)。把它们当成同一个东西,会犯两个错:一是"明明看到 frame_id = 5,怎么在另一份 trace 上对不上";二是"把 frame_id 当时间序"——老路径上它恰好递增,FrameTimeline 路径上不是。
5.4 两处官方口径的自相矛盾(别选一个当真理)
读源码时顺手记下两处"官方没说圆"的地方。这两处本轮都核过一遍:一处能在真数据上判成定论并给出取值区间,另一处判定了"注释与实现确实不一致"(正文一律按实现口径算):
android_app_vsync_delay_per_frame的注释与实现不一致(本轮已读到源码全文,判成定论)。 该表定义在per_frame_metrics.sql,注释两句自相矛盾:第一句写 "The time between the VSYNC-app signal and the start of Choreographer work"(信号→开工),第二句写 "time difference between the actual frame start … and start of theChoreographer#doFrameslice";而实现体是SELECT frame_id, act.ts - exp.ts AS app_vsync_delay FROM distinct_frames AS f JOIN slice AS exp ON (f.expected_frame_timeline_id = exp.id) JOIN slice AS act ON (f.actual_frame_timeline_id = act.id)——即 actual 轨起点 − expected 轨起点,口径是"被调度到开工",不是注释第一句的"信号到开工"。真数据(wattson_jank_cuj.pb)上该表 117 行,取值区间 0.368 ms ~ 10.527 ms、中位 0.584 ms(v58.2 实跑);它只有 117 行(不是 220)也是内连接的结果,与 7.2 节同源。jank_type.sql的入参来源(本轮已在真数据上交叉验证,由"存疑"转"结论")。 注释说入参是"来自args.display_value、key 为Jank type的值",而actual_frame_timeline_slice本身就有jank_type列。本轮直接把两者比出来:以SELECT count() AS rows_n, sum(CASE WHEN jank_type = extract_arg(arg_set_id,'Jank type') THEN 1 ELSE 0 END) AS equal_rows, sum(CASE WHEN jank_type IS NOT extract_arg(arg_set_id,'Jank type') THEN 1 ELSE 0 END) AS diff_rows FROM actual_frame_timeline_slice在三份 trace 上实跑,三份均为equal_rows = rows_n、diff_rows = 0(android_startup_real.perfetto_trace2028/2028、wattson_jank_cuj.pb217/217、webview_jank.pb1031/1031,且arg_set_id无空值)。结论:jank_type列与 args 侧 key=Jank type是同值关系——注释里那句args.display_value说的就是同一份值。这是两处"官方口径自相矛盾"里第一处被实测判定的。
android_app_vsync_delay_per_frame 的实测区间:最小值 0.368 ms / 中位数 0.584 ms / 最大值 10.527 ms;实现体是 act.ts − exp.ts(被调度 → 开工),注释第一句的"信号 → 开工"量不到这段@ 本机自跑,trace_processor_shell v58.2-add693d8b5.5 亲手验证"标准库到底建了什么"
下面这段 SQL 不查帧,而是查标准库自己——排查"表名对不上"的第一招:
-------------------------------------【枚举模块引入的对象】------------------------------------------
-- 描述:先 INCLUDE 再枚举,确认模块到底建了哪些表/视图/函数
-- 依据:trace_processor_shell v58.2 实跑(sqlite_master 枚举)
----------------------------------------------------------------------------------------------------
INCLUDE PERFETTO MODULE android.frames.timeline;           --【1】先引入帧归属模块

SELECT type, name                                          --【2】type 区分 table / view / function
FROM sqlite_master
WHERE name LIKE 'android_frames%'
   OR name LIKE '\_frames%' ESCAPE '\'                     --【3】内部表以下划线开头,要单独捞
ORDER BY type, name;
下面对【1】【3】特别说明。【1】的顺序不能反:per_frame_metrics 依赖 timeline。【3】的内幕是:标准库把不打算给你直接用的东西加了下划线前缀(看到的有 _frames_maxsdk_28、_get_frame_table_with_id、_cpu_time_per_frame_fallback 等)。它们可以查,但不是接口——版本升级时名字与列都可能变,写进长期脚本就是定时炸弹。
这一章收在这里。 三件事:帧题域是四模块协作(7 / 9 / 3 个对象);android_frames 的四个 count 列各有反直觉取值;all_frames 是两条路的并集,老路径的 frame_id 是现造行号。
本章对应的官方源码:帧归属与 SDK 分叉在
android/frames/timeline.sql,老路径在android/frames/timeline_maxsdk28.sql。
六、把一帧查出来:三段查询与列选择
下面我们开始装零件。 前面五章给"是什么"与"为什么",这一章给"怎么问"。三段查询,每段一个问题,跑在真 trace 上,数字全部来自实跑输出。
6.1 查询路径:四层结构,一层一个问题
先看看查询路径,因为"表名对不上"是这类分析里最高频的卡点:
读法是"自下而上、按需停靠"。 只想知道"这份 trace 有没有帧数据",看最底层两张原生表的行数就够;想知道"哪一帧超期",上到 android_frame_stats;想回答"怪谁",才用分类函数。别一上来就从顶层开始——顶层视图要做 CPU 时间聚合,在没有应用侧切片的 trace 上会返回空结果(第七章给实证),你会误以为"这份 trace 没有掉帧"。
6.2 第一问:这一帧到底掉没掉
第一段查询只做一件事:把"超期"数出来,并且同时给出分布——只报"掉了 42 帧"没信息量,你还得知道这批帧超得多离谱:
-------------------------------------【第一问:掉了多少、超了多少】-----------------------------------
-- 描述:先引入帧归属,再引入判据;用 overrun 而不是 was_jank 数掉帧
-- 实测:wattson_jank_cuj.pb 上 215 帧有 overrun 值,其中 >0 的 42 帧、≤0 的 173 帧
----------------------------------------------------------------------------------------------------
INCLUDE PERFETTO MODULE android.frames.timeline;
INCLUDE PERFETTO MODULE android.frames.per_frame_metrics;

SELECT
  count()                                             AS frames,                   --【1】能算出 overrun 的帧数
  sum(iif(overrun > 0, 1, 0))                         AS janky_frames,             --【2】这才是掉帧数
  round(min(overrun) / 1e6, 2)                        AS min_overrun_ms,           --【3】最提前的那一帧
  round(max(overrun) / 1e6, 2)                        AS max_overrun_ms,           --【4】最超期的那一帧
  round(avg(overrun) / 1e6, 2)                        AS avg_overrun_ms
FROM android_frames_overrun;                          --【5】只含 frame_id 与 overrun 两列的最小视图
下面对【2】【5】特别说明。【2】数的是 overrun > 0,不是 was_jank = 1。【5】解释了为什么这一行要写在 android_frames_overrun 上——它只有两列,不依赖 CPU 时间聚合,因此对"缺应用侧切片"的 trace 更宽容。
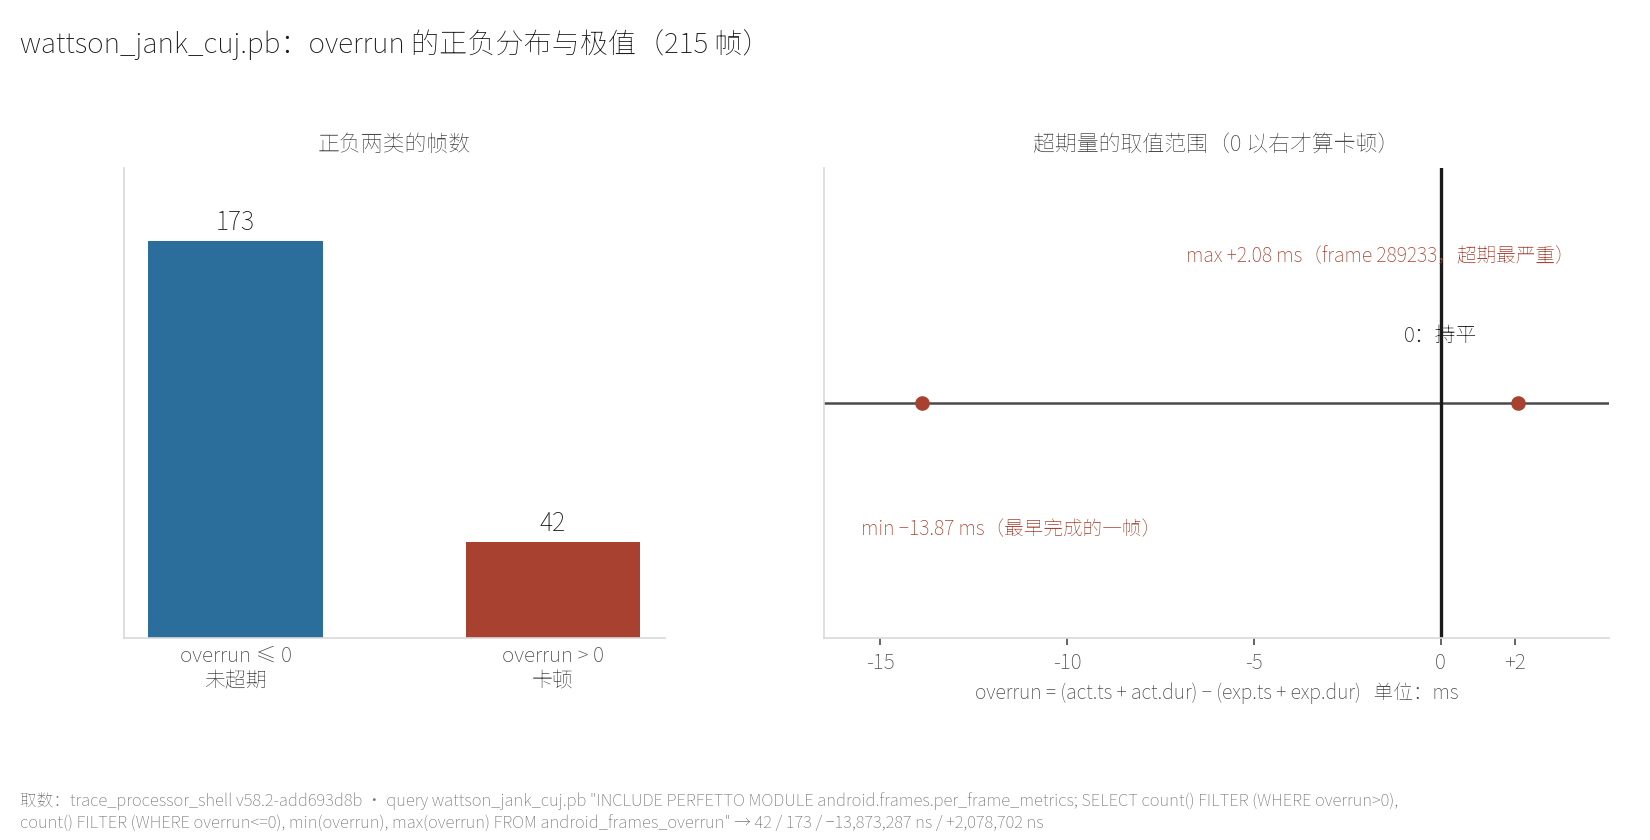
wattson_jank_cuj.pb 上 overrun 的正负分布(42 正 / 173 负)与极值(−13.87 ms 到 +2.08 ms)@ 本机自跑,trace_processor_shell v58.2-add693d8b这张图是第七章的伏笔。 记住这 42 帧:同一个 trace、同一帧集合,改用 was_jank 去数,答案会变成 1 帧。差的 41 帧不是"争议帧",是"根本没被算进去"的帧 [^src1]。这一点下一章用三份 trace 的对照再证一次,并给出成因链。
6.3 第二问:怪谁(以及为什么不能用等值比较)
写这一段时的第一个动作不是 SELECT,是想清楚能不能用 =。先看看 jank_type 长什么样:
-------------------------------------【第二问:怪谁——统计 jank_type 的分布】---------------------------
-- 描述:jank_type 是逗号拼接的多值,所以分布统计要用"包含"而不是"等于"
-- 实测:android_startup_real.perfetto_trace 的 2028 条 actual 帧上,取值分布见下
----------------------------------------------------------------------------------------------------
SELECT
  jank_type,
  count() AS frames
FROM actual_frame_timeline_slice                    --【1】判据列在原生表上就有,不必先 INCLUDE
GROUP BY jank_type
ORDER BY frames DESC;

-- 反例:下面这种写法会漏掉多值形态(真数据里确有 1 条 "App Deadline Missed, Buffer Stuffing")
SELECT count() AS missed
FROM actual_frame_timeline_slice
WHERE jank_type = 'App Deadline Missed';            --【2】等值比较:漏掉逗号拼接的帧

-- 正确写法:用 GLOB(与标准库 jank_type.sql 的判据口径一致)
SELECT count() AS missed
FROM actual_frame_timeline_slice
WHERE jank_type GLOB '*App Deadline Missed*';        --【3】子串命中:多值形态也能被捞到
下面对【1】【2】特别说明。【1】是个好消息:jank_type、present_type、on_time_finish、prediction_type 这些列直接长在原生表上(actual_frame_timeline_slice 共 25 列),不引入任何模块就能查——那些视图是"聚合与派生",不是"取数的唯一入口"。【2】是本篇第三次强调:jank_type 可以是逗号拼接的多值。真数据里那 1 条多值帧在两值各自都在清单内,却会让等值统计漏掉一帧;帧数少时不显眼,但口径错了就是错了——这种错误不会报警。
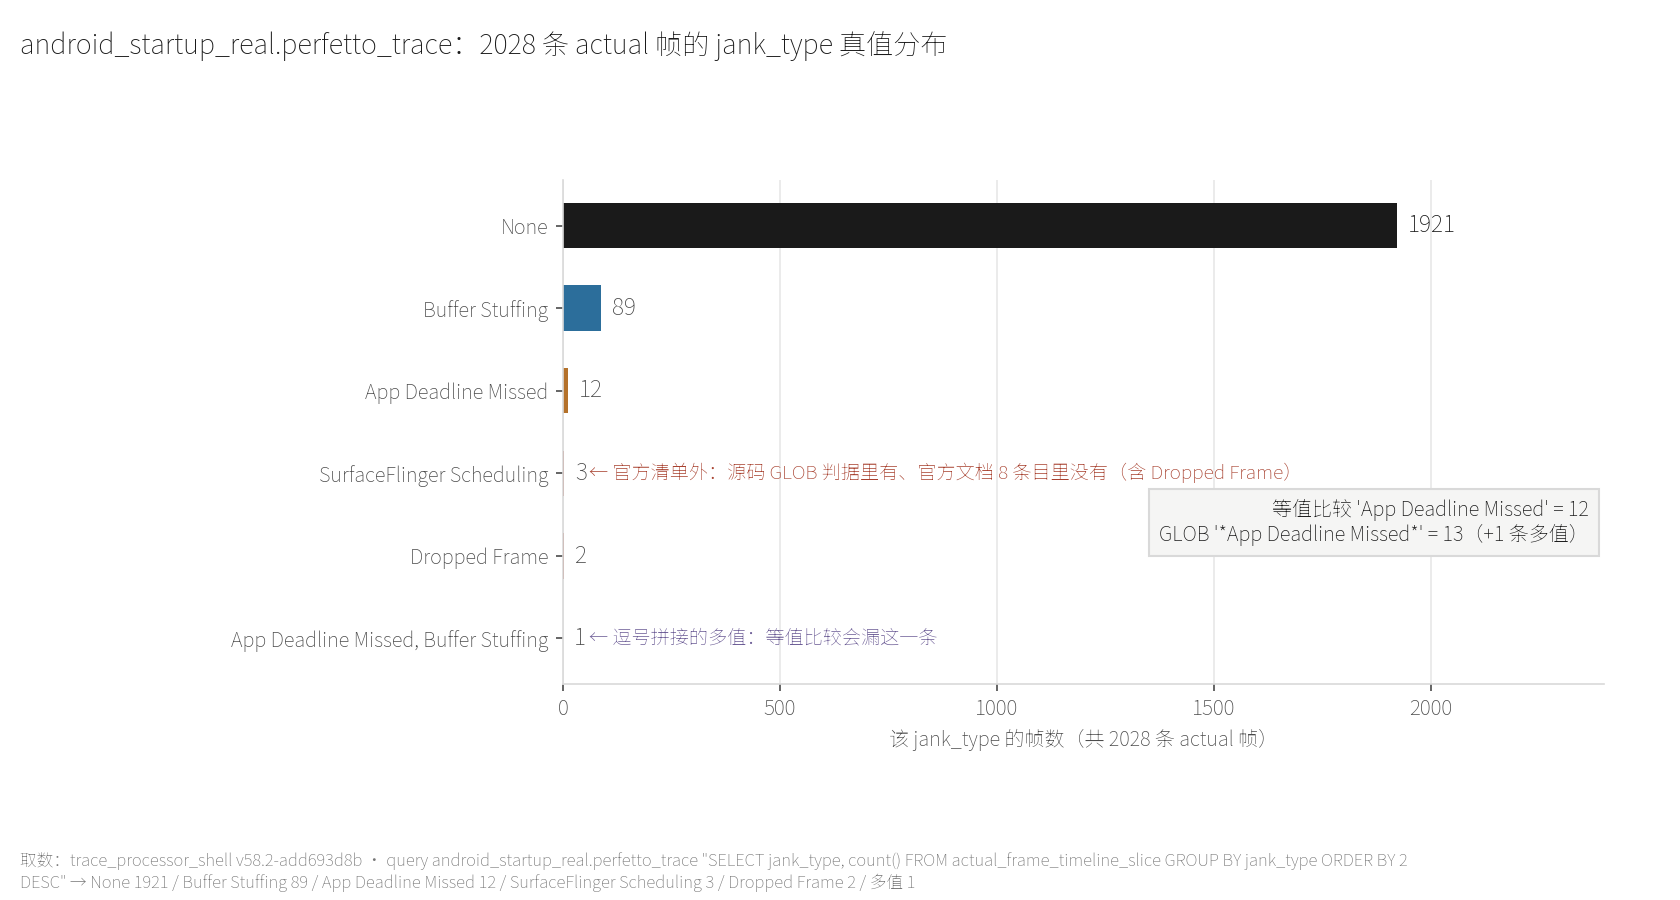
jank_type 是多值逗号拼接,且实现侧多出的取值真会出现——等值比较会漏,GLOB 才命中@ 本机自跑,trace_processor_shell v58.2-add693d8b图上还有一处:None 有 1921 条,并不意味着"只有 107 帧有问题"。 它是 2028 条 actual 帧的完整分布,None 就是"呈现无异常"这个正常值。要做占比归一化,第二步才是把 None 从分母摘掉;但第一步永远是先把"多值"与"清单外取值"处理掉,否则分母本身就是错的 [^src4]。
6.4 第三问:慢在哪一段
先看看第三问。android_frame_stats 给了三个现成的分解列:overrun(超期量)、ui_time(应用侧 UI 时间)、cpu_time(帧的 CPU 时间)。差别正是分段的意义:
| 你看到的现象 | 该问的列 | 说明 |
|---|---|---|
| 超期了,但 CPU 时间很小 | overrun 大、cpu_time 小 |
通常是等待造成的(等 GPU、等合成、被调度推迟) |
| CPU 时间很大 | cpu_time 大 |
CPU 侧真忙,看后三档严重度 |
| CPU 时间很大但 UI 时间小 | ui_time 小于 cpu_time |
时间花在主线程之外(渲染线程或输入等待) |
| 两轨起点错开很多 | android_app_vsync_delay_per_frame |
被调度与真开始之间的耽搁(注意 5.4 节的不一致) |
这张表把一个"卡"字拆成了四种互斥的问法。 跳过这一步,就只剩"帧掉了"三个字;而这一步几乎不花额外成本——三个列都在同一个视图里。
6.5 列选择速查(把本章压成一页)
| 问题 | 停靠层 | 关键列 |
|---|---|---|
| 这份 trace 有没有帧数据 | 原生两表 | expected_frame_timeline_slice 的 count() |
| 这一帧掉没掉 | android_frames_overrun |
overrun(> 0 才算) |
| 掉了算什么严重度 | android_frame_stats |
was_jank / was_slow_frame / was_big_jank / was_huge_jank |
| 呈现档位如何 | 原生表 | present_type / on_time_finish / prediction_type |
| 怪谁 | 分类函数 | android_is_app_jank_type / android_is_sf_jank_type / android_is_missed_frame_type |
| 一帧落在几个 layer 上 | android_frames_layers |
layer_id / layer_name |
这一章收在这里。 三段查询加一张速查表。下一章要讲的,恰好是这三段查询最容易在哪里给出"看起来正常、其实错误"的答案。
本章对应的官方依据:视图与列定义见 标准库文档索引 与 SQL 表参考;自跑方式见 Trace Processor 命令行参考。
七、边界与陷阱:取不到,还是取到了但不是你想的
下面我们进入本篇最该记的一章。 前面的判据都对,但各自有一个"会静默失效"的条件。这一章把陷阱分两类:取不到(返回 0 行,至少能发现)与取到了但不是你想的(返回了数,但数不对)。后一类才危险。
7.1 陷阱矩阵
分类维度值得记住:按"是否报错"分,不按"是否严重"分。 frame_slice 返回 0 行是"取不到",一眼能发现;而 was_jank 少报一个数量级是"取到了但不是你想的",它和正确答案长得一模一样。在性能分析里,后者的代价高得多——它会一路演变成"优化结论",而没人会怀疑一个数据。
7.2 陷阱一:was_jank 会少报一个数量级
三份真 trace 上,overrun > 0 的帧数与 was_jank 报出的帧数对照如下:
| trace | overrun > 0 的帧数 |
was_jank 报出的帧数 |
差异 |
|---|---|---|---|
android_startup_real.perfetto_trace |
236 | 13 | 少报 223 帧 |
webview_jank.pb |
149 | 0 | 全部漏掉 |
wattson_jank_cuj.pb |
42 | 1 | 少报 41 帧 |
第二行最刺眼:webview_jank.pb 上 149 帧实际超期,was_jank 一帧都没报出来。 根因不在"哪个列更准",在能不能算出来——这一条已由源码坐实,不再是从可观测反推:android_frame_stats 的定义体是 FROM android_frames_overrun JOIN android_frames_ui_time USING (frame_id) JOIN _estimated_cpu_time_per_frame USING (frame_id),三段全是裸 JOIN(等值内连接),一处 LEFT JOIN 都没有;而 android_frames_ui_time 取自 android_frames_choreographer_do_frame(依赖 Choreographer#doFrame 切片)、android_frames_overrun 又要求该 frame_id 同时落在 actual 与 expected 两张 timeline 表里(它本身是 _frame_id_count_in_actual_timeline 与 _frame_id_count_in_expected_timeline 的内连接,per_frame_metrics.sql 里就是这么写的)。于是任何一腿缺失,这一帧就从结果集里整行消失——webview_jank.pb 上 doFrame 切片为 0,android_frames_ui_time 为空,内连接一交,android_frame_stats 直接是 0 行,was_jank 自然报 0;android_startup_real.perfetto_trace 上 android_frame_stats 只剩 792 行(android_frames_overrun 是 1395 行),也是同一机制在削行。
android_frame_stats 的三段裸内连接:android_frames_overrun 1395 行经两道等值内连接后只剩 792 行,一处 LEFT JOIN 都没有——这就是 was_jank 少报的机制@ 本机自跑,trace_processor_shell v58.2-add693d8b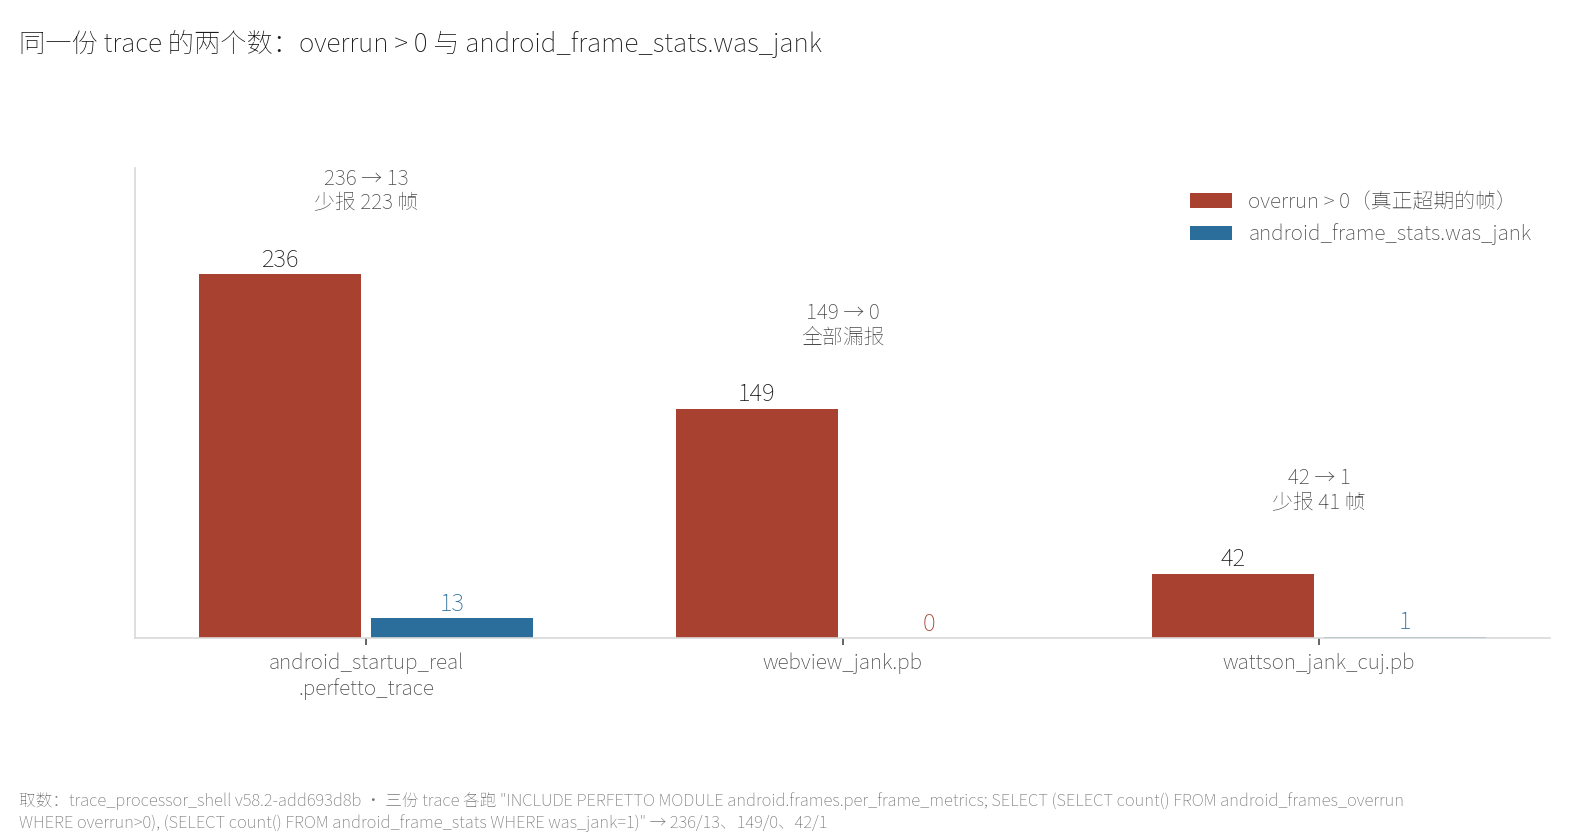
was_jank 数掉帧会少报一个数量级(236→13、149→0、42→1),根因是该视图依赖应用侧切片做 CPU 时间聚合@ 本机自跑,trace_processor_shell v58.2-add693d8b正确用法不是"永远别用 was_jank",是"知道它在什么条件下会漏"。 当 trace 同时含 FrameTimeline 与 atrace 应用侧切片时,差距会缩小但仍不等(42 对 1)——只要问题是"掉了多少帧",就用 overrun;was_jank 只在想同时看 CPU 时间档位时才需要 [^src2]。
7.3 陷阱二:有 FrameTimeline ≠ 有帧原料切片
第二类陷阱是"表里有数、另一张表里没数",最容易让人怀疑自己的语法:
| 查询对象 | webview_jank.pb |
wattson_jank_cuj.pb |
|---|---|---|
actual_frame_timeline_slice |
1031 | 217 |
expected_frame_timeline_slice |
851 | 215 |
Choreographer#doFrame* 切片 |
0 | 466 |
DrawFrame* 切片 |
0 | 252 |
android_frames |
0 | 220 |
android_frame_stats |
0 | 117 |
左右对比:FrameTimeline 数据与 atrace 应用侧切片是两路独立采集。 左边那份有 1031 条帧的完整期望/实际窗口,却一条 doFrame 切片都没有;右边两份齐全。缺了应用侧切片,所有需要"把帧拆到线程"的视图都会空掉,但"帧本身超没超"仍然算得出来(它只依赖两轨窗口)。
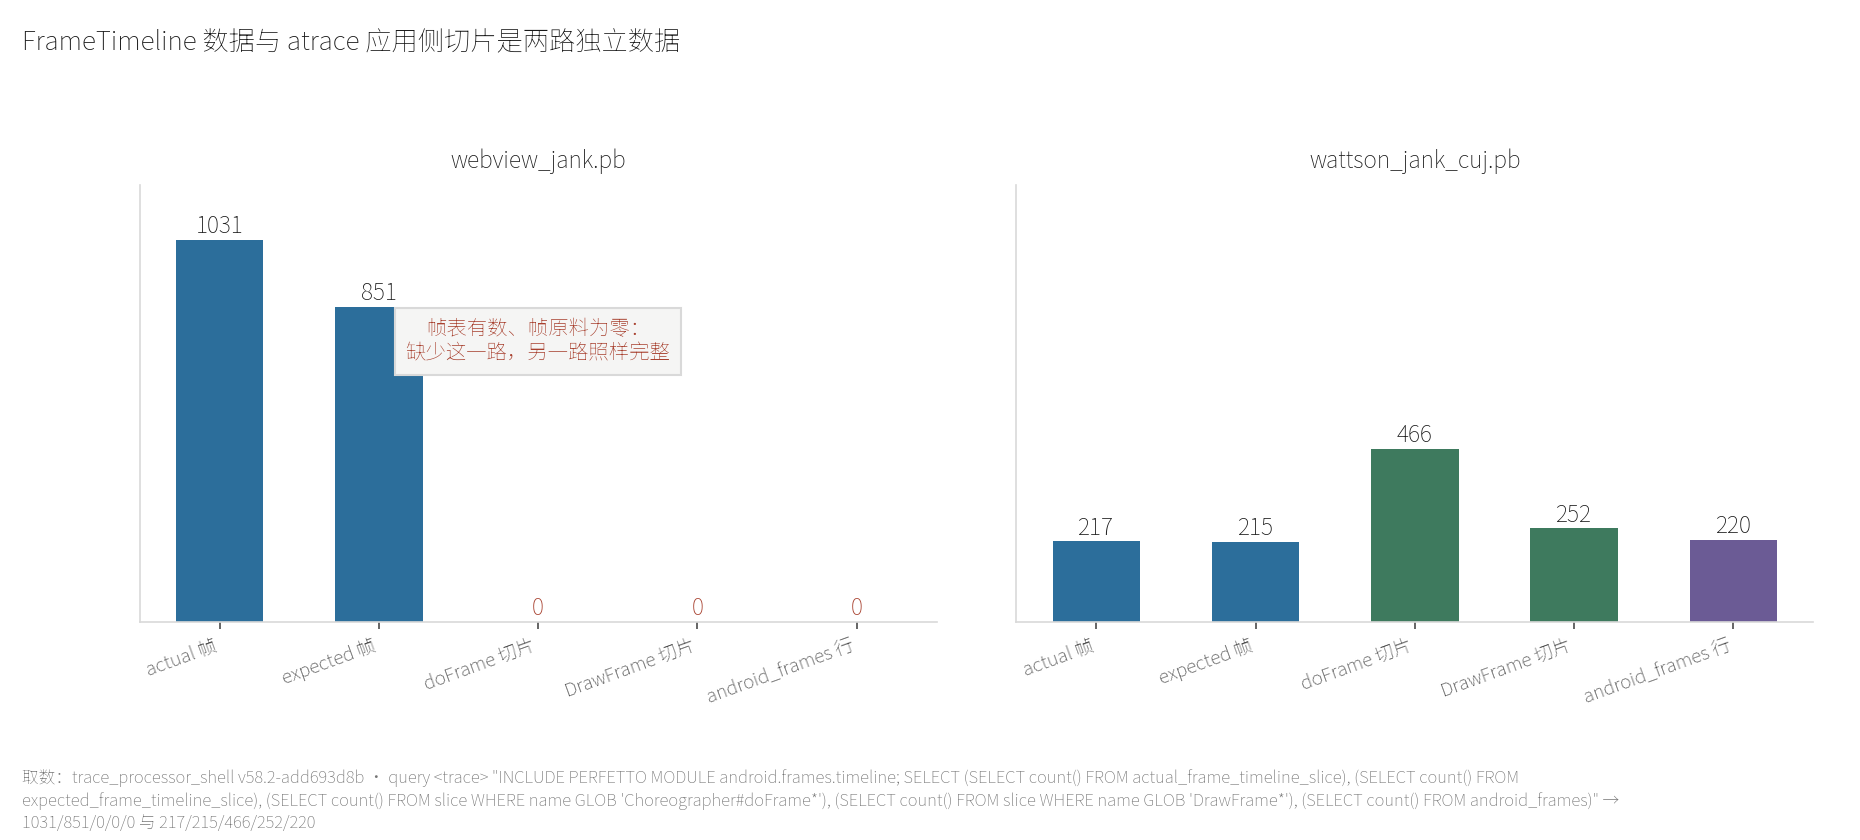
webview_jank.pb 有 1031 条 actual 帧却 doFrame = 0 / DrawFrame = 0——FrameTimeline 与 atrace 是两路独立数据@ 本机自跑,trace_processor_shell v58.2-add693d8b实战解法只有一个动作:跑判据之前先确认"我要问的那一路数据在不在"。 只判断"超没超",两表有数就够;一旦要问"超在哪段代码",就必须先确认应用侧切片存在——否则你会花半小时调 SQL,最后发现 trace 里根本没有那路数据 [^src3]。
7.4 陷阱三:内置视图为空,以及一个不存在的表名
下面我们看看第三个陷阱:你要查的那个"表",可能根本不由这份数据填充,或者根本不存在。
- 内置视图
frame_slice恒为 0 行,而它到底由谁填充——本轮读到了建视图 SQL。 直接查SELECT sql FROM sqlite_master WHERE name = 'frame_slice',它的定义是CREATE VIEW frame_slice AS SELECT s.id, s.ts, s.dur, s.track_id, s.category, s.name, s.depth, s.parent_id, s.arg_set_id, extract_arg(s.arg_set_id,'layer_name') AS layer_name, extract_arg(s.arg_set_id,'frame_number') AS frame_number, extract_arg(s.arg_set_id,'queue_to_acquire_time') AS queue_to_acquire_time, extract_arg(s.arg_set_id,'acquire_to_latch_time') AS acquire_to_latch_time, extract_arg(s.arg_set_id,'latch_to_present_time') AS latch_to_present_time FROM slice AS s JOIN track AS t ON s.track_id = t.id WHERE t.type = 'graphics_frame_event'。关键是末行的过滤条件:它只取track.type = 'graphics_frame_event'的切片——那是 atraceFrameEvents那一路的轨道类型,与 FrameTimeline 的帧不在同一种轨道上:实测actual_frame_timeline_slice的 2028 行全部落在type = 'android_actual_frame_timeline'的轨道上。在六份 trace 上实测(actual分别 2028 / 217 / 1031 / 280 / 113 / 16 行),frame_slice全部是 0 行,且六份 trace 里graphics_frame_event轨道数都是 0——所以"恒为空"不是 bug,是这条视图的数据源在 FrameTimeline trace 里本来就不存在:拿它当"帧表"用,等于拿错了数据通路。 - 表名
frame_timeline_slice不存在。 这个拼法很自然(把 expected / actual 合成一个通用名),但实测:对它做列查询或计数查询都直接报错no such table: frame_timeline_slice;官方标准库文档页全文检索该名也零命中。真实存在的是两张原生表expected_frame_timeline_slice与actual_frame_timeline_slice,外加那个恒为空的内置视图frame_slice。 旧资料里写着frame_timeline_slice的,一律不要照抄。
7.5 边界清单:还有这四条要记住
| 边界 | 说明 | 正确姿势 |
|---|---|---|
| 没有 FrameTimeline 数据 | 标准库自动回退到 SDK 28 之前的老路径拼帧,frame_id 口径随之改变 |
先按 6.1 的最底层确认"有没有 actual 数据",再决定用哪套口径 |
| SurfaceView 不支持 | 官方明确写了 FrameTimeline 目前不支持 SurfaceViews | 这类画面(相机预览、视频播放、游戏画面)不在本判据覆盖范围内 |
frame_id = -1 与 resynced 切片被剔除 |
标准库显式过滤 frame_id != 0 AND frame_id != -1;形如"resynced to 1234 in 20.0ms"的切片也会被剔除 |
你查到的帧数少于切片条数,这是设计如此,不是丢数据 |
| 一个 vsync 多个 DrawFrame | 真数据上 draw_frame_count = 2 有 32 行 |
用 android_frames 的 draw_frame_count 判断,别拿 DrawFrame 切片条数当帧数 |
第二行还有一处细节:在 wattson_jank_cuj.pb 上看到的 *FT#Missed*Callback* 切片共 4 条,全部是 FT#MissedHWUICallback#289719、#289734、#289794、#289854 这一类形态,合成器侧一条都没有。标准库解析这张内部表时,用 max(name GLOB '*SF*') 与 max(name GLOB '*HWUI*') 分别产出"合成器侧漏回调"与"应用框架侧漏回调"两个标记——"vsync 回调是谁漏的"就藏在这两个标记里:这次漏在应用框架侧。
*FT#Missed*Callback* 匹配 4 条,合成器侧标记 0 条、应用框架侧标记 4 条——这次漏回调的是应用框架侧@ 本机自跑,trace_processor_shell v58.2-add693d8b7.6 一段自检查询:先确认你的数据能不能回答你的问题
把本章收成一段动作:在跑任何判据之前先跑一段"体检",确认四件事。
-------------------------------------【开查之前先体检:四问一屏】-------------------------------------
-- 描述:跑判据之前先确认数据通路,避免把"缺数据"读成"没掉帧"
-- 实测:webview_jank.pb 上第 2/3/4 问会给出 0,wattson_jank_cuj.pb 上四问都有数
----------------------------------------------------------------------------------------------------
SELECT 'actual 帧'      AS item, count() FROM actual_frame_timeline_slice   --【1】帧本身有没有
UNION ALL
SELECT 'doFrame 切片',   count() FROM slice WHERE name GLOB 'Choreographer#doFrame*'  --【2】帧原料有没有
UNION ALL
SELECT 'frame_slice',    count() FROM frame_slice                          --【3】内置视图恒为 0,别用它
UNION ALL
SELECT 'frames 行数',    count() FROM android_frames;                       --【4】拼出来的帧数(需先 INCLUDE)
下面对【1】【3】特别说明。【1】是所有讨论的前提:这行是 0,说明这份 trace 不含 FrameTimeline 数据,后面一切判据都不适用(标准库也会自动走老路径)。【3】是一个"反直觉的固定值":在六份真 trace 上跑这一问,结果全是 0,但你不会收到任何警告——它就是一个合法的空结果。把它放进体检脚本,是为了一旦换了 trace 结果全空,第一时间排除这个固定不变的空源。
这一章收在这里。 三句话:was_jank 会少报一个数量级,数掉帧用 overrun > 0;FrameTimeline 与 atrace 是两路数据;frame_slice 恒为空、frame_timeline_slice 不存在。
本章对应的官方依据:无效
frame_id的过滤规则与*FT#Missed*Callback*的解析见android/frames/timeline.sql。
八、收口清单与结语
好了,最后一章我们做三件事: 把全篇压成一张可截图的表、把边界再钉一遍、把"下一站"指个方向。
8.1 收口矩阵:判据 / 归因 / 查询
这张表的三列对应三个问题:先问判据(这一帧掉没掉)、再问归因(掉在谁身上)、最后问查询(用哪一列去问)。顺序不能倒:先有判据,归因才有意义;先有归因,查询才知道该捞哪一列。
再做一次归类,三列只有四类手段:改判据(用 overrun > 0 不用 was_jank)、改对齐键(用 token 不用时间戳)、改比较方式(用 GLOB 不用等值)、先体检再下结论(确认数据通路再跑判据)。先修判据,再修对齐,最后才谈工程化:判据错了,后面三步都是在错误结论上加速。
8.2 下一站方向:从"帧掉没掉"到"帧里的时间去哪"
先看看下一站。本篇回答了"这一帧掉没掉、怪谁",但下一个问题立刻就来:如果这一帧真的掉了,它的时间到底花在哪了? 这就是已知的下一站方向:把一帧之内的 CPU 时间拆到线程与切片上。
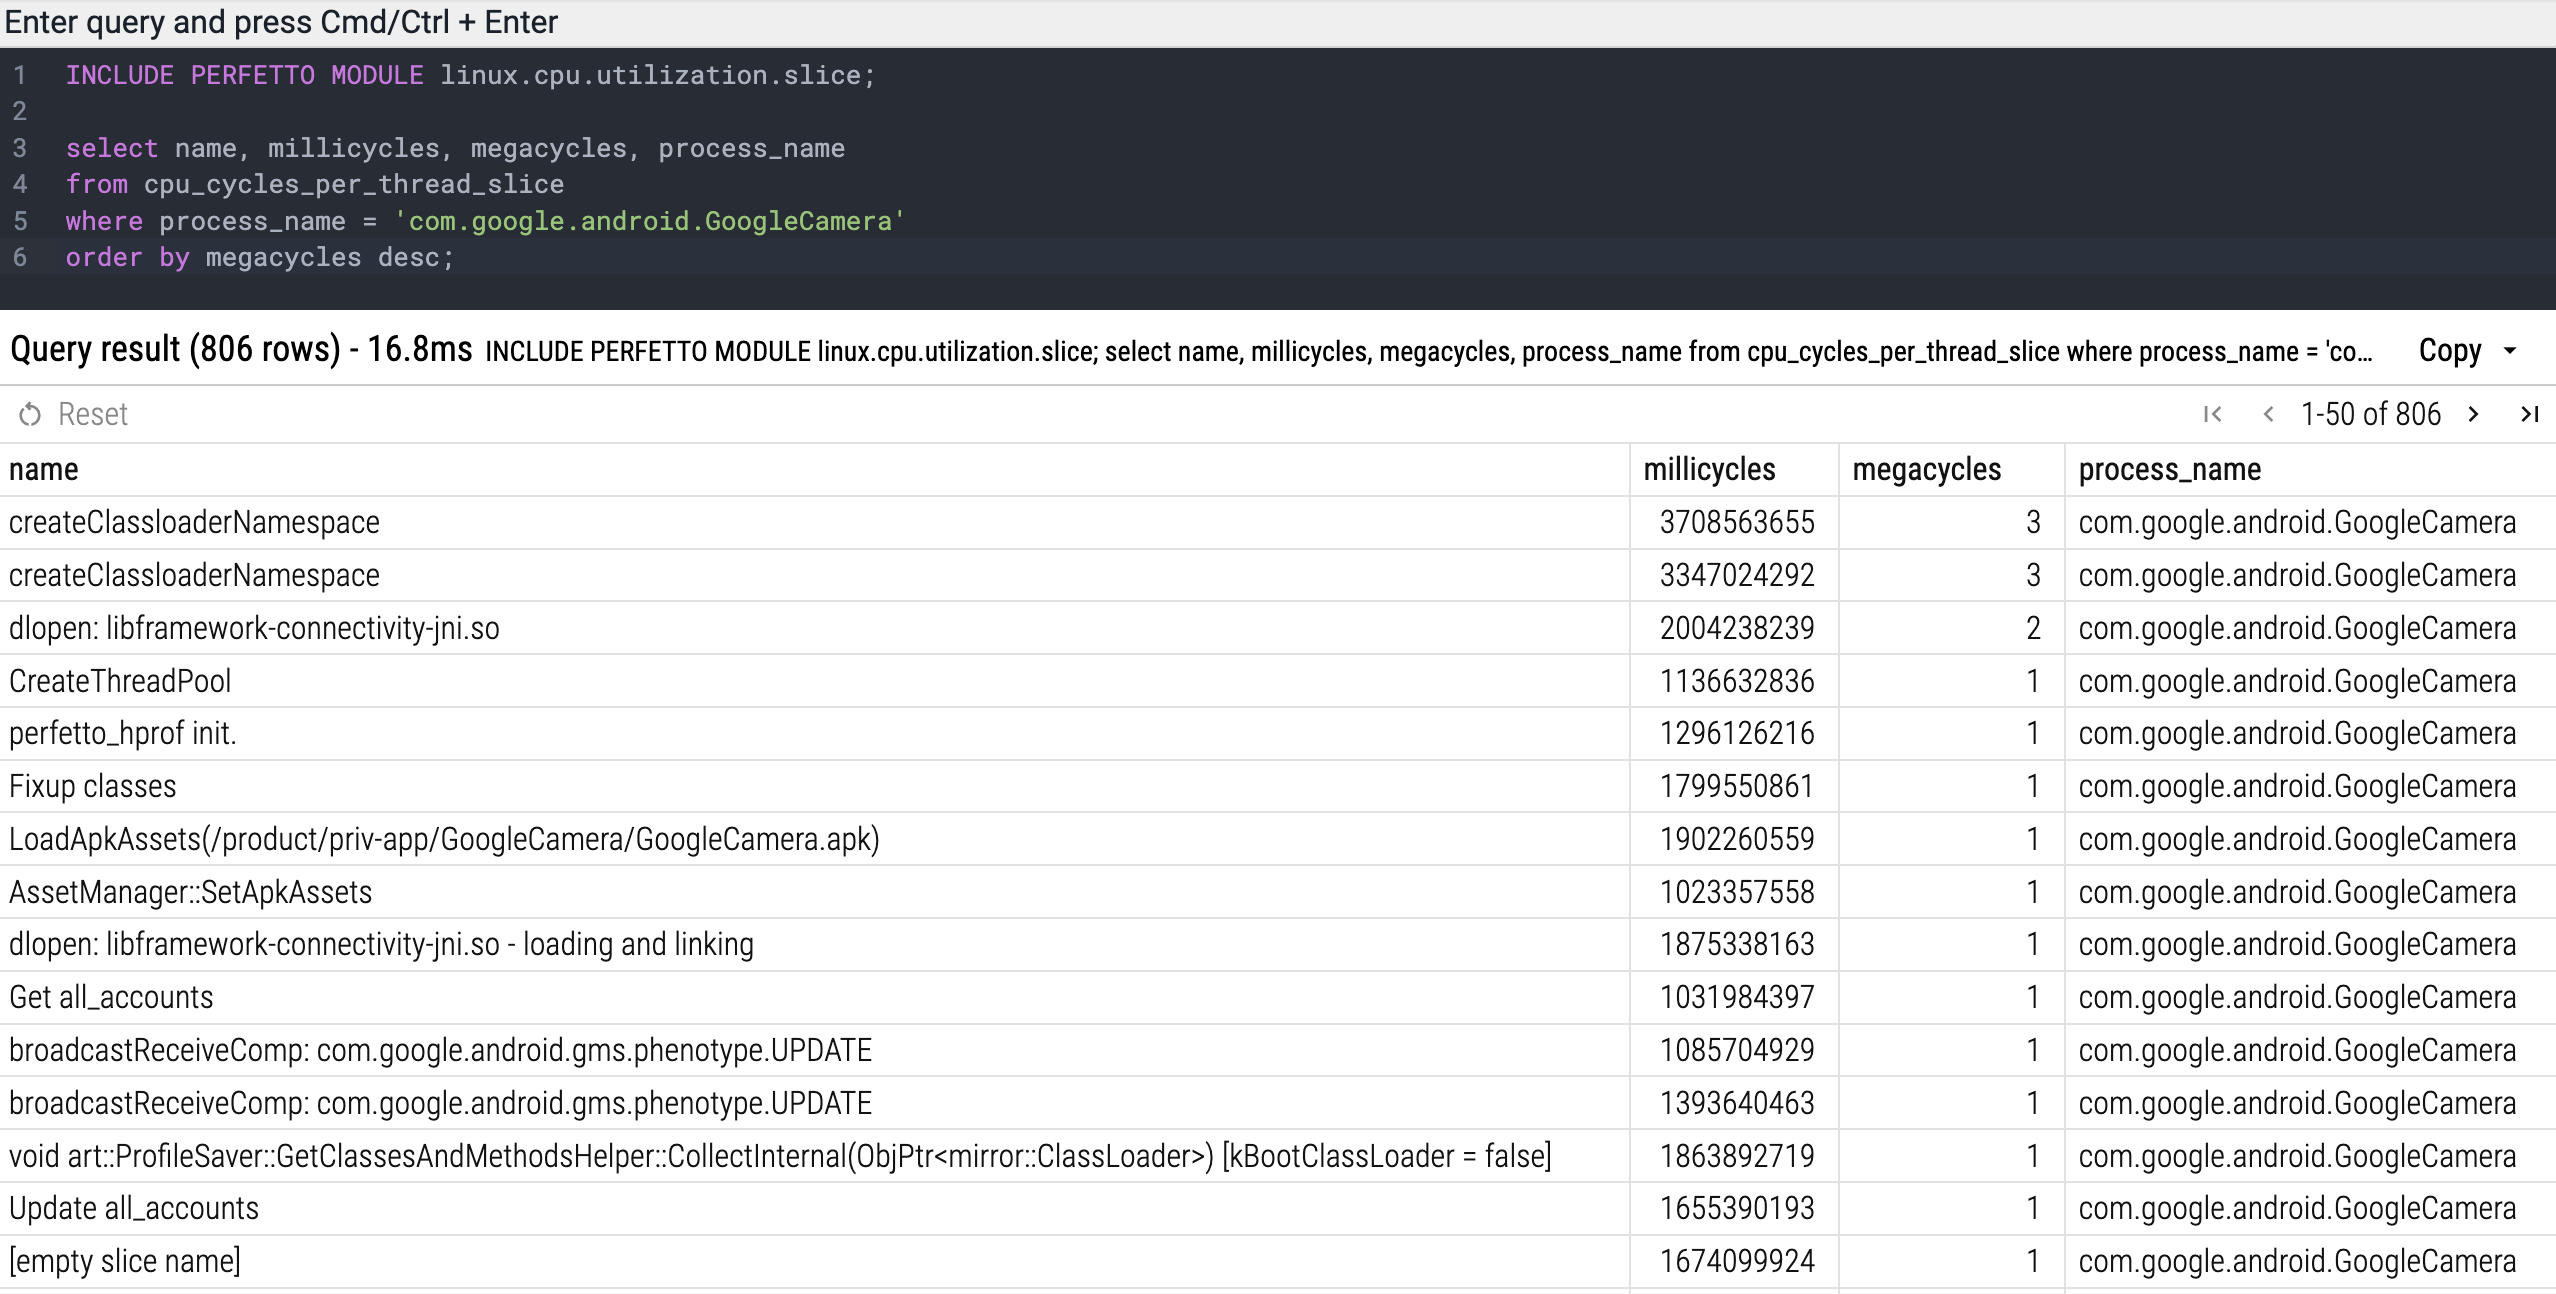
这张图(原图 2556×1294)[^ext6] 恰好接在本篇的缺口上。 本篇的 cpu_time 是"一帧的 CPU 时间之和",它只说"这一帧花了 37 毫秒",但不告诉你这 37 毫秒花在哪段代码上——后者要把帧的时间窗与线程上的切片做区间关联,属于另一个题域。本篇只指方向,不展开:ep11 即第 十一 篇《实战一:一条链路揪 GPU 瓶颈》,此处不做标题级预告。
8.3 边界再确认表
0.5 节开篇时给过一次边界,走完全篇之后再确认一次:
| 本篇讲了 | 本篇没讲(→ 对应篇目) |
|---|---|
| 帧的三段分段与 token 对齐 | 帧数据的 packet 与字段结构 → 属 ep07 |
| 两条时间线的定义差与取 max 的终点 | 数据源注册、采集配置与丢包成因 → 属 ep08 |
overrun 判据、四档严重度、呈现档位 |
SQL 语法入门、CREATE PERFETTO TABLE / INDEX 的判据 → 属 ep09 |
| 8 个 jank 条目、责任方分流、文档与实现的不一致 | slices.* 家族、SPAN_JOIN 与区间连接、2 × S × N 内存模型 → 属 ep09 |
| 四模块分工与 SDK 28 分水岭 | 帧内 CPU 时间归集(拆到线程与切片)→ 属 第 十一 篇《实战一:一条链路揪 GPU 瓶颈》 |
| 三段可执行查询与开查前的体检 | 上层业务指标(cujs / startup)如何消费帧数据 → 只指出依赖关系 |
第五行最该留意。 它是本篇唯一的"向前开口":帧的时间窗算清楚了,窗内的时间归属没拆。除此之外,本篇的题域是一个闭环。
8.4 资源清单与参考资料来源
- FrameTimeline 数据源页(jank 定义、两轨语义、8 条目、颜色码、示例 SQL)—— https://perfetto.dev/docs/data-sources/frametimeline
- 标准库文档索引(四模块的视图、函数与依赖图)—— https://perfetto.dev/docs/analysis/stdlib-docs
- SQL 表参考(两张 timeline 表的列定义)—— https://perfetto.dev/docs/analysis/sql-tables
- PerfettoSQL 入门(时间单位、
INCLUDE语义、最佳实践)—— https://perfetto.dev/docs/analysis/perfetto-sql-getting-started - PerfettoSQL 语法(
CREATE PERFETTO …与模块引入)—— https://perfetto.dev/docs/analysis/perfetto-sql-syntax - Trace Processor(会话与嵌入,自跑脚本的载体)—— https://perfetto.dev/docs/analysis/trace-processor
- 批处理 Trace Processor(多 trace 并行跑同类查询)—— https://perfetto.dev/docs/analysis/batch-trace-processor
- Trace Processor 命令行参考(
query/server/summarize/export)—— https://perfetto.dev/docs/reference/trace-processor-cli - 命令行分析入门(导出与配方)—— https://perfetto.dev/docs/getting-started/command-line-analysis
- Android trace 分析入门(图形流水线的官方上手路径)—— https://perfetto.dev/docs/getting-started/android-trace-analysis
- 时钟同步概念(跨时钟域对齐帧与 CPU 时的依据)—— https://perfetto.dev/docs/concepts/clock-sync
- 采集侧相邻数据源:atrace —— https://perfetto.dev/docs/data-sources/atrace
- 采集侧相邻数据源:GPU 计数器 —— https://perfetto.dev/docs/data-sources/gpu
- TrackEvent 插桩(应用侧切片从哪来)—— https://perfetto.dev/docs/instrumentation/track-events
- Perfetto UI 使用说明(轨道、选中与 Flow events 的操作)—— https://perfetto.dev/docs/visualization/perfetto-ui
- Trace Processor 架构设计(列式存储与视图实现位置)—— https://perfetto.dev/docs/design-docs/trace-processor-architecture
- Debug Tracks(把查询结果画回时间轴)—— https://perfetto.dev/docs/analysis/debug-tracks
- trace packet proto 参考(
FrameTimelineEvent,回指 ep07)—— https://perfetto.dev/docs/reference/trace-packet-proto - 测试约定(策略与回归基线)—— https://perfetto.dev/docs/contributing/testing
- 源码:
android/frames/模块目录 —— https://github.com/google/perfetto/tree/main/src/trace_processor/perfetto_sql/stdlib/android/frames - 源码:
frames/timeline.sql(帧归属、token 过滤、SDK 28 分叉)—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/android/frames/timeline.sql - 源码:
frames/per_frame_metrics.sql(公式、四档阈值、回退估值)—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/android/frames/per_frame_metrics.sql - 源码:
frames/jank_type.sql(三个分类函数与 GLOB 判据)—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/android/frames/jank_type.sql - 源码:
frames/timeline_maxsdk28.sql(老拼帧路径)—— https://github.com/google/perfetto/blob/main/src/trace_processor/perfetto_sql/stdlib/android/frames/timeline_maxsdk28.sql - 工具:
trace_processor下载入口 —— https://get.perfetto.dev/trace_processor - 数据:官方 test data 桶(本轮 6 份含 FrameTimeline 的 trace 来源)—— https://storage.googleapis.com/perfetto/test_data/
- 数据:官方 Android 示例 trace(阶段 1 的反例:帧数为 0)—— https://storage.googleapis.com/perfetto-misc/example_android_trace_30s_1
- Android 平台侧 jank 检测(镜像站)—— https://developer.android.google.cn/studio/profile/jank-detection
- Android 平台侧性能度量(16.7 ms 与刷新率的来历,镜像站)—— https://developer.android.google.cn/topic/performance/measuring-performance
- Android
FrameMetrics参考页(Added in API level 24,即 Android 7.0 与平台侧帧指标的时间归属,镜像站)—— https://developer.android.google.cn/reference/android/view/FrameMetrics - Android Compose 性能 codelab(复述五色码,镜像站)—— https://developer.android.google.cn/codelabs/jetpack-compose-performance
- 社区:AOSP 课程《Frame Drops & Jank Analysis》(二手)—— https://aospinsider.com/courses/aosp-course-4/20-frame-drops-jank-analysis/
- 社区:用 FrameTimeline 诊断 Android jank(二手)—— https://mvpfactory.io/blog/diagnosing-android-jank-with-frametimeline-api-surfaceflinger-deadlines-hwui
参考资料来源:判据、公式、阈值与取值面以 Perfetto 官方现行文档与 google/perfetto 源码为一手依据;所有帧级真值均为本机自跑产物,跑法为 trace_processor_shell(v58.2-add693d8b)对官方 test data 中 6 份 trace 执行查询,命令与输出可复现;配图为官方文档配图(Google,Apache-2.0)与本系列自绘;社区材料仅作旁证。官方 analysis 分区 2026 年重构后的现行路径已逐条核对,本篇不引用已失效路径。
下篇预告:第 十一 篇《实战一:一条链路揪 GPU 瓶颈》已上线;"下一站方向"是把一帧内 CPU 时间拆到线程与切片。
开篇快捷键:数掉帧用 overrun > 0,别用 was_jank;对齐用 token,别用时间戳;jank type 用 GLOB,别用等值;下判据之前先跑一次四问体检。
以上。 希望这一路"从看着卡到算得清"的梳理,能让你下次遇到"用户说卡"时不再靠试错,而是一路问下去:这份 trace 里有没有帧、这一帧超没超、超的这段该记在谁头上。
本文由@溯光 出品,让"一帧到底有没有掉"变成一个可复现的判断。
With Best Wishes.
[^ext1]: 题图「轨道实景」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/frametimeline/timeline_tracks.png,配套 https://perfetto.dev/docs/data-sources/frametimeline),作者:Google,Apache-2.0 许可;实测尺寸 1595×157。
[^ext2]: 图「SF 侧同名 token」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/frametimeline/sf-vsyncid.png,配套 https://perfetto.dev/docs/data-sources/frametimeline),作者:Google,Apache-2.0 许可;实测尺寸 621×353。
[^ext3]: 图「Flow events 连线」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/frametimeline/select-app-slice.png,配套 https://perfetto.dev/docs/data-sources/frametimeline),作者:Google,Apache-2.0 许可;实测尺寸 1237×714。
[^ext4]: 图「actual slice 详情面板」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/frametimeline/selection.png,配套 https://perfetto.dev/docs/data-sources/frametimeline),作者:Google,Apache-2.0 许可;实测尺寸 1173×604。
[^ext5]: 图「DisplayFrame 的跨进程箭头」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/frametimeline/select-sf-slice-1.png,配套 https://perfetto.dev/docs/data-sources/frametimeline),作者:Google,Apache-2.0 许可;实测尺寸 1414×528。
[^ext6]: 图「把 CPU 时间归集到线程与切片」取自 Perfetto 官方文档(GitHub google/perfetto 的 docs/images/android-trace-analysis-cpu-utilization-slice.png,配套 https://perfetto.dev/docs/getting-started/android-trace-analysis),作者:Google,Apache-2.0 许可;实测尺寸 2556×1294。
[^src1]: 自跑图「overrun 正负分布与极值」由本机 trace_processor_shell(v58.2-add693d8b)对官方 test data wattson_jank_cuj.pb 执行查询生成;215 帧中 overrun > 0 42 帧、≤ 0 173 帧,min −13,873,287 ns、max +2,078,702 ns。
[^src2]: 自跑图「was_jank 少报对照」由本机对 android_startup_real.perfetto_trace(236→13)、webview_jank.pb(149→0)、wattson_jank_cuj.pb(42→1)三份 trace 同口径查询生成。
[^src3]: 自跑图「两路独立数据对照」由本机对 webview_jank.pb(actual 1031 / expected 851 / doFrame 0 / DrawFrame 0 / android_frames 0)与 wattson_jank_cuj.pb(217 / 215 / 466 / 252 / 220)执行查询生成。
[^src4]: 自跑图「jank_type 多值形态与真值分布」由本机对 android_startup_real.perfetto_trace 的 2028 条 actual 帧分组统计生成,并对照 jank_type.sql 的 GLOB 判据。