本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-cpp-language-foundations
题图 零成本的两笔账:时间侧接近免费,空间侧不免费 @ 本系列绘制
本系列已发表篇目(全系列共 12 篇,分四波连载):
- ep01 对象布局、对齐与 padding:sizeof 的真相——第一波·布局与内存
- ep02 分配器解剖:malloc → jemalloc/mimalloc → pmr arena——第一波·布局与内存
- ep03 值语义的账:move/拷贝/SSO/emplace_back——第一波·布局与内存
- ep04 编译期账本:模板实例化与 -ftime-trace——第二波·编译器与链接器
- ep05 优化器的边界:UB、严格别名与向量化报告——第二波·编译器与链接器
- ep06 名字与符号:ABI、修饰、可见性、PLT 与 IAT——第二波·编译器与链接器
- ep07 链在一起:LTO 与 PGO 的收益从哪来——第二波·编译器与链接器
- ep08 分发的代价:虚函数、模板、variant 与类型擦除——第三波·运行时代价
背景与边界
好了,上一篇量的是"把类型藏起来"的代价。这一篇量的是语言机制替你留下的痕迹。
异常处理与 RTTI(Run-Time Type Information,运行时类型信息)是 C++ 里最容易被一句话概括、也最容易被一句话误解的两个机制。它们各有一句流传很广的宣传语:异常是"零成本的",RTTI 是"不用就不花代价的"。这两句话都对,但都只对了一半。
这一篇要把"零成本"拆成两笔账来算。 时间侧一笔,空间侧一笔。这两笔账的答案不一样,而且在不同工具链上方向还可能相反。
0.1 一句话结论先放这里
- 时间侧:零成本基本成立。 不抛异常时,
try/catch包住的代码与返回错误码同速,两套工具链实测都在 1.3 至 2.6 ns/op 之间,差值落在噪声里。 - 时间侧的另一半:一旦真抛,成本是错误码的千倍量级。 MSVC 实测 2,693 ns/op,GCC 实测 1,775 ns/op,而同一位置的错误码是 1.6 至 1.8 ns/op。这条与微软官方"与函数调用开销大致相当"的表述不在同一口径上。
- 空间侧:不免费,且方向随编译器变。 只加一个
try块,MSVC 的 exe 涨 10,752 字节;noexcept在 MSVC 上反而更大,在 GCC 上更小。 - RTTI 是强制捆绑的,但"关掉 RTTI"省下的字节远比传说中少。 实测 512 字节(MSVC)与 1,224 字节(GCC),而关掉之后异常捕获照常工作。
0.2 实测环境
| 项 | 值 |
|---|---|
| MSVC | cl / link / dumpbin 19.44.35228(工具集 14.44.35207),/std:c++17 /O2 /EHsc |
| GCC | MSYS2 ucrt64 g++ 16.2.0(Rev3) + binutils objdump 2.47,目标 x86_64-w64-mingw32 |
| 计时 | 被测进程内 std::chrono::steady_clock,每档跑 3 次取中位 |
| 负载 | 非抛出路径 2,000 万次;抛出路径 200 万次;dynamic_cast / typeid 各 2,000 万次 |
| 平台 | Windows x64,PE/COFF |
这张表里有一处必须提前说清:本机的 GCC 产出的是 PE/COFF、走的是 SEH 模型,不是 ELF + DWARF。所以本篇所有关于"GCC 用 .eh_frame 与 .gcc_except_table"的说法都会当面被本机读数修正(§四)。
0.3 本篇不涉及什么(边界声明)
- 不涉及微软 x64 侧语言相关处理器数据的逐字段规范。微软没有公开这个格式,官方原话是这份数据"格式未指定、完全由所用处理器决定"。本篇对 MSVC 内部表的描述一律以本机转储与反汇编为证据,不声称引自规范。
- 不涉及 Itanium 运行库的逐函数实现。只引 ABI 规范与两份实现源码的接口处。
- 不做 Clang/LLVM 的本机实测:本机无 Clang、无 WSL。LLVM 的
zero-cost定义与__cxa_*运行库钩子只引官方原文。 - 不涉及嵌入式工具链的裁剪清单。
-ffunction-sections -fdata-sections -fno-unwind-tables这类组合开关的效果不归本篇,中文侧流传的"直降 40%"正是这类组合的数字(§8.4)。 - 不给"该不该用异常"的立场建议。本篇给判据与读数;立场属于工程约束,不属于性能问题。
0.4 按需跳读
本篇 11 章,三条路线:
- 只想知道"这笔账我怎么算":读 §一(代价挪到哪)、§三(空间侧多少字节)、§八(关掉 RTTI 会怎样)、§九(判据)——四章,约 3,000 字。
- 正在调一段会抛异常的热路径:加读 §二(时间侧实测)与 §五(noexcept 的账)。
- 想学方法(怎么自己量):读 §四(表落在哪个段)、§六(vtable 槽位)、§七(
dynamic_cast怎么量)、§十(证据形态与复现)。
0.5 这一篇与上一篇的接续
ep08 量的是 vtable有没有(Op 的 8 字节全是 vfptr),并顺手转储了它的布局。这一篇接着量 vtable 的头两个槽:一个是 offset-to-top,一个是 typeinfo 指针。
这两个槽是理解 RTTI 的钥匙,也是理解"为什么关掉 RTTI 之后异常还能用"的钥匙。ep08 §8.3 那张类布局转储,可以直接拿来做这一篇的起点。
0.6 为什么这一篇要分"时间"与"空间"两笔账
"零成本"先来看看这个说法的原始出处把话说得很准,值得逐字抄一遍:
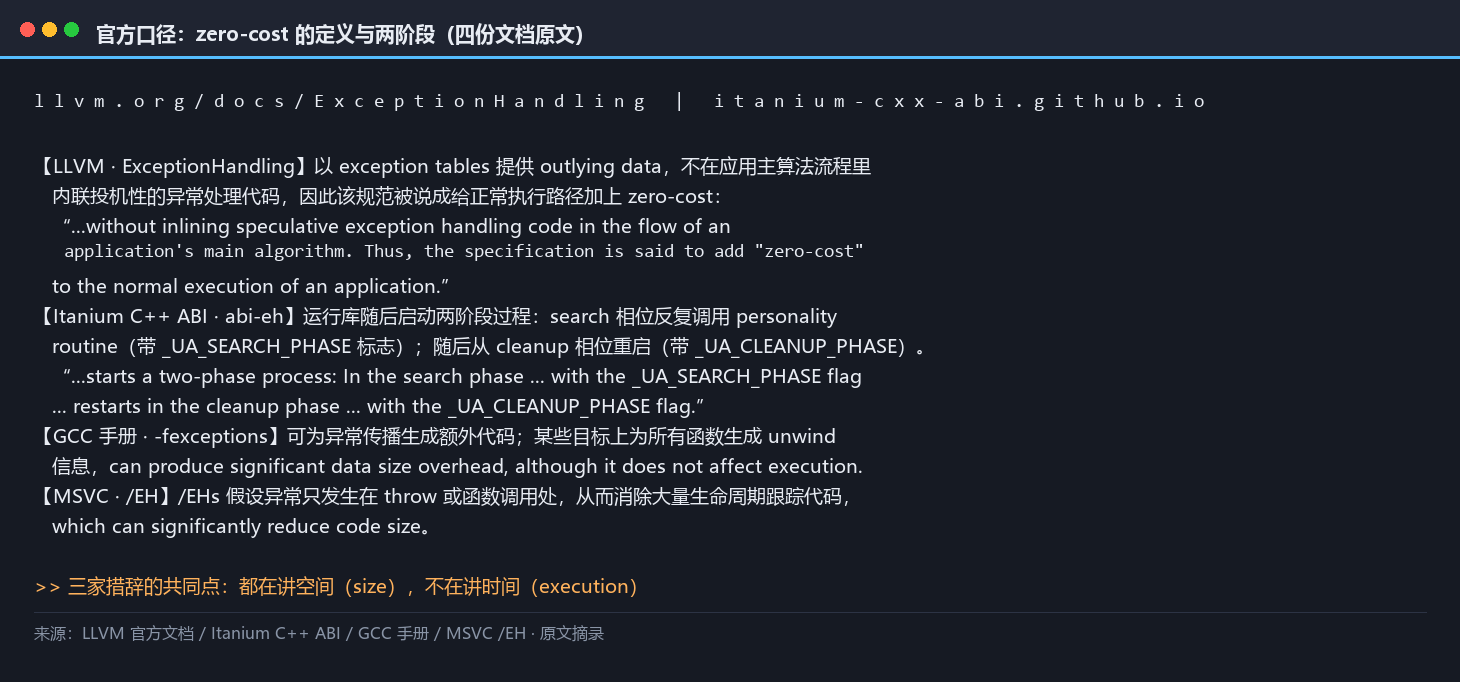
The Itanium ABI Exception Handling Specification defines a methodology for providing outlying data in the form of exception tables without inlining speculative exception handling code in the flow of an application's main algorithm. Thus, the specification is said to add "zero-cost" to the normal execution of an application.
—— LLVM 官方文档 Exception Handling
拆开看这句话,它 claim 的对象是正常执行路径(normal execution),手段是把代价挪到外围的表里(outlying data in the form of exception tables)。时间被省下了,代价被换成了空间。
所以"零成本到底成不成立"这个问题,必须一问时间、一问空间。只回答其中一半,就是在替这句话做广告。
两笔账的读数在后面的章节里会分开出现:时间侧只有几个纳秒的差别,空间侧则是以千字节计的段增量。把这两组数字混在一句话里说,就会得出零成本既成立又不成立的矛盾结论。
WG21 的 P0709 提案在讨论"更高效的异常"时,也专门澄清过这个词:
"zero overhead" is not claiming zero cost ... (a) "if you don't use it you don't pay for it" and (b) "if you do use it you can't reasonably write it more efficiently by hand."
—— P0709R4 Zero-overhead deterministic exceptions: Throwing values
按这个口径,本篇要验的其实就是 (a):"不用就不付"这句在时间上成立到什么程度,在空间上又成立到什么程度。
一、两阶段与三张表:代价挪到了哪里
言归正传,先把机制说清楚,后面的读数才有地方落。
1.1 正常路径上什么都不做
好了,抛异常这个动作,在正常路径上没有对应的指令。编译器不会在每一个可能抛出的调用点后面插一段"如果抛了怎么办"的代码。
这正是原文里那句 without inlining speculative exception handling code 的意思:不做投机性的内联。如果按老办法(setjmp 内联式)在每个函数入口存一份机器状态,那么每个函数调用都要付这笔钱;表驱动把这份钱从每次调用挪到了表里的每条记录。
1.2 抛出的那一刻:两阶段
下面进入抛出之后发生的事情,Itanium ABI 拆成了两个明确的阶段:
The runtime framework then starts a two-phase process: In the search phase, the framework repeatedly calls the personality routine, with the
_UA_SEARCH_PHASEflag ... the framework restarts in the cleanup phase ... with the_UA_CLEANUP_PHASEflag.
- 搜索阶段(search):从抛出点沿着调用栈往上走,逐帧问"这一帧能接住吗"。这个阶段只看不拆,所以栈还是完整的。
- 清理阶段(cleanup):找到能接住的帧之后,再走一遍,这次真正地把中间的帧拆掉,包括析构沿途所有已经构造完成的局部对象。
分两阶段的原因是 catch 的匹配可能依赖栈上对象的状态。如果第一遍就拆,那么"匹配失败、需要继续往上找"时,栈已经毁了。
1.3 每一帧都要回答一个问题:personality routine
栈帧怎么知道"我能不能接住这个异常"?靠编译器在 unwind 描述里留的一个函数指针:
a language and vendor specific personality routine will be stored by the compiler in the unwind descriptor for the stack frames requiring exception processing.
—— 同上
本篇实测里,MSVC 侧这一环没有独立的符号名(由异常表的处理器标志指定),而 GCC 侧能看到 __gxx_personality_seh0(§4.4,那个 seh0 后缀是本篇的一处意外)。
1.4 清理代码放在哪:landing pad
下面进入需要清理的帧里,编译器会生成一段独立的代码,叫 landing pad:
A section of user code intended to catch, or otherwise clean up after, an exception. It gains control from the exception runtime via the personality routine.
—— 同上
landing pad 是空间账的主要来源。 它平时躺在代码段里从不执行,但它占了字节。而它的存在条件是"这一帧有东西要清理"——最简单的判据就是作用域里有没有带析构函数的局部对象(§3.3 实测对照)。
1.5 能不能接住:类型匹配需要什么
catch 匹配的是一个类型。要在运行期判断"这个异常对象的类型,是不是 catch (const MyErr&) 想要的类型",运行库手里必须有类型信息。
这就是异常与 RTTI 的第一处耦合:抛一个类类型的异常,需要那个类型的 type_info。P0709 把这件事说得更直白:
today's dynamic exception types violate the zero-overhead principle, and do not have statically boundable space and time costs. In particular, throw requires dynamic allocation and catch of a type requires RTTI.
—— P0709R4
"throw 需要动态分配"这一半,在本篇实测里能看到现场(GCC 侧的 __cxa_allocate_exception);"catch 一个类型需要 RTTI"这一半,则是 §8 那一节要拆的账——因为它看起来与"关掉 RTTI"矛盾,但实测证明不矛盾。
1.6 官方口径对得上:三张表
说白了,三段原文摆在一起,"代价挪到表里"这件事就成形了:
| 工具链 | 官方表述 | 出处 |
|---|---|---|
| LLVM | 提供 outlying data in the form of exception tables,不在正常路径内联投机代码 | ExceptionHandling |
| GCC | 生成异常传播所需额外代码;某些目标上为所有函数生成 unwind 信息,can produce significant data size overhead, although it does not affect execution | Code-Gen Options |
| MSVC | /EHs 假设"异常只发生在 throw 或函数调用处",这允许消除大量生命周期跟踪代码,which can significantly reduce code size |
/EH |
三家的措辞有一个共同点:都在说空间,而不是时间。 GCC 那句 although it does not affect execution 与 significant data size overhead 并置,就是"零成本"这个词的完整账目。
把三段原文并排放,还能看出一个共同的处理方式:三家都把机制写进了手册,却都没有给自己的实现附一组体积读数。这不是疏漏,而是因为这一层的数字与目标平台、优化级别、代码形态都强相关,写进手册反而会误导。
1.7 为什么是两遍,而不是一遍
言归正传,两阶段这个设计常被当成"实现细节",但它解决的是一个很具体的问题。举一个反例:
void middle() {
  Guard g(g_sink);        // 有析构,需要清理
  top();                  // top 里抛了
  // 这里接不住 —— middle 没有 catch
}
middle 这一帧有东西要清理(Guard 的析构),但它接不住这个异常。调用链是 low → middle → top,而 catch 在更上面的 low 里。
如果只有一遍、边走边拆:
- 从
top往上走到middle,发现"这帧要清理" → 拆掉Guard; - 继续往上走到
low,发现"这帧接不住" → 继续往上; - 走到真正能接住的那一帧。
问题在于第 1 步就破坏了栈。如果 catch 的匹配需要查 middle 帧里的某个对象(比如 catch 的处理器要读一个已经析构的局部变量的值,或者更常见的情形:某个帧既是"要清理"又是"可能接住",而判断能否接住依赖运行时状态),那么这份状态在第 1 步就没了。
所以 ABI 把它拆成两遍:第一遍只问"能不能接住",第二遍才真拆。 这就是 _UA_SEARCH_PHASE 与 _UA_CLEANUP_PHASE 两个标志的来历,也是"两阶段"这个名字的由来。
代价是什么? 栈要走两遍。
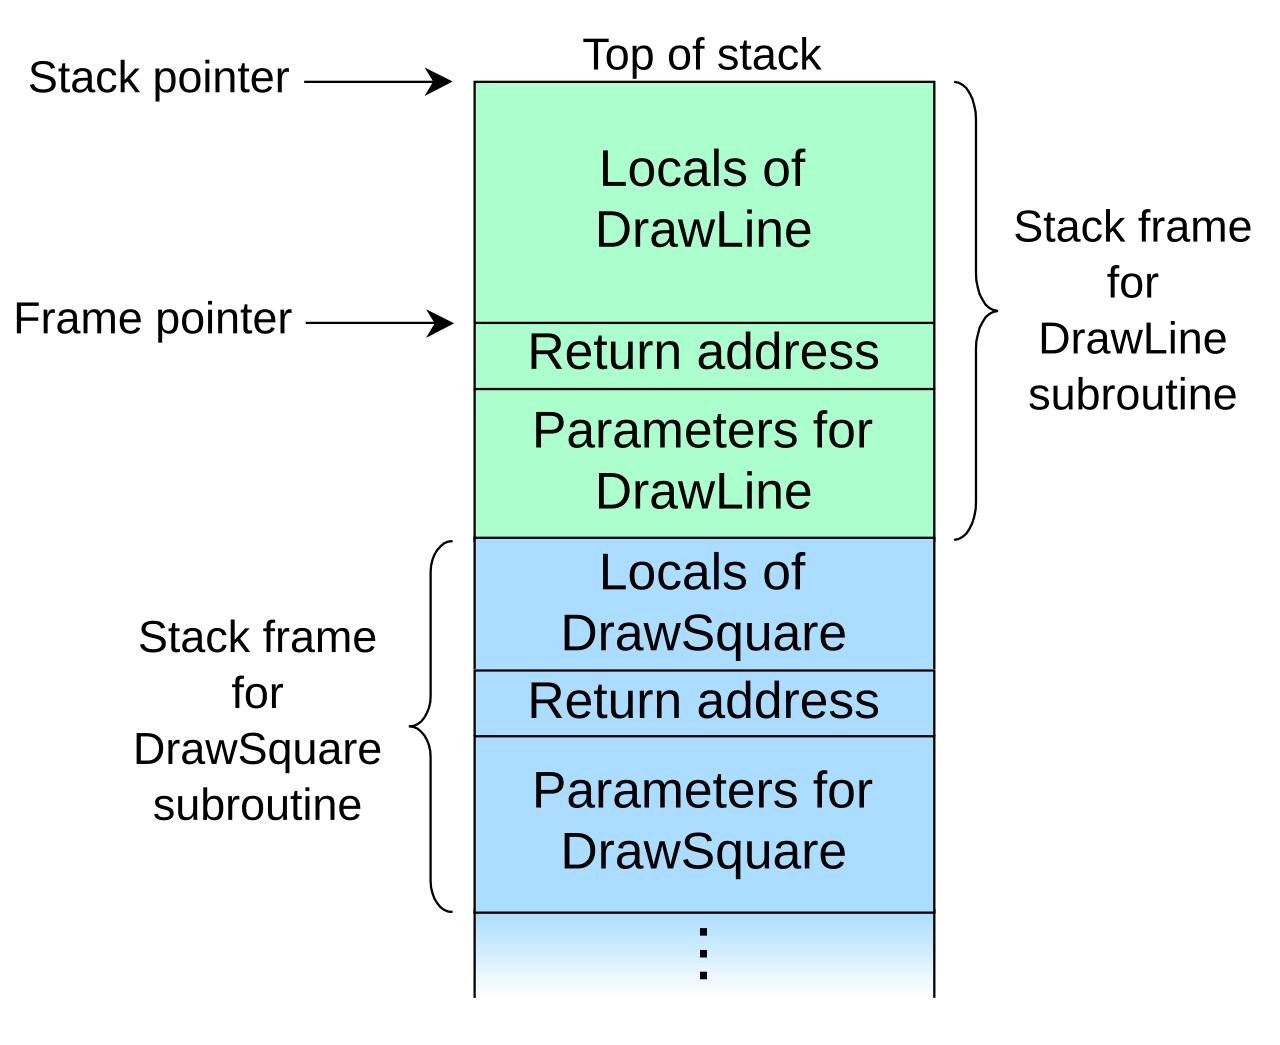
把"两遍"这件事落到栈的形状上看会更清楚:一帧里除了局部变量,还压着返回地址与调用者的帧指针。
清理阶段要做的就是按这些帧逐个回退,把每一帧里已经构造完成的对象析构掉。
(这张栈帧图取自 Wikimedia Commons 的公共域素材,是本篇唯一一张外部示意图;异常与 RTTI 两个主题
在 Commons 上没有可用的示意图,相关类目直接文件为 0,检索痕迹见 search-log.jsonl。)这也是 §2.3 里 2,693 ns 的一部分来源——不过要说明,本篇没有把搜索阶段与清理阶段分别计时,只量了端到端的那一次 throw(§2.4 有一处诚实标注)。
二、时间侧实测:不抛时免费,抛一次千倍
机制说完,开始量。
2.1 被测对象:把两条路径做到只差一个变量
要量"异常要不要钱",好了,对照必须只差一个变量:同一段业务逻辑,一版用返回值报错,一版用异常报错,且都不触发错误。
// 【1】错误码版:返回值携带状态
__attribute__((noinline)) int step_ec(int x, int *sink) {
  if (x < 0) return -1;          // 永不命中的错误分支
  *sink += x;
  return 0;
}

// 【2】异常版:同一份逻辑,改成 throw
__attribute__((noinline)) void step_ex(int x, int *sink) {
  if (x < 0) throw MyErr(x);     // 永不命中的错误分支
  *sink += x;
}

// 【3】循环里的两种包法
for (long i = 0; i < N; ++i) {
  int r = step_ec(i & 0xFF, &sink);   // 错误码版
  if (r) break;
}
for (long i = 0; i < N; ++i) {
  try { step_ex(i & 0xFF, &sink); }    // 异常版:try 包住调用
  catch (const MyErr &) { break; }
}
下面对这段代码特别说明三点。
第一,错误分支被写成永不命中。i & 0xFF 的取值范围是 0 至 255,x < 0 永远为假。这样两版都走在"正常路径"上,量的才是零成本 claim 的那一半。
第二,noinline 是刻意的。跨函数才需要异常表;如果把 step_ex 内联进循环,try 块的边界会跟着移动,读数就混进了"内联改变了控制流"这个变量。
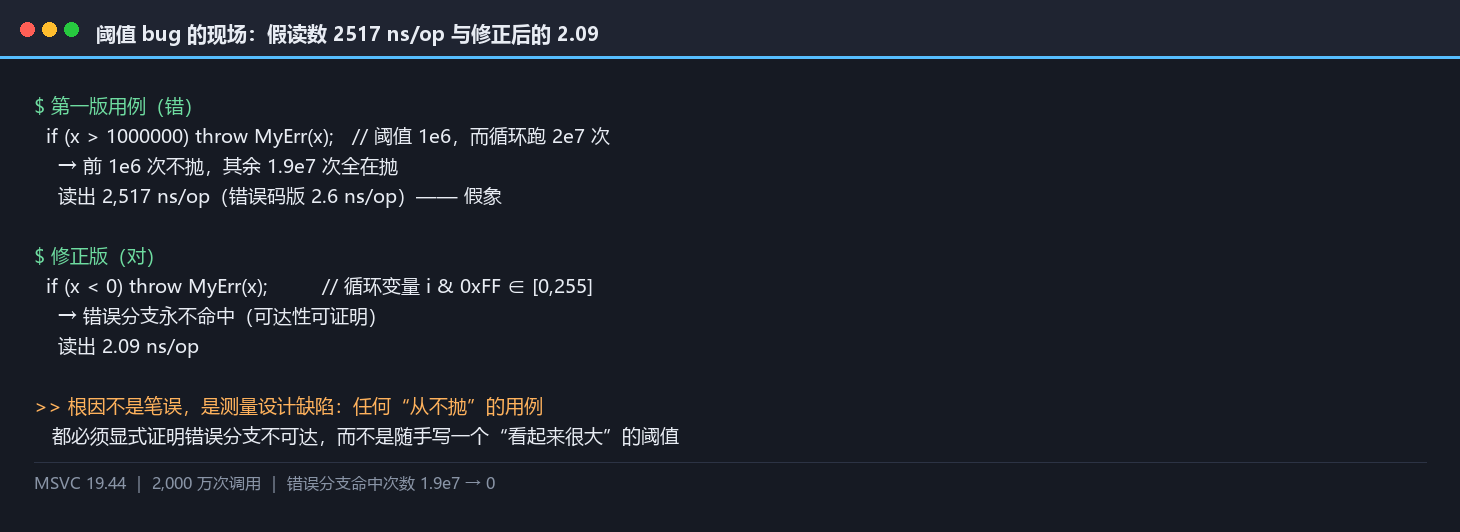
第三,阈值必须写对。本篇第一版用例把错误分支写成 x > 1000000,而循环跑 2,000 万次,于是"从不抛"这一版实际一直在抛,读出 2,517 ns/op 的假象。改成本例的写法之后读数才落地。这个坑记在 §2.4。
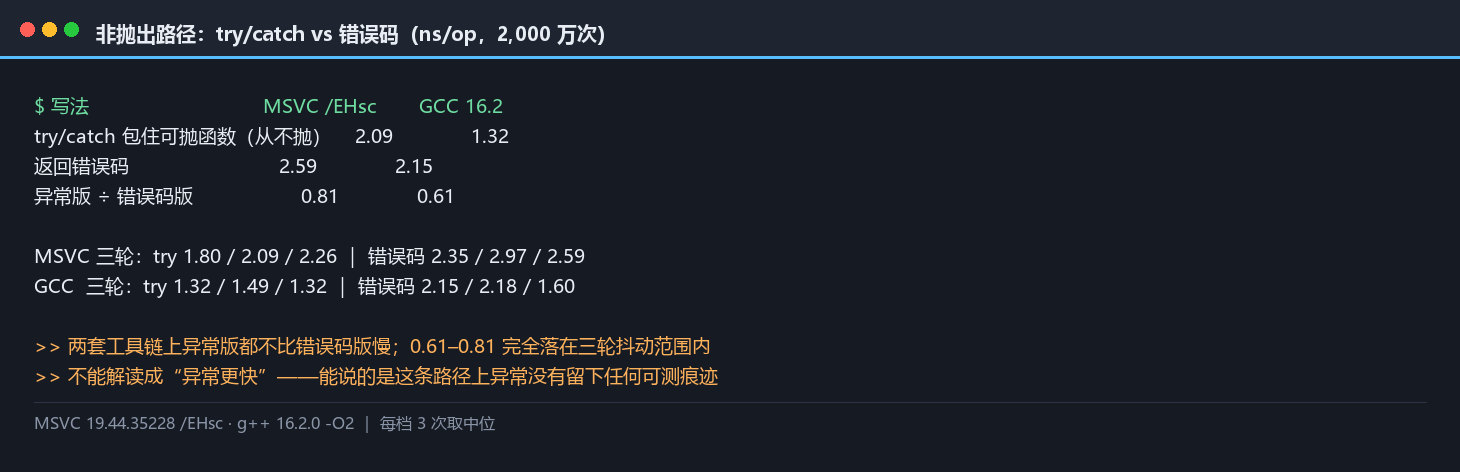
2.2 读数:不抛的时候,try/catch 不比错误码慢
非抛出路径,2,000 万次调用,单位 ns/op:
| 写法 | MSVC 19.44 /EHsc |
GCC 16.2 |
|---|---|---|
try/catch 包住可抛函数(从不抛出) |
1.80 / 2.09 / 2.26(中位 2.09) | 1.32 / 1.49 / 1.32(中位 1.32) |
| 返回错误码 | 2.35 / 2.97 / 2.59(中位 2.59) | 2.15 / 2.18 / 1.60(中位 2.15) |
| 异常版 ÷ 错误码版 | 0.81 | 0.61 |
读数说明一切:异常版不比错误码版慢。 两套工具链上它甚至略快,而 0.6 至 0.8 这个比值完全落在三轮抖动(MSVC 一轮 2.35、一轮 2.97)的范围内,不能解读成"异常更快"。
说白了,能说的是:在这条路径上,异常机制没有留下任何可测的痕迹。 这正是"零成本"claim 的时间侧部分。
这条结论对写代码的直接含义是:不要因为怕慢而回避在常态路径外写 try 块。真正决定代价的是抛出,而不是 try 这个语法本身。下一节把抛出那一次的成本单独量出来,两相对照就完整了。
2.3 抛出一次:千倍量级
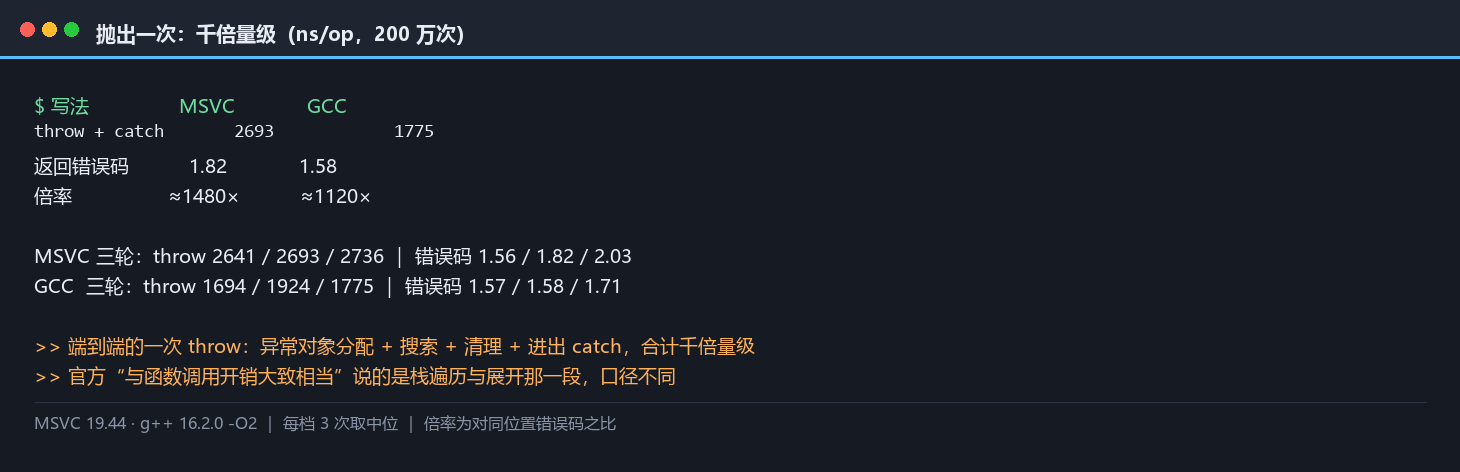
把同一个函数改成每次都抛,2,000,000 次调用:
| 写法 | MSVC | GCC |
|---|---|---|
throw + catch |
2641 / 2693 / 2736(中位 2693) | 1694 / 1924 / 1775(中位 1775) |
| 返回错误码 | 1.56 / 1.82 / 2.03(中位 1.82) | 1.57 / 1.58 / 1.71(中位 1.58) |
| 倍率 | ≈1480× | ≈1120× |
千倍量级,而不是"与函数调用相当"。 这个差值与微软官方那句表述的落差值得说清,因为它经常被用来安慰"异常不慢":
一旦引发异常,栈遍历 + 展开的开销与"函数调用开销大致相当"。
官方说的是栈遍历与展开这一段,它确实只相当于若干次函数调用;但一次完整的 throw 不止这一段,还包括异常对象的分配(__cxa_allocate_exception 或 MSVC 的对应路径)、类型匹配(要在表里找能接住这一类型的那一帧)、以及进入与退出 catch(__cxa_begin_catch / __cxa_end_catch)。本篇量的是端到端的那一次 throw,口径不同,数字自然差两个数量级。
把两者放在一起的正确说法是:展开这一段不贵,一次完整的抛出很贵。
2.4 一千倍在刻度上是什么样
先来看看2693 与 1.82 放在同一张线性刻度的图上,错误码那一列会塌成一条线。这不是作图技巧问题,而是这两个量本来就不该用同一个刻度看。
按对数刻度,从 1.8 ns 到 2693 ns 是三个数量级。这个数量级差在本篇后面还会出现两次:一次是 RTTI 关掉的体积收益(传说与实际差三个数量级,§8.4),一次是 dynamic_cast 的形状差(同一份代码在两家工具链上差一个数量级,§7.2)。
建议的直觉:把异常当成"错误路径上的 malloc + 一次栈回溯"。它不该出现在热路径的常态分支上——不是因为慢,而是因为它的量级和常态分支不在一个世界里。
2.5 那个假读数是怎么来的(以及为什么值得写出来)
下面进入第一次跑非抛出用例时,读数是 2,517 ns/op,而错误码版是 2.6 ns/op。一个"从不抛出"的版本,比同样"从不抛出"的错误码版慢了近千倍——这与零成本的 claim 直接冲突。
根因是阈值的量纲错了:
// 【错】阈值 1e6,而循环跑 2e7 次 → 后 1.9e7 次全在抛
if (x > 1000000) throw MyErr(x);

// 【对】阈值高于循环变量量程 → 错误分支永不命中
if (x < 0) throw MyErr(x);
第一版里 x 就是循环计数器,1e6 这个阈值让前 100 万次不抛、之后全抛。于是那一版量的是"混合路径",而中位数被抛出路径主导。
这个坑值得写出来,因为它不是笔误,而是测量设计缺陷:任何"从不抛出"的用例,都必须显式证明错误分支不可达(本例用 x < 0 配合 i & 0xFF 的取值域),而不是随手写一个"看起来很大"的阈值。
2.6 那 2,693 ns 花在哪四段上
端到端的一次 throw,从符号与反汇编里能看出至少四段开销都在场:
| 段 | 现场证据 | 做什么 |
|---|---|---|
| 异常对象的分配 | GCC 侧 call __cxa_allocate_exception |
为异常对象找存储(标准原话:"allocated in an unspecified way") |
| 搜索阶段 | 由 personality routine 反复调用,带 _UA_SEARCH_PHASE |
沿栈逐帧问"能不能接住",只看不拆 |
| 清理阶段 | GCC 侧 cleanup landing pad 里的 call _Unwind_Resume |
回头拆帧,逐个析构沿途对象 |
| 进出 catch | __cxa_begin_catch / __cxa_end_catch(MSVC 侧为 main$catch$0 funclet) |
登记异常已被接住、退出时清理 |
必须诚实标注一处边界:本篇没有把四段分别计时。表里的"在哪一段"是从符号与反汇编推断的,不是从读数拆出来的。要做四段分解,需要额外设计插桩(比如自定义 std::terminate_handler 或者逐段手工重写调用协议),本篇没有做,留作后续。
能说的是:这四段缺一不可地出现在反汇编里,所以 2,693 ns 不是单一原因造成的。把"异常慢"归给其中任何一段,都需要先把它单独量出来。
2.7 把 2,693 ns 摊到频率上
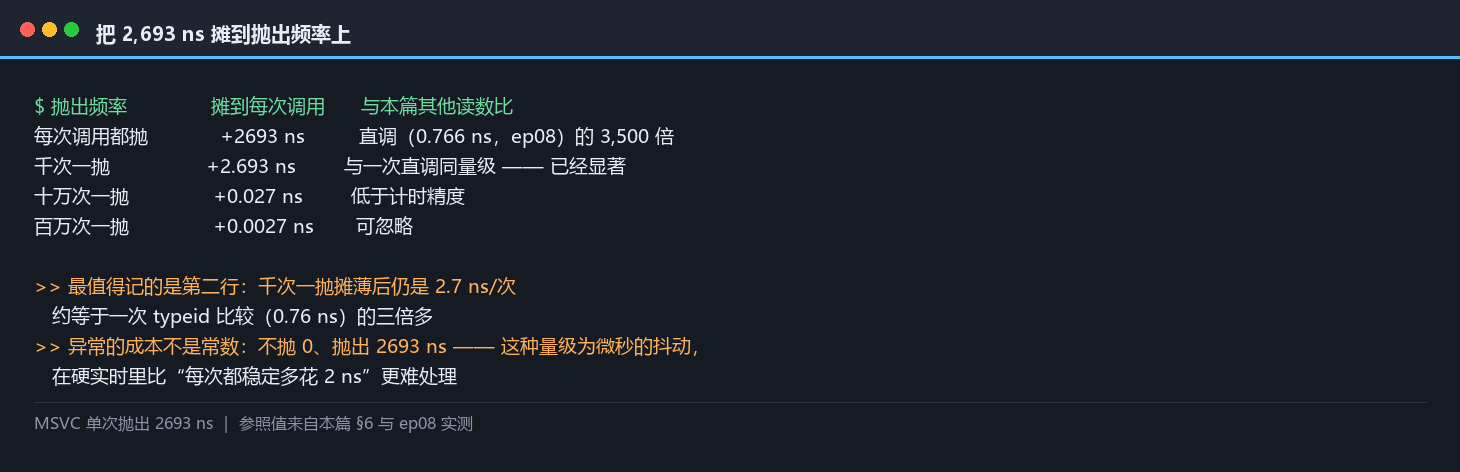
言归正传,单次 2,693 ns 这个数字本身不构成结论,构成结论的是它乘上频率之后的样子:
| 抛出频率 | 摊到每次调用 | 与本篇其他读数比 |
|---|---|---|
| 每次调用都抛 | +2,693 ns | 直调(0.766 ns,ep08 实测)的 3,500 倍 |
| 千次一抛 | +2.693 ns | 与一次直调同量级,已经显著 |
| 十万次一抛 | +0.027 ns | 低于计时精度 |
| 百万次一抛 | +0.0027 ns | 可忽略 |
表里最值得记的是第二行。 直觉上"千次一抛已经很罕见",但它摊薄之后仍是 2.7 ns/次——而本篇 §6.5 量过 typeid 的一次比较只要 0.76 ns,ep08 量过的一次 variant 单态访问是 0.766 ns。一次千分之一概率的异常,把它摊到每次调用上,成本相当于把那次调用的分发方式从"直调"换成"经过一次 typeid 比较"。
这条换算还解释了为什么"硬实时"场景排斥异常:不是因为它慢,而是因为它的成本不是常数——不抛时 0,抛出时 2,693 ns。一个不确定的、量级为微秒的抖动,在硬实时里比"每次都稳定多花 2 ns"更难处理。
2.8 判据(第一条)
判据一(时间侧):异常的时间成本可以近似为零——前提是它不被抛出。所以问"这里能不能用异常",先问的是"这里抛出的频率有多高":
- 从不抛出(真正的异常情况)→ 时间账可以忽略;
- 每 N 次调用抛一次,N 是百万级 → 把
N × 2693 ns与业务本身的开销比一比,通常仍然可以忽略; - 每 N 次调用抛一次,N 是千级或更小 → 这已经不是异常用法,而是把异常当控制流用,需要重新设计。
下一篇(ep10)会换一个角度问同一类问题:seq_cst 在 x86 上贵不贵。
三、空间侧实测:一个 try 块值多少字节
好了,时间侧算完,轮到空间侧。这一章要把"开销"从一个形容词变成一个数字。
3.1 四个变体:把 try 与析构拆开量
下面进入空间账的变量有两个:有没有 try 块、作用域里有没有带析构函数的局部对象。两个变量交叉,得到四个变体:
// 【s1】无 try 无析构
int s1(int x, int *sink) { *sink += x; return x; }

// 【s2】有 try 无析构 —— 隔离出"try 块本身"的代价
int s2(int x, int *sink) {
  try { return may_throw(x, sink); }
  catch (const MyErr &) { return -1; }
}

// 【s3】有 try + 带析构的局部对象 —— 加上"清理通道"的代价
int s3(int x, int *sink) {
  Guard g(sink);                      // 析构函数把 sink 写回
  try { return may_throw(x, sink); }
  catch (const MyErr &) { return -1; }
}

// 【s4】无 try + 带析构的局部对象 —— 隔离出"析构本身"的代价
int s4(int x, int *sink) { Guard g(sink); *sink += x; return x; }
下面对这四个变体特别说明两点。
第一,Guard 的析构函数必须有一个可观测的副作用(往 sink 里写),否则优化器会把整个对象消掉,s3 与 s2 就分不开了。
第二,四个变体都要能编出独立的 obj,不要把四个函数放进同一个 TU 的同一段里——它们是四个独立的段尺寸对照。
3.2 段尺寸对照
单位:字节。obj 是该目标文件的总大小。
| 变体 | MSVC .text |
MSVC .pdata |
MSVC .xdata |
MSVC obj | GCC .text |
GCC .xdata |
GCC obj |
|---|---|---|---|---|---|---|---|
| s1 无 try 无析构 | 808 | 48 | 124 | 8,827 | 1,008 | 144 | 5,706 |
| s2 有 try 无析构 | 2,312 | 816 | 2,012 | 63,918 | 2,032 | 1,040 | 8,697 |
| s3 有 try + 析构对象 | 3,545 | 816 | 2,204 | 74,462 | 2,544 | 1,168 | 9,995 |
| s4 无 try + 析构对象 | 2,297 | 432 | 1,244 | 43,770 | 2,032 | 784 | 8,742 |
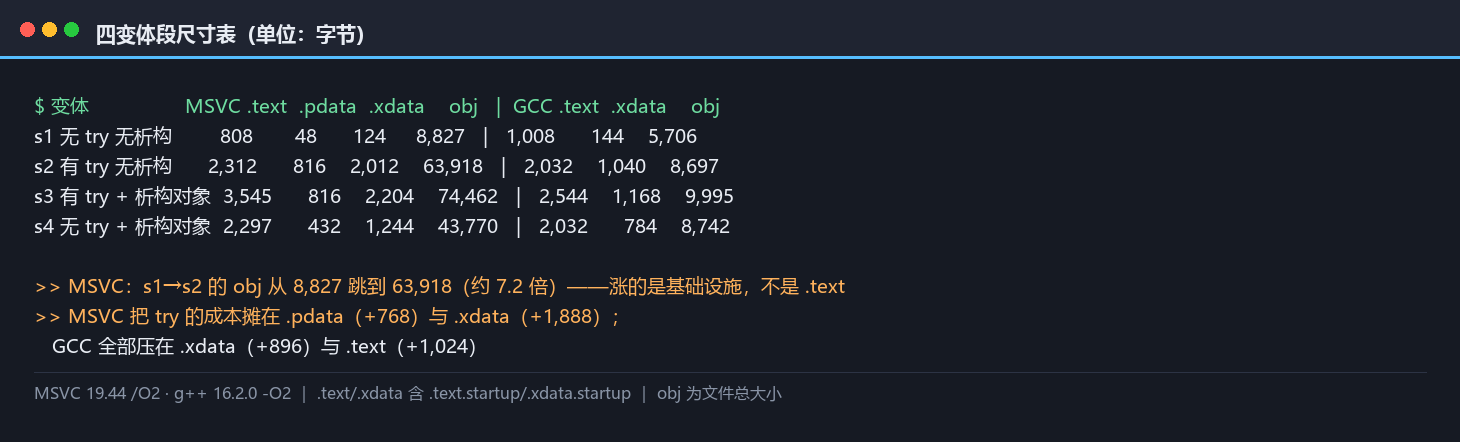
先看最反直觉的一列:obj 体积的跳变。 MSVC 从 s1 的 8,827 字节跳到 s2 的 63,918 字节——一个 try 块让目标文件涨了约 55 千字节(约 7.2 倍)。这不是代码段涨了,.text 只从 808 涨到 2,312;涨的是编译器和运行库一起塞进来的那套异常基础设施(异常表、类型描述、以及被引用进来的运行库段落)。
再看两家的分工。 MSVC 把 try 的成本摊在 .pdata(+768)与 .xdata(+1,888)上;GCC 在没有 try 时的 .pdata 只有 36 字节(一条函数记录),全部增长压在 .xdata(+896)与 .text(+1,024)。
3.3 从 obj 到 exe:一个 try 块值 10,752 字节
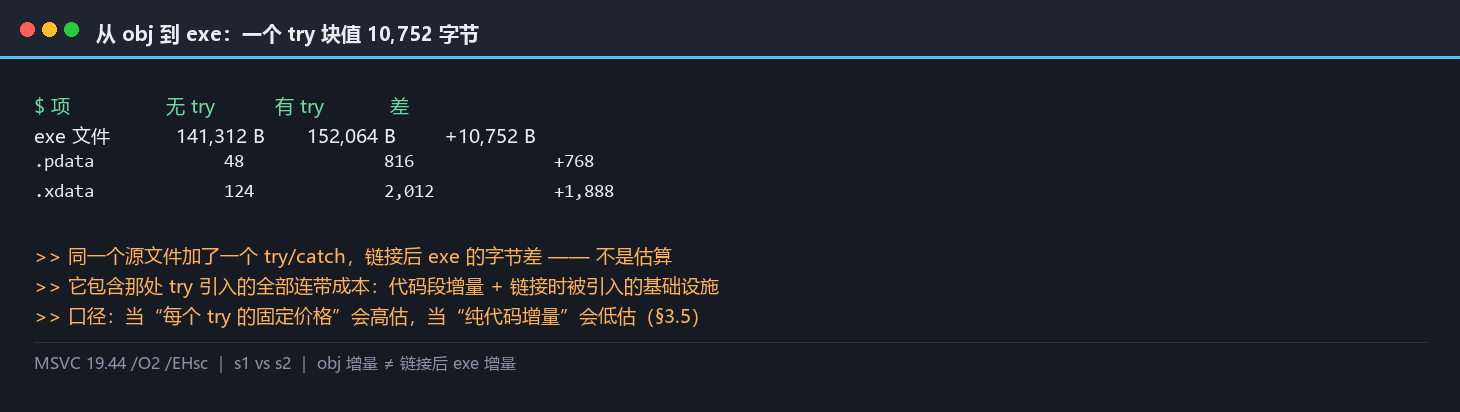
先来看看obj 的数字容易被质疑"那只是编译器中间产物"。把它链接成 exe 再量一次:
| 项 | 无 try |
有 try |
差 |
|---|---|---|---|
| exe 文件 | 141,312 B | 152,064 B | +10,752 B |
.pdata |
48 | 816 | +768 |
.xdata |
124 | 2,012 | +1,888 |
一个 try 块,10.7 千字节。 这是本篇最直白的一个数字:它不是估算,是同一个源文件加了一个 try/catch、链接后 exe 的字节差。
对照 GCC 侧的 exe 段:
| 变体 | GCC .text |
GCC .xdata |
|---|---|---|
| s1 | 29,040 | 916 |
| s2 | 30,064 | 1,812 |
| s3 | 30,576 | 1,940 |
| s4 | 30,064 | 1,556 |
GCC 侧 .xdata 从 916 涨到 1,812(+896),.text 从 29,040 涨到 30,064(+1,024)。同一件事,两个数量级之外的量级是一致的,但落点是两张不同的表。
注意这个数字的口径:它包含那一处 try 引入的全部连带成本,既有代码段的增量,也有链接时被引入的基础设施。把它当成每个 try 的固定价格会高估,当成纯代码增量会低估,下一节会把两者的口径差说清。
3.4 清理通道:带析构的局部对象贵在哪
s2 到 s3 这一跳,加的是一个带析构函数的局部对象。读数:
| 工具链 | .text 差 |
.xdata 差 |
|---|---|---|
| MSVC | +1,233 | +192 |
| GCC | +512 | +128 |
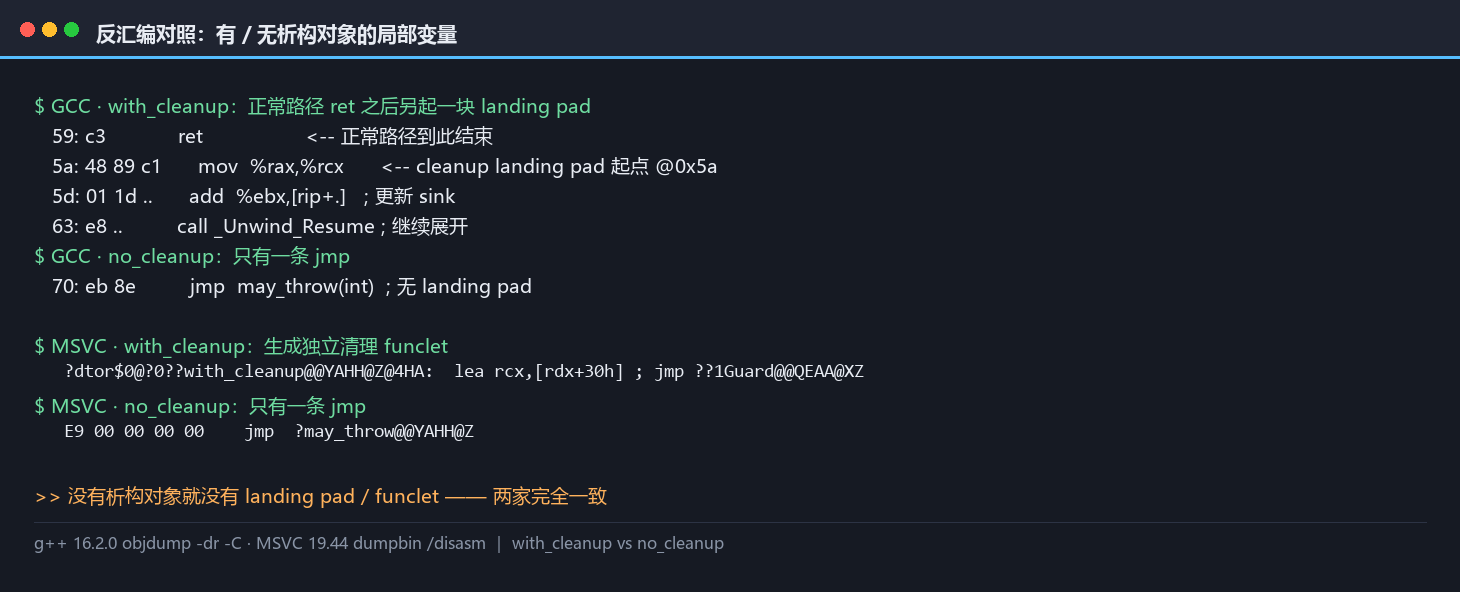
.text 涨的那一千多字节就是 cleanup 通道:为了让异常穿过 s3 这一帧时能正确析构 Guard,编译器生成了一段独立的清理代码。
这段代码在反汇编里能直接看到(§4.5 有现场)。它平时躺在代码段里,从不执行,但它占了字节。
反过来说,这一节也给了一条可操作的省字节规则:如果作用域里没有带析构函数的对象,try 块就不会引入 cleanup 通道(s2 与 s1 的 .text 差全部来自 catch 块的正文与调用协议,而不是清理)。
3.5 段尺寸怎么读(口径说明)
说白了,段尺寸这组数字最容易被误读,先把口径写清。
.text 是代码段:函数正文、landing pad、funclet 都在这里。try 块本身的正文(catch 分支的代码)也算在这里。
.pdata 是函数表:PE/COFF 上的一张索引,每条记录回答"某个地址区间属于哪个函数、它的 unwind 信息在哪"。它的大小与函数个数成正比,与函数体大小无关。
.xdata 是 unwind 信息:UNWIND_INFO 与语言相关数据。它的大小与需要展开的函数个数和每个函数的清理复杂度成正比。
obj 是目标文件总大小,包含以上三者,还包括符号表、重定位表与调试信息。这就是为什么 obj 的数字会跳变——§3.2 里 s1 到 s2 那 55 KB 的增量,绝大部分不是代码,而是被引用进来的基础设施与符号/重定位信息。
一条使用提醒:不要拿 size 命令的输出直接加总当"代码大小"。.pdata 与 .xdata 是数据,它们和 .text 同属"你要为异常付的钱",但性质不同——一个是每条指令的字节,一个是每帧的记录。
3.6 try 数量与 obj 体积
把 §4.3 的斜率提前看一眼(同一批数据的 obj 列):
| N 个 try | MSVC obj | GCC obj |
|---|---|---|
| 1 | 5,900 | 2,191 |
| 4 | 8,512 | 2,363 |
| 16 | 18,883 | 3,043 |
| 64 | 60,563 | 5,779 |
MSVC 这一列不是线性的:从 1 个到 4 个涨了 2,612 字节,从 4 个到 16 个涨了 10,371 字节(平均每 try 865 字节),从 16 个到 64 个涨了 41,680 字节(平均每 try 868 字节)。
前一段偏小、后两段稳定,说明存在一块固定的基础设施成本(大约几千字节,第一个 try 触发)加上每个 try 的边际成本(约 870 字节)。GCC 侧的数字小得多(2,191 到 5,779),边际约 57 字节。
⇒ 用量级给结论:MSVC 上"每个 try 约 870 字节"是一个可用的估算;而 §3.3 量到的 exe 增量 10,752 字节里,包含了那次链接引入的整块基础设施,所以它比"870 × 1"大——两个数字不矛盾,量的是不同口径(obj 增量 vs 链接后的 exe 增量)。
3.7 一条可验证的省字节规则
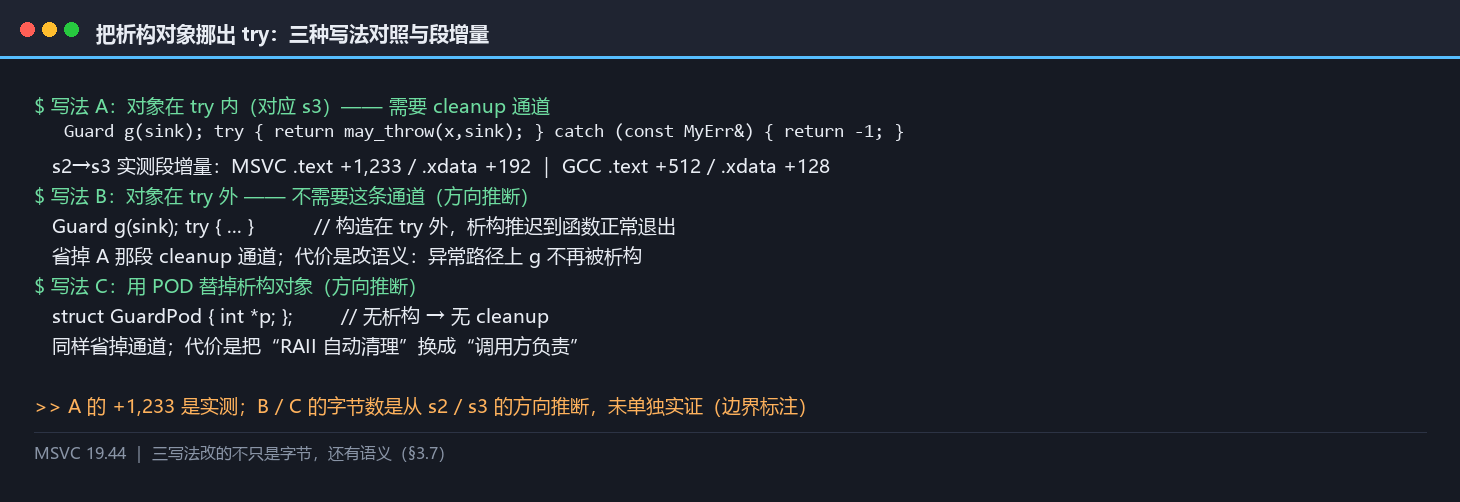
言归正传,把 §3.2 的 s2 与 s3 反过来读一次:s3 比 s2 多的东西只有一件——一个带析构函数的局部对象。而它带来 .text +1,233 字节(§3.4)。于是有一条规则可以直接写出来:
把带析构的对象挪出 try 的作用域,就能省掉这段 cleanup 通道。
三种写法摆在一起看:
// 【写法 A】对象在 try 内 —— 需要 cleanup 通道(对应 s3)
int a(int x, int *sink) {
  Guard g(sink);                     // 析构写在 try 内
  try { return may_throw(x, sink); }
  catch (const MyErr &) { return -1; }
}

// 【写法 B】对象在 try 外 —— 不需要这条通道(对应 §3.2 的 s2 方向)
int b(int x, int *sink) {
  Guard g(sink);                     // 构造在 try 外,析构在函数末尾
  try { return may_throw(x, sink); }
  catch (const MyErr &) { return -1; }
}

// 【写法 C】用 POD 替掉析构对象 —— 连带改掉类型的语义
struct GuardPod { int *p; };         // 没有析构函数
int c(int x, int GuardPod g) {
  try { return may_throw(x, g.p); }
  catch (const MyErr &) { return -1; }
}
但这条规则不能直接照用,因为它改的是语义,不只是字节。
- 写法 B 变的是什么? 在 A 里,异常穿过这一帧时
g会被析构(析构发生在展开过程中);在 B 里,g的析构推迟到函数正常退出时执行。如果g的析构里有必须及时提交的东西(比如解锁、刷缓冲、回滚标记),B 会改变可观测行为。 B 省下的这 1,233 字节,代价正是把"异常路径上也要析构"这个保证换掉。 - 写法 C 变的是什么? 它把"RAII 类型的自动清理"换成了"调用方自己负责"。在错误分支里
may_throw抛出时,g.p指向的资源不会被释放——除非may_throw自己保证。
⇒ 正确用法是:先用 §9.1 判据二判断"这个目标是否体积受限",如果是,再去核对"这个析构在异常路径上是否必须执行"。两条都过,再动手。
必须标注的边界:本篇只实测了 §3.2 的四个变体(有/无 try × 有/无析构对象),写法 B 与写法 C 的字节数是从那四档的方向推断的,没有单独实证。要把它们坐实,需要再跑一轮:Guard 构造在 try 外、GuardPod 版本各编一次并量段尺寸。
3.8 空间账的判据
判据二(空间侧):异常的空间成本是按帧计的,不是按抛出次数计的。你永远不抛,这 10.7 千字节也要付。
这条推论有三个用法:
- 量级判断:一个
try块约 10 KB(本篇负载下)。如果模块里有 200 个try块,那是 2 MB 量级——对桌面程序无关紧要,对 512 KB 的固件是致命的。 - 方向判断:
.text的增长主要来自 cleanup 通道。把带析构的对象挪出try的作用域(改成先构造、后进 try,或者用 POD),可以不付这一段。 - 开关判断:整个模块不用异常时,
-fno-exceptions//EHs-c-能把这一整块基础设施从二进制里拿掉。代价是代码里一处throw都不许有(§8.3 实测了两家在"关掉之后还用"时的不同态度)。
四、表落在哪个段:PE/COFF 下没有 .gcc_except_table
4.1 一句流传很广的对应关系,在本机不成立
先来看看关于异常表的位置,中文技术文章里常见这样一条对应关系:
| 异常表 | unwind 表 | |
|---|---|---|
| GCC | .gcc_except_table |
.eh_frame |
| MSVC | .xdata / .pdata |
同左 |
这条对应关系本身没错——它对 ELF 目标成立。GCC 的 internals 文档里也确实是这么写的:
The default is a section named
.gcc_except_tableon machines that support named sections viaASM_OUTPUT_SECTION_NAME.
但本机装的是 MSYS2 的 GCC,目标三元组是 x86_64-w64-mingw32,产出 PE/COFF。在这个目标上,上表右列的两段都不存在。
4.2 本机 objdump 的段列表
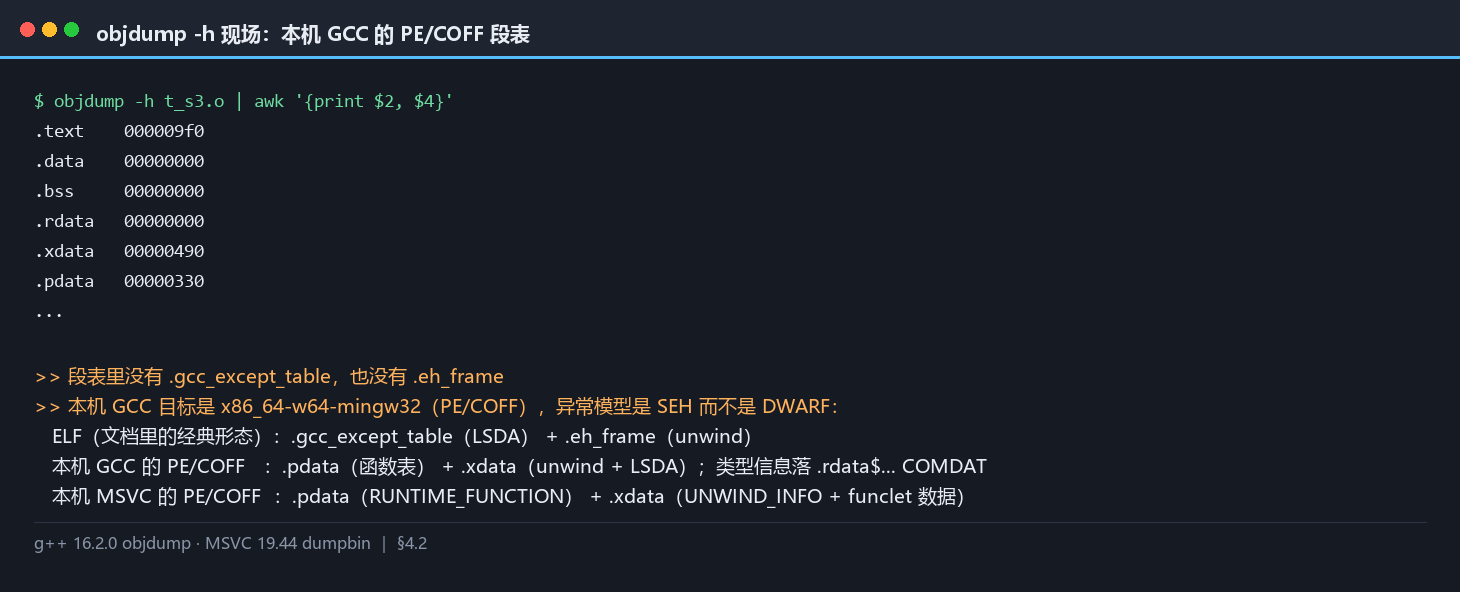
把 s3 的 obj 丢给 objdump -h:
$ objdump -h s3_try_dtor.o
Sections:
Idx Name          Size
  0 .text         00000840
  1 .data         00000000
  2 .bss          00000010
  3 .xdata        00000488
  4 .pdata        0000018c
  5 .rdata        00000010
  6 .text.startup 000001b0
  7 .xdata.startup 00000008
  8 .pdata.startup 0000000c
  9 .rdata$_ZTS5MyErr 00000010
 10 .rdata$_ZTI5MyErr 00000010
 11 .rdata$zzz    00000030
段表里没有 .gcc_except_table,也没有 .eh_frame。
这张列表里还有一处值得单独指出的现场:第 9、10 两项 _ZTS5MyErr 与 _ZTI5MyErr 是 COMDAT 段——它们正好是"异常类型 MyErr 的类型名字符串"与"它的 type_info 对象"。这个目标文件里之所以出现了类型信息,唯一的原因是它 throw 了 MyErr。这正是 GCC 手册那句 exception handling uses the same information, but it will generate it as needed 的物证(§8.2 会用到)。
原因是这个目标的异常模型不是 DWARF 而是 SEH:
| 目标形态 | 异常表的落点 |
|---|---|
| ELF(文档里的经典形态) | .gcc_except_table(LSDA)+ .eh_frame(unwind) |
| 本机 GCC 的 PE/COFF | .pdata(函数表)+ .xdata(unwind + LSDA),类型信息落 .rdata$... COMDAT |
| 本机 MSVC 的 PE/COFF | .pdata(RUNTIME_FUNCTION)+ .xdata(UNWIND_INFO + funclet 数据) |
这是一个"读文档以为知道、一跑就发现不是"的典型案例。 值得记一笔的原因是:一旦按 ELF 的段名去数"异常表有多大",在 Windows 目标上会数出零,于是得出完全错误的结论。
4.3 本机段列表现场
同样一份 s3,两家工具链的段名对照:
| 内容 | GCC(PE/COFF) | MSVC |
|---|---|---|
| 函数表 | .pdata(一条 RUNTIME_FUNCTION / 函数) |
.pdata(同左) |
| unwind 信息 | .xdata |
.xdata(UNWIND_INFO) |
| 语言相关数据 | .xdata(LSDA 区,由 personality 解析) |
.xdata(funclet 数据、$stateUnwindMap、$ip2state) |
| 类型信息 | .rdata$... COMDAT |
.rdata |
MSVC 侧那几个 $ 开头的符号名,在 dumpbin 的输出里长这样(§4.5 有完整现场):
$cppxdata$?with_cleanup@@YAHH@Z
$stateUnwindMap$?with_cleanup@@YAHH@Z
$ip2state$?with_cleanup@@YAHH@Z
这几个符号名没有公开规范。 微软官方关于 x64 异常处理的文档把这一块描述成:
Language-specific handler data — The function's language-specific exception handler data. The format of this data is unspecified and completely determined by the specific exception handler in use.
所以本节对 MSVC 侧内部表的描述,全部以本机转储为证据,不声称引自规范。这是本篇边界声明里第一条的具体落点。
这张表的作用是让后面所有关于段尺寸的读数都能对上位置:看到 pdata 就知道在说函数记录,看到 xdata 就知道在说展开信息,看到 rdata 就知道在说类型描述。三者在两家的名字不同,职责一一对应。
4.4 斜率:try 块数量与表条目
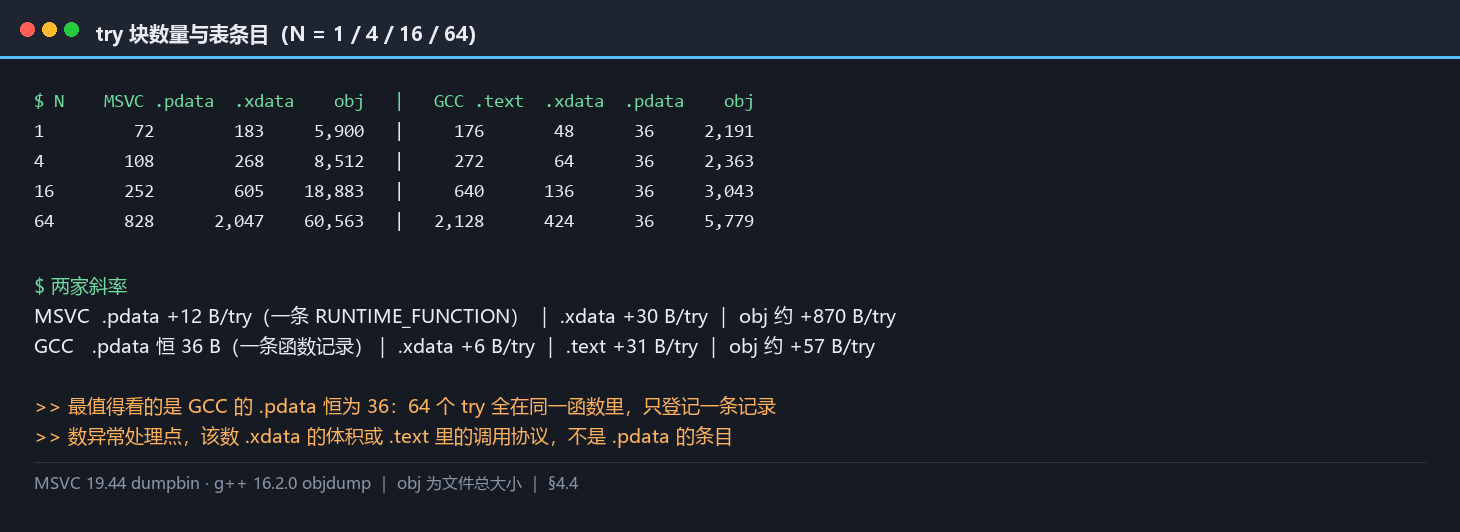
单个 try 的成本量完了,接下来量斜率——N 个 try 块会带来多少增量。四个变体,N = 1 / 4 / 16 / 64:
| N | MSVC .pdata |
MSVC .xdata |
MSVC obj | GCC .text |
GCC .xdata |
GCC .pdata |
GCC obj |
|---|---|---|---|---|---|---|---|
| 1 | 72 | 183 | 5,900 | 176 | 48 | 36 | 2,191 |
| 4 | 108 | 268 | 8,512 | 272 | 64 | 36 | 2,363 |
| 16 | 252 | 605 | 18,883 | 640 | 136 | 36 | 3,043 |
| 64 | 828 | 2,047 | 60,563 | 2,128 | 424 | 36 | 5,779 |
两家的斜率:
| 项 | MSVC | GCC |
|---|---|---|
| 函数表 | .pdata +12 B / try(一条 RUNTIME_FUNCTION) |
.pdata 恒 36 B(一条函数记录) |
| 语言相关数据 | .xdata +30 B / try |
.xdata +6 B / try |
| 代码段 | 含在 obj 增量里 | .text +31 B / try |
| obj 总增量 | 约 +870 B / try | 约 +57 B / try |
这张表里最值得看的是 GCC 的 .pdata:恒为 36 字节。 因为那 64 个 try 都在同一个函数里,函数表只登记一条记录。而它把每个 try 的信息压进了 .xdata(+6 B/个)与 .text(+31 B/个)。
⇒ "数异常表的条目"这件事,必须先问清是哪家的哪张表。 按 .pdata 数,GCC 侧会数出"64 个 try 只有 1 条记录"这种看似荒谬的结论——因为它数的根本不是同一个东西。
斜率表还有一个用法:用它反推异常处理点的数量。如果已知模块的 xdata 比基线多出若干字节,除以每点的边际就能估出大概有多少个可抛出点,这比翻代码数 try 快得多。
4.5 为什么 x64 上每个函数都要一条记录
好了,有一个现象容易被忽略:s1 那个完全没有 try、也没有析构对象的函数,.pdata 里也有 48 字节。GCC 侧更极端:64 个 try 全在一个函数里时,.pdata 恒为 36 字节(一条记录)。
原因是 x64 的栈展开是表驱动的,不能靠帧指针链。微软官方文档把这件事写成一条要求:
Table-based exception handling requires a table entry for all functions that allocate stack space or call another function ... These entries are sorted, and put in the
.pdatasection of a PE32+ image.
"所有分配栈空间或调用其它函数的函数" ——在 x64 上这个集合几乎是"所有函数"。所以 .pdata 的存在与"你用不用异常"无关,它是 x64 上运行期回溯调用栈的前提(也用于调试器与栈保护)。
这条推论有两个实际用法:
.pdata不是异常的成本,是 x64 的成本。 想让它变小,唯一的办法是减少函数个数(合并小函数、内联、-ffunction-sections配--gc-sections)。这也解释了为什么嵌入式裁剪清单里-ffunction-sections -fdata-sections贡献最大(§8.4)。try的成本要减去这条基线。一个函数本来就有一条记录,加了try之后是同一条记录变大(多了清理信息),而不是"多一条记录"。MSVC 侧 §4.4 量到的+12 B / try正是这条记录的增长。
4.6 现场:landing pad 与那三个运行时符号
下面进入反汇编层面的对照,是这一章最直观的一段。
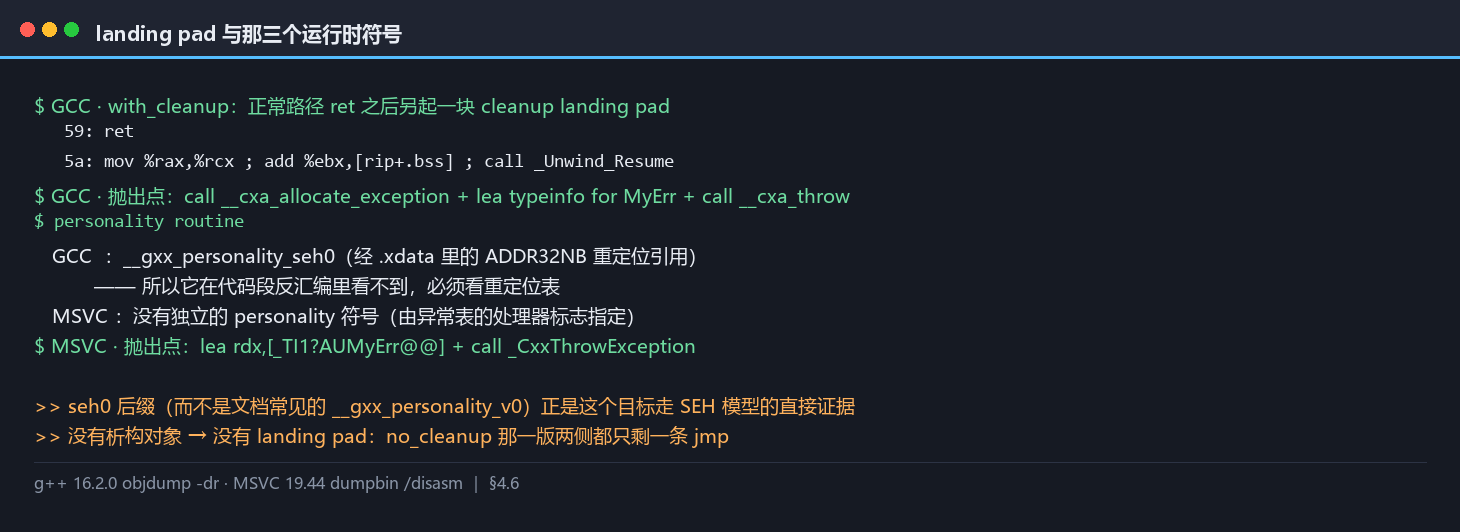
条件:同一个函数,一版有带析构的局部对象(with_cleanup),一版没有(no_cleanup)。
| 检查点 | MSVC | GCC(ucrt64 / x64) |
|---|---|---|
| 有析构的函数 | 生成独立清理 funclet ?dtor$0@?0??with_cleanup@@YAHH@Z@4HA,以及 $cppxdata / $stateUnwindMap / $ip2state |
正常路径 ret 之后另起一块 0x5a 字节 的 cleanup landing pad:更新 sink 后 call _Unwind_Resume |
| 无析构的函数 | 仅 jmp may_throw,无 funclet |
仅 jmp may_throw,无 landing pad |
| 抛出点 | call _CxxThrowException |
call __cxa_allocate_exception + lea typeinfo for MyErr + call __cxa_throw |
| catch 处理 | main$catch$0 / __catch$main$0 funclet |
__cxa_begin_catch … __cxa_end_catch |
| personality | 无独立符号(由异常表的处理器标志指定) | __gxx_personality_seh0 |
三条结论:
- 没有析构对象就没有 landing pad。
no_cleanup那一版,两家的反汇编里都只有一条jmp。这一条与 §3.4 的 +1,233 字节对得上——钱花在清理通道上,不花在try这个语法上。 - GCC 侧能看到 personality 符号,MSVC 侧看不到。 GCC 的
__gxx_personality_seh0是通过.xdata里的ADDR32NB重定位引用的,所以在代码段反汇编里看不到它,必须看重定位表。这也是一个"按常规方法找不到"的坑。 - 符号名里有个意外:本机是
__gxx_personality_seh0,而不是文档与中文文章里常见的__gxx_personality_v0。seh0后缀正是"这个目标走 SEH 模型"的直接证据,与 §4.2 的段列表互为印证。
4.6 两家的表能不能互算
§4.4 那张斜率表里,MSVC 的 .xdata 是 +30 B / try,GCC 是 +6 B / try——差 5 倍。能不能据此说 GCC 的异常表更省?不能,因为这个比较把分母切错了。
把同一件事的各部分加起来才公平:
| 项 | MSVC | GCC |
|---|---|---|
| 函数表 | .pdata +12 B / try |
.pdata 恒 36 B(一条函数记录) |
| 语言相关数据 | .xdata +30 B / try |
.xdata +6 B / try |
| 代码段 | 含在 obj 增量里 | .text +31 B / try |
| 合计(可加部分) | ≈ +42 B / try | ≈ +37 B / try |
两家的合计是同一个量级(42 对 37)。 差别不在"谁更省",而在谁把这一笔记在哪张表上:
- MSVC 把"每个
try的信息"放进.pdata与.xdata这两张元数据表,代码段基本不动; - GCC 把大部分放进
.text(每个try对应的调用协议与分支)与.xdata,.pdata完全不涨。
这条的实际用处是防止一次典型的误判:如果你按 .pdata 的条目数去估算"这个模块有多少个异常处理点",在 GCC 侧会得到"一个函数一条记录"的结论(64 个 try 也只有 36 字节),会严重低估。要数异常处理点,该数的是 .xdata 的体积或 .text 里的调用协议,不是 .pdata。
五、noexcept 的账:两家方向相反
5.1 语义:默认就是"可能抛"
先看标准怎么规定默认值:
The predicate indicating whether a function cannot exit via an exception is called the exception specification ... If the predicate is false, the function has a potentially-throwing exception specification, otherwise it has a non-throwing exception specification.
If a declaration of a function does not have a noexcept-specifier, the declaration has a potentially throwing exception specification unless it is a destructor or a deallocation function or is defaulted on its first declaration.
默认是 potentially-throwing。 不写 noexcept 的函数,编译器必须假设它可能抛出,于是要为它准备清理通道。
那么写上 noexcept 应该能省掉这部分,对吗?本机实测给出了一个分家的答案。
5.2 读数:MSVC 更大,GCC 更小
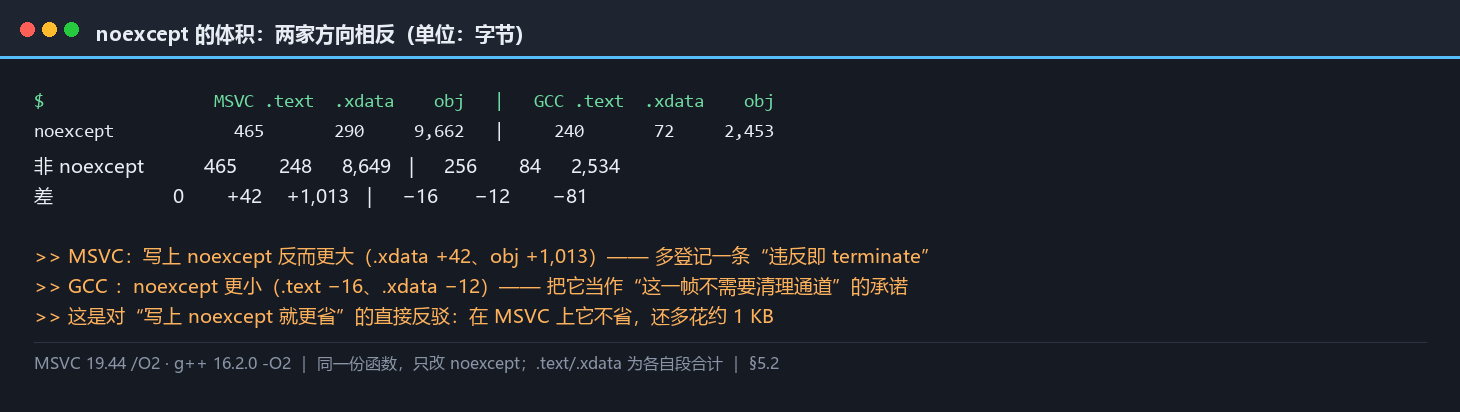
同一份函数,一版 noexcept、一版不带,其余完全相同:
MSVC .text |
MSVC .xdata |
MSVC obj | GCC .text |
GCC .xdata |
GCC obj | |
|---|---|---|---|---|---|---|
noexcept |
465 | 290 | 9,662 | 240 | 72 | 2,453 |
非 noexcept |
465 | 248 | 8,649 | 256 | 84 | 2,534 |
| 差 | 0 | +42 | +1,013 | −16 | −12 | −81 |
MSVC 的 noexcept 反而更大(.xdata +42、obj +1,013 字节),GCC 的 noexcept 更小(.text −16、.xdata −12)。
方向的差异来自两家对 noexcept 的处理取向:
- GCC 把
noexcept当作"这一帧不需要清理通道"的承诺,于是少生成表项与清理路径——这正是 P3313R0 期待的优化方向。 - MSVC 要保证
noexcept被违反时一定terminate,于是多登记一条"违反即终止"的处理器。所以它比不带noexcept的版本多出一份数据。
这条是对"写上 noexcept 就更省"这个直觉的直接反驳。 在 MSVC 上,它不省,还多花约 1 KB。
5.3 委员会侧的实测:P3313R0
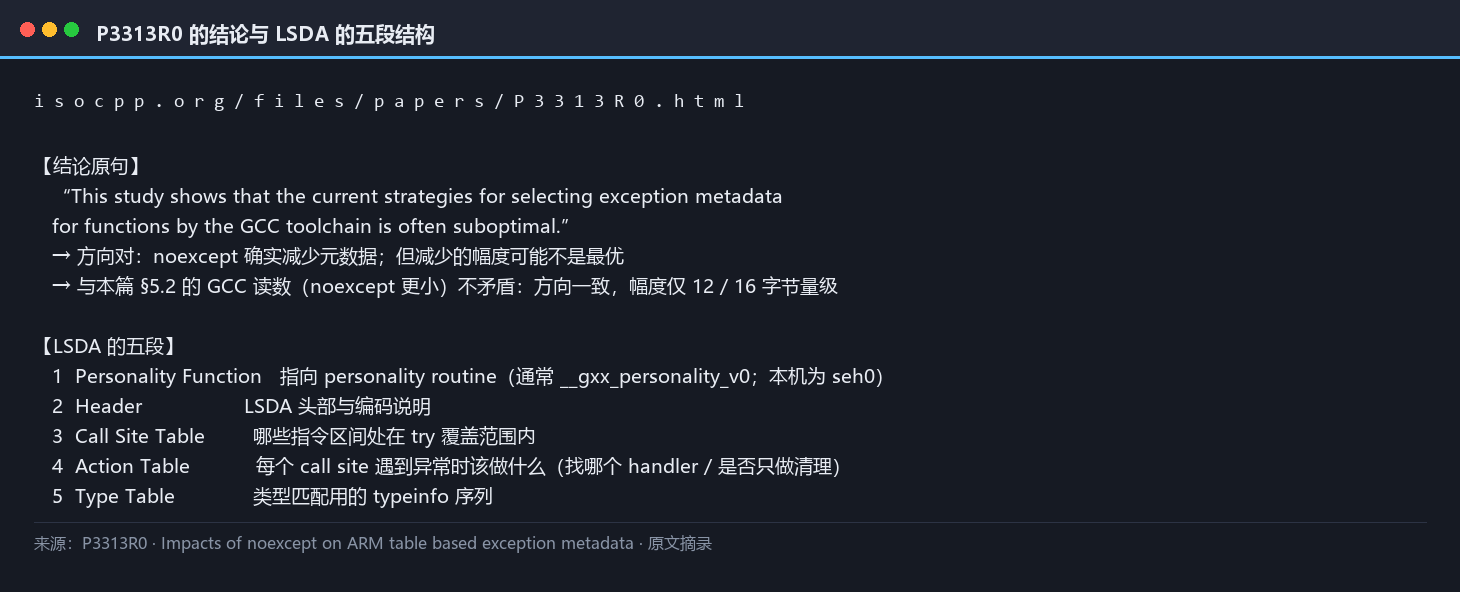
GCC 那个方向是不是"已经做到最优"?WG21 的 P3313R0 专门量过这件事(对象是 ARM 的 table-based 异常元数据):
This study shows that the current strategies for selecting exception metadata for functions by the GCC toolchain is often suboptimal.
—— P3313R0 · Impacts of noexcept on ARM table based exception metadata
这篇提案同时给了 LSDA 的五段结构(它把 LSDA 拆得很清楚,本篇 §1 的"三张表"说法在它这里有更细的版本):
| 段 | 作用 |
|---|---|
| Personality Function | 指向 personality routine(通常 __gxx_personality_v0;本机是 __gxx_personality_seh0) |
| Header | LSDA 头部与编码说明 |
| Call Site Table | 哪些指令区间处在 try 覆盖范围内 |
| Action Table | 每个 call site 遇到异常时该做什么(找哪个 handler、是否只做清理) |
| Type Table | 类型匹配用的 typeinfo 序列 |
本篇 §5.2 的 GCC 读数(noexcept 更小)与 P3313R0 的结论(GCC 的选择"often suboptimal")并不矛盾:方向对(noexcept 减少元数据),但减少的幅度可能不是最优。这也解释了为什么本篇的 noexcept 差值只有 12 与 16 字节这个量级。
5.4 noexcept 的收益主要在调用点
说白了,§5.2 量的是函数自身的字节,那一栏 MSVC 侧是负收益。但 noexcept 真正的收益不在这里,而在调用点:
// 调用者不知道 callee 会不会抛 → 必须为这个调用点准备清理通道
void caller_unknown(Guard &g) { may_throw(g.sink); }

// 编译期已知 callee 不抛 → 这个调用点不需要清理通道
void caller_known(Guard &g) { will_not_throw(g.sink); }
前者一旦抛出,caller_unknown 这一帧要负责析构 g,于是需要一个 landing pad;后者因为前提是"不会有异常穿过这里",编译器可以不生成。
本篇没有量调用点侧的字节差,只量了函数自身(§5.2)。这是一处必须标注的边界——把 noexcept 的收益写成"函数自身省几十字节",会低估它;写成"到处都是正收益",则会被 §5.2 的 MSVC 读数打脸。
⇒ 保守而正确的说法是:noexcept 的收益与"有多少个调用点因此省掉清理通道"相关,函数自身那几十字节的增减是次要的(而且在 MSVC 上方向是负的)。
5.5 noexcept 的判据
判据三(noexcept):写不写 noexcept,先问意图,再问字节。
- 写
noexcept的第一理由是语义承诺,不是优化。 它告诉调用者"这里不会抛",让调用者可以省掉自己的清理通道(这一层的收益会外溢到调用点,可能比自身那几十字节大得多)。 - 不要把
noexcept当减体积开关。本机读数里 MSVC 侧它是负收益。 noexcept被违反的后果是std::terminate,不可 catch。标准原话是"如果异常处理机制直接调用的函数因异常退出,则调用std::terminate"。这条比体积重要得多。- 移动构造与移动赋值应当写
noexcept——这属于容器扩容时的强异常保证,与本篇的体积账无关,但值得在这里点一句。
六、RTTI 的第一笔账:vtable 里的强制槽位
言归正传,异常这本账里,有一条隐线一直在起作用:类型匹配需要类型信息。现在把这条线单独拎出来量。
6.1 vptr 之前的那两个词
上一篇(ep08 §8.4)量过 vtable 的槽位排布。这一篇要看的是 vtable开头之前的部分。
Itanium ABI 把 vtable 里指回 typeinfo 的那一项写成强制存在:
The typeinfo pointer points to the typeinfo object used for RTTI. It is always present. All entries in each of the virtual tables for a given class must point to the same typeinfo object. A correct implementation of typeinfo equality is to check pointer equality.
槽位的具体位置,ABI 工作组的原始文档写得更直白:
This entry is located two words ahead of the location pointed to by the vptr (i.e., entry "-2") ... Every vtable shall contain one entry pointing to an object derived from std::type_info. This entry is located at the word preceding the location pointed to by the vptr (i.e., entry "-1").
vtable 里在虚函数之前有两个固定位置:-2 放 offset-to-top(从当前子对象的 vptr 回到完整对象的偏移),-1 放 typeinfo 指针。程序里的 vptr 指向第一个虚函数,所以这两个槽要用负索引取。
这两个槽不是"用了 RTTI 才有的"——它们是 vtable 的固有部分。所以"关掉 RTTI 能省多少"这个问题的答案,从一开始就不该期待很大(§8.1 实测证实)。
6.2 MSVC 放的是另一种东西
MSVC 不用负索引那一套。它把 COL(Complete Object Locator)的指针放在 vftable 之前:
MSVC compiler puts a pointer to the structure called 'Complete Object Locator' just before the vftable.
COL 的结构(x64 版):
struct RTTICompleteObjectLocator {
  uint32_t signature;      // x64 下为 COL_SIG_REV1
  uint32_t offset;         // 子对象在完整对象里的偏移
  uint32_t cdOffset;
  uint32_t pTypeDescriptor;   // 类型描述符(image-base relative RVA)
  uint32_t pClassDescriptor;  // 类层级描述符
  uint32_t pSelf;
};
来源:RTTI Internals in MSVC 与 OpenRCE。
两套 ABI 的差别可以一句话概括:Itanium 把 typeinfo 挂在 vptr 的负方向,MSVC 把 COL 挂在 vftable 的负方向。 位置都在 vtable 之前,但一个是"槽"、一个是"指针"。
位置差的直接影响在取值代码上,但更重要的一层是类型名的存放方式:Itanium 侧把类型名以未修饰的形式写在 typeinfo 对象里,MSVC 侧把修饰名写在类型描述符里。这一点直接决定了两个运行时之间能不能互相识别类型。
6.3 本机转储:GCC 侧
objdump 出来的 .rdata$_ZTV3Der(48 字节):
$ objdump -s -j .rdata$_ZTV3Der der.o
 0x00: 00000000 00000000   -> offset-to-top = 0        // [0]
 0x08: <reloc _ZTI3Der>     -> &typeinfo for Der        // [1]
 0x10: <reloc _ZN3DerD1Ev>  -> ~Der() [D1, complete]    // [2] <- vptr 指向这里
 0x18: <reloc _ZN3DerD0Ev>  -> ~Der() [D0, deleting]    // [3]
 0x20: <reloc _ZN3Der1fEv>  -> Der::f()                 // [4]
 0x28: <reloc _ZN3Der1gEv>  -> Der::g()                 // [5]
vptr 指向 +0x10,所以:
vptr[-1](即+0x08)= typeinfo 指针,与 ABI 原文的-1槽逐位对上;vptr[-2](即+0x00)= offset-to-top,实测值 0,与"单继承、vptr 在对象偏移 0"一致。
好了,两条破坏性析构(D1 完整对象版、D0 删除版)也在表里,这与 ep08 §8.4 的记录一致。
6.4 本机转储:MSVC 侧
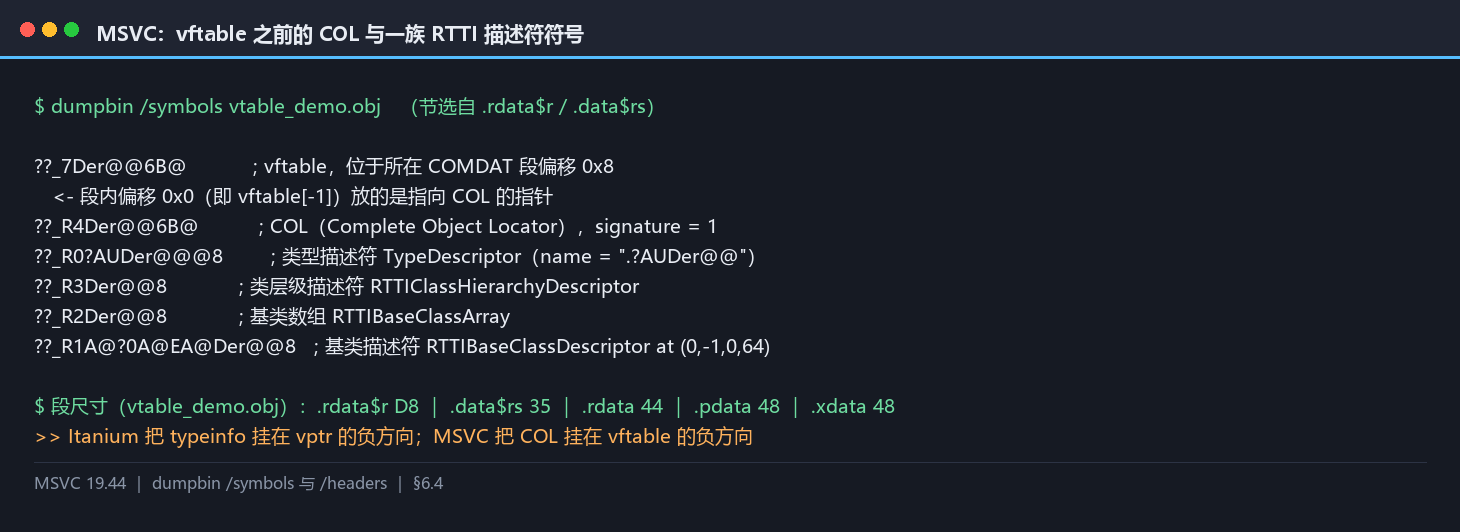
dumpbin 出来的 vftable 与它前面的 COL:
??_7Der@@6B@          ; vftable,位于所在 COMDAT 段偏移 0x8
  <- 段内偏移 0x0(即 vftable[-1])放的是指向 COL 的指针
??_R4Der@@6B@         ; COL,signature = 1
??_R0?AUDer@@@8       ; 类型描述符 TypeDescriptor(name = ".?AUDer@@")
??_R3Der@@8           ; 类层级描述符 RTTIClassHierarchyDescriptor
??_R2Der@@8           ; 基类数组 RTTIBaseClassArray
??_R1A@?0A@EA@Der@@8  ; 基类描述符 RTTIBaseClassDescriptor
与 Itanium 侧的对照:
| GCC(Itanium 布局) | MSVC | |
|---|---|---|
| vtable 符号 | .rdata$_ZTV3Der(48 B) |
??_7Der@@6B@(段内偏移 0x8) |
| 虚函数之前 | [0] offset-to-top、[1] typeinfo |
8 字节指针 → ??_R4Der@@6B@(COL) |
| 取 RTTI 的方式 | vptr[-1] 与 vptr[-2] |
vftable[-1] 解一层指针 |
| 类型名 | _ZTI3Der 内的 NTBS "3Der" |
??_R0?AUDer@@@8 内的修饰名 ".?AUDer@@" |
这就是 ep06 那条结论的一个具体落点:同一个 Der,两套工具链的 RTTI 符号名毫无共同点——_ZTI3Der 与 ??_R0?AUDer@@@8 之间不存在机械转换关系。
顺带说明两处容易看错的细节:MSVC 的 vftable 符号所在 COMDAT 段偏移为八,是因为段首那八个字节要留给 COL 指针;而 GCC 的 offset-to-top 在本例中是零,是因为单继承下 vptr 就在对象偏移零处,这两个零值含义不同。
6.5 三个 typeinfo 派生类
Itanium ABI 不只有一个 type_info,而是一族。三个与"继承形状"直接相关的:
| 结构 | 用在什么类上 | 附加字段 |
|---|---|---|
__class_type_info |
没有基类的类 | 一个 flags 字(含"是否多态""有无虚基""有无私有基"等位) |
__si_class_type_info |
单继承、基类非虚 | 一个指向基类 type_info 的指针 |
__vmi_class_type_info |
有多重继承或虚基 | 一个基类描述数组,每项含 type / offset / is_virtual / is_public |
来源:Updated RTTI description。本机转储里,Der(单继承自 Base)拿到的是 SI 型:_ZTI3Der 里写着 name "3Der" 与 base "4Base"。
这三个结构的存在,解释了 §7 的读数形状。 dynamic_cast 的算法必须在运行期沿这些描述走:
- 单继承(SI 型)→ 只需要比一次基类指针;
- 多重或虚继承(VMI 型)→ 要遍历基类描述数组,还要处理虚基偏移——这就是 §7.2 里 cross cast 两家都最贵(31.89 / 28 ns)的结构性原因。
MSVC 侧有对应的一族描述符(??_R0 类型描述符、??_R2 基类数组、??_R3 类层级描述符、??_R1A 基类描述符),字段名不同、职责相同。
这三个结构的划分带来的一个实际后果是:typeinfo 之间不能靠强转互相访问。拿到一个 class_type_info 指针时,无法判断它实际是 SI 型还是 VMI 型,只能由实现按继承形状决定生成哪一种,调用方无从选择。
6.6 typeid 的读数
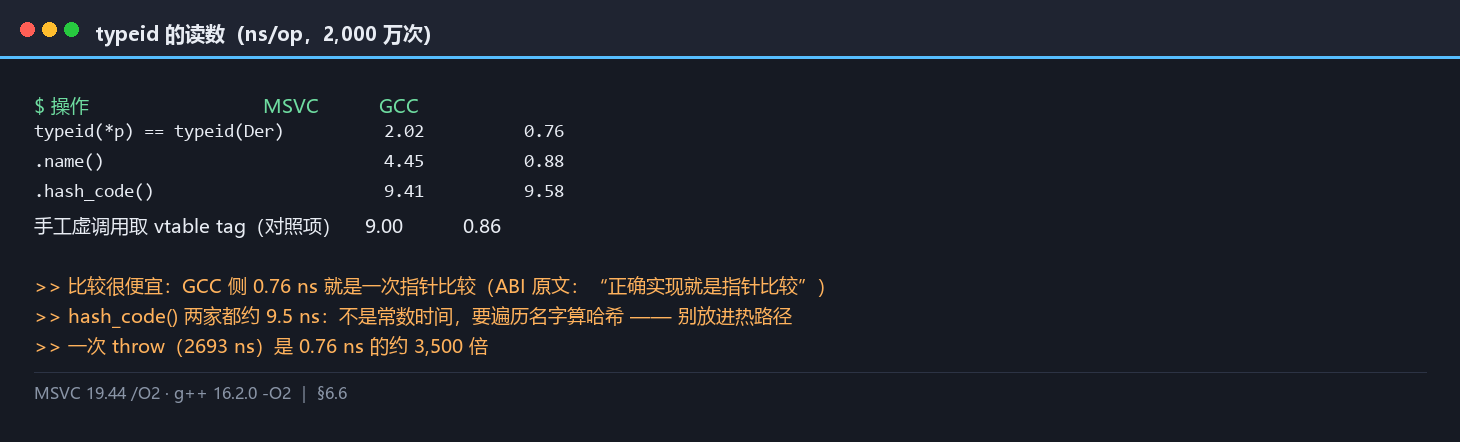
typeid 的花费分三种,量出来差别很大。2,000 万次,单位 ns/op:
| 操作 | MSVC | GCC |
|---|---|---|
typeid(*p) == typeid(Der) |
2.02 | 0.76 |
.name() |
4.45 | 0.88 |
.hash_code() |
9.41 | 9.58 |
| 手工虚调用取 vtable tag(对照项) | 9.00 | 0.86 |
三条结论:
- 比较很便宜。 Itanium ABI 的原文说过"正确的实现就是指针比较",本机 GCC 侧 0.76 ns 正是这个量级。MSVC 侧 2.02 ns 略高,但同样属于"一次
vptr载入加一次比较"的成本。 name()也便宜,因为返回的是已经躺在只读数据里的字符串指针。hash_code()两家都要约 9.5 ns。 它不是指针比较——标准要求它对同一类型稳定、且能跨"同一类型的多个type_info对象"一致,所以实现要遍历名字算哈希。这是本篇里"看起来像常数时间、实际不是"的第一个例子。
对比一下 §2.3 的抛出成本 2,693 ns:一次 typeid 比较 0.76 ns,两者差 3,500 倍。这解释了为什么"用 typeid 做分发"在写法上比 throw/catch 便宜得多——但它仍然比 ep08 量过的 variant 单态访问(0.766 ns/op,与直调同速)贵一倍。
七、RTTI 的第二笔账:dynamic_cast 不是 O(1)
7.1 标准说了什么
下面进入dynamic_cast 的语义在标准里写得很清楚,关键是那句 "a runtime check is applied":
Otherwise, a runtime check is applied to see if the object pointed or referred to by v can be converted to the type pointed or referred to by T. ... (9.1) If ... v points ... to a public base class subobject of a C object, and if only one object of type C is derived from the subobject ... the result points ... to that C object; (9.2) Otherwise, if ... the type of the most derived object has a base class, of type C, that is unambiguous and public ... (9.3) Otherwise, the runtime check fails.
教材侧的定性描述是:
Unlike typeid, dynamic_cast<> is not a constant time operation ... the time depends on the complexity of the class hierarchy ... it has to traverse the derivation tree of the obj until it has located the target object in it.
学术侧最近给了一个量化数字:
we show that using C++'s dynamic_cast results in up to a 4× slowdown and that our optimization can recover most of the overhead.
—— PLDI 2025: Link-Time Optimization of Dynamic Casts in C++ Programs
那么本机量出来是多少?答案是:倍率高得多,而且两家的形状完全不同。
7.2 四个场景的读数
| 场景 | MSVC | GCC |
|---|---|---|
| 单态已知(静态类型 = 运行时类型 = 目标) | 0.48 | 0.52 |
depth1:Base* → 链上第 1 级派生 |
10.56(22×) | 44 – 56(中位 50,≈96×) |
depth4:Base* → 链上第 4 级派生 |
12.19(25×) | 4.8 – 5.6(中位 5.2,≈10×) |
cross cast:多继承侧向(ILeft* → IRight*) |
31.89(66×) | 27 – 29(中位 28,≈54×) |
这张表里有三件反直觉的事。
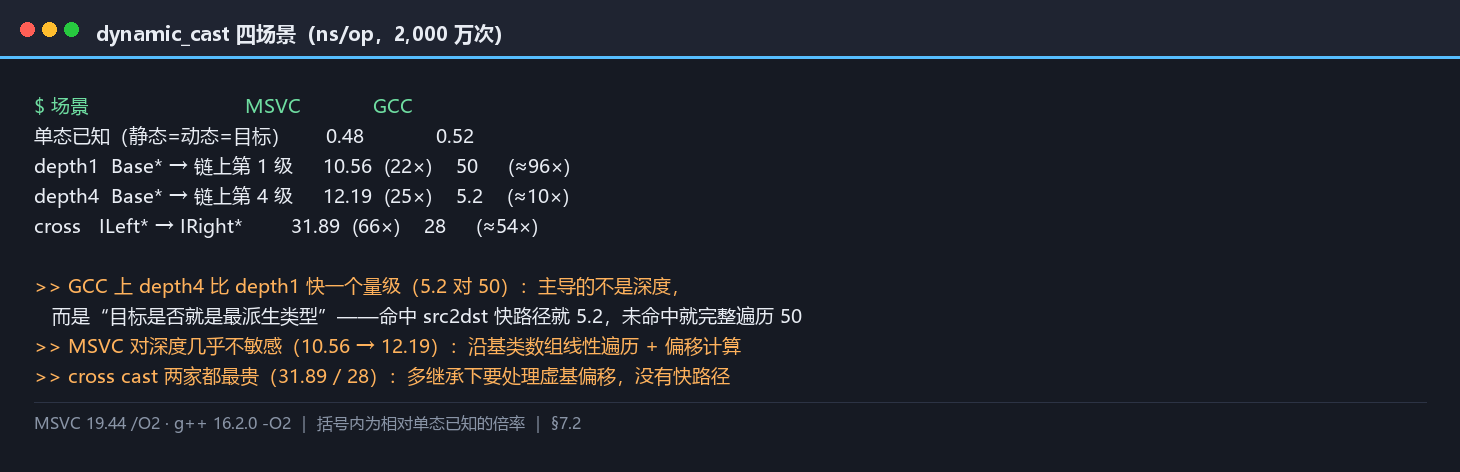
第一件:单态已知几乎免费。 0.48 与 0.52 ns/op,与直调同量级。因为编译器能静态判定"这次转换必然成功",整个 dynamic_cast 被折成了恒等(最多加一次空指针检查)。所以"dynamic_cast 慢"这句话,只在你不知道目标类型时成立。
第二件(最反直觉):GCC 上 depth4 比 depth1 快一个量级。 5.2 ns 对 50 ns。多下一层派生反而更快,这在直觉上说不通——除非你知道实现的形状(§7.3)。
第三件:MSVC 对深度几乎不敏感。 depth1 是 10.56,depth4 是 12.19,差不到 20%。它是线性遍历,每多一层多一点点,而起点本身就有一个固定开销。
⇒ "dynamic_cast 是 O(继承树)` 这句教科书结论没错,但它没告诉你常数项有多大、形状是什么样。 本机读数里,同一份语义在两个工具链上的形状完全不同:一个是平的(MSVC),一个是驼的(GCC 在 depth1 有个峰)。
7.3 为什么 GCC 的 depth1 反而最贵
先来看看原因藏在 __dynamic_cast 的第四个参数里。ABI 给这个函数留了一个静态提示:
void* std::__dynamic_cast(void *sub, std::__class_type_info *src, std::__class_type_info *dst, std::ptrdiff_t obj2sub_offset);obj2sub_offset: a static hint ... special negative values are: -1: no hint; -2: src is not a public base of dst; -3: src is a multiple public base type but never a virtual base type
libstdc++ 的实现里,这个提示有一条快速路径:
// Avoid virtual function call in the simple success case. if (src2dst >= 0 && src2dst == -prefix->whole_object && whole_type == dst_type) return const_cast
(whole_ptr);
翻译成人话:当"目标类型恰好就是最派生类型"时,src2dst 提示命中,__dynamic_cast 直接返回,不进入层级遍历。
于是 depth1 与 depth4 的差别不是"深度",而是"目标是不是最派生类型":
- depth4 那个用例里,运行时对象的最派生类型就链上第 4 级,目标是它自己 → 提示命中,走快路径(5.2 ns);
- depth1 那个用例里,最派生类型是第 4 级,目标是第 1 级 → 提示不命中,进入完整遍历(50 ns)。
这是一处"代码写对了、但量的是别的东西"的陷阱:用例的命名(depth1 / depth4)暗示了"深度",而实际主导读数的是"目标与最派生类型是否同一"。这也解释了为什么 libc++abi 的实现里把这段注释成 "a really hot path that can be further optimized with the src2dst_offset hint":
This is a really hot path that can be further optimized with the
src2dst_offsethint.
7.4 MSVC 那边的形状
MSVC 侧没有这个 hint 参数(接口不同)。它的行为更像一次沿类层级描述符逐项比对:从对象的 COL 出发,读类层级描述符里的基类数组,逐条比对类型描述符,找到匹配就按 PMD 结构(mdisp / pdisp / vdisp)算偏移。
这解释了 MSVC 侧读数为什么是"平的":
| 场景 | MSVC | 说明 |
|---|---|---|
| depth1 | 10.56 | 一次数组遍历 + 偏移计算 |
| depth4 | 12.19 | 多走三层,每层成本很小 |
| cross cast | 31.89 | 多继承下要处理多个子对象与虚基偏移 |
cross cast 是两家都最贵的一档(31.89 / 28 ns),因为多继承下要沿 __vmi_class_type_info 或 MSVC 的虚基描述走,还要处理虚基偏移。这一档没有快路径可走。
7.5 转换失败的路径(本篇的边界)
标准对失败有两种处理:
(9.3) Otherwise, the runtime check fails. ... A failed cast to reference type throws an exception of a type that would match a handler of type
std::bad_cast.
落到两种目标类型上:
- 转到指针类型失败 → 返回
nullptr; - 转到引用类型失败 → 抛
std::bad_cast。
本篇只量了成功的路径。 §7.2 的四个场景全部是"转换成功"的读数;失败路径没有单独计时。这是一处必须标注的边界,原因是失败路径的成本结构完全不同:
- 指针版本失败时,实现往往能提前返回(Itanium 侧对应
src2dst提示的-2值:"src 不是 dst 的公开基类",直接return nullptr,不进入遍历); - 引用版本失败时要构造并抛出一个
bad_cast异常对象——按 §2.3 的读数,那是一次完整throw的价格(千倍量级)。
⇒ 一条可以带走的结论:用 dynamic_cast<T*> 判类型、失败走 nullptr 分支,比用 dynamic_cast<T&> 判类型、失败走 catch (bad_cast) 便宜得多。这条不是风格偏好,它差着三个数量级。
7.6 dynamic_cast 的判据
判据四(dynamic_cast):按这个顺序问,前一条不过就不问下一条。
- 这次转换在编译期能不能定? 能(静态类型就是目标类型,或只做上转型)→ 它免费,随便用。
- 运行时类型是不是恰好就是目标类型? 是 → GCC 走快路径(约 5 ns);但这条不能靠假设,要么实测、要么别赌。
- 目标是不是"最派生类型"以外的类型? 是 → 准备好付 10 至 50 ns 一档的钱(本篇读数范围)。
- 是不是多继承侧向转换? 是 → 约 30 ns 起。
- 这一档在热路径上吗? 在,且上面的数字比你的业务本身大 → 换成 ep08 量过的方案(封闭集合用
variant,或加一层显式的类型标签)。
一句话:dynamic_cast 的真正成本不在"深度"上,在"目标能不能被静态或提示命中"上。 这一点本机读数比教材说得清楚。
八、关掉 RTTI 会怎样
8.1 官方怎么说,实测是多少
说白了,两家的官方文档都承认,关掉 RTTI 会小一些:
/GRincreases the size of the .rdata sections of your image. If your code does not use dynamic_cast or typeid, /GR- may produce a smaller image.—— MSVC
/GR
-fno-rtti— Disable generation of information about every class with virtual functions for use by the C++ run-time type identification features ... If you don't use those parts of the language, you can save some space by using this flag. Note that exception handling uses the same information, but it will generate it as needed.
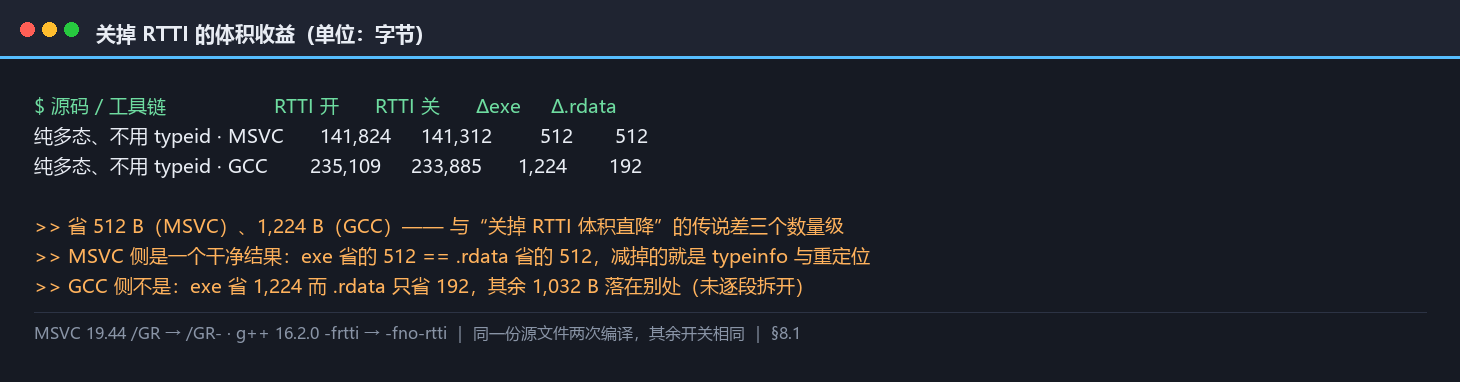
本机读数:
| 源码 | 工具链 | RTTI 开 | RTTI 关 | Δexe | Δ.rdata |
|---|---|---|---|---|---|
| 纯多态类,不用 typeid | MSVC /GR → /GR- |
141,824 / 44,032 | 141,312 / 43,520 | 512 | 512 |
| 同上 | GCC -frtti → -fno-rtti |
235,109 / 4,040 | 233,885 / 3,848 | 1,224 | 192 |
用 typeid + dynamic_cast |
MSVC /GR → /GR- |
204,800 / 50,176 | 204,288 / 49,664 | 512 | 512 |
| 同上 | GCC -fno-rtti |
234,999 | 编译失败 | — | — |
省 512 字节(MSVC)、1,224 字节(GCC)。 这个量级与"关掉 RTTI 体积直降"的传说不在一个世界里。
两个数字都来自同一份源文件的两次编译:一次带 RTTI 开关、一次不带,其余开关完全相同。这样做的目的是把变量压到只剩一个,避免把链接器优化或库版本的差别误记到 RTTI 头上。
8.2 为什么只省这么点:两个原因
原因一:那两个槽是 vtable 的固有部分(§6.1)。 Itanium ABI 的原文说得很清楚,typeinfo 指针 "is always present"。关掉用户侧 RTTI 并没有把这两个槽拿掉——它拿掉的是为每个多态类生成的 typeinfo 对象(.rdata 里那几份),以及 vtable 里指向它的重定位。
原因二:异常那一侧仍要生成它需要的部分。 这就要说 GCC 手册里那句 "it will generate it as needed" 了。异常的类型匹配需要的 typeinfo,是"按需生成"的——你关掉用户侧 RTTI,编译器仍然会为"被 catch 的类型"生成类型信息。所以省下的只有"用户侧那一份"。
8.3 决定性实验:关掉 RTTI 之后,异常还能不能用
这一节是本篇最值得单独拿出来说的一刀,因为它把"异常需要 RTTI"这句半真半假的话劈开了。
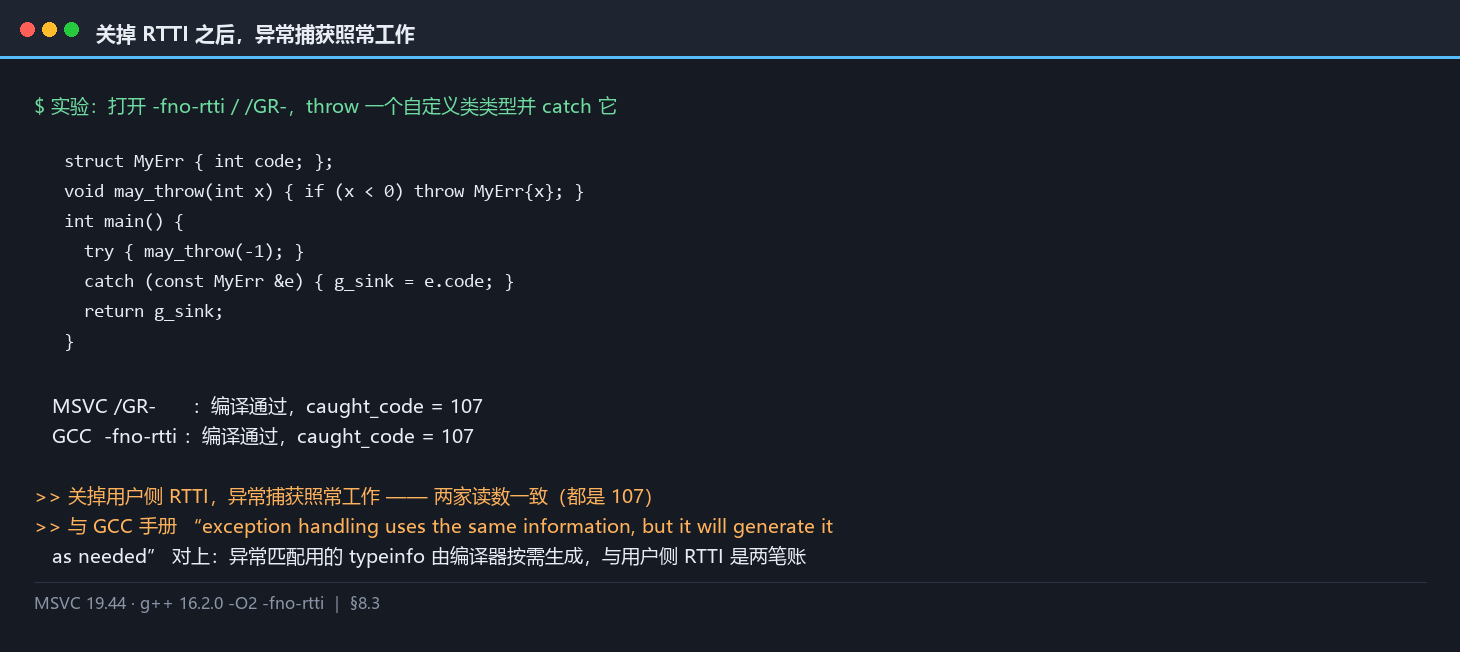
实验:把 -fno-rtti / /GR- 打开,然后 throw 一个自定义类类型的异常并 catch 它。
MSVC /GR- |
GCC -fno-rtti |
|
|---|---|---|
throw 自定义类类型并 catch |
编译通过,caught_code = 107 |
编译通过,caught_code = 107 |
同时用 typeid / dynamic_cast |
仅告警 C4541,仍能编出 | 硬错误:cannot use 'typeid' with '-fno-rtti' |
// 【1】关掉 RTTI 之后,这一段在两家上都能编、都能跑
struct MyErr { int code; };
void may_throw(int x) { if (x < 0) throw MyErr{x}; }
int main() {
  try { may_throw(-1); }
  catch (const MyErr &e) { g_sink = e.code; }   // 两家实测 caught_code = 107
  return g_sink;
}
两家的 caught_code 都是 107。 关掉用户侧 RTTI,异常捕获照常工作。
这条与 GCC 手册那句 "exception handling uses the same information, but it will generate it as needed" 完全对上——"同一份信息"指的是编译器手里的类型信息是同一套;"按需生成"指的是它不会因为你关了 -fno-rtti 就不给异常生成。
⇒ 正确说法是:"异常的类型匹配需要类型信息,但这份信息由编译器按需生成,与你是否开启用户侧 RTTI 无关。" 把"异常需要 RTTI"读成"关 RTTI 会破坏异常",是个流传很广的误读。
8.4 两家的态度不同:警告还是拒绝
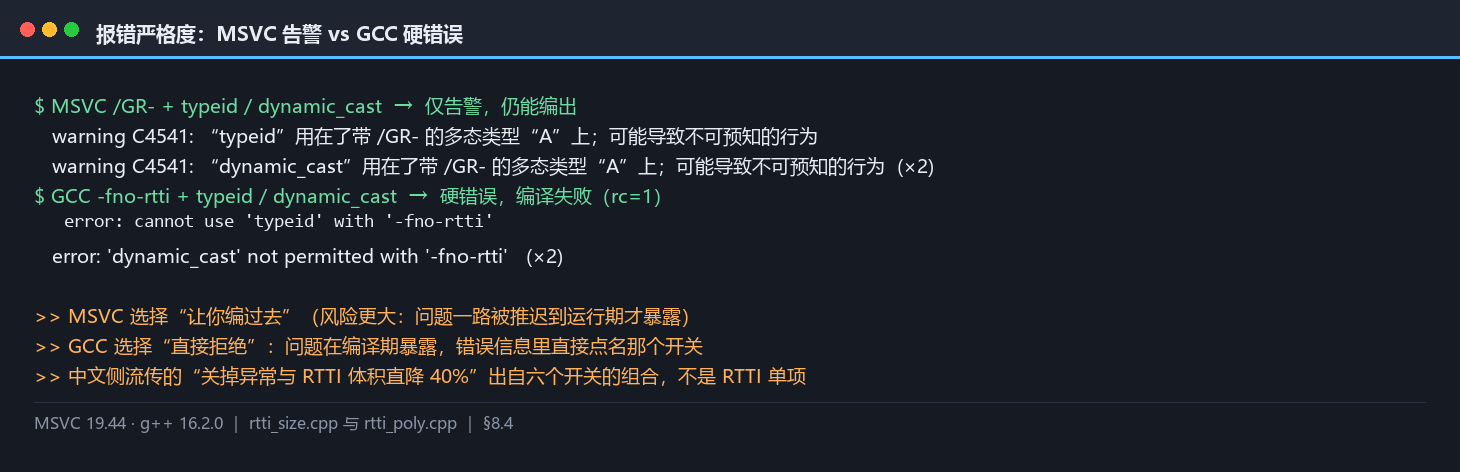
同一个"关掉 RTTI 之后还用 RTTI",两家的处理方式完全不同:
MSVC /GR- + typeid |
GCC -fno-rtti + typeid |
|
|---|---|---|
| 编译结果 | 告警 C4541,仍能编出 | 硬错误,编译失败 |
| 提示信息 | 类型信息不可用,typeid 结果可能不准确 |
cannot use 'typeid' with '-fno-rtti' |
| 风险 | 编出来了,但运行期行为可能不符合预期 | 编不出来,问题在编译期暴露 |
这条差异值得记住:MSVC 选择"让你编过去",GCC 选择"直接拒绝"。在工程上,能编过去的那一侧风险更大——它会一路跑到运行期才出问题。
顺带把中文侧流传最广的那个数字拆一下。"关掉异常与 RTTI,体积直降 40%"出自 MCU 裸机的裁剪清单:
推荐
-fno-exceptions -fno-rtti -fno-threadsafe-statics -ffunction-sections -fdata-sections -fno-unwind-tables
那个 40% 是六个开关合起来的效果,其中 -ffunction-sections -fdata-sections 配 --gc-sections 往往贡献大头。把它记到 RTTI 头上,会得到与本节实测(512 与 1,224 字节)差三个数量级的预期。
还有一个更隐蔽的差别:GCC 的拒绝发生在编译期,错误信息里直接点名了那个开关;MSVC 的告警不会阻断构建,也不会阻止链接,只在构建日志里留下一条提示。工程里真正危险的是后一种。
8.5 .rdata 明细与那 1,032 字节的去处
言归正传,把官方那句"/GR 增大 .rdata"落到本机读数上:
| 工具链 | Δexe | Δ.rdata |
差额落在哪 |
|---|---|---|---|
| MSVC | 512 | 512 | 全部落在 .rdata,与官方表述完全一致 |
| GCC | 1,224 | 192 | 其余 1,032 字节不在 .rdata 里 |
MSVC 侧是一个干净的结果:exe 省的 512 字节与 .rdata 省的 512 字节相等,说明关掉 /GR 减掉的就是那几份 typeinfo 对象与指向它们的重定位,没有连带影响。
GCC 侧不是。 exe 省 1,224 而 .rdata 只省 192,剩下的 1,032 字节落在别处。本篇没有把差额逐段拆开,所以只能说方向(落在代码段与重定位项上),不能说构成。这是一处如实标注的未完成项。
这条对照本身有个用处:官方说"减小 .rdata",但 exe 的总变化可能远大于 .rdata 的变化。 只看 .rdata 会低估收益(GCC 侧低估了 6 倍),只看 exe 会看不出机制(MSVC 侧看不出)。两个一起看才对。
8.6 判据与工程建议
判据五(关不关 RTTI):按这个顺序问。
- 代码里有没有
dynamic_cast或typeid? 有且不能改 → 关不掉(GCC 直接拒绝,MSVC 会告警)。先做 §7 那份评估,再决定要不要改掉它们。 - 关掉能省多少? 本篇实测:单篇级别 512 至 1,224 字节。除非你在做固件、或者依赖链上有成百上千个多态类,否则这一笔不值得为它牺牲可维护性。
- 真正的体积杠杆在哪? 异常那一侧(一个
try块 10.7 KB,§3.3)与模板实例化那一侧(ep04 量过:2,913 与 65,361 字节,22 倍)都比 RTTI 大得多。按量级排,RTTI 排最后。 - 关掉之后一定要跑一遍异常用例。 §8.3 的实测说明异常不会坏,但各家在边界上的严格度不同(§8.4),跑一遍比读文档可靠。
三条可操作的工程建议:
- 给不会再被继承的类写上
final。 这条在 ep08 §9.2 出现过一次(有助于去虚拟化),在 RTTI 这一侧同样成立:final让编译器知道"不需要为多态分发保留这条分支",同时也影响类型层级描述符的规模。 - 别为了省 RTTI 去关 RTTI。 本篇读数说明这笔账很小;真要减体积,先看
try块的数量与模板实例化的数量。 typeid比较可以放心用在热路径上,hash_code()不行。 前者 0.76 ns(一次指针比较),后者 9.5 ns(要遍历名字算哈希),差一个量级。需要做类型键时,优先用type_info的地址或自己维护的枚举,别用hash_code()。
九、选型判据与工程建议
好了,前面八章都在量代价,这一章把它们收成一组可以在设计评审里直接用的判据。
判据按顺序问,不按重要性排——因为前一条的答案会决定后一条要不要问。
六条判据的顺序本身就是结论的一部分:只有前一条不构成瓶颈,后面的权衡才有意义。把它们倒过来问,会得到一组互相矛盾的答案。这也是这一章不按重要性排序的原因。
9.1 六条判据,按顺序问
判据一(时间侧):这段代码会抛异常吗?抛出频率有多高?
- 从不抛出(真正的异常情况)→ 时间账可以忽略(§2.2 实测 2.09 ns/op);
- 百万次一抛 →
2693 ns ÷ 1e6可以忽略; - 千次一抛或更频繁 → 这不是异常用法,是拿异常当控制流,重新设计。
判据二(空间侧):这段代码在体积受限的目标上吗?
- 桌面、服务端 → 一个
try块 10.7 KB 可以忽略; - 固件、插件、内核模块 → 按
try块数量乘一遍(§3.3),再决定哪些try可以合并或挪出。
判据三(noexcept):这个函数会不会抛?
- 不会抛 → 写上。理由是语义承诺,不是字节(§5.2 实测 MSVC 侧它反而更大);
- 移动构造、移动赋值、
swap→ 应当写,为了容器的强异常保证; - 拿不准 → 不写。默认 potentially-throwing 是保守且正确的选择。
判据四(dynamic_cast):这次转换能不能静态定?
- 能(上转型、静态类型就是目标)→ 免费,随便用;
- 不能,但运行时类型恰好是目标 → GCC 走快路径(约 5 ns),但别赌,实测;
- 不能,目标不是最派生类型 → 10 至 50 ns 一档(§7.2);
- 多继承侧向 → 约 30 ns 起;
- 在热路径上且上面的数字比业务本身大 → 换方案(
variant、显式类型标签、把转换挪出循环)。
判据五(typeid):用哪一种用法?
- 比较(
typeid(a) == typeid(b))→ 可以用在热路径上,0.76 ns; name()→ 便宜,但结果依赖实现(修饰名 vs 可读名,两套工具链完全不同);hash_code()→ 不要放进热路径,9.5 ns,比比较贵一个量级;- 需要稳定的类型键 → 用
type_info地址或自己维护的枚举。
判据六(关不关 RTTI):只有前面五条都指向"RTTI 是瓶颈"时才问这一条。
- 省 512 至 1,224 字节(§8.1)。量级上它排在异常与模板实例化之后;
- 关掉之后跑一遍异常用例(§8.3 证明异常不会坏,但各家严格度不同)。
9.2 常见误用清单
把本篇实测能直接支持的五条误用列出来,按代价的来源归类,每条配一句"该怎么做":
| 误用 | 为什么是误用 | 该怎么做 |
|---|---|---|
| 在热循环里用异常表示"正常的分支" | 一次抛出 1,775 至 2,693 ns,是错误码的千倍量级(§2.3) | 正常分支用返回值;异常只留给真正的异常 |
以为不写 noexcept 就"更省" |
MSVC 侧不写反而更小(§5.2,方向与直觉相反) | 按语义写,不按体积写 |
用 dynamic_cast 在循环里逐元素判类型 |
depth1 一档就是 10 至 50 ns(§7.2) | 把转换挪出循环,或改成显式的类型标签 |
用 typeid(...).hash_code() 当类型键 |
9.5 ns,要遍历名字算哈希(§6.5) | 用 type_info 地址或自己的枚举 |
| 为了省体积去关 RTTI | 实测只省 512 至 1,224 字节(§8.1),而一个 try 块就是 10.7 KB |
先看异常表与模板实例化两笔大账 |
9.3 关于"异常 vs 错误码"的流行说法
这个争论常年不停,而本篇的读数能给双方各自划出哪一半站得住:
| 一方的说法 | 本篇能证到什么程度 | 依据 |
|---|---|---|
| "异常是零成本的" | 时间侧站得住(2.09 vs 2.59 ns/op),空间侧站不住(一个 try 块 10.7 KB) |
§2.2 / §3.3 |
| "异常很慢" | 只在抛出频率高时成立;千次一抛就摊薄到 2.693 ns/次 | §2.7 |
| "错误码更快" | 在常态分支上不成立;本篇实测错误码那版反而略慢(2.59 vs 2.09) | §2.2 |
| "错误码体积小" | 成立,因为不引入异常表与 cleanup 通道 | §3 |
| "关掉异常与 RTTI 体积直降 40%" | 把六个开关的合计效果记到了一个开关头上 | §8.4 |
这张表想说明的是:这类争论常常是双方各说半笔账。 支持异常的人说的是时间,反对的人说的是空间;两句都对,两句都不完整。本篇 §0.6 之所以一上来就把"零成本"拆成两笔,就是为了让这个争论有个可对齐的坐标系。
还有一笔账本篇量不了,也一并标注:错误码在"忘记检查返回值"上的代价是正确性问题,不是性能问题。 纳秒尺子量不出它,本篇的读数也不该被用来支持任何一种错误处理风格。
十、收束与下一篇钩子
10.1 全篇读数汇总
下面进入把本篇测出的全部读数集中在一张表里,便于对照与复核。每一档的原始日志都随篇留档在 evidence/ 下,表里任何一个数字都可以逐字回溯到某一行的日志。
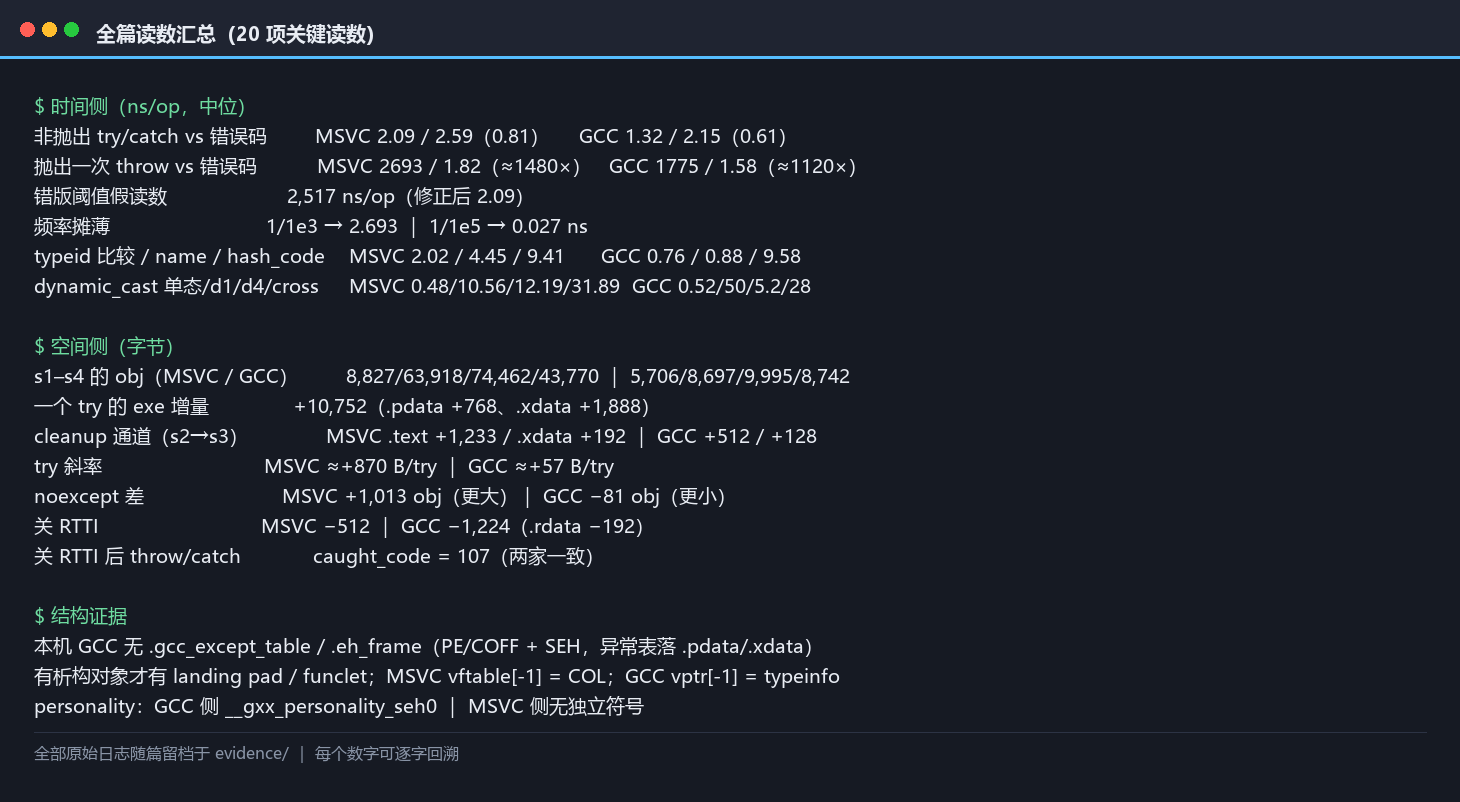
时间侧(ns/op,中位)
                              MSVC 19.44      GCC 16.2
非抛出 try/catch                2.09            1.32
非抛出 返回错误码                2.59            2.15
抛出一次 throw+catch         2,693           1,775
抛出位置 返回错误码              1.82            1.58
倍率                        ≈1,480×         ≈1,120×

空间侧(字节)
一个 try 块(exe)              +10,752         +1,024(.text)/+896(.xdata)
try + 析构对象(.text)          +1,233            +512
try 斜率(.pdata)            +12 / try        恒 36
try 斜率(.xdata)            +30 / try        +6 / try

noexcept(obj 字节)
MSVC  noexcept 更大              +1,013            —
GCC   noexcept 更小                  —             −81

RTTI
关 RTTI 省(exe)                512            1,224
关 RTTI 后异常                  caught_code=107  caught_code=107
dynamic_cast 单态              0.48            0.52
dynamic_cast depth1           10.56           50
dynamic_cast depth4           12.19            5.2
dynamic_cast cross cast       31.89           28
typeid 比较                     2.02            0.76
typeid hash_code                9.41            9.58
10.2 两套工具链的证据形态
本篇的结论之所以敢写"两家方向相反",是因为每一处判断都有不依赖时间的证据兜底。
| 证据形态 | MSVC 侧 | GCC 侧 |
|---|---|---|
| 段尺寸 | dumpbin /headers 与 /section |
objdump -h |
| 符号与重定位 | dumpbin /symbols、/relocations |
objdump -r、nm |
| vtable 槽位 | dumpbin /disasm 看 ??_7Der@@6B@ |
objdump -s -j .rdata$_ZTV3Der |
| 内部表结构 | $cppxdata / $stateUnwindMap / $ip2state |
.xdata 里的 LSDA 区 |
| personality | 无独立符号(由异常表处理器标志指定) | __gxx_personality_seh0(需看重定位表) |
| 计时 | 进程内 steady_clock 三轮中位 |
同左 |
10.3 复现流程
复现这一篇不需要任何私有环境:两条工具链(MSVC 19.44 与 g++ 16.2,都要 C++17)、四个变体的源文件、以及 dumpbin / objdump。全部原始日志与转储随篇留档于 evidence/。
一个提醒:objdump 在 PE/COFF 目标上看不到 personality 符号(它在重定位项里),要看重定位表;MSVC 侧看不到独立的 personality 符号(没有这个名字)。
10.4 自检清单
- [ ] 先确认这块代码会不会抛(不抛,时间账可忽略)
- [ ] 再确认抛出频率(千次一抛就别用异常当控制流)
- [ ] 体积受限时按 try 块数量乘一遍(一个 try 约 10.7 KB)
- [ ] 把带析构的对象挪出
try作用域(省掉 cleanup 通道) - [ ]
noexcept按语义写,不按体积写(MSVC 侧它反而更大) - [ ]
dynamic_cast先问能不能静态定(能就免费) - [ ] 循环里的
dynamic_cast挪出去或换方案 - [ ]
typeid用比较、别用hash_code() - [ ] 关 RTTI 之前先算异常表与模板实例化两笔大账
- [ ] 关 RTTI 之后跑一遍异常用例(两家严格度不同)
- [ ] 全部原始输出留档(否则前面十条都只是"相信")
10.5 与系列其他篇目的交叉点
这篇不是孤立的,它与系列里四篇有直接接口:
- 与 ep01《对象布局、对齐与 padding》:本篇 §6 的 vtable 槽位是对象布局的一部分。
Guard这个带析构的局部对象为什么能撑起一条 cleanup 通道,答案在 ep01 的"析构函数使类型不再 trivial"那一节。 - 与 ep04《编译期账本》:异常表的体积账与模板实例化的体积账是同一类。ep04 量过 2,913 与 65,361 字节(22 倍),本篇量过 10,752 字节(一个 try)——两笔账放在一起看,才知道减体积该从哪下手。
- 与 ep06《名字与符号》:本篇 §6.4 的
_ZTI3Der与??_R0?AUDer@@@8正是 ep06"两套修饰文法毫无共同点"那条结论在 RTTI 上的落点。 - 与 ep08《分发的代价》:两篇的靶子互为补充。ep08 量的是分发的代价(
variant/ 虚函数 / 类型擦除),本篇量的是类型信息本身的代价。§6.5 那个对比(typeid比较 0.76 ns vsvariant单态访问 0.766 ns)说明:在能静态定类型的时候,两者的成本几乎一样;差别出现在不能定的时候。
10.6 一条可以搬走的方法
把本篇的做法抽象成三步:
- 先把宣传语拆成可分别计量的两半。"零成本"拆成时间侧与空间侧,"RTTI 开销"拆成 typeinfo 的体积与
dynamic_cast的时间——拆不开的说法就没法验。 - 让对照组只差一个变量,并且那个变量能被数出来(有没有
try、有没有析构对象、N等于几、目标是不是最派生类型)。 - 同时取时间与结构两类证据,冲突时以结构为准。 本篇 §7.3 那个例子最典型:读数(5.2 vs 50 ns)先出来,反直觉;结构证据(快路径的源码)后到位,才把"深度"这个词换成"目标是不是最派生类型"。
这三步与 ep07、ep08 的方法论是同一条。这一篇多了一种结构证据:段尺寸表。当你能把"一个语法结构值多少字节"直接量出来时,"开销大不大"这类争论就不再需要靠感觉。
10.7 本篇的六处反直觉
把这一篇的六处"与直觉相反"集中一次,方便复核与引用:
| # | 反直觉 | 读数 | 小节 |
|---|---|---|---|
| 1 | 不抛异常时,try/catch 不比错误码慢 |
2.09 vs 2.59 ns/op(比值 0.81) | §2.2 |
| 2 | 抛出一次不是"与函数调用相当",而是千倍量级 | 2,693 vs 1.82 ns/op(≈1,480×) | §2.3 |
| 3 | noexcept 在 MSVC 上更大,在 GCC 上更小 |
+1,013 vs −81 字节(obj) | §5.2 |
| 4 | 本机 GCC(PE/COFF)没有 .gcc_except_table 与 .eh_frame |
段表里两者皆无,走 .pdata/.xdata |
§4.2 |
| 5 | GCC 上 dynamic_cast 转到更深的派生类反而快一个量级 |
depth4 5.2 对 depth1 50 ns | §7.2 |
| 6 | 关掉 RTTI 之后,异常捕获照常工作 | 两家 caught_code 都是 107 |
§8.3 |
六处里第 3、5 两处是"两家方向相反",第 4、6 两处是"流传的说法与本机不符"。这四处的共同处理方式都是:如实记录,不取一家结论当通例,也不回避与文档的出入。
10.8 资源清单
- 规范与标准:Itanium C++ ABI(异常处理章、RTTI 章)|C++ working draft([except.spec]、[expr.dynamic.cast]、[expr.typeid])
- 厂商文档:MSVC(
/EH、x64 EH、/GR)|GCC(Code-Gen Options、C++ Dialect Options)|LLVM Exception Handling - 委员会文件:P3313R0(noexcept 与异常元数据的实测)|P0709R4(静态异常与"零开销"的澄清)
- 实现源码:libstdc++
dyncast.cc|libc++abiprivate_typeinfo.cpp - 逆向与实测:OpenRCE: Reversing MSVC Part II|RTTI Internals in MSVC|PLDI 2025: LTO of Dynamic Casts
- 本篇证据:四个变体源文件 + 两套工具链全部原始日志、段尺寸、反汇编与读数,见本篇目录
evidence/
10.9 下一篇:内存序与原子
这一篇算的是"语言替你留下的痕迹"里异常与类型信息这两笔。下一篇算第三笔,也是最少被量化的一笔:
seq_cst 在 x86 上免费吗?
std::atomic 的默认内存序是 seq_cst(顺序一致),它承诺的是全序。这个承诺在 x86 上需要多少条指令、在 ARM 上需要多少——以及为什么"x86 是强内存模型"这句话只对了一半。取证的难点在于:这一篇的核心证据(lock 前缀、mfence、以及编译屏障前后的指令重排)全都落在反汇编里,而"哪一半免费"的边界要靠编译器在哪种目标上生成哪种指令来定。
以上。希望能对大家有所帮助。下一篇见。