站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:一个 effect 从源码到画面,中间过了几道
好了,上一篇我们把"这门语言是什么、谁在编"讲完了:它借的是 DX9 年代 HLSL 的语法底子,多出来的那几类东西逼着它自带编译器,而编译产物是一串能被图形 API 直接吃的字节码。
于是问题自然就来了:这串字节码交出去之后,谁在每帧把它跑起来?
关于这一层,中文技术圈最流行的一句话是"ReShade 就是一个后处理链,按顺序把效果跑一遍"。这句话不算错,但它把三件最难的事一起糊过去了:"按顺序"里的那个顺序是谁定的、一个 pass 写出来的东西怎么变成下一个 pass 的输入、效果里那些"当前时间""鼠标位置""画面深度"到底是谁在什么时候塞进去的。
说白了,本篇要回答的就是这三件事,而答案比"按依赖图执行"这种直觉要朴素得多,也硬得多:
- 顺序从哪来——运行时的执行顺序只有两个来源,没有依赖图。这一条是整篇最反直觉的地方,也是必须用官方源码逐字证明的地方(第二章)。
- 状态怎么落到 API 上——一个 pass 里写的渲染状态,在创建期就被折进了一个不可分割的管线对象,运行期只剩下几次绑定与一次发射(第三章)。
- 数据是谁填的——效果能读到的十六个运行时数据源里,十五个由 core 按帧填,第十六个不在 core(第四章)。
第五章讲预设与性能模式,那里藏着"为什么开了性能模式之后变量就调不动了"的答案;第六章讲 GPU 计时的粒度;第七章把本机的读数摊开——69 个效果源、70 个 technique、160 个 pass 到底长什么样。
上面这张边界图是这一篇的地图:十一篇各占一层,本篇只占中间那一层。左边两篇讲"怎么进来、用什么写",本篇讲"跑起来是什么样",右边几篇才轮到跨 API、add-on、深度与生态。
读这张图的正确姿势是从下往上看:先看最底下那句红线——本篇不涉及效果算法本身(Bloom 的核、色调映射的曲线都归后处理篇)、不涉及 add-on 的 C++ 回调面(第六篇)、不涉及跨 API 的差异(第五篇)。把边界先钉死,后面五章才敢往深里钻;不钉死的话,写到"深度"就会滑进第七篇,写到"顺序"就会滑进第五篇。
0.1 全系列目录总览(十一篇)
依然是惯例,先给系列地图。本系列沿"一个外部注入的运行时"从入口一路拆到效果生态,十一篇的落点如下(本篇即第四行):
| # | 篇目 | 这一篇要回答的那一问 |
|---|---|---|
| 一 | 总论:注入式后处理与管线内后处理的边界 | 它到底动的是哪一段?和引擎自带的后处理差在哪? |
| 二 | 代理 DLL、加载顺序与导出表挂钩 | 它凭什么进得来?进来之后怎么把调用接过去? |
| 三 | ReShade FX:语言血统、独立编译器与纹理语义 | 效果是拿什么写的?编译器为什么能单独拿出去用? |
| 四 | 本篇:effect runtime——technique / pass 图、render state 与运行时数据源 | 一个 effect 从源码到画面,中间过了几道? |
| 五 | 跨 API 抽象:D3D9/10/11/12、OpenGL、Vulkan 的差异与统一 | 同一套东西怎么盖住六种图形 API? |
| 六 | Add-on API:事件模型、跨 API 资源交换与两种构建的分野 | 想在运行时插手更深的事,接口长什么样? |
| 七 | 深度缓冲的工程学:自动关闭、MSAA、UI 缺失与子矩形错位 | 为什么深度类效果时灵时不灵? |
| 八 | 效果生态与许可地图:同一份清单里的 MIT 与"禁止再分发" | 那些效果到底能不能用、能不能转? |
| 九 | 自跑一:注入本地 D3D11 demo——逐效果前后对比 | 真跑一遍是什么样子? |
| 十 | 自跑二:效果栈与帧耗账,外加自写一个小 .fx | 代价是多少?自己写一个要几步? |
| 十一 | 合规与工程取舍的合集:把十一篇的账并到一处 | 这条路线值不值得用、边界在哪? |
阅读路径:只想知道"效果为什么排在那个位置"的朋友,读第零章与第二章就够;要搞明白"一个 pass 的状态到底变成哪几次 API 调用"的,第三、四章是主线;现在就在调预设、想知道"性能模式为什么把变量锁住"的,直接跳第五章。
0.2 本篇的三层证据
好了,按本站惯例把证据分层,免得把不同来源的话混着说:
- 官方源码与官方文档(带文件路径与版本口径):
source/runtime.cpp、runtime_internal.hpp、runtime_api.cpp、runtime_manager.cpp、state_block.*、source/dxgi/dxgi_swapchain.cpp、examples/09-depth/generic_depth_addon.cpp,以及官网的 add-on 文档、ini 设置说明与各版本发布说明。凡引原话一律给英文逐字; - 本机实测(只读):本机
E:\GameData\ReShade\Shaders\Effects\下 69 个.fx与Presets\下 12 个.ini,用自写的探针脚本离线解析出结构读数(效果数、技术数、pass 数与分布、pass 键写法、运行时数据源用法)。一个文件都不改动; - 既有结论:只在前面三篇已经核过的位置上引用(例如"官方明令不得分发二进制与着色器文件"),不重复取证。
0.3 本篇不涉及什么(边界声明)
OK,先把边界钉在前面。第一,不讲后处理算法本身。 Bloom、色调映射、环境光遮蔽这些算法的实现归《实时渲染管线探析》第三篇。本篇只在第二章借它们的中间产物说明"pass 链与中间渲染目标"——借的是形状,不是算法。
第二,不讲 add-on 的 C++ 接口细节。 第四章会引出官方那个深度 add-on,但只讲它做了什么(把深度绑上去、把一个布尔量改掉),不讲它的回调注册、事件模型与构建方式——那是第六篇。
第三,不讲跨 API 差异。 第三章会出现 bind_pipeline、begin_render_pass 这类抽象调用,它们背后的统一层是第五篇;本篇只把它当作"运行期真正发出去的命令"来用,不展开它在六种 API 上各自翻译成什么。
第四,不讲深度工程。 第四章会讲"深度缓冲是一张可以被采样的纹理",但"为什么有些游戏拿不到深度、MSAA 下深度为什么错位、UI 为什么会挡住深度"全是第七篇。
第五,不提供任何官方二进制与着色器文件的再分发。 官方明文写着 "Do NOT share the binaries or shader files. Link users to this website instead.",所以本篇的效果源码只截官方仓库与自己量的读数,第三方效果一律只说位置、不给内容。
0.4 四条读法约定(沿用本系列体例)
- 官方文字优先,社区转述只作线索。 本篇有两处引用了官方论坛的回复,其中一处作者是社区里的 Ganossa、不是项目作者 crosire——引用时会明确标出作者,不把社区作者的话安到 crosire 头上。第三处很关键:本轮检索没有取到 crosire 关于"technique 执行顺序"的逐字长篇回复,所以正文不写"作者说过",只写能核到出处的部分。
- 数字一律带来源。 本篇的量化结论分两类:一类来自官方源码的逐字(枚举有几项、滑窗有多长),一类来自本机探针的实测(69 个效果、160 个 pass、十六个数据源用了九个)。
- 参数口径一句话:所有本机读数都来自同一台机器(Windows 11 build 26200、RTX 3060 Laptop、ReShade 6.7.3)上的一份只读副本;探针脚本不改动任何文件。
- 落空照实写。 本机没能拿到的读数(比如 GPU 计时那一栏的具体毫秒数——它只在叠加层界面里显示,而本机跑 demo 时无法交互)会明确写"测不了",不用估算值凑。
- 关键术语首次出现写双语。 沿用本站体例,关键术语第一次出现时写成
中文(English)——本篇会反复用到的三个是渲染目标(render target)、描述符表(descriptor table)、稳定排序(stable sort);之后为行文简洁只用中文。
一、一次 present 里发生了什么
1.1 先找这层代码住在哪
言归正传,要讲执行,先得找到执行者在哪个文件里。这里有个很容易踩的坑:很多人以为有一个叫 effect_runtime.cpp 的文件——毕竟官网文档里那个类就叫 effect_runtime。
本机实测的结论是:没有这个文件。effect runtime 的实现全在 source/runtime* 这一族里,而最重要的那个文件叫 runtime.cpp,本机取到的版本约 4504 行。
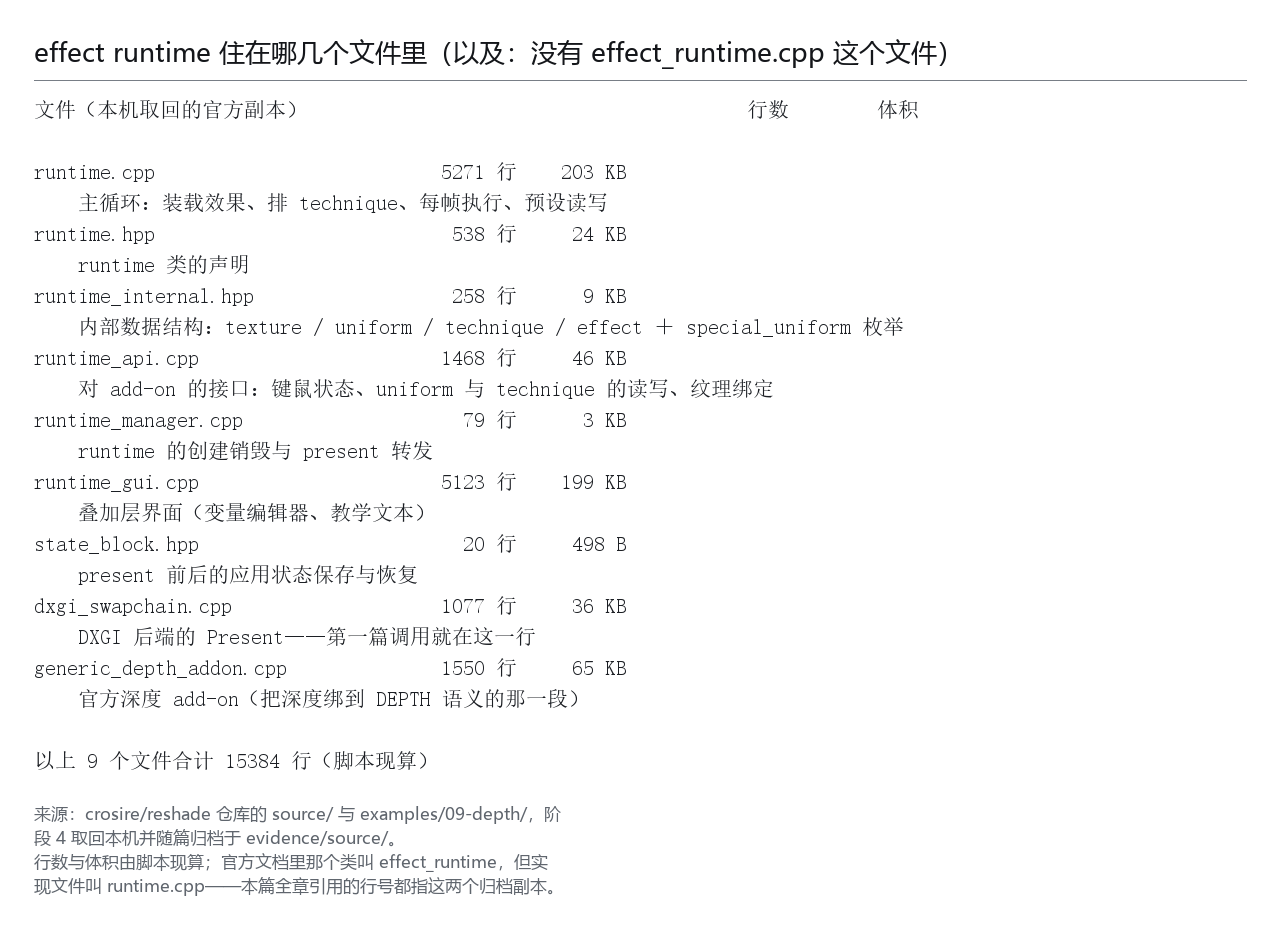
上面这张面板把这族文件列了出来:runtime.cpp 是躯干(装载效果、排 technique、on_present()/update_effects()/render_effects()/render_technique() 都在这里),runtime.hpp 是类声明,runtime_internal.hpp 是内部数据结构(纹理、uniform、technique、effect,以及本篇要反复引用的那个 special_uniform 枚举),runtime_api.cpp 是对外的 add-on 接口,runtime_manager.cpp 管创建销毁与 present 转发,state_block.* 负责 present 前后的状态保存与恢复。
这张表有个用法:后面每讲一处机制,我都会给出它在哪一族的哪个文件里。能给到文件一级,是"我核过"和"我记得"的分界线——凡是只能给到"官方文档里说过"的,我都会明说。
1.2 一次 present 的四步
先来看看时机。那这一层是什么时候被调到的?答案是:在游戏把画面交出去的那一刹那。DXGI 后端在 Present 的第一行就把调用接下来(source/dxgi/dxgi_swapchain.cpp):
HRESULT STDMETHODCALLTYPE DXGISwapChain::Present(UINT SyncInterval, UINT Flags){ on_present(Flags); … reshade::present_effect_runtime(_impl);
接住之后,on_present() 里按顺序做四件事:
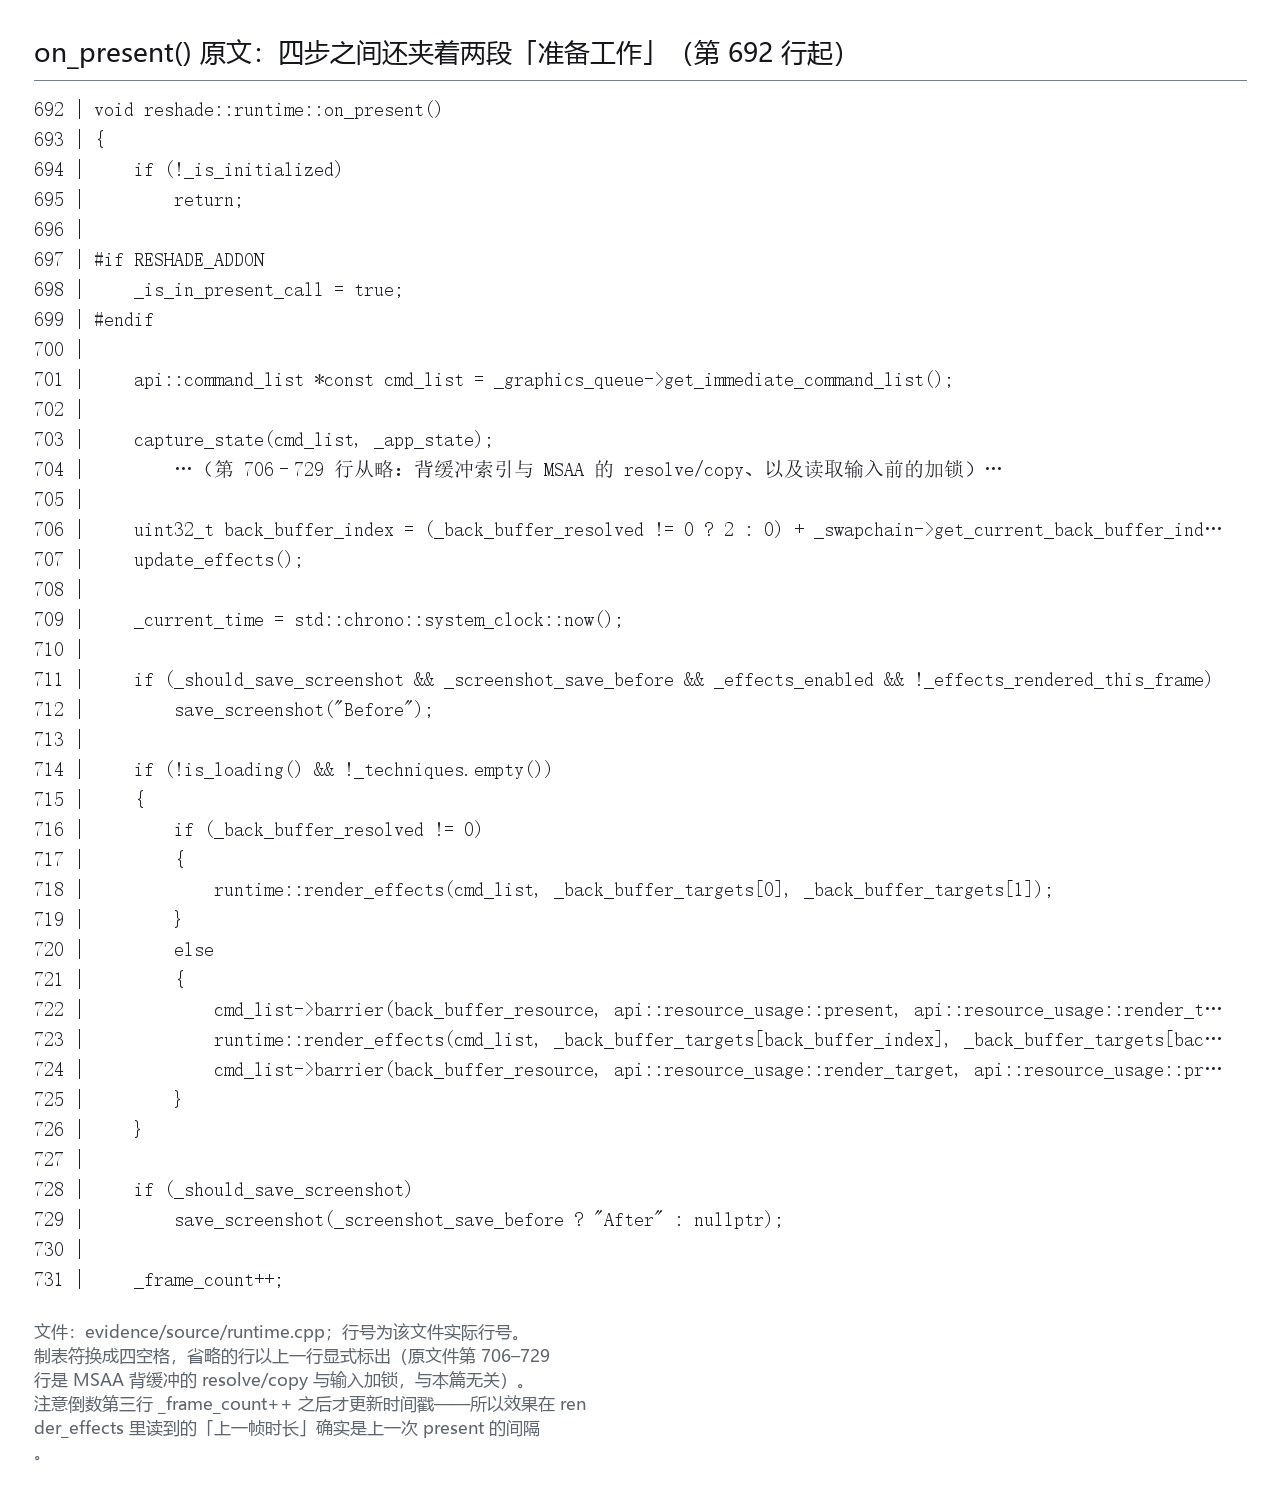
面板上的四行就是全部骨架:先取图形队列的立即命令列表,再捕获应用状态,再更新效果,再渲染效果,最后把帧号加一。原文是:
api::command_list *const cmd_list = _graphics_queue->get_immediate_command_list();capture_state(cmd_list, _app_state);update_effects();if (!is_loading() && !_techniques.empty())runtime::render_effects(cmd_list, _back_buffer_targets[back_buffer_index], _back_buffer_targets[back_buffer_index + 1]);…_frame_count++;
这里有两处值得停下来看:
capture_state在渲染效果之前执行,它保存的是应用自己的图形状态(管线、渲染目标、视口、描述符表等等)。游戏在 present 那一刻的各种状态会被完整记下来,效果跑完之后再原样装回去。这是"注入式后处理为什么能对游戏透明"的物理基础——不存不恢复,游戏下一帧就会因为状态被改而画出奇怪的东西;is_loading()那个判断说明装载中不渲染。效果的编译与创建发生在别处,present 这一路只在"装载完了且确实有 technique"时才往下走。
上面这张调用链图把从 Present 到 render_technique 的路画了出来。请留意这条链的一个重要特征:中间没有调度器。没有"任务队列"、没有"依赖解析"、没有"异步提交",就是一层一层往下调,直到把 pass 发出去。这个特征解释了本篇后面所有的"为什么":为什么顺序只能靠一份表、为什么一个 pass 写坏了会直接影响下一个 pass、为什么"少一个 pass 就少一份开销"这句话是真的。
1.3 这条链在整条管线的什么位置
为了不让"present 之后才开始跑效果"这句话显得突兀,得先给个坐标。
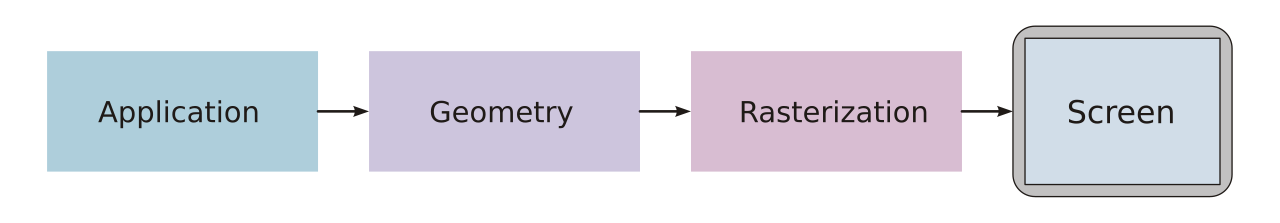
这张图是 Commons 上一张三段式的管线示意(CC0,本篇交付的是 1280×223 的 PNG 渲染):应用段(提交绘制命令)→ 几何段(顶点变换、图元装配)→ 光栅化段(像素着色、写入目标)。图上的文字只有四个英文词:Screen、Application、Geometry、Rasterization。
ReShade 这一类注入式后处理的落点在图的最右端:它接在"游戏画完这一帧、准备把画面交给交换链"的那一刻,在画面真正上屏之前插进去一次自己的渲染。它插的不是管线的某一段,而是"这一帧画完了"这个时刻。
这也解释了效果本身的形状:后处理的 pass 几乎不需要几何。它们多数是"画一个覆盖全屏的三角形或四边形,然后每个像素做一次着色"——所以在效果源里,那些 pass 的顶点数是固定的、像素着色器是全屏的。
1.4 update_effects 与 render_effects 的分工
说白了,上一节那四步里中间两步的名字很像,很容易被当成同一件事:update_effects() 与 render_effects()。这里把它们的边界划清,因为它直接决定了"什么时候能改效果、什么时候改不动"。
update_effects() 管的是"装载这件事的推进"——效果要编译、要创建管线与资源、要处理预处理器定义的变化,这些都不是一帧能做完的事,所以它被拆出来,每帧往前推一点。它的存在解释了一个日常现象:改了一个效果或改了预处理器定义之后,画面不会立刻变,而是"下一次装载走完"才变。界面上那句"重新加载效果"做的就是催这一步。
render_effects() 管的是"这一帧的执行"——先把十六个运行时数据源按当前帧的值填一遍,再按 _technique_sorting 逐个 technique 往下走。第四章要讲的那段 switch 就在它的最前面。
这两步的顺序不能颠倒:效果没装载完就渲染,会拿到空的效果列表;数据源没填就执行,效果这一帧读到的就是上一帧甚至初值。所以 on_present 里那四步不是可以随便排的清单,而是有依赖的——捕获状态要在最前(否则恢复的内容不干净),装载推进要在渲染前,数据填充要在 technique 循环前,帧号自增要在最后。
回看第 1.2 节那张调用链图会更清楚:从 Present 到 render_technique 中间确实没有调度层,但有两处"准备工作"——一处是状态捕获,一处是装载推进。它们是"注入式"特有的成本:内置后处理的引擎不需要捕获应用状态(因为它就是应用的一部分),也不需要每帧推进装载(引擎在关卡加载时就编译完了)。第一章到这里就把"执行者是谁、在什么时候跑"讲完了,接下来第二章进入正题:它凭什么按那个顺序跑。
二、顺序从哪来:没有依赖图
2.1 两个来源,两条规则
好了,先说结论。很多人(包括笔者最初)会默认:既然后处理的效果之间有先后关系(先环境光遮蔽、再泛光、最后色调映射),那运行时里应该有一张依赖图,或者至少有一套拓扑排序。
实测结论是:没有。 顺序只有一个来源和一个覆盖机制:
- effect 文件内的声明顺序——同一个效果文件里写了几个 technique,它们就按写的先后排;
- 预设里的
TechniqueSorting——预设可以列一份顺序表,运行时用一次稳定排序把声明顺序覆盖掉;没被列进表里的 technique 则按名字排在后面。
上面这张图把这两条规则并排画了出来,并在下方标了那句最要紧的话:没有拓扑排序、没有依赖图。请把这张图和上一章的调用链图连起来看——正是因为没有调度层,"顺序"这件事才只能落在"一份表"上。如果中间有一个调度器,它自然可以算依赖;既然中间没有,那么谁想在运行时决定顺序,唯一的办法就是把那份表改掉。
这份表就是预设里那一行 TechniqueSorting 的全部意义。 一句话说清:在 ReShade 里,调整效果的先后,不是写代码,而是改一行配置。
2.2 排序代码里的三行注释
OK,上面那句话不是从文档里读来的,是从函数体里读来的。runtime.cpp 装载完效果之后,有一次重排:
// Reorder techniquesstd::stable_sort(_technique_sorting.begin(), _technique_sorting.end(), …// Keep the declaration order within an effect fileif (lhs.effect_index == rhs.effect_index) return false;// Sort the remaining techniques alphabetically using their label or name
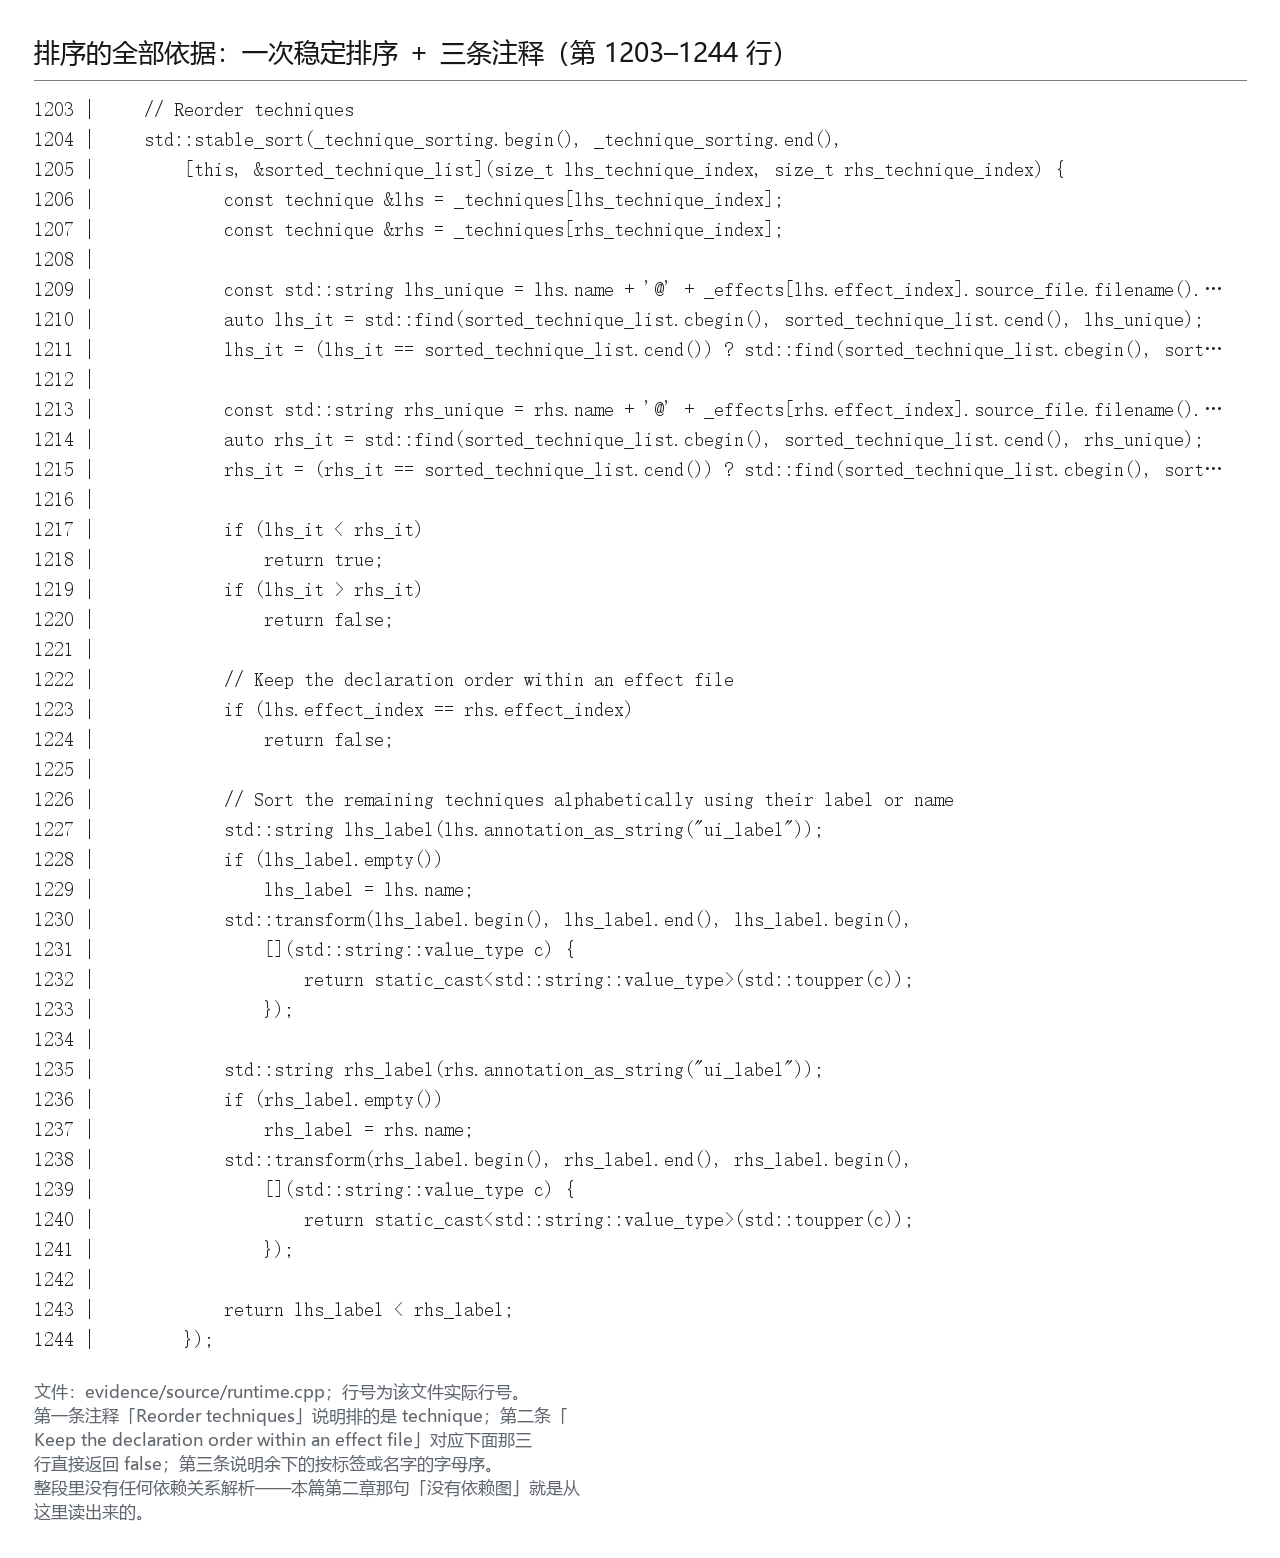
面板上那三行注释值得逐字读一遍,因为它们把规则讲得比任何文档都清楚:
- "Reorder techniques"——这是在给 technique 排序,不是给 pass、不是给 effect;
- "Keep the declaration order within an effect file"——同一个效果文件内,声明顺序保留。下面那行
if (lhs.effect_index == rhs.effect_index) return false;就是这个语义:同一个文件里的两个 technique 比较时直接返回"不比",稳定排序于是保持原序; - "Sort the remaining techniques alphabetically using their label or name"——预设没覆盖到的、跨文件的那些,按标签或名字字母序。
这三行同时给出了一个很容易忽略的推论:既然排序用 std::stable_sort,"预设覆盖"就只是把被列出的那些挪到指定位置,没被列出的仍然稳定地待在后面。所以预设里 TechniqueSorting 通常比 Techniques 长——因为排序表要覆盖全部,而启用表只关心开着的那些。下一节的实文印证了这条推论。
2.3 本机预设的实文:一个可验证的推论
OK,上面那条推论可以直接在本机验。
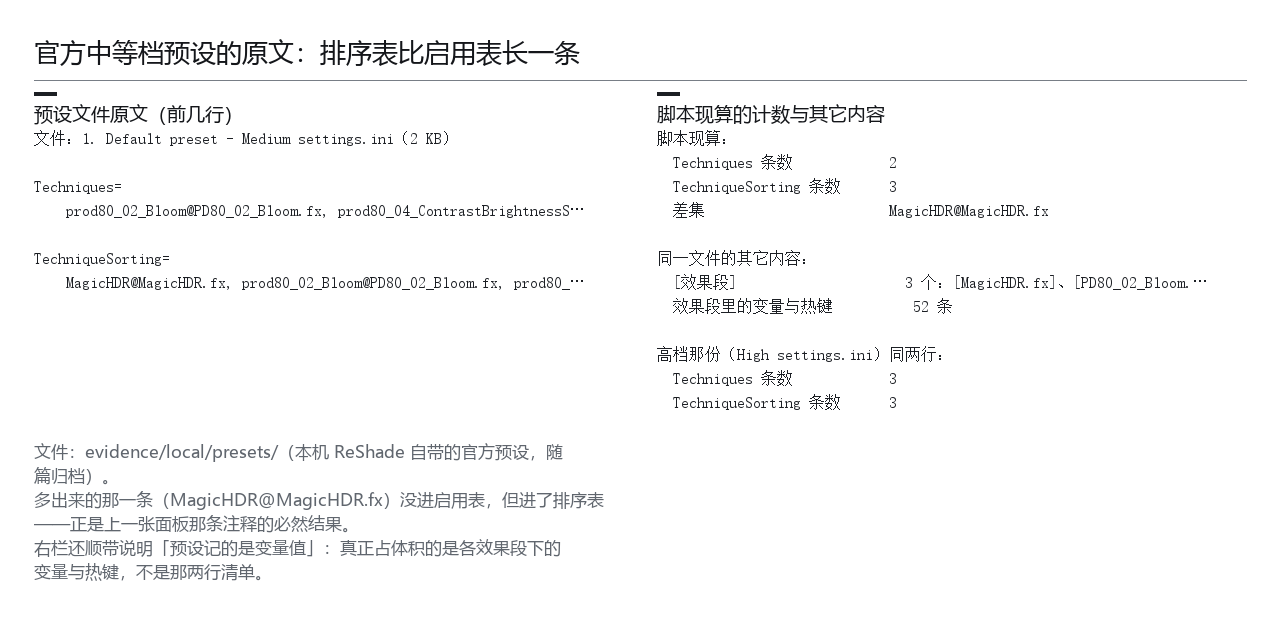
上面这张面板是本机 Presets\ 目录里那份官方中等档预设的原文。读法是数两行:Techniques= 后面列了 2 个,TechniqueSorting= 后面列了 3 个。
多出来的那一个就是"没启用但参与了排序"的 technique。 这不是巧合,而是上一节那三行注释的必然结果——排序表要覆盖全部 technique 的先后,启用表只放这次要跑的那几个。本机另一份社区大预设(32,835 字节)里同样是这个包含关系。
换个角度说:Techniques 决定"跑不跑",TechniqueSorting 决定"按什么次序跑"。 两份清单各管一件事,这是理解预设界面的关键——界面里那些能拖动排序却又没打勾的项目,存在的理由就在这里。
2.4 那 pass 之间的"依赖"怎么办
说白了,顺序讲完了,但马上会遇到第二个问题:一个 technique 内部的多个 pass,显然是有先后的(第一个 pass 的结果要给第二个用),这难道不算依赖吗?
算,但它不是被"解析"出来的,而是被"顺序"隐式保证的。runtime.cpp 里执行一个 technique 时,pass 是严格按下标走的:
for (size_t pass_index = 0; pass_index < tech.permutations[permutation_index].passes.size(); ++pass_index)
pass 从 0 号开始按数组顺序执行,没有任何前置判断。那"第一个 pass 的结果给第二个用"是怎么办到的?靠共享纹理——前一个 pass 把结果写进某个渲染目标,后一个 pass 把那张目标声明为输入纹理;同时,中间会有一次资源状态转换(第三章会讲到那行 barrier),避免"同一张纹理既被读又被写"的未定义行为。
顺带说清一处社区里常见的困惑:同一个 pass 里既读背缓冲又写背缓冲是不行的。官方论坛有一个专门的排障帖就是问这个,结论就是冲突。这不是 ReShade 的限制,而是"读写同一张纹理"这件事本身在任何图形 API 上都不成立。
2.5 借一张图看"pass 链"长什么样
抽象讲了这么多,该给实物了。下面四张图不是 ReShade 的效果,而是同一个多遍技术的四个阶段(Commons,CC BY-SA 4.0),用来把"每个 pass 写一张自己的目标、下一个 pass 读它"这件事变成看得见的东西。
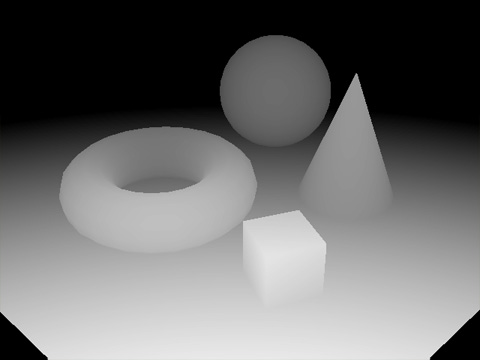
第一张是深度遍的作者机产物:整个场景只留下深度信息。
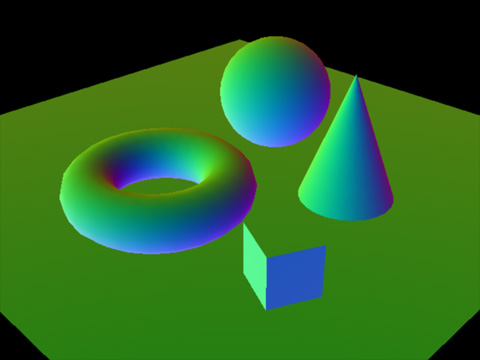
第二张是法线遍:同一帧,但写出去的是每个像素的法线朝向。请注意它和第一张是同一帧的两种不同输出——这就是"每个 pass 有自己的一张渲染目标"的字面意思。
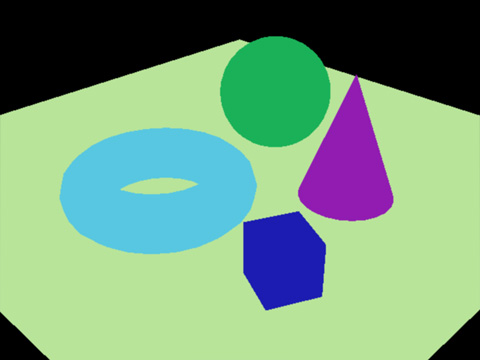
第三张是颜色遍:基础颜色。到这里可以回看一眼第二章开头那句疑问——为什么一个技术会有这么多遍? 因为每一遍产出的东西都要留给后面的遍去用,而这个"留给"必须落到一张具体的纹理上。
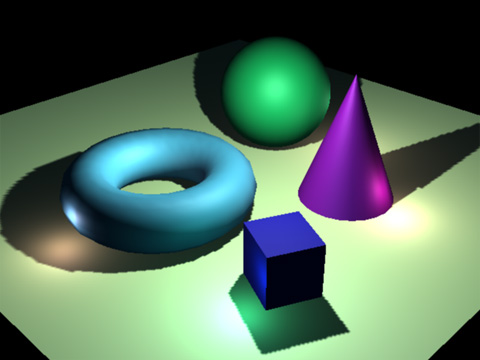
第四张是合成结果。把这四张连起来读,就是一句大白话:中间目标是为了让后面的遍能读到前面的结果,而它们之间的先后,靠的是一份顺序表而不是一张依赖图。
这里要按第五篇的边界声明把话说清:这四张图来自延迟着色(一种把着色推迟到几何遍之后的思路),本篇借的只是它的形状——多遍、中间目标、串成一条链。延迟着色的算法本身不在这里讲,ReShade 的效果也不必用延迟着色的思路来写。把它当"多遍技术长什么样"的通用示意即可。
2.6 为什么"没有依赖图"反而是合理的
OK,讲到这里多数人会有一个自然的反应:既然效果之间明明有先后关系,为什么不干脆做一张依赖图?这一节试着把这个"为什么"讲清楚,因为它能解释很多设计选择。
第一,这条链上没有"语义未知"的东西。 依赖图的价值在于"我不知道谁该先跑,所以让系统算"。而后处理链上每一环的输入输出都是同一个形状——一张全屏的图进、一张全屏的图出。既然形状一样,那么"谁先谁后"就不是正确性问题,而是效果问题:先泛光再色调映射和反过来,两次都能跑完,只是画面不同。系统算不出"哪个更好看",因为它根本没有评判依据。
第二,顺序的"正确"由写效果的人决定,而不是由数据流决定。 一位在官方论坛上答过这个问题的作者把这件事说得很直接(作者是社区成员,不是项目作者):
"A shader is part of a technique and a technique is the group of one or more shader in the pipeline. While you could order a shader within its own technique, global ordering can only be done between techniques." —— Correct Image Pipeline
这句话点明了"可排序单位"就是 technique,也顺带解释了为什么本篇第二章一直在说 technique 的排序、而不说 pass 的排序——pass 的先后是技术内部的实现细节,只有 technique 的先后才是用户能调的那一层。
第三,依赖图会带来它自己的成本。 一张要每帧解析的依赖图意味着运行时要建图、要检测环、要处理"用户手动指定顺序"与"依赖推导顺序"冲突时的优先级。而注入式运行时最怕的就是"在别人的帧里做太多事"——它借用的是游戏的帧时间,任何额外开销都直接体现为掉帧。用一份装载期就排好、运行期只需顺序遍历的数组,换掉一张每帧要维护的图,是一笔非常划算的买卖。
把这三条合起来,"没有依赖图"就不再像是"没做",而是一个明确取舍的结果:既然形状相同、判断标准在作者手里、而运行时又最缺预算,那么把顺序交给一份表、把决定权交给用户,是唯一同时满足"低开销"和"可调整"的做法。
第二章到此把"顺序"讲完了:只有两个来源,没有依赖图,pass 按下标走,依赖靠共享纹理与状态转换隐式维系。下一章换一个角度:既然顺序这么朴素,那每个 pass 里写的那些渲染状态,最后是怎么变成真真切切的 API 调用的。
三、两段式:状态怎么落到 API 上
3.1 第一段:创建期就把状态折进管线
言归正传,上一篇讲过一个现象:这门语言把渲染状态写在效果文件里——pass 里可以直接写渲染目标、写掩码、清屏、sRGB 写开关,而不像纯 HLSL 那样把这些东西交给宿主程序。
那这些写在文件里的状态,最后去了哪?答案是两段式里的第一段:在效果被装载、编译完成的那一刻,它们就被折进了一个不可分割的管线对象(pipeline state object)。
runtime.cpp 在创建这个对象时,把 pass 里的状态一项项填进"子对象"列表,然后一次性交给设备:
blend_state.render_target_write_mask[i] = pass.render_target_write_mask[i];subobjects.push_back({ api::pipeline_subobject_type::blend_state, 1, &blend_state });if (!_device->create_pipeline(permutation.layout, static_cast<uint32_t>(subobjects.size()), subobjects.data(), &pass.pipeline))
官方头文件里给这个句柄的定性只有一句,而它把"为什么创建期就要做完"说得很直白:
/// An opaque handle to a pipeline state object.——include/reshade_api_pipeline.hpp(第 1067 行)
关键词是 opaque(不透明的):拿到它的代码只能把它递给下一次绑定,看不见、也改不了里面的任何一项。这也就是"折进去之后运行期只剩绑定"的字面依据。
上面这张图就是这段的第一段:着色器 + 混合状态 + 写掩码 + 采样状态一起进 create_pipeline,出来的是 pass.pipeline 这一个句柄。它是"不透明"的——拿到它的代码改不了里面任何一项。
这有个实际后果:如果你想在效果运行的时候改混合方式,你不能"改一下状态再画",只能换一个已经建好的管线对象。这也解释了为什么有些效果会为同一个 pass 准备多份排列(permutation)——不同的编译期开关会产生不同的管线,运行期按条件挑一个用,而不是临场改状态。
3.2 第二段:运行期只剩绑定与发射
OK,到了每帧真正执行的时候,render_technique() 里的 pass 循环做的全是"绑定—发射"这一类动作。下面这张面板是把这些调用按 pass 里能写的东西对齐后的逐字摘录:
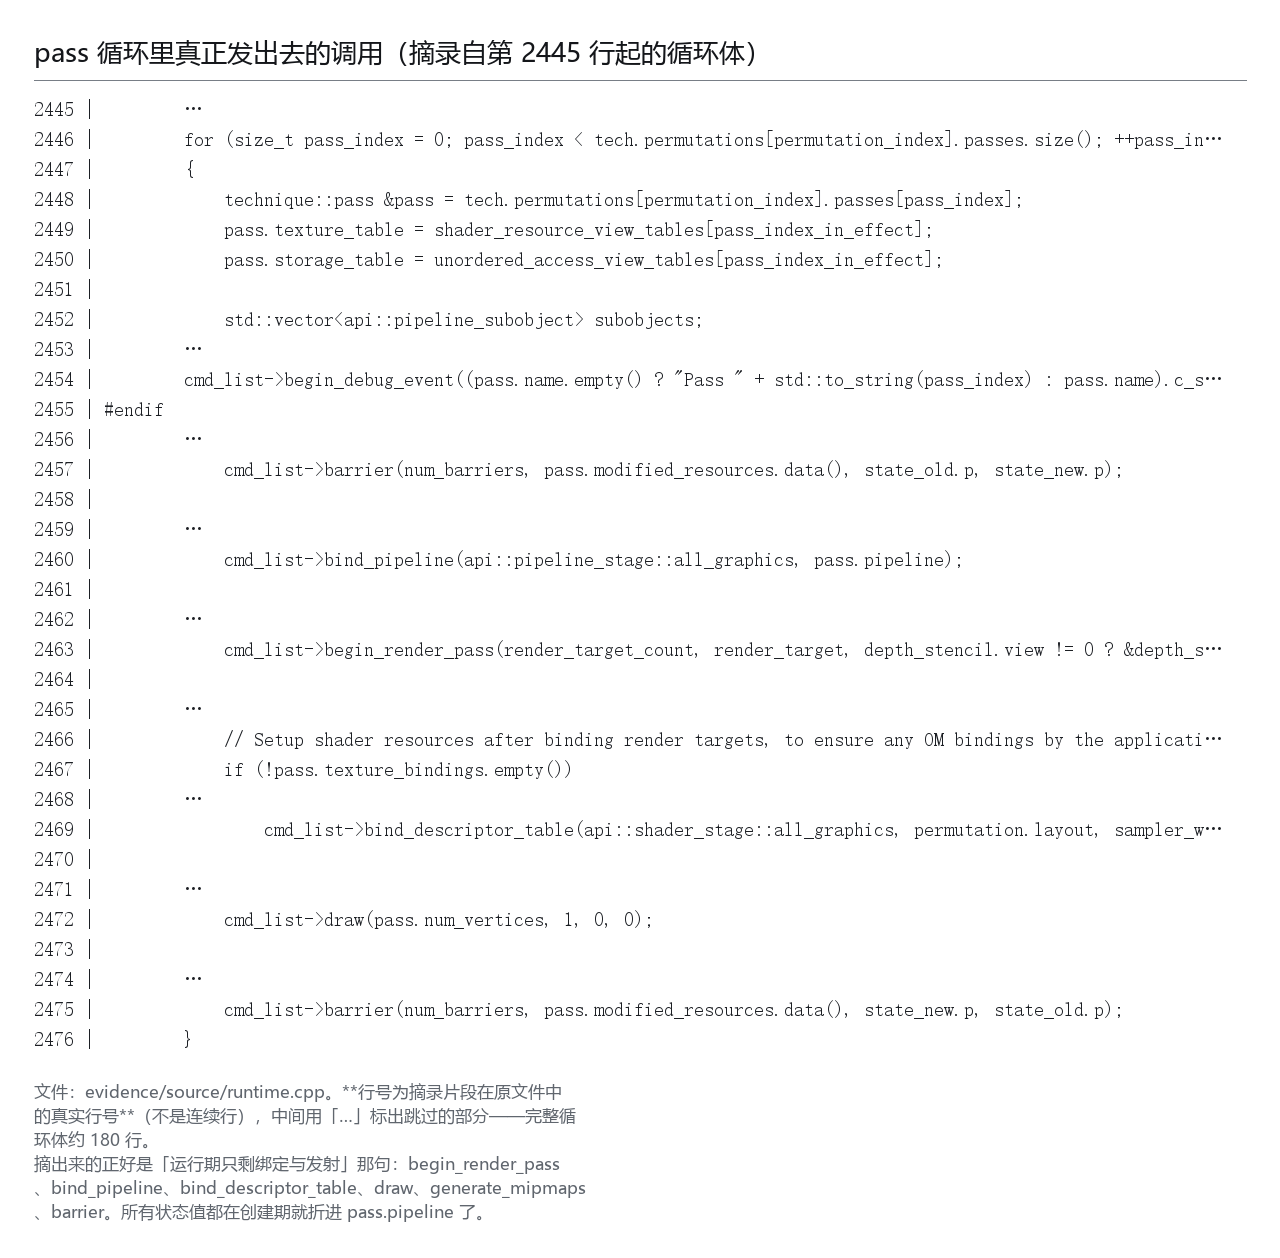
把面板上的行逐条对着 pass 里能写的东西看,会发现它们是严格一一对应的:
| pass 里的键 | 落到哪个调用(逐字) |
|---|---|
未写 RenderTarget |
render_target[0].view = pass.srgb_write_enable ? back_buffer_rtv_srgb : back_buffer_rtv; |
写了 RenderTarget |
render_target[i].view = pass.render_target_views[i]; |
ClearRenderTargets |
render_target[i].load_op = api::render_pass_load_op::clear; |
| (开始渲染) | cmd_list->begin_render_pass(render_target_count, render_target, depth_stencil.view != 0 ? &depth_stencil : nullptr); |
VertexShader/PixelShader/拓扑/写掩码 |
cmd_list->bind_pipeline(api::pipeline_stage::all_graphics, pass.pipeline); |
| 纹理与采样器 | cmd_list->bind_descriptor_table(api::shader_stage::all_graphics, permutation.layout, …, pass.texture_table); |
| 视口/裁剪 | cmd_list->bind_viewports(0, 1, &viewport); / cmd_list->bind_scissor_rects(0, 1, &scissor_rect); |
VertexCount |
cmd_list->draw(pass.num_vertices, 1, 0, 0); / 计算 pass 走 cmd_list->dispatch(...) |
GenerateMipMaps |
cmd_list->generate_mipmaps(modified_texture); |
| (写前的状态转换) | cmd_list->barrier(num_barriers, pass.modified_resources.data(), state_old.p, state_new.p); |
这张表就是"两段式"的第二段:所有需要"想"的事都在创建期做完了,运行期只剩下把已经做好的东西按顺序递出去。
表里有一处顺序很讲究,源码给出了理由——先绑渲染目标,再绑资源:
// Setup shader resources after binding render targets, to ensure any OM bindings by the application are unset at this point (e.g. a depth buffer that was bound to the OM and is now bound as shader resource)
这行注释说的是:应用(游戏)可能在那一刻把深度缓冲绑在输出合并阶段上;如果先绑资源再换渲染目标,就会出现"同一张深度缓冲既在输出侧又在输入侧"的冲突。先换目标、再绑资源,顺序反过来就不会踩这个坑。 这类细节正是"注入式"要额外操心、而引擎内置后处理不用操心的部分。
还有一处对调试很友好:每个 technique 与每个 pass 都会打一个调试标记——cmd_list->begin_debug_event(tech.name.c_str()); 与 cmd_list->begin_debug_event((pass.name.empty() ? "Pass " + std::to_string(pass_index) : pass.name).c_str());。这意味着在 GPU 调试器(比如 RenderDoc)里,你可以直接看到效果的执行轨迹,而不是一堆无名的 draw call。 顺带一提,下一章的 barrier 也用到了 pass.modified_resources——它是运行时自己记下来的一份"这个 pass 会改哪些资源"的清单。
3.3 未写渲染目标时落到哪:背缓冲与一次隐式拷贝
上表第一行讲的是"未写 RenderTarget 的 pass 落到背缓冲"。这句话有两个细节值得展开。
细节一:背缓冲有 sRGB 与普通两份。 原文是 pass.srgb_write_enable ? back_buffer_rtv_srgb : back_buffer_rtv——pass 里那个 sRGB 写开关,选的就是这两个目标中的哪一个。这是一处很省心的设计:写效果的人不必自己处理色彩空间,写一个开关就行。
细节二:还有一次隐式拷贝。 未写渲染目标的 pass 会触发 needs_implicit_back_buffer_copy = true,于是运行时会先把上一遍的背缓冲拷进本效果的 color_tex:
// Save back buffer of previous passconst api::resource resources[2] = { back_buffer_resource, _effect_permutations[permutation_index].color_tex};cmd_list->copy_texture_region(back_buffer_resource, 0, nullptr, _effect_permutations[permutation_index].color_tex, 0, nullptr);
上面这张图把这条回退路径画了出来:没写目标 → 落到背缓冲 → 并把上一遍的背缓冲先拷一份到自己的颜色纹理。
为什么要拷这一份? 因为"读上一遍的画面"和"写这一遍的画面"不能落在同一张纹理上(就是第 2.4 节那条冲突)。所以运行时先把上一遍的结果搬到一张中间纹理上,效果从这个中间纹理读,往背缓冲写。这一段开销是"没写渲染目标"换来的便利的代价——它也是社区那句"能自己指定目标就自己指定"背后的实际理由。
官方论坛里有一位答复者对这件事的说法,可以作为旁证(注意作者是社区成员,不是项目作者):
"the RTVs provided to that function are what ReShade will consider the 'default backbuffer' while rendering. Meaning any passes that do not have a render target specified in ReShade FX effect code will end up in those RTVs (the former when the 'SRGBWriteEnable' pass state is false, the latter when it is true)" —— Providing game data to ReShade
3.4 本机这批效果的 pass 键是怎么写的
好了,讲完机制,来看本机 69 个效果源的实际写法。探针把每个 pass 里出现的键全部收集起来,结果是:
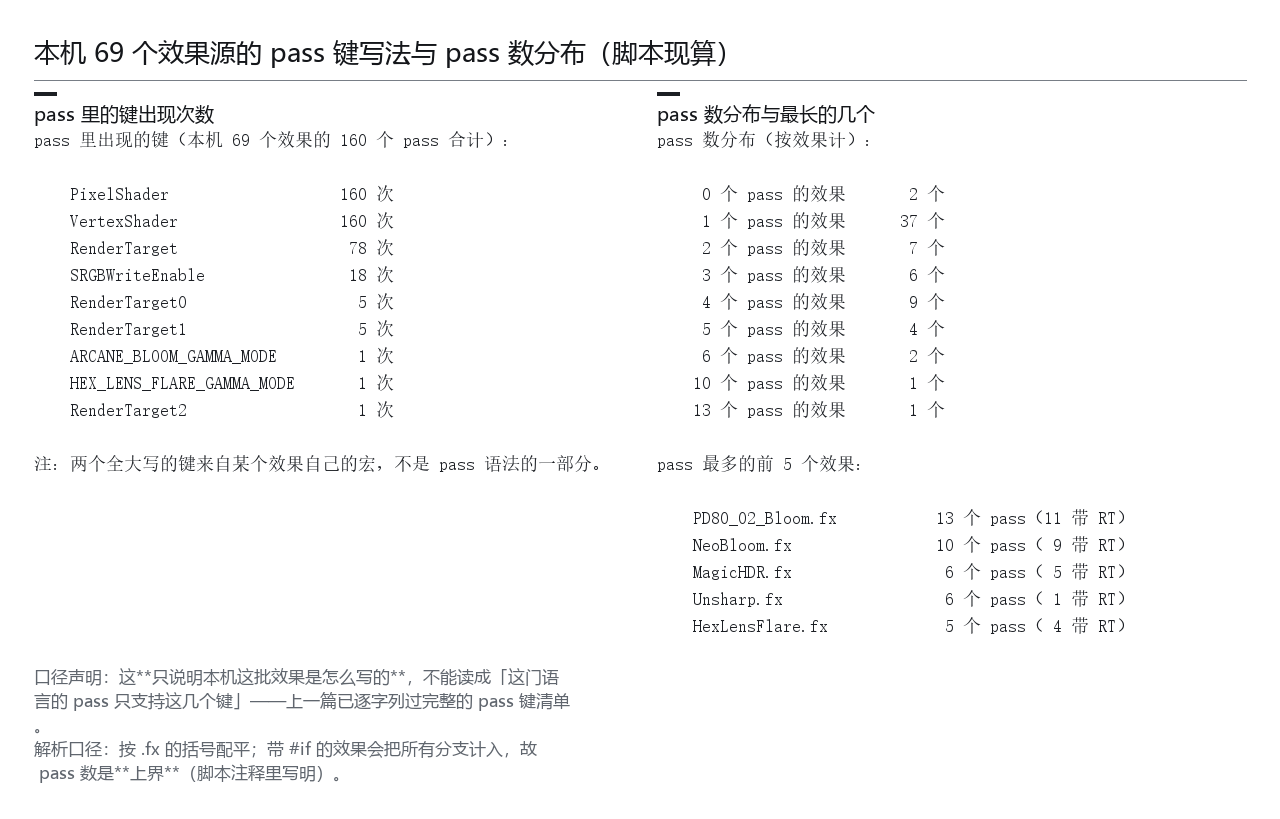
先来看看读数。VertexShader 与 PixelShader 各出现 160 次(每个 pass 各一次,正好对应 160 个 pass);RenderTarget 78 次,加上带编号的 RenderTarget0/RenderTarget1/RenderTarget2 共 11 次(5 + 5 + 1);SRGBWriteEnable 18 次。
这里必须把口径写清楚,否则会误导:这只说明本机这批效果是怎么写的,不能读成"这门语言的 pass 只支持这几个键"。上一篇已经把完整的 pass 键清单逐字列过了;本机这批效果几乎只用了着色器与渲染目标这两类,原因也很直白——后处理效果大多是全屏像素运算,既不需要顶点数、也不需要拓扑与视口这类几何侧的键。
顺带一个有意义的交叉验证:160 个 pass 里 83 个写了渲染目标(78 + 5,多目标那几处算一次)。接近一半的 pass 选择把结果写进自己的目标,而不是背缓冲。这与 3.3 节讲的开销问题是同一件事的两面:写自己的目标多一份资源,但不触发那次隐式拷贝。
3.5 把三段串起来:一个 pass 的完整生命周期
讲完两段式,把时间轴拉直一次,看一个 pass 从"文件里的一段文字"到"每帧被发出去"一共经过哪几站。这条时间轴同时也是第三章的小结:
| 阶段 | 发生什么 | 一次还是每帧 |
|---|---|---|
| 装载期 · 编译 | 效果源码被编译,pass 的着色器变成字节码 | 一次(或改预处理器定义时重来) |
| 装载期 · 建管线 | 着色器 + 混合状态 + 写掩码 + 采样状态一起交给 create_pipeline,得到 pass.pipeline |
一次 |
| 装载期 · 建资源 | 这个效果要用的中间纹理与采样器视图建好(写了自己的渲染目标的那些在这里拿到自己的资源) | 一次 |
| 每帧 · 填数据 | render_effects() 开头那段 switch 把十六个运行时数据源按当前帧的值填一遍 |
每帧 |
| 每帧 · 绑定与发射 | 换渲染目标、bind_pipeline、bind_descriptor_table、draw 或 dispatch |
每帧,每个 pass 一遍 |
| 每帧 · 收尾 | 需要的话 generate_mipmaps、barrier;是最后一个 pass 就回背缓冲 |
每帧 |
这张表想说明的是"两段式"的代价分布:装载期很重(编译、建管线、建资源都在那里),运行期很轻(只有绑定与发射)。这正好解释了为什么"改一个预处理器定义"会卡一下——它把前三站整段重来一次。也解释了为什么"少一个 pass 就少一份开销"——最后两站是每个 pass 每帧都要付的。
第三章到此把"状态怎么落地"讲完了:装载期折进管线,运行期只剩绑定;没写渲染目标的走背缓冲回退,并多一次隐式拷贝。下一章换个方向——不问"怎么发命令",问"效果能看到什么"。
四、十六个数据源:十五个在 core,第十六个不在
4.1 一张枚举表说明了数据源住在哪
前面三章讲的是"怎么跑"。从这一章开始讲"效果能看到什么"。
效果能拿到的运行时数据,官方在语言参考里列了一张取值表(上一篇引用过)。按语言参考的口径,这些取值一共 16 个。但它们是不是都由同一个地方提供?这件事语言参考没写,得去源码里看。
runtime_internal.hpp 里有一个枚举,逐字如下:
none, frame_time, frame_count, random, ping_pong, date, timer, key,mouse_point, mouse_delta, mouse_button, mouse_wheel,overlay_open, overlay_active, overlay_hovered, screenshot, unknown
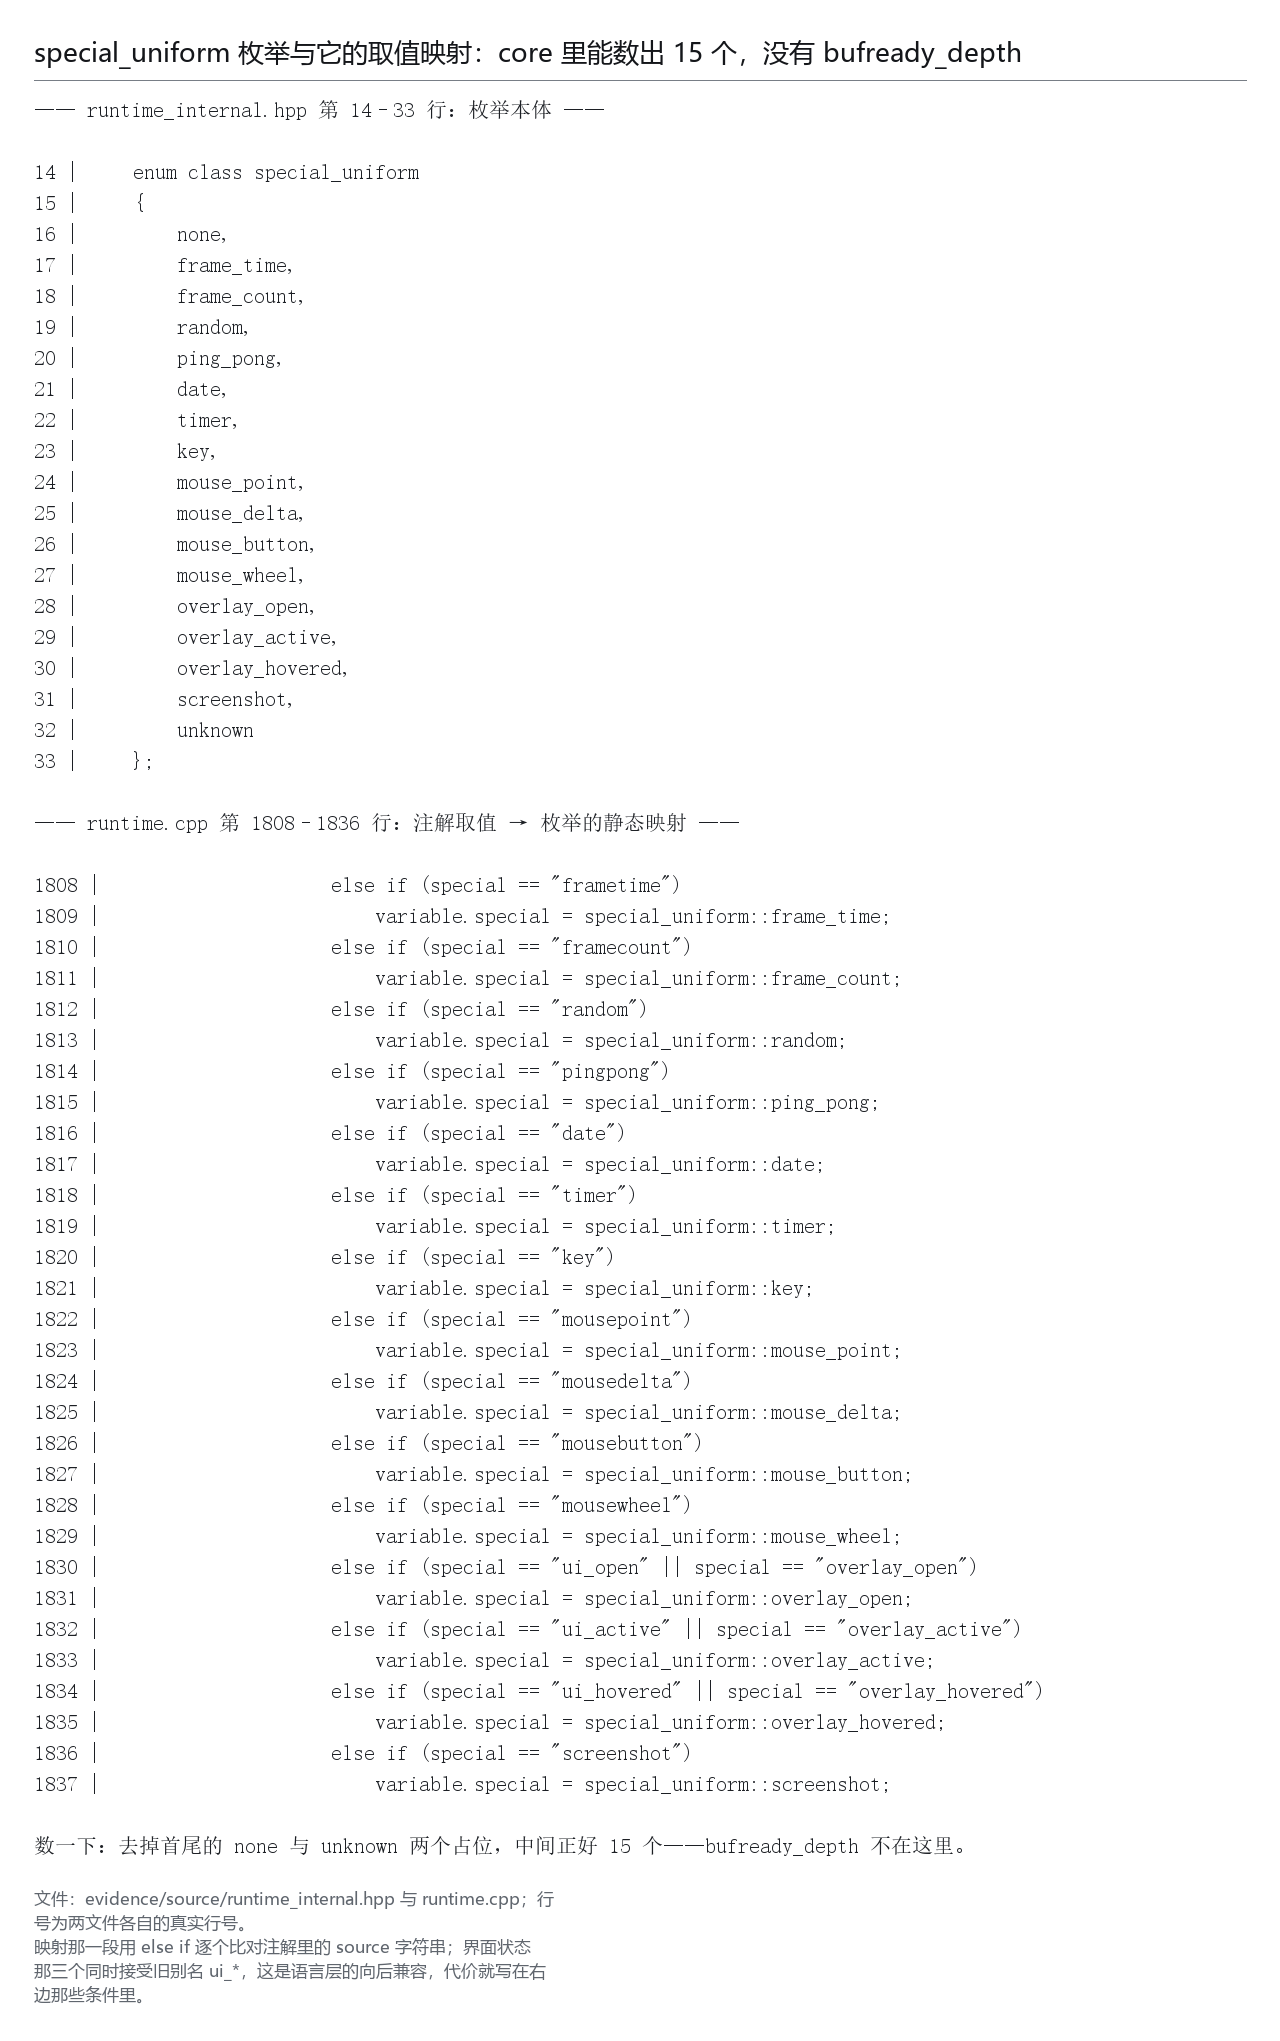
上面这张面板就是这段枚举的原文。数一下:去掉首尾的 none 与 unknown 两个占位,中间正好 15 个。bufready_depth 不在这张表里。
这就是本篇标题里"十五个在 core"的来历——它是一个可以逐字数出来的事实,而不是概括。至于第十六个为什么不在,下一节说。
上面这张分工图把十六个数据源排成了两栏:左栏十五个由 core 按帧填,右栏那一个由 add-on 从外面塞进来。这张图是第四章的地图,后面三节分别讲:枚举怎么被填、每帧在哪儿填、以及那"从外面塞进来"具体是怎么塞的。
4.2 每帧在哪儿填:一段 switch
装载效果的时候,源码把注解里的 source = "…" 静态映射成枚举值。逐字是这样一组赋值(节选):
else if (special == "frametime") variable.special = special_uniform::frame_time;else if (special == "framecount") … frame_count;/"random"/"pingpong"/"date"/"timer"/"key"/"mousepoint"/"mousedelta"/"mousebutton"/"mousewheel"/"ui_open" || "overlay_open"/"ui_active" || "overlay_active"/"ui_hovered" || "overlay_hovered"/"screenshot"
这组赋值里有一处细节值得读者留意:界面状态那三个同时接受旧别名 ui_*——所以老效果里写的 source = "ui_open"; 仍然能用。这属于"语言层的向后兼容",而兼容的代价就直接体现在这组 else if 里。
真正往里填值的地方,在 render_effects() 开头那一整段 switch (variable.special) 里。逐字例如:
case special_uniform::frame_time: set_uniform_value(variable, _last_frame_duration.count() * 1e-6f); break;case special_uniform::timer: … std::chrono::duration_cast<std::chrono::milliseconds>(_last_present_time - _start_time).count() …case special_uniform::overlay_active: case special_uniform::overlay_hovered:// These are set in 'draw_variable_editor' when overlay is openif (!_show_overlay) set_uniform_value(variable, 0);
这里有三处信息量:
frametime来自"上一帧用了多久",不是"这一帧开始到现在的时长"。所以效果里用frametime做动画时,本质上是在跟着帧间隔走——掉帧时动画会变慢,这是效果写作者需要知道的口径;timer是从起始时刻到当前 present 的毫秒数,是真正的累加时间;- 界面状态那几个在叠加层没打开时被强制置 0,而它们的"打开时"的值是由界面代码在画变量编辑器的时候填的。源码注释把这个分工写得很直白,引用时不必解释。
4.3 第十六个:由 add-on 从外面塞进来
现在回答第 4.1 节留下的问题:bufready_depth 为什么不在 core 的枚举里?
因为深度不是 core 能拿到的。 这一句是整个第四章最硬的一处,也是本系列把它放在第四篇而不是第七篇讲的原因:深度这件事,core 不做,由 add-on 做。
官方示例里的深度 add-on 干了三件事,逐字如下:
runtime->update_texture_bindings("DEPTH", data.selected_shader_resource, data.selected_shader_resource);runtime->enumerate_uniform_variables(nullptr, [&data](effect_runtime *runtime, effect_uniform_variable variable) {char source[32];if (runtime->get_annotation_string_from_uniform_variable(variable, "source", source) &&std::strcmp(source, "bufready_depth") == 0)runtime->set_uniform_value_bool(variable, data.selected_shader_resource != 0);});
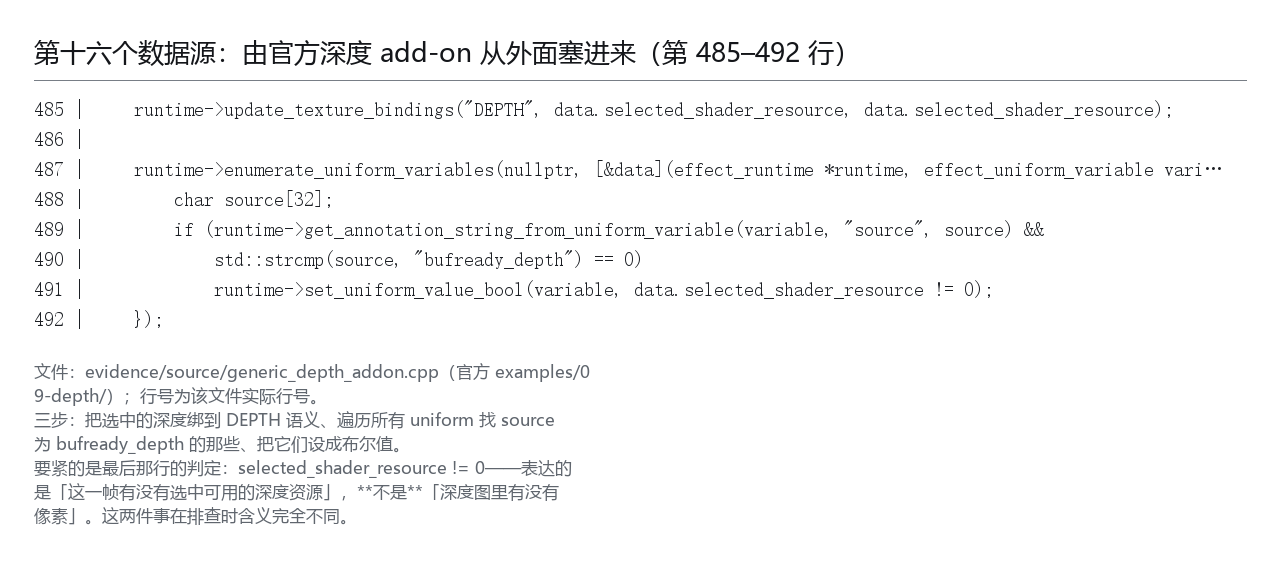
上面这张面板就是这段逐字原文,读法可以拆成三步:
- 把选中的深度资源绑到
DEPTH这个语义上(第一行); - 遍历所有 uniform 变量,找出注解里
source写的是bufready_depth的那些(中间的判断); - 把它们设成一个布尔值,取值是"选中的资源不等于零"(最后一行)。
这里有一个非常容易被想歪的地方,必须点明:第 3 步的判定是 selected_shader_resource != 0——也就是"这一帧有没有选中、有没有建出可用的深度资源视图",而不是"检查深度图里的像素是不是全零"。换句话说,bufready_depth 表达的是"深度准备好了没有",不是"深度里有没有东西"。 这个区别在实际排查里很关键:一个全黑但有内容的深度缓冲,和"根本没拿到深度",对应的布尔值是一样的。
顺带说清"选中"的口径:它是每帧统计各候选资源的用量、取最大的那个。这是 add-on 自己的策略,不是 core 的规则——这也再次说明深度这件事整个归外部插件管。官方文档对绑定接口的说明是:
"Binds new shader resource views to all texture variables that use the specified semantic." "…The resource the shader resource views point to has to be in the
resource_usage::shader_resourcestate at the timerender_effectsorrender_techniqueis executed."
最后那句限定很重要:绑上去的资源在被效果读到的时候,必须处在"可作着色器资源"的状态。如果 add-on 忘了做这一步状态转换,效果读到的东西就是未定义的——这也是"深度类效果时灵时不灵"的一个可能来源(完整的排查归第七篇)。
4.4 深度缓冲就是一张可采样的纹理
上面讲的都是"谁绑、谁填",但少了一张"那东西长什么样"的图。
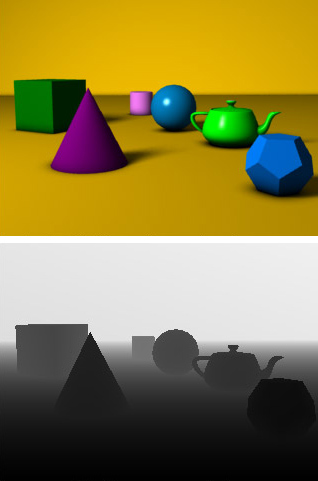
上面这张对照来自 Commons(CC BY 2.0,去文字版):左边是场景,右边是同一帧的深度缓冲。深度缓冲在数据上就是一张单通道的图——离相机近的地方值小、远的地方值大。也正因为它是"一张图",它才能被当作纹理采样:GetLinearizedDepth() 这类入口做的事,就是把这张图里的深度值按一定的编码(远近、是否反向)还原成线性距离。
这张图还解释了两件事:
- 为什么深度类效果的输入是"一张图"而不是"一堆几何"——Effect runtime 拿不到几何,它拿到的是应用画完之后的产物;
- 为什么本机 69 个效果里几乎没人直接声明
: DEPTH语义——本机实测:: COLOR的真实声明有 11 处,而: DEPTH的真实声明是 0 处(两种口径都查了,都是 0)。深度一律走头文件里的入口:include "ReShade.fxh"出现在 58/69 个效果里,ReShade::BackBuffer用了 67 次,ReShade::DepthBuffer只有 1 次,而ReShade::GetLinearizedDepth()用了 20 次。
这组读数的含义很清楚:约定俗成的写法是通过头文件提供的入口函数去拿深度,而不是自己声明一张深度纹理。 至于为什么大家都这么写(而不是直接声明),第七篇会讲——那涉及"拿不到深度"时怎么降级、以及不同图形 API 下深度格式的差异。
4.5 语义纹理的接缝:三个分支
第四章还剩最后一处:既然深度是通过"语义"绑上去的,那么语义这套机制在 core 里是怎么分发资源的?
答案是一段三分支的代码,也是本篇认为最能说明"语言与运行时的接缝"在哪的一段:
if (sampler_texture->semantic == "COLOR") srv = _effect_permutations[permutation_index].color_srv[binding.srgb];else if (const auto it = _texture_semantic_bindings.find(sampler_texture->semantic); it != _texture_semantic_bindings.end())srv = binding.srgb ? it->second.second : it->second.first;else srv = _empty_srv;
三个分支的意思分别是:
COLOR是内建的——它不走注册表,直接用本效果的颜色资源(还分了 sRGB 与非 sRGB 两份);- 其余语义走注册表——谁的语义名在
_texture_semantic_bindings里注册过,就用注册的那张资源(同样分 sRGB 两份); - 谁都没注册的,落到
_empty_srv——一张空资源。
说白了,第三个分支值得单独说一句:它意味着"语义写错了不会崩,但会读到空"。从工程角度看这是有意的——插件没准备好深度时,效果读到的是一张空纹理,画面可能出现奇怪的结果,但程序不会挂。从写效果的角度看这是一个坑:DEPTH 写错成 Depth 之类,编译器不会报错,运行时也不会告诉你,只是结果不对。这一处的排查经验(先看有没有注册、再看 bufready_depth 那个布尔量)比语法本身更值钱。
4.6 换个分法看这十六个:按「谁决定取值」归类
第 4.2 到 4.4 节是按"住在哪"分的(core 十五个、add-on 一个)。如果按"谁决定这个值"再归一次类,十六个会分成三组,这个分法对写效果更有指导意义:
| 组 | 数据源 | 谁决定取值 | 写效果时的注意点 |
|---|---|---|---|
| 自发型 | 时间类(帧间隔、帧号、累计计时) | core 每帧递增 | 与真实时间绑定的动画用"累计计时",与帧有关的动效用"帧间隔";掉帧时两者表现不同 |
| 跟随型 | 输入类(鼠标位置、位移、按键、滚轮)与随机、乒乓 | core 读应用输入,或按帧推进 | 值可能在某几帧保持不变(没有输入时),所以不能假设"每帧都不同" |
| 协商型 | 界面状态三个、截图标记、深度就绪 | core 或 add-on 的外部状态说了算 | 这三类最容易被想错:界面没打开时它们是零,"深度就绪"表达的是资源有没有选中而不是画面里有没有东西 |
说白了,这张表最有用之处在第三组。 自发型与跟随型都是"取值本身是确定的",而协商型的值取决于运行时之外的状态——叠加层开没开、有没有截图流程、add-on 有没有准备好深度。所以这三类在效果里应当被当作"可能随时为零的量"来写,而不是"一定有意义的值"。上一篇讲的"请求而不是读取"在这里落地成了一句作业规范。
第四章小结:效果能读到的十六个运行时数据源里,十五个由 core 的 special_uniform 按帧填(每帧在 render_effects() 开头的 switch 里),第十六个深度就绪由 add-on 塞进来;而纹理语义的分发是"内建 COLOR + 注册表 + 空资源兜底"三段式。一句话:core 管时间、输入与界面状态,深度与外部资源归插件。
五、预设与性能模式:存什么、折什么
5.1 怎么判定一个文件是预设
第五章讲的是"用户能改的那一层"。先看一个很实际的问题:运行时凭什么认出一个 .ini 是预设,而不是随便一个配置文件?
runtime.cpp 里的判定只有一行,后面还带了一句注释:
// Otherwise ensure the file has a technique list, which should make it a presetreturn !resolve_path(path, ec) || reshade::ini_file::load_cache(path).has({}, "Techniques");
判定条件就是"文件里有没有 Techniques 这一段"。 这句话顺带解释了一个现象:为什么一个空文件也能被当成预设——它只要有一段空的 Techniques 就够了。对本系列的读者来说,这条也解释了为什么预设可以手工写、可以只写几行——因为它本质上就是一份带 Techniques 的配置。
5.2 存什么、不存什么
那保存预设的时候,哪些东西会写进文件?save_current_preset() 给出的答案是四类:
Techniques——只放已启用的 technique,格式是名称@效果文件名;TechniqueSorting——放全部 technique 的顺序(第 2.3 节实测的那个"比上面长"的来源);PreprocessorDefinitions——预处理器定义;- 每个效果自己的段——
[效果名.fx]下面写变量名=值,加上热键Key<名称>。
而不保存的东西,也是源码里一行 continue 决定的:
if (variable.special != special_uniform::none || variable.annotation_as_uint("nosave")) continue;
上面这张图把"存"与"不存"分成两栏。不存的两类正好对应第四章的两个概念:
special != none的是运行时数据源——它们的值是每帧现算的,存进文件没有意义(存了也会被下一帧覆盖);- 带
nosave注解的——这是效果作者主动声明"这一项别存",通常用于那些由效果自己管理的中间状态。
把这两条放在一起看,可以得到一个很实用的结论:预设文件里保存下来的,全是"用户的选择";凡是"每帧现算的"和"效果自己管的",一个都不会进去。 这也解释了为什么一份预设文件往往比你想象的短——它记的是差异,不是状态。
5.3 性能模式:把 uniform 折成编译期常量
第五章最后一节讲一个几乎所有用户都点过、但很少有人知道它做了什么开关:性能模式。
它的实现只有两行关键字,逐字如下:
// Recompile effects if preprocessor definitions have changed or running in performance mode (in which case all preset values are compile-time constants)pp.add_macro_definition("__RESHADE_PERFORMANCE_MODE__", _performance_mode ? "1" : "0");codegen.reset(reshadefx::create_codegen_dxbc(shader_model, !_no_debug_info, _performance_mode, _performance_mode ? 3 : 1));
官方对这条设定的定义(一手):
"Performance mode compiles effects with a higher optimization level and replaces all uniform variables with constants (based on the values in the preset) to further increase optimization potential." —— 官方 ini 设置说明
把这两处合起来看,"性能模式"到底做了什么就清楚了:它不是"更用力地优化同一份代码",而是换了一种编译方式——把预设里的每个变量值当作常量,在编译期就折进去,于是优化器能把这些值周围的计算一起化简(create_codegen_* 最后一个参数从 1 变成 3,也是这件事的一个旁证)。
代价写在源码注释里,非常直白:
// Cannot save in performance mode, since there are no variables to retrieve values from then// TODO: Do we want to save spec constants here too? The preset will be rather empty in performance mode otherwise.
界面上的提示语说得更客气一些:
"Once you have finished tweaking your preset, be sure to enable the 'Performance Mode' check box. This will reload all effects into a more optimal representation that can give a performance boost, but disables variable tweaking and this list."
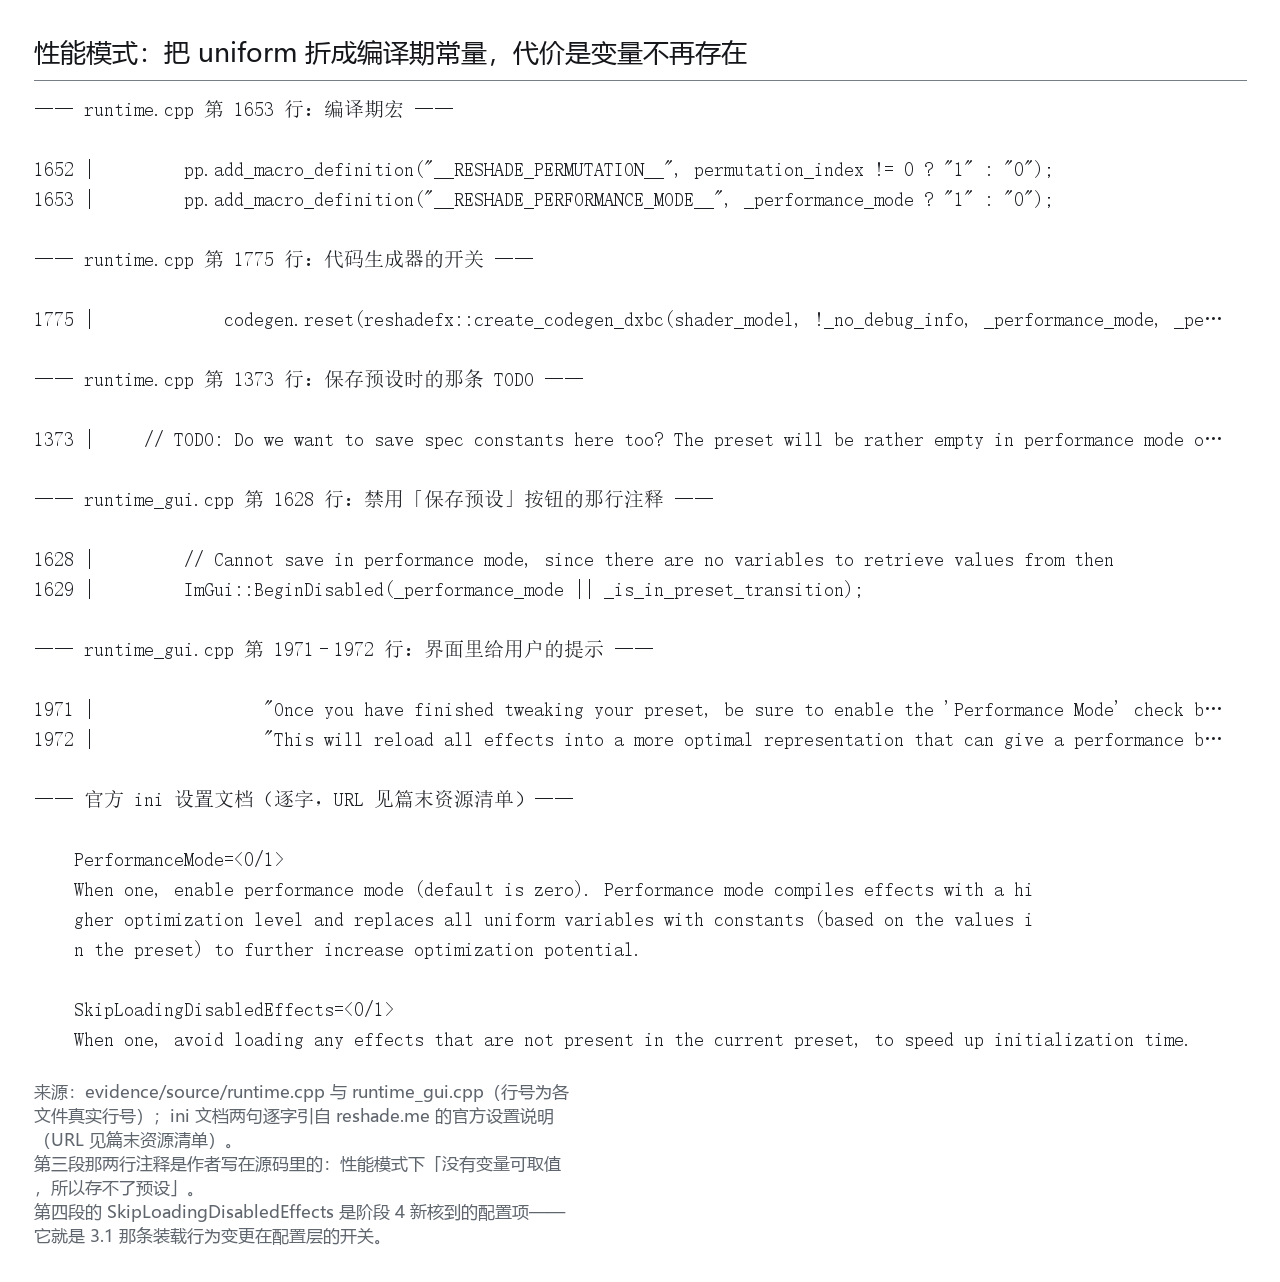
上面这张面板把三处原文并置:宏定义与代码生成器开关、源码里那两行注释、以及官方设置文档的定义句。
有一种常见疑问可以在这里直接回答:为什么开了性能模式之后,变量列表变空、也存不了预设?因为变量已经不存在了。 它们被折成了常量,运行时的变量表自然就空了——不是界面把它藏起来了,而是背后真的没有变量可读。所以"先调好、再开性能模式"这个顺序不是建议,而是唯一可行的顺序。
还有一处版本史上的行为变更,对使用者很有用(一手):
"After switching to performance mode ReShade will now load only those effects that are actually enabled in the current preset (starting with the next launch of the game)" —— 3.1 发布帖
这句话解释了另一个常见困惑:为什么切换到性能模式以后,效果列表里的项目少了一大半?因为从下一次启动开始,它只装载预设里启用的那些效果。 这不是 bug,是有意为之。
而这条行为在配置层也是明写的——官方设置文档里给它留了一个开关:
SkipLoadingDisabledEffects=<0/1>When one, avoid loading any effects that are not present in the current preset, to speed up initialization time.
这不是隐藏机制,而是一个可以关掉的优化。 想让它别偷懒、把整个列表都装进来,把这个开关关掉即可(代价是初始化时间回到从前)。顺带说一句:到了这个版本,"性能模式"这个名字已经有点名不副实了——它同时管着两件事,一件是把变量折成常量,另一件是少装几个效果。
六、GPU 计时:technique 与每个 pass 各一份
6.1 计时的粒度比多数人以为的细一层
第六章讲一件很小但很有意思的事:运行时给出的耗时数字,粒度到底有多细。
常见印象是"一个效果一个耗时"。实际上 render_technique() 里用时间戳查询包住了两层:
const bool gather_gpu_statistics = _gather_gpu_statistics && _timestamp_frequency != 0 && effect.query_heap != 0 && permutation_index == 0;if (gather_gpu_statistics) { … const uint64_t tech_duration = timestamps[1] - timestamps[0];tech.average_gpu_duration.append(tech_duration * 1'000'000'000ull / _timestamp_frequency);for (size_t pass_index = 0; …) { … tech.permutations[0].passes[pass_index].average_gpu_duration.append(…); } }
读这段代码要抓两件事:
- 第一件是"两层":technique 有一份
average_gpu_duration,它的每个 pass 也各有一份。界面里那句"这个效果花了 0.170 毫秒",可以再往下拆到每个 pass 各花了多少; - 第二件是"滑窗"。容器的声明在
runtime_internal.hpp里:moving_average<uint64_t, 60> average_gpu_duration;——六十帧的滑动平均。界面上的数字因此不是"上一帧"的瞬时值,而是最近六十帧的平均值。
官方发布说明里能核到这条能力是什么时候加进去的(一手):
"Added separate GPU timing statistics for each pass in a technique" / "Fixed timestamp query values in D3D9" —— 6.5 发布说明
"每个 pass 各一份"这件事,正好和第二章那句社区实测连上了。 论坛里有一位用户做过这样的对照:某个抗锯齿效果在性能模式下从大约 0.170 毫秒降到 0.030 毫秒,并由此总结出"每个 pass 都有一份固定开销,不管它实际算多少,所以 pass 越少越好"(作者是社区成员。原帖:How does performance mode actually work?)。
把这两件事接起来看,第三章那个"两段式"就有了实测意义上的解释:既然每个 pass 至少要走一遍 begin_render_pass → bind_pipeline → bind_descriptor_table → draw,那这份开销就与 pass 里算了多少无关——它是"发一条渲染命令"的固定成本。所以"把两个 pass 合成一个"往往比"把 pass 里的算法优化一遍"更立竿见影。
6.2 本机这一栏取不到,如实写"测不了"
按本系列的规矩,这一节要交代本机实测的落空项。
本机没有取到 GPU 计时读数。 原因不在效果上,而在通道上:average_gpu_duration 只在叠加层界面里显示,而本机跑 demo 做只读解析时无法与叠加层交互,因此拿不到那个界面上的数字。
所以本篇关于耗时的内容只引官方源码与发布说明,不给任何本机毫秒数。 拿估算值充数会让第三节那张"固定开销"的推论看起来有数据支撑,其实没有——宁可写"测不了"。第九篇与第十篇会在自跑环节把这条补上(那时会真正把叠加层打开截图),本篇不越位。
6.3 这层运行时的行为演进(只列能核到出处的几处)
依然是惯例,凡涉及"某个版本行为变了"的表述,本篇只写能核到出处的。就 effect runtime 这一层,能核到的行为演进有这么几处:
| 版本 | 这一层的变化 | 出处 |
|---|---|---|
| 0.15 | 语法分析从生成器改为手写递归下降(编译器侧,上一篇已逐字引) | 官方 0.15 发布帖 |
| 3.1 | 切换性能模式后,改为只装载当前预设里启用的效果 | 3.1 发布说明逐字 |
| 6.5 | 新增逐 pass 的 GPU 计时统计;并修正 D3D9 的时间戳查询取值 | 6.5 发布说明逐字 |
| 6.7 / 6.8 | 本轮检索核到 2026 年内这两版各有发布说明条目(本篇未逐条引用其内容) | 官方发布说明 |
这张表的用法不是"编年史",而是"哪些说法必须带版本号":凡是"性能模式会怎样""计时到哪一级"这类描述,都在版本之间改过——所以正文引用时一律带上版本号与出处。在这条线上,"我记得是这样"不可靠,因为行为确实改过。 这也是本篇第二章引用社区经验时为什么要标作者、第五章为什么要标发布版本的原因。
七、本机读数:69 个效果源长什么样
7.1 结构读数:技术与 pass 的计数
先来看看这份样本。第七章把本机那份只读样本摊开。样本是 E:\GameData\ReShade\Shaders\Effects\ 下的 69 个 .fx,用自写探针做离线解析(只读,不改任何文件)。
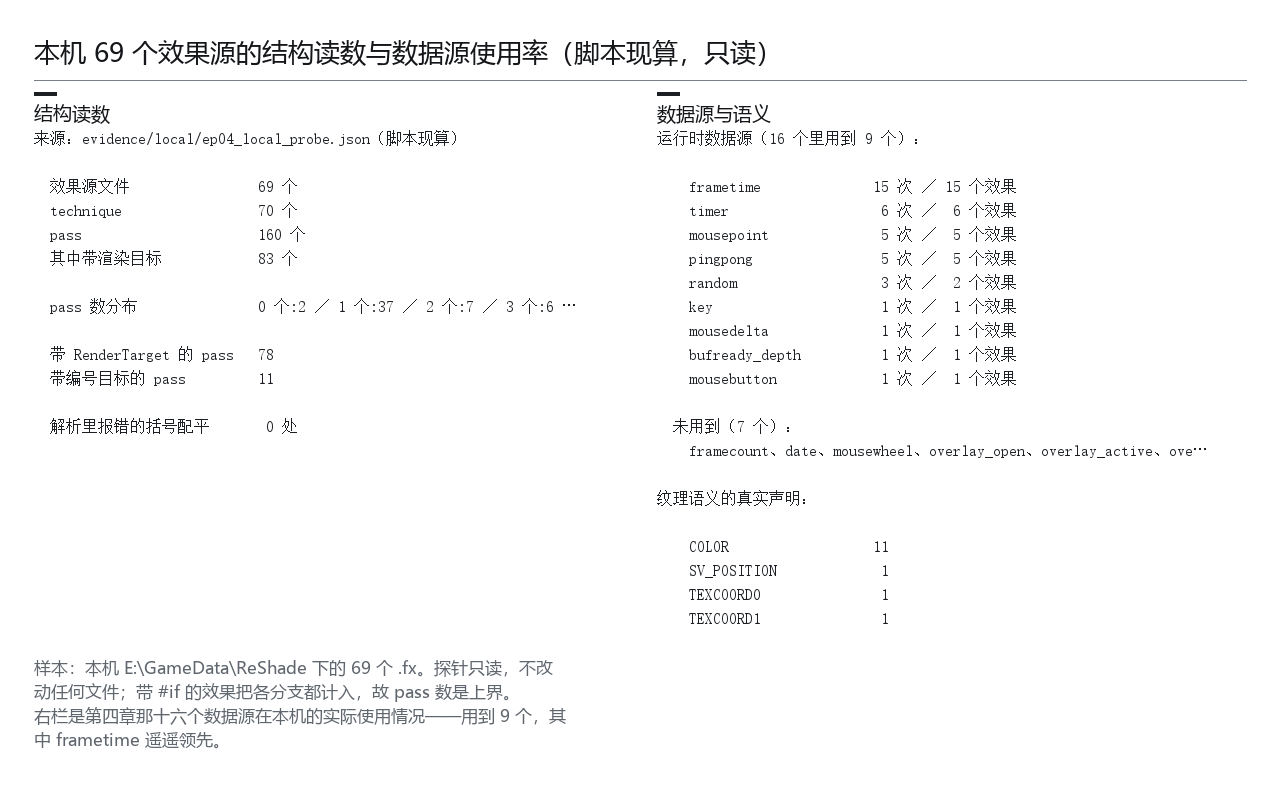
上面这张面板是读数汇总,逐项如下:
| 项 | 读数 |
|---|---|
| 效果文件 | 69 个 |
| technique 合计 | 70 个 |
| pass 合计 | 160 个 |
| 带渲染目标的 pass | 83 个 |
| pass 数分布 | 1 个:37 | 2 个:7 | 3 个:6 | 4 个:9 | 5 个:4 | 6 个:2 | 10 个:1 | 13 个:1 |
| pass 最多的 | PD80_02_Bloom.fx,13 个(其中 11 个带渲染目标) |
| 运行时数据源 | 16 个里用到 9 个 |
include "ReShade.fxh" |
58/69 |
: COLOR 真实声明 |
11 处 | : DEPTH 真实声明 0 处 |
| 本机预设文件 | Presets\ 下 12 个 .ini |
这张表有几处值得停下来读:
- 一个效果文件平均一个 technique(69 个文件 70 个 technique),而平均每个 technique 两个多 pass(70 个 technique 160 个 pass)。这说明「效果」与「technique」在本机这批样本里几乎是一对一,而复杂度的差异全在 pass 数量上;
- pass 数分布是长尾的:37 个 technique 只有一个 pass(占了 70 个里的一半以上),而最长的那一位有 13 个。这条分布直接支撑了第三节的实用建议——大多数效果其实很简单,栈里那些"卡"的感觉往往来自少数几个多 pass 的效果;
- 上面那张 13 个 pass 的读数可以和上一篇呼应:ep03 从编译产物缓存里数出的也是 13 个,两条独立口径互证。这不是巧合——同一条装载路径既决定编译产物,也决定 pass 数组。
7.2 数据源的实际使用:十六个里只用到了九个
本机样本里实际出现的运行时数据源只有 9 个:
| 数据源 | 出现次数 |
|---|---|
frametime |
15 |
timer |
6 |
mousepoint |
5 |
pingpong |
5 |
random |
3 |
key |
1 |
mousedelta |
1 |
mousebutton |
1 |
bufready_depth |
1 |
而没被用到的 7 个是:framecount、date、mousewheel、overlay_open、overlay_active、overlay_hovered、screenshot。
这张表最值得看的不在"用了什么",而在"谁用得最多":frametime 15 次,遥遥领先。这解释了一个很常见的观察——很多效果(扫描线、噪点、抖动、流水)都在动,而它们的动几乎全靠 frametime 与 timer 这两个时间量。同时它也说明第四章那十六个数据源里有一大半很少被普通效果用到:界面状态那三个主要给调试与工具类效果,screenshot 只在截图流程里有意义。
顺带一个口径提醒:bufready_depth 在本机只出现 1 次——它对应某个深度类效果。这恰好说明本机这批样本不是"深度类效果"的重镇,所以第七篇那个话题在这份样本上能取到的证据有限。把样本的局限说清楚,比把结论说满更重要。
7.3 两处旁证:编译产物与预设文件
结构读数之外,本机还有两处文件可以直接看,它们分别从"编译侧"和"配置侧"给本篇的结论做旁证。
先来看看第一处——编译产物。 本机 Cache\ 目录下有 571 个 .cso、571 个 .asm 与 142 个 .i(上一篇已核过)。这里的有用信息不是数量,而是命名形态:产物名里带着效果的标识与一个哈希段,而同一个效果的不同着色器入口各占一个文件。这与第三章那张"编译对象粒度是着色器入口点"的结论是一致的——缓存是编译的产物,它的粒度自然就跟着编译走,而不是跟着 pass 走。两份读数(上一篇从缓存数、本篇从源码数)在这件事上互证。
第二处是预设文件。 本机 Presets\ 下有 12 个 .ini,体积跨度很大:官方那两份中等与高档预设都在 1,600~1,700 字节,社区大预设 32,835 字节,另有一份 44,015 字节。这个跨度本身就说明了一件事:预设文件的大小几乎完全取决于"它记了多少条变量值",而不是取决于它启用了多少效果。这与第 5.2 节那句"它记的是差异,不是状态"正好对上——一份大预设里绝大多数内容是各效果段下面的变量值与热键,而不是那个短短的 Techniques 清单。
两处旁证合起来的用法:凡是本篇给出的结论,尽量让它有"两个独立来源"——源码逐字一处、本机读数一处;或者本机读数一处、上一篇的独立口径一处。单一来源的结论会明确标注为单一来源(比如 6.2 节那条"测不了",就只有官方源码与发布说明支撑)。
7.4 三条量化小结
先来看看小结。第七章末尾把本篇的量化结论收成三条,每条都写明来源:
- 顺序靠一份表:
_technique_sorting的排序规则只有"声明顺序 + 预设覆盖"两条,源码逐字可核;本机实测印证——官方中等档预设里排序表 3 条、启用表 2 条,排序表比启用表长; - 数据源分两处提供:core 的
special_uniform枚举里能数出 15 个(去掉首尾占位),第十六个深度就绪不在其中,由 add-on 通过update_texture_bindings("DEPTH", …)与一次布尔赋值填进去;本机样本里这十六个只用到 9 个; - 执行成本与结构有关:160 个 pass 里 83 个带自己的渲染目标(不触发隐式拷贝),77 个走背缓冲回退(其中未写目标的那些会先拷一份上一遍的画面)。这一条是"结构影响开销"的量化依据,而不是从社区帖子转述的经验。
八、几处容易说错的地方
本篇涉及的都是"机制",而机制最容易在转述里走形。下面四条是笔者在中文与英文资料里都反复见到的说法,逐条对着源码与官方文字核一遍。
误说法一:「ReShade 按依赖图把效果排好再执行」。
核过的结论是没有依赖图。顺序只有两个来源(effect 文件内的声明顺序、预设 TechniqueSorting 的稳定覆盖),源码里那次 std::stable_sort 的比较函数还是"同一文件内直接返回不比"。pass 之间的先后由数组下标保证,而 pass 之间的"依赖"是共享纹理 + 一次状态转换隐式维系的。社区里有经验的说法其实是"没有所谓正确顺序,只是有些东西需要特定的相对关系"(原帖:Revisiting Optimal Effect Ordering)——这句话和源码是一致的。
误说法二:「运行时数据源一共十六个,都在 core 里」。
十六个的数量没错,位置错了。core 的枚举里能逐字数出 15 个,bufready_depth 不在里面。它由 add-on 从外面填。这个区别不是抠字眼:它决定了"深度类效果为什么不工作"要从插件那一侧查,而不是去 core 里找。
误说法三:「bufready_depth 会去检查深度图里有没有内容」。
源码里的判定是 data.selected_shader_resource != 0——"有没有选中一个深度资源",不是"深度图里有没有东西"。两者在排查时的含义完全不同:一张全黑但有内容的深度缓冲,这个布尔量是"真"。
误说法四:「性能模式是更卖力地优化同一份代码」。 它是换了编译方式:把 uniform 折成编译期常量。所以"变量调不动、预设存不了、效果列表变短"这三件事是同一个原因的三个表现,不是三个各自独立的现象。顺带说清顺序:因为折常量用的是预设里的值,所以"先调好再开"不是习惯问题,而是唯一可行的操作顺序。
四条放在一起,其实是一件事的四个侧面:这门运行时的设计取向是"把能定的都在装载期定下来,运行期只做最少的判断"。 顺序不现场算而是排好表、状态不现场改而是折进管线、变量不现场查而是折成常量——同一种取向重复出现了三次。 看到这一层,第一章那条"中间没有调度器"的调用链就不再只是"实现简单",而是一个一致的工程取舍。
九、边界与接口
9.1 和邻篇的分工
OK,先把本篇与其余各篇的接口交代清楚:
- 交给第三篇(已发)的:本篇只提到"pass 里的渲染状态写在效果文件里",而"这些写法在语言层各自意味着什么、编译器怎么处理"是第三篇已经讲过的;
- 交给第五篇的:第三章那张表里
bind_pipeline、begin_render_pass、bind_descriptor_table这些调用,是抽象层的名字。它们在 D3D9/D3D11/D3D12/OpenGL/Vulkan 上各自翻译成什么、为什么必须分开维护多份后端——这是第五篇的主线。本篇的角色是把"运行期要发哪些命令"这件事讲定,第五篇才有确切的输入; - 交给第六篇的:第四章那个深度 add-on 只露了一角(绑资源、改布尔量)。它的回调怎么注册、事件在哪些点触发、"两种构建"怎么分野,都归第六篇;
- 交给第七篇的:第四章讲了"深度缓冲是一张可采样的纹理",而"为什么拿不到深度、MSAA 下为什么错位、UI 为什么会挡住深度"是第七篇。
9.2 三处没答上的问题
依然是惯例,也要把本篇没能回答的问题摆出来,而不是装作讲全了:
- crosire 本人对"technique 执行顺序"的完整表述没有取到。 本篇用的是源码、官方文档与发布说明,以及官方论坛里社区成员的说明(已标作者)。没有把社区作者的话安到项目作者头上,也没有替作者补全立场。 若后续取到那处长篇回复,本篇的第二章可以补一段逐字引用;
- 本机没有取到 GPU 计时读数(原因见 6.2)。所以第三节那条"固定开销"的推论,只有源码与社区实测两侧支撑,缺本机这一侧。第九、十篇会补;
- 本机样本里深度类效果只有 1 个(
bufready_depth出现 1 次),所以第四章的结论在"深度这一类效果"上的样本量很薄。这一点已写进 7.2,不做掩饰。
资源清单
官方源码(一手,本篇逐字引用过的)
- ReShade 仓库
- source/runtime.cpp:主循环、排序、pass 执行、预设读写
- source/runtime_internal.hpp:
special_uniform枚举、六十帧滑窗容器 - source/runtime_api.cpp:对 add-on 的接口
- source/dxgi/dxgi_swapchain.cpp:
Present的第一行 - examples/09-depth/generic_depth_addon.cpp:深度注入的逐字来源
官方文档与发布说明(一手)
- Add-on Documentation:管线对象"不可分割"的定性
- 官方 ini 设置说明:性能模式的定义
- 6.5 发布说明:逐 pass 计时
- 3.1 发布帖:性能模式下的装载行为变更
- 语言参考 REFERENCE.md:十六个运行时数据源的取值表
官方论坛(社区一手,引用须标注作者)
- Revisiting Optimal Effect Ordering:「没有所谓正确顺序,只是有些东西需要特定关系」
- Correct Image Pipeline:Ganossa 说明"可排序单位是 technique,且每个 technique 都有固定开销"
- How does performance mode actually work?:0.170 → 0.030 毫秒的实测对照
- Providing game data to ReShade:未写渲染目标时落到哪两个目标
- BackBuffer and RenderTarget at one pass?:同一 pass 读写背缓冲的冲突
- How to pass information from one pixel shader pass to another?:pass 之间传递结果的惯用做法
图片素材(Wikimedia Commons,逐张核过许可与图内文字)
- File:Graphics pipeline 2 en.svg(CC0)
- File:Deferred rendering pass dep.jpg(CC BY-SA 4.0)
- File:Deferred rendering pass nor.jpg(CC BY-SA 4.0)
- File:Deferred rendering pass col.jpg(CC BY-SA 4.0)
- File:Deferred rendering pass res.jpg(CC BY-SA 4.0)
- File:Z-buffer no text.jpg(CC BY 2.0)


本机样本(只读,不外发)
E:\GameData\ReShade\Shaders\Effects\:69 个.fx(结构读数与 pass 键统计的来源)E:\GameData\ReShade\Presets\:12 个.ini(Techniques与TechniqueSorting对照的来源)
下篇预告
下一篇是《跨 API 抽象:D3D9/10/11/12、OpenGL、Vulkan 的差异与统一》。这一篇讲的是"运行期发出了哪些命令",而下一问紧接着就来:同一套命令,凭什么能在六种图形 API 上跑? 一次 bind_pipeline 在 D3D11 上是绑状态对象、在 D3D12 上却是另一回事;一张纹理在 OpenGL 与 Vulkan 里的状态转换规则也不一样。那一篇要拆的就是这层抽象:它把哪些差异吃掉了、哪些差异吃不掉而必须漏出来。
落款
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号「溯光的图形笔记」与个人博客 yyy3d.online。
这一篇把"一个 effect 从源码到画面中间过了几道"讲完了。希望能对大家有所帮助——尤其是第二章那句"没有依赖图"和第四章那句"第十六个不在 core 里",它们比任何参数都更容易被记反。如果这篇让你下次调预设时不再到处找那张不存在的依赖图,目的就达到了。