本文由@溯光 出品,转载请注明出处 站点链接:技术博客页
系列文章前言
系列定位
这个系列只回答一个问题:同样是「把矢量变成像素」,为什么市面上会同时活着五套做法完全不同的引擎,而它们各自还都活得挺好?
本篇是第三篇,也是钻到最底下的一篇。第二篇沿着 Skia 把「一次 draw」从 API 面拆到了后端,可它留了一个悬空的问题没答:命令进来的时候带着的是曲线,出去的时候落下的却是像素——中间那一步,矢量到底是怎么变成像素的?这一篇补的就是这一步。它不在 API 层,也不在后端层,而在两者之间的光栅化核心:曲线怎么变成线段、线段怎么变成覆盖率、覆盖率怎么变成屏幕上的灰度。
所以这一篇的门槛不在 API,而在几何。很多朋友能熟练写出 path.cubicTo(...),却说不清这条三次曲线在屏幕空间中最终被折成了多少段、这个段数是按什么算出来的、以及为什么一个三角形路径做抗锯齿只需要大约 3 + H 条扫描线而十六倍超采样要 4H 条。这些数字在 Skia 的源码里都写着,只是散在七八个文件里。我们把它们收拢到一条链上。
系列文章写作风格说明
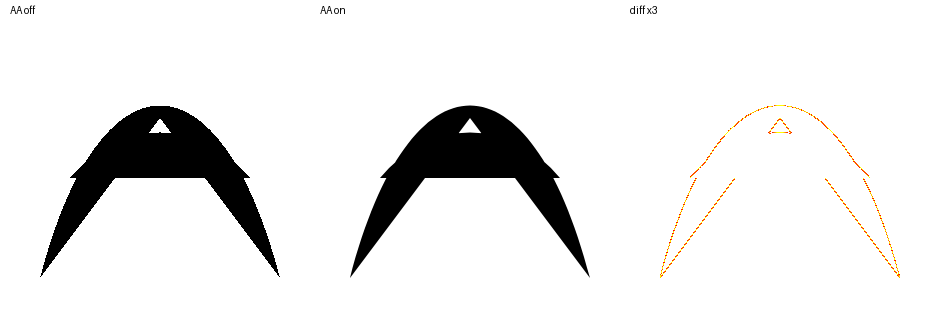
- 篇幅规划:每篇 16,000 至 20,000 汉字、10 章左右,每章 1,400 到 2,300 字。
- 写作顺序:先立坐标系(ep01),再沿 Skia 主线走机制(ep02 到 ep06),中间穿插三次自跑(ep07、ep08、ep10),最后与 Vello 前沿和三个对照项合流(ep09、ep11)。
- 每篇都给可核对的量化结论与出处;用「本机实测」与「官方原文」两条腿站住,凡是二手转述一律标注口径。
- 本系列不搬运厂商官方配图。需要图示时,我们用自己跑、自己算、自己画的图;外部示意图只取自 Wikimedia Commons 的通用概念图。
- 凡是前序系列已经占领的题域,本篇只引用、不复述——边界见 0.3 节。
全系列内容总览
- 【2D 矢量引擎深挖】(一) 2D 矢量引擎全景:五款引擎各在哪个生态
- 【2D 矢量引擎深挖】(二) Skia 架构:SkCanvas API 分层 + CPU(Raster) vs GPU backend
- 【2D 矢量引擎深挖】(三) 矢量引擎核心:贝塞尔细分、tessellation、analytic AA 与 coverage
- 【2D 矢量引擎深挖】(四) 字形光栅化:字形数据组织、blob 与 CJK
- 【2D 矢量引擎深挖】(五) Skia GPU backend:覆盖 approach 与 instanced tessellation
- 【2D 矢量引擎深挖】(六) Graphite:Skia 新一代 compute 后端
- 【2D 矢量引擎深挖】(七) 自跑一:Skia 路径 CPU vs GPU 与 overdraw 可视化
- 【2D 矢量引擎深挖】(八) 自跑二:SKP 回放与字体渲染差异
- 【2D 矢量引擎深挖】(九) Vello:GPU compute 矢量引擎的 Sparse Strips 与 prefix-scan
- 【2D 矢量引擎深挖】(十) 自跑三:Vello GPU、CPU、Hybrid 三路对比
- 【2D 矢量引擎深挖】(十一) 与 Godot 2D、Cairo、Rive 对照,以及与 Android 显示栈、VFX 的交叉索引
相关资源链接
- 系列主题的坐标系(第一篇):【2D 矢量引擎深挖】(一) 2D 矢量引擎全景
- 上一篇(主线引擎的 API 分层):【2D 矢量引擎深挖】(二) Skia 架构
- 本篇引用最密的两个源码文件:SkScan_AAAPath.cpp | WangsFormula.h
- 本篇本机自跑用的绑定:skia-python 发行页
本篇总览与边界:只回答三件事,不复述什么
先说说这一篇要干什么。它不是绘图教程,也不是源码导览,而是一条「矢量到像素」的动线。上一篇把一次 draw 送到了后端门口,这一篇要走进门去,看清楚门里那台机器:它先做什么、后做什么、每一步用什么数当尺子。顺序很重要:先明白曲线为什么必须被折成线段,才谈得上「怎么折」;先分清「段数」与「覆盖率」是两件事,才谈得上「为什么段数算得准还不够」。
0.1 全篇知识地图:十一章的顺序与产出
先来看看这张表。它不是并列的知识点,而是一条从曲线到灰度的动线——顺序不能颠倒:先有「曲线必须变线段」这个前提,才谈得上细分与段数;先把几何折成了线段,才谈得上扫描转换与覆盖率;先看清 CPU 这一侧怎么算准覆盖率,才有基准去看 GPU 那一侧怎么绕开它。
| 章节 | 在回答什么 | 你会拿到什么 |
|---|---|---|
| 零、总览与边界 | 本篇只回答哪三件事、不复述什么? | 三件题域 + 四块让出去的题域 + 术语双语对照 |
| 一、曲线为什么必须先变成线段 | 扫描转换器为什么只认直线? | 头注释原文 + build() 与 buildPoly() 两条入口 + 弦高容差 |
| 二、贝塞尔细分 | 点是怎么一层层分出来的? | De Casteljau 分层 + Bernstein 基 + Y 极值切分 + 段数上界 2⁶ |
| 三、Skia 为什么还要第三种曲线 conic | 多出来的那个权重 w 换来了什么? | 有理二次的定义 + kConicTol = 0.25 + pow2 0..5 与存储 (1+2N) |
| 四、段数是猜的还是算的 | 段数有没有公式? | Wang 公式全文 + 最坏情况闭式解 + conic 变体的出处 |
| 五、tessellation 有哪两条路 | CPU 与 GPU 各自怎么把曲线变三角形? | 六阶段三角化 + 单调剖分 + 面包屑三角形补 T-junction |
| 六、线段怎么变成覆盖率 | 一条线段到像素之间还差什么? | 活动边表 + 像素覆盖面积 + 两种填充规则 |
| 七、analytic AA 为什么只要 3+H 条扫描线 | 解析抗锯齿省在哪里? | 非等距扫描线三类 y + 排除面积 + 定点精度与 alpha 抖动 |
| 八、三套工业实现到底差在哪 | Skia、FreeType、Cairo 各自的选择 | 三套实现的精度与策略并置矩阵 |
| 九、GPU 那两条路怎么绕开覆盖率 | GPU 上还有别的解法吗? | stencil-then-cover 两阶段 + 隐式化 u²−v + 超采样上限 |
| 十、前沿把同一件事重做成了什么 | 新一代为什么又改了? | Sparse Strips 的 4×4 tile + Graphite 的 z 值降 overdraw |
0.2 本篇只回答三件事
先来看看第一件事。第一件:曲线怎么变成线段。从 SkPath 里的 verb 与点,到 Skia 内部那条「每条曲线最多折成多少段」的硬上界,再到 Wang 公式这条能把「容差」直接换算出「段数」的公式。这件事的产出是一组有序的直线段。
第二件:线段怎么变成覆盖率。一组线段进了扫描转换器之后,怎么被切成扫描线之间的梯形、怎么把「像素被盖住了多少」算成一个 0 到 255 的数。这件事的产出是一张覆盖率图,也就是抗锯齿的本质。
第三件:这个数怎么变成屏幕上的灰度。覆盖率不是终点,它要和颜色、和 alpha 混合规则接上,再落到目标面上。这一层我们只讲到「覆盖率交出去」为止,混合与合成归 ep02 讲过的 Canvas 状态与涂抹链。
| 问题 | 主角 | 关键证据 | 本篇产出 |
|---|---|---|---|
| 曲线怎么变成线段 | 细分与平整化 | MAX_COEFF_SHIFT 6、Wang 公式 |
一组有序线段 |
| 线段怎么变成覆盖率 | 扫描转换与解析覆盖 | 非等距扫描线、排除面积 | 一张覆盖率图 |
| 覆盖率怎么变成灰度 | alpha 抖动与交付 | snapAlpha、blitter 接口 |
交给混合链的 alpha |
0.3 本篇不复述什么:四块已经占领的题域
边界不是客套——它防的是两篇文章讲同一件事又都讲半截。前序系列与后续篇目占了不少地,我们一块块让出去。
好了,边界一块块说。第一块:字形光栅化,归 ep04。本系列第四篇专门讲字形数据组织、blob 与 CJK 提示。本篇在讲「曲线怎么折成线段」时会碰到字形轮廓也是曲线这件事,但不展开——你在这里看到的所有细分结论,对字形轮廓同样成立,正因为成立,才不必重复第二遍。
第二块:GPU 后端的落地,归 ep05。本篇第九节会讲 GPU 上「stencil-then-cover」与「隐式化着色器」两条路,但只讲到它们如何绕开逐像素覆盖率为止。这些几何在 Ganesh 里怎么变成一条条 op、怎么写进命令缓冲,是第五篇的事。
第三块:Graphite 的内部机制,归 ep06。第十节会用 Graphite 的「z 值降 overdraw」收束前沿,但只立一句分界线:它把 2D 绘制重新理解成「带深度的 3D 场景」。Recorder、Recording、多线程调度这些内部结构,是第六篇的事。
第四块:Vello 的完整流水线,归 ep09。第十节同样只用 Vello 的结论性特征——4×4 tile 加解析覆盖率——当对照,不展开它的 flatten、prefix-sum 与排序三段。
另外两处也顺手让出去:引擎生态位的对照(谁在哪一格)归 ep01 与 ep11;SDF 距离场文字渲染是字形领域的技术,归 ep04 的视野,本篇只在第九节把它作为一种「绕开覆盖率的思路」提一句。
0.4 边界声明与量化锚点
边界声明先行:本篇不涉及字形光栅化(含 SDF 文字)、不涉及 GPU 后端的命令与 op 组织、不展开 Graphite 与 Vello 的内部机制、不复述引擎生态位对照。凡出现 Graphite、字形、Vello 这些词,都只作对照项与分界线,深度留给对应篇目。
量化锚点同样是纪律。下表把本篇所有关键数字集中列一次,后文每处引用都与它一致;凡属「本机实测」的,环境写在表下。
| 锚点 | 数值 | 性质 | 来源 |
|---|---|---|---|
| 单条曲线折线段数上界 | 2⁶ = 64 段 | 源码常量 | SkEdge.cpp 的 MAX_COEFF_SHIFT 6 |
| conic 折 quad 的容差 | 0.25 像素 | 源码常量 | SkEdgeBuilder.cpp 的 kConicTol = 0.25f |
| conic→quad 的段数参数 | pow2 0..5(1..32 段) | API 文档 | SkPath.h 的 ConvertConicToQuads 注释 |
| 每细分一次误差变化 | 降为 1/4 | 源码注释 | SkEdge.cpp「cuts this dist (error) by 1/4」 |
| 细分的目标精度 | 1/8 像素 | 源码注释 | SkEdge.cpp「down by 3 should give us 1/8 pixel accuracy」 |
| AAA 存活 alpha 抖动阈值 | ≥248 归满、≤7 归零 | 源码实现 | SkScan_AAAPath.cpp 的 snapAlpha |
| 掩码 blitter 宽度上限 | 32 像素 | 源码常量 | SkScan_AAAPath.cpp 的 kMAX_WIDTH = 32 |
| 扫描线数(三角路径) | 约 3 + H(对比 16× 超采样的 4H) | 源码注释 | SkScan_AAAPath.cpp 头注释 |
| FreeType 子像素精度 | 8 位(ONE_PIXEL = 256) | 源码常量 | ftgrays.c 的 PIXEL_BITS = 8 |
| Cairo 覆盖率网格 | GRID_Y = 15、GRID_X = 256、GRID_XY = 7680 | 源码常量 | cairo-tor-scan-converter.c |
| GPU 超采样的常见上限 | 每像素 8 个样本 | 论文 | HPG18 半解析可见性论文 |
上述源码常量均取自 Skia main 分支(
raw.githubusercontent.com/google/skia/main)。本机实测环境统一为 skia-python 144.0.post2(对应 Skia m144),Windows 11 / x86_64;凡后文出现「本机实测」,均指该环境,除非另注。
0.5 术语双语对照(先备着)
这一篇的术语比上一篇更底层,先把它们排一次队,后面就不再逐个解释。中文名是我们自己拟的,英文名是源码与论文里的原始叫法——如果你在别处看到不同的译法,以英文名为准。
| 中文 | 英文 | 一句话定义 |
|---|---|---|
| 平整化 | flattening | 把曲线折成一组直线段 |
| 细分 | subdivision | 把一条曲线切成更短曲线 |
| 德卡斯特里奥算法 | De Casteljau's algorithm | 反复取中点来求曲线上的点与切分曲线 |
| 伯恩斯坦基 | Bernstein basis | 用一组基函数的加权和表示贝塞尔曲线 |
| 有理二次曲线 | rational quadratic (conic) | 带权重 w 的二次曲线,能精确表示圆弧 |
| 镶嵌 / 三角化 | tessellation | 把路径区域拆成三角形 |
| 单调多边形 | monotone polygon | 沿某方向扫描时与每条垂线至多交一条线段的多边形 |
| 扫描转换 | scan conversion | 把几何图形转化为像素覆盖 |
| 覆盖率 | coverage | 一个像素被图形盖住的比例,0 到 1(实现里常为 0..255) |
| 解析抗锯齿 | analytic anti-aliasing | 用解析积分直接算覆盖率的抗锯齿 |
| 超采样 | supersampling | 用更高分辨率采样再平均的抗锯齿 |
| 有向距离场 | signed distance field | 用「到形状边界的带符号距离」表示形状 |
一、曲线为什么必须先变成线段
下面我们开始第一阶段。这一章要回答一个看起来不像问题的问题:矢量引擎明明会画曲线,为什么内部还要先把它折成线段?答案不难,但它是后面所有章节的地基——不理解这一层,后面讲的细分、段数、扫描线全都会失去意义。
1.1 扫描转换器只认直线段
# 平整化的形状:曲线先折成线段,再进扫描线结构
for curve in path:  chop_at_y_extrema();  subdivide_until(chord_height < tol)
先来看一句原文。Skia 解析抗锯齿(analytic anti-aliasing,下称 AAA)实现的总纲注释里,开篇第一句就把这件事说死了:
We consider a path as a collection of line segments, as quadratic/cubic curves are converted to small line segments.
——
SkScan_AAAPath.cpp头注释
这句话的意思是:在扫描转换器眼里,世界上没有曲线,只有线段。曲线在进入扫描转换之前,就已经被「折」成了一段段足够短的直线。这句话值得反复读,因为它解释了后面所有看似奇怪的设计:
- 为什么 Skia 要给每条曲线算一个「段数」?因为段数决定了折线的形状精度。
- 为什么这个段数有硬上界?因为要防止病态输入把内存吃光。
- 为什么三次曲线要先在 Y 极值处切开?因为折完的线段要按 y 排序进扫描线结构,而一段折线如果跨越了曲线的 Y 极值,它在同一 y 上就会出现两个交点,扫描线的「一个 y 对应一组有序交点」这个前提就没了。
其中:ε 是弦高容差,单位是屏幕像素;曲线越弯、ε 越小,折出的段数越多。
这套「先折后扫」的原理不是 Skia 的选择,而是整个 2D 光栅化界几十年的共同结构。第九节我们会看到,GPU 上的 stencil-then-cover 与隐式化着色器是两条真正的例外:它们试图让曲线不变成线段、直接在着色器里判定内外。而恰恰是「要绕开折线」这件事,让它们背上了各自的历史包袱。
1.2 两条入口:build() 与 buildPoly()
既然要折,那就在建边表的时候顺手折掉。 Skia 的边表构建器 SkEdgeBuilder 有两条入口,正好对应「路径里有没有曲线」这两种情况:
| 入口 | 适用 | 做的事 |
|---|---|---|
buildPoly() |
路径只含直线段 | 直接按线段建边,省掉一切曲线处理 |
build() |
路径含曲线 | 先调 SkChopQuadAtYExtrema / SkChopCubicAtYExtrema 在极值处切分,再把每段折成线段 |
两条入口的分工来自
SkEdgeBuilder.cpp;SkGeometry.h里两个 chop 函数的注释只有一句:「This is called by the scan converter.」
这条分工透露了一个工程现实:「路径里全是直线」是最常见的快路径,值得为它单开一条分支。凡是能确定输入是折线的场景(比如界面里那些直角矩形边框、图标里的多边形),系统都会尽量走 buildPoly()。性能优化的第一条永远是「让常见情况走最短的代码路径」,这里就是活例子。
1.3 折到什么程度才算够:弦高容差
那么「段数够不够」是怎么判的?判据叫弦高容差(tolerance):折线是曲线的弦,弦与曲线之间会有一段最大距离,这个距离就是误差。只要它小于一个阈值(常见取 0.25 或 0.1 像素),肉眼就看不出来了。
- Skia 在建边表时折 conic 用的容差写死为
kConicTol = 0.25f,也就是 0.25 像素; - 而内部细分的目标精度注释写的是 1/8 像素。
两个数不一样,因为它们管的是两件事。 0.25 是「conic 先折成若干条二次曲线」这一层的外层容差;1/8 像素 是「一条二次/三次曲线再折成线段」这一层的内层精度。一层管粗,一层管细,这是典型的逐级收敛结构——先粗判该切几段,再对每段做细收敛。
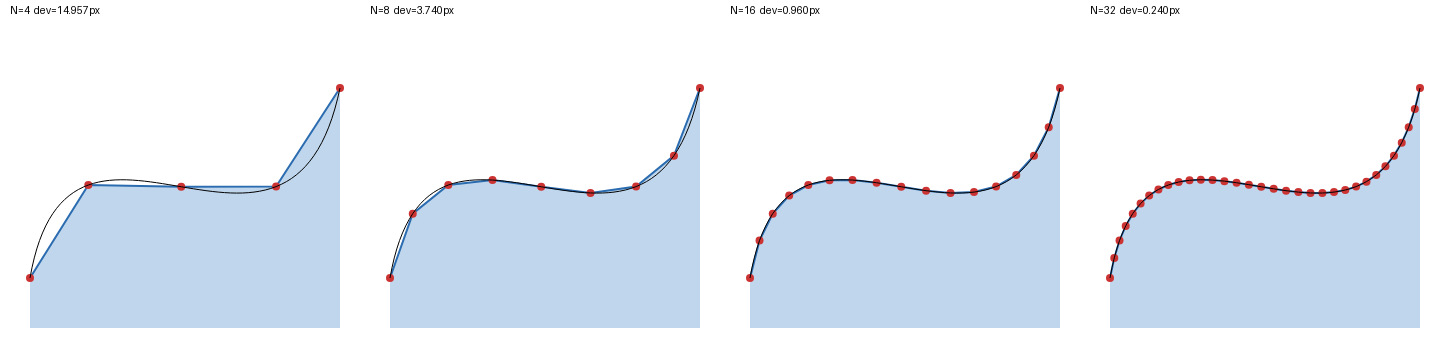
这里有个容易被忽略的推论:平整化是「屏幕空间」的事。同一条曲线,放大到全屏和缩小成一个图标,折出来的段数完全不同——因为容差是按屏幕像素定的。这也解释了为什么矢量图放大不会糊:放大之后系统会重新算一次段数,折得更细。矢量所谓「无损缩放」,物理上就是「按当前尺度重算折线」。
本章对应的官方依据:扫描转换只认线段一句见 SkScan_AAAPath.cpp 头注释;两条建边入口见 SkEdgeBuilder.cpp。
1.4 本章收在哪里
第一章走完,我们手里有了一句可复用的判据:在光栅化这件事上,曲线的第一身份是「待折的线段集合」。同时也有了三件共识:折线精度用弦高容差衡量;Skia 为「纯折线路径」单开了 buildPoly() 快路径;容差是屏幕空间的,所以矢量缩放才需要重算。
下一章要回答的是:那到底怎么折?一条三次贝塞尔,怎么变成一组有序的短线段,而且段数还不能随便多。
二、贝塞尔细分:点怎么一层层分出来
下面我们进入第二阶段。这一章回答「怎么折」:从贝塞尔曲线的参数表示出发,讲清三件事——怎么在曲线上取点(De Casteljau)、曲线的数学形式长什么样(Bernstein 基)、以及为什么必须先在 Y 极值处切一刀。最后落到 Skia 那条硬上界:一条曲线最多折成 2⁶ = 64 段。
2.1 De Casteljau:一层层取中点
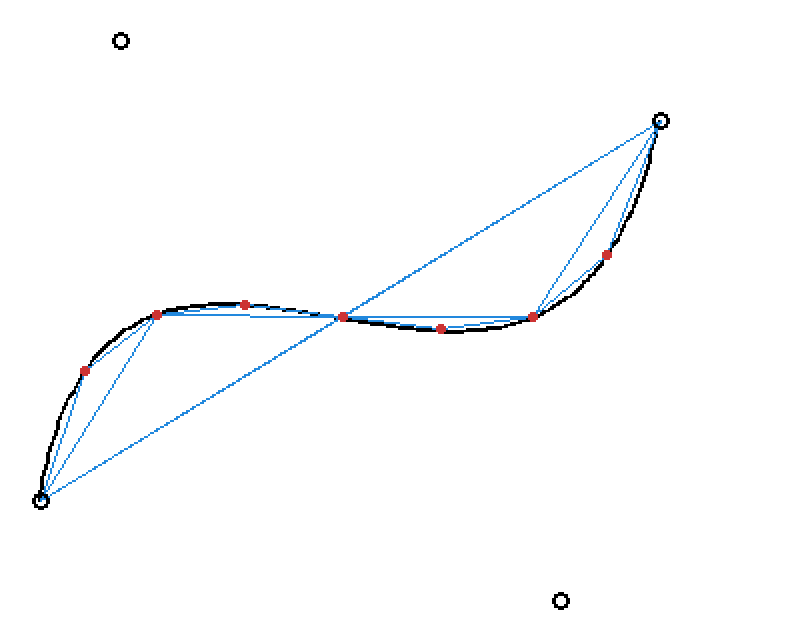
先讲最直观的取点办法。给一条三次贝塞尔曲线,控制点记为 P₀、P₁、P₂、P₃。想知道参数 t 处的曲线点在哪,De Casteljau 算法的做法是:
- 在 P₀P₁、P₁P₂、P₂P₃ 三条线段上,各按 t 的比例取一个点,得到三个新点;
- 这三个新点连成两条新线段,再按同样的比例各取一个点,得到两个点;
- 这两点连成一条线段,再按同样比例取一个点——它就在曲线上。
这个「逐层按比例取点」的过程有个漂亮的副产品:它同时给出了把曲线在 t 处切成两条曲线的所有控制点。也就是说,取点和切分是同一件事,不需要额外的公式。这就是为什么所有引擎的细分都从 De Casteljau 讲起——它不是最省算力的算法,但它是最容易讲清、也最容易做数值稳定的算法。
2.2 Bernstein 基:换一个写法,看见另一种性质
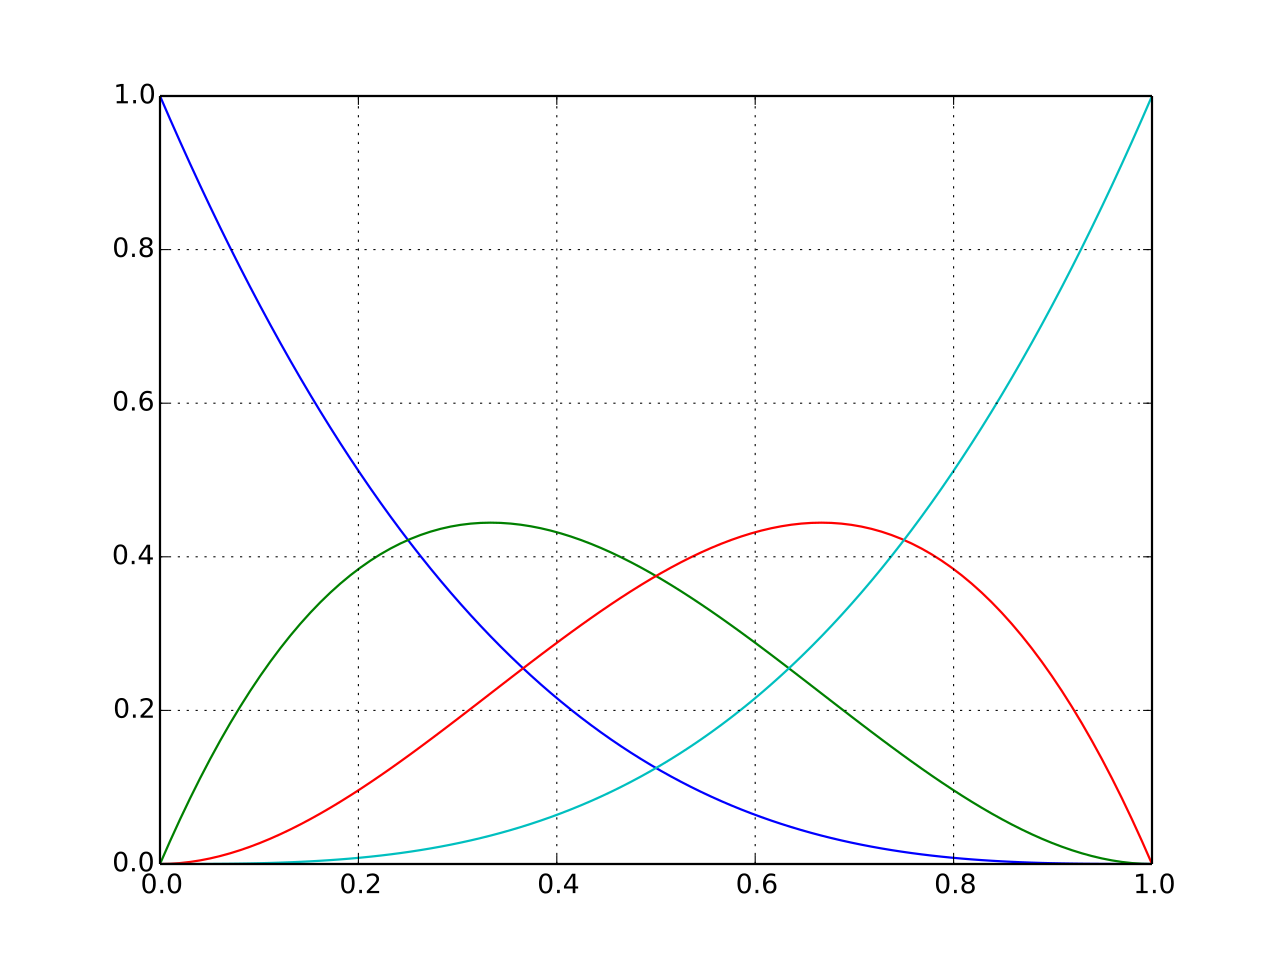
De Casteljau 讲的是「怎么算」,Bernstein 基讲的是「它到底是什么」。三次贝塞尔曲线可以写成四个基函数的加权和:
B(t) = (1−t)³·P₀ + 3(1−t)²t·P₁ + 3(1−t)t²·P₂ + t³·P₃
四个系数 (1−t)³、3(1−t)²t、3(1−t)t²、t³ 就是三条 Bernstein 基函数。它们的和恒等于 1——这是贝塞尔曲线一个极其有用的性质:曲线永远落在控制点形成的凸包内,因为它是控制点的凸组合。
凸包性质还有一个工程含义:它给了包围盒一个廉价的上界。想知道这条曲线会画到哪,不必求曲线上的极值点,直接取控制点的包围盒即可——它一定包含曲线。第四节的 Wang 公式要判「这条曲线在屏幕空间有多大」,用的就是这个性质。
2.3 为什么必须先在 Y 极值处切一刀
现在回来了那个伏笔。折完的线段要送进扫描转换器,而扫描转换器的核心结构是「按 y 推进的活动边表」:对每一条扫描线 y,它要能算出一组有序的 x,然后从左到右填。
麻烦在于:一段折线如果在扫描方向上先增后减,它就会与同一条扫描线相交两次。在活动边表里,一条边只登记一个「当前 x」,多出来的那个交点就没有位置安放——是漏掉、还是重复填?两种都会画错。
解决办法朴素得让人拍腿:在 x 或 y 的极值点把曲线切开,让每一段都单调。极值点可以解析求出(对 x(t)、y(t) 求导,解出 t 即可),切开之后每一段都是单调的,扫描线上就只有一个交点。这就是 Skia 里那两个 SkChopQuadAtYExtrema / SkChopCubicAtYExtrema 的来由,注释里那句「This is called by the scan converter」不是说明,是因果。
顺带说一句,三次曲线比二次曲线麻烦得多。二次曲线的极值点最多一个,切一刀就单调;三次曲线求导后是个二次方程,最多两个极值点,而且形状还分好几类。Skia 内部就把三次曲线分成了六类:
| 类型 | 形态 |
|---|---|
kSerpentine |
蛇形(有一个拐点) |
kLoop |
自交成环 |
kLocalCusp |
局部尖点 |
kCuspAtInfinity |
尖点在无穷远 |
kQuadratic |
退化成二次 |
kLineOrPoint |
退化成直线或一个点 |
分类函数
SkClassifyCubic的注释里直接写了出处:「Resolution Independent Curve Rendering using Programmable Graphics Hardware」——正是第九节要讲的 Loop-Blinn 论文。同一个数学分类,在 CPU 侧的用途是「决定怎么切」,在 GPU 侧的用途是「决定用哪个隐式方程」。
2.4 段数上界:为什么是 2⁶ = 64
现在讲那条硬上界。折得越细越准,这谁都知道;但「越准越好」在工程上是不成立的——病态输入(比如一个长度极大、曲率极端的曲线)会让段数爆炸,内存和耗时一起失控。所以必须有个上限。
Skia 的上界写在一个宏里:
#define MAX_COEFF_SHIFT 6—— This limits the number of lines we use to approximate a curve.——
SkEdge.cpp
MAX_COEFF_SHIFT 6 意味着段数用「2 的幂」表示,最大就是 2⁶ = 64 段。注释里还有一句后话很有意思:「now that this is in an unsigned byte, we could go up to 7」——意思是存储字段已经是一个无符号字节了,理论上可以放到 2⁷ = 128。代码里留着这种「其实还能再放一点」的注释,是成熟项目的常态:上限不是算出来的极限,而是当时够用又不冒险的一个选择。
那么「细分一次」到底改善多少?注释给了一个准确的答案:
each subdivision (shift value) cuts this dist (error) by 1/4
down by 3 should give us 1/8 pixel accuracy
——
SkEdge.cpp
误差按 1/4 收缩,这是二次收敛的特征。直觉上也好理解:曲线的「弯曲程度」由其二阶差分刻画,而二阶差分随细分呈平方衰减。误差按平方收敛,意味着「想再准一倍,代价是段数乘四」——这条成本曲线决定了所有引擎都不会去追极限精度,而是在 1/8 像素这种「刚好够」的位置停下。
本章对应的官方依据:曲线分段与精度常量见 SkEdge.cpp;chop 与 conic 折 quad 见 SkGeometry.h。
2.5 本章收在哪里
第二章走完,我们拿到了四件东西:De Casteljau 的逐层取点、Bernstein 基与凸包性质、Y 极值切分的因果、段数上界 2⁶ 与 1/4 收敛。
还欠一个关键问题没答:这个 64 是上限,那实际该用几段?上面讲的都是「怎么折」,但「折几段」这件事,Skia 在 CPU 侧用的是一套启发式估算,而在 GPU 侧有一条第 4 章要讲的公式。在此之前,我们得先认识 Skia 特有的第三种曲线——conic。因为它的段数算法,恰好是那套公式的「非 Wang」版本。
三、Skia 为什么还要第三种曲线 conic
下面我们进入第三阶段。上一篇提过一句:Skia 的路径里不止直线、二次、三次三种 verb,还有一个 kConic。这一章把这件事讲透:多出来的那个权重 w 到底换来了什么,以及它给光栅化带来了什么额外成本。
3.1 conic 是有理二次:多出来的那个权重
先说它是什么。普通二次贝塞尔(抛物线段)的公式是:
B(t) = (1−t)²·P₀ + 2(1−t)t·P₁ + t²·P₂
conic 给它中间那项乘上一个权重 w,再整体除以权重的和:
             (1−t)²·P₀ + 2(1−t)t·w·P₁ + t²·P₂
B(t) = ————————————————————————————————
              (1−t)²  +  2(1−t)t·w  +  t²
这种「分子分母都是多项式」的形式叫有理参数曲线,这个具体形式叫有理二次(rational quadratic)。分子分母都是二次,所以它在齐次坐标里其实就是一条普通的二次曲线——这也正是它能精确表示圆弧的原因。
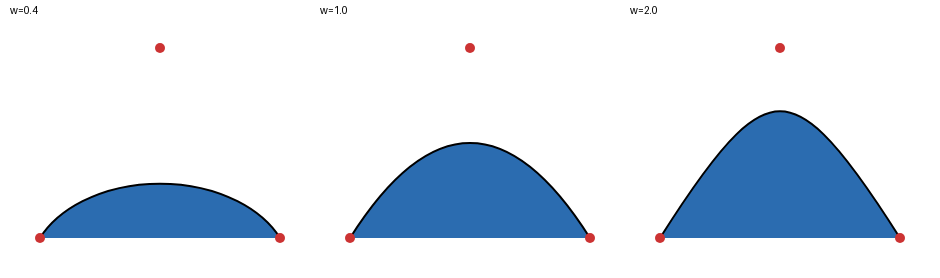
那个 w 决定了什么?一句话:它决定了曲线「往控制点 P₁ 鼓多少」。
| w 取值 | 曲线形态 | 能表示什么 |
|---|---|---|
| w < 1 | 比抛物线更「塌」,向弦靠拢 | 双曲线段 |
| w = 1 | 退化成普通二次贝塞尔 | 抛物线段 |
| w > 1 | 比抛物线更「鼓」 | 椭圆段,特定取值下是圆弧 |
关键在最后一格:w = cos(θ) 时,conic 能表示精确的圆弧。这就是 Skia 需要它的全部理由——圆是这个世界上最常见的图形,而贝塞尔曲线画不出精确的圆,只能逼近。二次逼近一个四分之一圆的最大误差约千分之二七,三次逼近可以压到万分之二七,但都不是零。而 conic 一上手就是精确的。
这笔账算得很清楚:为了「圆是精确的」这一条,Skia 要在路径表示里多存一个浮点权重、在扫描转换前多一层「conic 折 quad」的处理、在段数估算里多一套非 Wang 的公式(第四节)。换来的好处是:从圆角矩形到圆形进度条,Skia 画出来的圆弧没有逼近误差。这是个非常 Skia 的取舍——它宁愿在内部结构上复杂一点,也不愿在输出上留一点误差。
3.2 conic 怎么折:容差 0.25 与 pow2 0..5
言归正传,问题来了:扫描转换器只认线段,conic 再精确也得先折掉。那怎么折? Skia 走的是两步走:先把 conic 折成若干条二次曲线,再把每条二次曲线折成线段。
第一步的 API 叫 ConvertConicToQuads,它的文档注释里有两条必须记住的约定:
Approximates conic with quad array. ... Maximum quad count is 2 to the pow2. Every third point in array shares last SkPoint of previous quad and first SkPoint of next quad.
——
SkPath.h
「2 的 pow2 次方条」加「每第三个点共用」,这两句合起来描述了一种很紧凑的存储布局。一条二次曲线要三个控制点;如果把 N 条二次曲线首尾相接存下来,相邻两条之间会共用端点,那么总点数就是 2N + 1,正好对应「每第三个点共用」的说法。Skia 把这个 N 也写进了注释:
N = 1 << pow2. The amount of storage needed is (1 + 2 * N)——
SkGeometry.h的chopIntoQuadsPOW2
而 pow2 的常规取值范围是 0 到 5,也就是 1 到 32 条二次曲线(这条来自 API 文档的参数说明)。为什么又是「2 的幂 + 上限」?因为「取 2 的幂」意味着不用浮点舍入、不用四舍五入——段数天然就是可枚举的整数档位,实现里可以直接移位。这是 Skia 反复出现的模式:能用位移就不用浮点,能用整数档位就不留连续区间。
第二步的容差写在一个常量里:
constexpr float kConicTol = 0.25f;——
SkEdgeBuilder.cpp
0.25 像素。建边表的时候,Skia 用这个容差调 computeQuads 先算出该折几条二次曲线(computeQuadPOW2 的注释写着「return the power-of-2 number of quads needed to approximate this conic with a sequence of quads. Will be >= 0.」),再逐条折成线段。
本章对应的官方依据:conic 的 verb 与权重见 SkPath 概览;
kConicTol与pow2 0..5见 SkEdgeBuilder.cpp。
3.3 本章收在哪里
第三章走完,我们认识了 Skia 的第三种曲线:有理二次 conic,靠一个权重 w 换取『圆可以精确表示』这个能力;它在进入扫描转换前要经过先折 quad、再折线段的两步处理;每一步都有自己的容差与段数档位。
到这里,三种曲线都到齐了。但还有一个问题悬在空中:「该折几段」这个数字,到底是怎么定的?上面讲的是上界(64 段)和档位(pow2 0..5),可实际用哪一档,总要有个算法。Skia 在 CPU 侧用的是启发式估算,在 GPU 侧用的是一条有名字、有出处的公式。下一章就讲它。
四、段数是猜的还是算的:Wang 公式
下面我们进入第四阶段。这一章回答「折几段」这个核心问题。答案是有公式的,而且这个公式在图形学界有名字、有出处、有最坏情况的闭式解。如果说前面三章是「怎么折」,这一章是「折多少」——它是本篇最硬的一块内容。
4.1 Wang 公式:把容差直接换成段数
先来看看原文。 Skia 的 WangsFormula.h 头注释把这个公式讲得很完整,我们逐句读:
Wang's formula gives the minimum number of evenly spaced (in the parametric sense) line segments that a bezier curve must be chopped into in order to guarantee all lines stay within a distance of "1/precision" pixels from the true curve. Its definition for a bezier curve of degree "n" is as follows:
maxLength = max([length(p[i+2] - 2p[i+1] + p[i]) for (0 <= i <= n-2)])
numParametricSegments = sqrt(maxLength * precision * n*(n - 1)/8)
(Goldman, Ron. (2003). 5.6.3 Wang's Formula. Pyramid Algorithms: A Dynamic Programming Approach to Curves and Surfaces for Geometric Modeling. Morgan Kaufmann Publishers.)
——
WangsFormula.h
这段话里有三个要点,值得拆开看:
第一,「最小段数」是保证性的。公式给的不是经验值,而是「保证所有线段与真实曲线的距离都在 1/precision 像素之内」所需的最小段数。「保证」这个词很重要——它意味着这是一个可证明的上界,不是一个调参调出来的数。
第二,公式里那串 p[i+2] - 2p[i+1] + p[i] 是二阶差分。对二次曲线它只算一次(i=0),对三次曲线算两次(i=0,1)取最大。二阶差分正是「弯曲程度」的度量——曲线越弯,二阶差分越长,算出来的段数越多。这与第二章「误差按 1/4 收缩」是同一件事的两个视角。
第三,段数与 precision 是「平方」关系。看公式里的 sqrt(...):段数 ∝ √precision。所以想要 4 倍精度,段数只需要 2 倍。这一点很关键,因为它和第二章的「细分一次误差降为 1/4」互为逆命题——同一个二次收敛关系,从两个方向描述。
实现层面还有个小技巧:连续三个 length_term 都不是直接开根。因为开根号在向量指令里代价不低,Skia 把「Wang 公式的 4 次方」直接算出来(quadratic_p4 / cubic_p4),再用 root4() 或 nextlog16() 取回。nextlog16 这个名字本身就说明了「只用 2 的幂」这个传统:它算的是 ceil(log16(x)),也就是「要取到 2 的几次幂」。
| 函数 | 算的是 | 用途 |
|---|---|---|
nextlog2 |
ceil(log2(x)) |
基础对数 |
nextlog4 |
ceil(log2(√x)) |
二次曲线的段数档位 |
nextlog16 |
ceil(log2(⁴√x)) |
二次/三次曲线的段数档位(最常用) |
nextlog64 |
ceil(log2(⁶√x)) |
更高阶的档位 |
注释里还留了一句边界处理:「For +infinity return 128」——无穷大时返回 128,而不是崩溃或返回一个巨大整数。这种「病态输入给一个合理兜底」的写法,是数值代码的基本修养。
4.2 最坏情况:闭式解
说白了,工程上还需要另一个数:万一控制点摆得最坏,这条曲线最多要几段?因为 GPU 侧的缓冲要预先分配,分配多少必须有个确定的上界。Skia 给了闭式解:
worst_case_cubic_p4(precision, devWidth, devHeight) = 4 * length_term_p2<3>(precision) * (devWidth² + devHeight²)
This is simply a special case of the cubic formula where we maximize its value by placing control points on specific corners of the bounding box.
——
WangsFormula.h
这句话的数学含义很漂亮: Wang 公式里的 maxLength 是二阶差分,而它的最大值受控制点包围盒尺寸限制——把控制点摆在包围盒的特定角上就能取到最大。于是「最坏情况段数」被化成了包围盒尺寸的函数,只需知道屏幕空间宽高,不必看具体控制点。这条闭式解直接服务于内存分配:先按上界分配、按实际使用——这个套路在实时图形里到处都是。
4.3 conic 的公式不是 Wang 的
现在回到第三节那个悬念。 conic 的段数公式长得很像 Wang,但 Skia 的注释明确否定了这个说法:
This is not actually due to Wang, but is an analogue from (Theorem 3, corollary 1): J. Zheng, T. Sederberg. "Estimating Tessellation Parameter Intervals for Rational Curves and Surfaces." ACM Transactions on Graphics 19(1). 2000.
——
WangsFormula.h
为什么要专门注明?因为有理曲线比多项式曲线多了一个分母,而「分母不为常数」会让「二阶差分」这个度量失去直接意义——你不能只对着控制点算差分就完事,还要考虑权重的变化。Zheng 与 Sederberg 那篇论文处理的正是「有理」这件事。
实现里能看到这个额外的复杂度:
| 变量 | 含义 |
|---|---|
C(包围盒中心) |
先把三个点平移 −C,注释说这是为了「improves translation-invariance」——见论文 Sec. 3.3 |
max_len |
平移后三个点到原点的最大距离 |
dp = −2w·p1 + p0 + p2 |
分子部分的二阶差分 |
dw = abs(−2w + 2) |
权重的变化率——这一项在多项式曲线里不存在 |
denom = 4 * min(w, 1) |
分母 |
rp_minus_1 = max(0, max_len * precision − 1) |
论文里 ε = 1/precision 的对应项 |
注意 dw 那一项。它是整个实现里唯一「因为 w 会变而多出来」的东西,也是 conic 公式无法照搬 Wang 的根本原因。一行代码,把「有理」与「多项式」的区别说得明明白白。
本章对应的官方依据:Wang 公式全文与最坏情况闭式解见 WangsFormula.h;原始出处为 Goldman《Pyramid Algorithms》5.6.3。
4.4 本章收在哪里
第四章走完,我们拿到了「折几段」的完整答案:CPU 侧有启发式估算,GPU 侧用 Wang 公式;Wang 公式给出的是「保证精度所需的最小段数」,段数与精度成平方关系;最坏情况有只依赖包围盒的闭式解;而 Skia 特有的 conic 用的是 Zheng-Sederberg 的有理版本,多出一个权重变化项 dw。
几何这一侧到此为止。接下来要问的是:折出来的这一堆线段(或者按 GPU 的做法,被 tessellate 出的一堆三角形),是怎么被组织起来交给光栅化的?第五章讲两条 tessellation 路线。
五、tessellation 有哪两条路
下面我们进入第五阶段。「tessellation」这个词在 2D 领域有点歧义:CPU 侧它是「把路径区域拆成能填的三角形」,GPU 侧它是「用着色器并行地把曲线炸成三角形」。这一章把两条路都讲清,并说清它们的共同难题——接缝。
5.1 CPU 路线:三角化的六个阶段
# CPU 侧三角化六阶段
linearize -> build_mesh -> sort_by_Y -> simplify -> monotone_partition -> triangulate
先来看看 CPU 侧。 Skia 的实现叫 GrTriangulator,它的头注释把流程写得像一份施工顺序:
1) Linearize the path contours into piecewise linear segments; 2) Build a mesh of edges...; 3) Sort the vertices in Y (and secondarily in X); 4) Simplify the mesh by inserting new vertices at intersecting edges; 5) Tessellate the simplified mesh into monotone polygons; 6) Triangulate the monotone polygons directly into a vertex buffer
——
GrTriangulator.h
这六步里有三个信息值得停下来想。
第一,第一步就是第一章讲过的那件事。「Linearize into piecewise linear segments」——曲线先变线段,这一步在 CPU 与 GPU 两条路上都要走,不是哪条路的专利。
第二,第三步按 Y 排序是全局排序。把顶点按 Y(并列时按 X)排一遍,是为了后面用扫描线思路做「找交点 → 剖分」。这解释了为什么三角化是 CPU 侧相对贵的操作:它本质上是平面几何里的一套组合算法,复杂度与顶点数、交点数都相关,不是线性扫一遍就完。
第三,第五步的产物是「单调多边形」而不是直接三角形。这一步是 Skia 三角化算法的核心,出处也写在注释里:「Triangulating Simple Polygons and Equivalent Problems」(Fournier & Montuno)。为什么先剖成单调多边形?因为单调多边形的三角化是线性时间的——剖分把最难的部分(一般多边形)先化归成好处理的部分(单调多边形),代价是要多做一次剖分。这是计算几何里非常经典的「分解-求解」套路。而第四步的求交化简,用的是 Bentley-Ottmann 线扫描。
顺带记几个实现参数:三角化接口带明确容差(PathToTriangles(path, tolerance, clipBounds, ...)、pathToContours(tolerance)、appendQuadraticToContour(..., toleranceSqd, ...)),内存用块状竞技场分配,块大小 16 KB(kArenaDefaultChunkSize = 16 * 1024)。
5.2 单调剖分:把难问题化归成好问题
单调多边形为什么值钱?它的定义是:存在一个方向,使沿该方向的每条垂线与多边形边界至多交一条线段。由此带来一个极有用的后果——从凸顶开始可以线性地把顶点一个个「剪耳朵」成三角形,不会剪错;而一般多边形没有这个保证,可能剪到一半发现剪出个洞。所以整条路线是:一般多边形 →(加辅助线)→ 单调多边形 →(线性剪)→ 三角形,多花一次剖分,换来最后一步的简单与稳定。实现里 fPreserveCollinearVertices 与 fRoundVerticesToQuarterPixel 两个开关,就是剖分阶段对共线点、过近点这些退化情形做的兜底。
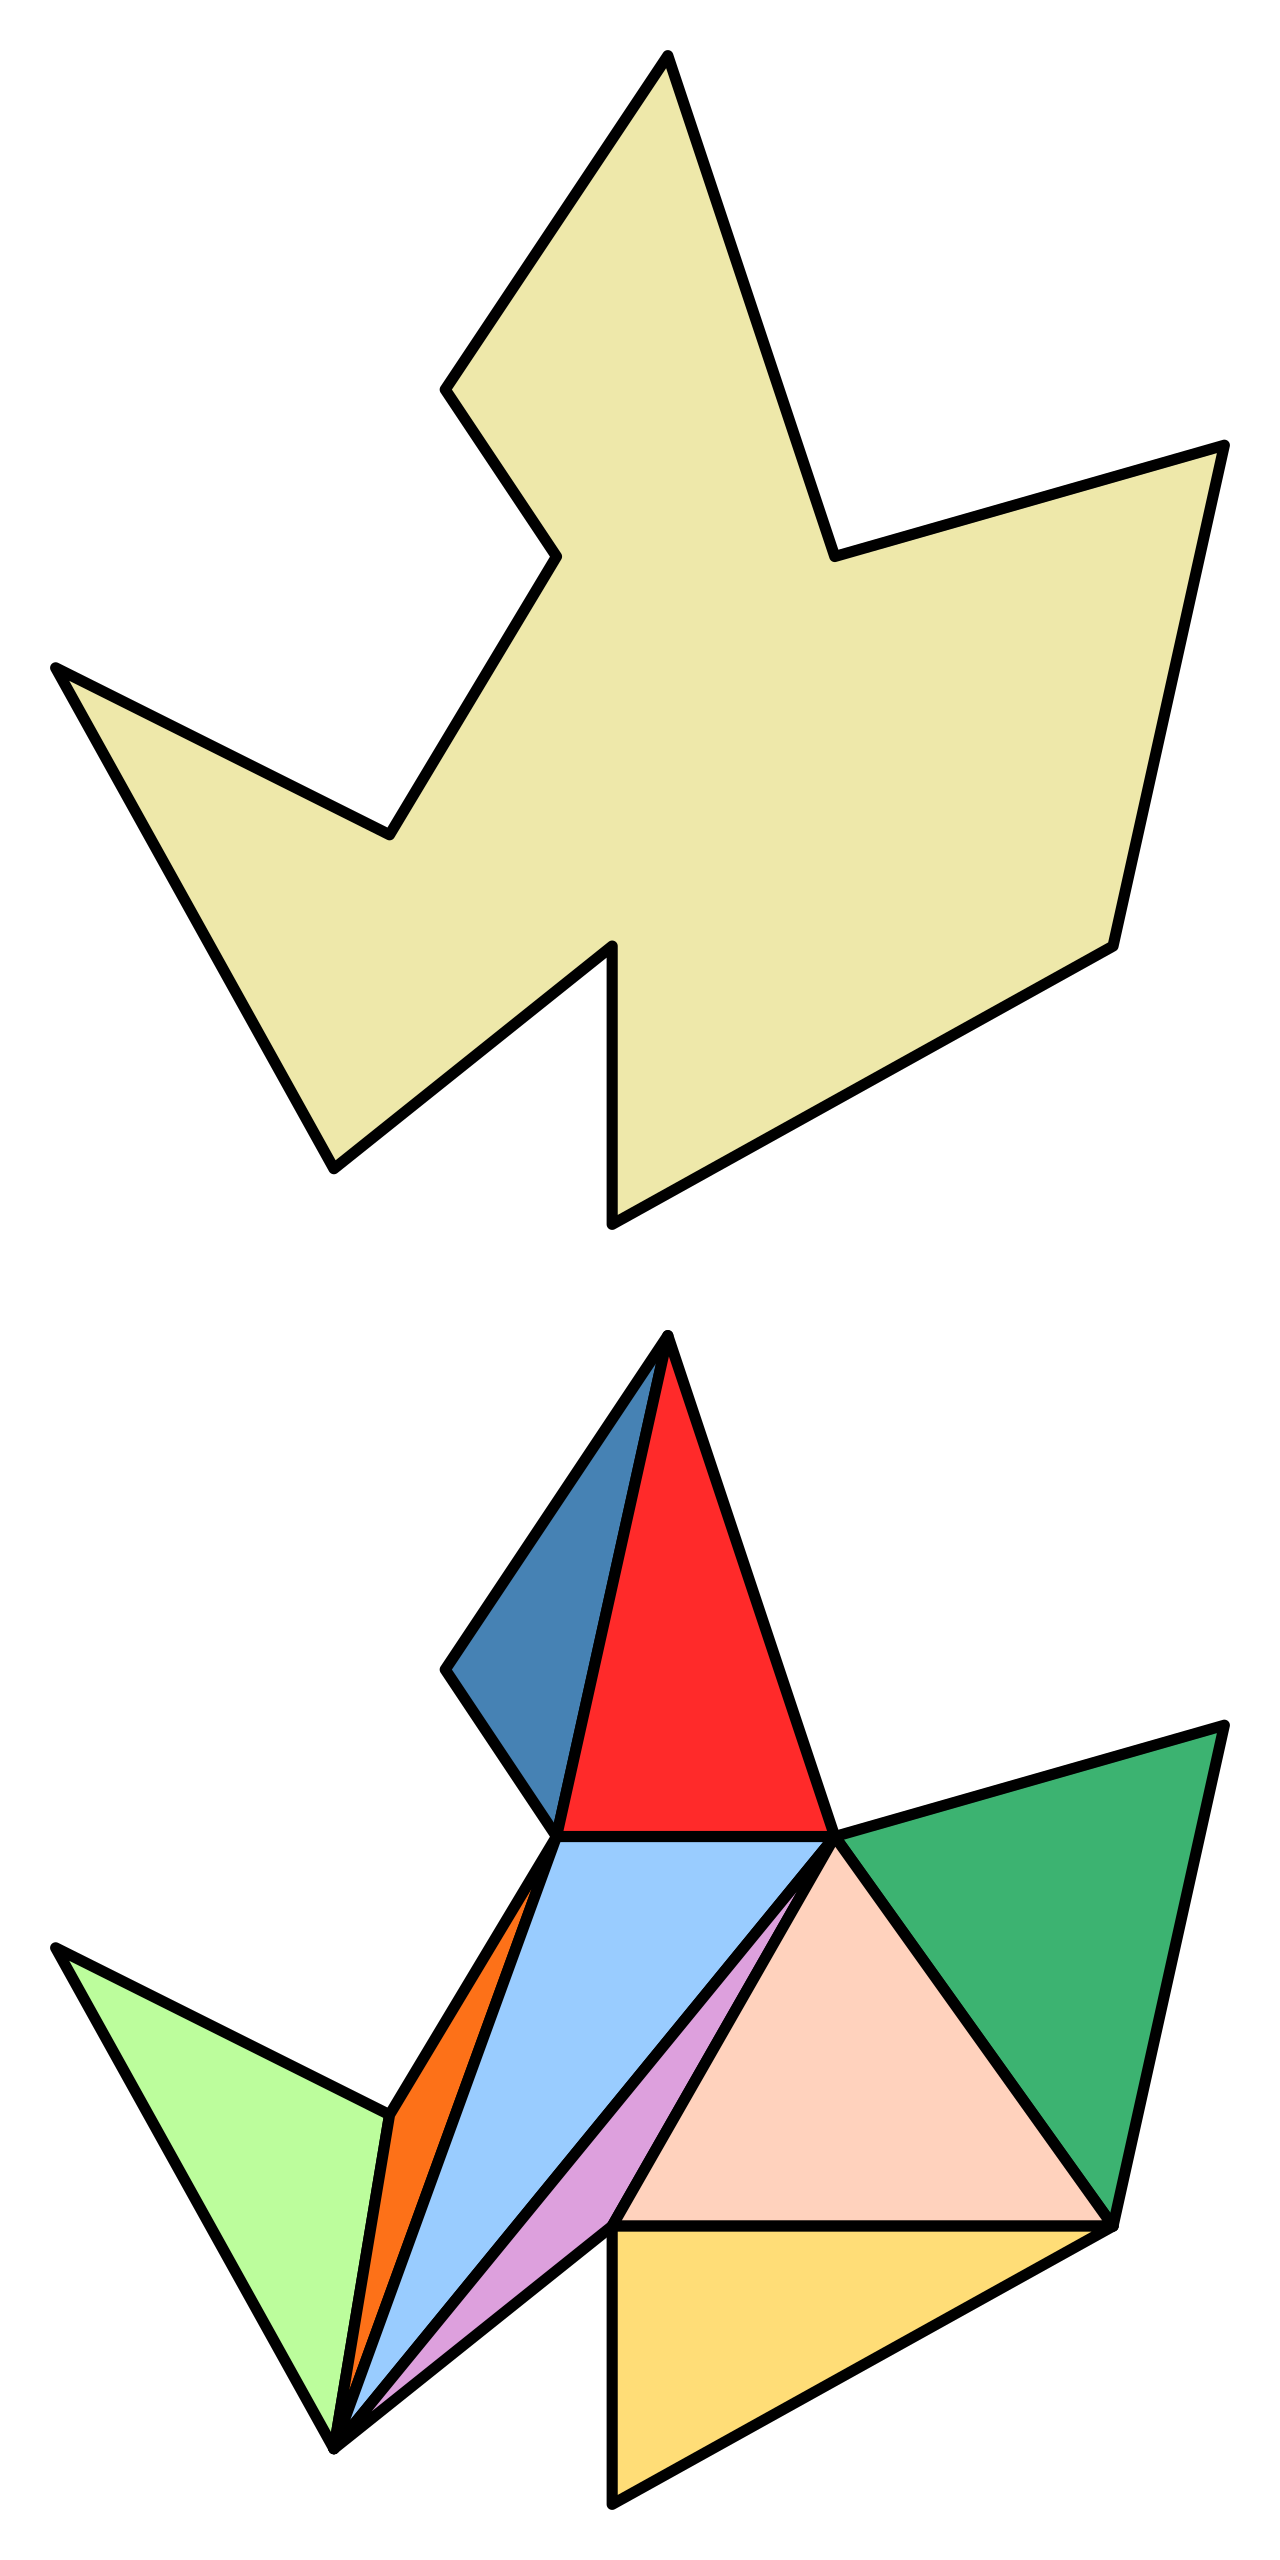
5.3 接缝问题与面包屑三角形
两条路线都要面对同一个麻烦:接缝。折线化的轮廓(外圈曲线)与内部三角化出来的多边形之间,顶点不可能严丝合缝对齐——外面折了 17 段,里面可能剖出 19 个顶点,中间就留下一个个细缝(T-junction)。缝小的看不见,缝大的会漏出背景色,在抗锯齿的边缘上尤其明显。
Skia 的解法名字很可爱,注释原文:
The breadcrumb triangles serve as a glue that erases T-junctions between a path's outer curves and its inner polygon triangulation.
——
GrTriangulator.h
「面包屑」这个名字取得很准:它在接缝处撒下一串很窄的三角形,把这些缝「粘」住。注意它们的角色——它们不是为了填色,而是为了补缝,所以实现里有一个专门的开关 fEmitCoverage 管覆盖率输出,与面包屑是两件事。
其中:tolerance 是线性化容差,clipBounds 是裁剪范围,两者共同决定三角化的顶点规模。
这个细节很能说明 2D 光栅化的真实难度:数学上讲清了「怎么剖分」只是第一步,工程上真正花时间的,往往是「两套算法接在一起时那半像素的缝」。第九节我们还会在 GPU 侧看到同一个问题的另一种解法。
本章对应的官方依据:六阶段与面包屑三角形见 GrTriangulator.h;单调剖分出处为 Fournier & Montuno。
5.4 本章收在哪里
第五章走完,我们看到 CPU 侧把路径变成三角形的完整六步,以及其中最值钱的一步——用单调剖分把难问题化归成好问题;也看到了两条路线共同的敌人是接缝,Skia 用「面包屑三角形」把它粘掉。
几何到此彻底就绪:曲线变成了线段,线段围起来的区域变成了三角形(或直接变成按 y 组织的边表)。下一章开始,视角切换——不再问「几何长什么样」,而是问「像素被盖住了多少」。
六、线段怎么变成覆盖率
下面我们进入第六阶段。这是本篇的转折章。前面五章都在讲几何,从这一章起,主角变成像素。核心问题只有一句话:一个像素被图形盖住了一部分,那「一部分」要算成多少?
6.1 活动边表:按 y 推进
先来看看扫描转换的基本结构。把折线化的轮廓看成一组边,每条边有起止 y。经典做法是维护一张活动边表(active edge table):
- 按 y 从小到大推进扫描线;
- 有边进入当前扫描线范围就加入活动表,离开就移除;
- 每条扫描线上,把活动边的 x 交点排序;
- 按填充规则在相邻交点之间填色。
Skia 的实现里能看到这个结构:SkScan_Path.cpp 中有 SkEdge* currE = prevHead->fNext; 这样的链表推进、validate_edges_for_y(currE, curr_y) 这样的校验,以及 proc(blitter, curr_y, PREPOST_START) 这样的「行前/行中/行后」回调。PREPOST_START 这个枚举名说明了 blitter 接口的设计:一次扫描行会被拆成「开始前 / 进行中 / 结束后」三段通知,便于某些 blitter 做缓存刷新。
建边阶段在这里还要处理一个细节:垂直边的合并。 SkEdgeBuilder.cpp 里有一条判断:
return SkAbs32(a - b) < 0x100;
0x100 是 16.16 定点数里的 1/256,也就是「两个 x 差不到 1/256 像素就算相等」——这样能把近乎垂直的边合并掉,减少活动表的规模。更值得记的是这条判断旁边的一句注释:
We only consider edges that were originally lines to be vertical to avoid numerical issues (crbug.com/1154864).
只有「本来就是直线」的边才参与垂直合并,曲线折出来的边不参与。为什么?因为曲线折出来的边方向是近似的,把它们当垂直处理会引入数值问题——这条注释挂着具体的 bug 号,是一处真实的工程妥协。
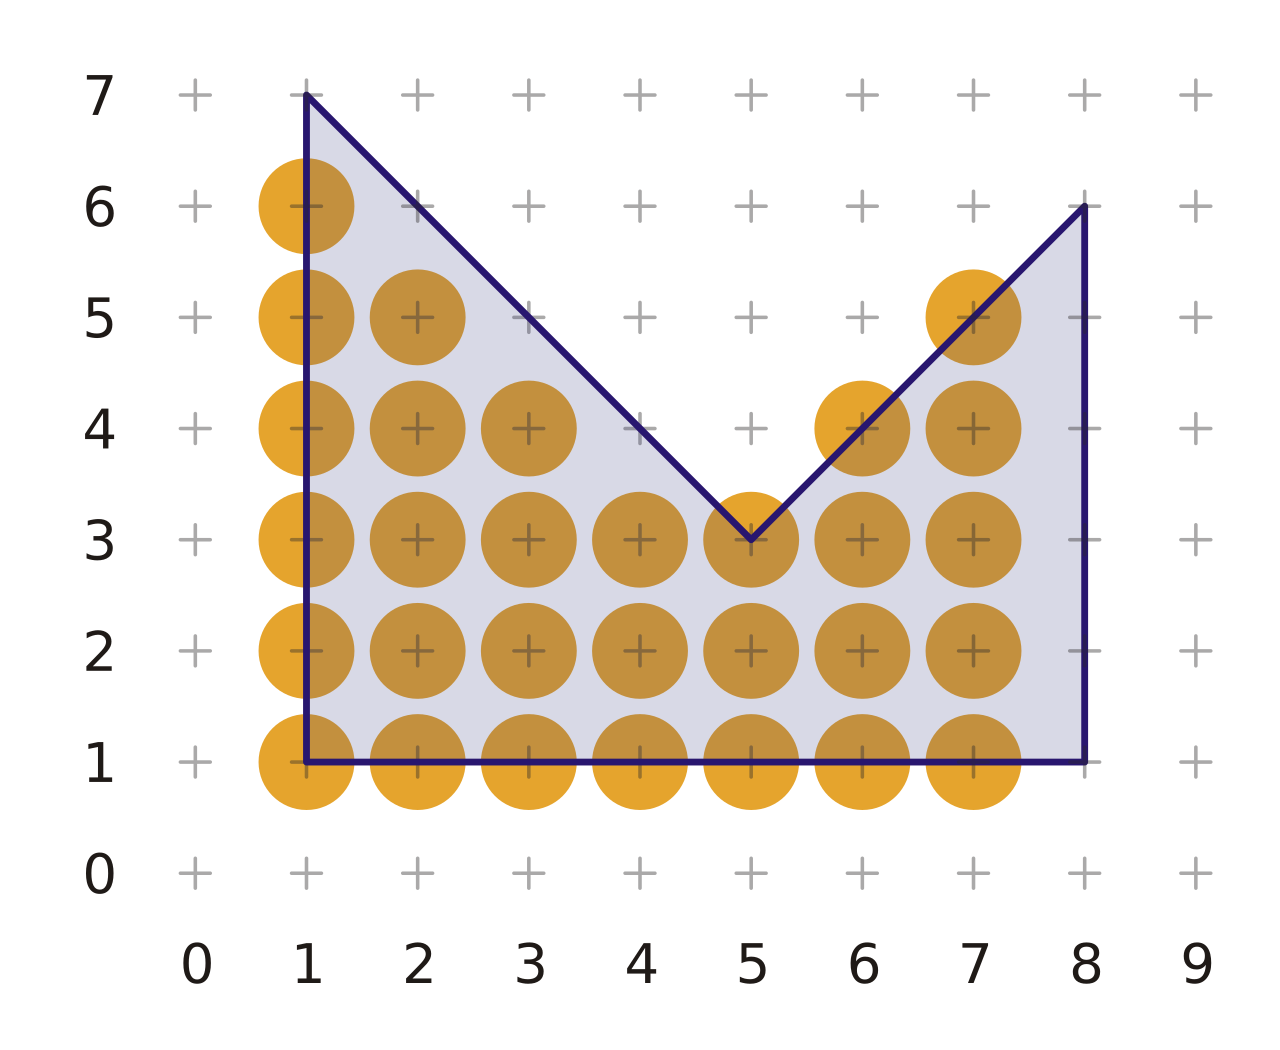
6.2 像素被盖住了多少:面积就是覆盖率
现在到了最关键的一问:单个像素怎么算覆盖率?答案朴素得几乎让人失望——算面积。
一个像素是一个 1×1 的正方形。图形盖住它的部分是一个多边形(通常是梯形或三角形)。两者的交集面积,就是覆盖率。覆盖 30% 就是 0.3,覆盖 100% 就是 1。
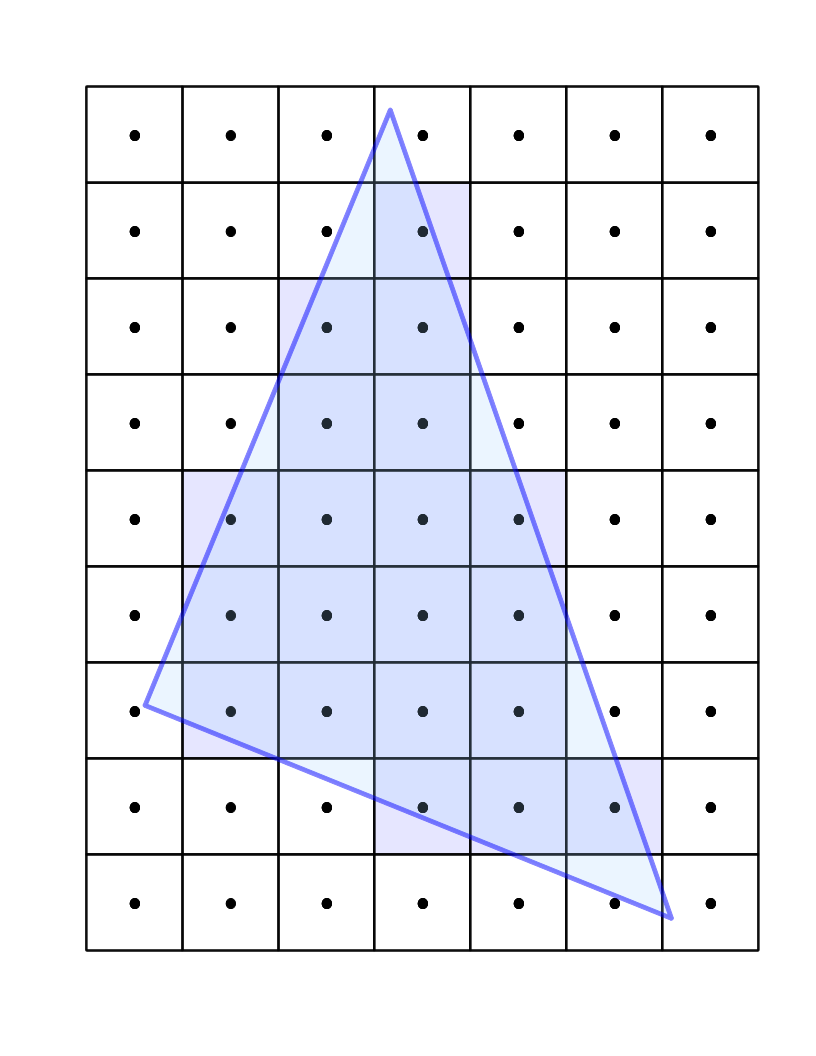
其中:coverage 取值落在 [0, 1],乘上 255 就是 8 位 alpha。
这个定义简单,但它的实现方式分出了两大流派:
| 流派 | 做法 | 代表 |
|---|---|---|
| 超采样 | 在像素内打若干个样本,数有多少个落在图形内 | 16× 超采样(子像素网格) |
| 解析法 | 直接解析算出交集面积 | Skia AAA、FreeType、Cairo tor |
超采样的优点是简单——它不需要任何几何求交,只需要「点是否在图形内」这个判定。缺点是精度被样本数锁死:16 倍采样意味着覆盖率只能取 17 个档位(0/16 到 16/16),而 8 位 alpha 有 256 个档位。这就是第七节要讲的「解析法为什么更准」的由来:不是算法更聪明,而是它没有把精度浪费在档位量化上。
6.3 两种填充规则:edge fill 与 fence fill
还有一个容易被忽略的细节:扫描线上「哪一段该填」怎么判?同一组交点,按不同规则填出来是不同的图形。Skia 实现了两种常见策略,名字很形象:
| 规则 | 做法 | 适用 |
|---|---|---|
| edge fill | 遇到边就切换「填/不填」状态 | 一般多边形填充 |
| fence fill | 只在特定方向(如向下)的边处切换 | 减少重复填充,常用于扫描线算法的优化 |
这两种规则在几何上是等价的(对简单多边形),差别在代价结构上。 edge fill 对每条边都要切换状态;fence fill 只对一侧的边切换,于是同一段区间可能被填两次或更多次——如果填充操作是「覆盖」,多填一次无所谓;但如果填充操作是累加(抗锯齿的 alpha 累加正是累加),多填就会把 alpha 加爆。所以规则与混合方式必须配套设计,这是光栅化里非常容易出错的一处。
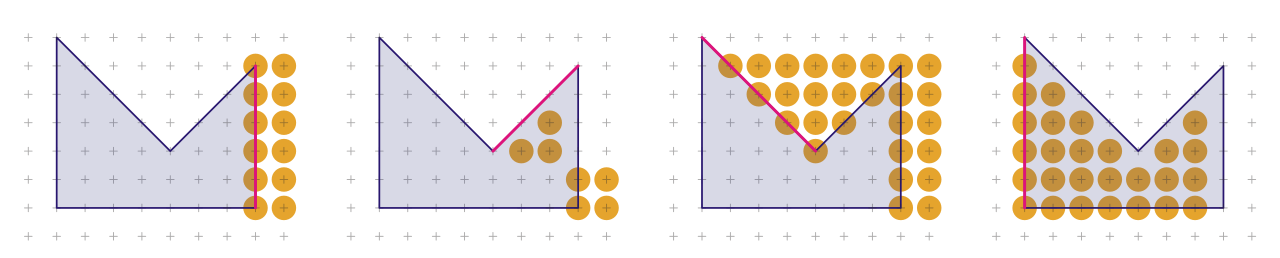
本章对应的官方依据:扫描转换入口与掩码上限见 SkScan.h;垂直边合并的 bug 号为 crbug.com/1154864。
6.4 本章收在哪里
第六章走完,我们跨过了从几何到像素的那道桥:活动边表按 y 推进、像素覆盖率由「交集面积」定义、填充规则决定哪一段被填。也看到了垂直边合并那个带 bug 号的工程细节,以及两种填充规则与混合方式必须配套的原因。
七、analytic AA 为什么只要 3+H 条扫描线
下面我们进入第七阶段。这一章讲 Skia 的解析抗锯齿,也是全篇技术含量最高的一章。它的核心是一句反直觉的话:算得准的那个算法,反而算得更快。而支持这句话的证据,是 Skia 源码里的一段对比数字。
7.1 非等距扫描线:三类 y
先来看看旧办法的毛病。超采样的扫描线是等距的。Skia 的注释里把两种旧做法的取法都列了出来:
the previous non-AA algorithm 用
y = 1/2 + 0, 1/2 + 1, 1/2 + 2, ...the previous 16-supersampling AA algorithm 用y = 1/8 + 1/4, 1/8 + 2/4, 1/8 + 3/4, ...——
SkScan_AAAPath.cpp
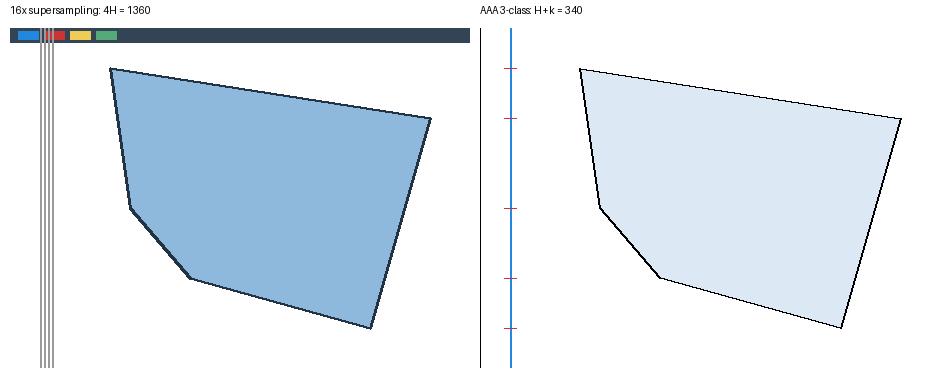
等距的好处是简单,坏处是「大量扫描线白跑了」。想象一个高 500 像素的三角形:超采样每像素要打 4 条纵向扫描线,于是总共约 2,000 条;而其中绝大多数扫描线切出来的截面形状长得一模一样,算出来的覆盖率其实是同一批数。
Skia 的做法是:只在「形状会变」的地方放扫描线。注释列了扫描线 y = c_i 的三类取值:
- an integer between [0, H]
- the y value of a line segment endpoint
- the y value of an intersection of two line segments
——
SkScan_AAAPath.cpp
这三类值就是几何发生变化的全部位置:整数行覆盖像素行边界,端点行切开线段起止,交点行切开两线段交叉。三类位置之间,截面是纯梯形——算一次就能平移复用。
7.2 排除面积:为什么「算外面」比「算里面」容易
好了,扫描线放好了,接下来算覆盖率。这里 Skia 用了一个非常巧的转换。原注释说得很清楚:单个像素的覆盖率本质是「像素矩形与梯形」的交集面积(区域 A),但 A 的形状可能很复杂,所以别算 A,算它外面那两块:
we can compute the excluded area, which are B and C, quite easily, because they're just triangles.
——
SkScan_AAAPath.cpp
注释里甚至画了个 ASCII 图说明这个位置关系:
+-----------\----+
|            \  C|
|             \  |
\              \ |
|\      A       \|
| \              \
|  \             |
| B \            |
+----\-----------+
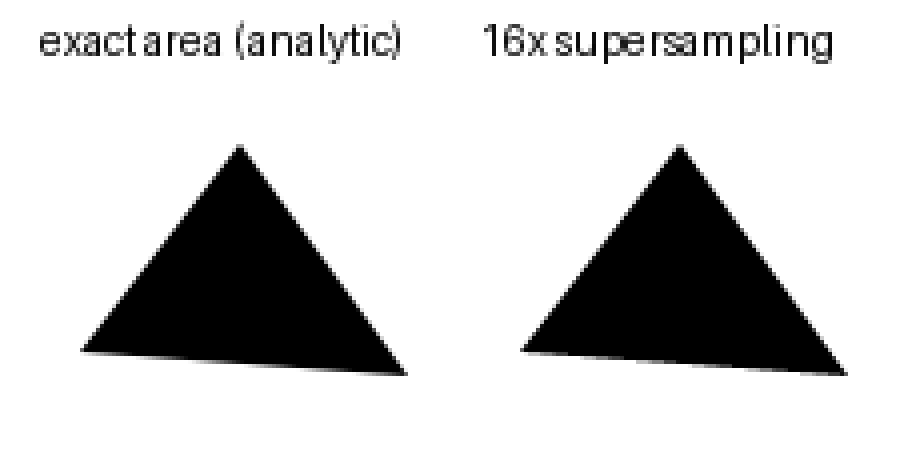
中间那块不好算的 A 是「像素被梯形盖住的部分」,而上下两块 B、C 是两个直角三角形——面积一眼可得。于是 覆盖率 = 1 − (B + C) / 像素面积。这就是标题里那个「解析」的含义:不是采样估算,而是真的把面积积出来。
注释还补了一句为什么这个转换总是成立:
we can prove that an excluded region (take B as an example) is either itself a simple trapezoid (including rectangles, triangles, and empty regions), or its opposite (the opposite of B is A + C) is a simple trapezoid. In any case, we can compute its area efficiently.
换句话说:无论梯形怎么摆,总有一侧是简单形状。这条「对偶」性质让实现不必对边界情况做各种特判——算法的正确性不依赖枚举所有情形,而依赖一条可证明的对称性。这是数值代码里最让人安心的一种设计。
7.3 3 + H:那句话的分量
现在讲那个数字。头注释里有一段直白的对比:
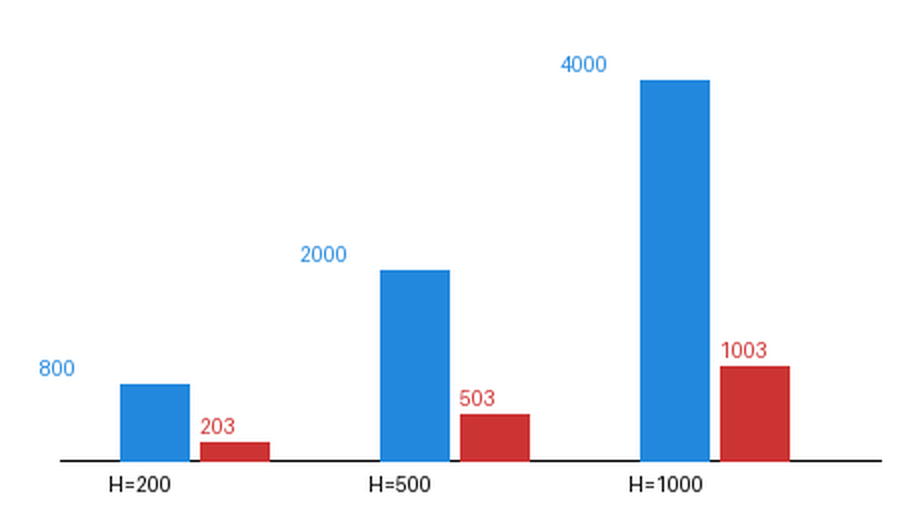
For example, given a triangle path, the number of scan lines in our algorithm is only about 3 + H while the 16-supersampling algorithm has about 4H scan lines.
——
SkScan_AAAPath.cpp
这里 H 是绘制区域的高度。一个三角形:三条边,每条边最多贡献两个端点 y;加上每条扫描线至少要在每个整数行出现一次——于是扫描线总数约等于 H 加上一个与边数相关的小常数(这个例子里是 3)。而 16× 超采样是每个像素行打 4 条,所以是 4H。
H 取 500 时是 503 对 2000,差 4 倍;这个差距与图形复杂度无关,因为扫描线数量由几何变化点决定。
其中:H 是绘制区域的高度,k 是与边数相关的常数(三角路径下为 3)。
更重要的是质量那句话:
our algorithm has a higher quality because it generates ground-truth coverages analytically. It is also faster because it has much fewer unnecessary horizontal scan lines.
「又快又准」不是营销语,而是这个算法结构的必然结果:因为不采样,所以没有档位量化误差;因为扫描线只放在必要处,所以没有冗余计算。两件事的根源是同一个——把扫描线放在几何变化处。
7.4 定点精度与 alpha 抖动
剩下的是工程细节,但每一处都决定「解析算出来的精确覆盖率」能不能真落到 8 位 alpha 上。
第一处:边用定点数表示。 SkAnalyticEdge.h 定义了 static constexpr int kDefaultAccuracy = 2;,并给出 SnapY 的实现与理由:「先左移、舍入、再右移」会导致某些值被算错,Skia 改成「加半个单位再截断」。边上还有 Winding : kCW = 1, kCCW = -1 用符号表方向、fDY = abs(1/fDX) 只用于梯形 blitting 的注释。
第二处:alpha 的抖动(snap)。解析算出的覆盖率是连续的,输出却只有 8 位,于是 Skia 在 RunBasedAdditiveBlitter 里做了这样一件事:
// Blitting 0xFF and 0 is much faster so we snap alphas close to them
SkAlpha snapAlpha(SkAlpha alpha) { return alpha > 247 ? 0xFF : alpha < 8 ? 0x00 : alpha; }
注意阈值是 247 与 8,不是 255 与 0——凡是 ≥248 的覆盖率直接当「完全不透明」,≤7 的直接当「完全透明」。理由写在注释里:blit 255 和 0 比 blit 254 和 1 快得多,因为前者走「填充」快路径、后者必须走「混合」慢路径。让约 3% 的边缘像素取极值,换边缘像素大量走快路径——抗锯齿到最后拼的不是数学,而是这类「哪 3% 可以不要」的判断。
第三处:掩码缓冲多留的那两个字节。小路径走掩码缓存,宽度上限 32 像素(kMAX_WIDTH)、存储上限 1024(kMAX_STORAGE),而数组声明里多留两字节,注释写的是「we add 2 because we can write 1 extra byte at either end due to precision error」——多留一格,是因为这里的定点运算会在边界上偶尔多写一个字节。
第四处:兜底路径。 AAA 并非所有情形都能走。SkScan.h 里写着:路径太大时抗锯齿会退化成非抗锯齿(BW),除非外层先把它切成小块;而 getRealBlitter(forceRealBlitter) 的注释也提到「fall back to the old code path」。新算法上线不等于旧代码删掉,而是留一条兜底的路——这是成熟工程的常态。
本章对应的官方依据:三类扫描线与
3 + H对比见 SkScan_AAAPath.cpp;定点精度与SnapY见 SkAnalyticEdge.h。
7.5 本章收在哪里
第七章走完,我们拿到了本篇最核心的一组结论:Skia 的解析 AA 把扫描线放在三类「几何变化点」上,用「排除面积」把复杂的交集面积算成两个三角形,于是三角路径只要约 3 + H 条扫描线(对比超采样的 4H),并且覆盖率是解析的真值而非采样估算。
同时也看到了这套算法能落地的四个工程前提:定点数的安全舍入、alpha 抖动到 0/255、掩码缓冲多留两字节、以及一条退回旧实现的兜底路径。
到这里,我们讲的全是 Skia。但问题是:别的引擎做的是同样的选择吗?下一章把 FreeType 与 Cairo 拉出来并排看——它们面对的数学问题完全一样,选择却相当不同。
八、三套工业实现到底差在哪
下面我们进入第八阶段。上一章的结论如果只讲 Skia,容易让人以为「解析算覆盖率」是唯一正确答案。这一章把 FreeType 的 ftgrays 与 Cairo 的 tor 扫描转换器摆在一起,看同样的数学问题在三个项目里长出了三种不同的样子。
8.1 FreeType ftgrays:精确覆盖 + 8 位子像素
先来看看 FreeType。它的抗锯齿光栅化器在 ftgrays.c 里,文件开头的自述相当有性格:
A new
perfect'anti-aliasing renderer ... computes the exact coverage for each pixel cell from straight line segments——
ftgrays.c
注意「exact」这个词与两个前提:一是覆盖率由直线段算出(曲线要先折线),所以曲线部分的覆盖率是近似的——FreeType 自己也不回避这一点,注释里明说曲线是反复分裂展平的,偏差估到远小于一像素为止;二是「每个像素 cell」——它也是逐像素算面积的路子,与 Skia AAA 同一阵营。
但它有两点与 Skia 明显不同。
第一,思想的出处不同,实现也刻意不同。注释写明思想源自Raph Levien 的 LibArt,但实现完全不同——coverage 的存储方式不同,且用整数运算、不做浮点的路径排序。这句话信息量很大:「解析算覆盖率」这个思想在 1990 年代末就有了(LibArt),此后二十年各家的分歧不在思想,而在「用什么数表示、怎么排序」这些工程选择上。
第二,精度与性能的取舍写在常量里:
| 项 | 值 | 含义 |
|---|---|---|
PIXEL_BITS |
8 | 子像素用 8 位表示 |
ONE_PIXEL |
256 | 一个像素等于 256 个子像素单位 |
| 填充规则编码 | FT_FILL_RULE 用最高位表非零规则、第 8 位表 even-odd |
一个字节塞下两种规则 |
| 扫描遍数 | 单遍(标准 FT2 渲染器为两遍) | |
| 速度优势区间 | 尺寸小于 80 像素时比标准渲染器更快 | |
| 距离近似 | FT_HYPOT 用 α=1、β=3/8 近似,最大误差 < 7% |
「小于 80 像素更快」这行很关键。它说明 FreeType 的设计目标从一开始就是小尺寸字形——ASCII 正文里一个字母也就一二十像素高,在这个尺度上单遍扫描加整数运算的收益远大于一切优化;而 8 位子像素(256 档)也刚好匹配字形对精度的要求——再细就被 hinting 与 gamma 校正淹没了。
8.2 Cairo tor:逐行在「解析」与「超采样」之间二选一
说白了,Cairo 的选择最有意思,因为它既不是纯解析也不是纯超采样,而是「逐行挑一个」。 cairo-tor-scan-converter.c 的注释交代了来历:这是 Glitter paths 的扫描转换器并入 Cairo,本质是 David Turner 对 Tor Andersson 的 15×17 超采样光栅器的重实现(源自 Apparition 图形库)。
核心策略一句话说清:
逐扫描行低成本地在「整行解析覆盖率」与「超采样」之间二选一
——
cairo-tor-scan-converter.c
判据也很清楚:只有在有边在某行内起止、或该行存在边相交时才退化为超采样。这与第七节 Skia 的「三类扫描线」是同一个洞察——形状不变的行,解析算一次就行;形状变化的行,老老实实采样。
它的网格常量值得单独记,因为它们决定了覆盖率的分辨率:
| 常量 | 值 | 含义 |
|---|---|---|
GRID_Y |
15 | 纵向子像素档位 |
GRID_X_BITS / GRID_X |
8 / 256 | 横向子像素档位 |
GRID_XY |
7680 | 单位面积 = 2 × 256 × 15,用于「面积 → alpha」映射 |
15 这个数字很可能是那台 15×17 超采样光栅器留下的痕迹。一个横向 256 档、纵向 15 档的网格,横向精度远高于纵向——这不奇怪:扫描转换天然按行组织,纵向的「行内细分」比横向贵得多,所以纵向档位取得少。
它的数据结构也很直给:
struct cell { uncovered_area; covered_height }
每个 cell 存「未覆盖面积」与「覆盖高度」,左边界记正号、右边界记负号,最后遍历 cell 列表累加 delta,生成 RLE 压缩的 A8 span。这就是第六节讲的「面积即覆盖率」在工程上的具体形态:沿扫描线累积一个「已覆盖面积」的增量序列。
另外 Cairo 还有一条 botor 变体(名字来自 Bentley-Ottmann),只在边事件处维护活动边表以跳过无变化区域——注意这与 Skia 三角化里用的 Bentley-Ottmann 是同一套几何思想,同一个算法在不同项目里反复出现。
8.3 三套实现并置对照
言归正传,把三家摆在同一个表里。这张表是本章的结论,也是本篇的一个参照系——后面第九节讲 GPU 时,我们会用同一张表来对照 GPU 的两条路。
| 维度 | Skia AAA | FreeType ftgrays | Cairo tor |
|---|---|---|---|
| 覆盖率算 | 解析(排除面积法) | 解析(cell 精确覆盖) | 逐行二选一(解析 / 超采样) |
| 扫描线取法 | 三类几何变化点 | 单遍扫描 | 变化行解析、其余行超采样 |
| 子像素精度 | 定点 + alpha 抖动 | 8 位(256 档) | 网格 15×256 |
| 曲线处理 | 先折线段(另有 conic 两步) | 反复分裂展平 | 先折线段 |
| 设计目标 | 通用 2D、大图小块 | 小尺寸字形(<80 px 更快) | 通用、跨平台 |
| 覆盖率数据流 | blitter 接口(行前/行中/行后) | A8 覆盖率位图 | cell 列表 → RLE span |
| 特色取舍 | alpha≥248 归满、≤7 归零 | 整数运算、不做浮点排序 | 只在变化行付超采样代价 |
其中:三家的差异集中在精度表示与目标尺寸两项上,数学内核相同。
读这张表可以得出一个原理判断:三家的数学内核高度一致,分歧全在「为谁优化」。 Skia 面对的是「什么都可能画」的通用场景,所以它把扫描线取法做到几乎最优、并准备一条在超大路径上退化的兜底路;FreeType 面对的是十几像素高的字形,所以它选了单遍 + 整数,甚至不介意曲线覆盖率是近似的;Cairo 要跨平台且兼容历史,于是保留了三套转换器(tor、botor 等)让上层按场景挑。
换句话说:光栅化算法没有「最优解」,只有「为某类输入最优的解法」。这句话第十节还会被验证一次——因为新一代引擎改的正是「为谁优化」这个前提。
本章对应的官方依据:FreeType 精确覆盖与 8 位子像素见 ftgrays.c;模块说明见 FreeType 光栅化文档;Cairo 网格常量见 cairo-tor-scan-converter.c。
8.4 本章收在哪里
第八章走完,我们用三套工业实现互相照了一遍:Skia 的解析 AA、FreeType 的单遍精确覆盖、Cairo 的逐行二选一。三者的数学内核相同,分歧集中在精度表示、扫描组织与目标尺寸上。
到这里,CPU 侧的整条链已经完整:曲线 → 线段 → 活动边表 → 覆盖率 → alpha。下一章换到 GPU,看两条试图跳过「逐像素算覆盖率」这一步的路线——它们为什么会绕弯,以及绕弯的代价是什么。
九、GPU 那两条路怎么绕开覆盖率
下面我们进入第九阶段。 CPU 侧的一切都建立在「有一个能逐像素算面积的处理器」这个前提上。GPU 没有这个前提——它是上千个线程并行执行同一个着色器,让它在像素里做「求交、算面积」很别扭。于是 GPU 上的矢量绘制走了两条完全不同的路。
9.1 stencil-then-cover:用模板缓冲「数内外」
# stencil-then-cover
stencil: rasterize path bounds -> cover: draw conservative geom, test stencil
第一条路叫 stencil-then-cover(下称 StC),出处是 Kilgard 与 Bolz 的「GPU-accelerated Path Rendering」(SIGGRAPH 2012,产品化为 OpenGL 扩展 NV_path_rendering)。它的想法非常巧妙,分两步:
| 阶段 | 做什么 |
|---|---|
| Stencil | 把路径的边界几何(可以在 CPU 侧预先算好)栅格化进模板缓冲,用增减计数表示「这个像素被几条边跨过」;再按填充规则判定哪些像素在内部 |
| Cover | 画一块保守的几何(包围盒或三角形扇),但对每个像素先测模板缓冲——只给内部像素着色,然后把模板清掉 |
一句话概括:用模板缓冲当「内外判定器」,把「逐像素算面积」这件事换成了「逐像素查一个计数器」。
为什么这样能快?因为路径几何被缓存了。注释里提到路径对象可以在 GPU 侧保留几何数据,重复绘制同一路径时不必重算;而「覆盖」阶段画的是极大的简单几何,GPU 对「画一大堆三角形」这件事极其擅长。代价是抗锯齿要靠模板的多重采样来做——NV path rendering 用的是每像素 16 个样本。
论文里的实测数字值得记(GeForce 560M 笔记本电脑):
| 场景 | 耗时 |
|---|---|
| Snail Bob | 5 ms |
| Van Gogh SVG(含渐变) | 5.26 ms |
| 完整 SIGGRAPH 网页 | 4.8 ms |
| 含裁剪的 SVG | 1.9 ms |
这份论文还顺手评述了当时各家实现的困境,其中一句与我们的主题直接相关:
Skia/Ganesh 先试 stencil,后改为 CPU 算 coverage mask 上传为纹理,受每路径动态纹理更新拖累。
—— Kilgard & Bolz (2012)
这句话解释了为什么 Skia 的 GPU 路径长期没有走 StC。上传纹理这件事在小路径上重复绘制时开销可观;而 CPU 算覆盖率又回到「CPU 干活」。所以 Skia 的当前选择是多样的:小路径走 CPU 算覆盖率并缓存成图集(atlas),大路径走 GPU 三角化——这正好是 ep05 的主题。
论文里还有一个数字,是理解整件事的背景:
移动设备的屏幕密度远超 PC——iPad 显示屏 264 DPI,而 PC 常规约 100 DPI。
—— Kilgard & Bolz (2012)
屏幕密度越高,「每个边缘像素都要算准覆盖率」的代价就越突出。这是为什么 GPU 侧的矢量绘制一直在找新解法——不是为了跑得更快,而是因为像素越来越多。
9.2 隐式化着色器:让像素自己判断内外
第二条路更激进:干脆不让曲线变成线段。这就是第九节开头提到的 Loop-Blinn 方法(「Resolution Independent Curve Rendering using Programmable Graphics Hardware」,2005)。它的数学核心是隐式化:
每条参数曲线 [x(t), y(t)] 都可以消去参数 t,写成 f(x, y) = 0 的形式。一旦有了这个隐式方程,着色器只需要在像素处求 f 的符号——符号为正在曲线一侧,为负在另一侧。对外侧轮廓做一次符号判定,内外就分开了。
这条路最漂亮的两个结果:
| 曲线次数 | 隐式形式 | 着色器开销 |
|---|---|---|
| 二次 | u² − v = 0 |
1 次乘法 + 1 次加法 |
| 三次 | k³ − lmn = 0(整型曲线退化为 k³ − lm) |
略高,仍是多项式求值 |
注意二次那行的开销:一次乘法加一次加法。相比之下,在屏幕空间直接解出通用二次曲线的系数需要「几十次算术运算」。而它还有第三个好处:预处理只需给贝塞尔控制点赋一组纹理坐标,由 GPU 透视正确插值完成,无需逐帧重算曲线系数。
三次曲线那一行则把我们在第二章见过的分类又拉回来了:所有平面三次曲线可归为 serpentine(蛇形)、cusp(尖点)、loop(自交环) 三类射影型,其代数表示统一为 k³ − lmn = 0(这一结果可追溯到 1852 年 Salmon 的工作)。这正是 Skia 里 SkCubicType 那六个枚举值的数学来源——第二章它是「决定怎么切」的依据,这里它是「决定用哪个隐式方程」的依据。
代价也很明确:曲线不能有自交外的退化、需要为每个曲线段准备三角形外壳、以及抗锯齿要靠硬件梯度(hardware gradients)。所以这条路虽然在数学上「分辨率无关」,工程上却始终没能在通用 2D 库里取代折线法。
9.3 Nehab-Hoppe:把图元流塞进格子
第三条路是 Nehab 与 Hoppe 的「Random-Access Rendering of General Vector Graphics」(ACM TOG / SIGGRAPH Asia 2008)。它把路径预处理成一张格子(lattice):每个格子用变长编码记下穿过它的图元流,像素着色器运行时解析这个流,得到该像素处的覆盖。于是实现了随机访问——任意像素独立算出自己的覆盖率,不必按扫描线顺序处理。
它最硬的结论是:同时做预滤波与超采样,而抗锯齿不增加额外显存带宽。插值采样通常要读多个样本、带宽随采样数线性增长,这条性质是对 GPU 光栅化的根本性改善。几个设计取值也值得记:格子内局部坐标只用 8 位或 16 位(格子小,不需要全局精度);路径段统一用 linear / quadratic 表示(cubic 自适应细分为 quadratic);填充用 even-odd 规则;预滤波核首选抛物线核 k(d) = 4/3·(1−d²),d∈[−1,1],论文明确说 box 核「明显不令人满意」。
这篇论文里最容易被忽略、也最有分量的一个细节,是它区分了两种透明度:「颜色自带的 alpha」属非线性 sRGB 空间,「边界覆盖率」必须在线性空间处理,两者不能混。混合公式形如 blend(c, f, o) = lerp(sRGB⁻¹(over(f, sRGB(c))), c, o)——先把颜色拉回线性空间混合,再变换回去。
一句话总结第九节: GPU 上的三条路都在做同一件事——把「逐像素解析求面积」换成某种「并行友好的等价判定」,代价分别是模板缓冲的多重采样、数学上的退化限制、预处理与存储开销。再补一个约束数字:一篇 2018 年的论文(HPG18 半解析可见性)给出过 GPU 超采样的常见上限——通常限于每像素 8 个样本,继续加样本只是线性增加空间与成本而收益递减。
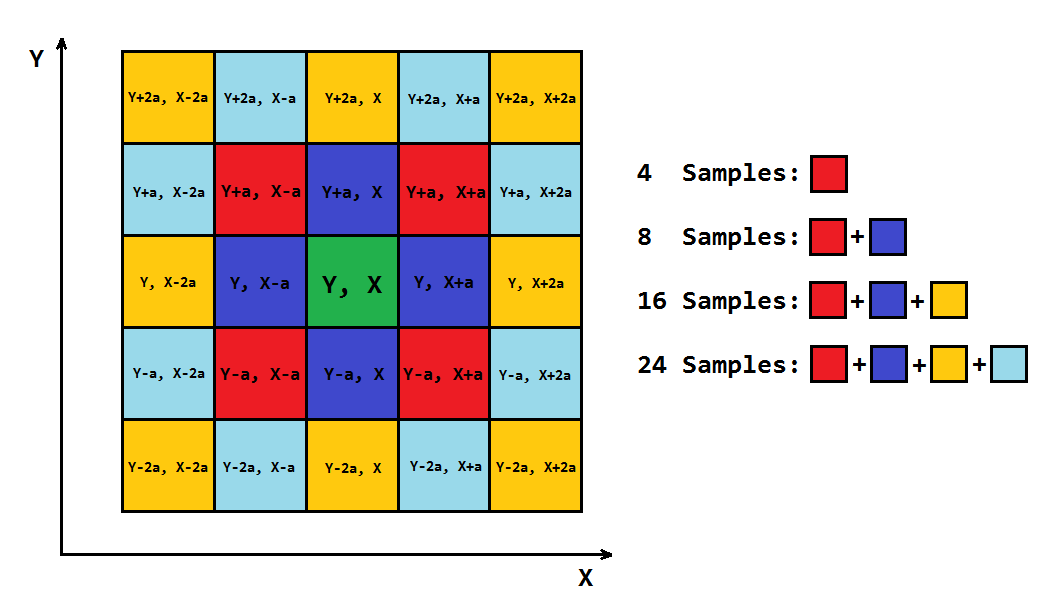
这条上限正是「另一条路」存在的理由:靠采样解决覆盖率,样本数一到 8 就撞墙;解析法没有这个墙。
本章对应的官方依据:stencil-then-cover 与实测数据见 Kilgard & Bolz, GPU-accelerated Path Rendering;隐式化见 GPU Gems 3 第 25 章。
9.4 本章收在哪里
第九章走完,我们把 GPU 侧的三条路和它们的代价都过了一遍:StC 用模板缓冲换缓存收益、隐式化用数学换并行、格子编码用预处理换随机访问。也看到了「每像素 8 样本」这条行业上限,以及论文对当时各家实现的评述——它解释了为什么 Skia 的 GPU 路径至今仍是「CPU 算小路径、GPU 算大路径」的混合结构。
到这里,本篇的三件事都讲完了。最后一章把视角拉到最前面:新一代引擎(Vello 与 Graphite)把同一件事重做成了什么样,以及它们改的到底是哪个前提。
十、前沿把同一件事重做成了什么
下面我们进入最后一个阶段。前面九章讲的是「这二十年怎么做」。这一章讲「为什么现在要改」——而答案不是算法退化了,是硬件和负载变了。我们只看两家:Vello 与 Graphite,都只讲到与本篇主题(曲线 → 覆盖率)交界的那一层。
10.1 Vello sparse strips:tile 化 + 解析覆盖率
其中:这里的 tile 指屏幕空间的固定尺寸像素块,条带指相邻 tile 合并后的水平区间。
先来看看 Vello 的做法。它是 Rust 生态的 GPU compute 2D 引擎,核心算法叫 sparse strips(稀疏条带)。它的思路可以概括成一句话:把屏幕切成 4×4 像素的小块(tile),只给「被几何穿过」的 tile 建条目,其余一概不管。
这件事解决的是老结构的复杂度问题。传统扫描转换是「按扫描线顺序处理整幅画布」,复杂度可以写成 O(pixels × shapes)——一个大形状覆盖全屏时,每个像素都要被它扫一遍,这是最坏情况。而 tile 化之后,复杂度变成 O(tiles × shapes_per_tile):每个 tile 只关心穿过它的那些形状。
它的数据结构和流水线大致是:
| 阶段 | 做什么 |
|---|---|
| Flatten | 自适应细分(容差约 0.1 像素)把曲线折成线段,三次曲线用 SIMD 加速 |
| Tiling | 以 4×4 像素为单位,计算每个像素的分数覆盖(即解析 AA),只保留非零覆盖的边缘像素 |
| Strip generation | 把相邻水平 tile 合并成条带(strip) |
| Coarse / Fine | 粗粒度生成 Fill 与 AlphaFill 两类命令,细粒度按 kernel 执行 |
几个细节值得和前面几章对照:
- tile 的字段里有
winding——填充规则的判定被放进了 tile 数据结构里(第六节的 NonZero / EvenOdd 在这里是数据,不是分支); - strip 结构里有个
fill_gap位——因为 4×4 tile 只有 16 个像素,内部像素的填充是隐式的,不需要显式存覆盖率; - 解析 AA 发生在 Tiling 阶段——注意这不是「先采样再平均」,而是和 Skia AAA 同源的思路:直接在 tile 内算分数覆盖。
为什么 tile 是 4×4?这个尺寸是个平衡点:太大则稀疏性变差(内部填充浪费),太小则条目数与合并开销上升。顺带说一句,另有研究(ETH Zurich 的硕士论文《High-performance 2D graphics rendering on the CPU using sparse strips》)系统测过 tile size 对效率的影响——这个参数至今仍是实验对象。
对本篇主题而言,Vello 的意义是:它没有放弃解析覆盖率(第七节那个思路),而是把「扫描线」换成了「tile」,把「按行顺序」换成了「可并行」。算法内核没变,组织方式变了。
10.2 Graphite:给 2D 绘制加上 z
# 交错扫描的复杂度
O(pixels x shapes)  ->  O(tiles x shapes_per_tile)
好了,再看 Graphite。它是 Skia 面向现代 GPU API 重写的光栅化后端,2025 年 7 月 Google 官方博客介绍了它(首先在 Apple Silicon Mac 的 Chrome 上线)。与本篇主题相关的是它的一个概念转变:
2D 深度测试:给每个 draw 分配 z = painter's order;不透明物体可重排以减少 overdraw,透明仍前后绘制;裁剪改为「仅深度 draw」,使 shader 不再依赖 clip stack 状态。
—— Google Chrome 官方博客(2025-07-08)
这句话值得慢慢读。「painter's order」是画家算法——后来的画在上面,所以必须按顺序画,这是 2D 绘制的铁律。Graphite 的做法是把「顺序」编码成一个 z 值,于是:
- 顺序这件事从「执行顺序」变成了「深度缓冲里的一个数」;
- 不透明物体之间谁先画就不重要了(反正深度测试会保证结果正确),于是可以重排、可以合并、可以并行;
- 相邻的遮挡关系被深度测试自动消掉——这就是「减少 overdraw」的机制。
对我们的主题来说,这是一个方向性的信号:前九章讲的都是「怎么把几何变成覆盖」,而 Graphite 在讲「怎么少算一些覆盖」——同一个像素被画三次,前两次是纯粹的浪费,深度测试把这两次省掉了。
但 Graphite 在本篇主题上保留了一个明确的缺口:
当前 Graphite 依赖 MSAA,但在老集成 GPU 上性能差、非 tiling GPU 上内存开销高,需回退 CPU 路径光栅化(atlas 缓存);compute path rasterization 可同时改善画质(MSAA 常限 4 sample/px)与性能。
—— 同上
这段话把两件事连起来了:一是 Graphite 目前仍用 MSAA 做抗锯齿,而 MSAA 的样本数常被限制在 4;二是它的未来方向是GPU compute 路径光栅化,官方明确点名了两个近期实现——Pathfinder 与 Vello。
整篇的线索在这里收拢:第九节说 GPU 超采样「每像素 8 样本」撞墙,Graphite 说 MSAA「常限 4 样本」,两家在同一堵墙前;而 Vello 的 4×4 tile + 解析覆盖率正是绕开样本数的一条路。所谓「前沿」不是新算法打败旧算法,而是负载逼着工程捡起那些一直存在却太麻烦的解法。
本章对应的官方依据:Vello 的 tile 与条带结构见 sparse_strips 目录;Graphite 的 z 值与 MSAA 现状见 Introducing Skia Graphite。
10.3 边界回指与预告
最后把本篇的边界再回指一次,免得越界。
- 逐像素覆盖率这件事,到此讲完。混合、合成、混合模式与 alpha 规则是 ep02 讲过的 Canvas 状态与涂抹链的事,本篇只把覆盖率「交出去」;
- Graphite 的内部机制(Recorder、Recording、多线程调度)留给 ep06,本篇只立「z = painter's order」这一句分界线;
- Vello 的 flatten、prefix-sum 与排序三段留给 ep09,本篇只用它的 tile 与解析覆盖率当对照;
- 字形光栅化(含 SDF 文字)留给 ep04——本篇的细分与覆盖结论对字形轮廓同样成立,故不在此复述。
下一篇我们要往哪里走?这一篇讲的都是「路径怎么变像素」,但屏幕上的字不是靠一条条路径画出来的——它有自己的一整套数据结构:字形轮廓怎么组织、什么叫 blob、CJK 几万个字怎么管、以及 hinting 与子像素渲染怎么回事。第四篇《字形光栅化》会把本篇的细分与覆盖结论当作现成工具,去拆字体这条独立的管线。
参考资料
Skia 官方源码与文档(A 级)
- SkPath 概览
- SkScan_AAAPath.cpp
- WangsFormula.h
- SkEdge.cpp
- SkEdgeBuilder.cpp
- SkGeometry.h
- SkAnalyticEdge.h
- SkScan.h
- GrTriangulator.h
其它引擎与论文(A 级)
- FreeType ftgrays.c
- FreeType 光栅化模块文档
- Cairo tor 扫描转换器
- GPU Gems 3 第 25 章:Rendering Vector Art on the GPU
- Loop & Blinn 2005:Resolution Independent Curve Rendering
- Nehab & Hoppe 2008:Random-Access Rendering of General Vector Graphics
- Kilgard & Bolz:GPU-accelerated Path Rendering
- Introducing Skia Graphite(Google Chrome 官方博客)
- HPG18:半解析可见性
开源项目与参考
- Vello 仓库 | sparse_strips 目录
- Linebender 月度进展(2026 Q1)
- ETH Zurich 硕士论文:sparse strips 的 CPU 渲染
- Skia CPU 光栅化管线(DeepWiki) | Vello sparse strips 架构(DeepWiki)
- xplain:光栅化章节
- Blend2D 演示
图片版权
配图三类:外部示意图取自 Wikimedia Commons(图注标作者与许可);本机自跑实截由 skia-python 144.0.post2 生成;自绘图为本系列绘制,走 styles/qianmo/palette.json 色板单源。
系列下一篇预告:第四篇《字形光栅化:字形数据组织、blob 与 CJK》——本篇把「曲线怎么变像素」讲完了,下一篇换一种输入:不是一条条路径,而是几万个字形。我们会看字形轮廓怎么被组织成可查的数据、什么叫 blob、CJK 的字量如何管理,以及 hinting 与子像素渲染为什么是字形独有的两件事。
本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。
With Best Wishes.