站点链接:技术博客页 | 公众号:溯光的图形笔记
切口:上一篇把账落到了桌上,这一篇问这套账是什么时刻、谁算的
上一篇我们跟着 RenderingDevice(渲染设备)这条线走到收口,末尾那个结论是「同一份先后顺序,落到四张不同的桌子上」。那一篇把「顺序」当成一个已经存在的东西来用——它讲了四条驱动怎么选、分叉长在三处、两张能力表各往哪边保守,没说的是:这份顺序是在哪一刻被算出来的,以及算它的时候,物理、逻辑、渲染这三件事到底谁先谁后。
这一章问的就是这个。它看起来像实现细节,实际上是「一次绘制怎么落到 GPU 上」这句话里最容易被跳过的一段:前面八篇都在讲「落点链」,这一篇要讲这条链在时间轴上是怎么排布的。
0.1 本系列的位置:从「落到哪张桌子」往下走到「什么时刻」
好,前面八篇把一次绘制的落点链走完了大半:对象模型(第二篇)→ 服务层接口(第三篇)→ 画布剔除与排序(第四篇)→ 画布渲染抽象(第五篇)→ 批处理(第六篇)→ RenderingDevice 与渲染依赖图(第七篇)→ 后端分叉(第八篇)。本篇接在第八篇后面,换一个轴走下去:前八篇走的是「空间」这条轴(命令经过谁、落到哪里),本篇走的是「时间」这条轴(这一份份账按什么节拍被驱动出来)。
整个系列按这两条轴铺开,目录如下(本篇即第九行):
| # | 篇目 | 它回答的问题 | 状态 |
|---|---|---|---|
| 01 | 全景与边界 | 四层架构是什么、一次 2D 绘制要经过谁 | 已发布 |
| 02 | 对象模型 | 谁在什么时候把命令层下发 | 已发布 |
| 03 | 服务层接口 | 命令长什么样、怎么被排队 | 已发布 |
| 04 | 画布剔除与排序 | 画什么、按什么顺序 | 已发布 |
| 05 | 画布渲染抽象 | 绘制项里存了什么、怎么被提交 | 已发布 |
| 06 | 批处理 | 一批能装多少、按什么切、代价在哪 | 已发布 |
| 07 | RenderingDevice 抽象 |
命令列表怎么变成一张依赖图 | 已发布 |
| 08 | 后端分叉 | 四条驱动怎么选、分叉长在哪几处 | 已发布 |
| 09 | 主循环与多线程(本篇) | 这套账在什么时刻、被哪个线程算出来 | 本篇 |
| 10 | 资源侧 | 一张纹理从盘上到显存 | 待写 |
| 11 | 收官 | 这条链整体买到了什么 | 待写 |
其中:这张表要看的不是「进度」,而是本篇与相邻两篇的接缝——第八篇交出「这份顺序落到哪张桌子上」,第十篇接手「桌上那些资源从哪来」。夹在中间的这一篇,问的是驱动这一切的那个节拍本身。系列里好几位老朋友会在这里再出现一次:RenderingServer、SceneTree、服务器的同步接口——但这一篇看的是它们的调用时机,不是它们的内部结构。
0.2 口径先对齐:三个帧、两个计数器、一个分数
好了,先把几个词钉死,否则「错位」这个词说不清。工程里大家混用「帧」,可是引擎内部至少有三种东西都被叫成「帧」:
| 词 | 引擎里的落点 | 谁在数它 | 频率 |
|---|---|---|---|
| 物理帧(physics tick) | MainLoop::physics_process(double) → SceneTree::physics_process |
Engine.get_physics_frames() |
定步长,默认 60 Hz |
| 逻辑帧(idle frame) | MainLoop::process(double) → SceneTree::process |
Engine.get_process_frames() |
不定,跑多快算多快 |
| 渲染帧(drawn frame) | RenderingServer::draw() |
Engine.get_frames_drawn() |
还要看渲染循环开不开(第八章) |
其中:这三个词的分量完全不同——物理帧是定步长的,逻辑帧是不定的,渲染帧还要过一个开关。本篇后面所有「错位」,指的都是这三条节拍之间的相位差,不是「掉帧」。另外还有两个量要一并记住:一个是插值分数(Engine.get_physics_interpolation_fraction()),它回答「现在这一次绘制,落在两次物理之间哪个位置」;另一个是过程步长(process_step),它就是这次逻辑帧拿到的时间长度。这两条在第五章会用上。
0.3 本篇的边界:不涉及什么
OK,按本系列的惯例先把边界写清,免得后面读到别的意思:
| 不涉及 | 为什么 |
|---|---|
| 线程级观测(谁在哪个线程执行哪段) | 本机是 Windows 自建构建,探针只能拿到启动行与计数,拿不到「哪个线程在跑哪段」。本篇所有线程结论只从源码与官方文档读,探针只提供启动行与计数 |
| 物理螺旋(physics spiral of death)的本机复现 | 官方有定义,但要复现需要一个持续超帧预算的场景;本机没有稳定手段 ⇒ 只转述官方定义,不做本机实验 |
| 多核 / SMT / 功耗散热 | 属《GPU 架构剖析》题域(系列边界③),本篇不碰硬件侧 |
| 渲染实现内部 | 属第五、六、七篇;本篇只落到 main/、core/os/、core/object/、core/templates/、servers/ 的入口与包裹层 |
0.4 一帧的账是哪一行算出来的
对齐完词,先看一件具体的事。引擎每一帧都要决定「这一帧跑几次物理、逻辑走多长、现在插值到哪儿」——这三件事不是散在各处的,它们由一行代码算出来:
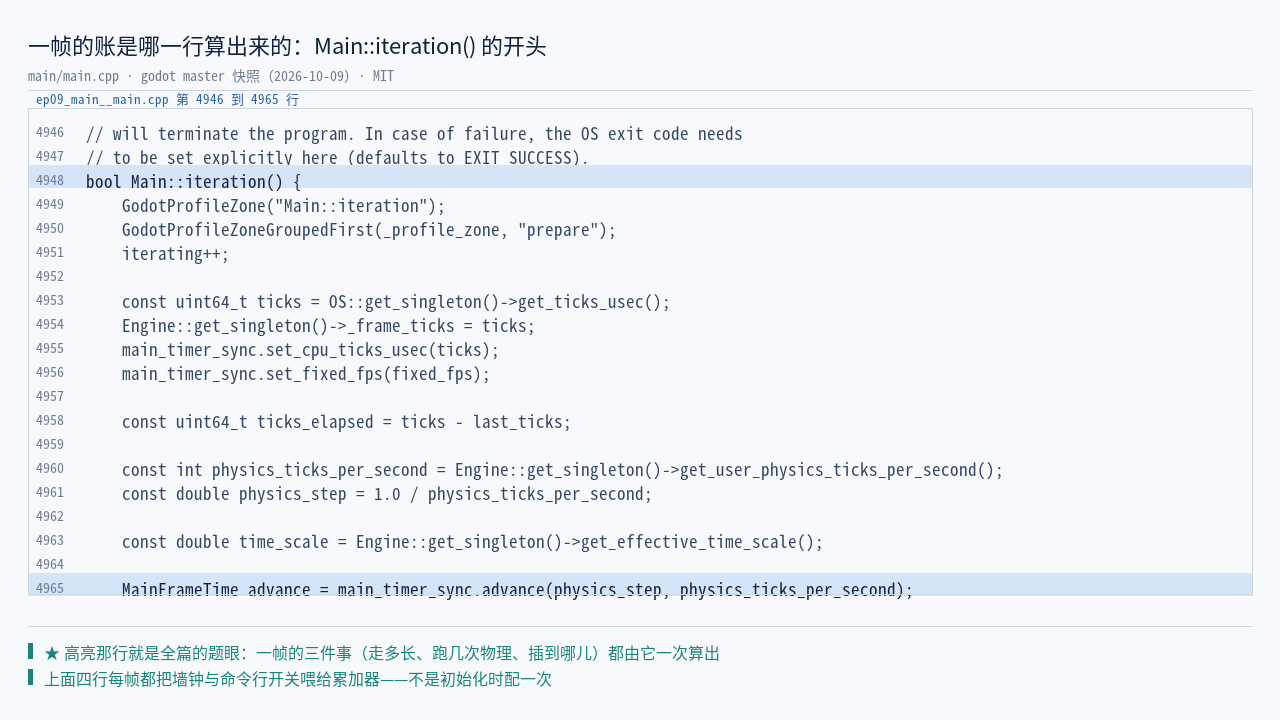
Main::iteration() 的开头:取墙钟、算物理步长,再把这一帧交给累加器@ godot master 快照(2026-10-09)原文截取 · MITbool Main::iteration() {
const uint64_t ticks = OS::get_singleton()->get_ticks_usec();
Engine::get_singleton()->_frame_ticks = ticks;
main_timer_sync.set_cpu_ticks_usec(ticks);
main_timer_sync.set_fixed_fps(fixed_fps);
const uint64_t ticks_elapsed = ticks - last_ticks;
const int physics_ticks_per_second = Engine::get_singleton()->get_user_physics_ticks_per_second();
const double physics_step = 1.0 / physics_ticks_per_second;
const double time_scale = Engine::get_singleton()->get_effective_time_scale();
MainFrameTime advance = main_timer_sync.advance(physics_step, physics_ticks_per_second);
好了,其中:这一行返回的是一个只有三个字段的小结构体——process_step(本次逻辑帧走多长)、physics_steps(本次要跑几个物理步)、interpolation_fraction(插值到哪)。第一章到第五章,讲的都是这三个字段各自怎么来的、怎么被用掉。而它上面的那四行也值得留意:set_cpu_ticks_usec(ticks) 与 set_fixed_fps(fixed_fps) 是在每次循环开头把墙钟与命令行开关喂给累加器的,不是在初始化时一次配好。
本章出处:源码 main.cpp(:4948–4965,本机 master 快照 2026-10-09)。
0.5 三个可检验命题
本篇只回答三个问题,每个都要能落到可核对的东西上。
先说第一个,「一帧跑几次物理」是谁定的。答案不是配置出来的,是算出来的:引擎攒一段墙钟时间,攒够一个物理步就放一次;不够就这次不放。这件事在源码里是一个 for 循环加一个累加器(第三章、第四章)。
再说第二个,三个节拍能不能对齐。答案是能对上,但代价是有账号的——官方文档里写着上限,而本机实测拿到的是下限侧的极端:默认档 180 个 idle 帧里,178 个帧一个物理步都没跑。这一点很反直觉,但它是帧率远高于物理频率时的正常结果(第五章、第十一章)。
最后说第三个,这些事发生在哪个线程上。答案分三段:引擎内置默认是 Safe(不是 Separate),Separate 是一条要手动打开的岔路,而且官方给它标了「实验性」;跨线程的安全性不是一刀切,而是三档——有的可直接跨、有的要开开关、有的完全不可跨(第七章、第九章、第十章)。下图先把三个节拍摆到一起:
其中:这张图想说的不是「物理慢渲染快」,而是三条节拍压根不是同一个东西——一个由固定时间片驱动,一个由「这一圈花了多久」驱动,还有一个由窗口与开关驱动。把这三条当同一条看,后面每一条结论都会歪。
另外三条读法约定,请在读完全篇时记住:
| 约定 | 为什么 |
|---|---|
| 行号属于某个提交,不属于版本号 | 本篇所有行号按 master 快照 2026-10-09,逐条回本机 clone 复核,不做算术平移 |
| 本机读数一律写明前提 | 引擎为自建版本 4.8.dev.custom_build.7177493c1、Vulkan 1.3.280 - Forward+、必须在带窗口下跑;少了任一条读数就不可比 |
| 测不了就写「测不了」 | 本篇有两处如实登记为口径边界(0.3 那两条),不用推测或别的数据填空 |
本章出处:官方类参考 MainLoop、Engine、SceneTree(本机 XML 快照 evidence/stage1/ 与 ep09_doc__classes_*.xml)。
一、主循环的形状:MainLoop 声明几个钩子,谁实现它
这一章要把「主循环」这个词从模糊印象落成一张具体的表。它的价值在于:你以为自己知道的那个回调清单,和引擎内部真正在用的那份,数量不一样。
1.1 官方怎么说
先看官方类参考的第一句,逐字:
MainLoop is the abstract base class for a Godot project's game loop. It is inherited by SceneTree,
which is the default game loop implementation used in Godot projects, though it is also possible to
write and use one's own MainLoop subclass instead of the scene tree.
紧接着还有一句讲「谁来提供这个实现」的:
Upon the application start, a MainLoop implementation must be provided to the OS; otherwise, the
application will exit. This happens automatically (and a SceneTree is created) unless a MainLoop
Script is provided from the command line (with e.g. godot -s my_loop.gd) or the
application/run/main_loop_type project setting is overwritten.
其中:这两句把结构说清了——MainLoop 是抽象基类,SceneTree 是默认实现,而且这个「默认实现」是可以被替换的(写一个继承 MainLoop 的脚本,用 godot -s 跑)。SceneTree 本身并不是主循环这个概念,它只是主循环的默认那一份实现。
1.2 头文件里的钩子有六个
说白了,这个抽象基类到底声明了几个可以覆写的点——答案不是四个。看头文件:
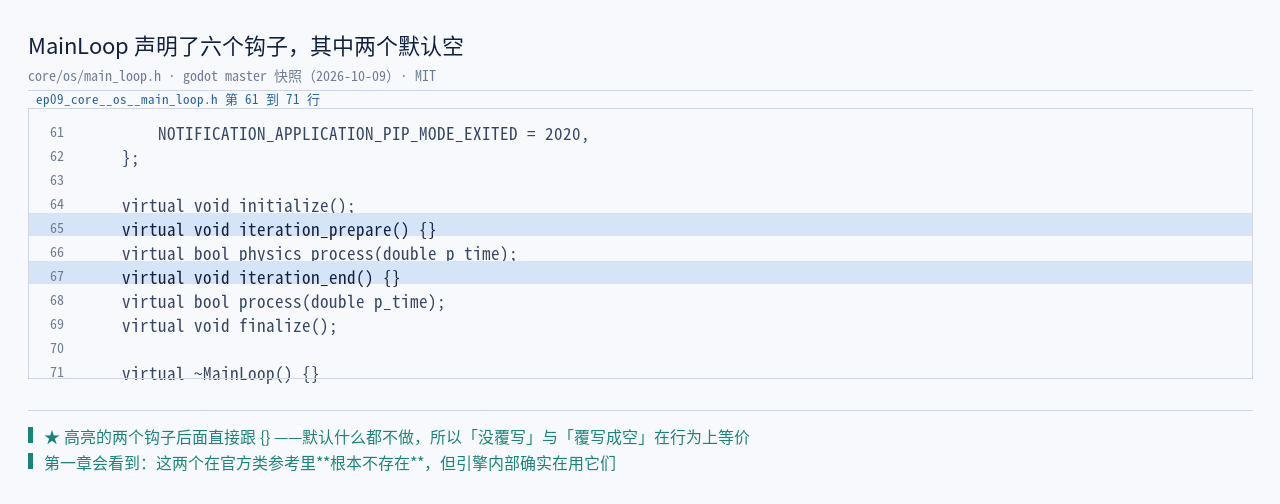
MainLoop 的六个虚钩子;其中两个后面直接跟大括号,默认什么都不做@ godot master 快照(2026-10-09)原文截取 · MIT virtual void initialize();
virtual void iteration_prepare() {}
virtual bool physics_process(double p_time);
virtual void iteration_end() {}
virtual bool process(double p_time);
virtual void finalize();
其中:注意这六行里的花括号。iteration_prepare() 和 iteration_end() 后面直接跟着 {}——它们是默认空的虚函数,不覆写就等于什么都不做。而 initialize() / physics_process() / process() / finalize() 只有声明,具体实现落在 MainLoop:: 的某个 .cpp 里。六个钩子,两个默认空、四个有实现,这是本篇第一章的第一个事实。
1.3 但文档里只有四个
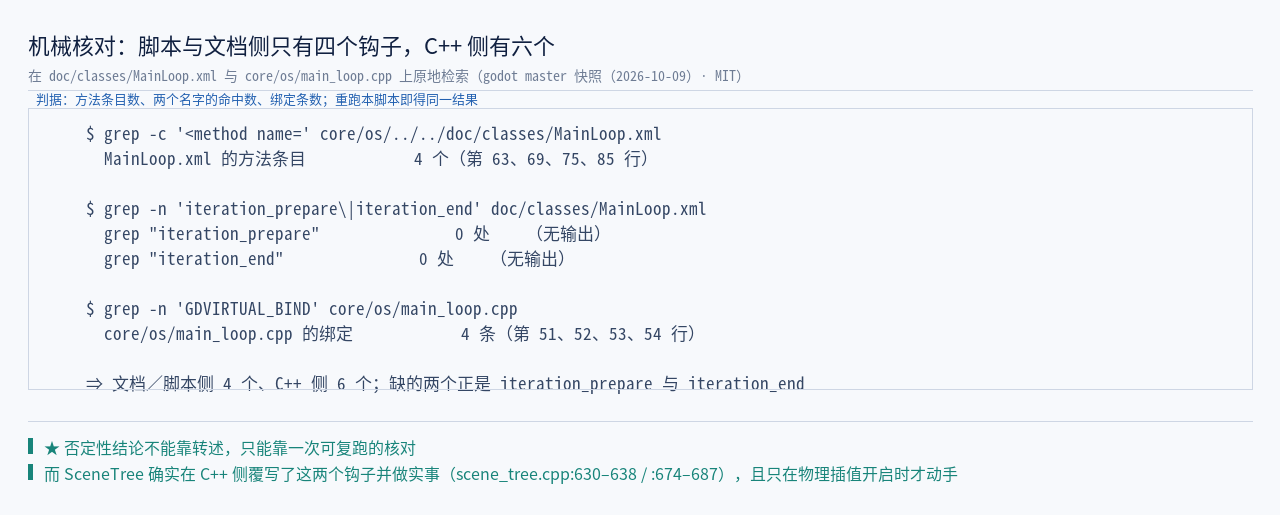
有意思的地方来了。同一批 API 的官方类参考里,MainLoop 一共只挂了 4 个方法,而且搜不到 iteration_prepare 与 iteration_end:
MainLoop.xml 只有 4 个方法条目,iteration_prepare 与 iteration_end 零命中@ godot master 快照(2026-10-09)· 本机原地检索 · MIT <method name="_finalize" qualifiers="virtual">
<method name="_initialize" qualifiers="virtual">
<method name="_physics_process" qualifiers="virtual">
<method name="_process" qualifiers="virtual">
四条,就到这儿。而对应到 main_loop.cpp 的绑定处,GDVIRTUAL_BIND 也只有四条(_initialize / _physics_process / _process / _finalize);在这份 XML 快照里检索 iteration_prepare 与 iteration_end,0 命中。两个口径并排:
| 口径 | MainLoop 的方法数 | 那两个内部钩子 |
|---|---|---|
官方类参考 XML / GDVIRTUAL_BIND(脚本与文档侧) |
4 | 不在 |
C++ 头文件 main_loop.h |
6 | iteration_prepare / iteration_end |
OK,其中:这条差异不是文档漏写,而是分层的结果:GDVIRTUAL_BIND 是把一个 C++ 虚函数暴露给脚本的宏,只有绑过的才能在 GDScript 里写 _process 这样的回调。这四个是脚本侧能看到的;另两个没绑,所以你在 GDScript 里写不出来。但它们在 C++ 侧确实存在、确实被调用——下面就看谁在调用它。
1.4 那两个「写不出来」的钩子,引擎自己在用
SceneTree 作为默认实现,把这六个钩子里的四个覆写了(scene_tree.h 里有四条 override)。其中就包括那两个脚本写不出来的:
void SceneTree::iteration_prepare() {
    if (_physics_interpolation_enabled) {
        // Make sure any pending transforms from the last tick / frame
        // are flushed before pumping the interpolation prev and currents.
        flush_transform_notifications();
        get_scene_tree_fti().tick_update();
        RenderingServer::get_singleton()->tick();
    }
}

void SceneTree::iteration_end() {
    // When physics interpolation is active, we want all pending transforms
    // to be flushed to the RenderingServer before finishing a physics tick.
    if (_physics_interpolation_enabled) {
        flush_transform_notifications();
#ifndef _3D_DISABLED
        _client_physics_interpolation.physics_process();
#endif
    }
}
其中:这两个函数的体量很小,位置却很关键:它们被挂在「每一个物理步」的头与尾(第三章会给调用点)。而且两者都有一道同样的门——只有 _physics_interpolation_enabled 为真时才动手。这解释了「官方为什么不把它们暴露给脚本」:它们的职责是让物理插值的变换在物理步前后对齐,属于引擎自己的内部节拍,不是给项目逻辑用的钩子。
顺着这条线索把六个钩子的落位画出来:
其中:这张图里有两点要记住。第一,三个钩子(iteration_prepare / physics_process / iteration_end)是「每个物理步一份」的,不是「每帧一份」的;第二,process(逻辑帧)在它们全部结束之后才轮到。这两条合起来,就是第三章那条补跑循环的全部内容。
本章出处:源码 main_loop.h(:64–69)、main_loop.cpp(:51–54)、scene_tree.cpp(:630–638、:674–687)|官方 MainLoop 类参考。
二、一次迭代里发生了什么
第一章讲的是「有哪些钩子」,这一章讲「它们按什么顺序被调」。顺序这件事,官方在文档里给了一句话的定论,而源码把这句话摊成了几百行。
2.1 先看返回值的三个字段怎么被用掉
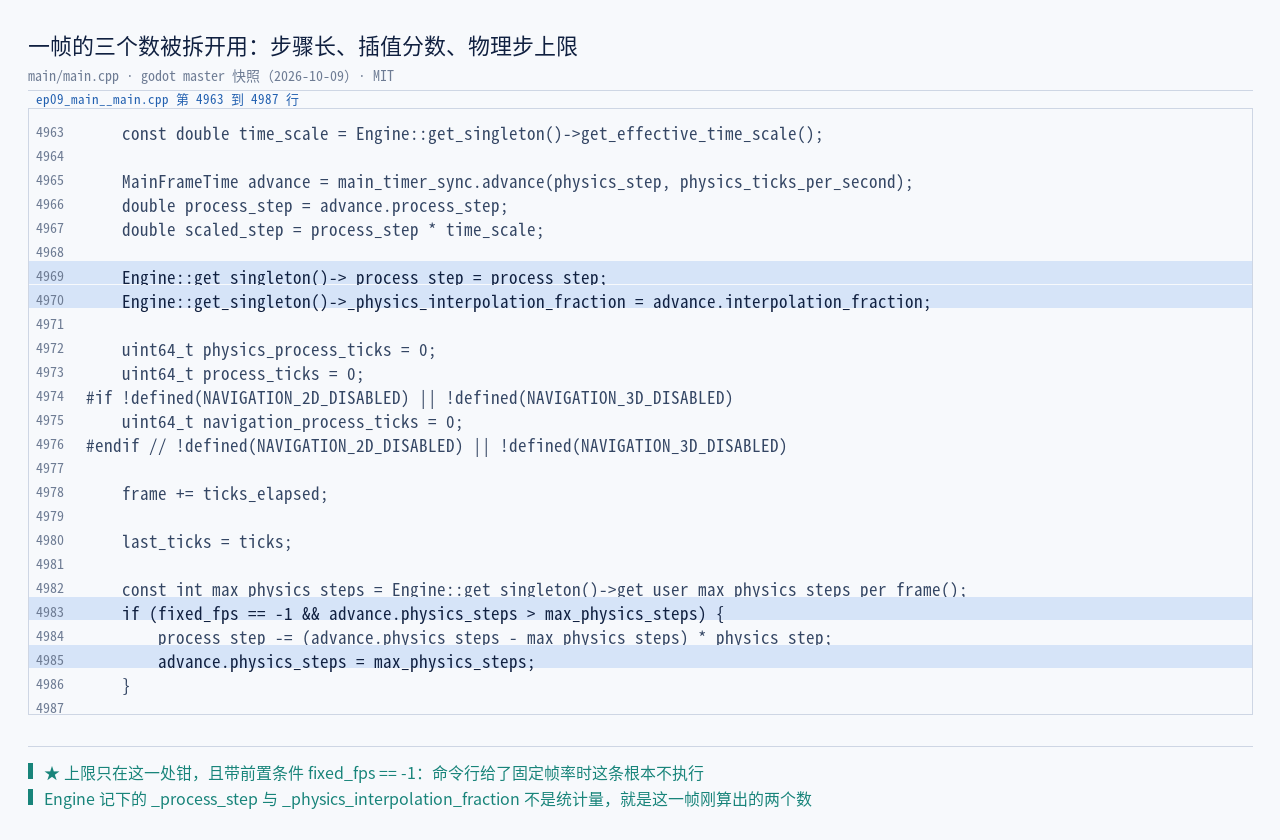
接着 0.4 那一行往下读。advance 拿到了之后,引擎立刻把它拆开用:
_process_step、_physics_interpolation_fraction,以及只在 fixed_fps == -1 时才生效的补步上限@ godot master 快照(2026-10-09)原文截取 · MIT MainFrameTime advance = main_timer_sync.advance(physics_step, physics_ticks_per_second);
double process_step = advance.process_step;
double scaled_step = process_step * time_scale;
Engine::get_singleton()->_process_step = process_step;
Engine::get_singleton()->_physics_interpolation_fraction = advance.interpolation_fraction;
…
const int max_physics_steps = Engine::get_singleton()->get_user_max_physics_steps_per_frame();
if (fixed_fps == -1 && advance.physics_steps > max_physics_steps) {
process_step -= (advance.physics_steps - max_physics_steps) * physics_step;
advance.physics_steps = max_physics_steps;
}
说白了,其中:这一段里有两条容易被略过、但解释力很强的细节。第一,_process_step 与 _physics_interpolation_fraction 都是引擎自己记下来的引擎级状态——所以 Engine.get_process_step() 与 Engine.get_physics_interpolation_fraction() 读的不是什么统计量,而是这一帧刚刚算出来的那两个数。第二,物理步的上限只在这一处钳,而且带一个前置条件 fixed_fps == -1:命令行用 --fixed-fps 指定了固定帧率之后,这条钳制根本不执行——因为那种模式下帧率是人为给定的,不需要再防「一帧补跑太多把帧率拖垮」。
2.2 官方的定论:物理在前、逻辑在后、渲染最后
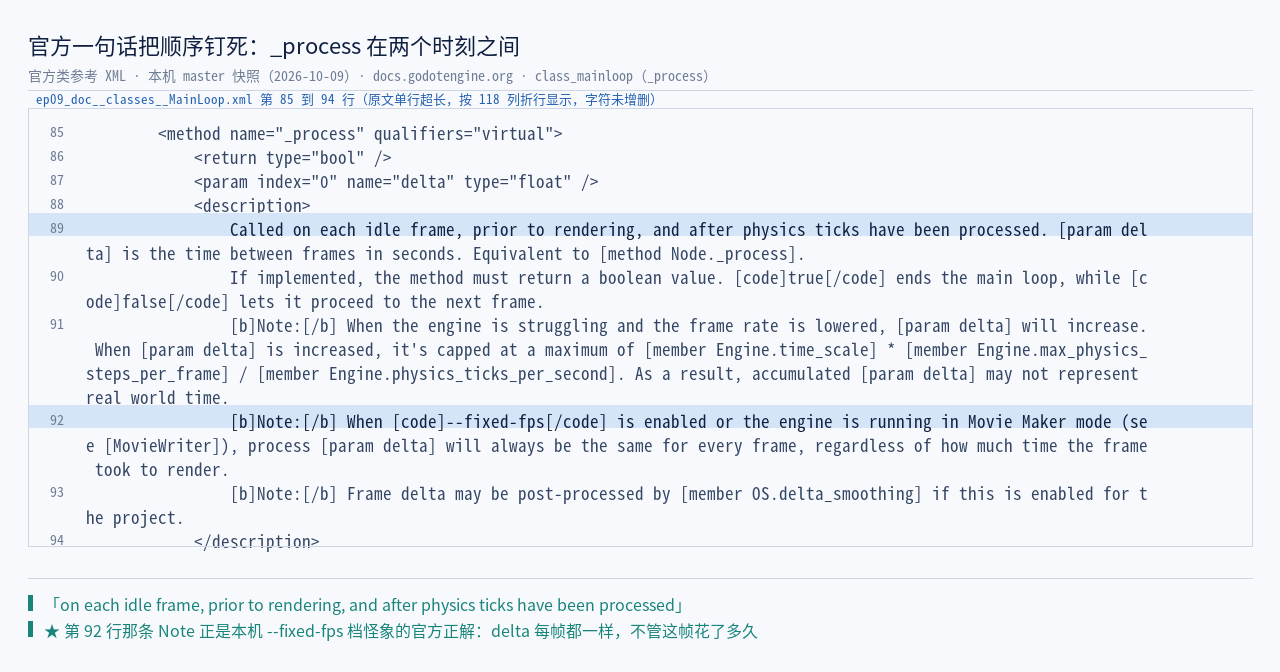
顺序这件事,官方在 _process 的说明里一句话写完了,逐字:
_process 的定位:每个 idle 帧一次,在渲染之前、物理步之后@ 官方类参考 XML(本机 master 快照 2026-10-09)Called on each idle frame, prior to rendering, and after physics ticks have been processed.
delta is the time between frames in seconds. Equivalent to Node._process.
好,其中:这句话值得逐段拆开看:「on each idle frame」(每个 idle 帧一次)、「prior to rendering」(在渲染之前)、「after physics ticks have been processed」(在物理步处理完之后)。三个时间点一给,顺序就定死了——物理 → 逻辑 → 渲染。而且注意它说的是 _process 的位置,不是 _physics_process 的位置;把两个回调的说法合起来看,就能推出整条链。
2.3 源码里的那条链
好了,官方给的是定论,源码给的是它被写在哪几行。把 Main::iteration() 的三段并排看:
物理段(for 循环体内,可跑 N 次)           main.cpp:4997–5080
逻辑段(每帧一次)                          main.cpp:5086–5101
渲染段(每帧一次,可被开关拦下)              main.cpp:5103–5128
三段里每一段各自调了谁、落在那一行,列成一张对照(行号按 master 快照 2026-10-09,逐条回本机 clone 复核):
| 段 | 调用 | 行号 |
|---|---|---|
| 物理段 | iteration_prepare() |
:5013 |
| 物理段 | PhysicsServer3D/2D::sync() 与 flush_queries() |
:5017 / :5023(sync)|:5018 / :5024(flush) |
| 物理段 | main_loop->physics_process(...) |
:5028 |
| 物理段 | NavigationServer2D/3D::physics_process(...) |
:5046 / :5050 |
| 物理段 | end_sync() 与 step(...)(含两次 message_queue->flush()) |
:5056 / :5071(flush)|:5061–5068(end_sync + step) |
| 物理段 | iteration_end() |
:5074 |
| 逻辑段 | main_loop->process(process_step * ts) |
:5089 |
| 逻辑段 | message_queue->flush() 与 NavigationServer2D/3D::process(...) |
:5092(flush)|:5096 / :5100(process) |
| 渲染段 | RenderingServer::sync() |
:5104 |
| 渲染段 | draw(wants_present, scaled_step) 与 increment_frames_drawn() |
:5120 / :5124(draw)|:5121 / :5125(计数) |
其中:这三段合起来回答了一个常见疑问:「一帧里先算物理还是先算逻辑」到底能不能配?不能。它是硬编码在这几十行里的固定次序,没有开关。所以本篇不写「可以调换顺序」这类话——能调的只有三样东西:物理步的频率、每帧最多补几步、以及这一帧到底画不画。
2.4 一处容易被忽略的注释
在物理段的开头,有一行注释解释了「为什么插值要在物理步之前准备」:
        // Prepare the fixed timestep interpolated nodes BEFORE they are updated
        // by the physics server, otherwise the current and previous transforms
        // may be the same, and no interpolation takes place.
        GodotProfileZoneGrouped(_physics_zone, "main loop iteration prepare");
        OS::get_singleton()->get_main_loop()->iteration_prepare();
其中:这行注释把第一章那个「写不出来的钩子」的用途说透了:插值要的是「上一物理位置」和「当前物理位置」两个变换,如果 iteration_prepare 不抢在物理服务器更新之前把上一帧的变换记下来,两者就会变成同一个值,插值自然没有效果。这也解释了为什么它必须是「每个物理步一份」——插值要的是每个物理步的前后状态,不是每帧的。
本章出处:源码 main.cpp(:4966–4986、:4997–5080、:5086–5101、:5103–5128)|官方 MainLoop 类参考 · _process。
三、那条补跑循环
到这里顺序讲完了,但最重要的一处机制还没讲:那条 for 循环本身。它决定了「一个 idle 帧里物理跑几次」,而这件事是「逻辑帧与物理帧错位」的直接原因。
3.1 循环长什么样
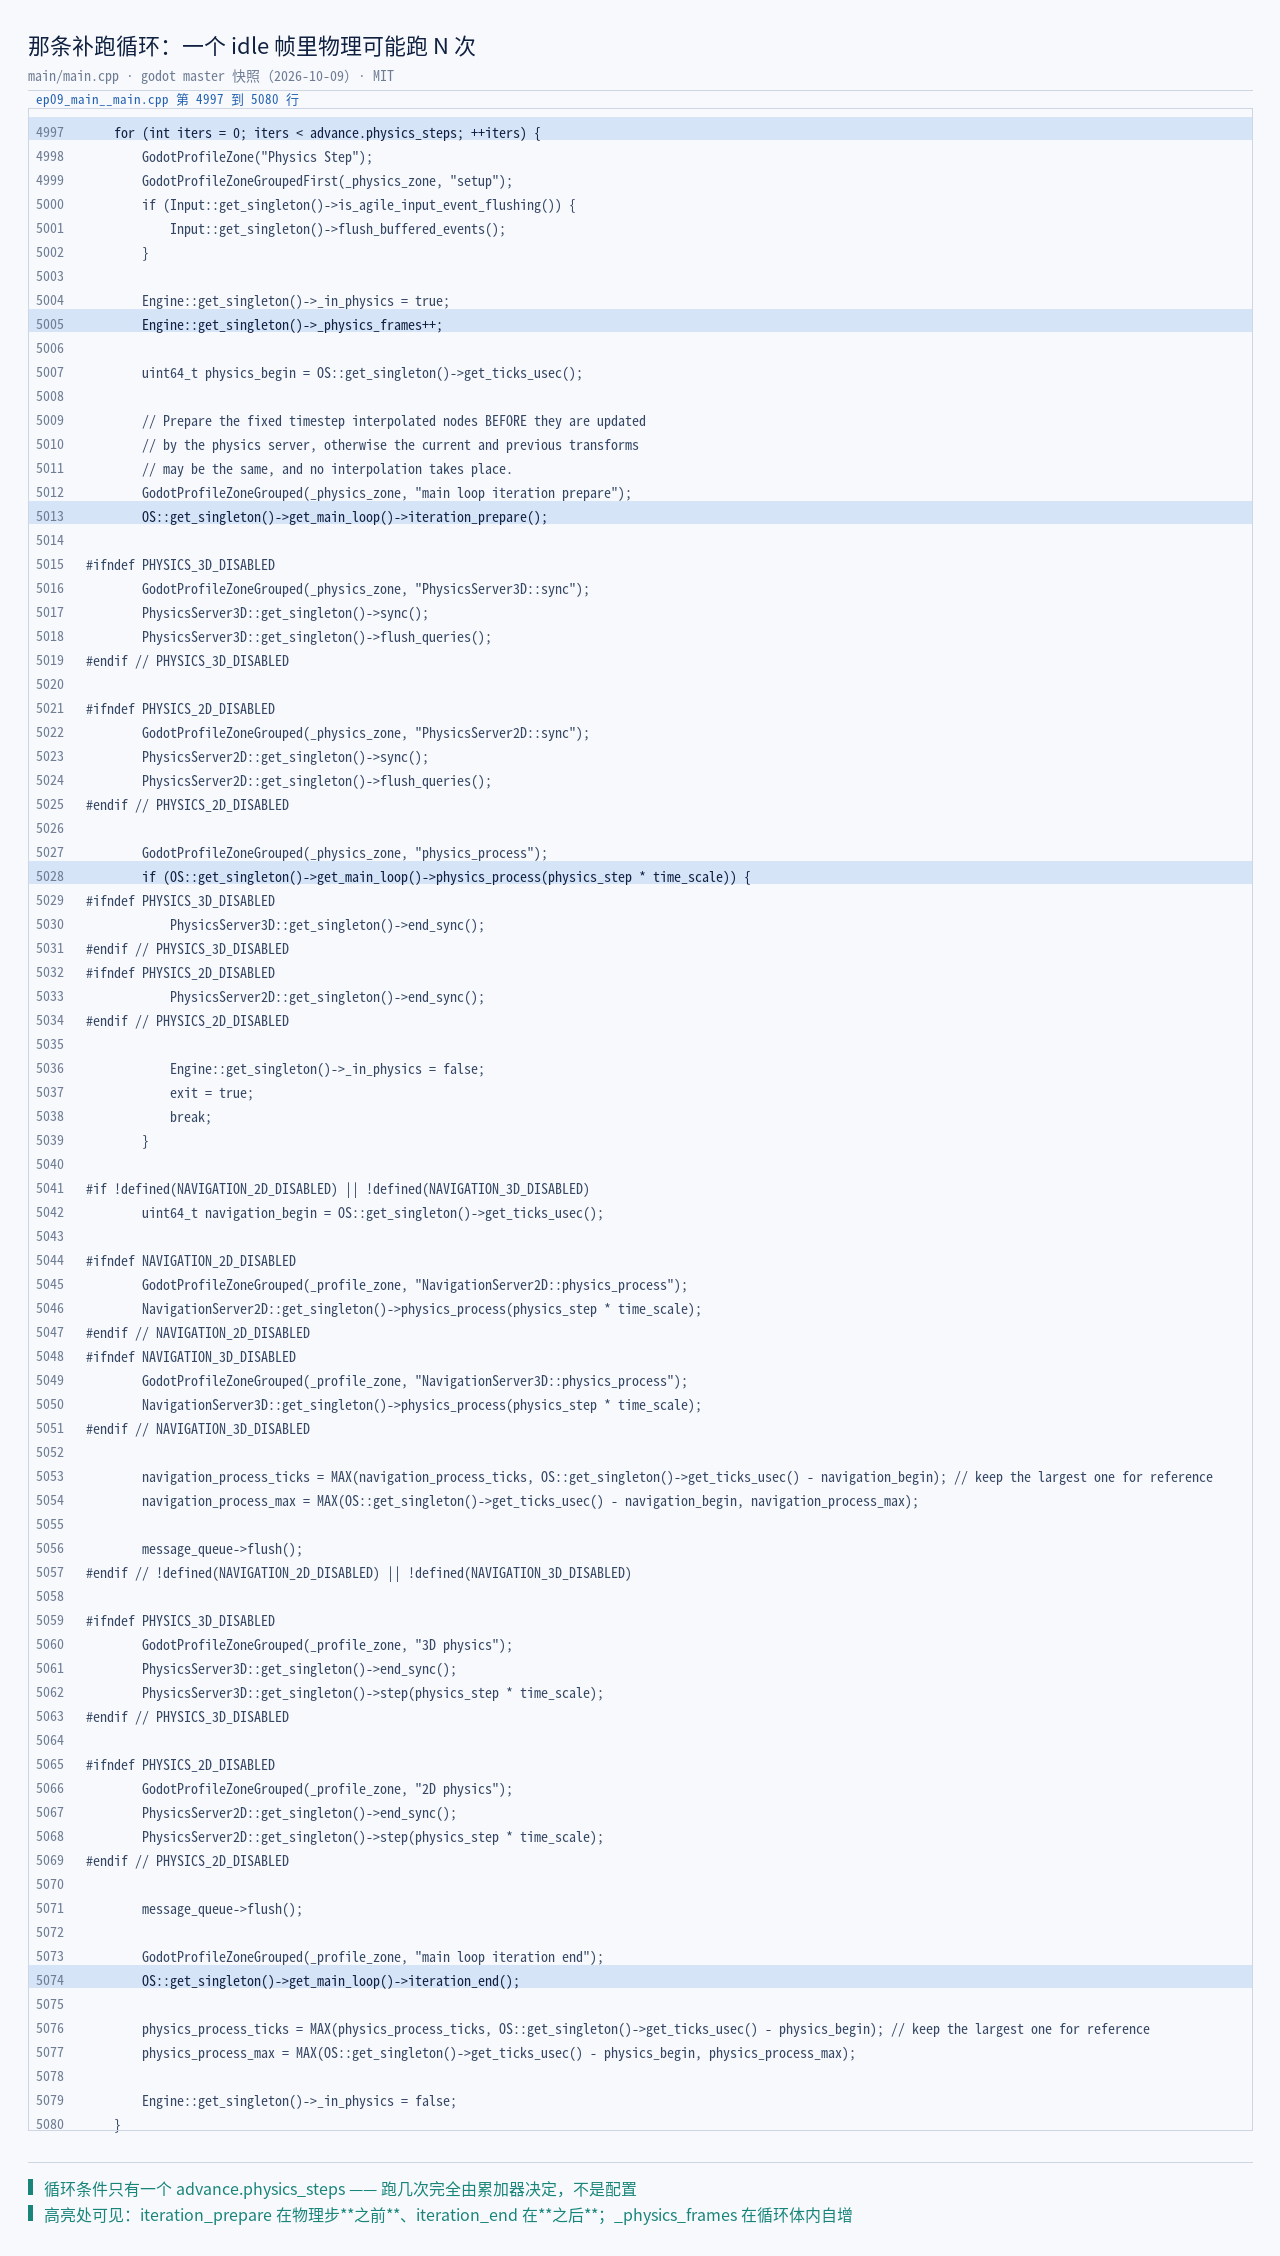
_physics_frames 在循环体内自增@ godot master 快照(2026-10-09)原文截取 · MIT for (int iters = 0; iters < advance.physics_steps; ++iters) {
…
Engine::get_singleton()->_in_physics = true;
Engine::get_singleton()->_physics_frames++;
…
OS::get_singleton()->get_main_loop()->iteration_prepare();
…
PhysicsServer3D::get_singleton()->sync();
PhysicsServer3D::get_singleton()->flush_queries();
…
if (OS::get_singleton()->get_main_loop()->physics_process(physics_step * time_scale)) {
…
exit = true;
break;
}
…
PhysicsServer3D::get_singleton()->end_sync();
PhysicsServer3D::get_singleton()->step(physics_step * time_scale);
…
message_queue->flush();
GodotProfileZoneGrouped(_profile_zone, "main loop iteration end");
OS::get_singleton()->get_main_loop()->iteration_end();
…
Engine::get_singleton()->_in_physics = false;
}
其中:这个循环只有一句话是「条件」,其余全是「循环体」——跑几次完全由 advance.physics_steps 决定。而在循环体里有两件事值得单独记住:第一,Engine::_physics_frames++ 在循环体内(所以它是「物理步数」而不是「帧数」);第二,message_queue->flush() 在这一段里出现了两次(:5056 与 :5071),都夹在物理服务器调用的前后——这是「物理步内部也要把延迟调用放出去」的痕迹,第九章会回到它。
3.2 官方给的上限
言归正传,advance.physics_steps 最多能到几?官方在 _physics_process 的说明里给了上限,逐字:
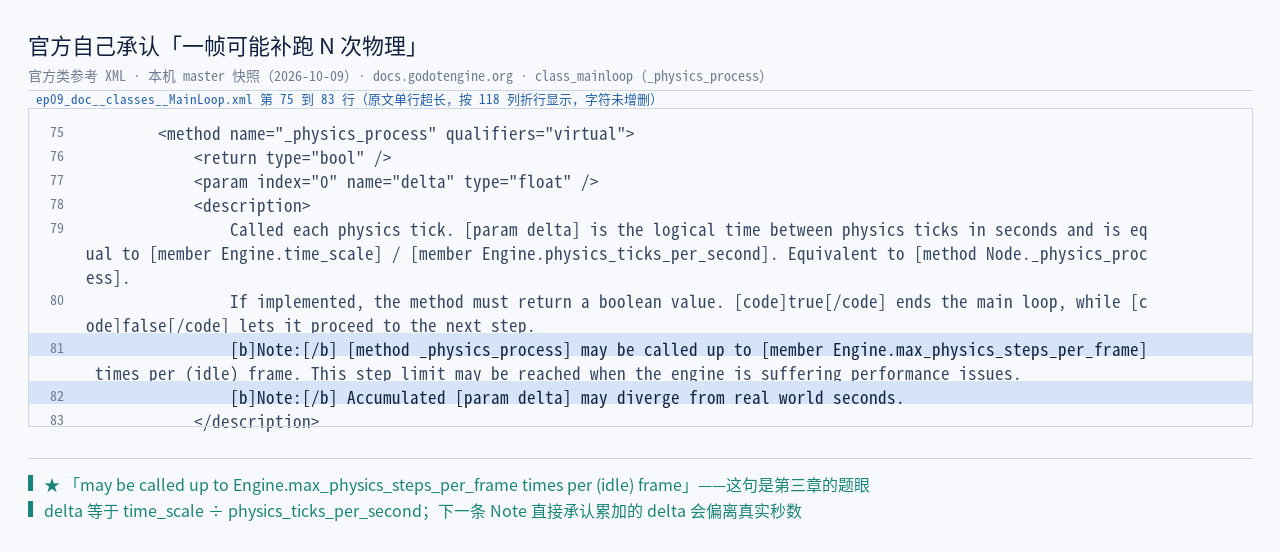
_physics_process 最多可能被调 max_physics_steps_per_frame 次@ 官方类参考 XML(本机 master 快照 2026-10-09)Called each physics tick. delta is the logical time between physics ticks in seconds and is equal to
Engine.time_scale / Engine.physics_ticks_per_second. Equivalent to Node._physics_process.
If implemented, the method must return a boolean value. true ends the main loop, while false lets it
proceed to the next step.
Note: _physics_process may be called up to Engine.max_physics_steps_per_frame times per (idle) frame.
This step limit may be reached when the engine is suffering performance issues.
Note: Accumulated delta may diverge from real world seconds.
其中:两条 Note 各说了一半。第一条给出上限值是 max_physics_steps_per_frame(默认 8),并说明什么时候会撞到它:「当引擎正遭遇性能问题」——也就是帧变长、一个 idle 帧里攒下了太多物理时间。第二条更值得注意:「累加起来的 delta 可能与真实世界秒数产生偏差」——这是官方主动承认「逻辑时间 ≠ 物理时间」。第五章会看到,这个偏差的短期形态就是那个插值分数。
至于为什么要有 8 这个数,官方在 ProjectSettings 里把代价写全了:
Controls the maximum number of physics steps that can be simulated each rendered frame. The default
value is tuned to avoid situations where the framerate suddenly drops to a very low value beyond a
certain amount of physics simulation. … This snowballs into a situation where framerate keeps dropping
until it reaches a very low framerate (typically 1-2 FPS) and is called the physics spiral of death.
其中:这段说的是「上限太低会怎样」。反过来的代价官方也写了:「如果渲染 FPS 低于 physics_ticks_per_second / max_physics_steps_per_frame,游戏会显得变慢」——按默认值算,这个门槛是 60 ÷ 8 = 7.5 FPS。这一道闸的两头各有一个故障:设太小会「变慢」,不设会「螺旋」。这也是为什么本项目把它放在工程设置里而不是写死。
3.3 上限与下限:本机实测走的是哪一侧
官方文档给的是上限。那本机实测拿到的是什么?先看形状:
本机默认档的实测结果是:180 个 idle 帧里,178 个帧跑了 0 个物理步,只有 2 个帧跑了 1 个(详见第十一章)。一个物理步都没跑,是因为这一段里帧率(自算约 3580 帧/秒)远高于物理频率(60 Hz)——一个物理周期里过去了大约 60 个 idle 帧。
其中:把官方的上限与本机的下限并排放,这条循环的全貌才出来:「一帧补跑 N 次物理」里的 N 是个变量,本机在轻场景下拿到的常态是 0。所以「逻辑帧与物理帧错位」这句话的准确读法不是「物理跟不上」,而是「两条节拍本来就不在一个频率上,多数帧根本不包含物理步」。至于为什么会有 0 这个值而不是每帧分摊一点——那是累加器的活,下一章接着讲。
本章出处:官方 MainLoop 类参考 · _physics_process|ProjectSettings 类参考 · physics/common/max_physics_steps_per_frame(本机 XML 快照 :2717)|源码 main.cpp(:4997–5080)|本机探针 evidence/probe/E_ep09_A_default.txt。
四、累加器:这一帧跑几次物理,是攒出来的
第三章留了一个问题:为什么多数帧跑 0 次物理,而不是每帧分摊一点点?答案在一个叫 time_accum 的成员里,它属于 MainTimerSync(主时钟同步器)。这一章把它拆开。
4.1 返回值只有三个字段
OK,先看接口。advance() 返回的是一个小结构体,字段就三个:
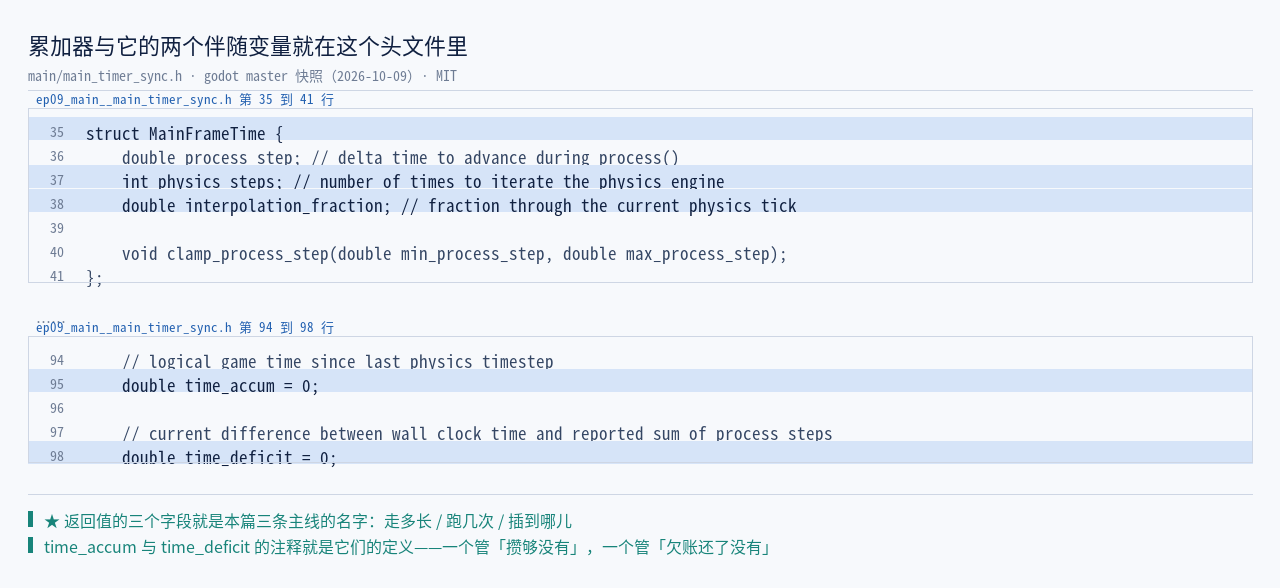
struct MainFrameTime {
    double process_step; // delta time to advance during process()
    int physics_steps; // number of times to iterate the physics engine
    double interpolation_fraction; // fraction through the current physics tick

    void clamp_process_step(double min_process_step, double max_process_step);
};
而累加器本身,在 MainTimerSync 的私有成员里,注释写得很直白:
    // logical game time since last physics timestep
    double time_accum = 0;

    // current difference between wall clock time and reported sum of process_steps
    double time_deficit = 0;
其中:两个变量的注释就是它们的定义。time_accum 是「距离上一个物理步,还攒着多少逻辑时间」;time_deficit 是「墙钟时间与报出去的 process_step 之和之间的差额」——前者管「攒够了没有」,后者管「欠账还了没有」。这一章主要讲第一个,第二个在第五章收尾时会再出现一次。
4.2 三步:攒、取整、扣回
advance() 的调用链不长:advance() 先跟墙钟要一个 cpu_process_step,再交给 advance_checked(),后者调用 advance_core()。真正决定「跑几次」的就是 advance_core() 的开头三行:
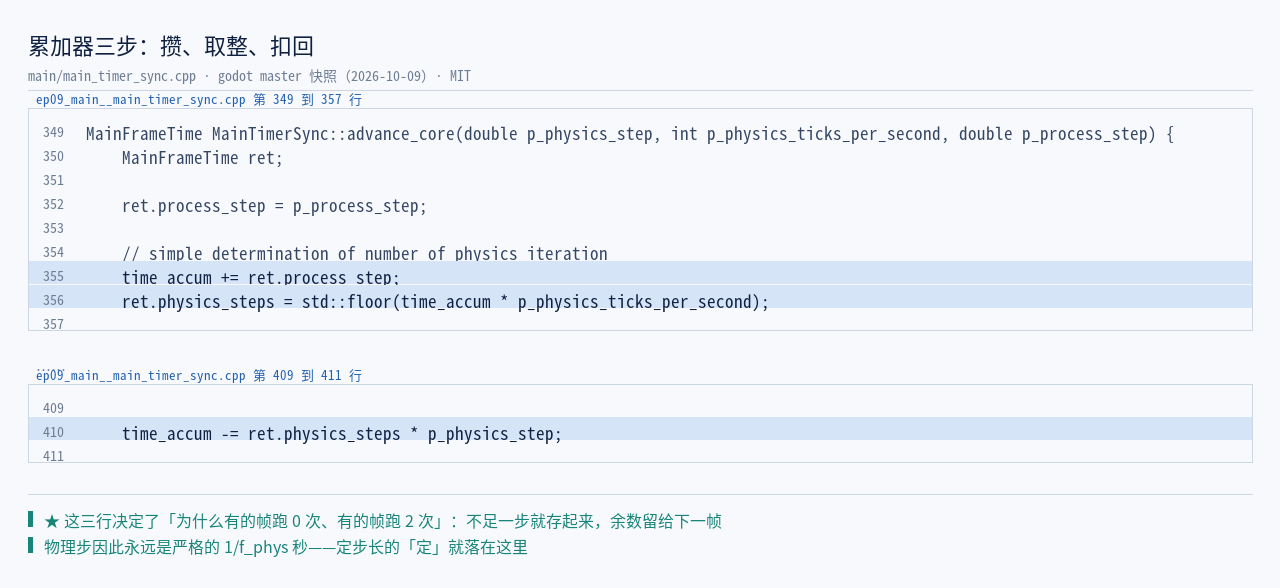
process_step、取整成物理步数、再把用掉的整步扣回去@ godot master 快照(2026-10-09)原文截取 · MITMainFrameTime MainTimerSync::advance_core(double p_physics_step, int p_physics_ticks_per_second, double p_process_step) {
MainFrameTime ret;
ret.process_step = p_process_step;
// simple determination of number of physics iteration
time_accum += ret.process_step;
ret.physics_steps = std::floor(time_accum * p_physics_ticks_per_second);
…
time_accum -= ret.physics_steps * p_physics_step;
写成式子就是:
$$ \text{time\_accum} \mathrel{+}= \text{process\_step};\qquad \text{physics\_steps} = \left\lfloor \text{time\_accum} \times f_{\text{phys}} \right\rfloor;\qquad \text{time\_accum} \mathrel{-}= \text{physics\_steps} \times \frac{1}{f_{\text{phys}}} $$
其中:
- $f_{\text{phys}}$ 就是 physics_ticks_per_second,默认 60;
- 第一步 += 是攒:把这一帧的墙钟时间加进累加器;
- 第二步 $\lfloor \cdot \rfloor$ 是取整:攒够了几个整物理步就放几个;
- 第三步 -= 是扣回:放出去的整步数要从累加器里减掉,余数留下。
说白了,这就是一个「不足一步就存起来」的蓄水池。它带来的直接后果是:物理步不会被打断、也不会被拉伸——永远是严格的 1/60 秒;而渲染帧则每次都可能不一样长。这条「一边严格、一边随意」的分配方式,就是「错位」这个词的机制来源。
4.3 余数留下来之后
好了,把上面三步画到时间轴上,形状很清楚:
其中:图上那几条竖线就是物理步的落点。请留意两件事:第一,物理步的间隔是等距的(都是 1/60 秒),而帧的落点是疏密不均的——这正是「定步长」这个词的含义。第二,除不尽的时候余数会跨帧累积,所以「这一帧跑 0 次、下一帧跑 1 次」是正常现象,不是丢步。
不过 advance_core() 并不是只有这三行。它后面还有一段不算短的处理:把这次的步数与最近若干帧的「典型步数」比较,再按 physics_jitter_fix 做一次上下限修正。这段代码的意图写在注释里——// try to keep it consistent with previous iterations(尽量和之前的迭代保持一致),用的是一张 12 格的历史表:
    // number of frames back for keeping accumulated physics steps roughly constant.
    // value of 12 chosen because that is what is required to make 144 Hz monitors
    // behave well with 60 Hz physics updates. The only worse commonly available refresh
    // would be 85, requiring CONTROL_STEPS = 17.
    static const int CONTROL_STEPS = 12;
其中:这段注释把一个设计数字的来源交代清楚了:12 这个窗口是为「144 Hz 显示器配 60 Hz 物理」选的——144 ÷ 60 = 2.4,不是整数,所以物理步只能在帧之间来回摊(2、2、3、2、2、3…),需要足够长的窗口才能让摊出来的序列稳定。这也回答了一个常见疑问:physics_jitter_fix 调的到底是什么?它调的是「为了让帧间隔看起来均匀,允许游戏内时钟偏离真实时钟多少」——所以它是一个平滑度与时钟准确度之间的兑换率,不是「物理质量」的开关。
本章出处:源码 main_timer_sync.h(:35–41、:94–104)、main_timer_sync.cpp(:349–357、:388–404、:410、:530–543)|官方 ProjectSettings 类参考 · physics_jitter_fix。
五、两个计数器,以及一个「从余数里长出来」的分数
第四章讲清了物理步怎么攒出来。这一章要把「谁在数数」与「画到哪儿了」这两件事分开——它们最容易被当成同一件事。
5.1 官方专门写了一句 Note 来区分两个计数器
SceneTree.get_frame() 这个方法名起得很容易让人误解,官方干脆在说明里点破,逐字:
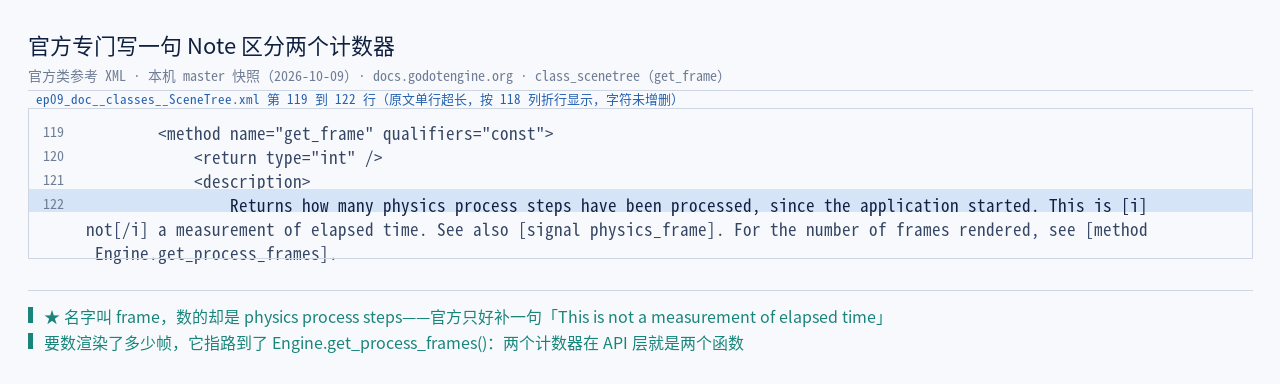
SceneTree.get_frame 补的那句 Note:它数的是物理步,不是帧@ 官方类参考 XML(本机 master 快照 2026-10-09)Returns how many physics process steps have been processed, since the application started.
This is not a measurement of elapsed time. See also physics_frame.
For the number of frames rendered, see Engine.get_process_frames.
好,其中:这句话里有两处修正读者直觉的地方。第一,SceneTree.get_frame() 返回的不是帧数,是物理步数——名字叫 frame,数的是 physics_process。第二,它明确指路:要数「渲染了多少帧」,去读 Engine.get_process_frames()。一个名字像帧、数的是物理步;一个名字像「处理了几帧」、数的才是逻辑帧。这两句是官方写给自己的注解,也正好是这一章要立的靶子。
5.2 插值分数从哪来
那「现在画在两次物理之间的哪个位置」这个信息从哪来?回到第四章那个累加器。在 advance_checked() 的结尾,有一行:
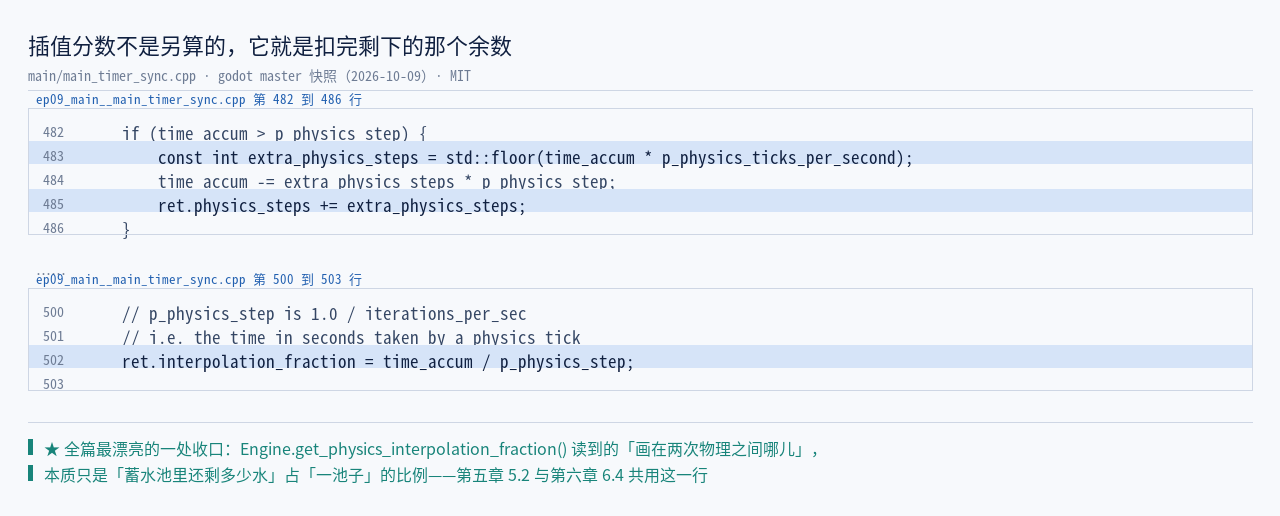
    // p_physics_step is 1.0 / iterations_per_sec
    // i.e. the time in seconds taken by a physics tick
    ret.interpolation_fraction = time_accum / p_physics_step;
其中:这一行是本章的题眼。插值分数不是另外算出来的,它就是第四章那个「扣完剩下的余数」除以一个物理步长。余数为 0 时分数是 0(刚好落在物理步上),余数接近一整个物理步时分数接近 1。所以 Engine.get_physics_interpolation_fraction() 读到的数,本质是「蓄水池里还剩多少水」占「一池子」的比例。这个词的用法在第六章 6.4 会落到画面上。
5.3 三个量放在一条时间轴上
说白了,把三个量——_physics_frames、_process_frames、_frames_drawn——放到同一条时间轴上,错位就看得见了:
其中:这张图上有三条不同形状的曲线,对应三种不同的计数方式。_physics_frames 是在 for 循环体里自增的,所以它一帧里可能跳好几格;_process_frames 是每 idle 帧一格,最平直;_frames_drawn 只在真的调了 RenderingServer::draw() 之后才加一——而「真不真画」还要看第八章那两个条件。三个计数器、三种节奏,谁也不能替代谁。本机五档实测里这三个值的差距就摆在表上:默认档 180 个 idle 帧期间,physics_frames 只从 0 走到 4,而 process_frames 与 frames_drawn 都到了 209(含预热段)——同一段时间里,物理走了 4 步、逻辑走了 209 帧、渲染了 209 帧。
5.4 官方给的那个上限,是一个「钳在 delta 上」的数
顺手把一处容易漏的参数补上。官方在 _process 的说明里写了 delta 的上限,逐字:
Note: When the engine is struggling and the frame rate is lowered, delta will increase. When delta is
increased, it's capped at a maximum of Engine.time_scale * Engine.max_physics_steps_per_frame /
Engine.physics_ticks_per_second.
其中:按默认值代进去,这个上限是 1 × 8 ÷ 60 ≈ 0.1333 秒。它的含义是:即使某一帧卡了半秒,交给逻辑的 delta 也只会报 0.1333 秒——因为这一帧最多只补 8 个物理步,物理时间只走了那么多。这解释了为什么卡顿时游戏会「变慢」而不是「跳过去」:逻辑时间被物理步数钳住了,它跑不快。
本章出处:官方 SceneTree 类参考 · get_frame(本机 XML 快照 :119–122)、MainLoop 类参考 · _process|源码 main_timer_sync.cpp(:482–502)、main.cpp(:5121、:5125)|本机探针 evidence/probe/E_ep09_summary.txt。
5.5 工程上该读哪一个
三个计数器分清之后,一个实用问题就冒出来了:排查问题时该读哪一个?答案取决于你想知道的是哪件事,读错一个就会得到「一切正常」的假象。
| 你想知道 | 该读 | 为什么 |
|---|---|---|
| 游戏逻辑推进了多少 | Engine.get_process_frames() |
它数的是 idle 帧——也就是 _process 被调了几次 |
| 物理推进了多少 | Engine.get_physics_frames() / SceneTree.get_frame() |
它数的是物理步,与帧率无关;拿它当帧率用是最常见的误读 |
| 画面出了多少帧 | Engine.get_frames_drawn() |
它只在真的调了 draw() 之后才加一,受第八章那三个条件影响 |
| 这一帧画在两次物理之间的哪儿 | Engine.get_physics_interpolation_fraction() |
就是第五章那个「余数 ÷ 物理步」 |
其中:这张表里第二行是重点。SceneTree.get_frame() 名字里带 frame,数的却是物理步——官方正是因为知道这个坑,才在说明里补了那句 This is not a measurement of elapsed time。而在本机默认档那种高帧率场景下,这个坑会显得特别大:get_frame() 在 180 个 idle 帧里只涨了 2,而 process_frames 已经涨了 180。把前者的涨速当成帧率,就会得出「这台机器只有 2 FPS」这种离谱结论。读数之前先问一句「这个函数数的是哪个节拍」,是本篇最实用的一条经验。
六、官方管它叫 jitter:四个旋钮、两个故障、两版解法
前面五章讲的是「引擎怎么算」。这一章换个角度:当它算出来的节拍与显示器对不上时,官方准备了哪些旋钮、把这件事叫什么名字、版本上又是怎么解的。
6.1 四个旋钮各管什么
官方为这件事准备了四个工程设置,它们的分工很清楚:
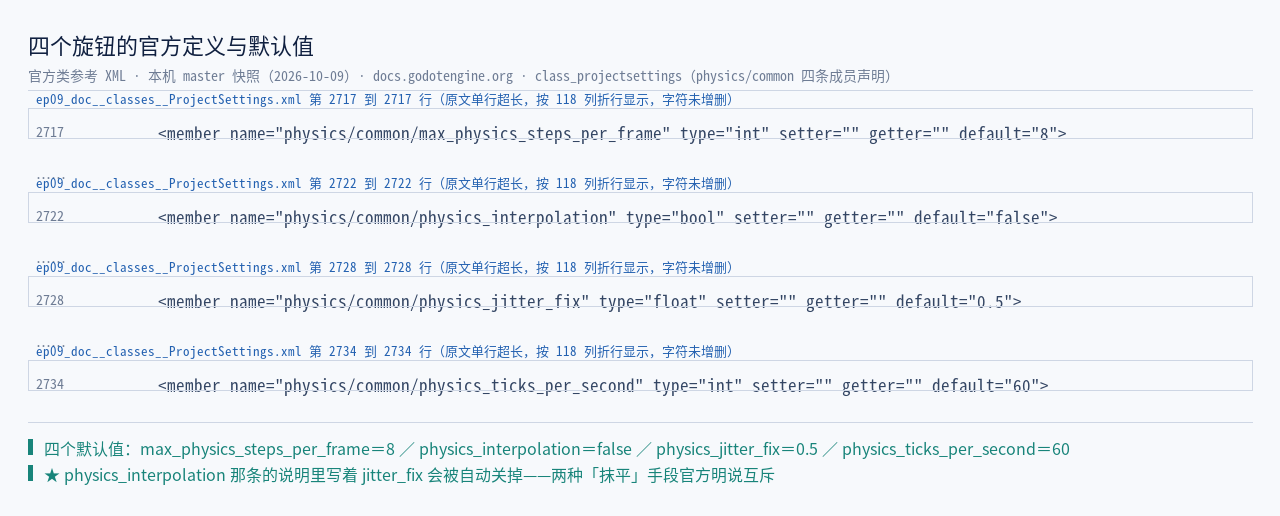
四个成员声明并排(type 与 default 都取自声明行本身):
| 成员 | 类型 | 默认值 |
|---|---|---|
physics/common/physics_ticks_per_second |
int | 60 |
physics/common/max_physics_steps_per_frame |
int | 8 |
physics/common/physics_jitter_fix |
float | 0.5 |
physics/common/physics_interpolation |
bool | false |
其中:四个旋钮两两成对,各治一条故障:
| 旋钮 | 治什么 | 代价写在哪 |
|---|---|---|
physics_ticks_per_second |
物理仿真的精度 | 官方:CPU 占用大约与它成正比;低于 30 时物理行为可能崩坏;改它还会改变阻尼手感 |
max_physics_steps_per_frame |
防物理螺旋 | 官方:设太小会让游戏「显得变慢」(按默认值算,门槛是 60 ÷ 8 = 7.5 FPS) |
physics_jitter_fix |
抹平帧率抖动 | 官方:值越大,游戏内时钟与真实时钟偏离越多;超过 2 会觉得「反应迟钝」 |
physics_interpolation |
治台阶效应 | 官方:它与 physics_jitter_fix 不兼容——开插值会自动把 jitter fix 关掉 |
注意上表最后一行。官方在 physics_interpolation 的说明里写了一句 Property physics_jitter_fix is automatically disabled if physics_interpolation is set to true, as the two methods are incompatible.——两种「抹平」手段不能同开:一个是在时间轴上挪物理步的位置去凑帧,一个是在两次物理之间插出中间位置。这一点值得记住,因为社区里常见的建议是「一起开」,而官方明确说二者互斥。
这三个数里还有一个值得单独记:上表第二行那句「显得变慢」,官方在 physics_ticks_per_second 的说明里也重复了一遍,用的是定义式的说法——the game will appear to slow down if the rendering FPS is less than 1 / max_physics_steps_per_frame of physics_ticks_per_second。把「慢」写成一个可以算出来的比值,而不是一种感觉,这是官方文档里少见的严谨处。
6.2 两个故障,两个名字
言归正传,再分清两件常被混为一谈的事。「抖」和「慢」在官方文档里是两个不同的故障,各有各的定义。
第一个是抖动(jitter),官方在物理插值的开篇文档里给了机制解释:
the engine does not necessarily render at the same rate. … What happens if the physics tick rate is
out of phase with the frame rate? … This jump can be seen in other combinations of tick / frame rate as
glitches, or jitter, caused by this staircasing effect due to the discrepancy between physics tick time
and rendered frame time.
另一个是物理螺旋(physics spiral of death),官方在 ProjectSettings 里给了完整定义:
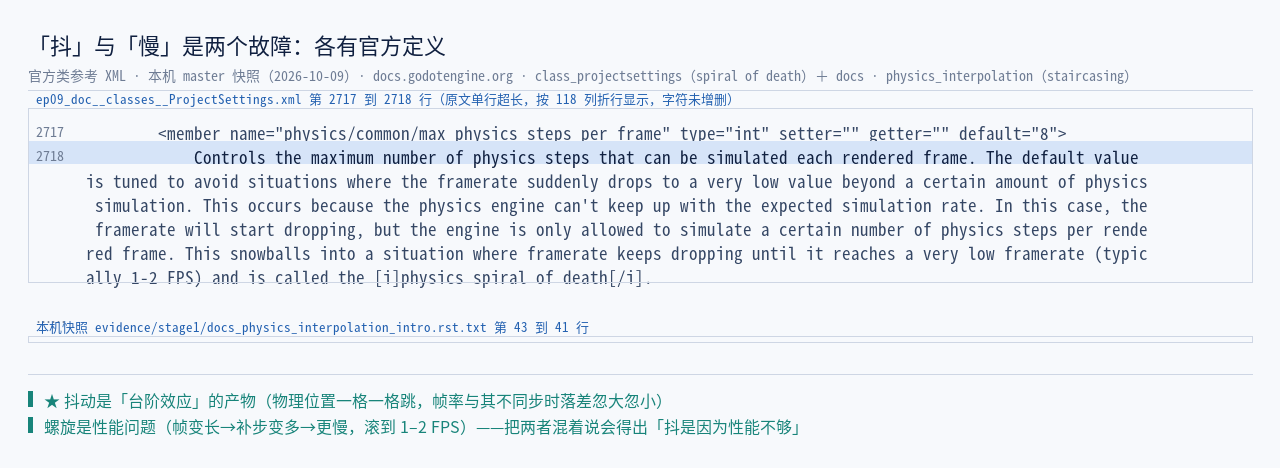
This snowballs into a situation where framerate keeps dropping until it reaches a very low framerate
(typically 1-2 FPS) and is called the physics spiral of death.
其中:两个名字对应两条完全不同的因果链。抖动是「台阶效应」(staircasing)的产物——物理位置是一格一格跳的,当帧率与物理频率的比不是整数时,这一帧看到的位置和上一帧之间的落差就会忽大忽小,看上去就是「一顿一顿」。螺旋则是性能问题——帧变长、需要补的物理步变多、补不完又拖长下一帧,越滚越慢直到 1–2 FPS。前者是观感问题、后者是性能故障;把两者混着说,就会得出「抖动是因为性能不够」这种错结论。
6.3 版本上是怎么解的
官方对「抖」这个问题的解法不是一次到位的,而是分两步落地:4.3 给 2D 物理插值,4.4 才补上 3D。而在多线程这条线上,4.3 也做了一次基础性改动。三段官方原文如下:
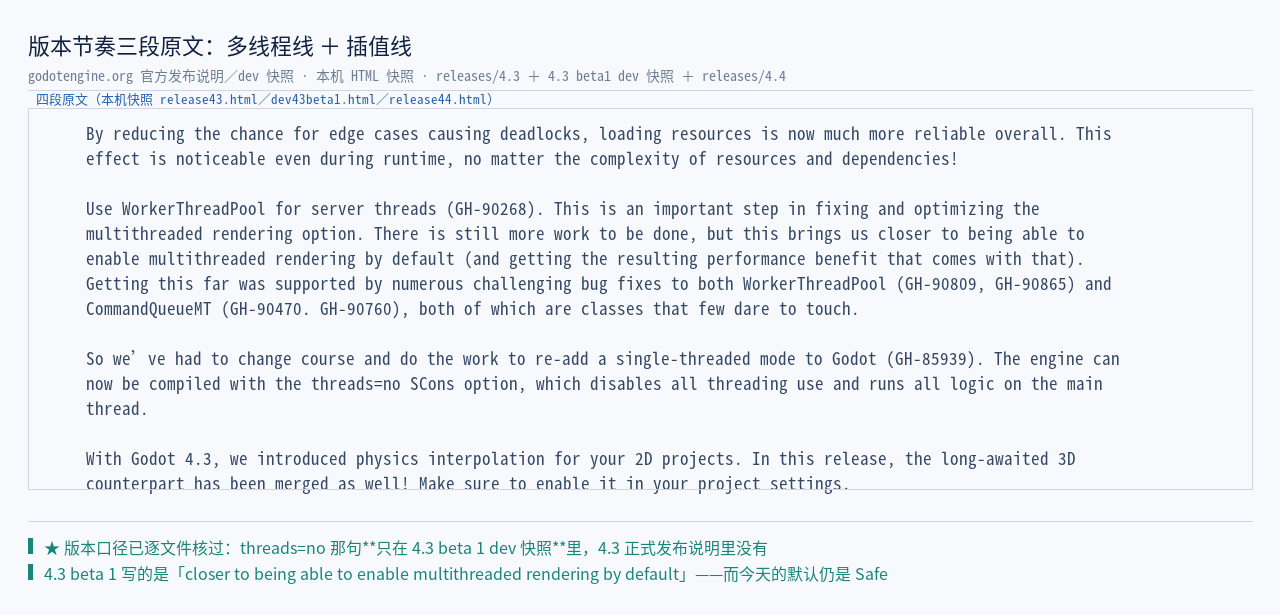
threads=no、4.4 的 3D 物理插值@ godotengine.org 官方发布说明与 dev 快照(本机 HTML 快照)4.3 发布说明里,多线程改进是作为一条总目列出来的:
General multi-threading improvements
By reducing the chance for edge cases causing deadlocks, loading resources is now much more
reliable overall.
4.3 beta 1 开发快照里另有两句,一句讲线程池改服务线程,一句讲可以整个关掉线程:
Use WorkerThreadPool for server threads (GH-90268). This is an important step in fixing
and optimizing the multithreaded rendering option. … this brings us closer to being able to
enable multithreaded rendering by default…
The engine can now be compiled with the threads=no SCons option, which disables all
threading use and runs all logic on the main thread.
4.4 发布说明补上另一半——插值那条线的 3D 版:
With Godot 4.3, we introduced physics interpolation for your 2D projects. In this release, the
long-awaited 3D counterpart has been merged as well!
其中:这三段里有一条关于版本口径的细节要说明:threads=no 那句,本篇已经逐文件核对过三份落盘快照,它只出现在 4.3 beta 1 的 dev 快照里,4.3 正式发布说明里没有——所以引用时出处要写 4.3 beta 1,不能写成 4.3 发布说明。出处差一个版本,读者去查就会扑空。
还有一处细节值得留意:4.3 beta 1 那句自述写的是「this brings us closer to being able to enable multithreaded rendering by default」——这是 2024 年的话。而本篇第七章会看到,直到本篇取材的这份 master 快照,默认档仍然是 Safe。「加了」与「默认开」之间隔着的东西,比版本号看起来的多。
6.4 插值到底插在哪儿
§6.1 里那个 physics_interpolation 开关,打开之后画面到底变了什么?用第五章那个分数来说就清楚了:
其中:物理服务器每一步只算出「当前位置」,它并不知道这一帧要画在哪个瞬间。所以插值要做的是:拿上一步的位置与本步的位置,按那个分数做一次线性插值——分数 0.49,画两点之间的 49%。这也顺带解释了为什么 SceneTree::iteration_prepare()(第一章 1.4)必须抢在物理服务器更新之前把「上一步位置」记下来:不记,两点就重合了,插值就无从谈起。
6.5 把版本排开
顺着 6.3 那三段原文,把版本排成一条线:
其中:这条时间线里最值得记住的是两条线并行走但待遇不同:插值 4.3 起就能在工程设置里打开,而多线程渲染到今天仍然不是默认(第七章给出源码依据)。所以「版本节奏」这一节不是年表,而是一条写正文时要守住的纪律:说某项能力「有了」的时候,一定要顺口说清它在哪一档、默认是开还是关。
本章出处:官方 物理插值开篇文档(本机快照 docs_physics_interpolation_intro.rst.txt)、Fixing jitter, stutter and input lag、ProjectSettings 类参考(:2717 / :2722 / :2728 / :2734)|发布说明 4.3 / 4.4 / 4.3 beta 1 dev 快照(本机 HTML 快照 evidence/stage1/ 三份)。
七、渲染线程模型:默认是 Safe,Separate 是一条要手动开的岔路
齿轮讲完了,换到线程这条轴上。这一章要回答一个最容易传错的常识:「Godot 的多线程渲染」到底是不是默认状态。答案是不是,而且这件事在源码里只需要看一个参数。
7.1 三个取值,顺序就是档位
先看枚举:
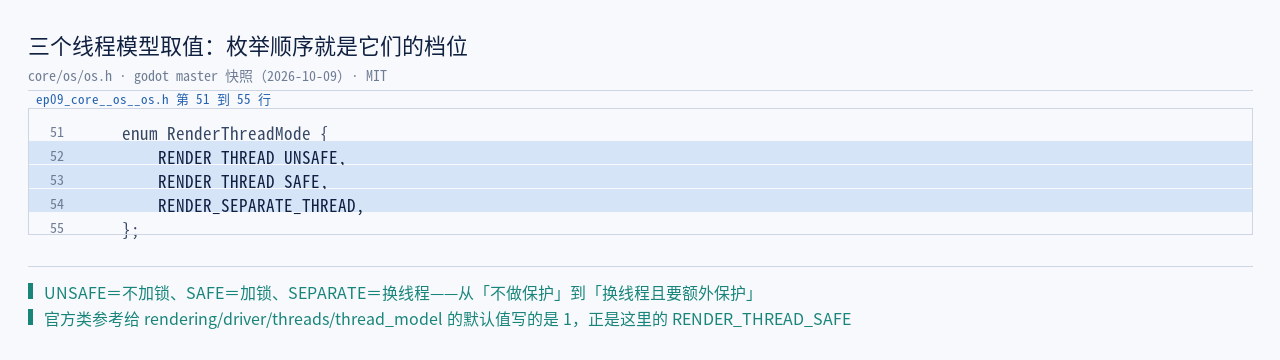
enum RenderThreadMode 的三个取值:枚举顺序就是档位顺序@ godot master 快照(2026-10-09)原文截取 · MIT enum RenderThreadMode {
RENDER_THREAD_UNSAFE,
RENDER_THREAD_SAFE,
RENDER_SEPARATE_THREAD,
};
其中:三个取值的语义在名字里:UNSAFE 是不加锁、SAFE 是加锁、SEPARATE 是把渲染挪到独立线程。它们不是三个「选项」,而是三个档位——从「完全不做保护」到「保护但同线程」再到「换线程但要额外保护」。按本机 --help 的说法,第一个已经被标成弃用:Render thread mode ("unsafe" [deprecated], "safe", "separate").
7.2 默认值写在源码的哪一处
OK,关键的一行在这里:
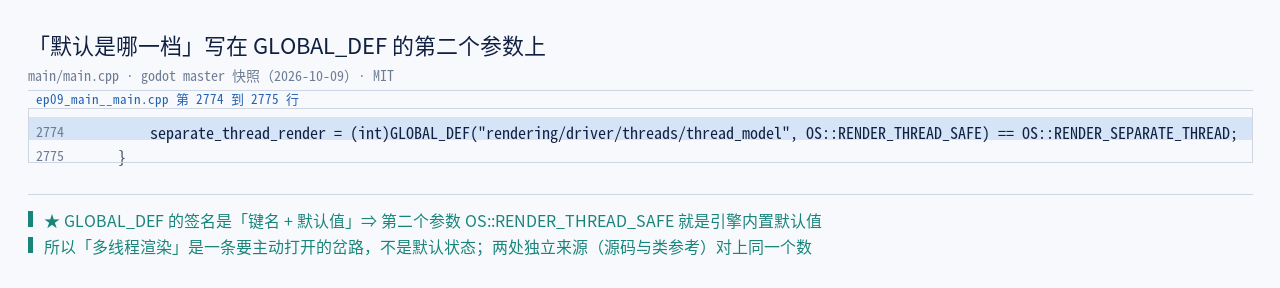
GLOBAL_DEF 的第二个参数上:引擎内置默认是 Safe 不是 Separate@ godot master 快照(2026-10-09)原文截取 · MIT separate_thread_render = (int)GLOBAL_DEF("rendering/driver/threads/thread_model", OS::RENDER_THREAD_SAFE) == OS::RENDER_SEPARATE_THREAD;
好了,其中:这一个参数把话说尽了。GLOBAL_DEF 的签名是「键名 + 默认值」,所以第二个参数 OS::RENDER_THREAD_SAFE 就是引擎内置的默认值——只有当项目设置被显式改成 Separate 时,separate_thread_render 才为真。官方类参考也从另一头印证了这一点:rendering/driver/threads/thread_model 那条的 default 一栏写的是 1,而按 enum RenderThreadMode 的顺序,1 正是 RENDER_THREAD_SAFE。两处独立来源对上同一个数。
7.3 官方给它标了「实验性」
说白了,更值得引的是官方对这条设置的态度。ProjectSettings 类参考里,thread_model 这一条带了一个 experimental 属性,逐字:
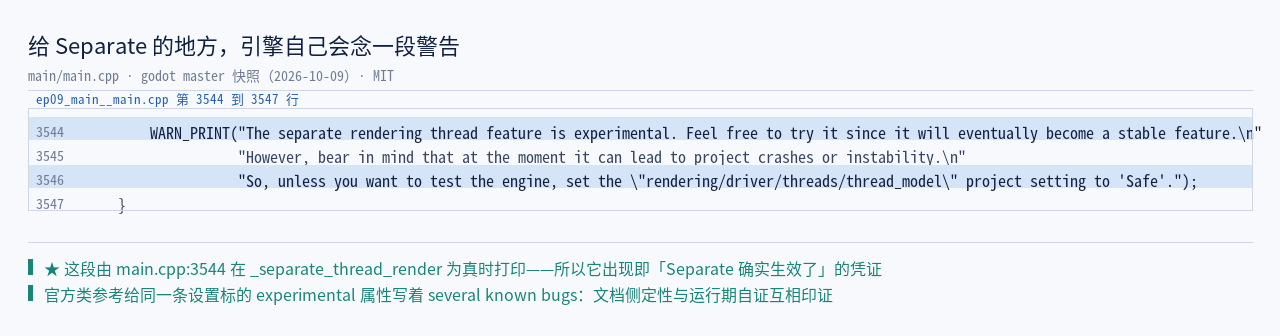
Separate 时引擎自己打印的警告:实验性,且建议改回 Safe@ godot master 快照(2026-10-09)原文截取 · MIT(ProjectSettings,thread_model 的 experimental 属性)
This setting has several known bugs which can lead to crashing, especially when using particles
or resizing the window. Not recommended for use in production at this stage.
(main.cpp:3544–3546,运行期警告)
The separate rendering thread feature is experimental. Feel free to try it since it will eventually
become a stable feature. …
So, unless you want to test the engine, set the "rendering/driver/threads/thread_model" project
setting to 'Safe'.
OK,其中:这两处来源的分工值得说清:类参考的那条是「文档侧」的定性,main.cpp 的那条是「运行期」的自证。它们说的是同一件事,但用法不同——第十一章会看到,当本机用 --render-thread separate 跑起来时,引擎自己会把第二段打印到日志里,等于当场承认「你现在走的是实验路径」。有坑的岔路,引擎会自己说。
把三个档位并排:
| 档位 | 谁默认 | 渲染在哪 | 代价写在官方哪一处 |
|---|---|---|---|
Unsafe |
— | 主线程,不加保护 | 命令行 --help 标 [deprecated];运行期另有 unsupported in Godot 4 and will be removed |
Safe |
引擎内置默认 | 主线程,服务器侧加锁 | 官方类参考 default="1";也正是官方警告里推荐的档位 |
Separate |
不是(要手动开) | 独立渲染线程 | 官方 experimental 属性:「several known bugs … Not recommended for use in production」 |
其中:这张表里最值得记住的是最后一列的写法差异——官方对 Safe 的态度是「推荐」,对 Separate 的态度是「实验」。所以本篇不会写「开多线程渲染能提速」这种话,只写清它是什么档、默认是哪一档、要开它在哪一处开。至于开了之后线程级上发生了什么,本机看不到(0.3 那条边界),只能从源码与官方文档读——第九章接着讲。
本章出处:源码 os.h(:51–55)、main.cpp(:2774、:3544–3546)|官方 ProjectSettings 类参考 · rendering/driver/threads/thread_model(本机 XML 快照 :2949)、Thread-safe APIs(本机快照 docs_thread_safe_apis.rst.txt:84–91)。
八、一帧到底画不画
第七章讲的是「渲染在哪条线程上」。这一章讲另一件更基本的事:这一帧到底调不调 draw()。它看起来不该有疑问——每帧不该都画一次吗?源码给出的答案是:不一定,而且有三个条件叠在一起。
8.1 「画」这件事是一根可关的开关
好了,先在 RenderingServer 里找到这根开关:
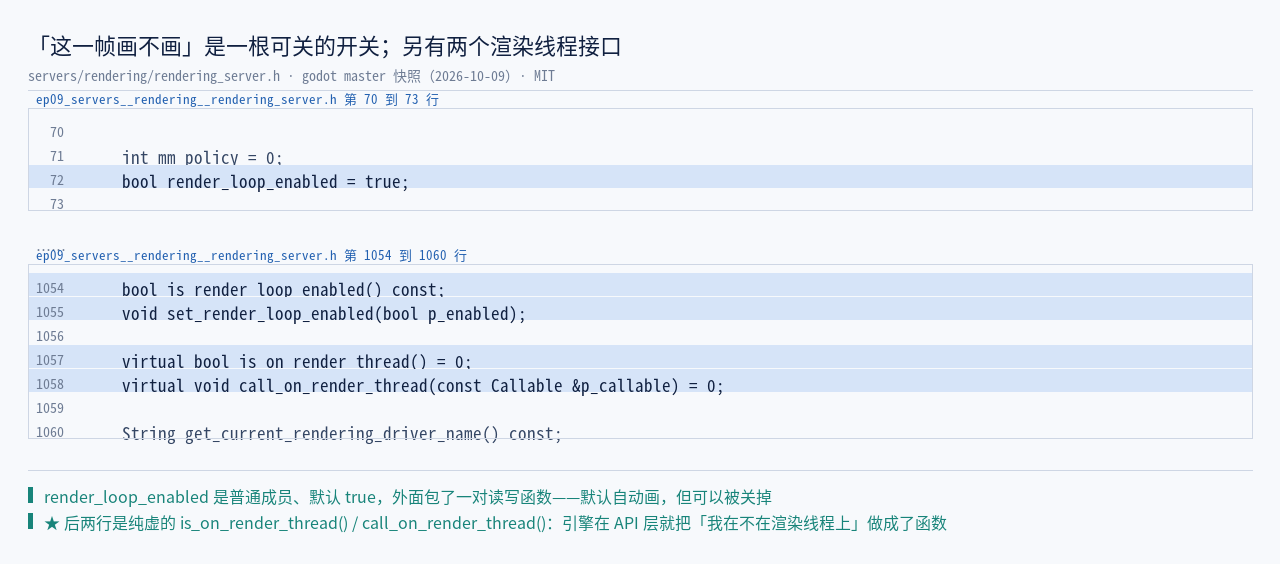
render_loop_enabled 这根开关,以及两个关于渲染线程的纯虚接口@ godot master 快照(2026-10-09)原文截取 · MIT bool render_loop_enabled = true;
…
bool is_render_loop_enabled() const;
void set_render_loop_enabled(bool p_enabled);
…
virtual bool is_on_render_thread() = 0;
virtual void call_on_render_thread(const Callable &p_callable) = 0;
其中:render_loop_enabled 是一个普通成员、默认 true,外面包了一对读写函数——所以「每帧自动画」这件事是默认行为,但它可以被关掉。后两个纯虚函数更值得留意:is_on_render_thread() 与 call_on_render_thread() 是引擎提供给你的、用来问「我在不在渲染线程上」以及「请到渲染线程上执行」的接口。这正好补上 0.3 那条边界缺的那一块:本机确实看不到「谁在哪个线程」,但引擎自己在 API 层把这个问题做成了一个函数。
谁在关这根开关?本机源码里有三处写入点,用途各不相同:
| 位置 | 谁在写 | 写成什么 |
|---|---|---|
main.cpp:774 |
编辑器/工具路径 | set_render_loop_enabled(false)——由编辑器自己驱动重绘 |
main.cpp:3595 |
--disable-render-loop |
set_render_loop_enabled(!disable_render_loop)——命令行关掉 |
main.cpp:5114 |
Main::iteration() |
只读它,决定这一步要不要 draw |
8.2 idle 段的原文
三个条件的现场在 idle 段。原文如下:
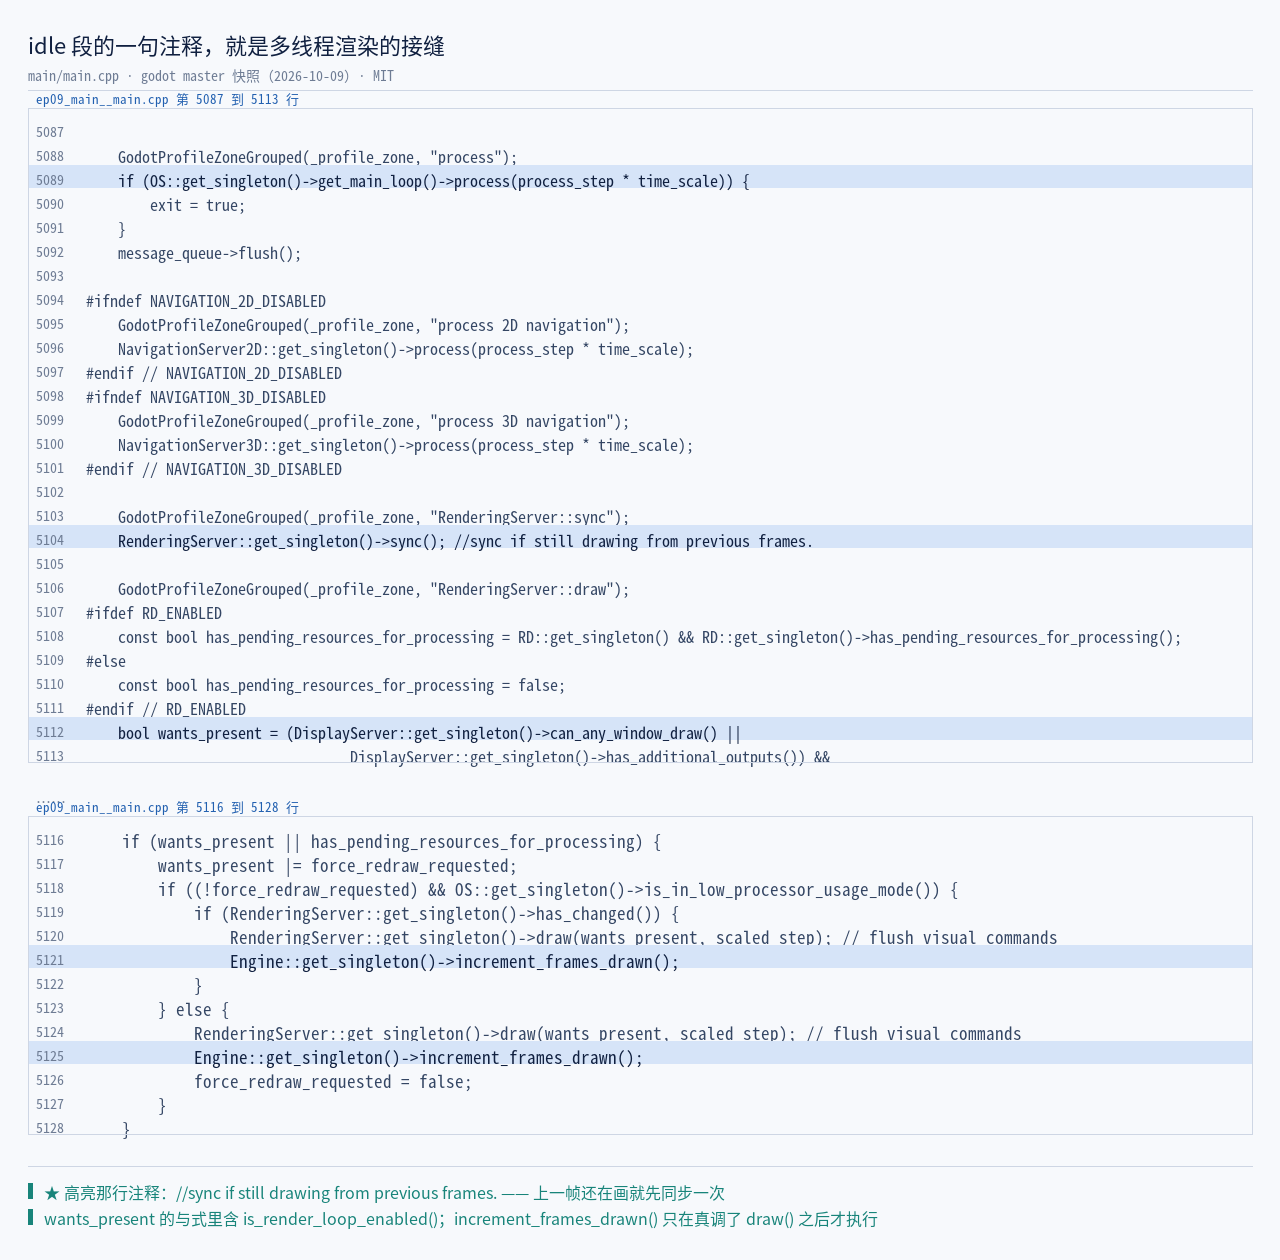
sync if still drawing from previous frames 就是多线程渲染的接缝@ godot master 快照(2026-10-09)原文截取 · MIT GodotProfileZoneGrouped(_profile_zone, "process");
if (OS::get_singleton()->get_main_loop()->process(process_step * time_scale)) {
exit = true;
}
message_queue->flush();
…
NavigationServer2D::get_singleton()->process(process_step * time_scale);
NavigationServer3D::get_singleton()->process(process_step * time_scale);
GodotProfileZoneGrouped(_profile_zone, "RenderingServer::sync");
RenderingServer::get_singleton()->sync(); //sync if still drawing from previous frames.
GodotProfileZoneGrouped(_profile_zone, "RenderingServer::draw");
…
bool wants_present = (DisplayServer::get_singleton()->can_any_window_draw() ||
DisplayServer::get_singleton()->has_additional_outputs()) &&
RenderingServer::get_singleton()->is_render_loop_enabled();
if (wants_present || has_pending_resources_for_processing) {
wants_present |= force_redraw_requested;
if ((!force_redraw_requested) && OS::get_singleton()->is_in_low_processor_usage_mode()) {
if (RenderingServer::get_singleton()->has_changed()) {
RenderingServer::get_singleton()->draw(wants_present, scaled_step); // flush visual commands
Engine::get_singleton()->increment_frames_drawn();
}
} else {
RenderingServer::get_singleton()->draw(wants_present, scaled_step); // flush visual commands
Engine::get_singleton()->increment_frames_drawn();
force_redraw_requested = false;
}
}
说白了,其中:这一段里最值得单独记住的是那一句注释:
RenderingServer::get_singleton()->sync(); //sync if still drawing from previous frames.
「上一帧还在画,就先同步一次」——这句话就是多线程渲染的接缝。如果渲染在主线程上(默认的 Safe 档),draw() 返回时画面已经画完,这次 sync() 基本是空转;但如果渲染被挪到了另一个线程(Separate 档),上一次 draw() 可能还没结束,这一次 sync() 就得等它——等这一步,就是「多线程渲染」在时间轴上留下的痕迹。这条注释不是解释渲染怎么做,而是解释「两个线程怎么交接」。
8.3 三个条件
把 idle 段那几行展开成一张判断图:
其中:三个条件的分工是:窗口能不能画(比如窗口最小化了就不能)、渲染循环开不开(第八章 8.1 那根开关)、低耗模式下有没有变化(has_changed())。而 increment_frames_drawn() 只在前两个条件已经成立、且真的调了 draw() 之后才执行——所以「渲染帧数」这个计数器天然比「逻辑帧数」更小。第五章那张三计数器时间轴里最后一条曲线为什么最矮,答案就在这几行。
顺带说一句 has_pending_resources_for_processing:它是 wants_present 之外的「或」条件,管的是「有资源还等着上 GPU」。所以即使这一帧不该出画面,资源该处理的还是会处理。这一处也是「不画」与「什么都没做」的区别所在。
本章出处:源码 rendering_server.h(:72、:1054–1058)、main.cpp(:774、:3595、:5086–5128)|官方 命令行教程 · --disable-render-loop。
九、跨线程的边界
齿轮和开关都讲完了,剩下的是本篇真正的主题:线程。这一章要回答一个最实用的问题:为什么在别的线程里碰一下场景树就会崩,而碰另一类东西却没事?回答不是「因为不安全」,而是三档边界。
9.1 官方那份清单
官方在《Thread-safe APIs》里把边界列全了。这份清单值得逐条看,因为它每一条都对应一个具体的 API:
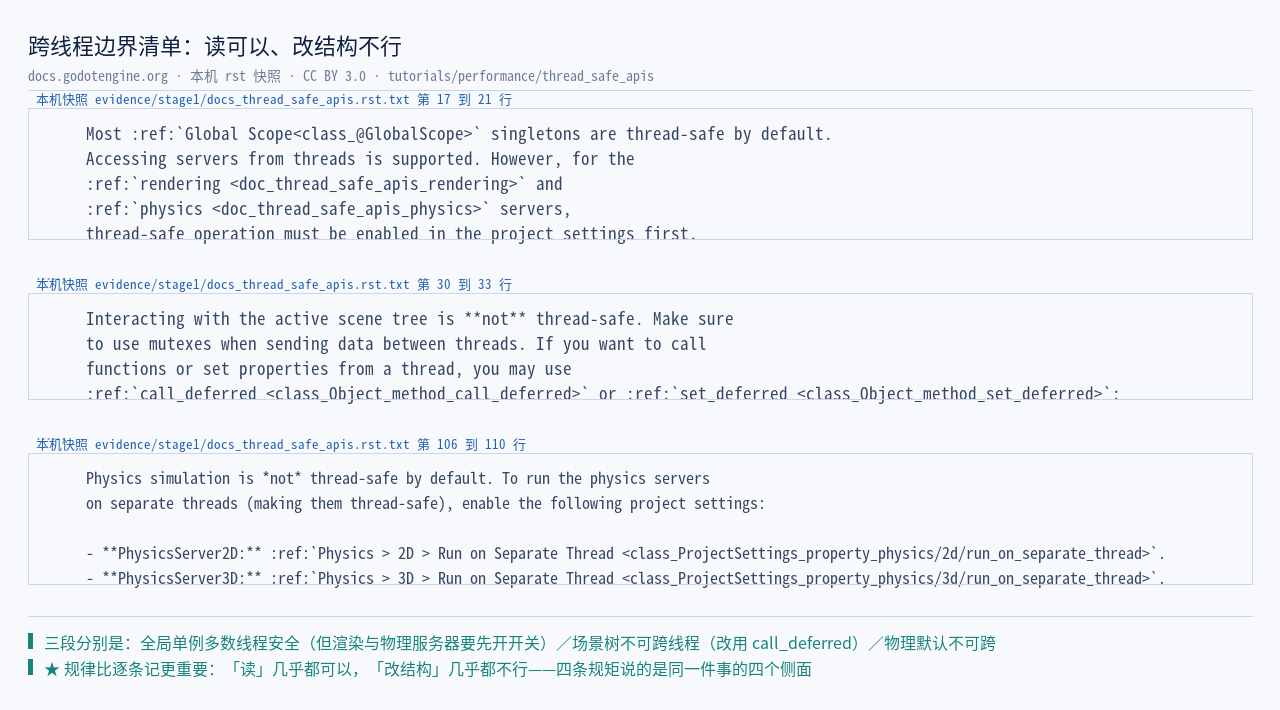
Most Global Scope singletons are thread-safe by default. Accessing servers from threads is supported.
However, for the rendering and physics servers, thread-safe operation must be enabled in the project
settings first.

Interacting with the active scene tree is not thread-safe. Make sure to use mutexes when sending data
between threads. If you want to call functions or set properties from a thread, you may use
call_deferred or set_deferred.

Instancing nodes that render anything in 2D or 3D (such as Sprite2D or MeshInstance3D) is not
thread-safe by default. To run the rendering driver on a separate thread, set the Rendering > Driver >
Thread Model project setting to Separate. Note that the Separate thread model has several known bugs,
so it may not be usable in all scenarios.

Physics simulation is not thread-safe by default. To run the physics servers on separate threads
(making them thread-safe), enable the following project settings:
  PhysicsServer2D: Physics > 2D > Run on Separate Thread.
  PhysicsServer3D: Physics > 3D > Run on Separate Thread.
另外三条零散但同样重要:
The navigation-related helper classes like AStar2D, AStar3D, and AStarGrid2D are not thread-safe.
They can be used with threads to some limited capacity, but using two or more threads on the same
AStar object causes corruption.

In GDScript, reading and writing elements from multiple threads is OK, but anything that changes the
container size (resizing, adding, or removing elements) requires locking a mutex.

Modifying a unique resource from multiple threads is not supported. However, handling references on
multiple threads is supported. Hence loading resources on a thread is as well - scenes, textures,
meshes, etc - can be loaded and manipulated on a thread and then added to the active scene on the main
thread.
其中:这份清单里藏着一个规律,比逐条记更重要:「读」几乎都是可以的,「改结构」几乎都是不行的。场景树不能跨线程、AStar 不能两个线程同时用、GDScript 容器「改尺寸要锁」、唯一资源「不能跨线程改」——四条说的是同一件事的四个侧面。而官方给的解法也统一:不要在别的线程里改,把改动交回主线程——场景树用 call_deferred,资源用「线程里加载好、主线程里挂上去」。
这解释了为什么「跨线程」在工程上常常被写成「跨线程交接」而不是「跨线程操作」。交接这件事,才是引擎真正支持的那一半。把这份清单按「谁负责保证安全」这条尺子归类,正好落成 9.3 那三层。
9.2 三个安全缓冲,各自身份不同
OK,那「交接」是怎么实现的?引擎里负责这件事的不是一个组件,而是三个,它们的身份要分清:
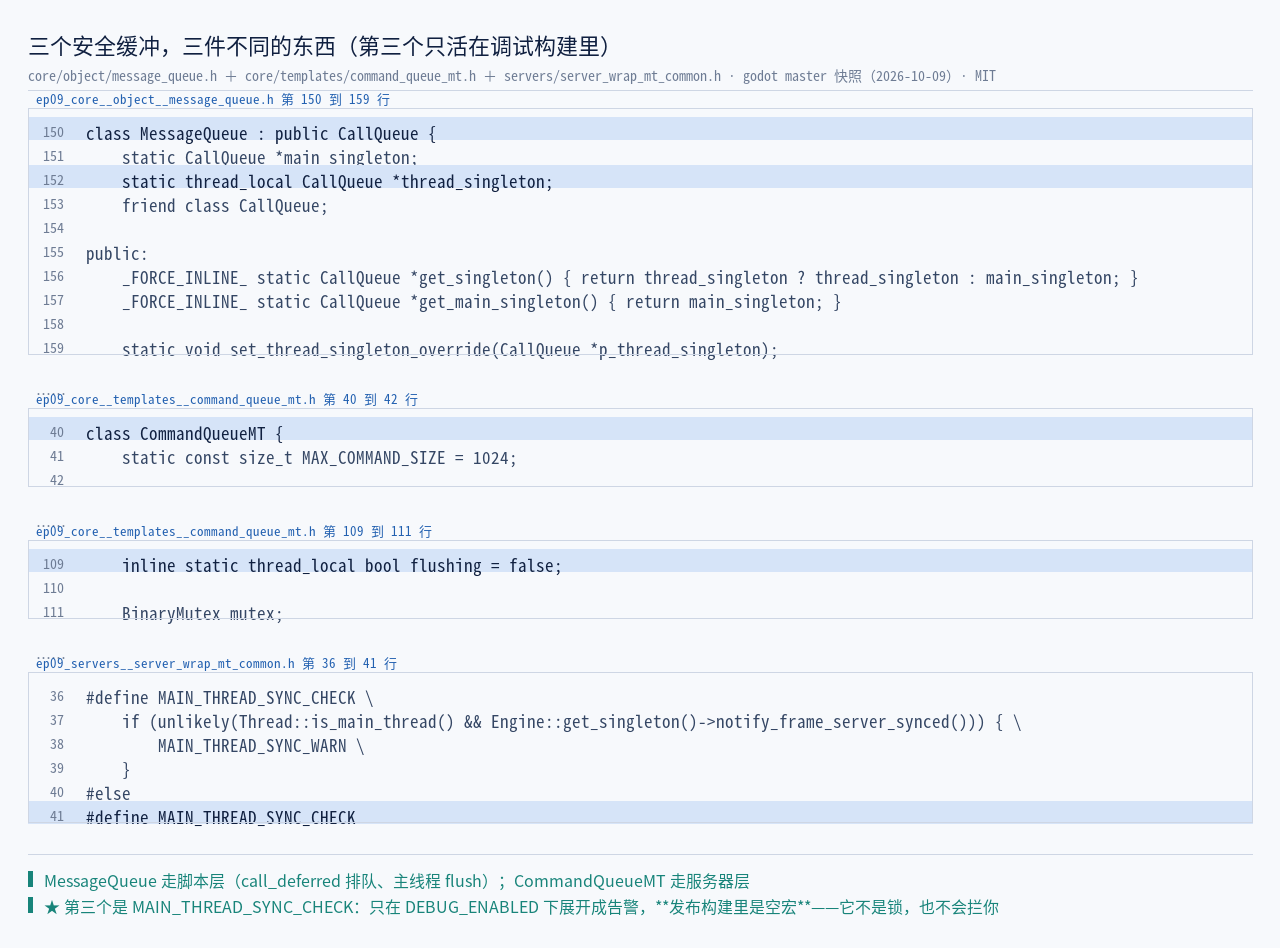
第一个是 core/object/message_queue.h:150 起的:
class MessageQueue : public CallQueue {
    static thread_local CallQueue *thread_singleton;
    …
    _FORCE_INLINE_ static CallQueue *get_singleton() { return thread_singleton ? thread_singleton : main_singleton; }
    static void set_thread_singleton_override(CallQueue *p_thread_singleton);
第二个是 core/templates/command_queue_mt.h:40 起的:
class CommandQueueMT {
    …
    inline static thread_local bool flushing = false;
    BinaryMutex mutex;
第三个是 servers/server_wrap_mt_common.h:36–41:
#ifdef DEBUG_ENABLED
#define MAIN_THREAD_SYNC_CHECK \
    if (unlikely(Thread::is_main_thread() && Engine::get_singleton()->notify_frame_server_synced())) { \
        MAIN_THREAD_SYNC_WARN \
    }
#else
#define MAIN_THREAD_SYNC_CHECK
#endif
其中:三个东西的分工是这样的:
| 缓冲 | 谁在用 | 干什么 |
|---|---|---|
MessageQueue(继承 CallQueue) |
脚本层 | call_deferred / set_deferred 把调用排进来,等主线程在帧的固定位置 flush() 掉 |
CommandQueueMT |
服务器层 | 把对服务器的调用攒成命令,由服务器线程按序执行 |
MAIN_THREAD_SYNC_CHECK |
仅调试构建 | 在主线程上发现「服务器还没同步」时发一条告警 |
第三行的身份最容易被误解。它不是一道锁、也不是一次拦截,而是只在 DEBUG_ENABLED 下展开的一个告警宏;发布构建里它被定义成空——发布版里它对越界调用什么都不做。如果有人把它当成「引擎会保护我」,那就把调试期的警告当成了运行期的保证。
另外注意 MessageQueue 里那个 thread_local:get_singleton() 的实现是「有线程私有的就用线程私有的,没有就回落到全局那个」。这正是「可以在别的线程里排队、但队列是分开的」这一设计的落点。
9.3 三档边界画在一起
说白了,把前面所有的散点收成一张图:
其中:这张图的三层不是「安全程度」,而是「你需要多做多少事」——第一层只要换个调用方式(add_child → add_child.call_deferred);第二层要去工程设置里开开关,而且开了之后性能不一定更好;第三层无论怎么配都不行,只能换成「线程里算好、主线程里改」。第三层不给你任何配置项,这本身就是官方给的最强表态。
本章出处:官方 Thread-safe APIs(本机快照 docs_thread_safe_apis.rst.txt,逐条见 :17–21、:30–33、:84–91、:106–110、:127–130、:135–137、:142–145)|源码 message_queue.h、command_queue_mt.h、server_wrap_mt_common.h。
十、工作线程池:两条硬规矩
第九章讲了「不能跨什么」,这一章讲官方的推荐做法:WorkerThreadPool(工作线程池)。它比裸 Thread 省事,代价是两条规矩必须守。
10.1 它是什么
言归正传,官方类参考的描述写得比文档正文更准,逐字:
The WorkerThreadPool singleton allocates a set of Threads (called worker threads) on project startup and
provides methods for offloading tasks to them. This can be used for simple multithreading without having
to create Threads.
Tasks hold the Callable to be run by the threads. WorkerThreadPool can be used to create regular tasks,
which will be taken by one worker thread, or group tasks, which can be distributed between multiple
worker threads.
其中:两个关键区分。第一,它在「项目启动时」就把线程建好了——所以它是常驻的,不是每次用现开现关;这也解释了本机启动行里那句 WorkerThreadPool: 16 threads, 4 max low-priority.:线程池在启动阶段就已经把 16 条工作线程(其中最多 4 条跑低优先级任务)备好了。第二,它有两种任务:普通任务(一条线程跑一份)与组任务(同一份逻辑分给多条线程跑)。后者的官方示例就是「给竞技场里的每个敌人算 AI」。
对应的声明在这几个位置:
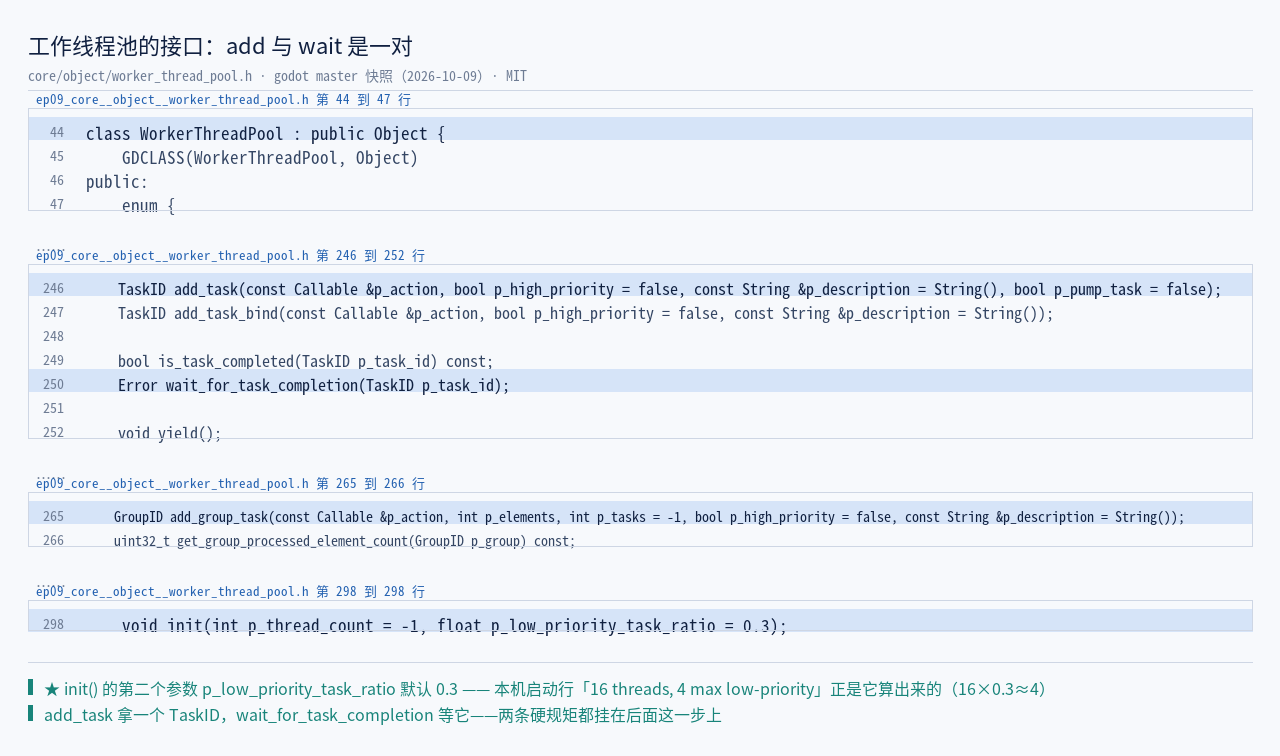
add_task 与 wait_for_task_completion 是一对,init() 的低优先级比例默认 0.3@ godot master 快照(2026-10-09)原文截取 · MITclass WorkerThreadPool : public Object {
…
TaskID add_task(const Callable &p_action, bool p_high_priority = false, const String &p_description = String(), bool p_pump_task = false);
…
Error wait_for_task_completion(TaskID p_task_id);
…
GroupID add_group_task(const Callable &p_action, int p_elements, int p_tasks = -1, bool p_high_priority = false, const String &p_description = String());
…
void init(int p_thread_count = -1, float p_low_priority_task_ratio = 0.3);
其中:init() 的签名里那个 p_low_priority_task_ratio = 0.3 值得停一下——本机启动行报的是「16 threads, 4 max low-priority」,16 × 0.3 ≈ 4.8,取整正是 4。源码里的默认比例与本机运行期报出来的数对得上,这是一次不需要猜测的交叉验证:启动行的出处不是别的,就是这一行默认参数。
10.2 两条硬规矩
add_task 与 add_group_task 的官方说明里各有一段一模一样的 Warning,逐字:
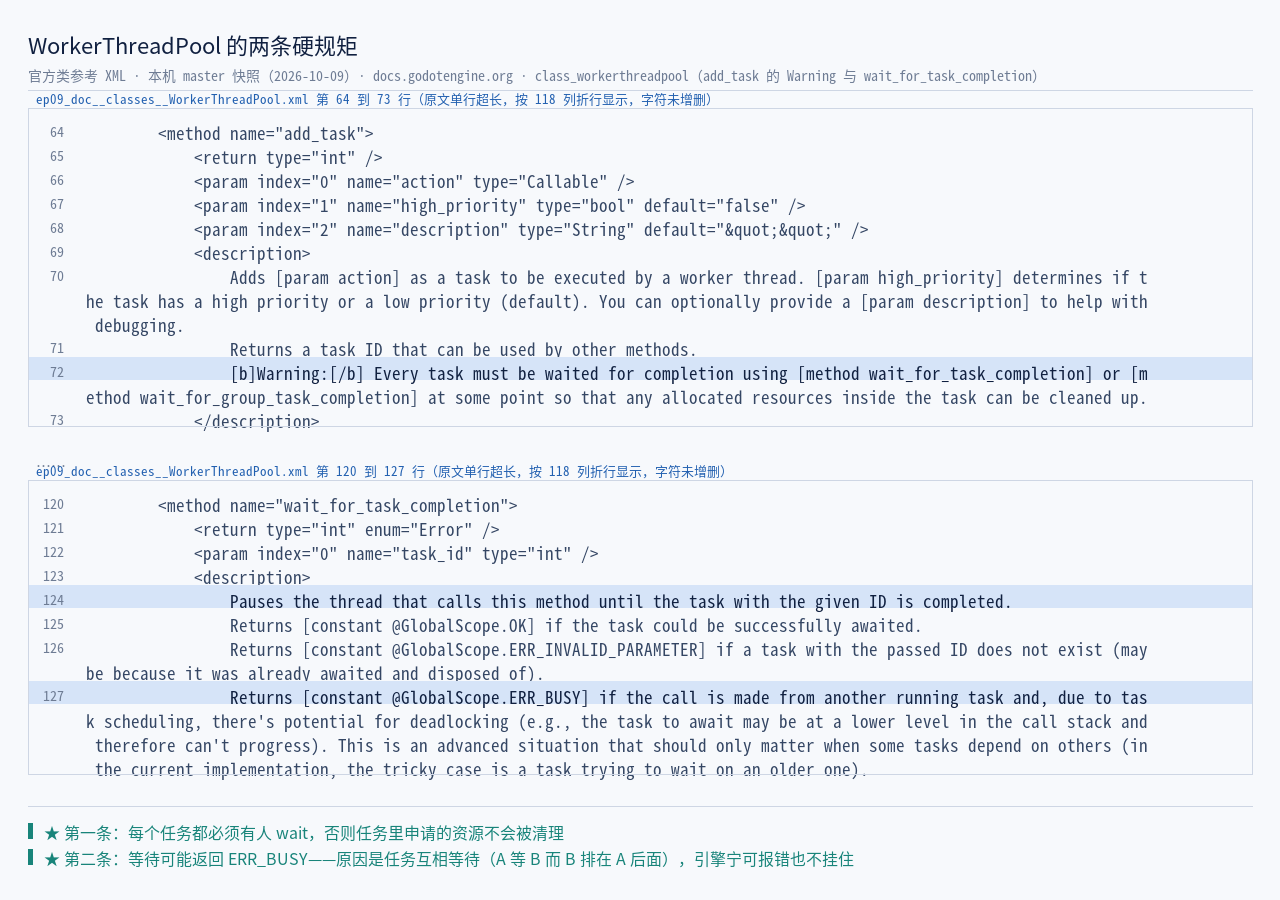
WorkerThreadPool 的两条硬规矩:任务必须有人等,等待可能返回 ERR_BUSY@ 官方类参考 XML(本机 master 快照 2026-10-09)Warning: Every task must be waited for completion using wait_for_task_completion or
wait_for_group_task_completion at some point so that any allocated resources inside the task can be
cleaned up.
而 wait_for_task_completion 本身的返回值也把坑写明了:
Pauses the thread that calls this method until the task with the given ID is completed.
Returns OK if the task could be successfully awaited.
Returns ERR_INVALID_PARAMETER if a task with the passed ID does not exist (maybe because it was
already awaited and disposed of).
Returns ERR_BUSY if the call is made from another running task and, due to task scheduling, there's
potential for deadlocking (e.g., the task to await may be at a lower level in the call stack and
therefore can't progress).
好了,其中:第一条规矩是「必须有人等它」——不等,任务内部申请的资源就不释放;第二条是「等待有可能失败」,失败码是 ERR_BUSY,原因是任务之间互相等待:如果 A 在等 B,而 B 恰好排在 A 后面,那就是一个死锁的形状,引擎在这种情况下直接返回 ERR_BUSY 而不是挂住。所以 wait_for_task_completion 的返回值不是「成功/失败」二选一,而是三种情况——写成 if (err != OK) 吞掉错误,就等于把这条信息扔了。
另外官方还有一条提醒,虽然不在 Warning 里但同样实用:「如果分给线程的活本身不费算力,用这个单例反而会拖慢性能」——线程池不是免费午餐,跨线程交接本身有成本。
10.3 正确的用法长什么样
好了,把两条规矩画成图:
其中:这张图上只有一条路径,没有分支——add_task 与 wait_for_task_completion 是一对,中间那段「主线程继续干活」才是收益所在。所以第十章的结论可以写成一句话:线程池把你从「怎么开线程」里解放出来,代价是「你必须记得收尾」。至于这些工作线程与渲染线程(第七章)是不是同一批——不是:工作线程池服务的是「你派下去的活」,渲染线程是引擎自己的那条;两者在源码里是两套东西。本机看不到线程级的实况,所以这一条只从源码读,不在正文里给「观测到几条线程在跑」的说法。
本章出处:官方 WorkerThreadPool 类参考(本机 XML 快照,Warning 见 :61 / :72,返回值见 :124–127)|源码 worker_thread_pool.h(:44、:246、:250、:265、:298)|本机启动行 evidence/probe/E_ep09_A_default.txt。
10.4 什么时候不该用线程池
第十章讲到这里都是「怎么用」,但官方在类参考里还留了一条反向提醒,值得单独成节——因为它正好解释了「为什么我开了多线程反而更慢」这半个疑问:
Note: Using this singleton could affect performance negatively if the task being distributed between
threads is not computationally expensive.
其中:这句话的判据是「这份活本身费不费算力」,不是「它是不是 IO」。一次任务的成本分两半:干活本身的耗时与派发/等待的固定开销。当后者大于前者时,把它扔给线程池就是净亏。所以工程上有一条老经验在这里同样成立:先量,再并行。先确认这段代码是热点,再确认它的耗时量级明显高于交接开销,那时线程池才是正解;反过来,把一堆几十微秒的活拆到 16 条线程上,多半只会换来更差的帧时间与更难查的偶发问题。
这一条也与第九章那条边界呼应:线程池解决的是「谁来干」,不解决「能不能跨」。任务里要碰场景树,照样得走 call_deferred;任务里要改唯一资源,照样不行。换执行者不改变约束。
十一、本机五档对照
OK,前面十章讲的都是「源码与文档怎么写」。这一章换到本机:同一份工程、同一个场景,只改命令行,五档跑下来看到什么。
11.1 五档的结果
探针工程在 evidence/probe/(ep09_probe.gd / .tscn / project.godot 与一键复跑脚本)。唯一自变量是命令行,工程与场景全程不动。它每帧读一次 Engine.get_physics_frames() 做差,统计「一个 idle 帧里跑了几个物理步」:
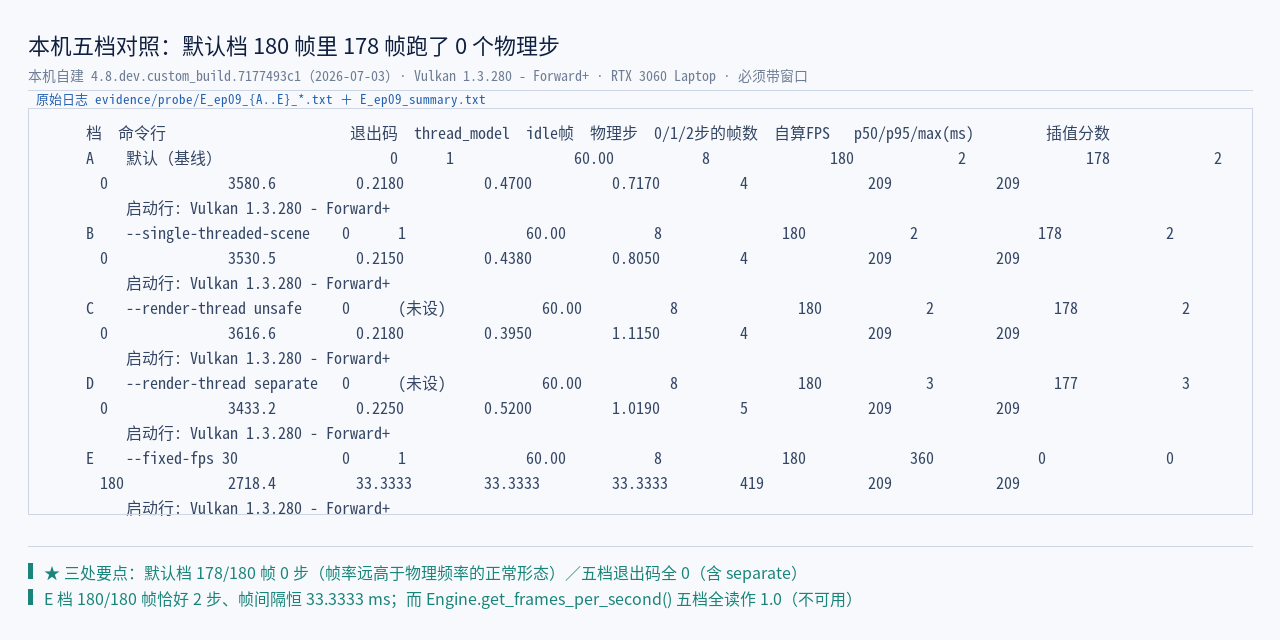
--fixed-fps 30 档则是每帧恰好 2 步@ 本机实测 · Godot 4.8.dev.custom_build.7177493c1(自定义构建)| 档 | 命令行 | 退出码 | thread_model |
idle 帧 | 物理步 | 0 / 1 / 2 步的帧数 | 自算 FPS | 帧间隔 p50 / p95 / max (ms) | 插值分数 |
|---|---|---|---|---|---|---|---|---|---|
| A | 默认 | 0 | 1 |
180 | 2 | 178 / 2 / 0 | 3580.6 | 0.2180 / 0.4700 / 0.7170 | 0.0041 → 0.9981 |
| B | --single-threaded-scene |
0 | 1 |
180 | 2 | 178 / 2 / 0 | 3530.5 | 0.2150 / 0.4380 / 0.8050 | 0.0052 → 0.9948 |
| C | --render-thread unsafe |
0 | (未设) | 180 | 2 | 178 / 2 / 0 | 3616.6 | 0.2180 / 0.3950 / 1.1150 | 0.0001 → 0.9941 |
| D | --render-thread separate |
0 | (未设) | 180 | 3 | 177 / 3 / 0 | 3433.2 | 0.2250 / 0.5200 / 1.0190 | 0.0046 → 0.9958 |
| E | --fixed-fps 30 |
0 | 1 |
180 | 360 | 0 / 0 / 180 | 2718.4 | 33.3333 / 33.3333 / 33.3333 | 0.5000 → 0.5000 |
启动行五档相同:Vulkan 1.3.280 - Forward+ | WorkerThreadPool: 16 threads, 4 max low-priority.
其中:表里有三行结论可以先落地。第一,最重要的一格是 A 档的「178 / 2 / 0」——默认配置下,180 个 idle 帧里有 178 个一个物理步都没跑。这不是异常,而是第三章说的「帧率远高于物理频率」的正常结果。第二,五档退出码全是 0,包括 --render-thread separate;这条要专门记一下,因为社区里常把 Separate 说成「开了就崩」,而本机的事实是能跑,问题在别处(experimental 那三条已知 bug)。第三,E 档是唯一形状干净的一档:180 个帧每个都恰好跑 2 个物理步,帧间隔 min = p50 = p95 = max = 33.3333 ms——因为那一档的帧率是命令行给定的,不是跑出来的。
11.2 运行期自报:三件从日志里读出来的事
上表里有三格不平常,都能在日志里找到引擎自己说的话:
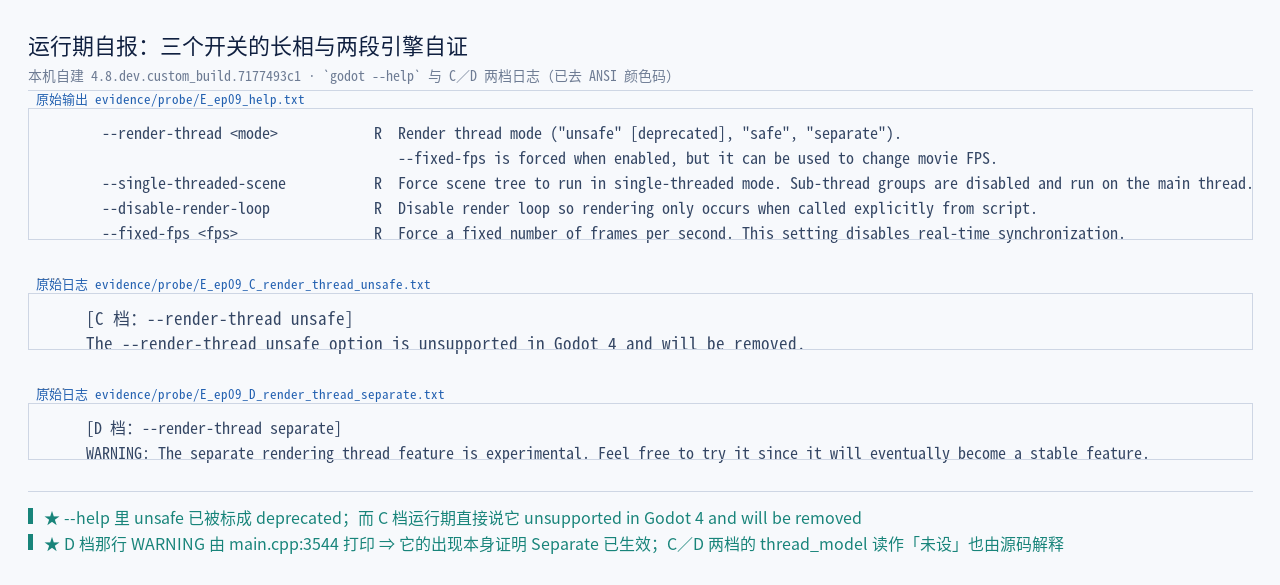
unsafe 与 separate 两档各自打印的自证@ 本机实测 · Godot 4.8.dev.custom_build.7177493c1(自定义构建)(本机 godot --help)
--render-thread <mode> R Render thread mode ("unsafe" [deprecated], "safe", "separate").
--single-threaded-scene R Force scene tree to run in single-threaded mode. Sub-thread groups are
disabled and run on the main thread.
--fixed-fps <fps> R Force a fixed number of frames per second. This setting disables
real-time synchronization.
--disable-render-loop R Disable render loop so rendering only occurs when called explicitly
from script.
(C 档:--render-thread unsafe)
The --render-thread unsafe option is unsupported in Godot 4 and will be removed.
(D 档:--render-thread separate)
WARNING: The separate rendering thread feature is experimental. Feel free to try it since it will
eventually become a stable feature.
其中:三件事都来自引擎自己,不是我们的推断。第一件,--render-thread 的合法值里 unsafe 被标成了 [deprecated],这是命令行层面的表态,与第七章那张档位表对得上。第二件,C 档跑起来之后,日志里出现一行「unsupported in Godot 4 and will be removed」——这一档在今天已经不被支持了。第三件,D 档跑起来之后,日志里出现第七章引过的那段 WARNING;它由 main.cpp:3544 在 _separate_thread_render 为真时打印,所以它的出现本身就是「Separate 确实生效了」的凭证。
还有一格要看:C/D 两档的 thread_model 读数是「未设」,而 A/B/E 三档读到的是 1。这不是探针出错——回到第七章那一行源码就明白了:
separate_thread_render = (int)GLOBAL_DEF("rendering/driver/threads/thread_model", OS::RENDER_THREAD_SAFE) == OS::RENDER_SEPARATE_THREAD;
GLOBAL_DEF 只在命令行没有覆盖这条设置时才执行。命令行给了 --render-thread 之后,项目设置里就不存在这个键了,所以读出来是「未设」。这一格是本篇最典型的一处「读数怪,但源码一句话解释得清」,也正因为解释得清,它反而成了「命令行优先级高于项目设置」的一个现场证据。
11.3 三处不能下结论的地方
说白了,这一章的价值有一半在「不给什么结论」上。三条边界逐条写明:
| 不能给结论的地方 | 为什么 |
|---|---|
| A 与 B 谁更快 | A 档 p50 是 0.2180 ms,B 档是 0.2150 ms,差 0.003 ms——小于本机的 run-to-run 噪声底。小于噪声底的差异不构成结论 |
Separate 的性能 |
D 档帧间隔 p95 是 0.5200 ms、max 是 1.0190 ms,都比 C 档高;但这只是一次运行的读数,且这一档的线程级行为本机看不到,不足以支撑「开 Separate 更慢」 |
--fixed-fps 30 那一档的快慢 |
那一档的帧率是给定的,墙钟快慢没有意义(见下) |
第三行要单独说,因为它是本篇最容易读歪的一格。E 档的帧间隔恒为 33.3333 ms,但同一档的实测墙钟只用了 77.3 ms 就跑完 180 个 idle 帧(自算约 2718 帧/秒)——报出来的 delta 是 33.3333 ms,真实每帧只花了约 0.43 ms。这不是矛盾,官方在 _process 的说明里写过:
Note: When --fixed-fps is enabled or the engine is running in Movie Maker mode (see MovieWriter),
process delta will always be the same for every frame, regardless of how much time the frame took to
render.
其中:这句话说明白了「--fixed-fps 到底改了什么」——它把 delta 与真实时间脱钩了。本机的实测恰好是这句话的现场复现:33.3333 ms 的 delta 对应 0.43 ms 的墙钟,差约 77 倍。也正因为如此,--fixed-fps 那一档的读数不能拿来与其他四档比速度,它只能用来验证「物理步是怎么被摊开的」。
还有一处口径必须写明:引擎自报的 Engine.get_frames_per_second() 在五档里全部读作 1.0——短测量窗口下这个 API 拿不到有效值。所以本篇表里的 FPS 一栏写的是自算 FPS(墙钟),帧间隔写的是实测分位数,两者是不同口径的聚合,不得混用,也不得写成「引擎报告的 FPS」。
最后把五档的形状画在一起:
其中:这张图上最该记住的不是任何一个数,而是五档的形状差异都来自同一件事:一个 idle 帧里跑了几个物理步。A–D 四档是 0 或 1,E 档是 2——形状变了,机器没变,变的只是「这一帧该跑几次物理」这个决定。
本章出处:本机探针 evidence/probe/(ep09_run_probes.py 一键复跑,原始日志 E_ep09_A_default.txt 等五份、汇总 E_ep09_summary.txt、命令行快照 E_ep09_help.txt)|官方 MainLoop 类参考 · _process 的 --fixed-fps 那条 Note|源码 main.cpp(:2774、:3544)。
十二、收官:三个节拍、一道闸、三层边界
下面我们开始收尾:把前十一章收成三句话,再补两件该说的实话。
12.1 三句话
第一句:这次迭代的顺序是硬编码的,能调的只有节拍。Main::iteration() 把一帧切成三段——物理段、逻辑段、渲染段,顺序写在代码里(第二章)。可调的是三样:物理频率(physics_ticks_per_second)、每帧最多补几步(max_physics_steps_per_frame)、以及这一帧到底画不画(is_render_loop_enabled())。没有「先逻辑后物理」这种开关。
第二句:「一帧跑几次物理」是累加器攒出来的,不是配置出来的。time_accum 每帧攒进一个 process_step,攒够一个物理步取一次整,余数留下(第四章)。这条机制带来两个直接后果:物理步永远是严格的 1/60 秒,而 idle 帧的长度随缘;以及本机默认档下 178/180 的帧一个物理步都不跑——这不是丢步,是「两条节拍不在一个频率上」的正常形态(第三章、第十一章)。
第三句:线程这条轴上,引擎的默认是保守的,边界是三档的。引擎内置默认 Safe,Separate 是手动开的岔路且官方标了实验性(第七章);跨线程的规矩不是「能不能」,而是「要不要多做一步」——可直接跨(call_deferred / 线程池任务)、要开开关才可跨(渲染与物理服务器)、完全不可跨(场景树、AStar、唯一资源修改)(第九章)。
把这三句收成一张图:
12.2 几个反复出现的现象,对到机制上
调研期间在官方论坛与问答区反复出现的现象大致有三类。这里只做机制对应,不引用无法核对的原句、也不写热度数字——那些数据本轮没有证实过。
| 现象 | 对上的机制 | 在哪一章 |
|---|---|---|
| 物理相关的活(比如为大块地形生成碰撞体)在主线程做,一卡就把帧预算顶穿了 | 物理段在 idle 段之前、且这一段里没人替你分摊:主线程上的一次长调用会直接把这一帧的长度加上去。官方的解法在第十章:把这类活派给 WorkerThreadPool,但必须有人等它 |
第二章、第十章 |
| 在别的线程里发信号或者挂节点,偶发卡死 | 场景树不可跨线程(第九章 9.1)。官方给的路线只有一条:call_deferred / set_deferred 把改动排队,交回主线程执行;MessageQueue 就是那个队列 |
第九章 |
| 开了多线程渲染之后性能反而下降 | 两处机制叠加:一是第八章那句话——RenderingServer::sync() 要等上一次 draw() 画完,交接本身有成本;二是官方对 Separate 的定性——它至今是实验档,官方类参考写着「several known bugs … Not recommended for use in production」 |
第七章、第八章 |
其中:这三行放在一起看,会发现它们不是三个不同的问题,而是同一件事的三个切面:凡是跨过「主线程 / 渲染线程 / 工作线程」这三条边界的动作,都要付交接成本;付了成本不一定划算。所以本篇不写「多线程更快」,只写清「边界在哪、成本付给谁」。
把这三行再往上一层看,它们其实对应着三种不同的「不该跨」:第一行是位置问题——你把活放在了错的那条时间轴上(不该占 idle 段前面的物理段);第二行是所有权问题——你去改了不属于你的那份数据(场景树的成员);第三行是收益问题——你跨了边界,但省下的算力还不够抵消交接。三种问题的解法完全不同:第一种靠调度(换个线程干)、第二种靠交接(排到主线程再改)、第三种只能靠测量(先量再并行)。把三类混成一类,就会去用「加锁」解决收益问题,用「多开线程」解决所有权问题——两条路都走不通。
12.3 本篇没做的三件事
按本系列的惯例,边界也写出来——这三件本篇没有做,读者别从本篇里读出它们:
| 没答的问题 | 为什么没答 |
|---|---|
| 「谁在哪个线程上」的线程级观测 | 本机是 Windows 自建构建,探针只能拿到启动行与计数;要看「哪个线程在跑哪段」得靠线程级采样工具,本轮没做。所以本篇的线程结论全部来自源码与官方文档,探针只提供启动行与计数 |
| 物理螺旋的本机复现 | 官方有定义,但要稳定复现需要一个持续超帧预算的场景;本机没有把握,就不做——只转述官方定义 |
--fixed-fps 30 档「插值分数恒为 0.5000」的机制解释 |
这一档的插值分数实测 min = max = 0.5000,而默认档是 0.0041 → 0.9981。读数可用,但本机自建版本(4.8.dev.custom_build.7177493c1,2026-07-03 构建)与本篇的源码快照(master,2026-10-09 抓)不是同一个提交,本轮没能据 advance_checked() 逐步推出这个值。推不出就只给读数、不给解释,也不把版本差异说成引擎行为 |
其中:第三条尤其想说一句:「测到了但解释不了」就该写成「测到了但解释不了」。它比一个编圆的因果链有用得多——下一轮换到同版本的源码快照,这一格就能补上。
12.4 证据分层与下一步
本篇的材料三层,缺一层就会在结论上留缺口:官方文档与类参考定口径(六个钩子、两个计数器、四个旋钮、线程安全清单)、源码定落点(Main::iteration() 的三段、累加器三步、thread_model 的默认值)、本机定实况(五档启动行与读数,含 178/180 这个反直觉的格子)。三层的分工是固定的:文档说「设计上是这样」,源码说「代码里确实这样」,本机说「这台机器上跑出来是这样」。
关于第十篇(资源侧):第八篇讲了「落到哪张桌子上」,本篇讲了「什么时候算、谁来算」,下一篇接的是「桌上那些东西从哪来」——一张纹理从磁盘读到显存,中间经过哪些人、什么时候被上传、什么时候会被释放。同一批服务器与同一批锁会在那里再出现一次。
本章出处:本篇全部结论的取值口径见上文各章的「本章出处」;本机材料可复跑,入口是 content/blog/godot-engine-ep09-main-loop-threading/evidence/probe/ep09_run_probes.py,原始日志在 evidence/probe/E_ep09_*.txt。
相关链接
官方类参考
- MainLoop(六钩子的四个脚本侧回调、两条 Note)
- SceneTree(
get_frame那句「数的是物理步、不是帧」) - Engine(
max_physics_steps_per_frame、physics_jitter_fix、get_physics_interpolation_fraction) - ProjectSettings(四个旋钮,与
thread_model的experimental属性) - WorkerThreadPool(两条硬规矩与
ERR_BUSY)
官方教程与文档
- Idle and physics processing(两种回调的语义基线)
- Thread-safe APIs(本系列的跨线程边界清单)
- Using multiple threads(线程与互斥锁的用法)
- Physics interpolation introduction(staircasing 那段)
- Fixing jitter, stutter and input lag(「抖」的官方命名)
- Command line tutorial(
--render-thread/--single-threaded-scene/--fixed-fps) - Internal rendering architecture
官方发布说明
- Godot 4.3 发布说明(多线程改进与 2D 物理插值)
- Godot 4.4 发布说明(3D 物理插值)
- 4.3 beta 1 开发快照(
WorkerThreadPool for server threads与threads=no;本篇已核对:这两句只在 beta 1 快照里,4.3 正式发布说明里没有)
源码入口(master 快照 2026-10-09)
- main.cpp:
Main::iteration()(:4948–5136)、thread_model(:2774)、实验性警告(:3544) - main_timer_sync.h / main_timer_sync.cpp:累加器与插值分数
- main_loop.h / main_loop.cpp:六个钩子与四条绑定
- scene_tree.cpp:两个帧与两个内部钩子的实现
- os.h:
enum RenderThreadMode - rendering_server.h:
render_loop_enabled与两个渲染线程接口 - message_queue.h / command_queue_mt.h / server_wrap_mt_common.h:三个安全缓冲
- worker_thread_pool.h:线程池接口
本机材料(可复跑)
- 探针工程与一键复跑脚本:
content/blog/godot-engine-ep09-main-loop-threading/evidence/probe/(ep09_run_probes.py) - 原始日志:
E_ep09_A_default.txt、E_ep09_B_single_threaded_scene.txt、E_ep09_C_render_thread_unsafe.txt、E_ep09_D_render_thread_separate.txt、E_ep09_E_fixedfps30.txt、E_ep09_help.txt、E_ep09_summary.txt
社区讨论(仅作现象来源,本篇未引用其原句与热度)
- Stutters generating terrain collision on separate thread
- Camera3D interpolation jitter fix
- Thread used for saving causes frame drop
系列前篇
- 第八篇 后端分叉:Vulkan / Direct3D 12 / Metal / OpenGL|第七篇
RenderingDevice抽象与渲染依赖图|第六篇 批处理|第五篇 画布渲染抽象|第四篇 画布剔除与排序|第三篇 服务层接口|第二篇 对象模型|第一篇 全景与边界
下篇预告(第十篇 · 资源侧):下一篇接着问「桌上那些东西从哪来」——一张纹理从磁盘读到显存要经过谁、什么时候被真正上传、什么时候会被释放。同一批服务器、同一批锁会在那里再出现一次,而这一次的主角是资源与引用计数。
以上。本篇所有源码行号一律按 godot master 快照(2026-10-09),逐条回本机 clone 复核,不做算术平移;本机读数一律写明引擎为自建版本 4.8.dev.custom_build.7177493c1(2026-07-03 构建)、Vulkan 1.3.280 - Forward+、必须带窗口;其中 Engine.get_frames_per_second() 在短窗口下读作 1.0,故本篇一律用自算 FPS 与实测墙钟,两者不混用。希望能对大家有所帮助。
With Best Wishes.