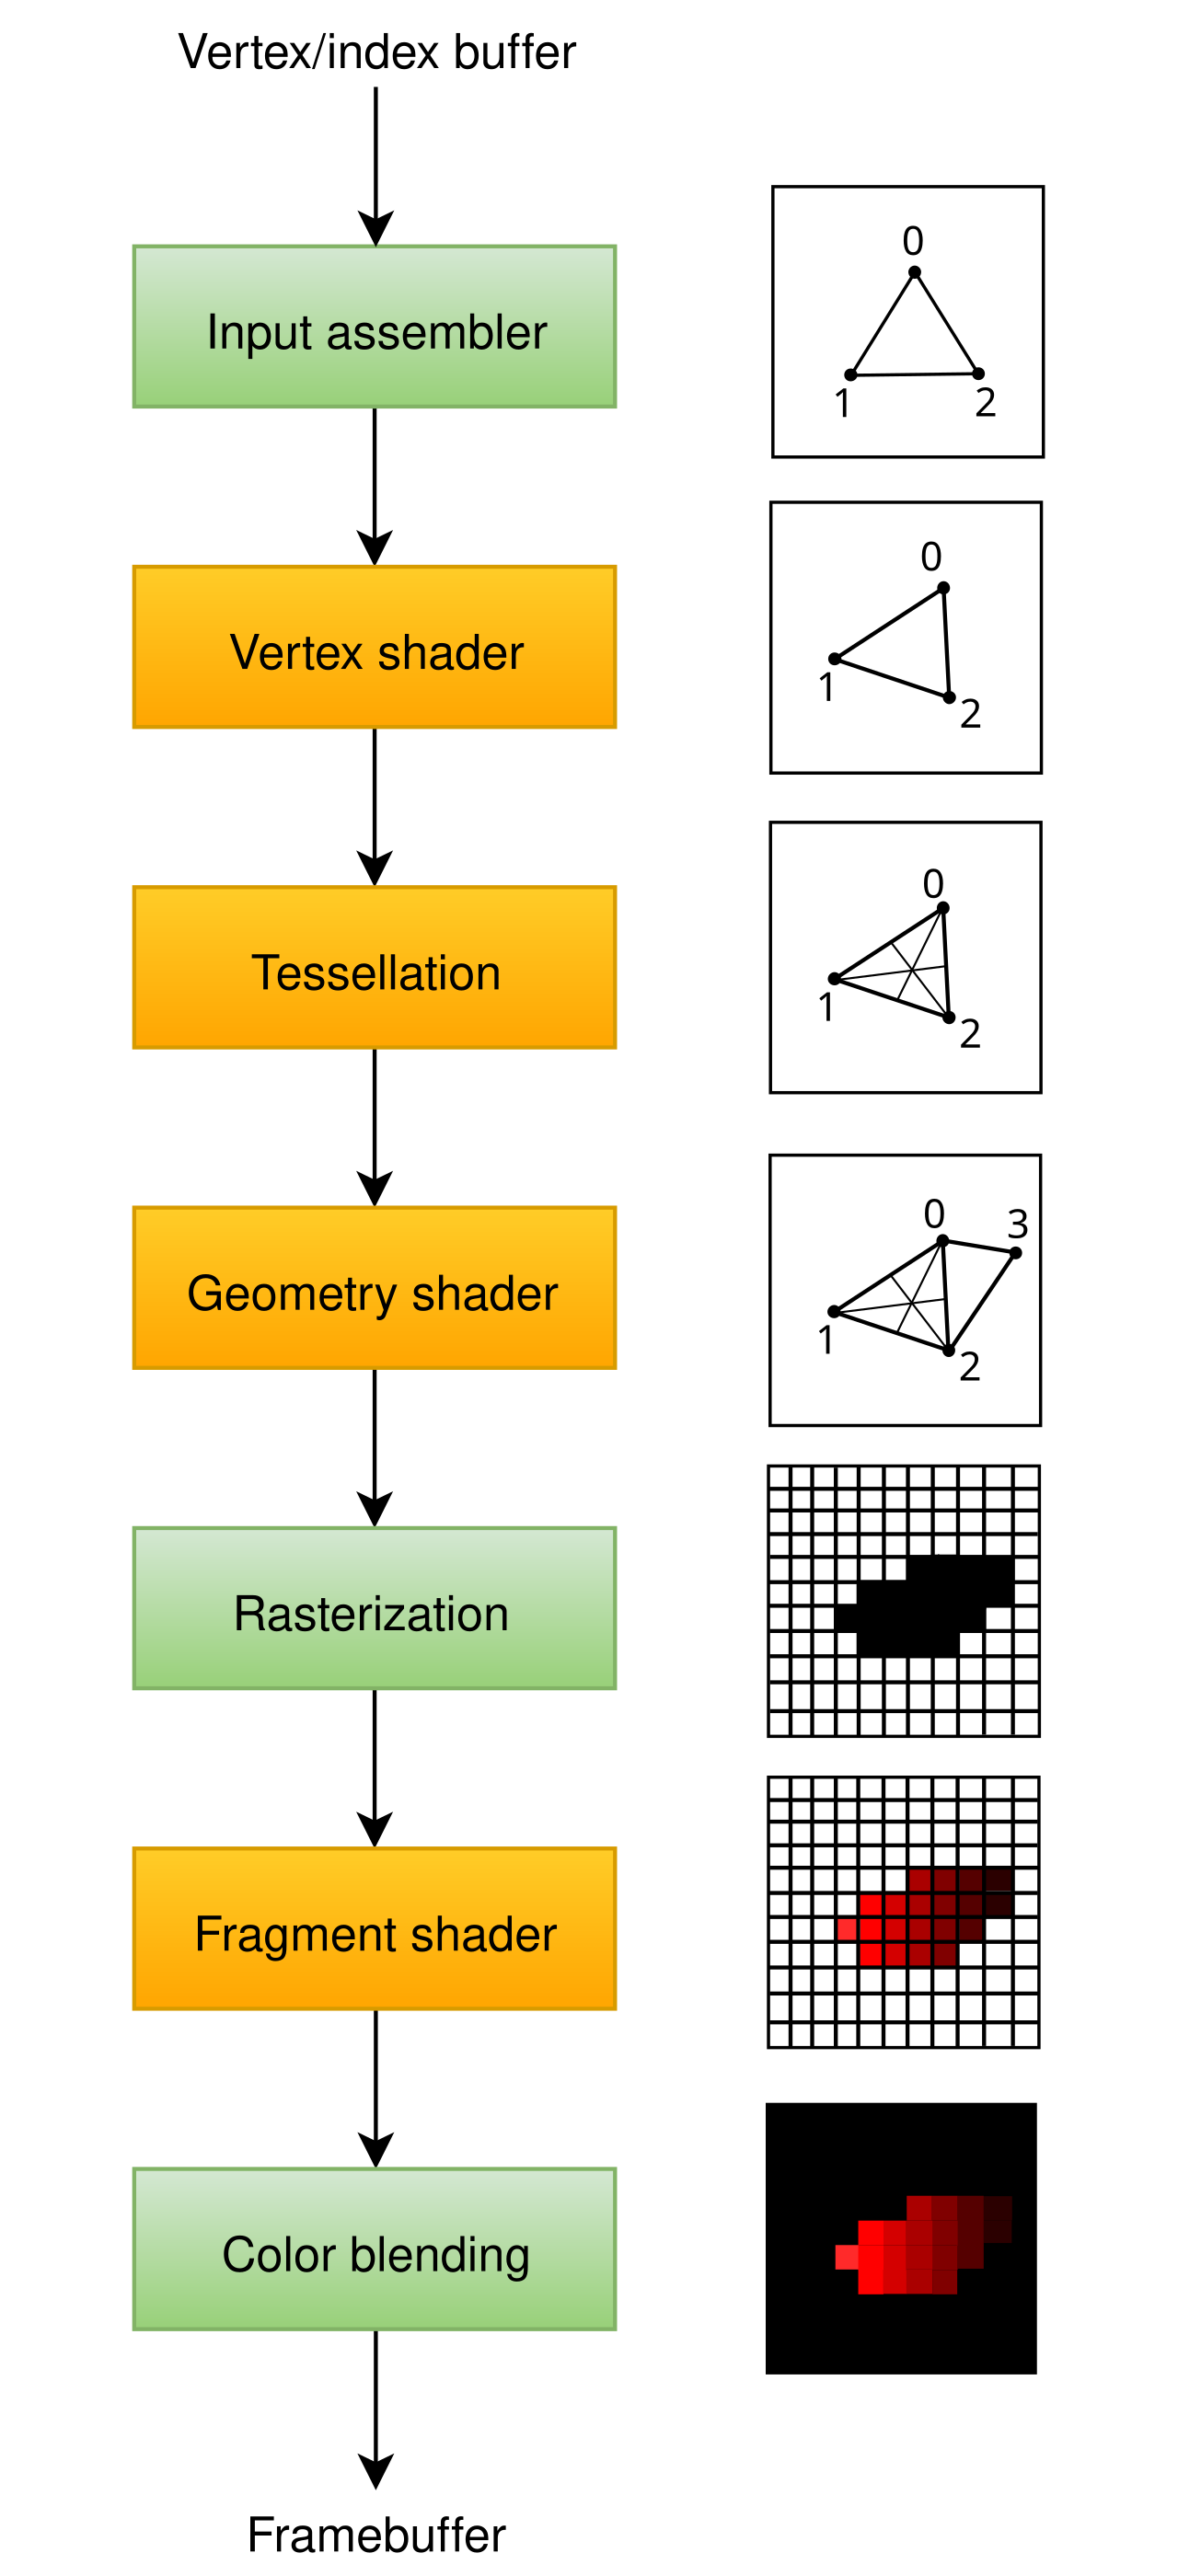
系列配套:GitHub 源码仓库(demo 代码与生成本次全部示意图的工具)|在线阅读入口(本站发布) 题图来自《A trip through the Graphics Pipeline 2011》(Fabian Giesen,CC0 1.0)。
一句话点题
0.1 一次 Draw 提交之后
在 API 的世界里,「画一次」只是一行调用:D3D 的 DrawIndexed、Vulkan 的 vkCmdDrawIndexed、GL 的 glDrawElements。但从这行调用返回,到 GPU 真正开始处理,中间隔着一整条我们平时看不见的路——一次绘制在这条路上先是变成一串命令包,再被写进一块环形缓冲,最后被一颗叫命令处理器(Command Processor)的硬件单元逐个捞出来、译成寄存器的写。
这一篇要回答的三个问题其实就一件事:谁在提交、提交成什么、前端怎么消化。我们把「一行调用的返回」当成起点——因为这是每一位图形程序员都能亲手摸到的第一个可观测点;把「命令处理器取出下一条命令包」当成终点——因为从那里开始,数据就进了 GPU 自己掌握的节奏(In-Flight 状态),CPU 想再插话就难了。
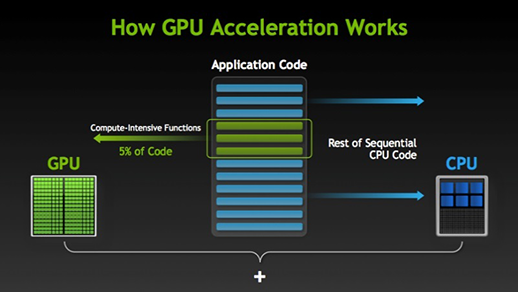
我们要给「提交一次绘制」画一张可核对的地图:谁在 CPU 侧把命令组织好,谁在 GPU 侧把它吃下去,中间隔着哪些缓冲与寄存器,每一步是一次函数调用还是一条总线上的搬运。
0.2 本篇在系列里的位置与边界
本系列《GPU 架构剖析》共十二篇,讲的是同一件事的另一层:同一个渲染管线,在硅片上是由哪些单元、按什么顺序、付什么代价完成的。前两个系列分别在算法层(《实时渲染管线探析》)和约束层(《移动端图形与功耗》)讲过它,本篇从硬件实现层切入,是第一站。
整个系列是一条从命令走向像素的线:命令前端(本篇)→ 显存与地址空间 → 着色器核 → 纹理与缓存 → 光栅化与像素后端 → 架构演进与逐年回归,本篇正站在这条线的起点。
这篇的边界要先说死,免得牵扯不清:本篇只讲「命令怎么进去」,不碰「进去之后显存怎么排布」——那是 ep02《显存与地址空间》的主场;也不重讲移动端 TBR/TBDR 的取舍,那在《移动端图形与功耗》ep02/ep03 已经写透,本篇只在必要处引用结论。
一句话把本篇点透:理解一次 Draw 的提交,就等于理解「CPU 与 GPU 之间那层薄薄的、却决定了无数性能问题的协议」。
一、从 API 到硅片:五层软件栈
1.1 原理与概念:五层栈的分工
我们习惯说「一次 draw 到 GPU」,但实际上从你的程序到 GPU 的寄存器,中间隔着至少五层。这五层不是同一家公司写的,它们各管一段,彼此通过约定好的接口交接。
第一层是你的应用——它决定「画什么、用什么状态画」,把绘制意愿表达成 API 调用。第二层是 API 运行时——它把调用转成更底层的对象操作,维护句柄(Handle)与资源表。第三层是用户态驱动(User-mode Driver, UMD)——它是关键中的关键,负责把 API 层的高级操作翻译成 GPU 能懂的机器指令级序列,也就是命令缓冲。第四层是内核态驱动与其调度器。第五层才是硅片本身。
值得停下来强调的是第三层:着色器其实是用户态驱动编译的,不是 GPU「自己」会的。你在闪烁屏幕上敲进去的 HLSL/GLSL,在创建 PSO(Pipeline State Object,管线状态对象)时被用户态驱动编译成设备相关的指令,再被封装成命令包。所以「驱动程序」这个称呼容易误导——它不只是做调度,它是那个「让高级语言跑在硅片上」的编译器与翻译官。
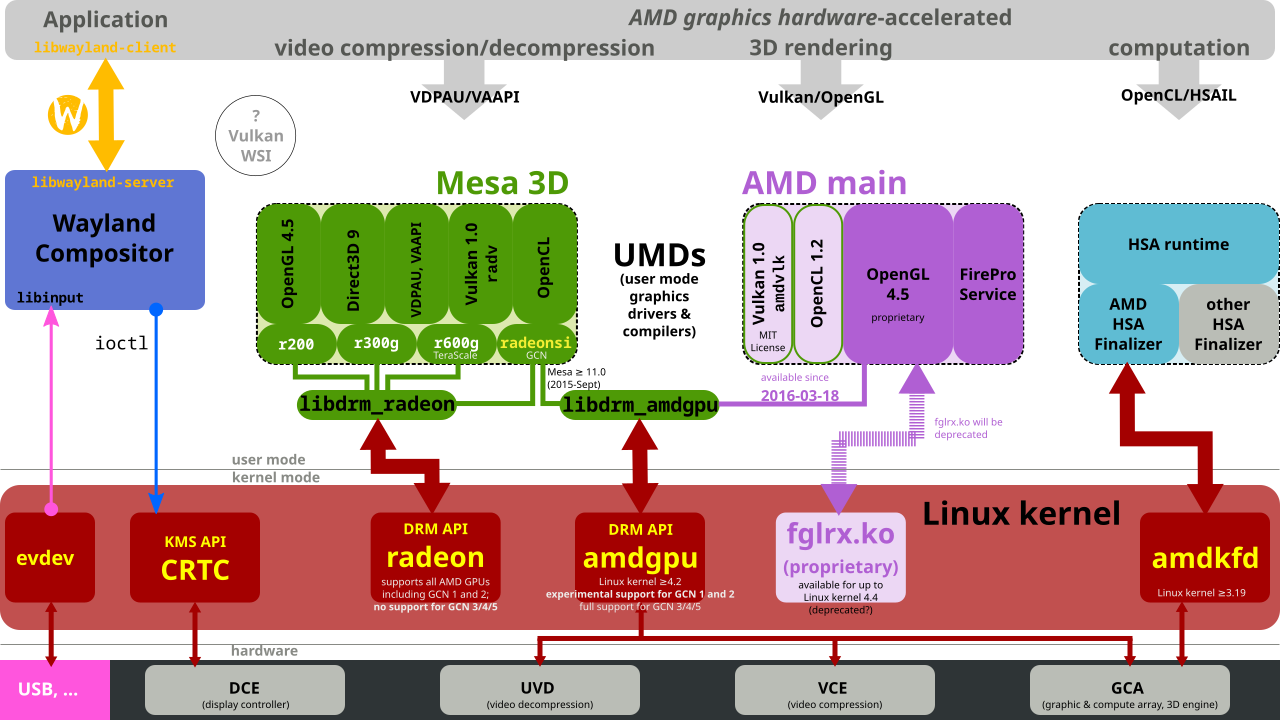
拿开源栈能看得更清楚。Linux 上最常见的组合是 Mesa(用户态)→ DRM(Direct Rendering Manager,内核态)→ AMDGPU/radeon(内核驱动),每一层的边界被内核源码和接口文档钉得死死的,不存在「谁都能改任意层」的情况。真实的图形软件栈分层,比任何抽象图都更能说明「五层」不是一句比喻。
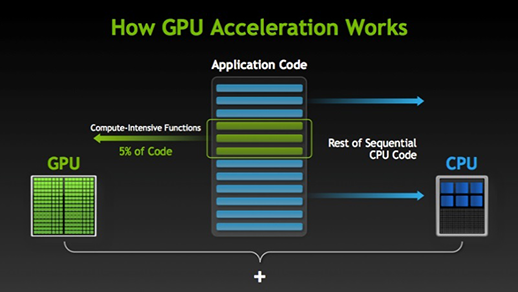
1.2 用户态驱动在做什么
用户态驱动日常其实只做四件事:编着色器、分配资源、创建视图、写命令缓冲。前两件偏向「慢而少」的管理工作,后两件偏向「快而多」的每帧工作。把分工画出来,你就能理解为什么性能问题一半出在「不该每帧做的事被拖进了每帧循环」。
编译着色器往往不在 draw 调用里发生,而是发生在创建 PSO 时——这也是为什么首次创建 PSO 会卡一下,而 Warm-up(预热)阶段常看到「Dummy Draw」:先把会用的管线、资源、图元都过一遍,把迟到的编译和分配提前到加载期做完。
资源分配还有个不直观的事实:同一个着色器,会因为状态组合的不同存在多份变体(Variant)。同一个 VS 在「深度写开/关」「遇混合开/关」时,可能分别被编译成不同的指令序列。这就是所谓「变体爆炸」的源头,也是 PSO 数量失控时 CPU 侧卡顿的根源。
现代显式 API(Vulkan、D3D12)的用意到这里就亮出来了:它把资源如何组织、状态如何切换的选择权从驱动手里交还给应用。Vulkan 的简化管线从功能上看「少」,但少的是驱动偷偷替你做的优化——你拿回的是确定性。
1.3 内核态驱动与前端的唯一性
与用户态驱动可以开很多份、每进程一份不同,内核态驱动在系统里通常只有一份实例。这不是巧合:它掌管的是物理硬件、是只能被一个实体发号施令的资源。
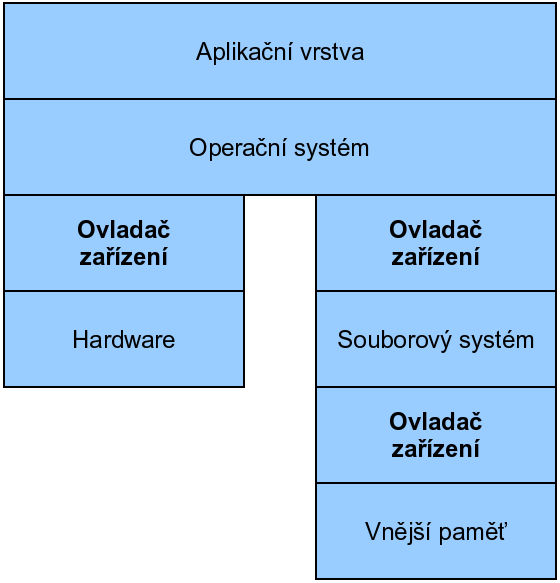
内核态驱动的职责清单很专一:管理物理显存、设置显示模式、处理 GPU 中断、跑设备看门狗(Watchdog,防止 GPU 卡死拖垮系统)。它不做「编译着色器」这种每进程的活,因为那是用户态的事。设备驱动在整个系统结构里的位置,从操作系统教科书到 Linux 内核文档都能看到同样的骨架。
用户态和内核态之间的每次跨跃,代价都不小——一次系统调用意味着权限切换、栈切换、安全检查,动辄几百甚至上千周期。所以图形栈的设计原则是把高频操作放在用户态(写命令缓冲就在用户态完成),只在必要时才穿过内核。
1.4 实现与配置:一次 DrawIndexed 的参数与状态
把镜头推到最具体的一次调用 DrawIndexed。它的参数不多,但每一个都指向下游某个具体的硬件单元。
绘制之前,GPU 侧必须「就绪」的状态集合其实远超相机与模型矩阵。深度状态、光栅状态、混合状态、VS/PS、顶点输入布局、目标格式……这一大坨东西在显式 API 里被封装成一个 PSO,一次绑定,省去运行时逐项校验。
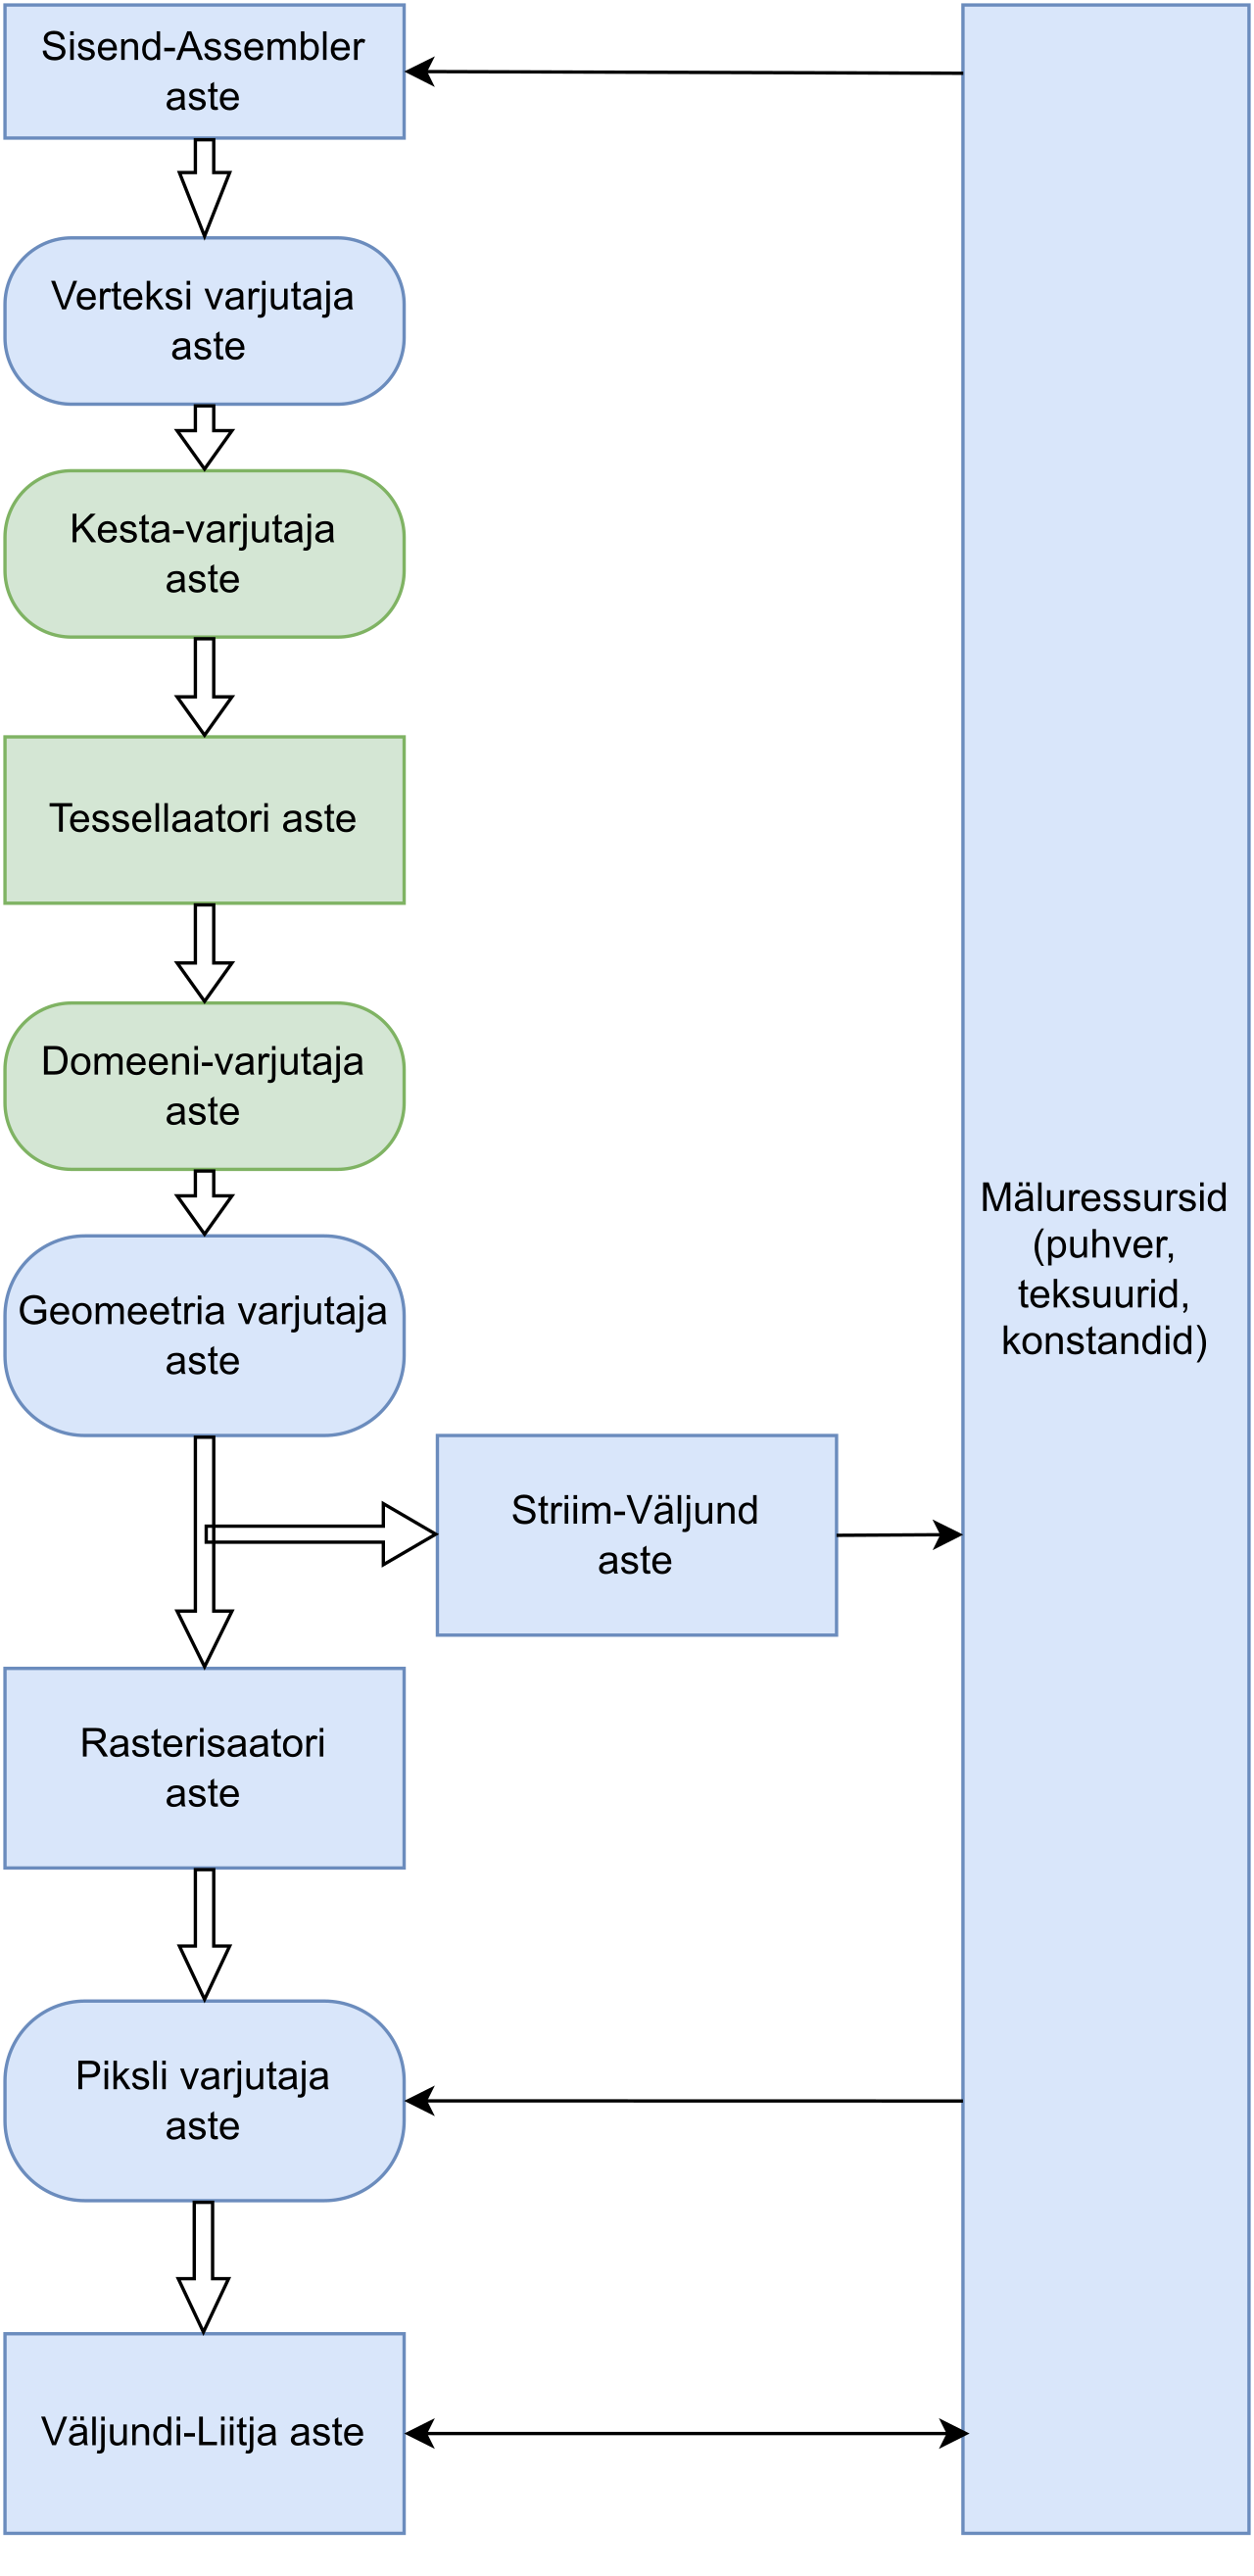
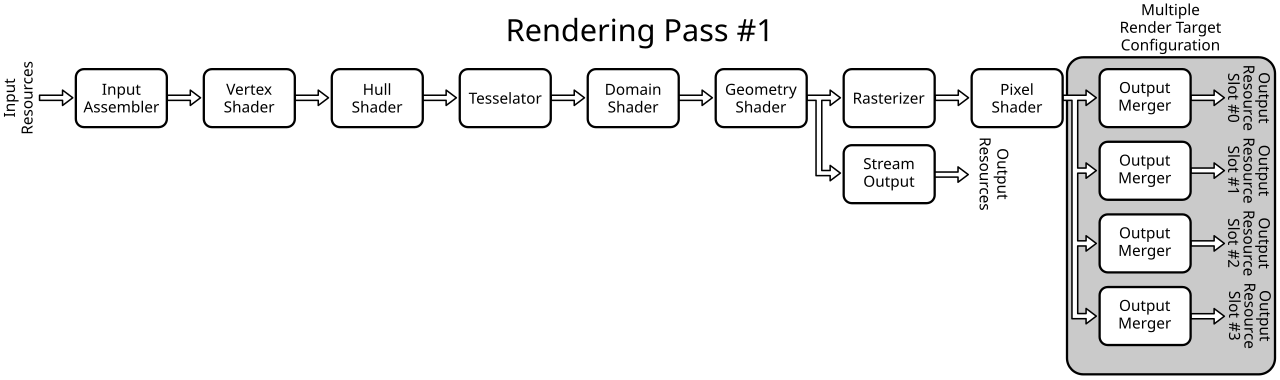
想看清这些阶段各吃进、输出什么,最好把它们拿到同一张逻辑管线图里——从 IA(Input Assembler,输入装配)一直排到 OM(Output Merger,输出合并)。
参数校验发生在哪一侧,也值得说清:显式 API 把大部分校验放到创建期——PSO 创建时就把组合合法性查完;而 draw-time 只剩「符号与描述符对不对得上」这类轻校验。这正是 D3D12 的 CPU 效率设计动机之一。
1.5 效果与量化:五层的调用次数与耗时量级
把五层摆在同一张表上,量级差异一眼就能看出来:调用次数从「每帧几次」到「每 draw 几百次」隔着三个数量级,耗时从纳秒到毫秒也隔着三个数量级。
其中最容易踩坑的一点是「哪一层是每帧一次」。资源创建、管线创建这类管理调用是「每帧一次都嫌多」的;而写命令缓冲、绑定描述符这类是「每个 draw 都得来」的。把高频的东西藏进低频的调用里,是常见的性能反模式。
提交路径上有几个可观测点:API 调用返回前的 C++ 栈、CPU 侧命令缓冲末尾、GPU 侧前端计数器。三个点分别回答「用户态花了多少」「驱动写了多少」「硬件吃了多少」,对不上号说明某一层出了问题。
纳秒、微秒、毫秒三个数量级放在一条尺子上,读者就能直观看到:一次 draw 的成本即使被拆到最细,也不会掉到一个「感觉无所谓」的数量级——提交本身就有固定开销,这为后面第五章埋了伏笔。
二、主命令缓冲:为什么它是环形缓冲
2.1 原理与概念:环形缓冲的形态
进入 GPU 侧之前,先把 CPU 侧最后一块拼图讲清——命令缓冲。它分为两种:主命令缓冲(Primary Command Buffer)与次命令缓冲(Secondary Command Buffer,即命令列表)。主缓冲里放的,是系统级命令和对 3D 命令缓冲的调用;3D 命令缓冲才是装「画什么」的地方。
为什么要用环形缓冲,而不是推到底就结束的线性缓冲?核心原因是读写解耦:CPU 是生产者,从一端把命令包写进去;GPU 是消费者,从另一端把命令包读出去。环形结构让写指针和读指针各走各的,生产者永远在前、消费者永远在后,谁也不堵谁——只要缓冲区没被耗尽。
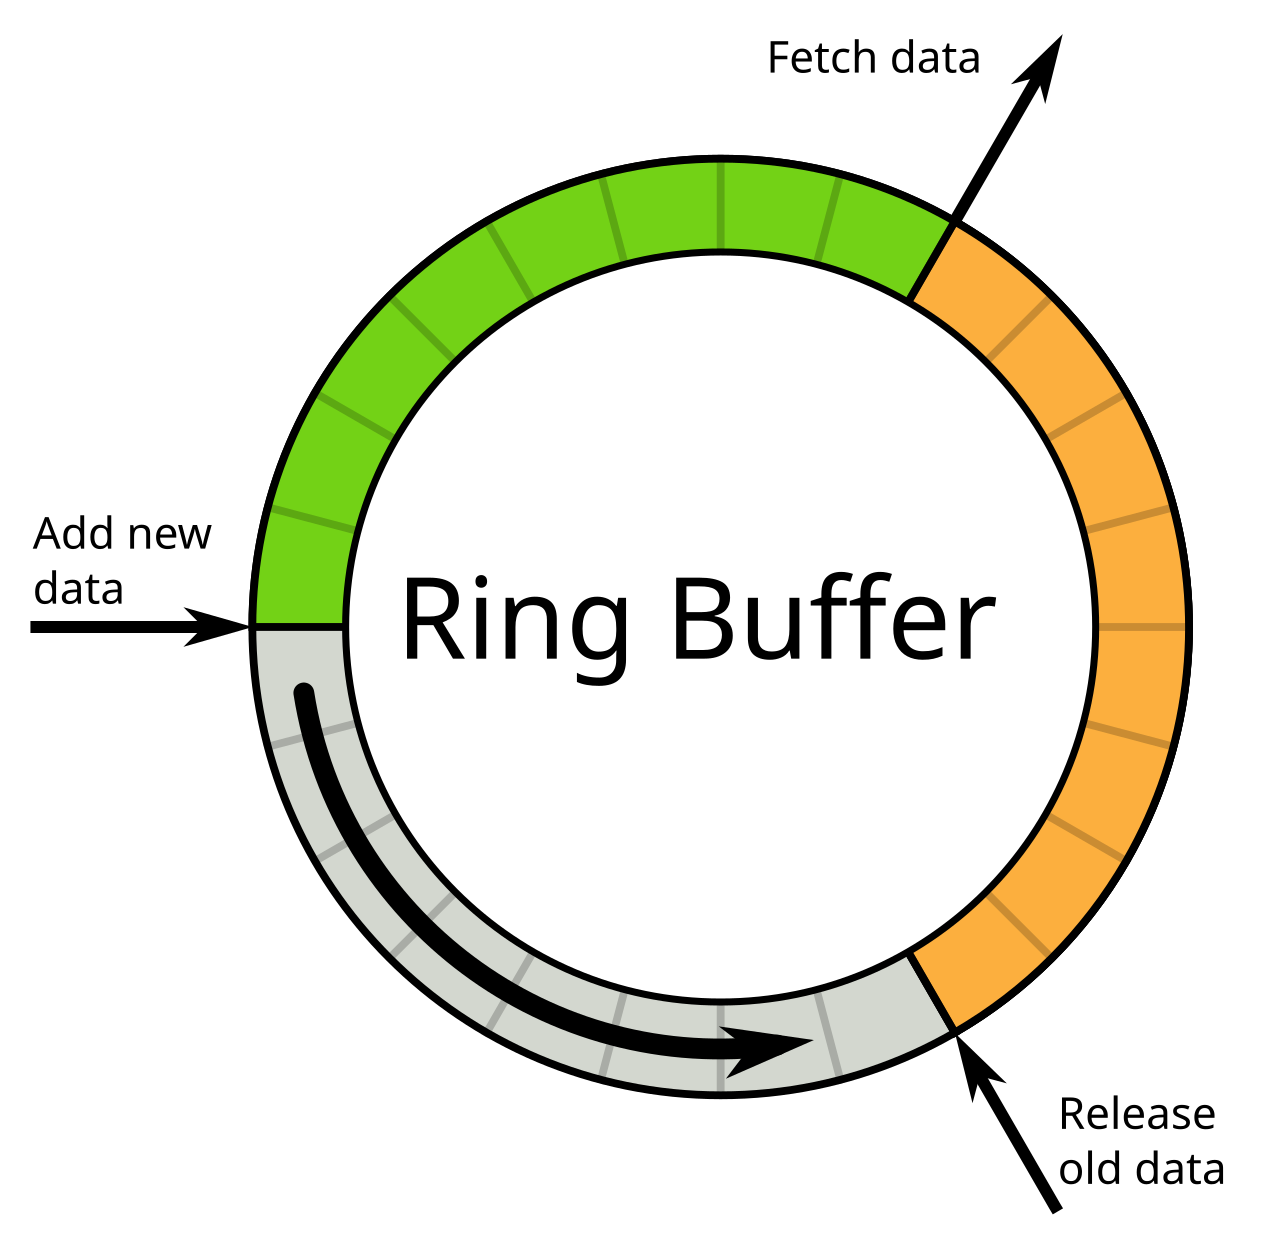
环形缓冲有两个指针:读指针(Read Pointer)与写指针(Write Pointer)。读者追上写者说明读得比写得快——缓冲区空了;写者追上读者说明写得比读得快——缓冲区满了。
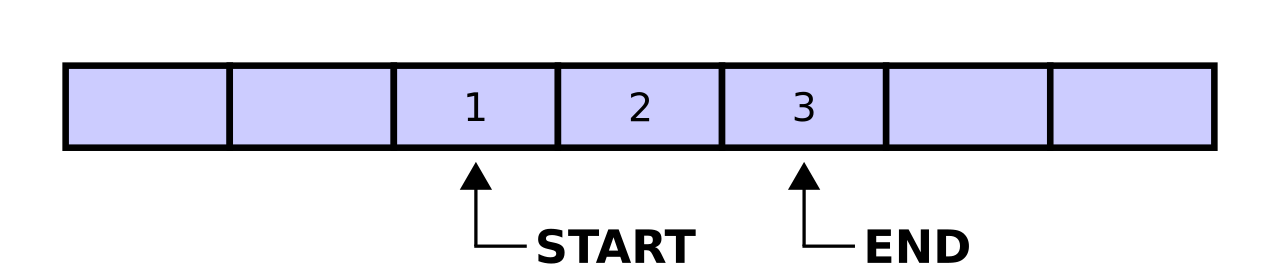
环形 vs 线性不是口味问题:线性缓冲被读到底就必须「倒带」或新建,生产者必须等消费者清空;环形缓冲允许生产者绕回,把「当前批次 vs 历史批次」自然区分开,是显式且自洽的。
缓冲耗尽时的行为很值得记一笔:写指针逼近读指针时,驱动要么阻塞等待 GPU 消费(这会让 CPU 停下来,是最典型的「驱动卡顿」来源),要么吐掉一部分内容改走更慢的路径。这两种都是你要在 profiler 里找的病征。
2.2 命令包的格式与前端解码状态机
GPU 前端拿到的不是「一次 draw」,而是一条条命令包(Command Packet)。每个包有一个最小骨架:类型 + 长度 + 载荷。类型告诉解码器「这是什么」,长度告诉解码器「这个包占多少字节」,载荷装着参数。
真正在解码这些包的,是一台叫命令处理器的专用状态机。它不是通用 CPU,它的指令集非常窄——只认识一串紧凑的命令包格式,解码速度快、面积小。可以说,前端就是一台解码状态机。
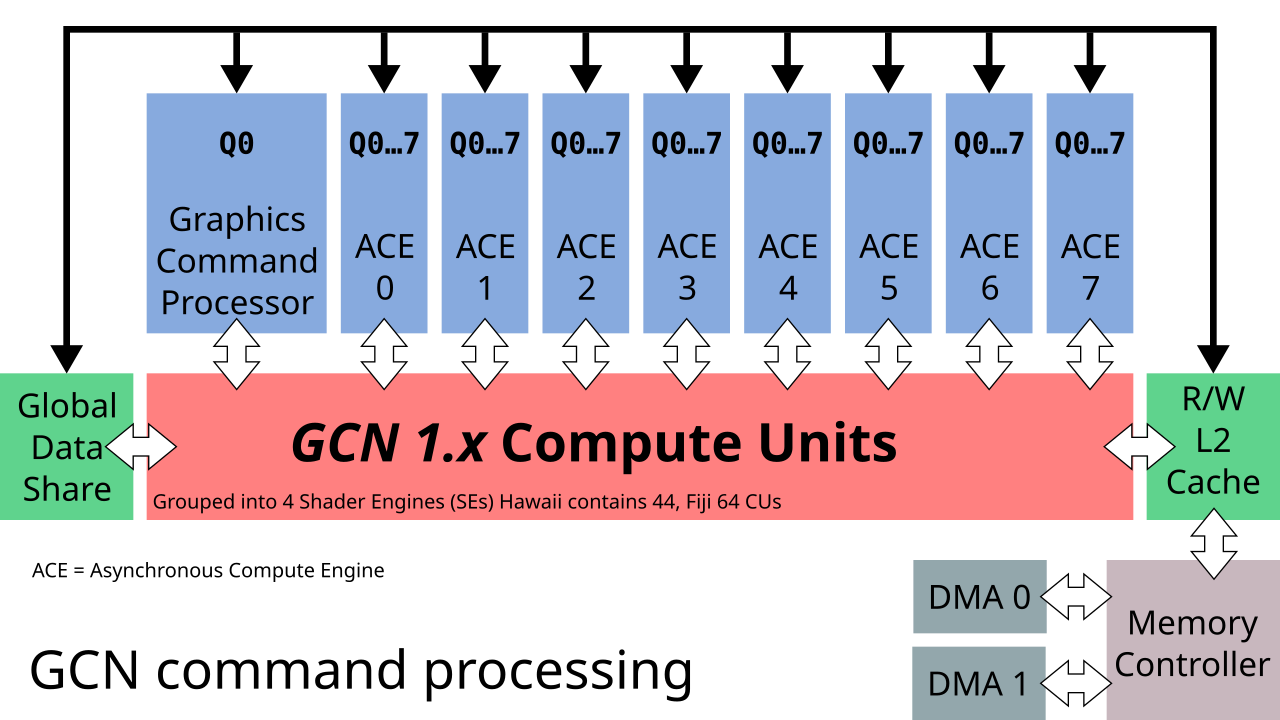
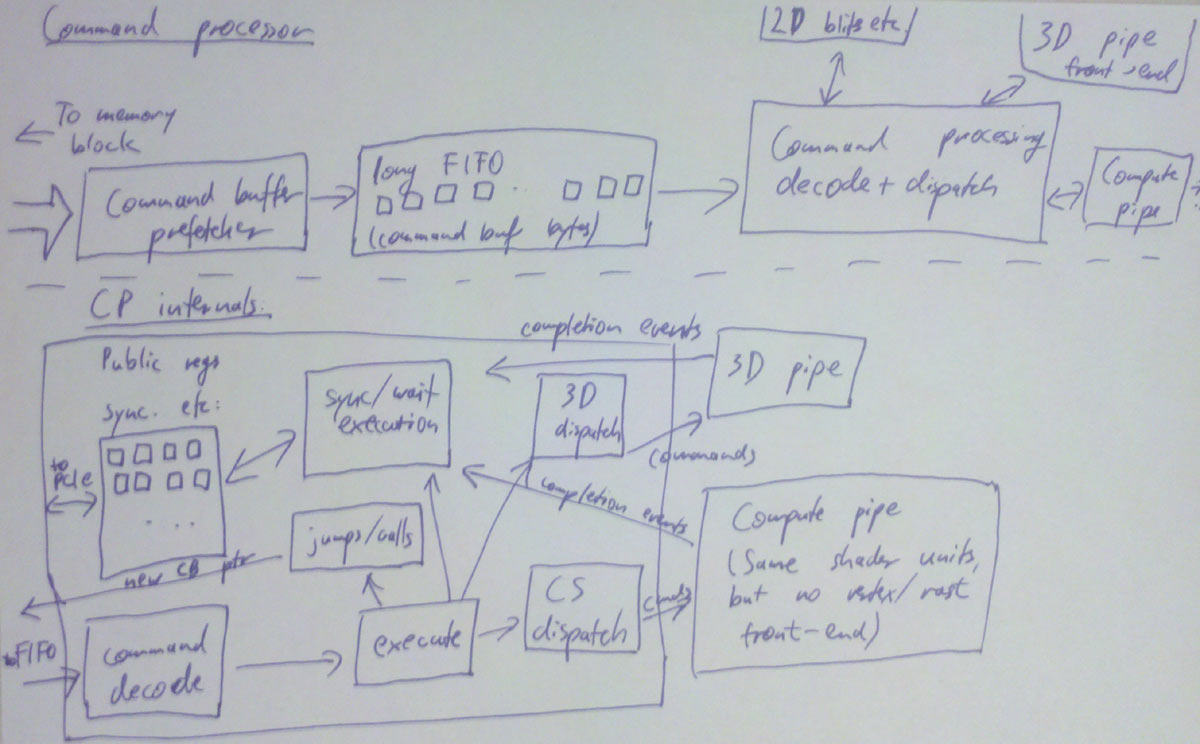
一张来自开放社区的 AMD GCN 命令处理流程图,直接画出了这个阶段:命令从环形缓冲被拾起,被译成寄存器的写,再被分发到底下的各执行单元。这是本篇所有外部示意图里与主题最对位的一张。
如果把这台命令处理器再拆开看,它其实是一个由好几块分工不同的子部件组成的整体:前端有个命令缓冲预取器(Command Buffer Prefetcher)提前把还没生效的命令拉进一条很深的 FIFO;FIFO 之后是解码与分发(Decode + Dispatch)单元,把包解开、按类型分流;进入内部后,执行(Execute)单元负责真正的行为,同步/等待(Sync/Wait)单元处理「若事件 X 则 Y」的等待,3D/计算分发把命令送到各自的管线前端。CPU 一侧通过公共寄存器(Public Registers)看到并操纵这些内部状态——这正是上一节说「读写指针是寄存器」的由来。这一整块,就是 GPU 的那颗「命令状态机」。
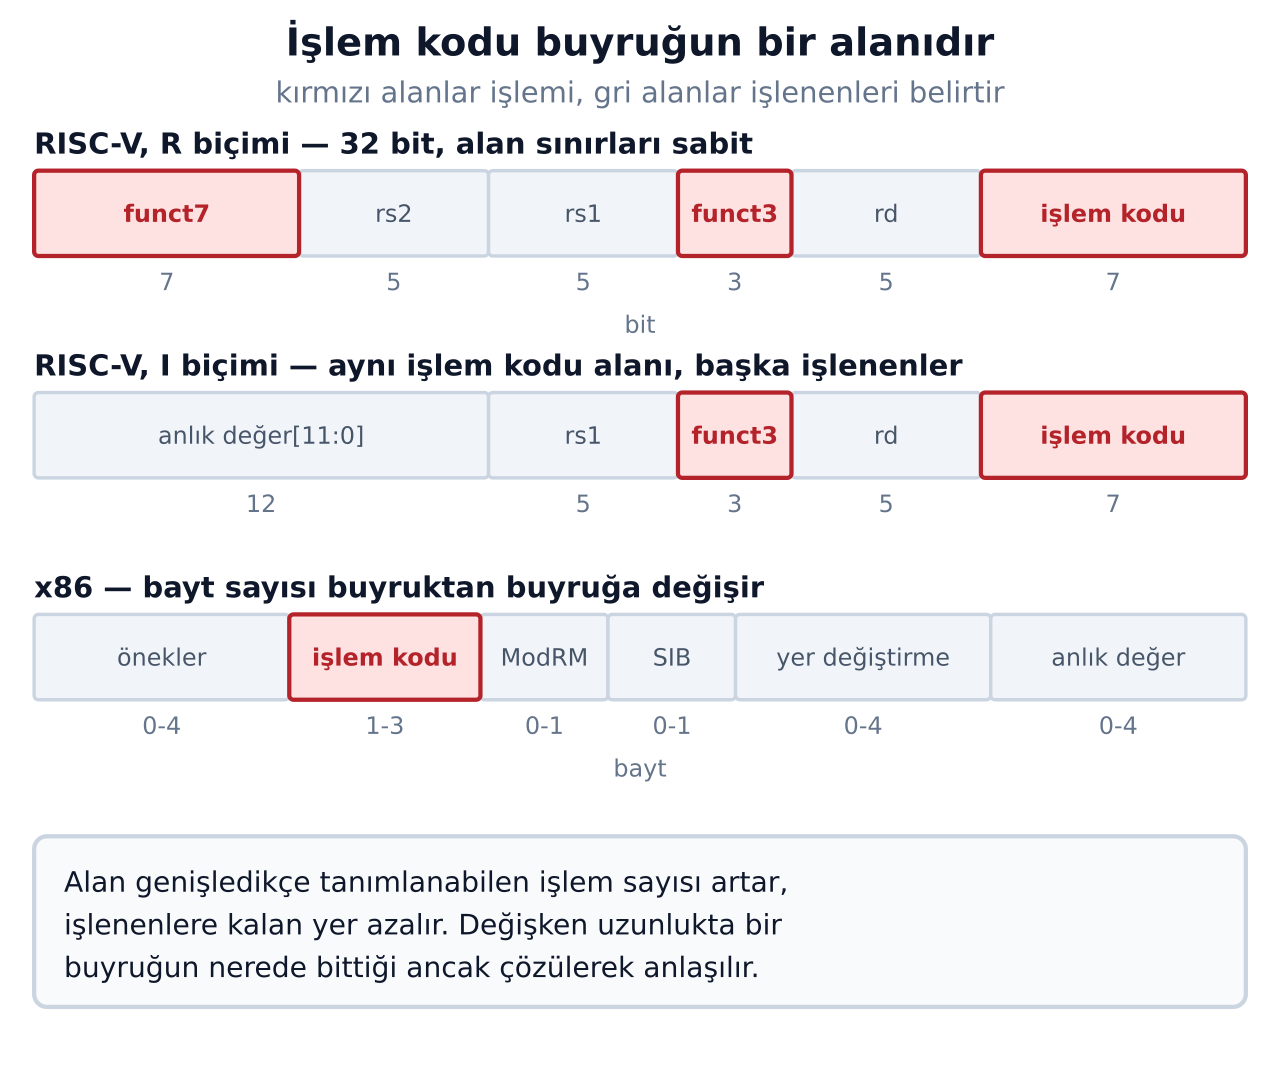
命令包的格式设计,与 CPU 指令编码的「定长 vs 变长」是一个同构问题。固定长度好解码、好对齐,但浪费带宽;变长省带宽、但解码要现场判断边界,前端更复杂。显卡命令包通常在两者间找平衡:常用命令用紧凑的变长格式,批量状态用定长格式。
虽然时代在变,2D 命令至今仍常留一块专用硬件。不是现代 GPU 不会画 2D,而是桌面合成、文本渲染这类 2D 工作负载吃的是「低延迟、确定性」——把它从通用 3D 前端里分出去,避免 3D 的流水状态拖累它。
2.3 读写指针是内存映射寄存器
接下来是这个机制里最反直觉、也最重要的一环:读写指针并不放在显存或内存里,而放在命令处理器上的内存映射寄存器(Memory-Mapped Register, MMR)里。
普通内存访问要过缓存、走总线,Core 与 CCU 之间的读写是带状态的;而内存映射寄存器是 CPU 与 GPU 共享的浅层、低延迟通道——CPU 一侧写,GPU 一侧直接读,中间不经过那个高延迟的主存储层次。这两类的差别,决定了「同步命令该走哪条路」。
一次提交的完整时序可以画成一条链:CPU 层序地把命令包写进环形缓冲 → 推进写指针 → 触发一次「敲门铃」(Doorbell,写一个特殊寄存器)→ 命令前端被唤醒 → 取指开始读命令包。
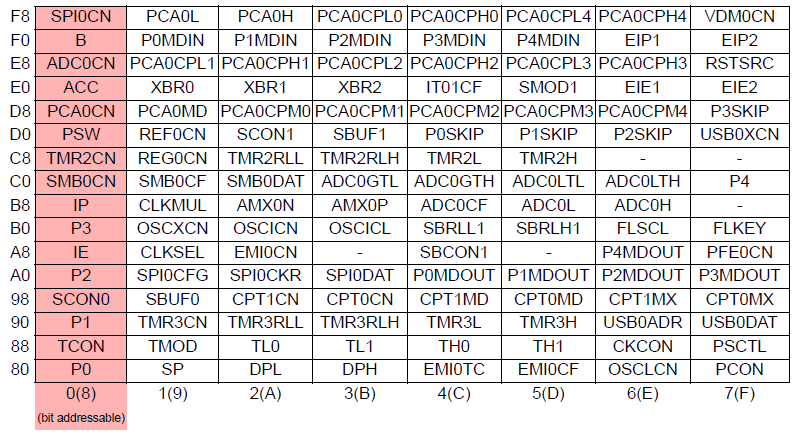
寄存器/内存映射的「文件式」表示,在硬件手册里通常就是一张 SFR(Special Function Register,特殊功能寄存器)内存映射表——每个偏移、每一位、什么含义、谁可以写。
2.4 实现与配置:命令包布局示例
命令包的布局可以用一级伪码 + 逐字段释义来落到纸上。一个典型的「设置状态」包可能是:
DWORD 0 : OPCODE = 0x0A, CNT   = 5          ; 类型与包内字数
DWORD 1 : REG_BASE = 0x0A1C                  ; 要写的寄存器基址
DWORD 2 : DATA[0] = depth_enable             ; 按序写入的寄存器值
...
而一次 DrawIndexed 展开来看,不是一条包,而是一串:先是定义状态(深度、光栅、混合),再是绑定管线,最后才是那条「开始画 N 个索引」的绘制包。
状态包与绘制包之间存在先后顺序约束——绘制包依赖它之前的状态包已经把相应寄存器写到位。这解释了为什么「乱序提交状态」会触发不必要的重解析或冲刷。
把命令包与 API 调用对照起来,你会看到多对多而非一对一的映射:一次 vkCmdBindPipeline 可能拆成好几条寄存器写,一条绘制包也可能对应接口上的一次绑定加一次绘制。这层映射是驱动优化的主战场之一。
2.5 效果与量化:前端吞吐与预取
GPU 在执行一个长命令流时,深度预取(Prefetch)是抵消高延迟的主要手段:命令前端不会等把整个缓冲拉进本地才开始干活,而是把「还没轮到」的命令包提前拉进片上的浅队列,让主存储的高延迟被隐藏在大规模流水里。
命令包体积是能实测的口径:同一次绘制,不同硬件、不同版本驱动下的包长可能差几倍。这也是为什么有时「增加 draw 数」比「增加顶点数」更伤——前者线性涨的是前端带宽与解码量。
当片上前端 FIFO 深度不足时,前端会「吃」得比预取快:命令供不应求,执行单元被迫干等,GPU 进入欠载(Underutilization)——这就是 draw call 上限总是撞在「前端带宽/解码」而不是光栅化上的原因。
三、状态变更:为什么「只改一个状态」也可能很贵
3.1 状态单元的两难
前面说的命令包,本质上全是在写寄存器。那么问题来了:状态该存在哪?这背后是一组相悖的目标——状态单元要么「自己记住状态」(带状态),要么「每次下传」(无状态)。
带状态的好处是省:每条命令默认沿用上次的状态,不用把每个参数重发一遍。代价是串扰——一个状态改了,可能影响后续所有命令的正确性,于是前端没法只改「那一个点」。
这就是为什么「只改一个状态也可能很贵」:现代渲染是高度并行的流水线,一个共享状态位可能在几十上百个并行单元里各存了一份副本。改动一个位,要么逐个同步(慢),要么干脆冲刷(flush)整个流水段重来(更慢)。
3.2 四种硬件处理策略
业界在这么多年里演化出四种互相竞争的处理策略。策略一:改状态就做部分管线冲刷(Partial Flush)——老式实现常见,简单但会把流水打断。
策略二:单元完全无状态,状态随数据逐级下传——每个图元、每个片元带着自己的状态走,干净但带宽暴涨,几乎只在理论上完整成立。
策略三:多份状态副本 + 选择位——把几组常用状态各自存成一份「槽」,命令里用一两比特选当前用哪份。PSO 的一小部分是这种思想的产物:状态被预编译成有限份,运行时只切选择位。
策略四:寄存器重命名式的按需分配——借鉴 CPU,给状态分配「虚拟寄存器」,冲突时才真正搬移。这是最灵活也最贵的一种,主要出现在高端实现中。
四种策略摆在同一条评价维度(解码简单性 / 带宽 / 流水连续性 / 实现成本)下,取舍一目了然。没有银弹——这也是为什么「减少状态切换」永远是前端优化的头号纪律。
3.3 实现与配置:管线状态对象与预校验
显式 API 把上面的权衡收进了一个对象——PSO。它的精妙在于把「运行时校验」前移到「创建时校验」:创建 PSO 时,驱动把状态组合合法性、硬件能否实现、需要哪些子集资源一次查清,并在内部把它分解成几组可切的状态槽。
创建期与运行期的分工因此清晰:创建期做重校验(状态组合、资源绑定、硬件能力),运行期只做轻校验(绑定是否匹配、句柄是否有效)。这让 draw-time 的 CPU 成本大幅下降,是 D3D12/Vulkan 比旧 API CPU 开销低的核心理由。
状态对象也有命中与未命中之分:命中时驱动直接复用已编译的子状态;未命中(首次遇到该组合)时触发懒编译,这正是「替换 PSO 导致卡一下」的来源。PGO 预热就为把未命中全塞进加载期。
状态组合爆炸的量级值得量化:深度 2 态 × 混合 几十态 × 光栅 若干态 × 不同 shader 变体……乘起来是十万到百万级的潜在组合。预编译全量不现实,所以现实策略是「只编译用到的 + 懒编译」。
3.4 效果与量化:状态切换的代价排序
不同状态变更的代价相差悬殊,排个序对开销管理很有用:切换绑定(PSO)最贵,其次是裁剪/剪刀与目标格式,最便宜的是纯着色常量。
状态变更次数与 draw 次数是两条相互放大的曲线:draw 数上升 → 状态切换绝对次数上升 → 每切换一次的代价 × 次数 = 前端总开销暴增。这也是「合批减少 draw」省的不只是循环,而是省掉了中间夹着的状态往返。
把状态按变化频率分组,是工程上最实用的手法:每帧不变的(稀有态)锁一次、每批才变的(中频态)放批头、每个 draw 都变的(高频态)极致精简。这组拆分本身就是优化。
四、同步:push/pull、序列号与围栏
4.1 push 与 pull 两个模型
CPU 与 GPU 之间的「谁通知谁」,演化出两个模型。push 模型靠中断通知:GPU 完成某件事后发个中断把 CPU 撬起来。中断来得及时,但路径长、开销大,只适合高频到「必须立即处理」的事件(如错误、帧完成回调)。
pull 模型靠 CPU 轮询可见寄存器:CPU 主动去读一个 GPU 会更新并发布的寄存器,读到预期值就继续。轮询省掉了中断路径,但让 CPU 因为「等」而空转(Busy-Wait)。
两种模型在延迟与开销上互有取舍:push 延迟低但单次贵,pull 单次便宜但让 CPU 空转、累计也不便宜。现实实现常按事件优先级混用——高优先级走 push,普通状态走 pull。同步命令的统一抽象是「若事件 X 则 Y」:条件满足才推进,是围栏与信号量的共同内核。
4.2 序列号与围栏
命令缓冲会被反复使用,于是需要一个不变量来避免「读到旧数据」:每个命令缓冲带着一个单调递增的序列号(Sequence Number)。驱动只把「已提交到 N 号」作为推进依据,永不回退。
序列号的主要敌人是乱序与重读旧值:没有它,CPU 无法判断「我读到的到底是这次的完成,还是上一帧的残留」。寄存器 + 单调计数,让「该读谁」成为一个无歧义的问题。
围栏(Fence)有两种语义:时间线围栏(Timeline Fence,可被多次 signal/wait,值单调)与一次性二进制围栏(Binary Fence,一 signal 一 wait)。前者适合多队列多帧流水,后者是简单的完成信号。混用是常见 bug 源。
同步要是没做好,卡顿会长成很阴间的样子——不是整段掉帧,而是时间线上密集的微卡顿(Micro Stuttering):帧的平均间隔对不上用户的体验节奏,帧间隔分布图上拖着一条条尖峰尾巴。
4.3 实现与配置:围栏与信号量的 API 序列
一条完整的跨队列同步,在显式 API 里是一段可核对序列:创建 fence → 在目标队列上 vkQueueSignalSemaphore → 在依赖队列上 vkQueueWaitSemaphore → 主线程 vkWaitForFences。每一步的等待对象在 CPU 侧还是设备侧,决定了谁会被卡住。
帧循环里有三处经典同步点:每帧开头的下一帧命令可写、命令提交后、帧完成并取到可写目标。把三处摆成环,就能看清死锁与空转的常见位置。
同步点配置有章可循:能设备侧内联就不让 CPU 空转、能前置等待就不后置、能共用 fence 就不各建各的。这张配置清单能直接照抄到项目代码评审上。
4.4 效果与量化:同步的代价
设备侧等待与 CPU 侧等待的代价差是数量级的:设备侧是硬件内联在命令流里,几乎不额外花线程时间;CPU 侧是主线程空转浪费功耗与调度。所以「看起来一次 waitForFences,实则整个 cpu 在等」是最容易误读的坑。
同步过度与同步不足各有病征:过度同步 = 明明没依赖却互相等,表现为「CPU/GPU 交替空闲」的不稳定帧时间;同步不足 = 该等不等,表现为闪烁、错误帧、资源在写时被读(洞)。
同步开销的观测口径要知道:GPU 时间戳多数不含 CPU 等待的墙钟时间,要量同步代价得看「CPU 侧 fence 到 GPU 侧首命令」的间隔,或直接计主线程空转。
五、前端开销与小 draw 的成本结构
5.1 一次 draw 在前端要过几道
一个 draw 在前端实际要经过的环节远比「一句调用」多:参数落位 → 状态打包 → 写命令缓冲 → 推指针 → 敲铃 → 前端取包 → 解码 → 分发。每一步都在消耗。
关键在于拆分固定开销与规模开销:与图元数量无关的部分(解析包、改状态、管线切换)是每条 draw 都要付的「门票」;与图元数量相关的部分(顶点处理、光栅化)才是「按量计费」。这两类混在一起时,很难定位前端瓶颈。
提交路径上依旧保留那三个可观测点——但值得补一句:正由于固定开销存在,「draw 数下降一定是前端问题」和「draw 数上升都是前端问题」两种笼统归因都是错的,拐点在哪取决于固定开销与单 draw 图元量的相对大小。
5.2 小 draw 的成本结构
为什么小 draw 的单位成本比大 draw 高?因为固定开销被很少的图元摊销:一起画 1000 个图元时门票摊得很薄,一起画 2 个图元时门票占了大头。
套用成本模型就能看清:总成本 = 每 draw 固定开销 × draw 数 + 每图元开销 × 图元总数。前一项催你减少 draw,后一项催你减少图元。两者不是一回事。
于是「什么规模以下合批更划算」是一个可以算的题:当「K 个 draw 的固定开销之和」超过「把 K 个 draw 合成一个大 draw 后状态统一带来的额外负荷」时,就该合批。这个交点往往很早就到——因为单个 draw 的固定开销常是几百 cycle。
顶点复用率会显著改变上面的账:同样画 N 个三角形,索引化且高复用时每图元开销被摊薄;逐顶点重复提交时每图元开销自主外生涨。所以「合批」的收益很大程度取决于顶点索引复用率。
5.3 实现与配置:合批、实例化与间接提交
三种减少 draw 数的主力手段:合批(Batching,把状态相容的物体一起画)、实例化(Instancing,同一几何画 N 份)、间接提交(Indirect Draw,由设备侧决定参数)。它们吃得是同一道题的不同解法,适用边界各不相同。
实例化把 N 个 draw 压成 1 个:一份顶点、N 份逐实例数据,硬件在一次调用里重复 N 次。instance count、vertex stride 这些参数一并带上,画树、草、粒子全靠它。
合批不是免费的——它有状态相容性约束:同一批里物体的深度、混合、光栅、shader 必须一致,否则合不进来或要拆。这条约束是「合批 vs 质量」的张力所在。
三种手段都挂着一份配置清单:何时用哪种、各参数的语义、兼容性要求。直接填造型的配置表比理论更重要。
5.4 效果与量化:draw 数量的代价曲线
draw 数量与帧时间不是线性:在固定开销主导区,曲线近线性上涨;越过某点后,前端带宽或解锁成为新瓶颈,曲线变陡甚至跳频。这条曲线的形态能告诉我们该在哪停止「无限合批」。
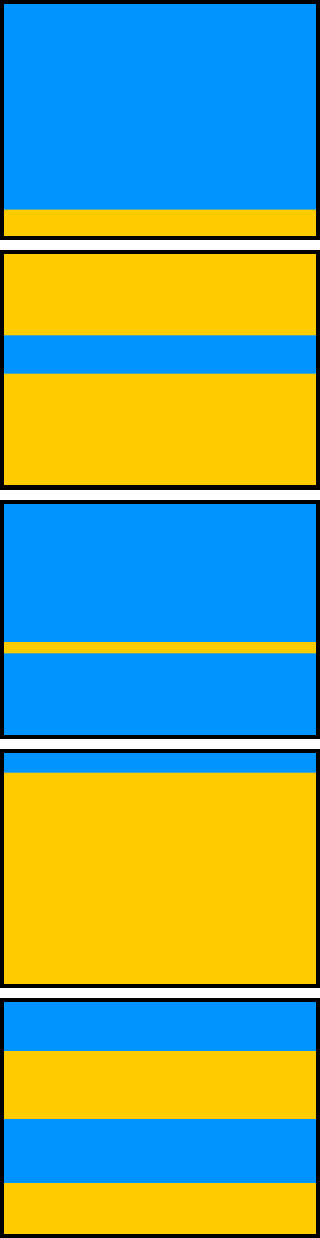
拐点在哪、受什么影响:前端解码吞吐、命令包体积、PSO 切换次数共同决定它。单独看 draw 数不说明问题,得看「单位时间的命令字节流过前端多少」。
曲线读数的观测口径要固定:得用稳定的可复现场景、固定相机与负载,才谈得上 draw 数 → 帧时间 的因果,否则只是噪音。
六、走向现代化:bindless、间接提交与 GPU-driven
6.1 描述符管理与 bindless
传统上,CPU 必须在每个 draw 前把「这次要用哪些资源」绑定好——这是每 draw 一次的 CPU 负担。bindless(无绑定)把这层改掉:资源被放进一张按需增长的描述符表,shader 按索引取资源,CPU 只需每帧把表绑定一次。
于是绑定从「每 draw 一次」变成「每帧一次」——这是把高频操作变成低频操作最典型的一例。前端也因此少承受一轮又一轮的绑定校验。
但 bindless 把校验负担转移了:CPU 侧轻了,校验挪到设备侧运行时,由硬件在访问描述符时做有效性检查。这是「把固定开销搬到 GPU 上」的又一案例,规避它要在 shader 里做边界纪律。
多渲染目标(MRT,Multiple Render Targets)可以一次把颜色写进多个目标,它和描述符表一样是资源绑定形态的延伸——讨论绑定,绕不开它。
6.2 间接提交与 GPU-driven
间接提交(Indirect Draw)更进一步:绘制参数不是 CPU 现场决定的,而是由 GPU 先算好、放进缓冲区,vkCmdDrawIndirect 只带一个「去读参数」的指针。参数生成移到了设备侧。
GPU-driven 渲染把「哪些要画」也搬到设备侧:可见性剔除(Frustum/Occlusion Culling)在 GPU 上做,cull 结果直接驱动下一批间接 draw。CPU 彻底退出每 draw 决策。
前端在这条路径上的角色变了:从「每 draw 被 CPU 命令」变成「消费参数缓冲」。CPU 侧的 draw 调用锐减,前端压力转移成设备侧生成参数的开销。
代价转移到了哪里?答案是可观测的:CPU 每 draw 开销 ↓、设备的剔除与参数生成开销 ↑。它需要更严的同步(CPU 读写同一缓冲的时机)和更足的显存。这条路径解决的是「前端带宽」瓶颈,却可能制造「显存/同步」瓶颈。
6.3 实现与配置:前端开销相关的配置清单
前端开销相关的配置项其实可以列成一张会查错的清单,每一条都能在运行期观测读到量。
有几个配置在两代硬件间语义变了:比如同一句「depthWriteEnable=false」,在老硬件上可能导致深度测试被推迟(退化为 late-Z),而新硬件上支持拆分测试——语义变了,代价账要重算,这正是 ep12 的主题,但本篇先埋下。
上线前的验收项同样可以清单化:跑一遍 PSO 预编译、压测 draw 数拐点、核对同步点是否全走设备侧、用帧时间分布看是否有微卡顿尾。
6.4 效果与量化:现代路径相对 2011 的读数差
同一负载,在传统路径(每 draw 绑定 + CPU 提交)与现代化路径(bindless + 间接 + GPU-driven)上的读数差是实打实的:CPU 侧 draw 相关开销可降一个数量级,代价是设备侧同步与显存开销上升。
但要冷静归因:这些差异里哪些是前端本身的、哪些不是——bindless 省的主要是 CPU 侧命令生成,不是光栅化;GPU-driven 的收益来自剔除率与前台空闲,不是命令解码。归错因,优化就做偏。
结论有适用边界:这些读数脆弱地依赖场景的 draw 密集度、剔除率、目标平台。以为「bindless 一定快」是抽象化了的危险说法——它只在「draw 密集、绑定是瓶颈」时才对。
七、三条可核对的结论
7.1 可核对的结论与出处
把全篇压成三条可带走、可核对的结论:
结论一:一次 draw 的 CPU 侧成本分两半——「命令生成」与「状态管理」。 命令生成随 draw 数线性涨、随 bindless/间接锐减;状态管理由 PSO 预编译决定。出处:显式 API 呈递与 Microsoft《D3D12 CPU Efficiency Spec》。
结论二:前端是「状态机 + 环形缓冲 + 内存映射寄存器」三件套,瓶颈通常在解码与预取深度,而非光栅。 出处:AMD GCN 命令处理公开图、厂商命令前端架构依据、本系列 §2.5 的吞吐推理。
结论三:小 draw 的单位成本高,是因为固定门票少图元摊销。 合批/实例化/间接是应对它的三种手段,收益有量化拐点。出处:本系列 §5 的成本模型与曲线。
每条结论都要有观测口径,否则就是观点。把「怎么量、看哪个计数器、剔掉什么变量」写清,三条结论才有可证伪性——这是本系列每篇都收在「一笔可核对的代价账」上的原因。
也要诚实标注哪些结论在换硬件后可能不成立:命令包体积、预取深度、状态切换代价都是厂商实现细节,同一结论在新架构上可能从「红线」变成「挨打」——这正是 ep12 要逐年重估的对象。
7.2 与后续篇目的分工
本篇与 ep02 分好工:本篇负责「命令怎么被接收与解码」,ep02 负责「进去之后显存怎么排布」——地址空间、MMU、页表、TLB 是 ep02 的主场。
有几个问题必须等 ep02 才能答:命令包里的地址如何翻译、GPU 侧如何做页表 walk、TLB 未命中时的惩罚——这些是「显存与地址空间」的题,本篇只把「命令里带着地址」交棒过去。
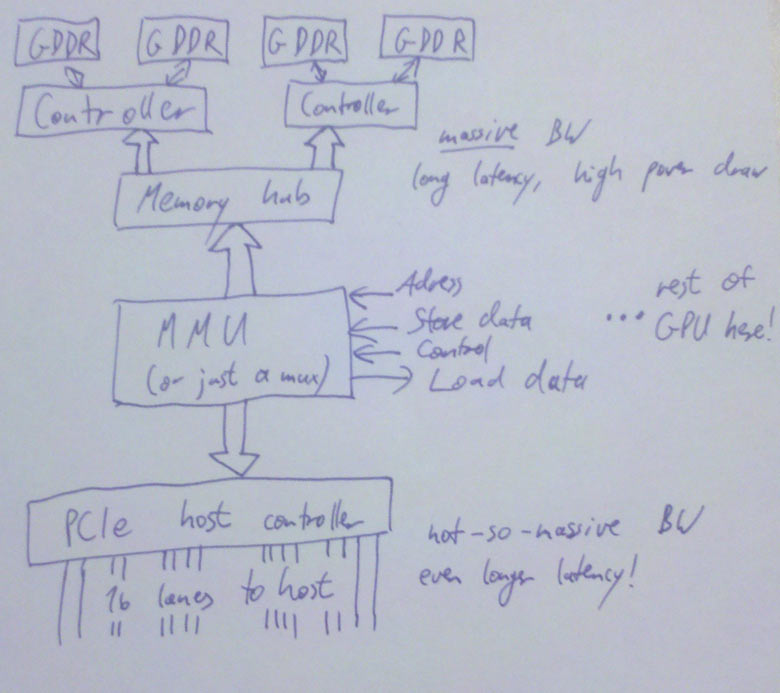
在 ep02 接过这根指挥棒之前,先看一眼它要拆解的那片底盘——GPU 的存储层次。下层是带宽极高、延迟与功耗也极高的 GDDR 显存,经控制器汇聚进 Memory Hub;上层经 MMU 连到 GPU 计算单元,再往上是被 PCIe 与主机隔开、带宽「不那么可观」的系统内存。命令缓冲和显存资源就分布在这个层次里,谁该放在离执行单元近、还是离主机近的位置,正是 ep02 一整篇的分账主题。
八、源码与数据链接
8.1 规范与文档层级
本篇的证据链是分级的:规范条款(定义语义)→ 官方文档/白皮书(描述实现)→ 现场实测数据(验证真实性)。引用时按这个层级回溯,避免把「厂商宣传」当成「验收标准」。
每条结论对应的可回溯出处,本次实际命中:显式 API 呈递模型见 Vulkan 规范《Command Buffers》 与 D3D12 CPU Efficiency Spec;五层软件栈与命令处理器见主参考 《A trip through the Graphics Pipeline 2011》 Part 1–2(CC0);GPU 侧实现依据见各厂商公开架构页(链接补齐于阶段 6)。
8.2 可复现的观测手段
前端开销不是玄学,可以复现观测。手段:CPU 侧命令生成计数(Draw 数与绑定数)、前端计数器(命令字节/秒)、帧时间分布、PSO 命中统计。每一步都有对应 profiler 与 API 计数器。
各手段能证明/不能证明什么也要划清:帧时间分布能证明「有卡顿」,但不能证明卡顿在 CPU 侧还是 GPU 侧;前端计数器能证明「解码量」但测不到「同步等待」——把工具的能力边界写死,观测才不走样。
九、边界:本篇不涉及的部分
9.1 技术边界白名单
收个尾,把本篇边界钉牢:本篇不讲显存地址空间的翻译细节(ep02)、不讲 TBR/TBDR 的带宽账(《移动端》ep02/ep03)、不讲着色器核与占用率(ep03)、不讲光栅化/深度/像素后端(ep06–ep08)。这些在对应篇目有各自完整的一章。
与已完结两系列不重叠的原因要讲明:算法层回答「怎么算对」,约束层回答「在移动端怎么省」,本篇回答「硅片上怎么实现」——三个视角补的不是同一块空白。
有几条结论依赖厂商未公开文档,必须标注:如具体命令包字段布局、预取深度确值、状态切换的精确 cycle 数——这些都是 NDA 细节,本文只到机制层并如实标注为推测/未公开。
9.2 哪些图只能自绘,以及为什么
全篇绝大多数示意图走自绘,这不是「懒得找」,而是结构性约束:命令前端与软件栈的内部机制没有公开可得的高质量示意图——厂商只有 NDA 文档,Khronos 规范图不可再分发。可转载确实只有 13 处真图(软件栈分层、环形缓冲、命令处理流程图、die shot 等,均来自 CC 许可的 Wikimedia Commons 与 CC0 的主参考系列),检索痕迹已留证于 search-log.jsonl。
规范图不可再分发、厂商图不开放,意味着「照着规范画一张自己的框图」是合法且必要的路径——自绘不是降级,是许可边界下的正确姿势。凡图内文字引自家厂商图,本系列在阶段 4 统一登记许可并注明。
十、这一章留下的问题
10.1 三个未答问题
这一章走到头,留下三个没答完的问题,交给后续篇目:
问题一:命令包里的地址,到了 GPU 侧如何翻译? 页表、MMU、TLB 未命中惩罚——这是 ep02《显存与地址空间》的题。
问题二:一次 draw 里的顶点,到底被哪些 SIMD 单元、按什么占用率处理? 命令前端把 draw 交给着色器核之后的因果链,是 ep03 的主场。
问题三:2011 年的命令前端机制,今天变了多少、没变多少? 本篇埋的「语义变了代价账要重算」,ep12 会逐条重估。
三个问题各自卡在哪也已定位:第一个卡在地址翻译的硬件实现,第二个卡在SIMD 执行模型,第三个卡在厂商公开度——也正是全文反复标注「规范 vs 推测」的那层边界。
10.2 下篇预告与系列进度
《GPU 架构剖析》系列进度:已完成【一】从 API 到命令前端;下一篇《显存与地址空间:带宽极高,延迟也极高》将回答「命令包里的那些地址,进了 GPU 之后是怎么被找到的一排物理内存的」。
按系列进度做下索引:本篇【一】从 API 到命令前端已完成,下一篇【二】显存与地址空间直接在此打点接力,把命令包里的地址接到物理内存那一排上。
本篇反复出现的那句「规范 vs 推测」,是理解整套硬件的钥匙。下一篇我们从命令前端的出口出发,走进显存。下篇再见。
相关链接与参考资料(全篇可回溯出处):Vulkan 规范 Command Buffers / Vulkan 规范 Memory Allocation / D3D12 CPU Efficiency Spec / 主参考系列(CC0) / 厂商公开架构页(阶段 6 补全链接)
With Best Wishes. 本文由@溯光 出品,转载请注明出处。我们在硅片到像素之间,继续挖下去。