本文由@溯光 出品 站点:https://yyy3d.online/blog/ | 本系列:https://yyy3d.online/blog/#topic-vulkan-best-practices
题图 四套体系的地图与一台机器的能力快照:Guide / Tutorial / Samples / Validation 各管什么,以及本机在这张地图上站在哪 @ 本系列绘制
全系列篇目总览(共 10 篇,本篇为第 1 篇):
- 本篇 · ep01 官方最佳实践到底在哪:四套体系的边界与本机能力实勘——地图与本机能力基线
- ep02 2026 新范式:Vulkan 1.4 基线、Dynamic Rendering 与 Shader Objects——新范式
- ep03 同步最佳实践:barrier 精细化、sync2 与时间线信号量——同步
- ep04 管线缓存:绝不在 draw time 建管线——管线缓存
- ep05 Render Pass 与 Subpass:attachment 策略与 tile 内存——render pass / subpass
- ep06 命令缓冲与多线程录制:secondary CB 与 false sharing——命令缓冲
- ep07 描述符与内存分配:从 256 字节的告警说起——描述符
- ep08 Layout Transition:barrier 的代价落在哪——layout transition
- ep09 Swapchain 与 Present:image 数量、旋转与 waitIdle→fence——swapchain
- ep10 验证层 Best Practices:从 warn 到修复的真图闭环(收束篇)——验证层闭环
除本篇外的九篇尚在排期,发布后回填链接。本系列的写作边界(四条不写与一条未核实)见 §0.3 的边界声明与 §12.1 的五条边界汇总。
先说清楚这一篇要干什么
OK,官方最佳实践这件事,最容易踩的坑,是"找不到"而不是"读不懂"。我们在写这一篇之前,先把本机环境、官方材料的边界、以及"哪些结论只引官方口径、哪些是本机实测"这三件事一次性摊开——因为后面九篇的所有读数,都要挂在这张地图上。
0.1 这一篇回答三个问题
先来看看第一个问题:Khronos 官方到底有没有一份叫"Vulkan 最佳实践"的文档? 这个问题看起来像常识,但我们实测检索之后发现,连"有没有"这一点都存在普遍的误判。第二个问题:这台机器上,Vulkan 到底提供给我们什么? 设备、扩展、时间戳能力、验证层——这些不是"环境准备",它们本身就是证据的来源。第三个问题:官方说的和我量到的,差在哪?
这三个问题构成了本篇的三条主线,也构成本系列后续所有篇目的方法论。先说结论,大家心里有个底:官方没有那份白皮书;官方的最佳实践散在四套体系里,而且其中一个关键开关默认是关着的;本机是一台能满足本文全部取证需求的机器,但能力边界需要写清楚。
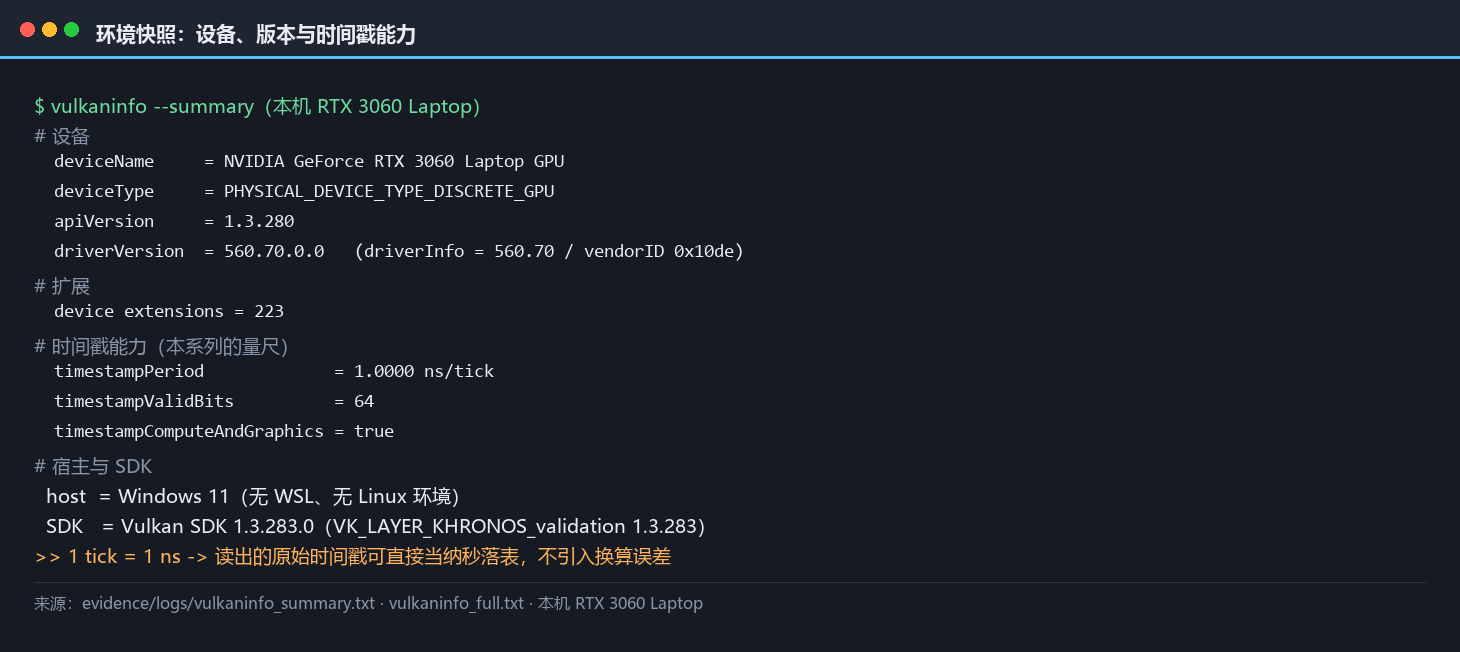
0.2 本机环境快照
好了,老规矩,先上环境。这一节是读数基线,不是"环境准备"——后面凡是出现"本机实测"四个字,说的都是下面这台机器。
| 项 | 读数 |
|---|---|
| GPU | NVIDIA GeForce RTX 3060 Laptop GPU(PHYSICAL_DEVICE_TYPE_DISCRETE_GPU) |
| 设备 API 版本 | 1.3.280 |
| 驱动版本 | 32.0.15.6070(驱动自报 560.70) |
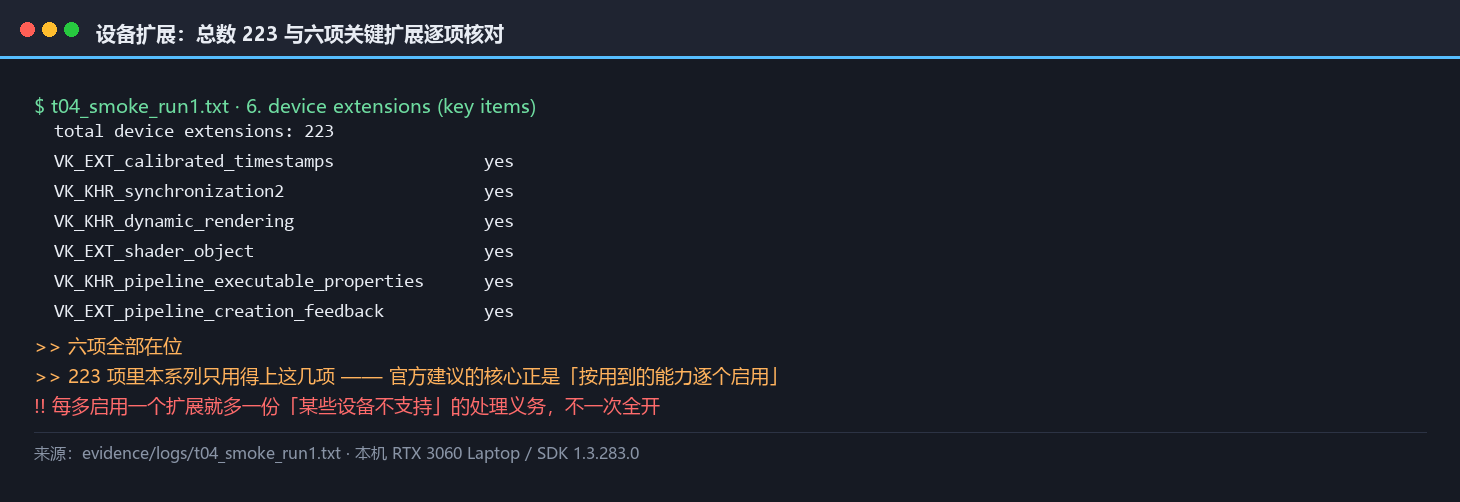
| 设备扩展总数 | 223 项 |
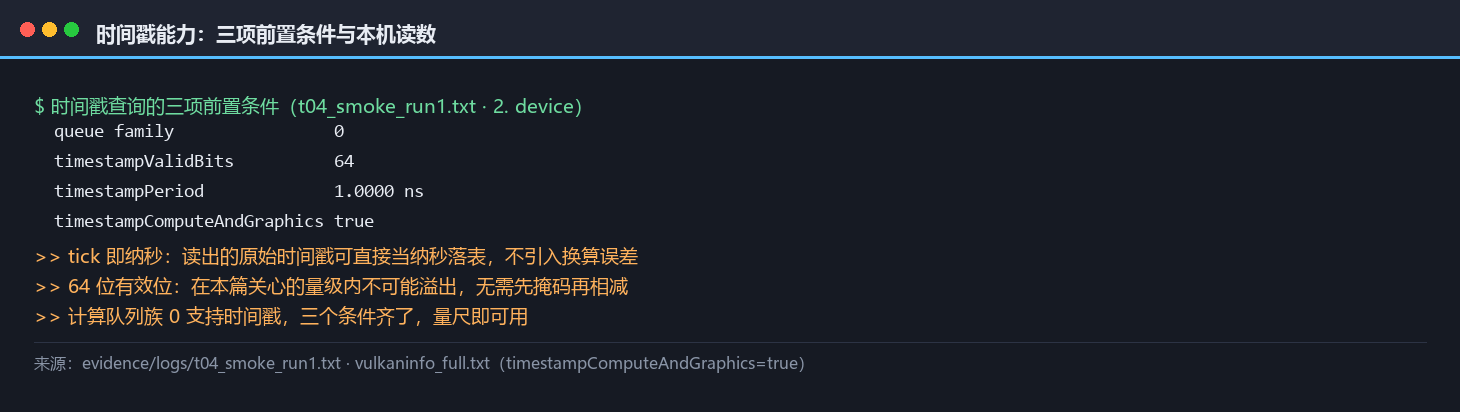
| 时间戳能力 | timestampPeriod = 1.0000 ns/tick|timestampValidBits = 64|timestampComputeAndGraphics = true |
| Vulkan SDK | 1.3.283.0(含 VK_LAYER_KHRONOS_validation、vkconfig、glslangValidator、dxc、spirv-* 全套) |
| 抓帧工具 | RenderDoc 已装(MIT 许可) |
| 主机 | Windows 11,无 WSL、无 Linux 环境 |
有两点要说透。第一,timestampPeriod = 1.0 这个读数很关键:它意味着一个 tick 就等于一纳秒,所以我们从 GPU 里读出来的时间戳可以直接落表,不需要再乘一个奇怪的系数、也不会因为换算引入误差。第二,223 项扩展这个数字不是拿来炫耀的,它后面要用来做一次真正的判断:官方那套"按需请求扩展"的最佳实践,在本机这条链路上到底有没有被我们走对。
0.3 边界声明:本篇不涉及什么
说白了,按惯例,把"不写什么"写在前面,比写完再解释省事得多。
第一,不做跨厂商对照。 本机只有一块 NVIDIA 独显。跨厂商的"同一份 SPIR-V 在不同厂商驱动下怎样"这件事,需要两台机器,而且 RenderDoc 的抓帧默认可跨系统搬运的能力有限——我们只能做"各自机器上同类测量的并列",不做"同一份证据的跨厂商对照"。第二,不给驱动内部 JIT 的结论。 Vulkan 没有任何官方接口能让我们看到驱动编译器内部的中间表示或 JIT 决策;能看到的最多是我们自己提交的 SPIR-V,以及工具对它的反汇编。第三,不给指令集规范的断言。 NVIDIA 没有公开 SASS 的官方 ISA 文档,nvdisasm 的输出只能作为观测性描述,不能说成"规范规定如此"。第四,时间戳的使用有同步域边界:vkCmdWriteTimestamp 只保证同一次提交内 happens-after 的时间戳不递减,跨帧、跨队列相减必须成对采样,或启用校准时间戳扩展——本机该扩展在,但本篇不做校准实测。
还有一条属于"核对不出结论就不写":VK_DEVICE_LAYERS 这个环境变量名我们在官方文档里没有核实到(device layer 的概念早已废弃),所以本篇不会把它当作现行变量名使用。
0.4 本篇的读法:按需跳读
OK,这一篇的结构是"两半",两半的读法不一样,所以先给一条跳读路线。
只想知道"官方材料在哪"的人:读第一章到第五章。这五章全是文档地图,不需要机器,任何人看了都能用。只想知道"这台级别的机器能测什么"的人:直接从第六章开始。这七章全是本机读数与工具,前面没看也不影响。准备照着做一遍的人:第十一章的实验台那一节是入口,三个文件加一个脚本,照着跑一遍就有自己的读数。
还有一处需要提前提醒:本篇的"本机实测"指的是本机运行输出,不是"我观察到的现象"。 两者差别在哪?前者有原始日志可核,日志随篇入库;后者只能凭记录者的话。本系列后面每一篇都按前者写,所以第五节之后凡是出现读数的地方,都能在 evidence/logs/ 里找到对应的文件。
如果只打算带走一句话,那应该是这一句:官方的最佳实践不是一份文档,而是一张需要自己拼的地图——而且其中一个关键开关默认是关的。
一、先破一个迷思:官方没有那份「最佳实践白皮书」
1.1 搜「Vulkan best practices」,为什么总感觉少点什么
好了,大家如果去搜这个关键词,会得到一堆结果:厂商的技术博客、会议的演讲 PDF、某个作者的免费章节。看完之后会有一种奇怪的感觉——每一篇都在讲最佳实践,但没有一篇是"官方的、成体系的"那份。这种"碎片感"不是错觉,它是官方文档组织方式的一个直接后果。
我们在调研阶段先做了一件事:把"Khronos 官方是否有名为 Best Practices for Vulkan 的独立文档"当作一个待证事实去查。结论是:没有。Khronos 官方没有一份叫这个名字的白皮书,也没有一个专页承担"最佳实践总纲"的角色。
那官方的最佳实践写在哪?散在四套体系里。这就是本篇要从头讲清的事情。
1.2 不是一份文档,而是三种形态
OK,把官方材料摊开之后,会看到"最佳实践"以三种完全不同的形态存在——这正是碎片感的来源:
形态一:专页。 Vulkan Guide 里有明确的页面就叫这个名字或承担这个职责,比如版本与移植指南里有一节直接叫 Best Practices,另有一整页讲 Tile Based Rendering (TBR) Best Practices,还有 Common Pitfalls、Deprecated 这种讲"别这么写"的页。它们是一页一页的规范文字。
形态二:样本页里的四段结构。 Vulkan Samples 的 Performance 类样本,每一页都按 Do / Don't / Impact / Debugging 四段来写——"该怎么做、别怎么做、影响有多大、出问题怎么查"。它比专页更接近"操作手册",而且带官方量化的数字。
形态三:一个开关。 这一种最容易被忽略:验证层(Validation Layers)里有一项检查就叫 Best Practices,它把"性能隐患、可疑用法、常见错误、以及规范没禁止但会出问题的写法"打包成告警。但它默认是关着的——这一条我们在第五章会用本机实测展开。
同一样东西,三种载体,难怪"搜不到那份总纲"。
1.3 一个诚实的副产品:检索噪声有多大
说白了,说到这里插一句题外话,它本身也是一个发现。我们在 Wikimedia Commons 上找本系列的配图素材时,按流程先枚举类目,结果 Category:Vulkan (API)、Category:SPIR-V、Category:Graphics pipelines、Category:Device drivers、Category:Shaders、Category:NVIDIA GeForce、Category:Graphics cards 七个类目全部返回 0 个文件。
换成关键词检索之后,噪声就来了:搜 device driver 会返回 VirtualBox 的安装截图、BOSS 蓝调吉他效果器、以及一张人力车夫的照片;搜 Vulkan 更是有趣——Commons 上 Vulkan 这个类目里装的是火山与造船厂(德语和挪威语里 Vulkan 就是火山,还有一家历史悠久的德国船厂叫 Bremer Vulkan)。
我们把这件事如实写进素材清单里,因为它说明一个问题:"搜不到"经常不是"不存在",而是"词被别的东西占用了"。 这也是本系列后续篇目在检索真实素材时的一条纪律——先把词的问题排除掉,再谈素材有没有。
二、四套体系的分工:Guide / Tutorial / Samples / Validation
好了,现在正式上地图。这一章要回答的是:四套体系各管什么、规模多大、我们什么时候该翻哪一本。先给总览表,再逐套展开。
| 体系 | 载体 | 规模(本机核到的) | 它的"最佳实践"长什么样 |
|---|---|---|---|
| Vulkan Guide | 文档站 | 三块、约 74 页 | 专页(TBR、versions、pitfalls、deprecated…) |
| Vulkan Tutorial | 教程 + 会议课程 | 基础 18 章 + FAQ,另 10 门进阶课 | 收尾页的「专业开发最佳实践」八条 |
| Vulkan Samples | 可运行样本库 | API 14 / Extension ~40 / Performance 25 / Tooling 仅 1 | 每页 Do / Don't / Impact / Debugging 四段 |
| Validation Layers | 层 + 配置工具 | 一层 + 一个配置文件面 | 一组默认关闭的检查开关 |
这四套全部出自 Khronos(Samples 由 Arm 等捐赠、Guide 与 Tutorial 由 Khronos 维护),所以我们在相关位置标注它们的官方标识。
顺手把许可分层记一下,因为后面涉及素材时会反复用到:Guide 的源码仓库是 CC-BY-4.0,Samples 的代码是 Apache-2.0 但资产各自有许可(其中含标注非商用的件),Tutorial 里部分课程是 CC BY-SA 4.0,规范与头文件则属 Apache-2.0 系。同一个组织出品的四套材料,代码、文档、资产三层的授权条款并不一致——这一条在第四章讲"为什么不直接跑官方样本"时会用上,也是本系列在选素材时先分类型、再谈能不能用的原因。
2.1 Guide 这边:约 74 页该怎么读
OK,Vulkan Guide 是四套里最像"手册"的。它分成三块:Logistics Overview(17 页,讲怎么入门、版本、平台、工具、CTS)、Using Vulkan(约 40 页,讲怎么用,同步、内存、管线缓存、线程、动态状态、描述符都在这一块)、When and Why to use Extensions(17 页,讲什么时候该用哪个扩展)。
读它有一条偷懒但有效的路子:先只读 Using Vulkan 这块。因为"最佳实践"密度最高的页面几乎都在这里——同步、内存分配、管线缓存、线程、动态状态、常见坑,一个不落。Logistics 那块是给"刚拿到 SDK、还没决定要不要用 Vulkan"的人读的,Extensions 那块是给"遇到具体瓶颈、要挑扩展"的人读的。
2.2 Tutorial 那边:基础 18 章之外,真正的重头是 10 门进阶课
说白了,Vulkan Tutorial 的结构值得单独说,因为它最近完成了一次"现代化改造":以 Vulkan 1.4 为基线,用 dynamic rendering 取代老的 render pass 写法,用时间线信号量,Slang 作为主要着色语言,C++20 + Vulkan-Hpp 的 RAII 封装。基础章从 00 Introduction 一路到 17 Multithreading,外加 FAQ。
但真正有分量的是并列的 10 门进阶课:光线追踪、构建一个简单引擎、高级 glTF 角色管线、高级 Vulkan 计算、同步专课、机器学习推理、XR(OpenXR)、AI 辅助的 Vulkan 开发、glTF/KTX2 资产迁移,以及一门 SIGGRAPH 2026 的课——《How to write a Vulkan application in 2026》。那门课的主线正是"2026 年该怎么写":命令录制与提交、以 Shader Objects 为中心的管线管理、dynamic rendering、以及描述符管理的新方案。
还有一处容易被跳过、但我们必须点出来的:构建简单引擎那门课的收尾页里,有一节叫 Best Practices for Professional Vulkan Development,八条,讲的是工程纪律,而不是 API——自动化与 CI、尽早且持续地开验证层、给对象命名、从项目开始就做崩溃处理、评估 robustness 扩展的取舍、跨平台跨驱动充分测试、把依赖的扩展与特性文档化、持续跟踪生态更新。
这八条是整个官方体系里最接近"最佳实践总纲"的东西,而它藏在一门引擎课程的末尾。
2.3 Samples 那边:四类样本的规模差,本身就是一条信息
好了,Vulkan Samples 是"可运行的示例库",分四类。把它们的数量摊在一起看,会看到一条很有意思的规模差:
| 类别 | 数量 | 定位 |
|---|---|---|
| API samples | 14 个(另有 13 个 Vulkan-Hpp 转写版) | 用最少抽象演示 API 本身 |
| Extension samples | 约 40 个 | 逐个演示扩展的用法 |
| Performance samples | 25 个 | 演示推荐做法 + 实时剖析信息 |
| Tooling samples | 1 个 | 只有 Profiles Library |
Tooling 类只有 1 个样本这件事,比它看起来更有信息量:它说明官方把"工具"这块交给 SDK 与生态,而不是做成样本库的一部分。同时也说明一件事——如果你想要"官方最佳实践"的密度,Performance 类才是那 25 个真东西。它们的页头写得很直白:show the recommended best practice together with real-time profiling information(把推荐做法与实时剖析信息一起展示)。
那 25 个样本的主题,本身就是一份"Vulkan 性能议题清单"。而它们真正的说服力来自一处:页面里带着数字。举一个:管线缓存那个样本里写着,在 Mali-G76 手机上启用管线缓存、销毁并重建管线耗时 24.4 ms,关掉缓存时是 50.4 ms——翻倍还不止,会直接掉帧。这是官方自己承认并量化过的代价。
2.4 本章判据
读到这里,判断一件事只看一条:当有人说"官方关于 X 的最佳实践怎么写的",你能不能立刻说出它在四套里的哪一套、什么形态。说得出来,这一章就过关了;说不出来,说明只记住了"有四套",没记住分工。
下一章我们钻到 Guide 里面去,看那 74 页里到底哪些页才算"最佳实践"——以及为什么有一页的名字里明明有 Best Practices,却跟大多数项目没关系。
三、Guide 的 74 页里,哪些页才算「最佳实践」
好了,上一章说 Guide 是最像手册的一套。但"像手册"是双刃剑——74 页里既有"最佳实践",也有"入门导航"和"扩展选型"。这一章把它们分开。
3.1 名字里写着 Best Practices 的那一页
OK,Guide 里最名正言顺的一处,是版本与移植指南里的一节,叫 Best Practices。它讲的事情很具体:当你在按版本向设备请求特性时,该怎么做才不会踩坑——比如不要盲目请求全部可选特性、要按实际用到的能力最小化请求、要把"需要 Vulkan 1.3 的某个特性"和"需要某个扩展"这两件事分清楚。
这一节的价值在于它点到了 Vulkan 的一个结构性事实:Vulkan 的能力是"按请求启用"的,不是"默认就有"的。你把特性结构里的某个布尔值设为 VK_TRUE,但设备并不支持,结果就是创建一个不完整的功能集合——错误往往不在这一行,而在后面某处莫名其妙的行为上。
3.2 平台专属页与通用页:性质完全不同
好了,Guide 里那些带"Best Practices"或"别这么写"味道的页,其实分成性质完全不同的两类。
第一类是平台专属的。 最典型的是 Tile Based Rendering (TBR) Best Practices 那一页。它讲的是一整套针对移动端分块渲染架构的优化:loadOp / storeOp 怎么设才能少读写内存、瞬态附件(transient attachment)怎么用、MSAA 怎么在片上完成解析(on-chip resolve)、动态渲染的本地读取(local read)能省掉什么、着色器里直接访存 tile image 的姿势、以及分箱(binning)这一趟的意义。这些建议在桌面独显上大部分不成立——因为桌面 GPU 不是分块架构,片上内存那笔账根本不存在。
第二类是通用的。 Common Pitfalls 与 Deprecated 就是这一类。前者讲的是"新手一定会踩的坑"(务必开验证层、按需重建命令缓冲、管线数量、交换链资源复用、描述符集的使用习惯),后者讲"这些东西已经弃用、该换成什么"——device layers 换成实例层、老的 render pass 写法换成 dynamic rendering、TOP_OF_PIPE / BOTTOM_OF_PIPE 换成 synchronization2 的写法。
所以本章的判据只有一句:翻到一页带"最佳实践"字样的文档时,先问它面向哪一类硬件。 分块渲染那页写得再好,对一台桌面独显的机器来说也只是"别人的最佳实践"。这条判据在后面几篇里会反复用到——我们每引用一条官方建议,都要说清它成立的前提。
3.3 还有几页值得单独排期
OK,除了那两类,Guide 里还有几页是"整页讲一件事、而且这一页值得单独排一期"。列出来,这也是本系列后续几篇的选题依据:
内存分配那一页把三件事讲透了:子分配(一次大分配、自己切成小块,受 maxMemoryAllocationCount 约束)、离散与统一内存的搬运(离散卡上要经暂存缓冲,统一内存上不用)、以及延迟分配内存(lazily allocated,也就是分块架构上的片上内存)。第五章里验证层报的那两条分配阈值告警,判据就出自这一页。
管线缓存那一页讲的是一件事:VkPipelineCache 可以被序列化到文件,下次运行直接读回来用。这意味着"首次启动卡顿"这件事是可以跨运行摊掉的——只要发行时把缓存一起带上。
线程那一页有一个容易被忽略的前提:Vulkan 不是"线程安全的状态机",它要求应用自己做外部同步;但它给了两条不靠锁的并行路子——按命令池、按描述符池分给不同线程。这两条是"多线程录制"的正统做法。
同步那一页旁边还挂着一页例子集(以 synchronization2 的 API 给出大量用例),把"计算↔计算、计算↔图形、图形↔图形、传输、信号量交互、交换链获取与呈现"这些排列组合逐条给了代码。这一页是后面第三篇的主要依据。
还有一页要提一句,因为它的定位很特别:描述符堆那一页开头就说明自己是帮助理解 API 映射,而不是推荐用法。这种"明确声明不推荐"的官方页面不多见,值得记住这个分寸。
四、Samples:25 个 Performance 样本的「四段结构」是怎么写的
好了,如果说 Guide 是"说明书",Samples 就是"对照实验记录"。而它最值得学的地方,不是那 25 个主题,而是它记录一件事的方式。
4.1 25 个样本,其实是一份性能议题清单
OK,把那 25 个 Performance 样本按主题聚一下,会看到官方认为"值得单独写一个样本"的议题都被覆盖了:
| 主题簇 | 样本 |
|---|---|
| 管线与资源 | pipeline_cache、graphics_pipeline_library 相关议题 |
| 渲染结构 | render_passes、subpasses、msaa、image_compression_control、afbc |
| 同步与屏障 | pipeline_barriers、layout_transitions、wait_idle |
| 描述符与常量 | descriptor_management、constant_data、specialization_constants |
| CPU 侧提交 | command_buffer_usage、multithreading_render_passes、multi_draw_indirect、async_compute |
| 带宽与数据格式 | 16bit_arithmetic、16bit_storage_input_output、texture_compression_basisu、texture_compression_comparison |
| 交换链与呈现 | swapchain_images、surface_rotation |
这张表本身就是一条结论:官方认定的 Vulkan 性能议题,一半以上在"资源与结构"上,而不是在"指令"上。管线什么时候建、附件怎么设、屏障怎么排、描述符怎么管——这些是"结构性"决定;真正落到"这台机器快多少"的,往往是在这些地方省下来的。
4.2 四段结构:Do / Don't / Impact / Debugging
好了,每一个 Performance 样本页,都按同一个四段结构写:
Do —— 该怎么做。Don't —— 别怎么做。Impact —— 影响有多大。Debugging —— 出问题怎么查。
这四段里,最有价值的是后两段。原因很直白:Do 和 Don't 说起来容易,网上到处都是"别在 draw time 建管线"这种话;真正稀缺的是 Impact(这条建议值多少)和 Debugging(我怎么知道我的项目踩了)。
这也解释了为什么本系列要花这么大力气自建实验台——如果我们只抄 Do/Don't,写出来的东西和网上已有的没区别;能自己补上 Impact 和 Debugging 的,才是这一篇的增量。
4.3 官方自己给的数字
说白了,官方也不是只讲道理。举一个被反复引用的例子:pipeline_cache 那个样本里,在一台 Mali-G76 手机上做了一次实验——启用管线缓存后,销毁并重建管线的耗时是 24.4 ms;关掉缓存,同样的重建动作要 50.4 ms。差了不止一倍,而 50 ms 已经足够让一帧掉出去。
注意这个数字的边界:它是 Mali-G76、移动端的读数。它证明的是"管线重建很贵"这件事在移动端有多贵,不能直接搬到桌面独显上——我们在后面写管线缓存那一篇时,会用本机实测给出桌面端的对应量级,而不是引用这个数字充数。这也是本系列的一条规矩:引用官方数字时,连它的硬件前提一起引。
4.4 一个必须交代的取舍:为什么不直接跑官方样本
OK,读到这里大家可能会问:既然 Samples 是官方写的、还能跑,为什么本系列不直接拿它当实验台?这一节把取舍说清楚,因为它影响后面每一篇的证据形态。
第一个原因是许可的层次不一样。 Vulkan-Samples 的代码是 Apache-2.0,可以随便用;但资产(assets)各自有许可——里面既有 CC BY 3.0、CC0、BSD 这类宽松的,也有 CC-BY-NC-4.0 这种明确标注"非商用"的。截图里渲染的是什么资产、这张图能不能用,取决于资产而不是代码。本系列既然要自己出图,就不如把变量消掉。
第二个原因是获取成本。 GitHub 上这个仓库没有提供 Windows 预编译包(发行页是空的),要跑就得自己构建:CMake、Python、Visual Studio 之外,还得用 git-lfs 把子模块(含资产仓库)一起拉下来——整个仓库体量很大。对一篇要可复现的文章来说,"先构建一个很大的东西"本身就是一道门槛。
所以本系列的选择是:自写最小用例,官方样本只作"文本来源与对照"。 具体说,官方样本页里的 Do / Don't / Impact / Debugging 四段我们可以逐条引用(引的是文本,不是截图),而"这台机器上值多少"由自写用例量出来。
这个取舍的代价要如实说:自写用例的覆盖面不如官方那 25 个样本——它们经过多年打磨,边界情况覆盖得比我们临时写的小用例全。补偿办法是在每一篇的对应位置引用官方样本页的结论作为对照,凡是我们自己量不到的地方,就说清"这一条只引官方口径,本篇不做本机实测"。这就是把"证据边界"写在明处的意思。
五、Validation:那个开关,默认是关的
好了,这一章是本篇最"反直觉"的一章。我们先把结论放前面:官方给你准备了一整套最佳实践检查,但它默认不打开。
5.1 官方设置表里写着的那一行
先来看看 VK_LAYER_KHRONOS_validation 的官方文档——那里有一张设置总表。表里有一项叫 Best Practices,类型是布尔值,默认值写的是 false。而且不只是主项——各厂商的子项(Arm、AMD、Imagination、NVIDIA)同样是默认 false。
这项检查自己怎么描述自己?官方的说法是:它会指出"性能隐患、可疑用法、常见错误,以及规范没有明确禁止但会出问题的写法"。它检查的东西,正好就是"最佳实践"这个词覆盖的范围。
为什么这件事重要:验证层在大家印象里是"开了就会报错"的东西,所以很多人以为开了层就等于开了全部检查。事实是——核心校验默认开,最佳实践校验默认关。你不主动打开,官方准备的那套 Do/Don't 检查一条都不会出现。
5.2 我把它打开之后,看到了什么
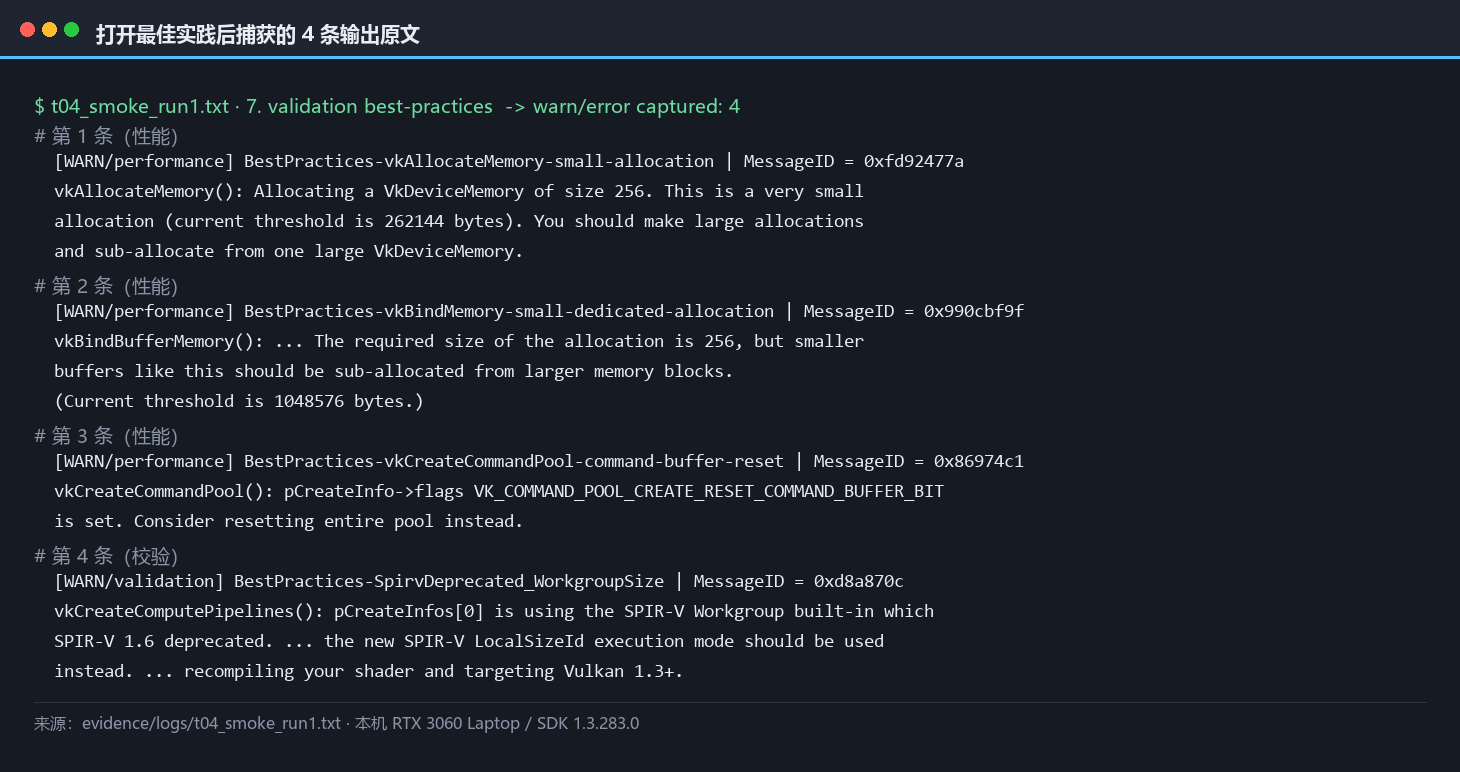
好了,口说无凭,我们直接在本机跑一次。做法是用一个最小 Vulkan 计算用例(自写的 vk_smoke.c,配一段自写的计算着色器),在创建实例时显式请求最佳实践特性,再用调试信使(debug messenger)把告警打到标准输出。跑一次,拿到 4 条:
| 类型 | MessageID | 内容 |
|---|---|---|
| 性能 | 0xfd92477a |
BestPractices-vkAllocateMemory-small-allocation:分配了 256 字节,低于阈值 262144,应当大块分配后自行子分配 |
| 性能 | 0x990cbf9f |
BestPractices-vkBindMemory-small-dedicated-allocation:256 字节的缓冲独占了一整块内存,阈值 1048576,小缓冲应当从大块里子分配 |
| 性能 | 0x86974c1 |
BestPractices-vkCreateCommandPool-command-buffer-reset:命令池设了「逐命令缓冲重置」,建议改为整池重置 |
| 校验 | 0xd8a870c |
BestPractices-SpirvDeprecated_WorkgroupSize:SPIR-V 1.6 弃用了 WorkgroupSize 内建,Vulkan 1.3+ 应改用 LocalSizeId,重新编译着色器并把目标定为 Vulkan 1.3+ 即可 |
这四条里有两条含具体阈值(262144 字节与 1048576 字节),一条给的是改法(整池重置),还有一条最有意思——它说的不是代码写错,是编译着色器时的目标版本老了。那一条的因果链值得单独记:SPIR-V 1.6 弃用 WorkgroupSize 内建 → 验证层在创建计算管线时提示 → 修法是重新编译着色器并把目标定为 1.3+。从"官方做了一个弃用决定"到"我该改哪一行命令",验证层把它串起来了。
而这三条性能告警(两条分配阈值 + 一条命令池)恰好对应官方 Performance 样本里的 descriptor_management 主题——官方样本里有 Do/Don't,本机跑一次就有告警,改完再跑就能对比。这条闭环,就是本系列每一篇都要走的路。
5.3 三种配置方式,以及它们的优先级
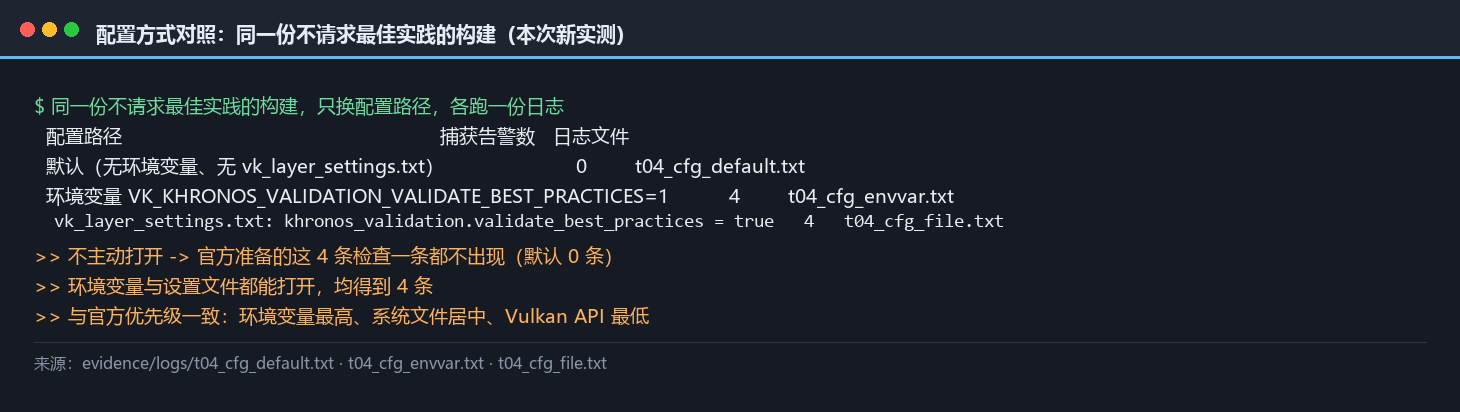
OK,知道了要打开,下一个问题是在哪打开。官方给了三种方式,并且明确了优先级:
| 方式 | 载体 | 优先级 |
|---|---|---|
| 环境变量 | VK_KHRONOS_VALIDATION_* 等 |
最高 |
| 系统文件 | vk_layer_settings.txt、vk_loader_settings.json |
中 |
| Vulkan API | VkLayerSettingsCreateInfoEXT 链进实例创建的 pNext |
最低 |
优先级这件事的实际意义是:如果环境变量和代码里的设置打架,环境变量赢。 这在排查现场很好用(不用改代码就能换配置),但在构建环境里容易埋雷(本地测试用的环境变量带进了 CI,行为就和代码里写的不一样)。
另外还有两个环境变量值得记住:VK_LOADER_DEBUG 用来打开加载器自己的日志(取值 error / warn / info / debug / layer / driver / all),排查"我的层到底加载了没"时它是第一手材料;VK_LAYER_PATH 与 VK_ADD_LAYER_PATH 用来追加层搜索路径,跑自编译的层时必用。
光看表格不算证据,我们补了一个对照实验:拿同一份没有在代码里请求最佳实践特性的构建(编译时用宏跳过了那段请求代码),只换配置路径各跑一次。结果是默认路径捕获 0 条告警,环境变量与 vk_layer_settings.txt 两条路径各捕获 4 条——和上面那张表的优先级完全对上。"默认是关的"这句话,到这里才落地成可核的读数。
5.4 一个正在发生的接口换代
说白了,顺手记一件正在发生的事,它后面几篇会用到。老的配置接口 VK_EXT_validation_features(以及更早的 VK_EXT_validation_flags)已经被标注为弃用——官方在 VK_EXT_layer_settings 的文档里用的词是 "subsumes"(吞并),原文的意思是:这个扩展涵盖了旧接口提供的全部功能。
配置层的姿势已经换成"通用层设置"了:不再有"验证层专属的设置结构",而是任何层都可以通过同一套 VkLayerSettingEXT 声明自己的设置项。这也解释了为什么官方推荐用图形化的配置工具来管这些开关——开关的数量和层级已经不适合靠手写环境变量维护了。
5.5 本章判据
两句话记住这一章:第一,"开了验证层"不等于"开了最佳实践检查",后者默认关着;第二,打开它的最好方式取决于场合——排查现场用环境变量,工程里用配置工具或代码显式请求。
到这里,"官方怎么说"这一半基本讲完了。接下来换到另一半:这台机器上,到底是什么样。下一章开始,我们把设施一件件量过去。
六、本机能力实勘(一):设备、扩展与时间戳
好了,"官方怎么说"这一半在第五章收了尾,从这一章开始换成"这台机器上是什么"。三章连读:设备与扩展、查询姿势、工具链清点。
6.1 设备与版本:读数的第一行
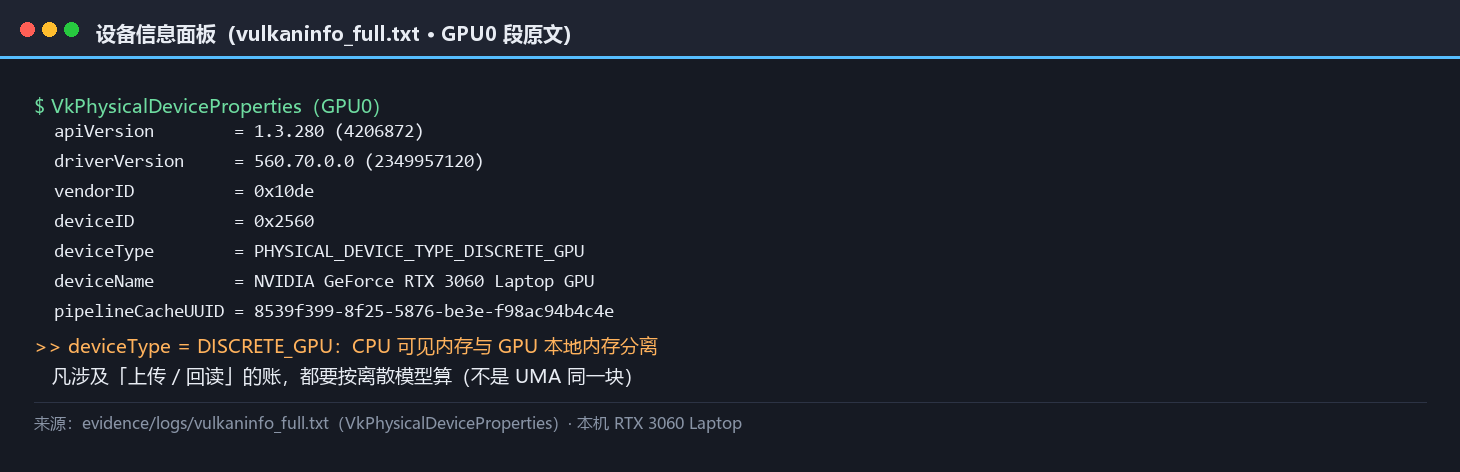
OK,任何一次 Vulkan 实测,第一行永远是设备信息。本机读到的核心字段如下:
| 字段 | 读数 | 说明 |
|---|---|---|
deviceName |
NVIDIA GeForce RTX 3060 Laptop GPU | 笔记本独显 |
deviceType |
PHYSICAL_DEVICE_TYPE_DISCRETE_GPU |
离散 GPU,不是集成显卡 |
apiVersion |
1.3.280 | 驱动支持的 Vulkan 版本 |
driverVersion |
560.70 | 驱动自报版本 |
这里有一个容易看漏的点:deviceType 这一项决定了后面一批建议是否适用。官方指南里"内存分配"那一章有一套离散/统一内存(Discrete / UMA)的区分——离散 GPU 上,CPU 可见的内存与 GPU 本地内存是两块,跨过去要付搬运的代价;集成 GPU 上是同一块。本机是离散,所以后面凡涉及"上传/回读"的账,都要按离散的模型算。
6.2 223 项扩展:多不等于好
先来看看扩展这一面。本机 vkEnumerateDeviceExtensionProperties 报出 223 项设备扩展。这个数字本身没什么意义,有意思的是官方那套"按需请求扩展"的最佳实践,在这里怎么落地。
我们挑六个与本系列直接相关的关键项做了逐项核对,六项全部在位:
| 扩展 | 本文/后续篇用途 |
|---|---|
VK_EXT_calibrated_timestamps |
把 GPU tick 校准到 CPU 时钟(本篇只确认在位,不做校准实测) |
VK_KHR_synchronization2 |
同步的新写法(第三篇) |
VK_KHR_dynamic_rendering |
2026 新范式的基础(第二篇) |
VK_EXT_shader_object |
管线管理的新方案(第二篇) |
VK_KHR_pipeline_executable_properties |
看管线内部(后续剖析用) |
VK_EXT_pipeline_creation_feedback |
管线创建反馈(第四篇) |
223 项里我们只用得上几项——这正是官方建议的核心:不要一次全开。 每多启用一个扩展,就多一份"这个能力在某些设备上不存在"的处理义务;而启用扩展本身还有创建期的开销。所以正确的做法是按用到的能力逐个启用、并把"不支持时怎么办"一起想好。
6.3 时间戳能力:本系列的量尺
好了,这一节是本系列后续所有读数的地基。Vulkan 的时间戳查询有三个前置条件必须逐项核,本机的读数如下:
timestampPeriod = 1.0000 ns/tick。 含义是"时间戳每加一个 tick,对应多少纳秒"。本机是 1.0——一个 tick 就是一纳秒,读出来的原始值可以直接当纳秒用,不引入换算误差。这个值不是所有设备都等于 1(很多移动 GPU 是几十),所以每次换机器都要重读。
timestampValidBits = 64。 时间戳值里有效的位数。64 位意味着在我们关心的量级内不可能溢出——如果这个值偏小(比如 36 位),就得先做掩码处理再相减。
timestampComputeAndGraphics = true。 所有图形或计算队列都支持时间戳。本机计算队列族是 0,timestampValidBits 为 64,可用。
三个条件齐了,量尺就可用。而"怎么用"这件事官方有专门的样本页讲——samples/api/timestamp_queries,它把流程写得比规范好读:建一个 VK_QUERY_TYPE_TIMESTAMP 的查询池、录制时先重置、在要测的两端各写一个时间戳、提交后用 VK_QUERY_RESULT_64_BIT | VK_QUERY_RESULT_WAIT_BIT 读回来,最后乘 timestampPeriod 换算。它还特意提醒一句不同队列的时间戳不可比——这句话我们后面会亲眼验证它为什么重要。
6.4 和官方截图对照一下
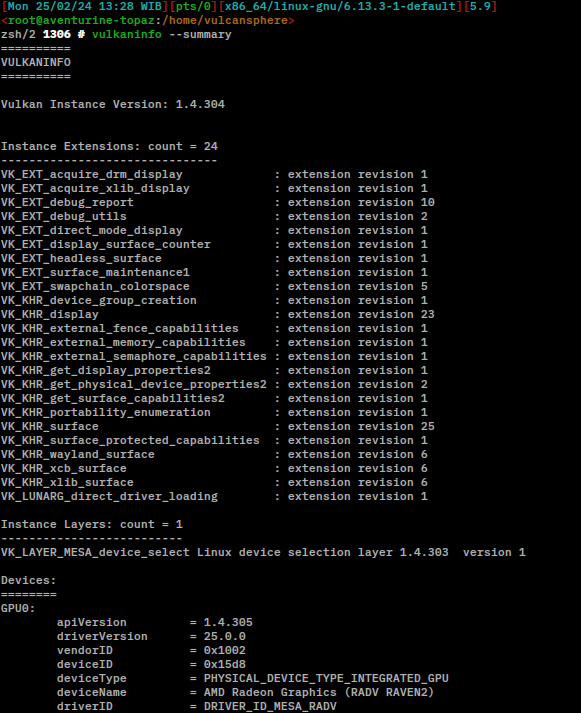
OK,官方自己在 Commons 上放了一张 vulkaninfo 的截图(公有领域,由 Khronos Group 上传)。把它和本机输出并排看,会发现两件事:一是格式是一致的(同样的分节、同样的字段排布,因为工具就出自同一处);二是内容差得很远——官方那张截的是它自己的机器,字段值与本机完全不同。
这正是本系列要强调的:工具一致,读数不一致,所以"能跑一遍"永远比"看过截图"重要。
七、本机能力实勘(二):查询的姿势
说白了,设备能力查出来就完了?不。"怎么查"本身有一条官方演进史,踩错姿势会在扩展链上留下隐患。
7.1 为什么官方推荐 ...2 与 pNext 链
先来看看 Vulkan 1.0 时代:查特性用 vkGetPhysicalDeviceFeatures、查属性用 vkGetPhysicalDeviceProperties。问题出在这两个函数填的结构体——它们没有 sType 和 pNext。
这两个字段看着不起眼,却是 Vulkan 可扩展性的地基:有了它们,结构体就能串成一条链,后续扩展往链上加自己的节点,实现方依次填值。而 Vulkan 1.0 的那两个结构体没有这两个字段,于是任何后续扩展想加特性,都只能再开一个新函数。
官方的解法是 VK_KHR_get_physical_device_properties2(后来被提升进 Vulkan 1.1 核心):它把原有的特性、限制、格式属性结构包进带 sType / pNext 的新结构,让应用自己构造一条链、由实现填入。于是 vkGetPhysicalDeviceFeatures2 与 vkGetPhysicalDeviceProperties2 成了推荐入口,而老的 vkGetPhysicalDeviceFeatures 在官方文档里被明确标为 superseded(已被取代)、属 Legacy。
对写代码的人来说,这条演进史的实际含义是:如果你还在用旧函数查特性,那么任何一个"用扩展声明的可选能力"都查不到——不是设备没有,是你没问对。本系列后面所有涉及"设备支持什么"的地方,一律走 ...2 与 pNext 链。
7.2 按版本聚合的特性结构
OK,走 pNext 链之后,下一个问题是"链上挂什么"。Vulkan 的答案是按版本聚合:VkPhysicalDeviceVulkan11Features、Vulkan12Features、Vulkan13Features、Vulkan14Features——每个结构体承载"某个核心版本引入的那批特性"。
这个设计解决了一个真实的痛点:在按版本聚合的结构出现之前,查一个 1.1 引入的特性,得挂上它原来所属的那个扩展结构(比如 VkPhysicalDeviceShaderDrawParametersFeatures)。同一代特性散在几十个结构里,代码难看,也容易漏。 聚合之后,只要链上挂四个结构,就覆盖了核心版本的完整特性面。
要提醒的是:聚合结构与扩展结构不是二选一,而是对同一批能力的两种表达。 挂哪个由你的目标版本决定——如果你的应用已经要求 Vulkan 1.3,就用聚合结构;如果还要兼容 1.1,就得留扩展结构的路径。
7.3 本机按特性链查一遍
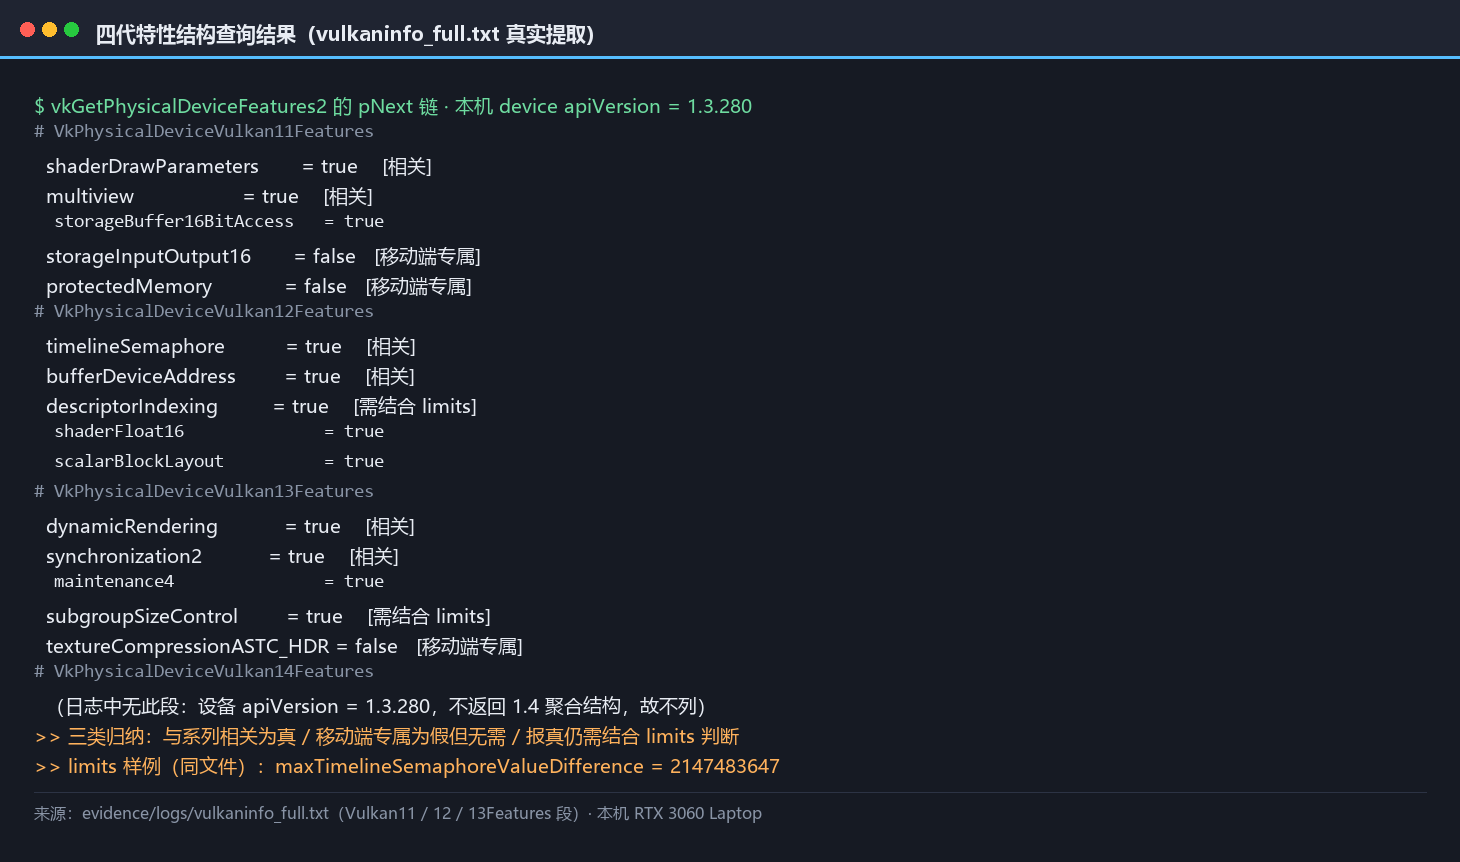
好了,姿势讲完了,本机跑一遍。把各代特性结构依次挂上 pNext 链,调一次 vkGetPhysicalDeviceFeatures2。这里先遇到一个只能靠实测发现的事实:本机设备的 API 版本是 1.3.280,所以实际返回的是 1.1 / 1.2 / 1.3 三代的聚合结构,1.4 的那一个根本不会被返回(vulkaninfo 的全量输出里也没有那一段)。结构有没有值,取决于设备的 API 版本——这一条本身就是判据:如果你的代码只挂 1.4 的聚合结构,在一台 1.3 设备上你什么也问不到。
本机返回的结果可以归纳成三类:
第一类,与本系列直接相关的,全部为真。 比如 shaderDrawParameters(1.1)、timelineSemaphore 与 bufferDeviceAddress(1.2)、dynamicRendering 与 synchronization2(1.3)——这几项在后续几篇里都会被实际用上。
第二类,本机为假、但我们也不需要它。 典型的是各代里那些面向移动端或特殊场景的特性(分块渲染相关、部分子组特性)。为假不等于"设备差",只说明这次查询里它不支持,而我们的方案本来就没打算用。
第三类,需要额外确认的。 有少数特性即使结构里报了真,实际使用时仍要结合限制值(limits)判断——比如某个能力"支持"但"上限只有 1",那就等于不可用。举一个本机归档里查得到的例子:maxTimelineSemaphoreValueDifference 报的是 2147483647(evidence/logs/vulkaninfo_full.txt),也就是 32 位有符号整数的上限,含义接近"没有实际约束";但换一台设备这个值可能小得多,而时间线信号量的差值一旦越界,行为就是未定义的。这也是官方那节 Best Practices 反复强调的:请求特性之前先把限制值核一遍。
八、本机能力实勘(三):工具链清点
好了,证据要能复跑,靠的是工具。这一章把本机在位的工具逐个点清,并给出各自能产出的证据形态。
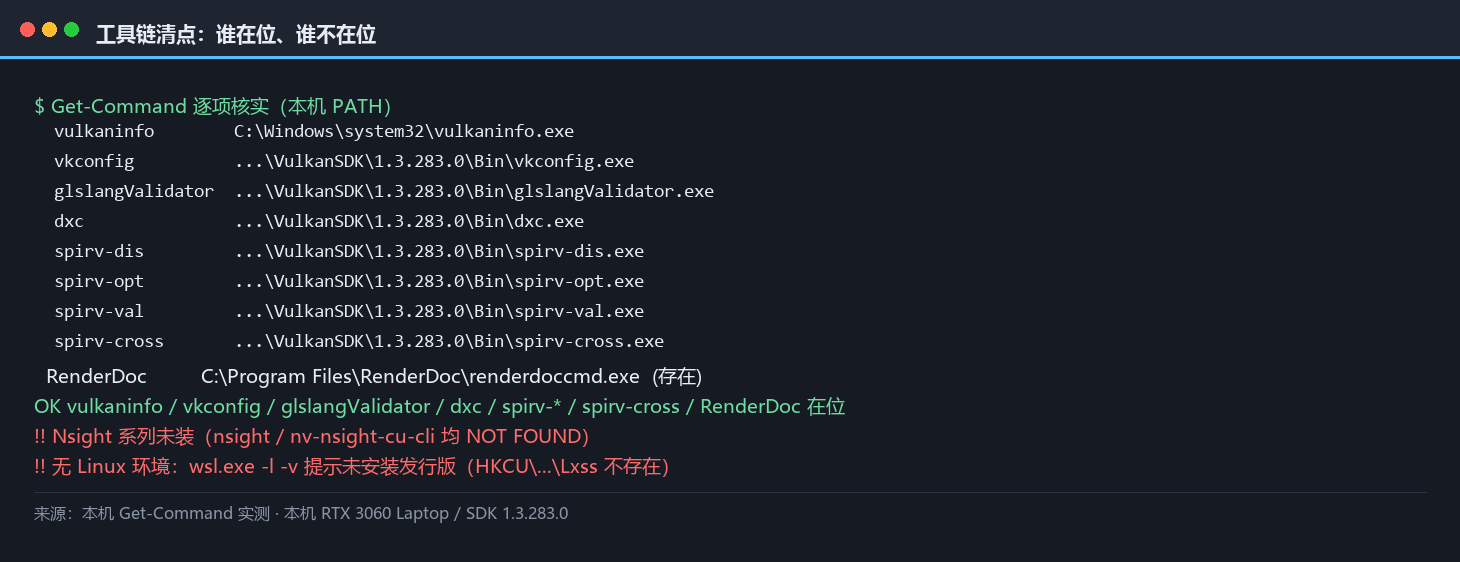
8.1 谁在位、谁不在位
| 工具 | 状态 | 能产出什么证据 |
|---|---|---|
vulkaninfo |
在位(SDK 自带) | 设备/扩展/格式/队列族的完整快照,可出文本、HTML、JSON |
vkconfig |
在位(SDK 自带) | 层与驱动的配置管理,可生成配置脚本 |
glslangValidator |
在位(SDK 自带) | GLSL → SPIR-V,附反汇编文本 |
dxc |
在位(SDK 与 Windows SDK 各一份) | HLSL → DXIL,附 -Fc 文本反汇编 |
spirv-dis / spirv-opt / spirv-val |
在位(SDK 自带) | SPIR-V 反汇编、优化、校验 |
spirv-cross |
在位(SDK 自带) | SPIR-V → GLSL/MSL/HLSL/JSON 反射 |
| RenderDoc | 在位(MIT) | 抓帧、管线状态导出、着色器反汇编 |
| Nsight 系列 | 未装 | 需另行安装;GPU Trace 还需授权性能计数器 |
两个空白要说清:一是没有 Nsight,所以本系列不引用 Nsight 的读数;二是没有 Linux 环境(本机无 WSL),这决定了那些需要 DRM/KMS 的观测在本系列里根本不做——不是难,是没有采集面。
8.2 vulkaninfo 的选项面
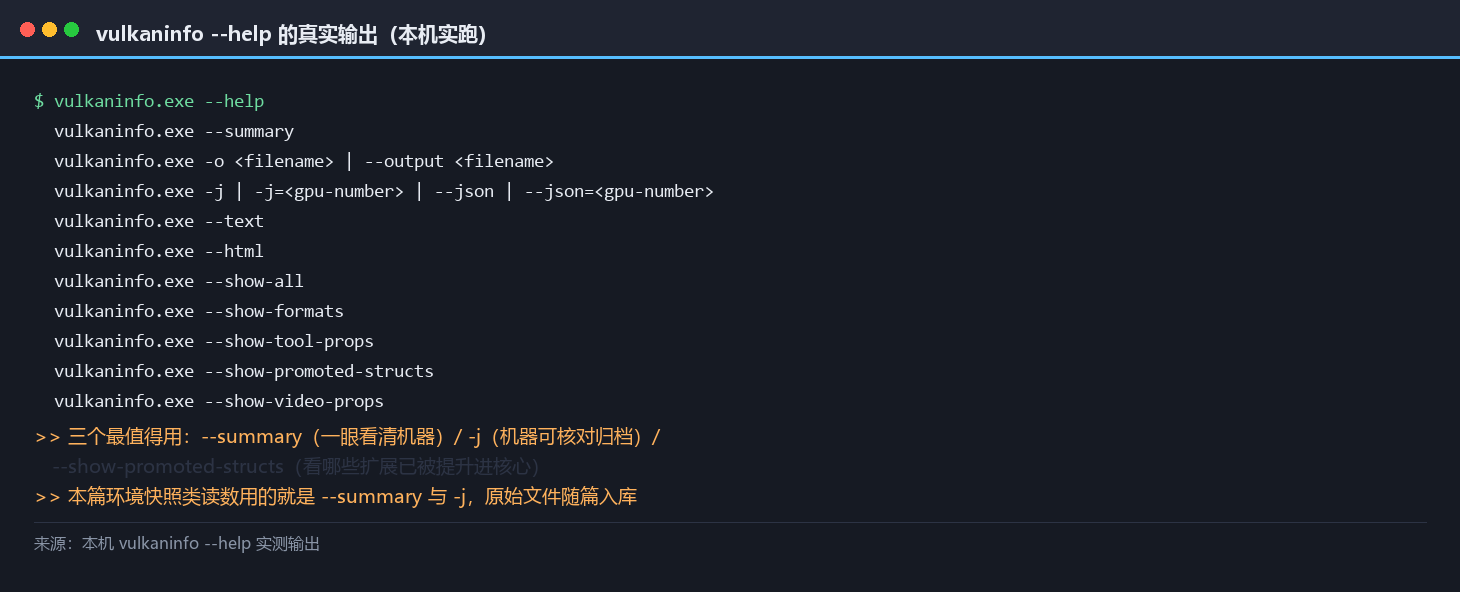
OK,vulkaninfo 不只是"跑一下看输出"。本机实跑 --help,官方列出的选项面全部可用,而且每一项都对应一种证据形态:
vulkaninfo.exe --summary                      # 一行式摘要
vulkaninfo.exe -o <filename>                  # 输出到文件
vulkaninfo.exe -j | -j=<gpu-number>           # JSON(可指定 GPU 序号)
vulkaninfo.exe --text                         # 文本(默认)
vulkaninfo.exe --html                         # HTML
vulkaninfo.exe --show-all                     # 全部字段
vulkaninfo.exe --show-formats                 # 格式能力明细
vulkaninfo.exe --show-tool-props              # 工具属性
vulkaninfo.exe --show-promoted-structs        # 被提升进核心的结构
vulkaninfo.exe --show-video-props             # 视频相关属性
其中最值得用的三个:--summary(一眼看清机器,适合贴在文章开头的环境节)、-j(JSON 输出,适合做机器可核对的归档)、--show-promoted-structs(看"哪些扩展已经被提升进核心"——这一项直接服务第 7.1 节讲的那条演进史)。
本篇后面的所有"环境快照类"读数,用的就是 --summary 与 -j;原始文件随篇入库。
8.3 SDK 里的层,不止一个验证层
说白了,"层"这个词在 Vulkan 里是个通用机制,验证层只是最有名的一个。本机的 SDK 里同时装着几个用途完全不同的层,值得分开认清:
验证层(VK_LAYER_KHRONOS_validation)——管正确性与最佳实践告警,就是第五章那个默认关着的检查所在的地方。着色器对象层(VK_LAYER_KHRONOS_shader_object)——当驱动本身不支持 VK_EXT_shader_object 时,这一层用软件方式把该扩展模拟出来。能力模拟层(VK_LAYER_KHRONOS_profiles)——第十章要讲的 Profiles 工具,随 SDK 发布。
这三层的分工,正好对应三种不同的"缺能力"处境:代码写错了(验证层)、驱动少了某个扩展但我想先写代码(着色器对象层)、我想测低端设备上的行为但手上没有低端设备(能力模拟层)。
顺带说一句为什么官方推荐用图形化配置工具来管这些:光是一个验证层,设置项就有几十个,还要分主项与各厂商子项;再叠上 Profiles 的 profile 选择、层的启用顺序,手写环境变量维护起来很容易出错。vkconfig 这类工具的定位就是把"选哪些层、按什么顺序、每层什么设置"变成一份可保存、可切换的配置。
8.4 抓帧通道:能注入,但没帧可抓
言归正传,这里是本篇唯一一个"实测之后改了结论"的地方。
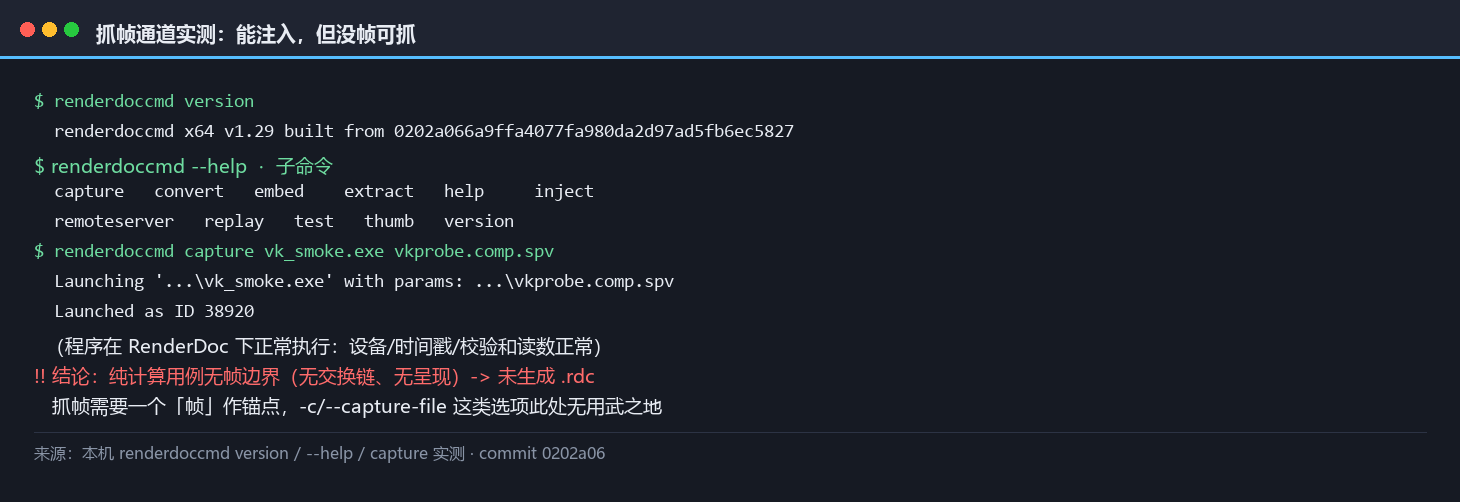
素材清单里我们给抓帧通道标的是 partial——因为 RenderDoc 的官方文档没有专门页讲 renderdoccmd 的子命令,只能靠本机实测确认。这次实测的结果如下:
先说结论:通道本身是通的。 renderdoccmd 在位(x64 v1.29),子命令有 capture、convert、extract、inject、replay、thumb、version 等。用 renderdoccmd capture <exe> <args> 启动我们的最小用例,注入成功、程序在 RenderDoc 下正常执行,验证层输出与时间戳读数都正常(那一次跑出 27,104 ns)。
但抓帧产物没有生成——原因不是工具坏了,而是我们的用例没有帧。 本机这个最小用例是纯计算的控制台程序:只有一次计算派发,没有交换链、没有呈现、没有帧边界。RenderDoc 的抓帧需要一个"帧"作为锚点,所以 -c/--capture-file(抓帧文件名模板)这类选项在这里没有用武之地。
这条边界要写清楚:本系列第一篇用不上抓帧,因为"材料地图"这一篇的证据是文档口径与本机能力查询;从第二篇(2026 新范式)开始,只要出现交换链与呈现,抓帧通道就会真正投入使用——届时我们给出的会是 .rdc 与从它导出的管线状态,而不是"我用过 RenderDoc"这句话。
九、本机实勘(四):把验证层打开,跑出真读数
好了,前面几章都是"看"——看设备、看扩展、看工具。这一章换成"量":把本机的能力真跑一遍,看看能拿到什么形态的证据。
9.1 四条告警,逐条拆开看
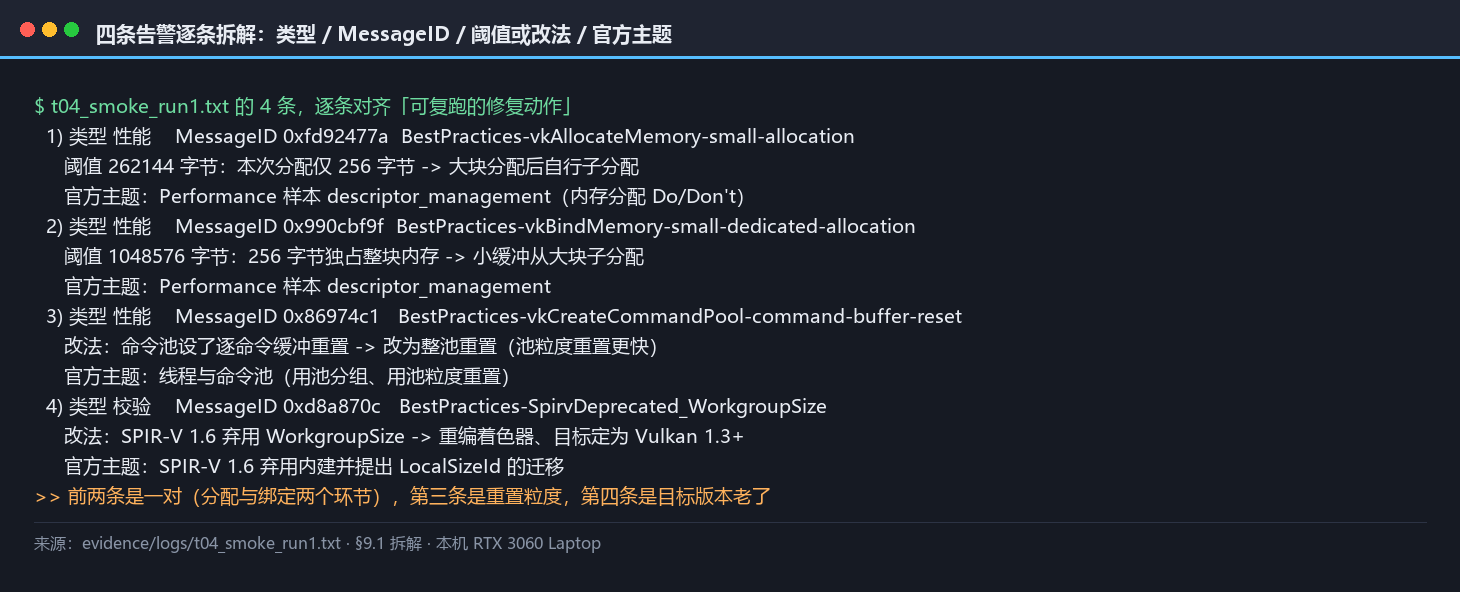
OK,第五章已经列过那四条输出,这里把它们拆得更细一点,因为每一条都对应一个可以独立复跑的修复动作。
第一条与第二条是一对,讲的是同一件事的两个环节。 我们给一个 64 个浮点数的存储缓冲分配内存,走的是最直白的 vkAllocateMemory + vkBindBufferMemory。验证层立刻指出:这次分配只有 256 字节,低于"小分配"的阈值 262144 字节;紧接着第二条指出,这 256 字节独占了一整块内存,而阈值是 1048576 字节。
两条合起来说的是一件在 Vulkan 里很关键的事:内存分配是"昂贵且有限"的资源。驱动能给的分配次数有上限(maxMemoryAllocationCount),每次分配本身也有成本;所以官方建议"大块分配、自行子分配"——一次拿到一块大的,然后像自己的分配器那样切给各个缓冲。这两条阈值就是官方把这条建议量化的产物。
第三条讲的是命令池的重置粒度。 我们在创建命令池时设了"逐命令缓冲重置"的标志,验证层建议改成整池重置。这一条对应的是官方在"线程与命令池"那章讲的结构:用池来分组、用池粒度来重置,比逐个缓冲重置更省——因为重置一整池比逐个重置更快,而池的设计本身就是为了让"每帧重置"这件事变成一次调用。
第四条最有意思,它指的不是我们写错了代码,而是我们编译着色器时的目标版本老了。 提示原文的意思是:这个计算管线用的 SPIR-V 里带了 WorkgroupSize 内建,而 SPIR-V 1.6 已经弃用它;如果用 VK_KHR_maintenance4 或 Vulkan 1.3+,应该改用 LocalSizeId 执行模式,重新编译着色器并把目标定为 Vulkan 1.3+ 即可。
9.2 从一条弃用决定,到一行编译命令
言归正传,上面第四条值得单独展开,因为它是整篇里"官方决定 → 验证层提示 → 我该改哪一行"这条链走得最完整的一次。
链条是这样的:第一步,Khronos 在 SPIR-V 1.6 里把 WorkgroupSize 内建标记为弃用,原因是有了新的 LocalSizeId——后者把工作组尺寸从"装饰"变成"执行模式",与 Vulkan 1.3 的核心化配套。第二步,验证层把这条弃用决定实现成一个检查项;只要管线用到的 SPIR-V 还带老写法,创建管线时就会提示。第三步,修法不在 SPIR-V 字节码,而在着色器源头——重新编译,并把编译目标定到 Vulkan 1.3+。
这条链的价值在于:它把"版本迁移"从一件凭记忆的事,变成了工具会主动告诉你的事。 大家如果做过从 Vulkan 1.0 迁到 1.3 的项目,会知道最容易漏的往往是这类"某个写法被悄悄换掉了"的细节,而不是大功能。
9.3 GPU 时间戳:同一段代码,跑了五遍
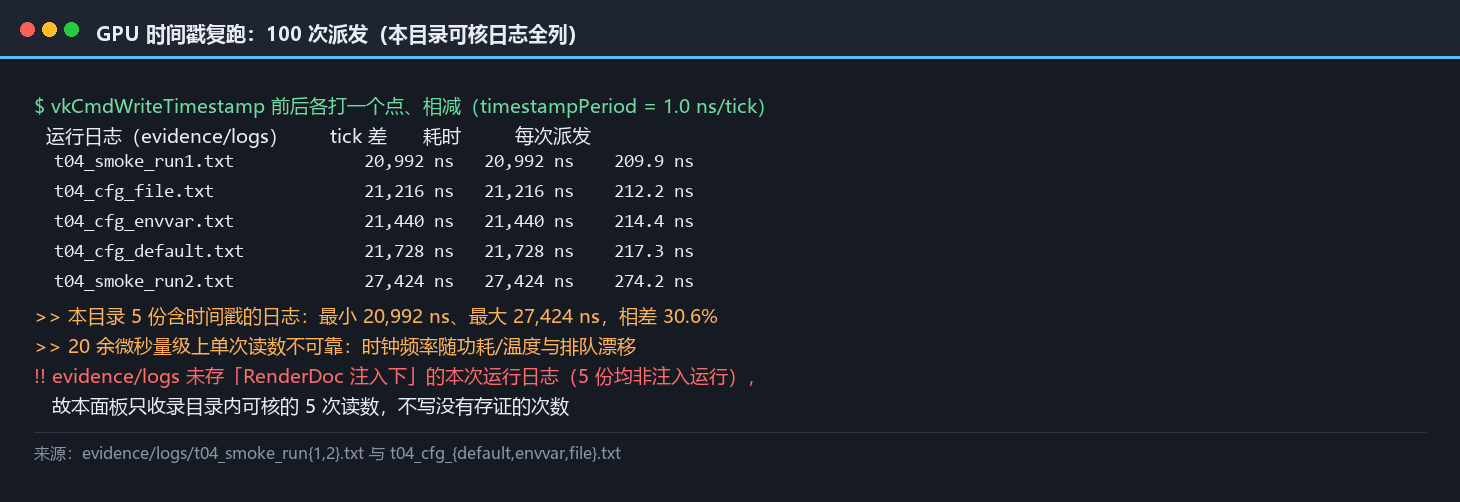
好了,终于到了本篇最"硬"的读数。做法很简单:在 100 次 vkCmdDispatch 的前后各写一个时间戳,读回来相减,乘上 timestampPeriod(本机 1.0,所以 tick 差就是纳秒)。我们跑了五次,五次的完整输出都归档在 evidence/logs/:
| 次序 | 归档文件 | tick 差 | 换算耗时 | 每次派发 |
|---|---|---|---|---|
| 第 1 次 | t04_smoke_run1.txt |
20,992 | 20,992 ns | 209.9 ns |
| 第 2 次 | t04_cfg_file.txt |
21,216 | 21,216 ns | 212.2 ns |
| 第 3 次 | t04_cfg_envvar.txt |
21,440 | 21,440 ns | 214.4 ns |
| 第 4 次 | t04_cfg_default.txt |
21,728 | 21,728 ns | 217.3 ns |
| 第 5 次 | t04_smoke_run2.txt |
27,424 | 27,424 ns | 274.2 ns |
五次读数的最小值 20,992 ns,最大值 27,424 ns,相差 30.6%。 这个波动本身就是一条结论:在几十微秒这个量级上,单次读数不可靠。原因不难理解——GPU 的时钟频率不是恒定的(功耗与温度会调它),派发前后还有其他活动在排队,而 100 次派发的总时长本来就只有二十几微秒。
这里还有一条纪律要交代:本系列只引用归档日志里能逐行回溯的读数。做实验的过程中另有一次是在 RenderDoc 注入下跑通的(当时输出显示 27,104 ns),但那一次的 stdout 没有落成文件,因此不进上表——"我跑过、我看到"不构成证据,能贴在仓库里的文件才算。
所以本系列在后续篇目里会守两条纪律:一是同一配置至少跑三遍,报最小值与中位数,不报单次;二是只做同机同构建的横向比较,不做跨机的绝对值比较——因为 timestampPeriod 与频率特性都不同。
还有一条来自官方样本页的提醒,这里正好用上:不同队列的时间戳不可比。原因在规范里写得很直白——时间戳只保证"同一次提交内、happens-after 的两个时间戳不递减";跨提交、跨队列的时间戳要不递减,得启用校准时间戳扩展。所以"拿两个队列的时间戳相减"这种做法,得到的不是耗时,是一个没有意义的差。
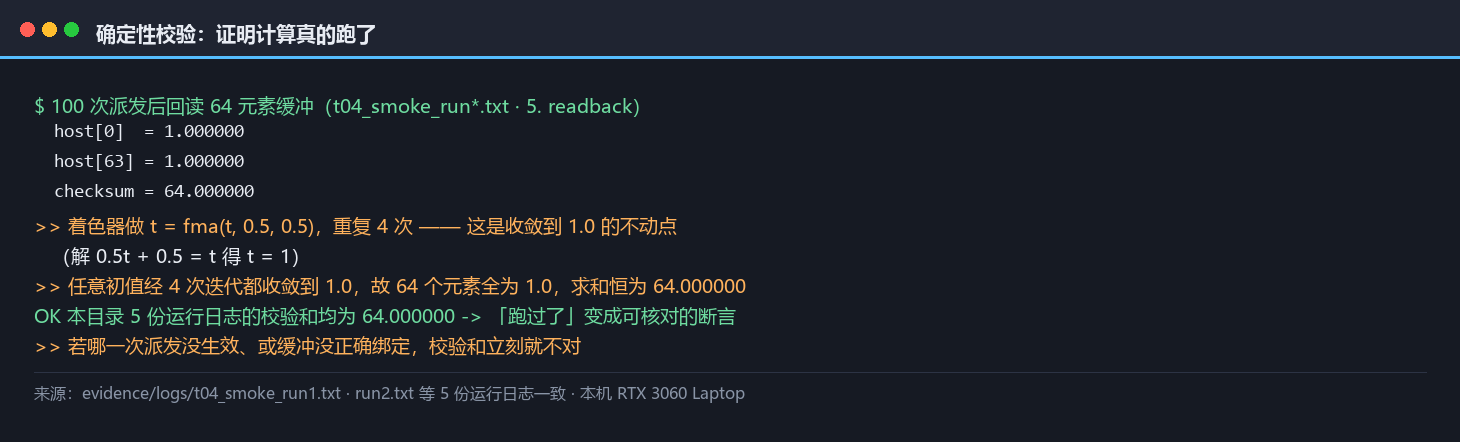
9.4 校验和:证明计算真的跑了
OK,时间戳只说明"这段时间里 GPU 动了"。要证明我们的计算真的按预期执行了,还得看结果。于是我们给那个计算着色器设计了一个可以精确验证的性质:
着色器做的是 t = fma(t, 0.5, 0.5),重复四次。这是一个收敛到 1.0 的不动点——不管初始值是多少,t 都会向 1.0 收敛(0.5t + 0.5 的不动点解就是 t = 1)。所以 100 次派发之后,64 个元素的值全部收敛到 1.0,读回来求和必然是 64.000000。
实测结果:五次运行、每一次的校验和都是 64.000000,host[0] 与 host[63] 也都是 1.000000。
这个设计的意义在于它把"跑过了"变成了可核对的断言。 如果哪一次派发没生效、或者缓冲没正确绑定,校验和立刻就不对。本系列后面每一篇的自建实验台都会保留这个习惯——给每个用例配一个可以精确验证的输出,而不是靠"看起来对"。
十、能力对照实验:Profiles 能做和不能做的
好了,还剩一块地图没讲:当你想测"我的程序在低端设备上会不会出问题",但手上只有一台高配机器,怎么办?官方的答案是 Vulkan Profiles。
10.1 它是"模拟",不是"仿真"
先来看看那个必须说准的区别。Profiles 层的能力是把更-capable 设备的查询结果向下钳制——比如把最大纹理尺寸报到一个小值、把某些扩展报成不支持。官方在文档里用的词是 simulate(模拟)而非 emulate(仿真)。
这个区别的实际后果是:它不能给一台低端设备凭空加能力,只能把高配机器的报告"降下来"。 它能回答的问题是"如果这台机器的能力只有这么多,我的程序会不会崩、会不会没走降级路径",而不能回答"这段代码在真实低端设备上跑多快"。
还有两条使用细节值得记住:一是层序上 Profiles 层应该放最后(最靠近驱动);二是它有一个 fail_on_error 选项,打开之后,如果应用请求了 profile 里没有的能力,vkEnumeratePhysicalDevices 会直接返回初始化失败——用暴力手段把"没查询就乱用"这件事变成崩溃。
10.2 有哪些现成的 profile
OK,Profiles 是一组"保证被多个实现支持"的特性集合。官方与 LunarG 维护了几族具名 profile,可以直接拿来用:
| 族 | 代表 | 用途 |
|---|---|---|
| Khronos 路线图 | VP_KHR_roadmap_2022 / _2024 / _2026 |
按路线图年份对齐能力基线 |
| LunarG 桌面基线 | VP_LUNARG_desktop_baseline_2022 / _2023 / _2024 / _2026 |
桌面平台的现实下限 |
| Android | VP_ANDROID_vulkan_profile_2021 / _2022 / _2025 |
安卓设备的能力分级 |
| Android 版本要求 | VP_ANDROID_15/16/17_requirements |
对应系统版本的最低要求 |
| LunarG 最低要求 | VP_LUNARG_minimum_requirements_1_0 … _1_4 |
各核心版本的最低可用集合 |
这套东西对我们这种"只有一台机器"的处境特别有用:它让"降级路径有没有写对"这件事可以在一台机器上验。 但要记住 10.1 说的那条边界——它验的是行为(会不会崩、有没有走 fallback),不是性能。
10.3 在本机怎么用,以及它的边界
好了,说清楚它是什么之后,还得说清怎么用。Profiles 的用法可以概括成三步:挑一个 profile(比如桌面基线里和你目标平台最接近的那一版)、把它绑到 Profiles 层上(层的顺序放在最后,最靠近驱动)、然后正常跑你的程序。跑的时候,应用通过 vkGetPhysicalDevice* 系列读到的就是被钳制之后的值,而不是本机的真实值。
这里最容易踩的一脚是层序。 Profiles 层要放最后(靠近驱动那一侧),因为它是在"应用与驱动之间"改写查询结果;如果它被别的层挡在后面,改写就落不到应用能看到的位置。
第二个要注意的是它到底验什么。 前面说过它是 simulate 而不是 emulate——所以它不能回答"这段代码在低端设备上跑多快":钳制只是把能力报告改小,真实的执行单元、缓存、带宽都没变。它能回答的是行为问题:我的程序在读到一个小于预期的限制值时,是优雅降级还是崩掉。
第三点是它和验证层的配合。 官方推荐的姿势是两层一起开:Profiles 负责"把能力降下来",验证层负责"在你越界时说一声"。fail_on_error 那个选项则是更暴力的版本——直接让请求了不存在能力的设备枚举失败,把"忘了查询就用"这件事变成一开始就跑不起来。
最后一条边界要写清楚:本篇只把 Profiles 的机制与清单核到官方口径,不做本机实测。原因不是做不了,而是它属于"降级路径"主题——那一课要放在真正有图形链路的篇目里讲,才有可观察的行为可验。这一条也印证了本篇 §4.4 说的那个习惯:量不到的地方,就明说只引官方口径。
十一、这一篇的方法:三步,以及一个可复跑的实验台
好了,地图与实勘都讲完了,把方法收一下。本系列每一篇都走同样的三步:
第一步,问官方怎么说。 找到这件事在四套体系里的位置,把它原本的形态与前提条件一起记下来——特别注意"这条建议面向哪一类硬件"(第三章那条判据)。
第二步,问本机是什么。 用 ...2 与 pNext 链把能力查全,用工具把现场抓下来。这一步产出的必须是有原始文件可核的读数,不是"我记得好像是"。
第三步,问差在哪。 官方说"管线创建很贵",本机是多少;官方说"最佳实践检查能发现问题",本机打开后报了什么。差的这一部分,才是这一篇自己的增量。
这三步落到工程上,就是一个最小实验台。本篇的实验台已经随篇入库,结构如下:
evidence/
├── src/     vk_smoke.c(最小计算用例,纯 ASCII 注释)| vkprobe.comp(自写着色器 + 编出的 SPIR-V)
├── tools/   run_t04_smoke.ps1(一键:编着色器 → 编用例 → 跑两遍 → 落日志)
└── logs/    t04_smoke_run{1,2}.txt | t04_cfg_{default,envvar,file}.txt | vulkaninfo_summary.txt | vulkaninfo_full.txt
它一共只有三个文件、一个脚本,但覆盖了本篇的全部三类证据:验证层告警(打开最佳实践特性后的输出)、GPU 时间戳(五次复跑)、确定性校验(读回结果)。任何一位读者拿到它,都能在自己的机器上复跑一遍,然后对比自己那份 timestampPeriod 与读数——这就是"可核验"这三个字的最低成本实现。
十二、边界、自检清单,以及下一篇要做什么
12.1 边界五条
OK,开篇声明过的四条,加上实测中新发现的一条,一起收在这里:
第一,不做跨厂商对照——本机单卡,跨厂商需要两台机器,且同一次抓帧不可跨系统搬运。第二,不给驱动内部 JIT 的结论——Vulkan 无此官方接口,能看的只有自己提交的 SPIR-V 与工具反汇编。第三,不给指令集规范的断言——NVIDIA 未公开 SASS 官方 ISA 文档,nvdisasm 的输出只作观测性描述。第四,时间戳有同步域边界——跨帧、跨队列相减必须成对采样或启用校准时间戳,本篇不做校准实测。第五,VK_DEVICE_LAYERS 未核实——该变量名在官方文档中未找到(device layer 概念已废弃),本篇不作为现行变量名使用。
12.2 十条自检清单
说白了,这套清单是给"准备用 Vulkan 写点东西、或者准备审别人的 Vulkan 代码"的人用的。前五条管环境,后五条管习惯。
环境五条:① timestampPeriod 与 timestampValidBits 读了吗(要测时间就得先读);② deviceType 是离散还是统一内存(决定上传回读的账怎么算);③ 能力查询走的是 ...2 与 pNext 链,还是老的 vkGetPhysicalDeviceFeatures;④ 扩展是按需启用还是"能开的都开";⑤ 验证层开了吗——以及最佳实践检查开了吗(默认是关的)。
习惯五条:⑥ 内存是大块分配 + 自我子分配,还是每来一个缓冲分配一次;⑦ 命令池是按池粒度重置,还是逐个缓冲重置;⑧ 管线是在初始化期建好缓存,还是在 draw 的时候现建;⑨ 每个用例有没有一个可以精确验证的输出(不是"看起来对");⑩ 读数是不是至少跑了三遍、报的是不是最小值。
其中第 ⑤ 与第 ⑨ 是最容易跳过、也最贵的两条:前者让你少发现问题,后者让你发现问题之后不知道是哪一步坏了。
12.3 下一篇:2026 年该怎么写
言归正传,下一篇进正题。官方在 SIGGRAPH 2026 那门课里给出的"2026 年写法",与我们大多数人手上的 Vulkan 代码有一代差距:以 Vulkan 1.4 为基线,用 dynamic rendering 取代老的 render pass,用时间戳查询与时间线信号量管理同步,用 Shader Objects 重新组织管线,用 Descriptor Heap 处理描述符。
那一条条听起来都像"新东西",但真正要回答的是老问题:换掉之后,本机到底差多少? 下一篇我们会搭出第一条真正的图形链路(交换链 + 呈现 + 抓帧),把新旧两条路径放在同一台机器上量一次——那时候 renderdoccmd 的抓帧通道也会真正上线,给出的会是 .rdc 文件与从它导出的管线状态,而不是这一篇里的"通道可用"四个字。
资源清单
- 本机源码与证据:
evidence/src/vk_smoke.c(最小 Vulkan 计算用例)|evidence/src/vkprobe.comp+vkprobe.comp.spv(自写着色器与 SPIR-V)|evidence/tools/run_t04_smoke.ps1(一键复跑)|evidence/logs/(验证层输出、时间戳读数、vulkaninfo摘要与全量) - 官方材料入口:Vulkan Guide(
docs.vulkan.org/guide/latest/)|Vulkan Tutorial(/tutorial/latest/)|Vulkan Samples(/samples/latest/)|Validation Layers 文档(LunarG)|Vulkan 规范(docs.vulkan.org/spec/latest/) - 本篇主要引用的官方页面:Guide 的
versions#_best_practices、tile_based_rendering_best_practices、common_pitfalls、deprecated、memory_allocation、pipeline_cache、threading、layers、loader|Tutorial 收尾页的「专业开发最佳实践」八条|Samples 的samples/performance/pipeline_cache与samples/api/timestamp_queries|验证层的khronos_validation_layer设置表与layer_configuration|VK_EXT_layer_settings、VK_EXT_validation_features、vkGetPhysicalDeviceFeatures、VK_KHR_get_physical_device_properties2的 refpage|Vulkan-Profiles 的OVERVIEW.md与 Profiles 层说明 - 工具:
vulkaninfo|vkconfig|glslangValidator|dxc|spirv-dis/spirv-opt/spirv-val/spirv-cross|RenderDoc - 延伸阅读(文中有引用、本机未实测):Vulkanised 会议的最佳实践演讲集|厂商最佳实践指南(AMD RDNA Performance Guide、NVIDIA Vulkan Dos and Don'ts、Arm Vulkan API Best Practices on Arm GPUs、Qualcomm Adreno Developer Guide、Imagination PowerVR Performance Recommendations、Samsung Vulkan Usage Recommendations)|Arseny Kapoulkine《Writing an Efficient Vulkan Renderer》
参考资料
Vulkan Guide(官方)
- Vulkan Guide 首页|Versions & Porting Guide|Tile Based Rendering Best Practices|Common Pitfalls|Deprecated
- Memory Allocation|Pipeline Cache|Threading|Dynamic State|Descriptor Heap
- Synchronization|Synchronization Examples|Querying Properties/Extensions/Features
- Loader|Layers|Validation Overview|Profiling|Vulkan Profiles|Development Tools
Vulkan Tutorial 与 Samples(官方)
- Vulkan Tutorial|专业开发最佳实践(引擎课收尾页)|How to write a Vulkan application in 2026(SIGGRAPH 2026)
- Samples 总览|Performance samples|pipeline_cache 样本|timestamp_queries 样本|Tooling / Profiles Library 样本
验证层与配置(LunarG SDK 文档 + Khronos 仓库)
- VK_LAYER_KHRONOS_validation(设置表)|Layers Configuration|Vulkan Configurator(vkconfig)|Vulkan Information(vulkaninfo)
- Validation Layers 的最佳实践文档|Vulkan Loader:层的发现与注册|Vulkan Loader:隐式层与显式层
规范与 refpage(官方)
- VK_EXT_layer_settings|VK_EXT_validation_features(已弃用)
- vkGetPhysicalDeviceFeatures(superseded)|VK_KHR_get_physical_device_properties2|VkPhysicalDeviceVulkan13Features
- vkCmdWriteTimestamp|vkGetQueryPoolResults|VK_EXT_calibrated_timestamps|规范:Limits(timestampPeriod)
Vulkan Profiles 工具(官方)
厂商与社区(对照与反例)
- AMD RDNA Performance Guide|NVIDIA:Vulkan Dos and Don'ts|Arm:Vulkan API Best Practices on Arm GPUs
- Arseny Kapoulkine:Writing an Efficient Vulkan Renderer|vulkan-tutorial.com(已自陈过时)
下篇预告
第二篇《2026 新范式:Vulkan 1.4 基线、Dynamic Rendering 与 Shader Objects》——官方在 SIGGRAPH 2026 给出的那一代写法,我们把它逐条搬到本机,搭出第一条带交换链与呈现的图形链路,并让 renderdoccmd 的抓帧通道真正产出第一份 .rdc。老写法与新写法在同一台机器上各量一次。
落款
希望能对大家有所帮助。 本文由@溯光 出品,转载请注明出处。本文同步发布于公众号与个人博客。