站点链接:技术博客页 CSDN版文章链接: https://bbs.csdn.net/ 知乎专栏版文章链接: https://www.zhihu.com/people/suguang
一句话点题:一帧从文件再变回状态
上一篇文章我们跟完了抓帧的前半程:RenderDoc[RenderDoc 官方文档](https://renderdoc.org/docs/) 把你要抓的一帧,从
一条时间流里用「进进程 → 拦 API → 卡帧界 → 排命令 → 抄资源 → 写文件」的流水线切成一份文件(.rdc)落盘。
你多半也已经在 Event Browser 里翻过 draw call、在 Texture Viewer 里看过某张颜色缓冲了。但很少有人停下来问这一句:
这份 .rdc 文件落到盘上之后,RenderDoc 是怎么把它再一次变成一个能让你交互分析的"活的"一帧的?
这个问题不是纯好奇。你在界面里看到的每一张纹理、每一个 shader、每一条 pipeline state、每一次 Pixel History 的求值, 统统不是"从文件里读出来的现成数据",而是回放引擎在那块 replay device 上重放命令、重建状态之后,再按需查询出来的结果。 换句话说,分析面板不过是"回放引擎当前状态"的一面镜子。你不懂回放到哪个点、状态是怎么一点一点重建起来的,就永远看不懂 "为什么这个 buffer 此刻是这样";懂了,你就从"在读文件"进阶到"在看一台机器怎么把文件变回世界"。
这篇就要把这条"变回"的链完整剖开。我们按"从磁盘到状态"的发生顺序走:先看 .rdc 作为二进制容器,文件头、Section、版本
是怎么组织的(容器层);再看 RenderDoc 打开它之后怎么探 API、建回放上下文(打开层);接着是回放引擎的核心动作,用
ReplayController 把帧事件一点一点推进,每一步重建到什么状态(事件推进层);然后看资源状态是靠什么机制恢复的(序列化与
懒加载,资源层);最后看这些状态怎么被远程回放借走、怎么支撑起你界面上的各种分析面板(通信与查询层)。
先给结论再展开,好让你带着地图走:回放是"重放安装",不是"解压缩"。.rdc 里存的不是一张可以摊开的像素图,而是一份
"当初哪些 CPU 调用依次发生过、各自引用了哪些资源的指令日志"。回放引擎把这串日志在 replay device 上重新执行一遍,驱动状态机
会自己再走一遍,于是纹理、缓冲区、管线状态都在当前这一步"活"了过来。分析面板要哪块,就按需向这块"活"的状态要。这是理解
本系列后续每一篇、也是理解 RenderDoc 一切分析能力的钥匙。选择"重放安装"而非"直接解包",是整套回放机制的脊梁,也是今天要
立住的第一件事。
这就是本篇的内容总览与目录地图,方便你定位自己要补的那一环。这一篇分九章:零立主线(把一帧从文件变回状态);一讲容器(.rdc 不是
zip,文件头、Section、序列化版本三个硬事实);二讲打开(校验、探 API、建回放上下文);三讲帧事件推进(ReplayController
的三步推进与 initial pass);四讲资源状态恢复(chunk 序列化、懒加载、ID 重映射);五讲远程回放(Local/Proxy/Split 三模式
与按需查询包);六讲跨 API 统一(各后端查询汇到一份 PipeState);七收拢成一张决策表,回答"每个分析面板依赖哪个中间
状态";八用一张全景图收束整台机器。前六章是主线,七、八是这条线在应用层的两个落点。这种"容器 → 打开 → 推进 → 恢复 → 查询"
的骨架,正好对位一台回放机从文件到可分析状态的六道工序。
在开走之前,也把本篇范围的边界说清楚,免得你拿着一份过大的期待来读。本篇不讨论:如何用 RenderDoc 抓帧与看面板的具体操作 (那是上一篇与后续实践篇的事);不深入某个具体 API(D3D11、Vulkan、GL、Metal)的实践细节差异(那是各 API 篇的事);不涉及 性能数值的横向对比(本文讲机制,不测基准,基准会单独开篇)。本篇专注一件事:回放引擎这部机器本身,从它怎么读 .rdc,到它 怎么把状态重建出来、再支撑起界面上的每个分析结果。
我们接下来分章走这台回放机。主线是一条从「文件 → 打开 → 推进 → 恢复 → 查询」的链条:读头 → 探 API → 建上下文 → 推进帧事件 → 重建资源 → 按需查询。六个动作,六道工序,把"一帧"从磁盘上的字节重新焐热成一个可分析的实时状态。
这张六工序图就是本文全程的地图:第一章讲容器(读头/遍历 Section),第二章讲打开(探 API/建上下文),第三、四章讲推进与 恢复(ReplayController 与序列化),第五章讲远程(Proxy/Local/Split),第六、七章讲"这些状态怎么支撑分析面板"并收拢成一 张决策表。你随时能回到这张图上找到自己站在哪一道工序,就不会在回放机制里迷路。
在正式开走之前,值得先把态度立正:为什么要把"回放怎么工作"讲这么透,而不是只教你怎么用那几个 Viewer 面板?因为这套机制的 每一个环节,都在决定你能相信屏幕上那个数字到什么程度。纹理看着是 16 位的还是 8 位的,取决于文件里那段资源当初怎么被序列化; Pixel History 能不能算,取决于回放推进到了哪一步、有没有足够的设备状态;远程回放要不要 GPU,取决于你选的模式。把黑盒拆开之后, 你会发现"在 RenderDoc 里看到一个值"和"理解这个值是怎么被回放出来的"之间,隔着整一台回放机。这篇文章想给你的,不是"多会点几 个分析面板",而是"在相信每一个分析结果之前,先知道它背后那段重建到底发生了什么"。带着这张地图去读分析面板,你读到的不再是 被机制糊住的黑盒输出,而是你自己能归因的证据。这条主线贯穿全篇,也接住了上一篇文章立住的判断顺序:"先归因范围,再谈手段"。
一、.rdc 不是 zip,是一个自描述二进制容器
很多人以为 .rdc 跟 .zip 差不多,点开就是一个资源包的压缩文件,解压出来就是纹理、shader、命令列表各就各位。其实两回事。
.rdc 是 RenderDoc 自定义的二进制容器:它不依赖任何通用的"文件里有什么"的自描述格式,而是自己定义文件头、自己定义 Section、
自己管版本。这一章我们把容器层最硬的三个事实拆开:文件头(魔数与版本)、Section 布局、序列化版本。
1.1 文件头:魔数、版本、程序版本
打开一个 .rdc,第一件最先遇到的是文件头。RenderDoc 用一个结构体 FileHeader 记录文件的元信息,它长这样(字段名与含义取自官方源码 renderdoc/serialise/rdcfile.h):
//-----------------------------------【FileHeader】---------------------------------------
// 描述:.rdc 文件最开头的定长头部,用于快速识别文件类型与版本
//------------------------------------------------------------------------------------------
struct FileHeader {
    uint32_t magic;        //【1】魔数,恒为 0x00C0FFEE,用于识别"这是不是 RenderDoc 文件"
    uint32_t version;      //【2】内部序列化版本,决定文件能否被当前版本打开
    size_t   headerLength; //【3】头部之后的字段区长度,跳过它才能找到正文
    char     progVersion[8]; //【4】生成该文件的 RenderDoc 程序版本,供提示与诊断
};
- 第一个字段 magic(魔数),恒为
0x00C0FFEE,它是"你是不是 RenderDoc 文件"的第一道指纹。 - 第二个字段 version(版本号),记录文件用的是哪一代内部序列化规则,直接决定新旧版本能否互开。
- 第三个字段 headerLength,让打开方知道头部到底多长、正文从哪开始,方便流式遍历。
- 第四个字段 progVersion,保留用哪个 RenderDoc 程序版本生成的字符串,方便提示"请用更新的工具打开"。
在 renderdoc/serialise/rdcfile.cpp 里,打开文件做校验的第一件事就是比对魔数:if (magic != MAGIC_HEADER) ...,对不上就直接拒绝
打开,根本不会去碰后面的内容。这一段校验是整套回放可信度的起点:只有通过魔数校验的文件,才有资格被送进回放引擎。
下面这段源码就是魔数校验的实际逻辑(来自官方仓库 rdcfile.cpp),我们不必逐行背,只要看清"先验魔数、再读头"这一步:
//-----------------------------------【.rdc 打开校验】-------------------------------------
// 描述:回放端打开 .rdc 的头几步:验魔数 → 读头 → 校验属性
//------------------------------------------------------------------------------------------
bool RDCFile::Open(Stream *file, ...) {
    //【1】先读魔数,对不上直接拒开
    if (file->Read(magic) != MAGIC_HEADER) { return false; }
    //【2】再按 FileHeader 布局读版本与本文件程序版本
    ... = file->Read(header);
    //【3】校验本工具能否理解该版本,不理解则报"需要更新 RenderDoc"
}
下面对这块源码特别说明:魔数校验是"是不是"的判据,版本校验是"能不能懂"的判据。前者挡住随便一个别的文件,后者挡住版本
太旧看不懂新格式的文件。两者都过了,这份 .rdc 才真正进入"被回放"的候选名单。完整源码见 rdcfile.cpp。
1.2 Section 布局:压缩长度、类型、flags
文件头之后,是一串有序的 Section。BinarySectionHeader 用类似下面的字段描述每一个 Section(来自 rdcfile.h):
//-----------------------------------【BinarySectionHeader】--------------------------------
// 描述:描述文件里一个独立数据块的定位信息
//------------------------------------------------------------------------------------------
struct BinarySectionHeader {
    SectionType type;        //【1】这是哪种数据块:二进制 or ASCII 文本
    size_t      length;      //【2】压缩后长度
    size_t      uncompressedLength; //【3】解压后长度
    uint64_t    version;     //【4】本 Section 自己的版本
    uint32_t    flags;       //【5】标志位,决定是否压缩等
};
- type(Section 类型) 标明这个块是二进制数据还是 ASCII 文本,不同类型后续处理方式不同。
- length / uncompressedLength 是"压缩后/解压后"两个长度,回放端据此决定是否解压、分配多大缓冲。
- version / flags 是 Section 自身的版本与属性位,给读到它的代码一个"我该怎么理解你"的提示。
rdcfile.cpp 里还守着一个关键约束:没有任何两个 Section 拥有相同的 section type 或 name,一旦出现重复就被判为 malformed(格式损坏)。
这个"唯一性"是个数据完整性钩子:它保证"每个语义块在文件里只有一个家",回放时按需查询某个 Section 不会撞到两个互相矛盾的版本。
1.3 序列化版本:为什么 v0.x 打不开
.rdc 不是为"一次成型"设计的,它要能在 RenderDoc 版本演进时被打开、被理解。为此 RenderDoc 把内部序列化系统打了版本:从某个
V1_0_VERSION = 0x00000100 起,版本号会写进文件;早于它的 v0.x 文件不再被新工具兼容。这个设计意味着三件事:
- 旧文件可能打不开:如果你手里有个 v0.x 时代存下的
.rdc,新版 RenderDoc 大概率直接拒绝或做不了完整回放。 - 版本既是门槛也是契约:版本号统一了"文件里每个块长什么样"的解读规则,避免不同版本对同一字节读出相反含义。
- 回放必须在"懂的版本"下进行:回放引擎能不能推进,前提是它能按该版本规则解析命令流。版本对不上,"重放安装"就无从谈起。
这部分是容器层的收尾:文件头宣示"我是谁、什么规则写的",Section 组织"内容在哪里、怎么解",版本决定"谁能懂"。三者合起来,
.rdc 就从一个普通文件升格成一套可被回放引擎"按契约还原"的数据包。
懂容器层的实际回报,是你诊断"为什么打不开"时能按层归因:如果魔数都不对,说明这根本不是 .rdc(或文件被截断);如果魔数对但
版本太高,说明是"工具太旧";如果都能通过却被判 malformed,多半是 Section 布局被改动或损坏。三种失败,三种定位手段,这正是
"分层设计"给你的诊断杠杆。RenderDoc 官方文档对文件格式与如何打开 .rdc 有专门一节说明(见 RenderDoc 文档"Loading and working with captures"),
可以作为你这个诊断流程的对照。顺便一提,容器层也解释了为什么不同版本的 RenderDoc 之间 .rdc 会有兼容性边界:版本字段不是摆设,
它是"这份文件遵守几号规则"的显式声明,回放引擎据此决定自己够不够格去解它。
二、打开的本质:校验、探 API、建回放上下文
容器层只是"能读",真正的回放要"能跑"。这一章讲打开 .rdc 之后,RenderDoc 怎么从一份文件走进一块 replay device 上的"活的"世界。
2.1 校验完文件,怎么知道该用哪套后端
按上一章的流程打开文件后,RenderDoc 面对的第一个问题是:这份 capture 是用哪个图形 API 抓的?应该用哪套回放后端来演它? 答案在文件内容与回放设备能力两者的交会上:文件里记录了当初抓帧所用的 API(Vulkan / D3D11 / D3D12 / GL / Metal…),RenderDoc 据此 选取对应的回放驱动;再结合本机或远程设备实际支持哪些图形后端,决定"这个文件在这台设备上能不能回放、有哪个后端能回放"。
这一步本质是把"文件描述的世界"对齐到"设备撑得起的世界"。Vulkan 文件要落在支持 Vulkan 的后端上,D3D12 文件要落在 D3D12 后端上,
API 对不上,回放必然失败。这也是为什么有些 .rdc 在别的机器上打不开或显示不全,不是文件坏了,是那台设备缺对应的回放后端。
2.2 回放上下文:replay device 上的一次"第二人生"
选定后端之后,RenderDoc 会在 replay device 上建立一个回放上下文(replay context)。可以这样理解:抓帧时,你的应用进程里有一套 "正在运行的资源与命令流";回放时,RenderDoc 在 replay device 上再造了另一套同样编排的资源与命令流,只是这一次它不是服务于 真实渲染,而是服务于"让你离线观察"。前端是驾驶舱,replay device 是引擎舱;两者物理分离,靠回放控制通道连起来。
这个"第二人生"是整套分析的地基:你在 Texture Viewer 里看到的纹理,是这个"第二套"里的纹理;你在 Pipeline State 里看到的管线, 是这个"第二套"里的管线。回放上下文就是一个可以让你随时调查的、与真实渲染等价但受控的沙箱。后面所有动作,推进帧事件、恢复资源、 按需查询,都发生在这套"第二人生"里。
三、帧事件推进:ReplayController 的三步
容器打开了、上下文建好了,接下来是回放机的心脏:把帧一点一点推进到你要看的那个事件。这一章是全文的机制核心。
3.1 重放的是 API 调用序列,不是重放像素
这一章最重要的洞察,一句话:回放不是把像素倒出来,而是把当初记录的 API 调用序列重放一遍,让 GPU 驱动状态机自己再走一次。
.rdc 里存的是一份"指令日志":哪条命令、以什么参数、引用哪块资源、按什么顺序。ReplayController 就是那台逐条重放这份日志、并把
每次重放后的状态暴露出来的机器。
你可以把它理解成录像带倒带重放:录像带里存的不是"景象本身",而是"当时发生的事件序列";重放就是把那些事件再触发一遍,让画面
自己重演。.rdc 同理。唯一的差别是:录像重放你拿到的是画面,.rdc 重放你拿到的是被重演出来的每一帧中间状态:纹理、网格、
管线、乃至每一个 draw 前后的缓冲内容。正因为是"重演"而非"解包",所以 Analysis 面板能在任意中间点上停下来、把那一瞬间的状态拿出来
给你看。
把"一份案例的体量"落到直觉:一个几秒的游戏画面,其 .rdc 里记录的 CPU 调用(draw、dispatch、bind、set state)通常是成千上万个
事件。RenderDoc 在 Event Browser 里给你拉出的一条条调用,就是从这一长串事件里按层次挑出来的。回放机面对的不是几十个、而是
数以万计的事件流,却仍然让你"点一下就在任意一步停住看状态"——这靠的不是把每个事件都重放一遍,而是靠"按需推进到那个点 + 把该
点状态现取出来"这套机制。理解了事件量级,你才真正明白三步推进、懒加载这些设计的必要性:它们是让"在几万个事件里任选一点看状
态"变得可行的工程答案。
3.2 三步推进法:WithoutDraw → OnlyDraw → FetchPipelineState
要"回放到第 N 个事件",不是把日志从头跑到第 N 条就完事。ReplayController::SetFrameEvent(eventId) 内部走的是标准三步(源码见
replay_controller.cpp):
//-----------------------------------【ReplayController 帧事件推进】----------------------------
// 描述:把回放推进到指定事件,并恢复该点的管线状态
//------------------------------------------------------------------------------------------
ReplayController::SetFrameEvent(eventId) {
    //【1】重放到目标事件之前的所有调用,但不下任何 draw(eReplay_WithoutDraw)
    m_pDevice->ReplayLog(eventId, eReplay_WithoutDraw);
    //【2】只执行目标这一条 draw(eReplay_OnlyDraw)
    m_pDevice->ReplayLog(eventId, eReplay_OnlyDraw);
    //【3】把此刻的管线状态取出来(FetchPipelineState),供分析面板用
    ... FetchPipelineState(eventId);
}
下面对这块源码特别说明,分两步跑不是多余,是刻意:这一步的关键在 WithoutDraw → OnlyDraw 的拆开。为什么要把"重放"和"只执行
目标 draw"分开?因为在你点开某个 draw call 时,RenderDoc 既要保证"前面的状态都就位了"(否则这个 draw 的输入是空壳),又不想把后面的
draw 也真的跑掉(那会污染你正在看的那一瞬间的状态)。于是它先把事件前的调用都重放到位(但不真画),再只画你想看的那一条,最后把
该点管线状态捞出来。三步合起来的语义是:"到这一步、且只到这一步"。完整源码见 replay_controller.cpp。
顺带解释 FetchPipelineState 为什么重要:分析面板里那一排 shader bound、blend state、viewports,不是在抓帧时存的现成值,而是这
一步从回放设备上现取的。它会随你推进到的 event 不同而变化,这正是"分析依赖当前回放状态"这一句最直观的体现。
值得多说一句的是 ReplayLog 的第三个模式:除了 WithoutDraw 与 OnlyDraw,回放驱动还分 eReplay_Full(完整重放,把日志一路
跑到目标事件)。SetFrameEvent 默认选的是 eReplay_WithoutDraw + eReplay_OnlyDraw 的组合,因为它希望停在"该上状态、但没真的
把目标 draw 之外的东西画出来"的精确切点上。如果你要的是"把这一帧完整跑完再看整帧结果",那就得走 eReplay_Full。三种模式在
回放三层语义里分别回答:要状态(WithoutDraw)、要那一条 draw 的执行(OnlyDraw)、要整段重放的产物(Full)。ReplayController
封装了这套三选一,让你在上层只关心"推进到哪个事件",而不必每次手动拼装调用。详见 replay_controller.cpp。
还有一个常被忽略的维度:视频回放可以被中断与校验。真实渲染里 GPU 会报错、会丢数据;回放机同样有失败路径——比如某个资源在
懒加载市场里迟迟拿不到、某个 draw 引用的 buffer 在文件里缺失。ReplayController 对这些不是无脑继续,而是把"能推进到哪一步、哪
一步断了"如实暴露出来(回调/错误码),让上层分析面板判断"当前状态哪些可信任、哪些是残缺的"。这也是回放机制里"可信度"的另一条
腿:不仅文件结构要过魔数/版本,回放过程本身的失败也要可追溯,否则你看到的"某个面板的数字"就可能是半截状态下的产物。
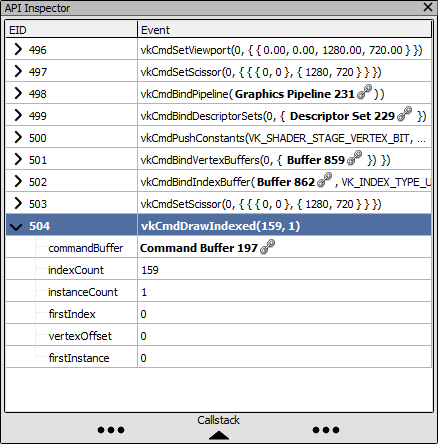
上面这套"先 WithoutDraw 重放到事件、再 OnlyDraw 画上一次、最后 FetchPipelineState 回溯状态"的三步,落到界面上就是你切到某个 EID 时看到的一切:API Inspector 里那串 vkCmdSetViewport、vkCmdBindPipeline、vkCmdDrawIndexed 参数,是回放机在回放态下现取的,而不是文件里预存的快照;对这些参数逐条展开与追踪的界面机制,RenderDoc 官方在 window_api_inspector.html 文档页 里有专门说明:
3.3 initial pass 与 ActionList:第一次推进要扫什么
第一次对一个 captured frame 做回放,不是细嚼慢咽地逐条执行,而是先做一次整体扫描:遍历整帧的命令流,构建一张 ActionList
(动作列表),并给每一个事件/资源建好 read-write 依赖分析:哪个 draw 读了哪块缓冲、写了哪块纹理,谁在谁之前,谁跟谁有依赖。
这一步的意义像"先列目录再读书":没有 ActionList,你没法在 Event Browser 里一点就跳到某个 draw;没有依赖分析,你不知道回放到某
一点的资源状态该由哪些前置动作喂起来。capture 里记录到"帧开始前"的那串调用,也在 initial pass 里被逐条 (verbatim) 读取执行,
资源创建时,抓帧时的 ID 会被映射到回放上下文里的 live 版本(细节见 4.3)。关于回放工作原理的官方描述,见 RenderDoc 文档 how_works.rst。
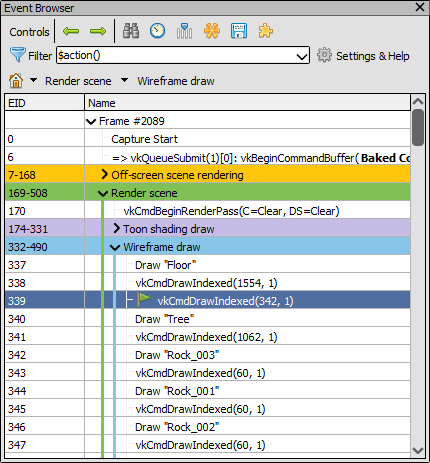
这张事件图谱就是 initial pass 之后的产物:从 Capture Start 到逐条 Draw,层次化的 ActionList 就是你在工具栏上一键定位到某个 draw 的依据:
一句话收束这一章:推进不是一次到位,而是"先整体扫描建依赖 → 逐事件三步推进 → 每步可停可查"。这三层动作拼起来,才是你在 UI 里"点一下往前一步"背后真实发生的机制。
四、资源状态恢复:chunk 序列化与懒加载
状态不光有"命令流",还有"它引用的资源"。这一章讲资源(纹理、缓冲、shader 等)是怎么从文件回到回放设备上的。
4.1 chunk-based 序列化:一段一段地还原
.rdc 里的资源不是整体一大坨,而是按 chunk(数据块) 组织的。chunk-based representation 意味着一个资源的二进制内容被拆成若干
数据块,每个块带有自己的定位信息(哪个资源、哪个字段、这段覆盖什么)。回放时,驱动把需要的 chunk 按序组装、映射成回放设备上的
"live 资源"。这样做的好处是可裁剪、可复用:不需要把整个文件都读进来,只把当前这一步用到的 chunk 喂给设备。
你可以把 chunk 想成乐高块的颗粒:整包资源是搭好的模型,文件里存的是分好类的颗粒说明书,回放按需一块块拼。哪个 draw 只用到某块 缓冲的某段区间,就只把那段的 chunk 送上设备,而不是把整份缓冲都倒过去。这一层直接解释了"为什么同一个 draw 在文件很大时依然能快 速查"。
这里有两个值得记住的结构事实。第一,chunk 是"可独立反序列化"的最小单位。一个资源可以由一个 chunk 构成,也可以由一串 chunk
构成;每个 chunk 在文件里带自己的定位与元数据,回放驱动读到一个 chunk 就能就地把它填进当前资源对象的对应段,而不必等整个资源
的所有 chunk 都齐了才动手。第二,引用计数与 ID 表是 chunk 之间"谁引用谁"的账本。资源之间不是一张张孤立的图,shader 引用
buffer、draw 引用 texture;序列化器给每种引用打上可识别的引用标记,回放端据此在 chunk 之间建立正确的链接。这两点合起来,才让
"按需取 chunk + 按引用链连起来"成为可能。具体到资源对象,回放驱动会把读到的 chunk 名与 ID 登记进一张全量资源表,供后续
GetResources、Texture/Mesh/Shader 面板按名查取。
一个直观的规模参照:一份典型游戏帧的 .rdc 里,纹理、缓冲这类大资源动辄占几百 KB 到几十 MB,而它内部按 chunk 切开后,你在
文件里只有真正需要的那部分会被读进内存。回放时"有没有把整个文件都 load 进来"是两套完全不同体量的活——前者可能只命中几 KB
的某一块,后者则要把整份几十 MB 全铺进设备。这就是 chunk 设计在工程上的直接收益:按需读、按需拼,文件再大也只在当前这一步
付出局部代价。
4.2 lazy init:不是所有资源都一次性还原
与 chunk 配套的,是懒加载(lazy initialization)。驱动可以"先不真正还原某些资源的内容",只占位,等到分析面板真正需要这块数据时, 再去取。这样初始化快、内存省,也避免为没人看的数据白付带宽。官方文档在说明回放工作原理时明确提到:driver 可 lazy initialize 资源 内容、能优化掉某些数据上传,分析视图的数据"通常依赖当前 replay event 状态 + 远程资源查询"。
一句话:懒加载让"贵的还原"推迟到"非用不可"。你只看了颜色缓冲,那台机器就不会把深度、模板、mesh、每个 shader 全部重建起来;等 你点开下一块,它才补上那一块。这种"按需焐热"是回放能保持体感流畅的第二个关键(第一个是三步推进的按需执行)。
那懒不懒是谁决定的?答案是:取决于资源类型与分析需求。有几种典型差异值得对号入座。
mesh 顶点/索引缓冲通常是懒的:你翻 Event Browser 时不一定要看某个 mesh 的顶点数据,回放机会等你在 Mesh Viewer 里点开某个 draw 的输入装配时才去把那份顶点数据焐热。贴图的分级 mip 也常按需取:你在 Texture Viewer 拉到一个低 mip,回放机只需把那一级 取上来,不必把全 mip 链都重建(Texture Viewer 对各种视图与 mip 档的交互方式,见官方 window_texture_viewer.html 文档页)。shader 的字节码则往往在"推进到该事件、FetchPipelineState 拉出这条管线"时就一次性到位,因为 它是分析面板几乎总是要看的资料,懒的收益不大。buffer(统一缓冲、常量缓冲等)偏向按"该 draw 有没有绑定它"来懒——某个顶点 阶段的 draw 没绑那块 buffer,就不去还原它的内容。
一句话收束:懒加载不是"一律不还原",而是"按需求优先级排队"——先还原可推断的骨架(ID 表、引用链),内容类数据(顶点、mip、 shader 字节)留给真正要看的那一步。这个顺序本身就是回放机"分析依赖回放状态"在资源侧的镜像:回放状态是一点一点长出来的,不 是文件一打开就齐的。
这里值得再补一个工程侧翼,让"懒加载到底省了什么"变得可感。回放引擎的公开接口(见 replay_controller 对外部资源查询的声明)反复强
调:driver 可以选择性地延迟资源内容的上传,而不必把捕获里每块数据都搬上设备。落实到量级上,一份记录了十几个 draw、上百个资源对
象的中型帧,.rdc 体积动辄百来 MB(字段与布局见 rdcfile 的 Section 组织),但 initial pass 建依赖时真正从磁盘焐热的往往只是目录、
ID 表与引用链,资源内容大多停留在"占位"。这便让"打开一个捕获"和"完整回放一个捕获"分成两档体量的开销:前者多在数百毫秒内完成,
后者才需把资源逐块铺进设备、按事件推到底。你多数时候只为了看某个 buffer、某块纹理,于是真正吃进内存与带宽的,只是那巨量文件中
与你当前关注点相关的一小块而已。这就是"按需焐热"在工程上兑现的收益。相关资源查询的接口声明见 replay_controller.h,Section 布局见 rdcfile.cpp。
4.3 资源 ID 重映射:抓帧时的 ID 如何对应回放里的 ID
抓帧时,你的应用在真实进程里建了一堆资源,每个有自己的 ID。回放时,RenderDoc 在这套"第二人生"里重新建了一批 live 资源,它们也有 自己的 ID。两者不是同一个 ID。所以 initial pass 里最重要的翻译工作之一就是资源 ID 重映射:抓帧日志里写的"引用资源 X",在回放 时被翻译成"引用回放约束下的 live 资源 Y"。
这个映射是所有依赖分析的承重墙:读 write 依赖分析要能对上"这个 draw 用的是哪个 live 缓冲",Texture Viewer 要能对上"这条 draw 写 的纹理在科目表里是几号"。ID 对不上,回放就"断了链",状态重建也就无从谈起。理解这块,你才算理解了"回放是第二套世界"在底层到底 意味着什么。
这个重映射有两层方向。正向是抓帧 ID → live ID:日志里每一条"引用资源 X"在回放时都被翻译成"引用 live 资源 Y"。反向你也常会 用到,就是当你点开某块纹理、某个缓冲去看"它是从哪个 ID 来"时,回放机又要把 live ID 翻译回捕获时的语义,好让依赖分析、资源表、 纹理面板能对上号。双向映射不一定保存在同一张表里,但语义上是互为逆映射的关系。
还有一处容易踩到的细节:ID 重映射发生在后期,缓存必须跟着失效。回放机不是把映射建一次就用到底;它会记录"哪些资源在文件里 是剪裁过的、哪些是懒加载占位的、哪些是跨 draw 复用的"。当你在分析面板间来回切换、推进到不同 event 时,回放机需要保证"同一个 live 资源"始终是同一个 ID,否则缓存就会命中一个早该失效的旧数据。这种"ID 语义一致性 + 缓存失效"的管理,是隐藏在交换接口之后、 却决定你这个分析结果靠不靠谱的那部分工程。
五、远程回放:让 GPU 不在本机也能分析
到这里,回放主链路已清楚。但还有个现实问题:GPU(尤其高端机)不总在你面前。远程回放让 .rdc 的分析能在另一块 GPU 上完成。这一章 讲三种模式和背后那条通信模型。
5.1 三种部署模式:Local / Proxy / Split
rdc-cli 提供三种远程回放模式,区别在"GPU 谁出、client 要不要装 RenderDoc":
- Local(本地回放):拿客户端本机的 GPU 直接回放,两边都在一台机器,最简单。
- Proxy(代理回放):客户端跑一个 daemon,通过它连到远程的
renderdoccmdserver,回放在那台远程设备上做,客户端只发指令、收结果。 - Split(分离回放):服务器端带 GPU 做重放,客户端可以不装 RenderDoc,纯粹作为"下发分析请求、接收结果"的壳。
这三种模式本质是对"GPU 在哪里"的三种回答:在我这儿(Local)、在我远程那台(Proxy)、在分离的服务器那儿(Split)。选哪种,取决于 你的 GPU 资源在哪、客户端装不装得起 RenderDoc。官方说明见 rdc-cli。
这里值得展开的是三种模式在网络拓扑与依赖上的真实差别,因为"选哪种"往往不是一道直觉题:
- Local 几乎没有网络维度:client、replay、GPU 同机,端的是一条内存内的控制通道,延迟可忽略,也无需处理远端资源上传。缺点 是"分析必须在装了 RenderDoc 并且有 GPU 的机器上做"。
- Proxy 引入一段真实网络往返:client 上的 daemon 通过 socket 连到远程
renderdoccmdserver,本地的分析面板发出请求、远程计算出 结果沿链路回传。它的价值在于"GPU 资源可以放在别处",代价是每一次按需查询都多一段网络时延,首次请求(要真取数据)明显比后续 (走缓存)慢。 - Split 把刀切得更开:client 甚至可以不要 RenderDoc、不要 GPU,只当"下发请求、收结果"的壳;真正的回放与重算都在分离的服务器 上完成。它最灵活,也最依赖网络的稳定性与带宽。
一个容易被忽略的共同点:远程回放无论哪种模式,你的分析面板看到的仍是一次次的"按需查询"。也就是说,远端回放状态 + 查询往返, 这两者才是远程分析能成立的支柱;模式只是决定"状态在哪儿、往返走哪条路"。
三种模式还有一个容易被"选型直觉"盖过的工程层面:连接是怎么建立、握手要交换什么。以 Proxy 为例,客户端的 daemon 首先要能定位远
程的 renderdoccmd server,双方通过 socket 建立连接后,会先做一次能力交换,互相告诉对方"我这边跑的是哪个 API 的驱动、支持哪些
查询类别",然后才进入常态的请求/响应。这个握手决定了"你远程分析时能查什么"的上限:server 侧没有实现的查询,client 端再全也会被
挡回或降级。正因如此,远程回放的分析能力,是"client 能请求的"与"server 能提供的"两者的交集,而不是单看一端;理解这个交集,
你就不会在"明明装好了却查不到某类数据"时一头雾水,那往往不是面板坏了,而是远端这次的回放驱动没把那类查询暴露给你。这类 Proxy 为
主的远程模式的官方叫法与用法,见 rdc-cli 项目说明;更底层的回放协议细节,则落在 replay_proxy.cpp 里。
5.2 ReplayProxyPacket:分析数据是怎么"按需"传回来的
远程回放能成立,靠一条基于请求/响应的通信通道。ReplayProxyPacket 枚举(源码见 core/replay_proxy.cpp)列出了这条通道上所有能请求的
东西:ReplayLog(推进回放)、CacheBuffer/TextureData、GetResources/GetTextures/GetBuffers(列资源)、GetBufferData/GetTextureData/
GetShader(取某块数据/某个 shader)、PixelHistory(算像素历史)…… 这些枚举本质上就是"回放设备当前状态的一次按需查询"的参数。
你可以把这串枚举读成"遥控器上的按钮":每个按钮是一次"从回放设备取点什么回来"的请求。纹理、mesh、shader 的分析数据,没有哪个是 抓帧时就存在文件里等你取的,它们都是这个遥控器按下去、回放设备现算现传的结果。完整源码见 replay_proxy.cpp。
5.3 从 UI 请求到回放设备:一次分析查询的往返
把 5.1、5.2 串起来,一次远程分析查询的完整往返是:你在客户端界面点开 Texture Viewer → 客户端把"给我这块纹理"翻译成一个
ReplayProxyPacket 请求 → 通过 Proxy/Split 通道发给回放设备 → 回放设备在它当前重放到的状态上取出/生成这块数据 → 沿原路回传客户端
渲染。中间每一步都可能受"当前推进到哪个 event"影响,这正是"分析依赖当前回放状态"的远程版本。
这也解释了为什么分析第一次会有点慢、第二次会变快:首次要真的去取/生成数据,之后常被缓存。你看到的响应时序,本身就是回放机"按需 供应"特性的侧写。
这里值得补一个时序直觉:本地回放下,一次查询往往在毫秒级内返回,因为数据就在同一台设备的内存里;而远程(Proxy/Split)回放下, 首次取/生成数据要跨网络走一整圈,可能涨到几十到几百毫秒,甚至更高——取决于纹理大小与带宽。这份差距量级上常是本地同款查询的 几倍到十倍:本地读一块 4K×4K 的纹理可能只需几毫秒,远程走一圈却要兜上百毫秒的网络往返。这个量级差不是 bug,而是"状态在远端" 的物理代价。所以远程分析里"第一次点开慢、第二次快"常常比本地明显得多:首查要真取,之后命中客户端缓存。这些引入的时延参数也提醒 你,分析面板报的那个"像素反算耗时",是在当前网络拓扑下测得的值,不同模式下不可直接横比。
六、PipelineState 跨 API 的统一视图
回放机的应用层,还有一个必须讲清的机制:跨 API 的统一。
6.1 GetD3D11/D3D12/GL/VulkanPipelineState 与 GetPipelineState
.rdc 可能是任何 API 抓的:Vulkan、D3D11、D3D12、GL…… 但你在 Pipeline State 面板里看到的,是一份统一的管线状态表单,而不是每个
API 各一套。ReplayController 提供了 GetD3D11/D3D12/GL/VulkanPipelineState() 这些针对具体 API 的查询,最终都汇到一个通用
GetPipelineState(),返回一份统一的 PipeState。
这份统一是设计取舍:回放引擎用一套中间表示屏蔽掉后端 API 差异,你在 UI 上看到的是"翻译后的共同语言",而不是 Vulkan 的 VkPipeline 或 D3D 的 ID3D11State 各说各话。这也意味着:换 API 抓同一场景,你在 Pipeline State 面板看到的抽象层级是一致的,只是底 层实现在各自的回放驱动里。关于这些查询的声明,见 replay_controller.h。
这个"统一"并不只是界面层面的一件外衣,它向下一直扎到回放驱动的查询接口。你可以这样理解它的分工:
- 向上(面向 UI):一份
PipeState中间结构,字段是"管线阶段轴 + 每个阶段的绑定/参数",UI 只要读懂这一种结构就能渲染所有 后端的管线面板。 - 向下(面向各后端):D3D11、D3D12、GL、Vulkan 各自的回放驱动,把自家原生管线对象翻译进这份中间结构。翻译发生在"查询"这一步,
而不是存进文件那一刻——因为原生的 VkPipeline 不会直接进
.rdc,进的是"当初创建管线时的参数与绑定"。
正因为查询发生在回放态,统一视图的取值也随你推进到哪个 event 而变:同一个 Pipeline State 面板,你停在 draw 前和停在 set state 之后,看到的 VkPipeline 绑定是不同的。这再一次印证整篇的主线——分析面板是回放状态的一面镜子,而回放的中间表示,让这面镜子对 不同 API 都长得一样。
还有一个细节常被问起:端到端状态里少了 API 专属的边角,算不算失真? 严格说,统一表示在追求"跨 API 可比"时,确实会舍弃每个 API 独有的一些字段(比如某些供应商扩展、某一代硬件的专属状态)。这是"统一"与"完整"之间的取舍:RenderDoc 选了用一套可比的 公共语言服务绝大多数分析场景,而对特别在意某个 API 细节的用户,仍可从原始捕获里按需取更底层的信息。理解这层取舍,你就不会 在"这面板怎么没显示我那几个专属项"上纠结。
若想看得更细,回放驱动把"统一"之外的 API 专属信息也留了后门:ReplayController 同时暴露 GetD3D11/D3D12/GetGL/GetVulkan 一族底层
查询(声明见 replay_controller.h),它们是"跳过统一层、直接问某个后端原生状态"的通道。对熟练 Vulkan 的读者,这等于在统一的
GetPipelineState() 之外,还保有一张能直查 VkPipeline/VkRenderPass 参数的出口;对 D3D 系,则能直接读回底层状态对象。这把"统
一"与"要不要看专属细节"的抉择下放给了你:日常分析走统一视图,真要抠某个 API 的细节就绕开中间表示直查底层。这种"统一为主、保留
专属后门"的双层设计,正是 RenderDoc 在"跨 API 可比"与"API 专属完备"之间取到的平衡,也让一份 .rdc 无论来自哪个后端,都能在同一
套查询入口下被完整拆解。这部分查询族的具体签名,可对照 replay_controller.h 逐条核对。
这就是那套统一中间表示长什么样的直观证据:VTX/VS/TCS/TES/GS/RS/FS 这一排管线阶段轴,无论底层是 D3D11 的 Hull/Domain Shader、GL 还是 Vulkan 的 Tess Shader,都被归一到同一套阶段上;你选中某个 stage,回放机就从 GetPipelineState() 现取它的绑定与参数(这一面板各阶段的含义与取值方式,
RenderDoc 官方在 window_pipeline_state.html 文档页 有逐项说明):

七、闭环:分析面板依赖的中间状态从哪来
机制讲完,收拢到最实用的问题:我界面上的每个面板,到底依赖哪个中间状态、从哪一步之后才可得?
7.1 一张决策表:分析数据 = 回放状态 + 按需查询
把本文机制收成一张决策表,方便你以后对着分析面板"反向归因":
先给你一张"分析面板 ↔ 回放依赖"的速查坐标,帮你把前面的机制对号入座。你会发现一个规律:几乎所有面板都落在"推进到某 event (+ 按需查询)"这条横轴上,区别只在"它要回放状态的哪一层、哪一步之后才可得"。按这个依赖,可以把全部分析面板归成四类,这种 分类帮你记住"每个面板背后站的是回放机的哪一段":
- 要时间轴的(Event Browser 的 ActionList):依赖 initial pass 的整体扫描,只需离线读目录,不依赖真实 GPU 重放。
- 要资源内容的(Texture / Mesh / Buffer):依赖回放推进到对应 event 并把该块资源焐热(懒加载),其中 Mesh 还多依赖输入装配的 ID 重映射对上号。
- 要管线态的(Pipeline State / Shader):依赖 FetchPipelineState 在回放态现取,随 event 而异(Shader 查看器的使用方式见官方 window_shader_viewer.html 文档页)。
- 要反算的(Pixel History):依赖"推进到 event + 回放态下的逐像素反算",是四类里对"当前回放状态完整性"最敏感的。
这条横轴把你看到的每一种分析都收进同一个解释框架:先推进到对的那个 event,再从那一刻的回放状态里现取你要的东西。
| 你看到的面板 | 它其实是从哪来的 | 依赖回放的哪一步 |
|---|---|---|
| Event Browser 的 draw list | initial pass 建的 ActionList | 3.3 首次扫描 |
| Texture Viewer 的一张纹理 | 回放推进到该 event 后的该块内存 | 3.2 推进 + 4.2 懒加载 |
| Mesh Viewer 的顶点输入 | 该 draw 绑定缓冲中按语义取出的部分 | 3.2 + 4.3 ID 重映射 |
| Pipeline State 表单 | 该 event 现取的统一 PipeState | 3.2 FetchPipelineState + 6.1 |
| Pixel History | 对某像素位置在回放态下反算 | 3.2 + 按需查询 |
这张表的核心结论一句话:分析面板"要什么",回放机"现给什么"。所有面板都不是读文件里画好的图,而是"回放状态 + 一次按需查询" 的产物。你把每一步推进理解透,这张表里的每一行就都能对上号。
穿起这张表的,是贯穿全文的同一句话:"回放状态是一点一点长出来的"。文件头宣示版本、Section 安排布局(一);打开时探 API、建 上下文(二);推进时三步走、先扫描(三);资源靠 chunk + 懒加载 + ID 重映射恢复(四);远程靠模式与查询包(五);跨 API 靠统一 中间表示(六)。六道工序不是并列的六个名词,而是你每一次在 UI 里"点到一个分析结果"背后真实执行的那台机器。这台机器越透明, 你可信它给出的每一个数字到这一步。用一句话量化这层信任:一台透明得多的回放机,能让你在同样一段调试里,把"以为加载就把整帧读 进内存"的那份误解(多数时候占到对文件体积认知的一大半)换成"按需焐热到哪、分析就建立在哪"的准确判断。看得懂这只靠一边拼起来 的机器,你就不再把"面板数字"当黑盒输出,而是当自己能归因、能复核、能复现的证据。
最后提醒一句关于信任的话:回放结果的可靠度,取决于"推进到的状态"与"当时的查询"两者的完整度。如果一个分析面板的取值依赖 某块没被懒加载的错误资源、或推进到了一个状态残缺的 event,它给出的就可能是半截结果,而不是全错的、也不是全对的。这正是为什么 把机制讲透的价值——知道"这个值是被哪一步重建出来的",你才判断得出它值不值得信。这也是本系列一直想给你的那根拐杖的落点:先归因范围,再谈手段;先看清回放机,再相信回放结果。
八、结语:看懂这台从文件变状态的回放机
走到这里,你应该已经看清这台机器的全貌:.rdc 是一份"指令日志 + 按 chunk 组织的资源"的容器(一);打开它要过魔数/版本、探 API、建
回放上下文(二);推进要三步走、先扫描建依赖(三);资源靠 chunk 组装 + 懒加载 + ID 重映射恢复(四);远程靠 Proxy/Local/Split + 一
串按需查询包(五);不同 API 由统一中间表示收敛(六)。合起来,就是一台把"被冻结的调用序"重新变成"活的中间状态"的回放机,而你所有
的分析都只是站在这台机器肩膀上往下看。
回到绪论那个问题:一帧被抓下来之后,是怎么被回放引擎重放与分析的? 现在的答案不再是一个黑盒:它是"读容器 → 探 API → 建上下文 → 推进帧事件 → 重建资源 → 按需查询"的六道工序,是"重放安装"而不是"解压缩"。看懂这台机器,你就从"会用 RenderDoc 的 Viewer"进阶到 "看得懂 RenderDoc 每个分析结果是怎么来的",而看得懂结果怎么来的,正是本系列一路想给你的那根拐杖。大数据量的真实感来自机制,不 来自那块按钮。
相关链接 - 上一篇:【性能剖析工具链】(二) 一帧是怎么被抓下来的:RenderDoc 抓帧机制解剖 https://yyy3d.online/blog/graphics-profiling-ep02-capture/ - 下一篇(预告):【性能剖析工具链】(四) 待定 - GitHub 仓库:https://github.com/baldurk/renderdoc - RenderDoc 官网与文档:https://renderdoc.org/docs/about.html
版权与出处说明
本章节中的示意图截图与源码片段:.rdc 文件头/Section 结构、ReplayController 三步推进、ReplayProxyPacket 枚举等源码片段,均摘自
RenderDoc 官方 GitHub 仓库(github.com/baldurk/renderdoc,MIT License,版权归原作者 Baldur Karlsson),原始文件路径为
renderdoc/serialise/rdcfile.cpp、rdcfile.h、renderdoc/replay/replay_controller.cpp、renderdoc/core/replay_proxy.cpp;
回放工作原理说明见于官方文档 how_works.rst(Debian 源码镜像,MIT)。其余时序、结构、流程示意图为本人(@溯光)自绘。第三方商标
(RenderDoc、Vulkan、Unreal Engine)归其各自权利方所有。
With Best Wishes.